Share
Embed
ちょっとだけ踏み込んだ ダイナミックプライシング 〜オンデマンド交通への拡張〜
AI技術開発部の宮本が社内勉強会にて発表した資料「ちょっとだけ踏み込んだダイナミックプライシング 〜オンデマンド交通への拡張〜」を公開しました。ダイナミックプライシングの基本と相乗り問題に対する拡張をまとめています。ぜひご覧ください。
GO Inc. dev
May 14, 2026
Transcript
25 slides
-
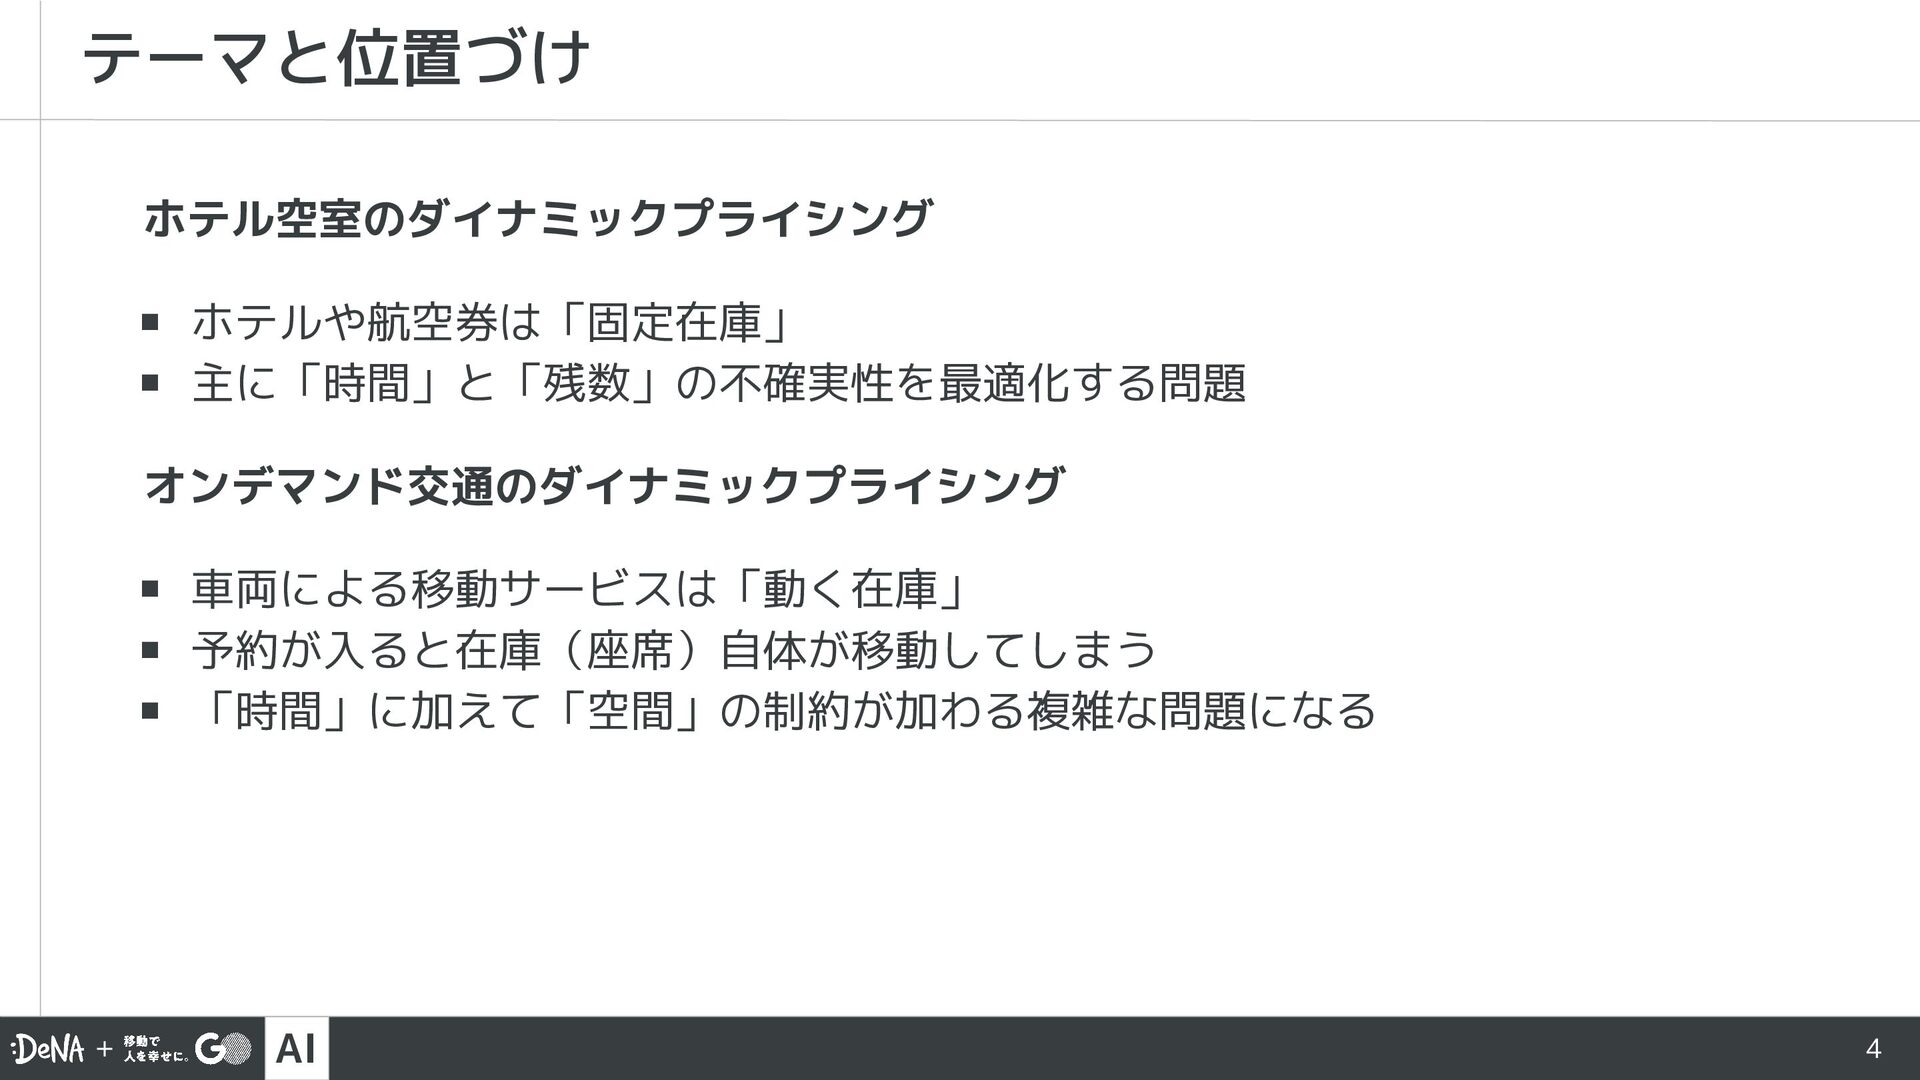
AI ホテル空室のダイナミックプライシング ▪ ホテルや航空券は「固定在庫」 ▪ 主に「時間」と「残数」の不確実性を最適化する問題 オンデマンド交通のダイナミックプライシング ▪ 車両による移動サービスは「動く在庫」 ▪
予約が入ると在庫(座席)自体が移動してしまう ▪ 「時間」に加えて「空間」の制約が加わる複雑な問題になる テーマと位置づけ 4 -
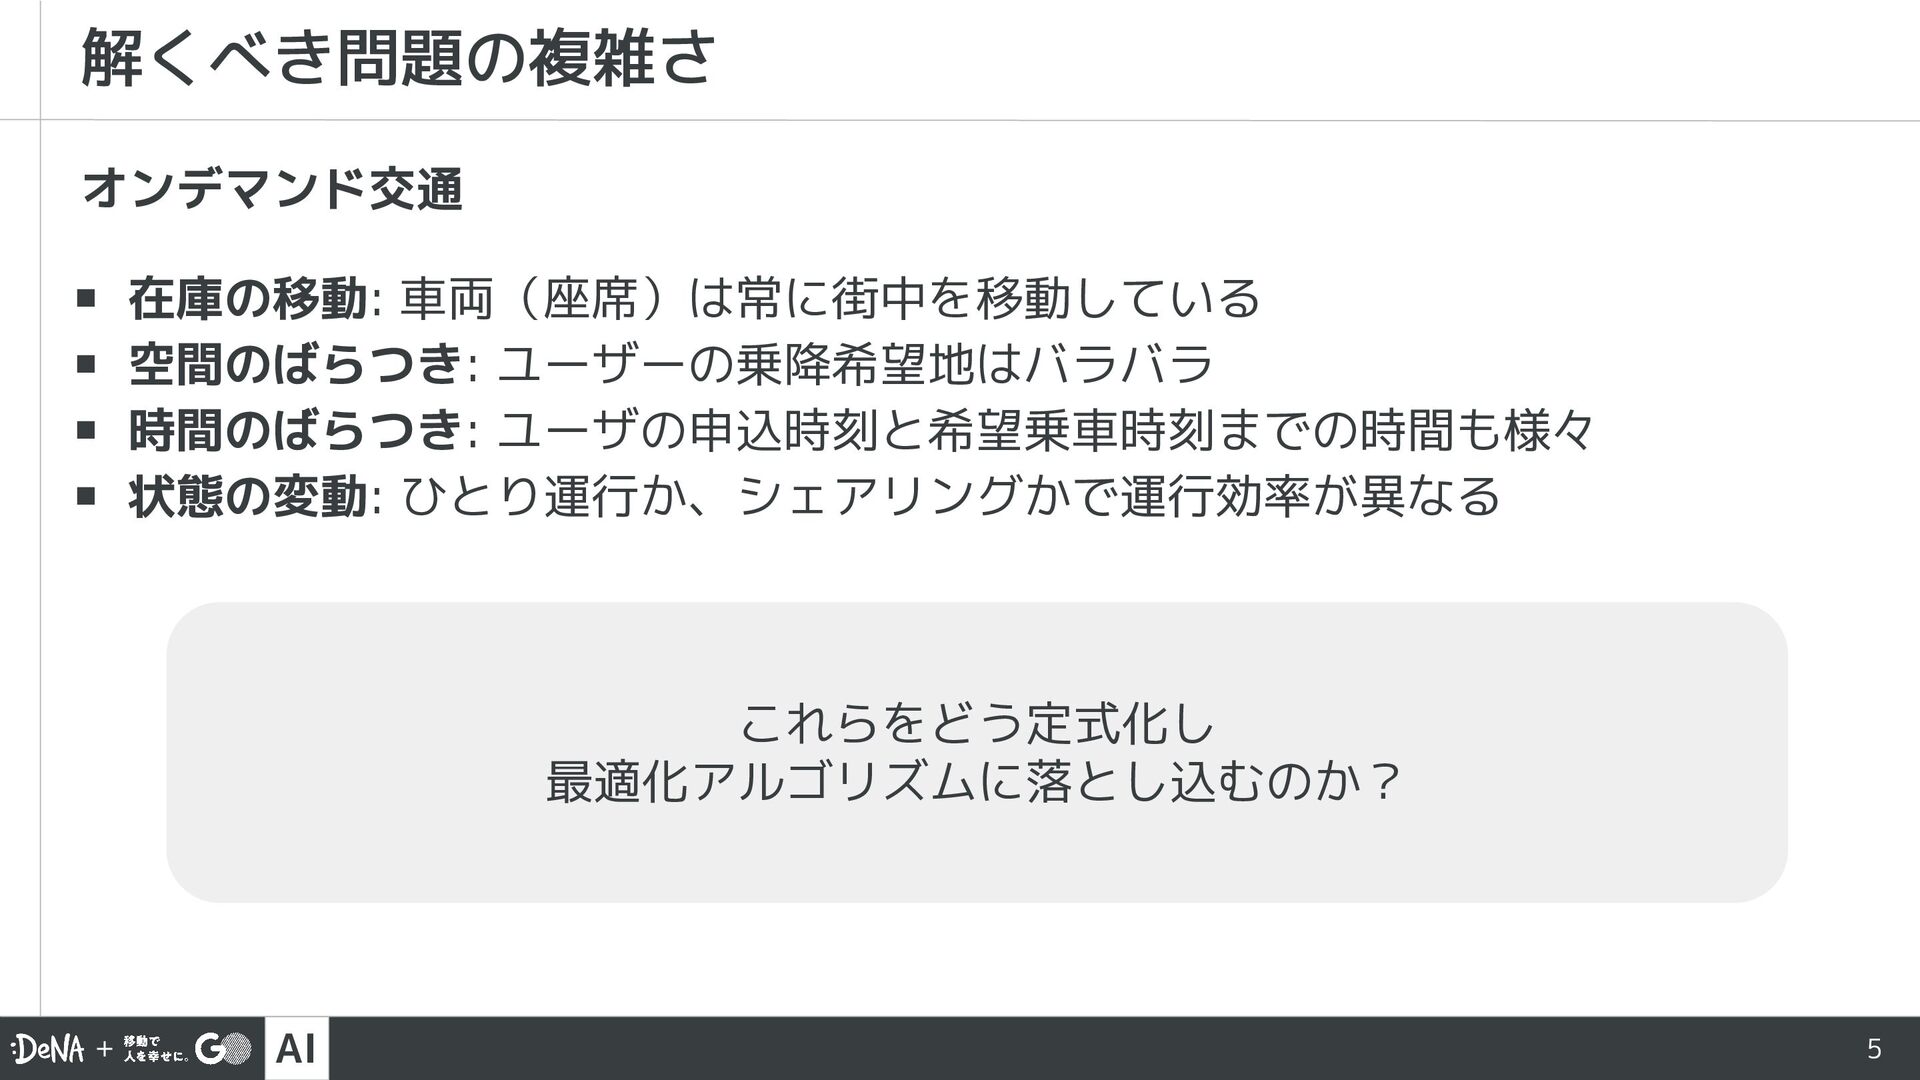
AI オンデマンド交通 ▪ 在庫の移動: 車両(座席)は常に街中を移動している ▪ 空間のばらつき: ユーザーの乗降希望地はバラバラ ▪ 時間のばらつき:
ユーザの申込時刻と希望乗車時刻までの時間も様々 ▪ 状態の変動: ひとり運行か、シェアリングかで運行効率が異なる 解くべき問題の複雑さ 5 これらをどう定式化し 最適化アルゴリズムに落とし込むのか? -
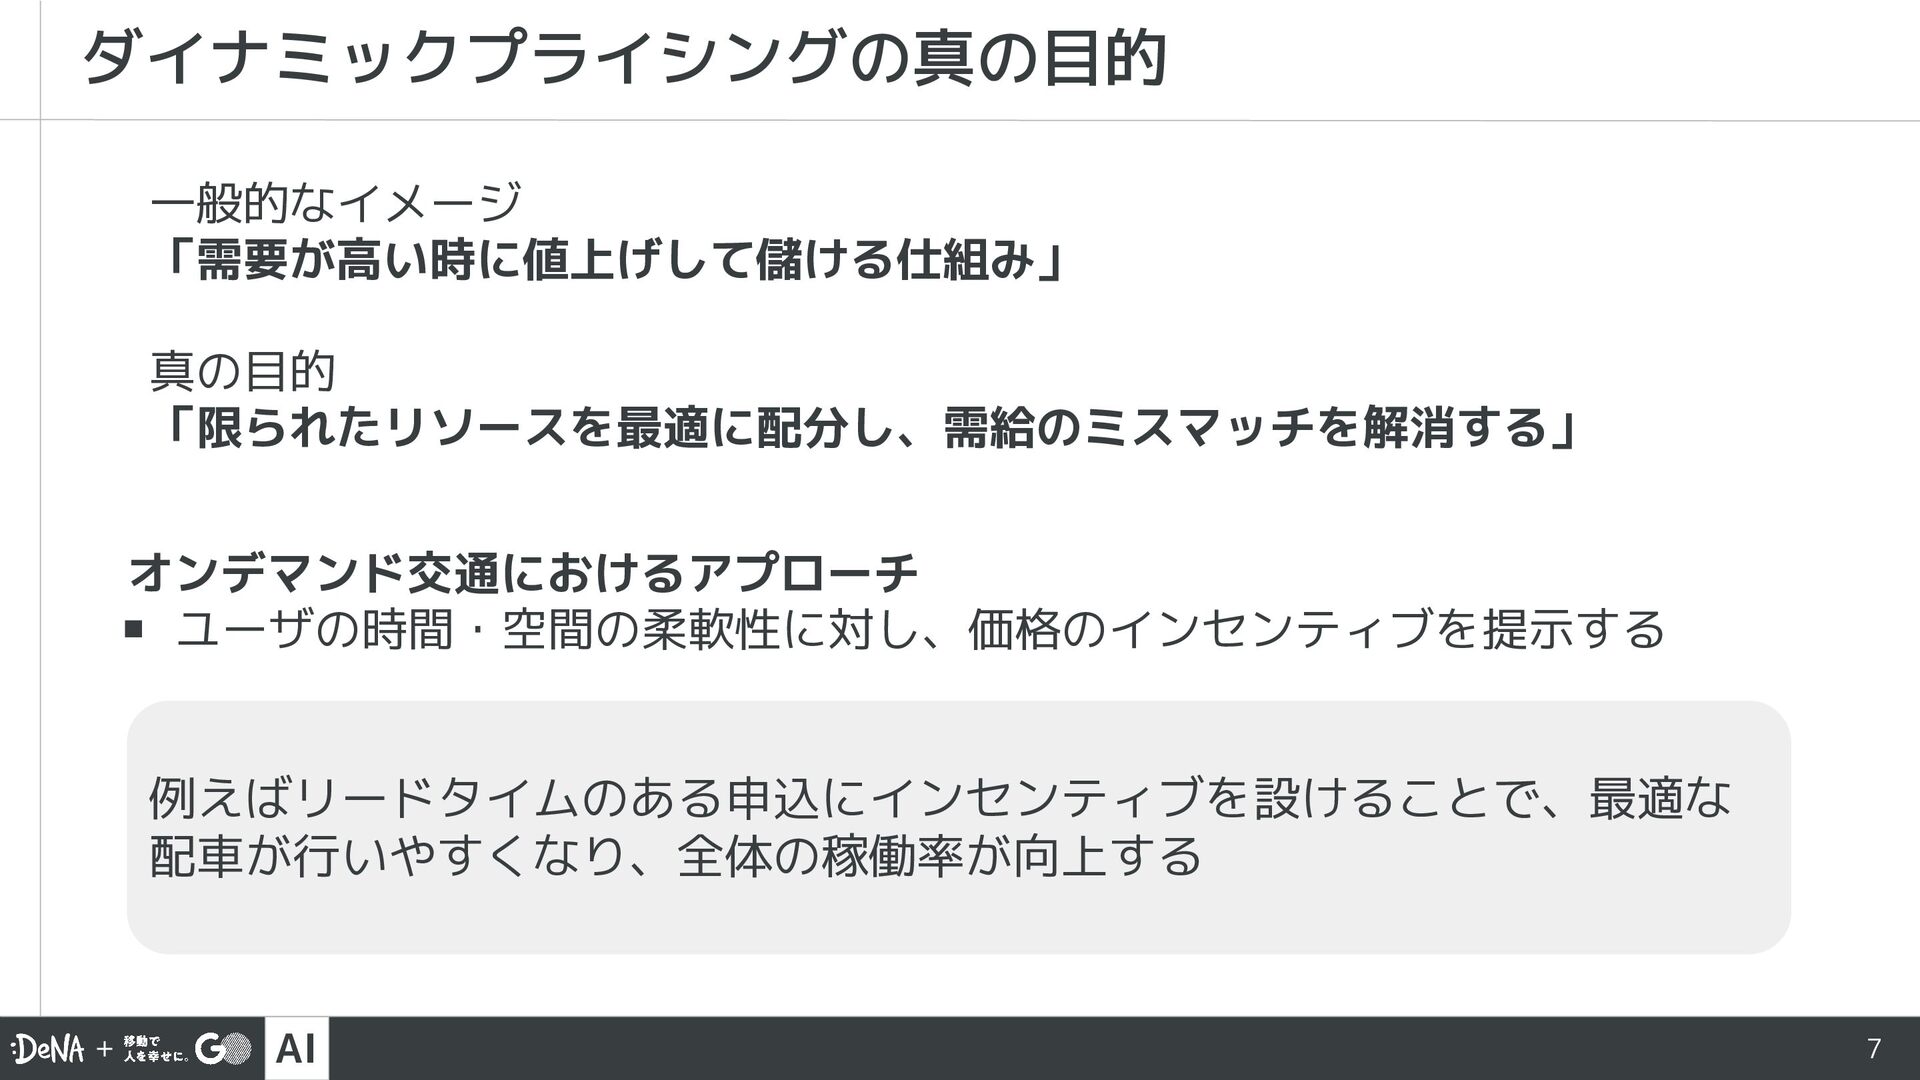
AI 一般的なイメージ 「需要が高い時に値上げして儲ける仕組み」 真の目的 「限られたリソースを最適に配分し、需給のミスマッチを解消する」 ダイナミックプライシングの真の目的 7 オンデマンド交通におけるアプローチ ▪ ユーザの時間・空間の柔軟性に対し、価格のインセンティブを提示する
例えばリードタイムのある申込にインセンティブを設けることで、最適な 配車が行いやすくなり、全体の稼働率が向上する -
AI LP(線形計画法)による最適化 8 不確実な需要のもとで、期待総収益関数E[R(I)]を最大化するIを探す 予算重視の予約、時間重視の予約が混在すると 収益関数は凹凸のある複雑な形状となる ▶ 第1項 : 「早割」のユーザをどこまで受け入れるか(上限I)
第2項 : 「直前」のユーザをどこまで受け入れるか ▪ Iを増やせば第2項の「残数」が減り、価格弾力性が低い需要を 取りこぼす(機会損失) ▪ Iを絞りすぎると、「直前」のユーザが現れなかった場合に「空 席」のままになるリスクがある(売れ残り) -
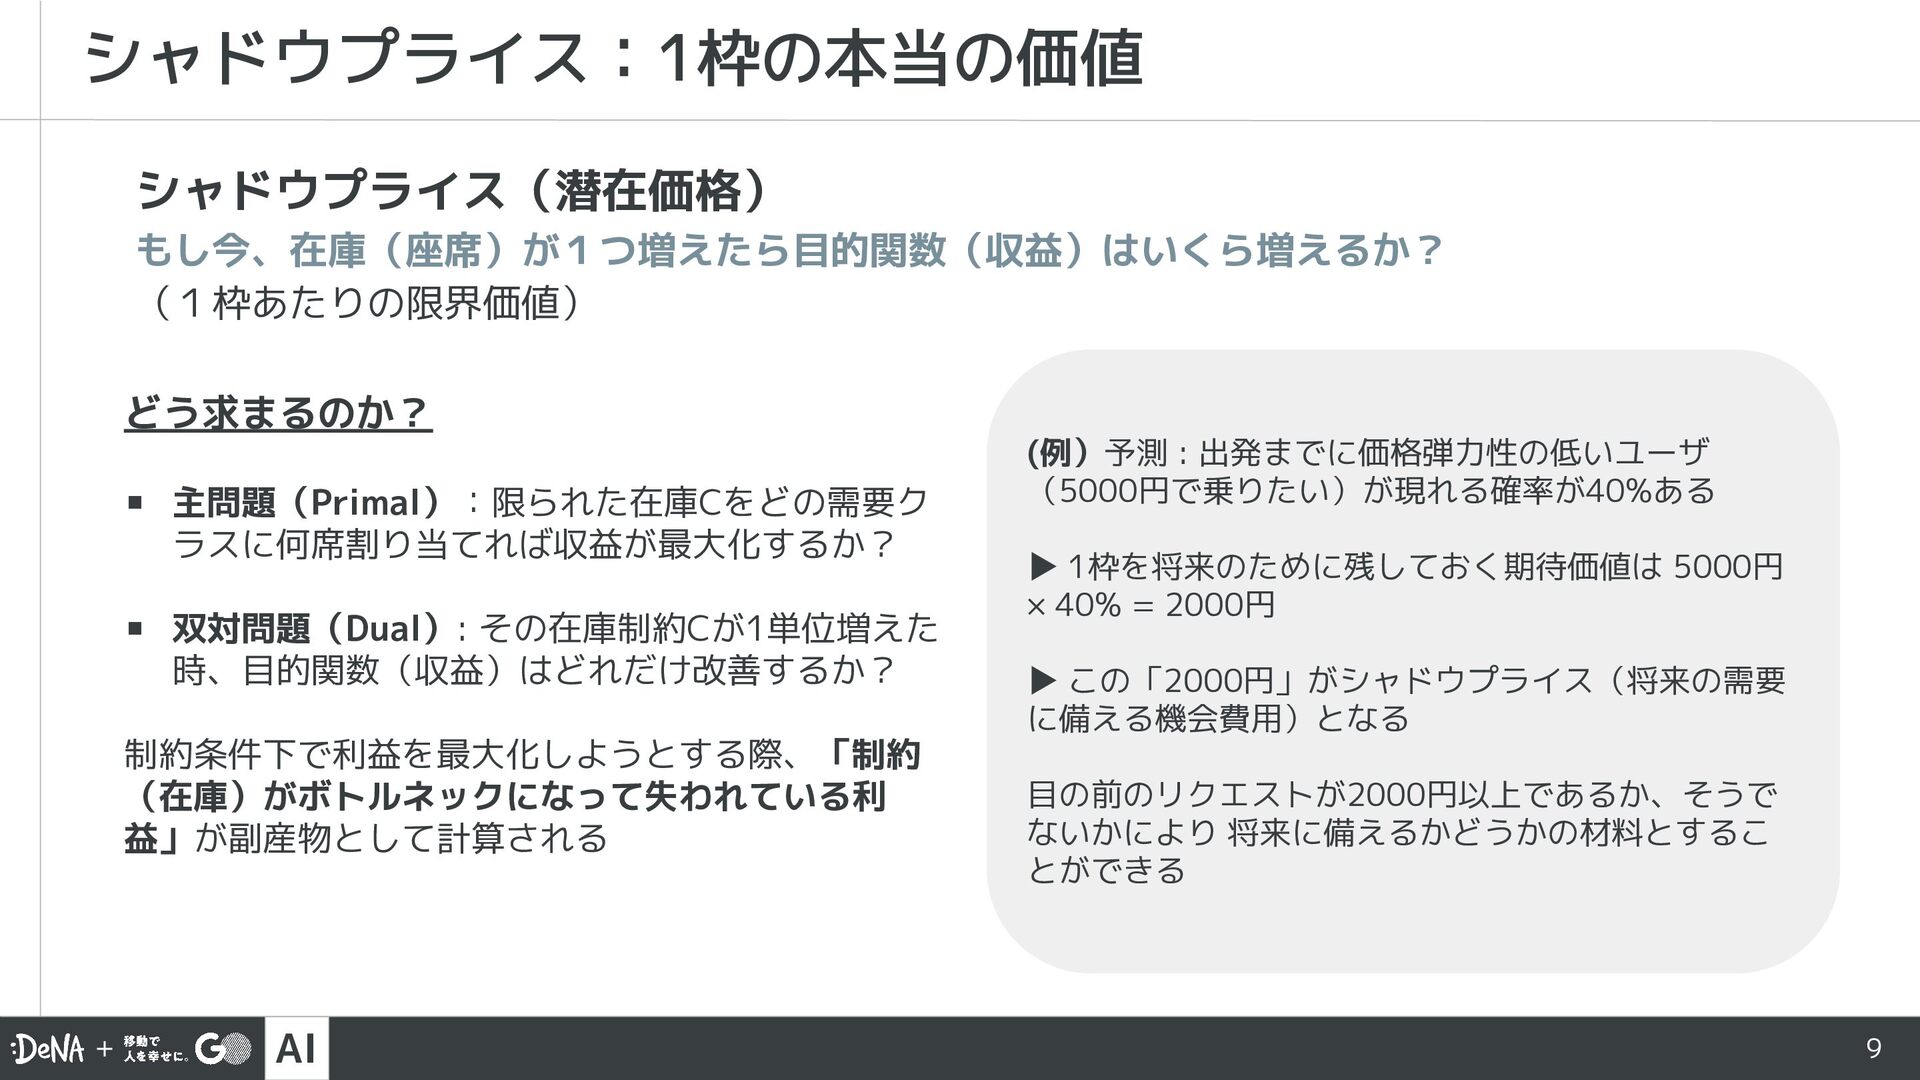
AI シャドウプライス:1枠の本当の価値 9 シャドウプライス(潜在価格) もし今、在庫(座席)が1つ増えたら目的関数(収益)はいくら増えるか? (1枠あたりの限界価値) どう求まるのか? ▪ 主問題(Primal):限られた在庫Cをどの需要ク ラスに何席割り当てれば収益が最大化するか?
▪ 双対問題(Dual): その在庫制約Cが1単位増えた 時、目的関数(収益)はどれだけ改善するか? 制約条件下で利益を最大化しようとする際、「制約 (在庫)がボトルネックになって失われている利 益」が副産物として計算される (例)予測 : 出発までに価格弾力性の低いユーザ (5000円で乗りたい)が現れる確率が40%ある ▶ 1枠を将来のために残しておく期待価値は 5000円 × 40% = 2000円 ▶ この「2000円」がシャドウプライス(将来の需要 に備える機会費用)となる 目の前のリクエストが2000円以上であるか、そうで ないかにより 将来に備えるかどうかの材料とするこ とができる -
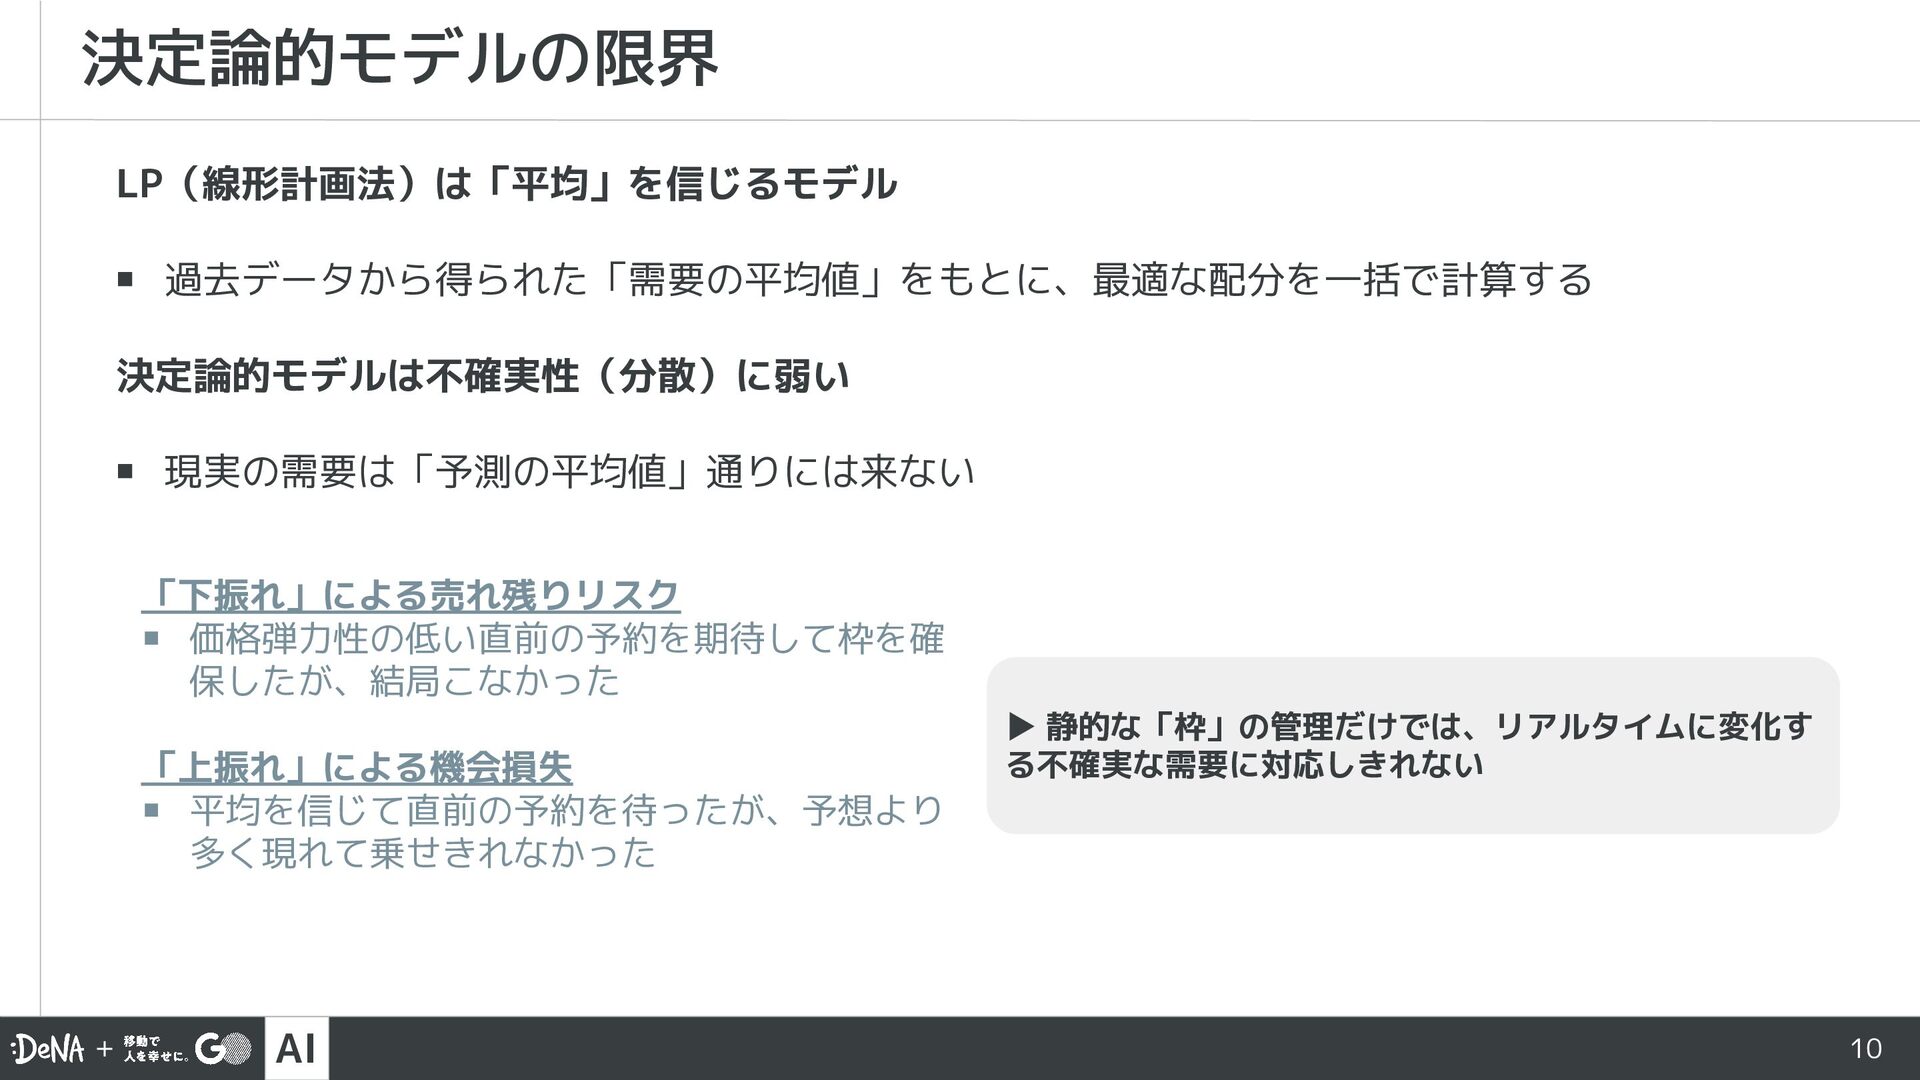
AI LP(線形計画法)は「平均」を信じるモデル ▪ 過去データから得られた「需要の平均値」をもとに、最適な配分を一括で計算する 決定論的モデルは不確実性(分散)に弱い ▪ 現実の需要は「予測の平均値」通りには来ない 決定論的モデルの限界 10 「下振れ」による売れ残りリスク
▪ 価格弾力性の低い直前の予約を期待して枠を確 保したが、結局こなかった 「上振れ」による機会損失 ▪ 平均を信じて直前の予約を待ったが、予想より 多く現れて乗せきれなかった ▶ 静的な「枠」の管理だけでは、リアルタイムに変化す る不確実な需要に対応しきれない -
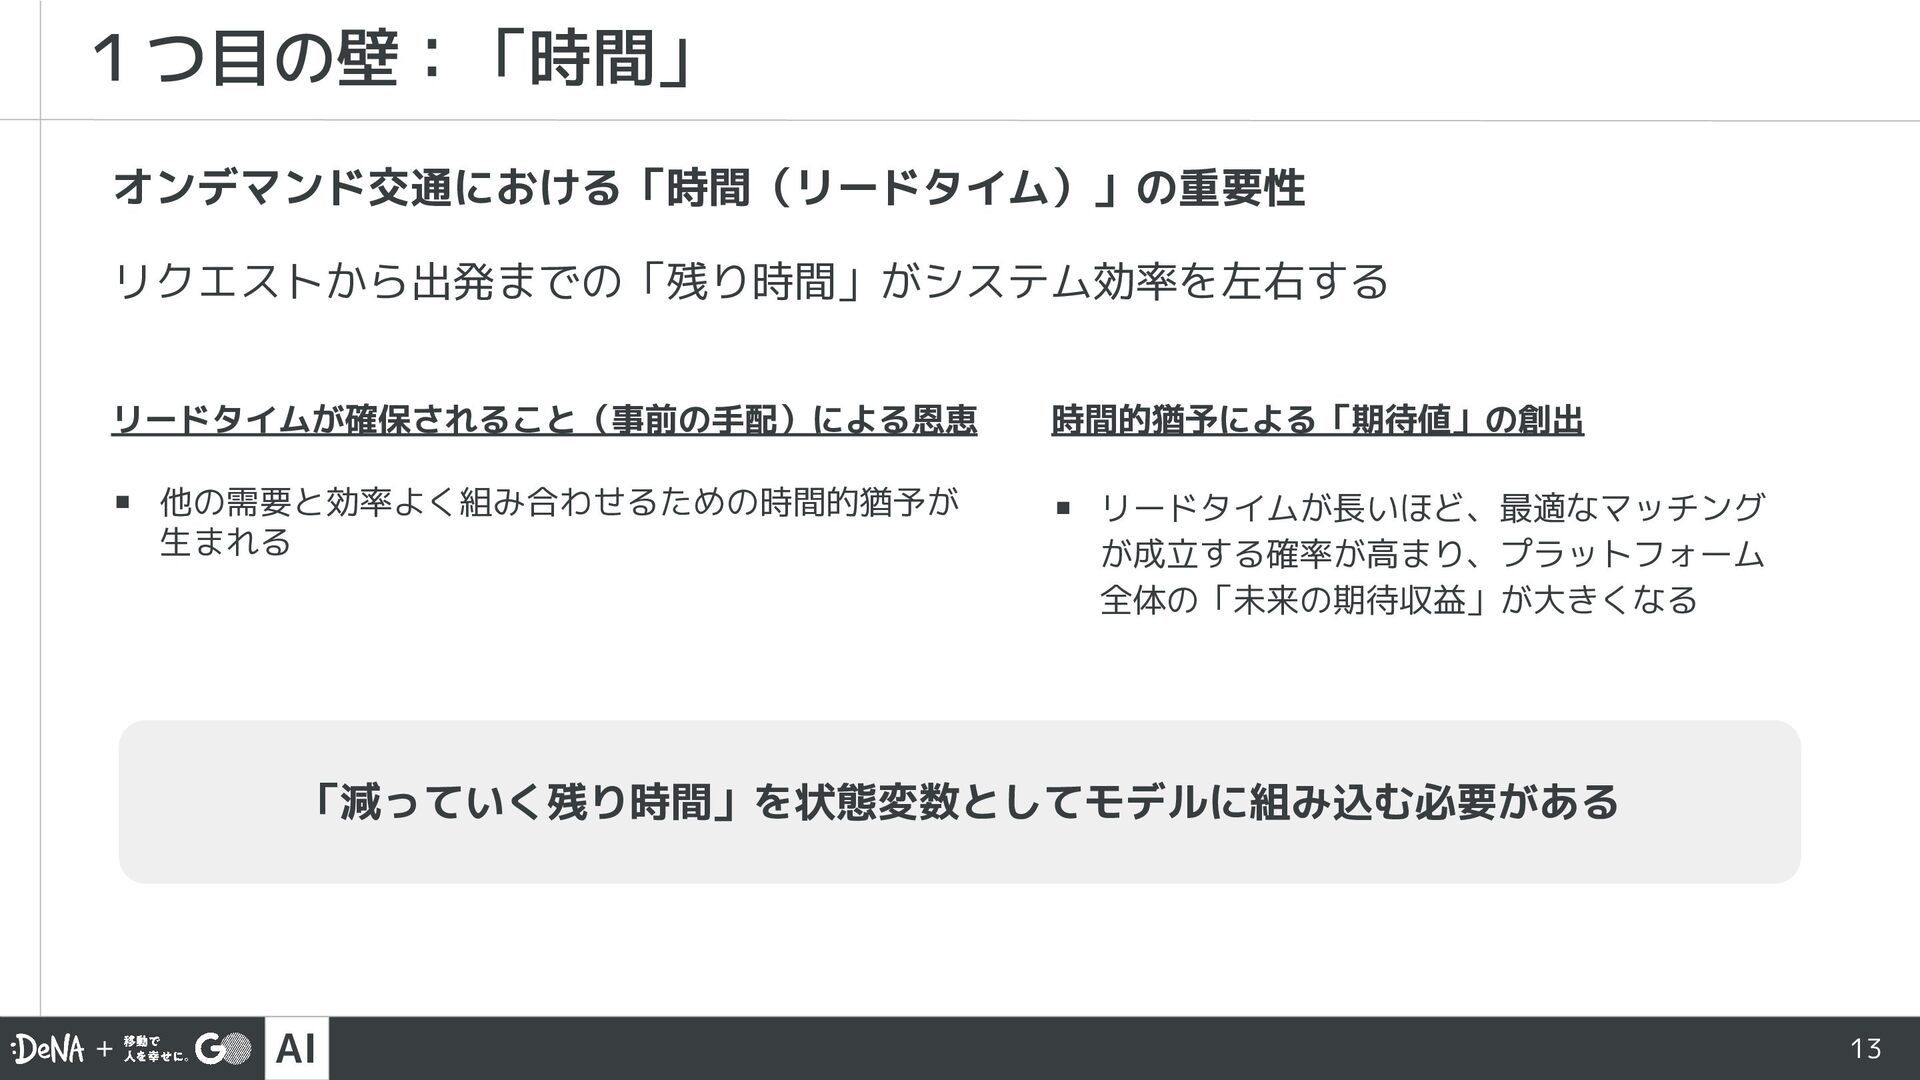
AI オンデマンド交通における「時間(リードタイム)」の重要性 リクエストから出発までの「残り時間」がシステム効率を左右する 1つ目の壁:「時間」 13 リードタイムが確保されること(事前の手配)による恩恵 ▪ 他の需要と効率よく組み合わせるための時間的猶予が 生まれる 時間的猶予による「期待値」の創出
▪ リードタイムが長いほど、最適なマッチング が成立する確率が高まり、プラットフォーム 全体の「未来の期待収益」が大きくなる 「減っていく残り時間」を状態変数としてモデルに組み込む必要がある -
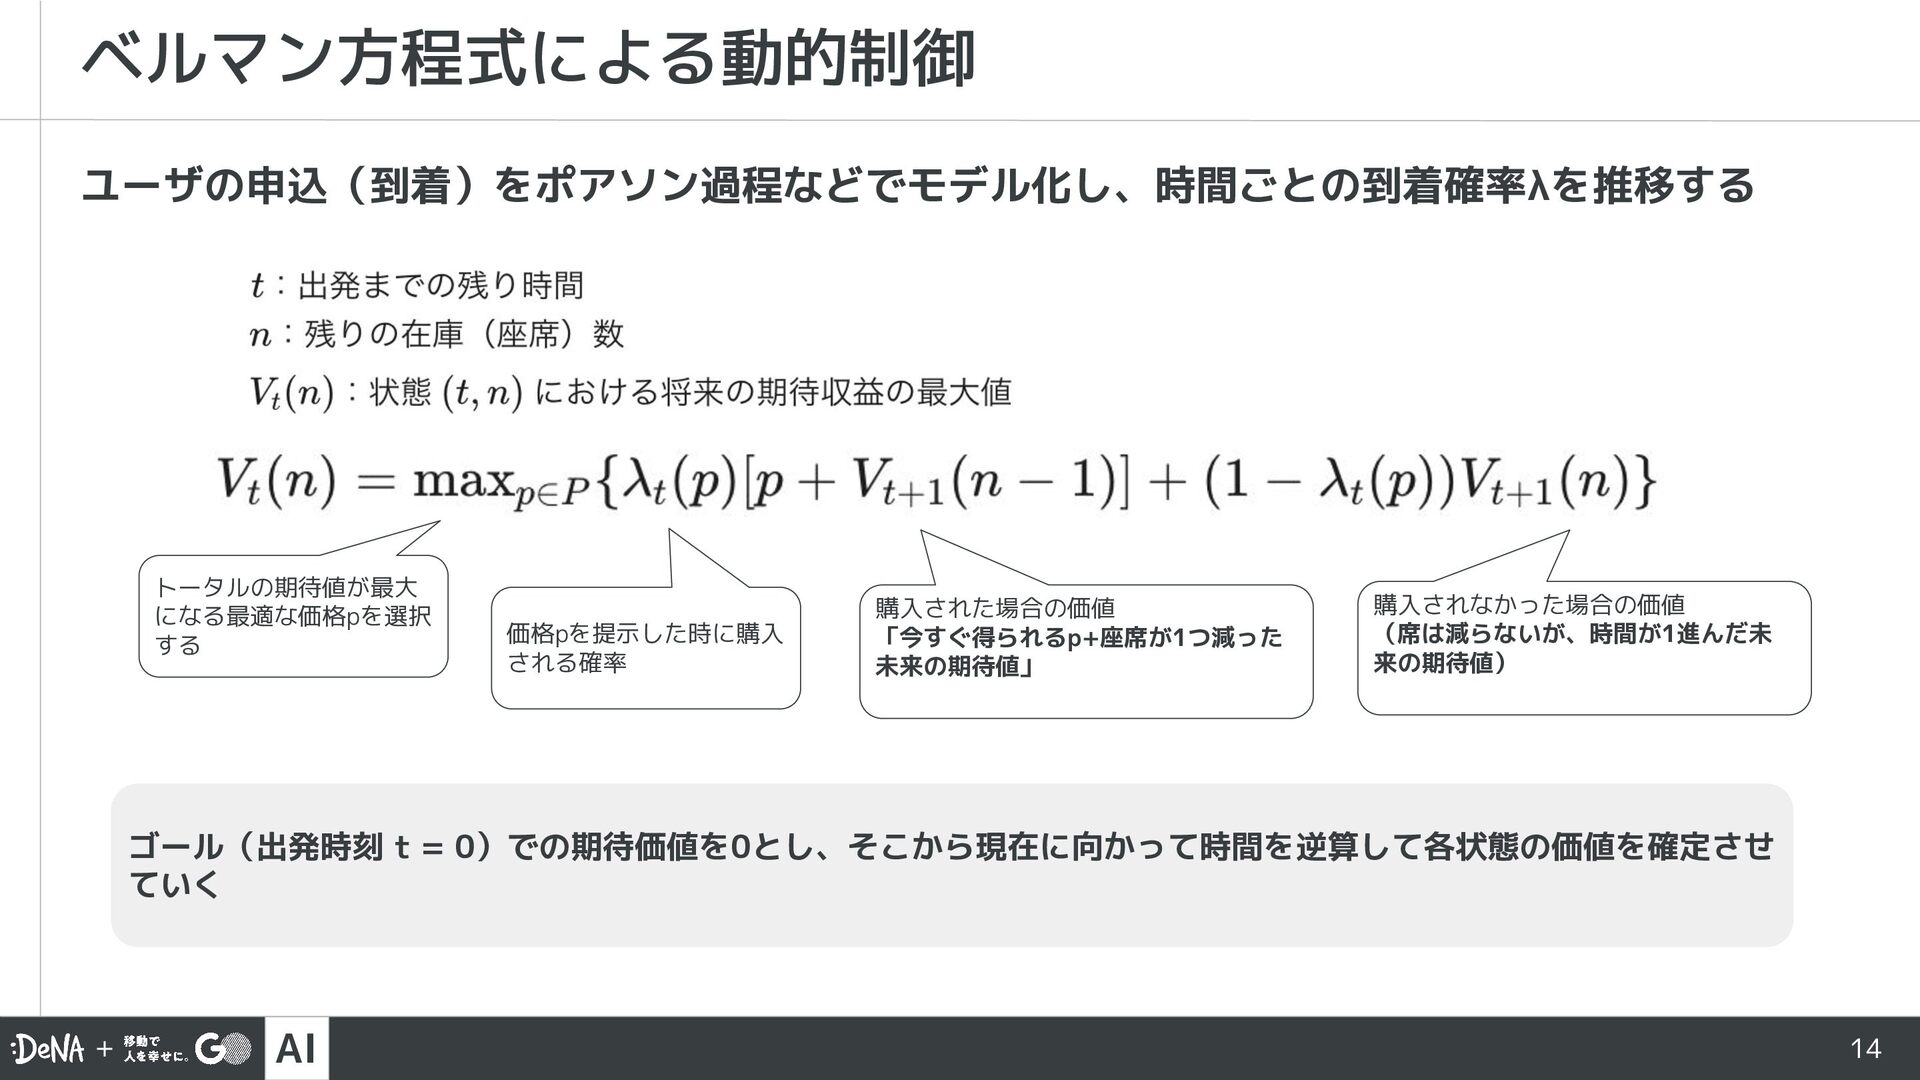
AI ベルマン方程式による動的制御 14 ユーザの申込(到着)をポアソン過程などでモデル化し、時間ごとの到着確率λを推移する ゴール(出発時刻 t = 0)での期待価値を0とし、そこから現在に向かって時間を逆算して各状態の価値を確定させ ていく トータルの期待値が最大
になる最適な価格pを選択 する 価格pを提示した時に購入 される確率 購入された場合の価値 「今すぐ得られるp+座席が1つ減った 未来の期待値」 購入されなかった場合の価値 (席は減らないが、時間が1進んだ未 来の期待値) -
AI ベルマン方程式の本質 15 ベルマン方程式を簡略化 現在の価値 = [今すぐ得られる報酬] + [未来の期待値] ▪
事前の手配(十分な残り時間)がある状態では、効率的な組み合わせが成立しやすくなり「未来の期 待値」が大きくなる ▪ システムとして死守すべき最低ライン(機会費用)に対して、「未来の期待値」が貢献するため、そ の分ユーザから「今すぐ得られる報酬(提示価格)」を割り引くことができる 直前の予約をベースとすると、事前の予約によって生み出される「期待値の増加分」を割引として 反映することができる 目の前のリクエストを承諾して得られる金額 残り時間t の間に、別の需要と効率よく組み合 わせることで得られる追加収益の期待値 -
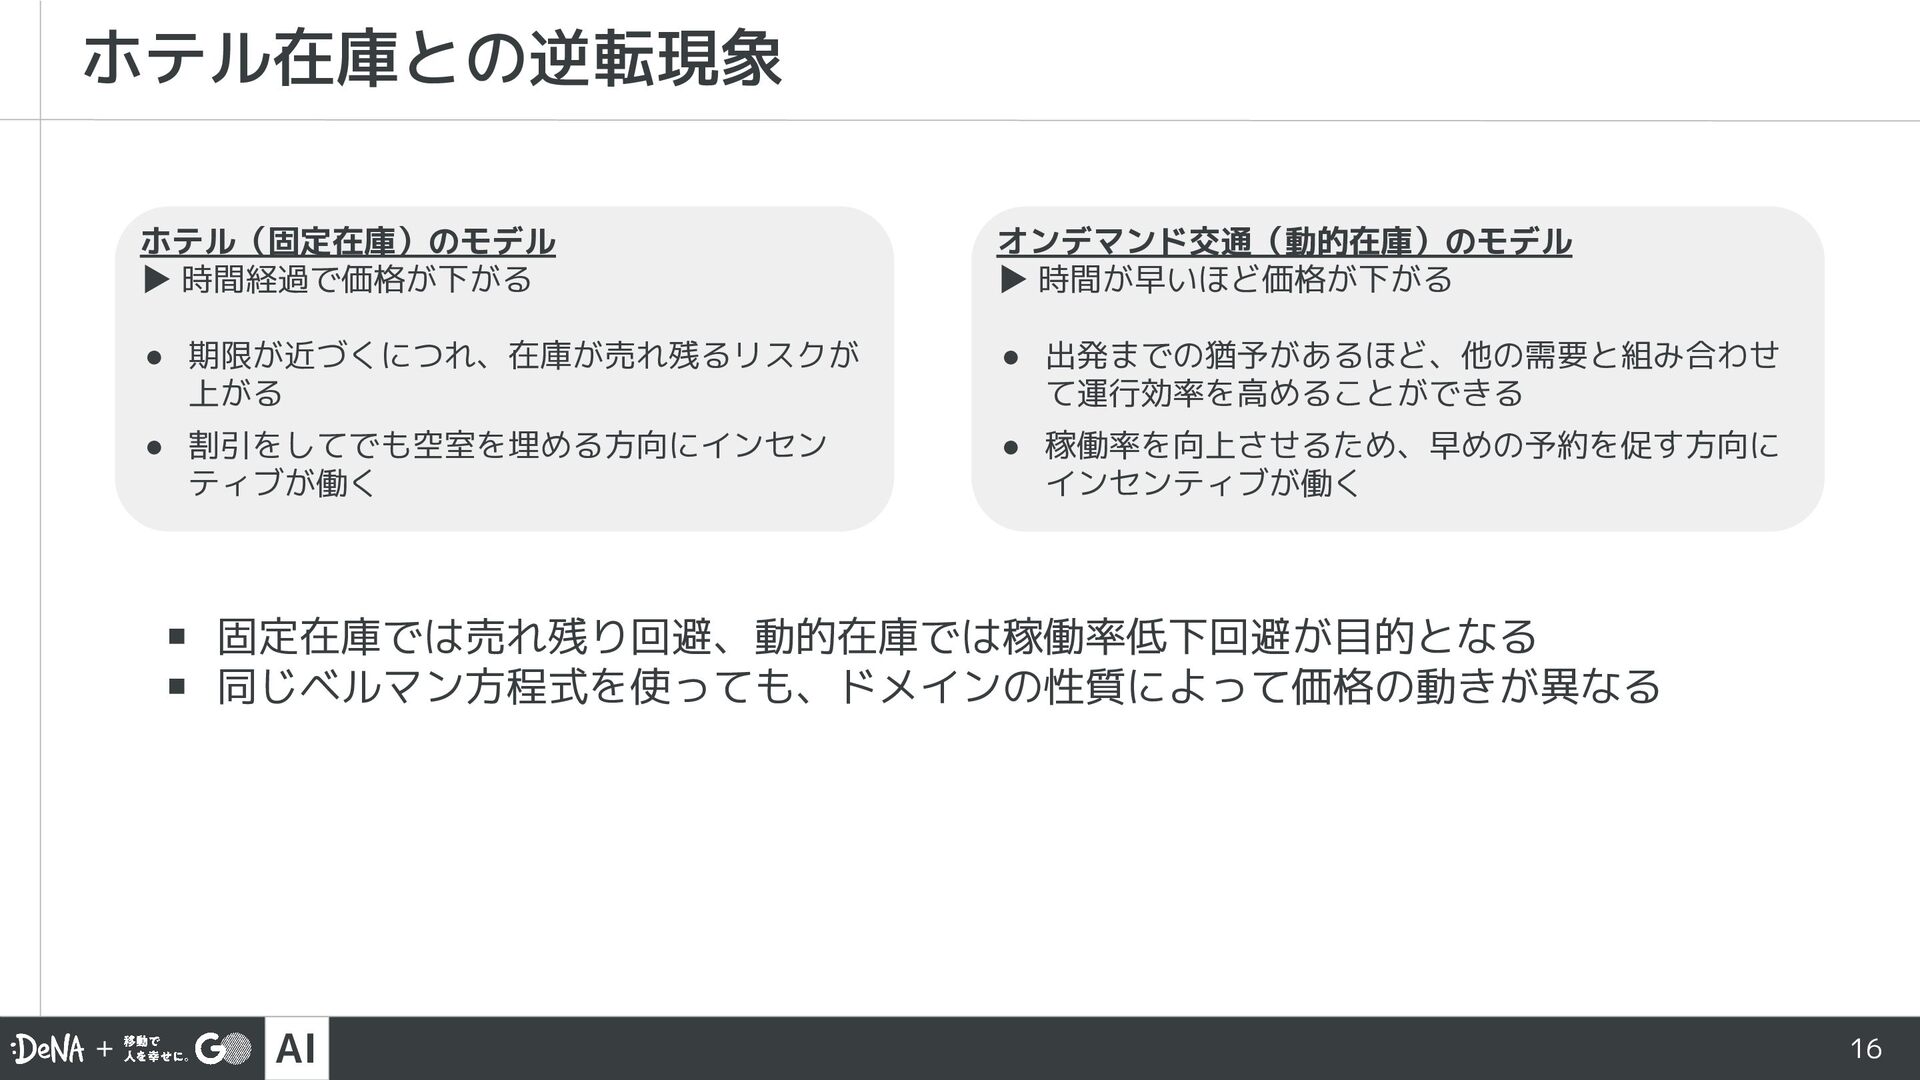
AI ホテル在庫との逆転現象 16 ホテル(固定在庫)のモデル ▶ 時間経過で価格が下がる • 期限が近づくにつれ、在庫が売れ残るリスクが 上がる •
割引をしてでも空室を埋める方向にインセン ティブが働く オンデマンド交通(動的在庫)のモデル ▶ 時間が早いほど価格が下がる • 出発までの猶予があるほど、他の需要と組み合わせ て運行効率を高めることができる • 稼働率を向上させるため、早めの予約を促す方向に インセンティブが働く ▪ 固定在庫では売れ残り回避、動的在庫では稼働率低下回避が目的となる ▪ 同じベルマン方程式を使っても、ドメインの性質によって価格の動きが異なる -
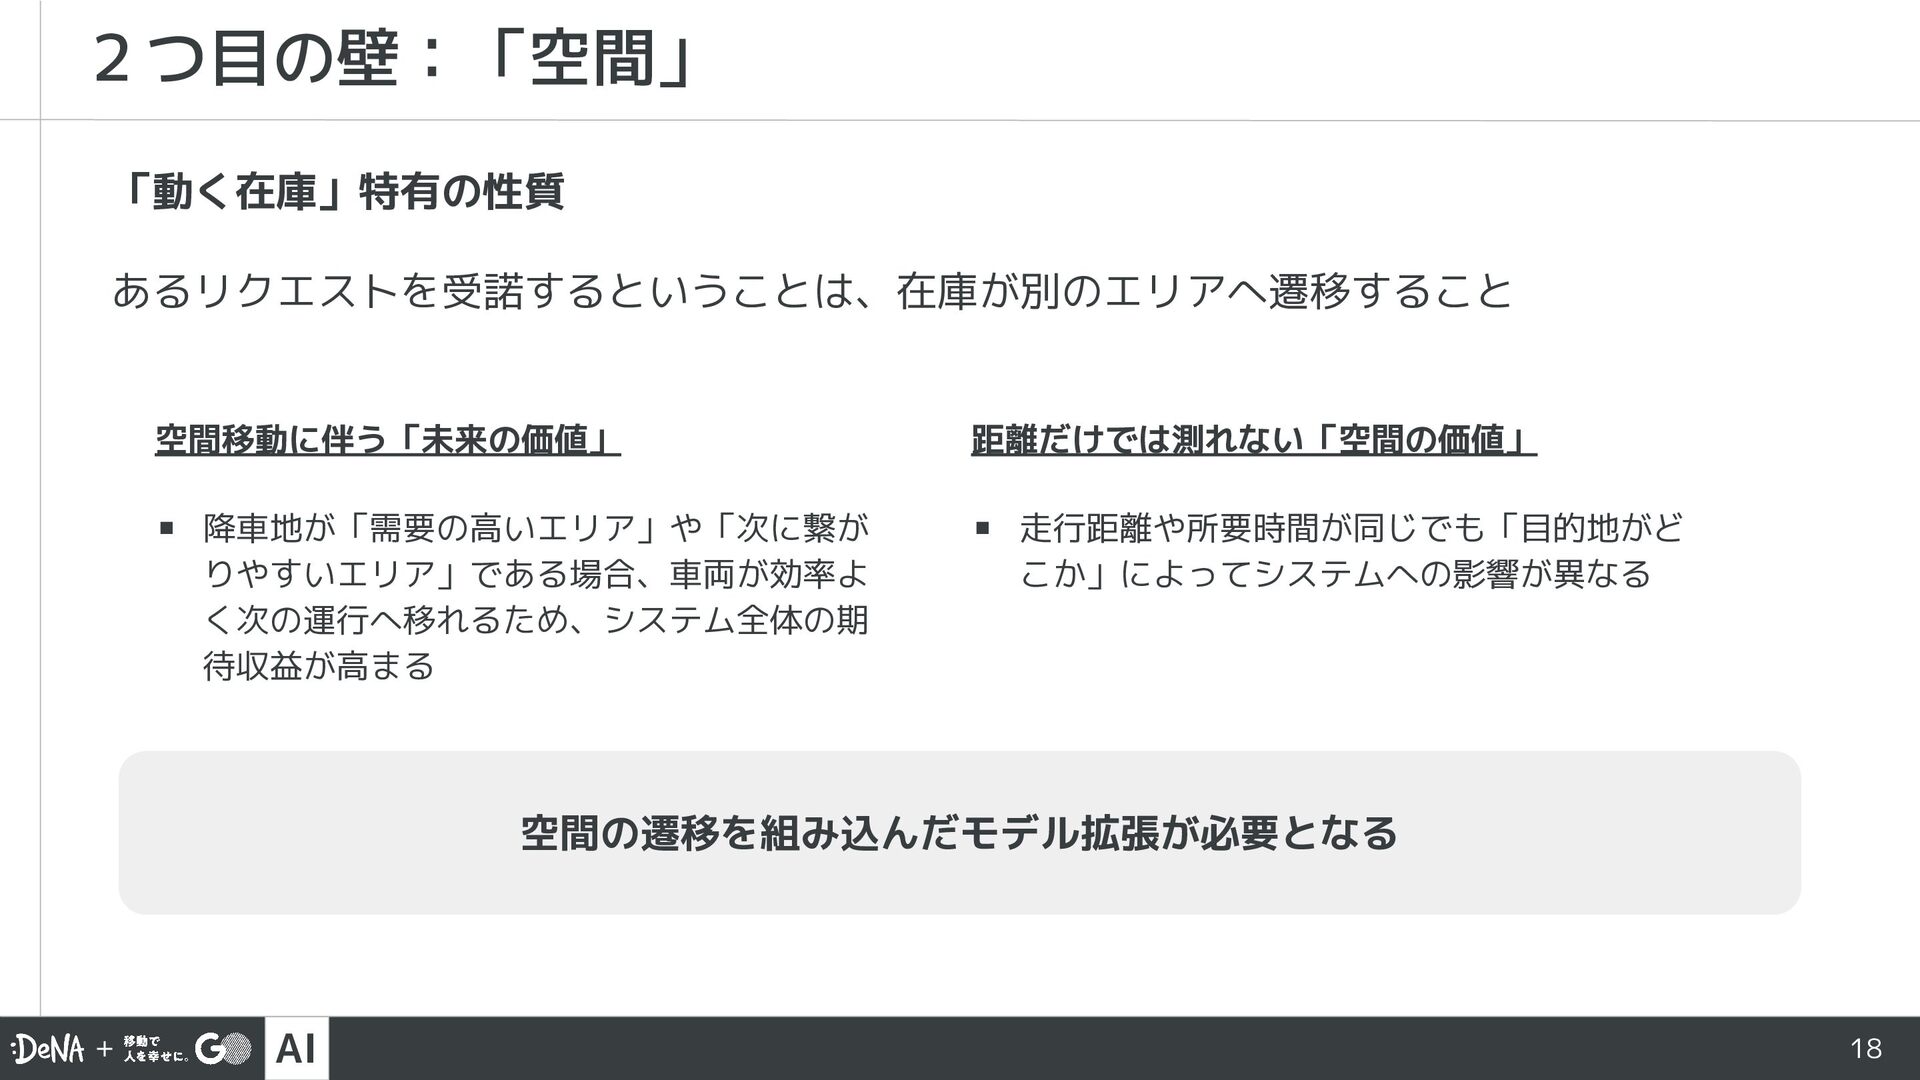
AI 2つ目の壁:「空間」 18 「動く在庫」特有の性質 あるリクエストを受諾するということは、在庫が別のエリアへ遷移すること 空間移動に伴う「未来の価値」 ▪ 降車地が「需要の高いエリア」や「次に繋が りやすいエリア」である場合、車両が効率よ く次の運行へ移れるため、システム全体の期
待収益が高まる 距離だけでは測れない「空間の価値」 ▪ 走行距離や所要時間が同じでも「目的地がど こか」によってシステムへの影響が異なる 空間の遷移を組み込んだモデル拡張が必要となる -
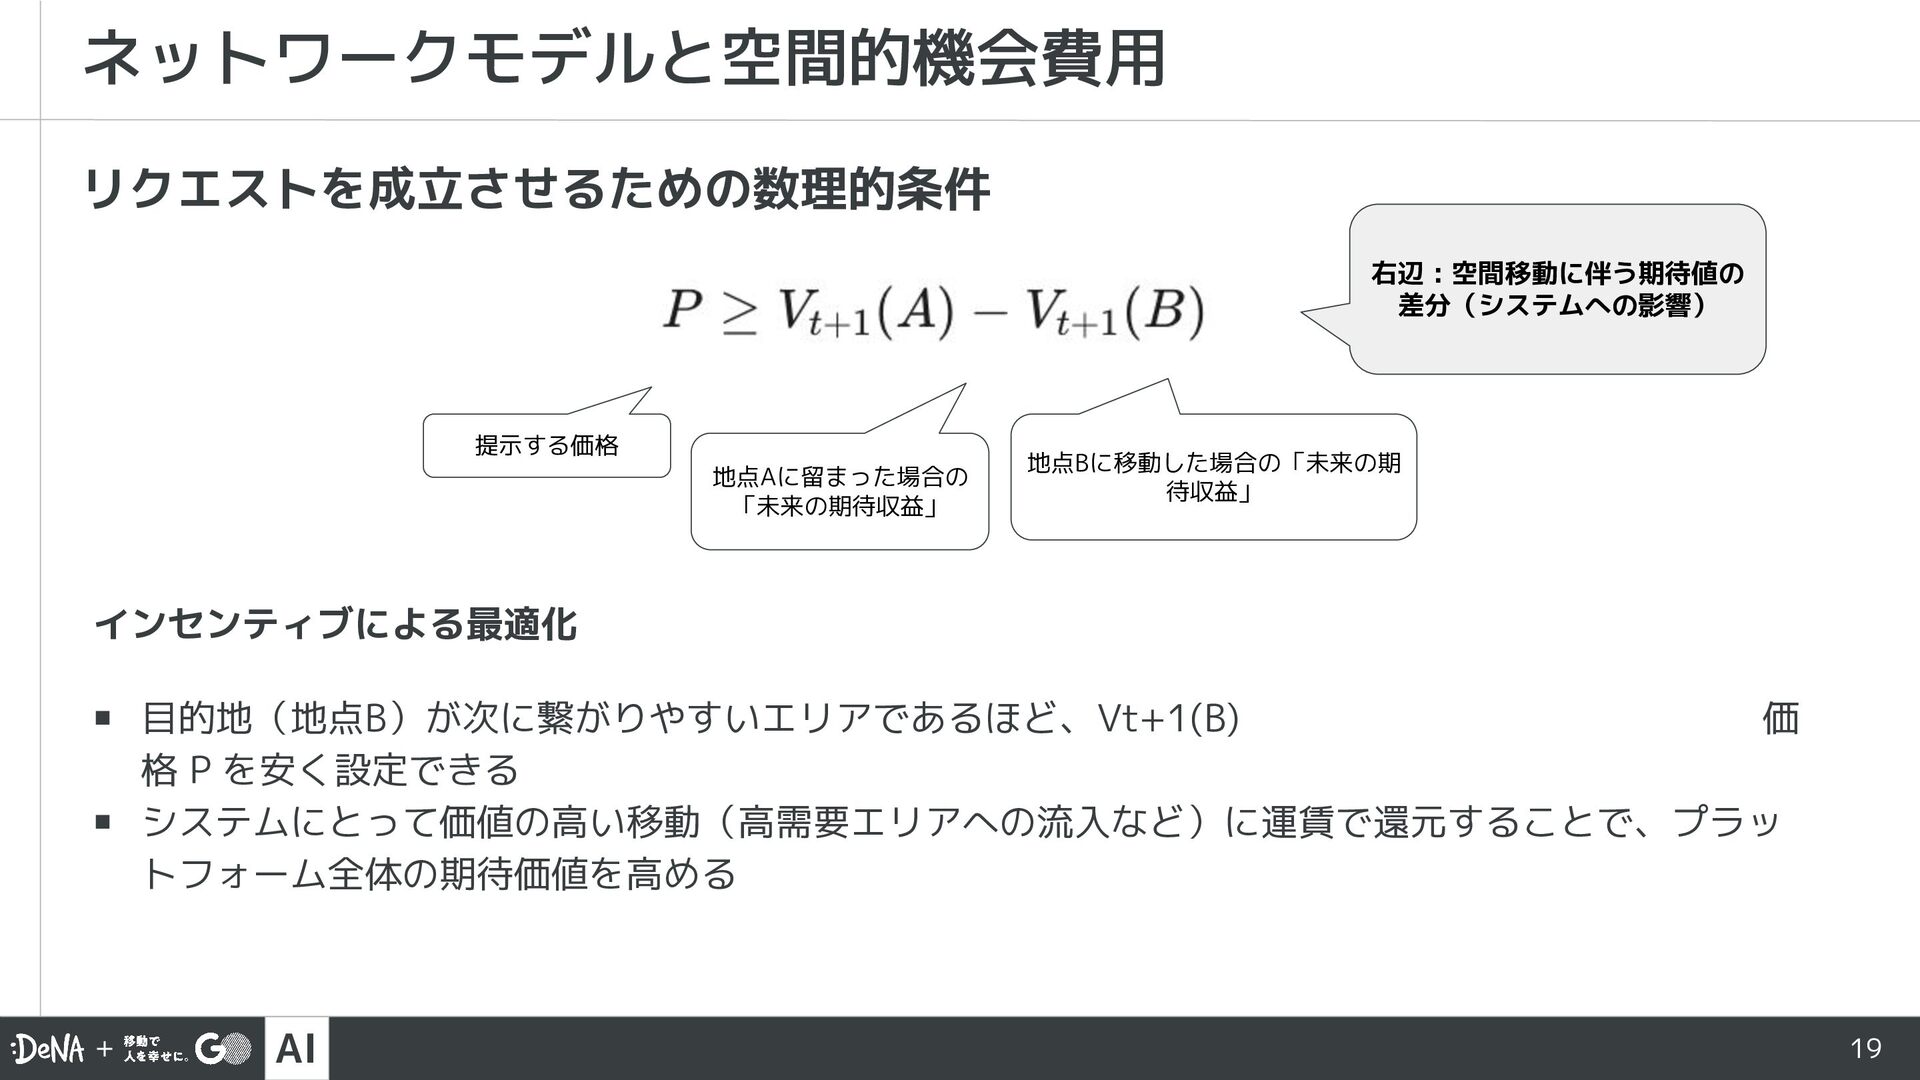
AI ネットワークモデルと空間的機会費用 19 リクエストを成立させるための数理的条件 提示する価格 地点Aに留まった場合の 「未来の期待収益」 地点Bに移動した場合の「未来の期 待収益」 右辺
: 空間移動に伴う期待値の 差分(システムへの影響) インセンティブによる最適化 ▪ 目的地(地点B)が次に繋がりやすいエリアであるほど、Vt+1(B)が大きくなり、結果として提示価 格 P を安く設定できる ▪ システムにとって価値の高い移動(高需要エリアへの流入など)に運賃で還元することで、プラッ トフォーム全体の期待価値を高める -
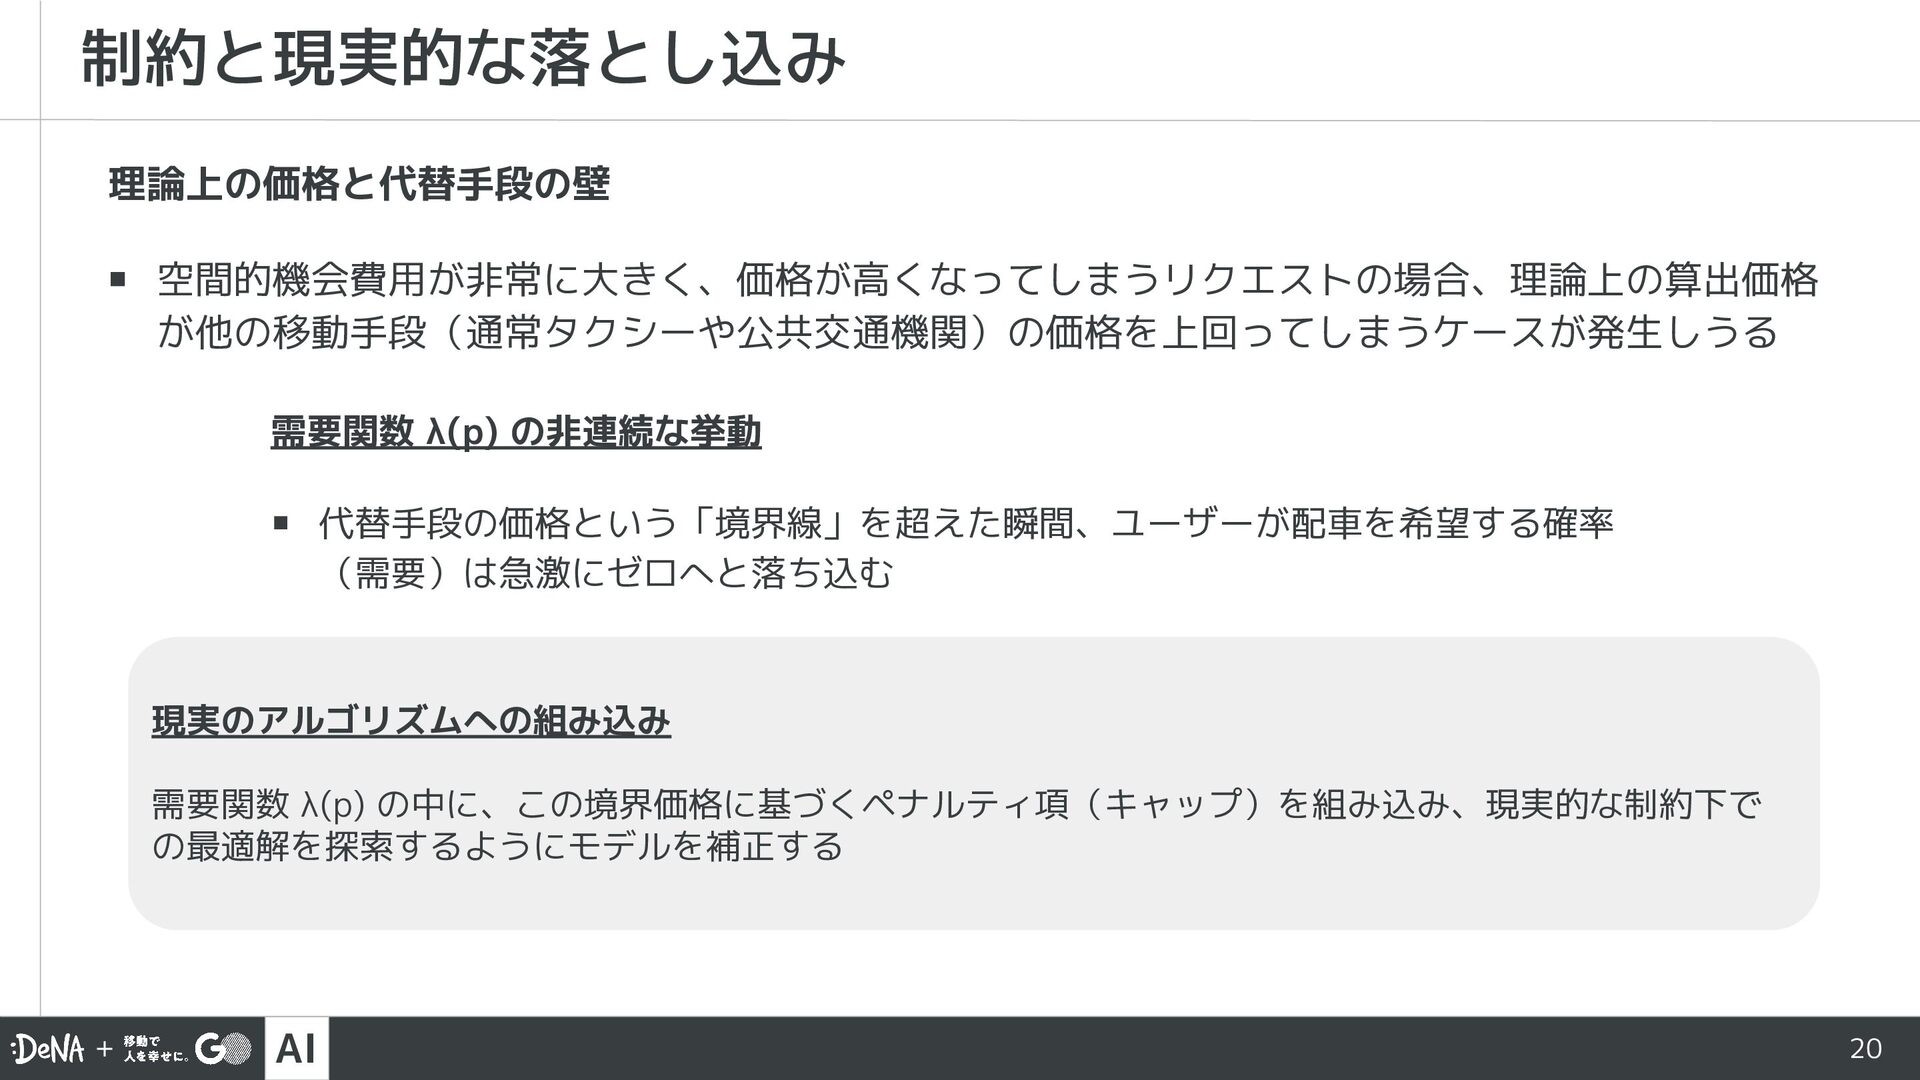
AI 理論上の価格と代替手段の壁 ▪ 空間的機会費用が非常に大きく、価格が高くなってしまうリクエストの場合、理論上の算出価格 が他の移動手段(通常タクシーや公共交通機関)の価格を上回ってしまうケースが発生しうる 制約と現実的な落とし込み 20 需要関数 λ(p) の非連続な挙動
▪ 代替手段の価格という「境界線」を超えた瞬間、ユーザーが配車を希望する確率 (需要)は急激にゼロへと落ち込む 現実のアルゴリズムへの組み込み 需要関数 λ(p) の中に、この境界価格に基づくペナルティ項(キャップ)を組み込み、現実的な制約下で の最適解を探索するようにモデルを補正する -
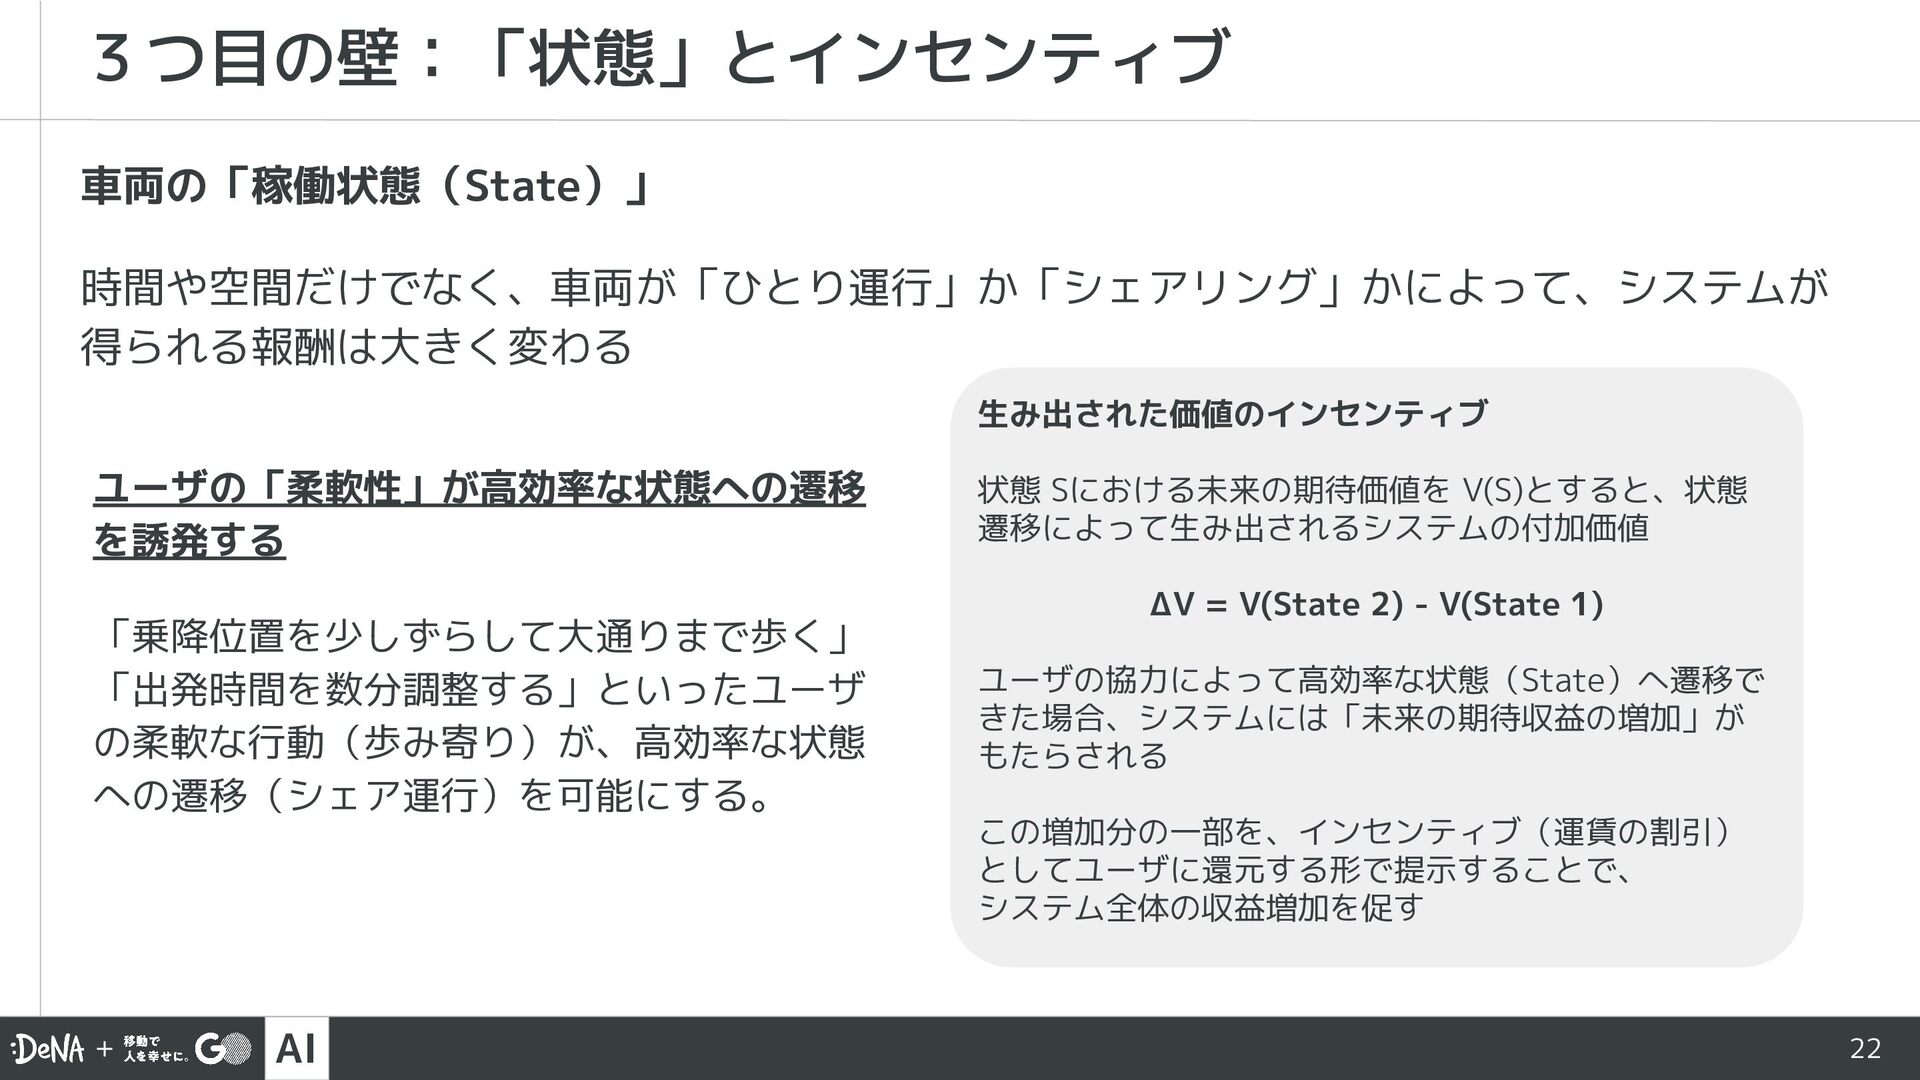
AI 3つ目の壁:「状態」とインセンティブ 22 車両の「稼働状態(State)」 時間や空間だけでなく、車両が「ひとり運行」か「シェアリング」かによって、システムが 得られる報酬は大きく変わる ユーザの「柔軟性」が高効率な状態への遷移 を誘発する 「乗降位置を少しずらして大通りまで歩く」 「出発時間を数分調整する」といったユーザ
の柔軟な行動(歩み寄り)が、高効率な状態 への遷移(シェア運行)を可能にする。 生み出された価値のインセンティブ 状態 Sにおける未来の期待価値を V(S)とすると、状態 遷移によって生み出されるシステムの付加価値 ΔV = V(State 2) - V(State 1) ユーザの協力によって高効率な状態(State)へ遷移で きた場合、システムには「未来の期待収益の増加」が もたらされる この増加分の一部を、インセンティブ(運賃の割引) としてユーザに還元する形で提示することで、 システム全体の収益増加を促す -
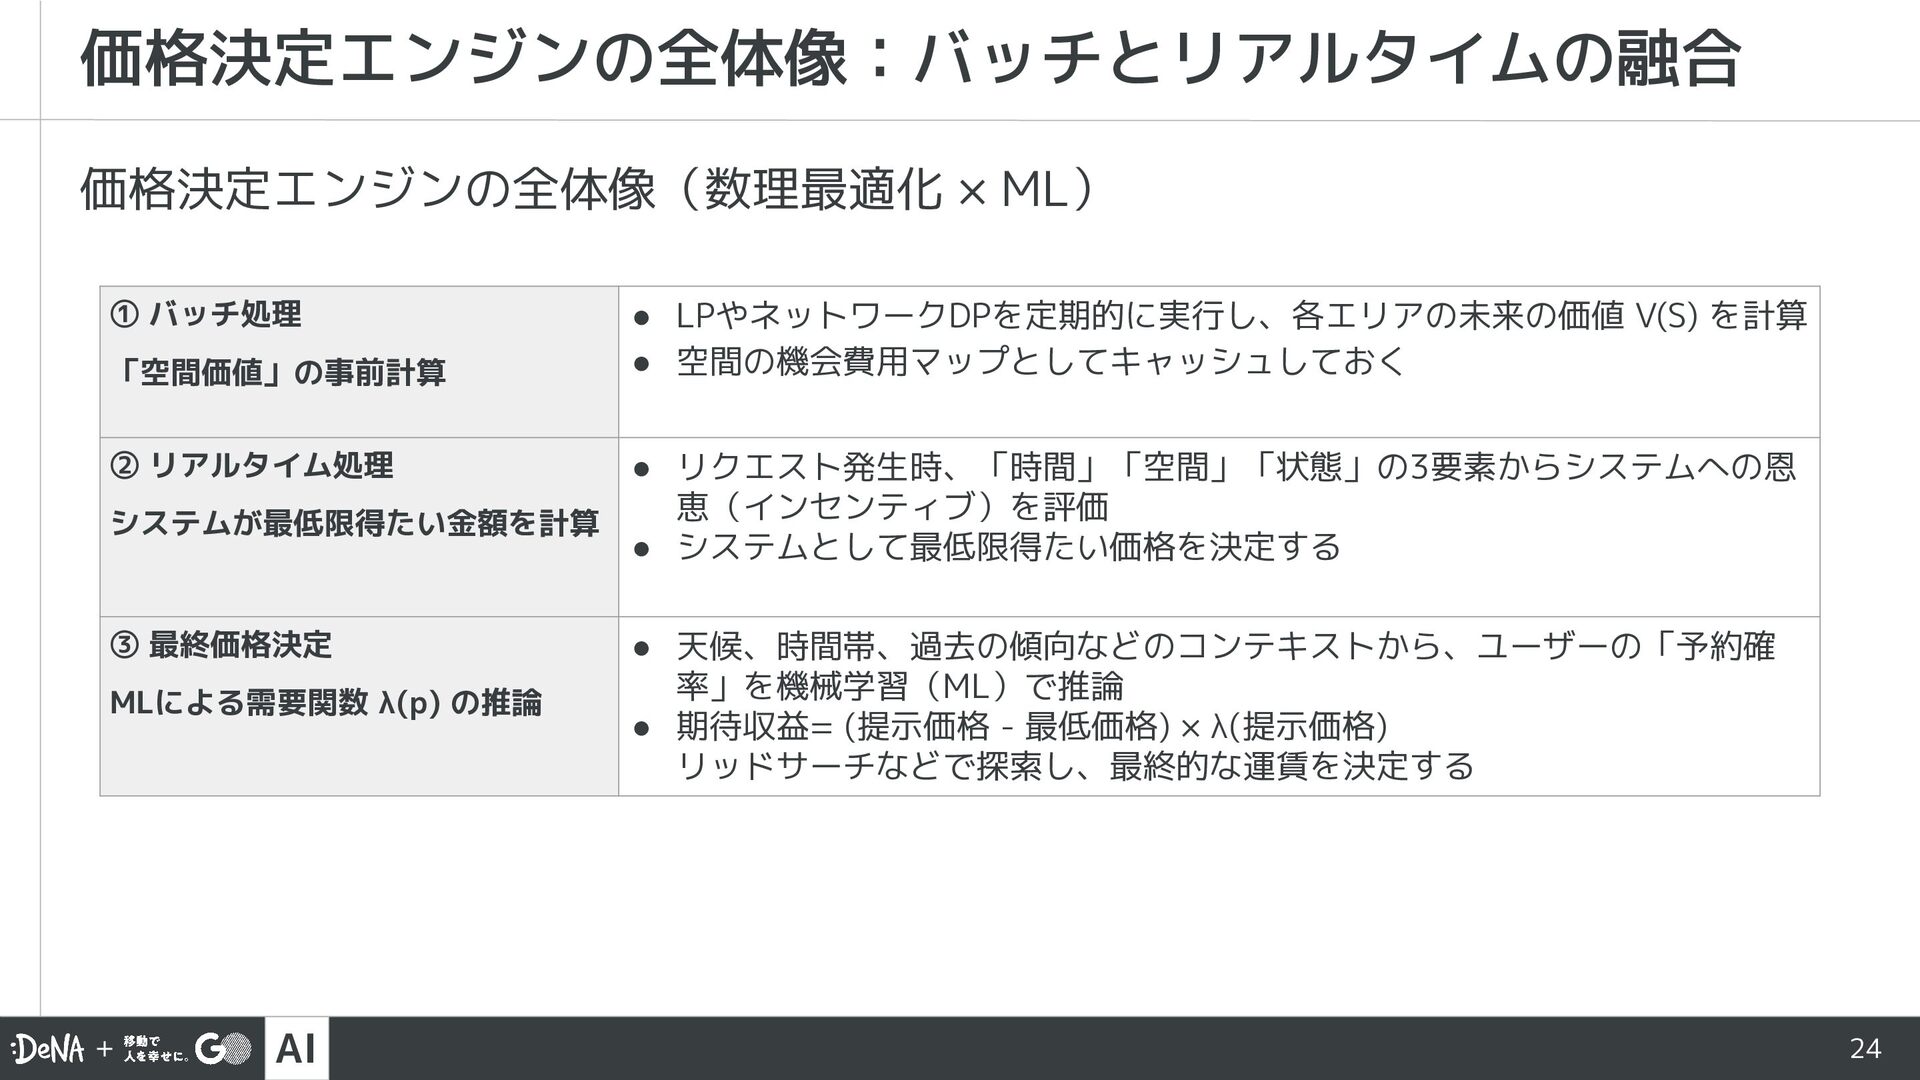
AI 価格決定エンジンの全体像(数理最適化 × ML) 価格決定エンジンの全体像:バッチとリアルタイムの融合 24 ① バッチ処理 「空間価値」の事前計算 •
LPやネットワークDPを定期的に実行し、各エリアの未来の価値 V(S) を計算 • 空間の機会費用マップとしてキャッシュしておく ② リアルタイム処理 システムが最低限得たい金額を計算 • リクエスト発生時、「時間」「空間」「状態」の3要素からシステムへの恩 恵(インセンティブ)を評価 • システムとして最低限得たい価格を決定する ③ 最終価格決定 MLによる需要関数 λ(p) の推論 • 天候、時間帯、過去の傾向などのコンテキストから、ユーザーの「予約確 率」を機械学習(ML)で推論 • 期待収益= (提示価格 - 最低価格) × λ(提示価格)が最大となるポイントをグ リッドサーチなどで探索し、最終的な運賃を決定する -
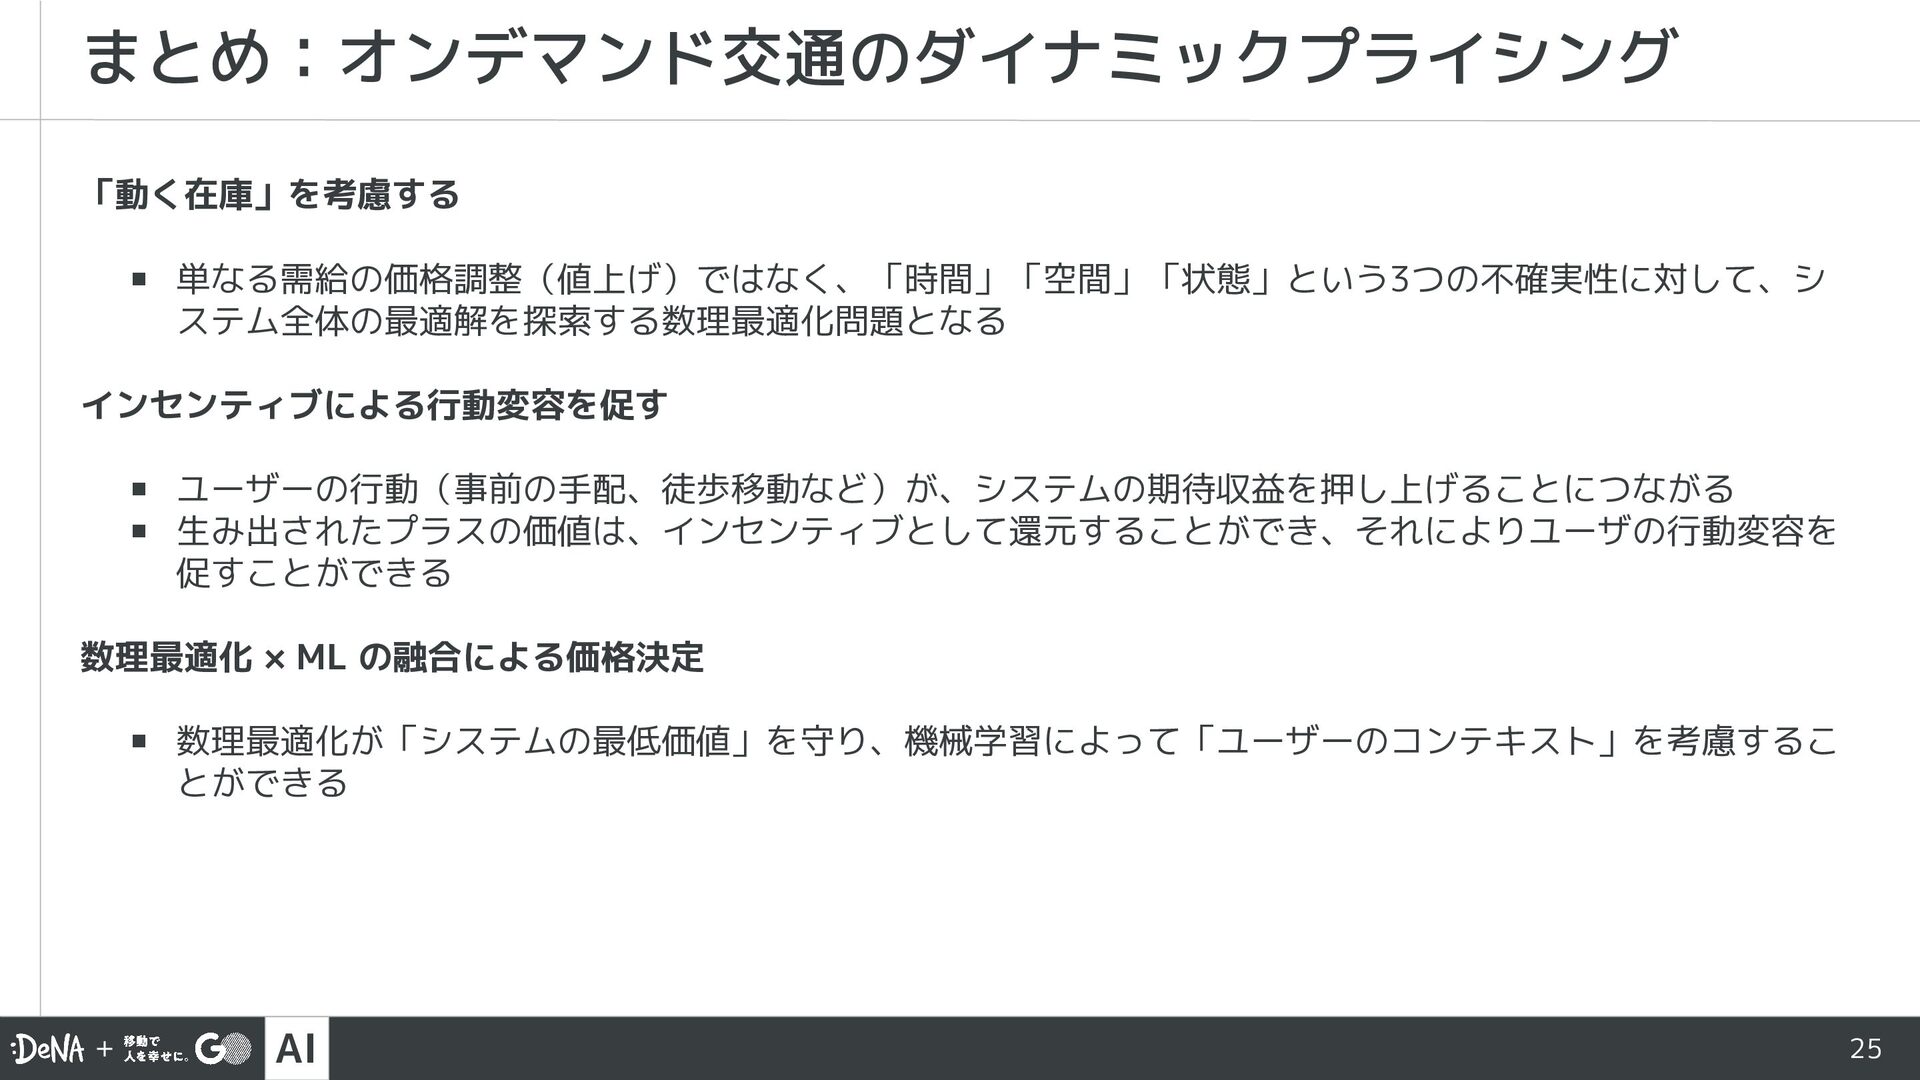
AI 「動く在庫」を考慮する ▪ 単なる需給の価格調整(値上げ)ではなく、「時間」「空間」「状態」という3つの不確実性に対して、シ ステム全体の最適解を探索する数理最適化問題となる インセンティブによる行動変容を促す ▪ ユーザーの行動(事前の手配、徒歩移動など)が、システムの期待収益を押し上げることにつながる ▪ 生み出されたプラスの価値は、インセンティブとして還元することができ、それによりユーザの行動変容を
促すことができる 数理最適化 × ML の融合による価格決定 ▪ 数理最適化が「システムの最低価値」を守り、機械学習によって「ユーザーのコンテキスト」を考慮するこ とができる まとめ:オンデマンド交通のダイナミックプライシング 25