Upgrade to Pro
— share decks privately, control downloads, hide ads and more …
Speaker Deck
Sign up for free
Menu
Search
Features
All features
Private URLs
Password Protection
Custom URLS
Scheduled publishing
Remove Branding
Restrict embedding
Deck Collections
Notes
Features
All features
Private URLs
Password Protection
Custom URLS
Scheduled publishing
Remove Branding
Restrict embedding
Deck Collections
Notes
Explore
Featured decks
Featured speakers
Programming
Technology
Storyboards
Explore
Featured decks
Featured speakers
Programming
Technology
Storyboards
Pricing
Search
Sign in
Sign up for free
Eval-centric_Agentic__RL.pdf
Search
Sponsored
·
Your Podcast. Everywhere. Effortlessly.
Share. Educate. Inspire. Entertain. You do you. We'll handle the rest.
→
mujirushi
November 04, 2026
87
0
Share
Embed
Copy iframe code
Copy JS code
Copy link
Start on current slide
Eval-centric_Agentic__RL.pdf
mujirushi
November 04, 2026
More Decks by mujirushi
See All by mujirushi
Agentic TaskにおけるOn-Policy Distillation入門.pdf
mujirushi
0
250
都市における人間移動予測の最前線___SIGSPATIAL_Cup_2025_上位解法の紹介_.pdf
mujirushi
1
560
KDDCup2025_CRAG-MM_Challenge上位解法の紹介.pdf
mujirushi
0
130
関西kaggler会_2025_1_Mujirushi.pdf
mujirushi
2
1.7k
Kagglerが学会コンペに参加したら無双できる説
mujirushi
2
2.9k
Featured
See All Featured
How to Build an AI Search Optimization Roadmap - Criteria and Steps to Take #SEOIRL
aleyda
1
2.2k
Navigating the Design Leadership Dip - Product Design Week Design Leaders+ Conference 2024
apolaine
2
500
Design in an AI World
tapps
1
380
A Tale of Four Properties
chriscoyier
163
24k
Paper Plane
katiecoart
PRO
5
54k
Accessibility Awareness
sabderemane
1
290
Designing Dashboards & Data Visualisations in Web Apps
destraynor
232
55k
Save Time (by Creating Custom Rails Generators)
garrettdimon
PRO
33
5.6k
Un-Boring Meetings
codingconduct
0
490
Bootstrapping a Software Product
garrettdimon
PRO
306
120k
Become a Pro
speakerdeck
PRO
31
6.3k
Ethics towards AI in product and experience design
skipperchong
2
460
Transcript
Eval-centric Agentic RL AI×ドメイン実践ナレッジ共有会 2026.10.20
自己紹介 • 氏名:鈴木 明作(スズキ メイサク) • 所属:松尾研究所 • Kaggle Competitions
Master
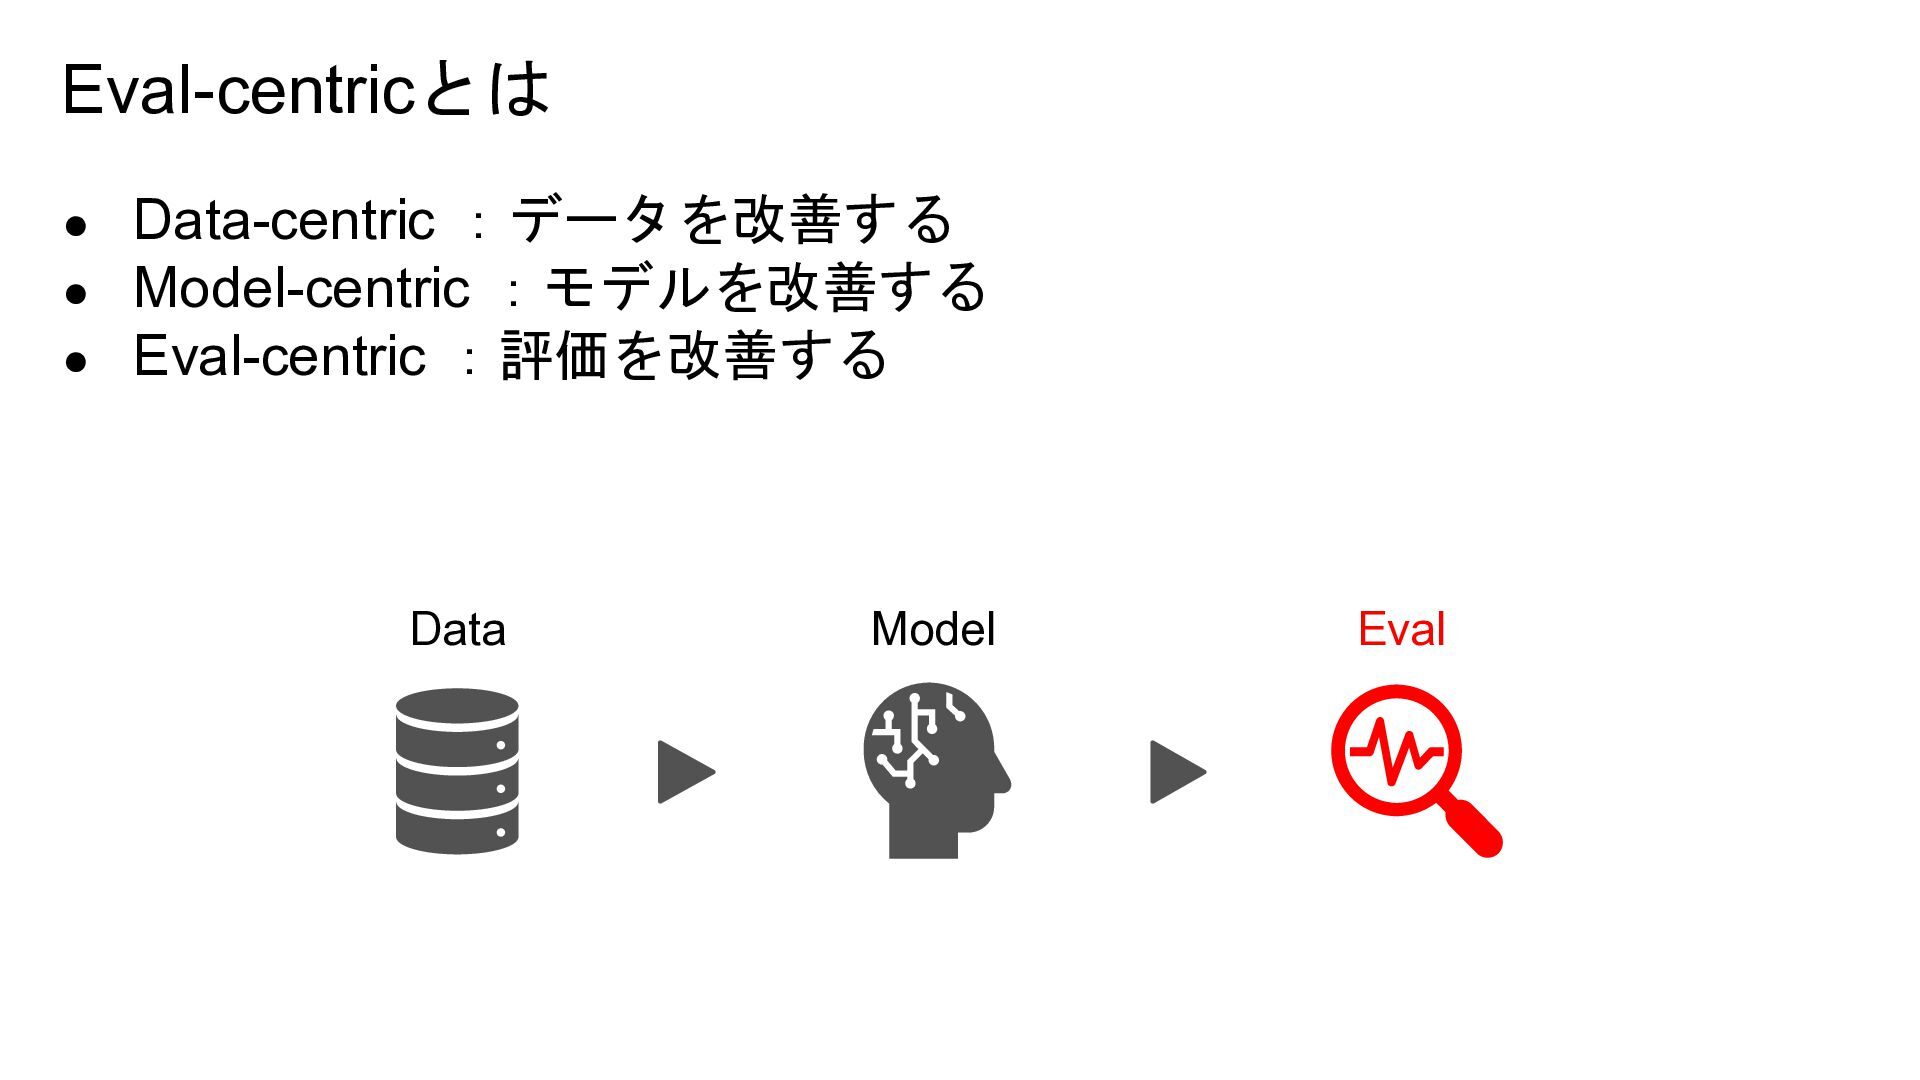
Eval-centricとは • • • Data-centric :データを改善する Model-centric :モデルを改善する Eval-centric :評価を改善する
Data Model Eval
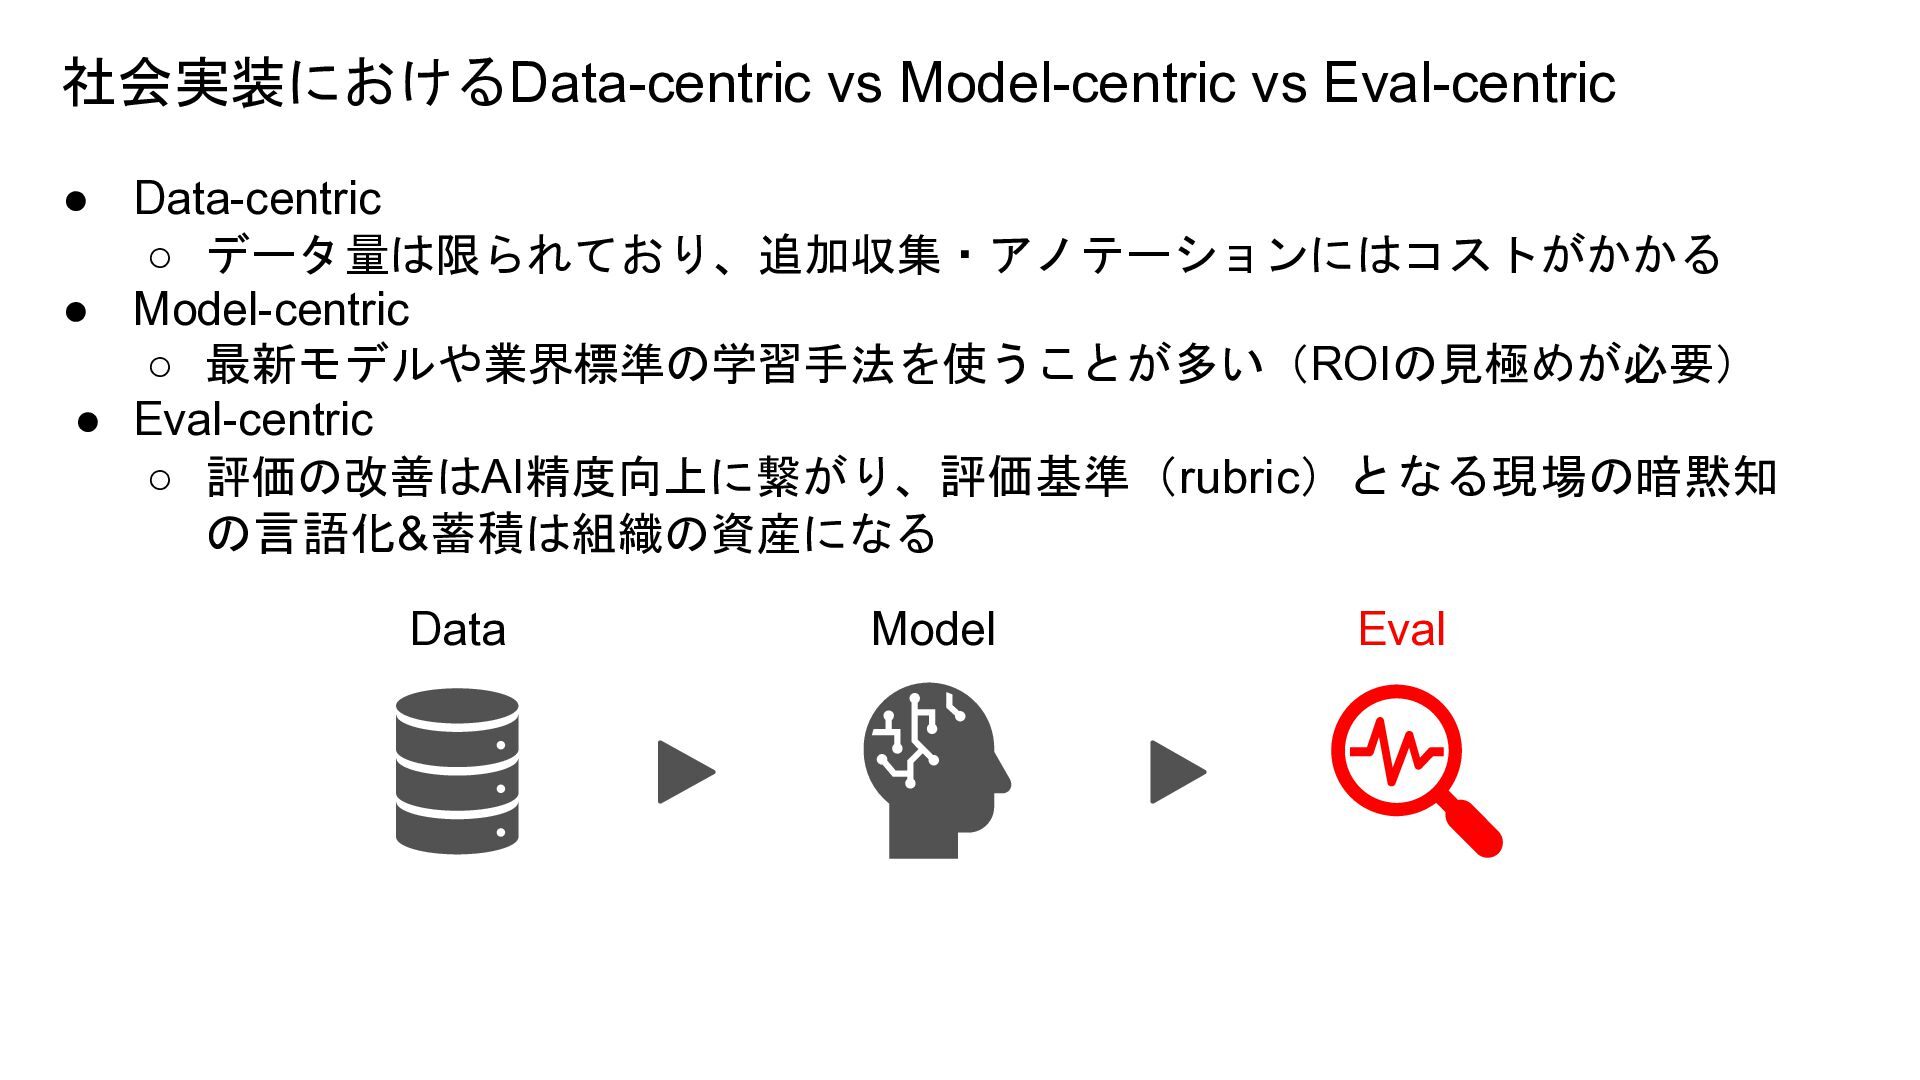
社会実装におけるData-centric vs Model-centric vs Eval-centric • Data-centric ◦ データ量は限られており、追加収集・アノテーションにはコストがかかる •
Model-centric ◦ 最新モデルや業界標準の学習手法を使うことが多い(ROIの見極めが必要) • Eval-centric ◦ 評価の改善はAI精度向上に繋がり、評価基準(rubric)となる現場の暗黙知 の言語化&蓄積は組織の資産になる Data Model Eval
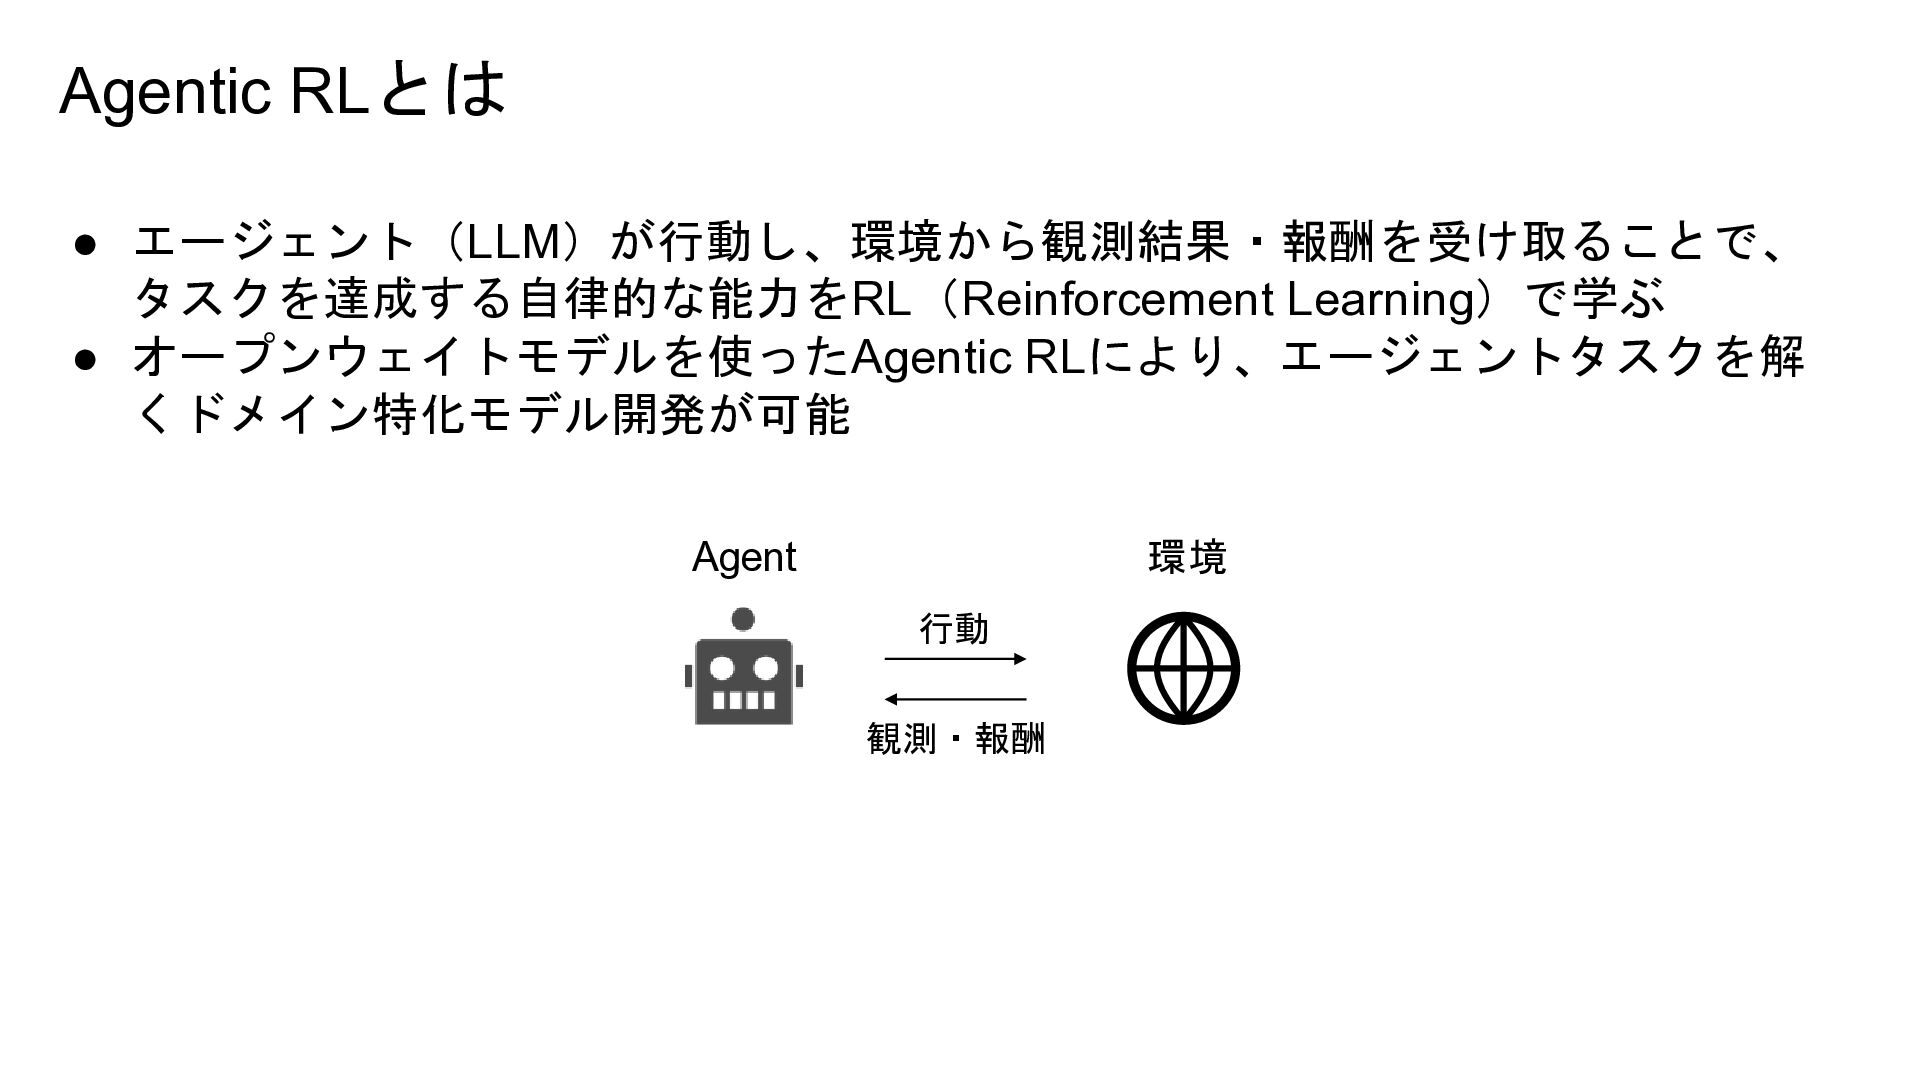
Agentic RLとは • エージェント(LLM)が行動し、環境から観測結果・報酬を受け取ることで、 タスクを達成する自律的な能力をRL(Reinforcement Learning)で学ぶ • オープンウェイトモデルを使ったAgentic RLにより、エージェントタスクを解 くドメイン特化モデル開発が可能
Agent 環境 行動 観測・報酬
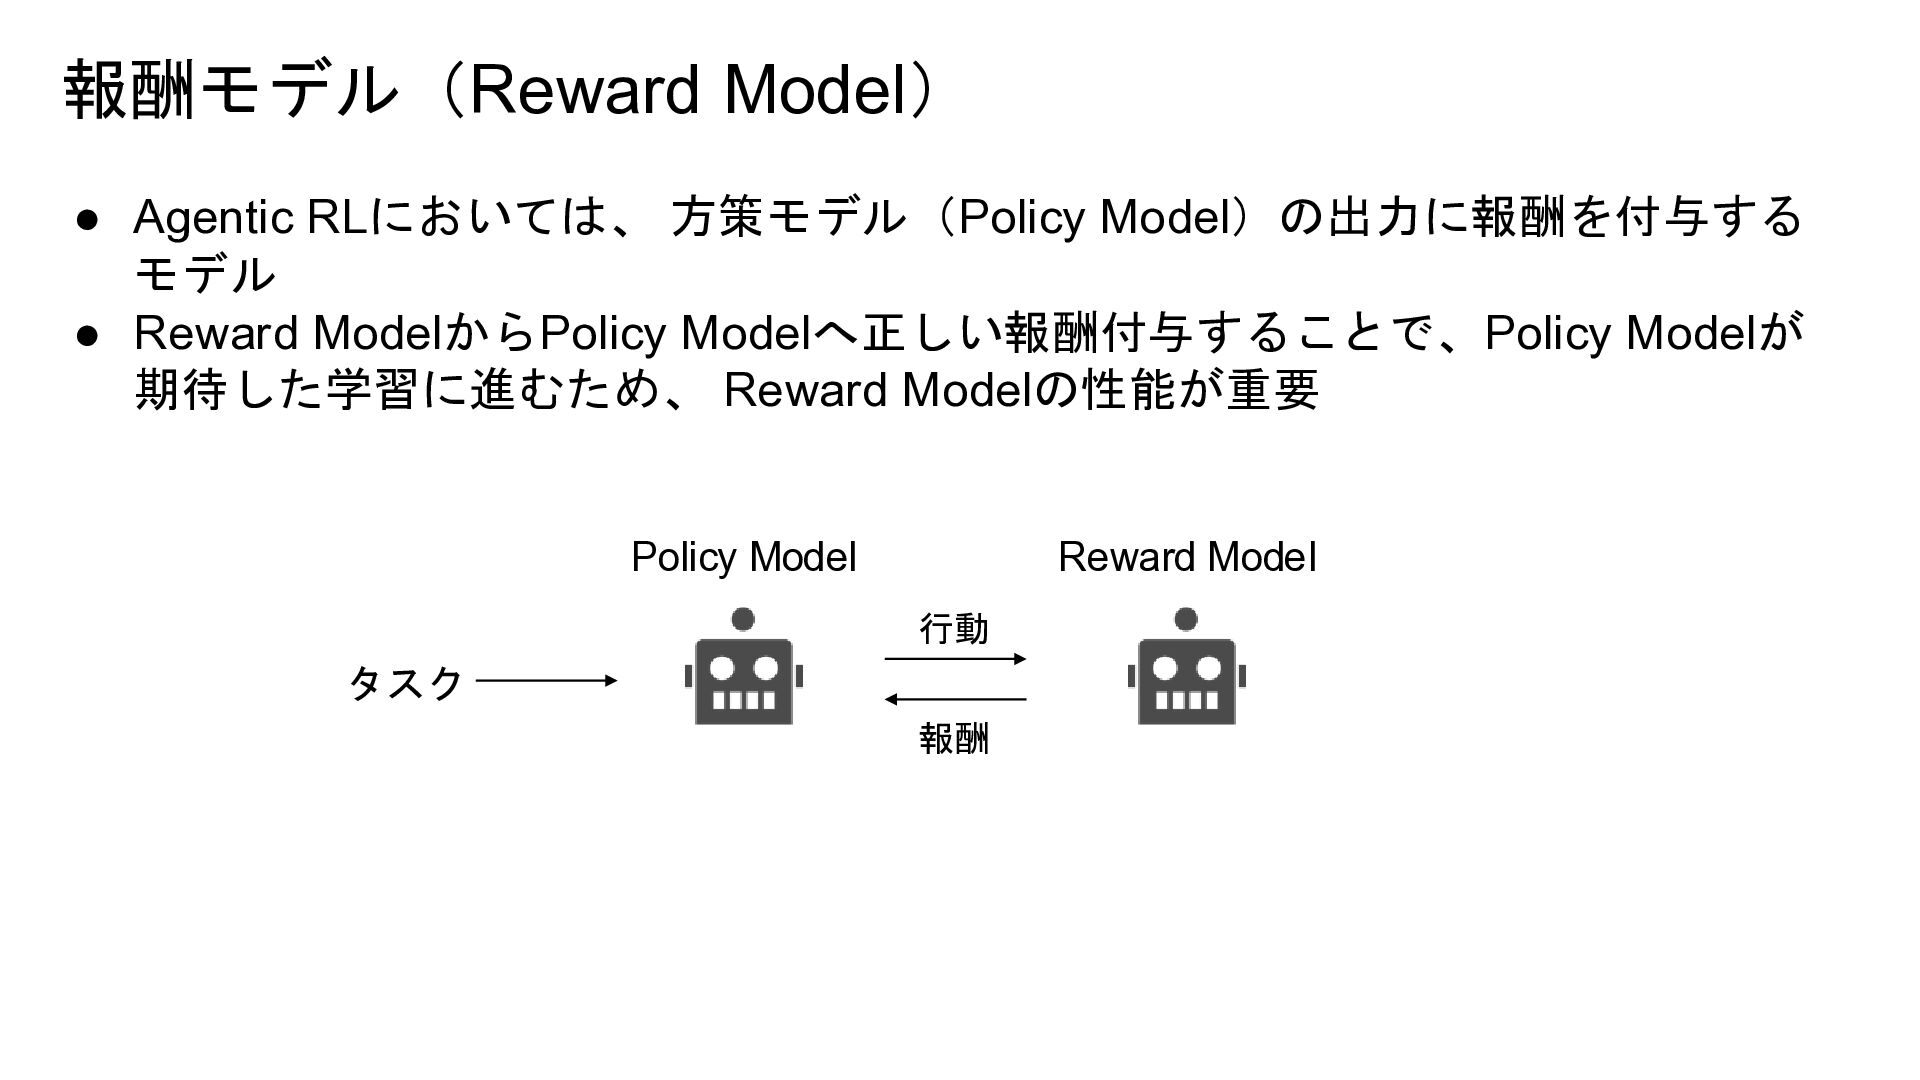
報酬モデル(Reward Model) • Agentic RLにおいては、 方策モデル(Policy Model)の出力に報酬を付与する モデル • Reward
ModelからPolicy Modelへ正しい報酬付与することで、Policy Modelが 期待した学習に進むため、 Reward Modelの性能が重要 Policy Model Reward Model 行動 タスク 報酬
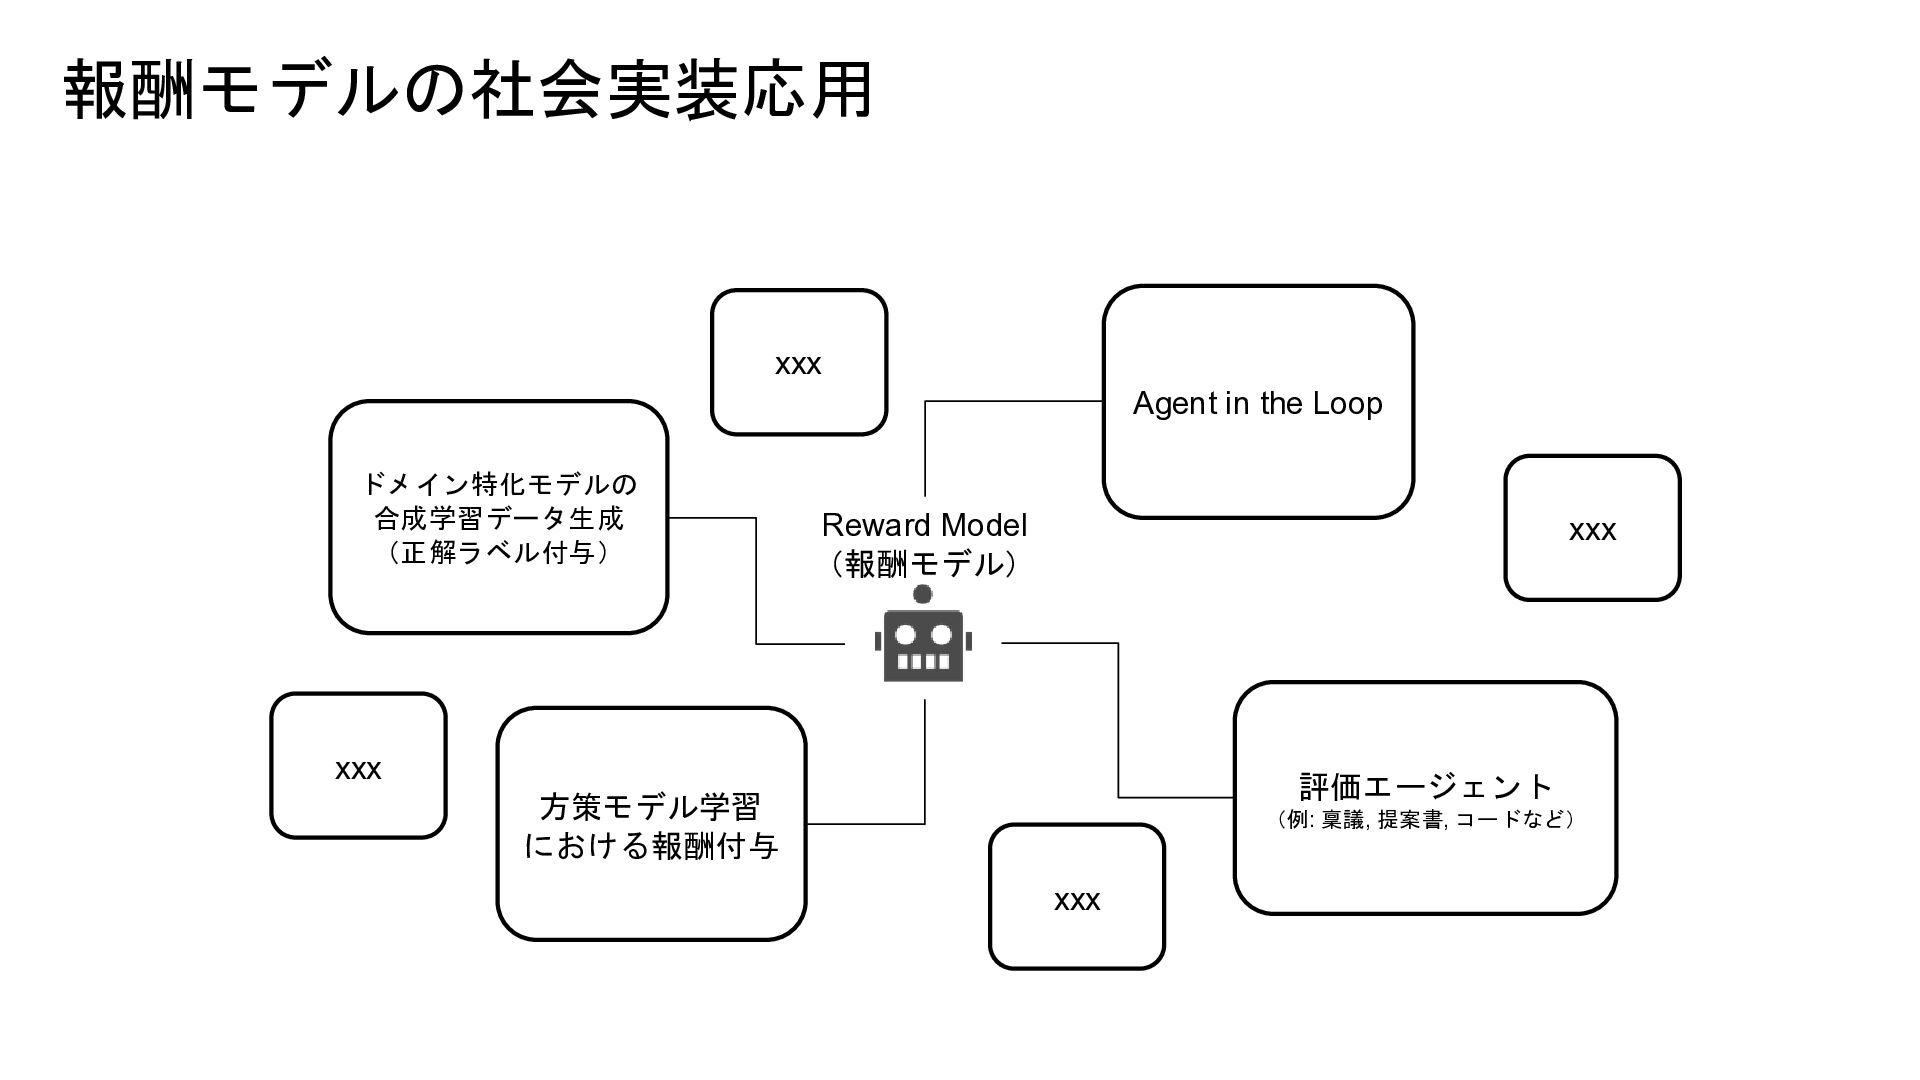
報酬モデルの社会実装応用 xxx Agent in the Loop ドメイン特化モデルの 合成学習データ生成 (正解ラベル付与) Reward
Model (報酬モデル) xxx xxx 評価エージェント 方策モデル学習 における報酬付与 (例: 稟議, 提案書, コードなど) xxx
参考. DeepSeek-V4(2026.4) • Policy Modelだけでなく、Reward ModelもRL https://arxiv.org/pdf/2606.19348
Eval-centric Agentic RLの舞台 • Enronは米国のエネルギー企業 • 粉飾決算をめぐる訴訟の過程で約50万通の社内メールが公開 • 現在はEnron社内メールが研究用データセットとしても利用されている https://www.amazon.co.jp//en/%E5%85%83%E3%82%A8%E3%83%B3%E3%83%AD%E3%83%B3%E7%A4%BE%E5%9
3%A1-%E3%82%B1%E3%83%B3%E3%83%BB%E3%83%AC%E3%82%A4%E5%85%83CEO%E3%82%B8%E3%82%A7%E3%83%95%E3%83%BB%E3%82%B9%E3%82%AD%E3%83% AA%E3%83%B3%E3%82%B0%E3%82%A2%E3%83%B3%E3%83%87%E3%82%A3%E3%83%BB%E3%83%95%E3%82%A 1%E3%82%B9%E3%83%88%E3%82%A6/dp/B000O1OBLE
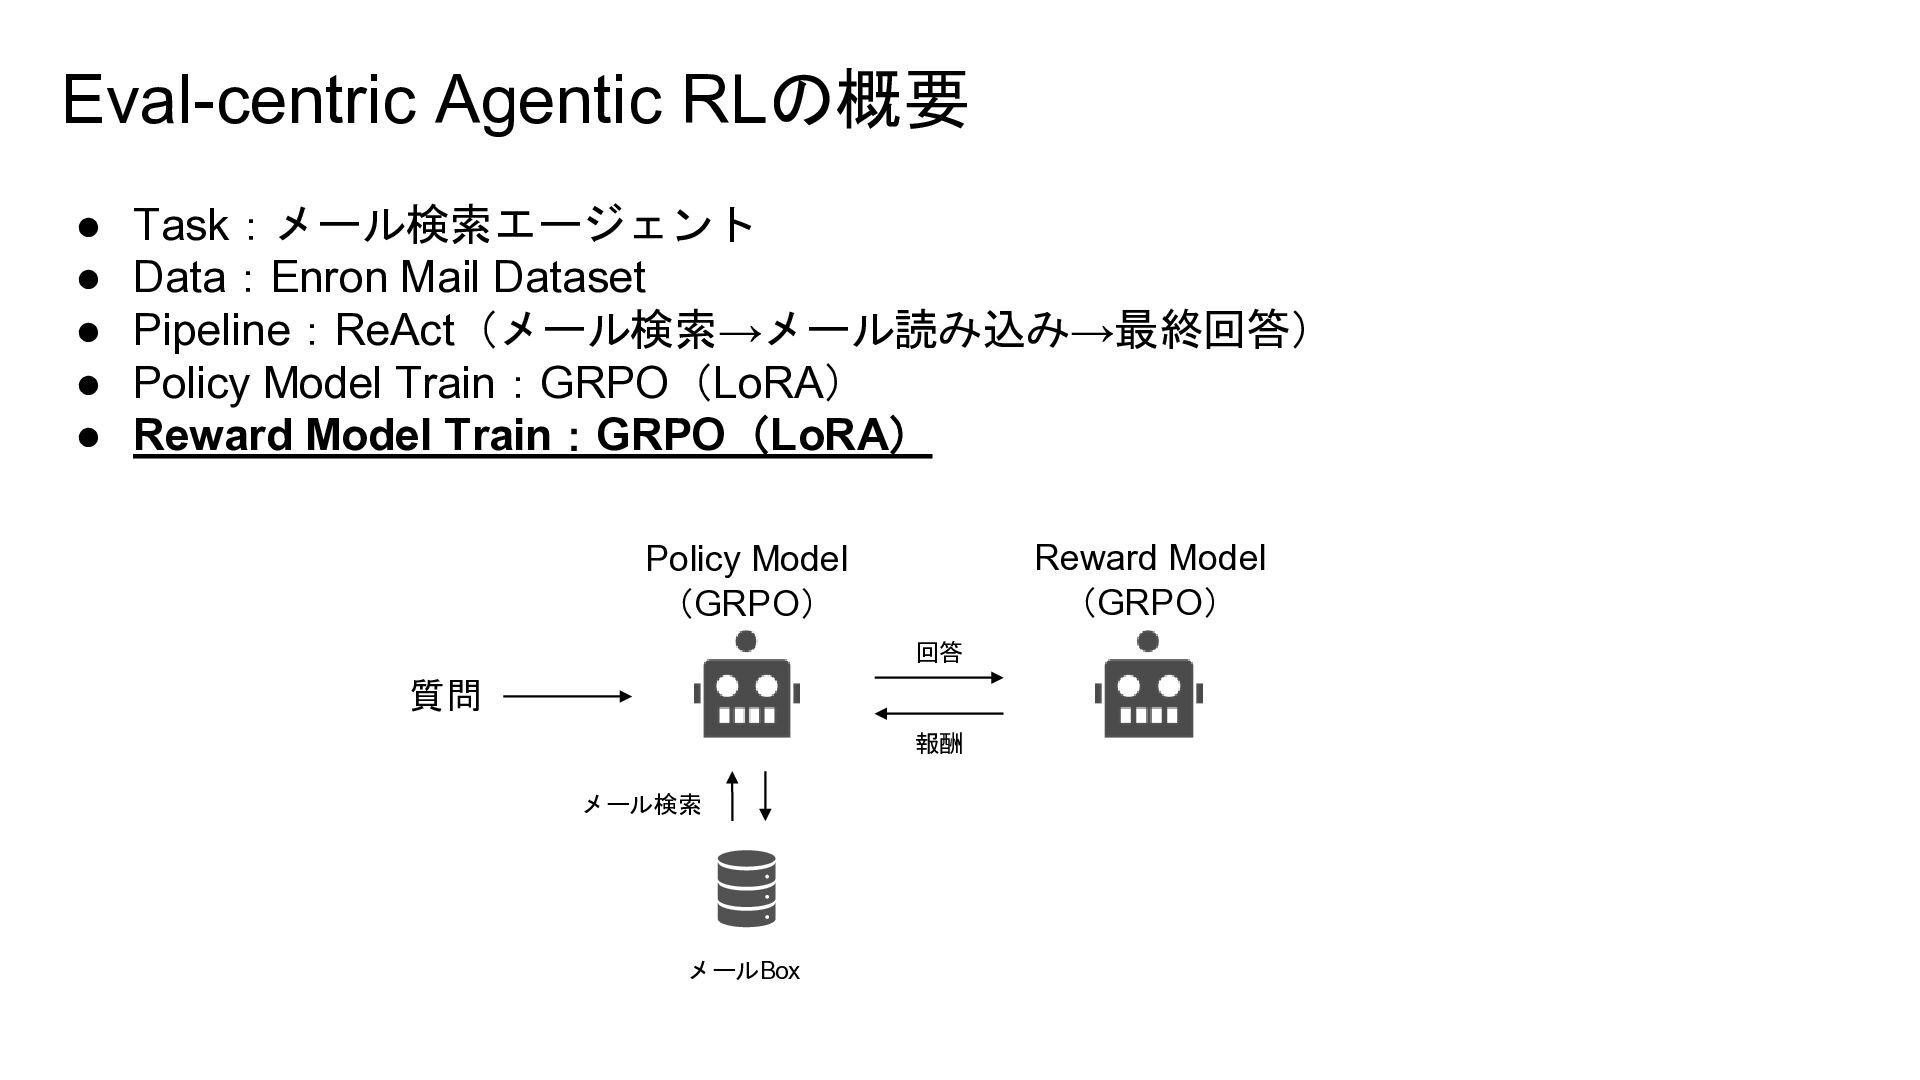
Eval-centric Agentic RLの概要 • Task:メール検索エージェント • Data:Enron Mail Dataset •
Pipeline:ReAct(メール検索→メール読み込み→最終回答) • Policy Model Train:GRPO(LoRA) • Reward Model Train:GRPO(LoRA) Reward Model (GRPO) Policy Model (GRPO) 回答 質問 報酬 メール検索 メールBox
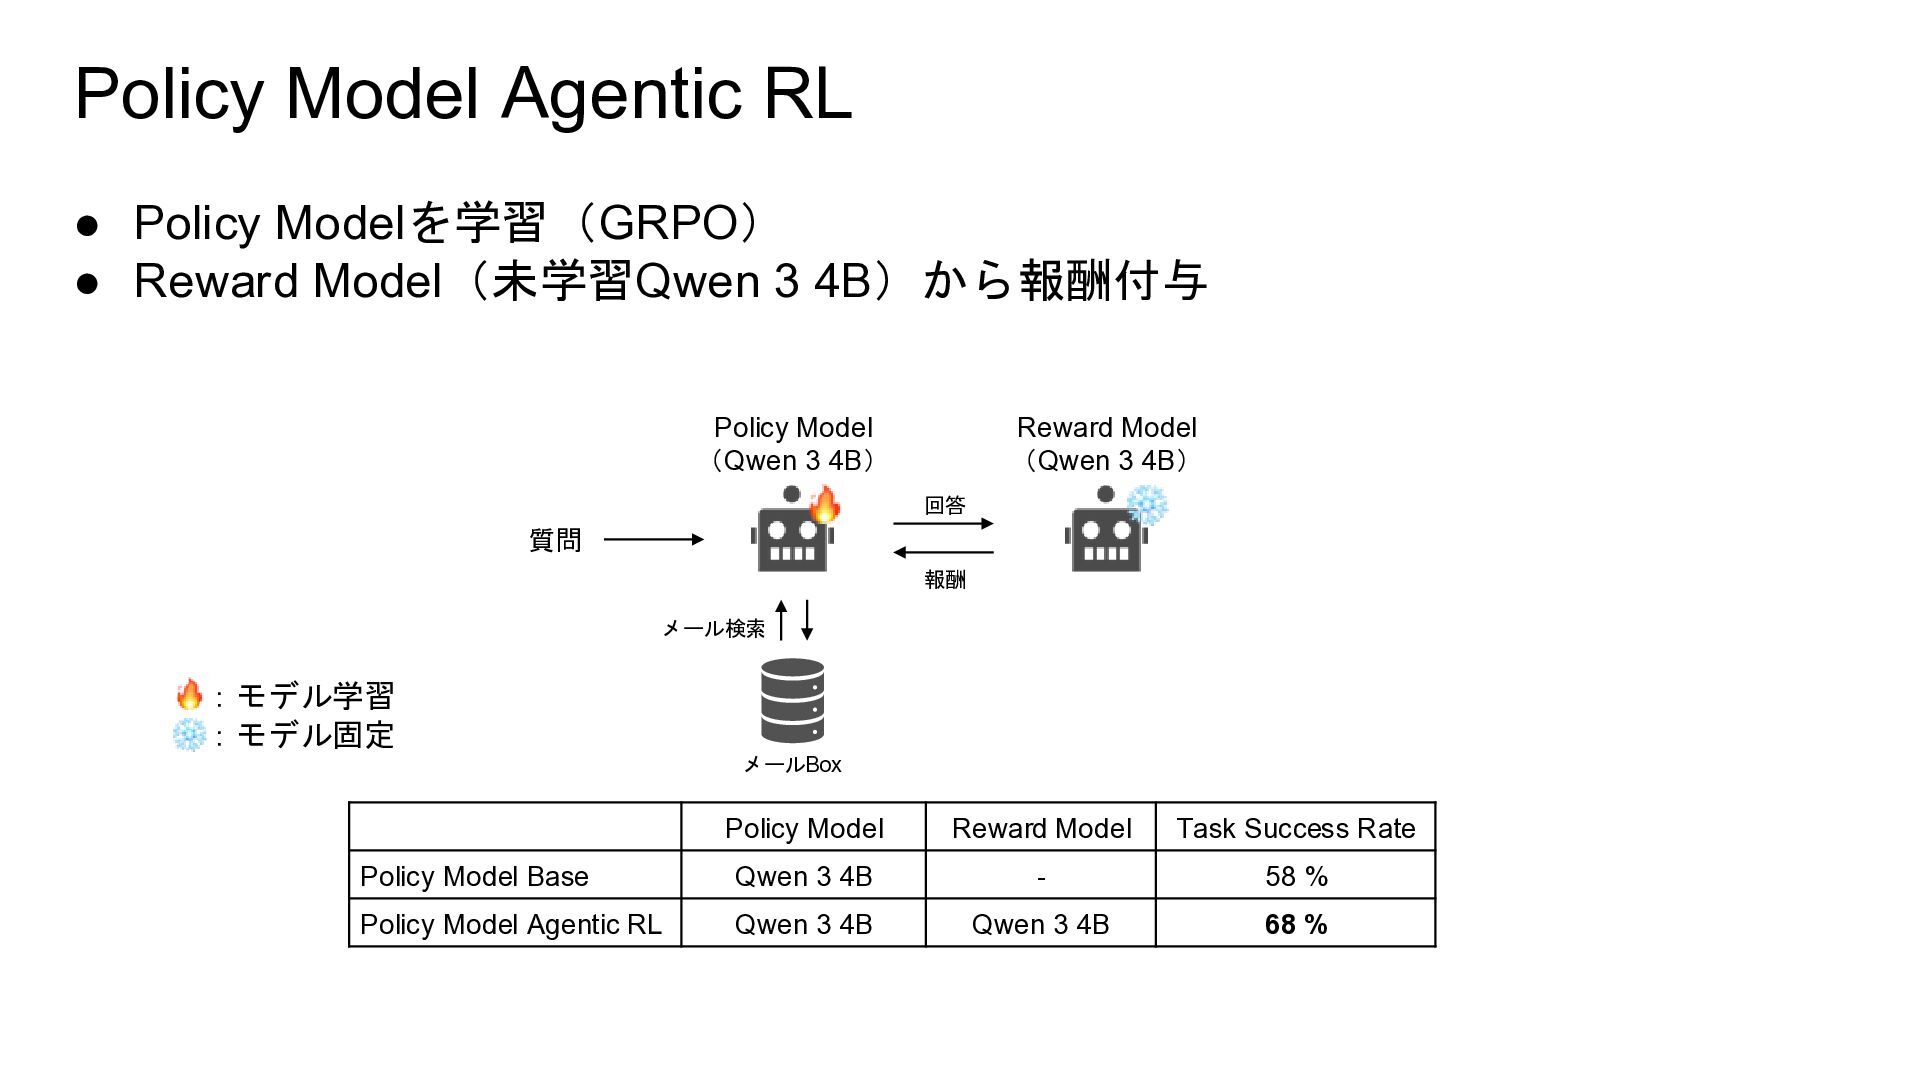
Policy Model Agentic RL • Policy Modelを学習(GRPO) • Reward Model(未学習Qwen
3 4B)から報酬付与 Reward Model (Qwen 3 4B) Policy Model (Qwen 3 4B) 回答 質問 報酬 メール検索 :モデル学習 :モデル固定 メールBox Policy Model Reward Model Task Success Rate Policy Model Base Qwen 3 4B - 58 % Policy Model Agentic RL Qwen 3 4B Qwen 3 4B 68 %
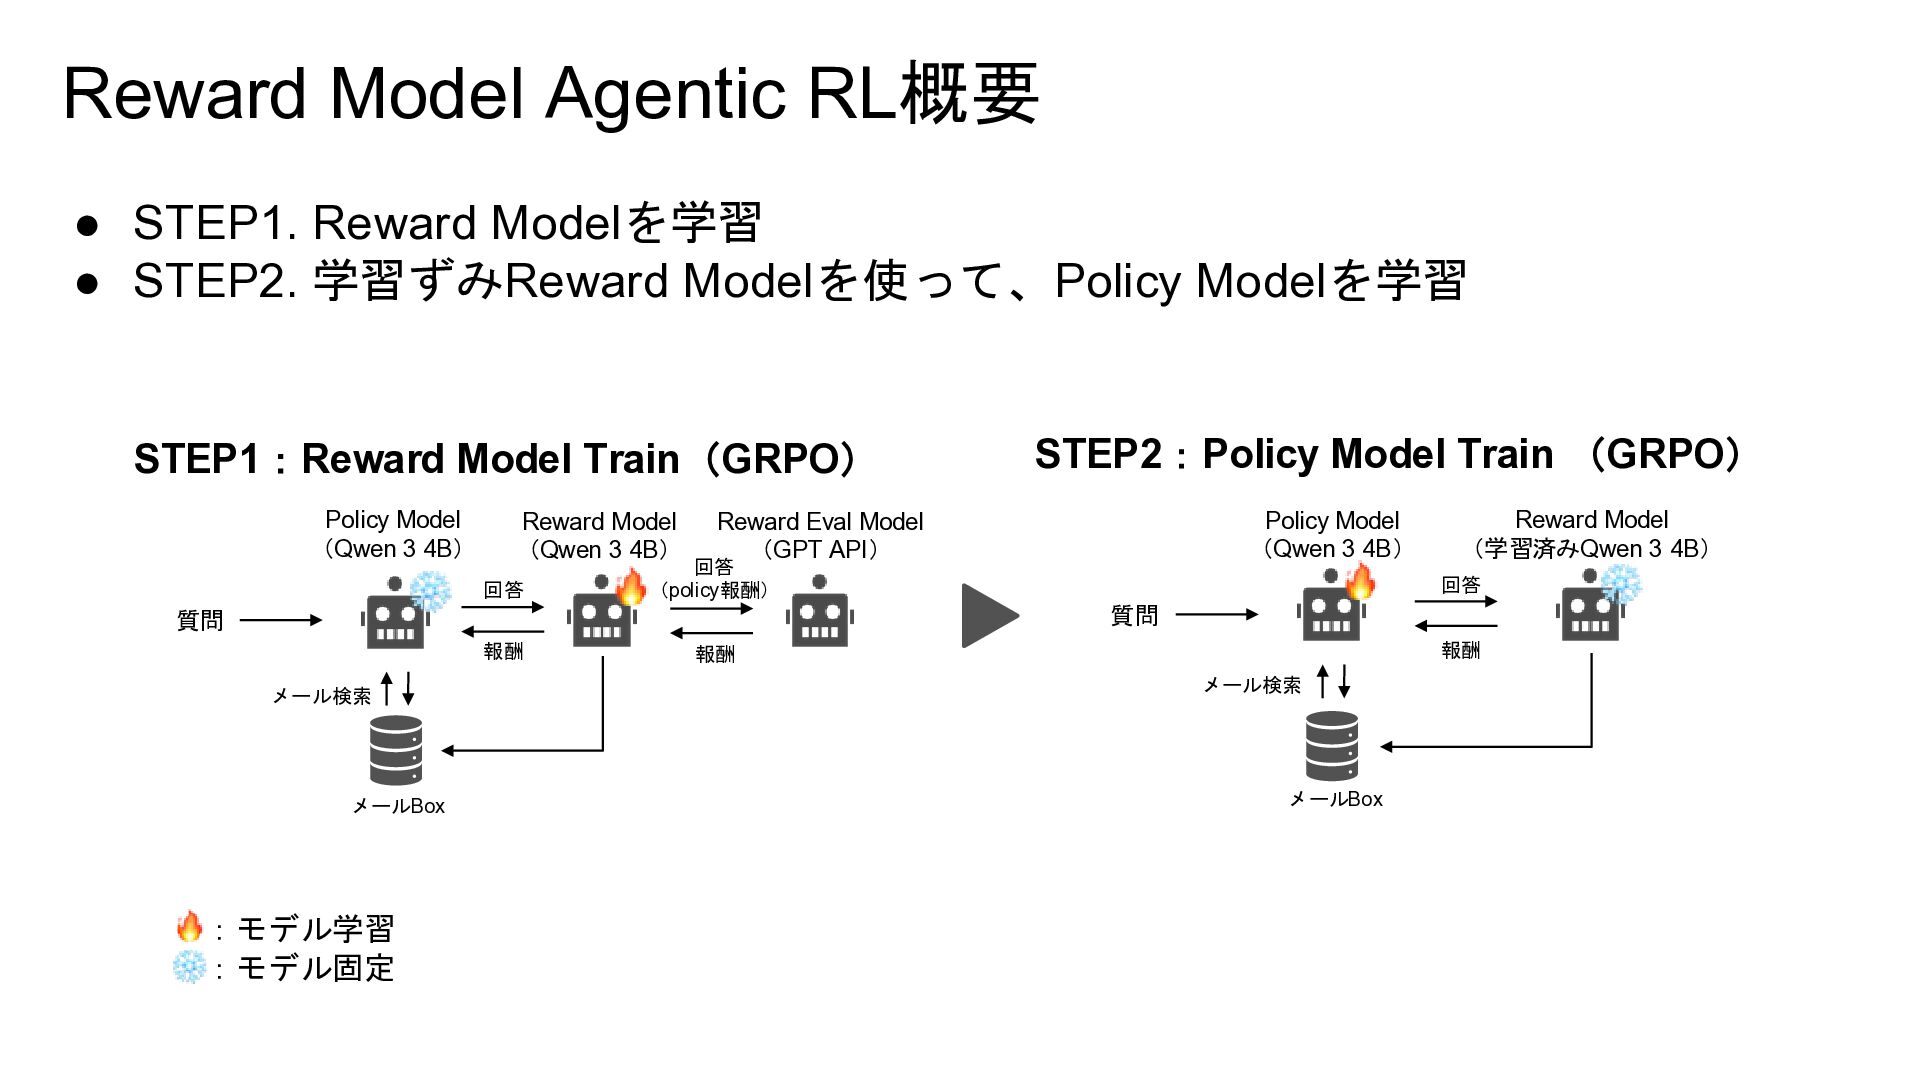
Reward Model Agentic RL概要 • STEP1. Reward Modelを学習 • STEP2.
学習ずみReward Modelを使って、Policy Modelを学習 STEP1:Reward Model Train(GRPO) Policy Model (Qwen 3 4B) Reward Model (Qwen 3 4B) 回答 STEP2:Policy Model Train (GRPO) Policy Model (Qwen 3 4B) Reward Eval Model (GPT API) 回答 (policy報酬) Reward Model (学習済みQwen 3 4B) 回答 質問 質問 報酬 メール検索 メールBox :モデル学習 :モデル固定 報酬 報酬 メール検索 メールBox
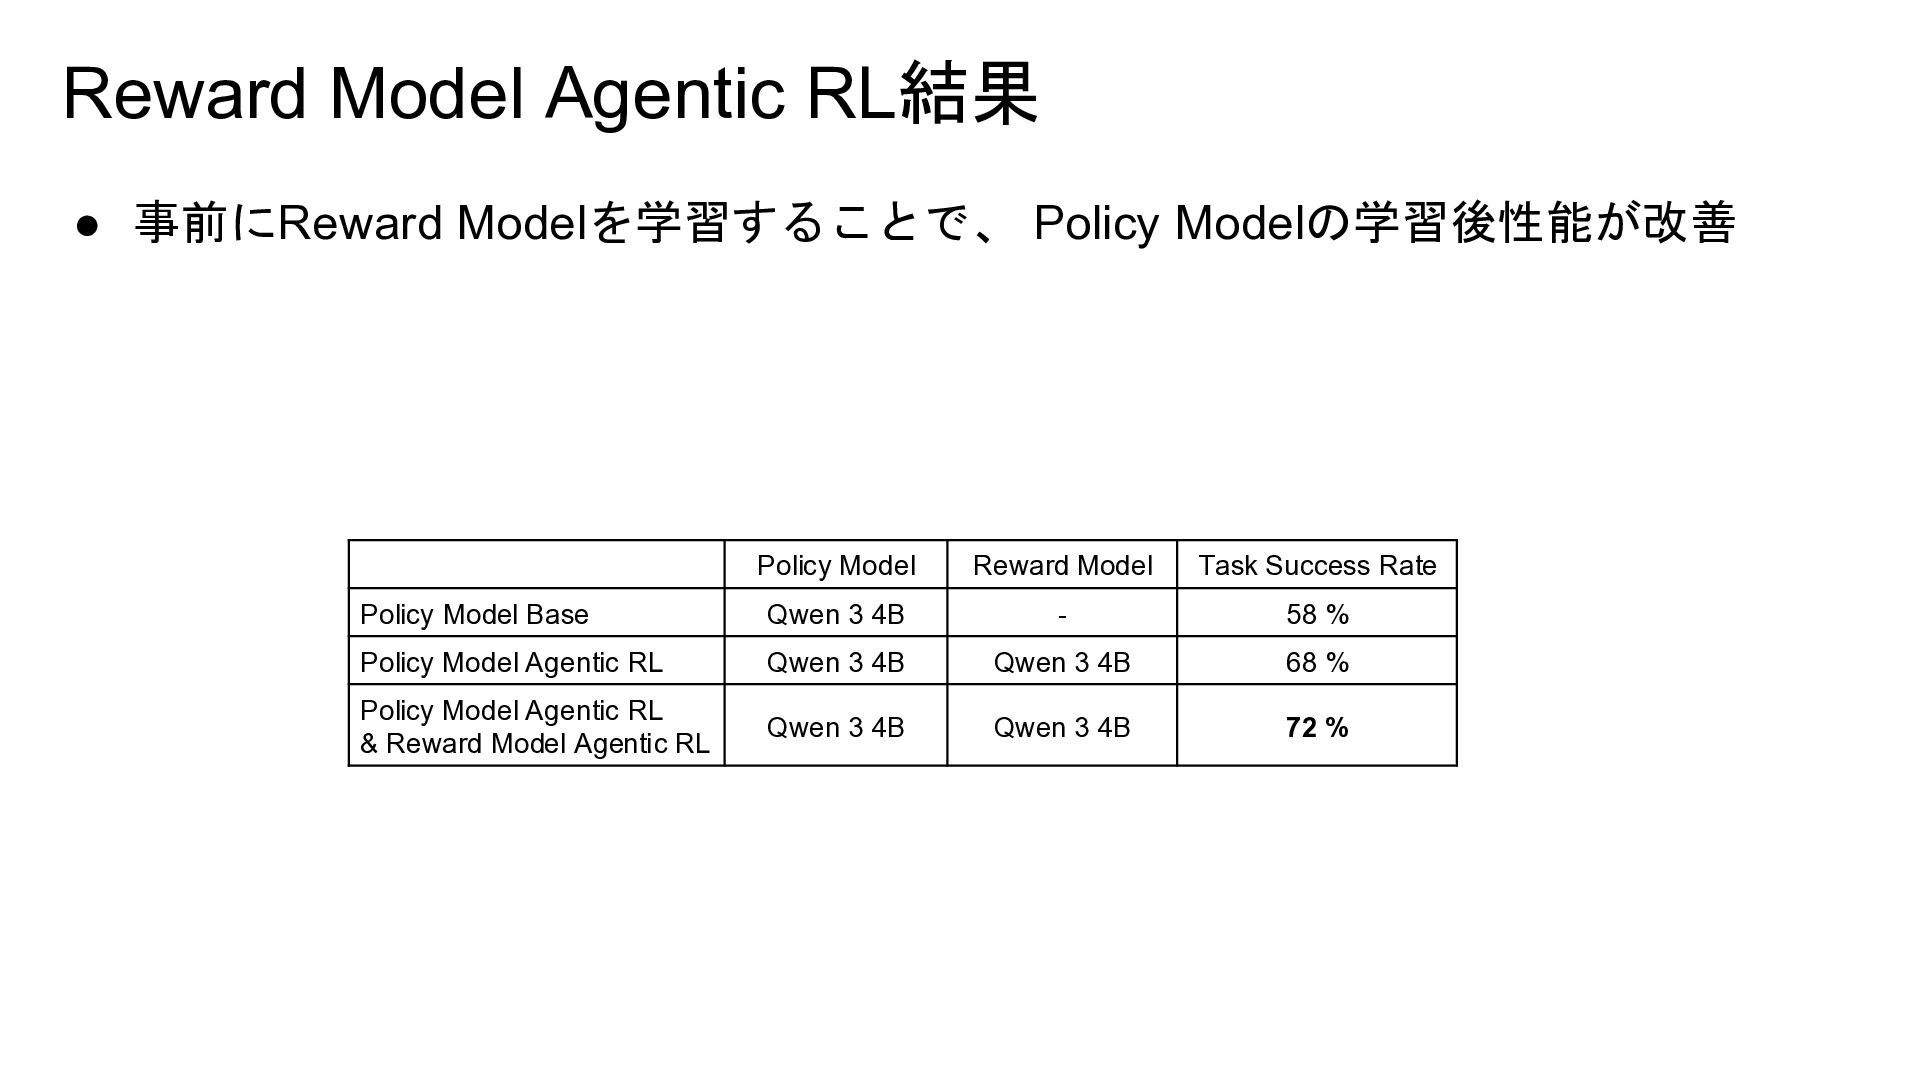
Reward Model Agentic RL結果 • 事前にReward Modelを学習することで、 Policy Modelの学習後性能が改善 Policy
Model Reward Model Task Success Rate Policy Model Base Qwen 3 4B - 58 % Policy Model Agentic RL Qwen 3 4B Qwen 3 4B 68 % Policy Model Agentic RL & Reward Model Agentic RL Qwen 3 4B Qwen 3 4B 72 %
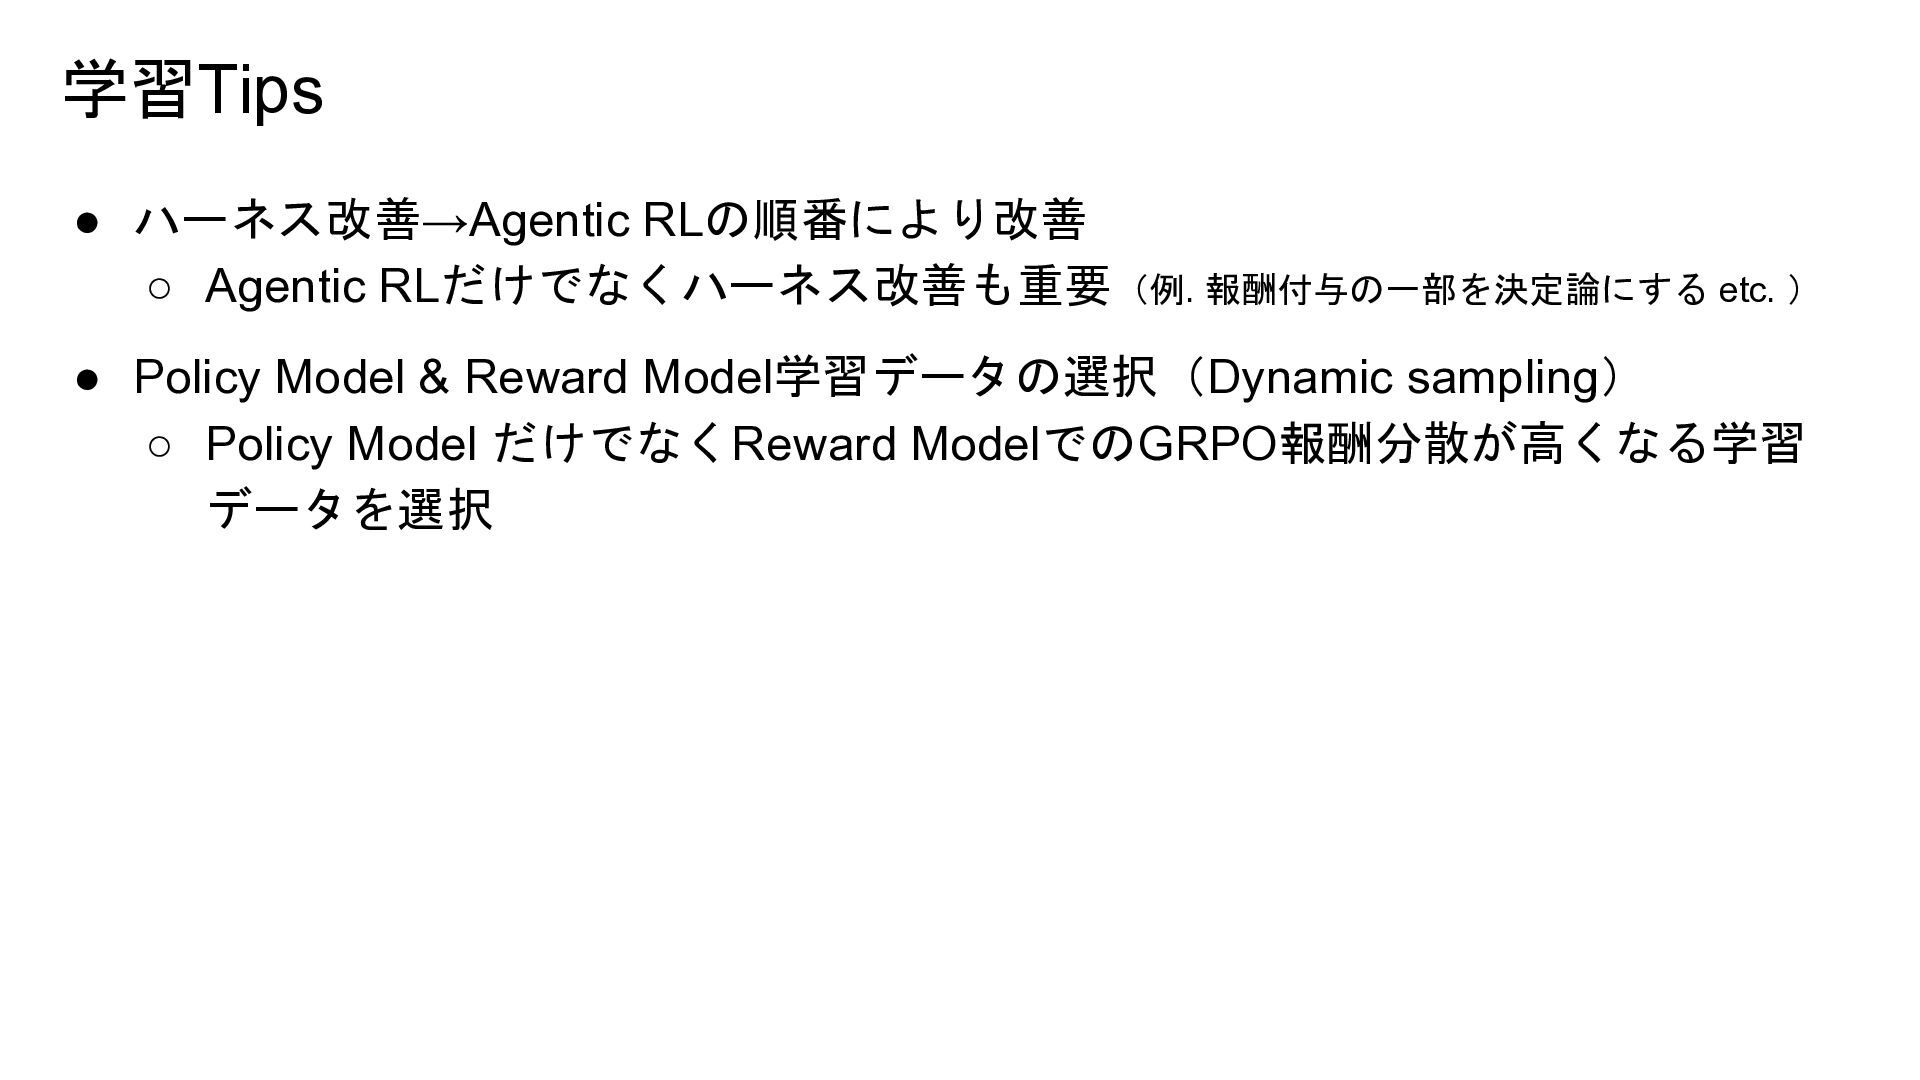
学習Tips • ハーネス改善→Agentic RLの順番により改善 ◦ Agentic RLだけでなくハーネス改善も重要(例. 報酬付与の一部を決定論にする etc. )
• Policy Model & Reward Model学習データの選択(Dynamic sampling) ◦ Policy Model だけでなくReward ModelでのGRPO報酬分散が高くなる学習 データを選択
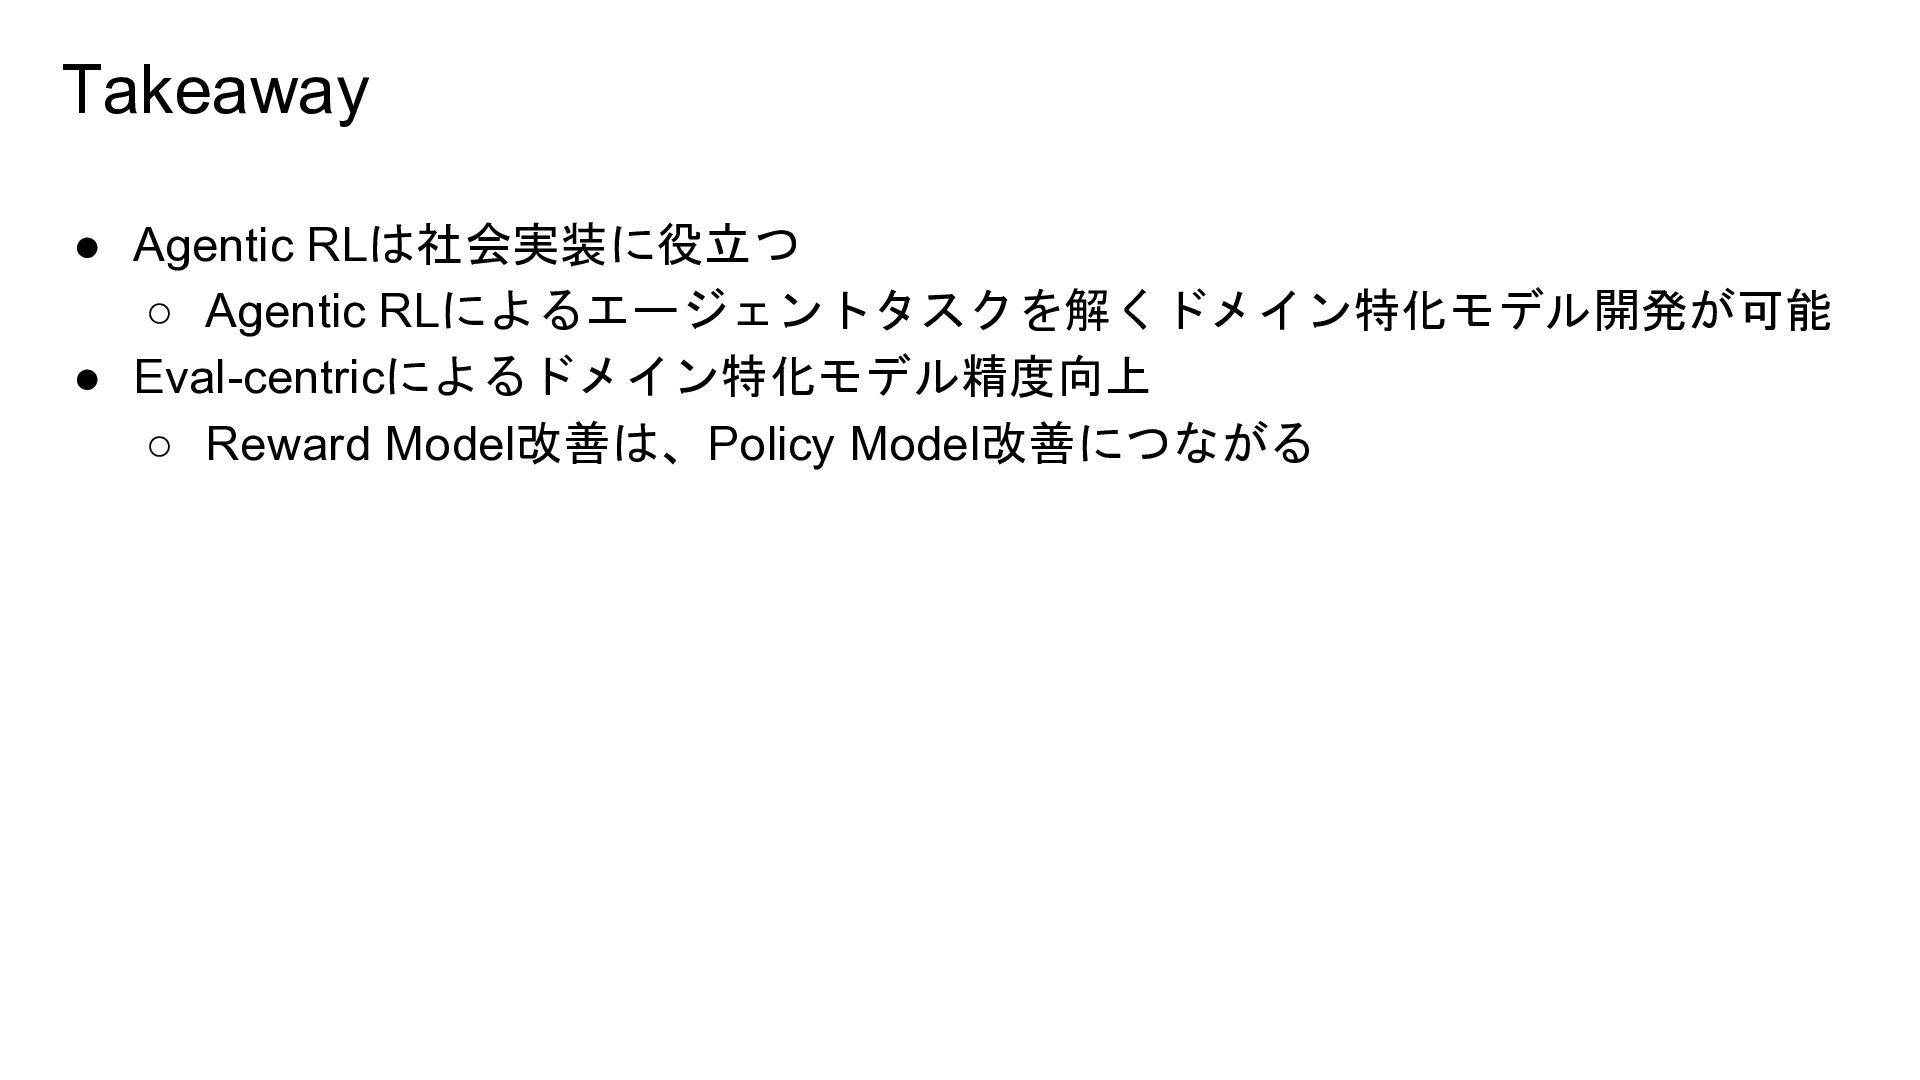
Takeaway • Agentic RLは社会実装に役立つ ◦ Agentic RLによるエージェントタスクを解くドメイン特化モデル開発が可能 • Eval-centricによるドメイン特化モデル精度向上 ◦
Reward Model改善は、Policy Model改善につながる

 Your Podcast. Everywhere. Effortlessly.


 mujirushi
 aleyda
 apolaine
 tapps
 chriscoyier
 katiecoart
 sabderemane
 destraynor
 garrettdimon
 codingconduct
 speakerdeck
 skipperchong