Share
Embed
Google Cloud を活用した大規模イベントを支えるクラウドアーキテクチャの実現
ABEMA のアプリケーションは Google Kubernetes Engine を中心としたマイクロサービスとして展開しています。昨年に開催された「FIFA ワールドカップ カタール 2022」の配信に向けて、我々のクラウドアーキテクチャにどのような懸念があったのか、どのように向き合ってきたのかについて、実際の活用事例を紹介します。
Katsutoshi Nagaoka
May 25, 2023
Transcript
62 slides
-
永岡 克利 株式会社 AbemaTV・Cloud Platform Group Manager Google Cloud を活用した大規模イベントを
支えるクラウド アーキテクチャの実現 -
2011 年 - 株式会社サイバーエージェント入社 2017 年 - ABEMA に参画 ABEMA
ではプロダクト開発の Technical Lead Engineer を経て、現在は Cloud Platform Group の Manager として Cloud Solution 全般を担当 スピーカー自己紹介 永岡 克利 株式会社 AbemaTV Cloud Platform Group Manager Software Engineer -
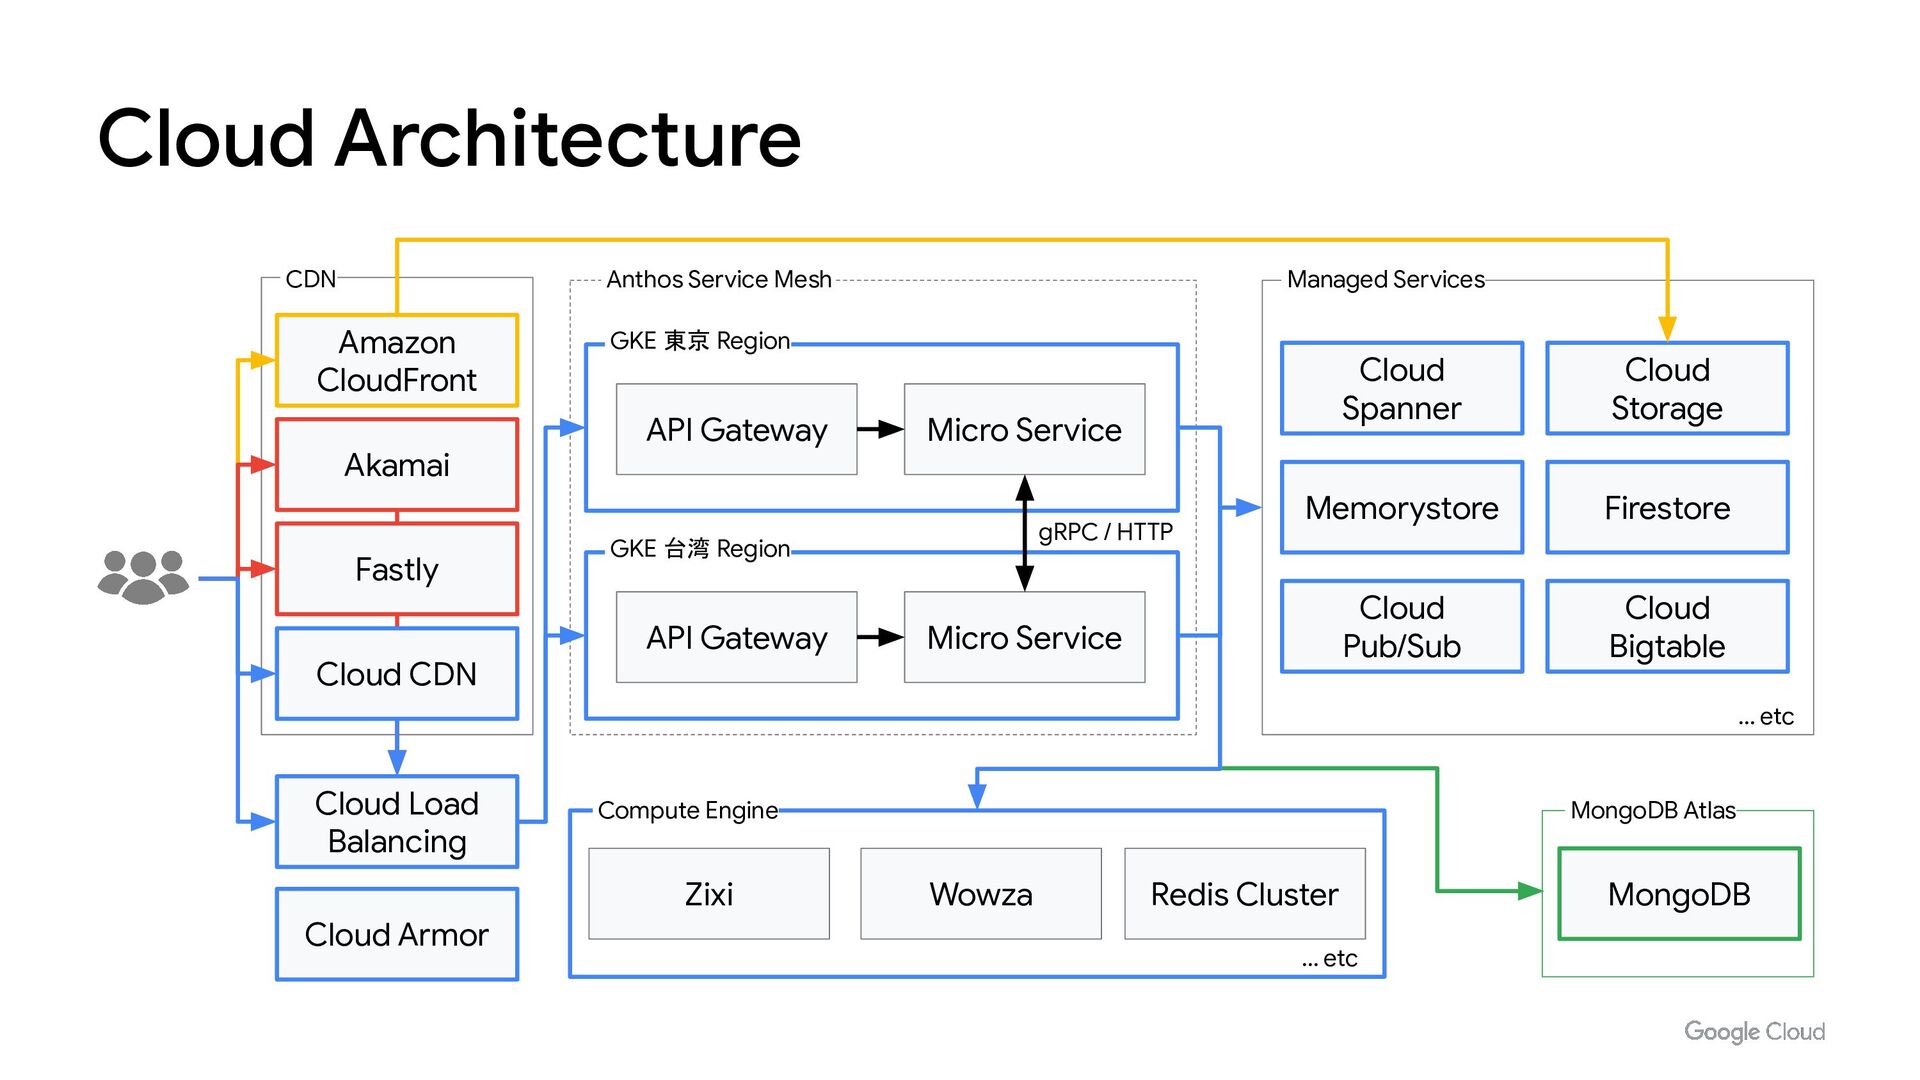
Cloud Storage Cloud Architecture Firestore Cloud Spanner Memorystore Cloud Bigtable
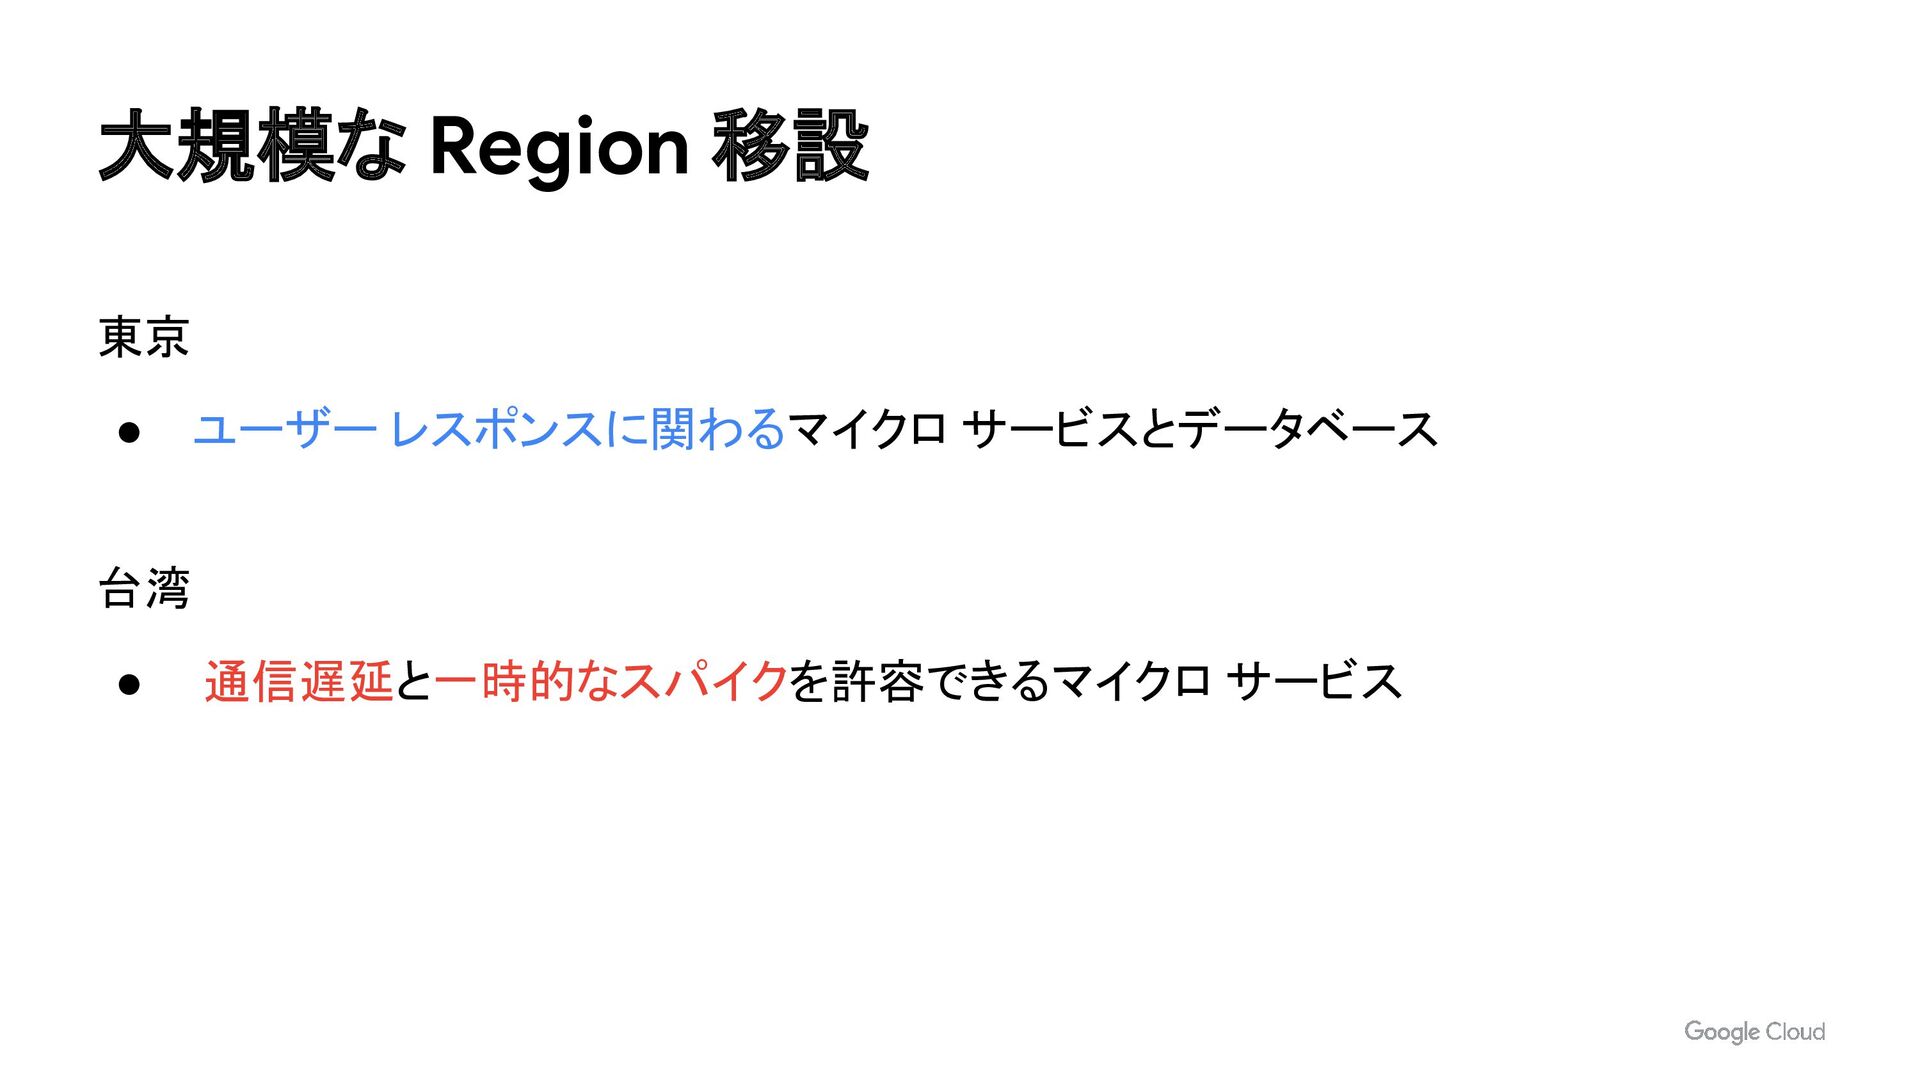
Cloud Pub/Sub GKE 東京 Region API Gateway Micro Service GKE 台湾 Region API Gateway Micro Service Anthos Service Mesh MongoDB Managed Services MongoDB Atlas Compute Engine Zixi Wowza Redis Cluster … etc … etc gRPC / HTTP Cloud CDN Cloud Load Balancing Cloud Armor Akamai Fastly CDN Amazon CloudFront -
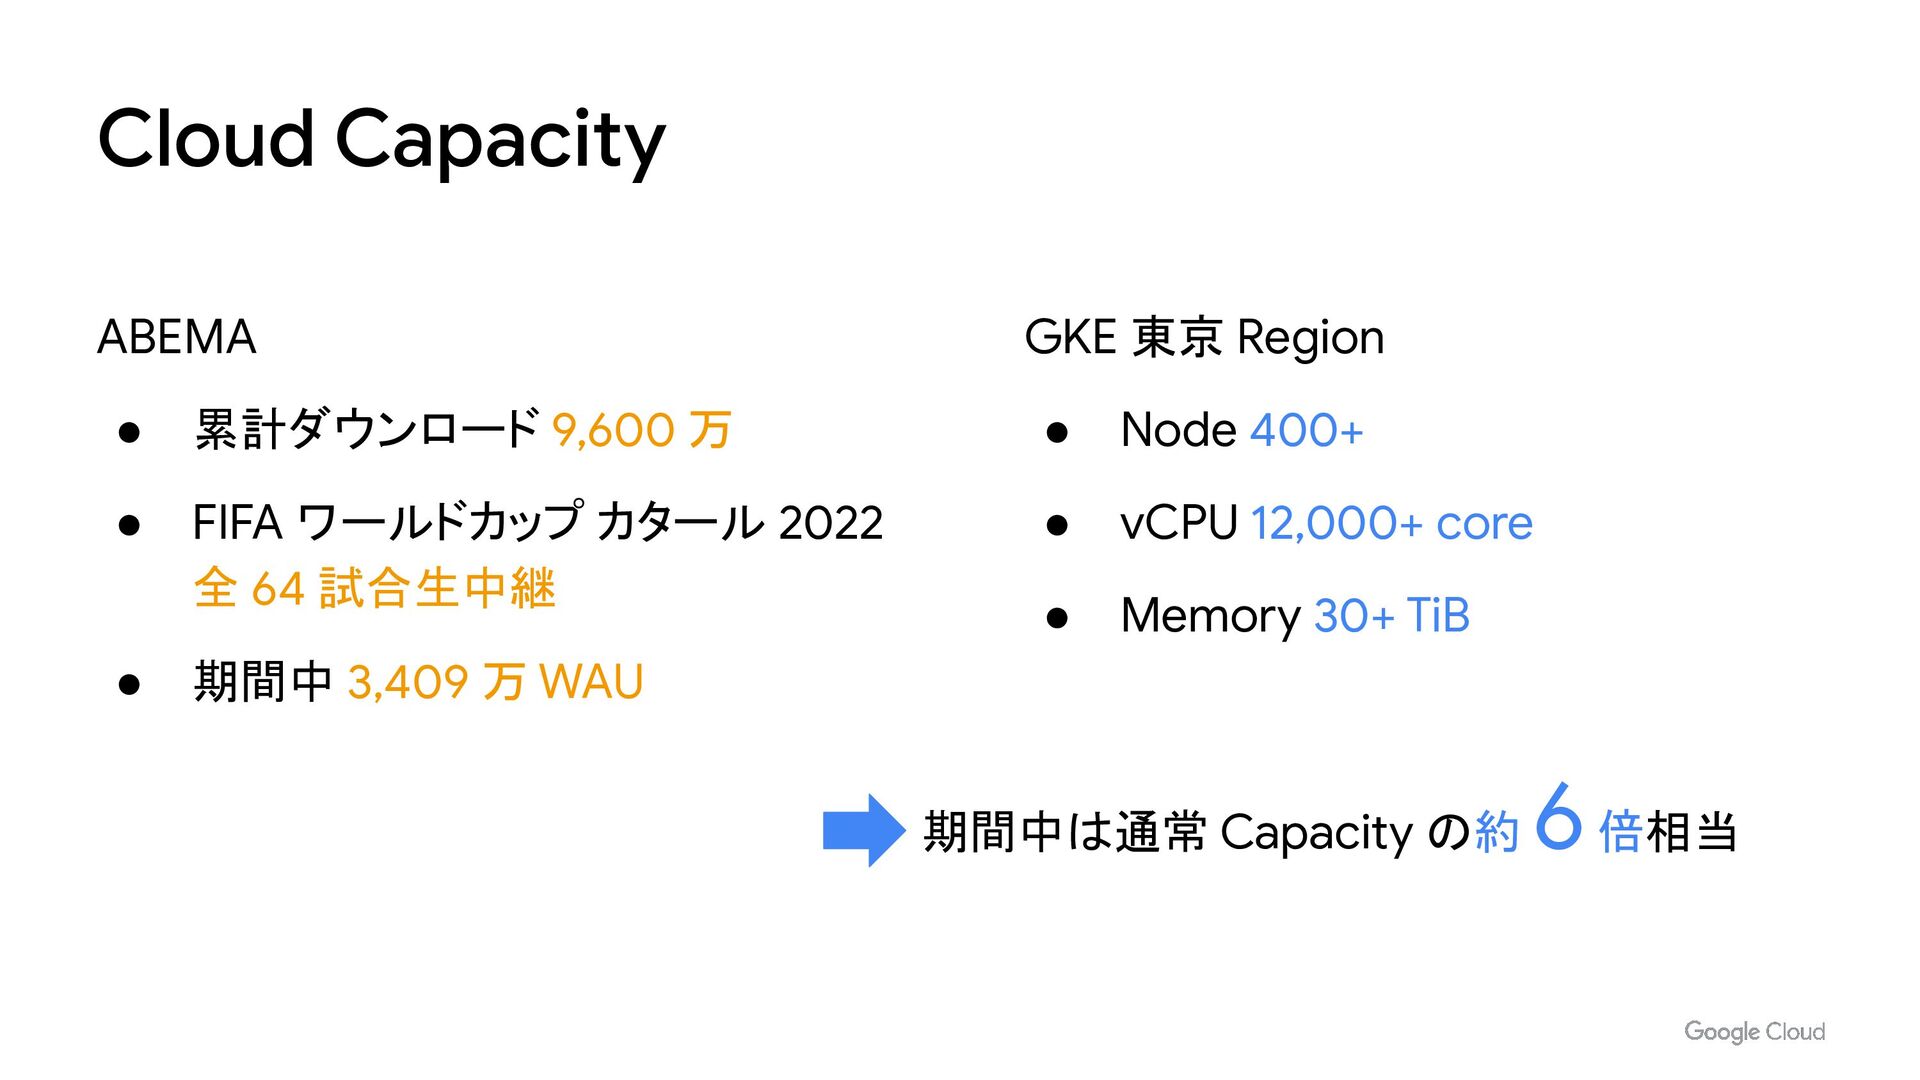
Cloud Capacity ABEMA • 累計ダウンロード 9,600 万 • FIFA ワールドカップ
カタール 2022 全 64 試合生中継 • 期間中 3,409 万 WAU GKE 東京 Region • Node 400+ • vCPU 12,000+ core • Memory 30+ TiB 期間中は通常 Capacity の約 6 倍相当 -
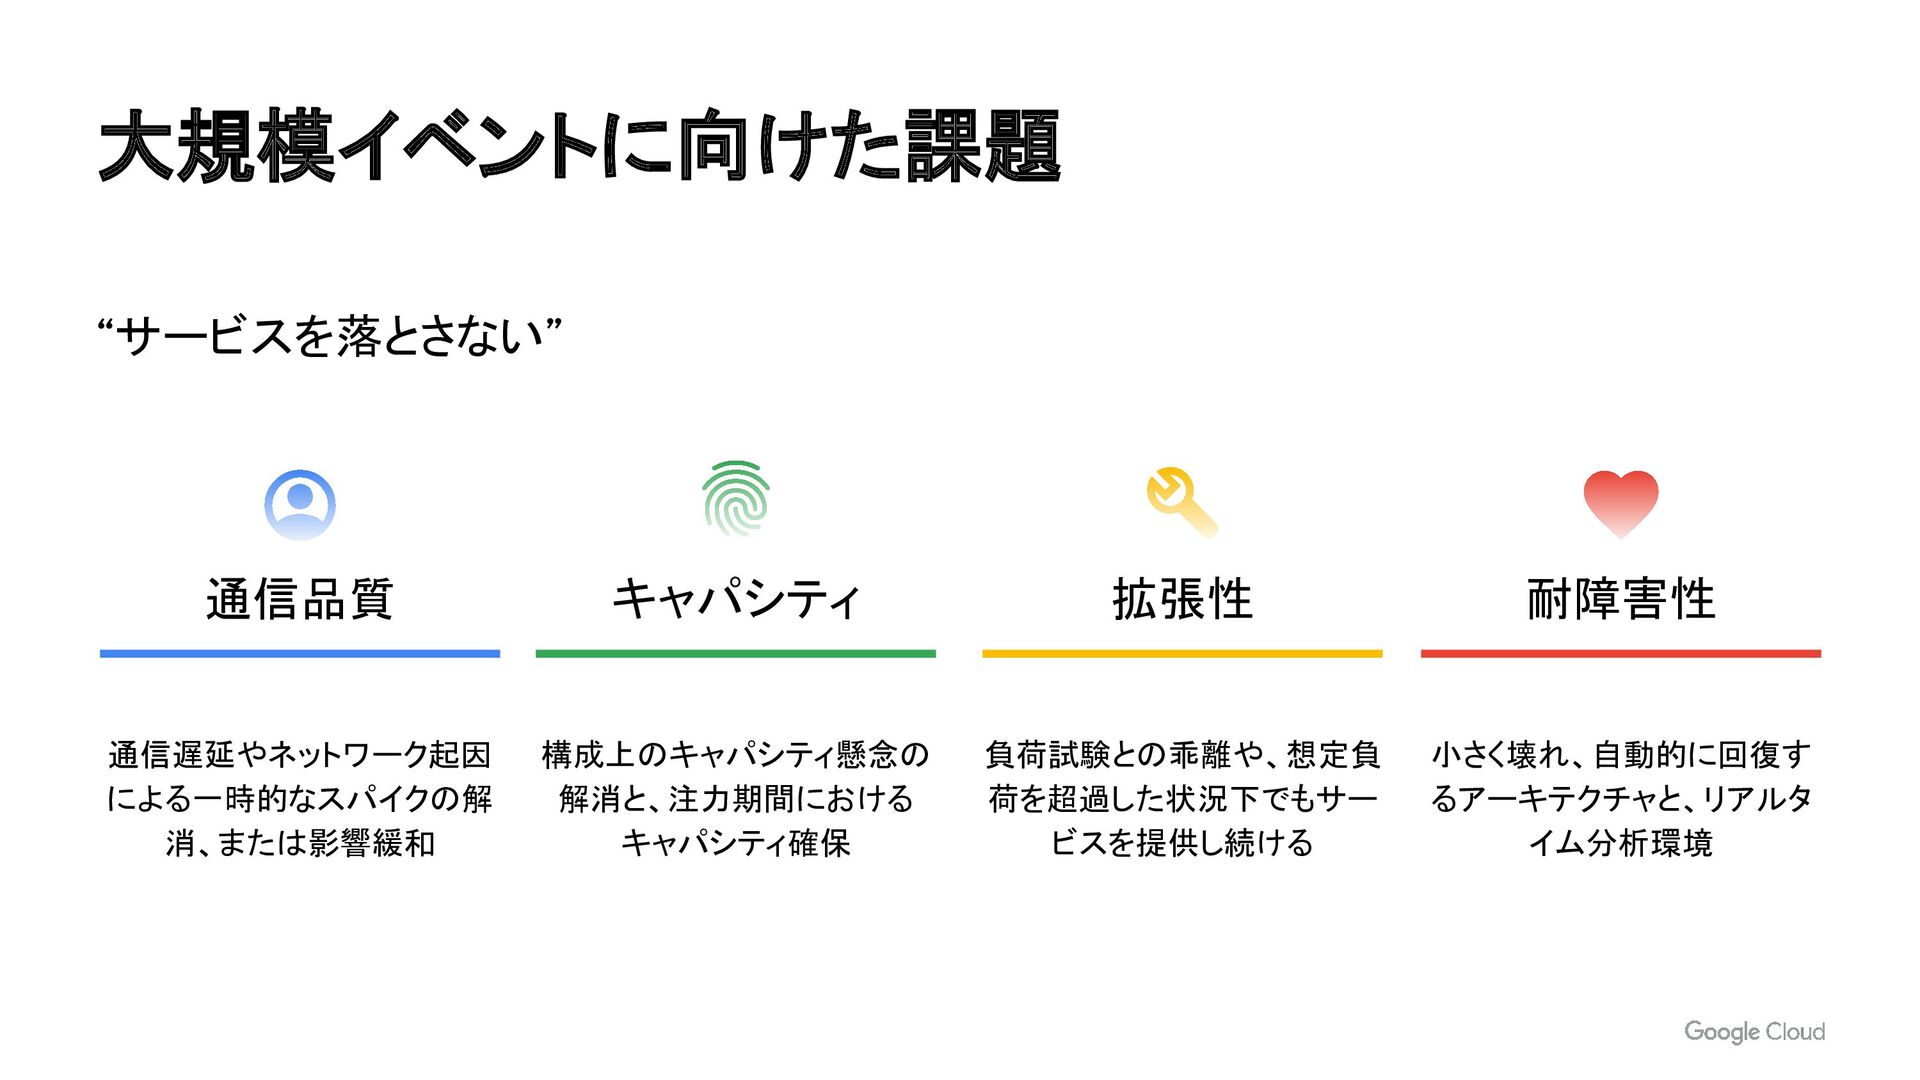
通信遅延やネットワーク起因 による一時的なスパイクの解 消、または影響緩和 大規模イベントに向けた課題 通信品質 キャパシティ 拡張性 耐障害性 構成上のキャパシティ懸念の 解消と、注力期間における
キャパシティ確保 負荷試験との乖離や、想定負 荷を超過した状況下でもサー ビスを提供し続ける 小さく壊れ、自動的に回復す るアーキテクチャと、リアルタ イム分析環境 “サービスを落とさない” -
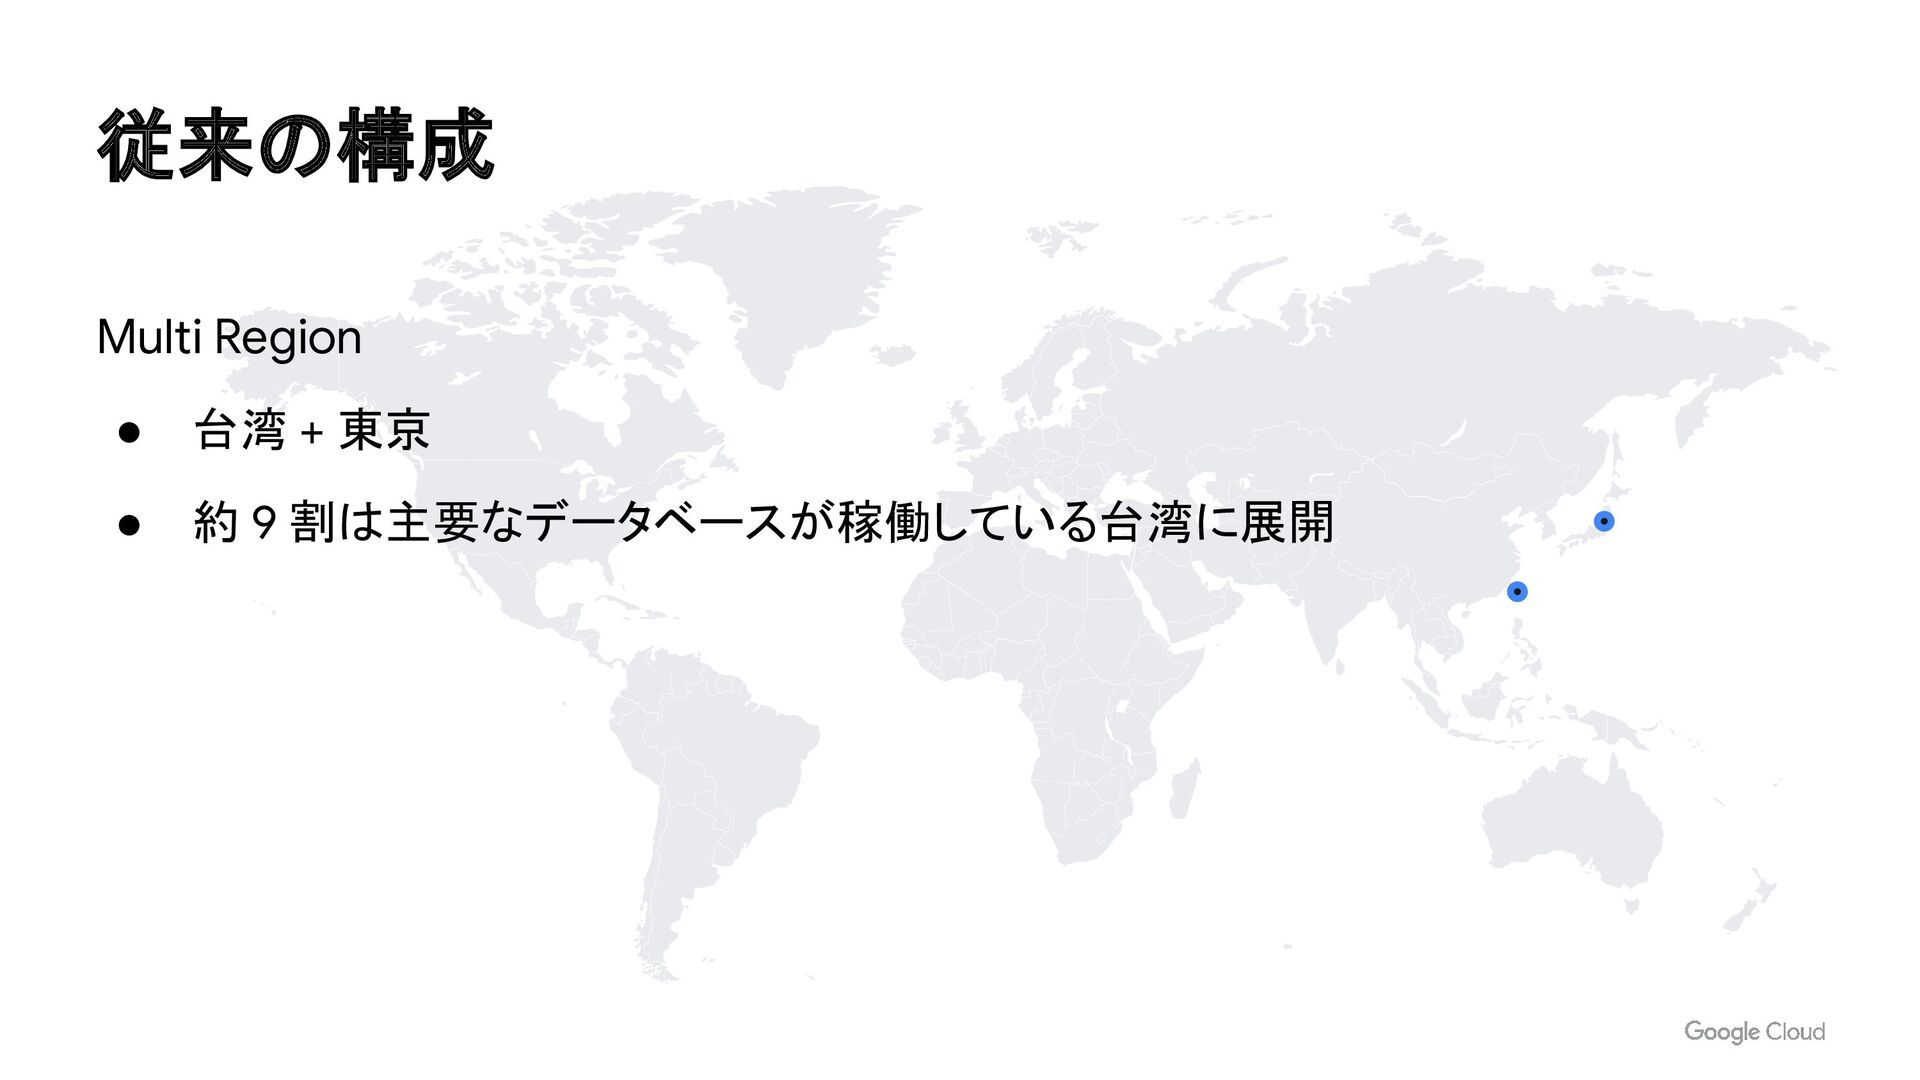
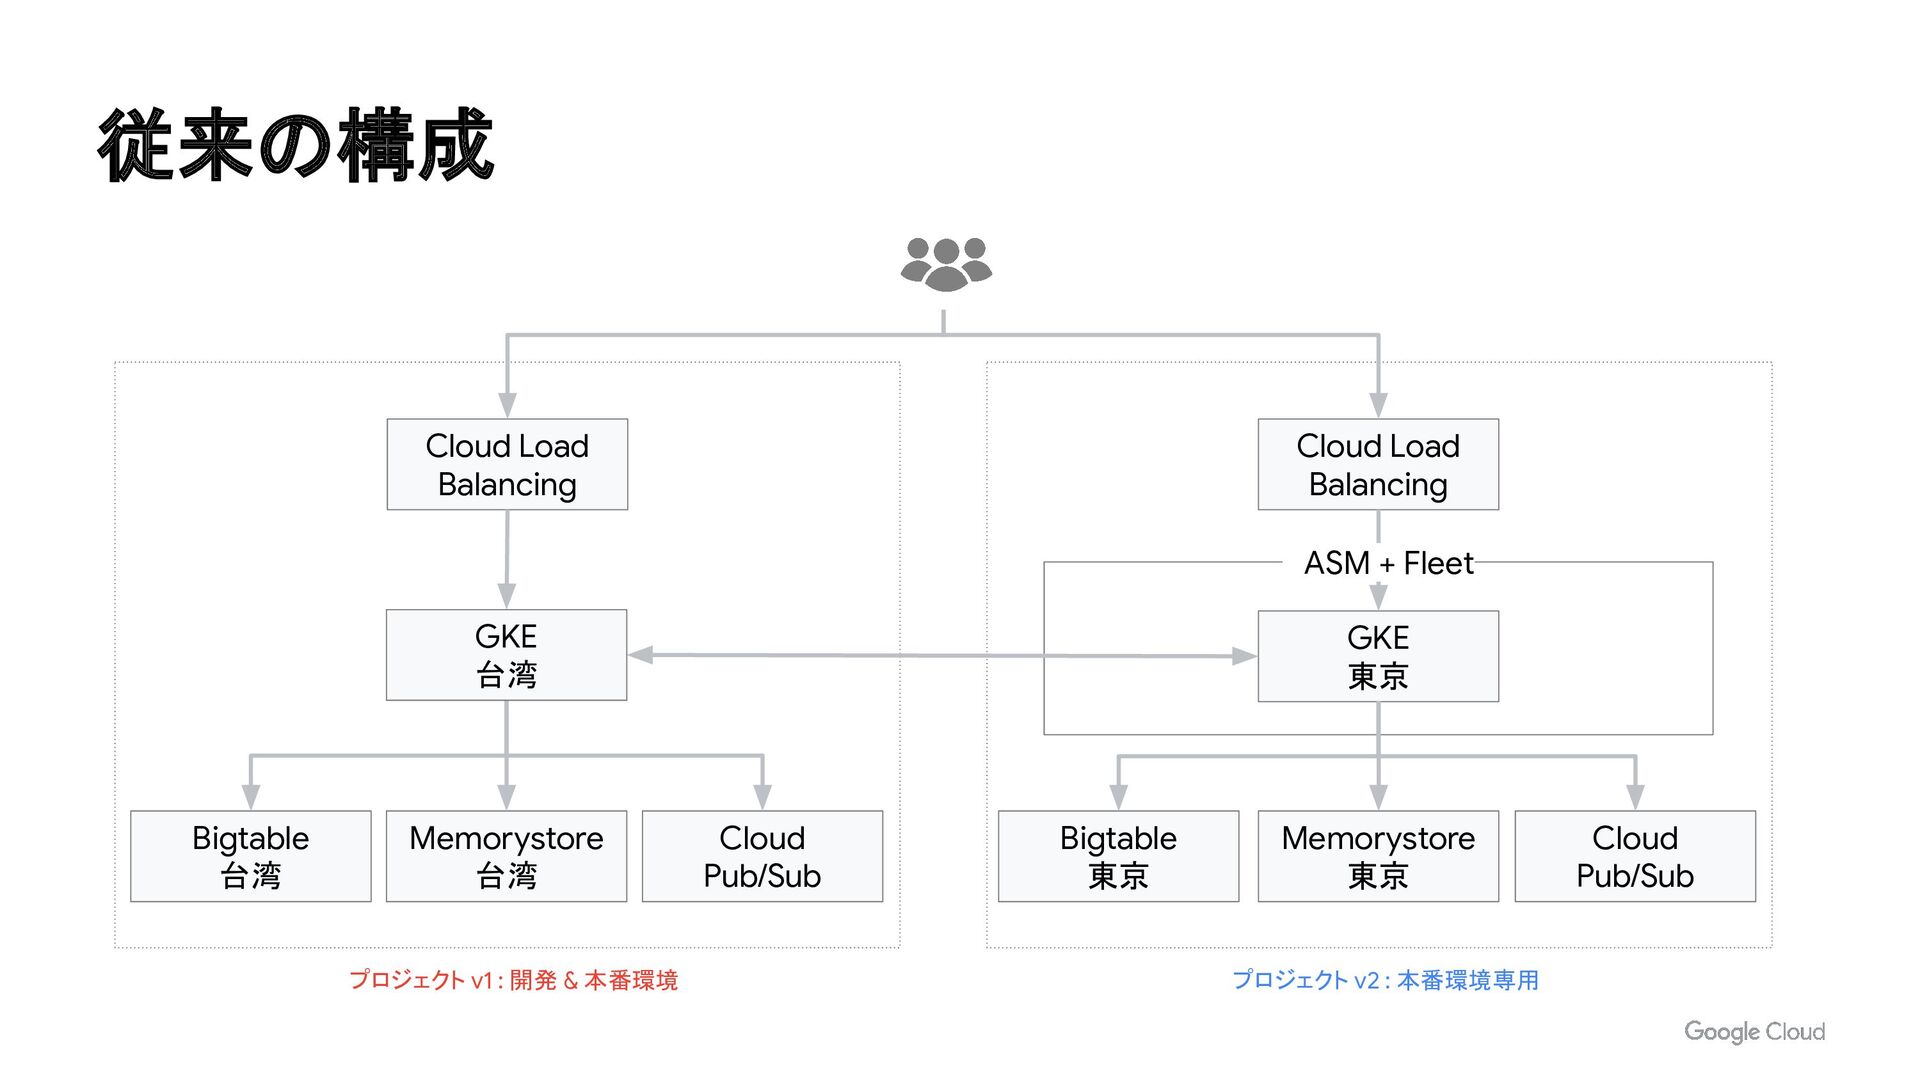
従来の構成 Bigtable 台湾 Memorystore 台湾 Bigtable 東京 Memorystore 東京 GKE
東京 Cloud Load Balancing Cloud Load Balancing Cloud Pub/Sub Cloud Pub/Sub プロジェクト v1 : 開発 & 本番環境 プロジェクト v2 : 本番環境専用 GKE 台湾 ASM + Fleet -
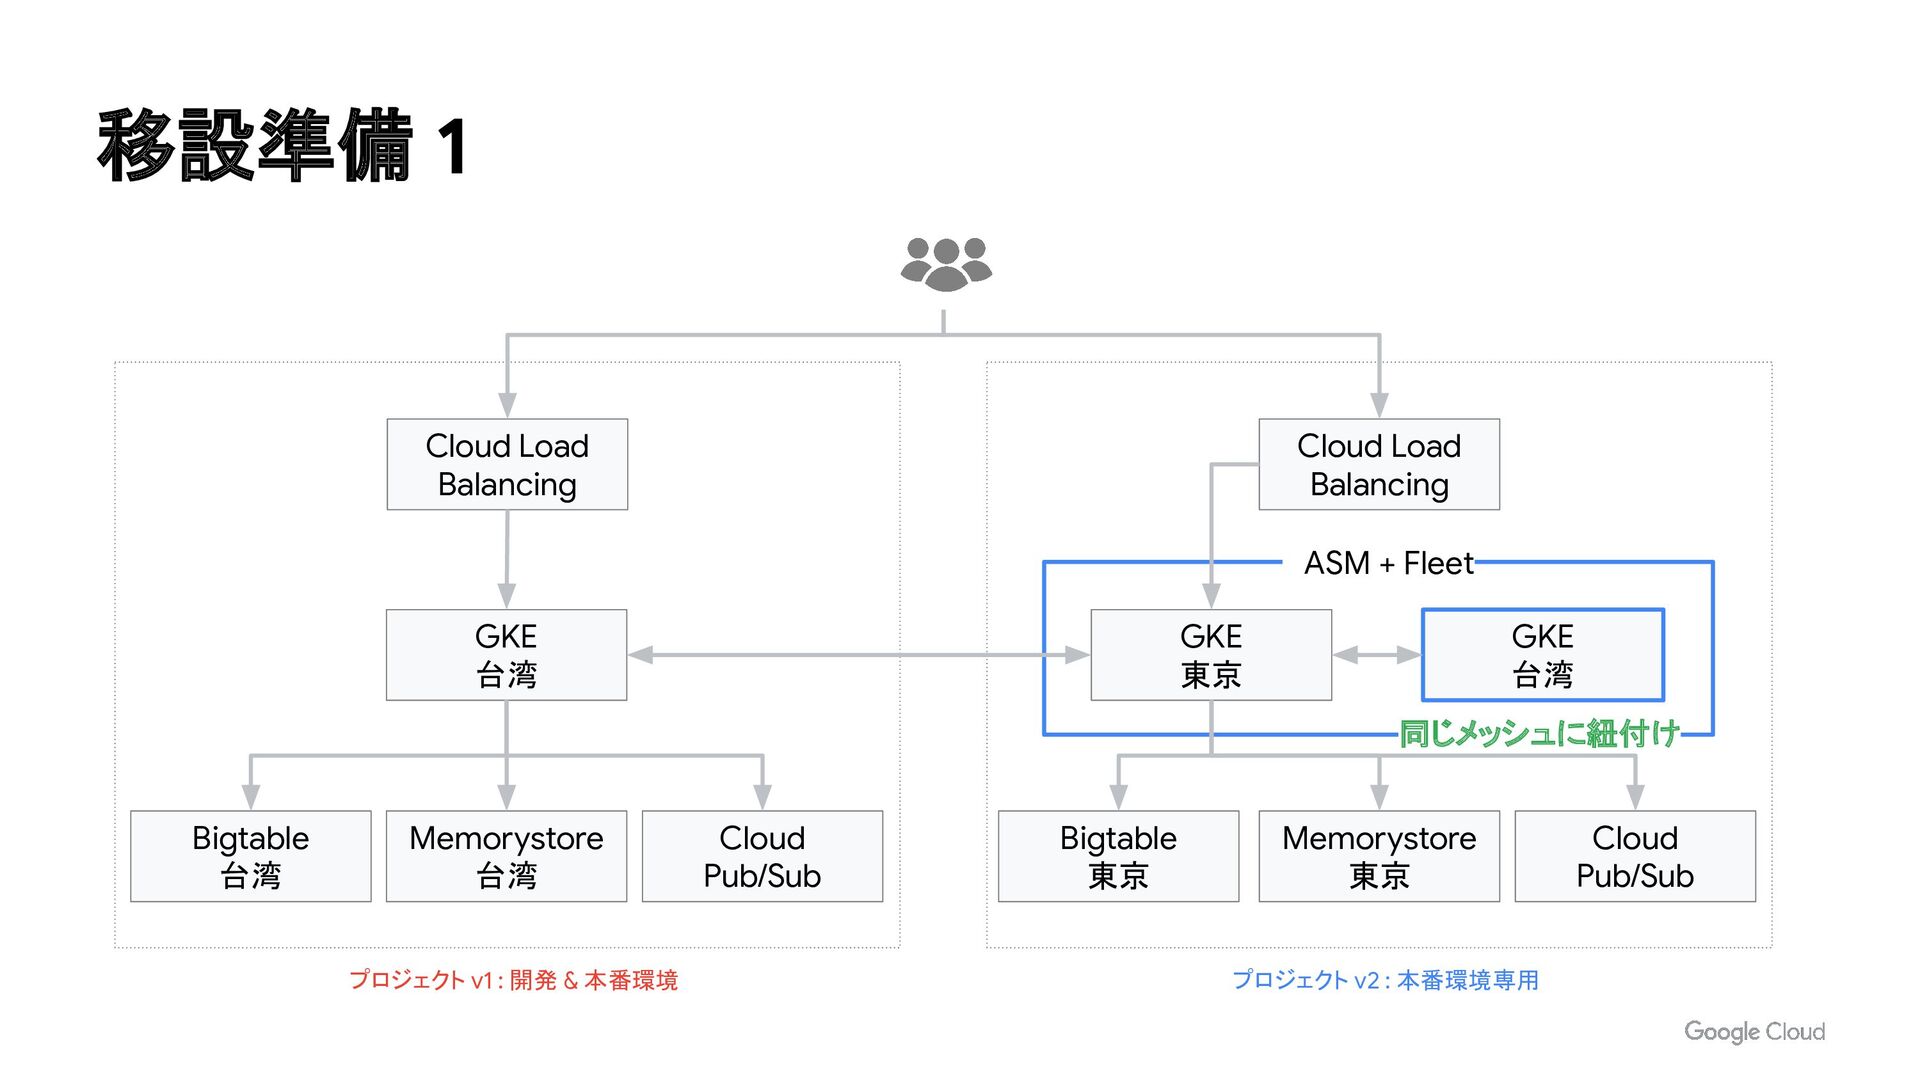
移設準備 1 ASM + Fleet Bigtable 台湾 Memorystore 台湾 Bigtable
東京 Memorystore 東京 GKE 台湾 GKE 東京 GKE 台湾 Cloud Load Balancing Cloud Load Balancing Cloud Pub/Sub Cloud Pub/Sub 同じメッシュに紐付け プロジェクト v1 : 開発 & 本番環境 プロジェクト v2 : 本番環境専用 -
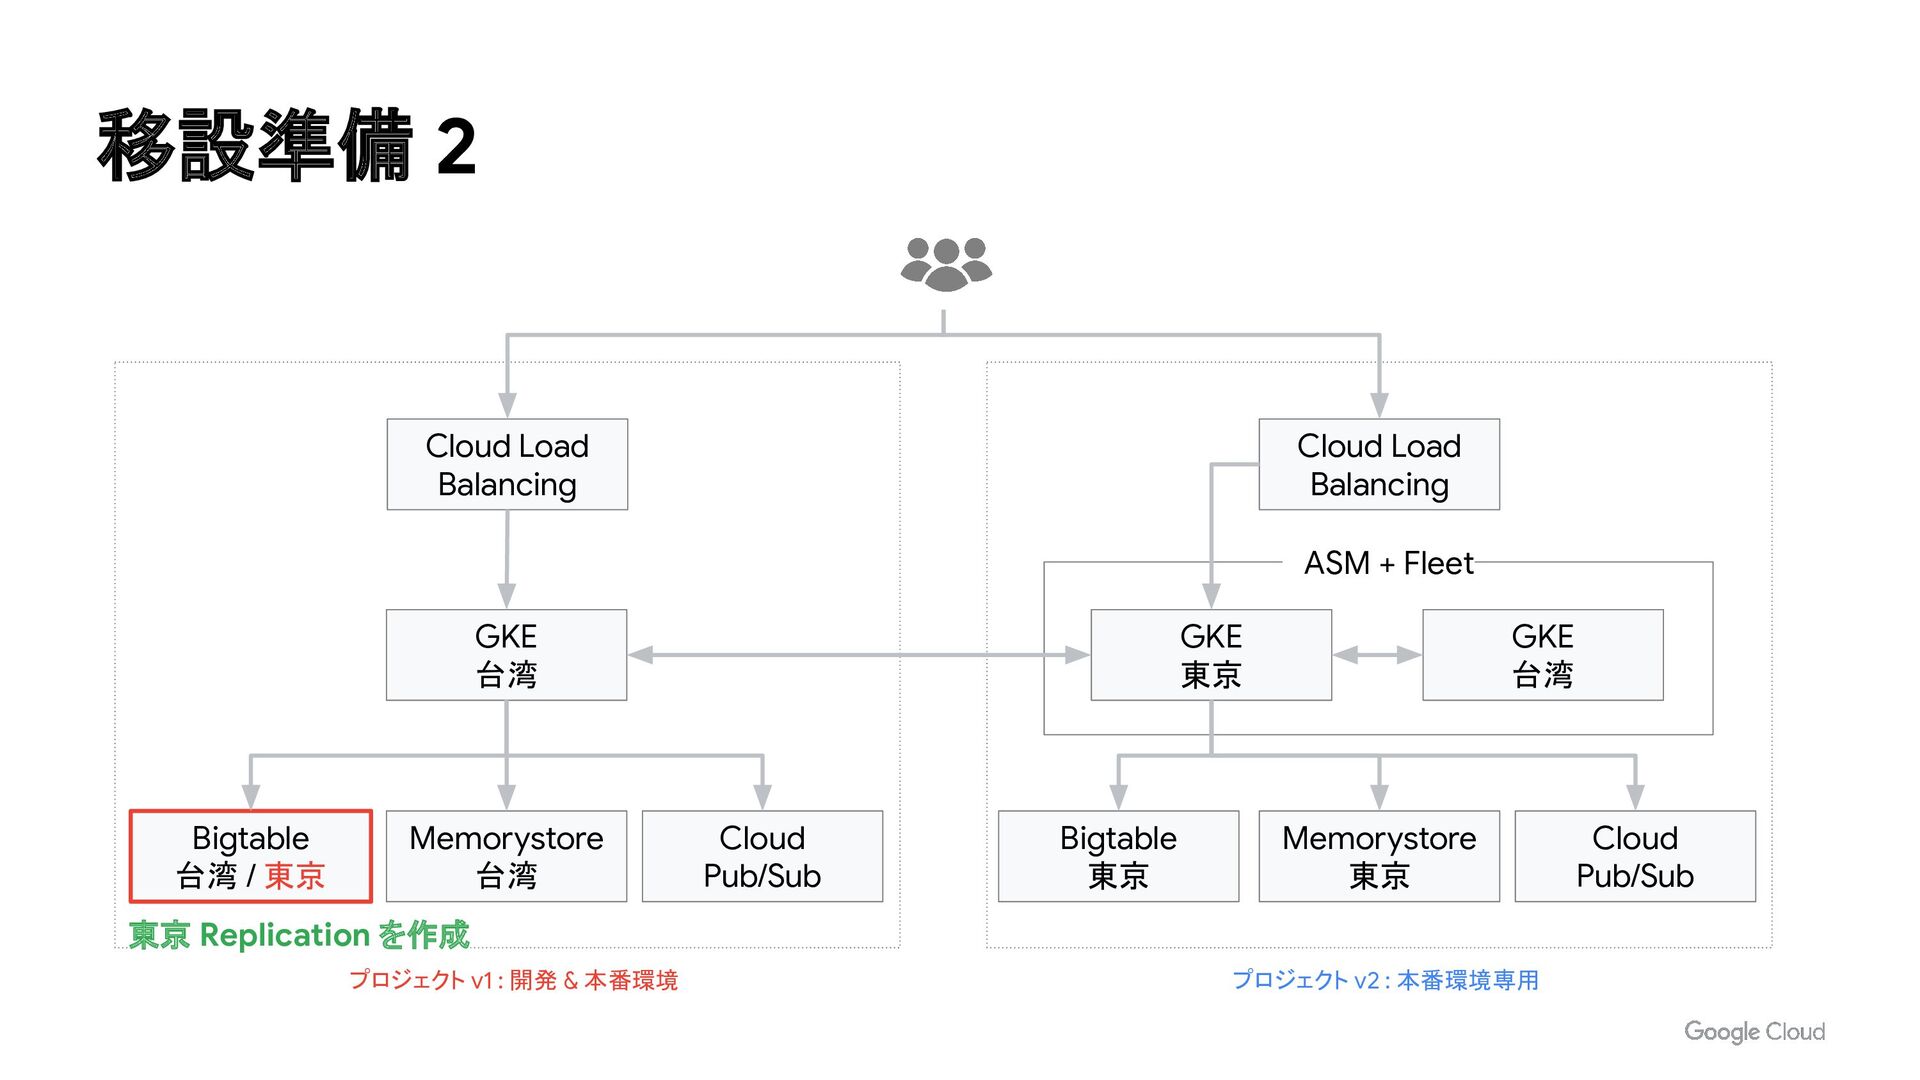
移設準備 2 ASM + Fleet Bigtable 台湾 / 東京 Memorystore
台湾 Bigtable 東京 Memorystore 東京 GKE 台湾 GKE 東京 GKE 台湾 Cloud Load Balancing Cloud Load Balancing Cloud Pub/Sub Cloud Pub/Sub 東京 Replication を作成 プロジェクト v1 : 開発 & 本番環境 プロジェクト v2 : 本番環境専用 -
移設準備 3 ASM + Fleet Bigtable 台湾 / 東京 Memorystore
台湾 Bigtable 東京 Memorystore 東京 GKE 台湾 GKE 東京 GKE 台湾 Cloud Load Balancing Cloud Load Balancing Cloud Pub/Sub Cloud Pub/Sub ❶ Restore ❸ 削除 ❷ 向き先を変更 with Cloud VPN プロジェクト v1 : 開発 & 本番環境 プロジェクト v2 : 本番環境専用 -
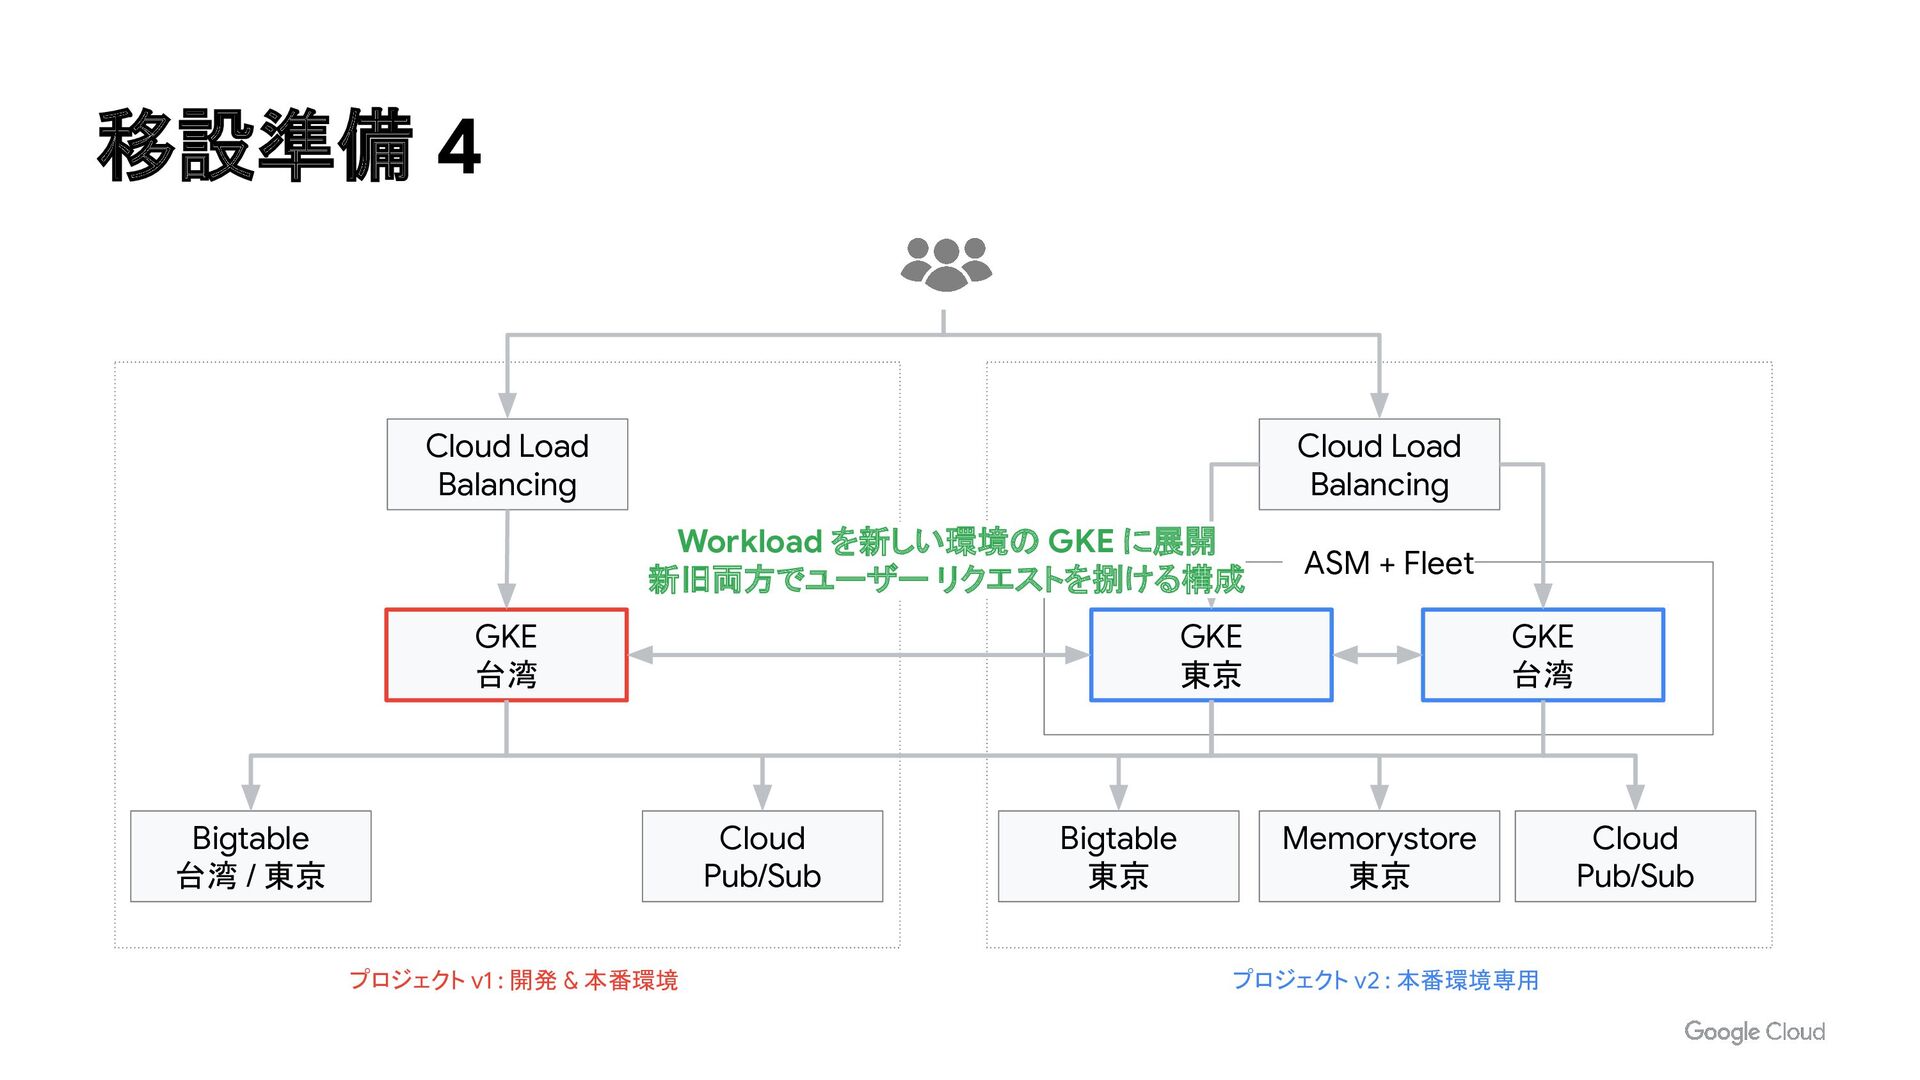
移設準備 4 プロジェクト v1 : 開発 & 本番環境 プロジェクト v2
: 本番環境専用 ASM + Fleet Bigtable 台湾 / 東京 Bigtable 東京 Memorystore 東京 GKE 台湾 GKE 東京 GKE 台湾 Cloud Load Balancing Cloud Load Balancing Cloud Pub/Sub Cloud Pub/Sub Workload を新しい環境の GKE に展開 新旧両方でユーザー リクエストを捌ける構成 -
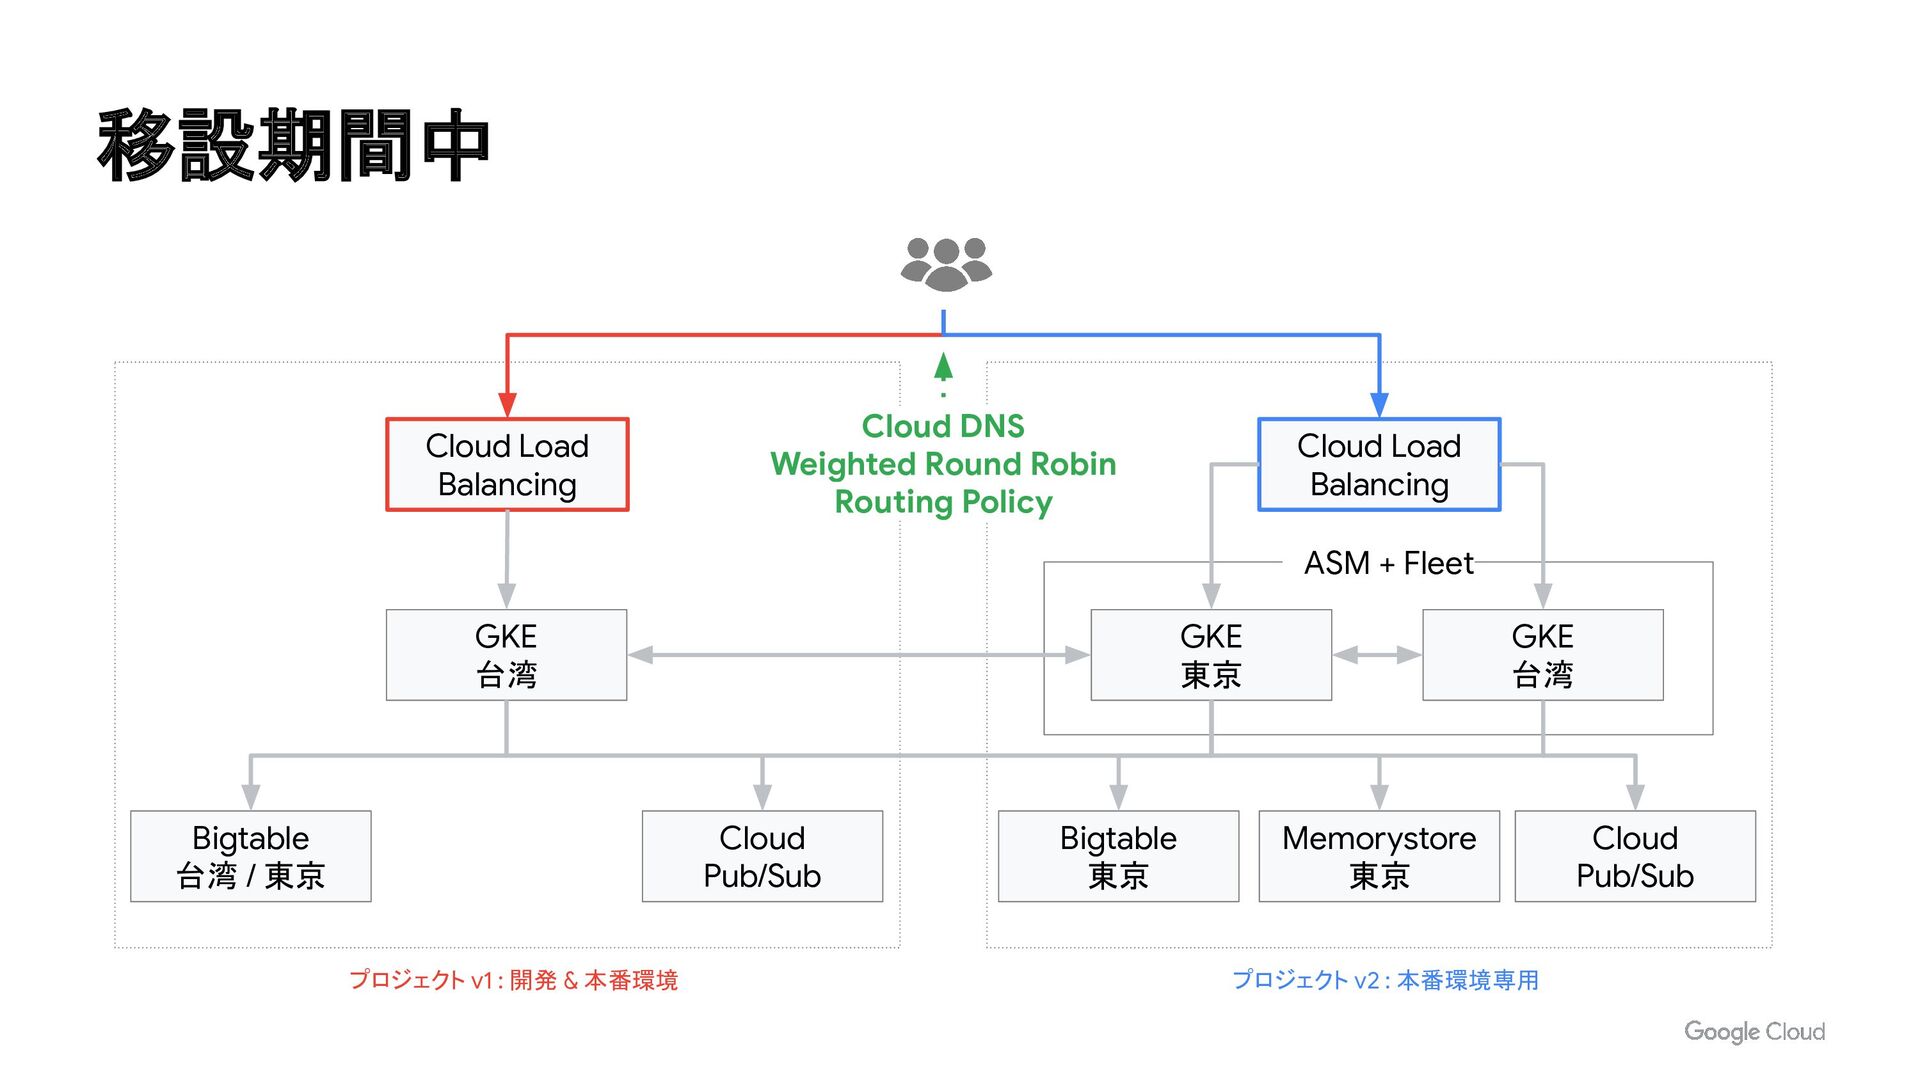
移設期間中 ASM + Fleet Bigtable 台湾 / 東京 Bigtable 東京
Memorystore 東京 GKE 台湾 GKE 東京 GKE 台湾 Cloud Load Balancing Cloud Load Balancing Cloud Pub/Sub Cloud Pub/Sub プロジェクト v1 : 開発 & 本番環境 プロジェクト v2 : 本番環境専用 Cloud DNS Weighted Round Robin Routing Policy -
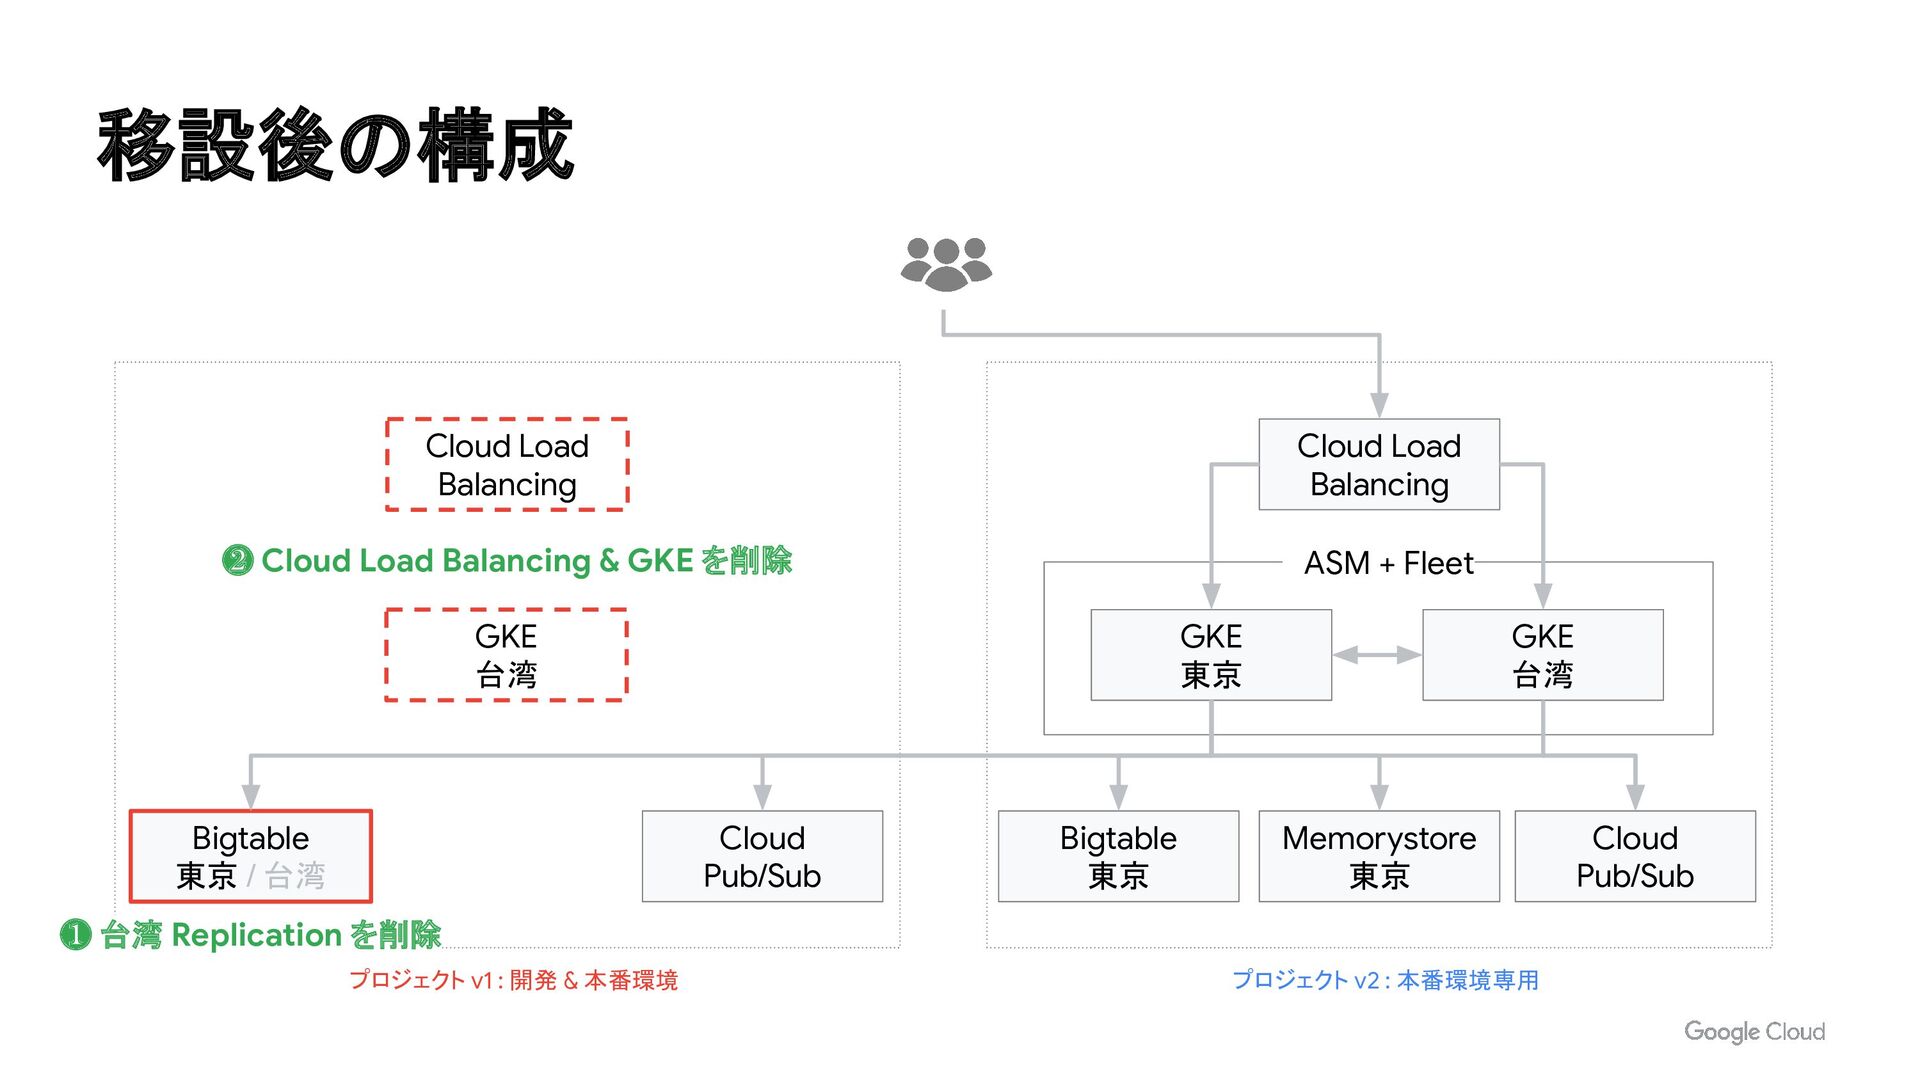
移設後の構成 ASM + Fleet Bigtable 東京 / 台湾 Bigtable 東京
Memorystore 東京 GKE 台湾 GKE 東京 GKE 台湾 Cloud Load Balancing Cloud Load Balancing Cloud Pub/Sub Cloud Pub/Sub プロジェクト v1 : 開発 & 本番環境 プロジェクト v2 : 本番環境専用 ❶ 台湾 Replication を削除 ❷ Cloud Load Balancing & GKE を削除 -
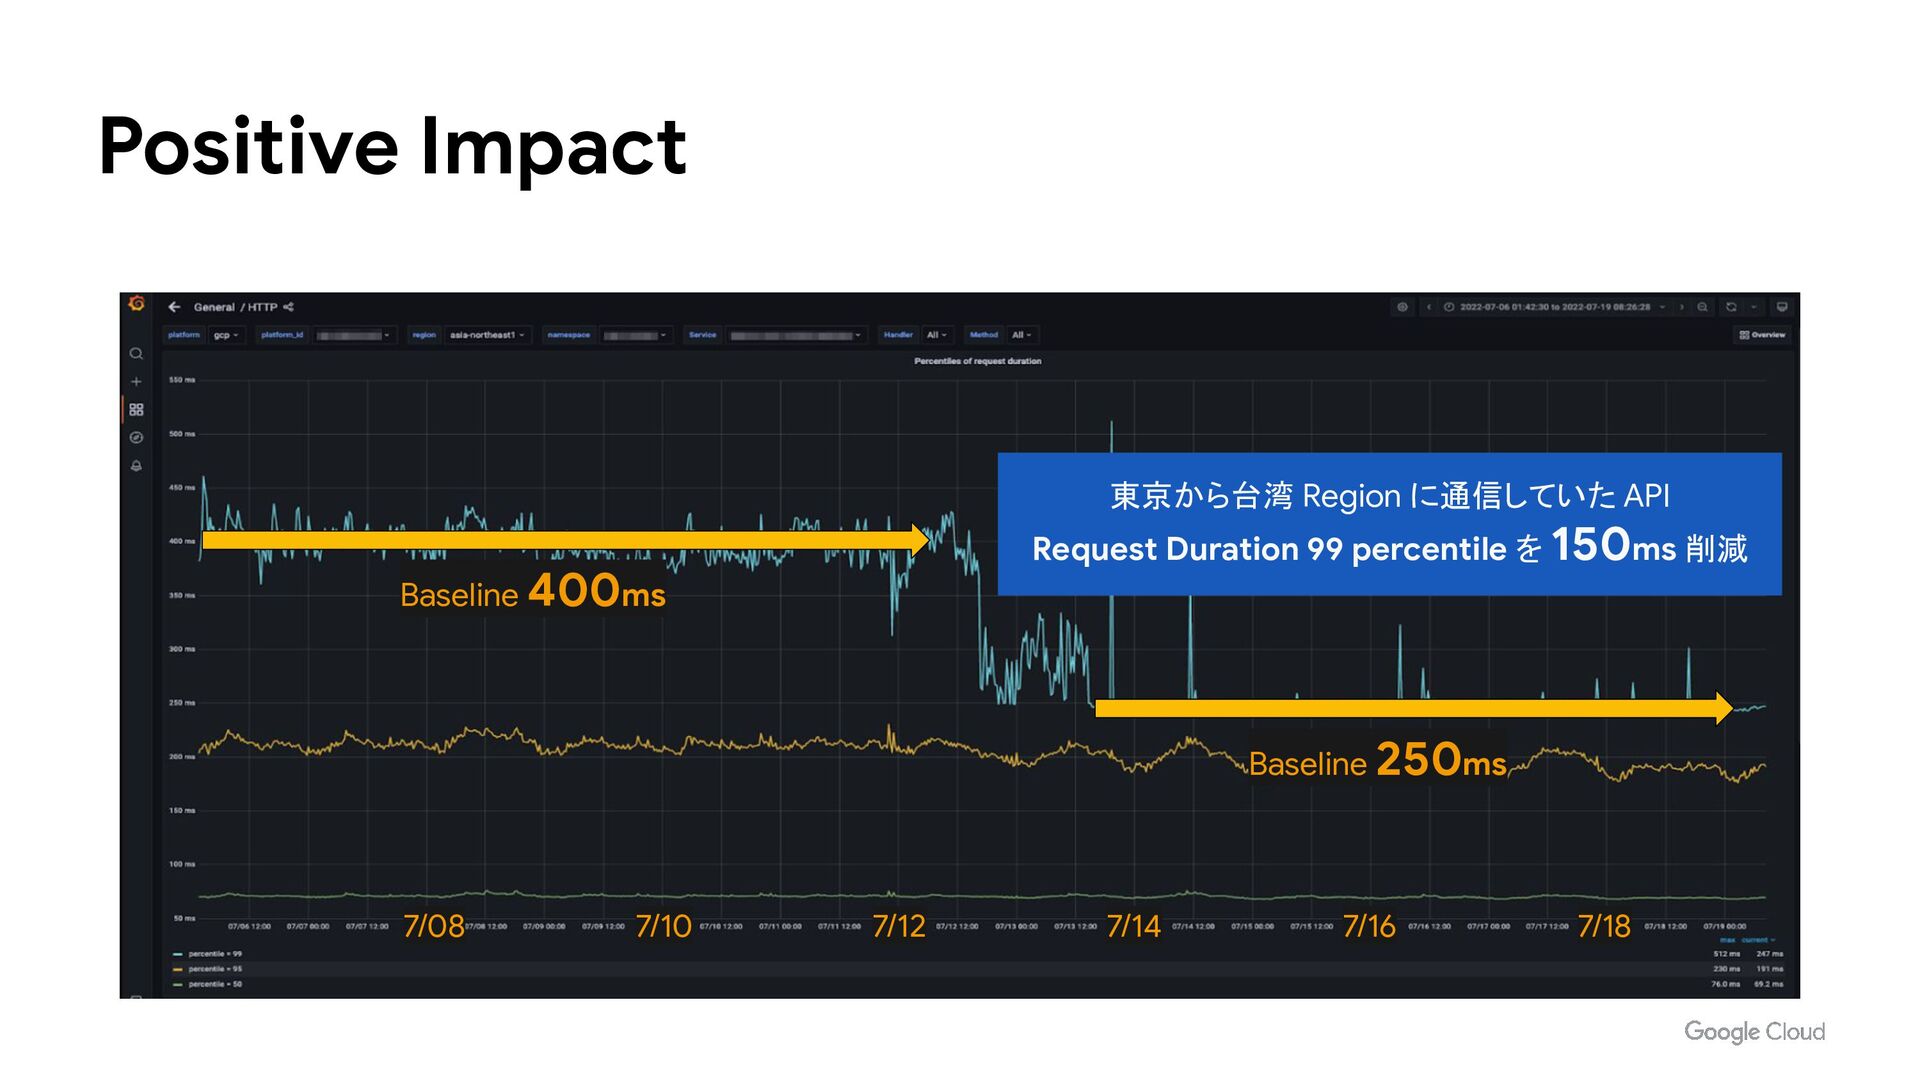
Positive Impact 東京から台湾 Region に通信していた API Request Duration 99 percentile
を 150ms 削減 Baseline 400ms Baseline 250ms 7/12 7/14 7/16 7/10 7/08 7/18 -
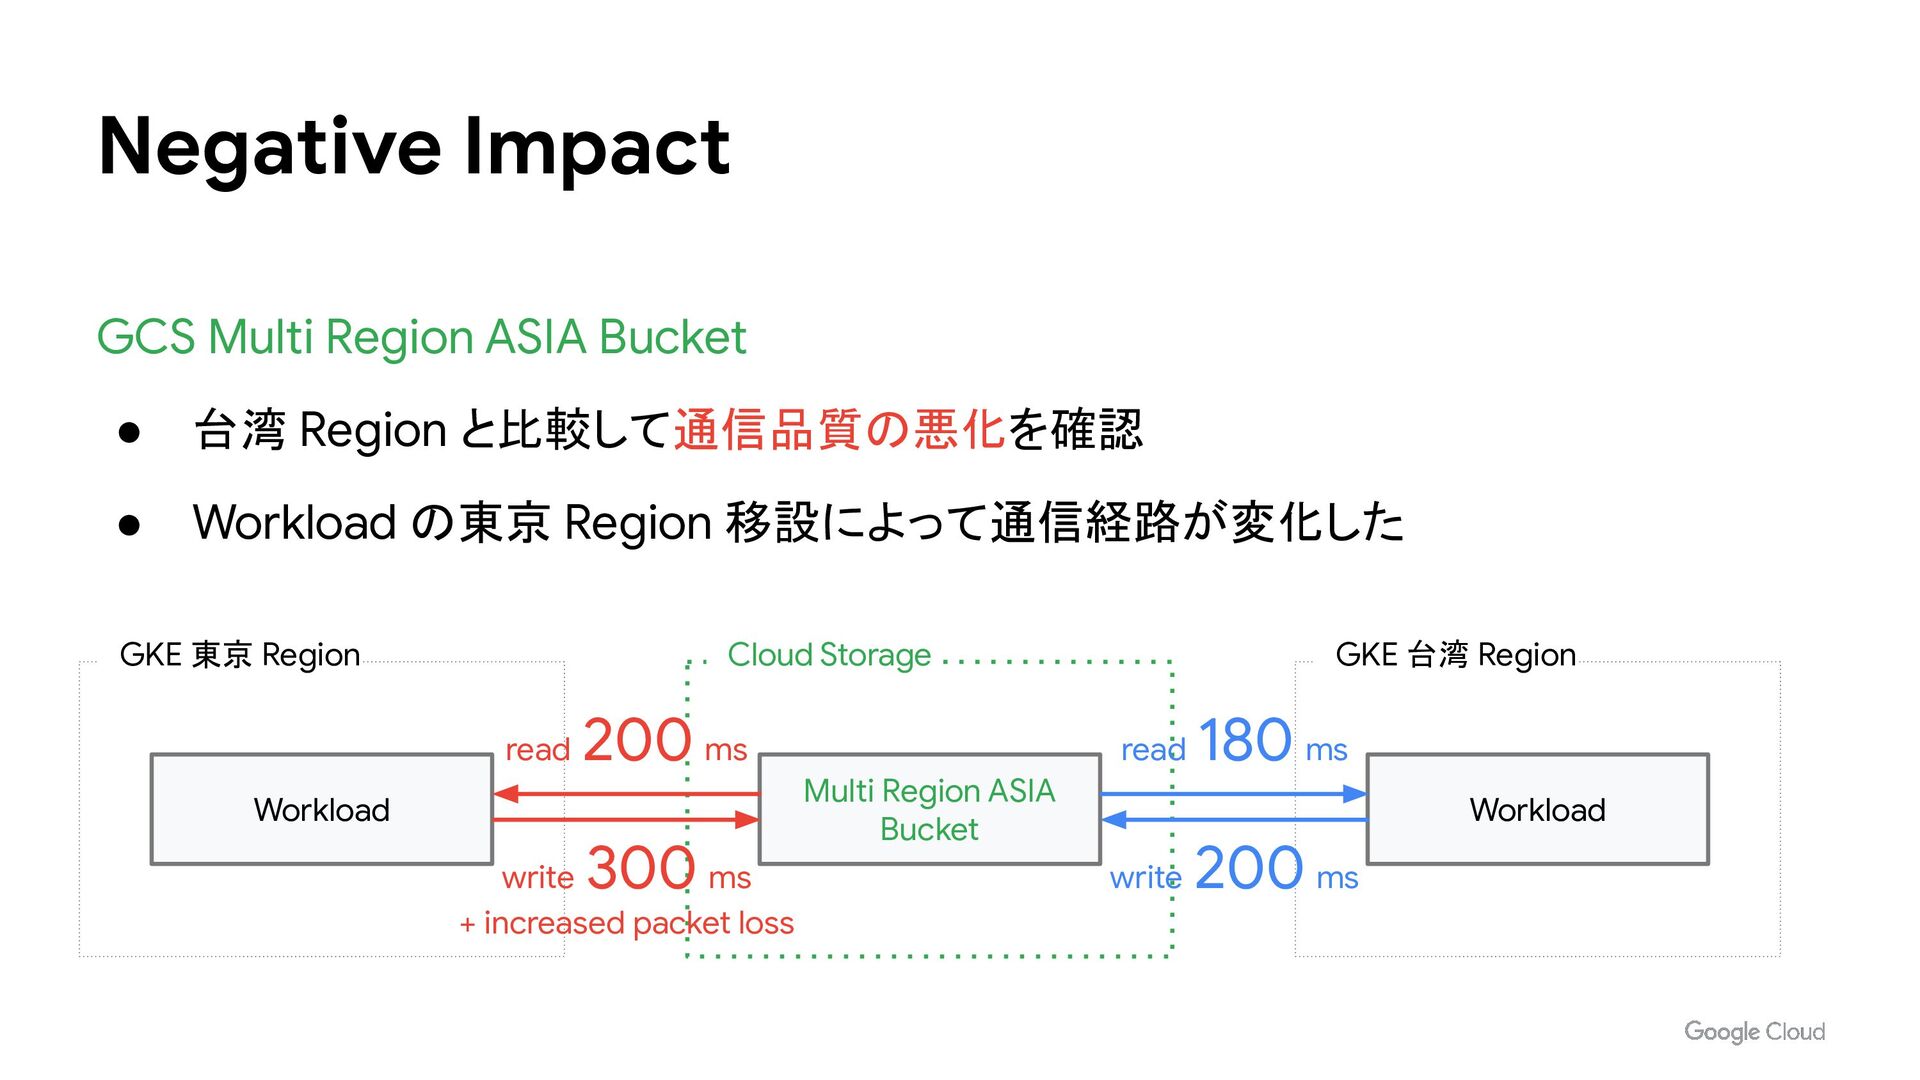
Negative Impact GCS Multi Region ASIA Bucket • 台湾 Region
と比較して通信品質の悪化を確認 • Workload の東京 Region 移設によって通信経路が変化した GKE 東京 Region GKE 台湾 Region Cloud Storage Workload Multi Region ASIA Bucket Workload write 200 ms write 300 ms read 200 ms read 180 ms + increased packet loss -
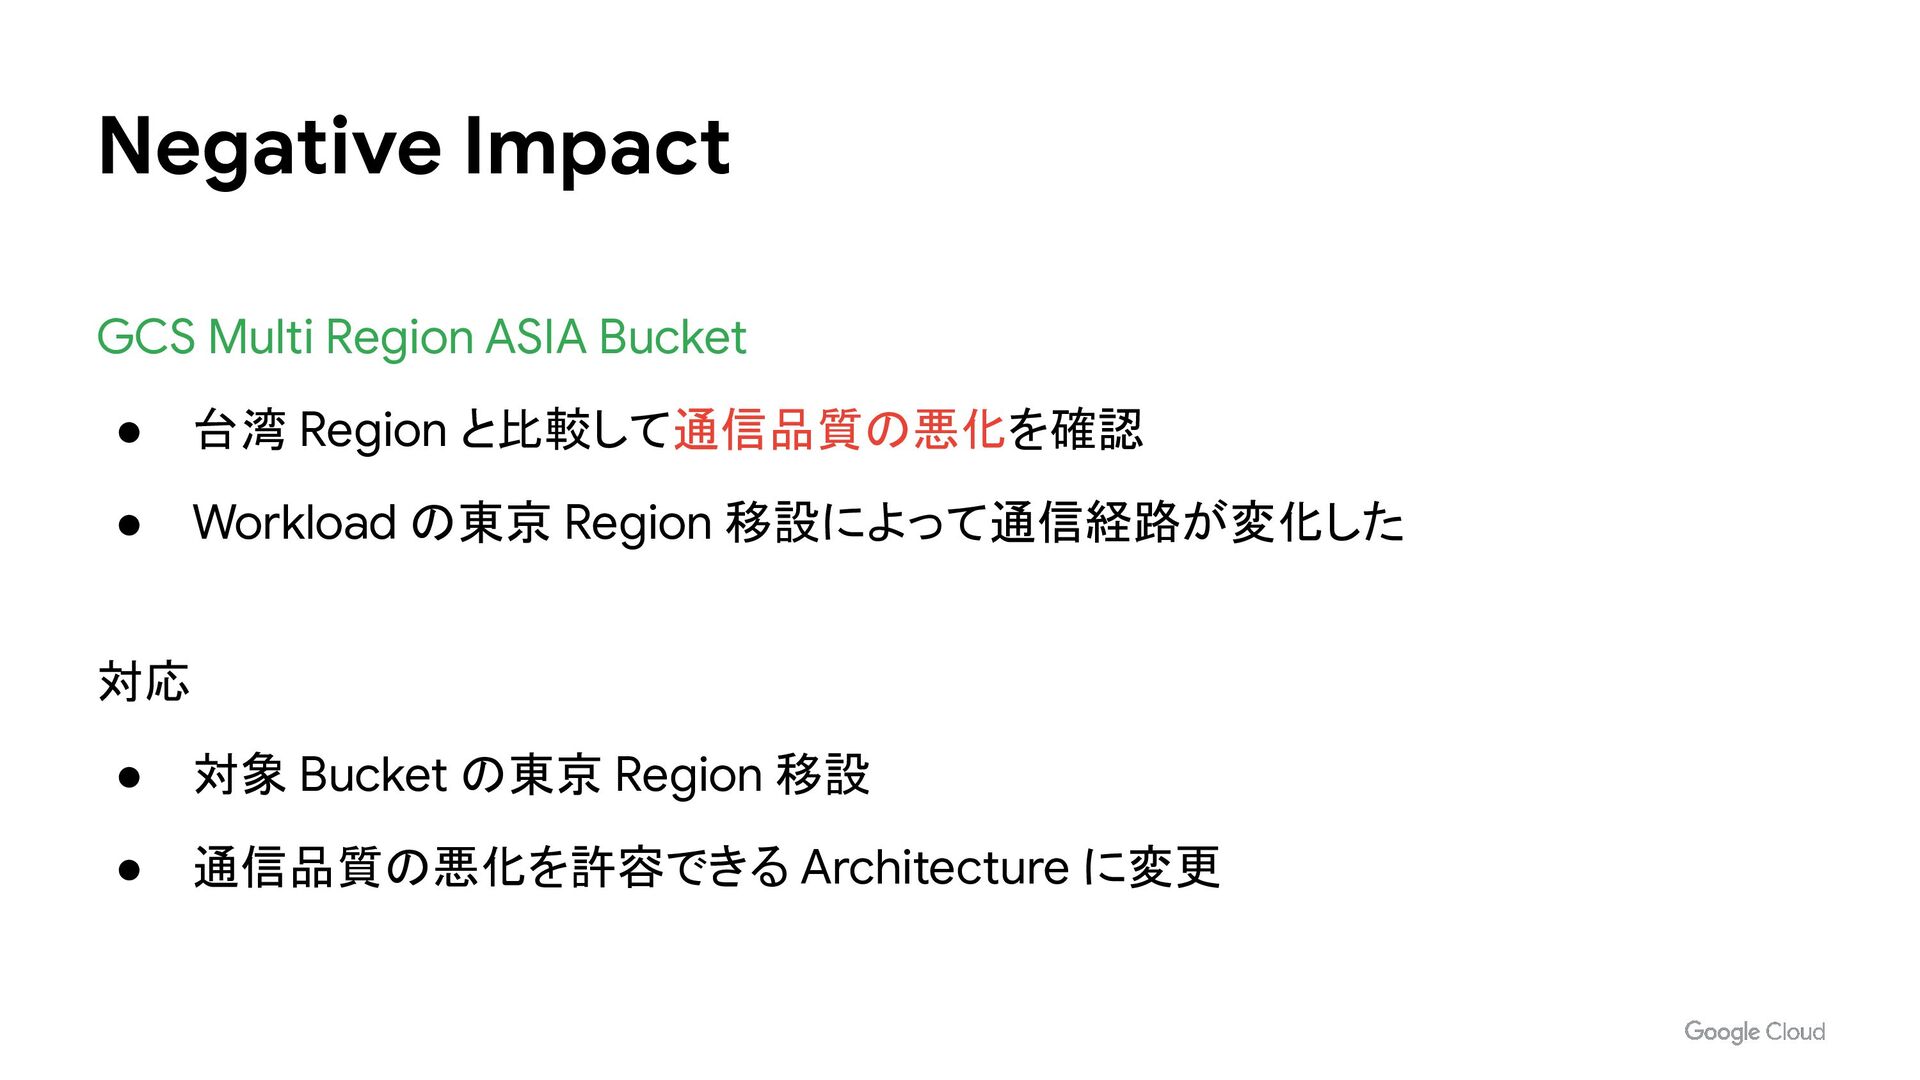
Negative Impact GCS Multi Region ASIA Bucket • 台湾 Region
と比較して通信品質の悪化を確認 • Workload の東京 Region 移設によって通信経路が変化した 対応 • 対象 Bucket の東京 Region 移設 • 通信品質の悪化を許容できる Architecture に変更 -
緊密な連携 • Google Cloud の Premium Support と Professional Services
• Cloud Architecture の理解と、共同体制での負荷試験 • 関連する全ての経路とコンポーネントに対して入念に確認 Capacity Planning -
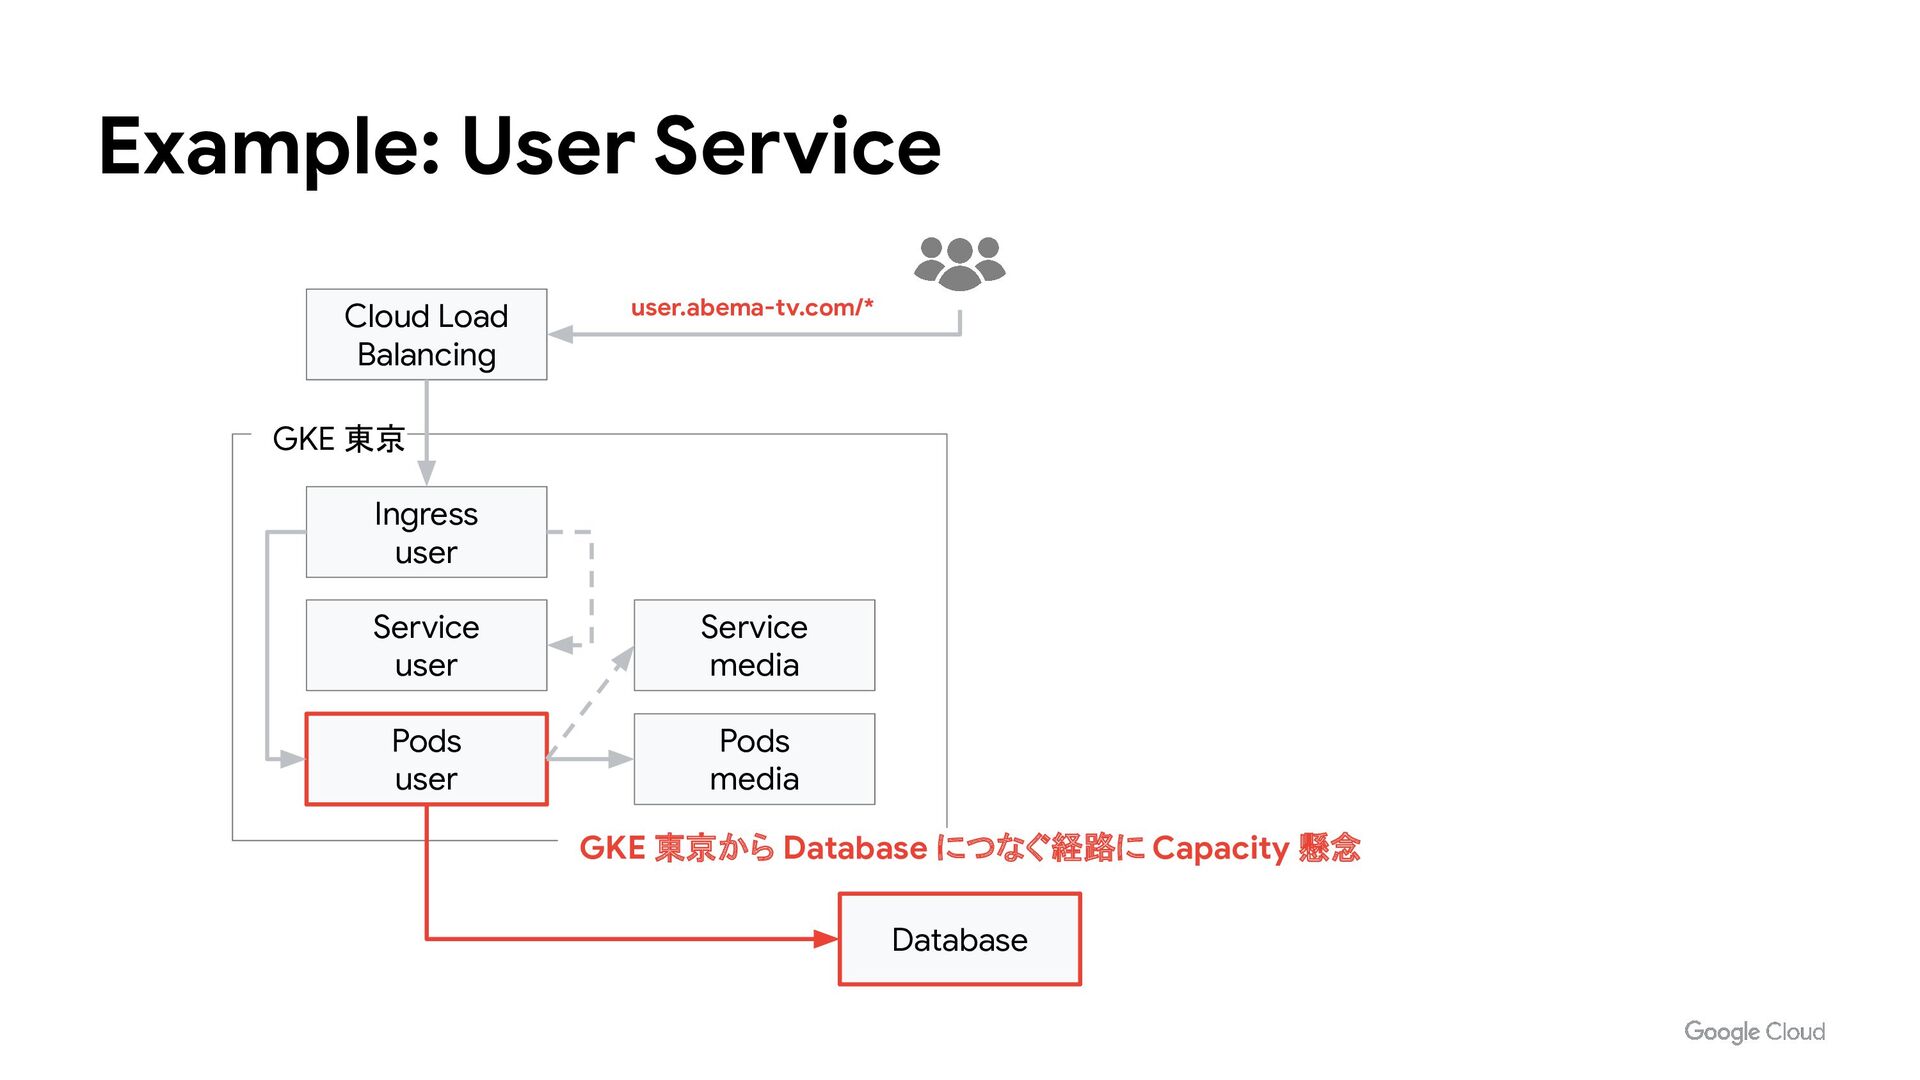
Example: User Service Cloud Load Balancing GKE 東京 Ingress user
Service user Pods user Service media Pods media Database user.abema-tv.com/* GKE 東京から Database につなぐ経路に Capacity 懸念 -
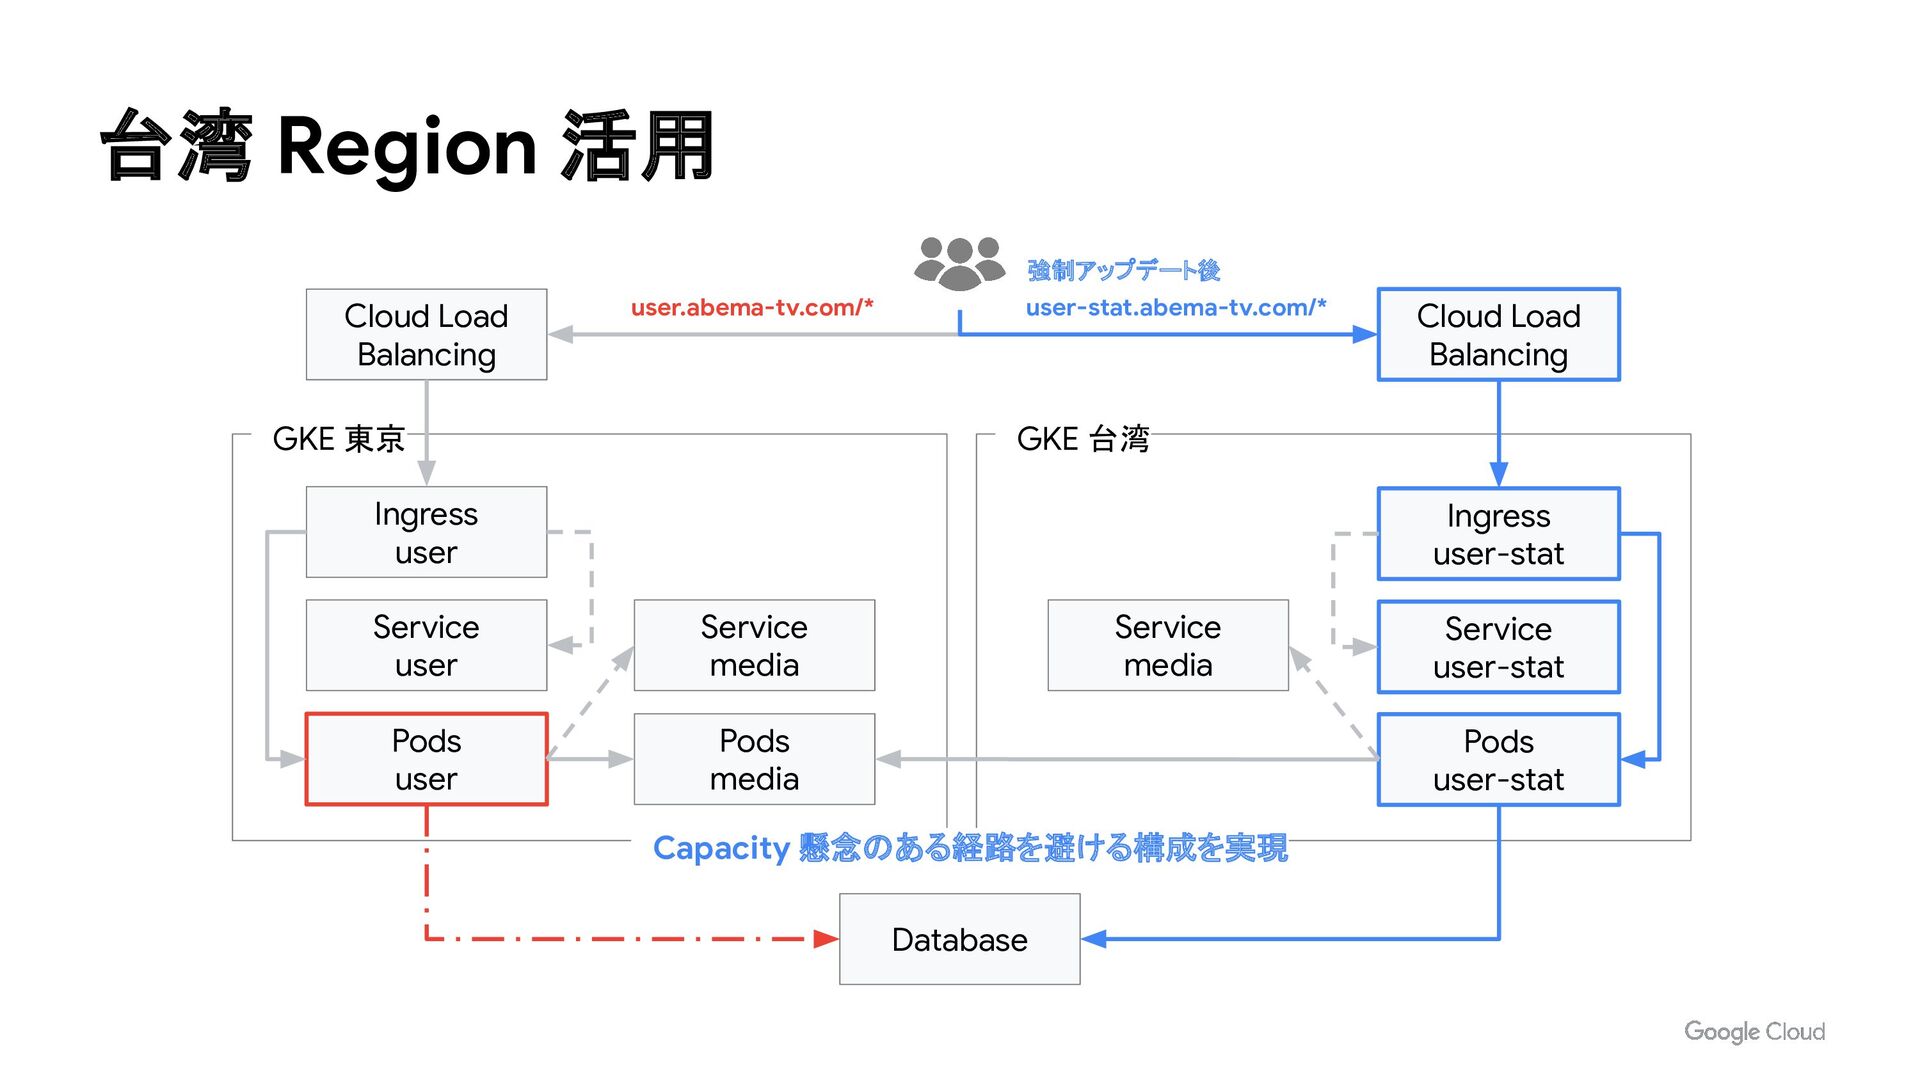
台湾 Region 活用 Cloud Load Balancing GKE 東京 Ingress user
Service user Pods user Service media Pods media Database GKE 台湾 Service media Service user-stat Pods user-stat Ingress user-stat Cloud Load Balancing user.abema-tv.com/* user-stat.abema-tv.com/* Capacity 懸念のある経路を避ける構成を実現 強制アップデート後 -
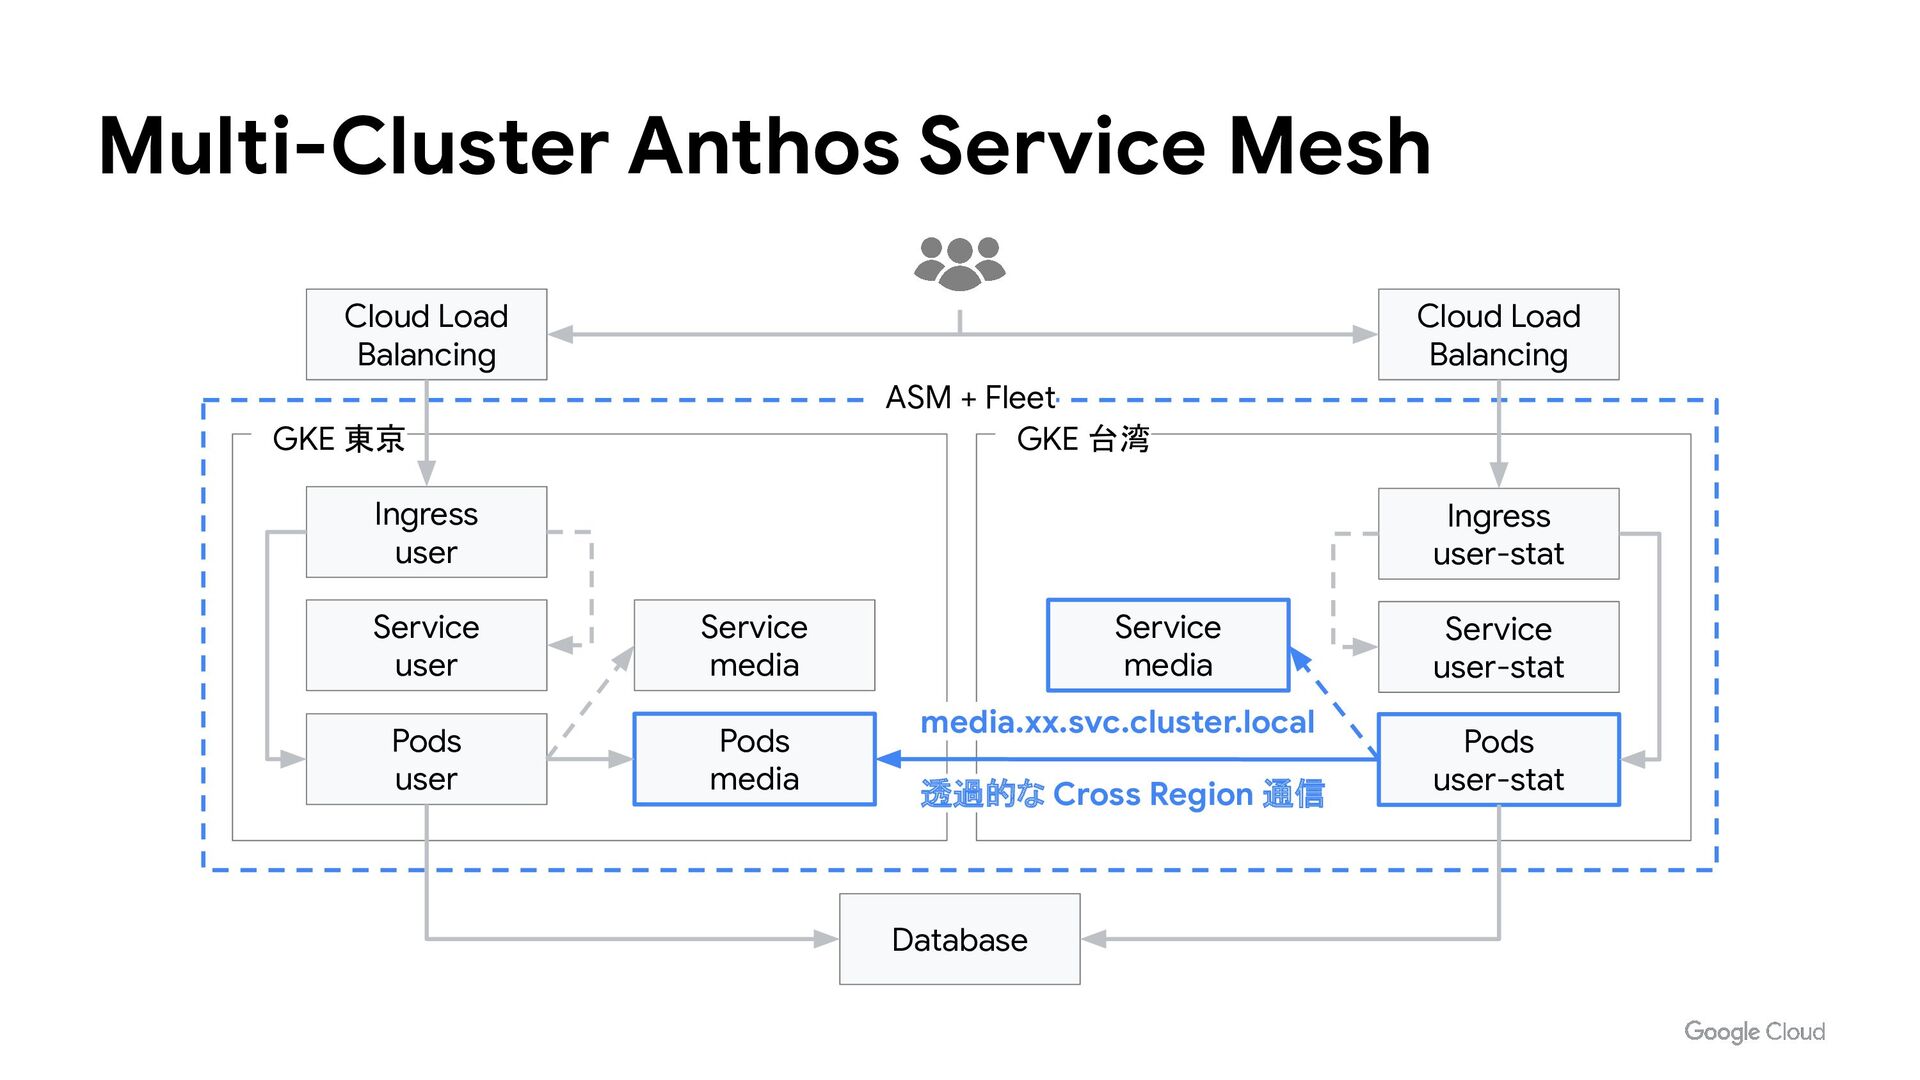
Multi-Cluster Anthos Service Mesh ASM + Fleet Cloud Load Balancing
GKE 東京 Ingress user Service user Pods user Service media Pods media Database GKE 台湾 Service media Service user-stat Pods user-stat Ingress user-stat Cloud Load Balancing 透過的な Cross Region 通信 media.xx.svc.cluster.local -
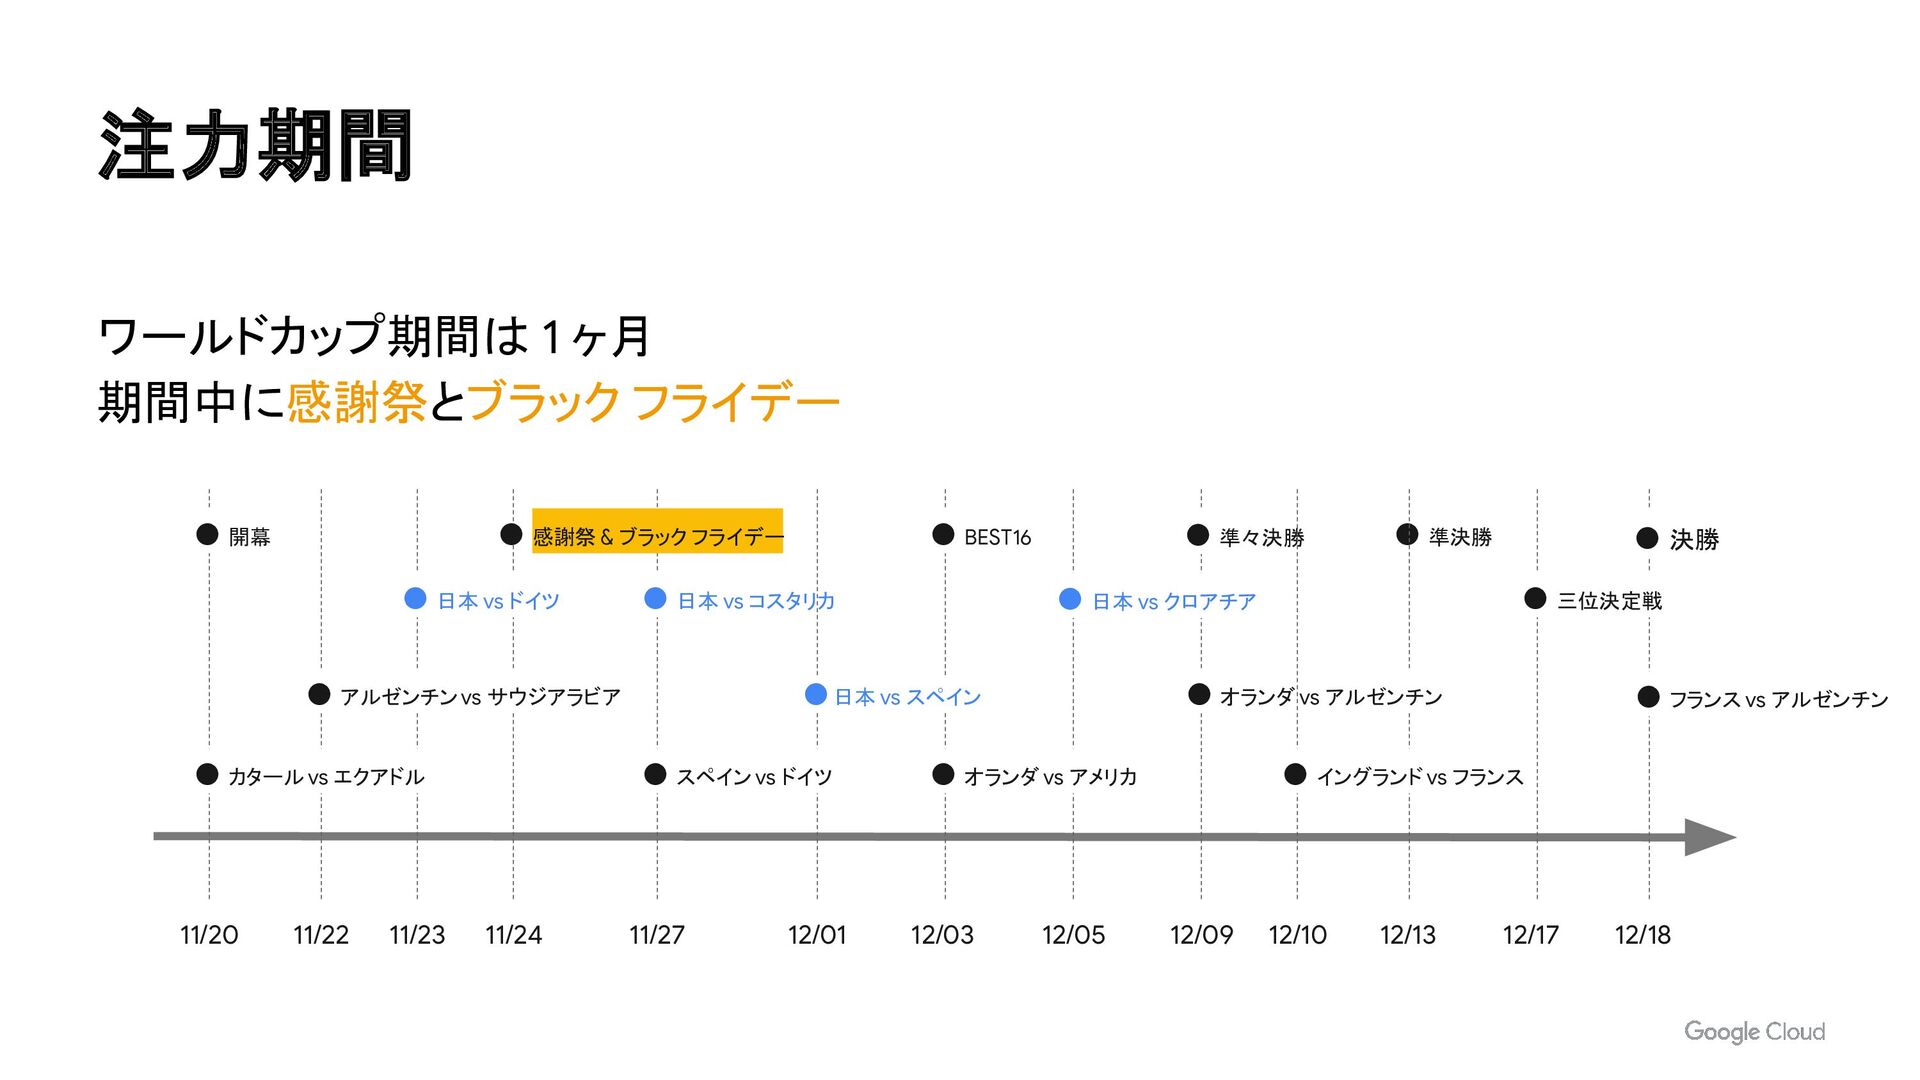
ワールドカップ期間は 1 ヶ月 期間中に感謝祭とブラック フライデー 注力期間 • 準決勝 11/20 12/18
12/13 12/03 11/24 • 開幕 • BEST16 12/09 • 準々決勝 • 決勝 11/23 • 日本 vs ドイツ 11/27 • 日本 vs コスタリカ 12/01 • 日本 vs スペイン 12/05 • 日本 vs クロアチア 12/17 • 三位決定戦 11/22 • アルゼンチン vs サウジアラビア • スペイン vs ドイツ • オランダ vs アルゼンチン 12/10 • イングランド vs フランス • フランス vs アルゼンチン • カタール vs エクアドル • オランダ vs アメリカ • 感謝祭 & ブラック フライデー -
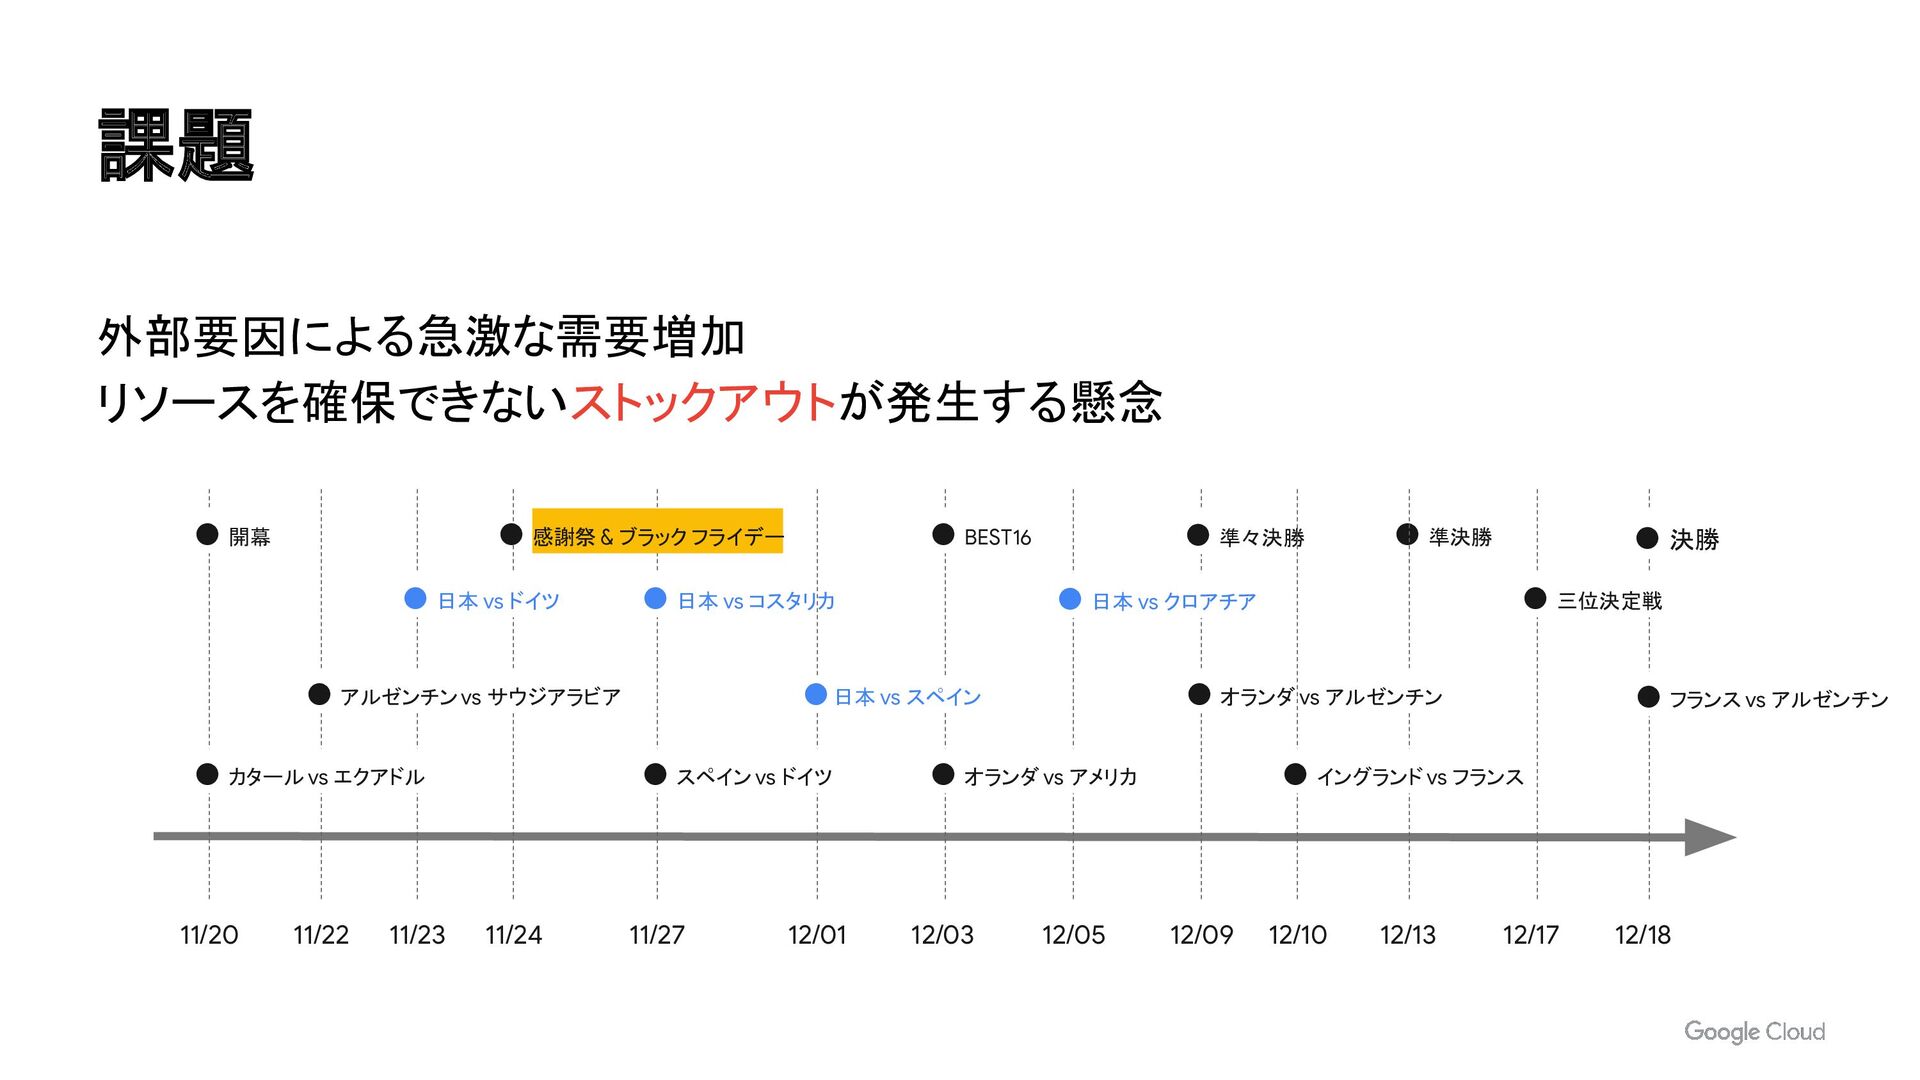
外部要因による急激な需要増加 リソースを確保できないストックアウトが発生する懸念 課題 • 準決勝 11/20 12/18 12/13 12/03 11/24
• 開幕 • BEST16 12/09 • 準々決勝 • 決勝 11/23 • 日本 vs ドイツ 11/27 • 日本 vs コスタリカ 12/01 • 日本 vs スペイン 12/05 • 日本 vs クロアチア 12/17 • 三位決定戦 11/22 • アルゼンチン vs サウジアラビア • スペイン vs ドイツ • オランダ vs アルゼンチン 12/10 • イングランド vs フランス • フランス vs アルゼンチン • カタール vs エクアドル • オランダ vs アメリカ • 感謝祭 & ブラック フライデー -
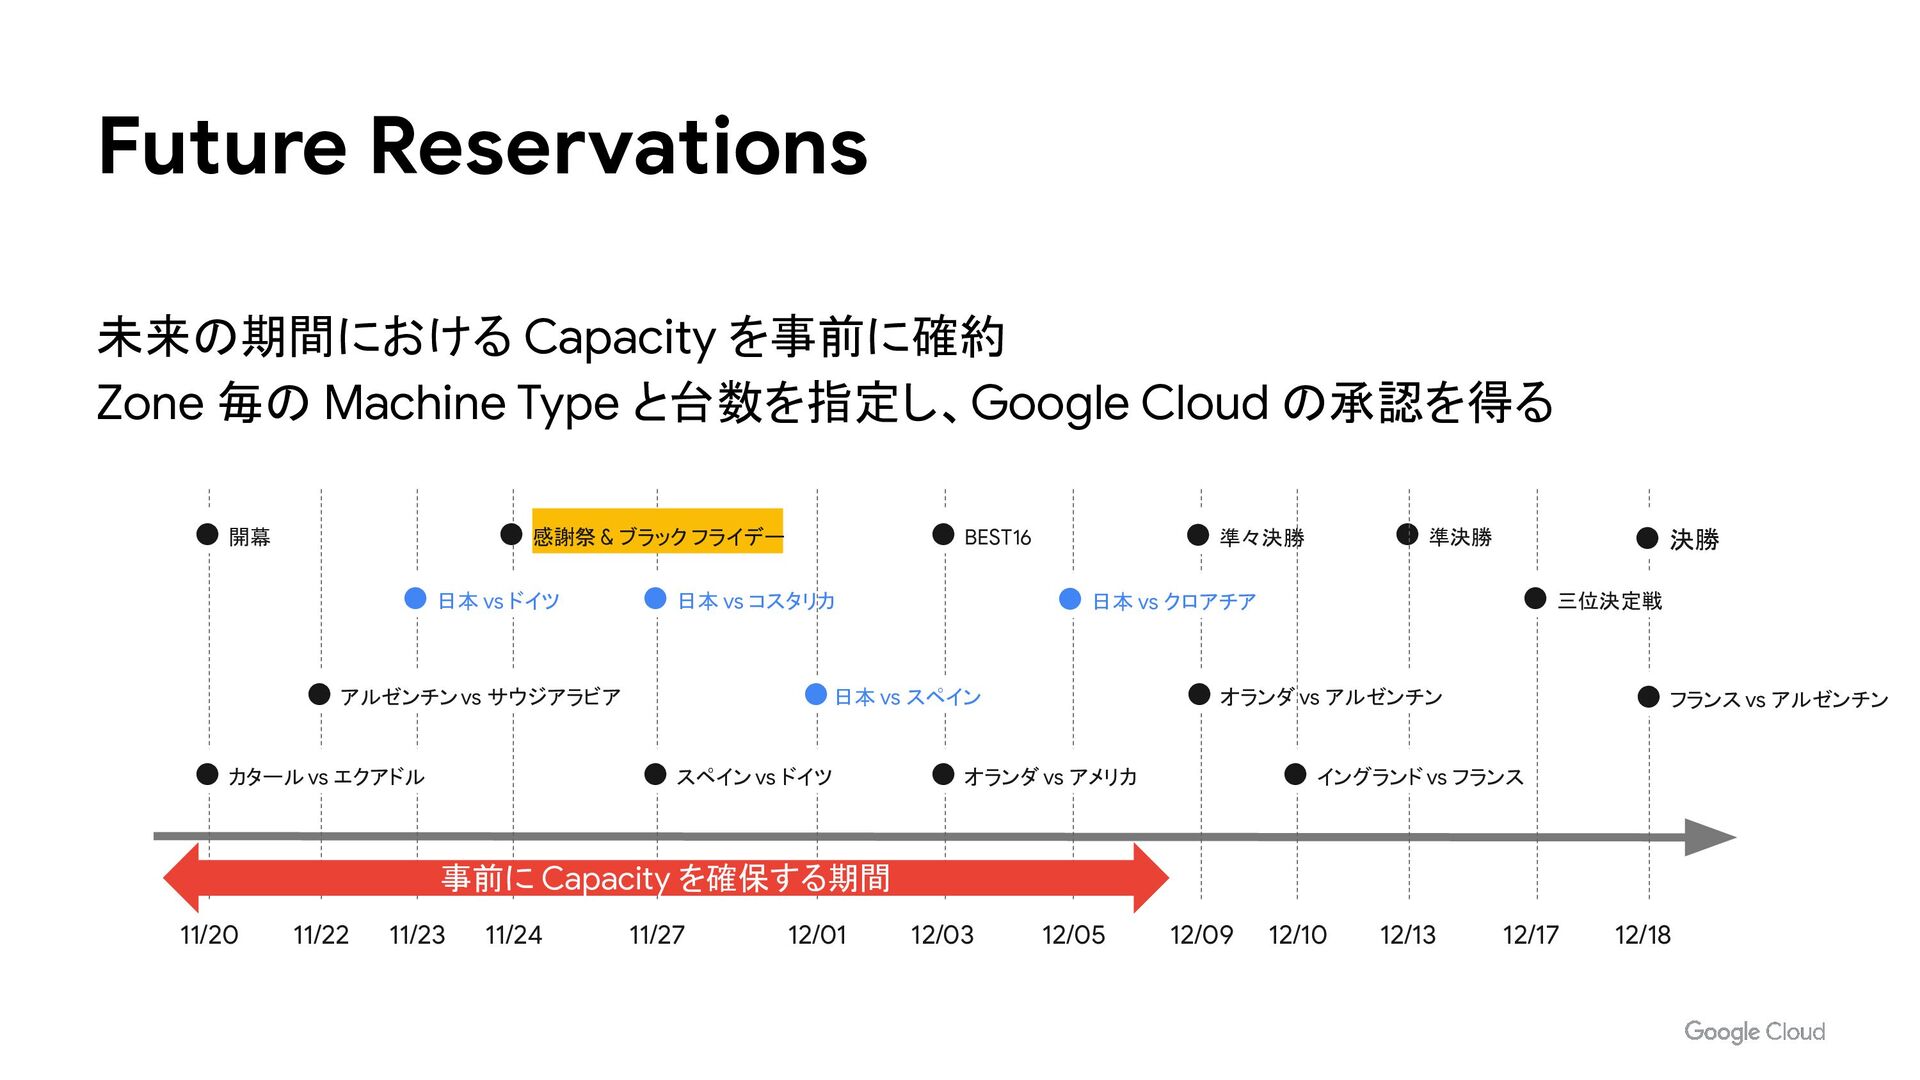
未来の期間における Capacity を事前に確約 Zone 毎の Machine Type と台数を指定し、Google Cloud の承認を得る
Future Reservations • 準決勝 11/20 12/18 12/13 12/03 11/24 • 開幕 • BEST16 12/09 • 準々決勝 • 決勝 11/23 • 日本 vs ドイツ 11/27 • 日本 vs コスタリカ 12/01 • 日本 vs スペイン 12/05 • 日本 vs クロアチア 12/17 • 三位決定戦 11/22 • アルゼンチン vs サウジアラビア • スペイン vs ドイツ • オランダ vs アルゼンチン 12/10 • イングランド vs フランス • フランス vs アルゼンチン • カタール vs エクアドル • オランダ vs アメリカ 事前に Capacity を確保する期間 • 感謝祭 & ブラック フライデー -
Capacity Planning • ワーストケースを想定した負荷試験 想定を超える負荷への対策 • ユーザー行動パターンの乖離 • ユーザー体験を損なわせない •
限られた Capacity を効率よく使用する 課題 -
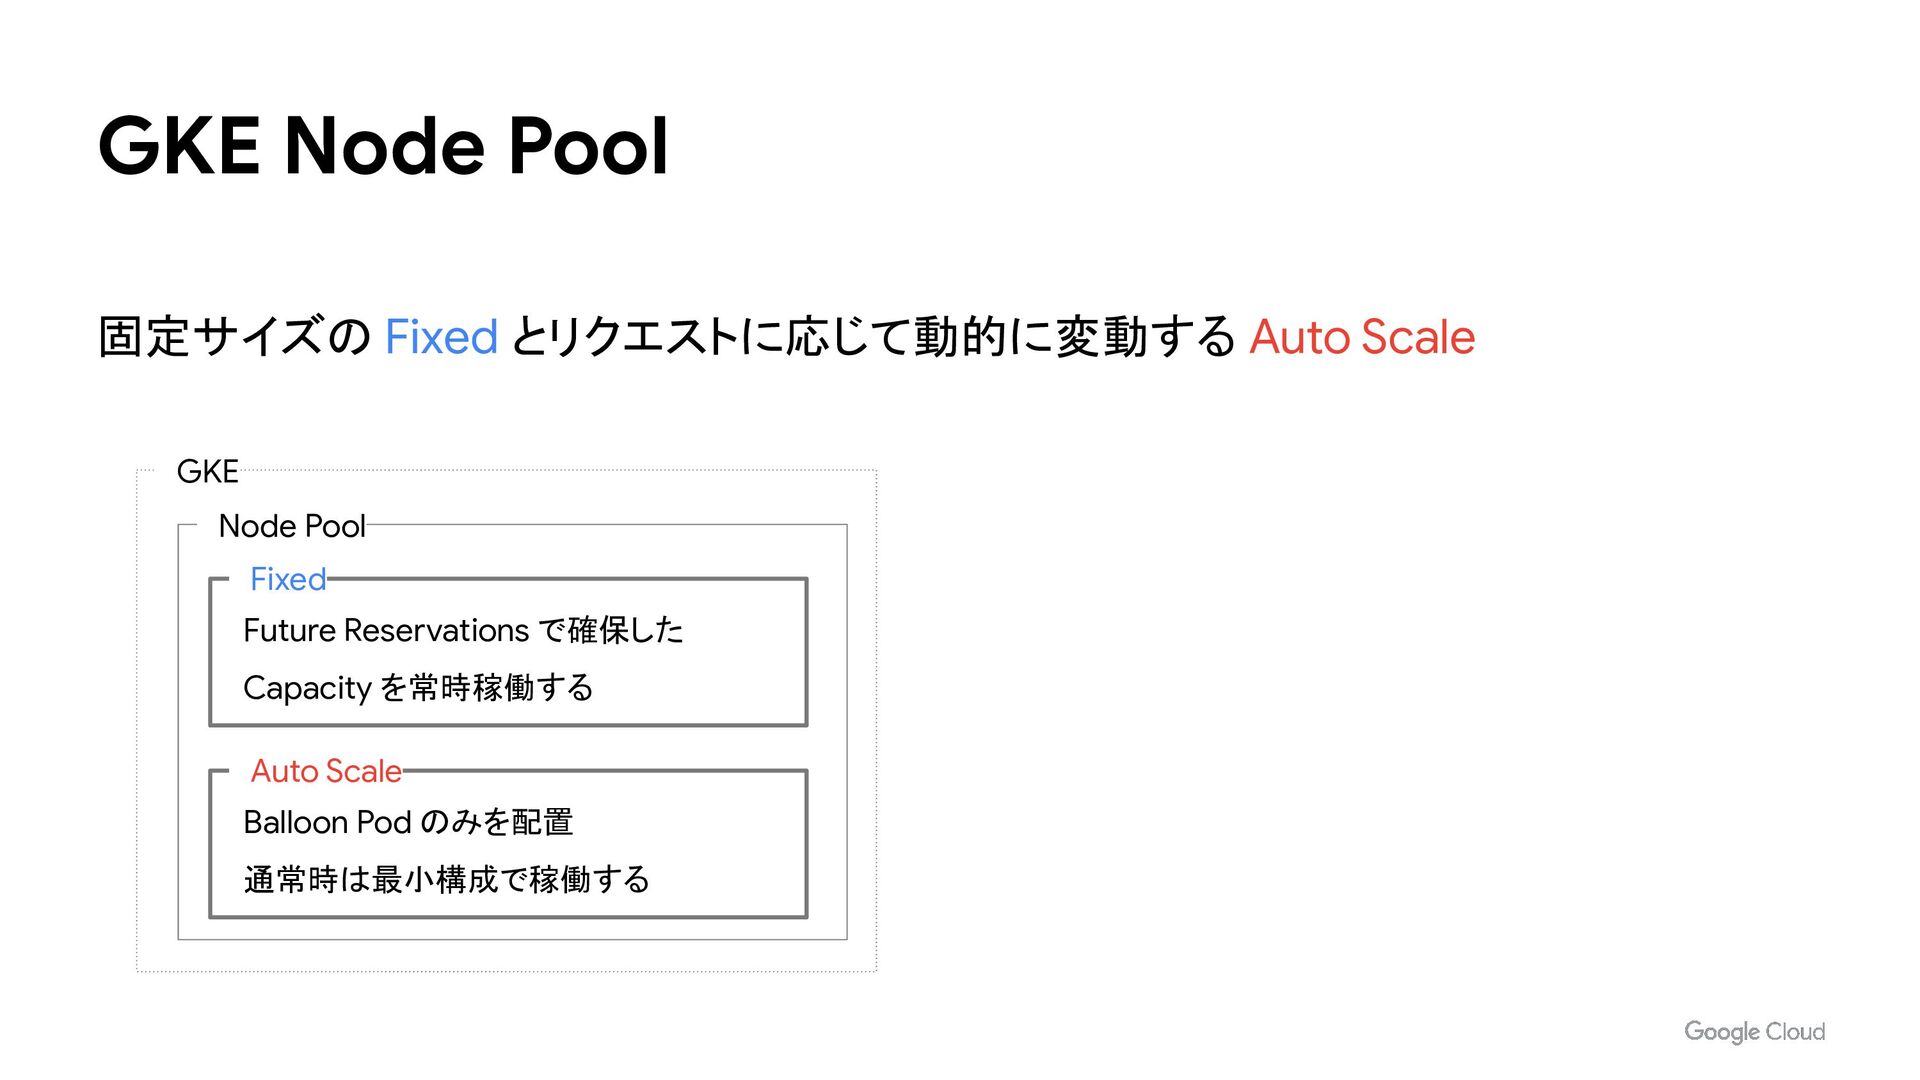
固定サイズの Fixed とリクエストに応じて動的に変動する Auto Scale GKE Node Pool GKE Node
Pool Future Reservations で確保した Capacity を常時稼働する Fixed Balloon Pod のみを配置 通常時は最小構成で稼働する Auto Scale -
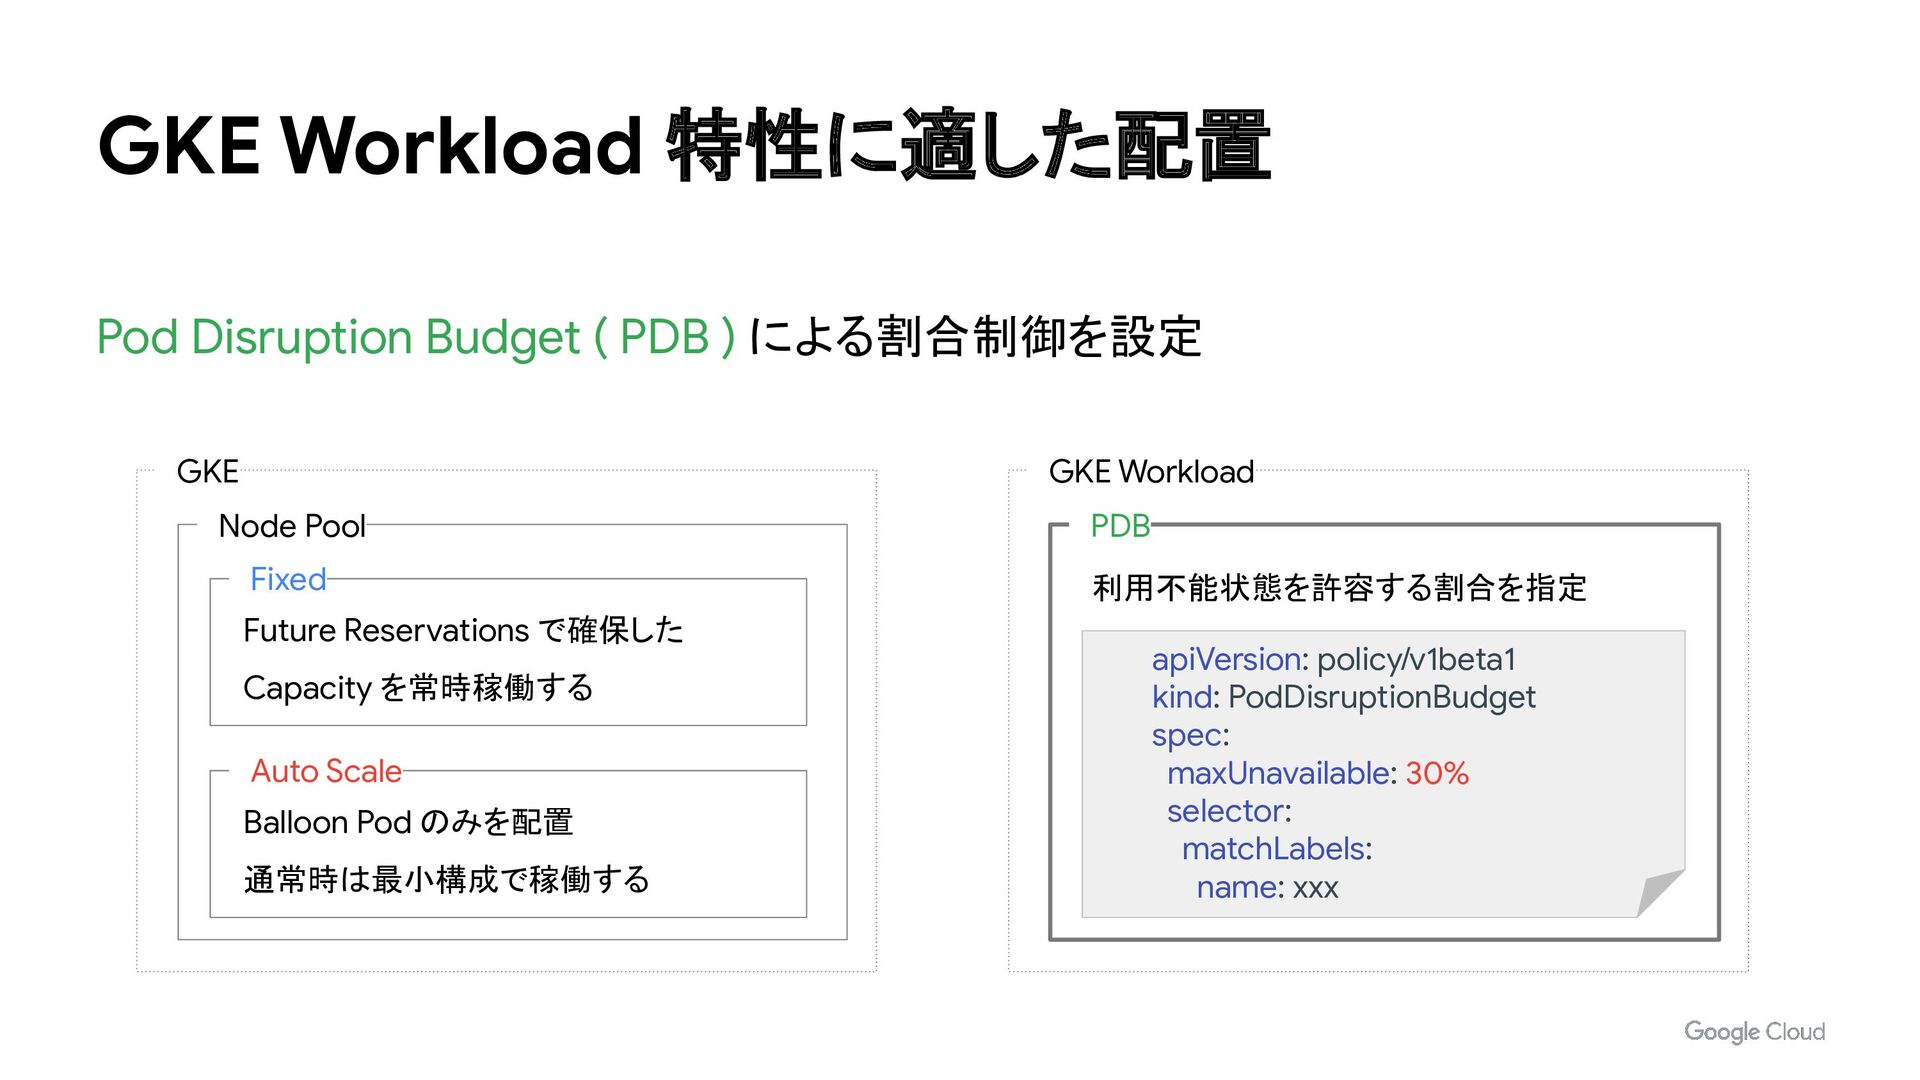
Pod Disruption Budget ( PDB ) による割合制御を設定 GKE Workload 特性に適した配置
GKE Workload PDB apiVersion: policy/v1beta1 kind: PodDisruptionBudget spec: maxUnavailable: 30% selector: matchLabels: name: xxx 利用不能状態を許容する割合を指定 GKE Node Pool Future Reservations で確保した Capacity を常時稼働する Fixed Balloon Pod のみを配置 通常時は最小構成で稼働する Auto Scale -
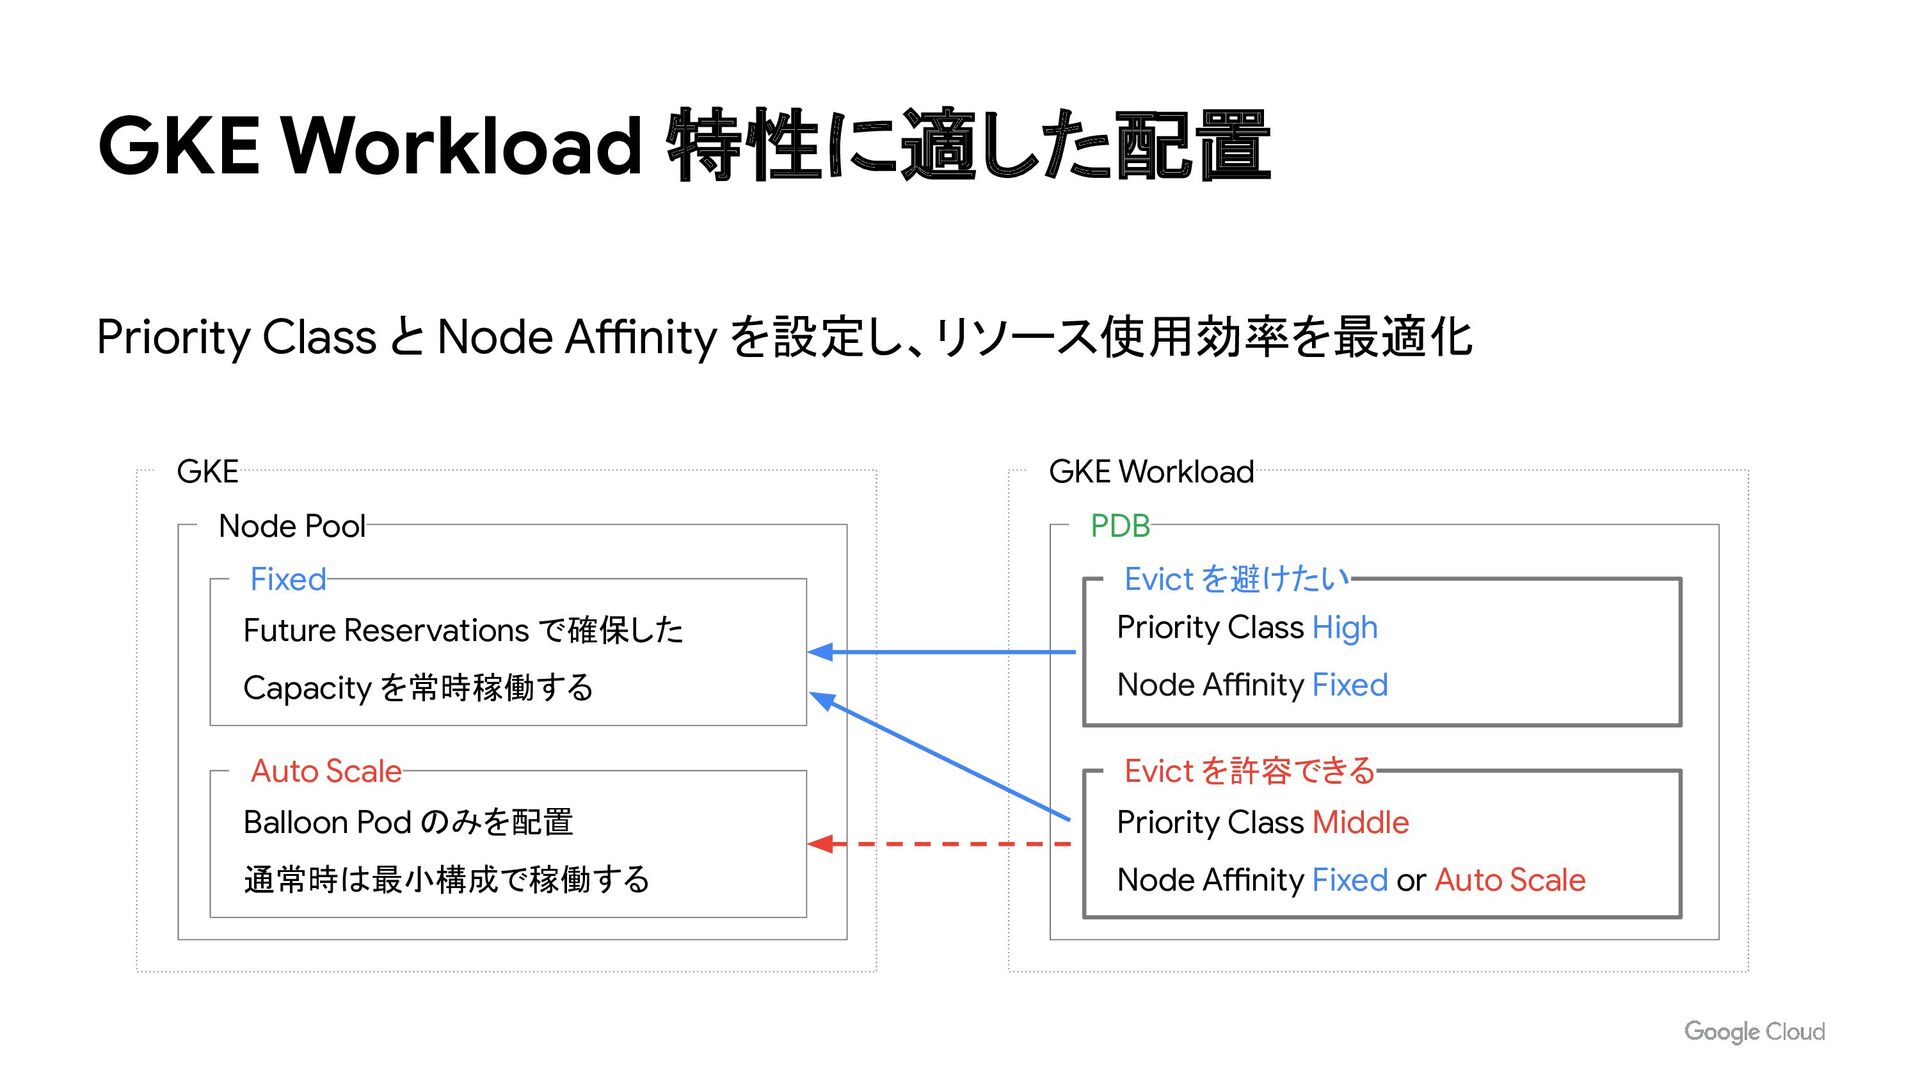
Priority Class と Node Affinity を設定し、リソース使用効率を最適化 GKE Workload 特性に適した配置 GKE
Workload GKE Node Pool Future Reservations で確保した Capacity を常時稼働する Fixed Balloon Pod のみを配置 通常時は最小構成で稼働する Auto Scale Evict を避けたい Priority Class Middle Node Affinity Fixed or Auto Scale Evict を許容できる Priority Class High Node Affinity Fixed PDB -
リクエストにアジャストなスケールを重視 • Auto Scaling Node Pool + Spot VM の割合が大きい
• Auto Scaling Profile は Optimize-utilization とし Balloon Pod を活用 • Descheduler for Kubernetes を用いて不必要な Node から Evict を促す 余談: 通常時の GKE ※ Descheduler for Kubernetes https://github.com/kubernetes-sigs/descheduler 大規模イベントでは安定性を最優先した戦略にシフト -
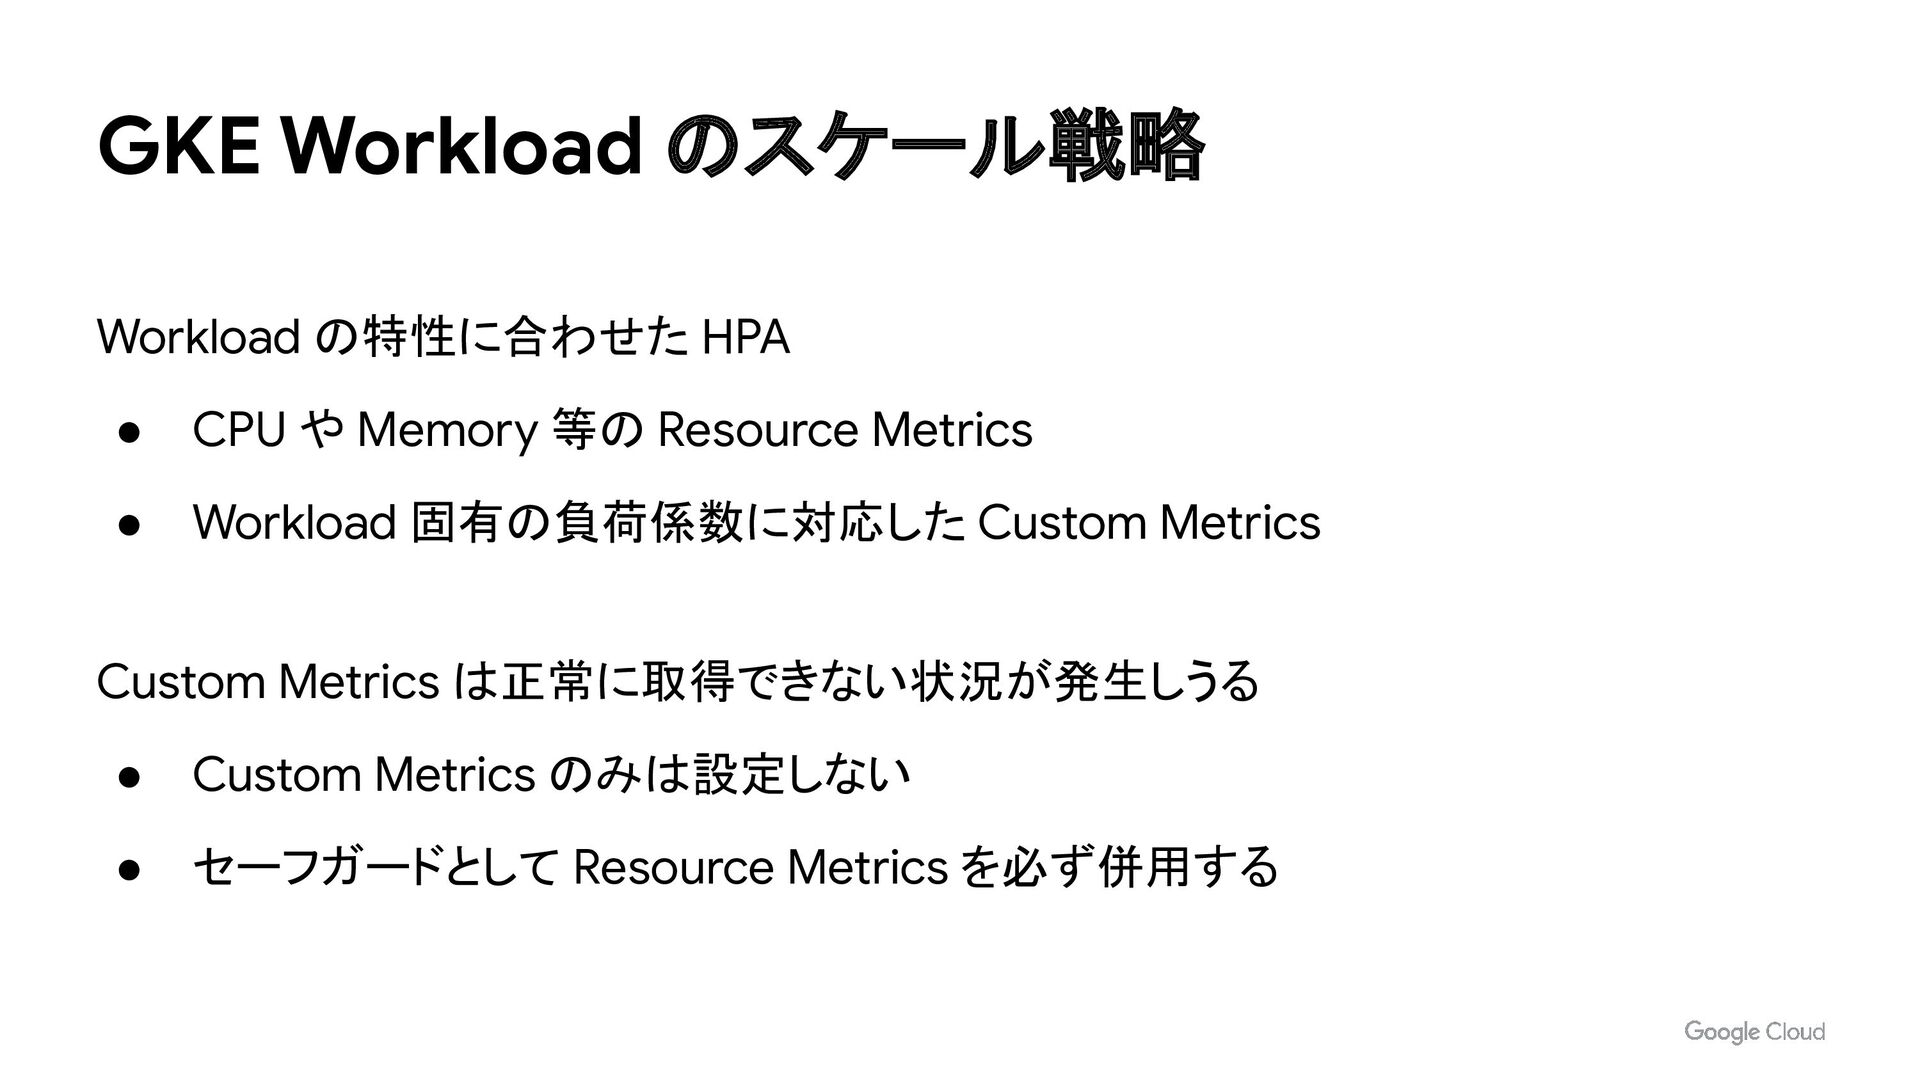
Workload の特性に合わせた HPA • CPU や Memory 等の Resource Metrics
• Workload 固有の負荷係数に対応した Custom Metrics Custom Metrics は正常に取得できない状況が発生しうる • Custom Metrics のみは設定しない • セーフガードとして Resource Metrics を必ず併用する GKE Workload のスケール戦略 -
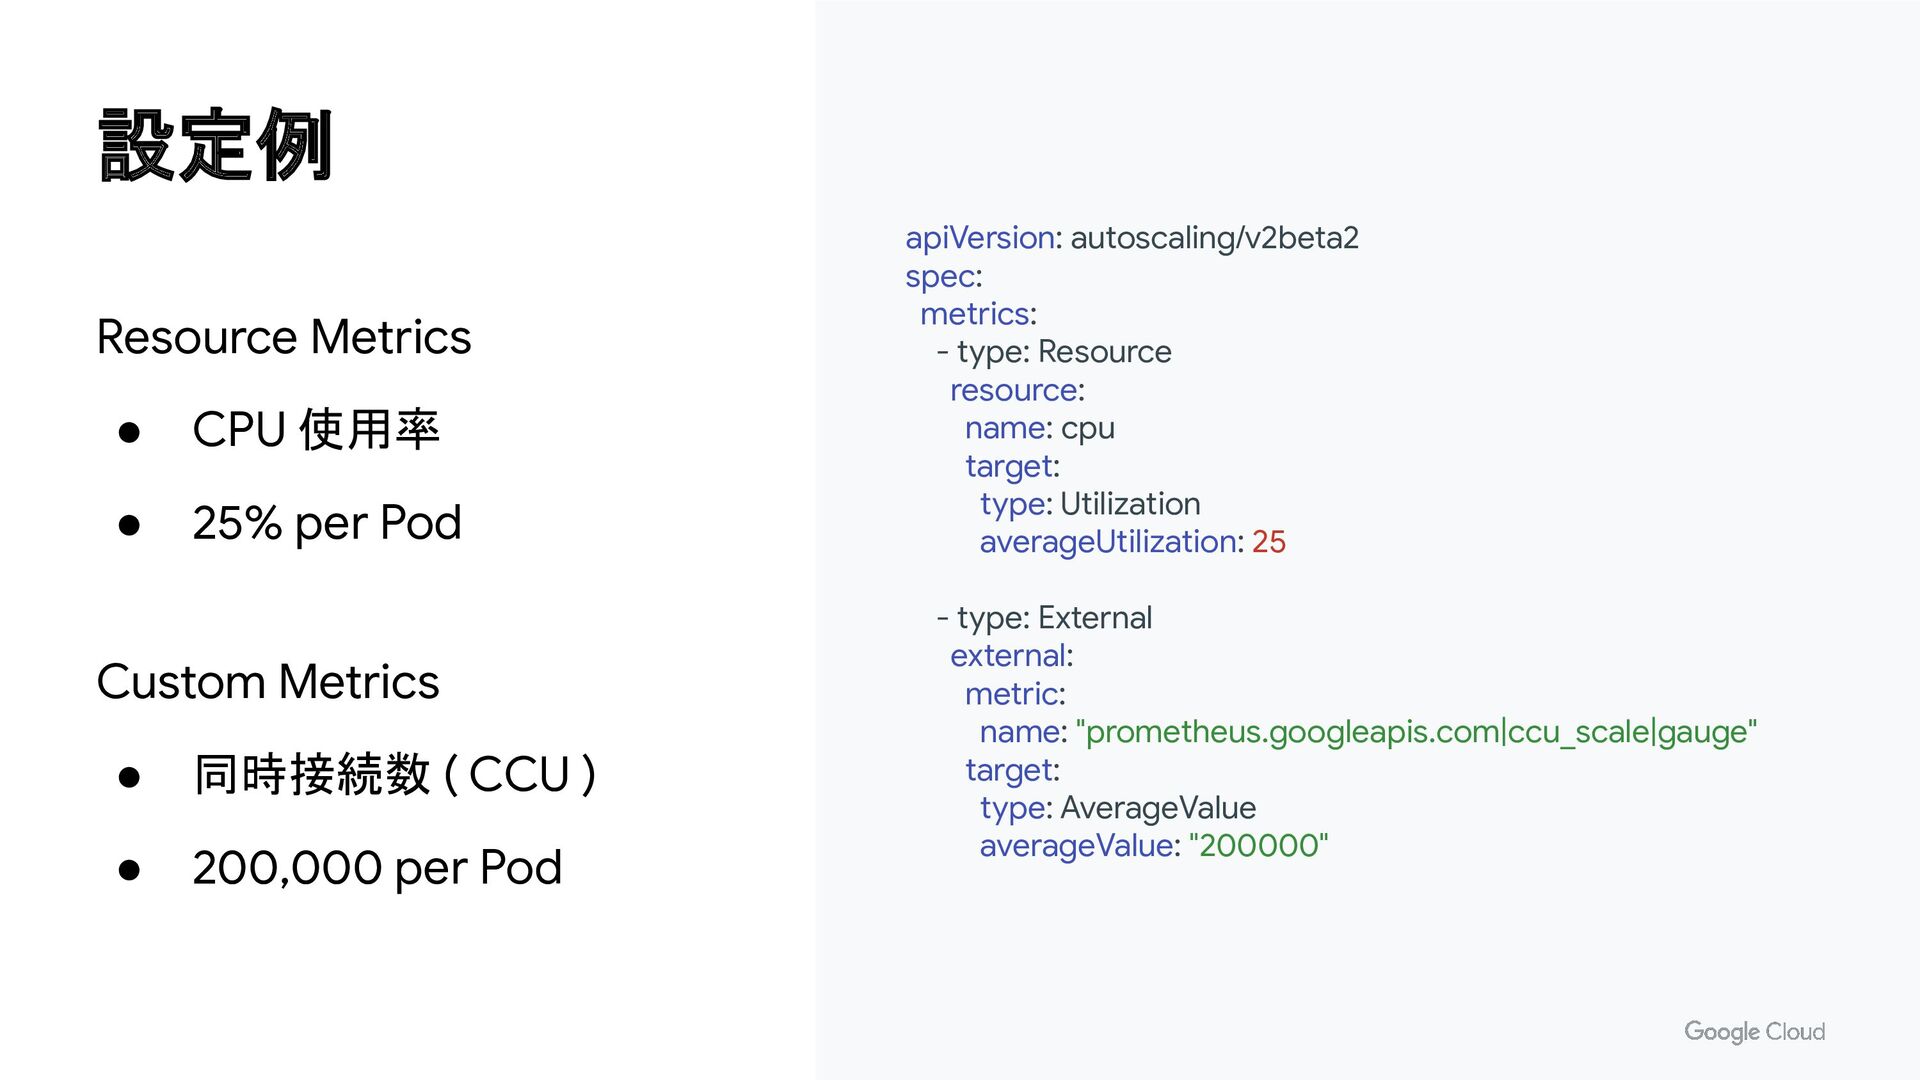
apiVersion: autoscaling/v2beta2 spec: metrics: - type: Resource resource: name: cpu
target: type: Utilization averageUtilization: 25 - type: External external: metric: name: "prometheus.googleapis.com|ccu_scale|gauge" target: type: AverageValue averageValue: "200000" 設定例 Resource Metrics • CPU 使用率 • 25% per Pod Custom Metrics • 同時接続数 ( CCU ) • 200,000 per Pod -
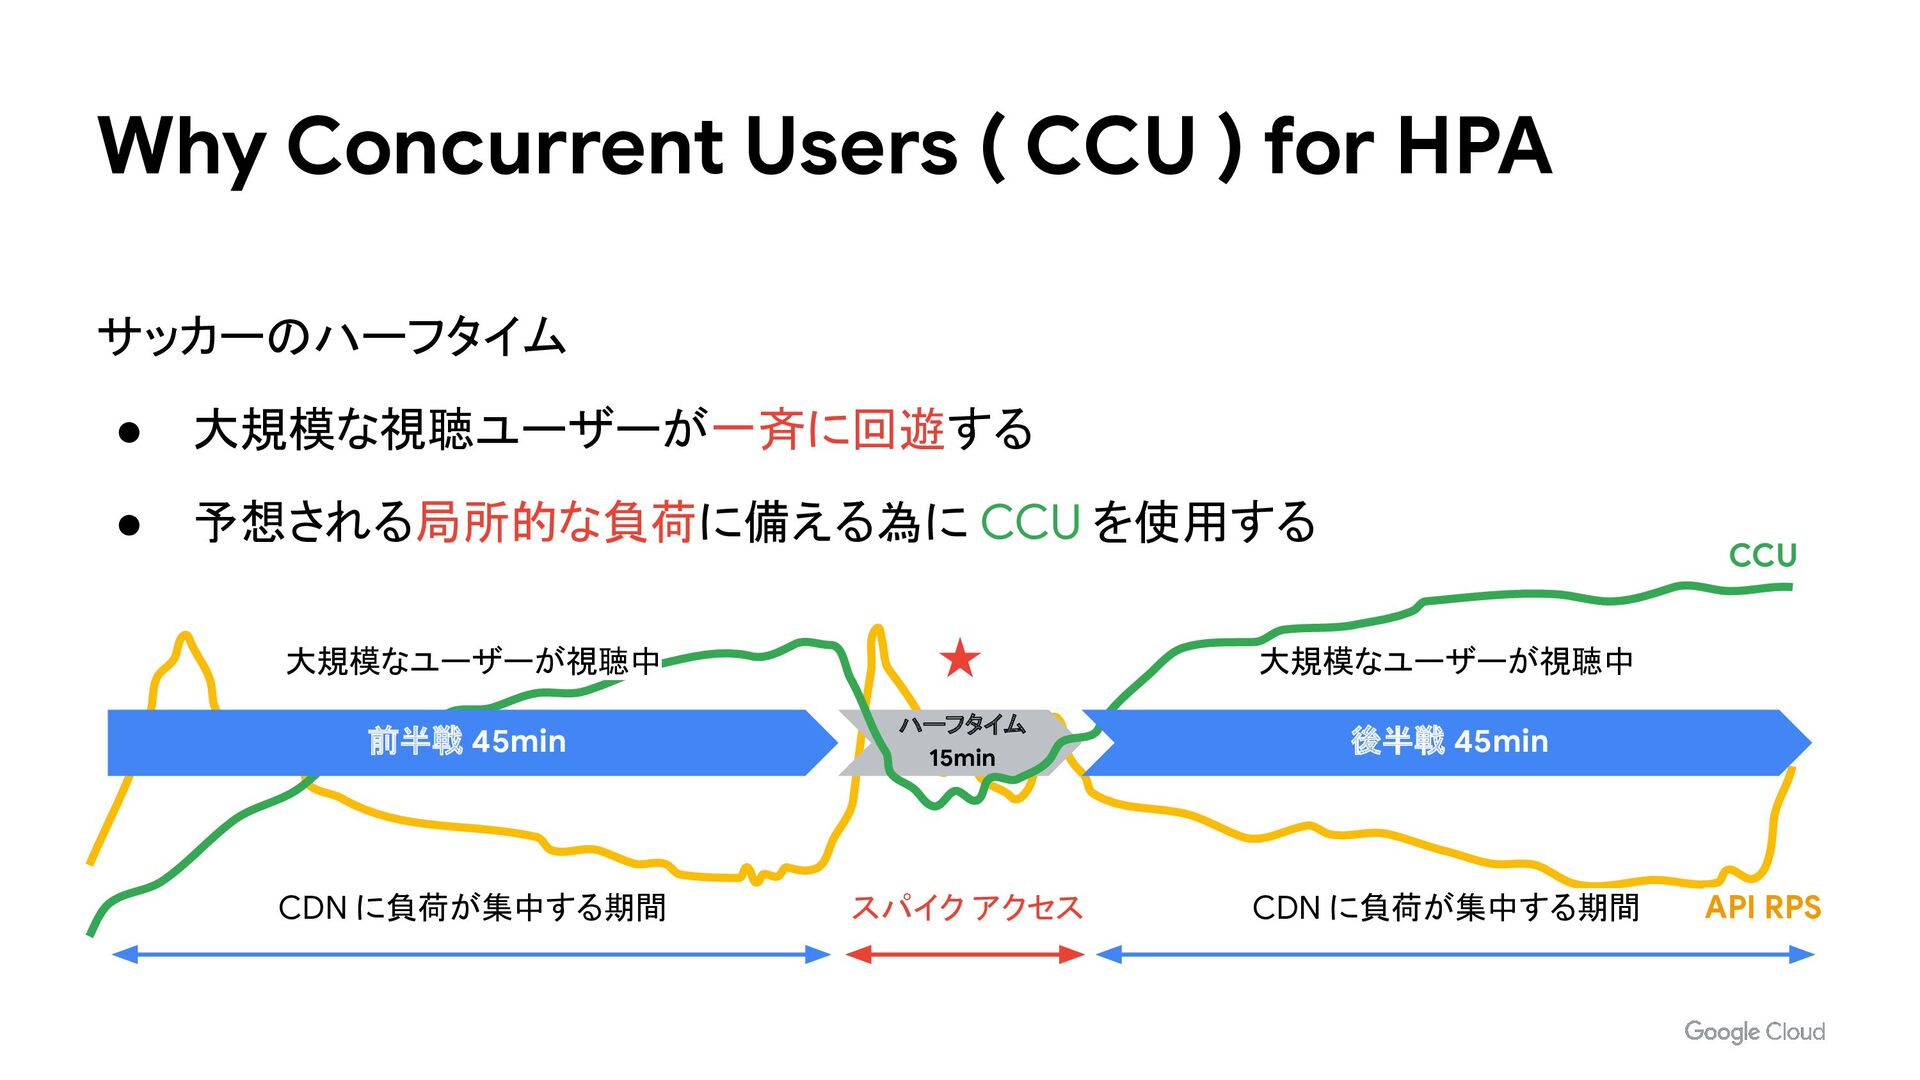
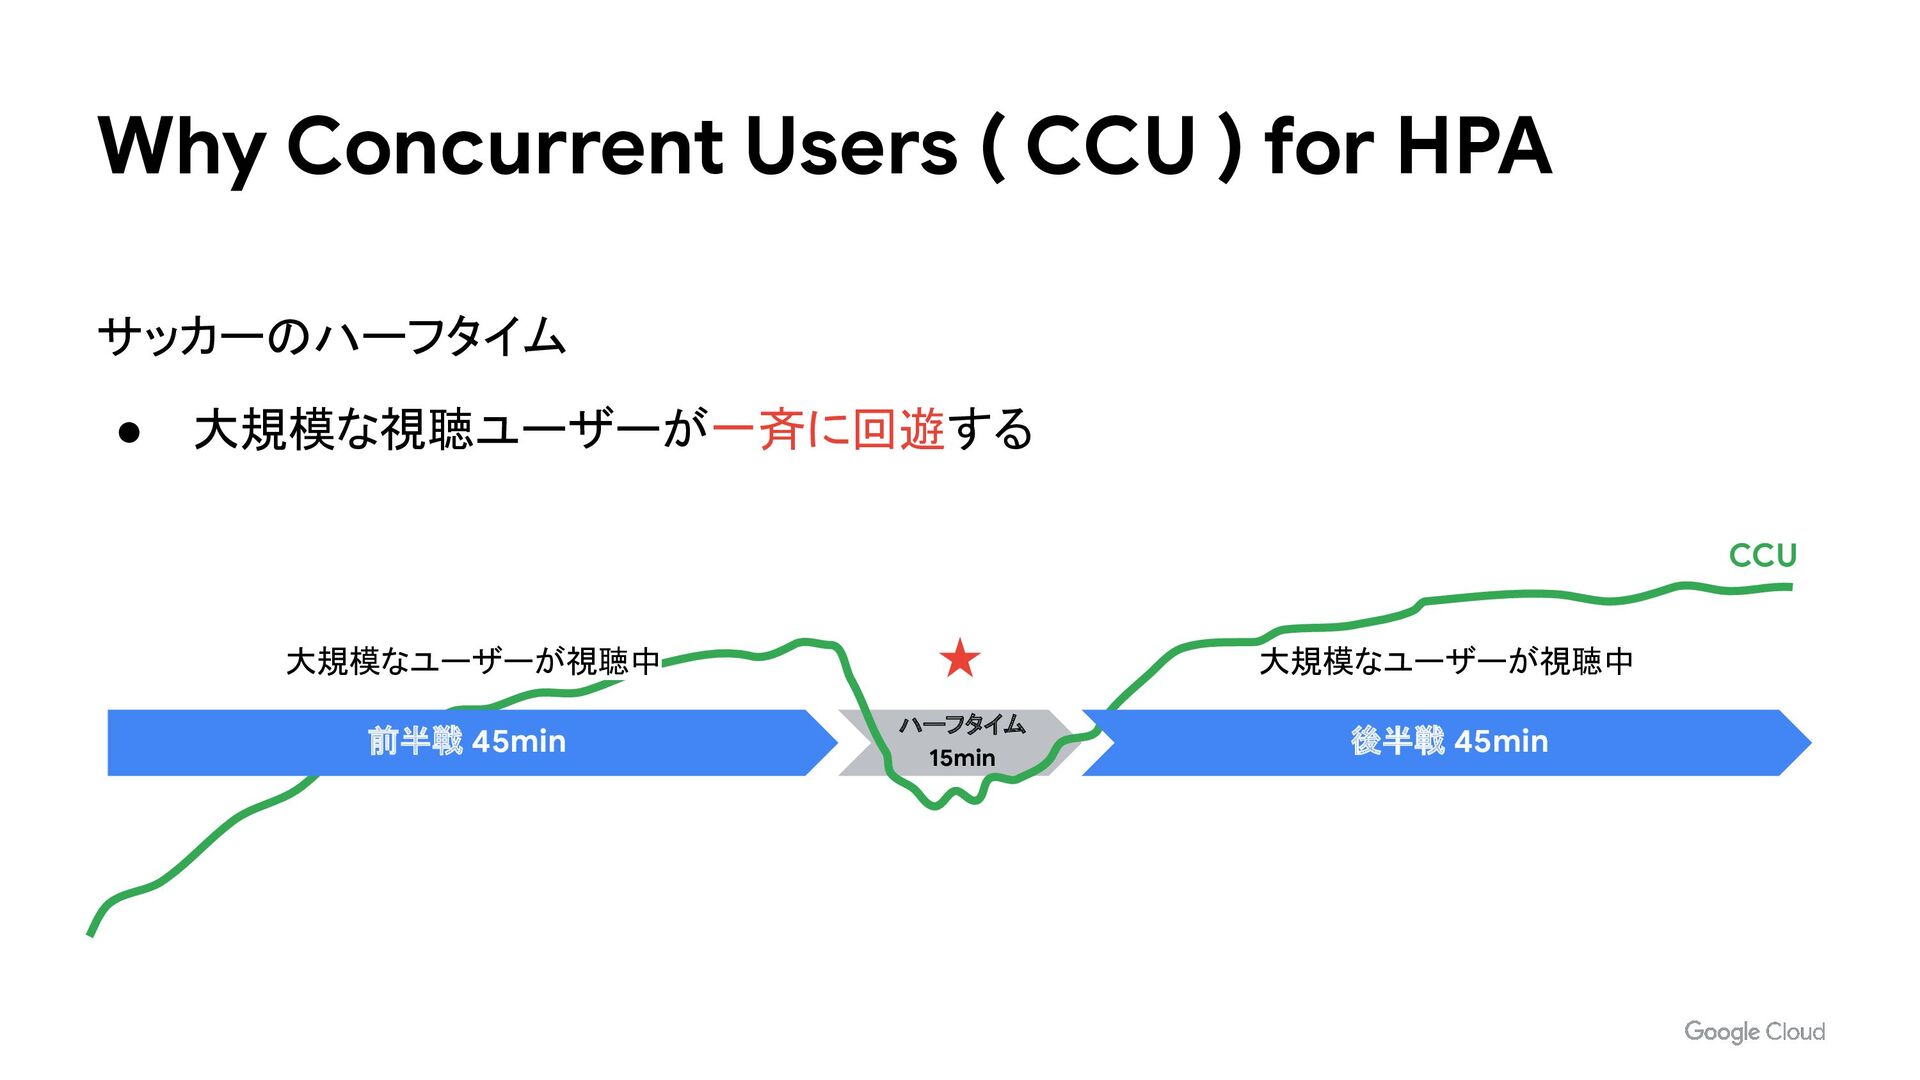
大規模なユーザーが視聴中 ★ ハーフタイム 15min サッカーのハーフタイム • 大規模な視聴ユーザーが一斉に回遊する Why Concurrent Users
( CCU ) for HPA 前半戦 45min 後半戦 45min 大規模なユーザーが視聴中 CCU -
大規模なユーザーが視聴中 スパイク アクセス ハーフタイム 15min サッカーのハーフタイム • 大規模な視聴ユーザーが一斉に回遊する • 予想される局所的な負荷に備える為に
CCU を使用する Why Concurrent Users ( CCU ) for HPA 前半戦 45min 後半戦 45min 大規模なユーザーが視聴中 CDN に負荷が集中する期間 CDN に負荷が集中する期間 CCU API RPS ★ -
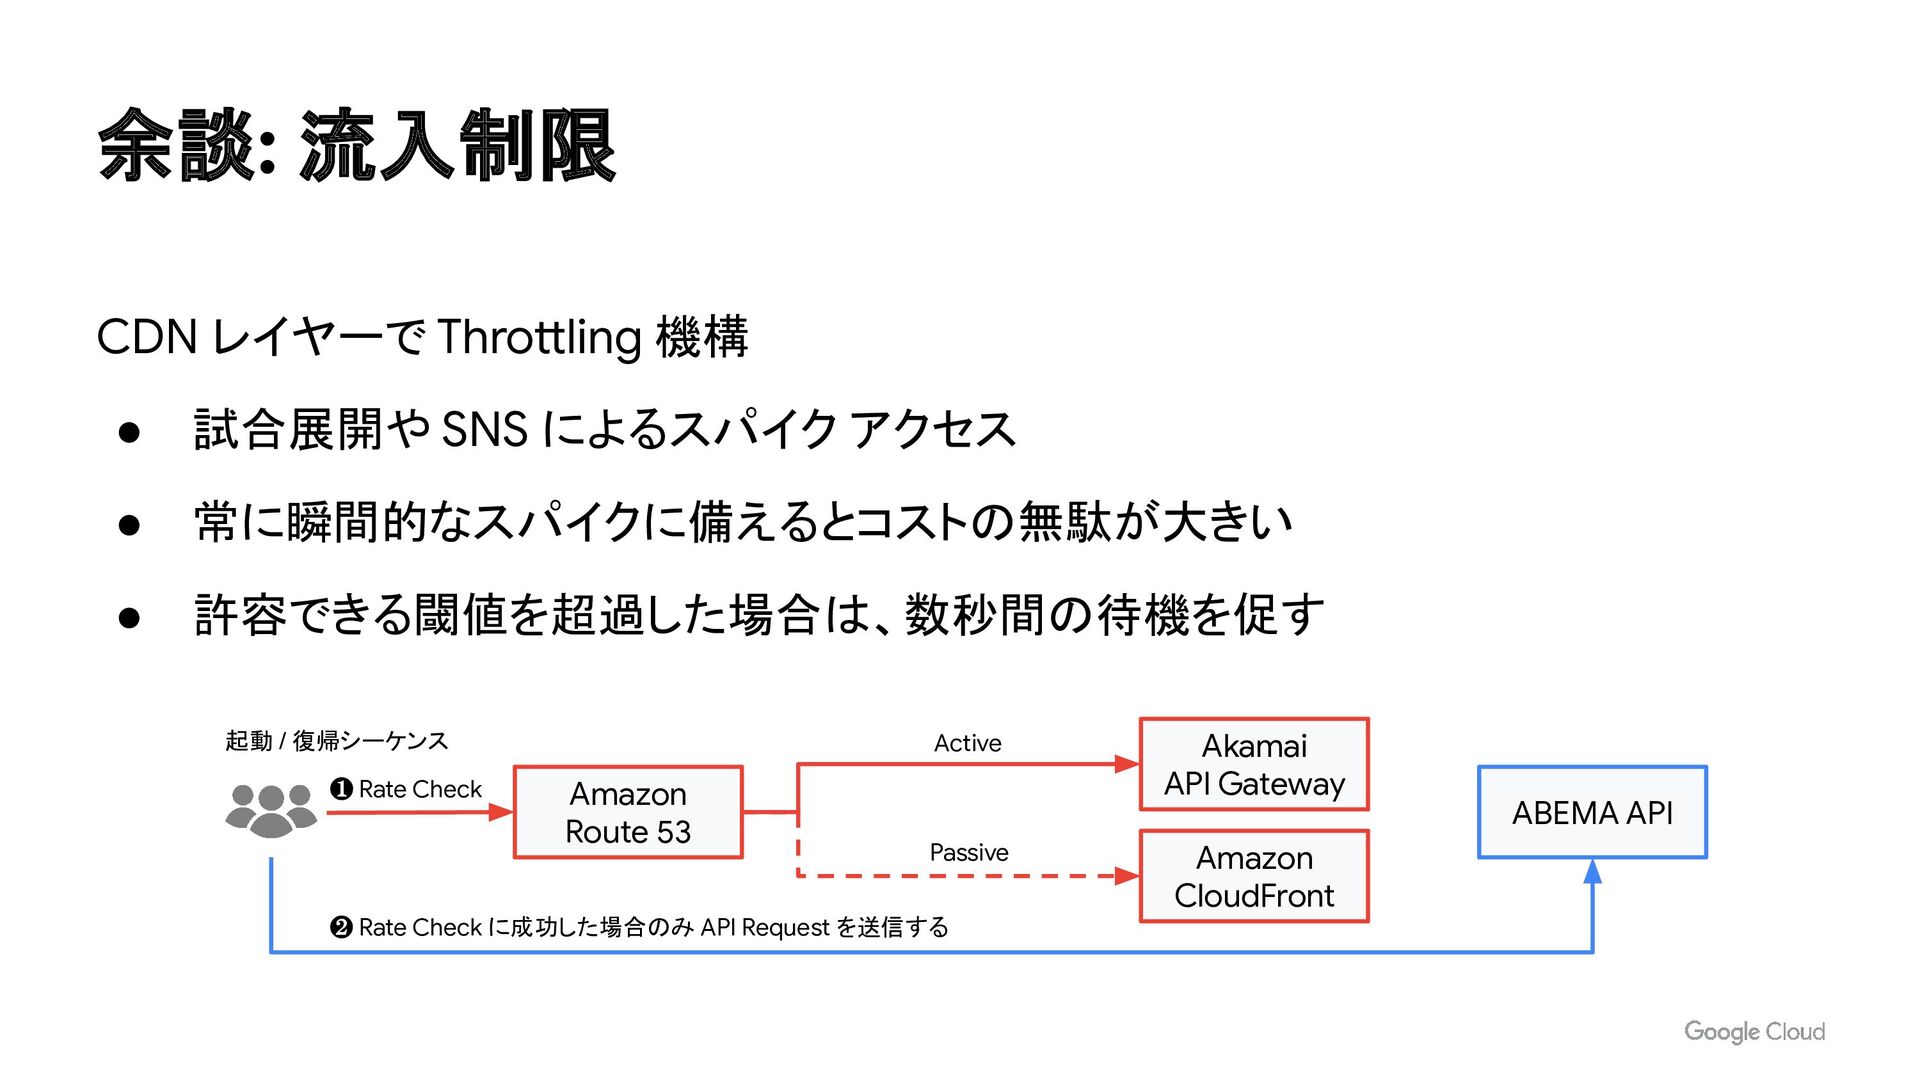
CDN レイヤーで Throttling 機構 • 試合展開や SNS によるスパイク アクセス •
常に瞬間的なスパイクに備えるとコストの無駄が大きい • 許容できる閾値を超過した場合は、数秒間の待機を促す 余談: 流入制限 Amazon Route 53 Akamai API Gateway Amazon CloudFront ABEMA API Active Passive ❷ Rate Check に成功した場合のみ API Request を送信する ❶ Rate Check 起動 / 復帰シーケンス -
GKE 東京 Monitoring System GKE 台湾 NS: monitoring Grafana HA
Grafana Unified Alert Victoria Metrics NS: monitoring Prometheus Prometheus Adapter HPA api Deployment api NS: user Pod(s) api Pod(s) api Pod(s) api Prometheus + Victoria Metrics Cluster Fetch Custom Metrics -
Custom Metrics の HPA 活用 • Monitoring System の障害が Workload
の Scalability に影響しうる 課題 -
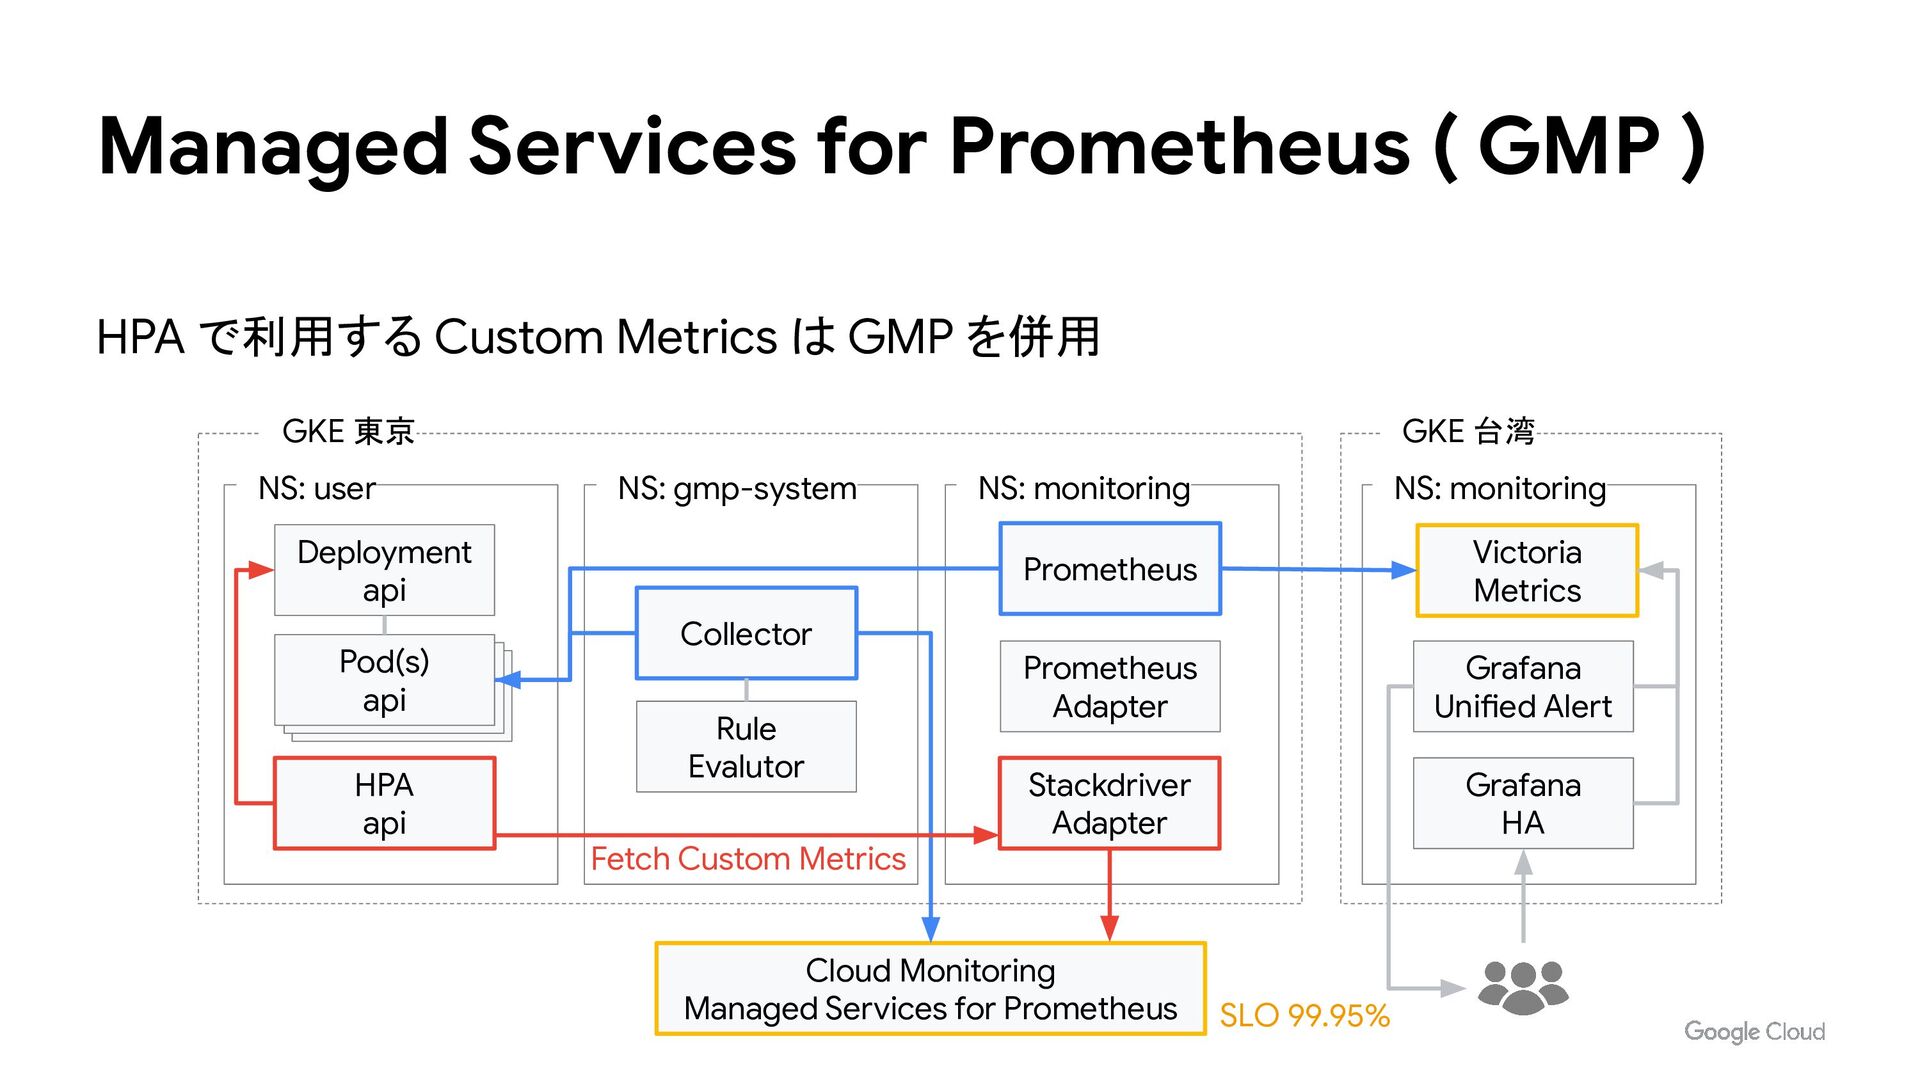
GKE 東京 Managed Services for Prometheus ( GMP ) GKE
台湾 Cloud Monitoring Managed Services for Prometheus NS: monitoring Grafana HA Grafana Unified Alert Victoria Metrics NS: monitoring Prometheus Prometheus Adapter Stackdriver Adapter NS: gmp-system Collector Rule Evalutor HPA api Deployment api NS: user Pod(s) api Pod(s) api Pod(s) api HPA で利用する Custom Metrics は GMP を併用 SLO 99.95% Fetch Custom Metrics -
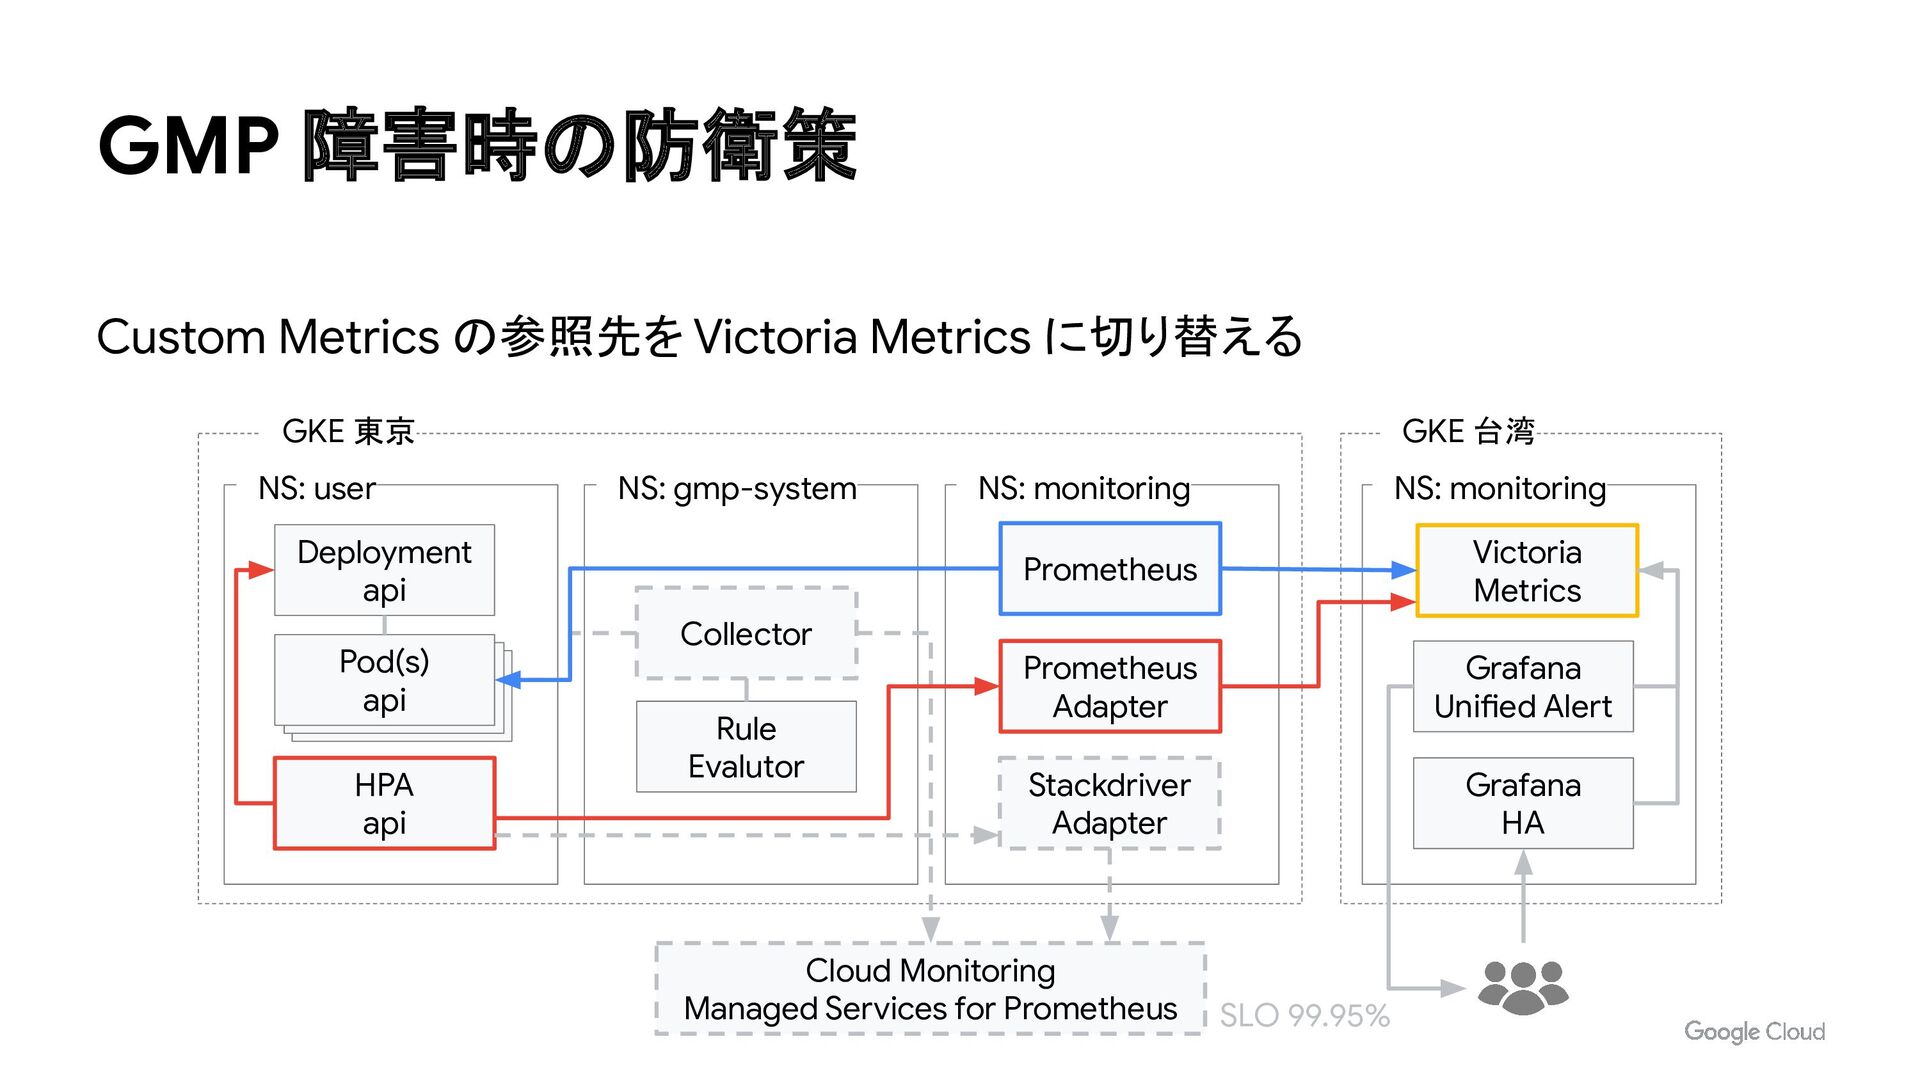
GKE 東京 GMP 障害時の防衛策 GKE 台湾 Cloud Monitoring Managed Services
for Prometheus NS: monitoring Grafana HA Grafana Unified Alert Victoria Metrics NS: monitoring Prometheus Prometheus Adapter Stackdriver Adapter NS: gmp-system Collector Rule Evalutor HPA api Deployment api NS: user Pod(s) api Pod(s) api Pod(s) api Custom Metrics の参照先を Victoria Metrics に切り替える SLO 99.95% -
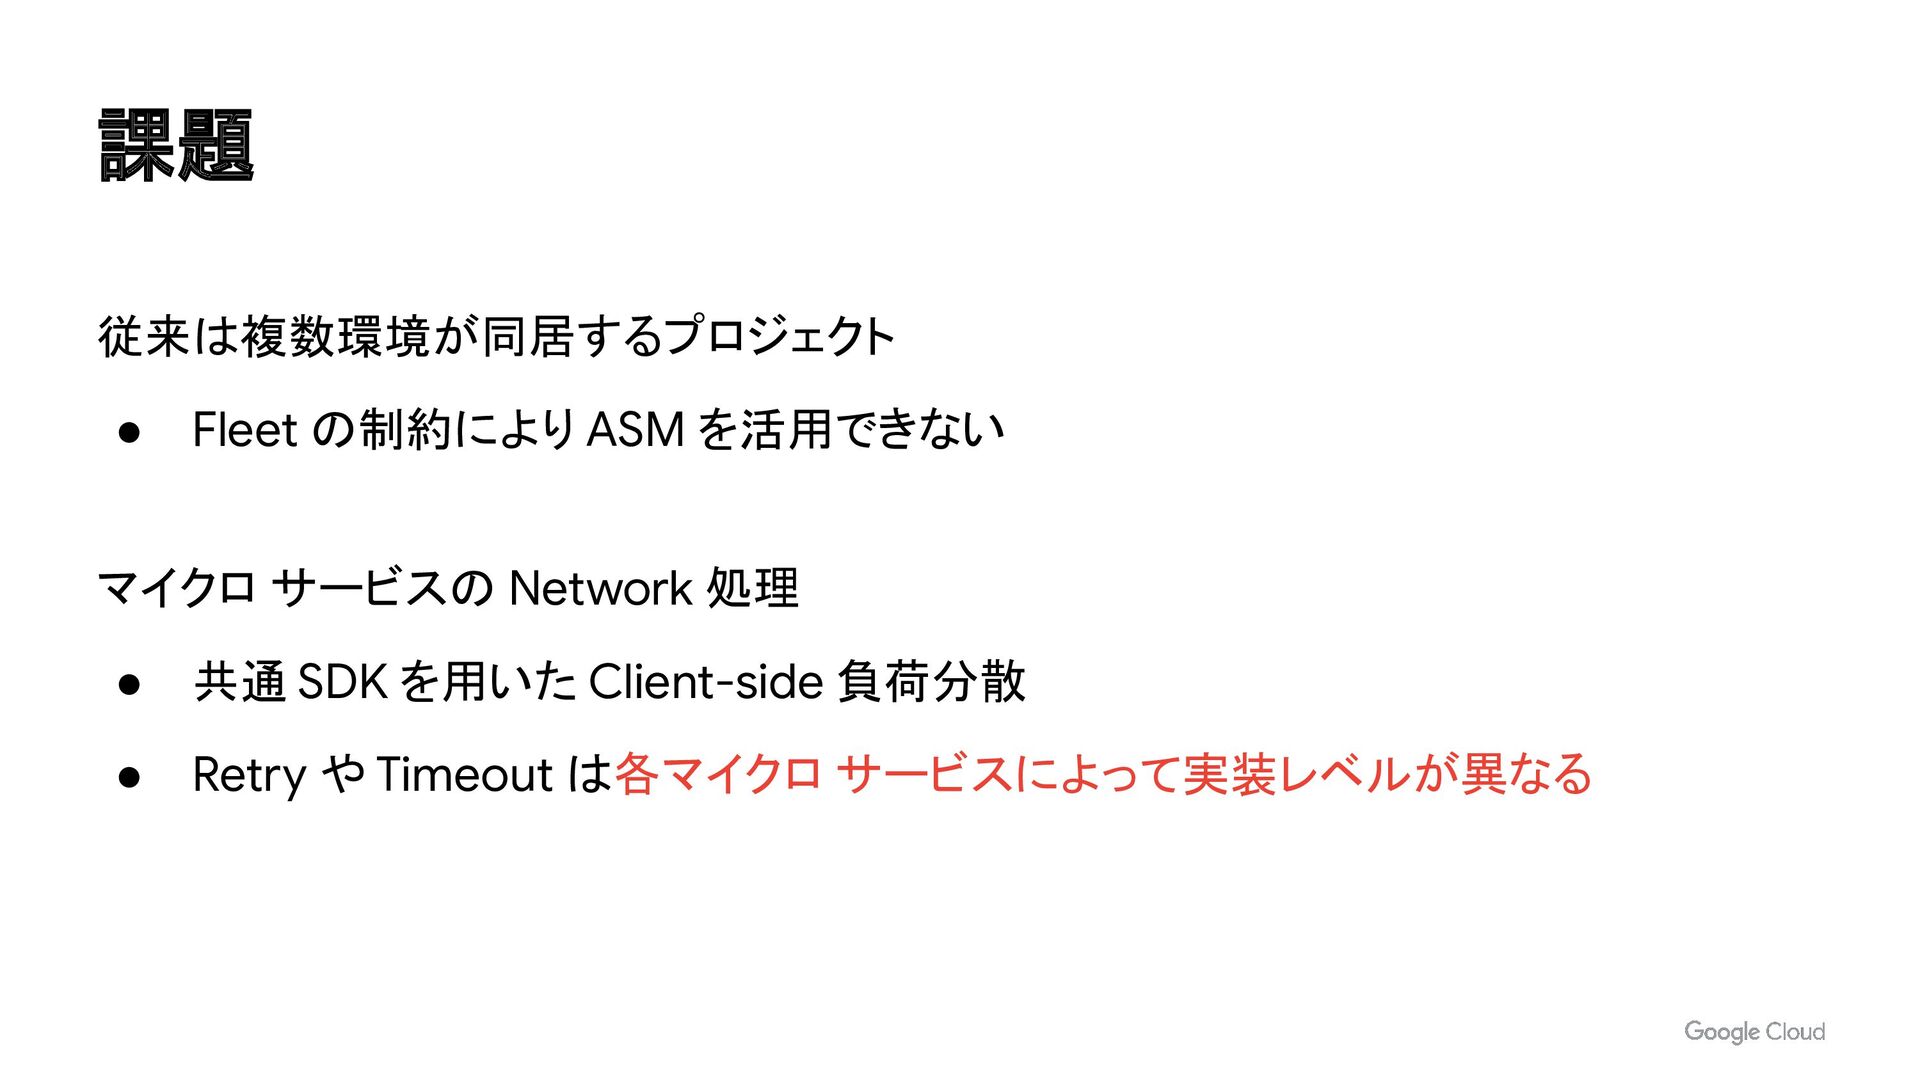
従来は複数環境が同居するプロジェクト • Fleet の制約により ASM を活用できない マイクロ サービスの Network 処理
• 共通 SDK を用いた Client-side 負荷分散 • Retry や Timeout は各マイクロ サービスによって実装レベルが異なる 課題 -
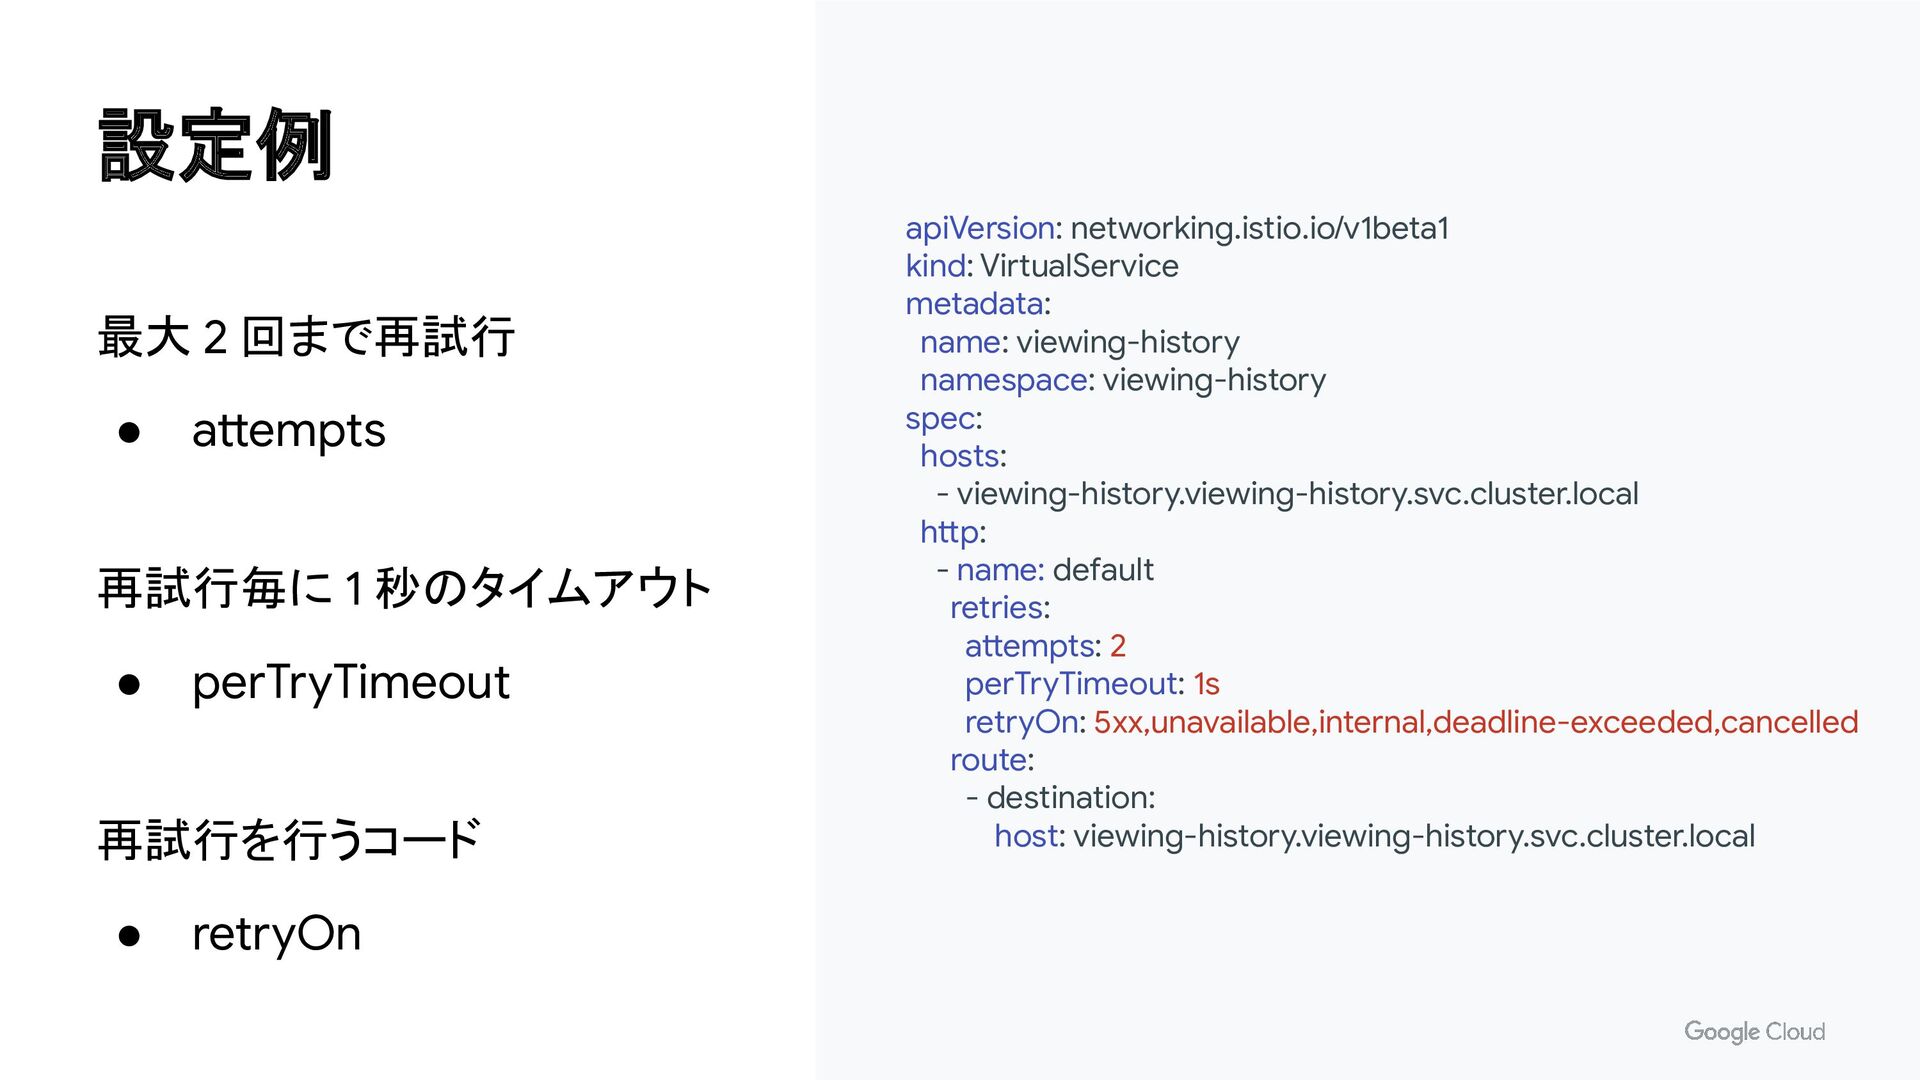
最大 2 回まで再試行 • attempts 再試行毎に 1 秒のタイムアウト • perTryTimeout
再試行を行うコード • retryOn 設定例 apiVersion: networking.istio.io/v1beta1 kind: VirtualService metadata: name: viewing-history namespace: viewing-history spec: hosts: - viewing-history.viewing-history.svc.cluster.local http: - name: default retries: attempts: 2 perTryTimeout: 1s retryOn: 5xx,unavailable,internal,deadline-exceeded,cancelled route: - destination: host: viewing-history.viewing-history.svc.cluster.local -
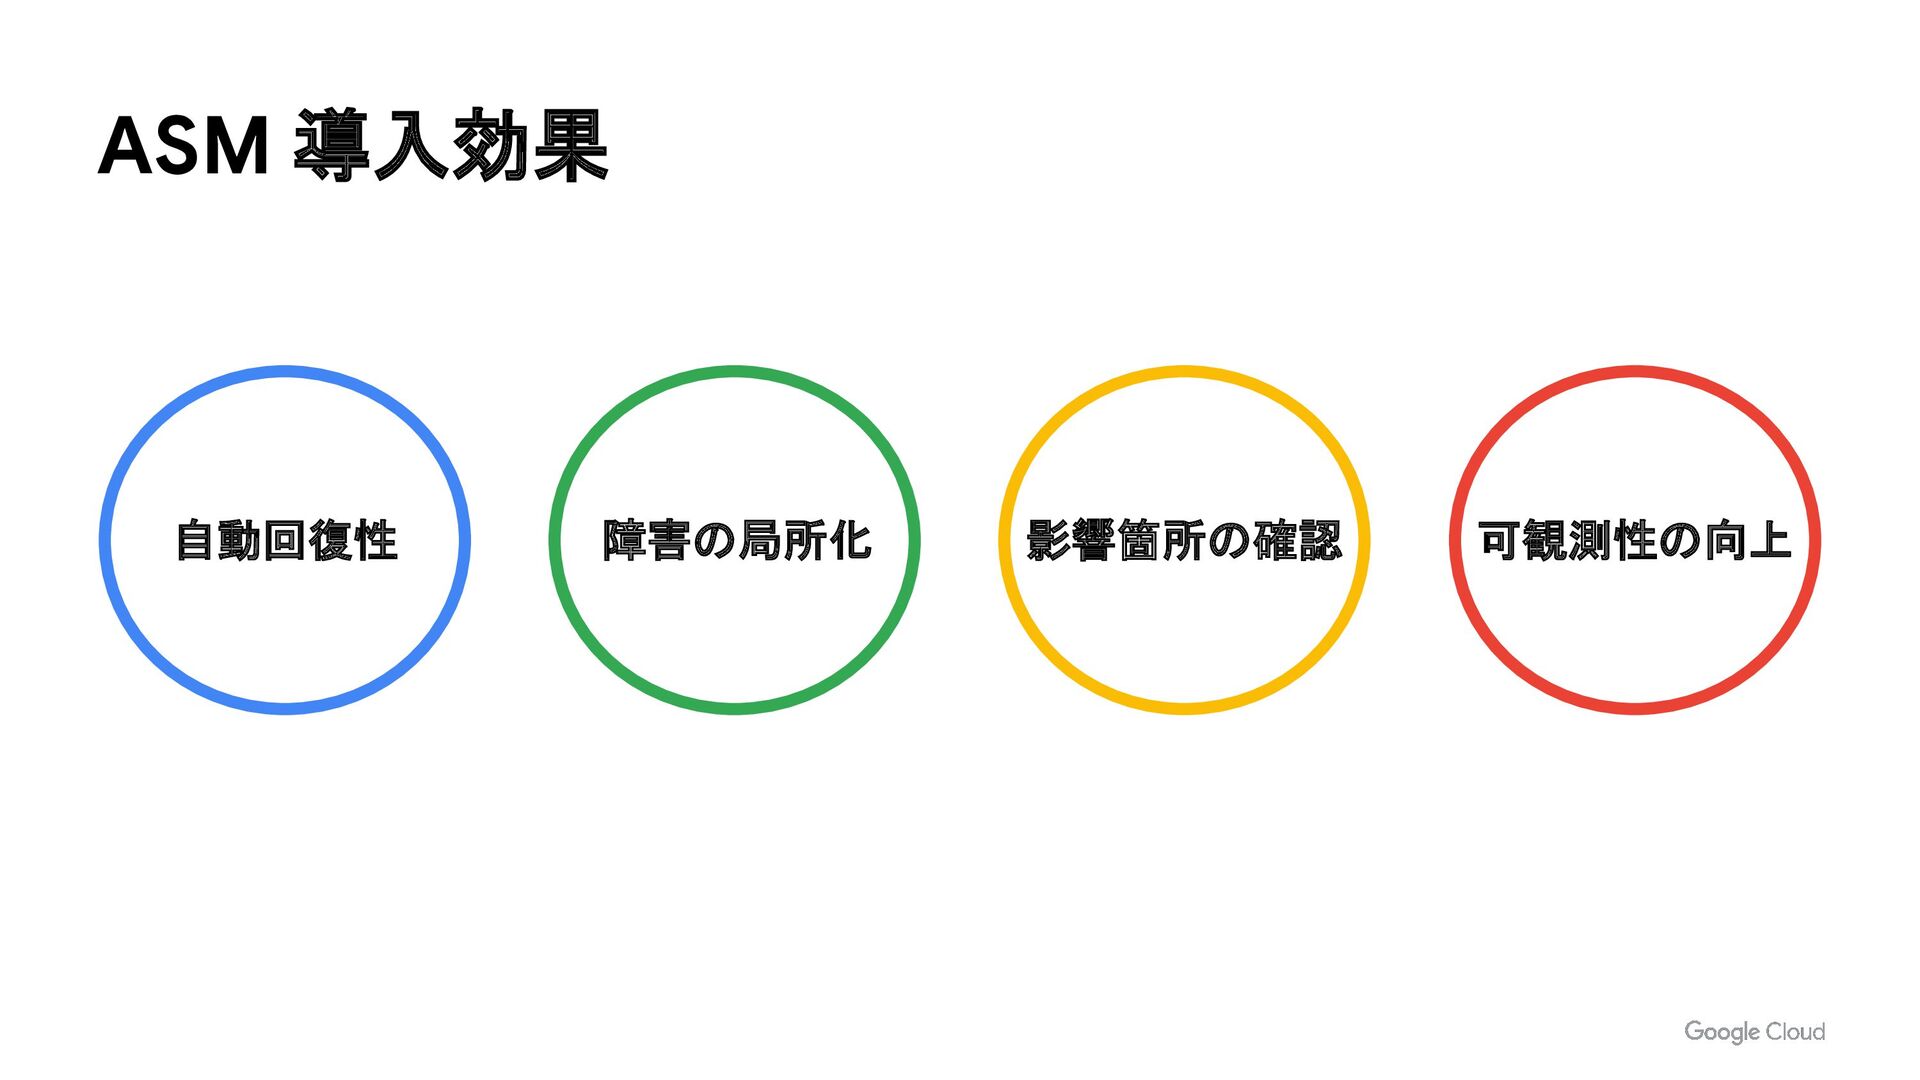
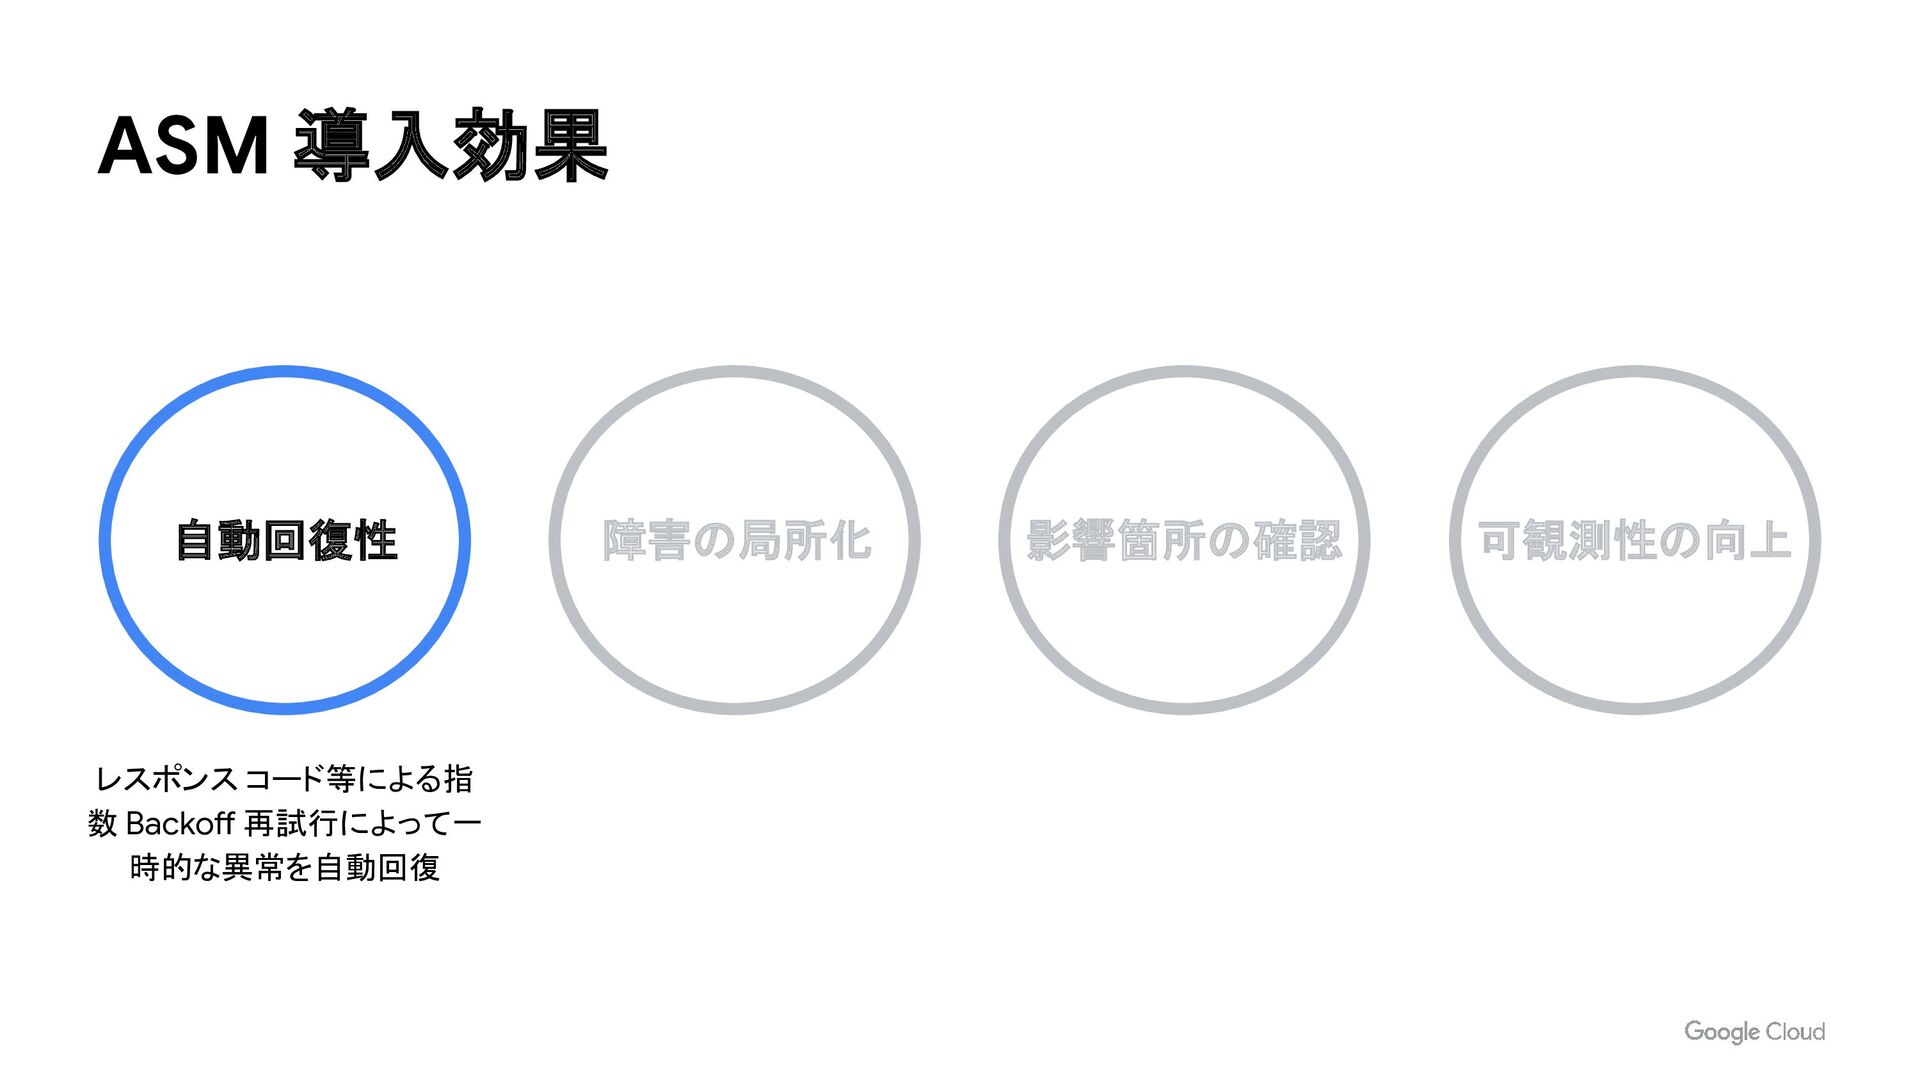
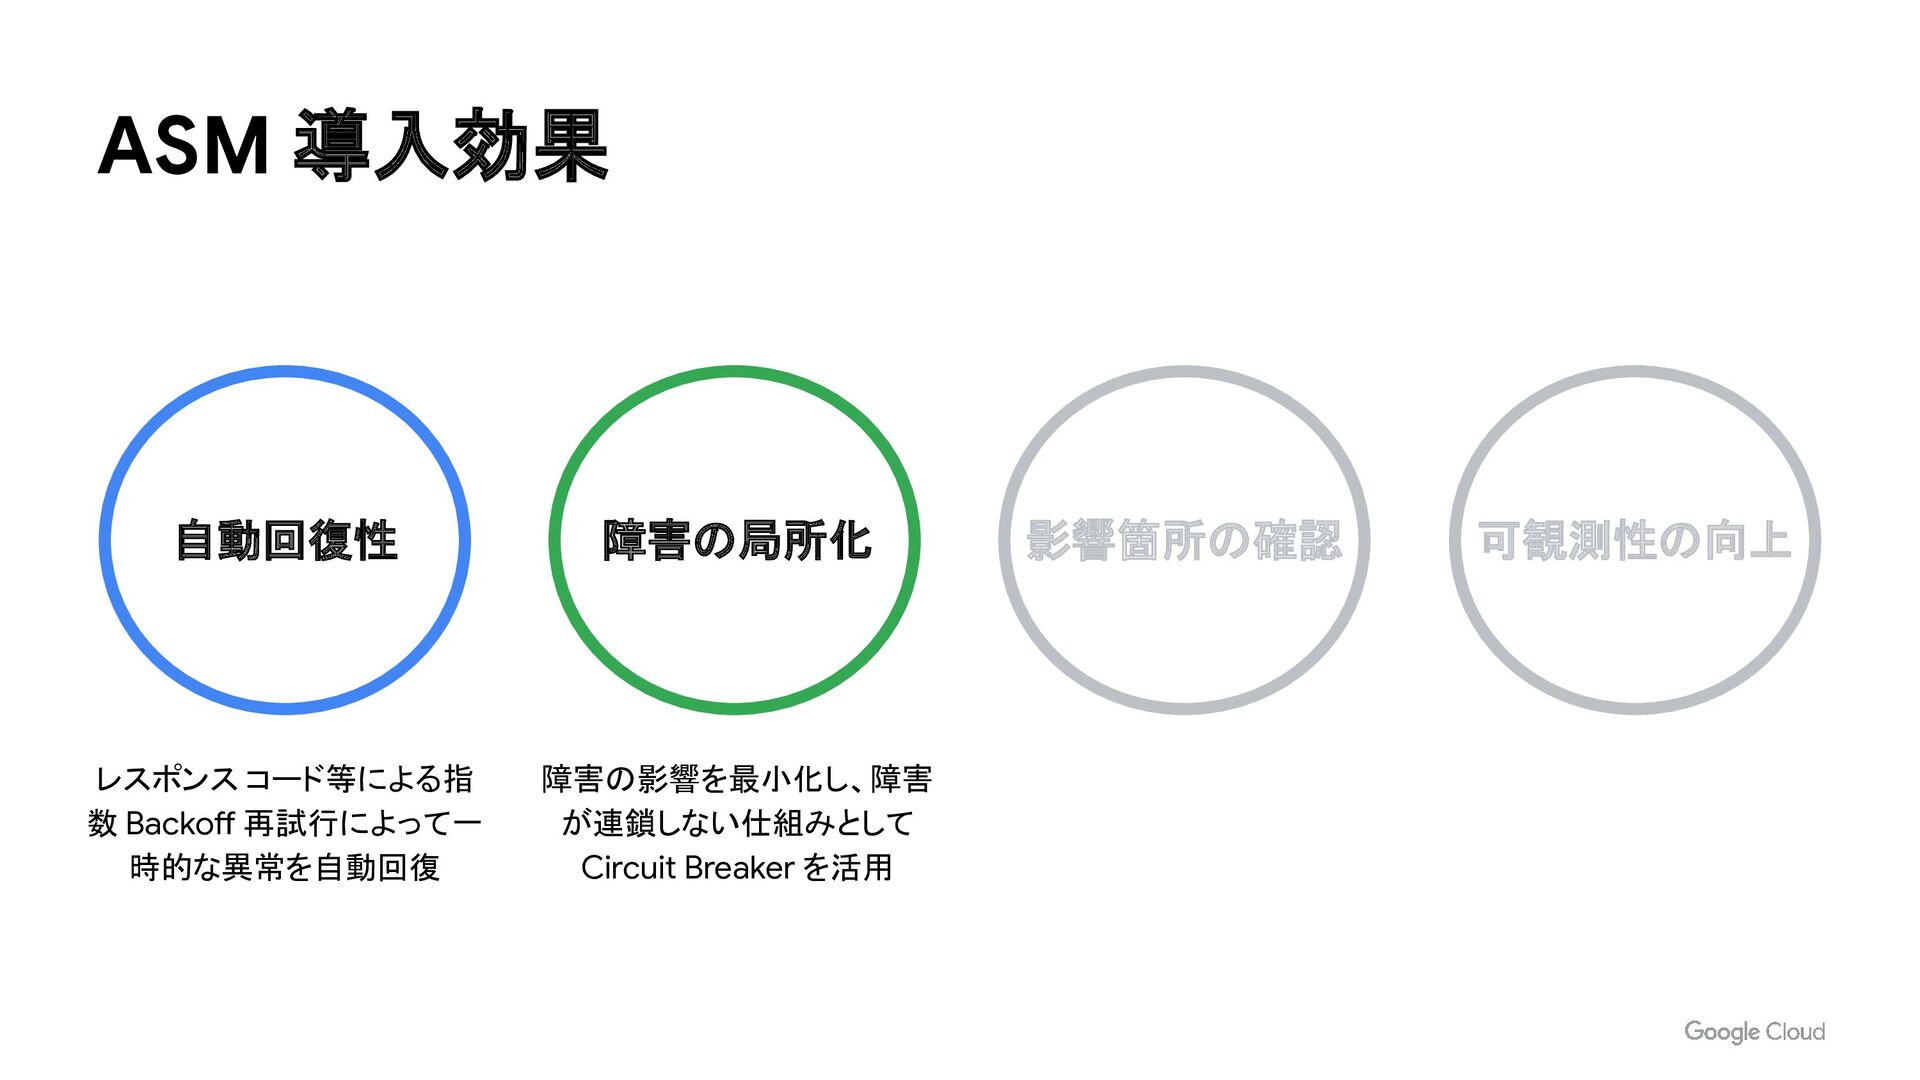
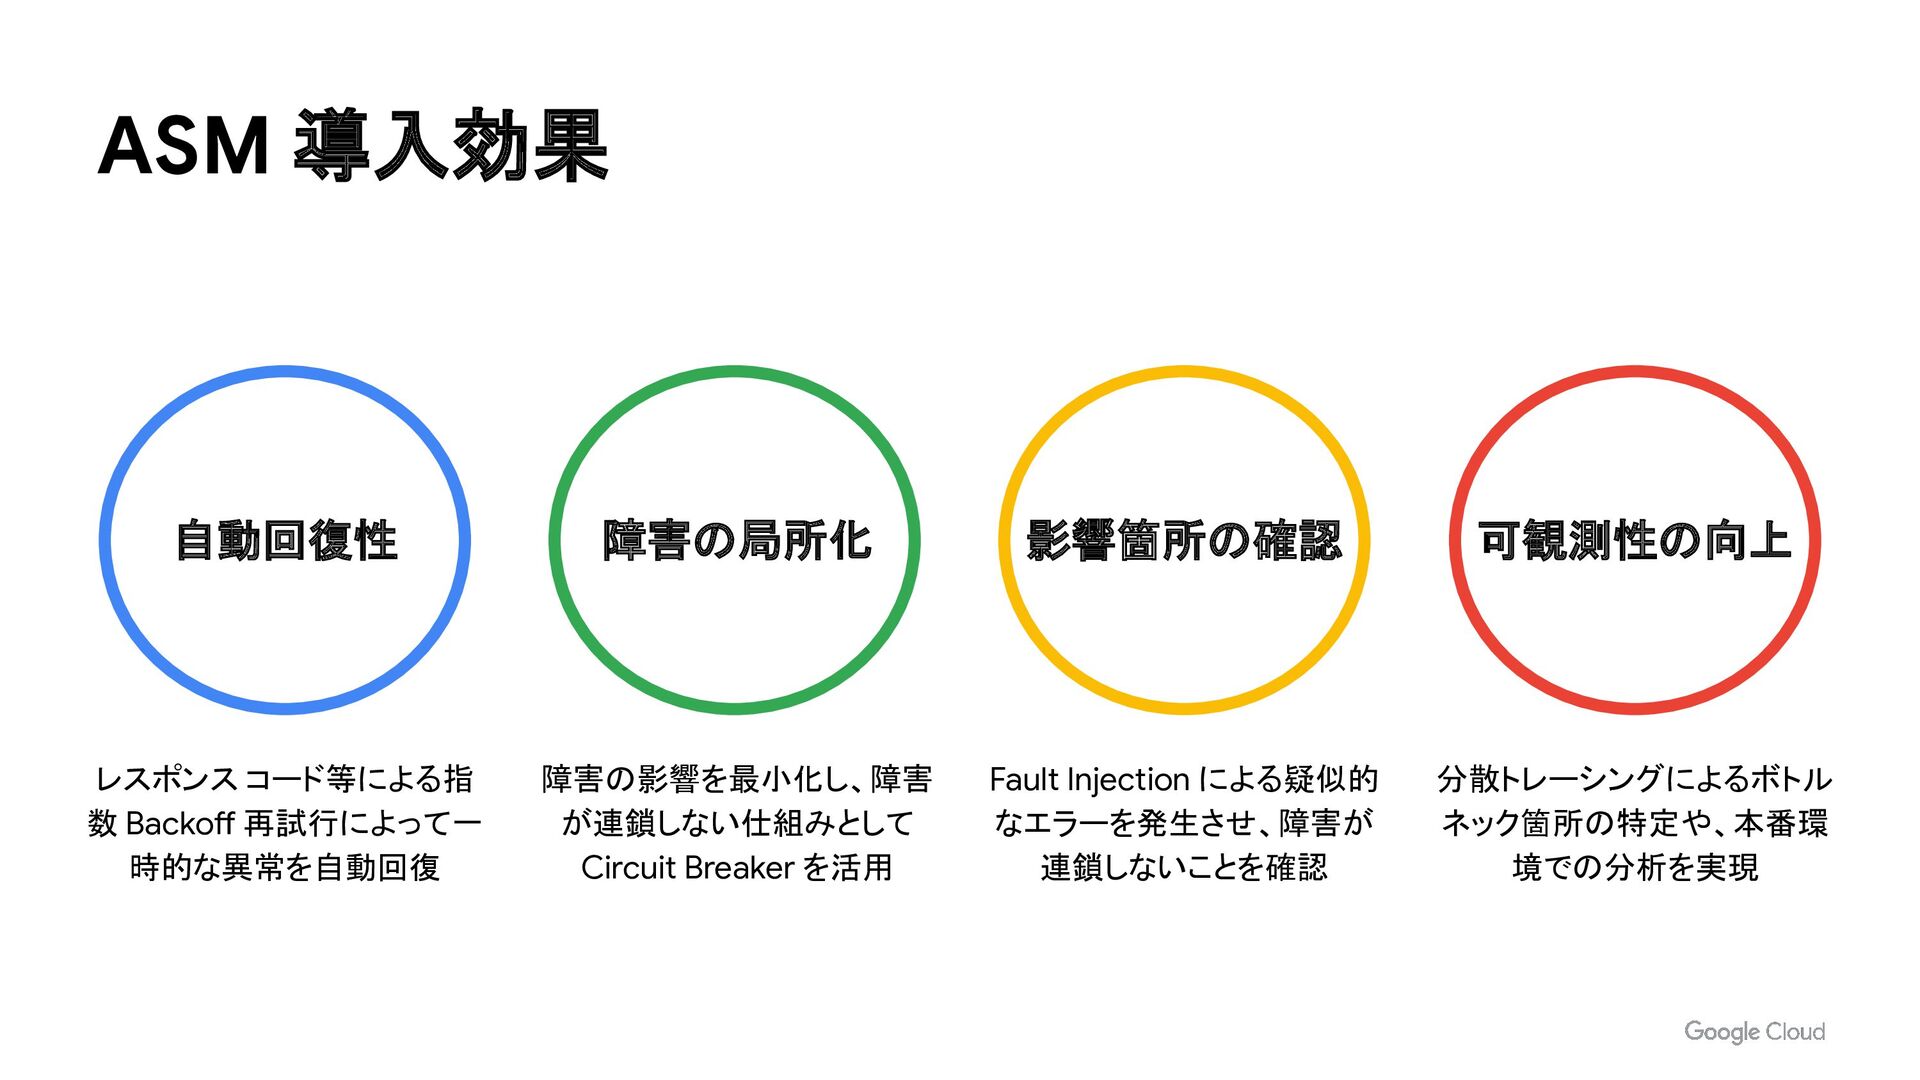
可観測性の向上 自動回復性 障害の局所化 影響箇所の確認 レスポンス コード等による指 数 Backoff 再試行によって一 時的な異常を自動回復
障害の影響を最小化し、障害 が連鎖しない仕組みとして Circuit Breaker を活用 ASM 導入効果 -
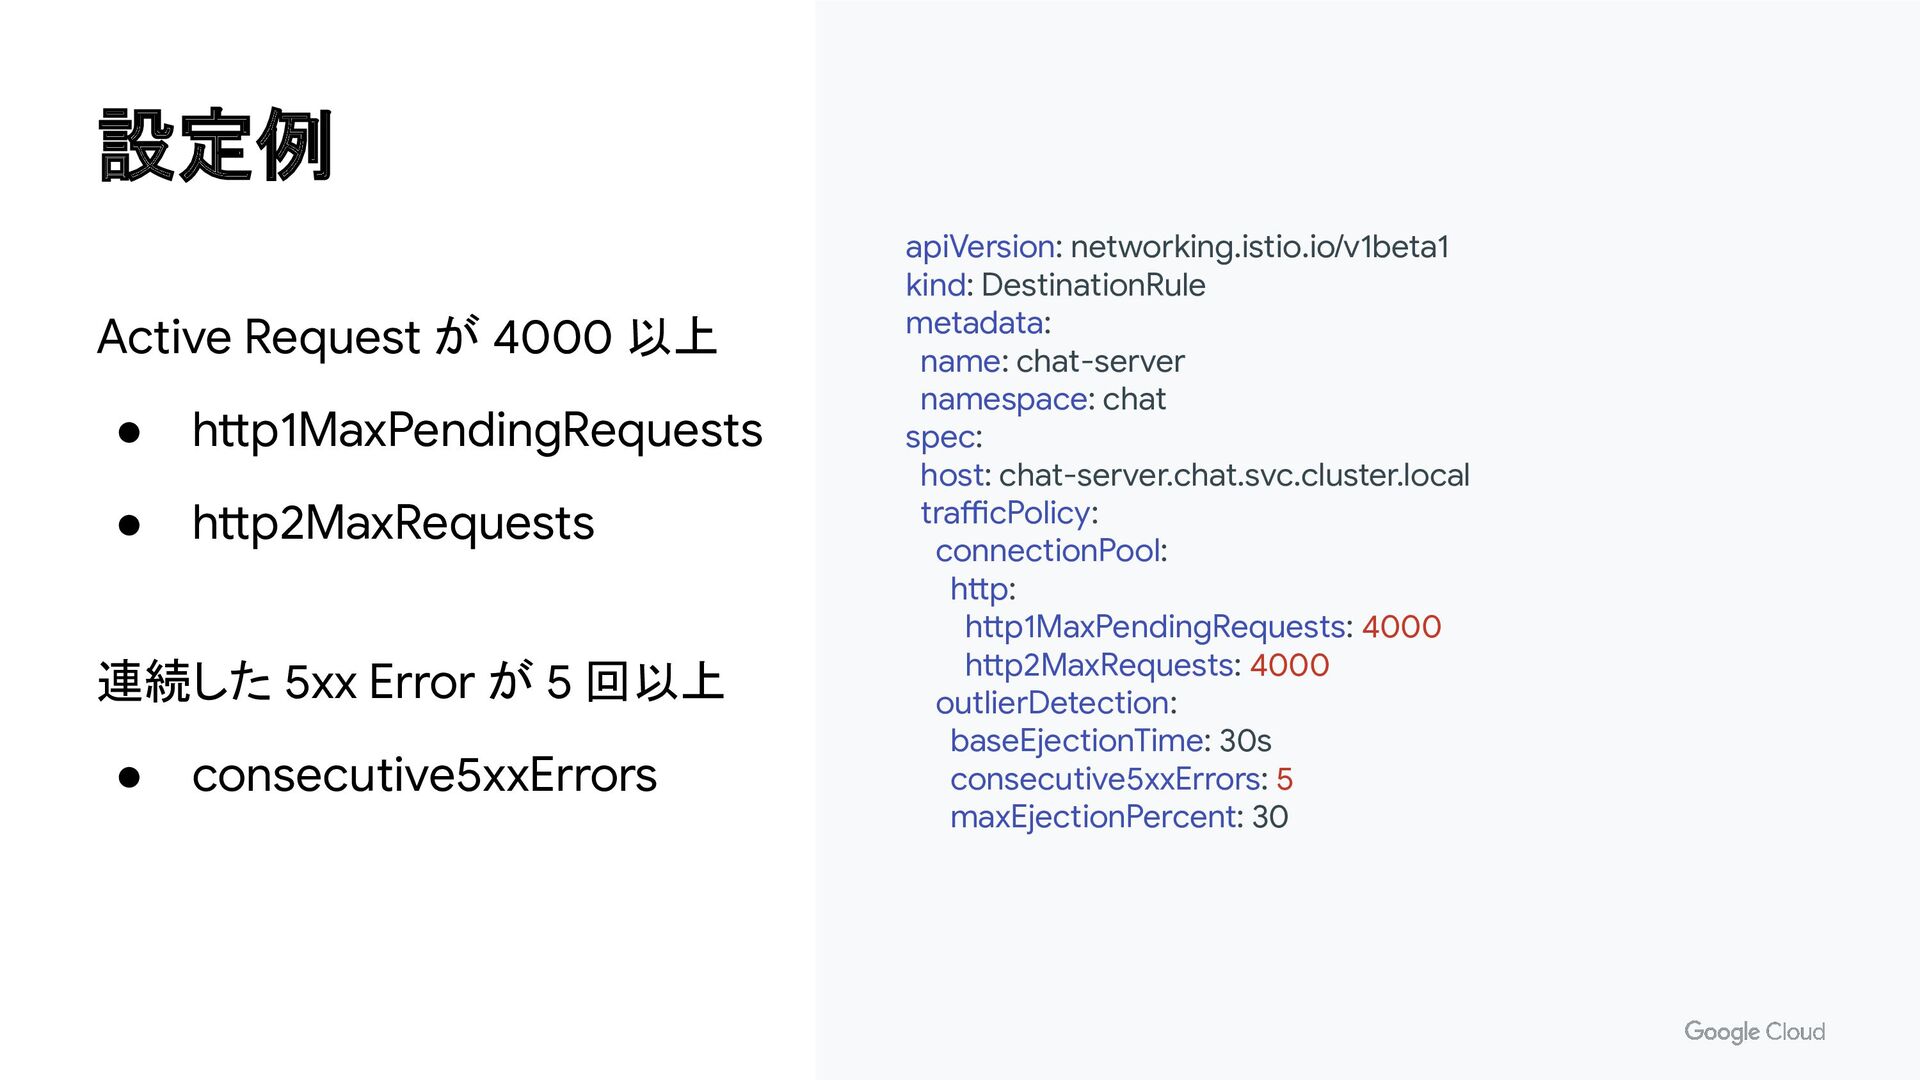
設定例 Active Request が 4000 以上 • http1MaxPendingRequests • http2MaxRequests
連続した 5xx Error が 5 回以上 • consecutive5xxErrors apiVersion: networking.istio.io/v1beta1 kind: DestinationRule metadata: name: chat-server namespace: chat spec: host: chat-server.chat.svc.cluster.local trafficPolicy: connectionPool: http: http1MaxPendingRequests: 4000 http2MaxRequests: 4000 outlierDetection: baseEjectionTime: 30s consecutive5xxErrors: 5 maxEjectionPercent: 30 -
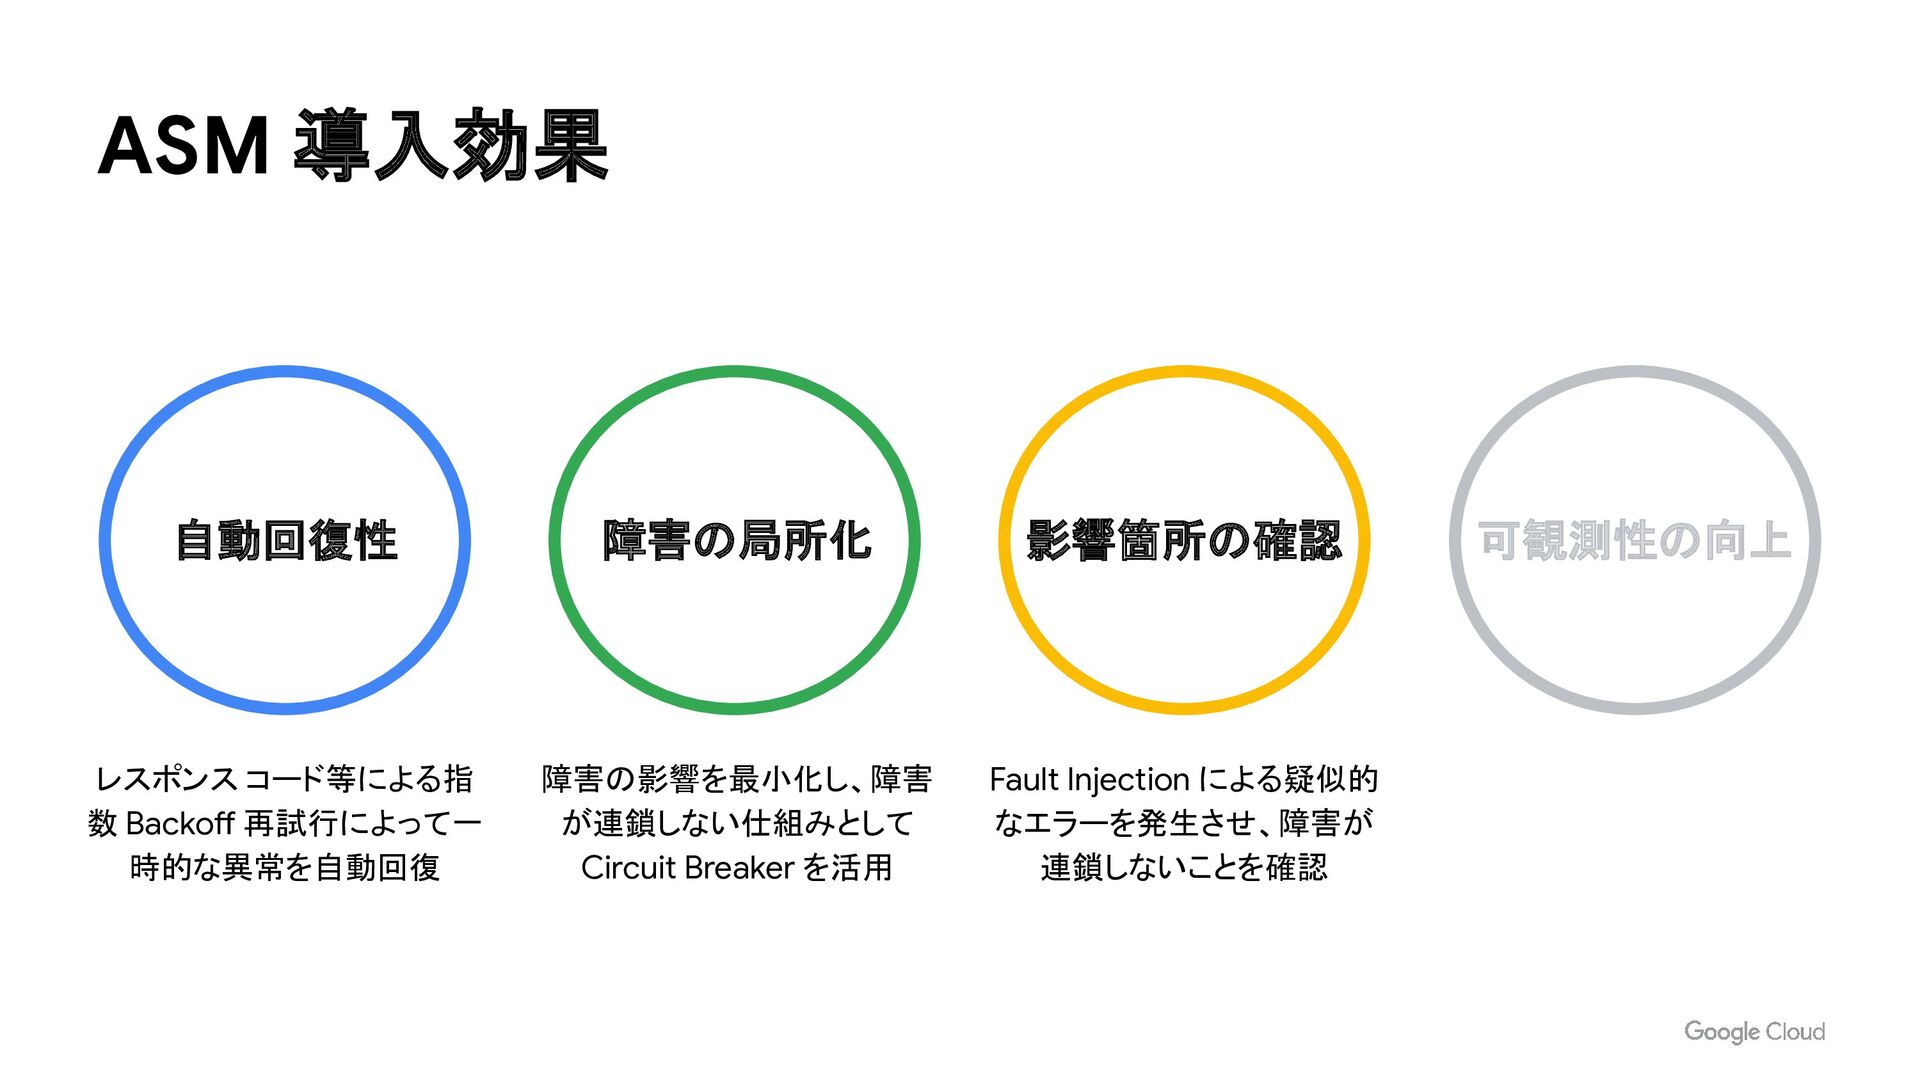
可観測性の向上 自動回復性 障害の局所化 影響箇所の確認 レスポンス コード等による指 数 Backoff 再試行によって一 時的な異常を自動回復
障害の影響を最小化し、障害 が連鎖しない仕組みとして Circuit Breaker を活用 Fault Injection による疑似的 なエラーを発生させ、障害が 連鎖しないことを確認 ASM 導入効果 -
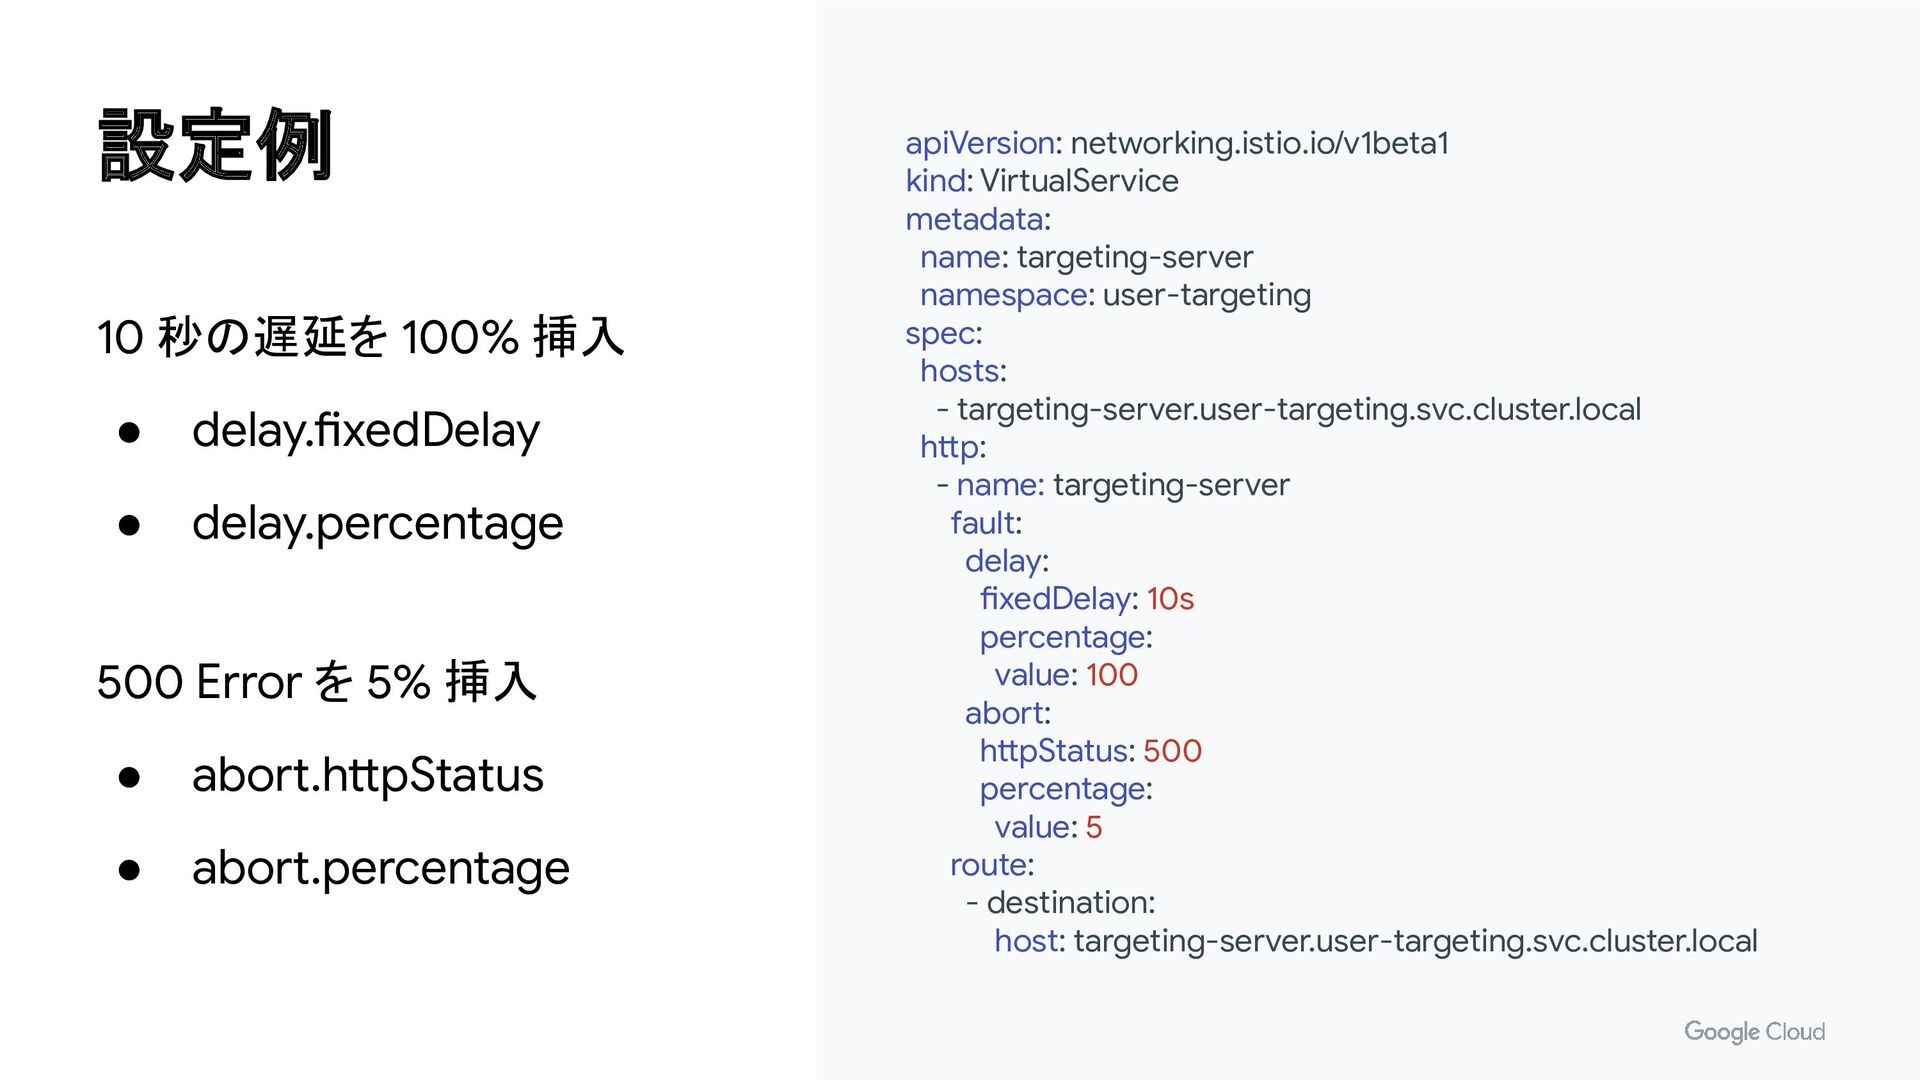
10 秒の遅延を 100% 挿入 • delay.fixedDelay • delay.percentage 500 Error
を 5% 挿入 • abort.httpStatus • abort.percentage 設定例 apiVersion: networking.istio.io/v1beta1 kind: VirtualService metadata: name: targeting-server namespace: user-targeting spec: hosts: - targeting-server.user-targeting.svc.cluster.local http: - name: targeting-server fault: delay: fixedDelay: 10s percentage: value: 100 abort: httpStatus: 500 percentage: value: 5 route: - destination: host: targeting-server.user-targeting.svc.cluster.local -
可観測性の向上 自動回復性 障害の局所化 影響箇所の確認 レスポンス コード等による指 数 Backoff 再試行によって一 時的な異常を自動回復
障害の影響を最小化し、障害 が連鎖しない仕組みとして Circuit Breaker を活用 Fault Injection による疑似的 なエラーを発生させ、障害が 連鎖しないことを確認 分散トレーシングによるボトル ネック箇所の特定や、本番環 境での分析を実現 ASM 導入効果 -
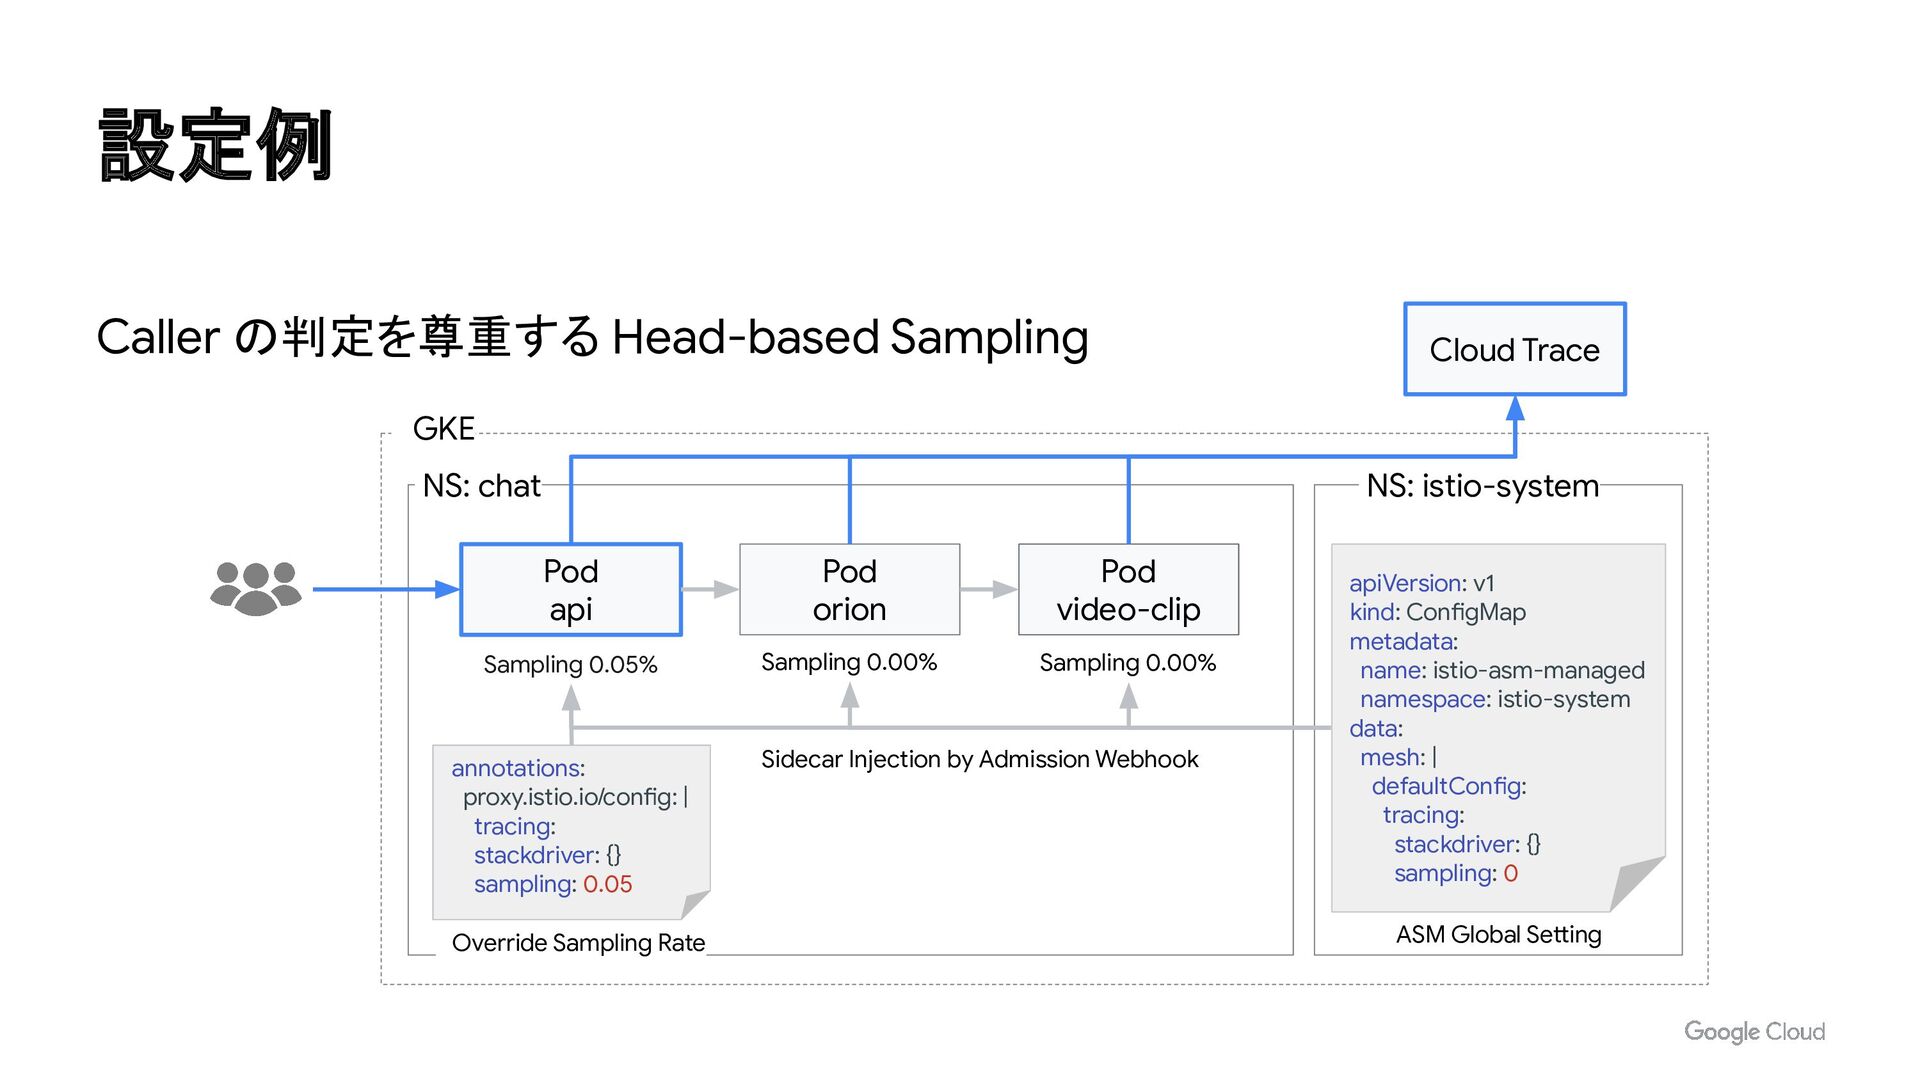
GKE 設定例 Cloud Trace NS: istio-system Pod video-clip Pod api
NS: chat Caller の判定を尊重する Head-based Sampling Pod orion apiVersion: v1 kind: ConfigMap metadata: name: istio-asm-managed namespace: istio-system data: mesh: | defaultConfig: tracing: stackdriver: {} sampling: 0 annotations: proxy.istio.io/config: | tracing: stackdriver: {} sampling: 0.05 Sampling 0.00% Sampling 0.00% Sampling 0.05% Sidecar Injection by Admission Webhook Override Sampling Rate ASM Global Setting -
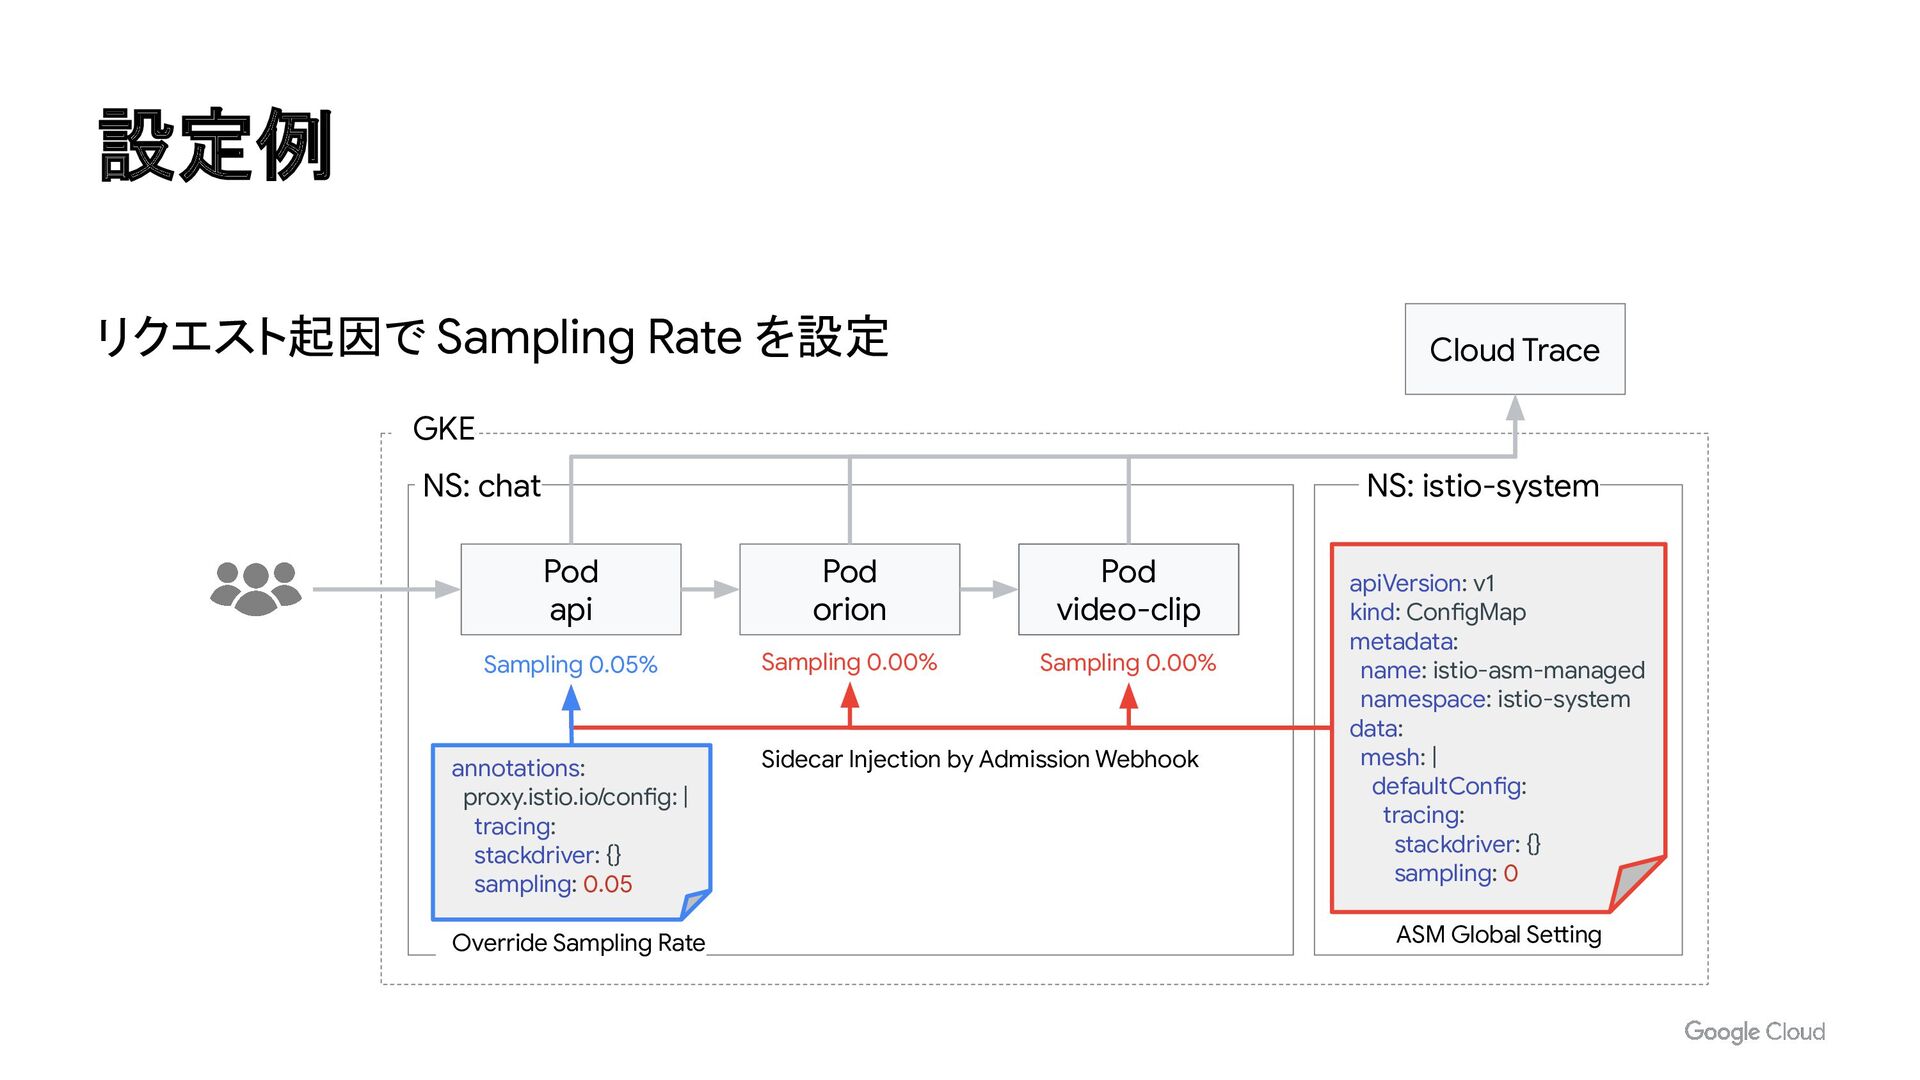
GKE 設定例 Cloud Trace NS: istio-system Pod video-clip Pod api
NS: chat リクエスト起因で Sampling Rate を設定 Pod orion apiVersion: v1 kind: ConfigMap metadata: name: istio-asm-managed namespace: istio-system data: mesh: | defaultConfig: tracing: stackdriver: {} sampling: 0 annotations: proxy.istio.io/config: | tracing: stackdriver: {} sampling: 0.05 Sampling 0.00% Sampling 0.00% Sampling 0.05% Sidecar Injection by Admission Webhook Override Sampling Rate ASM Global Setting -
大規模イベントの実現に向けて • Cloud Architecture の構成変更 • Multi Region による Capacity
確保とストックアウト対策 • 負荷に応じた GKE と GKE Workload のスケール戦略 • Anthos Service Mesh の恩恵を最大限に享受 まとめ -
技術的チャレンジ • Region 障害への耐久性 • Tail-based Sampling による分散トレーシング Google Cloud
をうまく活用した社会インフラの実現 • ユーザー体験の向上や本質的なビジネスに集中できるプラットフォーム 今後の展望