Share
Embed
Transcript
61 slides
-
2 専門: 生成モデル 実世界応用 [HP] • 最近 グラフィックデザインに注力 経歴: •
2021/4 - 現在: 研究員@CyberAgent AILab ◦ 8割研究 (主著 + 博士インターン/共同研究/他研究員と 共著) ◦ 2割そ 他 (プロダクトチームと 技術相談, PoC協力,実装提供,執筆 ...) • - 2021/3: B/M/D 山﨑研@東大 ◦ B&M: 物体検出&ドメイン適応,代表作 [Inoue+, CVPR’18] 600+引用 ◦ D: 画像生成 (線画・影など), Adobe Researchで 研究インターン経験 自己紹介 本日 スライド -
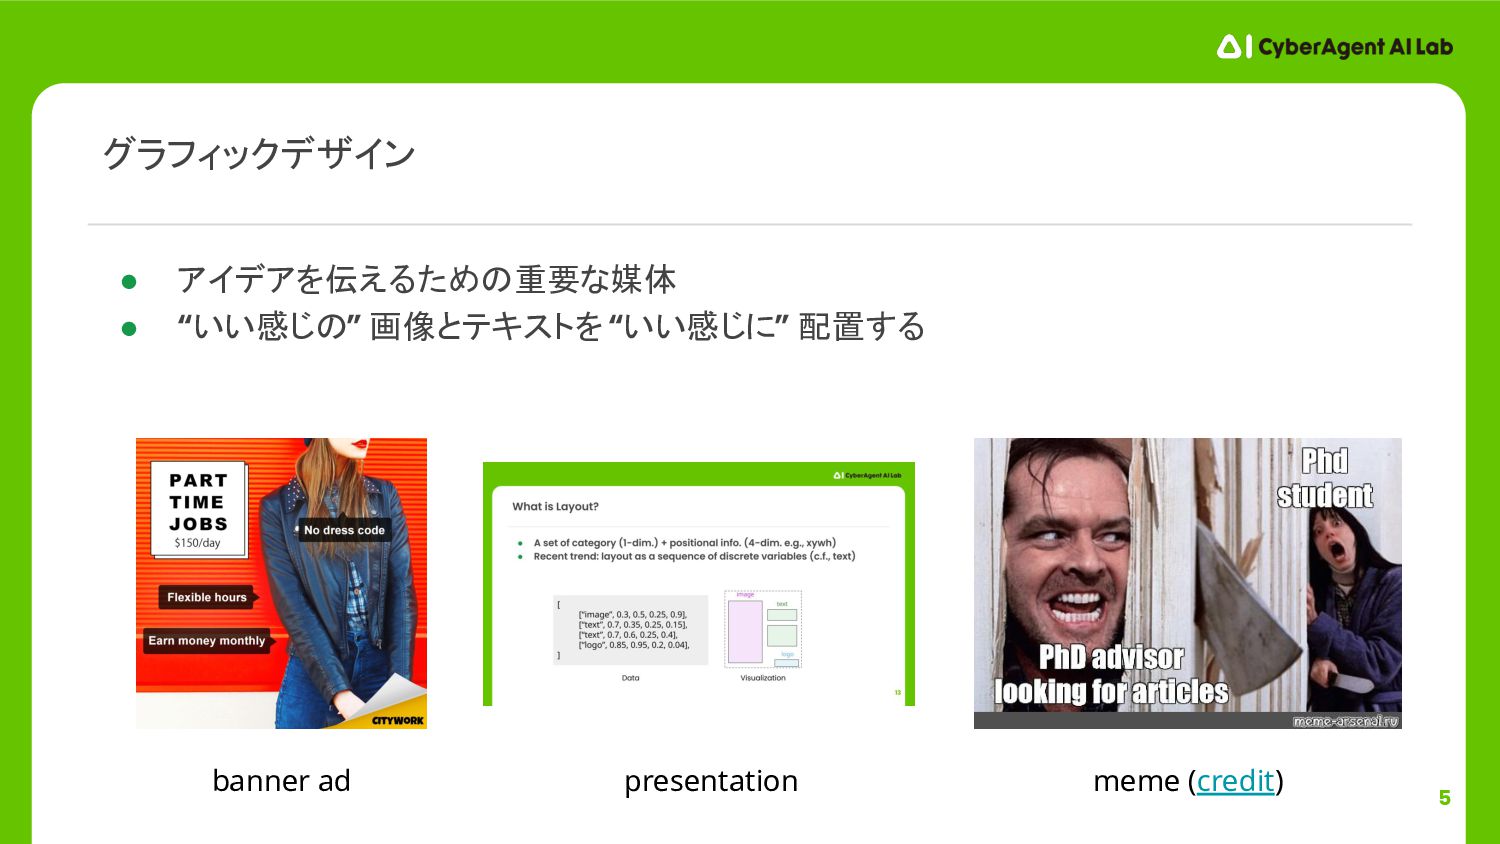
5 • アイデアを伝えるため 重要な媒体 • “いい感じ ” 画像とテキストを “いい感じに” 配置する
グラフィックデザイン banner ad presentation meme (credit) -
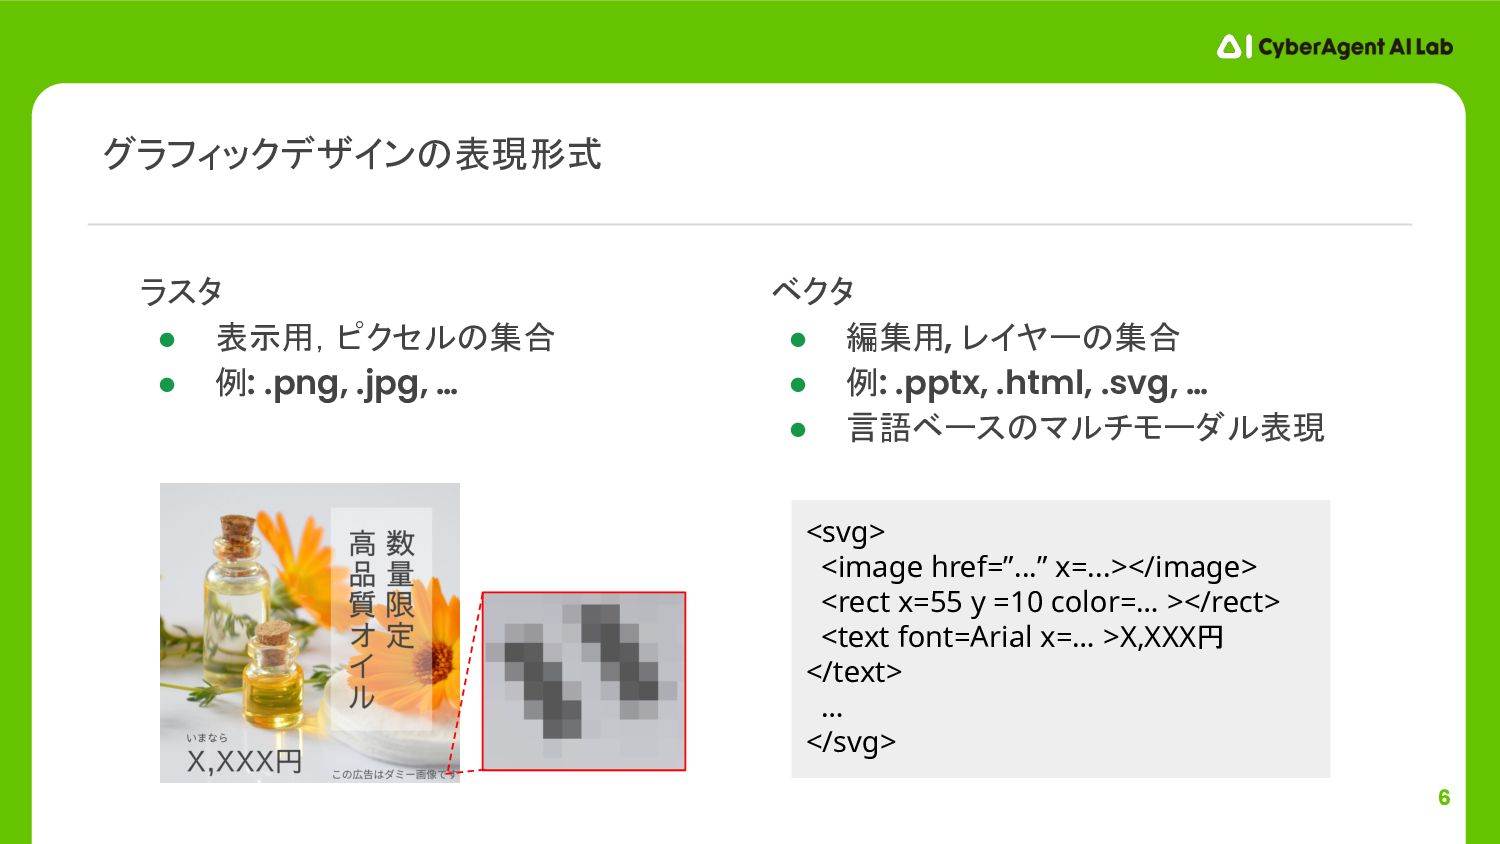
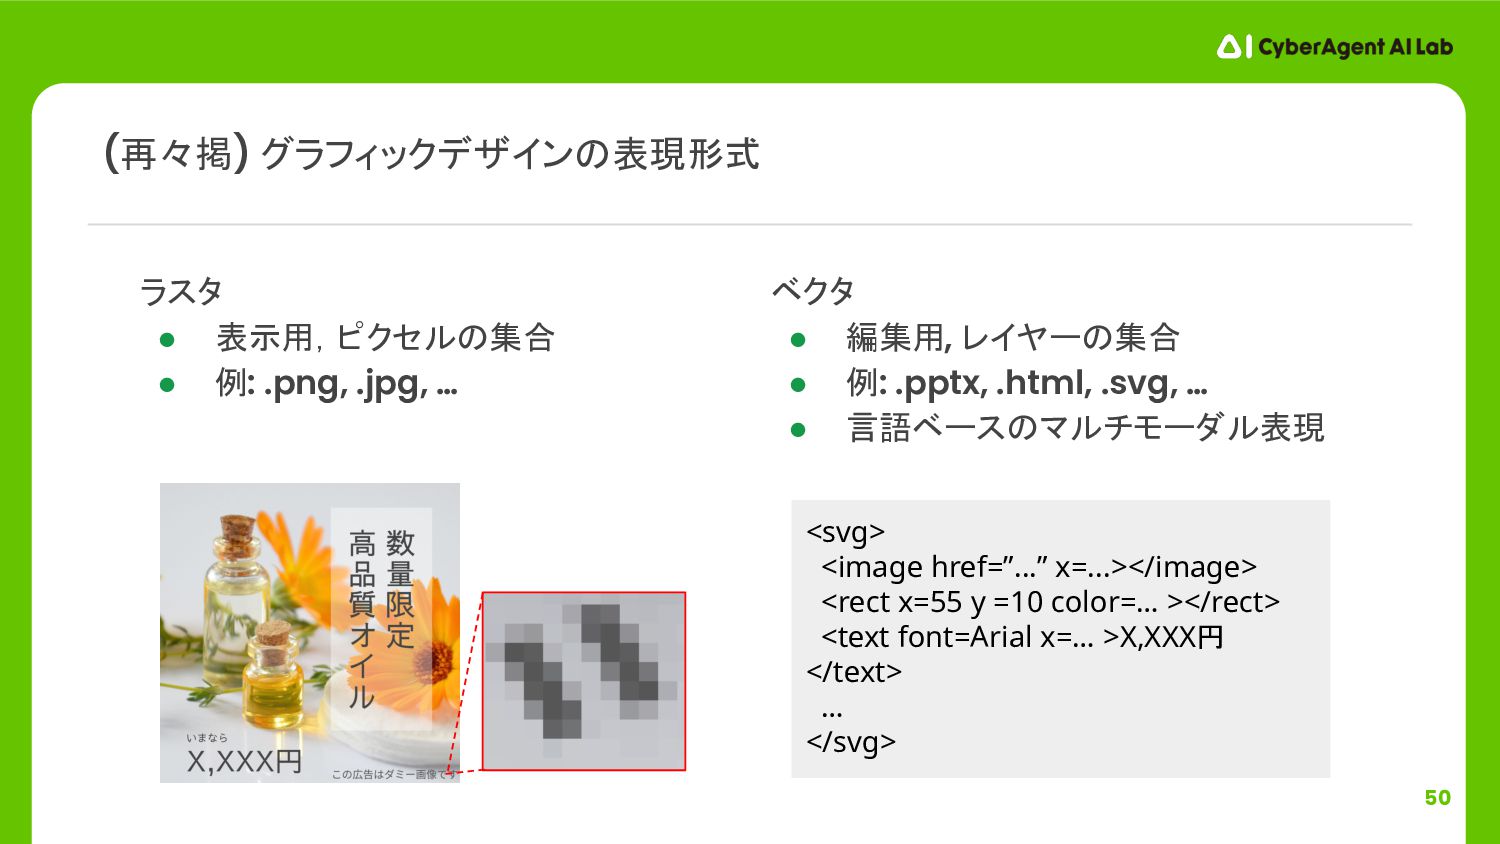
6 グラフィックデザイン 表現形式 <svg> <image href=”...” x=...></image> <rect x=55 y
=10 color=… ></rect> <text font=Arial x=… >X,XXX円 </text> … </svg> ラスタ • 表示用,ピクセル 集合 • 例: .png, .jpg, … ベクタ • 編集用, レイヤー 集合 • 例: .pptx, .html, .svg, … • 言語ベース マルチモーダル表現 -
7 データ 表現方法とそれに合わせた生成モデル 確立 • レイヤ • 画像・文章から細かなスタイリング情報まで多様な情報 多様な評価軸 (“いい感じ”を科学的に分解する)
• 尤度・読みやすさ・おしゃれさ・斬新さ ... 多彩なアプリケーション: Webページ・バナー・スライド・グラフ... 学術的ポテンシャル -
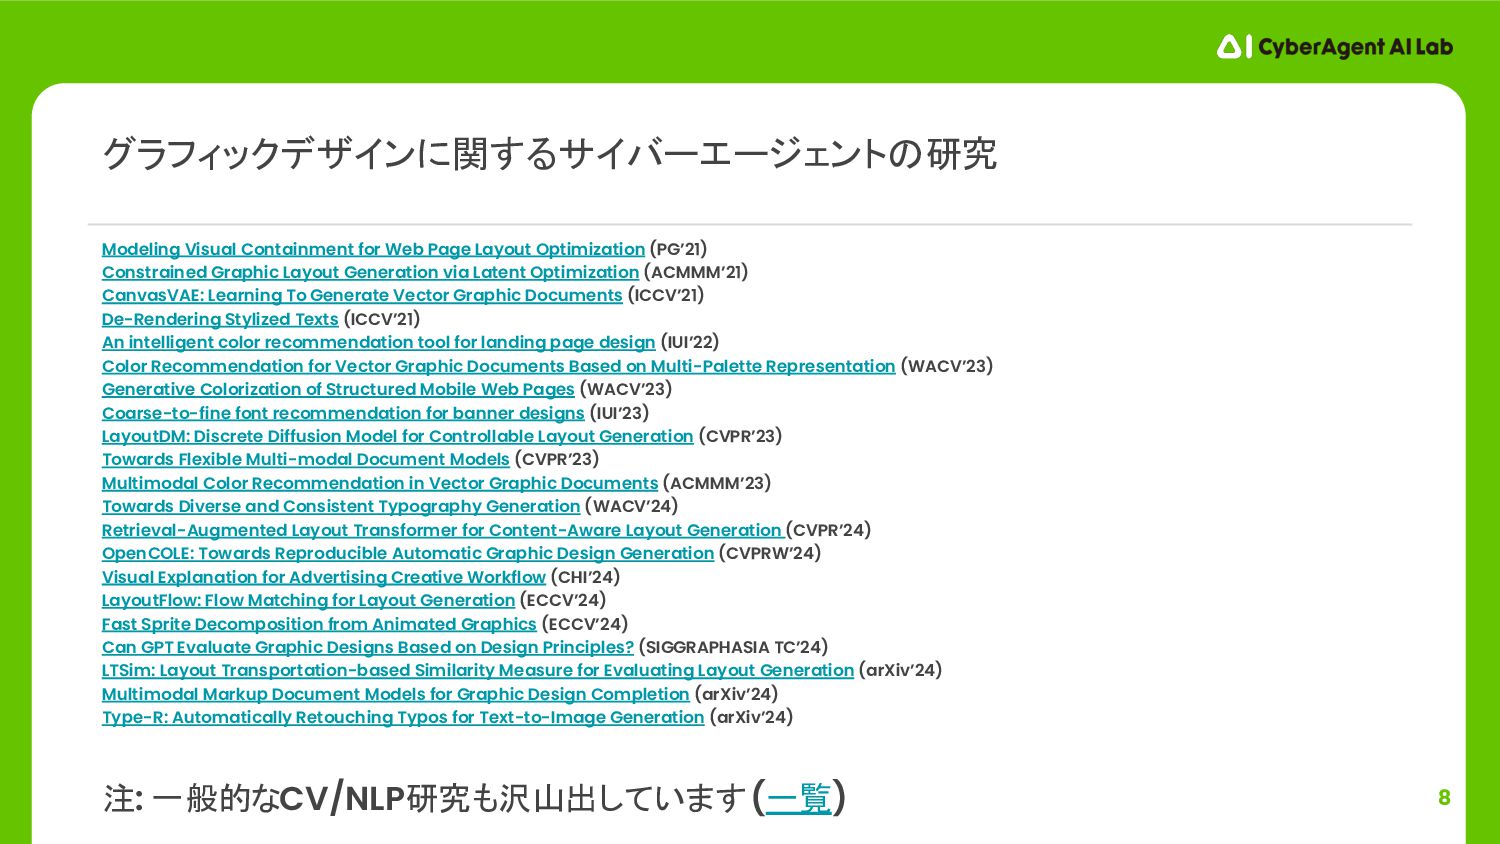
8 グラフィックデザインに関するサイバーエージェント 研究 注: 一般的なCV/NLP研究も沢山出しています (一覧) Modeling Visual Containment for
Web Page Layout Optimization (PG’21) Constrained Graphic Layout Generation via Latent Optimization (ACMMM’21) CanvasVAE: Learning To Generate Vector Graphic Documents (ICCV’21) De-Rendering Stylized Texts (ICCV’21) An intelligent color recommendation tool for landing page design (IUI’22) Color Recommendation for Vector Graphic Documents Based on Multi-Palette Representation (WACV’23) Generative Colorization of Structured Mobile Web Pages (WACV’23) Coarse-to-fine font recommendation for banner designs (IUI’23) LayoutDM: Discrete Diffusion Model for Controllable Layout Generation (CVPR’23) Towards Flexible Multi-modal Document Models (CVPR’23) Multimodal Color Recommendation in Vector Graphic Documents (ACMMM’23) Towards Diverse and Consistent Typography Generation (WACV’24) Retrieval-Augmented Layout Transformer for Content-Aware Layout Generation (CVPR’24) OpenCOLE: Towards Reproducible Automatic Graphic Design Generation (CVPRW’24) Visual Explanation for Advertising Creative Workflow (CHI’24) LayoutFlow: Flow Matching for Layout Generation (ECCV’24) Fast Sprite Decomposition from Animated Graphics (ECCV’24) Can GPT Evaluate Graphic Designs Based on Design Principles? (SIGGRAPHASIA TC’24) LTSim: Layout Transportation-based Similarity Measure for Evaluating Layout Generation (arXiv’24) Multimodal Markup Document Models for Graphic Design Completion (arXiv’24) Type-R: Automatically Retouching Typos for Text-to-Image Generation (arXiv’24) -
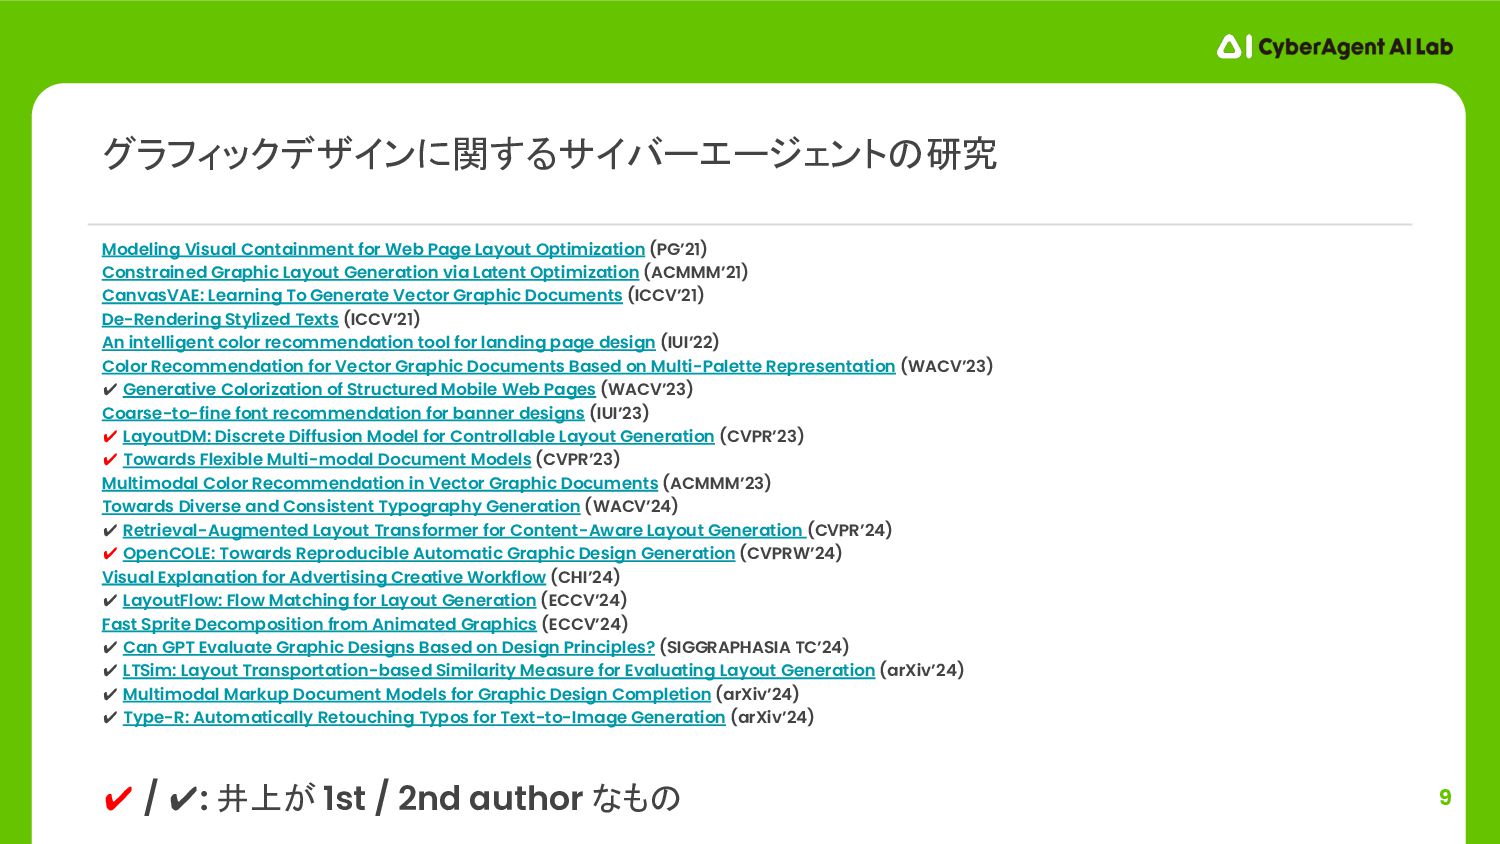
9 グラフィックデザインに関するサイバーエージェント 研究 ✔ / ✔: 井上が 1st / 2nd
author なも Modeling Visual Containment for Web Page Layout Optimization (PG’21) Constrained Graphic Layout Generation via Latent Optimization (ACMMM’21) CanvasVAE: Learning To Generate Vector Graphic Documents (ICCV’21) De-Rendering Stylized Texts (ICCV’21) An intelligent color recommendation tool for landing page design (IUI’22) Color Recommendation for Vector Graphic Documents Based on Multi-Palette Representation (WACV’23) ✔ Generative Colorization of Structured Mobile Web Pages (WACV’23) Coarse-to-fine font recommendation for banner designs (IUI’23) ✔ LayoutDM: Discrete Diffusion Model for Controllable Layout Generation (CVPR’23) ✔ Towards Flexible Multi-modal Document Models (CVPR’23) Multimodal Color Recommendation in Vector Graphic Documents (ACMMM’23) Towards Diverse and Consistent Typography Generation (WACV’24) ✔ Retrieval-Augmented Layout Transformer for Content-Aware Layout Generation (CVPR’24) ✔ OpenCOLE: Towards Reproducible Automatic Graphic Design Generation (CVPRW’24) Visual Explanation for Advertising Creative Workflow (CHI’24) ✔ LayoutFlow: Flow Matching for Layout Generation (ECCV’24) Fast Sprite Decomposition from Animated Graphics (ECCV’24) ✔ Can GPT Evaluate Graphic Designs Based on Design Principles? (SIGGRAPHASIA TC’24) ✔ LTSim: Layout Transportation-based Similarity Measure for Evaluating Layout Generation (arXiv’24) ✔ Multimodal Markup Document Models for Graphic Design Completion (arXiv’24) ✔ Type-R: Automatically Retouching Typos for Text-to-Image Generation (arXiv’24) -
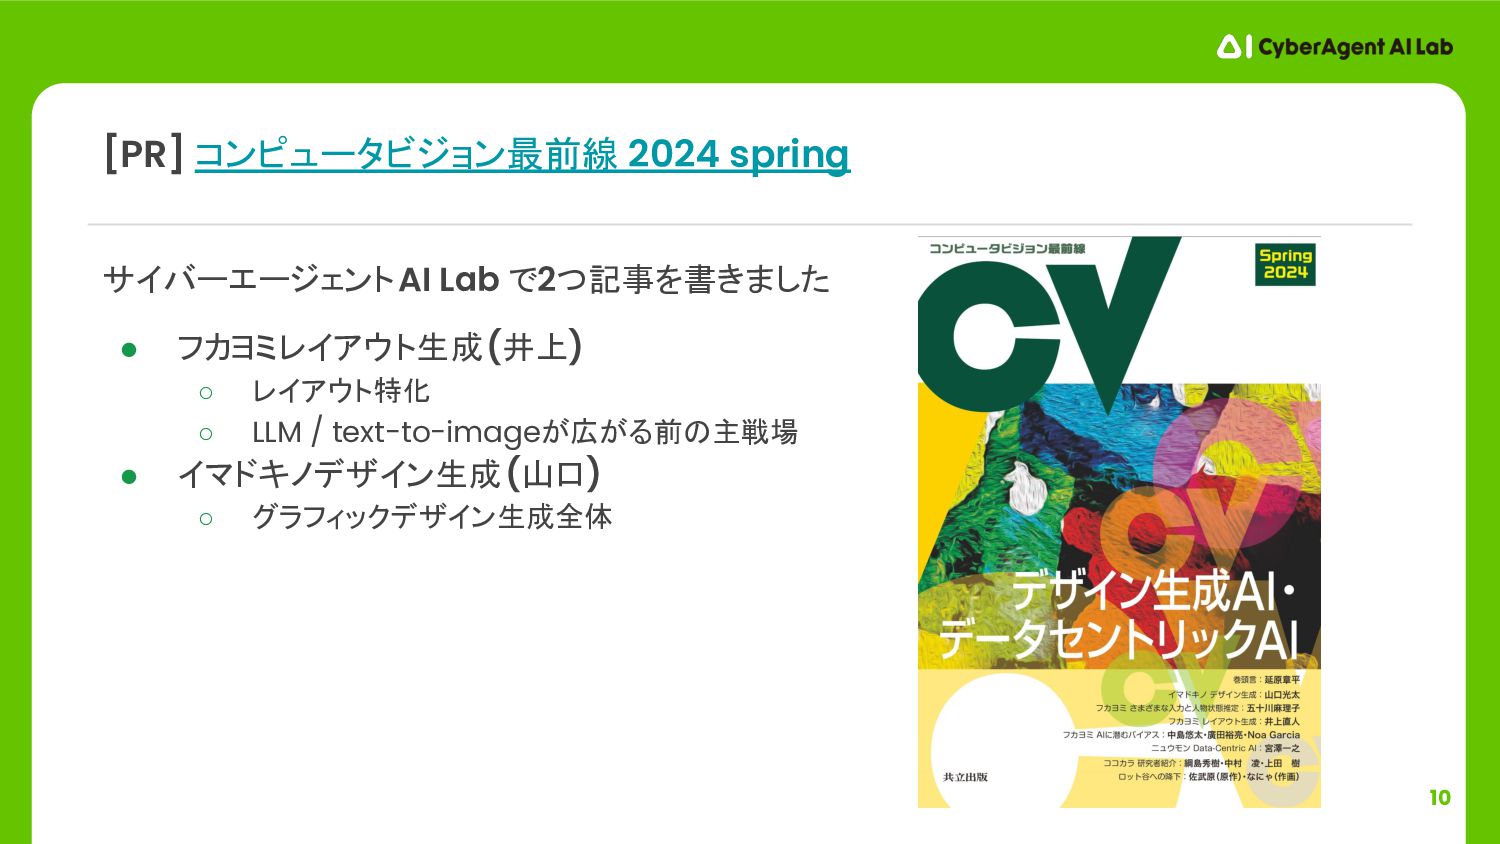
10 サイバーエージェント AI Lab で2つ記事を書きました • フカヨミレイアウト生成 (井上) ◦ レイアウト特化
◦ LLM / text-to-imageが広がる前 主戦場 • イマドキノデザイン生成 (山口) ◦ グラフィックデザイン生成全体 [PR] コンピュータビジョン最前線 2024 spring -
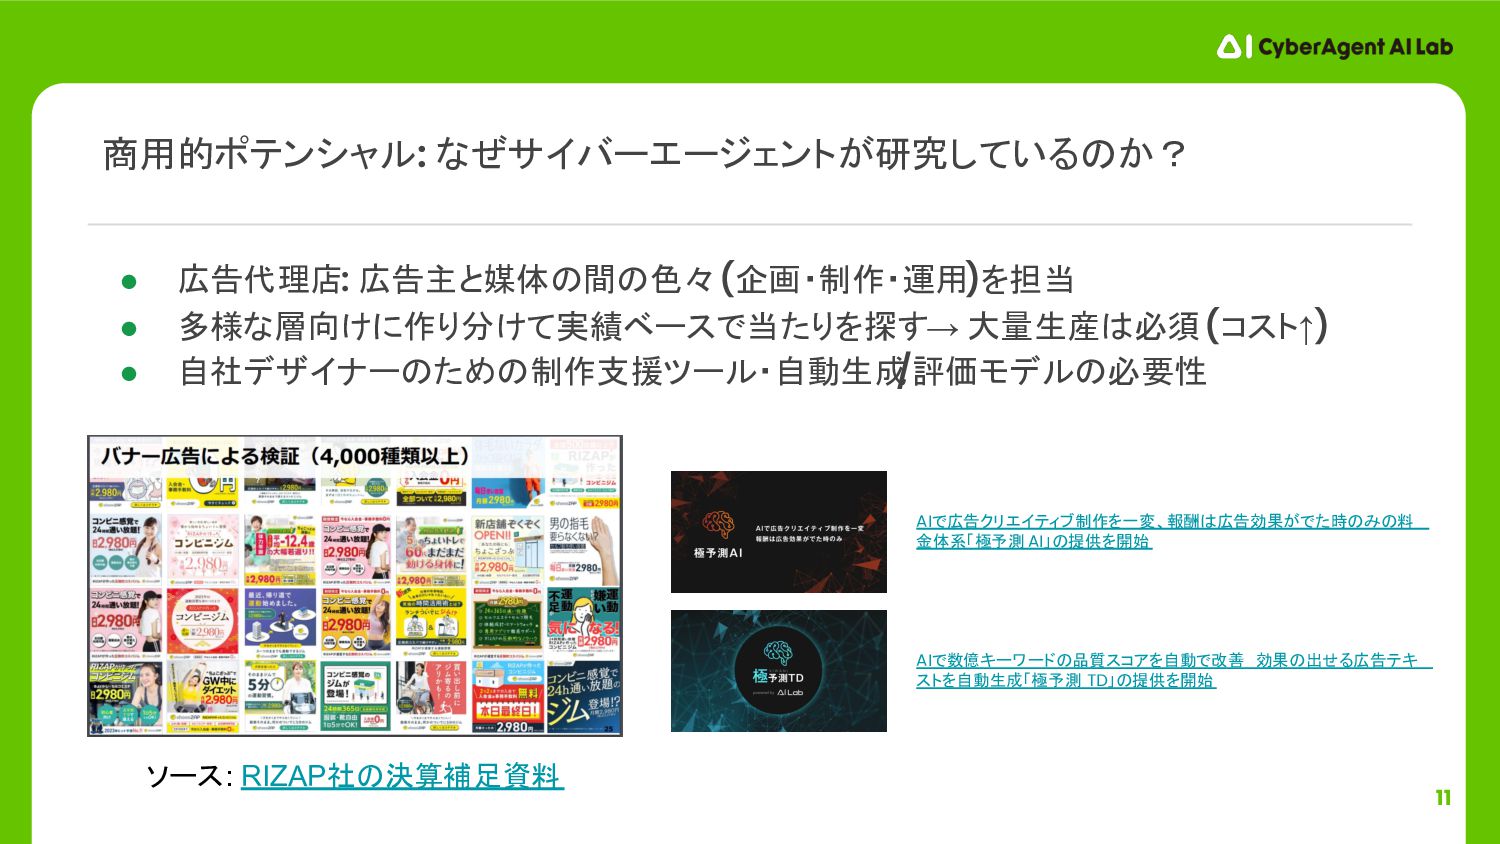
11 • 広告代理店: 広告主と媒体 間 色々 (企画・制作・運用)を担当 • 多様な層向けに作り分けて実績ベースで当たりを探す →
大量生産 必須 (コスト↑) • 自社デザイナー ため 制作支援ツール・自動生成 /評価モデル 必要性 商用的ポテンシャル: なぜサイバーエージェントが研究している か? ソース: RIZAP社 決算補足資料 AIで広告クリエイティブ制作を一変、報酬 広告効果がでた時 み 料 金体系「極予測 AI」 提供を開始 AIで数億キーワード 品質スコアを自動で改善 効果 出せる広告テキ ストを自動生成「極予測 TD」 提供を開始 -
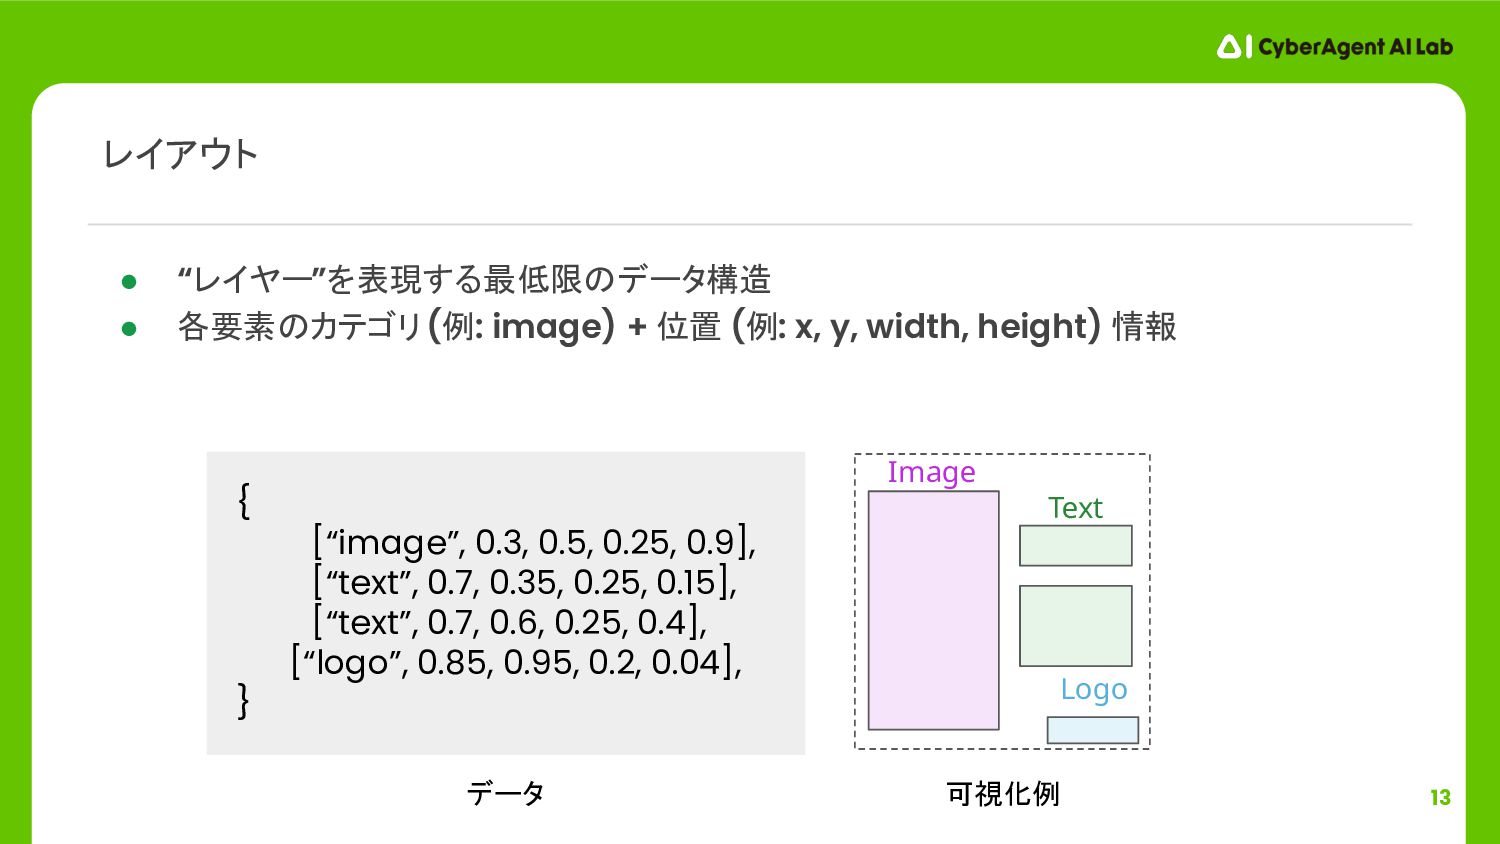
13 レイアウト • “レイヤー”を表現する最低限 データ構 • 各要素 カテゴリ (例: image)
+ 位置 (例: x, y, width, height) 情報 { [“image”, 0.3, 0.5, 0.25, 0.9], [“text”, 0.7, 0.35, 0.25, 0.15], [“text”, 0.7, 0.6, 0.25, 0.4], [“logo”, 0.85, 0.95, 0.2, 0.04], } データ 可視化例 Image Text Logo -
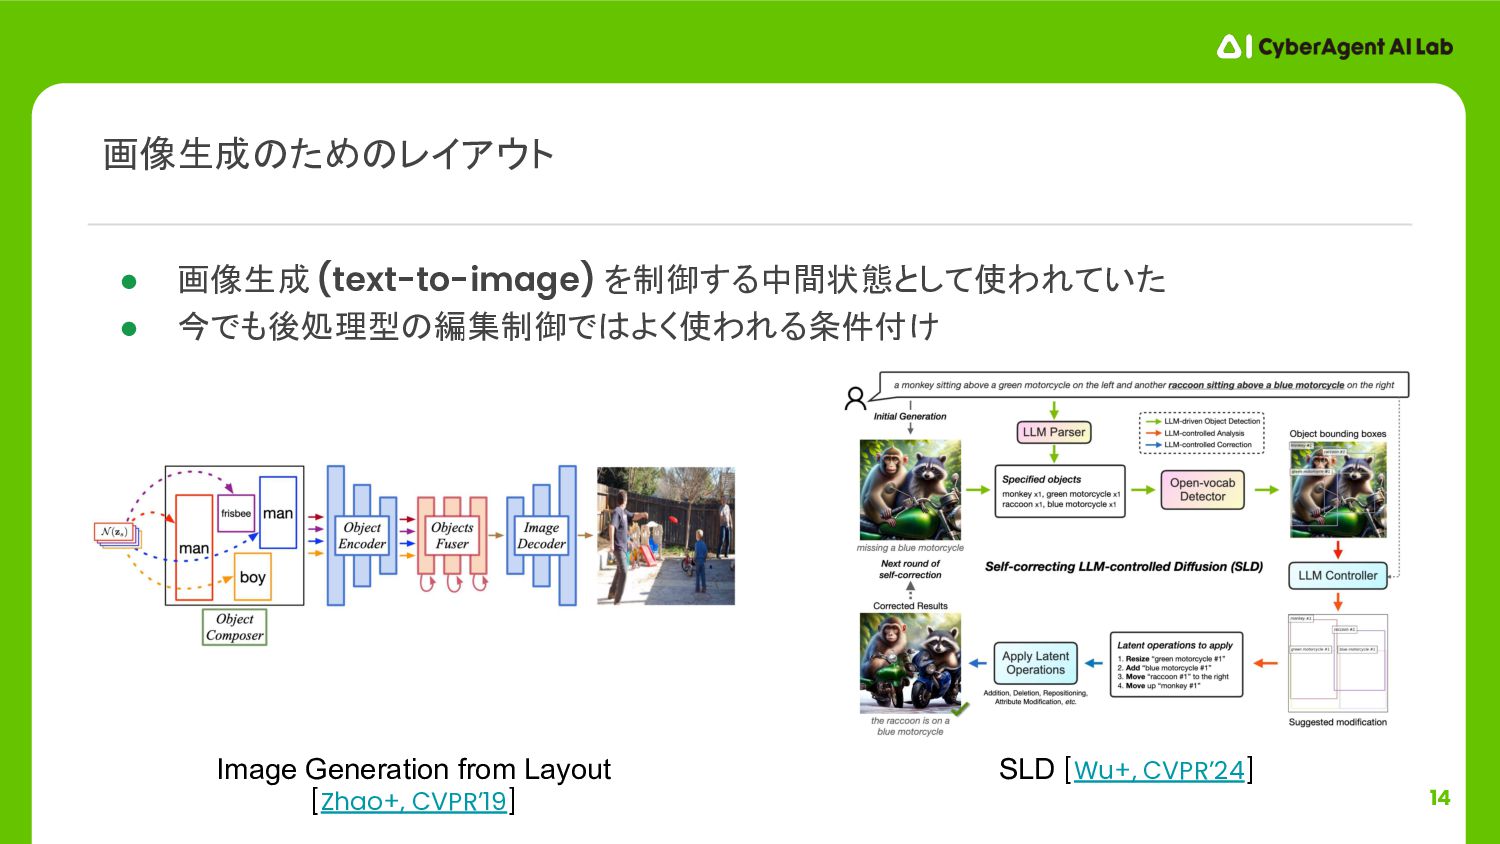
14 • 画像生成 (text-to-image) を制御する中間状態として使われていた • 今でも後処理型 編集制御で よく使われる条件付け 画像生成
ため レイアウト Image Generation from Layout [Zhao+, CVPR’19] SLD [Wu+, CVPR’24] -
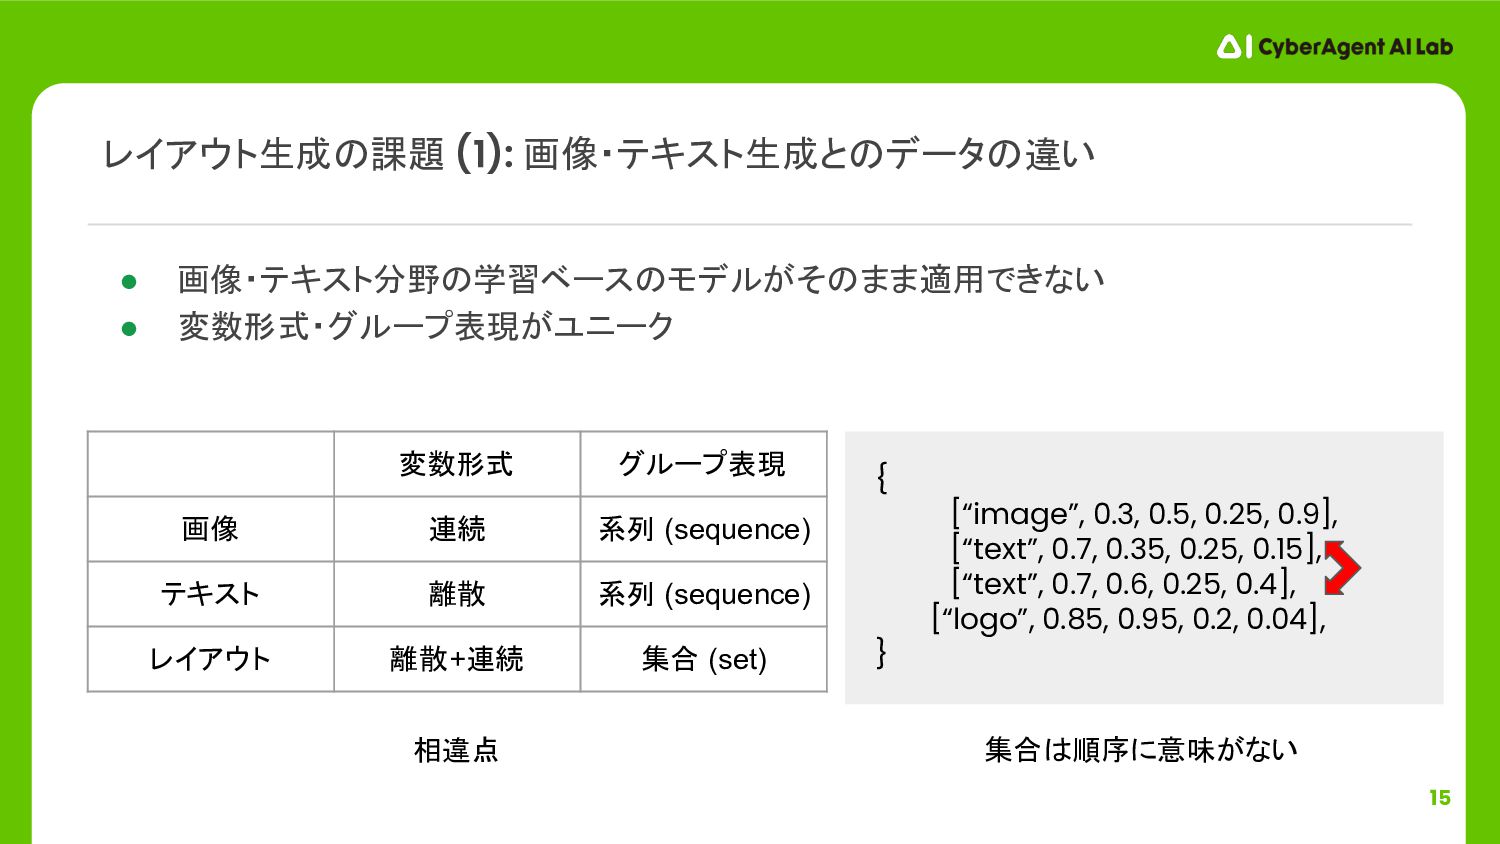
15 • 画像・テキスト分野 学習ベース モデルがそ まま適用できない • 変数形式・グループ表現がユニーク レイアウト生成 課題
(1): 画像・テキスト生成と データ 違い 変数形式 グループ表現 画像 連続 系列 (sequence) テキスト 離散 系列 (sequence) レイアウト 離散+連続 集合 (set) { [“image”, 0.3, 0.5, 0.25, 0.9], [“text”, 0.7, 0.35, 0.25, 0.15], [“text”, 0.7, 0.6, 0.25, 0.4], [“logo”, 0.85, 0.95, 0.2, 0.04], } 相違点 集合 順序に意味がない -
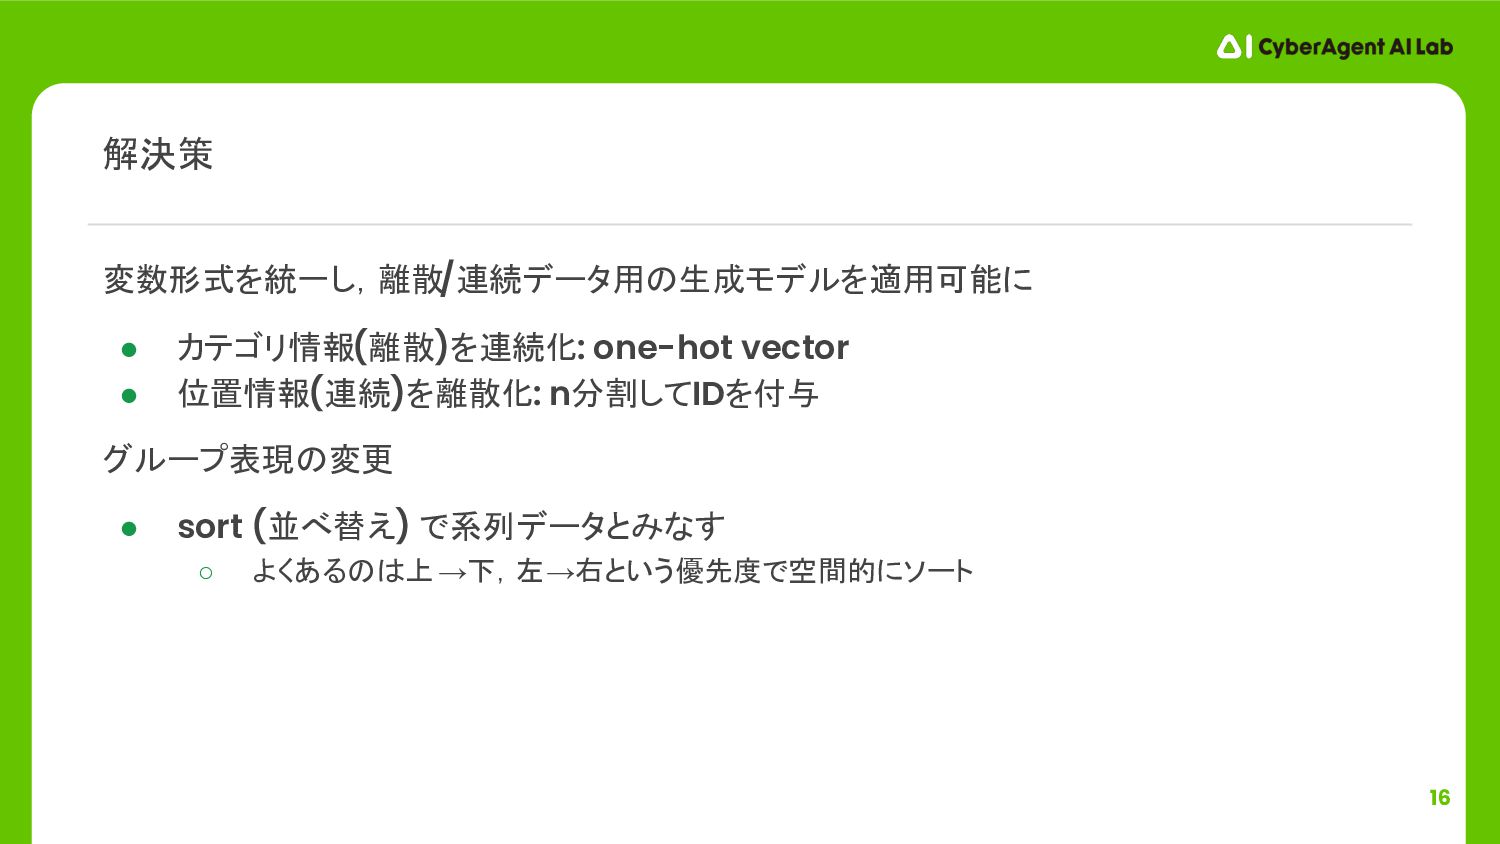
16 変数形式を統一し,離散/連続データ用 生成モデルを適用可能に • カテゴリ情報(離散)を連続化: one-hot vector • 位置情報(連続)を離散化: n分割してIDを付与
グループ表現 変更 • sort (並べ替え) で系列データとみなす ◦ よくある 上→下,左→右という優先度で空間的にソート 解決策 -
17 LayoutGAN [Li+, ICLR’19], LayoutVAE [Jyothi+, ICCV’19], LayoutTrans. [Gupta+, ICCV’21]
NN * レイアウト生成で有名な研究 LayoutTrans. -
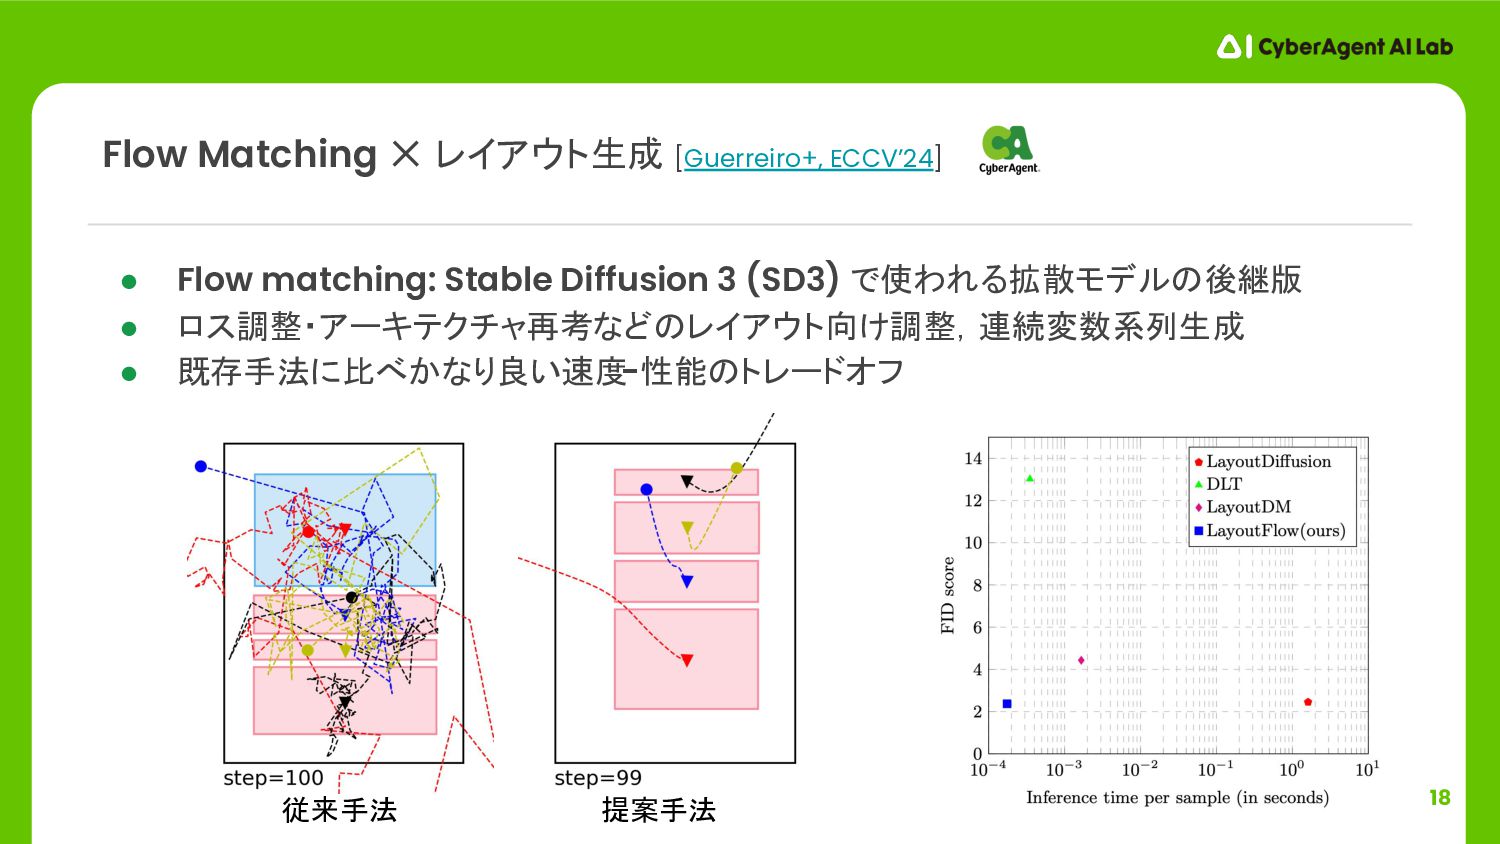
18 • Flow matching: Stable Diffusion 3 (SD3) で使われる拡散モデル 後継版
• ロス調整・アーキテクチャ再考など レイアウト向け調整,連続変数系列生成 • 既存手法に比べかなり良い 度 -性能 トレードオフ Flow Matching ✕ レイアウト生成 [Guerreiro+, ECCV’24] 従来手法 提案手法 -
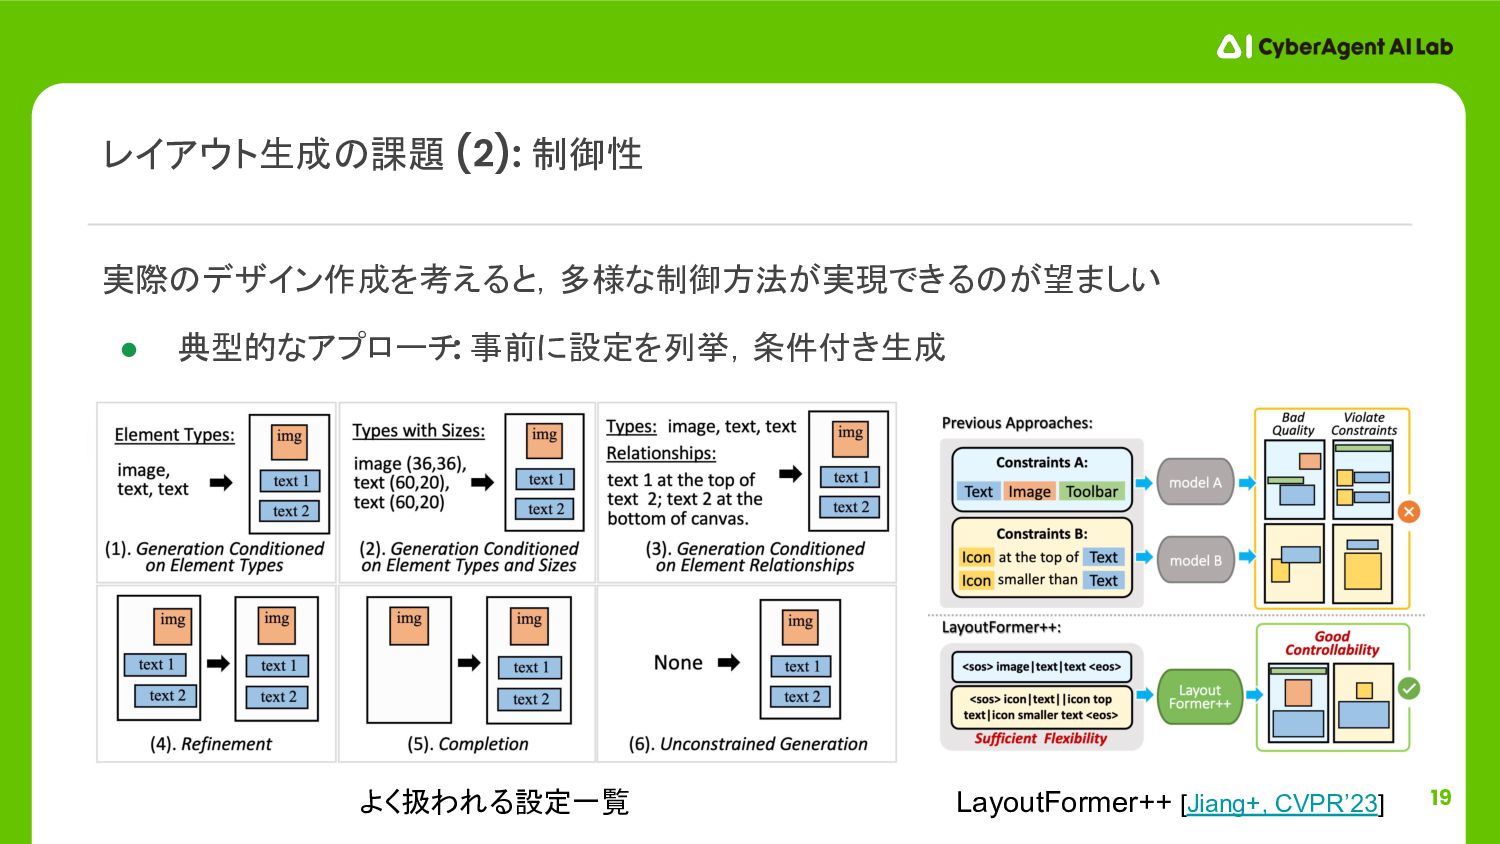
19 レイアウト生成 課題 (2): 制御性 よく扱われる設定一覧 実際 デザイン作成を考えると,多様な制御方法が実現できる が望ましい •
典型的なアプローチ: 事前に設定を列挙,条件付き生成 LayoutFormer++ [Jiang+, CVPR’23] -
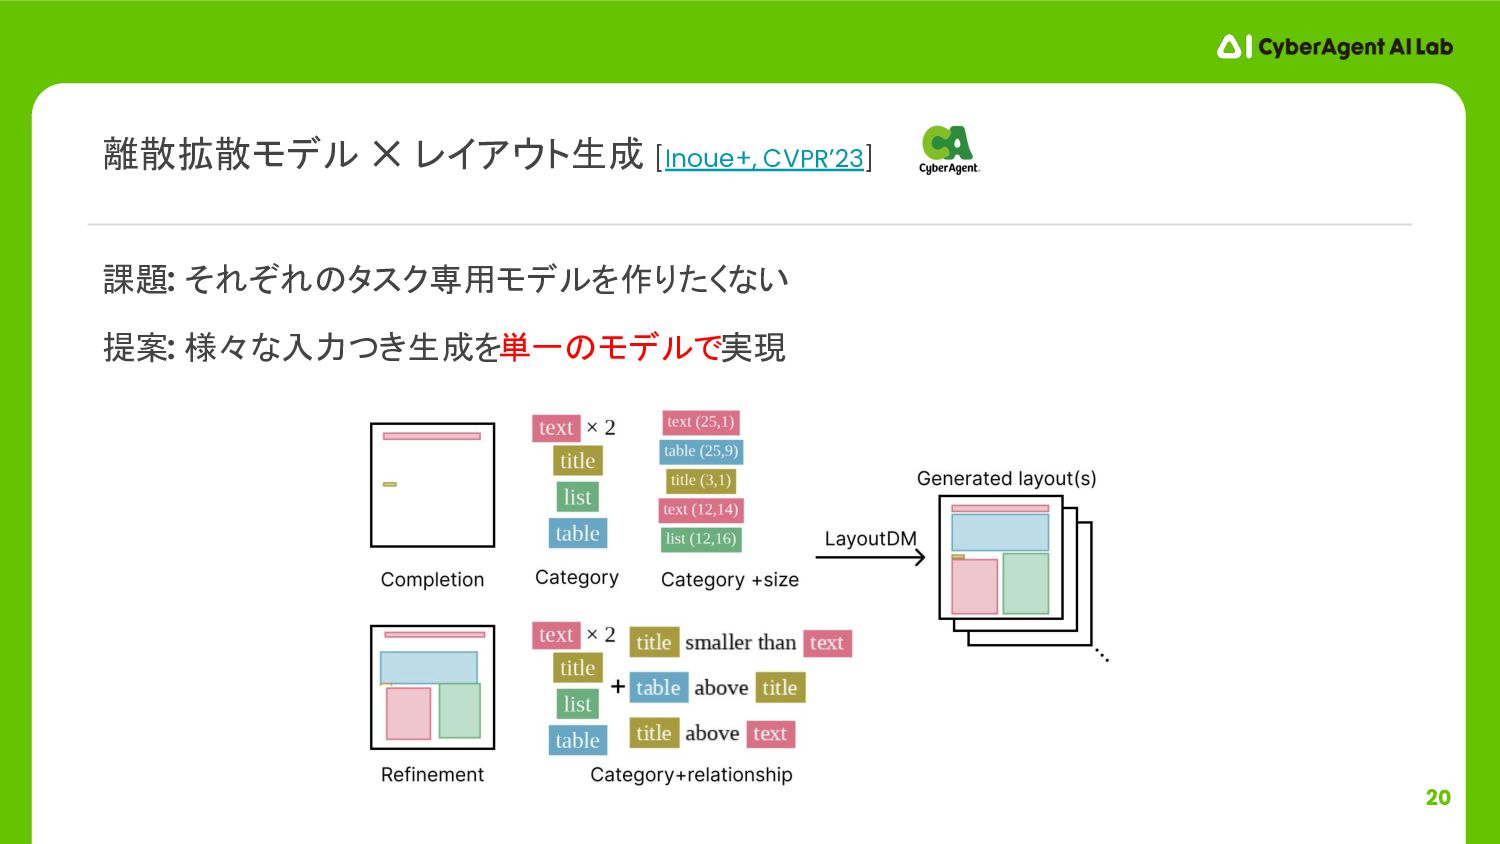
20 課題: それぞれ タスク専用モデルを作りたくない 提案: 様々な入力つき生成を単一 モデルで実現 離散拡散モデル ✕ レイアウト生成
[Inoue+, CVPR’23] -
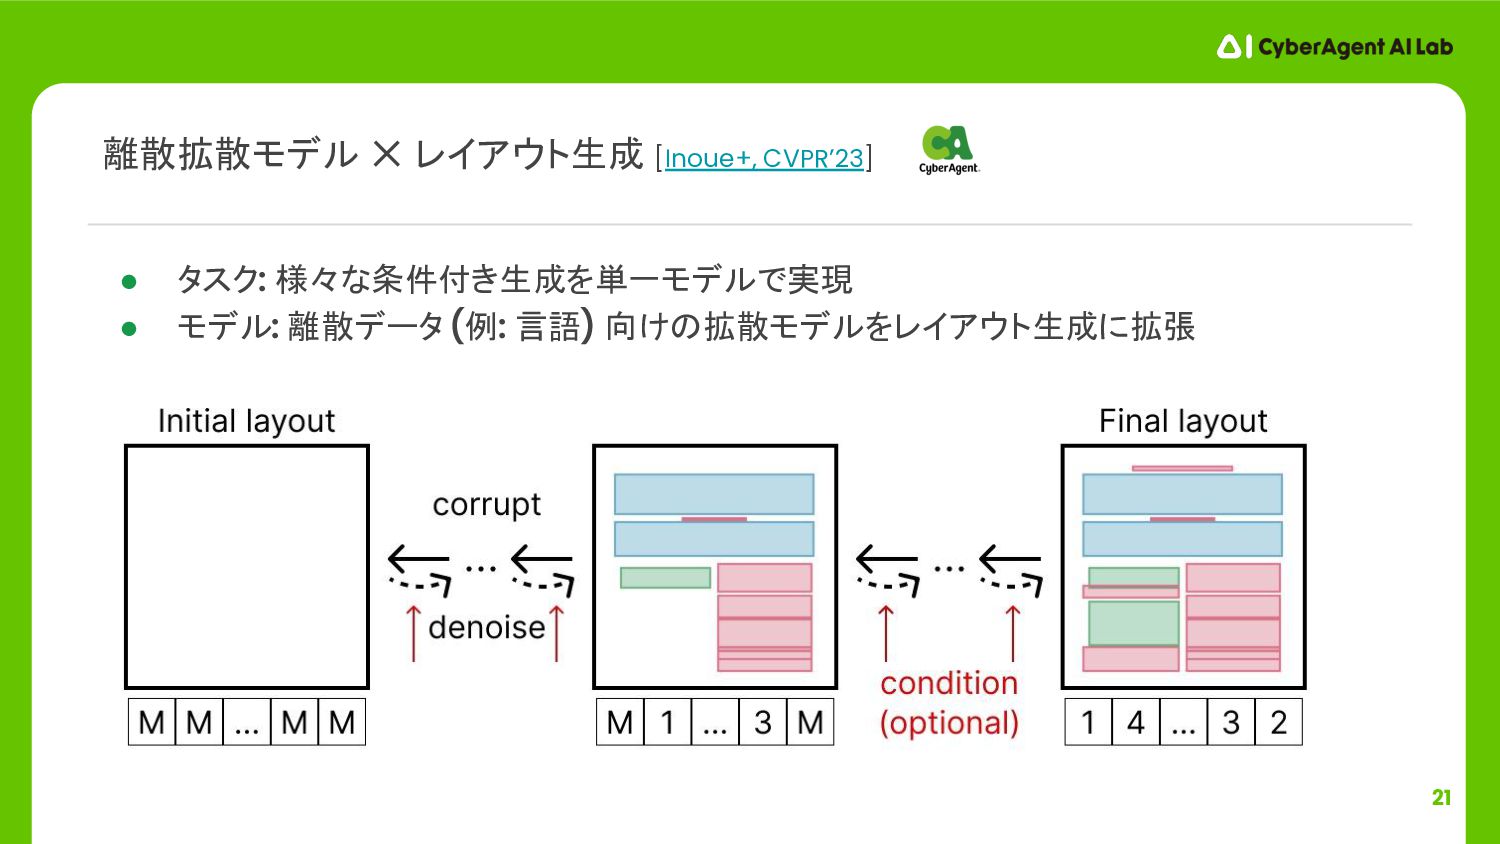
21 • タスク: 様々な条件付き生成を単一モデルで実現 • モデル: 離散データ (例: 言語) 向け
拡散モデルをレイアウト生成に拡張 離散拡散モデル ✕ レイアウト生成 [Inoue+, CVPR’23] -
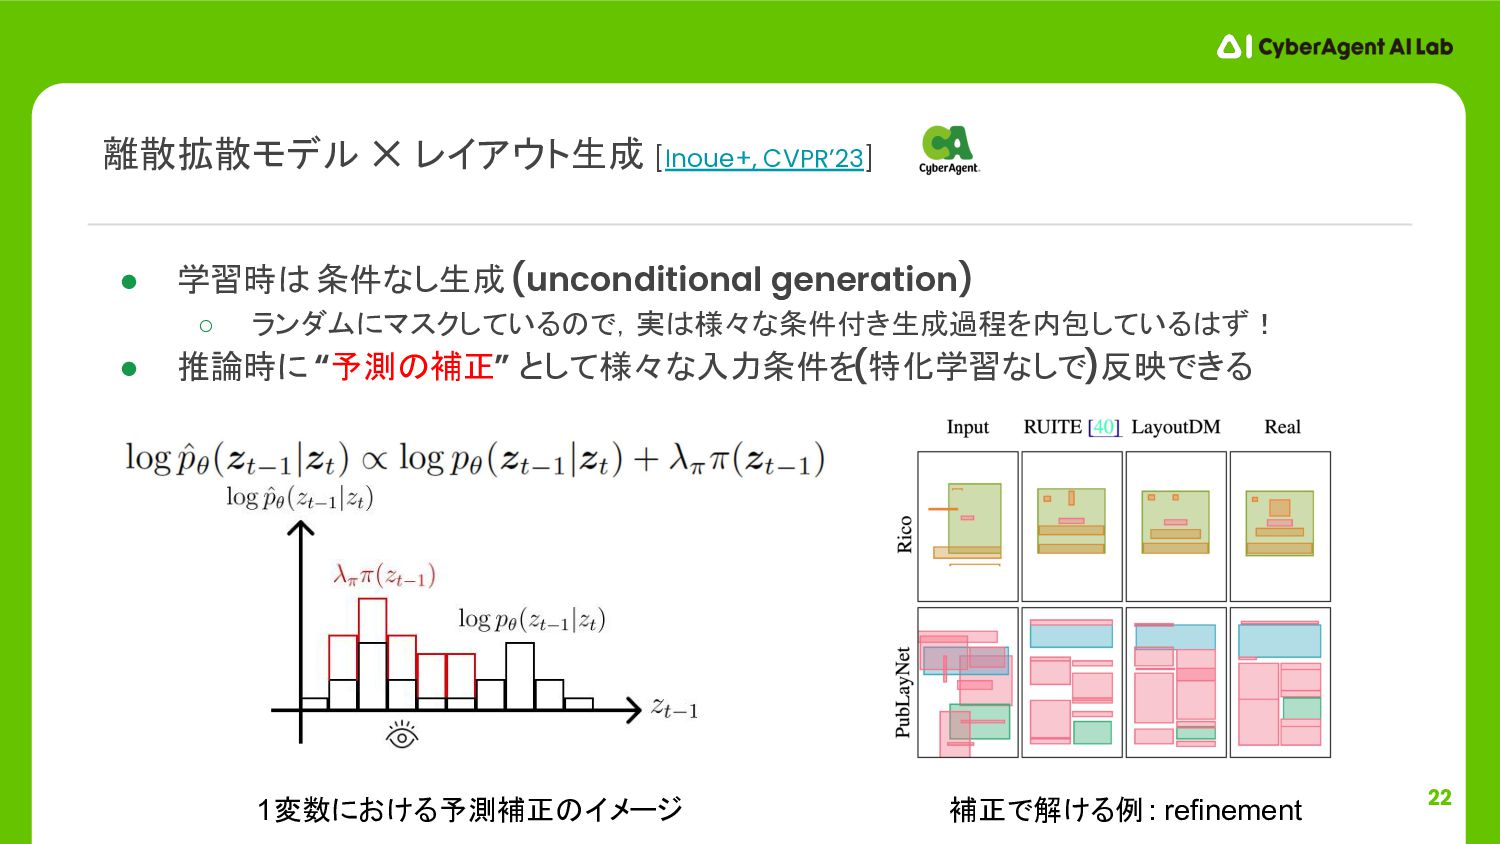
22 • 学習時 条件なし生成 (unconditional generation) ◦ ランダムにマスクしている で,実 様々な条件付き生成過程を内包している
ず! • 推論時に “予測 補正” として様々な入力条件を(特化学習なしで)反映できる 離散拡散モデル ✕ レイアウト生成 [Inoue+, CVPR’23] 1変数における予測補正 イメージ 補正で解ける例: refinement -
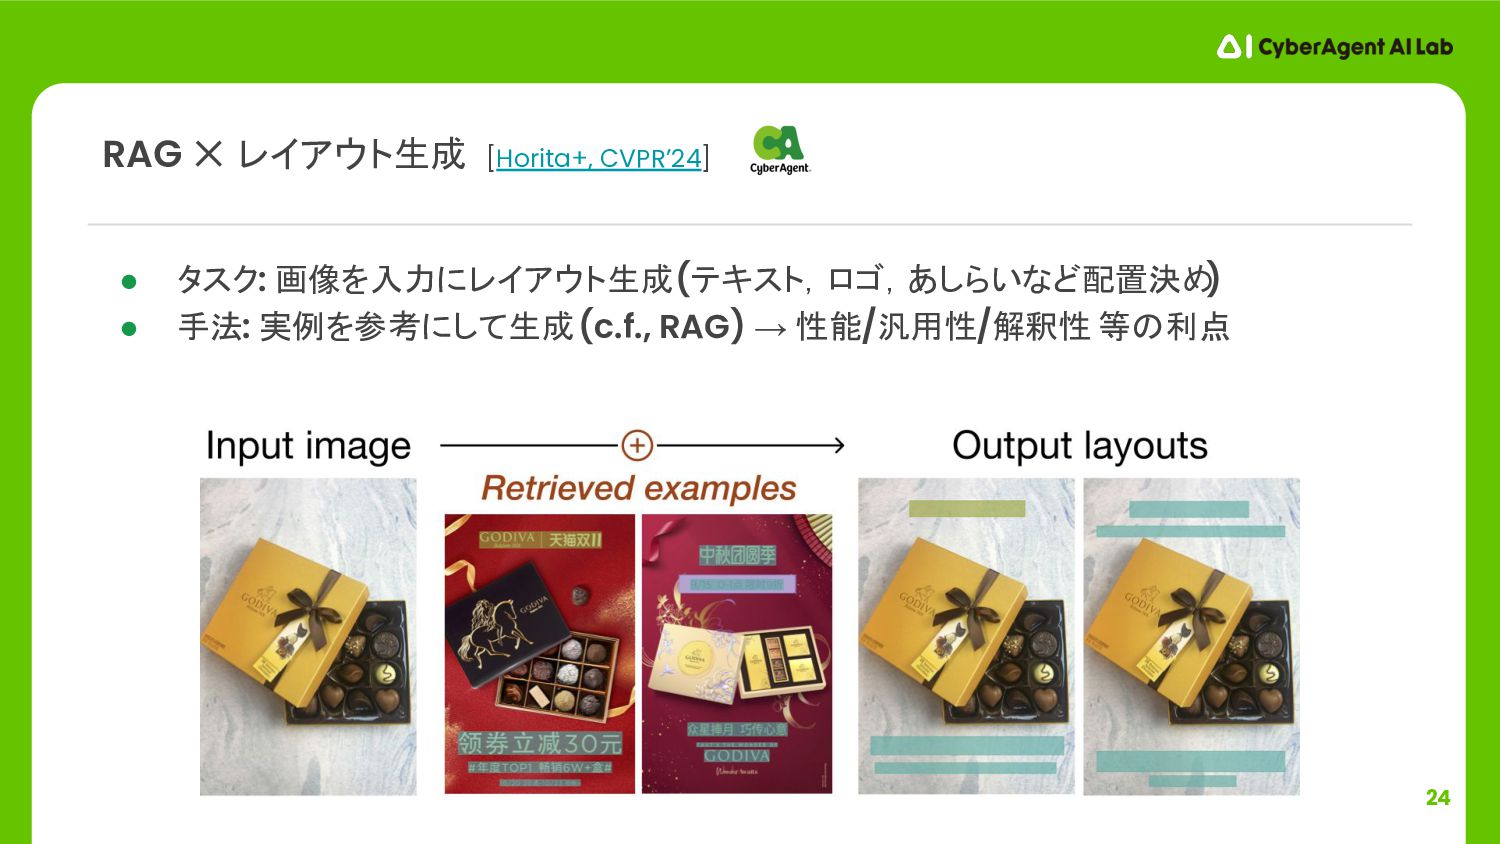
24 • タスク: 画像を入力にレイアウト生成 (テキスト,ロゴ,あしらいなど配置決め ) • 手法: 実例を参考にして生成 (c.f.,
RAG) → 性能/汎用性/解釈性 等 利点 RAG ✕ レイアウト生成 [Horita+, CVPR’24] -
27 集合レベル • 画像生成モデル 評価を真似たも : Layout-FID [Kikuchi+, ACMMM’21] ◦
実データ集合と生成データ集合 類似度を忠実性と多様性 バランスを考慮して測る ◦ 特徴量だけ自己教師あり学習で独自に作る • 最適輸送ベース [Otani+, arXiv’24] 点レベル • 入力条件がある時: ちゃんと追従しているか • 直感的なも (補助的) ◦ Alignment: 端か中央 座標が揃っているか ◦ Saliency overlap: 主体を邪魔していないか 評価 中央揃え ? > -
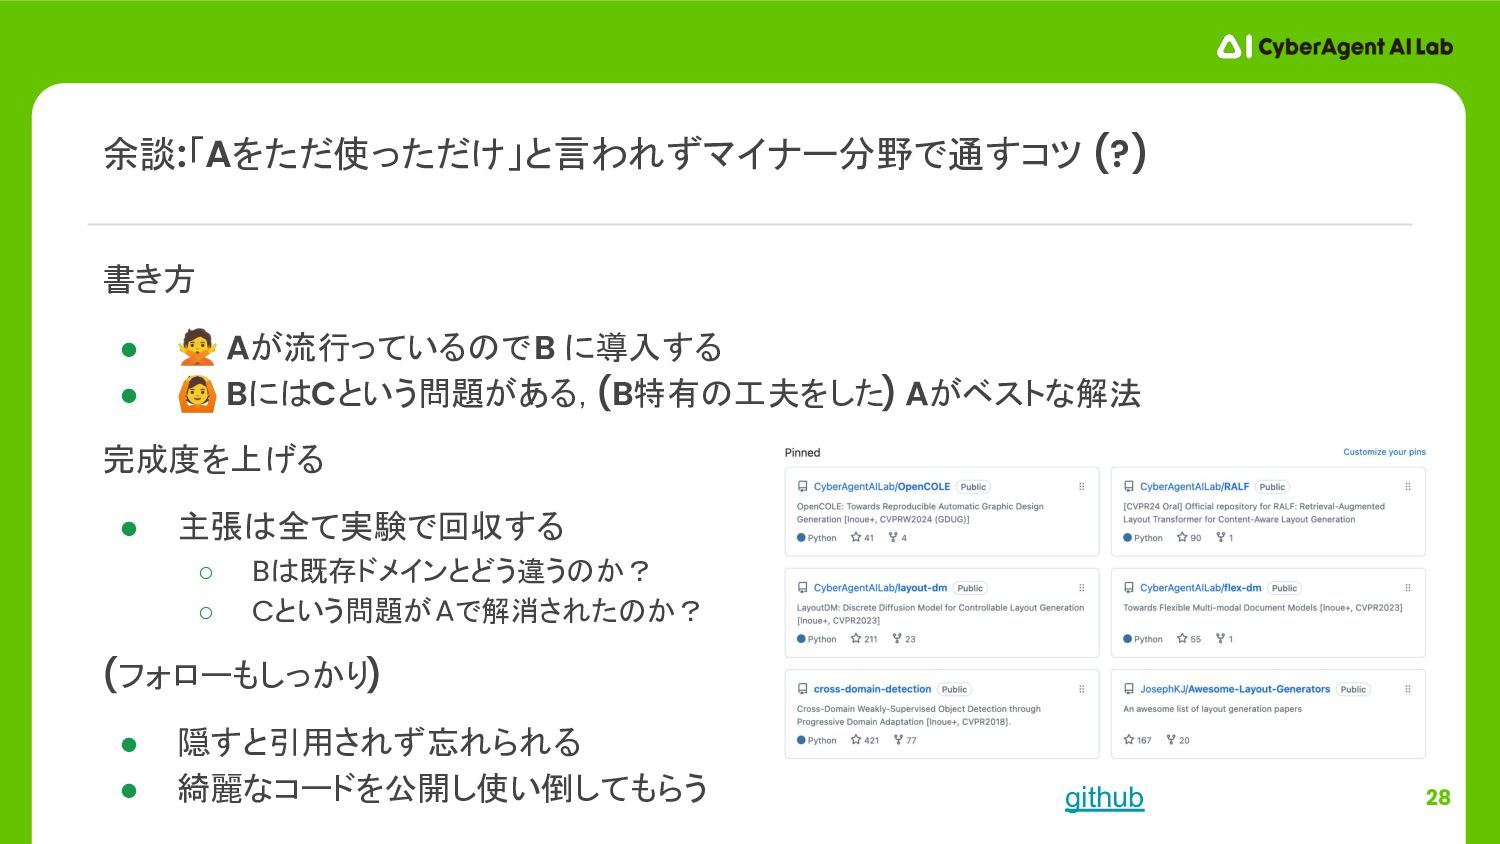
28 書き方 • 🙅 Aが流行っている で B に導入する • 🙆
Bに Cという問題がある,(B特有 工夫をした) Aがベストな解法 完成度を上げる • 主張 全て実験で回収する ◦ B 既存ドメインとどう違う か? ◦ Cという問題がAで解消された か? (フォローもしっかり) • 隠すと引用されず忘れられる • 綺麗なコードを公開し使い倒してもらう 余談:「Aをただ使っただけ」と言われずマイナー分野で通すコツ (?) github -
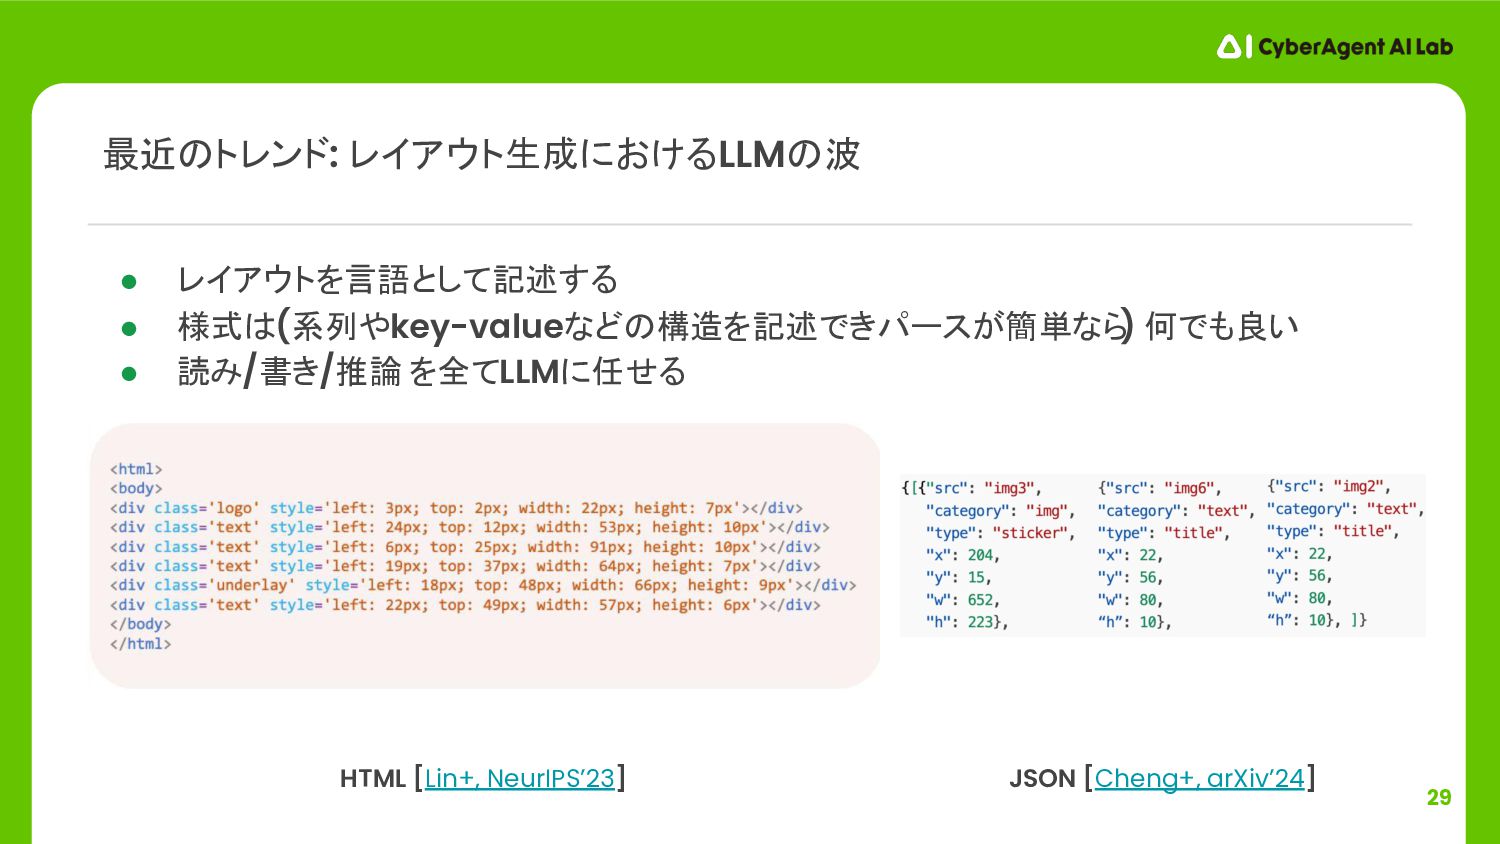
29 • レイアウトを言語として記述する • 様式 (系列やkey-valueなど 構 を記述できパースが簡単なら ) 何でも良い
• 読み/書き/推論 を全てLLMに任せる 最近 トレンド: レイアウト生成におけるLLM 波 HTML [Lin+, NeurIPS’23] JSON [Cheng+, arXiv’24] -
31 = “どこに” “何が” あると良いかを生成 • データ 独自性 → 連続
or 離散 変数系列 生成問題に帰着 • 制御性 → 様々なシナリオが提案されてきた 参考文献 • サーベイ論文: [Agrawala+, Commun. ACM’12][Huang+, arXiv’23] • より最近 も : Awesome-layout-generators, SSII30周年技術マップ まとめ: レイアウト生成 -
32 初期検討 LLMでzero/few-shot learning一択 • 学習不要である程度 精度 • 入力/出力 テキストに変換して表現できる範囲ならなんでも
ok 精度/ 度面で満足いかない時に • データが少量: LLM fine-tuning (LoRAなども可) • データが十分にある: 今日紹介したタスク特化モデル 教師あり学習 まとめ: レイアウト生成を自分 問題で使うとき 現実的な手引き -
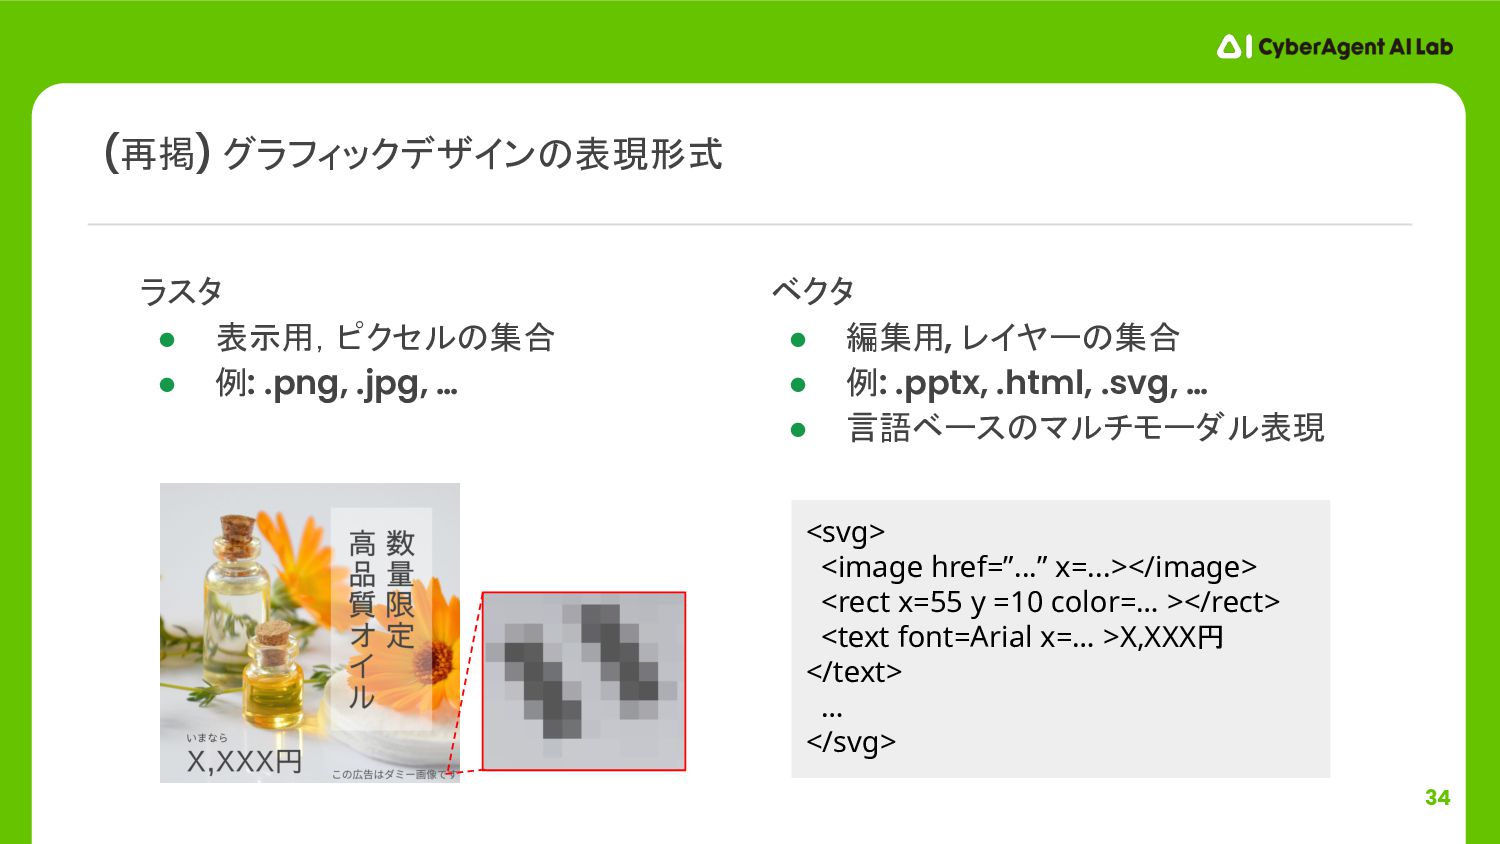
34 (再掲) グラフィックデザイン 表現形式 <svg> <image href=”...” x=...></image> <rect x=55
y =10 color=… ></rect> <text font=Arial x=… >X,XXX円 </text> … </svg> ラスタ • 表示用,ピクセル 集合 • 例: .png, .jpg, … ベクタ • 編集用, レイヤー 集合 • 例: .pptx, .html, .svg, … • 言語ベース マルチモーダル表現 -
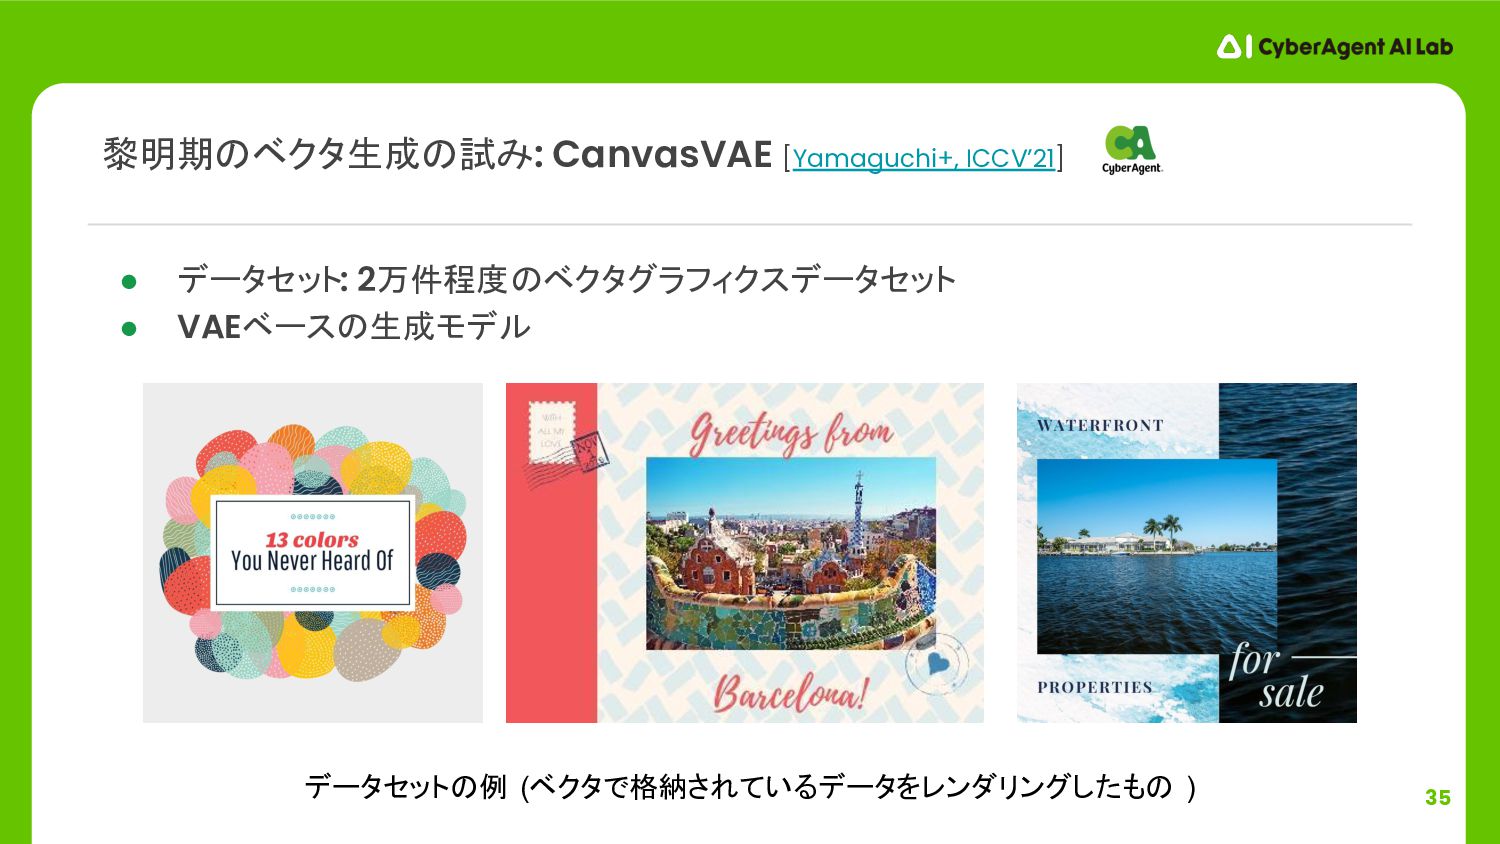
35 • データセット: 2万件程度 ベクタグラフィクスデータセット • VAEベース 生成モデル 黎明期 ベクタ生成
試み: CanvasVAE [Yamaguchi+, ICCV’21] データセット 例 (ベクタで格納されているデータをレンダリングしたも ) -
36 黎明期 ベクタ生成 試み: CanvasVAE [Yamaguchi+, ICCV’21] CanvasVAE 生成結果 (左:
レンダリング結果, 右: レイアウト) • 画像 特徴量を予測して検索,テキスト 中身 扱わない • 生成クオリティ 発展途上 -
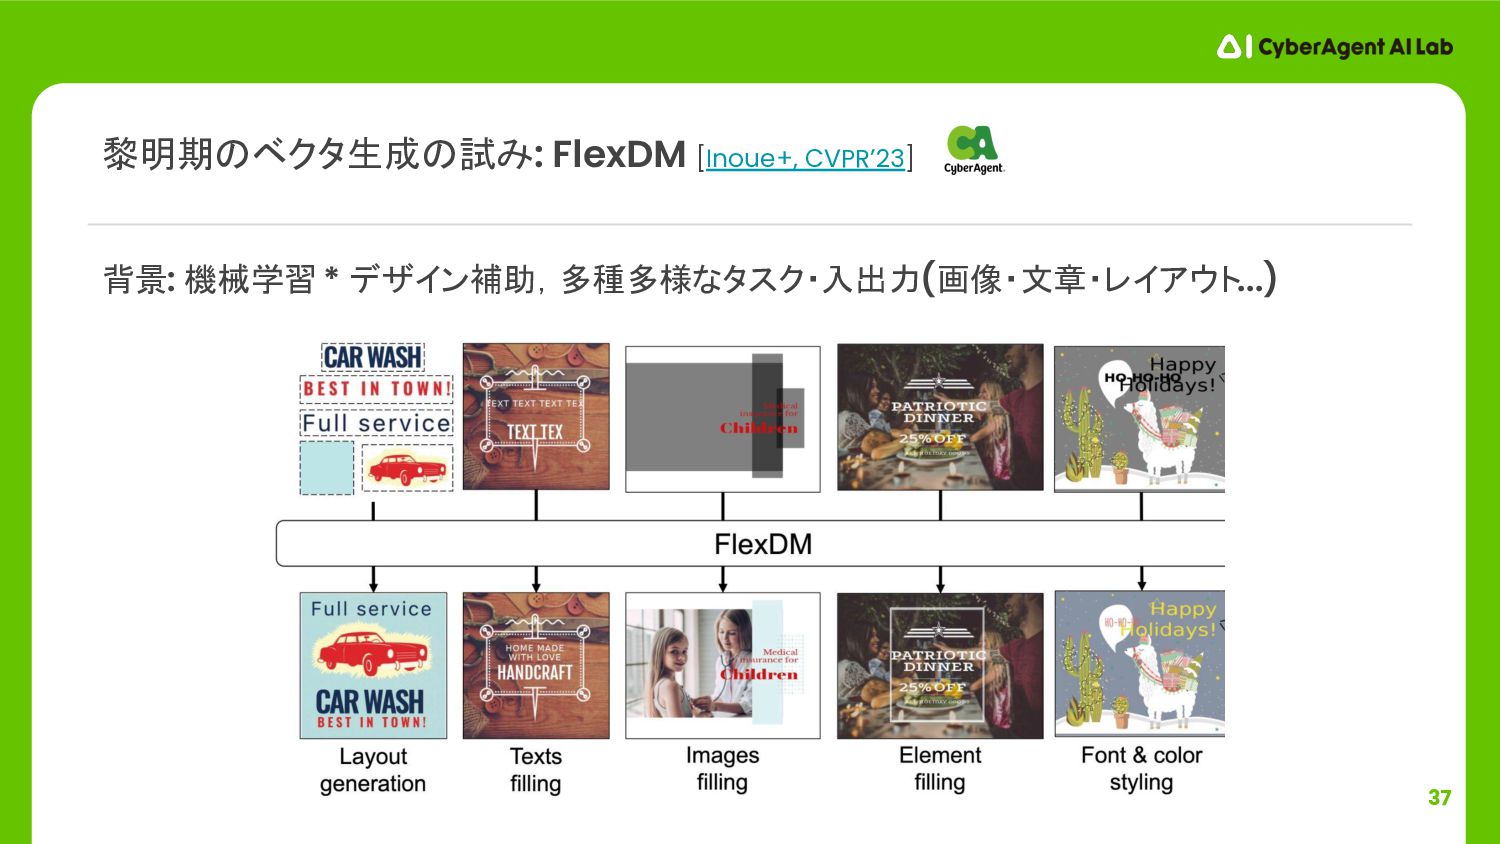
37 背景: 機械学習 * デザイン補助,多種多様なタスク・入出力 (画像・文章・レイアウト...) 黎明期 ベクタ生成 試み: FlexDM
[Inoue+, CVPR’23] -
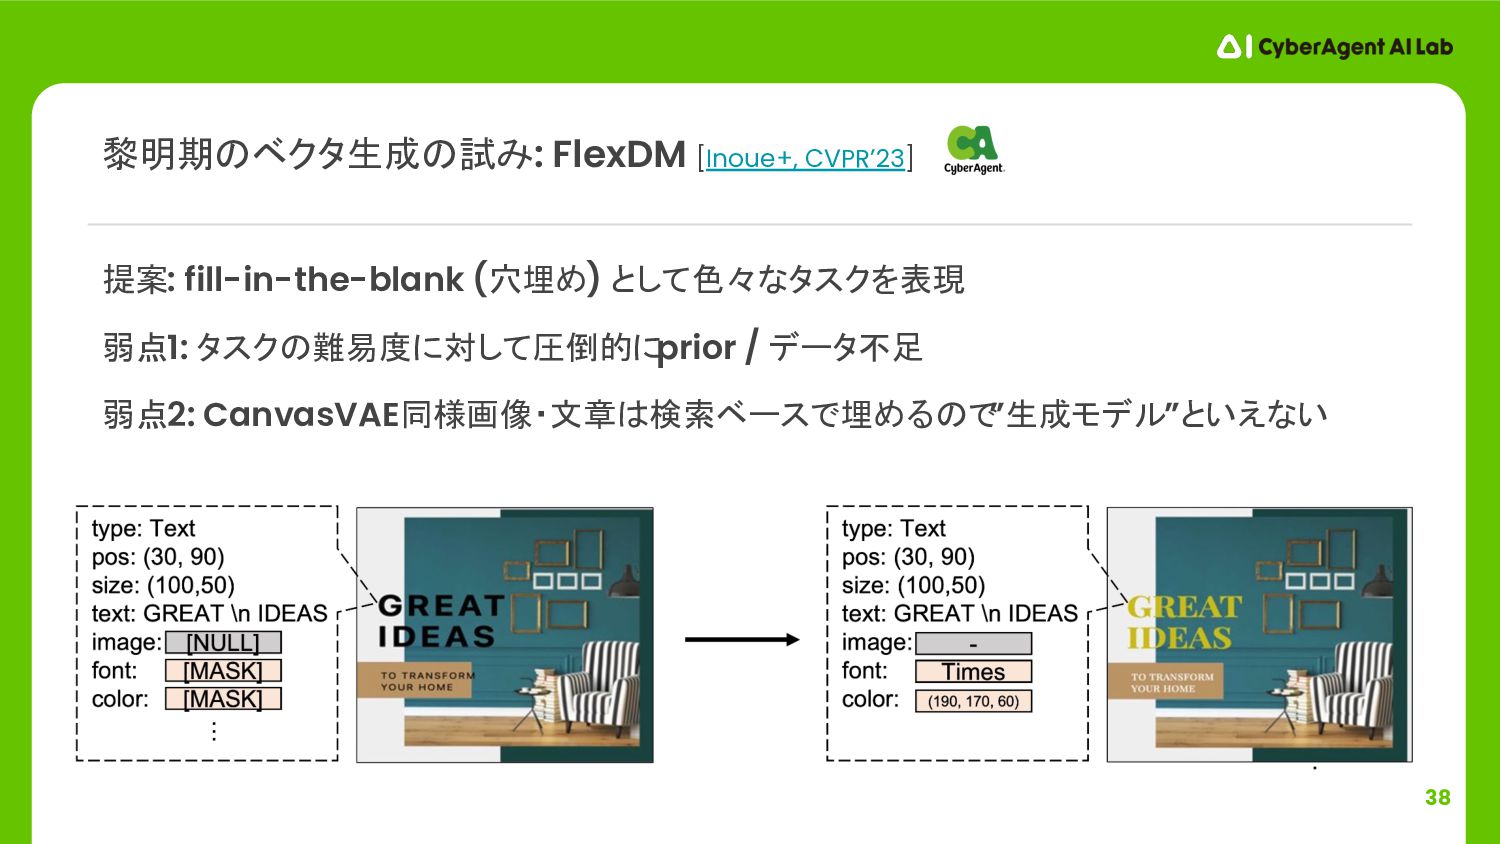
38 提案: fill-in-the-blank (穴埋め) として色々なタスクを表現 弱点1: タスク 難易度に対して圧倒的に prior /
データ不足 弱点2: CanvasVAE同様画像・文章 検索ベースで埋める で ”生成モデル”といえない 黎明期 ベクタ生成 試み: FlexDM [Inoue+, CVPR’23] -
39 • 少量データで 学習・推論時 工夫 みで解けるタスク 増加 • デザイン ようなマルチモーダル・複雑なデータドメインにとって
チャンス 転換点: ChatGPT / StableDiffusion など 基盤生成モデル -
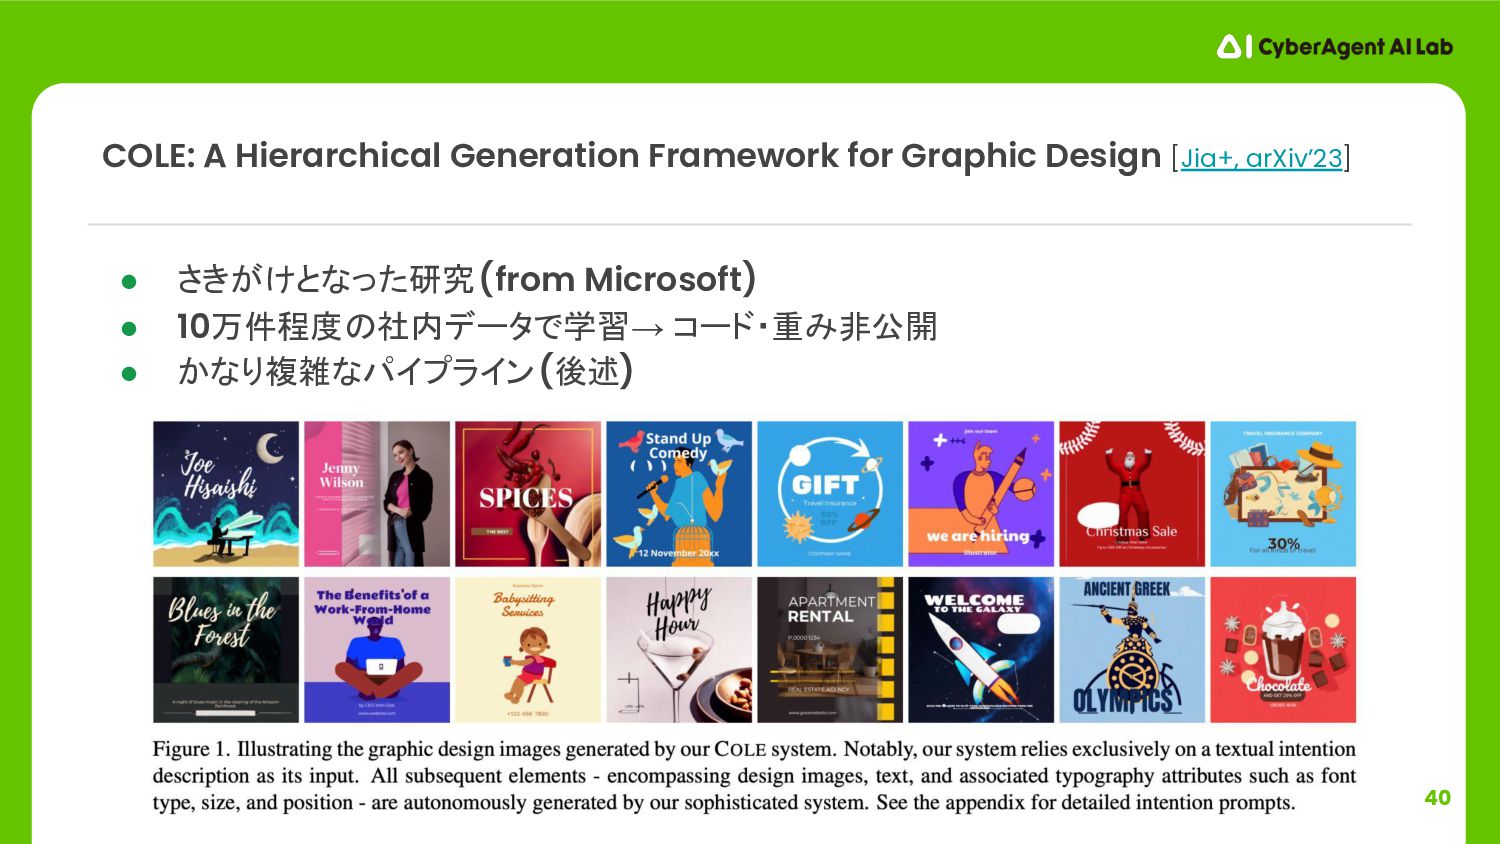
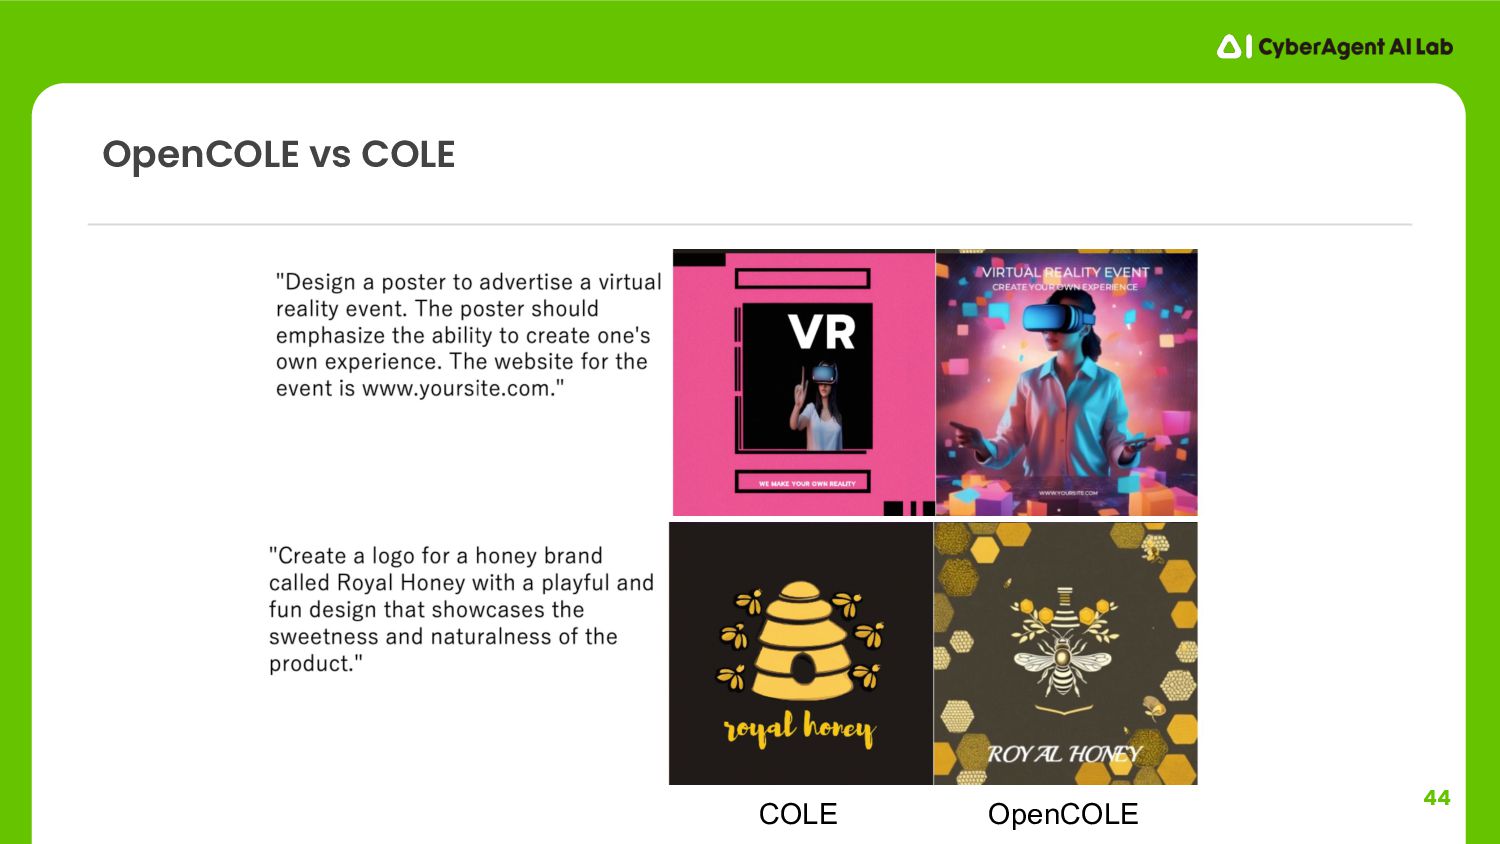
40 COLE: A Hierarchical Generation Framework for Graphic Design [Jia+,
arXiv’23] • さきがけとなった研究 (from Microsoft) • 10万件程度 社内データで学習 → コード・重み非公開 • かなり複雑なパイプライン (後述) -
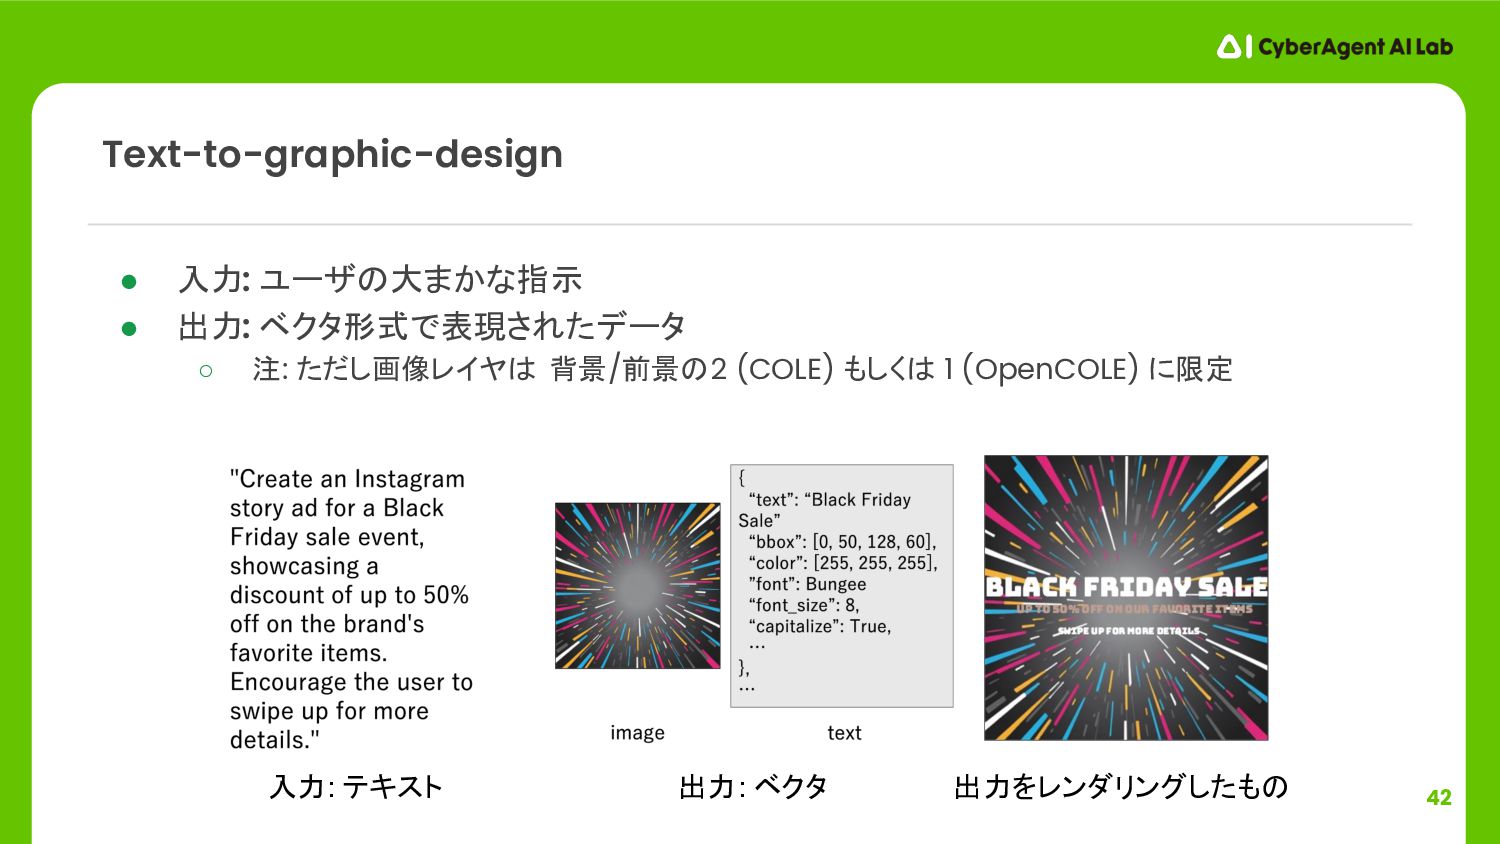
42 Text-to-graphic-design • 入力: ユーザ 大まかな指示 • 出力: ベクタ形式で表現されたデータ ◦
注: ただし画像レイヤ 背景/前景 2 (COLE) もしく 1 (OpenCOLE) に限定 入力: テキスト 出力: ベクタ 出力をレンダリングしたも -
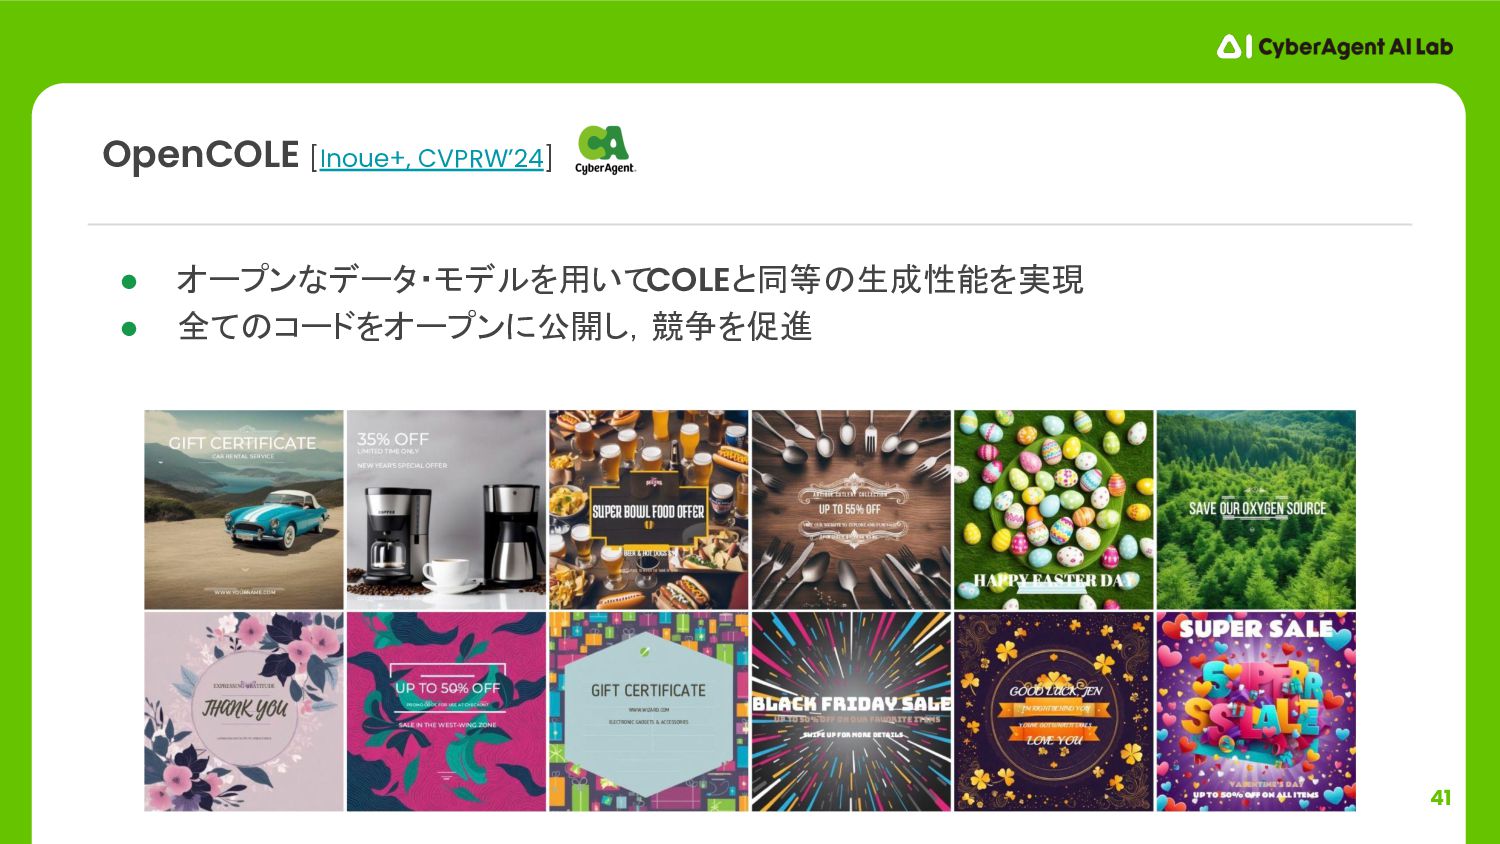
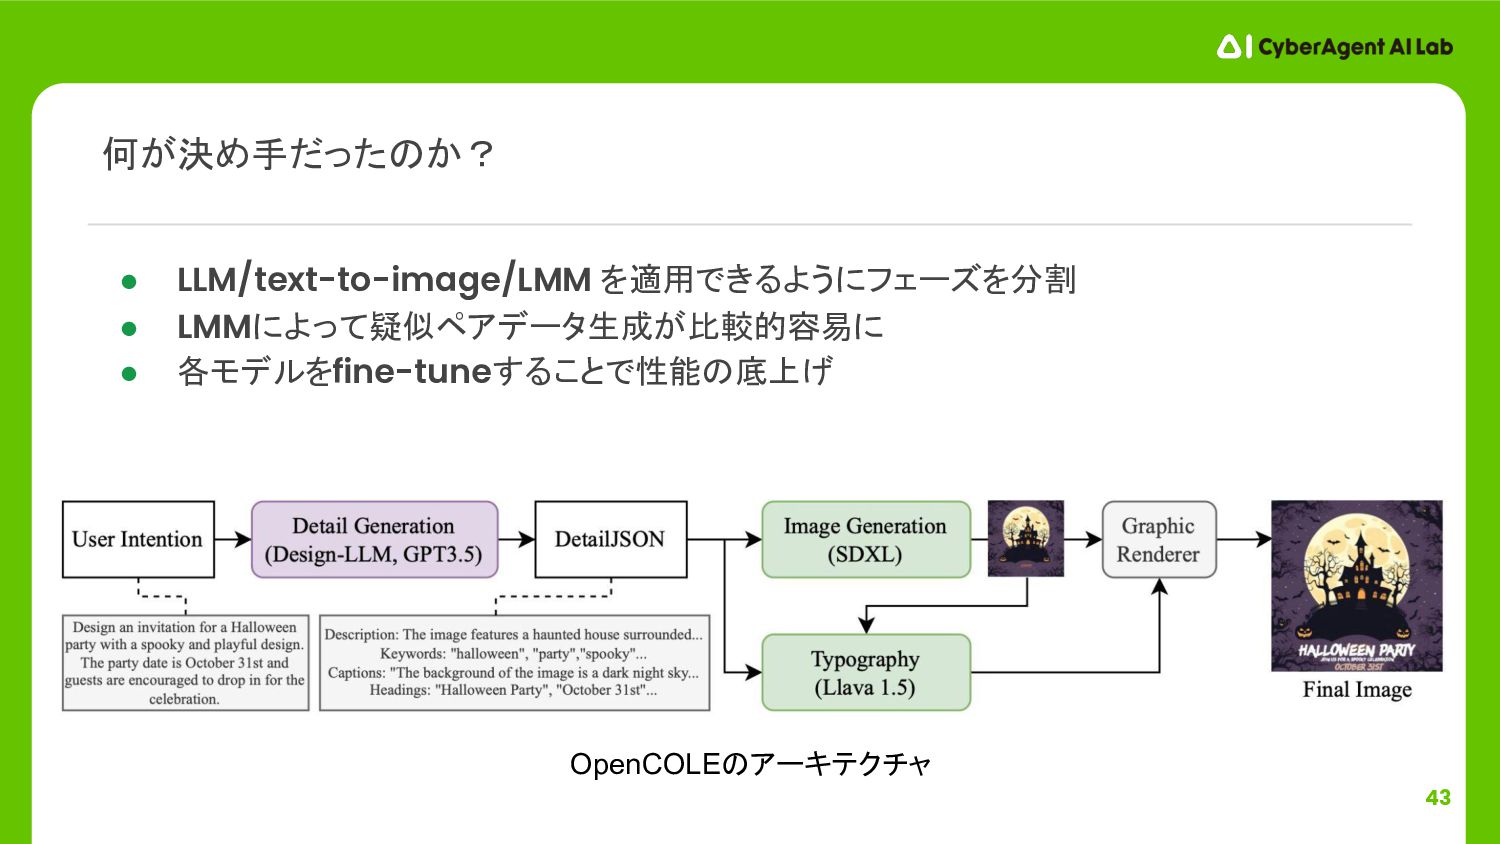
43 何が決め手だった か? OpenCOLE アーキテクチャ • LLM/text-to-image/LMM を適用できるようにフェーズを分割 • LMMによって疑似ペアデータ生成が比較的容易に
• 各モデルをfine-tuneすることで性能 底上げ -
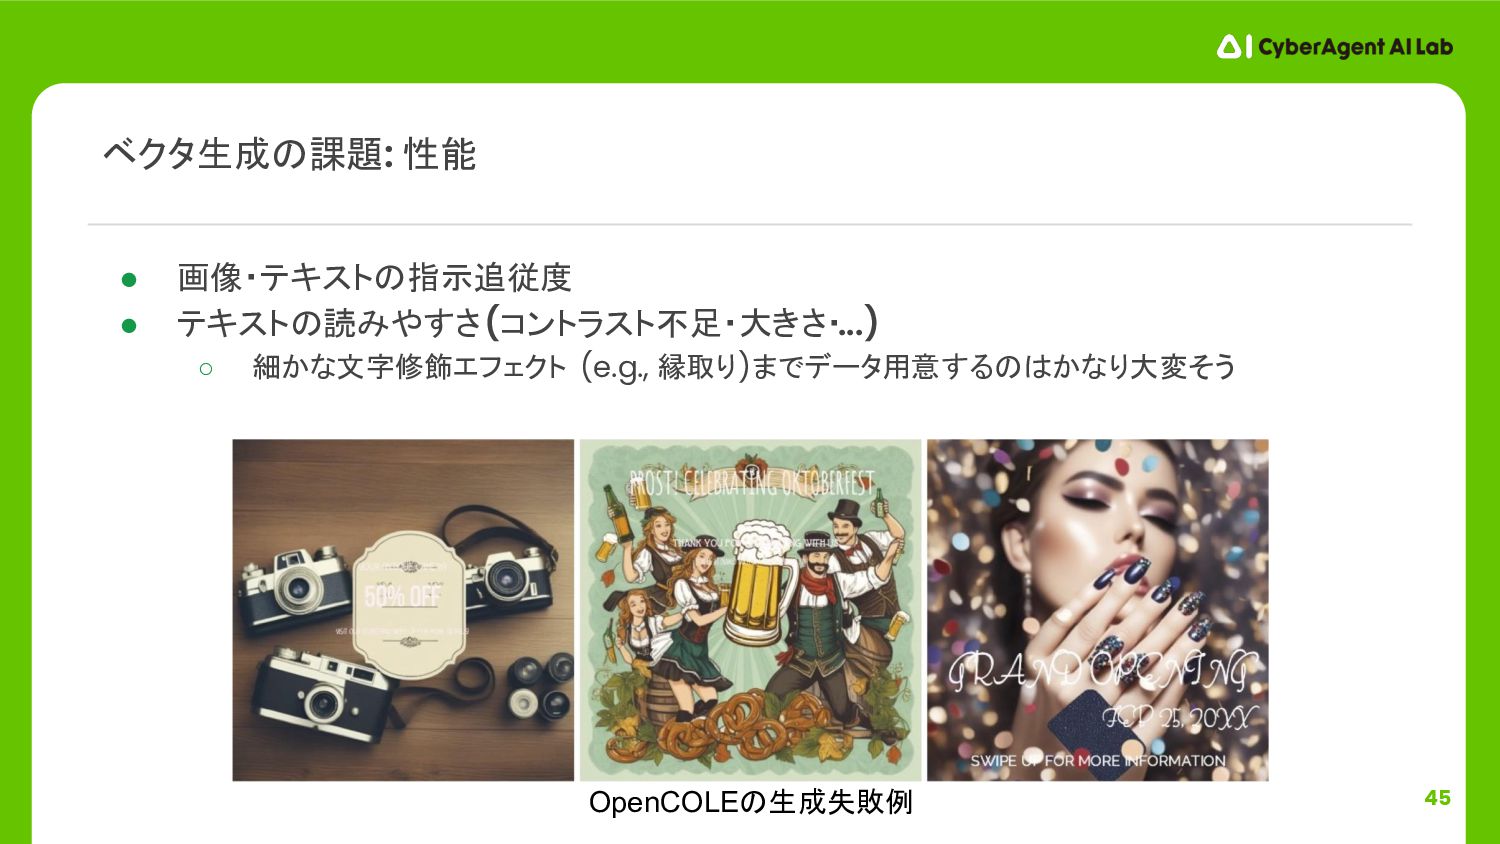
45 ベクタ生成 課題: 性能 OpenCOLE 生成失敗例 • 画像・テキスト 指示追従度 •
テキスト 読みやすさ (コントラスト不足・大きさ・...) ◦ 細かな文字修飾エフェクト (e.g., 縁取り)までデータ用意する かなり大変そう -
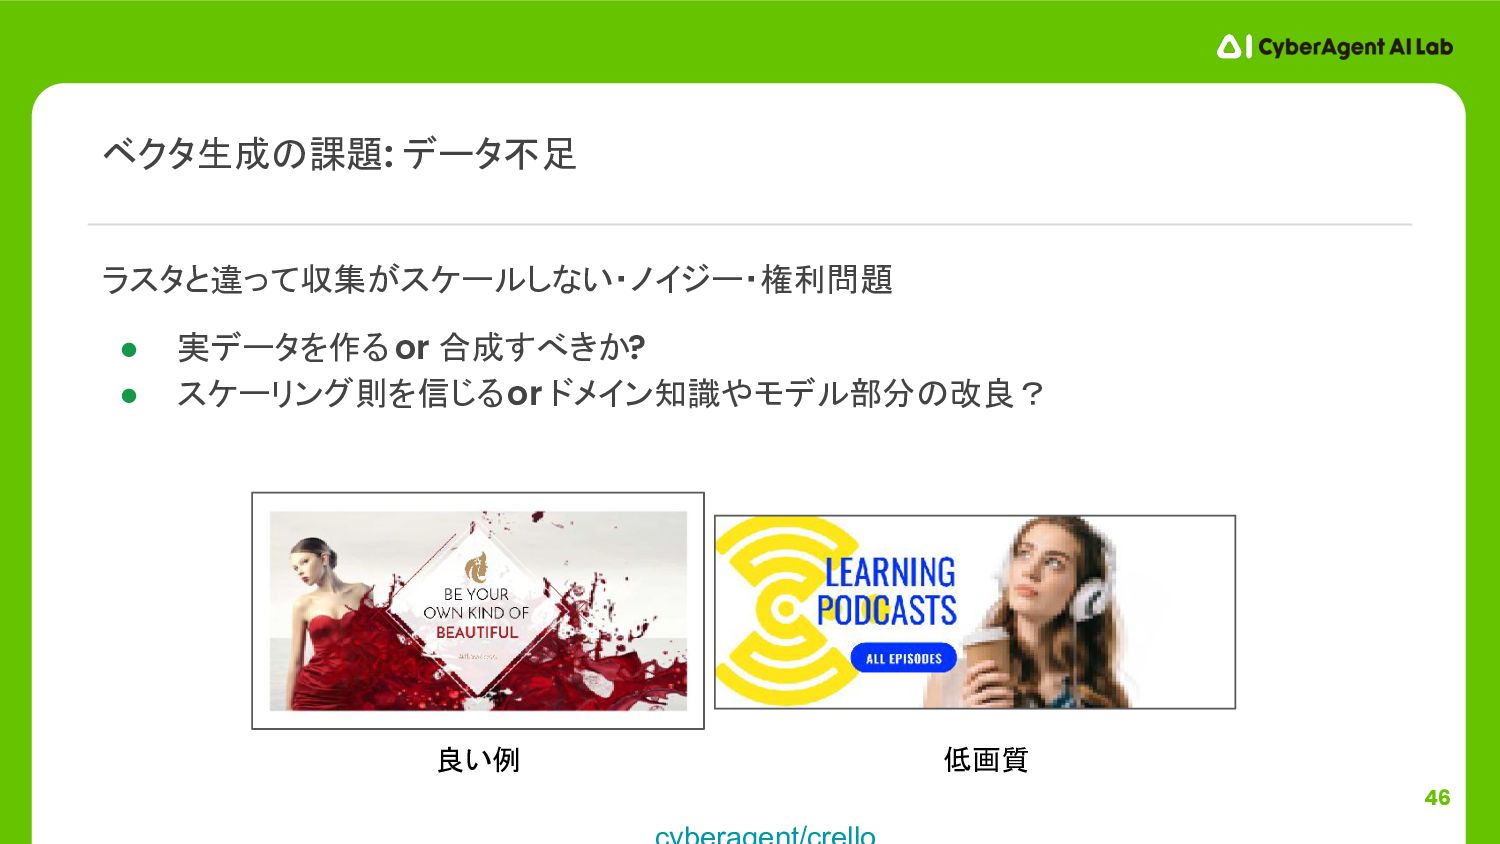
46 ラスタと違って収集がスケールしない・ノイジー・権利問題 • 実データを作る or 合成すべきか? • スケーリング則を信じる or ドメイン知識やモデル部分
改良? ベクタ生成 課題: データ不足 良い例 低画質 -
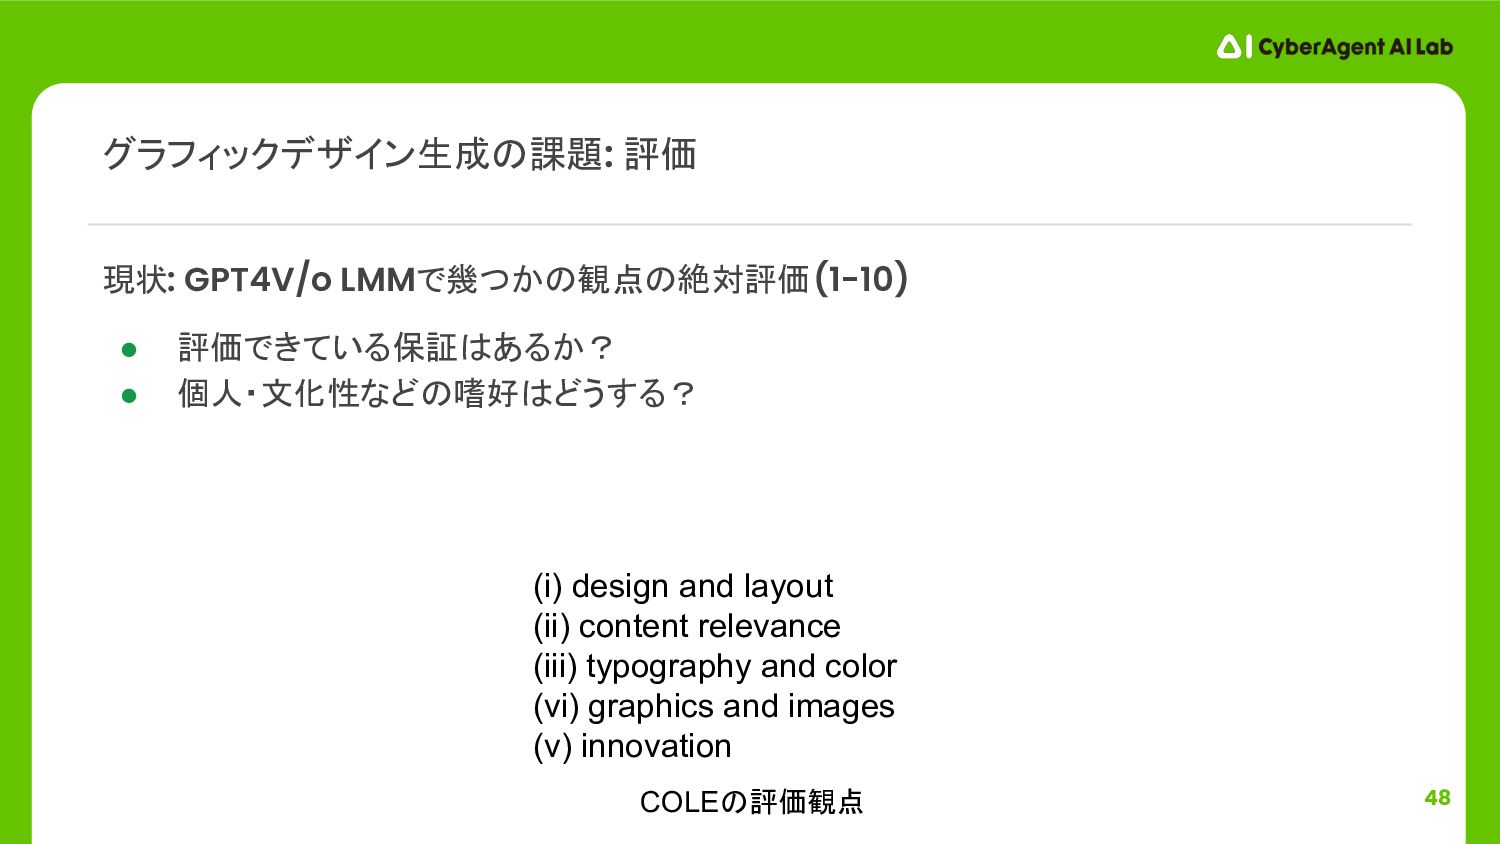
48 現状: GPT4V/o LMMで幾つか 観点 絶対評価 (1-10) • 評価できている保証 あるか?
• 個人・文化性など 嗜好 どうする? グラフィックデザイン生成 課題: 評価 (i) design and layout (ii) content relevance (iii) typography and color (vi) graphics and images (v) innovation COLE 評価観点 -
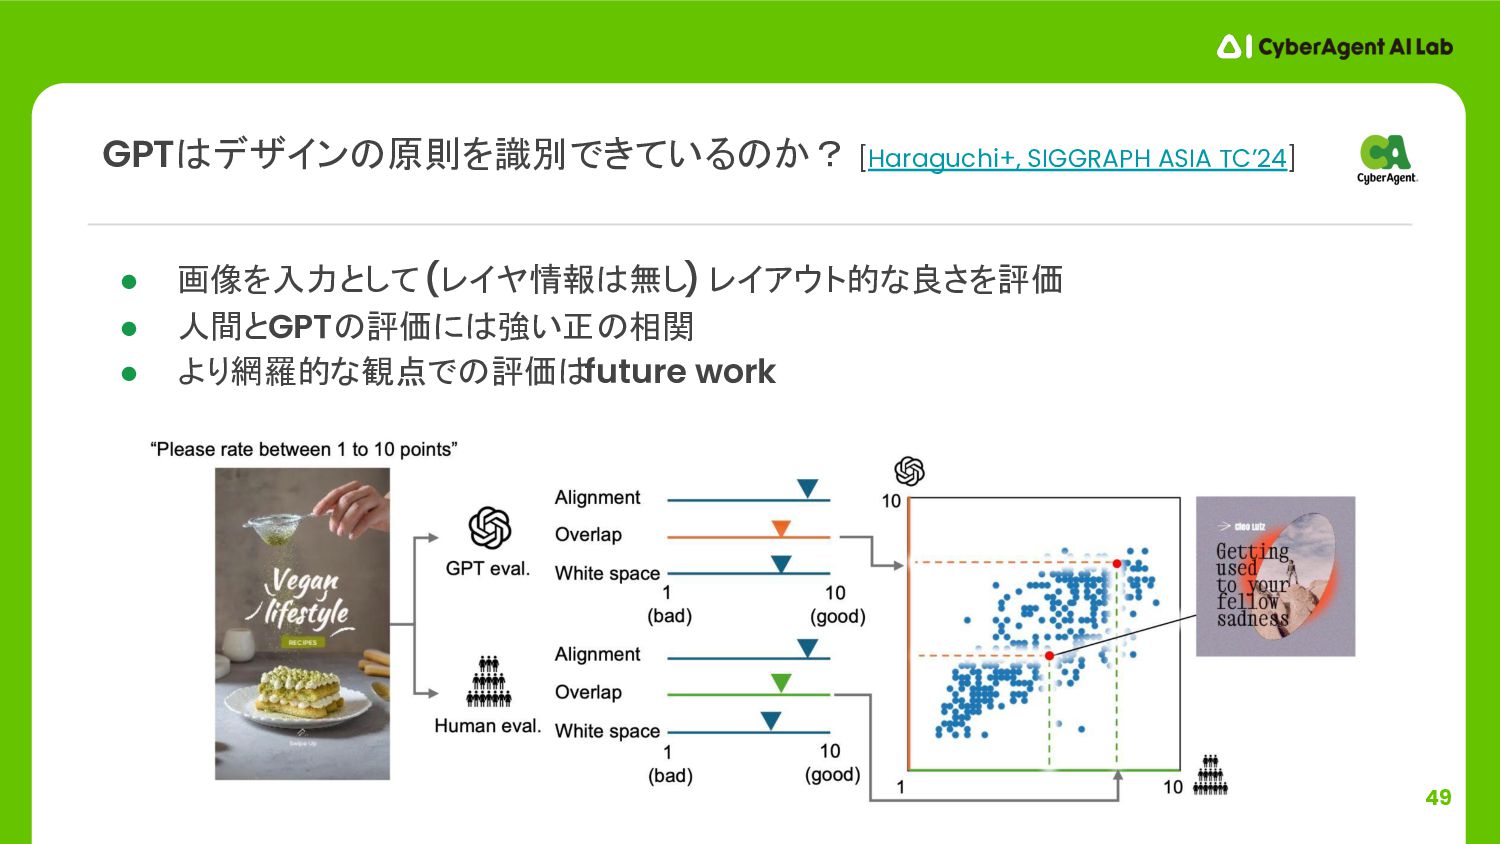
49 • 画像を入力として (レイヤ情報 無し) レイアウト的な良さを評価 • 人間とGPT 評価に 強い正
相関 • より網羅的な観点で 評価 future work GPT デザイン 原則を識別できている か? [Haraguchi+, SIGGRAPH ASIA TC’24] -
50 (再々掲) グラフィックデザイン 表現形式 <svg> <image href=”...” x=...></image> <rect x=55
y =10 color=… ></rect> <text font=Arial x=… >X,XXX円 </text> … </svg> ラスタ • 表示用,ピクセル 集合 • 例: .png, .jpg, … ベクタ • 編集用, レイヤー 集合 • 例: .pptx, .html, .svg, … • 言語ベース マルチモーダル表現 -
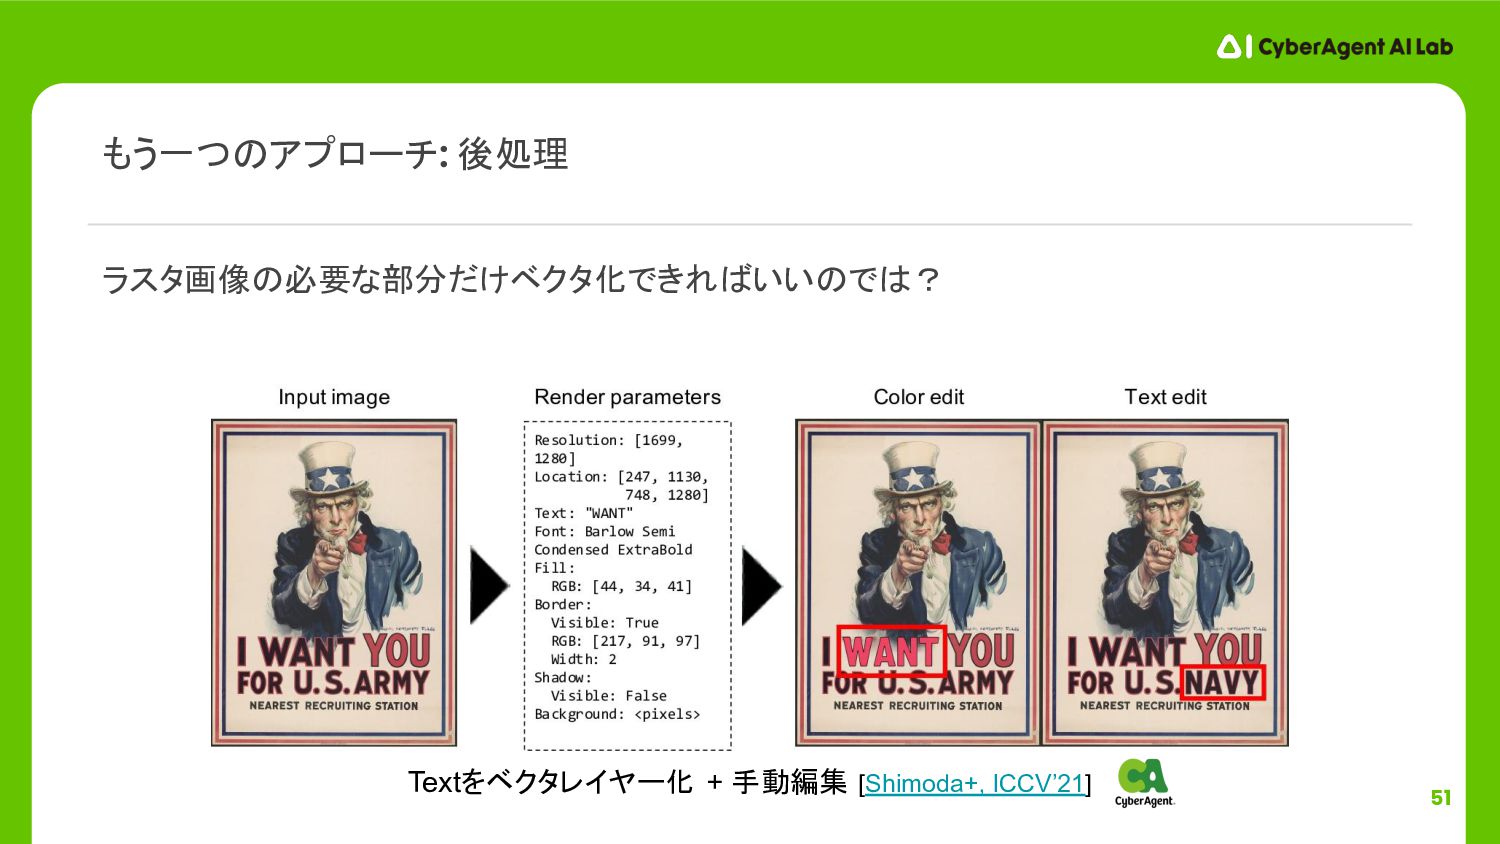
51 ラスタ画像 必要な部分だけベクタ化できれ いい で ? もう一つ アプローチ: 後処理 Textをベクタレイヤー化
+ 手動編集 [Shimoda+, ICCV’21] -
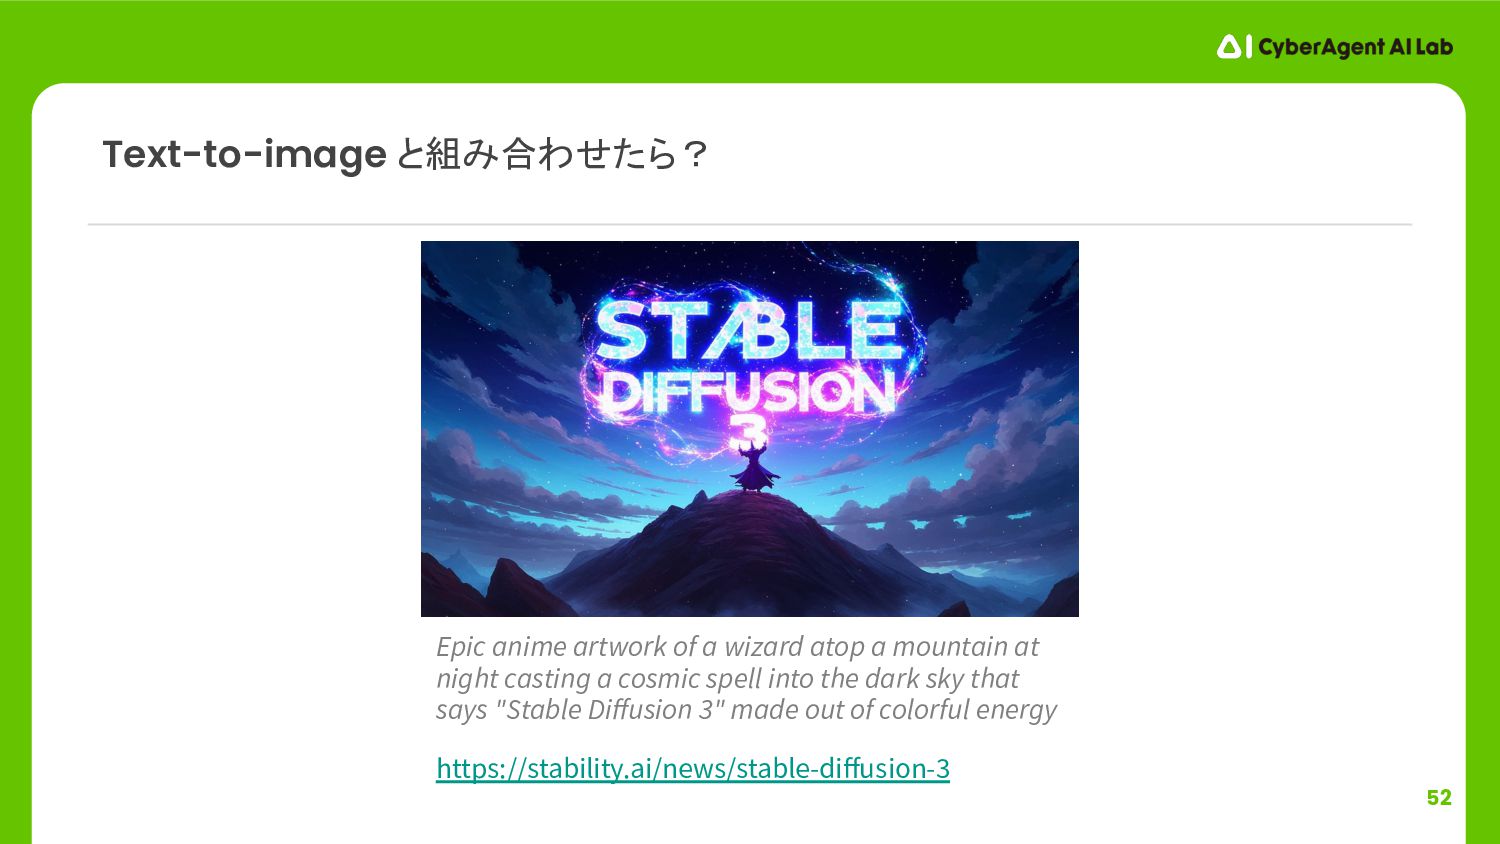
52 Text-to-image と組み合わせたら? Epic anime artwork of a wizard atop
a mountain at night casting a cosmic spell into the dark sky that says "Stable Diffusion 3" made out of colorful energy https://stability.ai/news/stable-diffusion-3 -
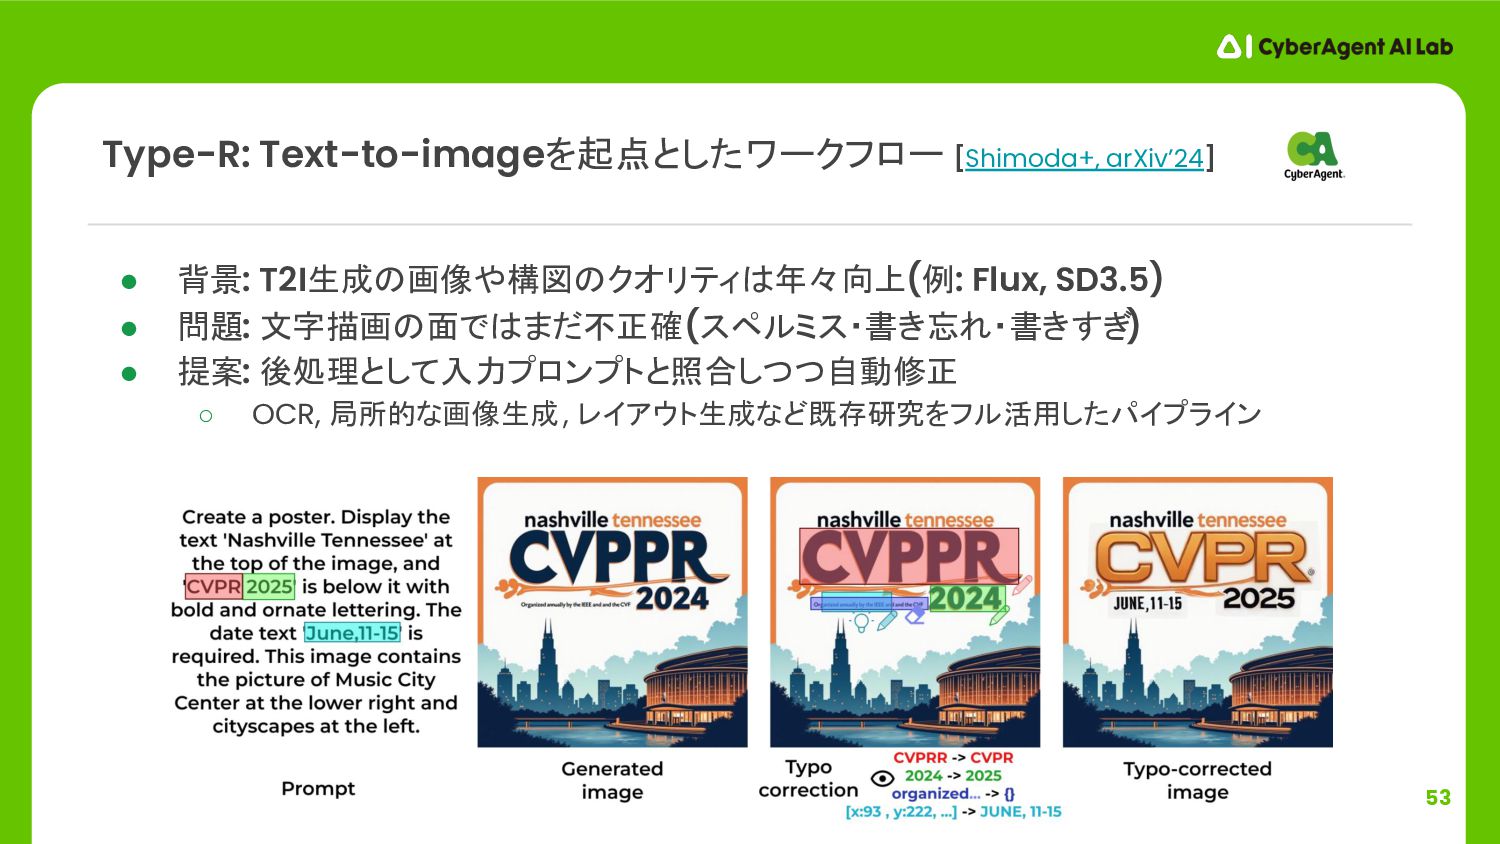
53 • 背景: T2I生成 画像や構図 クオリティ 年々向上 (例: Flux, SD3.5)
• 問題: 文字描画 面で まだ不正確 (スペルミス・書き忘れ・書きすぎ) • 提案: 後処理として入力プロンプトと照合しつつ自動修正 ◦ OCR, 局所的な画像生成, レイアウト生成など既存研究をフル活用したパイプライン Type-R: Text-to-imageを起点としたワークフロー [Shimoda+, arXiv’24] -
55 より複雑な構 化: [Jingye+, arXiv’24] • VLMでレイヤ構 を予測 • SAM
[Killirov+. ICCV’23] で画像も分解 -
56 より複雑な構 化: [Jingye+, arXiv’24] • VLMでレイヤ構 を予測 • SAM
[Killirov+. ICCV’23] で画像も分解 -
57 • 審美性・可読性 低さ → T2Iモデル 目覚ましい性能向上 • 編集性・エラー耐性 低さ
→ マルチモーダル認識・生成技術で修正・構 化 • 画像がメイン デザイン 条件によって こちらで許容される時代がくる? 課題 • 結局モジュールを幾つも追加する で煩雑 • 文章量が増えると一気に質が下がる • 細かな需要 (例: 日本語など多言語,ニッチかつ学習されていなさそうな領域 ) もう一つ 可能性: text-to-image + 後処理 -
58 • かなり複雑なマルチモーダルデータ 生成 • テキストベース 統一表現・基盤モデル活用により研究として扱えるタスクに 今後 方向性 •
より多量かつ表現力 高い学習データ 収集・獲得 • 評価から学習へ フィードバック? (例: RLHF等学習へ フィードバック) • 言語におけるChatGPT ような,生成・編集 万能モデルを作れないか? • 日進月歩 text-to-imageをより中心に据えた新たなワークフロー? まとめ: グラフィックデザイン生成 -
59 • 2024年に第1回, 2025年もCVPRで企画中です (通れ ) • 投稿お待ちしております [PR] Workshop
on Graphic Design Understanding and Generation link -
60 • 正社員 (リサーチサイエンティスト / リサーチエンジニア) • 研究インターン (参考: 2024冬募集)
情報 • 研究領域 • 論文一覧 [PR] We are hiring! -
61 謝辞 K. Kikuchi M. Otani K. Yamaguchi E. Simo-serra
(Waseda U.) CA みなさん 共同研究先 先生・学生・インターン みなさん W. Shimoda K. Masui R. Togashi D. Horita (UTokyo) K. Aizawa (UTokyo) J. Guerreiro (UTokyo) H. Nakayama (UTokyo) S. Uchida (Kyushu U.) D. Haraguchi H. Mitani (Kyushu U.)