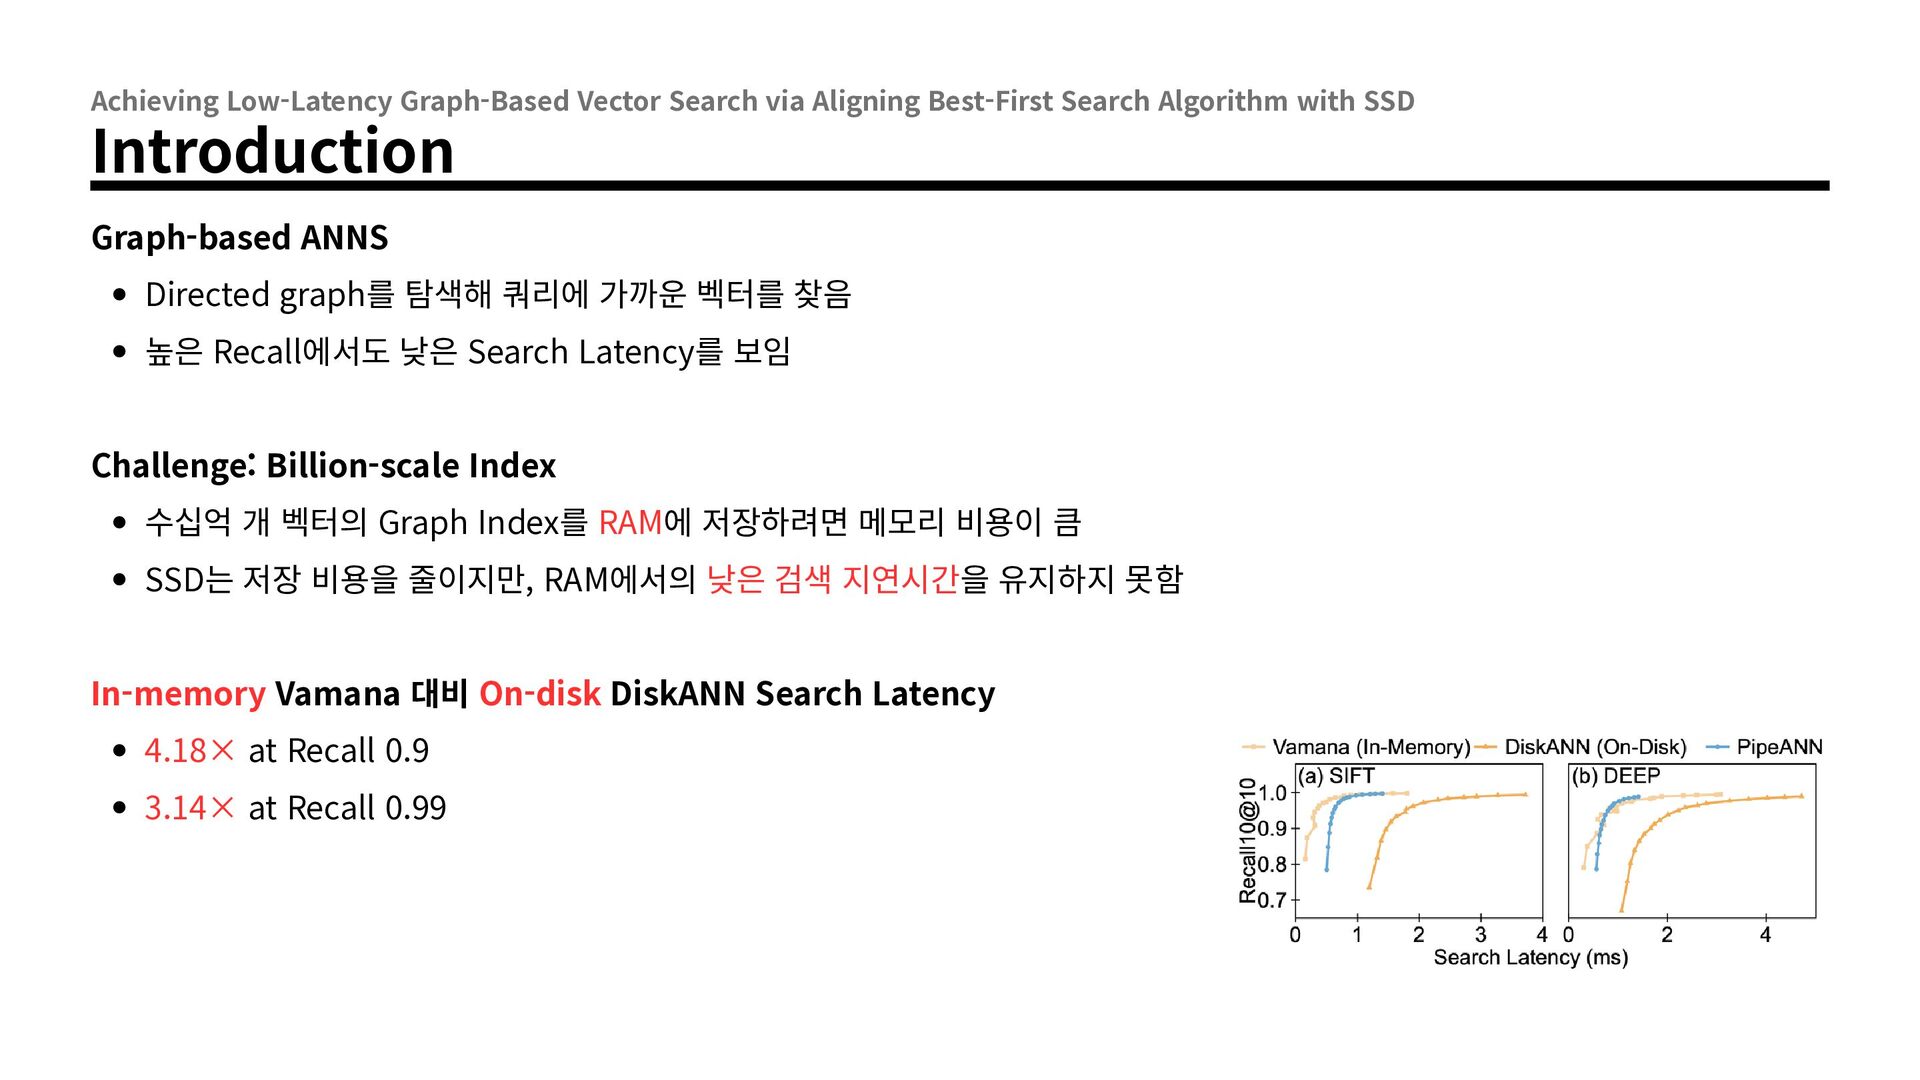
with SSD Introduction Graph-based ANNS Directed graph를 탐색해 쿼리에 가까운 벡터를 찾음 높은 Recall에서도 낮은 Search Latency를 보임 Challenge: Billion-scale Index 수십억 개 벡터의 Graph Index를 RAM에 저장하려면 메모리 비용이 큼 SSD는 저장 비용을 줄이지만, RAM에서의 낮은 검색 지연시간을 유지하지 못함 In-memory Vamana 대비 On-disk DiskANN Search Latency 4.18× at Recall 0.9 3.14× at Recall 0.99
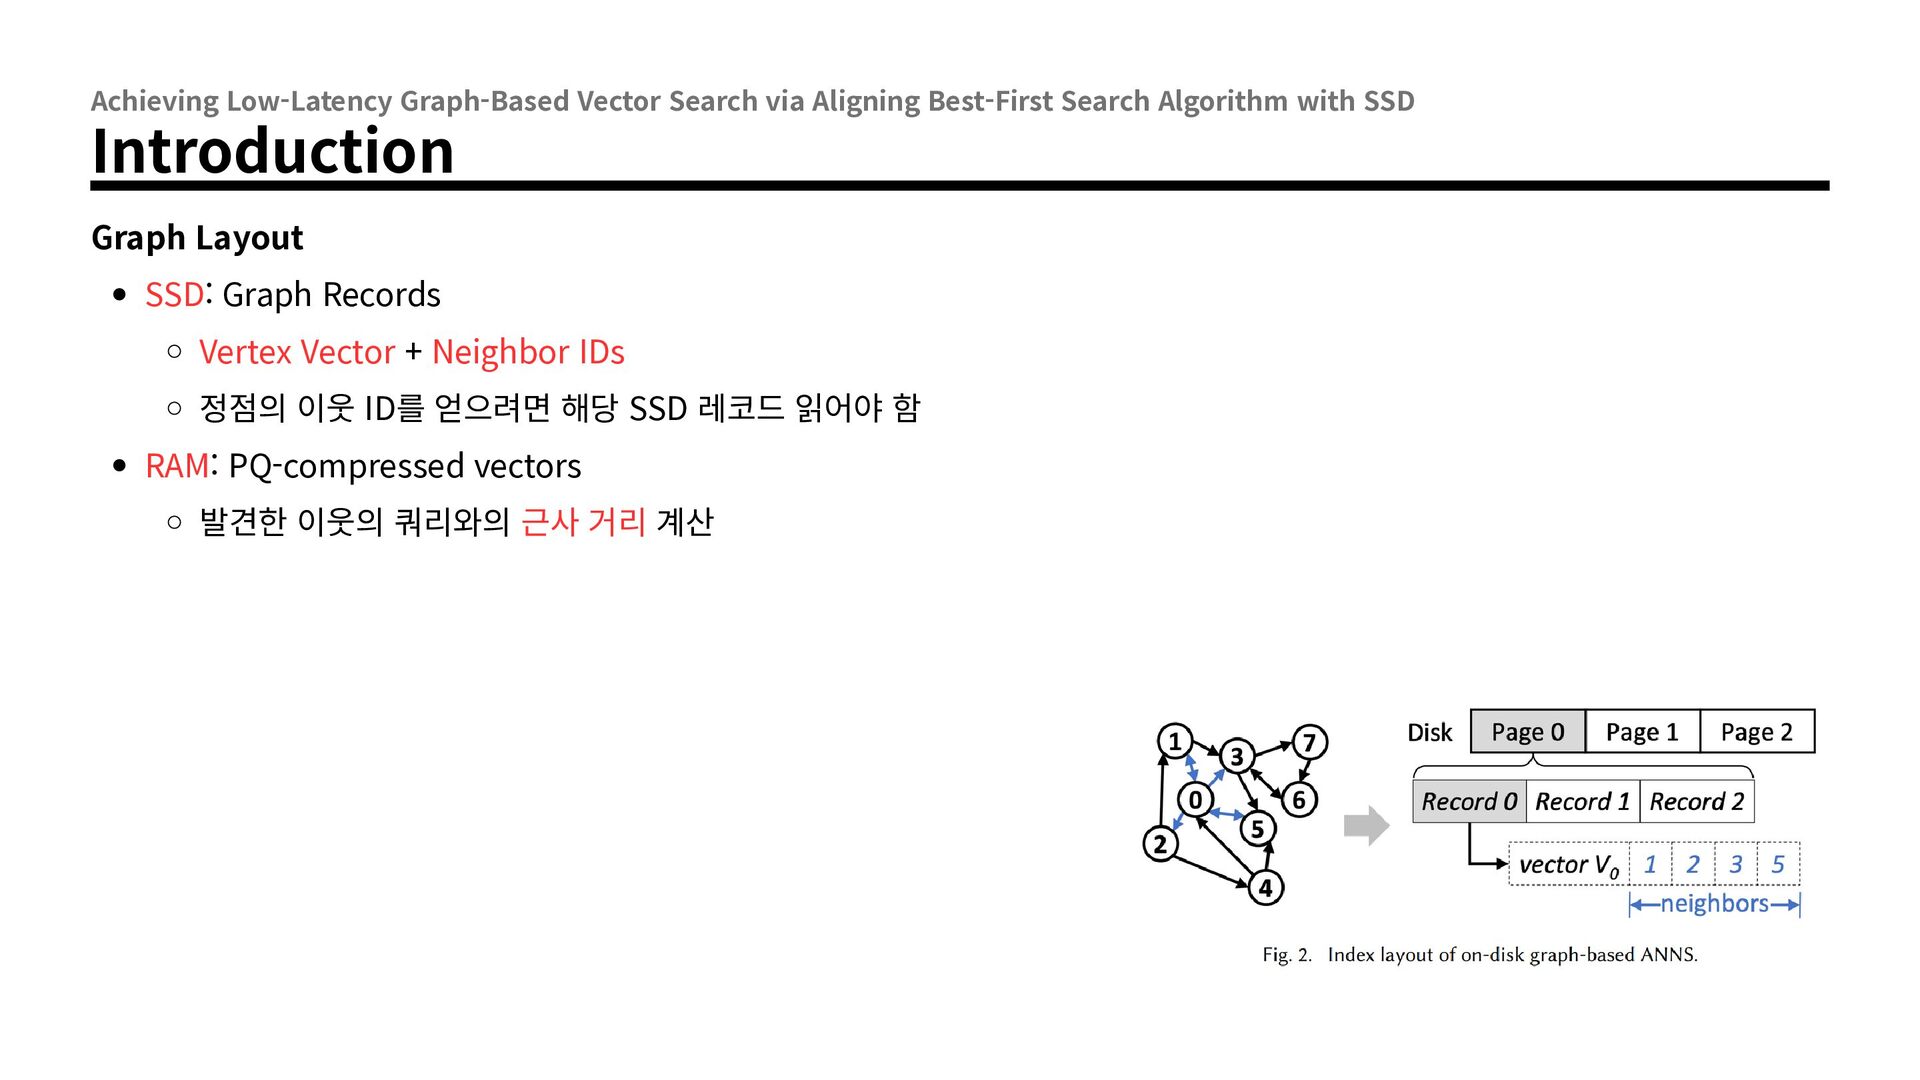
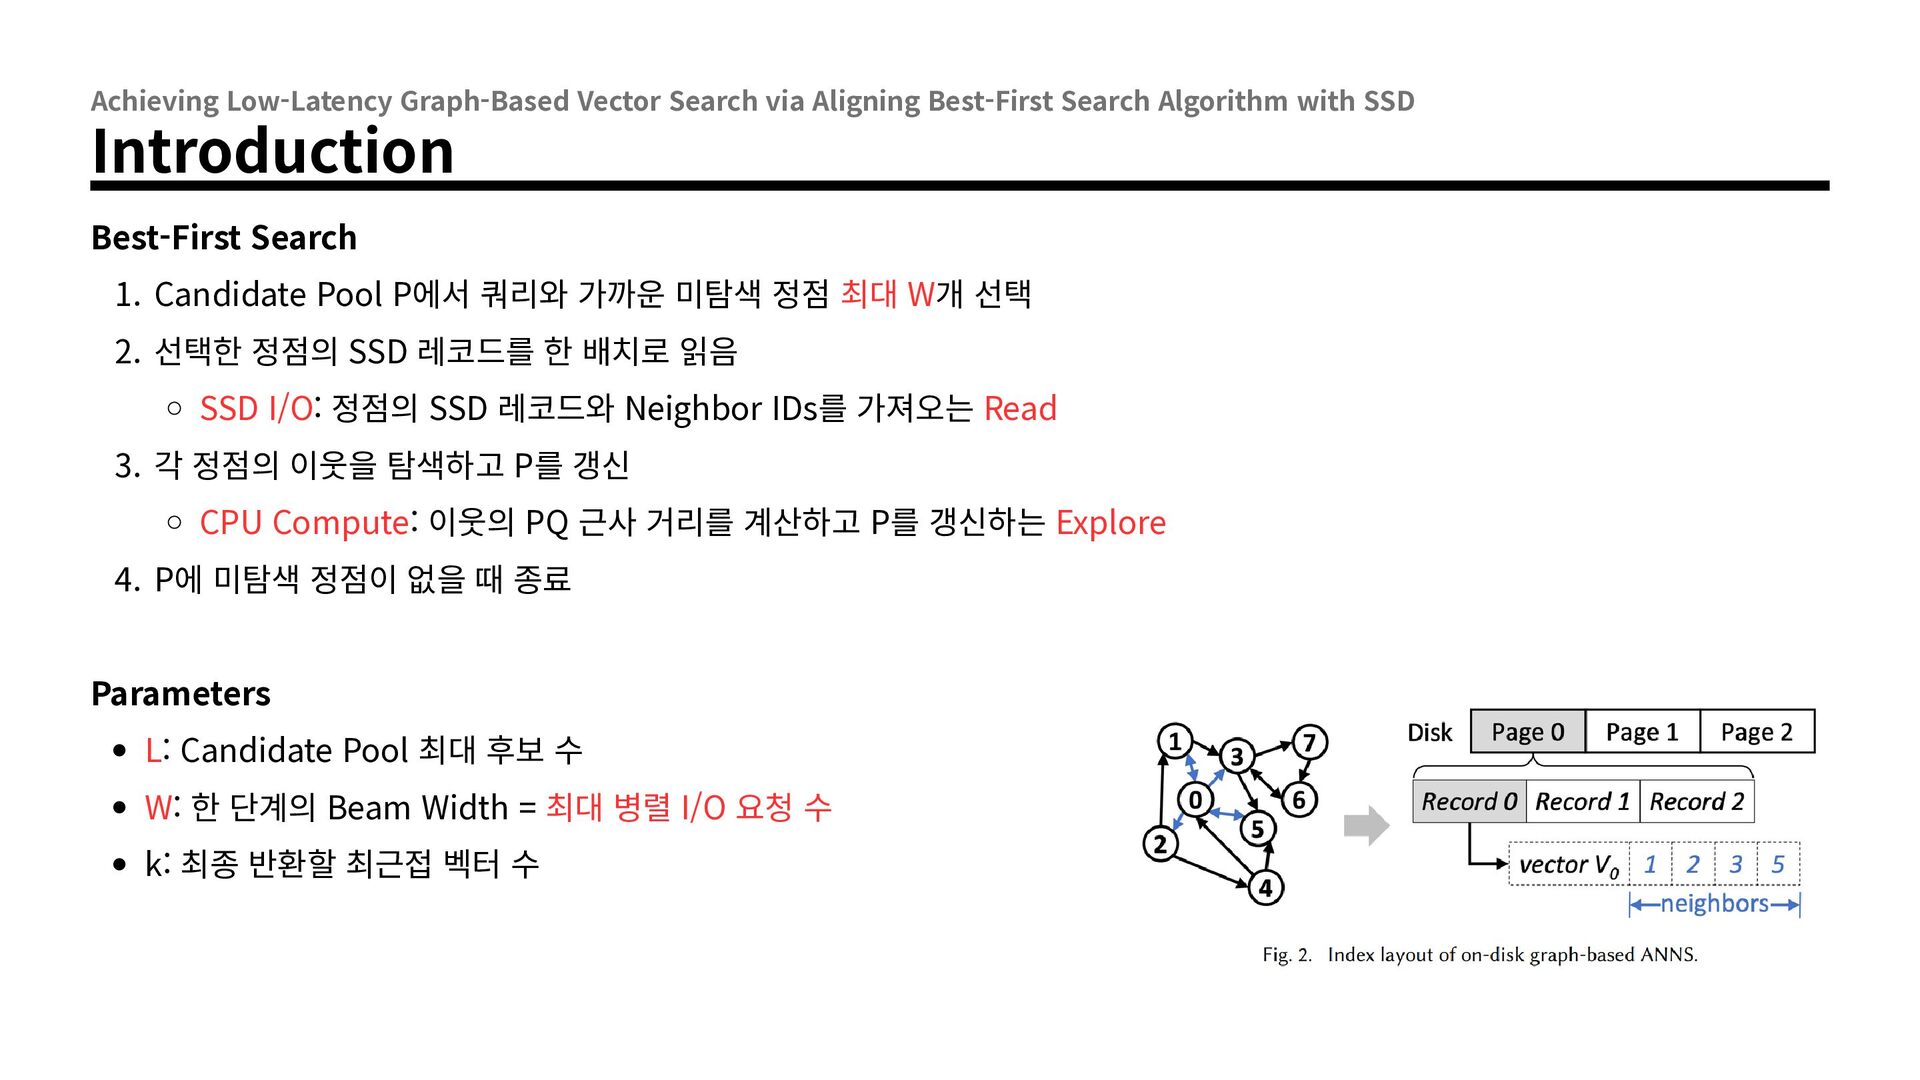
with SSD Introduction Graph Layout SSD: Graph Records Vertex Vector + Neighbor IDs 정점의 이웃 ID를 얻으려면 해당 SSD 레코드 읽어야 함 RAM: PQ-compressed vectors 발견한 이웃의 쿼리와의 근사 거리 계산
with SSD Introduction Best-First Search 1. Candidate Pool P에서 쿼리와 가까운 미탐색 정점 최대 W개 선택 2. 선택한 정점의 SSD 레코드를 한 배치로 읽음 SSD I/O: 정점의 SSD 레코드와 Neighbor IDs를 가져오는 Read 3. 각 정점의 이웃을 탐색하고 P를 갱신 CPU Compute: 이웃의 PQ 근사 거리를 계산하고 P를 갱신하는 Explore 4. P에 미탐색 정점이 없을 때 종료 Parameters L: Candidate Pool 최대 후보 수 W: 한 단계의 Beam Width = 최대 병렬 I/O 요청 수 k: 최종 반환할 최근접 벡터 수
with SSD Background SSD Characteristics Long I/O Latency: 읽기 하나에 μs에서 수십 μs 소요 Asynchronous, Parallel I/O: 여러 읽기 요청을 동시에 처리 가능 Best-First Search on SSD 긴 읽기 대기를 줄이기 위해 W > 1의 Batch Read 사용 W>1로 배치 내부의 읽기는 병렬화 but, 배치 단계 사이의 Compute–I/O 순서와 배치 전체 완료 대기는 유지 Why Low Latency Matters 대규모 검색·추천 서비스는 약 10ms 수준의 응답시간을 요구 검색 시간을 절약하면 같은 시간 예산에서 더 많은 정점을 탐색해 Recall을 높일 수 있음
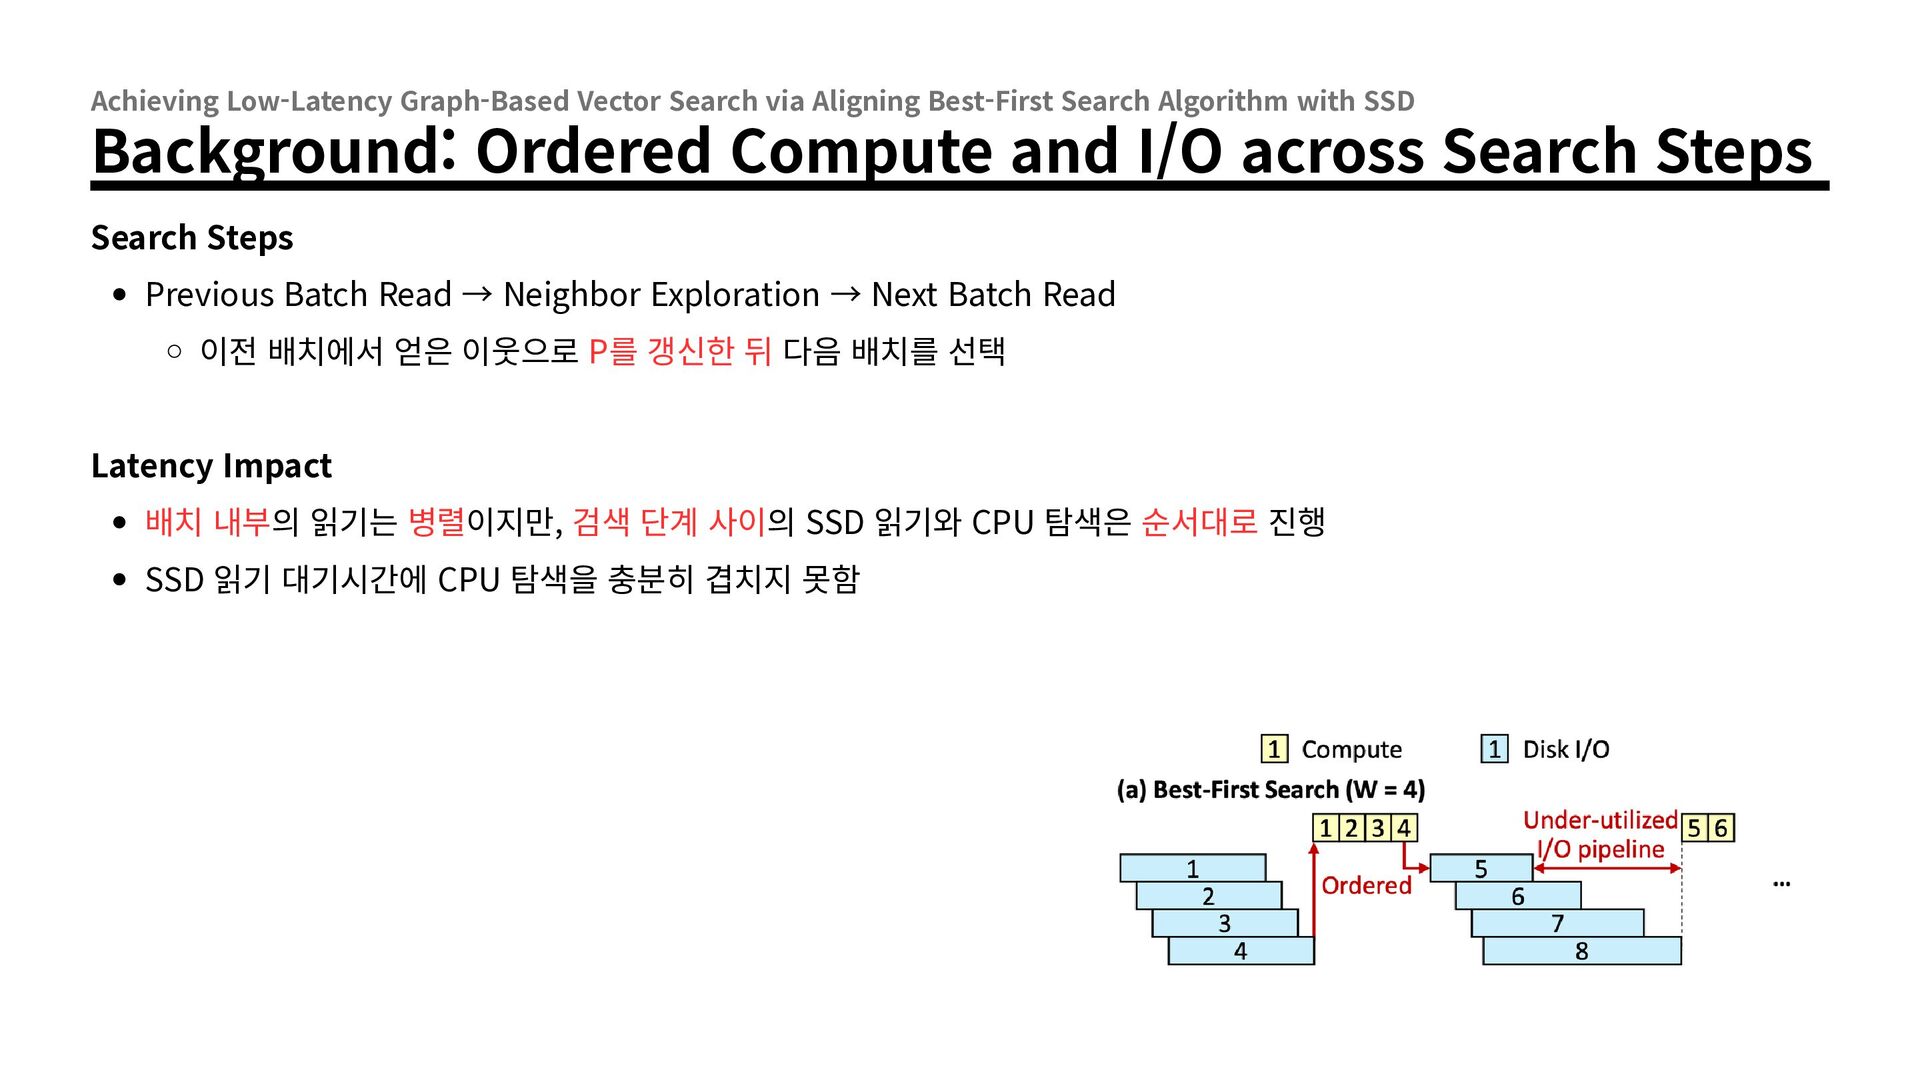
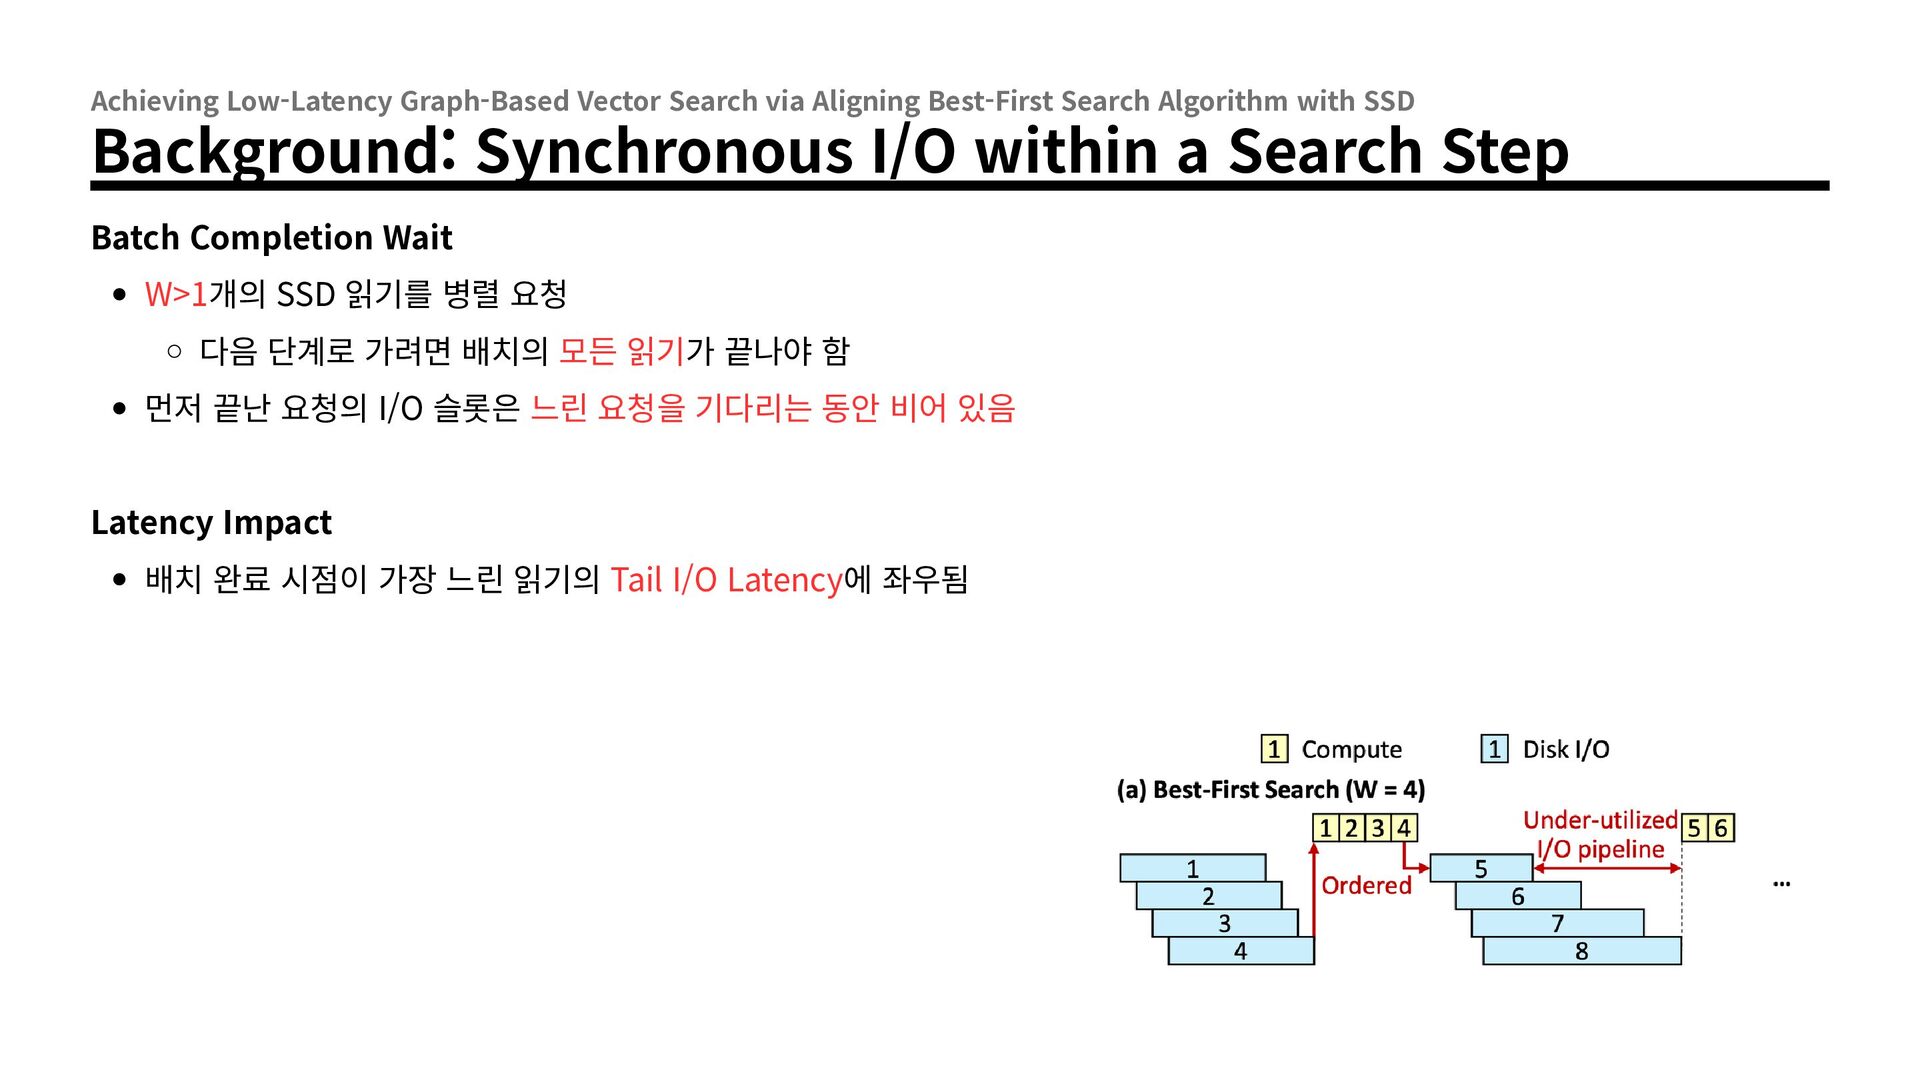
with SSD Background: Ordered Compute and I/O across Search Steps Search Steps Previous Batch Read → Neighbor Exploration → Next Batch Read 이전 배치에서 얻은 이웃으로 P를 갱신한 뒤 다음 배치를 선택 Latency Impact 배치 내부의 읽기는 병렬이지만, 검색 단계 사이의 SSD 읽기와 CPU 탐색은 순서대로 진행 SSD 읽기 대기시간에 CPU 탐색을 충분히 겹치지 못함
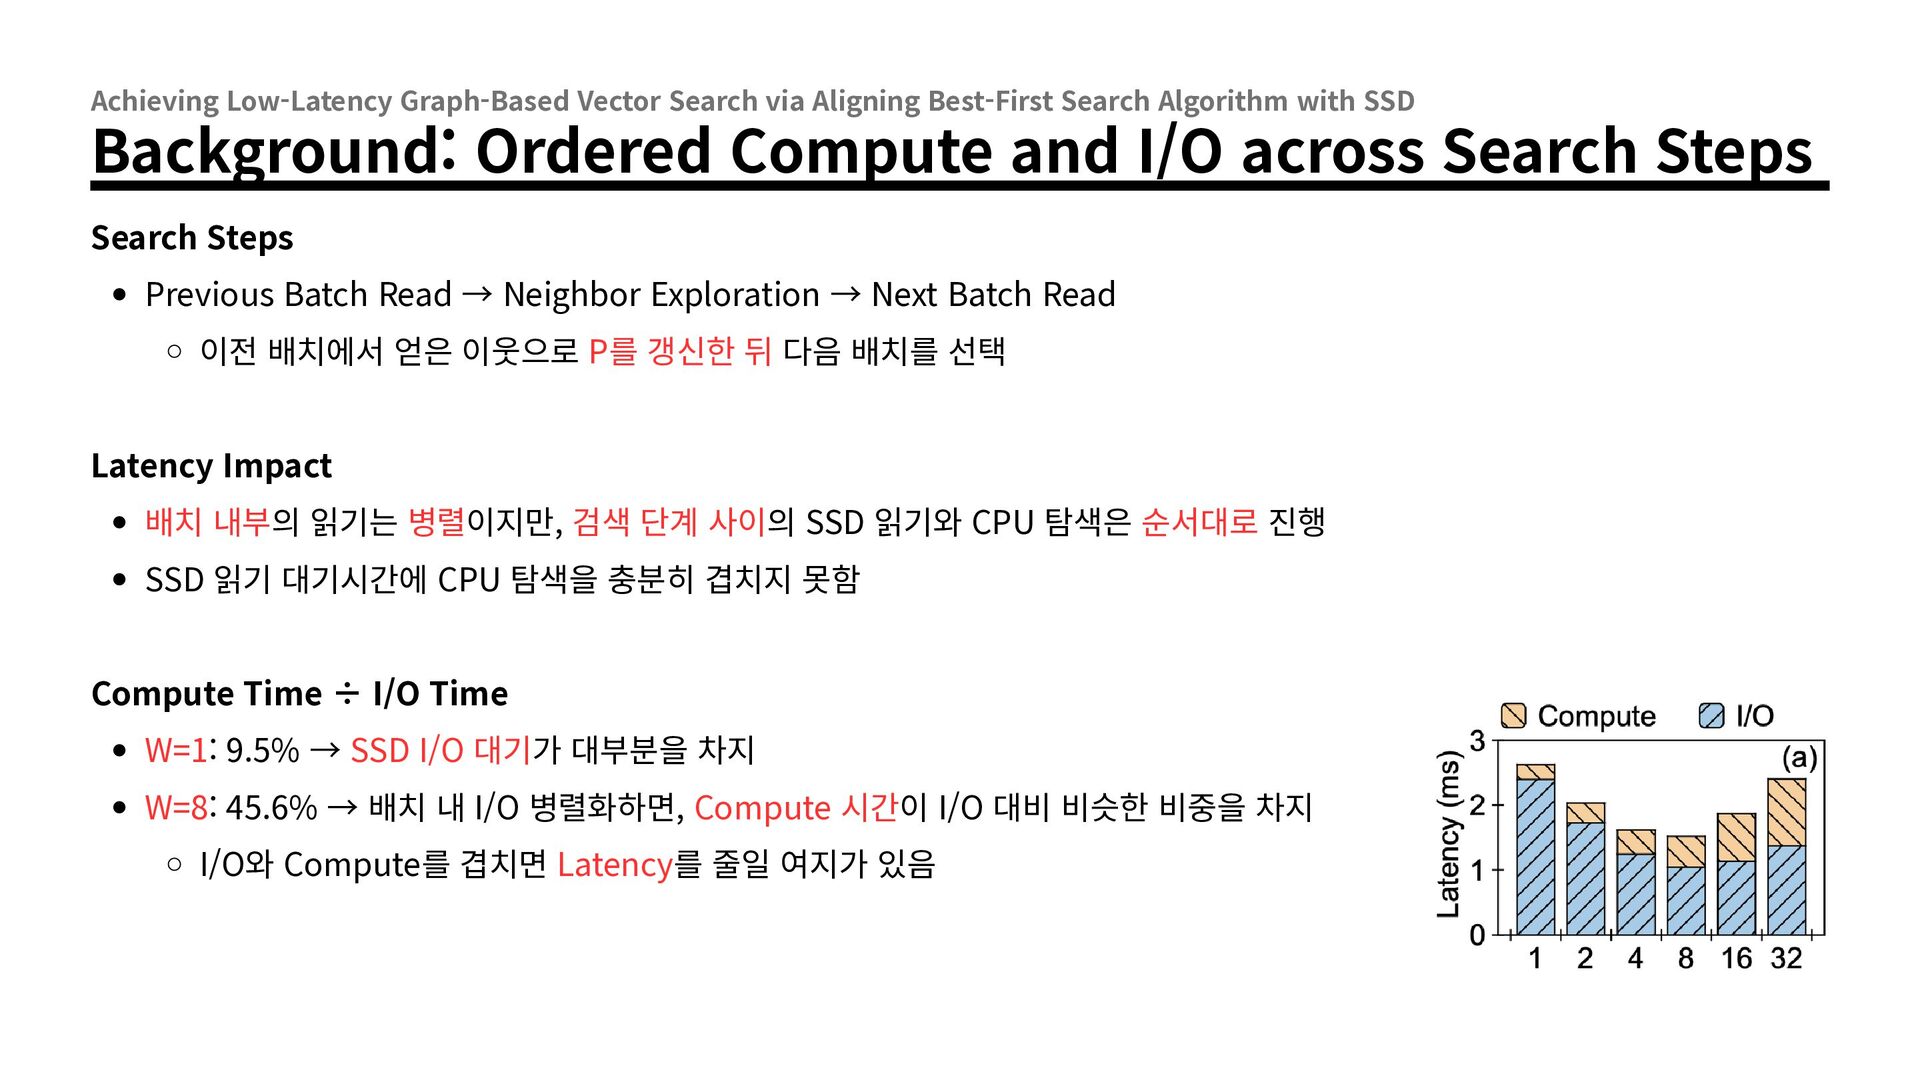
with SSD Background: Ordered Compute and I/O across Search Steps Search Steps Previous Batch Read → Neighbor Exploration → Next Batch Read 이전 배치에서 얻은 이웃으로 P를 갱신한 뒤 다음 배치를 선택 Latency Impact 배치 내부의 읽기는 병렬이지만, 검색 단계 사이의 SSD 읽기와 CPU 탐색은 순서대로 진행 SSD 읽기 대기시간에 CPU 탐색을 충분히 겹치지 못함 Compute Time ÷ I/O Time W=1: 9.5% → SSD I/O 대기가 대부분을 차지 W=8: 45.6% → 배치 내 I/O 병렬화하면, Compute 시간이 I/O 대비 비슷한 비중을 차지 I/O와 Compute를 겹치면 Latency를 줄일 여지가 있음
with SSD Background: Synchronous I/O within a Search Step Batch Completion Wait W>1개의 SSD 읽기를 병렬 요청 다음 단계로 가려면 배치의 모든 읽기가 끝나야 함 먼저 끝난 요청의 I/O 슬롯은 느린 요청을 기다리는 동안 비어 있음 Latency Impact 배치 완료 시점이 가장 느린 읽기의 Tail I/O Latency에 좌우됨
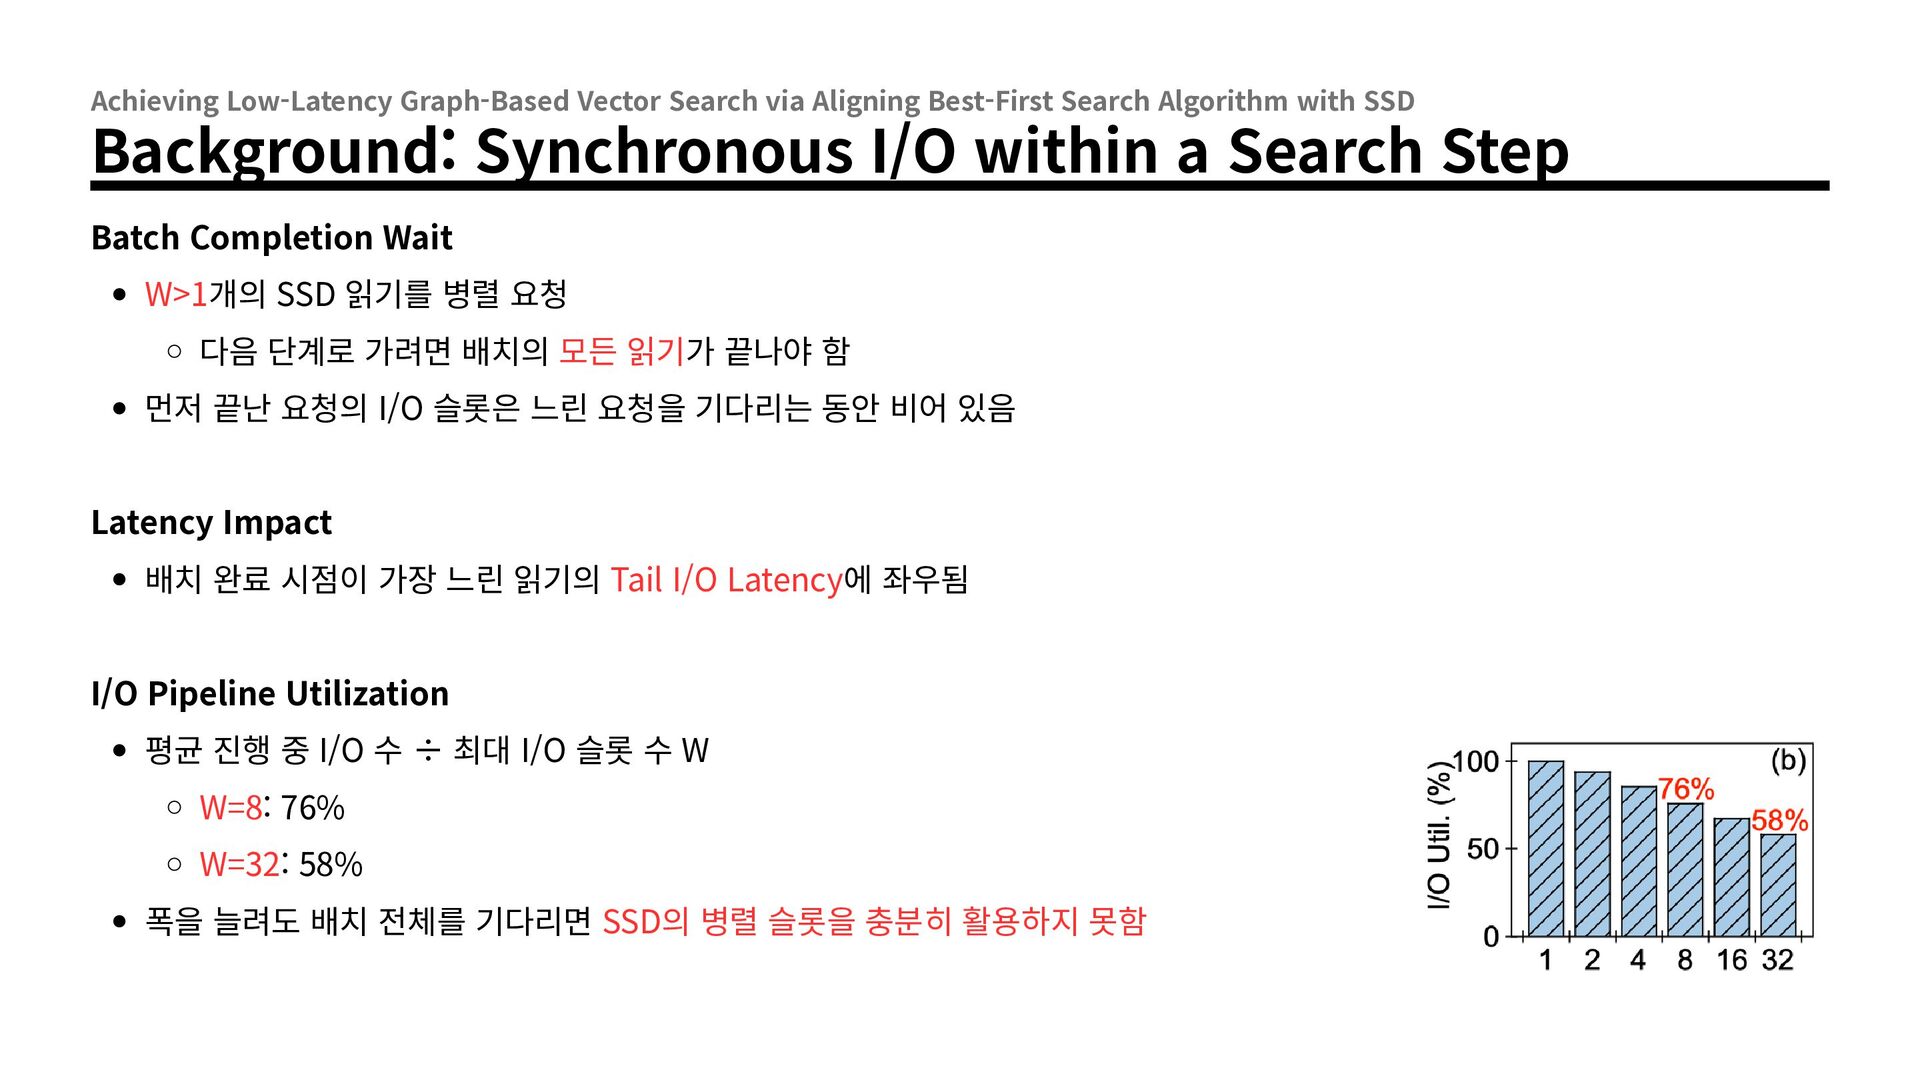
with SSD Background: Synchronous I/O within a Search Step Batch Completion Wait W>1개의 SSD 읽기를 병렬 요청 다음 단계로 가려면 배치의 모든 읽기가 끝나야 함 먼저 끝난 요청의 I/O 슬롯은 느린 요청을 기다리는 동안 비어 있음 Latency Impact 배치 완료 시점이 가장 느린 읽기의 Tail I/O Latency에 좌우됨 I/O Pipeline Utilization 평균 진행 중 I/O 수 ÷ 최대 I/O 슬롯 수 W W=8: 76% W=32: 58% 폭을 늘려도 배치 전체를 기다리면 SSD의 병렬 슬롯을 충분히 활용하지 못함
with SSD PipeSearch - Motivation Multiple Search Paths Graph의 한 정점에는 여러 진입 경로가 존재 Best-First가 우선하는 경로는 짧을 것으로 추정한 경로이며 유일한 경로가 아님 처리 순서를 완화하면 경로가 길어질 수 있지만, 다른 경로로 검색을 계속할 수 있음 Pseudo-dependency of Compute and I/O 다음 읽기 대상은 RAM의 Candidate Pool에 이미 있는 정점 ID로 선택 가능 진행 중인 I/O와 이웃 탐색을 모두 기다려야만 읽기를 요청할 수 있는 것은 아님
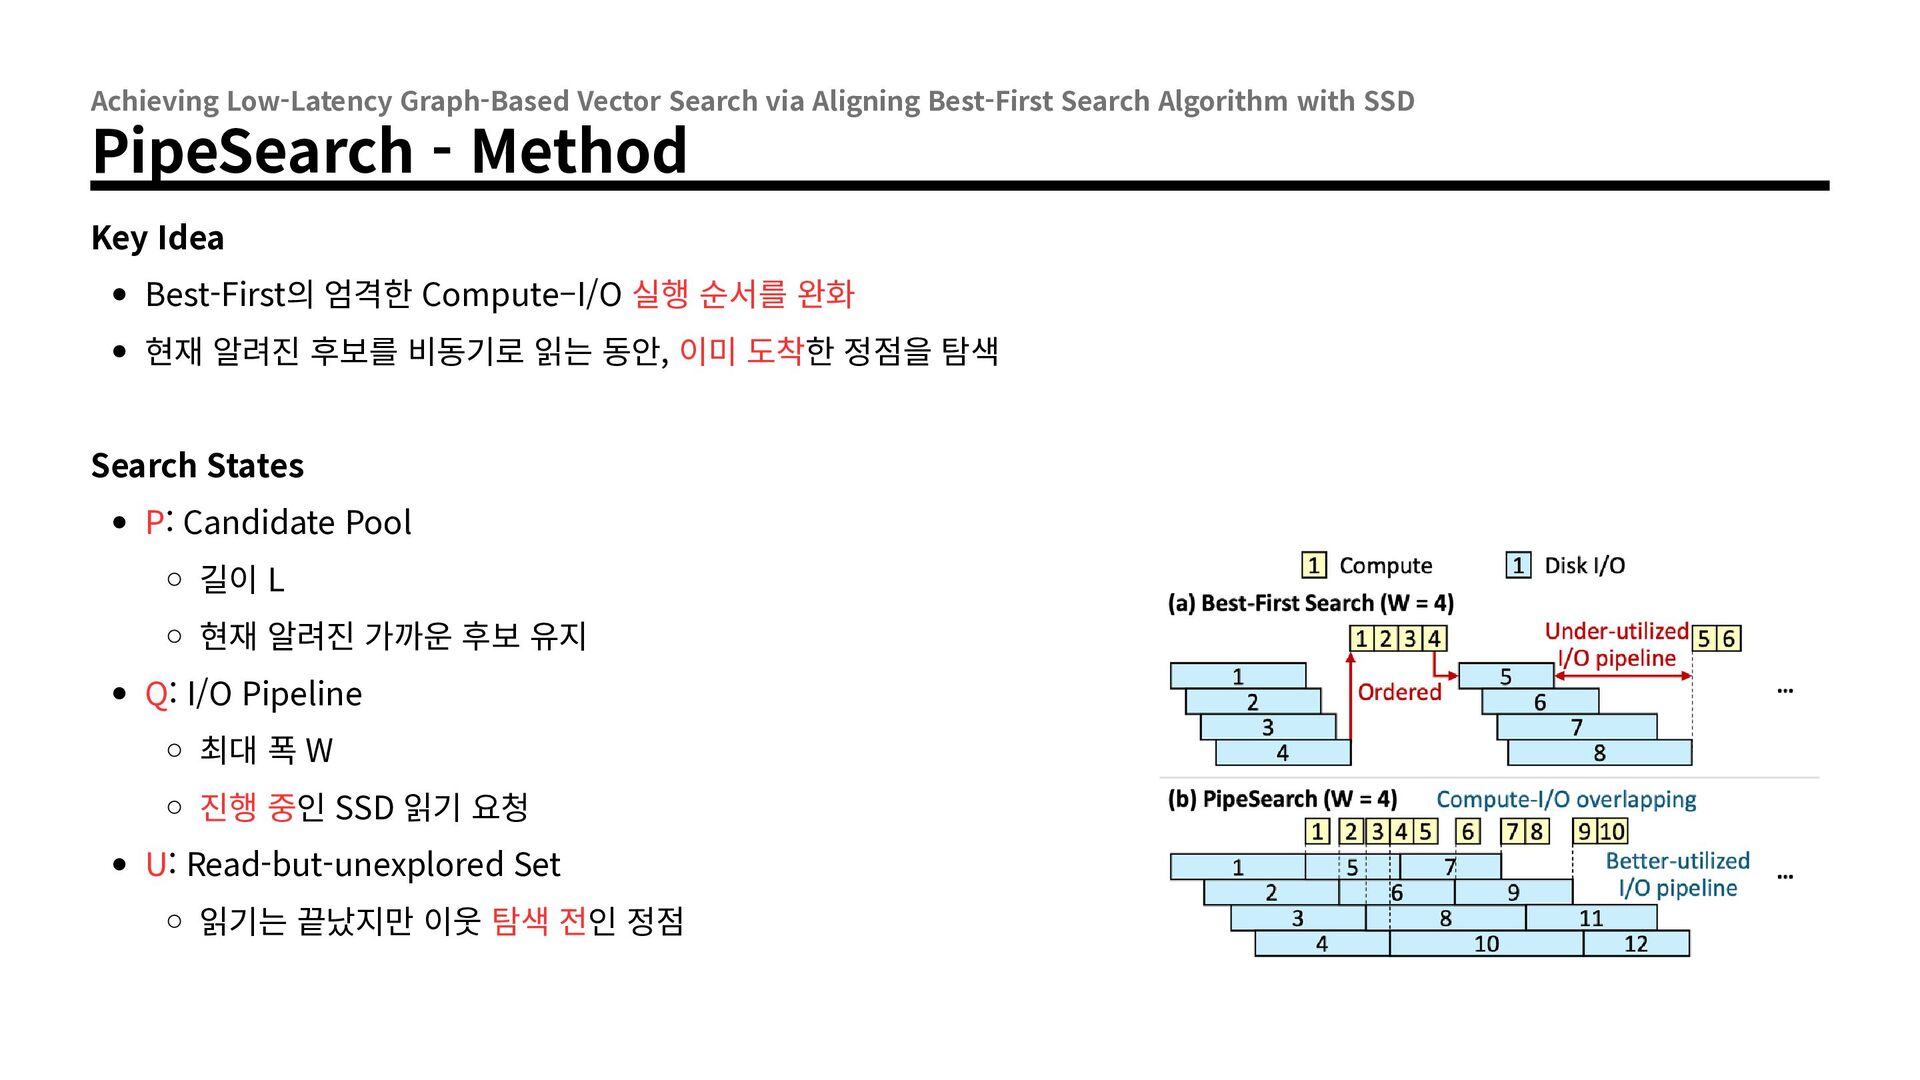
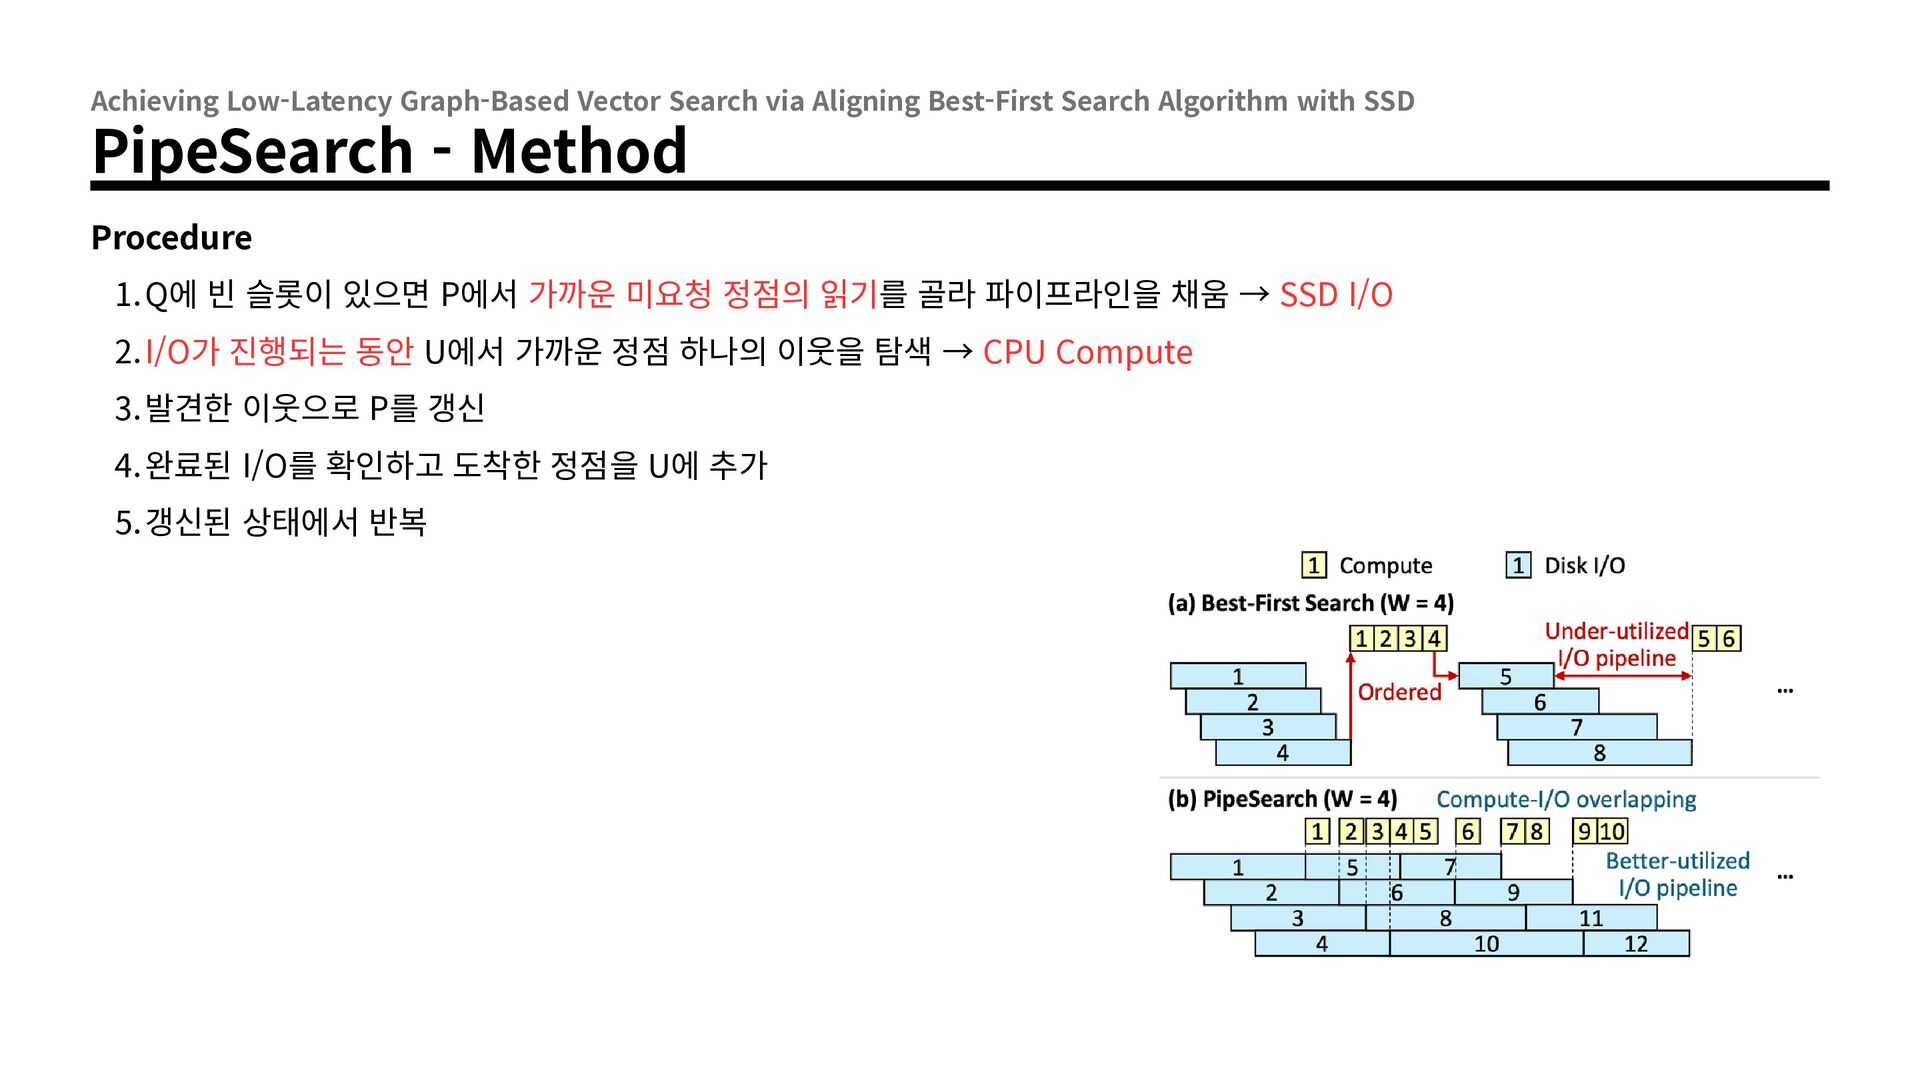
with SSD PipeSearch - Method Key Idea Best-First의 엄격한 Compute–I/O 실행 순서를 완화 현재 알려진 후보를 비동기로 읽는 동안, 이미 도착한 정점을 탐색 Search States P: Candidate Pool 길이 L 현재 알려진 가까운 후보 유지 Q: I/O Pipeline 최대 폭 W 진행 중인 SSD 읽기 요청 U: Read-but-unexplored Set 읽기는 끝났지만 이웃 탐색 전인 정점
with SSD PipeSearch - Method Procedure 1.Q에 빈 슬롯이 있으면 P에서 가까운 미요청 정점의 읽기를 골라 파이프라인을 채움 → SSD I/O 2.I/O가 진행되는 동안 U에서 가까운 정점 하나의 이웃을 탐색 → CPU Compute 3.발견한 이웃으로 P를 갱신 4.완료된 I/O를 확인하고 도착한 정점을 U에 추가 5.갱신된 상태에서 반복
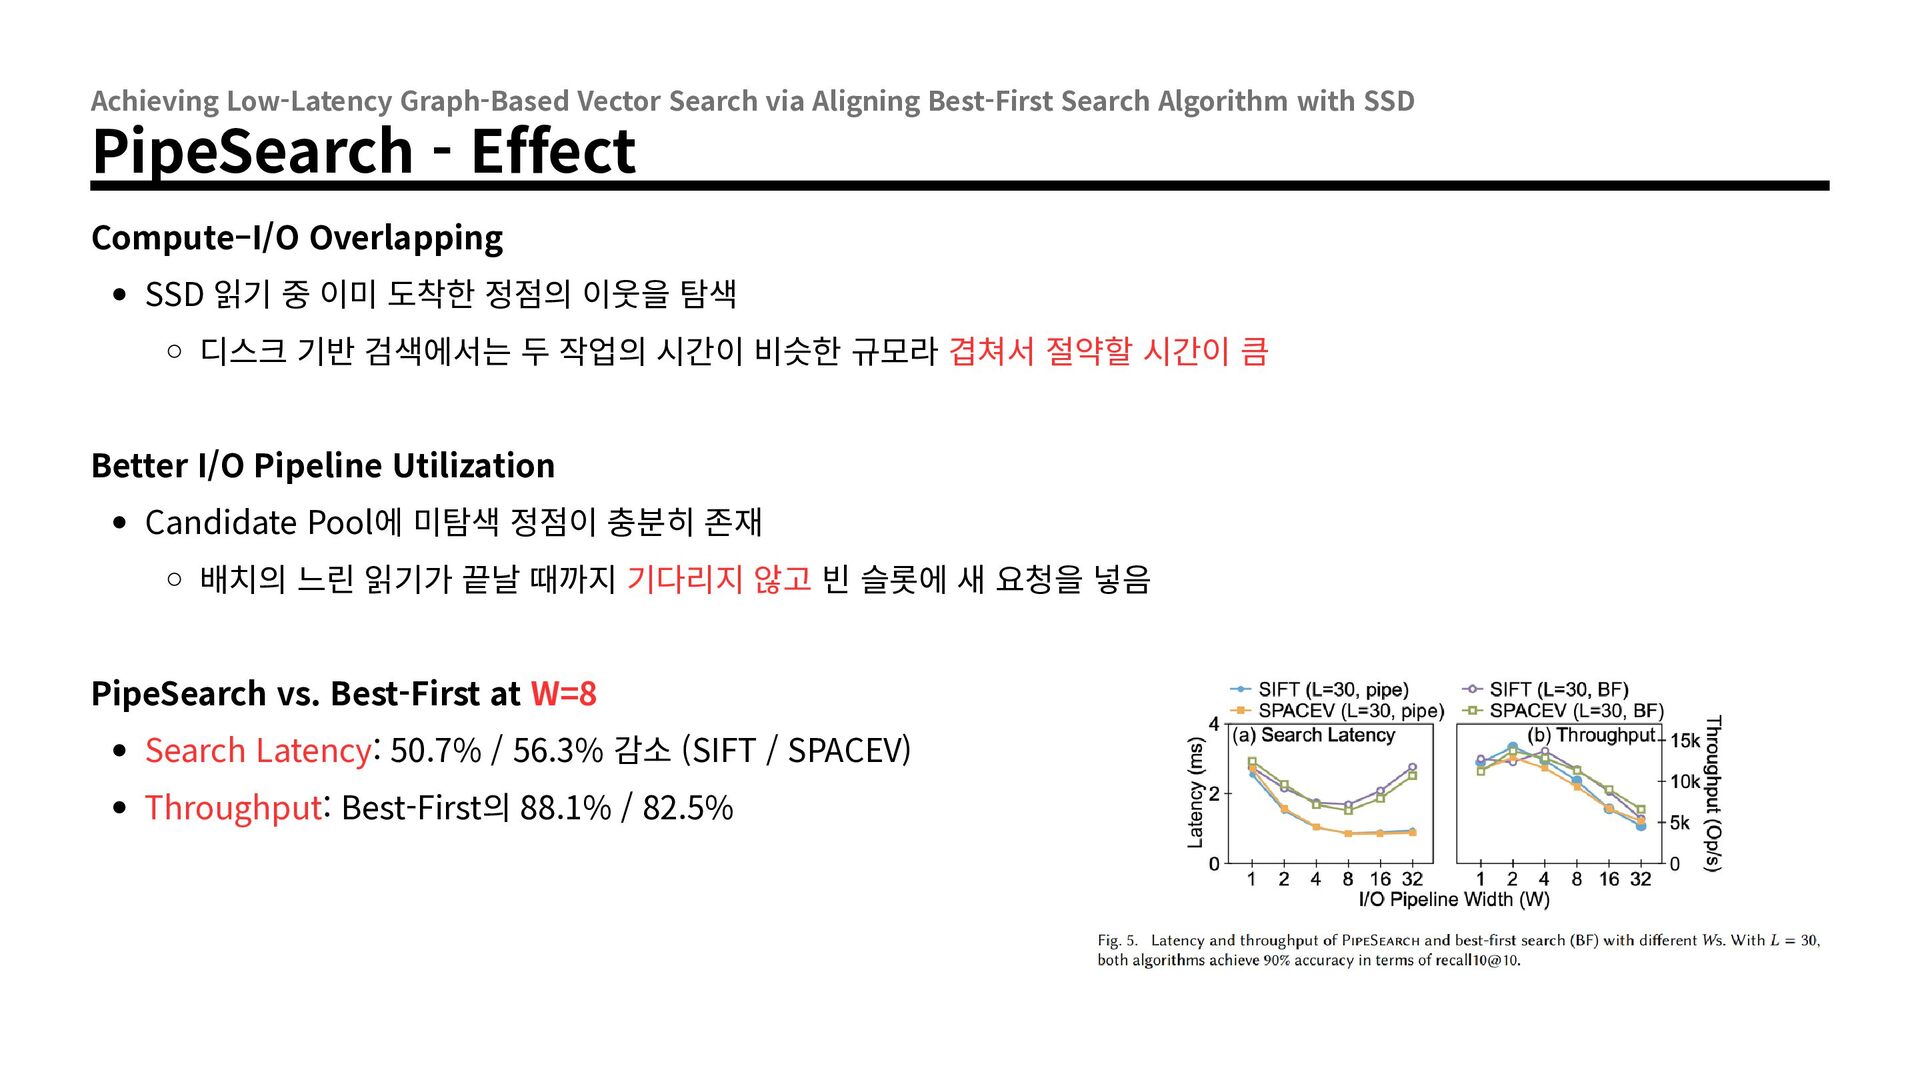
with SSD PipeSearch - Effect Compute–I/O Overlapping SSD 읽기 중 이미 도착한 정점의 이웃을 탐색 디스크 기반 검색에서는 두 작업의 시간이 비슷한 규모라 겹쳐서 절약할 시간이 큼 Better I/O Pipeline Utilization Candidate Pool에 미탐색 정점이 충분히 존재 배치의 느린 읽기가 끝날 때까지 기다리지 않고 빈 슬롯에 새 요청을 넣음 PipeSearch vs. Best-First at W=8 Search Latency: 50.7% / 56.3% 감소 (SIFT / SPACEV) Throughput: Best-First의 88.1% / 82.5%
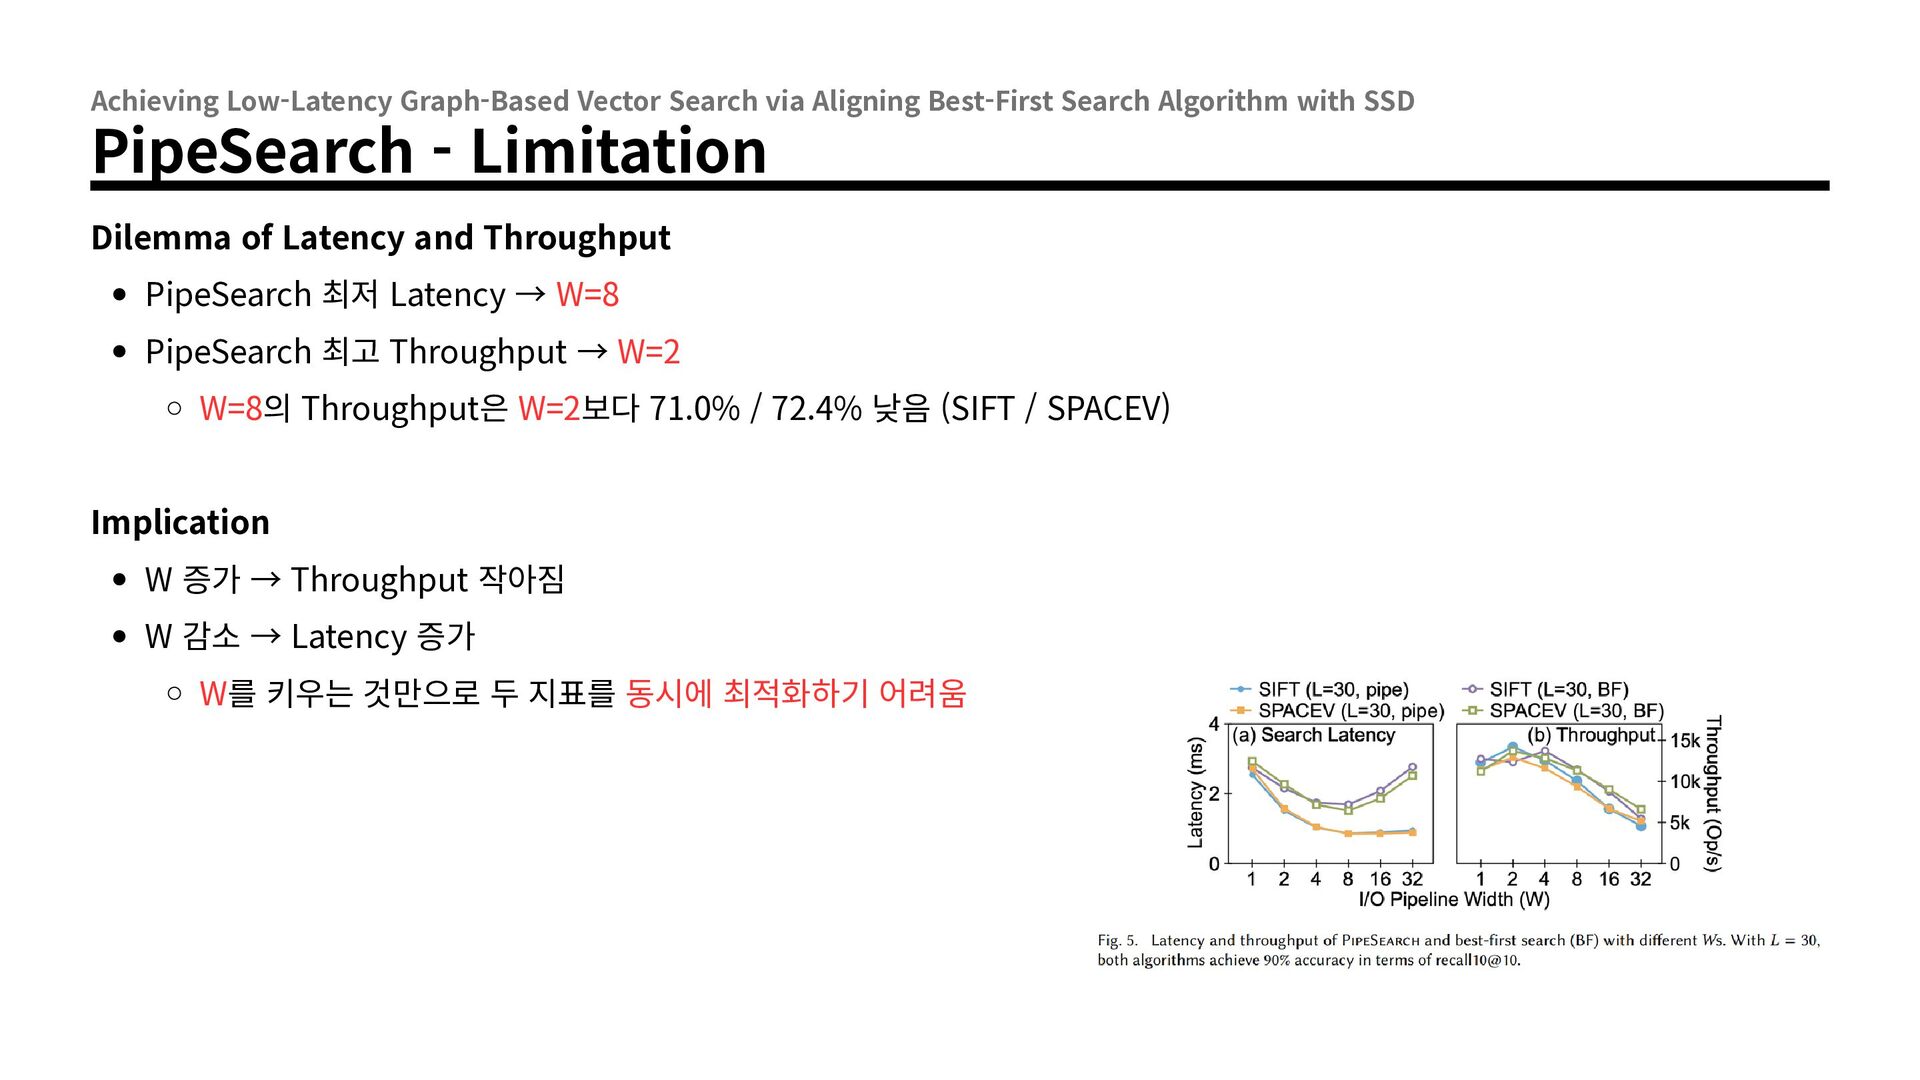
with SSD PipeSearch - Limitation Dilemma of Latency and Throughput PipeSearch 최저 Latency → W=8 PipeSearch 최고 Throughput → W=2 W=8의 Throughput은 W=2보다 71.0% / 72.4% 낮음 (SIFT / SPACEV) Implication W 증가 → Throughput 작아짐 W 감소 → Latency 증가 W를 키우는 것만으로 두 지표를 동시에 최적화하기 어려움
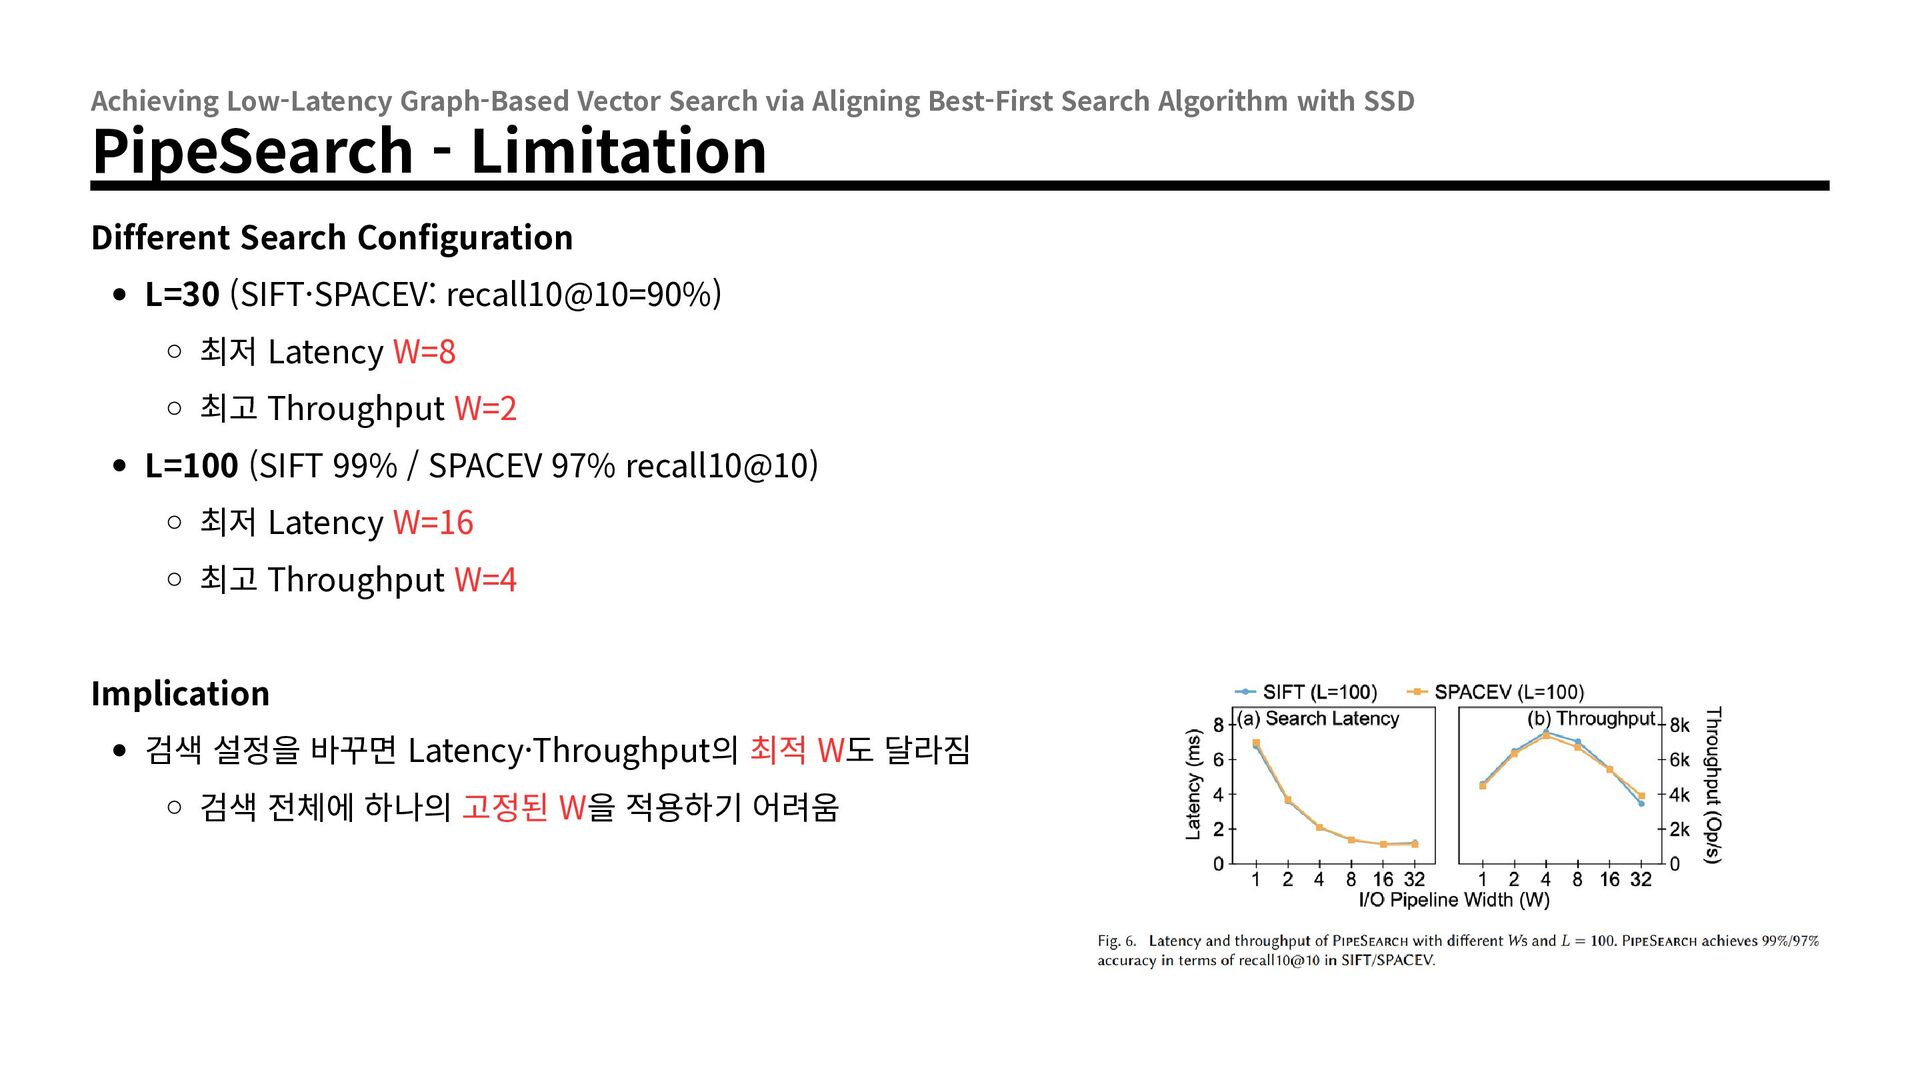
with SSD PipeSearch - Limitation Different Search Configuration L=30 (SIFT·SPACEV: recall10@10=90%) 최저 Latency W=8 최고 Throughput W=2 L=100 (SIFT 99% / SPACEV 97% recall10@10) 최저 Latency W=16 최고 Throughput W=4 Implication 검색 설정을 바꾸면 Latency·Throughput의 최적 W도 달라짐 검색 전체에 하나의 고정된 W을 적용하기 어려움
with SSD PipeSearch - Limitation Large Pipeline Width 탐색 결과가 나오기 전에 더 많은 후보를 미리 읽음 → Speculative I/O 증가 Accumulated Read-but-unexplored Vectors SSD 레코드는 도착했지만 이웃 정보가 아직 P에 반영되지 않음 오래된 Candidate Pool을 기준으로 다음 I/O를 선택 → 불필요한 I/O 증가 I/O Waste → More I/Os per Search → Earlier SSD Saturation → Lower Throughput PipeSearch의 낮은 Latency를 유지하면서 I/O Waste를 줄일 수 있을까?
with SSD Contribution Problem Characterization Best-First Search와 SSD 특성의 불일치 분석 단계 간 Compute–I/O 순서와 배치 내부의 완료 대기를 지연시간의 원인으로 규명 PipeSearch Algorithm 엄격한 검색 단계 간 순서 완화 Compute–I/O Overlapping과 I/O Pipeline Utilization 개선 PipeANN System Dynamic Pipeline Width와 I/O 결정 순서 최적화 PipeSearch의 I/O Waste를 줄여 Throughput 개선
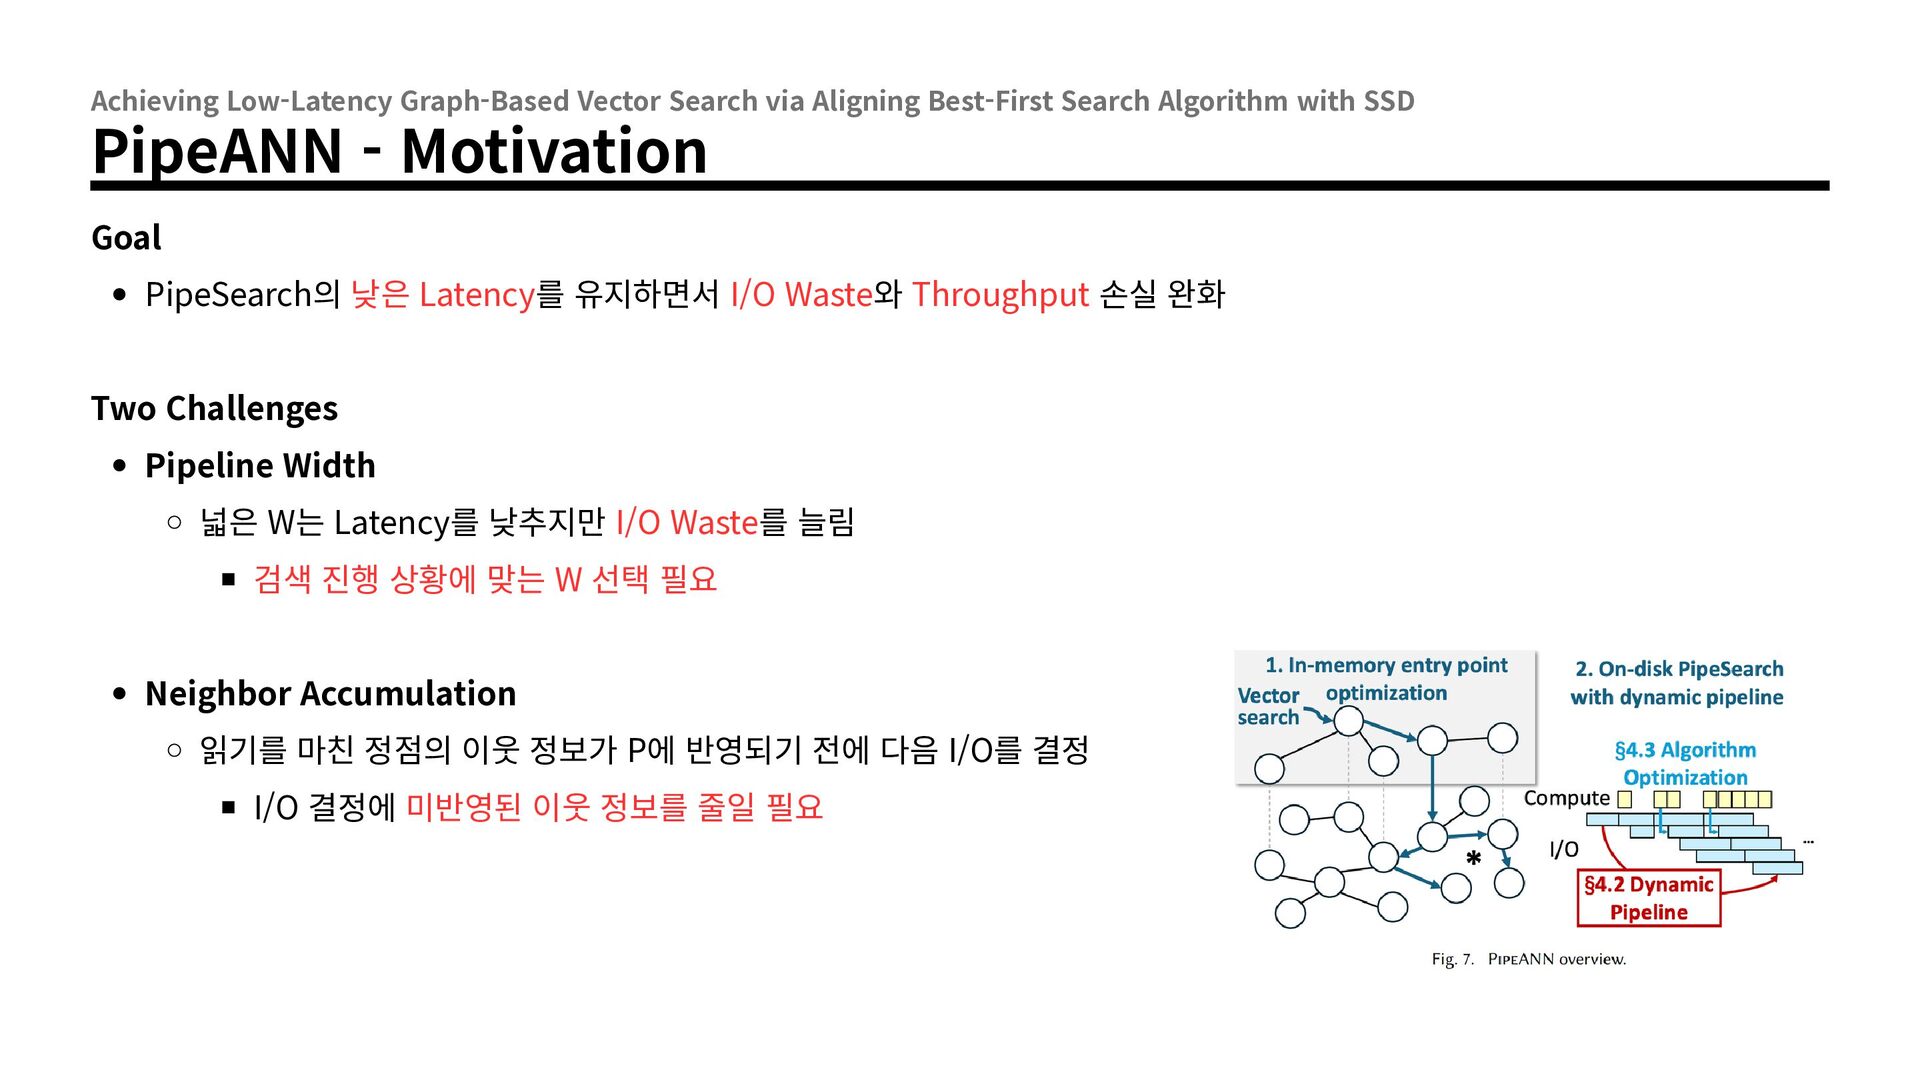
with SSD PipeANN - Motivation Goal PipeSearch의 낮은 Latency를 유지하면서 I/O Waste와 Throughput 손실 완화 Two Challenges Pipeline Width 넓은 W는 Latency를 낮추지만 I/O Waste를 늘림 검색 진행 상황에 맞는 W 선택 필요 Neighbor Accumulation 읽기를 마친 정점의 이웃 정보가 P에 반영되기 전에 다음 I/O를 결정 I/O 결정에 미반영된 이웃 정보를 줄일 필요
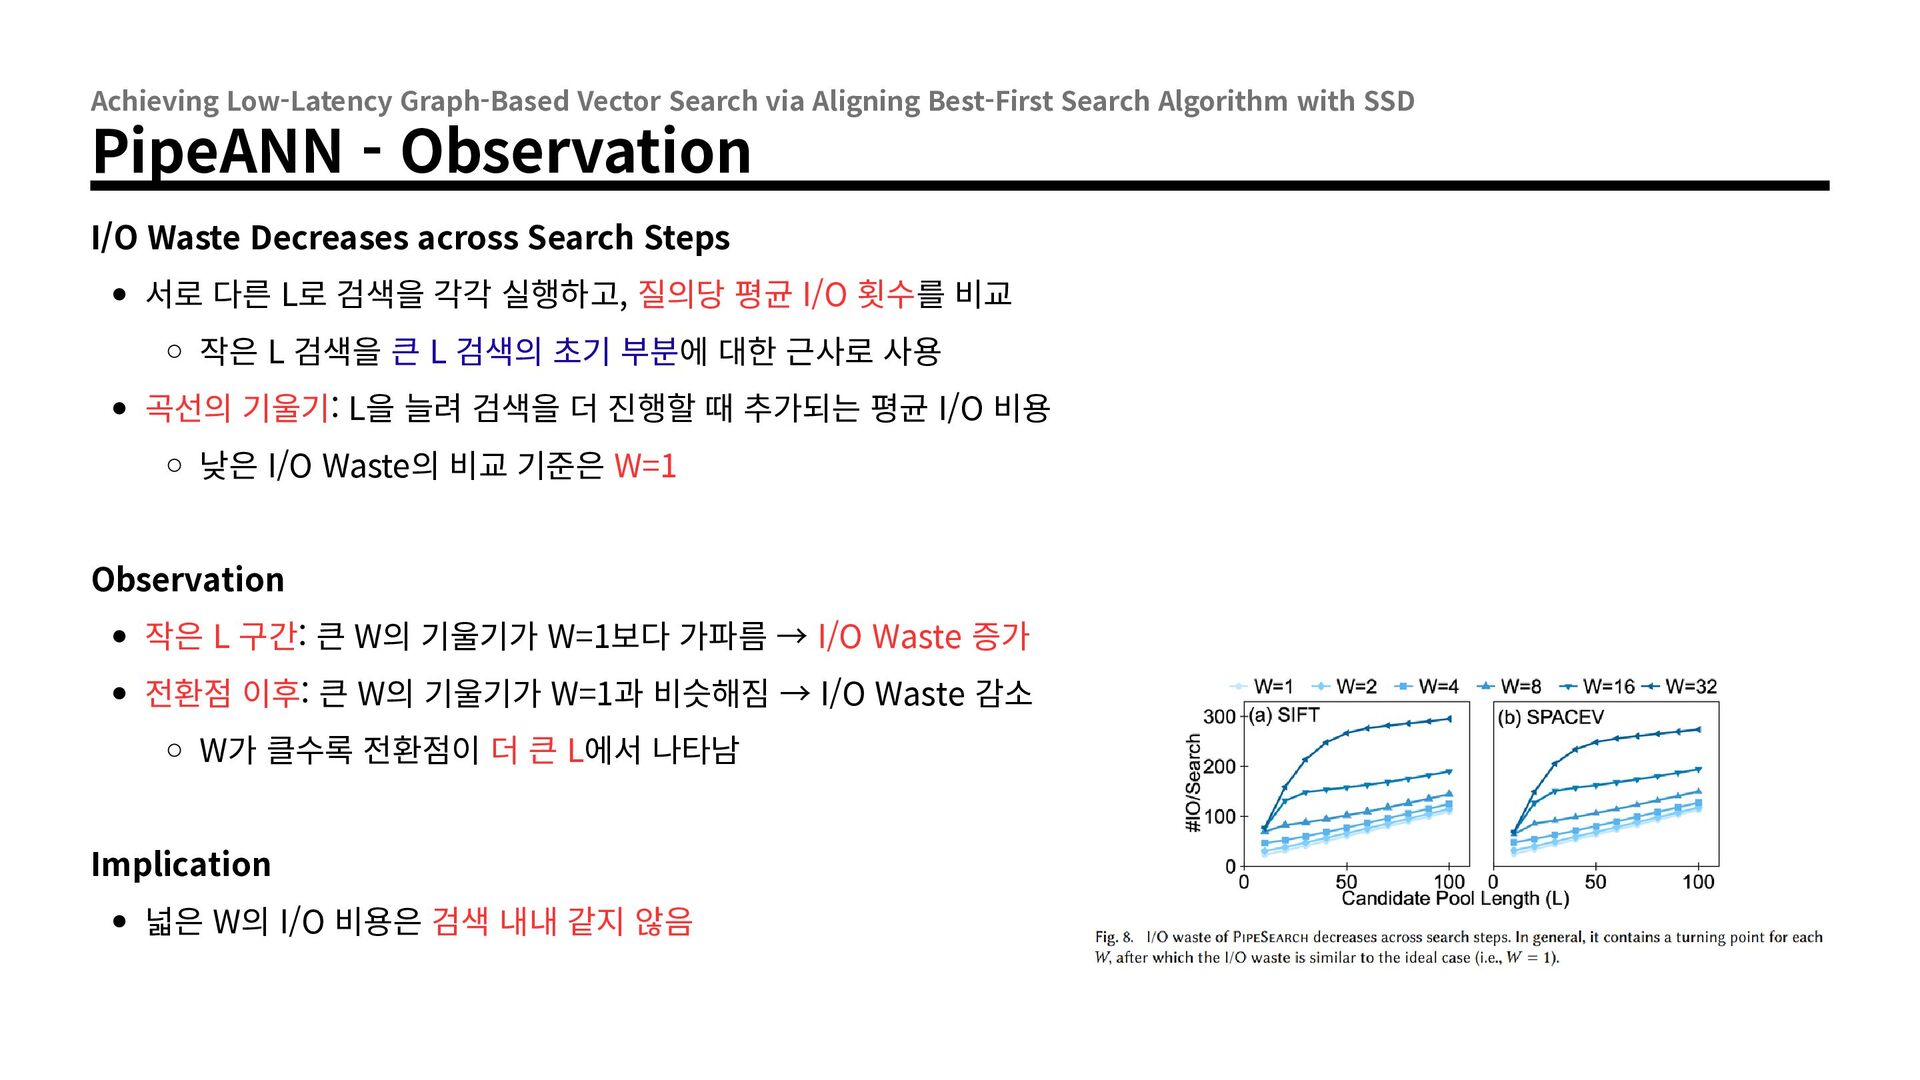
with SSD PipeANN - Observation I/O Waste Decreases across Search Steps 서로 다른 L로 검색을 각각 실행하고, 질의당 평균 I/O 횟수를 비교 작은 L 검색을 큰 L 검색의 초기 부분에 대한 근사로 사용 곡선의 기울기: L을 늘려 검색을 더 진행할 때 추가되는 평균 I/O 비용 낮은 I/O Waste의 비교 기준은 W=1 Observation 작은 L 구간: 큰 W의 기울기가 W=1보다 가파름 → I/O Waste 증가 전환점 이후: 큰 W의 기울기가 W=1과 비슷해짐 → I/O Waste 감소 W가 클수록 전환점이 더 큰 L에서 나타남 Implication 넓은 W의 I/O 비용은 검색 내내 같지 않음
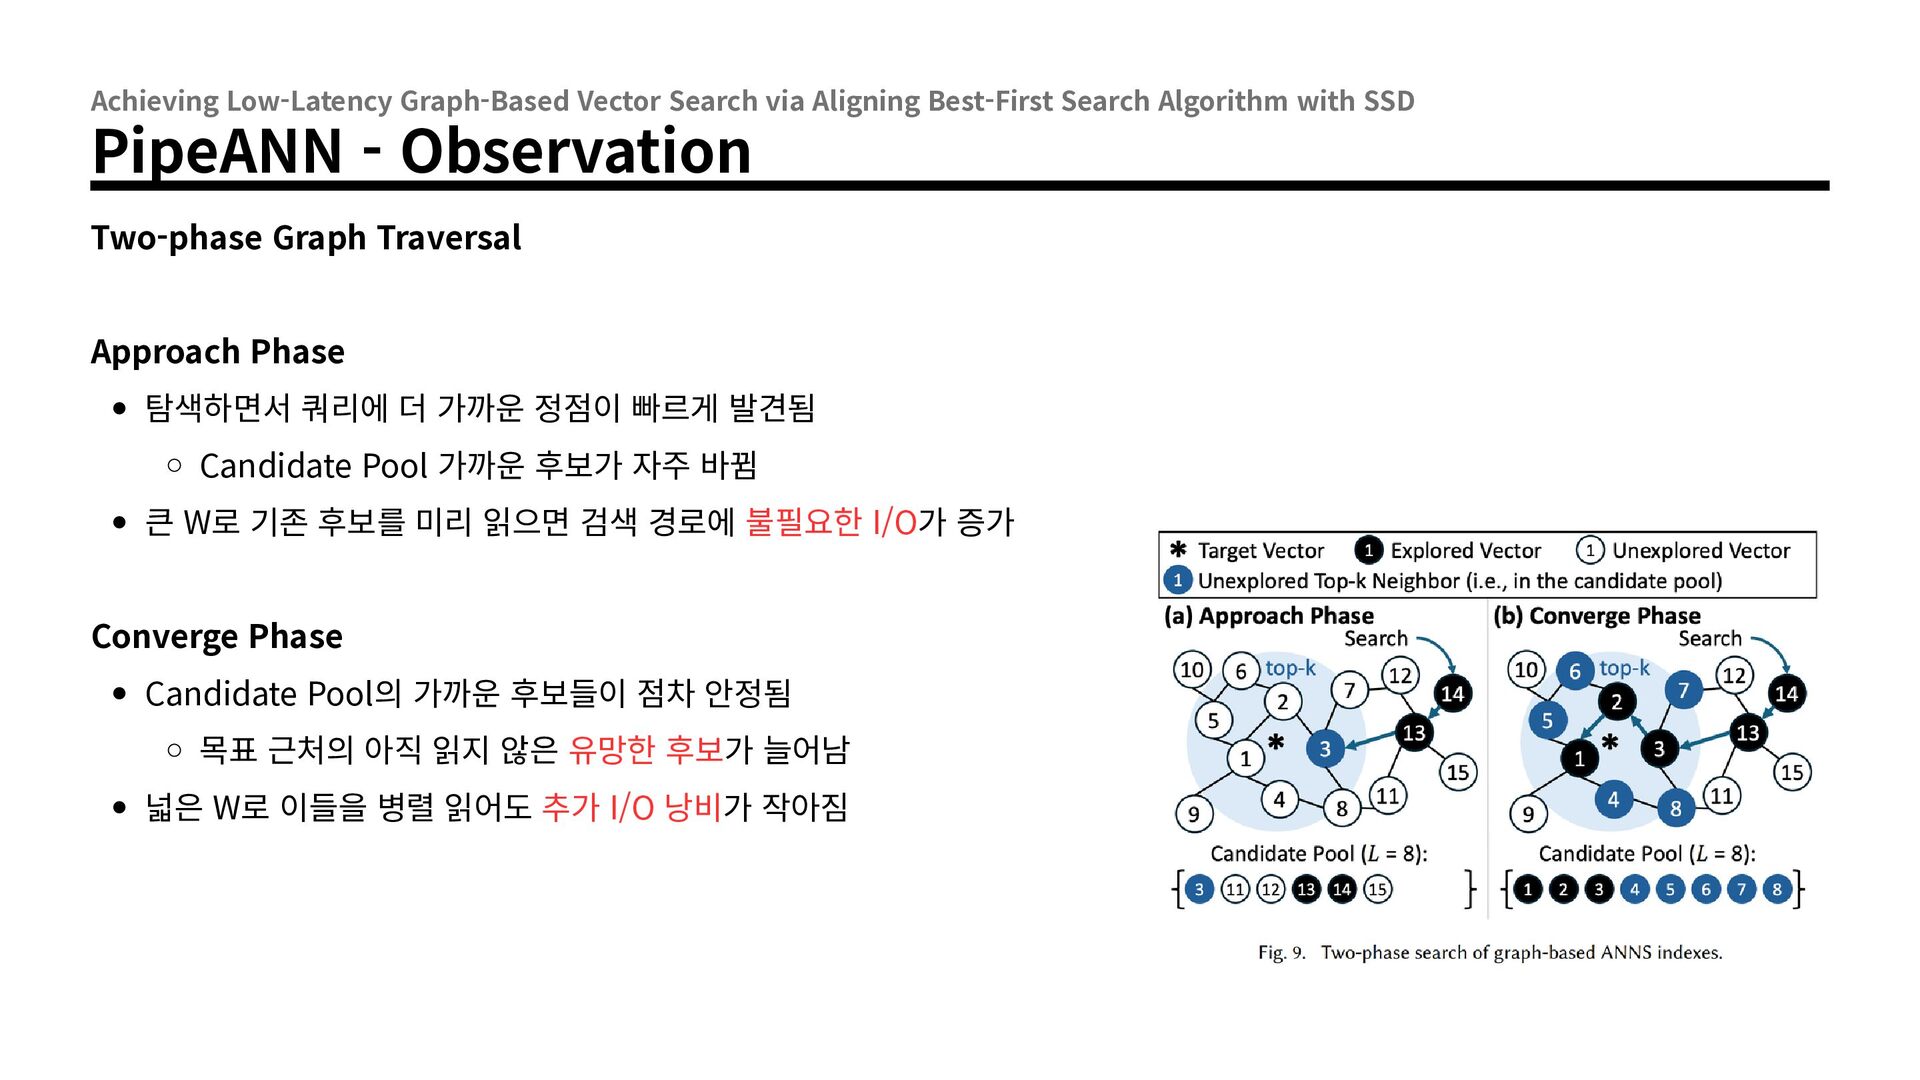
with SSD PipeANN - Observation Two-phase Graph Traversal Approach Phase 탐색하면서 쿼리에 더 가까운 정점이 빠르게 발견됨 Candidate Pool 가까운 후보가 자주 바뀜 큰 W로 기존 후보를 미리 읽으면 검색 경로에 불필요한 I/O가 증가 Converge Phase Candidate Pool의 가까운 후보들이 점차 안정됨 목표 근처의 아직 읽지 않은 유망한 후보가 늘어남 넓은 W로 이들을 병렬 읽어도 추가 I/O 낭비가 작아짐
with SSD PipeANN - Method Problem Approach Phase: 새로 찾은 가까운 정점이 P 앞쪽에 자주 들어옴 Converge Phase: 앞쪽 후보가 안정되며 미요청 정점의 위치가 뒤로 이동 Convergence Signal 정점 하나를 P를 갱신한 뒤, 거리순으로 P 확인 아직 읽기 요청을 보내지 않은 첫 정점의 index를 수렴 정도의 근사 지표로 사용 index ≥ 5 → Pipeline 폭 조절 시작 Starting Width Approach Phase에서는 W=4 유지
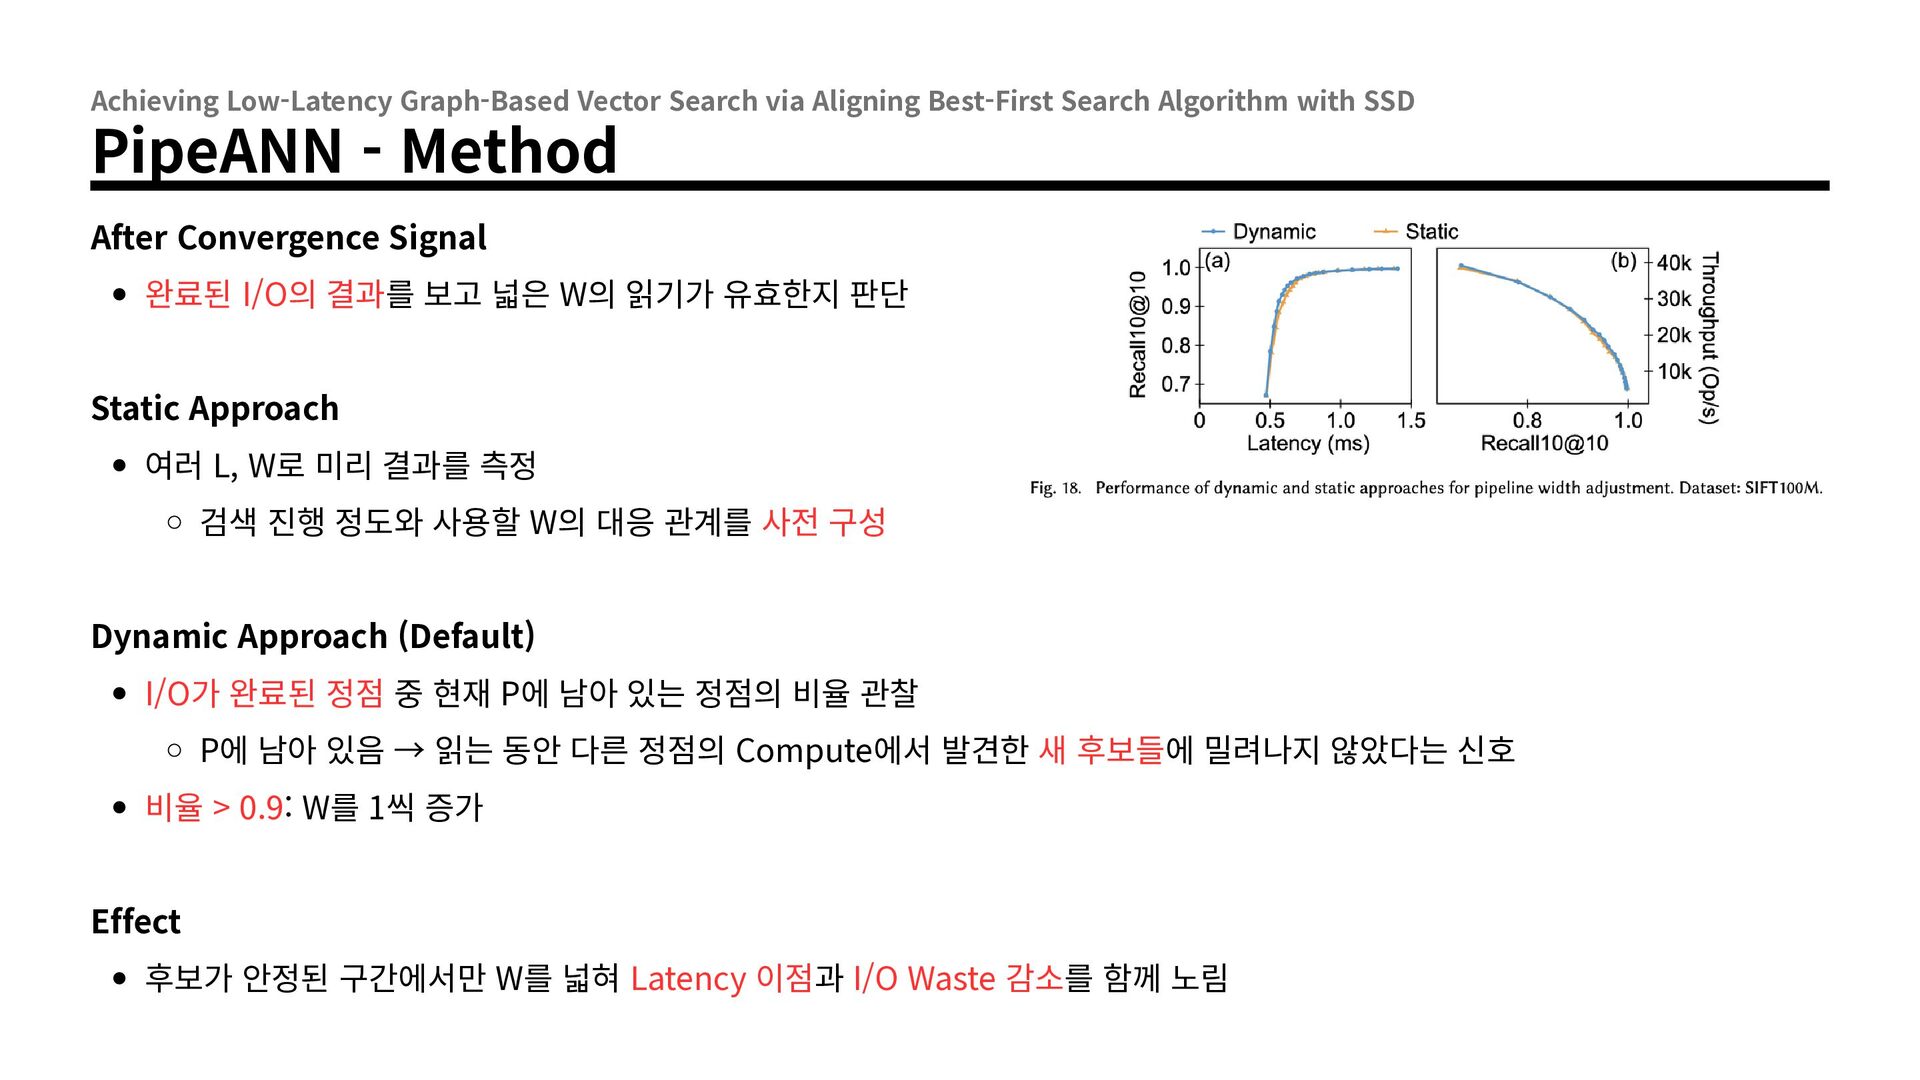
with SSD PipeANN - Method After Convergence Signal 완료된 I/O의 결과를 보고 넓은 W의 읽기가 유효한지 판단 Static Approach 여러 L, W로 미리 결과를 측정 검색 진행 정도와 사용할 W의 대응 관계를 사전 구성 Dynamic Approach (Default) I/O가 완료된 정점 중 현재 P에 남아 있는 정점의 비율 관찰 P에 남아 있음 → 읽는 동안 다른 정점의 Compute에서 발견한 새 후보들에 밀려나지 않았다는 신호 비율 > 0.9: W를 1씩 증가 Effect 후보가 안정된 구간에서만 W를 넓혀 Latency 이점과 I/O Waste 감소를 함께 노림
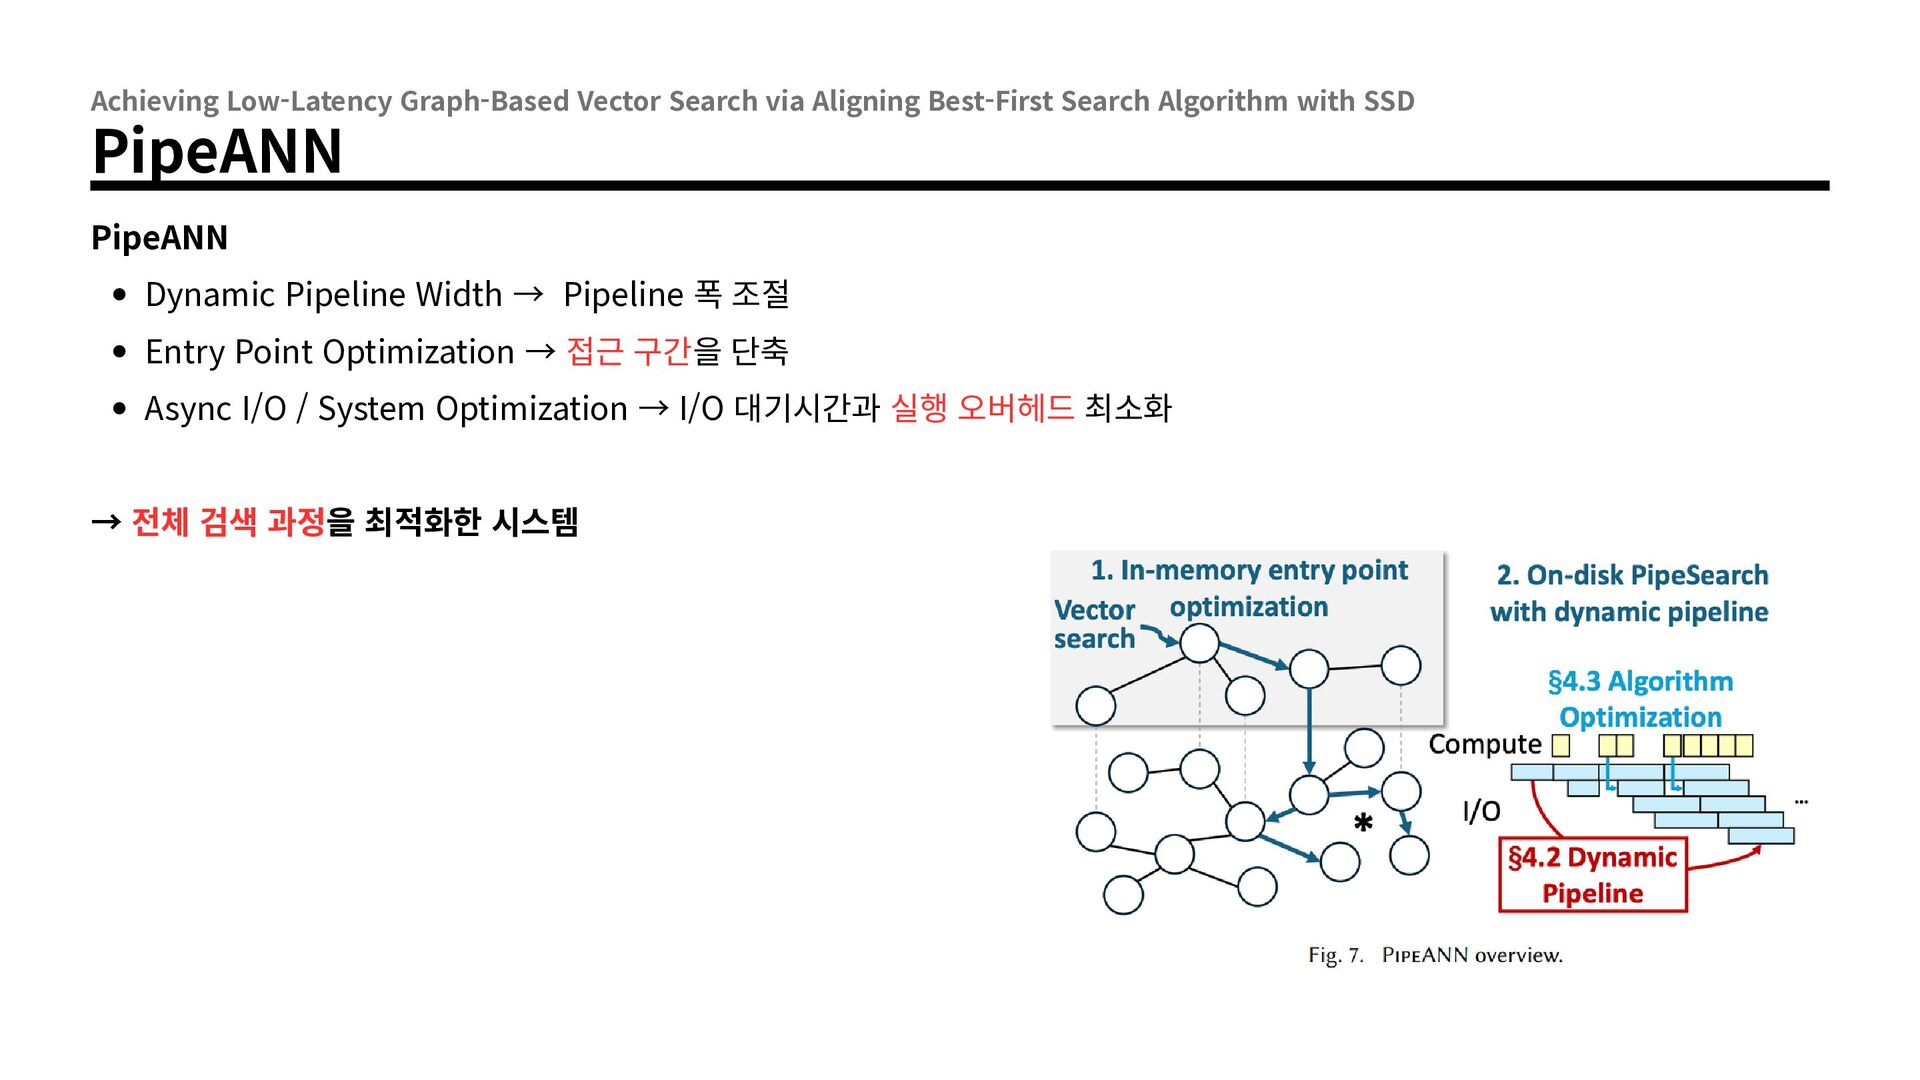
with SSD PipeANN - Design and Implementation Problem Approach Phase에서는 가까운 후보가 계속 새로 발견돼 Candidate Pool 앞부분이 자주 바뀜 이때 미리 읽은 정점이 이후 탐색에서 덜 유용해질 수 있어 I/O Waste가 커짐 Entry Point Optimization 데이터셋의 1%를 표본으로 RAM에 작은 Vamana Graph Index 구축 검색 시 쿼리와 가까운 Entry Points 선택 1% Sample Rate: 출발점 품질과 RAM 사용량의 균형 Max Out-degree 32: 출발점 탐색 시간을 줄이기 위해 제한 선택한 Entry Point에서 SSD PipeSearch를 W=4로 시작 Effect 좋은 출발점에서 검색을 시작해 Approach Phase를 줄이고, 초반 I/O Waste를 완화
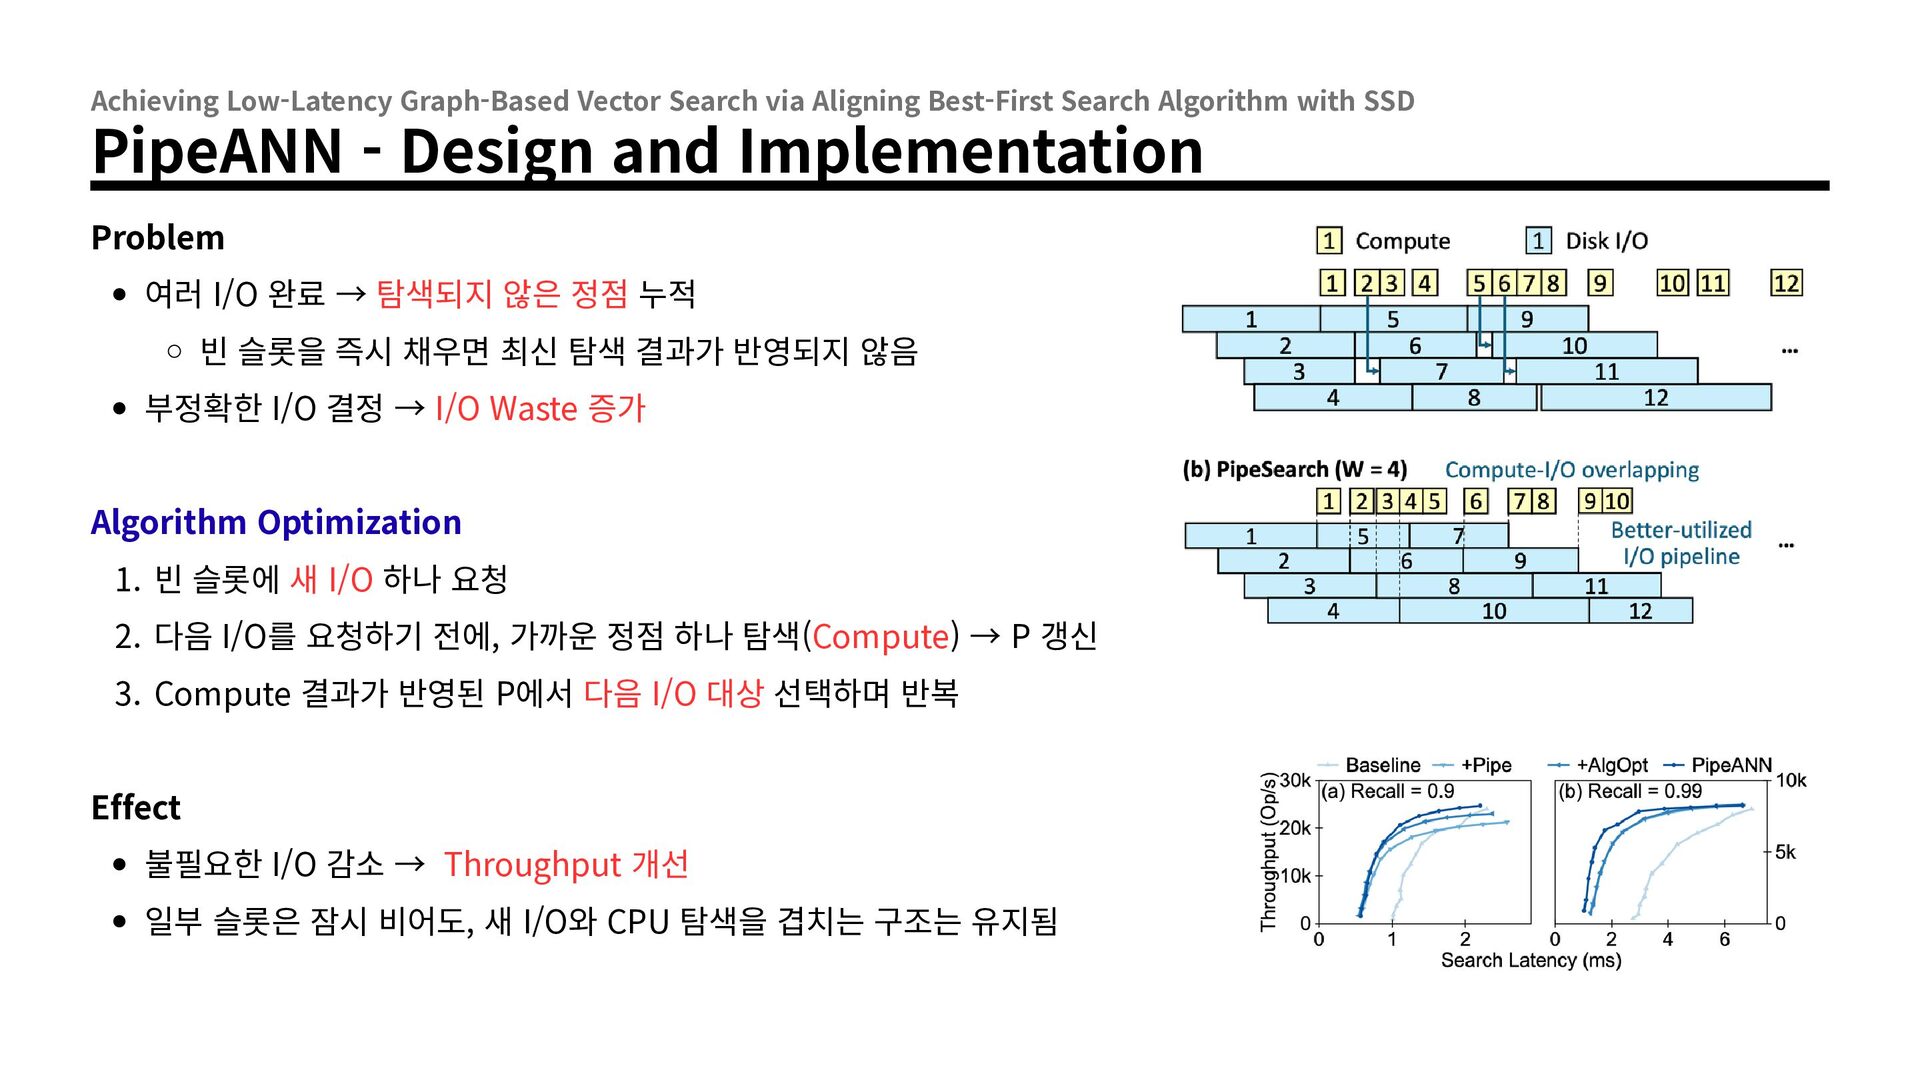
with SSD PipeANN - Design and Implementation Problem 여러 I/O 완료 → 탐색되지 않은 정점 누적 빈 슬롯을 즉시 채우면 최신 탐색 결과가 반영되지 않음 부정확한 I/O 결정 → I/O Waste 증가 Algorithm Optimization 1. 빈 슬롯에 새 I/O 하나 요청 2. 다음 I/O를 요청하기 전에, 가까운 정점 하나 탐색(Compute) → P 갱신 3. Compute 결과가 반영된 P에서 다음 I/O 대상 선택하며 반복 Effect 불필요한 I/O 감소 → Throughput 개선 일부 슬롯은 잠시 비어도, 새 I/O와 CPU 탐색을 겹치는 구조는 유지됨
with SSD PipeANN - Design and Implementation Problem 첫 SSD 읽기가 완료되어야 출발 정점의 이웃 정보를 얻고, 후속 I/O를 요청할 수 있음 NVMe SSD 기준 약 50μs Overlapping Initialization 첫 읽기가 진행되는 동안 현재 쿼리의 Local PQ Table 초기화 Global PQ Table: 여러 쿼리가 공통으로 사용하는 PQ 정보 Local PQ Table: Global PQ Table을 바탕으로 만든 쿼리별 거리 조회표 Global PQ Table을 읽을 때 AVX-512의 non-temporal load 사용 non-temporal load: 읽은 데이터가 캐시를 불필요하게 차지하는 것을 줄이도록 돕는 힌트 Effect 첫 SSD 읽기 대기와 쿼리별 검색 준비를 겹침 검색에 필요한 데이터가 캐시에서 밀려나는 것을 줄임
with SSD PipeANN - Design and Implementation Problem SSD 읽기 완료를 기다리는 동안 검색 스레드가 멈추면, CPU 탐색과 I/O를 겹칠 수 없음 Asynchronous I/O 검색 스레드마다 전용 io_uring 사용 io_uring: I/O 요청을 비동기로 제출하고 완료 결과를 확인하는 인터페이스 prep_read: 읽을 데이터와 위치를 지정해 요청을 준비 요청이 진행되는 동안 CPU는 이미 읽기가 끝난 정점의 이웃을 탐색 peek_batch_cqe: 완료된 요청을 기다리지 않고 확인 Effect SSD 읽기와 CPU 탐색을 겹침 배치의 모든 읽기가 끝나기 전에 먼저 완료된 결과를 활용할 수 있음
with SSD PipeANN - Design and Implementation Problem PipeANN은 읽기 요청을 자주 제출하고 완료 여부도 자주 확인 요청을 커널에 알리고 완료를 확인하는 데 드는 지연도 줄일 필요 Polling-based I/O io_uring의 두 큐 SQ (Submission Queue): 읽기 요청을 커널에 제출하는 큐 CQ (Completion Queue): 완료된 요청 결과를 받는 큐 기본 제출 방식: 요청을 큐에 넣은 뒤 시스템 호출로 커널에 알림 SQ polling: 커널 스레드가 제출 큐를 확인 → 커널에 요청을 알리는 시스템 호출을 줄일 수 있음 peek_batch_cqe: 완료 큐를 기다리지 않고 확인 Effect 요청 제출과 읽기 완료 확인의 지연을 줄여 짧은 I/O–Compute 반복을 지원
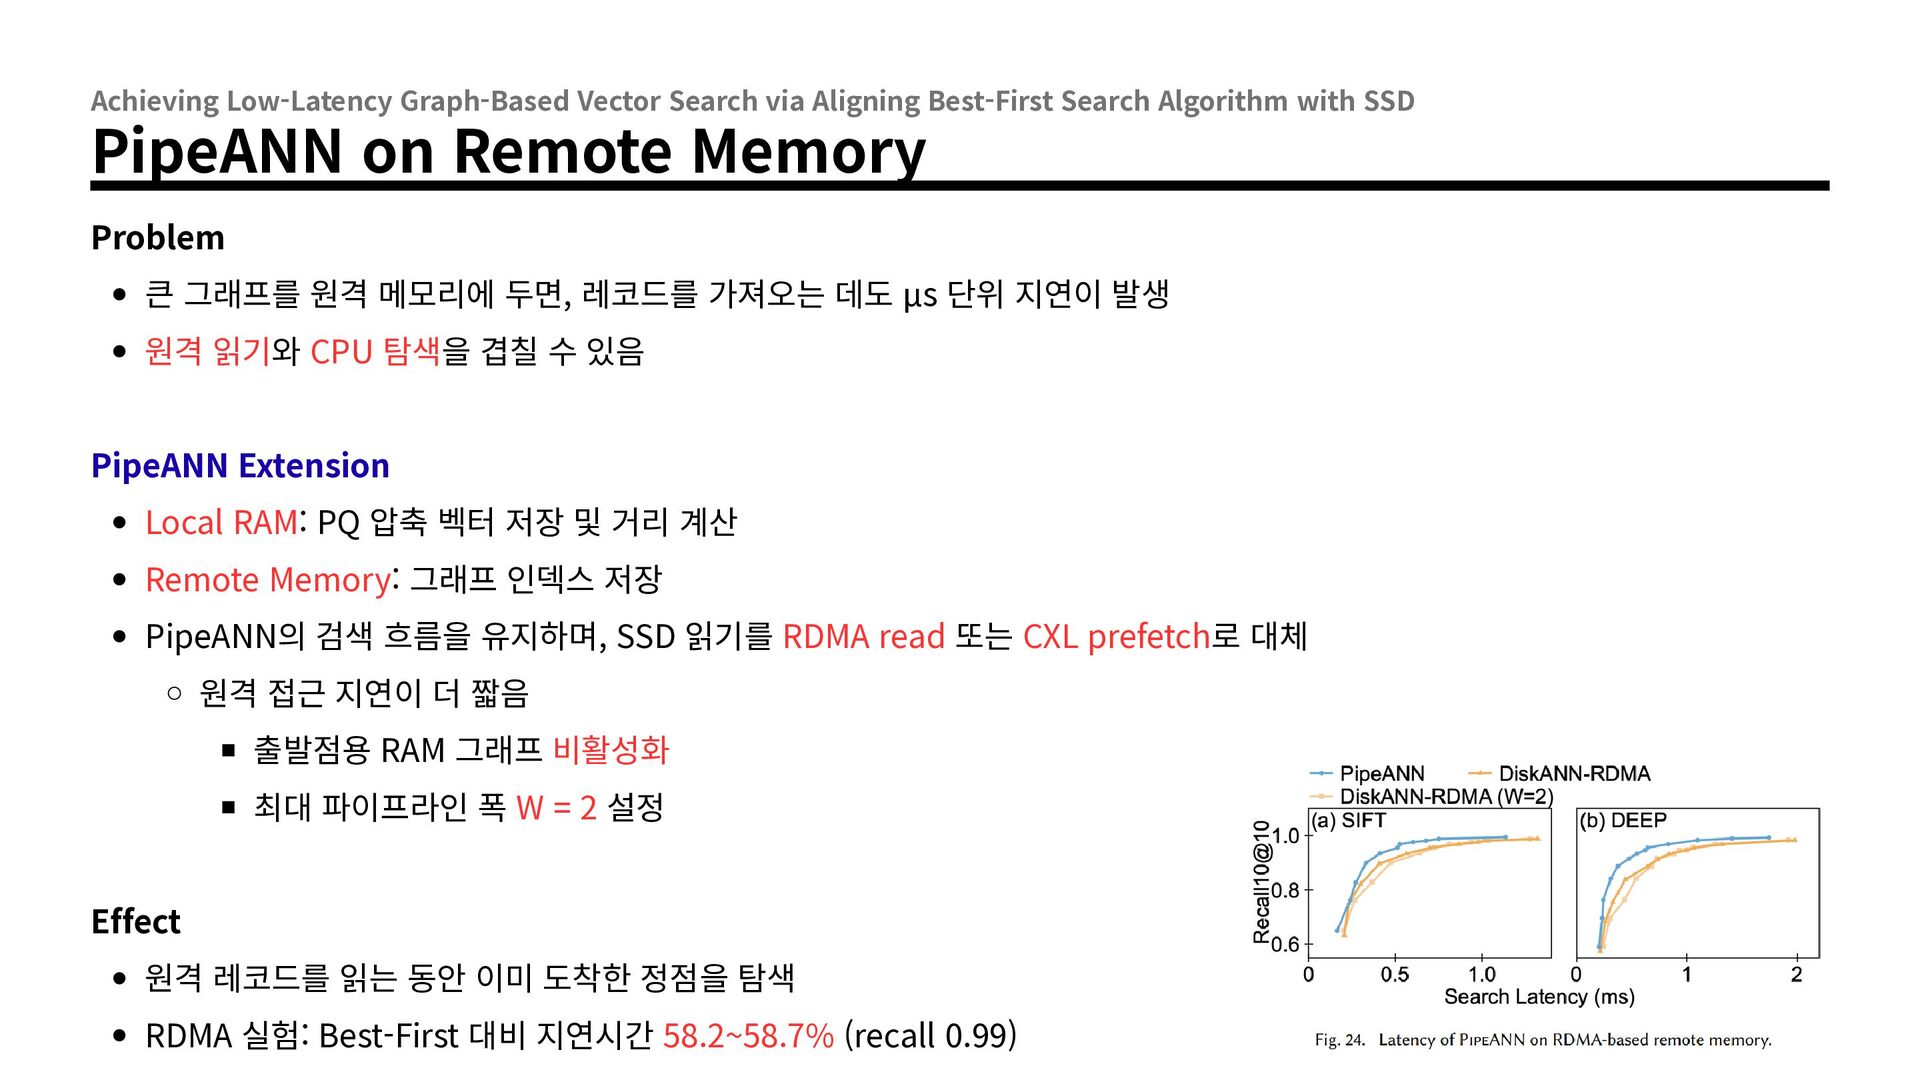
with SSD PipeANN on Remote Memory Problem 큰 그래프를 원격 메모리에 두면, 레코드를 가져오는 데도 μs 단위 지연이 발생 원격 읽기와 CPU 탐색을 겹칠 수 있음 PipeANN Extension Local RAM: PQ 압축 벡터 저장 및 거리 계산 Remote Memory: 그래프 인덱스 저장 PipeANN의 검색 흐름을 유지하며, SSD 읽기를 RDMA read 또는 CXL prefetch로 대체 원격 접근 지연이 더 짧음 출발점용 RAM 그래프 비활성화 최대 파이프라인 폭 W = 2 설정 Effect 원격 레코드를 읽는 동안 이미 도착한 정점을 탐색 RDMA 실험: Best-First 대비 지연시간 58.2~58.7% (recall 0.99)
with SSD PipeANN PipeANN Dynamic Pipeline Width → Pipeline 폭 조절 Entry Point Optimization → 접근 구간을 단축 Async I/O / System Optimization → I/O 대기시간과 실행 오버헤드 최소화 → 전체 검색 과정을 최적화한 시스템
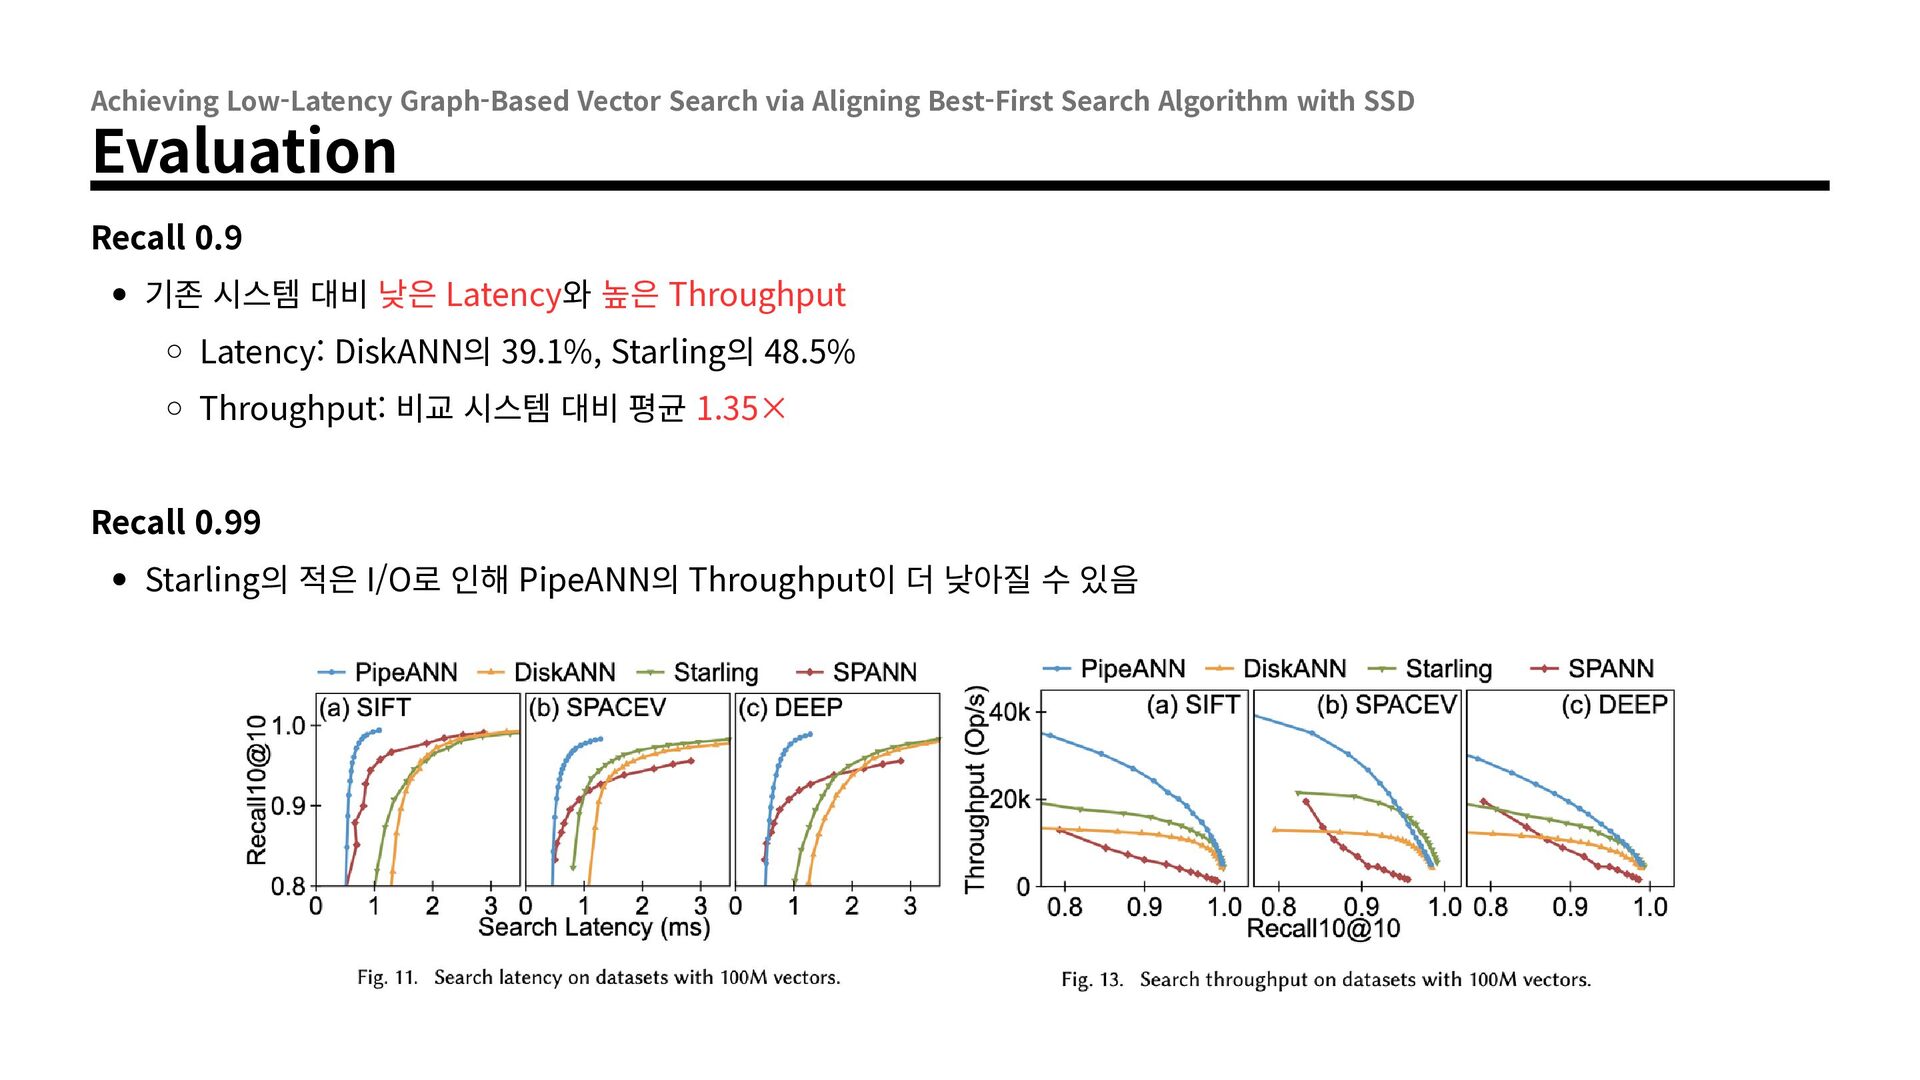
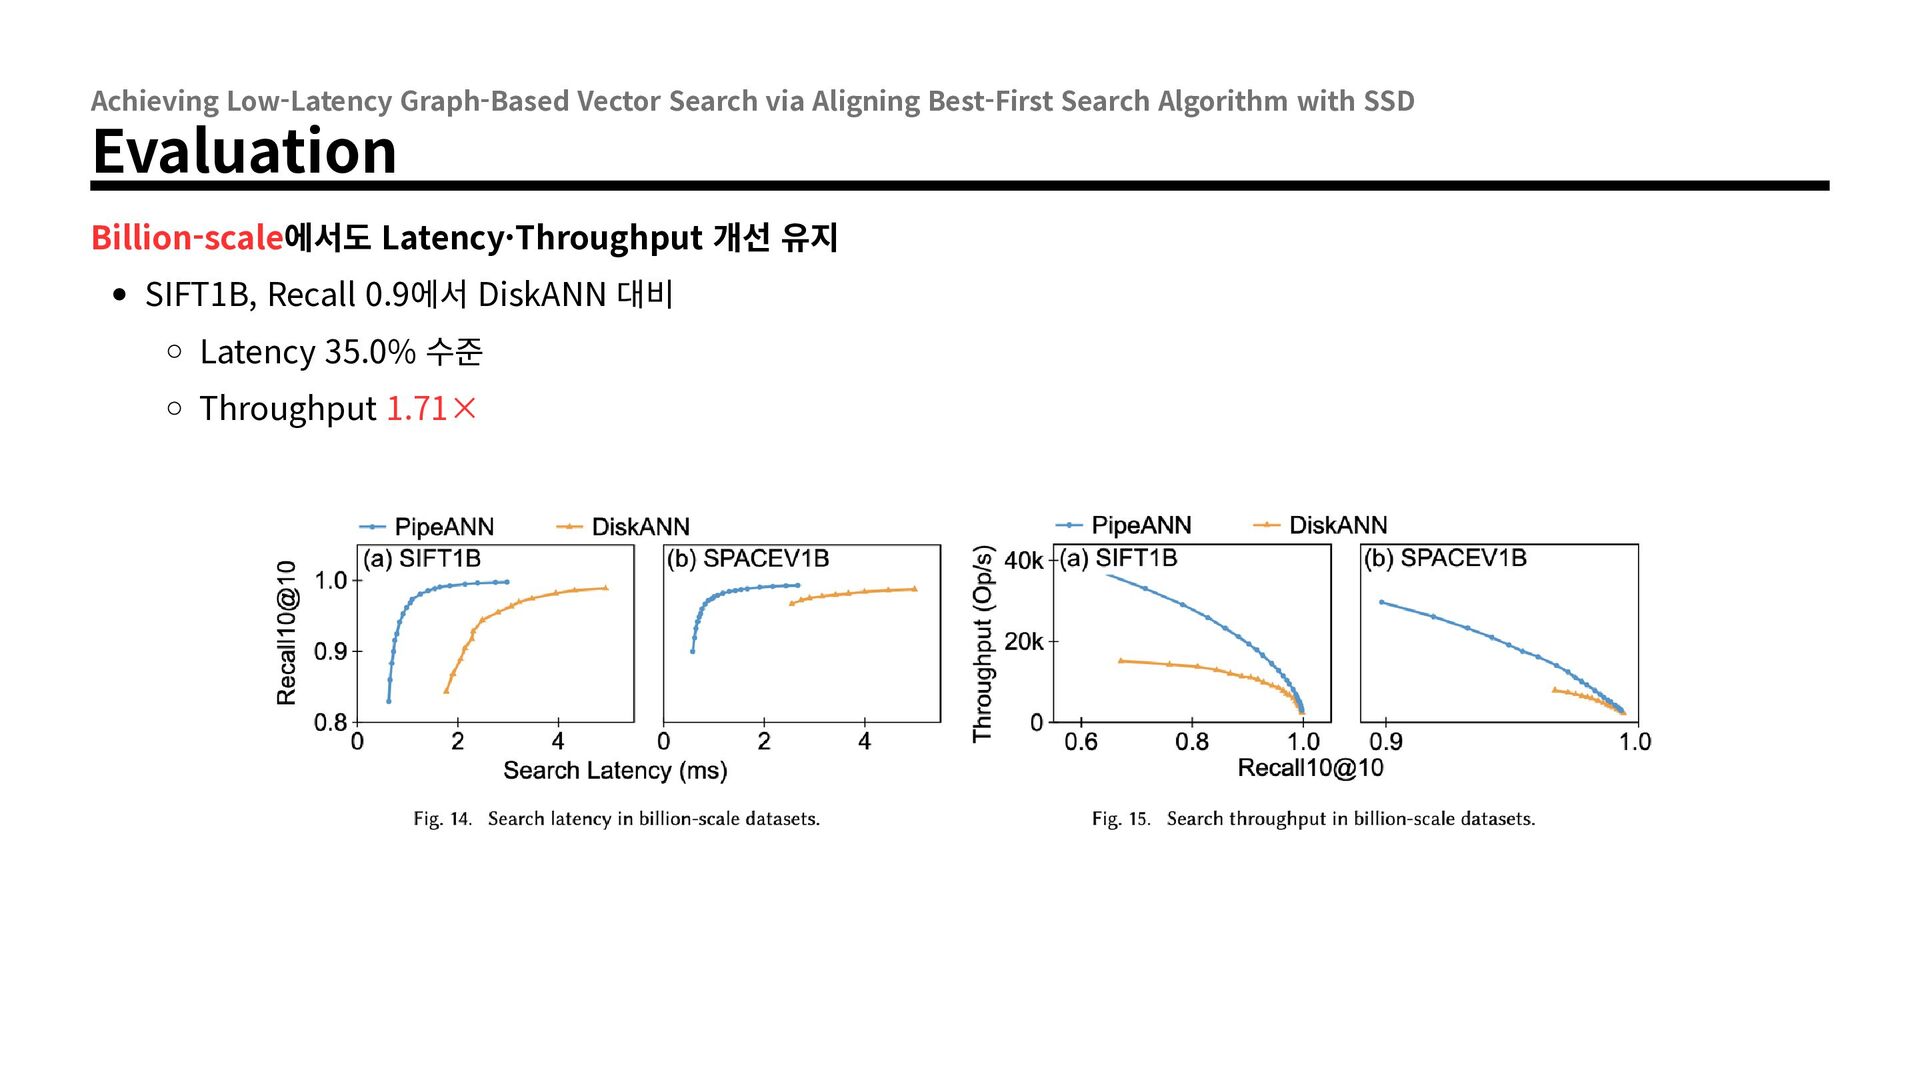
with SSD Evaluation Recall 0.9 기존 시스템 대비 낮은 Latency와 높은 Throughput Latency: DiskANN의 39.1%, Starling의 48.5% Throughput: 비교 시스템 대비 평균 1.35× Recall 0.99 Starling의 적은 I/O로 인해 PipeANN의 Throughput이 더 낮아질 수 있음
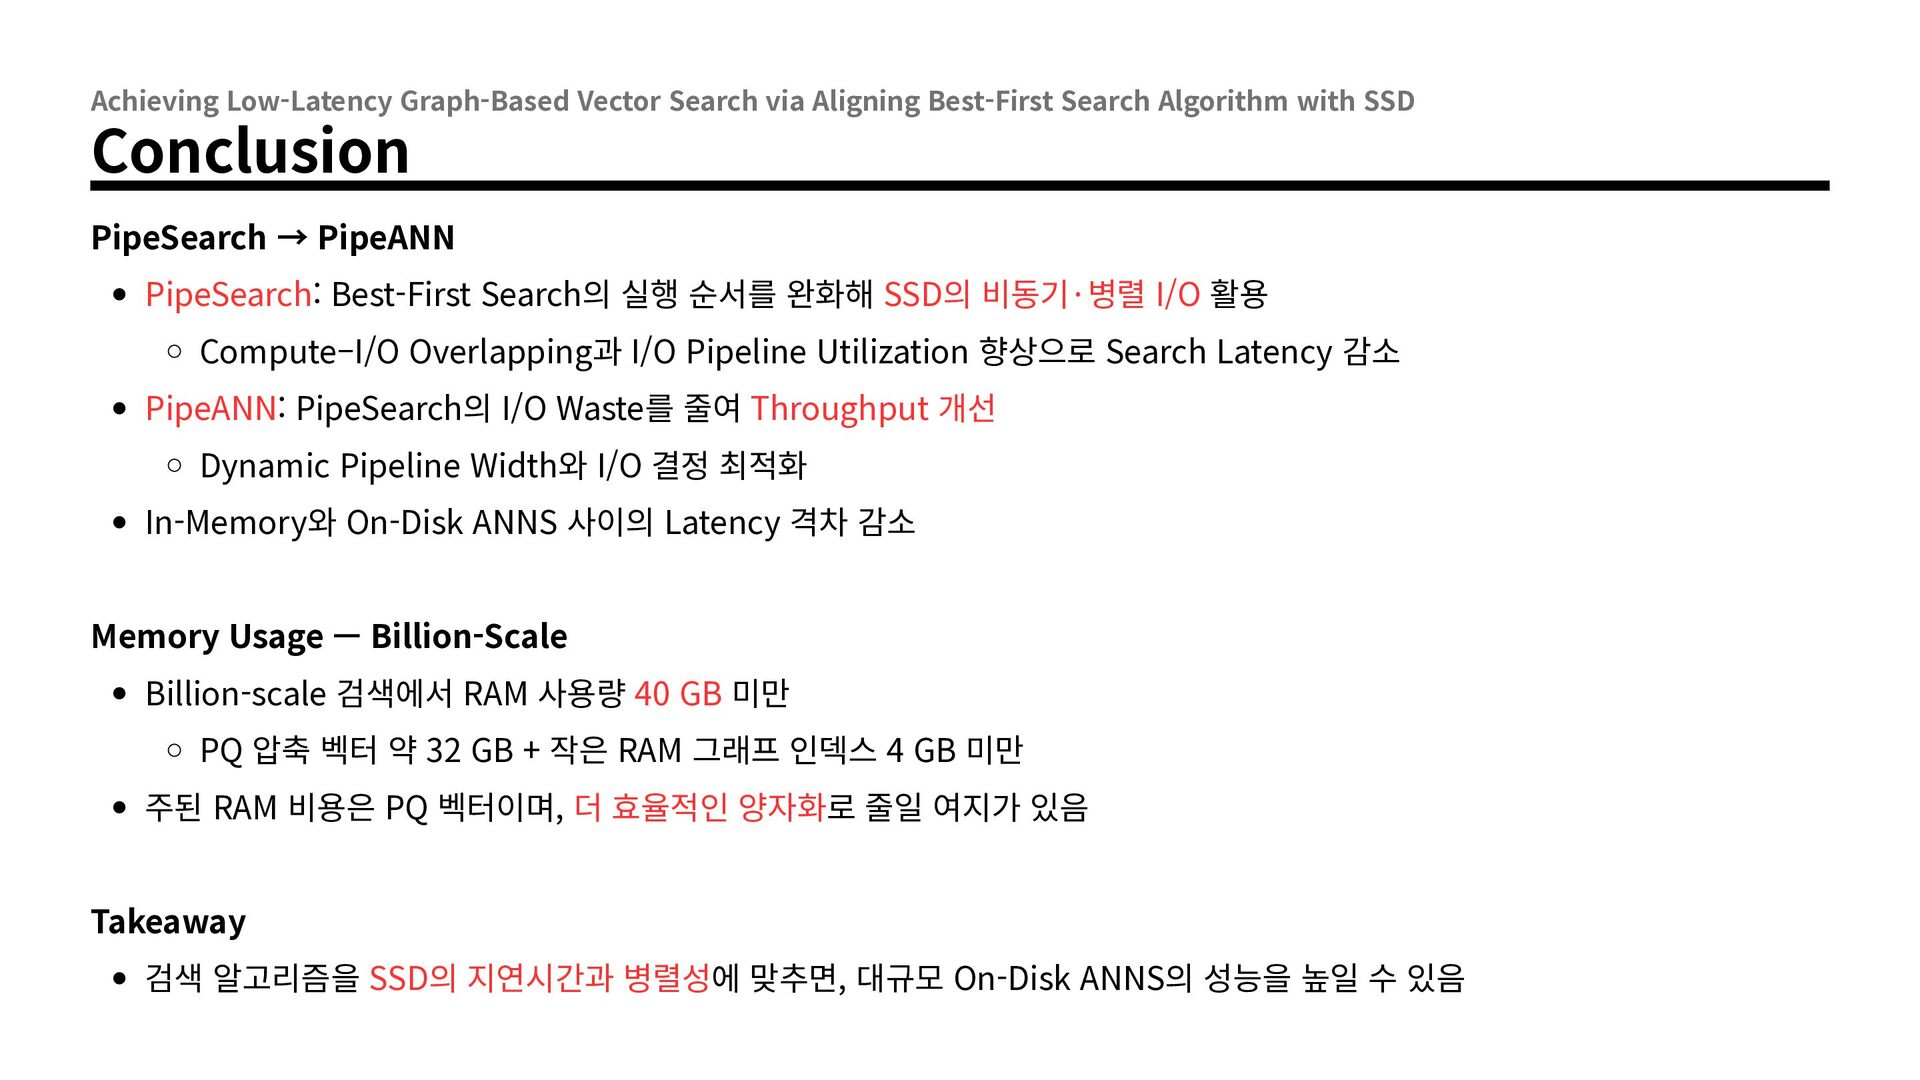
with SSD Conclusion PipeSearch → PipeANN PipeSearch: Best-First Search의 실행 순서를 완화해 SSD의 비동기·병렬 I/O 활용 Compute–I/O Overlapping과 I/O Pipeline Utilization 향상으로 Search Latency 감소 PipeANN: PipeSearch의 I/O Waste를 줄여 Throughput 개선 Dynamic Pipeline Width와 I/O 결정 최적화 In-Memory와 On-Disk ANNS 사이의 Latency 격차 감소 Memory Usage — Billion-Scale Billion-scale 검색에서 RAM 사용량 40 GB 미만 PQ 압축 벡터 약 32 GB + 작은 RAM 그래프 인덱스 4 GB 미만 주된 RAM 비용은 PQ 벡터이며, 더 효율적인 양자화로 줄일 여지가 있음 Takeaway 검색 알고리즘을 SSD의 지연시간과 병렬성에 맞추면, 대규모 On-Disk ANNS의 성능을 높일 수 있음


 nawkwoo
 signer
 takehaya
 tkng
 kinoue_smarthr
 shunk031
 hf149
 analokmaus
 institutdelelevage
 rfujii
 satai
 imai448
 recsyslab
 reverentgeek
 kevinliebholz
 3n
 aleyda
 akademiya2063
 helmedeiros
 sabderemane
 keavy
 skoyamalab
 kimpetersen