Upgrade to Pro
— share decks privately, control downloads, hide ads and more …
Speaker Deck
Sign up for free
Menu
Search
Features
All features
Private URLs
Password Protection
Custom URLS
Scheduled publishing
Remove Branding
Restrict embedding
Deck Collections
Notes
Features
All features
Private URLs
Password Protection
Custom URLS
Scheduled publishing
Remove Branding
Restrict embedding
Deck Collections
Notes
Explore
Featured decks
Featured speakers
Programming
Technology
Storyboards
Explore
Featured decks
Featured speakers
Programming
Technology
Storyboards
Pricing
Search
Sign in
Sign up for free
完全ローカル完結のLT文字起し、要約システム
Search
Sponsored
·
Your Podcast. Everywhere. Effortlessly.
Share. Educate. Inspire. Entertain. You do you. We'll handle the rest.
→
numa08
August 28, 2026
53
0
Share
Embed
Copy iframe code
Copy JS code
Copy link
Start on current slide
完全ローカル完結のLT文字起し、要約システム
numa08
August 28, 2026
More Decks by numa08
See All by numa08
Claude Code の /goal コマンドの話
numa08
0
12
FT8の話
numa08
0
26
What/Why/How MVVM on iOS
numa08
3
830
facilio
numa08
0
160
Kotlin でテストを書く
numa08
0
430
Android Testing Bootcamp 4
numa08
0
570
チームの進捗をちゃんと可視化したい話
numa08
1
1.1k
Realm を正しく使うには
numa08
5
1.7k
Realmを正しく使うには
numa08
2
440
Featured
See All Featured
Let's Do A Bunch of Simple Stuff to Make Websites Faster
chriscoyier
508
140k
CoffeeScript is Beautiful & I Never Want to Write Plain JavaScript Again
sstephenson
162
16k
Leveraging Curiosity to Care for An Aging Population
cassininazir
1
490
Visual Storytelling: How to be a Superhuman Communicator
reverentgeek
2
660
More Than Pixels: Becoming A User Experience Designer
marktimemedia
3
520
Abbi's Birthday
coloredviolet
3
9.9k
How GitHub (no longer) Works
holman
316
150k
Pawsitive SEO: Lessons from My Dog (and Many Mistakes) on Thriving as a Consultant in the Age of AI
davidcarrasco
0
240
Templates, Plugins, & Blocks: Oh My! Creating the theme that thinks of everything
marktimemedia
31
2.9k
How to Talk to Developers About Accessibility
jct
2
540
The SEO Collaboration Effect
kristinabergwall1
1
550
Building Experiences: Design Systems, User Experience, and Full Site Editing
marktimemedia
0
600
Transcript
誰が何を話したか、 覚えていますか? mujin-scribe — 完全ローカルの LT 記録システム numa08 / 裏テック無尽
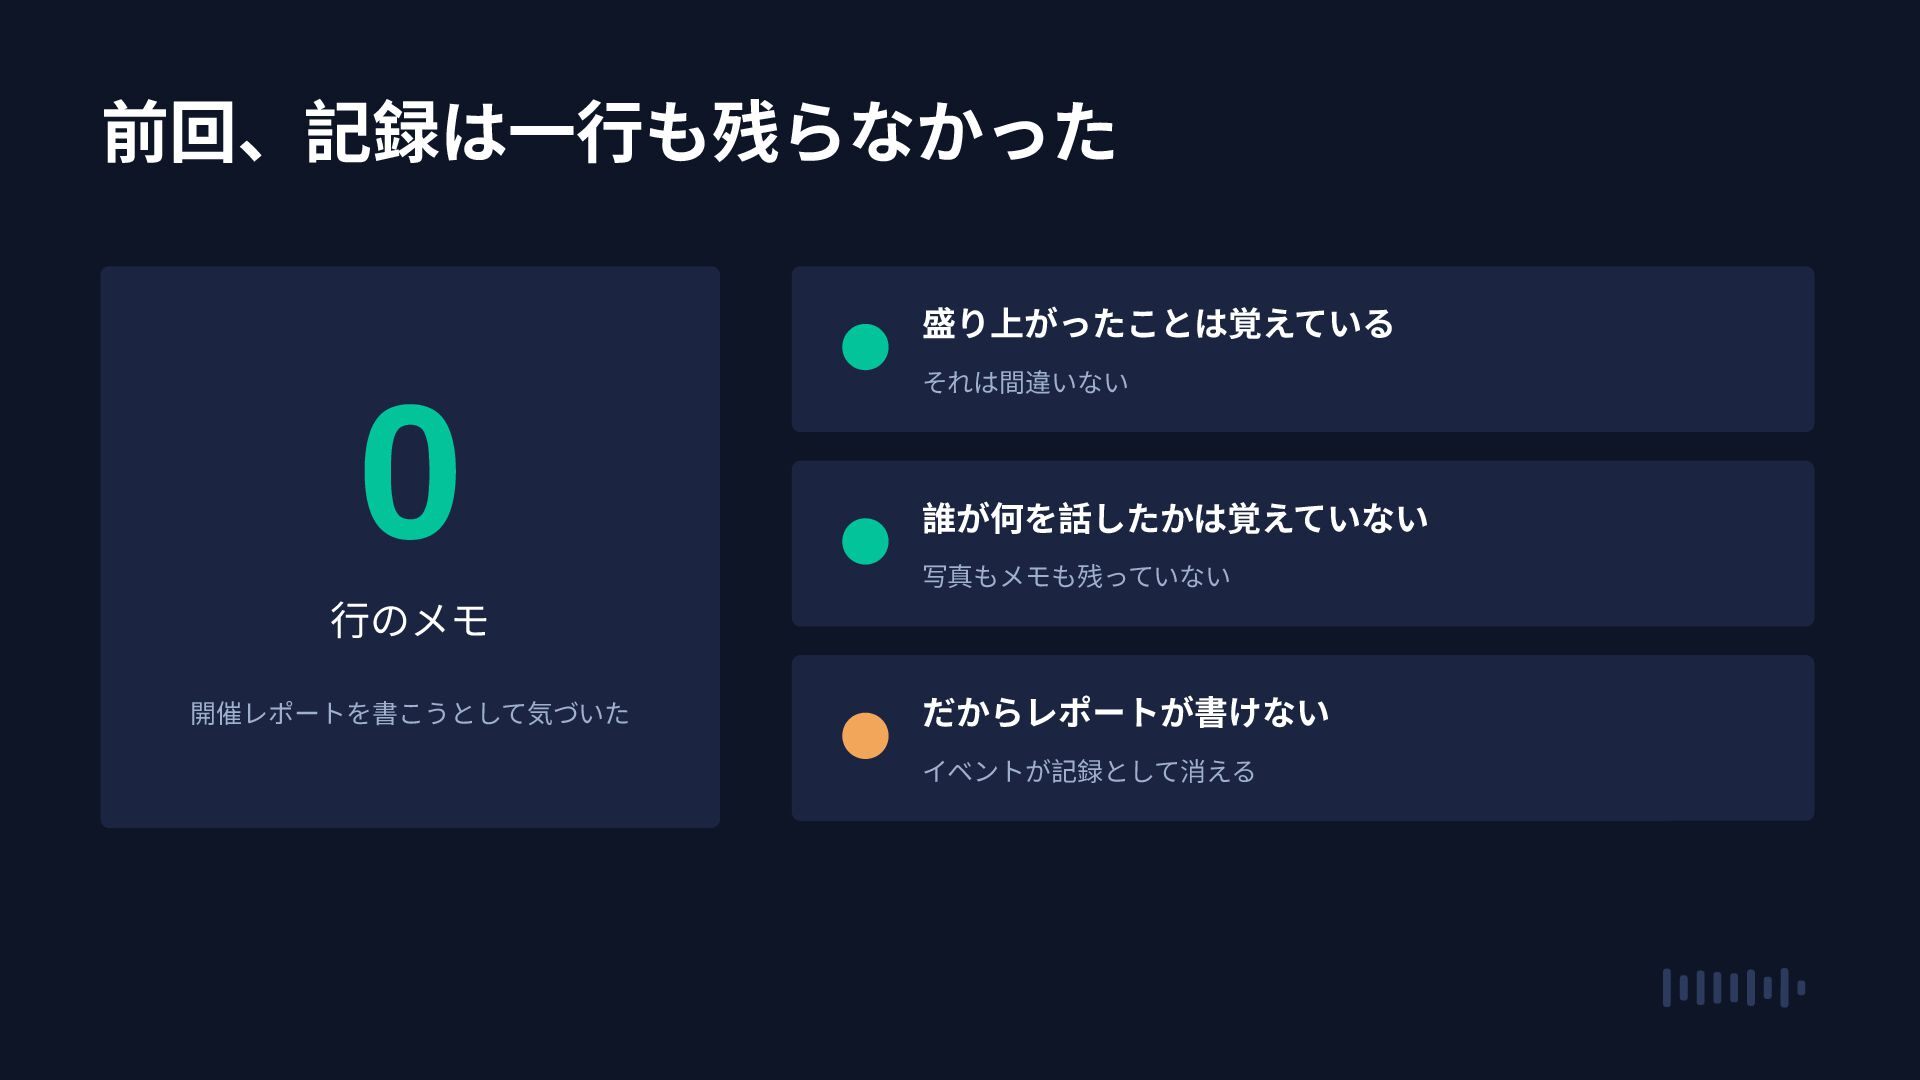
前回、記録は一行も残らなかった 盛り上がったことは覚えている 0 行のメモ 開催レポートを書こうとして気づいた それは間違いない 誰が何を話したかは覚えていない 写真もメモも残っていない だからレポートが書けない イベントが記録として消える
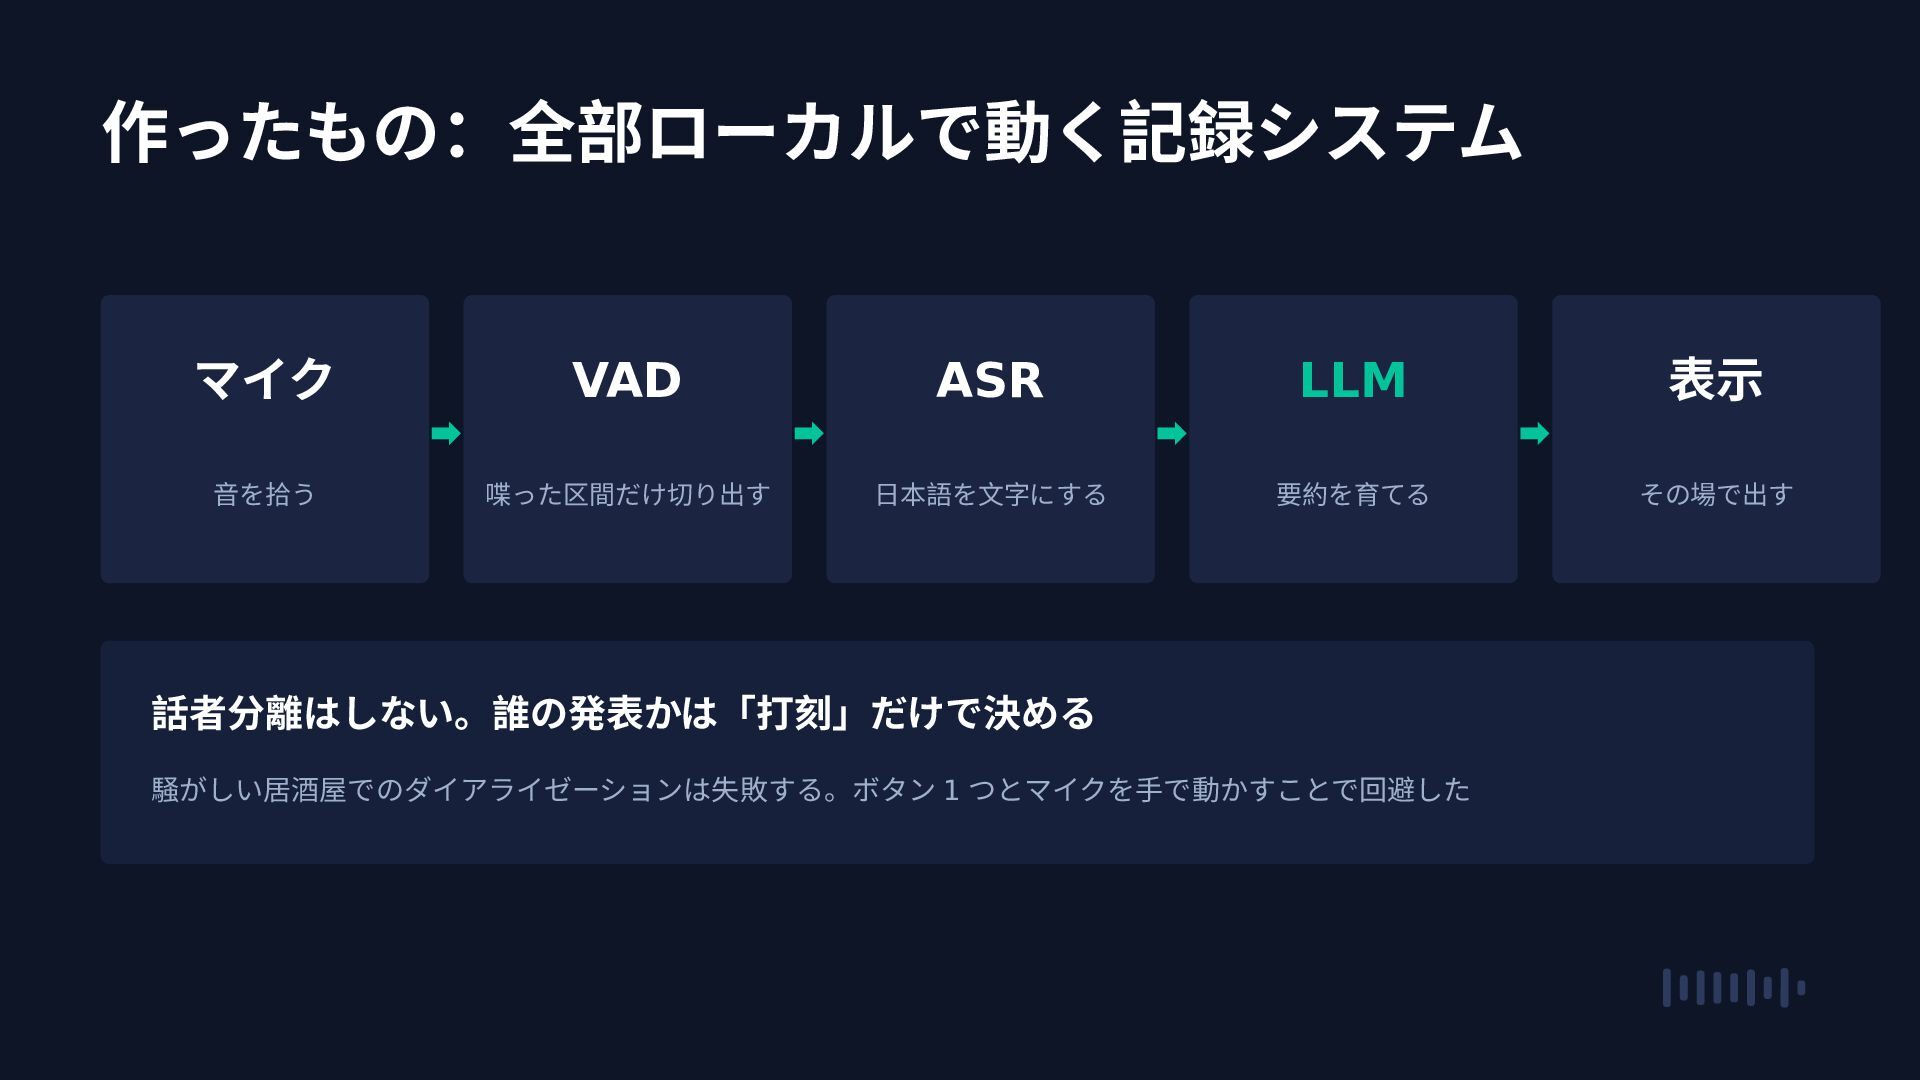
作ったもの:全部ローカルで動く記録システム マイク VAD ASR LLM 表示 音を拾う 喋った区間だけ切り出す 日本語を文字にする 要約を育てる
その場で出す 話者分離はしない。誰の発表かは「打刻」だけで決める 騒がしい居酒屋でのダイアライゼーションは失敗する。ボタン 1 つとマイクを手で動かすことで回避した
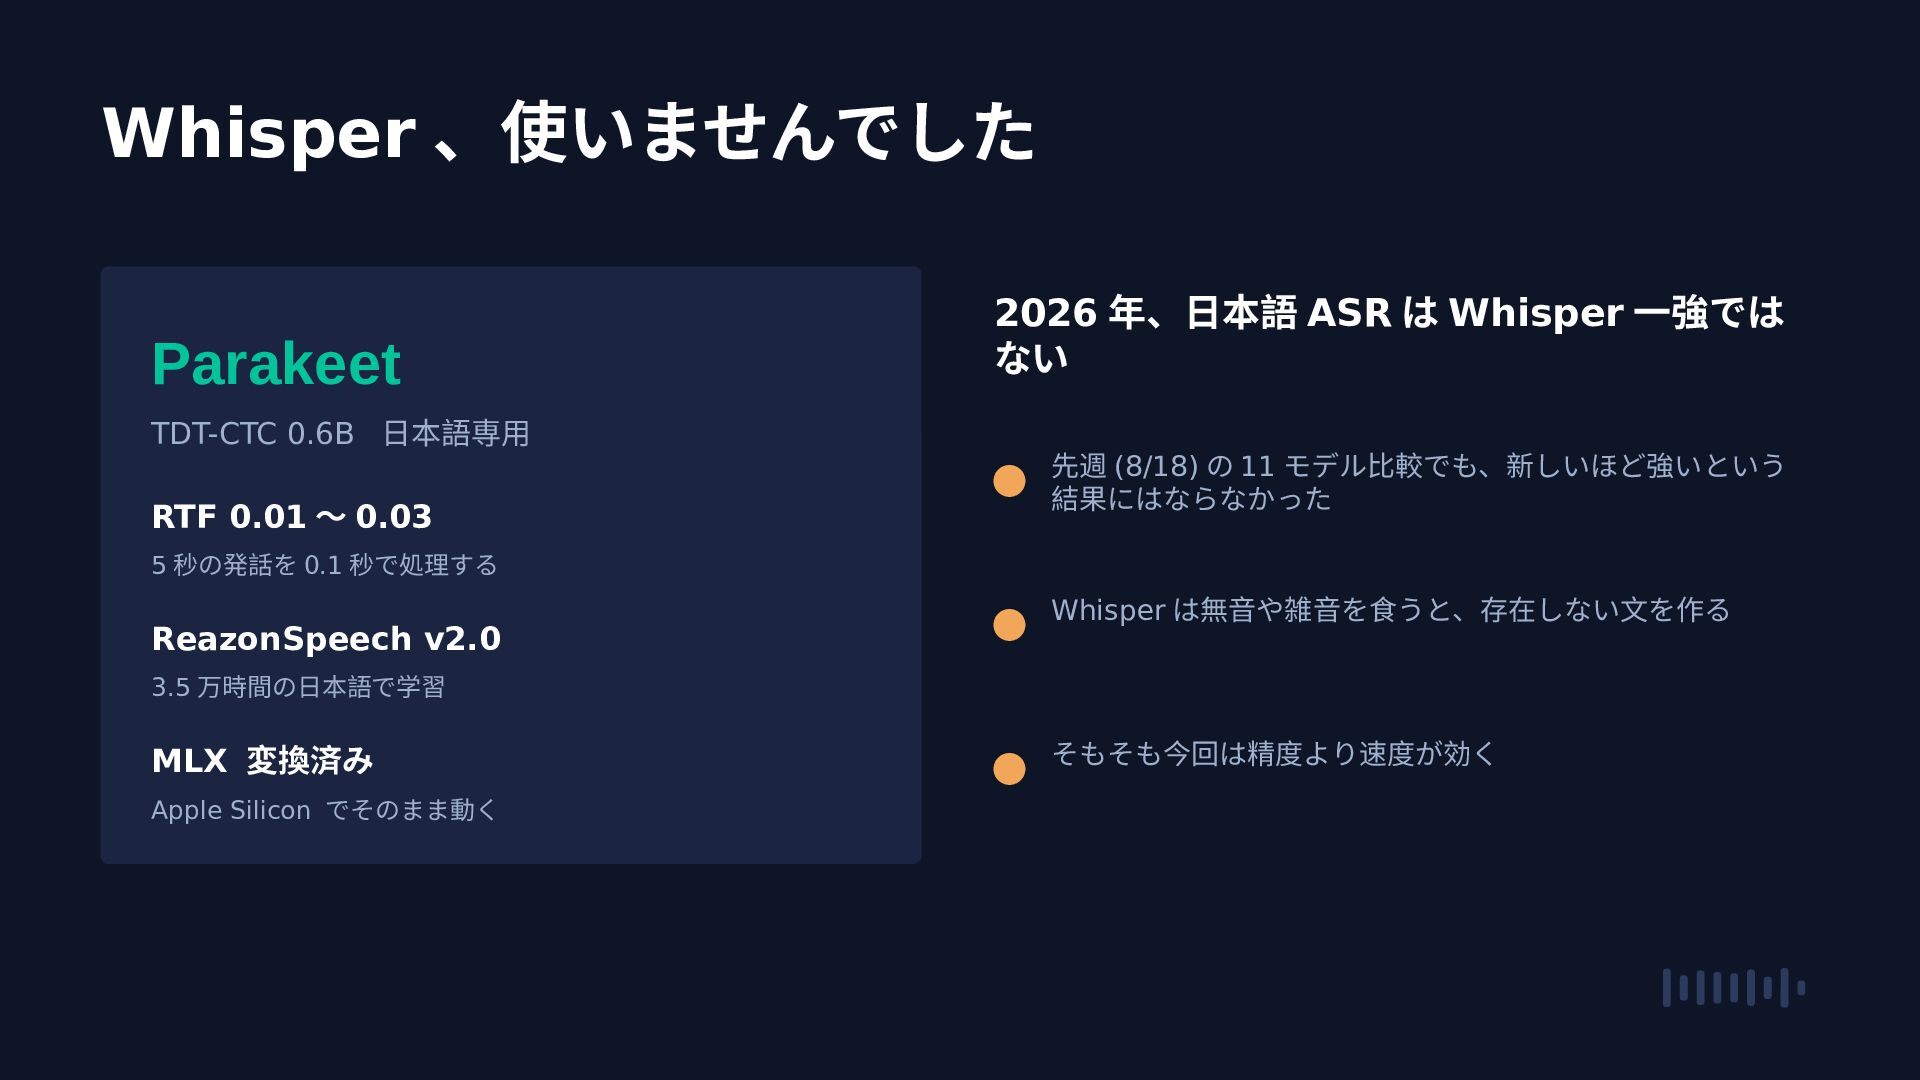
Whisper 、使いませんでした Parakeet TDT-CTC 0.6B 日本語専用 RTF 0.01 〜 0.03
2026 年、日本語 ASR は Whisper 一強では ない 先週 (8/18) の 11 モデル比較でも、新しいほど強いという 結果にはならなかった 5 秒の発話を 0.1 秒で処理する ReazonSpeech v2.0 Whisper は無音や雑音を食うと、存在しない文を作る 3.5 万時間の日本語で学習 MLX 変換済み Apple Silicon でそのまま動く そもそも今回は精度より速度が効く
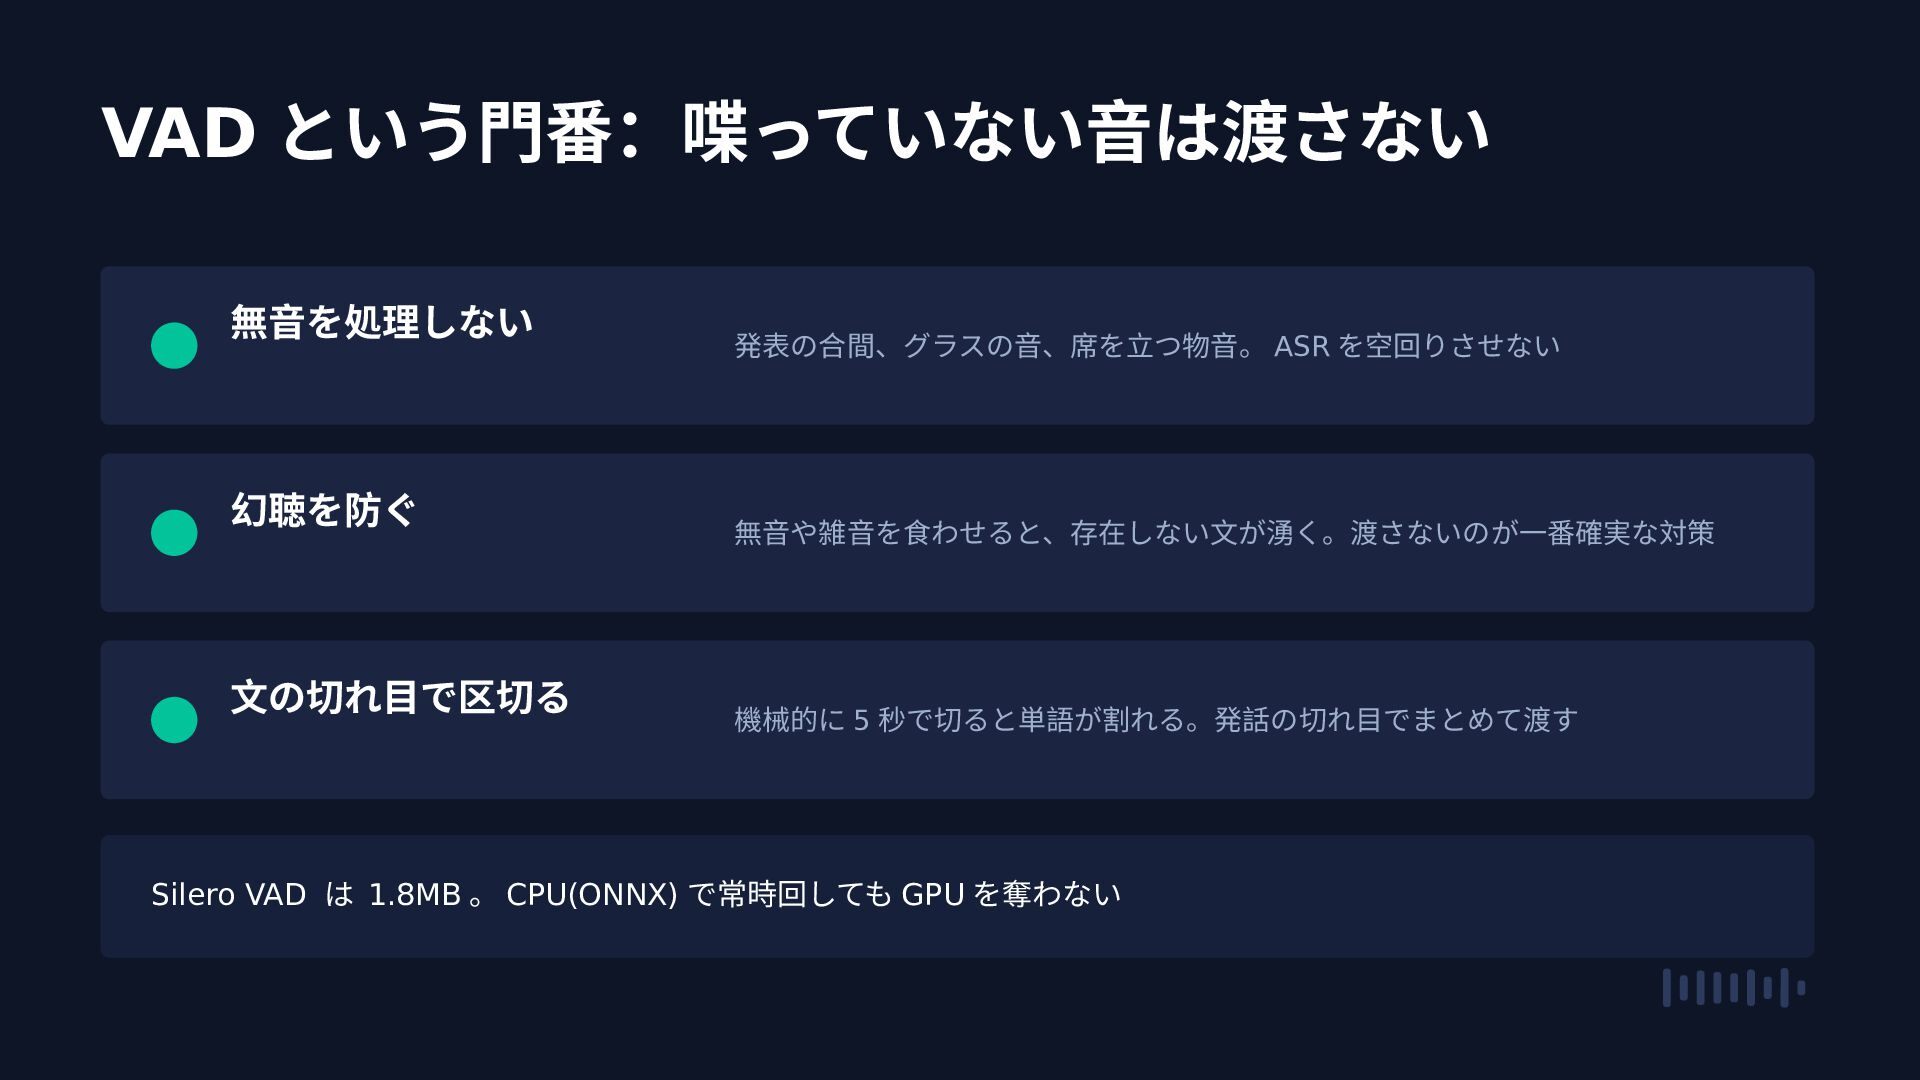
VAD という門番:喋っていない音は渡さない 無音を処理しない 幻聴を防ぐ 文の切れ目で区切る 発表の合間、グラスの音、席を立つ物音。 ASR を空回りさせない 無音や雑音を食わせると、存在しない文が湧く。渡さないのが一番確実な対策 機械的に
5 秒で切ると単語が割れる。発話の切れ目でまとめて渡す Silero VAD は 1.8MB 。 CPU(ONNX) で常時回しても GPU を奪わない
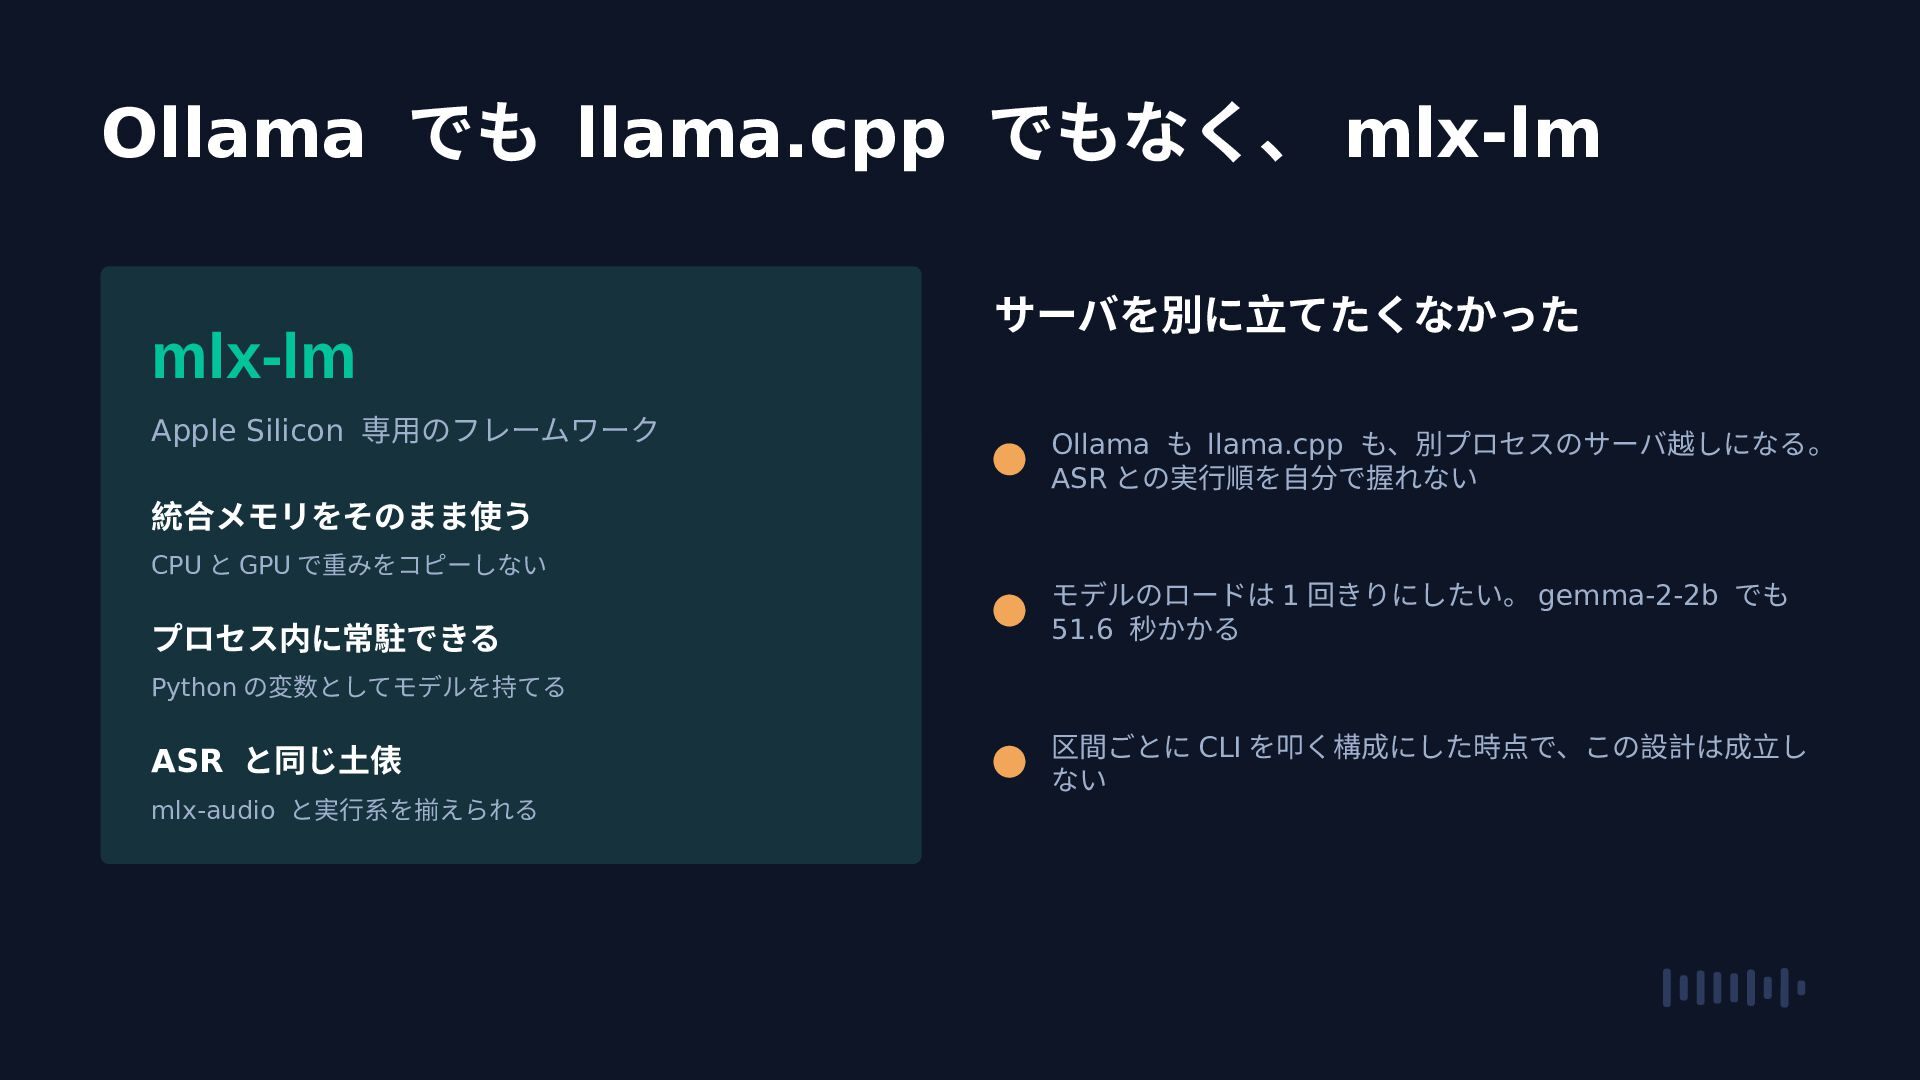
Ollama でも llama.cpp でもなく、 mlx-lm mlx-lm Apple Silicon 専用のフレームワーク 統合メモリをそのまま使う
CPU と GPU で重みをコピーしない プロセス内に常駐できる サーバを別に立てたくなかった Ollama も llama.cpp も、別プロセスのサーバ越しになる。 ASR との実行順を自分で握れない モデルのロードは 1 回きりにしたい。 gemma-2-2b でも 51.6 秒かかる Python の変数としてモデルを持てる ASR と同じ土俵 mlx-audio と実行系を揃えられる 区間ごとに CLI を叩く構成にした時点で、この設計は成立し ない
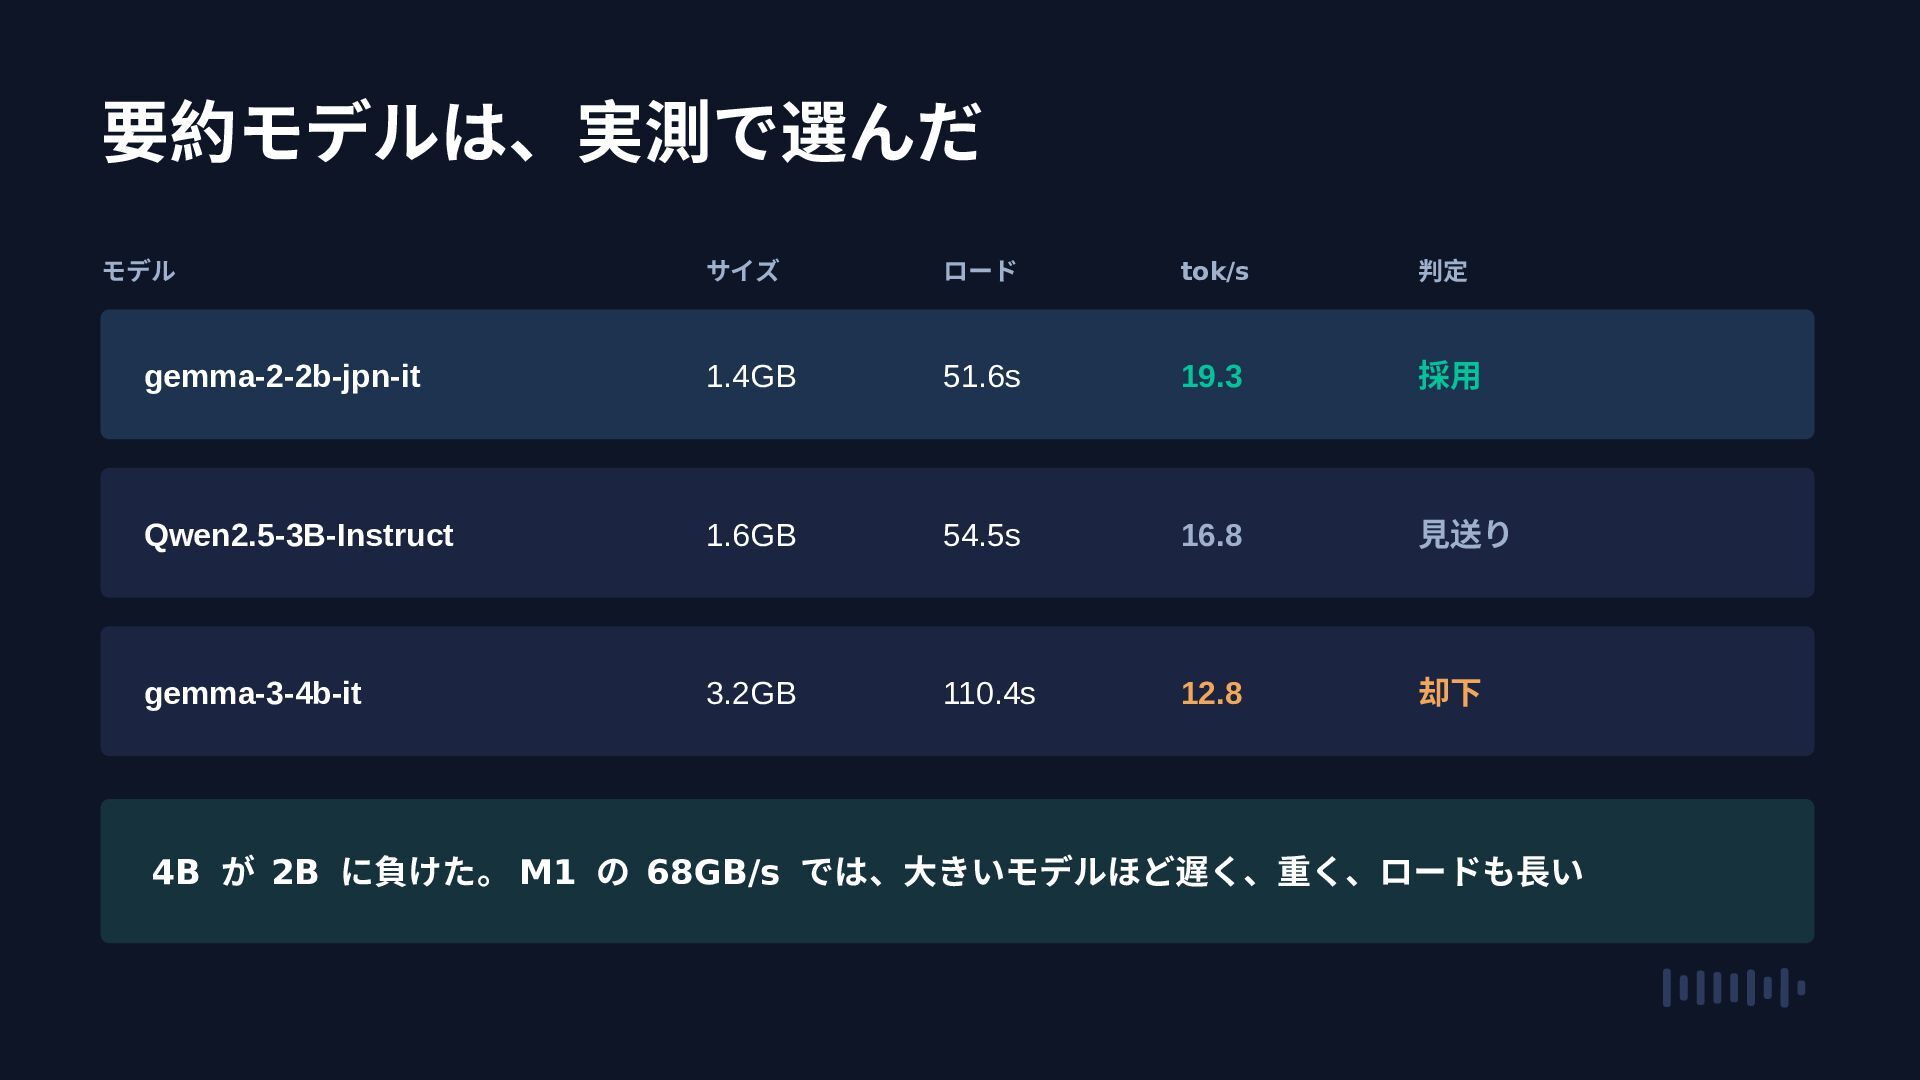
要約モデルは、実測で選んだ モデル サイズ ロード tok/s 判定 gemma-2-2b-jpn-it 1.4GB 51.6s 19.3
採用 Qwen2.5-3B-Instruct 1.6GB 54.5s 16.8 見送り gemma-3-4b-it 3.2GB 110.4s 12.8 却下 4B が 2B に負けた。 M1 の 68GB/s では、大きいモデルほど遅く、重く、ロードも長い
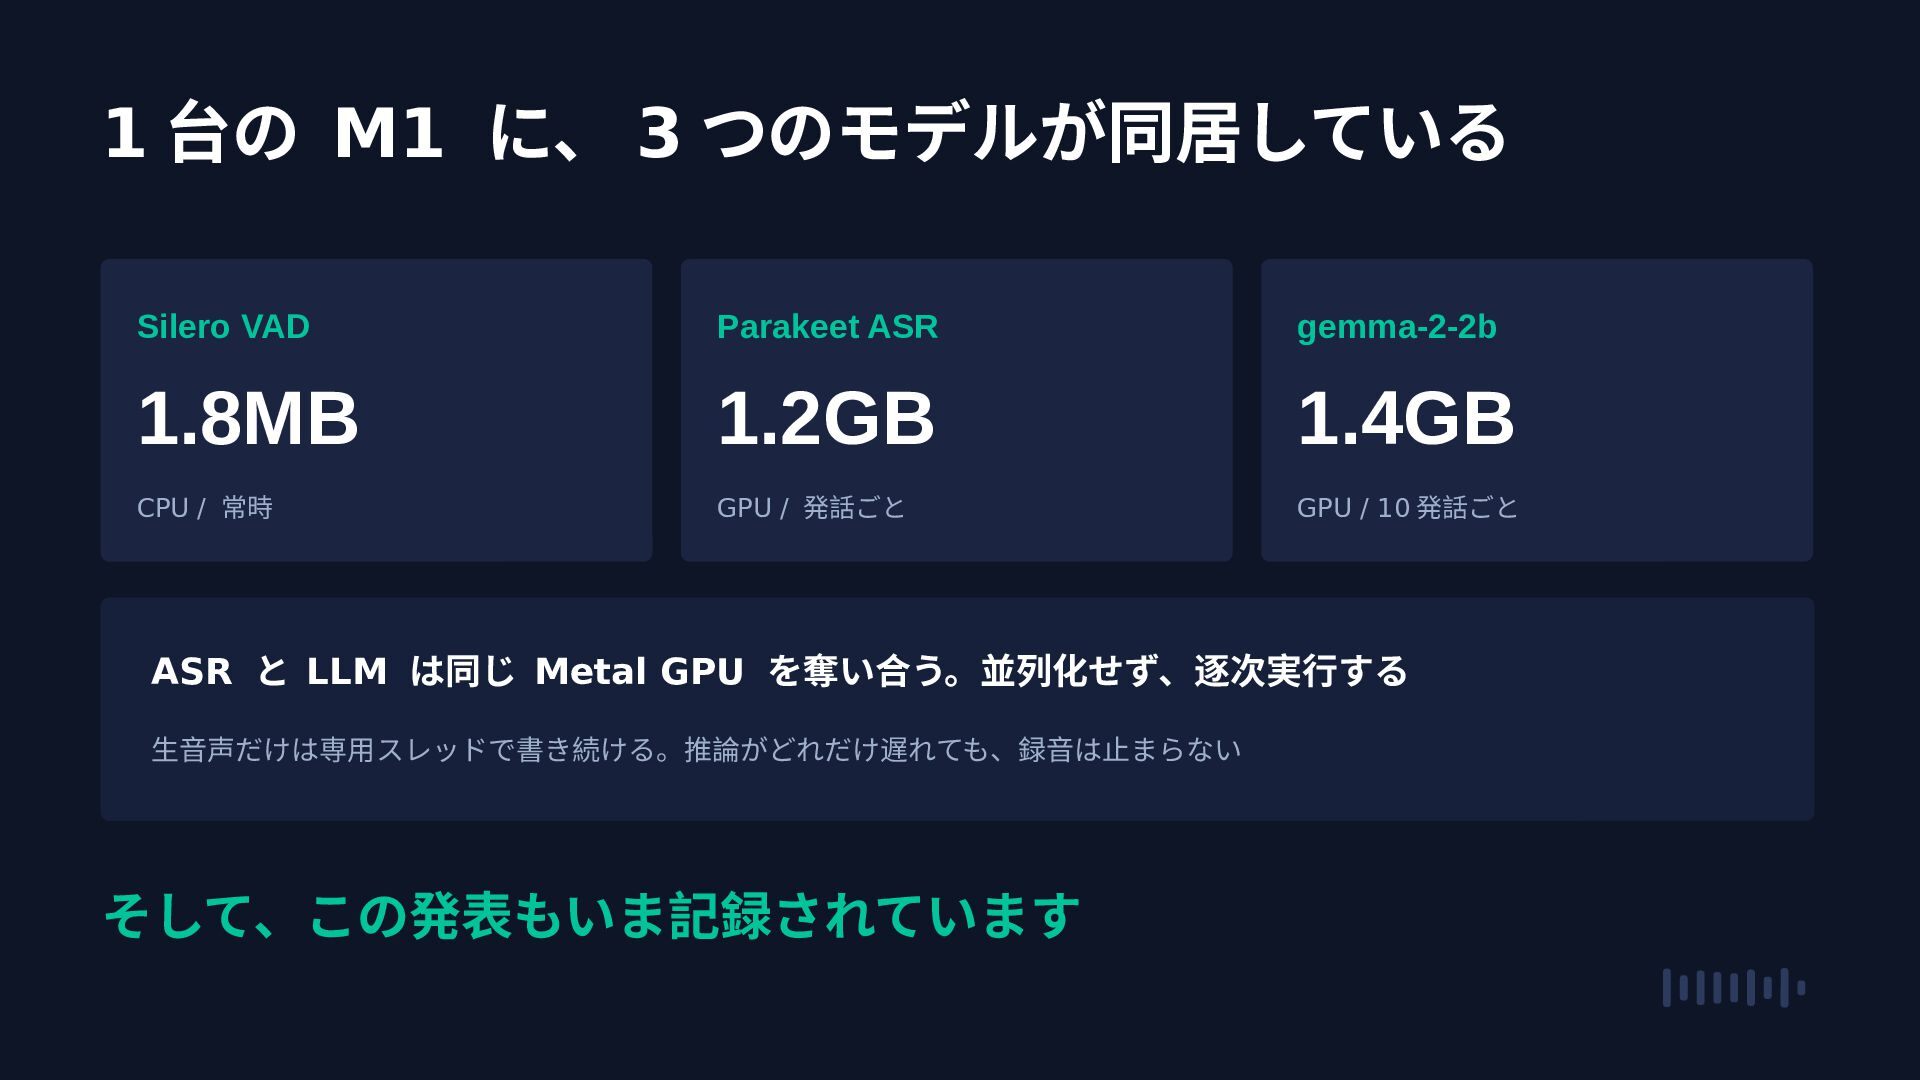
1 台の M1 に、 3 つのモデルが同居している Silero VAD Parakeet ASR
gemma-2-2b 1.8MB 1.2GB 1.4GB CPU / 常時 GPU / 発話ごと GPU / 10 発話ごと ASR と LLM は同じ Metal GPU を奪い合う。並列化せず、逐次実行する 生音声だけは専用スレッドで書き続ける。推論がどれだけ遅れても、録音は止まらない そして、この発表もいま記録されています


 numa08
 chriscoyier
 sstephenson
 cassininazir
 reverentgeek
 marktimemedia
 coloredviolet
 holman
 davidcarrasco
 jct
 kristinabergwall1