Share
Embed
Context Engineeringの取り組み
限りのあるContext Windowをどういうふうに管理するか(Context Engineering)に関して、AI運用勉強会でLTした時の資料になります。よろしくお願いします。
nutslove
February 04, 2026
Transcript
29 slides
-
自己紹介 2026/2/4 2 名前 李 俊起(イ ジュンギ) / Joonki Lee
所属 KINTOテクノロジーズ株式会社 Platform Group / Platform Engineer 関心分野 Observability Kubernetes 生成AI -
アジェンダ 2026/2/4 3 • 開発しているAgentについて • Context関連で直面した課題 • Context Engineeringの手法
• アラート原因分析Agentへの適用 • まとめ -
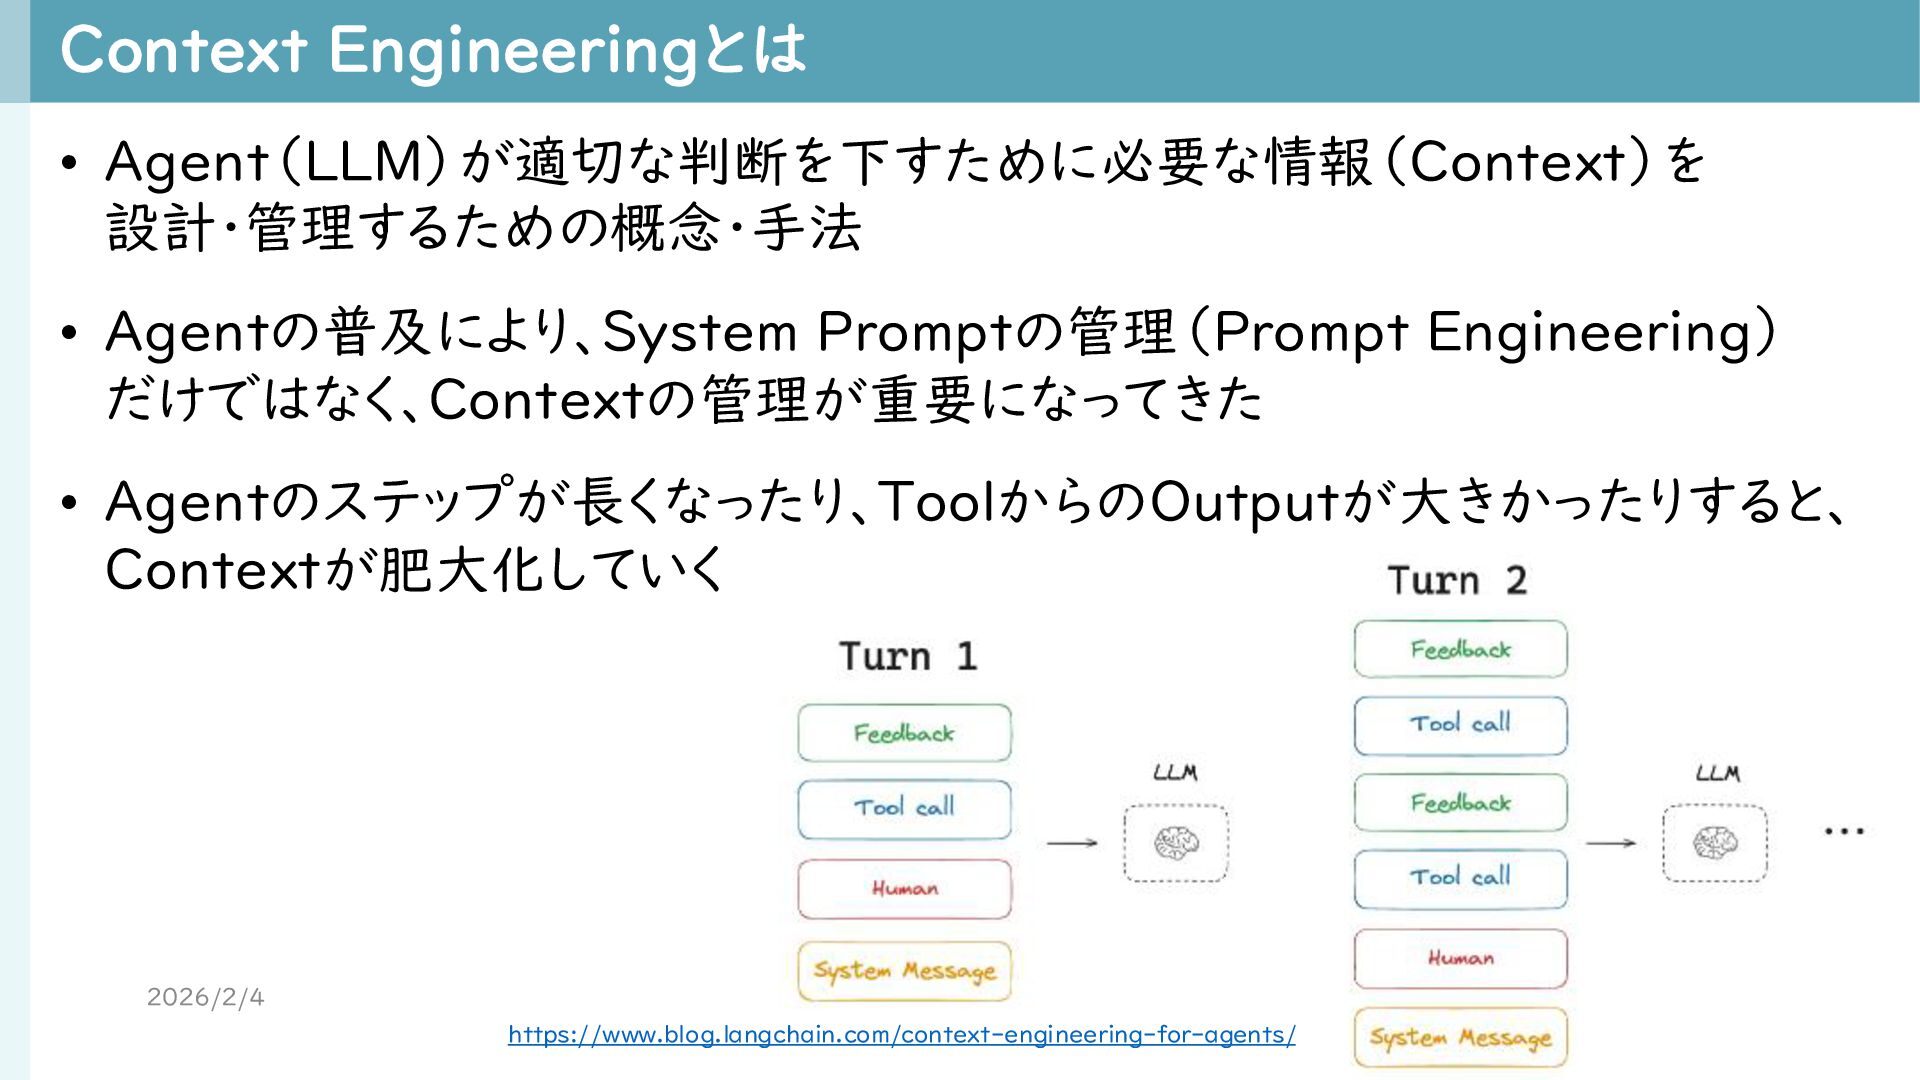
Context Engineeringとは 2026/2/4 9 • Agent(LLM)が適切な判断を下すために必要な情報(Context)を 設計・管理するための概念・手法 • Agentの普及により、System Promptの管理(Prompt
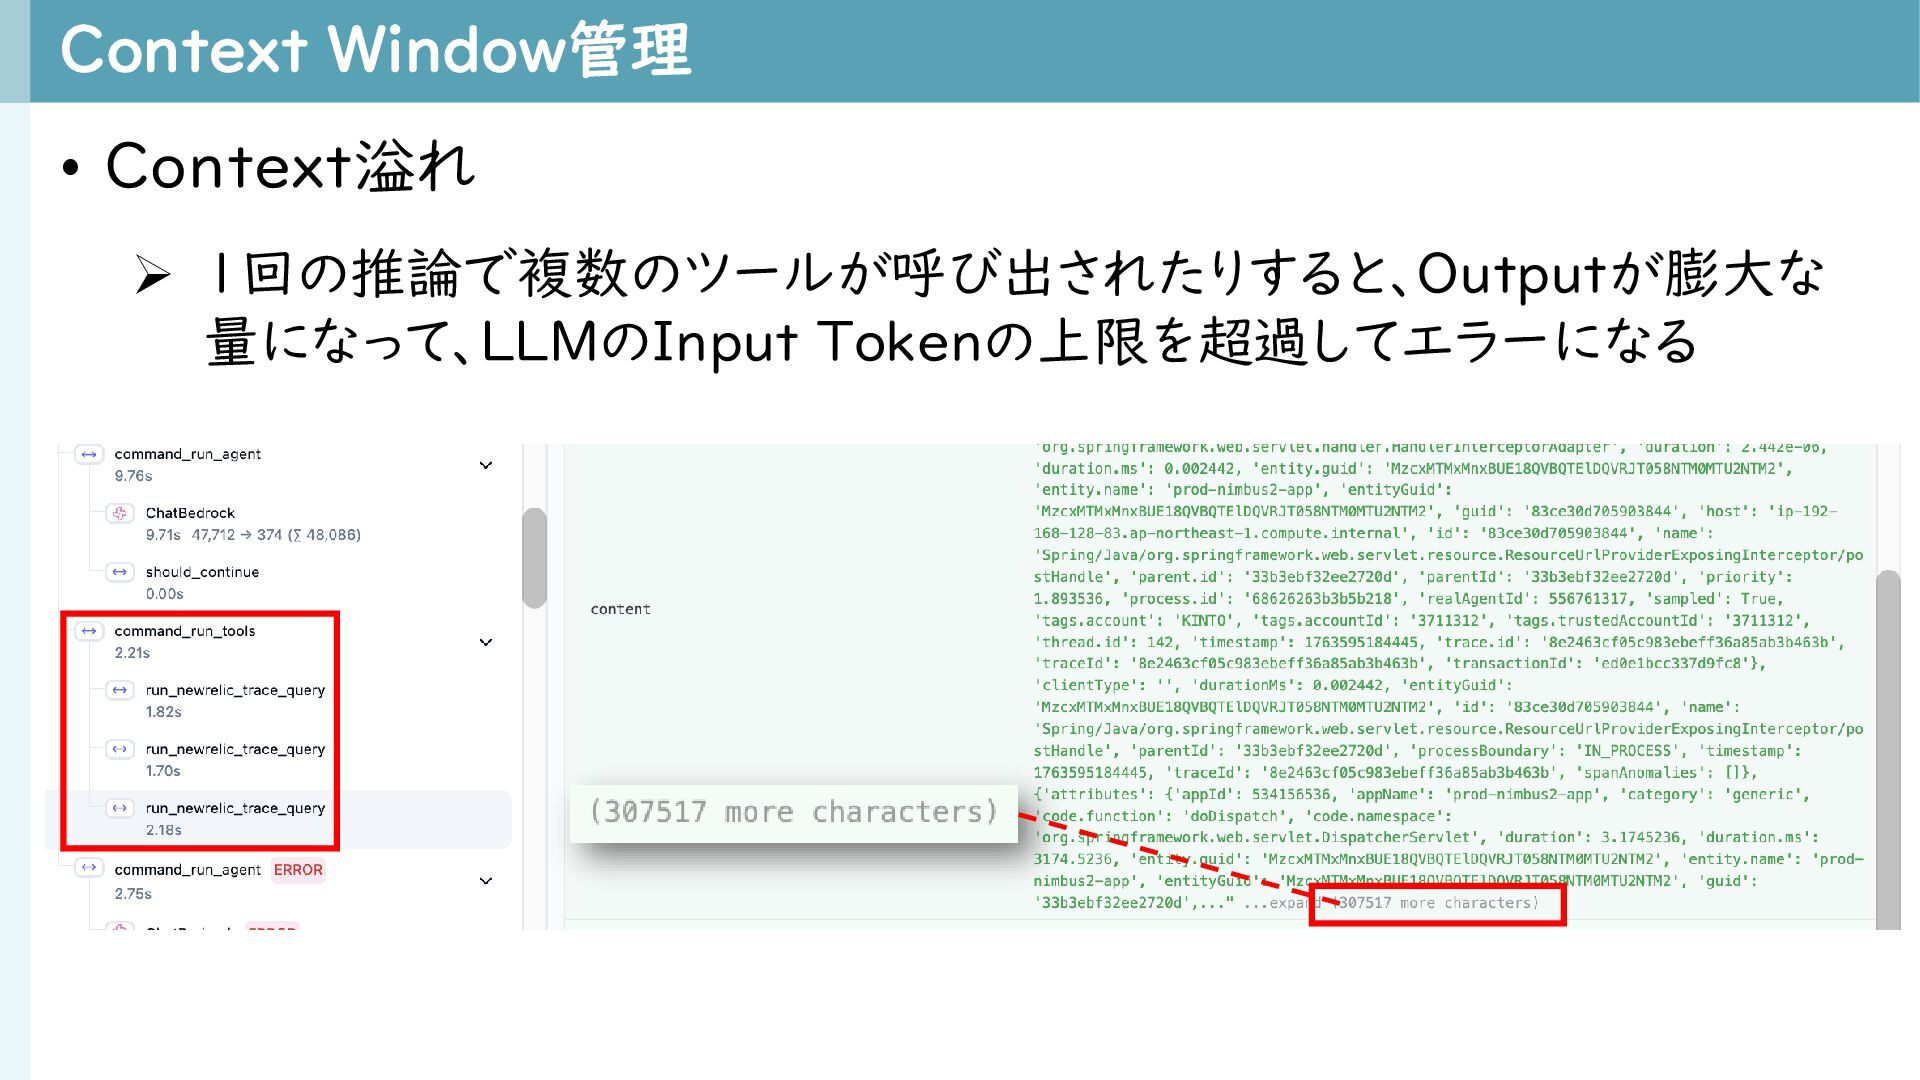
Engineering) だけではなく、Contextの管理が重要になってきた • Agentのステップが長くなったり、ToolからのOutputが大きかったりすると、 Contextが肥大化していく https://www.blog.langchain.com/context-engineering-for-agents/ -
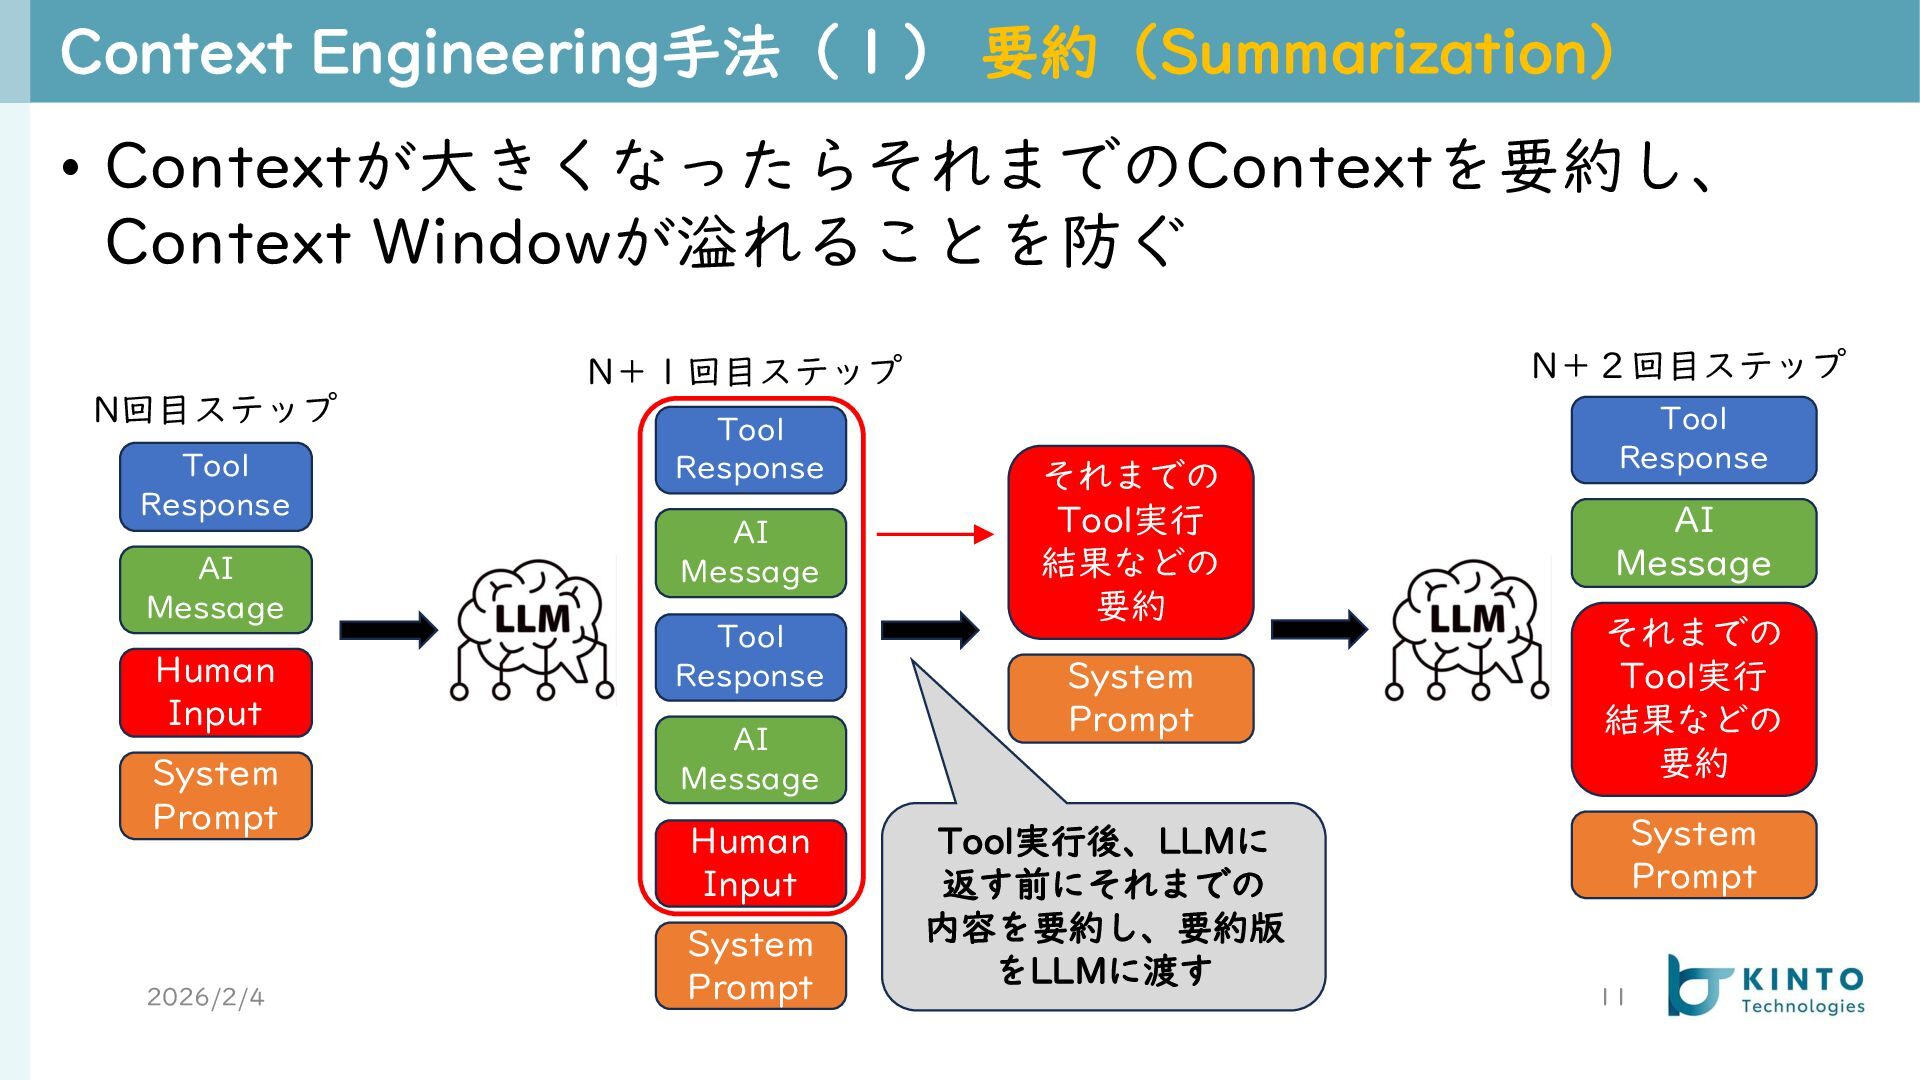
Context Engineering手法(1) 要約(Summarization) 2026/2/4 11 • Contextが大きくなったらそれまでのContextを要約し、 Context Windowが溢れることを防ぐ System
Prompt Human Input AI Message Tool Response N回目ステップ System Prompt Human Input AI Message Tool Response N+1回目ステップ AI Message Tool Response Tool実行後、LLMに 返す前にそれまでの 内容を要約し、要約版 をLLMに渡す System Prompt それまでの Tool実行 結果などの 要約 System Prompt それまでの Tool実行 結果などの 要約 AI Message Tool Response N+2回目ステップ -
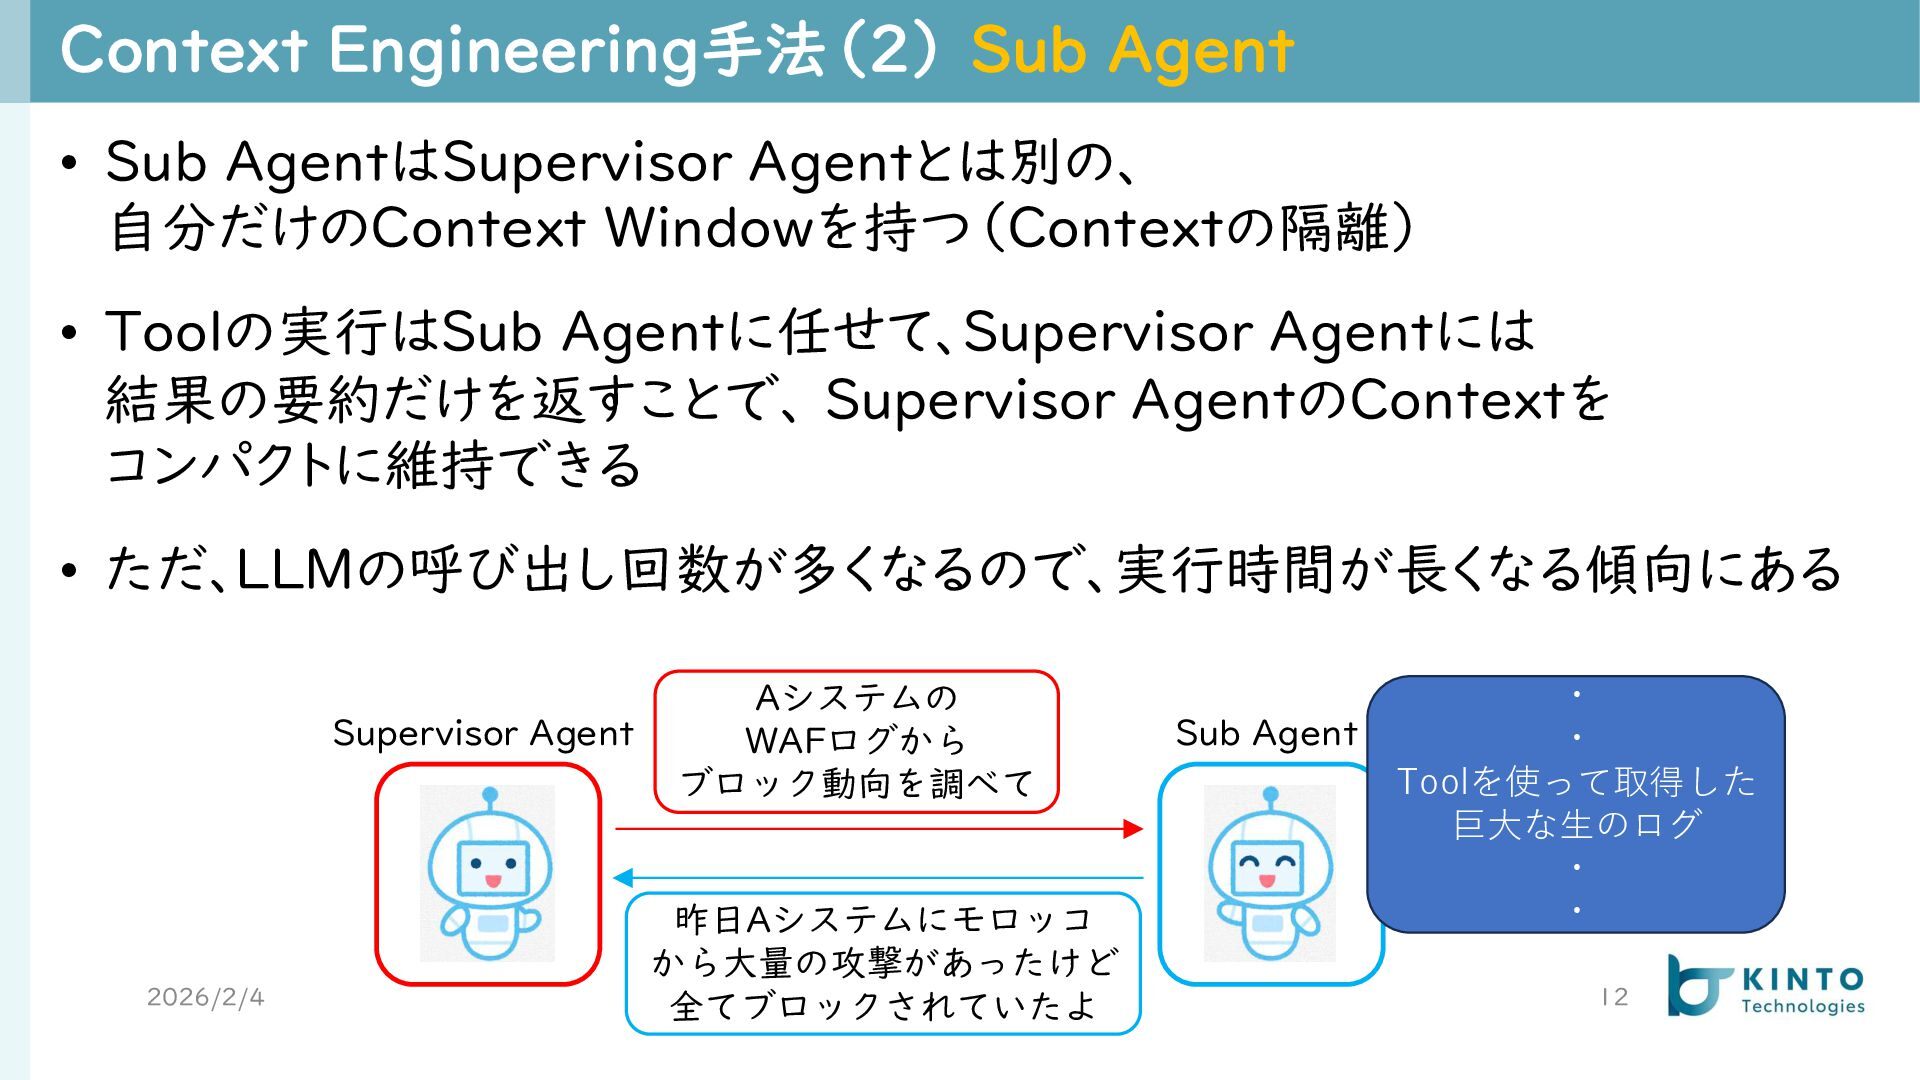
Context Engineering手法(2) Sub Agent 2026/2/4 12 • Sub AgentはSupervisor Agentとは別の、
自分だけのContext Windowを持つ(Contextの隔離) • Toolの実行はSub Agentに任せて、Supervisor Agentには 結果の要約だけを返すことで、 Supervisor AgentのContextを コンパクトに維持できる • ただ、LLMの呼び出し回数が多くなるので、実行時間が長くなる傾向にある Supervisor Agent Sub Agent Aシステムの WAFログから ブロック動向を調べて 昨日Aシステムにモロッコ から大量の攻撃があったけど 全てブロックされていたよ ・ ・ Toolを使って取得した 巨大な生のログ ・ ・ -
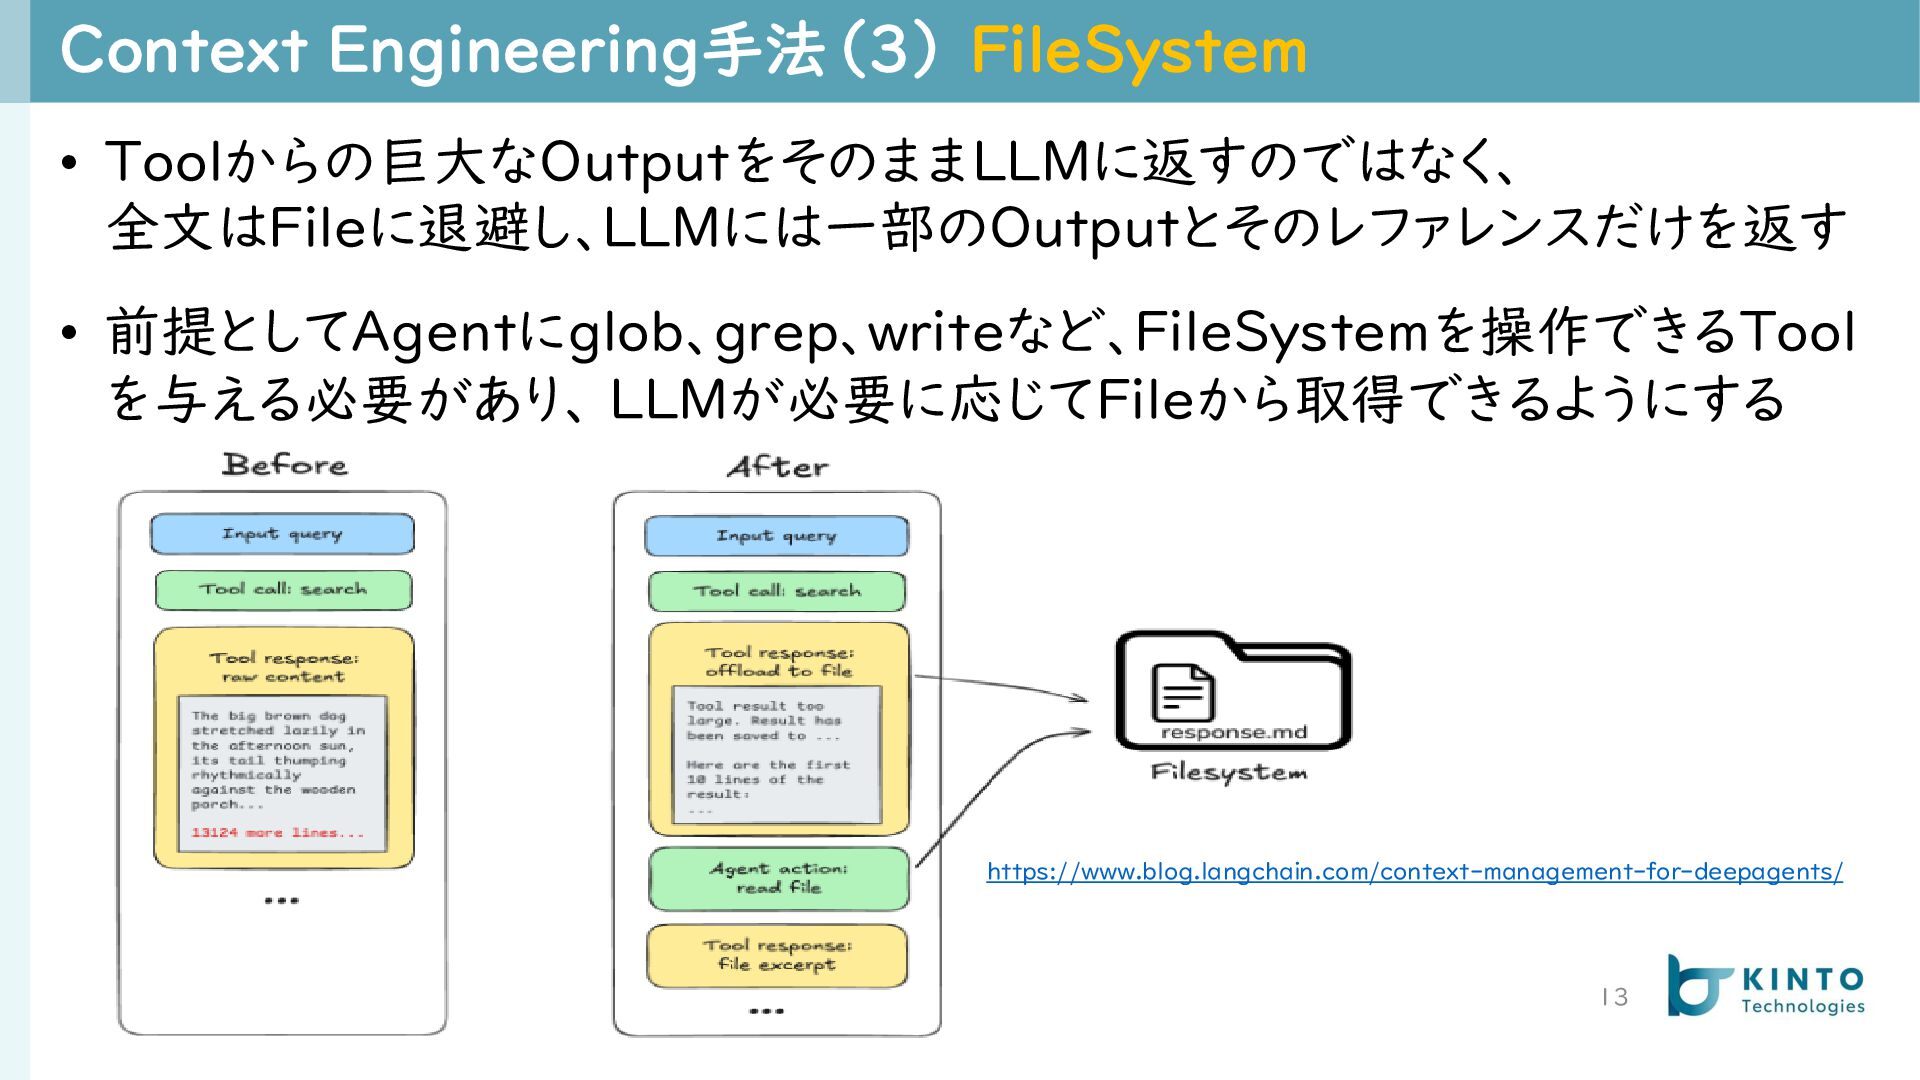
Context Engineering手法(3) FileSystem 2026/2/4 13 • Toolからの巨大なOutputをそのままLLMに返すのではなく、 全文はFileに退避し、LLMには一部のOutputとそのレファレンスだけを返す • 前提としてAgentにglob、grep、writeなど、FileSystemを操作できるTool
を与える必要があり、 LLMが必要に応じてFileから取得できるようにする https://www.blog.langchain.com/context-management-for-deepagents/ -
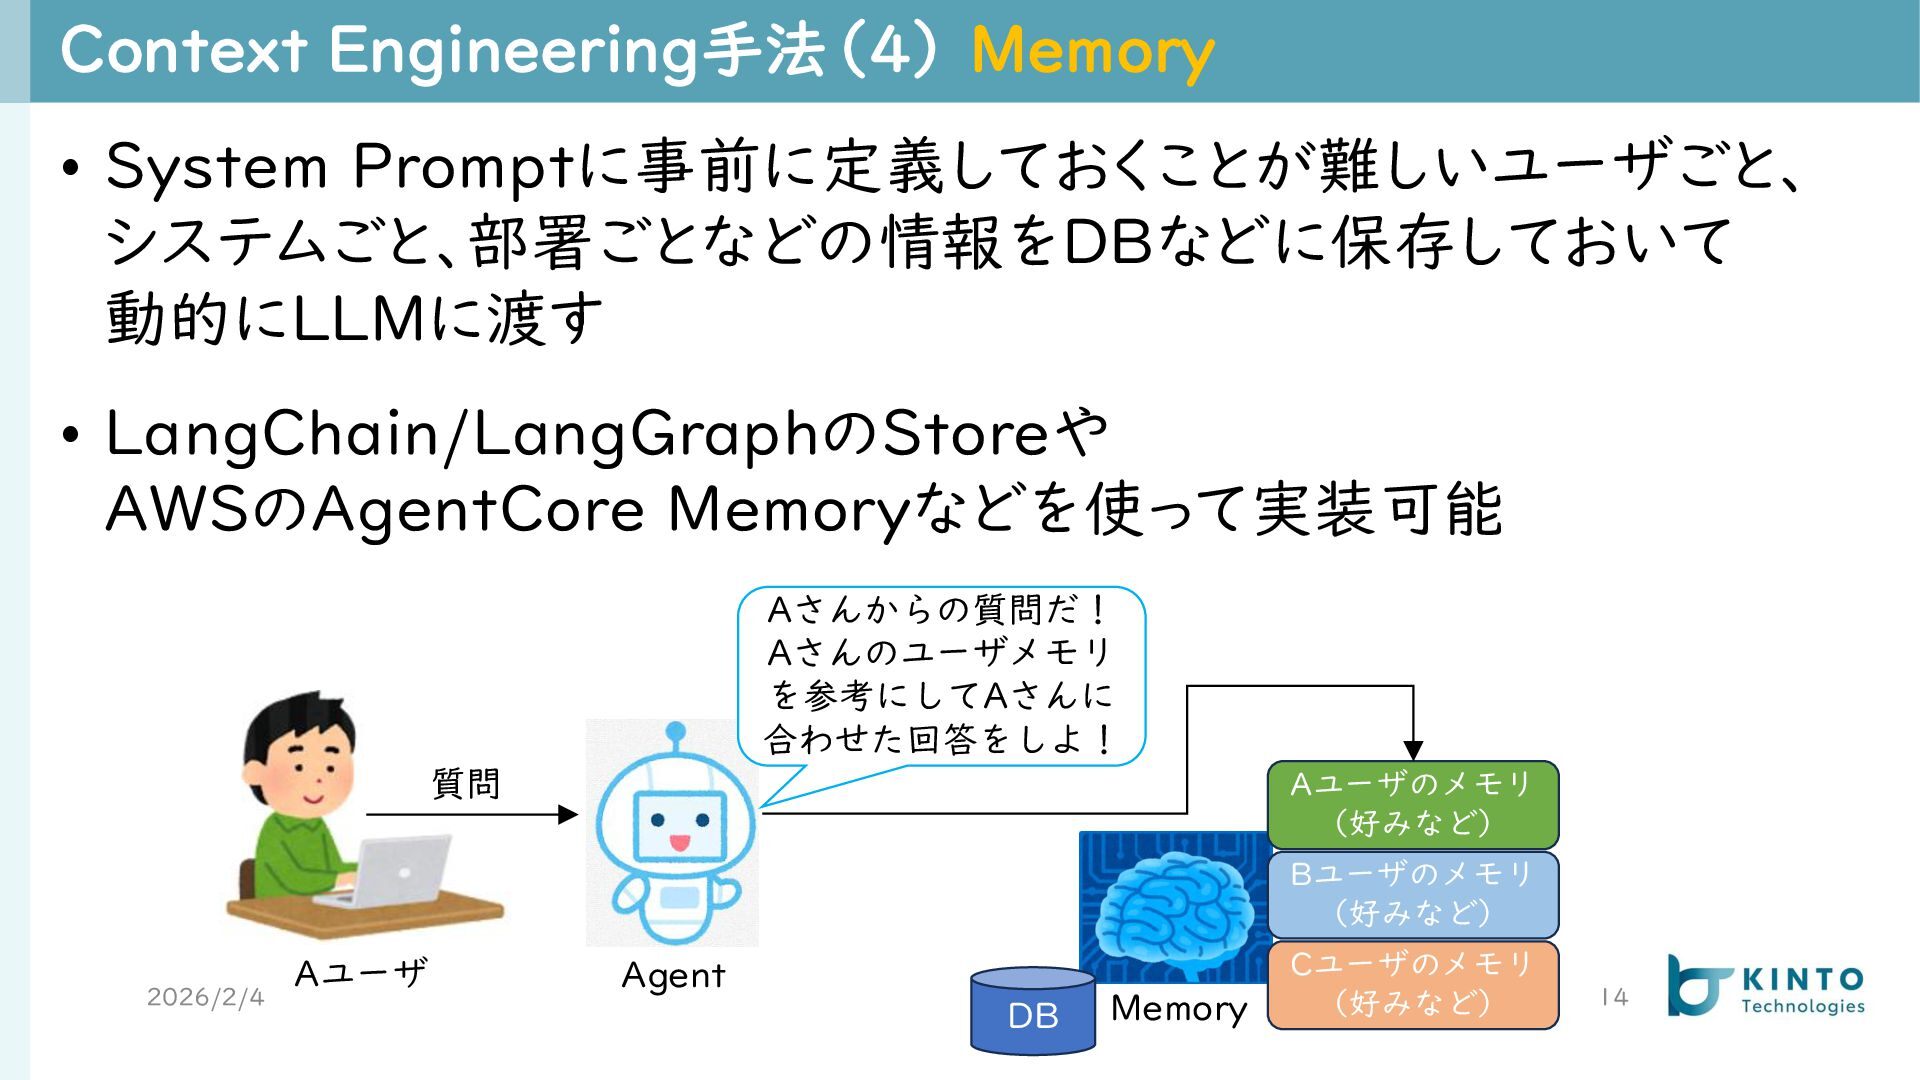
Context Engineering手法(4) Memory 2026/2/4 14 • System Promptに事前に定義しておくことが難しいユーザごと、 システムごと、部署ごとなどの情報をDBなどに保存しておいて 動的にLLMに渡す
• LangChain/LangGraphのStoreや AWSのAgentCore Memoryなどを使って実装可能 Memory DB Aユーザのメモリ (好みなど) Bユーザのメモリ (好みなど) Cユーザのメモリ (好みなど) Aユーザ Agent 質問 Aさんからの質問だ! Aさんのユーザメモリ を参考にしてAさんに 合わせた回答をしよ! -
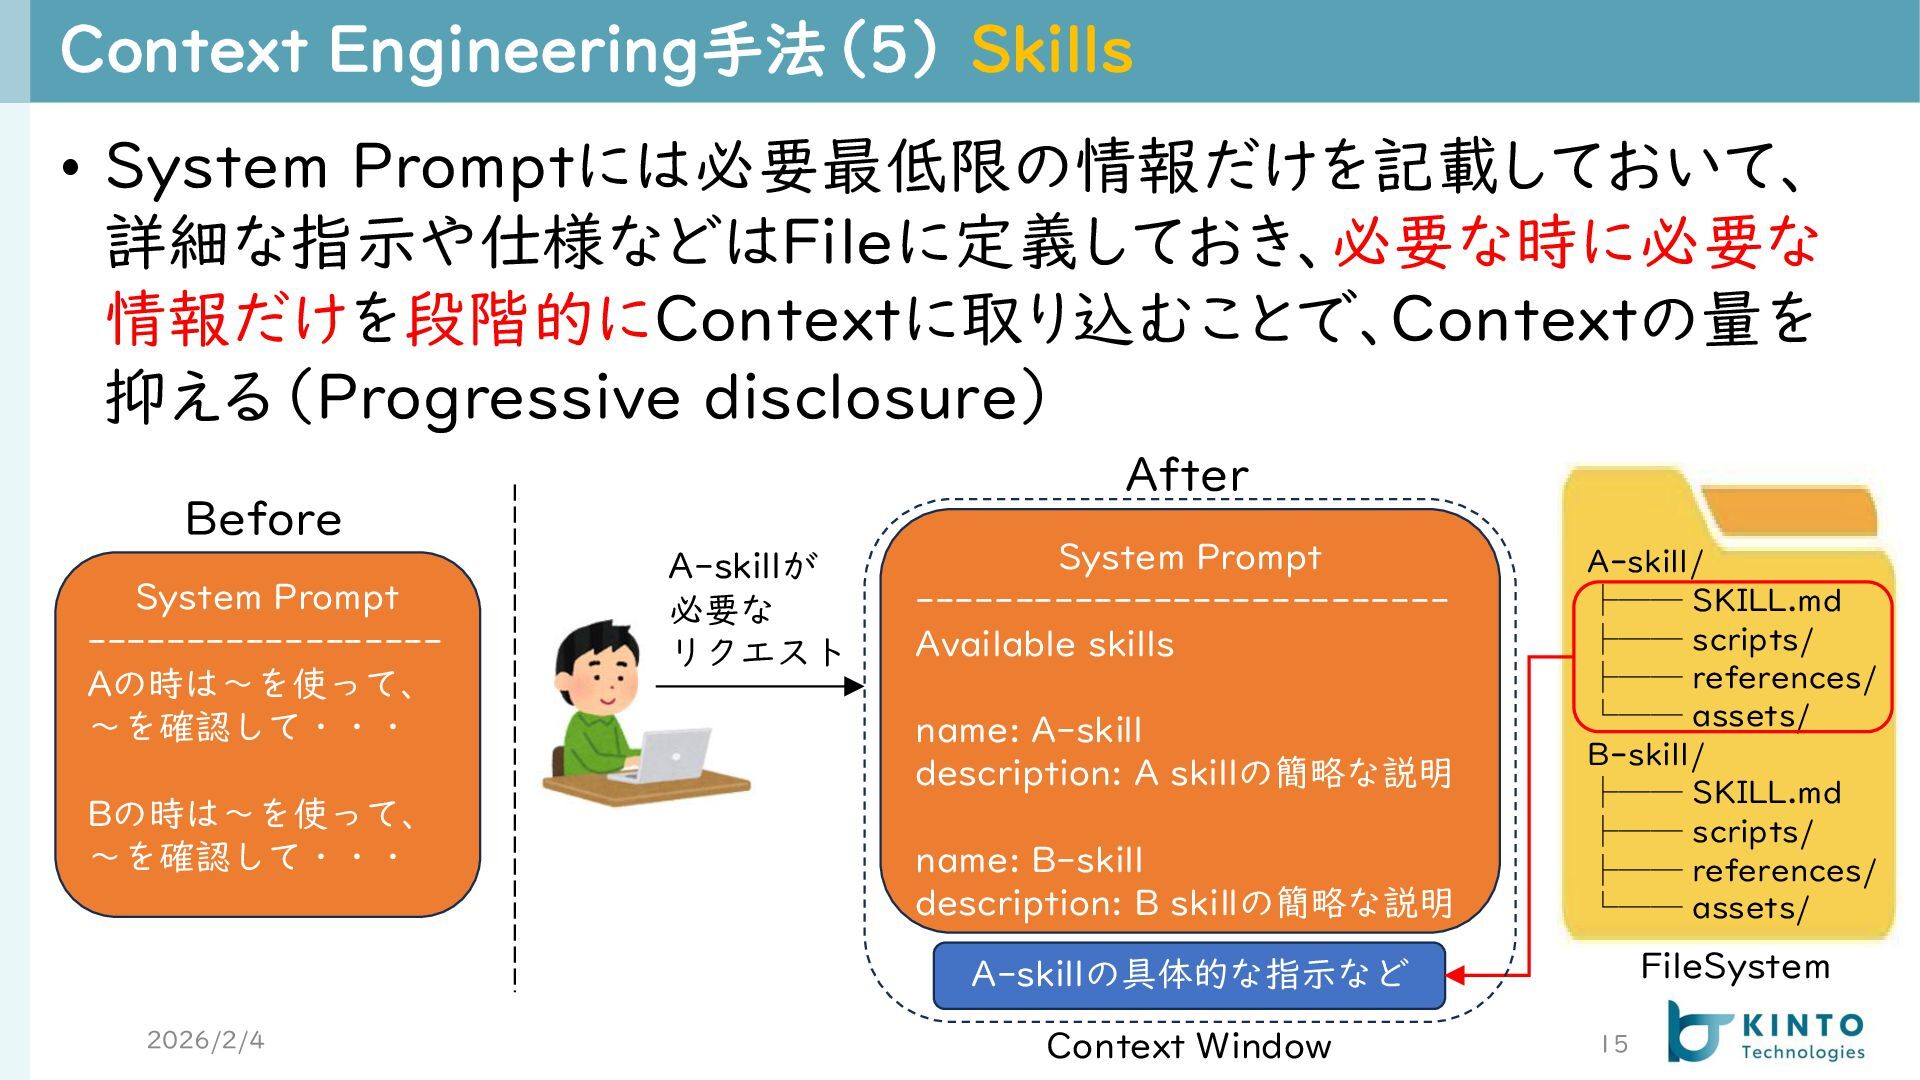
A-skillの具体的な指示など Context Engineering手法(5) Skills 2026/2/4 15 • System Promptには必要最低限の情報だけを記載しておいて、 詳細な指示や仕様などはFileに定義しておき、必要な時に必要な
情報だけを段階的にContextに取り込むことで、Contextの量を 抑える(Progressive disclosure) Before System Prompt ------------------ Aの時は〜を使って、 〜を確認して・・・ Bの時は〜を使って、 〜を確認して・・・ After System Prompt --------------------------- Available skills name: A-skill description: A skillの簡略な説明 name: B-skill description: B skillの簡略な説明 FileSystem A-skill/ ├── SKILL.md ├── scripts/ ├── references/ └── assets/ B-skill/ ├── SKILL.md ├── scripts/ ├── references/ └── assets/ A-skillが 必要な リクエスト Context Window -
Context Engineering手法(6) ToolのOutput最適化 2026/2/4 16 • ToolからのOutputをLLMにより最適なフォーマットに変換 した上でLLMに返す • ToolのOutputが一定のサイズを超える場合、Tool側で
Outputを返さずに「結果が大きすぎます。時間範囲やフィル タ条件を絞り込んでください」のようなガイドメッセージを 返すことで、LLMが自らクエリを修正して再実行できるよう にする -
アラート原因分析Agentで試した手法 2026/2/4 17 • Sub Agentパターンは、結局Sub Agent側でも1回の推論で 実行されるToolのOutputが大きすぎると同じ問題が起きる • Skills、Memoryは必要な時に必要な分だけをContextに取り入
れるための仕組みであって、ToolからのContext管理には適用で きない • FileSystem手法は改修範囲が大きいため、 まずは「要約」と「ToolのOutput最適化」2つを試すことに -
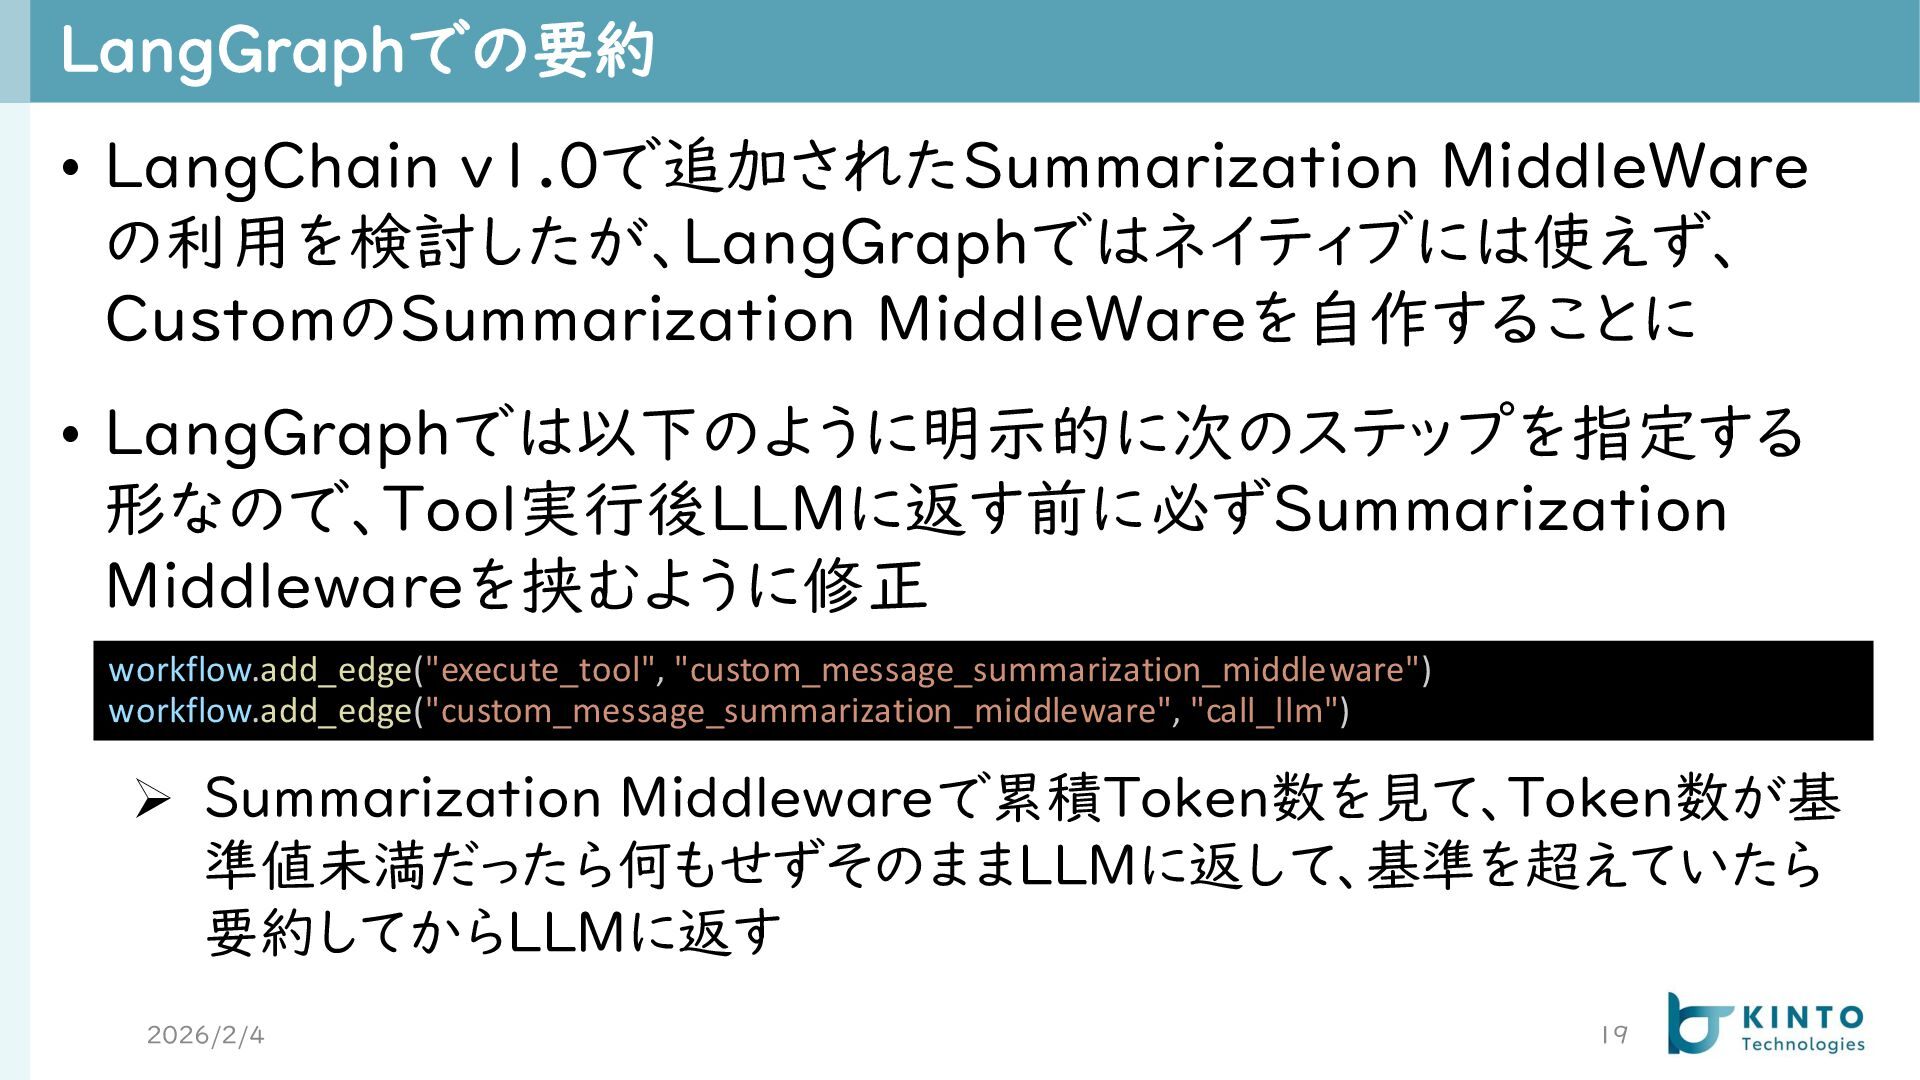
LangGraphでの要約 2026/2/4 19 • LangChain v1.0で追加されたSummarization MiddleWare の利用を検討したが、LangGraphではネイティブには使えず、 CustomのSummarization MiddleWareを自作することに
• LangGraphでは以下のように明示的に次のステップを指定する 形なので、Tool実行後LLMに返す前に必ずSummarization Middlewareを挟むように修正 ➢ Summarization Middlewareで累積Token数を見て、Token数が基 準値未満だったら何もせずそのままLLMに返して、基準を超えていたら 要約してからLLMに返す workflow.add_edge("execute_tool", "custom_message_summarization_middleware") workflow.add_edge("custom_message_summarization_middleware", "call_llm") -
要約処理でハマったポイント(1) 要約しすぎの問題 2026/2/4 20 • 直面した問題 ➢ Contextを要約しすぎて、要約後に重要なポイントが抜け落ち、 Agentが同じToolを再実行したり、次のアクションを正しく判断 できなくなる事象が起きた
• どう解決したか ➢ Structured Outputを使って、「それまでに実行したこと/その結果」、 「発見したこと」、「まだ確認できてないこと」、「次の推奨アクション」を 必ず残すようにして解決 -
要約処理でハマったポイント(2) Token計算 2026/2/4 21 • 直面した問題 ➢ 累積Token数のメタデータはLLM呼び出し後しか存在せず、Tool実行 直後(LLMに返す前)のToolのOutputを含めた累積Token数は自分 で求める必要があった
➢ BedrockのCountTokens APIがあったが、同じInput Tokenの上限 が適用され、累積メッセージが大きすぎる場合、エラーになる • どう解決したか ➢ LangChainに内部でToken数計算に使う関数があったため、 それを直接利用することで解決 -
要約処理でハマったポイント(3) 要約のためのバッファが残ってない 2026/2/4 22 • 直面した問題 ➢ 要約のタイミングで、すでにContextがLLMのInput Tokenの 上限を超えてしまっていて、要約させることができない
• どう解決したか ➢ Tokenの上限がより大きいLLM (Gemini)にフォールバック ➢ ToolのOutputが一定の文字数を超えた場合、 超過分を切り捨ててからLLMに返す -
TOON(Token-Oriented Object Notation) 2026/2/4 24 • LLM入力用として設計された、JSONからトークンを最小限 に抑え、モデルが構造を追いやすいコンパクトなフォーマッ トに変換してくれるライブラリ •
メトリクスなど、同じフィールド(timestamp, valueなど) が繰り返されるデータでは、JSONだとキーが毎回重複する のに対して、TOONは(CSVのように)ヘッダーを1回だけ 宣言してデータだけを並べるため、特に効果が大きい • 導入後、約10%のToken数削減の効果が見られた https://toonformat.dev/guide/getting-started -
※補足: Memoryを使ったユーザごとのカスタマイズ 2026/2/4 25 • 先日のUpdateで能動的にAgentを呼び出せるようになった • アラート契機の場合は、そのアラート分析に必要な情報とToolだけ をピンポイントで事前に取得・設定してからAgentを実行するので、 空振りが少ない
しかし、能動的なAgentは汎用的なので、空振りが多い • LangChain/LangGraphのStore機能を使ってユーザごとに 専用のメモリ(例: 使ってる監視ツール、担当システムなど)を 設定できるようにし、能動的な利用時でもユーザに合った適切な Toolや情報ソースを選択できるようにした -
今後について 2026/2/4 26 • Sub Agentパターンで、Sub Agentは安価なModelを使ったり、 Contextの隔離で分析にかかるLLMのコストを削減できるか検証 • FileSystemを活用するパターンも試して、
ToolのOutputが大き い場合、切り捨てるのではなく、全文をFileに退避し、LLM が必要に応じてFileから参照できるようにする