Upgrade to Pro
— share decks privately, control downloads, hide ads and more …
Speaker Deck
Sign up for free
Menu
Search
Features
All features
Private URLs
Password Protection
Custom URLS
Scheduled publishing
Remove Branding
Restrict embedding
Deck Collections
Notes
Features
All features
Private URLs
Password Protection
Custom URLS
Scheduled publishing
Remove Branding
Restrict embedding
Deck Collections
Notes
Explore
Featured decks
Featured speakers
Programming
Technology
Storyboards
Explore
Featured decks
Featured speakers
Programming
Technology
Storyboards
Pricing
Search
Sign in
Sign up for free
自作して見えた感情モデルの限界
Search
rindguitar
August 20, 2026
Programming
13
0
Share
Embed
Copy iframe code
Copy JS code
Copy link
Start on current slide
自作して見えた感情モデルの限界
VR ChatのDS集会8/6にて発表したスライドです。
rindguitar
August 20, 2026
Transcript
18 slides
自作して見えた 感情分析モデルの限界
自己紹介 Rin(rindguitar) 2024年11月からプログラミングを始 めた 機械学習(NLP・時系列予測)に挑戦 中 GitHub https://github.com/rindguitar
今日のテーマ 何を作っているのか? レビューで学習とファインチューニングするだけ で変わる?(OOD比較) 3. DAPTで汎用モデルに勝つ 4. その差は運じゃない?(多シード検証) 5. 感情分析の限界
6. まとめ — 学んだこと 1. 2.
1. 何を作っているか? で英語レビューを集め、感情分析をする モデル ベースは DistilBERT。Steamレビュー(7ゲーム・ 計1万件)で学習 目的はレビューからゲーム需要予測に繋げること ラベルは voted_up(👍/👎)を流用
— 手軽だが 粗いproxy(後で効いてくる) Steam API
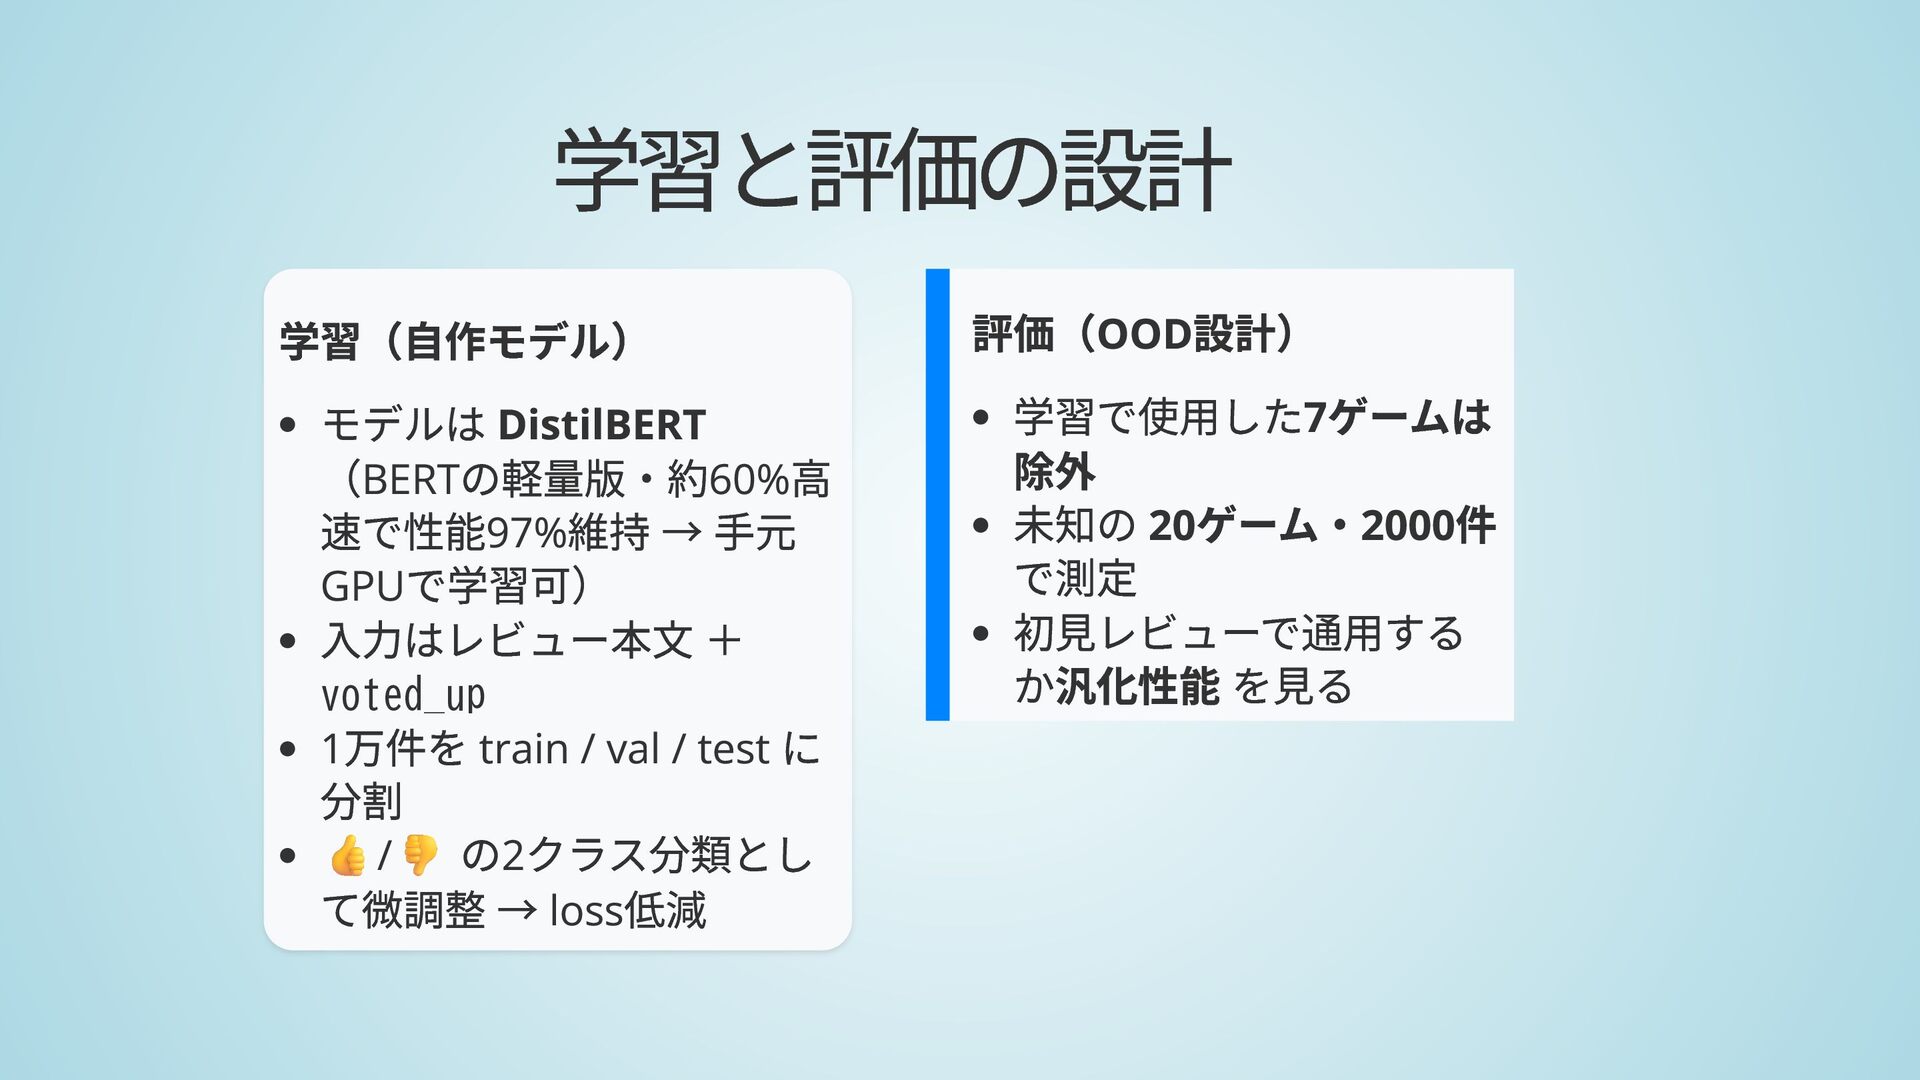
学習と評価の設計 学習(自作モデル) モデルは DistilBERT (BERTの軽量版・約60%高 速で性能97%維持 → 手元 GPUで学習可) 入力はレビュー本文
+ voted_up 1万件を train / val / test に 分割 👍/👎 の2クラス分類とし て微調整 → loss低減 評価(OOD設計) 学習で使用した7ゲームは 除外 未知の 20ゲーム・2000件 で測定 初見レビューで通用する か汎化性能 を見る
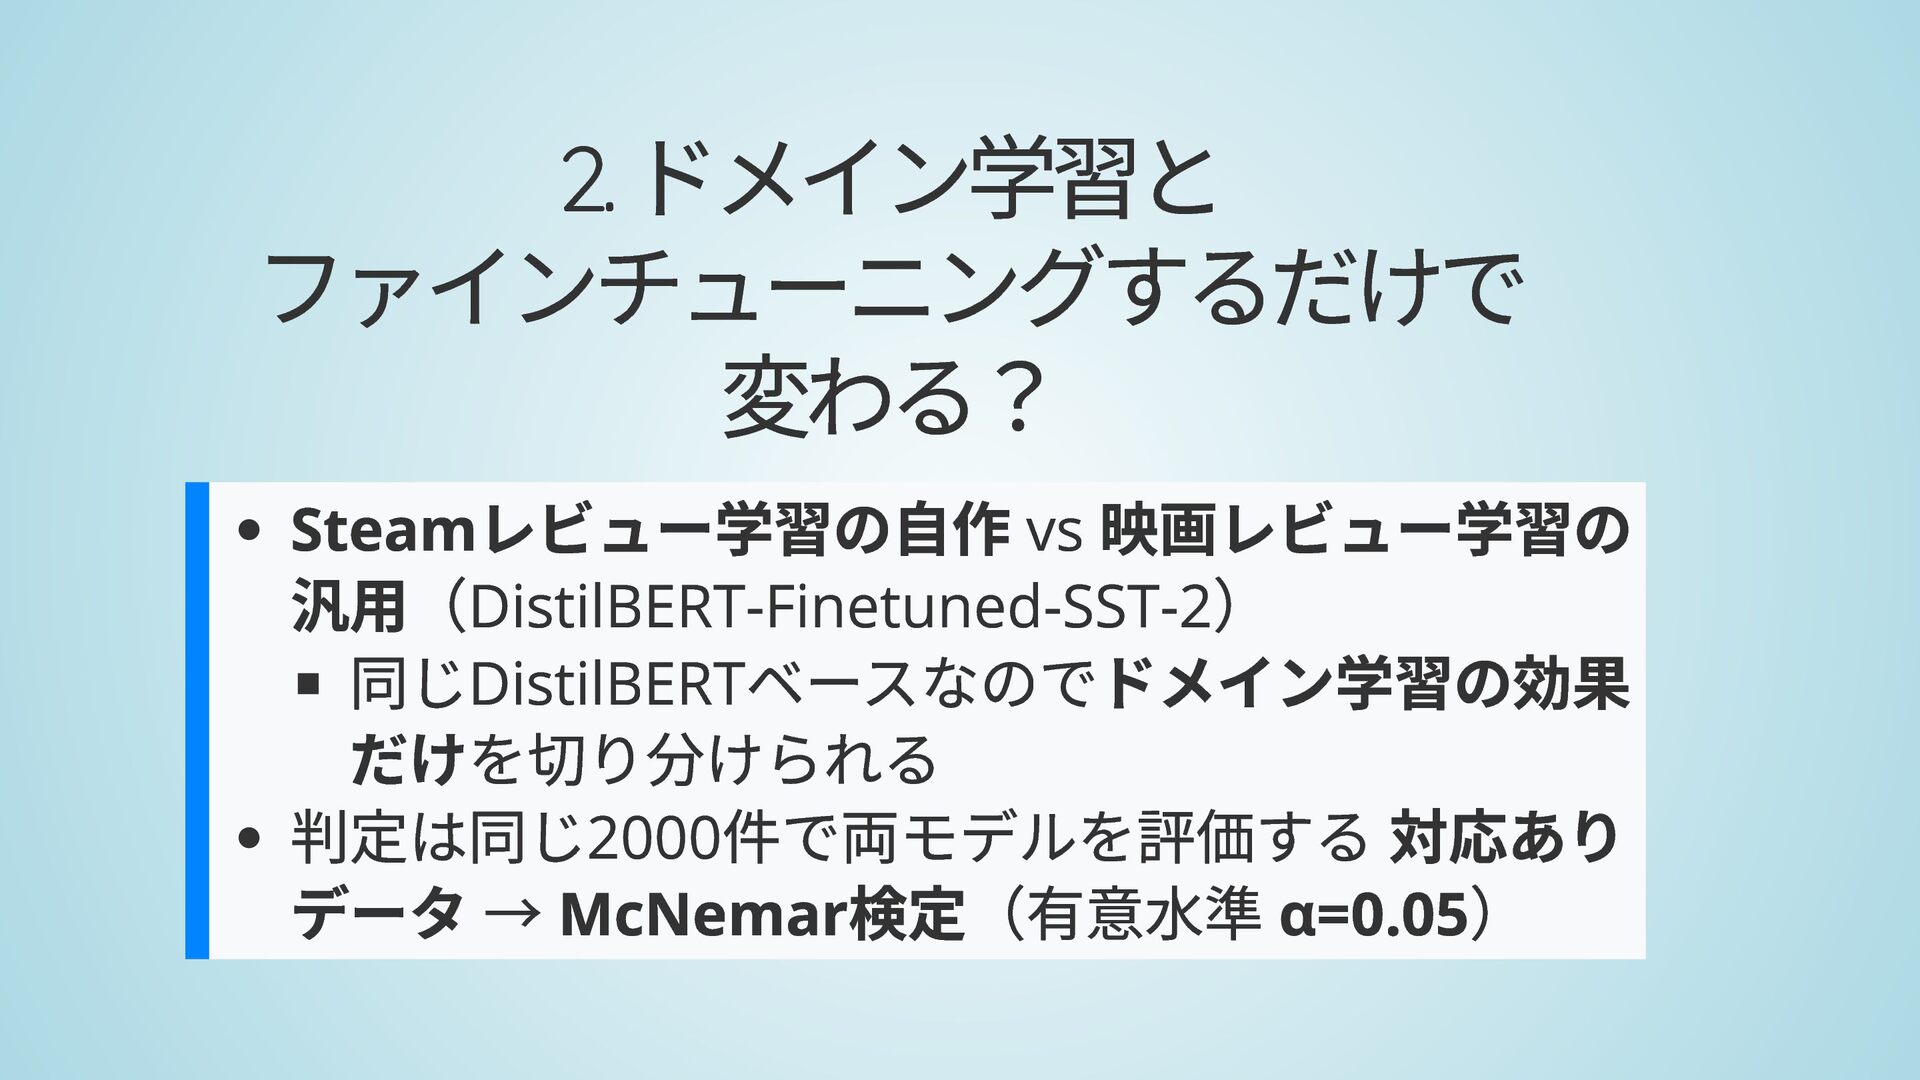
ドメイン学習と ファインチューニングするだけで 変わる? 2. レビュー学習の自作 映画レビュー学習の 汎用( ) 同じ ベースなのでドメイン学習の効果
だけを切り分けられる 判定は同じ2000件で両モデルを評価する 対応あり データ → McNemar検定(有意水準 α=0.05) Steam vs DistilBERT-Finetuned-SST-2 DistilBERT
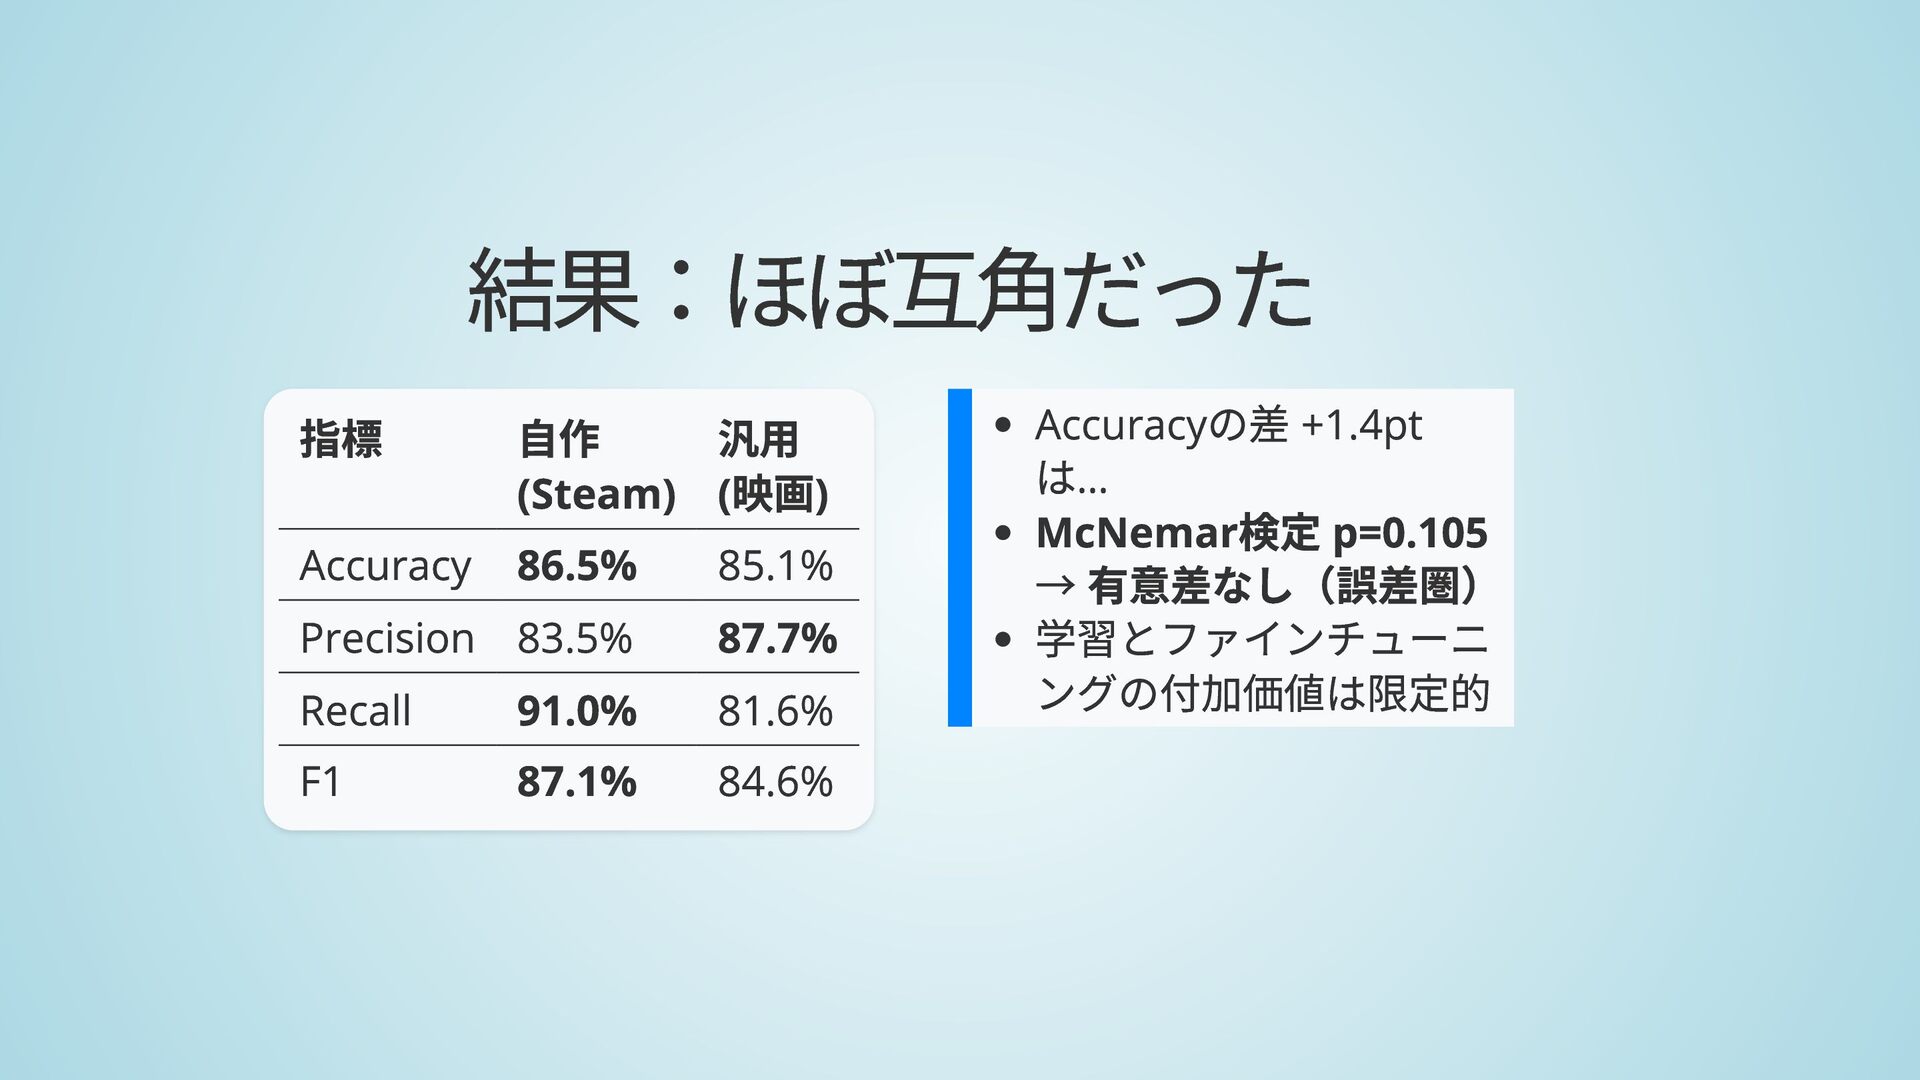
指標 結果:ほぼ互角だった Accuracy Precision Recall F1 自作 汎用 (Steam) (映画)
86.5% 83.5% 91.0% 87.1% 85.1% 87.7% 81.6% 84.6% の差 +1.4pt は 検定 p=0.105 → 有意差なし(誤差圏) 学習とファインチューニ ングの付加価値は限定的 Accuracy … McNemar
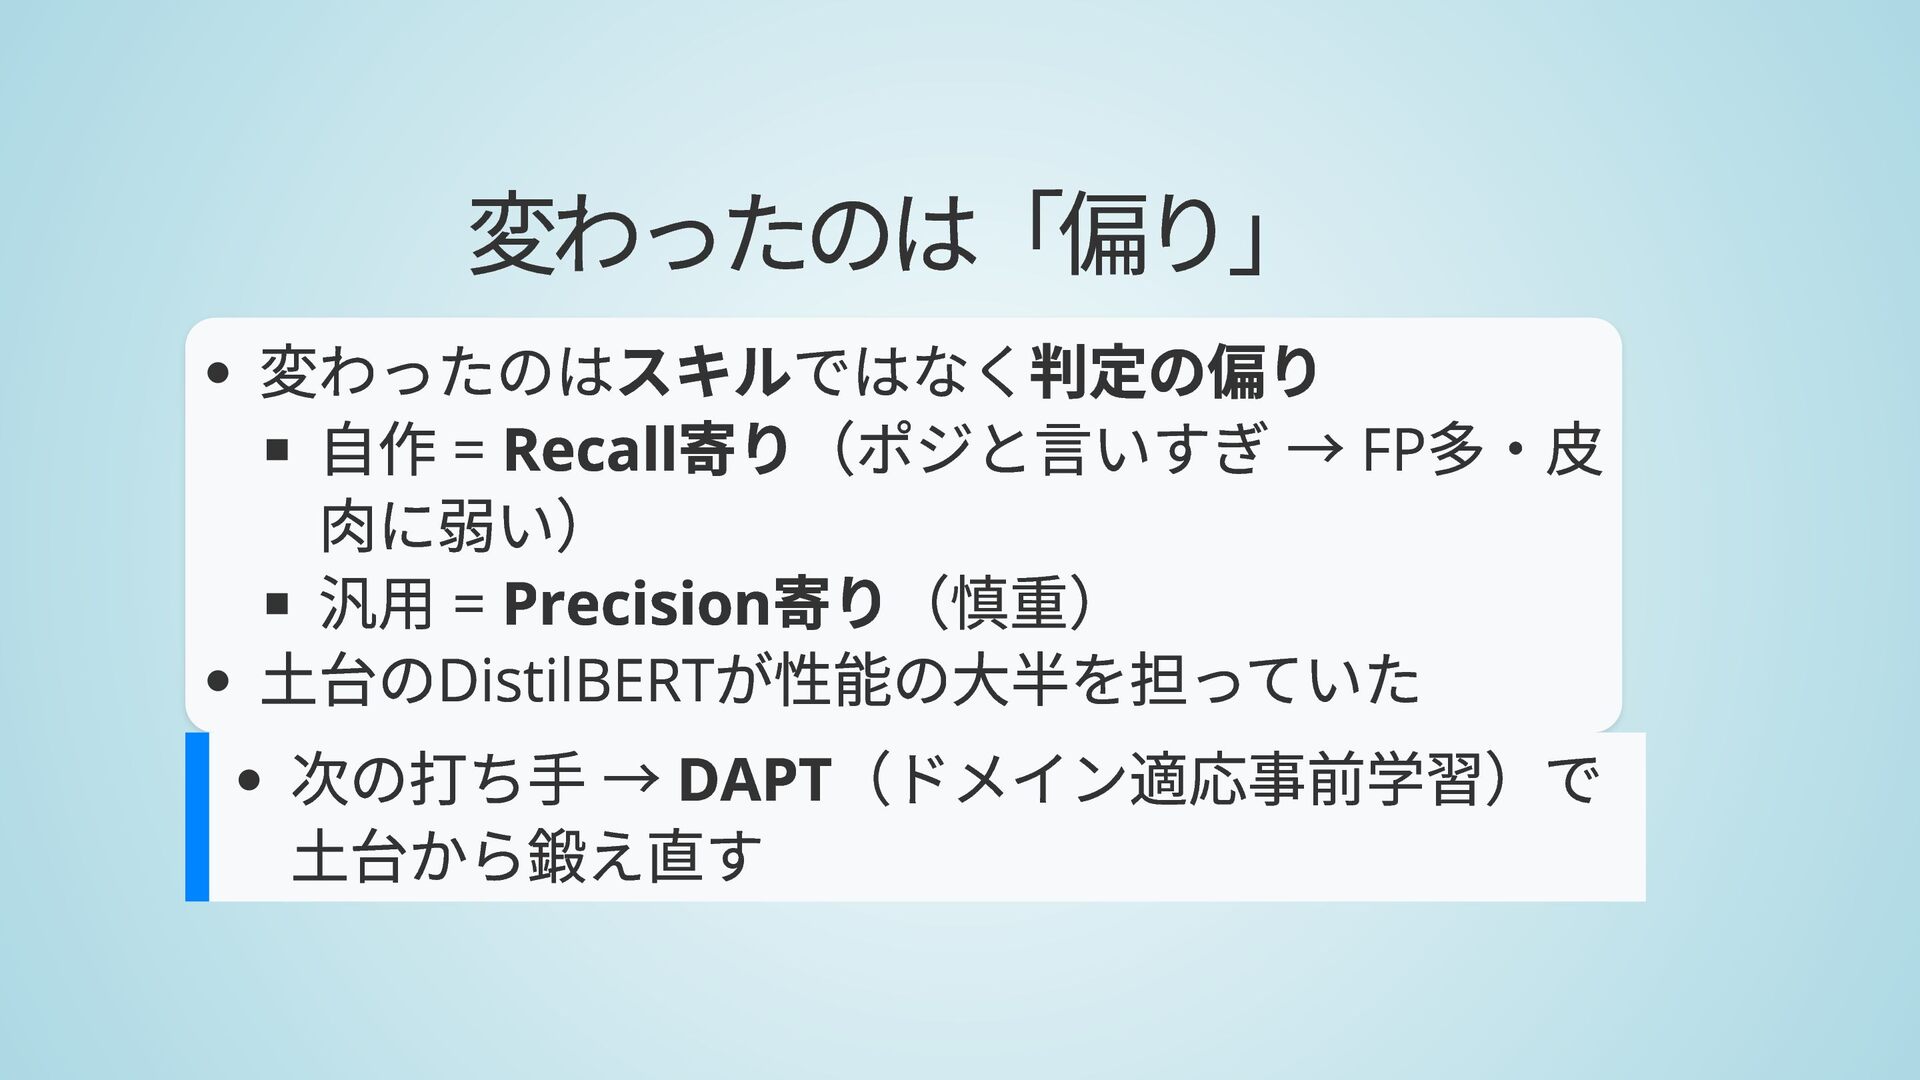
変わったのは「偏り」 変わったのはスキルではなく判定の偏り 自作 = Recall寄り(ポジと言いすぎ → FP多・皮 肉に弱い) 汎用 =
Precision寄り(慎重) 土台のDistilBERTが性能の大半を担っていた 次の打ち手 → DAPT(ドメイン適応事前学習)で 土台から鍛え直す
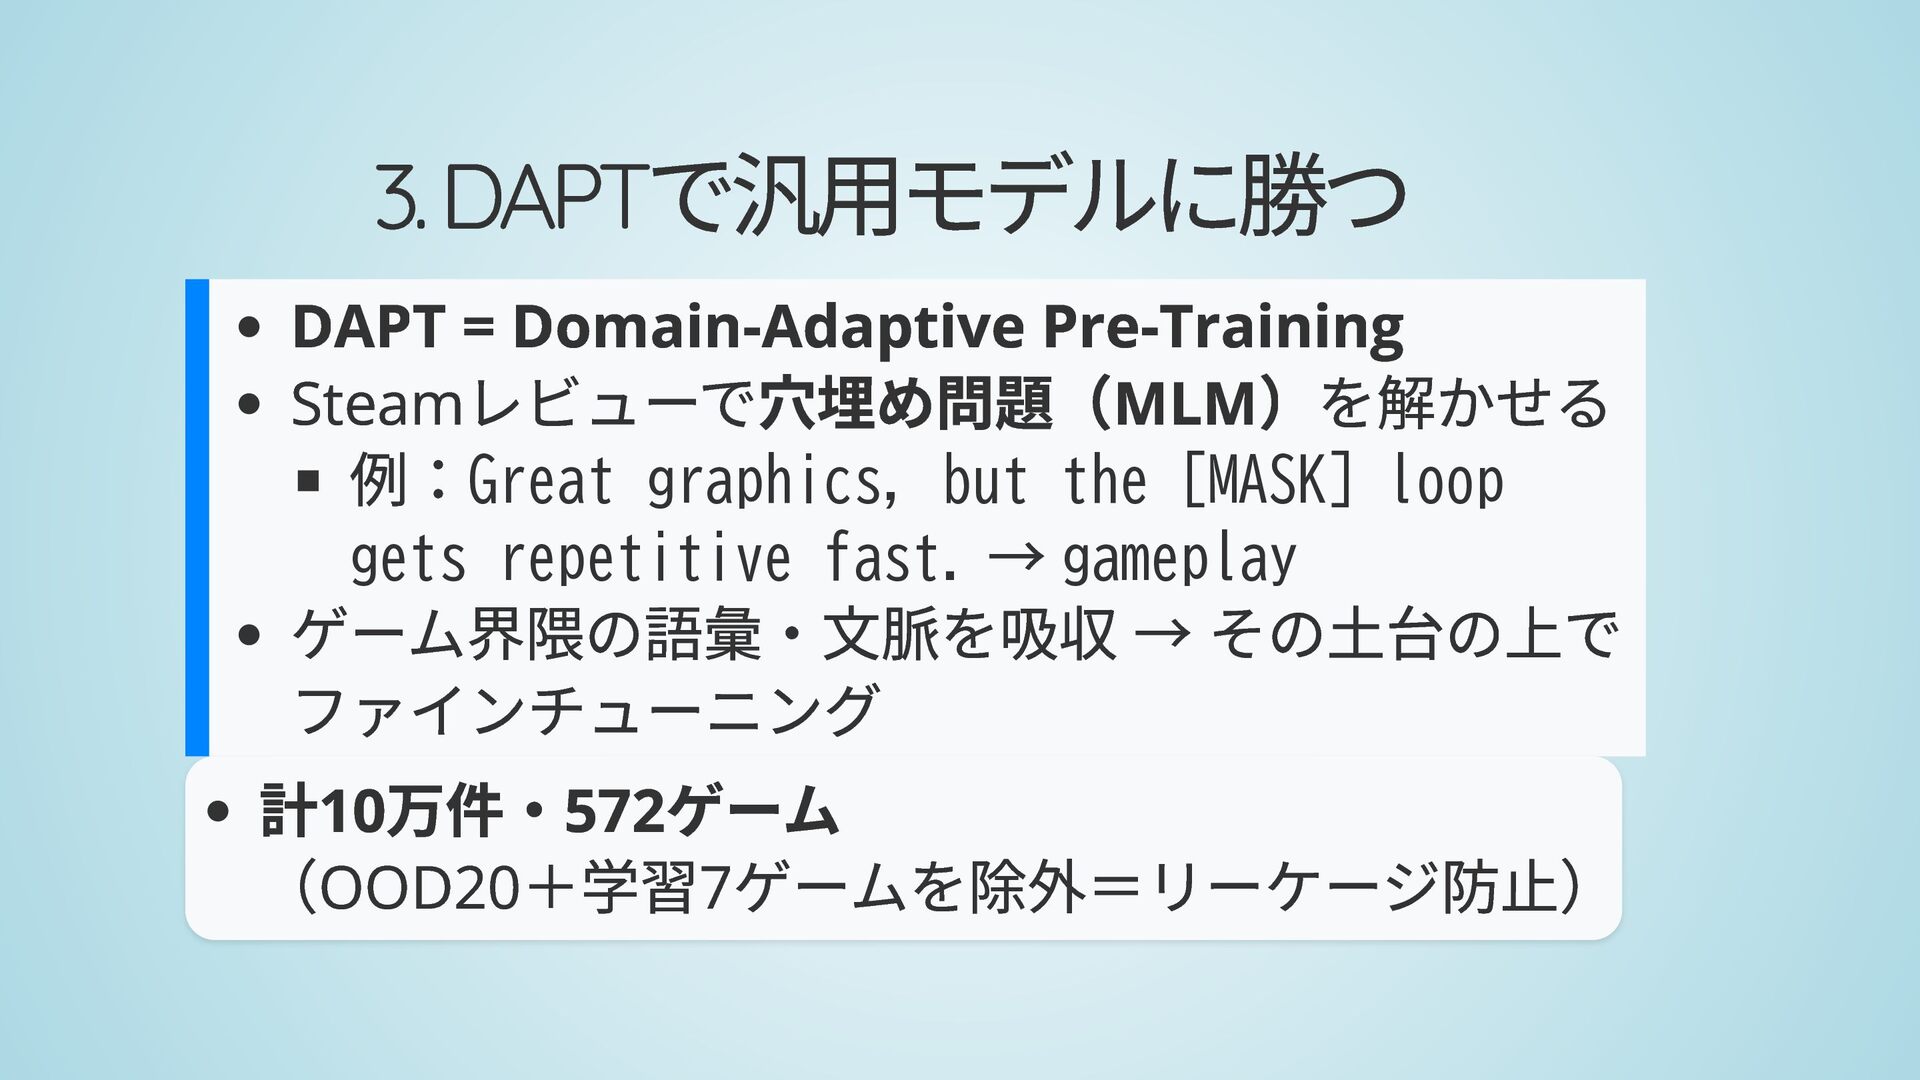
で汎用モデルに勝つ 3. DAPT DAPT = Domain-Adaptive Pre-Training Steam MLM レビューで穴埋め問題(
)を解かせる 例:Great graphics, but the [MASK] loop gets repetitive fast. → gameplay ゲーム界隈の語彙・文脈を吸収 → その土台の上で ファインチューニング 計10万件・572ゲーム (OOD20+学習7ゲームを除外=リーケージ防止)
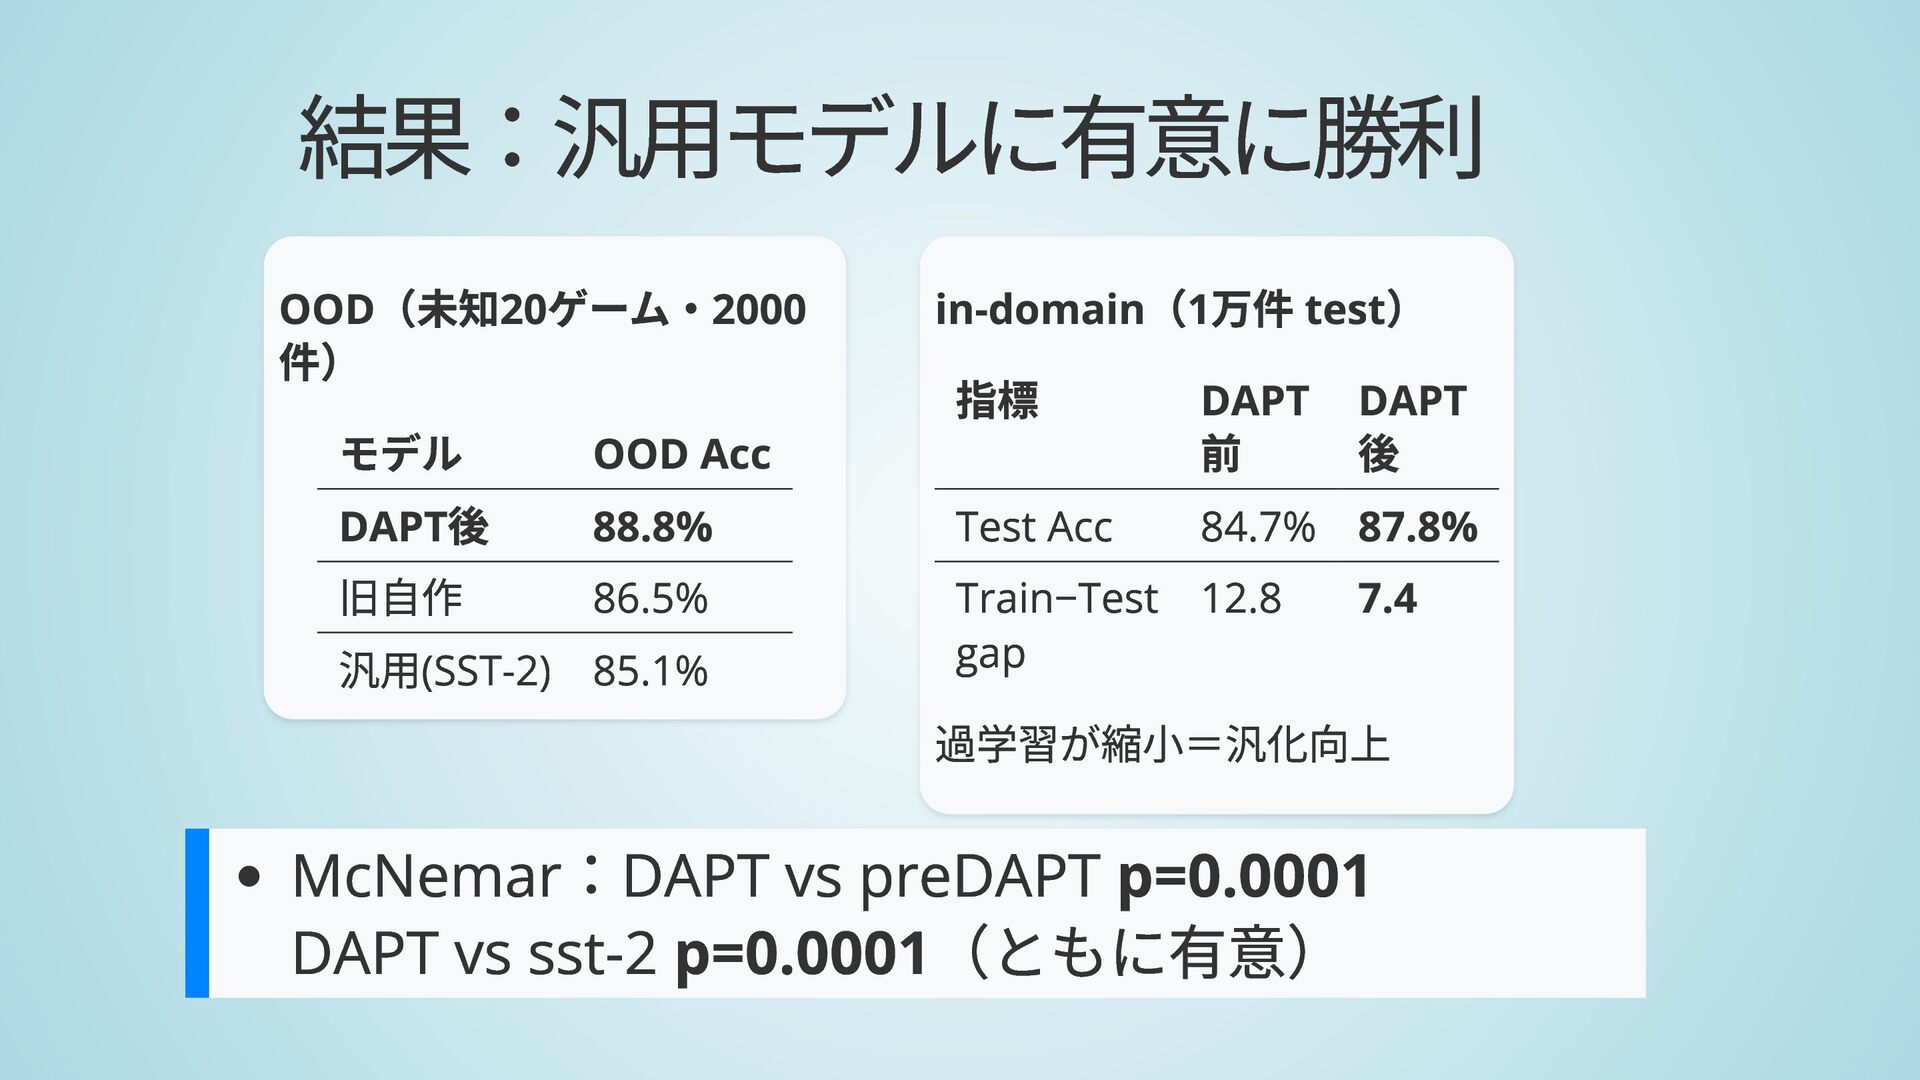
結果:汎用モデルに有意に勝利 OOD (未知20ゲーム・2000 件) モデル OOD Acc DAPT後 88.8% 旧自作
86.5% 汎用(SST-2) 85.1% : ( 万件 test) in-domain 1 指標 DAPT DAPT 前 後 Test Acc 84.7% 87.8% Train−Test 12.8 7.4 gap 過学習が縮小=汎化向上 McNemar DAPT vs preDAPT p=0.0001 DAPT vs sst-2 p=0.0001 (ともに有意)
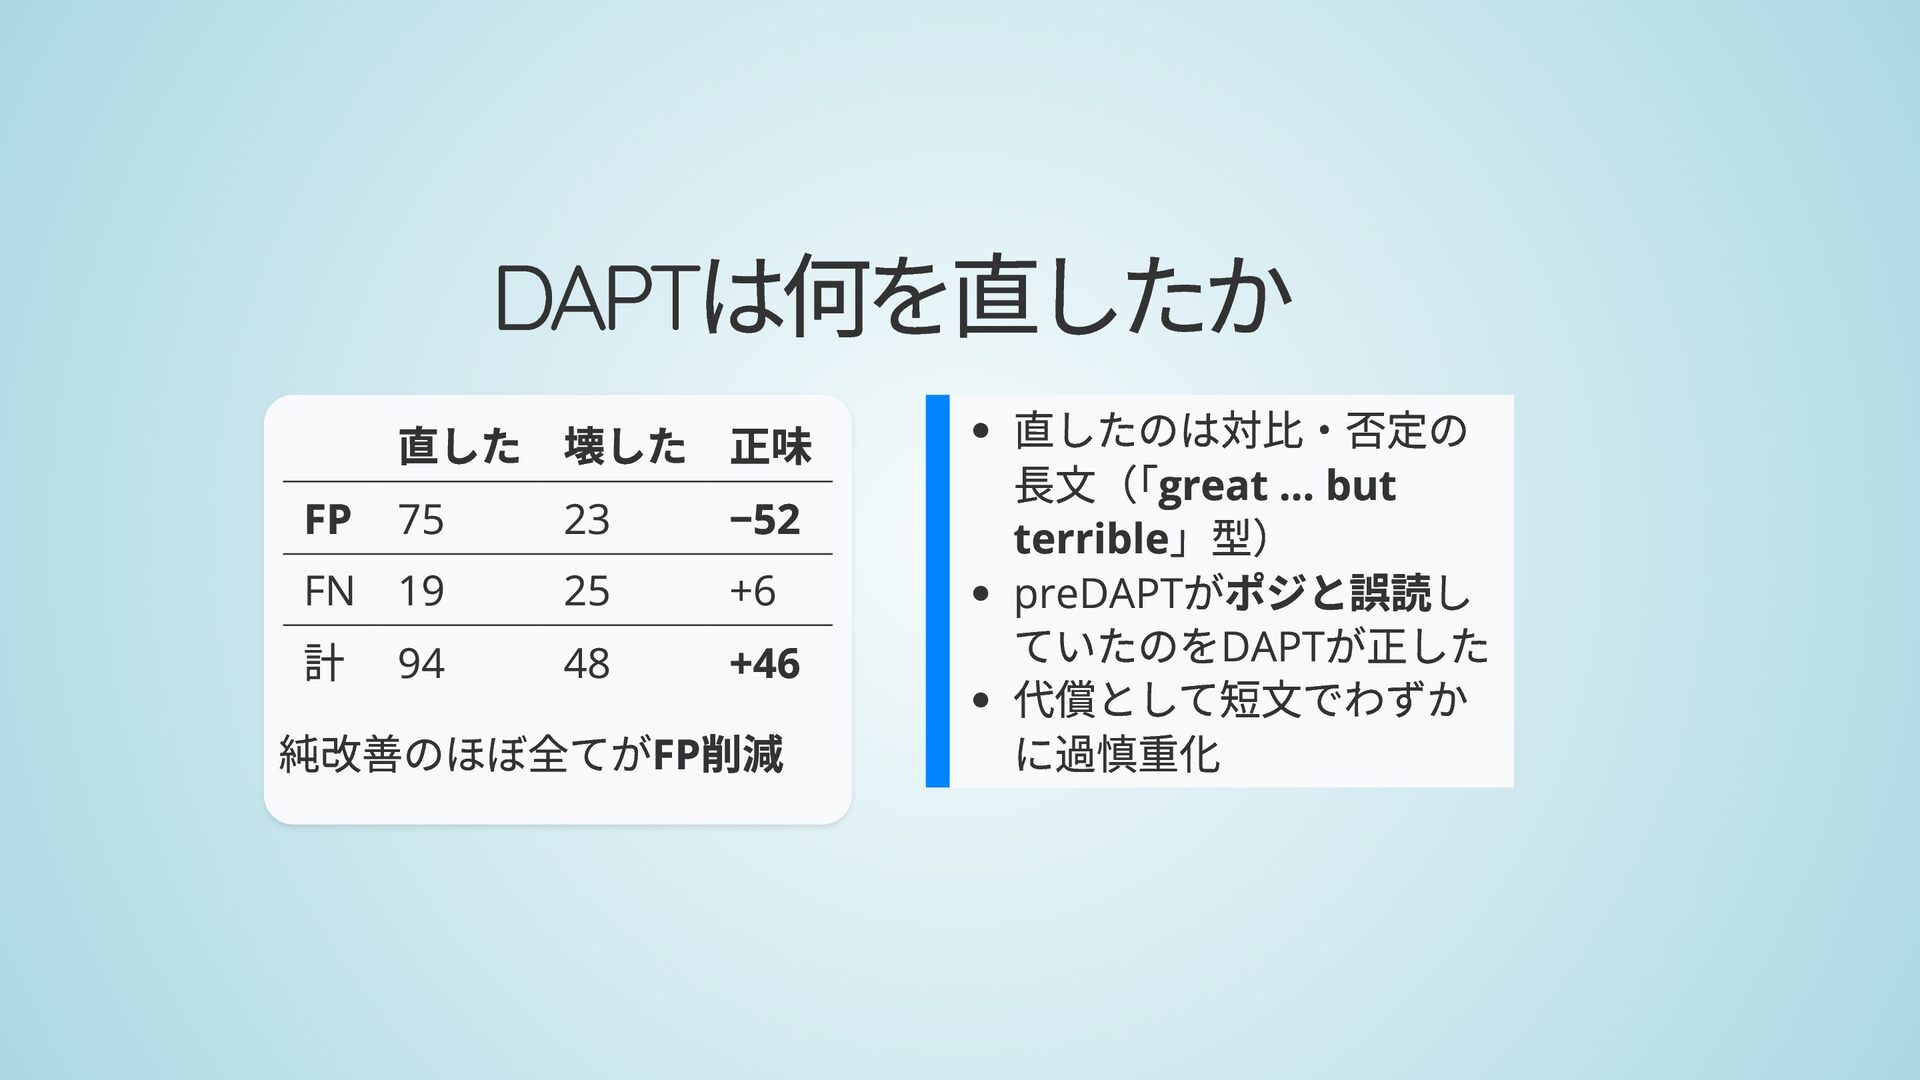
は何を直したか DAPT 直した 壊した 正味 FP 75 FN 19 94
23 25 48 −52 +6 +46 計 純改善のほぼ全てがFP削減 直したのは対比・否定の 長文(「great … but terrible」型) preDAPTがポジと誤読し ていたのをDAPTが正した 代償として短文でわずか に過慎重化
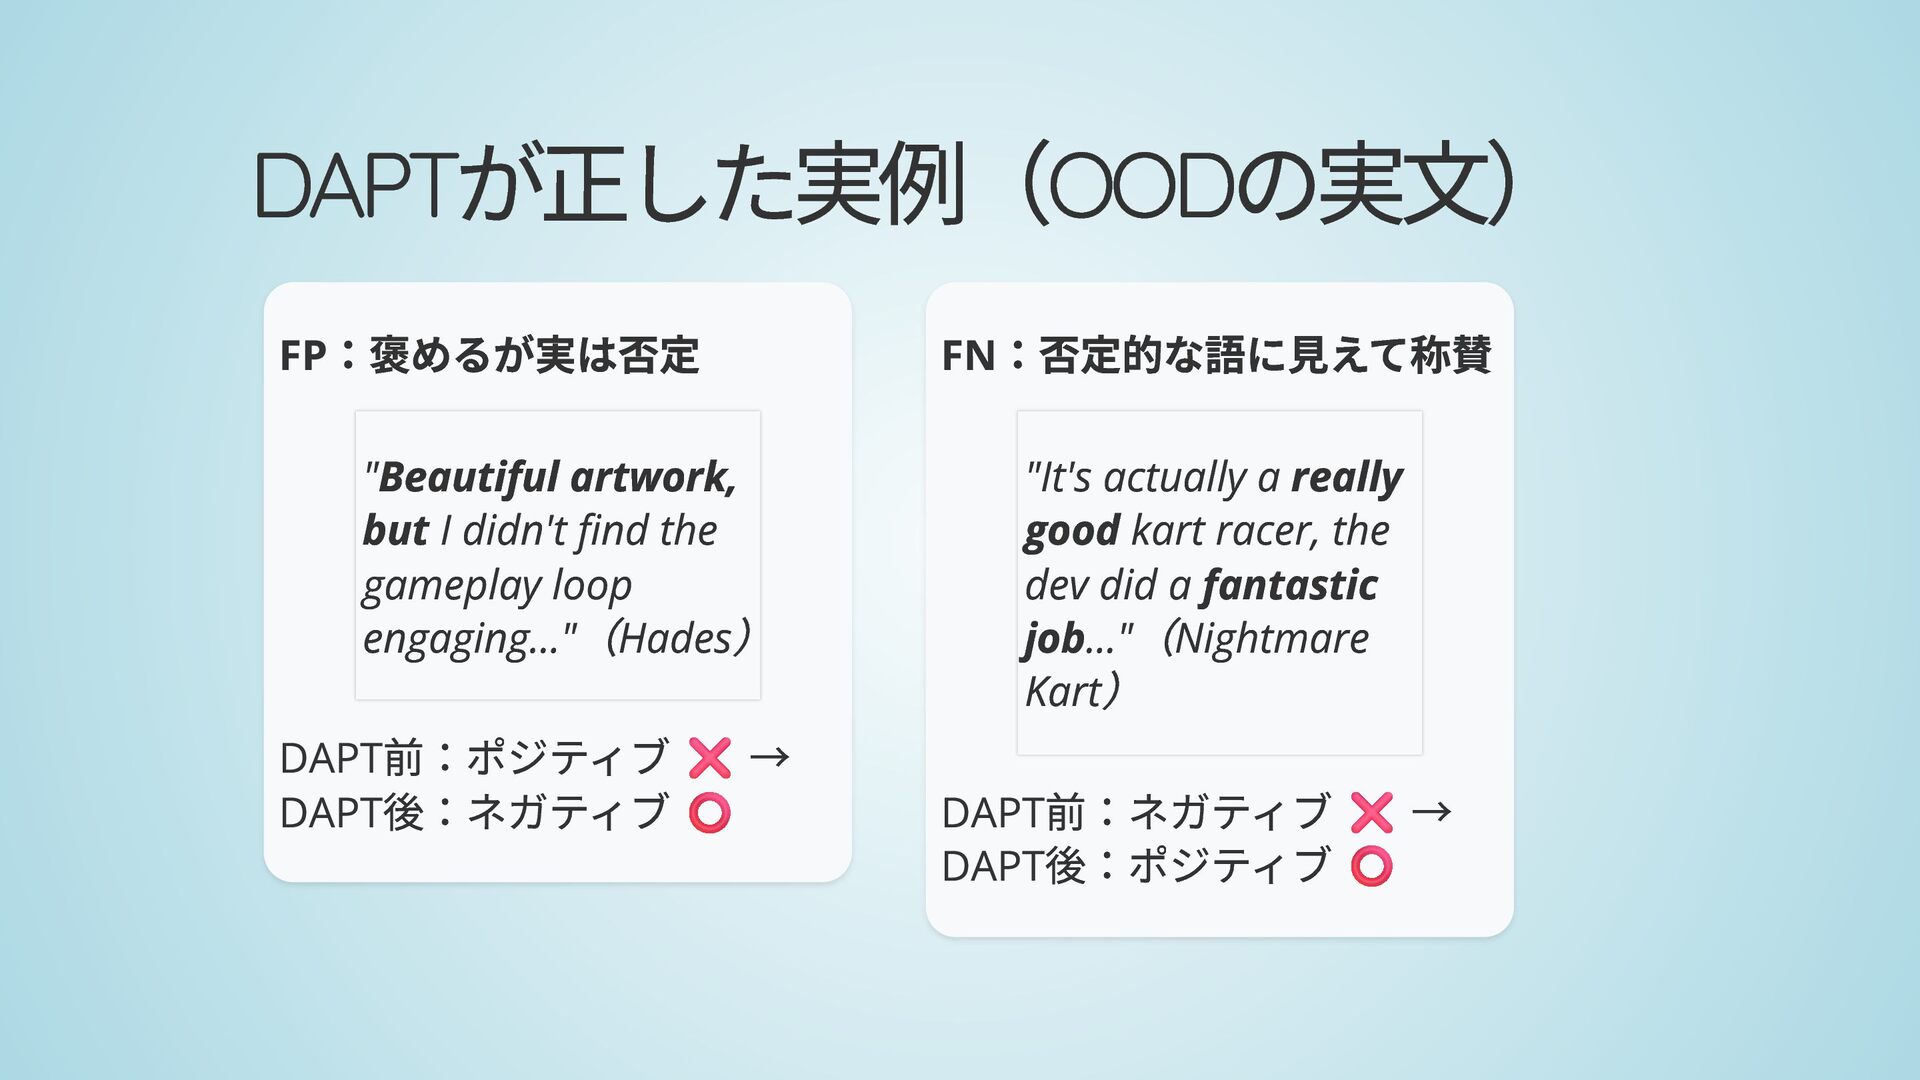
が正した実例(OODの実文) DAPT FP :褒めるが実は否定 "Beautiful artwork, but I didn't find
the gameplay loop engaging..." Hades ( ) DAPT前:ポジティブ ❌ → DAPT後:ネガティブ ⭕ :否定的な語に見えて称賛 FN "It's actually a really good kart racer, the dev did a fantastic job..." Nightmare Kart ( ) DAPT前:ネガティブ ❌ → DAPT後:ポジティブ ⭕
4. その差は運じゃない? の1回ずつでは、その差はシードの運かも しれない → 15回の独立試行(seed 0〜14)で頑健性を確認 (多シード反復) 気づき(学び):固定すべき乱数は2か所あった データ分割は固定していたが、学習の内部(重
み初期化・shuffle・dropout)が抜けていた ここを固定して初めて「各シード=再現可能な1 試行」になる seed=42
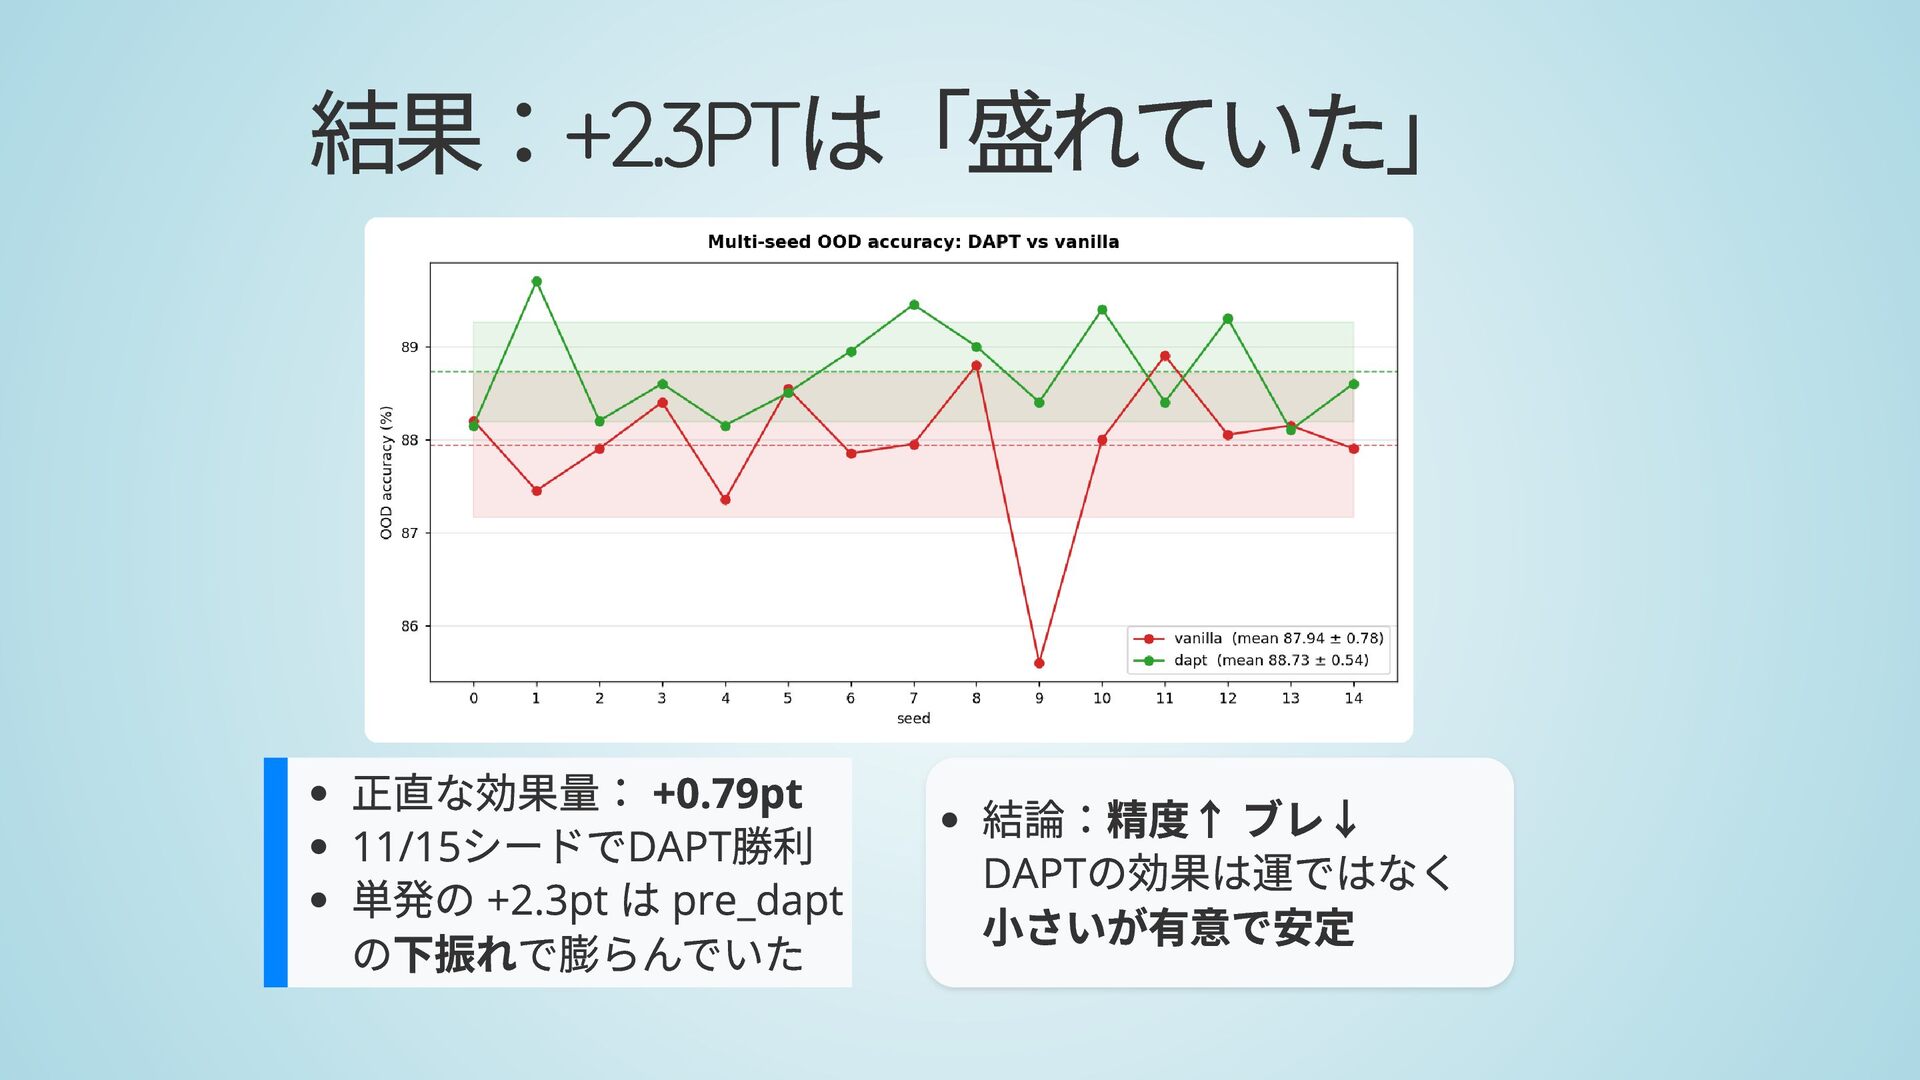
結果:+2.3PTは「盛れていた」 正直な効果量: +0.79pt 11/15シードでDAPT勝利 単発の +2.3pt は pre_dapt の下振れで膨らんでいた 結論:精度↑
ブレ↓ DAPTの効果は運ではなく 小さいが有意で安定
5. 感情分析の限界 で伸びたが、それでも OOD Acc は約89%で 頭打ち 原因はモデルではなく ラベルそのもの voted_up(👍/👎)は「本文の感情」ではなく
「推奨するか」 本文がネガでも👍、ポジでも👎 が混ざる → ラベル自体がノイズ つまり残りの誤りは、 賢いモデルでも消せない領域に入っている DAPT
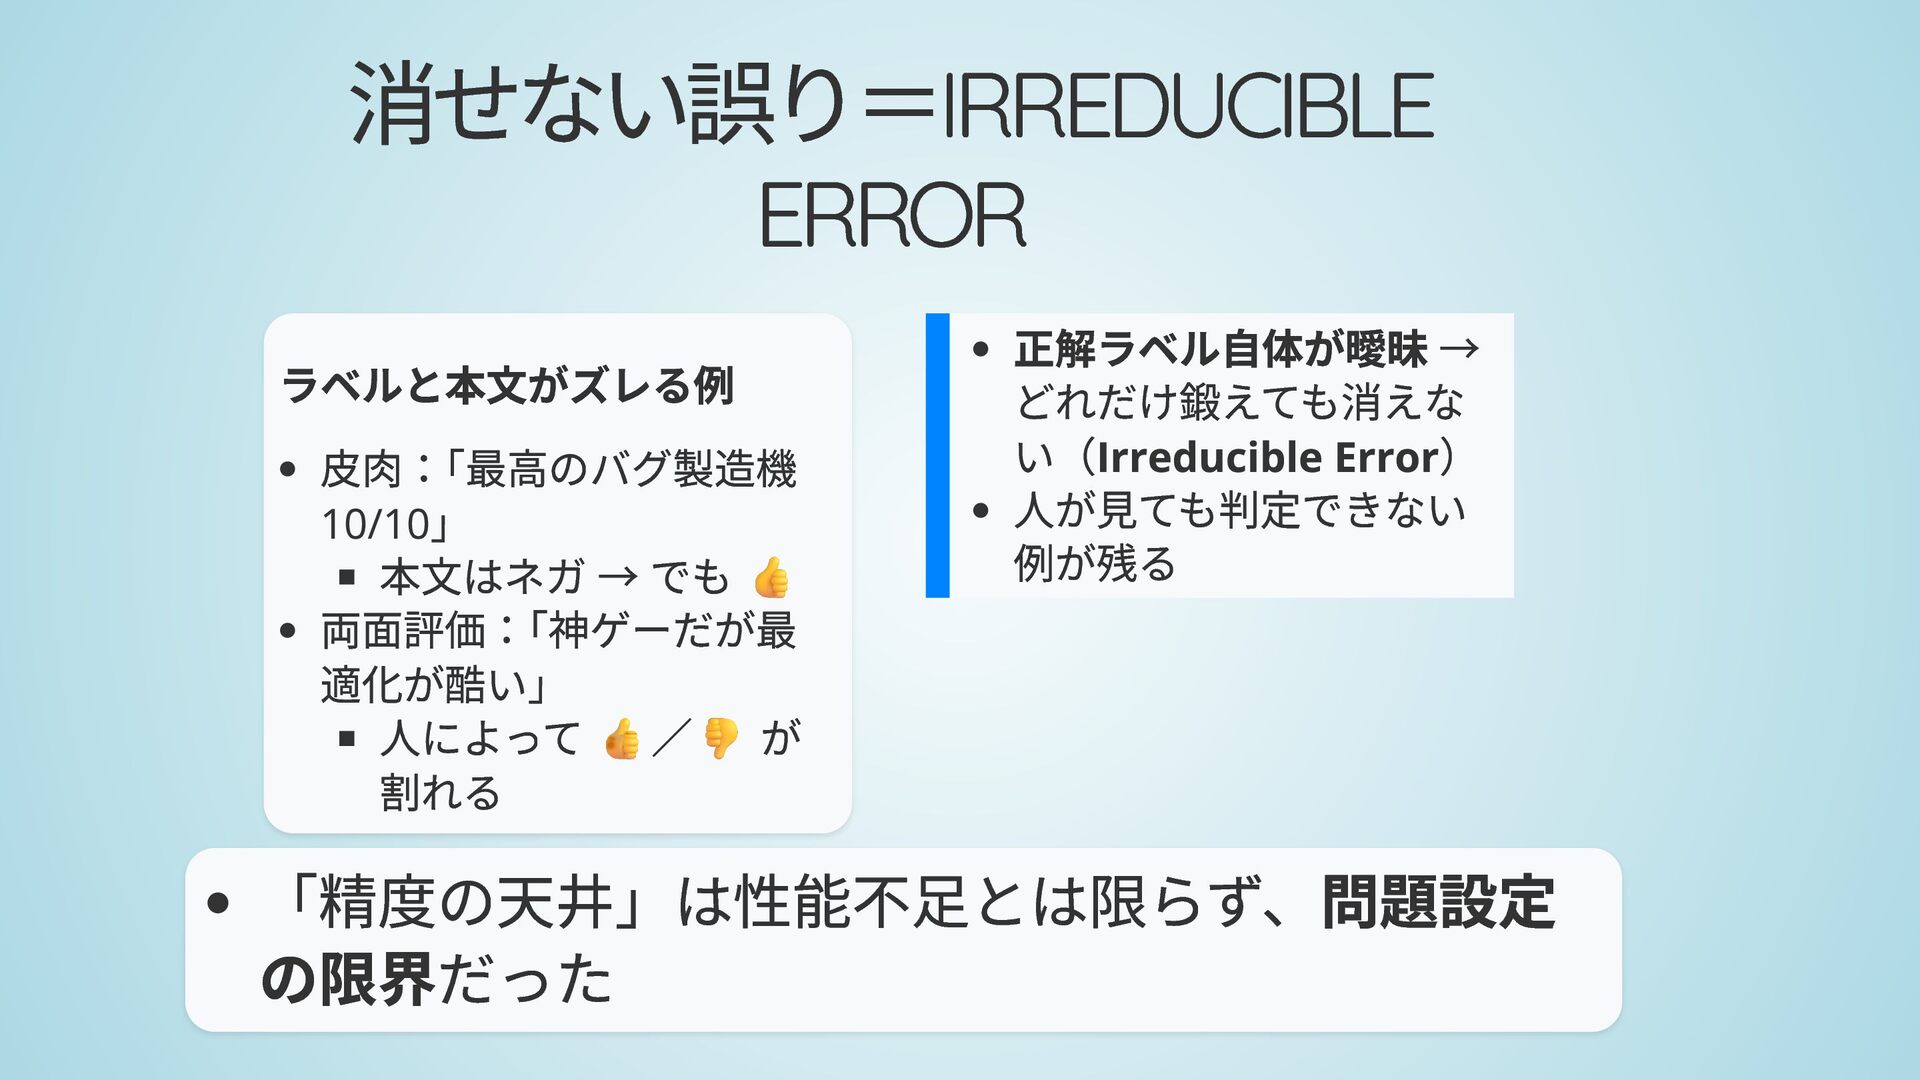
消せない誤り=IRREDUCIBLE ERROR ラベルと本文がズレる例 皮肉:「最高のバグ製造機 10/10」 本文はネガ → でも 👍 両面評価:「神ゲーだが最
適化が酷い」 人によって 👍/👎 が 割れる 正解ラベル自体が曖昧 → どれだけ鍛えても消えな い(Irreducible Error) 人が見ても判定できない 例が残る 「精度の天井」は性能不足とは限らず、問題設定 の限界だった
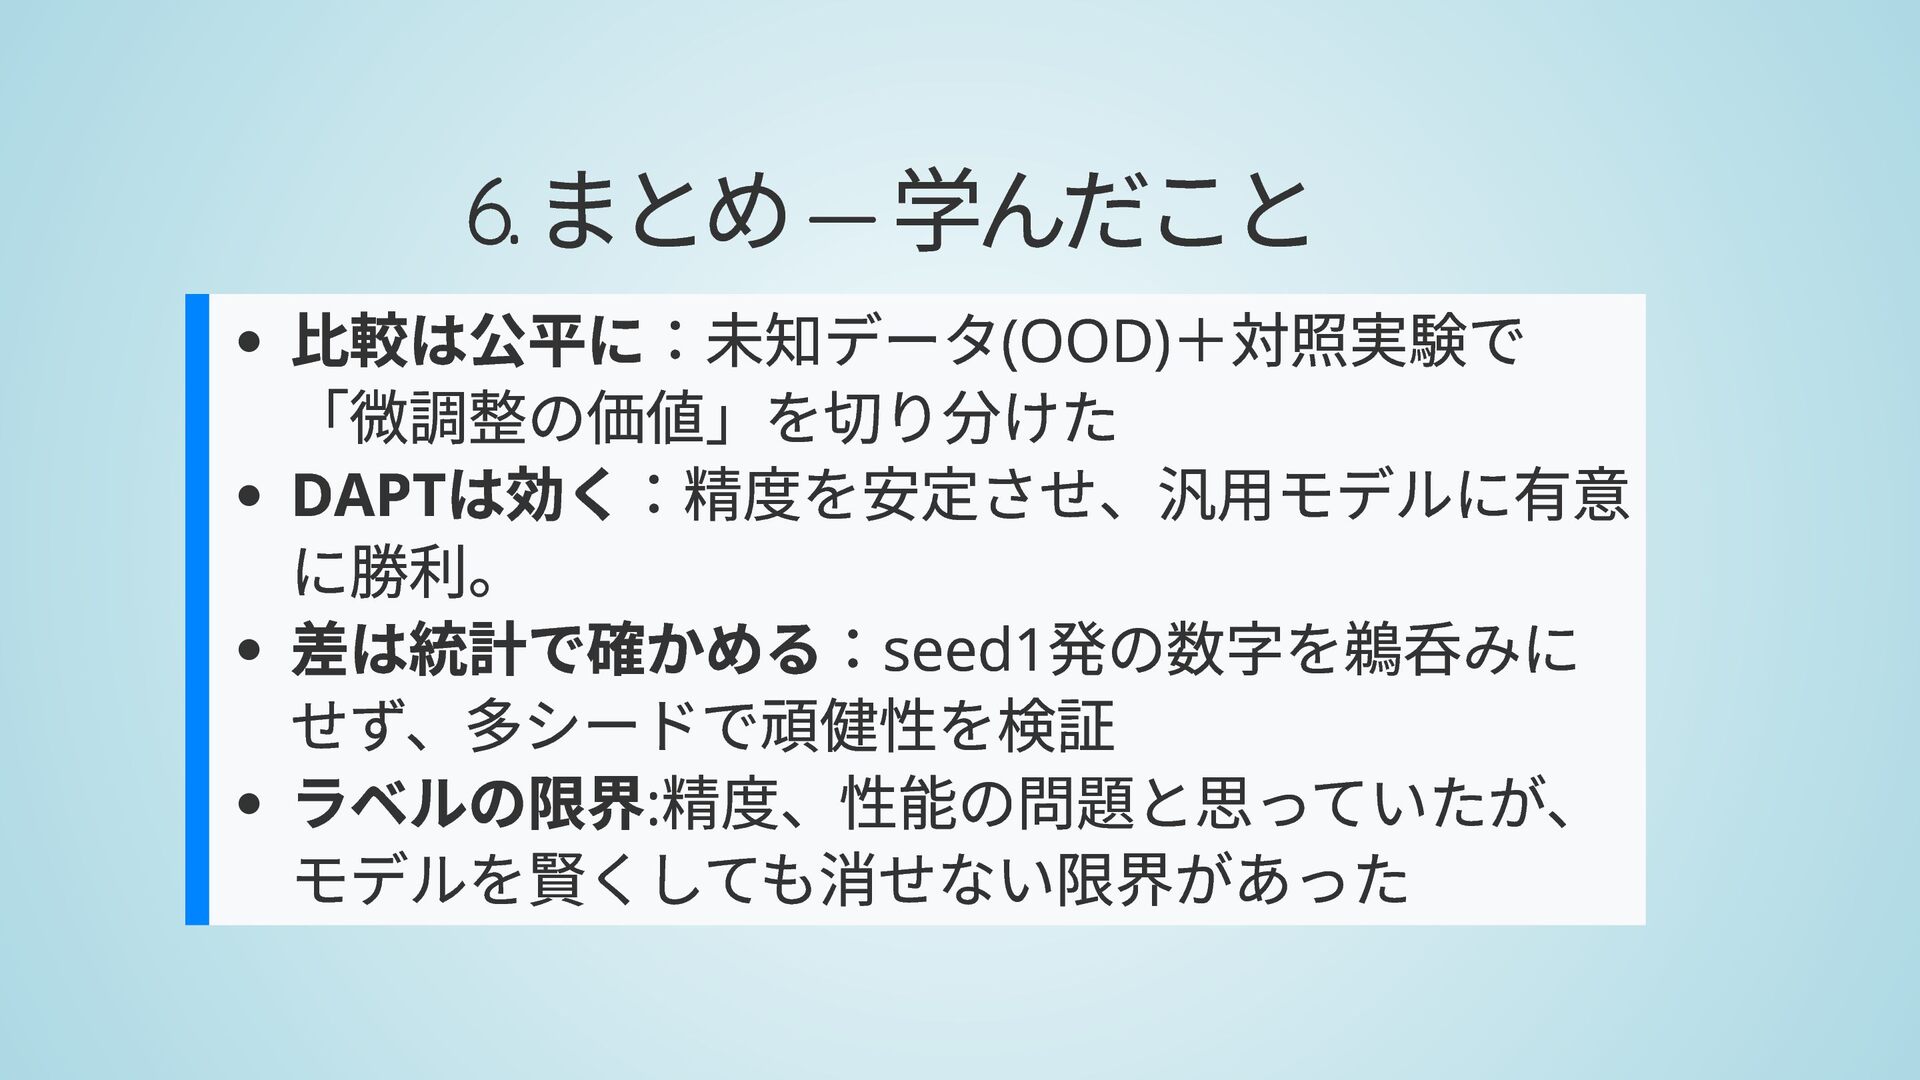
6. まとめ — 学んだこと 比較は公平に:未知データ(OOD)+対照実験で 「微調整の価値」を切り分けた DAPTは効く:精度を安定させ、汎用モデルに有意 に勝利。 差は統計で確かめる:seed1発の数字を鵜呑みに せず、多シードで頑健性を検証
ラベルの限界:精度、性能の問題と思っていたが、 モデルを賢くしても消せない限界があった
参考リンク リポジトリ: game-demand-forecast 用語解説: GitHub Wiki(OOD / データリーケージ / McNemar検定
/ DAPT ほか)
More Decks by rindguitar
See All by rindguitar
プログラミング初心者がAI Tuberを開発してみた
rindguitar
0
13
Other Decks in Programming
See All in Programming
flutter_test のその先へ — Flutter アプリの LLM 機能に「評価」という品質保証を
kosukesaigusa
0
200
疎結合とは何か?ソフトウェア設計における結合バランスについて考える #phpcon_niigata
kajitack
2
330
AIコーディング時代のKotest ユニットテストから APIレベルの仕様固定化テストへ
ooga04
0
280
オーケストレーション記述言語 Katari
yukikurage
0
270
Enforcing Your Architecture with Unit Tests in the AI Era (Swift Connection X)
steliosf
PRO
1
190
エラーチャンネルのボールを拾い続けて鍛えるエンジニアの地力 / phpcon-niigata2026
meihei3
1
450
AI駆動開発4年目の現在地(『あなたはFDEになるべきか?』イベント資料)
kumaiu
0
660
私なりのハーネスエンジニアリング ~独自の言語処理系の開発を通して~
seosoft
0
220
RaspberryPi 5で軽くはじめるk3sとtailscaleを用いたホームサーバー構築 (1)
nasum
0
400
クラウドエージェントは、 何がそんなに便利なのか / what makes cloud agents so useful
rkaga
5
930
小さなアプリを作って公開するまで
onozaty
0
200
[DroidKnights 2026] Workflow AX: From Auto-Documented Policies to E2E Testing
raeminkang
0
590
Featured
See All Featured
Winning Ecommerce Organic Search in an AI Era - #searchnstuff2025
aleyda
2
2.2k
Marketing to machines
jonoalderson
1
6k
What’s in a name? Adding method to the madness
productmarketing
PRO
24
4.2k
The State of eCommerce SEO: How to Win in Today's Products SERPs - #SEOweek
aleyda
2
12k
Bash Introduction
62gerente
615
220k
ラッコキーワード サービス紹介資料
rakko
5
5.9M
Marketing Yourself as an Engineer | Alaka | Gurzu
gurzu
0
380
Performance Is Good for Brains [We Love Speed 2024]
tammyeverts
12
2k
What the history of the web can teach us about the future of AI
inesmontani
PRO
3
810
Templates, Plugins, & Blocks: Oh My! Creating the theme that thinks of everything
marktimemedia
31
3k
From Legacy to Launchpad: Building Startup-Ready Communities
dugsong
0
380
HTML-Aware ERB: The Path to Reactive Rendering @ RubyCon 2026, Rimini, Italy
marcoroth
6
940


 rindguitar
 kosukesaigusa
 kajitack
 ooga04
 yukikurage
 steliosf
 meihei3
 kumaiu
 seosoft
 nasum
 rkaga
 onozaty
 raeminkang
 aleyda
 jonoalderson
 productmarketing
 62gerente
 rakko
 gurzu
 tammyeverts
 inesmontani
 marktimemedia
 dugsong
 marcoroth