Upgrade to Pro
— share decks privately, control downloads, hide ads and more …
Speaker Deck
Sign up for free
Menu
Search
Features
All features
Private URLs
Password Protection
Custom URLS
Scheduled publishing
Remove Branding
Restrict embedding
Deck Collections
Notes
Features
All features
Private URLs
Password Protection
Custom URLS
Scheduled publishing
Remove Branding
Restrict embedding
Deck Collections
Notes
Explore
Featured decks
Featured speakers
Programming
Technology
Storyboards
Explore
Featured decks
Featured speakers
Programming
Technology
Storyboards
Pricing
Search
Sign in
Sign up for free
信頼性・システムの観測・障害対応.pdf
Search
Sponsored
·
Your Podcast. Everywhere. Effortlessly.
Share. Educate. Inspire. Entertain. You do you. We'll handle the rest.
→
ryuichi1208
May 01, 2026
0
0
Share
Embed
Copy iframe code
Copy JS code
Copy link
Start on current slide
信頼性・システムの観測・障害対応.pdf
ryuichi1208
May 01, 2026
More Decks by ryuichi1208
See All by ryuichi1208
そのasync、止まってない? ”鉄板”イベントループ ブロッキング処理検出術
ryuichi1208
1
2.2k
AIでサービス運用はどう変わるのか
ryuichi1208
0
210
入門 再発防止策
ryuichi1208
17
7.8k
SREの組織構造と実践.
ryuichi1208
0
320
障害対応からの学びと体制づくり
ryuichi1208
0
1.2k
金曜日デプロイ、するかしないか.pdf
ryuichi1208
1
490
会話で作る信頼性
ryuichi1208
0
200
シグナル(Unix)と仲良くなる
ryuichi1208
1
210
LiteLLM Proxyの紹介
ryuichi1208
1
93
Featured
See All Featured
A Guide to Academic Writing Using Generative AI - A Workshop
ks91
PRO
1
500
SEOcharity - Dark patterns in SEO and UX: How to avoid them and build a more ethical web
sarafernandez
0
300
Highjacked: Video Game Concept Design
rkendrick25
PRO
1
470
The untapped power of vector embeddings
frankvandijk
2
1.9k
We Analyzed 250 Million AI Search Results: Here's What I Found
joshbly
1
2k
Distributed Sagas: A Protocol for Coordinating Microservices
caitiem20
333
23k
The Limits of Empathy - UXLibs8
cassininazir
1
700
Marketing to machines
jonoalderson
1
5.8k
DBのスキルで生き残る技術 - AI時代におけるテーブル設計の勘所
soudai
PRO
68
58k
Pawsitive SEO: Lessons from My Dog (and Many Mistakes) on Thriving as a Consultant in the Age of AI
davidcarrasco
0
250
Raft: Consensus for Rubyists
vanstee
142
7.7k
What Being in a Rock Band Can Teach Us About Real World SEO
427marketing
0
1.1k
Transcript
信頼性・システムの観測・障害対応 SREを0から学ぶ会 #1 渡部 龍一
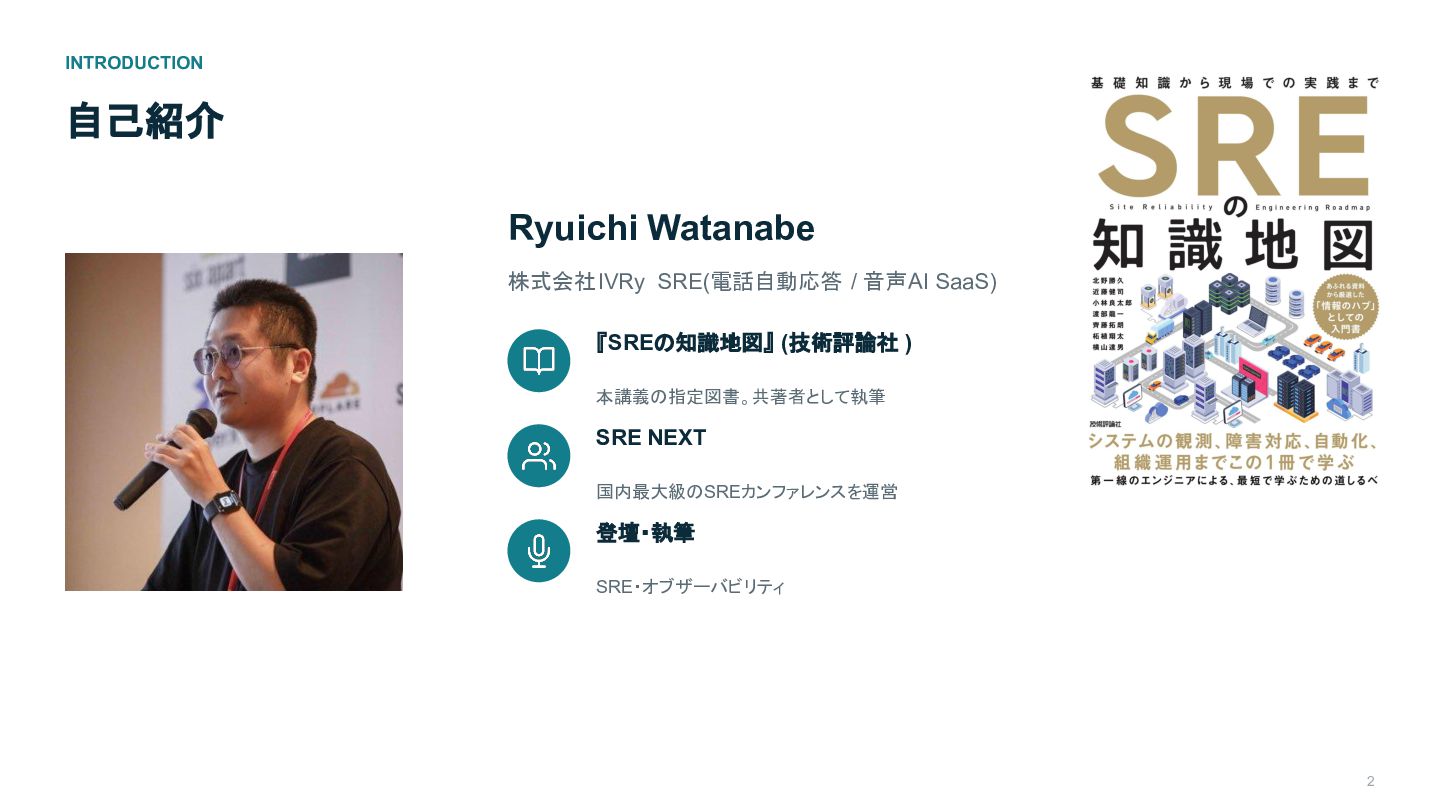
INTRODUCTION 自己紹介 Ryuichi Watanabe 株式会社IVRy SRE(電話自動応答 / 音声AI SaaS) 『SREの知識地図』
(技術評論社 ) 本講義の指定図書。共著者として執筆 SRE NEXT 国内最大級のSREカンファレンスを運営 (写真) 登壇・執筆 SRE・オブザーバビリティ 2
TODAY'S GOALS 本日のゴール — 3つ持ち帰ってください 信頼性を「共通言語」で語れる 「サイレント障害」に気づける観測を設計できる 障害発生時に何をすべきかの全体像を持つ 5
01 信頼性を言葉にする 6
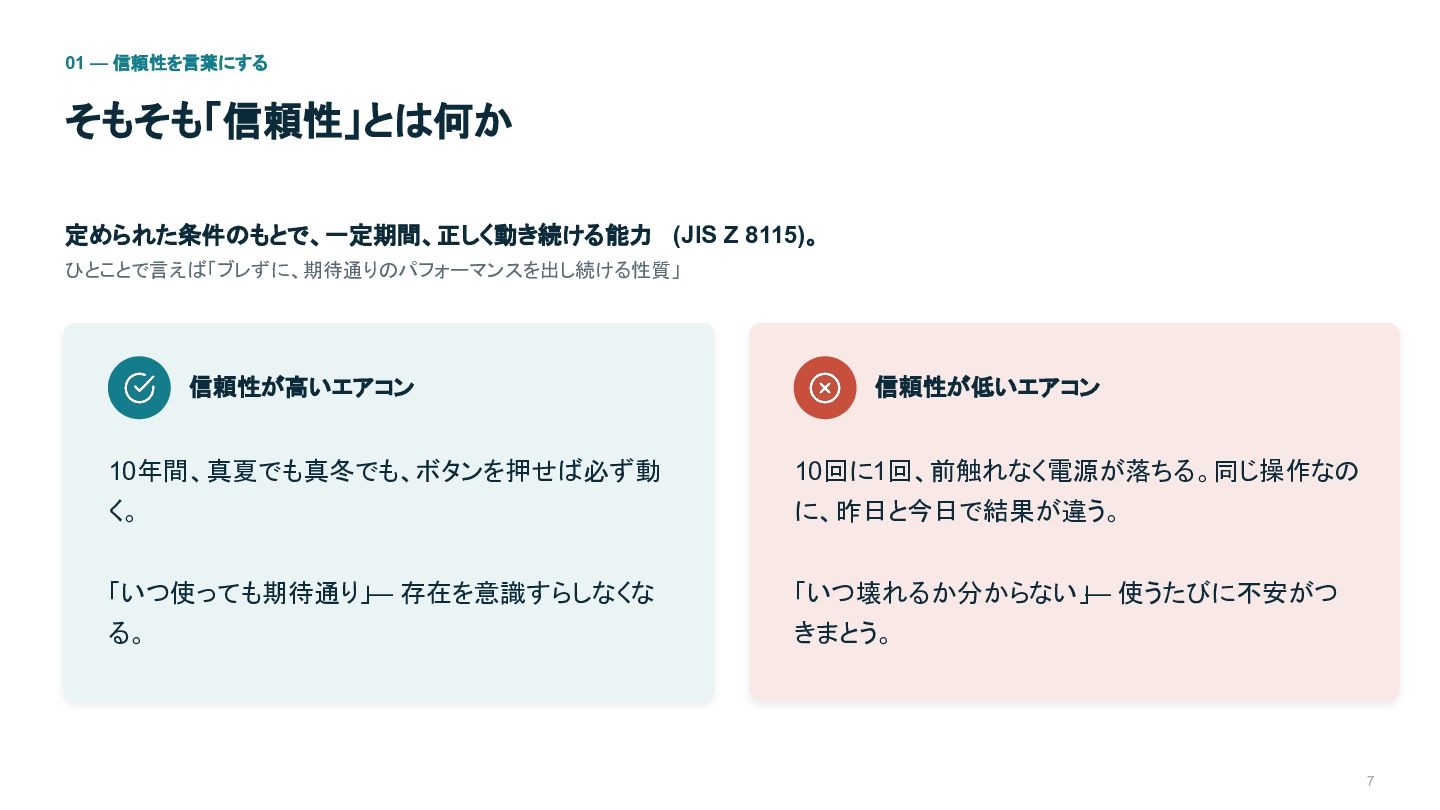
01 — 信頼性を言葉にする そもそも「信頼性」とは何か 定められた条件のもとで、一定期間、正しく動き続ける能力 (JIS Z 8115)。 ひとことで言えば「ブレずに、期待通りのパフォーマンスを出し続ける性質」 信頼性が高いエアコン
信頼性が低いエアコン 10年間、真夏でも真冬でも、ボタンを押せば必ず動 10回に1回、前触れなく電源が落ちる。同じ操作なの く。 に、昨日と今日で結果が違う。 「いつ使っても期待通り」— 存在を意識すらしなくな 「いつ壊れるか分からない」— 使うたびに不安がつ る。 きまとう。 7
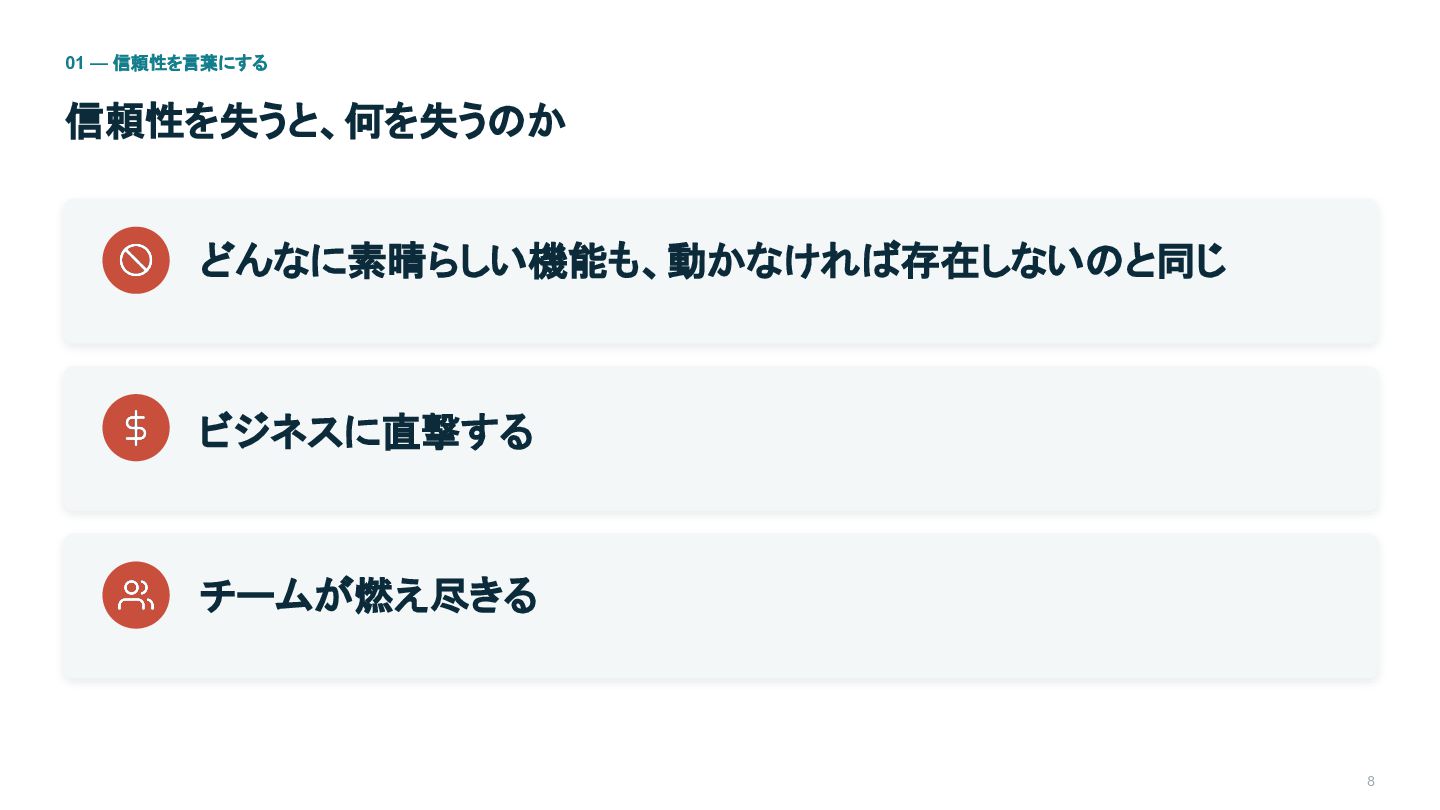
01 — 信頼性を言葉にする 信頼性を失うと、何を失うのか どんなに素晴らしい機能も、動かなければ存在しないのと同じ ビジネスに直撃する チームが燃え尽きる 8
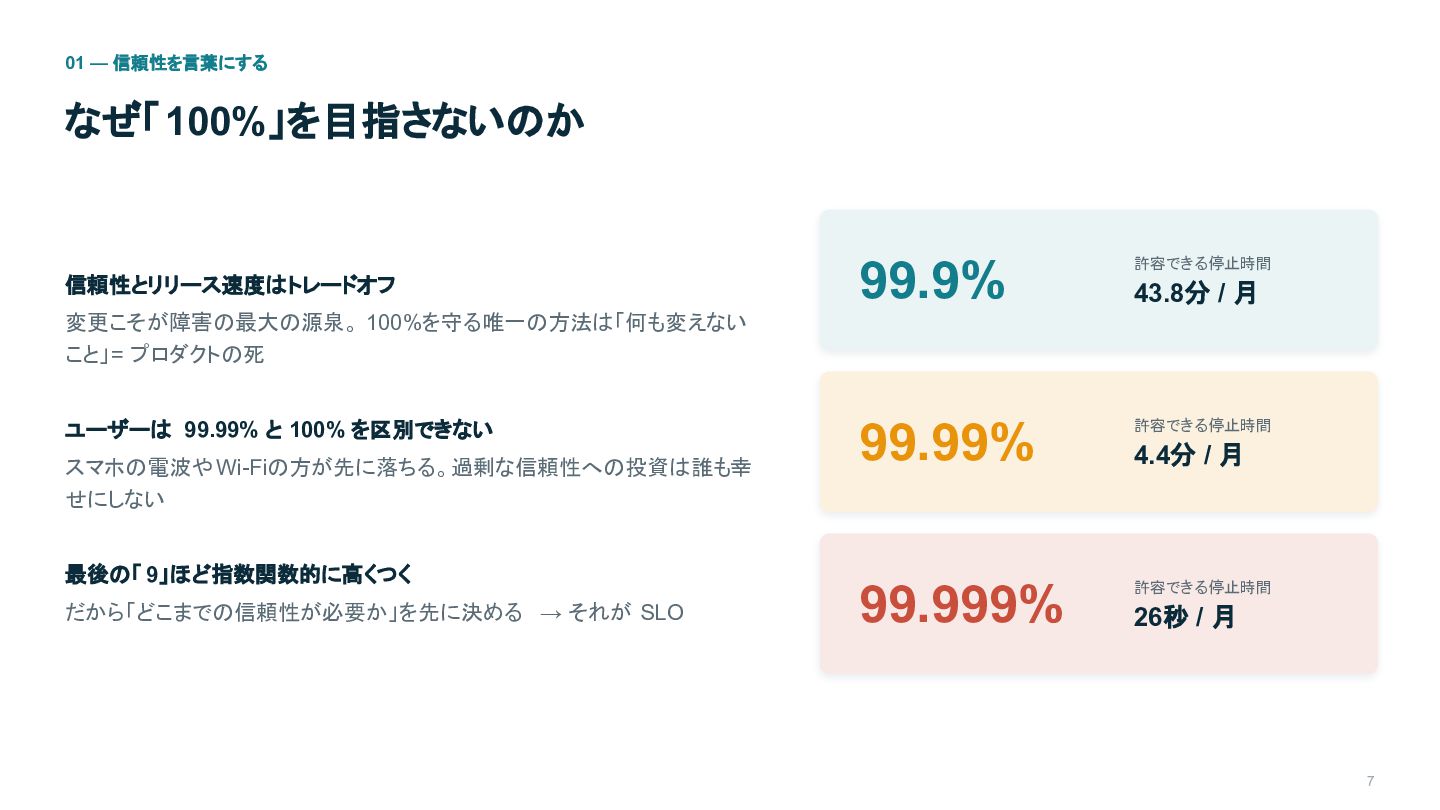
01 — 信頼性を言葉にする なぜ「100%」を目指さないのか 信頼性とリリース速度はトレードオフ 99.9% 許容できる停止時間 99.99% 許容できる停止時間 99.999%
許容できる停止時間 43.8分 / 月 変更こそが障害の最大の源泉。 100%を守る唯一の方法は「何も変えない こと」= プロダクトの死 ユーザーは 99.99% と 100% を区別できない スマホの電波や Wi-Fiの方が先に落ちる。過剰な信頼性への投資は誰も幸 せにしない 最後の「 9」ほど指数関数的に高くつく だから「どこまでの信頼性が必要か」を先に決める → それが SLO 4.4分 / 月 26秒 / 月 7
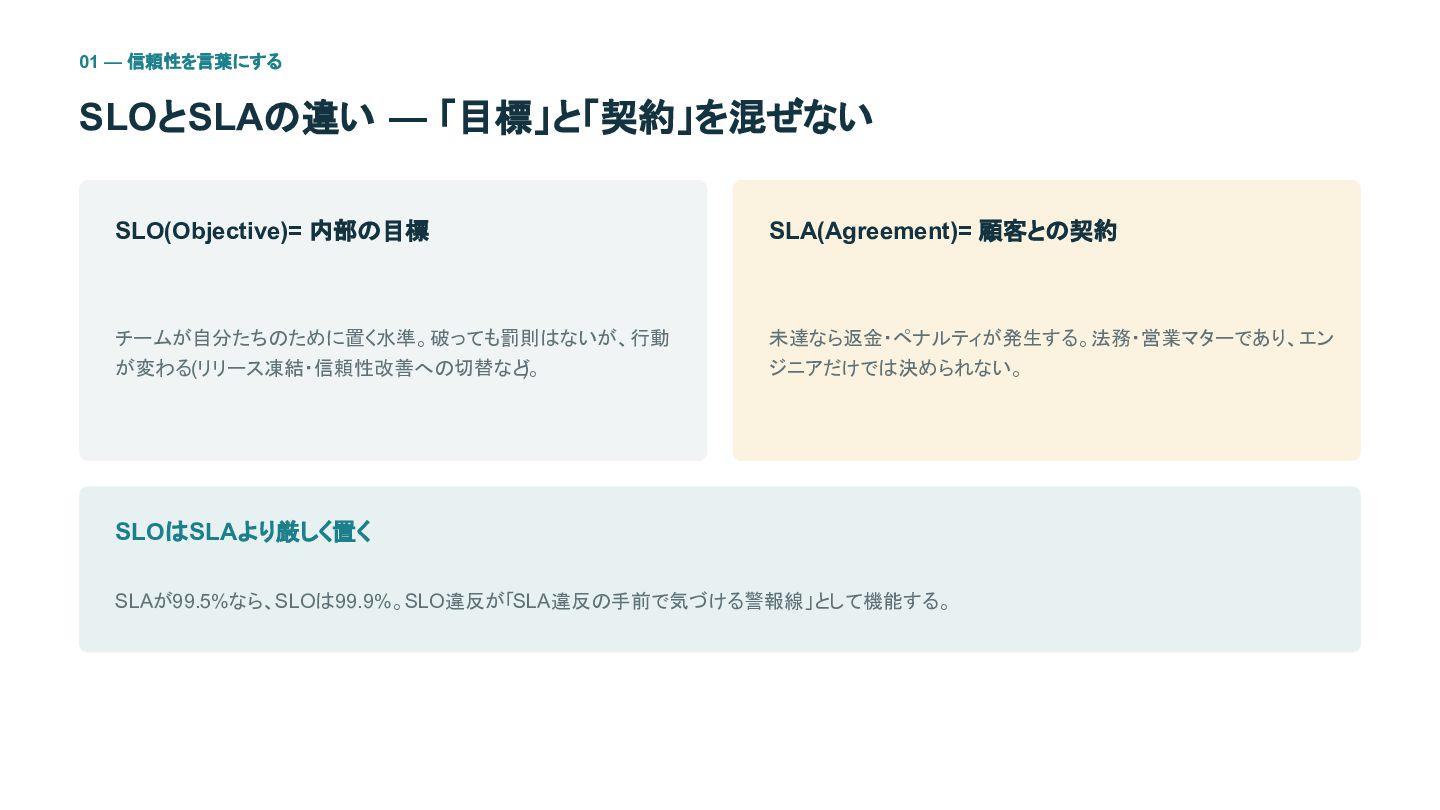
01 — 信頼性を言葉にする SLOとSLAの違い — 「目標」と「契約」を混ぜない SLO(Objective)= 内部の目標 SLA(Agreement)= 顧客との契約
チームが自分たちのために置く水準。破っても罰則はないが、行動 が変わる(リリース凍結・信頼性改善への切替など)。 未達なら返金・ペナルティが発生する。法務・営業マターであり、エン ジニアだけでは決められない。 SLOはSLAより厳しく置く SLAが99.5%なら、SLOは99.9%。SLO違反が「SLA違反の手前で気づける警報線」として機能する。
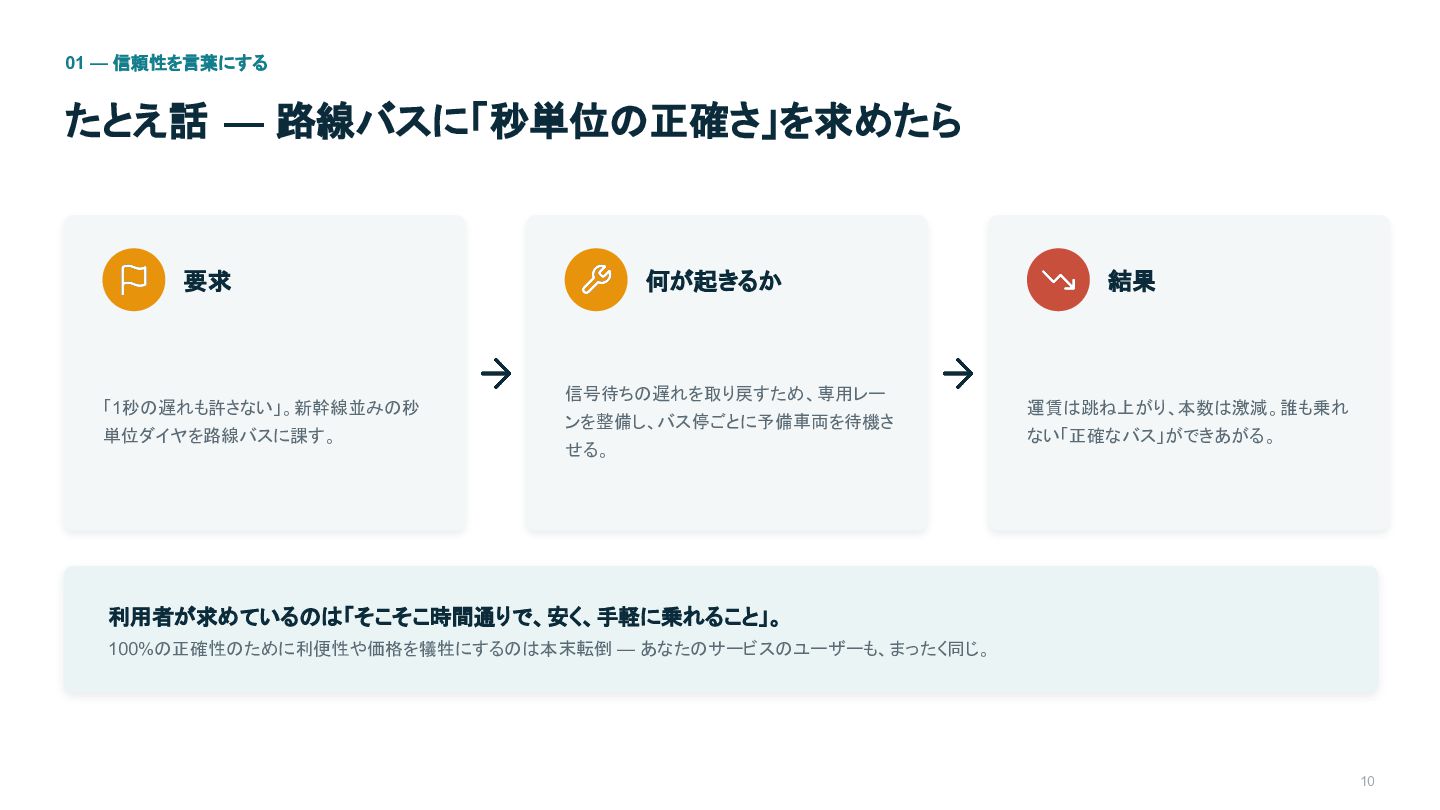
01 — 信頼性を言葉にする たとえ話 — 路線バスに「秒単位の正確さ」を求めたら 要求 「1秒の遅れも許さない」。新幹線並みの秒 単位ダイヤを路線バスに課す。 何が起きるか
信号待ちの遅れを取り戻すため、専用レー ンを整備し、バス停ごとに予備車両を待機さ せる。 結果 運賃は跳ね上がり、本数は激減。誰も乗れ ない「正確なバス」ができあがる。 利用者が求めているのは「そこそこ時間通りで、安く、手軽に乗れること」。 100%の正確性のために利便性や価格を犠牲にするのは本末転倒 — あなたのサービスのユーザーも、まったく同じ。 10
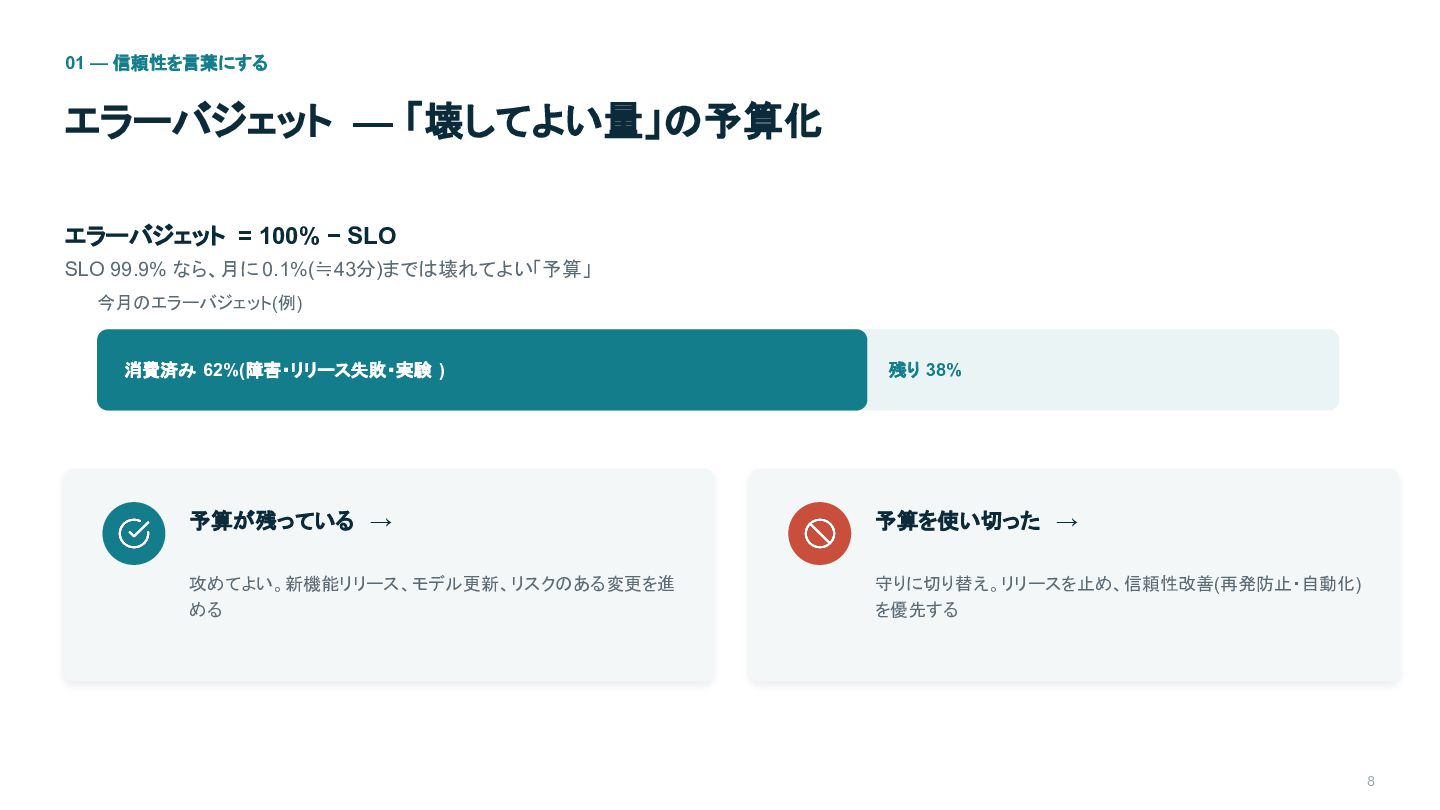
01 — 信頼性を言葉にする エラーバジェット — 「壊してよい量」の予算化 エラーバジェット = 100% −
SLO SLO 99.9% なら、月に 0.1%(≒43分)までは壊れてよい「予算」 今月のエラーバジェット(例) 消費済み 62%(障害・リリース失敗・実験 ) 残り 38% 予算が残っている → 予算を使い切った → 攻めてよい。新機能リリース、モデル更新、リスクのある変更を進 める 守りに切り替え。リリースを止め、信頼性改善(再発防止・自動化) を優先する 8
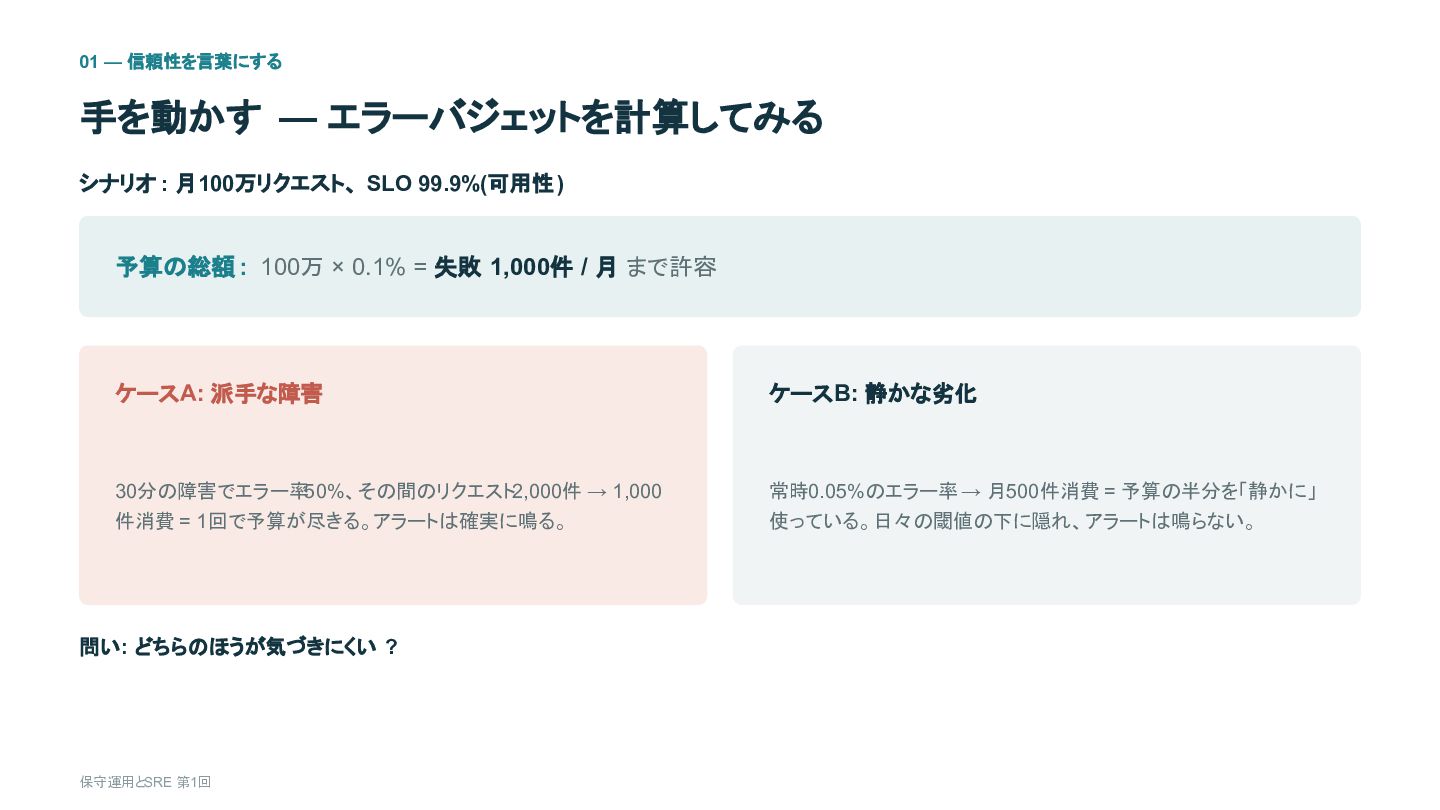
01 — 信頼性を言葉にする 手を動かす — エラーバジェットを計算してみる シナリオ : 月100万リクエスト、 SLO
99.9%(可用性 ) 予算の総額 : 100万 × 0.1% = 失敗 1,000件 / 月 まで許容 ケースA: 派手な障害 ケースB: 静かな劣化 30分の障害でエラー率50%、その間のリクエスト2,000件 → 1,000 常時0.05%のエラー率 → 月500件消費 = 予算の半分を「静かに」 件消費 = 1回で予算が尽きる。アラートは確実に鳴る。 使っている。日々の閾値の下に隠れ、アラートは鳴らない。 問い: どちらのほうが気づきにくい ? 保守運用とSRE 第1回
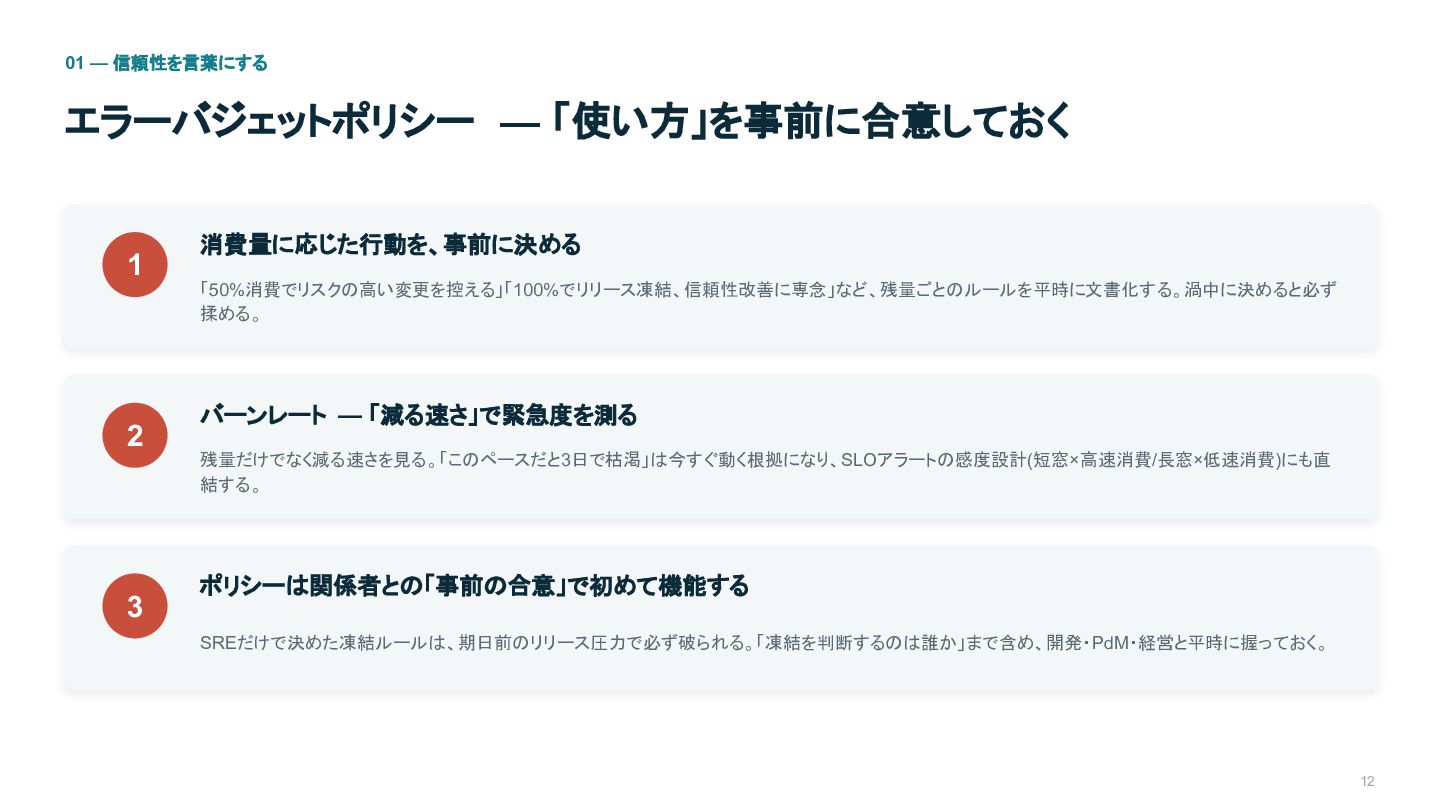
01 — 信頼性を言葉にする エラーバジェットポリシー — 「使い方」を事前に合意しておく 1 2 3 消費量に応じた行動を、事前に決める
「50%消費でリスクの高い変更を控える」「100%でリリース凍結、信頼性改善に専念」など、残量ごとのルールを平時に文書化する。渦中に決めると必ず 揉める。 バーンレート — 「減る速さ」で緊急度を測る 残量だけでなく減る速さを見る。「このペースだと3日で枯渇」は今すぐ動く根拠になり、SLOアラートの感度設計(短窓×高速消費/長窓×低速消費)にも直 結する。 ポリシーは関係者との「事前の合意」で初めて機能する SREだけで決めた凍結ルールは、期日前のリリース圧力で必ず破られる。「凍結を判断するのは誰か」まで含め、開発・PdM・経営と平時に握っておく。 12
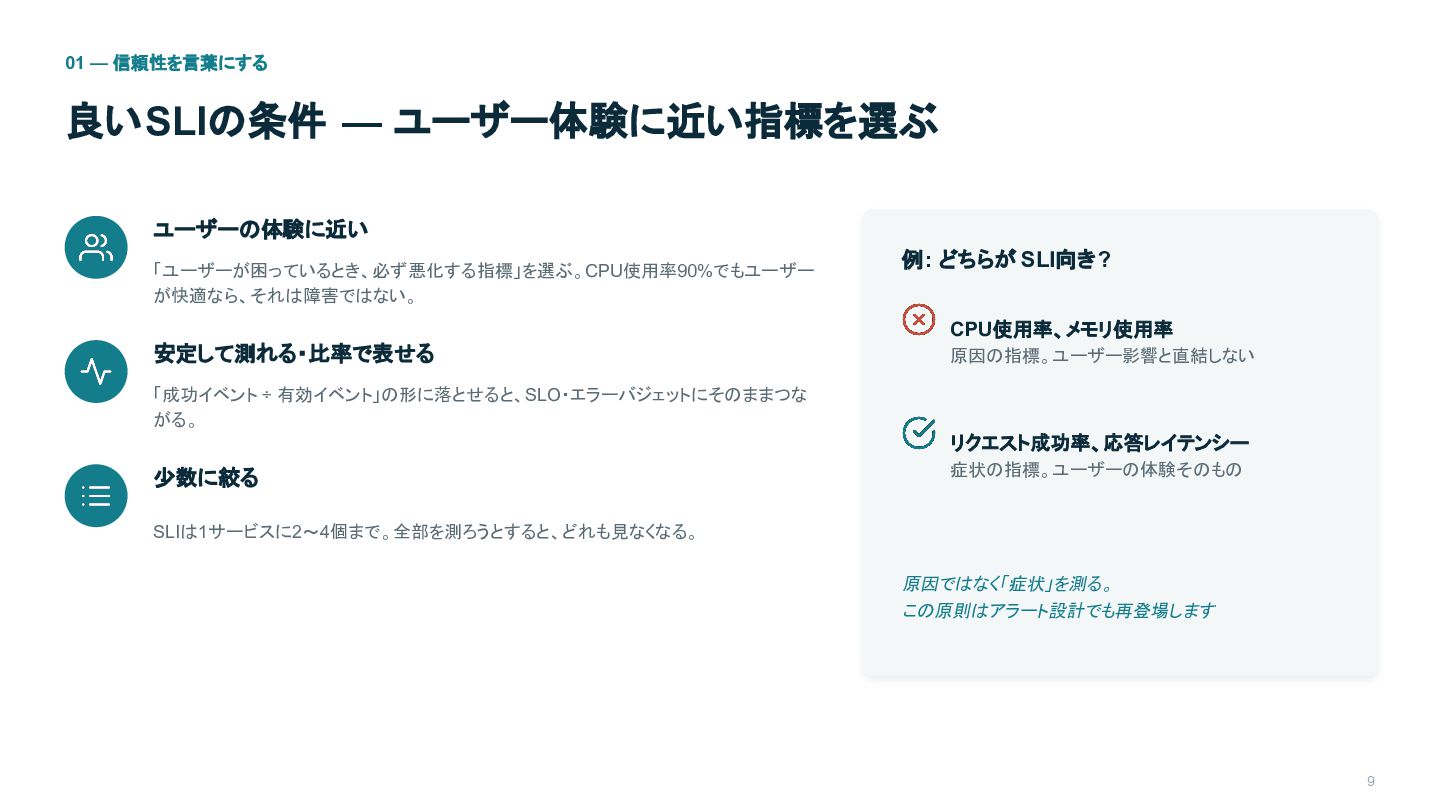
01 — 信頼性を言葉にする 良いSLIの条件 — ユーザー体験に近い指標を選ぶ ユーザーの体験に近い 「ユーザーが困っているとき、必ず悪化する指標」を選ぶ。CPU使用率90%でもユーザー が快適なら、それは障害ではない。 例:
どちらが SLI向き ? CPU使用率、メモリ使用率 安定して測れる・比率で表せる 原因の指標。ユーザー影響と直結しない 「成功イベント ÷ 有効イベント」の形に落とせると、SLO・エラーバジェットにそのままつな がる。 リクエスト成功率、応答レイテンシー 少数に絞る 症状の指標。ユーザーの体験そのもの SLIは1サービスに2〜4個まで。全部を測ろうとすると、どれも見なくなる。 原因ではなく「症状」を測る。 この原則はアラート設計でも再登場します 9
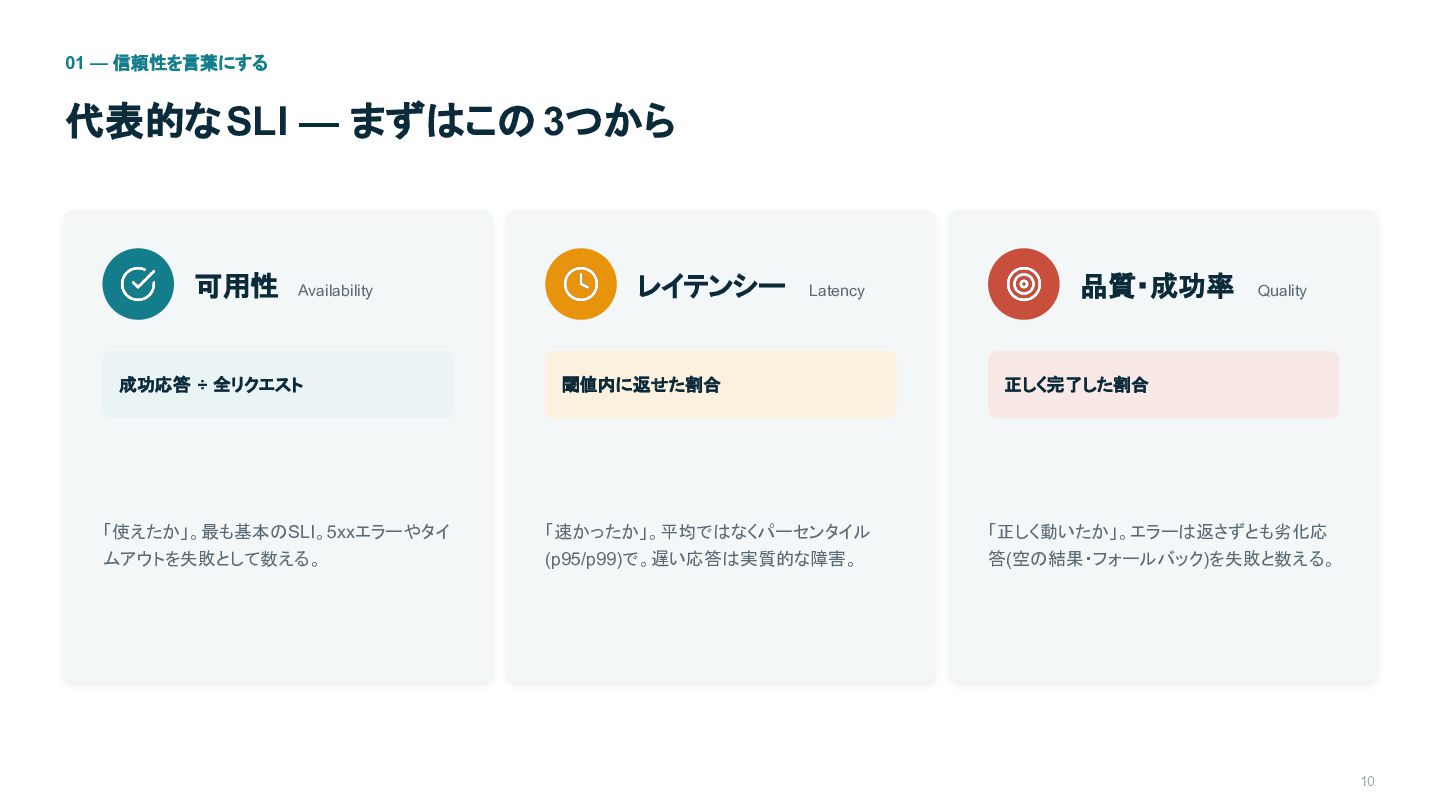
01 — 信頼性を言葉にする 代表的な SLI — まずはこの 3つから 可用性 Availability
成功応答 ÷ 全リクエスト 「使えたか」。最も基本のSLI。5xxエラーやタイ ムアウトを失敗として数える。 レイテンシー Latency 閾値内に返せた割合 「速かったか」。平均ではなくパーセンタイル (p95/p99)で。遅い応答は実質的な障害。 品質・成功率 Quality 正しく完了した割合 「正しく動いたか」。エラーは返さずとも劣化応 答(空の結果・フォールバック)を失敗と数える。 10
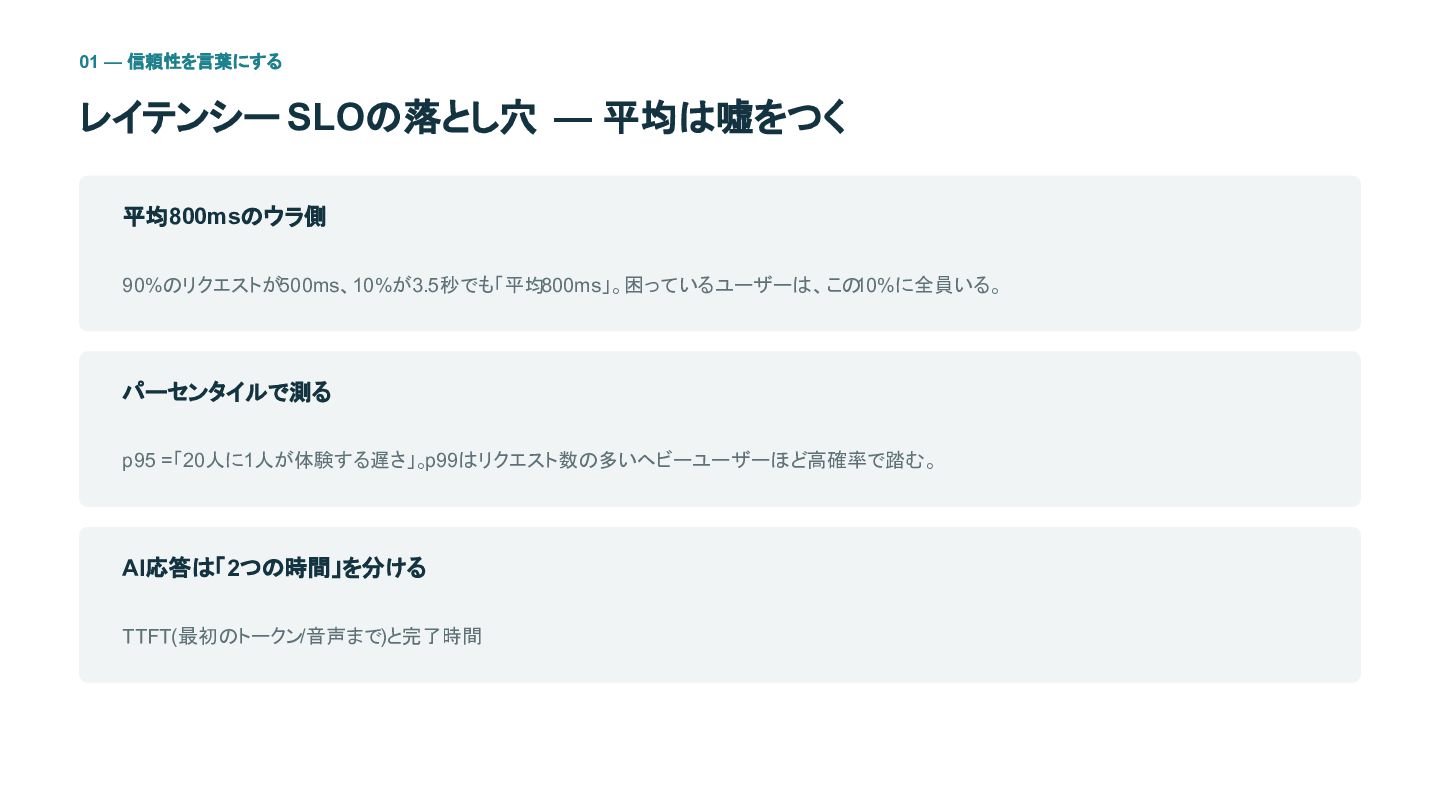
01 — 信頼性を言葉にする レイテンシー SLOの落とし穴 — 平均は嘘をつく 平均800msのウラ側 90%のリクエストが500ms、10%が3.5秒でも「平均800ms」。困っているユーザーは、この10%に全員いる。 パーセンタイルで測る
p95 =「20人に1人が体験する遅さ」。p99はリクエスト数の多いヘビーユーザーほど高確率で踏む。 AI応答は「2つの時間」を分ける TTFT(最初のトークン/音声まで)と完了時間
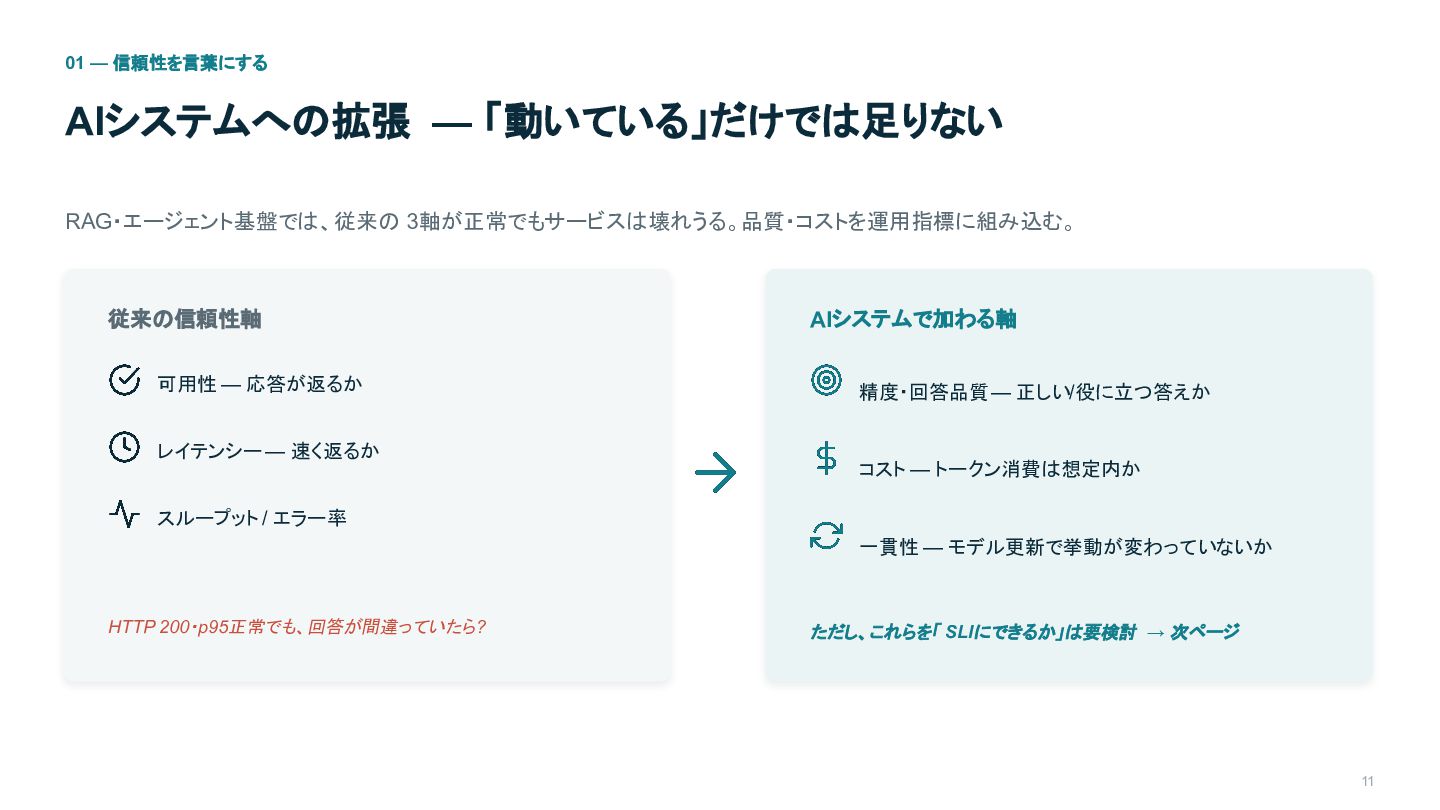
01 — 信頼性を言葉にする AIシステムへの拡張 — 「動いている」だけでは足りない RAG・エージェント基盤では、従来の 3軸が正常でもサービスは壊れうる。品質・コストを運用指標に組み込む。 従来の信頼性軸 可用性
— 応答が返るか レイテンシー — 速く返るか AIシステムで加わる軸 精度・回答品質 — 正しい/役に立つ答えか コスト — トークン消費は想定内か スループット / エラー率 一貫性 — モデル更新で挙動が変わっていないか HTTP 200・p95正常でも、回答が間違っていたら? ただし、これらを「 SLIにできるか」は要検討 → 次ページ 11
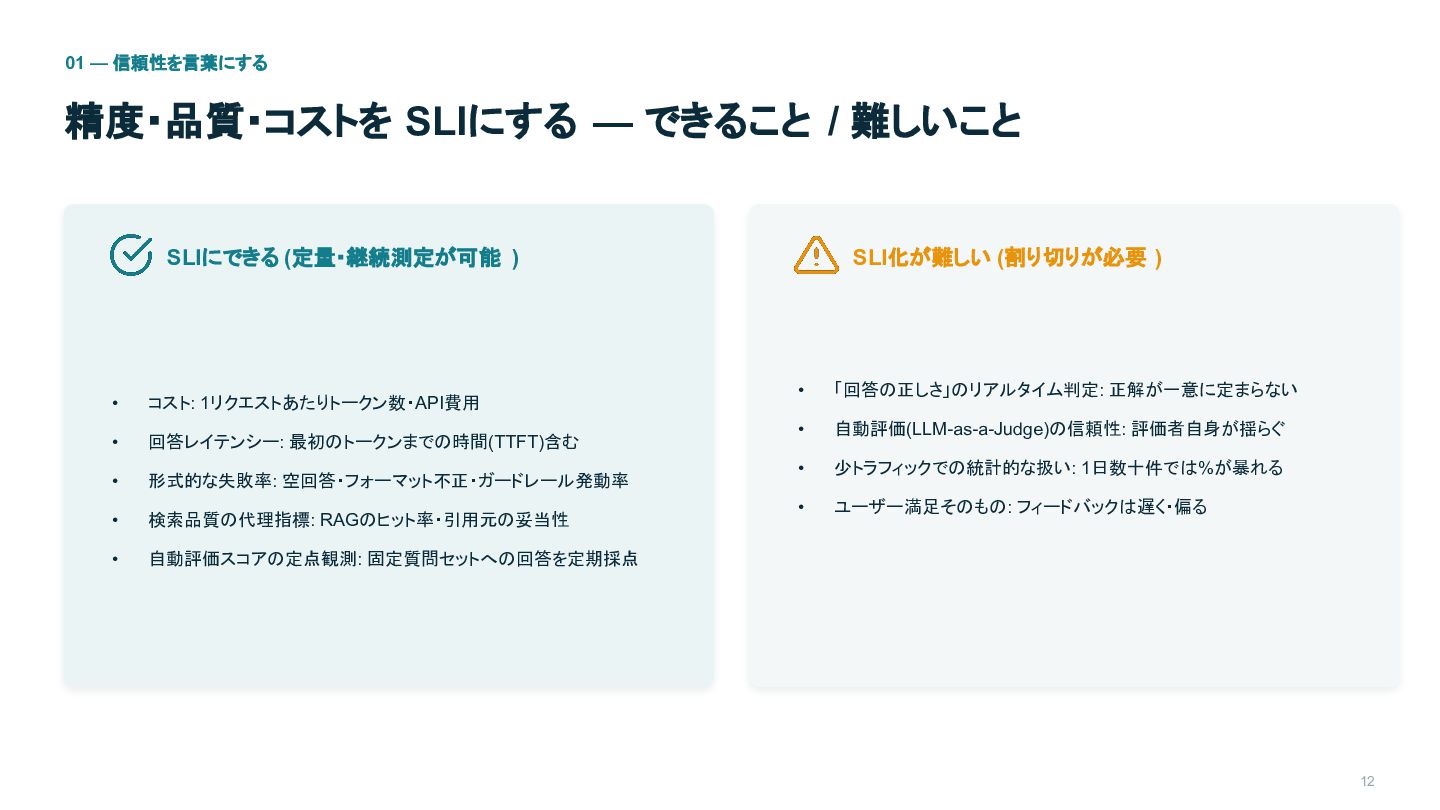
01 — 信頼性を言葉にする 精度・品質・コストを SLIにする — できること / 難しいこと SLIにできる
(定量・継続測定が可能 ) • コスト: 1リクエストあたりトークン数・API費用 • 回答レイテンシー: 最初のトークンまでの時間(TTFT)含む • 形式的な失敗率: 空回答・フォーマット不正・ガードレール発動率 • 検索品質の代理指標: RAGのヒット率・引用元の妥当性 • 自動評価スコアの定点観測: 固定質問セットへの回答を定期採点 SLI化が難しい (割り切りが必要 ) • 「回答の正しさ」のリアルタイム判定: 正解が一意に定まらない • 自動評価(LLM-as-a-Judge)の信頼性: 評価者自身が揺らぐ • 少トラフィックでの統計的な扱い: 1日数十件では%が暴れる • ユーザー満足そのもの: フィードバックは遅く・偏る 12
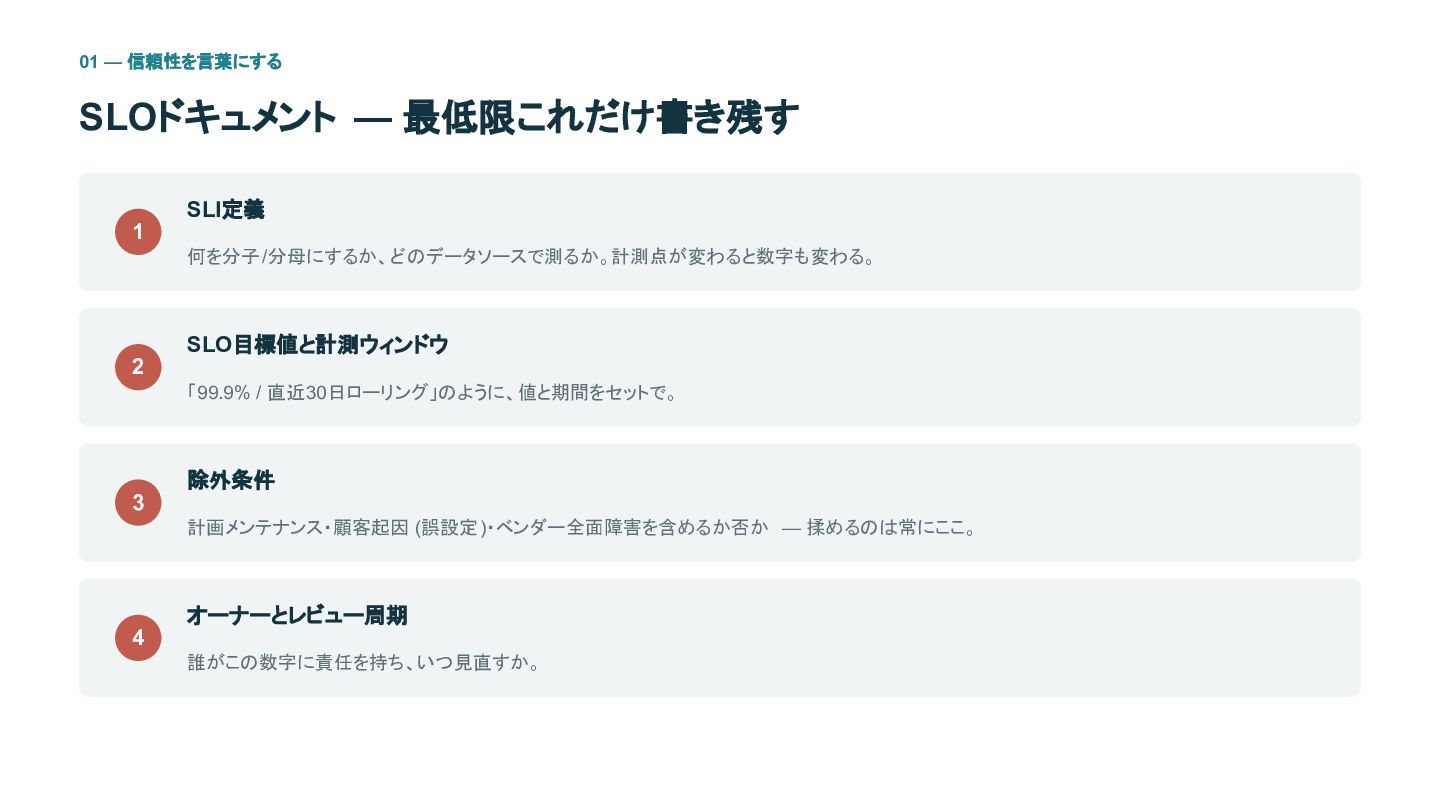
01 — 信頼性を言葉にする SLOドキュメント — 最低限これだけ書き残す SLI定義 1 何を分子 /分母にするか、どのデータソースで測るか。計測点が変わると数字も変わる。
SLO目標値と計測ウィンドウ 2 「99.9% / 直近30日ローリング」のように、値と期間をセットで。 除外条件 3 計画メンテナンス・顧客起因 (誤設定)・ベンダー全面障害を含めるか否か — 揉めるのは常にここ。 オーナーとレビュー周期 4 誰がこの数字に責任を持ち、いつ見直すか。
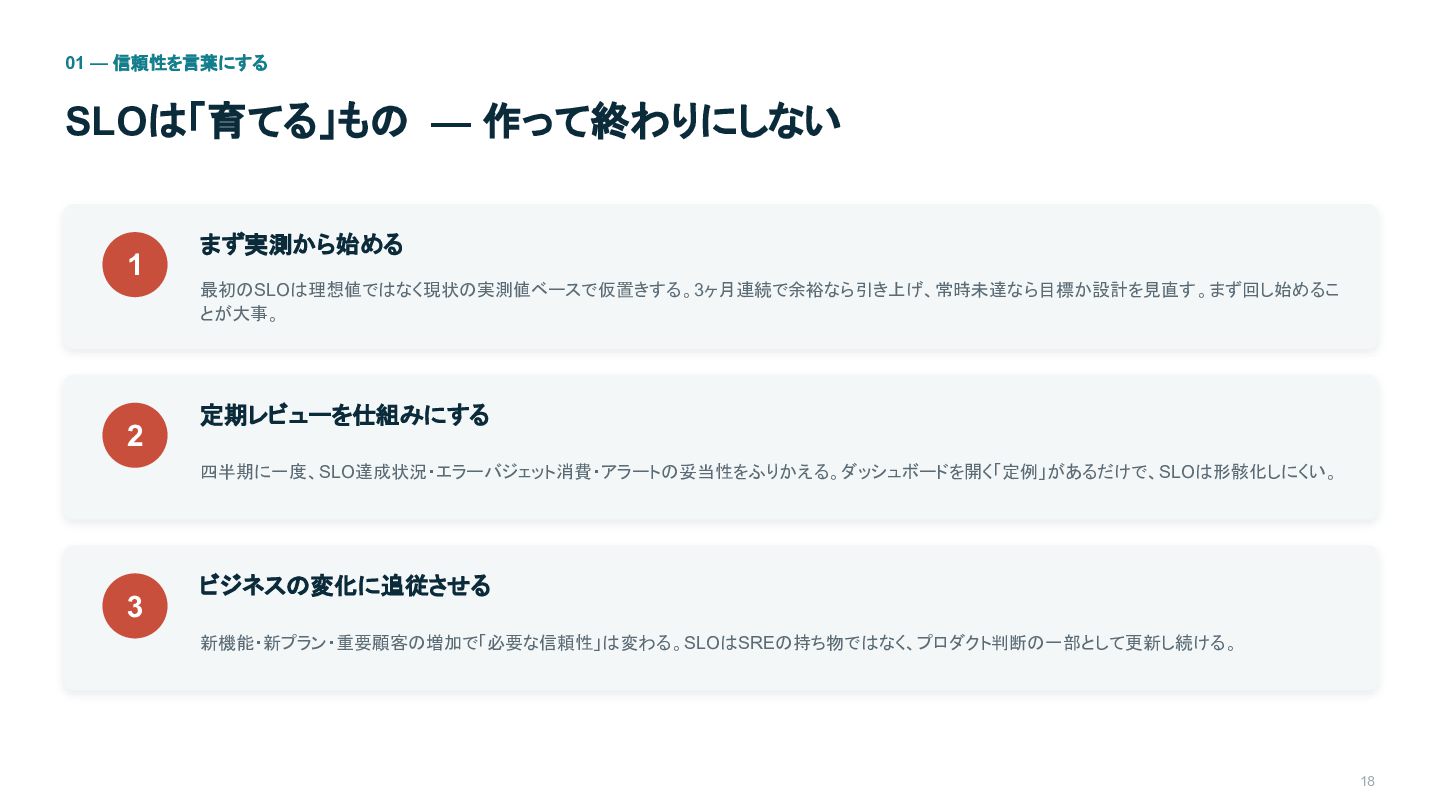
01 — 信頼性を言葉にする SLOは「育てる」もの — 作って終わりにしない 1 2 まず実測から始める 最初のSLOは理想値ではなく現状の実測値ベースで仮置きする。3ヶ月連続で余裕なら引き上げ、常時未達なら目標か設計を見直す。まず回し始めるこ
とが大事。 定期レビューを仕組みにする 四半期に一度、SLO達成状況・エラーバジェット消費・アラートの妥当性をふりかえる。ダッシュボードを開く「定例」があるだけで、SLOは形骸化しにくい。 3 ビジネスの変化に追従させる 新機能・新プラン・重要顧客の増加で「必要な信頼性」は変わる。SLOはSREの持ち物ではなく、プロダクト判断の一部として更新し続ける。 18
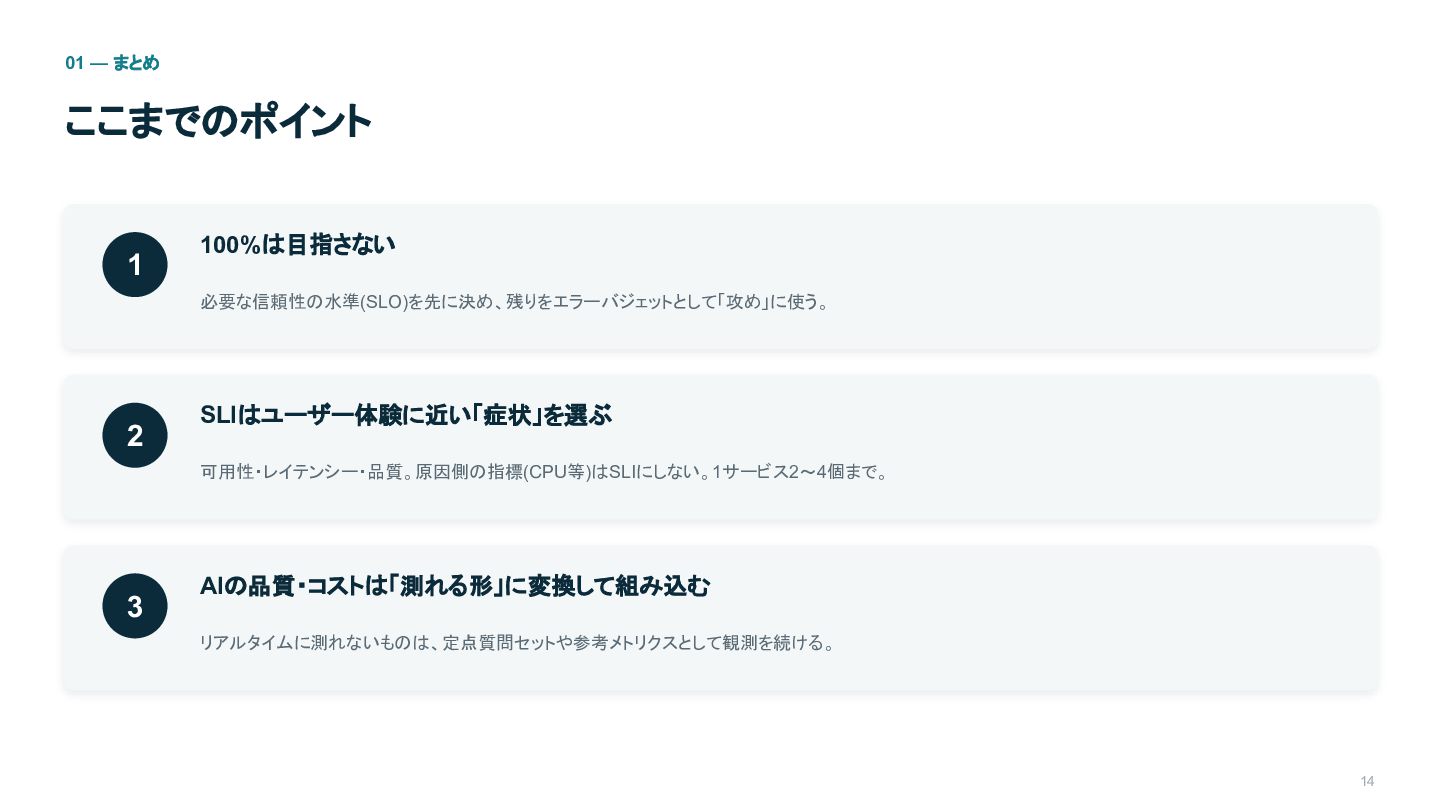
01 — まとめ ここまでのポイント 1 100%は目指さない 必要な信頼性の水準(SLO)を先に決め、残りをエラーバジェットとして「攻め」に使う。 2 SLIはユーザー体験に近い「症状」を選ぶ 可用性・レイテンシー・品質。原因側の指標(CPU等)はSLIにしない。1サービス2〜4個まで。
3 AIの品質・コストは「測れる形」に変換して組み込む リアルタイムに測れないものは、定点質問セットや参考メトリクスとして観測を続ける。 14
02 システムの観測と障害対応 エラーが出ない壊れ方に気づき、あわてず復旧する 20
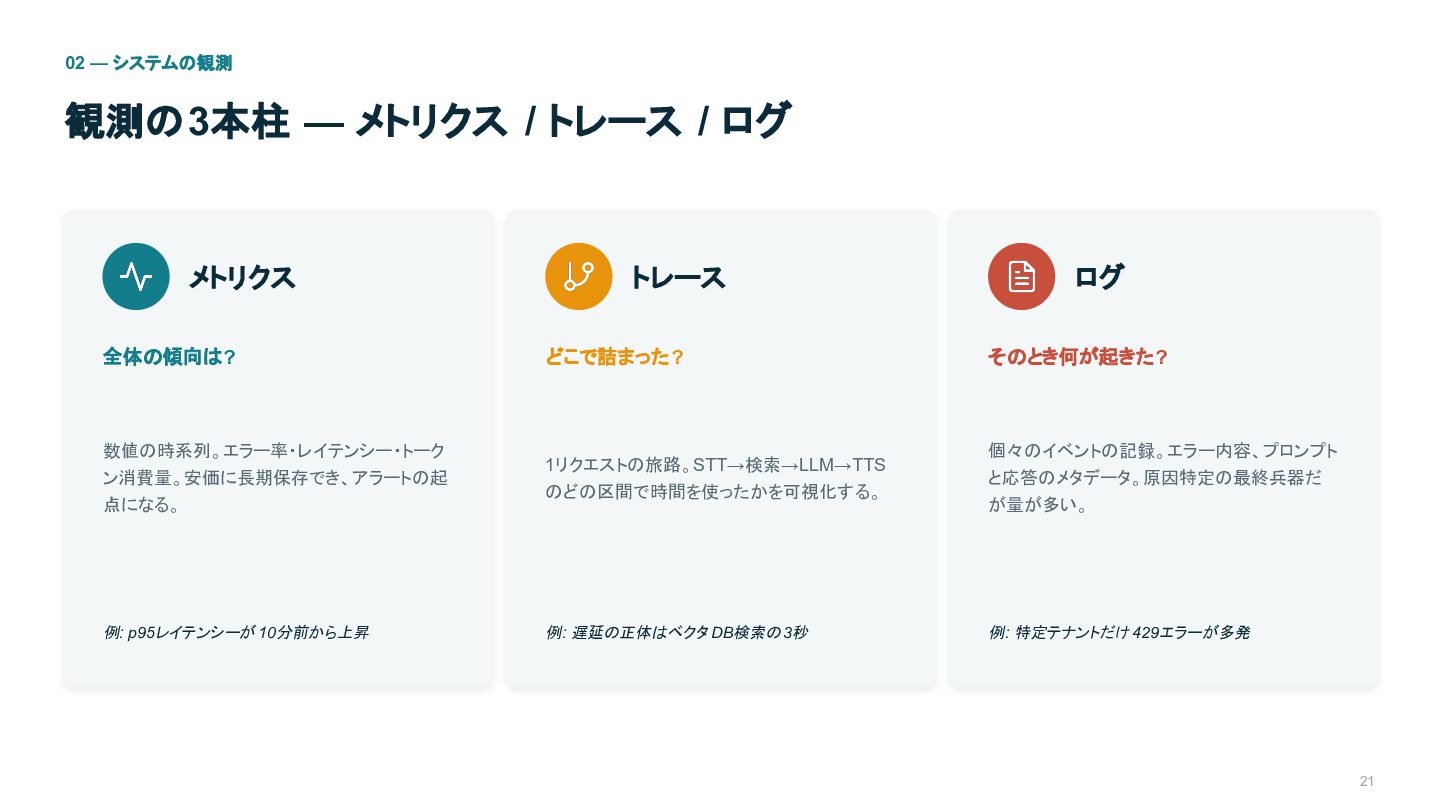
02 — システムの観測 観測の3本柱 — メトリクス / トレース / ログ
メトリクス トレース ログ 全体の傾向は? どこで詰まった? そのとき何が起きた? 数値の時系列。エラー率・レイテンシー・トーク ン消費量。安価に長期保存でき、アラートの起 点になる。 1リクエストの旅路。STT→検索→LLM→TTS のどの区間で時間を使ったかを可視化する。 個々のイベントの記録。エラー内容、プロンプト と応答のメタデータ。原因特定の最終兵器だ が量が多い。 例 : p95レイテンシーが 10分前から上昇 例 : 遅延の正体はベクタ DB検索の 3秒 例 : 特定テナントだけ 429エラーが多発 21
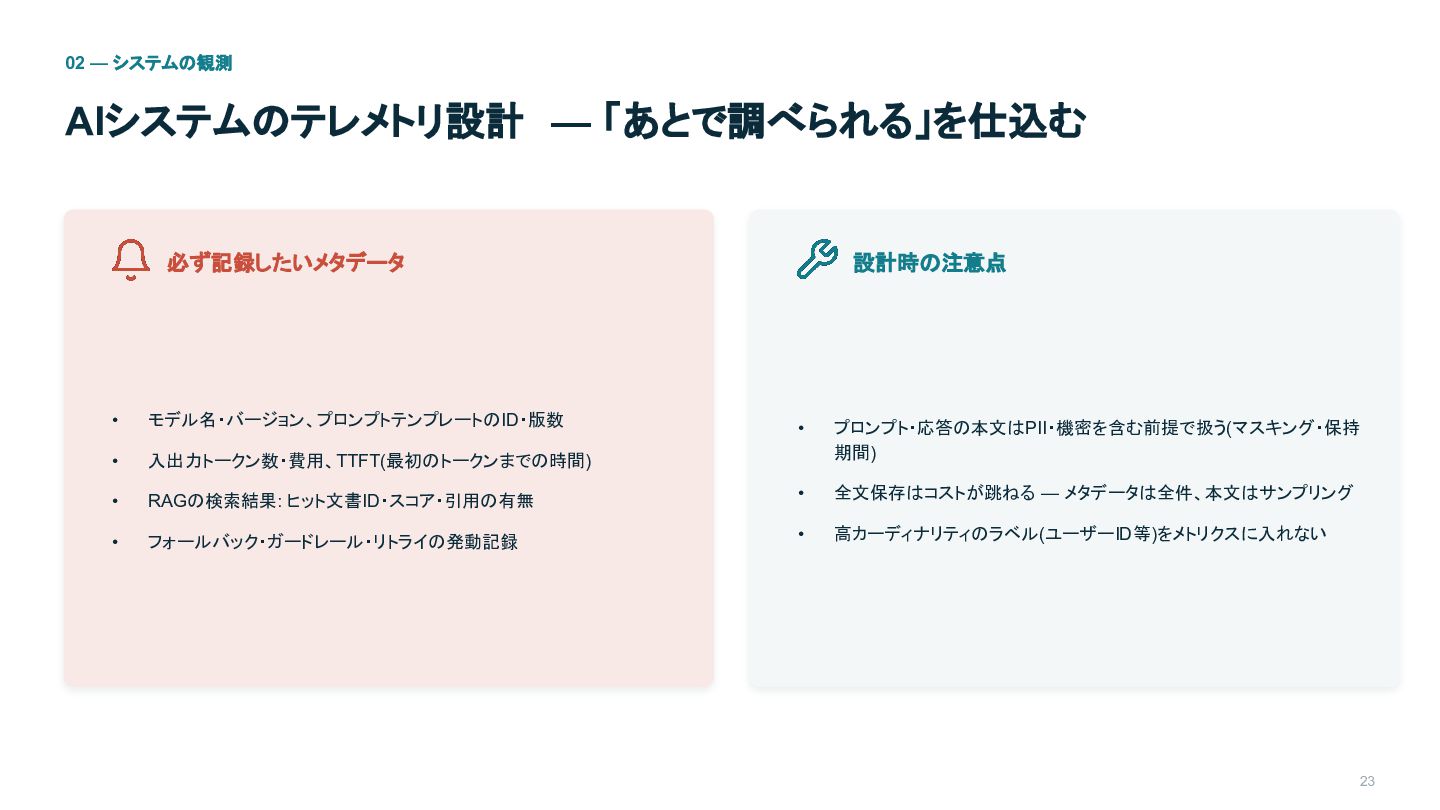
02 — システムの観測 AIシステムのテレメトリ設計 — 「あとで調べられる」を仕込む 必ず記録したいメタデータ • モデル名・バージョン、プロンプトテンプレートのID・版数 •
入出力トークン数・費用、TTFT(最初のトークンまでの時間) • • 設計時の注意点 • プロンプト・応答の本文はPII・機密を含む前提で扱う(マスキング・保持 期間) RAGの検索結果: ヒット文書ID・スコア・引用の有無 • 全文保存はコストが跳ねる — メタデータは全件、本文はサンプリング フォールバック・ガードレール・リトライの発動記録 • 高カーディナリティのラベル(ユーザーID等)をメトリクスに入れない 23
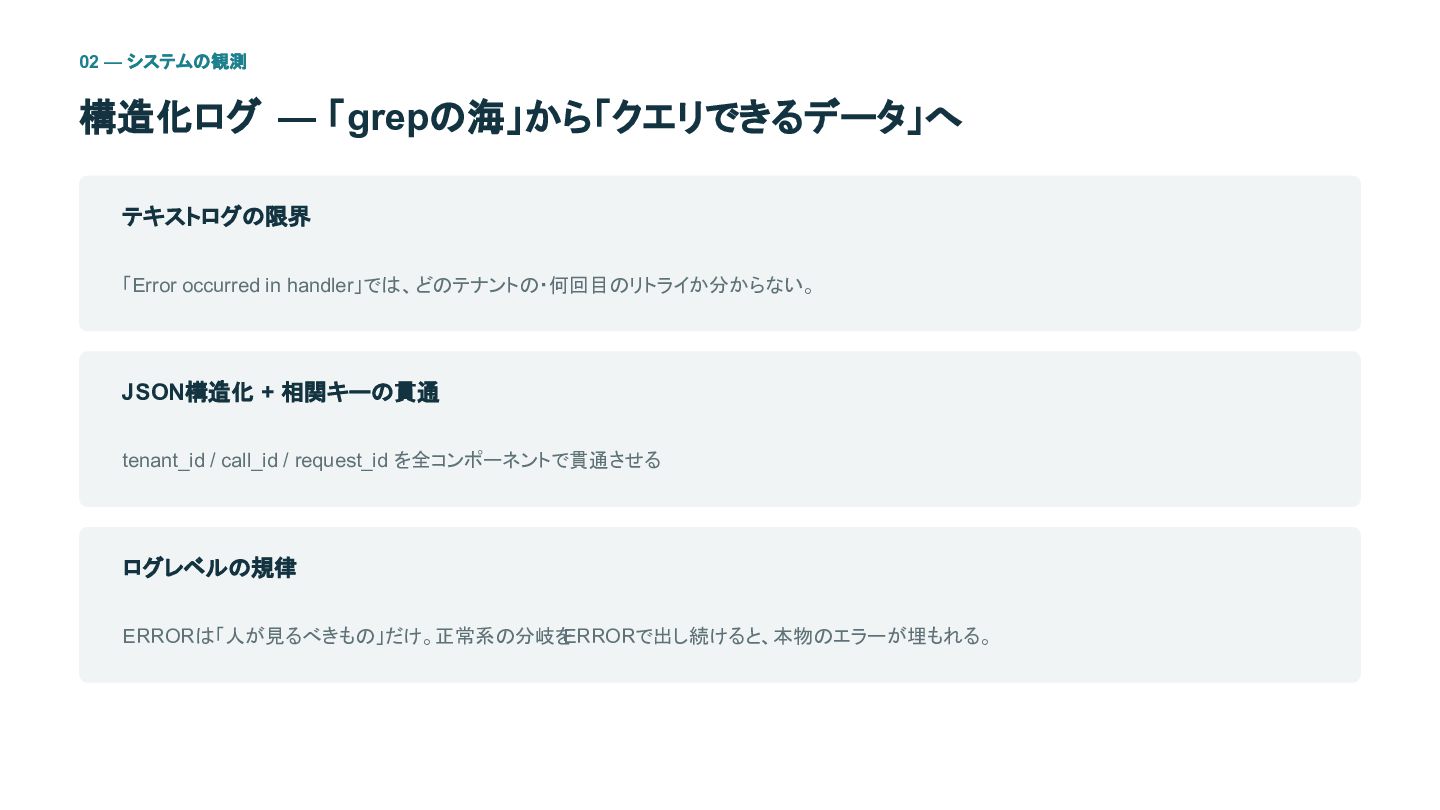
02 — システムの観測 構造化ログ — 「grepの海」から「クエリできるデータ」へ テキストログの限界 「Error occurred in
handler」では、どのテナントの・何回目のリトライか分からない。 JSON構造化 + 相関キーの貫通 tenant_id / call_id / request_id を全コンポーネントで貫通させる ログレベルの規律 ERRORは「人が見るべきもの」だけ。正常系の分岐をERRORで出し続けると、本物のエラーが埋もれる。
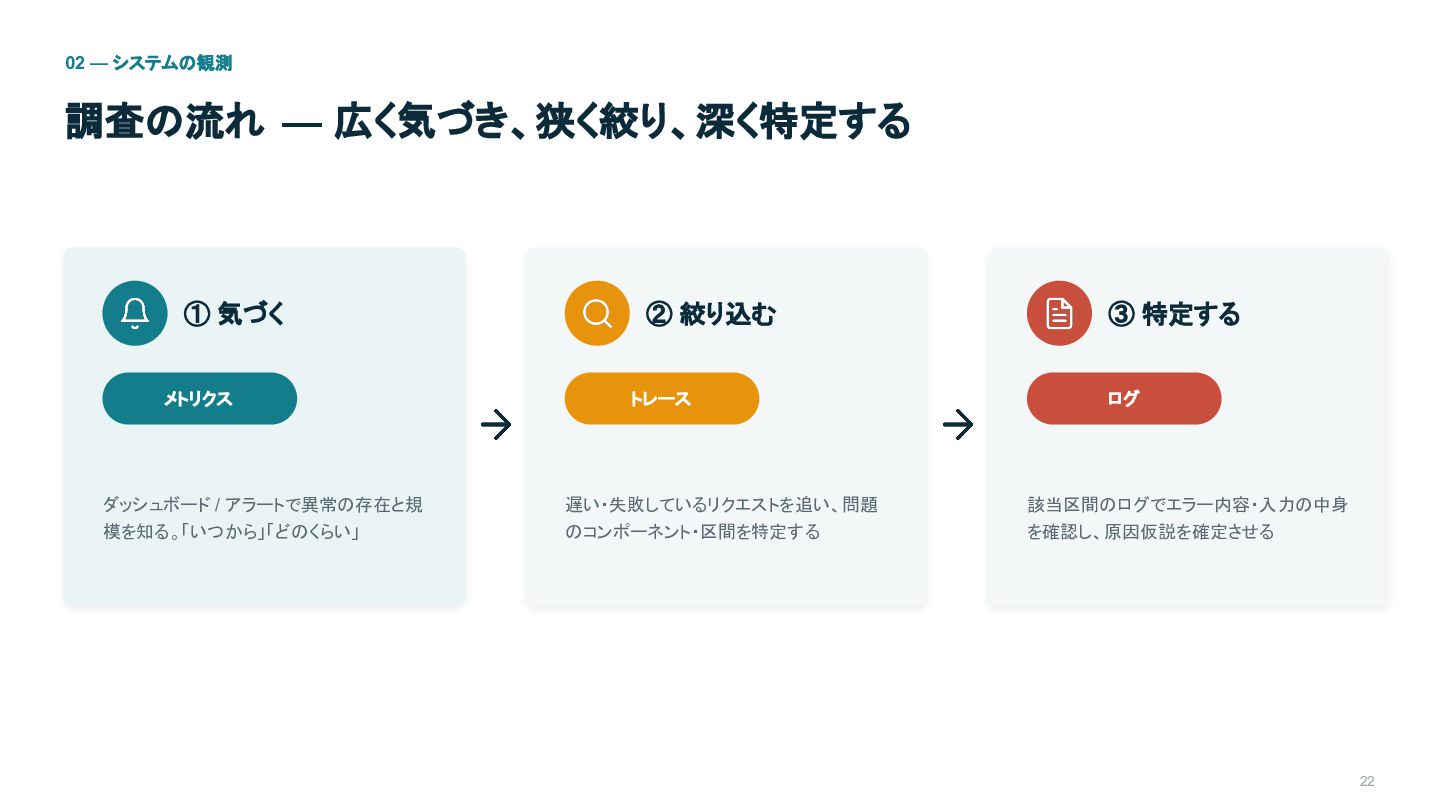
02 — システムの観測 調査の流れ — 広く気づき、狭く絞り、深く特定する ① 気づく メトリクス ダッシュボード
/ アラートで異常の存在と規 模を知る。「いつから」「どのくらい」 ② 絞り込む トレース 遅い・失敗しているリクエストを追い、問題 のコンポーネント・区間を特定する ③ 特定する ログ 該当区間のログでエラー内容・入力の中身 を確認し、原因仮説を確定させる 22
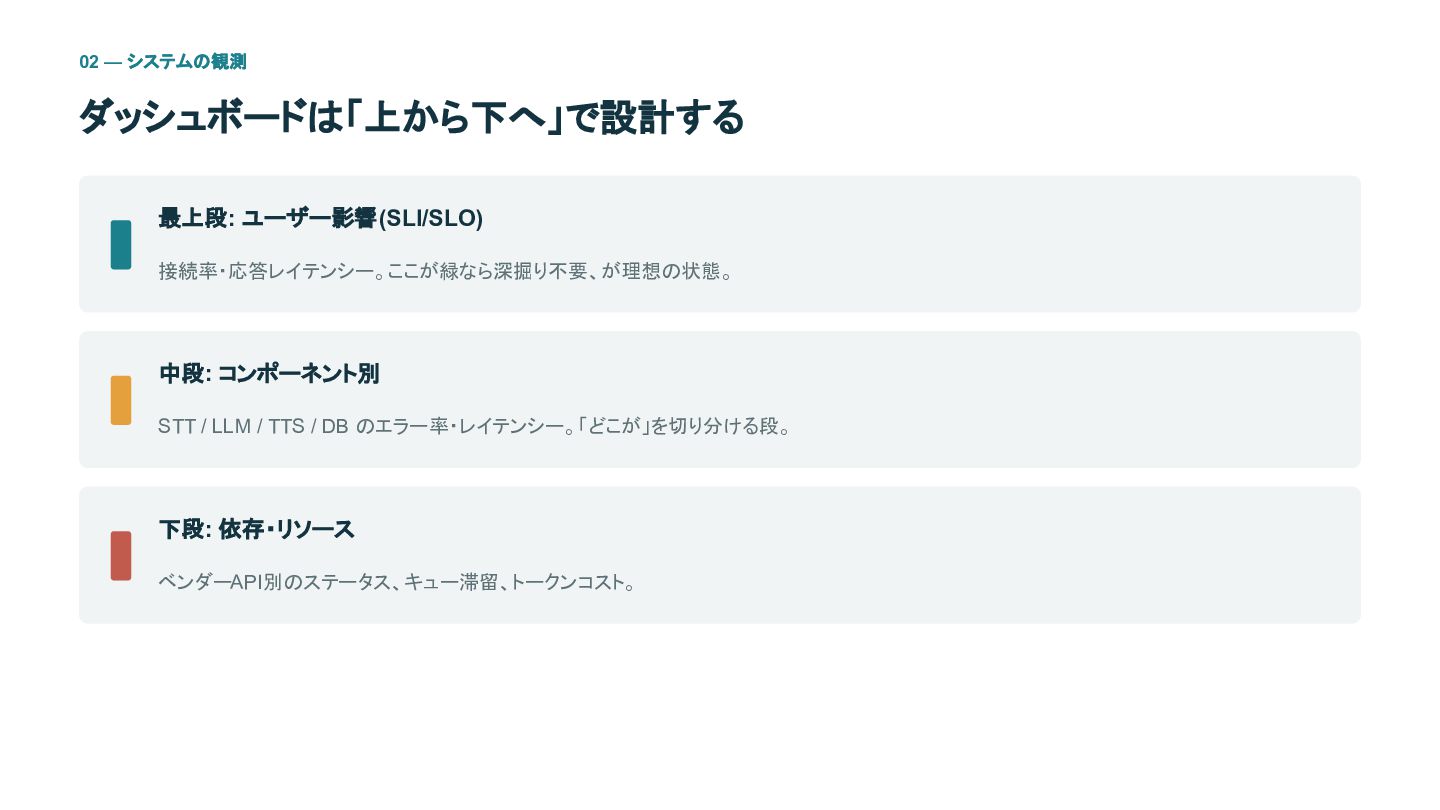
02 — システムの観測 ダッシュボードは「上から下へ」で設計する 最上段: ユーザー影響(SLI/SLO) 接続率・応答レイテンシー。ここが緑なら深掘り不要、が理想の状態。 中段: コンポーネント別 STT
/ LLM / TTS / DB のエラー率・レイテンシー。「どこが」を切り分ける段。 下段: 依存・リソース ベンダーAPI別のステータス、キュー滞留、トークンコスト。
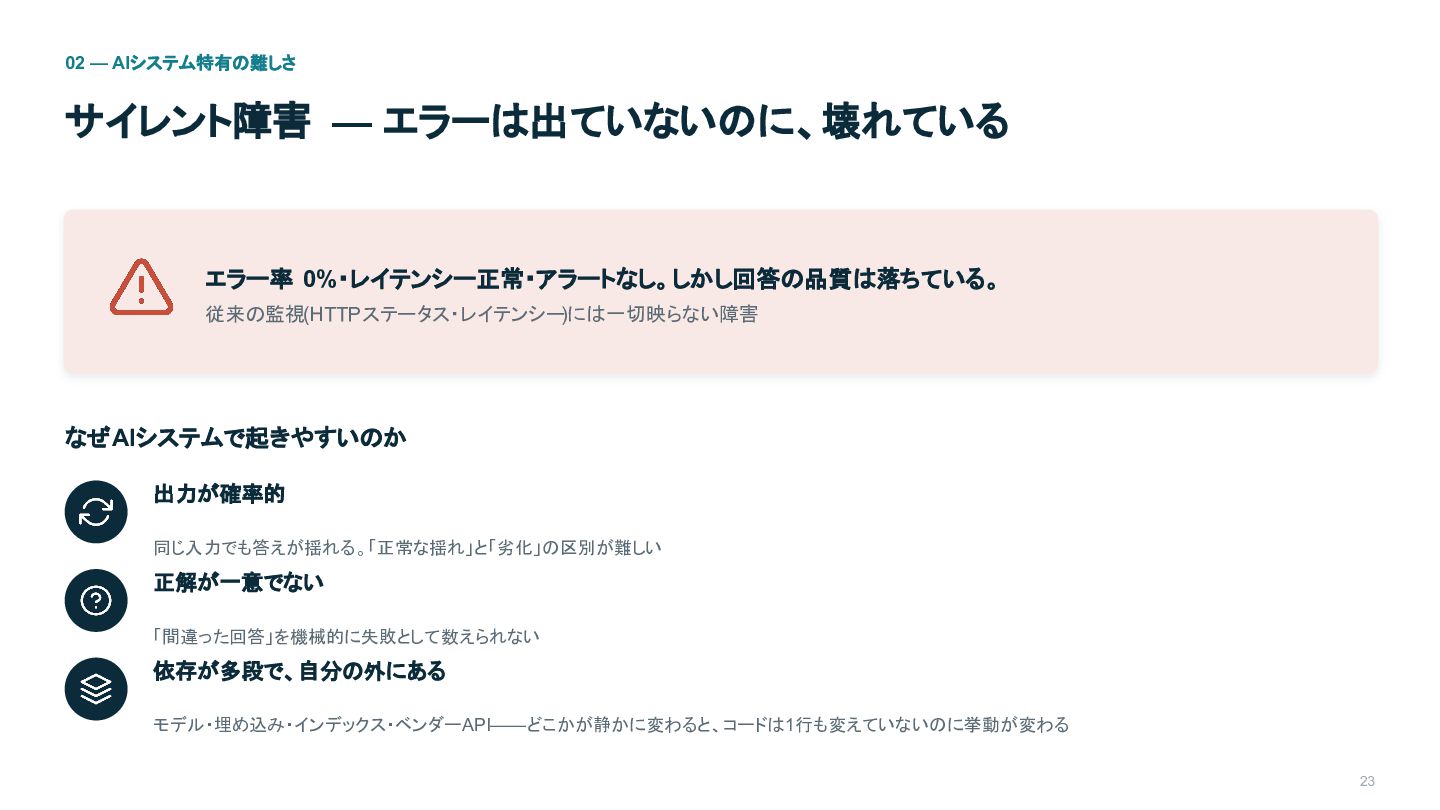
02 — AIシステム特有の難しさ サイレント障害 — エラーは出ていないのに、壊れている エラー率 0%・レイテンシー正常・アラートなし。しかし回答の品質は落ちている。 従来の監視(HTTPステータス・レイテンシー)には一切映らない障害 なぜAIシステムで起きやすいのか
出力が確率的 同じ入力でも答えが揺れる。「正常な揺れ」と「劣化」の区別が難しい 正解が一意でない 「間違った回答」を機械的に失敗として数えられない 依存が多段で、自分の外にある モデル・埋め込み・インデックス・ベンダーAPI——どこかが静かに変わると、コードは1行も変えていないのに挙動が変わる 23
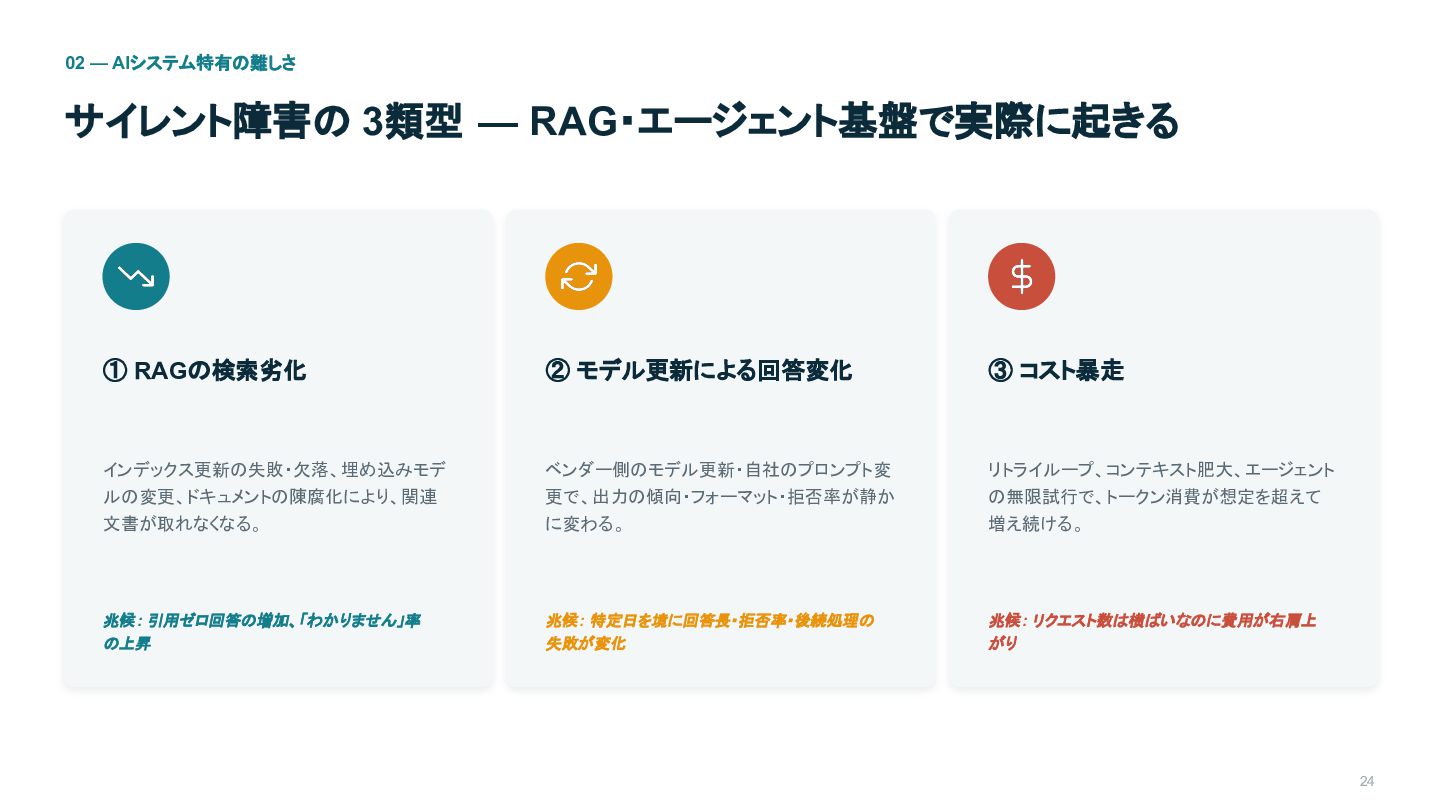
02 — AIシステム特有の難しさ サイレント障害の 3類型 — RAG・エージェント基盤で実際に起きる ① RAGの検索劣化 ②
モデル更新による回答変化 ③ コスト暴走 インデックス更新の失敗・欠落、埋め込みモデ ベンダー側のモデル更新・自社のプロンプト変 リトライループ、コンテキスト肥大、エージェント ルの変更、ドキュメントの陳腐化により、関連 文書が取れなくなる。 更で、出力の傾向・フォーマット・拒否率が静か に変わる。 の無限試行で、トークン消費が想定を超えて 増え続ける。 兆候 : 引用ゼロ回答の増加、「わかりません」率 の上昇 兆候 : 特定日を境に回答長・拒否率・後続処理の 失敗が変化 兆候 : リクエスト数は横ばいなのに費用が右肩上 がり 24
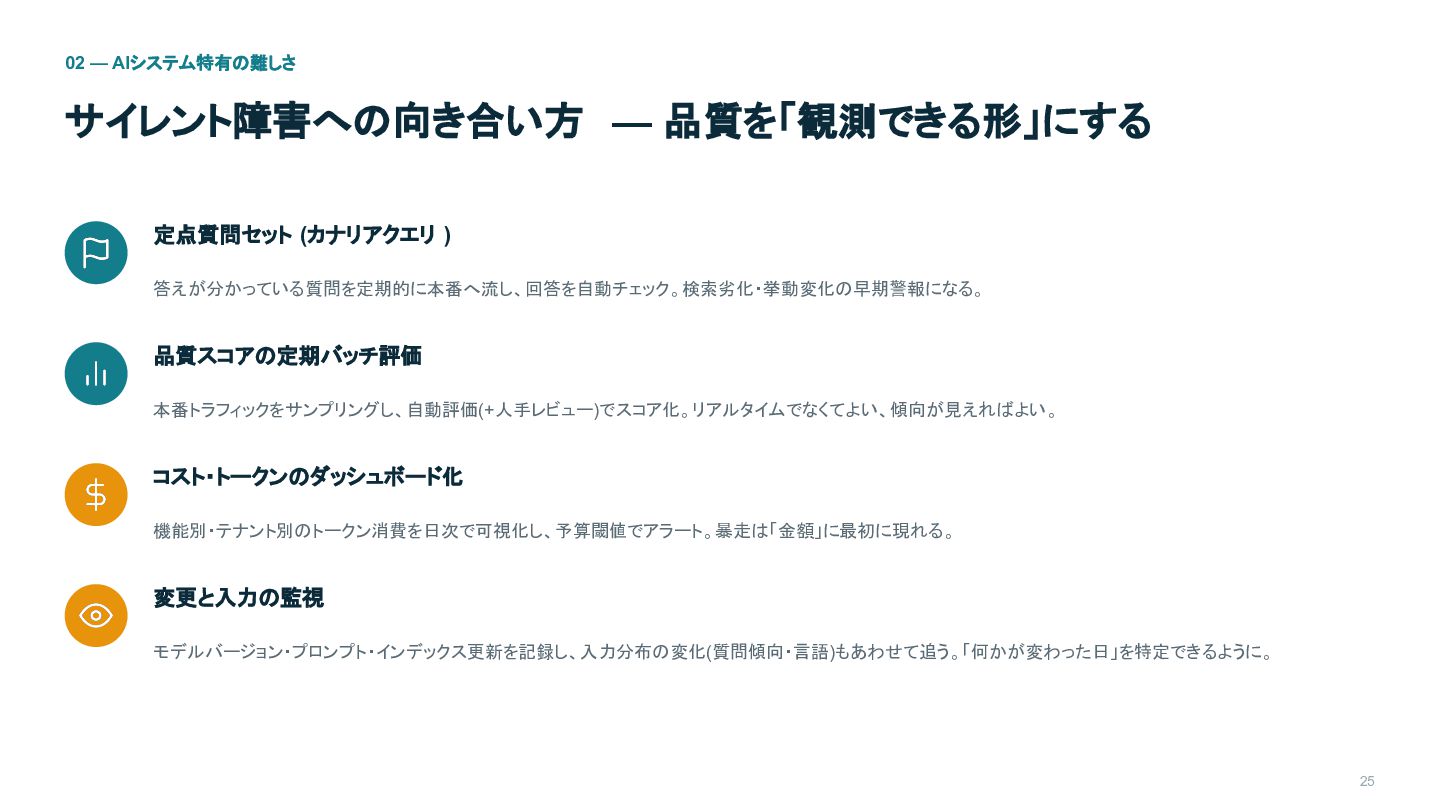
02 — AIシステム特有の難しさ サイレント障害への向き合い方 — 品質を「観測できる形」にする 定点質問セット (カナリアクエリ ) 答えが分かっている質問を定期的に本番へ流し、回答を自動チェック。検索劣化・挙動変化の早期警報になる。
品質スコアの定期バッチ評価 本番トラフィックをサンプリングし、自動評価(+人手レビュー)でスコア化。リアルタイムでなくてよい、傾向が見えればよい。 コスト・トークンのダッシュボード化 機能別・テナント別のトークン消費を日次で可視化し、予算閾値でアラート。暴走は「金額」に最初に現れる。 変更と入力の監視 モデルバージョン・プロンプト・インデックス更新を記録し、入力分布の変化(質問傾向・言語)もあわせて追う。「何かが変わった日」を特定できるように。 25
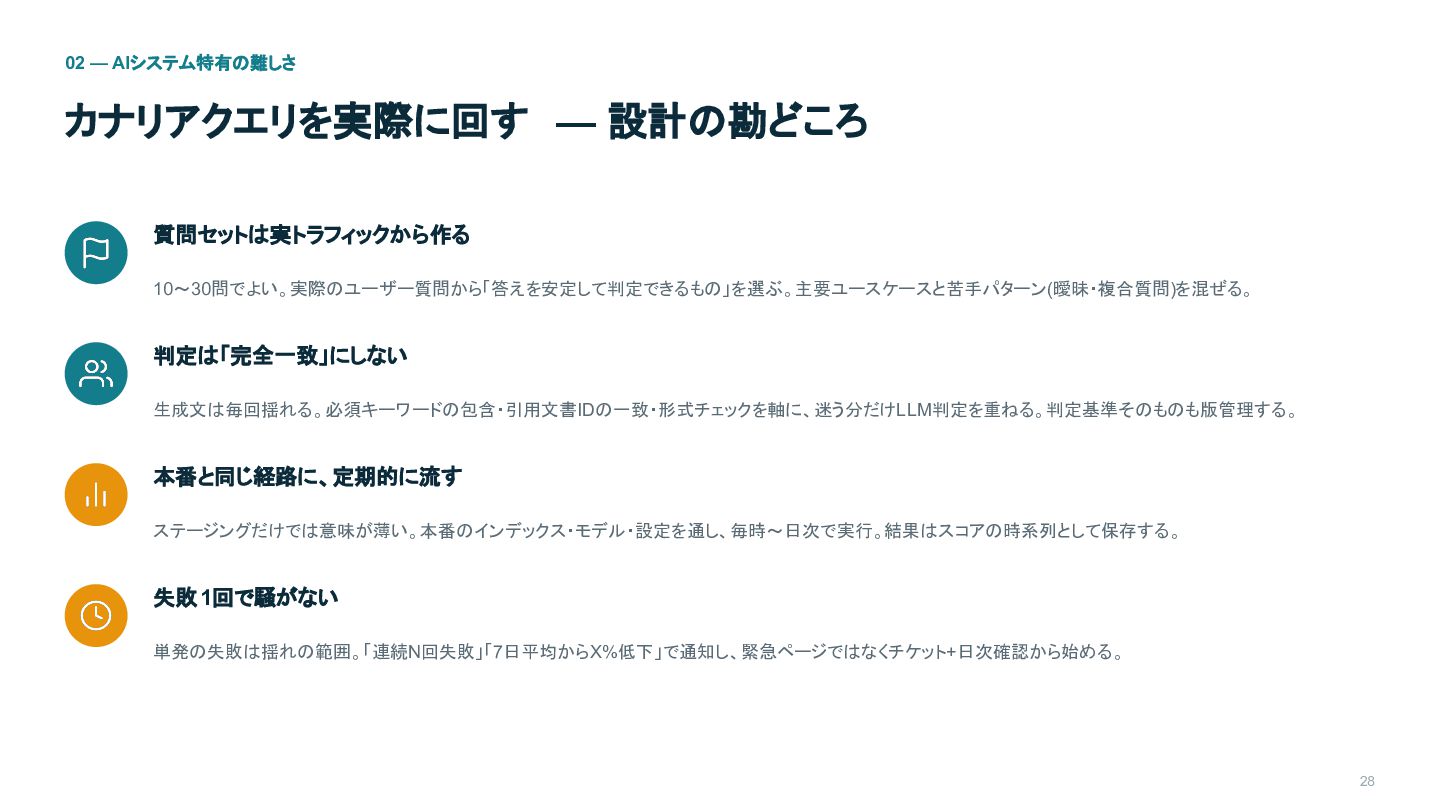
02 — AIシステム特有の難しさ カナリアクエリを実際に回す — 設計の勘どころ 質問セットは実トラフィックから作る 10〜30問でよい。実際のユーザー質問から「答えを安定して判定できるもの」を選ぶ。主要ユースケースと苦手パターン(曖昧・複合質問)を混ぜる。 判定は「完全一致」にしない 生成文は毎回揺れる。必須キーワードの包含・引用文書IDの一致・形式チェックを軸に、迷う分だけLLM判定を重ねる。判定基準そのものも版管理する。
本番と同じ経路に、定期的に流す ステージングだけでは意味が薄い。本番のインデックス・モデル・設定を通し、毎時〜日次で実行。結果はスコアの時系列として保存する。 失敗 1回で騒がない 単発の失敗は揺れの範囲。「連続N回失敗」「7日平均からX%低下」で通知し、緊急ページではなくチケット+日次確認から始める。 28
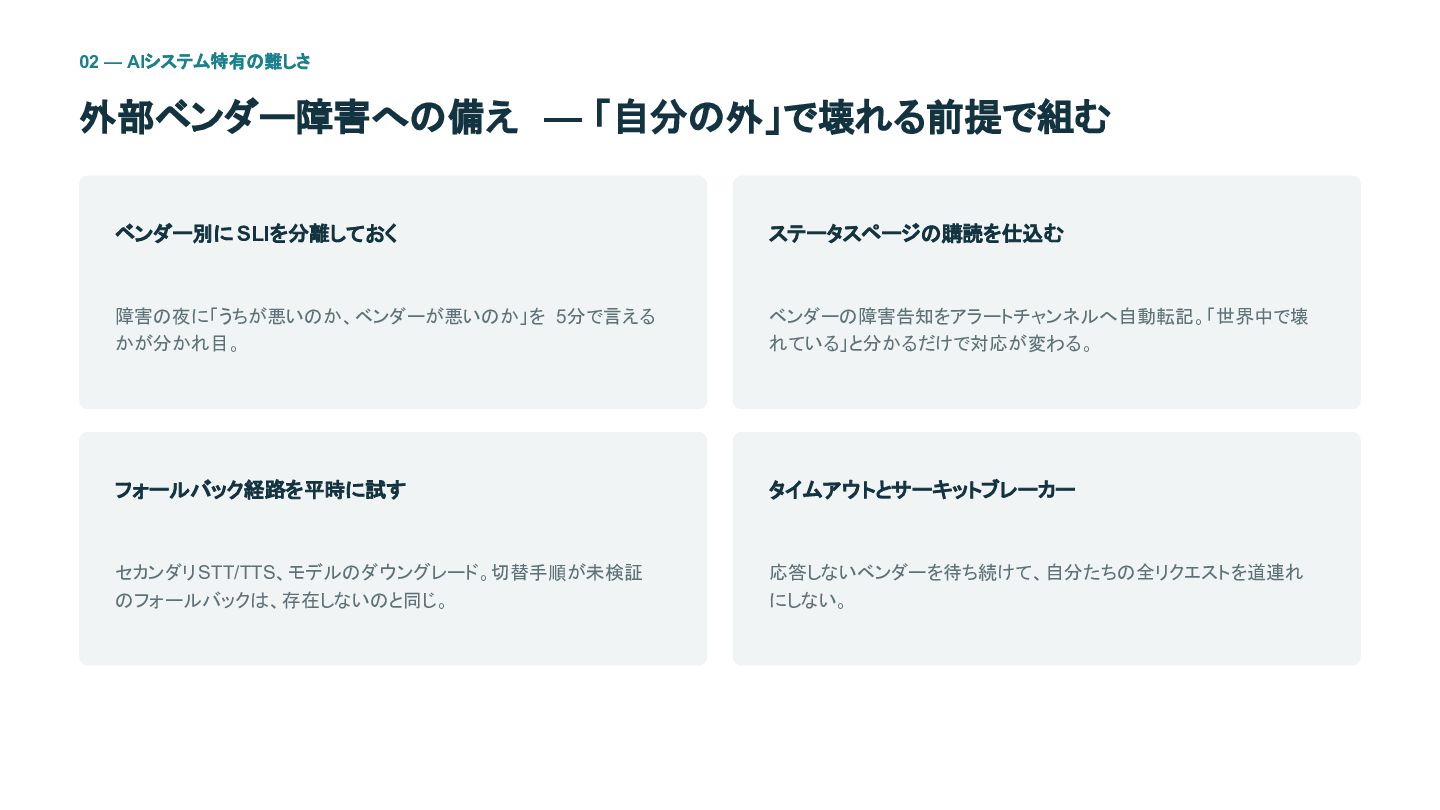
02 — AIシステム特有の難しさ 外部ベンダー障害への備え — 「自分の外」で壊れる前提で組む ベンダー別に SLIを分離しておく ステータスページの購読を仕込む 障害の夜に「うちが悪いのか、ベンダーが悪いのか」を
5分で言える かが分かれ目。 ベンダーの障害告知をアラートチャンネルへ自動転記。「世界中で壊 れている」と分かるだけで対応が変わる。 フォールバック経路を平時に試す タイムアウトとサーキットブレーカー セカンダリ STT/TTS、モデルのダウングレード。切替手順が未検証 のフォールバックは、存在しないのと同じ。 応答しないベンダーを待ち続けて、自分たちの全リクエストを道連れ にしない。
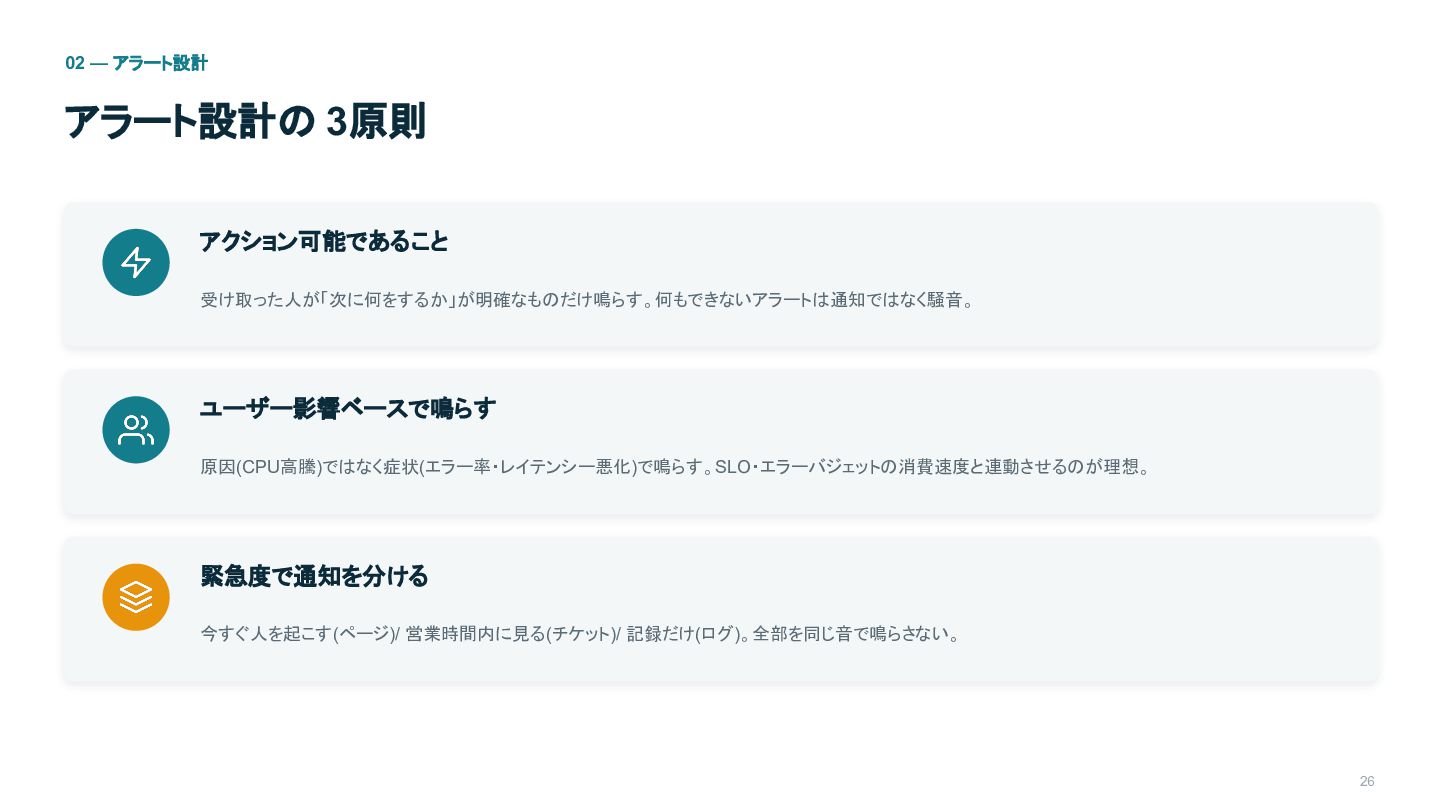
02 — アラート設計 アラート設計の 3原則 アクション可能であること 受け取った人が「次に何をするか」が明確なものだけ鳴らす。何もできないアラートは通知ではなく騒音。 ユーザー影響ベースで鳴らす 原因(CPU高騰)ではなく症状(エラー率・レイテンシー悪化)で鳴らす。SLO・エラーバジェットの消費速度と連動させるのが理想。 緊急度で通知を分ける
今すぐ人を起こす(ページ)/ 営業時間内に見る(チケット)/ 記録だけ(ログ)。全部を同じ音で鳴らさない。 26
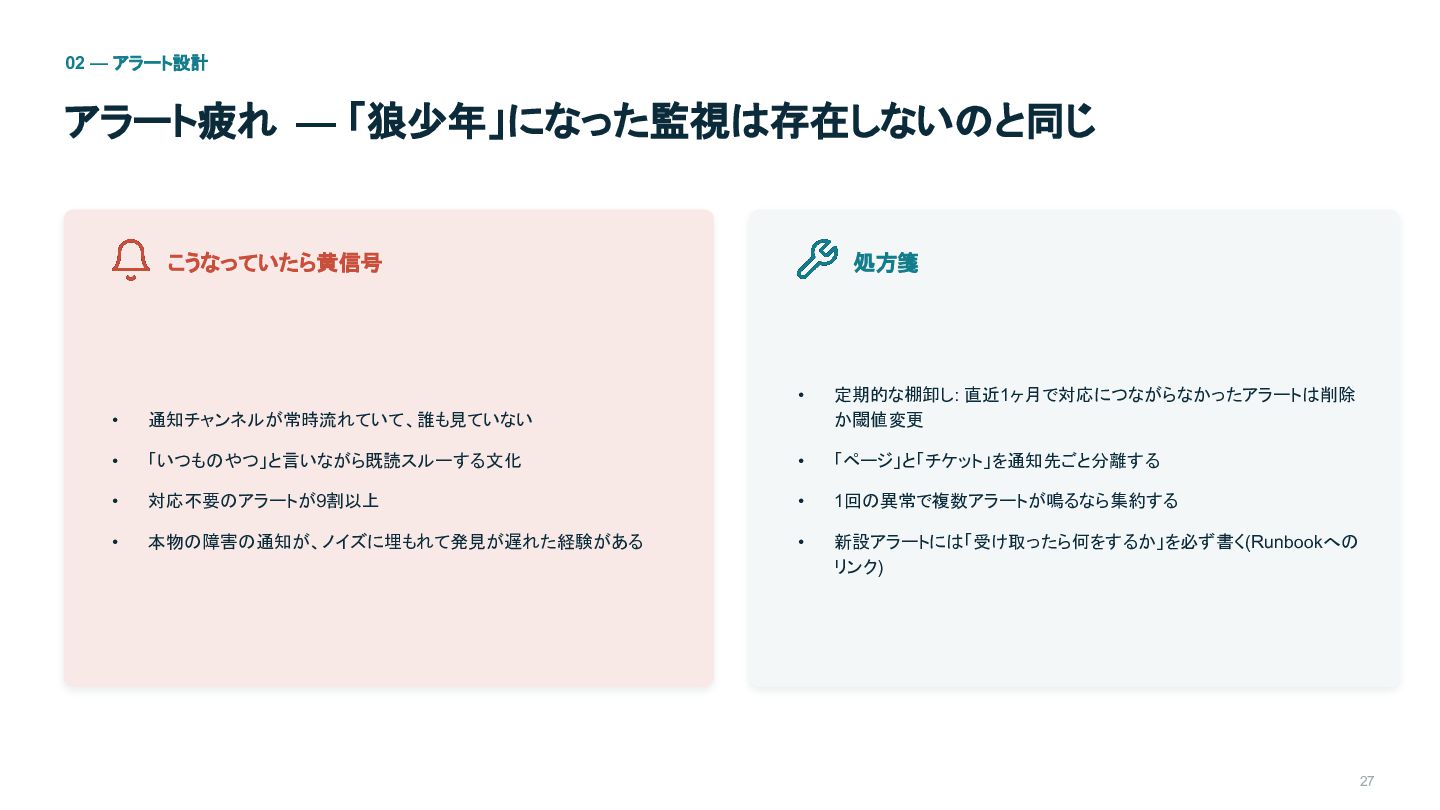
02 — アラート設計 アラート疲れ — 「狼少年」になった監視は存在しないのと同じ こうなっていたら黄信号 処方箋 • 定期的な棚卸し:
直近1ヶ月で対応につながらなかったアラートは削除 か閾値変更 「いつものやつ」と言いながら既読スルーする文化 • 「ページ」と「チケット」を通知先ごと分離する • 対応不要のアラートが9割以上 • 1回の異常で複数アラートが鳴るなら集約する • 本物の障害の通知が、ノイズに埋もれて発見が遅れた経験がある • 新設アラートには「受け取ったら何をするか」を必ず書く(Runbookへの リンク) • 通知チャンネルが常時流れていて、誰も見ていない • 27
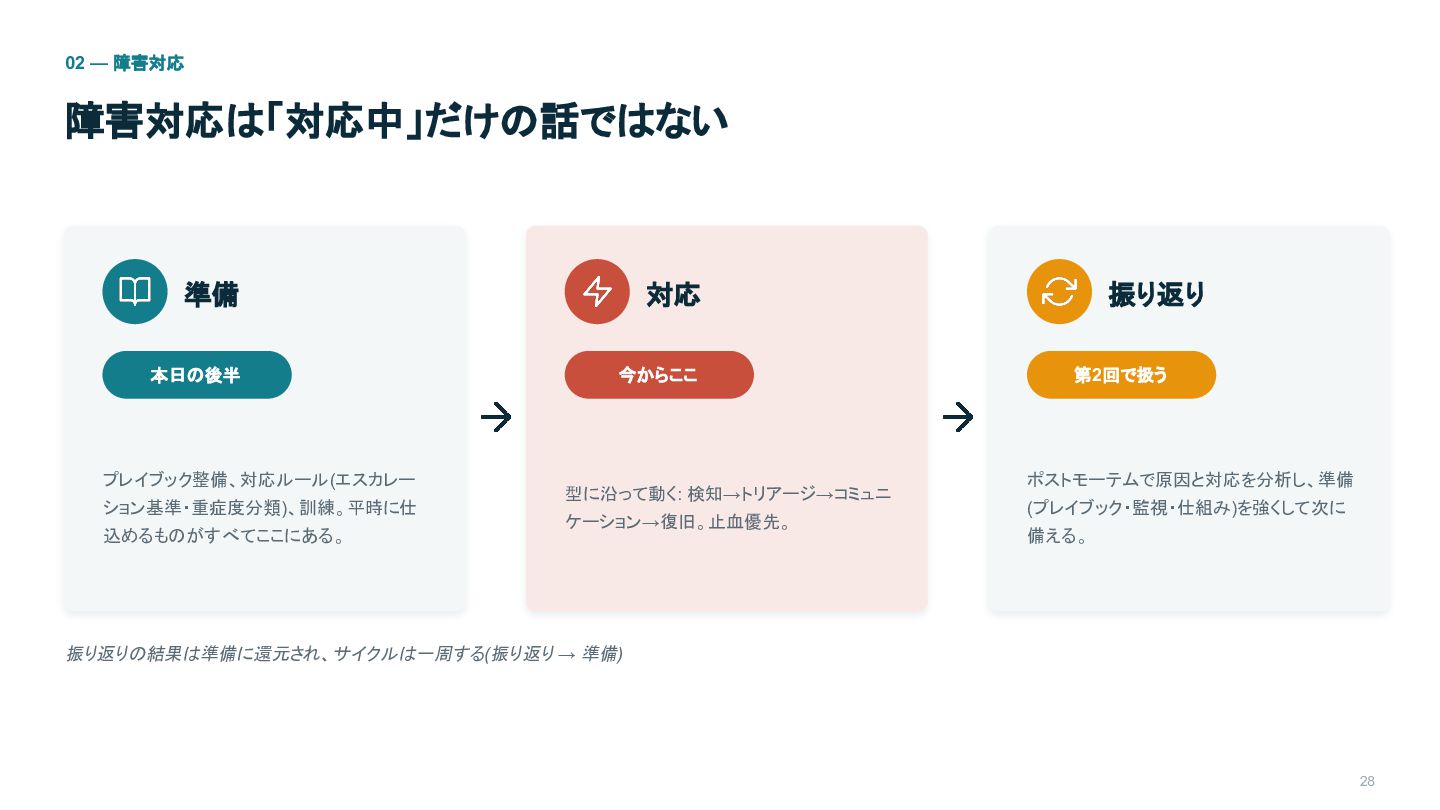
02 — 障害対応 障害対応は「対応中」だけの話ではない 準備 対応 本日の後半 今からここ プレイブック整備、対応ルール(エスカレー ション基準・重症度分類)、訓練。平時に仕
込めるものがすべてここにある。 型に沿って動く: 検知→トリアージ→コミュニ ケーション→復旧。止血優先。 振り返り 第2回で扱う ポストモーテムで原因と対応を分析し、準備 (プレイブック・監視・仕組み)を強くして次に 備える。 振り返りの結果は準備に還元され、サイクルは一周する(振り返り → 準備) 28
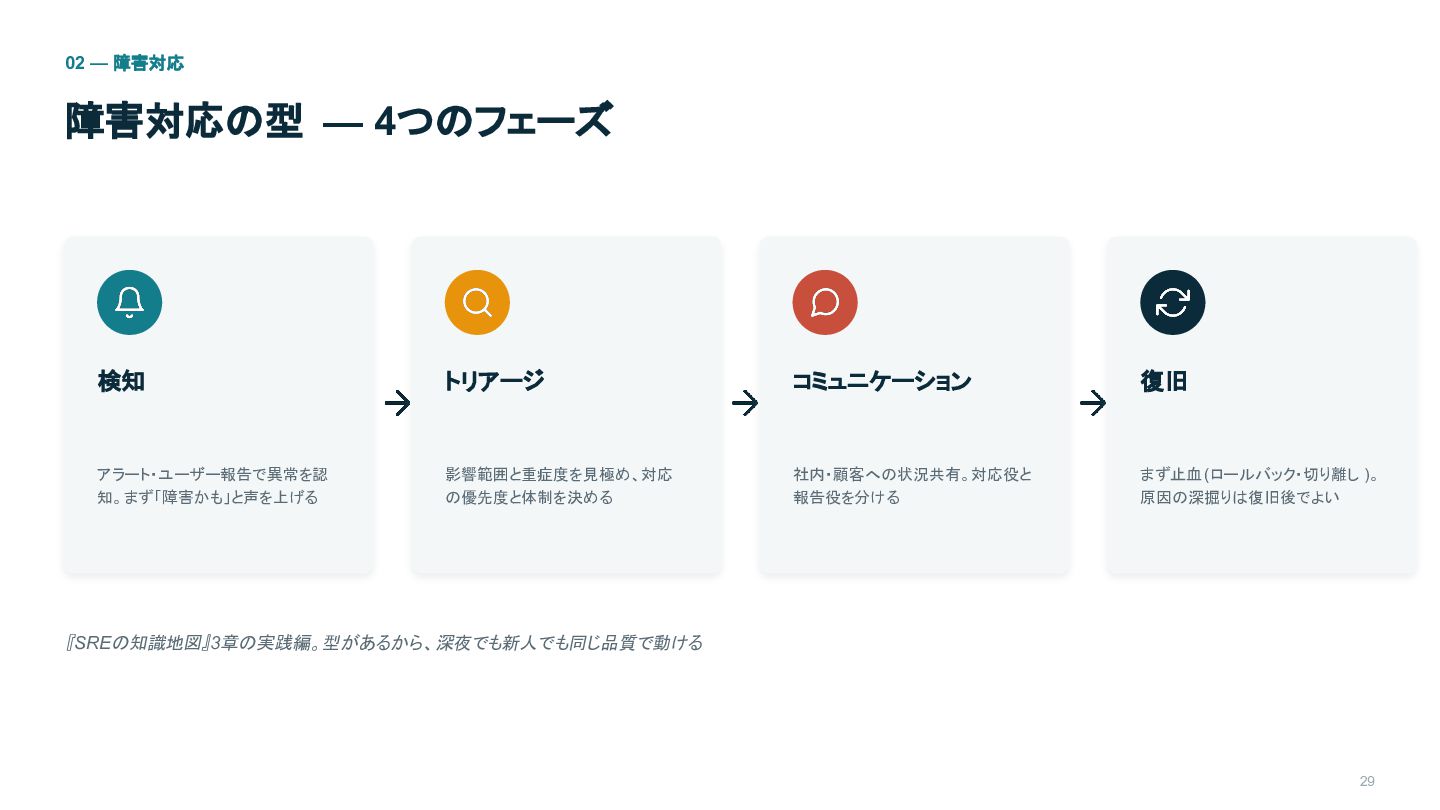
02 — 障害対応 障害対応の型 — 4つのフェーズ 検知 トリアージ コミュニケーション 復旧
アラート・ユーザー報告で異常を認 知。まず「障害かも」と声を上げる 影響範囲と重症度を見極め、対応 の優先度と体制を決める 社内・顧客への状況共有。対応役と 報告役を分ける まず止血 (ロールバック・切り離し )。 原因の深掘りは復旧後でよい 『SREの知識地図』3章の実践編。型があるから、深夜でも新人でも同じ品質で動ける 29
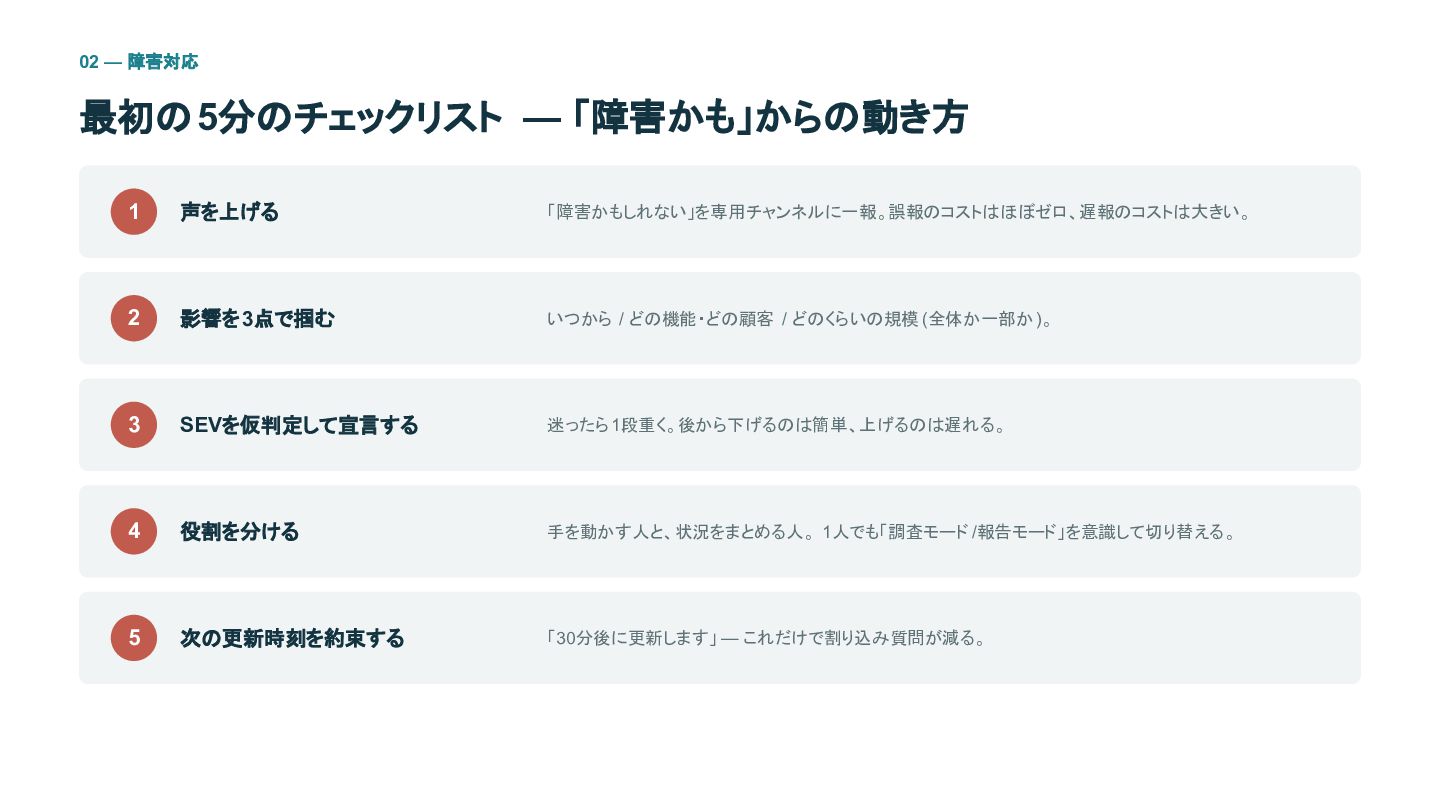
02 — 障害対応 最初の5分のチェックリスト — 「障害かも」からの動き方 1 声を上げる 「障害かもしれない」を専用チャンネルに一報。誤報のコストはほぼゼロ、遅報のコストは大きい。 2
影響を3点で掴む いつから / どの機能・どの顧客 / どのくらいの規模 (全体か一部か )。 3 SEVを仮判定して宣言する 迷ったら1段重く。後から下げるのは簡単、上げるのは遅れる。 4 役割を分ける 手を動かす人と、状況をまとめる人。 1人でも「調査モード /報告モード」を意識して切り替える。 5 次の更新時刻を約束する 「30分後に更新します」 — これだけで割り込み質問が減る。
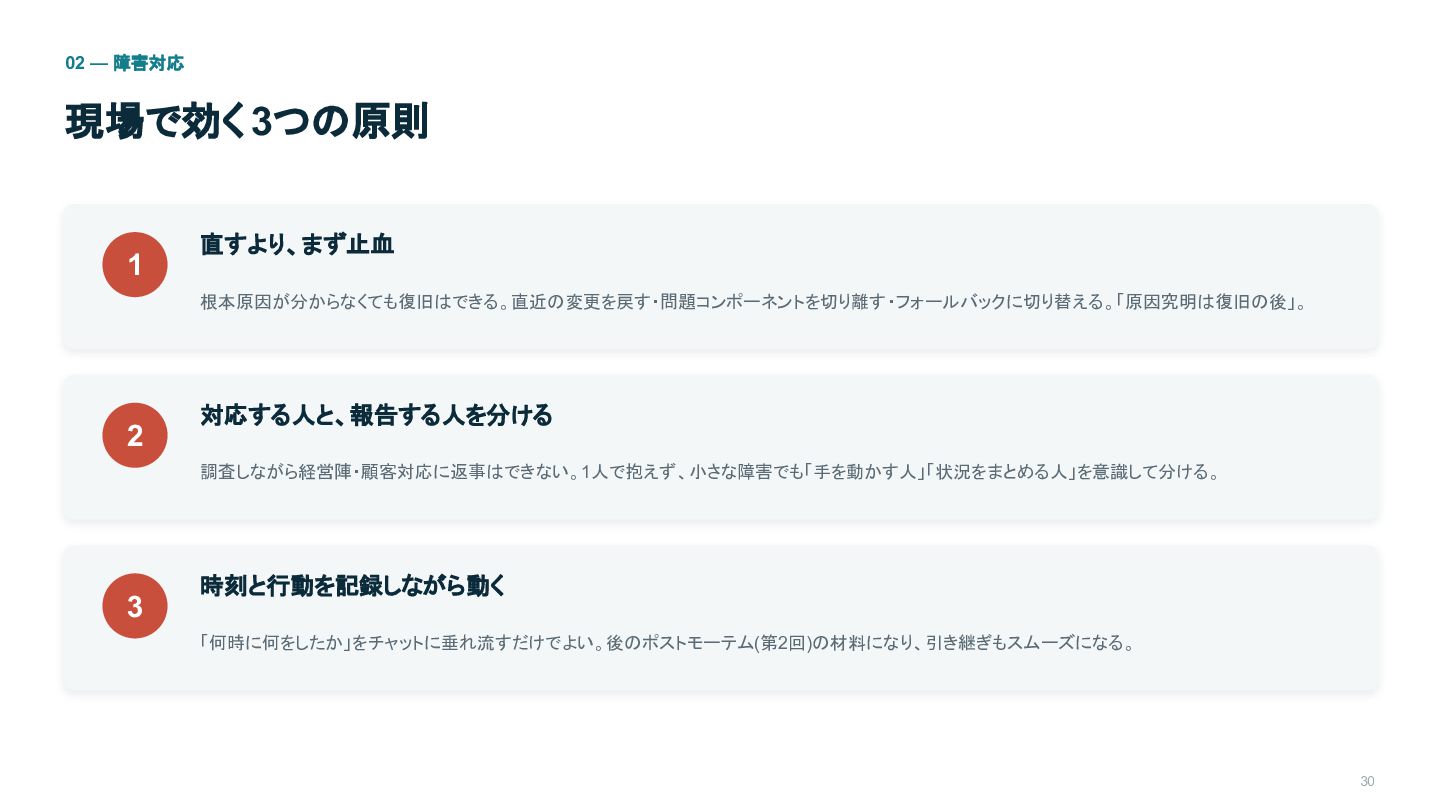
02 — 障害対応 現場で効く 3つの原則 1 直すより、まず止血 根本原因が分からなくても復旧はできる。直近の変更を戻す・問題コンポーネントを切り離す・フォールバックに切り替える。「原因究明は復旧の後」。 2 対応する人と、報告する人を分ける
調査しながら経営陣・顧客対応に返事はできない。1人で抱えず、小さな障害でも「手を動かす人」「状況をまとめる人」を意識して分ける。 3 時刻と行動を記録しながら動く 「何時に何をしたか」をチャットに垂れ流すだけでよい。後のポストモーテム(第2回)の材料になり、引き継ぎもスムーズになる。 30
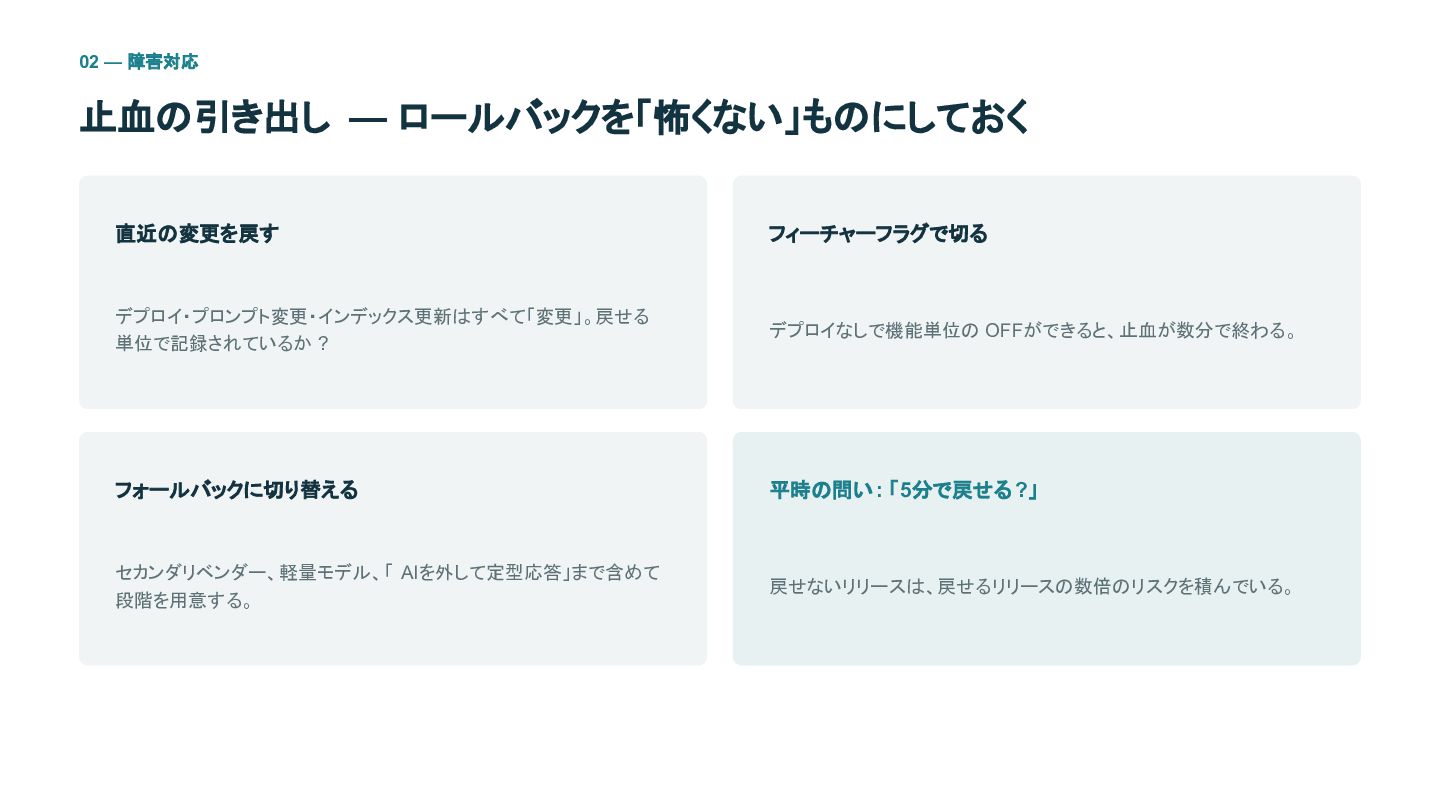
02 — 障害対応 止血の引き出し — ロールバックを「怖くない」ものにしておく 直近の変更を戻す フィーチャーフラグで切る デプロイ・プロンプト変更・インデックス更新はすべて「変更」。戻せる 単位で記録されているか
? デプロイなしで機能単位の OFFができると、止血が数分で終わる。 フォールバックに切り替える 平時の問い : 「5分で戻せる ?」 セカンダリベンダー、軽量モデル、「 AIを外して定型応答」まで含めて 段階を用意する。 戻せないリリースは、戻せるリリースの数倍のリスクを積んでいる。
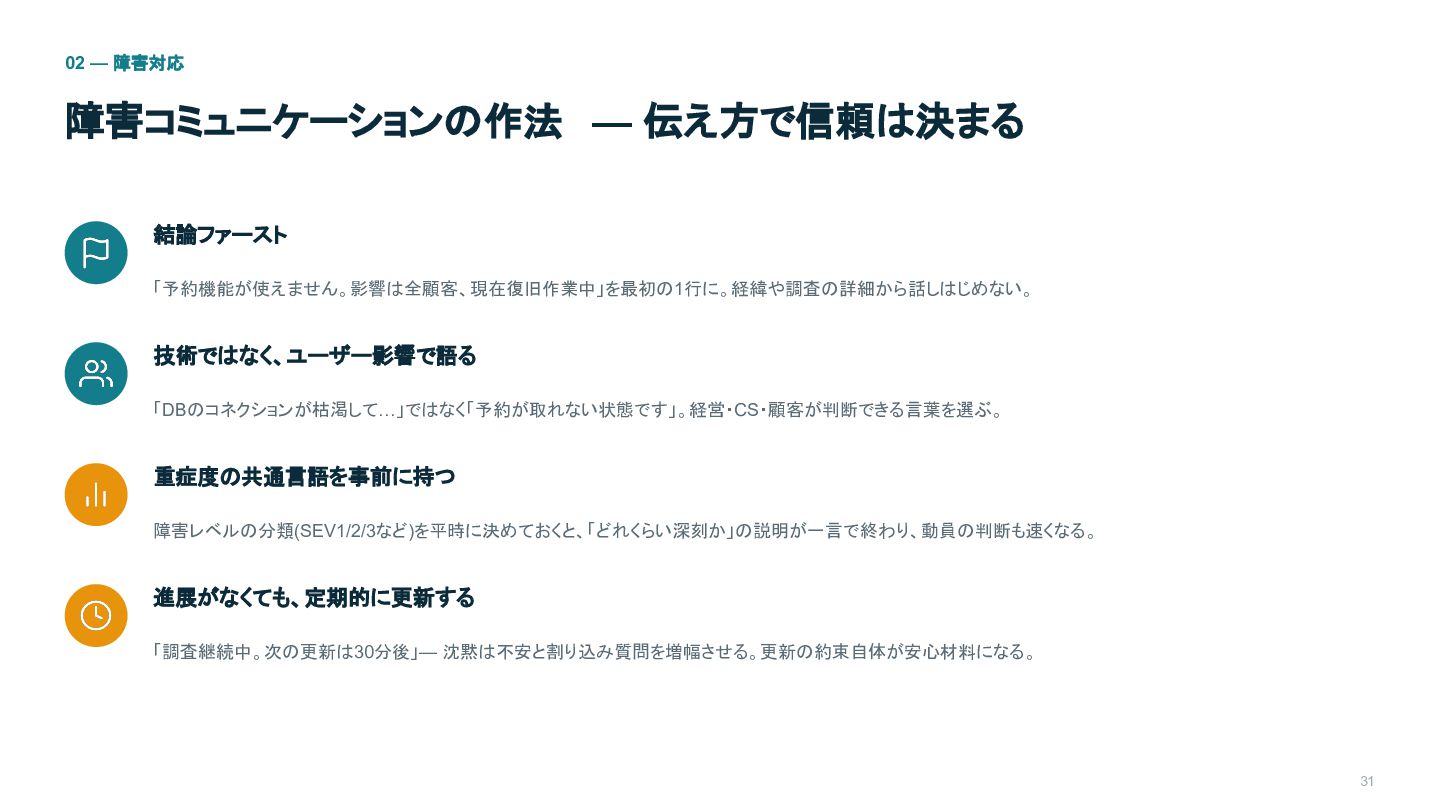
02 — 障害対応 障害コミュニケーションの作法 — 伝え方で信頼は決まる 結論ファースト 「予約機能が使えません。影響は全顧客、現在復旧作業中」を最初の1行に。経緯や調査の詳細から話しはじめない。 技術ではなく、ユーザー影響で語る 「DBのコネクションが枯渇して…」ではなく「予約が取れない状態です」。経営・CS・顧客が判断できる言葉を選ぶ。
重症度の共通言語を事前に持つ 障害レベルの分類(SEV1/2/3など)を平時に決めておくと、「どれくらい深刻か」の説明が一言で終わり、動員の判断も速くなる。 進展がなくても、定期的に更新する 「調査継続中。次の更新は30分後」— 沈黙は不安と割り込み質問を増幅させる。更新の約束自体が安心材料になる。 31
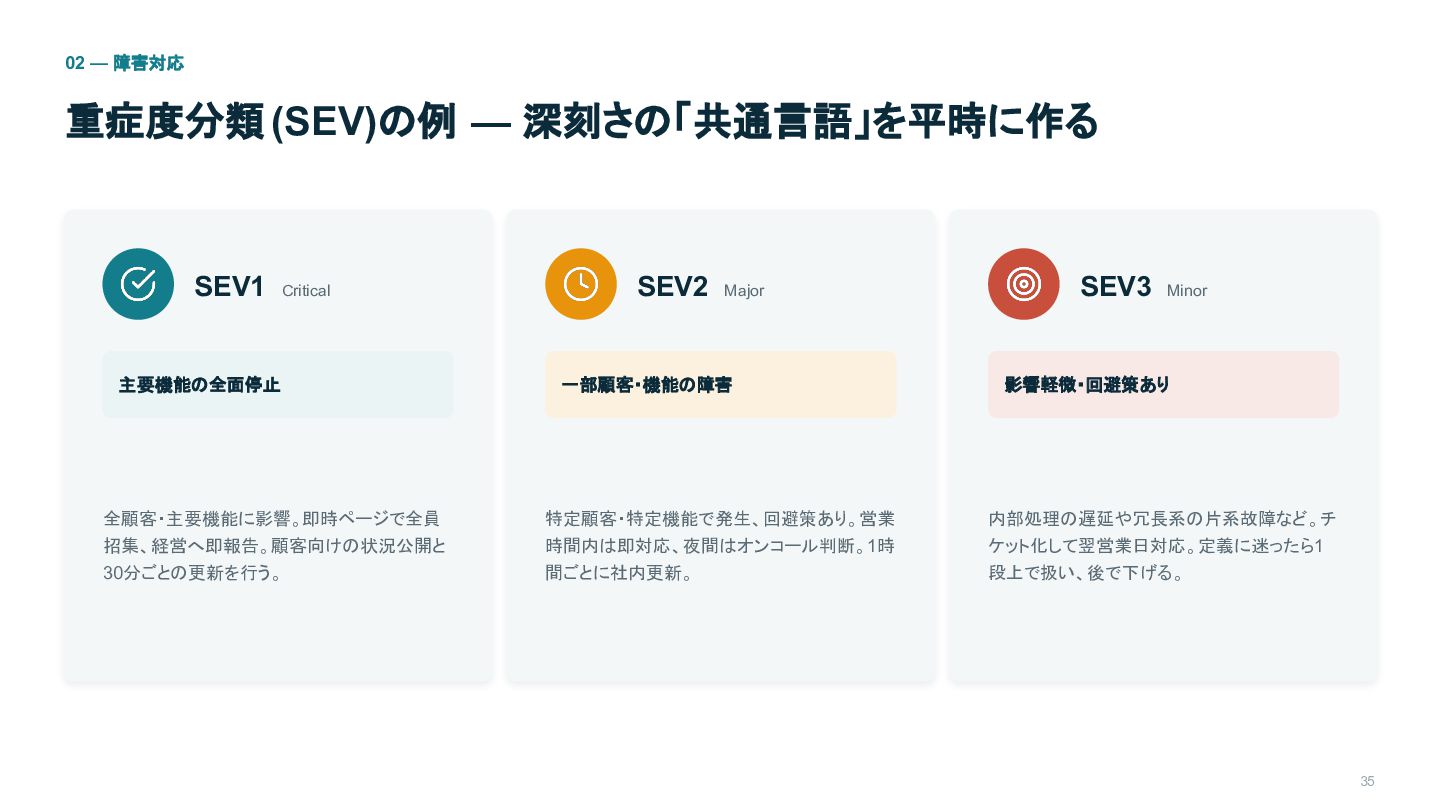
02 — 障害対応 重症度分類 (SEV)の例 — 深刻さの「共通言語」を平時に作る SEV1 Critical 主要機能の全面停止
全顧客・主要機能に影響。即時ページで全員 招集、経営へ即報告。顧客向けの状況公開と 30分ごとの更新を行う。 SEV2 Major 一部顧客・機能の障害 特定顧客・特定機能で発生、回避策あり。営業 時間内は即対応、夜間はオンコール判断。1時 間ごとに社内更新。 SEV3 Minor 影響軽微・回避策あり 内部処理の遅延や冗長系の片系故障など。チ ケット化して翌営業日対応。定義に迷ったら1 段上で扱い、後で下げる。 35
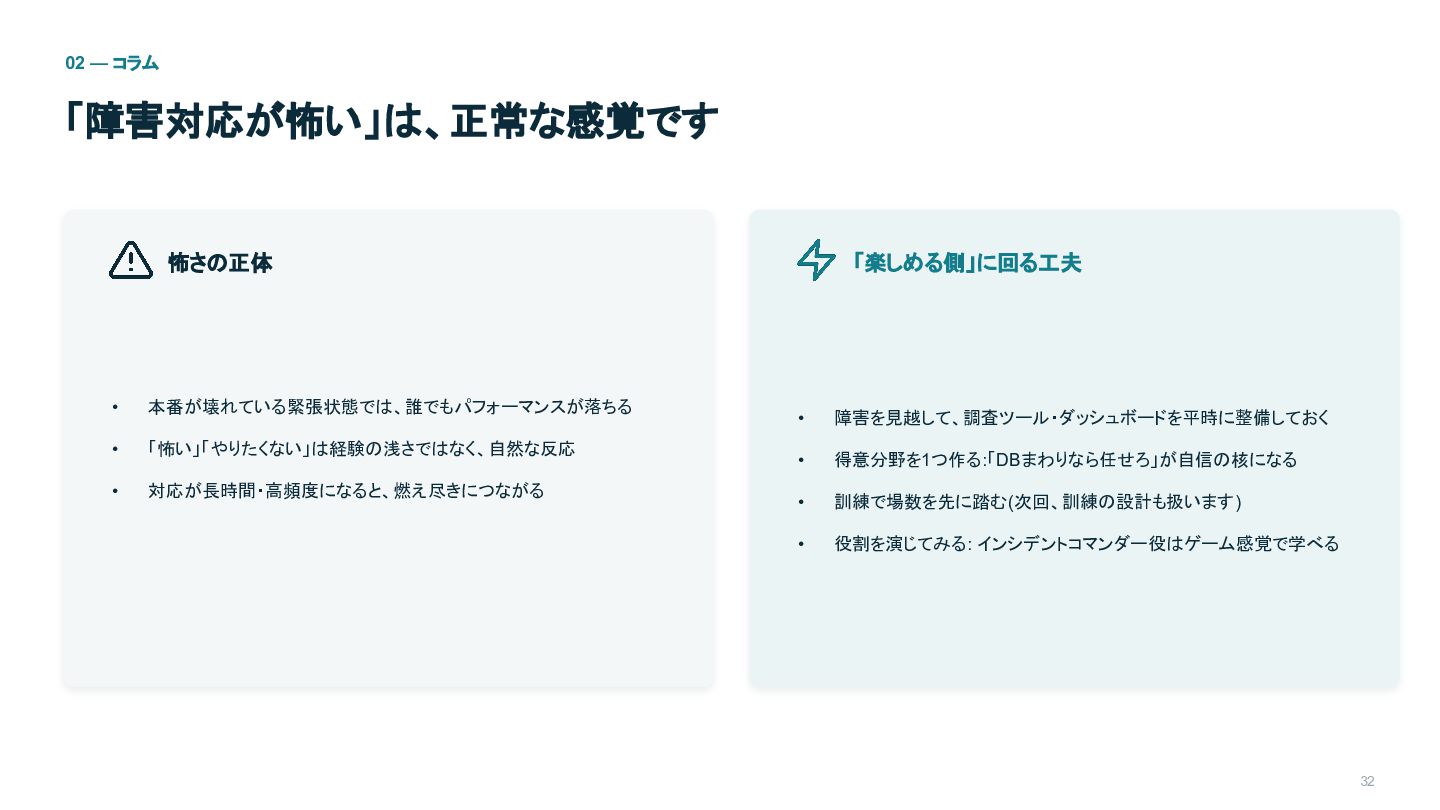
02 — コラム 「障害対応が怖い」は、正常な感覚です 怖さの正体 • 本番が壊れている緊張状態では、誰でもパフォーマンスが落ちる • 「怖い」「やりたくない」は経験の浅さではなく、自然な反応 •
対応が長時間・高頻度になると、燃え尽きにつながる 「楽しめる側」に回る工夫 • 障害を見越して、調査ツール・ダッシュボードを平時に整備しておく • 得意分野を1つ作る:「DBまわりなら任せろ」が自信の核になる • 訓練で場数を先に踏む(次回、訓練の設計も扱います) • 役割を演じてみる: インシデントコマンダー役はゲーム感覚で学べる 32
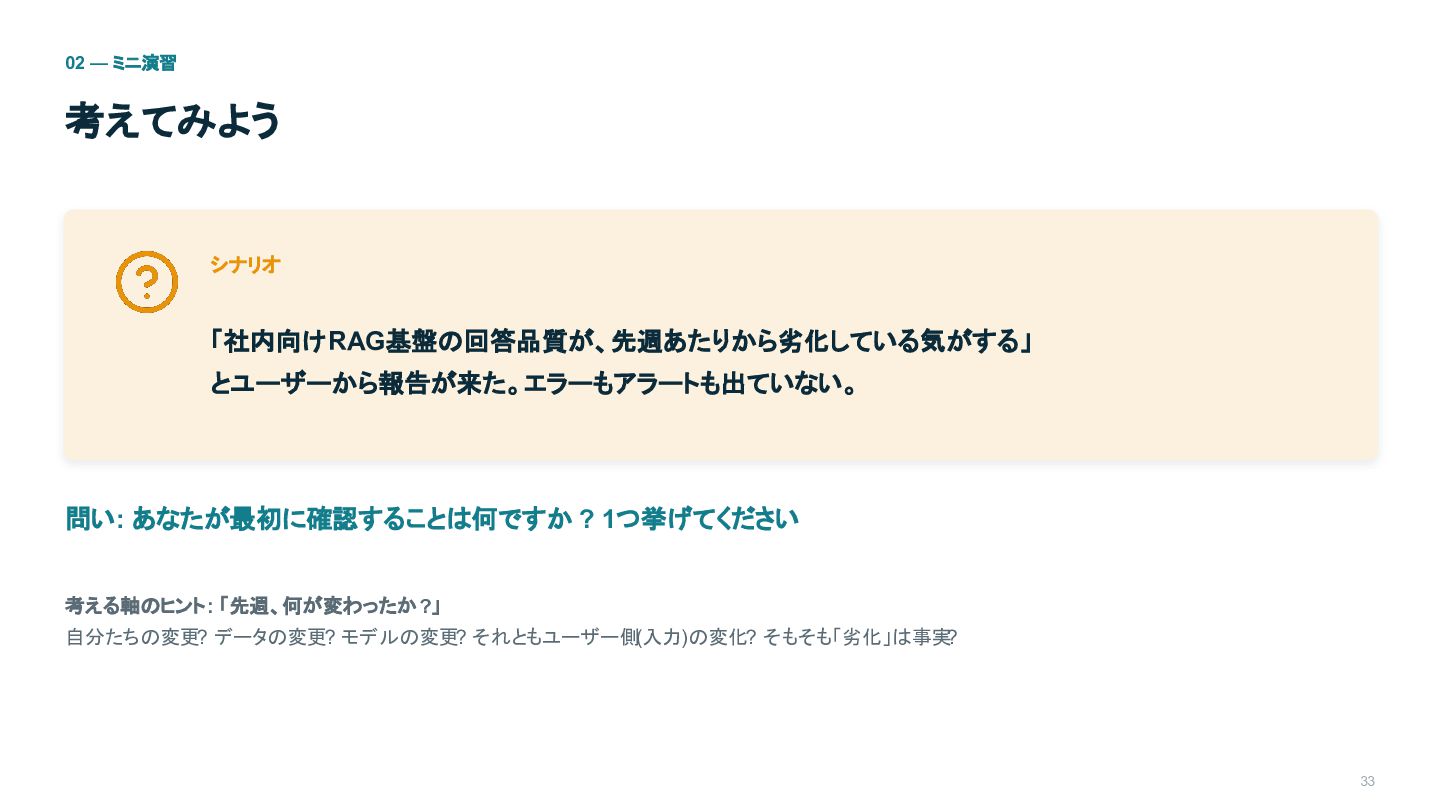
02 — ミニ演習 考えてみよう シナリオ 「社内向けRAG基盤の回答品質が、先週あたりから劣化している気がする」 とユーザーから報告が来た。エラーもアラートも出ていない。 問い: あなたが最初に確認することは何ですか ?
1つ挙げてください 考える軸のヒント: 「先週、何が変わったか?」 自分たちの変更? データの変更? モデルの変更? それともユーザー側(入力)の変化? そもそも「劣化」は事実? 33
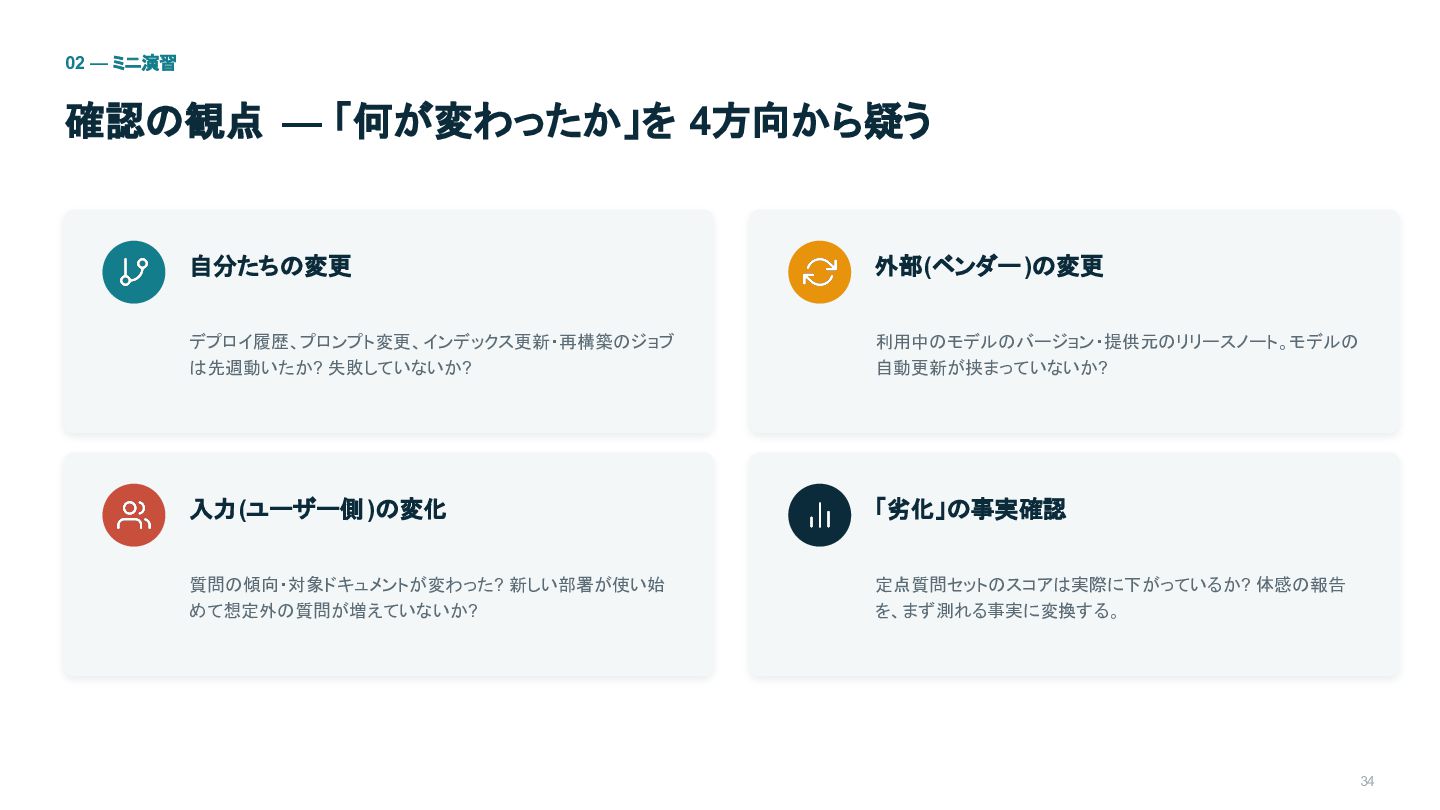
02 — ミニ演習 確認の観点 — 「何が変わったか」を 4方向から疑う 自分たちの変更 外部(ベンダー )の変更
デプロイ履歴、プロンプト変更、インデックス更新・再構築のジョブ は先週動いたか? 失敗していないか? 利用中のモデルのバージョン・提供元のリリースノート。モデルの 自動更新が挟まっていないか? 入力(ユーザー側 )の変化 「劣化」の事実確認 質問の傾向・対象ドキュメントが変わった? 新しい部署が使い始 めて想定外の質問が増えていないか? 定点質問セットのスコアは実際に下がっているか? 体感の報告 を、まず測れる事実に変換する。 34
02 — まとめ ポイント 1 メトリクスで気づき、トレースで絞り、ログで特定する 2 AIシステムは「静かに」壊れる 3 アラートは少なく鋭く、障害対応は型で動く
35


 ryuichi1208
 ks91
 sarafernandez
 rkendrick25
 frankvandijk
 joshbly
 caitiem20
 cassininazir
 jonoalderson
 soudai
 davidcarrasco
 vanstee
 427marketing