Upgrade to Pro
— share decks privately, control downloads, hide ads and more …
Speaker Deck
Sign up for free
Menu
Search
Features
All features
Private URLs
Password Protection
Custom URLS
Scheduled publishing
Remove Branding
Restrict embedding
Deck Collections
Notes
Features
All features
Private URLs
Password Protection
Custom URLS
Scheduled publishing
Remove Branding
Restrict embedding
Deck Collections
Notes
Explore
Featured decks
Featured speakers
Programming
Technology
Storyboards
Explore
Featured decks
Featured speakers
Programming
Technology
Storyboards
Pricing
Search
Sign in
Sign up for free
(CVPR2026) Back to Basics: Let Denoising Genera...
Search
Sponsored
·
Your Podcast. Everywhere. Effortlessly.
Share. Educate. Inspire. Entertain. You do you. We'll handle the rest.
→
Shumpei Takezaki
June 09, 2026
Science
350
0
Share
Embed
Copy iframe code
Copy JS code
Copy link
Start on current slide
(CVPR2026) Back to Basics: Let Denoising Generative Models Denoise
https://arxiv.org/abs/2511.13720
Shumpei Takezaki
June 09, 2026
More Decks by Shumpei Takezaki
See All by Shumpei Takezaki
(IJCNN2026) Cell Instance Segmentation via Multi-Task Image-to-Image Schrödinger Bridge
shumpei777
0
26
(IJCNN2026) SCoRe: Clean Image Generation from Diffusion Models Trained on Noisy Images
shumpei777
0
34
(Preprint) Diffusion Transformers with Representation Autoencoders
shumpei777
1
1.3k
(Blog post) Diffusion is spectral autoregression
shumpei777
3
1.4k
(Preprint) Diffusion Classifiers Understand Compositionality, but Conditions Apply
shumpei777
1
670
(ICLR2021) Score-Based Generative Modeling through Stochastic Differential Equations
shumpei777
1
720
(ICLR2023) Improving Deep Regression with Ordinal Entropy
shumpei777
0
64
(NeurIPS2024) Guiding a Diffusion Model with a Bad Version of Itself
shumpei777
0
59
(ICML2023) I2SB: Image-to-Image Schrödinger Bridge
shumpei777
0
81
Other Decks in Science
See All in Science
データベース03: 関係データモデル
trycycle
PRO
1
830
知能とはなにか -ヒトとAIのあいだ-
tagtag
PRO
0
190
Van Dare naar Durf
voginip
0
300
「遂行理論の未来」(松島斉教授最終講義記念セッションの発表資料)
shunyanoda
0
1k
因果推論と機械学習
sshimizu2006
1
1.5k
データベース02: データベースの概念
trycycle
PRO
2
1.4k
データベース06: SQL (3/3) 副問い合わせ
trycycle
PRO
1
1.1k
生成AIが科学とRAにもたらしていること:メタサイエンスの視点から
rmaruy
0
140
Controller Design for Symbolic Input-Output Systems Using Feedforward Neural Networks
konakalab
0
110
明治薬科大学講義_ビッグデータ解析を支えるデータベース技術とクラウドコンピューティング
ktatsuya
1
180
白金鉱業Meetup Vol.25 【初学者向け発表枠】「で、この施策って効いてるの」に答える効果検証の基礎 ~ATE / ATT / CATE / LATEを現場の問いに翻訳する~
brainpadpr
0
170
因果探索の発展と展望
sshimizu2006
2
1.1k
Featured
See All Featured
ラッコキーワード サービス紹介資料
rakko
1
4.9M
The Art of Delivering Value - GDevCon NA Keynote
reverentgeek
16
2.2k
HTML-Aware ERB: The Path to Reactive Rendering @ RubyCon 2026, Rimini, Italy
marcoroth
5
660
No one is an island. Learnings from fostering a developers community.
thoeni
21
3.8k
Learning to Love Humans: Emotional Interface Design
aarron
275
41k
Fantastic passwords and where to find them - at NoRuKo
philnash
52
3.8k
Building Better People: How to give real-time feedback that sticks.
wjessup
370
20k
The Director’s Chair: Orchestrating AI for Truly Effective Learning
tmiket
1
300
What’s in a name? Adding method to the madness
productmarketing
PRO
24
4.2k
AI in Enterprises - Java and Open Source to the Rescue
ivargrimstad
0
1.5k
技術選定の審美眼(2025年版) / Understanding the Spiral of Technologies 2025 edition
twada
PRO
120
120k
Agile Actions for Facilitating Distributed Teams - ADO2019
mkilby
0
280
Transcript
拡散モデルには画像を予測させよ 2026.06.09 Shumpei Takezaki
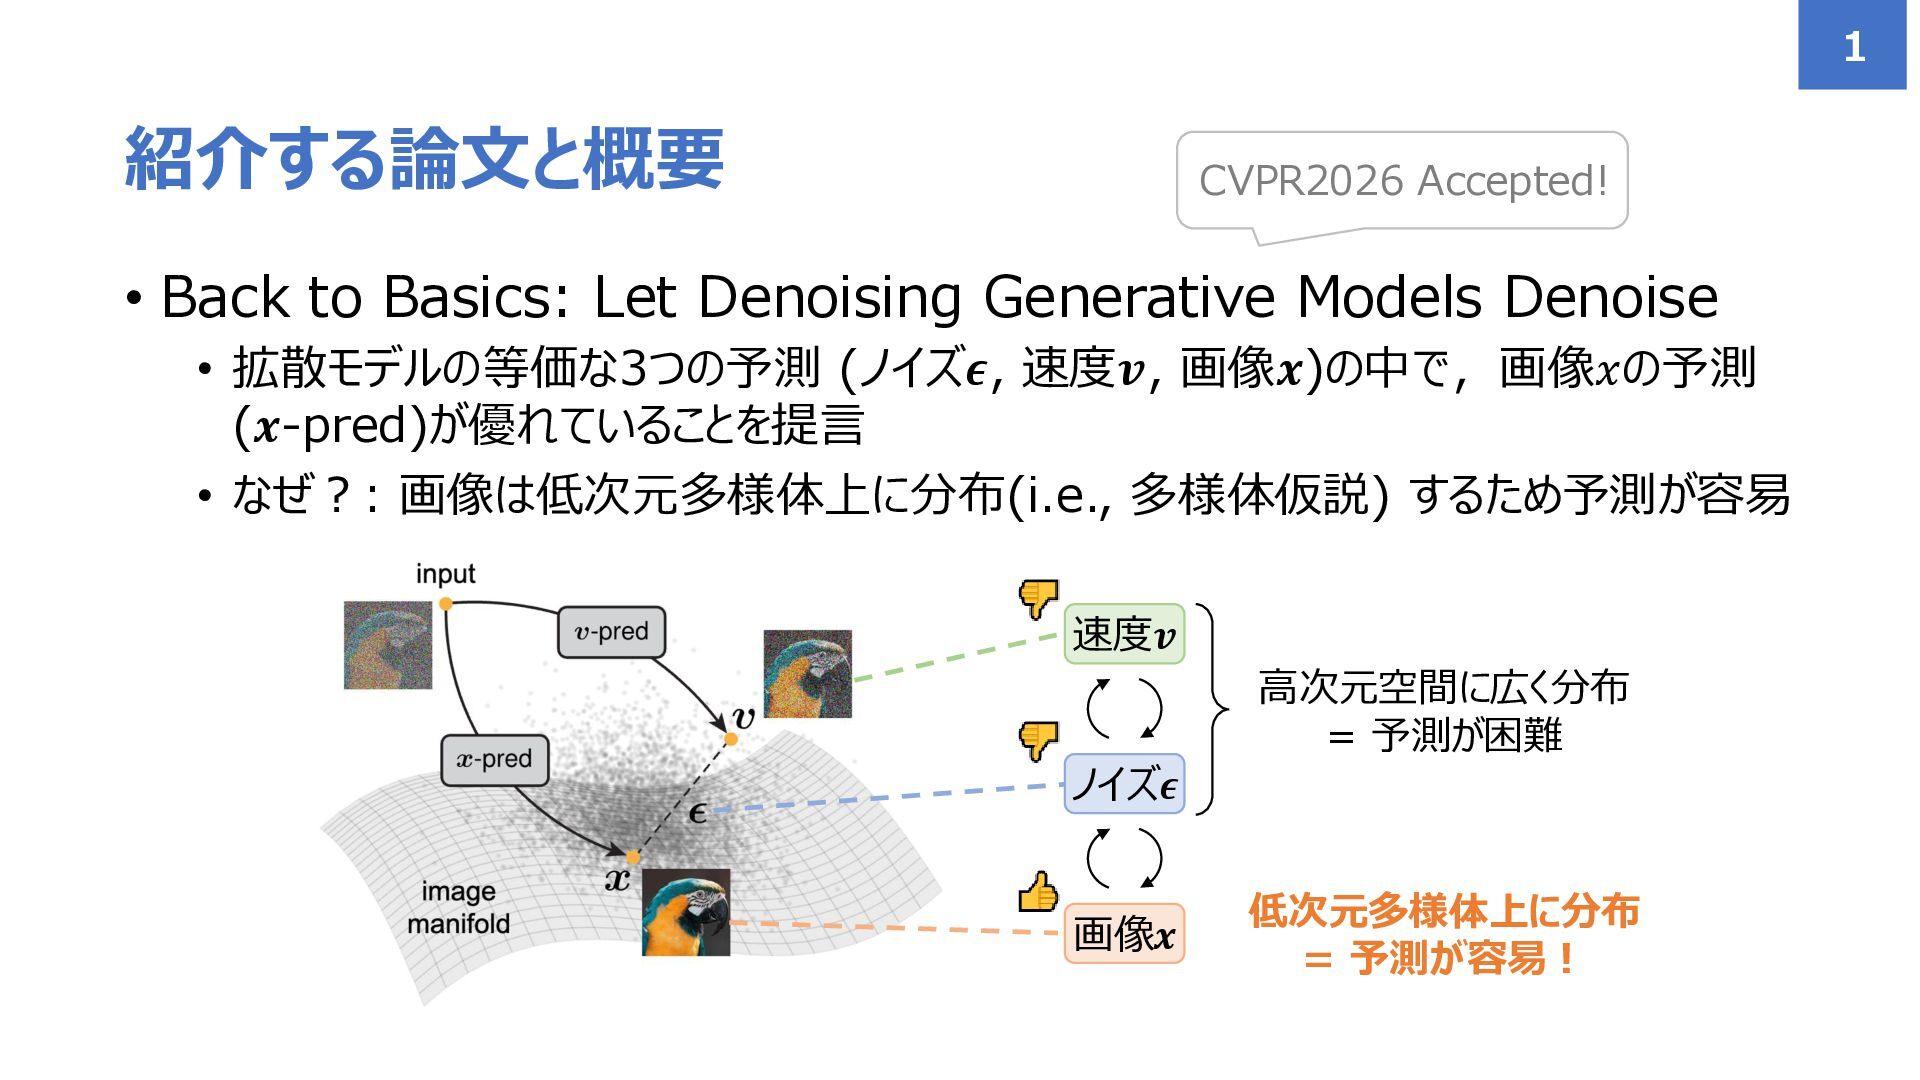
• Back to Basics: Let Denoising Generative Models Denoise •
拡散モデルの等価な3つの予測 (ノイズ𝝐, 速度𝒗, 画像𝒙)の中で,画像𝑥の予測 (𝒙-pred)が優れていることを提言 • なぜ?: 画像は低次元多様体上に分布(i.e., 多様体仮説) するため予測が容易 紹介する論文と概要 1 CVPR2026 Accepted! 画像𝒙 ノイズ𝝐 速度𝒗 高次元空間に広く分布 = 予測が困難 低次元多様体上に分布 = 予測が容易!
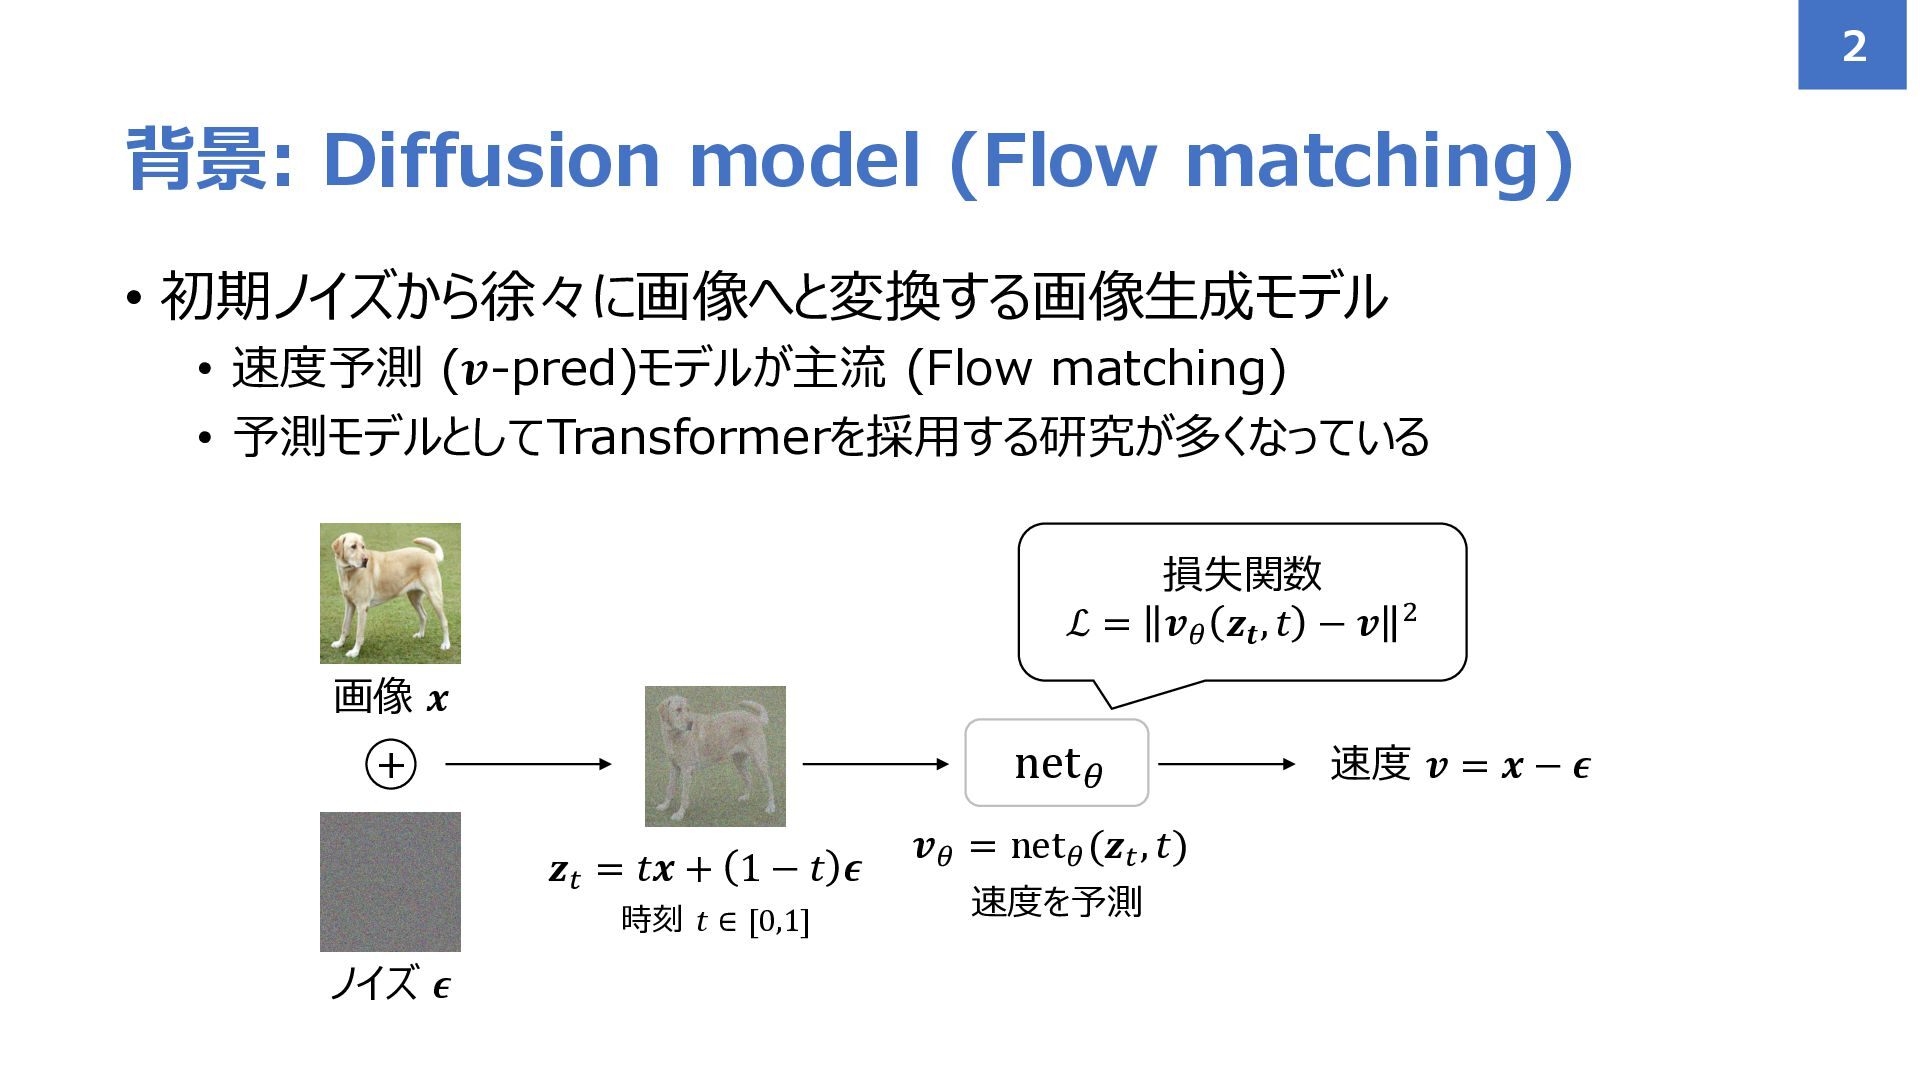
• 初期ノイズから徐々に画像へと変換する画像生成モデル • 速度予測 (𝒗-pred)モデルが主流 (Flow matching) • 予測モデルとしてTransformerを採用する研究が多くなっている 背景:
Diffusion model (Flow matching) 2 画像 𝒙 ノイズ 𝝐 net𝜃 𝒛𝑡 = 𝑡𝒙 + 1 − 𝑡 𝝐 時刻 𝑡 ∈ [0,1] + 速度 𝒗 = 𝒙 − 𝝐 損失関数 ℒ = 𝒗𝜃 𝒛𝒕 , 𝑡 − 𝒗 2 𝒗𝜃 = net𝜃 (𝒛𝑡 , 𝑡) 速度を予測
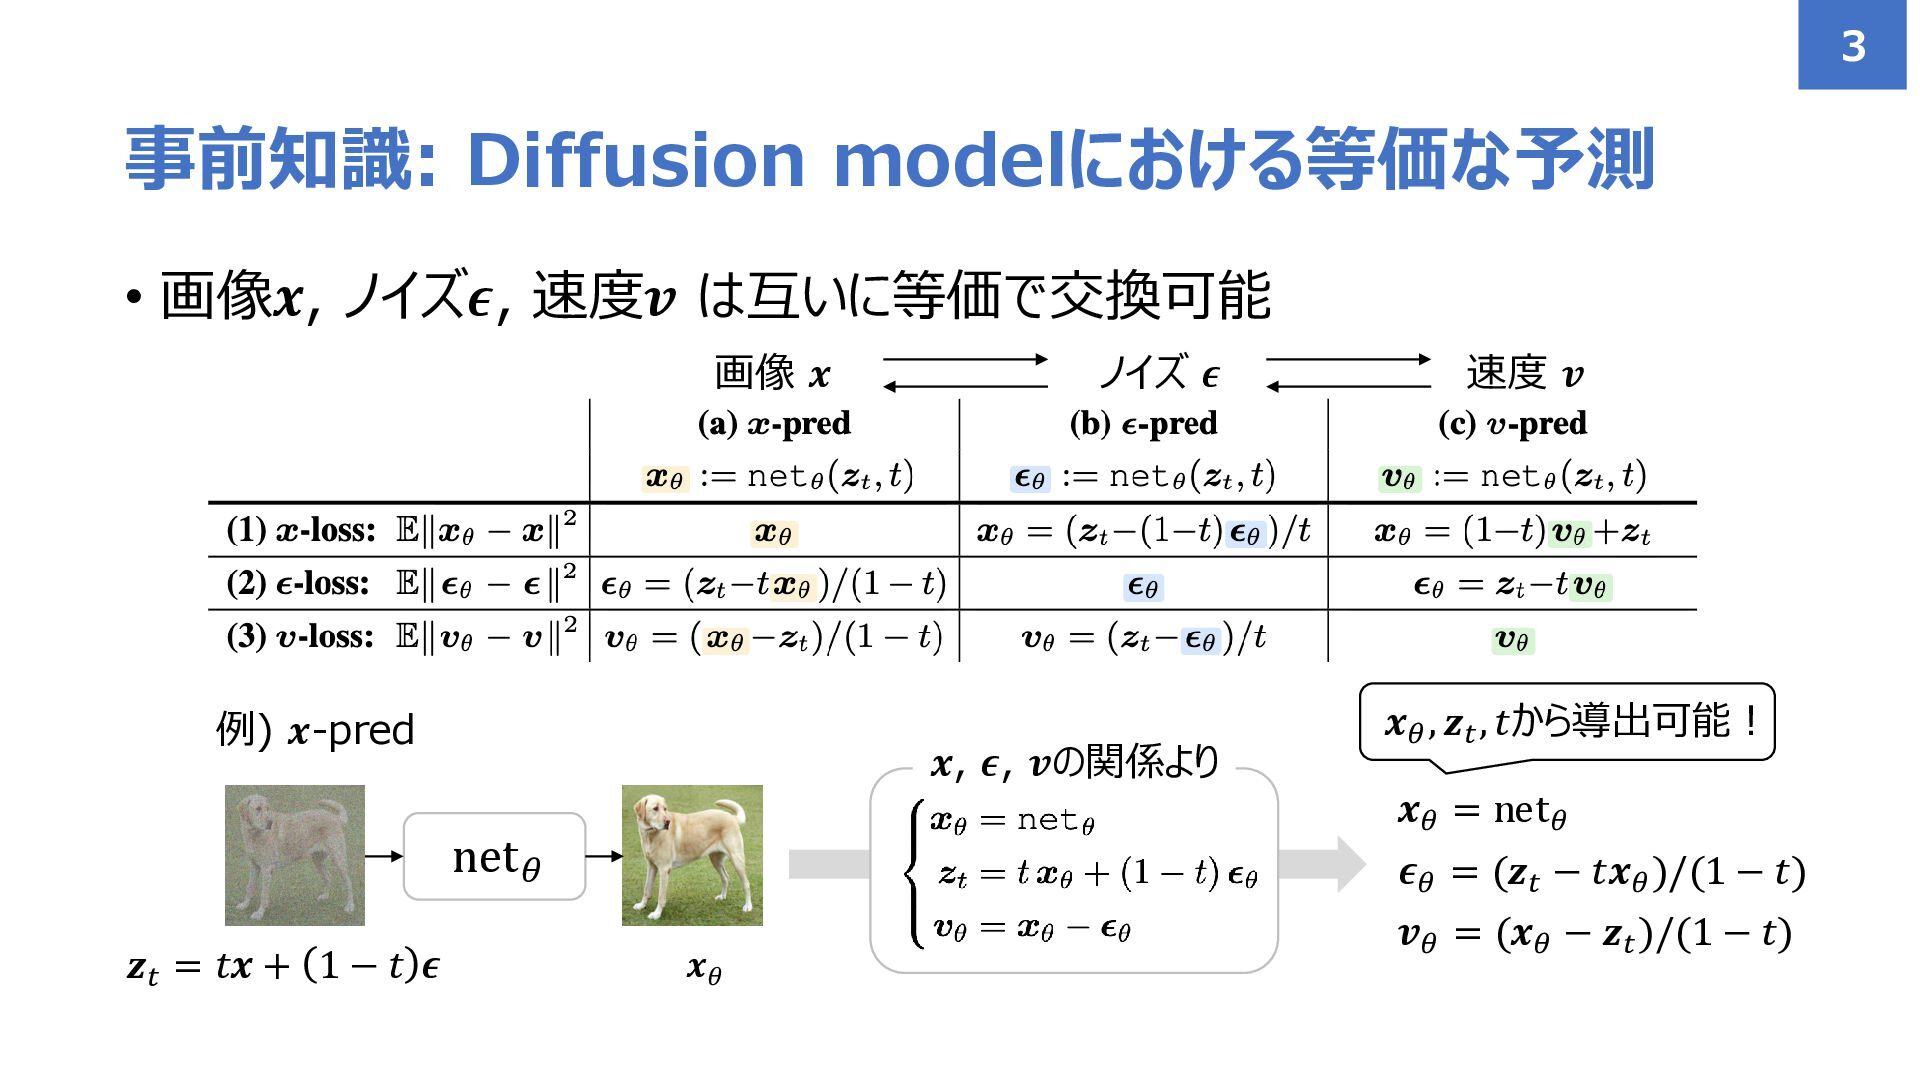
• 画像𝒙, ノイズ𝝐, 速度𝒗 は互いに等価で交換可能 事前知識: Diffusion modelにおける等価な予測 3 画像
𝒙 ノイズ 𝝐 速度 𝒗 net𝜃 例) 𝒙-pred 𝒛𝑡 = 𝑡𝒙 + 1 − 𝑡 𝝐 𝒙𝜃 𝒙𝜃 = net𝜃 𝝐𝜃 = (𝒛𝑡 − 𝑡𝒙𝜃 )/(1 − 𝑡) 𝒗𝜃 = (𝒙𝜃 − 𝒛𝑡 )/(1 − 𝑡) 𝒙, 𝝐, 𝒗の関係より 𝒙𝜃 , 𝒛𝑡 , 𝑡から導出可能!
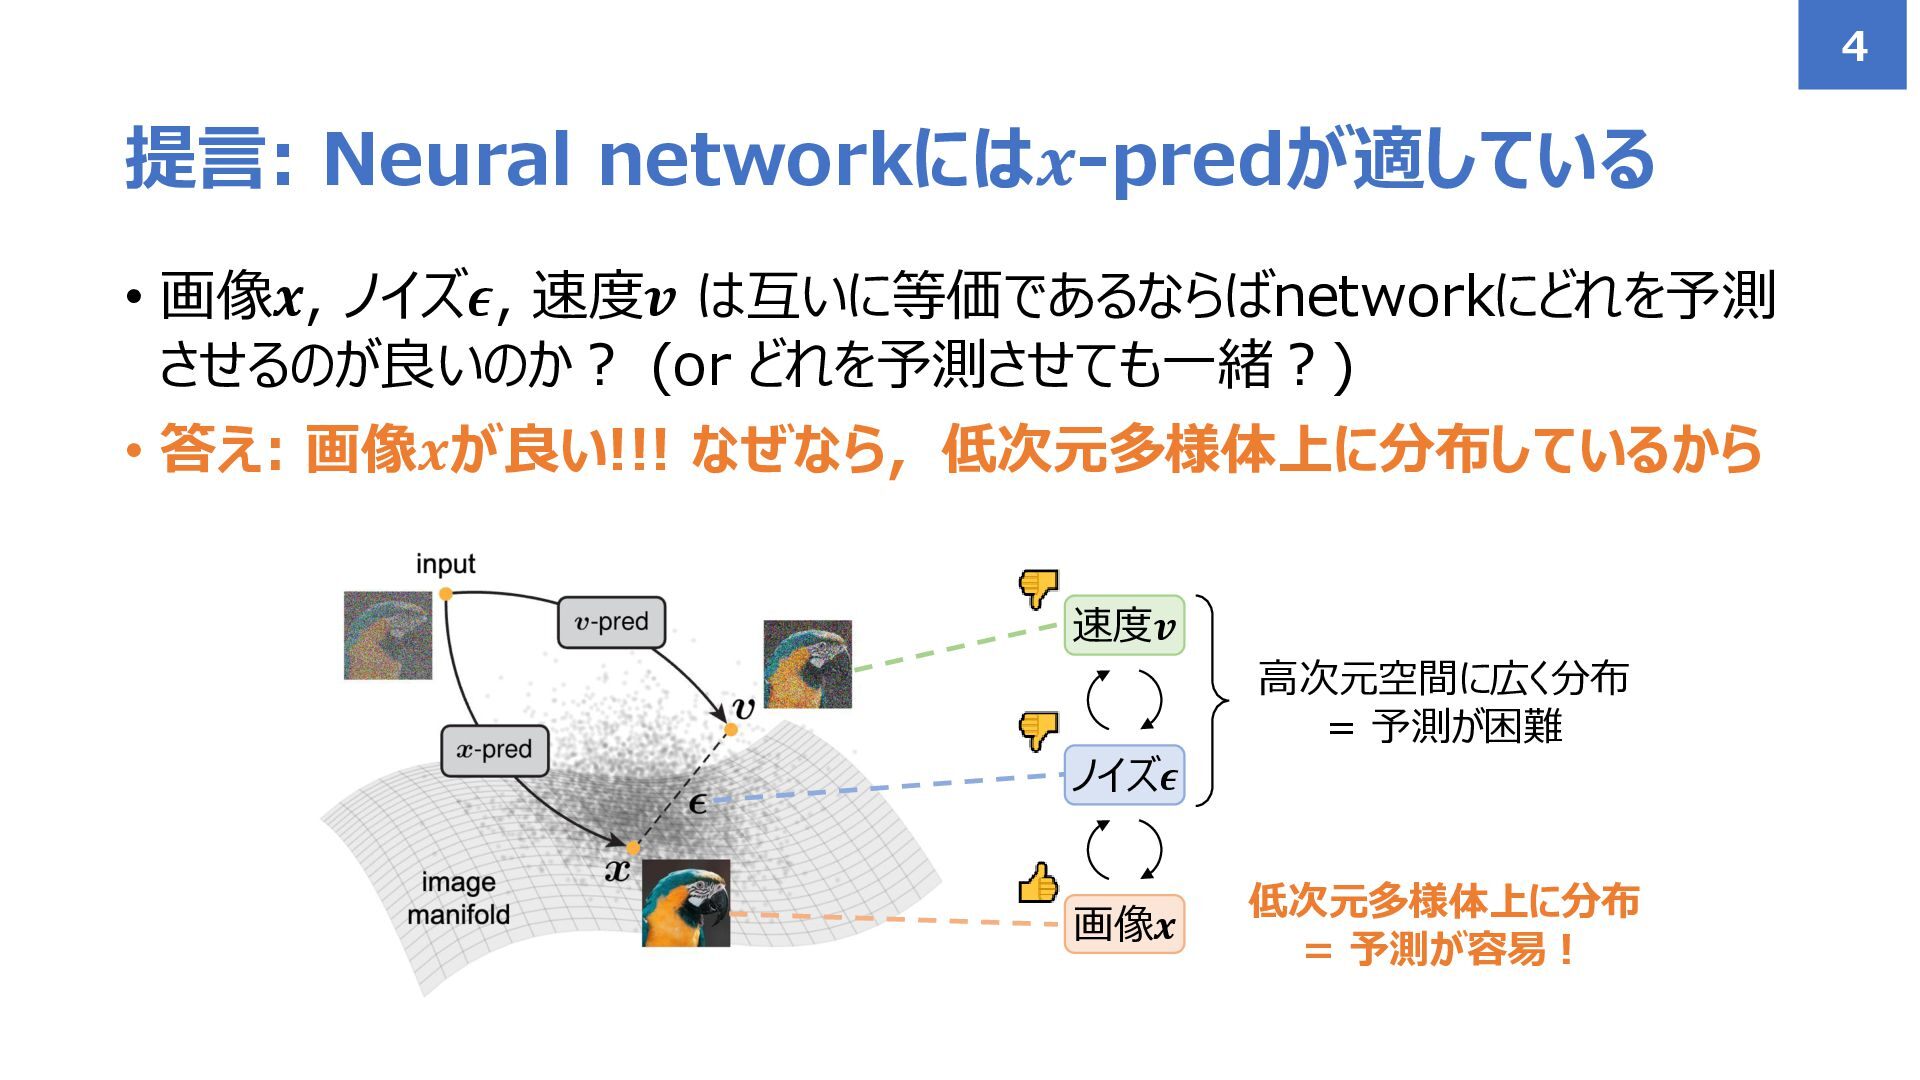
• 画像𝒙, ノイズ𝝐, 速度𝒗 は互いに等価であるならばnetworkにどれを予測 させるのが良いのか? (or どれを予測させても一緒?) • 答え:
画像𝒙が良い!!! なぜなら,低次元多様体上に分布しているから 提言: Neural networkには𝒙-predが適している 4 画像𝒙 ノイズ𝝐 速度𝒗 高次元空間に広く分布 = 予測が困難 低次元多様体上に分布 = 予測が容易!
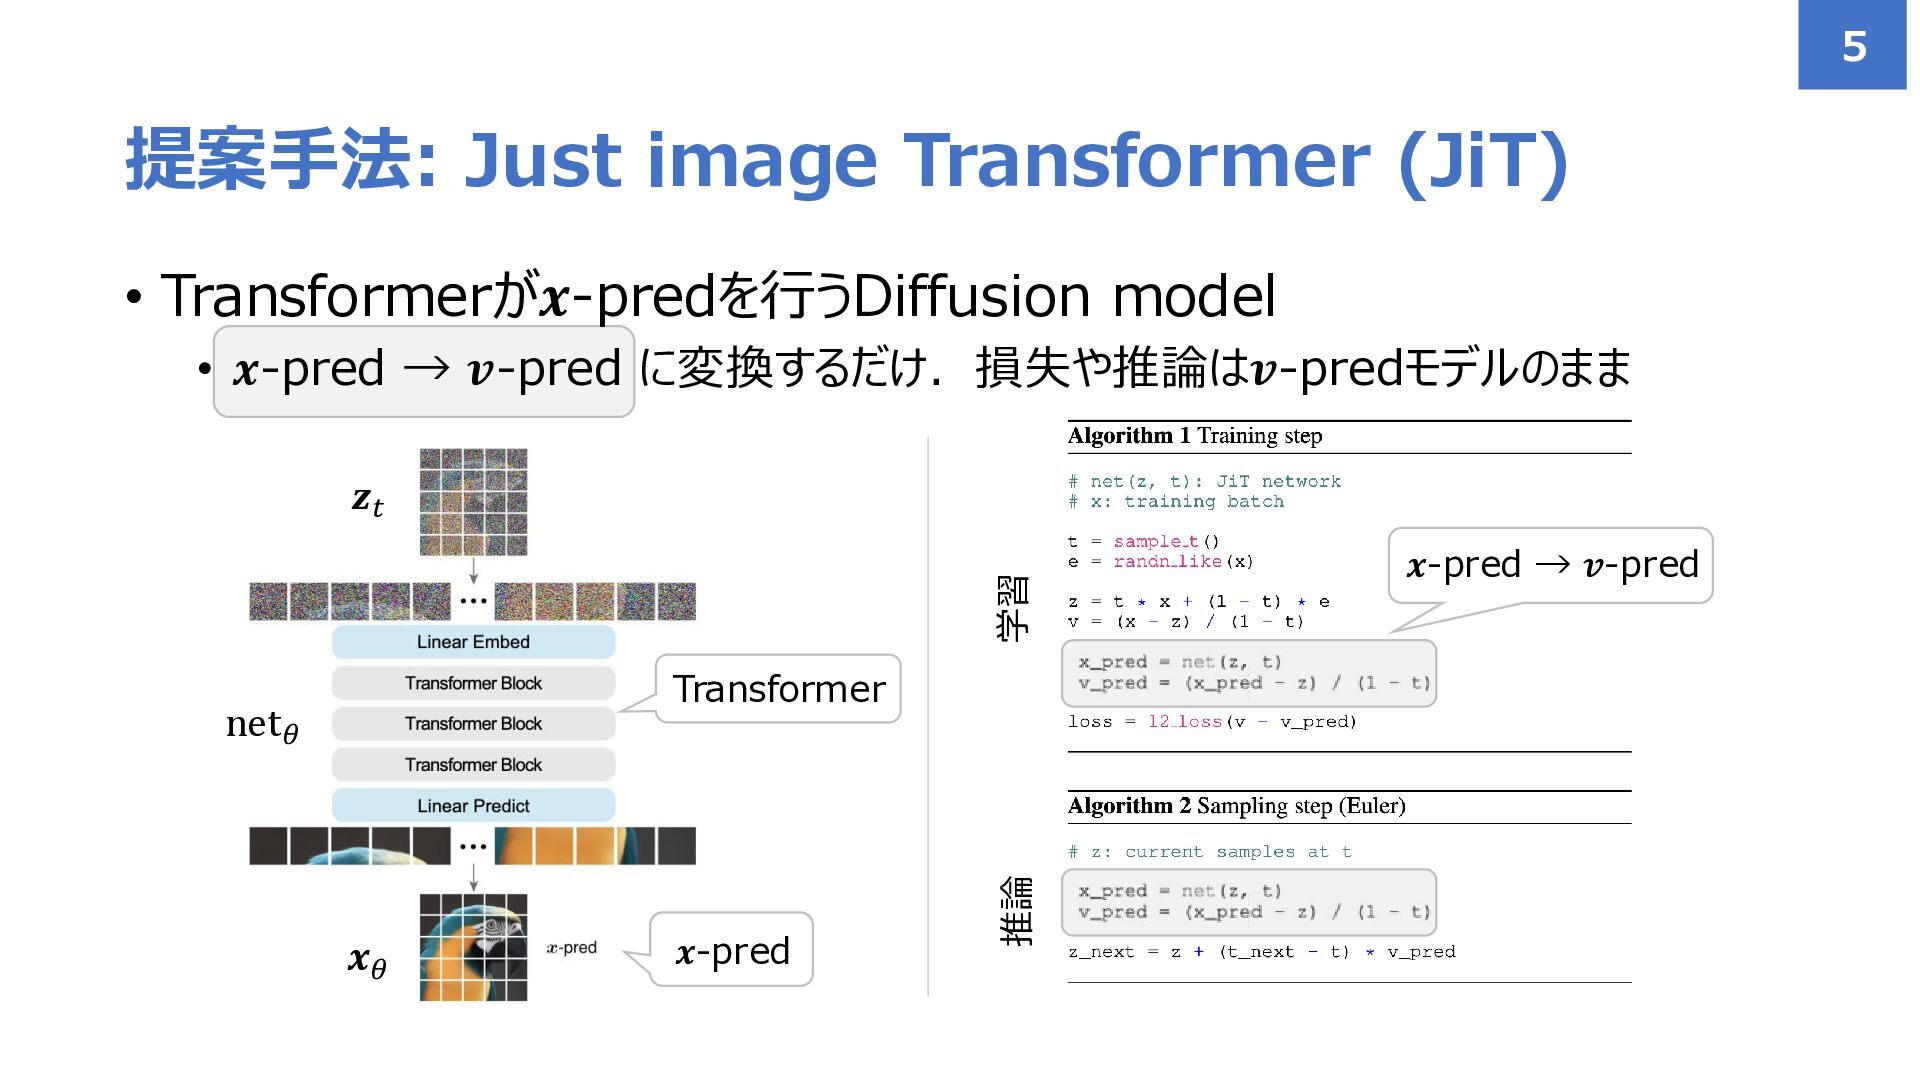
• Transformerが𝒙-predを行うDiffusion model • 𝒙-pred → 𝒗-pred に変換するだけ.損失や推論は𝒗-predモデルのまま 提案手法: Just
image Transformer (JiT) 5 𝒛𝑡 𝒙𝜃 net𝜃 𝒙-pred Transformer 𝒙-pred → 𝒗-pred 学習 推論
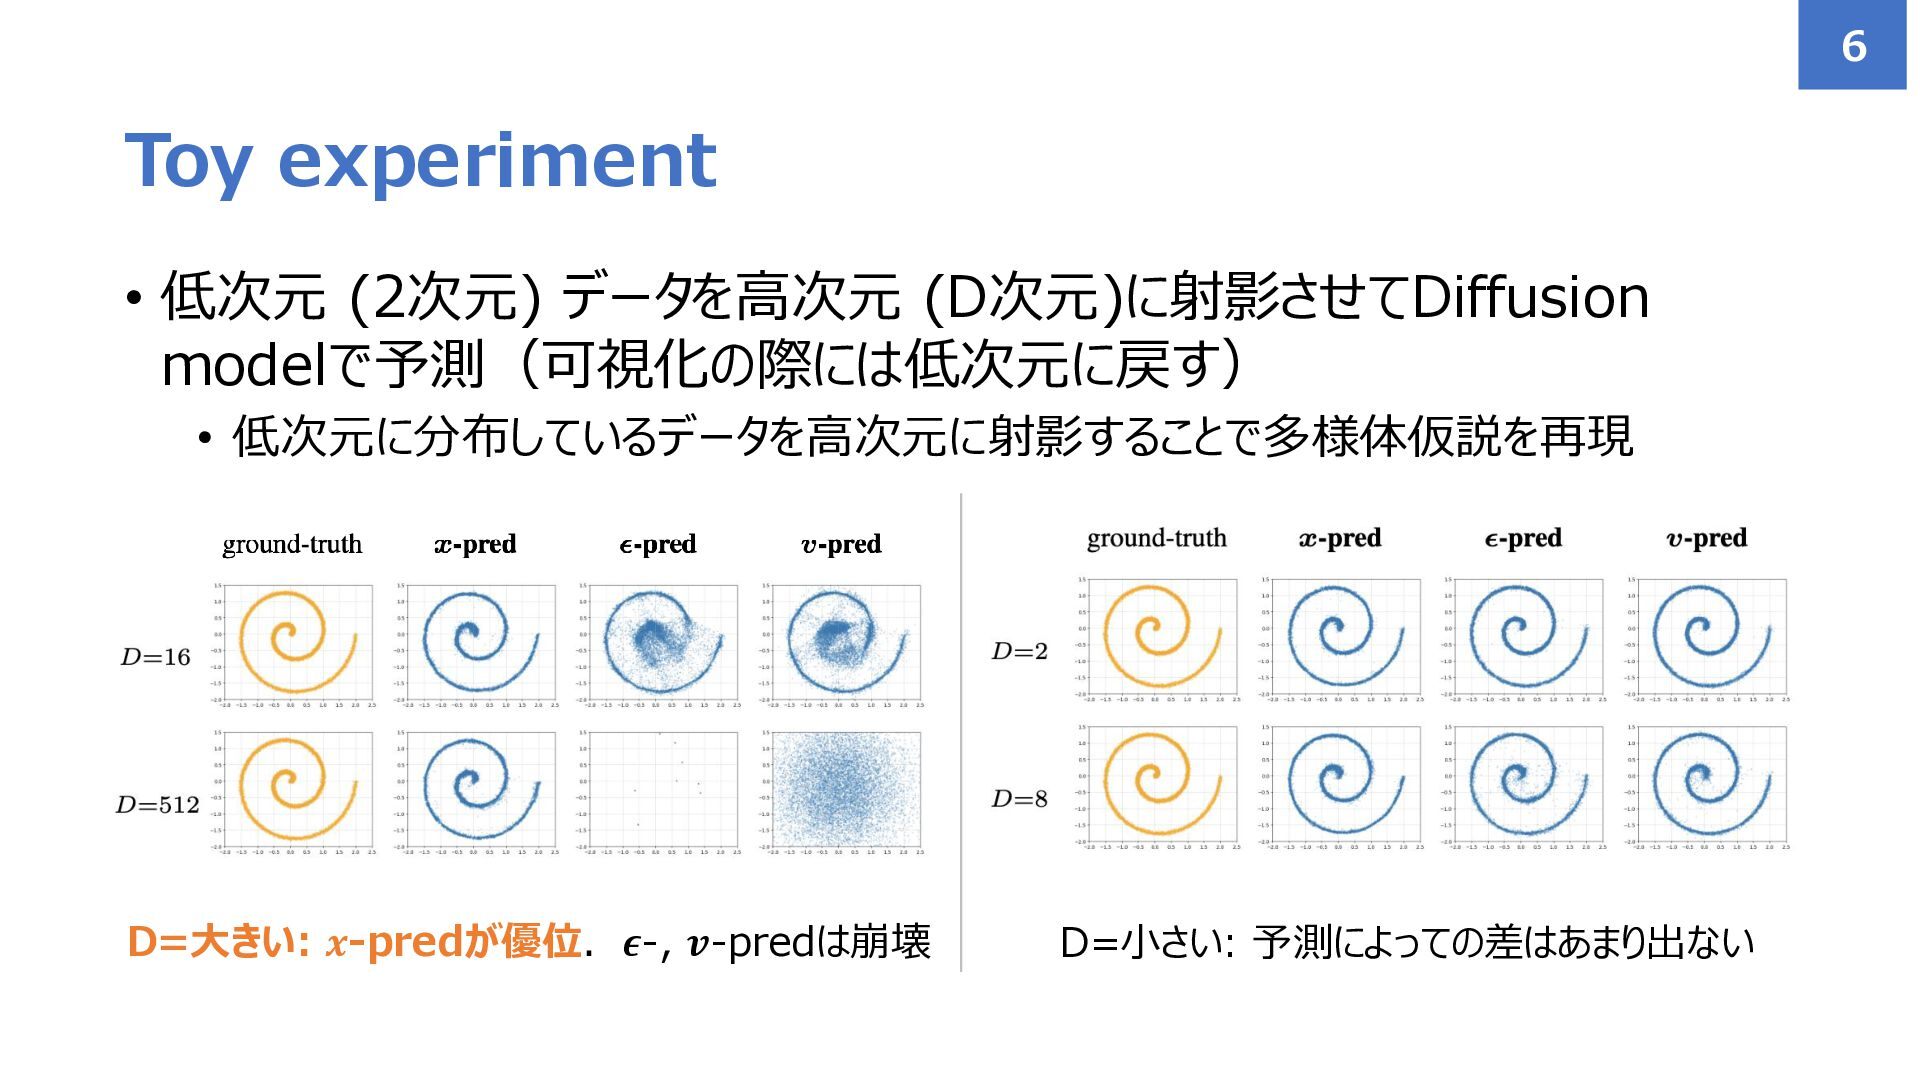
• 低次元 (2次元) データを高次元 (D次元)に射影させてDiffusion modelで予測(可視化の際には低次元に戻す) • 低次元に分布しているデータを高次元に射影することで多様体仮説を再現 Toy experiment
6 D=小さい: 予測によっての差はあまり出ない D=大きい: 𝒙-predが優位.𝝐-, 𝒗-predは崩壊
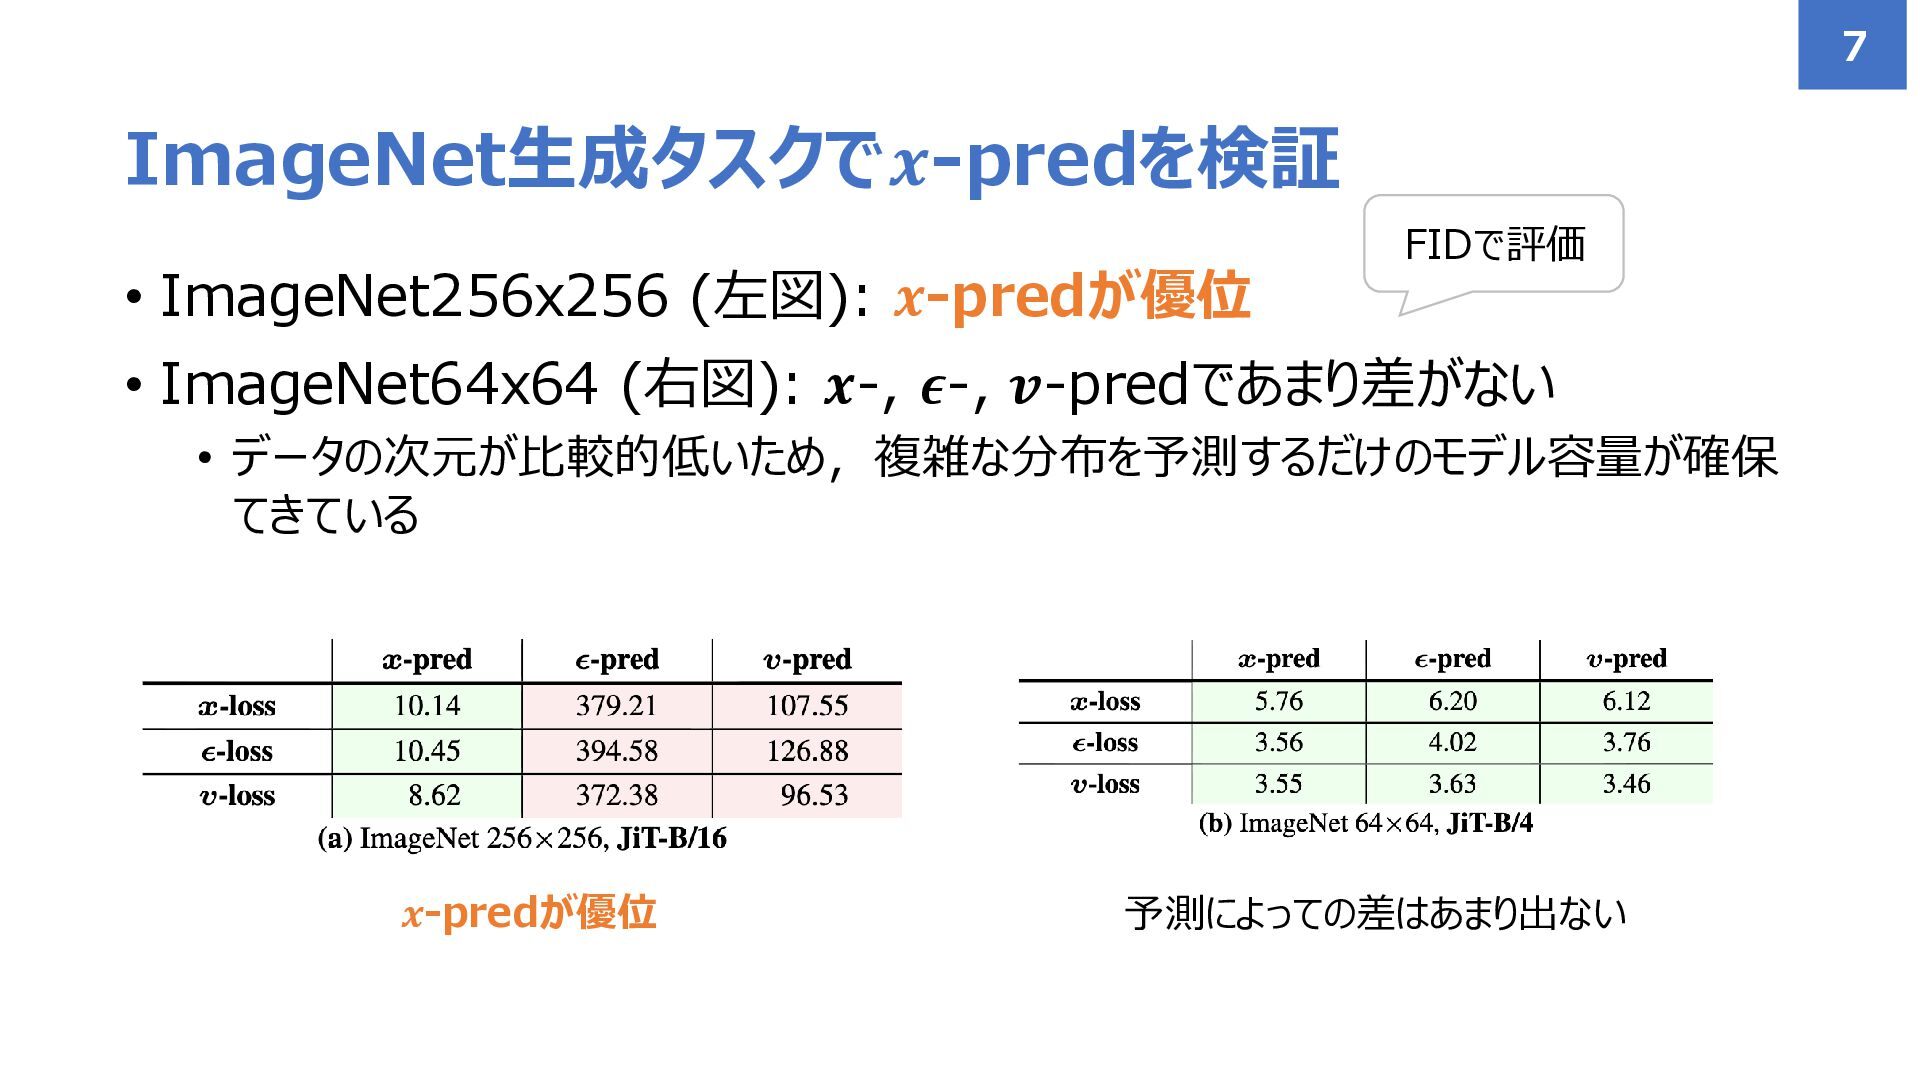
• ImageNet256x256 (左図): 𝒙-predが優位 • ImageNet64x64 (右図): 𝒙-, 𝝐-, 𝒗-predであまり差がない
• データの次元が比較的低いため,複雑な分布を予測するだけのモデル容量が確保 てきている ImageNet生成タスクで𝒙-predを検証 7 FIDで評価 𝒙-predが優位 予測によっての差はあまり出ない
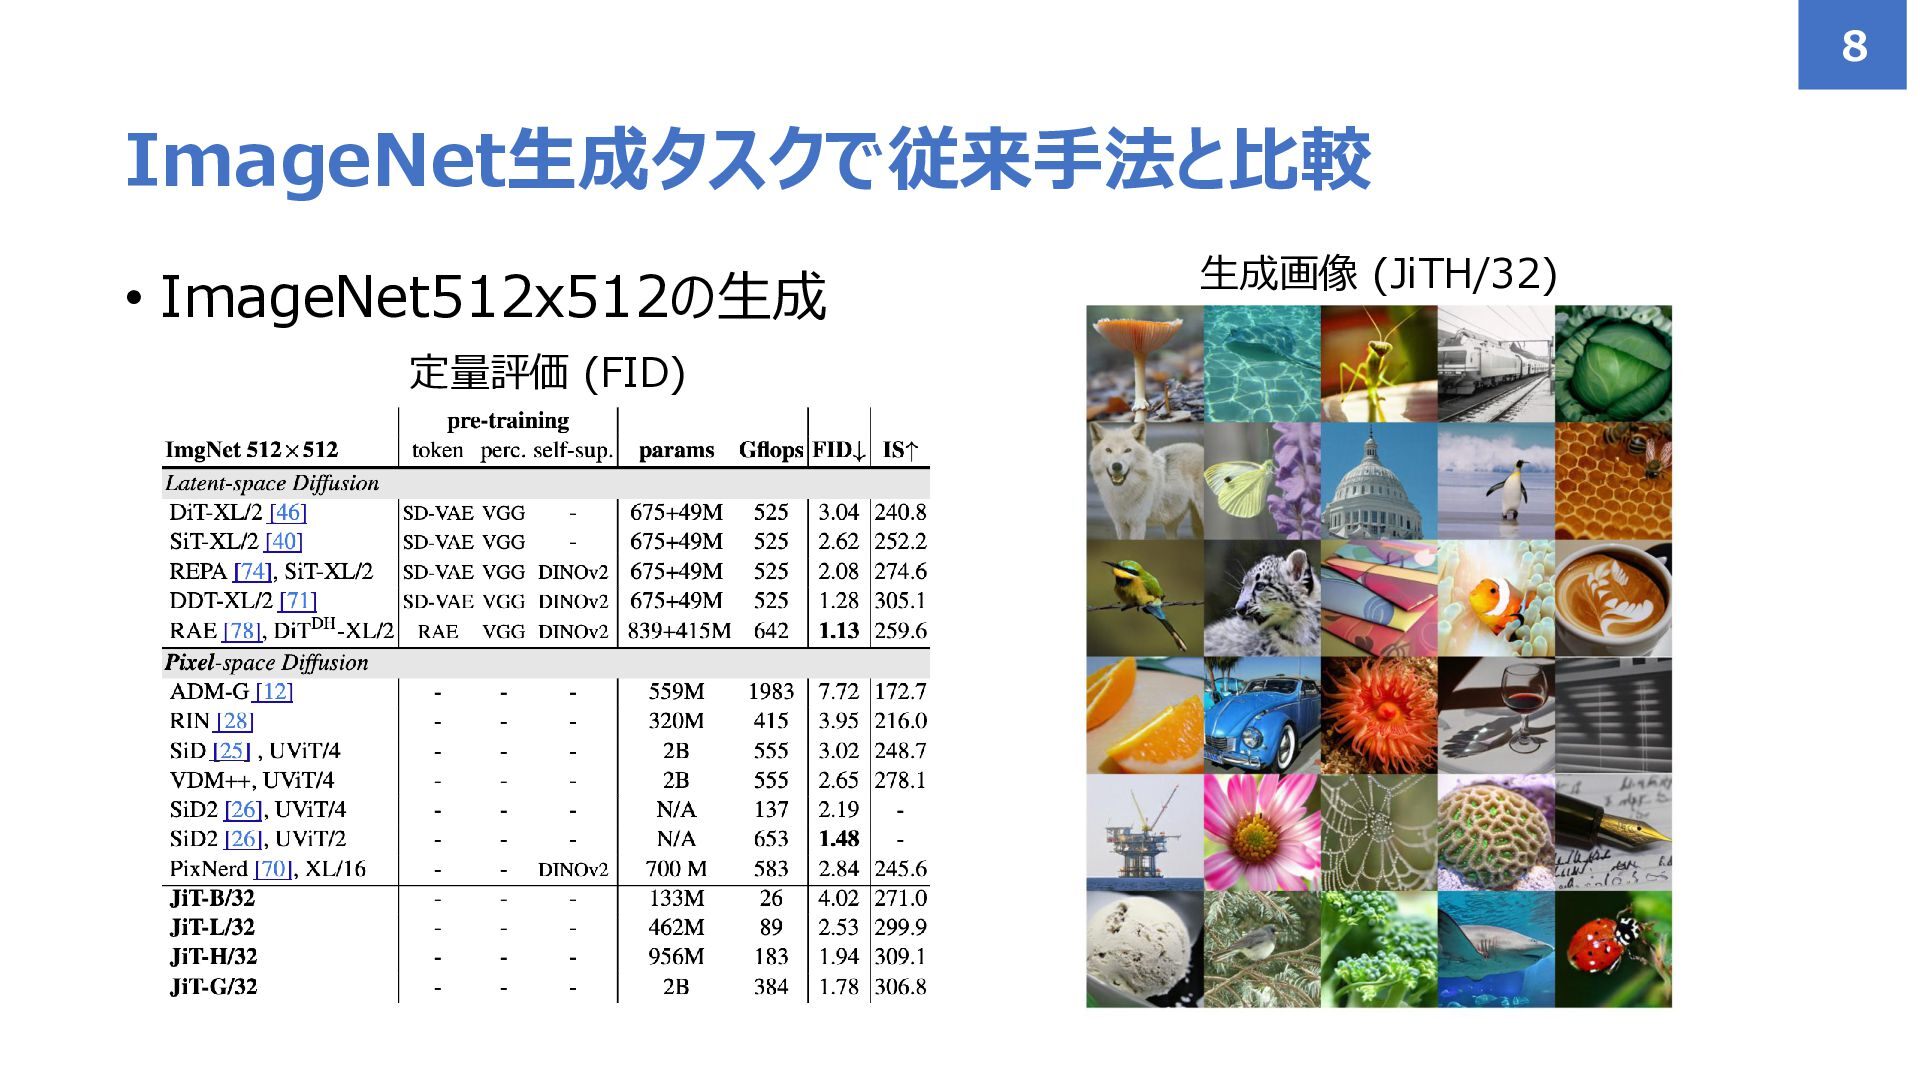
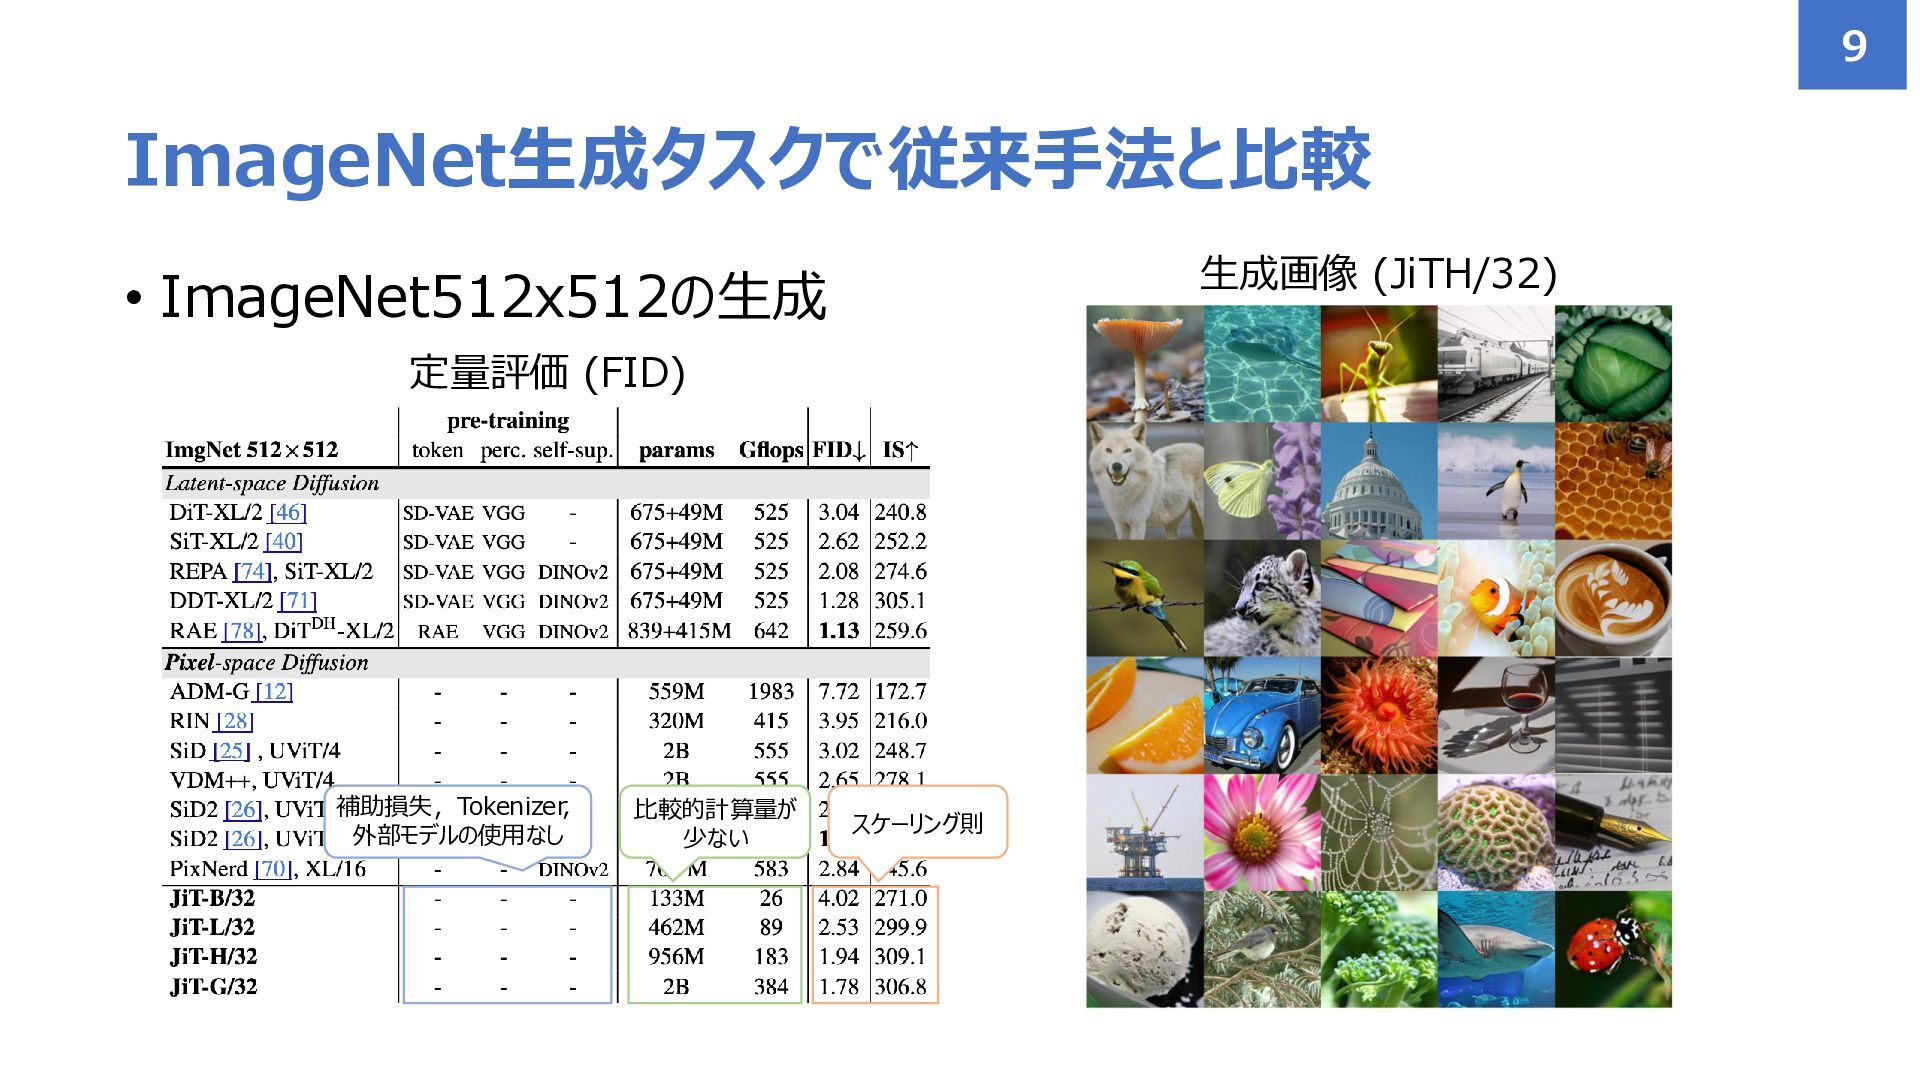
• ImageNet512x512の生成 ImageNet生成タスクで従来手法と比較 8 生成画像 (JiTH/32) 定量評価 (FID)
• ImageNet512x512の生成 ImageNet生成タスクで従来手法と比較 9 生成画像 (JiTH/32) 定量評価 (FID) 補助損失,Tokenizer, 外部モデルの使用なし
比較的計算量が 少ない スケーリング則
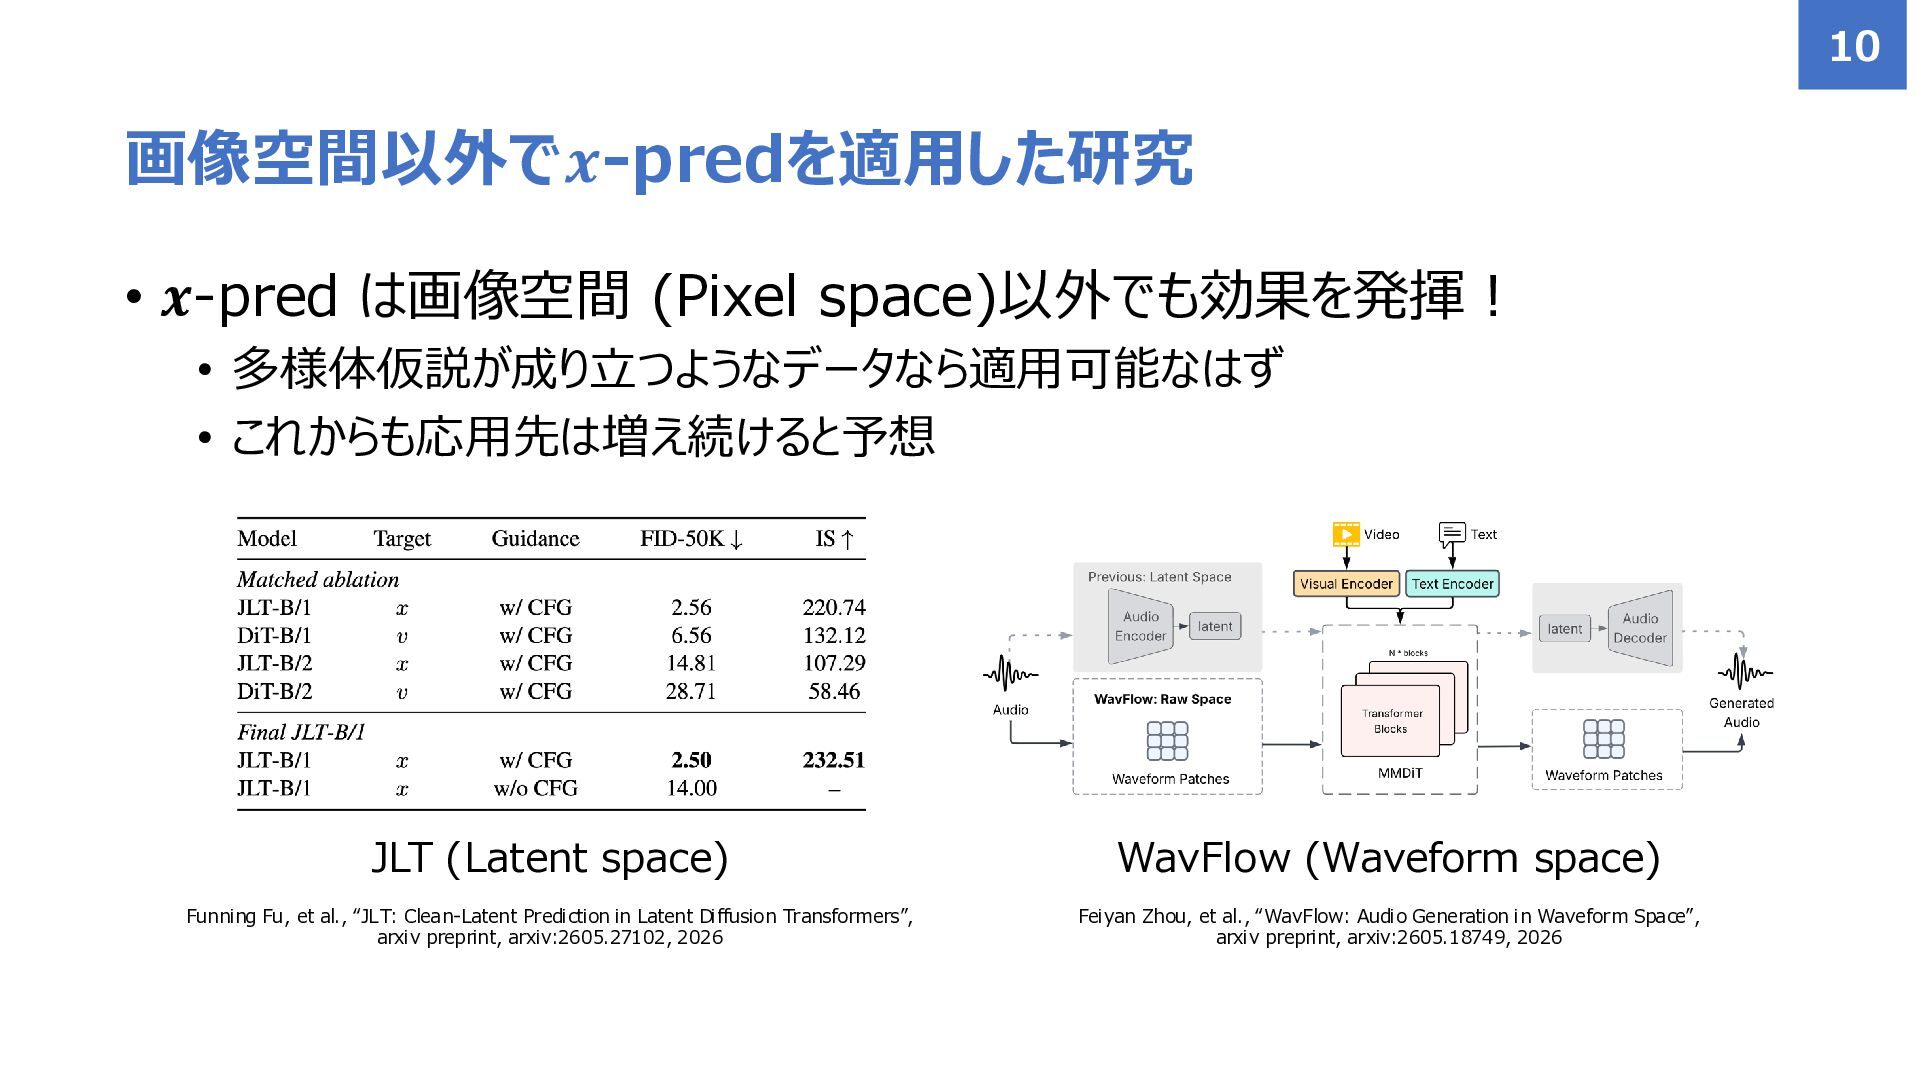
• 𝒙-pred は画像空間 (Pixel space)以外でも効果を発揮! • 多様体仮説が成り立つようなデータなら適用可能なはず • これからも応用先は増え続けると予想 画像空間以外で𝒙-predを適用した研究
10 WavFlow (Waveform space) JLT (Latent space) Funning Fu, et al., “JLT: Clean-Latent Prediction in Latent Diffusion Transformers”, arxiv preprint, arxiv:2605.27102, 2026 Feiyan Zhou, et al., “WavFlow: Audio Generation in Waveform Space”, arxiv preprint, arxiv:2605.18749, 2026
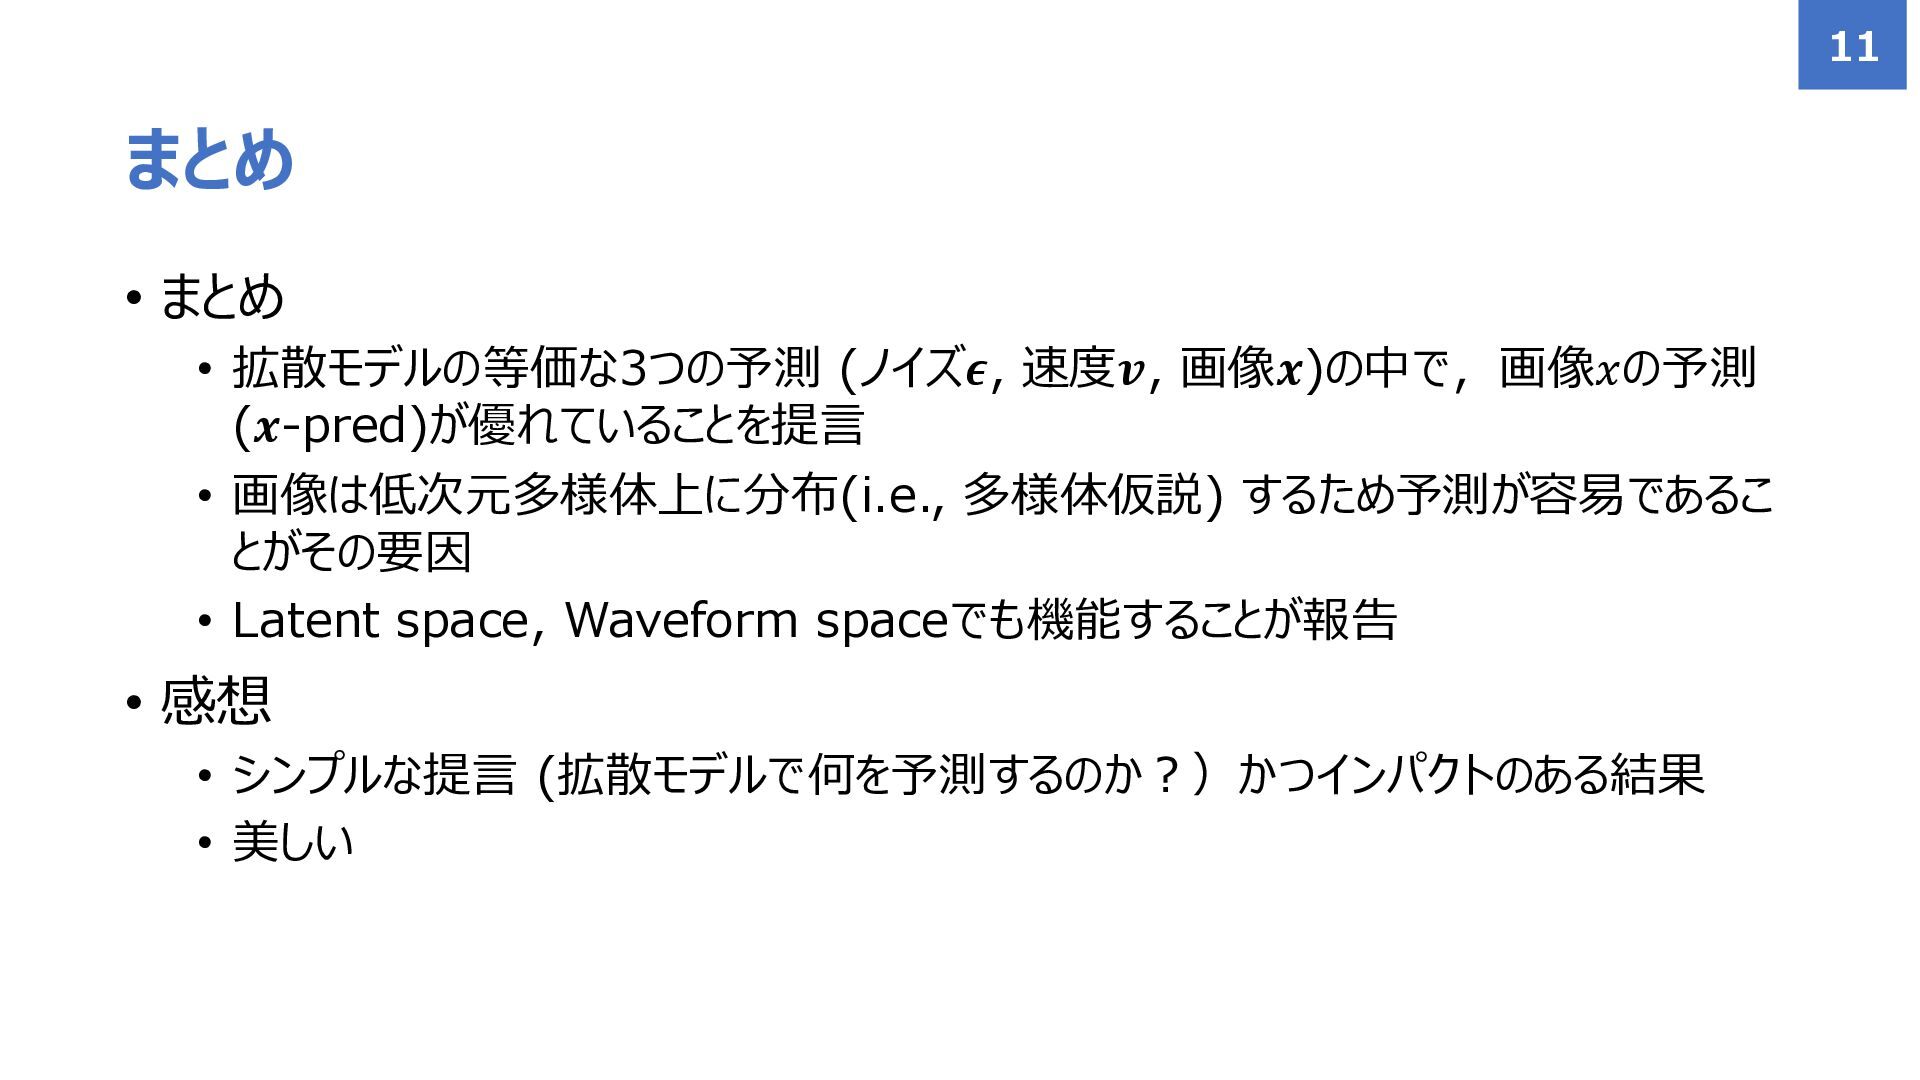
• まとめ • 拡散モデルの等価な3つの予測 (ノイズ𝝐, 速度𝒗, 画像𝒙)の中で,画像𝑥の予測 (𝒙-pred)が優れていることを提言 • 画像は低次元多様体上に分布(i.e.,
多様体仮説) するため予測が容易であるこ とがその要因 • Latent space, Waveform spaceでも機能することが報告 • 感想 • シンプルな提言 (拡散モデルで何を予測するのか?)かつインパクトのある結果 • 美しい まとめ 11


 shumpei777
 trycycle
 tagtag
 voginip
 shunyanoda
 sshimizu2006
 rmaruy
 konakalab
 ktatsuya
 brainpadpr
 rakko
 reverentgeek
 marcoroth
 thoeni
 aarron
 philnash
 wjessup
 tmiket
 productmarketing
 ivargrimstad
 twada
 mkilby