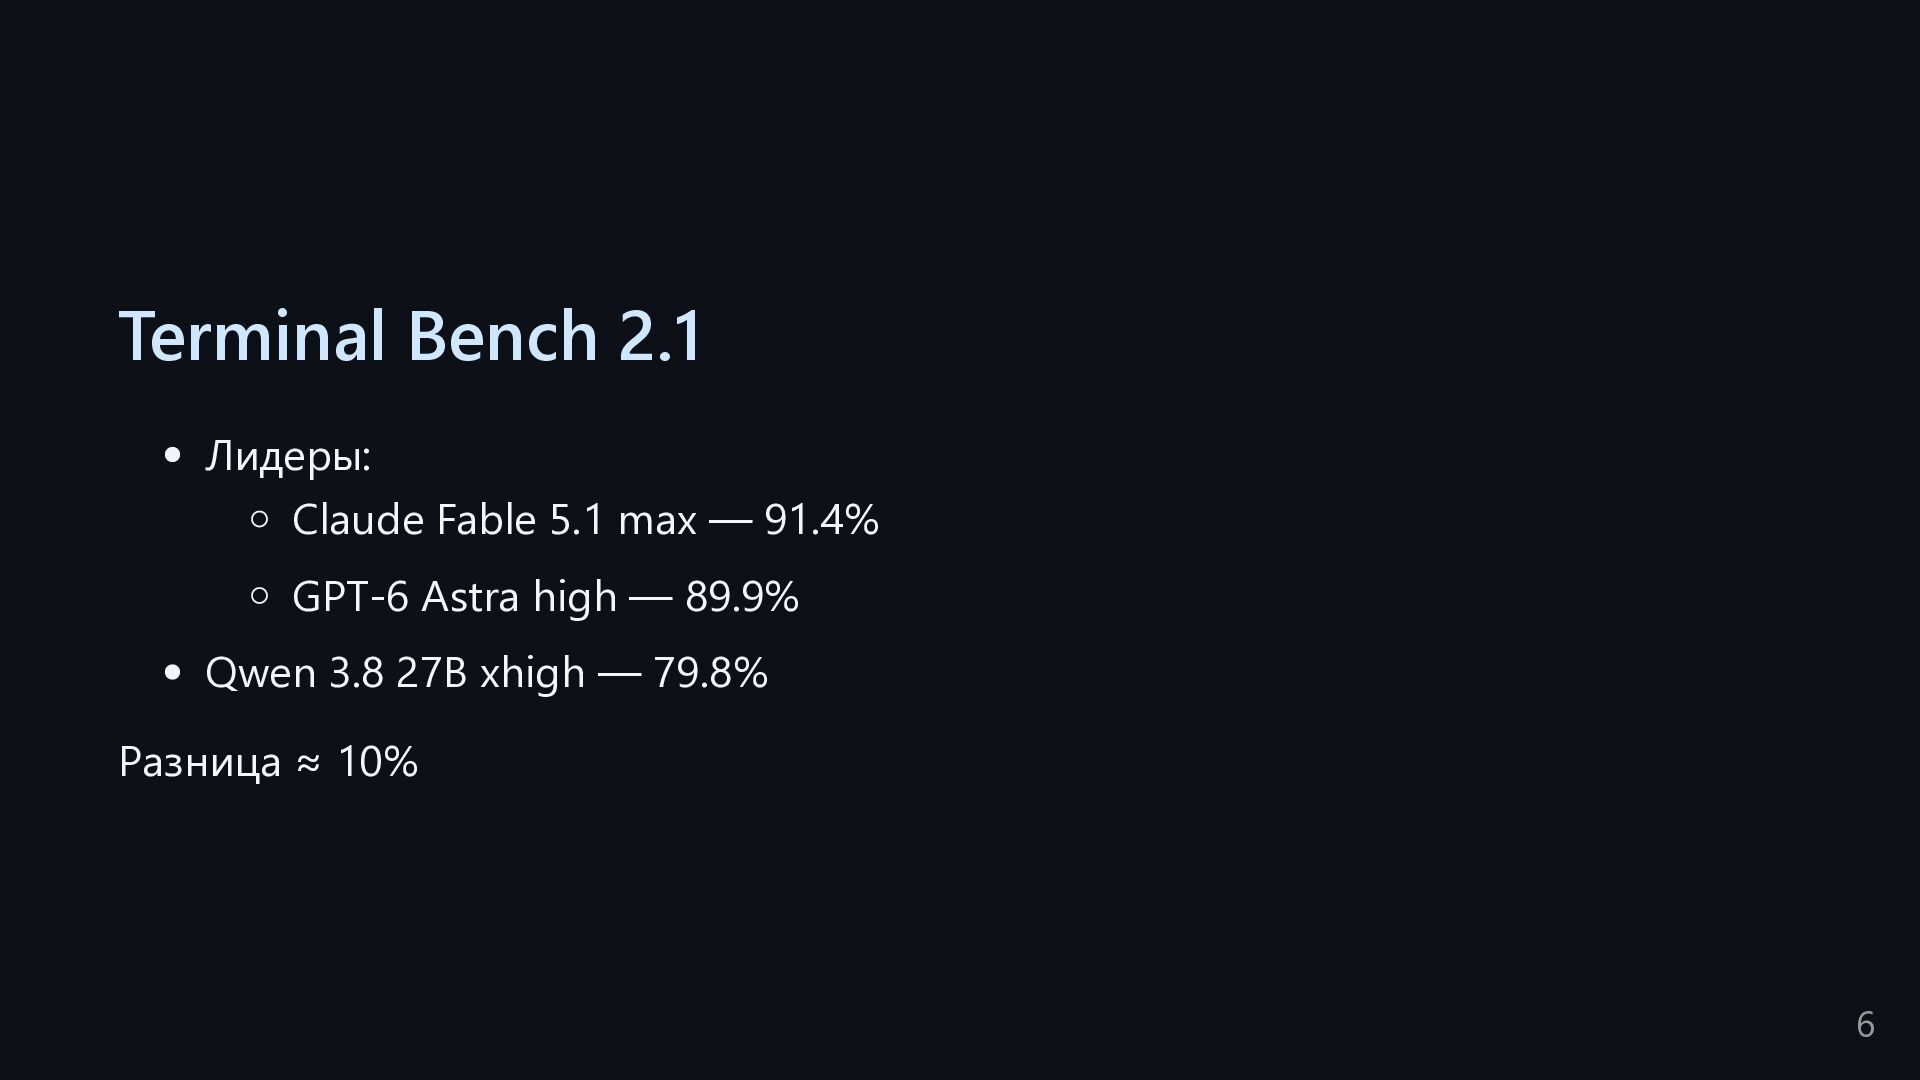
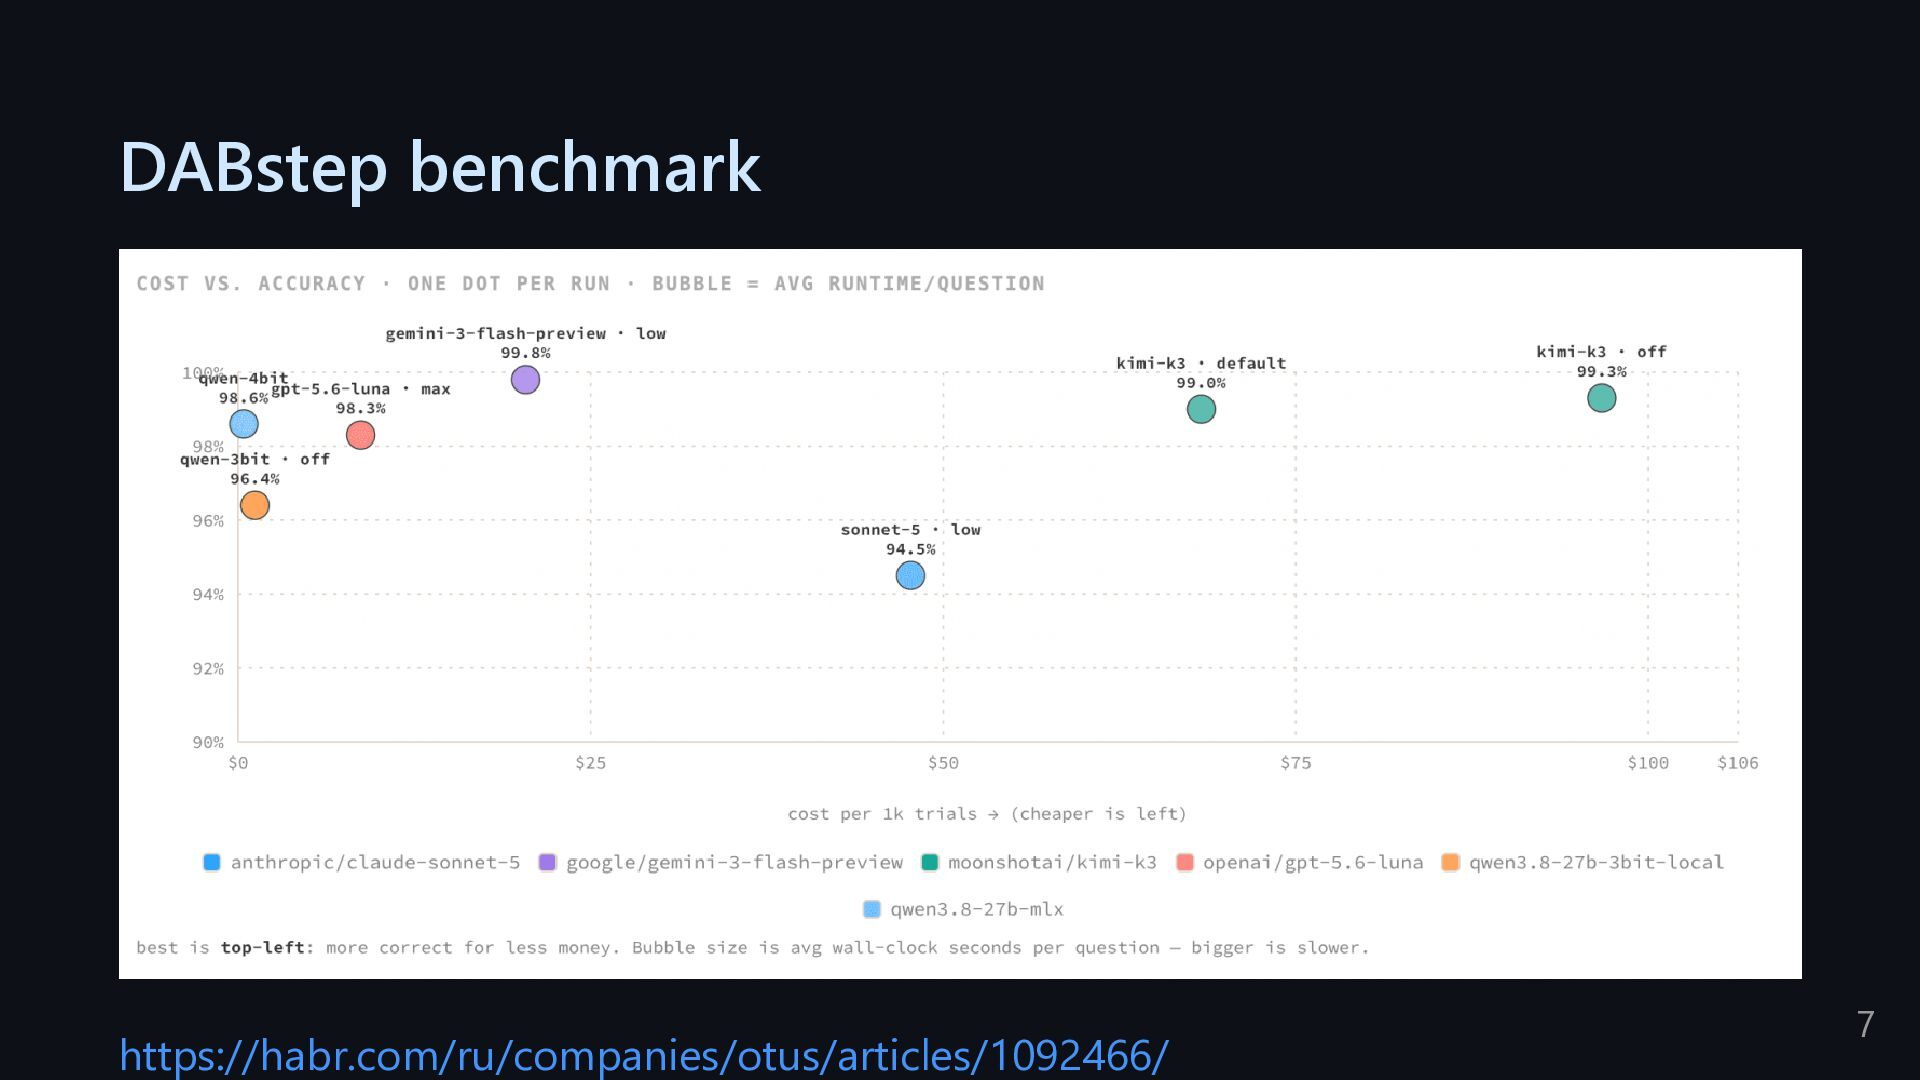
модели не такие уж тупые, как может показаться Terminal Bench 2.1: 90% top-tier модели 80% локальная модель, которую можно запустить даже на MacBook Air мир вообще во многом идёт в сторону локальных моделей 2
в IT, из них 18 лет коммерческого опыта работал в: департаменте информационной безопасности МТС IBS российских подразделениях Oracle и SAP сейчас делаю свои проекты, в т.ч. в сфере IT-образования 17M просмотров на YouTube «Диджитализируй!», 180К подписчиков вышла книга-видос «Логирующий Python!», смотрите в канале:) 3
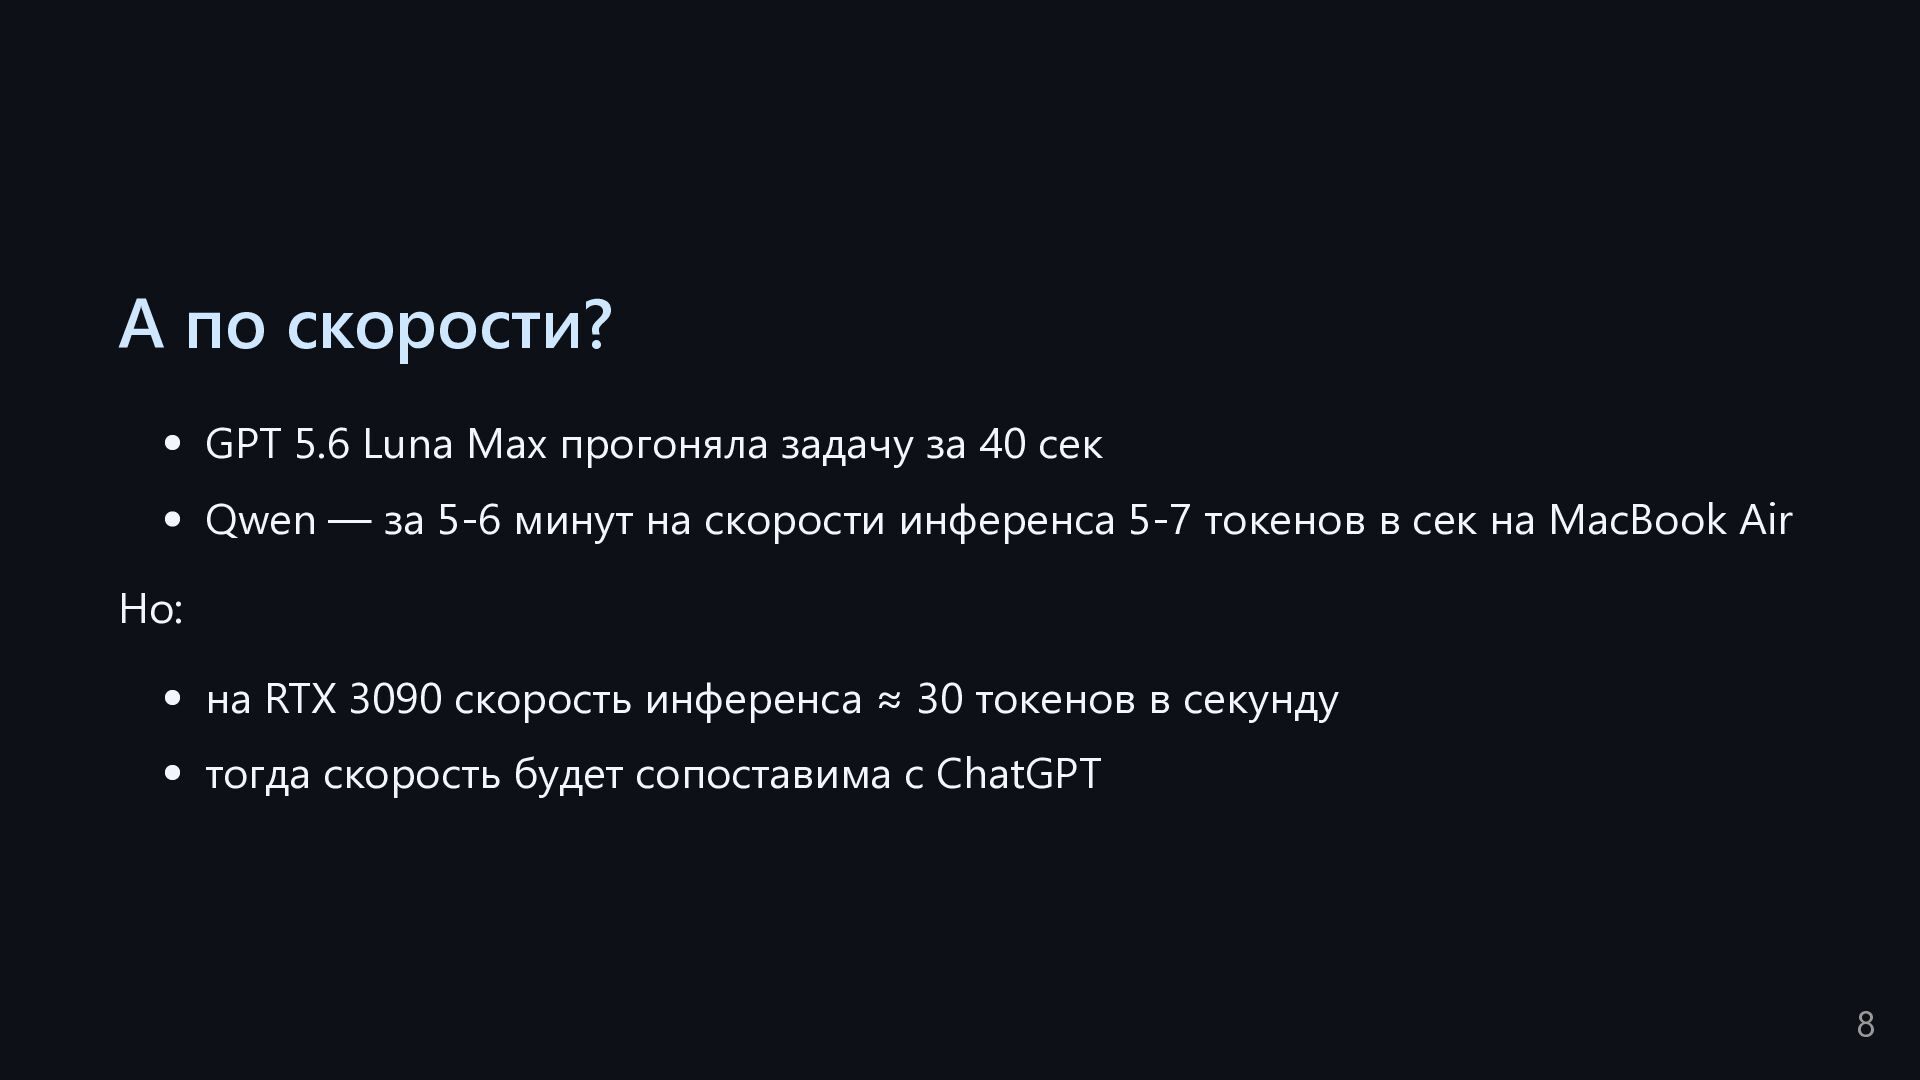
40 сек Qwen — за 5-6 минут на скорости инференса 5-7 токенов в сек на MacBook Air Но: на RTX 3090 скорость инференса ≈ 30 токенов в секунду тогда скорость будет сопоставима с ChatGPT 8
но вся ли работа интерактивна? нет, не вся уходите спать и ставите задачу: «Проанализируй все SQL-запросы, которые сегодня добавились в проект. Найди самые дорогие, предложи оптимизации, проверь их на тестовых данных. У тебя есть двенадцать часов. Утром покажи, какие изменения действительно ускоряют систему» 9
многократно все эксперименты — бесплатны лучший результат может выбираться самой моделью (или другой моделью-судьёй) или по объективному показателю, например, уменьшению стоимости запроса в планировщике PostgreSQL или путём экспертной вашей человеческой оценки 11
квантование — один параметр 0.5 байта благодаря квантованию модель помещается на локальный компьютер квантование может ухудшить качество, но 4-битное квантование обычно уже норм (больше лучше) 14
рассуждениям и работе с инструментами кол-во параметров перестало быть главной мерой интеллекта модели небольшая современная модель в конкретной задаче может оказаться полезнее огромной, но более старой 16
для генерации токена используется практически весь набор весов в moe для генерации следующего токена используется только часть всех весов поэтому MoE легче для локального инференса пример: qwen 3.6 35b a3b 20
— решение для изоляции и управления фоновыми агентами раньше локальная LLM чаще была приложением, которое пользователь запускает по необходимости, теперь Microsoft предполагает, что агент может постоянно работать на персональном устройстве, обрабатывать локальные документы, взаимодействовать с приложениями и выполнять фоновые задачи 25
IoT-устройствах без доступа к дата-центрам и GPU ИИ может научиться заражать бытовую технику (дешевые смарт-ТВприставки, камеры, умные приборы), поселяться на ней и оттуда заражать следующие устройства даже простейшая техника может вывезти небольшую модель: авторы раскатили на 15 Android TV-боксах по ~$55 Gemma4-26B-A4B, MoE модель от Google https://www.anthropic.com/research/self-replicating-ai 26
для лучшего результата не тупеют перед выходом новой модели работают без интернета (могут принимать решение в лесу или на крайнем севере, роботы и тп) 29


 sobolevn
 leegeunhyeok
 omatty198
 kmkim
 rkaga
 yahir0
 sodainc
 kamina_zzz
 simas
 a_matsuda
 marcoroth
 ivargrimstad
 yosuke_furukawa
 andyhume
 cassininazir
 tenderlove
 sarafernandez
 chriscoyier
 aleyda
 mfonobong
 popppiees
 hannesfritz
 axbom
 baasie