Upgrade to Pro
— share decks privately, control downloads, hide ads and more …
Speaker Deck
Sign up for free
Menu
Search
Features
All features
Private URLs
Password Protection
Custom URLS
Scheduled publishing
Remove Branding
Restrict embedding
Deck Collections
Notes
Features
All features
Private URLs
Password Protection
Custom URLS
Scheduled publishing
Remove Branding
Restrict embedding
Deck Collections
Notes
Explore
Featured decks
Featured speakers
Programming
Technology
Storyboards
Explore
Featured decks
Featured speakers
Programming
Technology
Storyboards
Pricing
Search
Sign in
Sign up for free
SNLP2020_mixtext
Search
Sho Takase
September 16, 2020
390
0
Share
Embed
Copy iframe code
Copy JS code
Copy link
Start on current slide
SNLP2020_mixtext
Sho Takase
September 16, 2020
More Decks by Sho Takase
See All by Sho Takase
⼤規模⾔語モデル事前学習の安定化(IBIS2026企画セッション講演) / IBIS2026_organized_session3
takase
1
760
snlp2025_prevent_llm_spikes
takase
0
590
snlp2024_multiheadMoE
takase
0
780
snlp2023_beyond_neural_scaling_laws
takase
0
500
snlp2023_rogue_scores
takase
0
490
[SNLP2022] ABC: Attention with Bounded-memory Control
takase
0
470
SNLP2020_sandwich
takase
0
390
ニューラル言語モデルの 研究動向(NL研招待講演資料)
takase
12
5.4k
Featured
See All Featured
HU Berlin: Industrial-Strength Natural Language Processing with spaCy and Prodigy
inesmontani
PRO
0
800
Building Experiences: Design Systems, User Experience, and Full Site Editing
marktimemedia
1
660
Digital Projects Gone Horribly Wrong (And the UX Pros Who Still Save the Day) - Dean Schuster
uxyall
2
3.8k
Leveraging Curiosity to Care for An Aging Population
cassininazir
1
560
How to optimise 3,500 product descriptions for ecommerce in one day using ChatGPT
katarinadahlin
PRO
3
3.9k
The #1 spot is gone: here's how to win anyway
tamaranovitovic
4
1.2k
Navigating Team Friction
lara
192
16k
Documentation Writing (for coders)
carmenintech
77
5.6k
Claude Code どこまでも/ Claude Code Everywhere
nwiizo
68
60k
A better future with KSS
kneath
240
18k
Become a Pro
speakerdeck
PRO
31
6.4k
Tell your own story through comics
letsgokoyo
1
1.1k
Transcript
MixText: Linguistically-Informed Interpolation of Hidden Space for Semi-Supervised Text Classification
Jiaao Chen, Zichao Yang, Diyi Yang ACL 2020 発表者︓⾼瀬 翔(東京⼯業⼤学) 2020/9/25 1 結果やモデルの図・表は論⽂より引⽤
概要 • Mixup [Zhang+ 17] を⾔語に拡張(TMix) – Mixup: 画像処理でのデータ拡張⼿法,⼊⼒と出⼒ラベルを混ぜ,新規 の訓練事例とする
• Self-training でラベルなしデータにラベルを付与し学習データ増量 – Self-training と TMix をあわせたものが MixText • ⽂書分類で効果を確認 – ベースラインよりも性能は⾼い – 既存のデータ拡張よりも良いかは謎に思える – TMix の貢献が⼤きいかどうかも怪しい気が… • 論⽂内の主張がたまに⼤きすぎる気が… – 任意の⼿法に使⽤可能(ただし実験は⽂書分類のみ) – 無限に訓練データを増やせる 2 0.3 × + 0.7 × = 0.3 × リス + 0.7 × レッサーパンダ
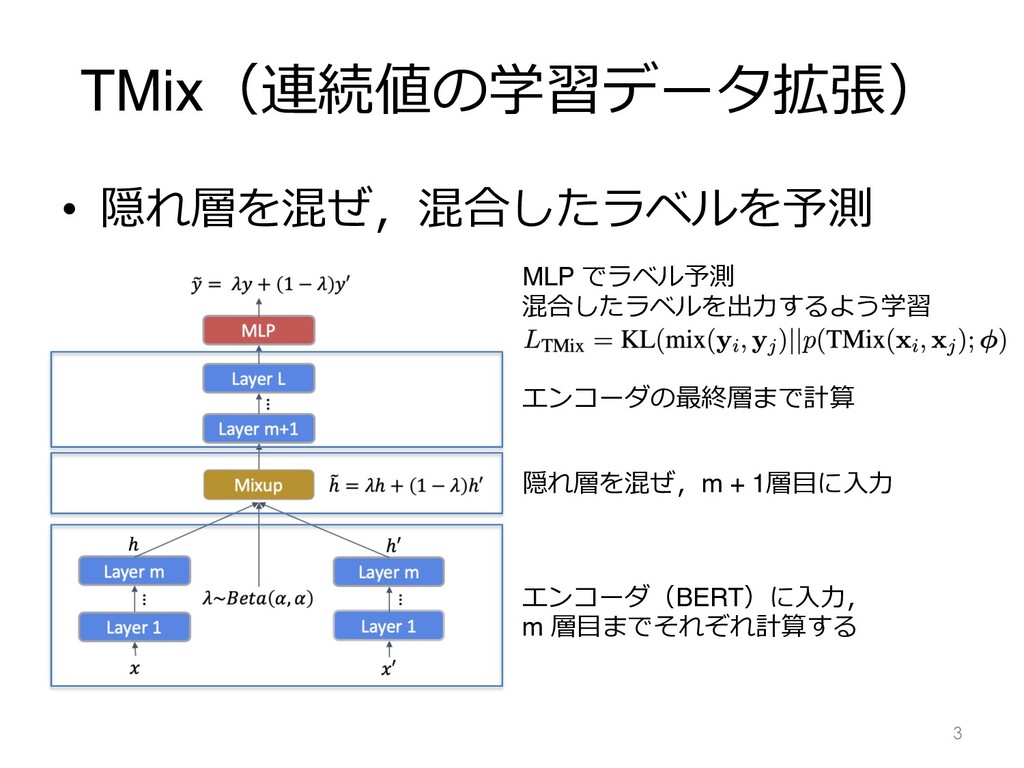
TMix(連続値の学習データ拡張) • 隠れ層を混ぜ,混合したラベルを予測 3 エンコーダ(BERT)に⼊⼒, m 層⽬までそれぞれ計算する 隠れ層を混ぜ,m + 1層⽬に⼊⼒
エンコーダの最終層まで計算 MLP でラベル予測 混合したラベルを出⼒するよう学習
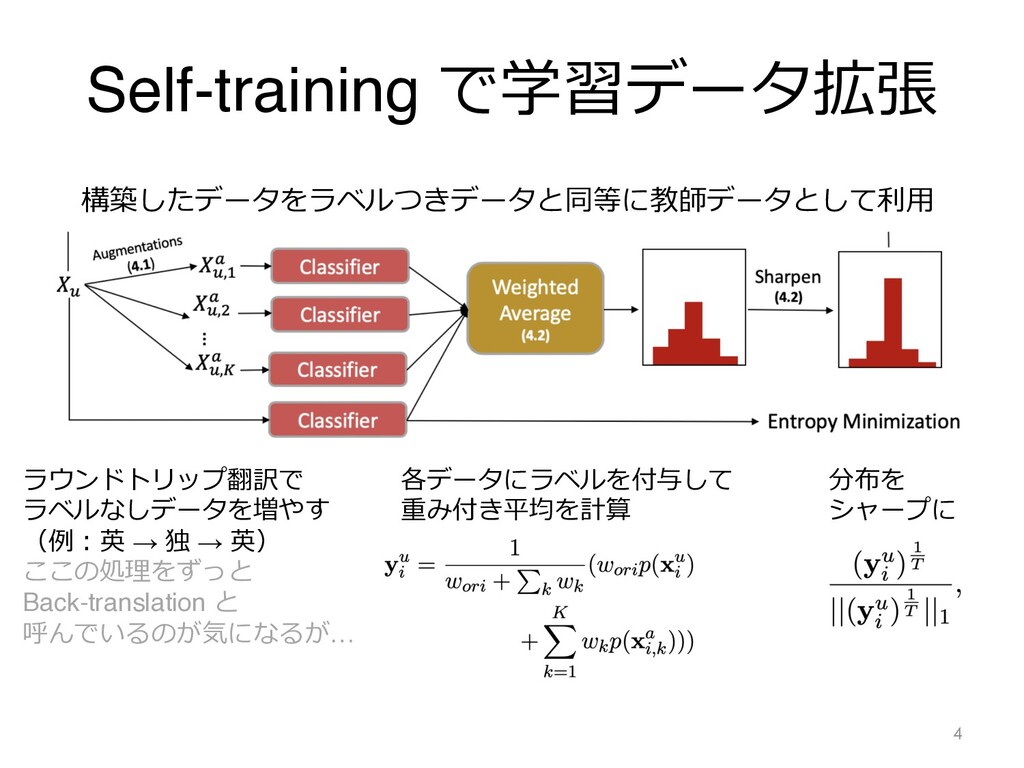
Self-training で学習データ拡張 4 ラウンドトリップ翻訳で ラベルなしデータを増やす (例︓英 → 独 → 英)
ここの処理をずっと Back-translation と 呼んでいるのが気になるが… 各データにラベルを付与して 重み付き平均を計算 分布を シャープに 構築したデータをラベルつきデータと同等に教師データとして利⽤
実験設定 • ⽂書分類の4つのデータで実験 • BERT-base をベースに実装 • ⽐較⼿法 – BERT︓データ拡張なしの
fine-tuning – UDA︓BERT base + 教師なしデータ拡張 [Xie+ 19] でデータ拡張 5
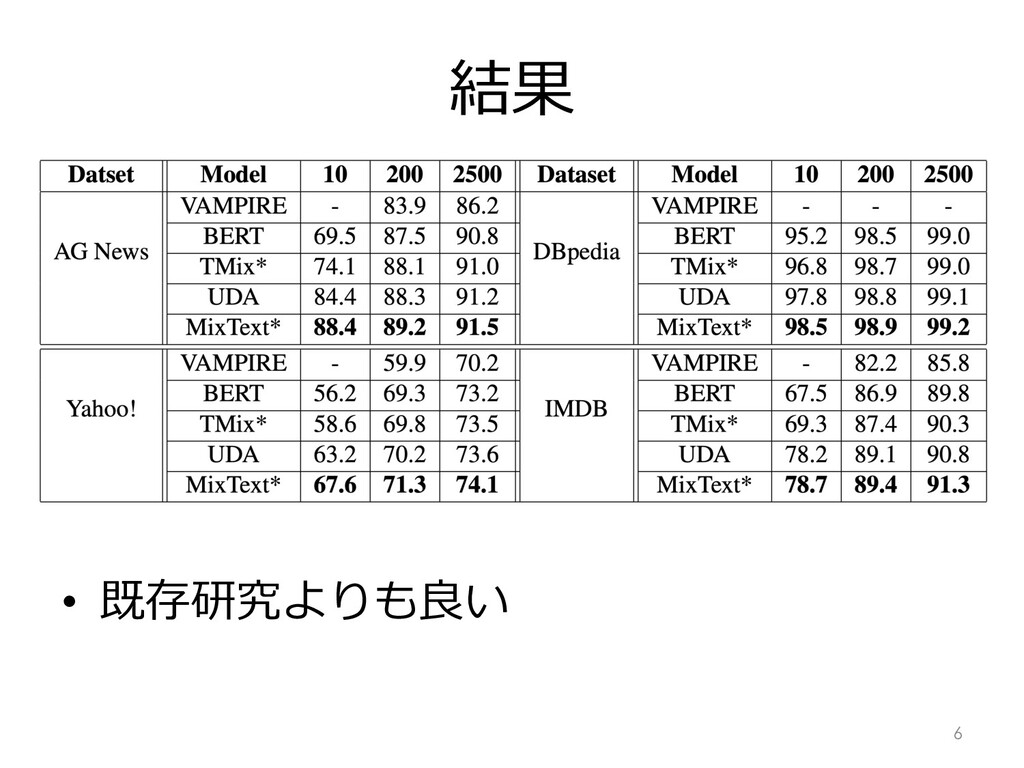
結果 • 既存研究よりも良い 6
Ablation study • 要素を抜いていったときの正解率の変化 7 ラベルなしデータを 抜いたときの性能低下が⼤きい TMix を⼊れた状態で ラベルなしデータを抜いた
結果が⾒たいが……
まとめ • Mixup [Zhang+ 17] を⾔語に拡張(TMix) – エンコーダの隠れ層を混合 – ラベルを混合し,教師データとして利⽤
• Self-training でラベルなしデータにラベルを 付与,学習データ増量 – ラウンドトリップ翻訳でラベルなし⼊⼒を増量 – ラベルなしデータにモデルの予測を付与 • ⽂書分類で効果を確認 – ベースラインよりも性能は⾼い – 既存のデータ拡張よりも良いかは謎に思える 8


 takase
 inesmontani
 marktimemedia
 uxyall
 cassininazir
 katarinadahlin
 tamaranovitovic
 lara
 carmenintech
 nwiizo
 kneath
 speakerdeck
 letsgokoyo