Upgrade to Pro
— share decks privately, control downloads, hide ads and more …
Speaker Deck
Sign up for free
Menu
Search
Features
All features
Private URLs
Password Protection
Custom URLS
Scheduled publishing
Remove Branding
Restrict embedding
Deck Collections
Notes
Features
All features
Private URLs
Password Protection
Custom URLS
Scheduled publishing
Remove Branding
Restrict embedding
Deck Collections
Notes
Explore
Featured decks
Featured speakers
Programming
Technology
Storyboards
Explore
Featured decks
Featured speakers
Programming
Technology
Storyboards
Pricing
Search
Sign in
Sign up for free
Fluent but Unfeeling_ The Emotional Blind Spots...
Search
Wataru Hirota
August 13, 2026
Research
71
1
Share
Embed
Copy iframe code
Copy JS code
Copy link
Start on current slide
Fluent but Unfeeling_ The Emotional Blind Spots of Language Models (2026/8/20 ウェブ・ソーシャルメディア読み会)
Wataru Hirota
August 13, 2026
More Decks by Wataru Hirota
See All by Wataru Hirota
(2022-05-28 Machine Learning 15Minutes!) 日本語ニュース分類から見る多言語モデル
tarohi24
0
110
The future of data system
tarohi24
0
100
Serializability and Snapshot Isolation.pdf
tarohi24
0
260
Entity Set Search of Scientific Literature: An unsupervised Ranking Approach
tarohi24
0
120
Other Decks in Research
See All in Research
Easy to Guess, Hard to Verify: Lessons from AIMO 3 for Olympiad-Level AI Mathematics
corochann
0
130
Hitting the buffers
beale
0
310
超効率化への挑戦:1bit LLMの現状と展望
yumaichikawa
0
890
Empreinte carbone des ovins : une approche globale (technique, économique, environnementale) – 4 années de résultats avec LIFE GREEN SHEEP
institutdelelevage
PRO
0
110
敵対生成プロンプト同時探索による内省型プロンプト最適化
kinoue_smarthr
0
450
Volatilité des marchés et sécheresse historique, l’élevage bovin viande sous contraintes en 2026
institutdelelevage
PRO
0
130
[CV勉強会@関東 CVPR2026] PSDesigner: Automated Graphic Design with a Human-Like Creative Workflow / kantocv 67th CVPR 2026
shunk031
0
380
Adapter les bergeries aux fortes chaleurs
institutdelelevage
PRO
0
150
Sleuthcon Keynote - How Cybercriminals (ab)use AI
fr0gger
0
400
Pesée et pointage par imagerie 3D : PHENO3D entre en phase de test terrains
institutdelelevage
PRO
0
120
【中間報告】国会議員の立法・政策実務を支える環境を巡る現状と課題
polipoli
0
770
Développer des solutions de réduction des émissions de méthane entérique : 1ers résultats Méthane 2030
institutdelelevage
PRO
0
260
Featured
See All Featured
svc-hook: hooking system calls on ARM64 by binary rewriting
retrage
2
630
実際に使うSQLの書き方 徹底解説 / pgcon21j-tutorial
soudai
PRO
203
77k
Building an army of robots
kneath
307
47k
KATA
mclloyd
PRO
35
16k
A designer walks into a library…
pauljervisheath
211
25k
What does AI have to do with Human Rights?
axbom
PRO
1
2.5k
Site-Speed That Sticks
csswizardry
13
1.6k
Designing for Performance
lara
612
70k
Navigating the moral maze — ethical principles for Al-driven product design
skipperchong
2
630
Six Lessons from altMBA
skipperchong
29
4.5k
Mozcon NYC 2025: Stop Losing SEO Traffic
samtorres
1
580
Building a A Zero-Code AI SEO Workflow
portentint
PRO
0
790
Transcript
Fluent but Unfeeling: The Emotional Blind Spots of Language Models
著者: Bangzhao Shu, Isha Joshi, Melissa Karnaze, Anh C. Pham, Ishita Kakkar, Sindhu Kothe, Arpine Hovasapian, Mai ElSherief. (Northeastern University, UC San Diego, UMass) 読み⼿: 広⽥航 (ストックマーク株式会社)
はじめに: この論⽂の3⾏まとめ 研究のモチベーション 「LLM は⼈間の感情を正しく予測出来るか?」という問を検証。既 存の同様のベンチマークは感情カテゴリの推定問題 (悲しい‧嬉しい‧etc..) を扱っている が、もっと細かい粒度で LLM
の能⼒を知りたい。また、第三者のアノテーションではな く、その⼈⾃⾝が感じた (self-disclosed) 感情と⽐較してベンチマークしたい。 検証⽅法 感情推定を Masked Token Prediction 問題として定式化。その⼈が書いた感情を 表す トークン の部分をマスクし、その単語が当てられるか?を検証。 結果 2種類の結果が得られた。(1) どのモデルも masked token の特定精度は低い (2) 第三者に LLM と⼈の token をそれぞれ⾒せると、LLM の予測した単語の⽅がより⽂脈に 適した単語だという結果に
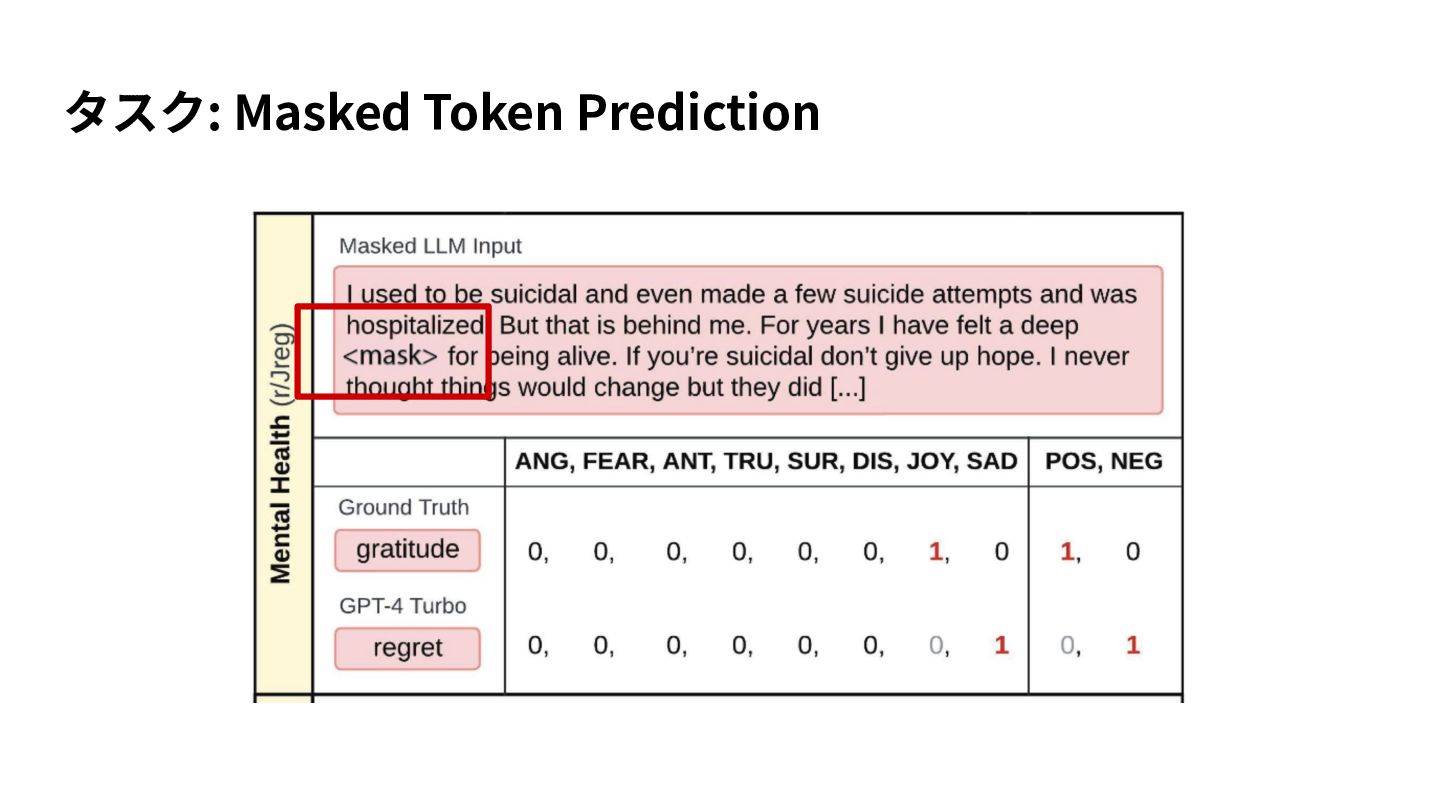
タスク: Masked Token Prediction
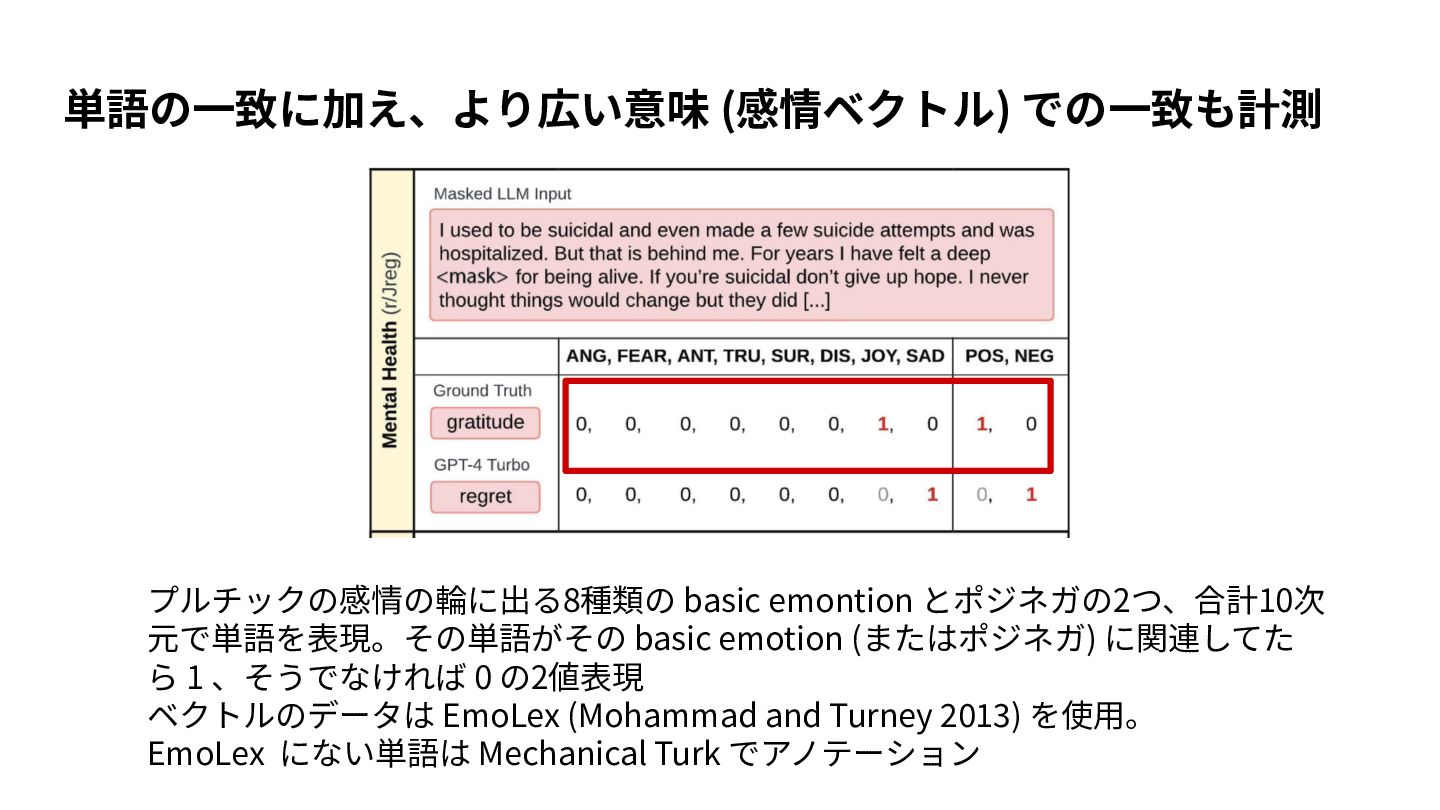
単語の⼀致に加え、より広い意味 (感情ベクトル) での⼀致も計測 プルチックの感情の輪に出る8種類の basic emontion とポジネガの2つ、合計10次 元で単語を表現。その単語がその basic emotion
(またはポジネガ) に関連してた ら 1 、そうでなければ 0 の2値表現 ベクトルのデータは EmoLex (Mohammad and Turney 2013) を使⽤。 EmoLex にない単語は Mechanical Turk でアノテーション
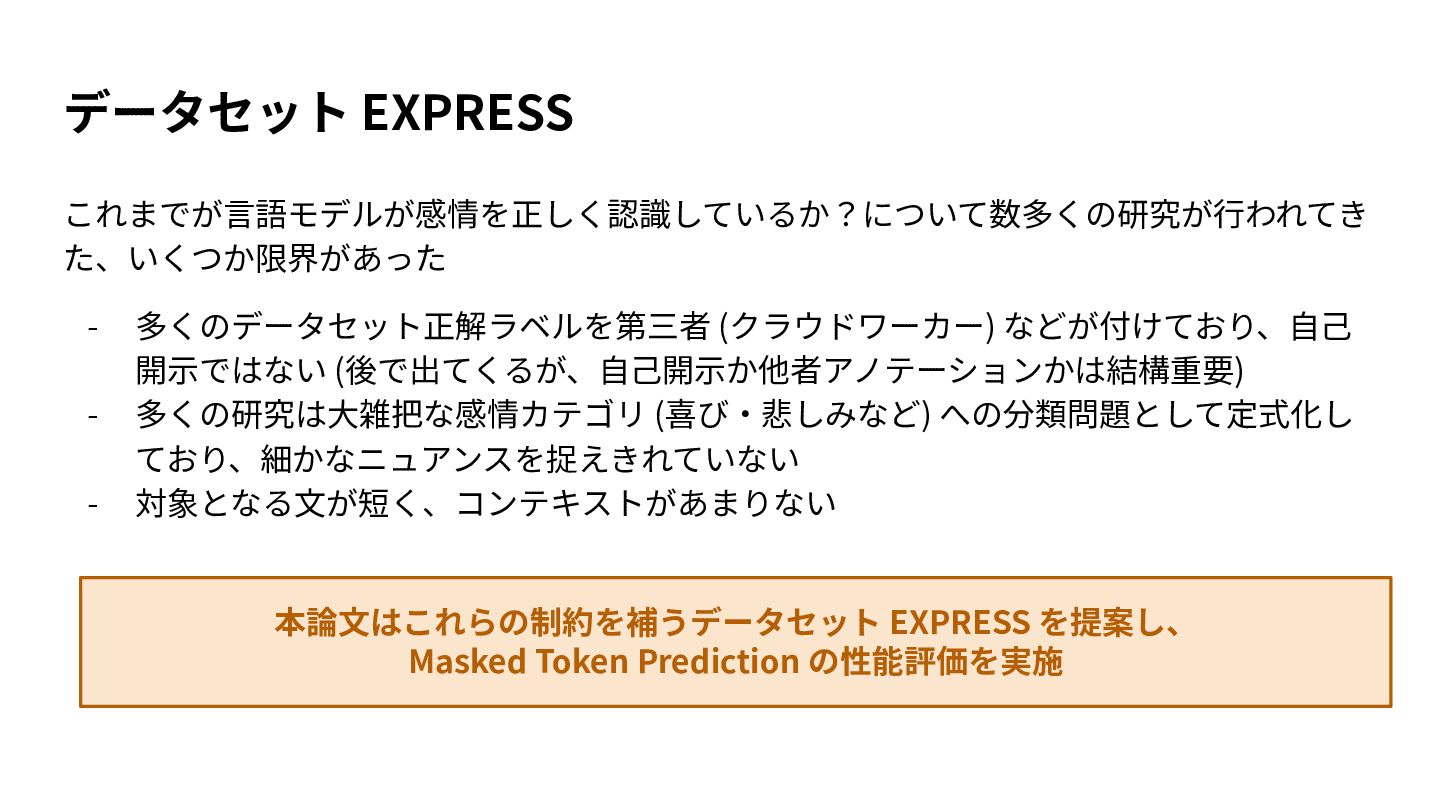
データセット EXPRESS これまでが⾔語モデルが感情を正しく認識しているか?について数多くの研究が⾏われてき た、いくつか限界があった - 多くのデータセット正解ラベルを第三者 (クラウドワーカー) などが付けており、⾃⼰ 開⽰ではない (後で出てくるが、⾃⼰開⽰か他者アノテーションかは結構重要)
多くの研究は⼤雑把な感情カテゴリ (喜び‧悲しみなど) への分類問題として定式化し ており、細かなニュアンスを捉えきれていない 対象となる⽂が短く、コンテキストがあまりない 本論⽂はこれらの制約を補うデータセット EXPRESS を提案し、 Masked Token Prediction の性能評価を実施
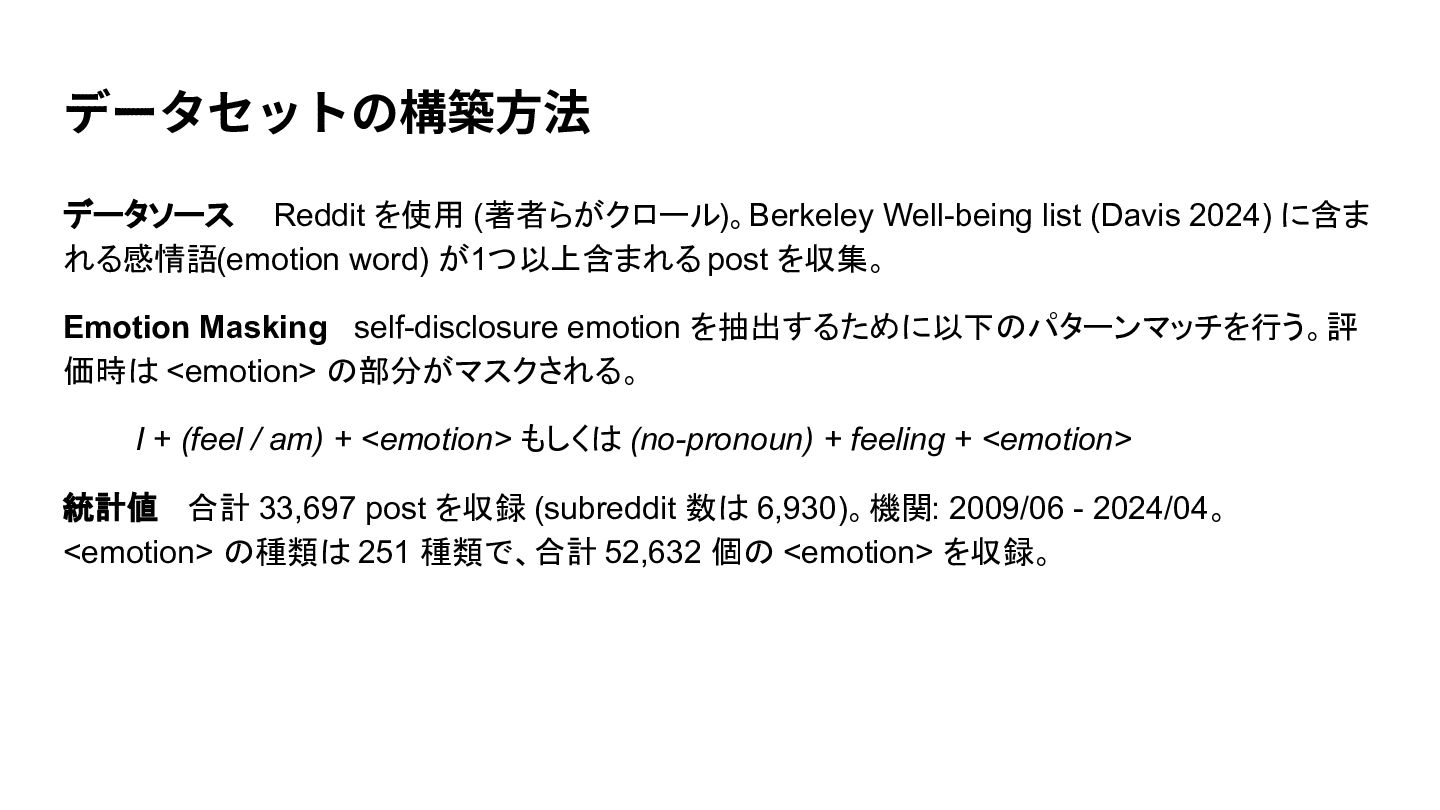
データセットの構築⽅法 データソース Reddit を使用 (著者らがクロール)。Berkeley Well-being list (Davis 2024) に含ま
れる感情語(emotion word) が1つ以上含まれる post を収集。 Emotion Masking self-disclosure emotion を抽出するために以下のパターンマッチを行う。評 価時は <emotion> の部分がマスクされる。 I + (feel / am) + <emotion> もしくは (no-pronoun) + feeling + <emotion> 統計値 合計 33,697 post を収録 (subreddit 数は 6,930)。機関: 2009/06 - 2024/04。 <emotion> の種類は 251 種類で、合計 52,632 個の <emotion> を収録。
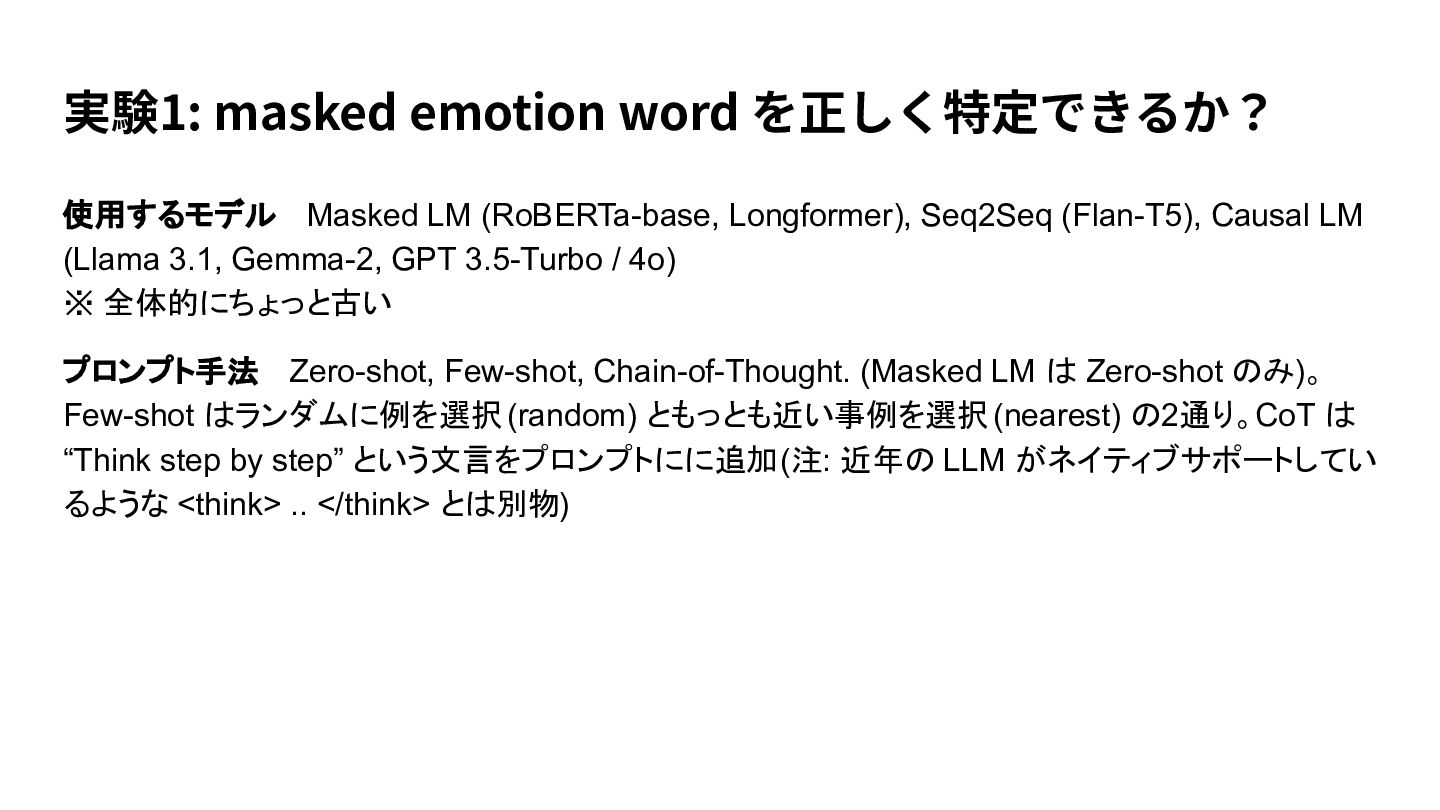
実験1: masked emotion word を正しく特定できるか? 使用するモデル Masked LM (RoBERTa-base, Longformer),
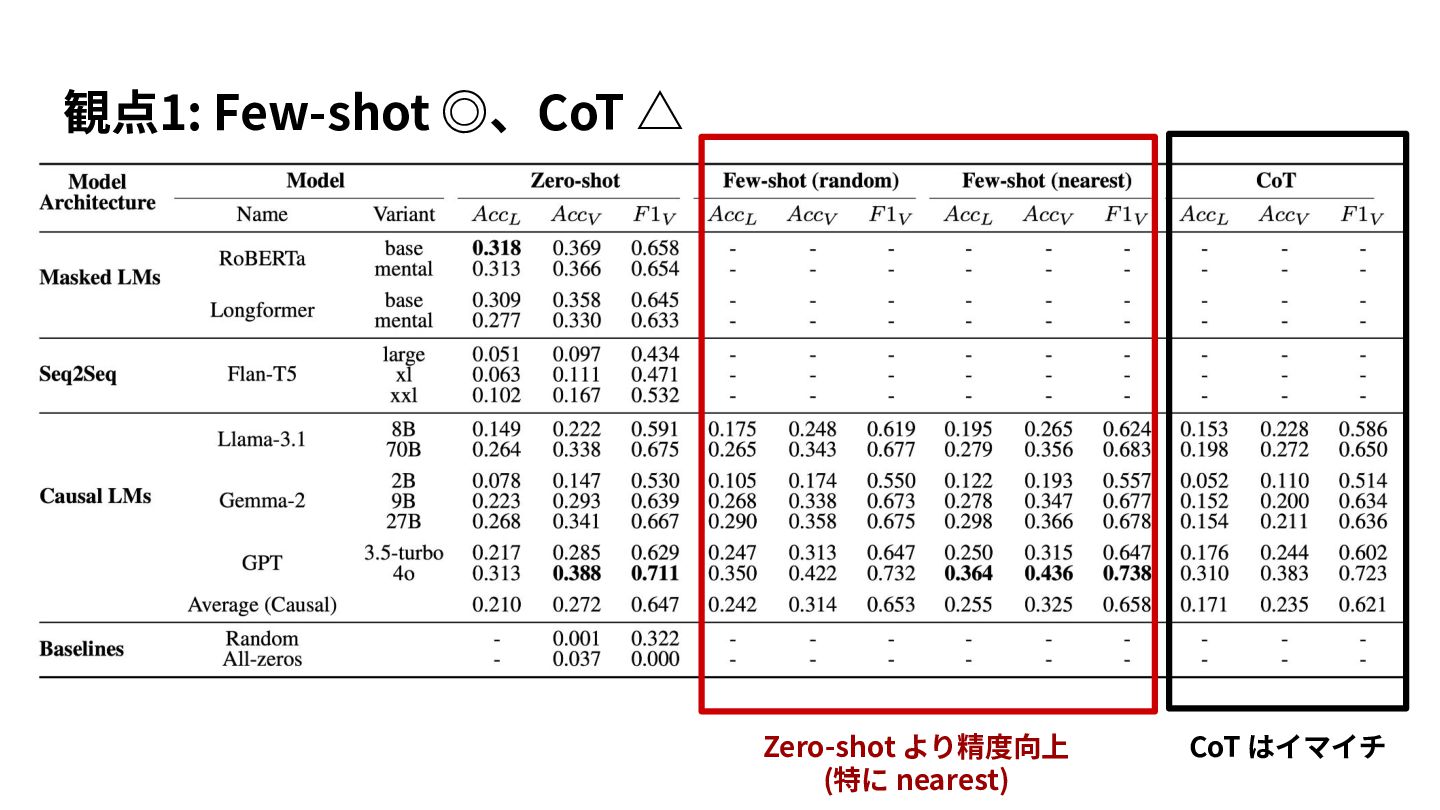
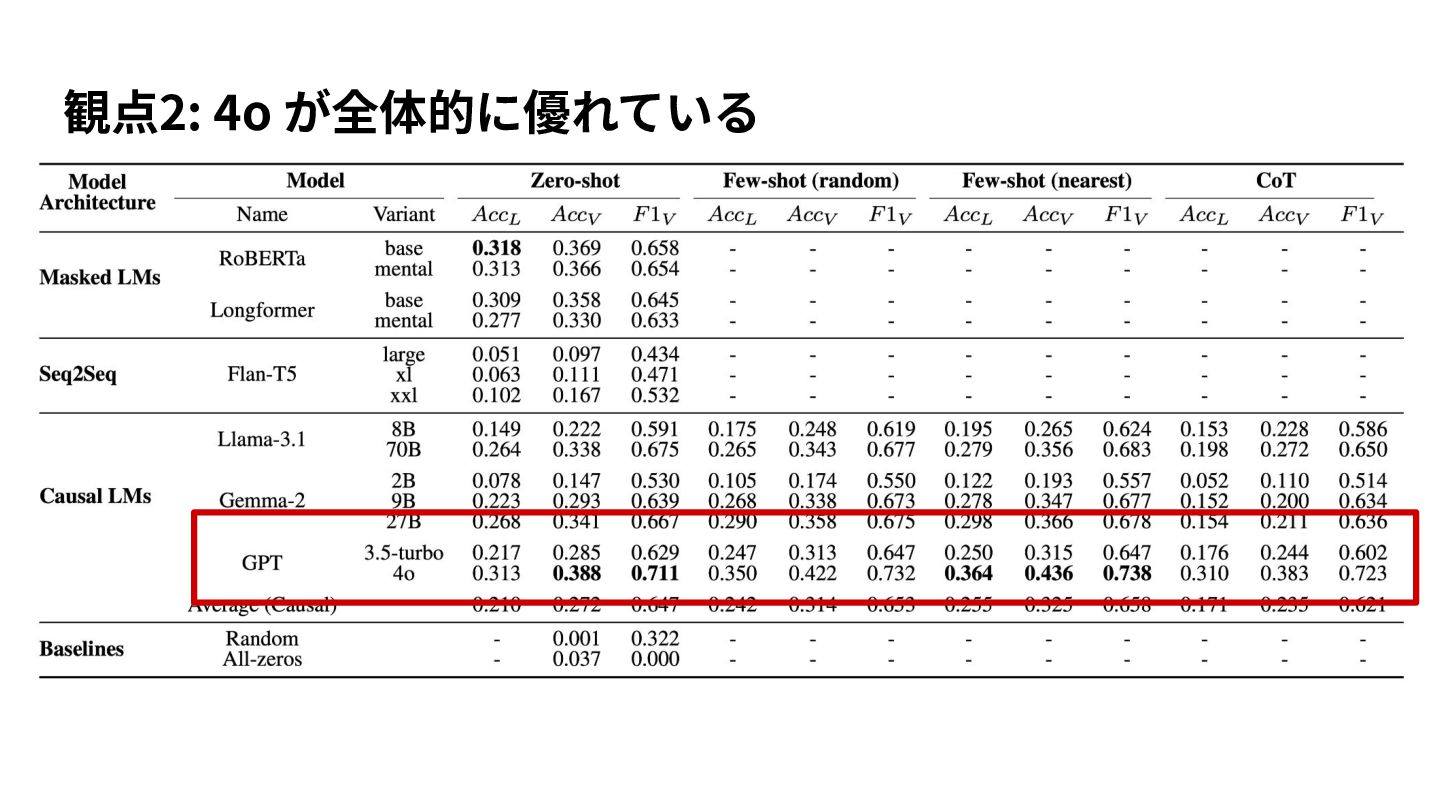
Seq2Seq (Flan-T5), Causal LM (Llama 3.1, Gemma-2, GPT 3.5-Turbo / 4o) ※ 全体的にちょっと古い プロンプト手法 Zero-shot, Few-shot, Chain-of-Thought. (Masked LM は Zero-shot のみ)。 Few-shot はランダムに例を選択 (random) ともっとも近い事例を選択 (nearest) の2通り。CoT は “Think step by step” という文言をプロンプトにに追加 (注: 近年の LLM がネイティブサポートしてい るような <think> .. </think> とは別物)
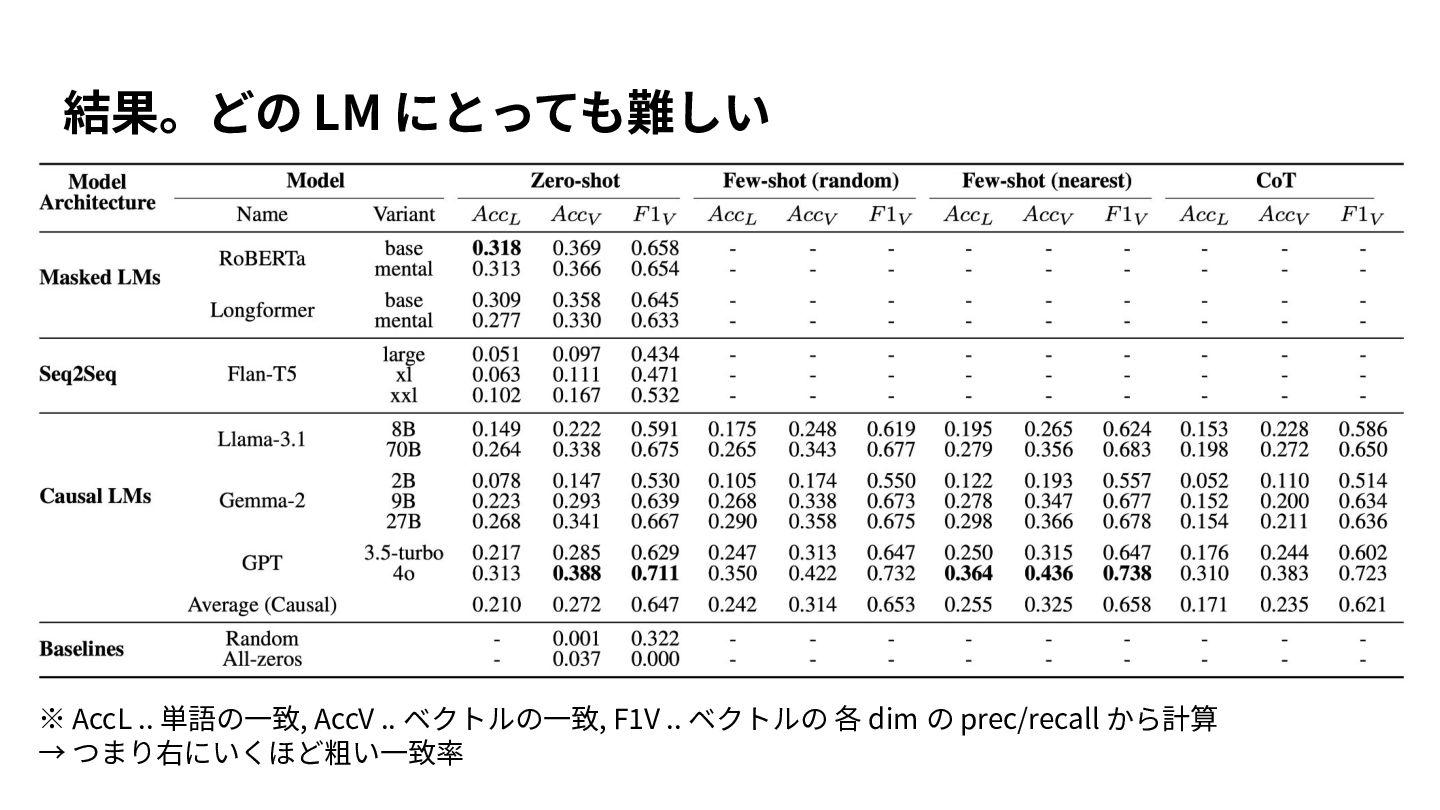
結果。どの LM にとっても難しい ※ AccL .. 単語の⼀致, AccV .. ベクトルの⼀致,
F1V .. ベクトルの 各 dim の prec/recall から計算 → つまり右にいくほど粗い⼀致率
観点1: Few-shot ◎、CoT △ Zero-shot より精度向上 (特に nearest) CoT はイマイチ
観点2: 4o が全体的に優れている
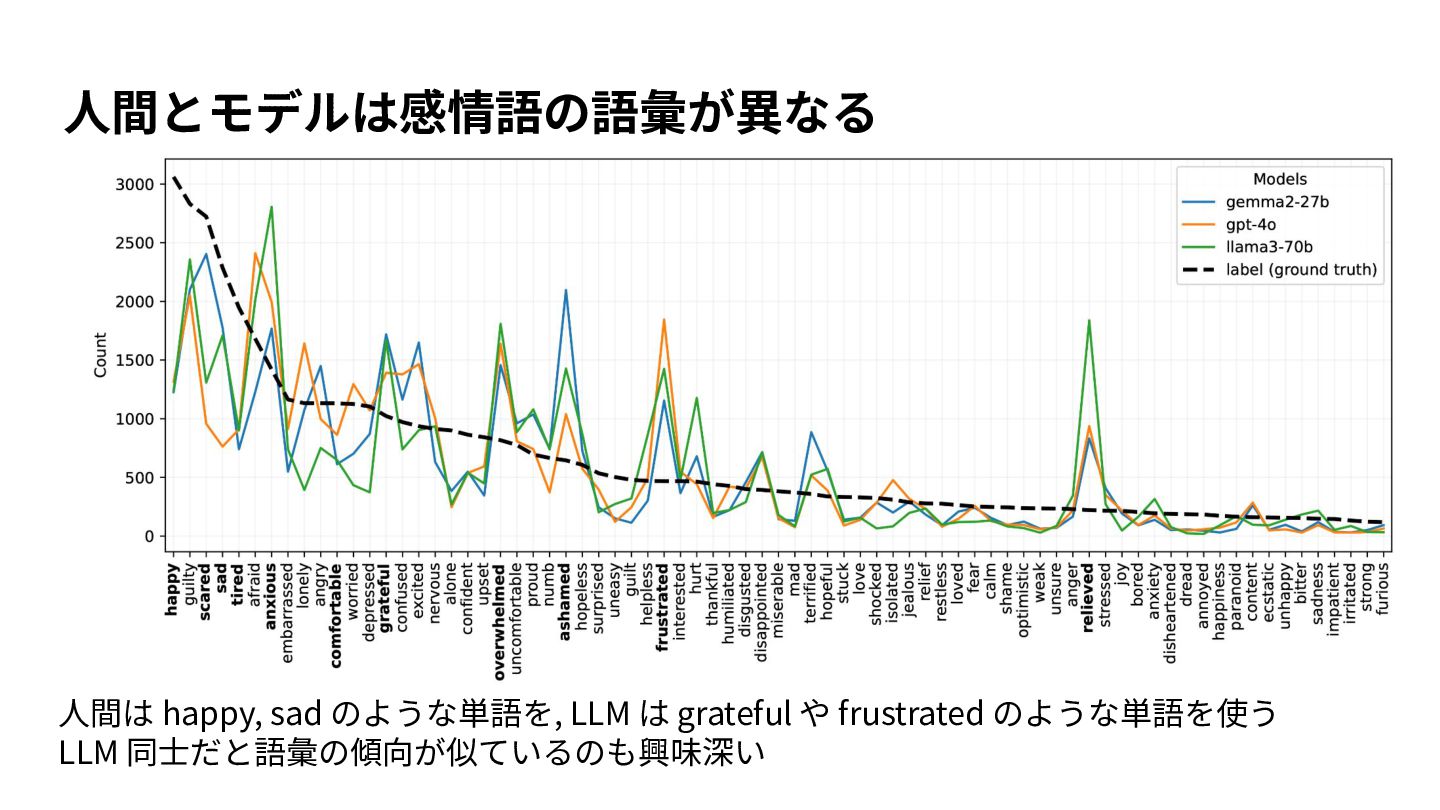
⼈間とモデルは感情語の語彙が異なる ⼈間は happy, sad のような単語を, LLM は grateful や frustrated
のような単語を使う LLM 同⼠だと語彙の傾向が似ているのも興味深い
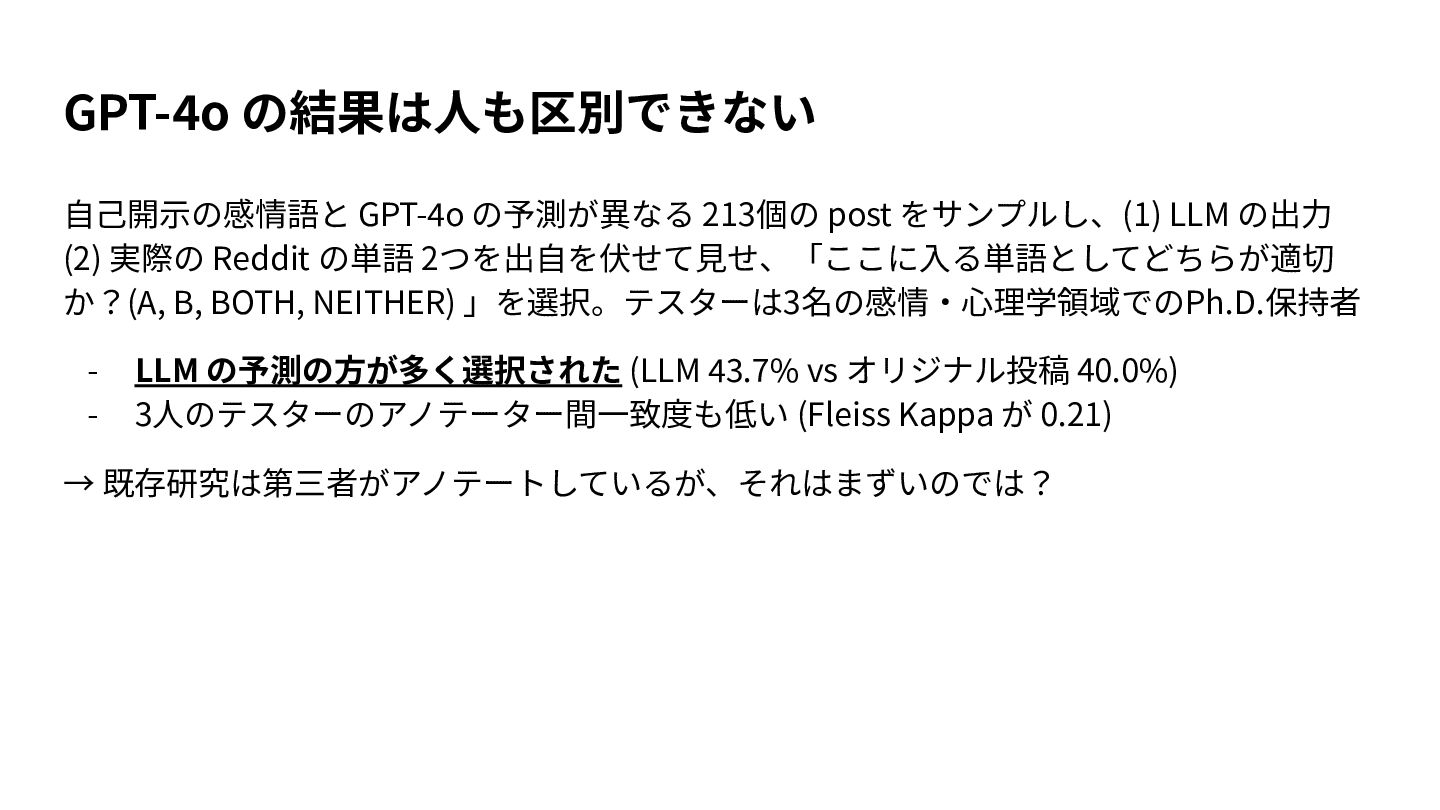
GPT-4o の結果は⼈も区別できない ⾃⼰開⽰の感情語と GPT-4o の予測が異なる 213個の post をサンプルし、(1) LLM の出⼒
(2) 実際の Reddit の単語 2つを出⾃を伏せて⾒せ、「ここに⼊る単語としてどちらが適切 か?(A, B, BOTH, NEITHER) 」を選択。テスターは3名の感情‧⼼理学領域でのPh.D.保持者 - LLM の予測の⽅が多く選択された (LLM 43.7% vs オリジナル投稿 40.0%) 3⼈のテスターのアノテーター間⼀致度も低い (Fleiss Kappa が 0.21) → 既存研究は第三者がアノテートしているが、それはまずいのでは?
最後に: 読み⼿ (広⽥) の感想 - 感情語を当てるというのが思ったより難しそう。最近の LLM だとどの程度なのかが気 になる。 LLM
がシンプルな感情語 (sad, happy, etc..) を⼈と⽐べてあまり使わない理由が気にな る。何かそうなるメカニズムがある? 「本⼈がどの程度許容できるか」も知りたい。第三者が⾒て LLM かオリジナルかはほ ぼ⾒分けられないという結論だったが、post を書いた本⼈がジャッジするとどうなの か?が気になる


 tarohi24
 corochann
 beale
 yumaichikawa
 institutdelelevage
 kinoue_smarthr
 shunk031
 fr0gger
 polipoli
 retrage
 soudai
 kneath
 mclloyd
 pauljervisheath
 axbom
 csswizardry
 lara
 skipperchong
 samtorres
 portentint