Share
Embed
単語分散表現と事前学習モデル - chiVe _ chiTra 利活用のための下準備 at WAP NLP Tech Talk #5
Google Colab上でのデモへのリンクはこちら
https://colab.research.google.com/drive/1Hr8Lyr5ocHl8Xhx4yAz6j36ALhZzmxrn?usp=sharing
WAP
April 28, 2022
Transcript
31 slides
-
© 2022 Works Applications Systems Co., Ltd. 単語分散表現と事前学習モデル chiVe /
chiTra 利活用のための下準備 ワークス徳島人工知能NLP研究所 栗原理聡 -
© 2022 Works Applications Systems Co., Ltd. 自己紹介 2 •
栗原 理聡(くりはら まさとし) • 2018.3 ◦ 東北大学大学院 乾・岡崎研究室(現 乾研究室)博士前期課程修了 • 2018.4 ~ ◦ 株式会社ワークスアプリケーションズ • 現職にて、未知語/低頻度語に対する語構成による分散表現 の研究開発に従事 • (冒頭で ワークス徳島... と言いましたが、東京在住です) -
© 2022 Works Applications Systems Co., Ltd. はじめに 対象 :
自然言語処理の活用を検討中の非専門家の方 • 本資料で扱うこと ◦ 単語分散表現として word2vec 、事前学習モデルとして BERT を取り上げ、その出 現背景・特徴の基本 ▪ ねらい : 自然言語処理分野で ベクトルを扱うことのイメージをつける • 本資料で扱わないこと ◦ word2vec、BERTのアルゴリズム、派生、およびその後の発展に関する詳細 3 -
© 2022 Works Applications Systems Co., Ltd. はじめに 本資料の内容 4
• 単語ベクトル? ◦ 単語の “意味” を計算機で扱うには ◦ どのような ベクトル を与えるとよいか • 単語分散表現(word2vec)、事前学習モデル(BERT) • 単語分散表現 ↔ 事前学習モデル ◦ 静的 ↔ 動的 ◦ 利用局面 • ビジネスでの利活用 ◦ 単語分散表現、事前学習モデルのファインチューニング -
© 2022 Works Applications Systems Co., Ltd. 単語ベクトル? 単語の “意味”
を 計算機 で扱うには • ベクトル(数値列) に変換する必要がある • どのような ベクトル を与えるとよいか? “ネコ” [0.2, 0.3, 0.9, …, 0.4] “スダチ” [0.8, -0.2, 0.1, …, 0.7] “イヌ” [0.3, 0.5, 0.6, …, 0.2] 6 -
© 2022 Works Applications Systems Co., Ltd. 単語ベクトル? どのような ベクトル
を与えるとよいか • 最も簡単な与え方: one-hot ベクトル (語のindexにのみ 1、それ以外 0) … … … … “ネコ” [0, 0, 0, …, 0, …, 0, …, 1, …, 0] “スダチ” [0, 0, 0, …, 0, …, 1, …, 0, …, 0] “イヌ” [0, 0, 0, …, 1, …, 0, …, 0, …, 0] • 問題点 🤔 ◦ 次元数が巨大 ◦ 単語間の関係を捉えられない 7 -
© 2022 Works Applications Systems Co., Ltd. 単語ベクトル? どのような ベクトル
を与えるとよいか • 最も簡単な与え方: one-hot ベクトル (語のindexにのみ 1、それ以外 0) … … … … “ネコ” [0, 0, 0, …, 0, …, 0, …, 1, …, 0] “スダチ” [0, 0, 0, …, 0, …, 1, …, 0, …, 0] “イヌ” [0, 0, 0, …, 1, …, 0, …, 0, …, 0] • 問題点 🤔 ◦ 次元数が巨大 ◦ 単語間の関係を捉えられない 語彙数分の次元が必要 chiVe の語彙数は 約300万! ※ chiVe v1.2 mc5 8 -
© 2022 Works Applications Systems Co., Ltd. 単語ベクトル? どのような ベクトル
を与えるとよいか • 最も簡単な与え方: one-hot ベクトル (語のindexにのみ 1、それ以外 0) … … … … “ネコ” [0, 0, 0, …, 0, …, 0, …, 1, …, 0] “スダチ” [0, 0, 0, …, 0, …, 1, …, 0, …, 0] “イヌ” [0, 0, 0, …, 1, …, 0, …, 0, …, 0] • 問題点 🤔 ◦ 次元数が巨大 ◦ 単語間の関係を捉えられない 動物 哺乳類 ペットとして人気 … ? ? 9 -
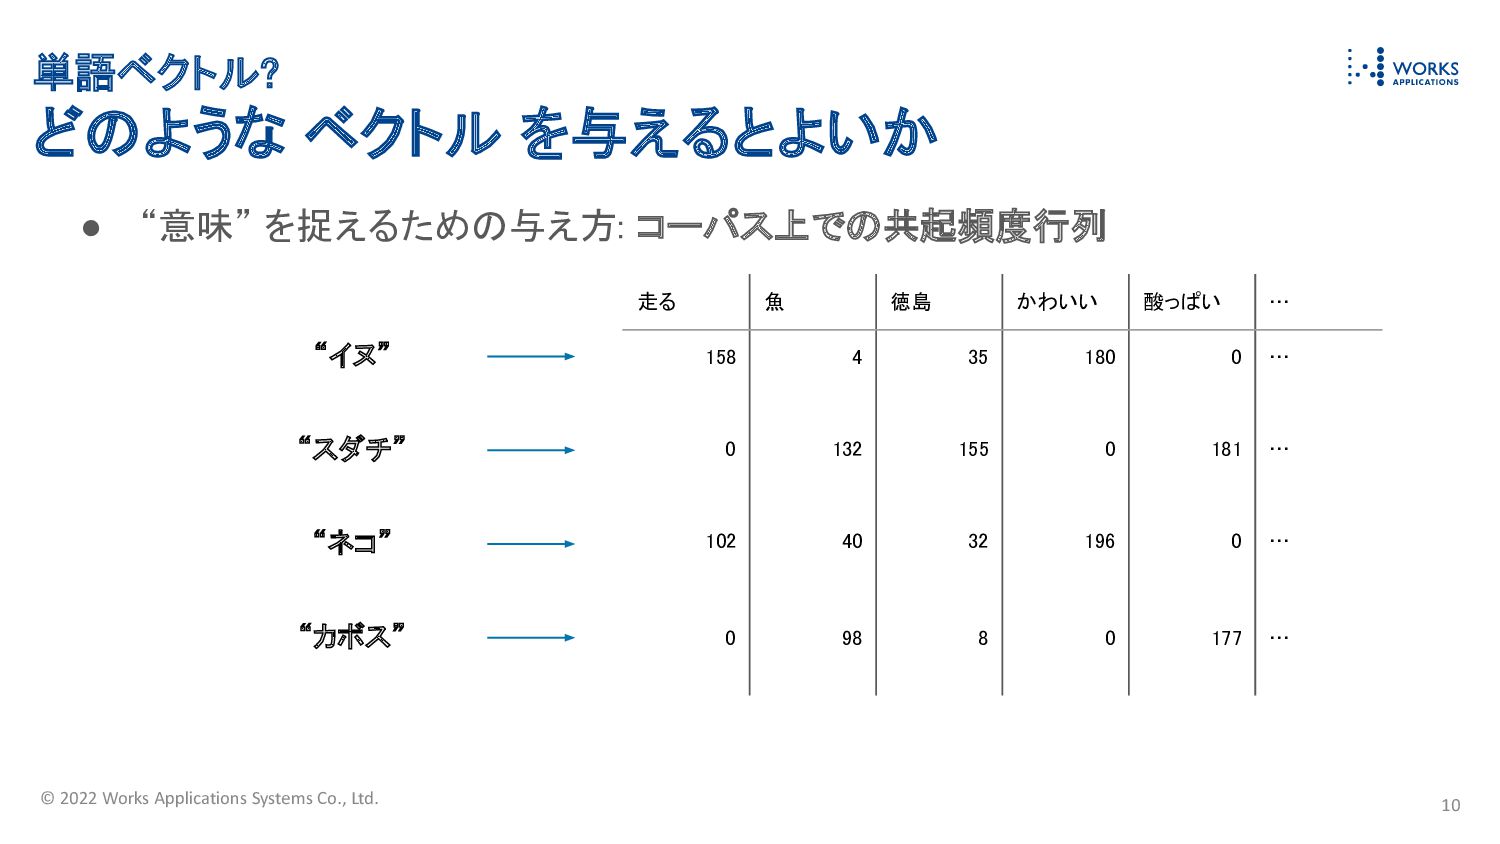
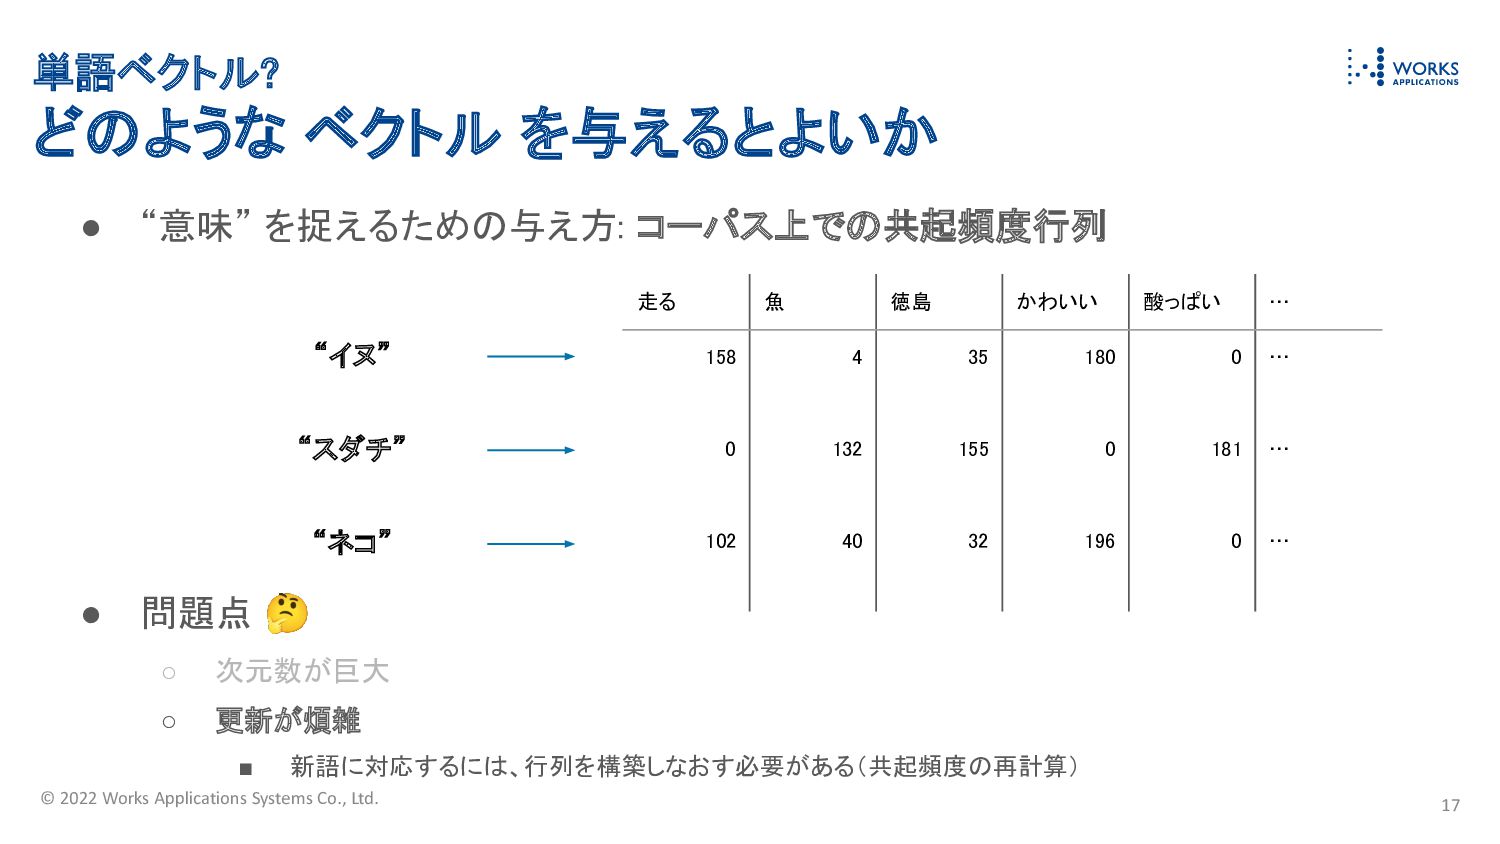
© 2022 Works Applications Systems Co., Ltd. 単語ベクトル? どのような ベクトル
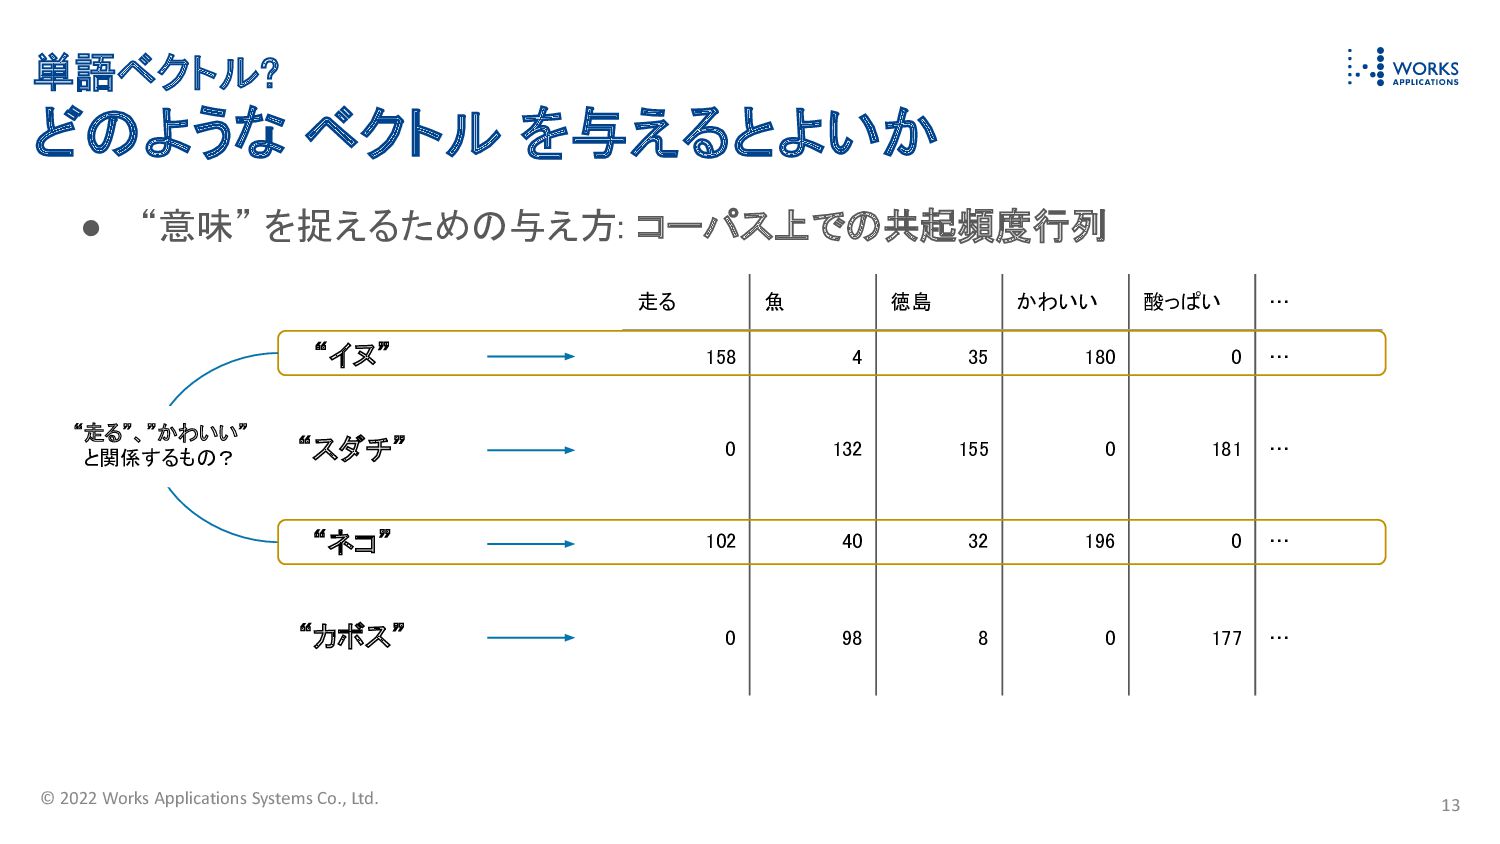
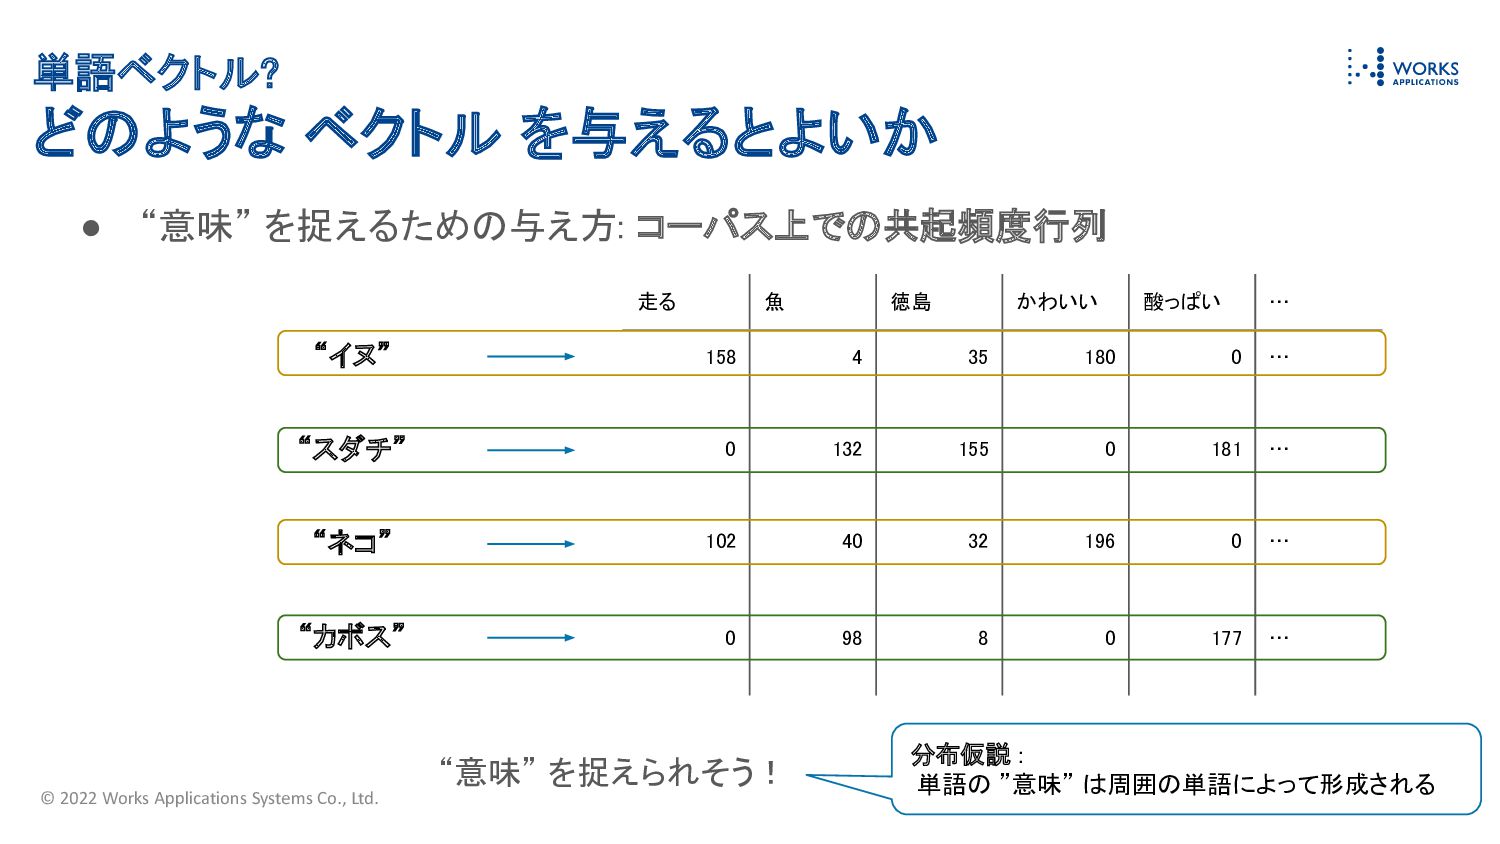
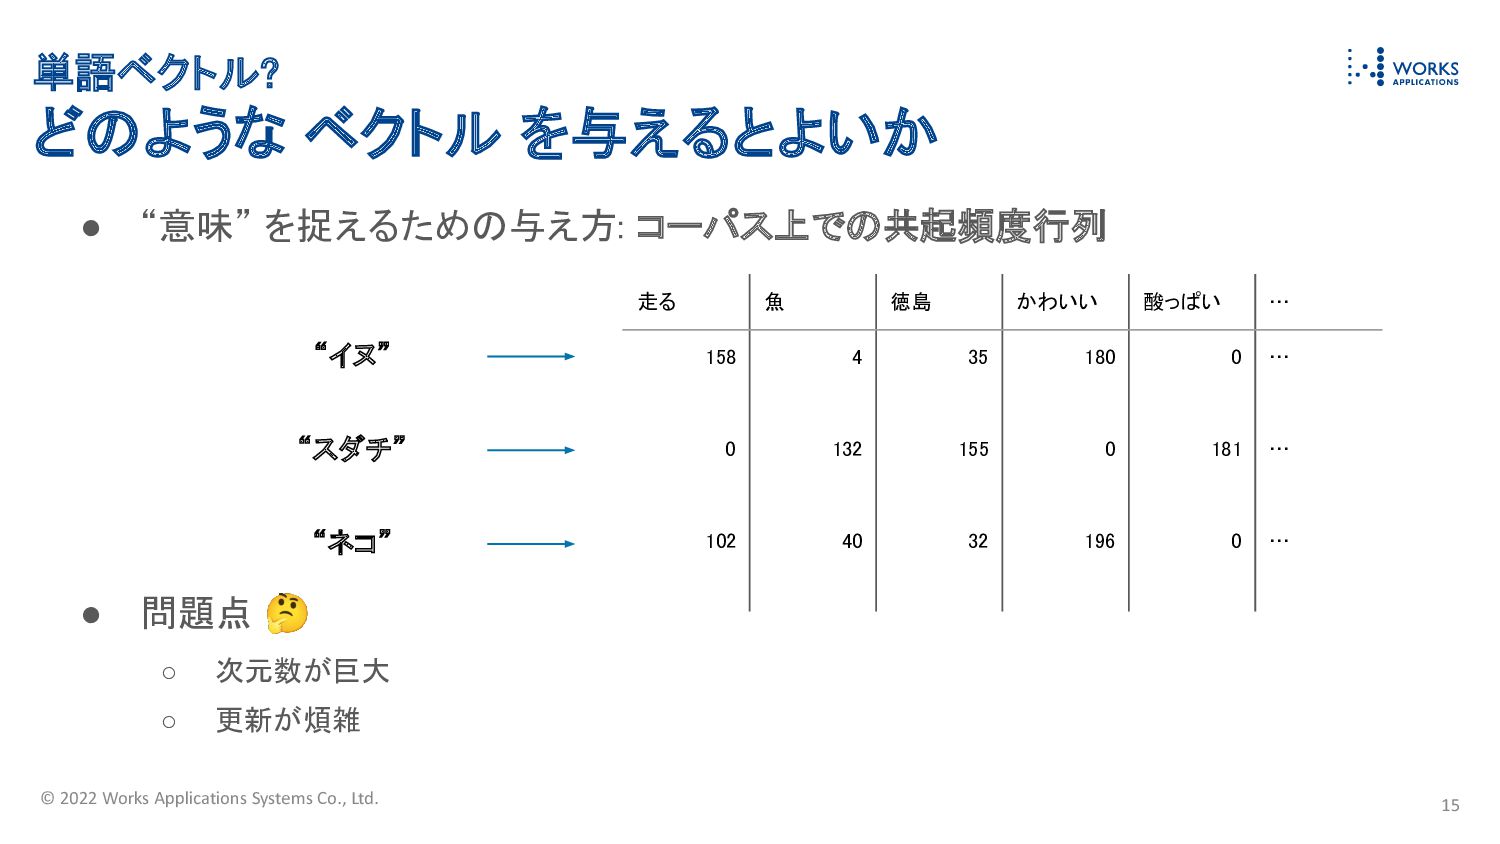
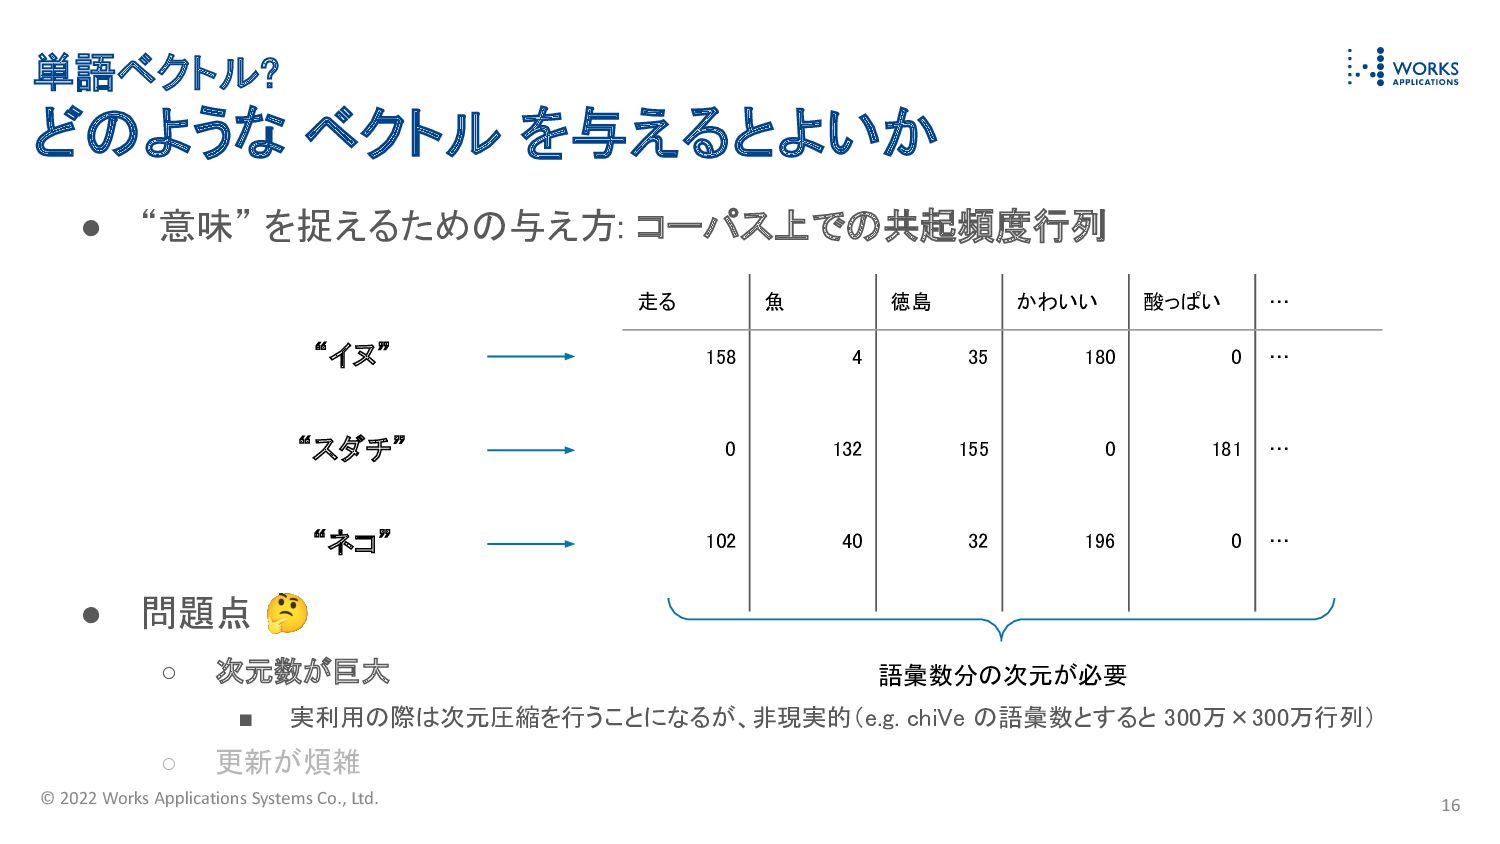
を与えるとよいか • “意味” を捉えるための与え方: コーパス上での共起頻度行列 “ネコ” “スダチ” “イヌ” 走る 魚 徳島 かわいい 酸っぱい … 158 4 35 180 0 … 0 132 155 0 181 … 102 40 32 196 0 … 0 98 8 0 177 … “カボス” 10 -
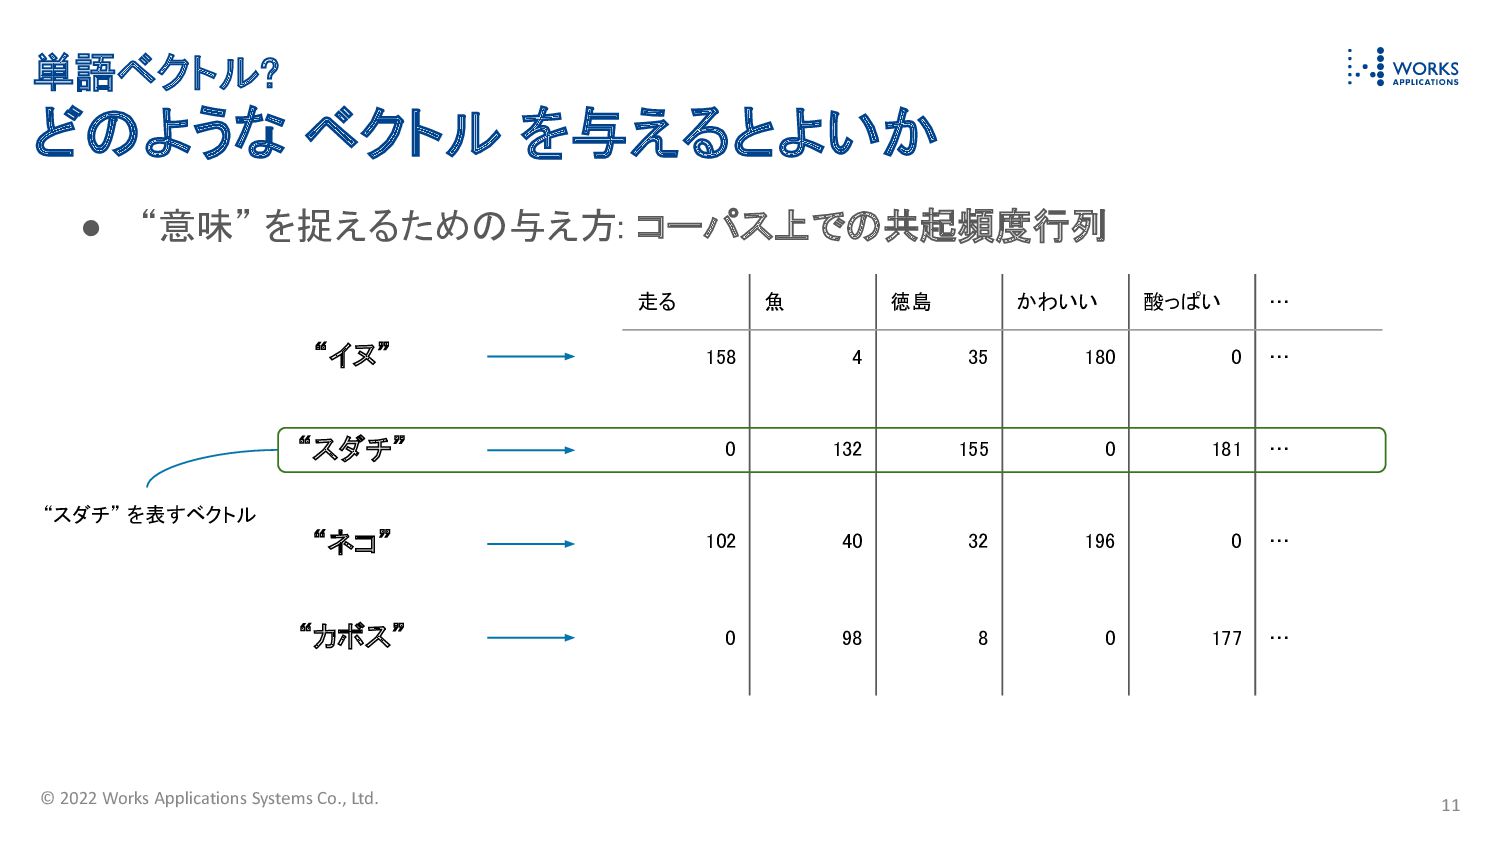
© 2022 Works Applications Systems Co., Ltd. 単語ベクトル? どのような ベクトル
を与えるとよいか • “意味” を捉えるための与え方: コーパス上での共起頻度行列 “ネコ” “スダチ” “イヌ” 走る 魚 徳島 かわいい 酸っぱい … 158 4 35 180 0 … 0 132 155 0 181 … 102 40 32 196 0 … 0 98 8 0 177 … “カボス” “スダチ” を表すベクトル 11 -
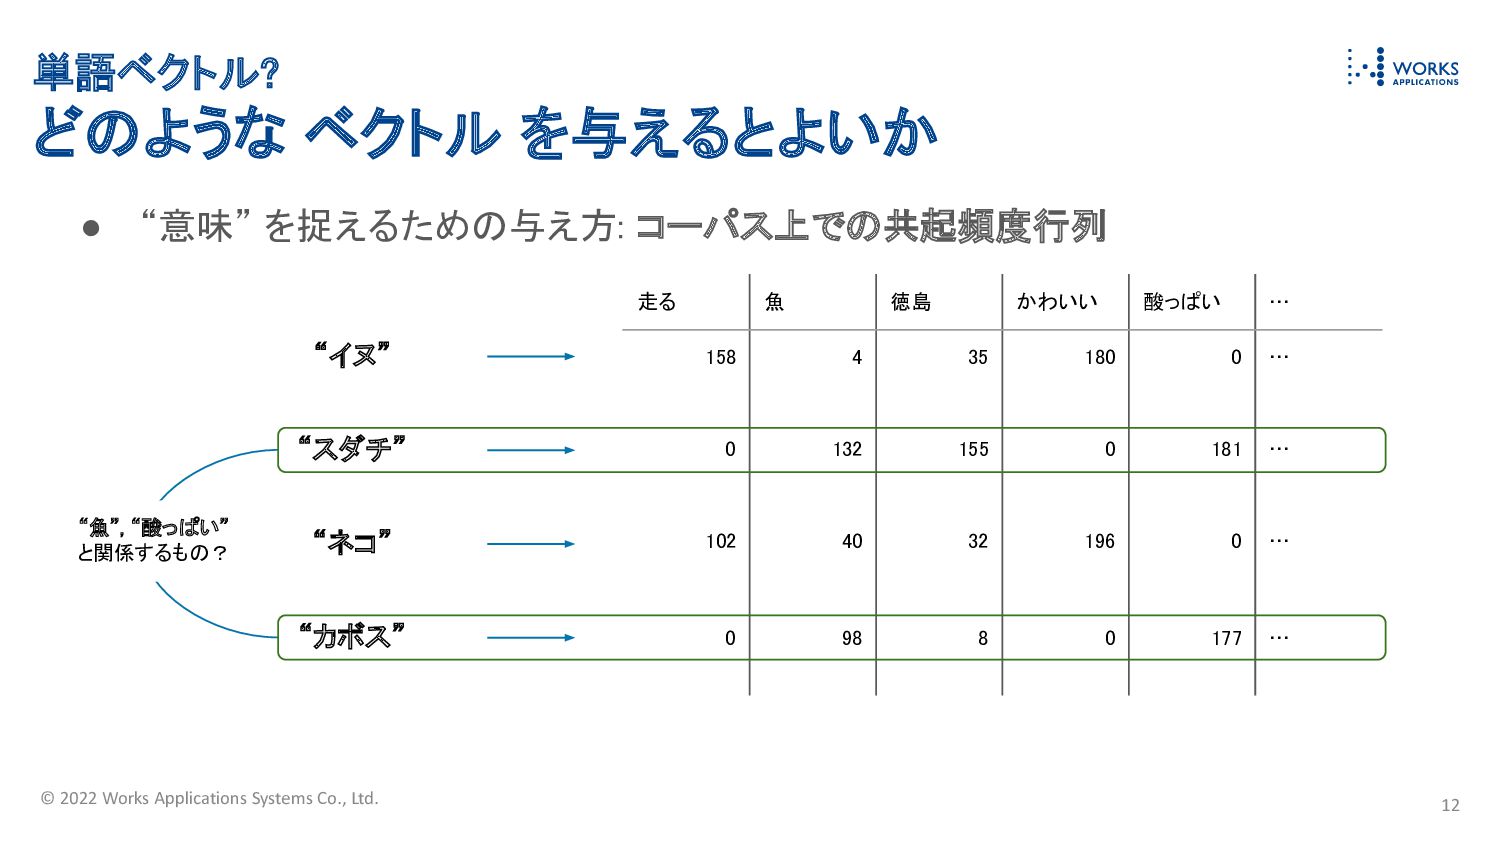
© 2022 Works Applications Systems Co., Ltd. 単語ベクトル? どのような ベクトル
を与えるとよいか • “意味” を捉えるための与え方: コーパス上での共起頻度行列 “ネコ” “スダチ” “イヌ” 走る 魚 徳島 かわいい 酸っぱい … 158 4 35 180 0 … 0 132 155 0 181 … 102 40 32 196 0 … 0 98 8 0 177 … “カボス” “魚”, “酸っぱい” と関係するもの? 12 -
© 2022 Works Applications Systems Co., Ltd. 単語ベクトル? どのような ベクトル
を与えるとよいか • “意味” を捉えるための与え方: コーパス上での共起頻度行列 “ネコ” “スダチ” “イヌ” 走る 魚 徳島 かわいい 酸っぱい … 158 4 35 180 0 … 0 132 155 0 181 … 102 40 32 196 0 … 0 98 8 0 177 … “カボス” “走る”、”かわいい” と関係するもの? 13 -
© 2022 Works Applications Systems Co., Ltd. 単語ベクトル? どのような ベクトル
を与えるとよいか • “意味” を捉えるための与え方: コーパス上での共起頻度行列 “ネコ” “スダチ” “イヌ” 走る 魚 徳島 かわいい 酸っぱい … 158 4 35 180 0 … 0 132 155 0 181 … 102 40 32 196 0 … 0 98 8 0 177 … “カボス” “意味” を捉えられそう! 14 分布仮説 : 単語の ”意味” は周囲の単語によって形成される -
© 2022 Works Applications Systems Co., Ltd. 単語ベクトル? どのような ベクトル
を与えるとよいか • “意味” を捉えるための与え方: コーパス上での共起頻度行列 “ネコ” “スダチ” “イヌ” 走る 魚 徳島 かわいい 酸っぱい … 158 4 35 180 0 … 0 132 155 0 181 … 102 40 32 196 0 … • 問題点 🤔 ◦ 次元数が巨大 ◦ 更新が煩雑 15 -
© 2022 Works Applications Systems Co., Ltd. 単語ベクトル? どのような ベクトル
を与えるとよいか • “意味” を捉えるための与え方: コーパス上での共起頻度行列 “ネコ” “スダチ” “イヌ” 走る 魚 徳島 かわいい 酸っぱい … 158 4 35 180 0 … 0 132 155 0 181 … 102 40 32 196 0 … • 問題点 🤔 ◦ 次元数が巨大 ▪ 実利用の際は次元圧縮を行うことになるが、非現実的(e.g. chiVe の語彙数とすると 300万×300万行列) ◦ 更新が煩雑 語彙数分の次元が必要 16 -
© 2022 Works Applications Systems Co., Ltd. 単語ベクトル? どのような ベクトル
を与えるとよいか • “意味” を捉えるための与え方: コーパス上での共起頻度行列 “ネコ” “スダチ” “イヌ” 走る 魚 徳島 かわいい 酸っぱい … 158 4 35 180 0 … 0 132 155 0 181 … 102 40 32 196 0 … • 問題点 🤔 ◦ 次元数が巨大 ◦ 更新が煩雑 ▪ 新語に対応するには、行列を構築しなおす必要がある(共起頻度の再計算) 17 -
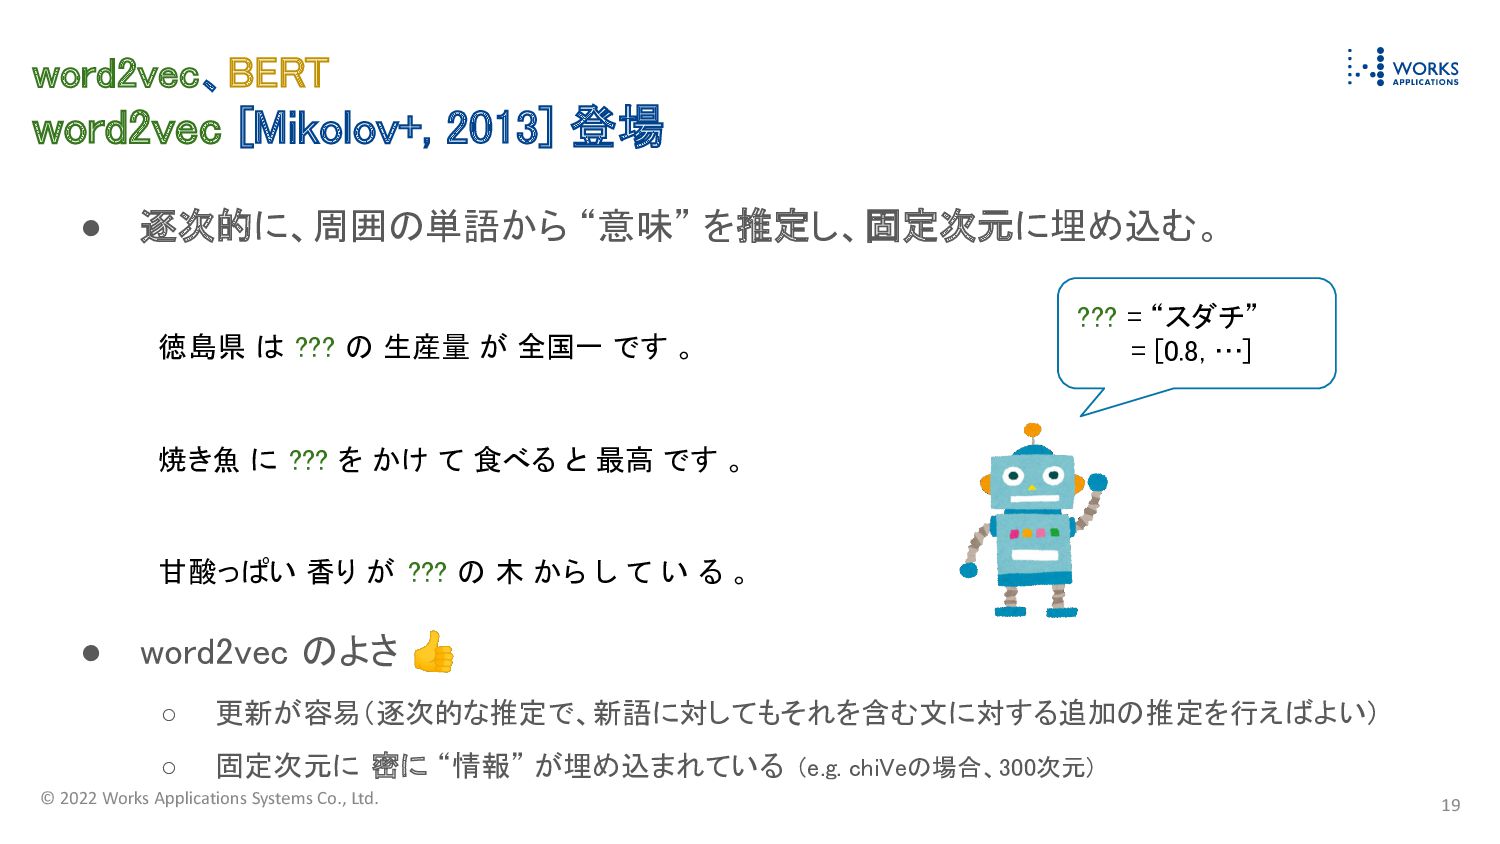
© 2022 Works Applications Systems Co., Ltd. word2vec、BERT word2vec [Mikolov+,
2013] 登場 • 逐次的に、周囲の単語から “意味” を推定し、固定次元に埋め込む。 徳島県 は ??? の 生産量 が 全国一 です 。 焼き魚 に ??? を かけ て 食べる と 最高 です 。 甘酸っぱい 香り が ??? の 木 から し て い る 。 • word2vec のよさ 👍 ◦ 更新が容易(逐次的な推定で、新語に対してもそれを含む文に対する追加の推定を行えばよい) ◦ 固定次元に 密に “情報” が埋め込まれている (e.g. chiVeの場合、300次元) ??? = “スダチ” = [0.8, …] 19 -
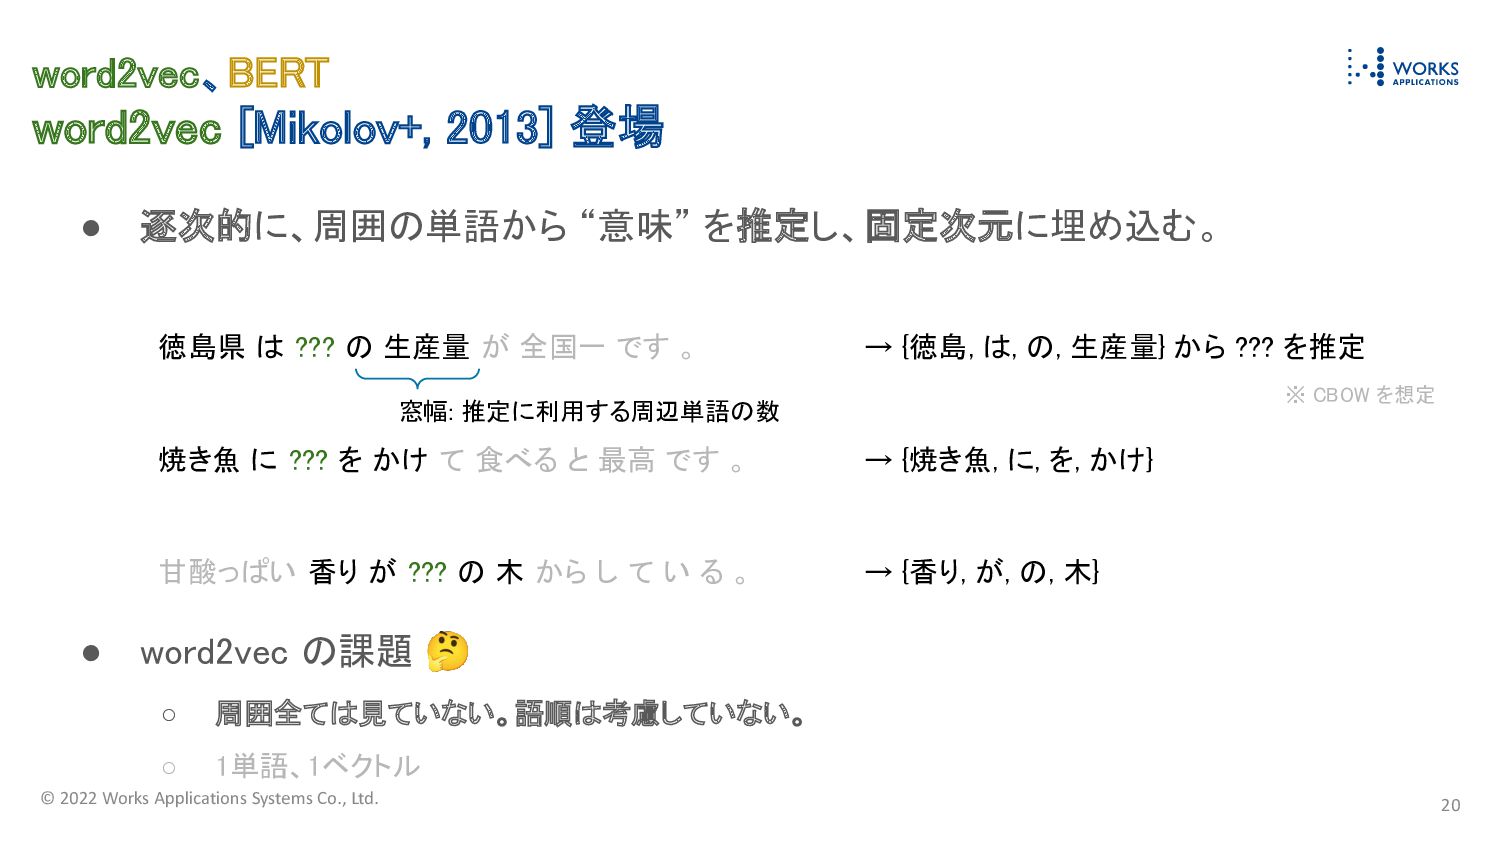
© 2022 Works Applications Systems Co., Ltd. word2vec、BERT word2vec [Mikolov+,
2013] 登場 • 逐次的に、周囲の単語から “意味” を推定し、固定次元に埋め込む。 徳島県 は ??? の 生産量 が 全国一 です 。 焼き魚 に ??? を かけ て 食べる と 最高 です 。 甘酸っぱい 香り が ??? の 木 から し て い る 。 • word2vec の課題 🤔 ◦ 周囲全ては見ていない。語順は考慮していない。 ◦ 1単語、1ベクトル 窓幅: 推定に利用する周辺単語の数 20 → {徳島, は, の, 生産量} から ??? を推定 → {焼き魚, に, を, かけ} → {香り, が, の, 木} ※ CBOW を想定 -
© 2022 Works Applications Systems Co., Ltd. word2vec、BERT word2vec [Mikolov+,
2013] 登場 • 逐次的に、周囲の単語から “意味” を推定し、固定次元に埋め込む。 • word2vec の課題 🤔 ◦ 周囲全ては見られない。 ◦ 1単語、1ベクトル(多義語に対し、”多義” を捉えられない) 徳島県 は ??? の 生産量 が 全国一 です 。 焼き魚 に ??? を かけ て 食べる と 最高 です 。 甘酸っぱい 香り が ??? の 木 から し て い る 。 ??? は ワークス が 開発 する 形態素解析器 です 。 !? ※ 実際には計算機は驚かず、これらすべての 文から ??? の “情報” を埋め込みます。 ※ 実際には形態素解析器の Sudachi を “スダチ” と表記することはありません。 21 -
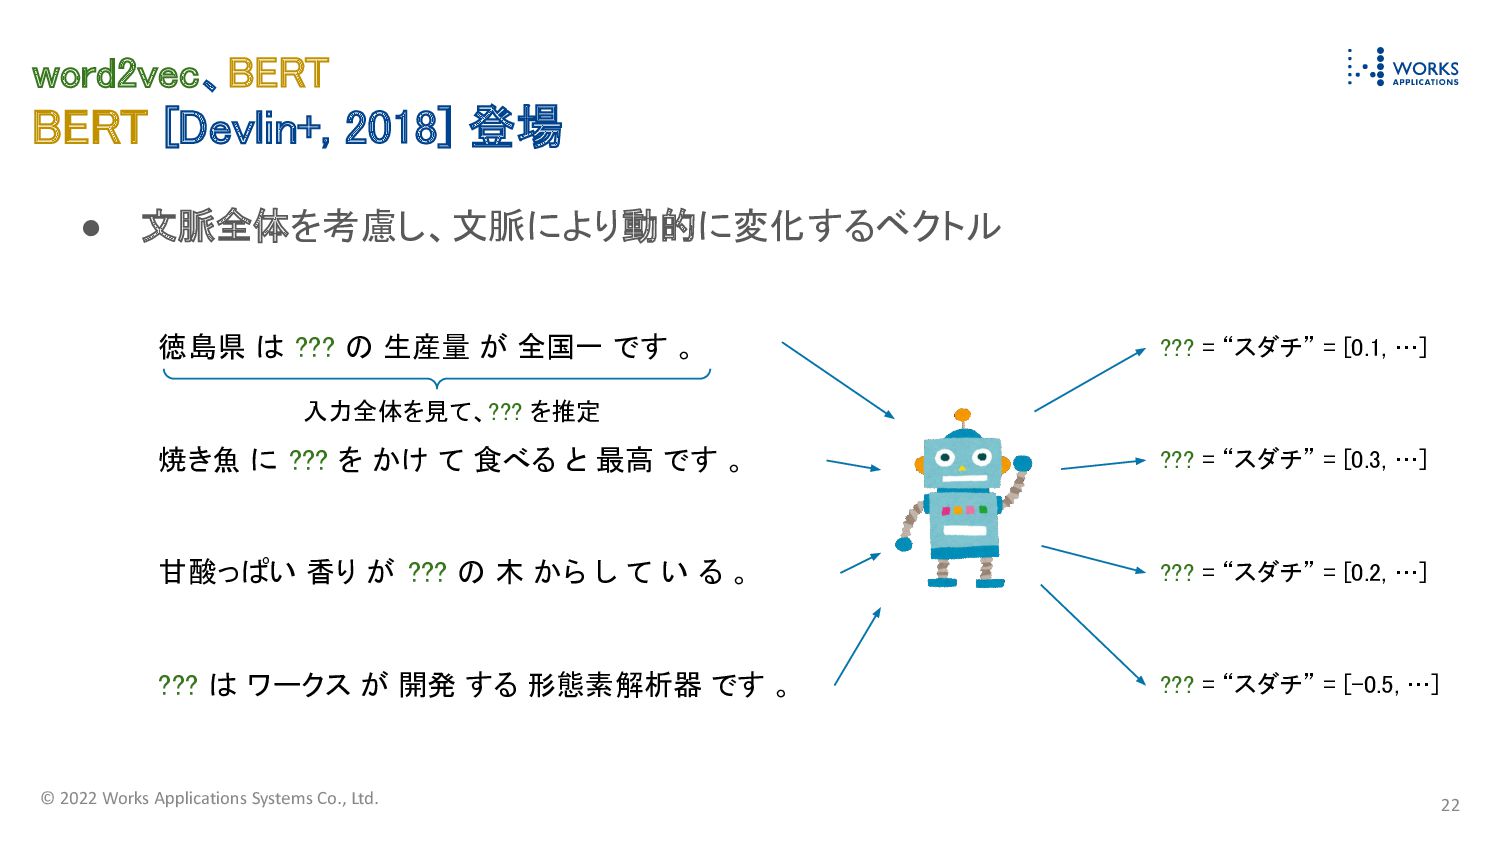
© 2022 Works Applications Systems Co., Ltd. • 文脈全体を考慮し、文脈により動的に変化するベクトル word2vec、BERT
BERT [Devlin+, 2018] 登場 徳島県 は ??? の 生産量 が 全国一 です 。 焼き魚 に ??? を かけ て 食べる と 最高 です 。 甘酸っぱい 香り が ??? の 木 から し て い る 。 ??? は ワークス が 開発 する 形態素解析器 です 。 22 ??? = “スダチ” = [0.1, …] ??? = “スダチ” = [0.3, …] ??? = “スダチ” = [0.2, …] ??? = “スダチ” = [-0.5, …] 入力全体を見て、??? を推定 -
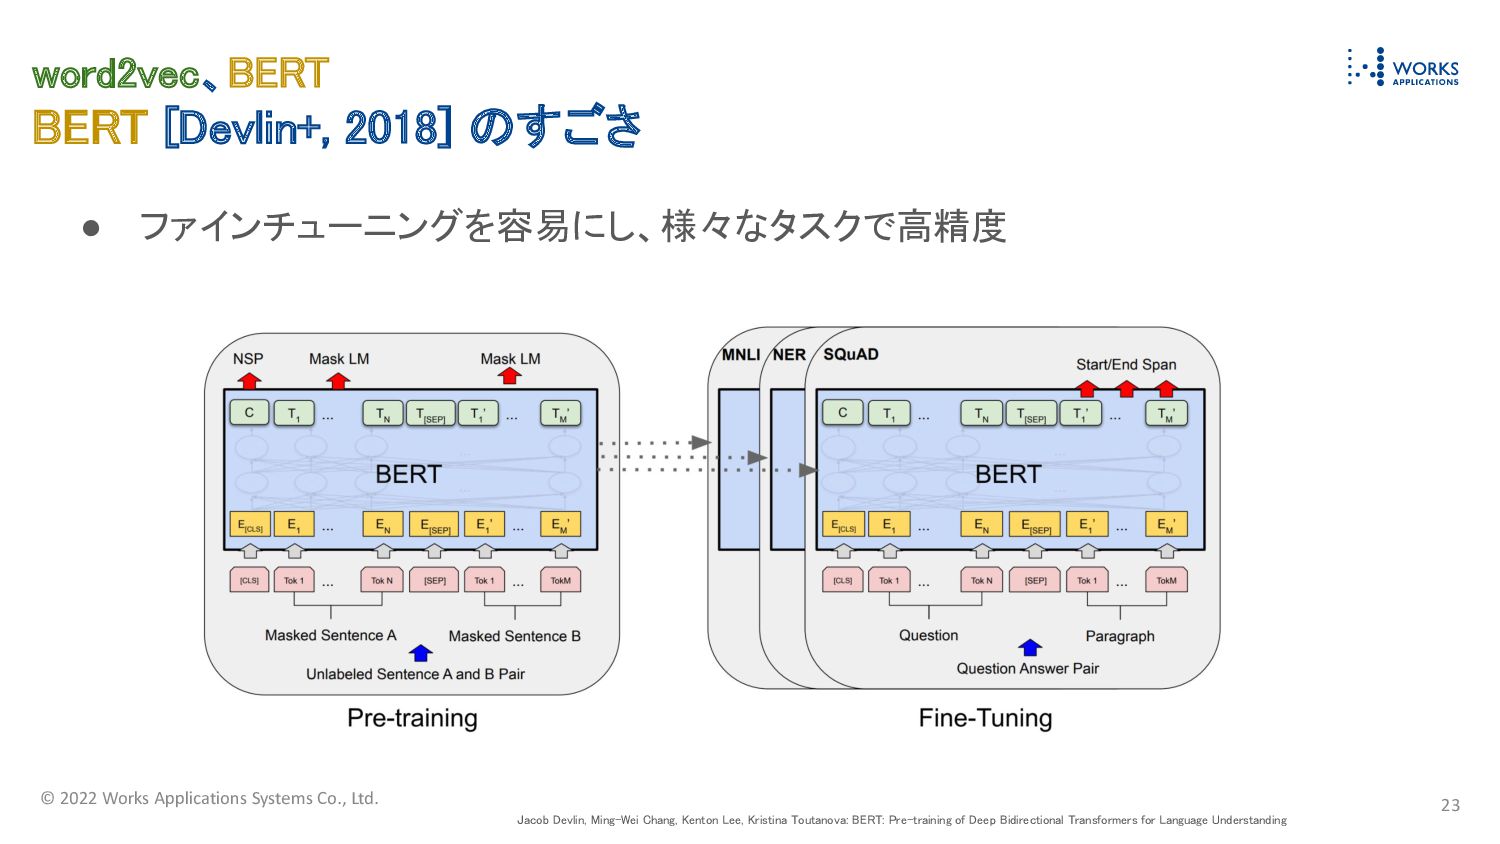
© 2022 Works Applications Systems Co., Ltd. • ファインチューニングを容易にし、様々なタスクで高精度 word2vec、BERT
BERT [Devlin+, 2018] のすごさ 23 Jacob Devlin, Ming-Wei Chang, Kenton Lee, Kristina Toutanova: BERT: Pre-training of Deep Bidirectional Transformers for Language Understanding -
© 2022 Works Applications Systems Co., Ltd. • chiVe, chiTraによる単語ベクトルの性質の違いデモ
◦ https://colab.research.google.com/drive/1Hr8Lyr5ocHl8Xhx4yAz6j36ALhZzmxrn?usp=sharing 単語分散表現 ↔ 事前学習モデル 静的 ↔ 動的 25 word2vec: 1単語に1つのベクトル BERT: 文脈によりベクトルが変化する Google Colab上でのデモへのリンクは 概要欄に載せています -
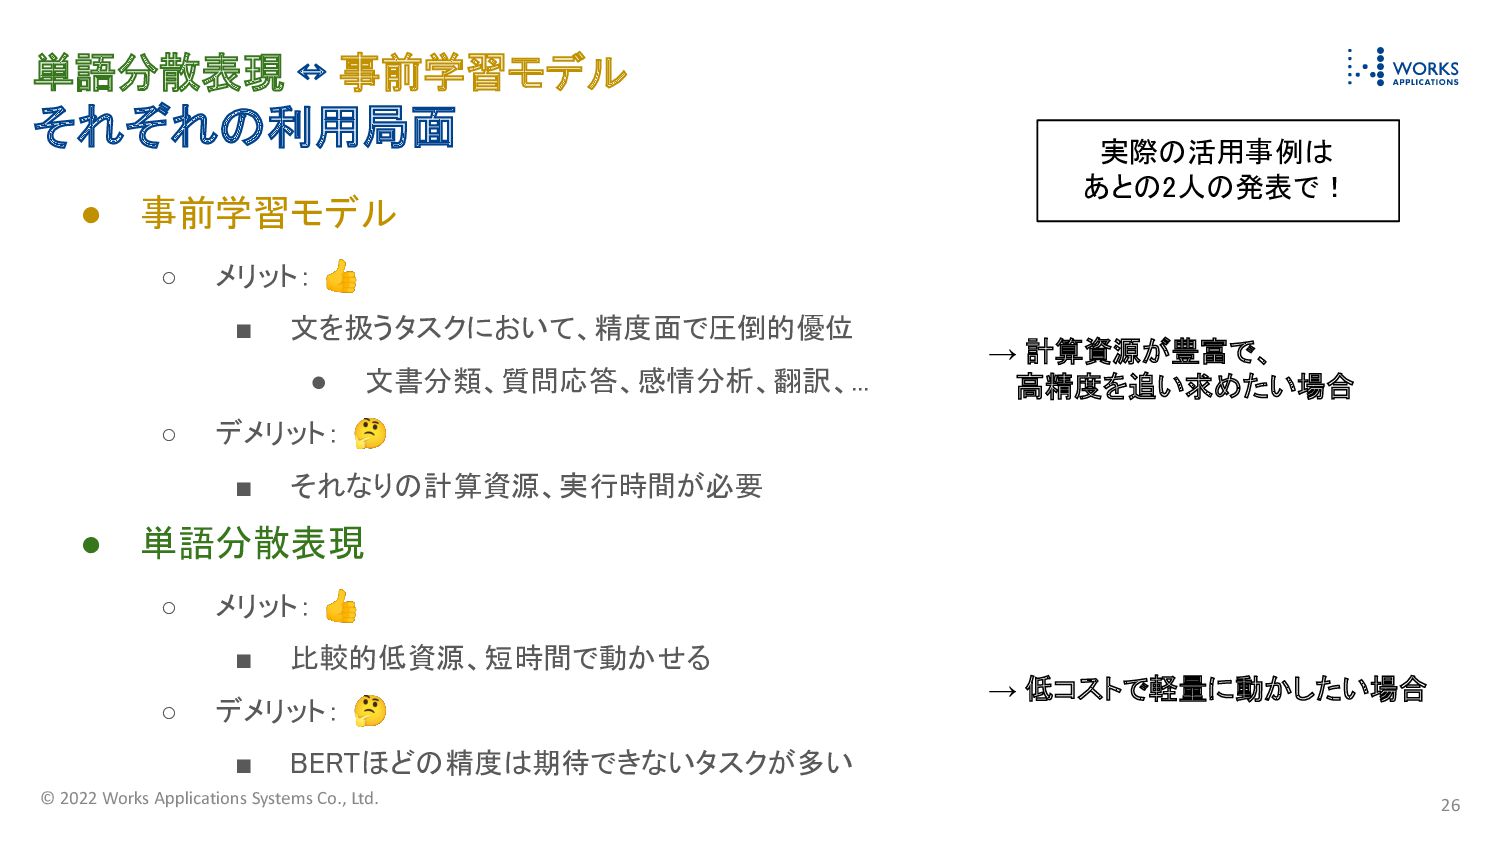
© 2022 Works Applications Systems Co., Ltd. 単語分散表現 ↔ 事前学習モデル
それぞれの利用局面 • 事前学習モデル ◦ メリット: 👍 ▪ 文を扱うタスクにおいて、精度面で圧倒的優位 • 文書分類、質問応答、感情分析、翻訳、... ◦ デメリット: 🤔 ▪ それなりの計算資源、実行時間が必要 • 単語分散表現 ◦ メリット: 👍 ▪ 比較的低資源、短時間で動かせる ◦ デメリット: 🤔 ▪ BERTほどの精度は期待できないタスクが多い 26 実際の活用事例は あとの2人の発表で! → 計算資源が豊富で、 高精度を追い求めたい場合 → 低コストで軽量に動かしたい場合 -
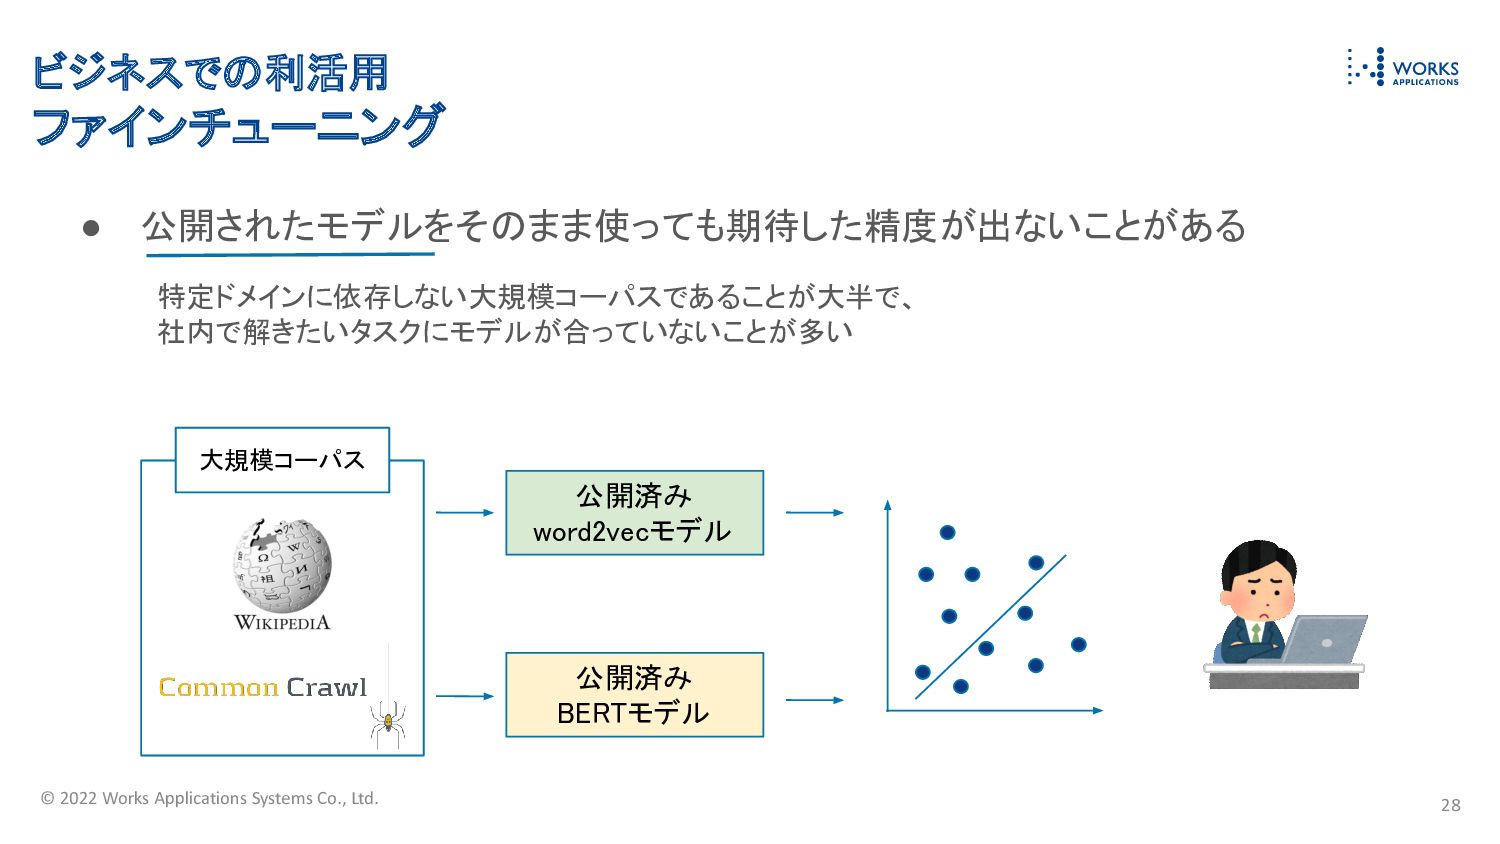
© 2022 Works Applications Systems Co., Ltd. • 公開されたモデルをそのまま使っても期待した精度が出ないことがある ビジネスでの利活用
ファインチューニング 28 公開済み word2vecモデル 公開済み BERTモデル 大規模コーパス 特定ドメインに依存しない大規模コーパスであることが大半で、 社内で解きたいタスクにモデルが合っていないことが多い -
© 2022 Works Applications Systems Co., Ltd. ビジネスでの利活用 ファインチューニング •
解きたいタスクに関連するデータでタスクにモデルを適合させる 29 社内データに適合した word2vecモデル 社内データに適合した BERTモデル 公開済み word2vecモデル 公開済み BERTモデル 社内データ 実際の活用事例は あとの2人の発表で! -
© 2022 Works Applications Systems Co., Ltd. • 単語ベクトル? ◦
単語の “意味” を 計算機 で扱うために ベクトル(数値列) に変換する必要がある ▪ one-hot ベクトル, コーパス上での共起頻度 ← 分布仮説 • 単語分散表現(word2vec)、事前学習モデル(BERT) ◦ word2vec: 逐次推定、固定次元 / BERT: 文脈全体を利用した推定、動的ベクトル • 単語分散表現 ↔ 事前学習モデル ◦ 静的 ↔ 動的 ◦ 利用局面 ▪ word2vec: 低コスト, 軽量 / BERT: 高精度の追求 • ビジネスでの利活用 ◦ 単語分散表現、事前学習モデルのファインチューニング 30 まとめ -
© 2022 Works Applications Systems Co., Ltd. References • Tomas
Mikolov, Kai Chen, Greg Corrado, Jeffrey Dean: Efficient Estimation of Word Representations in Vector Space ( https://arxiv.org/abs/1301.3781 ) • Jacob Devlin, Ming-Wei Chang, Kenton Lee, Kristina Toutanova: BERT: Pre-training of Deep Bidirectional Transformers for Language Understanding ( https://arxiv.org/abs/1810.04805 ) • Stanford University CS224n: Natural Language Processing with Deep Learning ( http://web.stanford.edu/class/cs224n/ ) • Chris McCormick, Nick Ryan: BERT Word Embeddings Tutorial ( https://mccormickml.com/2019/05/14/BERT-word-embeddings-tutorial/ ) • 横井祥: How to leverage optimal transport ( https://speakerdeck.com/eumesy/how-to-leverage-optimal-transport ) • 斎藤康毅: 『ゼロから作るDeep Learning 2』 (オライリー・ジャパン) • 小川雄太郎: 『つくりながら学ぶ! PyTorchによる発展ディープラーニング』 (マイナビ) 31