Share
Embed
アウトプット型学習のための主張抽出とRAGに基づく訂正・補足情報の生成
アウトプット型学習のための主張抽出とRAGに基づく訂正・補足情報の生成

兵庫県立大学 山本研究室
November 05, 2026
Transcript
52 slides
-
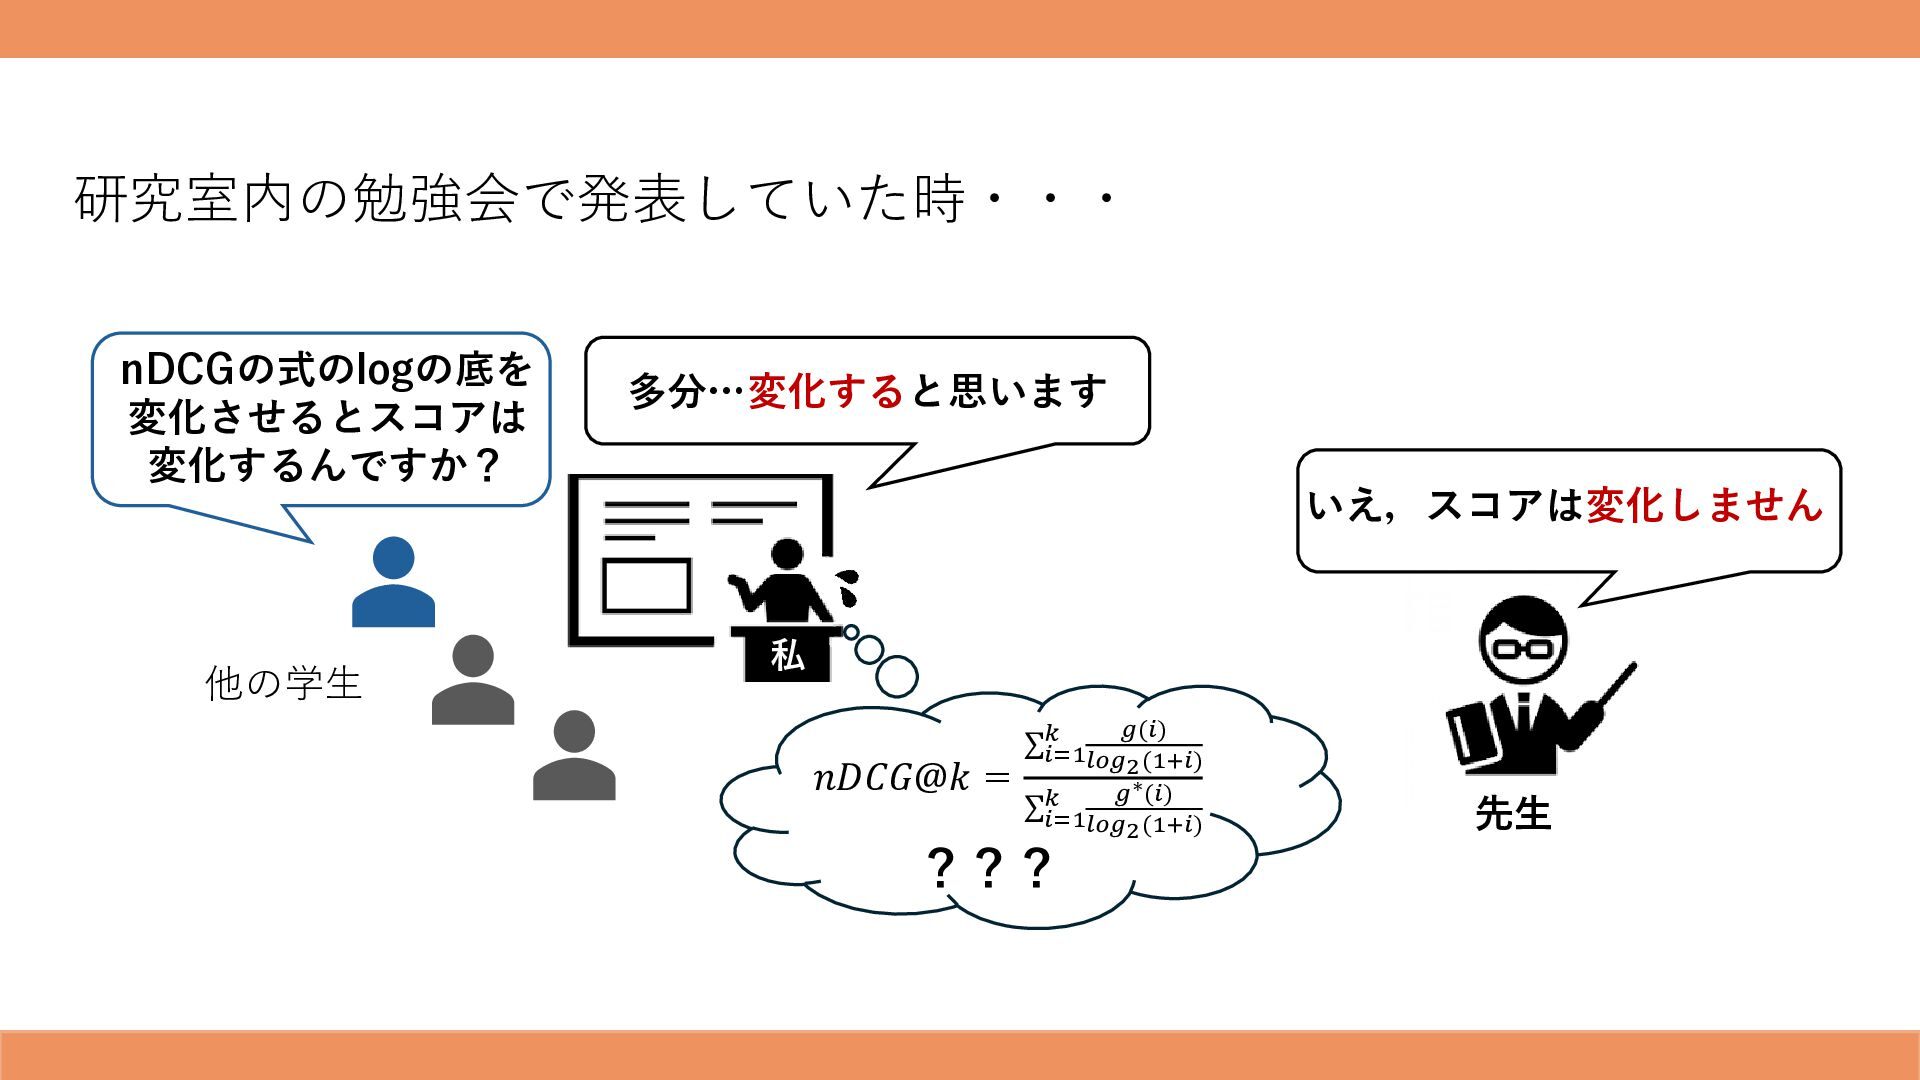
研究室内の勉強会で発表していた時・・・ nDCGの式のlogの底を 変化させるとスコアは 変化するんですか? 多分…変化すると思います いえ,スコアは変化しません 他の学生 私 𝑛𝐷𝐶𝐺@𝑘 =
𝑔(𝑖) 𝑙𝑜𝑔2 (1+𝑖) 𝑔∗ (𝑖) σ𝑘 𝑖=1𝑙𝑜𝑔2 (1+𝑖) σ𝑘 𝑖=1 ??? 先生 -
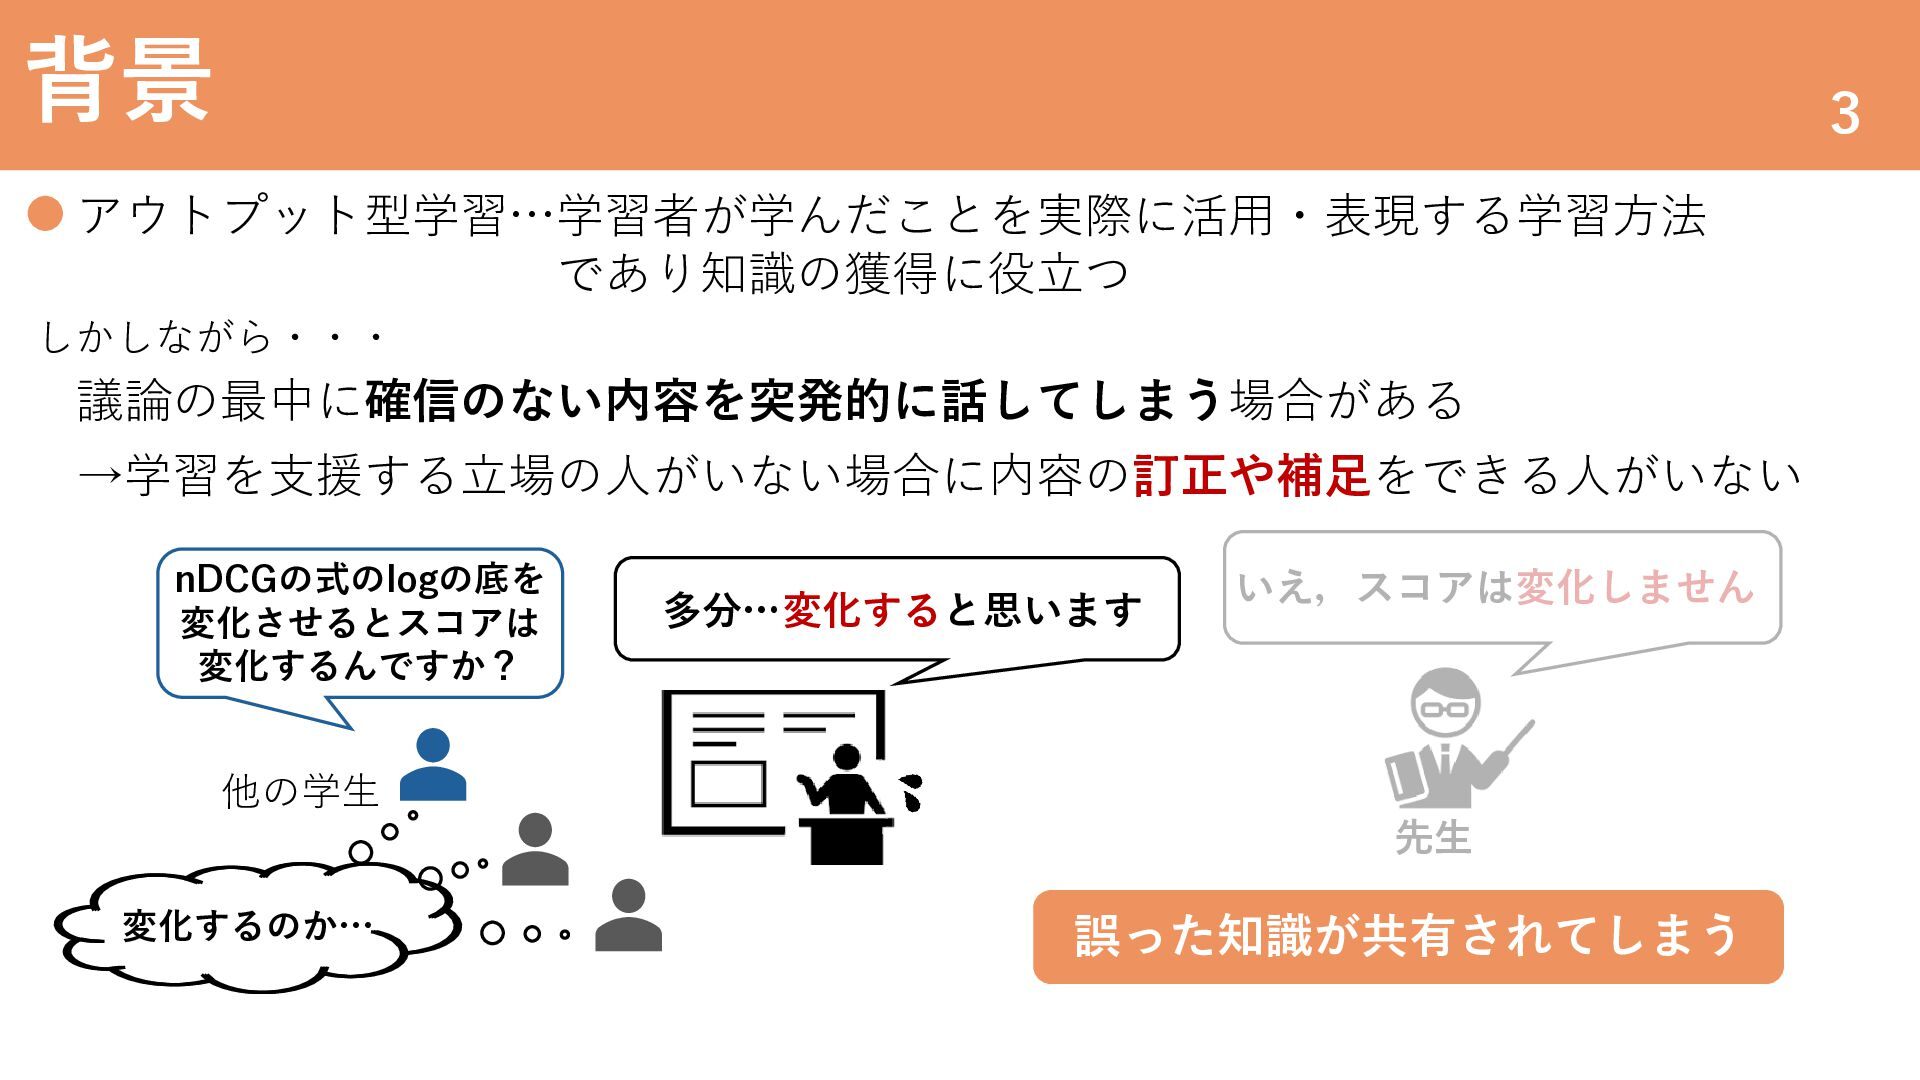
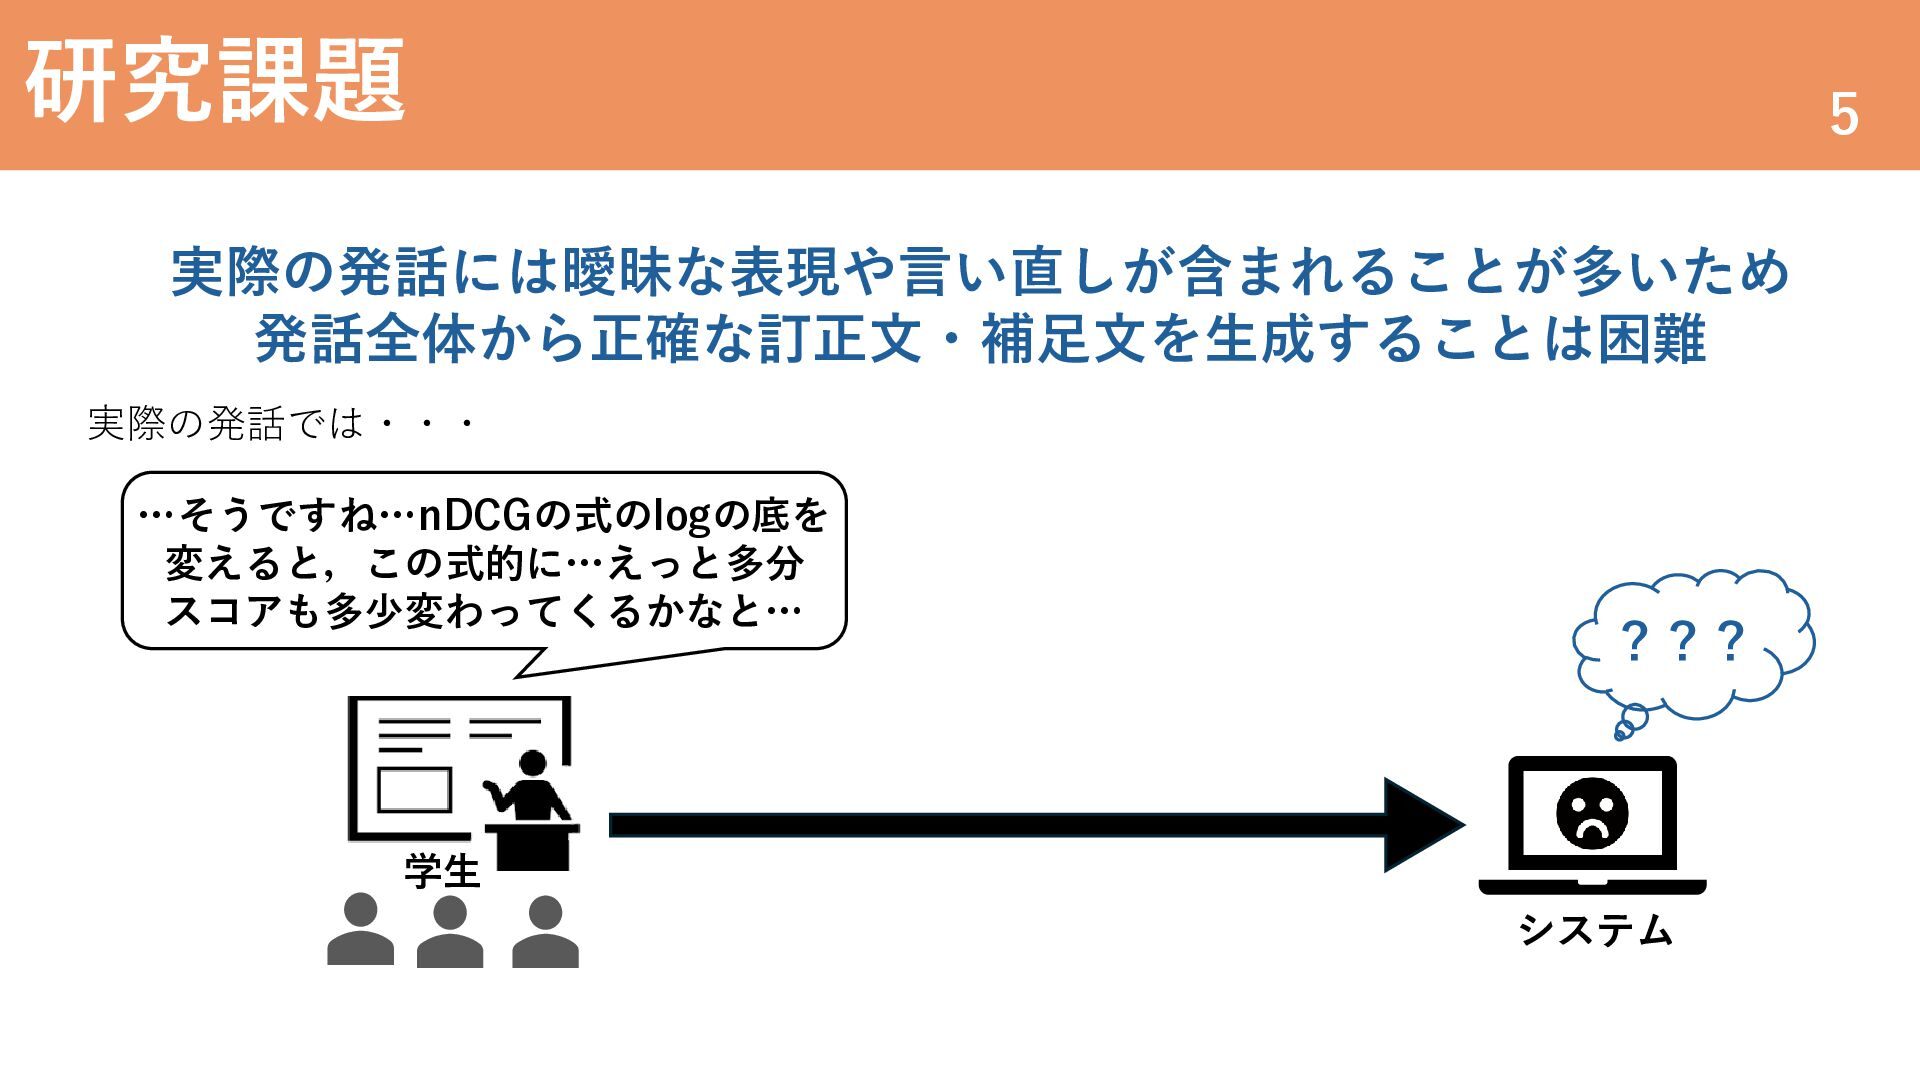
背景 3 アウトプット型学習…学習者が学んだことを実際に活用・表現する学習方法 であり知識の獲得に役立つ しかしながら・・・ 議論の最中に確信のない内容を突発的に話してしまう場合がある →学習を支援する立場の人がいない場合に内容の訂正や補足をできる人がいない nDCGの式のlogの底を 変化させるとスコアは 変化するんですか?
多分…変化すると思います いえ,スコアは変化しません 他の学生 先生 変化するのか… 誤った知識が共有されてしまう -
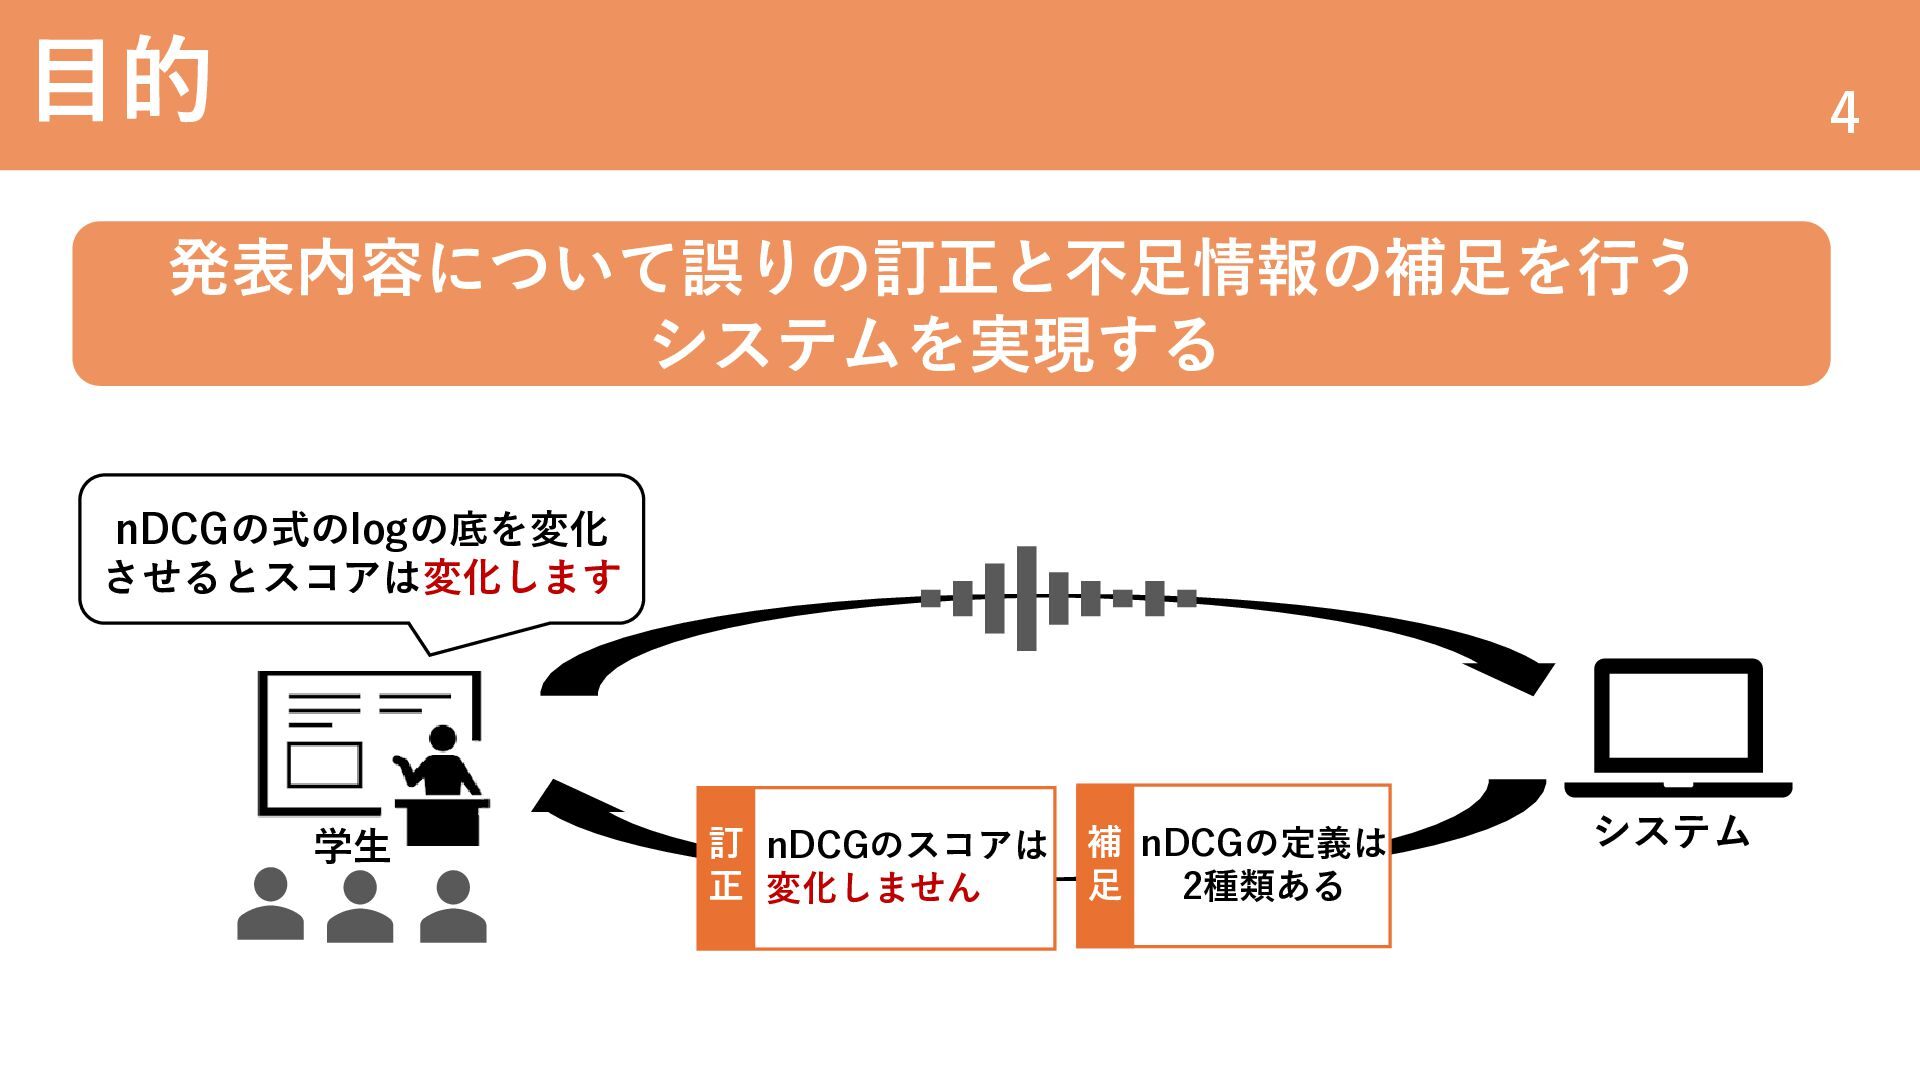
目的 4 発表内容について誤りの訂正と不足情報の補足を行う システムを実現する nDCGの式のlogの底を変化 させるとスコアは変化します 学生 訂 nDCGのスコアは 正
変化しません 補 nDCGの定義は 足 2種類ある システム -
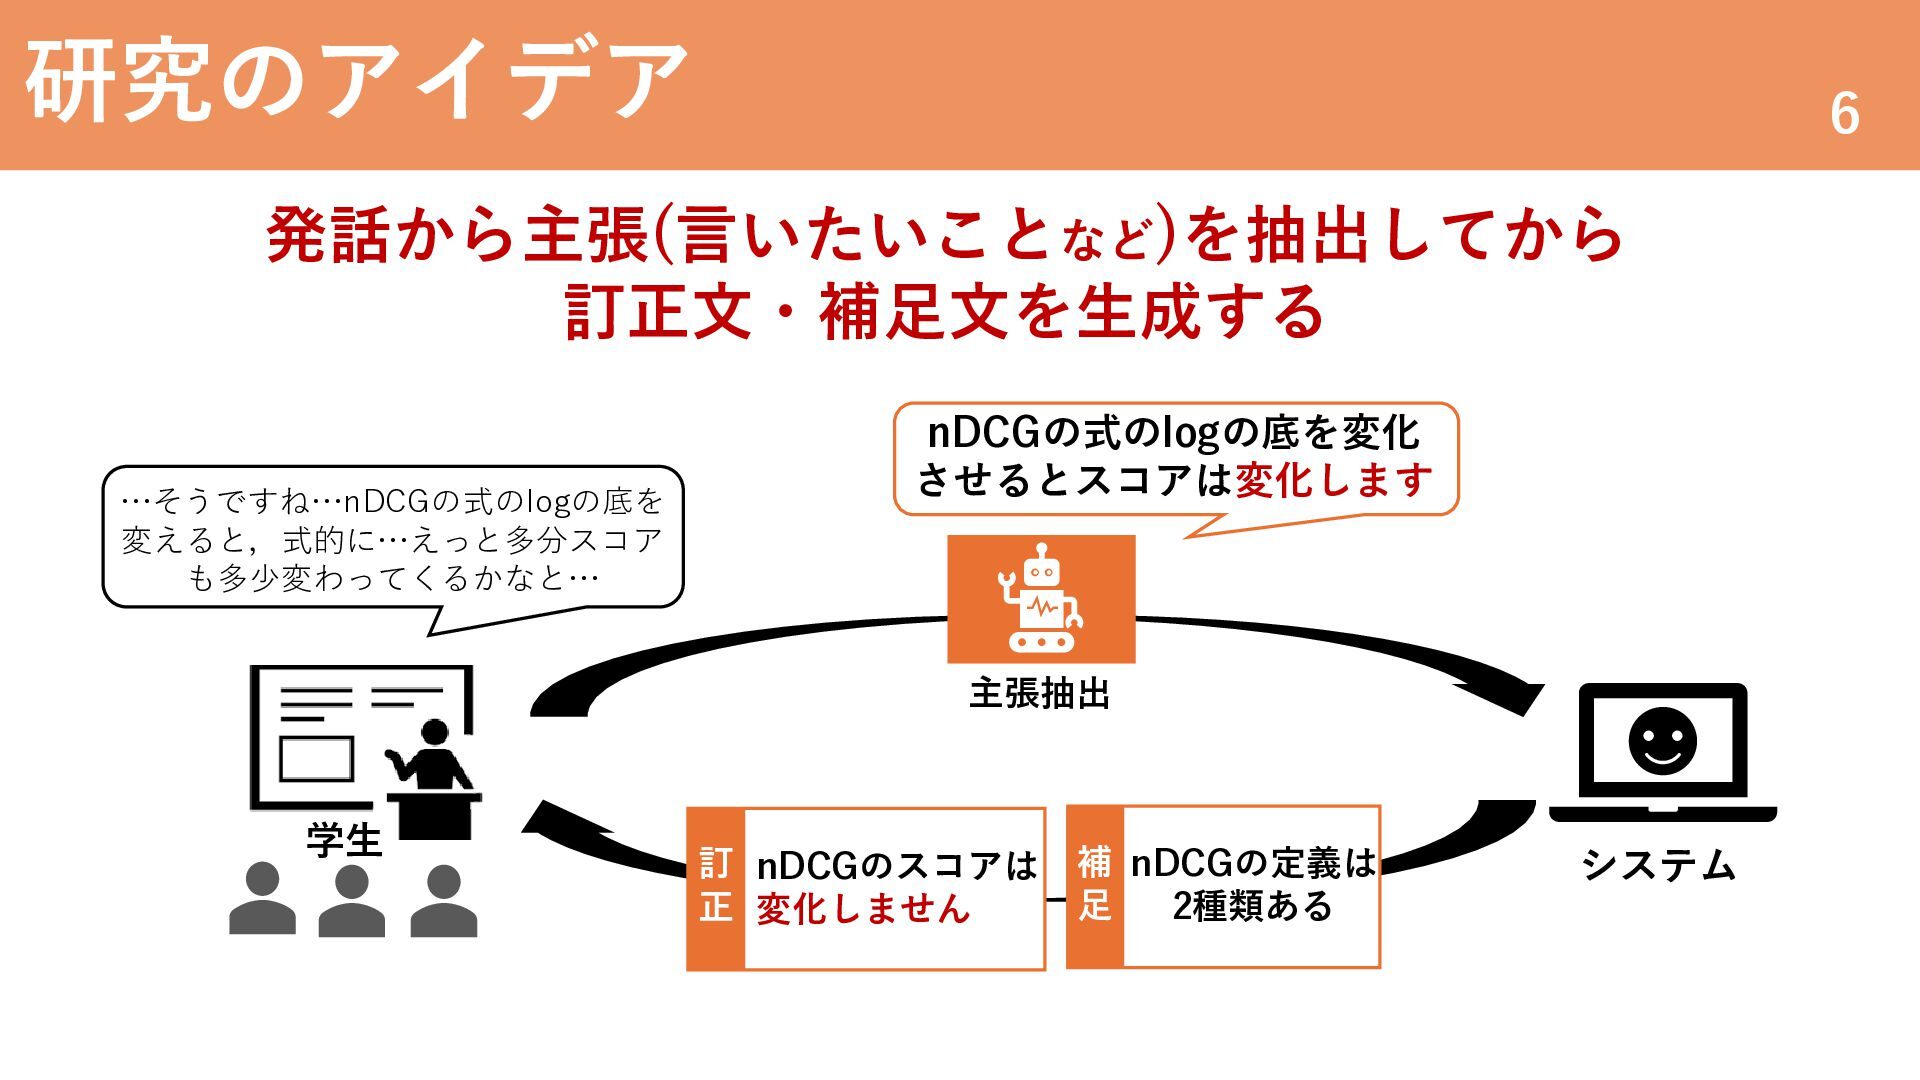
研究のアイデア 6 発話から主張(言いたいことなど)を抽出してから 訂正文・補足文を生成する …そうですね…nDCGの式のlogの底を 変えると,式的に…えっと多分スコア も多少変わってくるかなと… nDCGの式のlogの底を変化 させるとスコアは変化します 主張抽出
学生 訂 nDCGのスコアは 正 変化しません 補 nDCGの定義は 足 2種類ある システム -
関連研究 7 ー Web議論における関連情報推薦システム[1] ・Web議論を対象に情報提示の必要性を判定したうえで,LLMによる 関連情報の検索・要約を行うシステムを提案 ー RAGを活用した議事録の要約[2] ・議事録と補足資料を統合する要約パイプラインを提案し,要約の質向上を 示した
[1]木下良輔, 櫻井崇貴, 白松俊. LLMを用いたファクトチェック機 能の試作とWeb議論における関連情報推薦システムへの応用. 第12回市民共創知研究会2023(CCI-012), pp. 41–44, 3 2024. [2] Frederic Kirstein, Terry Ruas, Robert Kratel, and Bela Gipp. Tell me what I need to know: Exploring LLM based (personalized) abstractive multi–source meeting sum marization. In Proceedings of the 2024 Conference on Em pirical Methods in Natural Language Processing: Industry Track, pp. 920–939, 2024. -
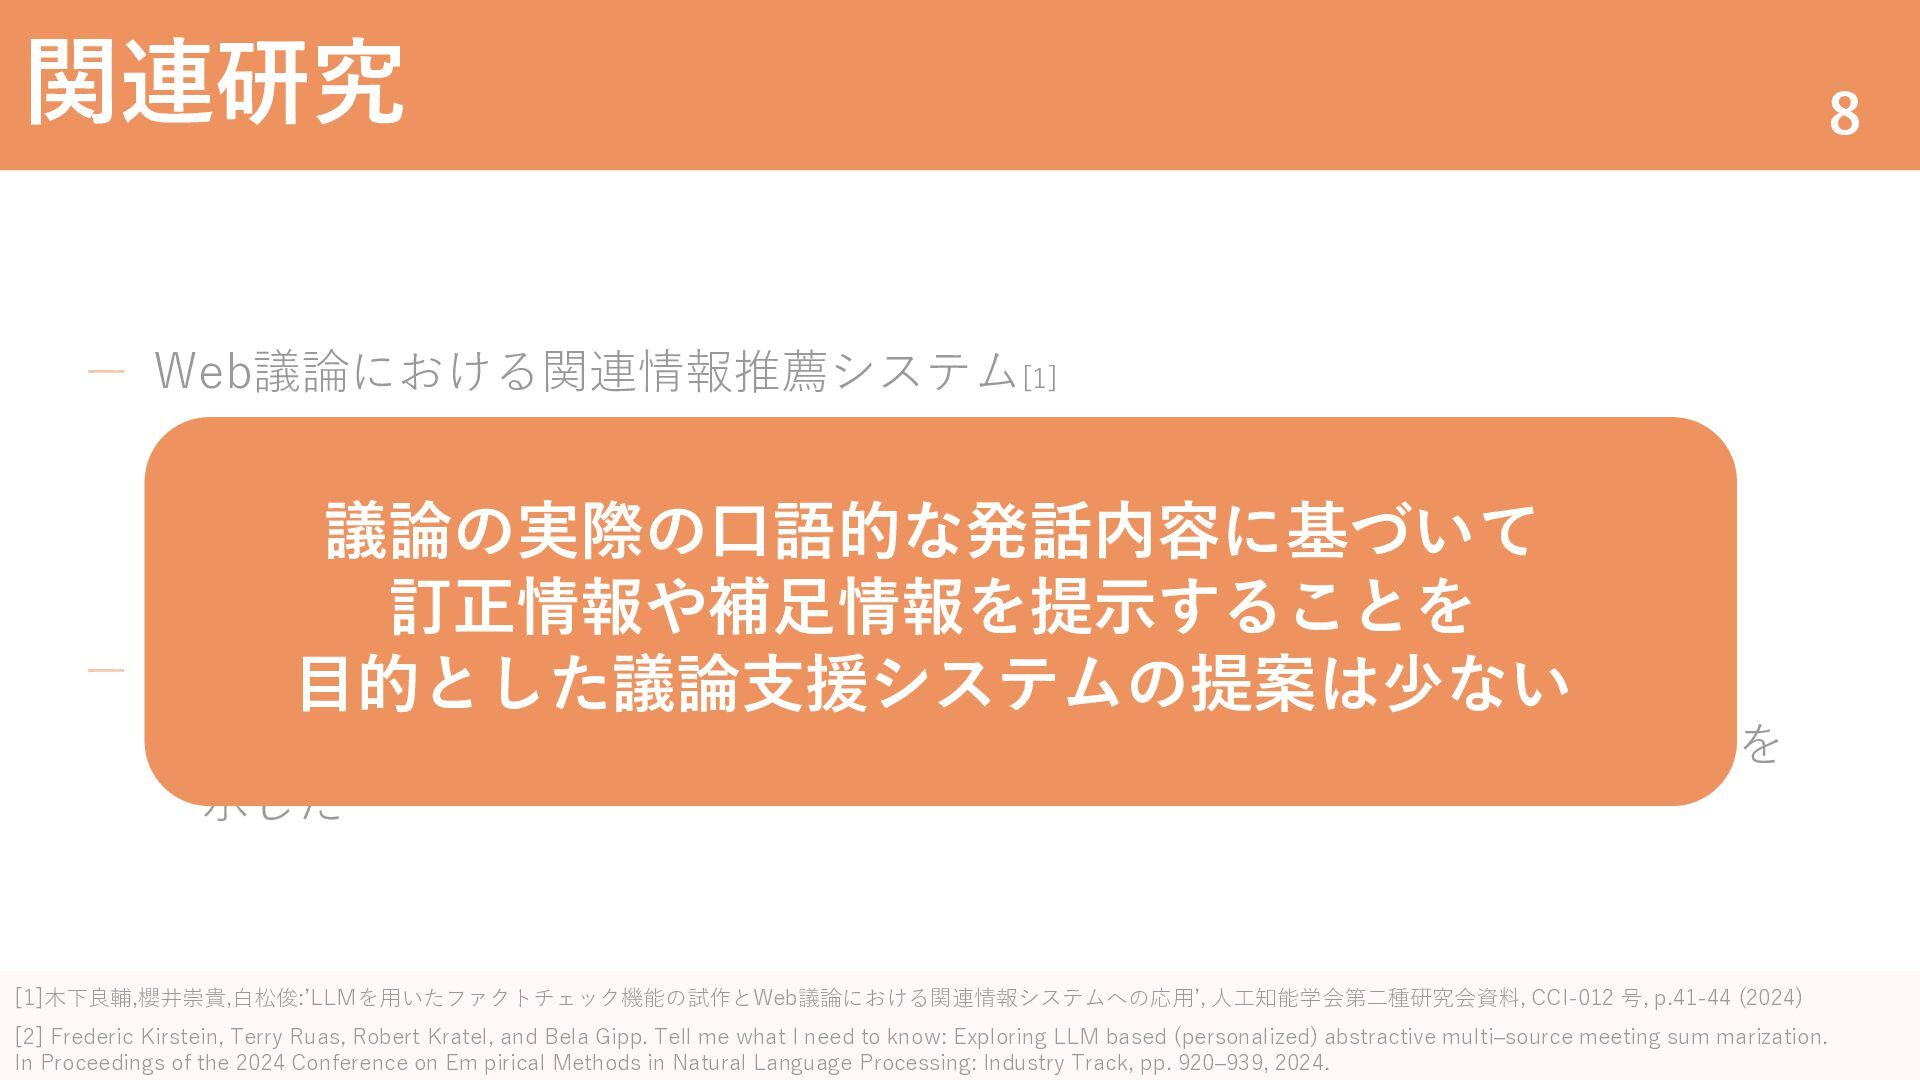
関連研究 ー Web議論における関連情報推薦システム[1] ・Web議論を対 象に,情報提示の必要性を判定したうえで,LLMによる 関連情報の検索・要約を行うシステムを提案 議論の実際の口語的な発話内容に基づいて 訂正情報や補足情報を提示することを ー RAGを活用した議事録の要約
[2] 目的とした議論支援システムの提案は少ない ・議事録と補足資料を統合する要約パイプラインを提案し,要約の質向上を 示した [1]木下良輔,櫻井崇貴,白松俊:’LLMを用いたファクトチェック機能の試作とWeb議論における関連情報システムへの応用’, 人工知能学会第二種研究会資料, CCI-012 号, p.41-44 (2024) [2] Frederic Kirstein, Terry Ruas, Robert Kratel, and Bela Gipp. Tell me what I need to know: Exploring LLM based (personalized) abstractive multi–source meeting sum marization. In Proceedings of the 2024 Conference on Em pirical Methods in Natural Language Processing: Industry Track, pp. 920–939, 2024. 8 -
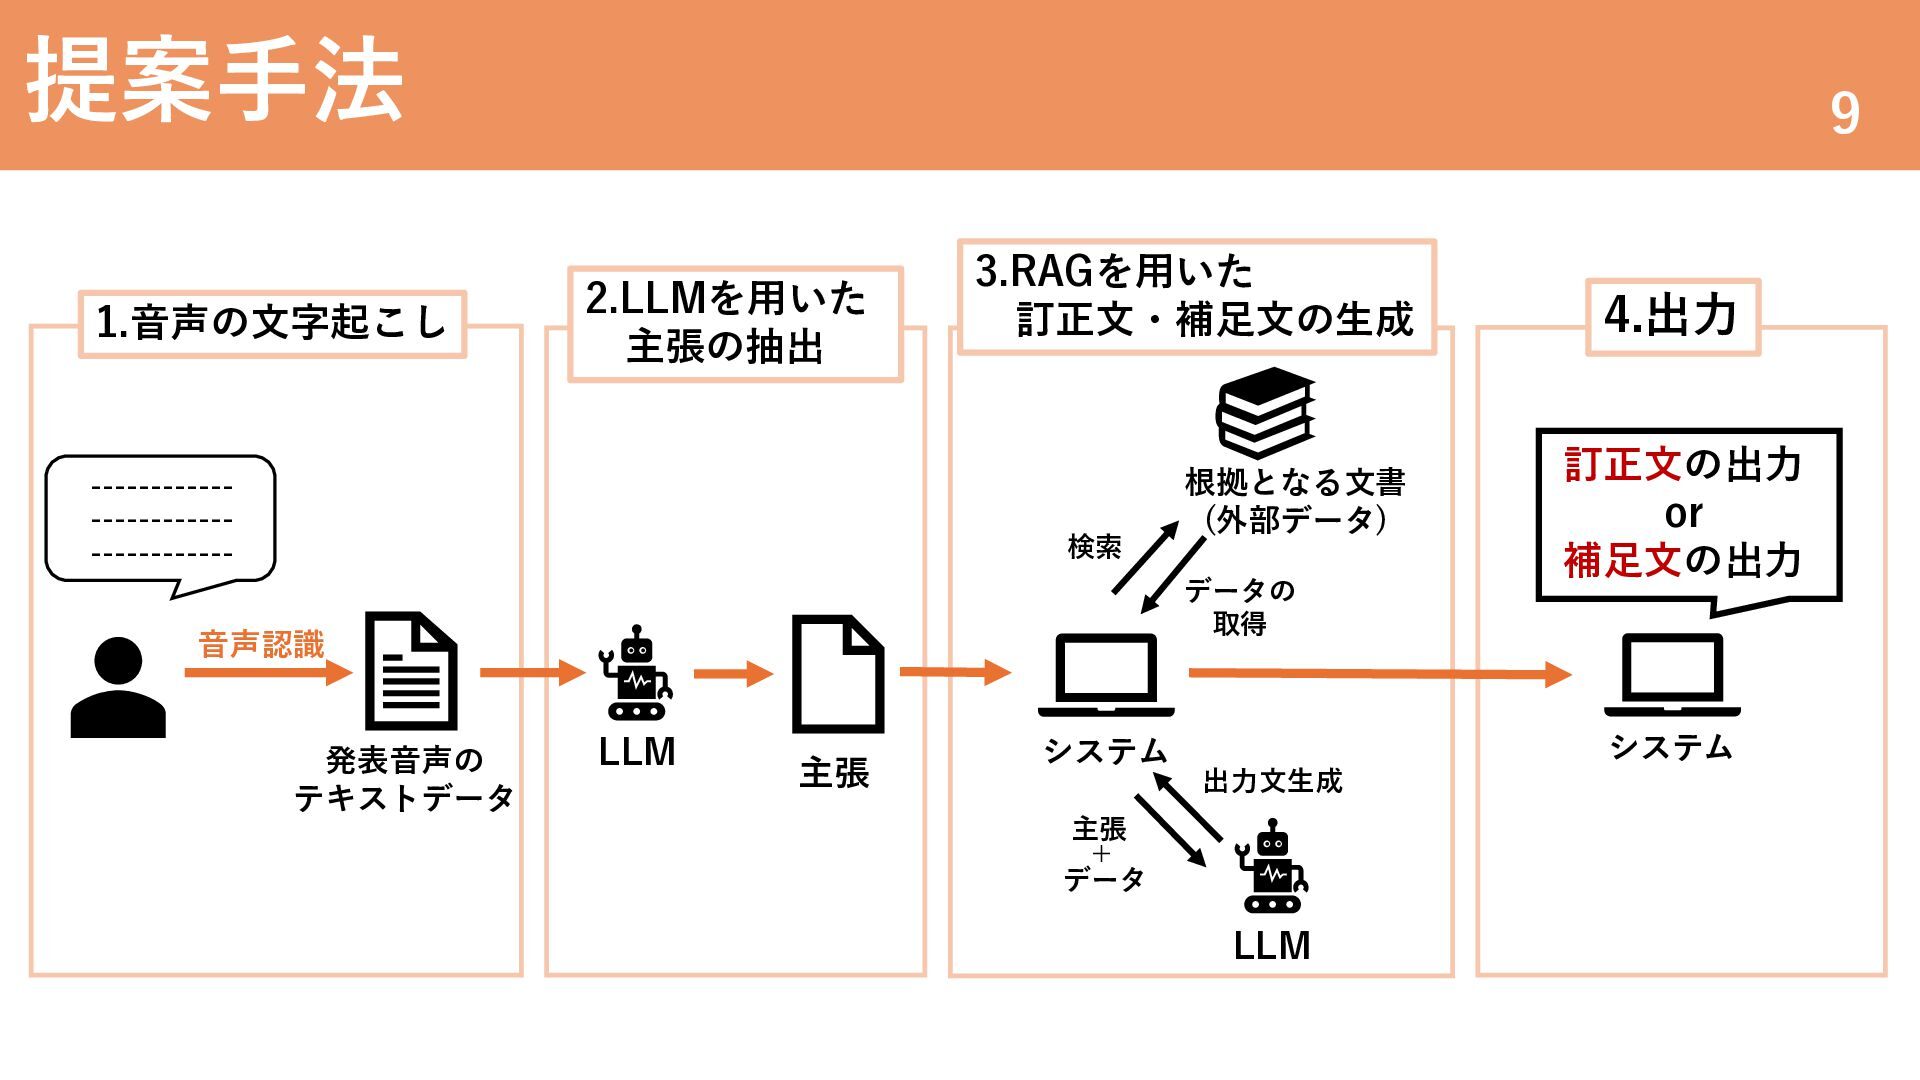
提案手法 1.音声の文字起こし 9 2.LLMを用いた 主張の抽出 ---------------------------------- 3.RAGを用いた 訂正文・補足文の生成 検索 データの
取得 音声認識 発表音声の テキストデータ 根拠となる文書 (外部データ) LLM 主張 システム 4.出力 訂正文の出力 or 補足文の出力 システム 出力文生成 主張 + データ LLM -
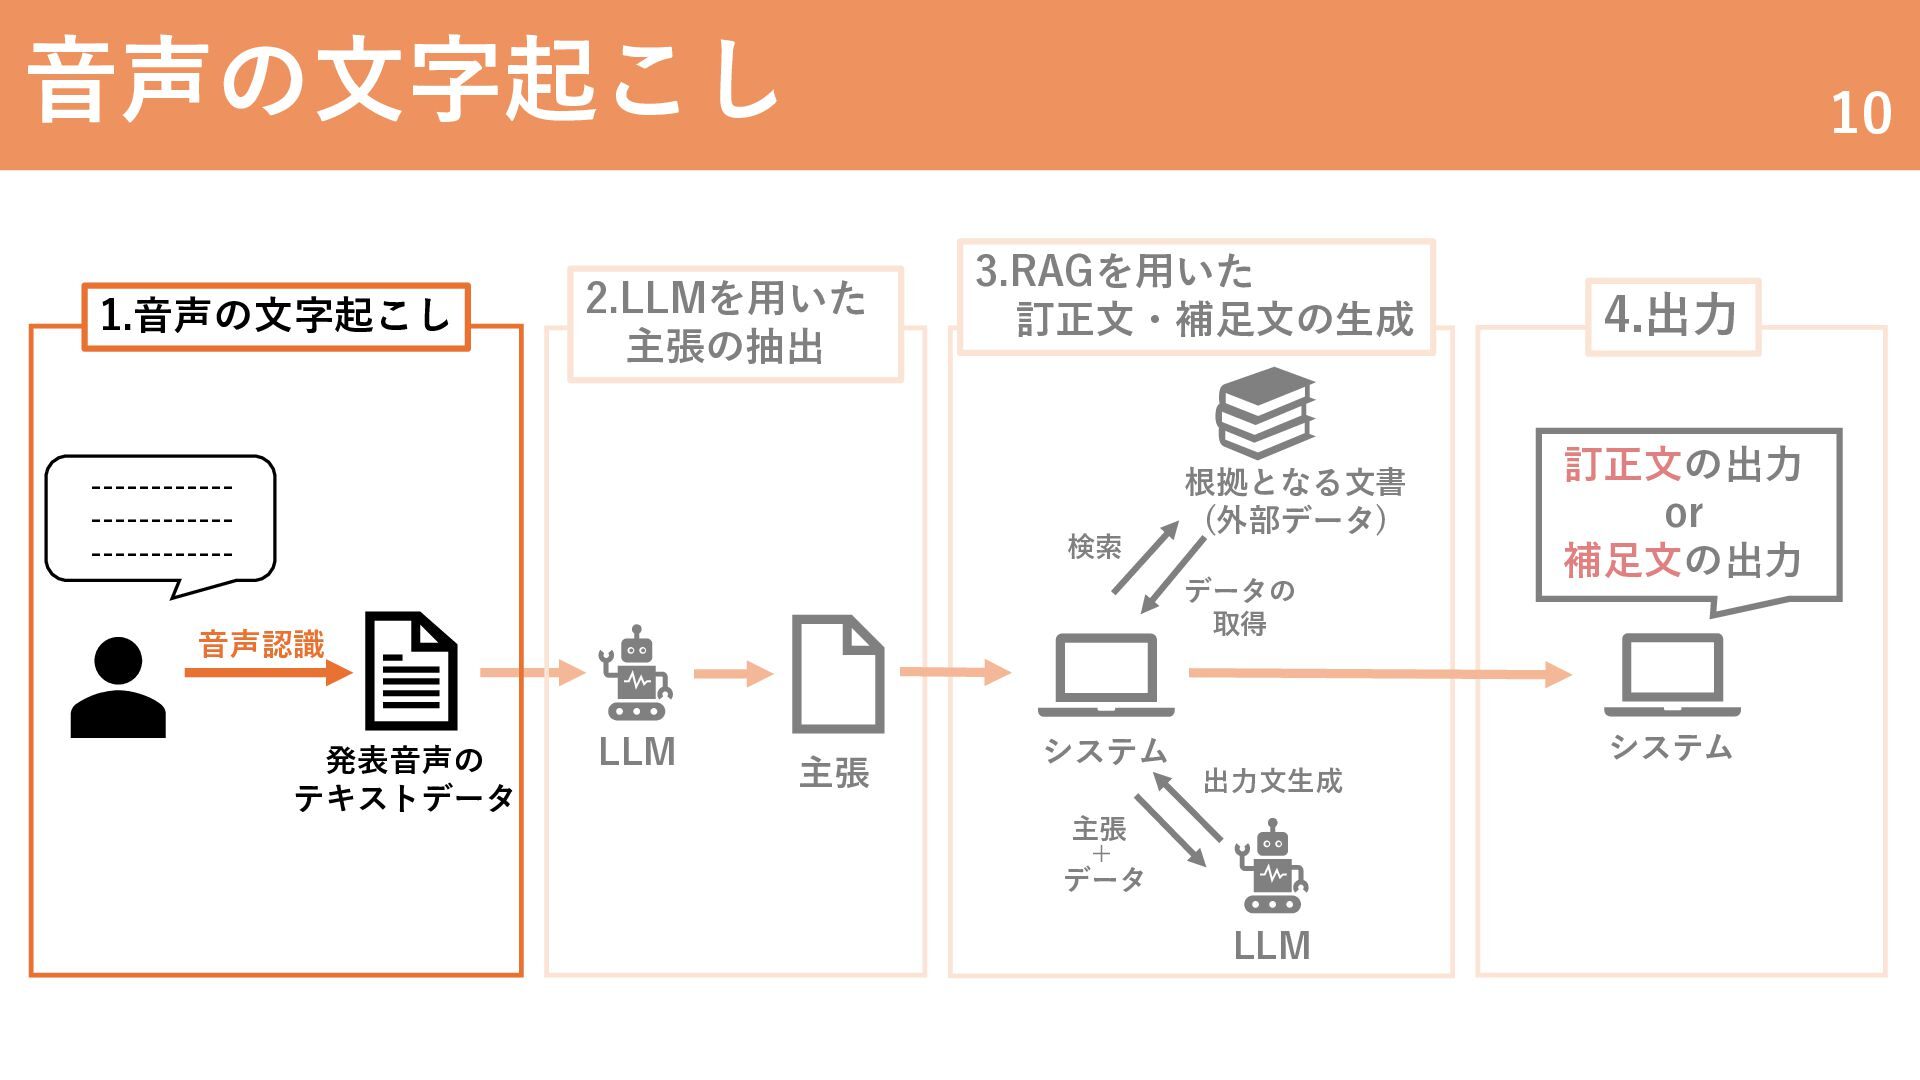
音声の文字起こし 1.音声の文字起こし 10 2.LLMを用いた 主張の抽出 ---------------------------------- 3.RAGを用いた 訂正文・補足文の生成 検索 データの
取得 音声認識 発表音声の テキストデータ 根拠となる文書 (外部データ) LLM 主張 システム 4.出力 訂正文の出力 or 補足文の出力 システム 出力文生成 主張 + データ LLM -
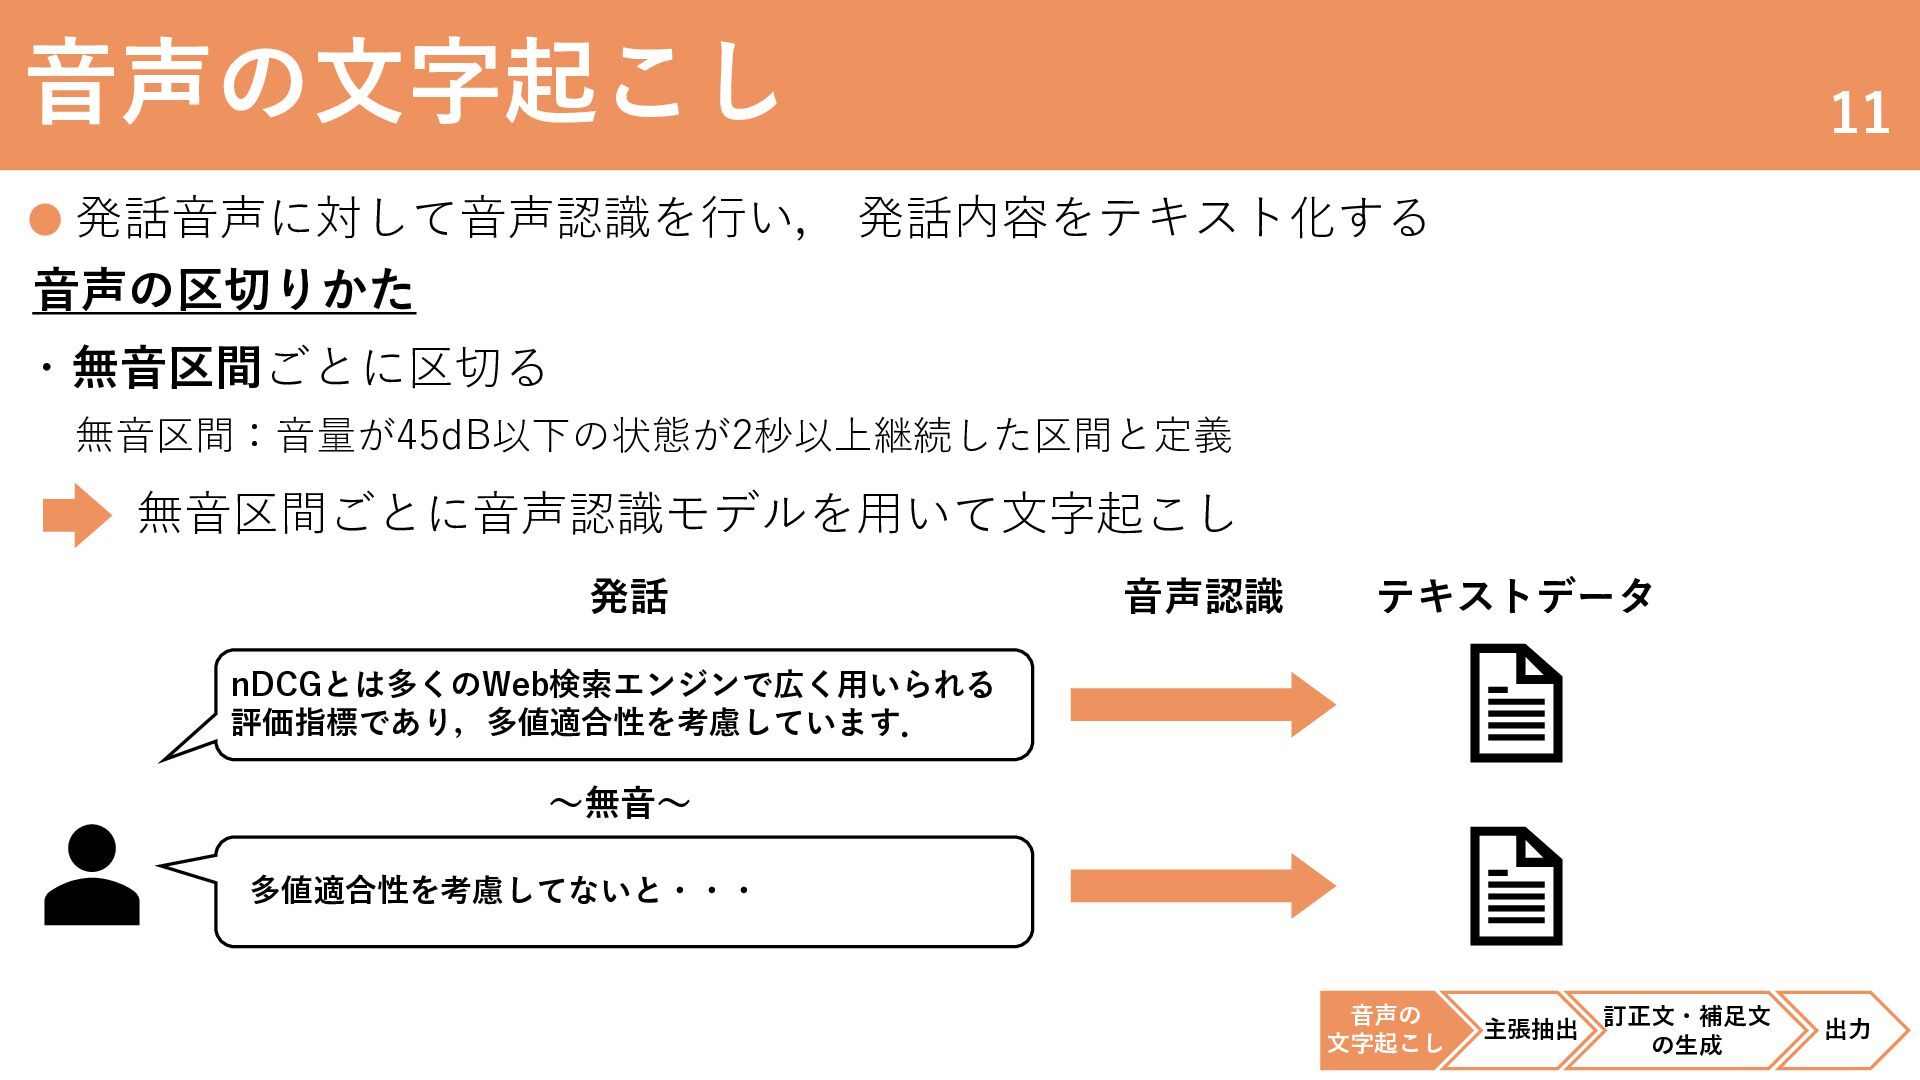
音声の文字起こし 11 発話音声に対して音声認識を行い, 発話内容をテキスト化する 音声の区切りかた ・無音区間ごとに区切る 無音区間:音量が45dB以下の状態が2秒以上継続した区間と定義 無音区間ごとに音声認識モデルを用いて文字起こし 発話 音声認識
テキストデータ nDCGとは多くのWeb検索エンジンで広く用いられる 評価指標であり,多値適合性を考慮しています. ~無音~ 多値適合性を考慮してないと・・・ 音声の 文字起こし 主張抽出 訂正文・補足文 の生成 出力 -
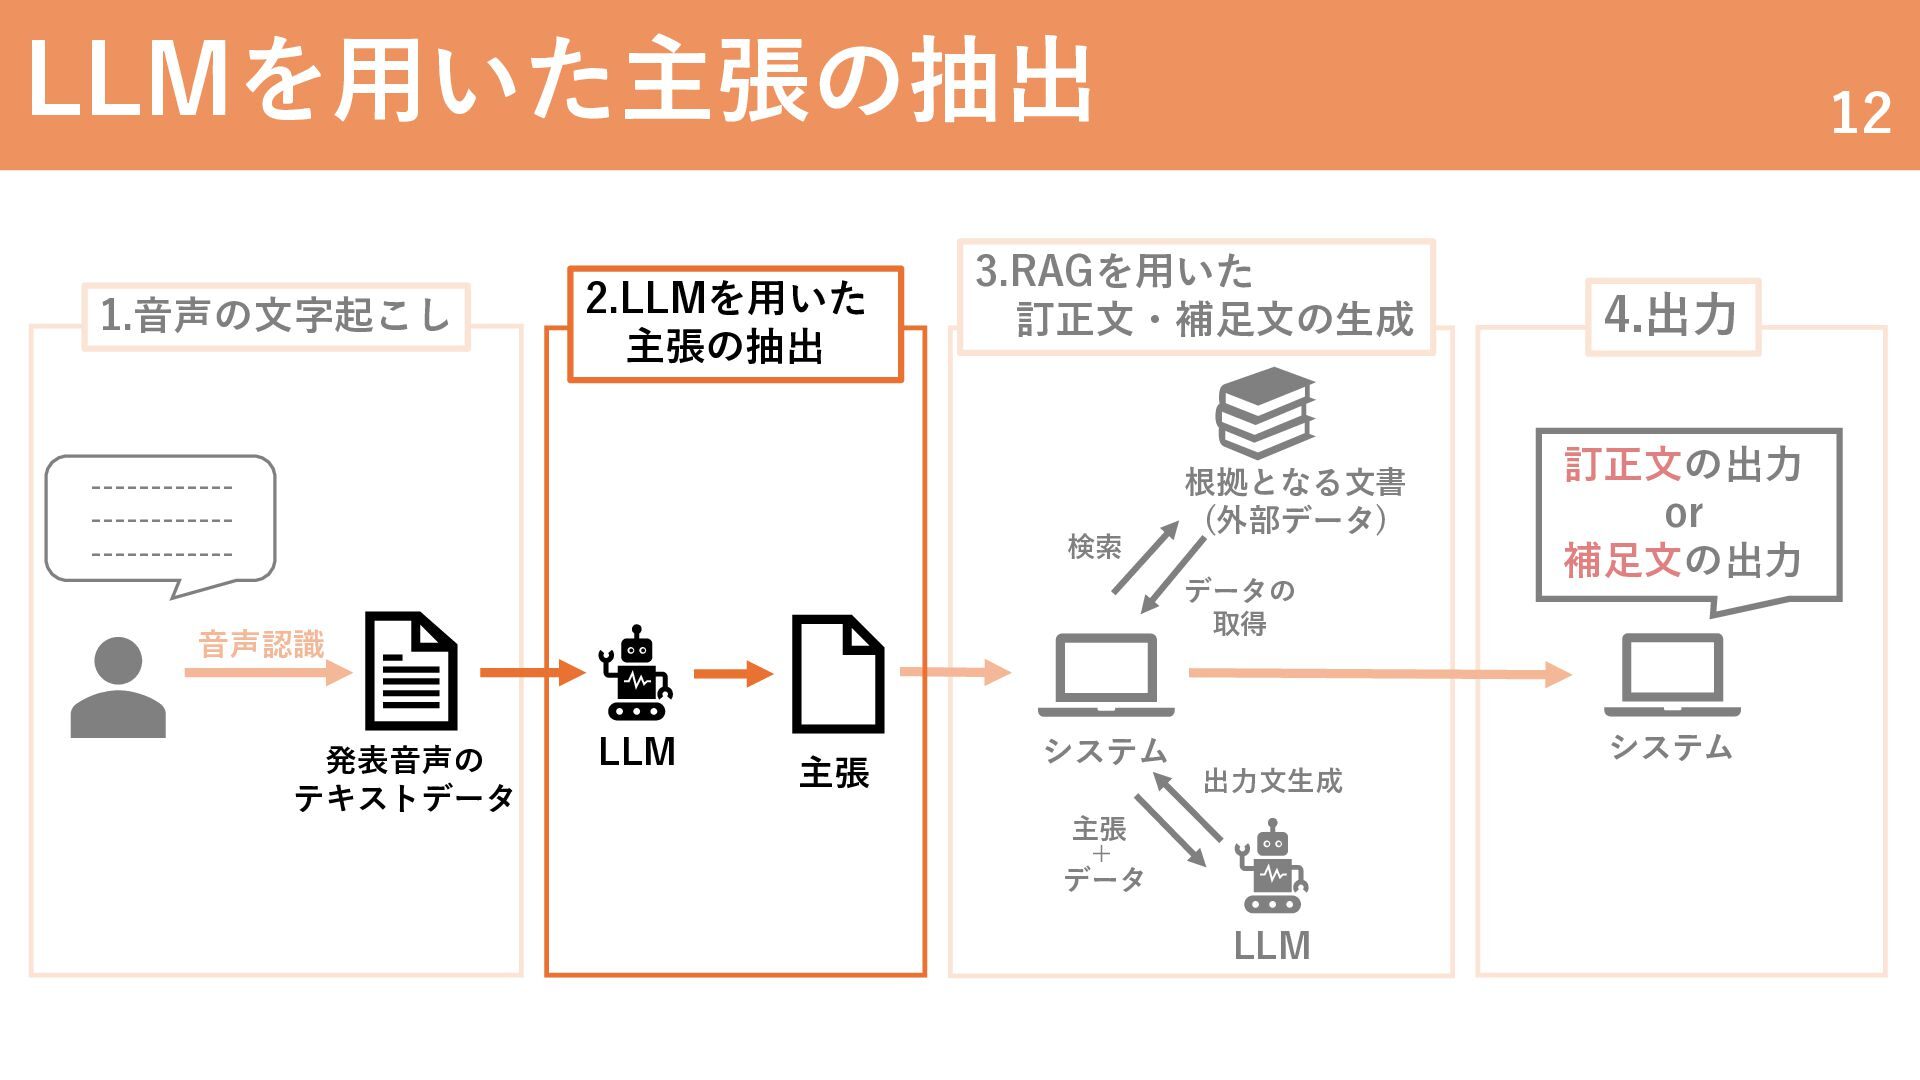
LLMを用いた主張の抽出 1.音声の文字起こし 2.LLMを用いた 主張の抽出 ---------------------------------- 3.RAGを用いた 訂正文・補足文の生成 検索 根拠となる文書 (外部データ)
データの 取得 音声認識 発表音声の テキストデータ 12 LLM 主張 システム 4.出力 訂正文の出力 or 補足文の出力 システム 出力文生成 主張 + データ LLM -
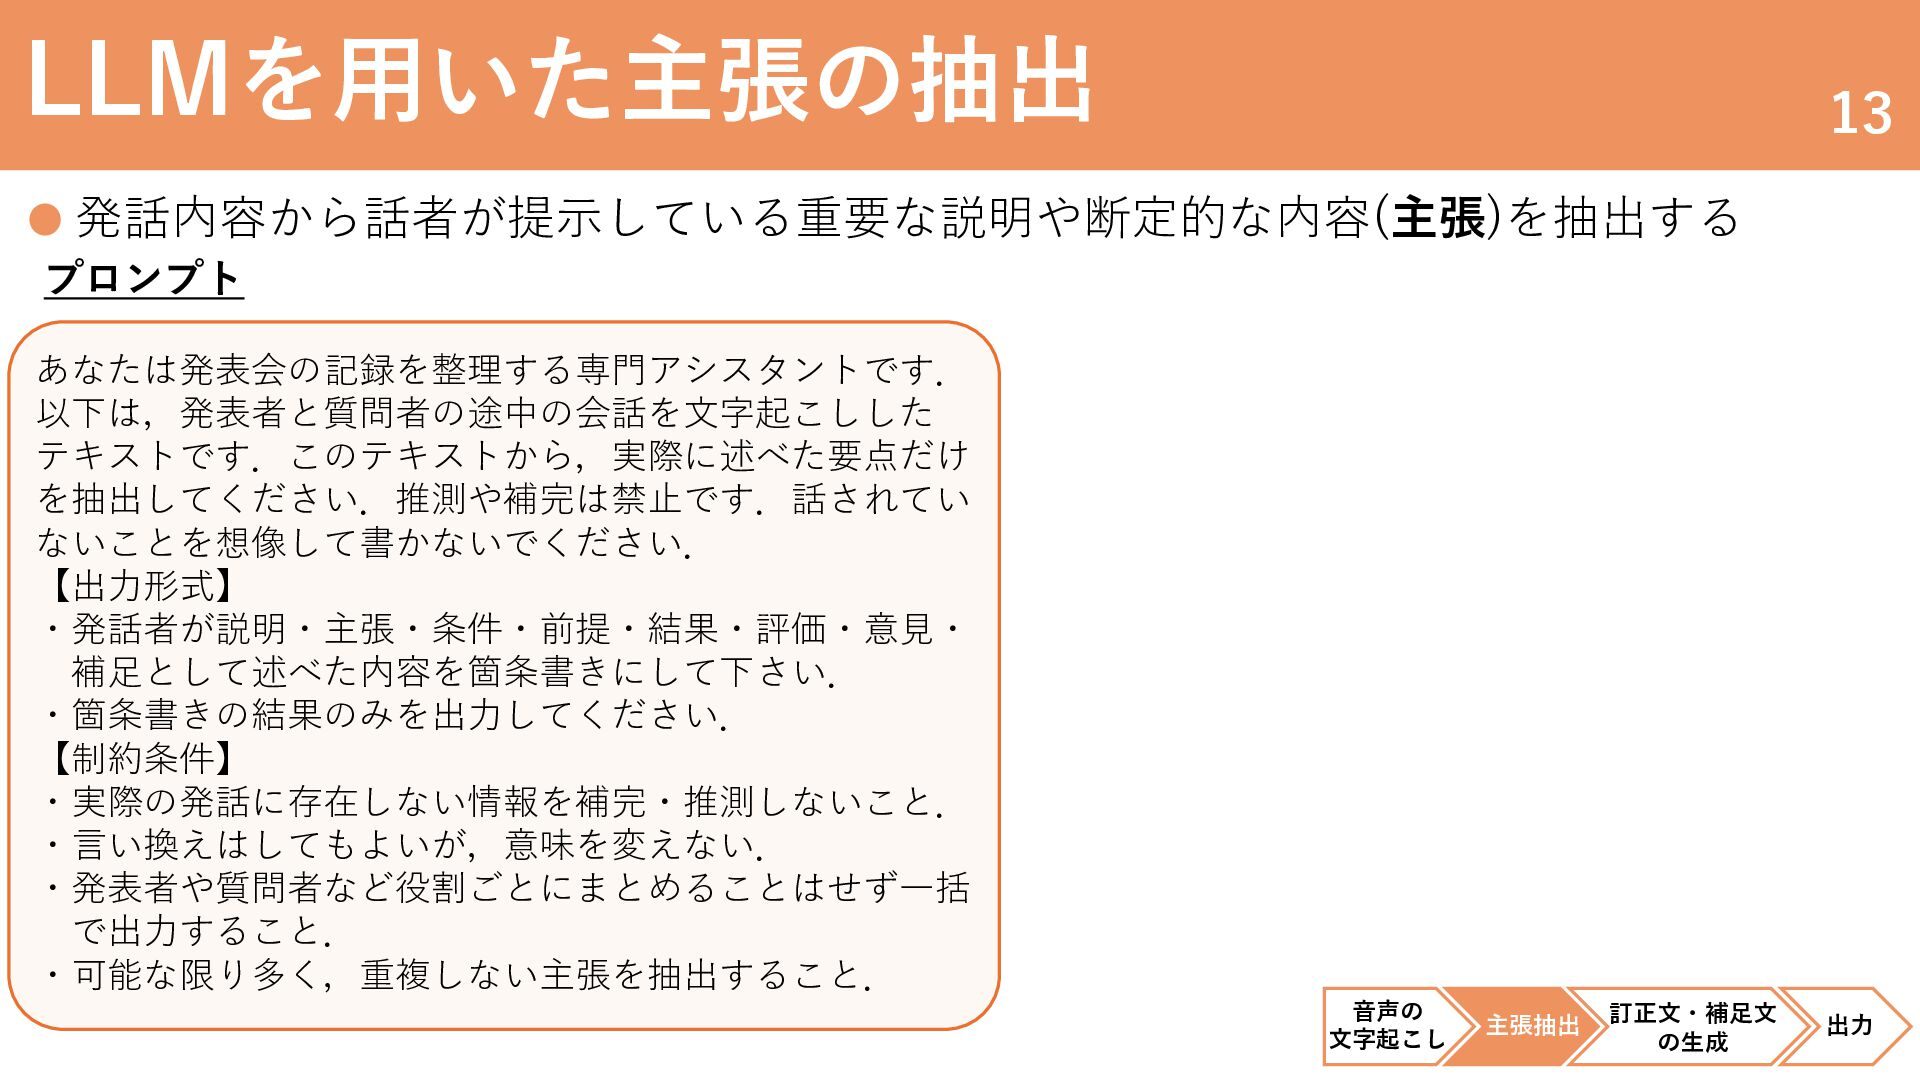
LLMを用いた主張の抽出 13 発話内容から話者が提示している重要な説明や断定的な内容(主張)を抽出する プロンプト あなたは発表会の記録を整理する専門アシスタントです. 以下は,発表者と質問者の途中の会話を文字起こしした テキストです.このテキストから,実際に述べた要点だけ を抽出してください.推測や補完は禁止です.話されてい ないことを想像して書かないでください. 【出力形式】
・発話者が説明・主張・条件・前提・結果・評価・意見・ 補足として述べた内容を箇条書きにして下さい. ・箇条書きの結果のみを出力してください. 【制約条件】 ・実際の発話に存在しない情報を補完・推測しないこと. ・言い換えはしてもよいが,意味を変えない. ・発表者や質問者など役割ごとにまとめることはせず一括 で出力すること. ・可能な限り多く,重複しない主張を抽出すること. 音声の 文字起こし 主張抽出 訂正文・補足文 の生成 出力 -
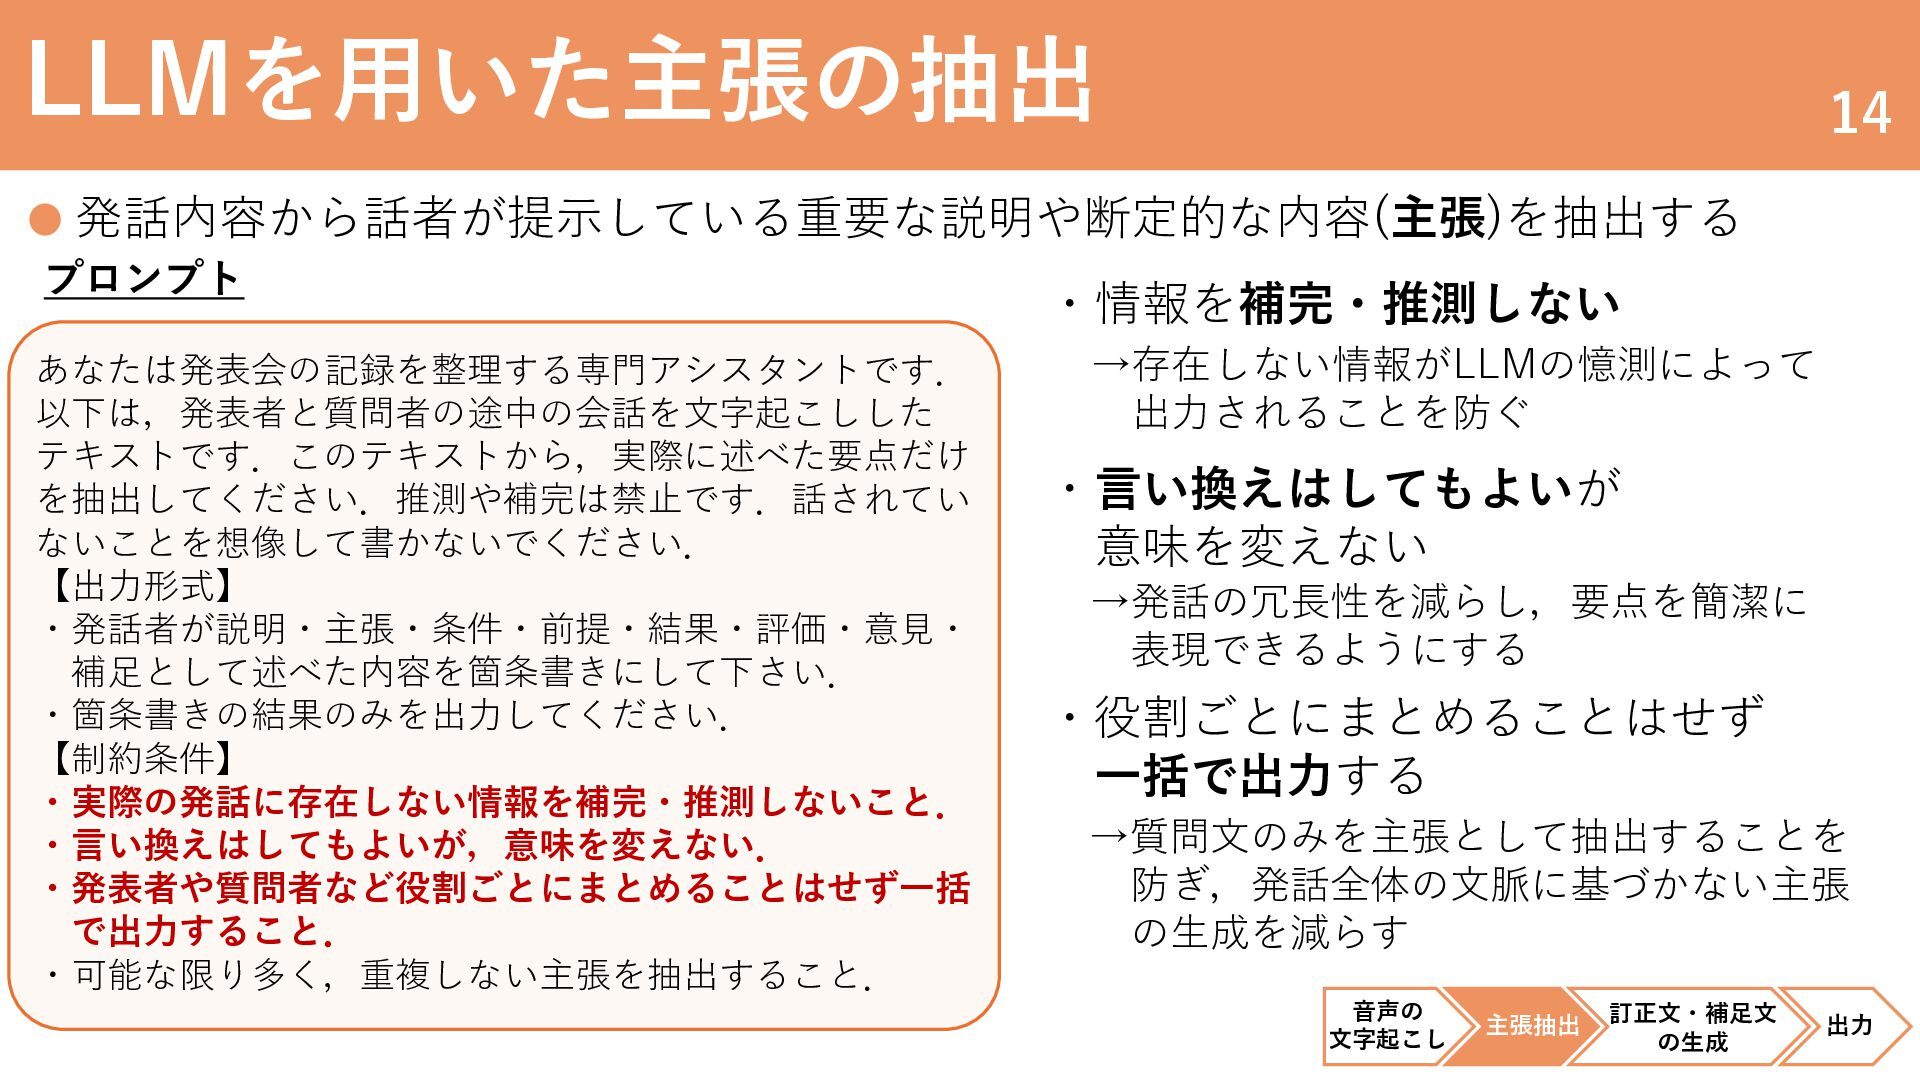
LLMを用いた主張の抽出 14 発話内容から話者が提示している重要な説明や断定的な内容(主張)を抽出する プロンプト あなたは発表会の記録を整理する専門アシスタントです. 以下は,発表者と質問者の途中の会話を文字起こしした テキストです.このテキストから,実際に述べた要点だけ を抽出してください.推測や補完は禁止です.話されてい ないことを想像して書かないでください. 【出力形式】
・発話者が説明・主張・条件・前提・結果・評価・意見・ 補足として述べた内容を箇条書きにして下さい. ・箇条書きの結果のみを出力してください. 【制約条件】 ・実際の発話に存在しない情報を補完・推測しないこと. ・言い換えはしてもよいが,意味を変えない. ・発表者や質問者など役割ごとにまとめることはせず一括 で出力すること. ・可能な限り多く,重複しない主張を抽出すること. ・情報を補完・推測しない →存在しない情報がLLMの憶測によって 出力されることを防ぐ ・言い換えはしてもよいが 意味を変えない →発話の冗長性を減らし,要点を簡潔に 表現できるようにする ・役割ごとにまとめることはせず 一括で出力する →質問文のみを主張として抽出することを 防ぎ,発話全体の文脈に基づかない主張 の生成を減らす 音声の 文字起こし 主張抽出 訂正文・補足文 の生成 出力 -
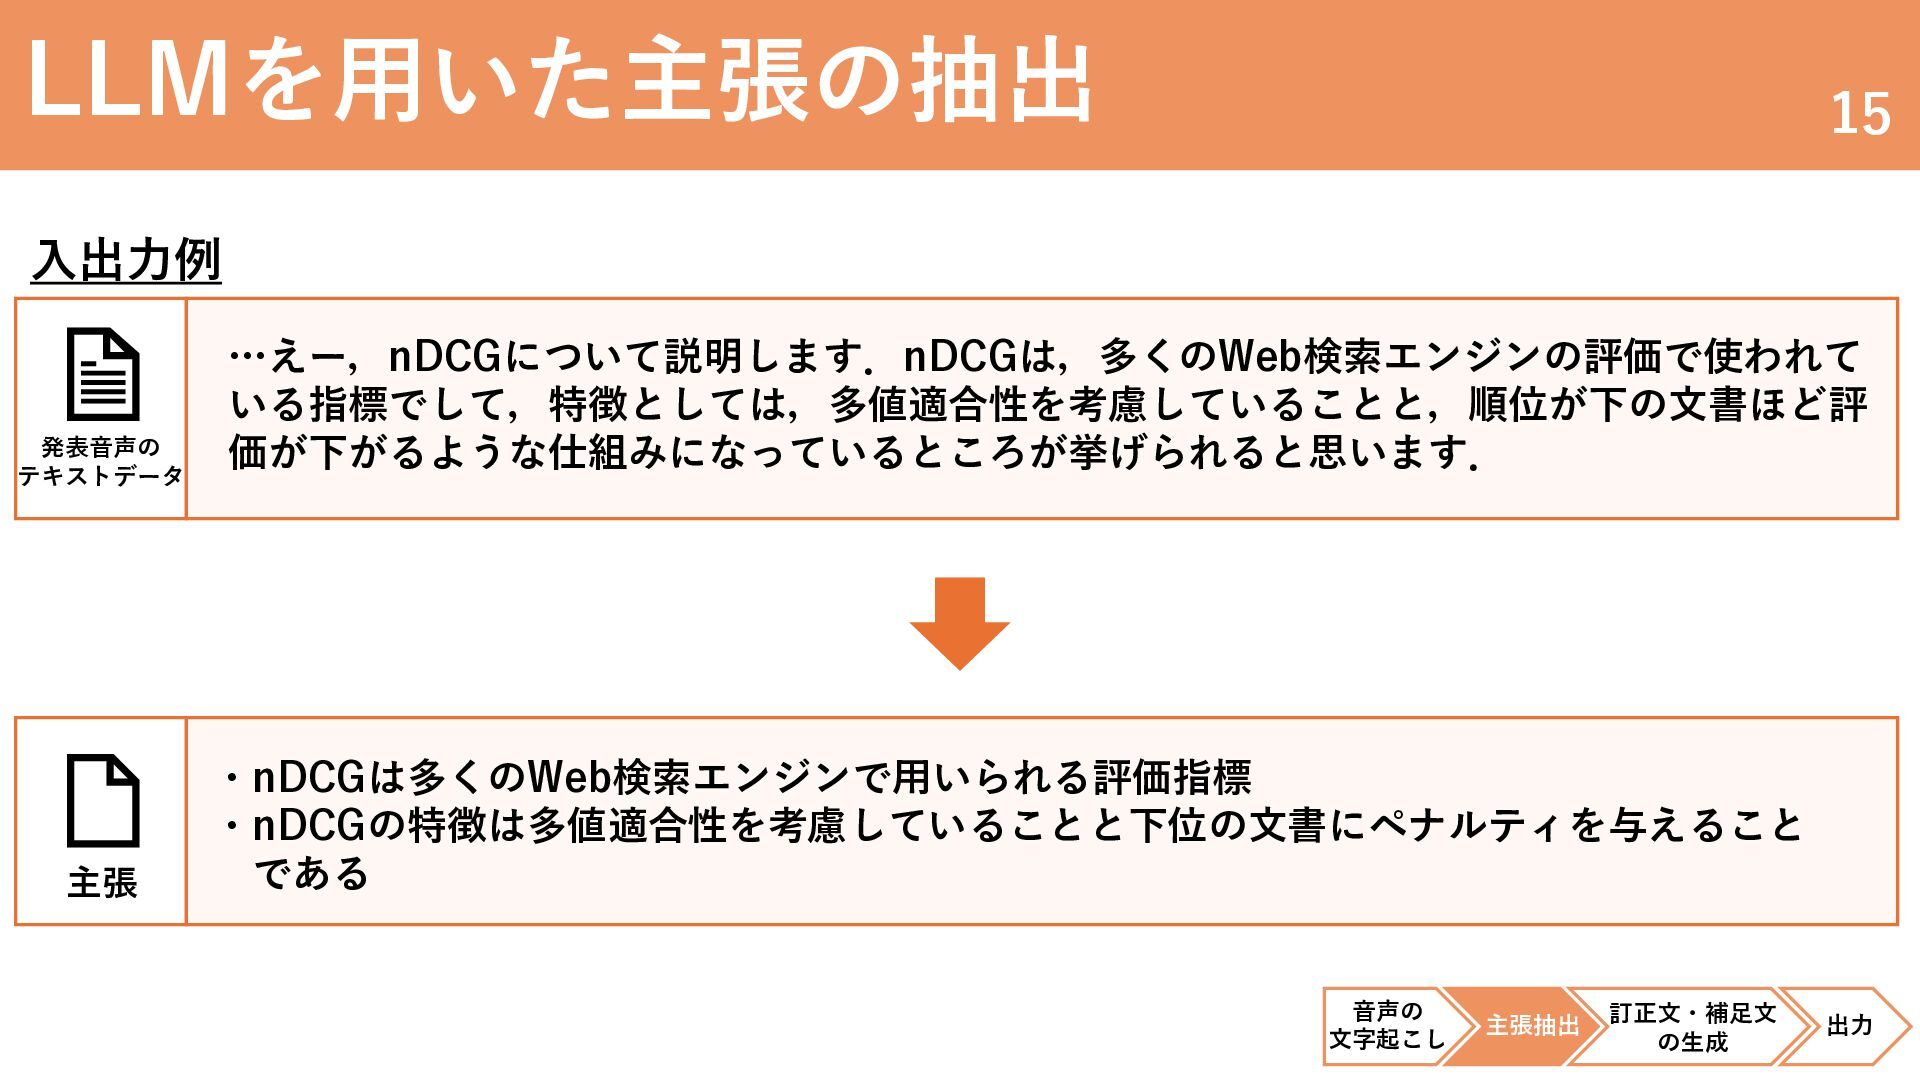
LLMを用いた主張の抽出 15 入出力例 発表音声の テキストデータ 主張 …えー,nDCGについて説明します.nDCGは,多くのWeb検索エンジンの評価で使われて いる指標でして,特徴としては,多値適合性を考慮していることと,順位が下の文書ほど評 価が下がるような仕組みになっているところが挙げられると思います. ・nDCGは多くのWeb検索エンジンで用いられる評価指標
・nDCGの特徴は多値適合性を考慮していることと下位の文書にペナルティを与えること である 音声の 文字起こし 主張抽出 訂正文・補足文 の生成 出力 -
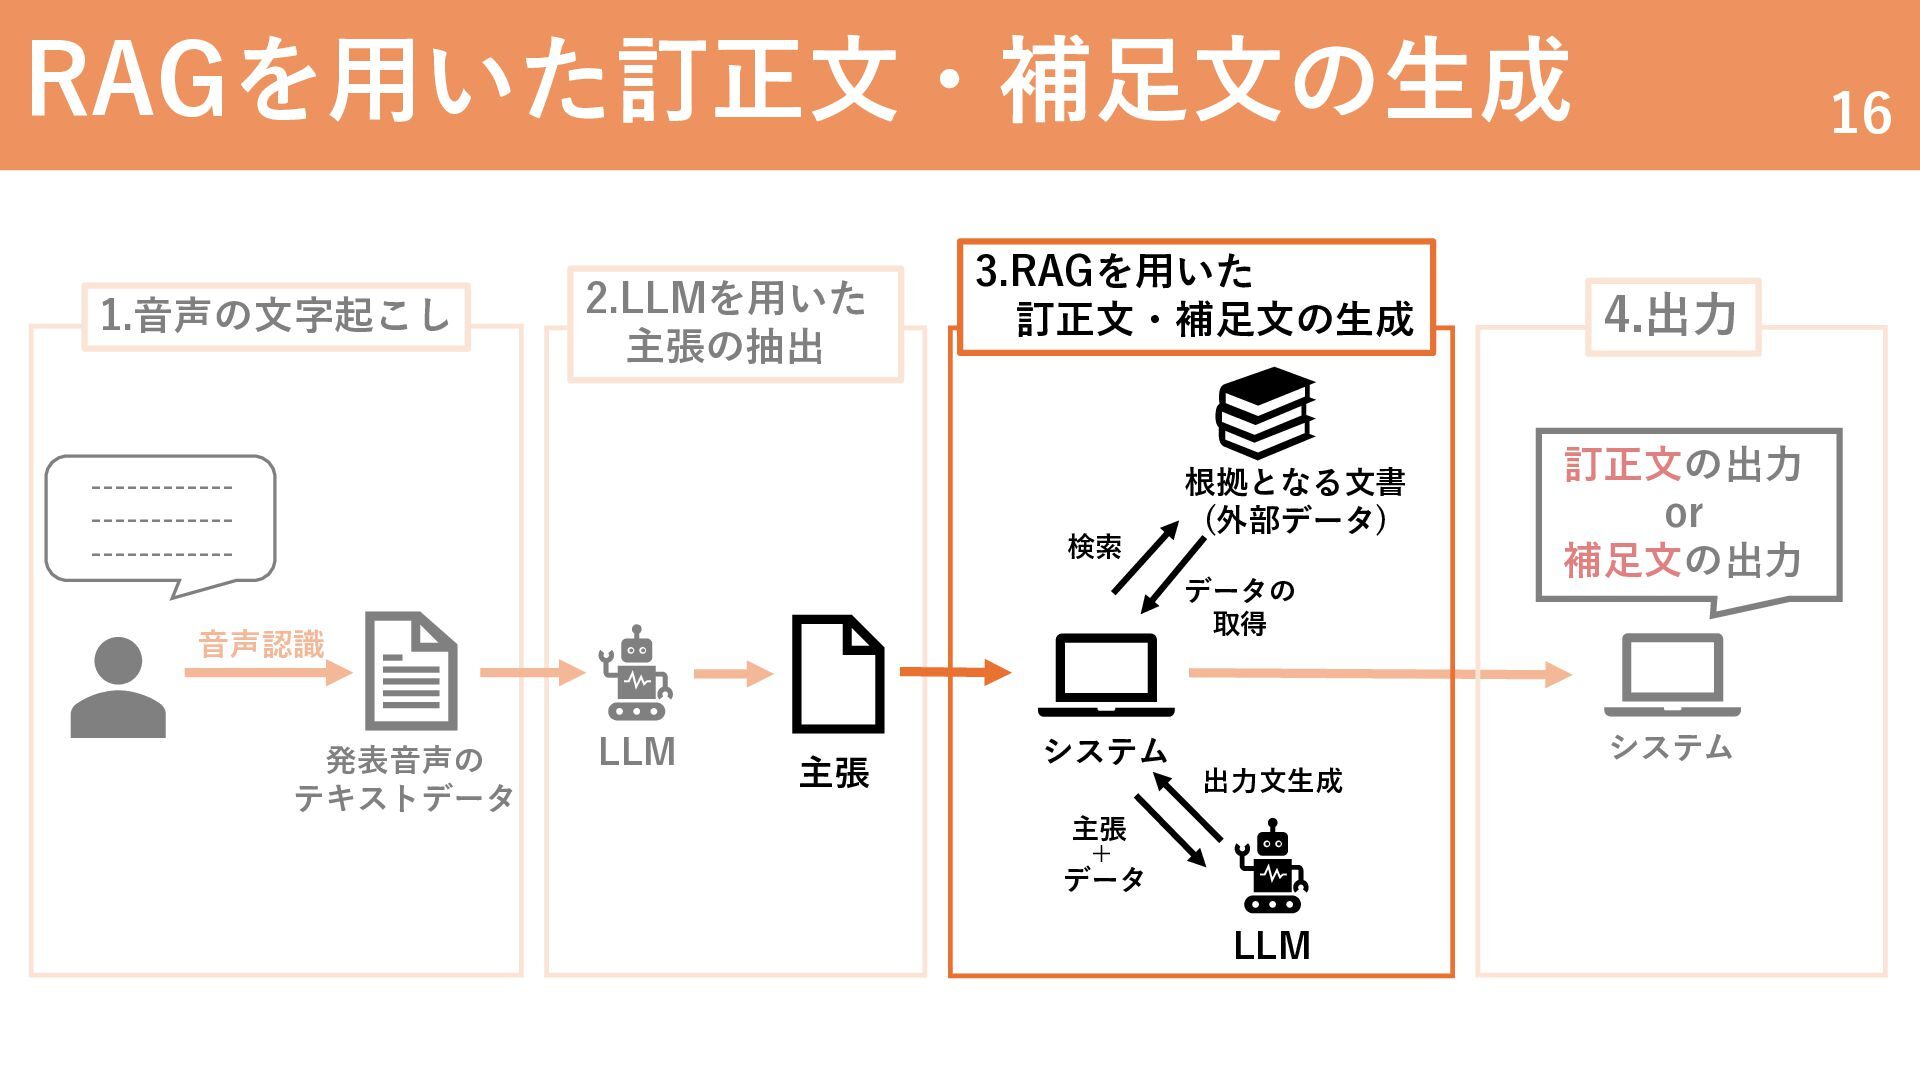
RAGを用いた訂正文・補足文の生成 1.音声の文字起こし 2.LLMを用いた 主張の抽出 ---------------------------------- 3.RAGを用いた 訂正文・補足文の生成 検索 データの 取得
音声認識 発表音声の テキストデータ 根拠となる文書 (外部データ) LLM 主張 システム 16 4.出力 訂正文の出力 or 補足文の出力 システム 出力文生成 主張 + データ LLM -
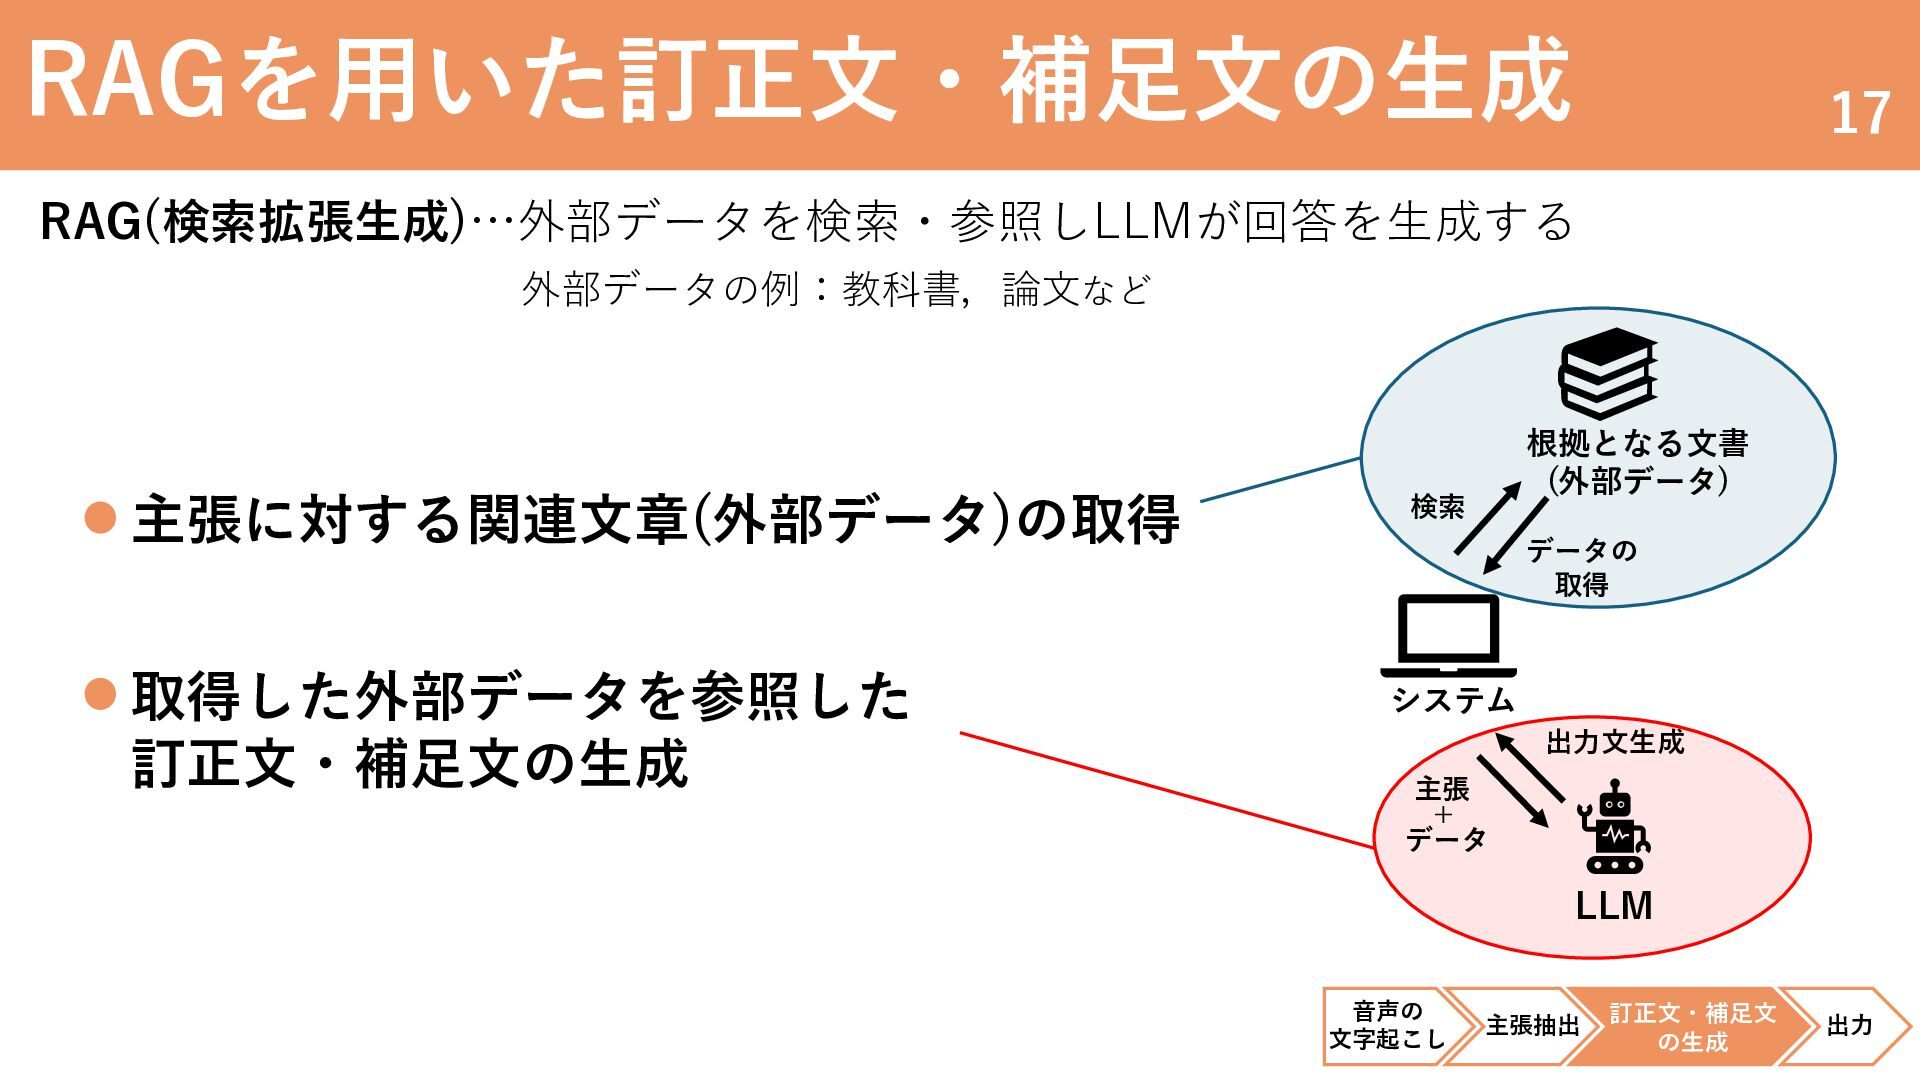
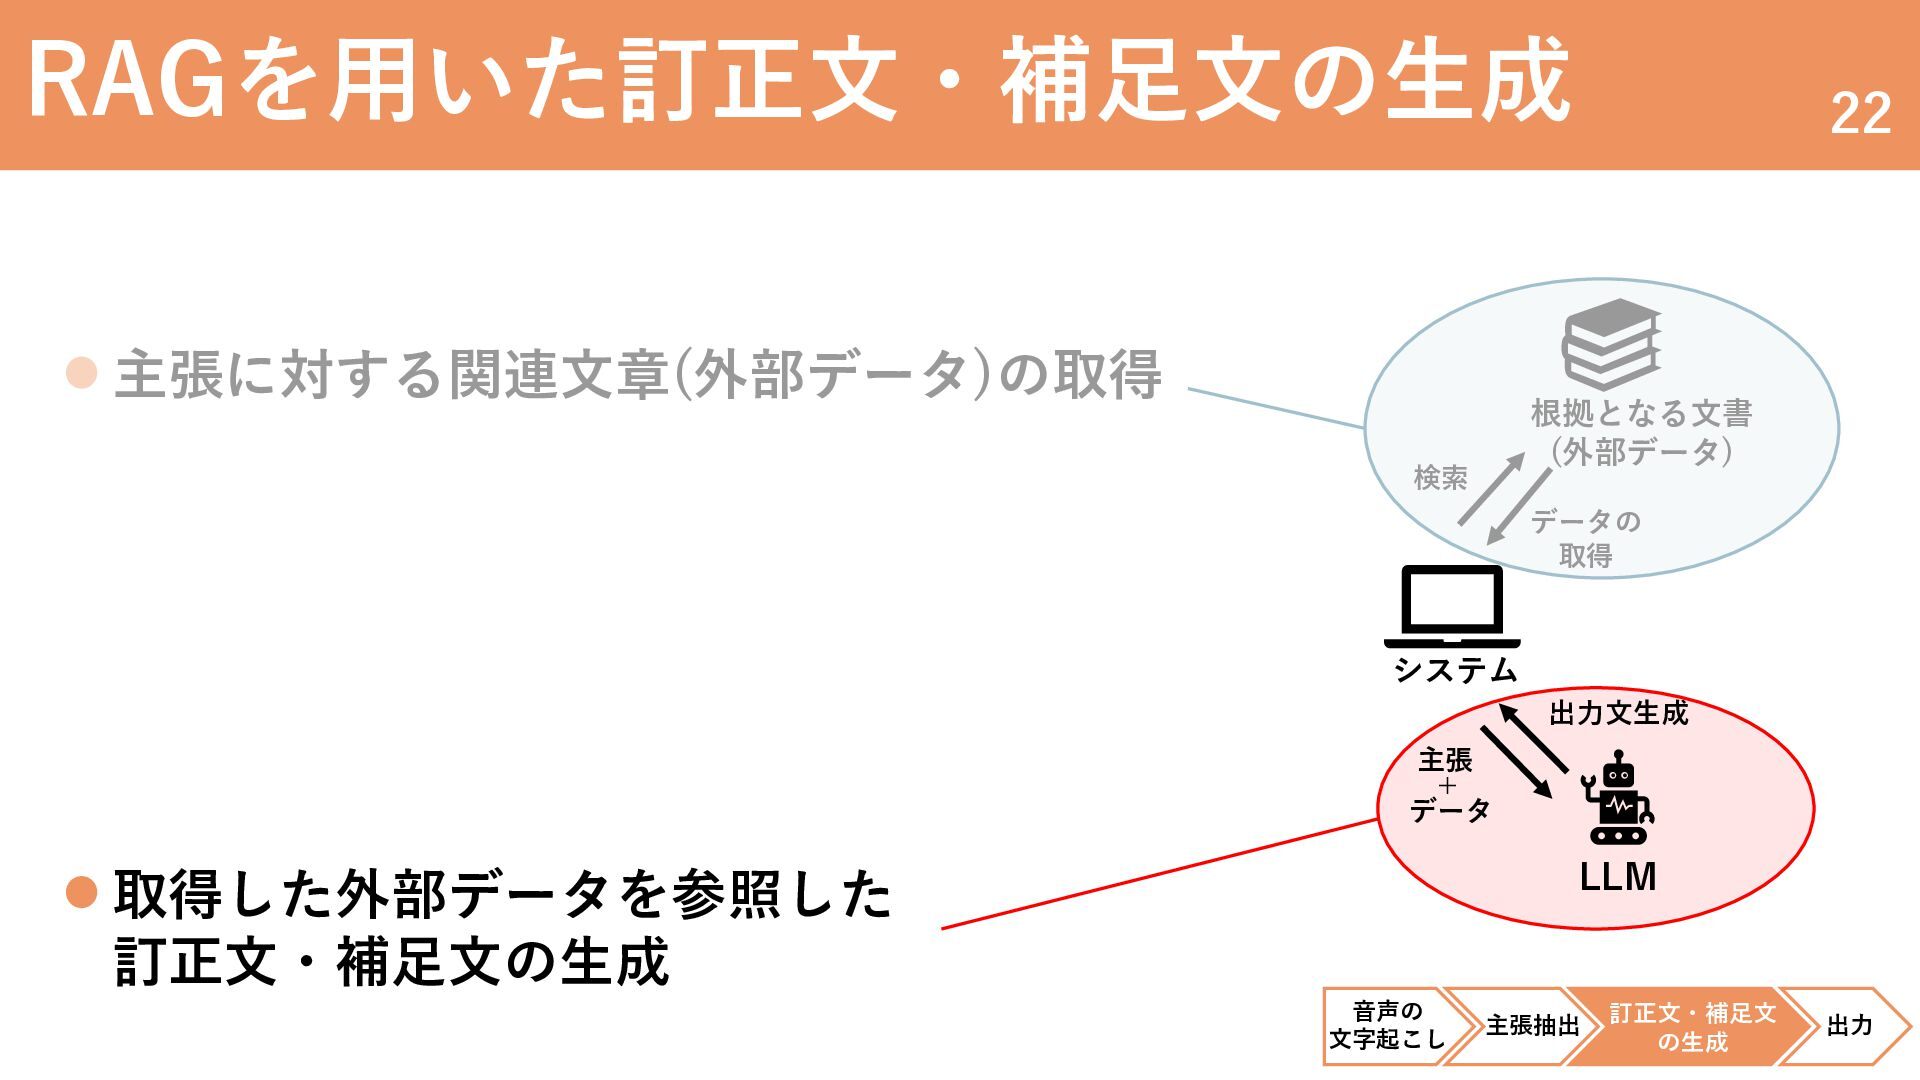
RAGを用いた訂正文・補足文の生成 17 RAG(検索拡張生成)…外部データを検索・参照しLLMが回答を生成する 外部データの例:教科書,論文など 主張に対する関連文章(外部データ)の取得 取得した外部データを参照した 訂正文・補足文の生成 根拠となる文書 (外部データ) 検索
データの 取得 システム 出力文生成 主張 + データ LLM 音声の 文字起こし 主張抽出 訂正文・補足文 の生成 出力 -
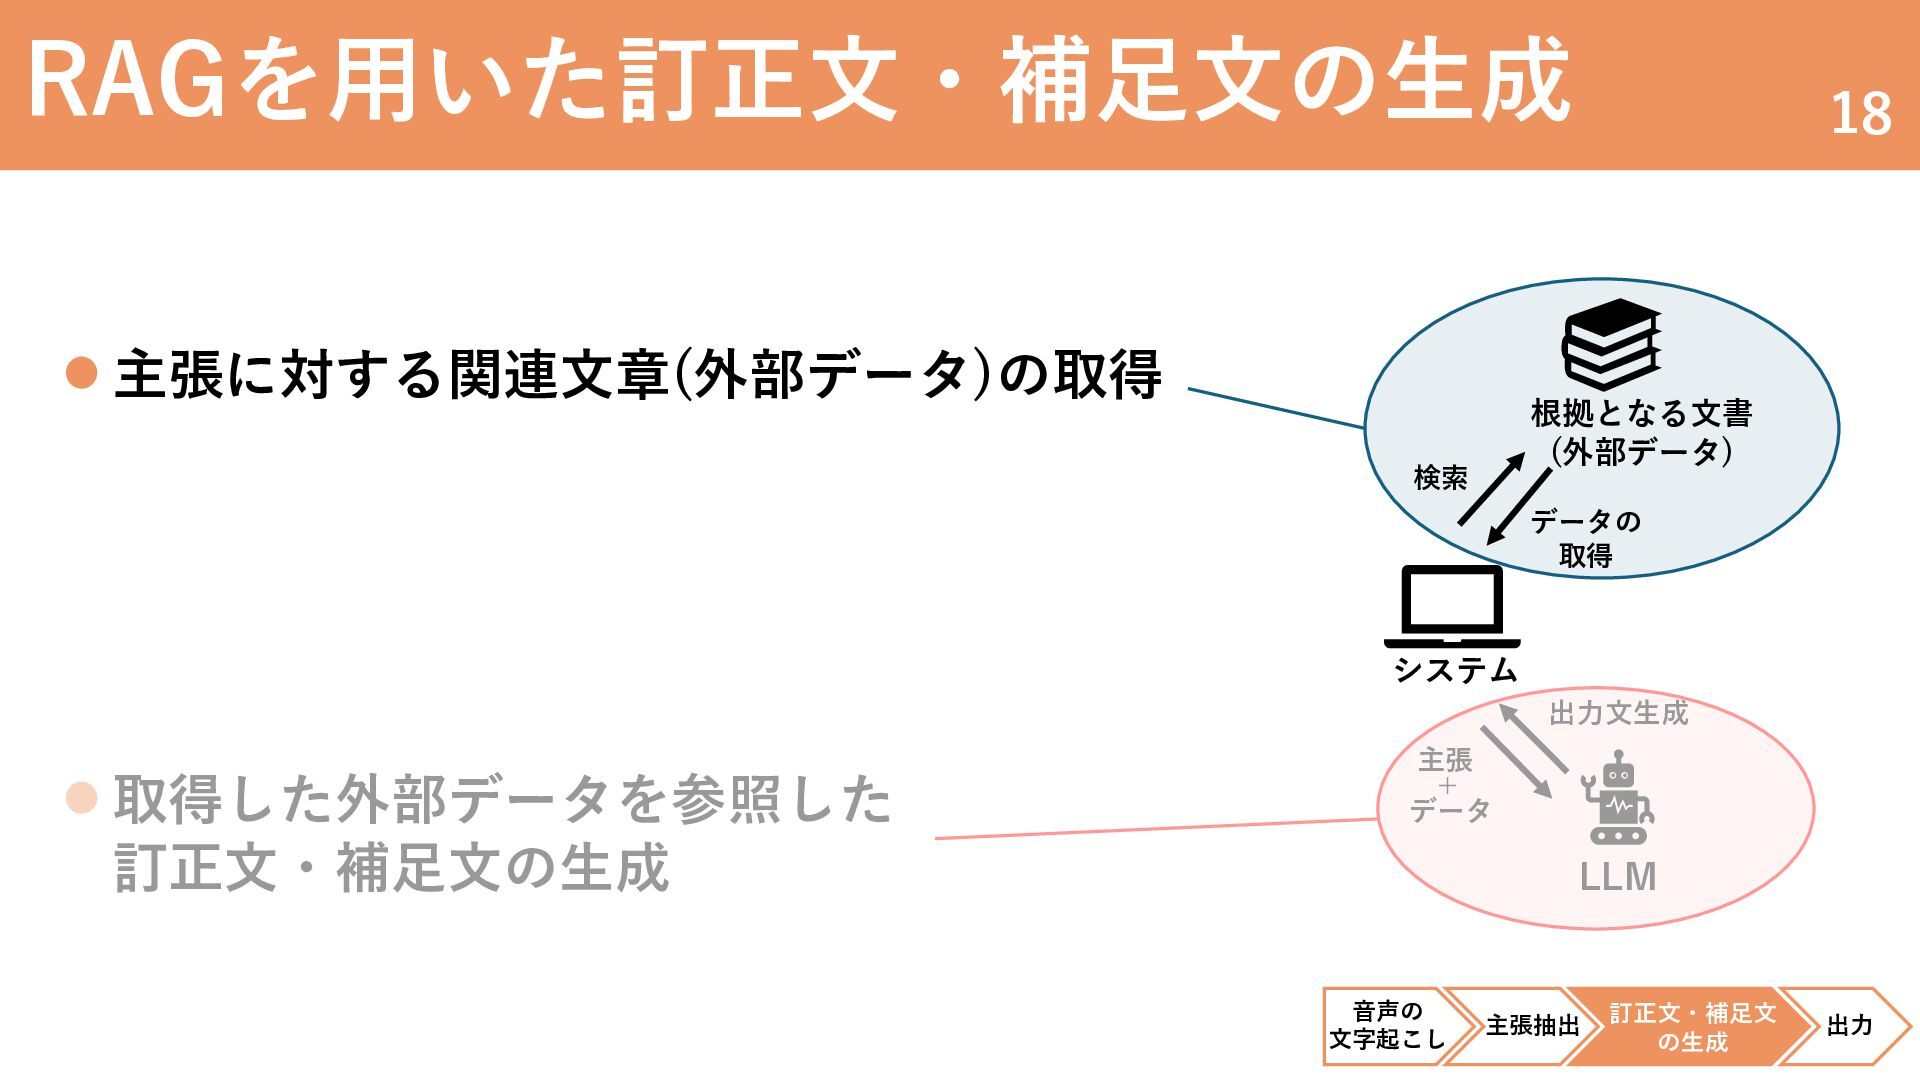
RAGを用いた訂正文・補足文の生成 主張に対する関連文章(外部データ)の取得 18 根拠となる文書 (外部データ) 検索 データの 取得 システム 出力文生成
取得した外部データを参照した 訂正文・補足文の生成 主張 + データ LLM 音声の 文字起こし 主張抽出 訂正文・補足文 の生成 出力 -
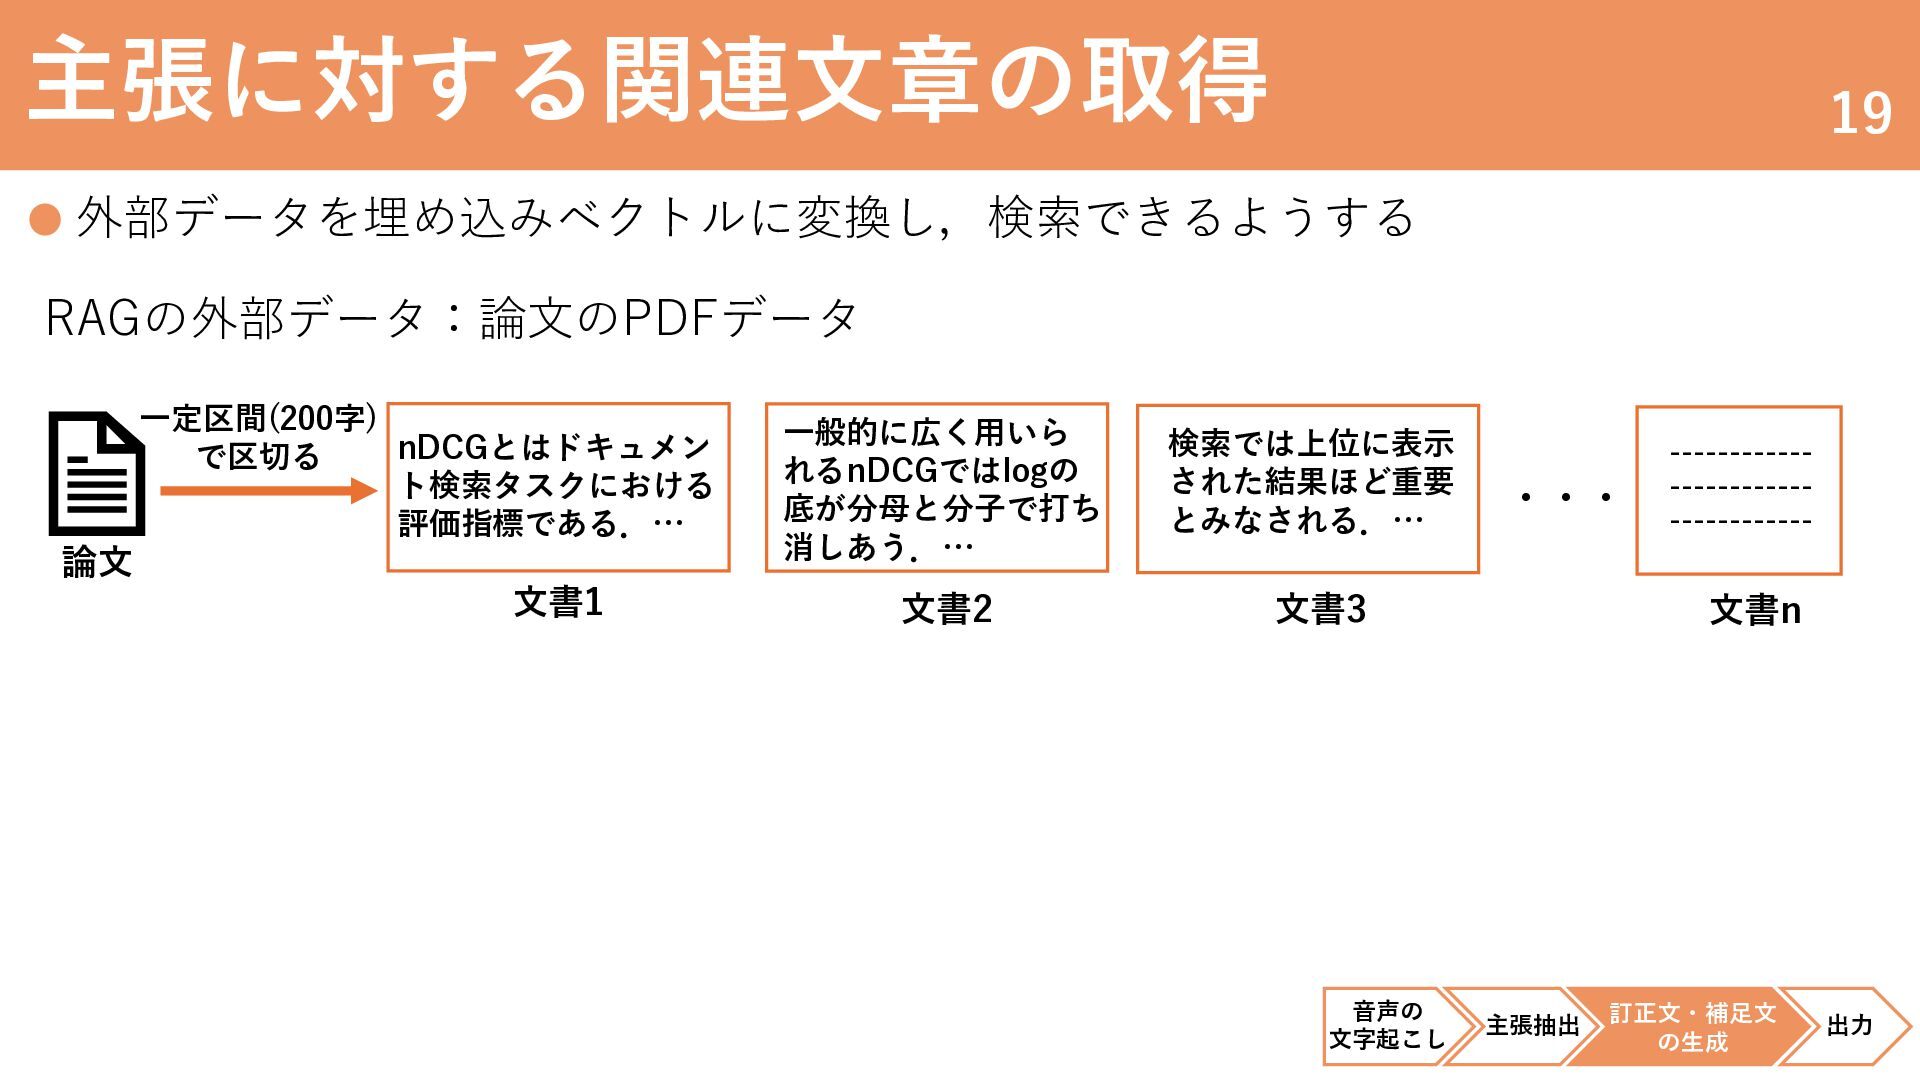
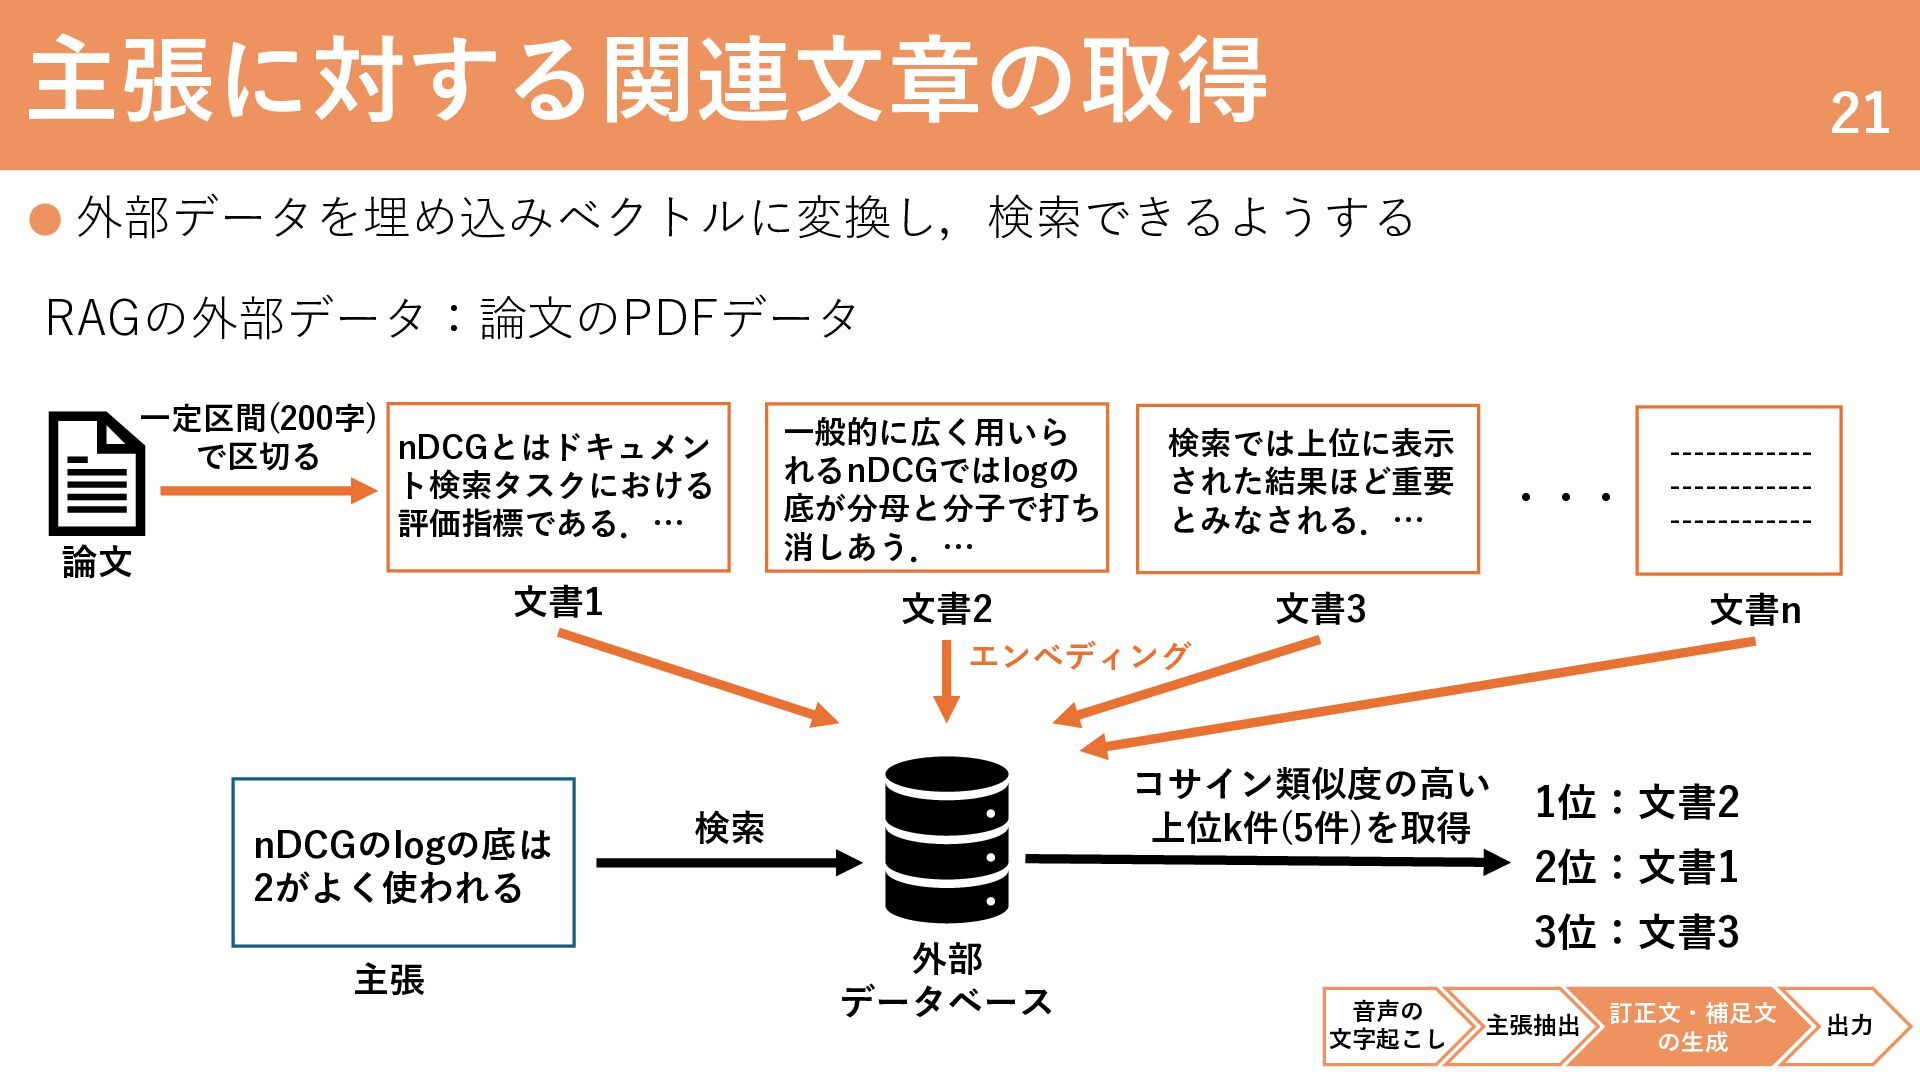
主張に対する関連文章の取得 19 外部データを埋め込みベクトルに変換し,検索できるようする RAGの外部データ:論文のPDFデータ 一定区間(200字) nDCGとはドキュメン で区切る ト検索タスクにおける 評価指標である.… 論文
文書1 一般的に広く用いら れるnDCGではlogの 底が分母と分子で打ち 消しあう.… 検索では上位に表示 された結果ほど重要 とみなされる.… 文書2 文書3 音声の 文字起こし ・・・ ---------------------------------- 文書n 主張抽出 訂正文・補足文 の生成 出力 -
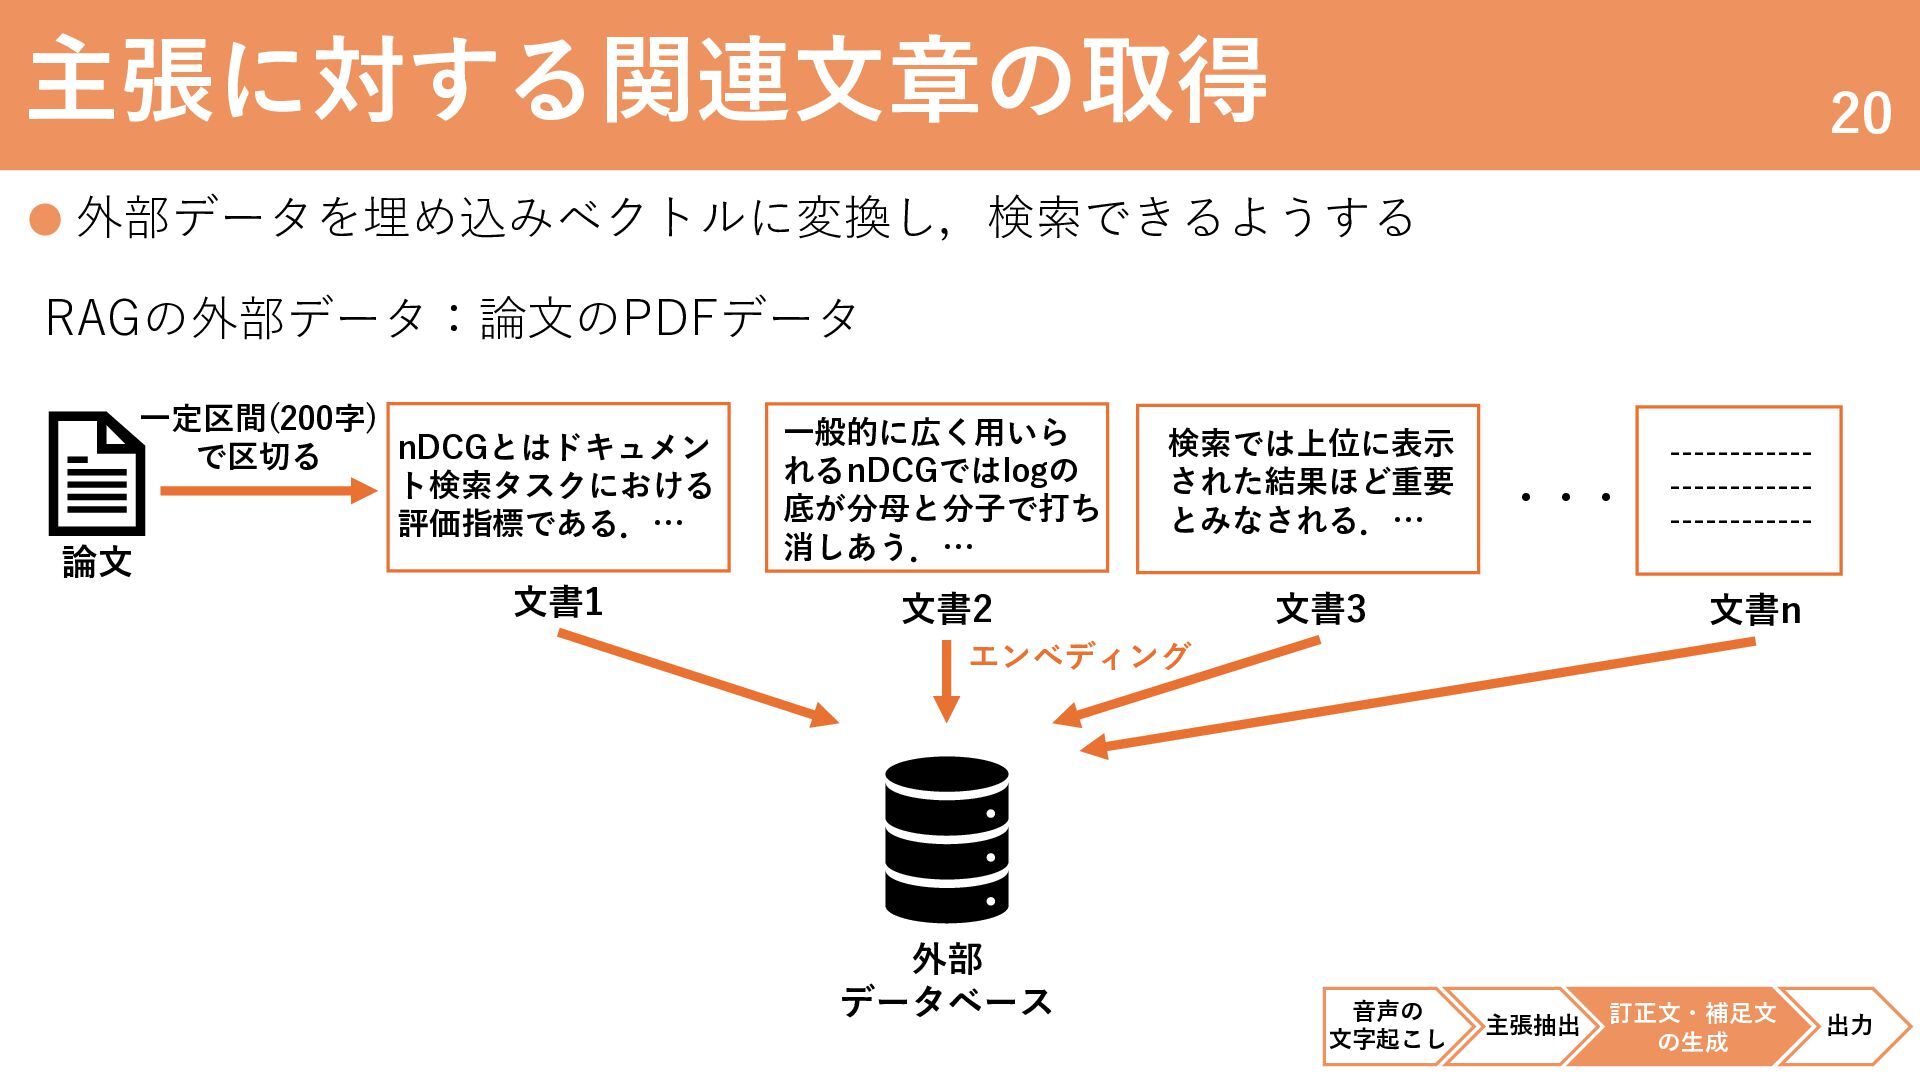
主張に対する関連文章の取得 20 外部データを埋め込みベクトルに変換し,検索できるようする RAGの外部データ:論文のPDFデータ 一定区間(200字) nDCGとはドキュメン で区切る ト検索タスクにおける 評価指標である.… 論文
文書1 一般的に広く用いら れるnDCGではlogの 底が分母と分子で打ち 消しあう.… 検索では上位に表示 された結果ほど重要 とみなされる.… 文書2 文書3 ・・・ ---------------------------------- 文書n エンベディング 外部 データベース 音声の 文字起こし 主張抽出 訂正文・補足文 の生成 出力 -
主張に対する関連文章の取得 21 外部データを埋め込みベクトルに変換し,検索できるようする RAGの外部データ:論文のPDFデータ 一定区間(200字) nDCGとはドキュメン で区切る ト検索タスクにおける 評価指標である.… 論文
文書1 一般的に広く用いら れるnDCGではlogの 底が分母と分子で打ち 消しあう.… 検索では上位に表示 された結果ほど重要 とみなされる.… 文書2 文書3 ・・・ ---------------------------------- 文書n エンベディング nDCGのlogの底は 2がよく使われる 主張 コサイン類似度の高い 上位k件(5件)を取得 検索 1位:文書2 2位:文書1 外部 データベース 3位:文書3 音声の 文字起こし 主張抽出 訂正文・補足文 の生成 出力 -
RAGを用いた訂正文・補足文の生成 主張に対する関連文章(外部データ)の取得 22 根拠となる文書 (外部データ) c 検索 データの 取得 システム
出力文生成 主張 + データ LLM 取得した外部データを参照した 訂正文・補足文の生成 音声の 文字起こし 主張抽出 訂正文・補足文 の生成 出力 -
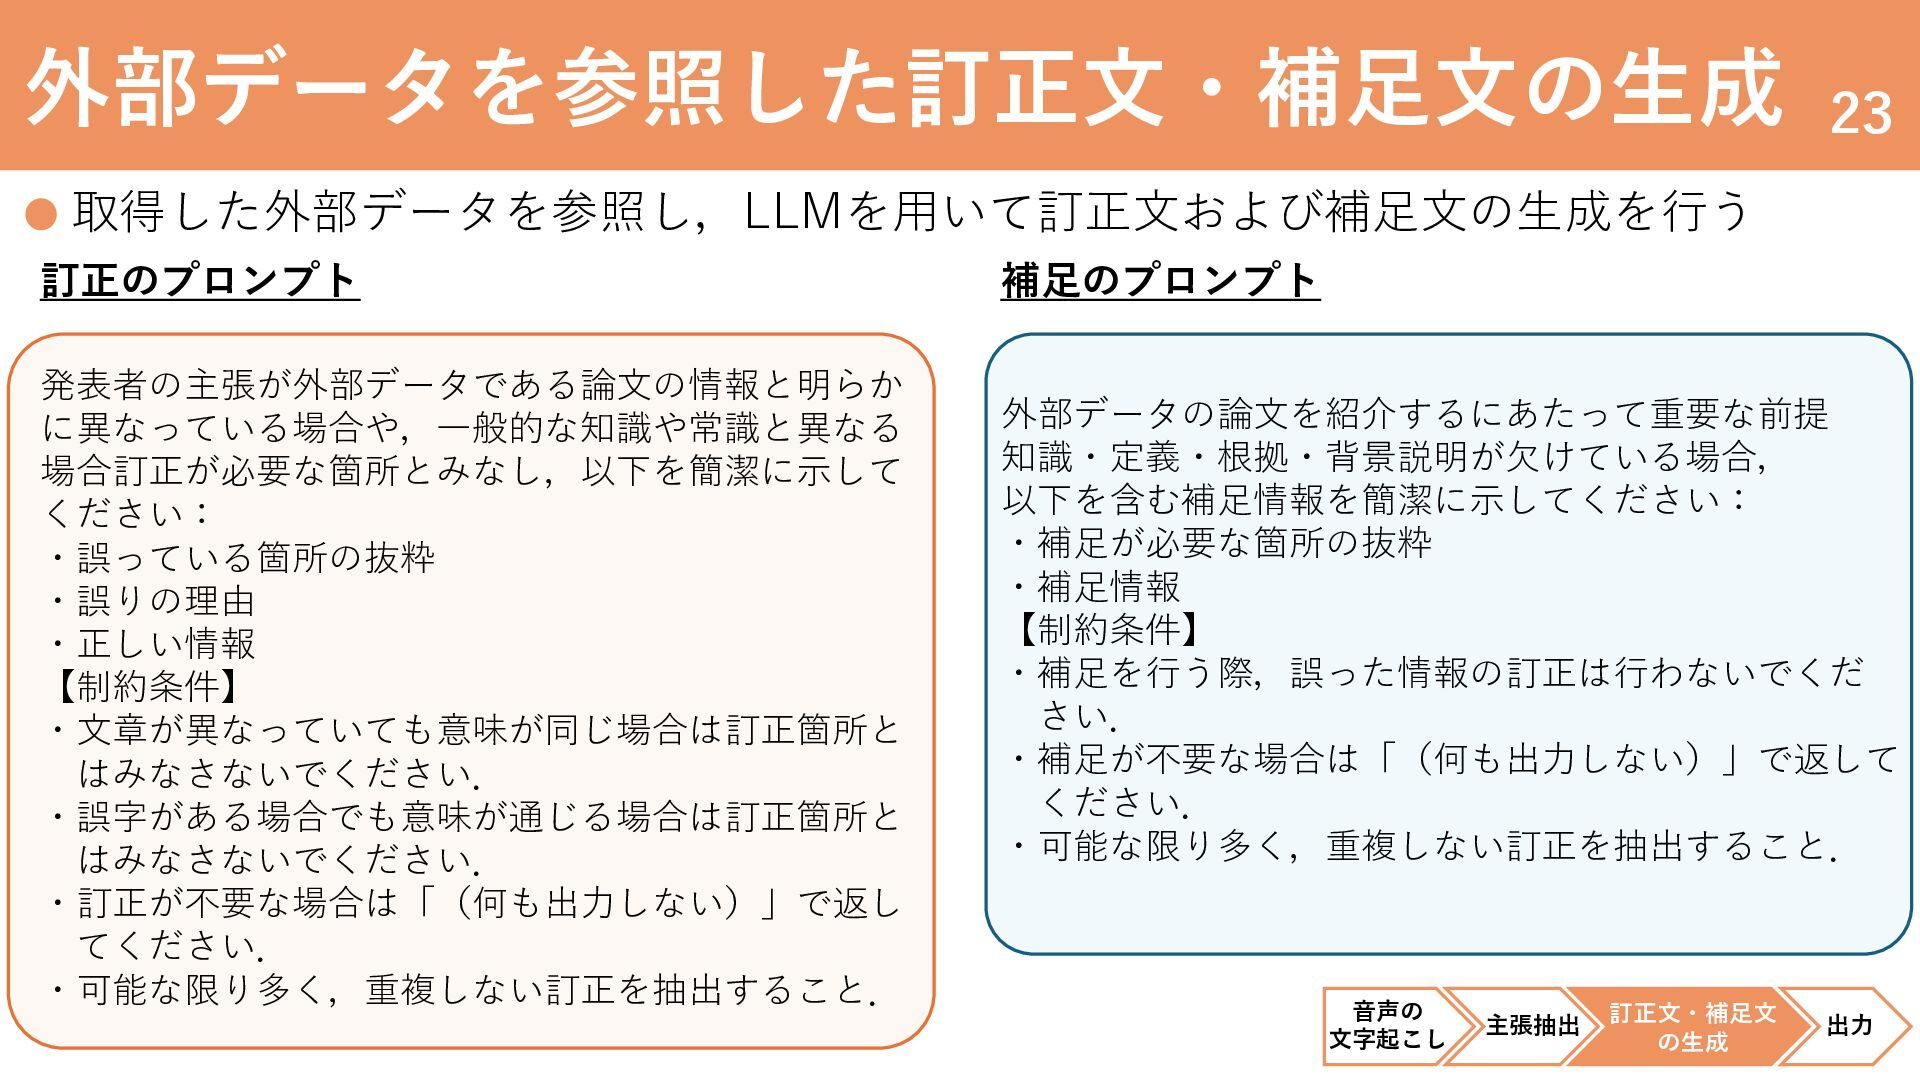
外部データを参照した訂正文・補足文の生成 23 取得した外部データを参照し,LLMを用いて訂正文および補足文の生成を行う 訂正のプロンプト 発表者の主張が外部データである論文の情報と明らか に異なっている場合や,一般的な知識や常識と異なる 場合訂正が必要な箇所とみなし,以下を簡潔に示して ください: ・誤っている箇所の抜粋 ・誤りの理由
・正しい情報 【制約条件】 ・文章が異なっていても意味が同じ場合は訂正箇所と はみなさないでください. ・誤字がある場合でも意味が通じる場合は訂正箇所と はみなさないでください. ・訂正が不要な場合は「(何も出力しない)」で返し てください. ・可能な限り多く,重複しない訂正を抽出すること. 補足のプロンプト 外部データの論文を紹介するにあたって重要な前提 知識・定義・根拠・背景説明が欠けている場合, 以下を含む補足情報を簡潔に示してください: ・補足が必要な箇所の抜粋 ・補足情報 【制約条件】 ・補足を行う際,誤った情報の訂正は行わないでくだ さい. ・補足が不要な場合は「(何も出力しない)」で返して ください. ・可能な限り多く,重複しない訂正を抽出すること. 音声の 文字起こし 主張抽出 訂正文・補足文 の生成 出力 -
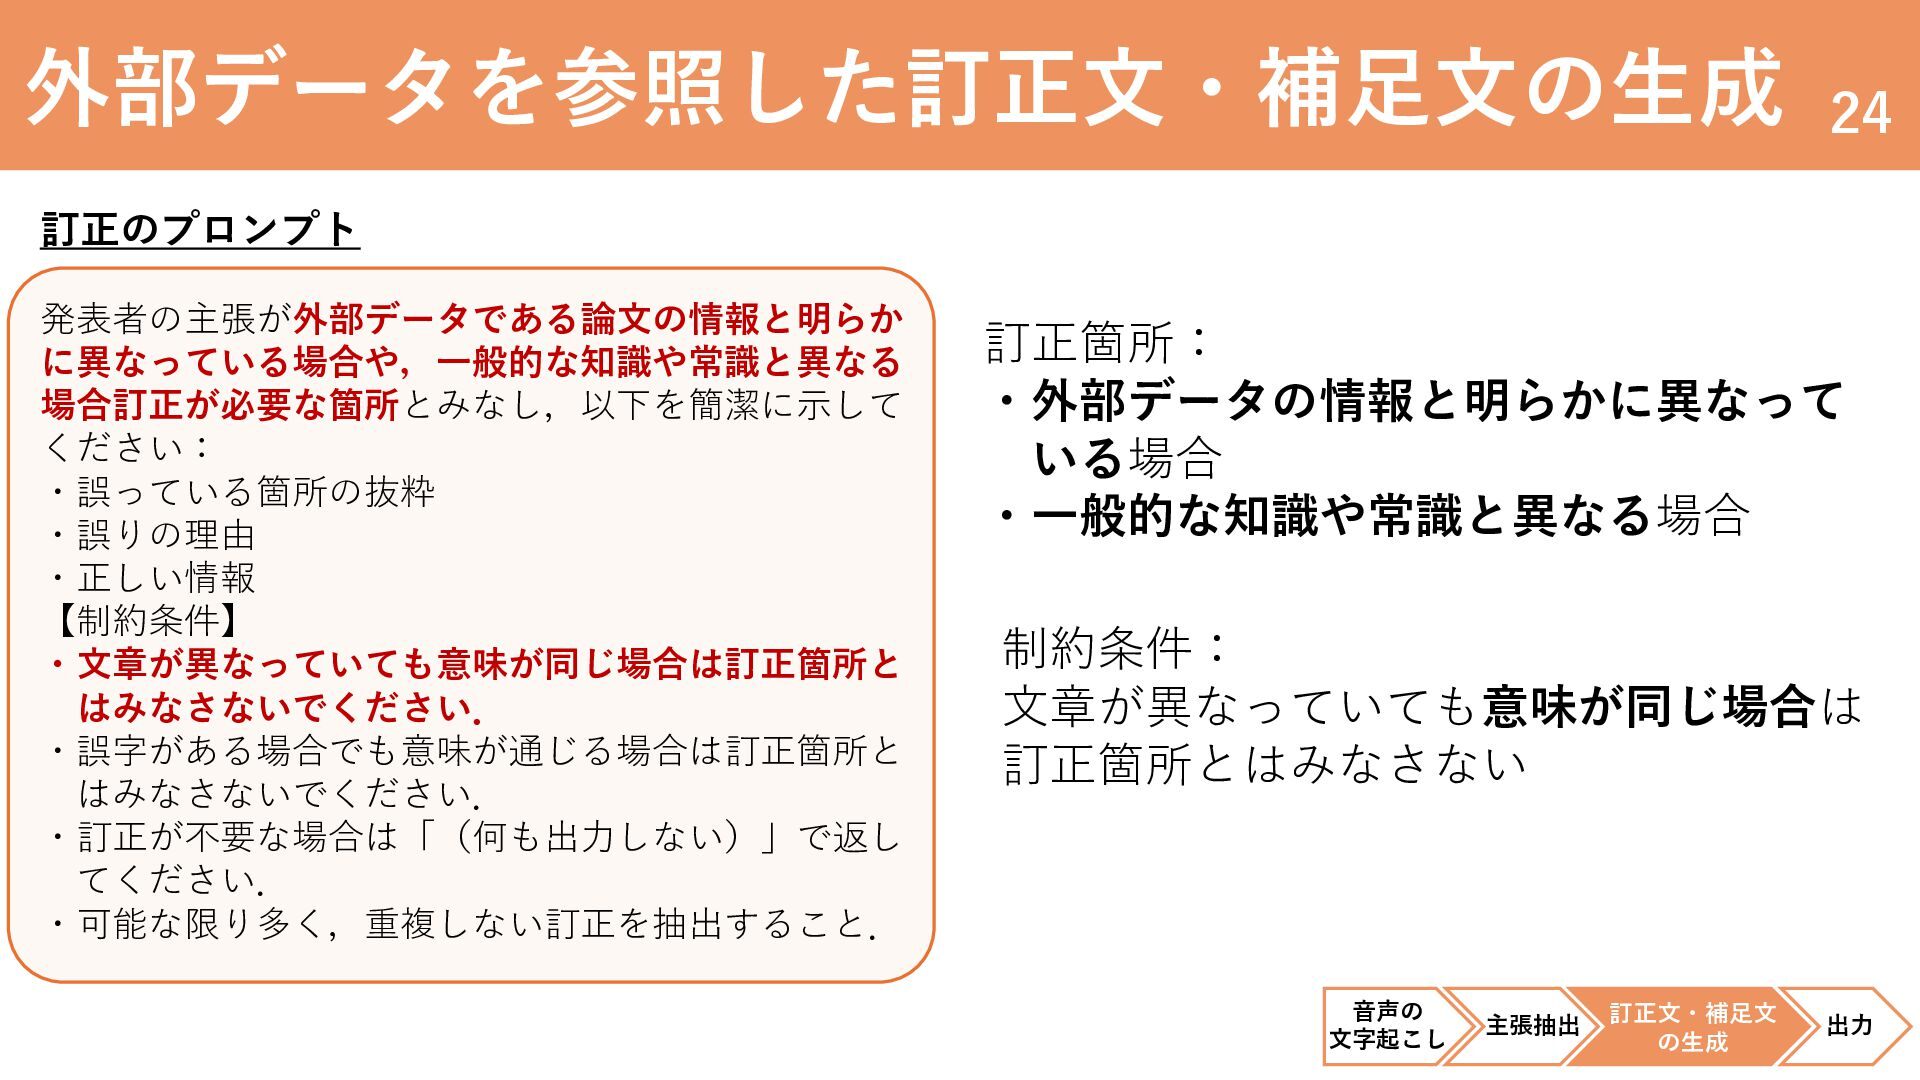
外部データを参照した訂正文・補足文の生成 24 訂正のプロンプト 発表者の主張が外部データである論文の情報と明らか に異なっている場合や,一般的な知識や常識と異なる 場合訂正が必要な箇所とみなし,以下を簡潔に示して ください: ・誤っている箇所の抜粋 ・誤りの理由 ・正しい情報
【制約条件】 ・文章が異なっていても意味が同じ場合は訂正箇所と はみなさないでください. ・誤字がある場合でも意味が通じる場合は訂正箇所と はみなさないでください. ・訂正が不要な場合は「(何も出力しない)」で返し てください. ・可能な限り多く,重複しない訂正を抽出すること. 訂正箇所: ・外部データの情報と明らかに異なって いる場合 ・一般的な知識や常識と異なる場合 制約条件: 文章が異なっていても意味が同じ場合は 訂正箇所とはみなさない 音声の 文字起こし 主張抽出 訂正文・補足文 の生成 出力 -
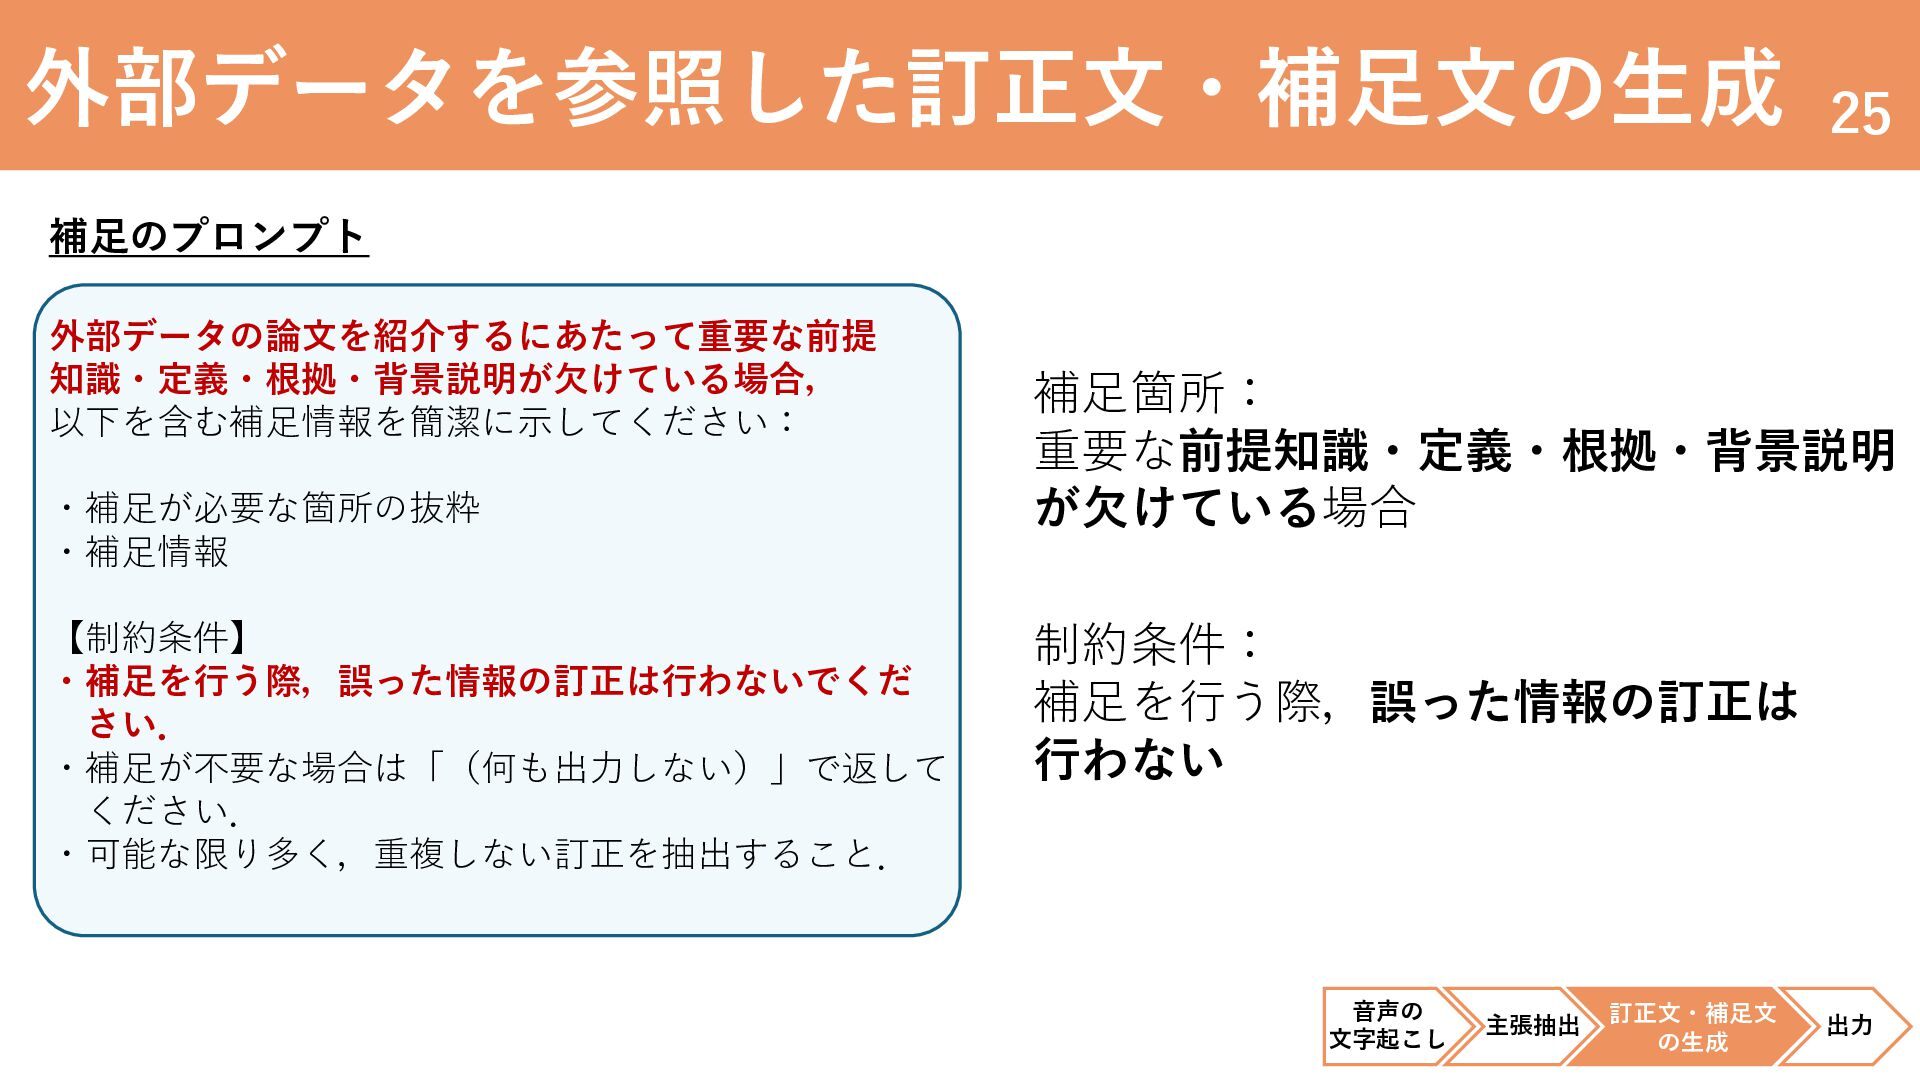
外部データを参照した訂正文・補足文の生成 25 補足のプロンプト 外部データの論文を紹介するにあたって重要な前提 知識・定義・根拠・背景説明が欠けている場合, 以下を含む補足情報を簡潔に示してください: ・補足が必要な箇所の抜粋 ・補足情報 【制約条件】 ・補足を行う際,誤った情報の訂正は行わないでくだ
さい. ・補足が不要な場合は「(何も出力しない)」で返して ください. ・可能な限り多く,重複しない訂正を抽出すること. 補足箇所: 重要な前提知識・定義・根拠・背景説明 が欠けている場合 制約条件: 補足を行う際,誤った情報の訂正は 行わない 音声の 文字起こし 主張抽出 訂正文・補足文 の生成 出力 -
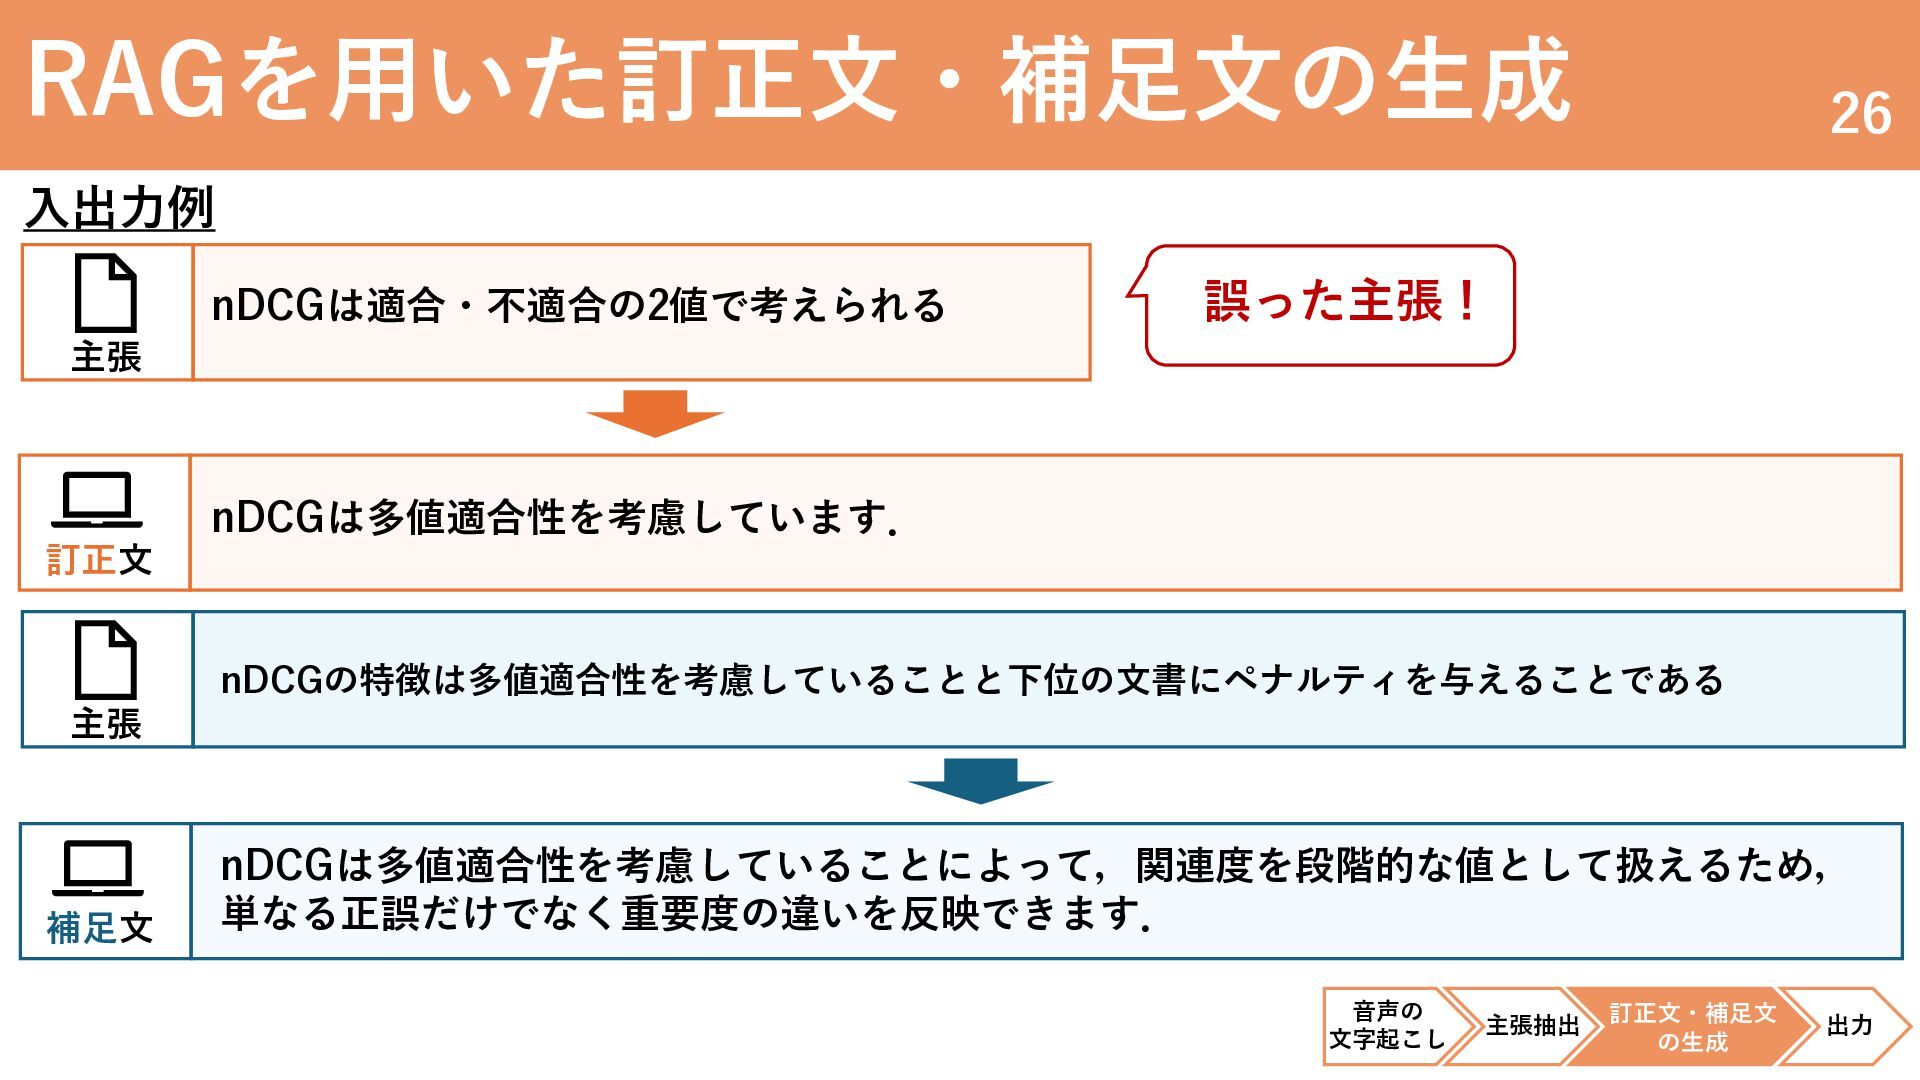
RAGを用いた訂正文・補足文の生成 26 入出力例 nDCGは適合・不適合の2値で考えられる 誤った主張! 主張 nDCGは多値適合性を考慮しています. 訂正文 nDCGの特徴は多値適合性を考慮していることと下位の文書にペナルティを与えることである 主張
補足文 nDCGは多値適合性を考慮していることによって,関連度を段階的な値として扱えるため, 単なる正誤だけでなく重要度の違いを反映できます. 音声の 文字起こし 主張抽出 訂正文・補足文 の生成 出力 -
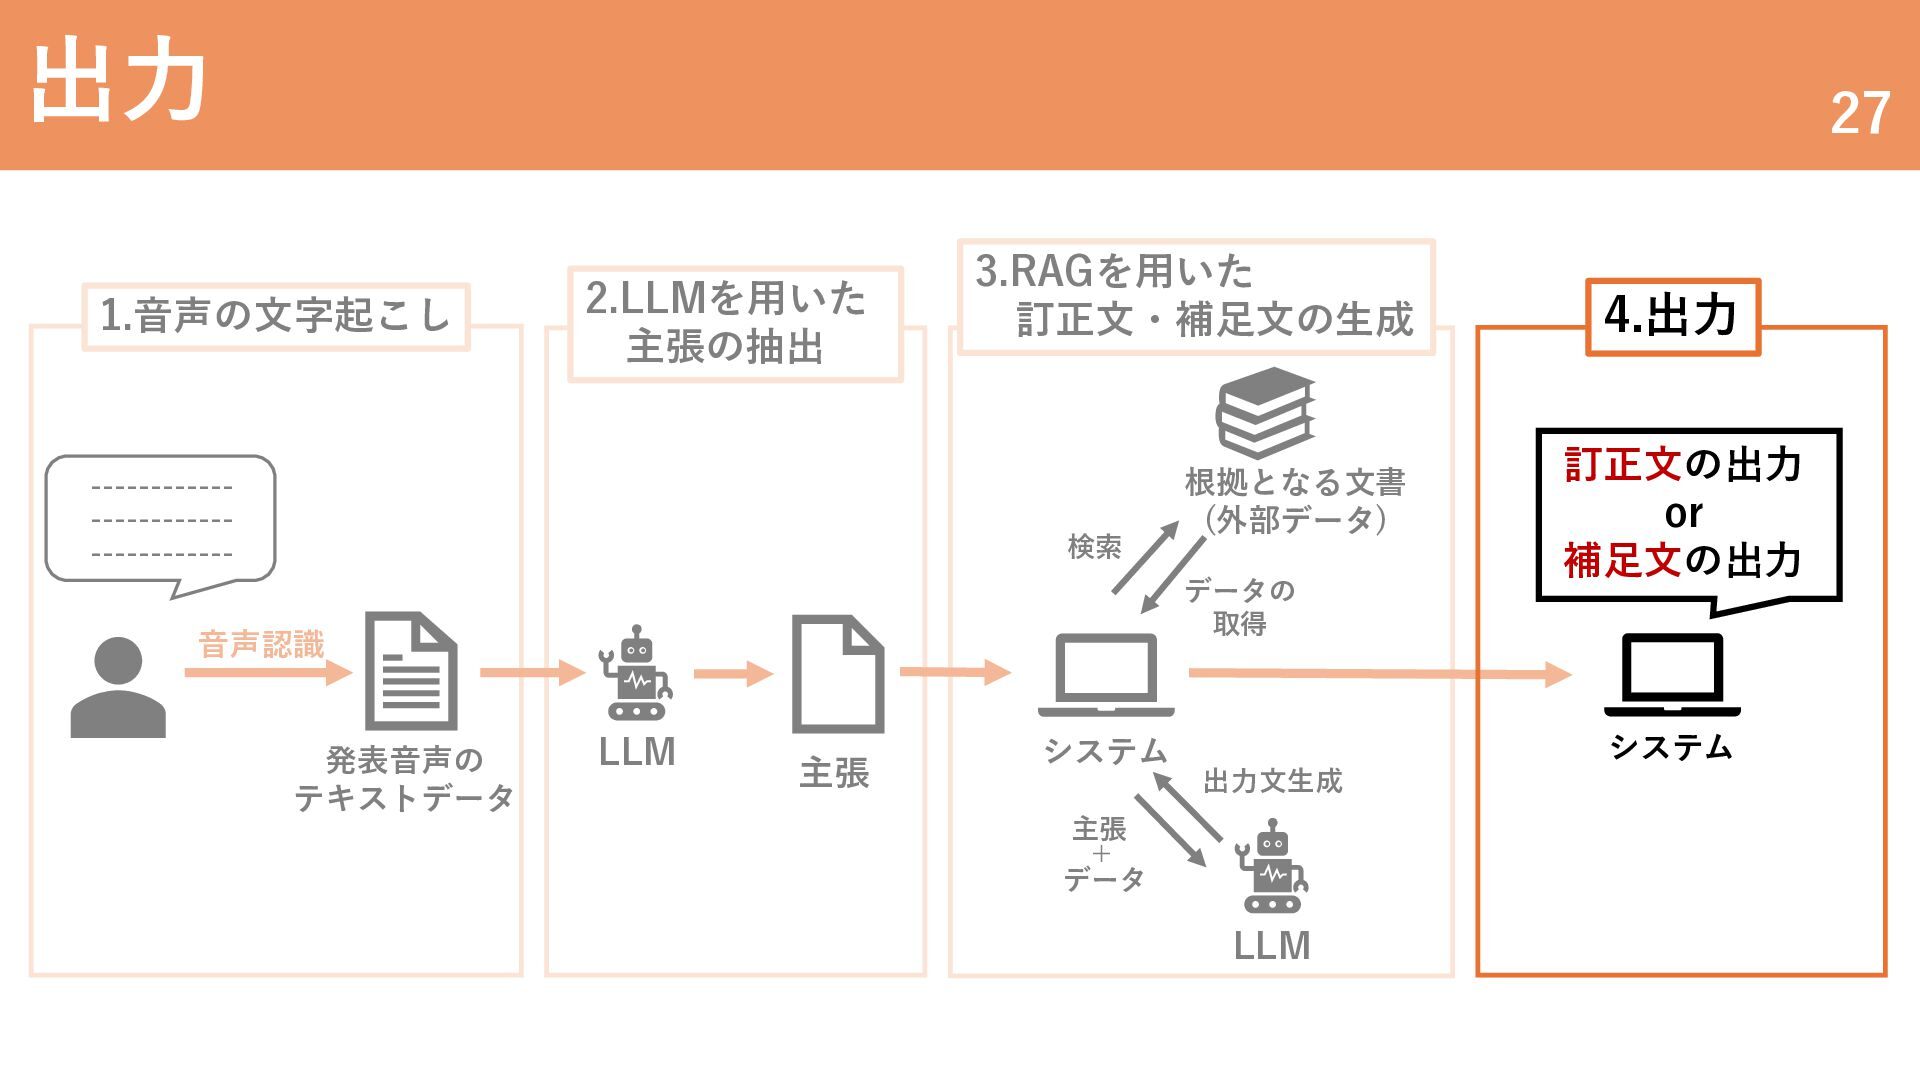
出力 27 1.音声の文字起こし 2.LLMを用いた 主張の抽出 ---------------------------------- 3.RAGを用いた 訂正文・補足文の生成 検索 データの
取得 音声認識 発表音声の テキストデータ 根拠となる文書 (外部データ) LLM 主張 システム 4.出力 訂正文の出力 or 補足文の出力 システム 出力文生成 主張 + データ LLM -
実験に用いたデータ 兵庫県立大学山本研究室内にて各自が選択した論文に関する発表を 質疑応答を含めて一人あたり約 10 分間で実施 ー 人数:学部生または院生11名 ※主張抽出の精度評価では11名分のデータを, 訂正文・補足文生成の精度評価には2名分のデータを用いた ー
収集データ:発表と質疑応答における音声データ 発表資料(スライド) 対象論文のPDFデータ 29 -
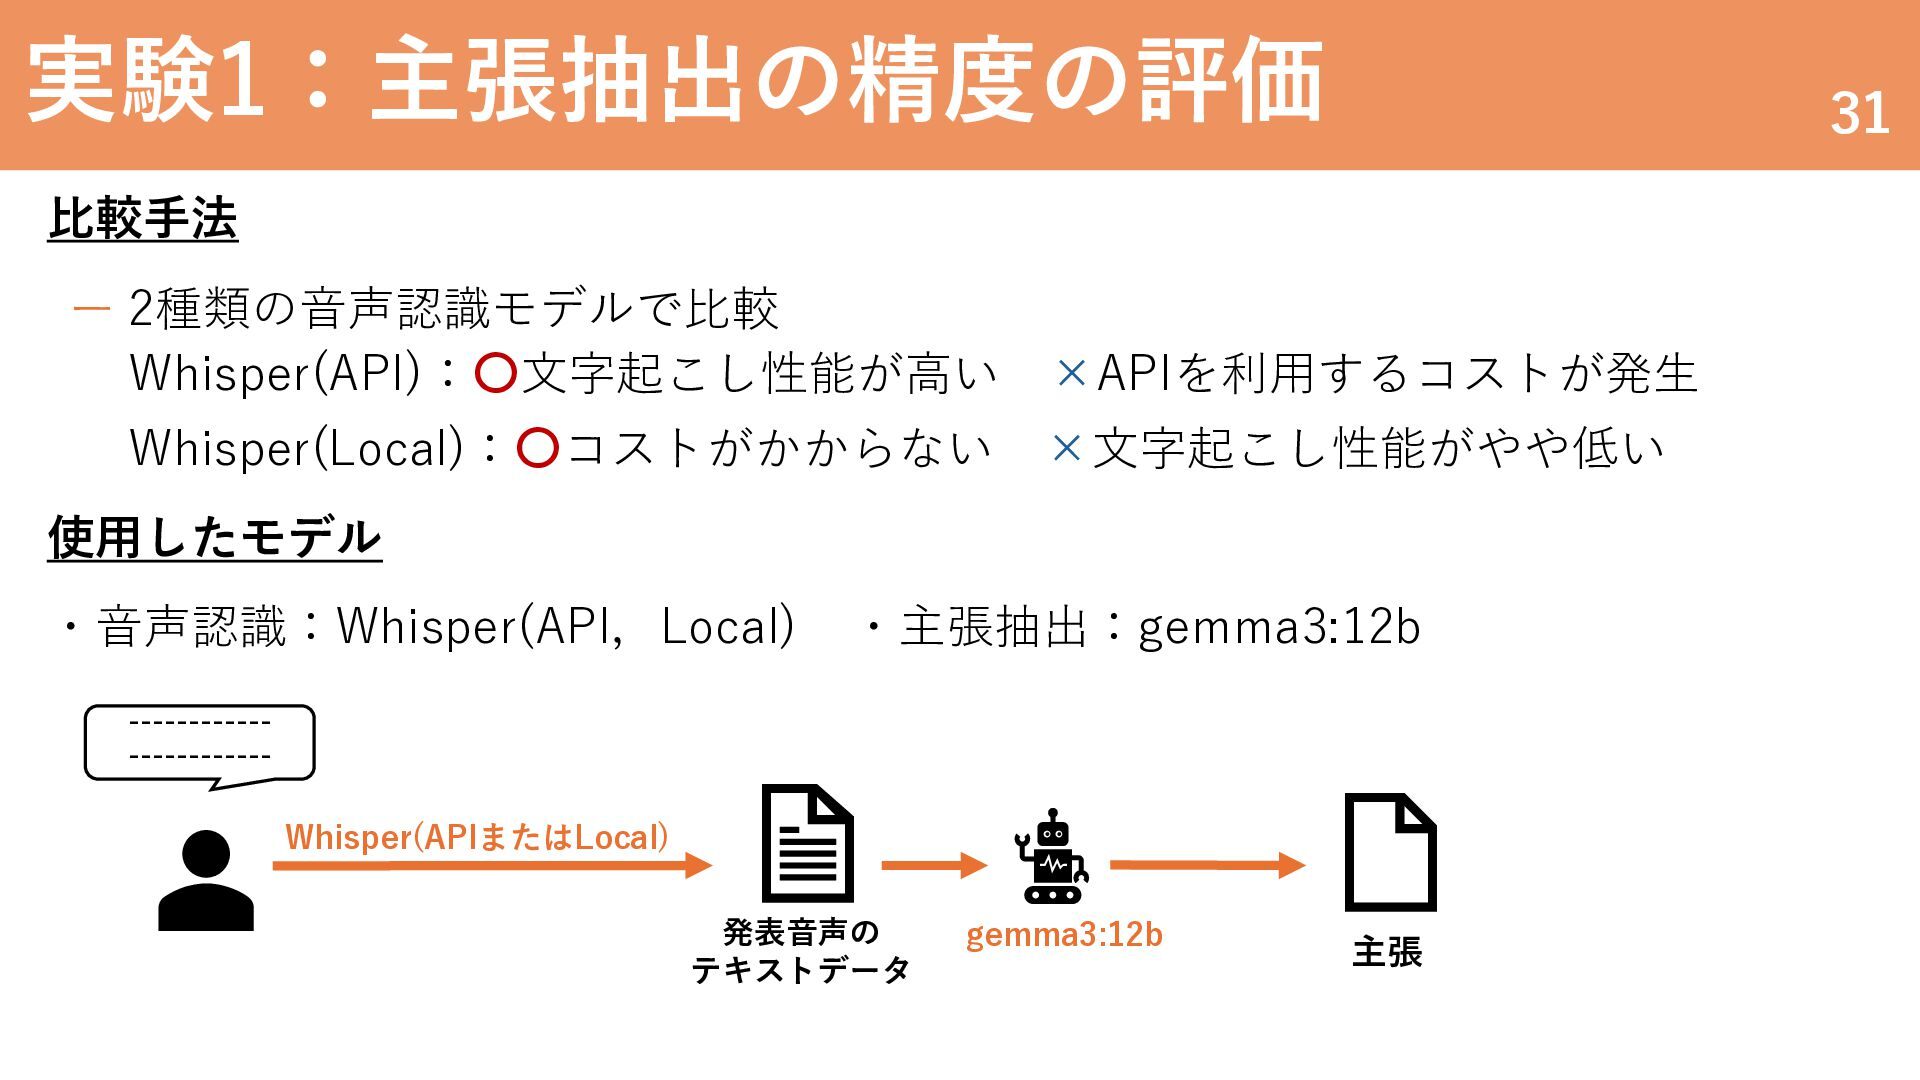
実験1:主張抽出の精度の評価 31 比較手法 ー 2種類の音声認識モデルで比較 Whisper(API):〇文字起こし性能が高い ×APIを利用するコストが発生 Whisper(Local):〇コストがかからない ×文字起こし性能がやや低い 使用したモデル
・音声認識:Whisper(API,Local) ・主張抽出:gemma3:12b ----------------------- Whisper(APIまたはLocal) 発表音声の テキストデータ gemma3:12b 主張 -
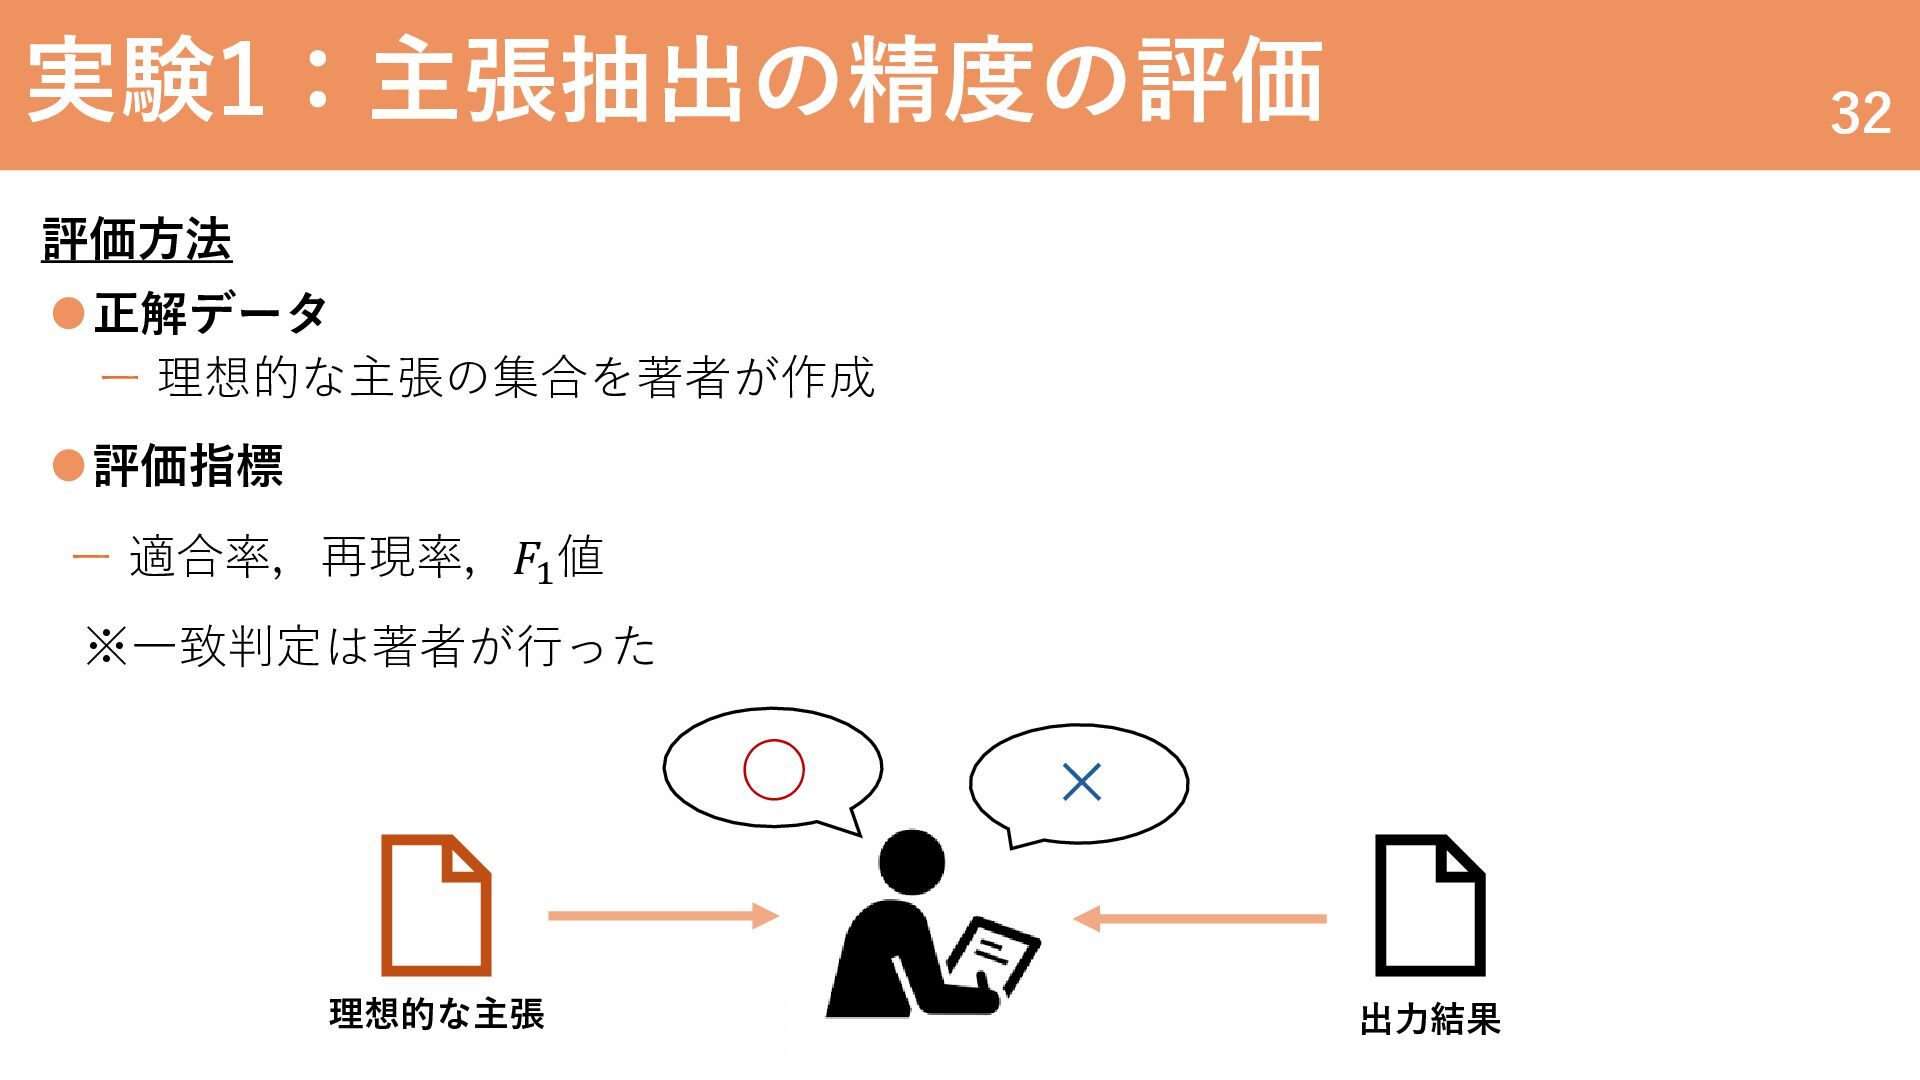
実験1:主張抽出の精度の評価 32 評価方法 正解データ ー 理想的な主張の集合を著者が作成 評価指標 ー 適合率,再現率,𝐹1 値
※一致判定は著者が行った ◦ 理想的な主張 × 出力結果 -
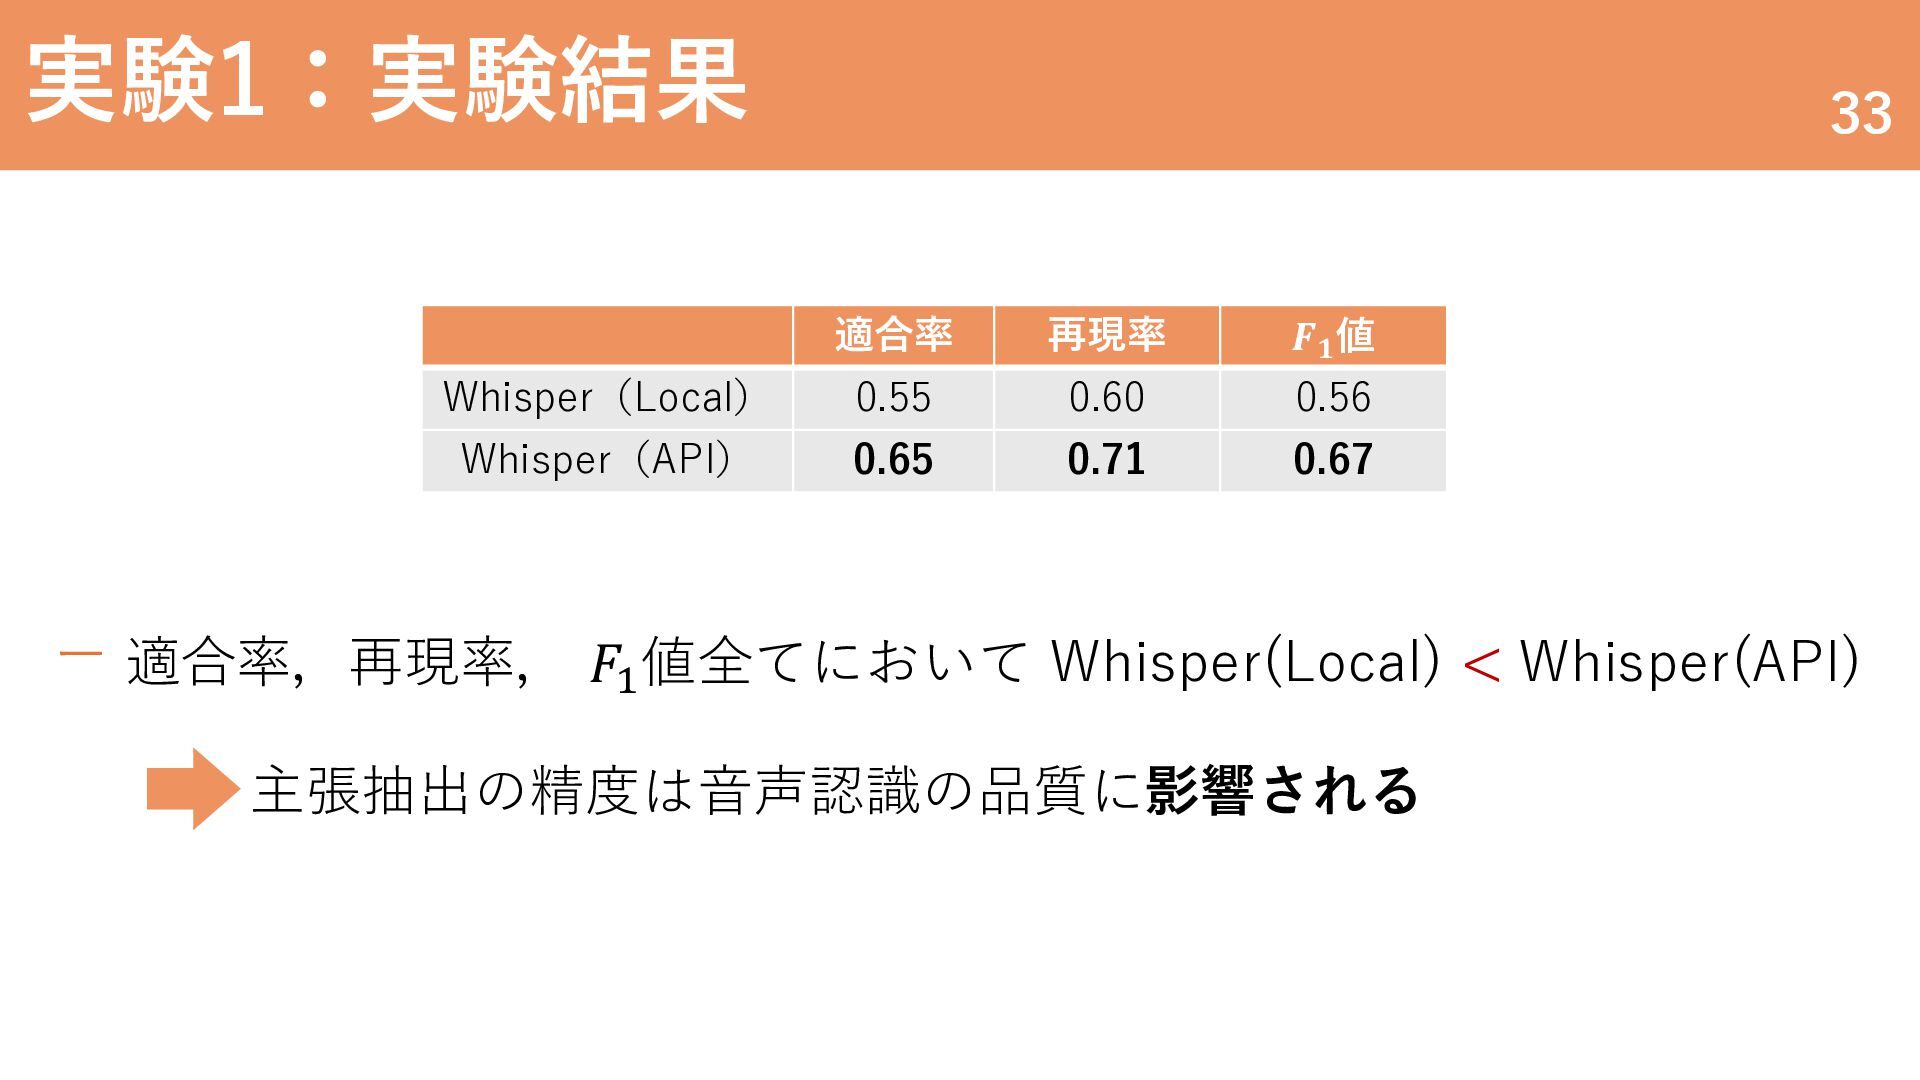
実験1:実験結果 33 適合率 再現率 𝑭𝟏 値 Whisper(Local) 0.55 0.60 0.56
Whisper(API) 0.65 0.71 0.67 ー 適合率,再現率, 𝐹1 値全てにおいて Whisper(Local) < Whisper(API) 主張抽出の精度は音声認識の品質に影響される -
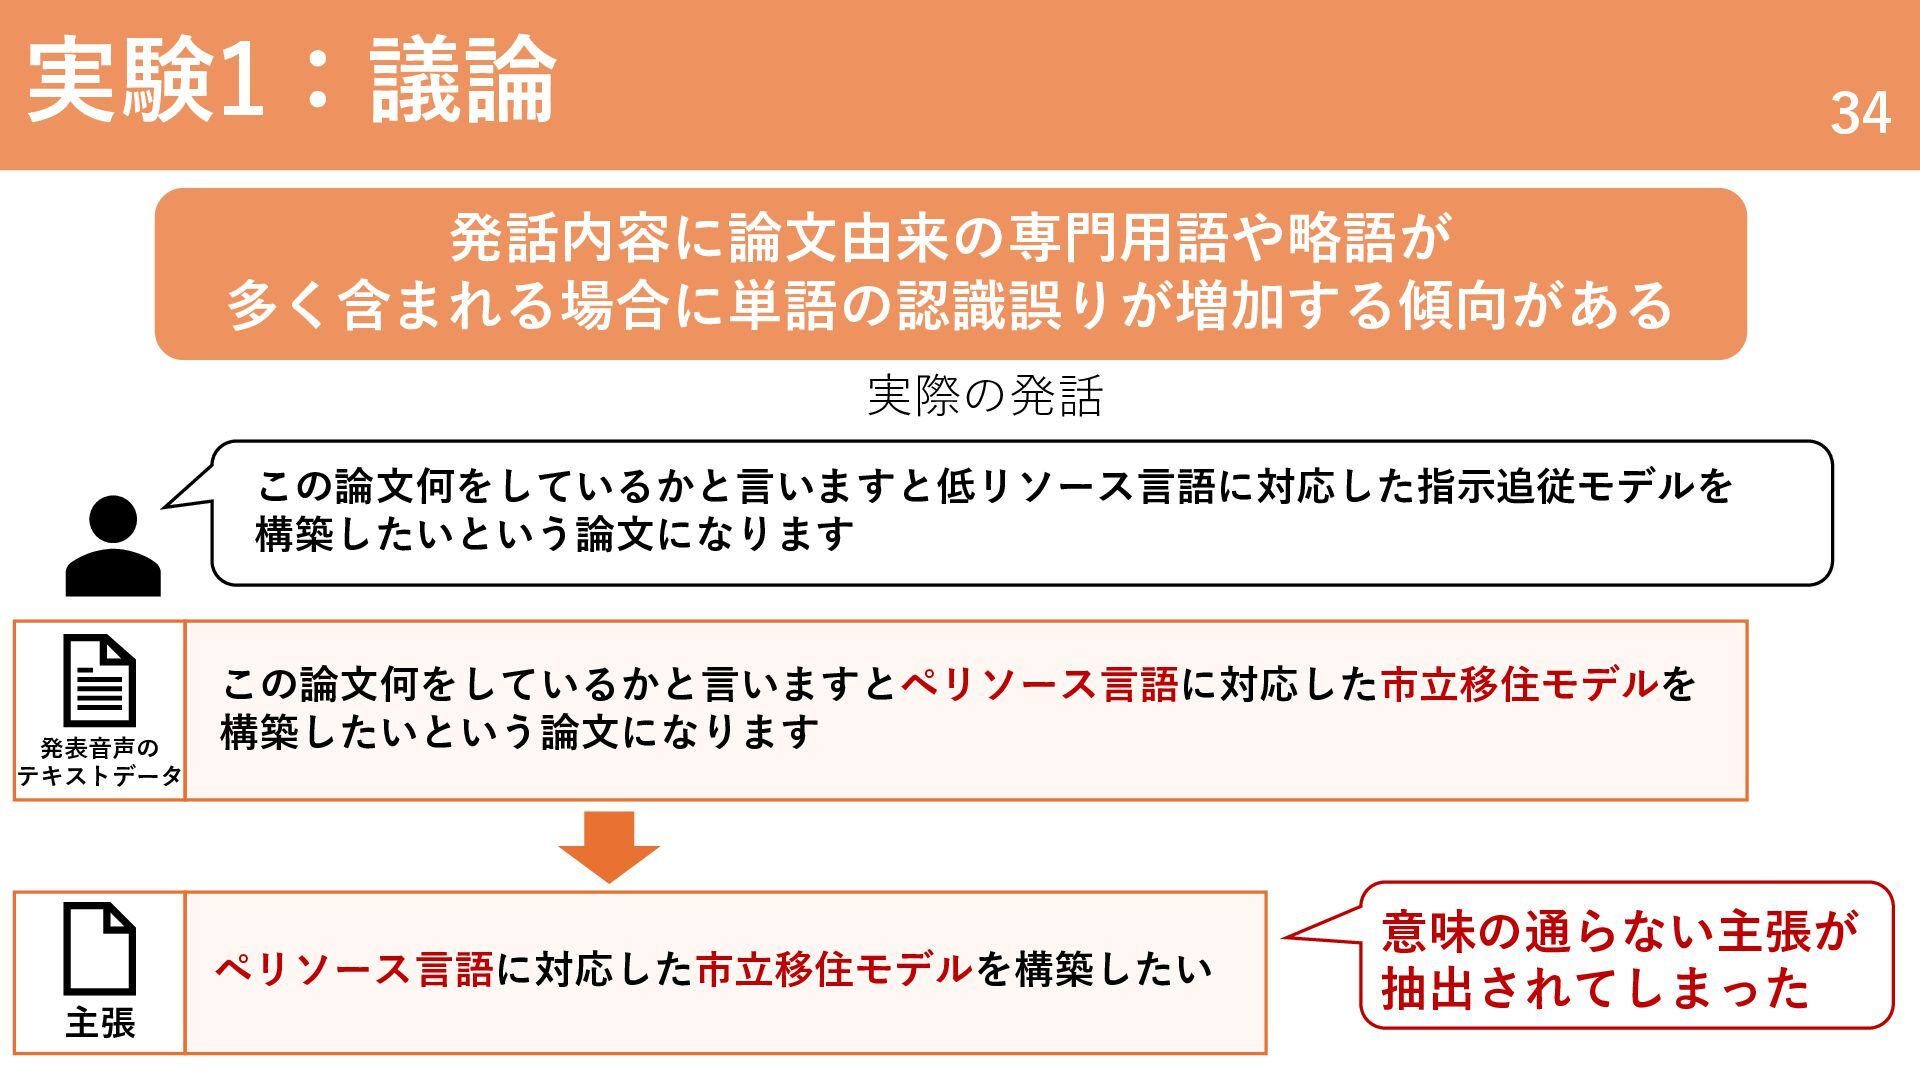
実験1:議論 34 発話内容に論文由来の専門用語や略語が 多く含まれる場合に単語の認識誤りが増加する傾向がある 実際の発話 この論文何をしているかと言いますと低リソース言語に対応した指示追従モデルを 構築したいという論文になります 発表音声の テキストデータ この論文何をしているかと言いますとペリソース言語に対応した市立移住モデルを
構築したいという論文になります ペリソース言語に対応した市立移住モデルを構築したい 主張 意味の通らない主張が 抽出されてしまった -
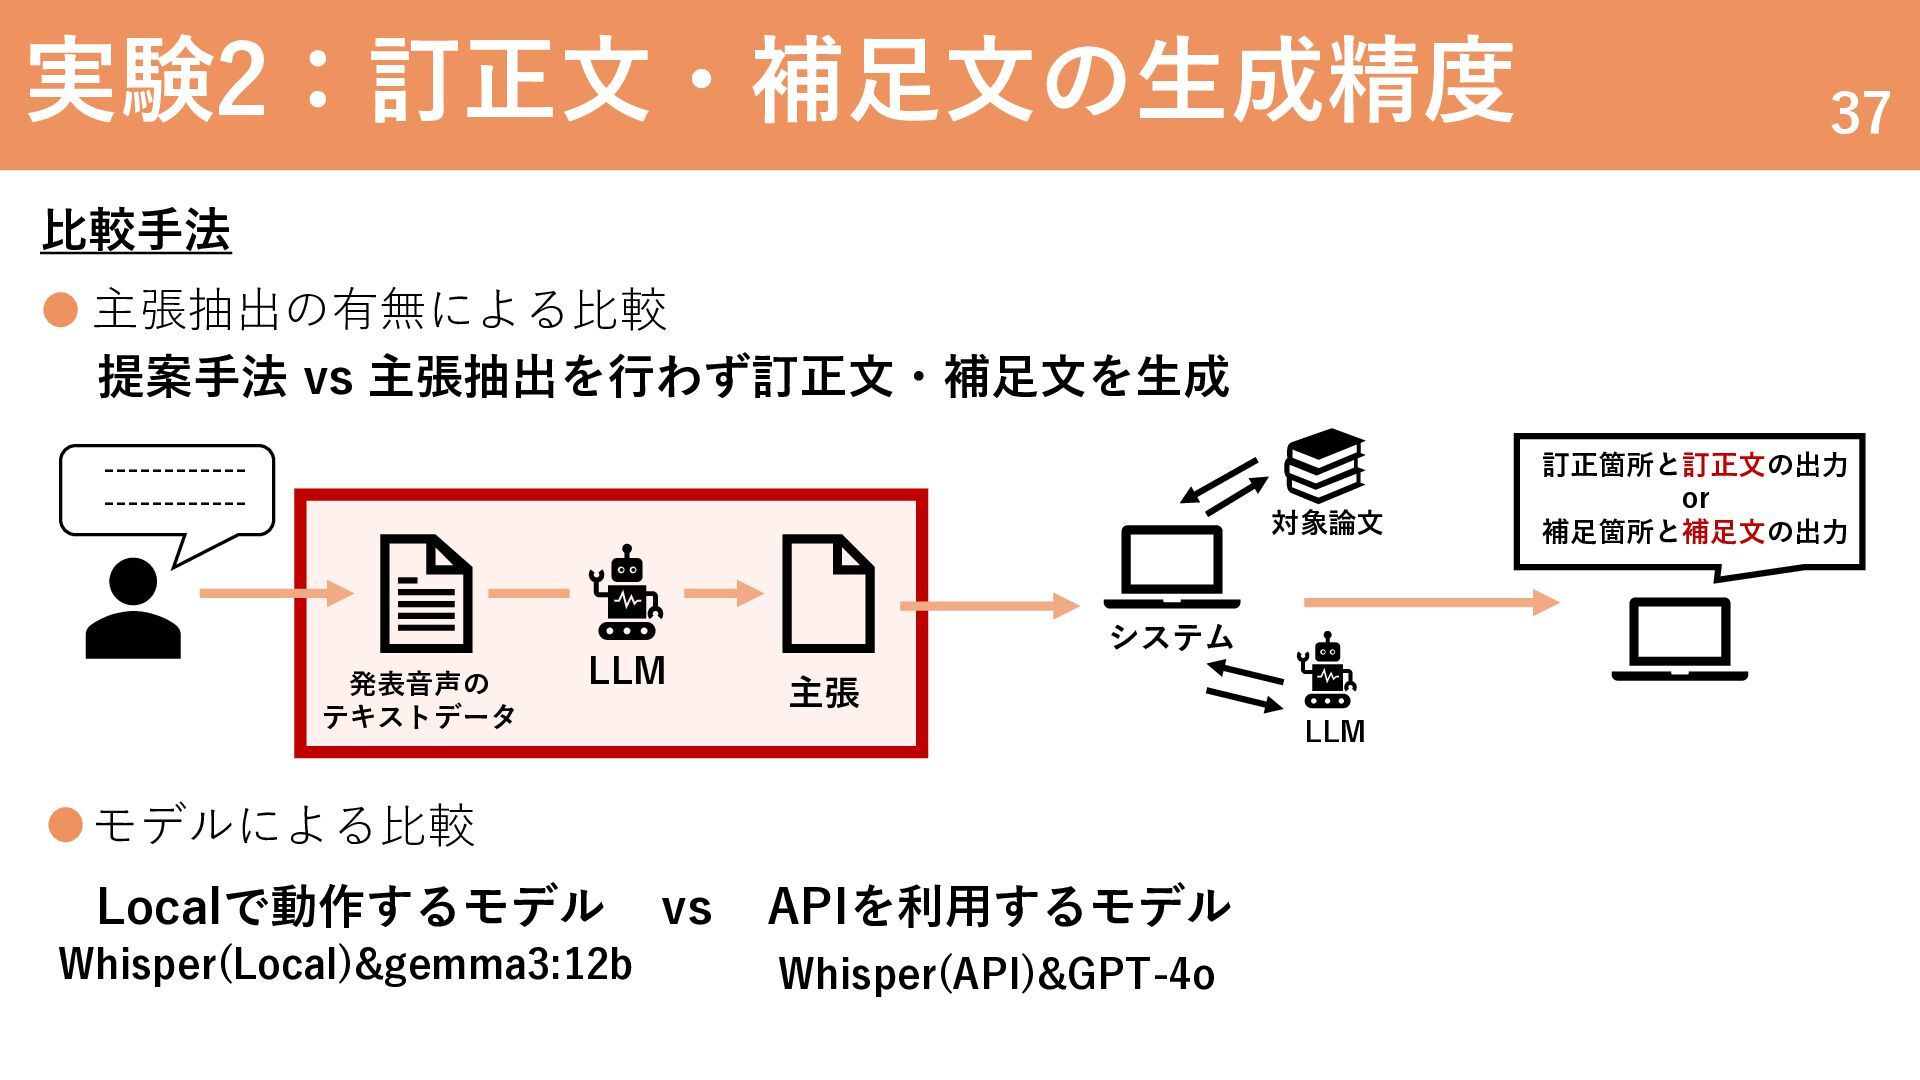
実験2:訂正文・補足文の生成精度 37 比較手法 主張抽出の有無による比較 提案手法 vs 主張抽出を行わず訂正文・補足文を生成 ----------------------- 対象論文 発表音声の
テキストデータ LLM システム 主張 LLM モデルによる比較 Localで動作するモデル Whisper(Local)&gemma3:12b vs APIを利用するモデル Whisper(API)&GPT-4o 訂正箇所と訂正文の出力 or 補足箇所と補足文の出力 -
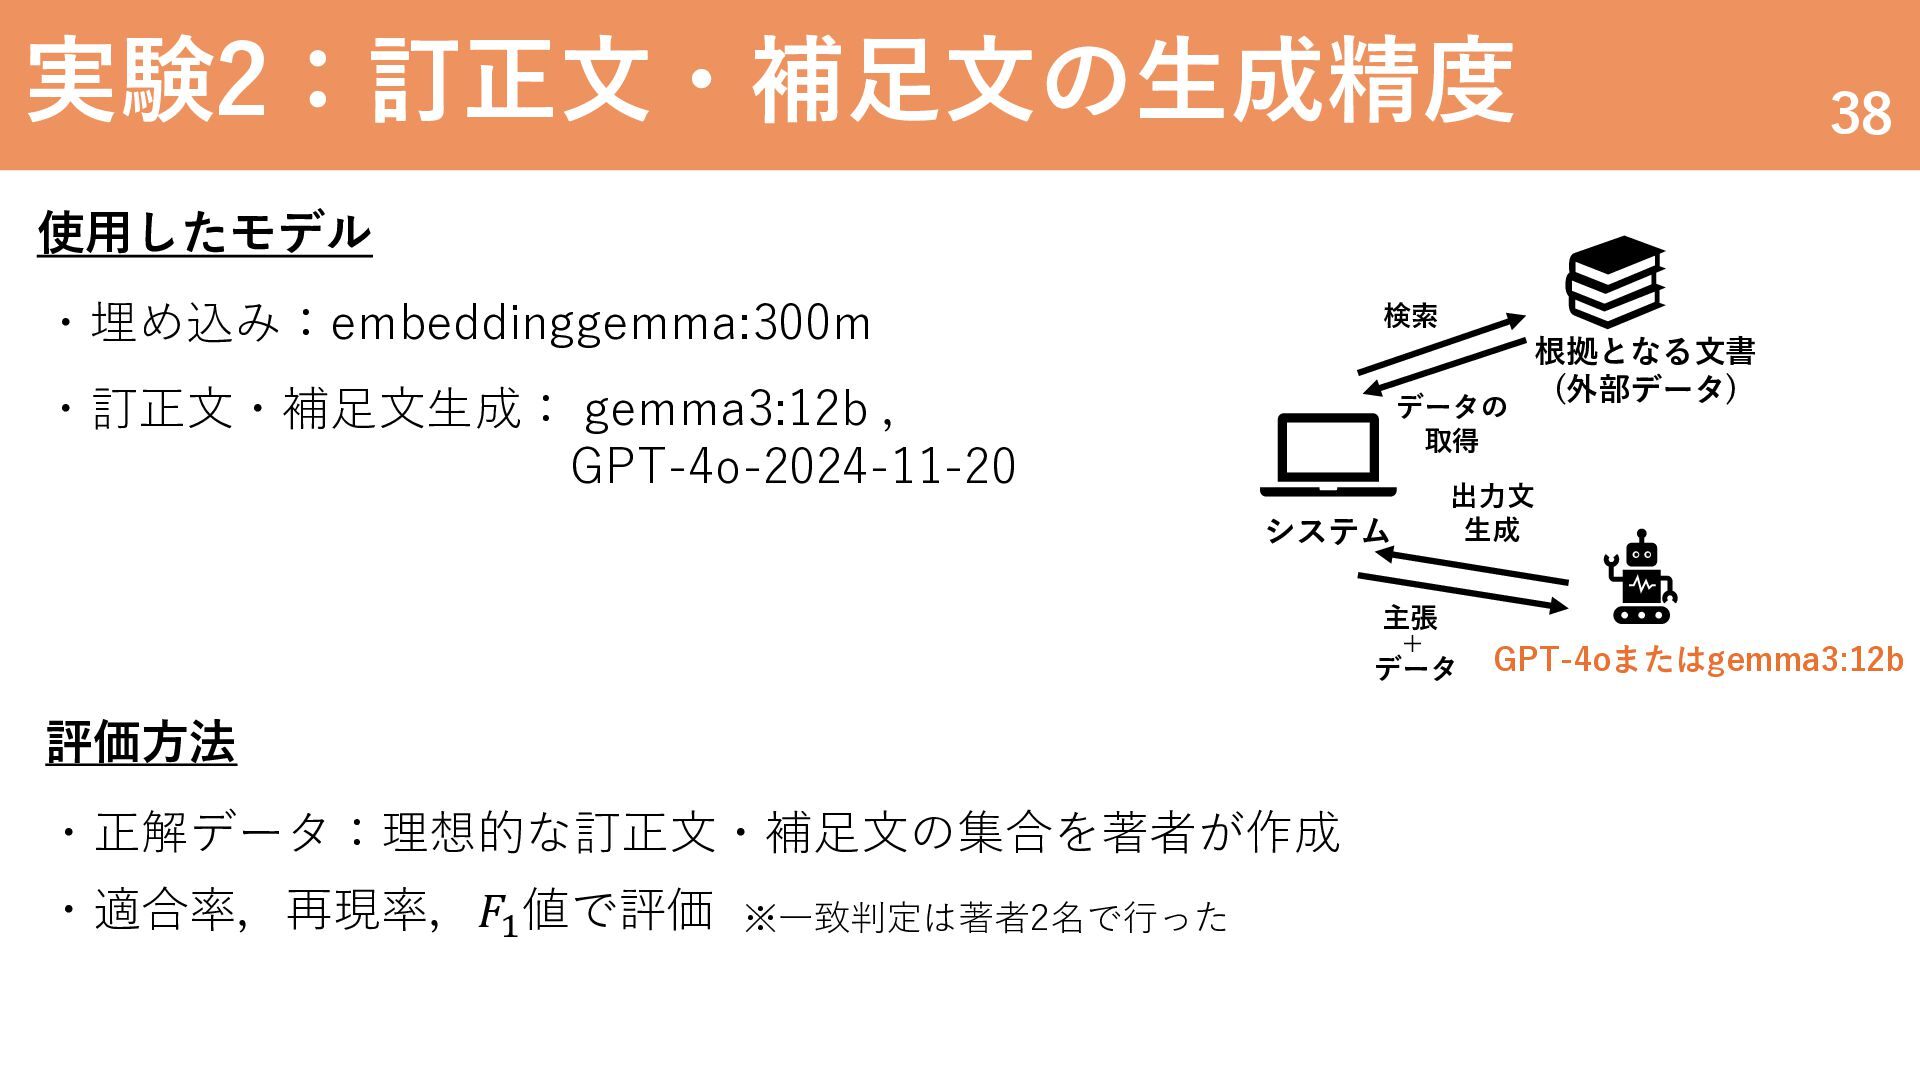
実験2:訂正文・補足文の生成精度 38 使用したモデル ・埋め込み:embeddinggemma:300m 検索 ・訂正文・補足文生成: gemma3:12b , GPT-4o-2024-11-20 データの
取得 システム 出力文 生成 主張 + データ 評価方法 ・正解データ:理想的な訂正文・補足文の集合を著者が作成 ・適合率,再現率,𝐹1 値で評価 ※一致判定は著者2名で行った 根拠となる文書 (外部データ) GPT-4oまたはgemma3:12b -
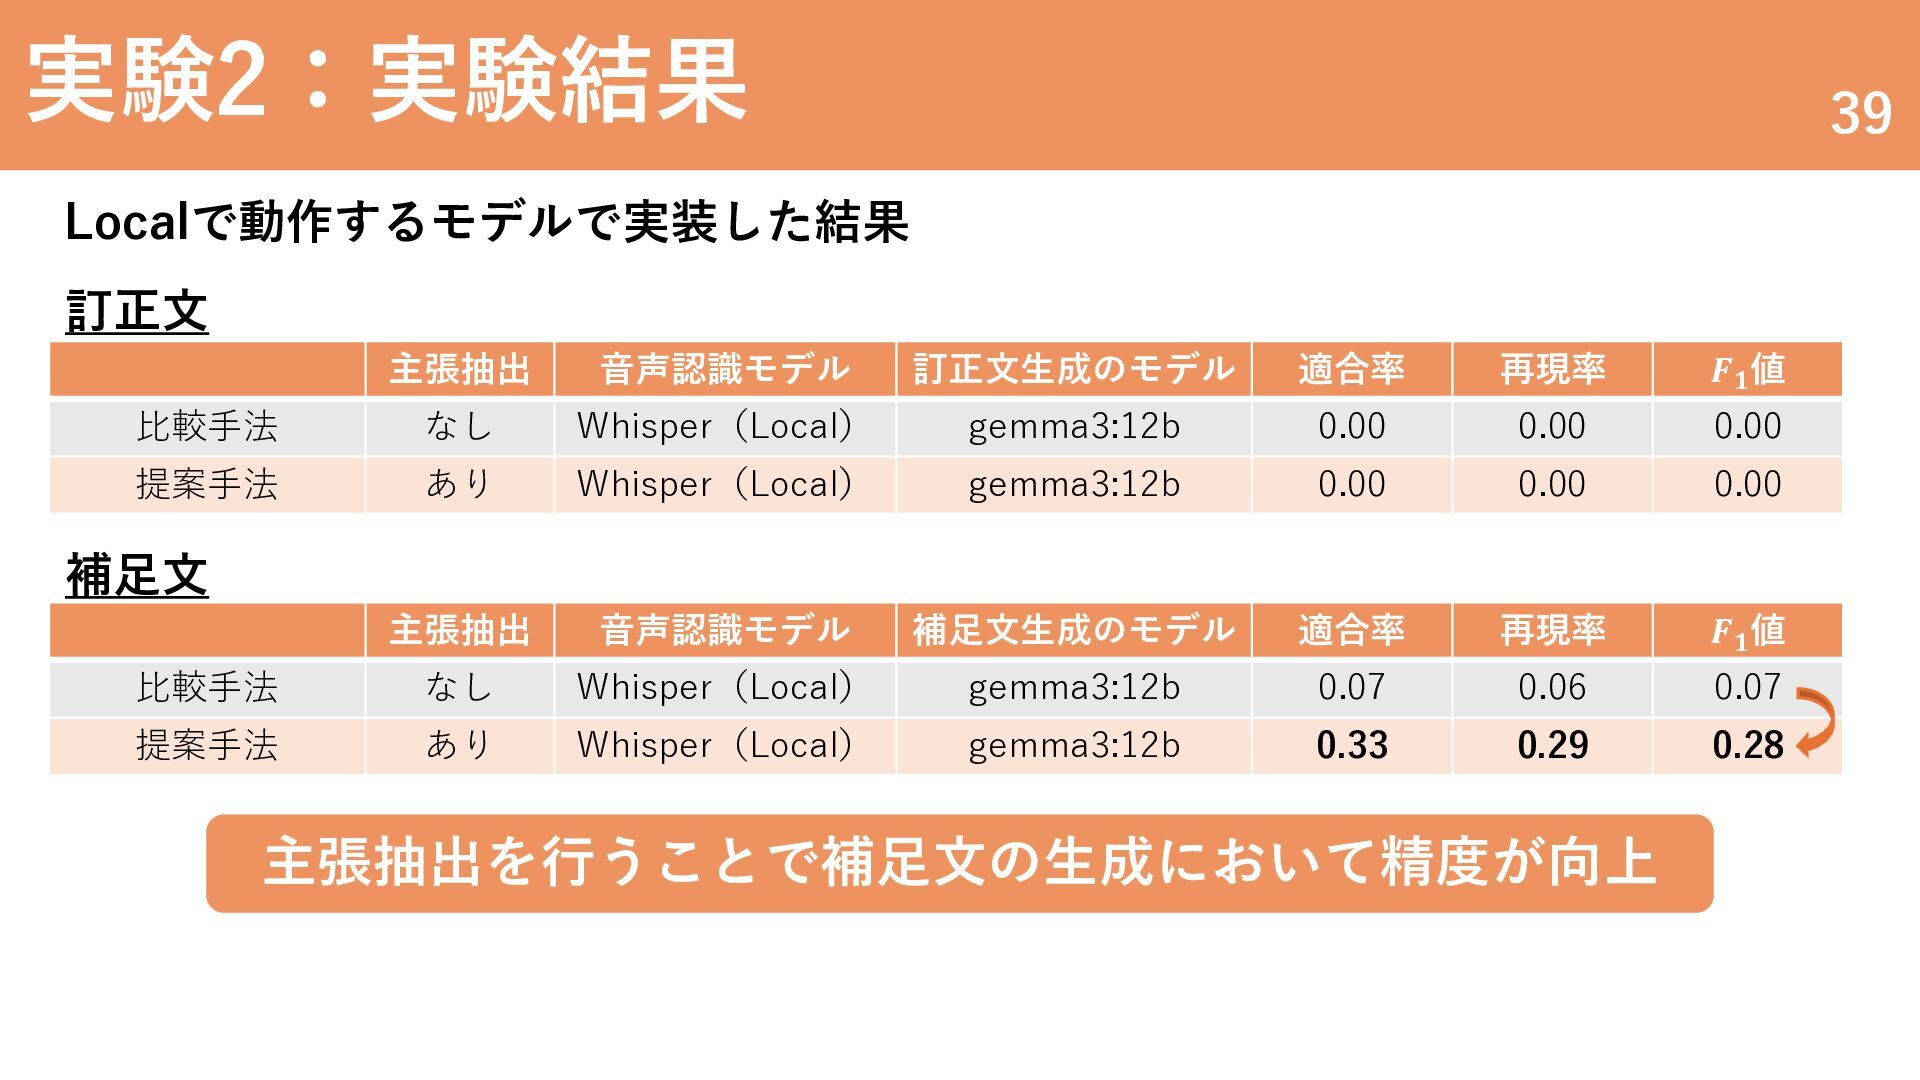
実験2:実験結果 39 Localで動作するモデルで実装した結果 訂正文 主張抽出 音声認識モデル 訂正文生成のモデル 適合率 再現率 𝑭𝟏
値 比較手法 なし Whisper(Local) gemma3:12b 0.00 0.00 0.00 提案手法 あり Whisper(Local) gemma3:12b 0.00 0.00 0.00 主張抽出 音声認識モデル 補足文生成のモデル 適合率 再現率 𝑭𝟏 値 比較手法 なし Whisper(Local) gemma3:12b 0.07 0.06 0.07 提案手法 あり Whisper(Local) gemma3:12b 0.33 0.29 0.28 補足文 主張抽出を行うことで補足文の生成において精度が向上 -
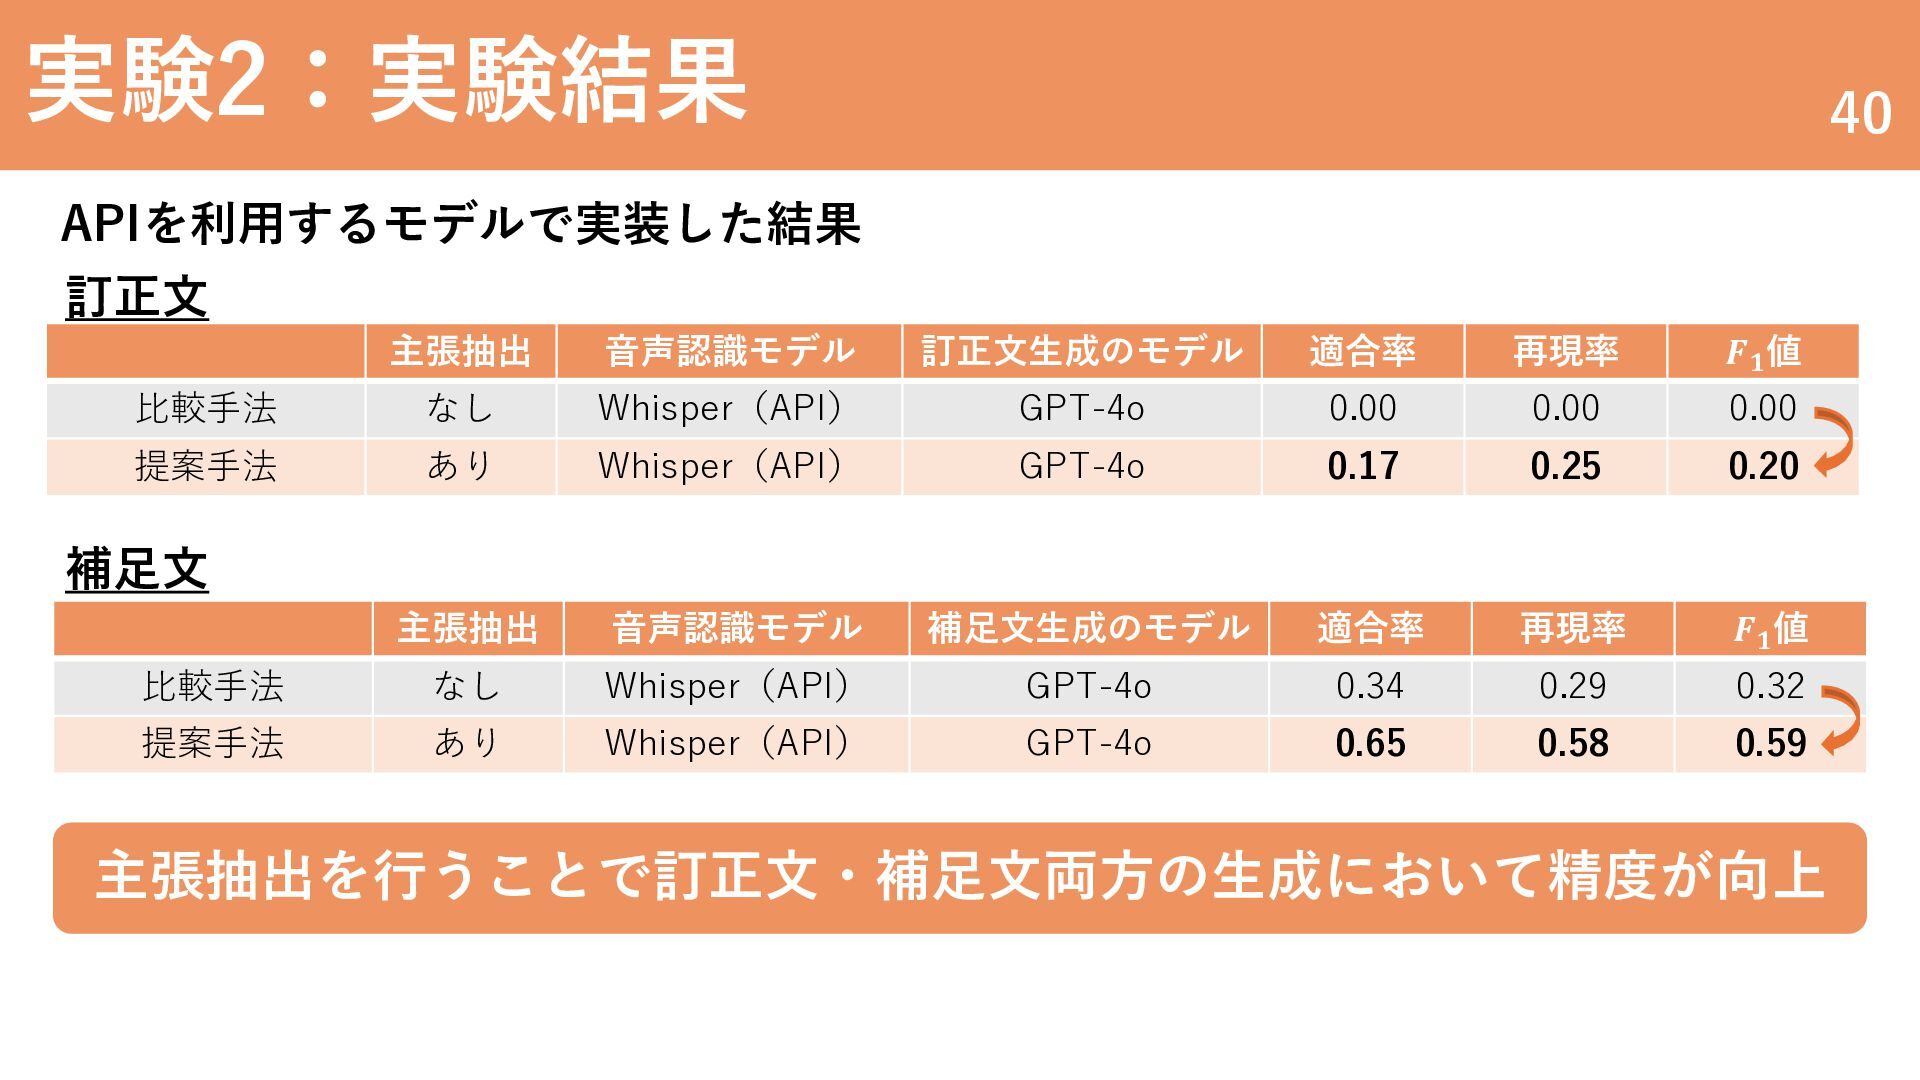
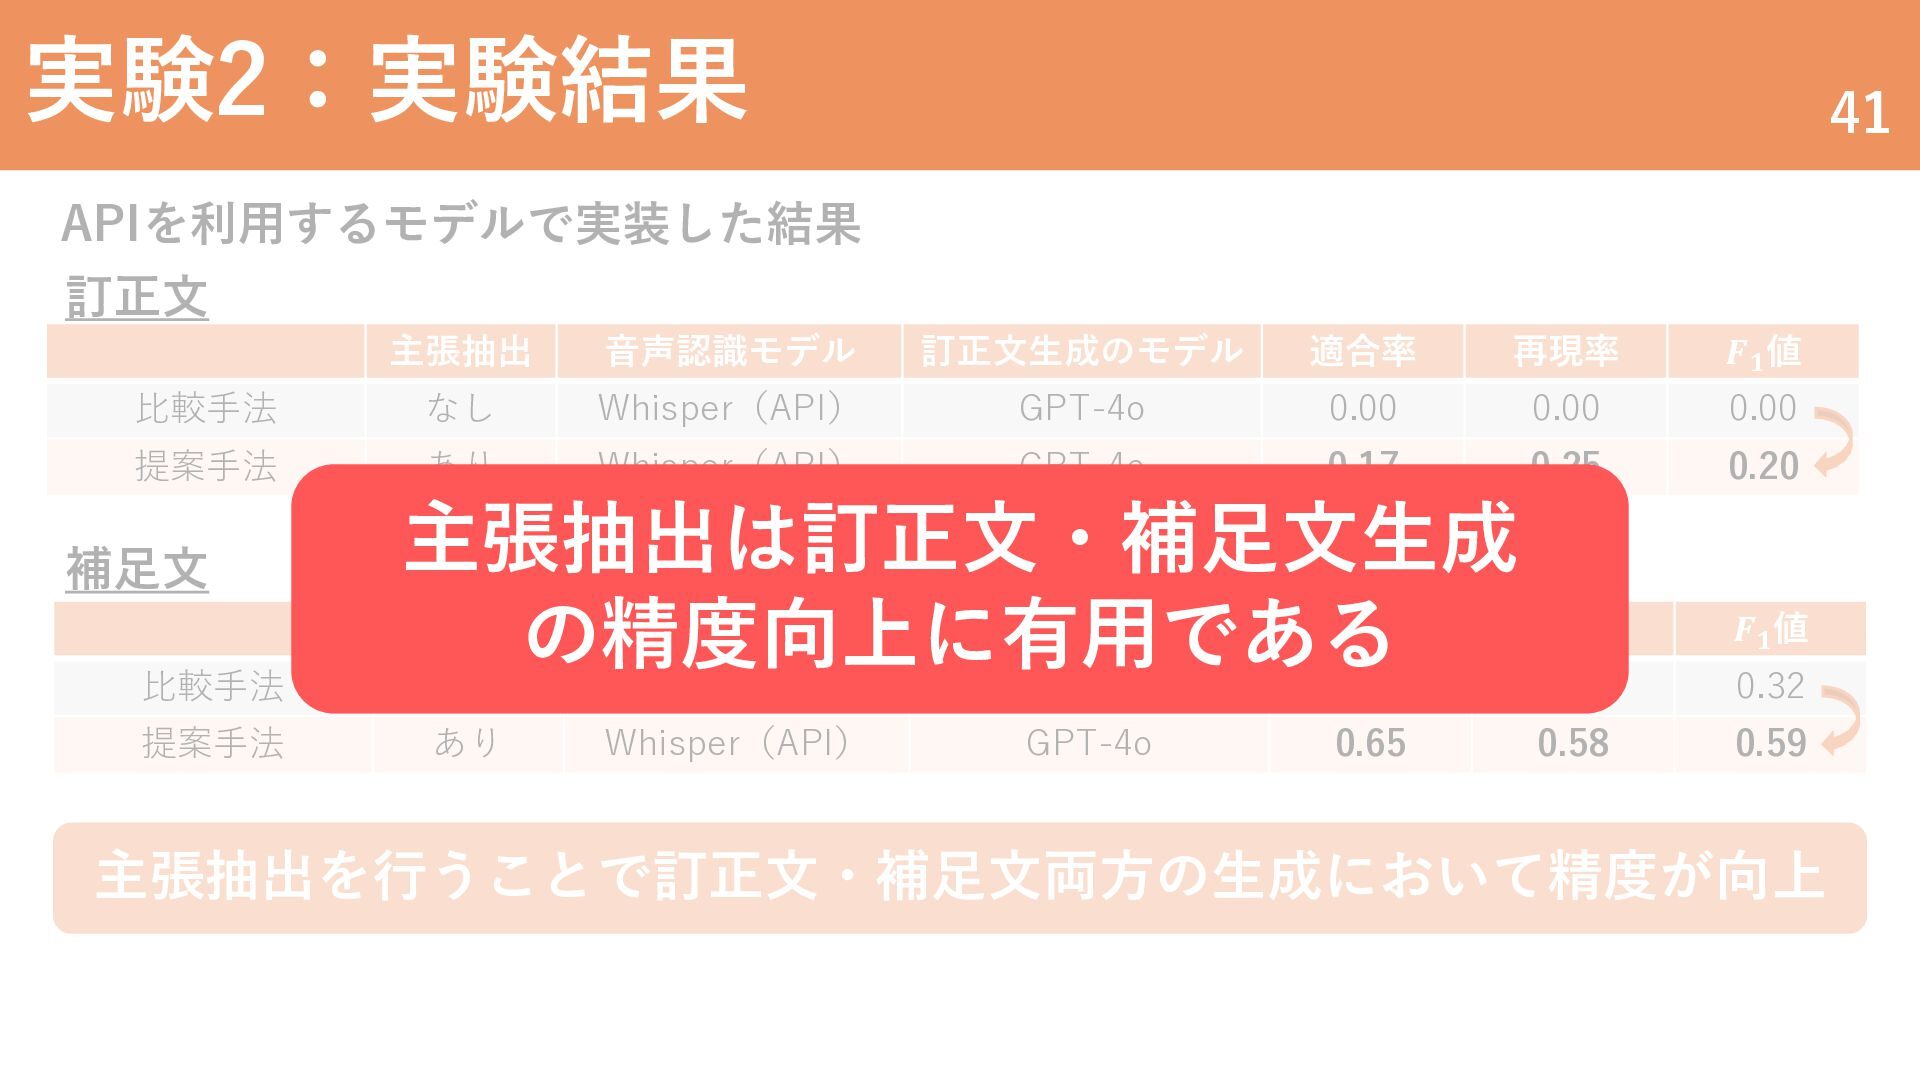
実験2:実験結果 40 APIを利用するモデルで実装した結果 訂正文 主張抽出 音声認識モデル 訂正文生成のモデル 適合率 再現率 𝑭𝟏
値 比較手法 なし Whisper(API) GPT-4o 0.00 0.00 0.00 提案手法 あり Whisper(API) GPT-4o 0.17 0.25 0.20 主張抽出 音声認識モデル 補足文生成のモデル 適合率 再現率 𝑭𝟏 値 比較手法 なし Whisper(API) GPT-4o 0.34 0.29 0.32 提案手法 あり Whisper(API) GPT-4o 0.65 0.58 0.59 補足文 主張抽出を行うことで訂正文・補足文両方の生成において精度が向上 -
実験2:実験結果 41 APIを利用するモデルで実装した結果 訂正文 主張抽出 音声認識モデル 訂正文生成のモデル 適合率 再現率 𝑭𝟏
値 比較手法 なし Whisper(API) GPT-4o 0.00 0.00 0.00 提案手法 あり Whisper(API) GPT-4o 0.17 0.25 0.20 補足文 比較手法 提案手法 主張抽出は訂正文・補足文生成 主張抽出 音声認識モデル 補足文生成のモデル 適合率 再現率 の精度向上に有用である なし Whisper(API) GPT-4o 0.34 0.29 あり Whisper(API) GPT-4o 0.65 0.58 𝑭𝟏 値 0.32 0.59 主張抽出を行うことで訂正文・補足文両方の生成において精度が向上 -
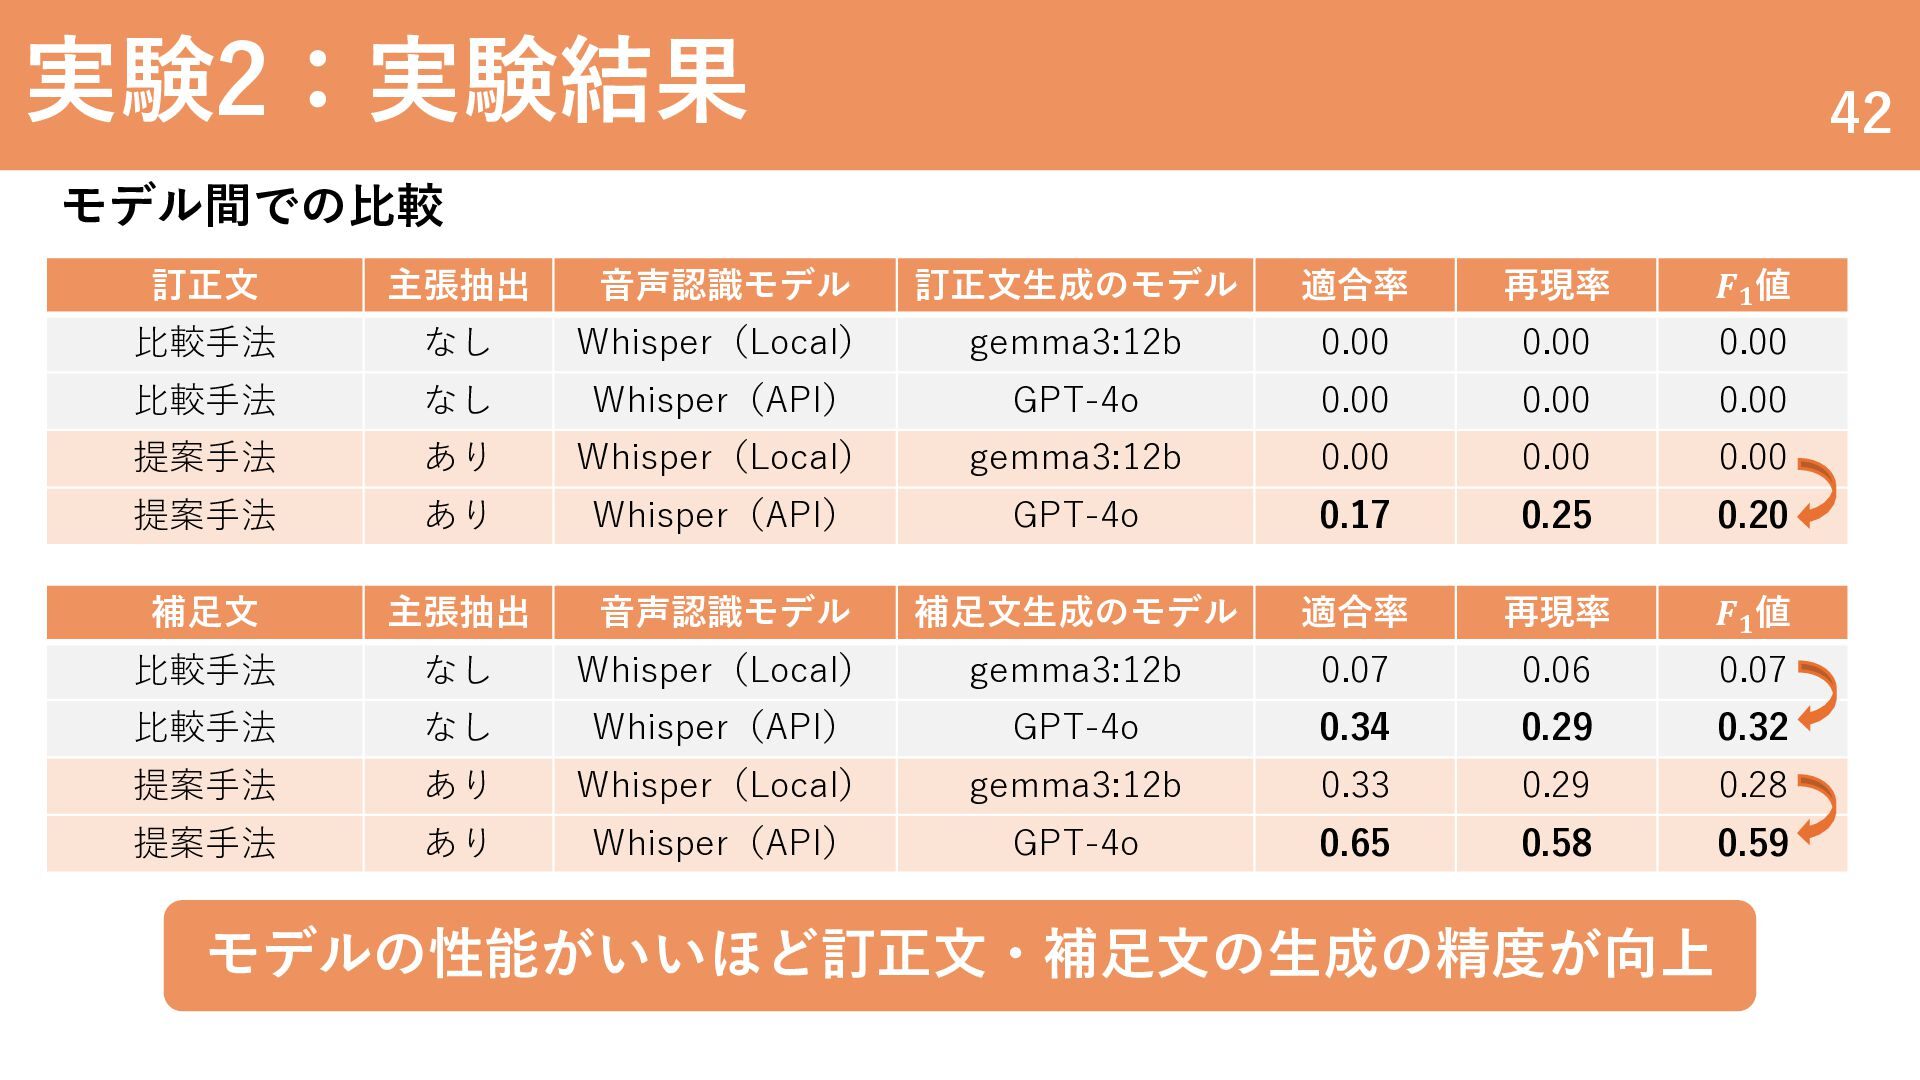
実験2:実験結果 42 モデル間での比較 訂正文 主張抽出 音声認識モデル 訂正文生成のモデル 適合率 再現率 𝑭𝟏
値 比較手法 なし Whisper(Local) gemma3:12b 0.00 0.00 0.00 比較手法 なし Whisper(API) GPT-4o 0.00 0.00 0.00 提案手法 あり Whisper(Local) gemma3:12b 0.00 0.00 0.00 提案手法 あり Whisper(API) GPT-4o 0.17 0.25 0.20 補足文 主張抽出 音声認識モデル 補足文生成のモデル 適合率 再現率 𝑭𝟏 値 比較手法 なし Whisper(Local) gemma3:12b 0.07 0.06 0.07 比較手法 なし Whisper(API) GPT-4o 0.34 0.29 0.32 提案手法 あり Whisper(Local) gemma3:12b 0.33 0.29 0.28 提案手法 あり Whisper(API) GPT-4o 0.65 0.58 0.59 モデルの性能がいいほど訂正文・補足文の生成の精度が向上 -
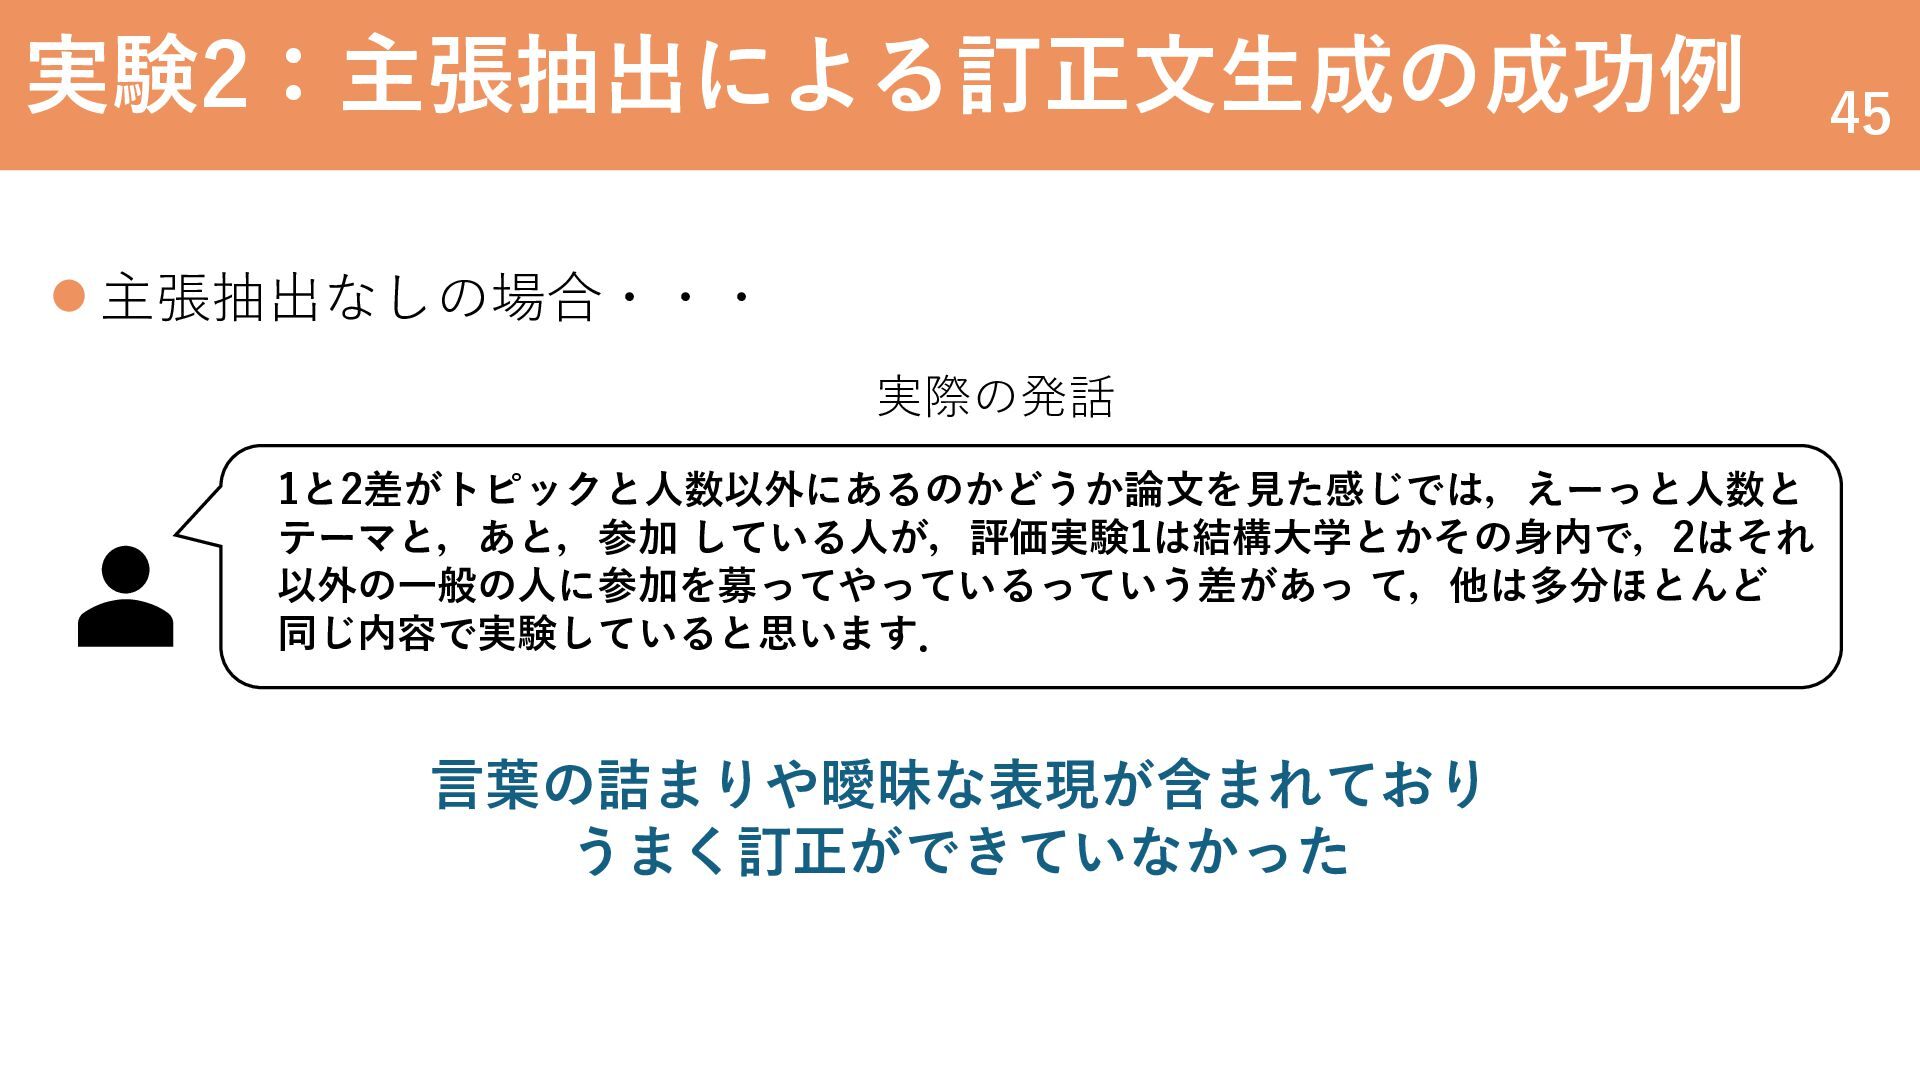
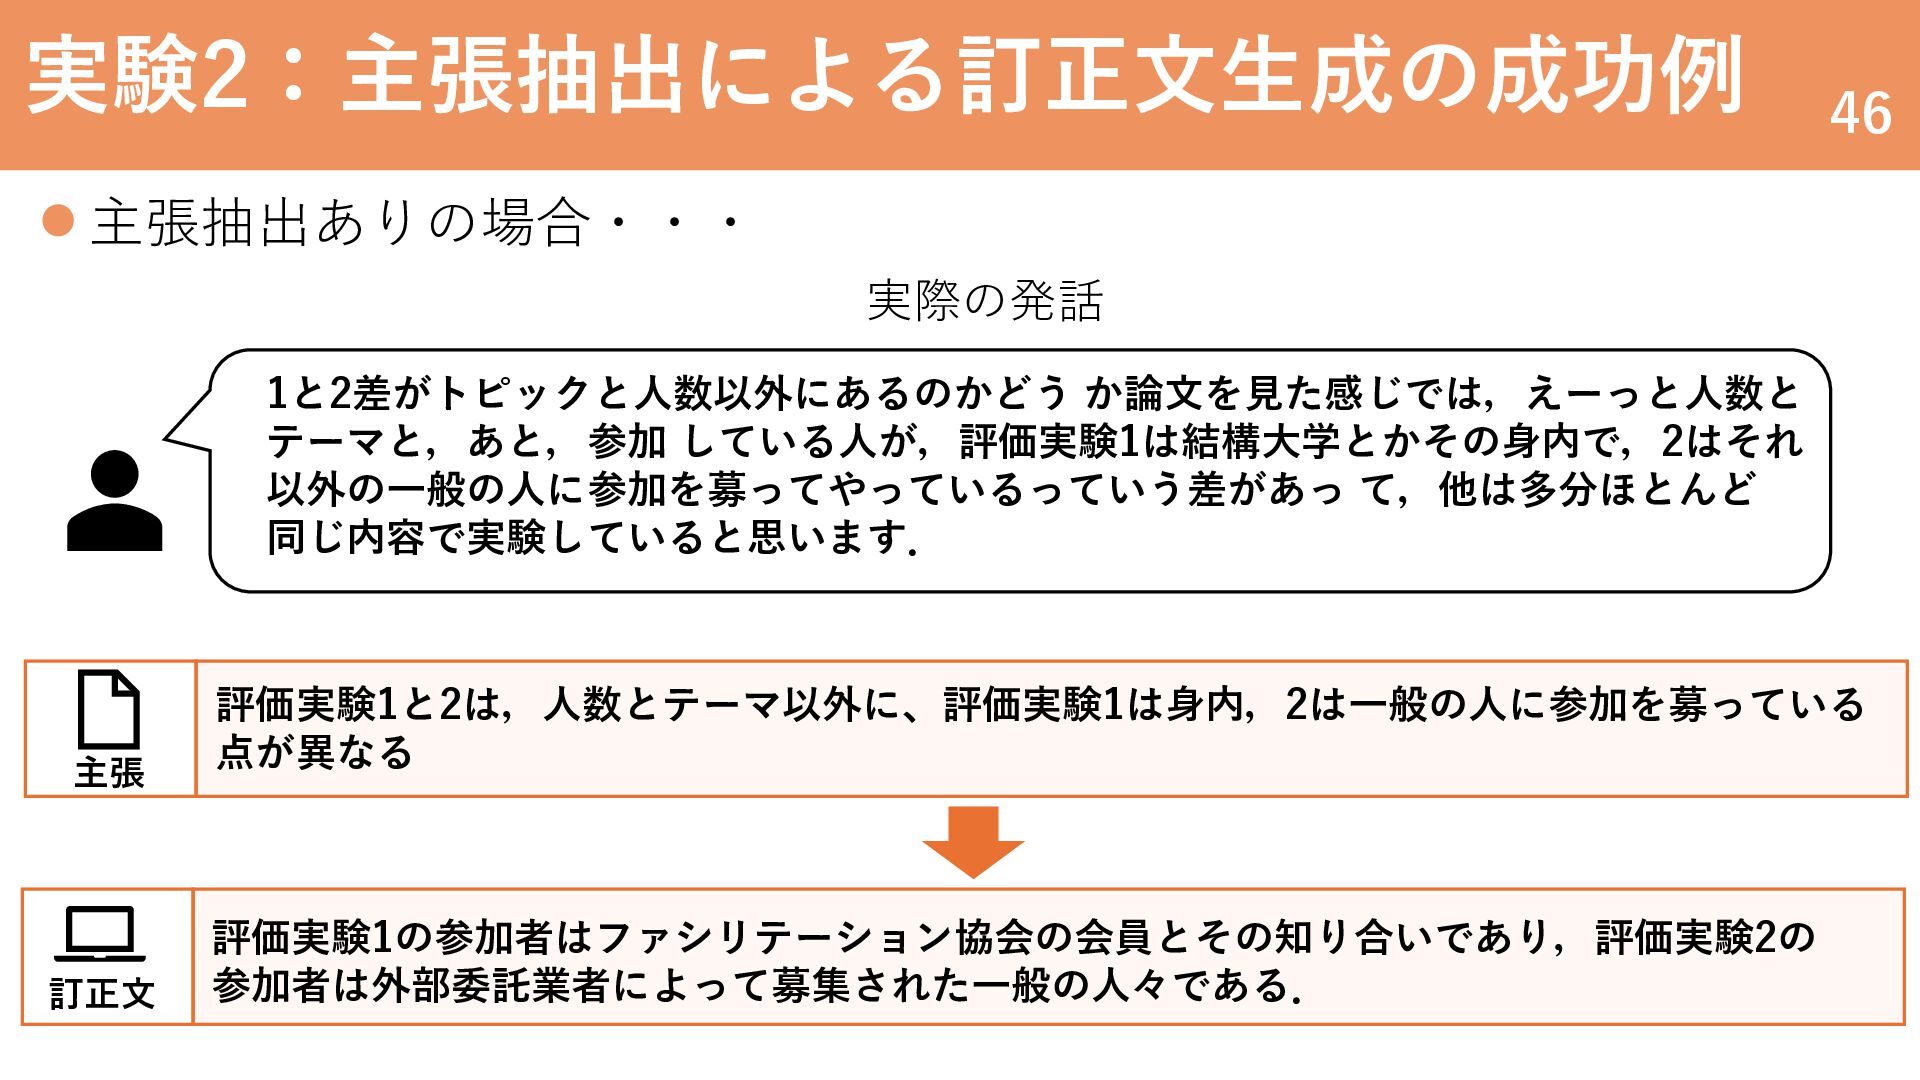
実験2:主張抽出による訂正文生成の成功例 46 主張抽出ありの場合・・・ 実際の発話 1と2差がトピックと人数以外にあるのかどう か論文を見た感じでは,えーっと人数と テーマと,あと,参加 している人が,評価実験1は結構大学とかその身内で,2はそれ 以外の一般の人に参加を募ってやっているっていう差があっ て,他は多分ほとんど
同じ内容で実験していると思います. 主張 訂正文 評価実験1と2は,人数とテーマ以外に、評価実験1は身内,2は一般の人に参加を募っている 点が異なる 評価実験1の参加者はファシリテーション協会の会員とその知り合いであり,評価実験2の 参加者は外部委託業者によって募集された一般の人々である. -
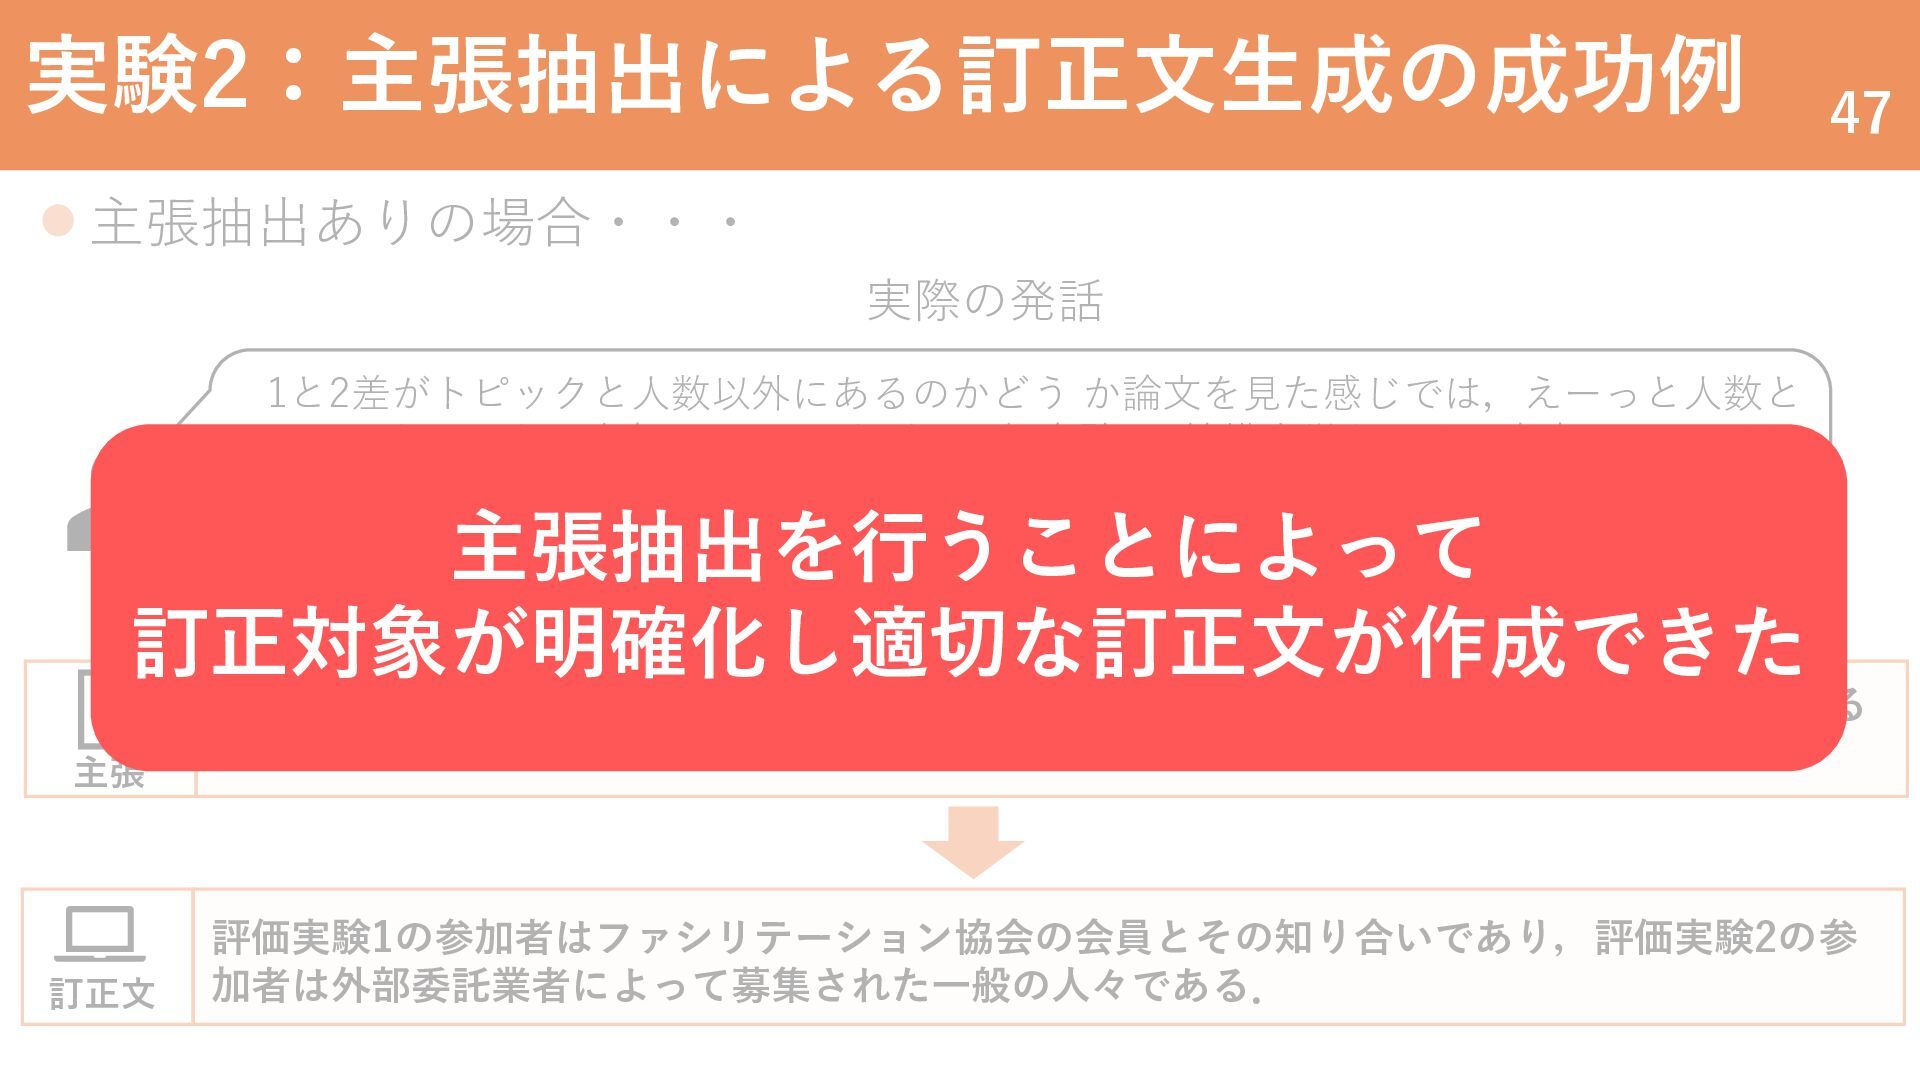
実験2:主張抽出による訂正文生成の成功例 47 主張抽出ありの場合・・・ 実際の発話 1と2差がトピックと人数以外にあるのかどう か論文を見た感じでは,えーっと人数と テーマと,あと,参加 している人が,評価実験1は結構大学とかその身内で,2はそれ 以外の一般の人に参加を募ってやっているっていう差があっ て,他は多分ほとんど
同じ内容で実験していると思います. 主張抽出を行うことによって 訂正対象が明確化し適切な訂正文が作成できた 主張 訂正文 評価実験1と2は,人数とテーマ以外に、評価実験1は身内,2は一般の人に参加を募っている 点が異なる 評価実験1の参加者はファシリテーション協会の会員とその知り合いであり,評価実験2の参 加者は外部委託業者によって募集された一般の人々である. -
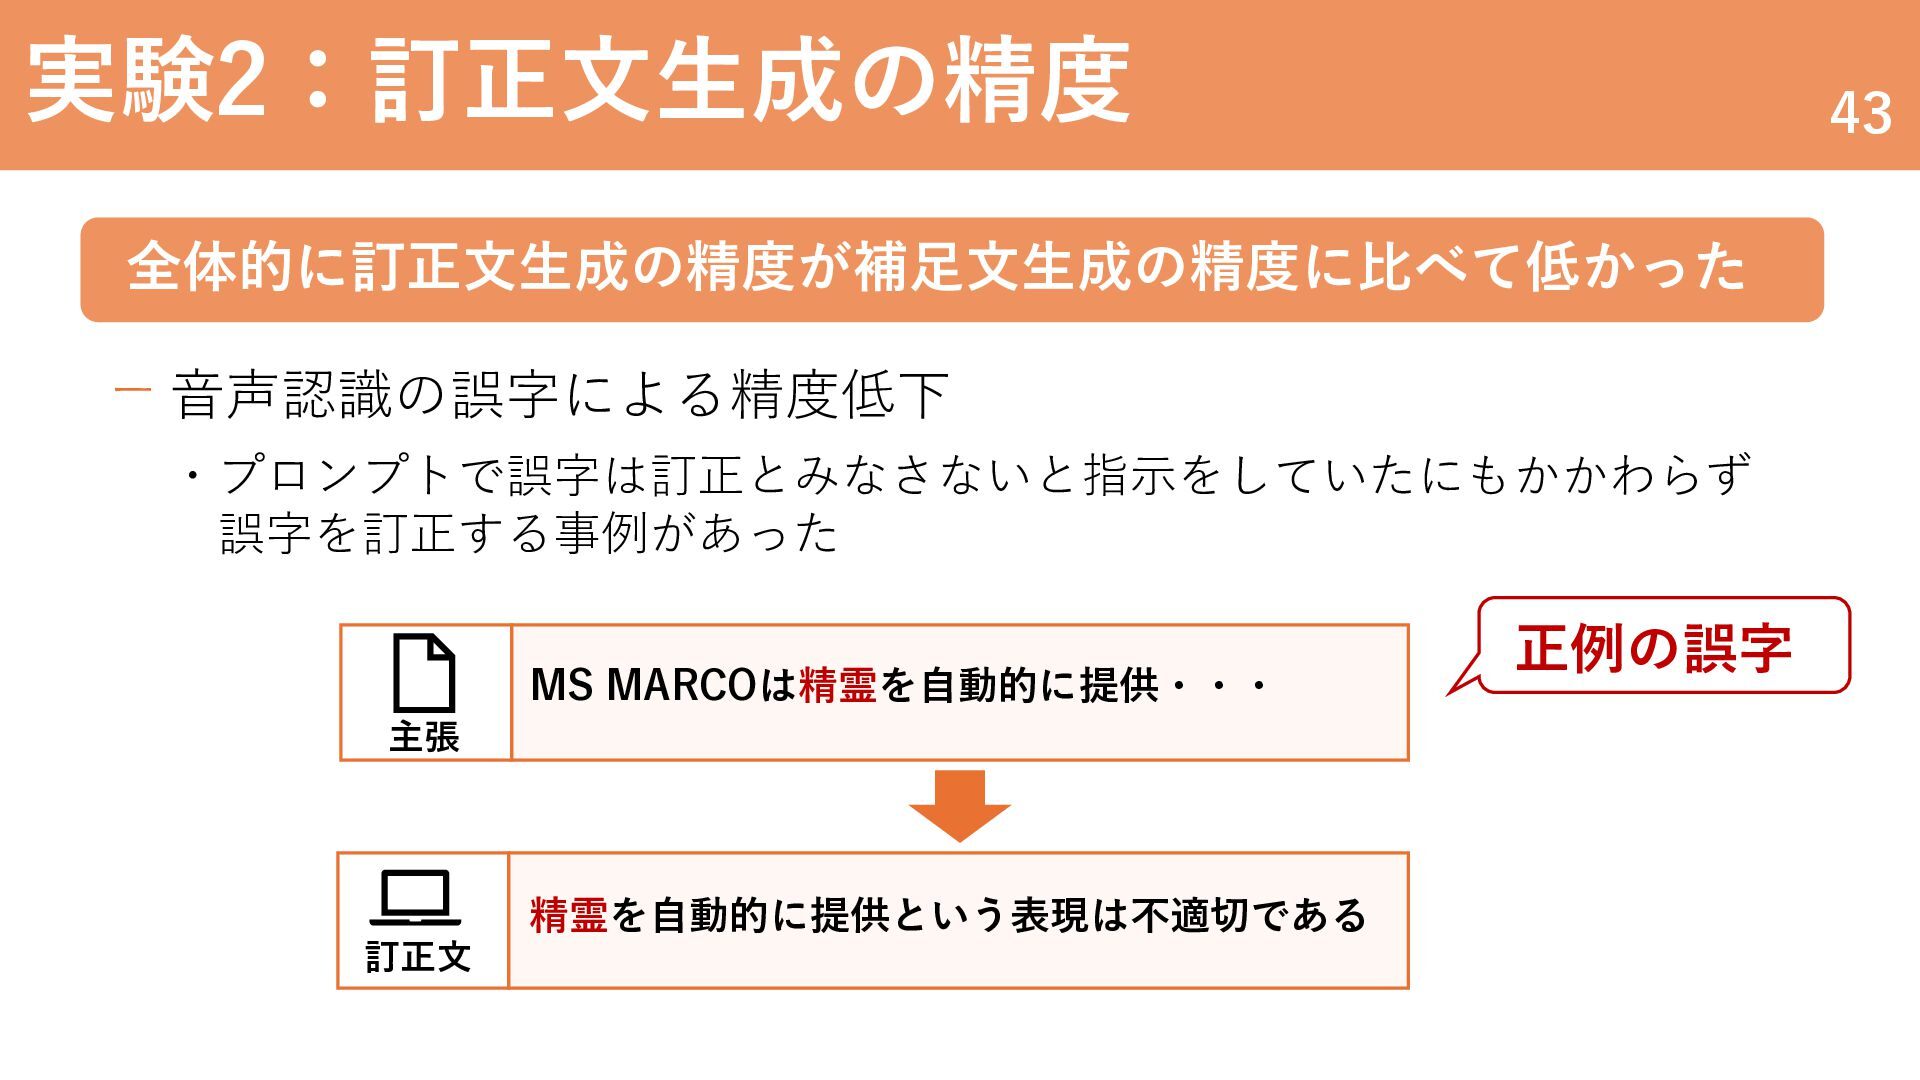
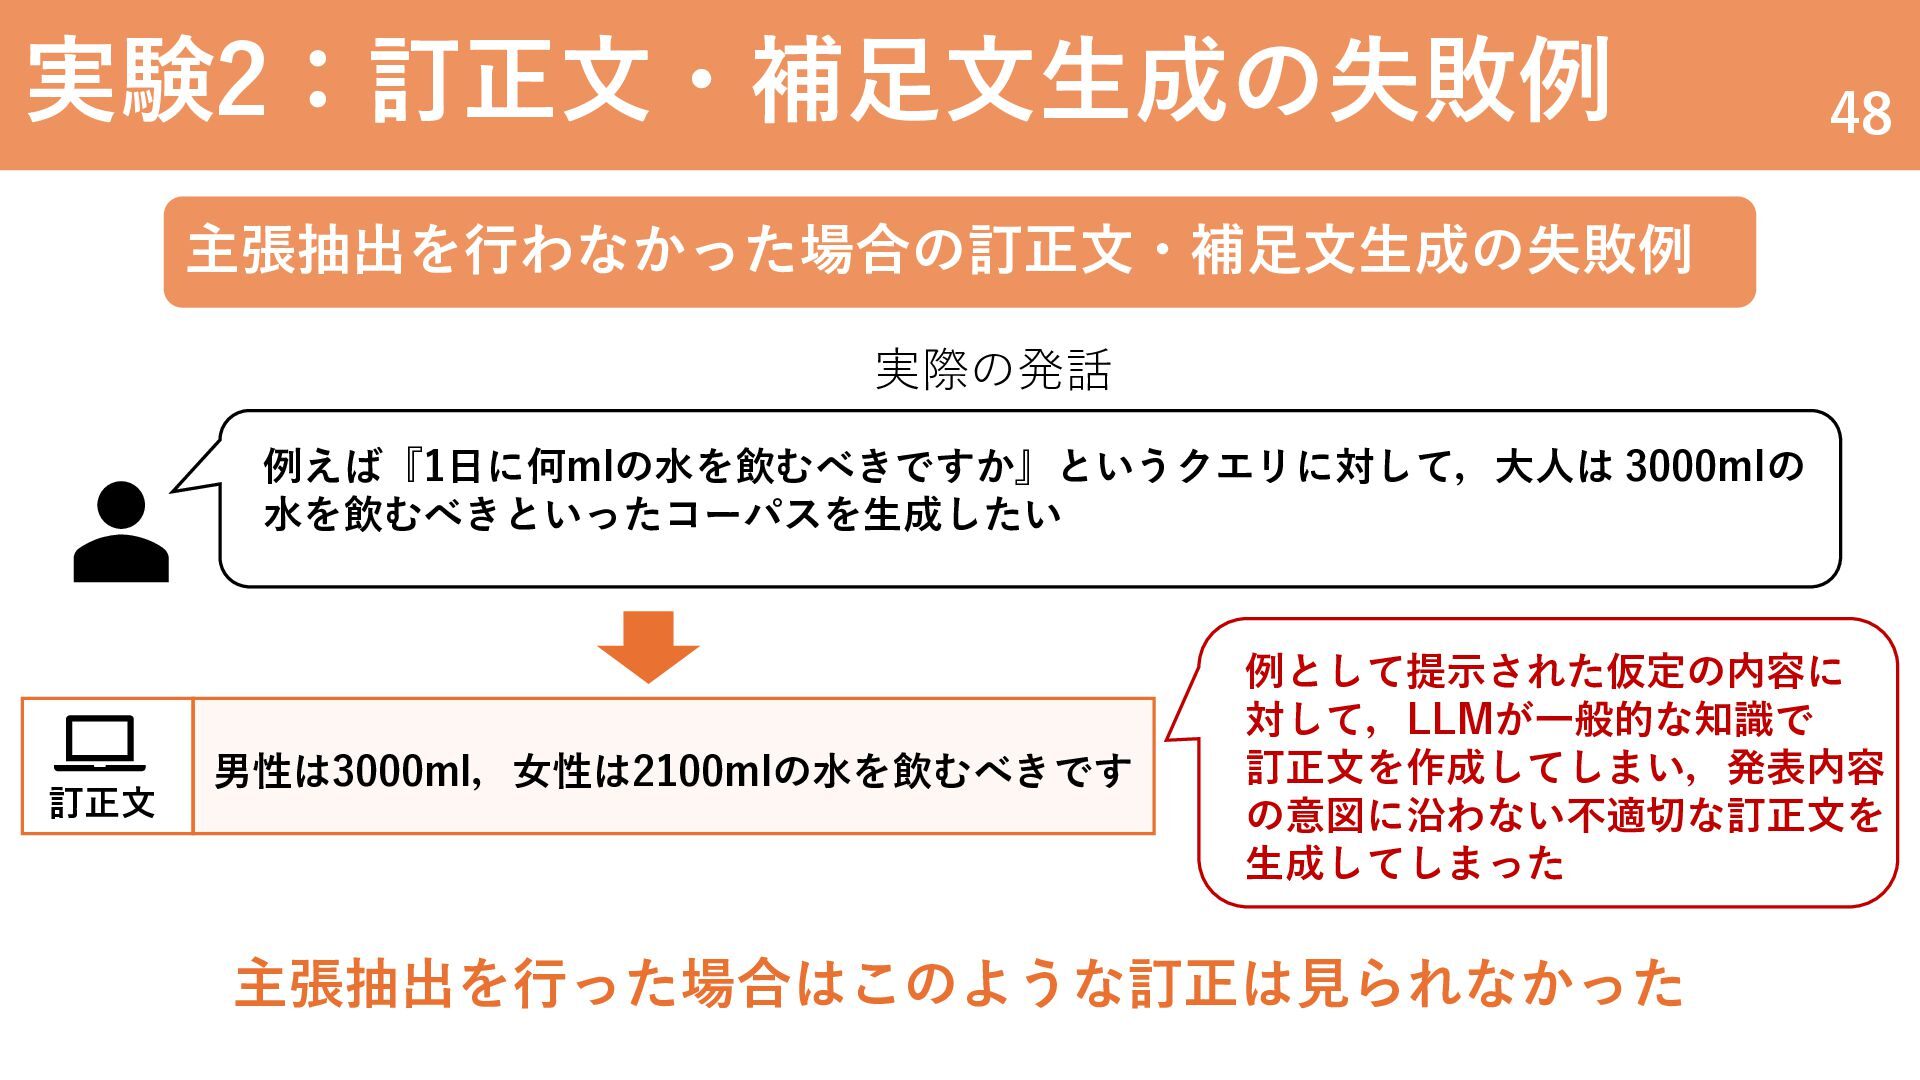
実験2:訂正文・補足文生成の失敗例 48 主張抽出を行わなかった場合の訂正文・補足文生成の失敗例 実際の発話 例えば『1日に何mlの水を飲むべきですか』というクエリに対して,大人は 3000mlの 水を飲むべきといったコーパスを生成したい 訂正文 男性は3000ml,女性は2100mlの水を飲むべきです 例として提示された仮定の内容に
対して,LLMが一般的な知識で 訂正文を作成してしまい,発表内容 の意図に沿わない不適切な訂正文を 生成してしまった 主張抽出を行った場合はこのような訂正は見られなかった
 yamamotolab
 trishagee
 inesmontani
 shpigford
 soudai
 michaelherold
 seathinner
 helenjbeal
 sabderemane
 katarinadahlin
 sferik
 szymonslowik
 tonyrice