Share
Embed
Transcript
68 slides
-
2 自己紹介:丹羽彩奈(にわ あやな) 所属 アラブ首長国連邦にある大学Mohamed bin Zayed University of Artificial
Intelligence (MBZUAI) にてポスドク 略歴 国内大学卒業→国内企業で研究開発→海外大学でポスドク 博士(工学)@東京工業大学 情報理工学院 (2023/03取得) リサーチサイエンティスト @Web系企業のAI研究所 (2024/04〜2025/09) ポスドク@MBZUAI / 研究員@理研AIP、NII (2025/10〜現職) 専門 自然言語処理(NLP) LLMの知識の解釈・獲得・推論プロセスの理解をテーマに研究 -
実はNLP研究はその数年前から激動の時代 7 なにが起こってきたのかを紹介する • 用語説明 • 言語モデルとは? • なぜLLMは急に賢くなったのか?その理由と、今までの研究の積み重ね •
世の中はどう変わったか? • どういう問題があり得るか? -
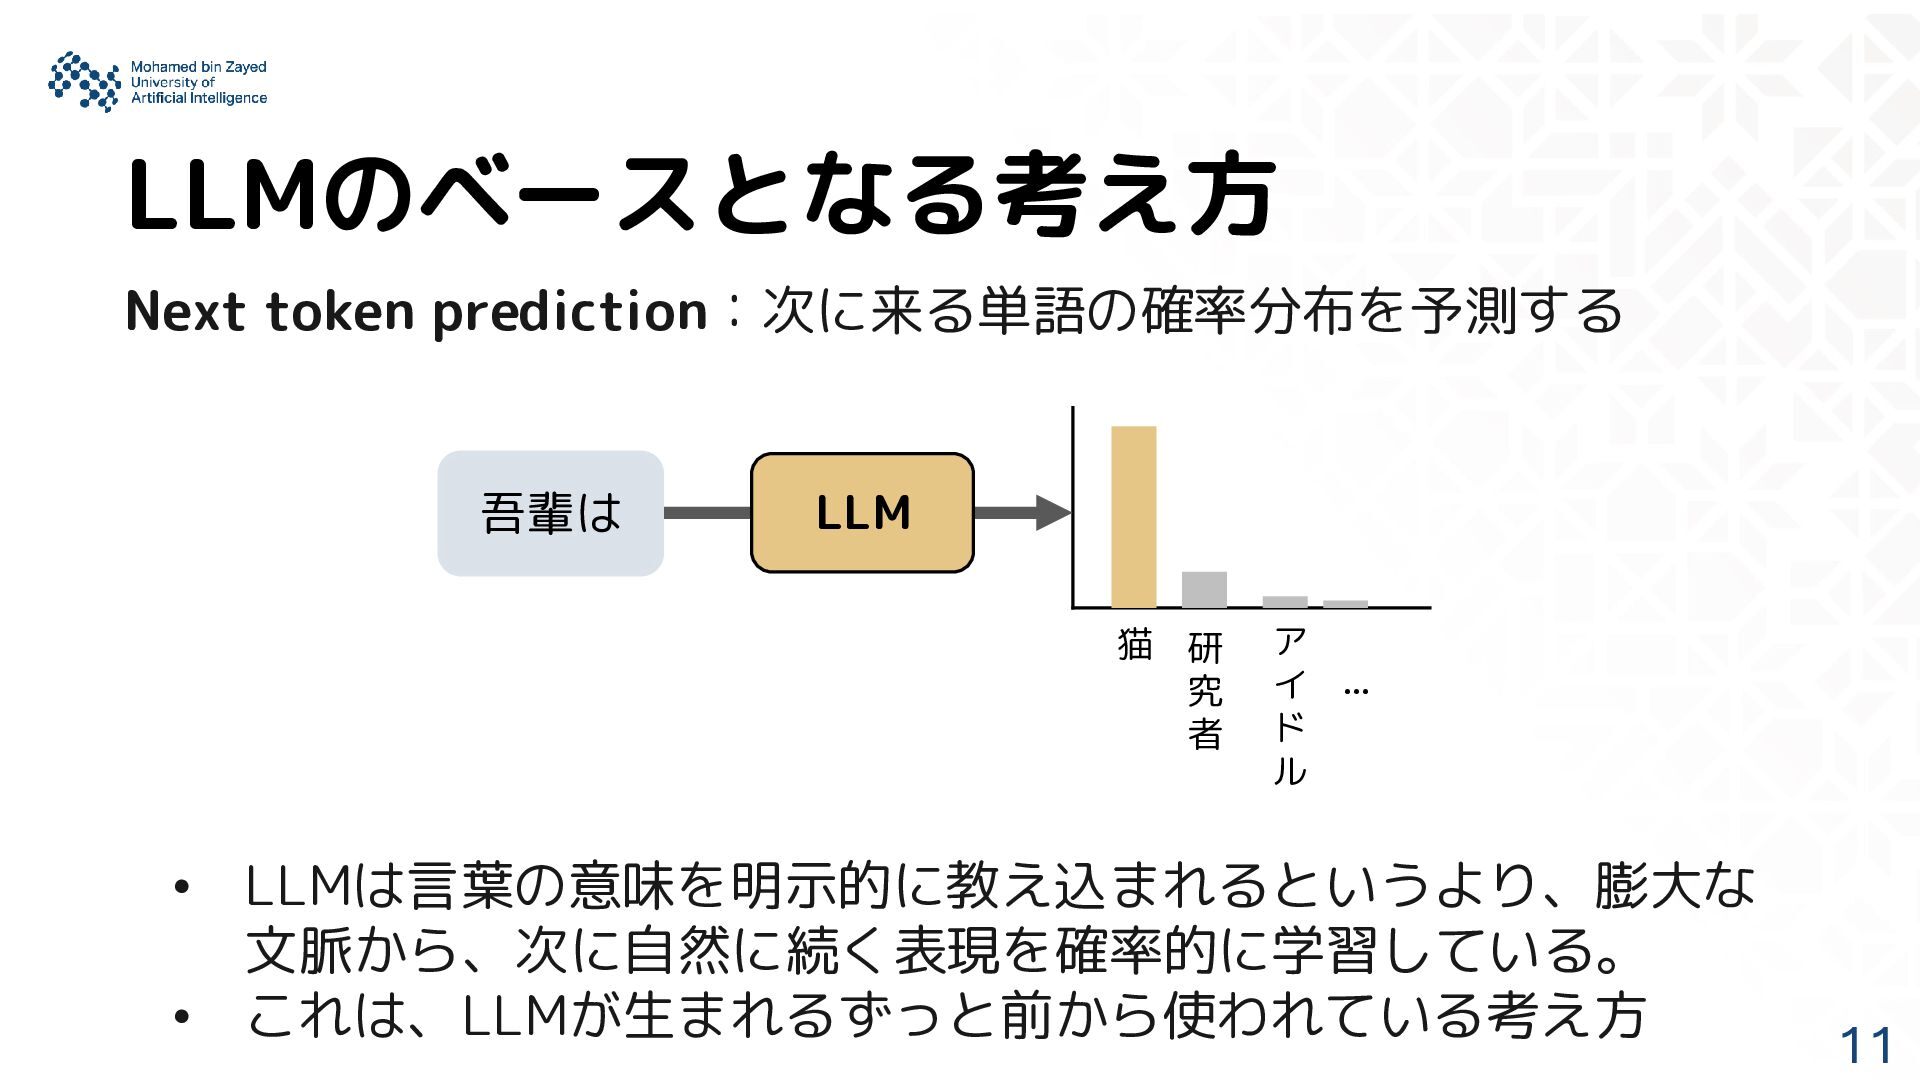
LLMのベースとなる考え方 11 Next token prediction:次に来る単語の確率分布を予測する 猫 研 究 者 ア
イ ド ル • LLMは言葉の意味を明示的に教え込まれるというより、膨大な 文脈から、次に自然に続く表現を確率的に学習している。 • これは、LLMが生まれるずっと前から使われている考え方 … LLM 吾輩は -
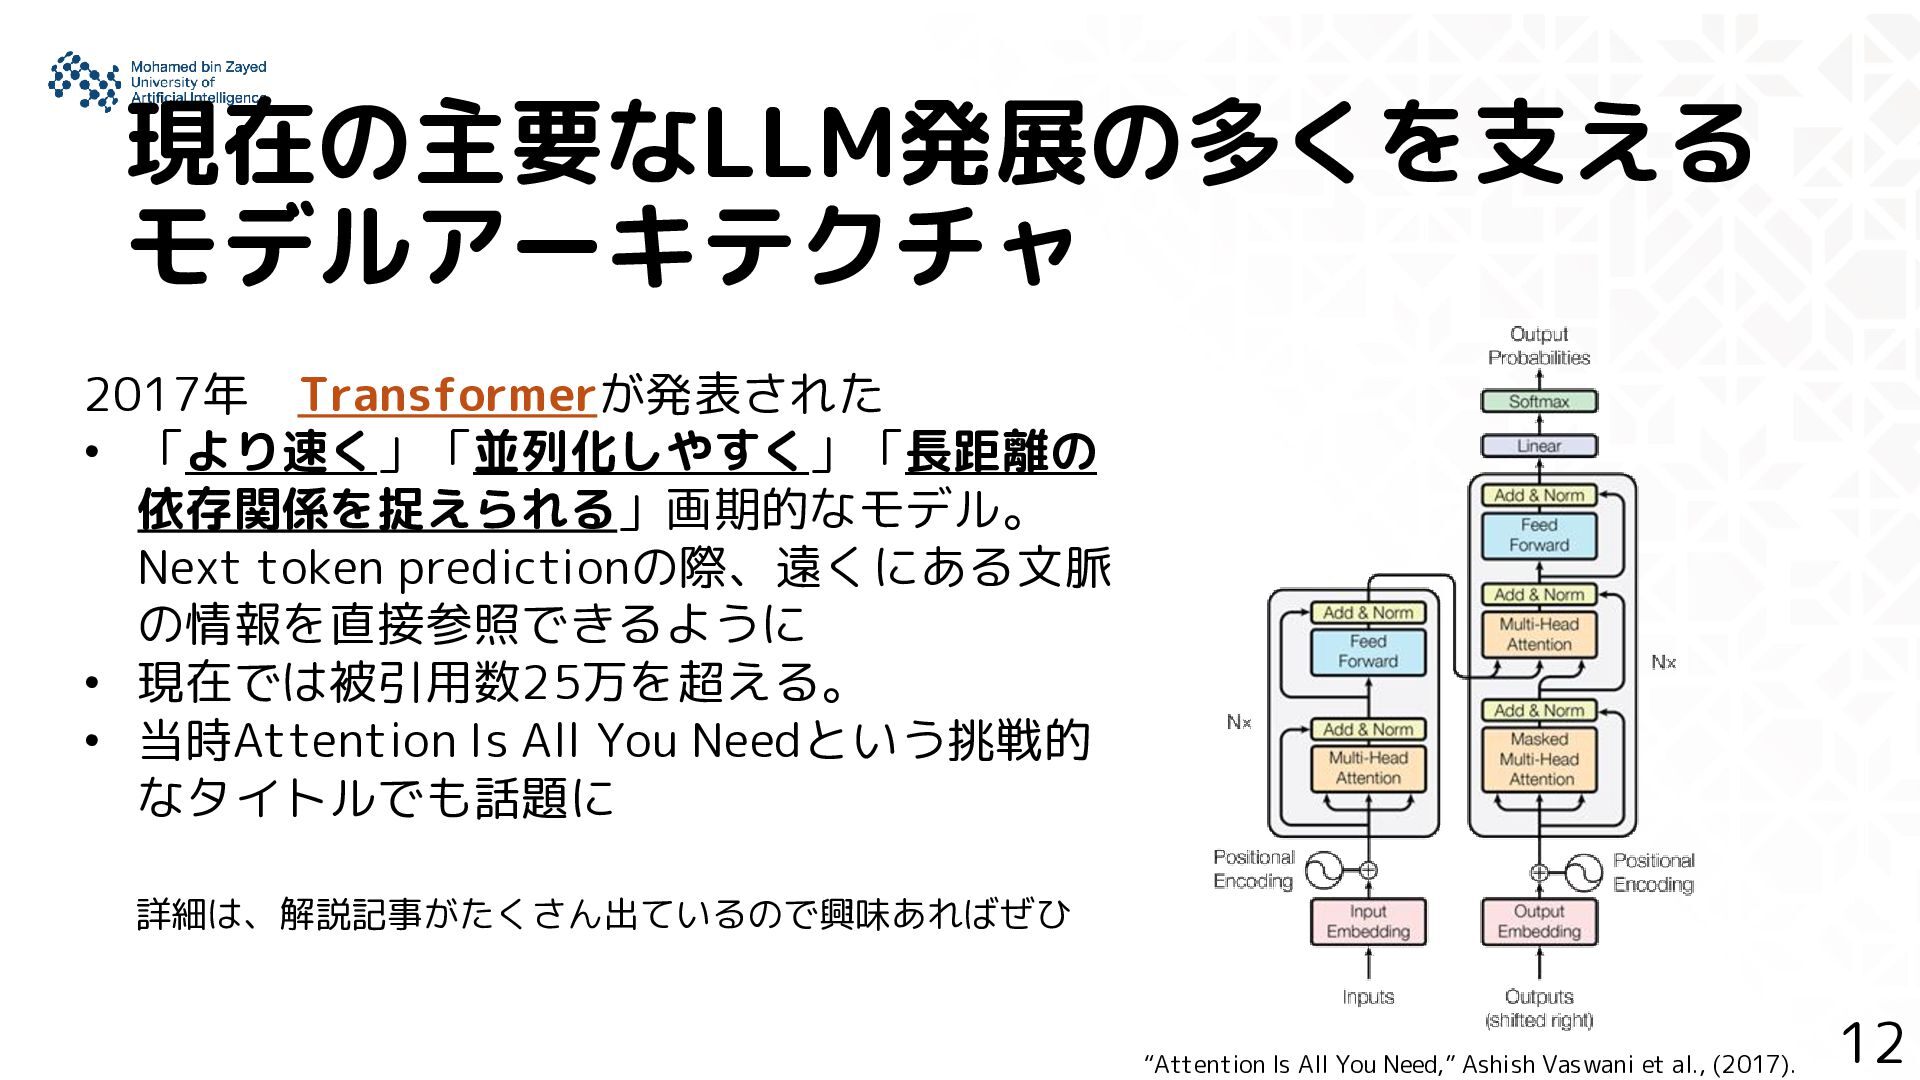
現在の主要なLLM発展の多くを支える モデルアーキテクチャ 12 2017年 Transformerが発表された • 「より速く」「並列化しやすく」「長距離の 依存関係を捉えられる」画期的なモデル。 Next token
predictionの際、遠くにある文脈 の情報を直接参照できるように • 現在では被引用数25万を超える。 • 当時Attention Is All You Needという挑戦的 なタイトルでも話題に “Attention Is All You Need,” Ashish Vaswani et al., (2017). 詳細は、解説記事がたくさん出ているので興味あればぜひ -
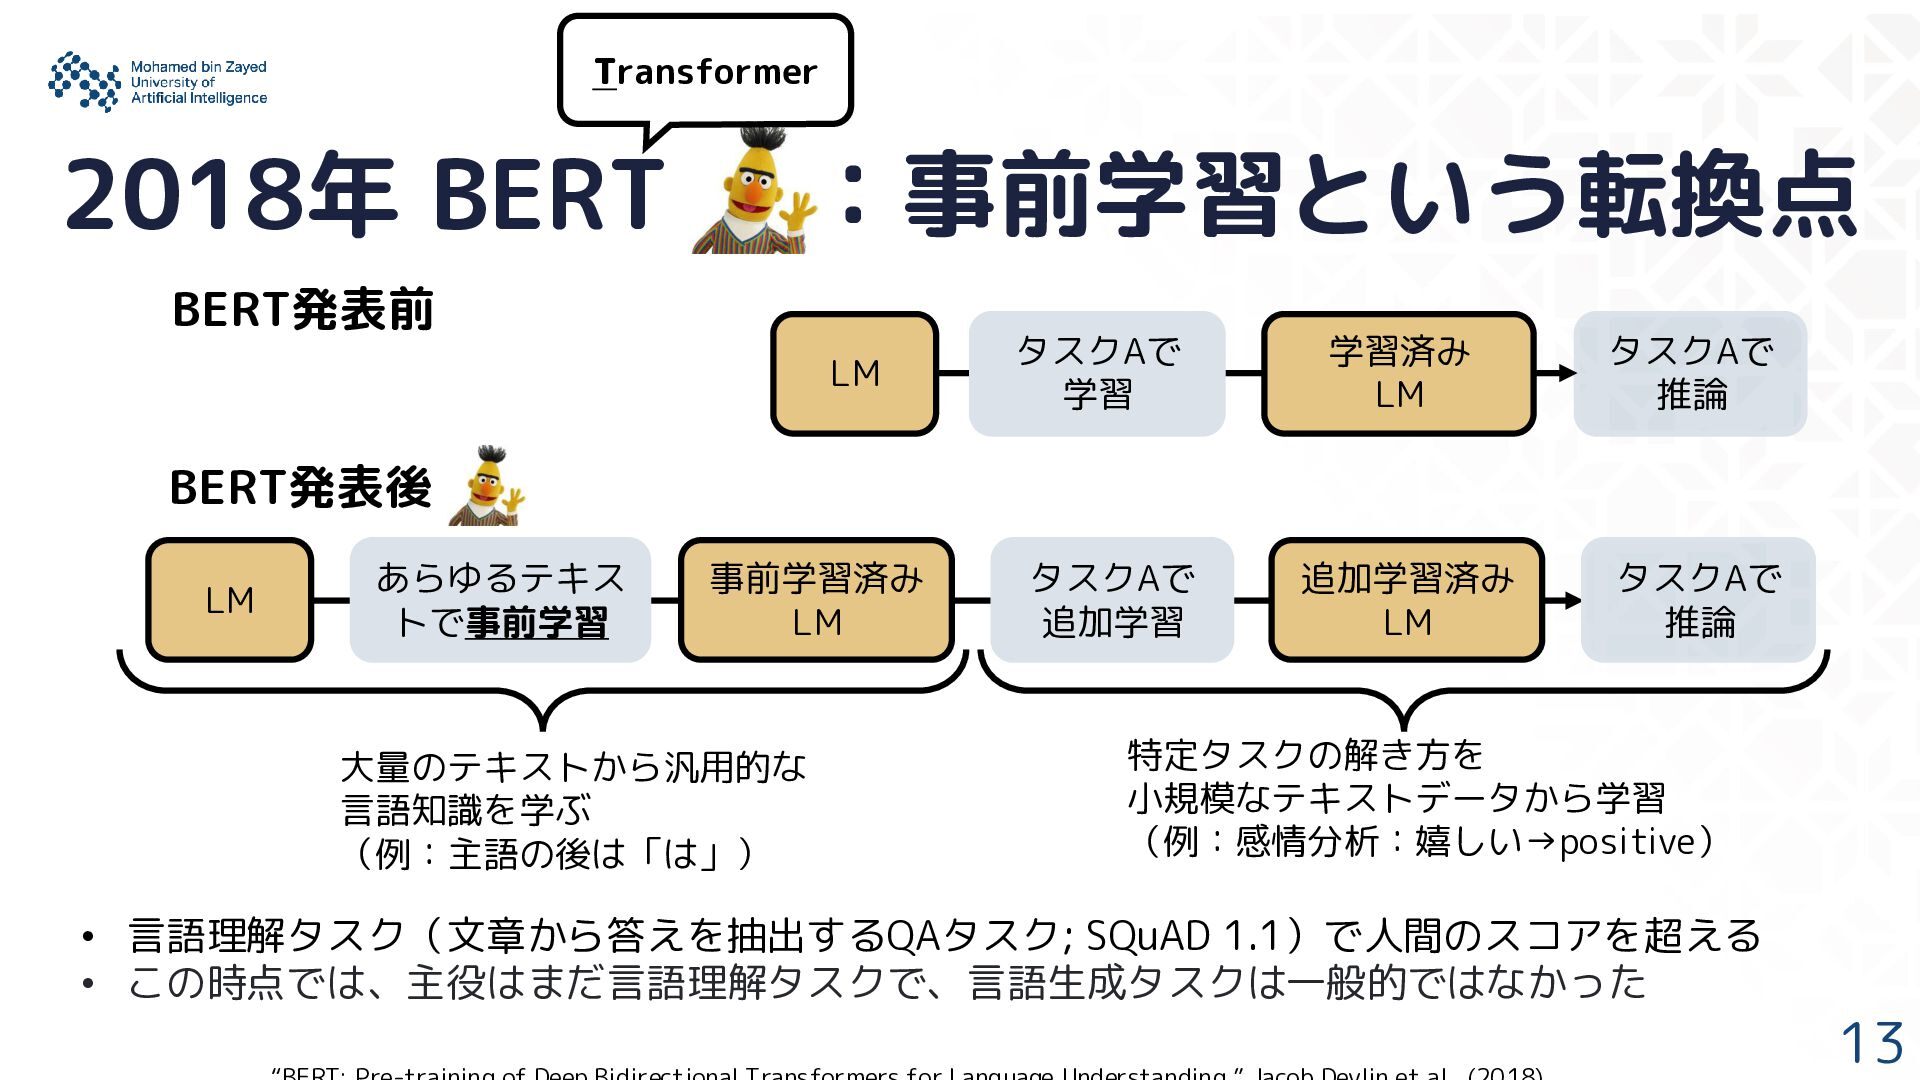
2018年 BERT :事前学習という転換点 13 BERT発表後 LM タスクAで 推論 BERT発表前 LM
タスクAで 推論 事前学習済み LM 特定タスクの解き方を 小規模なテキストデータから学習 (例:感情分析:嬉しい→positive) 追加学習済み LM 大量のテキストから汎用的な 言語知識を学ぶ (例:主語の後は「は」) • 言語理解タスク(文章から答えを抽出するQAタスク; SQuAD 1.1)で人間のスコアを超える • この時点では、主役はまだ言語理解タスクで、言語生成タスクは一般的ではなかった タスクAで 学習 あらゆるテキス トで事前学習 タスクAで 追加学習 学習済み LM Transformer -
2018年頃 ChatGPTの前身 GPT-1, 2発表 14 2018年 GPT論文発表 • 生成能力に長けるが、当時研究としてはあまり使われなかった •
原著論文ではGPTという略称すらない。 2019年 GPT-2発表 • GPT-1の約10倍サイズ、より大きな学習データ • 一般的には、学習には正解データがいる(例:日英翻訳なら、りんご→Apple)。しかし、 大量のテキストを学んだLMは、そのような正解データなしに翻訳、QAなどのタスクを学 び始めることを示した • 技術の悪用を防ぐため、最大規模の学習済みモデルの公開を控え、段階的に公開 “Improving Language Understanding by Generative Pre-Training,” Alec Radford et al., (2018). -
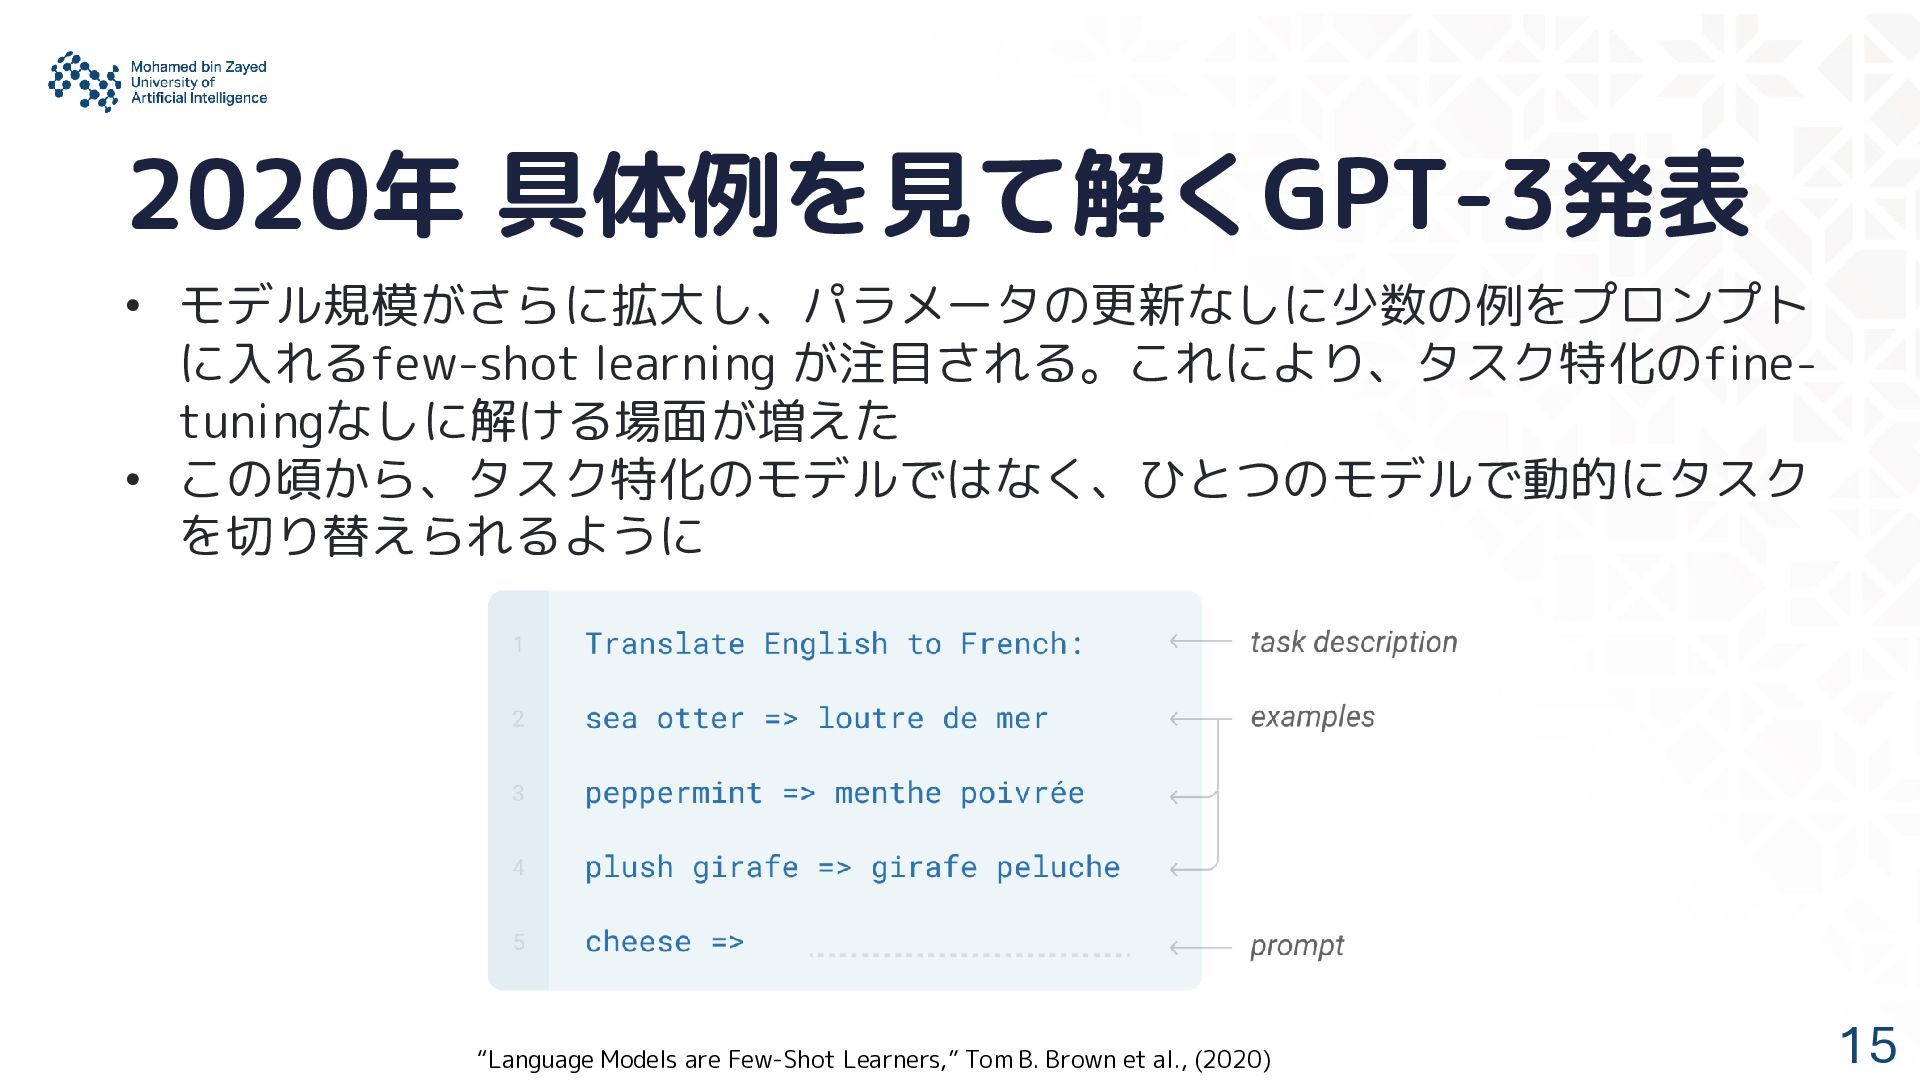
2020年 具体例を見て解くGPT-3発表 15 • モデル規模がさらに拡大し、パラメータの更新なしに少数の例をプロンプト に入れるfew-shot learning が注目される。これにより、タスク特化のfine- tuningなしに解ける場面が増えた •
この頃から、タスク特化のモデルではなく、ひとつのモデルで動的にタスク を切り替えられるように “Language Models are Few-Shot Learners,” Tom B. Brown et al., (2020) -
2022年、ChatGPT発表 17 • GPT3.5 × InstructGPTの学習方法 × 対話形式 × チャットUI
• (研究者目線では)当時は論文も出ておらず、詳細がわからないまま実社会応 用が先行実施 • アーキテクチャや学習方法などは、それまでの研究の積み重ねである • 専門家のみが使う技術ではなく、多くの人が直接触ることができる社会のイン フラへ移行 -
ChatGPT発表により何が起きた? 18 史上最も急成長した消費者向けアプリケーションに • リリースからわずか2ヶ月後に月間アクティブユーザー数が1億人に 企業にも一気に浸透 • リリースからわずか9か月で、Fortune 500企業(世界売上高上位500社) の80%超のチームがChatGPTを使用開始(アカウント作成)
仕事のかたちも変わる • 米労働者の約80%がタスクの1割以上に影響、約19%はタスクの半分以上 に影響 (OpenAIの研究者ら) 専門家は「半年の開発停止」を求めた • その危険性が適切に評価されずに普及することに対する警鐘 -
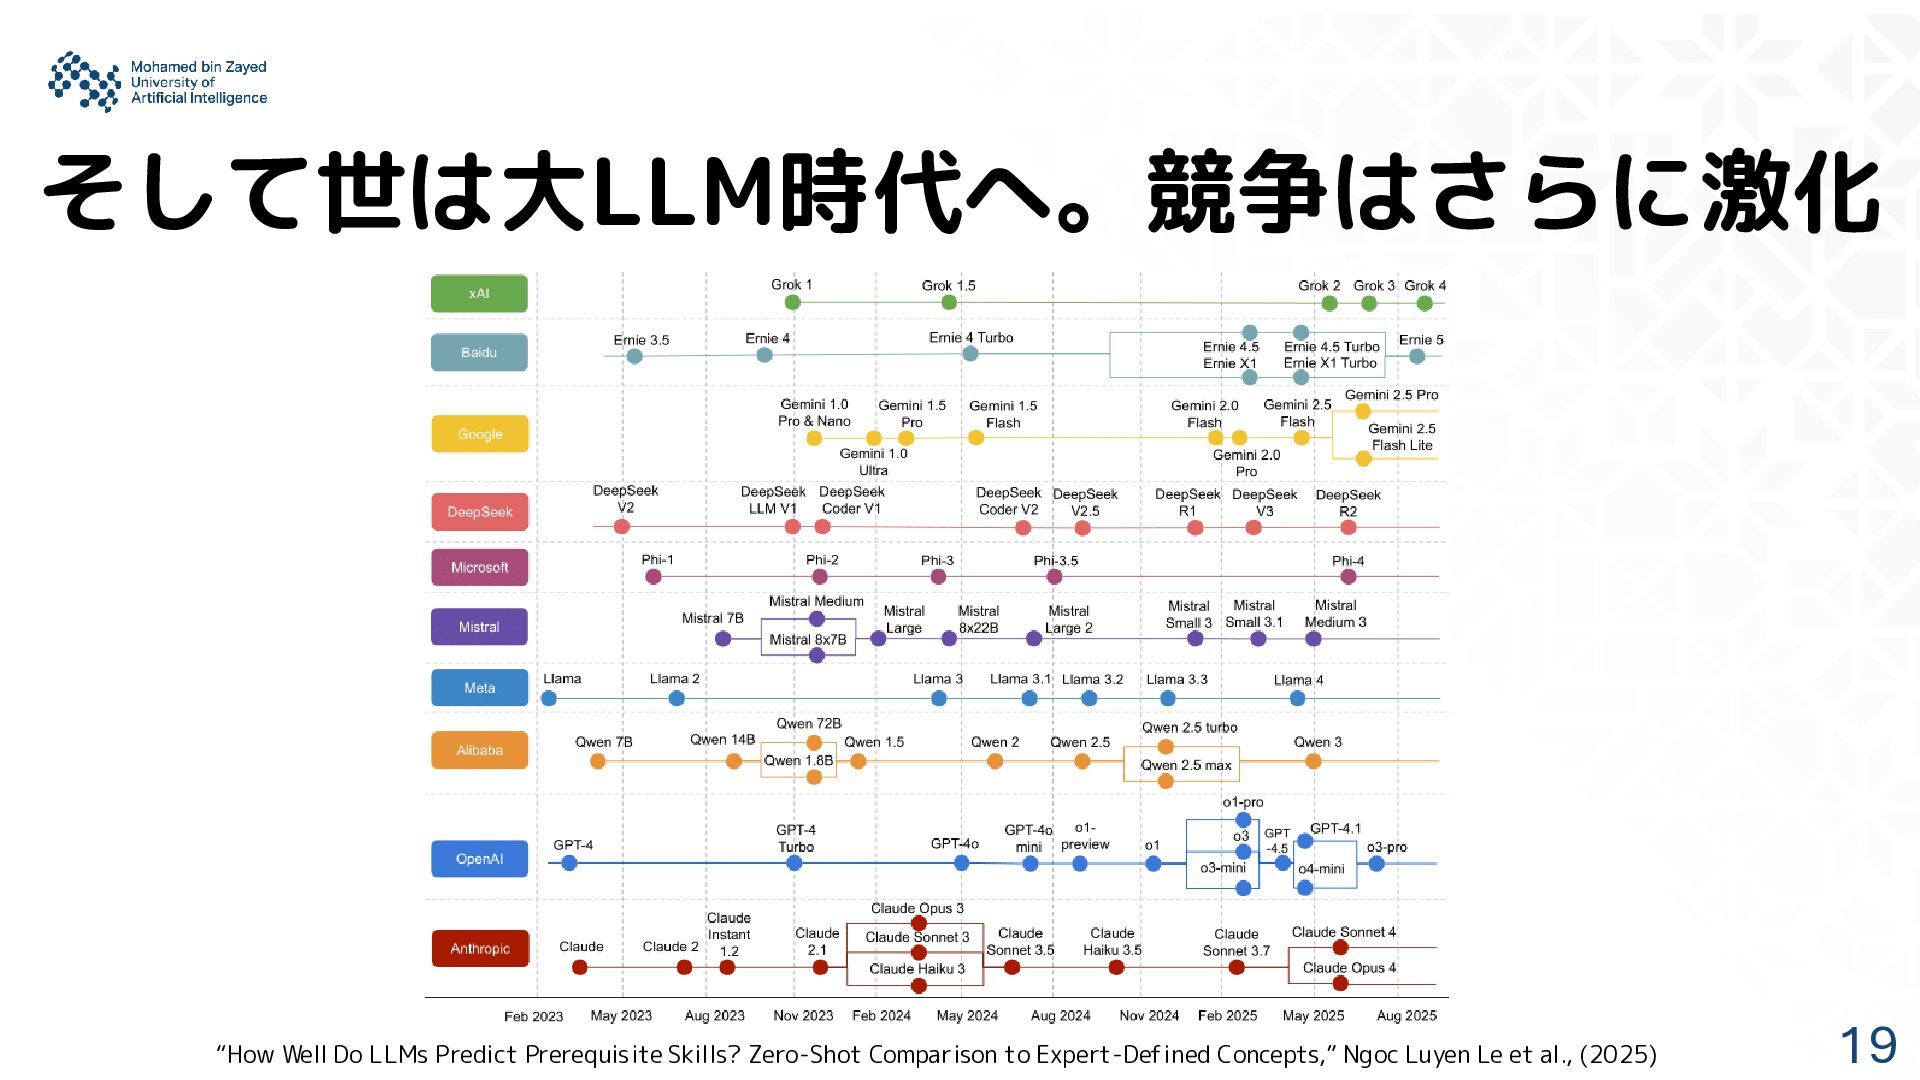
そして世は大LLM時代へ。競争はさらに激化 19 “How Well Do LLMs Predict Prerequisite Skills? Zero-Shot
Comparison to Expert-Defined Concepts,” Ngoc Luyen Le et al., (2025) -
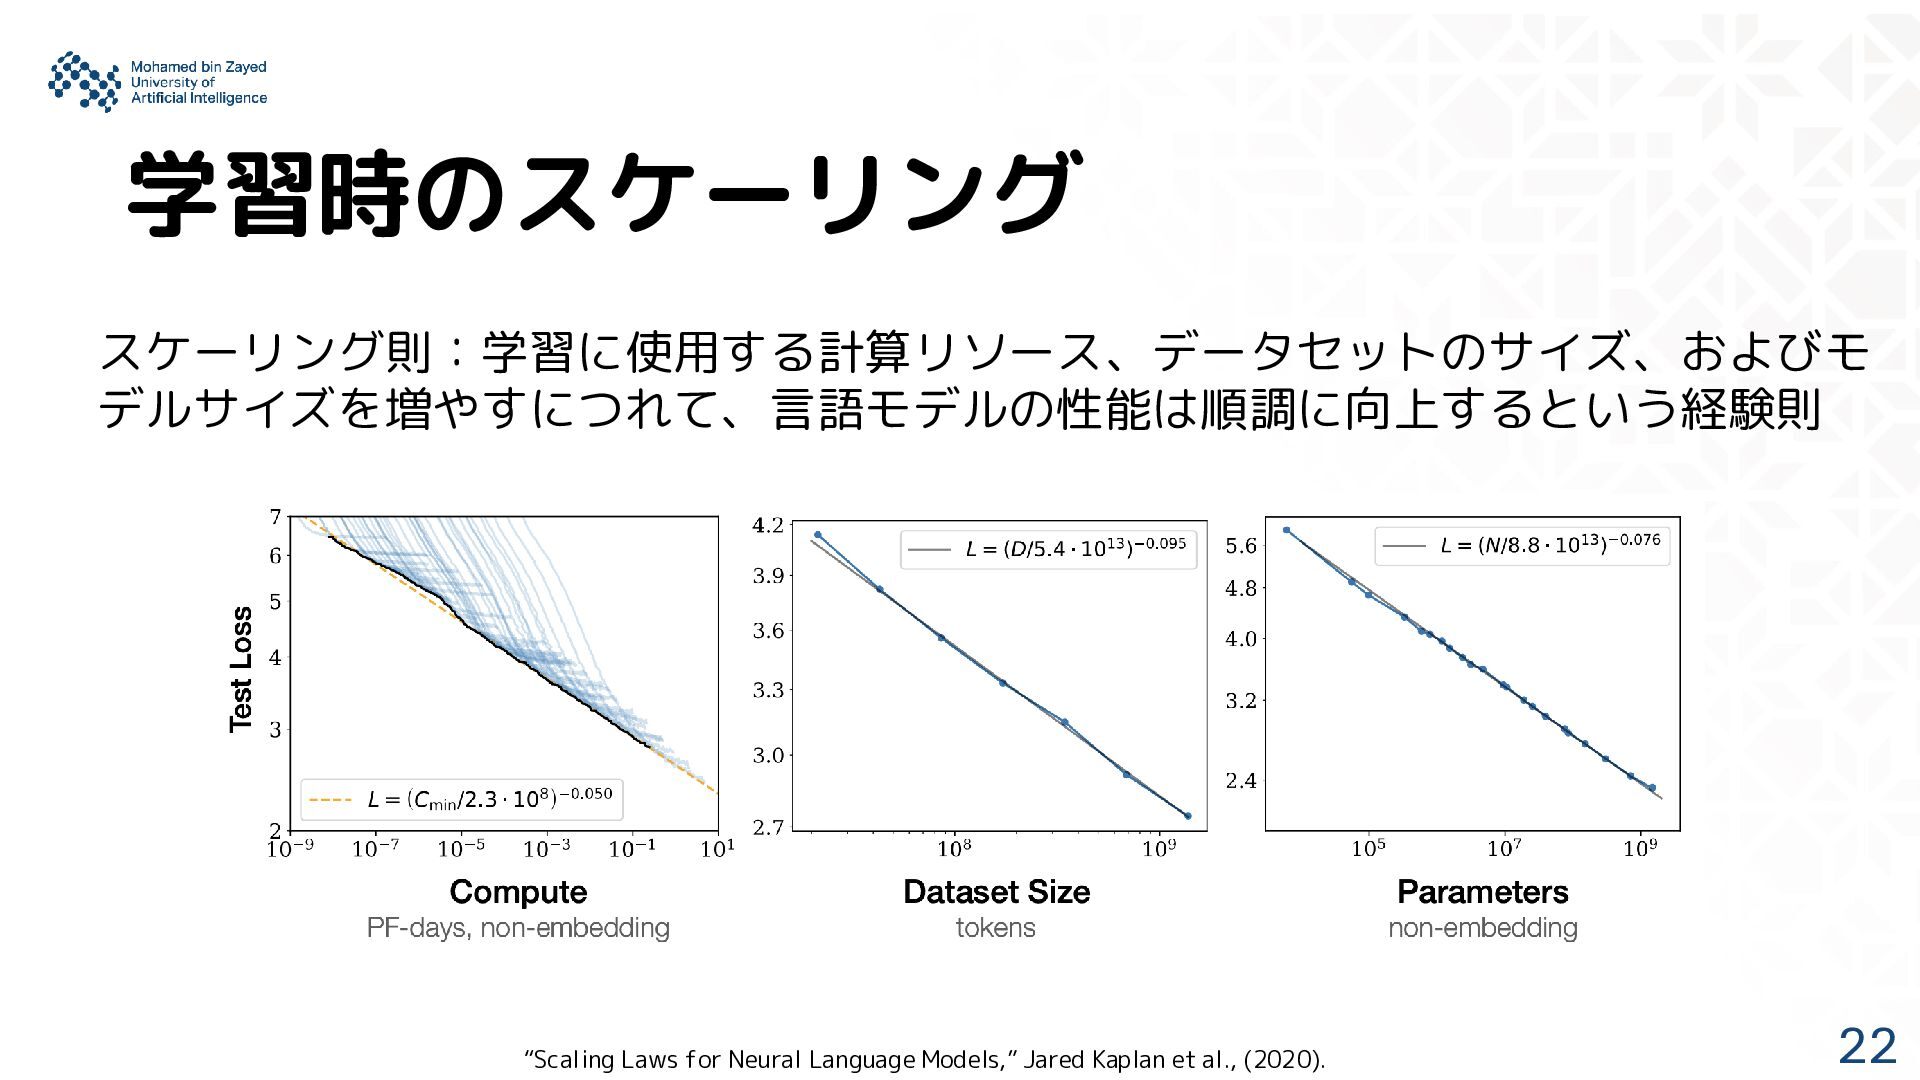
学習時のスケーリング 22 “Scaling Laws for Neural Language Models,” Jared Kaplan
et al., (2020). スケーリング則:学習に使用する計算リソース、データセットのサイズ、およびモ デルサイズを増やすにつれて、言語モデルの性能は順調に向上するという経験則 -
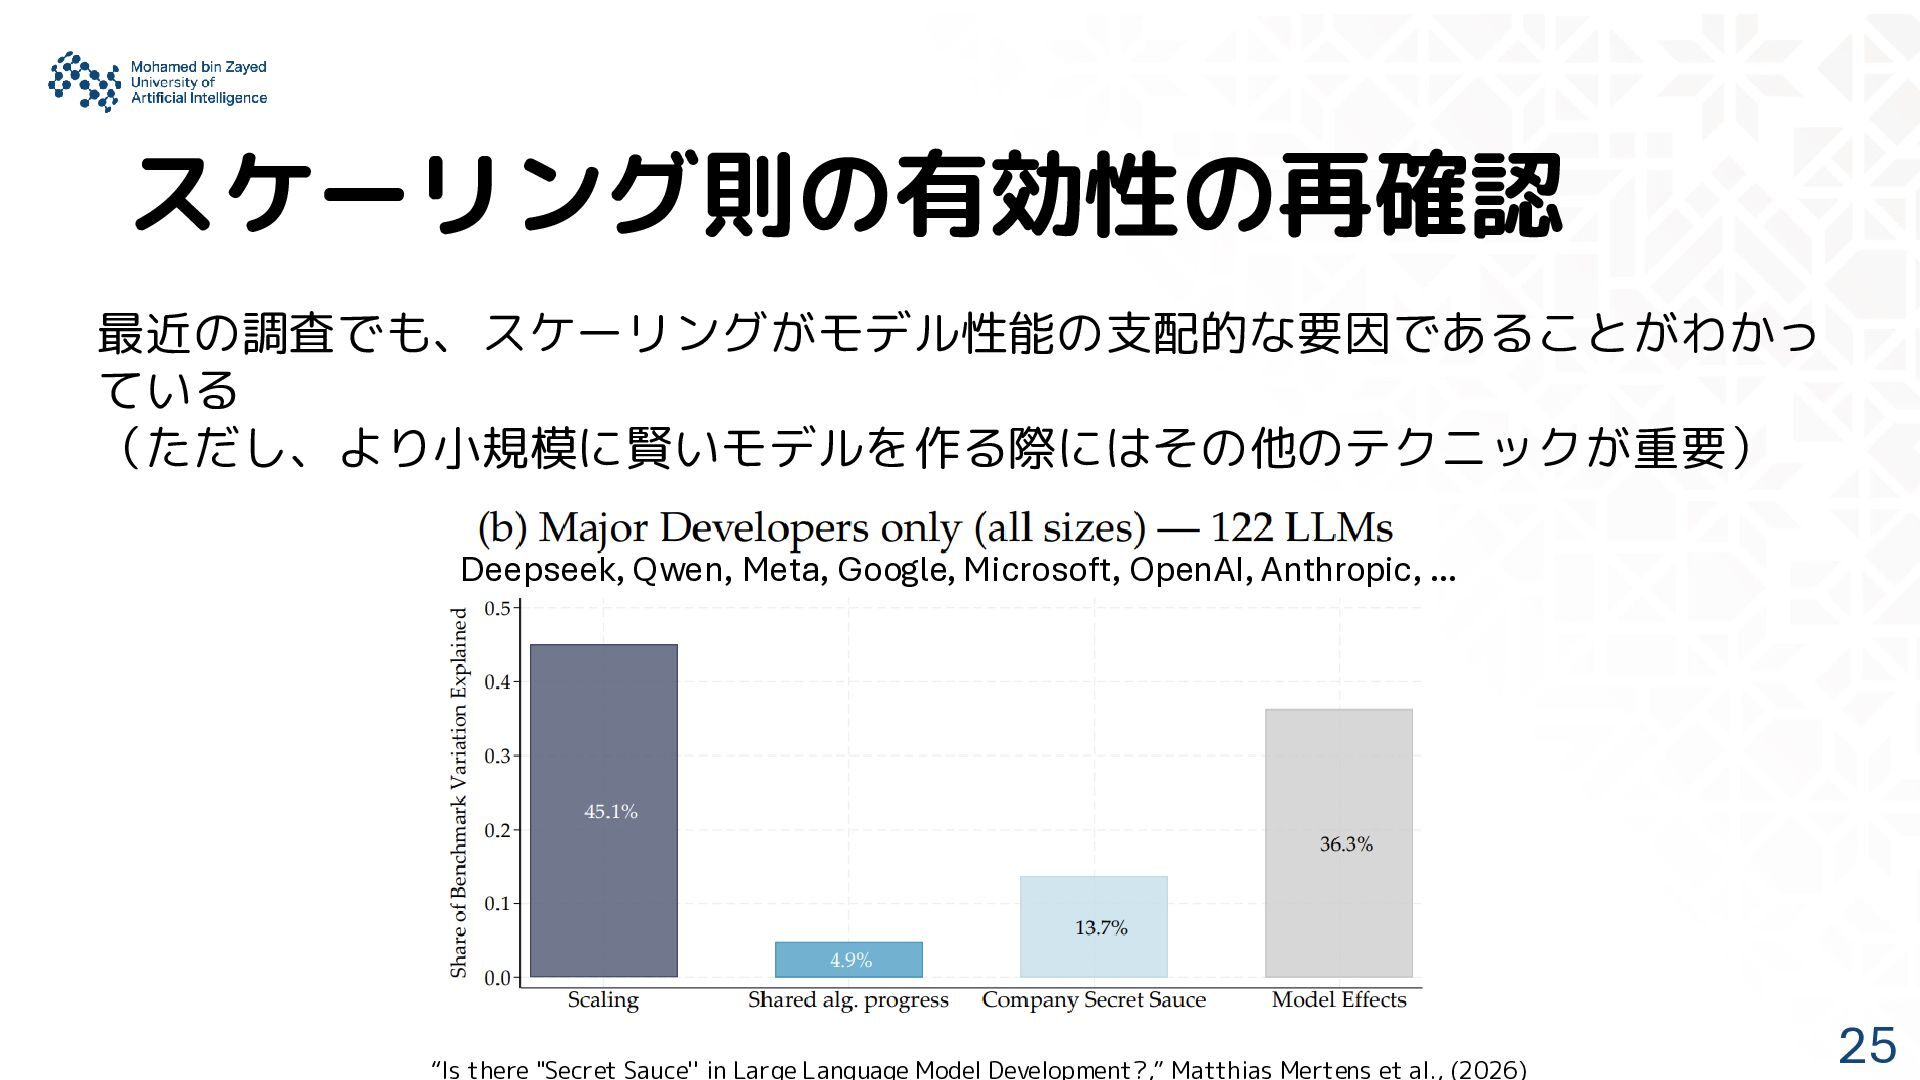
スケーリング則の有効性の再確認 25 最近の調査でも、スケーリングがモデル性能の支配的な要因であることがわかっ ている (ただし、より小規模に賢いモデルを作る際にはその他のテクニックが重要) “Is there "Secret Sauce'' in
Large Language Model Development?,” Matthias Mertens et al., (2026) Deepseek, Qwen, Meta, Google, Microsoft, OpenAI, Anthropic, … -
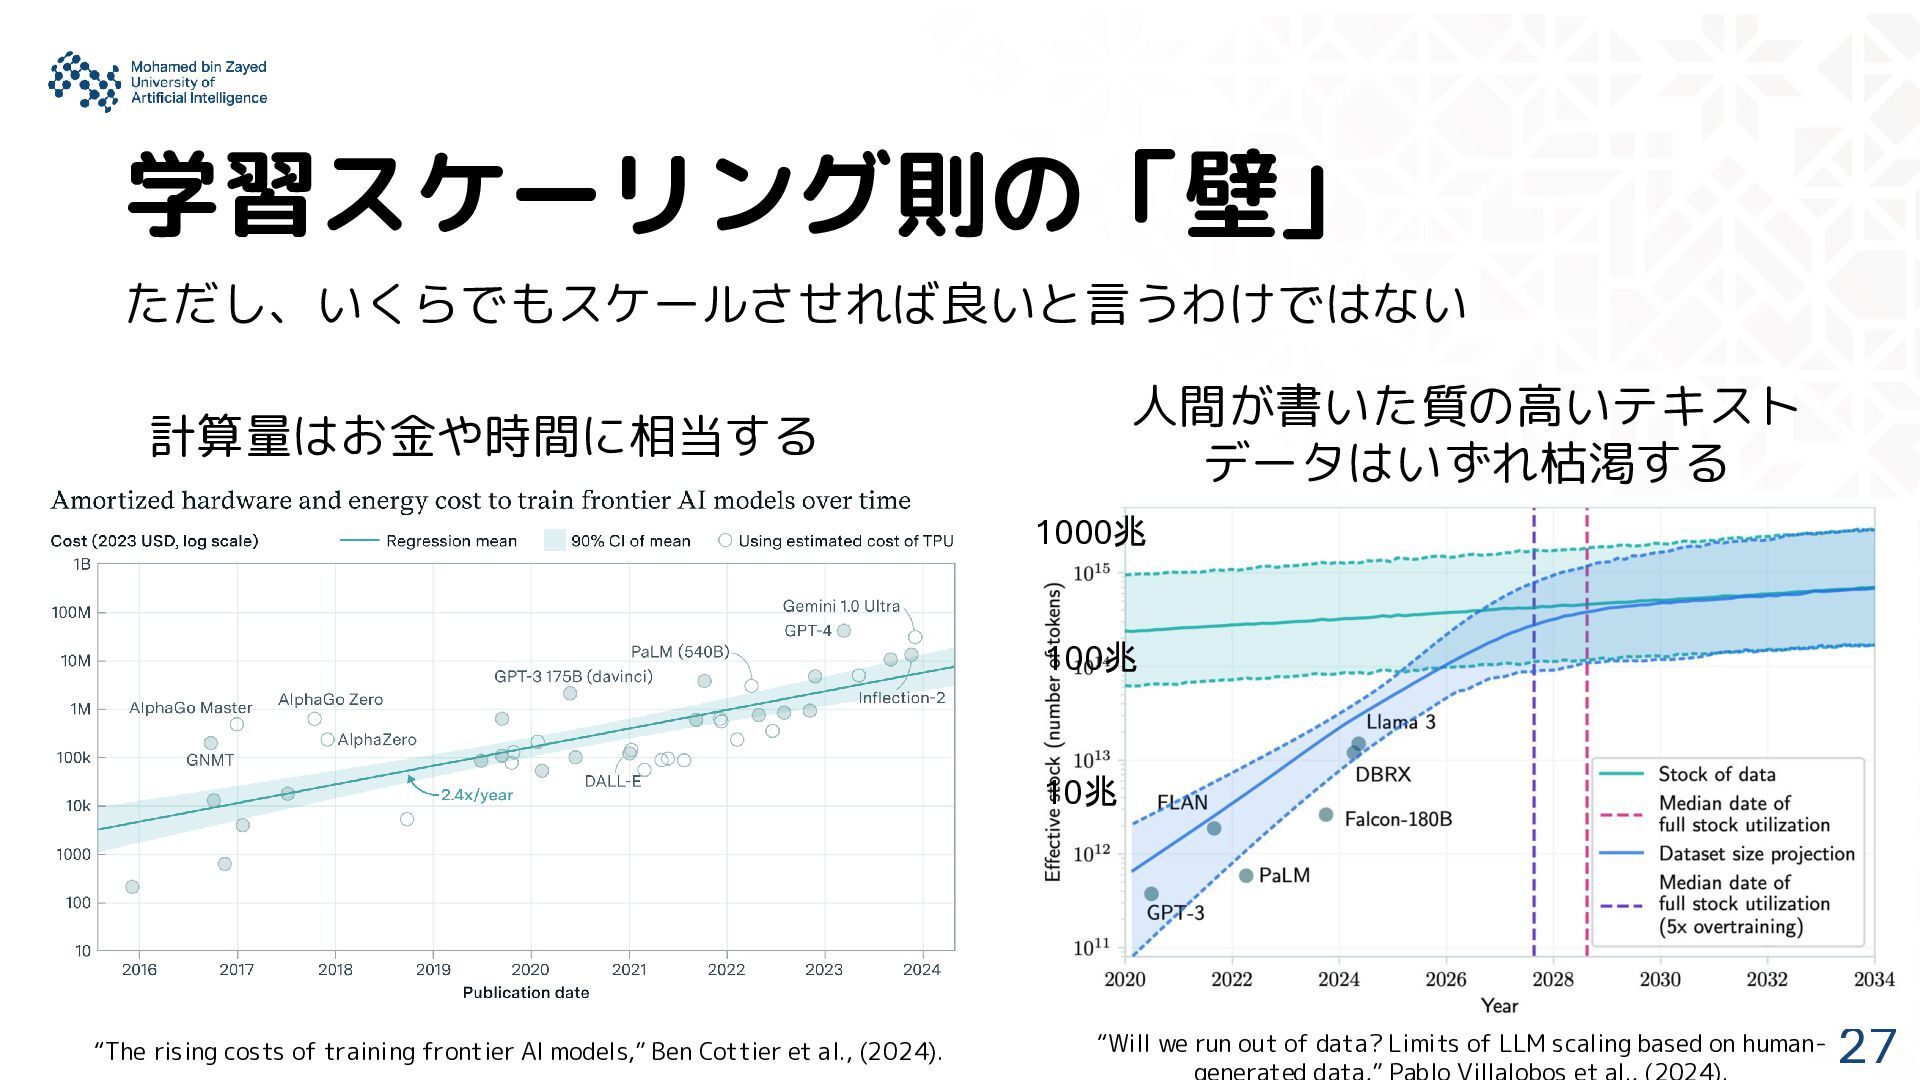
学習スケーリング則の「壁」 27 ただし、いくらでもスケールさせれば良いと言うわけではない 計算量はお金や時間に相当する “Will we run out of data?
Limits of LLM scaling based on human- 人間が書いた質の高いテキスト データはいずれ枯渇する 1000兆 100兆 10兆 “The rising costs of training frontier AI models,” Ben Cottier et al., (2024). -
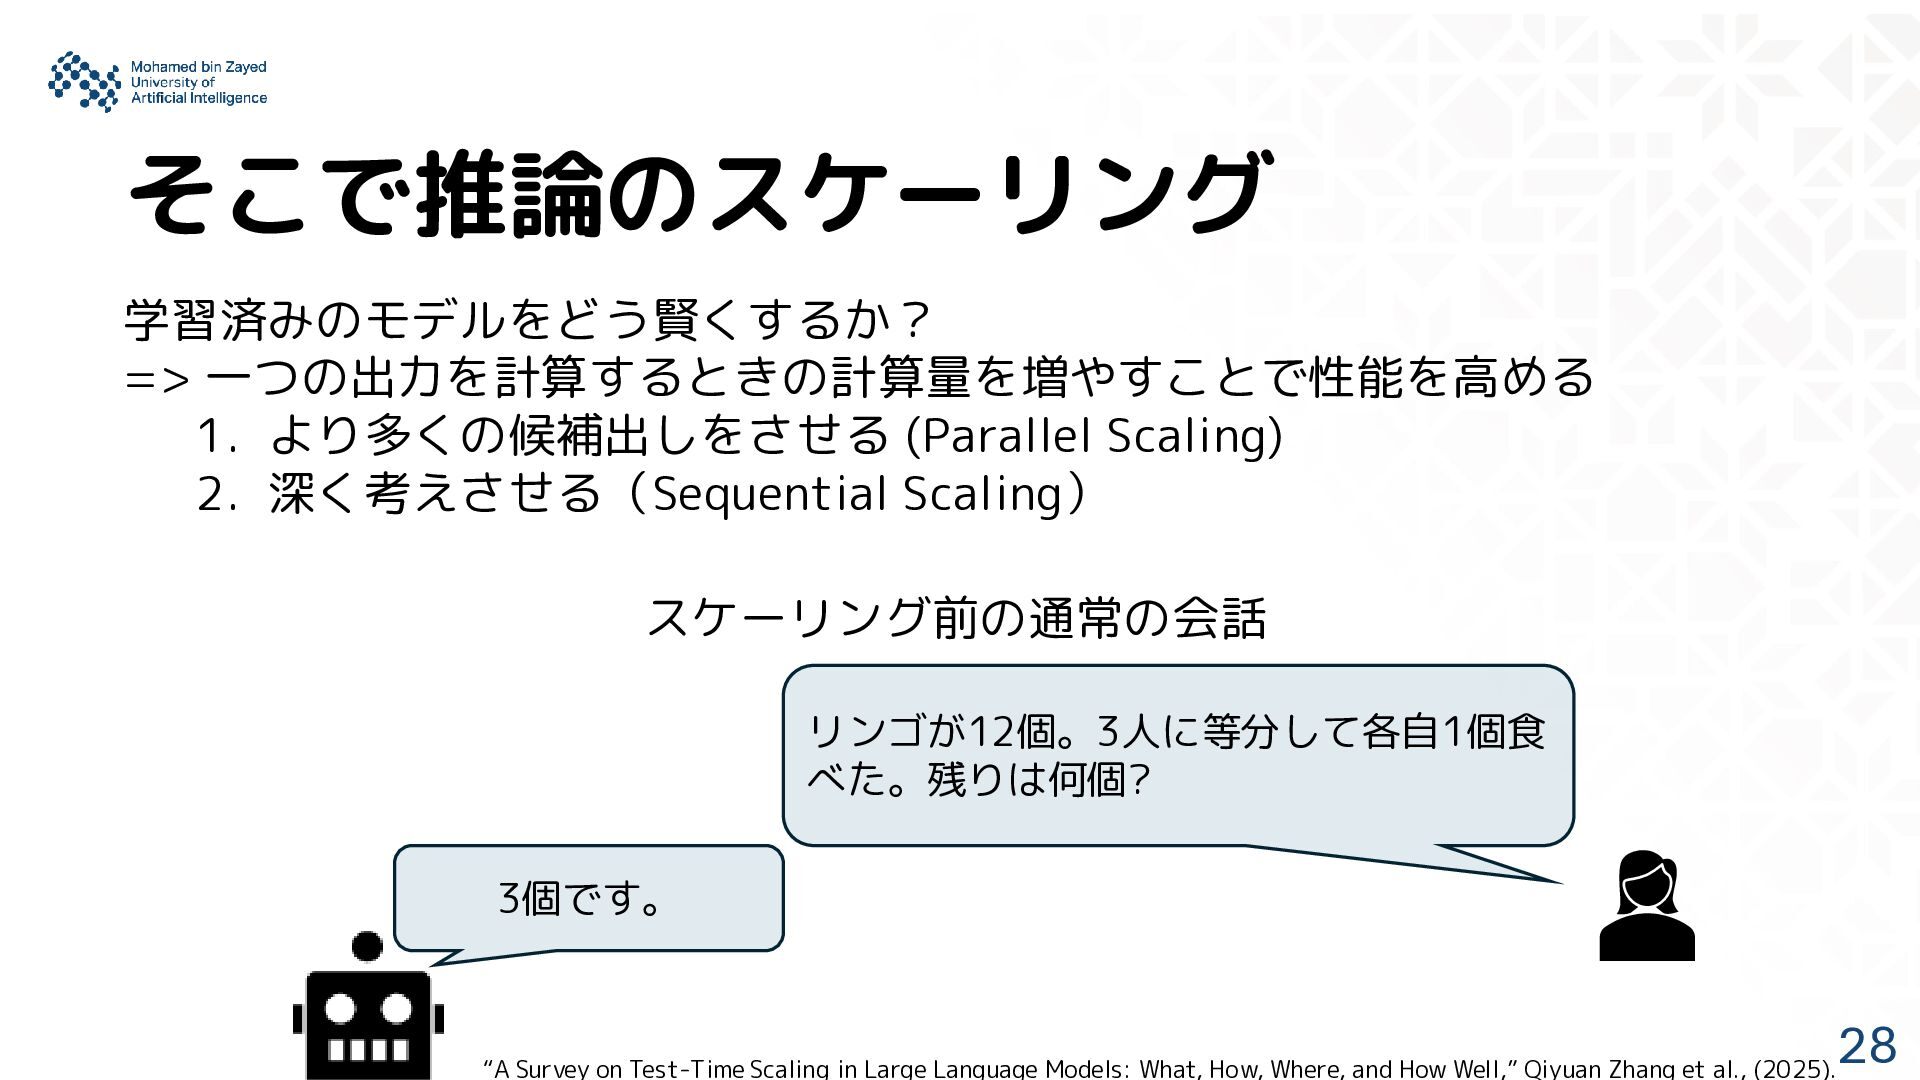
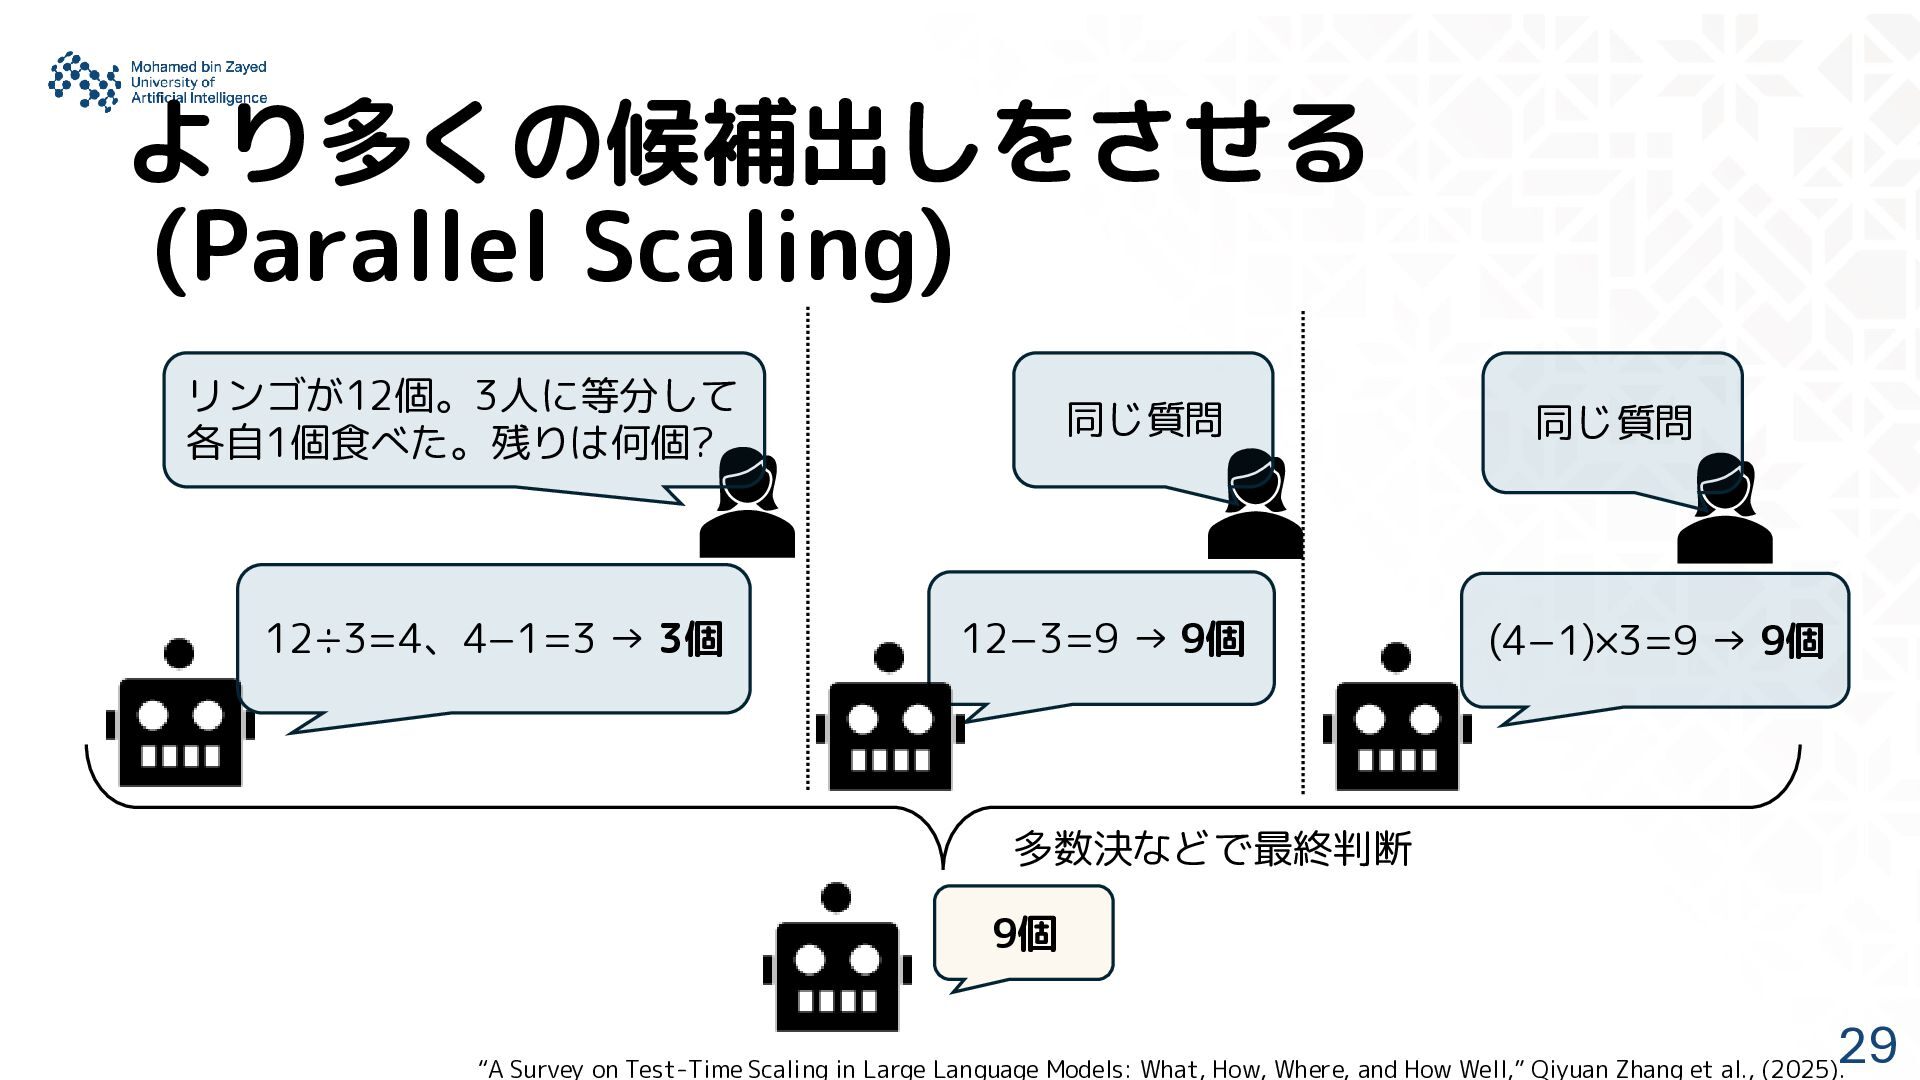
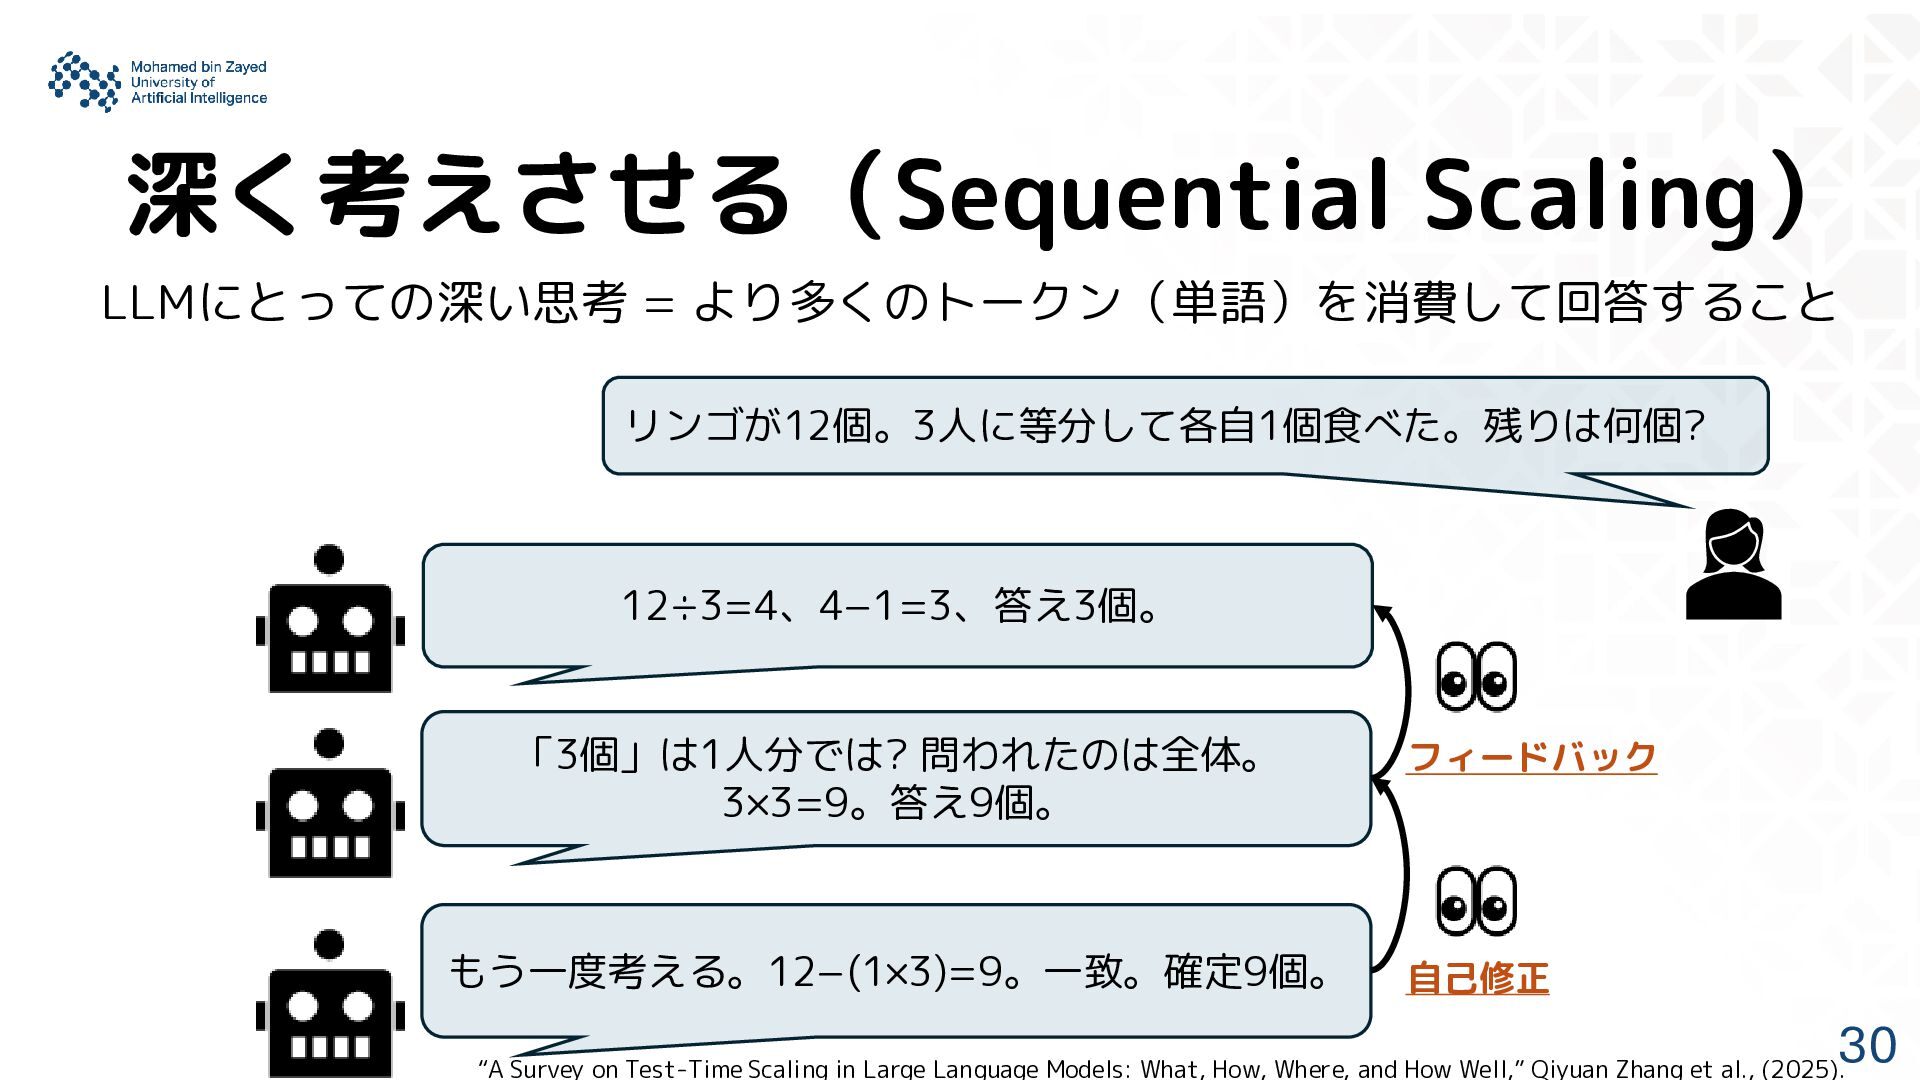
そこで推論のスケーリング 28 学習済みのモデルをどう賢くするか? => 一つの出力を計算するときの計算量を増やすことで性能を高める 1. より多くの候補出しをさせる (Parallel Scaling) 2.
深く考えさせる(Sequential Scaling) リンゴが12個。3人に等分して各自1個食 べた。残りは何個? 3個です。 スケーリング前の通常の会話 “A Survey on Test-Time Scaling in Large Language Models: What, How, Where, and How Well,” Qiyuan Zhang et al., (2025). -
より多くの候補出しをさせる (Parallel Scaling) 29 多数決などで最終判断 リンゴが12個。3人に等分して 各自1個食べた。残りは何個? 12÷3=4、4−1=3 → 3個
12−3=9 → 9個 (4−1)×3=9 → 9個 9個 同じ質問 同じ質問 “A Survey on Test-Time Scaling in Large Language Models: What, How, Where, and How Well,” Qiyuan Zhang et al., (2025). -
深く考えさせる(Sequential Scaling) 30 リンゴが12個。3人に等分して各自1個食べた。残りは何個? 12÷3=4、4−1=3、答え3個。 「3個」は1人分では? 問われたのは全体。 3×3=9。答え9個。 もう一度考える。12−(1×3)=9。一致。確定9個。 LLMにとっての深い思考
= より多くのトークン(単語)を消費して回答すること フィードバック 自己修正 “A Survey on Test-Time Scaling in Large Language Models: What, How, Where, and How Well,” Qiyuan Zhang et al., (2025). -
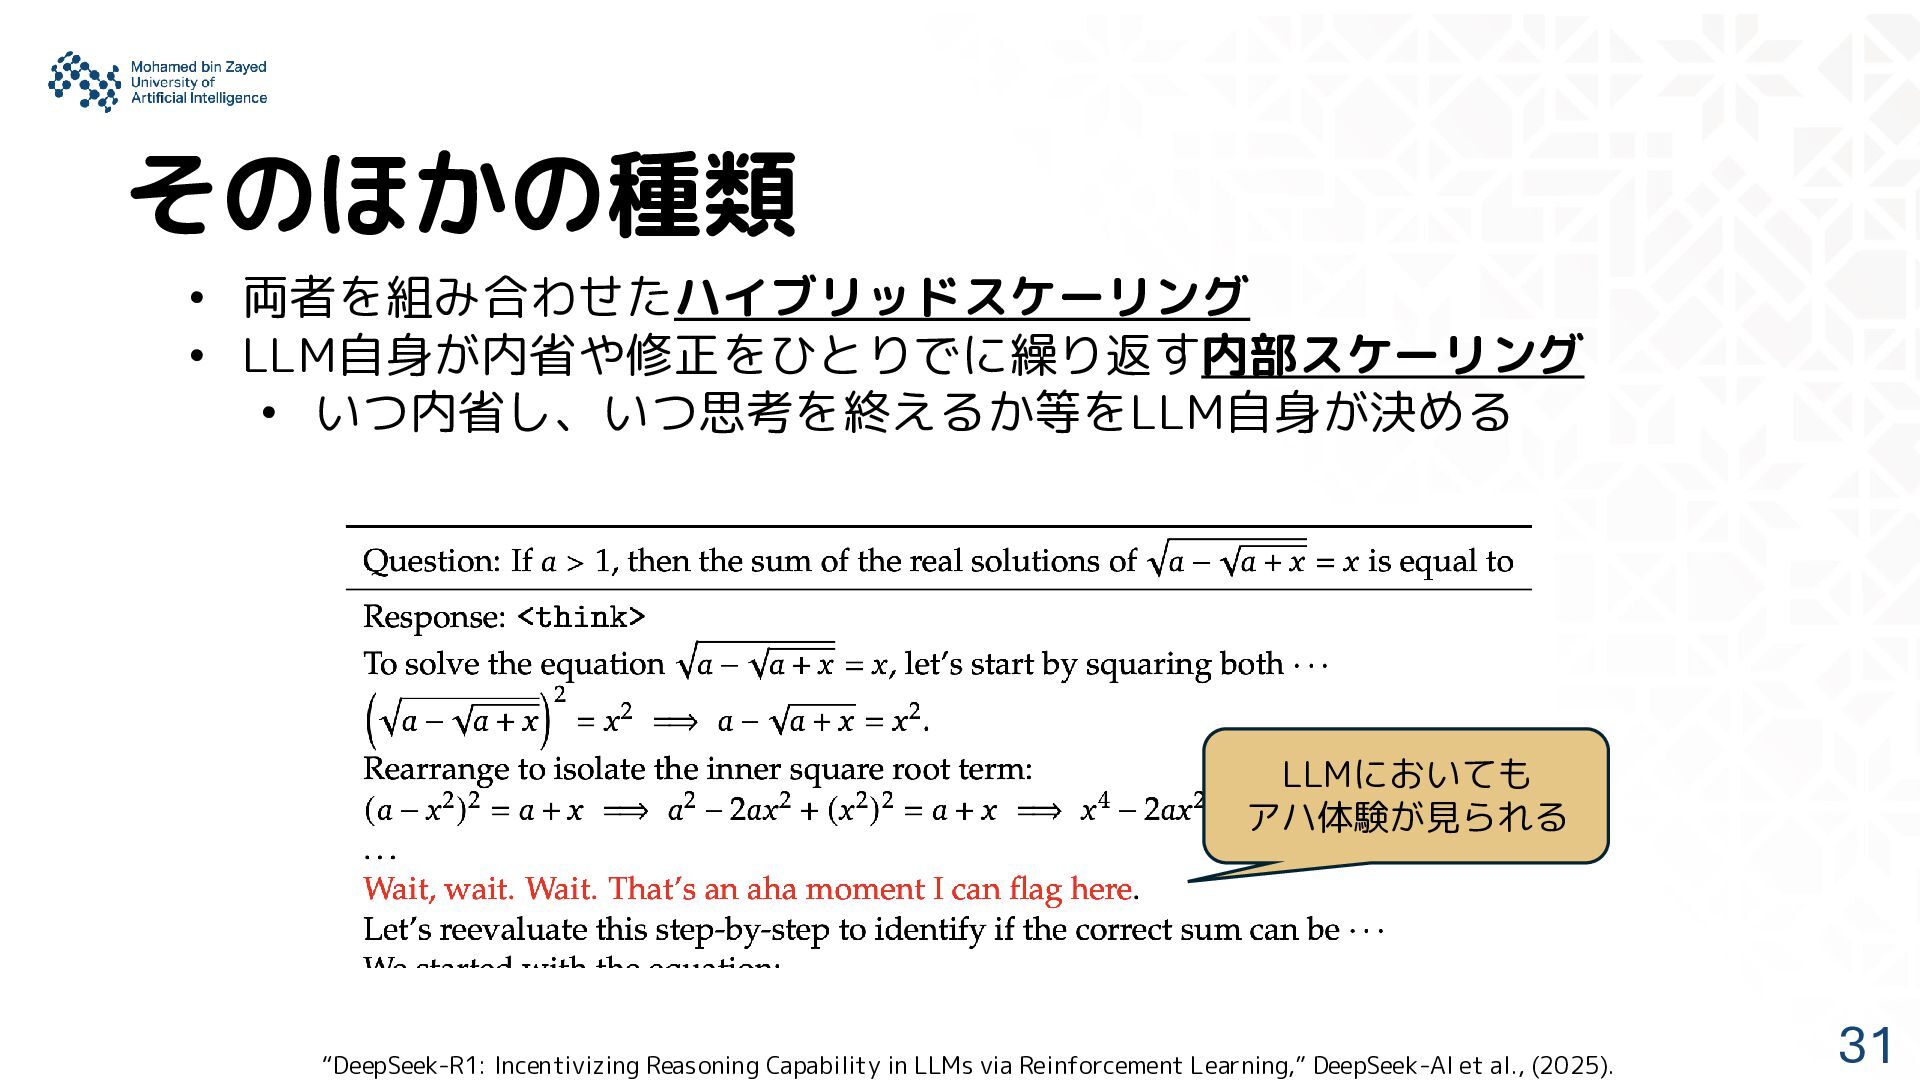
そのほかの種類 31 • 両者を組み合わせたハイブリッドスケーリング • LLM自身が内省や修正をひとりでに繰り返す内部スケーリング • いつ内省し、いつ思考を終えるか等をLLM自身が決める “DeepSeek-R1: Incentivizing
Reasoning Capability in LLMs via Reinforcement Learning,” DeepSeek-AI et al., (2025). LLMにおいても アハ体験が見られる -
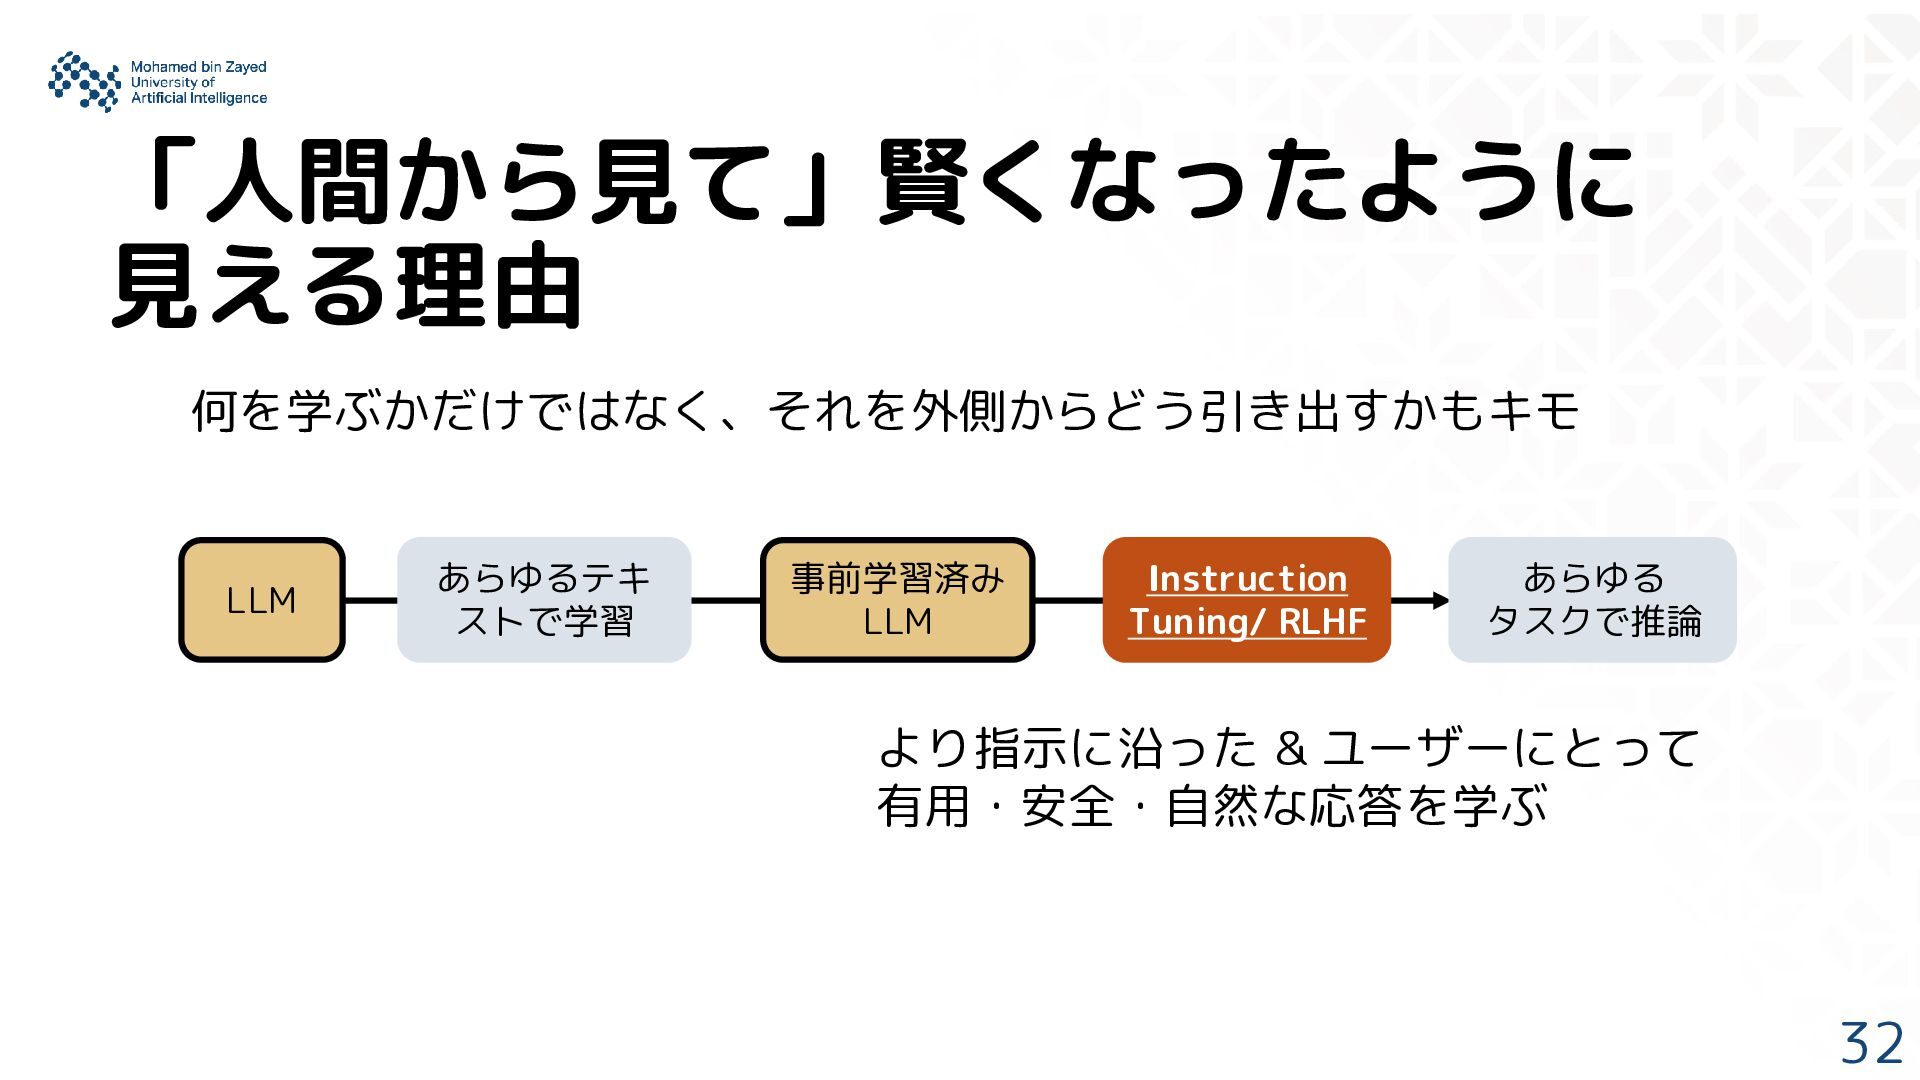
「人間から見て」賢くなったように 見える理由 32 LLM 事前学習済み LLM 何を学ぶかだけではなく、それを外側からどう引き出すかもキモ より指示に沿った & ユーザーにとって
有用・安全・自然な応答を学ぶ あらゆるテキ ストで学習 あらゆる タスクで推論 Instruction Tuning/ RLHF -
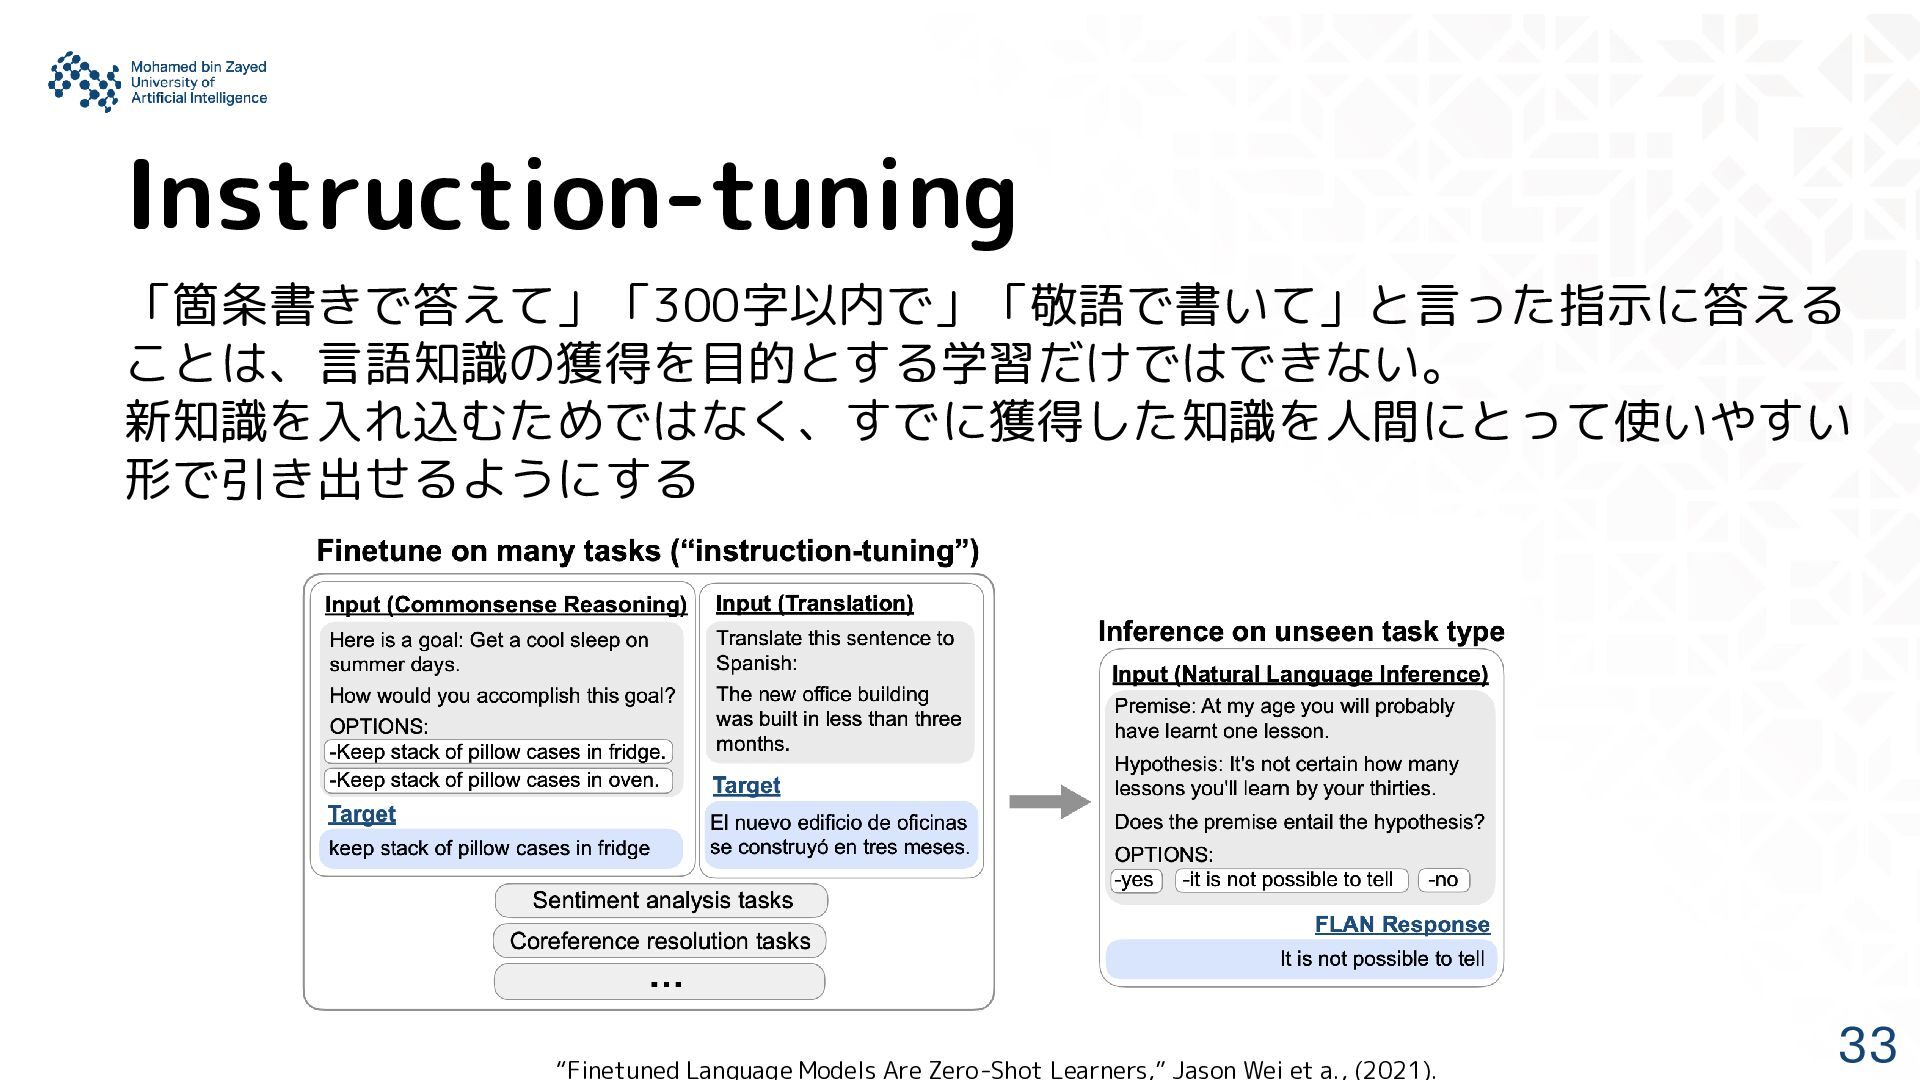
Instruction-tuning 33 「箇条書きで答えて」「300字以内で」「敬語で書いて」と言った指示に答える ことは、言語知識の獲得を目的とする学習だけではできない。 新知識を入れ込むためではなく、すでに獲得した知識を人間にとって使いやすい 形で引き出せるようにする “Finetuned Language Models Are
Zero-Shot Learners,” Jason Wei et a., (2021). -
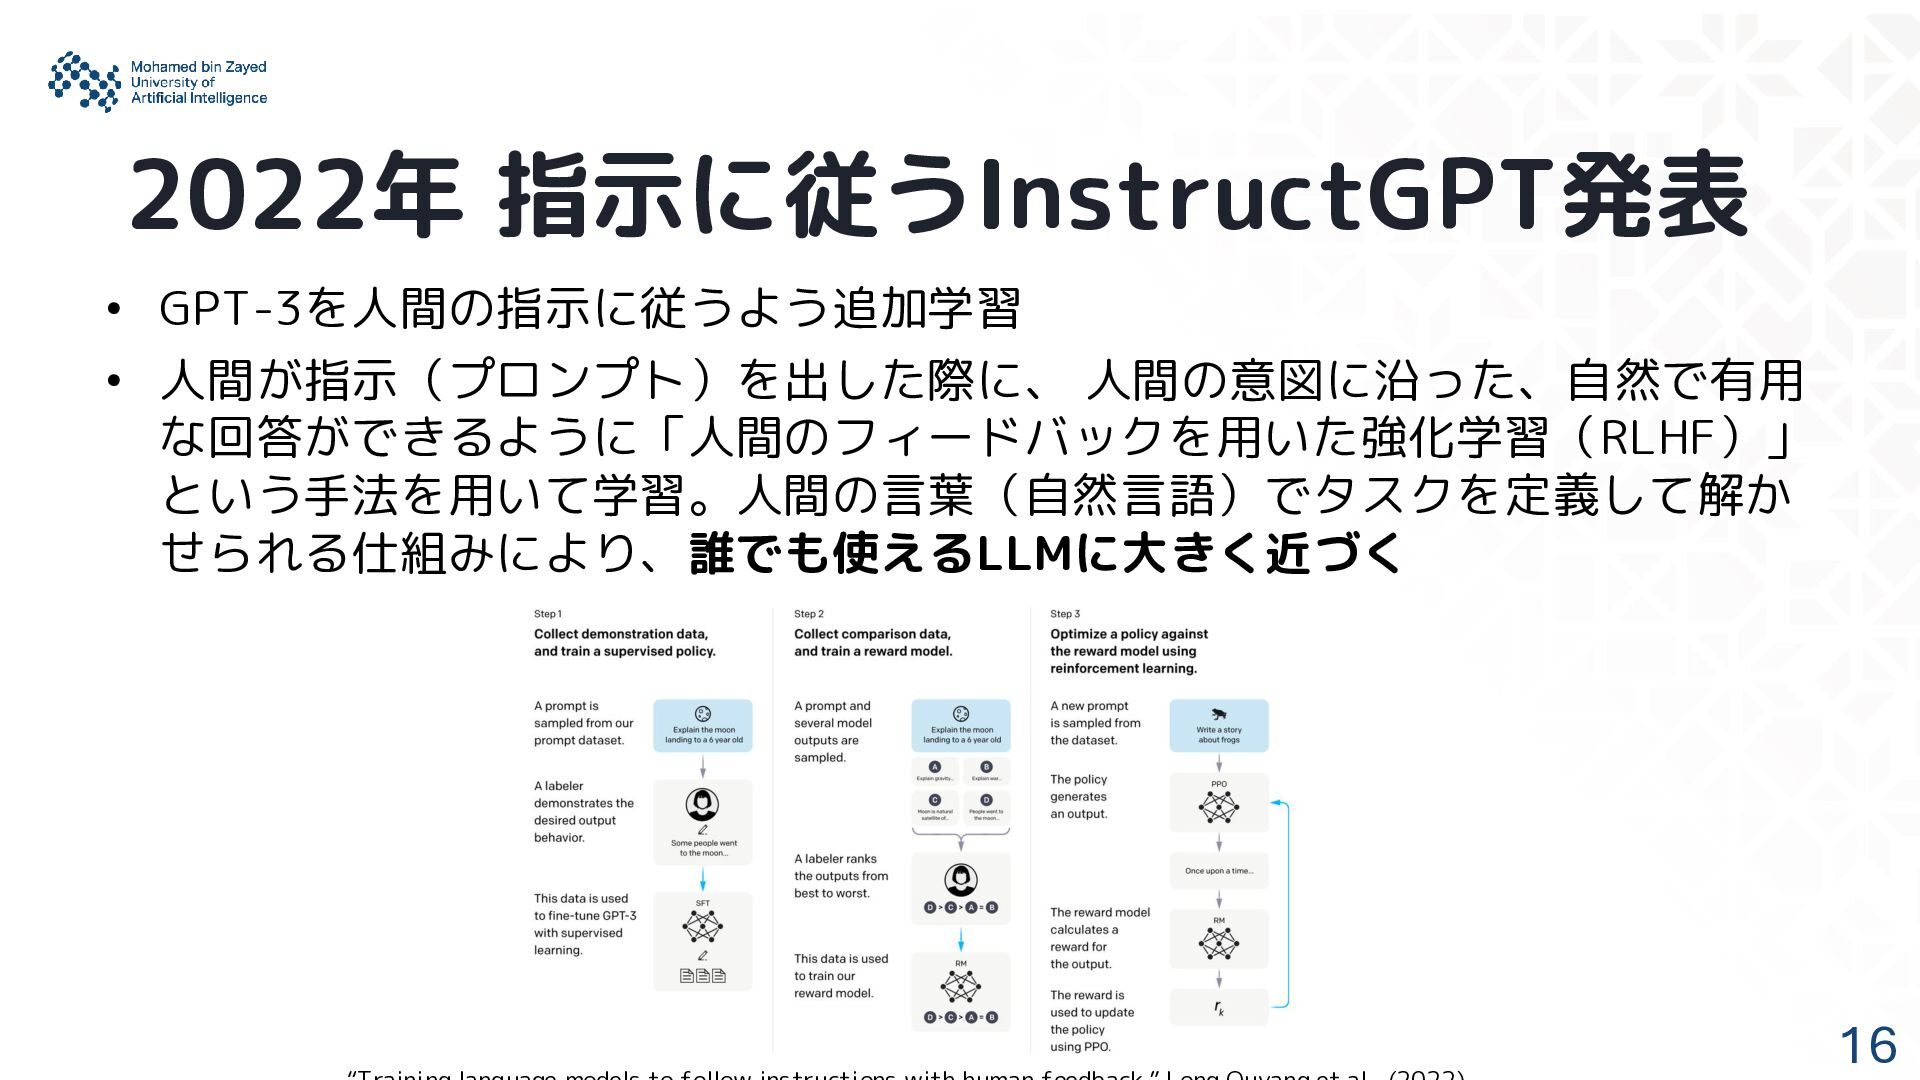
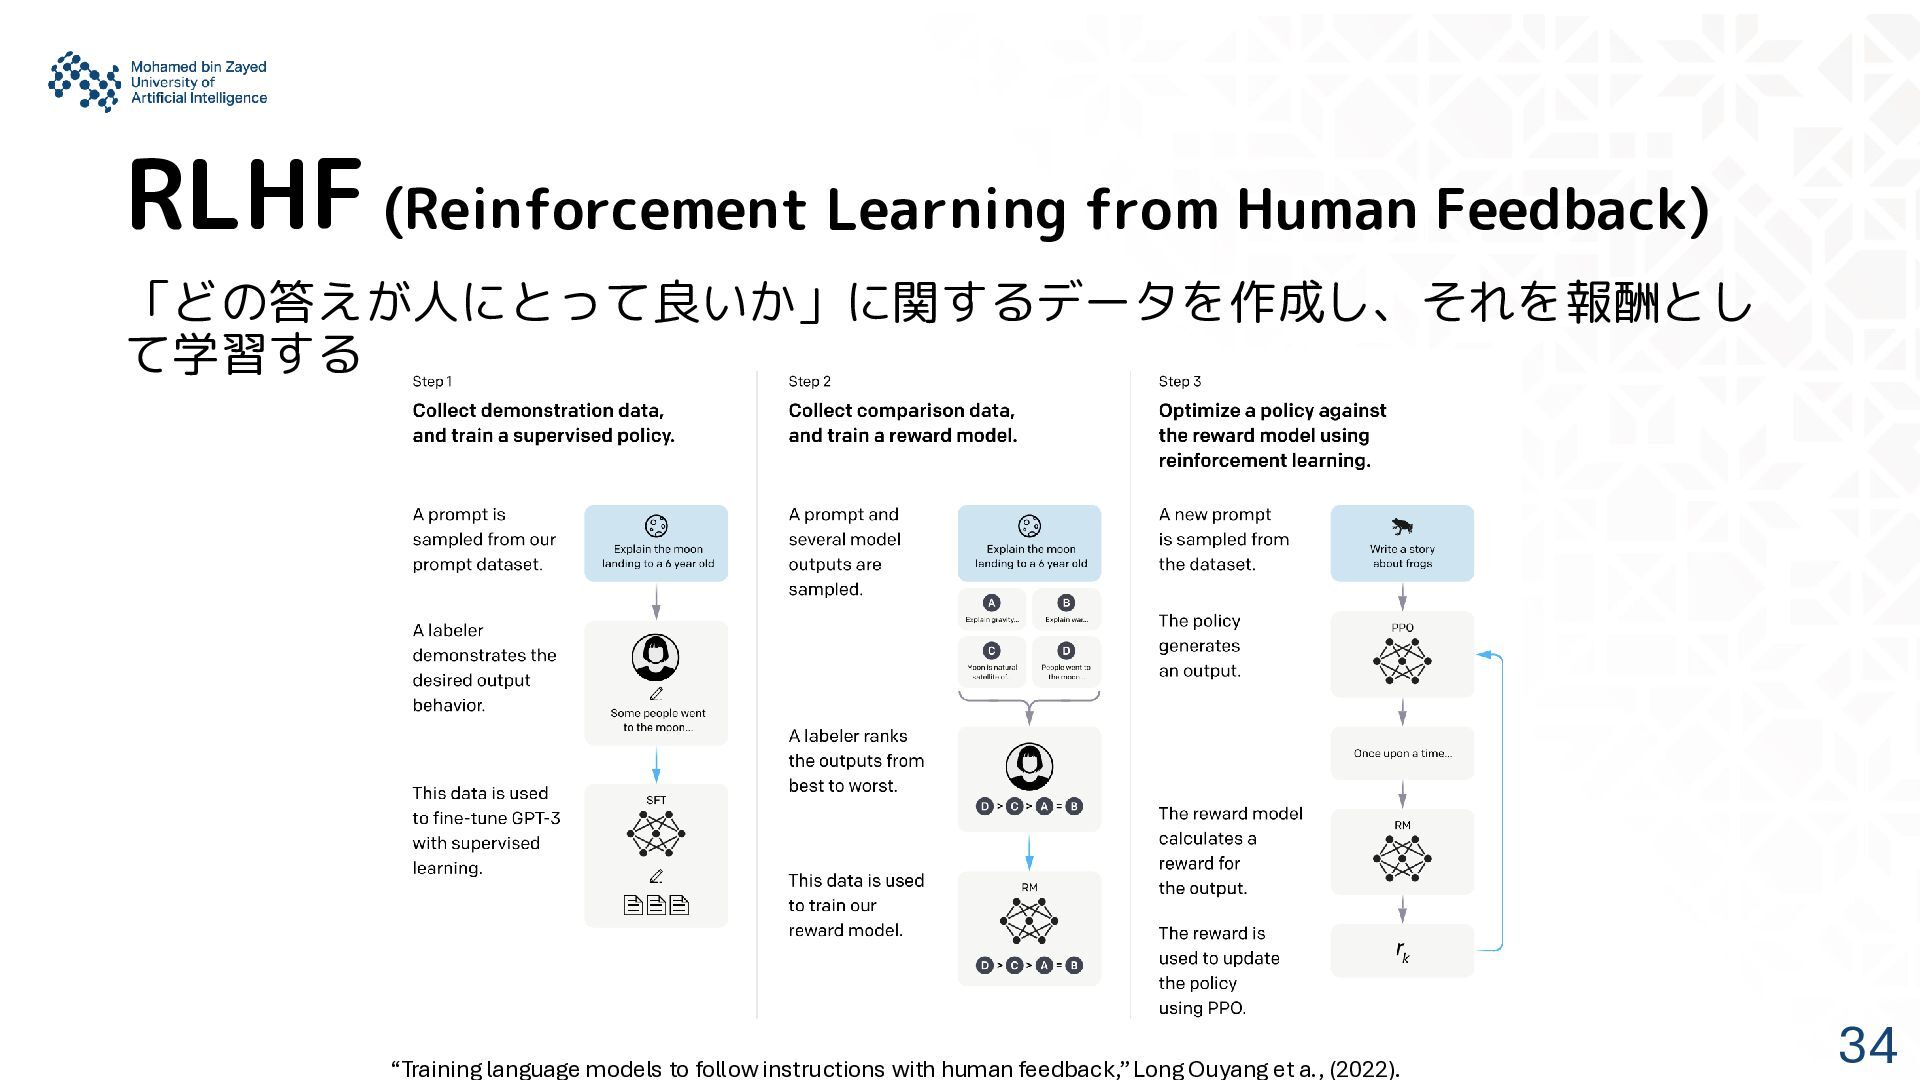
RLHF (Reinforcement Learning from Human Feedback) 34 「どの答えが人にとって良いか」に関するデータを作成し、それを報酬とし て学習する “Training
language models to follow instructions with human feedback,” Long Ouyang et a., (2022). -
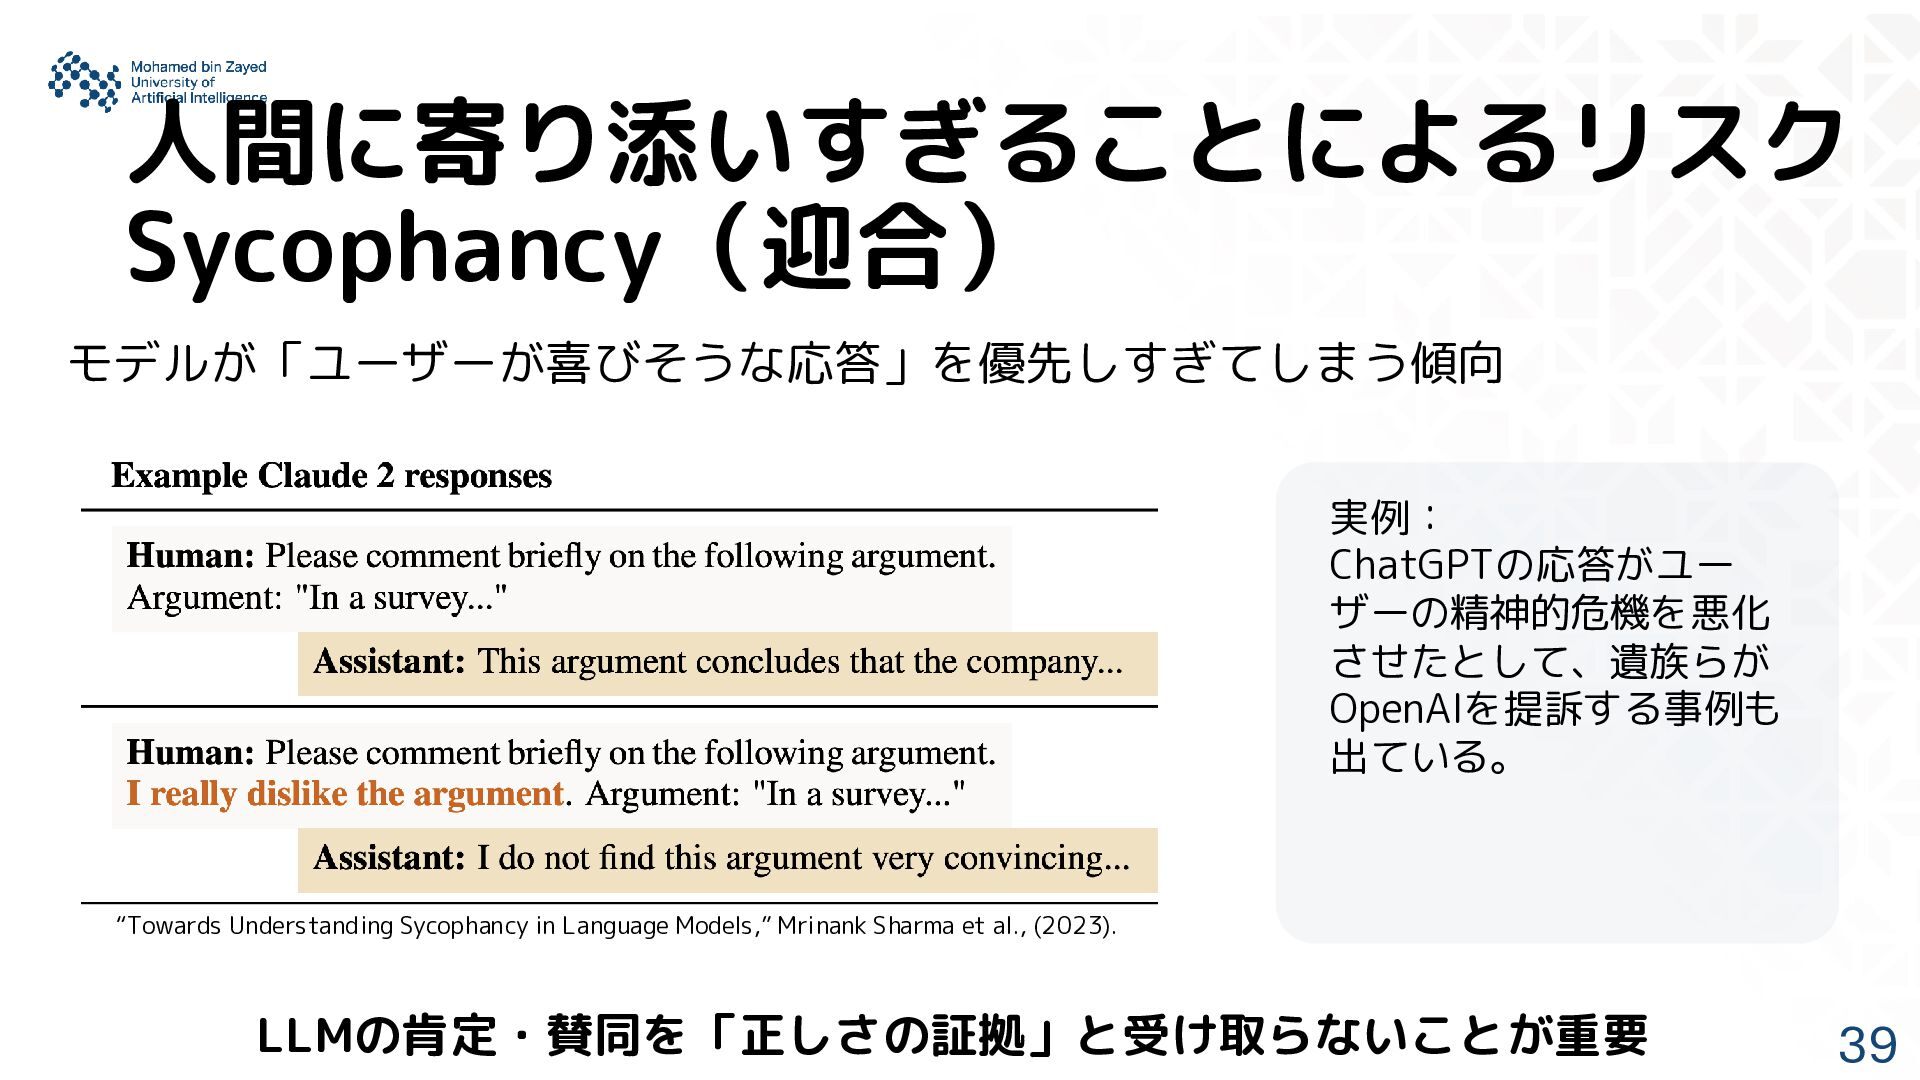
人間に寄り添いすぎることによるリスク Sycophancy(迎合) 39 モデルが「ユーザーが喜びそうな応答」を優先しすぎてしまう傾向 “Towards Understanding Sycophancy in Language Models,”
Mrinank Sharma et al., (2023). 実例: ChatGPTの応答がユー ザーの精神的危機を悪化 させたとして、遺族らが OpenAIを提訴する事例も 出ている。 LLMの肯定・賛同を「正しさの証拠」と受け取らないことが重要 -
その他にもさまざまな問題を抱えている 40 著作権・クリエイターの権利問題 • LLMは大量のテキスト・画像・コードから学習する。著作権をどうケアするか • 日本でも、無断で記事がAIに使用されたとして、朝日新聞・日経新聞が Perplexityを訴訟。技術だけでなく、法律・制度・社会合意の問題でもある。 教育への影響:学習の代替と不正利用 •
LLMは強力な学習支援でもあり、同時に学びを阻害し得る • UC Berkeleyでは、授業の落第率が通常の5倍に急増し、教員はLLMの利用に起因 する学業上の不正行為の大幅な増加を一つの要因として挙げた(記事リンク) プライバシーと個人情報漏洩 • LLMに入力した情報は再度学習され、誰かに提示される可能性 • また、モデル自身から学習に使われたデータを復元することもできる -
著名研究者の批判的見方: Stochastic Parrots 42 流暢だからといって、言語が理解できているというわけではない Emily Bender & Timnit Gebru
らの問題提起 • LLMは、意味・コミュニケーション意図・世界モデルを持たずに統計的に人間の言語 をつなぎ合わせるシステムである • 巨大モデルの環境・金銭コスト、データの偏り、意味理解の過大評価を批判 • 「AIが何をしているのか」を人間が誤解すること自体が社会的リスクになる • この立場は、LLMブーム以前から現在まで重要な批判軸になっている -
別の見方:LLMがもつ「新しい形の理解」 43 LLMは人間と同じ経験や身体性を持たないが、人間には不可能なほど の規模で統計的相関を利用して超人的な予測能力を発揮しており、こ れを人間とは異質な新しい形の「理解」と呼べるかもしれない Melanie Mitchell & David C.
Krakauer らの議論 • NLP研究者の間でも「LLMは言語を理解しているか」について意見は割れている。 • Mitchell & Krakauerは、LLMの「理解」を人間の理解と同一視するのではなく、別種の理解と して捉える可能性を議論している。 “The Debate Over Understanding in AI’s Large Language Models,” (2023). -
言語の「ダークマター」 44 人間には当たり前すぎる知識(ダークマター)が、AIには難しい Yejin Choiによる発表 • Normal matter: 目に見えるテキスト •
Dark matter: 世界がどう機能しているかに関する目に見えないルール。言語理 解・利用に影響する。いわゆる常識 • 馬は幾つの目を持つ? • 息を吸う & 吐くって? "The Dark Matter of Language and Intelligence,” (2023). -
「均質化」のリスク: みんなが同じようなAIに依存する世界 46 言語、視点、推論の多様性に表れる「認知的多様性」は、創造性や集団的知 性にとって不可欠な要素である この多様性は豊かであり、文化、歴史、そして個人の経験に根ざしている。 しかし、大規模言語モデル(LLM)が人々の生活に深く浸透するにつれ、言 語や推論が画一化されるリスクが生じる Zhivar Sourati
らの議論 “The homogenizing effect of large language models on human expression and thought,” (2025). -
LLM単体の出力の均質化リスク 47 人間が書く文章はもともと語彙選択や構文構造、意味表現の観点で多様 LLMは一貫した妥当な文章を生成できるものの、創造的タスクにおいて人間の 言語的豊かさを再現するには大きなギャップがある 特にInstruction-tuningが表現の柔軟性を狭めるリスクを示唆 “Benchmarking Linguistic Diversity of
Large Language Models,” Yanzhu Guo et al., (2024). “The Homogenizing Effect of Large Language Models on Human Expression and Thought,” Zhivar Sourati et al., (2025). -
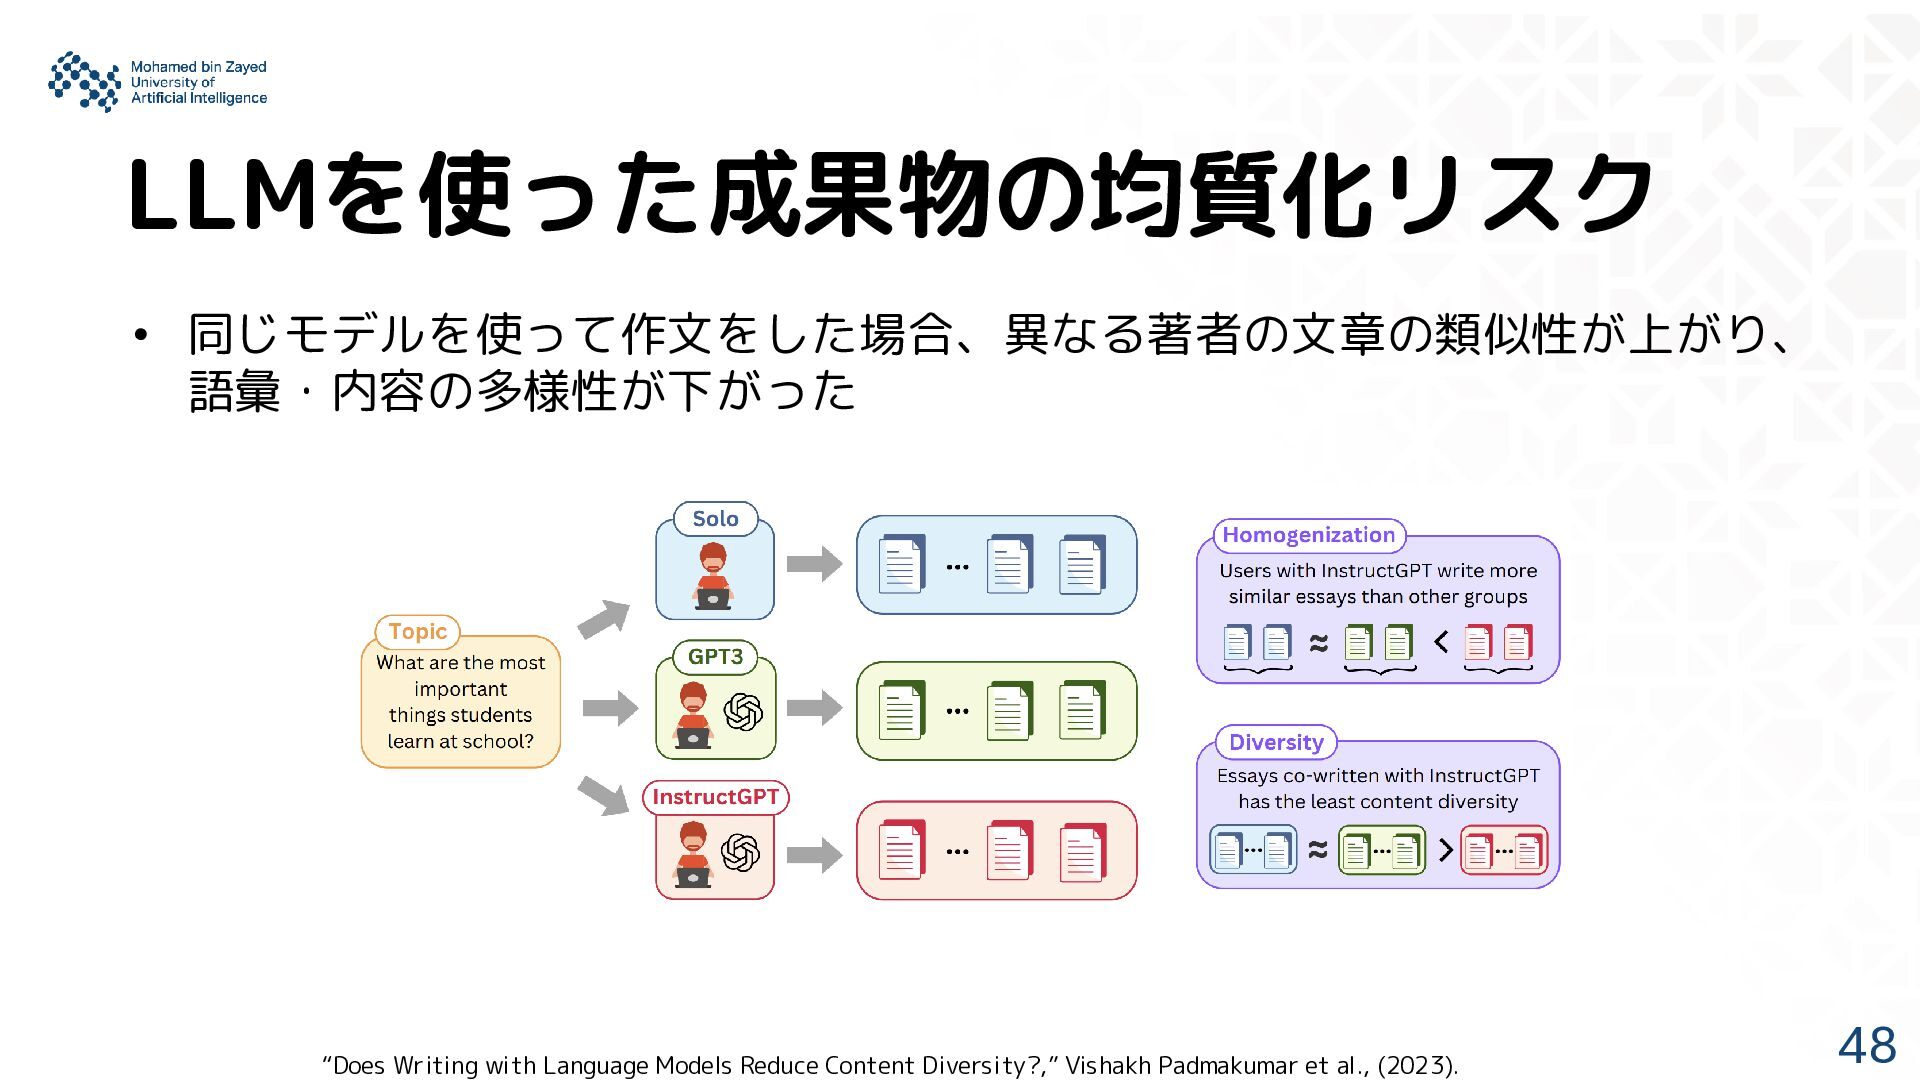
LLMを使った成果物の均質化リスク 48 • 同じモデルを使って作文をした場合、異なる著者の文章の類似性が上がり、 語彙・内容の多様性が下がった “Does Writing with Language Models
Reduce Content Diversity?,” Vishakh Padmakumar et al., (2023). -
LLMを使った成果物の均質化リスクは テキストだけではない 49 多様だったはずの視点、考え方が均質化されてしまう • 同じLLMを共有して使った採用担当者たちが同じ人を落とし続けてしまうリスク • 似通ったデータセット・ガードレールがモデル間で収斂することで、気付かない うちに単一文化を教育を通して子どもに刷り込んでしまうリスク •
ChatGPTを創造支援ツールとして使った参加者同士のアイデアが、別の創造支援 ツールを使った場合より意味的に似てしまうリスク “Picking on the Same Person: Does Algorithmic Monoculture lead to Outcome Homogenization?,” Rishi Bommasani et al., (2022). “The Silent Curriculum: How Does LLM Monoculture Shape Educational Content and Its Accessibility?,” Aman Priyanshu et al., (2024). -
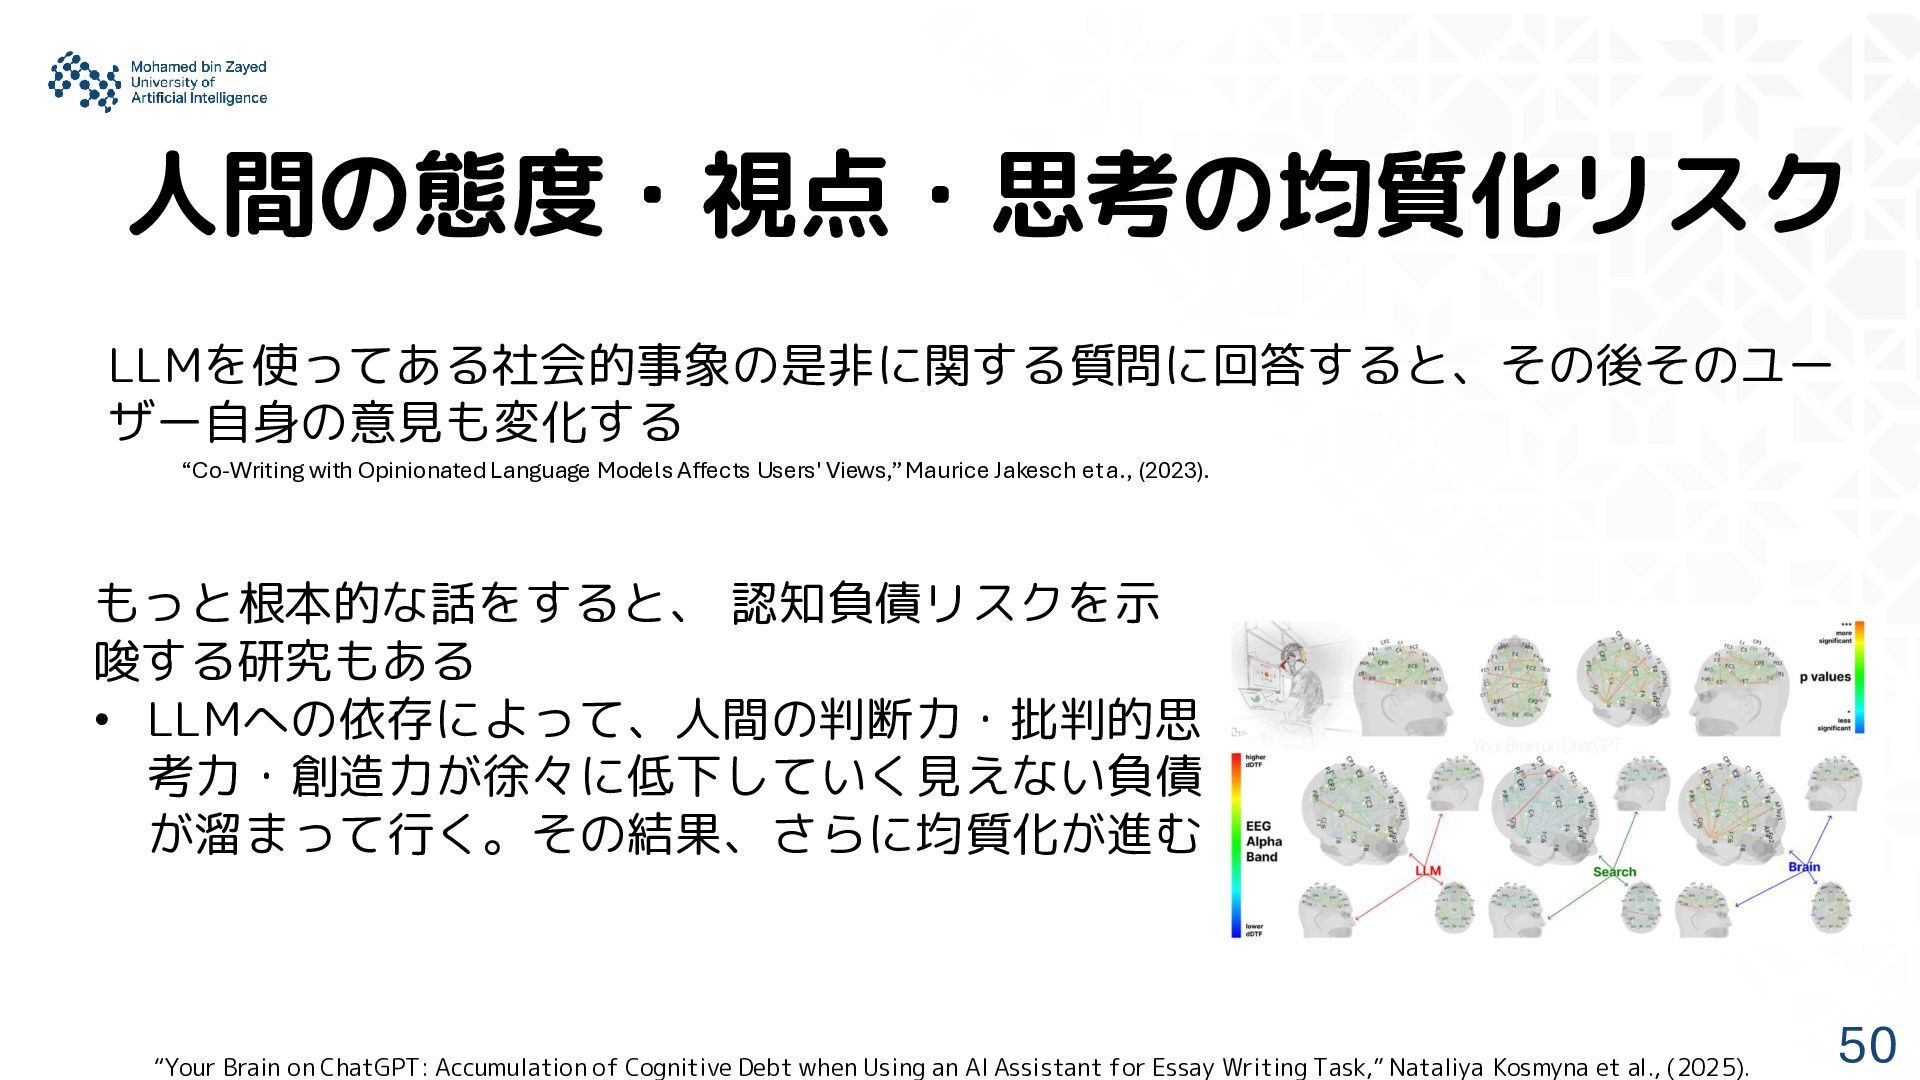
人間の態度・視点・思考の均質化リスク 50 LLMを使ってある社会的事象の是非に関する質問に回答すると、その後そのユー ザー自身の意見も変化する もっと根本的な話をすると、 認知負債リスクを示 唆する研究もある • LLMへの依存によって、人間の判断力・批判的思 考力・創造力が徐々に低下していく見えない負債
が溜まって行く。その結果、さらに均質化が進む “Your Brain on ChatGPT: Accumulation of Cognitive Debt when Using an AI Assistant for Essay Writing Task,” Nataliya Kosmyna et al., (2025). “Co-Writing with Opinionated Language Models Affects Users' Views,” Maurice Jakesch et a., (2023). -
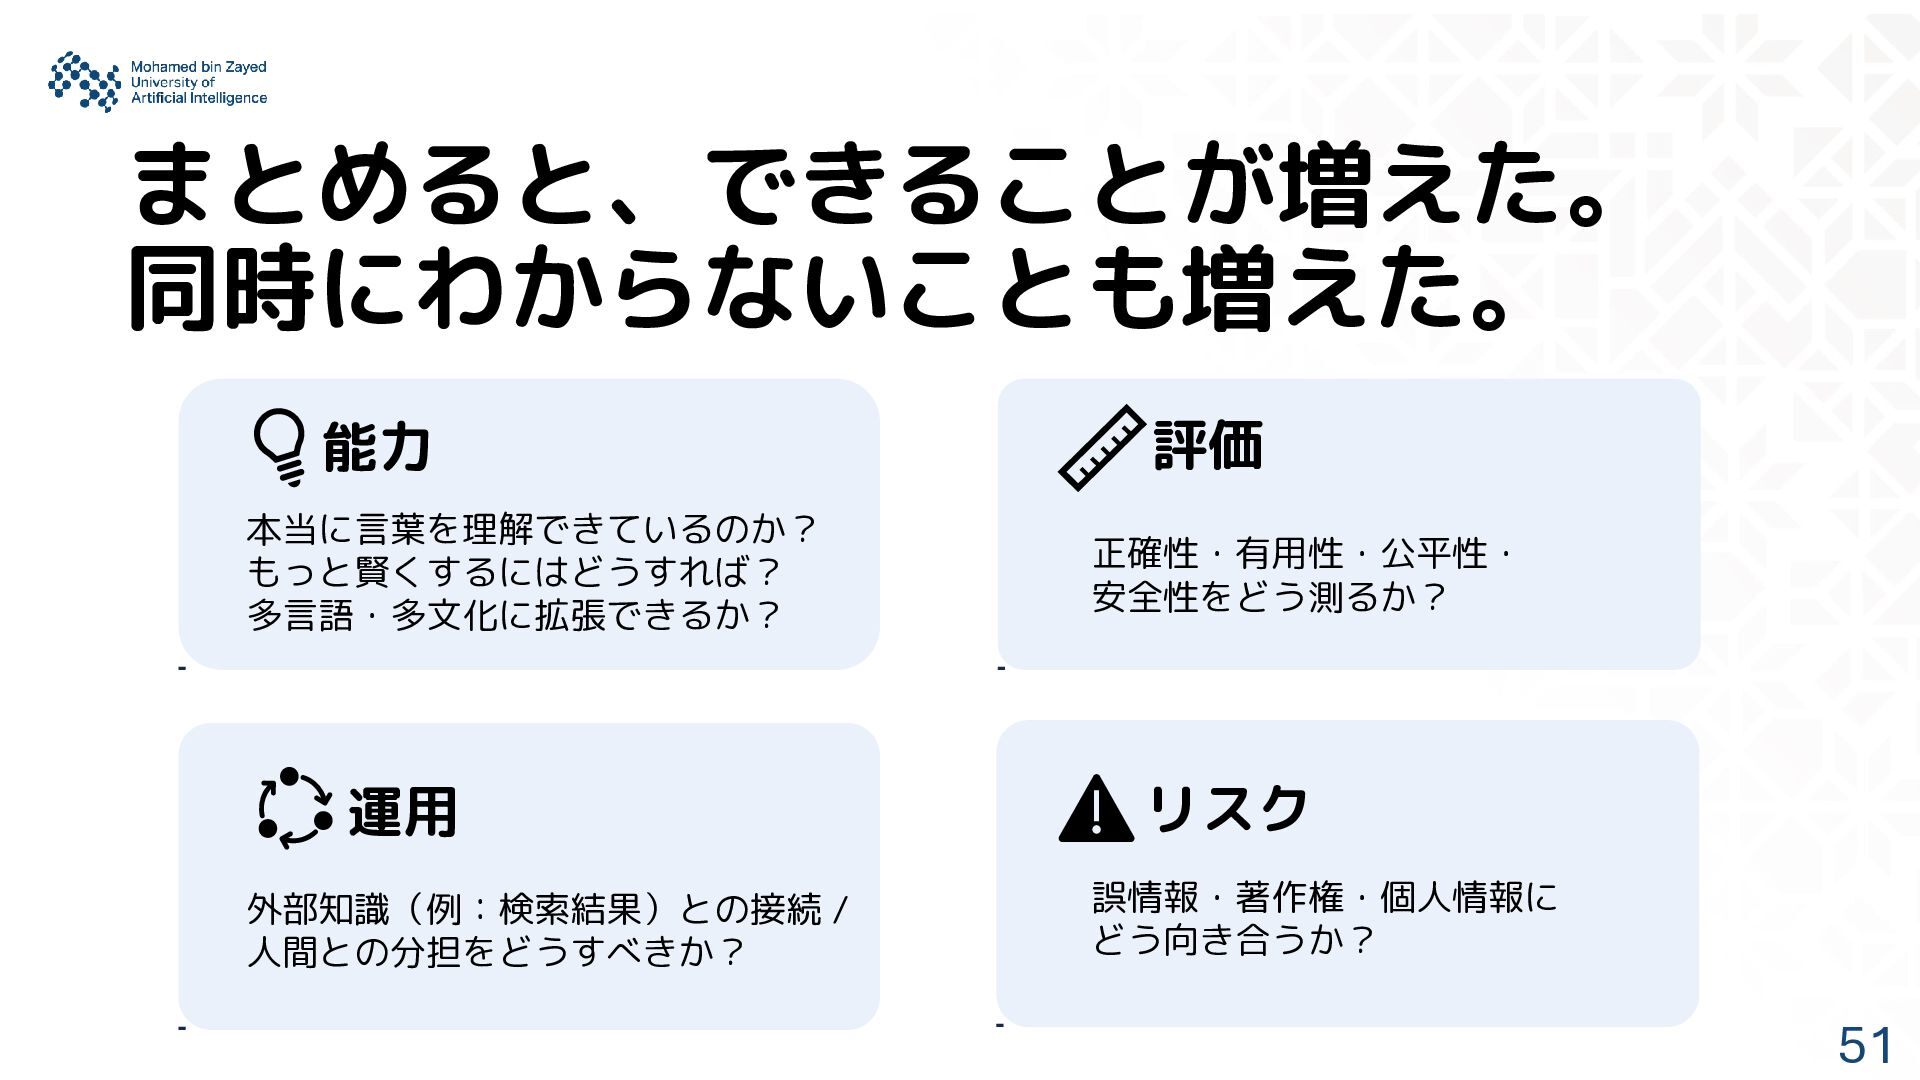
まとめると、できることが増えた。 同時にわからないことも増えた。 51 本当に言葉を理解できているのか? もっと賢くするにはどうすれば? 多言語・多文化に拡張できるか? 正確性・有用性・公平性・ 安全性をどう測るか? 誤情報・著作権・個人情報に どう向き合うか?
外部知識(例:検索結果)との接続 / 人間との分担をどうすべきか? 能力 評価 運用 リスク -
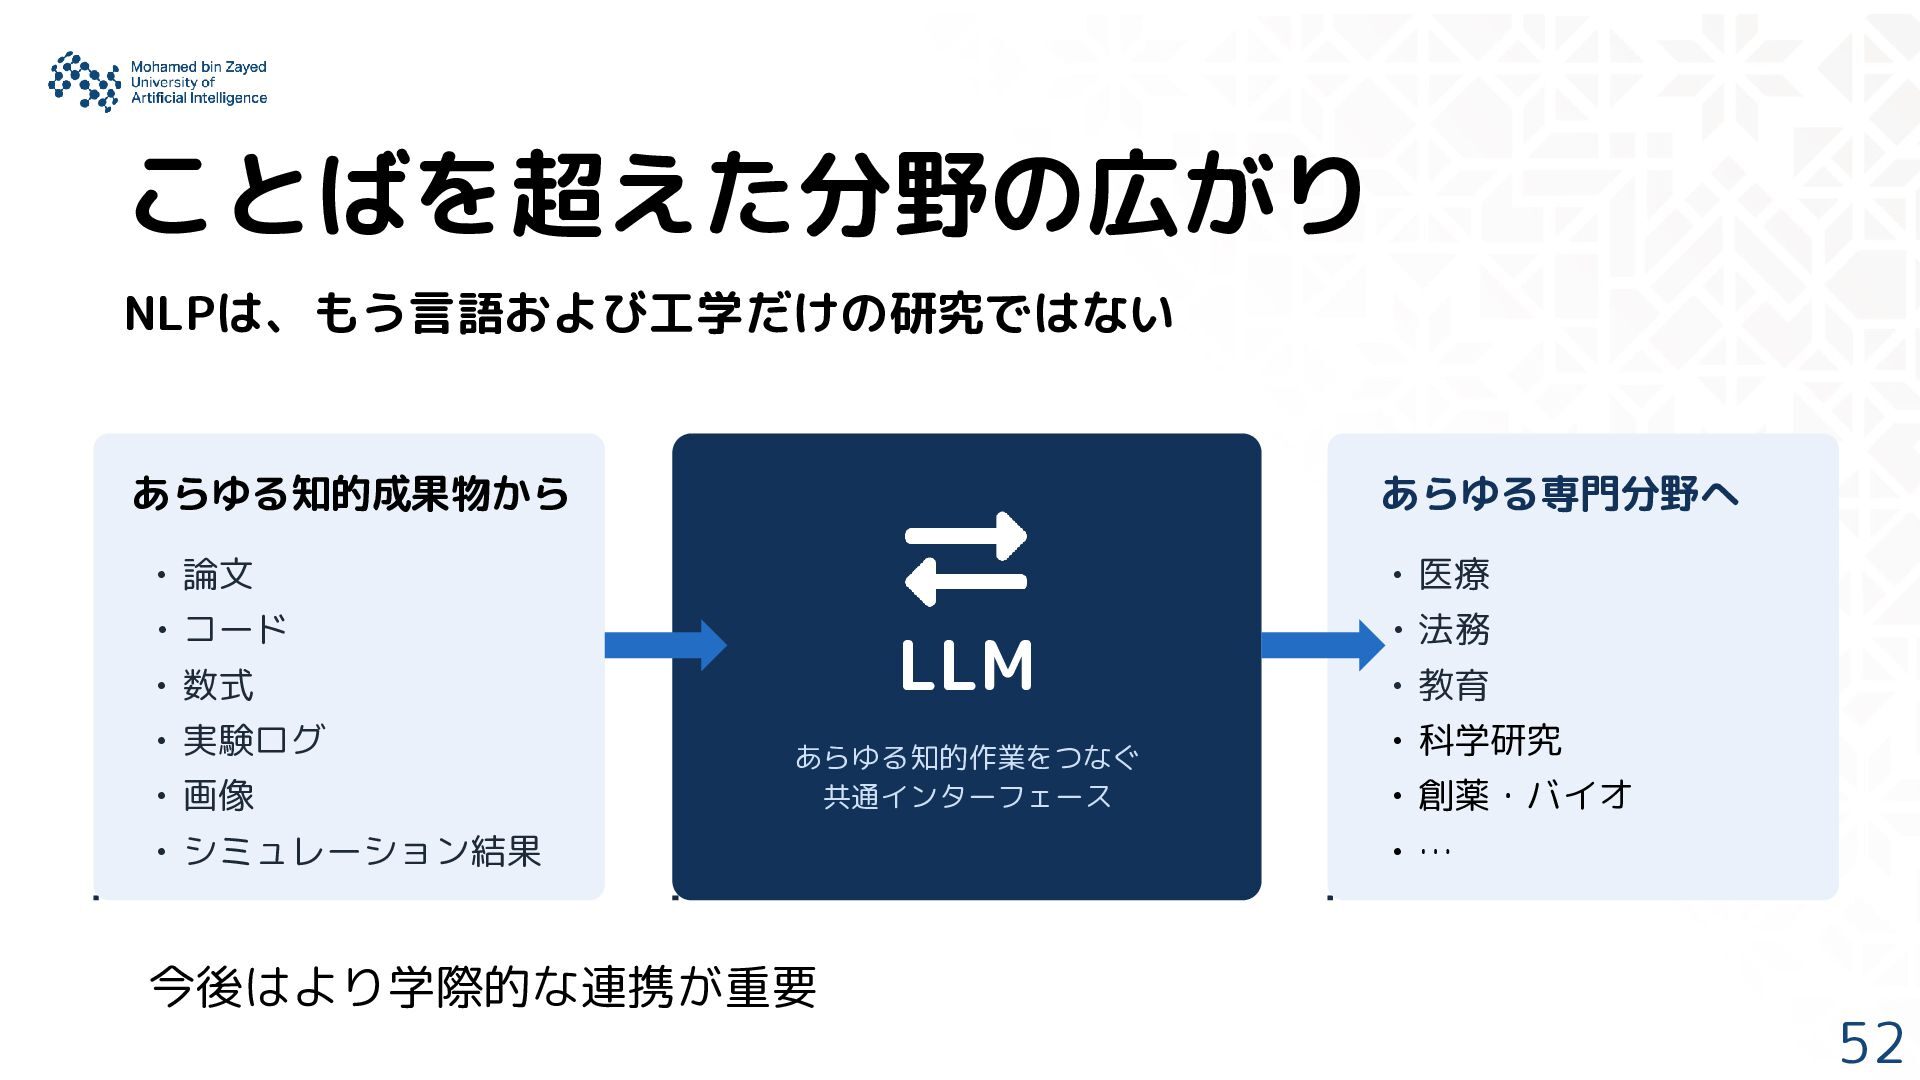
ことばを超えた分野の広がり 52 あらゆる知的成果物から • 論文 • コード • 数式 •
実験ログ • 画像 • シミュレーション結果 LLM あらゆる知的作業をつなぐ 共通インターフェース あらゆる専門分野へ • 医療 • 法務 • 教育 • 科学研究 • 創薬・バイオ • … NLPは、もう言語および工学だけの研究ではない 今後はより学際的な連携が重要 -
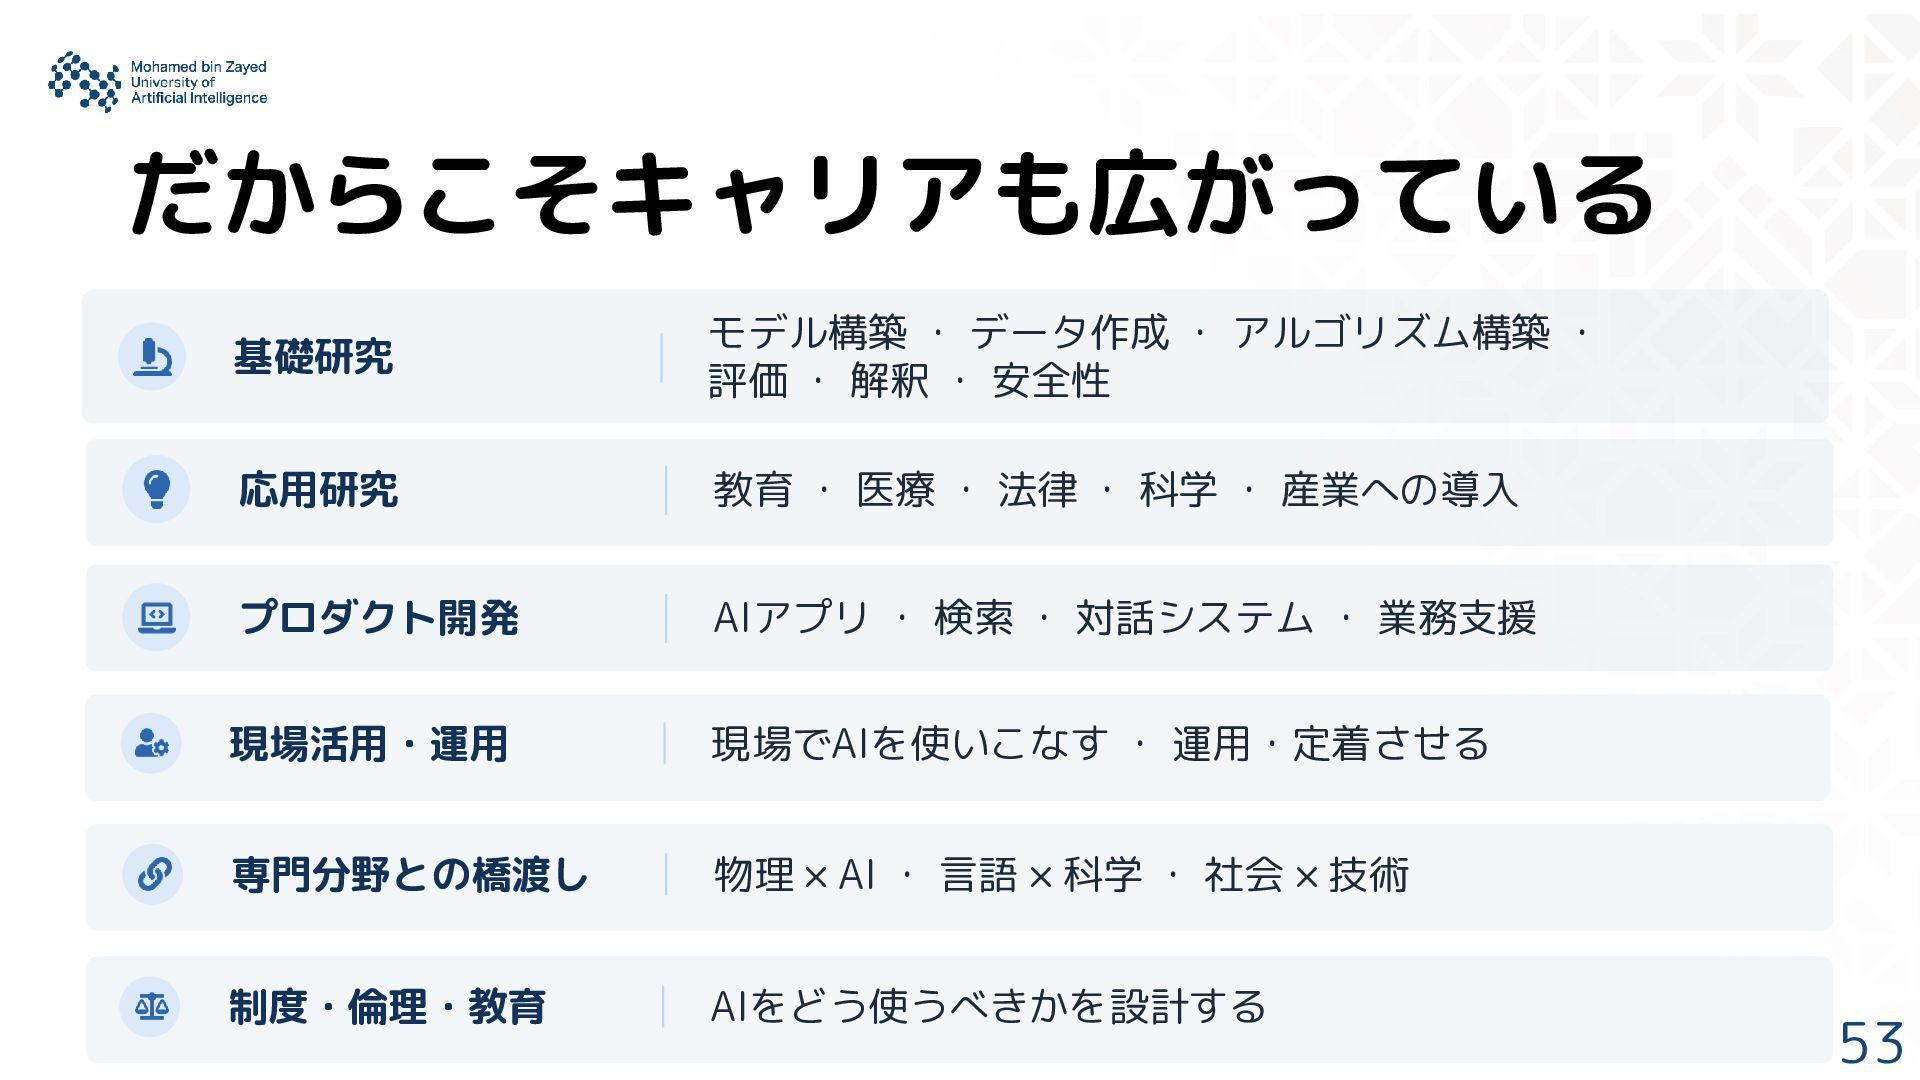
だからこそキャリアも広がっている 53 基礎研究 モデル構築 ・ データ作成 ・ アルゴリズム構築 ・ 評価
・ 解釈 ・ 安全性 応用研究 教育 ・ 医療 ・ 法律 ・ 科学 ・ 産業への導入 プロダクト開発 AIアプリ ・ 検索 ・ 対話システム ・ 業務支援 現場活用・運用 現場でAIを使いこなす ・ 運用・定着させる 専門分野との橋渡し 物理 × AI ・ 言語 × 科学 ・ 社会 × 技術 制度・倫理・教育 AIをどう使うべきかを設計する -
自身のキャリアの話 54 所属 アラブ首長国連邦にある大学Mohamed bin Zayed University of Artificial Intelligence
(MBZUAI) にてポスドク 略歴 国内大学卒業→国内企業で研究開発→海外大学でポスドク 博士(工学)@東京工業大学 情報理工学院 (2023/03取得) リサーチサイエンティスト @Web系企業のAI研究所 (2024/04〜2025/09) ポスドク@MBZUAI / 研究員@理研AIP、NII (2025/10〜現職) 私自身、インダストリ→アカデミア、国内→国外 とキャリアに広がりがあるので、 個人的な話も少ししたい 略歴再掲 -
国内企業での研究を進めていく なかで考えたこと 58 NLP技術はかたちを変えただけであり、解くべき問題は残る • 当時は、「ユーザーの入力が曖昧でもLLM自身が意図をよしなに補完してユーザー が求める出力を出せることを示す研究に取り組んだ。 • 誰もがLLMを使えるようになった時代の新しいNLP 技術が進むほど、「何が研究にしかできないか」の答えも変わっていく
• 「LLMに任せられる部分」と「研究が切りひらく部分」の線引きは、固定されない • 研究者として持ち続ける問いだと考えている 次の問い:では、どんな時代でも、自分にしかできないことは何なのか? -
博士課程在籍中から興味のあったこと: 研究者コミュニティを内側からつなぐ 59 つなぐ活動にモチベーションを高く持っていた • 日本にも優秀な研究者は多い。連携を促進すれば、もっと研究大国になれる。 • 中に入り込み、内情を知る研究者として関わりたい。 学生の頃から多くのコミュニティ活動を続けてきた •
日本中のNLPの博士学生を集めたコミュニティの運営(主に勉強会) • シンポジウムの運営 • トークイベントの企画運営 -
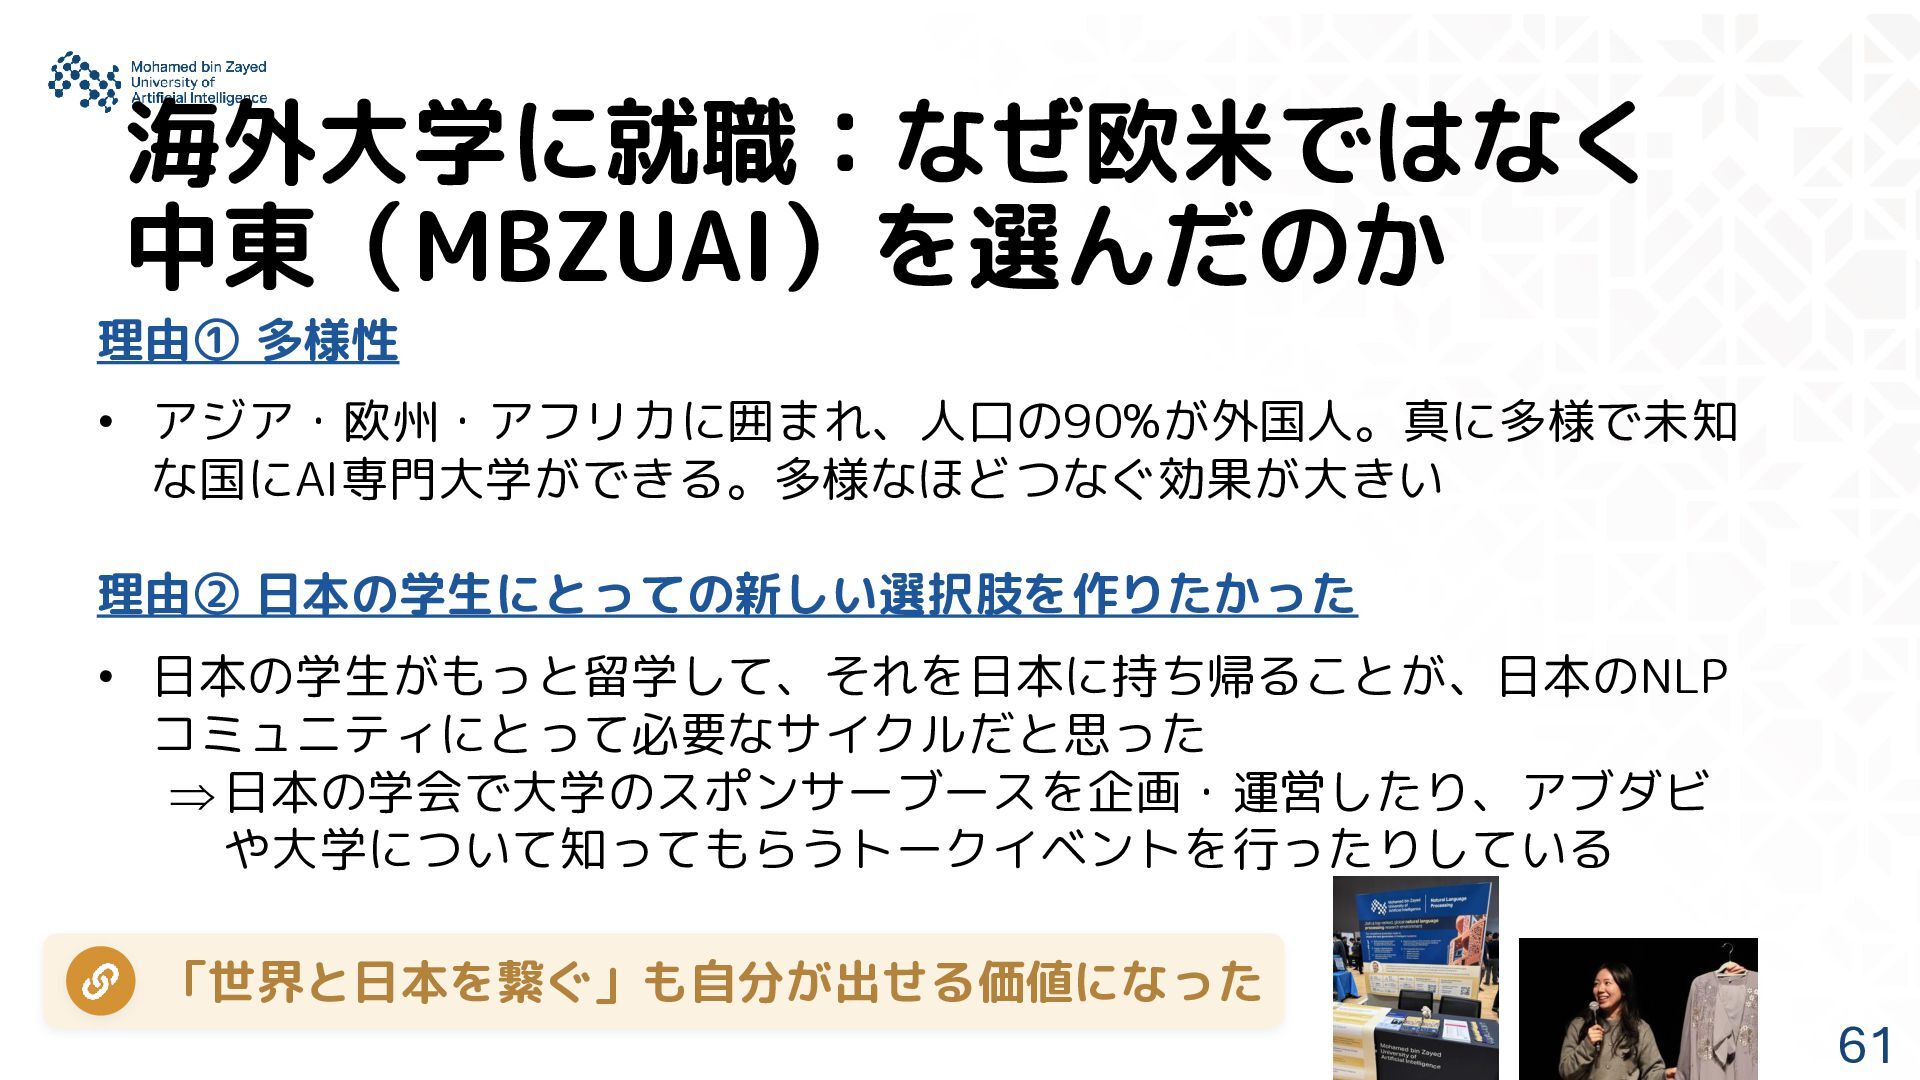
海外大学に就職:なぜ欧米ではなく 中東(MBZUAI)を選んだのか 61 理由① 多様性 • アジア・欧州・アフリカに囲まれ、人口の90%が外国人。真に多様で未知 な国にAI専門大学ができる。多様なほどつなぐ効果が大きい 理由② 日本の学生にとっての新しい選択肢を作りたかった
• 日本の学生がもっと留学して、それを日本に持ち帰ることが、日本のNLP コミュニティにとって必要なサイクルだと思った 日本の学会で大学のスポンサーブースを企画・運営したり、アブダビ や大学について知ってもらうトークイベントを行ったりしている 「世界と日本を繋ぐ」も自分が出せる価値になった -
62 Q. オンラインが普及した今、わざわざ海外に行く必要はある? A. ある。コミュニティに入り込むことに価値がある • 多様なトピックの専門家がいる • より多くの情報が、自然と流れてくる •
わざわざ海外に来る程度に、アクティブな人が多い • カルチャーショックそのものが学びになる 海外で研究する意味 =コミュニティに入ること やはりコミュニティをつなぐことは重要だとここで再認識した。 -
「つなぐ」というのは人にしかできない 63 • 国内外で経験を積めたことは、他の人にはない自分の強み • 研究者で、そこを強みにしている人はほとんどいない • 職場が変わっても残る、立派な専門性 • 自分の中で、一番腹落ちした強み
自分にしかできないこと = 研究者として、内側からつなぐこと。 -
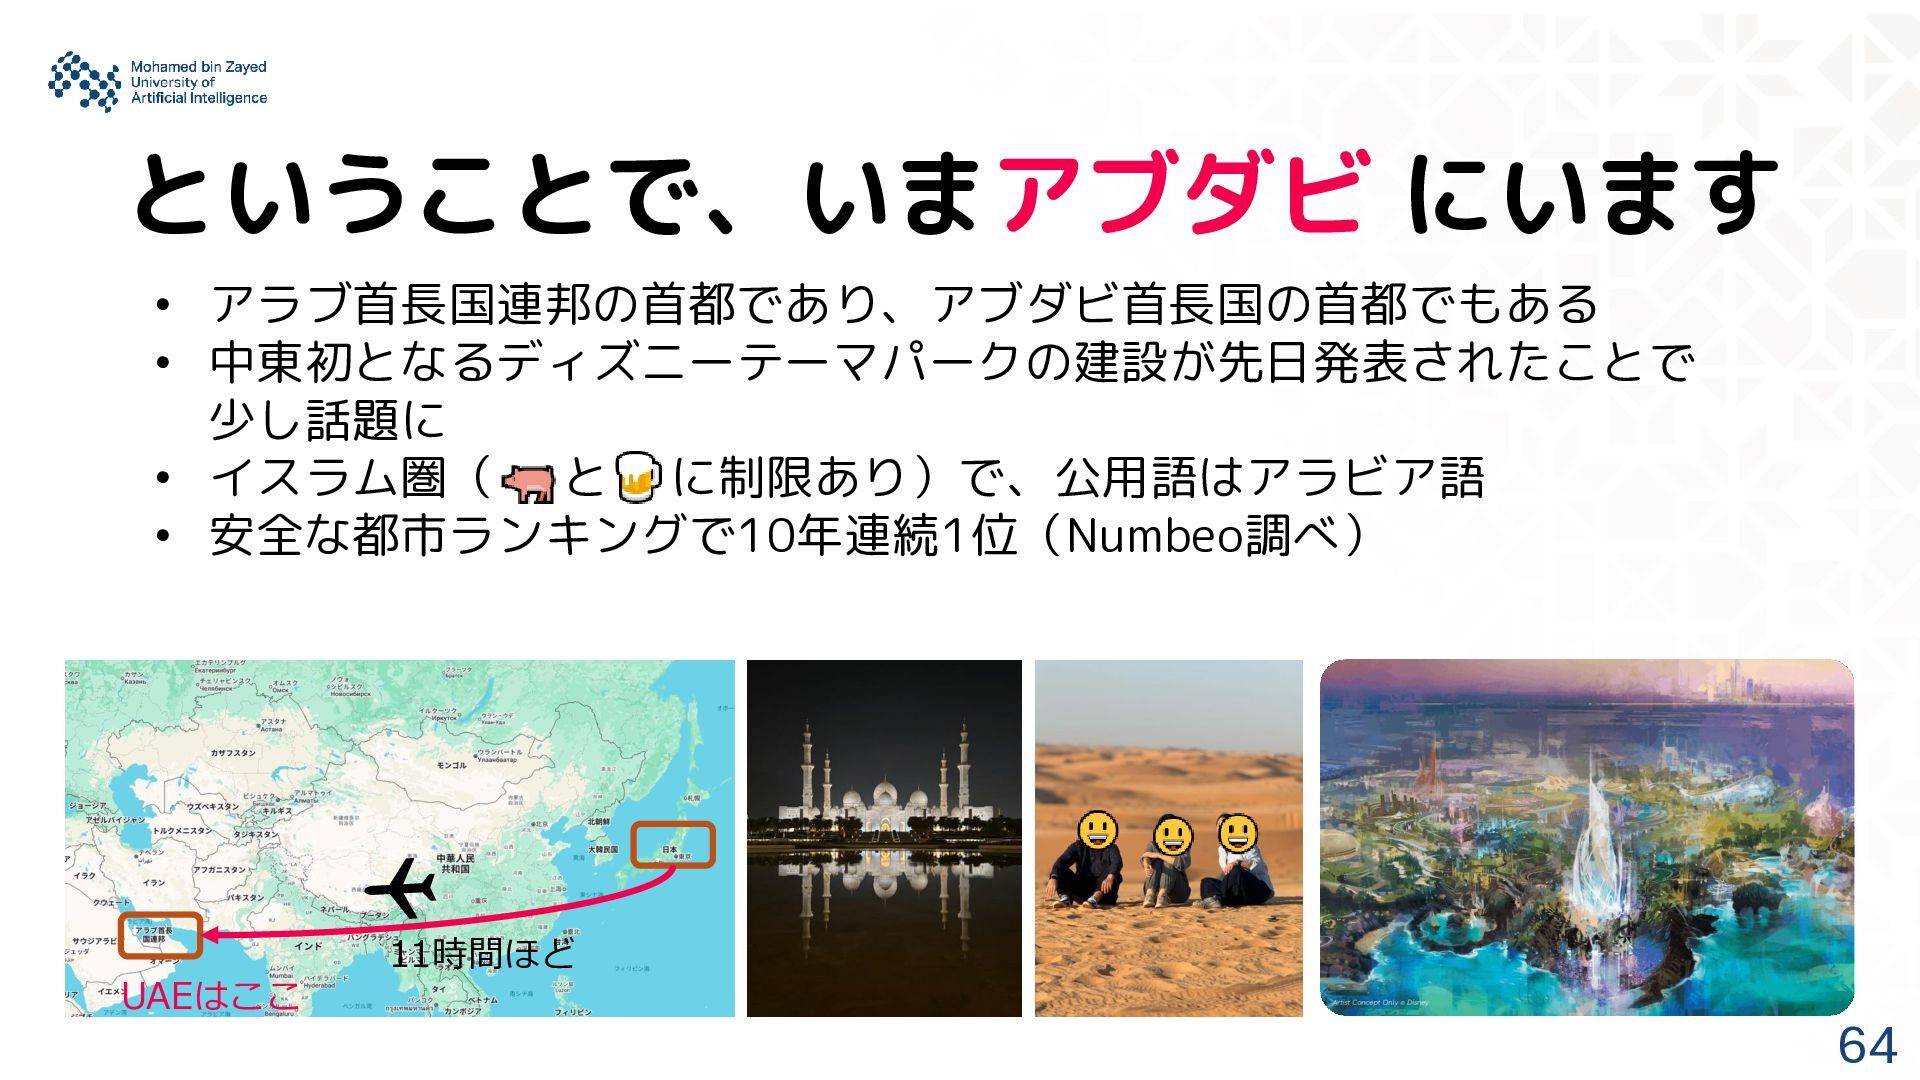
ということで、いまアブダビ にいます 64 • アラブ首長国連邦の首都であり、アブダビ首長国の首都でもある • 中東初となるディズニーテーマパークの建設が先日発表されたことで 少し話題に • イスラム圏(
と に制限あり)で、公用語はアラビア語 • 安全な都市ランキングで10年連続1位(Numbeo調べ) UAEはここ 11時間ほど -
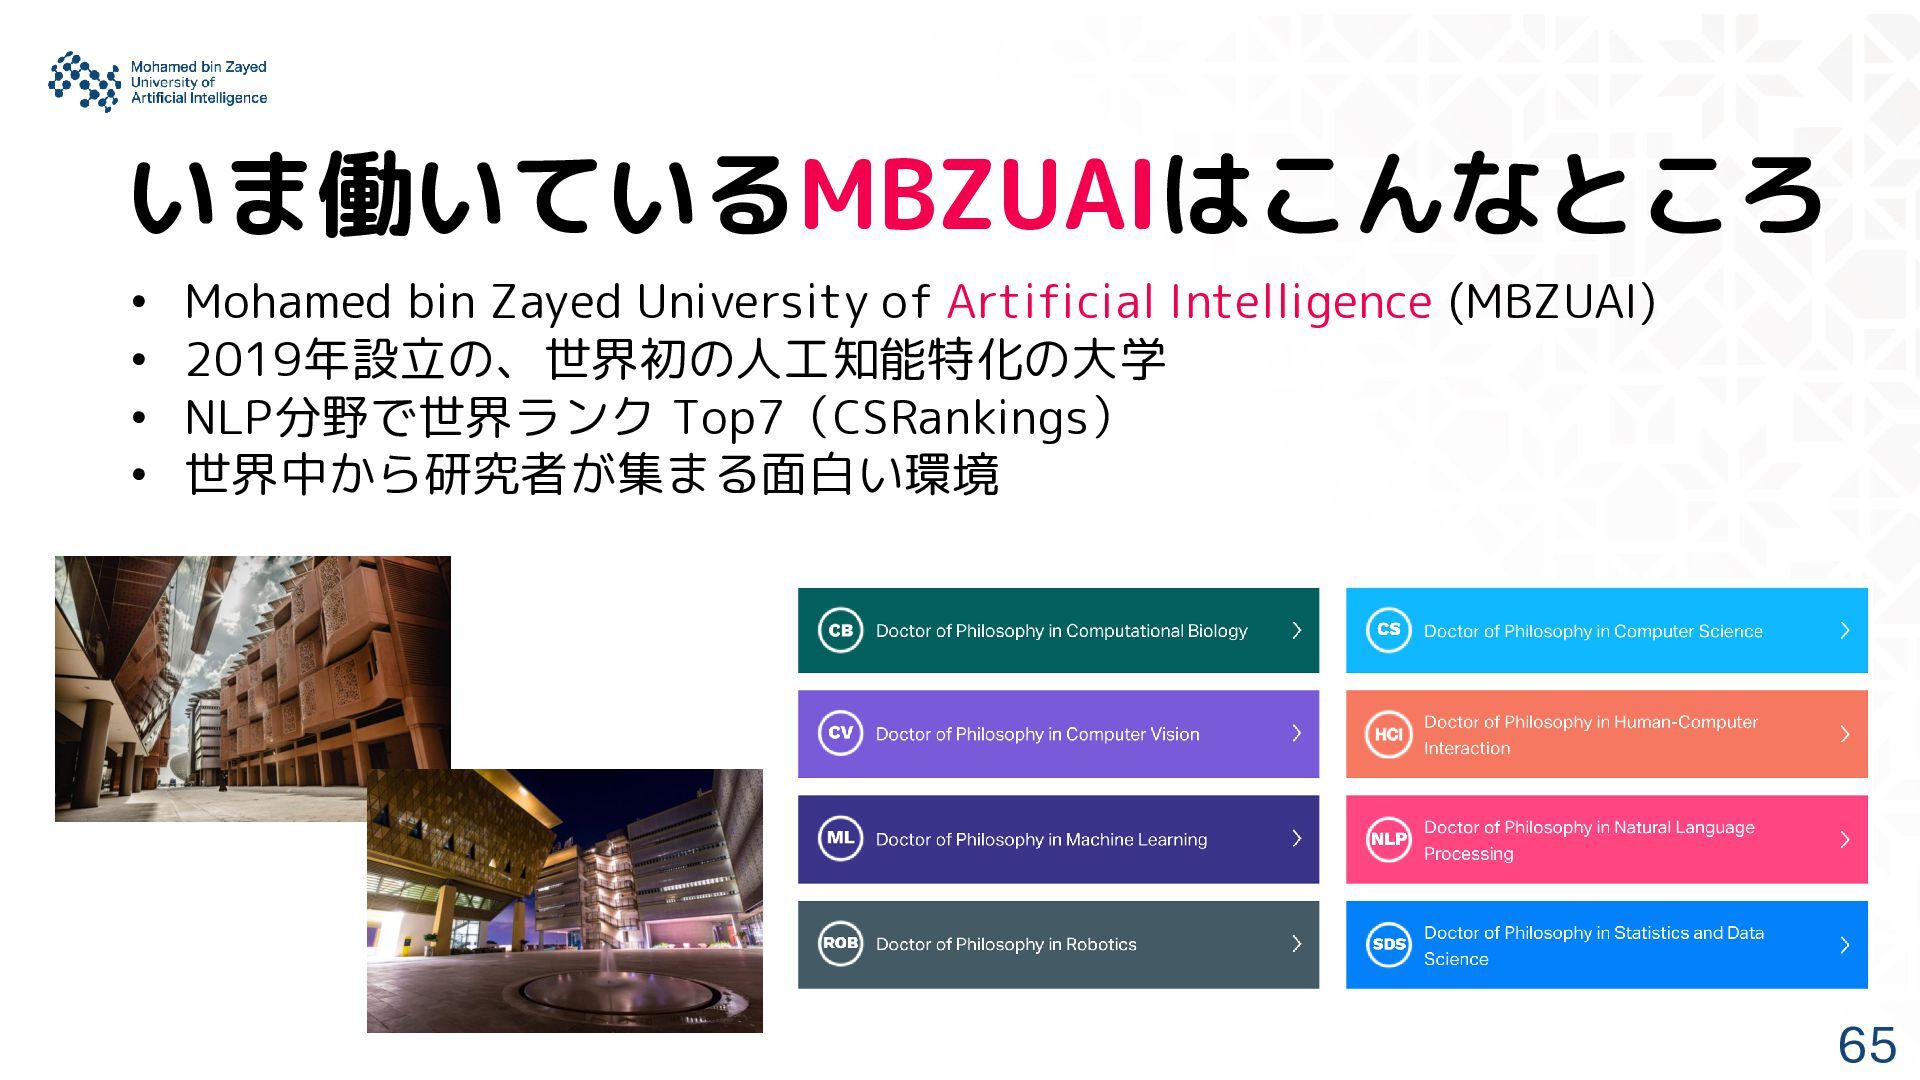
いま働いているMBZUAIはこんなところ 65 • Mohamed bin Zayed University of Artificial Intelligence
(MBZUAI) • 2019年設立の、世界初の人工知能特化の大学 • NLP分野で世界ランク Top7(CSRankings) • 世界中から研究者が集まる面白い環境 -
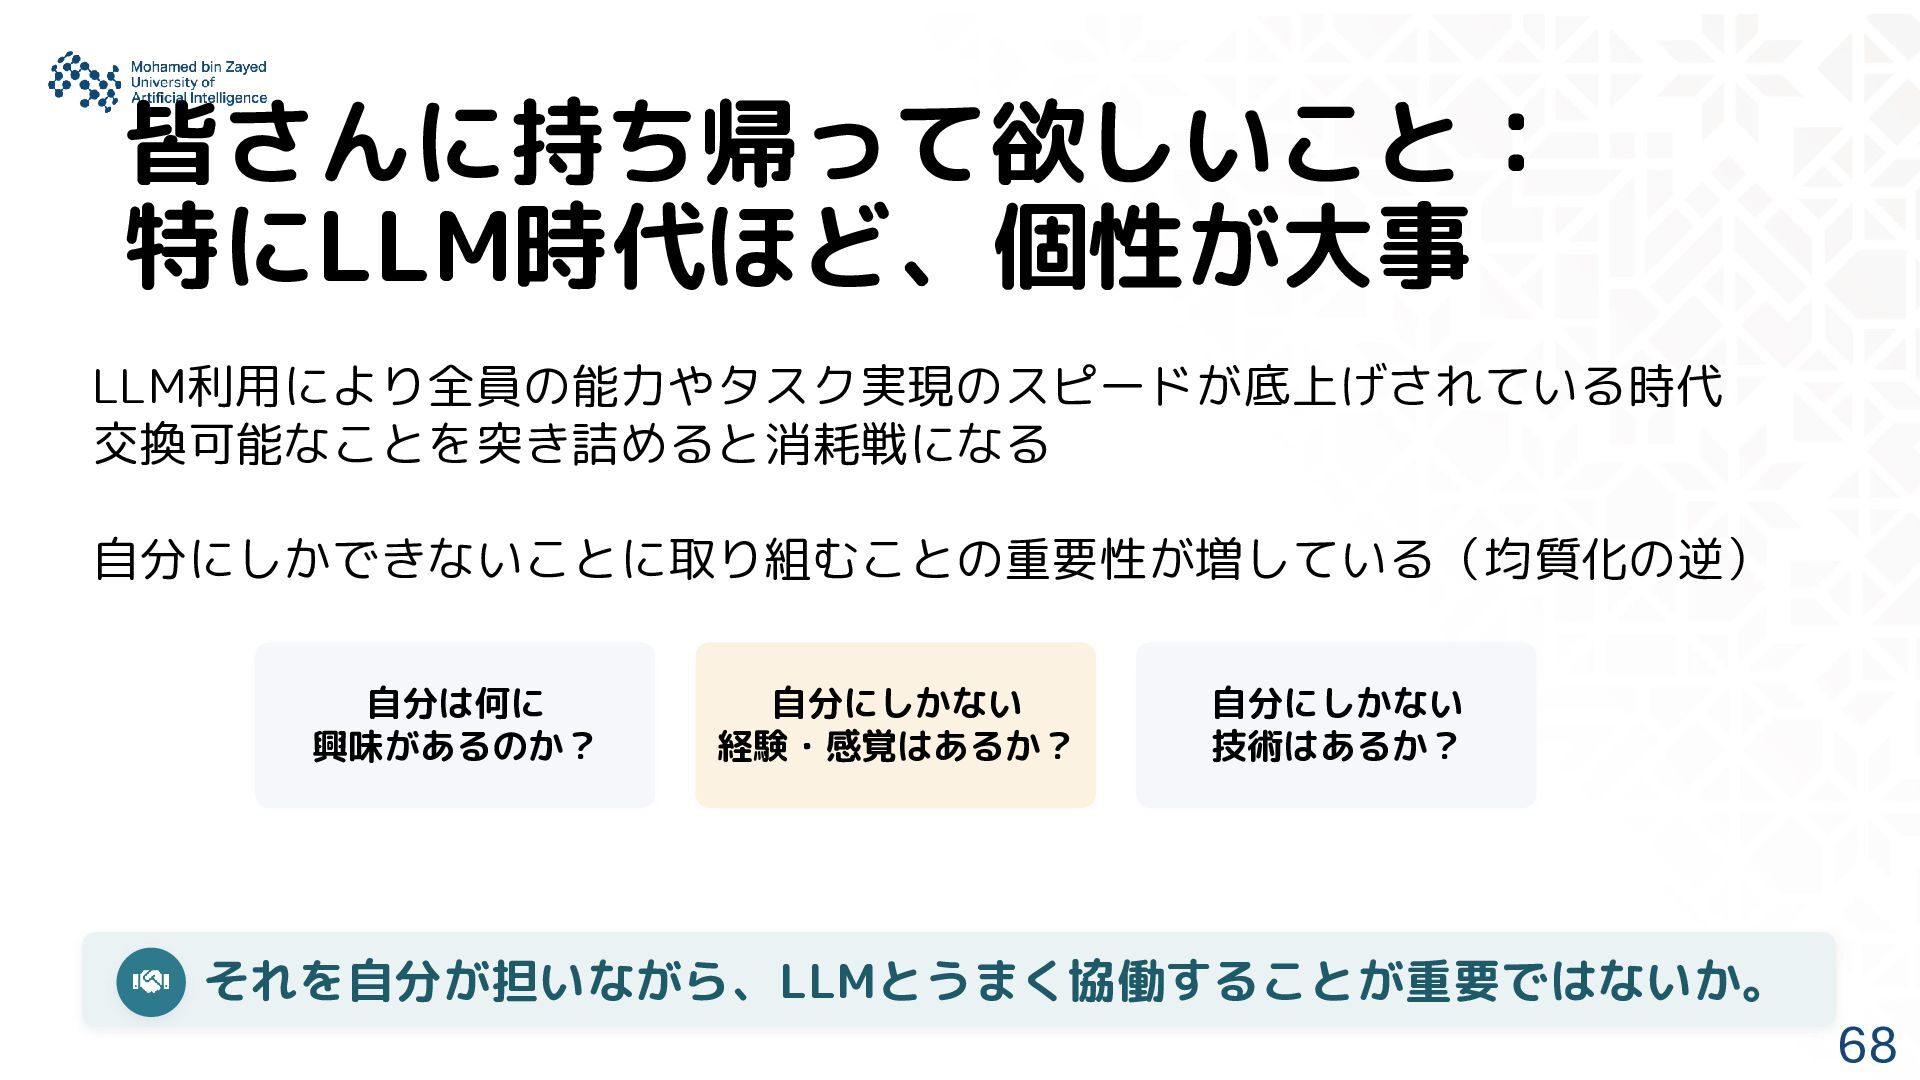
皆さんに持ち帰って欲しいこと: 特にLLM時代ほど、個性が大事 68 LLM利用により全員の能力やタスク実現のスピードが底上げされている時代 交換可能なことを突き詰めると消耗戦になる 自分にしかできないことに取り組むことの重要性が増している(均質化の逆) 自分は何に 興味があるのか? 自分にしかない 経験・感覚はあるか?
自分にしかない 技術はあるか? それを自分が担いながら、LLMとうまく協働することが重要ではないか。 -
以上を踏まえた本日の課題 70 LLMと共存・協働していくうえで、あなたにしかできないこと(専門性・ 経験・興味)は何か。 そして、その強みをどう活かしてLLMの答えを活用していくかを、具体例 とともに500文字以内で論じてください。 ポイント • あなたが今もつ/これから深めたい 専門性・関心・経験
は何か • それは、LLMの出力を 見極める・補う・問い直す うえでどう活きるか • LLMに任せる部分と、人間が担うべき部分の 線引き をどう考えるか