Upgrade to Pro
— share decks privately, control downloads, hide ads and more …
Speaker Deck
Sign up for free
Menu
Search
Features
All features
Private URLs
Password Protection
Custom URLS
Scheduled publishing
Remove Branding
Restrict embedding
Deck Collections
Notes
Features
All features
Private URLs
Password Protection
Custom URLS
Scheduled publishing
Remove Branding
Restrict embedding
Deck Collections
Notes
Explore
Featured decks
Featured speakers
Programming
Technology
Storyboards
Explore
Featured decks
Featured speakers
Programming
Technology
Storyboards
Pricing
Search
Sign in
Sign up for free
バンディットアルゴリズムと因果推論 / Bandit Algorithm And Casual...
Search
Sponsored
·
Your Podcast. Everywhere. Effortlessly.
Share. Educate. Inspire. Entertain. You do you. We'll handle the rest.
→
CyberAgent
PRO
February 22, 2019
Technology
2.8k
2
Share
Embed
Copy iframe code
Copy JS code
Copy link
Start on current slide
バンディットアルゴリズムと因果推論 / Bandit Algorithm And Casual Inference
サイバーエージェントの技術者(エンジニア・クリエイター)向けカンファレンス『CA BASE CAMP 2019』
バンディットアルゴリズムと因果推論
安井 翔太
CyberAgent
PRO
February 22, 2019
More Decks by CyberAgent
See All by CyberAgent
AIを使った広告商品の開発と評価設計の話
cyberagentdevelopers
PRO
1
30
動画広告の効果を技術で改善
cyberagentdevelopers
PRO
1
40
なぜWINTICKETはマイクロサービスをやめたのか
cyberagentdevelopers
PRO
2
62
”AIを使う” から ”AIに任せる” へ ─ 開発プロセスを再設計してAIを組織標準にするまで
cyberagentdevelopers
PRO
2
410
Databricks 導入から Genie 活用まで、全部やった話
cyberagentdevelopers
PRO
0
1.9k
専任DEゼロからの データ基盤構築 - Databricks x IaC x AIで 進める「データの民主化」-
cyberagentdevelopers
PRO
1
1.4k
「エンジニア進化論」2028年の開発完全自動化、エンジニアはどう進化するか
cyberagentdevelopers
PRO
10
10k
NAB Show 2026 動画技術関連レポート / NAB Show 2026 Report
cyberagentdevelopers
PRO
1
740
Local LLM Meetup #1 Opening
cyberagentdevelopers
PRO
1
560
Other Decks in Technology
See All in Technology
Kiro Crewをはじめよう
kizawa2020
1
130
More Freedom on the Same Shared GPU Cluster: A Small Team’s Experience with vCluster
nttcom
0
150
AIに攻撃される前に、AIに攻撃させる
tsuchikazu
0
170
会社説明資料
persolserverworks
0
9.7k
大型犬好きによるPugの紹介
yamanoku
1
110
Loop Engineering これくらいでいい
mikanichinose
0
210
Essential architectural thinking (revised edition)
ufried
0
110
メルペイ 会計システム概要と歴史
mewuto
0
200
オブザーバビリティを高める AI エージェント体験を考える / Designing AI Agent Experiences That Enhance Observability
aoto
PRO
2
330
今さら理解するウェブフォントver.2026
takanorip
3
660
AI駆動開発、viviONの1年 ── うまくいったこと・いかなかったこと
vivion
0
290
プロダクト価値を、 チームが使える判断軸に変える
vivion
0
140
Featured
See All Featured
The AI Revolution Will Not Be Monopolized: How open-source beats economies of scale, even for LLMs
inesmontani
PRO
3
3.8k
brightonSEO & MeasureFest 2025 - Winning Strategies for Black Friday CRO & PPC - Christian Goodrich
cargoodrich
3
860
My Coaching Mixtape
mlcsv
0
350
Creating an realtime collaboration tool: Agile Flush - .NET Oxford
marcduiker
35
2.6k
Lightning talk: Run Django tests with GitHub Actions
sabderemane
0
300
I Don’t Have Time: Getting Over the Fear to Launch Your Podcast
jcasabona
35
2.9k
A designer walks into a library…
pauljervisheath
211
25k
Pawsitive SEO: Lessons from My Dog (and Many Mistakes) on Thriving as a Consultant in the Age of AI
davidcarrasco
0
260
Crafting Experiences
bethany
1
380
Optimising Largest Contentful Paint
csswizardry
37
4k
Music & Morning Musume
bryan
48
7.4k
Un-Boring Meetings
codingconduct
0
450
Transcript
Bandit Algorithm And Causal Inference / / Shota Yasui
Who are you? Shota Yasui( ) @housecat 経歴 2013 新卒総合職⼊社(広告事業本部)
2015 アドテクスタジオへ異動 DMP/DSP/SSPで分析 AILabスタート ADEconチームスタート !2
.Bandit Algorithmとは? .Causal Inference + Bandit .Off-Policy Evaluation .Future Work
+ まとめ !3
Banditとは何か?
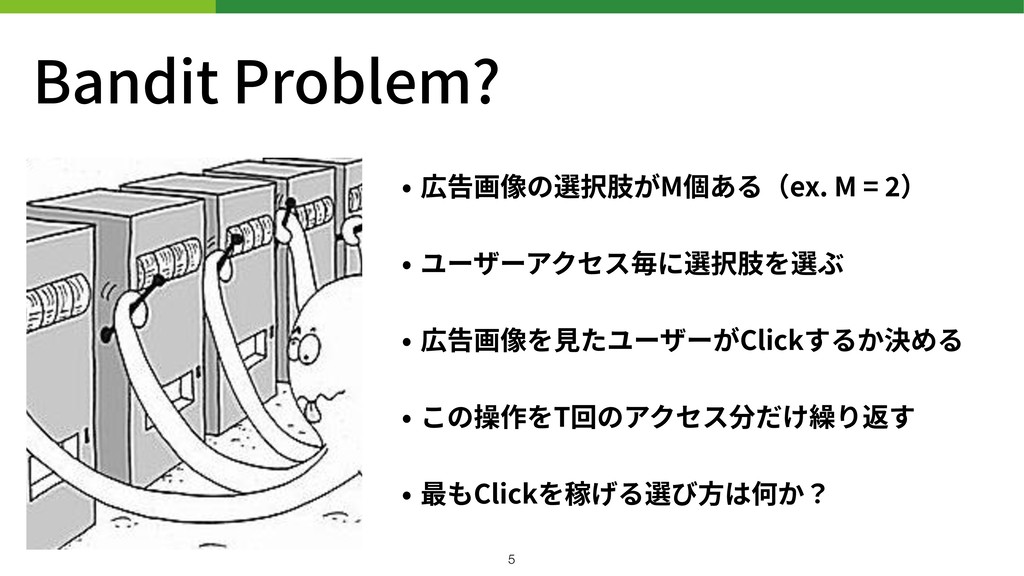
Bandit Problem? • 広告画像の選択肢がM個ある(ex. M = ) • ユーザーアクセス毎に選択肢を選ぶ •
広告画像を⾒たユーザーがClickするか決める • この操作をT回のアクセス分だけ繰り返す • 最もClickを稼げる選び⽅は何か? !5
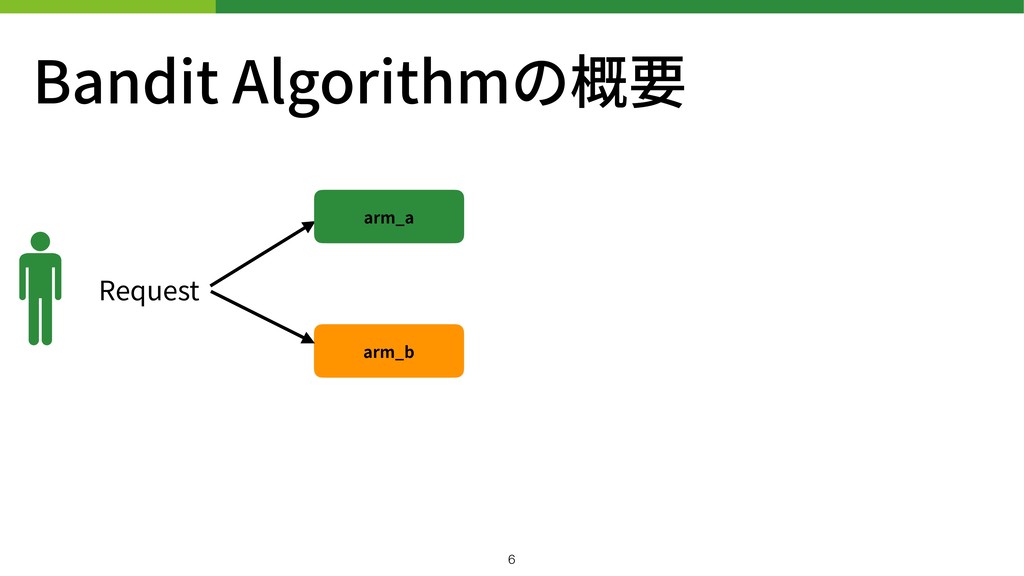
Bandit Algorithmの概要 arm_a arm_b Request !6
Bandit Algorithmの概要 arm_a E[r|A = a] V[r|A = a] arm_b
E[r|A = b] V[r|A = b] Request !7
Bandit Algorithmの概要 arm_a E[r|A = a] V[r|A = a] arm_b
E[r|A = b] V[r|A = b] Decision Rule (UCB/Thompson Sampling) Request arm_b Selected Arm !8
Bandit Algorithmの概要 arm_a E[r|A = a] V[r|A = a] arm_b
E[r|A = b] V[r|A = b] Decision Rule (UCB/Thompson Sampling) Request arm_b Selected Arm Feedback +Update !9
Banditの良いところ • 古典的にはAB-test(RCT)が使われていたタスク 前半AB-testして、後半は良かったのを使う。 代理店とかでよくやる。 • Banditだと得られるclick数がより多くなる armのモデルを更新しつつ モデルに従って選ぶ !10
Bandit Algorithmの概要 arm_a E[r|A = a] V[r|A = a] arm_b
E[r|A = b] V[r|A = b] Decision Rule (UCB/Thompson Sampling) Request arm_b Selected Arm Storage Feedback Batched Bandit Setting/interactive machine learning !11
Bandit Algorithmの概要 arm_a E[r|A = a] V[r|A = a] arm_b
E[r|A = b] V[r|A = b] Decision Rule (UCB/Thompson Sampling) Request arm_b Selected Arm Storage Feedback Update Batched Bandit Setting/interactive machine learning !12
Bandit Algorithmの概要 arm_a E[r|A = a,X] V[r|A = a,X] arm_b
E[r|A = b,X] V[r|A = b,X] Decision Rule (UCB/Thompson Sampling) Request arm_b Selected Arm Storage Feedback Update Batched Bandit Setting/interactive machine learning Contextual Bandit Case !13
Policyと呼ばれる部分 arm_a E[r|A = a,X] V[r|A = a,X] arm_b E[r|A
= b,X] V[r|A = b,X] Decision Rule (UCB/Thompson Sampling) Request arm_b Selected Arm Storage Feedback !14
Thompson + Batch arm_a E[r|A = a,X] V[r|A = a,X]
arm_b E[r|A = b,X] V[r|A = b,X] Decision Rule (UCB/Thompson Sampling) Request arm_b Selected Arm !15 腕の選択を複数回繰り返せば、 あるバッチでの真の確率を得られる。 ⼊ってくるリクエストに対して、 選択肢の選択確率が決まる。
バンディットのログで 因果推論(CI)
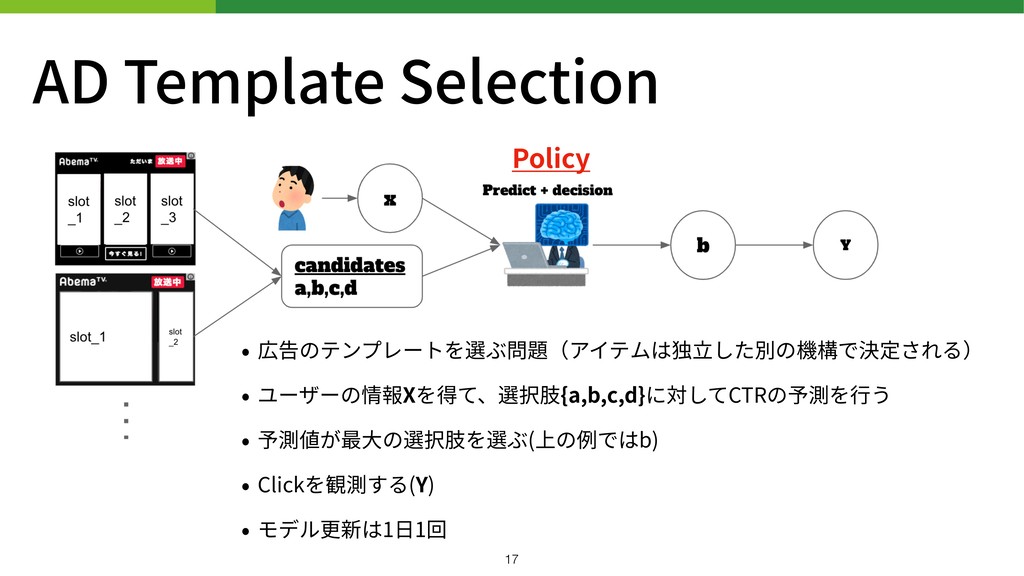
AD Template Selection • 広告のテンプレートを選ぶ問題(アイテムは独⽴した別の機構で決定される) • ユーザーの情報Xを得て、選択肢{a,b,c,d}に対してCTRの予測を⾏う • 予測値が最⼤の選択肢を選ぶ(上の例ではb) •
Clickを観測する(Y) • モデル更新は1⽇1回 Policy !17
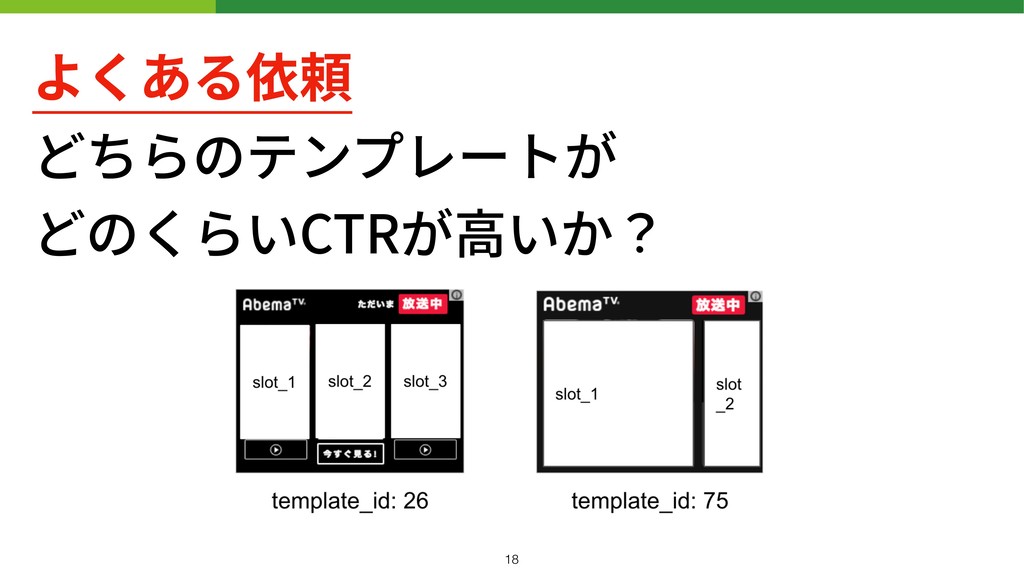
よくある依頼 どちらのテンプレートが どのくらいCTRが⾼いか? !18
Golden Standard Research Design !19
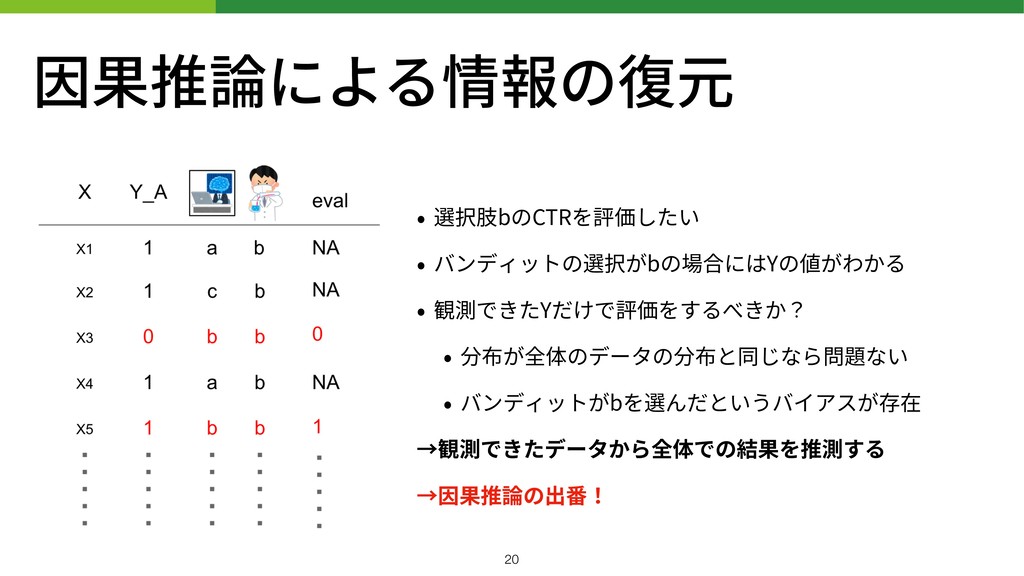
因果推論による情報の復元 • 選択肢bのCTRを評価したい • バンディットの選択がbの場合にはYの値がわかる • 観測できたYだけで評価をするべきか? • 分布が全体のデータの分布と同じなら問題ない •
バンディットがbを選んだというバイアスが存在 →観測できたデータから全体での結果を推測する →因果推論の出番! !20
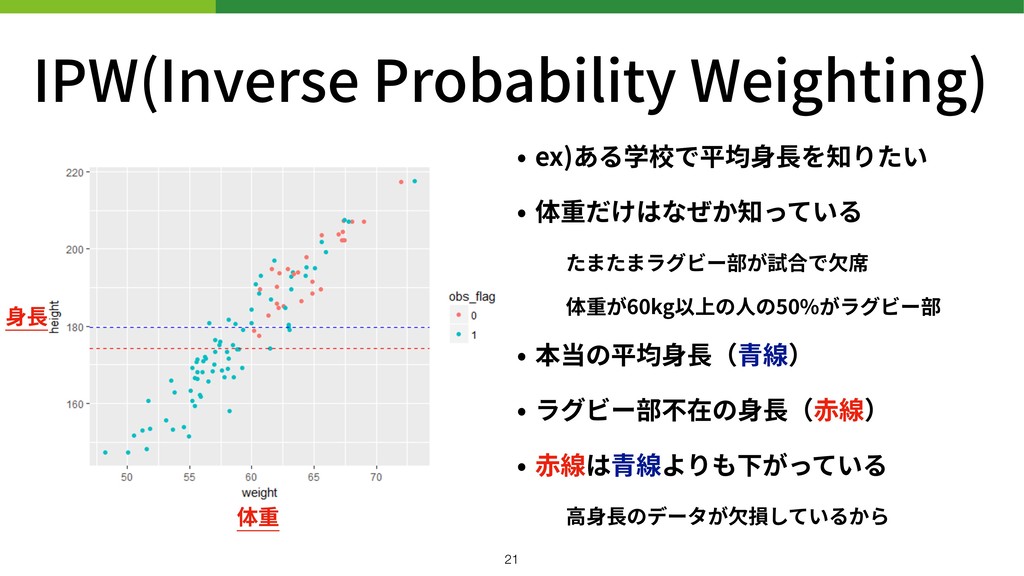
IPW(Inverse Probability Weighting) • ex)ある学校で平均⾝⻑を知りたい • 体重だけはなぜか知っている たまたまラグビー部が試合で⽋席 体重が60kg以上の⼈の50%がラグビー部 •
本当の平均⾝⻑(⻘線) • ラグビー部不在の⾝⻑(⾚線) • ⾚線は⻘線よりも下がっている ⾼⾝⻑のデータが⽋損しているから !21 ⾝⻑ 体重
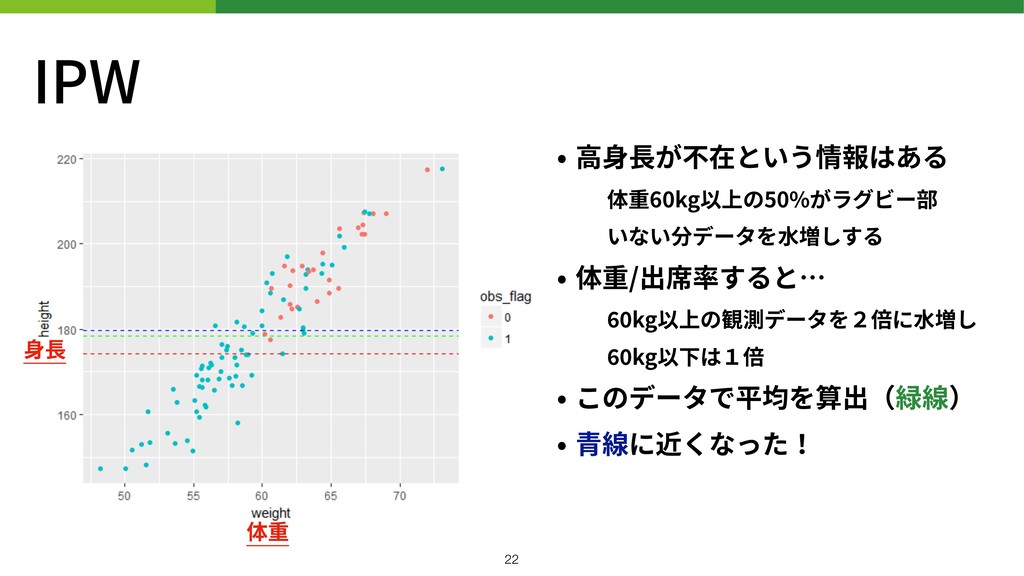
IPW • ⾼⾝⻑が不在という情報はある 体重60kg以上の50%がラグビー部 いない分データを⽔増しする • 体重/出席率すると… kg以上の観測データを2倍に⽔増し kg以下は1倍 •
このデータで平均を算出(緑線) • ⻘線に近くなった! !22 ⾝⻑ 体重
データが⽋損していて、 !23
得られたデータの 観測確率が分かっていれば、 = Propensity Score 再掲 !24
データを⽔増しして、 元の平均を推定することが可能。 !25
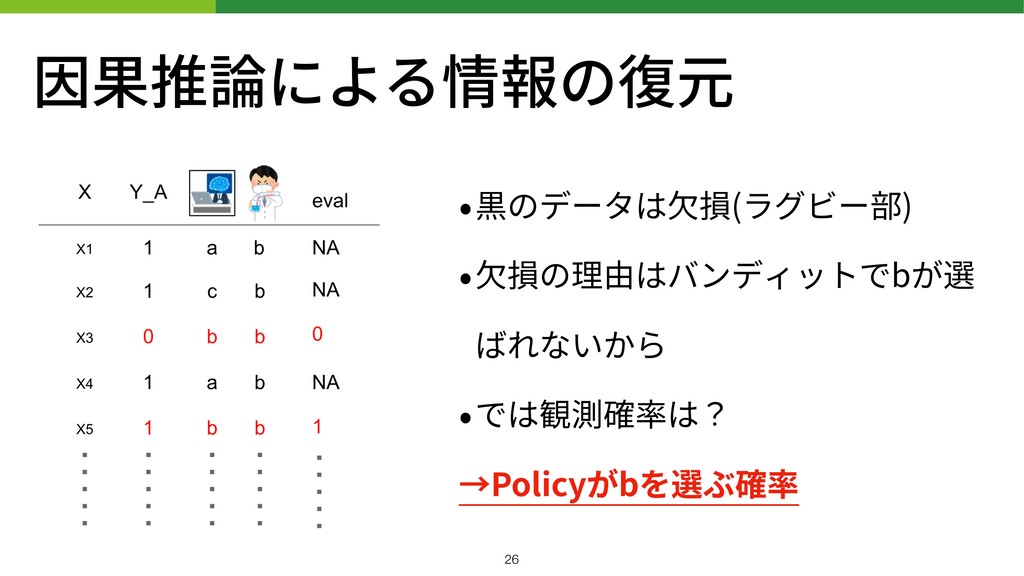
因果推論による情報の復元 •黒のデータは⽋損(ラグビー部) •⽋損の理由はバンディットでbが選 ばれないから •では観測確率は? →Policyがbを選ぶ確率 !26
True Propensity Score arm_a E[r|A = a,X] V[r|A = a,X]
arm_b E[r|A = b,X] V[r|A = b,X] Decision Rule (UCB/Thompson Sampling) Request arm_b Selected Arm Storage Feedback Batched Bandit Setting/interactive machine learning !27
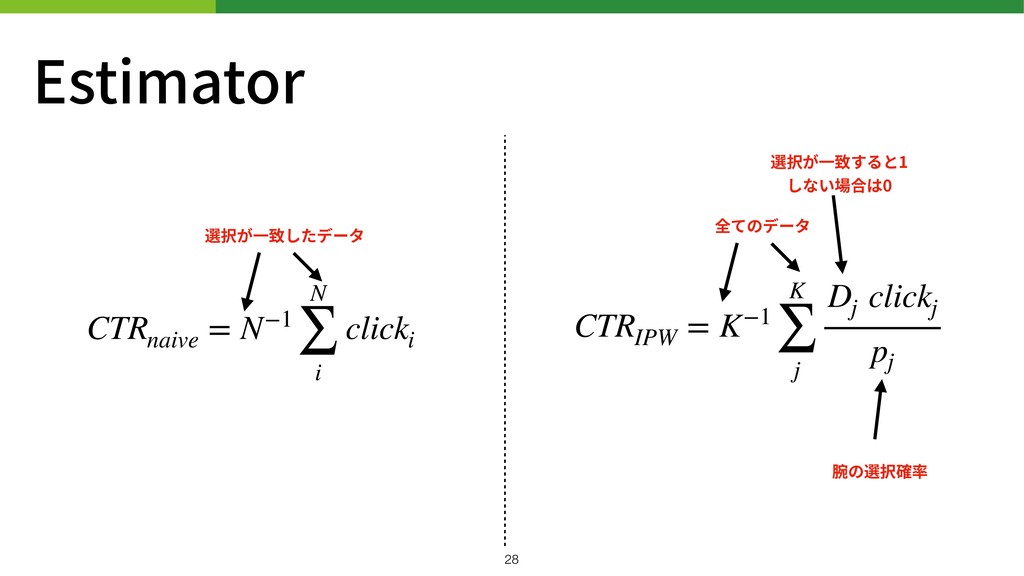
Estimator CTRnaive = N−1 N ∑ i clicki CTRIPW =
K−1 K ∑ j Dj clickj pj 選択が⼀致したデータ 全てのデータ 選択が⼀致すると1 しない場合は0 腕の選択確率 !28
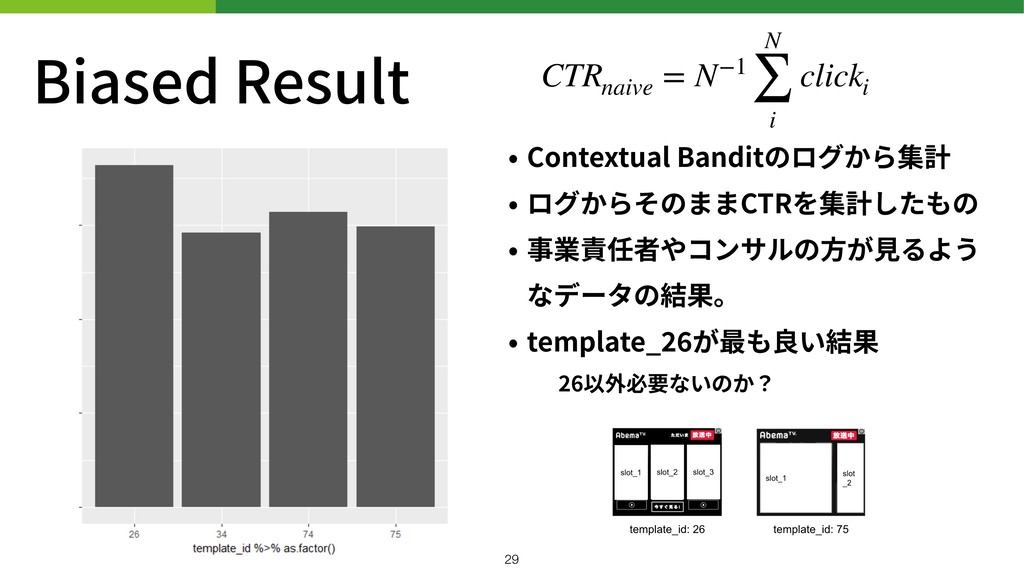
Biased Result • Contextual Banditのログから集計 • ログからそのままCTRを集計したもの • 事業責任者やコンサルの⽅が⾒るよう なデータの結果。
• template_ が最も良い結果 26以外必要ないのか? CTRnaive = N−1 N ∑ i clicki !29
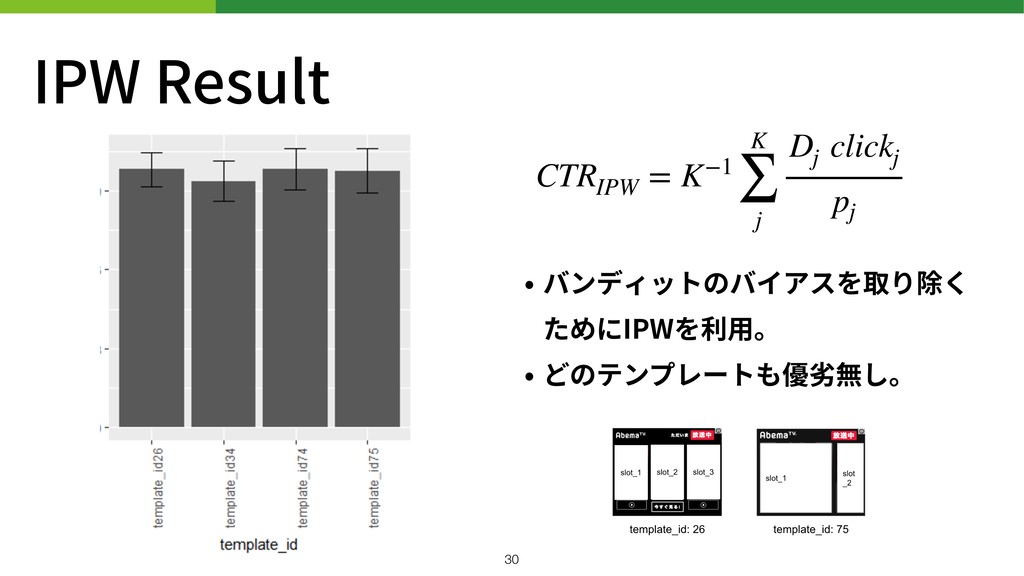
IPW Result • バンディットのバイアスを取り除く ためにIPWを利⽤。 • どのテンプレートも優劣無し。 CTRIPW = K−1
K ∑ j Dj clickj pj !30
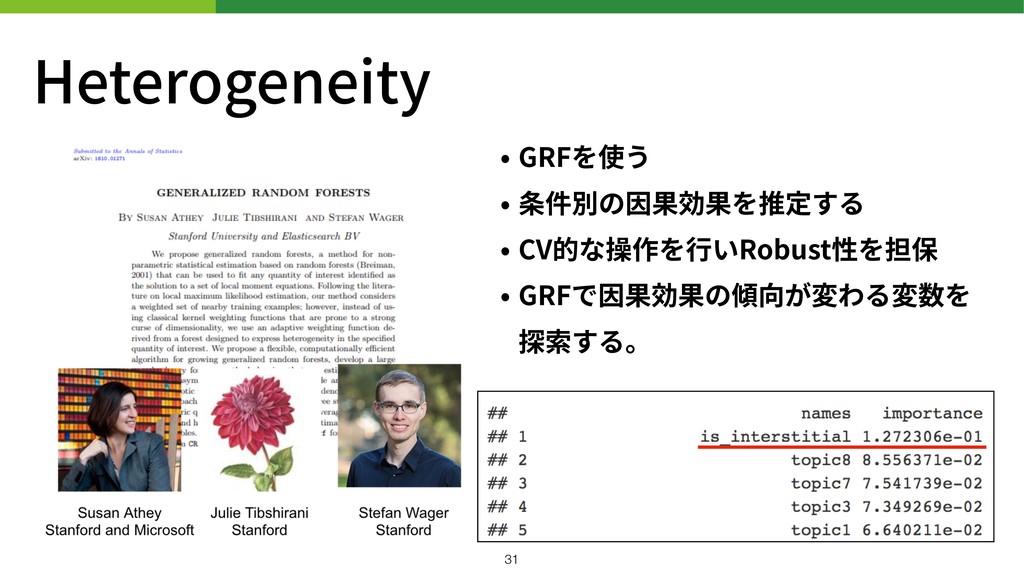
Heterogeneity • GRFを使う • 条件別の因果効果を推定する • CV的な操作を⾏いRobust性を担保 • GRFで因果効果の傾向が変わる変数を 探索する。
!31
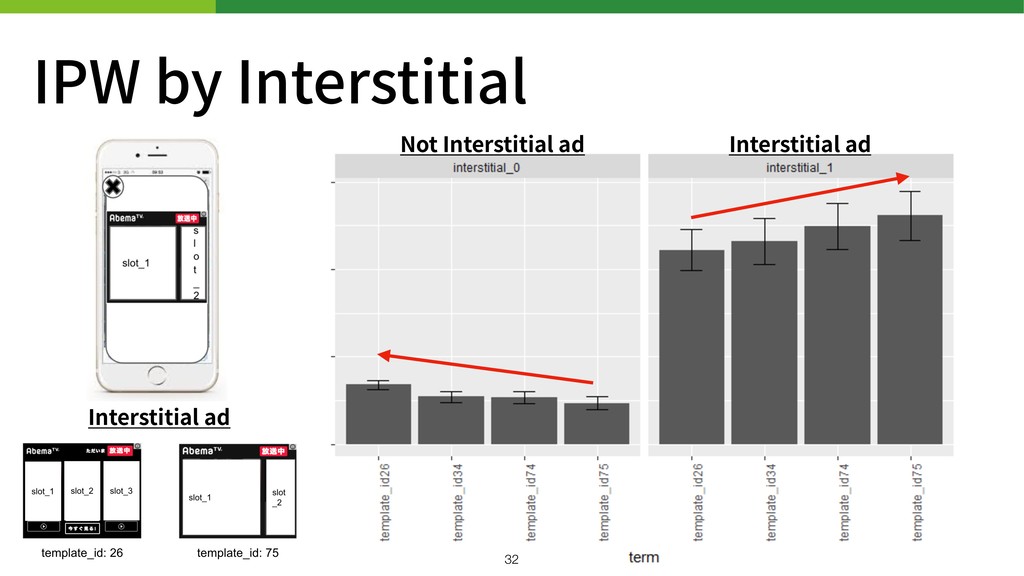
IPW by Interstitial Interstitial ad Not Interstitial ad Interstitial ad
!32
Banditのログでバイアスの少ない 事後的な分析が出来る。 !33
Off-Policy Evaluation (OPE)
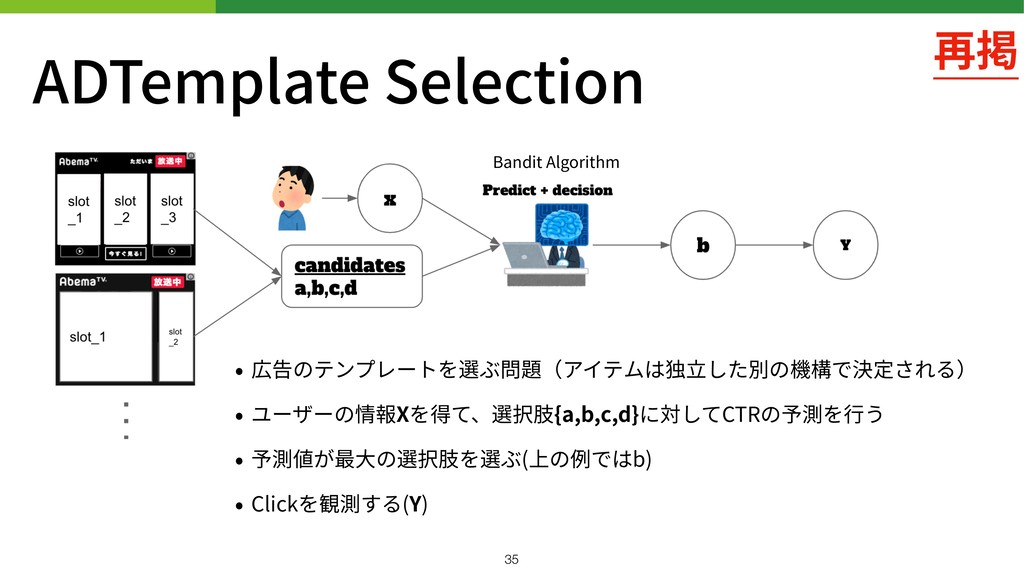
ADTemplate Selection • 広告のテンプレートを選ぶ問題(アイテムは独⽴した別の機構で決定される) • ユーザーの情報Xを得て、選択肢{a,b,c,d}に対してCTRの予測を⾏う • 予測値が最⼤の選択肢を選ぶ(上の例ではb) • Clickを観測する(Y)
Bandit Algorithm 再掲 !35
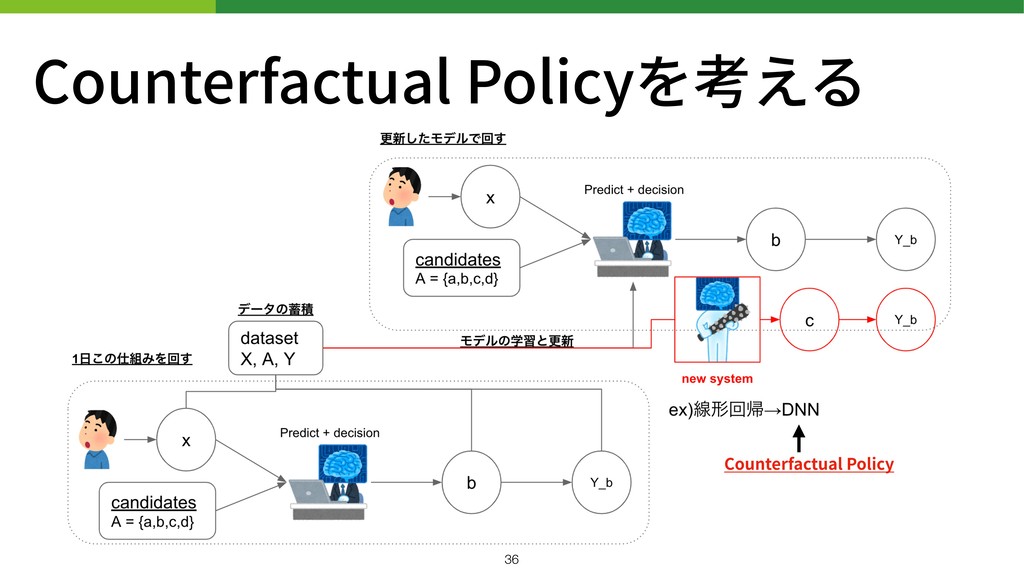
!36 Counterfactual Policyを考える Counterfactual Policy
Research Question How to compare two AI Systems? !37
Golden Standard Research Design !38
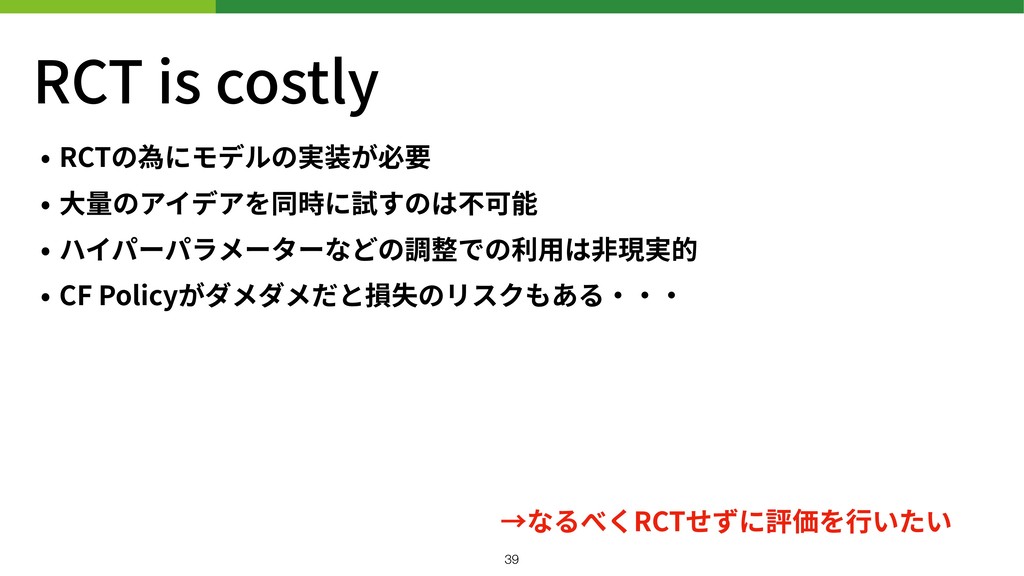
RCT is costly • RCTの為にモデルの実装が必要 • ⼤量のアイデアを同時に試すのは不可能 • ハイパーパラメーターなどの調整での利⽤は⾮現実的 •
CF Policyがダメダメだと損失のリスクもある‧‧‧ →なるべくRCTせずに評価を⾏いたい !39
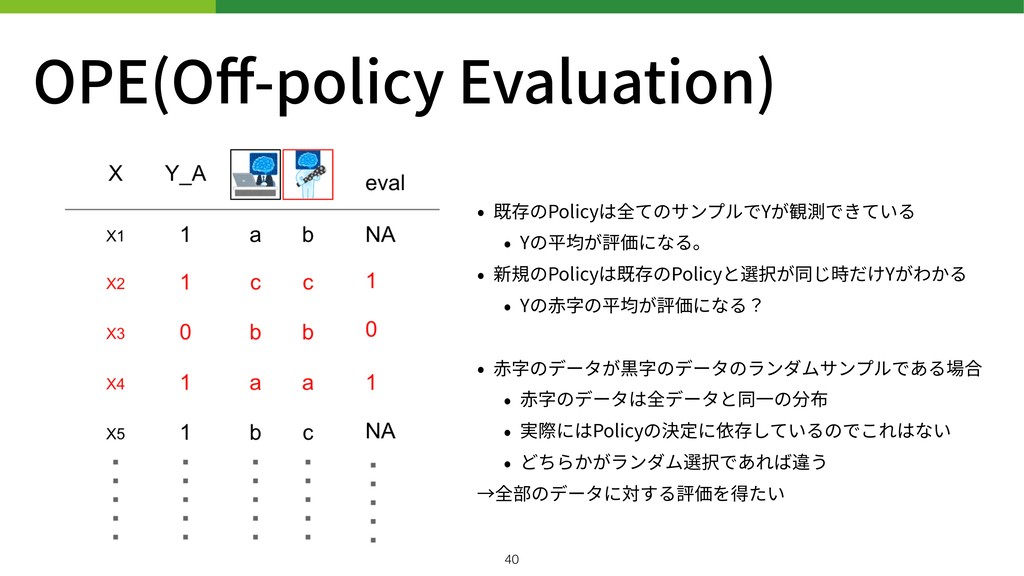
OPE(Off-policy Evaluation) • 既存のPolicyは全てのサンプルでYが観測できている • Yの平均が評価になる。 • 新規のPolicyは既存のPolicyと選択が同じ時だけYがわかる • Yの⾚字の平均が評価になる?
• ⾚字のデータが黒字のデータのランダムサンプルである場合 • ⾚字のデータは全データと同⼀の分布 • 実際にはPolicyの決定に依存しているのでこれはない • どちらかがランダム選択であれば違う →全部のデータに対する評価を得たい !40
そうだ、IPWを使おう。 !41
データが⽋損していて、 再掲 !42
得られたデータの 観測確率が分かっていれば、 = Propensity Score 再掲 !43
データを⽔増しして、 元の平均を推定することが可能。 再掲 !44
True Propensity Score arm_a E[r|A = a,X] V[r|A = a,X]
arm_b E[r|A = b,X] V[r|A = b,X] Decision Rule (UCB/Thompson Sampling) Request arm_b Selected Arm Storage Feedback Batched Bandit Setting/interactive machine learning 再掲 !45
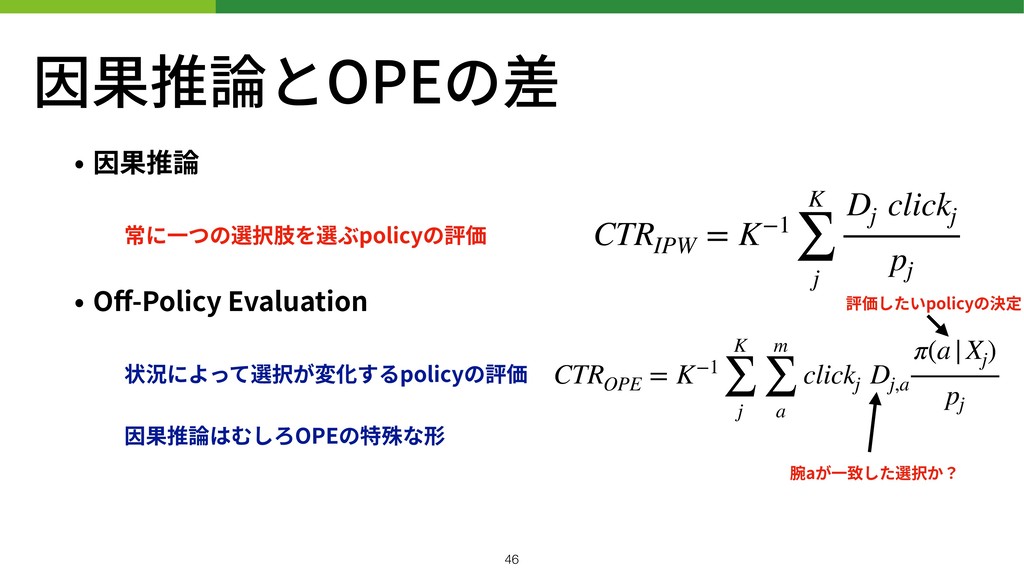
因果推論とOPEの差 • 因果推論 常に⼀つの選択肢を選ぶpolicyの評価 • Off-Policy Evaluation 状況によって選択が変化するpolicyの評価 因果推論はむしろOPEの特殊な形 CTRIPW
= K−1 K ∑ j Dj clickj pj CTROPE = K−1 K ∑ j m ∑ a clickj Dj,a π(a|Xj ) pj 腕aが⼀致した選択か? 評価したいpolicyの決定 !46
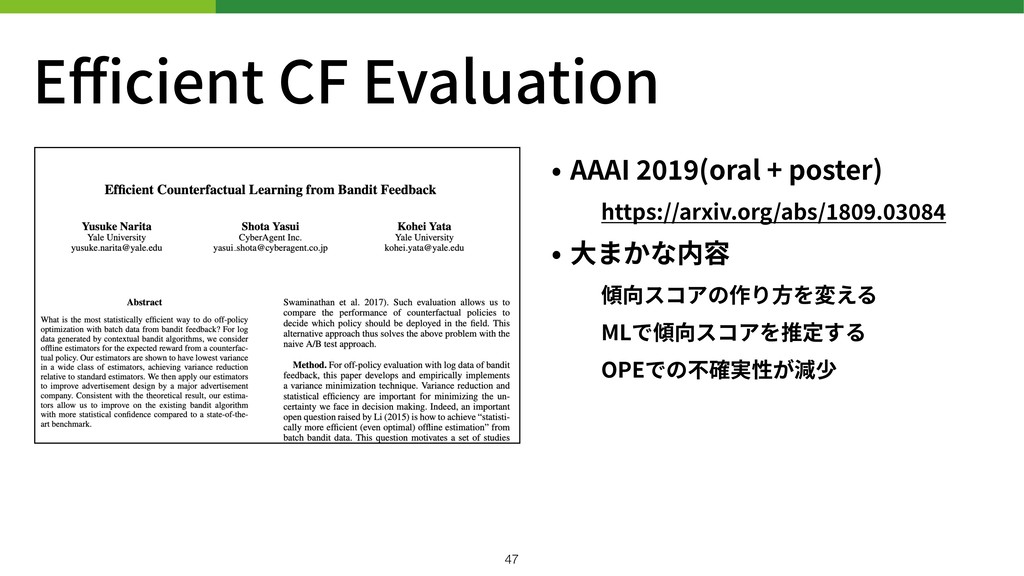
Efficient CF Evaluation • AAAI (oral + poster) https://arxiv.org/abs/ .
• ⼤まかな内容 傾向スコアの作り⽅を変える MLで傾向スコアを推定する OPEでの不確実性が減少 !47
True Propensity Score arm_a E[r|A = a,X] V[r|A = a,X]
arm_b E[r|A = b,X] V[r|A = b,X] Decision Rule (UCB/Thompson Sampling) Request arm_b Selected Arm Storage Feedback Batched Bandit Setting/interactive machine learning 再掲 !48
True Propensity Score arm_a E[r|A = a,X] V[r|A = a,X]
arm_b E[r|A = b,X] V[r|A = b,X] Decision Rule (UCB/Thompson Sampling) Request arm_b Selected Arm Storage Feedback Batched Bandit Setting/interactive machine learning 提案:選択確率をMLで推定してしまう。 •TPS= %でも実際のデータ上では55%だったりする。 •IPWではデータ上の割り振りを修正したい •ML/nonparametric-modelでデータ上の割り振りを学習する !49
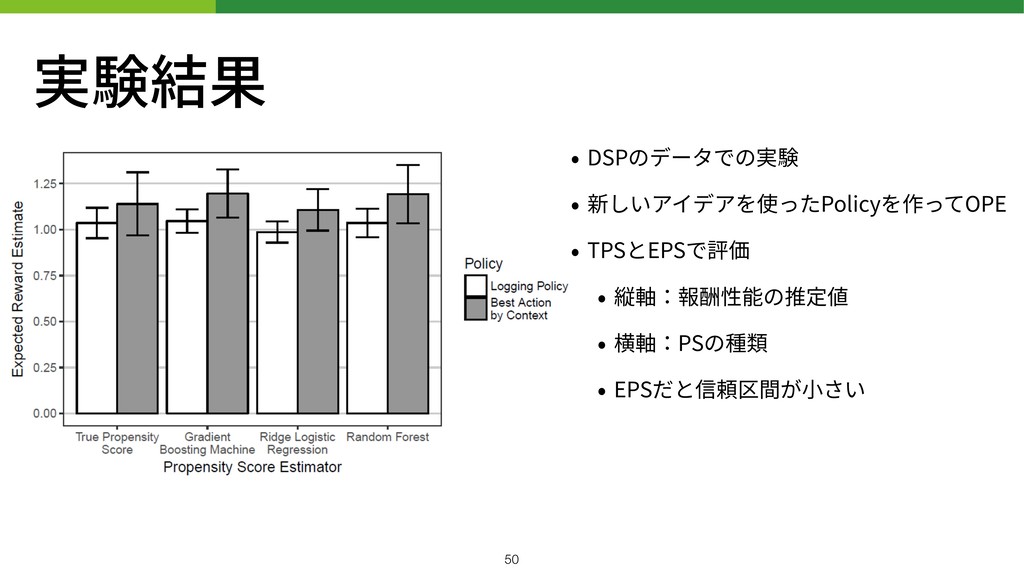
実験結果 • DSPのデータでの実験 • 新しいアイデアを使ったPolicyを作ってOPE • TPSとEPSで評価 • 縦軸:報酬性能の推定値 •
横軸:PSの種類 • EPSだと信頼区間が⼩さい !50
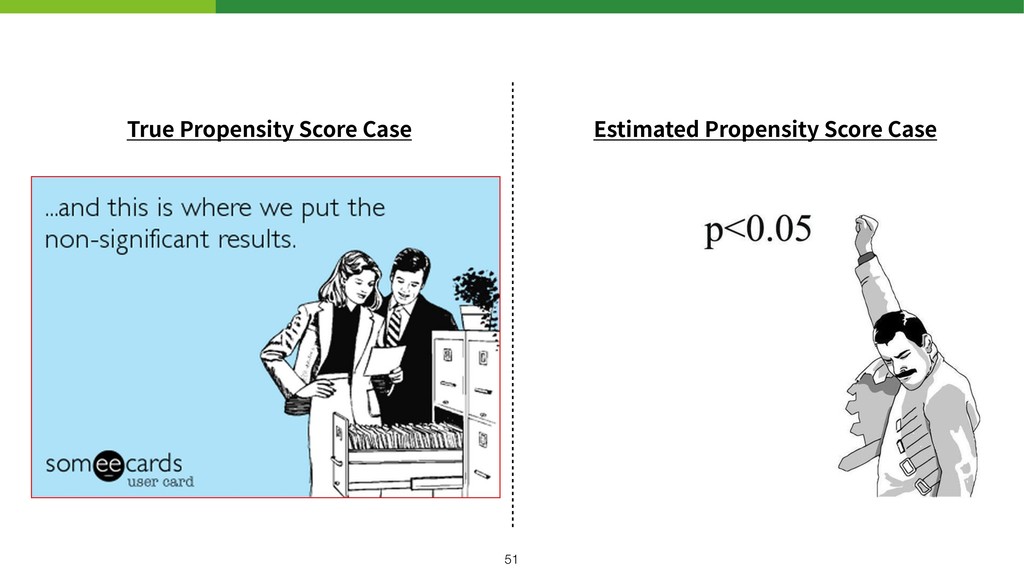
True Propensity Score Case Estimated Propensity Score Case !51
Banditのログでバイアスの少ない Policy評価ができた。 (しかも統計的に効率的に。) !52
Future Work + まとめ
分析(not予測)環境の変化 • 機械学習を利⽤した意思決定の⾃動化が進んできた RTB/Recommend/Ad Selection/Ranking/etc この6年間肩⾝が狭くなる⼀⽅ • ⼀⽅で)⾃動意思決定によって残されたデータを分析する必要性 What is
good policy? / Causal effect of some items →プロダクトとして⾃動意思決定と事後分析をセットで考える必要性 • バンディットはたまたまこの流れが早かった 他の機械学習タスクでもこの流れになる !54
分析者(not予測)が⽬指したいところ • ⾃動意思決定をデザインする(with ML Engineer) 事後的な分析を⾒込んだデザインをする必要がある arg maxやUCBからの卒業(報酬性能も低い) • ⾃動意思決定のデザインに応じた分析をデザインする
MDPを仮定する強化学習のログで因果推論はどうやるか? • 結局両⽅デザインしに⾏く必要がある データが⽣まれるプロセスから、 事後的な分析のプロセスまでをデザインする。 !55
21世紀の分析者は、 データのゆりかごから 墓場までをデザインする。 !56
Enjoy Your Design!


 cyberagentdevelopers
 kizawa2020
 nttcom
 tsuchikazu
 persolserverworks
 yamanoku
 mikanichinose
 ufried
 mewuto
 aoto
 takanorip
 vivion
 inesmontani
 cargoodrich
 mlcsv
 marcduiker
 sabderemane
 jcasabona
 pauljervisheath
 davidcarrasco
 bethany
 csswizardry
 bryan
 codingconduct