DevOps Architect (FGTech) depuis 2026, ex-architecte Groupe AGPM (2020-2025) et CTO Stratis (2010-2020, 100+ ingénieurs). • Certifié CKAD, Terraform Associate, Google Cloud, ArchiMate 3, Google AI Leader • Intervenant à l'ISEN (DevOps, Kubernetes, cloud), basé à Toulon
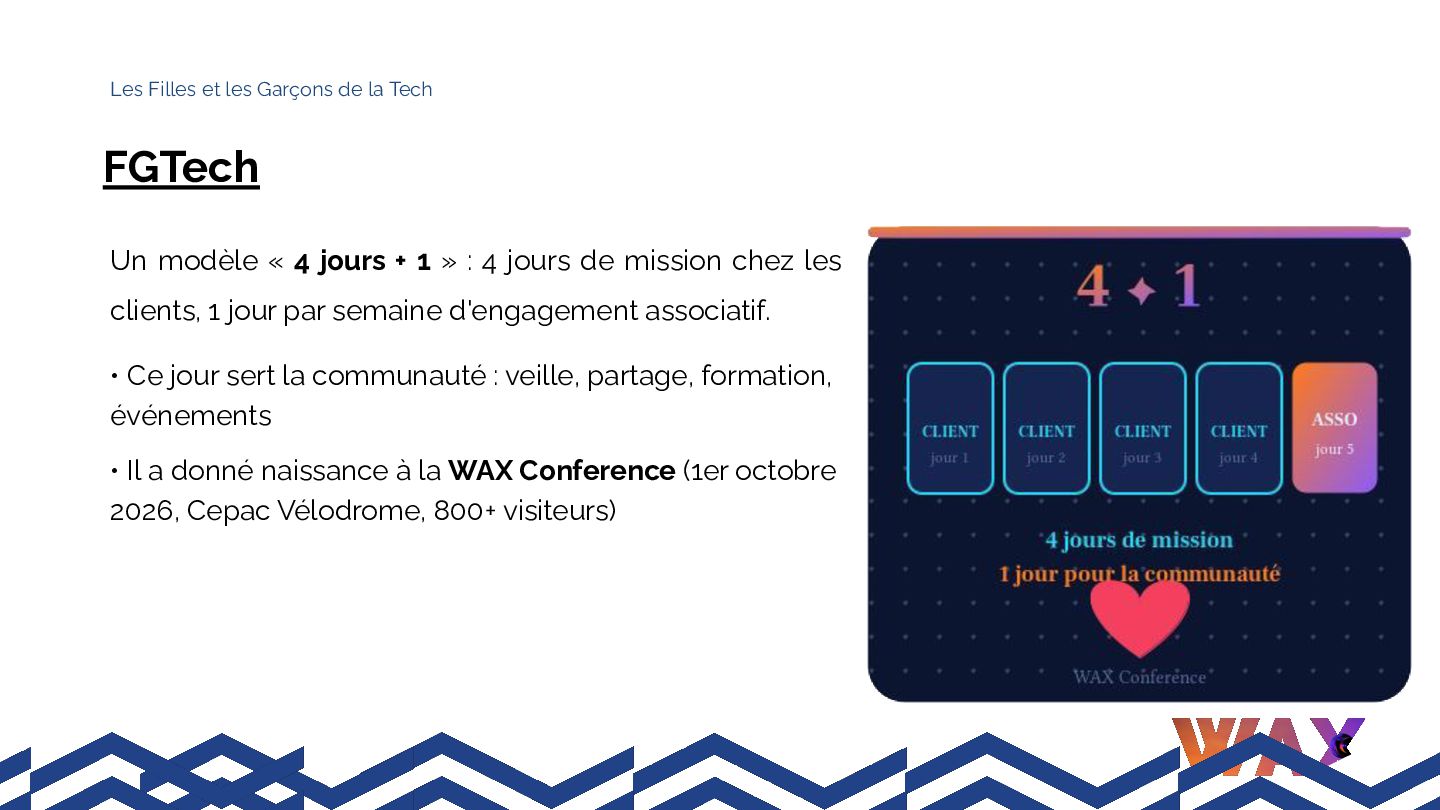
modèle « 4 jours + 1 » : 4 jours de mission chez les clients, 1 jour par semaine d'engagement associatif. • Ce jour sert la communauté : veille, partage, formation, événements • Il a donné naissance à la WAX Conference (1er octobre 2026, Cepac Vélodrome, 800+ visiteurs)
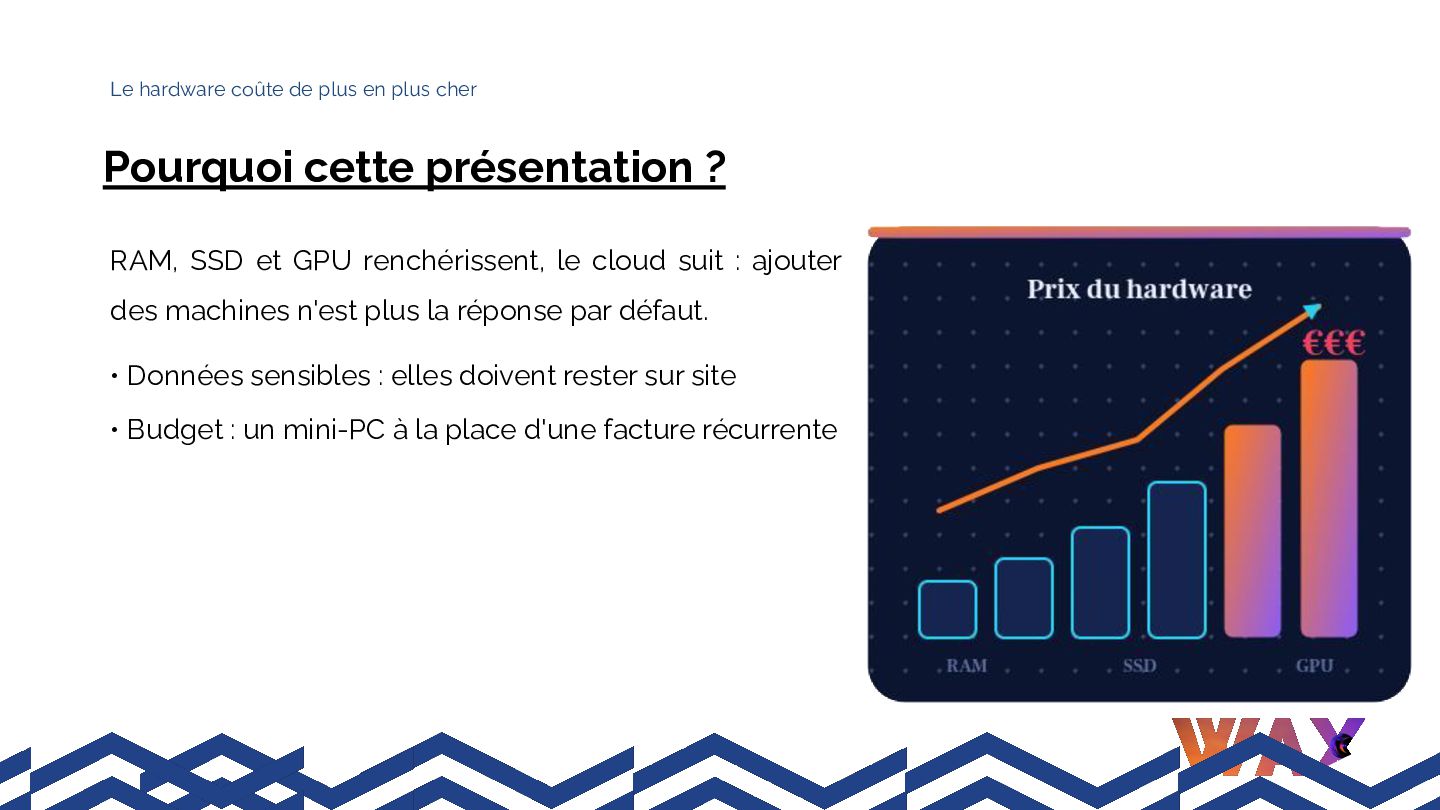
présentation ? RAM, SSD et GPU renchérissent, le cloud suit : ajouter des machines n'est plus la réponse par défaut. • Données sensibles : elles doivent rester sur site • Budget : un mini-PC à la place d'une facture récurrente
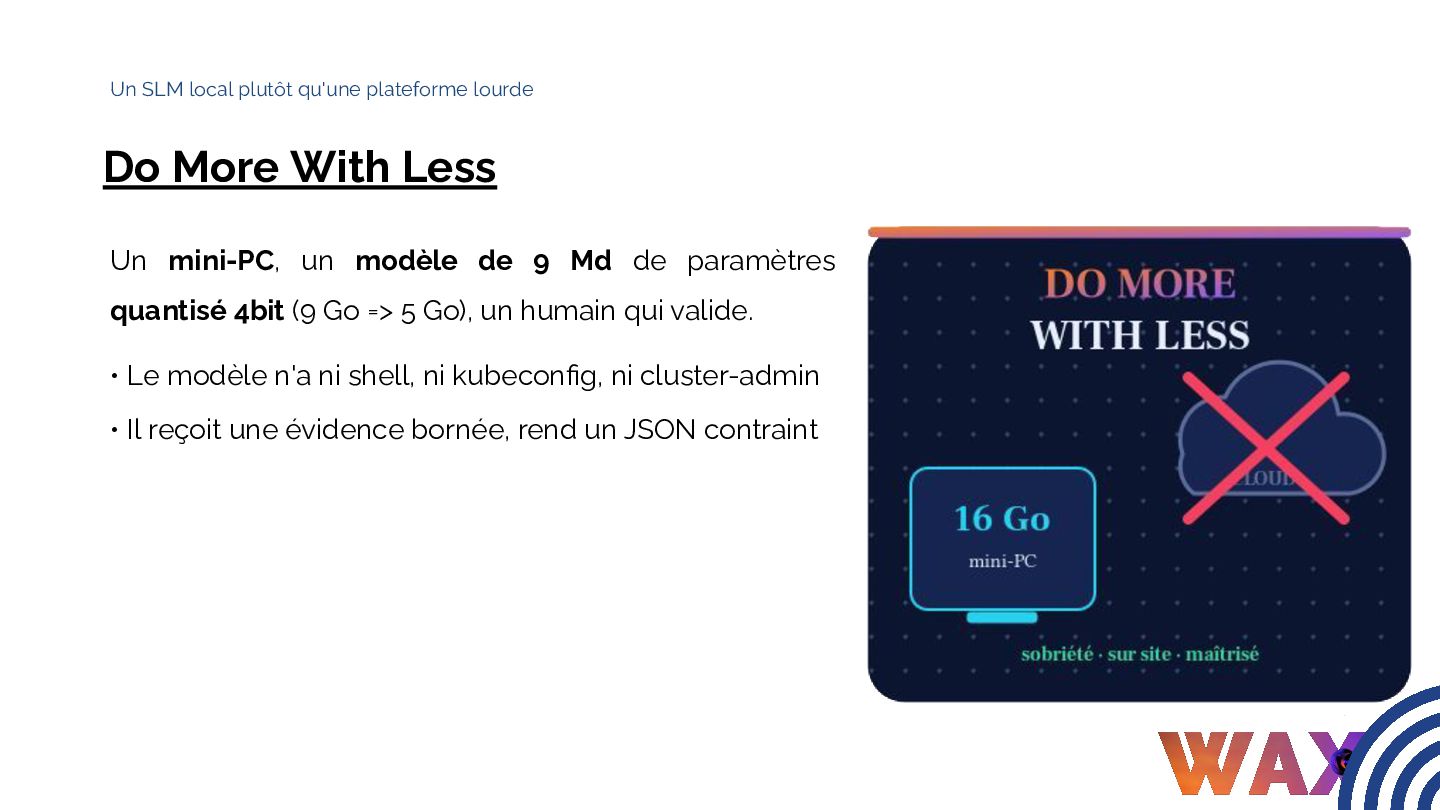
Less Un mini-PC, un modèle de 9 Md de paramètres quantisé 4bit (9 Go => 5 Go), un humain qui valide. • Le modèle n'a ni shell, ni kubeconfig, ni cluster-admin • Il reçoit une évidence bornée, rend un JSON contraint
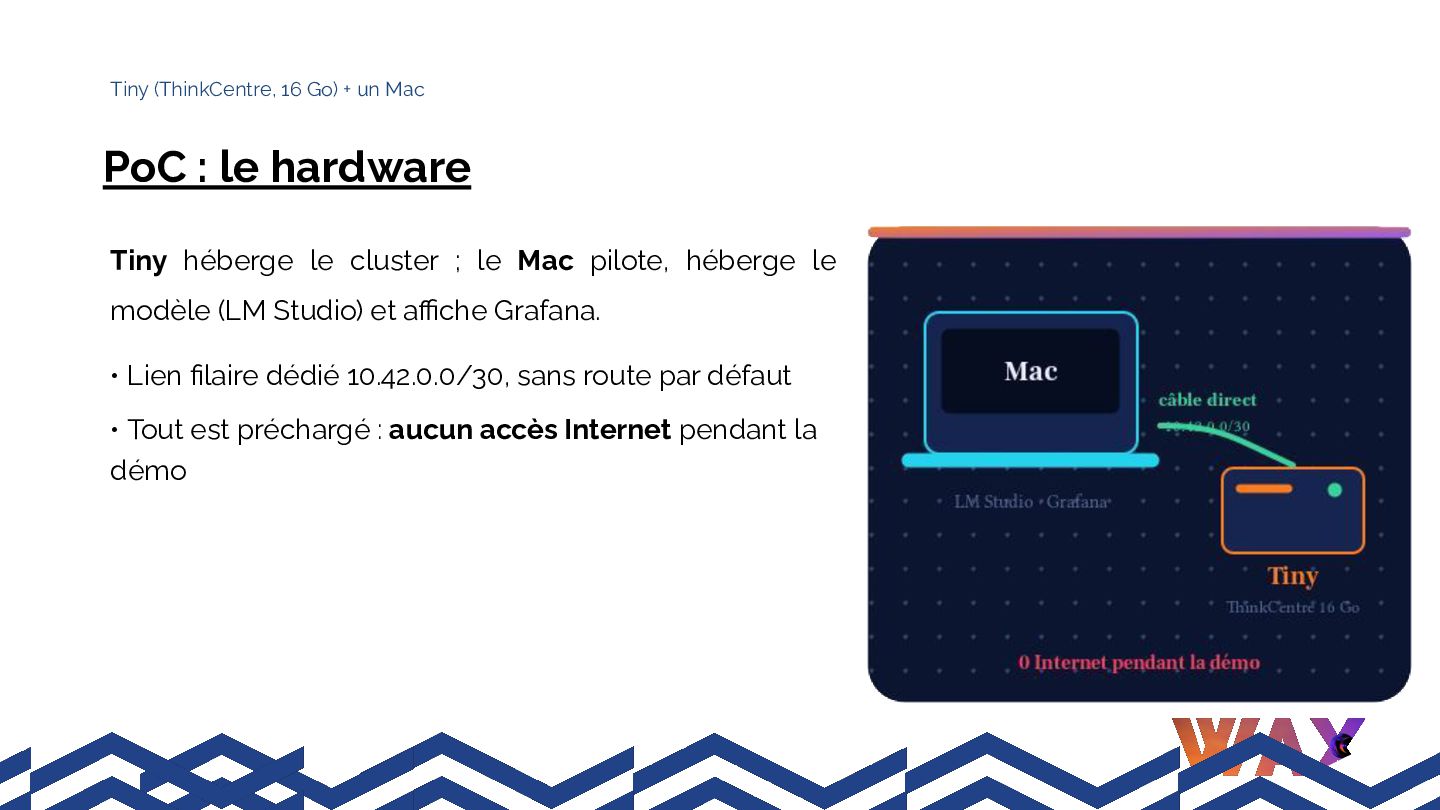
hardware Tiny héberge le cluster ; le Mac pilote, héberge le modèle (LM Studio) et affiche Grafana. • Lien filaire dédié 10.42.0.0/30, sans route par défaut • Tout est préchargé : aucun accès Internet pendant la démo
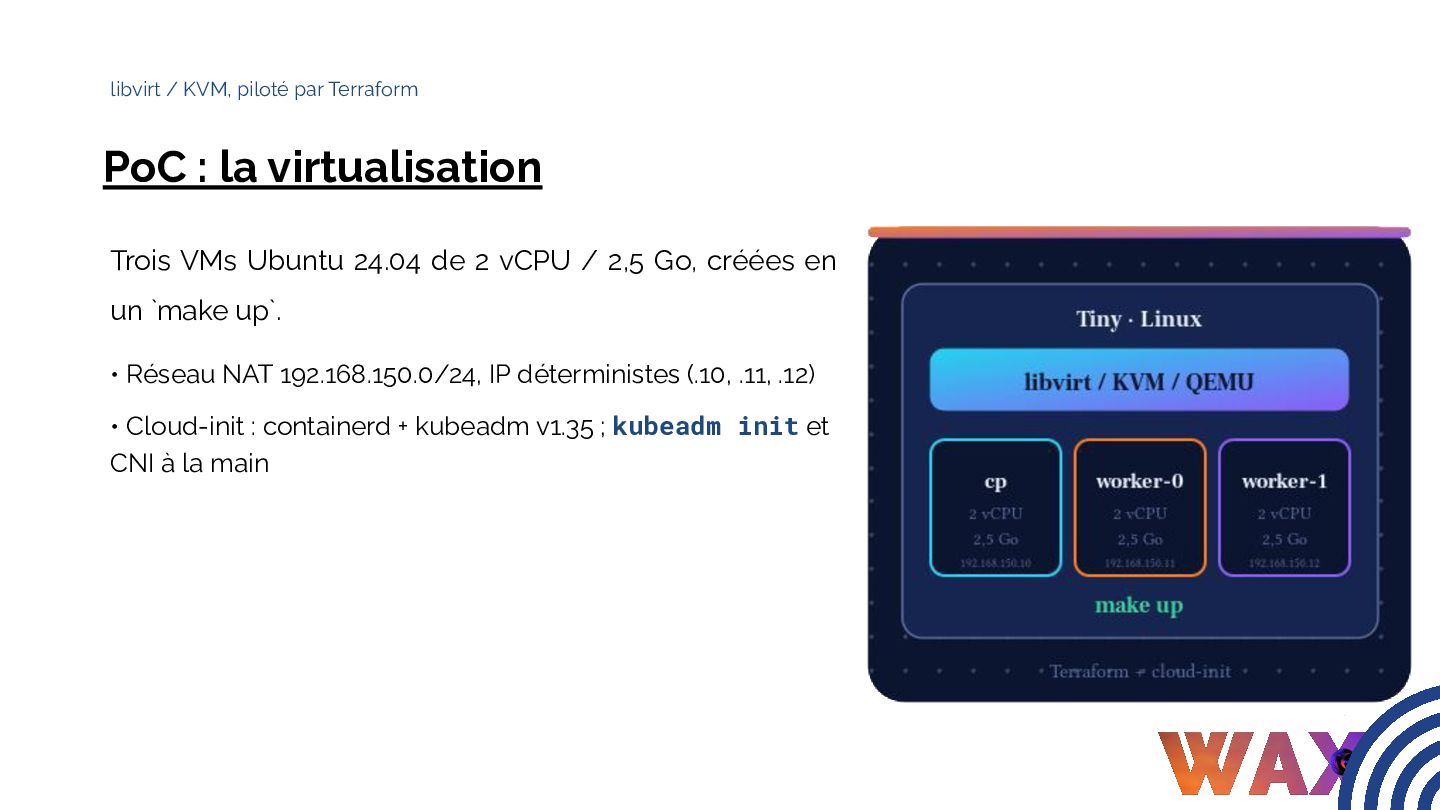
Trois VMs Ubuntu 24.04 de 2 vCPU / 2,5 Go, créées en un `make up`. • Réseau NAT 192.168.150.0/24, IP déterministes (.10, .11, .12) • Cloud-init : containerd + kubeadm v1.35 ; kubeadm init et CNI à la main
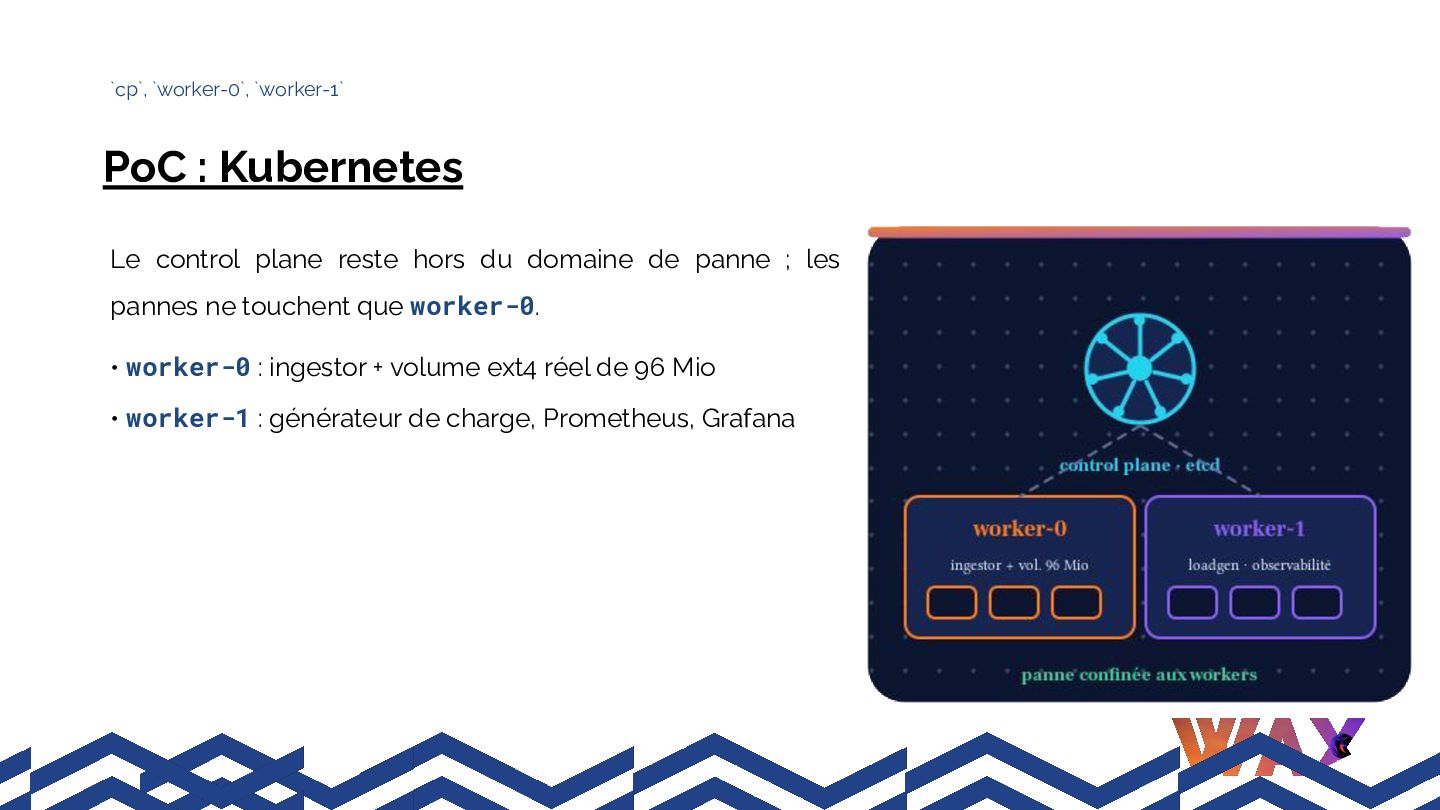
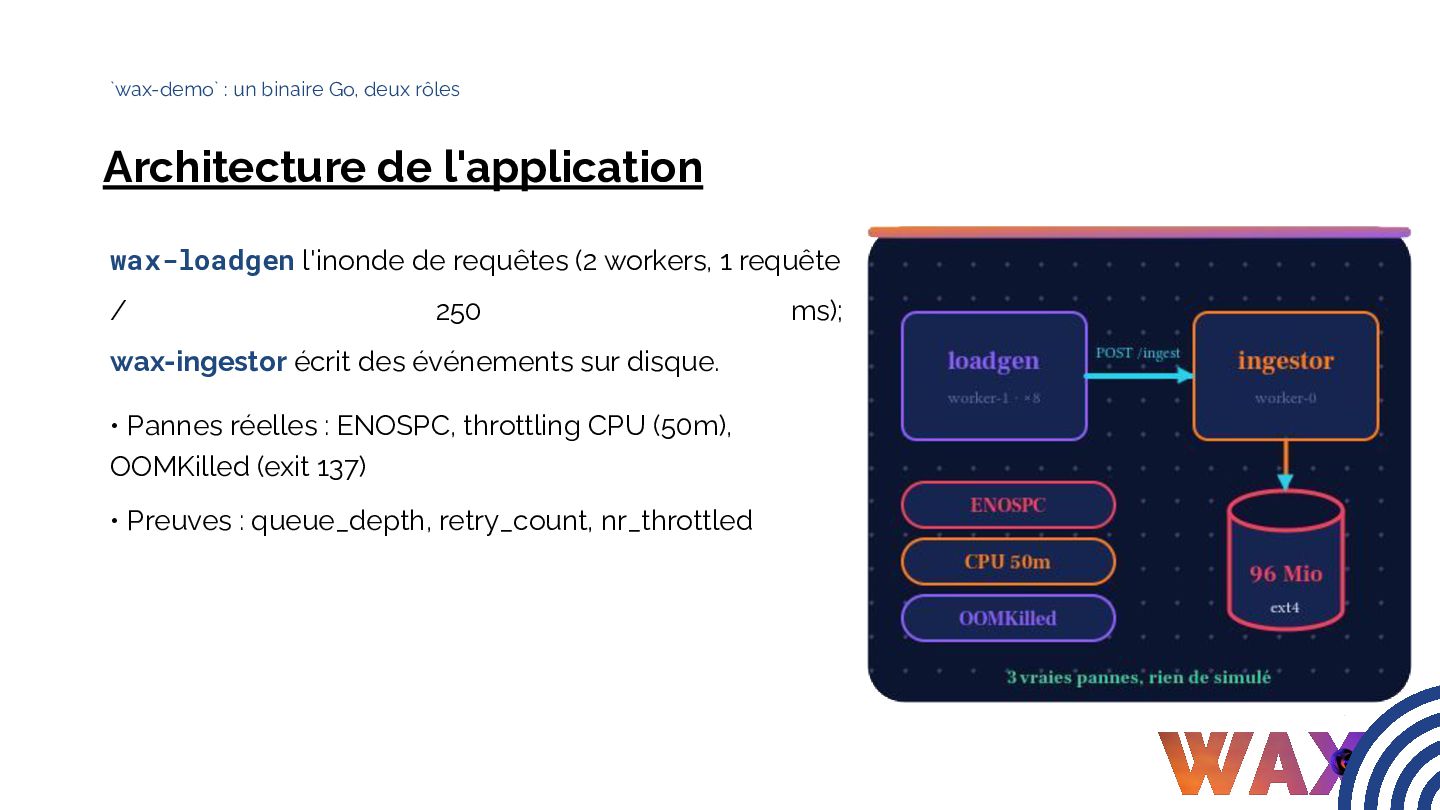
hors du domaine de panne ; les pannes ne touchent que worker-0. • worker-0 : ingestor + volume ext4 réel de 96 Mio • worker-1 : générateur de charge, Prometheus, Grafana
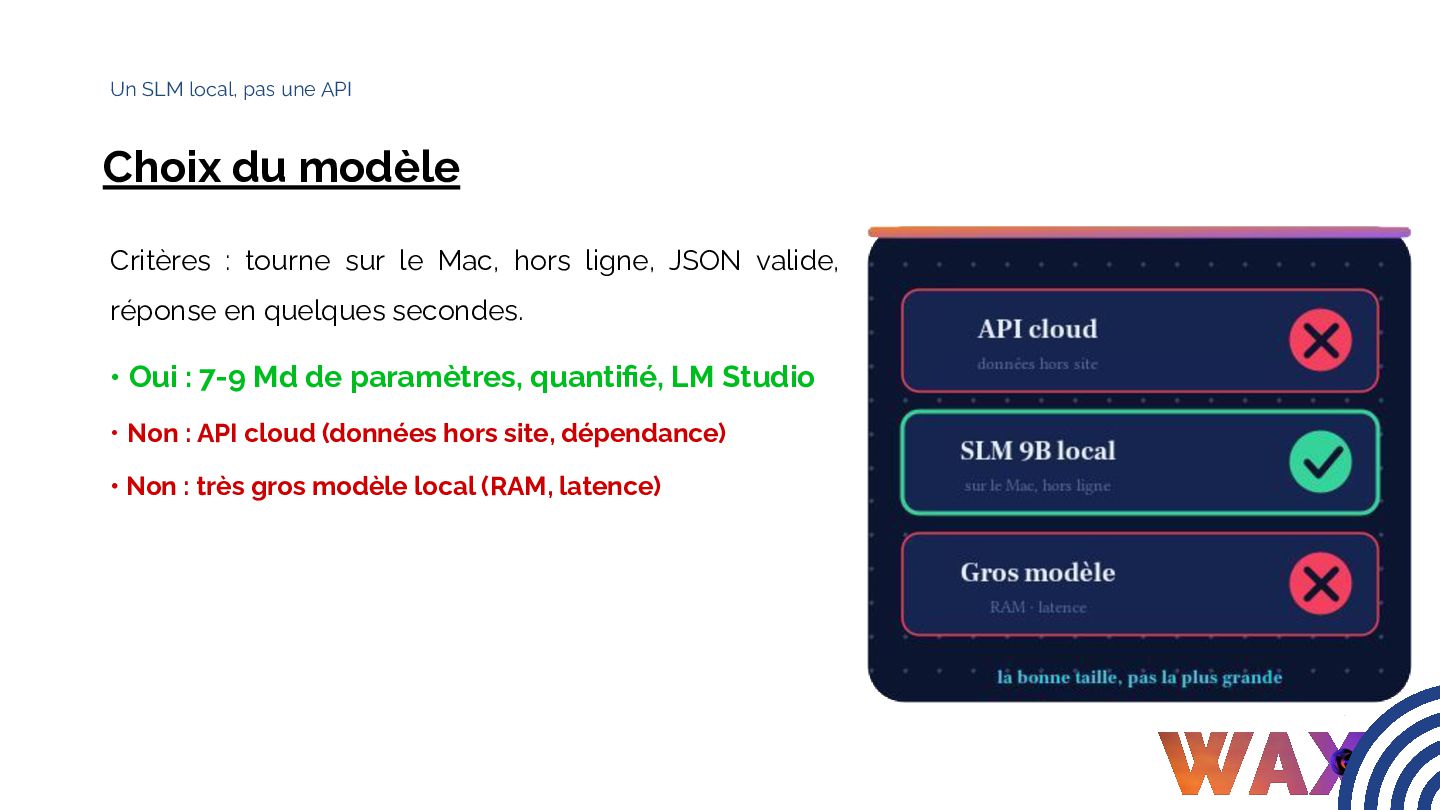
: tourne sur le Mac, hors ligne, JSON valide, réponse en quelques secondes. • Oui : 7-9 Md de paramètres, quantifié, LM Studio • Non : API cloud (données hors site, dépendance) • Non : très gros modèle local (RAM, latence)
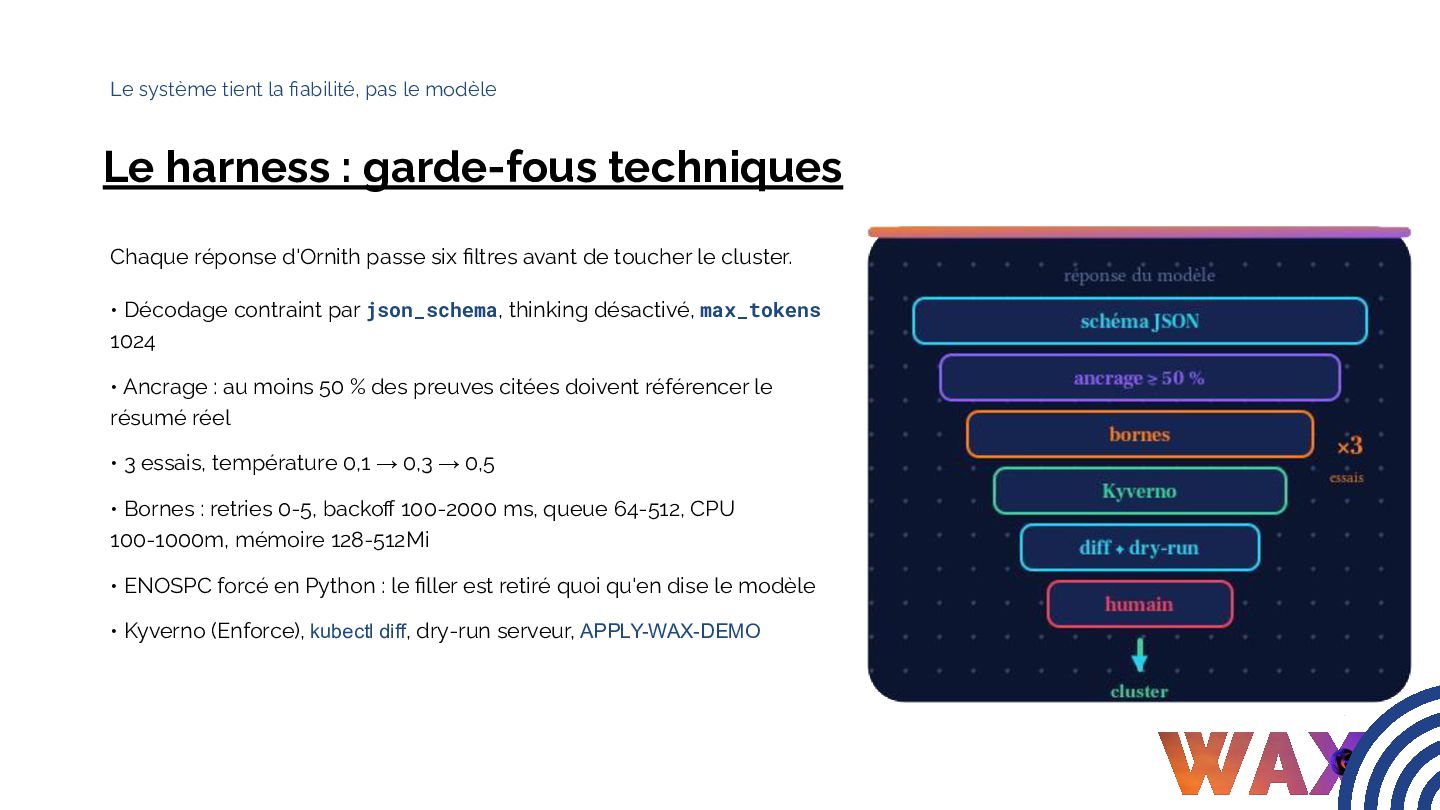
MLX (Apple Silicon), sans tokens de raisonnement avec notre template. • Respecte le schéma JSON contraint • Choisit retries, backoff, queue, CPU, mémoire depuis la preuve live • La fiabilité vient du système, pas du modèle
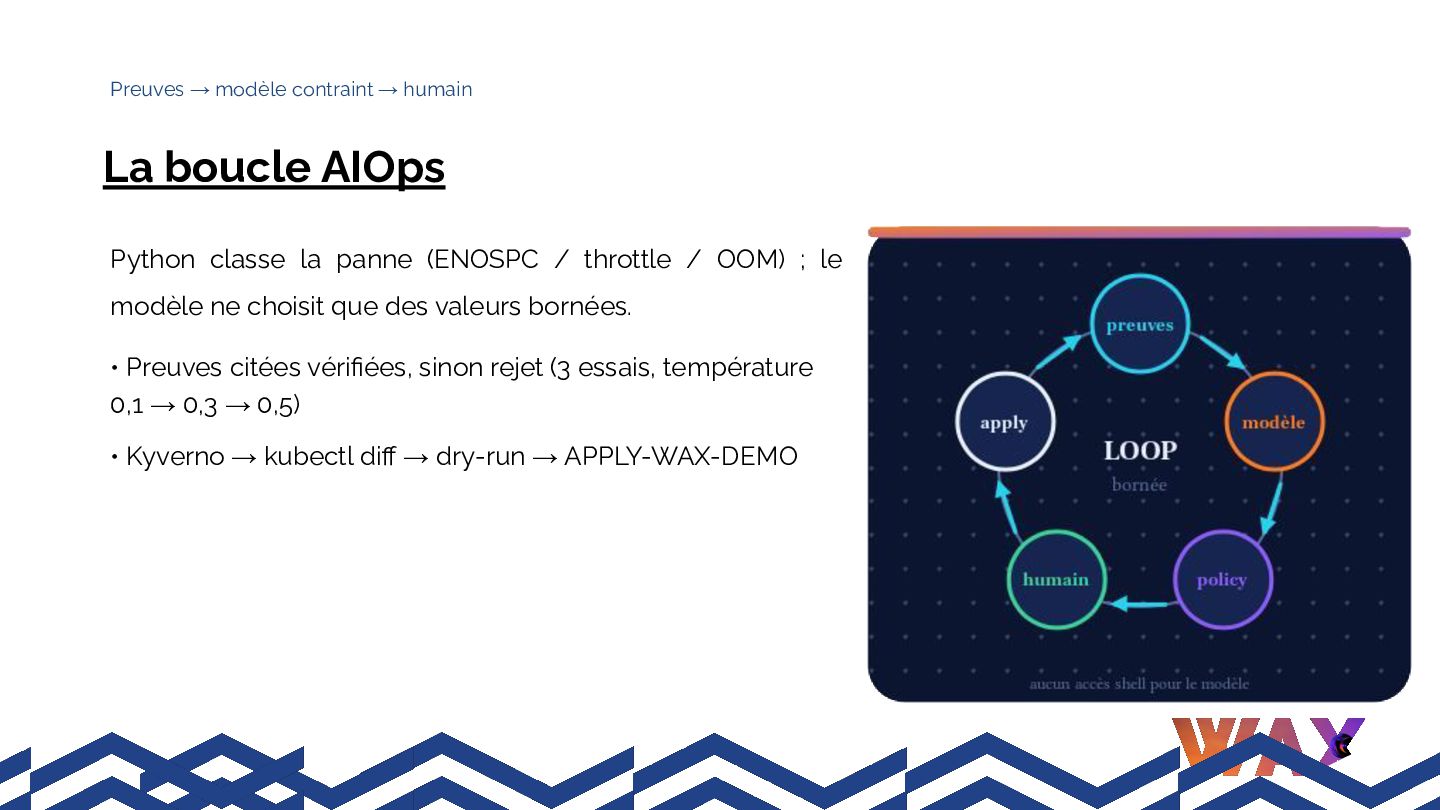
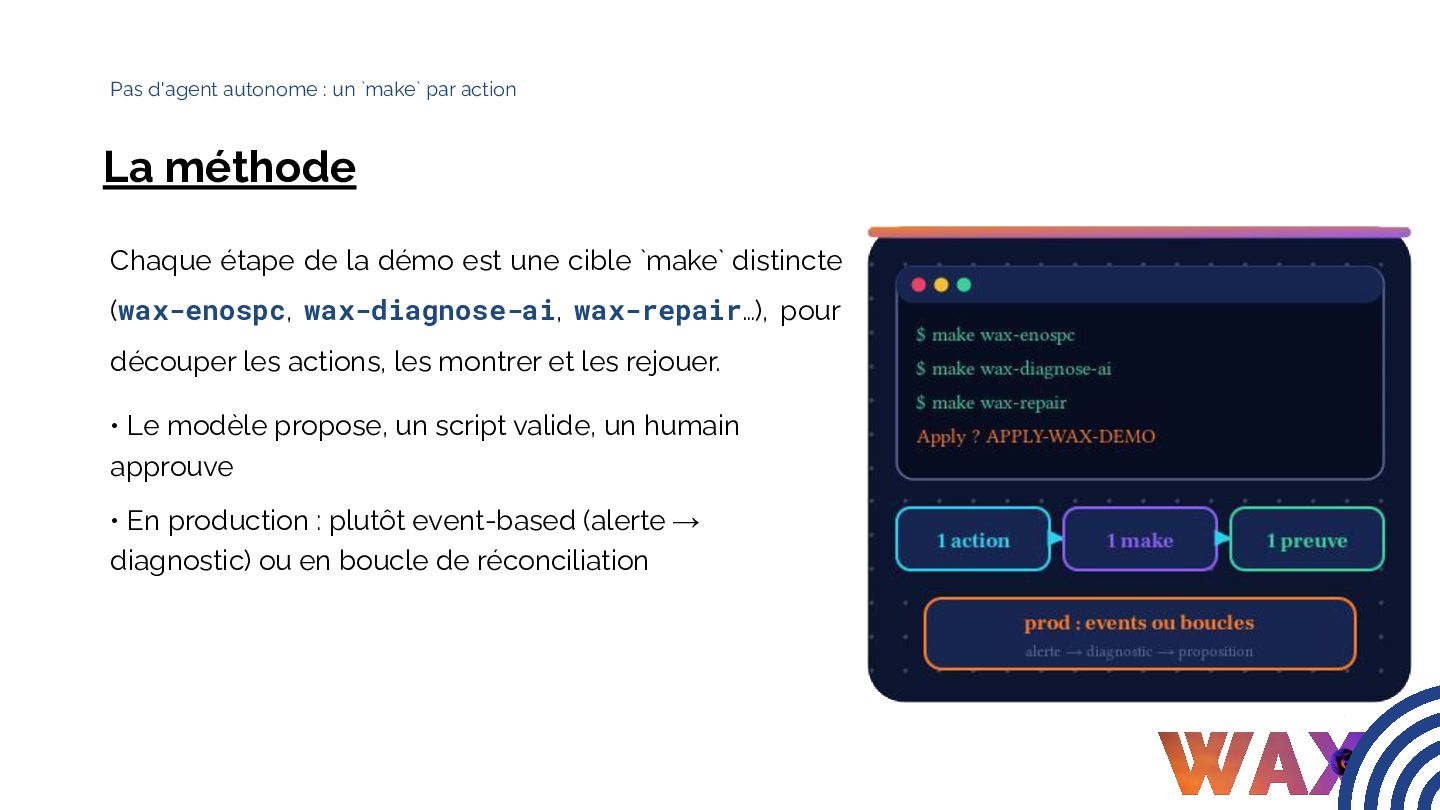
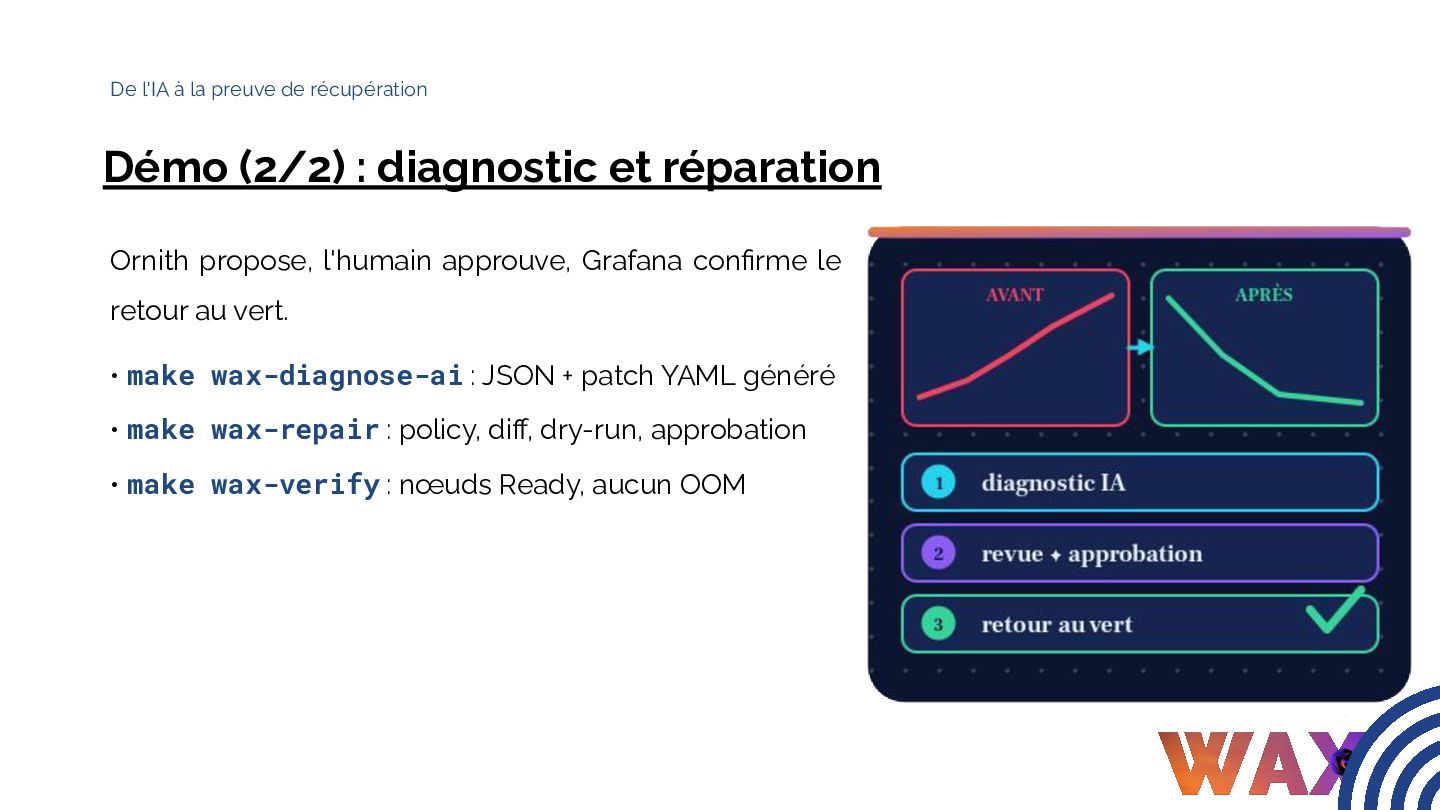
Chaque étape de la démo est une cible `make` distincte (wax-enospc, wax-diagnose-ai, wax-repair…), pour découper les actions, les montrer et les rejouer. • Le modèle propose, un script valide, un humain approuve • En production : plutôt event-based (alerte → diagnostic) ou en boucle de réconciliation
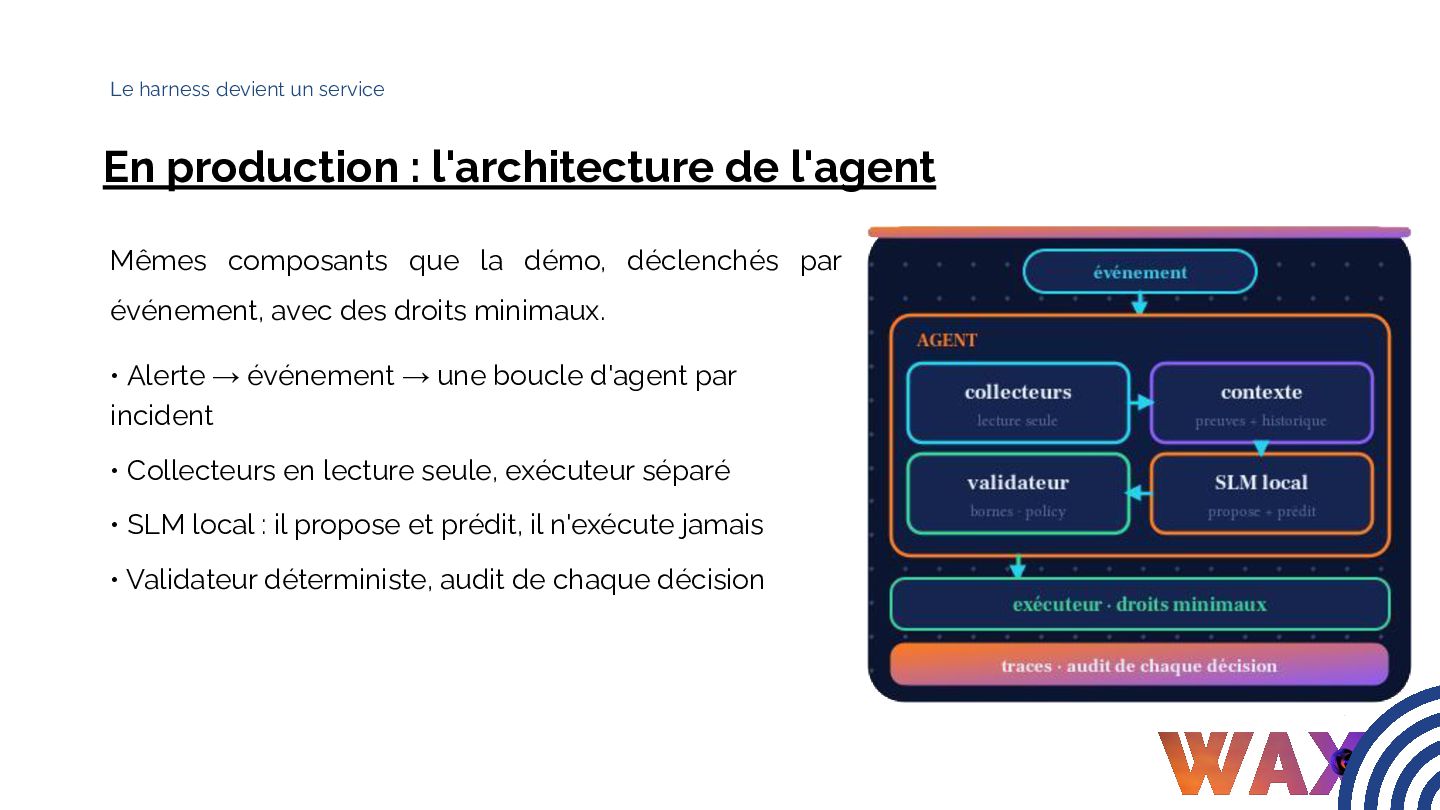
l'agent Mêmes composants que la démo, déclenchés par événement, avec des droits minimaux. • Alerte → événement → une boucle d'agent par incident • Collecteurs en lecture seule, exécuteur séparé • SLM local : il propose et prédit, il n'exécute jamais • Validateur déterministe, audit de chaque décision
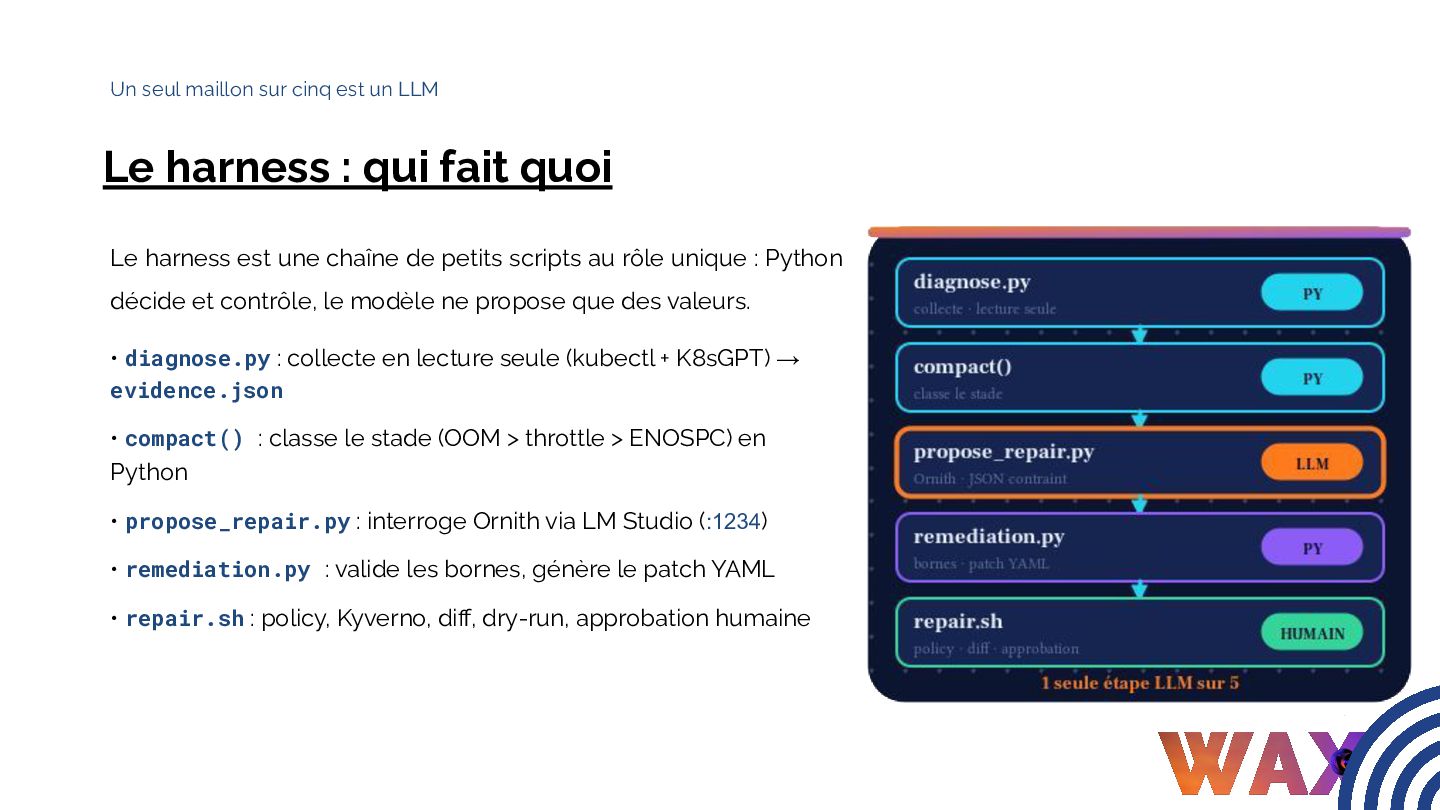
: qui fait quoi Le harness est une chaîne de petits scripts au rôle unique : Python décide et contrôle, le modèle ne propose que des valeurs. • diagnose.py : collecte en lecture seule (kubectl + K8sGPT) → evidence.json • compact() : classe le stade (OOM > throttle > ENOSPC) en Python • propose_repair.py : interroge Ornith via LM Studio (:1234) • remediation.py : valide les bornes, génère le patch YAML • repair.sh : policy, Kyverno, diff, dry-run, approbation humaine
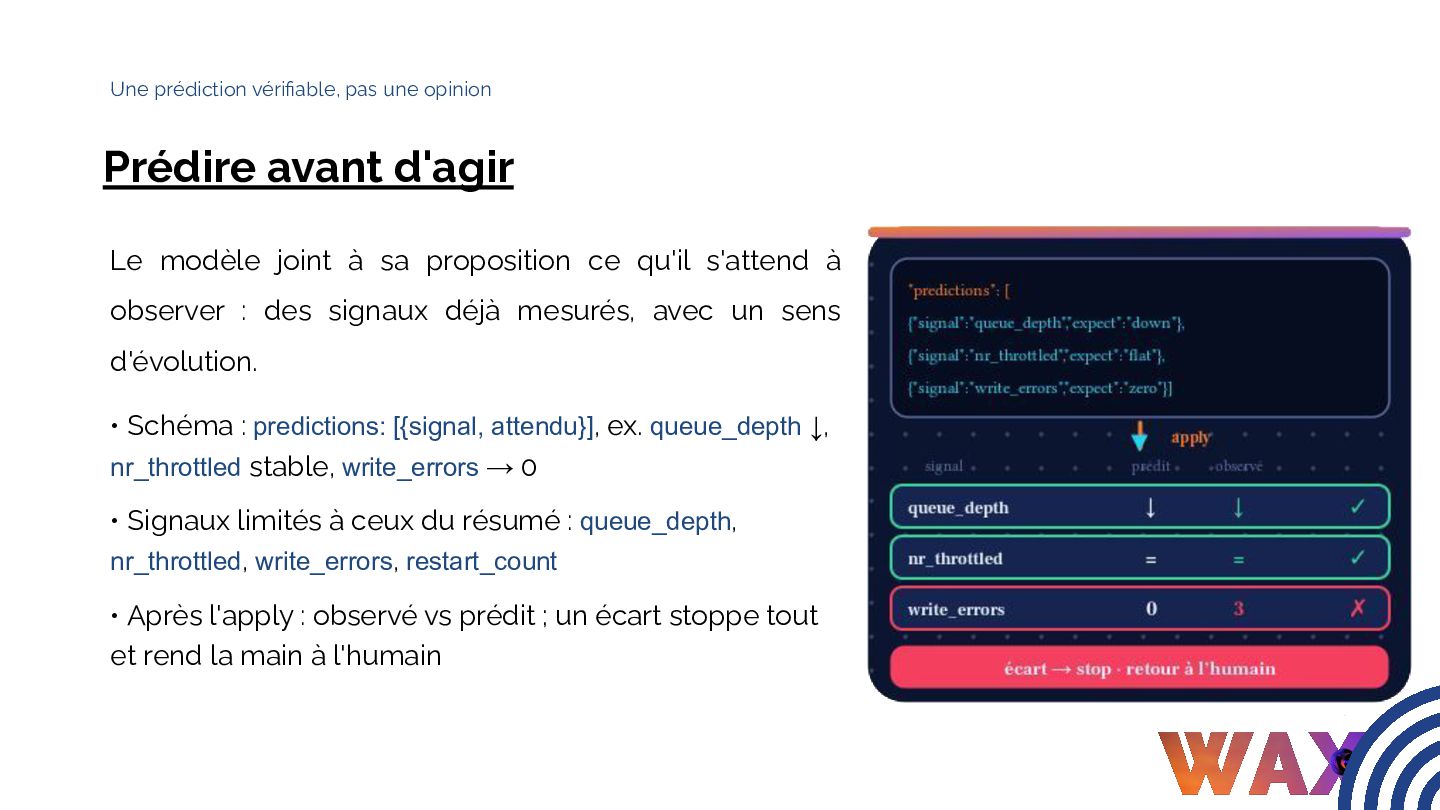
modèle joint à sa proposition ce qu'il s'attend à observer : des signaux déjà mesurés, avec un sens d'évolution. • Schéma : predictions: [{signal, attendu}], ex. queue_depth ↓, nr_throttled stable, write_errors → 0 • Signaux limités à ceux du résumé : queue_depth, nr_throttled, write_errors, restart_count • Après l'apply : observé vs prédit ; un écart stoppe tout et rend la main à l'humain
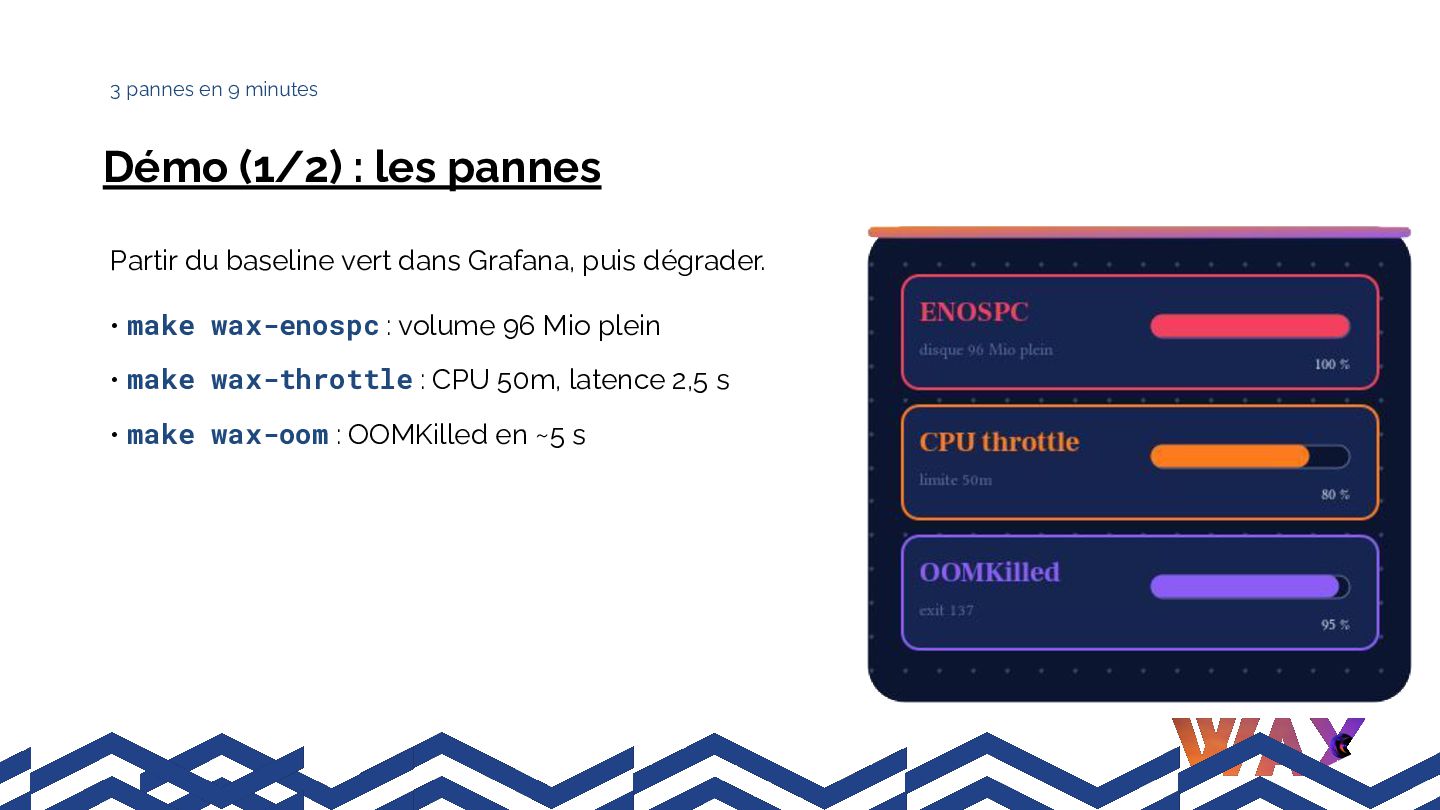
Partir du baseline vert dans Grafana, puis dégrader. • make wax-enospc : volume 96 Mio plein • make wax-throttle : CPU 50m, latence 2,5 s • make wax-oom : OOMKilled en ~5 s
de 9 Md de paramètres, et vous êtes toujours là. • Merci à FGTech, qui me soutient (4 jours + 1, c'est un vrai plus) • Merci aux sponsors qui soutiennent FGTech pour cette conf : Everpure, Portworx, Red Hat, Nutanix, Fortinet, EDB Postgres, Cheops Technology • make questions => fedir.fr


 fedir
 yukakoseki
 cyberagentdevelopers
 hotchpotch
 iwamot
 nori_shinoda
 kota2and3kan
 ikki0006
 cdataj
 naltatis
 eiei114
 keio_smilab
 yakumo
 philnash
 khoart
 codingconduct
 inesmontani
 konakalab
 chriscoyier
 427marketing
 aleyda
 apolaine
 cargoodrich
 orderedlist
 aarron