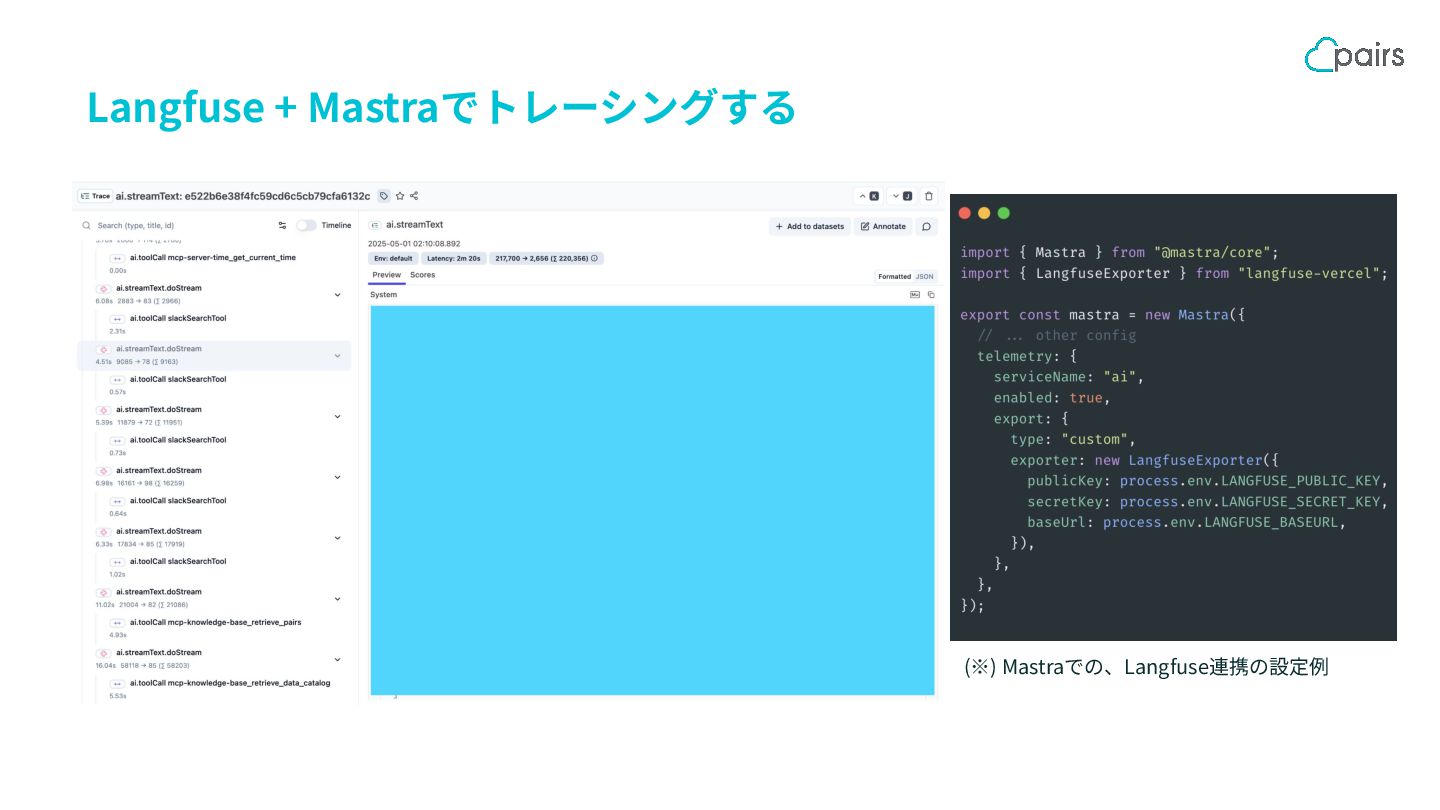
Share
Embed
ペアーズにおける評価ドリブンな AI Agent 開発のご紹介
2024/05/08 AWS オンラインセミナー、「AI Agent 開発の 0→1 - AWS の実証事例に学ぶ、企画から組織展開までのメソッド」での発表資料になります。
https://pages.awscloud.com/eib-aiml-250508-reg.html
fukubaka0825
May 08, 2025
Transcript
39 slides
-
About Me Nari | Takashi Narikawa(@fukubaka0825) • 株式会社エウレカ ◦ 2020年に⼊社
▪ SRE Team -> AI Team ◦ Senior MLOps Engineer ◦ 筋トレ、⿇雀、サウナ、memeが好き -
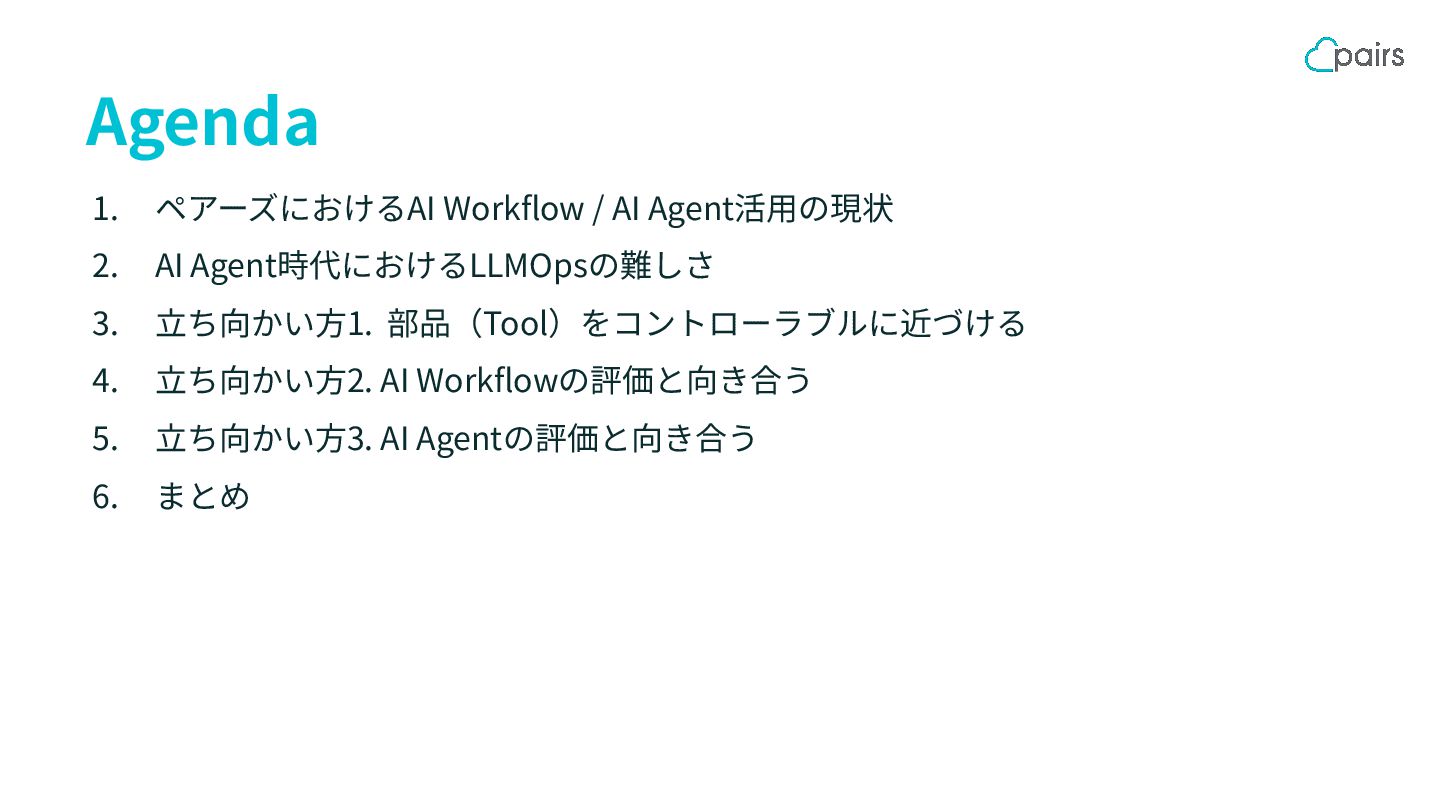
Agenda 1. ペアーズにおけるAI Workflow / AI Agent活⽤の現状 2. AI Agent時代におけるLLMOpsの難しさ
3. ⽴ち向かい⽅1. 部品(Tool)をコントローラブルに近づける 4. ⽴ち向かい⽅2. AI Workflowの評価と向き合う 5. ⽴ち向かい⽅3. AI Agentの評価と向き合う 6. まとめ -
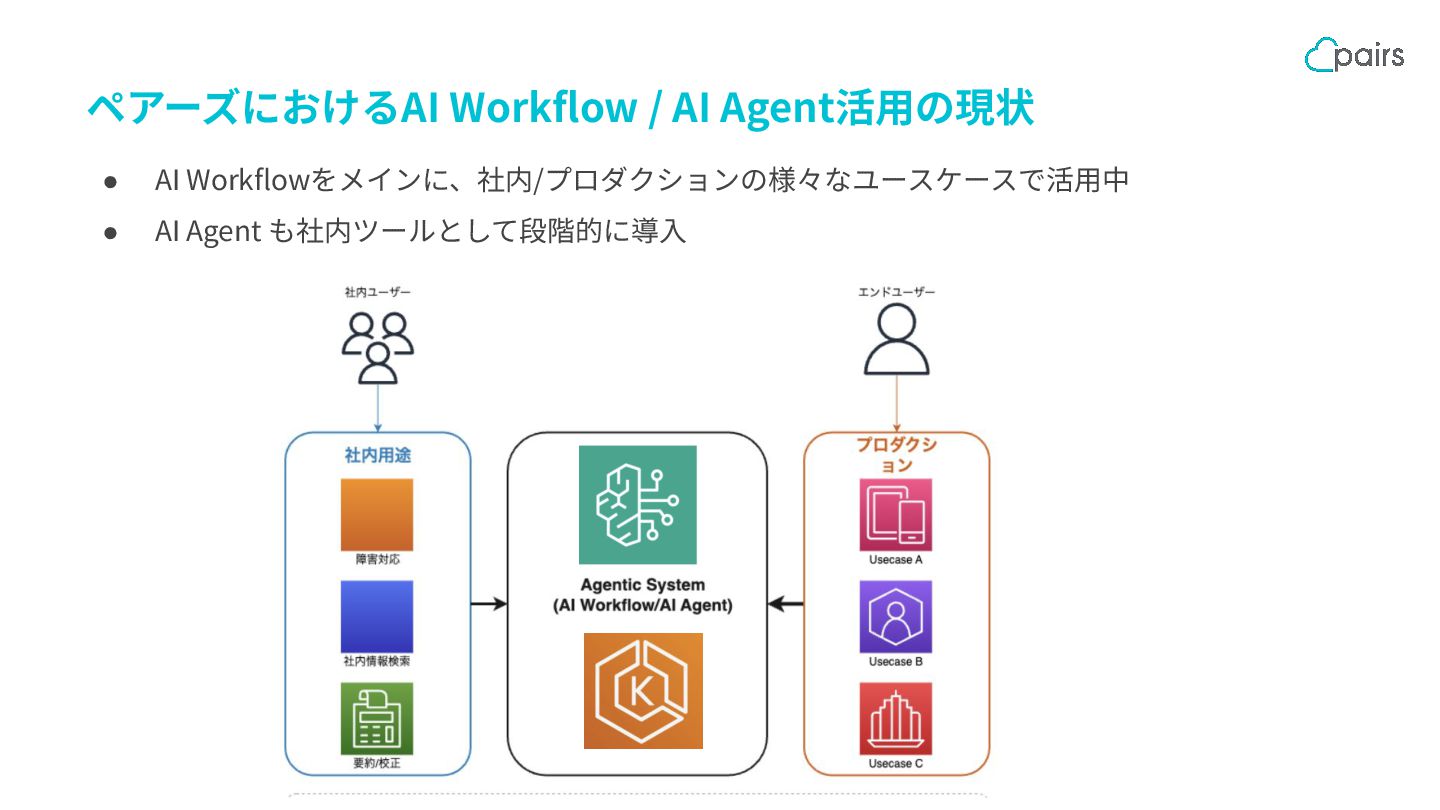
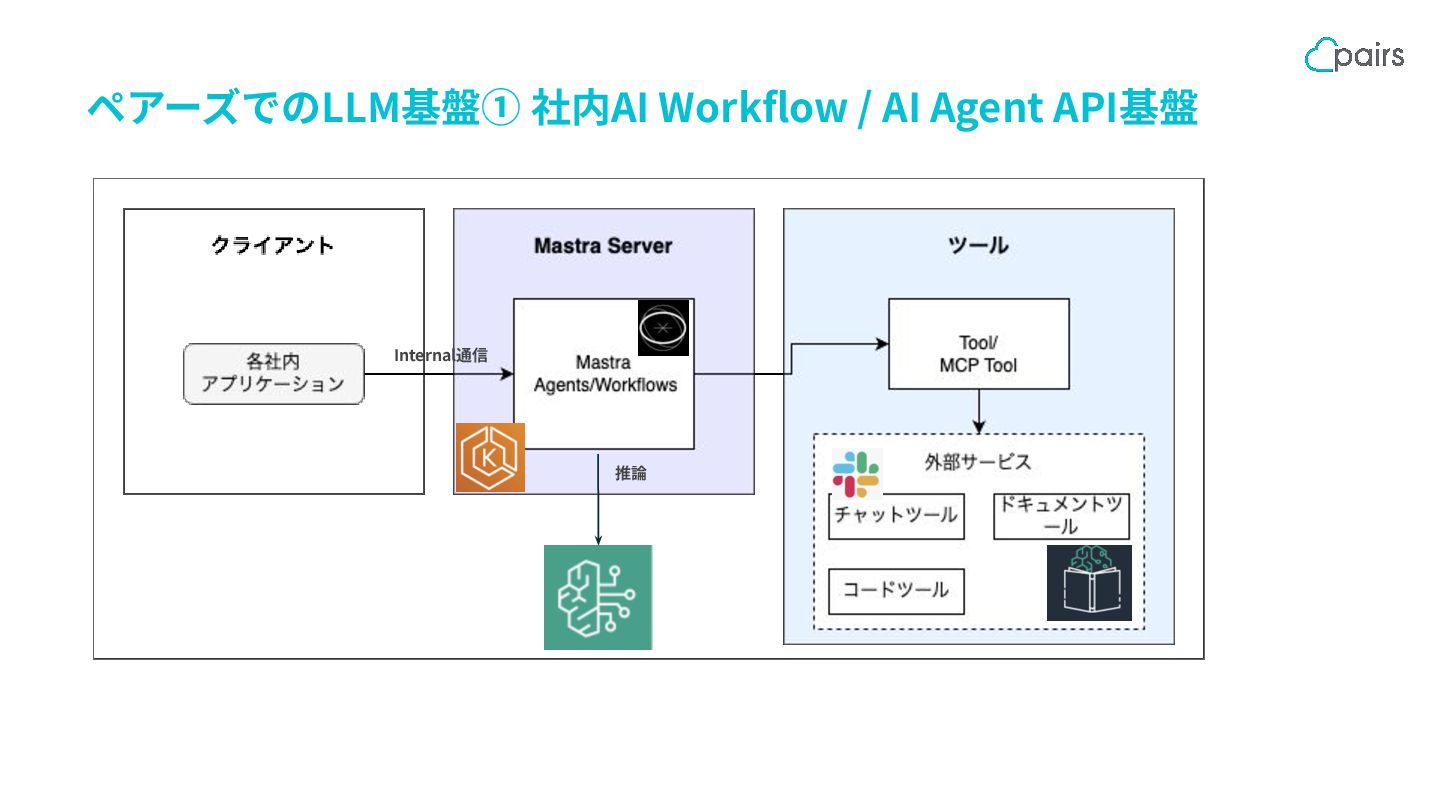
ペアーズにおけるAI Workflow / AI Agent活⽤の現状 • AI Workflowをメインに、社内/プロダクションの様々なユースケースで活⽤中 • AI
Agent も社内ツールとして段階的に導⼊ -
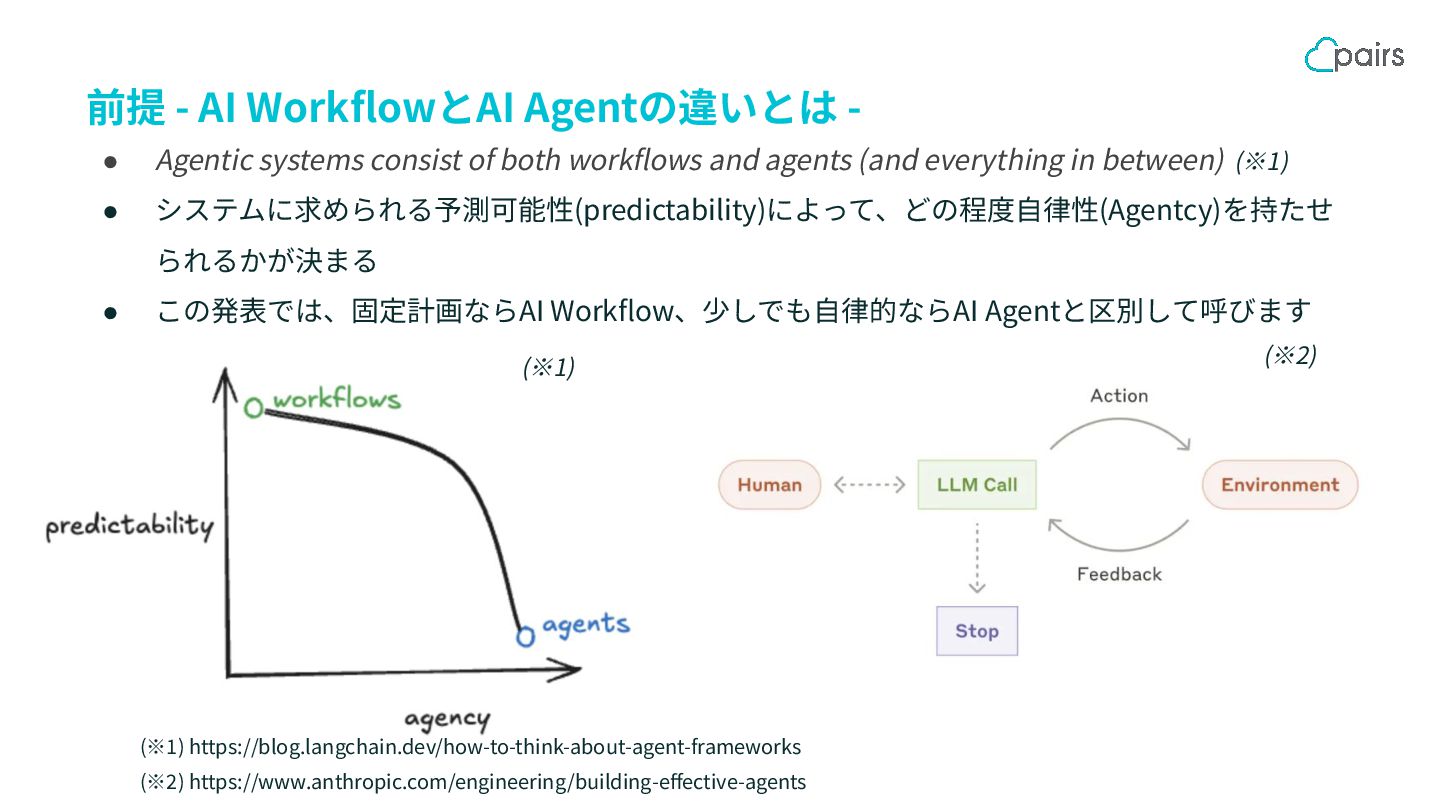
前提 - AI WorkflowとAI Agentの違いとは - • Agentic systems consist
of both workflows and agents (and everything in between) (※1) • システムに求められる予測可能性(predictability)によって、どの程度⾃律性(Agentcy)を持たせ られるかが決まる • この発表では、固定計画ならAI Workflow、少しでも⾃律的ならAI Agentと区別して呼びます (※1) https://blog.langchain.dev/how-to-think-about-agent-frameworks (※2) (※2) https://www.anthropic.com/engineering/building-effective-agents (※1) -
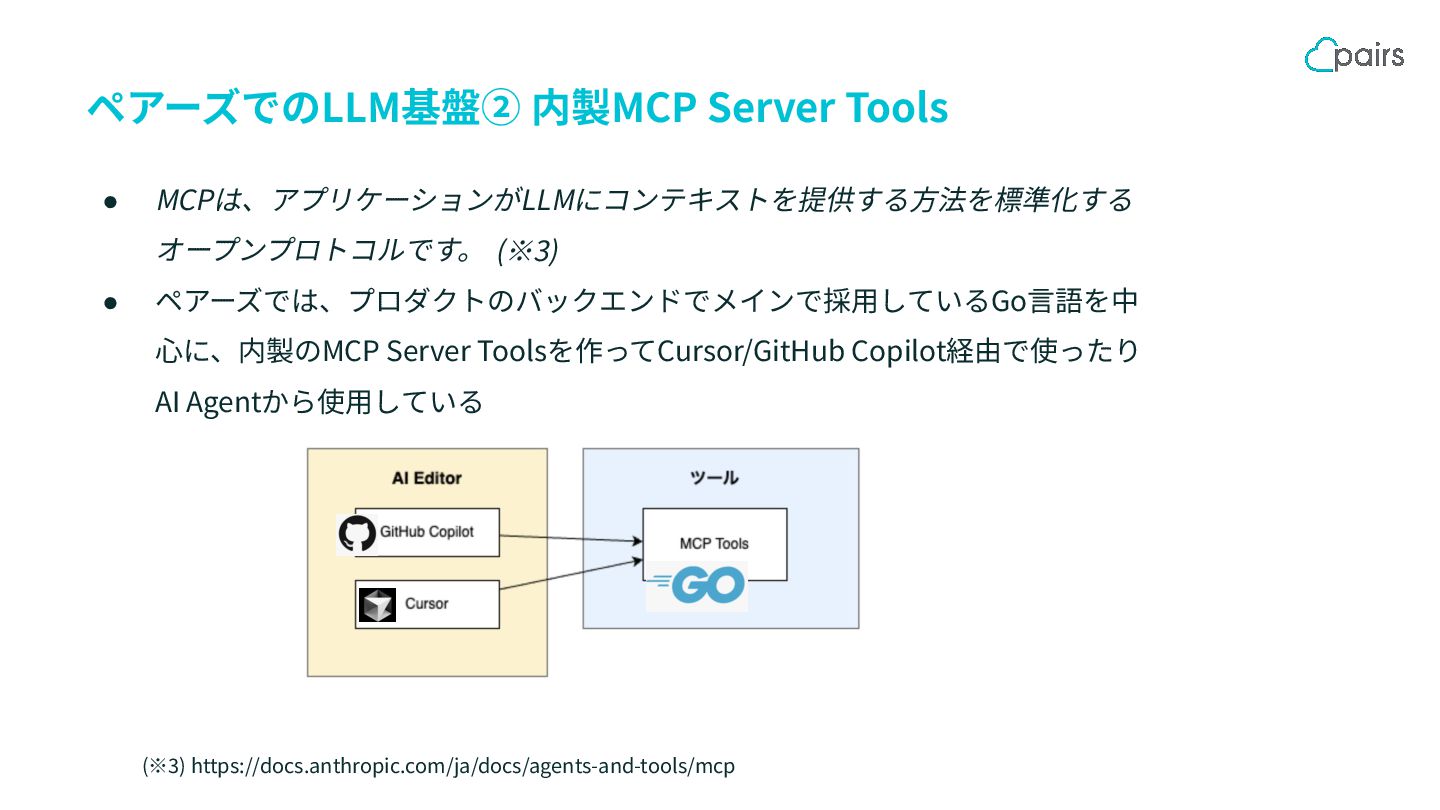
ペアーズでのLLM基盤② 内製MCP Server Tools • MCPは、アプリケーションがLLMにコンテキストを提供する⽅法を標準化する オープンプロトコルです。 • ペアーズでは、プロダクトのバックエンドでメインで採⽤しているGo⾔語を中 ⼼に、内製のMCP
Server Toolsを作ってCursor/GitHub Copilot経由で使ったり AI Agentから使⽤している (※3) (※3) https://docs.anthropic.com/ja/docs/agents-and-tools/mcp -
LLMOpsの難しさ(AI Agent) • AI Workflow時代の課題に追加して、以下の状態についても考慮する必要が出てきた ◦ Agenticに実⾏されるToolの軌跡 ◦ 短期/⻑期記憶管理 ◦
チャット以外をトリガーとする、イベント駆動な実⾏パターン • 考慮すべき事項が多すぎるが、どのようにこれらに⽴ち向かっていくか? -
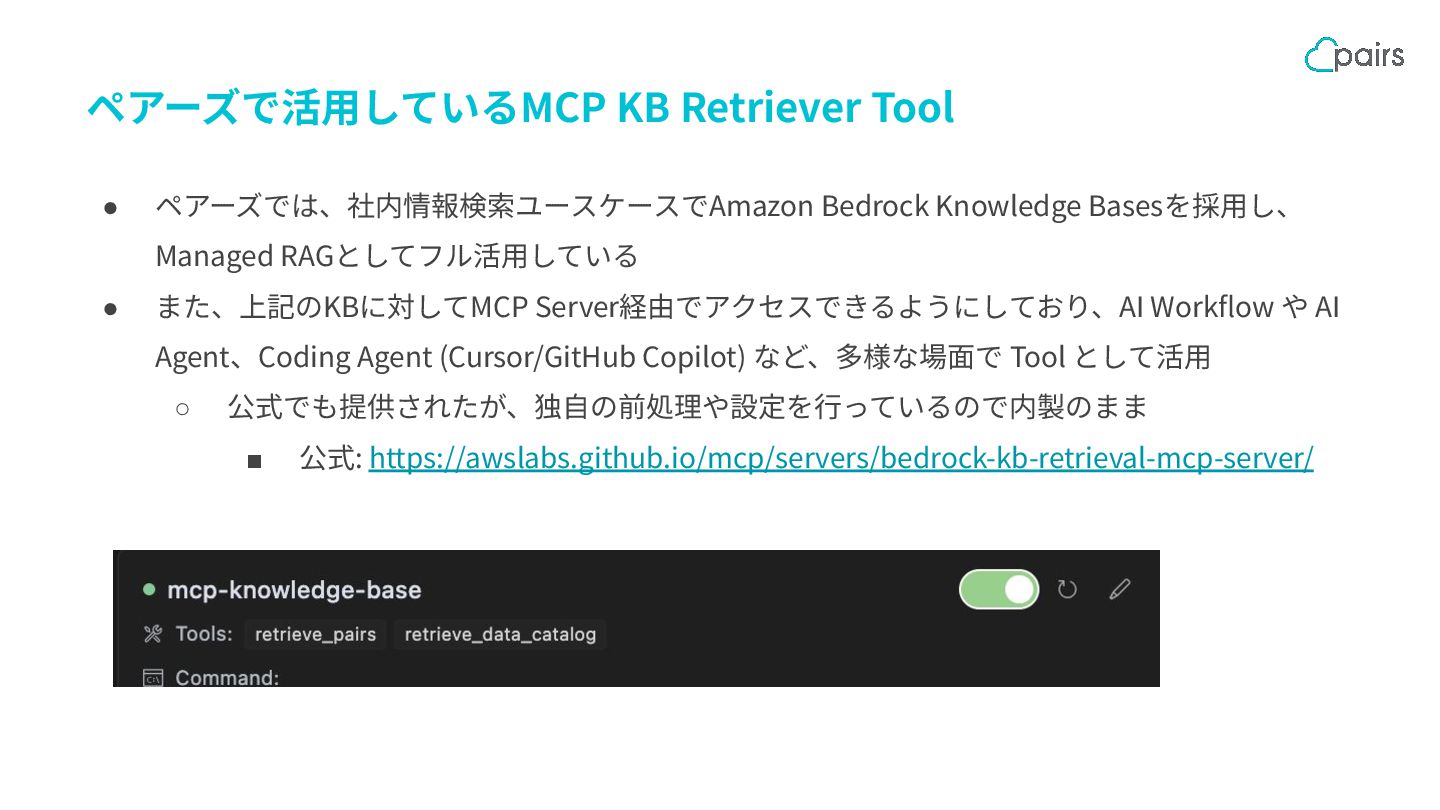
ペアーズで活⽤しているMCP KB Retriever Tool • ペアーズでは、社内情報検索ユースケースでAmazon Bedrock Knowledge Basesを採⽤し、 Managed
RAGとしてフル活⽤している • また、上記のKBに対してMCP Server経由でアクセスできるようにしており、AI Workflow や AI Agent、Coding Agent (Cursor/GitHub Copilot) など、多様な場⾯で Tool として活⽤ ◦ 公式でも提供されたが、独⾃の前処理や設定を⾏っているので内製のまま ▪ 公式: https://awslabs.github.io/mcp/servers/bedrock-kb-retrieval-mcp-server/ -
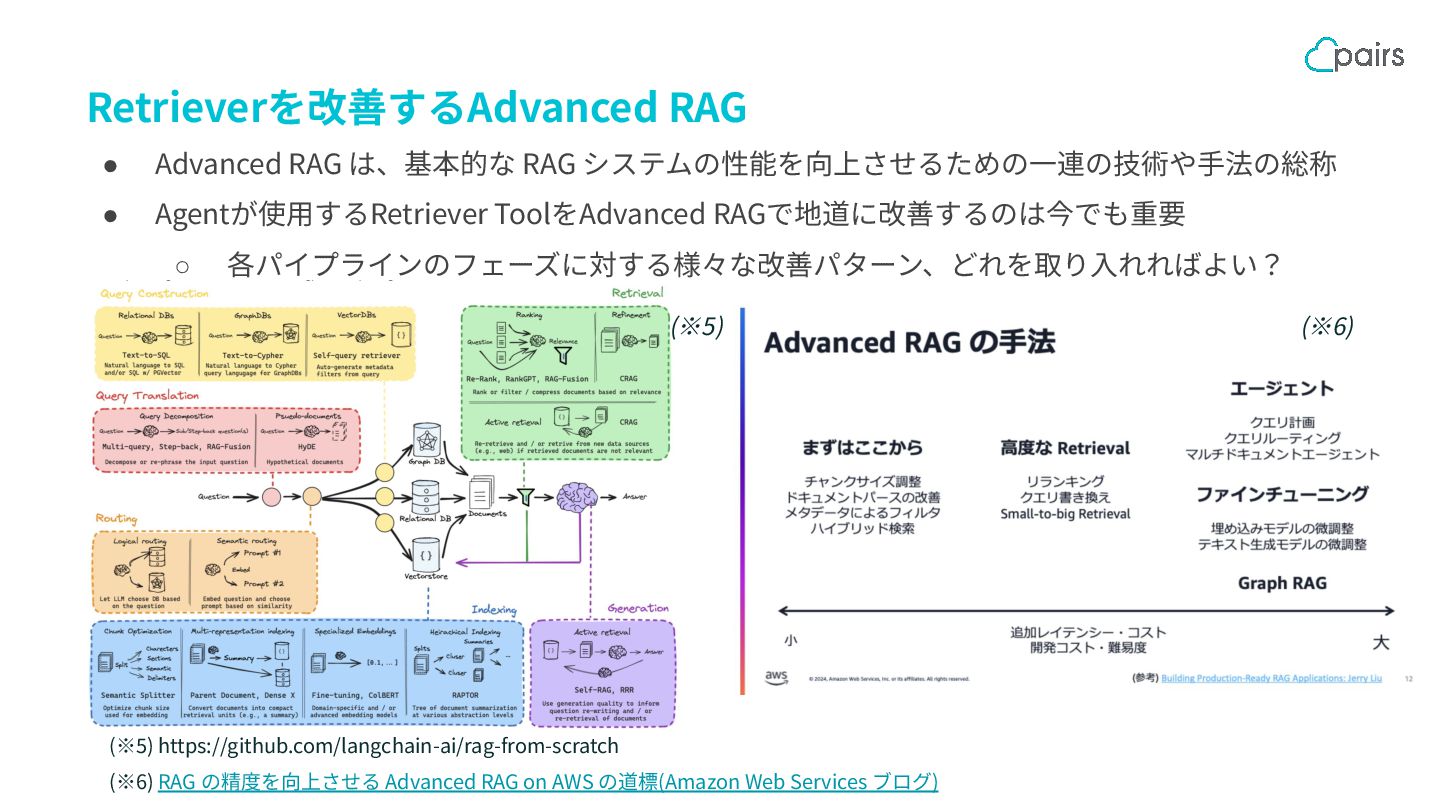
Retrieverを改善するAdvanced RAG (※5) https://github.com/langchain-ai/rag-from-scratch (※5) (※6) RAG の精度を向上させる Advanced RAG
on AWS の道標(Amazon Web Services ブログ) (※6) • Advanced RAG は、基本的な RAG システムの性能を向上させるための⼀連の技術や⼿法の総称 • Agentが使⽤するRetriever ToolをAdvanced RAGで地道に改善するのは今でも重要 ◦ 各パイプラインのフェーズに対する様々な改善パターン、どれを取り⼊れればよい? -
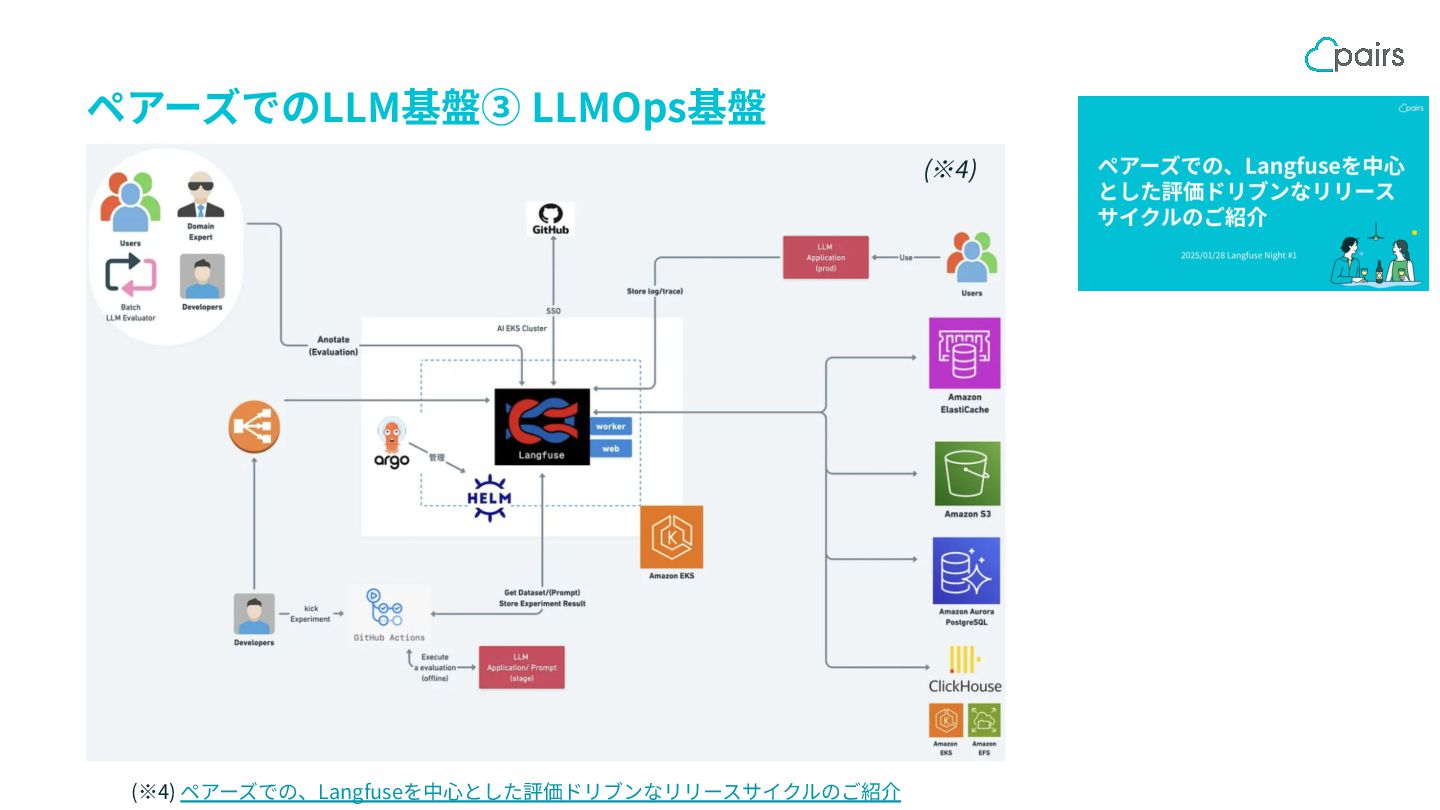
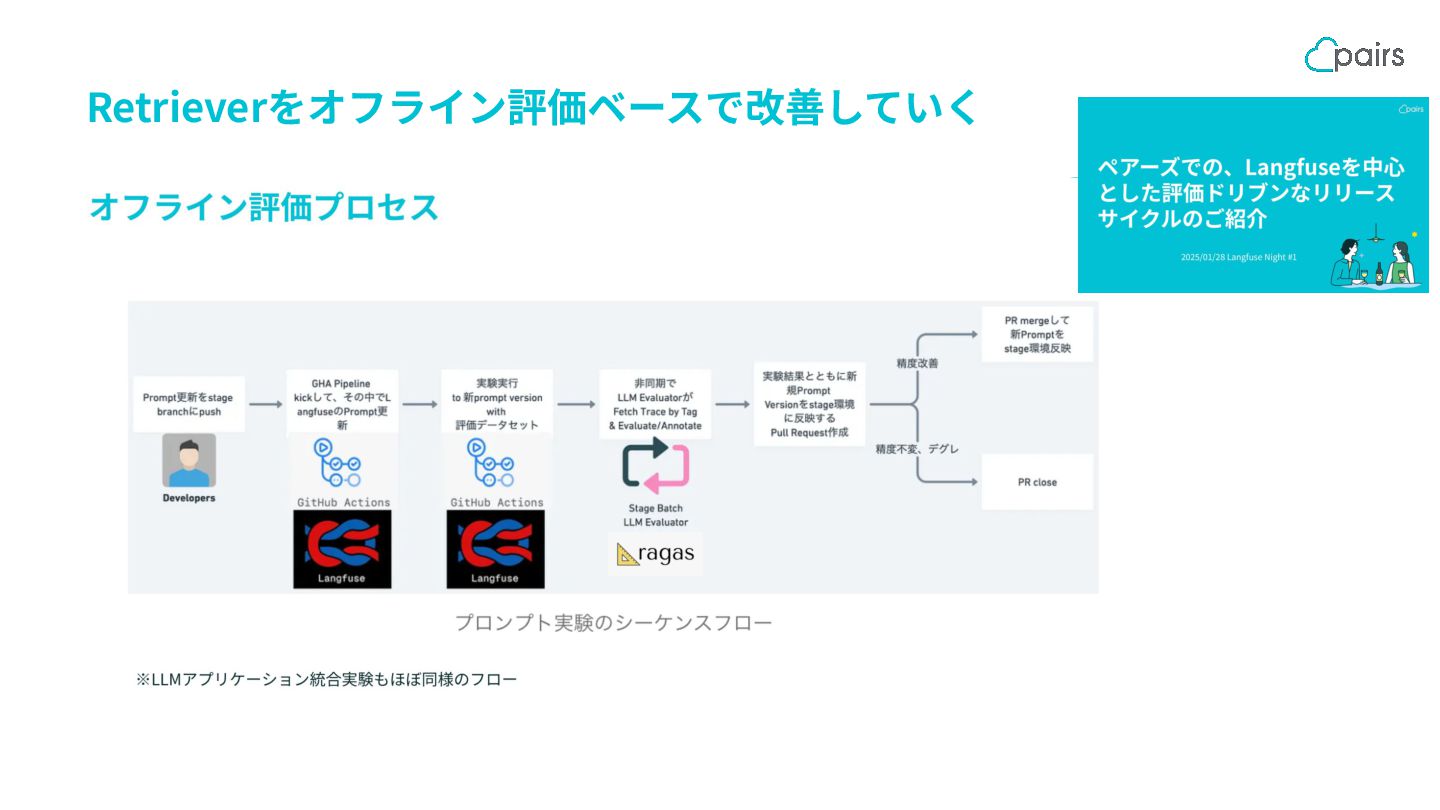
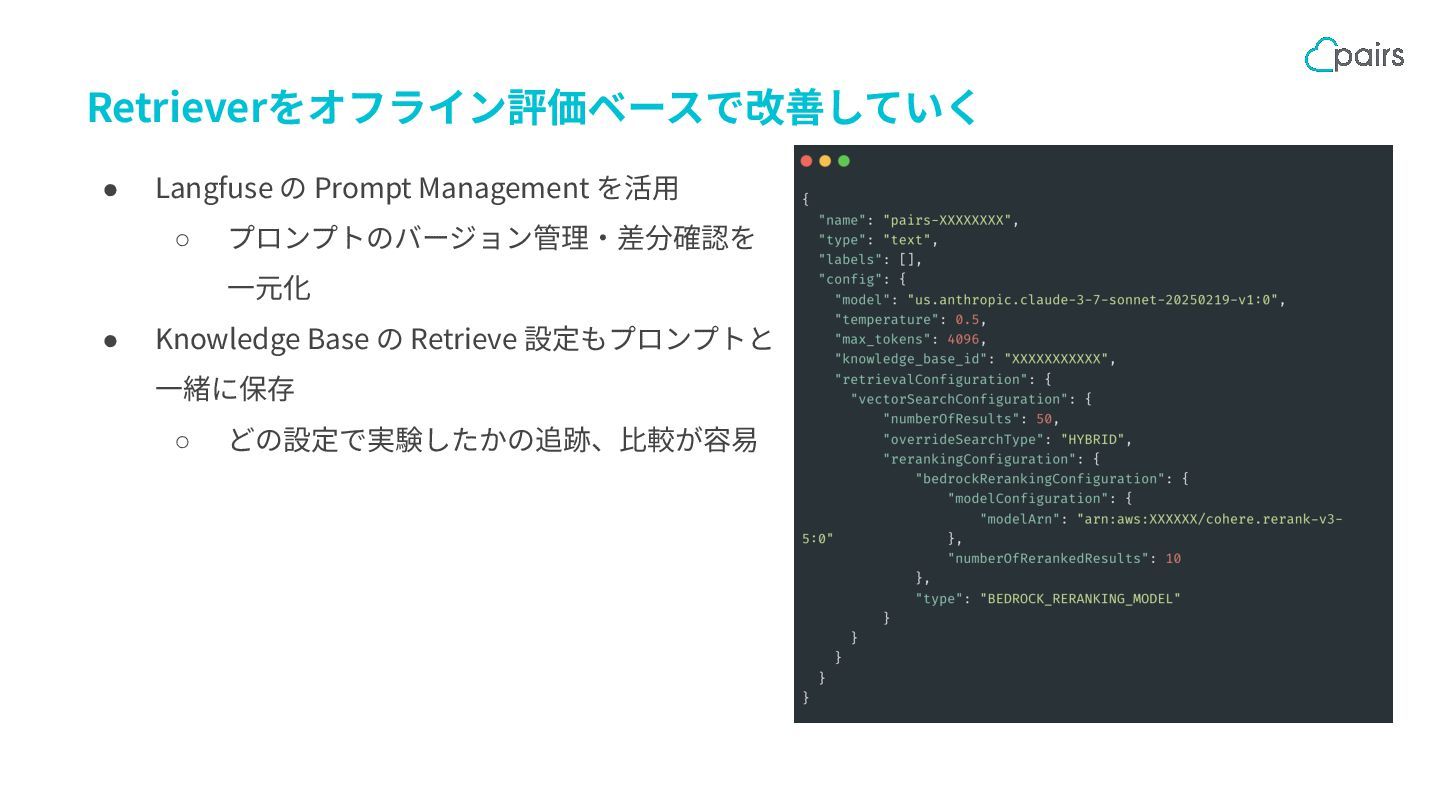
Retrieverをオフライン評価ベースで改善していく • Langfuse の Prompt Management を活⽤ ◦ プロンプトのバージョン管理‧差分確認を ⼀元化
• Knowledge Base の Retrieve 設定もプロンプトと ⼀緒に保存 ◦ どの設定で実験したかの追跡、⽐較が容易 -
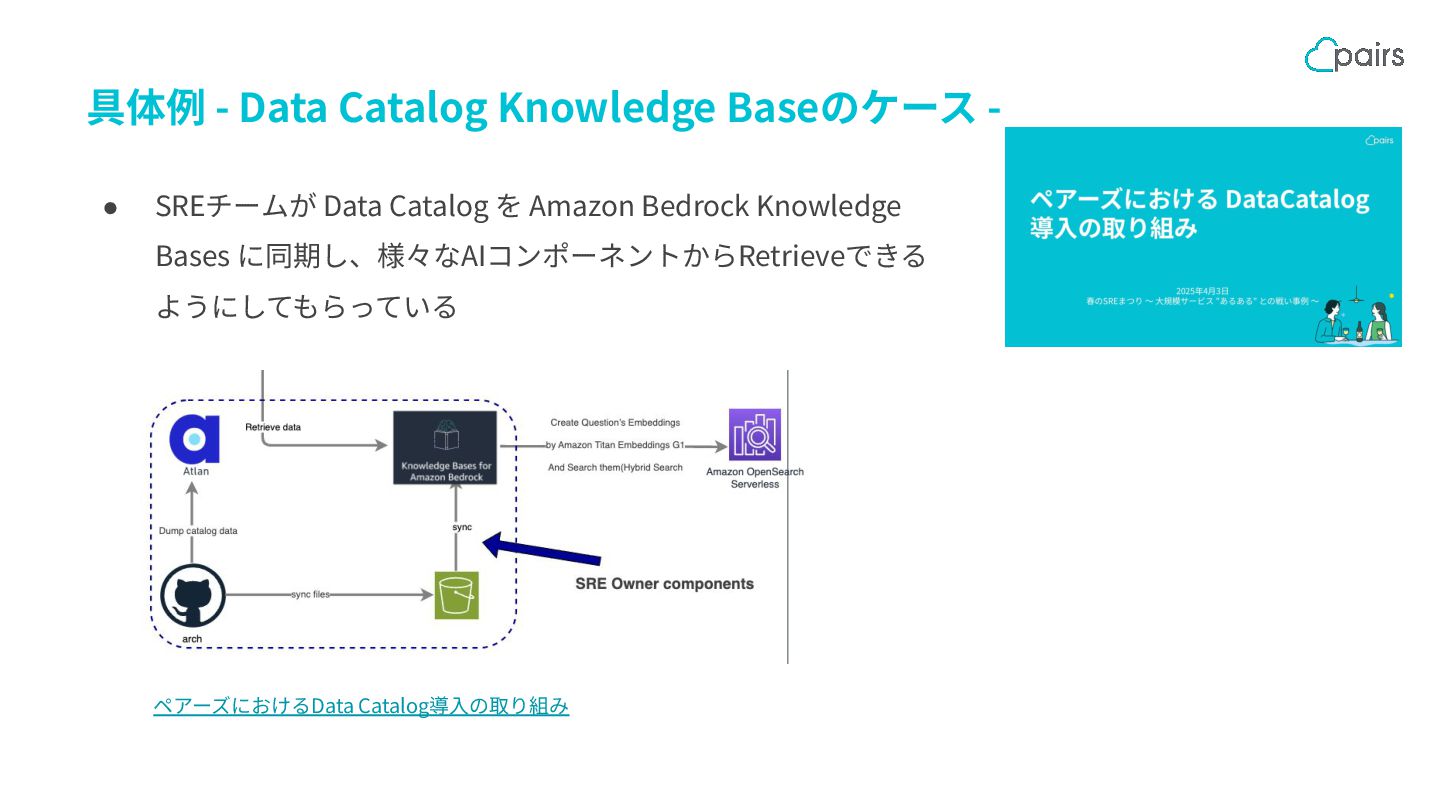
具体例 - Data Catalog Knowledge Baseのケース - • SREチームが Data
Catalog を Amazon Bedrock Knowledge Bases に同期し、様々なAIコンポーネントからRetrieveできる ようにしてもらっている ペアーズにおけるData Catalog導⼊の取り組み -
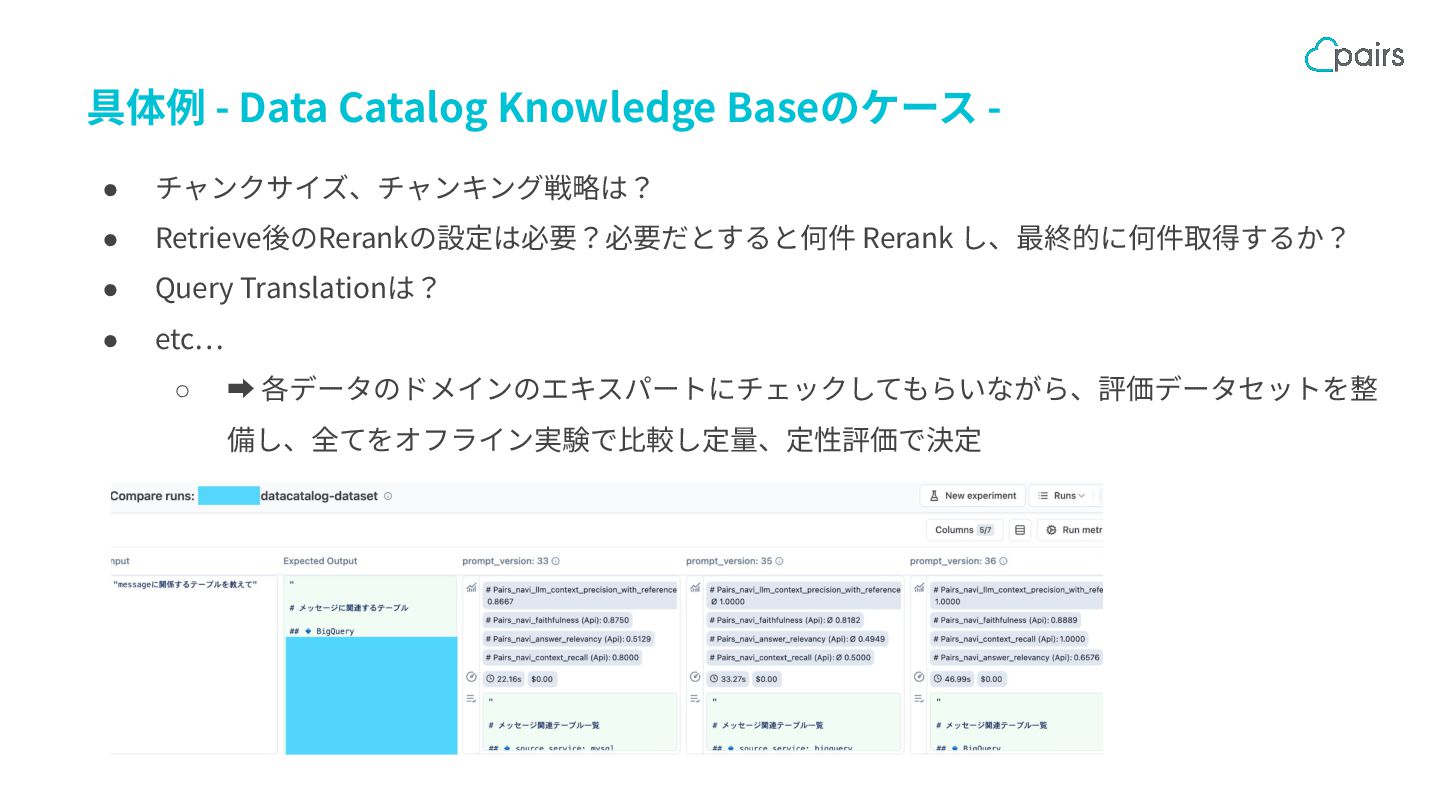
具体例 - Data Catalog Knowledge Baseのケース - • チャンクサイズ、チャンキング戦略は? •
Retrieve後のRerankの設定は必要?必要だとすると何件 Rerank し、最終的に何件取得するか? • Query Translationは? • etc… ◦ ➡ 各データのドメインのエキスパートにチェックしてもらいながら、評価データセットを整 備し、全てをオフライン実験で⽐較し定量、定性評価で決定 -
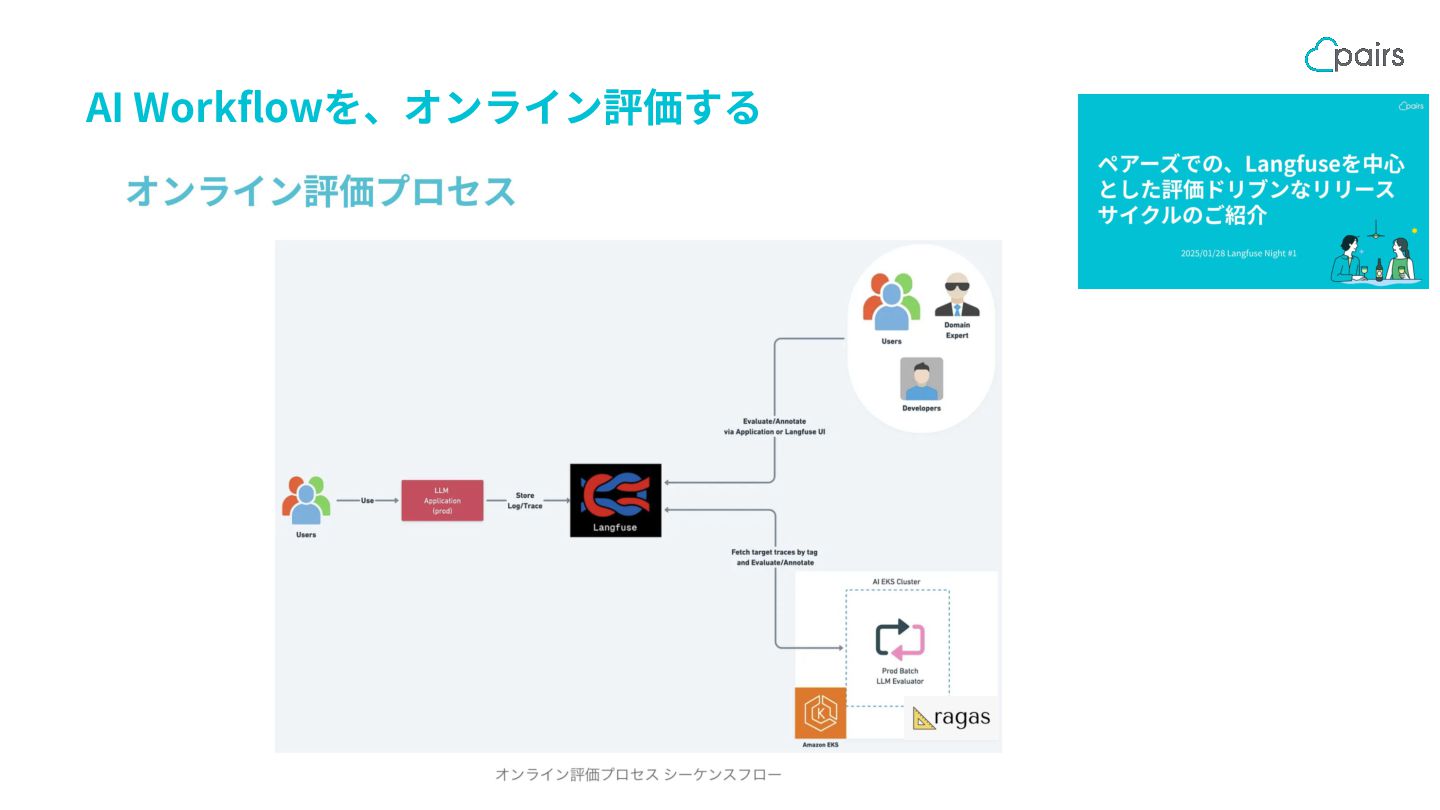
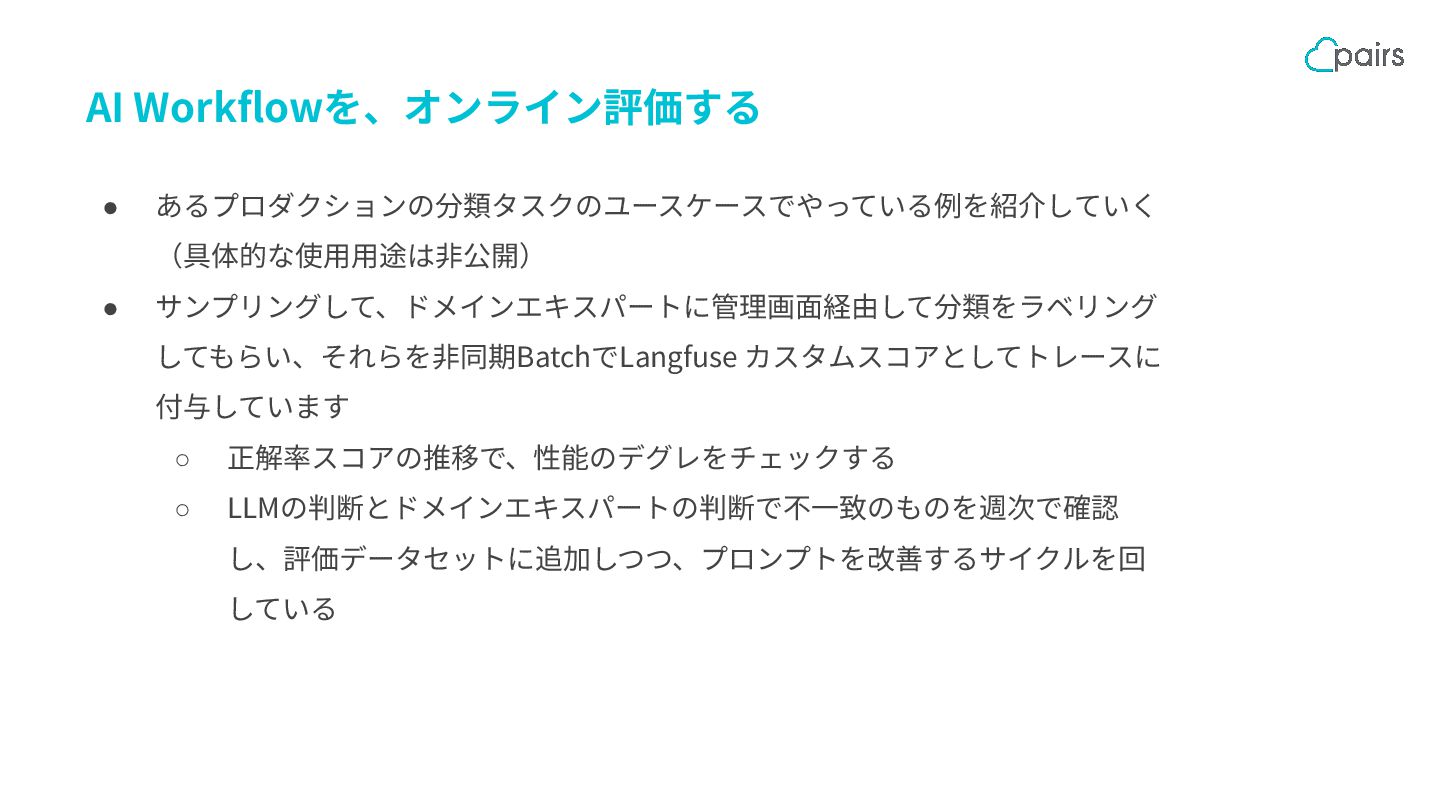
AI Workflowを、オンライン評価する • あるプロダクションの分類タスクのユースケースでやっている例を紹介していく (具体的な使⽤⽤途は⾮公開) • サンプリングして、ドメインエキスパートに管理画⾯経由して分類をラベリング してもらい、それらを⾮同期BatchでLangfuse カスタムスコアとしてトレースに 付与しています
◦ 正解率スコアの推移で、性能のデグレをチェックする ◦ LLMの判断とドメインエキスパートの判断で不⼀致のものを週次で確認 し、評価データセットに追加しつつ、プロンプトを改善するサイクルを回 している -
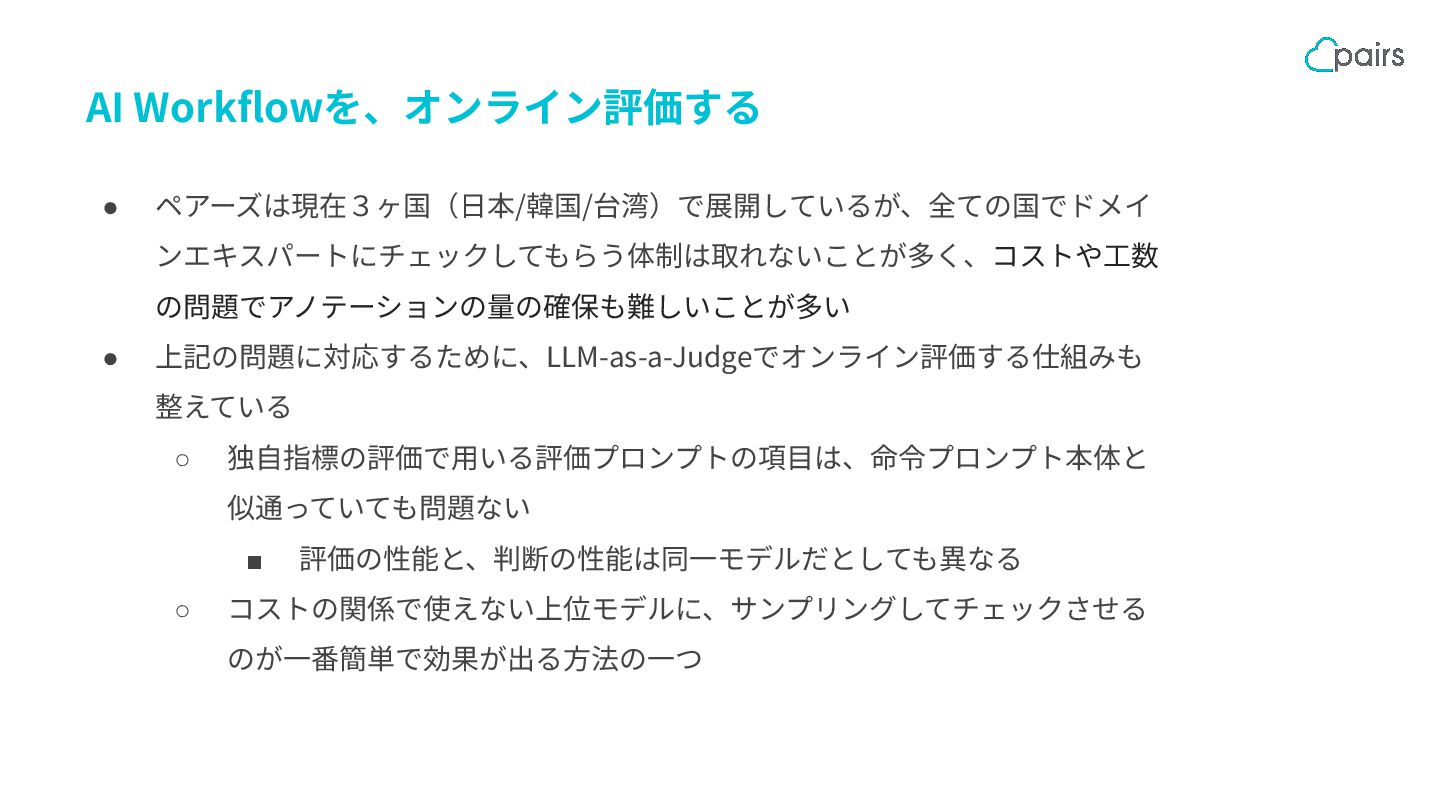
AI Workflowを、オンライン評価する • ペアーズは現在3ヶ国(⽇本/韓国/台湾)で展開しているが、全ての国でドメイ ンエキスパートにチェックしてもらう体制は取れないことが多く、コストや⼯数 の問題でアノテーションの量の確保も難しいことが多い • 上記の問題に対応するために、LLM-as-a-Judgeでオンライン評価する仕組みも 整えている ◦
独⾃指標の評価で⽤いる評価プロンプトの項⽬は、命令プロンプト本体と 似通っていても問題ない ▪ 評価の性能と、判断の性能は同⼀モデルだとしても異なる ◦ コストの関係で使えない上位モデルに、サンプリングしてチェックさせる のが⼀番簡単で効果が出る⽅法の⼀つ -
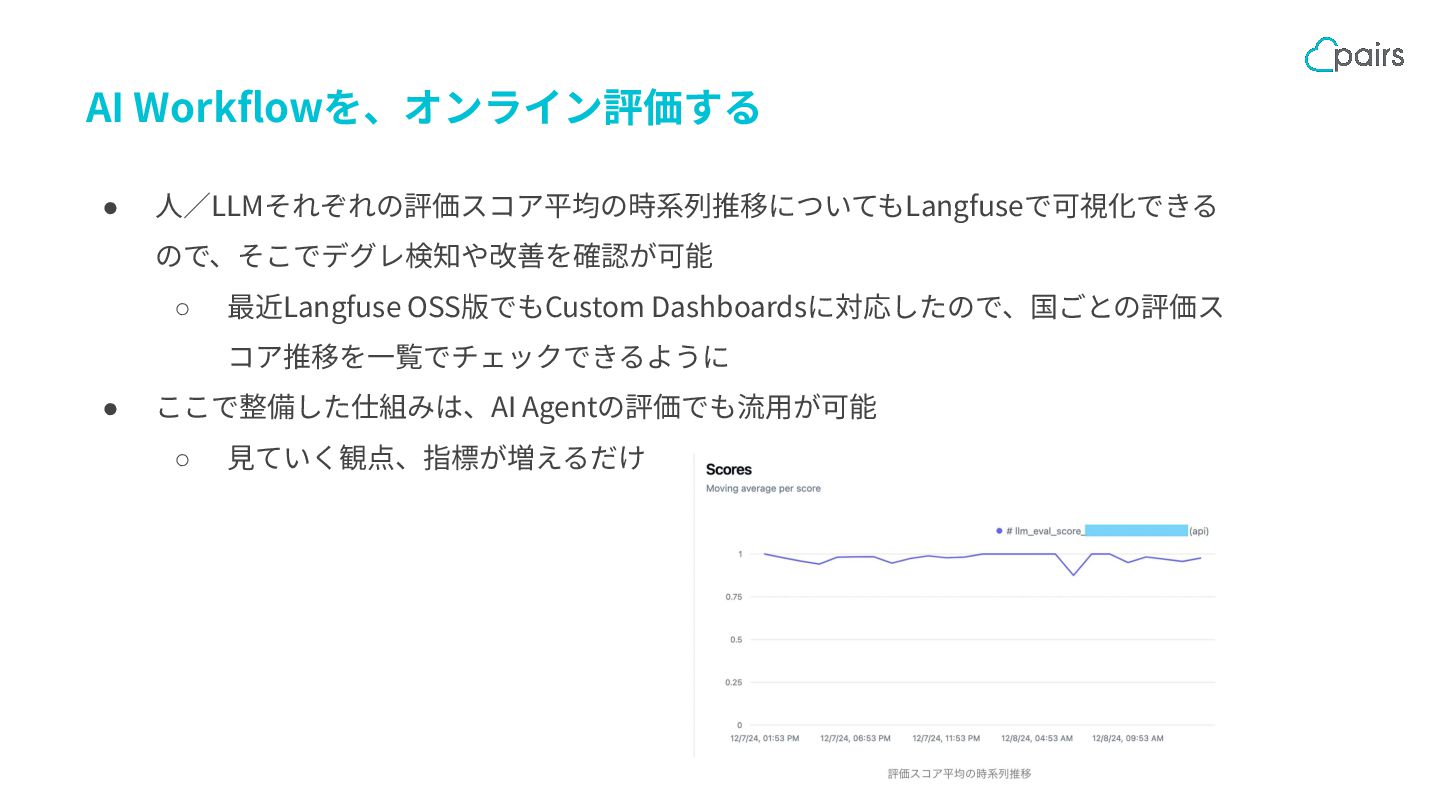
AI Workflowを、オンライン評価する • ⼈∕LLMそれぞれの評価スコア平均の時系列推移についてもLangfuseで可視化できる ので、そこでデグレ検知や改善を確認が可能 ◦ 最近Langfuse OSS版でもCustom Dashboardsに対応したので、国ごとの評価ス コア推移を⼀覧でチェックできるように
• ここで整備した仕組みは、AI Agentの評価でも流⽤が可能 ◦ ⾒ていく観点、指標が増えるだけ -
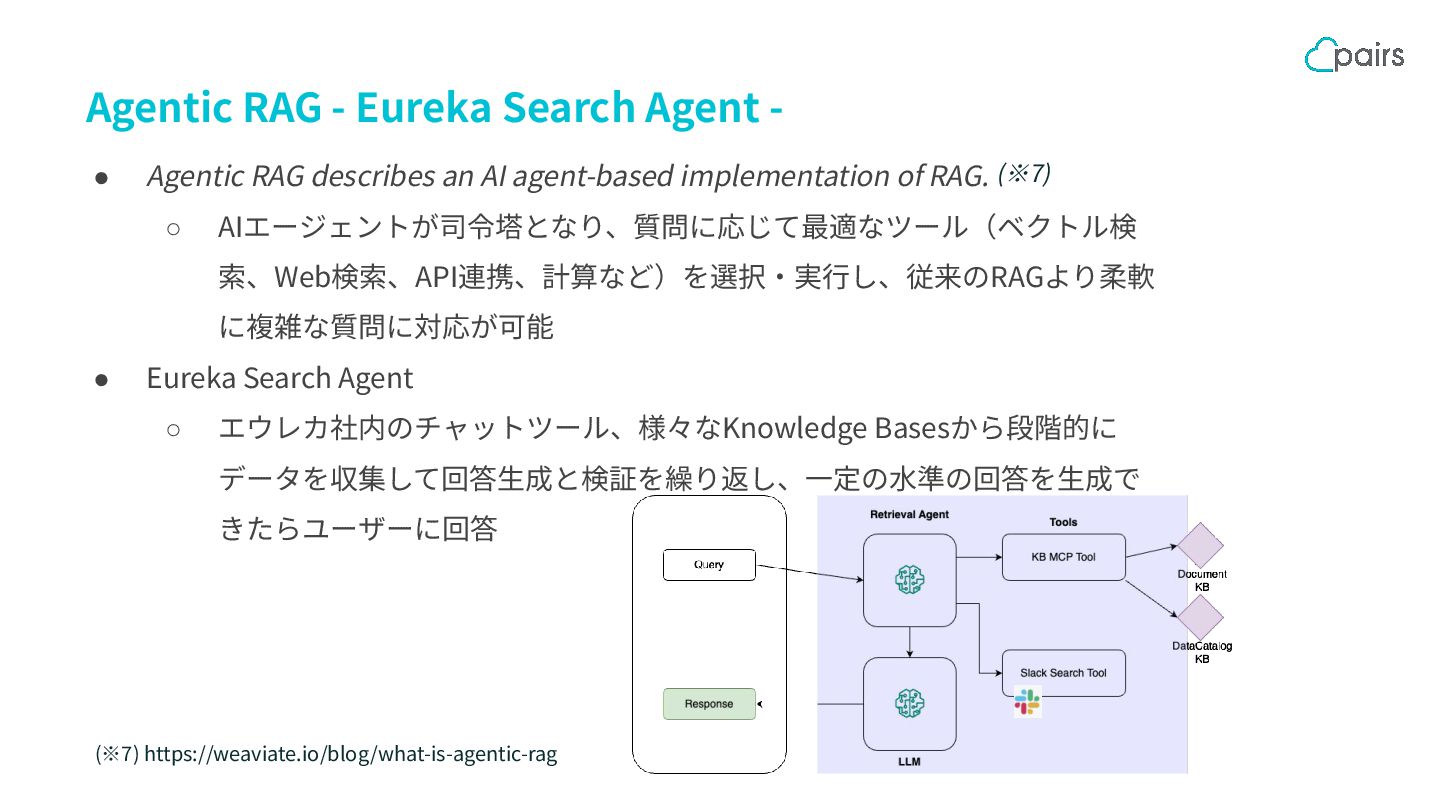
• Agentic RAG describes an AI agent-based implementation of RAG.
◦ AIエージェントが司令塔となり、質問に応じて最適なツール(ベクトル検 索、Web検索、API連携、計算など)を選択‧実⾏し、従来のRAGより柔軟 に複雑な質問に対応が可能 • Eureka Search Agent ◦ エウレカ社内のチャットツール、様々なKnowledge Basesから段階的に データを収集して回答⽣成と検証を繰り返し、⼀定の⽔準の回答を⽣成で きたらユーザーに回答 (※7) https://weaviate.io/blog/what-is-agentic-rag (※7) Agentic RAG - Eureka Search Agent - -
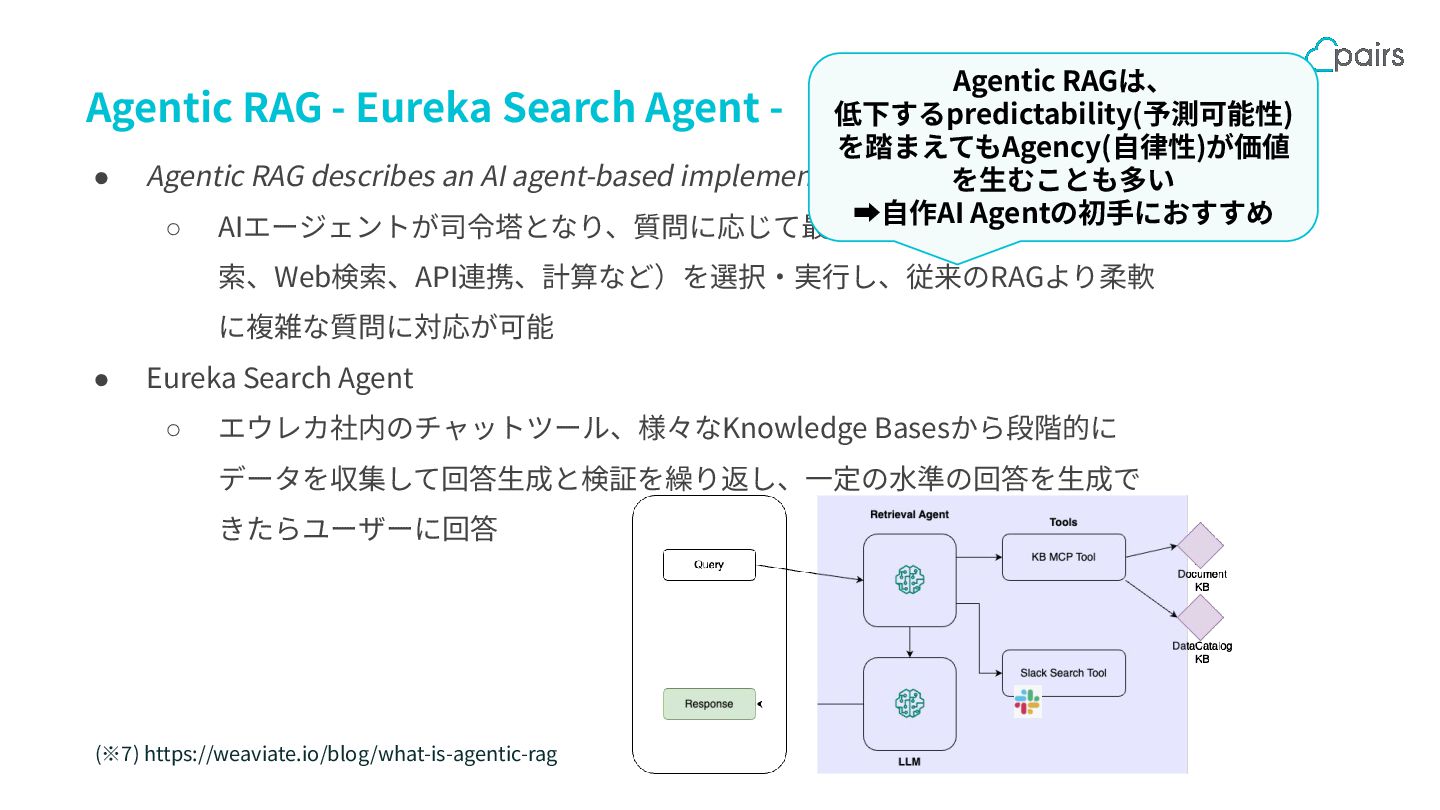
• Agentic RAG describes an AI agent-based implementation of RAG.
◦ AIエージェントが司令塔となり、質問に応じて最適なツール(ベクトル検 索、Web検索、API連携、計算など)を選択‧実⾏し、従来のRAGより柔軟 に複雑な質問に対応が可能 • Eureka Search Agent ◦ エウレカ社内のチャットツール、様々なKnowledge Basesから段階的に データを収集して回答⽣成と検証を繰り返し、⼀定の⽔準の回答を⽣成で きたらユーザーに回答 (※7) https://weaviate.io/blog/what-is-agentic-rag (※7) Agentic RAG - Eureka Search Agent - Agentic RAGは、 低下するpredictability(予測可能性) を踏まえてもAgency(⾃律性)が価値 を⽣むことも多い ➡⾃作AI Agentの初⼿におすすめ -
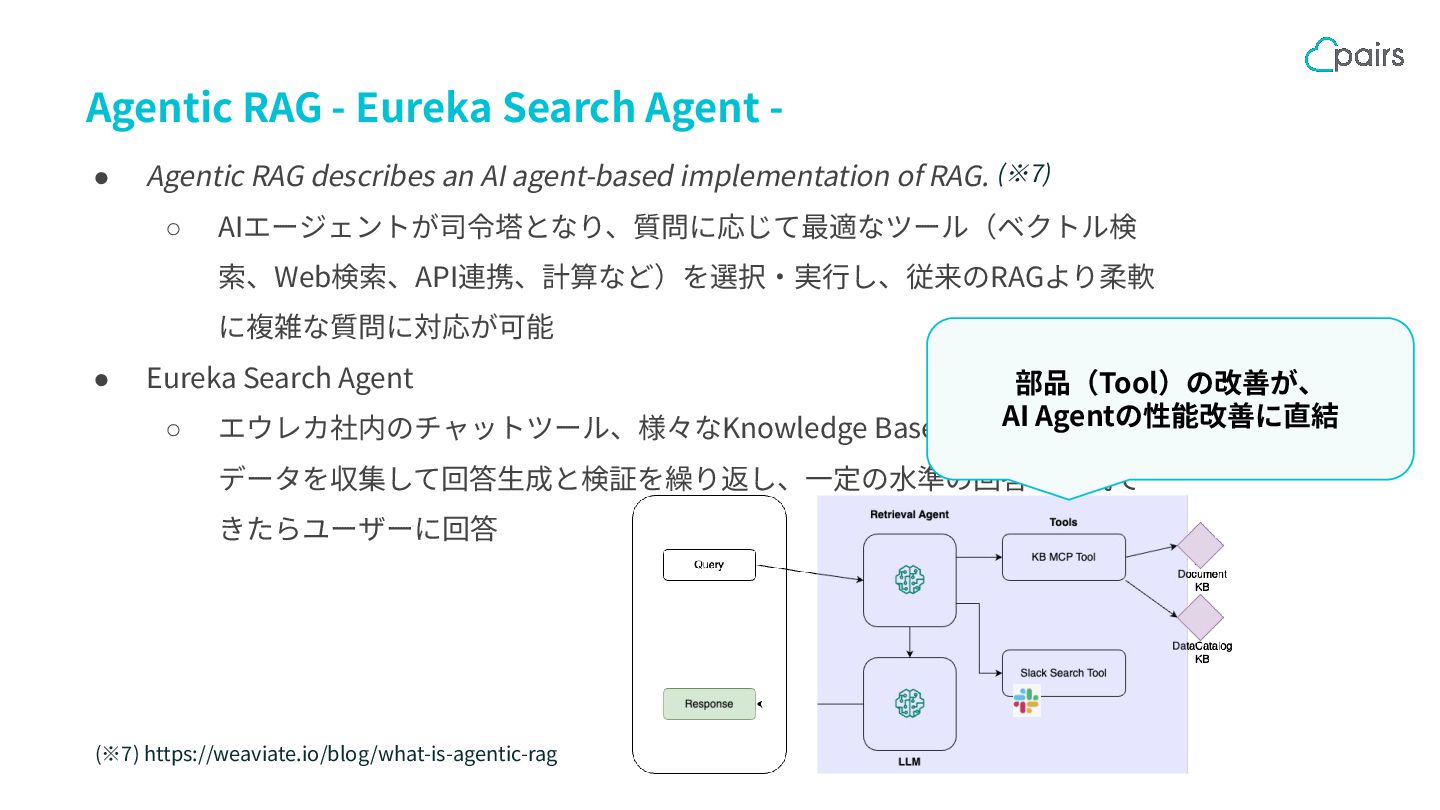
• Agentic RAG describes an AI agent-based implementation of RAG.
◦ AIエージェントが司令塔となり、質問に応じて最適なツール(ベクトル検 索、Web検索、API連携、計算など)を選択‧実⾏し、従来のRAGより柔軟 に複雑な質問に対応が可能 • Eureka Search Agent ◦ エウレカ社内のチャットツール、様々なKnowledge Basesから段階的に データを収集して回答⽣成と検証を繰り返し、⼀定の⽔準の回答を⽣成で きたらユーザーに回答 (※7) https://weaviate.io/blog/what-is-agentic-rag (※7) Agentic RAG - Eureka Search Agent - 部品(Tool)の改善が、 AI Agentの性能改善に直結 -
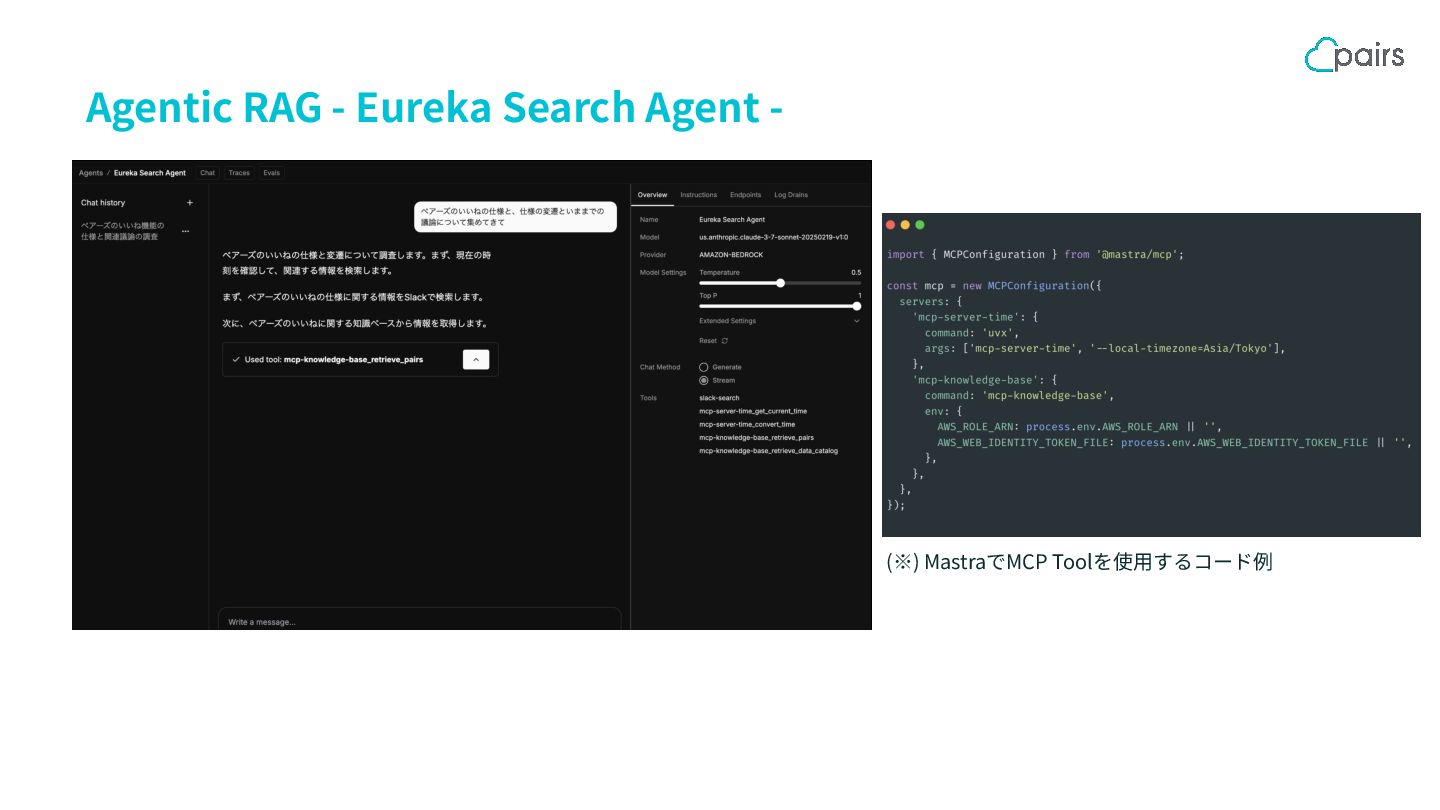
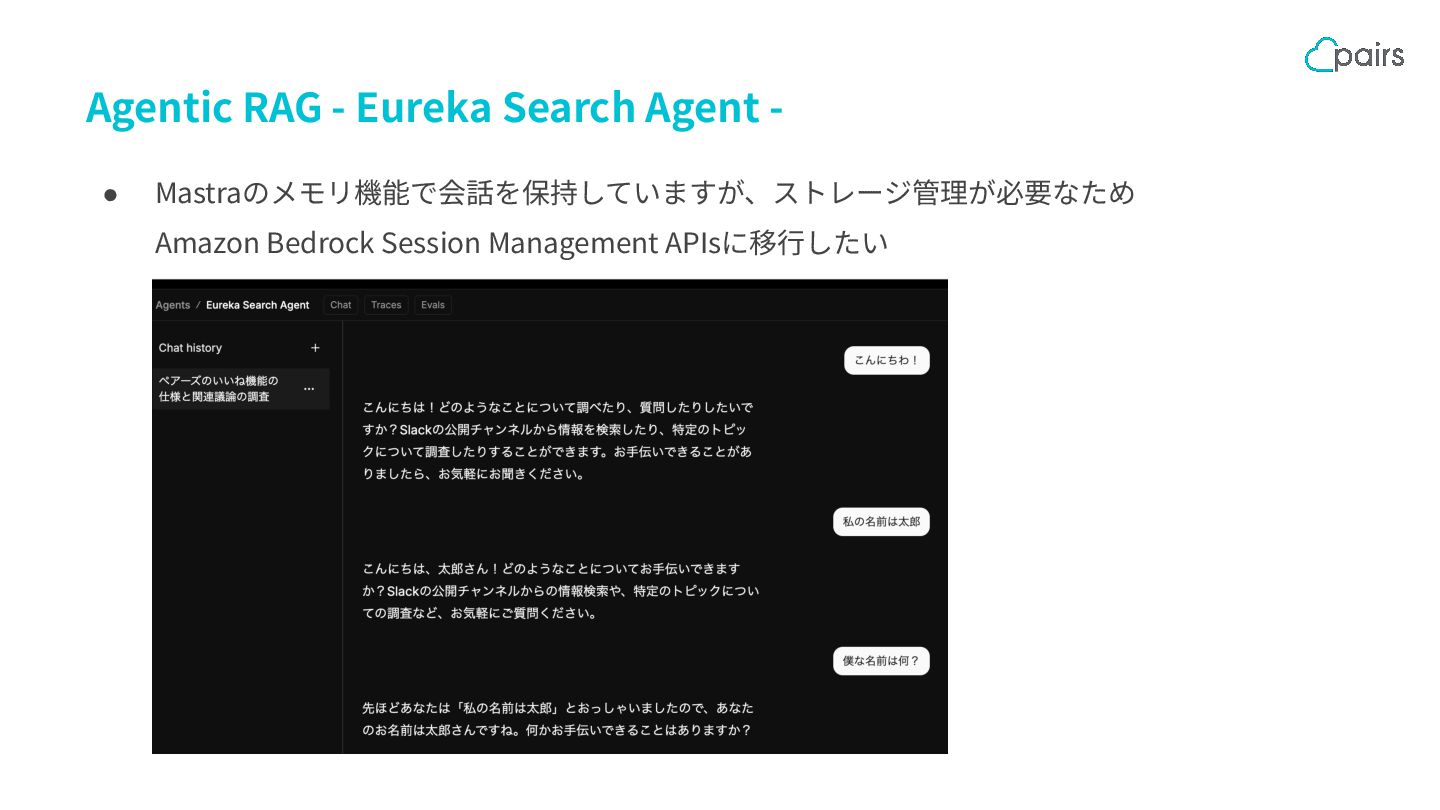
Agentic RAG - Eureka Search Agent - • Mastraのメモリ機能で会話を保持していますが、ストレージ管理が必要なため Amazon
Bedrock Session Management APIsに移⾏したい -
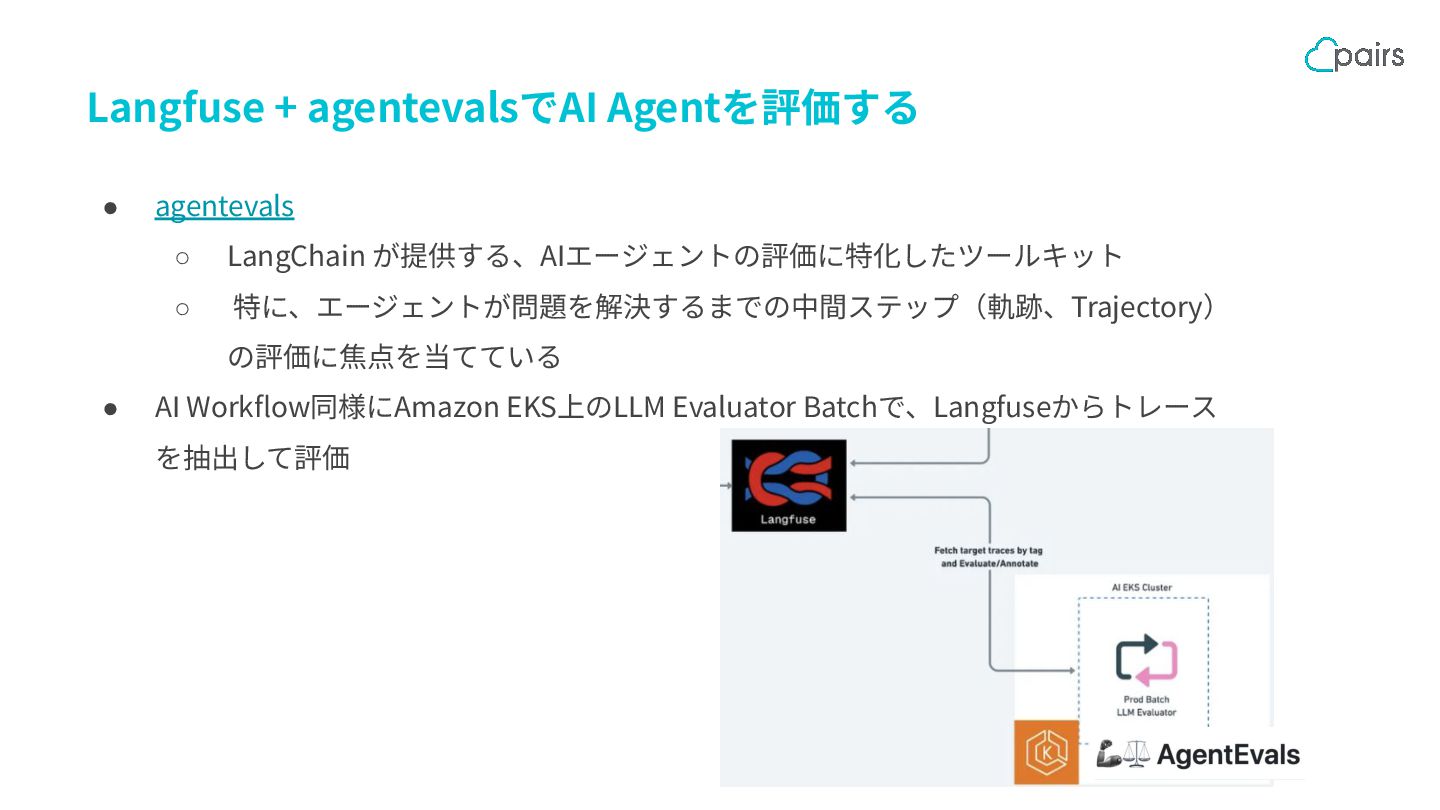
Langfuse + agentevalsでAI Agentを評価する • agentevals ◦ LangChain が提供する、AIエージェントの評価に特化したツールキット ◦
特に、エージェントが問題を解決するまでの中間ステップ(軌跡、Trajectory) の評価に焦点を当てている • AI Workflow同様にAmazon EKS上のLLM Evaluator Batchで、Langfuseからトレース を抽出して評価 -
Langfuse + agentevalsでAI Agentを評価する • 最終出⼒だけでなく以下の指標をLLM-as-a-Judgeでオンライン評価し、カスタムスコア として保存 ◦ Trajectory Accuracy
▪ create_trajectory_llm_as_judge関数 + TRAJECTORY_ACCURACY_PROMPT(事前 定義済みプロンプト) ▪ エージェントが⽬標達成のために、論理的で効率的なステップを踏んでいるか。 ユーザーの指⽰に沿って、適切なツールコールや判断を⾏っているか。 ◦ カスタム評価指標 ▪ create_trajectory_llm_as_judge関数は、評価⽤のプロンプトをカスタマイズする ことで、特定の観点に基づいた独⾃の評価指標を設定可能。あるケースではこの Toolを必ず呼び出さないといけないなどを設定できる -
まとめ • AI AgentはAI WorkflowやRAG、システムを淘汰するものではない ◦ 固定な計画でいいものはAI Workflowで、なんならLLMによる推論が不要なら ルールベースなシステムで⼗分なこともまだまだ多い ◦
そして、AI Agent⾃体がRAGやWorkflowをToolとしてよびだすことが多くあるため、 継続評価を通してコントローラブルに改善していったRAGやAI Workflowは、 AI Agent時代にも武器になる • AI Agentの評価は、最終出⼒だけでなく軌跡(Trajectory)も評価してコントローラブルにしつつ、 コストと効⽤のバランスを重要視する ◦ ⾃作AI Agentと初⼿としては、まずAgentic RAGをシングルエージェントで始めるのが、 ⾃律性(Agency)の価値を感じやすいのでおすすめ ◦ AI Workflowの評価の仕組みを流⽤することができる ◦ 動的計画な柔軟性、⾃律性(Agency)は、コスト向上や予測可能性(predictability)の低下を 踏まえても、ユーザーにとって価値を⼗分に産んでいるかをケアしながら調整する