Upgrade to Pro
— share decks privately, control downloads, hide ads and more …
Speaker Deck
Sign up for free
Menu
Search
Features
All features
Private URLs
Password Protection
Custom URLS
Scheduled publishing
Remove Branding
Restrict embedding
Deck Collections
Notes
Features
All features
Private URLs
Password Protection
Custom URLS
Scheduled publishing
Remove Branding
Restrict embedding
Deck Collections
Notes
Explore
Featured decks
Featured speakers
Programming
Technology
Storyboards
Explore
Featured decks
Featured speakers
Programming
Technology
Storyboards
Pricing
Search
Sign in
Sign up for free
多彩なデータに負けないデータ分析パイプライン構築
Search
gree_tech
PRO
October 16, 2026
Technology
13
0
Share
Embed
Copy iframe code
Copy JS code
Copy link
Start on current slide
多彩なデータに負けないデータ分析パイプライン構築
GREE Tech Conference 2026で発表された資料です。
https://techcon.gree.jp/2026/session/TrackA-1
gree_tech
PRO
October 16, 2026
More Decks by gree_tech
See All by gree_tech
AI駆動で挑むプロダクト刷新 ── アーキテクチャ設計とワークフロー最適化の実践事例 ──
gree_tech
PRO
0
13
『ヘブンバーンズレッド』のリグレッションテストにおけるストーリーの自動プレイ
gree_tech
PRO
0
14
REALITYにTAチームができるまでの軌跡〜ミッション:ガチャ本数5倍に対応せよ!〜
gree_tech
PRO
0
11
イベント続きでもミスらないライブサービスゲーム公式サイト運用システム開発
gree_tech
PRO
0
12
20年間 SNS サービス「GREE」 を支えた技術の刷新と、長期運用サービスの Kubernetes へのリアーキテクト
gree_tech
PRO
0
50
グラフ基盤ワークフローで実現するLLMによる自動ゲームプレイ
gree_tech
PRO
0
15
AIエージェントに脆弱性診断の仕事を奪われかけた ークローリングからコード全診断までの限界突破ー
gree_tech
PRO
0
21
アバター使っておもろいものを作り続けたい
gree_tech
PRO
0
12
爆速開発を支えるAIワークフローの現在地 ── AIが読めるデザインをどうつくるか
gree_tech
PRO
0
12
Other Decks in Technology
See All in Technology
⾮構造化データを価値に変える AI エージェント基盤とその組織
ivry_presentationmaterials
0
160
DGX Spark でどこまでハッキングができるのか?
kash1064
2
1.2k
継続的なAIコスト最適化
bgpat
1
300
LocalStack を使ったサーバーレスアプリケーション開発 / Serverless Development with LocalStack
kakakakakku
1
440
ソフトウェア ファクトリー - 再現性のあるソフトウェアの工場づくり / Software factory
iktakahiro
5
3.8k
脆弱性診断って、何をしているの? 〜弱点を見つけて、会社の改善につなげるまで〜
keeg
0
900
会社説明資料
persolserverworks
0
9.7k
転んだ話が背中を預ける理由になる / A_story_about_falling_down_gives_you_a_reason_to_watch_each_other_s_backs.pdf
pauli
3
370
子育てエンジニアの可処分時間が減っても成長を諦めない戦い方
sudoakiy
6
4.5k
PagerDuty Tech Hub-鳴らすけれど、人は動かない
ezaki
0
130
二歩目のフロントエンド・ウェブアクセシビリティ
camiha
2
480
Datadog の学び方 - あるいは、オブザーバビリティを学ぶとは何か
mananyuki
1
560
Featured
See All Featured
BBQ
matthewcrist
90
10k
SEO in 2025: How to Prepare for the Future of Search
ipullrank
3
3.9k
世界の人気アプリ100個を分析して見えたペイウォール設計の心得
akihiro_kokubo
PRO
74
43k
Data-driven link building: lessons from a $708K investment (BrightonSEO talk)
szymonslowik
1
1.4k
From π to Pie charts
rasagy
1
400
Technical Leadership for Architectural Decision Making
baasie
3
600
How to Build an AI Search Optimization Roadmap - Criteria and Steps to Take #SEOIRL
aleyda
1
2.2k
CSS Pre-Processors: Stylus, Less & Sass
bermonpainter
360
31k
Reflections from 52 weeks, 52 projects
jeffersonlam
356
22k
Tell your own story through comics
letsgokoyo
1
1.1k
Digital Projects Gone Horribly Wrong (And the UX Pros Who Still Save the Day) - Dean Schuster
uxyall
1
3.4k
4 Signs Your Business is Dying
shpigford
187
23k
Transcript
多彩なデータに負けない データ分析パイプライン構築 グリーエックス株式会社 山内 一貴
山内一貴 グリーエックス株式会社 データエンジニア 新卒ではメーカー企業での性能検査ソフトウェア 開発を経験したのち、2024年にGlossom株式会社 に入社。 現在はグリーエックス株式会社のデータエンジニ アとして、DXコンサルティング事業におけるデー タ分析基盤の整備・運用を担当。 2
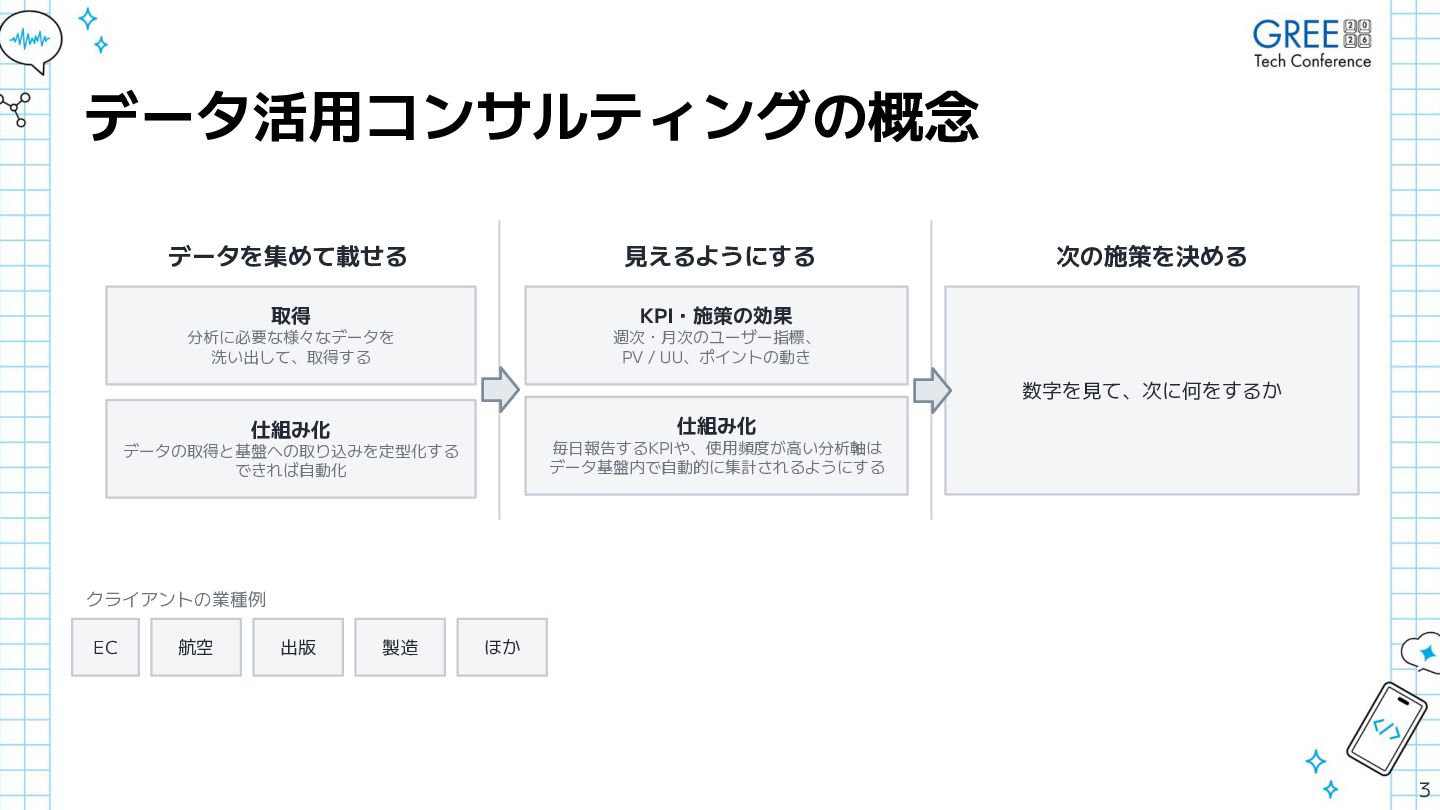
データ活用コンサルティングの概念 データを集めて載せる 見えるようにする 取得 KPI・施策の効果 分析に必要な様々なデータを 洗い出して、取得する 週次・月次のユーザー指標、 PV /
UU、ポイントの動き 次の施策を決める 数字を見て、次に何をするか 仕組み化 仕組み化 データの取得と基盤への取り込みを定型化する できれば自動化 毎日報告するKPIや、使用頻度が高い分析軸は データ基盤内で自動的に集計されるようにする クライアントの業種例 EC 航空 出版 製造 ほか 3
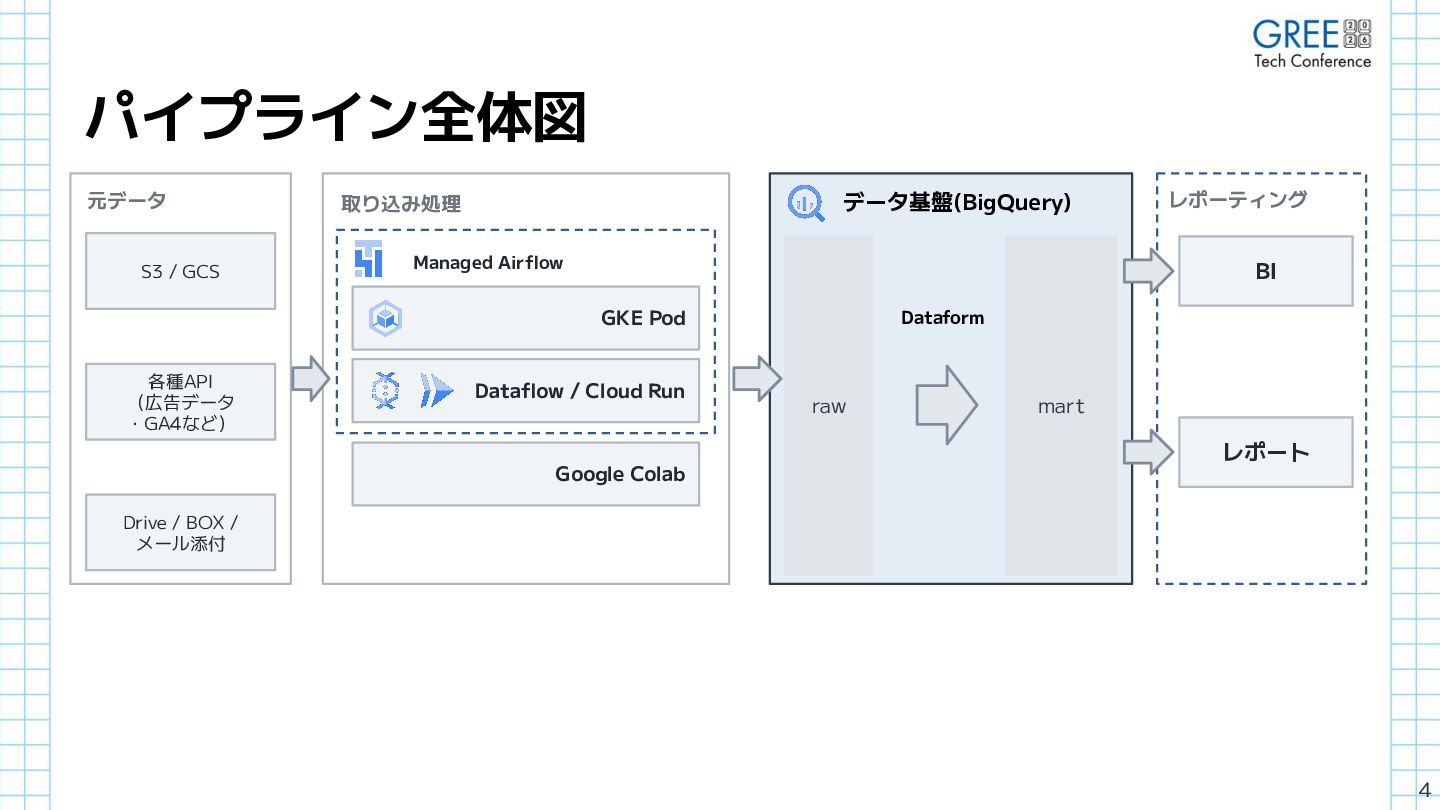
パイプライン全体図 元データ S3 / GCS データ基盤(BigQuery) 取り込み処理 Managed Airflow BI
GKE Pod 各種API (広告データ ・GA4など) レポーティング Dataflow / Cloud Run Dataform raw mart レポート Google Colab Drive / BOX / メール添付 4
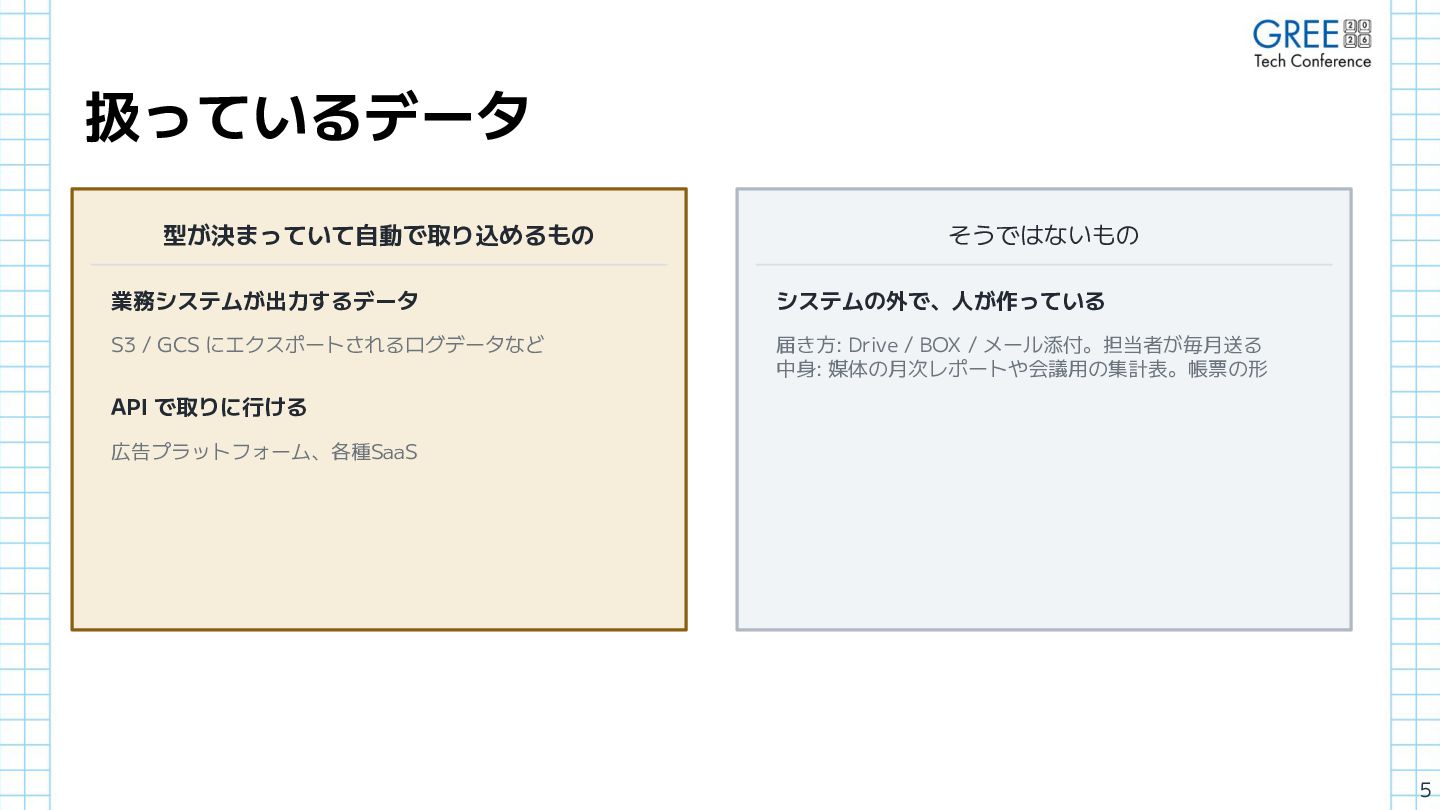
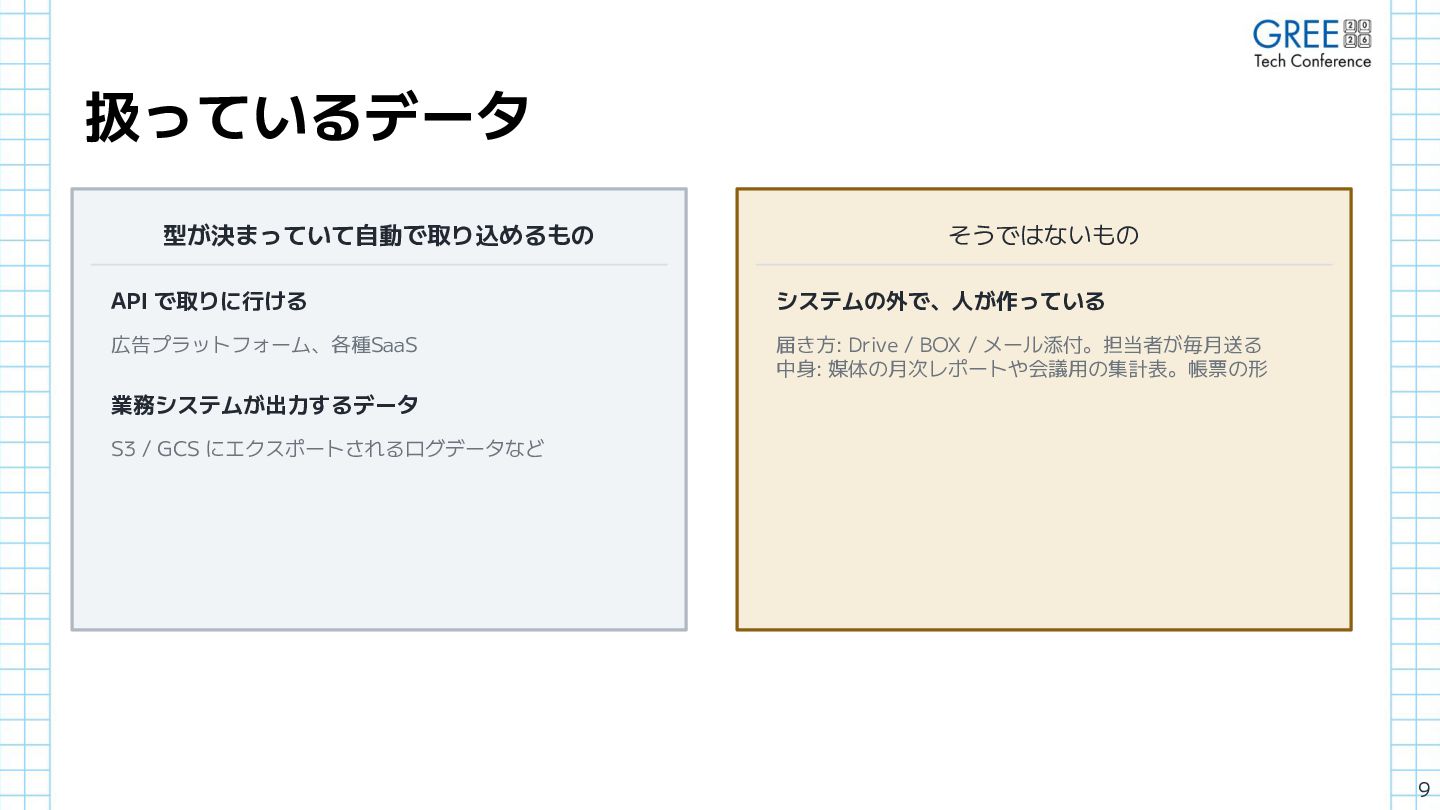
扱っているデータ 型が決まっていて自動で取り込めるもの そうではないもの 業務システムが出力するデータ システムの外で、人が作っている S3 / GCS にエクスポートされるログデータなど 届き方:
Drive / BOX / メール添付。担当者が毎月送る 中身: 媒体の月次レポートや会議用の集計表。帳票の形 API で取りに行ける 広告プラットフォーム、各種SaaS 5
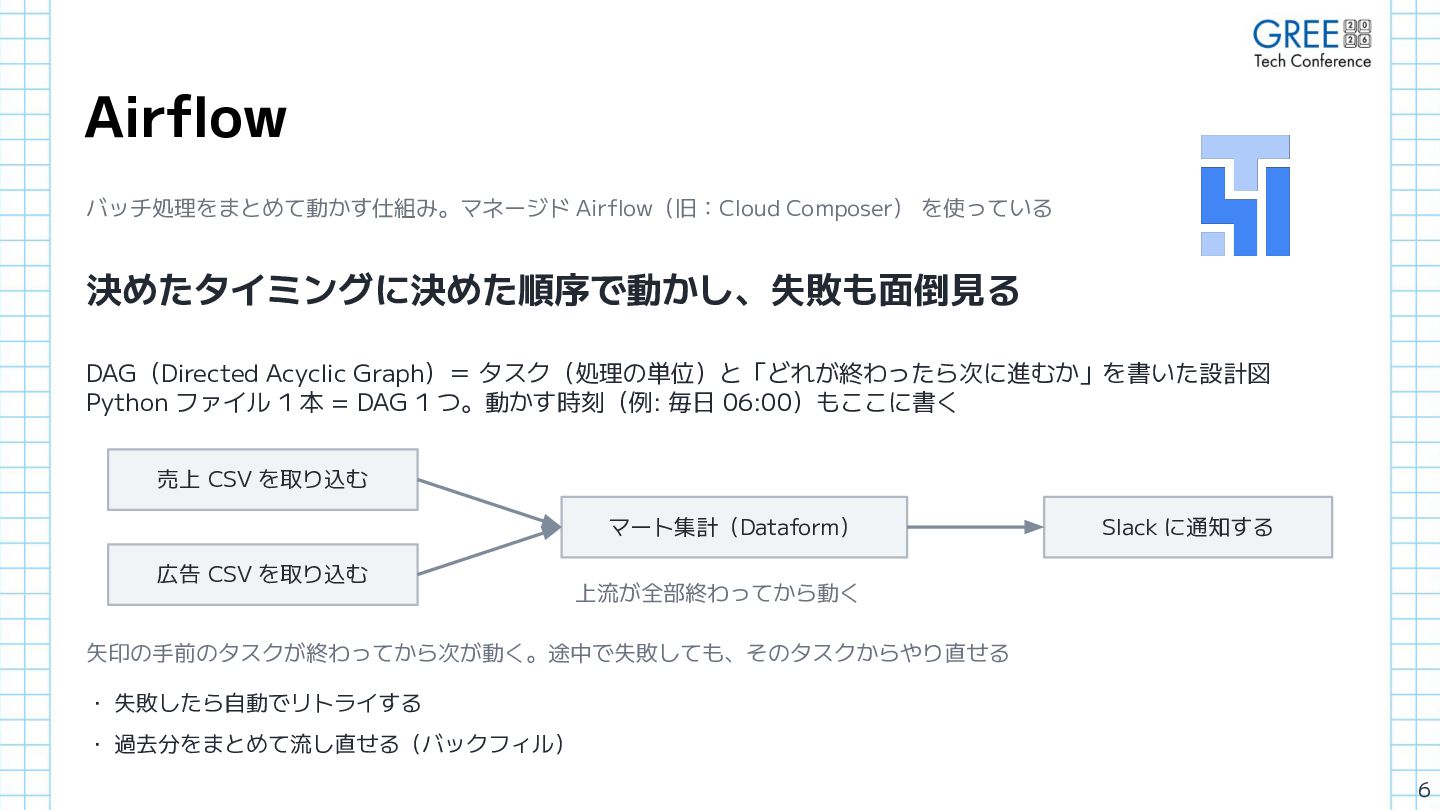
Airflow バッチ処理をまとめて動かす仕組み。マネージド Airflow(旧:Cloud Composer) を使っている 決めたタイミングに決めた順序で動かし、失敗も面倒見る DAG(Directed Acyclic Graph)= タスク(処理の単位)と「どれが終わったら次に進むか」を書いた設計図
Python ファイル 1 本 = DAG 1 つ。動かす時刻(例: 毎日 06:00)もここに書く 売上 CSV を取り込む マート集計(Dataform) 広告 CSV を取り込む Slack に通知する 上流が全部終わってから動く 矢印の手前のタスクが終わってから次が動く。途中で失敗しても、そのタスクからやり直せる ・ 失敗したら自動でリトライする ・ 過去分をまとめて流し直せる(バックフィル) 6
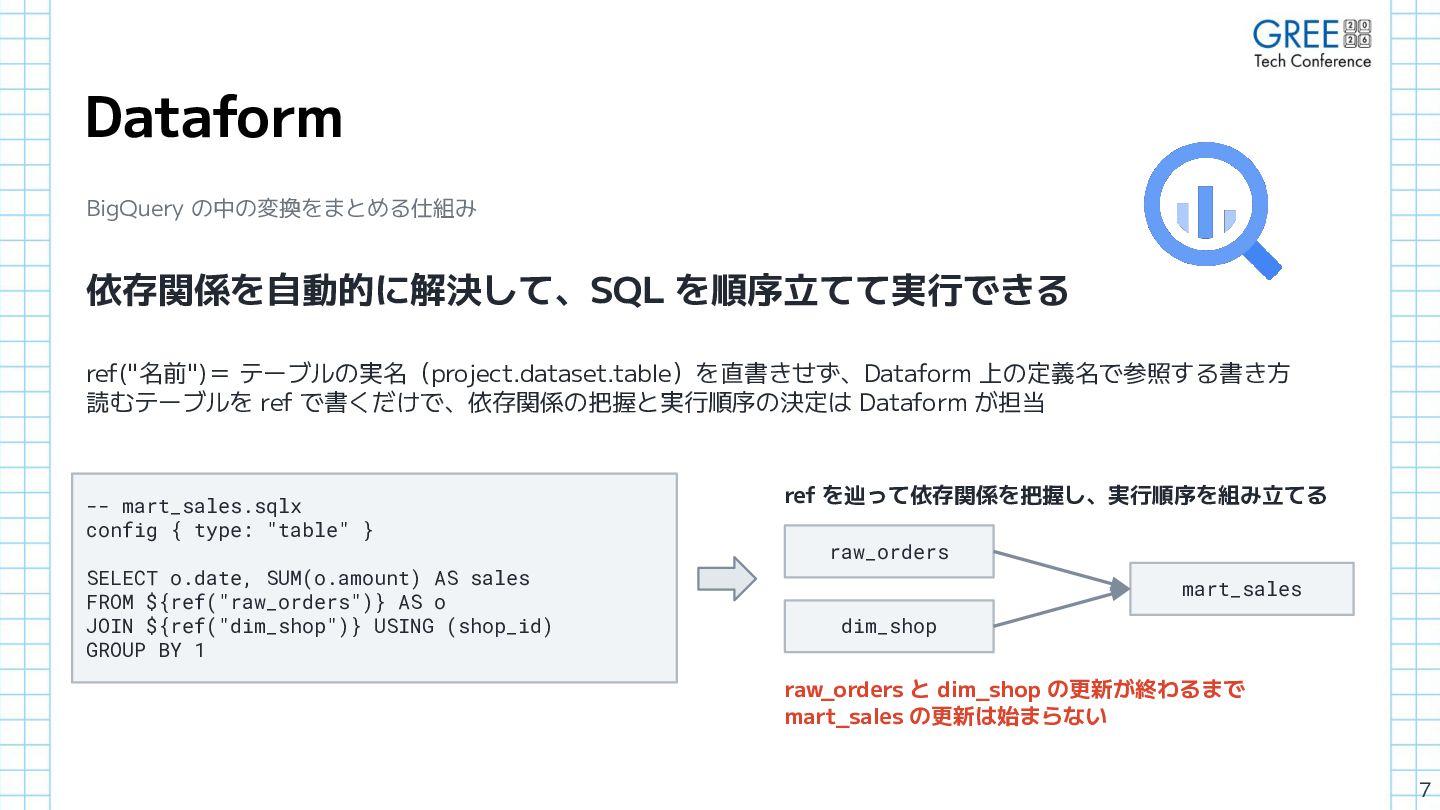
Dataform BigQuery の中の変換をまとめる仕組み 依存関係を自動的に解決して、SQL を順序立てて実行できる ref("名前")= テーブルの実名(project.dataset.table)を直書きせず、Dataform 上の定義名で参照する書き方 読むテーブルを ref
で書くだけで、依存関係の把握と実行順序の決定は Dataform が担当 -- mart_sales.sqlx config { type: "table" } SELECT o.date, SUM(o.amount) AS sales FROM ${ref("raw_orders")} AS o JOIN ${ref("dim_shop")} USING (shop_id) GROUP BY 1 ref を辿って依存関係を把握し、実行順序を組み立てる raw_orders mart_sales dim_shop raw_orders と dim_shop の更新が終わるまで mart_sales の更新は始まらない 7
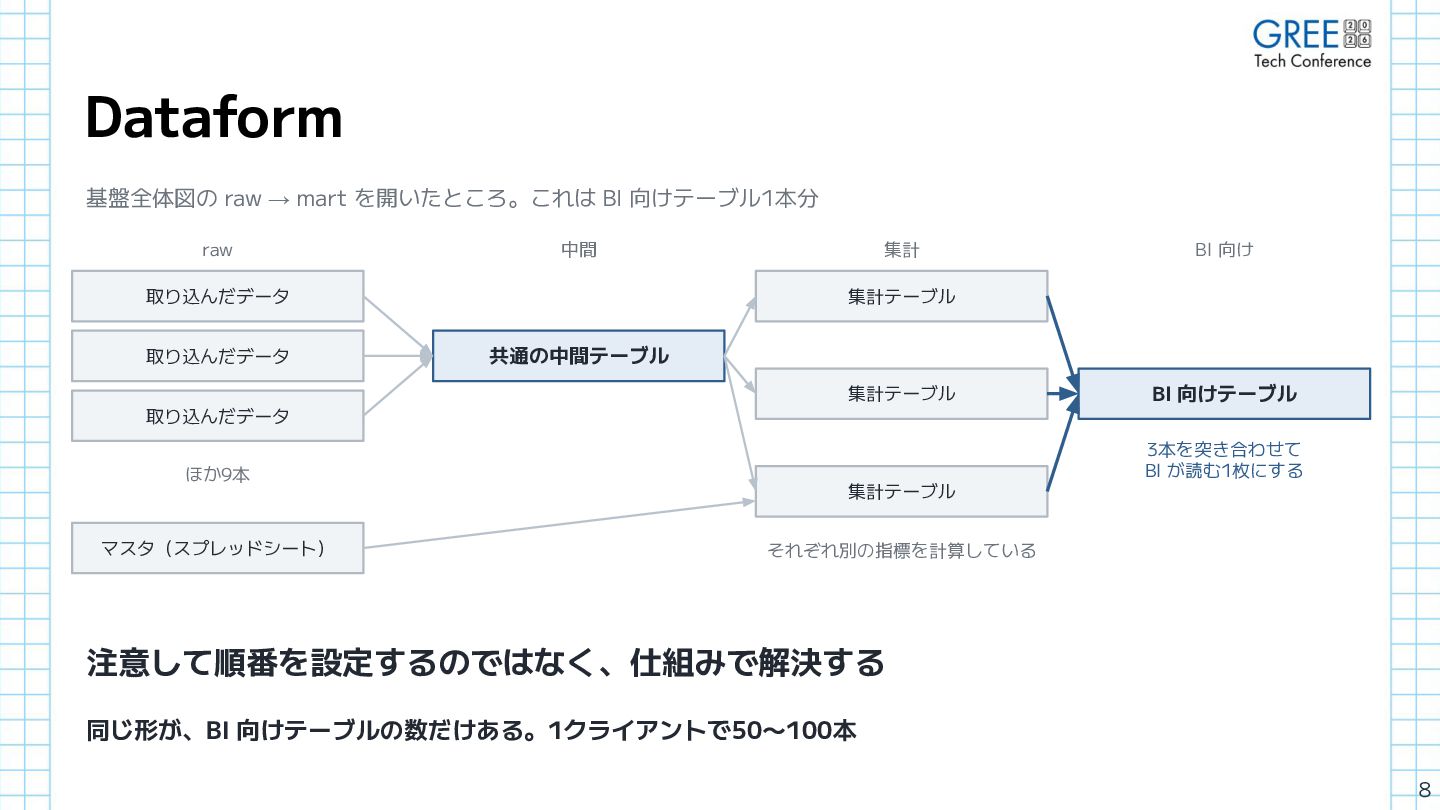
Dataform 基盤全体図の raw → mart を開いたところ。これは BI 向けテーブル1本分 raw 中間
取り込んだデータ 取り込んだデータ 集計 BI 向け 集計テーブル 共通の中間テーブル 集計テーブル BI 向けテーブル 取り込んだデータ ほか9本 マスタ(スプレッドシート) 3本を突き合わせて BI が読む1枚にする 集計テーブル それぞれ別の指標を計算している 注意して順番を設定するのではなく、仕組みで解決する 同じ形が、BI 向けテーブルの数だけある。1クライアントで50〜100本 8
扱っているデータ 型が決まっていて自動で取り込めるもの そうではないもの API で取りに行ける システムの外で、人が作っている 広告プラットフォーム、各種SaaS 届き方: Drive /
BOX / メール添付。担当者が毎月送る 中身: 媒体の月次レポートや会議用の集計表。帳票の形 業務システムが出力するデータ S3 / GCS にエクスポートされるログデータなど 9
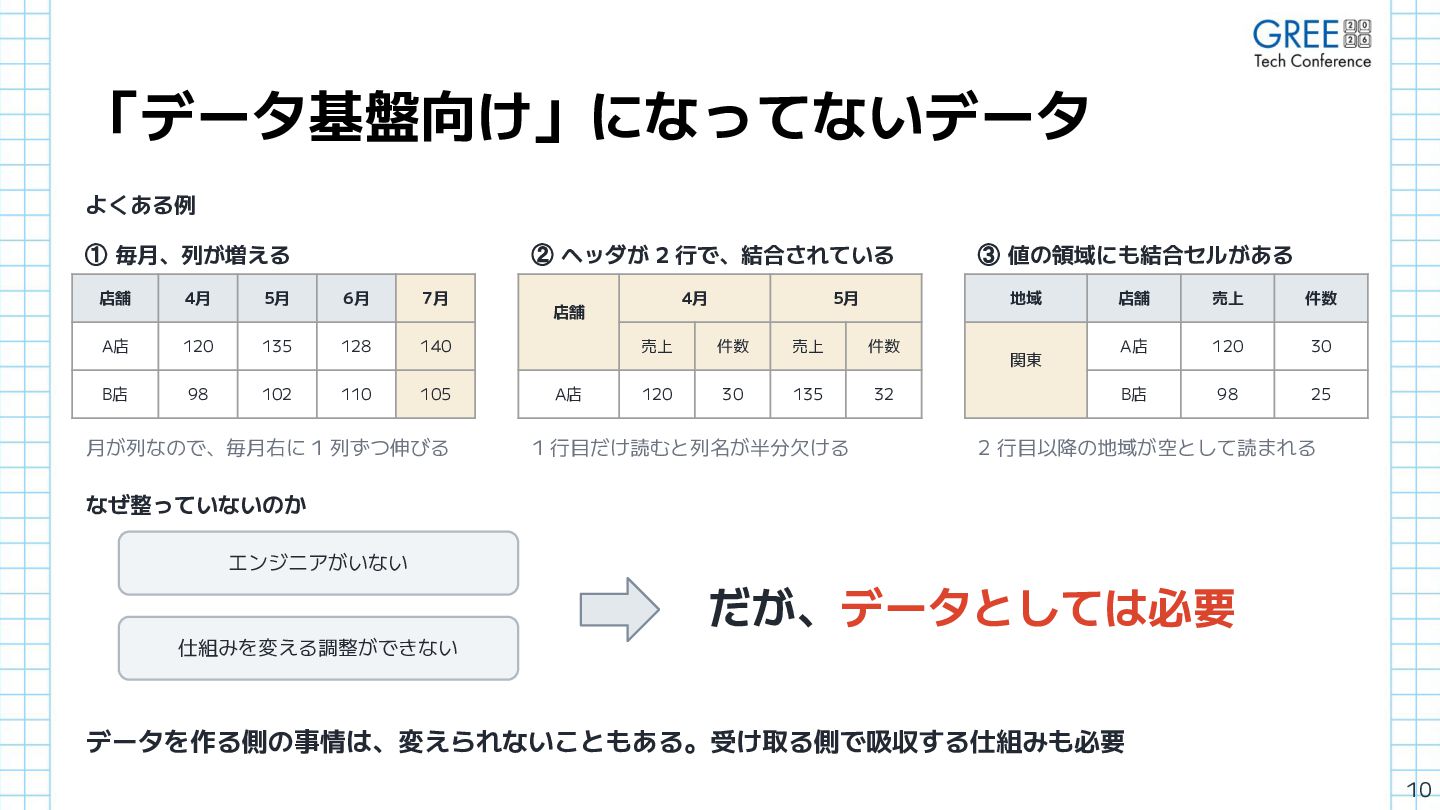
「データ基盤向け」になってないデータ よくある例 ① 毎月、列が増える ② ヘッダが 2 行で、結合されている 店舗 4月
5月 6月 7月 A店 120 135 128 140 B店 98 102 110 105 月が列なので、毎月右に 1 列ずつ伸びる 4月 店舗 A店 5月 地域 売上 件数 売上 件数 120 30 135 32 1 行目だけ読むと列名が半分欠ける ③ 値の領域にも結合セルがある 関東 店舗 売上 件数 A店 120 30 B店 98 25 2 行目以降の地域が空として読まれる なぜ整っていないのか エンジニアがいない だが、データとしては必要 仕組みを変える調整ができない データを作る側の事情は、変えられないこともある。受け取る側で吸収する仕組みも必要 10
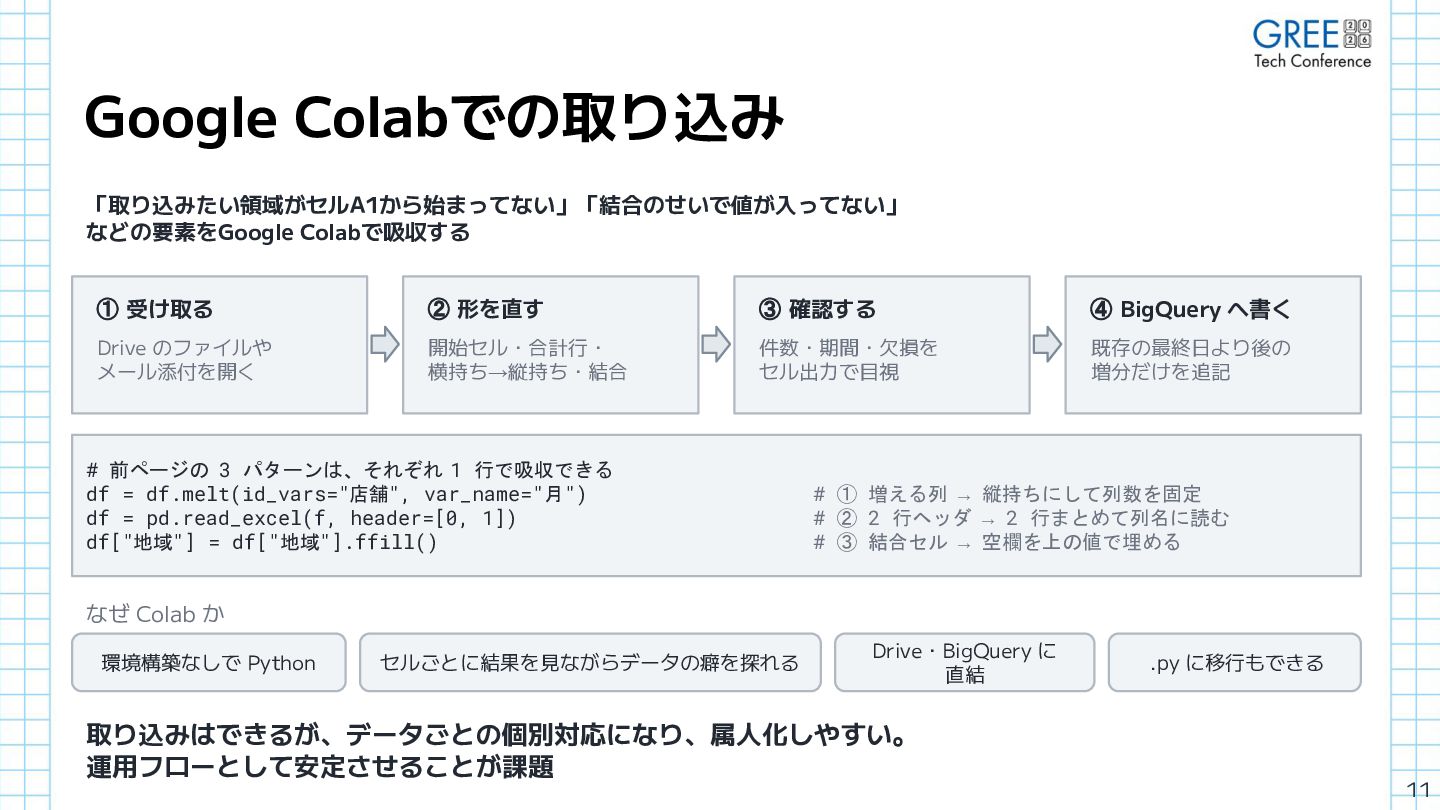
Google Colabでの取り込み 「取り込みたい領域がセルA1から始まってない」「結合のせいで値が入ってない」 などの要素をGoogle Colabで吸収する ① 受け取る ② 形を直す ③
確認する ④ BigQuery へ書く Drive のファイルや メール添付を開く 開始セル・合計行・ 横持ち→縦持ち・結合 件数・期間・欠損を セル出力で目視 既存の最終日より後の 増分だけを追記 # 前ページの 3 パターンは、それぞれ 1 行で吸収できる df = df.melt(id_vars="店舗", var_name="月") df = pd.read_excel(f, header=[0, 1]) df["地域"] = df["地域"].ffill() # ① 増える列 → 縦持ちにして列数を固定 # ② 2 行ヘッダ → 2 行まとめて列名に読む # ③ 結合セル → 空欄を上の値で埋める なぜ Colab か 環境構築なしで Python セルごとに結果を見ながらデータの癖を探れる Drive・BigQuery に 直結 .py に移行もできる 取り込みはできるが、データごとの個別対応になり、属人化しやすい。 運用フローとして安定させることが課題 11
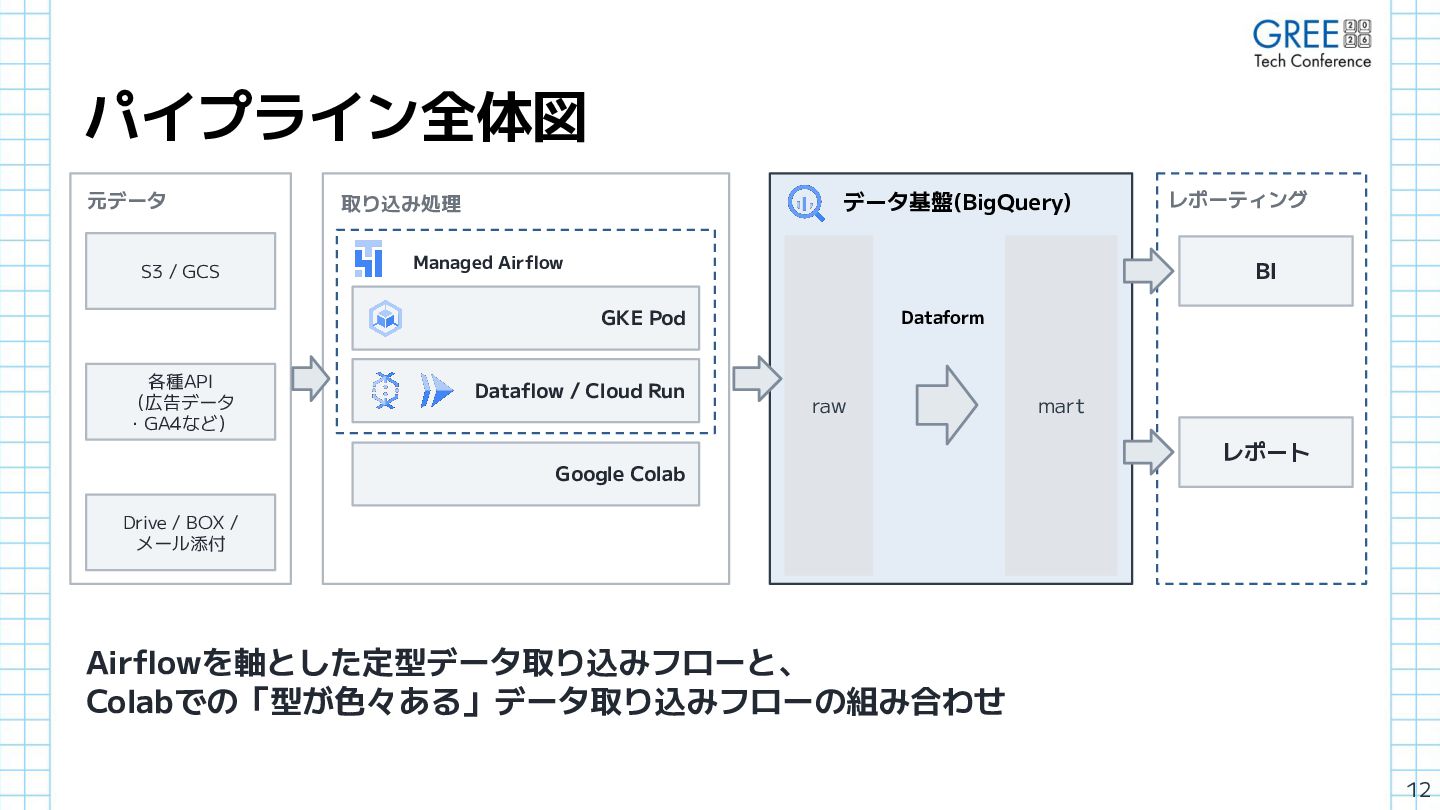
パイプライン全体図 元データ S3 / GCS データ基盤(BigQuery) 取り込み処理 Managed Airflow BI
GKE Pod 各種API (広告データ ・GA4など) レポーティング Dataflow / Cloud Run Dataform raw mart レポート Google Colab Drive / BOX / メール添付 Airflowを軸とした定型データ取り込みフローと、 Colabでの「型が色々ある」データ取り込みフローの組み合わせ 12
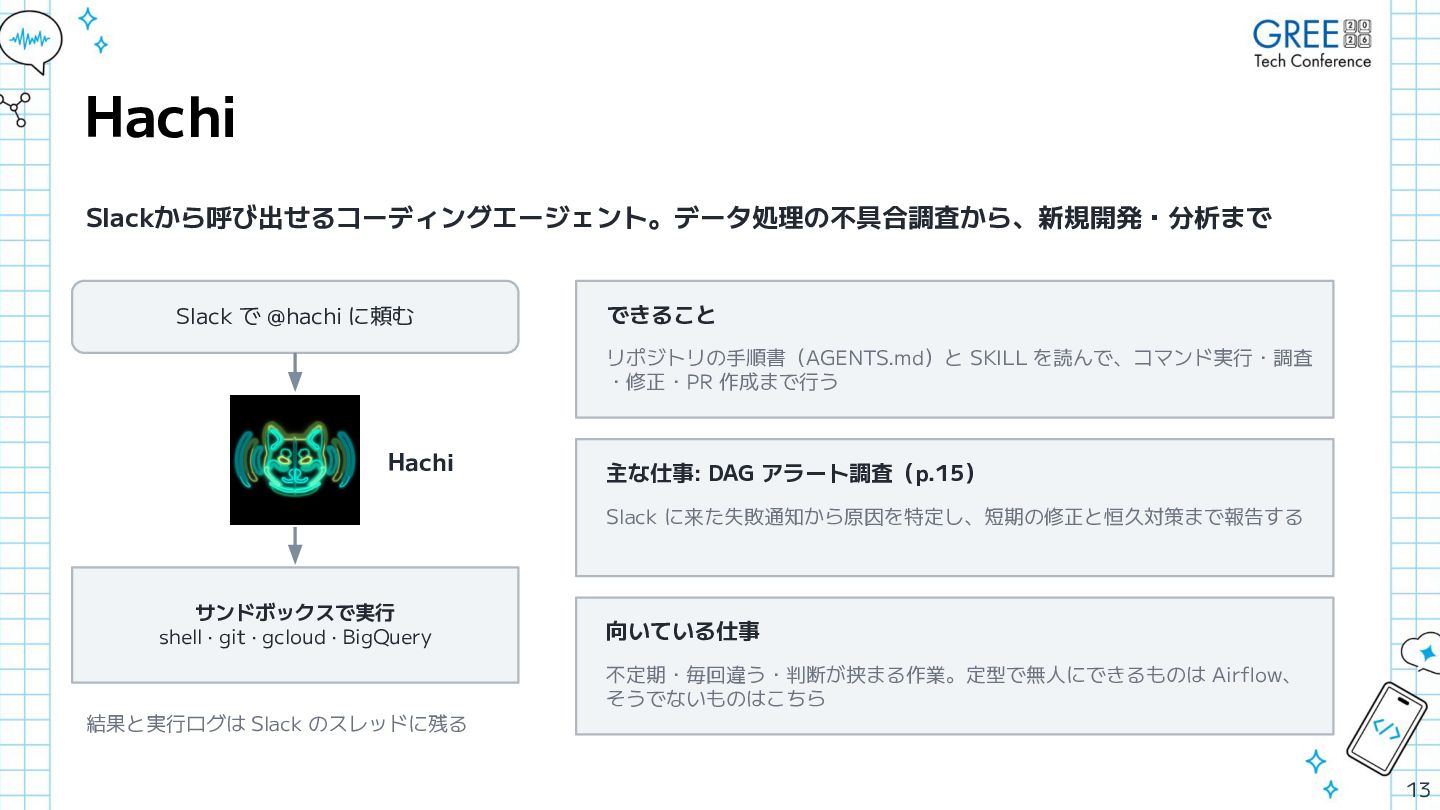
Hachi Slackから呼び出せるコーディングエージェント。データ処理の不具合調査から、新規開発・分析まで Slack で @hachi に頼む できること リポジトリの手順書(AGENTS.md)と SKILL を読んで、コマンド実行・調査
・修正・PR 作成まで行う Hachi 主な仕事: DAG アラート調査(p.15) Slack に来た失敗通知から原因を特定し、短期の修正と恒久対策まで報告する サンドボックスで実行 shell · git · gcloud · BigQuery 向いている仕事 不定期・毎回違う・判断が挟まる作業。定型で無人にできるものは Airflow、 そうでないものはこちら 結果と実行ログは Slack のスレッドに残る 13
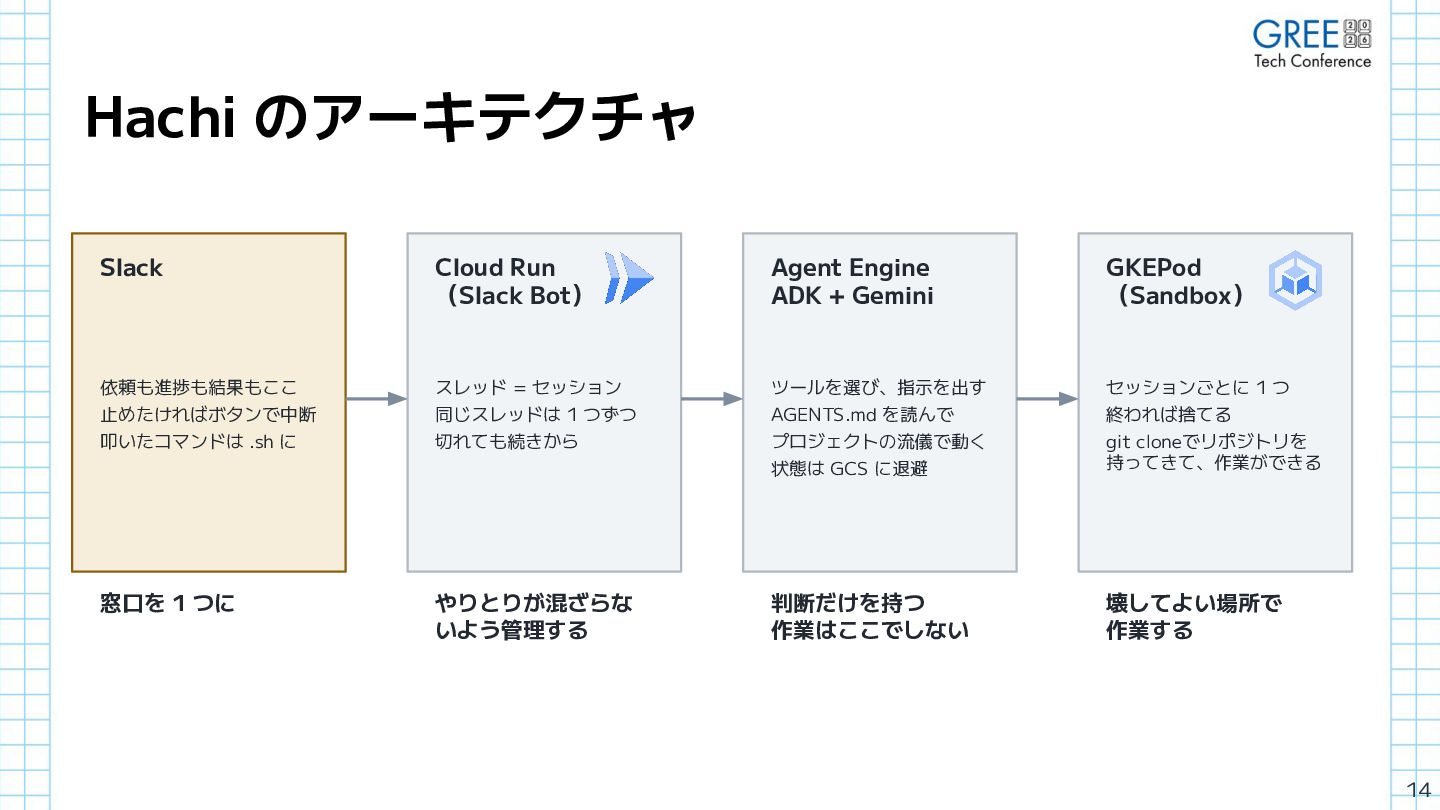
Hachi のアーキテクチャ Slack Cloud Run (Slack Bot) Agent Engine ADK
+ Gemini GKEPod (Sandbox) 依頼も進捗も結果もここ 止めたければボタンで中断 スレッド = セッション 同じスレッドは 1 つずつ ツールを選び、指示を出す AGENTS.md を読んで セッションごとに 1 つ 終われば捨てる 叩いたコマンドは .sh に 切れても続きから プロジェクトの流儀で動く 状態は GCS に退避 git cloneでリポジトリを 持ってきて、作業ができる 窓口を 1 つに やりとりが混ざらな いよう管理する 判断だけを持つ 作業はここでしない 壊してよい場所で 作業する 14
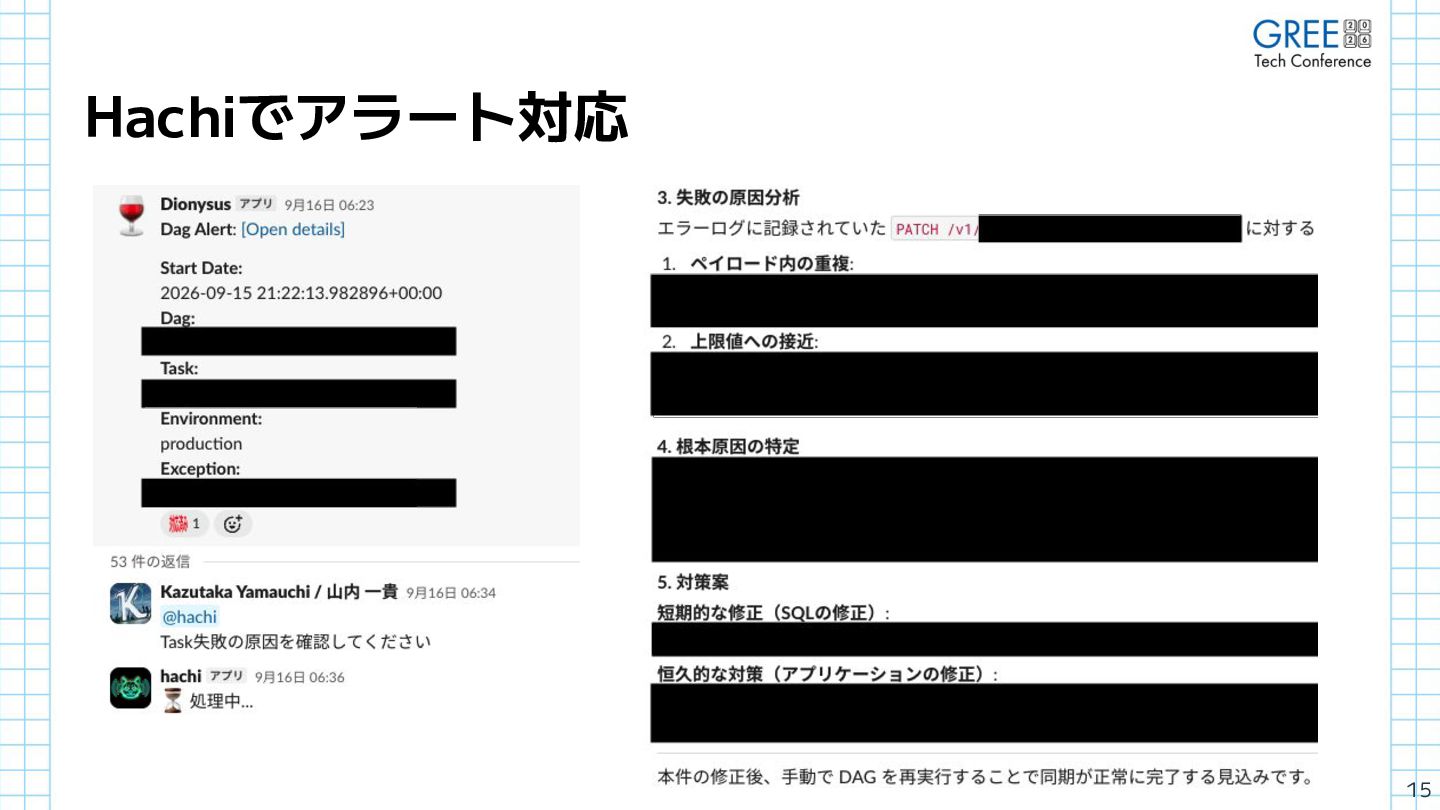
Hachiでアラート対応 15
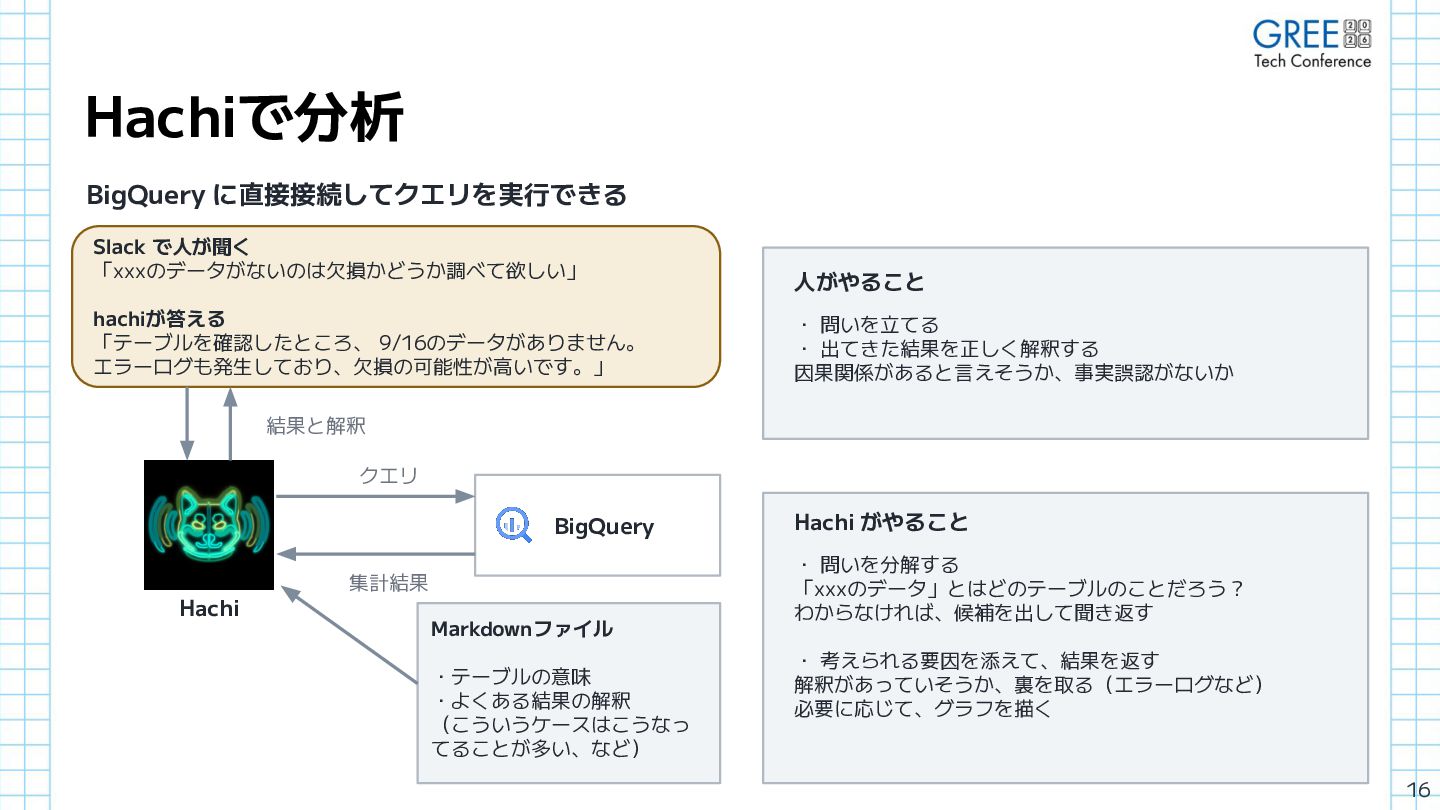
Hachiで分析 BigQuery に直接接続してクエリを実行できる Slack で人が聞く 「xxxのデータがないのは欠損かどうか調べて欲しい」 hachiが答える 「テーブルを確認したところ、 9/16のデータがありません。 エラーログも発生しており、欠損の可能性が高いです。」
人がやること ・ 問いを立てる ・ 出てきた結果を正しく解釈する 因果関係があると言えそうか、事実誤認がないか 結果と解釈 クエリ BigQuery 集計結果 Hachi Markdownファイル ・テーブルの意味 ・よくある結果の解釈 (こういうケースはこうなっ てることが多い、など) Hachi がやること ・ 問いを分解する 「xxxのデータ」とはどのテーブルのことだろう? わからなければ、候補を出して聞き返す ・ 考えられる要因を添えて、結果を返す 解釈があっていそうか、裏を取る(エラーログなど) 必要に応じて、グラフを描く 16
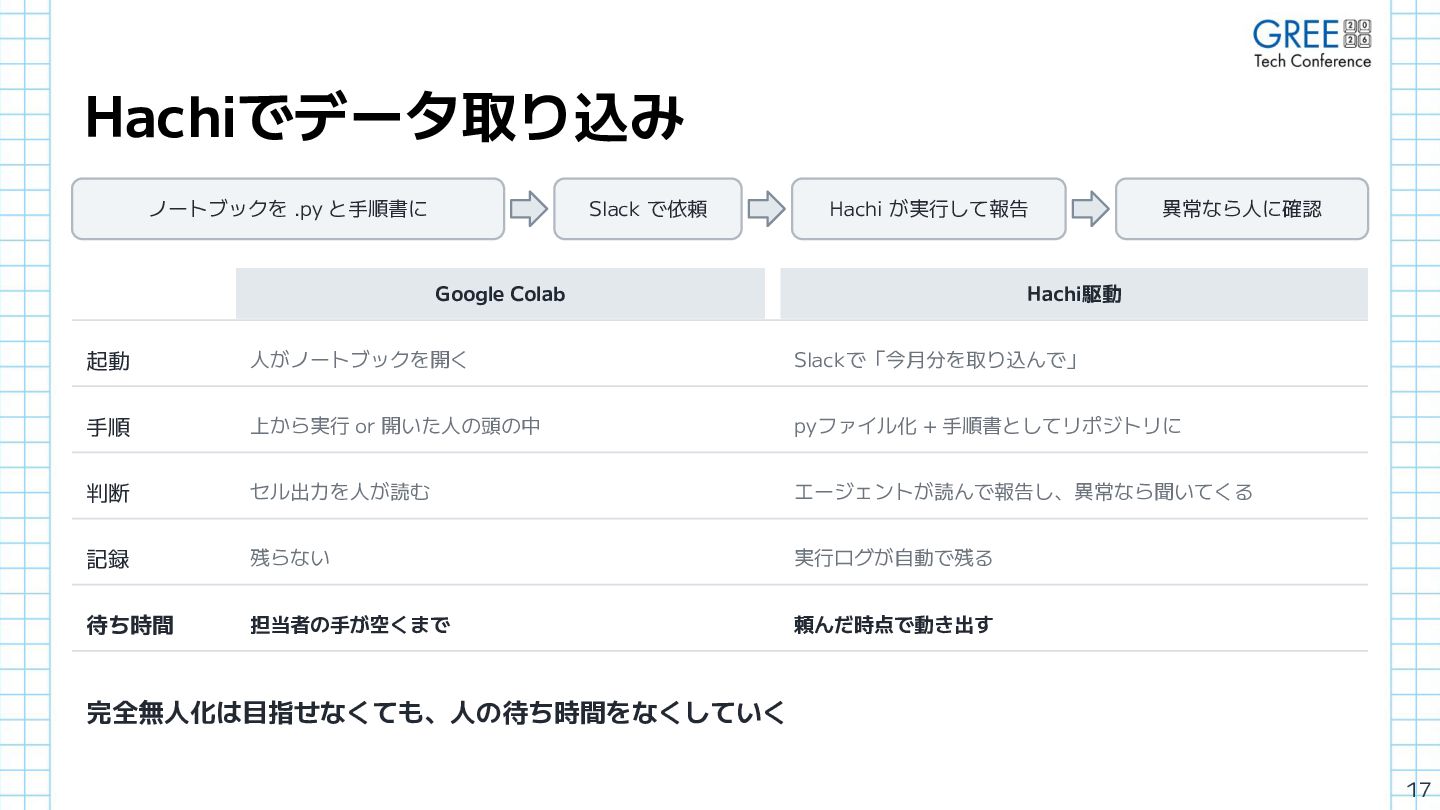
Hachiでデータ取り込み ノートブックを .py と手順書に Slack で依頼 Hachi が実行して報告 Google Colab
異常なら人に確認 Hachi駆動 起動 人がノートブックを開く Slackで「今月分を取り込んで」 手順 上から実行 or 開いた人の頭の中 pyファイル化 + 手順書としてリポジトリに 判断 セル出力を人が読む エージェントが読んで報告し、異常なら聞いてくる 記録 残らない 実行ログが自動で残る 待ち時間 担当者の手が空くまで 頼んだ時点で動き出す 完全無人化は目指せなくても、人の待ち時間をなくしていく 17
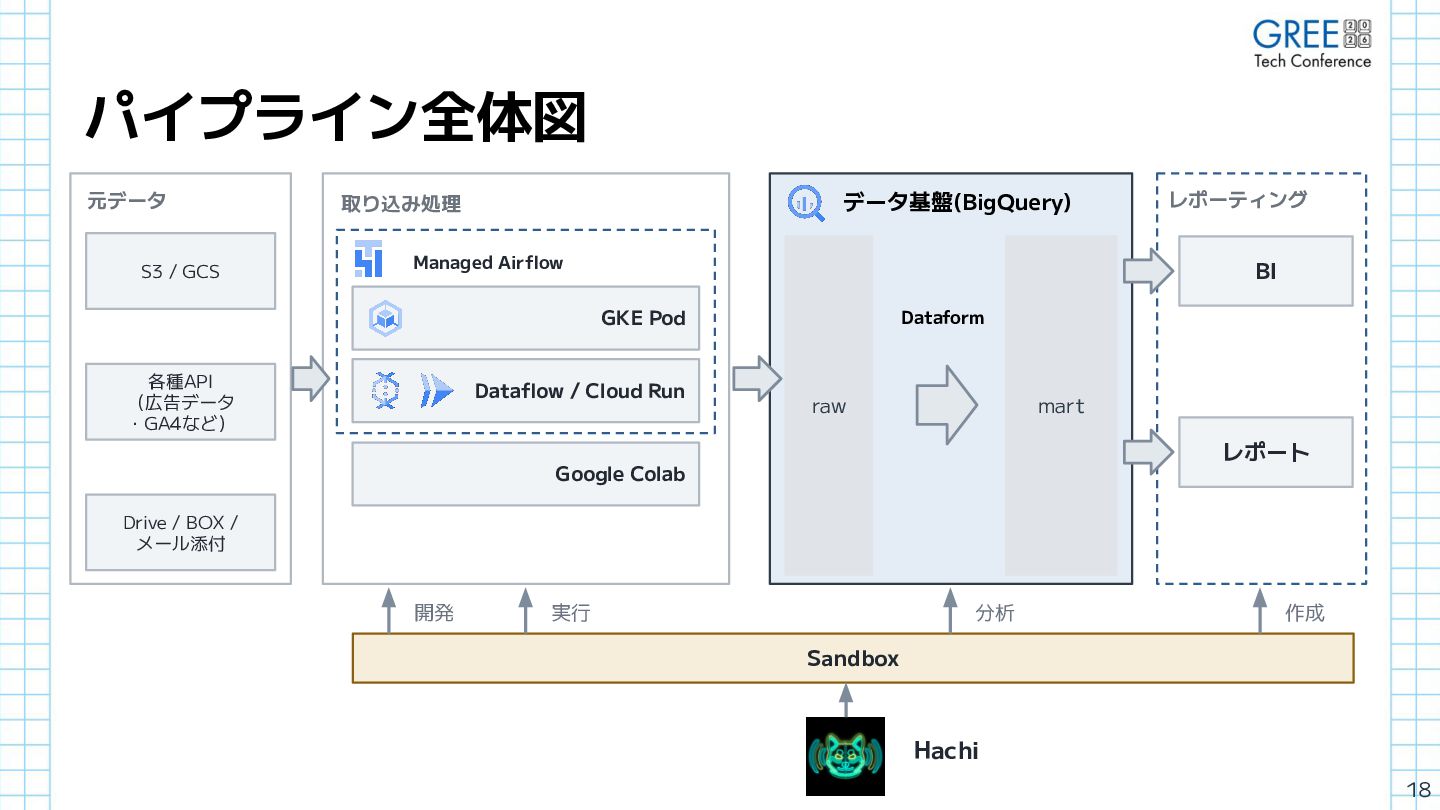
パイプライン全体図 元データ S3 / GCS データ基盤(BigQuery) 取り込み処理 Managed Airflow BI
GKE Pod 各種API (広告データ ・GA4など) レポーティング Dataflow / Cloud Run Dataform mart raw レポート Google Colab Drive / BOX / メール添付 開発 実行 分析 作成 Sandbox Hachi 18
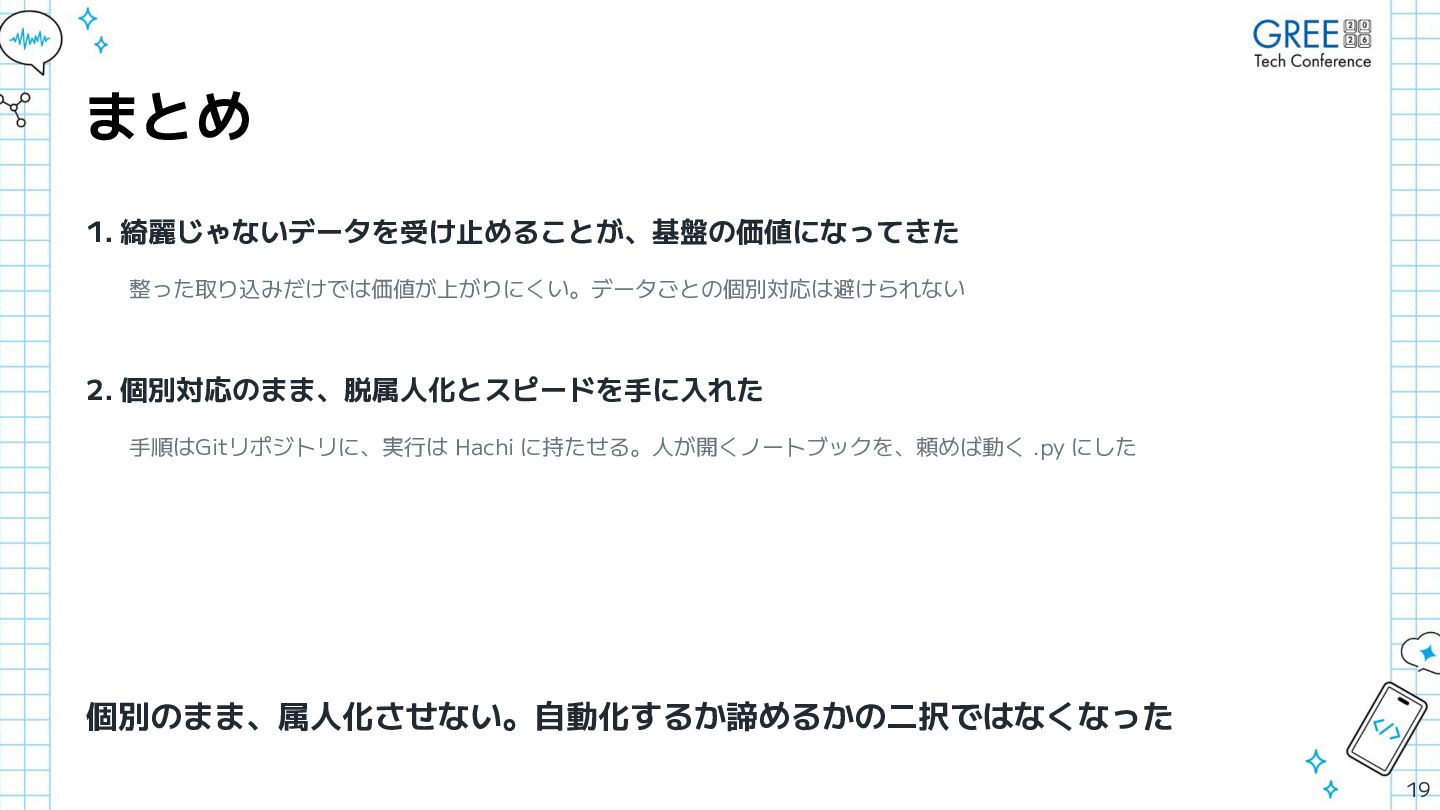
まとめ 1. 綺麗じゃないデータを受け止めることが、基盤の価値になってきた 整った取り込みだけでは価値が上がりにくい。データごとの個別対応は避けられない 2. 個別対応のまま、脱属人化とスピードを手に入れた 手順はGitリポジトリに、実行は Hachi に持たせる。人が開くノートブックを、頼めば動く .py
にした 個別のまま、属人化させない。自動化するか諦めるかの二択ではなくなった 19
None


 gree_tech
 ivry_presentationmaterials
 kash1064
 bgpat
 kakakakakku
 iktakahiro
 keeg
 persolserverworks
 pauli
 sudoakiy
 ezaki
 camiha
 mananyuki
 matthewcrist
 ipullrank
 akihiro_kokubo
 szymonslowik
 rasagy
 baasie
 aleyda
 bermonpainter
 jeffersonlam
 letsgokoyo
 uxyall
 shpigford