Share
Embed
20年間 SNS サービス「GREE」 を支えた技術の刷新と、長期運用サービスの Kubernetes へのリアーキテクト
GREE Tech Conference 2026で発表された資料です。
https://techcon.gree.jp/2026/session/TrackA-2
Transcript
43 slides
-
20年間 SNS サービス「GREE」を支えた 技術の刷新と、長期運用サービスの Kubernetes へのリアーキテクト 株式会社グリー 開発本部 インフラ事業部 AI
& Infra Solutionsグループ ID1チーム 岩井 良成 大迫 裕樹 -
岩井 良成 株式会社グリー アソシエイトマネージャー / リードエンジニア 2019 年 グリーに新卒入社 これまで
RDBMS/KVS の専門チームを兼務 ネイティブゲームを Kubernetes でリリース いま 長期運営タイトルのアーキテクチャ刷新に PM とエンジニアの 2 つの立場で取り組む 2 -
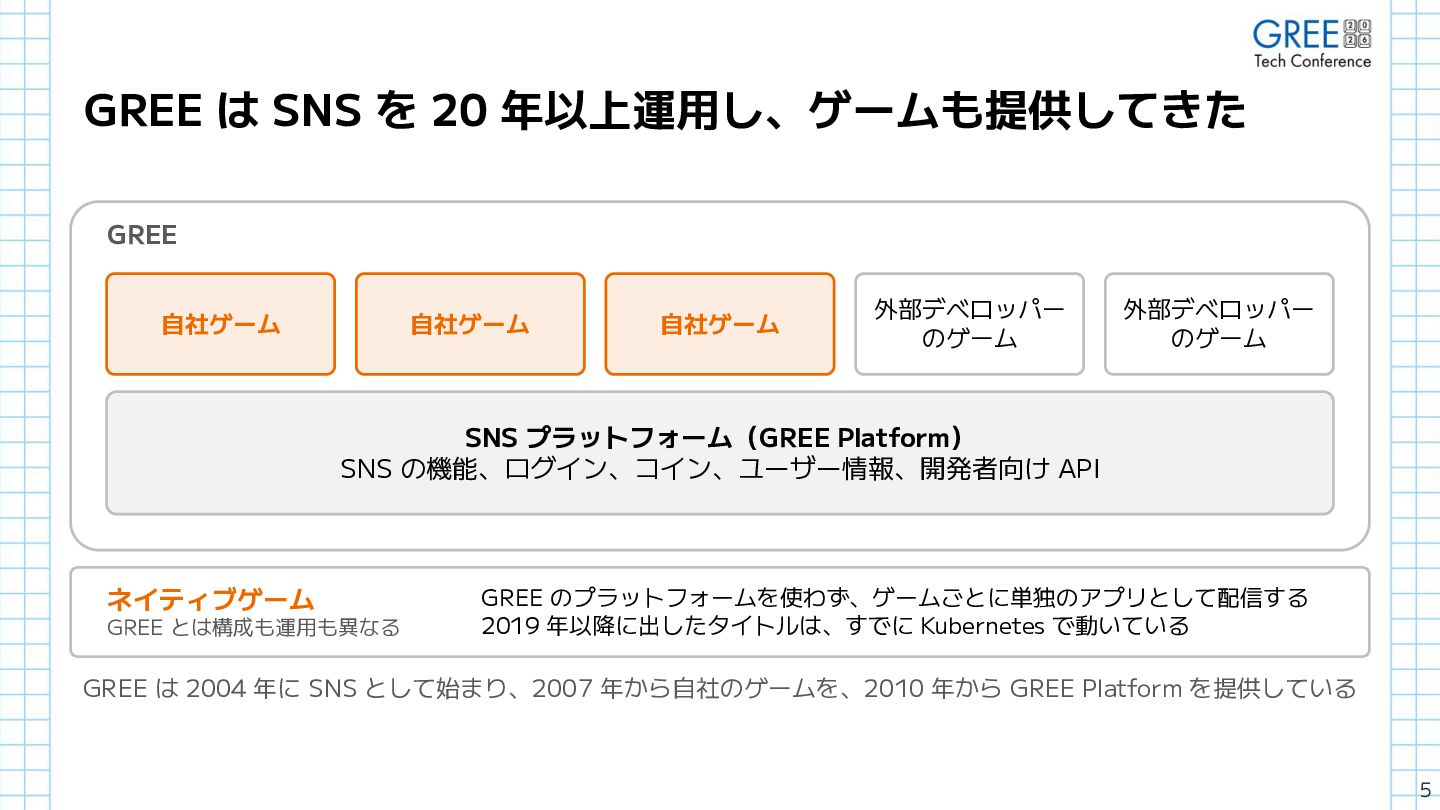
GREE は SNS を 20 年以上運用し、ゲームも提供してきた GREE 自社ゲーム 自社ゲーム 自社ゲーム
外部デベロッパー のゲーム 外部デベロッパー のゲーム SNS プラットフォーム(GREE Platform) SNS の機能、ログイン、コイン、ユーザー情報、開発者向け API ネイティブゲーム GREE とは構成も運用も異なる GREE のプラットフォームを使わず、ゲームごとに単独のアプリとして配信する 2019 年以降に出したタイトルは、すでに Kubernetes で動いている GREE は 2004 年に SNS として始まり、2007 年から自社のゲームを、2010 年から GREE Platform を提供している 5 -
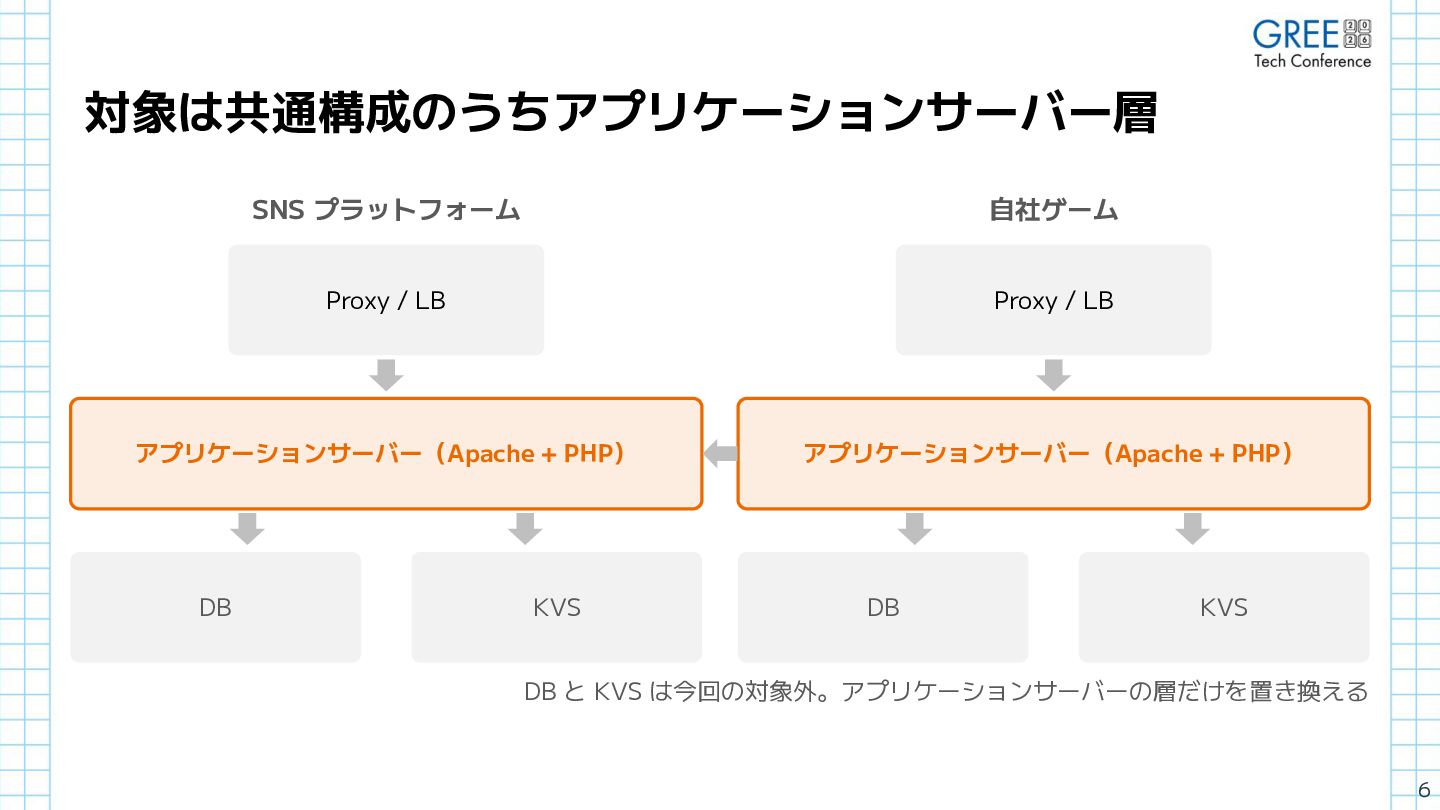
対象は共通構成のうちアプリケーションサーバー層 SNS プラットフォーム 自社ゲーム Proxy / LB Proxy / LB
アプリケーションサーバー(Apache + PHP) アプリケーションサーバー(Apache + PHP) DB KVS DB KVS DB と KVS は今回の対象外。アプリケーションサーバーの層だけを置き換える 6 -
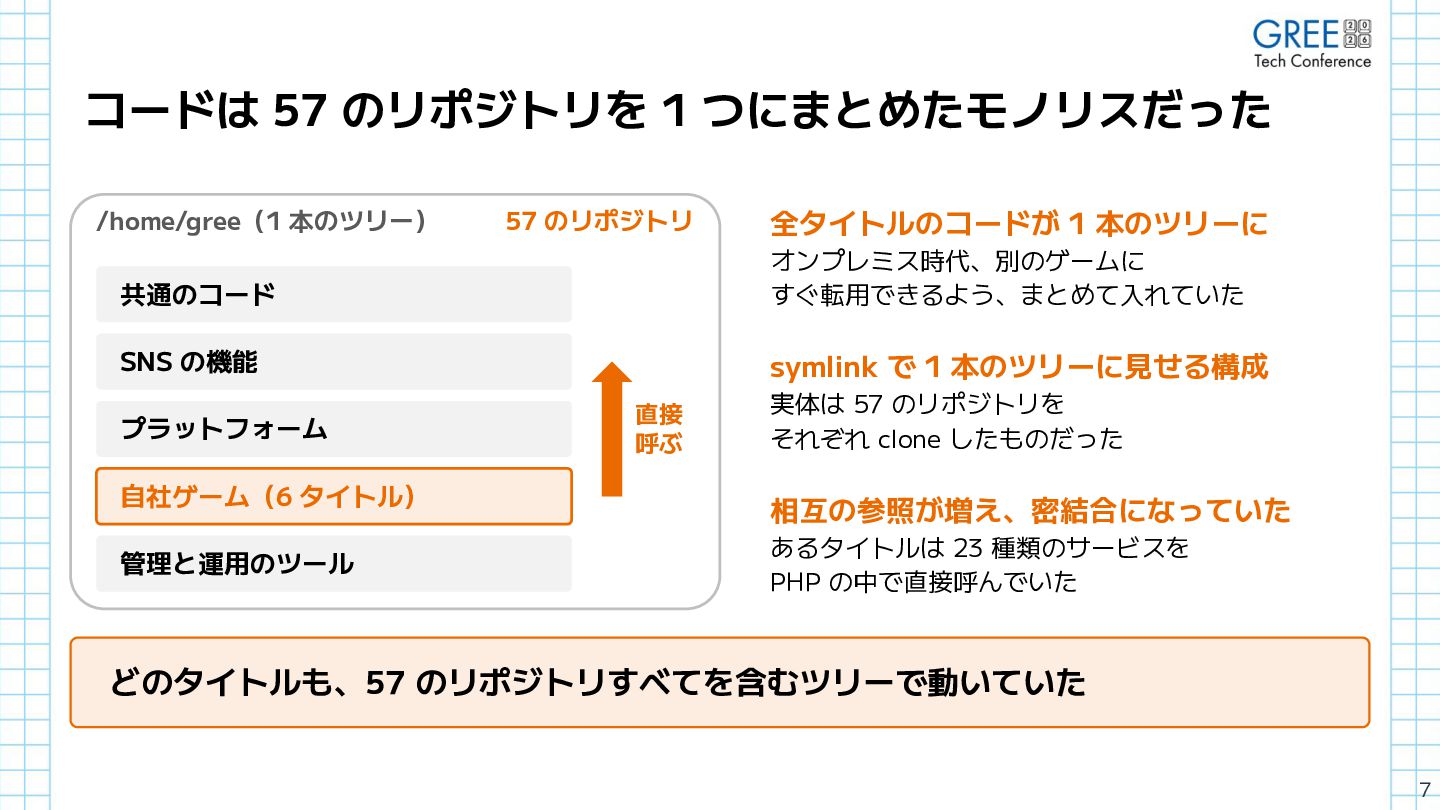
コードは 57 のリポジトリを 1 つにまとめたモノリスだった /home/gree(1 本のツリー) 57 のリポジトリ 全タイトルのコードが
1 本のツリーに 共通のコード オンプレミス時代、別のゲームに すぐ転用できるよう、まとめて入れていた SNS の機能 symlink で 1 本のツリーに見せる構成 プラットフォーム 自社ゲーム(6 タイトル) 管理と運用のツール 直接 呼ぶ 実体は 57 のリポジトリを それぞれ clone したものだった 相互の参照が増え、密結合になっていた あるタイトルは 23 種類のサービスを PHP の中で直接呼んでいた どのタイトルも、57 のリポジトリすべてを含むツリーで動いていた 7 -
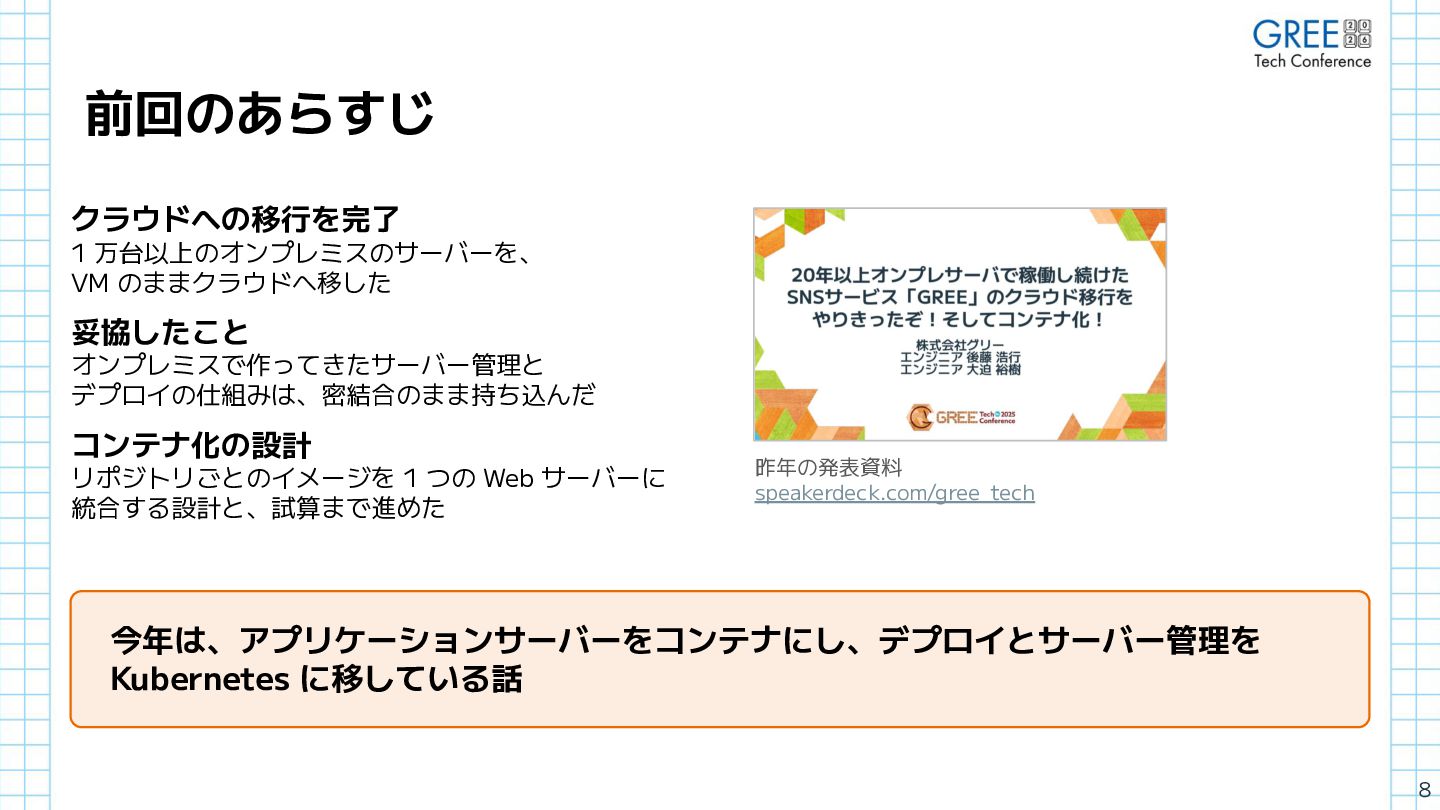
前回のあらすじ クラウドへの移行を完了 1 万台以上のオンプレミスのサーバーを、 VM のままクラウドへ移した 妥協したこと オンプレミスで作ってきたサーバー管理と デプロイの仕組みは、密結合のまま持ち込んだ コンテナ化の設計
リポジトリごとのイメージを 1 つの Web サーバーに 統合する設計と、試算まで進めた 昨年の発表資料 speakerdeck.com/gree_tech 今年は、アプリケーションサーバーをコンテナにし、デプロイとサーバー管理を Kubernetes に移している話 8 -
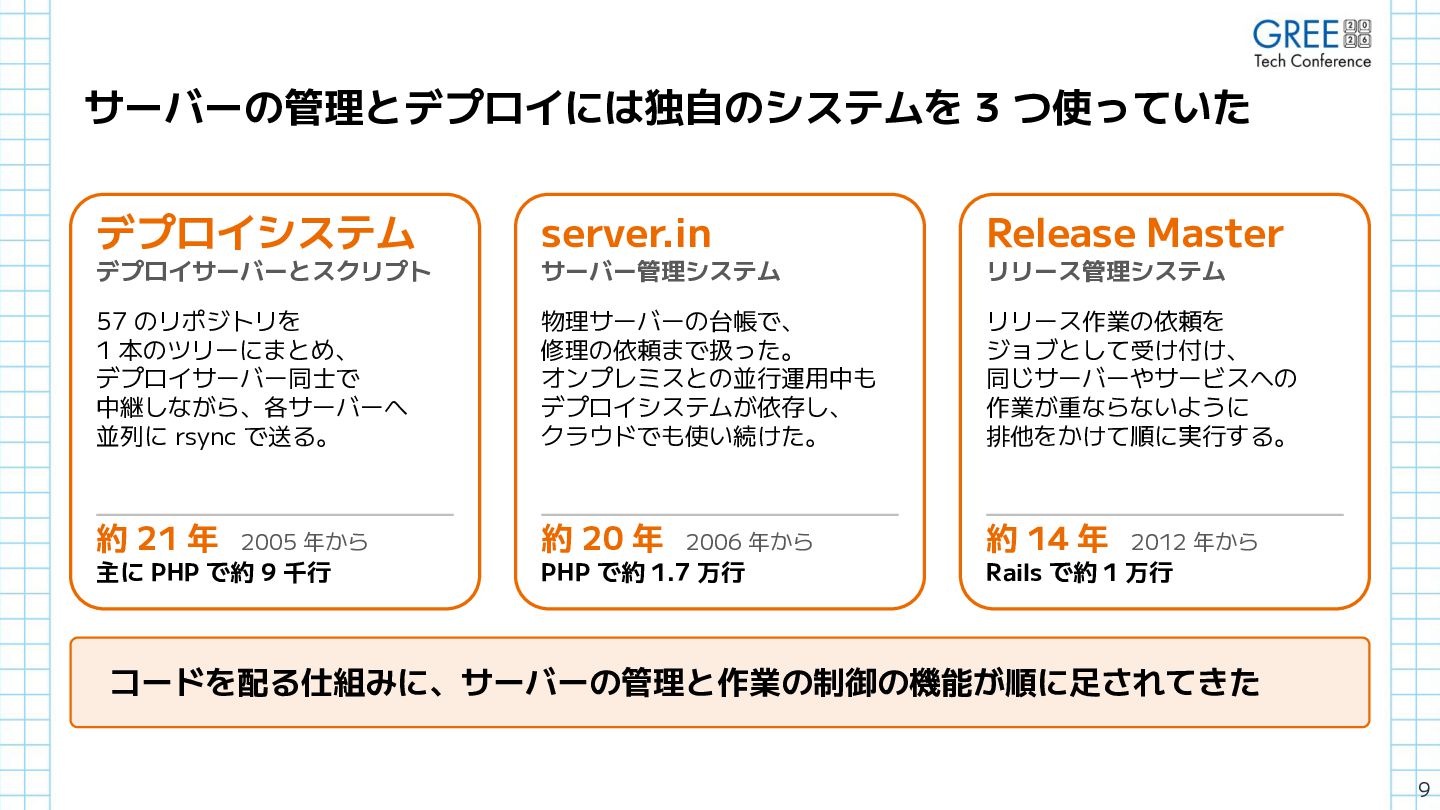
サーバーの管理とデプロイには独自のシステムを 3 つ使っていた デプロイシステム server.in Release Master デプロイサーバーとスクリプト サーバー管理システム リリース管理システム
57 のリポジトリを 1 本のツリーにまとめ、 デプロイサーバー同士で 中継しながら、各サーバーへ 並列に rsync で送る。 物理サーバーの台帳で、 修理の依頼まで扱った。 オンプレミスとの並行運用中も デプロイシステムが依存し、 クラウドでも使い続けた。 リリース作業の依頼を ジョブとして受け付け、 同じサーバーやサービスへの 作業が重ならないように 排他をかけて順に実行する。 約 21 年 2005 年から 約 20 年 2006 年から 約 14 年 2012 年から 主に PHP で約 9 千行 PHP で約 1.7 万行 Rails で約 1 万行 コードを配る仕組みに、サーバーの管理と作業の制御の機能が順に足されてきた 9 -
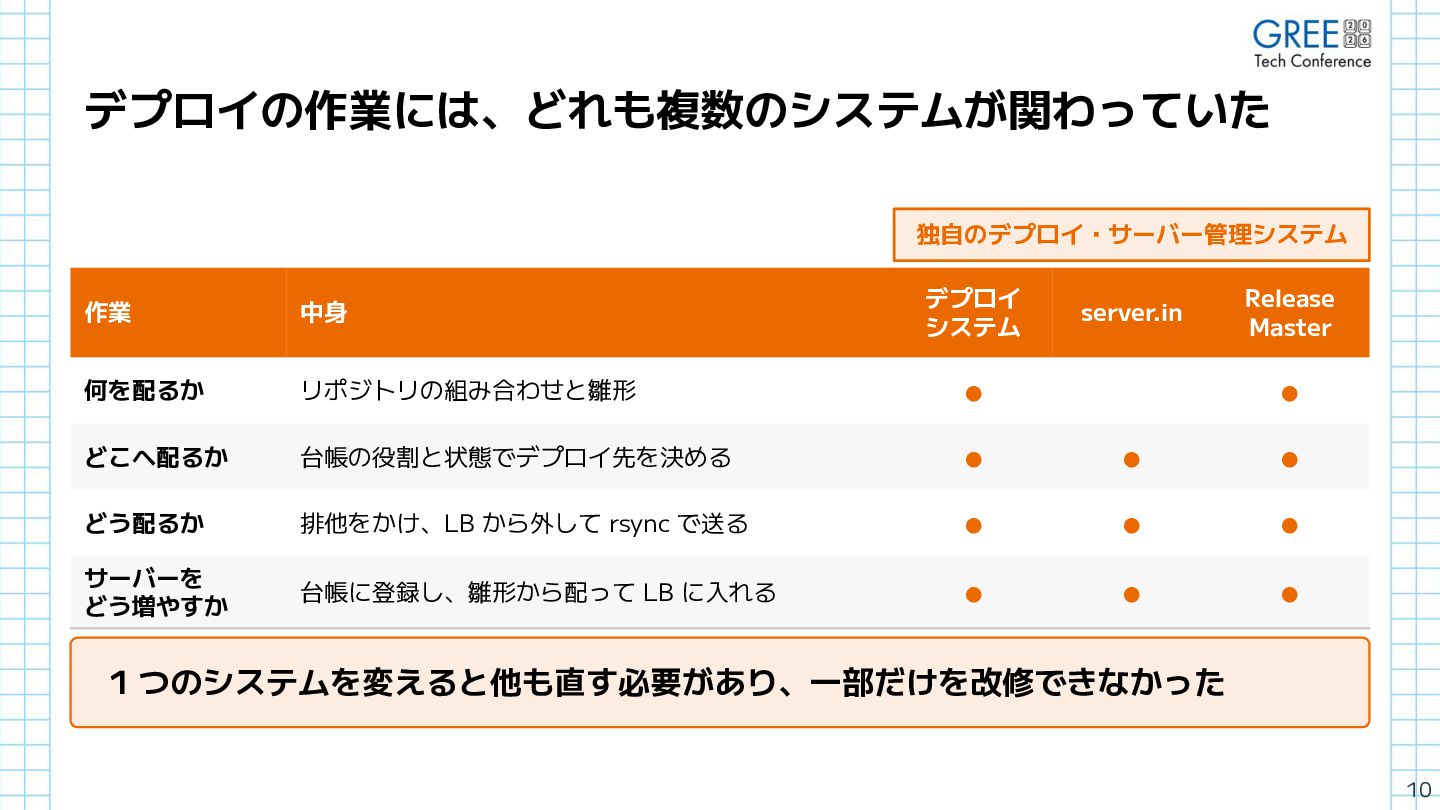
デプロイの作業には、どれも複数のシステムが関わっていた 独自のデプロイ・サーバー管理システム デプロイ システム server.in Release Master 作業 中身 何を配るか
リポジトリの組み合わせと雛形 • どこへ配るか 台帳の役割と状態でデプロイ先を決める • • • どう配るか 排他をかけ、LB から外して rsync で送る • • • サーバーを どう増やすか 台帳に登録し、雛形から配って LB に入れる • • • • 1 つのシステムを変えると他も直す必要があり、一部だけを改修できなかった 10 -
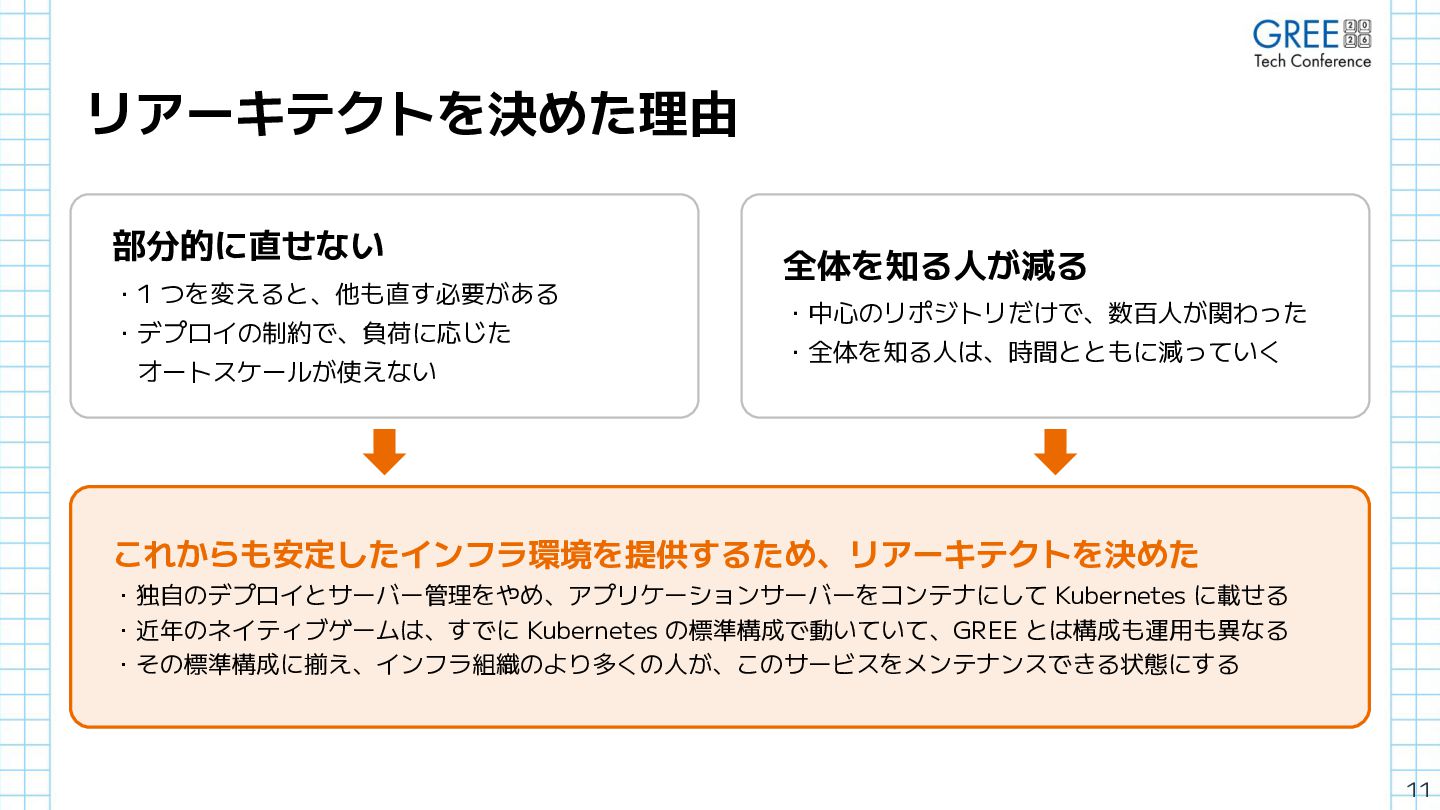
リアーキテクトを決めた理由 部分的に直せない ・1 つを変えると、他も直す必要がある ・デプロイの制約で、負荷に応じた オートスケールが使えない 全体を知る人が減る ・中心のリポジトリだけで、数百人が関わった ・全体を知る人は、時間とともに減っていく これからも安定したインフラ環境を提供するため、リアーキテクトを決めた
・独自のデプロイとサーバー管理をやめ、アプリケーションサーバーをコンテナにして Kubernetes に載せる ・近年のネイティブゲームは、すでに Kubernetes の標準構成で動いていて、GREE とは構成も運用も異なる ・その標準構成に揃え、インフラ組織のより多くの人が、このサービスをメンテナンスできる状態にする 11 -
大迫 裕樹 株式会社グリー シニアリードエンジニア 2019年にグリーへ新卒入社。 Kubernetes やモニタリング領域を中心に、 クラウドインフラの設計・構築・運用に従事。 近年は GREE
サービスの インフラ環境リアーキテクトに携わる。 13 -
昨年ここで話したこと アーキテクチャそのものの話 • VM で動作する巨大なモノリスを リポジトリ単位のコンテナイメージに分割 • Kubernetes 側で統合し、1 つの
web サーバーとして動作 • アプリケーションは改修なし 14 -
アーキテクチャをどう作ったか • 拡張では届かないと見切る (2020 年) • 最良の設計案に欠けたピースを探す (2023 年) •
基盤の細部を詰める (2024 年) • サービスに適用する (2023〜2026 年) 16 -
始まりはオートスケールの検討だった • 目的はコスト最適化 • VM で動く web サーバーを対象に、既存基盤を拡張 – スケジュールベースのスケーリングで、サーバー費用を大きく削減
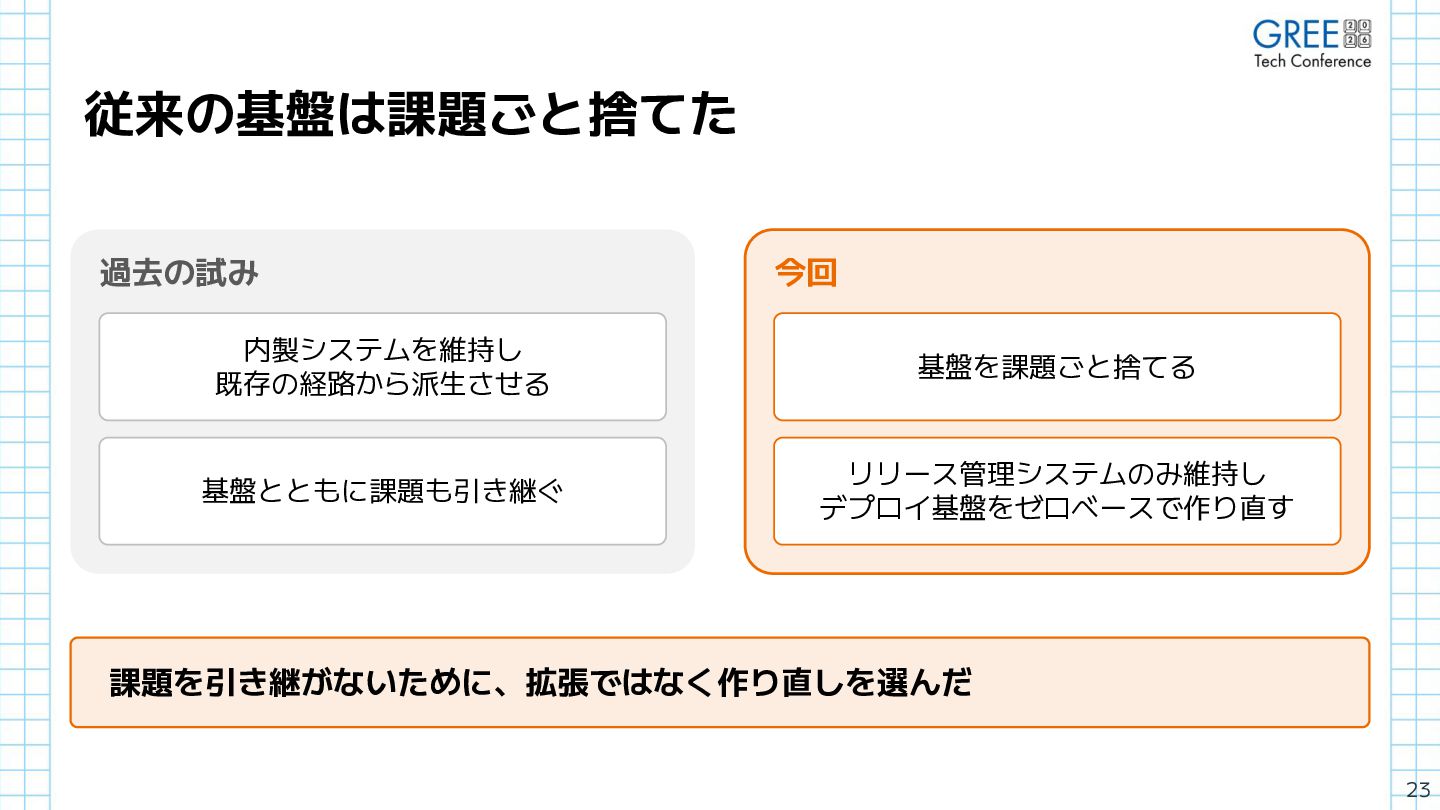
– 拡張部分はクラウドネイティブな作り • 負荷ベースのスケーリングは、既存基盤の拡張では実現できず見送り 課題は内製のデプロイとサーバー管理との密結合にあった 18 -
過去の試みでは拡張を選んだ 以前にもリアーキテクトのプロジェクトがあった • Kubernetes でコンテナ化 • 内製システム (デプロイやサーバー管理) を維持 •
デプロイ経路を既存の経路から派生 • 移行できたのは、データ依存が少なく運用がシンプルなサービスのみ スモールスタートしやすかったが、制約が残り 複雑化とリリースの柔軟性の低下を招いた 19 -
作り込みが複雑さを生んだ 最大の課題は仕組みの複雑さと、それを理解するためのコンテキストの高さ 独自の作り込み サービスごとの作り込み ・データの扱いを 独自のパッケージングとデプロイで実現 ・データの特性から生じる課題や制約に サービスごとのイメージや CI で対処
・仕組みが複雑になり、メンテナンスも困難 ・サービスごとの最適化はできたが 管理の負担と認知コストが高い 独自にも、サービスごとにも作り込まない。 汎用的な知識で理解できる、共通の構成にする 20 -
要件は既存の仕組みから導いた 内製のデプロイとリリース管理が実現・担保していたことを言語化 (再掲) 新しい仕組みが満たすべき要件 • ビルド時間とデプロイ時間が十分に短いこと • 個別にリリースとロールバックを制御できること • 各サーバーで使うリポジトリを選択できること
• 現行運用と両立すること • アプリケーション側の変更を必要としないこと 22 -
最良の設計案には、ピースが 1 つ欠けていた • • • 複数の設計案を検討 最良の設計案は、リポジトリごとのイメージを Kubernetes 側で
1 つの web サーバーに統合する構成 イメージの作成・取得・展開までは Kubernetes とエコシステムが強力に支援 欠けていたのは、展開したデータを web サーバーから参照する機構だった 24 -
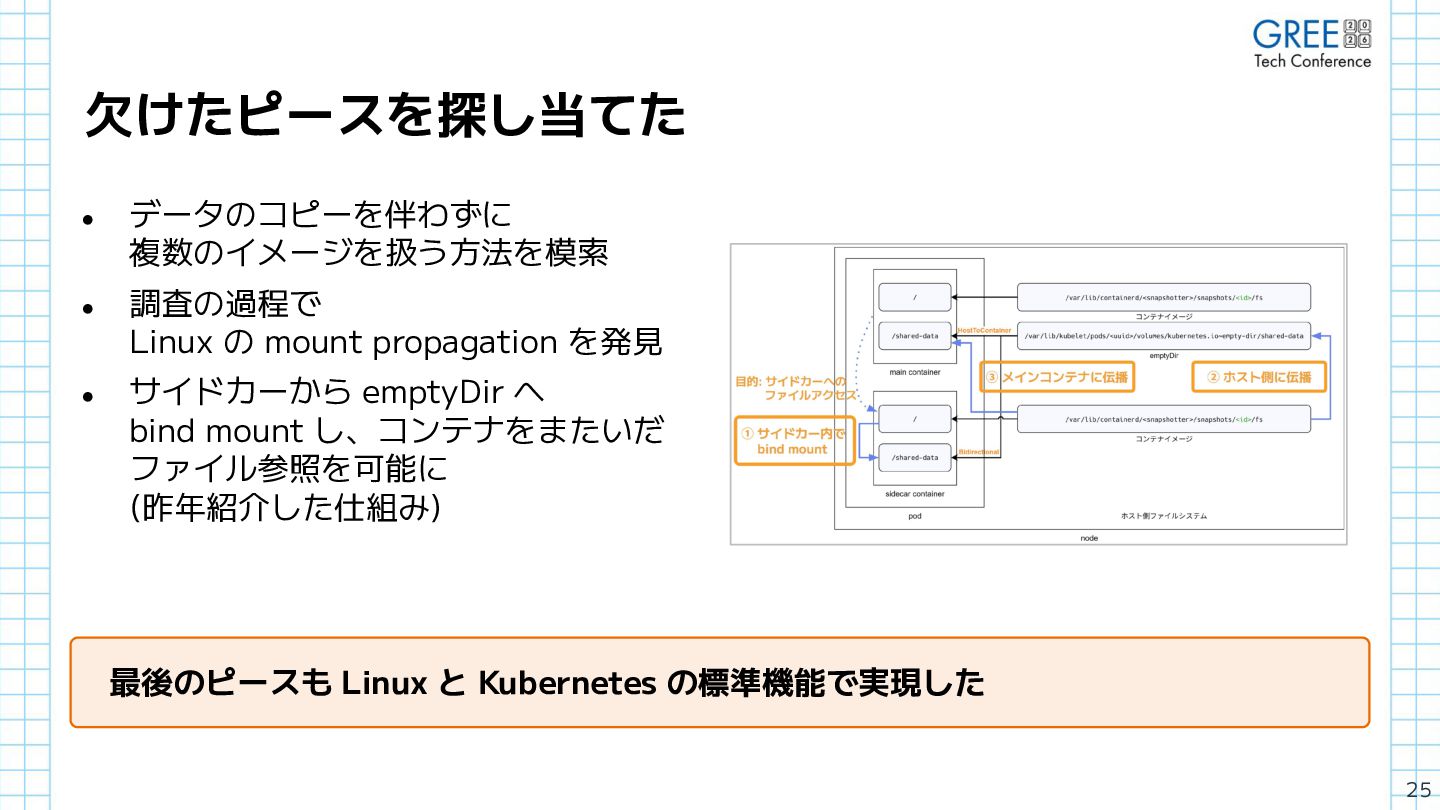
欠けたピースを探し当てた • • • データのコピーを伴わずに 複数のイメージを扱う方法を模索 調査の過程で Linux の mount
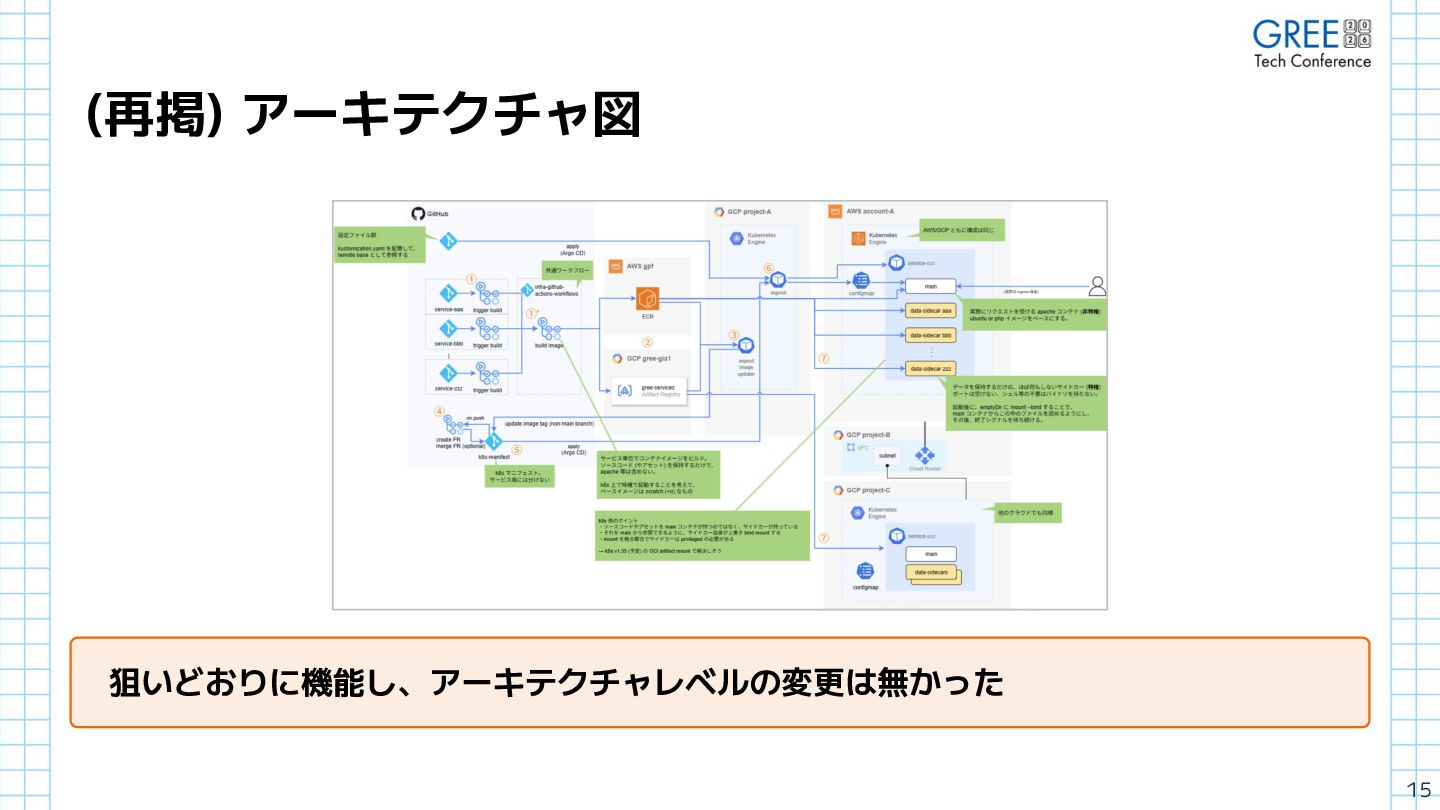
propagation を発見 サイドカーから emptyDir へ bind mount し、コンテナをまたいだ ファイル参照を可能に (昨年紹介した仕組み) 最後のピースも Linux と Kubernetes の標準機能で実現した 25 -
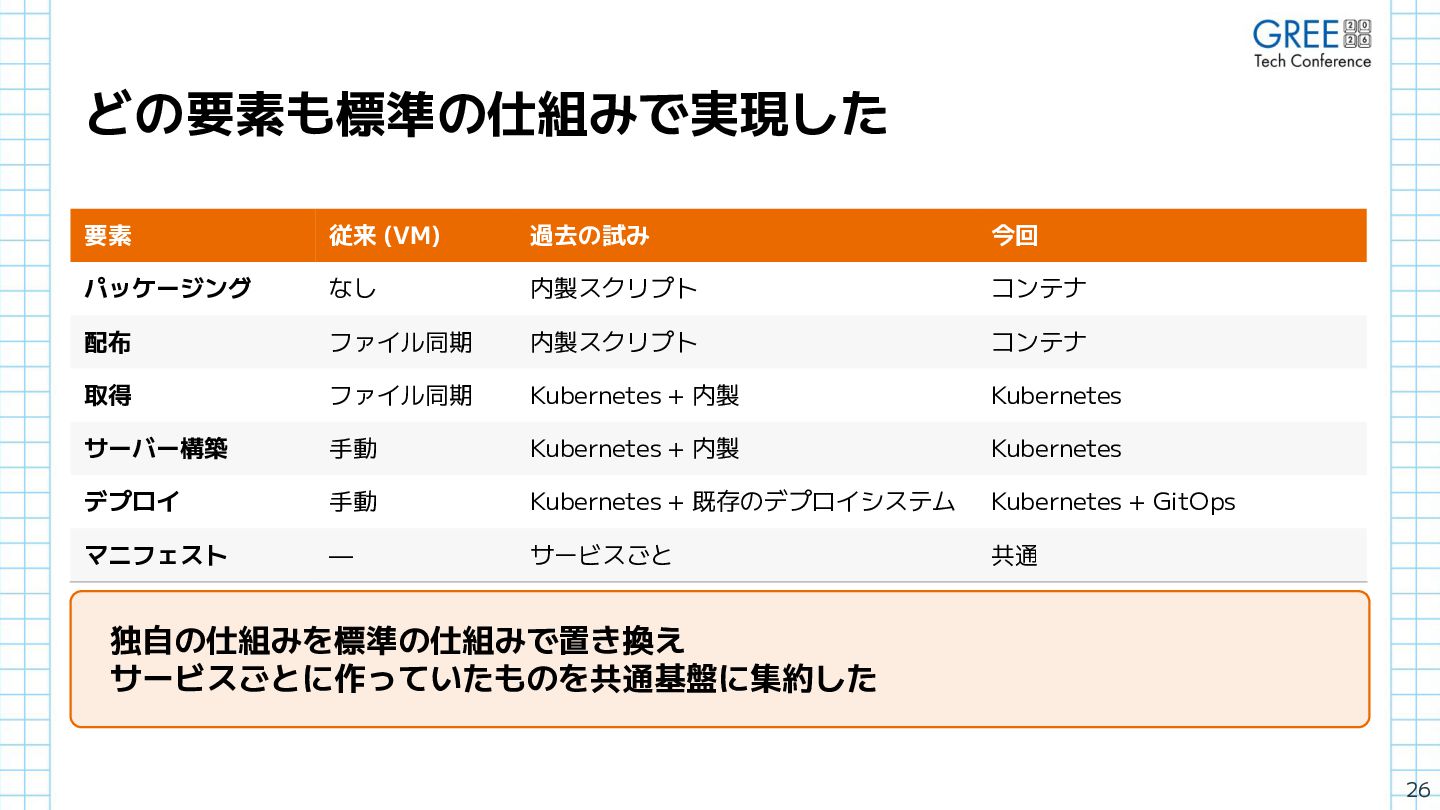
どの要素も標準の仕組みで実現した 要素 従来 (VM) 過去の試み 今回 パッケージング なし 内製スクリプト docker
(crane) アップロード 内製スクリプト (ファイル同期) 内製スクリプト docker (crane) ダウンロード 内製スクリプト (ファイル同期) Kubernetes + 内製 Kubernetes サーバー構築 手動 Kubernetes + 内製 Kubernetes ワークロード管理 手動 Kubernetes Kubernetes CI・マニフェスト管理 — サービスごと 共通 独自の仕組みを標準の仕組みで置き換え サービスごとに作っていたものを共通基盤に集約した 26 -
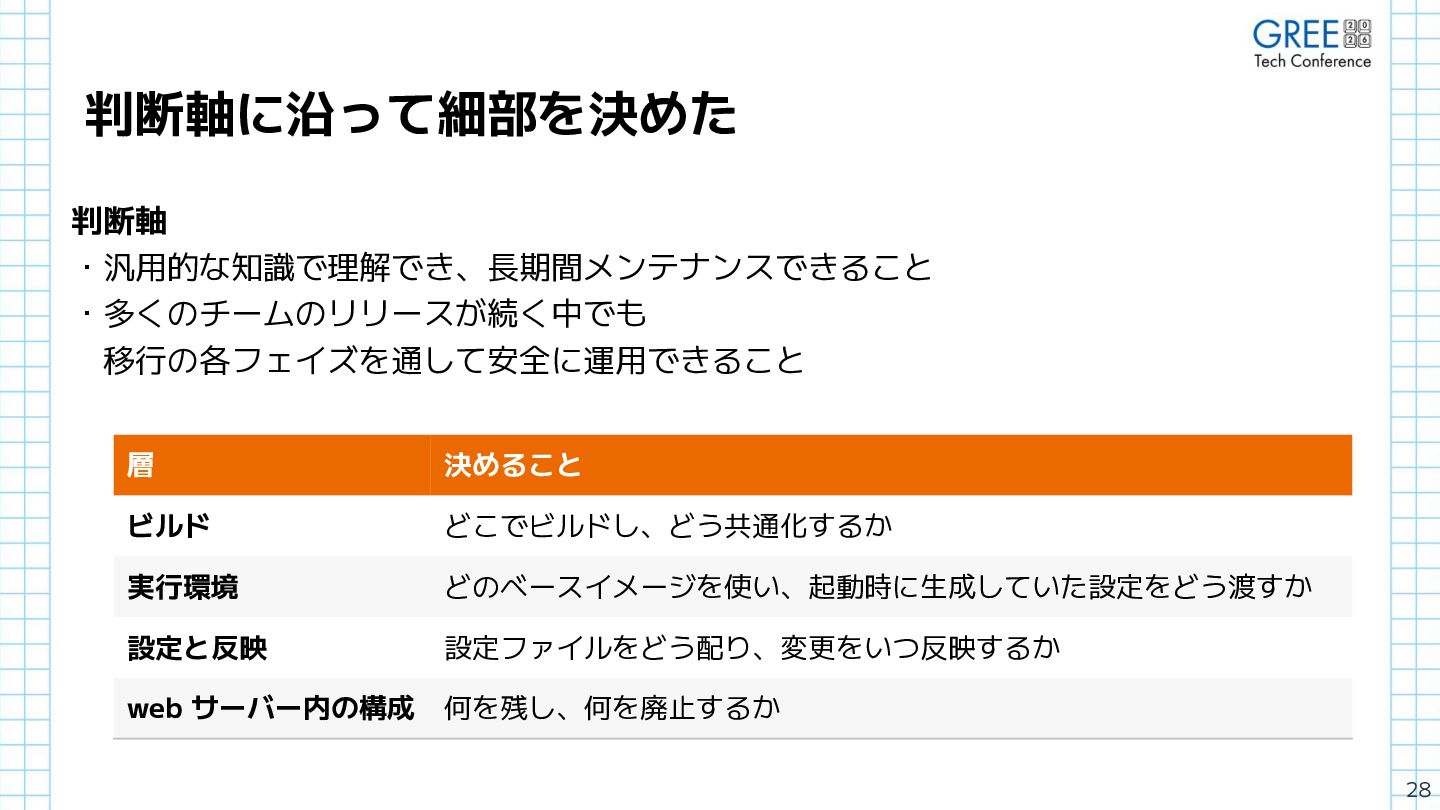
判断軸に沿って細部を決めた 判断軸 • • 汎用的な知識で理解でき、長期間メンテナンスできること 多くのチームのリリースが続く中でも 移行の各フェイズを通して安全に運用できること ◦ 事前構築・並行運用・移行後 層
決めること ビルド どこでビルドし、どう共通化するか 実行環境 どのベースイメージを使い、起動時に生成していた設定をどう渡すか 設定と反映 設定ファイルをどう配り、変更をいつ反映するか web サーバー内の構成 何を残し、何を廃止するか 28 -
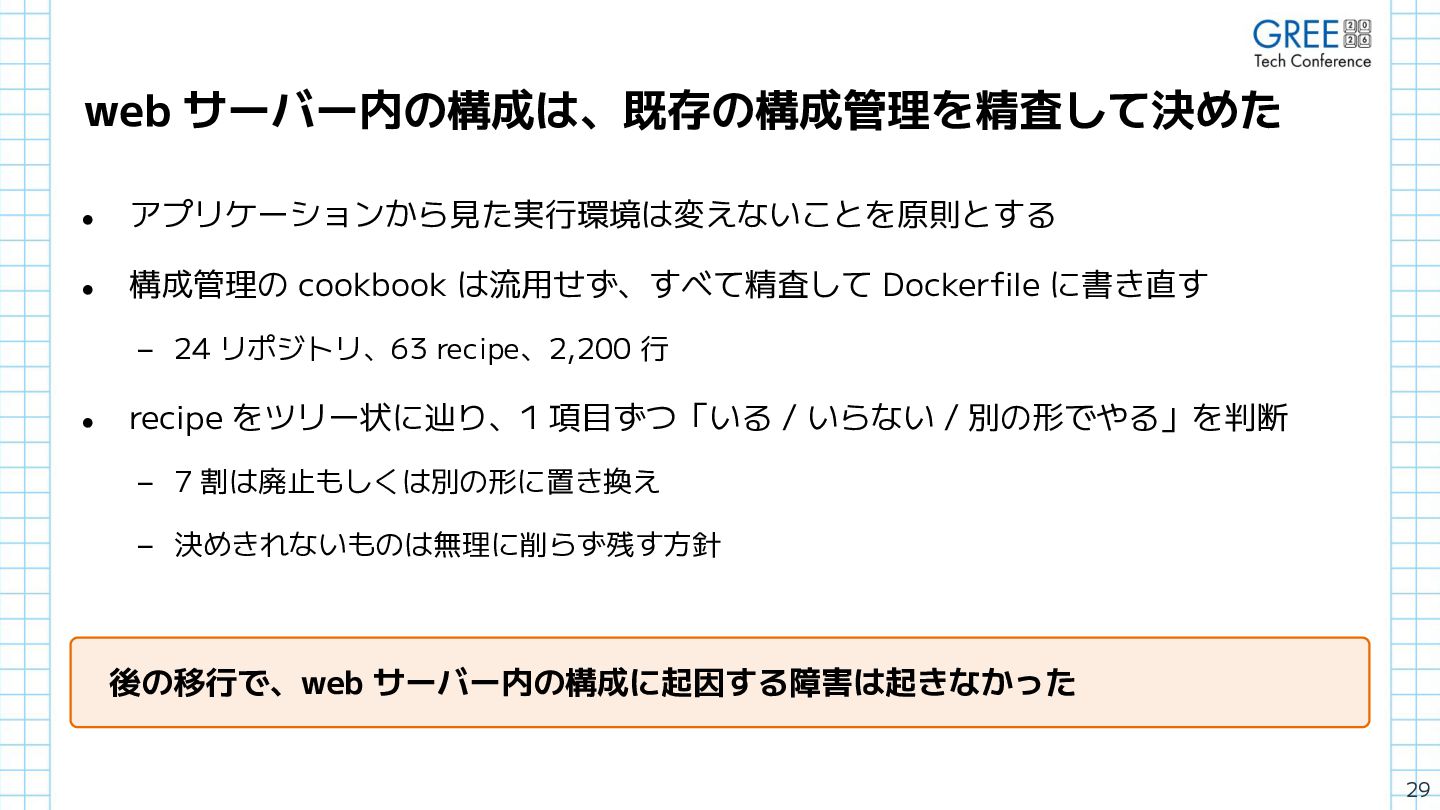
web サーバー内の構成は、既存の構成管理を精査して決めた • アプリケーションから見た実行環境は変えないことを原則とする • 構成管理の cookbook は流用せず、すべて精査して Dockerfile に書き直す
– 24 リポジトリ、63 recipe、2,200 行 • recipe をツリー状に辿り、1 項目ずつ「いる / いらない / 別の形でやる」を判断 – 7 割は廃止もしくは別の形に置き換え – 決めきれないものは無理に削らず残す方針 後の移行で、web サーバー内の構成に起因するサービス障害は起きなかった 29 -
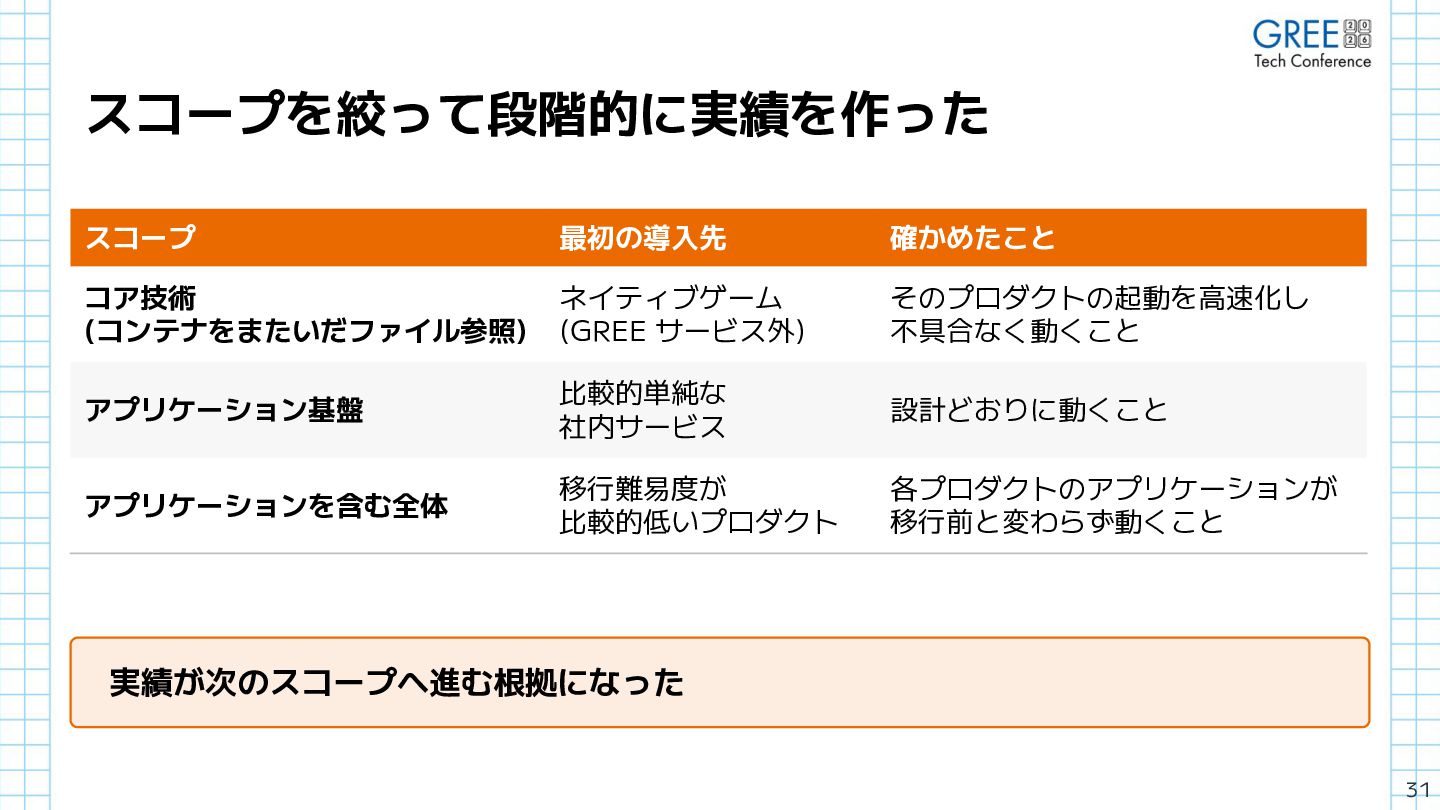
スコープを絞って段階的に実績を作った スコープ 最初の導入先 確かめたこと 1 コア技術 (コンテナ間のファイル参照) ネイティブゲーム (GREE サービス外)
そのプロダクトの起動を高速化し 不具合なく動くこと 2 アプリケーション基盤 比較的単純な 社内サービス 設計どおりに動くこと 3 アプリケーションを含む全体 移行難易度が 比較的低いプロダクト 各プロダクトのアプリケーションが 移行前と変わらず動くこと 順番 実績が次のスコープへ進む根拠になった 31 -
本番までの検証を設計する 1 検証環境 まず動作を確認 2 QA 専任部署によるリリース前のチェックを、 コンテナ環境で実施 3 staging
本番に近い構成で確認 4 実経路での社内向けプレビュー 経路は本番のまま、社内にだけ公開。 本番への投入前に、残った差分を発見 5 本番へ段階投入 比率を上げながら移行 32 -
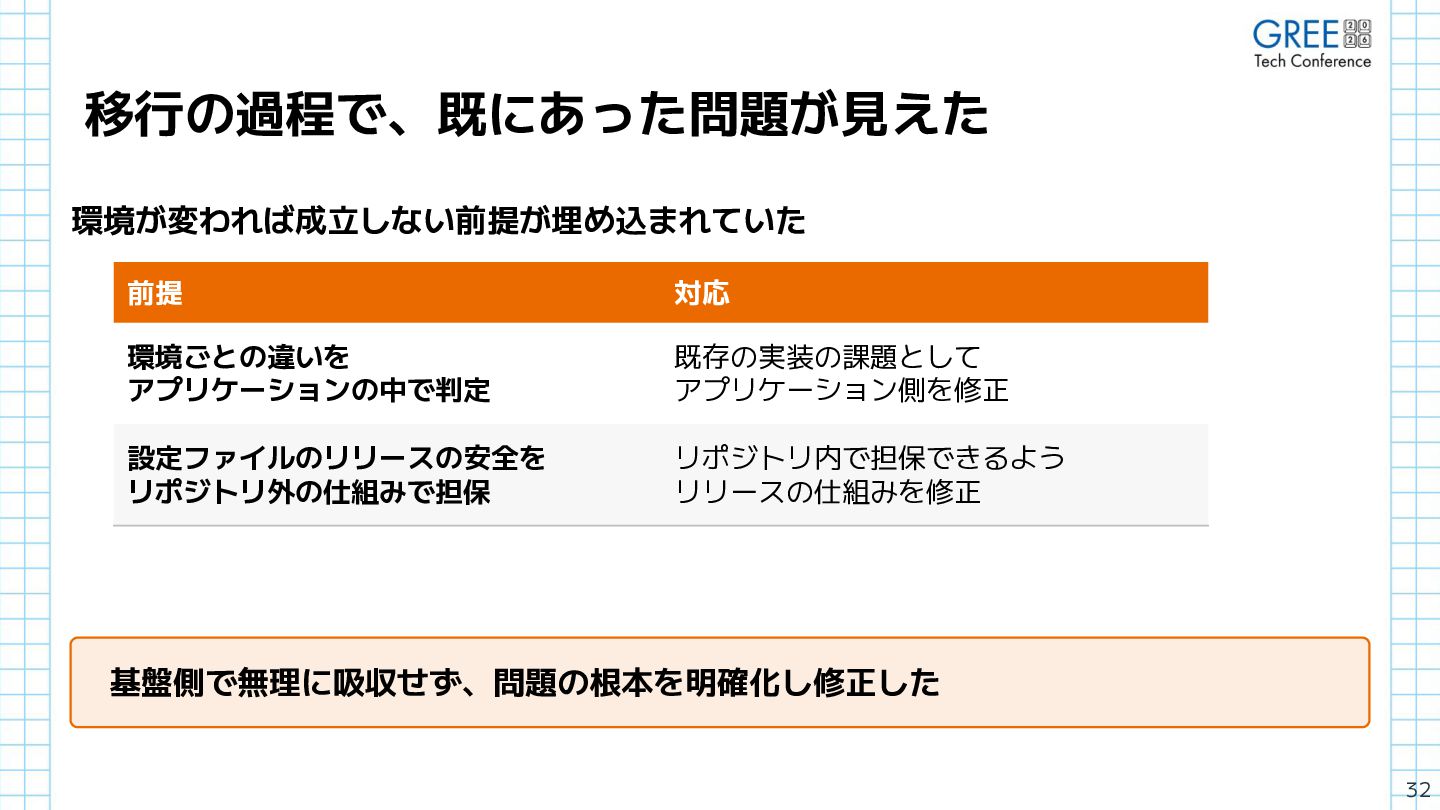
移行の過程で、既にあった問題が見えた 環境が変われば成立しない前提が埋め込まれていた 前提 対応 環境ごとの違いを アプリケーションの中で判定 既存の実装の課題として アプリケーション側を修正 設定ファイルのリリースの安全を リポジトリ外の仕組みで担保
リポジトリ内で担保できるよう リリースの仕組みを修正 基盤側で無理に吸収せず、問題の根本を明確化し修正した 33 -
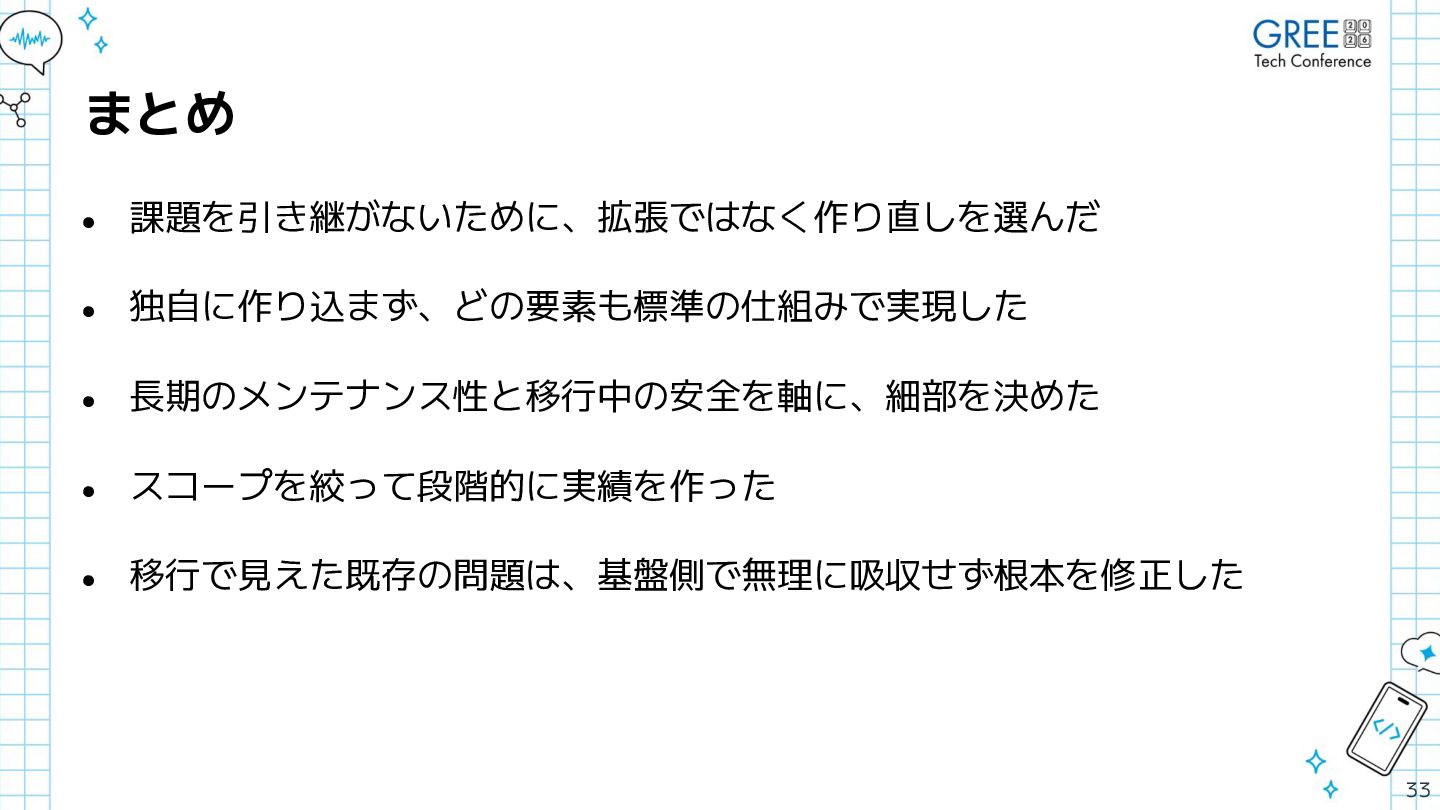
まとめ • 課題を引き継がないために、拡張ではなく作り直しを選んだ • 独自に作り込まず、どの要素も標準の仕組みで実現した • 長期のメンテナンス性と移行中の安全を軸に、細部を決めた • スコープを絞って段階的に実績を作った •
移行で見えた既存の問題は、基盤側で無理に吸収せず根本を修正した 34 -
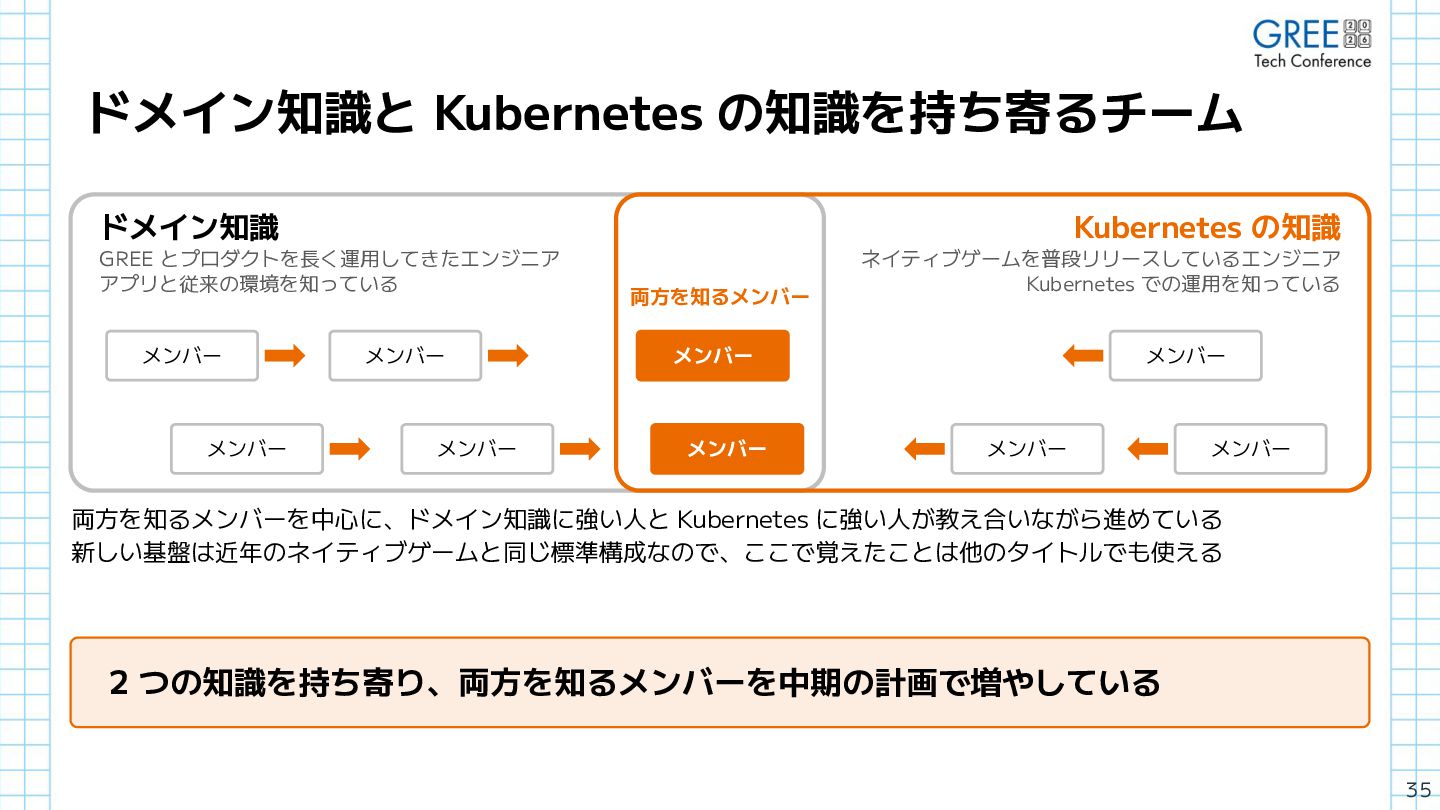
ドメイン知識と Kubernetes の知識を持ち寄るチーム ドメイン知識 Kubernetes の知識 GREE とプロダクトを長く運用してきたエンジニア アプリと従来の環境を知っている メンバー
メンバー メンバー メンバー 両方を知るメンバー ネイティブゲームを普段リリースしているエンジニア Kubernetes での運用を知っている メンバー メンバー メンバー メンバー メンバー 両方を知るメンバーを中心に、ドメイン知識に強い人と Kubernetes に強い人が教え合いながら進めている 新しい基盤は近年のネイティブゲームと同じ標準構成なので、ここで覚えたことは他のタイトルでも使える 2 つの知識を持ち寄り、両方を知るメンバーを中期の計画で増やしている 36 -
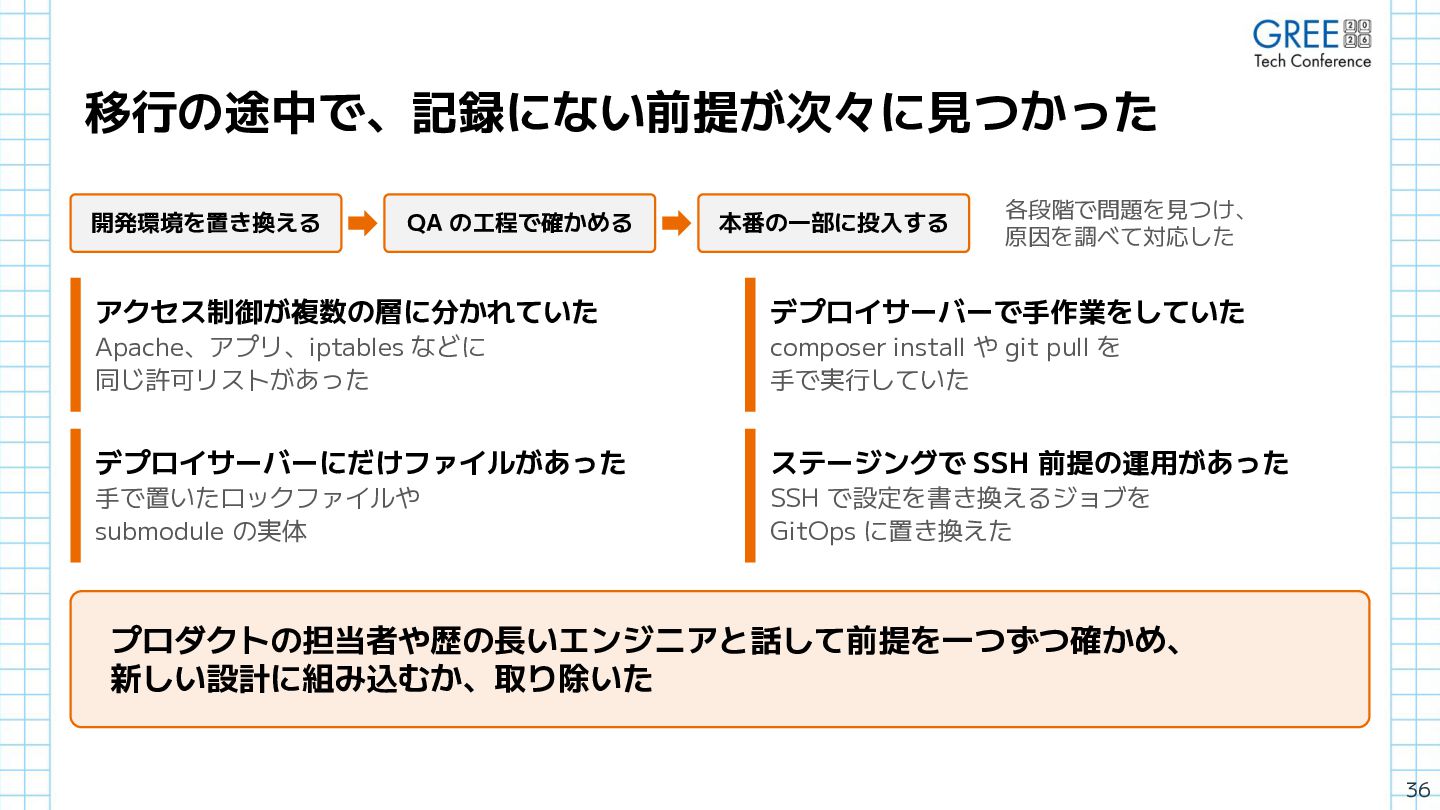
移行の途中で、記録にない前提が次々に見つかった 開発環境を置き換える QA の工程で確かめる 本番の一部に投入する 各段階で問題を見つけ、 原因を調べて対応した アクセス制御が複数の層に分かれていた デプロイサーバーで手作業をしていた Apache、アプリ、iptables
などに 同じ許可リストがあった composer install や git pull を 手で実行していた デプロイサーバーにだけファイルがあった ステージングで SSH 前提の運用があった 手で置いたロックファイルや submodule の実体 SSH で設定を書き換えるジョブを GitOps に置き換えた プロダクトの担当者や歴の長いエンジニアと話して前提を一つずつ確かめ、 新しい設計に組み込むか、取り除いた 37 -
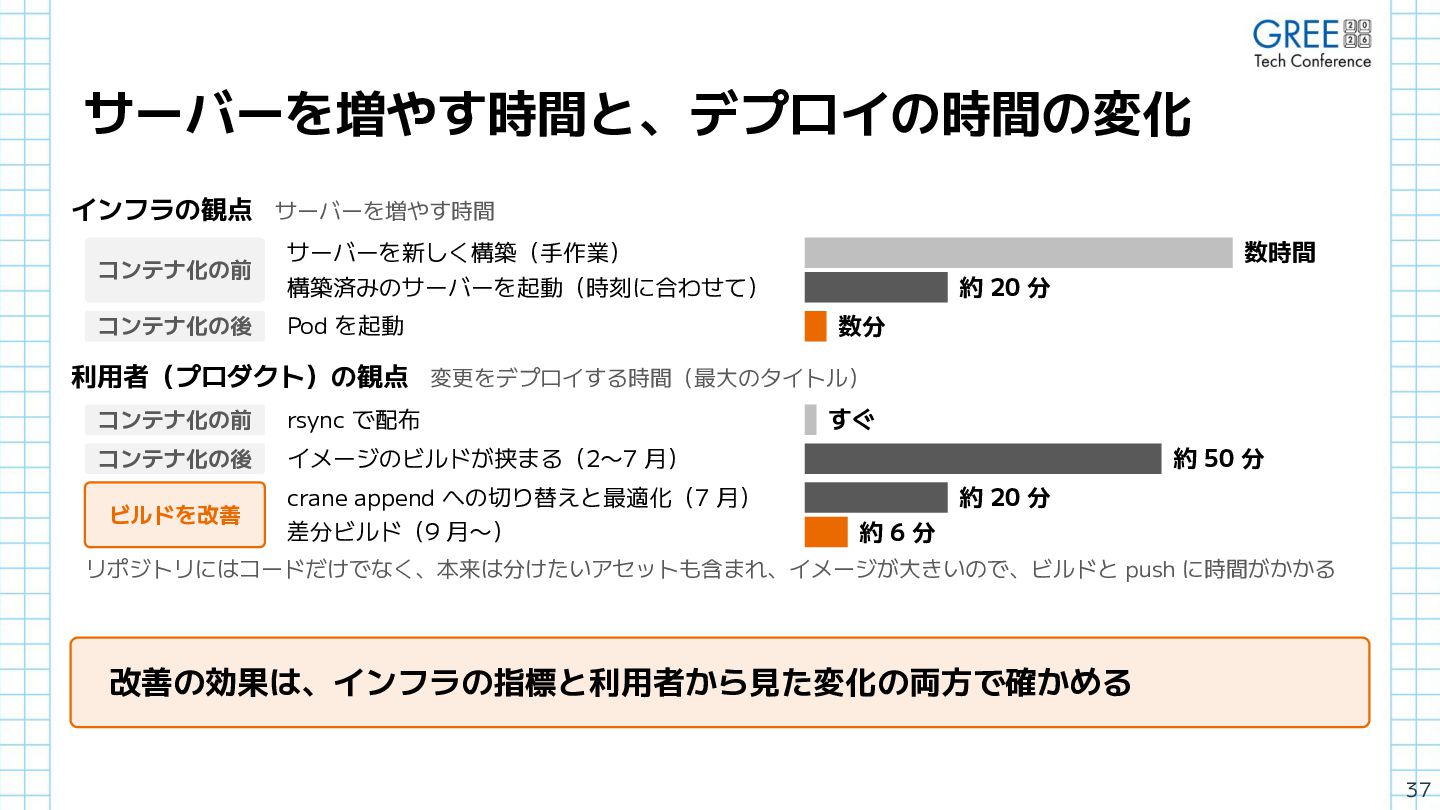
サーバーを増やす時間と、デプロイの時間の変化 インフラの観点 サーバーを増やす時間 コンテナ化の前 コンテナ化の後 数時間 サーバーを新しく構築(手作業) 約 20 分
構築済みのサーバーを起動(時刻に合わせて) Pod を起動 数分 利用者(プロダクト)の観点 変更をデプロイする時間(最大のタイトル) コンテナ化の前 rsync で配布 コンテナ化の後 イメージのビルドが挟まる(2〜7 月) ビルドを改善 すぐ 約 50 分 約 20 分 crane append への切り替えと最適化(7 月) 差分ビルド(9 月〜) 約6分 リポジトリにはコードだけでなく、本来は分けたいアセットも含まれ、イメージが大きいので、ビルドと push に時間がかかる 改善の効果は、インフラの指標と利用者から見た変化の両方で確かめる 38 -
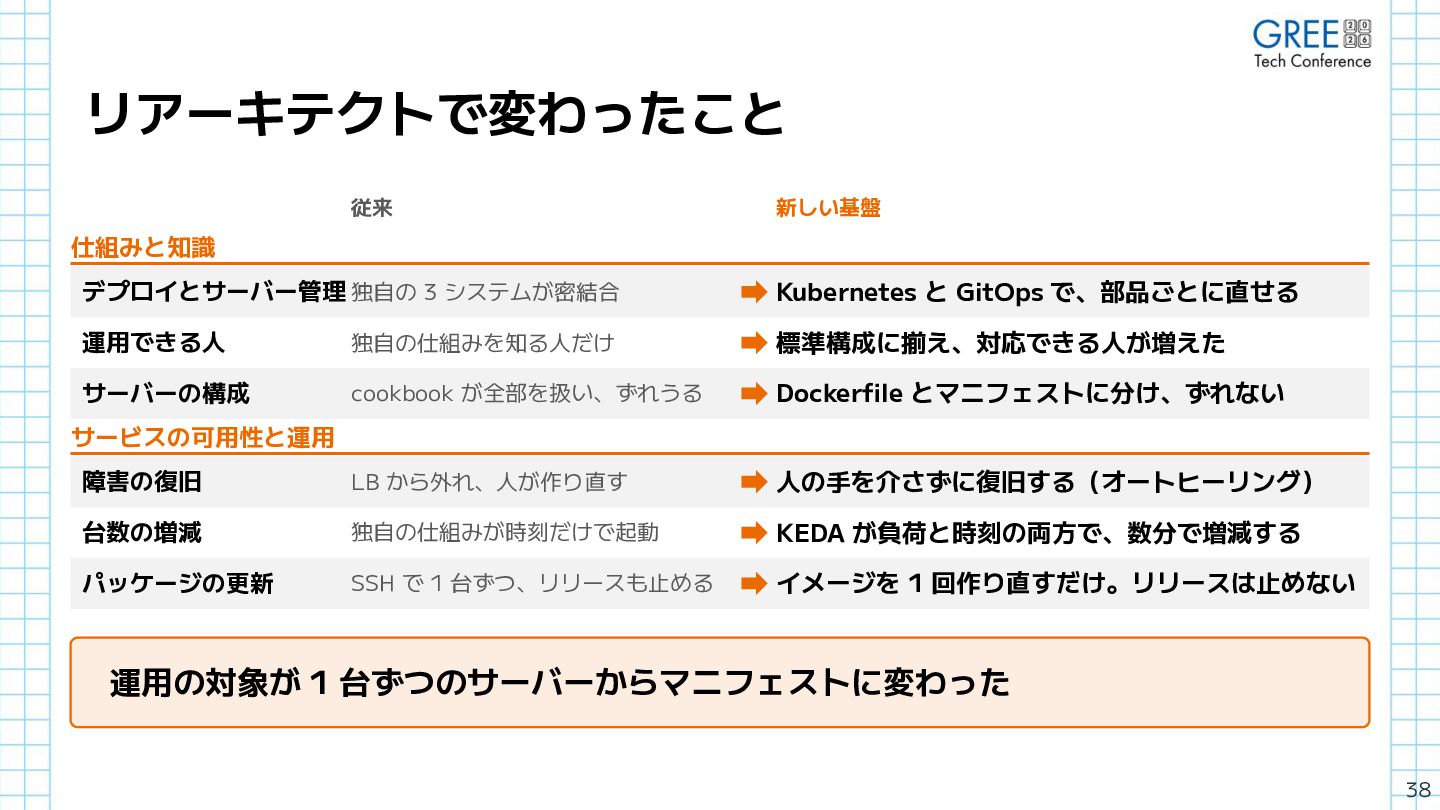
リアーキテクトで変わったこと 従来 新しい基盤 仕組みと知識 デプロイとサーバー管理 独自の 3 システムが密結合 Kubernetes と
GitOps で、部品ごとに直せる 運用できる人 独自の仕組みを知る人だけ 標準構成に揃え、対応できる人が増えた サーバーの構成 cookbook が全部を扱い、ずれうる Dockerfile とマニフェストに分け、ずれない 障害の復旧 LB から外れ、人が作り直す 人の手を介さずに復旧する(オートヒーリング) 台数の増減 独自の仕組みが時刻だけで起動 KEDA が負荷と時刻の両方で、数分で増減する パッケージの更新 SSH で 1 台ずつ、リリースも止める イメージを 1 回作り直すだけ。リリースは止めない サービスの可用性と運用 運用の対象が 1 台ずつのサーバーからマニフェストに変わった 39 -
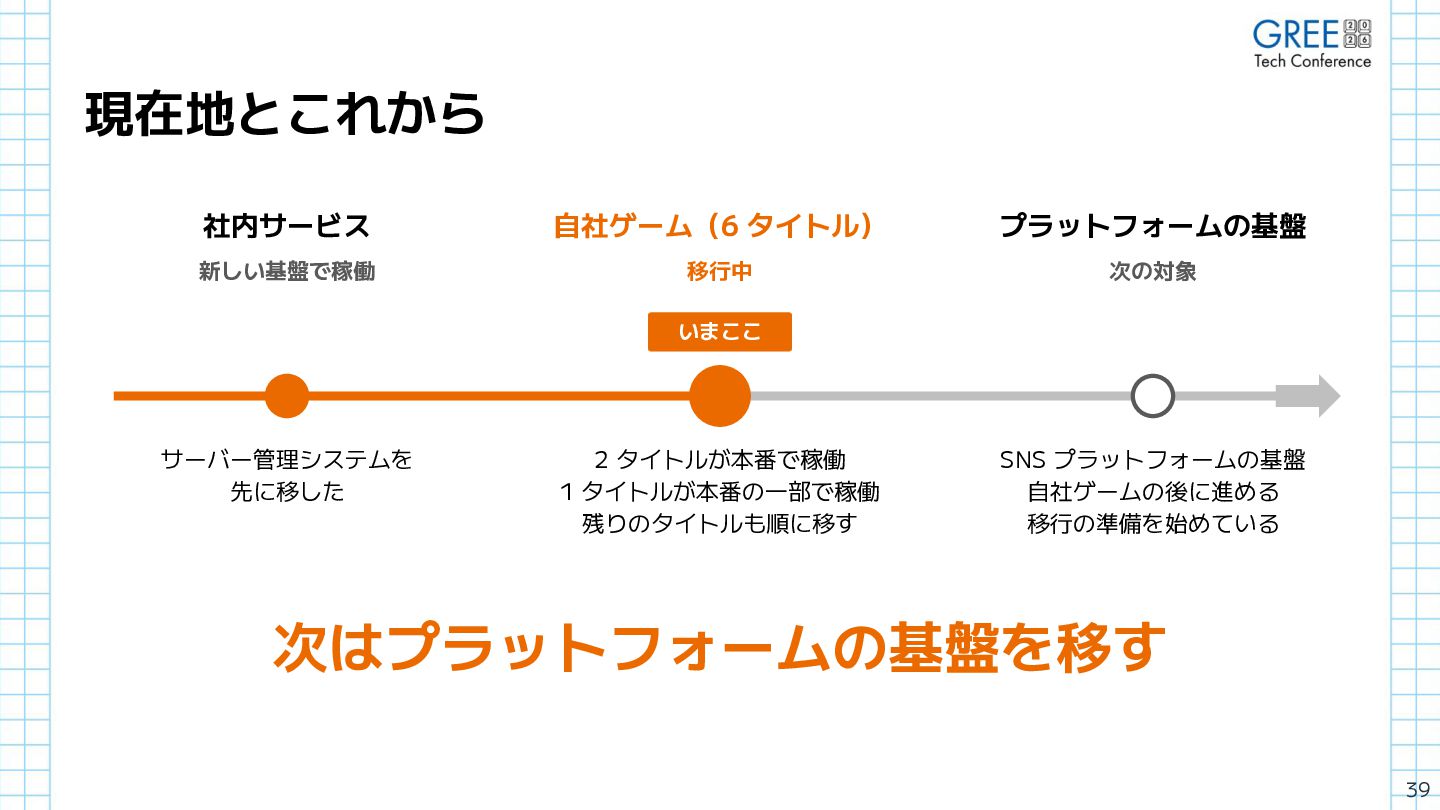
現在地とこれから 社内サービス 自社ゲーム(6 タイトル) プラットフォームの基盤 新しい基盤で稼働 移行中 次の対象 いまここ サーバー管理システムを
先に移した 2 タイトルが本番で稼働 1 タイトルが本番の一部で稼働 残りのタイトルも順に移す SNS プラットフォームの基盤 自社ゲームの後に進める 移行の準備を始めている 次はプラットフォームの基盤を移す 40