Upgrade to Pro
— share decks privately, control downloads, hide ads and more …
Speaker Deck
Sign up for free
Menu
Search
Features
All features
Private URLs
Password Protection
Custom URLS
Scheduled publishing
Remove Branding
Restrict embedding
Deck Collections
Notes
Features
All features
Private URLs
Password Protection
Custom URLS
Scheduled publishing
Remove Branding
Restrict embedding
Deck Collections
Notes
Explore
Featured decks
Featured speakers
Programming
Technology
Storyboards
Explore
Featured decks
Featured speakers
Programming
Technology
Storyboards
Pricing
Search
Sign in
Sign up for free
論文紹介:What Learning Algorithm is In-Context Lear...
Search
Kosuke Nishida
August 21, 2023
Research
1.2k
0
Share
Embed
Copy iframe code
Copy JS code
Copy link
Start on current slide
論文紹介:What Learning Algorithm is In-Context Learning? Investigation with Linear Models
第14回最先端NLP勉強会の論文(
https://openreview.net/forum?id=0g0X4H8yN4I
)紹介スライドです.
Kosuke Nishida
August 21, 2023
More Decks by Kosuke Nishida
See All by Kosuke Nishida
論文紹介:Not All Tokens Are What You Need for Pretraining
kosuken
1
320
⼤規模⾔語モデルとVision-and-Language
kosuken
6
2.4k
論文紹介: Memorisation versus Generalisation in Pre-trained Language Models
kosuken
2
1.3k
Other Decks in Research
See All in Research
CVPR2026論文紹介_VLMにとって良いvision encoderとは何か?Rethinking Model Selection in VLM Through the Lens of Gromov-Wasserstein Distance
kobayashi31
1
250
マーケットストリート 社会実験2024 in 秋葉原ジャンク通り 調査報告書
izumiyama_lab
1
160
論文紹介:Doc-to-LoRA: Learning to Instantly Internalize Contexts
yukako_nakano
0
180
進化?迷走?CasualConc ファミリーアプリの現在地 @ 英語コーパス学会 2026
casualconc
0
120
第64回CV・PRML勉強会 論文紹介:Linguistic Priors for Visual Decoupling: Towards Symmetric Vision-Brain Alignment
sokikatayama
0
230
生成AIなんでも展示会vol6 LT登壇資料 NexteraBERT
rikkabotan7
0
160
[SNLP2026] Scaling up Test-Time Compute with Latent Reasoning: A Recurrent Depth Approach
wataruuuuu
0
320
Karkada さんの論文 × 2 の紹介: (1) Closed-Form Training Dynamics Reveal Learned Features and Linear Structure in Word2Vec-like Models, (2) Symmetry in language statistics shapes the geometry of model representations
eumesy
PRO
1
800
Kaggle|AI Agent Security — しくじり先生、俺みたいになるな
pomcho555
1
110
超効率化への挑戦:1bit LLMの現状と展望
yumaichikawa
0
780
完全自律LLMエージェントでDIVER OSINT CTF 2026に挑戦してみた
analokmaus
0
690
全国町字単位空き家率推定データver1.0データ仕様
microbaseinc
0
270
Featured
See All Featured
How to Talk to Developers About Accessibility
jct
2
560
Bioeconomy Workshop: Dr. Julius Ecuru, Opportunities for a Bioeconomy in West Africa
akademiya2063
PRO
1
380
How To Speak Unicorn (iThemes Webinar)
marktimemedia
1
590
Intergalactic Javascript Robots from Outer Space
tanoku
273
27k
Building the Perfect Custom Keyboard
takai
2
890
The #1 spot is gone: here's how to win anyway
tamaranovitovic
4
1.2k
WENDY [Excerpt]
tessaabrams
14
40k
実際に使うSQLの書き方 徹底解説 / pgcon21j-tutorial
soudai
PRO
203
76k
Paper Plane
katiecoart
PRO
4
53k
Tell your own story through comics
letsgokoyo
1
1.1k
ReactJS: Keep Simple. Everything can be a component!
pedronauck
666
130k
Tips & Tricks on How to Get Your First Job In Tech
honzajavorek
1
780
Transcript
What Learning Algorithm is In-Context Learning? Investigation with Linear Models
紹介者︓ NTT⼈間研/東京⼤学 ⻄⽥光甫 Ekin Akyurek, Dale Schuurmans, Jacob Andreas, Tengyu Ma, Denny Zhou ICLR2023
• In-Context Learningはパラメータを更新せずに新しい関数を 学習することができる – 既存研究はどんな関数を学習できるかに焦点 – どのように関数を学習しているのかを知りたい • 理論的貢献︓
– 線形回帰モデルの学習アルゴリズムをTransformerが再現できる ことを⽰した • 実験的貢献︓ – Transformerが学習した関数が線形回帰モデルに近いことを⽰した 2 本研究の概要と貢献
3 この論⽂の主張のイメージ In-context Examples 𝑋, 𝑦 Test Example Transformer Decoder
𝑦! = 𝑤∗#𝑥! Transformerに 教師・評価データの 系列を与えると 理論&実験的に︓ 最適な線形回帰モデル による予測値を出⼒︕
• 準備 • 理論的貢献 – 線形回帰モデルの学習アルゴリズムをTransformerが再現できる • 実験的貢献 – Transformerが学習した関数が線形回帰モデルに近い
4 ⽬次
• ⼊⼒𝑥,パラメタ𝑤を𝑑次元ベクトルとし,出⼒𝑦を 𝑦 = 𝑤!𝑥とモデリング • 𝑥" , 𝑦" "#$,…,'()
から以下の損失で学習し,パラメタの 推定値' 𝑤 = 𝑤∗を得る 5 線形回帰モデルの定義 解の閉形式が存在 リッジ回帰. 𝜆 = 0で最⼩⼆乗法(OLS) ⼆乗誤差
• 補題1: ⼊⼒𝐻に対して以下の変換を実現する1層 Transformer Decoderが存在する – mov: ⾏列𝐻のある部分を別の箇所に移す – mul:
⾏列𝐻のある部分とある部分の積を別の箇所に出⼒ – div: ⾏列𝐻のある部分をある要素で割る – aff: ⾏列𝐻のある部分を,ある𝑊, 𝑏によってaffine変換して 別の箇所に出⼒ ※詳細は省略.変換のイメージのみ記載 ※Transformerのパラメタ𝜃は𝑊, 𝑏に依存 6 Transformerは以下の演算が可能 𝐻 movの例 Transformer Layer 𝑖: 𝑗⾏𝑡列を 𝑖!: 𝑗!⾏𝑠列で上書き
7 これから⽰すこと In-context Examples 𝑋, 𝑦 Test Example Transformer Decoder
𝑦! = 𝑤∗#𝑥! Transformerに 教師・評価データの 系列を与えると 最適な線形回帰モデル による 予測値を得られる︕ Transformer内部で mov, mul, div, aff演算を 適切に繰り返すことで
• 準備 • 理論的貢献 – 線形回帰モデルの学習アルゴリズムをTransformerが再現できる • 実験的貢献 – Transformerが学習した関数が線形回帰モデルに近い
8 ⽬次
• 線形回帰モデルを勾配法で学習するとき,以下の式を 反復して𝑤を更新する 9 線形回帰モデルを勾配法で学習する場合 𝛼︓学習率
• 層数𝑂(1),次元数𝑂(𝑑)のあるTransformerに • H($)を⼊⼒すると • 最終状態H(-)の𝑥' に相当する列は𝑤./𝑥' を要素に持つ • つまり,確率的勾配法の学習の1stepを再現
10 勾配法の1 step=Transformer変換 定理1︓確率的勾配法の学習の1stepを 計算するTransformerが存在する In-context Example 1つ Test Example
以下の⼿順で計算するだけ 11 定理1の証明
• 解の閉形式は逆⾏列の変換を含むため,計算したくない • データ数が1ならSherman-Morrison公式で回避できる • 𝑋!𝑋 = ∑ 𝑥" 𝑥"
!より,反復することで 𝑋!𝑋 + 𝜆𝐼 () が得られる 𝐴 = 𝜆𝐼, 𝐴"# = # $ 𝐼 𝑢 = 𝑣 = 𝑥% 12 線形回帰モデルを閉形式で解く場合 𝑑×𝑑の逆⾏列 𝐴 = 𝜆𝐼 + 9 %&' 𝑥% 𝑥% ( 𝑢 = 𝑣 = 𝑥')#
• 層数𝑂(1),次元数𝑂(𝑑!)のあるTransformerに • H(#)を⼊⼒すると • 最終状態H(%)の𝑥& に相当する列は𝑤'(𝑥& を要素に持つ • つまり,1データについての閉形式を再現
13 1データについての閉形式=Transformer変換 定理2︓Sherman-Morrison公式による 1データについての閉形式を計算する Transformerが存在する
• 類似の既存研究はあるが,浅い層数で実現可能なことを⽰した ことが経験的結果の説明として重要 • 定理は1step・1データに関する計算を⽰しているが, 層を重ねることで複数step・データに拡張可能 – 𝑛データから学習するときは定理1・2ともに層数𝑂(𝑛) • メタ学習からの解釈
– Inner-LoopをTransformerが内包していると考えられる – Transformerの事前学習がOuter-Loopに相当 • 線形回帰モデルの学習を再現できるって嬉しいの︖(私⾒) – ⽂埋め込みモデルを固定して,線形変換層だけを下流タスクで学習 することはNLPでよく⾏われる – Transformerの下側で⽂埋め込みの獲得,上側で「⽂埋め込みに基づく 線形回帰モデルの学習」をしているとも解釈できる – ここまで解釈を進めるとNLP的にも嬉しい(気がする) 14 議論・補⾜
• 準備 • 理論的貢献 – 線形回帰モデルの学習アルゴリズムをTransformerが再現できる • 実験的貢献 – Transformerが学習した関数が線形回帰モデルに近い
15 ⽬次
• Transformer変換が,勾配法・閉形式による線形回帰学習に, 学習アルゴリズムとして近いことを⽰したい • アルゴリズムの近さに関する評価指標が必要 16 評価したいこと
• 学習アルゴリズム𝒜によって得られた関数𝑓の予測の近さを 評価 17 指標1: Squared prediction difference In-Context exampleとtest
exampleに関する 期待値 予測値の差の2乗 𝑓はアルゴリズム𝒜で In-Context Example 𝐷から 学習した関数
• 学習アルゴリズム𝒜が学習したモデルを近似する線形モデル のパラメタ𝑤の近さを評価 ※ 𝒜が学習するモデルは線形変換に限らない 18 指標2: Implicit linear weight
difference In-Context exampleとtest exampleに関する 期待値 パラメタの差の ノルム 学習モデルを 最も再現する線形モデル 𝒜が学習したモデル による予測値
• ⽐較対象の学習アルゴリズム – k近傍法 – リッジ回帰の確率的勾配法(batch size=1, #step=#data) – リッジ回帰の最急降下法(batch
size=#data, #step=1) – リッジ回帰の閉形式(厳密解) • タスク – ⼊⼒𝑥・真のパラメタ𝑤* を4,8,16次元⽩⾊ノイズとする – {𝑥% , 𝑦% = 𝑤* +𝑥% }と𝑥, から𝑦, を予測 • Transformer – 𝐻(*)を⼊⼒し,𝑥, に相当する列の0⾏⽬の値を予測値とする – 16層512次元4ヘッド.⼊⼒での次元の違いはpaddingで対処 – Transformer⾃体を上記タスク・⼆乗誤差で50万step学習した 19 実験設定
• 実験では,TransformerがIn-Context Learningに関する 学習を⾏った 20 TransformerのIn-Context Learning学習 データ分布に関する 期待値 再現したい関数𝑓
= 𝑤* に関する期待値 Transformerに i-1個の⼊出⼒・ 1個の⼊⼒を 与えて数値を得る 正解𝑦% = 𝑤* +𝑥%
• Squared prediction difference(予測の近さ)で測ったとき, 最⼩⼆乗解(𝜆 = 0のときの閉形式)との距離が⼩さい – 8次元の問題なので,事例が8未満のときは不定解 –
閉形式はありうる解のうちノルムが最も⼩さい解を選ぶ – Transformerが閉形式と近いということは,Transformerもノルムが ⼩さい解を選んでいる • パラメタが⽩⾊ノイズなので,0(パラメタ事前分布平均)に近い解を 選んでいることをベイズの観点から語れるのでは︖ 21 Transformer変換は最⼩⼆乗解を再現する
• Implicit linear weight difference(パラメタの近さ)で測った ときも同様に最⼩⼆乗解に近い 22 Transformer変換は最⼩⼆乗解を再現する
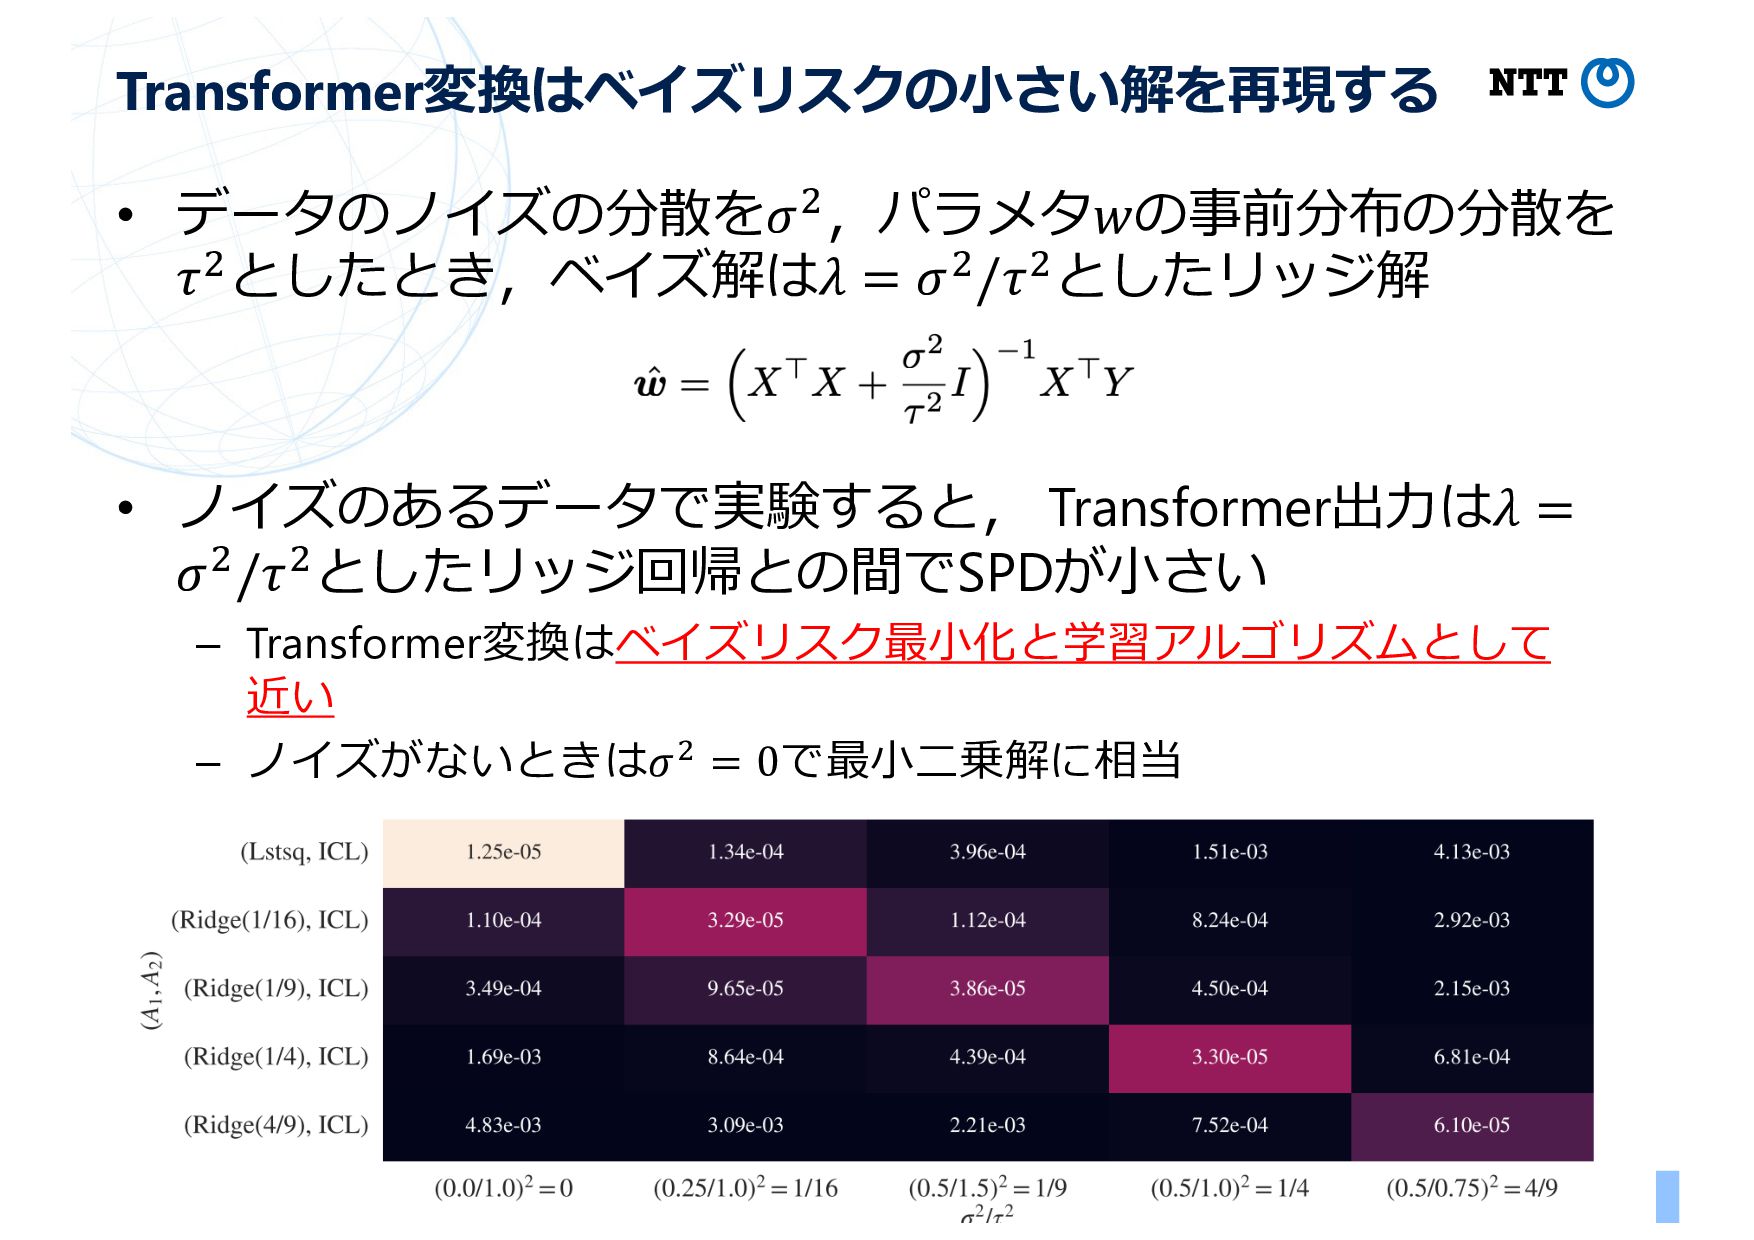
• データのノイズの分散を𝜎0,パラメタ𝑤の事前分布の分散を 𝜏0としたとき,ベイズ解は𝜆 = 𝜎0/𝜏0としたリッジ解 • ノイズのあるデータで実験すると, Transformer出⼒は𝜆 = 𝜎0/𝜏0としたリッジ回帰との間でSPDが⼩さい
– Transformer変換はベイズリスク最⼩化と学習アルゴリズムとして 近い – ノイズがないときは𝜎/ = 0で最⼩⼆乗解に相当 23 Transformer変換はベイズリスクの⼩さい解を再現する
• モーメント・パラメタを系列⽅向の重み付き和+Linear/MLP で復元するprobingを⾏い,MSEで評価 • まずモーメント,次にパラメタを復元 – 低層では復元できない.多層変換の重要性も確認 24 Probingによる検証 学習可能パラメタ
モーメント パラメタ
• 理論的貢献︓ Transformer変換は線形回帰の学習アルゴリズムを再現できる • 実験的貢献︓ – In-Context LearningしたTransformerはベイズリスク最⼩な 線形回帰モデルの予測値と近い予測を出⼒ •
私⾒︓ – 線形性を仮定しない学習をしたTransformerがベイズリスク最⼩な 線形回帰モデルと近いモデルを得るのは⾯⽩い – ⽐較⼿法の中で⼀番いいモデルがリッジ回帰の厳密解だった可能性も – 次単語予測で学習したTransformerが線形回帰の学習を再現するかは 不明 – 「なんでパラメタも更新しないでタスクに適応できるの︖」の 疑問への⼀つの答え 25 本研究のまとめ
• 層が少ないときは1stepの勾配法と近く,層が増えると リッジ回帰と近い • リッジ回帰と近づくには次元数が必要だが,𝑂(𝑑0)は不要 26 ⼩さいTransformerではどうなる︖


 kosuken
 kobayashi31
 izumiyama_lab
 yukako_nakano
 casualconc
 sokikatayama
 rikkabotan7
 wataruuuuu
 eumesy
 pomcho555
 yumaichikawa
 analokmaus
 microbaseinc
 jct
 akademiya2063
 marktimemedia
 tanoku
 takai
 tamaranovitovic
 tessaabrams
 soudai
 katiecoart
 letsgokoyo
 pedronauck
 honzajavorek