Upgrade to Pro
— share decks privately, control downloads, hide ads and more …
Speaker Deck
Sign up for free
Menu
Search
Features
All features
Private URLs
Password Protection
Custom URLS
Scheduled publishing
Remove Branding
Restrict embedding
Deck Collections
Notes
Features
All features
Private URLs
Password Protection
Custom URLS
Scheduled publishing
Remove Branding
Restrict embedding
Deck Collections
Notes
Explore
Featured decks
Featured speakers
Programming
Technology
Storyboards
Explore
Featured decks
Featured speakers
Programming
Technology
Storyboards
Pricing
Search
Sign in
Sign up for free
ON-LSTM
Search
Zhang Yixiao
July 05, 2019
Research
240
0
Share
Embed
Copy iframe code
Copy JS code
Copy link
Start on current slide
ON-LSTM
Zhang Yixiao
July 05, 2019
More Decks by Zhang Yixiao
See All by Zhang Yixiao
CoCon
ldzhangyx
0
420
vq-cpc
ldzhangyx
0
410
MixPoet
ldzhangyx
4
480
diora
ldzhangyx
0
320
drummernet
ldzhangyx
0
280
Other Decks in Research
See All in Research
OWASP AISVS - C7
shiell
2
820
LA-Bench 2025:実験指示から 実行可能手順を生成するためのデータセット/LA-Bench 2025: A Dataset for Generating Executable Experimental Procedures from Experimental Instructions
stktu
0
200
Fukui Shibiten 39 - AI Art
butchi
0
260
最先端NLP勉強会2026 論文紹介:Reasoning with Sampling: Your Base Model is Smarter Than You Think (ICLR 2026 paper)
kogoro
4
670
2026年6月_副業コンプライアンス調査_業界別リスク度分析_株式会社フクスケ.pdf
fkske
0
110
HackSick vol.7 LT資料【LLMアーキテクチャ入門・事前学習時の躓き所解説】 スパースなAttention・状態空間モデル
rikkabotan7
0
210
[SNLP2026] Scaling up Test-Time Compute with Latent Reasoning: A Recurrent Depth Approach
wataruuuuu
0
330
全国町字単位空き家率推定データver1.0データ仕様
microbaseinc
0
280
ros2-perf-multihost: Automated Coordination Framework for Objective Architecture Evaluation in Distributed Systems
takasehideki
0
130
MM-OVSeg: Multimodal Optical–SAR Fusion for Open-Vocabulary Segmentation in Remote Sensing
satai
3
150
Adapter les bergeries aux fortes chaleurs
institutdelelevage
PRO
0
110
学術バーQ AI研究最前線:自己教師あり学習による画像モデルの事前学習
naok615
0
140
Featured
See All Featured
Max Prin - Stacking Signals: How International SEO Comes Together (And Falls Apart)
techseoconnect
PRO
0
480
Fantastic passwords and where to find them - at NoRuKo
philnash
52
4k
The Success of Rails: Ensuring Growth for the Next 100 Years
eileencodes
47
8.4k
Building Experiences: Design Systems, User Experience, and Full Site Editing
marktimemedia
1
620
Believing is Seeing
oripsolob
1
240
Into the Great Unknown - MozCon
thekraken
41
2.8k
HU Berlin: Industrial-Strength Natural Language Processing with spaCy and Prodigy
inesmontani
PRO
0
740
Stewardship and Sustainability of Urban and Community Forests
pwiseman
0
540
Faster Mobile Websites
deanohume
310
32k
エンジニアに許された特別な時間の終わり
watany
109
250k
Chrome DevTools: State of the Union 2024 - Debugging React & Beyond
addyosmani
10
1.4k
The AI Revolution Will Not Be Monopolized: How open-source beats economies of scale, even for LLMs
inesmontani
PRO
3
3.8k
Transcript
ORDERED NEURONS: INTEGRATING TREE STRUCTURES INTO RECURRENT NEURAL NETWORKS (ICLR
2019, BEST PAPER AWARD
在语言模型中引入树结构 • 能获得抽象化级别不断提升的分层表征; • 能捕获复杂语言现象,如长期依赖问题与组分效应; • 能为梯度反向传播提供捷径。
ON-LSTM • 用有序神经元表达层次结构 • Contribution • 1.提高了语言模型的效果 • 2.可以无监督地学习到句子的句法结构
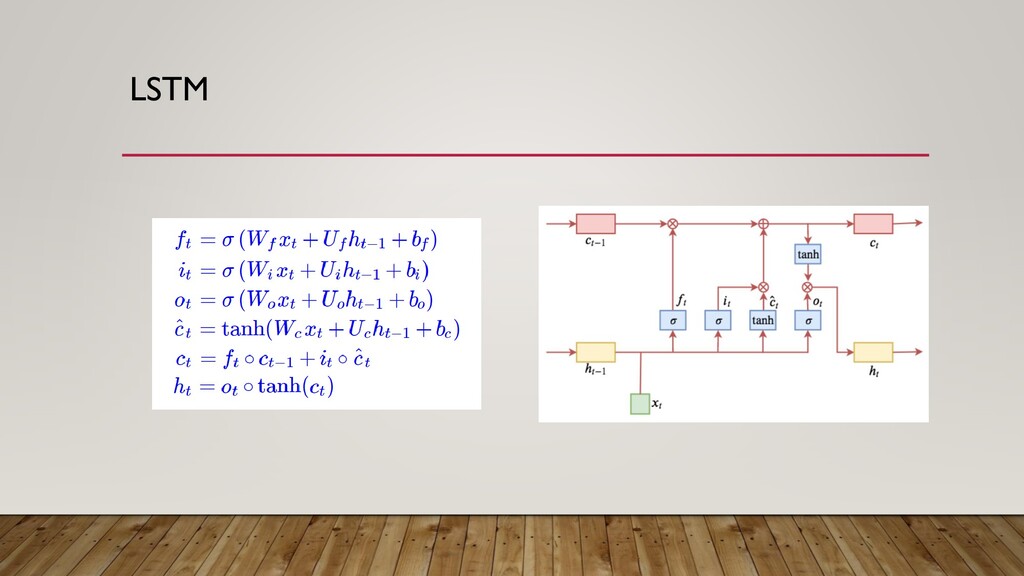
LSTM
语言和序信息 • 在常见的神经网络中,神经元通常都是无序的 • ON-LSTM则试图把这些神经元排个序,并且用这个序来表示一些特定的结构,从 而把神经元的序信息利用起来
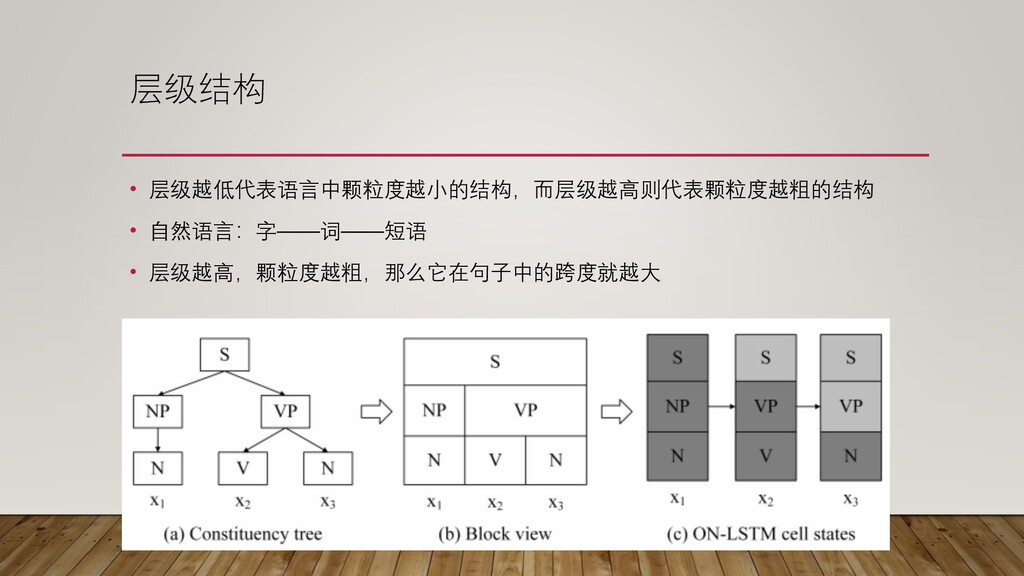
层级结构 • 层级越低代表语言中颗粒度越小的结构,而层级越高则代表颗粒度越粗的结构 • 自然语言:字——词——短语 • 层级越高,颗粒度越粗,那么它在句子中的跨度就越大
ON-LSTM的设计方向 • 层级越高,颗粒度越粗,那么它在句子中的跨度就越大 • 要求: • 1. 能区分高低层级的信息 • 2.
能让高层级的信息保留更久,底层级的信息更容易被遗忘
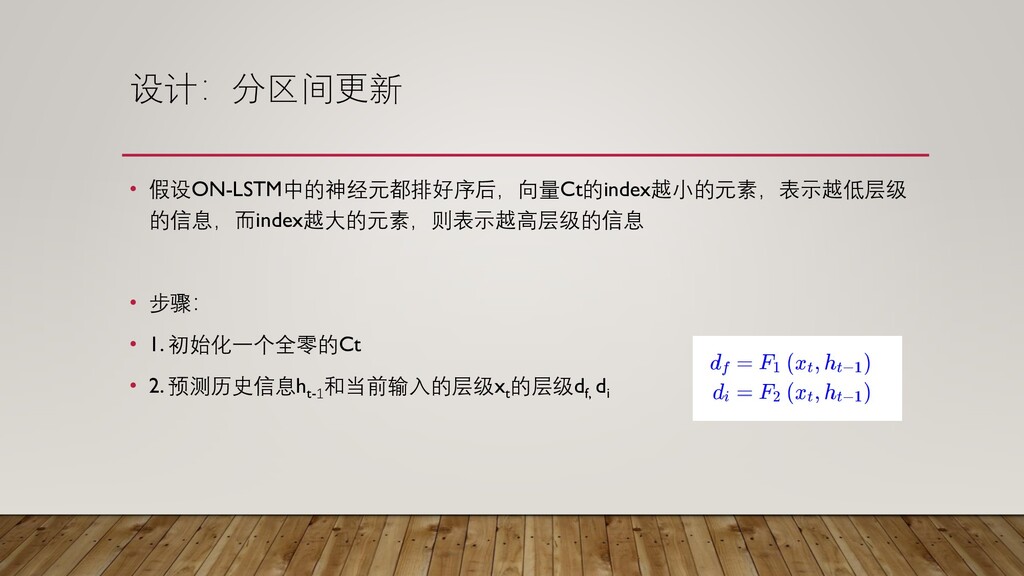
设计:分区间更新 • 假设ON-LSTM中的神经元都排好序后,向量Ct的index越小的元素,表示越低层级 的信息,而index越大的元素,则表示越高层级的信息 • 步骤: • 1. 初始化一个全零的Ct •
2. 预测历史信息ht-1 和当前输入的层级xt 的层级df, di
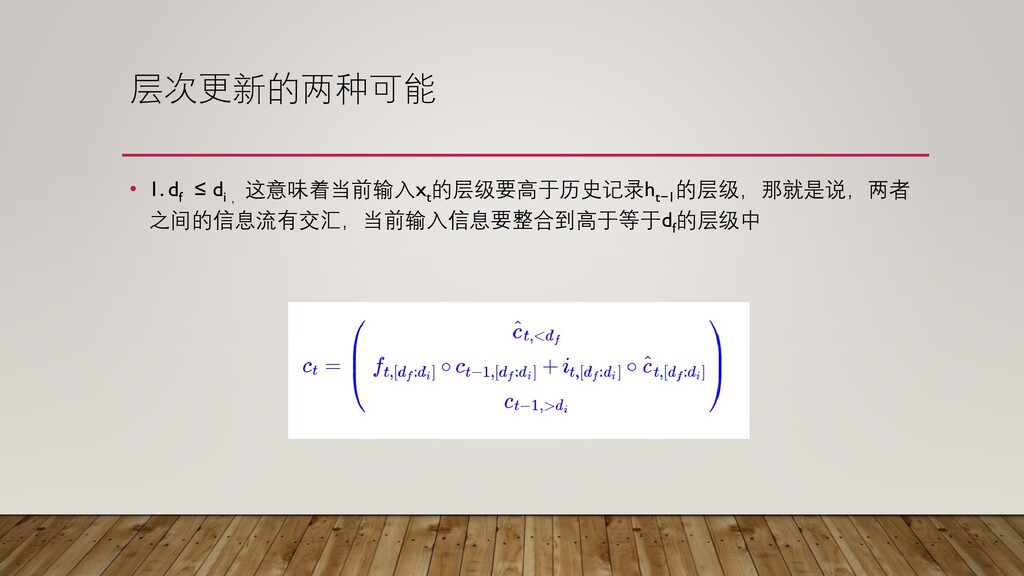
层次更新的两种可能 • 1. df ≤ di , 这意味着当前输入xt 的层级要高于历史记录ht−1 的层级,那就是说,两者
之间的信息流有交汇,当前输入信息要整合到高于等于df 的层级中
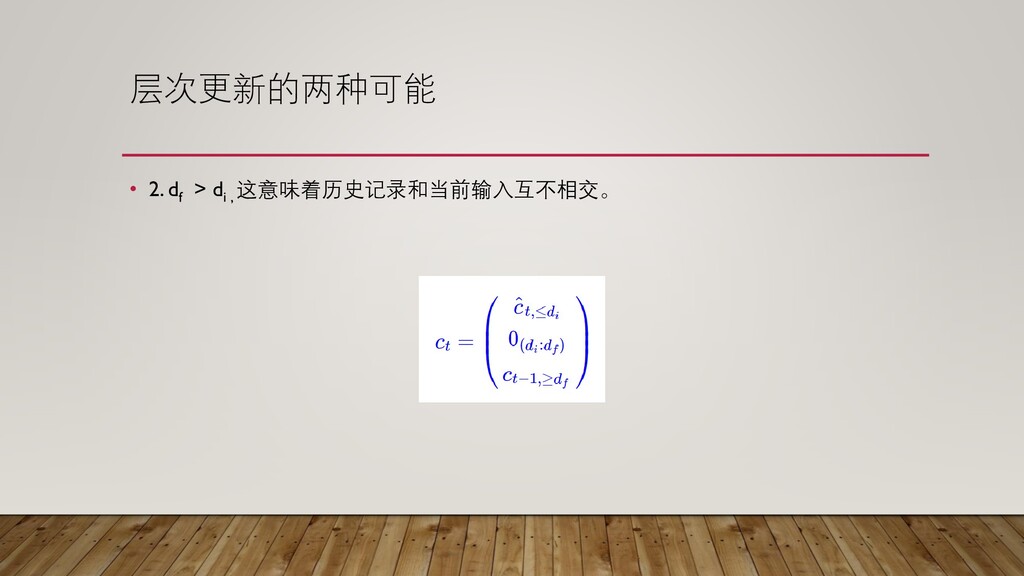
层次更新的两种可能 • 2. df > di , 这意味着历史记录和当前输入互不相交。
分层更新的作用 • 高层信息就可能保留相当长的距离(因为高层直接复制历史信息,导致历史信息可 能不断被复制而不改变); • 而低层信息在每一步输入时都可能被更新(因为低层直接复制输入,而输入是不断 改变的)。 • 所以就通过信息分级来嵌入了层级结构。 •
更通俗地说就是分组更新,更高的组信息传得更远(跨度更大),更低的组跨度更 小,这些不同的跨度就形成了输入序列的层级结构。
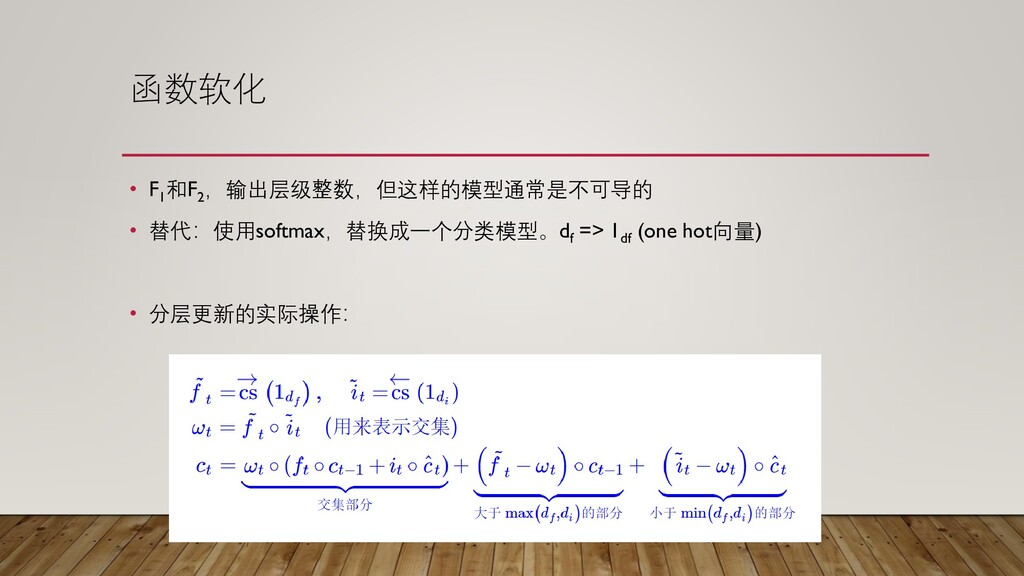
函数软化 • F1 和F2 ,输出层级整数,但这样的模型通常是不可导的 • 替代:使用softmax,替换成一个分类模型。df => 1df (one
hot向量) • 分层更新的实际操作:
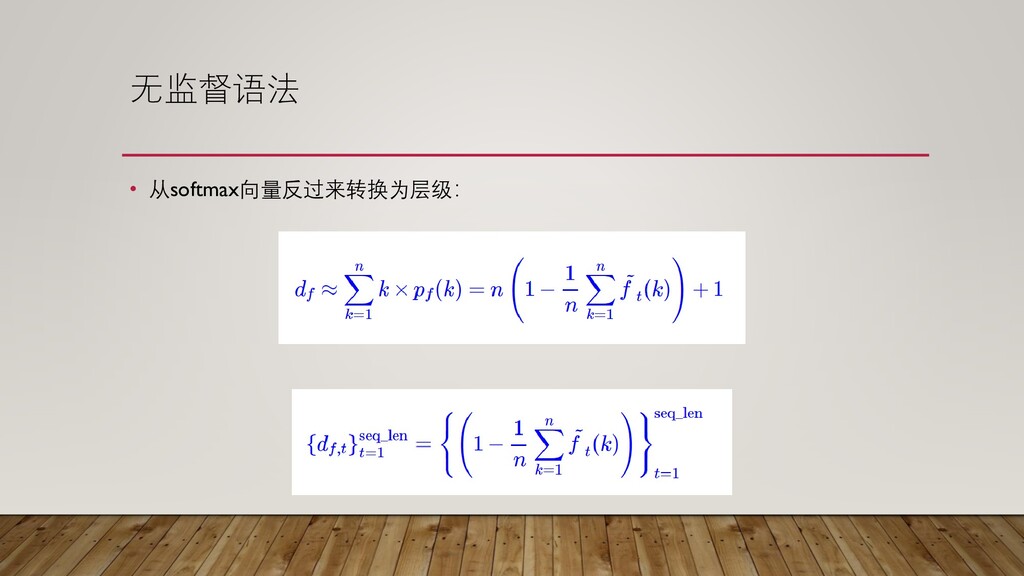
无监督语法 • 从softmax向量反过来转换为层级:
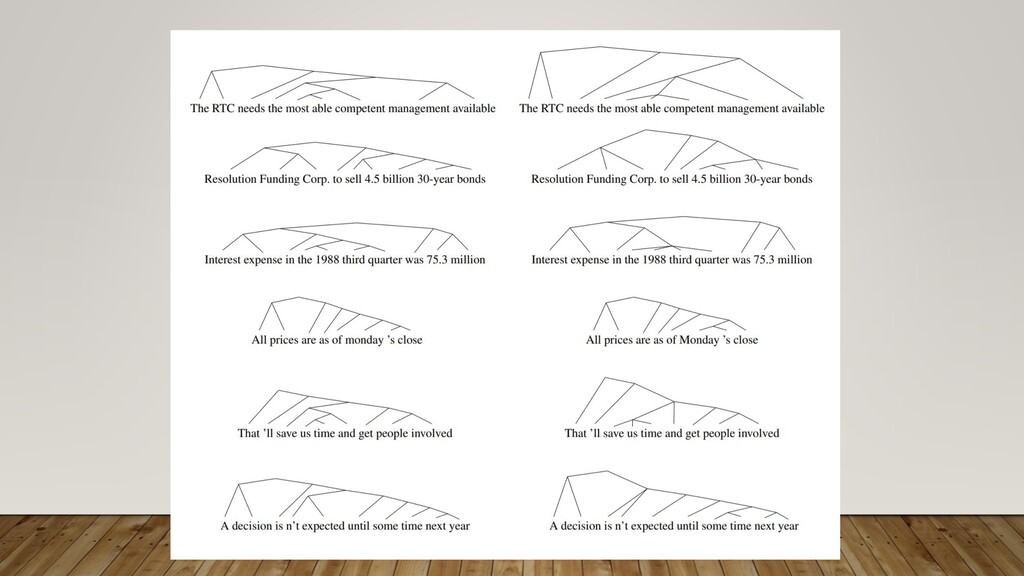
贪心算法析出层次结构 • 给定输入序列{xt }到预训练好的ON-LSTM,输出对应的层级序列{df,t }, • 然后找出层级序列中最大值所在的下标,比如k, • 那么就将输入序列分区为[xt<k ,[xk
,xt>k ]]。 • 然后对子序列xt <k和xt >k重复上述步骤,直到每个子序列长度为1。
None


 ldzhangyx
 shiell
 stktu
 butchi
 kogoro
 fkske
 rikkabotan7
 wataruuuuu
 microbaseinc
 takasehideki
 satai
 institutdelelevage
 naok615
 techseoconnect
 philnash
 eileencodes
 marktimemedia
 oripsolob
 thekraken
 inesmontani
 pwiseman
 deanohume
 watany
 addyosmani
![贪心算法析出层次结构 • 给定输入序列{xt }到预训练好的ON-LSTM,输出对应的层级序列{df,t }, • 然后找出层级序列中最大值所在的下标,比如k, • 那么就将输入序列分区为[xt<k ,[xk](https://files.speakerdeck.com/presentations/e8e0975272814e48a34ffc7257f1b63b/slide_13.jpg)