Share
Embed
ScoreMatchingRiesz for Automatic Debiased Machine Learning and Policy Path Estimation with an Application to Japanese Monetary Policy Evaluation
第36回 人工知能学会 金融情報学研究会(SIG-FIN)
MasaKat0
March 22, 2026
Transcript
24 slides
-
1 ScoreMatchingRiesz for Automatic Debiased Machine Learning and Policy Path
Estimation with an Application to Japanese Monetary Policy Evaluation 第36回 人工知能学会 金融情報学研究会(SIG-FIN) Masahiro Kato Osaka Metropolitan University Mizuho-DL Financial Technology Co., Ltd. -
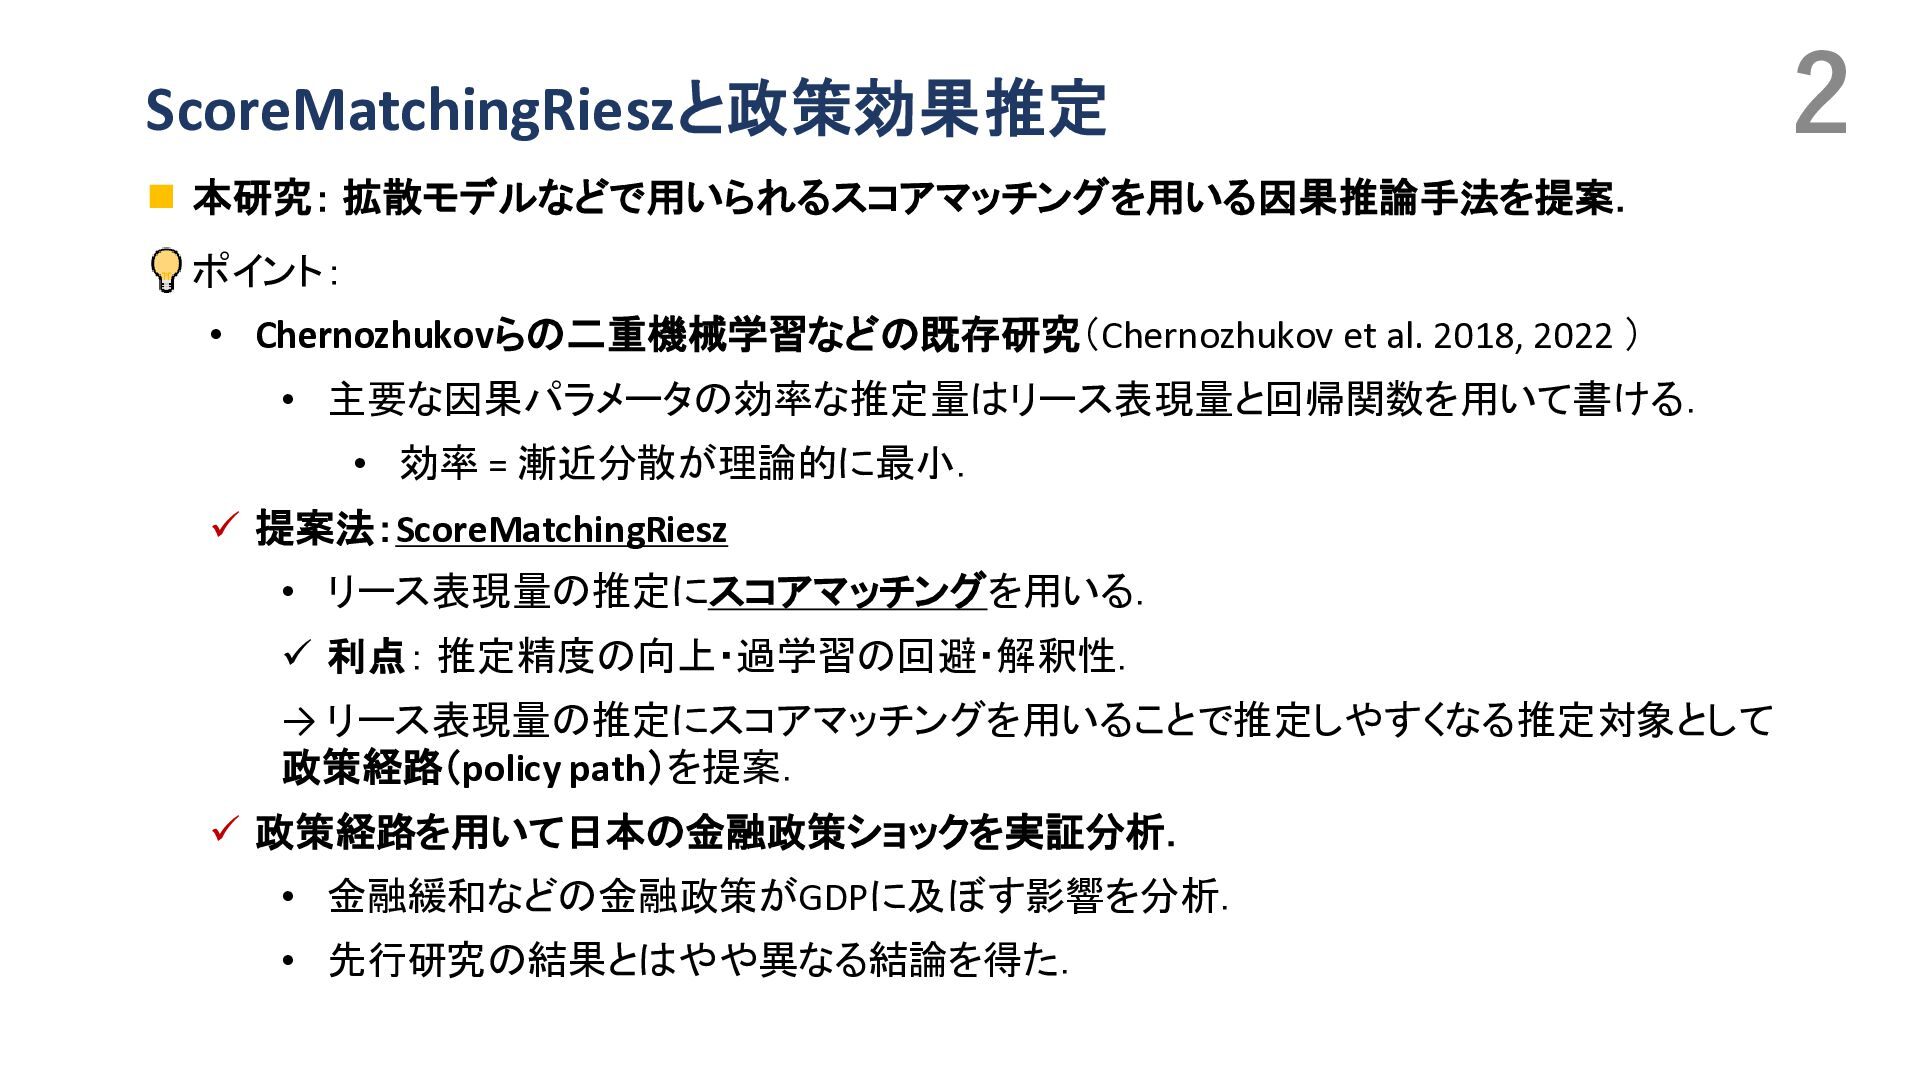
2 ScoreMatchingRieszと政策効果推定 ◼ 本研究: 拡散モデルなどで用いられるスコアマッチングを用いる因果推論手法を提案. ポイント: • Chernozhukovらの二重機械学習などの既存研究(Chernozhukov et al.
2018, 2022 ) • 主要な因果パラメータの効率な推定量はリース表現量と回帰関数を用いて書ける. • 効率 = 漸近分散が理論的に最小. ✓ 提案法:ScoreMatchingRiesz • リース表現量の推定にスコアマッチングを用いる. ✓ 利点: 推定精度の向上・過学習の回避・解釈性. → リース表現量の推定にスコアマッチングを用いることで推定しやすくなる推定対象として 政策経路(policy path)を提案. ✓ 政策経路を用いて日本の金融政策ショックを実証分析. • 金融緩和などの金融政策がGDPに及ぼす影響を分析. • 先行研究の結果とはやや異なる結論を得た. -
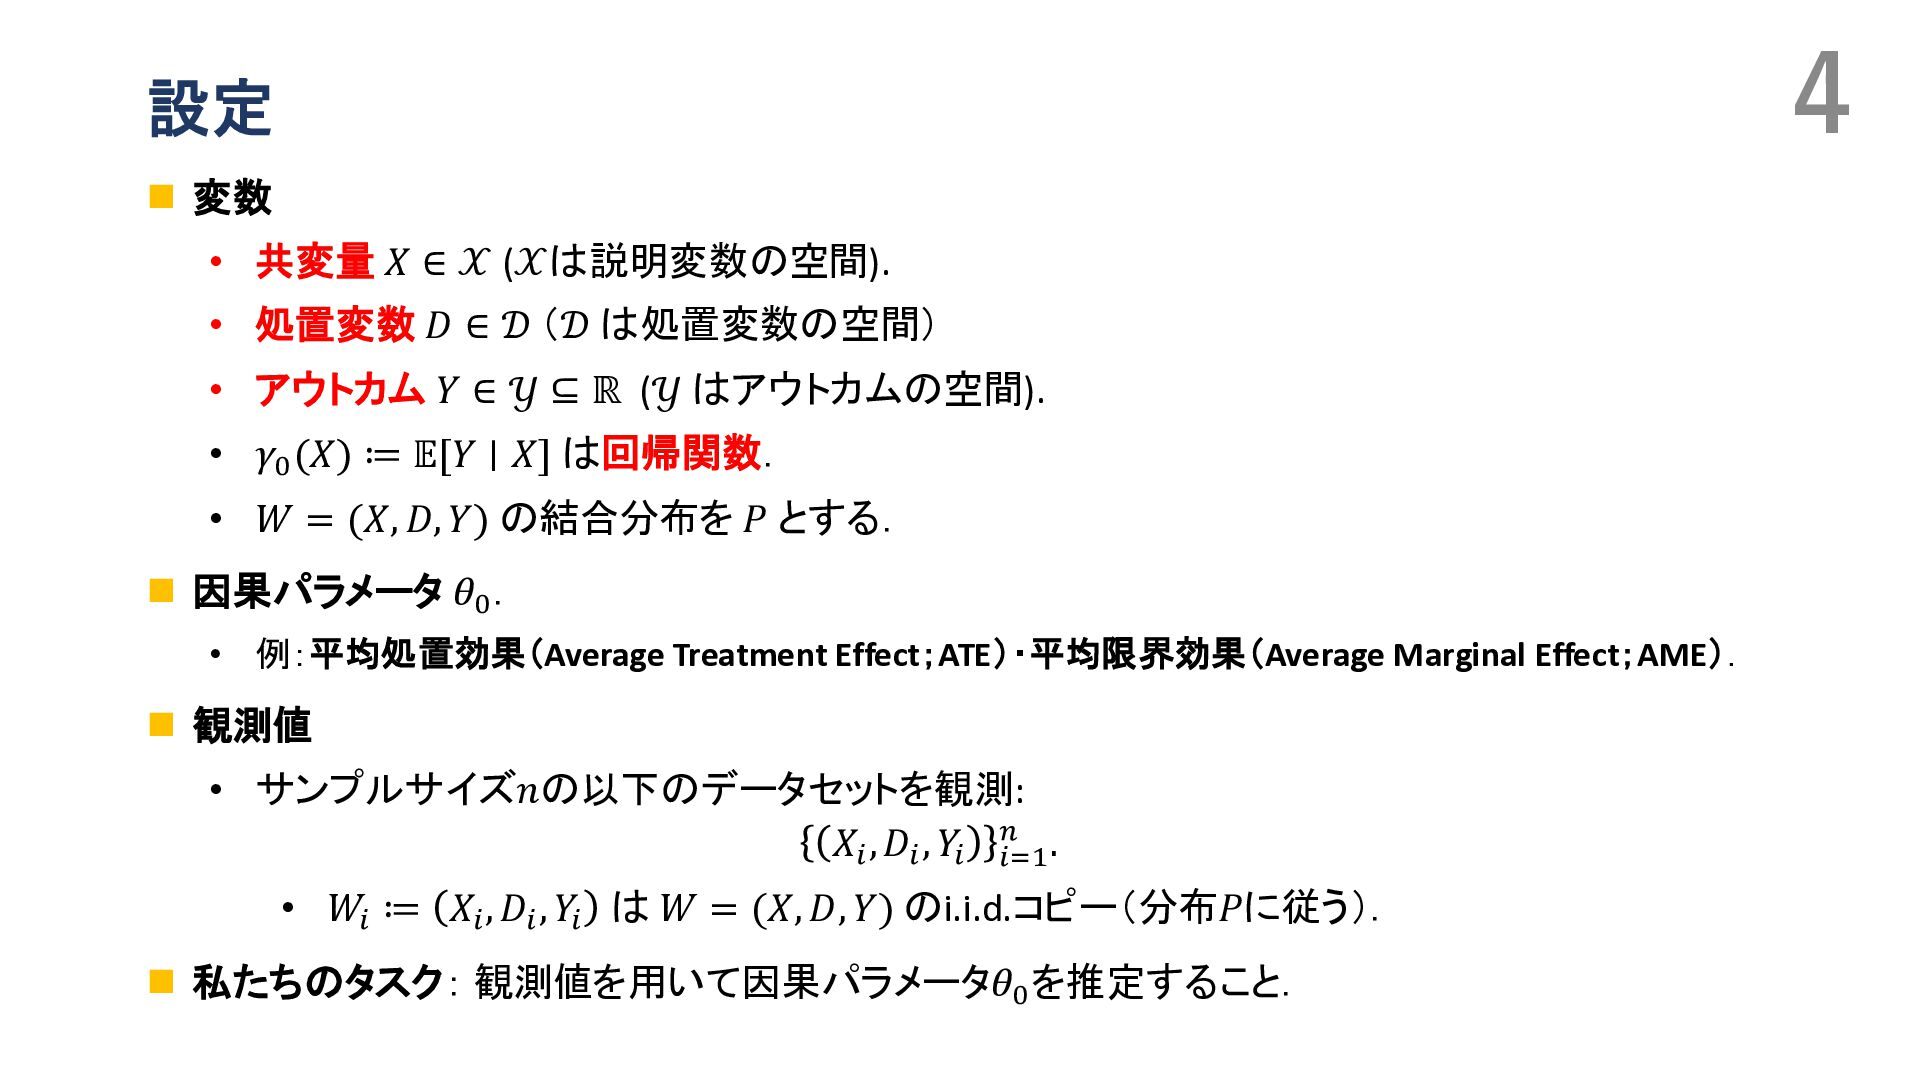
4 設定 ◼ 変数 • 共変量 𝑋 ∈ 𝒳 (𝒳は説明変数の空間).
• 処置変数 𝐷 ∈ 𝒟 (𝒟 は処置変数の空間) • アウトカム 𝑌 ∈ 𝒴 ⊆ ℝ (𝒴 はアウトカムの空間). • 𝛾0 (𝑋) ≔ 𝔼[𝑌 ∣ 𝑋] は回帰関数. • 𝑊 = (𝑋, 𝐷, 𝑌) の結合分布を 𝑃 とする. ◼ 因果パラメータ 𝜃0 . • 例:平均処置効果(Average Treatment Effect;ATE)・平均限界効果(Average Marginal Effect;AME). ◼ 観測値 • サンプルサイズ𝑛の以下のデータセットを観測: 𝑋𝑖 , 𝐷𝑖 , 𝑌𝑖 𝑖=1 𝑛 . • 𝑊𝑖 ≔ 𝑋𝑖 , 𝐷𝑖 , 𝑌𝑖 は 𝑊 = (𝑋, 𝐷, 𝑌) のi.i.d.コピー(分布𝑃に従う). ◼ 私たちのタスク: 観測値を用いて因果パラメータ𝜃0 を推定すること. -
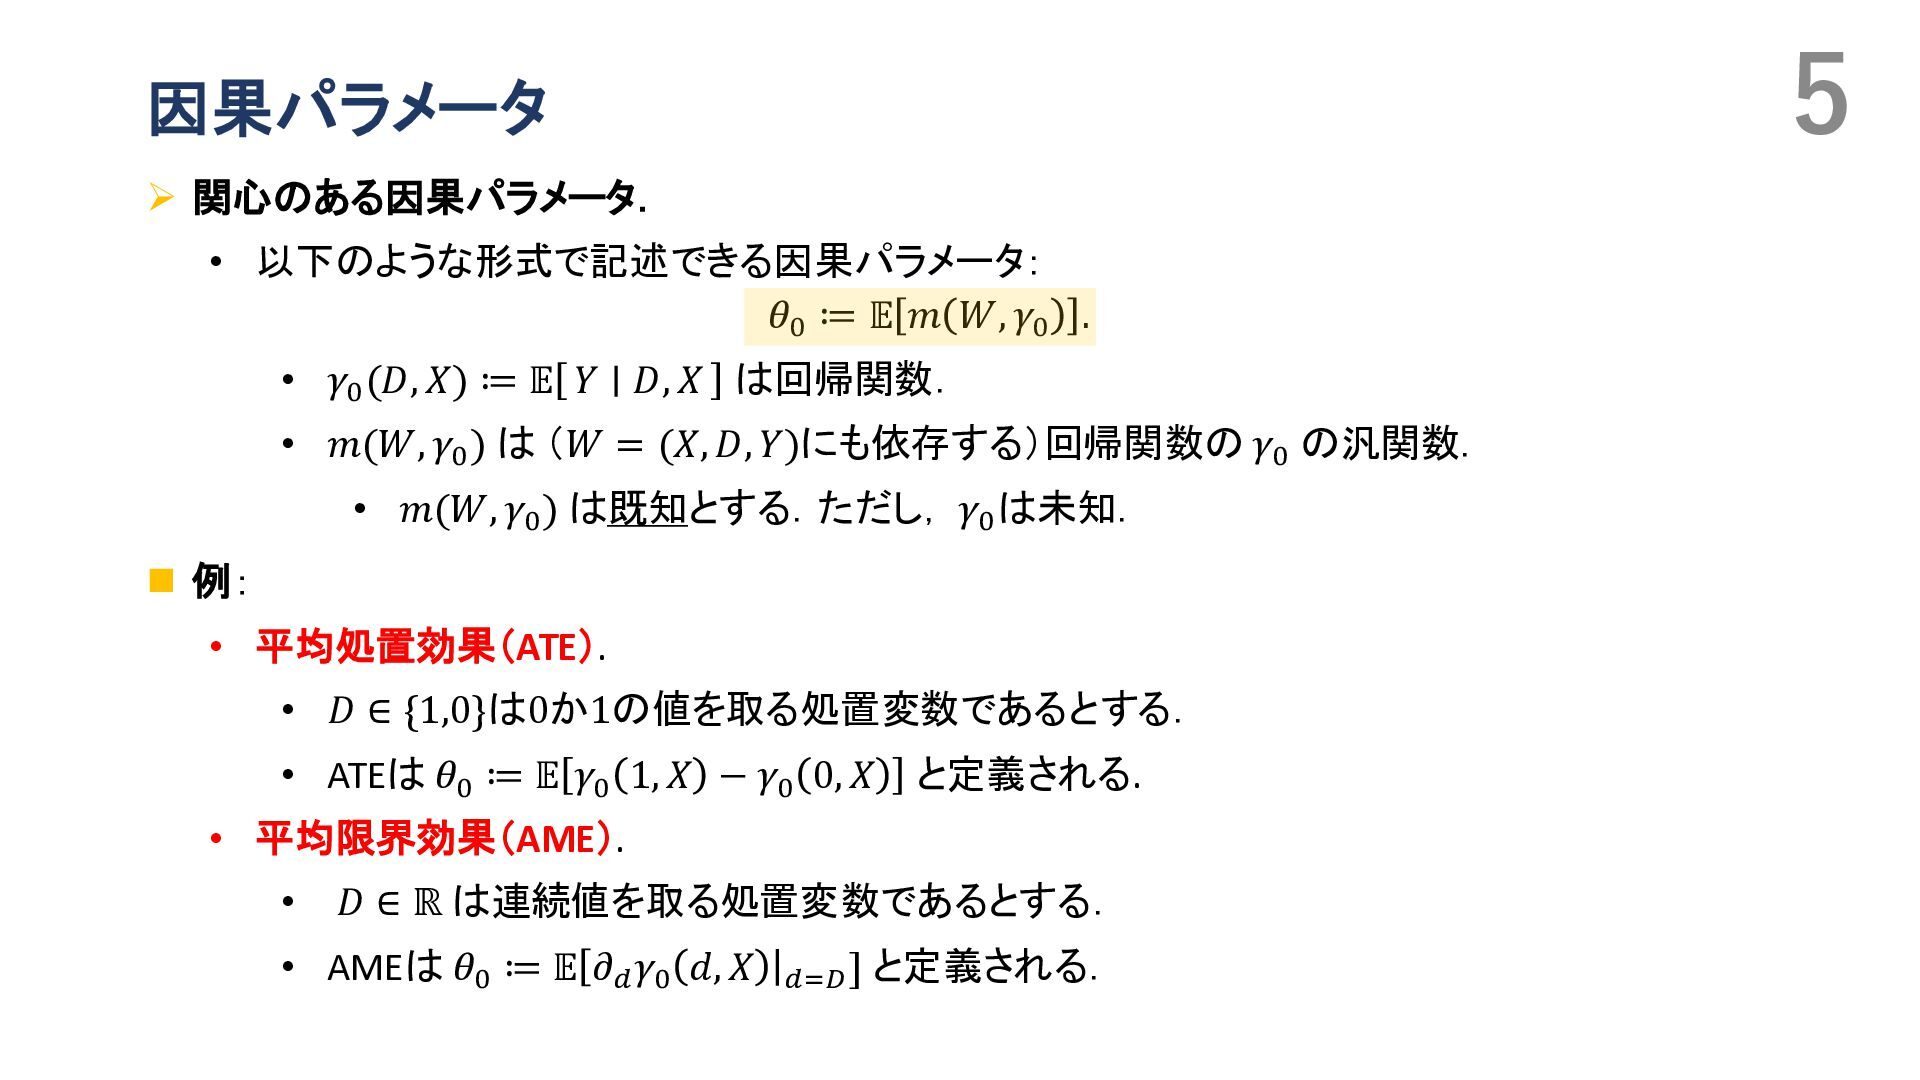
5 因果パラメータ ➢ 関心のある因果パラメータ. • 以下のような形式で記述できる因果パラメータ: 𝜃0 ≔ 𝔼 𝑚
𝑊, 𝛾0 . • 𝛾0 (𝐷, 𝑋) ≔ 𝔼 𝑌 𝐷, 𝑋 は回帰関数. • 𝑚(𝑊, 𝛾0 ) は (𝑊 = (𝑋, 𝐷, 𝑌)にも依存する)回帰関数の 𝛾0 の汎関数. • 𝑚(𝑊, 𝛾0 ) は既知とする.ただし, 𝛾0 は未知. ◼ 例: • 平均処置効果(ATE). • 𝐷 ∈ {1,0}は0か1の値を取る処置変数であるとする. • ATEは 𝜃0 ≔ 𝔼 𝛾0 1, 𝑋 − 𝛾0 0, 𝑋 と定義される. • 平均限界効果(AME). • 𝐷 ∈ ℝ は連続値を取る処置変数であるとする. • AMEは 𝜃0 ≔ 𝔼 𝜕𝑑 𝛾0 𝑑, 𝑋 𝑑=𝐷 ] と定義される. -
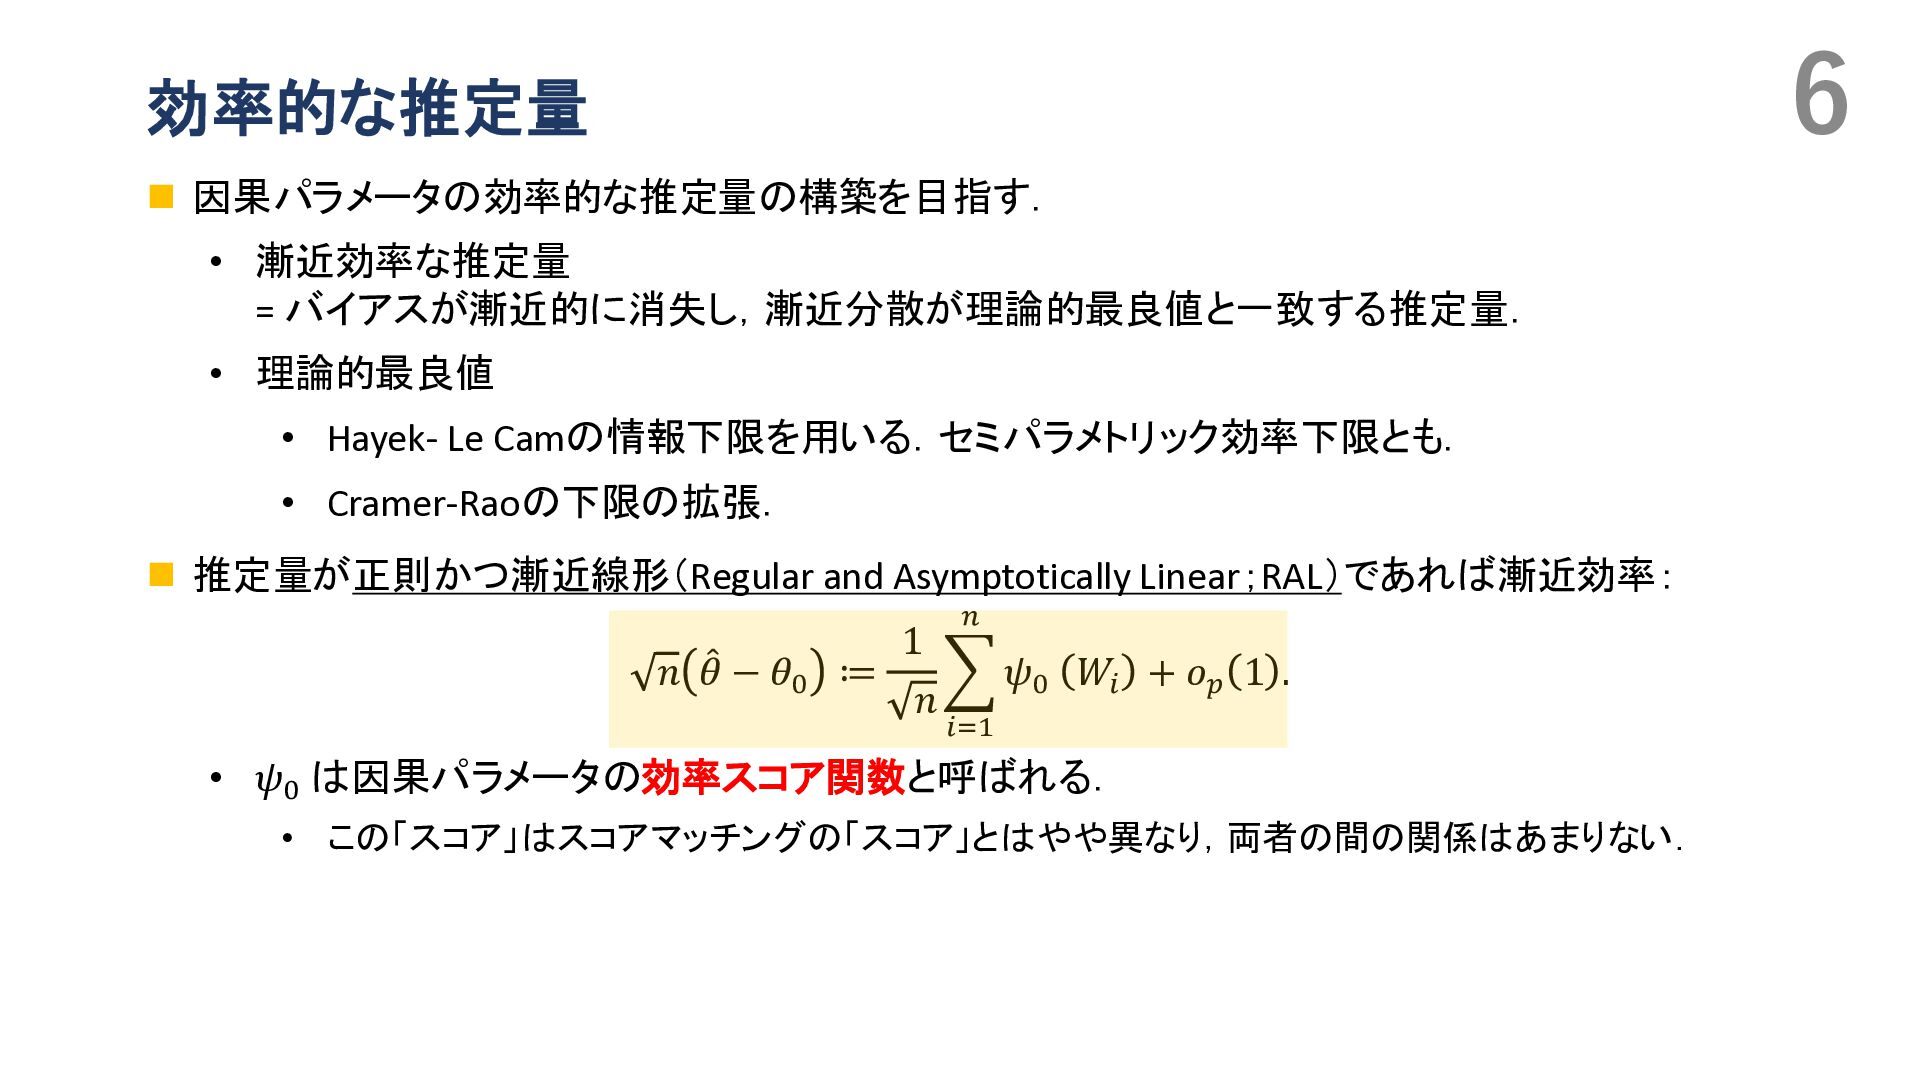
6 効率的な推定量 ◼ 因果パラメータの効率的な推定量の構築を目指す. • 漸近効率な推定量 = バイアスが漸近的に消失し,漸近分散が理論的最良値と一致する推定量. • 理論的最良値
• Hayek- Le Camの情報下限を用いる.セミパラメトリック効率下限とも. • Cramer-Raoの下限の拡張. ◼ 推定量が正則かつ漸近線形(Regular and Asymptotically Linear;RAL)であれば漸近効率: 𝑛 መ 𝜃 − 𝜃0 ≔ 1 𝑛 𝑖=1 𝑛 𝜓0 𝑊𝑖 + 𝑜𝑝 1 . • 𝜓0 は因果パラメータの効率スコア関数と呼ばれる. • この「スコア」はスコアマッチングの「スコア」とはやや異なり,両者の間の関係はあまりない. -
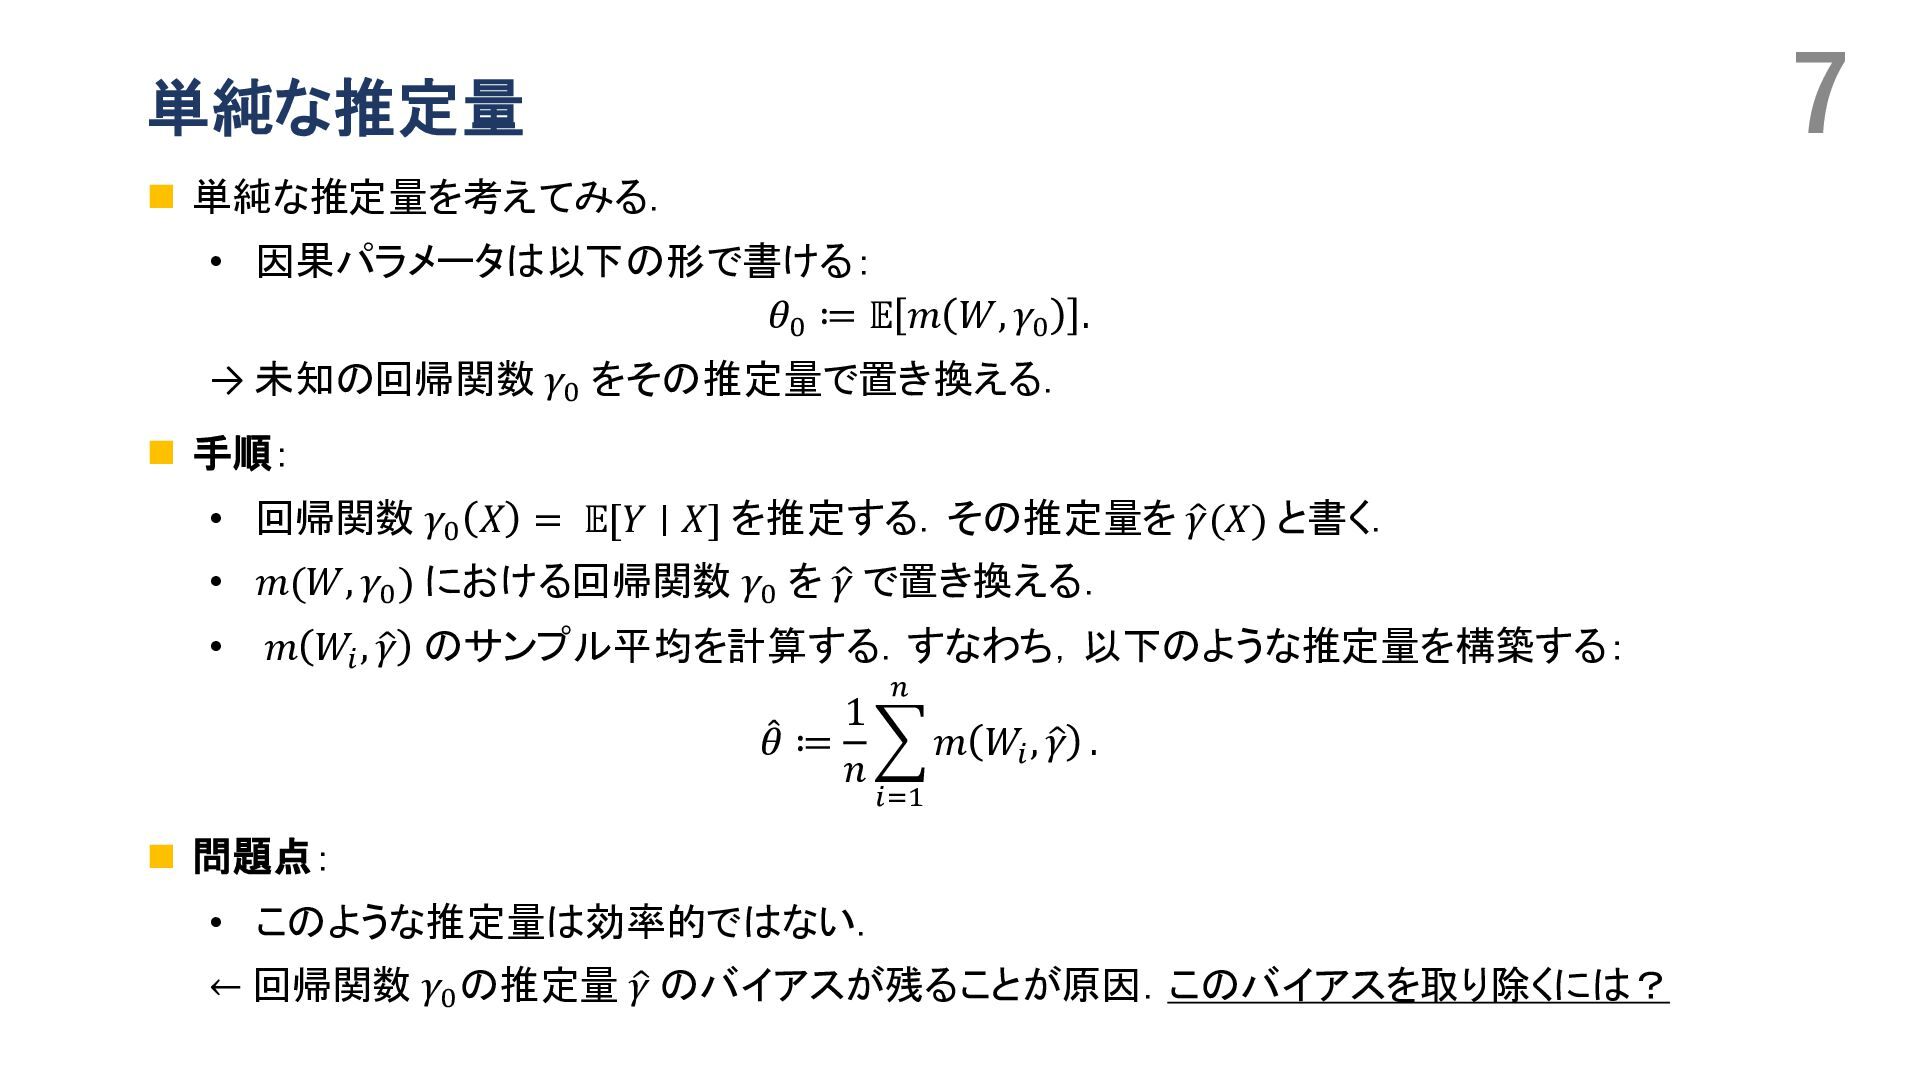
7 単純な推定量 ◼ 単純な推定量を考えてみる. • 因果パラメータは以下の形で書ける: 𝜃0 ≔ 𝔼 𝑚
𝑊, 𝛾0 . → 未知の回帰関数 𝛾0 をその推定量で置き換える. ◼ 手順: • 回帰関数 𝛾0 𝑋 = 𝔼[𝑌 ∣ 𝑋] を推定する.その推定量を ො 𝛾(𝑋) と書く. • 𝑚(𝑊, 𝛾0 ) における回帰関数 𝛾0 を ො 𝛾 で置き換える. • 𝑚 𝑊𝑖 , ො 𝛾 のサンプル平均を計算する.すなわち,以下のような推定量を構築する: መ 𝜃 ≔ 1 𝑛 𝑖=1 𝑛 𝑚 𝑊𝑖 , ො 𝛾 . ◼ 問題点: • このような推定量は効率的ではない. ← 回帰関数 𝛾0 の推定量 ො 𝛾 のバイアスが残ることが原因.このバイアスを取り除くには? -
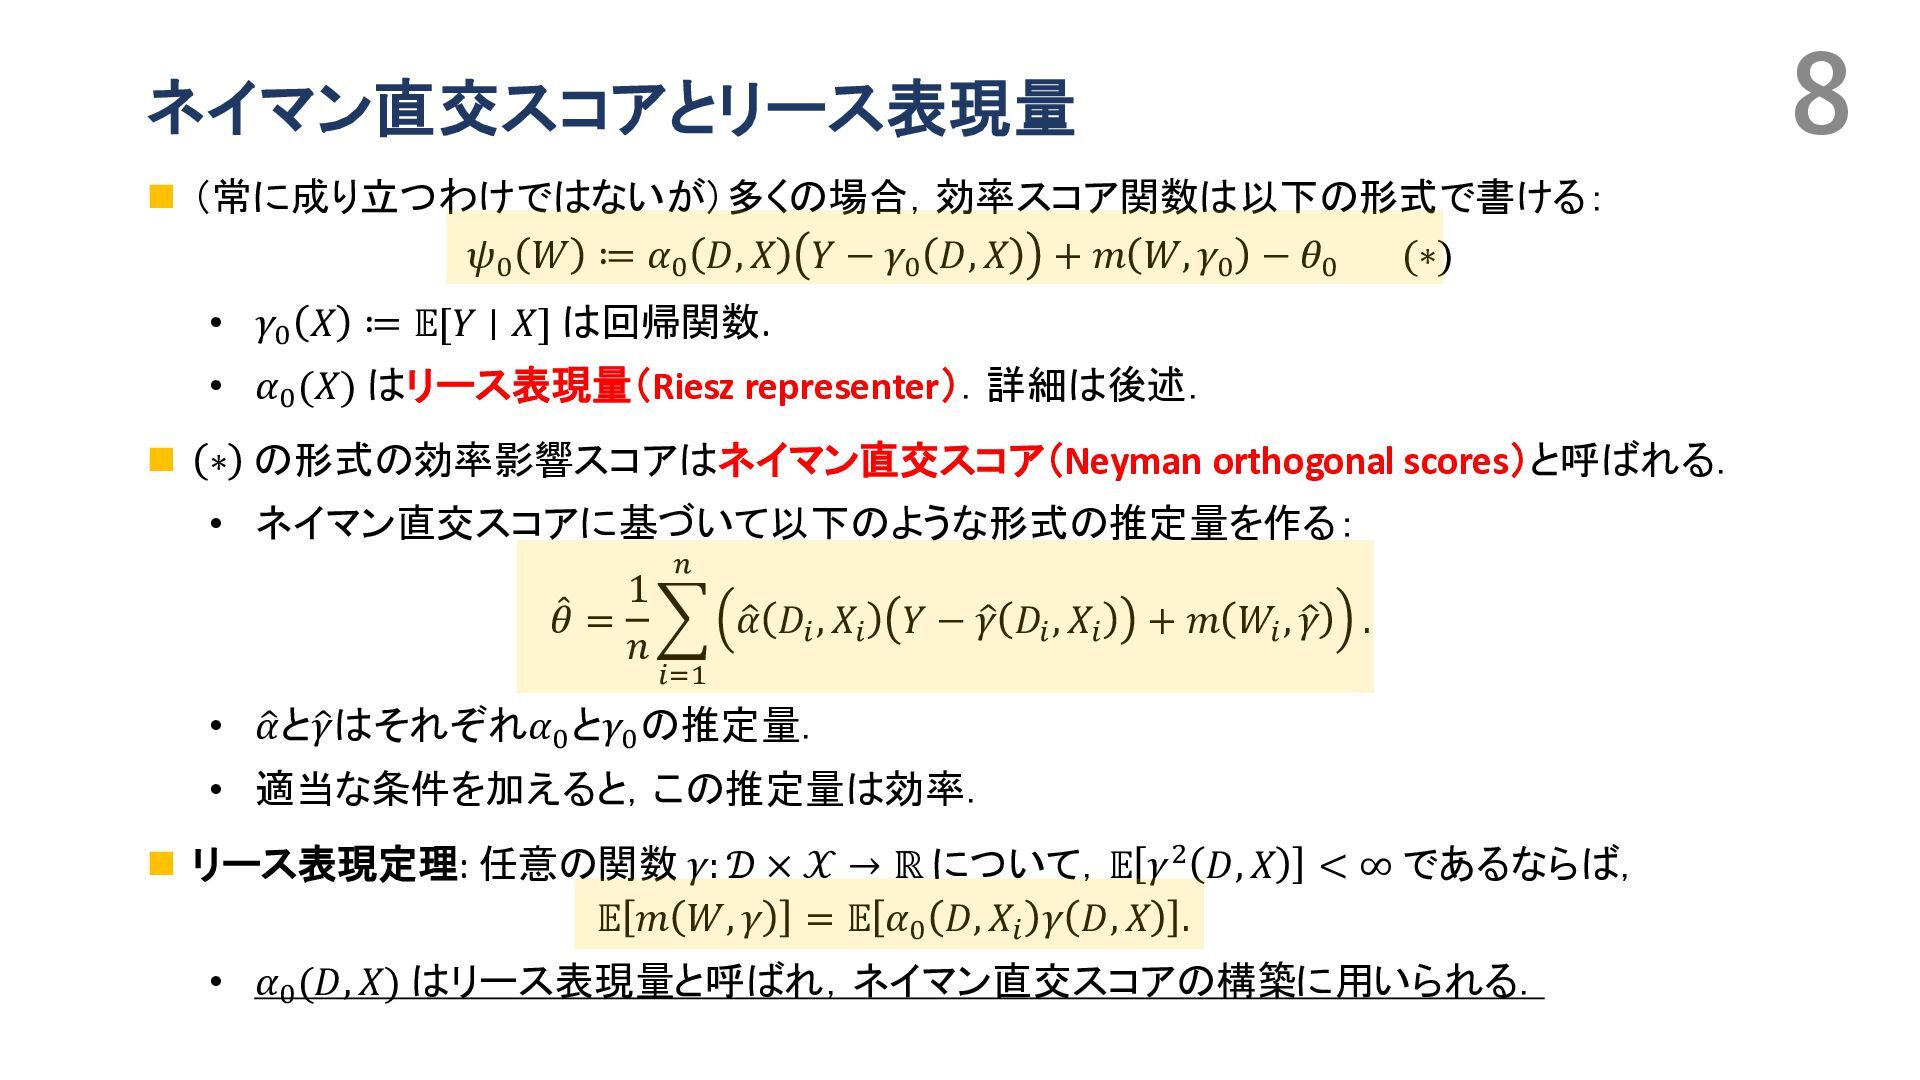
8 ネイマン直交スコアとリース表現量 ◼ (常に成り立つわけではないが)多くの場合,効率スコア関数は以下の形式で書ける: 𝜓0 𝑊 ≔ 𝛼0 𝐷, 𝑋
𝑌 − 𝛾0 𝐷, 𝑋 + 𝑚 𝑊, 𝛾0 − 𝜃0 (∗) • 𝛾0 𝑋 ≔ 𝔼[𝑌 ∣ 𝑋] は回帰関数. • 𝛼0 (𝑋) はリース表現量(Riesz representer).詳細は後述. ◼ ∗ の形式の効率影響スコアはネイマン直交スコア(Neyman orthogonal scores)と呼ばれる. • ネイマン直交スコアに基づいて以下のような形式の推定量を作る: መ 𝜃 = 1 𝑛 𝑖=1 𝑛 ො 𝛼 𝐷𝑖 , 𝑋𝑖 𝑌 − ො 𝛾 𝐷𝑖 , 𝑋𝑖 + 𝑚 𝑊𝑖 , ො 𝛾 . • ො 𝛼とො 𝛾はそれぞれ𝛼0 と𝛾0 の推定量. • 適当な条件を加えると,この推定量は効率. ◼ リース表現定理: 任意の関数 𝛾: 𝒟 × 𝒳 → ℝ について,𝔼 𝛾2 𝐷, 𝑋 < ∞ であるならば, 𝔼 𝑚 𝑊, 𝛾 = 𝔼 𝛼0 𝐷, 𝑋𝑖 𝛾 𝐷, 𝑋 . • 𝛼0 (𝐷, 𝑋) はリース表現量と呼ばれ,ネイマン直交スコアの構築に用いられる. -
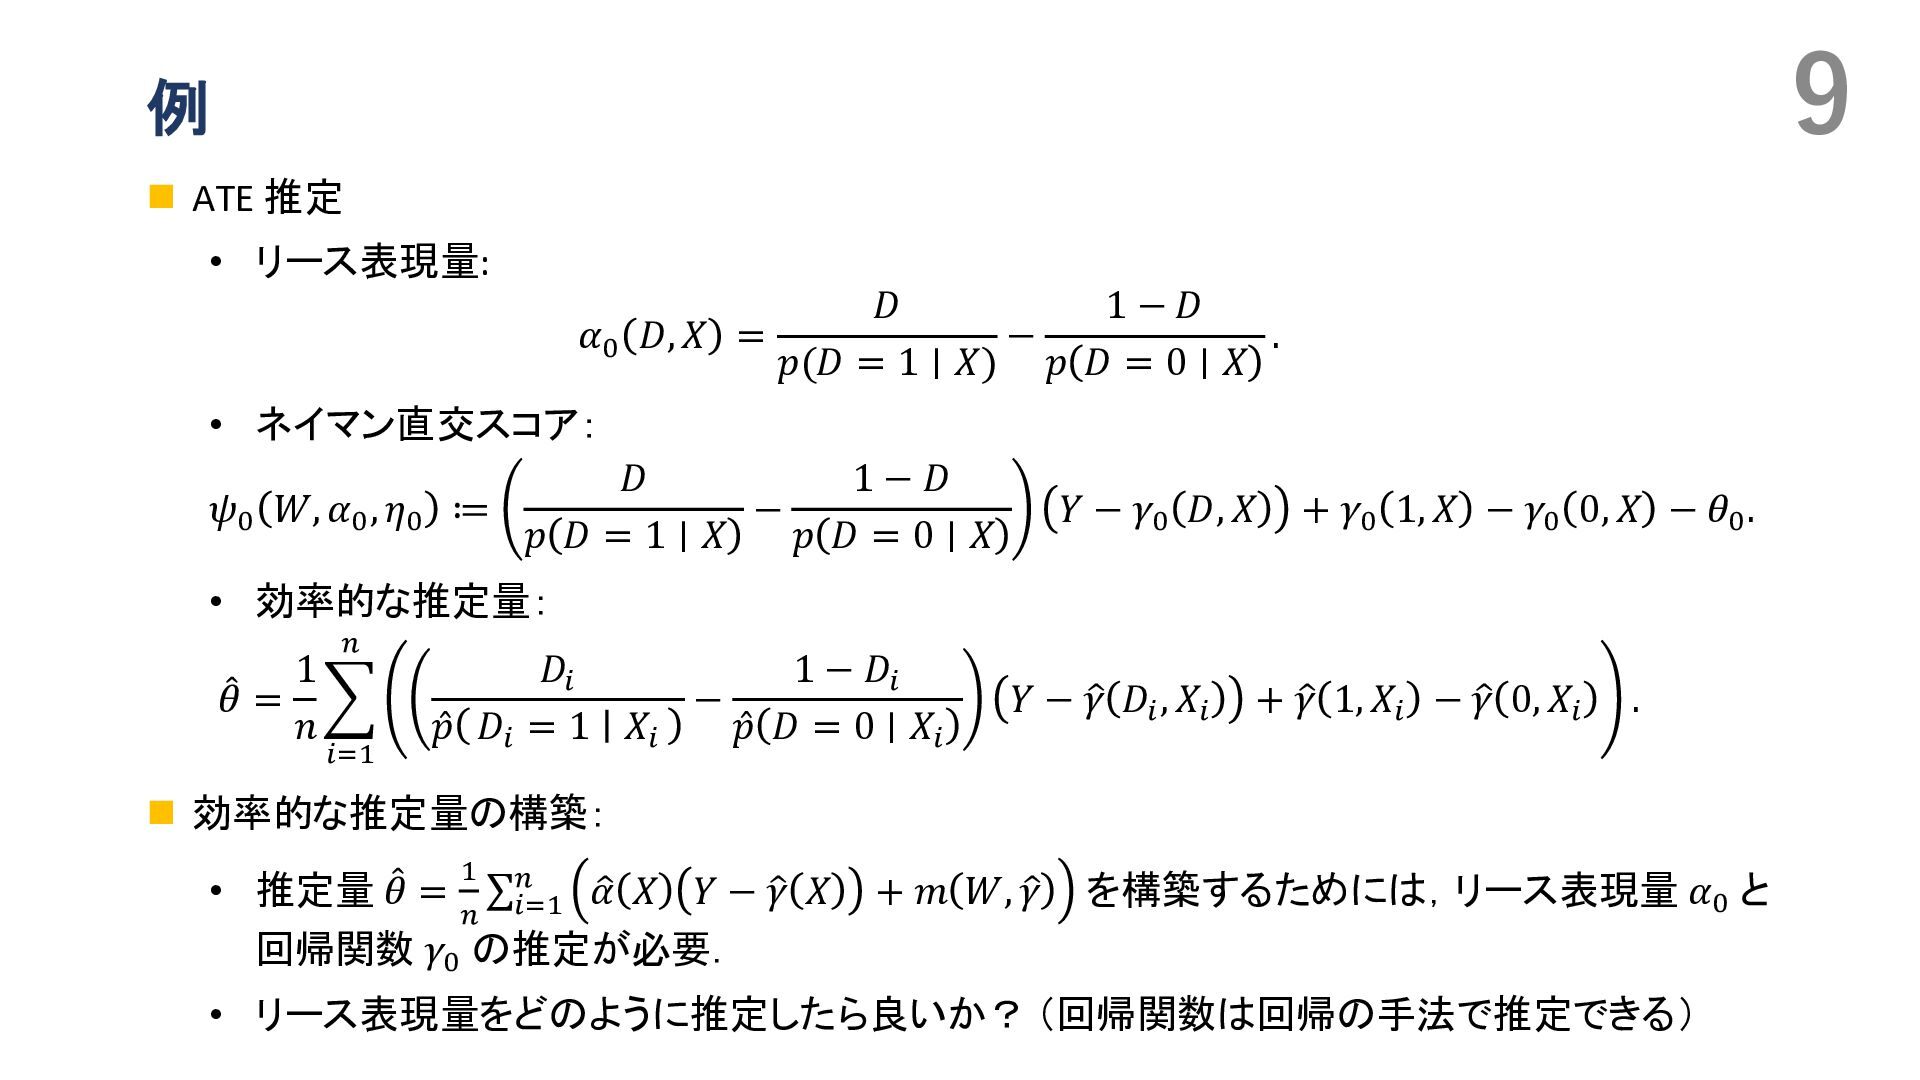
9 例 ◼ ATE 推定 • リース表現量: 𝛼0 𝐷, 𝑋
= 𝐷 𝑝(𝐷 = 1 ∣ 𝑋) − 1 − 𝐷 𝑝 𝐷 = 0 ∣ 𝑋 . • ネイマン直交スコア: 𝜓0 𝑊, 𝛼0 , 𝜂0 ≔ 𝐷 𝑝 𝐷 = 1 ∣ 𝑋 − 1 − 𝐷 𝑝 𝐷 = 0 ∣ 𝑋 𝑌 − 𝛾0 𝐷, 𝑋 + 𝛾0 1, 𝑋 − 𝛾0 0, 𝑋 − 𝜃0 . • 効率的な推定量: መ 𝜃 = 1 𝑛 𝑖=1 𝑛 𝐷𝑖 Ƹ 𝑝 𝐷𝑖 = 1 𝑋𝑖 − 1 − 𝐷𝑖 Ƹ 𝑝 𝐷 = 0 ∣ 𝑋𝑖 𝑌 − ො 𝛾 𝐷𝑖 , 𝑋𝑖 + ො 𝛾 1, 𝑋𝑖 − ො 𝛾 0, 𝑋𝑖 . ◼ 効率的な推定量の構築: • 推定量 መ 𝜃 = 1 𝑛 σ 𝑖=1 𝑛 ො 𝛼 𝑋 𝑌 − ො 𝛾 𝑋 + 𝑚 𝑊, ො 𝛾 を構築するためには,リース表現量 𝛼0 と 回帰関数 𝛾0 の推定が必要. • リース表現量をどのように推定したら良いか? (回帰関数は回帰の手法で推定できる) -
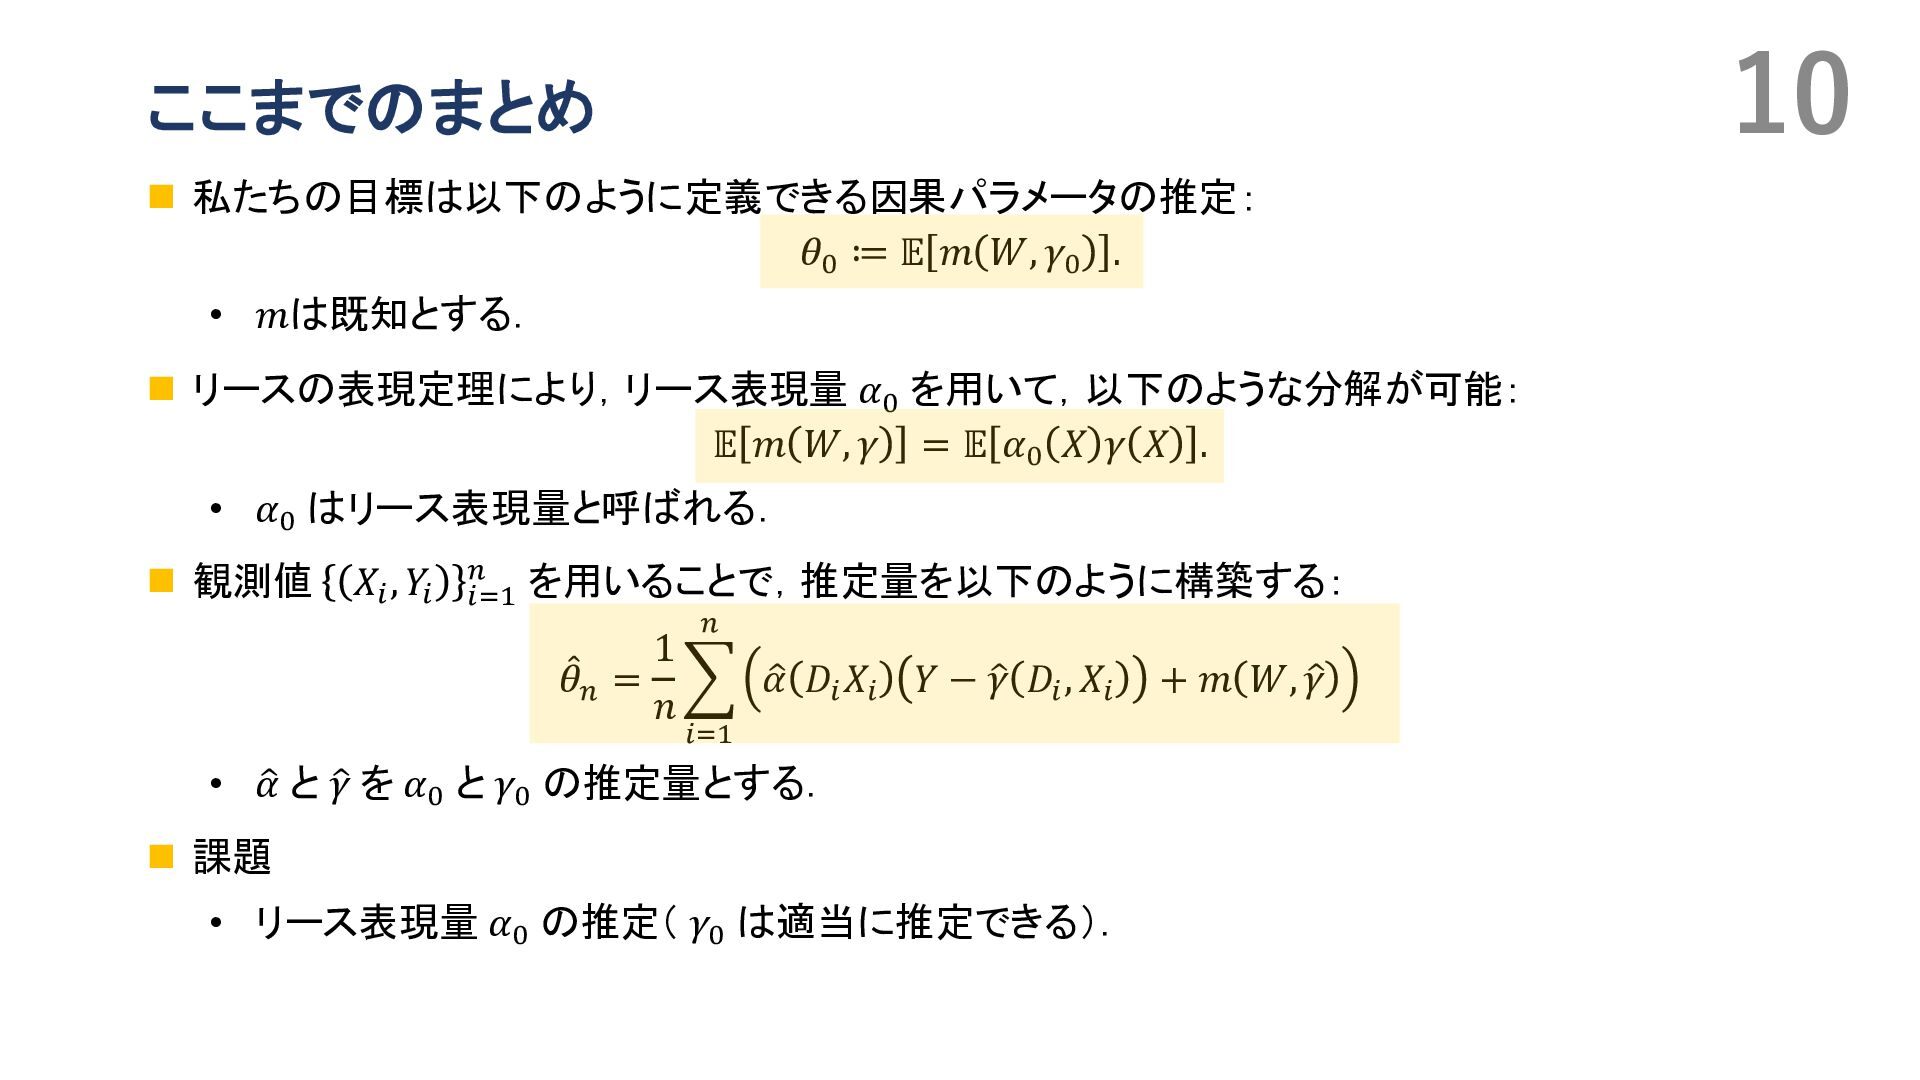
10 ここまでのまとめ ◼ 私たちの目標は以下のように定義できる因果パラメータの推定: 𝜃0 ≔ 𝔼 𝑚 𝑊, 𝛾0
. • 𝑚は既知とする. ◼ リースの表現定理により,リース表現量 𝛼0 を用いて,以下のような分解が可能: 𝔼 𝑚 𝑊, 𝛾 = 𝔼 𝛼0 𝑋 𝛾 𝑋 . • 𝛼0 はリース表現量と呼ばれる. ◼ 観測値 𝑋𝑖 , 𝑌𝑖 𝑖=1 𝑛 を用いることで,推定量を以下のように構築する: መ 𝜃𝑛 = 1 𝑛 𝑖=1 𝑛 ො 𝛼 𝐷𝑖 𝑋𝑖 𝑌 − ො 𝛾 𝐷𝑖 , 𝑋𝑖 + 𝑚 𝑊, ො 𝛾 • ො 𝛼 と ො 𝛾 を 𝛼0 と 𝛾0 の推定量とする. ◼ 課題 • リース表現量 𝛼0 の推定( 𝛾0 は適当に推定できる). -
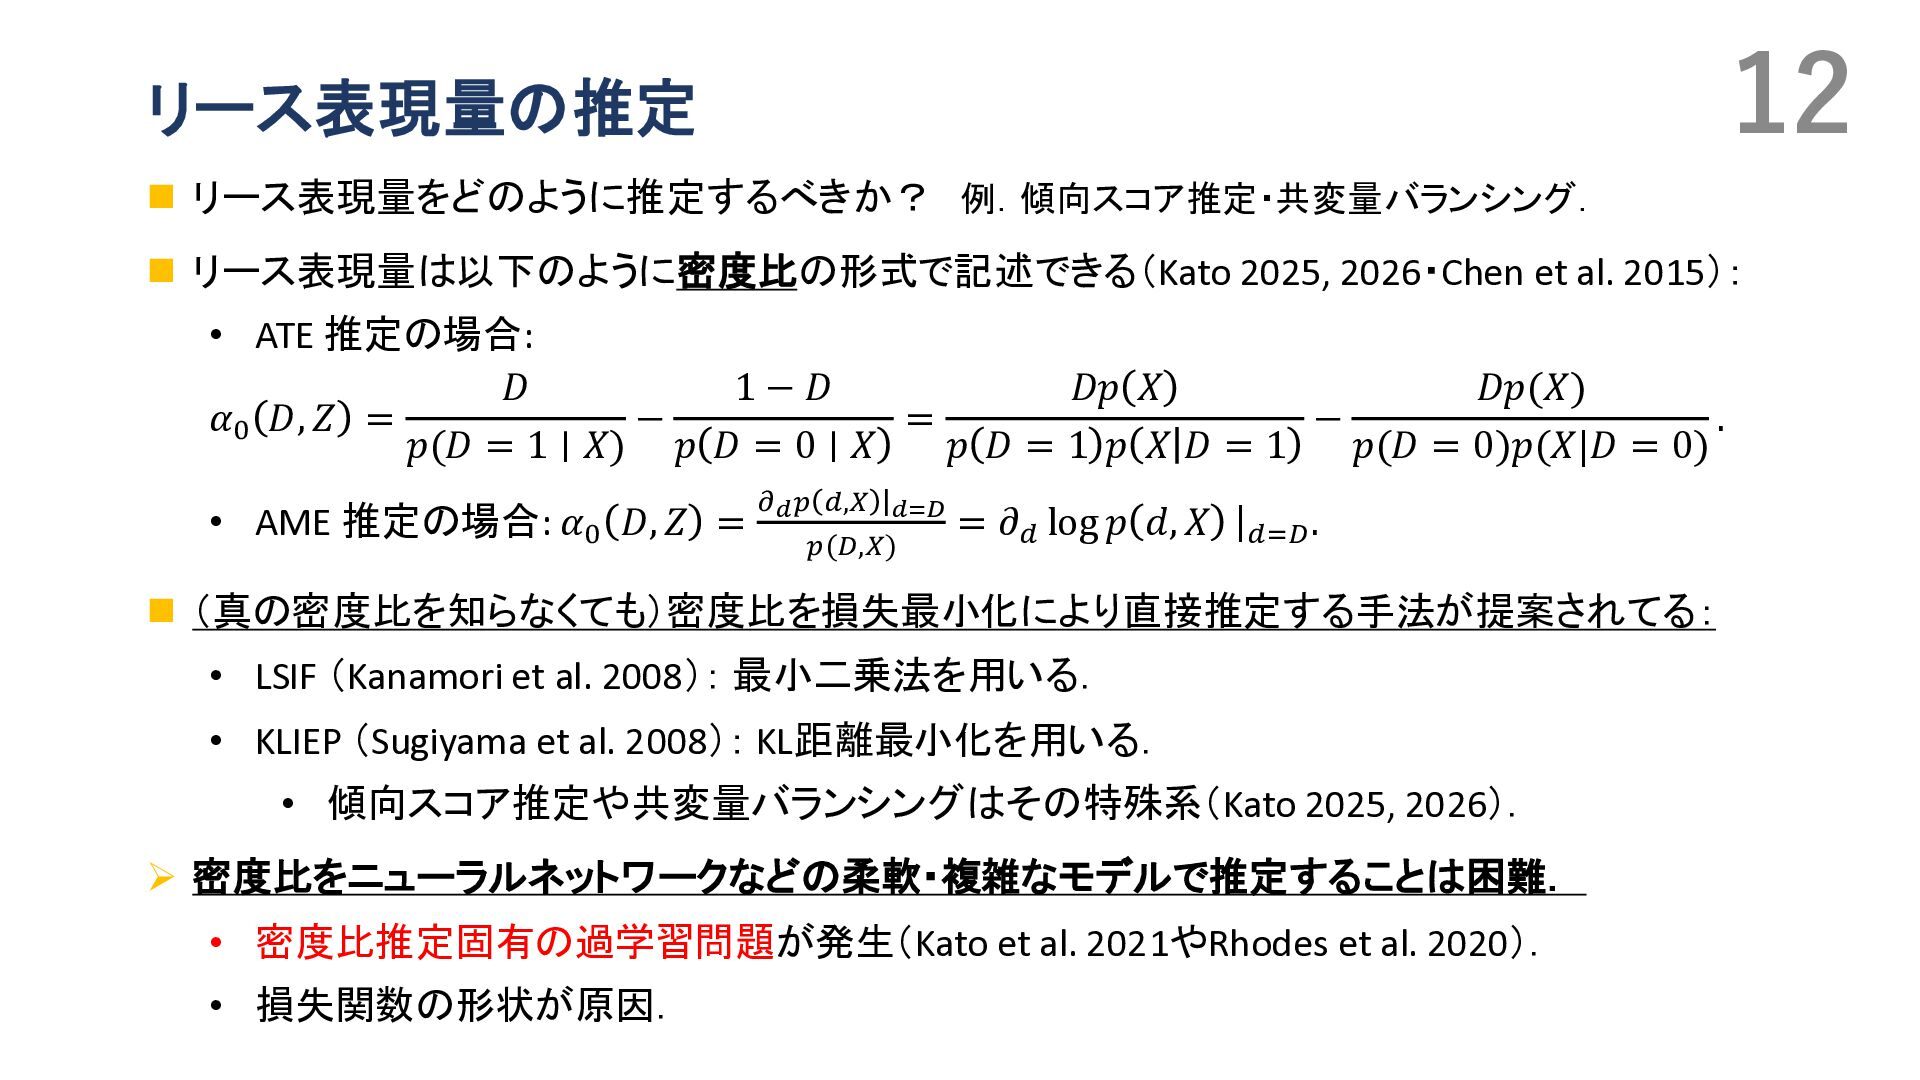
12 リース表現量の推定 ◼ リース表現量をどのように推定するべきか? 例.傾向スコア推定・共変量バランシング. ◼ リース表現量は以下のように密度比の形式で記述できる(Kato 2025, 2026・Chen et
al. 2015): • ATE 推定の場合: 𝛼0 𝐷, 𝑍 = 𝐷 𝑝(𝐷 = 1 ∣ 𝑋) − 1 − 𝐷 𝑝 𝐷 = 0 ∣ 𝑋 = 𝐷𝑝 𝑋 𝑝 𝐷 = 1 𝑝 𝑋 𝐷 = 1 − 𝐷𝑝(𝑋) 𝑝(𝐷 = 0)𝑝(𝑋|𝐷 = 0) . • AME 推定の場合: 𝛼0 𝐷, 𝑍 = 𝜕𝑑𝑝 𝑑,𝑋 |𝑑=𝐷 𝑝(𝐷,𝑋) = 𝜕𝑑 log 𝑝 𝑑, 𝑋 |𝑑=𝐷 . ◼ (真の密度比を知らなくても)密度比を損失最小化により直接推定する手法が提案されてる: • LSIF (Kanamori et al. 2008): 最小二乗法を用いる. • KLIEP (Sugiyama et al. 2008): KL距離最小化を用いる. • 傾向スコア推定や共変量バランシングはその特殊系(Kato 2025, 2026). ➢ 密度比をニューラルネットワークなどの柔軟・複雑なモデルで推定することは困難. • 密度比推定固有の過学習問題が発生(Kato et al. 2021やRhodes et al. 2020). • 損失関数の形状が原因. -
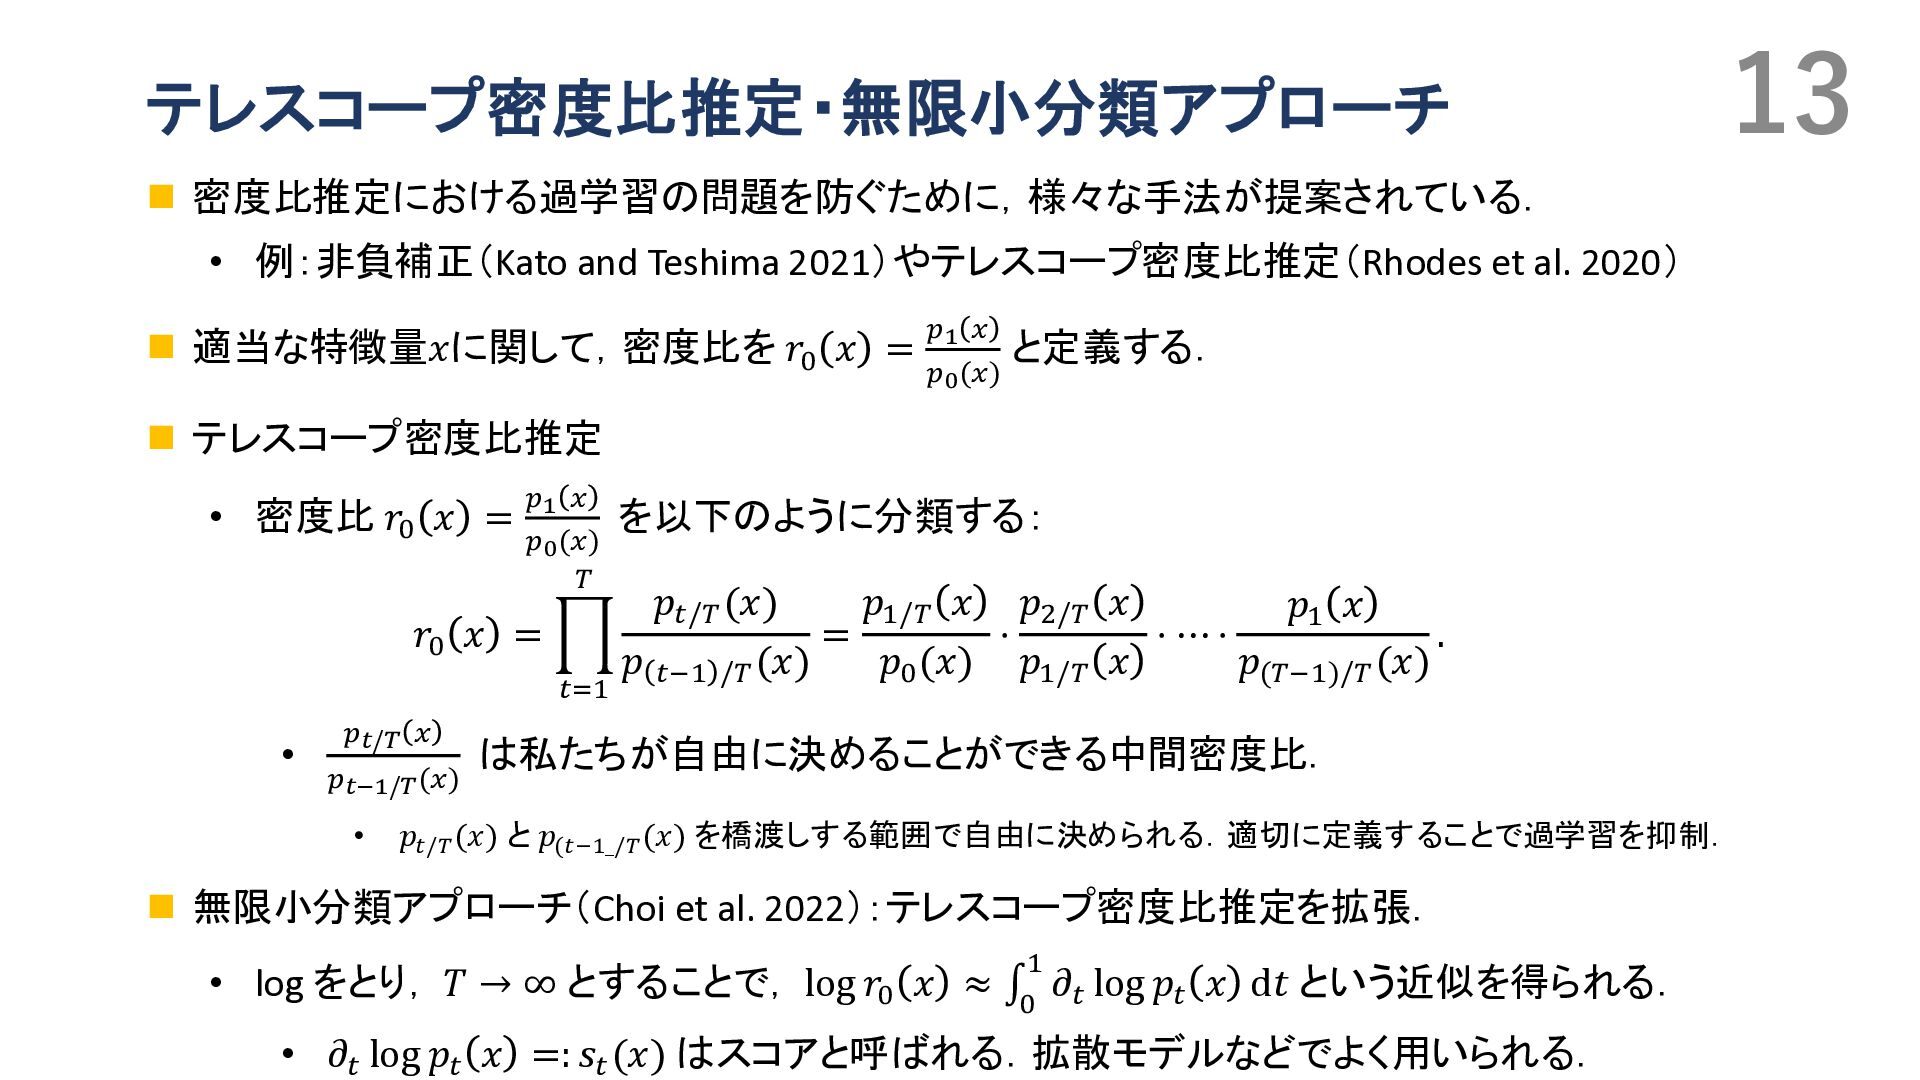
13 テレスコープ密度比推定・無限小分類アプローチ ◼ 密度比推定における過学習の問題を防ぐために,様々な手法が提案されている. • 例:非負補正(Kato and Teshima 2021)やテレスコープ密度比推定(Rhodes et
al. 2020) ◼ 適当な特徴量𝑥に関して,密度比を 𝑟0 𝑥 = 𝑝1 𝑥 𝑝0(𝑥) と定義する. ◼ テレスコープ密度比推定 • 密度比 𝑟0 𝑥 = 𝑝1 𝑥 𝑝0(𝑥) を以下のように分類する: 𝑟0 𝑥 = ෑ 𝑡=1 𝑇 𝑝𝑡/𝑇 (𝑥) 𝑝 𝑡−1 /𝑇 (𝑥) = 𝑝1/𝑇 𝑥 𝑝0 (𝑥) ⋅ 𝑝2/𝑇 𝑥 𝑝1/𝑇 𝑥 ⋅ ⋯ ⋅ 𝑝1 𝑥 𝑝(𝑇−1)/𝑇 (𝑥) . • 𝑝𝑡/𝑇 𝑥 𝑝𝑡−1/𝑇(𝑥) は私たちが自由に決めることができる中間密度比. • 𝑝𝑡/𝑇 (𝑥) と 𝑝(𝑡−1_/𝑇 (𝑥) を橋渡しする範囲で自由に決められる.適切に定義することで過学習を抑制. ◼ 無限小分類アプローチ(Choi et al. 2022):テレスコープ密度比推定を拡張. • log をとり, 𝑇 → ∞ とすることで, log 𝑟0 𝑥 ≈ 0 1 𝜕𝑡 log 𝑝𝑡 𝑥 d𝑡 という近似を得られる. • 𝜕𝑡 log 𝑝𝑡 𝑥 =: 𝑠𝑡 (𝑥) はスコアと呼ばれる.拡散モデルなどでよく用いられる. -
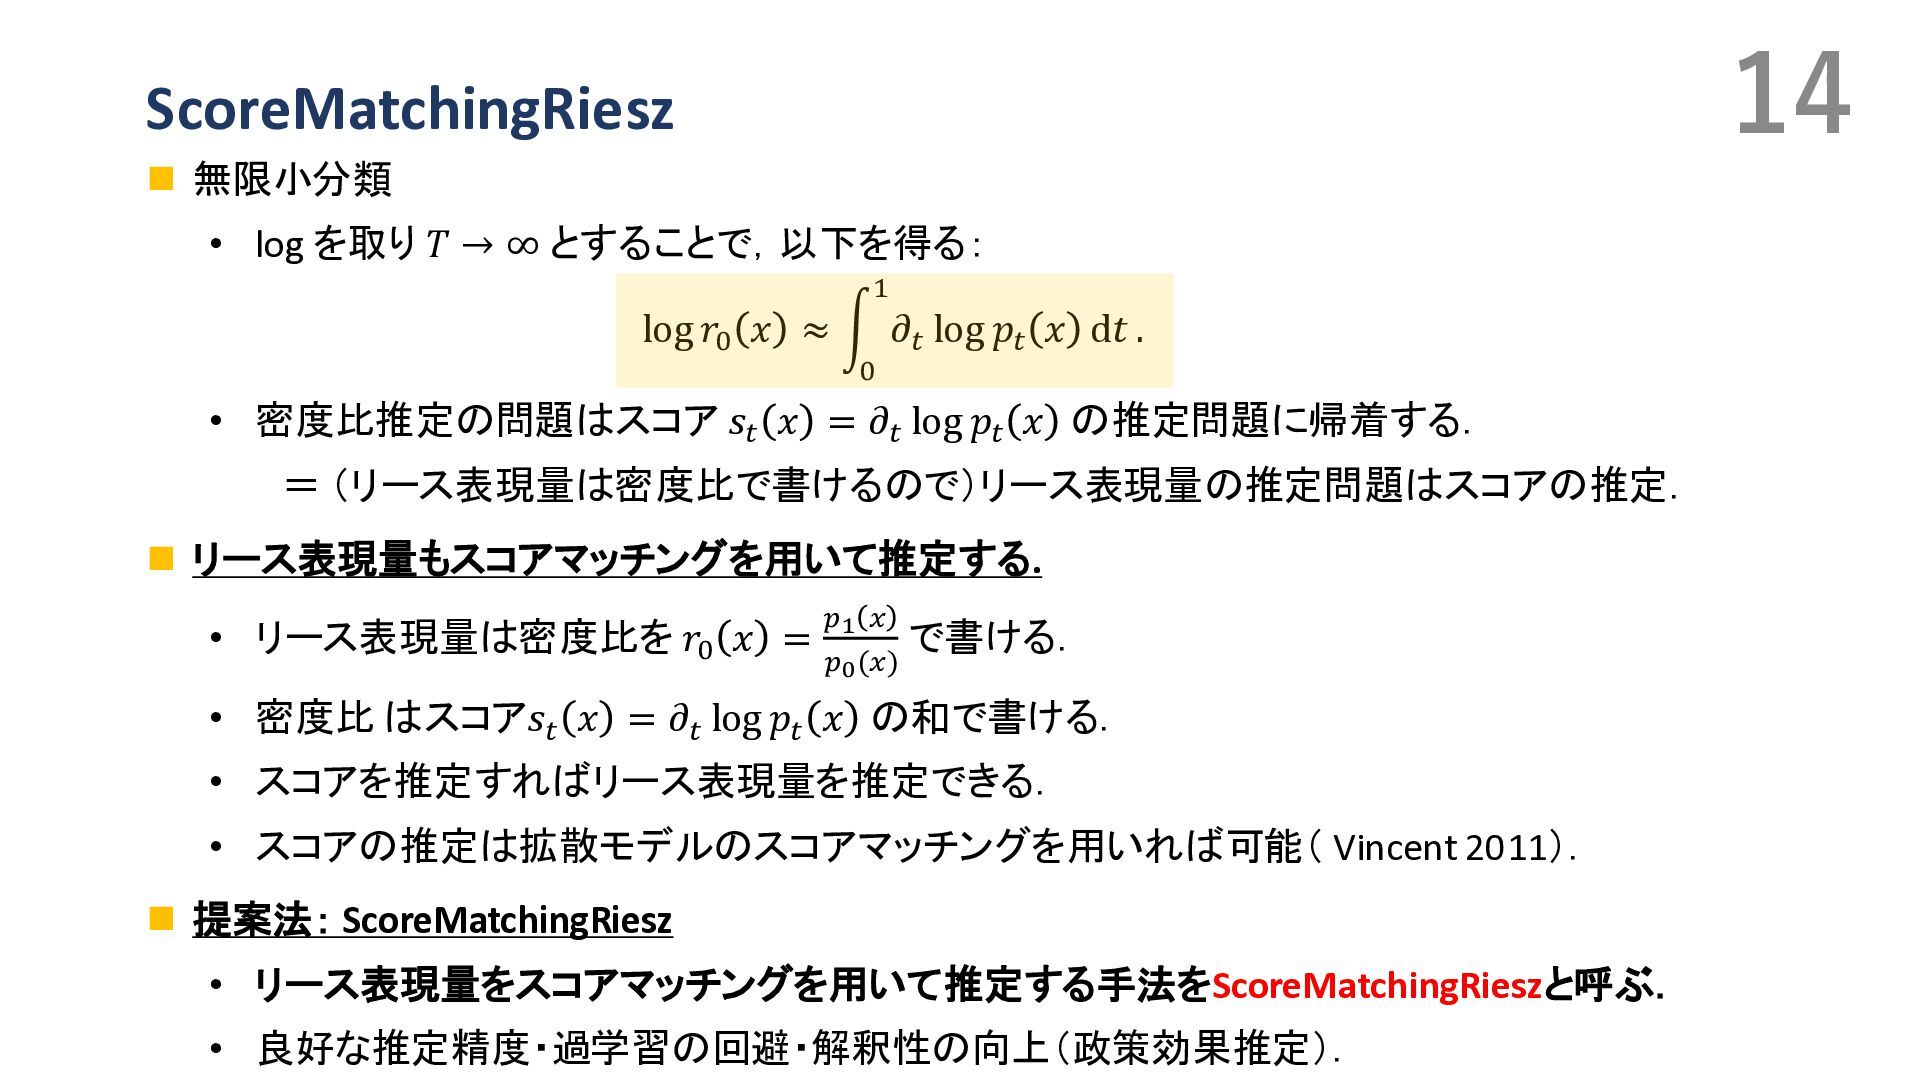
14 ScoreMatchingRiesz ◼ 無限小分類 • log を取り 𝑇 → ∞
とすることで,以下を得る: log 𝑟0 𝑥 ≈ න 0 1 𝜕𝑡 log 𝑝𝑡 𝑥 d𝑡 . • 密度比推定の問題はスコア 𝑠𝑡 𝑥 = 𝜕𝑡 log 𝑝𝑡 𝑥 の推定問題に帰着する. = (リース表現量は密度比で書けるので)リース表現量の推定問題はスコアの推定. ◼ リース表現量もスコアマッチングを用いて推定する. • リース表現量は密度比を 𝑟0 𝑥 = 𝑝1 𝑥 𝑝0(𝑥) で書ける. • 密度比 はスコア𝑠𝑡 𝑥 = 𝜕𝑡 log 𝑝𝑡 𝑥 の和で書ける. • スコアを推定すればリース表現量を推定できる. • スコアの推定は拡散モデルのスコアマッチングを用いれば可能( Vincent 2011). ◼ 提案法: ScoreMatchingRiesz • リース表現量をスコアマッチングを用いて推定する手法をScoreMatchingRieszと呼ぶ. • 良好な推定精度・過学習の回避・解釈性の向上(政策効果推定). -
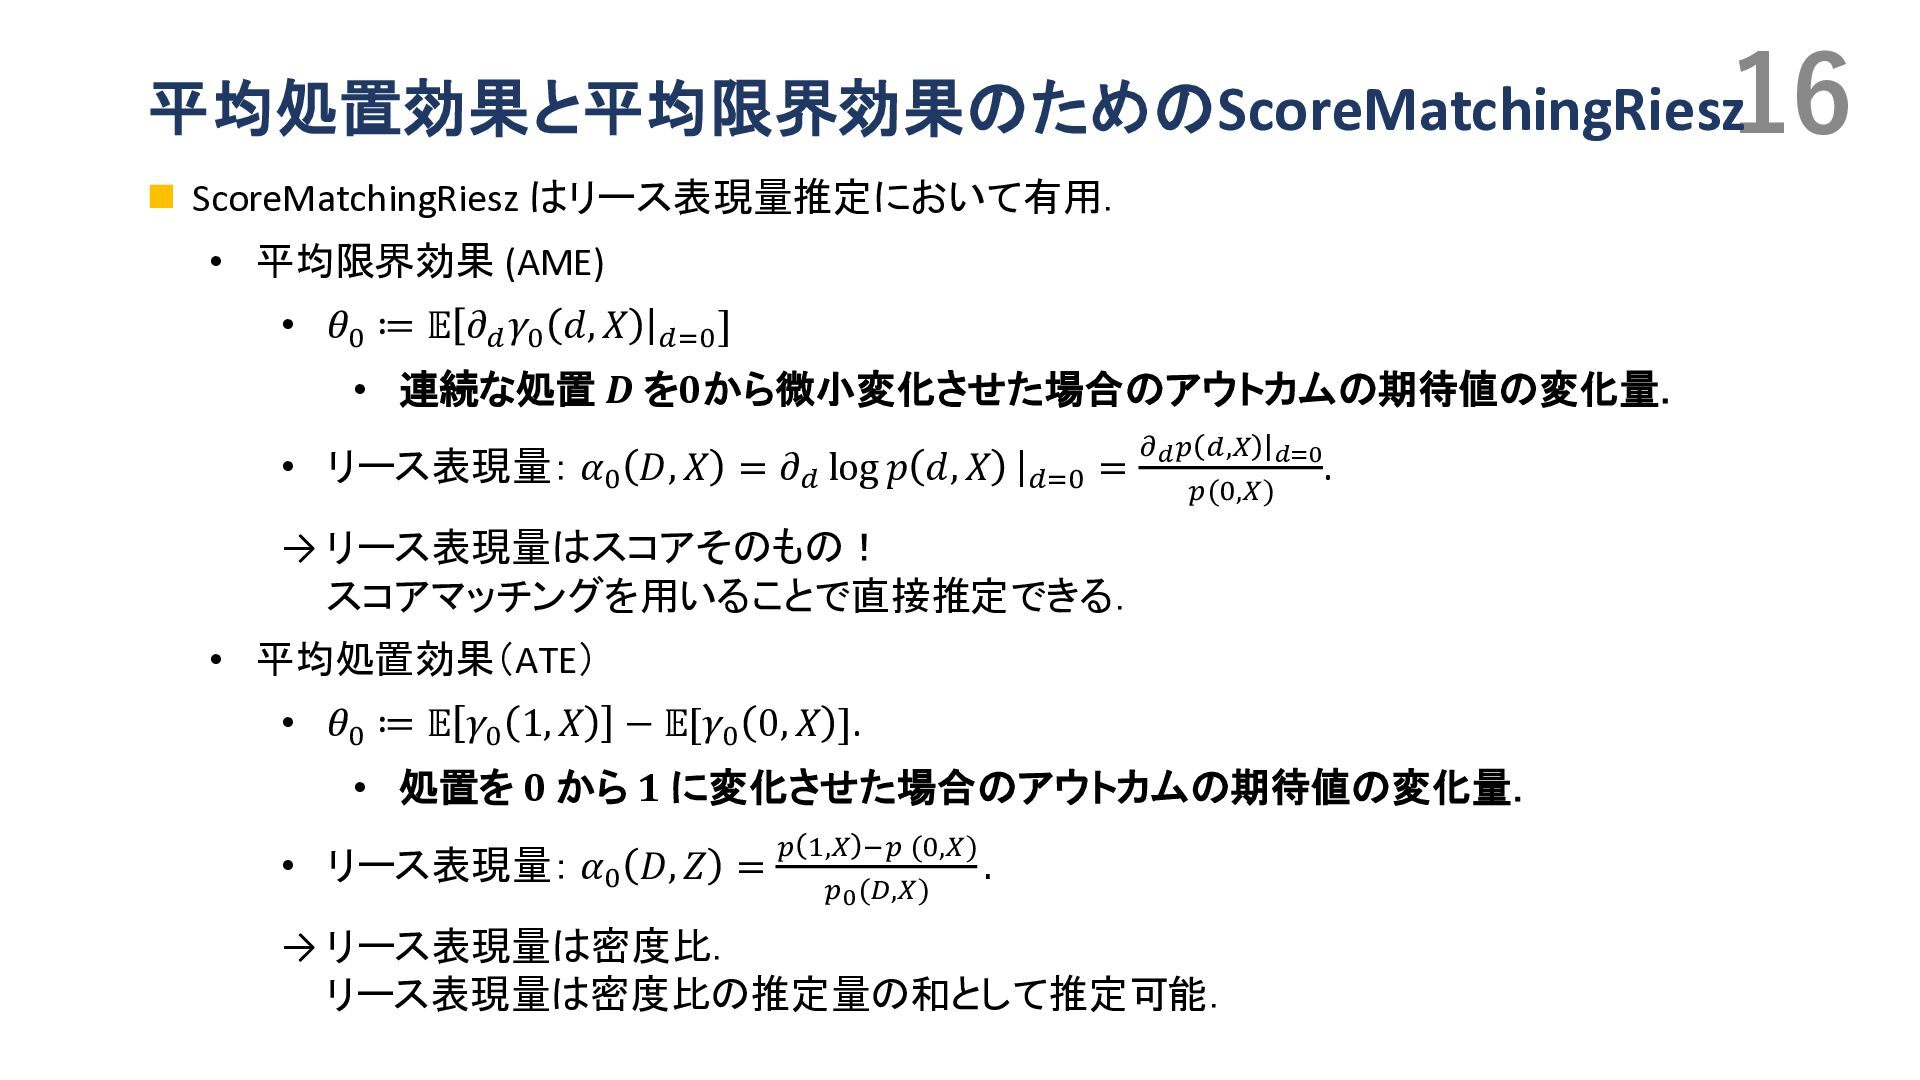
16 平均処置効果と平均限界効果のためのScoreMatchingRiesz ◼ ScoreMatchingRiesz はリース表現量推定において有用. • 平均限界効果 (AME) • 𝜃0
≔ 𝔼 𝜕𝑑 𝛾0 𝑑, 𝑋 𝑑=0 ] • 連続な処置 𝑫 を𝟎から微小変化させた場合のアウトカムの期待値の変化量. • リース表現量: 𝛼0 𝐷, 𝑋 = 𝜕𝑑 log 𝑝 𝑑, 𝑋 |𝑑=0 = 𝜕𝑑𝑝 𝑑,𝑋 |𝑑=0 𝑝(0,𝑋) . → リース表現量はスコアそのもの! スコアマッチングを用いることで直接推定できる. • 平均処置効果(ATE) • 𝜃0 ≔ 𝔼 𝛾0 1, 𝑋 − 𝔼[𝛾0 0, 𝑋 ]. • 処置を 𝟎 から 𝟏 に変化させた場合のアウトカムの期待値の変化量. • リース表現量: 𝛼0 𝐷, 𝑍 = 𝑝 1,𝑋 −𝑝 (0,𝑋) 𝑝0(𝐷,𝑋) . → リース表現量は密度比. リース表現量は密度比の推定量の和として推定可能. -
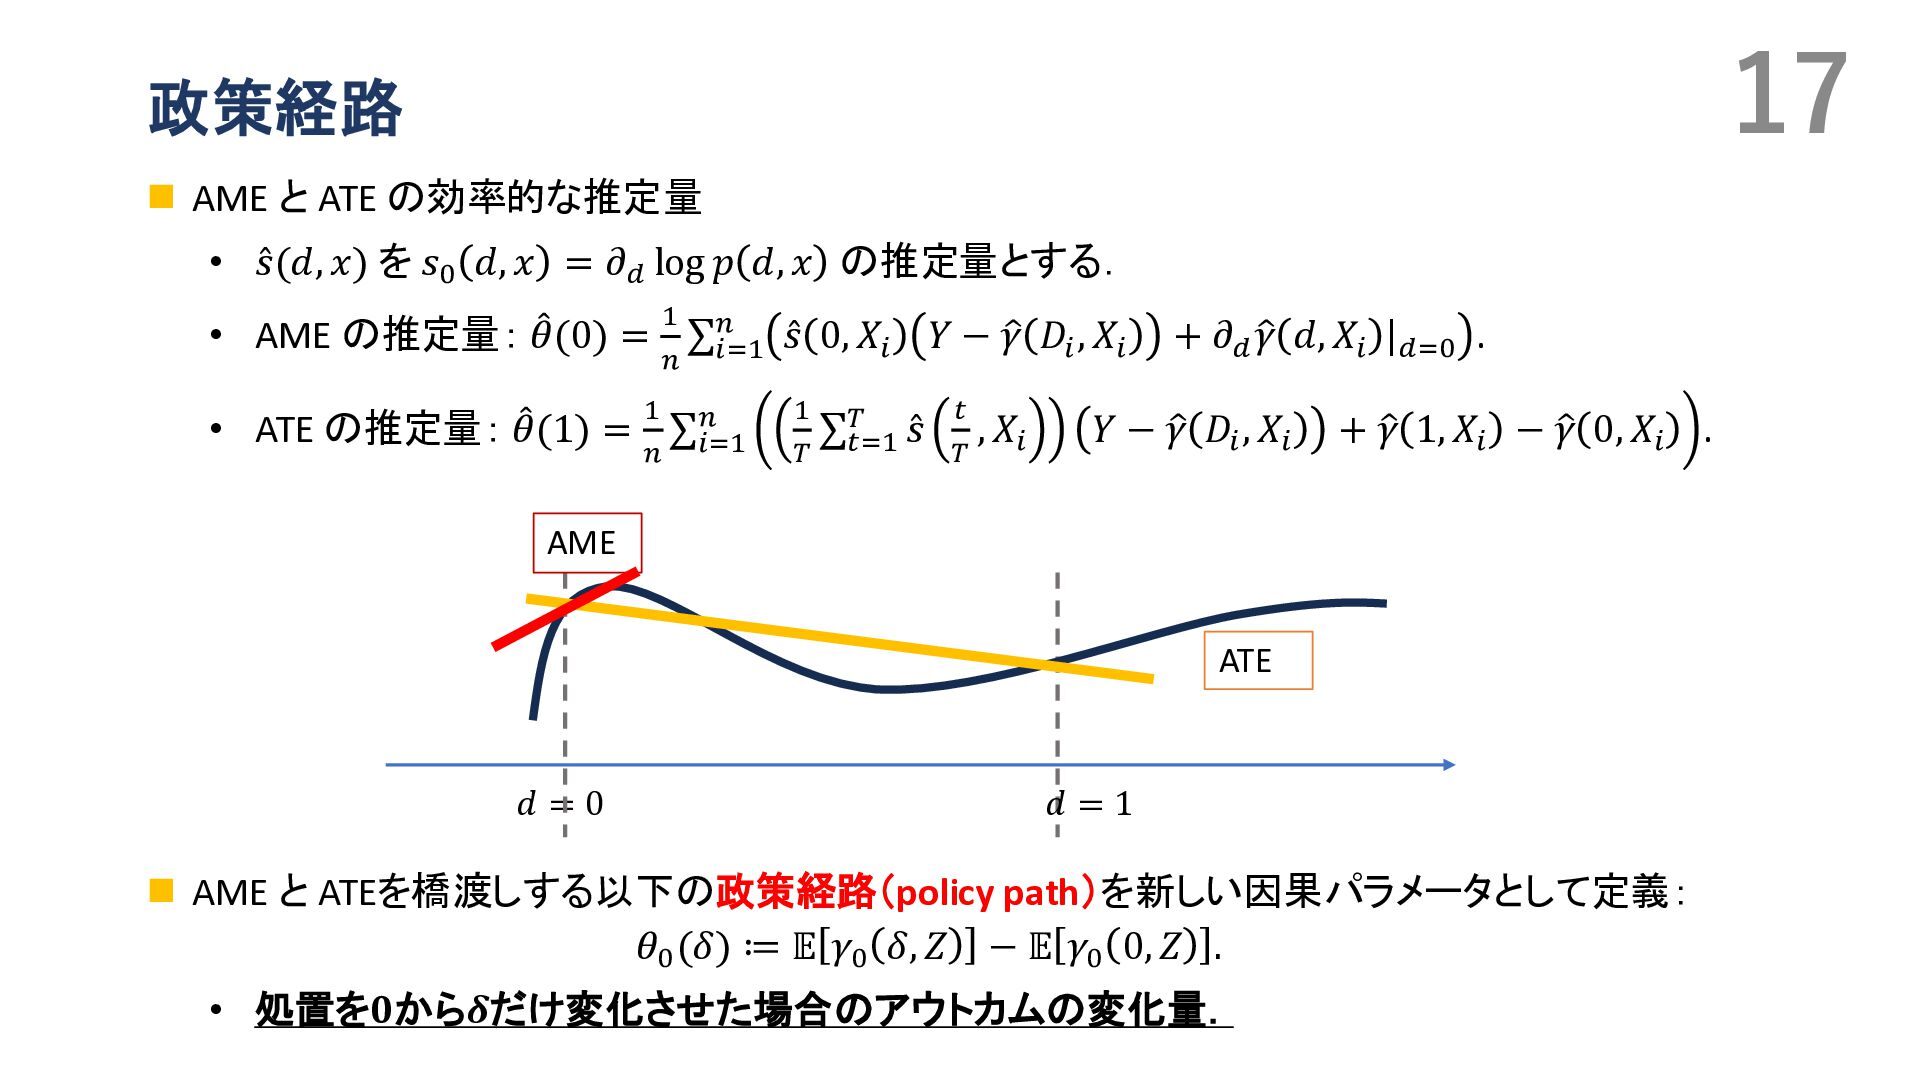
17 政策経路 ◼ AME と ATE の効率的な推定量 • Ƹ 𝑠(𝑑,
𝑥) を 𝑠0 𝑑, 𝑥 = 𝜕𝑑 log 𝑝 𝑑, 𝑥 の推定量とする. • AME の推定量: መ 𝜃(0) = 1 𝑛 σ 𝑖=1 𝑛 Ƹ 𝑠 0, 𝑋𝑖 𝑌 − ො 𝛾 𝐷𝑖 , 𝑋𝑖 + 𝜕𝑑 ො 𝛾 𝑑, 𝑋𝑖 |𝑑=0 . • ATE の推定量: መ 𝜃(1) = 1 𝑛 σ 𝑖=1 𝑛 1 𝑇 σ𝑡=1 𝑇 Ƹ 𝑠 𝑡 𝑇 , 𝑋𝑖 𝑌 − ො 𝛾 𝐷𝑖 , 𝑋𝑖 + ො 𝛾 1, 𝑋𝑖 − ො 𝛾 0, 𝑋𝑖 . ◼ AME と ATEを橋渡しする以下の政策経路(policy path)を新しい因果パラメータとして定義: 𝜃0 (𝛿) ≔ 𝔼 𝛾0 𝛿, 𝑍 − 𝔼 𝛾0 0, 𝑍 . • 処置を𝟎から𝜹だけ変化させた場合のアウトカムの変化量. 𝑑 = 0 𝑑 = 1 AME ATE -
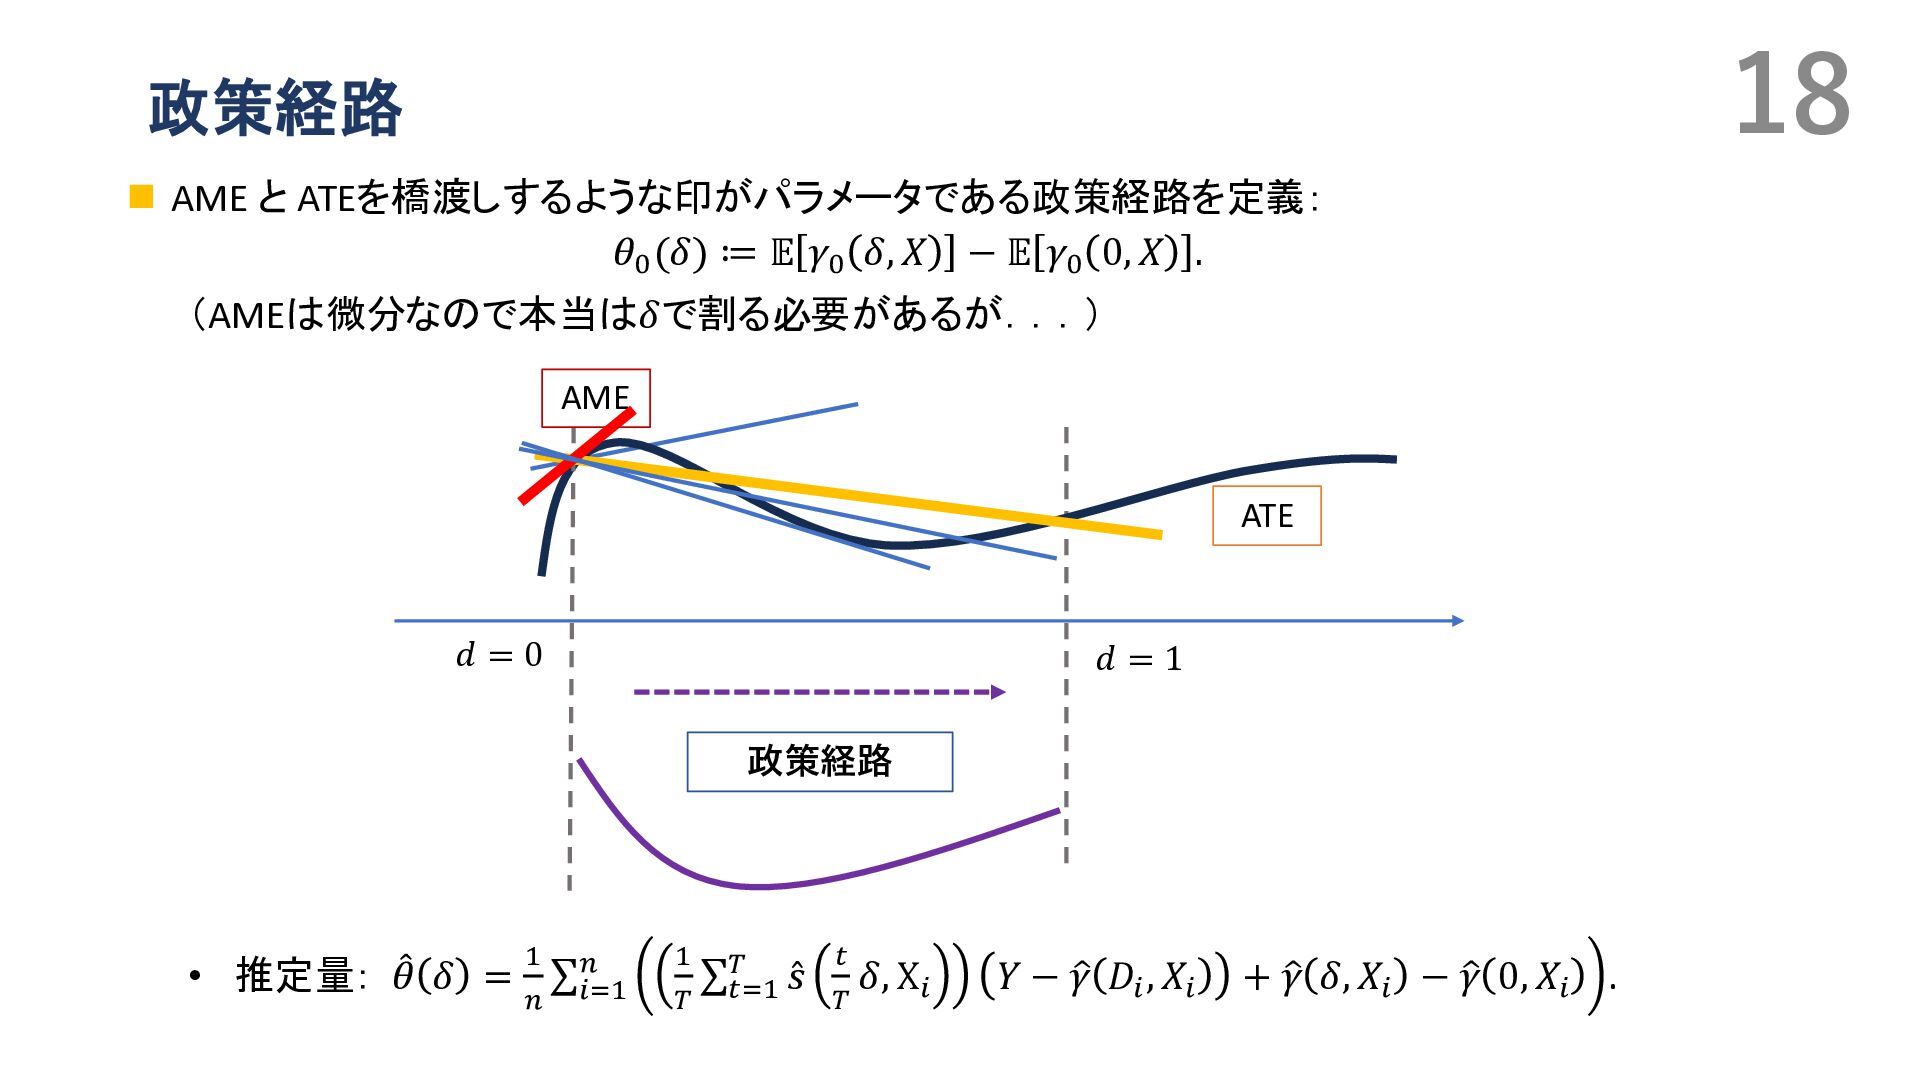
18 政策経路 ◼ AME と ATEを橋渡しするような印がパラメータである政策経路を定義: 𝜃0 (𝛿) ≔ 𝔼
𝛾0 𝛿, 𝑋 − 𝔼 𝛾0 0, 𝑋 . (AMEは微分なので本当は𝛿で割る必要があるが...) • 推定量: መ 𝜃 𝛿 = 1 𝑛 σ 𝑖=1 𝑛 1 𝑇 σ𝑡=1 𝑇 Ƹ 𝑠 𝑡 𝑇 𝛿, X𝑖 𝑌 − ො 𝛾 𝐷𝑖 , 𝑋𝑖 + ො 𝛾 𝛿, 𝑋𝑖 − ො 𝛾 0, 𝑋𝑖 . 𝑑 = 0 𝑑 = 1 AME ATE 政策経路 -
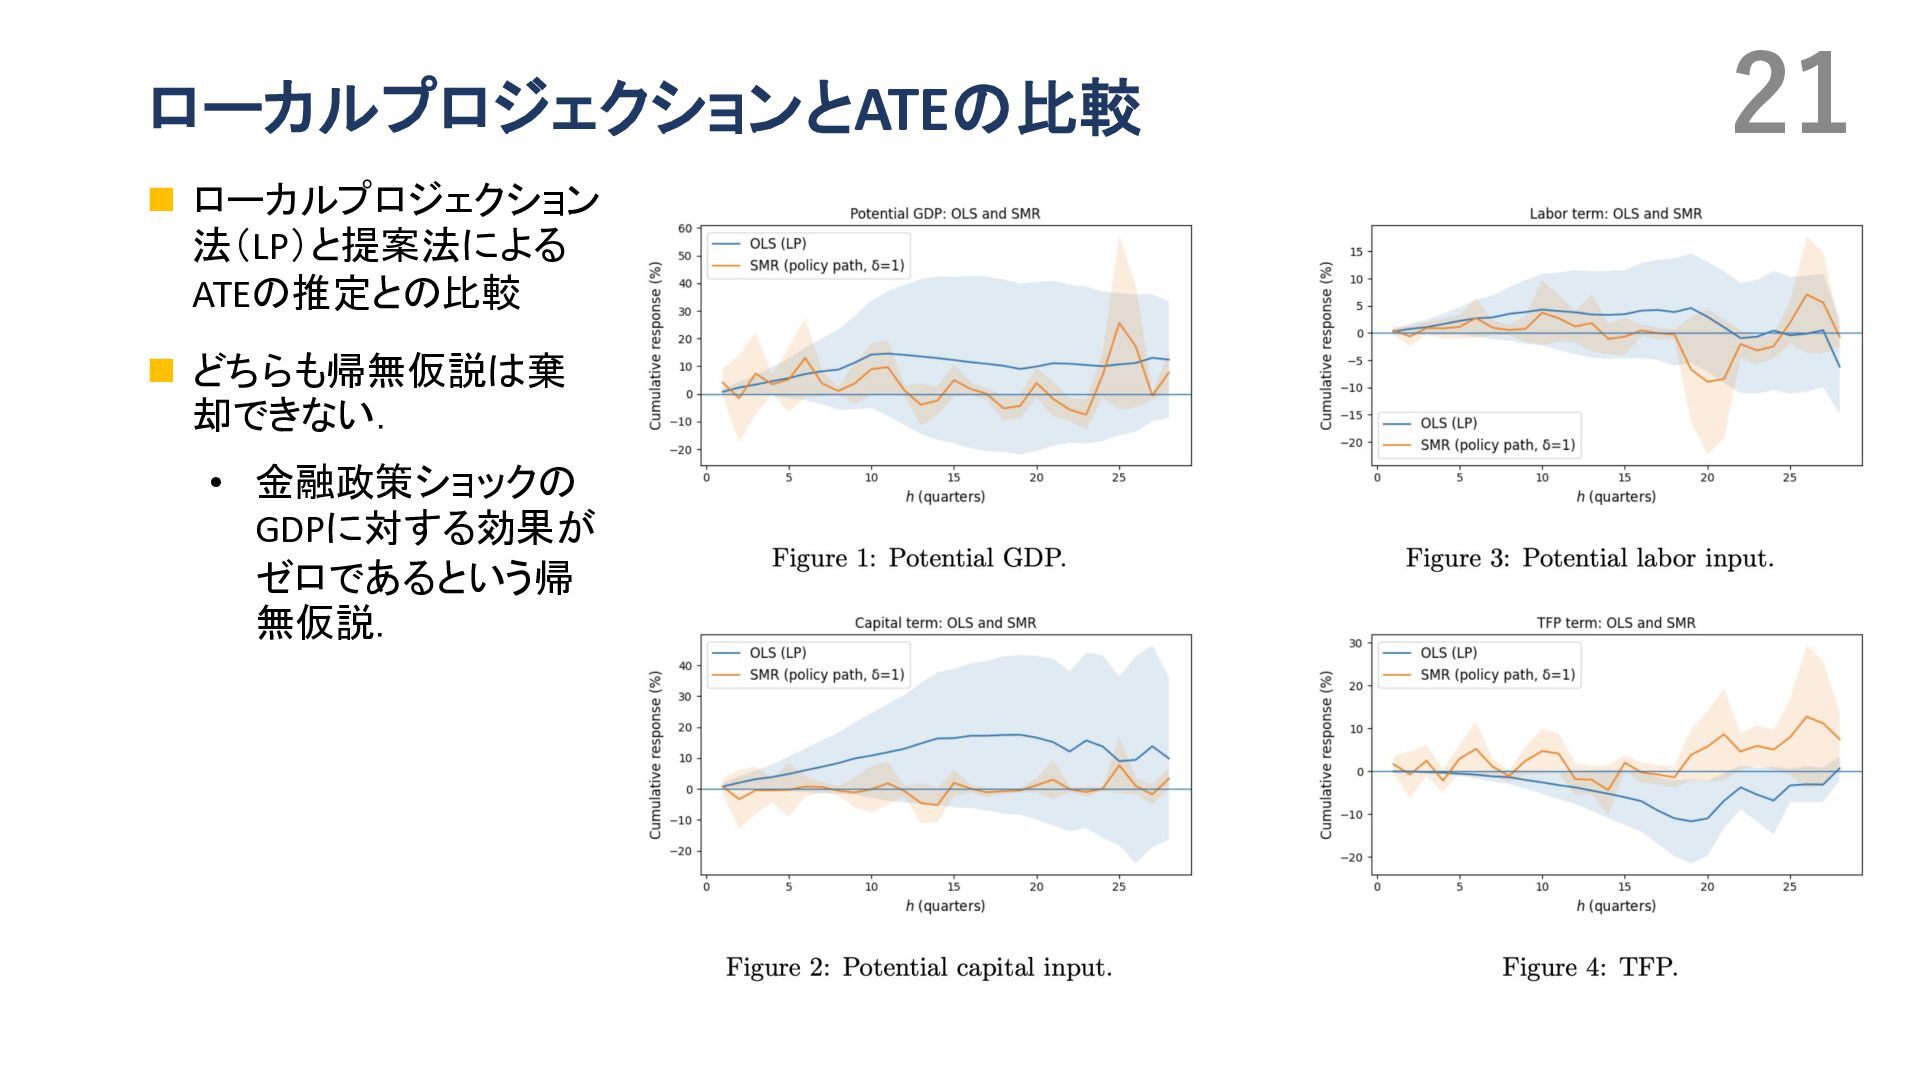
20 金融政策ショック ◼ 日本の金融緩和などの金融政策ショックが日本のGDPに与える影響の分析. • 金融ショックの定義自体が難しい. • 既存研究(伊藤ら 2024)の議論に基づいて識別・推定.本稿ではその詳細は省略. •
識別・推定された金融政策ショックを,ショックが与えられてからℎ期間後のGDPに回帰. • ℎは一単位あたり四半期とする. ◼ 既存研究: 伊藤・中野・幅・山中「金融政策の中長期的な影響」日銀ワーキングペーパー • 金融ショックを推定 • ローカルプロジェクション(local projection)法を用いてショックがGDPに与える影響を分析. • 実質的にOLS = ショックがGDPに与える影響は線形としている. ◼ 本研究 • 金融ショックの推定は伊藤らの方法に従う. • 平均処置効果(ATE)は線形性の仮定を外すことを可能にしている. • 政策経路を用いることでショックの大きさごとに異なる影響を調べることが可能. -
21 ローカルプロジェクションとATEの比較 ◼ ローカルプロジェクション 法(LP)と提案法による ATEの推定との比較 ◼ どちらも帰無仮説は棄 却できない. •
金融政策ショックの GDPに対する効果が ゼロであるという帰 無仮説. -
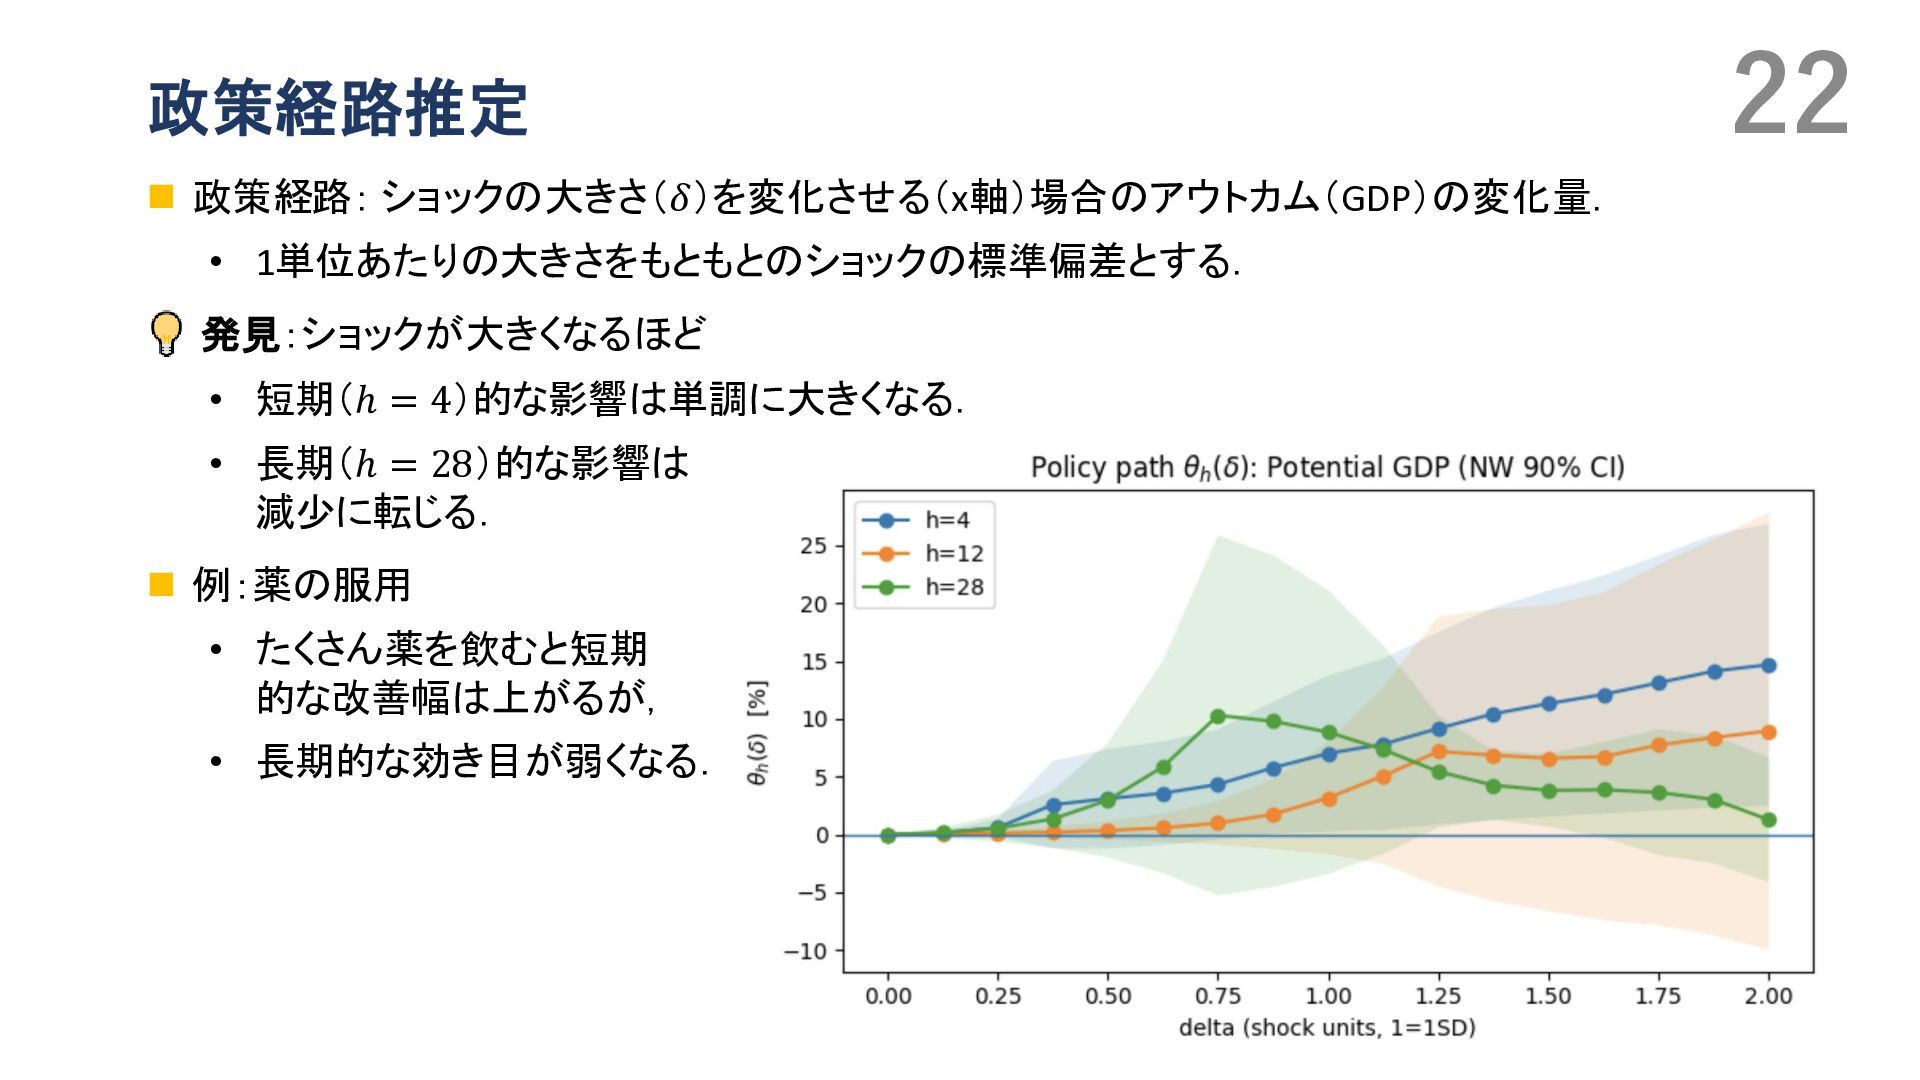
22 政策経路推定 ◼ 政策経路: ショックの大きさ(𝛿)を変化させる(x軸)場合のアウトカム(GDP)の変化量. • 1単位あたりの大きさをもともとのショックの標準偏差とする. 発見:ショックが大きくなるほど • 短期(ℎ
= 4)的な影響は単調に大きくなる. • 長期(ℎ = 28)的な影響は 減少に転じる. ◼ 例:薬の服用 • たくさん薬を飲むと短期 的な改善幅は上がるが, • 長期的な効き目が弱くなる. -
23 結論 ✓ 因果パラメータの推定手法を提案. • 拡散モデルのスコアマッチングを応用. • 多くの因果パラメータはスコアマッチングを用いて推定できる. • ScoreMatchingRieszと呼ぶことにする.
✓ ScoreMatchingRieszで推定しやすい推定対象の因果パラメータとして政策経路を提案. ✓ ScoreMatchingRieszと政策経路を用いて日本の金融政策を分析. • ショックが大きくなるほど,短期の効果は増大する可能性があるものの,長期の効果は減少 する可能性がある. • ショックの大きさに関わらず,金融政策ショックがGDPに与える影響がゼロであるという 帰無仮説を棄却できない. ➢ 今後の拡張 • 拡散モデルを用いる時系列データ生成との組み合わせ. • 微分値を用いる金融タスクへの応用. -
24 Reference • Victor Chernozhukov, Denis Chetverikov, Mert Demirer, Esther
Duflo, Christian Hansen, Whitney Newey, and James Robins. Double/debiased machine learning for treatment and structural parameters. The Econometrics Journal, 2018. • Victor Chernozhukov, Whitney K. Newey, and Rahul Singh. Automatic debiased machine learning of causal and structural effects. Econometrica, 2022 • Takafumi Kanamori, Shohei Hido, and Masashi Sugiyama. A least-squares approach to direct importance estimation. In JMLR, 2008. • Masahiro Kato and Takeshi Teshima. Non-negative bregman divergence minimization for deep direct density ratio estimation. In ICML, 2021. • B. Rhodes, K. Xu, and M.U. Gutmann. Telescoping density-ratio estimation. In NeurIPS, 2020. • Kristy Choi, Chenlin Meng, Yang Song, and Stefano Ermon. Density ratio estimation via infinitesimal classification. In AISTATS, 2022. • Oscar Jord`a. Estimation and inference of impulse responses by local projections. American Economic Review, 2005. • Yuichirou Ito, Shougo Nakano, Shunsuke Haba, and Takahiro Yamanaka. Medium- to long-term effects of monetary policy. Working Paper 24-J-21, Bank of Japan, Tokyo, Japan, November 2024. In Japanese. Original Japanese title: 金融政策の中 長期的な影響. • Masahiro Kato. Direct bias-correction term estimation for propensity scores and average treatment effect estimation, 2025. • Masahiro Kato. A Unified Framework for Debiased Machine Learning:\\ Riesz Representer Fitting under Bregman Divergence, 2026. • Pascal Vincent. A connection between score matching and denoising autoencoders. Neural Computation, 23(7):1661– 1674, 2011