Upgrade to Pro
— share decks privately, control downloads, hide ads and more …
Speaker Deck
Sign up for free
Menu
Search
Features
All features
Private URLs
Password Protection
Custom URLS
Scheduled publishing
Remove Branding
Restrict embedding
Deck Collections
Notes
Features
All features
Private URLs
Password Protection
Custom URLS
Scheduled publishing
Remove Branding
Restrict embedding
Deck Collections
Notes
Explore
Featured decks
Featured speakers
Programming
Technology
Storyboards
Explore
Featured decks
Featured speakers
Programming
Technology
Storyboards
Pricing
Search
Sign in
Sign up for free
インデックスのパフォーマンス調べてみた
Search
matumoto
October 15, 2022
Technology
130
0
Share
Embed
Copy iframe code
Copy JS code
Copy link
Start on current slide
インデックスのパフォーマンス調べてみた
2022/10月に行われた大LTでの発表資料です
イベントページはこちら
https://zli.connpass.com/event/261496/
matumoto
October 15, 2022
More Decks by matumoto
See All by matumoto
Go標準パッケージのI/O処理をながめる
matumoto
0
480
testingを眺める
matumoto
1
220
sync/v2 プロポーザルの 背景と sync.Pool について
matumoto
0
820
Goトランザクション処理
matumoto
1
94
いまいちどスライスの 挙動を見直してみる
matumoto
0
430
Go1.22のリリース予定の機能を見る
matumoto
0
98
GoのUnderlying typeについて
matumoto
0
250
Typed-nilについて
matumoto
0
390
GoのType Setsという概念
matumoto
0
64
Other Decks in Technology
See All in Technology
Databricksメトリクスビューはじめてのもくもく会
taka_aki
0
200
ai_cording_with_k8s_knowledge.pdf
mochizuki875
1
280
AIアプリを使い分けるための共通ツール基盤を考えてみる#devio2026
osawa
0
250
AI時代に必要な脅威モデリング― 変化の速度に負けない理解とリスク判断
masakane55
4
980
IR Today: Theory, Practice, and Agents
dtunkelang
0
350
プロダクト価値を、 チームが使える判断軸に変える
vivion
0
110
ビジネスを止めない技術的負債の返済のための戦略とその手法 - 技術的負債と向き合う / Complexity and Simplicity
soudai
PRO
3
550
【データ横丁主催】AI Agentがコンテキストを使って仕事をした後、何が残るのか― 組織の経験を次の判断に引き継ぐ「Agent Memory」
shisyu_gaku
2
330
組み立てて楽しむ AWS Blocks 入門
kmiya84377
0
210
全社共通データ基盤をつくる。ソニーのDatabricks活用とデータガバナンス設計の裏側
sony
0
420
自律型 AI をセキュアに実装!Gemini と MIG で作る動的コード実行環境
recruitengineers
PRO
1
210
Datadog の学び方 - あるいは、オブザーバビリティを学ぶとは何か
mananyuki
1
450
Featured
See All Featured
The Limits of Empathy - UXLibs8
cassininazir
1
700
Principles of Awesome APIs and How to Build Them.
keavy
128
18k
AI Search: Where Are We & What Can We Do About It?
aleyda
0
8k
How STYLIGHT went responsive
nonsquared
100
6.3k
KATA
mclloyd
PRO
35
16k
The Organizational Zoo: Understanding Human Behavior Agility Through Metaphoric Constructive Conversations (based on the works of Arthur Shelley, Ph.D)
kimpetersen
PRO
0
490
Large-scale JavaScript Application Architecture
addyosmani
515
110k
SEO for Brand Visibility & Recognition
aleyda
0
4.8k
Being A Developer After 40
akosma
91
590k
How to Create Impact in a Changing Tech Landscape [PerfNow 2023]
tammyeverts
56
3.5k
How People are Using Generative and Agentic AI to Supercharge Their Products, Projects, Services and Value Streams Today
helenjbeal
1
350
How to Get Subject Matter Experts Bought In and Actively Contributing to SEO & PR Initiatives.
livdayseo
0
210
Transcript
インデックスの パフォーマンス 調べてみた matumoto
自己紹介 • ハンドルネーム:matumoto • 本名:松本響輝 • 学年:28期 • 趣味:イカᔦꙬᔨ •
やってきた技術: ◦ ゲーム作り ◦ フロントエンド ◦ AtCoder 水💧 • Twitter:@matumoto_1234
インデックスについて
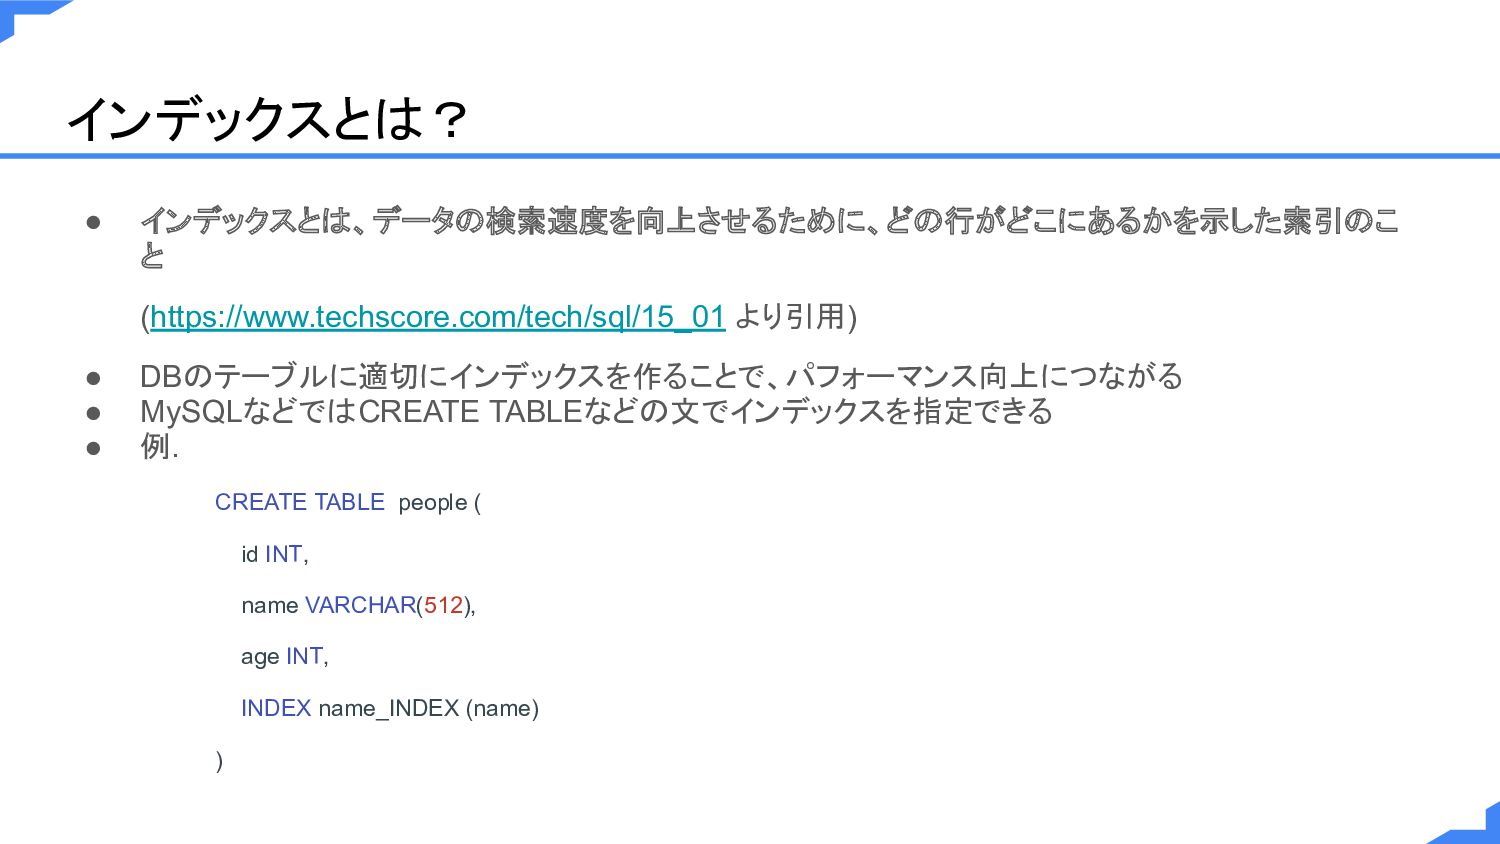
インデックスとは? • インデックスとは、データの検索速度を向上させるために、どの行がどこにあるかを示した索引のこ と (https://www.techscore.com/tech/sql/15_01 より引用) • DBのテーブルに適切にインデックスを作ることで、パフォーマンス向上につながる • MySQLなどではCREATE
TABLEなどの文でインデックスを指定できる • 例. CREATE TABLE people ( id INT, name VARCHAR(512), age INT, INDEX name_INDEX (name) )
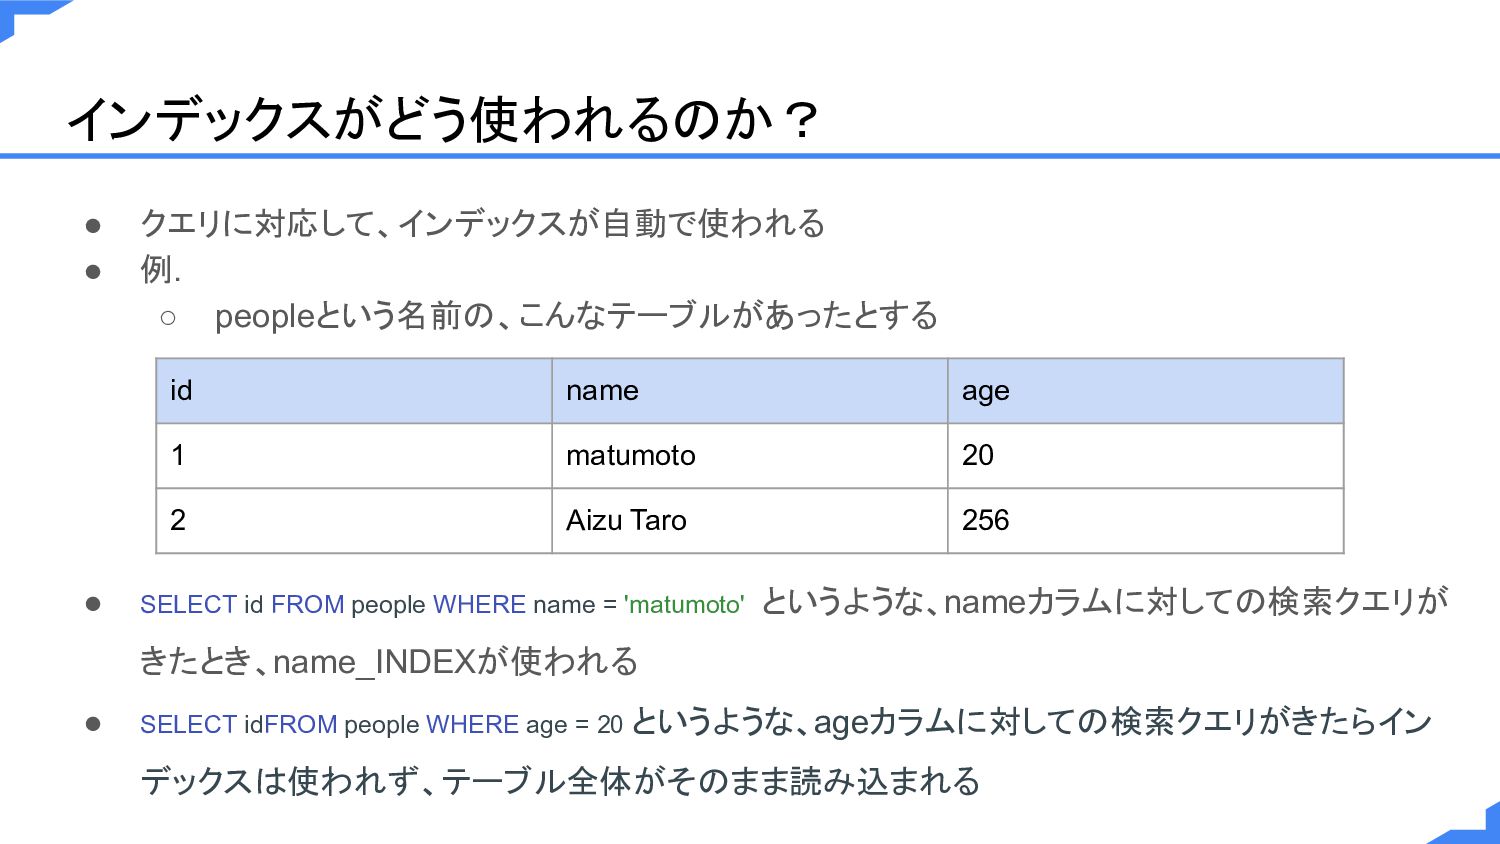
インデックスがどう使われるのか? • クエリに対応して、インデックスが自動で使われる • 例. ◦ peopleという名前の、こんなテーブルがあったとする id name age
1 matumoto 20 2 Aizu Taro 256 • SELECT id FROM people WHERE name = 'matumoto' というような、nameカラムに対しての検索クエリが きたとき、name_INDEXが使われる • SELECT idFROM people WHERE age = 20 というような、ageカラムに対しての検索クエリがきたらイン デックスは使われず、テーブル全体がそのまま読み込まれる
インデックスのパフォーマンス • インデックスは基本的に、ユニーク(重複がない)なもののほうがパフォーマンスが良い ◦ 例. PRIMARY KEYに基づくインデックスやUNIQUE制約のついたインデックスなど →なぜパフォーマンスが良いのか?(本題) →後述
インデックスの内部構造
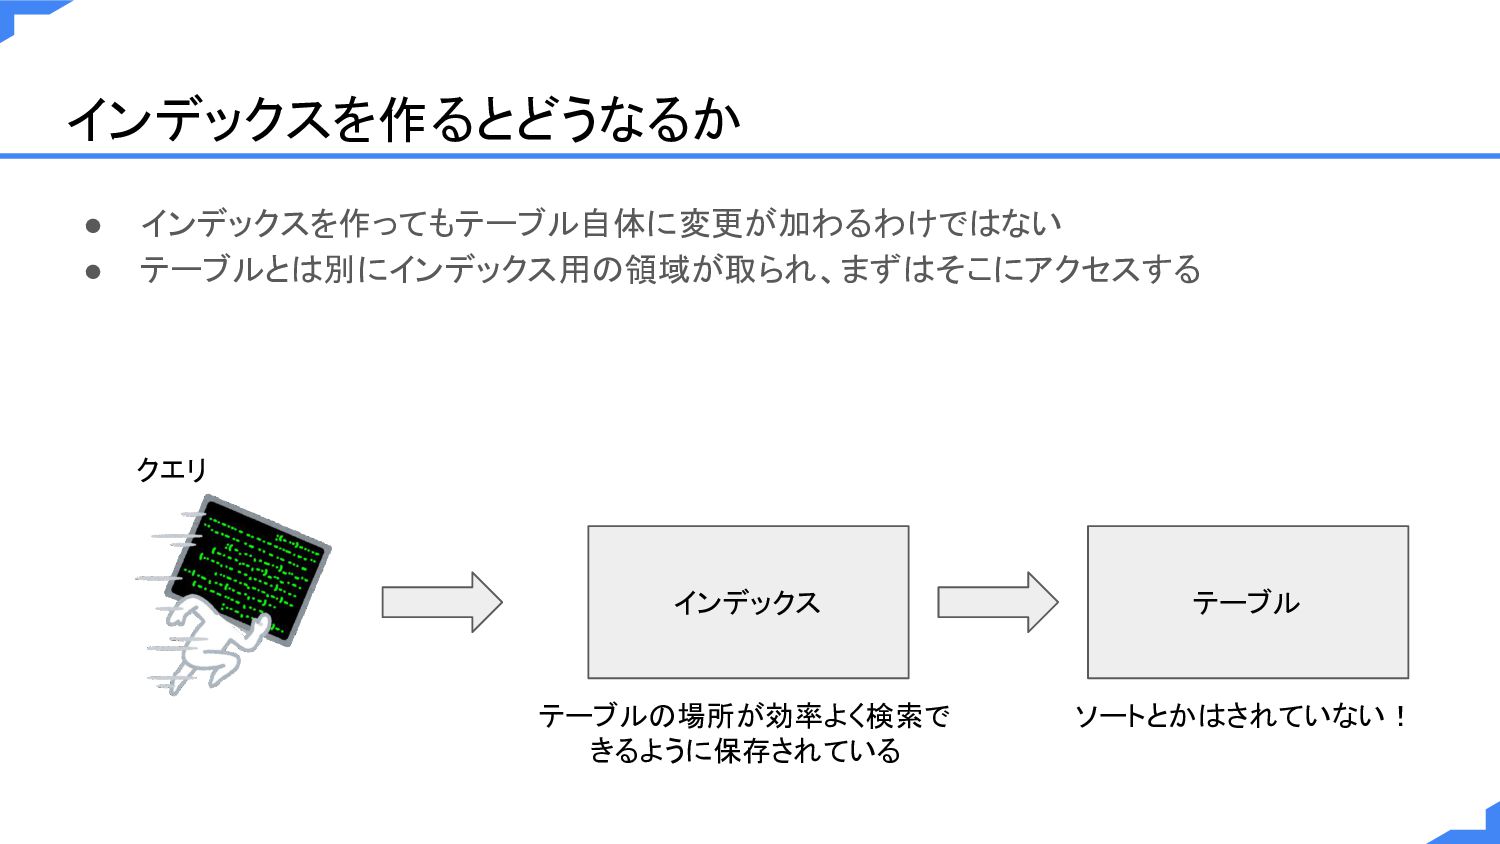
インデックスを作るとどうなるか • インデックスを作ってもテーブル自体に変更が加わるわけではない • テーブルとは別にインデックス用の領域が取られ、まずはそこにアクセスする テーブル インデックス クエリ ソートとかはされていない! テーブルの場所が効率よく検索で
きるように保存されている
インデックスはどうなっているか • B-treeというようなデータ構造がよく使われている ◦ 厳密にはB+treeや、B*treeという改良版が使われることが多い
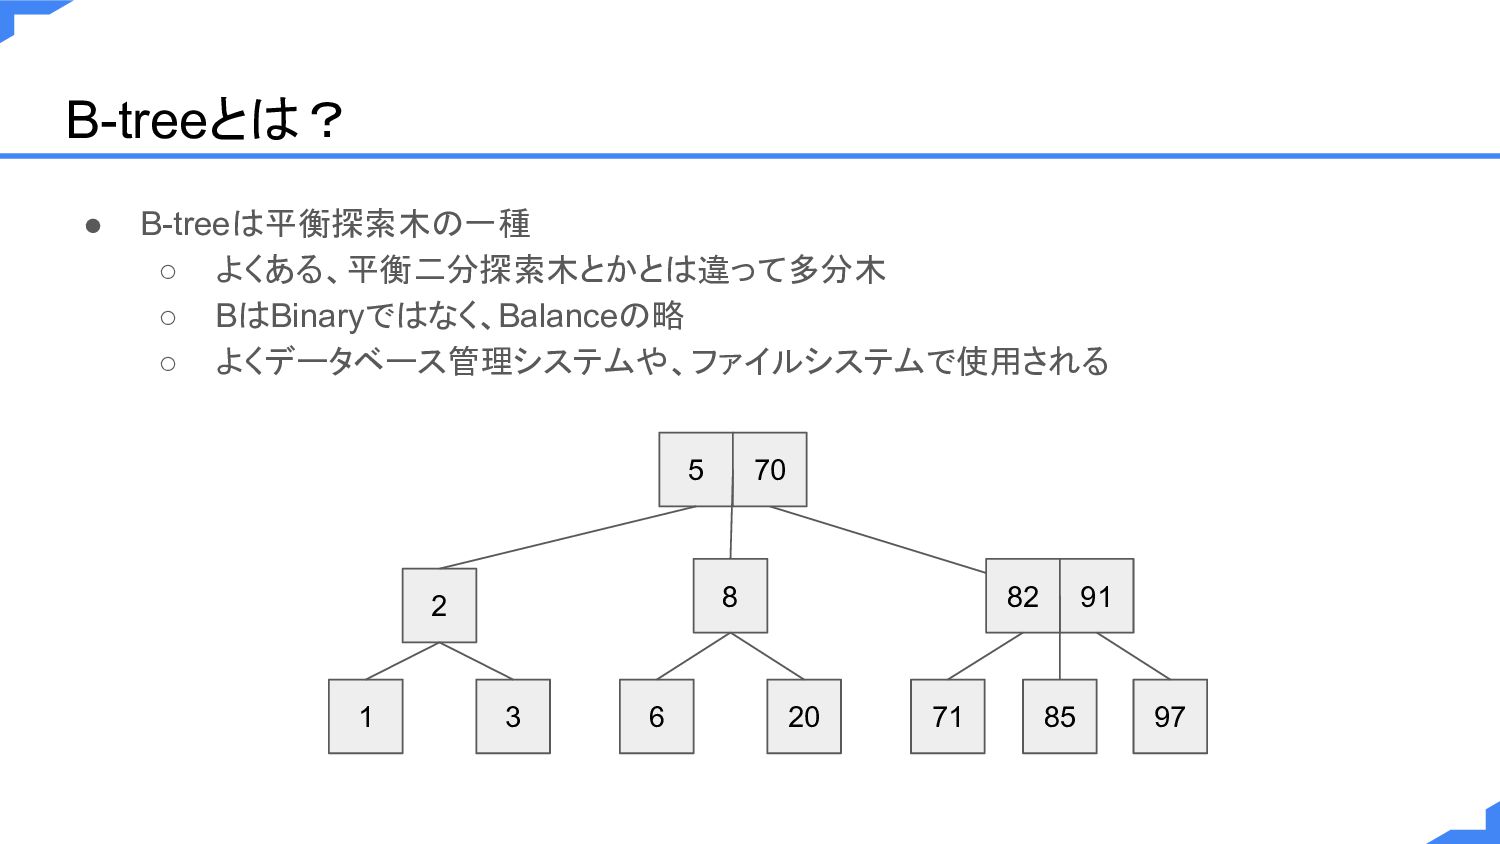
B-treeとは? • B-treeは平衡探索木の一種 ◦ よくある、平衡二分探索木とかとは違って多分木 ◦ BはBinaryではなく、Balanceの略 ◦ よくデータベース管理システムや、ファイルシステムで使用される 5
70 2 1 3 8 6 20 82 91 71 85 97
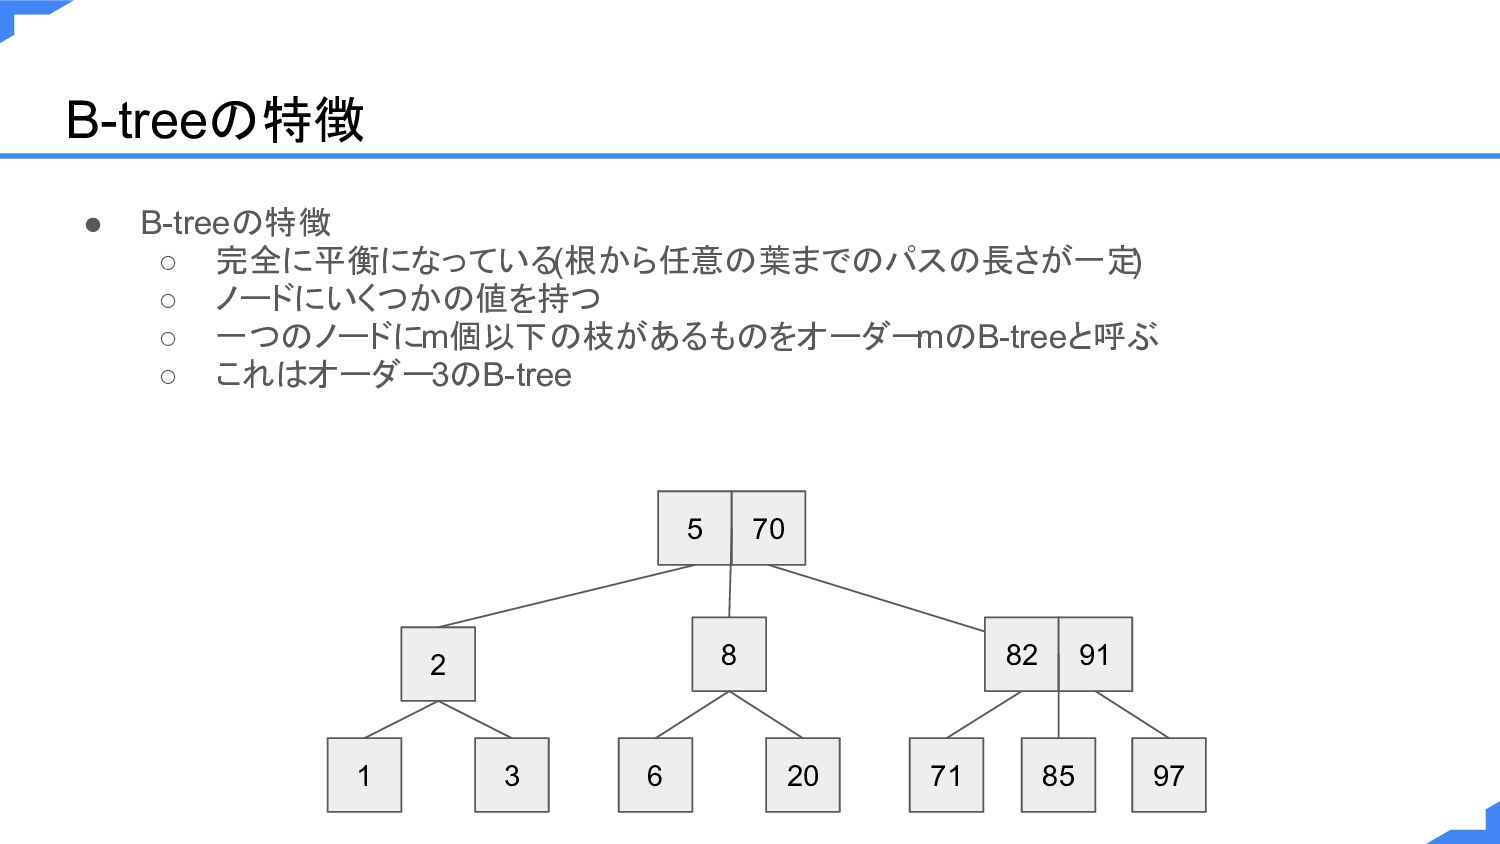
B-treeの特徴 • B-treeの特徴 ◦ 完全に平衡になっている(根から任意の葉までのパスの長さが一定 ) ◦ ノードにいくつかの値を持つ ◦ 一つのノードにm個以下の枝があるものをオーダー
mのB-treeと呼ぶ ◦ これはオーダー3のB-tree 5 70 2 1 3 8 6 20 82 91 71 85 97
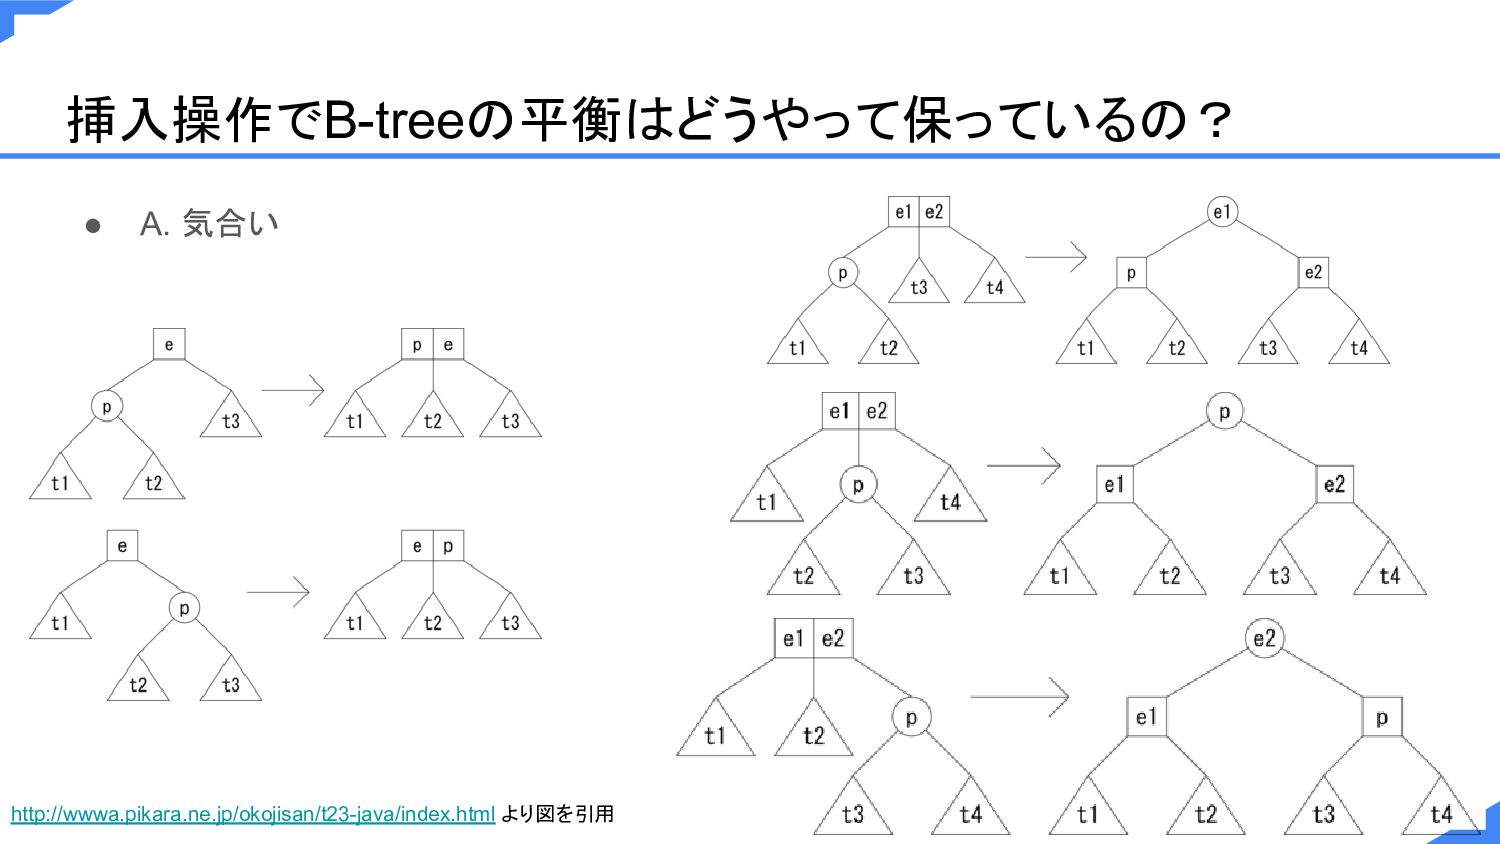
挿入操作でB-treeの平衡はどうやって保っているの? • A. 気合い http://wwwa.pikara.ne.jp/okojisan/t23-java/index.html より図を引用
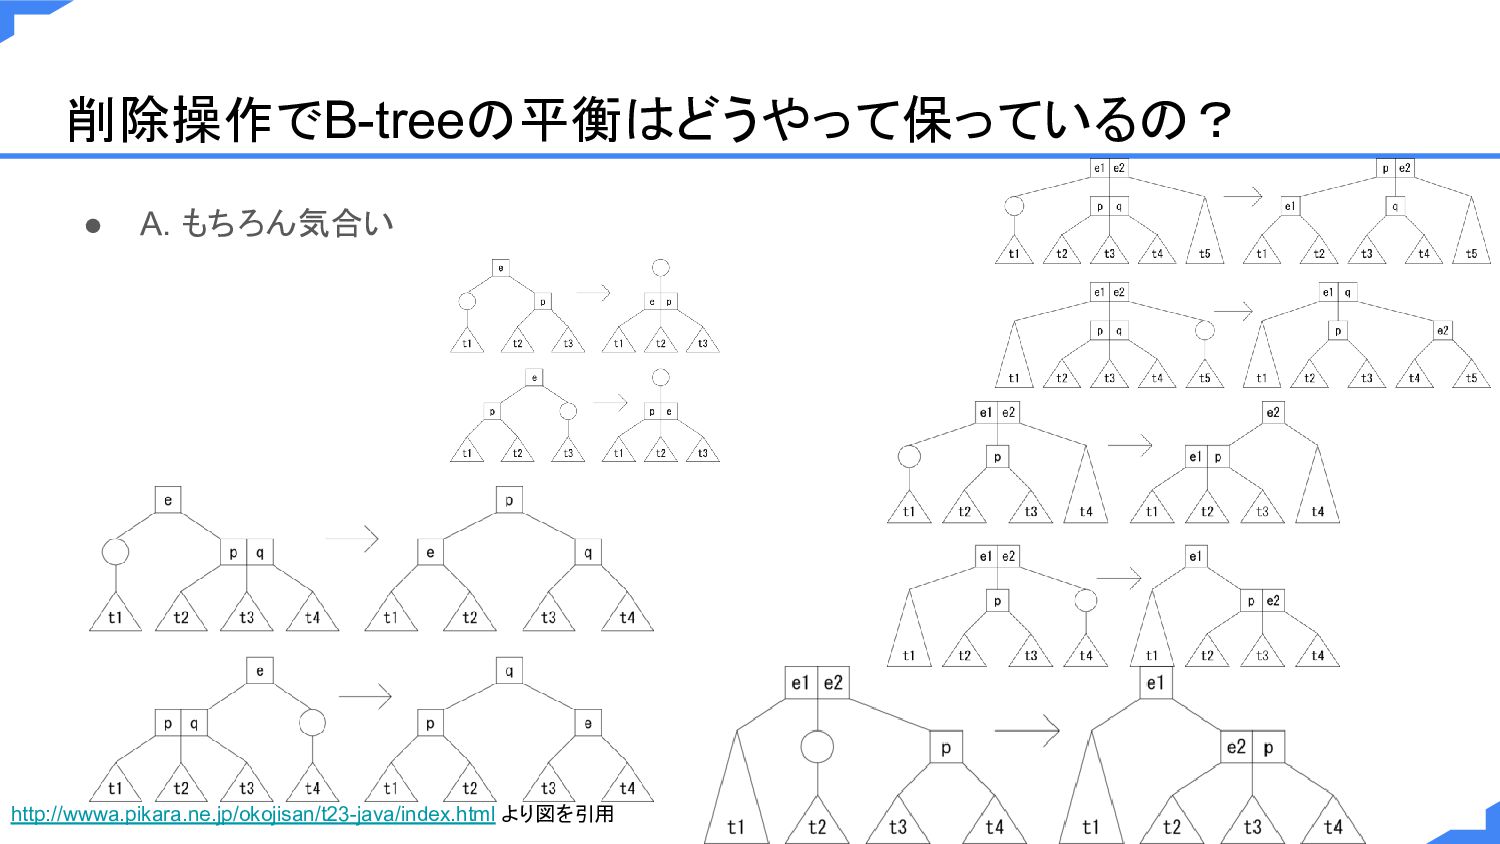
削除操作でB-treeの平衡はどうやって保っているの? • A. もちろん気合い http://wwwa.pikara.ne.jp/okojisan/t23-java/index.html より図を引用
B-treeの計算量 • B-treeの計算量 ◦ nを要素数とする ◦ 挿入:O(log n) ◦ 削除:O(log
n) ◦ 検索:O(log n) • AVL木や、赤黒木といった平衡二分探索木より速い? ◦ そんなことはなくて、遅い ◦ オーダーmのB-treeのノードを辿るときにO(m)回の値比較を行うので遅い ◦ データベース管理システムなどで使われるのは、「枝を辿るコスト」 >「値比較のコスト」な ため
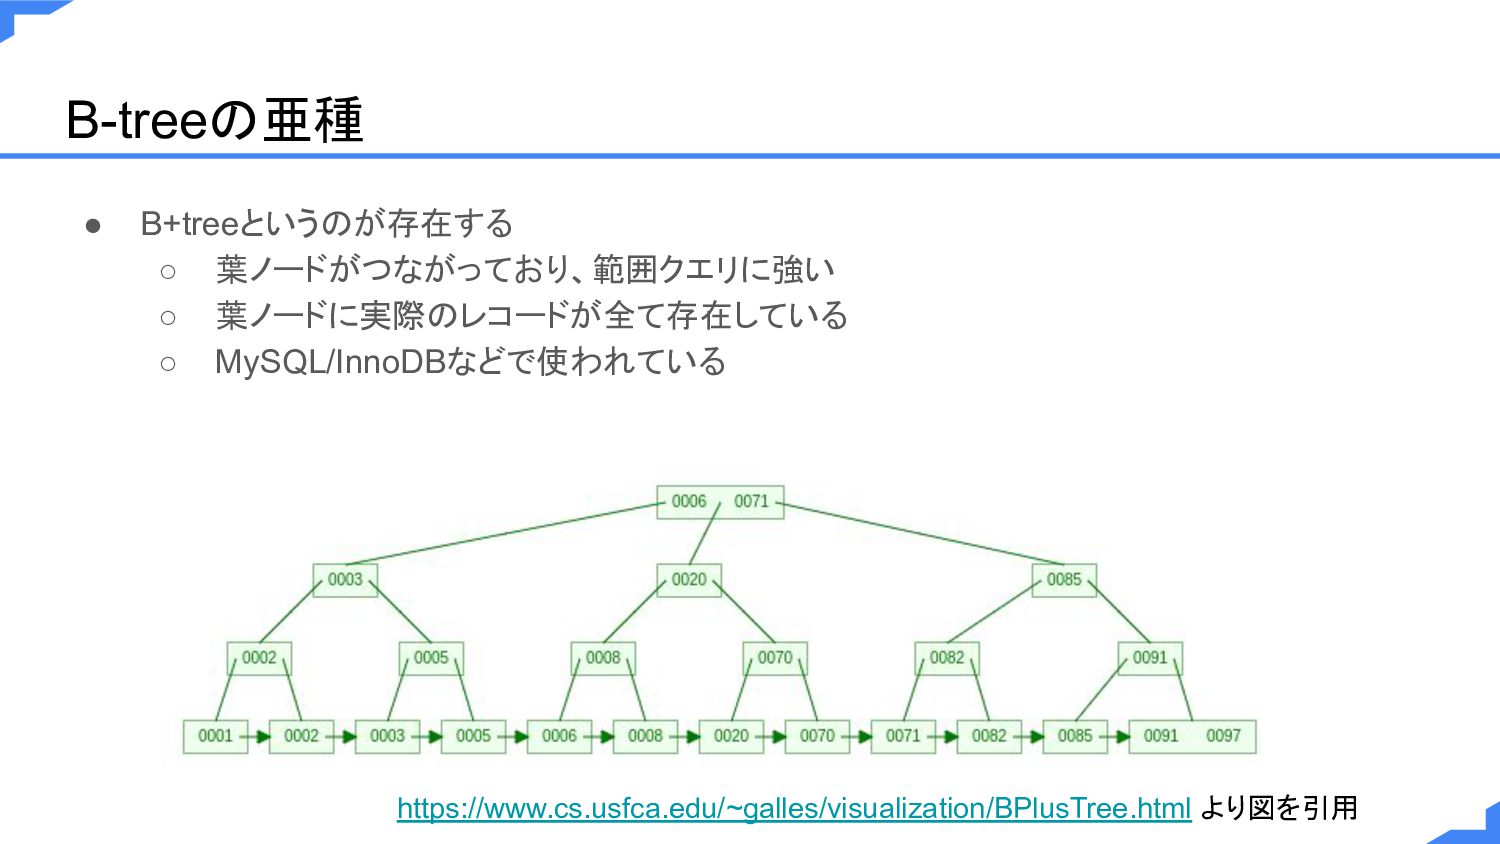
B-treeの亜種 • B+treeというのが存在する ◦ 葉ノードがつながっており、範囲クエリに強い ◦ 葉ノードに実際のレコードが全て存在している ◦ MySQL/InnoDBなどで使われている https://www.cs.usfca.edu/~galles/visualization/BPlusTree.html
より図を引用
インデックスの パフォーマンス
インデックスのパフォーマンス • SQLクエリをEXPLAINすると表示される「type」 • 主なものとしては、以下がある ◦ const:PRIMARY KEYのインデックスやUNIQUEインデックスを使う。最速 ◦ eq_ref:JOINのときにPRIMARY
KEYのインデックスやUNIQUEインデックスを使う ◦ ref:ユニークでないインデックスを使ったときの等価検索など ◦ range:インデックスを用いた範囲検索 (0 <= key <= 10を満たすkeyを検索するなど) ◦ index:フルインデックススキャン。インデックス全体を見る ◦ all:フルテーブルスキャン。インデックスが使用されていない • なぜユニークだと早くなる傾向にあるのか?
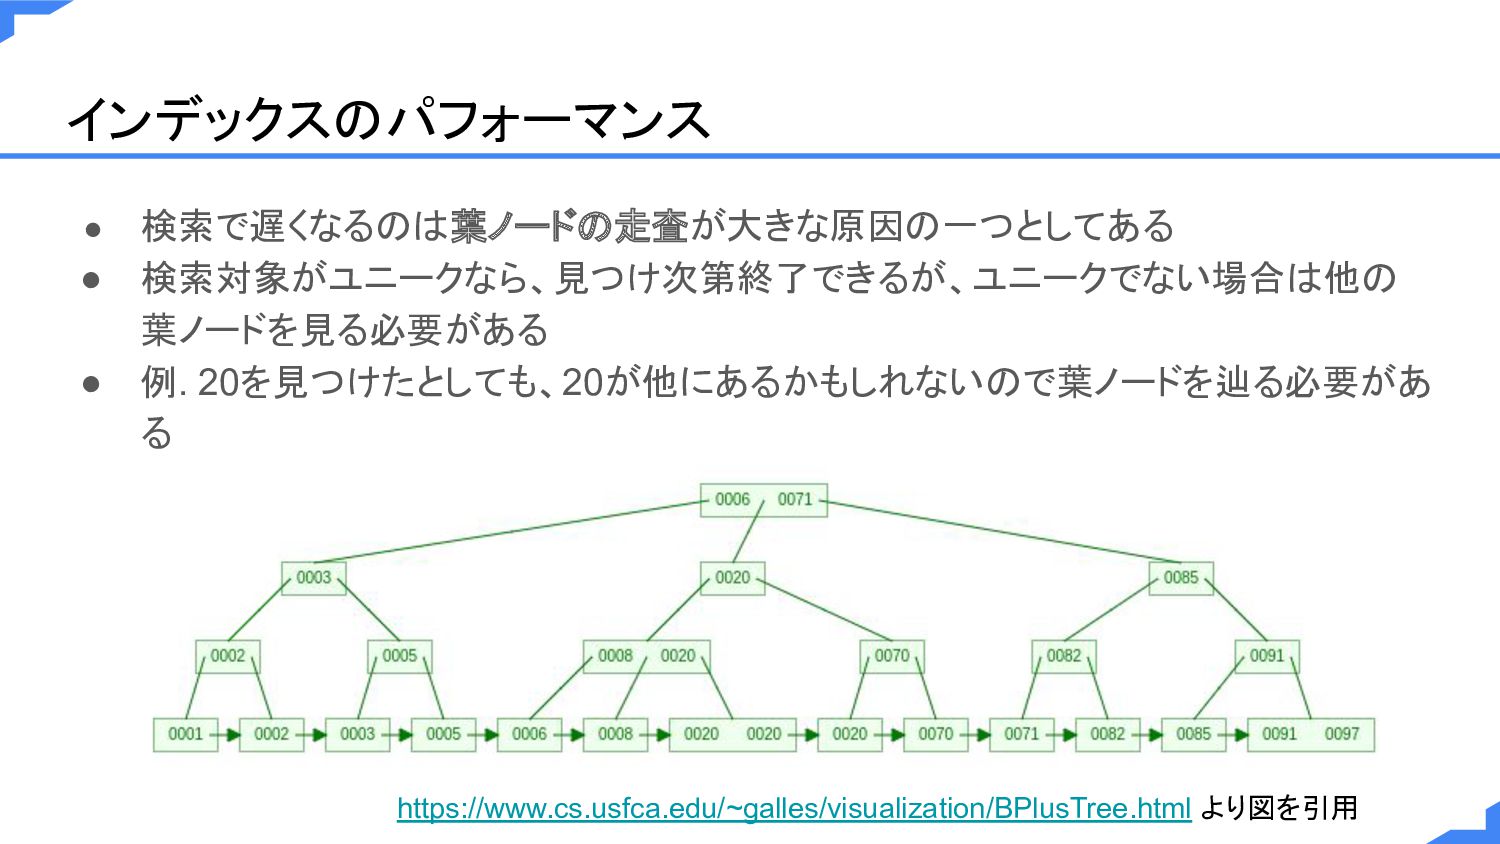
インデックスのパフォーマンス • 検索で遅くなるのは葉ノードの走査が大きな原因の一つとしてある • 検索対象がユニークなら、見つけ次第終了できるが、ユニークでない場合は他の 葉ノードを見る必要がある • 例. 20を見つけたとしても、20が他にあるかもしれないので葉ノードを辿る必要があ る
https://www.cs.usfca.edu/~galles/visualization/BPlusTree.html より図を引用
まとめ
まとめ • インデックスの内部構造はB-treeがベースになっていることが多くて、計算量は だ いたい O(log n) ◦ 範囲クエリでk個の要素がみつかるときは、 O(log
n + k) 程度
ご静聴ありがとうございました


 matumoto
 taka_aki
 mochizuki875
 osawa
 masakane55
 dtunkelang
 vivion
 soudai
 shisyu_gaku
 kmiya84377
 sony
 recruitengineers
 mananyuki
 cassininazir
 keavy
 aleyda
 nonsquared
 mclloyd
 kimpetersen
 addyosmani
 akosma
 tammyeverts
 helenjbeal
 livdayseo