Upgrade to Pro
— share decks privately, control downloads, hide ads and more …
Speaker Deck
Sign up for free
Menu
Search
Features
All features
Private URLs
Password Protection
Custom URLS
Scheduled publishing
Remove Branding
Restrict embedding
Deck Collections
Notes
Features
All features
Private URLs
Password Protection
Custom URLS
Scheduled publishing
Remove Branding
Restrict embedding
Deck Collections
Notes
Explore
Featured decks
Featured speakers
Programming
Technology
Storyboards
Explore
Featured decks
Featured speakers
Programming
Technology
Storyboards
Pricing
Search
Sign in
Sign up for free
Railsで挑む大量データ永続化 〜600億件を永続化するための設計とボトルネックとの戦い〜
Search
Shoichi Ochi
October 17, 2026
Technology
120
0
Share
Embed
Copy iframe code
Copy JS code
Copy link
Start on current slide
Railsで挑む大量データ永続化 〜600億件を永続化するための設計とボトルネックとの戦い〜
Kaigi on Rails 2026 登壇資料(日本語版)
Shoichi Ochi
October 17, 2026
More Decks by Shoichi Ochi
See All by Shoichi Ochi
Persisting Massive Data with Rails ~Designing for 60 billion rows, and fighting the bottlenecks~ Railsで挑む大量データ永続化 〜600億件を永続化するための設計とボトルネックとの戦い〜
occhi
0
410
Prevent Concurrency Problems! A Practical Introduction to Transactions
occhi
0
23
並行性の問題を防げ!実践トランザクション入門
occhi
0
290
ノイジーネイバー問題を解決する 公平なキューイング
occhi
0
250
高速化&コスト半減!? GitHub Actionsの サードパーティマネージドランナーの比較
occhi
1
950
HTTPじゃ遅すぎる! SwitchBotを自作ハブで動かして学ぶBLE通信
occhi
0
2.3k
Other Decks in Technology
See All in Technology
DGX Spark でどこまでハッキングができるのか?
kash1064
0
1.1k
自主式軟體工廠
philipz
0
260
OSC2026on_the-world-is-waiting-for-your-voice.pdf
naruoga
0
370
AIがコードを書く時代に、エンジニアは何で自分の価値を証明するのか / In an era where AI writes code how do engineers prove their value
carta_engineering
3
870
LLM機能を自作して分かるSnowflake Cortex AIの強み
nayuts
0
370
AIに攻撃される前に、AIに攻撃させる
tsuchikazu
0
170
Kiro Crewをはじめよう
kizawa2020
1
150
AI時代のAPI開発を加速する品質ガードレール / API Quality Guardrails in the AI Era
yokawasa
0
190
Essential architectural thinking (revised edition)
ufried
0
120
Classmethod Company Deck
satoshi7
0
130
FactoryBotアンチパターン / factory_bot anti-patterns
toshimaru
0
150
Datadog の学び方 - あるいは、オブザーバビリティを学ぶとは何か
mananyuki
1
560
Featured
See All Featured
Paper Plane (Part 1)
katiecoart
PRO
2
11k
Navigating Algorithm Shifts & AI Overviews - #SMXNext
aleyda
1
1.7k
The Limits of Empathy - UXLibs8
cassininazir
2
720
Keith and Marios Guide to Fast Websites
keithpitt
413
23k
Max Prin - Stacking Signals: How International SEO Comes Together (And Falls Apart)
techseoconnect
PRO
0
490
ピンチをチャンスに:未来をつくるプロダクトロードマップ #pmconf2020
aki_iinuma
128
56k
The Web Performance Landscape in 2024 [PerfNow 2024]
tammyeverts
12
1.3k
Practical Tips for Bootstrapping Information Extraction Pipelines
honnibal
25
2.1k
XXLCSS - How to scale CSS and keep your sanity
sugarenia
250
1.3M
Helping Users Find Their Own Way: Creating Modern Search Experiences
danielanewman
31
3.4k
Introduction to Domain-Driven Design and Collaborative software design
baasie
1
1k
Beyond borders and beyond the search box: How to win the global "messy middle" with AI-driven SEO
davidcarrasco
3
280
Transcript
Railsで挑む大量データ永続化 〜600億件を永続化するための設計とボトルネックとの戦い〜 Shoichi Ochi (@occhi) Kaigi on Rails 2026 2026-10-17
Slides are available at: 今日の資料リンクに飛べるQRコード 2
600億件の履歴データ 3
要件に合わせてどう扱う? 4
扱い方が決まったら、設計はどう考える? 5
今回は、そんな話をします 6
自己紹介 おち しょういち 越智 翔一 SmartBank, Inc. Software Engineer 経歴:
イタンジ株式会社 → GMOビューティー株式会社 → 株式会社スマートバンク 趣味: 筋トレ @ochi11181101 @sho-work 7
88
複雑な技術的課題も、 要件・制約の整理とボトルネックの特定・分析を 積み重ねることで解決できる 9
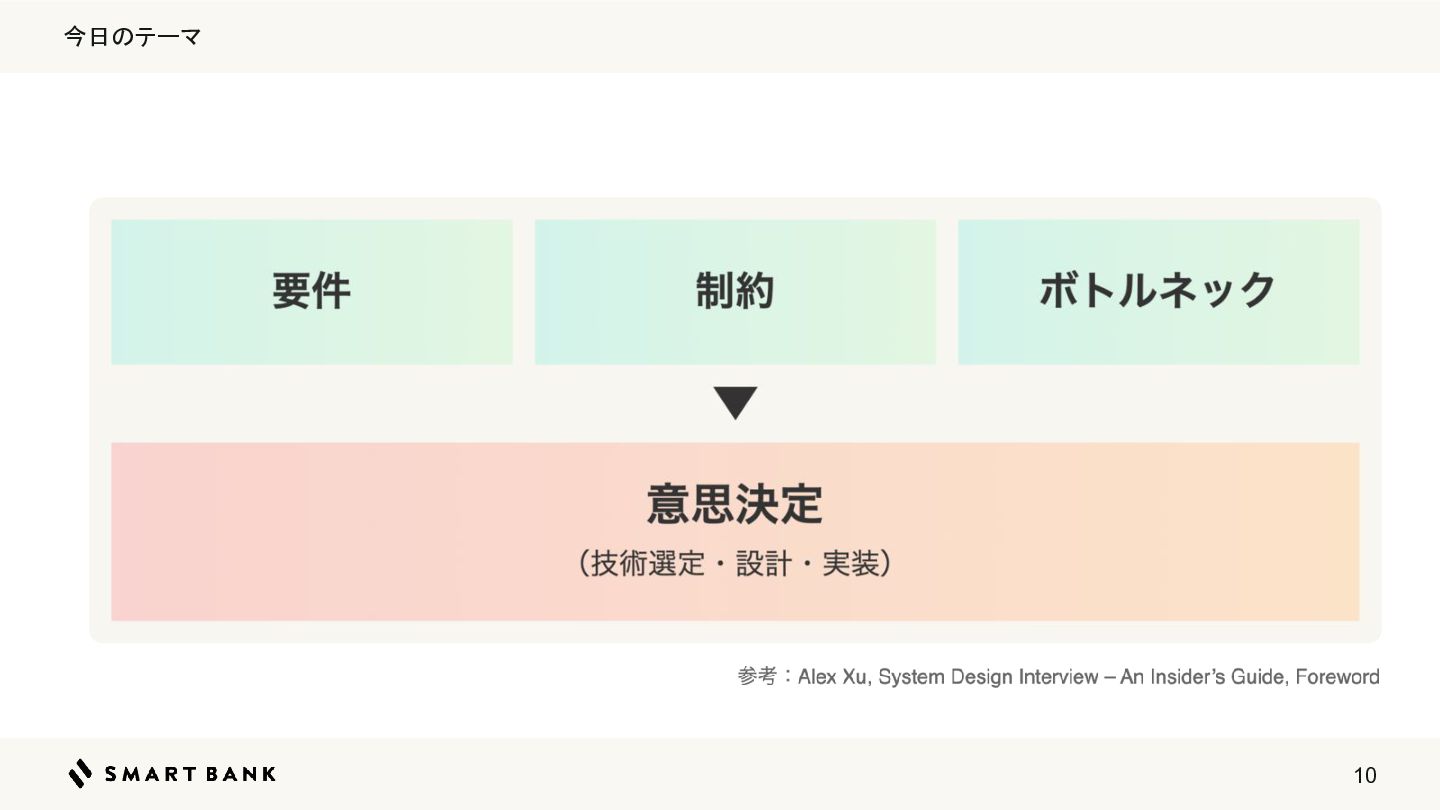
今日のテーマ 10
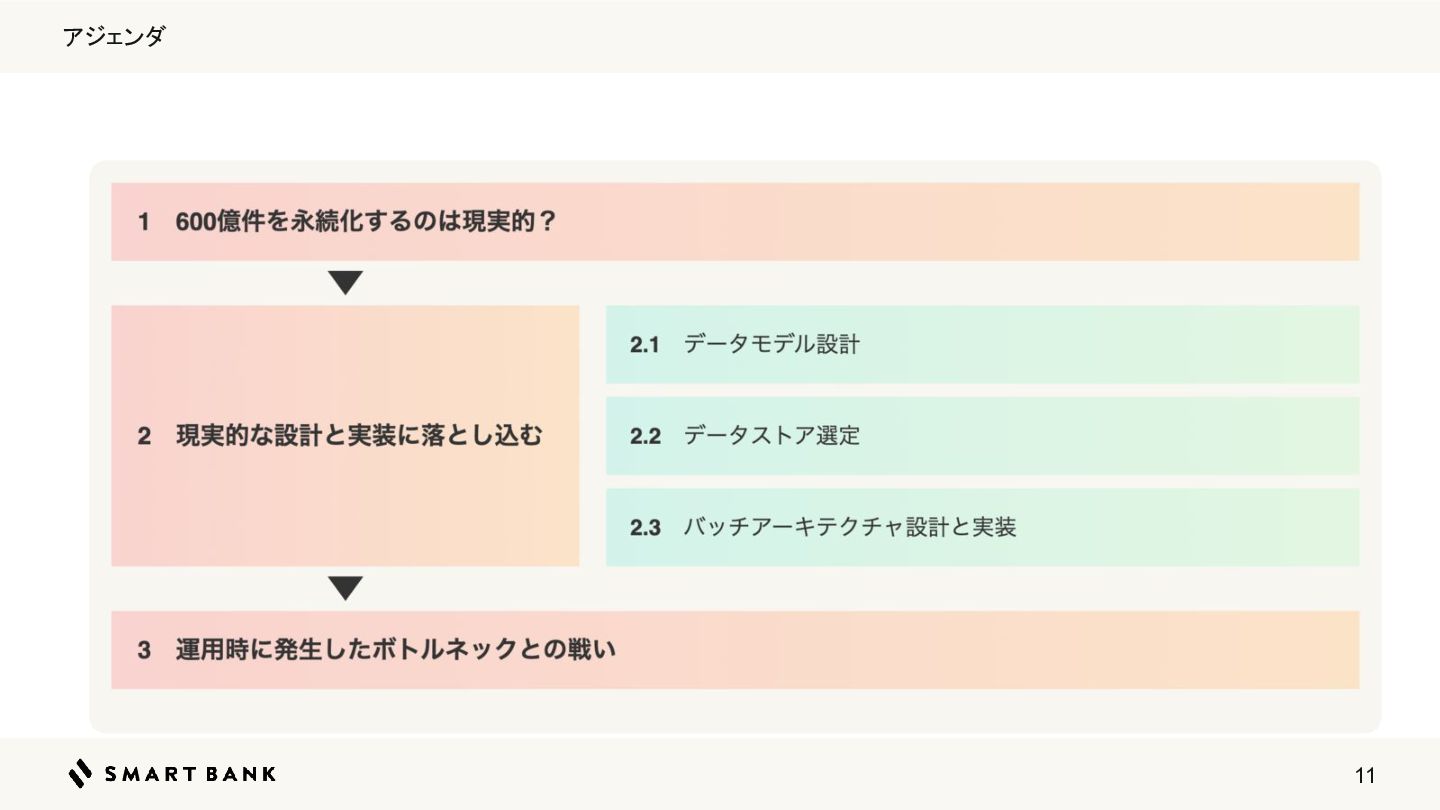
アジェンダ 11
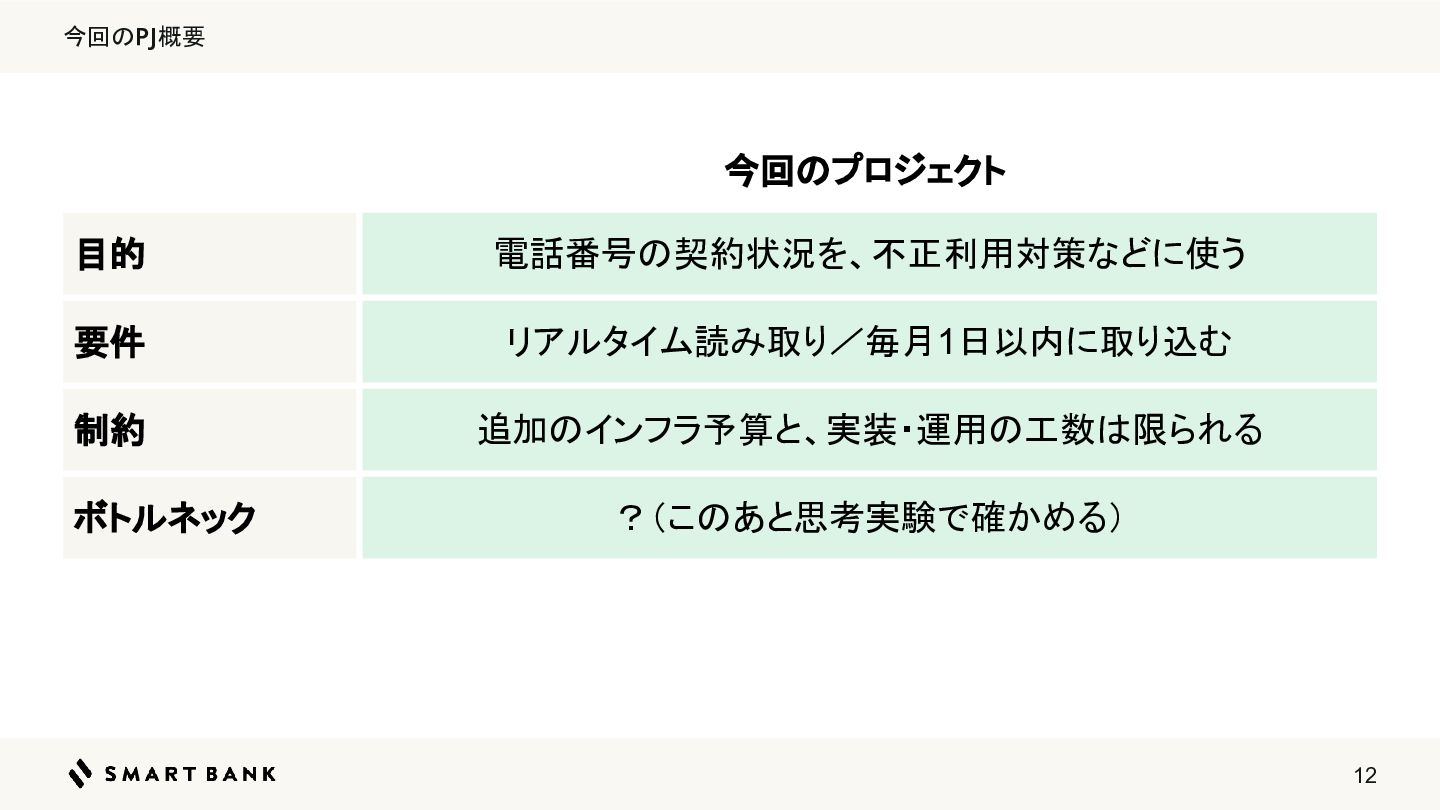
今回のPJ概要 今回のプロジェクト 目的 電話番号の契約状況を、不正利用対策などに使う 要件 リアルタイム読み取り/毎月1日以内に取り込む 制約 追加のインフラ予算と、実装・運用の工数は限られる ボトルネック ?(このあと思考実験で確かめる)
12
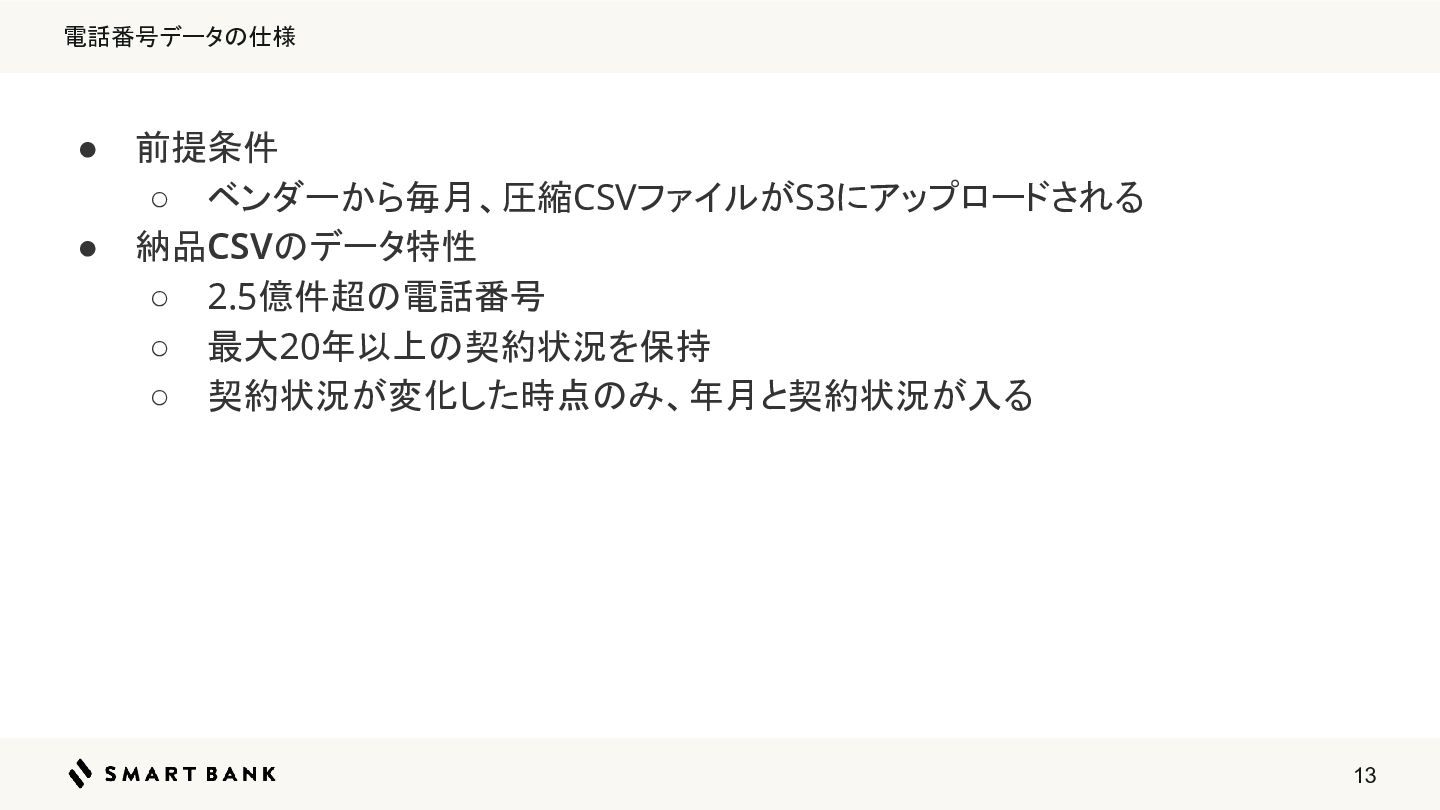
電話番号データの仕様 • • 前提条件 ◦ ベンダーから毎月、圧縮CSVファイルがS3にアップロードされる 納品CSVのデータ特性 ◦ 2.5億件超の電話番号 ◦
最大20年以上の契約状況を保持 ◦ 契約状況が変化した時点のみ、年月と契約状況が入る 13
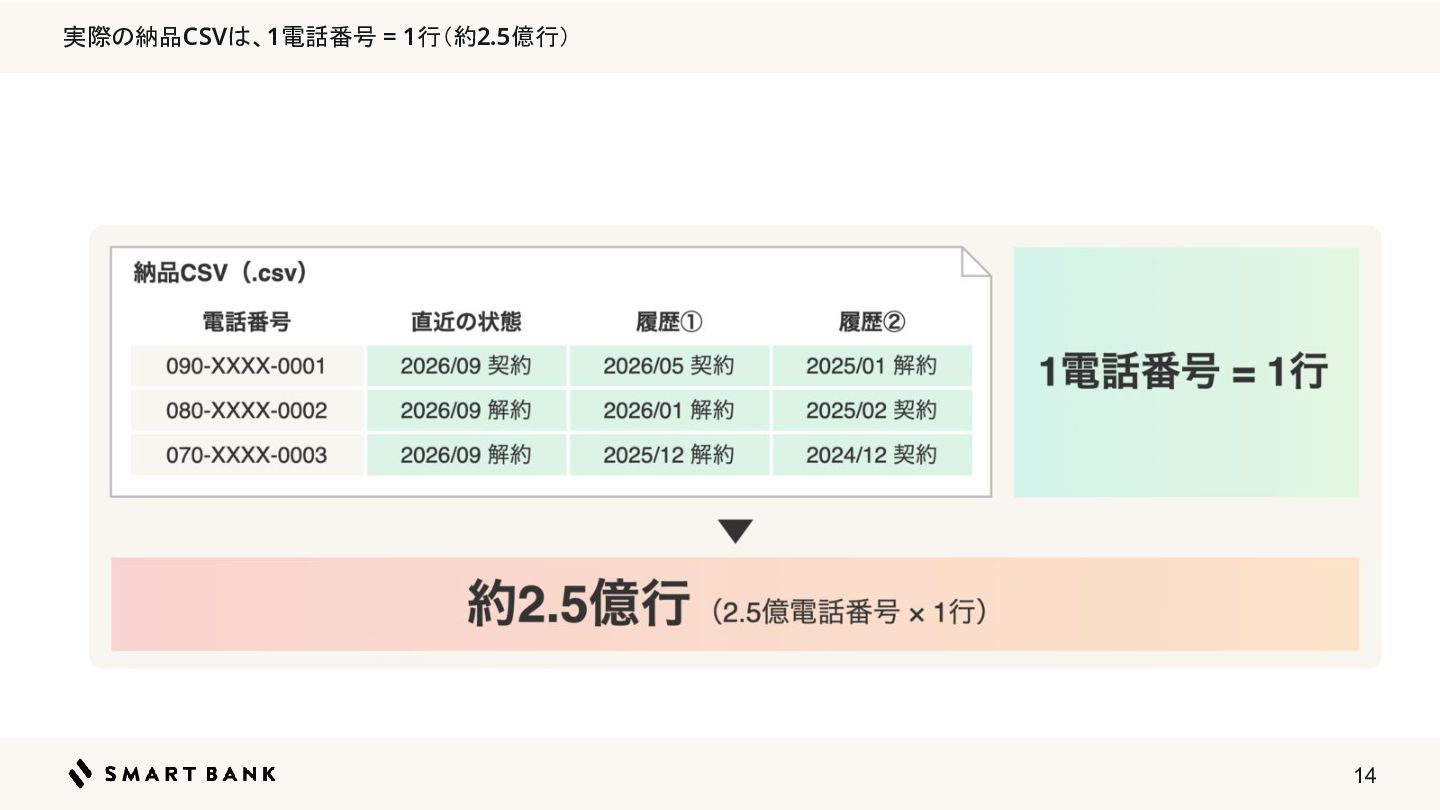
実際の納品CSVは、1電話番号 = 1行(約2.5億行) 14
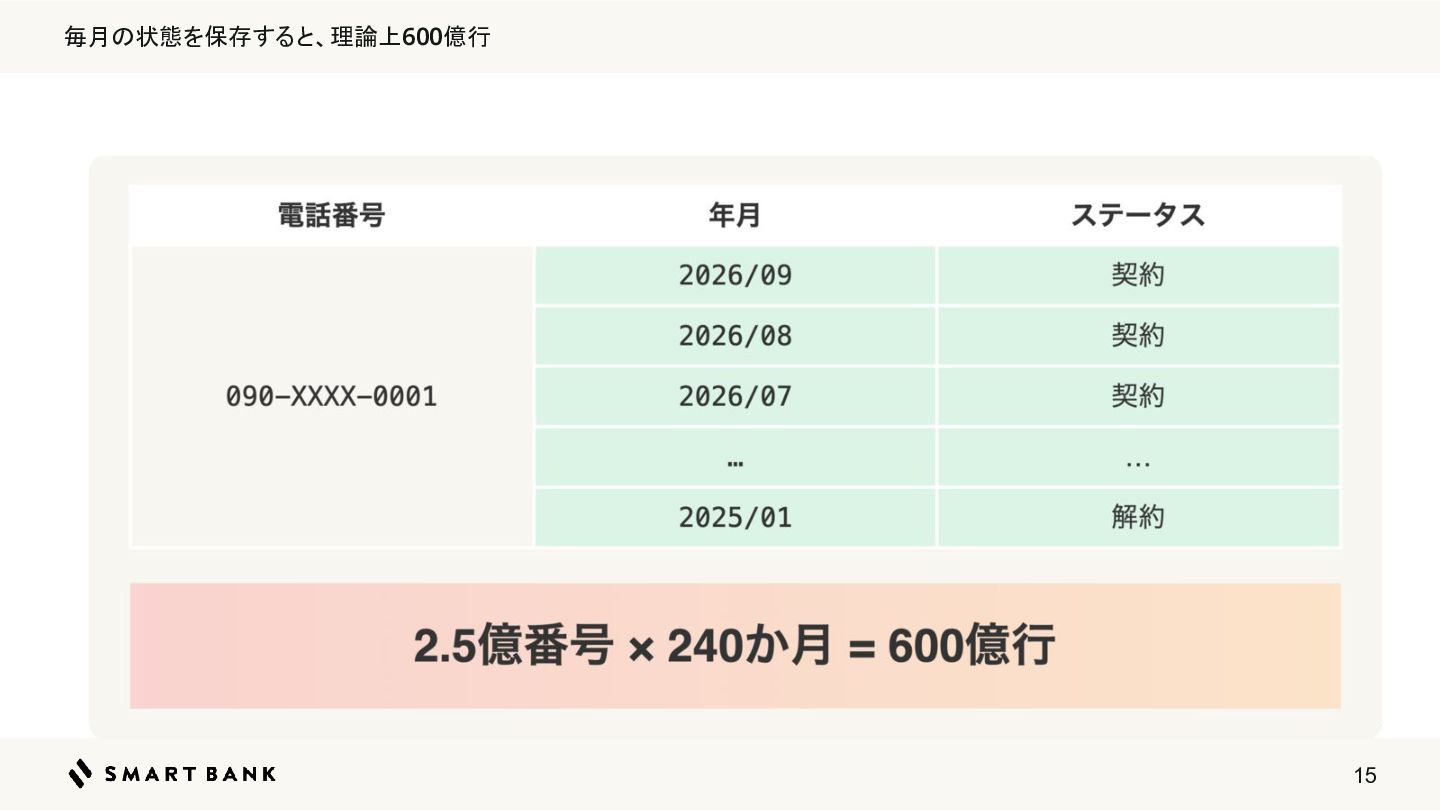
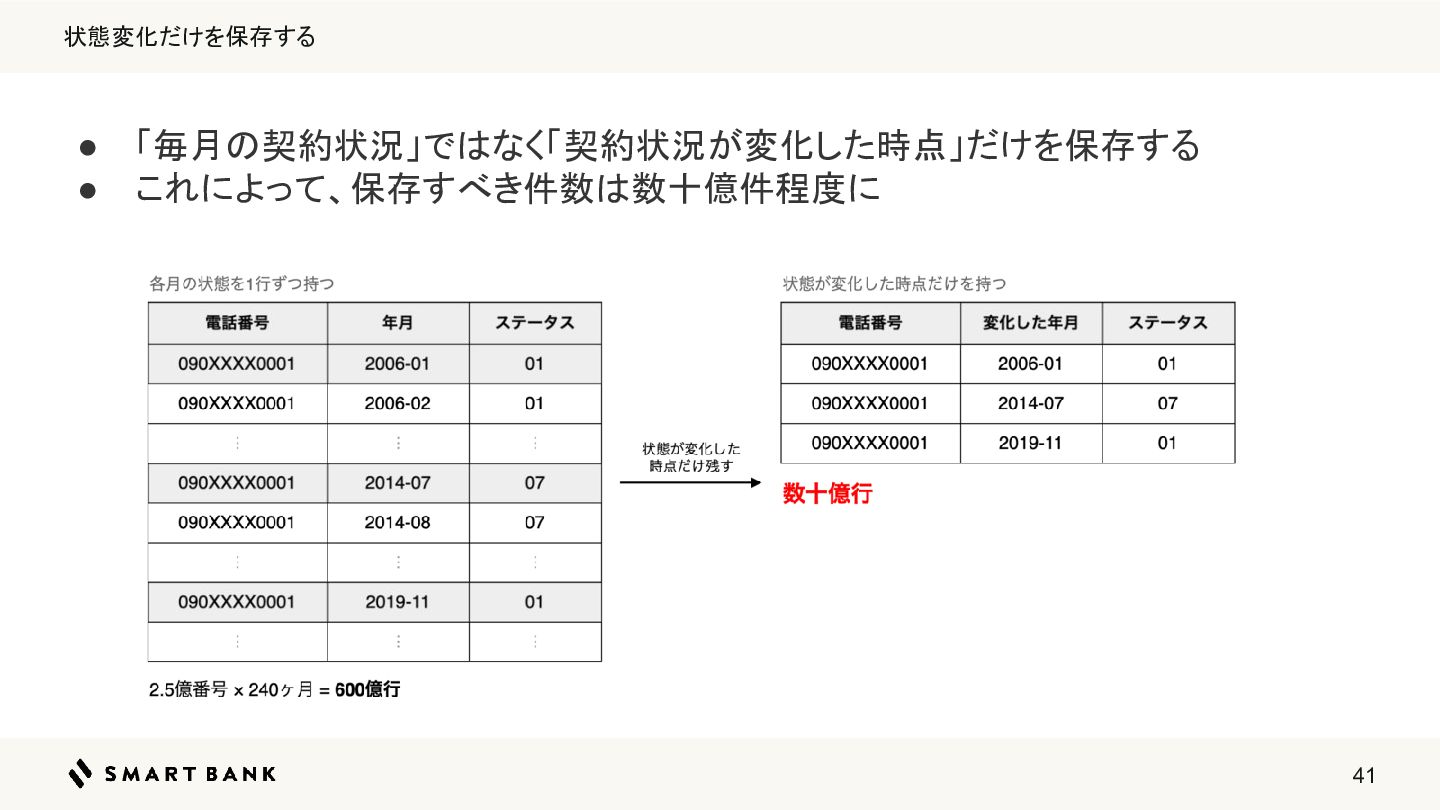
毎月の状態を保存すると、理論上600億行 15
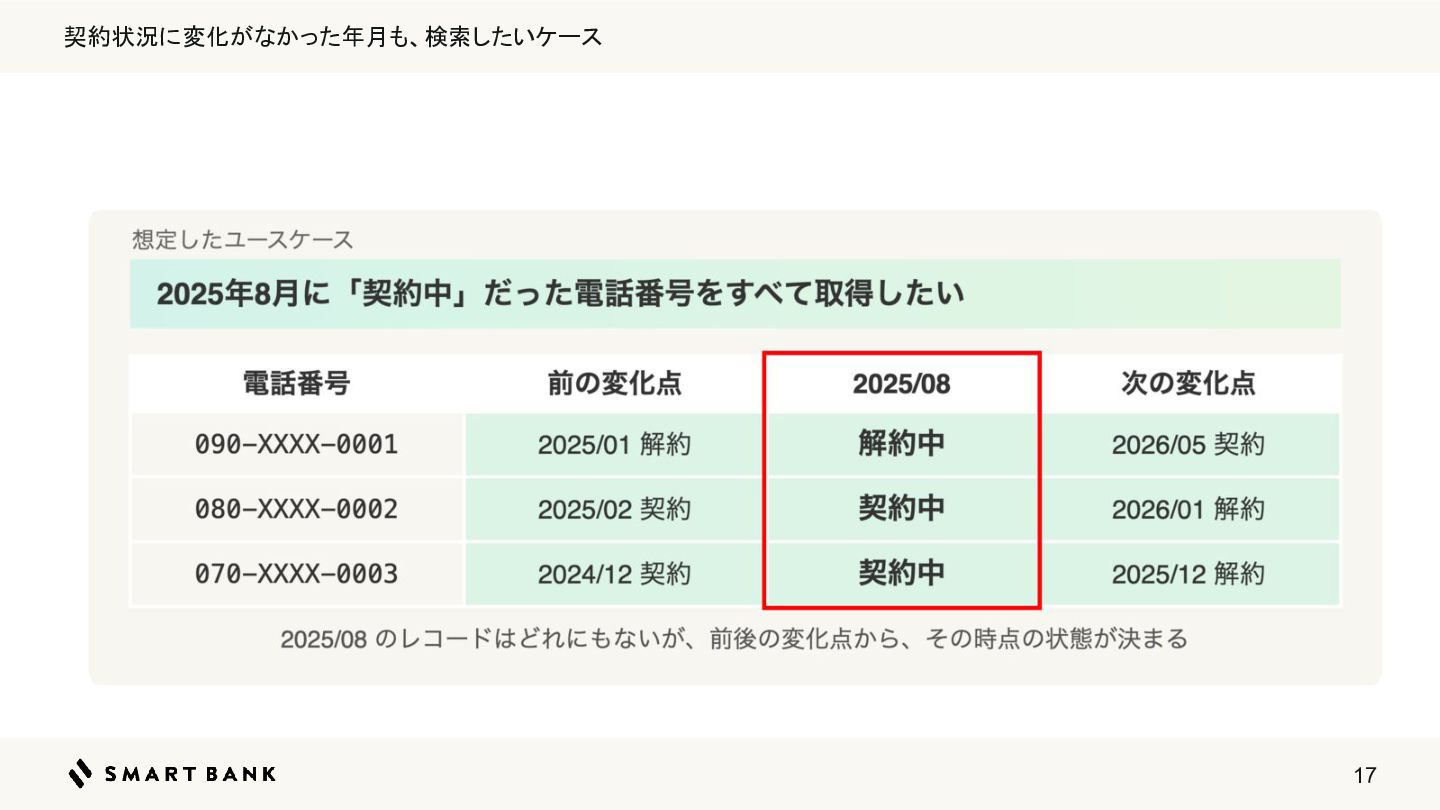
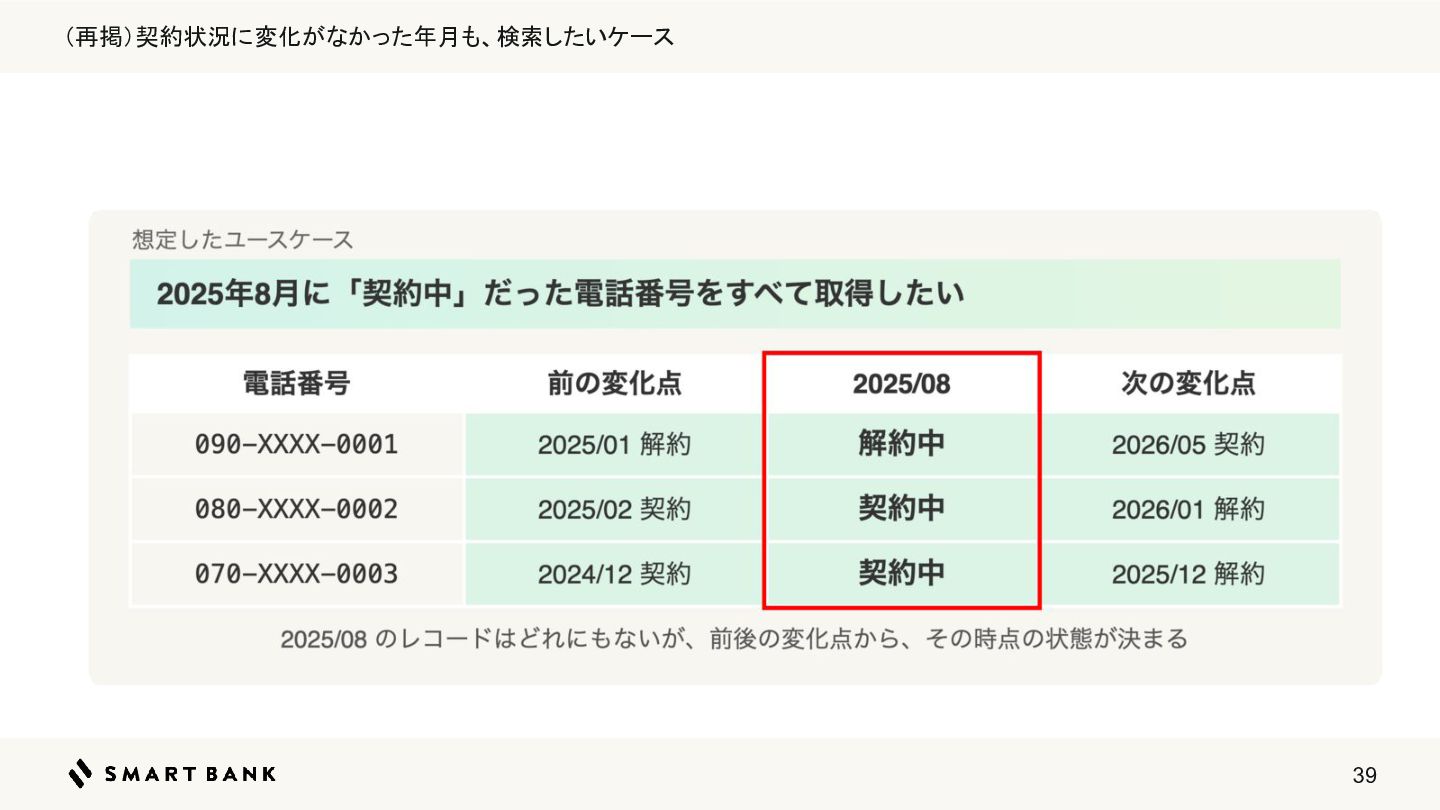
600億件保存する必要はあるのか? 契約状況が変化していない年月のデータも必要なケースを考える 16
契約状況に変化がなかった年月も、検索したいケース 17
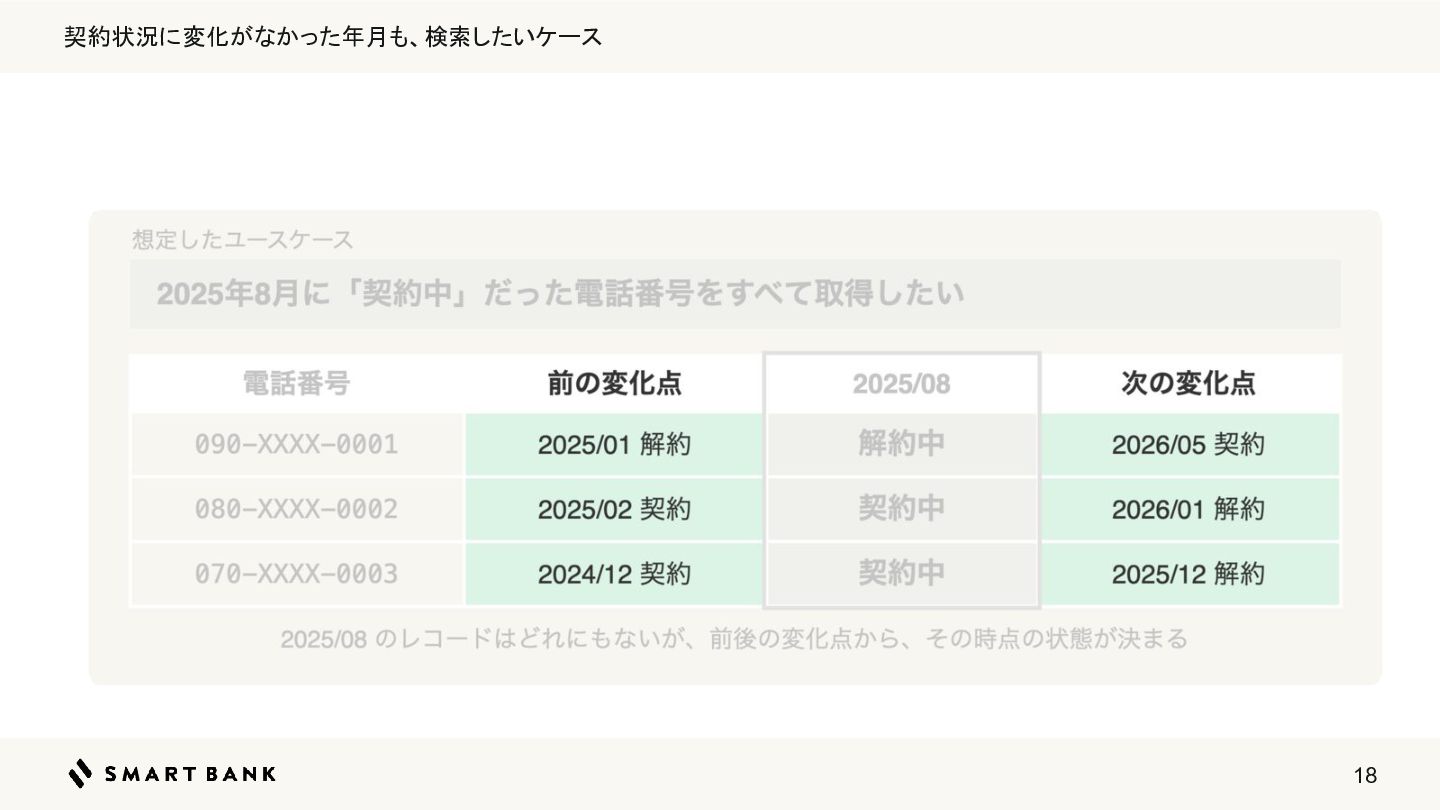
契約状況に変化がなかった年月も、検索したいケース 18
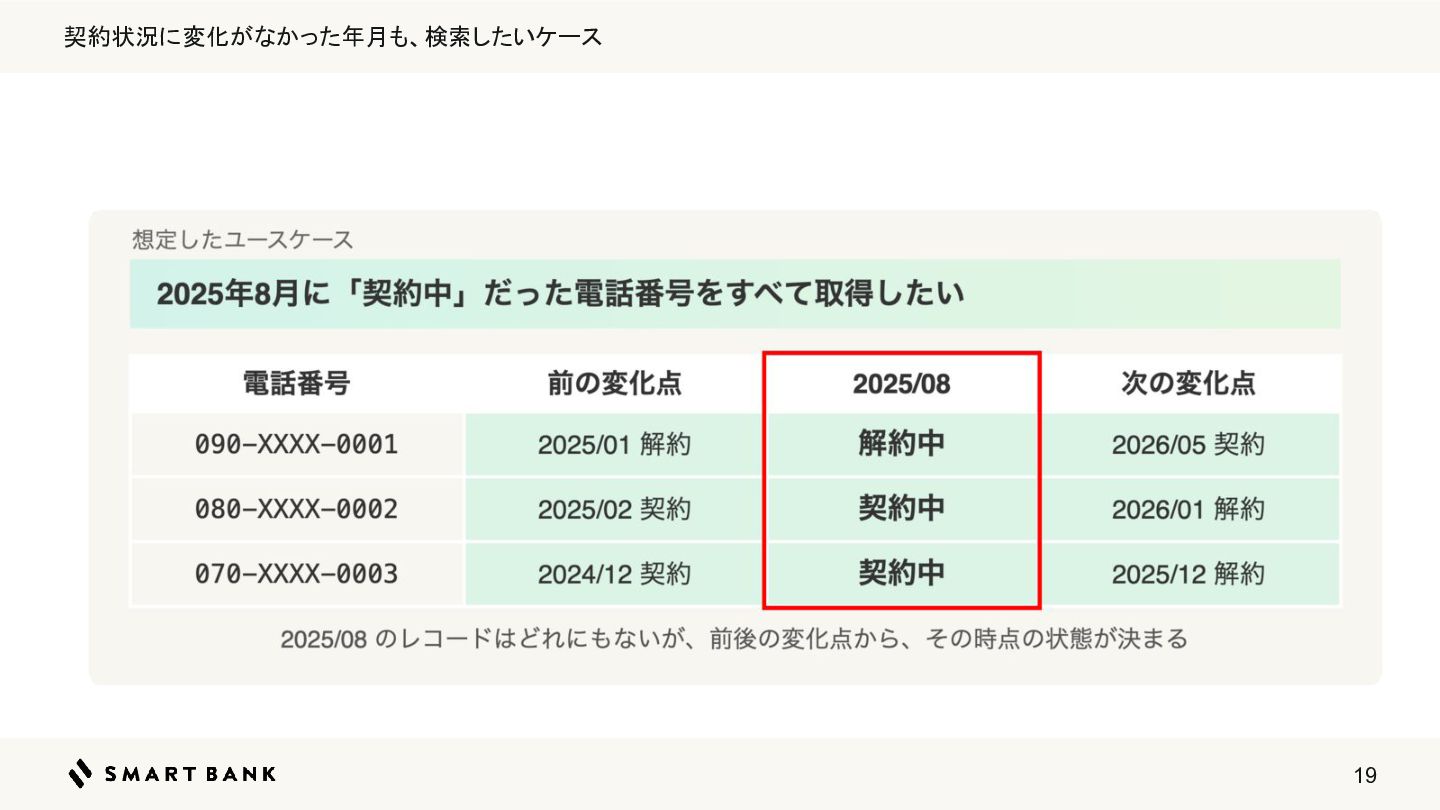
契約状況に変化がなかった年月も、検索したいケース 19
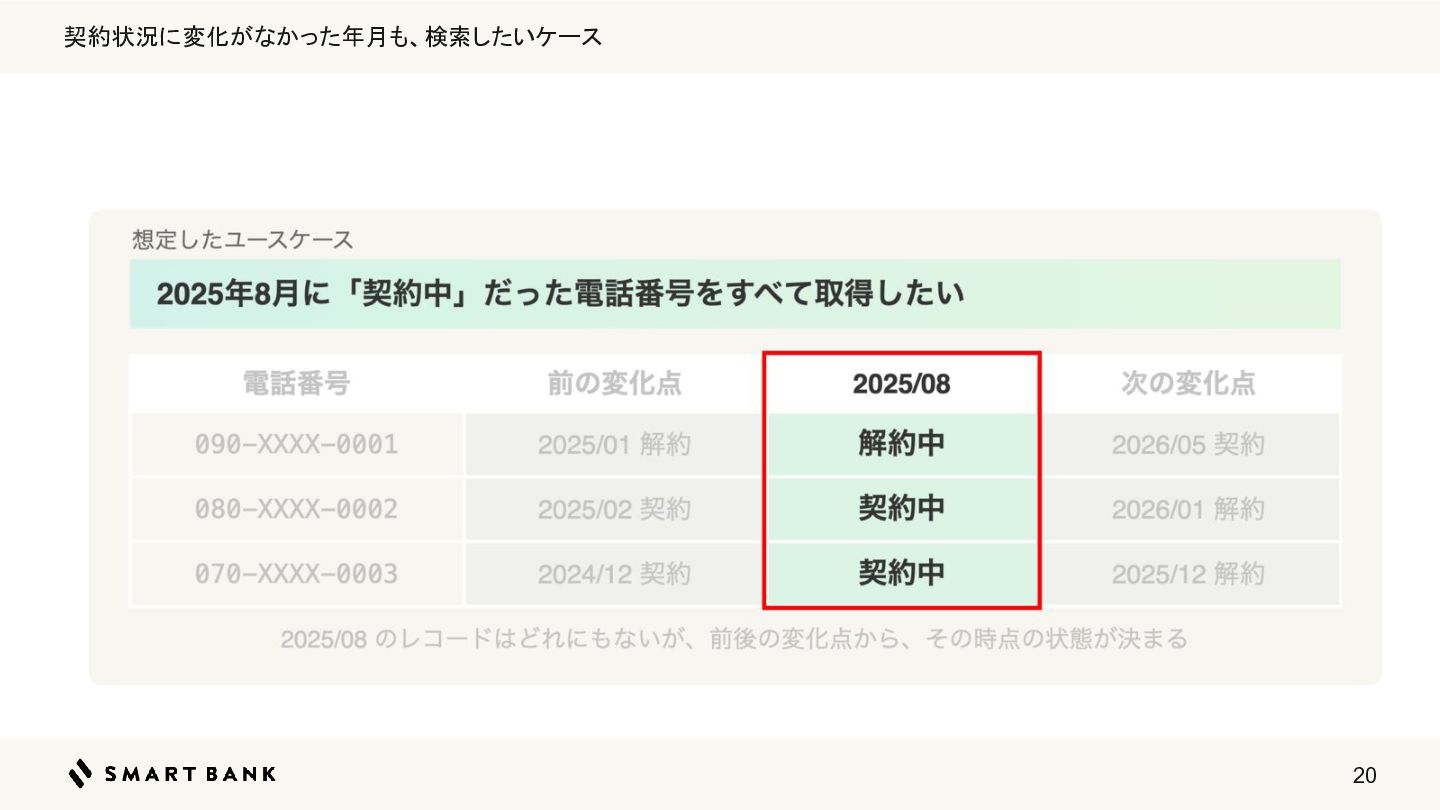
契約状況に変化がなかった年月も、検索したいケース 20
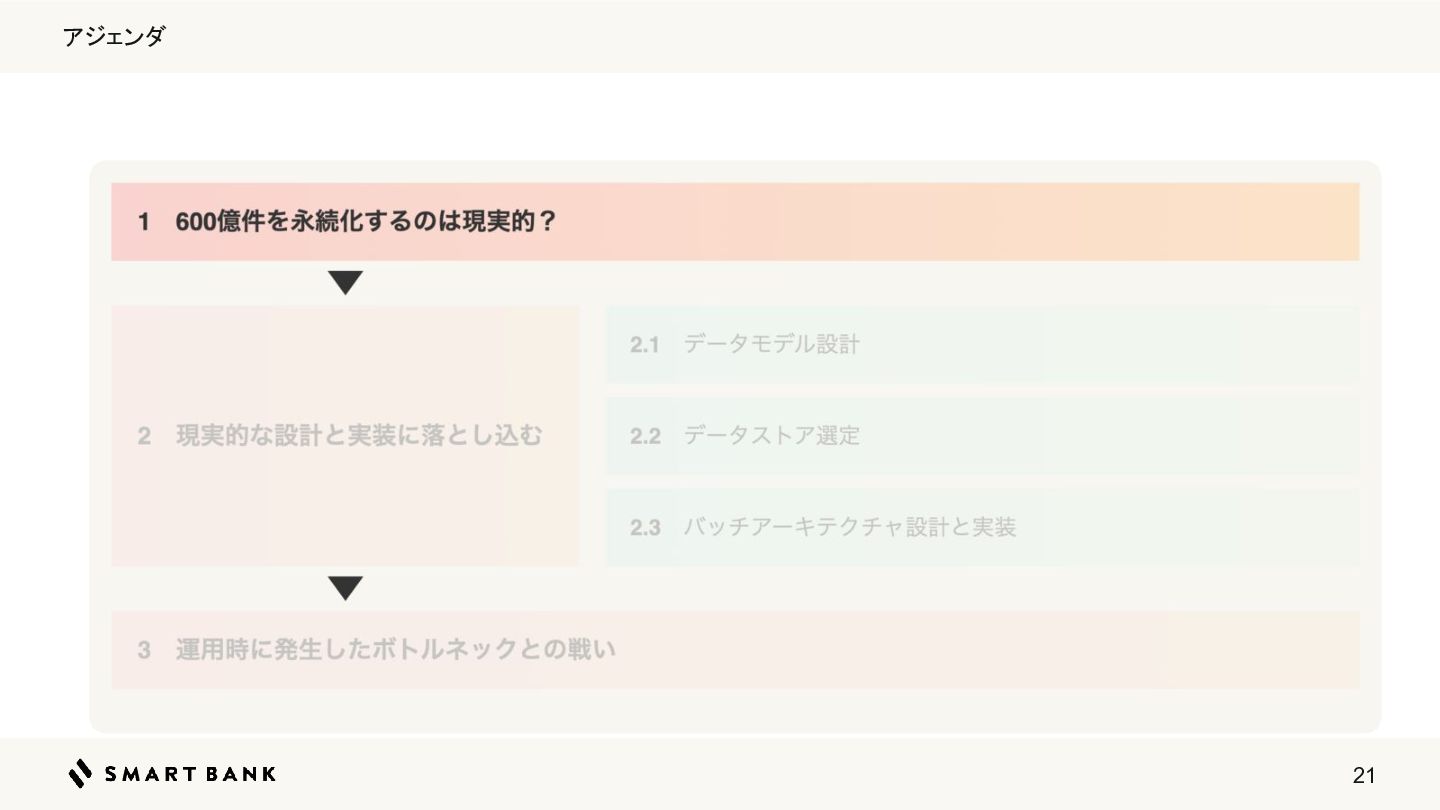
アジェンダ 21
1. 600億件を永続化するのは現実的?🤔 22
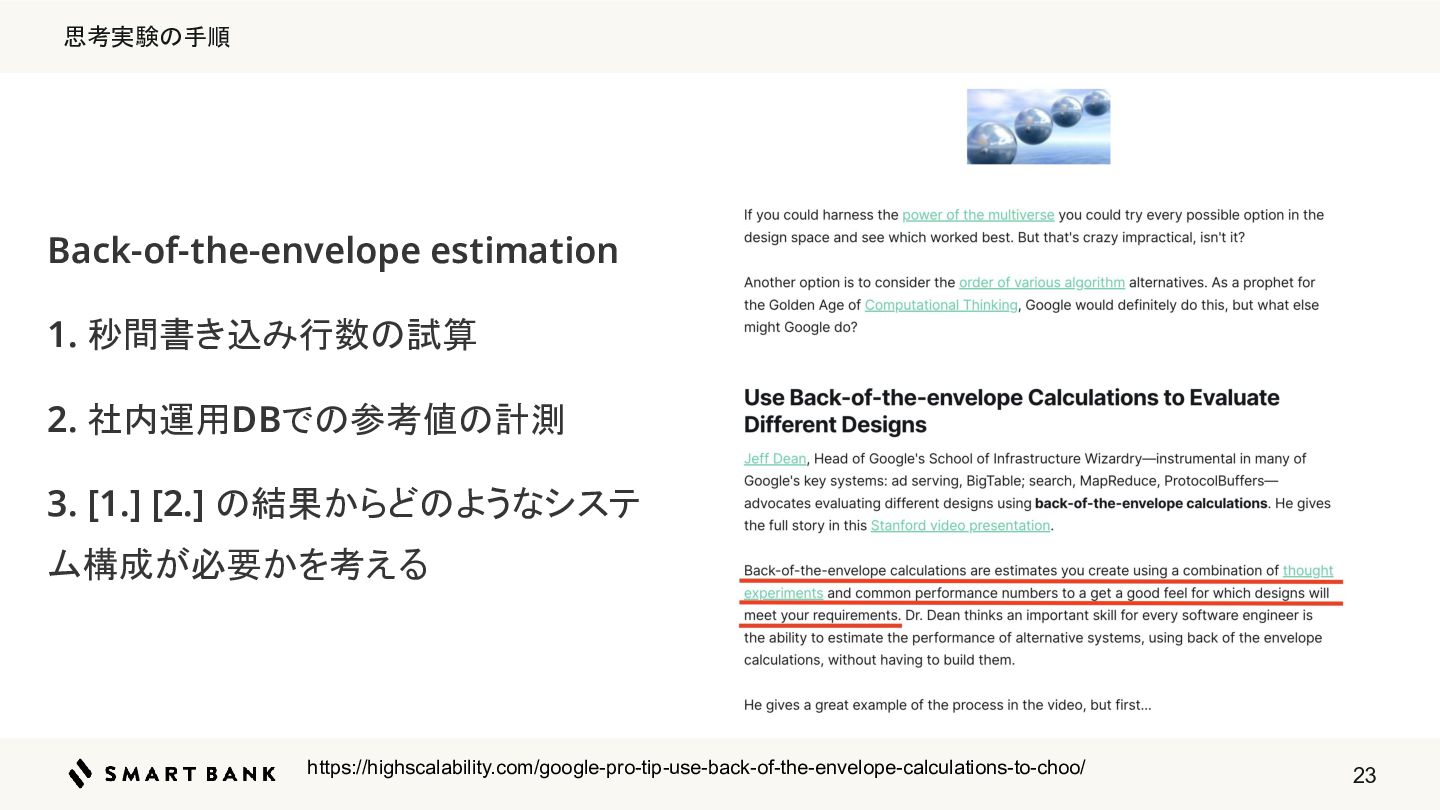
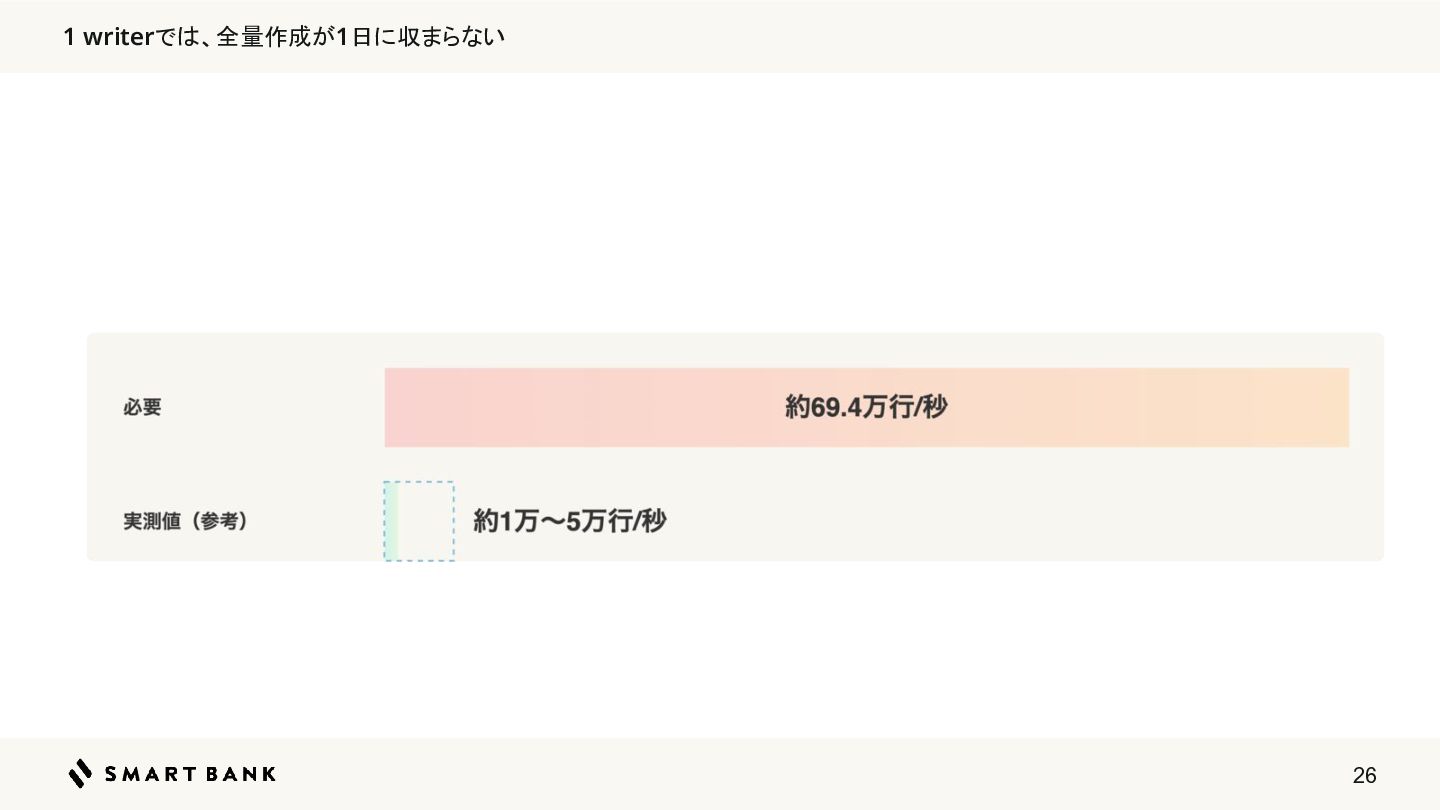
思考実験の手順 Back-of-the-envelope estimation 1. 秒間書き込み行数の試算 2. 社内運用DBでの参考値の計測 3. [1.] [2.]
の結果からどのようなシステ ム構成が必要かを考える https://highscalability.com/google-pro-tip-use-back-of-the-envelope-calculations-to-choo/ 23
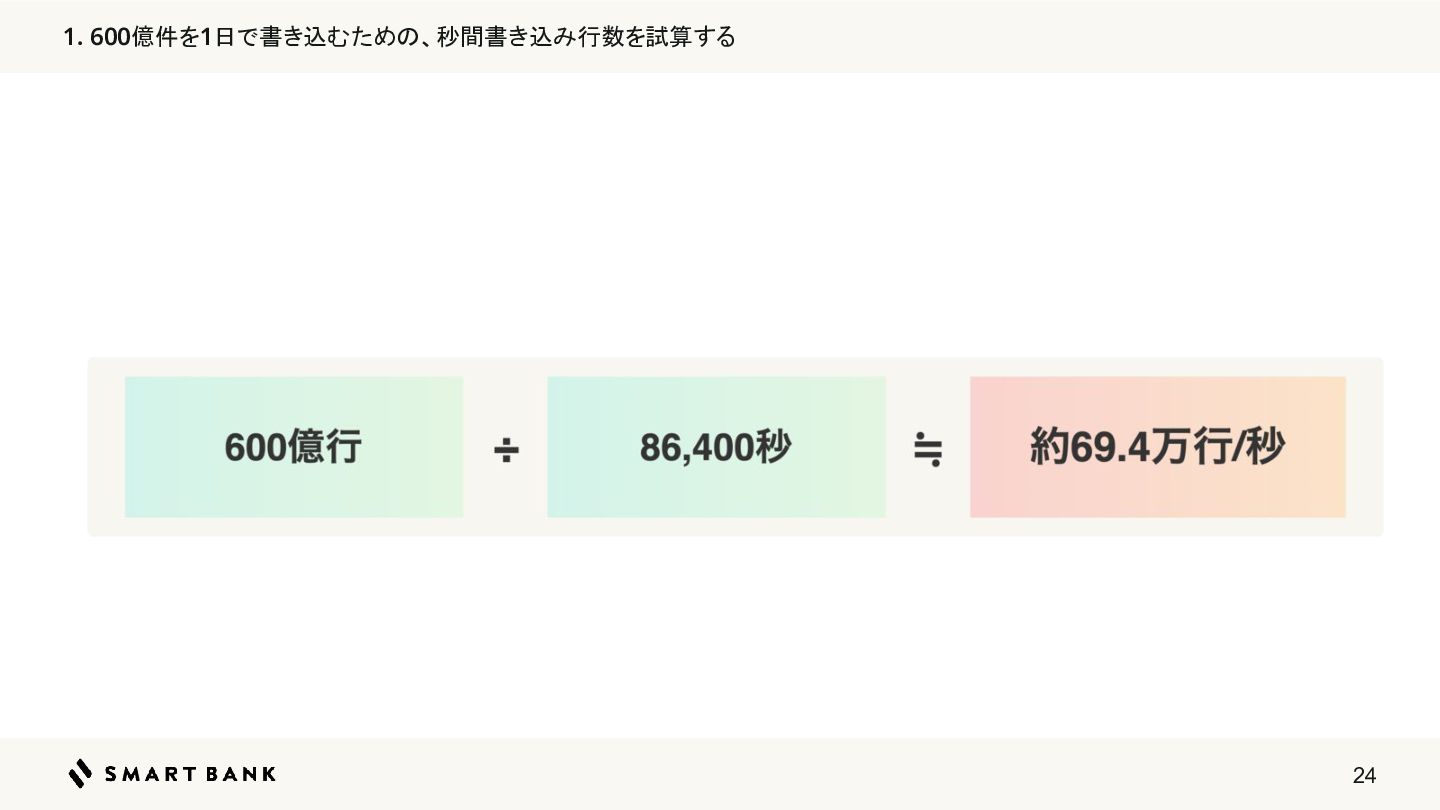
1. 600億件を1日で書き込むための、秒間書き込み行数を試算する 24
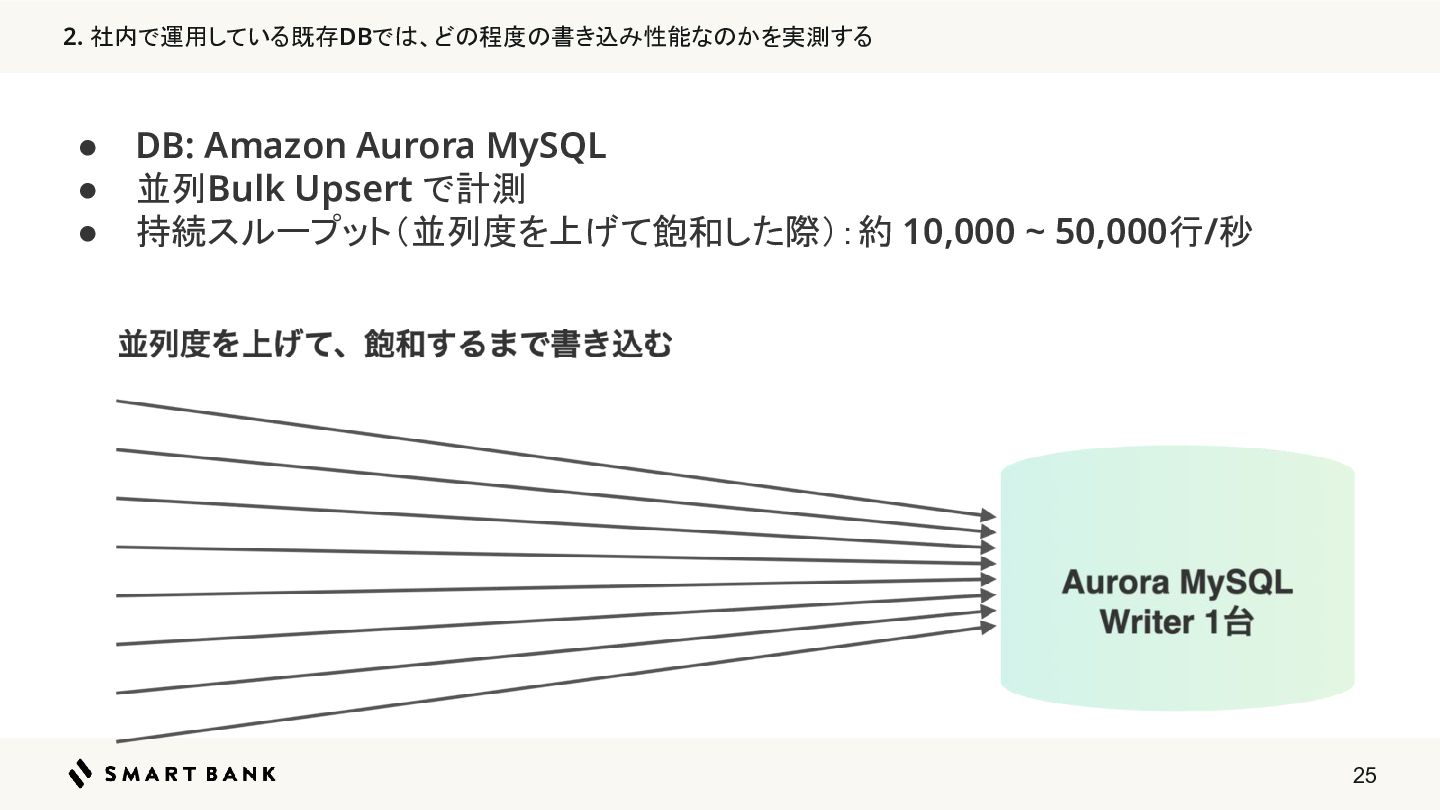
2. 社内で運用している既存DBでは、どの程度の書き込み性能なのかを実測する • • • DB: Amazon Aurora MySQL 並列Bulk
Upsert で計測 持続スループット(並列度を上げて飽和した際):約 10,000 ~ 50,000行/秒 25
1 writerでは、全量作成が1日に収まらない 26
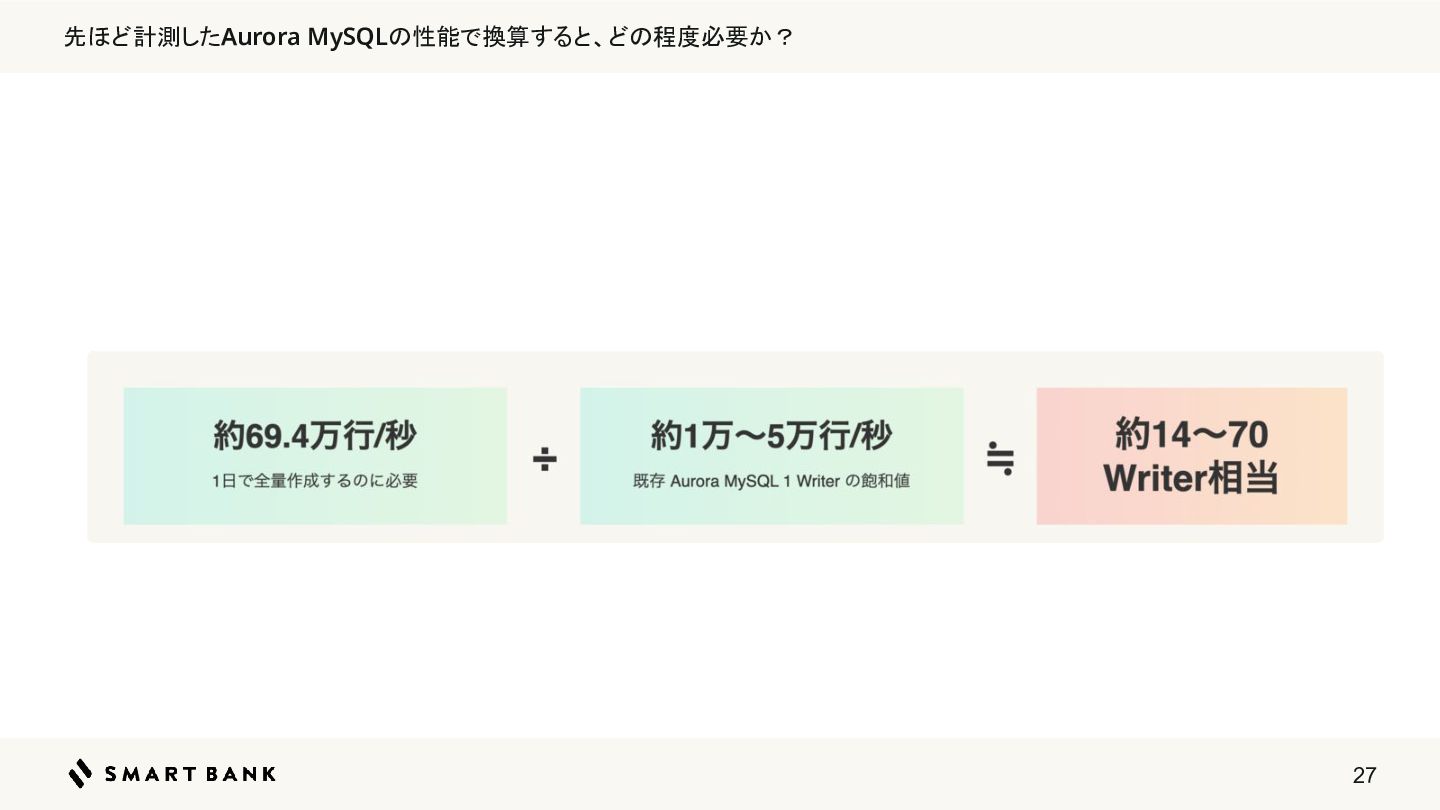
先ほど計測したAurora MySQLの性能で換算すると、どの程度必要か? 27
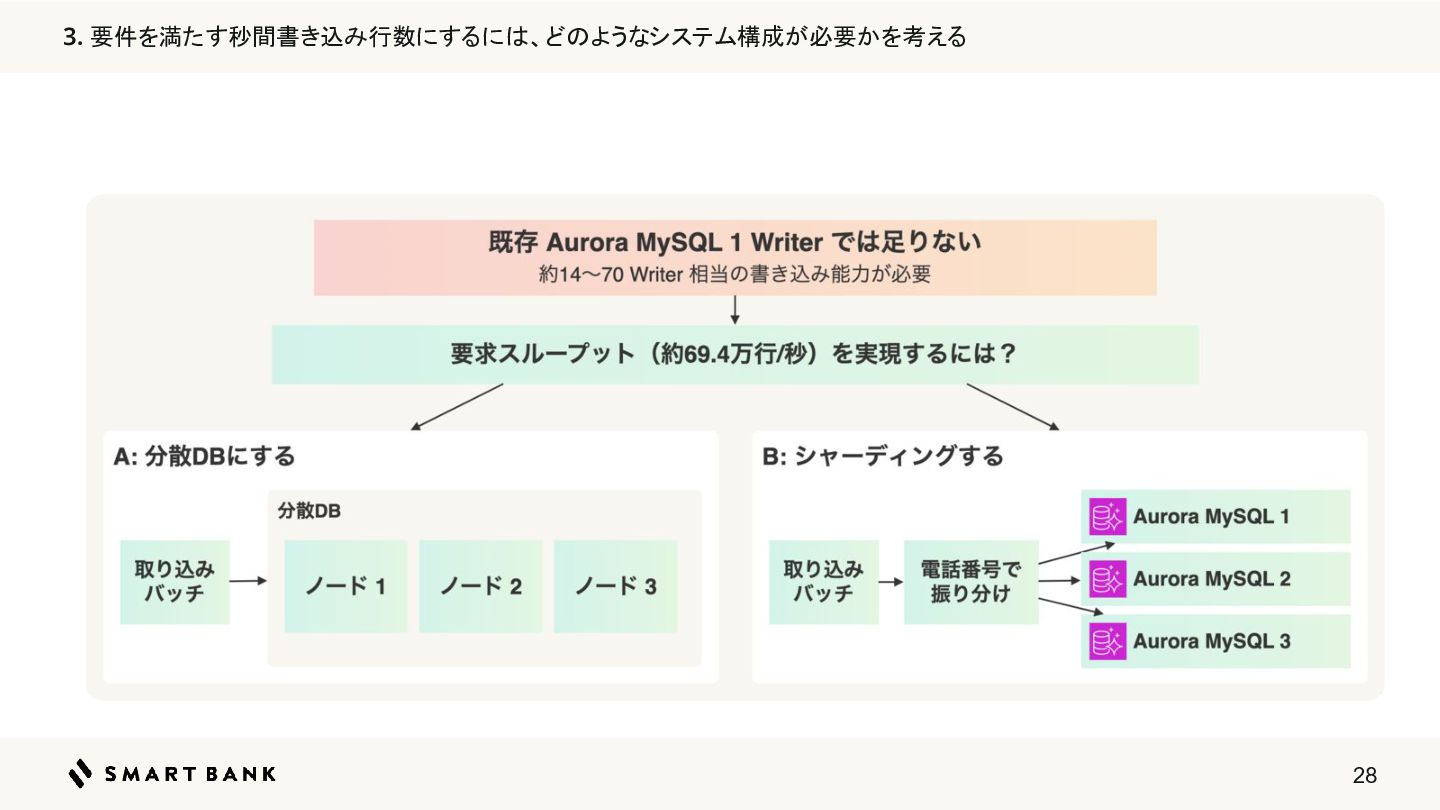
3. 要件を満たす秒間書き込み行数にするには、どのようなシステム構成が必要かを考える 28
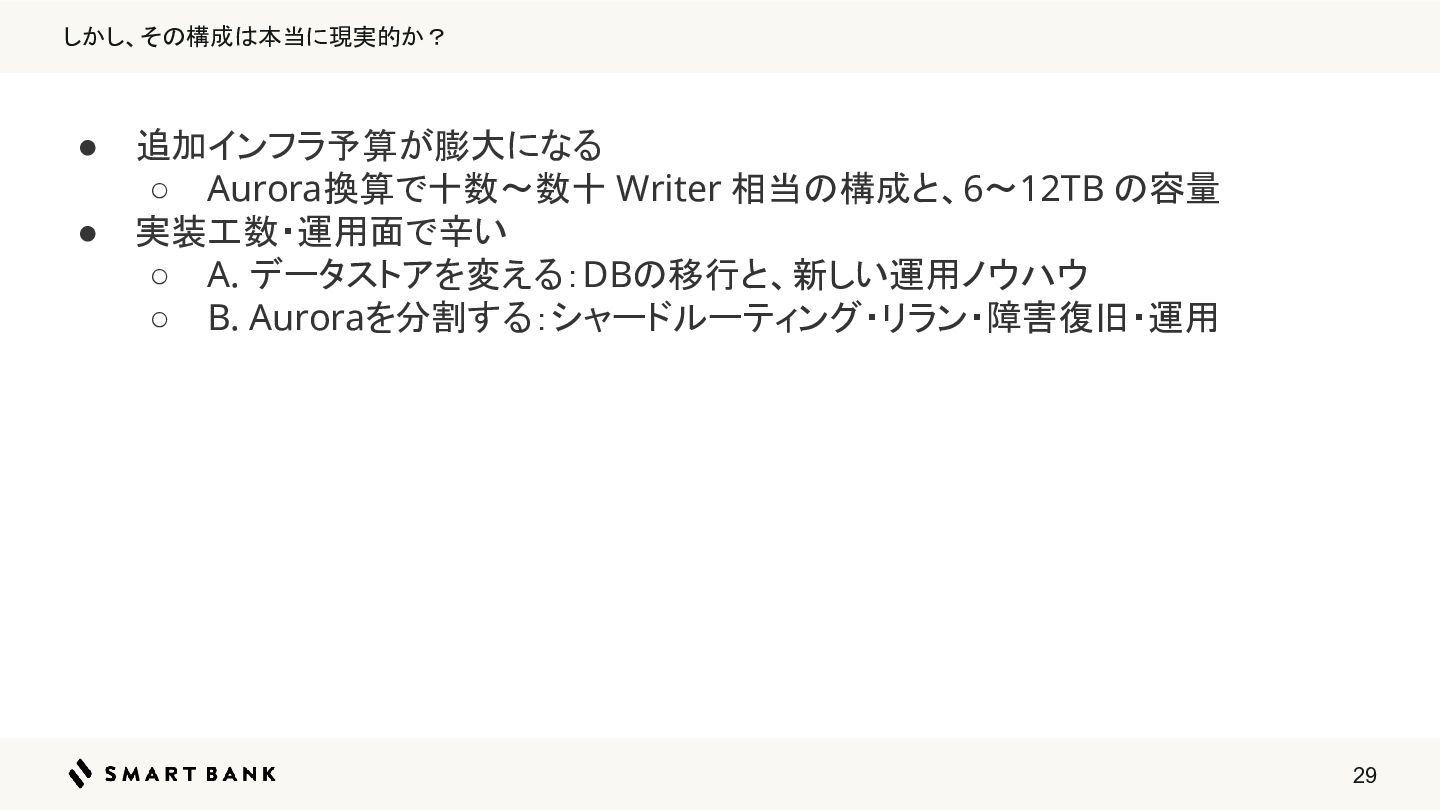
しかし、その構成は本当に現実的か? • • 追加インフラ予算が膨大になる ◦ Aurora換算で十数〜数十 Writer 相当の構成と、6〜12TB の容量 実装工数・運用面で辛い
◦ A. データストアを変える:DBの移行と、新しい運用ノウハウ ◦ B. Auroraを分割する:シャードルーティング・リラン・障害復旧・運用 29
うーん、現実的じゃないな・・・🤯 30
一度冷静になって、 要件から見直そう🧘🧘 31
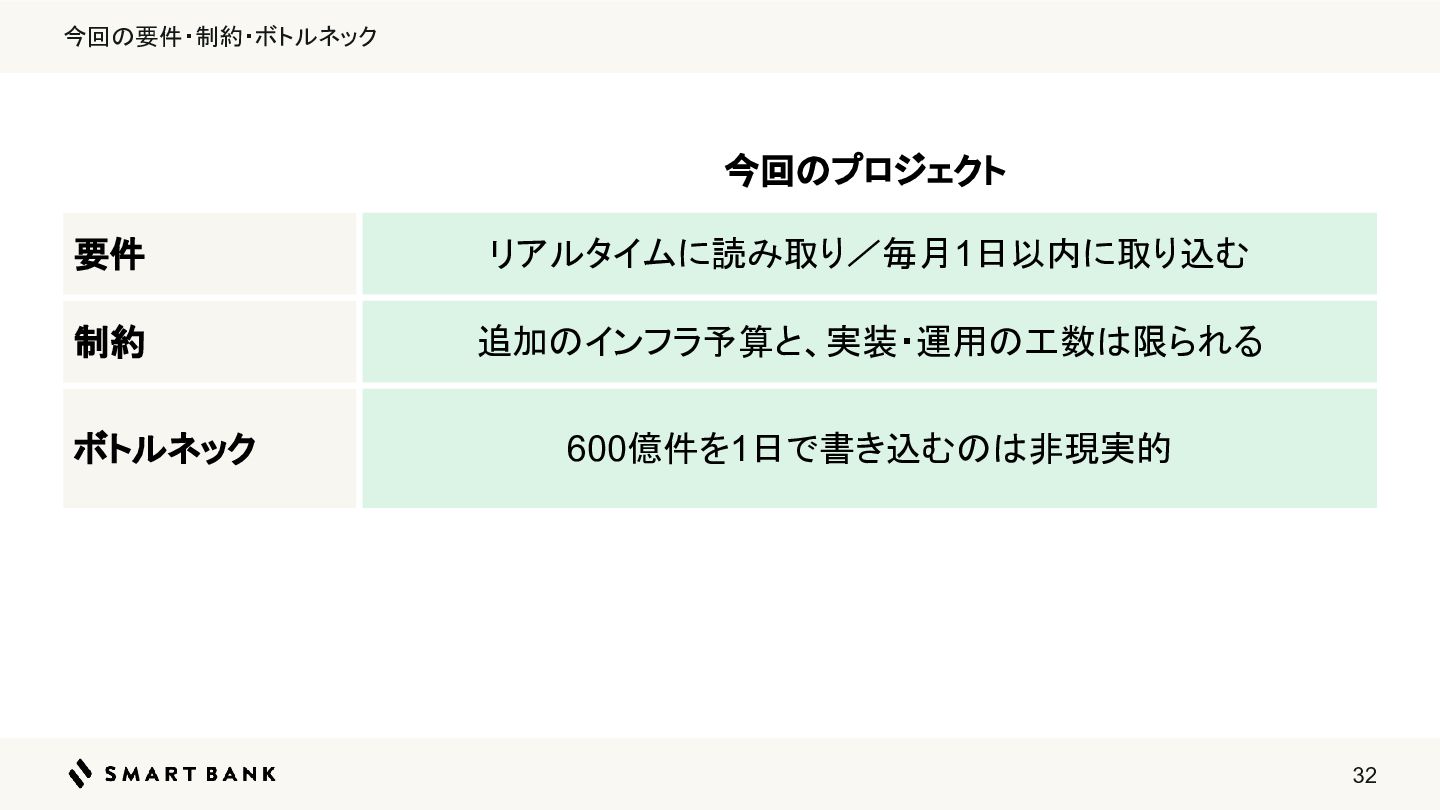
今回の要件・制約・ボトルネック 今回のプロジェクト 要件 リアルタイムに読み取り/毎月1日以内に取り込む 制約 追加のインフラ予算と、実装・運用の工数は限られる ボトルネック 600億件を1日で書き込むのは非現実的 32
2. 現実的な設計と実装に落とし込む 33
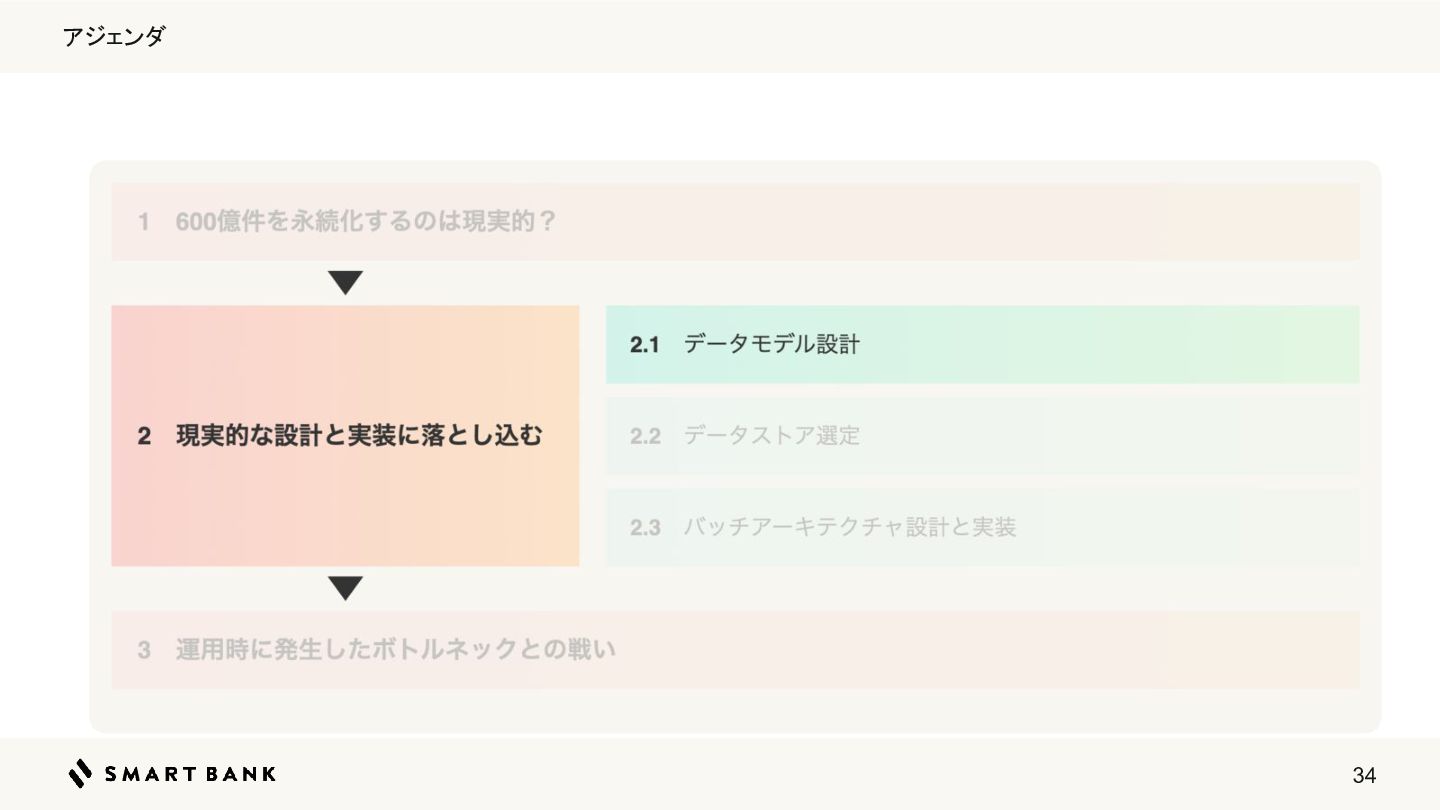
アジェンダ 34
2.1 データモデル設計 35
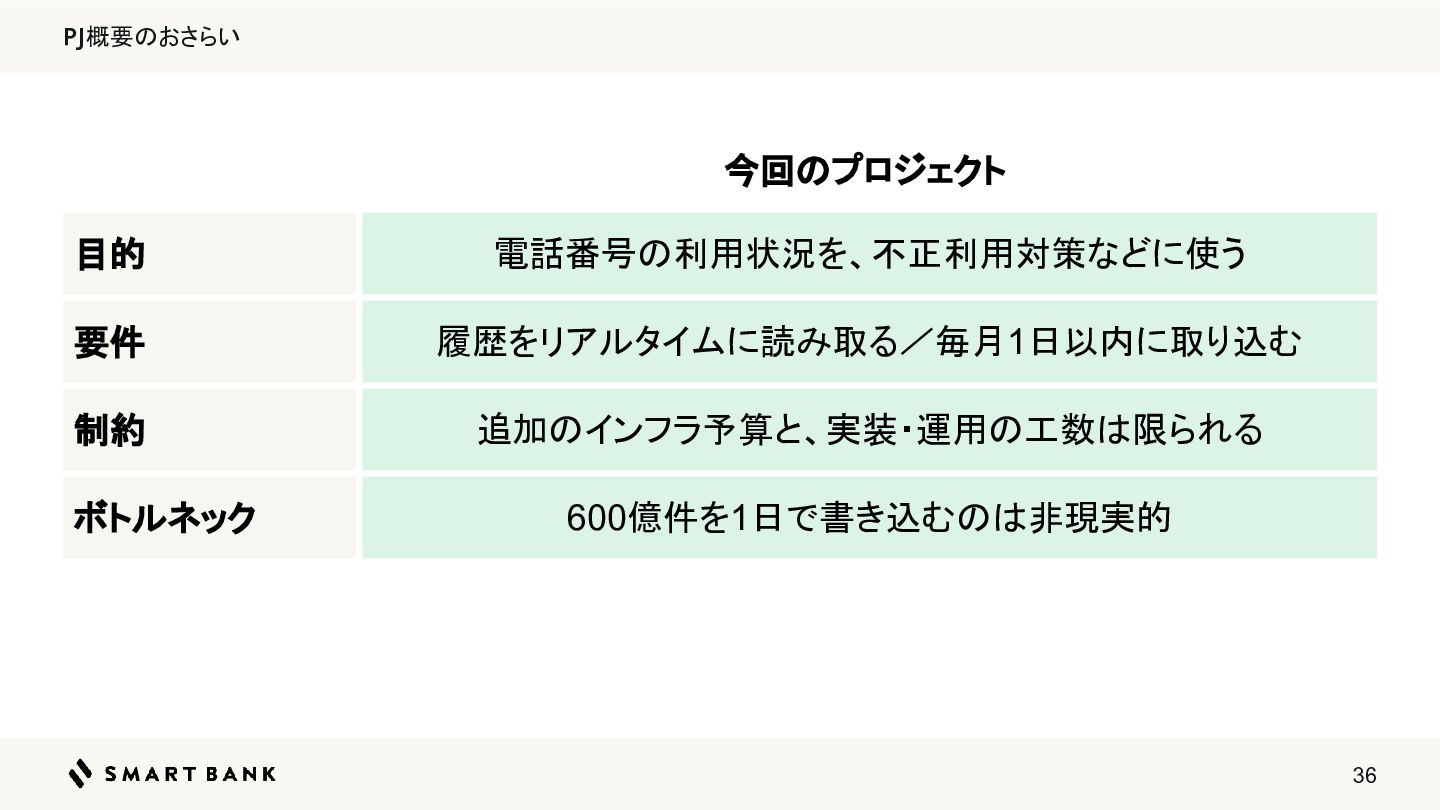
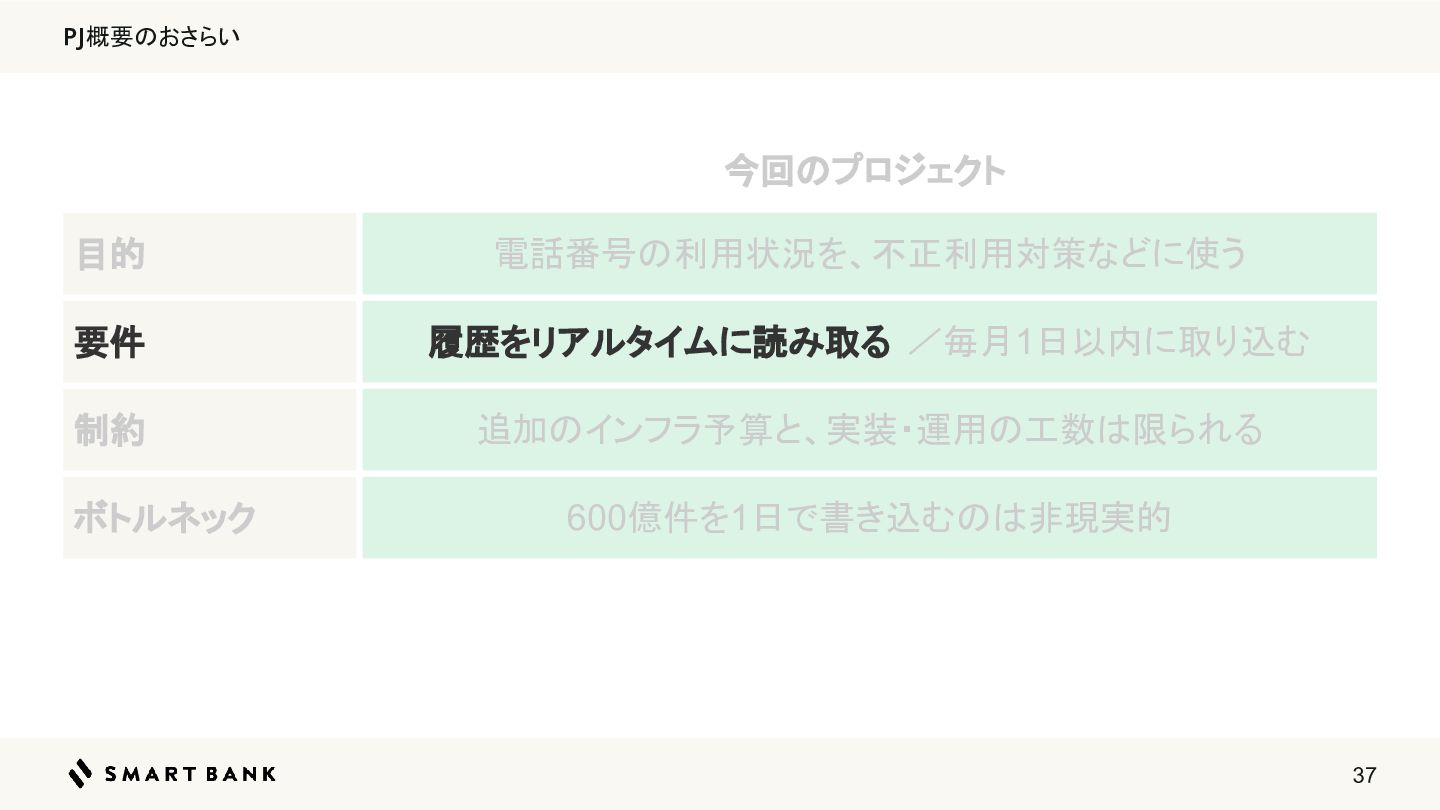
PJ概要のおさらい 今回のプロジェクト 目的 電話番号の利用状況を、不正利用対策などに使う 要件 履歴をリアルタイムに読み取る/毎月1日以内に取り込む 制約 追加のインフラ予算と、実装・運用の工数は限られる ボトルネック 600億件を1日で書き込むのは非現実的
36
PJ概要のおさらい 今回のプロジェクト 目的 電話番号の利用状況を、不正利用対策などに使う 要件 履歴をリアルタイムに読み取る /毎月1日以内に取り込む 制約 追加のインフラ予算と、実装・運用の工数は限られる ボトルネック
600億件を1日で書き込むのは非現実的 37
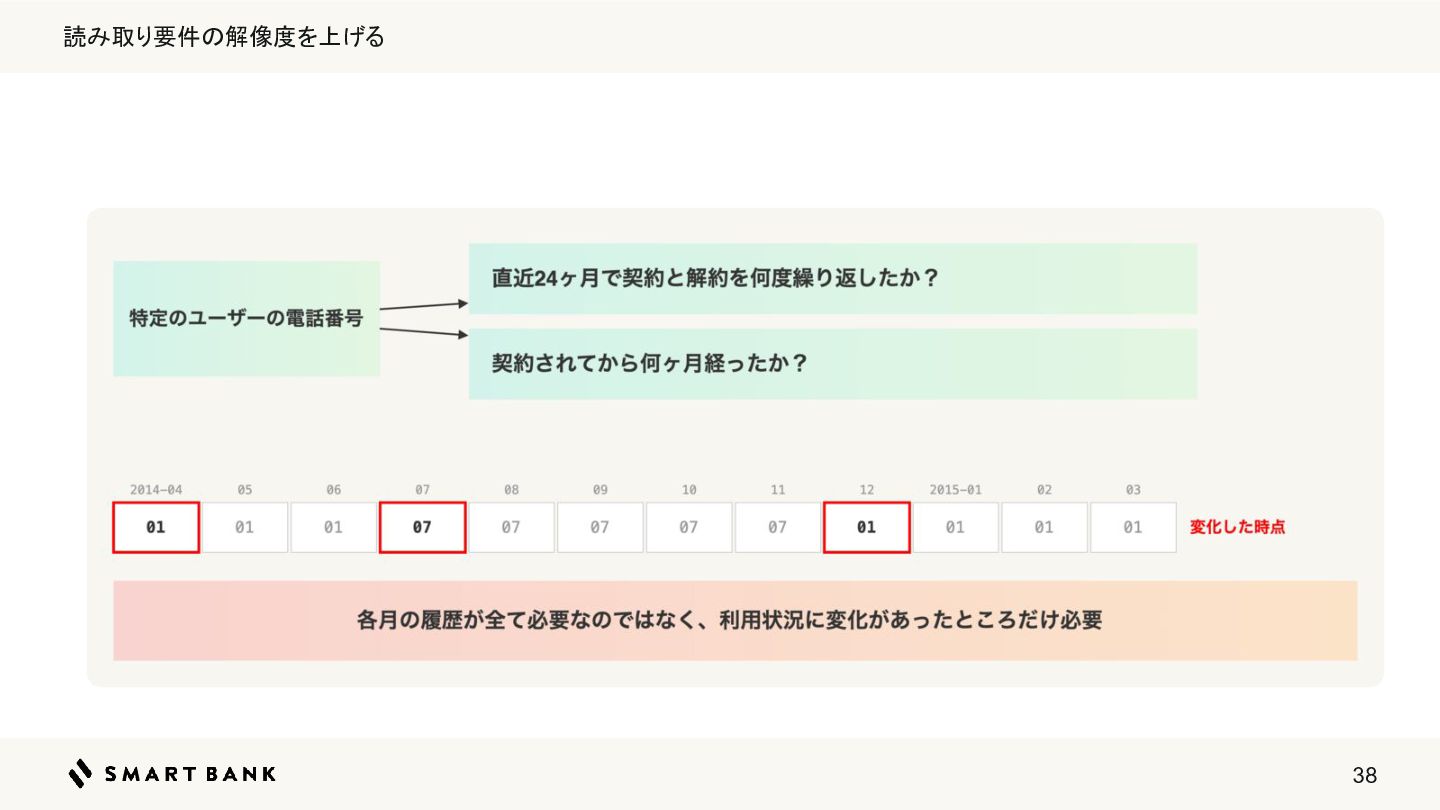
読み取り要件の解像度を上げる 38
(再掲)契約状況に変化がなかった年月も、検索したいケース 39
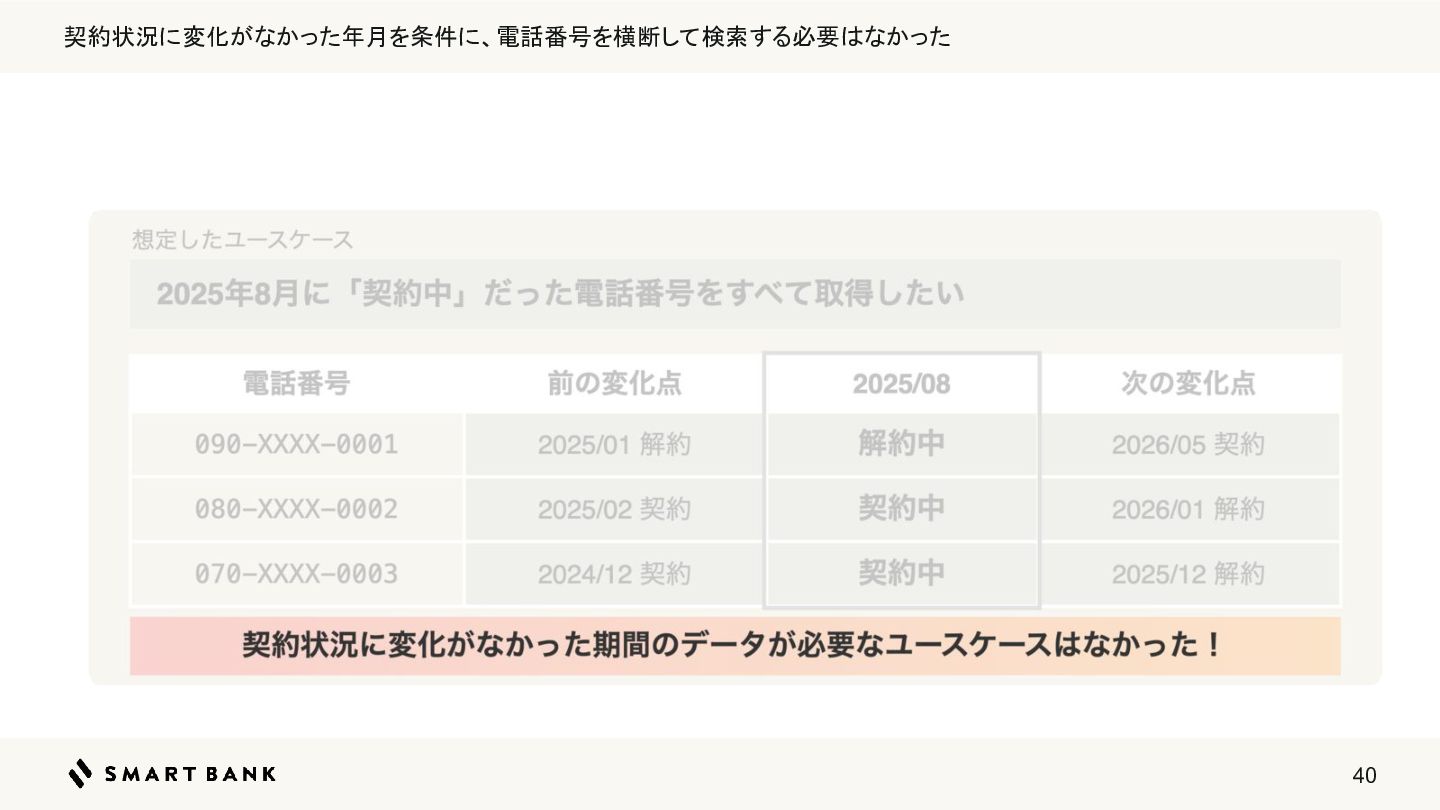
契約状況に変化がなかった年月を条件に、電話番号を横断して検索する必要はなかった 40
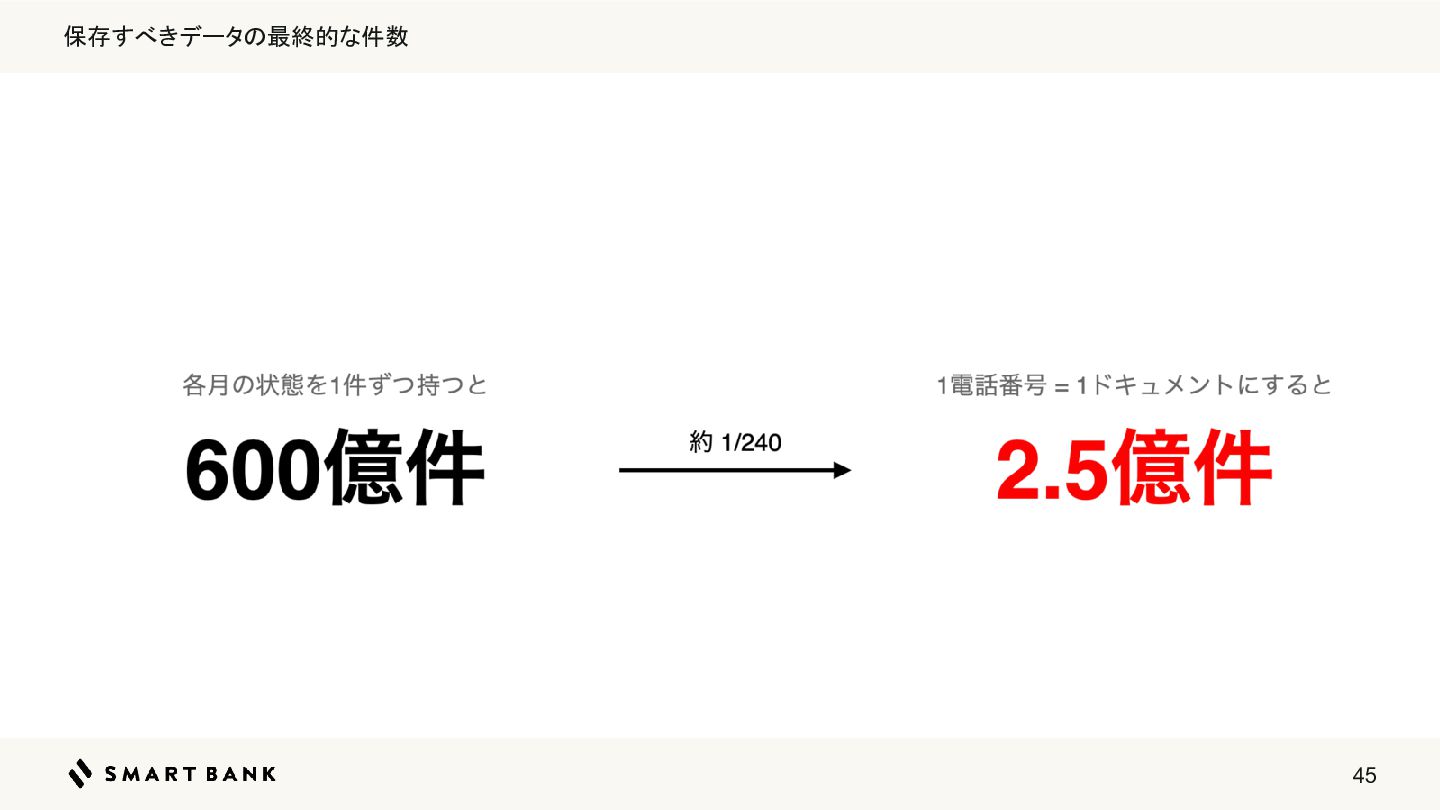
状態変化だけを保存する • • 「毎月の契約状況」ではなく「契約状況が変化した時点」だけを保存する これによって、保存すべき件数は数十億件程度に 41
まだ数十億件なので、さらに削れないか考える 履歴を1件ずつ、独立したレコードとして持つ必要がある? 42
読み取りたい単位から考える • 履歴の年月・ステータスを使って、横断的に検索・集計したいという要件はない → 履歴を1件ずつ、独立したレコードとして持つ必要はない 43
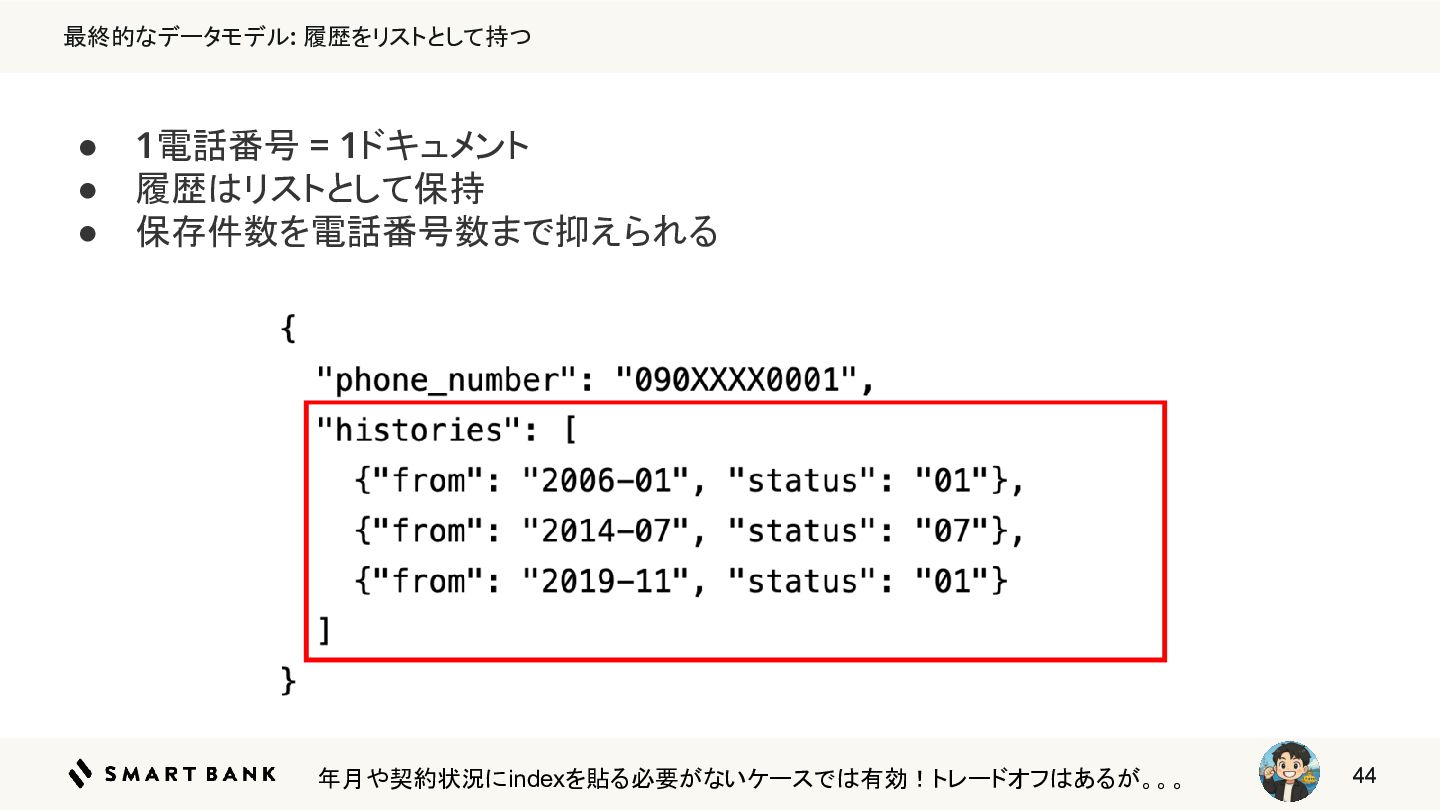
最終的なデータモデル: 履歴をリストとして持つ • • • 1電話番号 = 1ドキュメント 履歴はリストとして保持 保存件数を電話番号数まで抑えられる
年月や契約状況にindexを貼る必要がないケースでは有効!トレードオフはあるが。。。 44
保存すべきデータの最終的な件数 45
2.5億件の永続化は、現実的か? 46
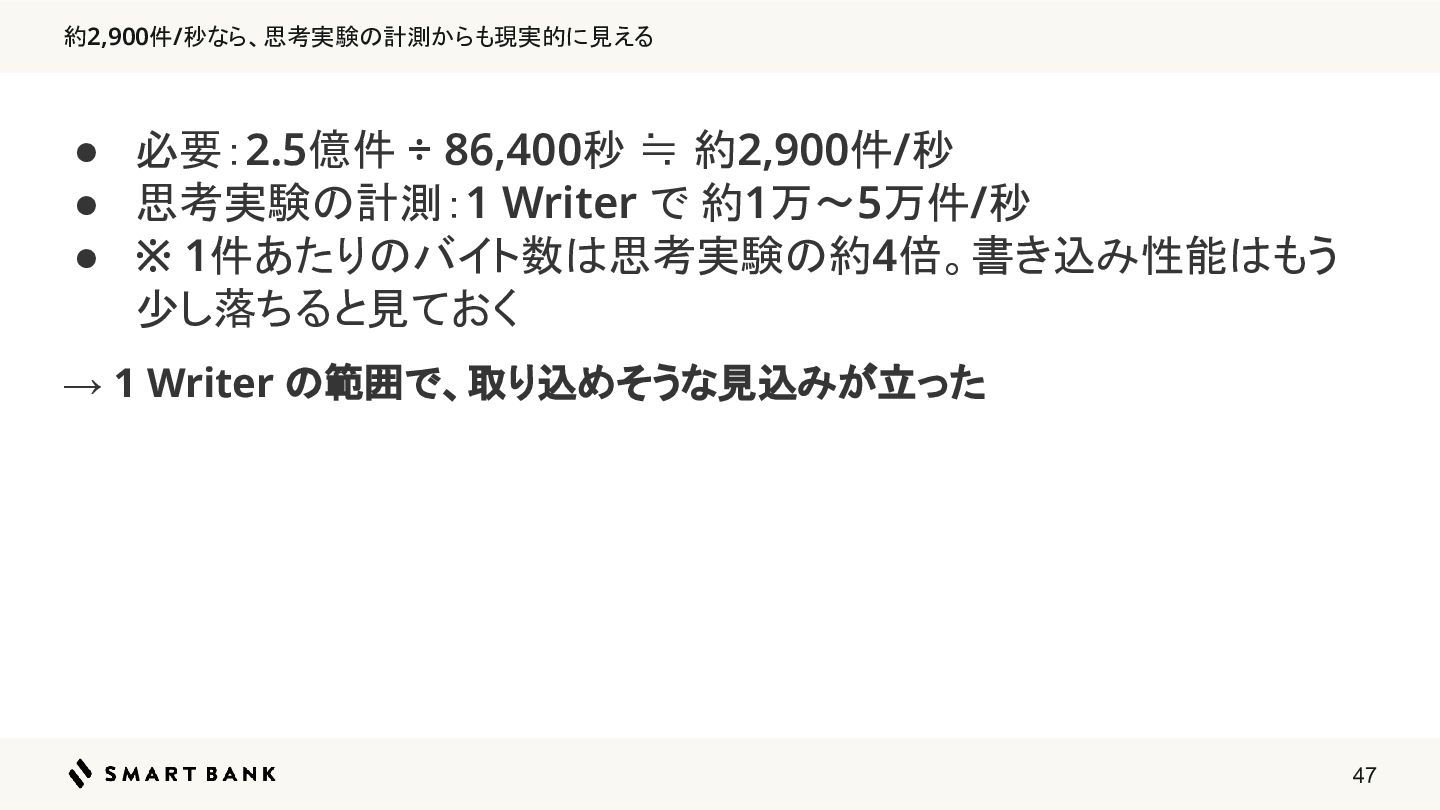
約2,900件/秒なら、思考実験の計測からも現実的に見える • 必要:2.5億件 ÷ 86,400秒 ≒ 約2,900件/秒 • 思考実験の計測:1 Writer
で 約1万〜5万件/秒 • ※ 1件あたりのバイト数は思考実験の約4倍。書き込み性能はもう 少し落ちると見ておく → 1 Writer の範囲で、取り込めそうな見込みが立った 47
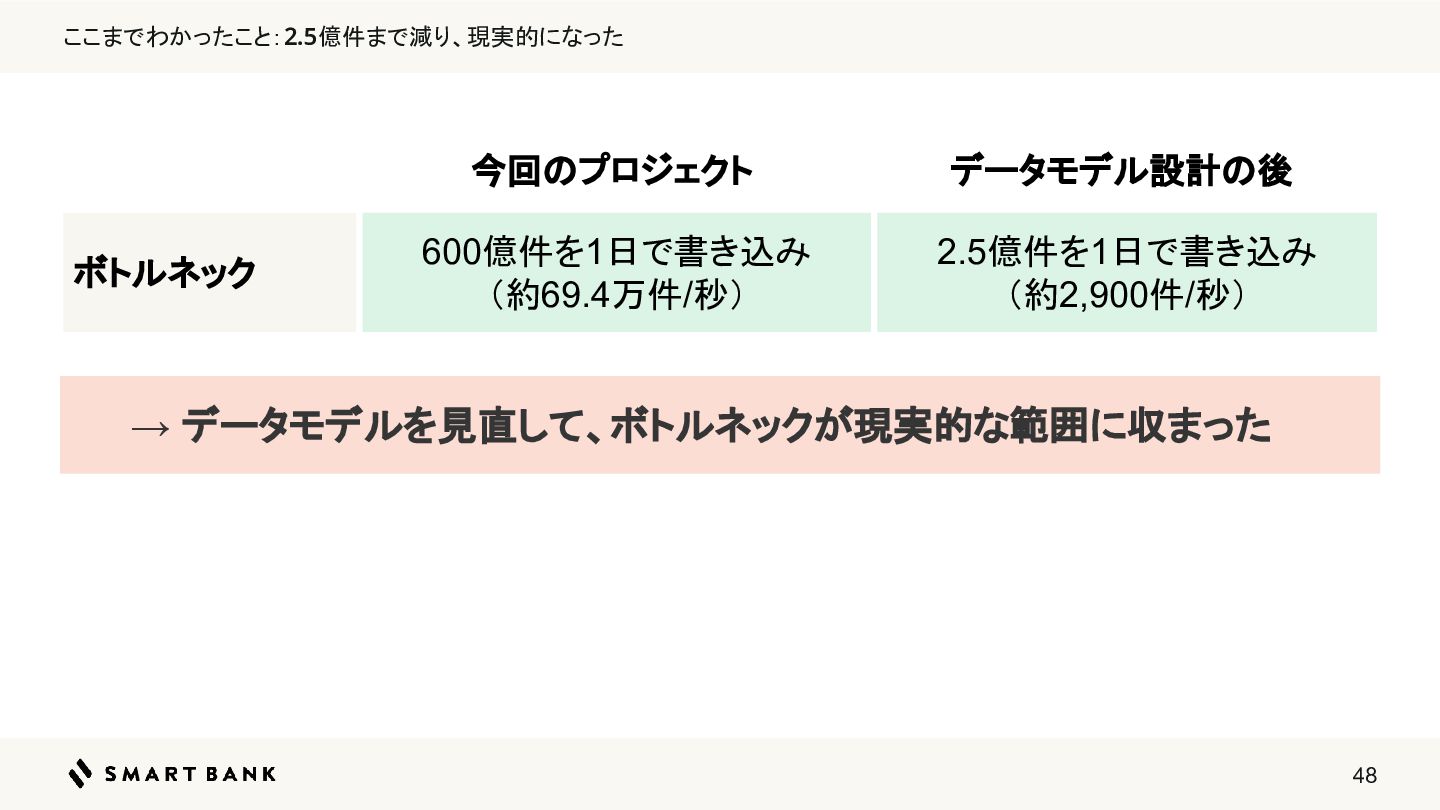
ここまでわかったこと:2.5億件まで減り、現実的になった ボトルネック 今回のプロジェクト データモデル設計の後 600億件を1日で書き込み (約69.4万件/秒) 2.5億件を1日で書き込み (約2,900件/秒) → データモデルを見直して、ボトルネックが現実的な範囲に収まった
48
アジェンダ 49
2.2 データストア選定 50
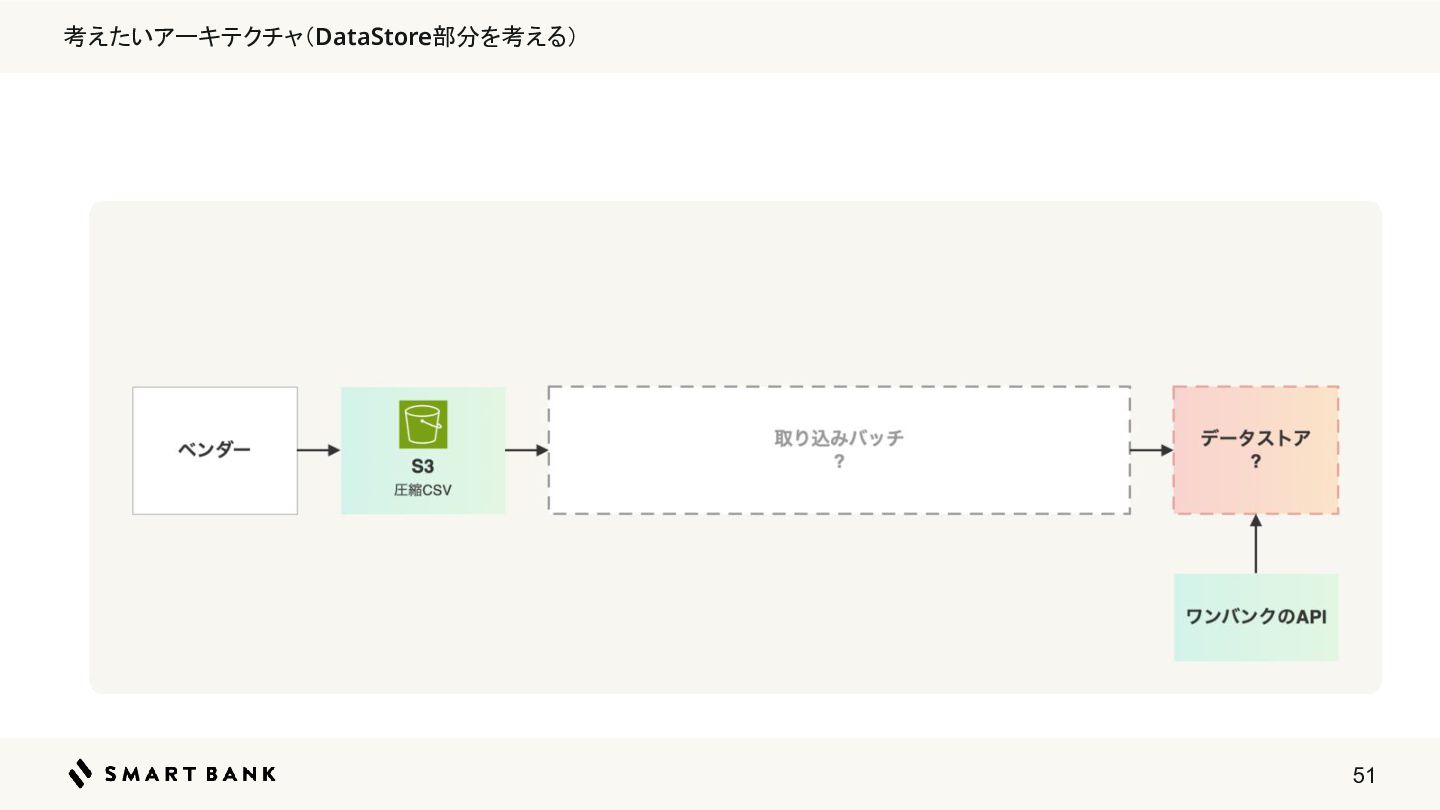
考えたいアーキテクチャ(DataStore部分を考える) 51
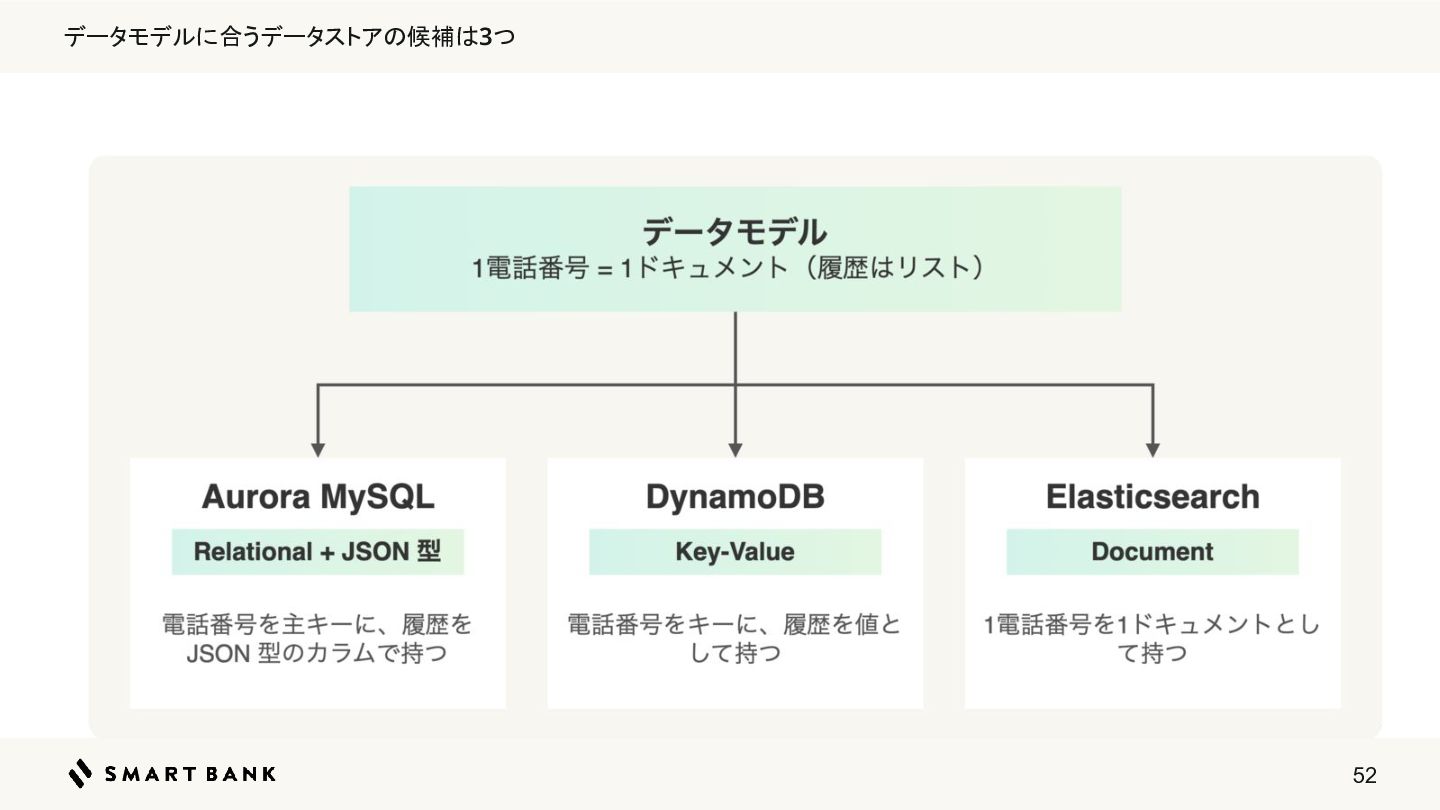
データモデルに合うデータストアの候補は3つ 52
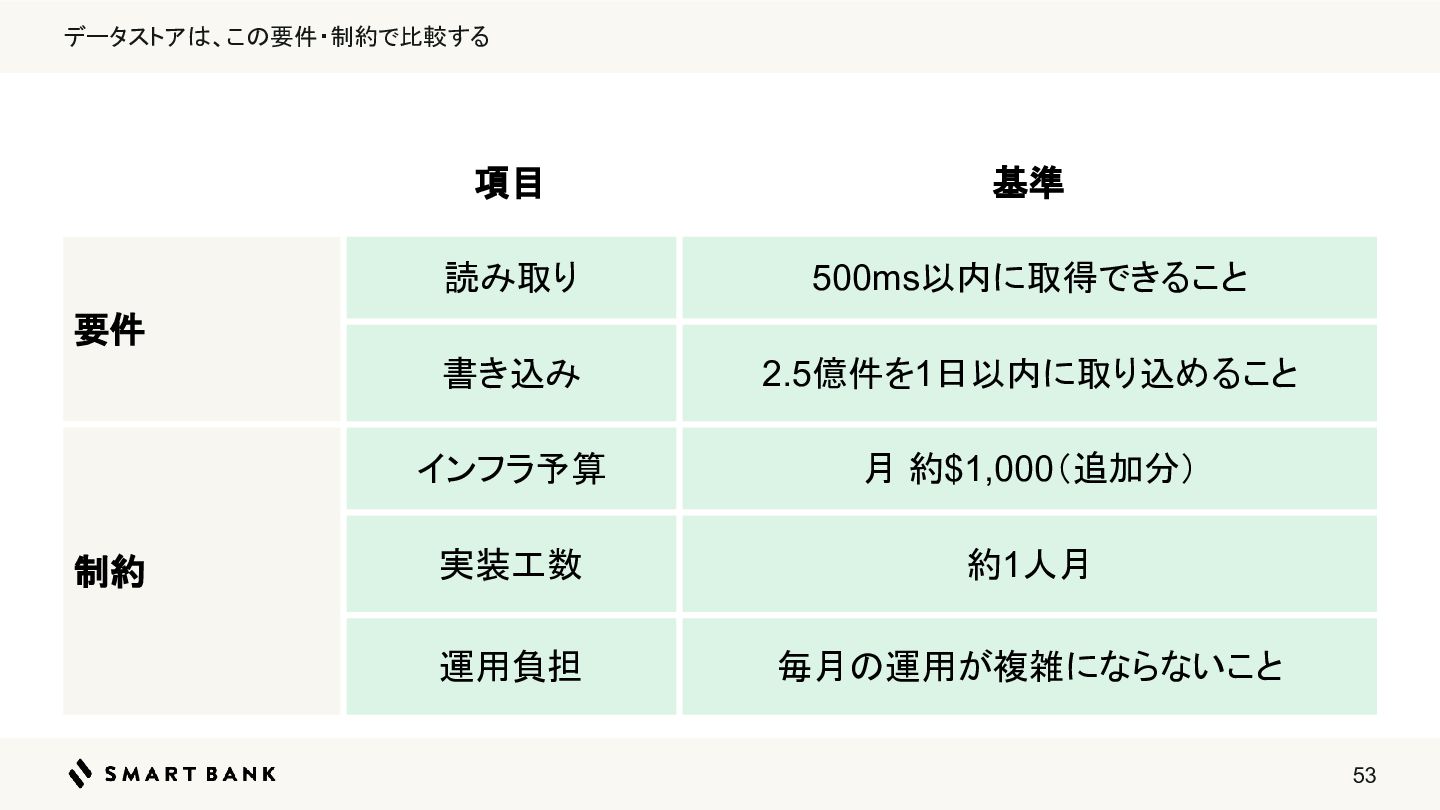
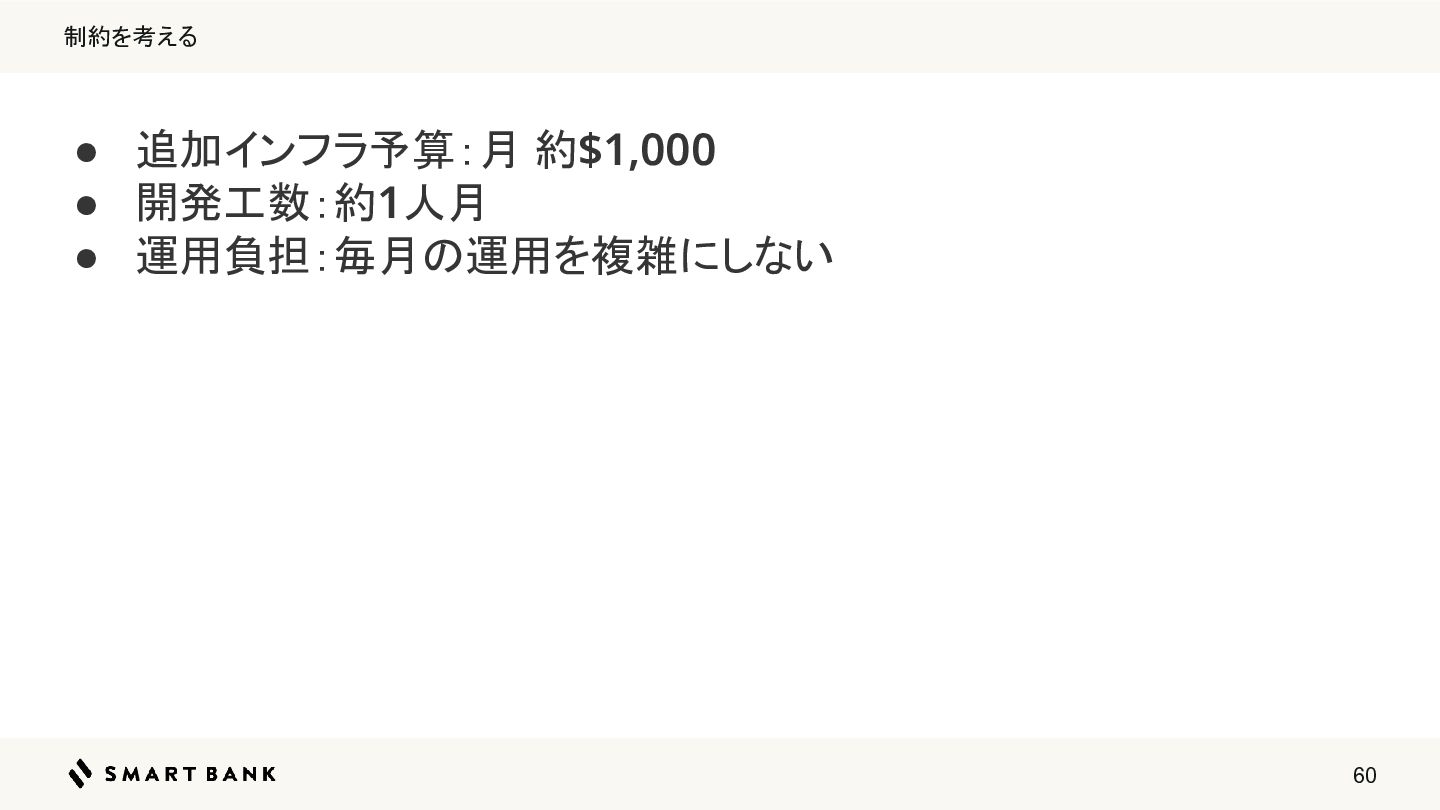
データストアは、この要件・制約で比較する 項目 基準 読み取り 500ms以内に取得できること 書き込み 2.5億件を1日以内に取り込めること インフラ予算 月 約$1,000(追加分)
実装工数 約1人月 運用負担 毎月の運用が複雑にならないこと 要件 制約 53
要件の観点で比較する 54
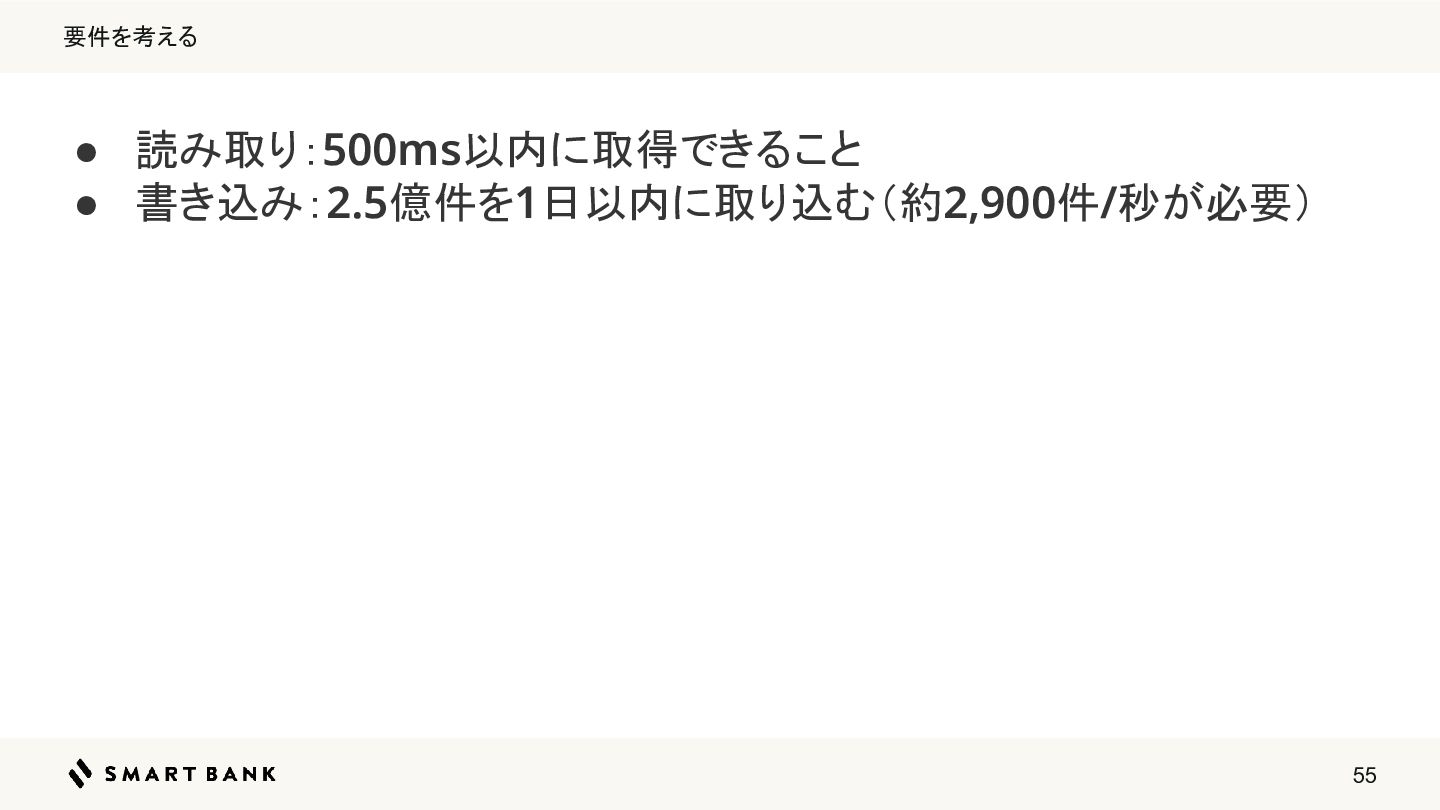
要件を考える • 読み取り:500ms以内に取得できること • 書き込み:2.5億件を1日以内に取り込む(約2,900件/秒が必要) 55
読み取り・書き込み要件を満たせるか調査 ※ 詳細はAppendixに記載 56
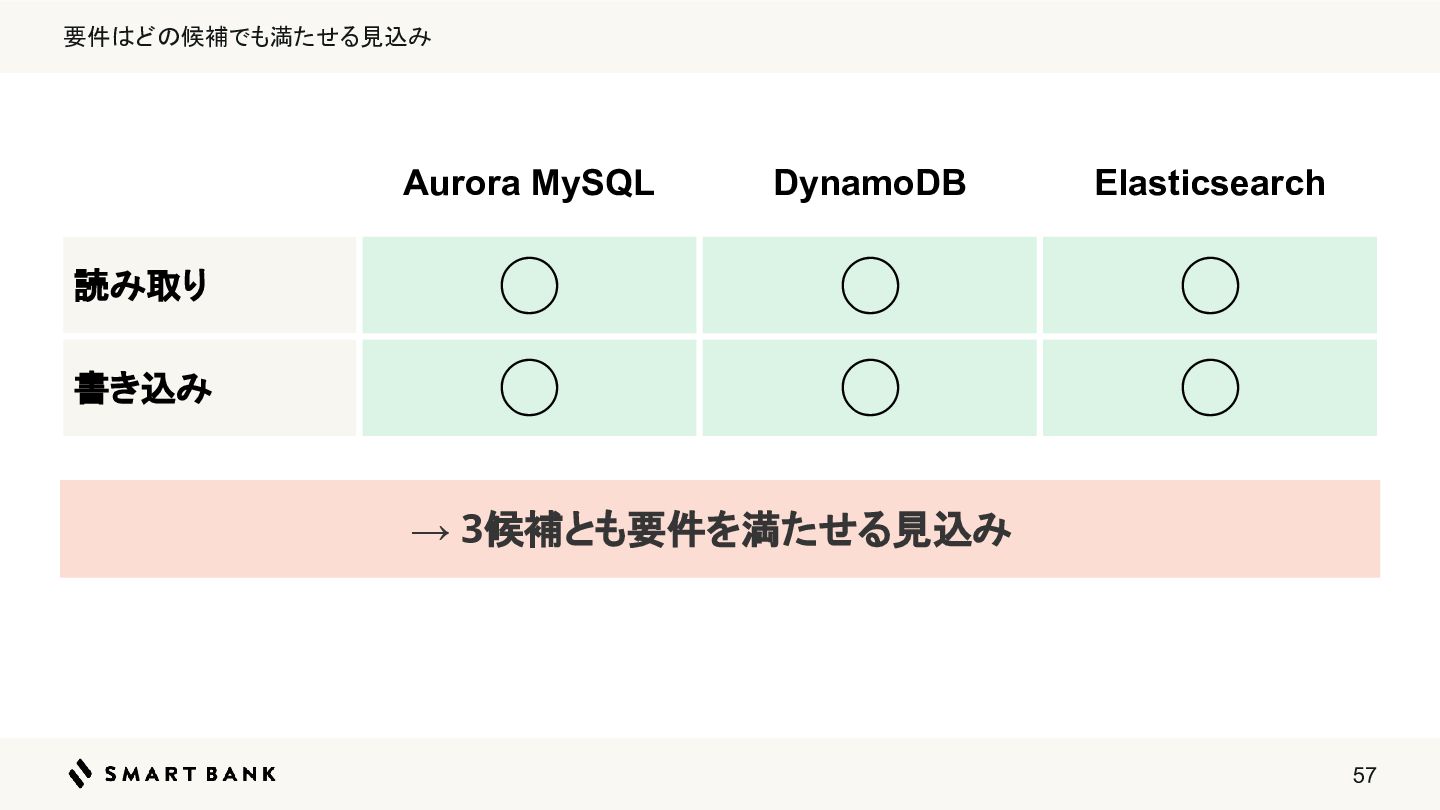
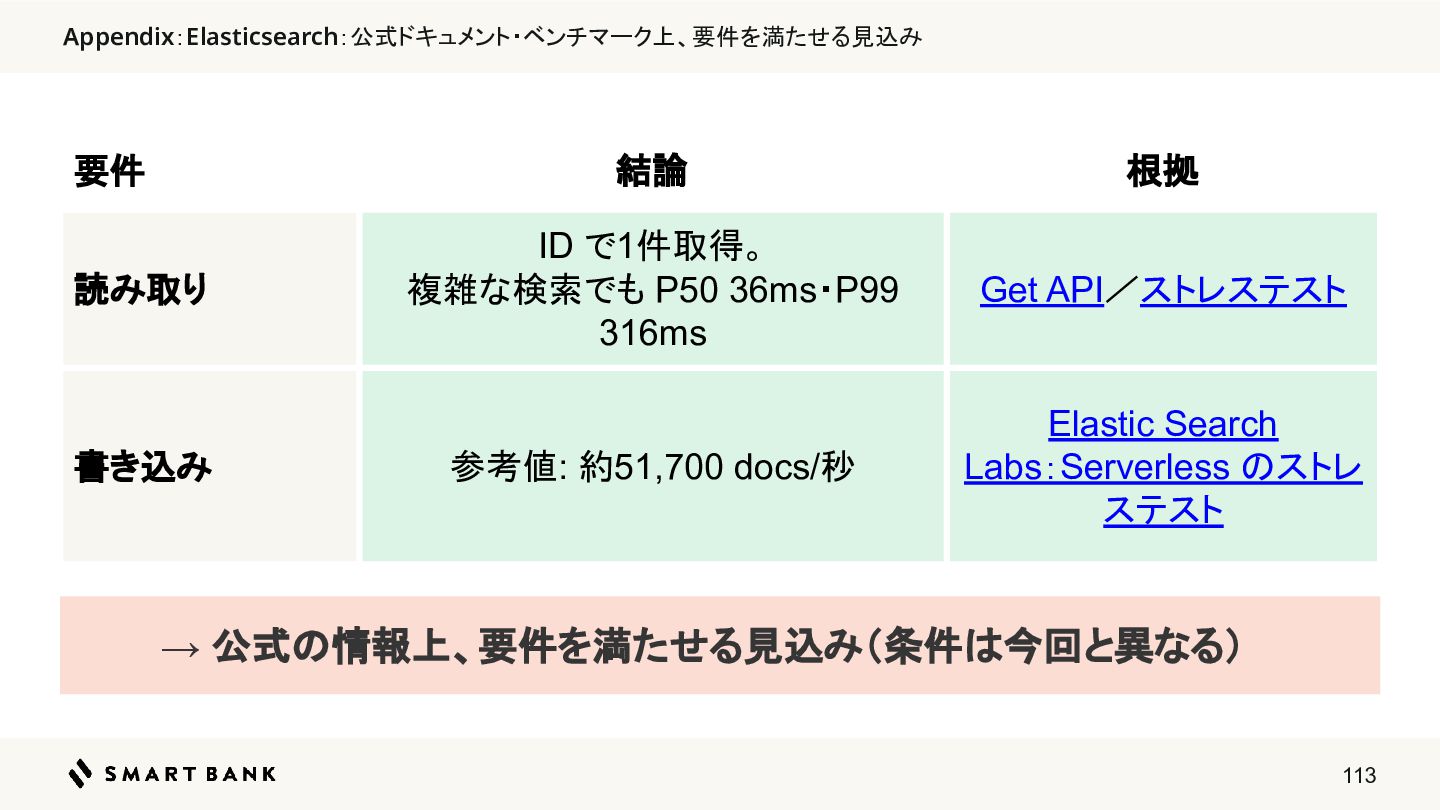
要件はどの候補でも満たせる見込み Aurora MySQL DynamoDB Elasticsearch 読み取り ◯ ◯ ◯ 書き込み
◯ ◯ ◯ → 3候補とも要件を満たせる見込み 57
要件の観点では差がつかない 58
次に、制約の観点で比較する 59
制約を考える • 追加インフラ予算:月 約$1,000 • 開発工数:約1人月 • 運用負担:毎月の運用を複雑にしない 60
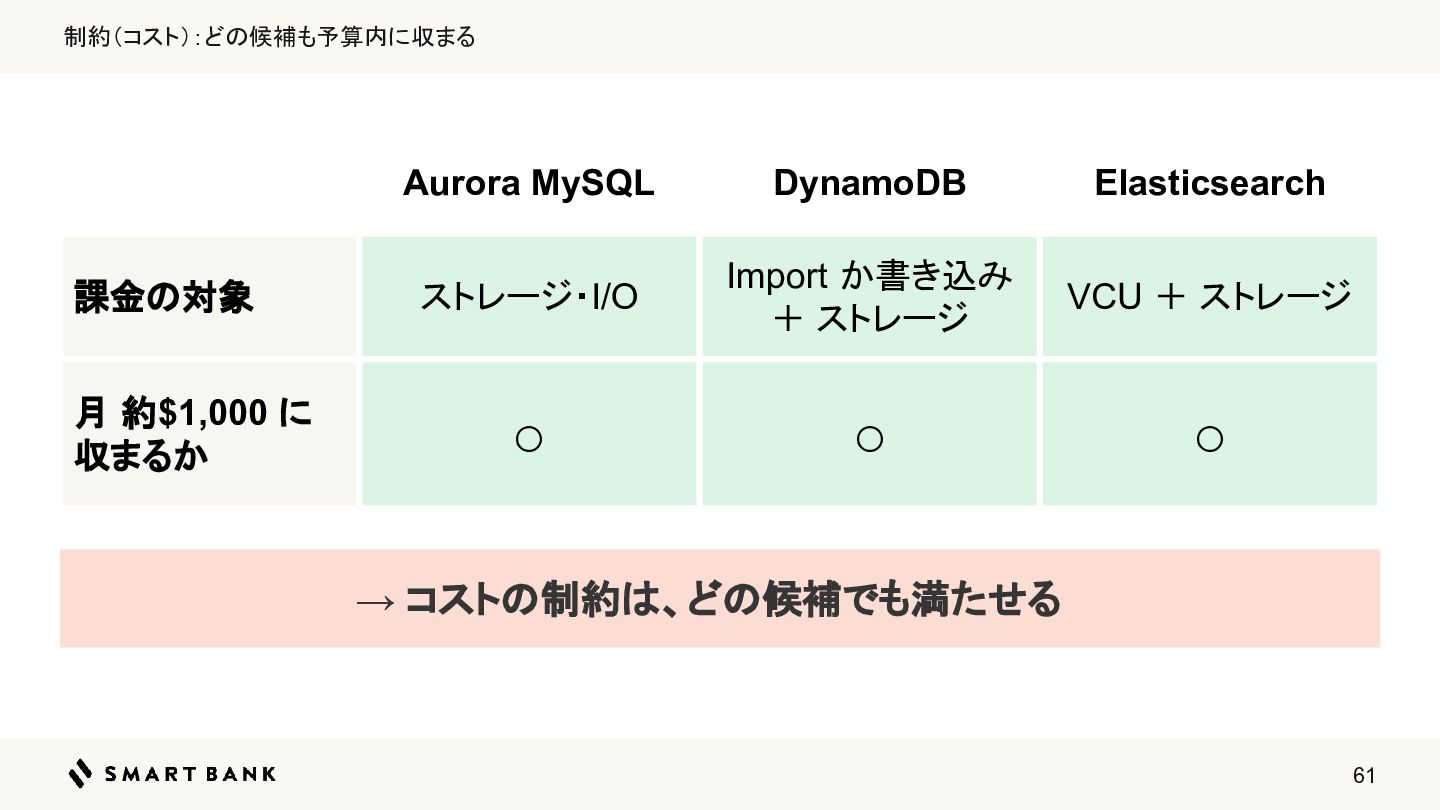
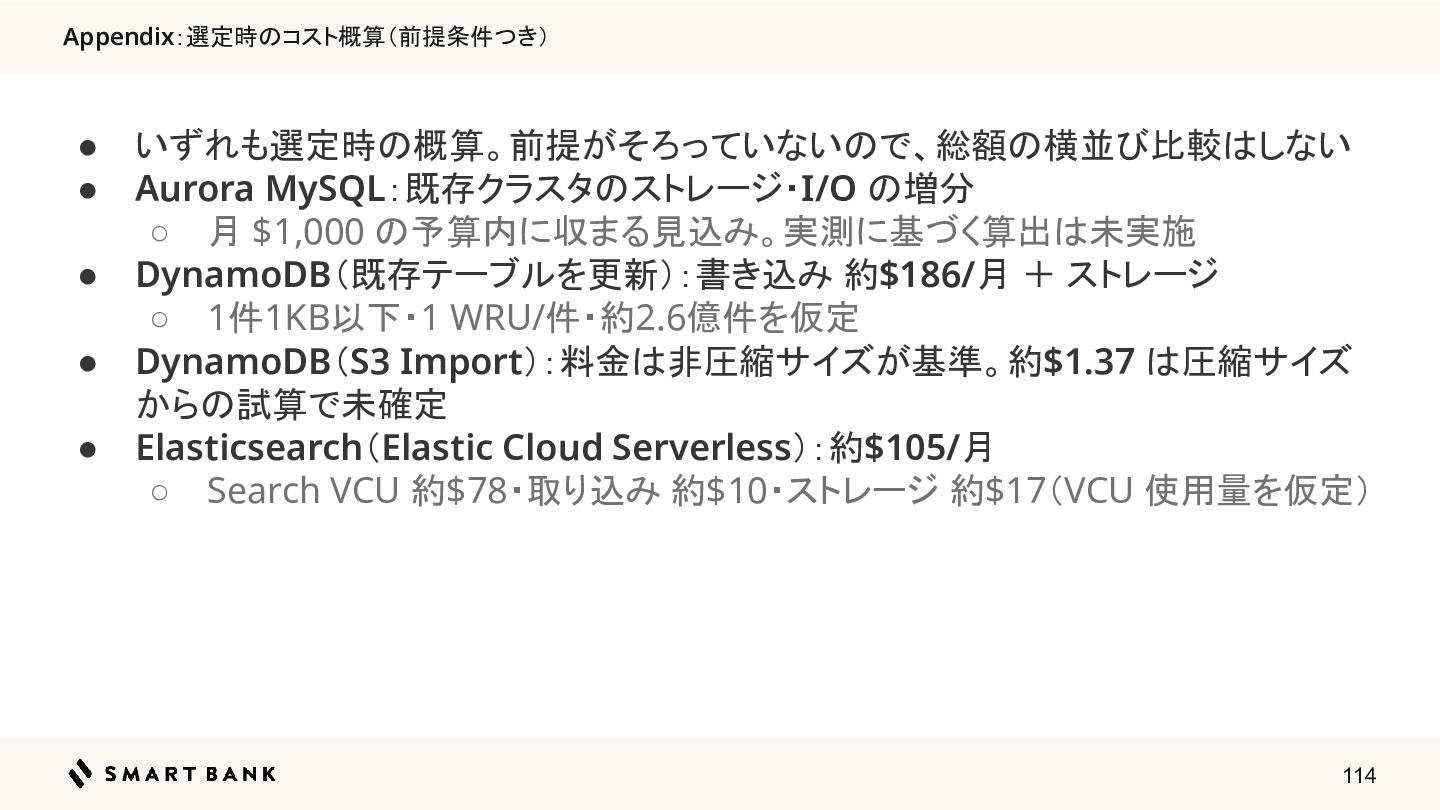
制約(コスト):どの候補も予算内に収まる 課金の対象 月 約$1,000 に 収まるか Aurora MySQL DynamoDB Elasticsearch
ストレージ・I/O Import か書き込み + ストレージ VCU + ストレージ ◦ ◦ ◦ → コストの制約は、どの候補でも満たせる 61
開発工数・運用負担の観点で考える 62
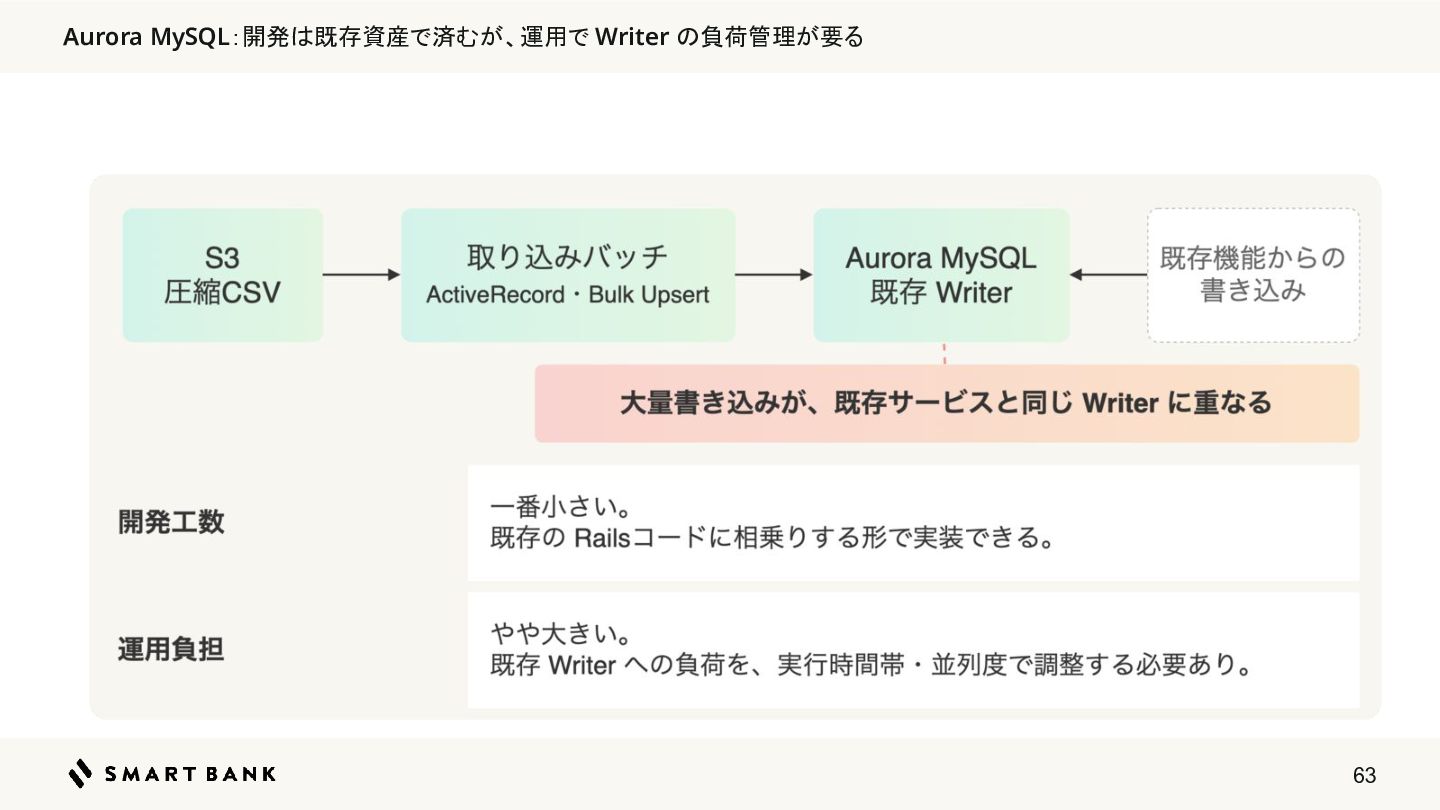
Aurora MySQL:開発は既存資産で済むが、運用で Writer の負荷管理が要る 63
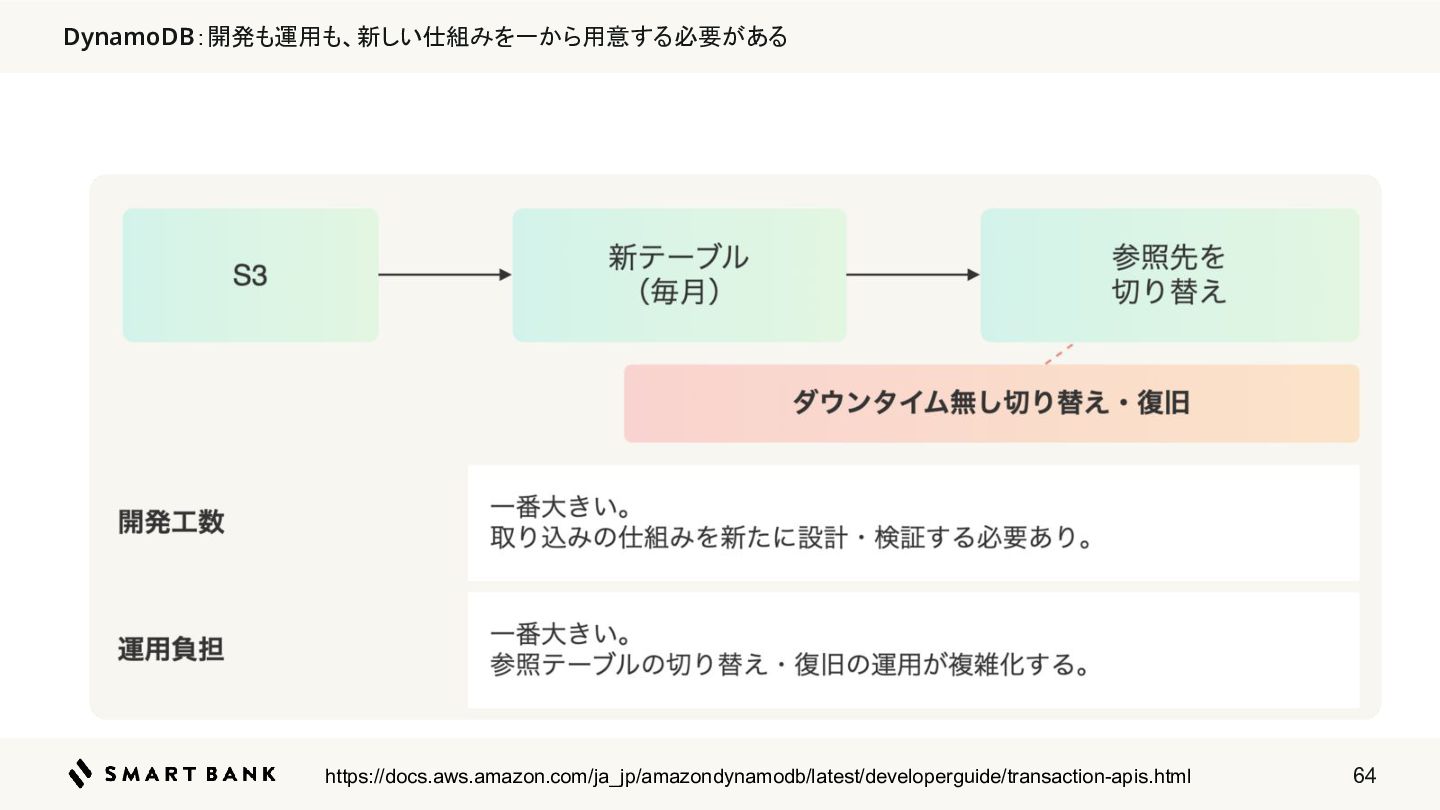
DynamoDB:開発も運用も、新しい仕組みを一から用意する必要がある https://docs.aws.amazon.com/ja_jp/amazondynamodb/latest/developerguide/transaction-apis.html 64
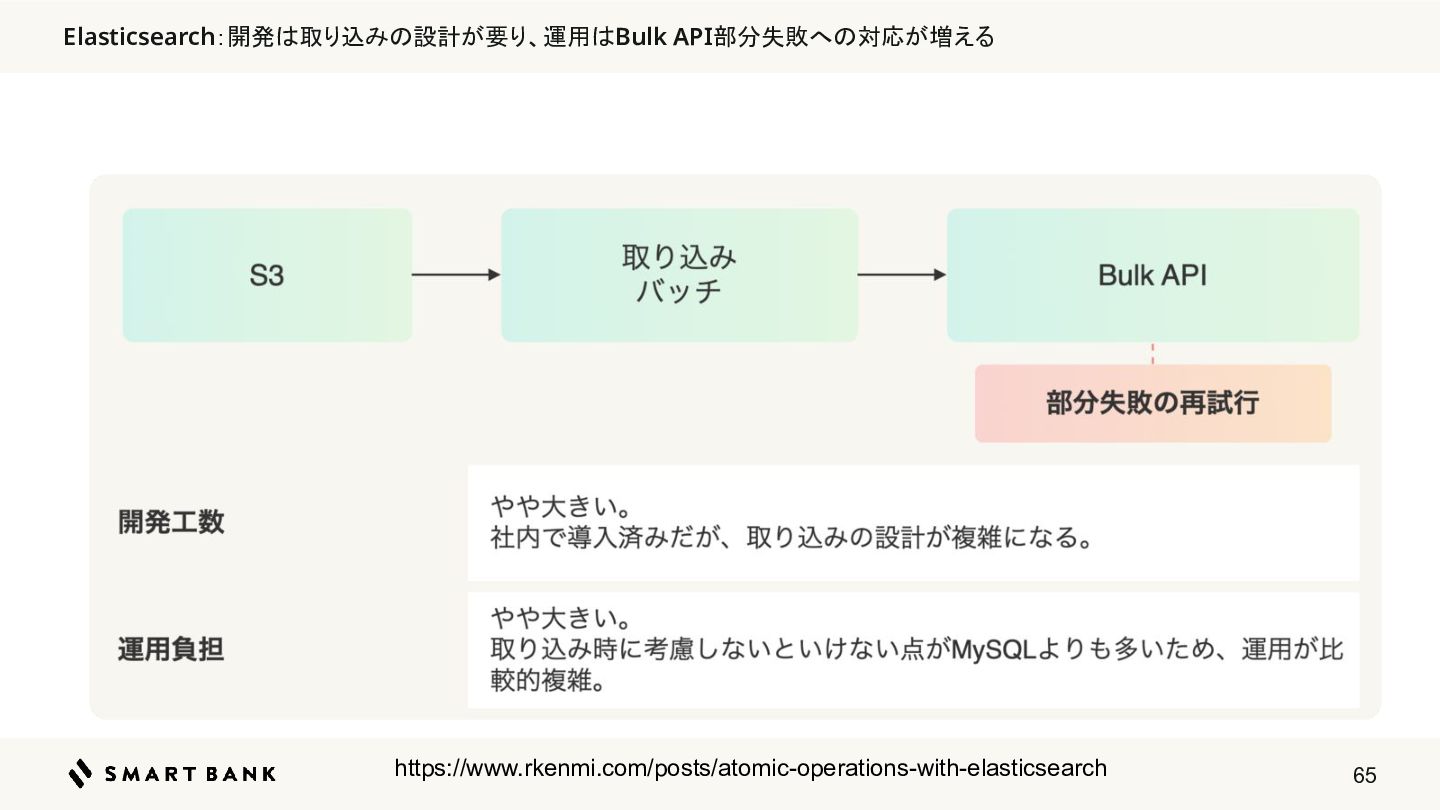
Elasticsearch:開発は取り込みの設計が要り、運用はBulk API部分失敗への対応が増える https://www.rkenmi.com/posts/atomic-operations-with-elasticsearch 65
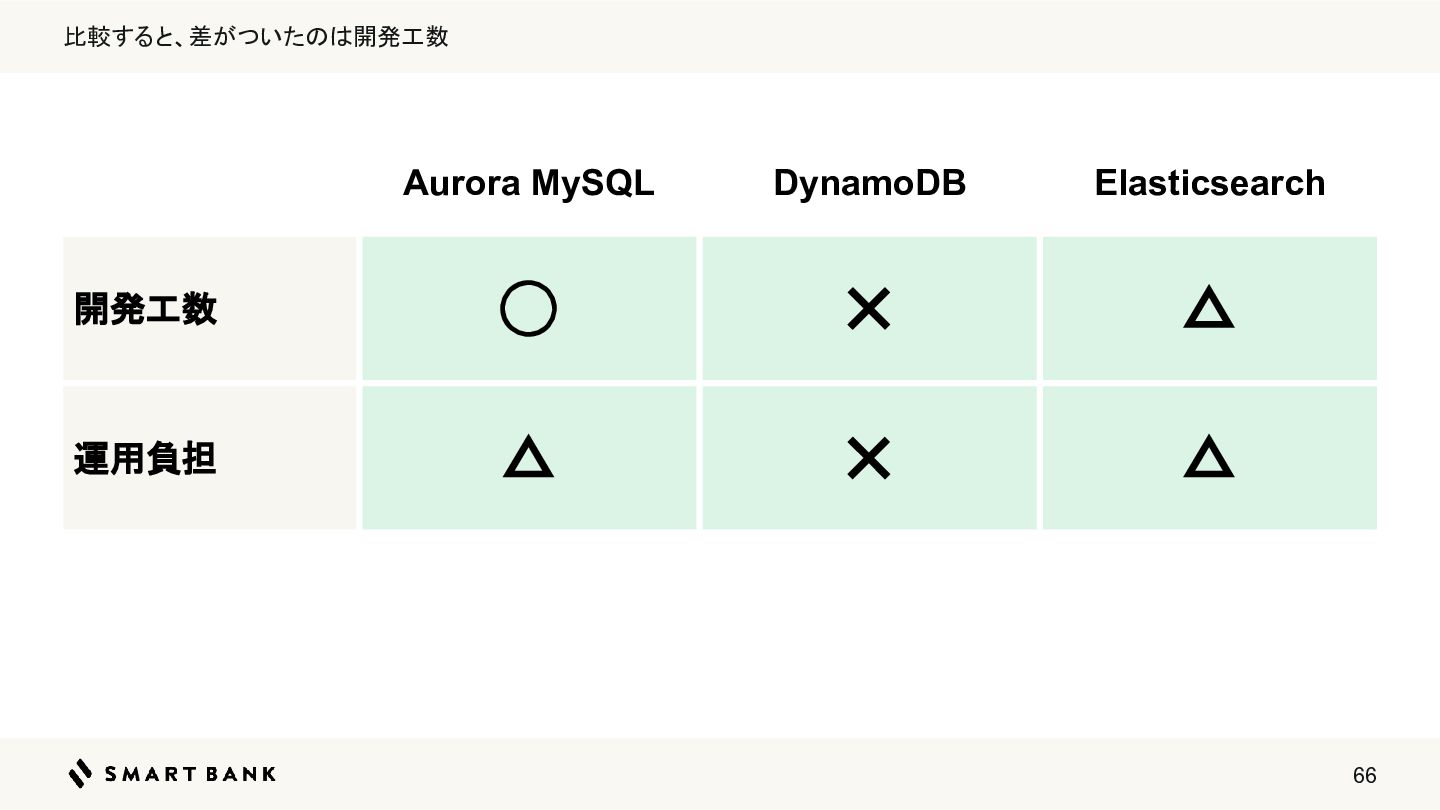
比較すると、差がついたのは開発工数 Aurora MySQL DynamoDB Elasticsearch 開発工数 ◯ ✕ △ 運用負担
△ ✕ △ 66
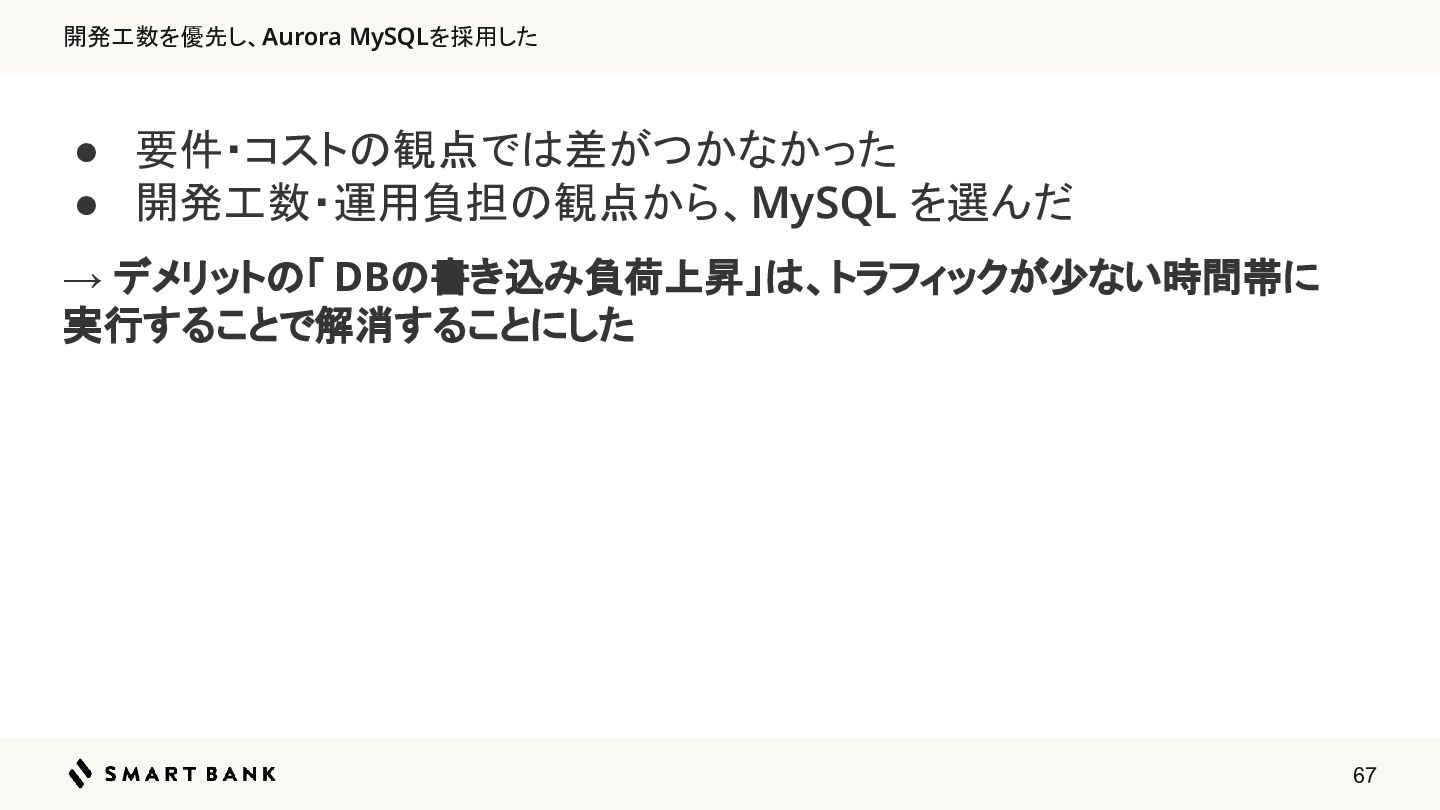
開発工数を優先し、Aurora MySQLを採用した • 要件・コストの観点では差がつかなかった • 開発工数・運用負担の観点から、MySQL を選んだ → デメリットの「 DBの書き込み負荷上昇」は、トラフィックが少ない時間帯に
実行することで解消することにした 67
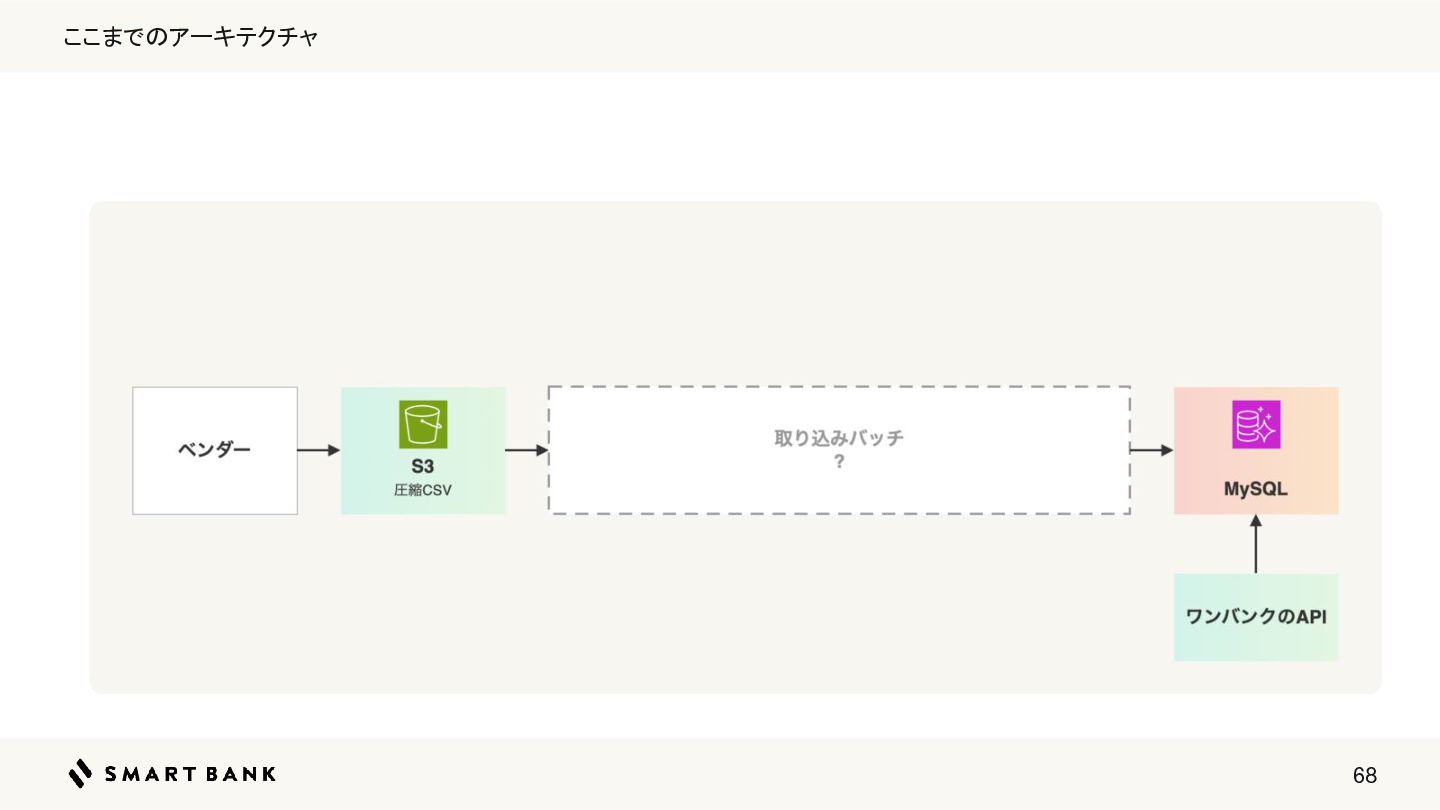
ここまでのアーキテクチャ 68
アジェンダ 69
2.3 バッチアーキテクチャ設計と実装 70
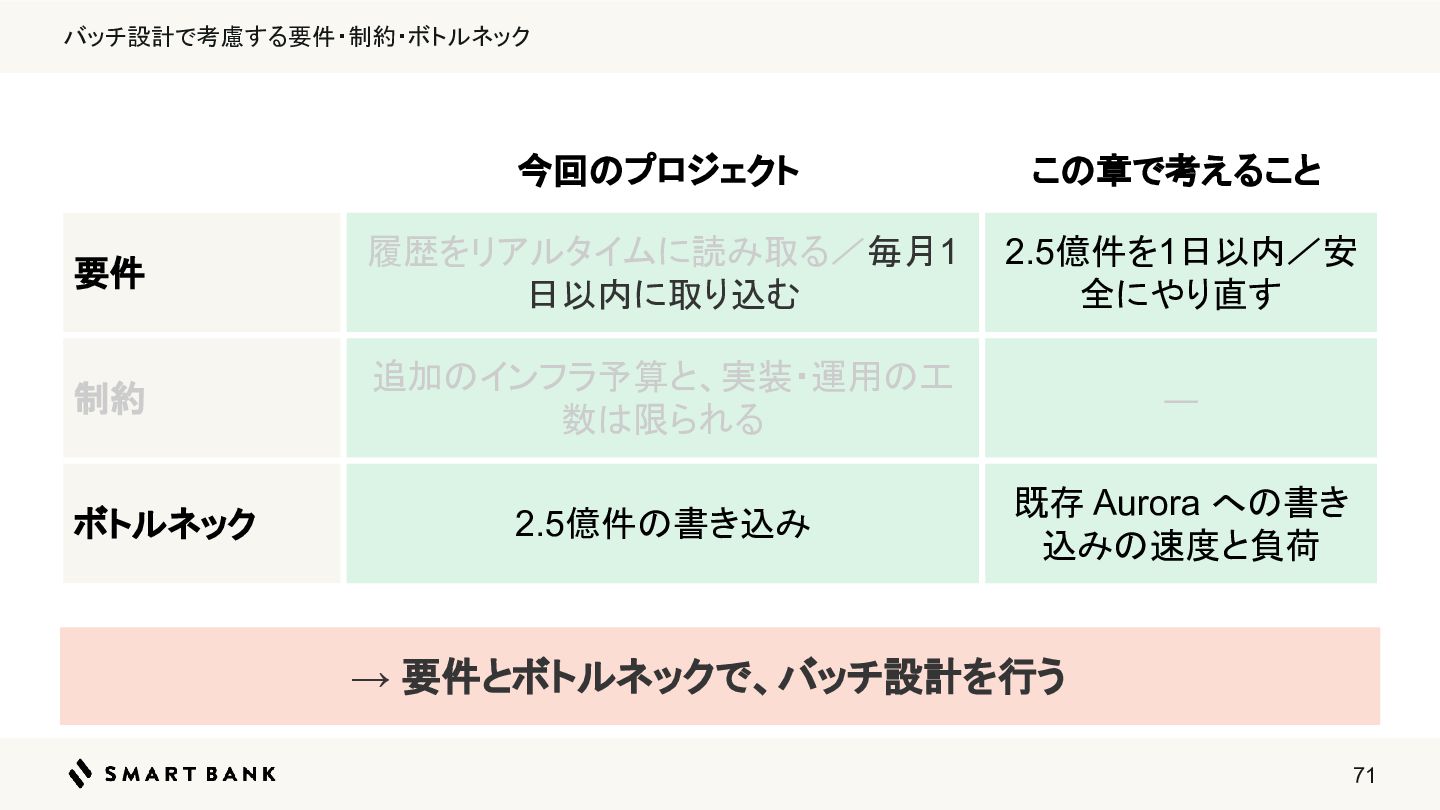
バッチ設計で考慮する要件・制約・ボトルネック 今回のプロジェクト この章で考えること 要件 履歴をリアルタイムに読み取る/毎月1 日以内に取り込む 2.5億件を1日以内/安 全にやり直す 制約 追加のインフラ予算と、実装・運用の工
数は限られる ― 2.5億件の書き込み 既存 Aurora への書き 込みの速度と負荷 ボトルネック → 要件とボトルネックで、バッチ設計を行う 71
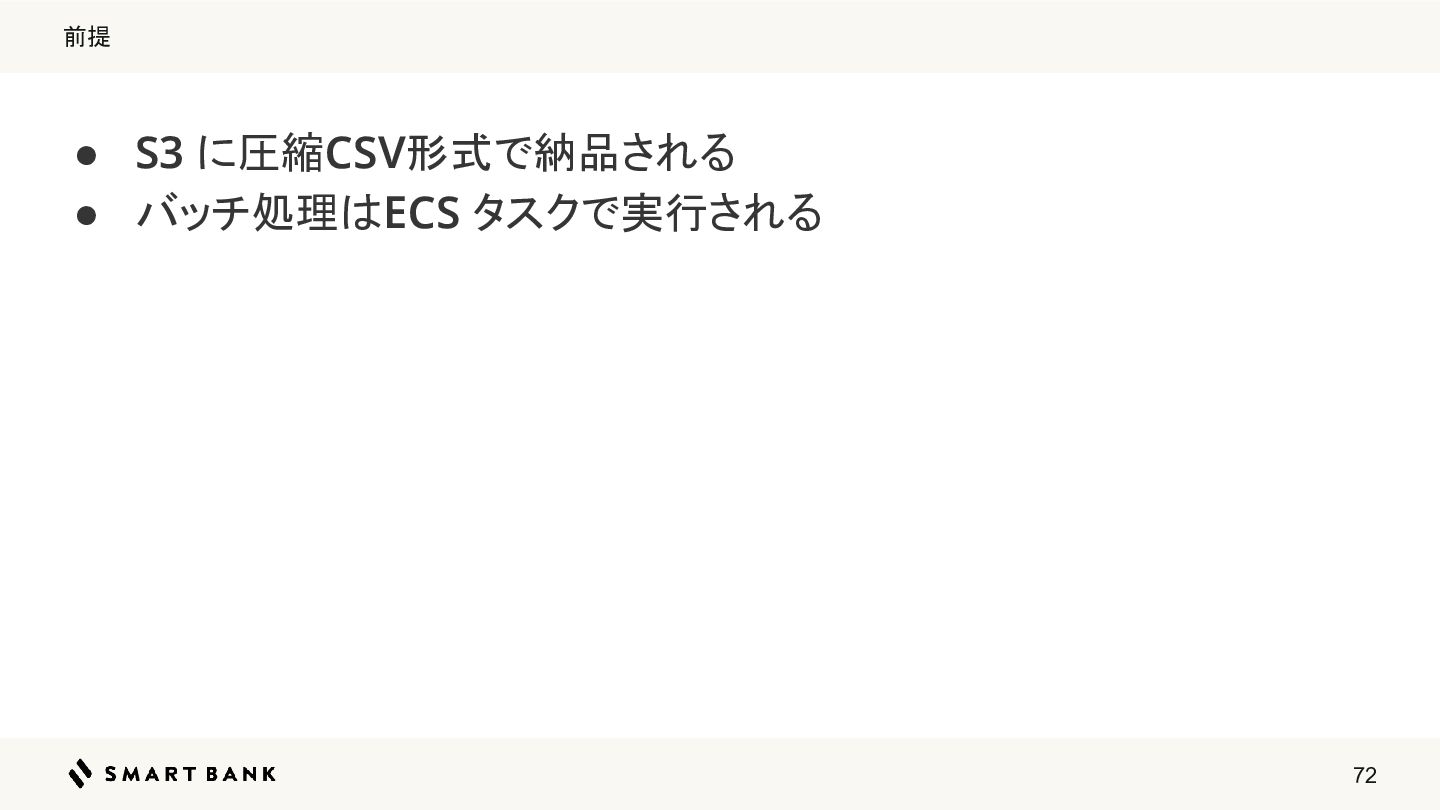
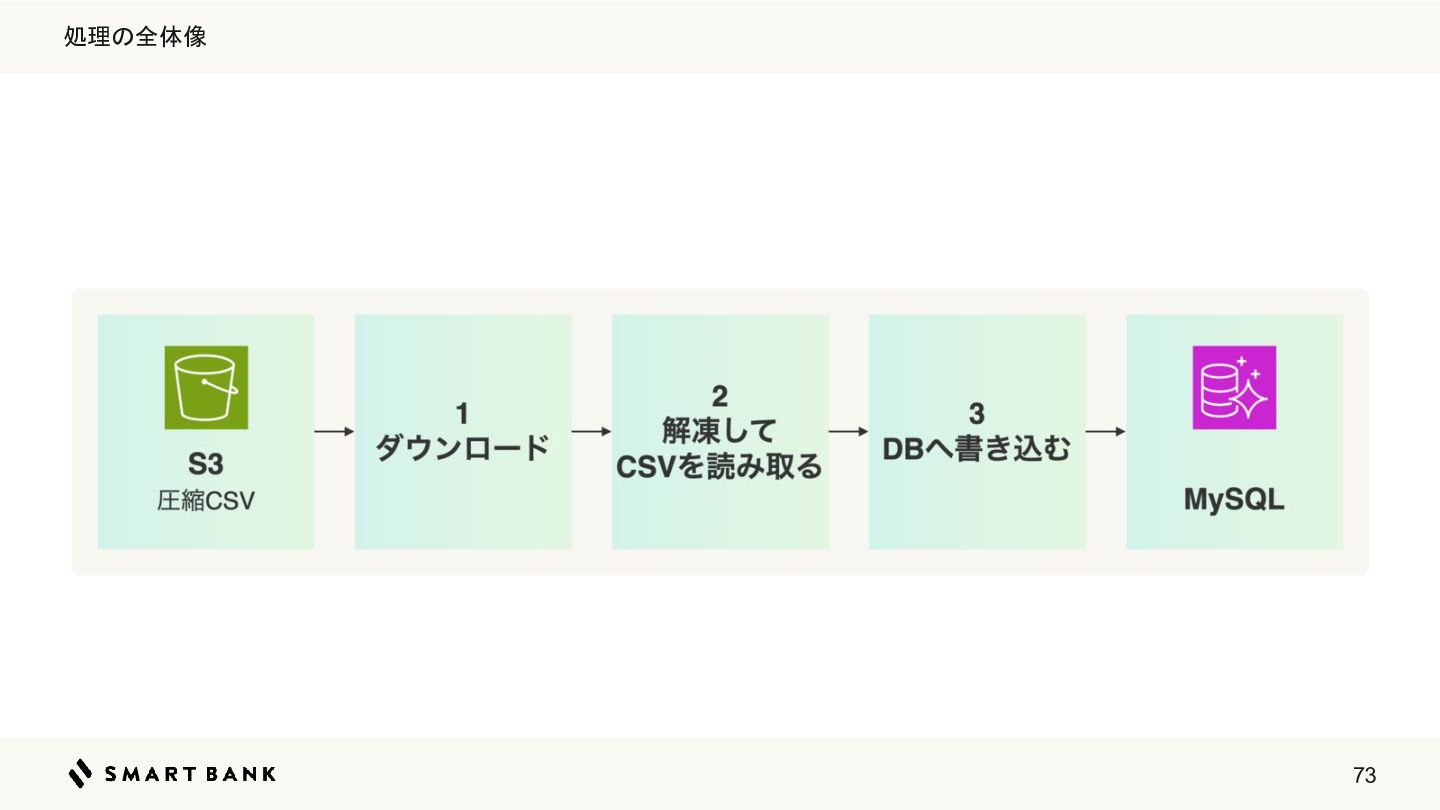
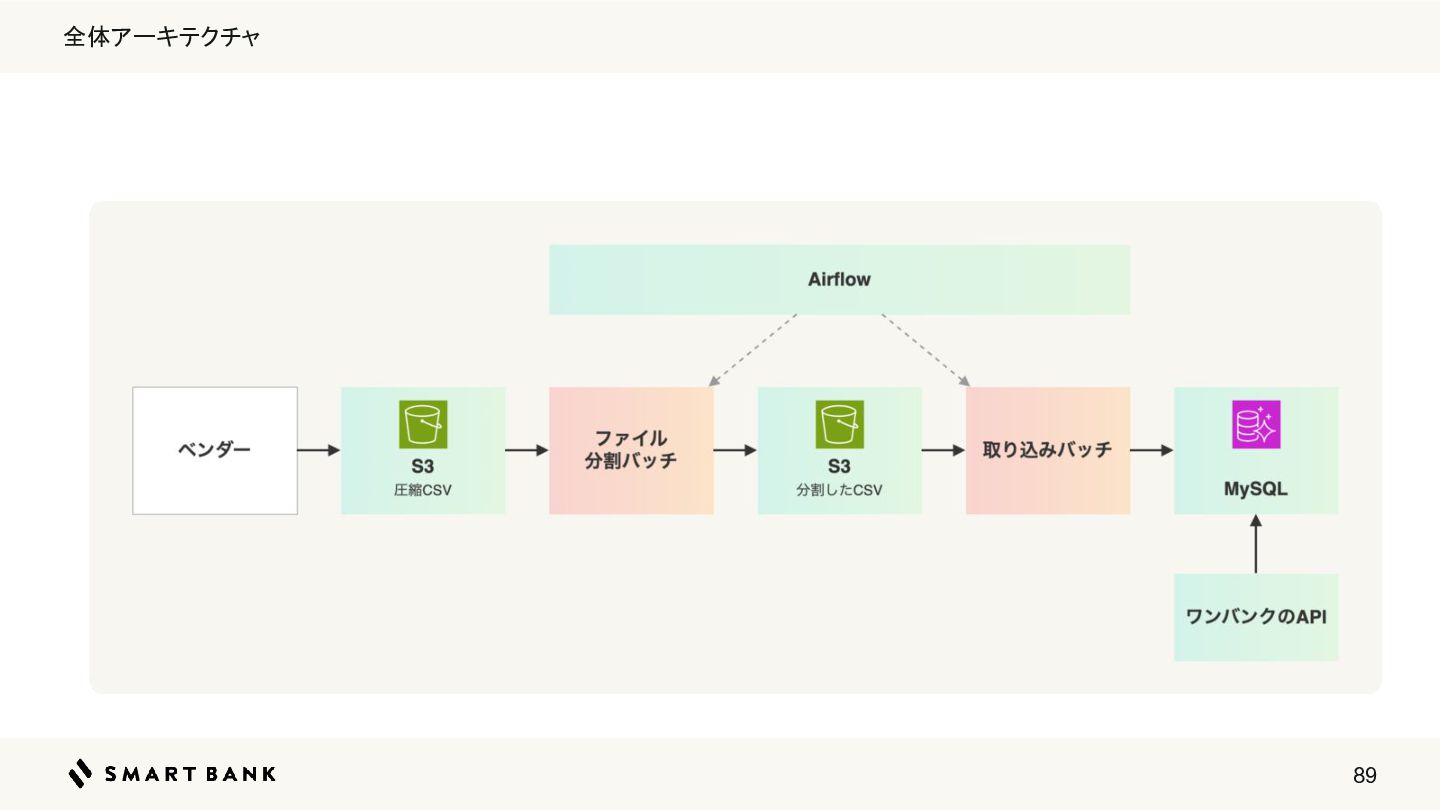
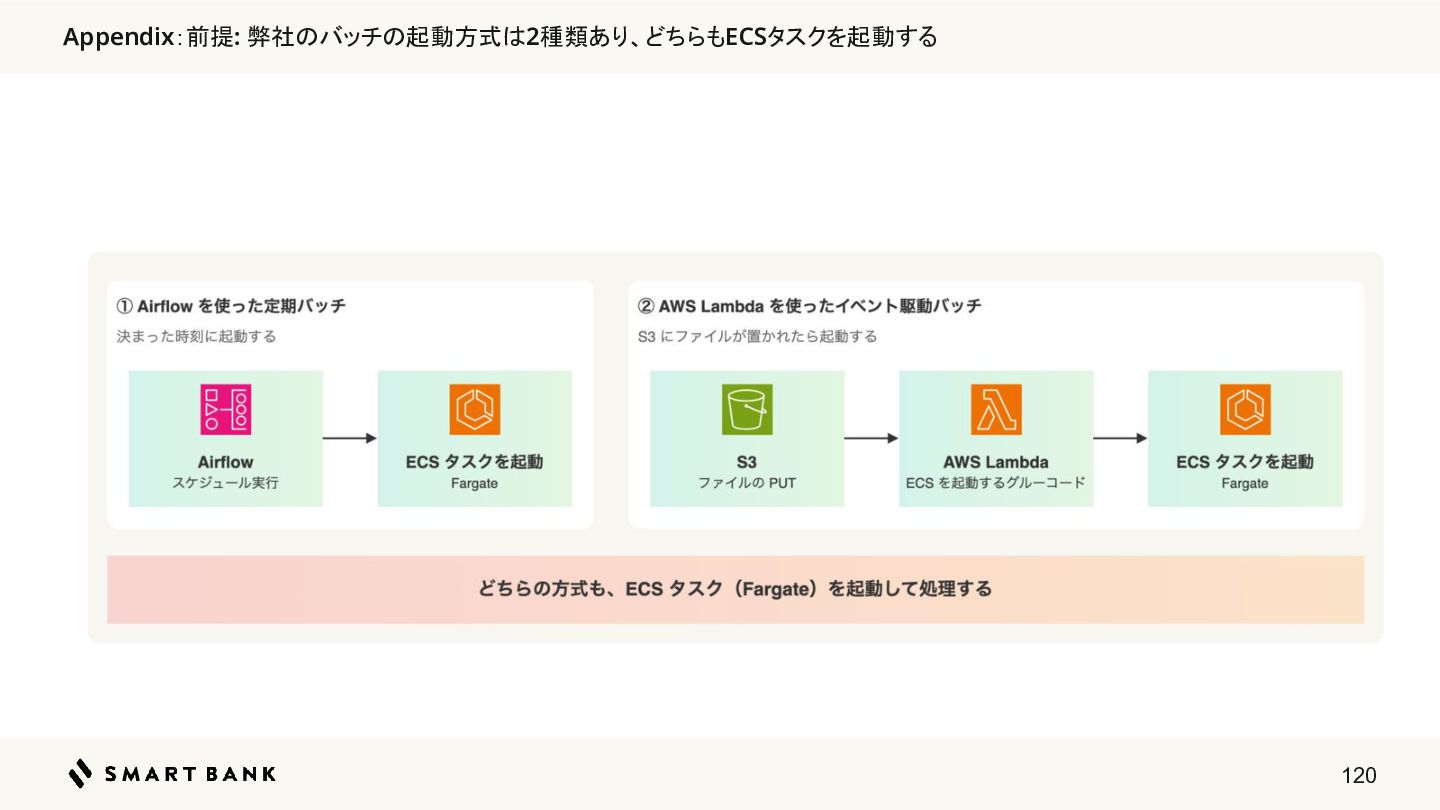
前提 • S3 に圧縮CSV形式で納品される • バッチ処理はECS タスクで実行される 72
処理の全体像 73
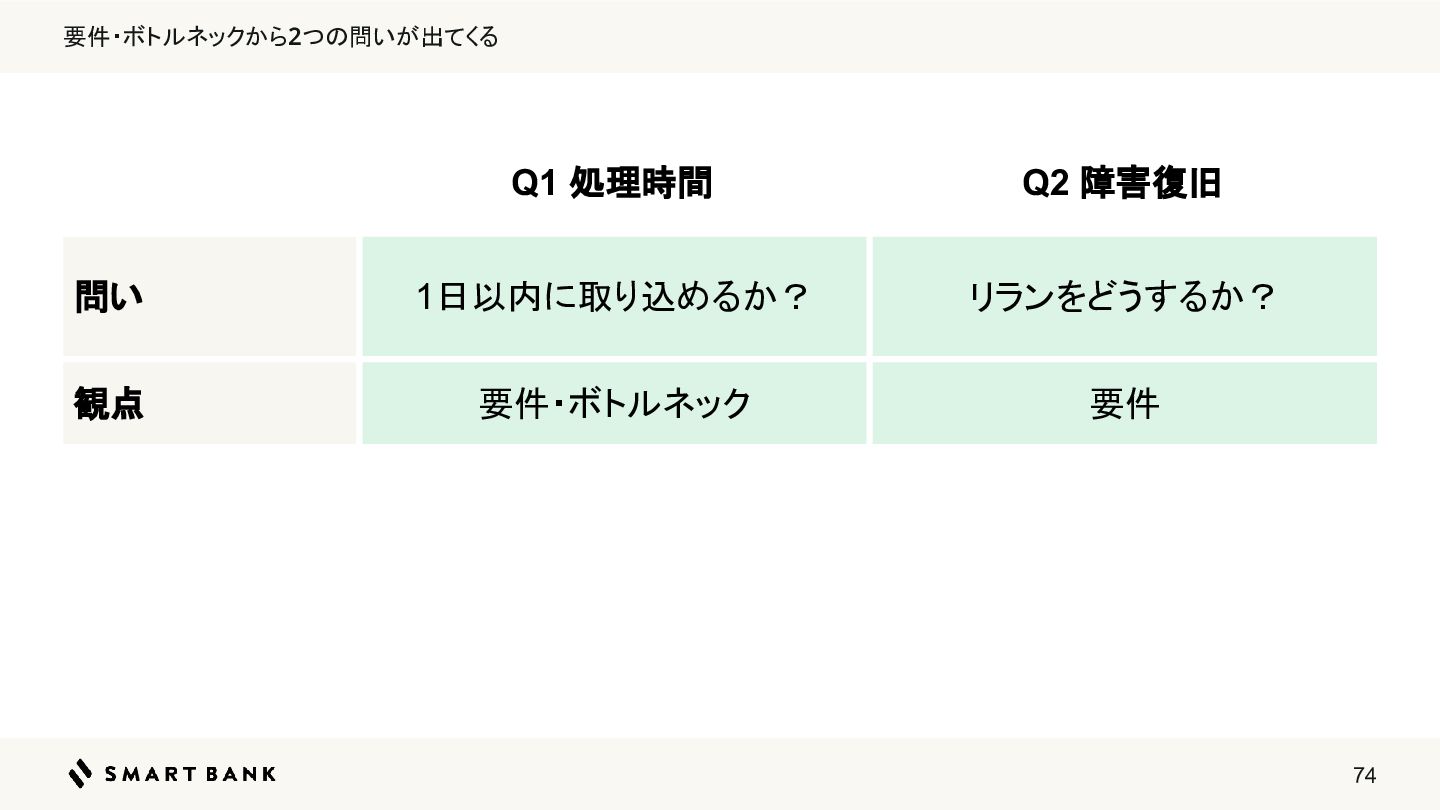
要件・ボトルネックから2つの問いが出てくる Q1 処理時間 Q2 障害復旧 問い 1日以内に取り込めるか? リランをどうするか? 観点 要件・ボトルネック
要件 74
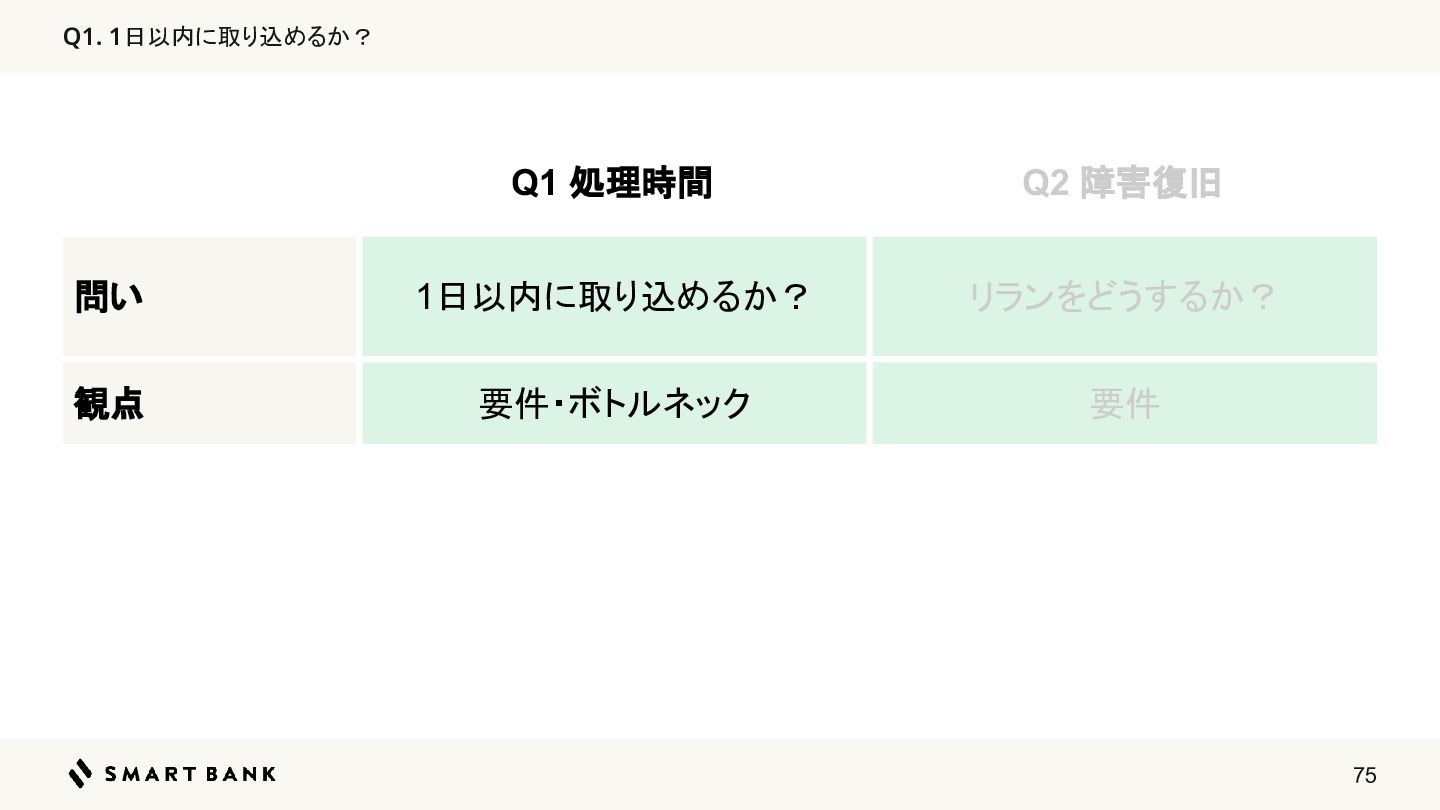
Q1. 1日以内に取り込めるか? Q1 処理時間 Q2 障害復旧 問い 1日以内に取り込めるか? リランをどうするか? 観点
要件・ボトルネック 要件 75
1日以内に取り込めるにはどうする? 76
Q1:1日以内に取り込むには、並列化が必要 • 必要:2.5億件 ÷ 86,400秒 ≒ 約2,900件/秒 • 直列で書き込んだ計測値:約1,000件/秒 77
Q1:1日以内に取り込むには、並列化が必要 • 必要:2.5億件 ÷ 86,400秒 ≒ 約2,900件/秒 • 直列で書き込んだ計測値:約1,000件/秒 →
並列取り込みにしないと実現できない (3並列以上) 78
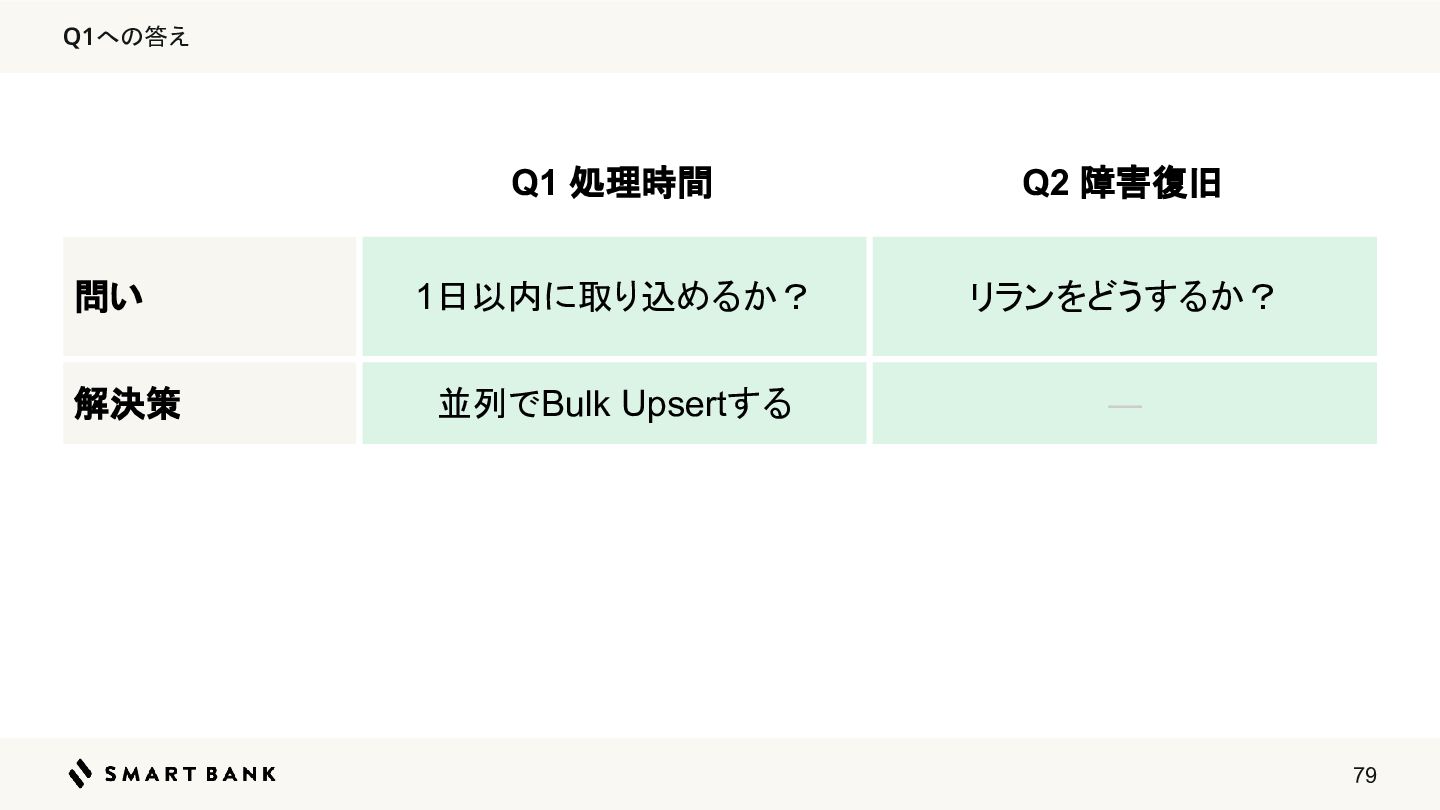
Q1への答え Q1 処理時間 Q2 障害復旧 問い 1日以内に取り込めるか? リランをどうするか? 解決策 並列でBulk
Upsertする ― 79
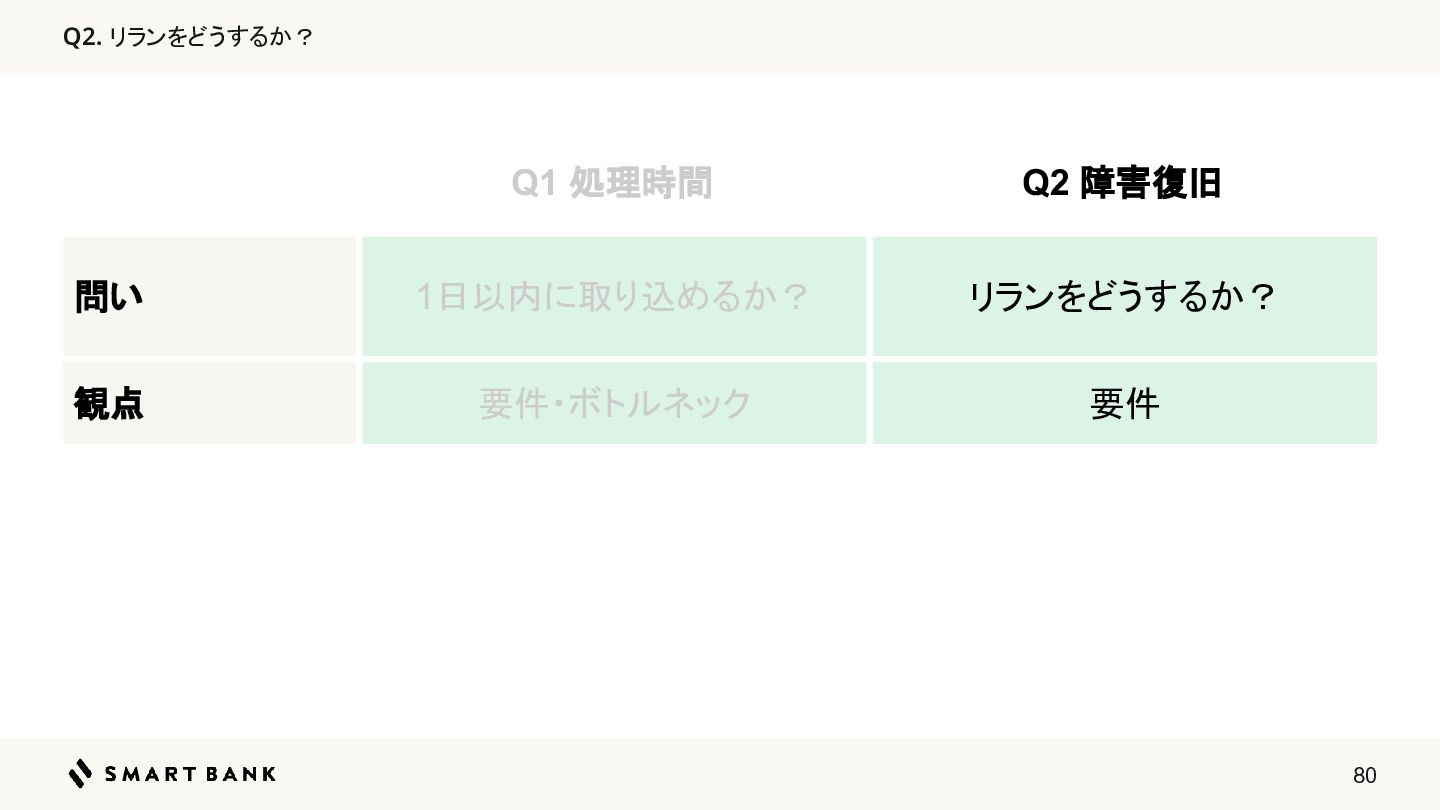
Q2. リランをどうするか? Q1 処理時間 Q2 障害復旧 問い 1日以内に取り込めるか? リランをどうするか? 観点
要件・ボトルネック 要件 80
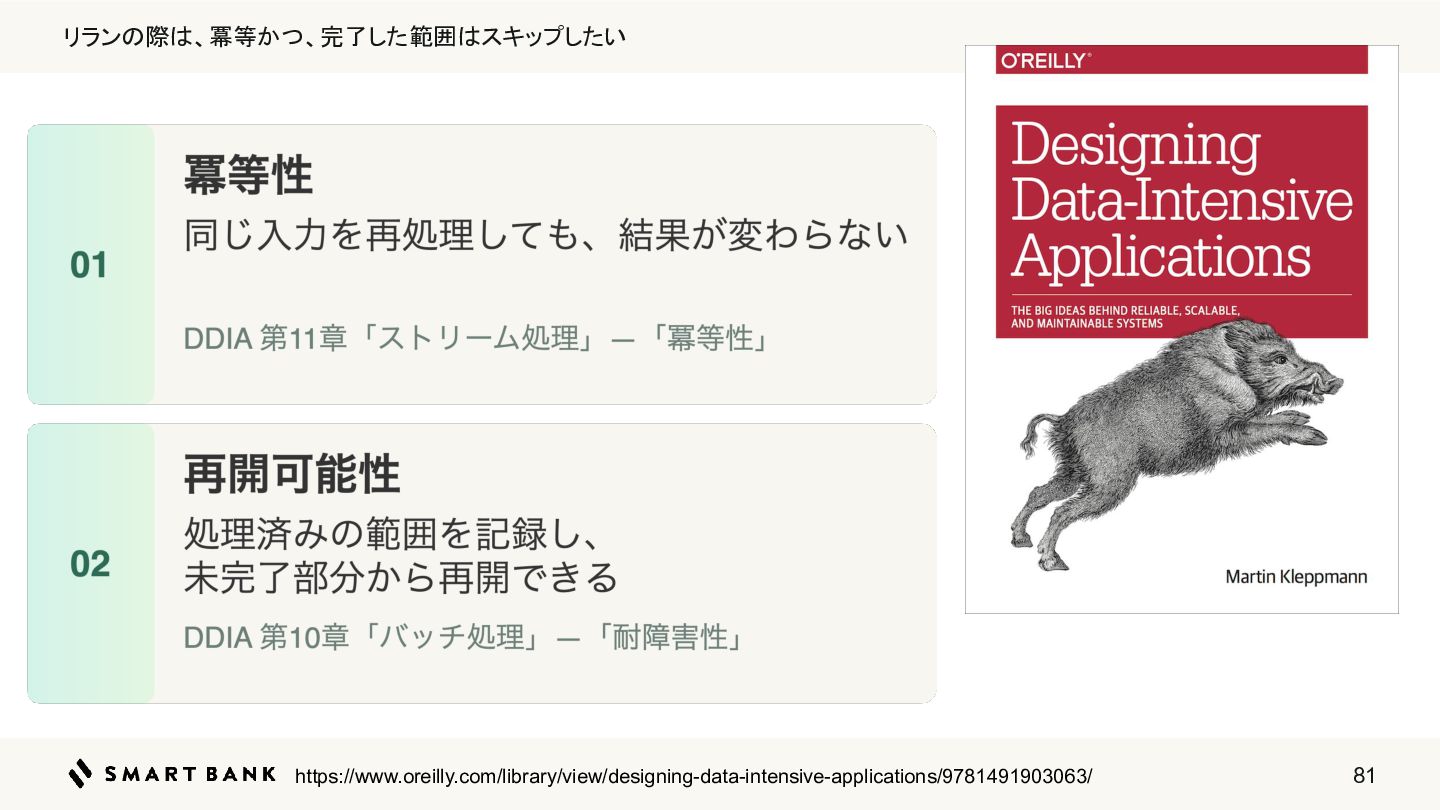
リランの際は、冪等かつ、完了した範囲はスキップしたい https://www.oreilly.com/library/view/designing-data-intensive-applications/9781491903063/ 81
冪等性 82
冪等性:Bulk Upsertで、同じ入力なら同じ結果にする • 電話番号をキーに、Bulk Upsert で書き込む • 同じデータを何度取り込んでも、結果は変わらない 83
冪等性:Bulk Upsertで、同じ入力なら同じ結果にする • 電話番号をキーに、Bulk Upsert で書き込む • 同じデータを何度取り込んでも、結果は変わらない → ただし、全件を再処理するコストは残る
84
再開可能性 途中から再開したいので、実現方法を考える 85
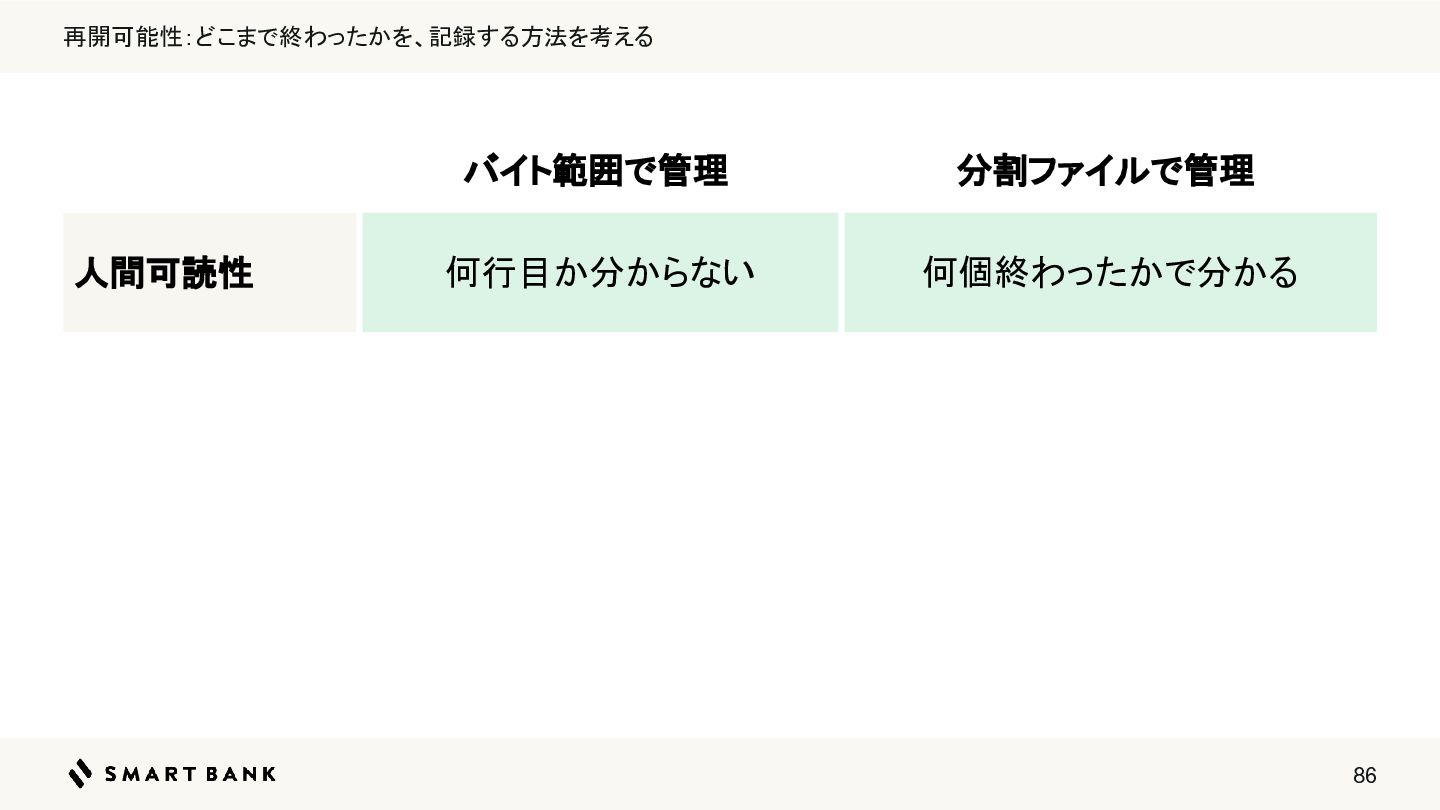
再開可能性:どこまで終わったかを、記録する方法を考える 人間可読性 バイト範囲で管理 分割ファイルで管理 何行目か分からない 何個終わったかで分かる 86
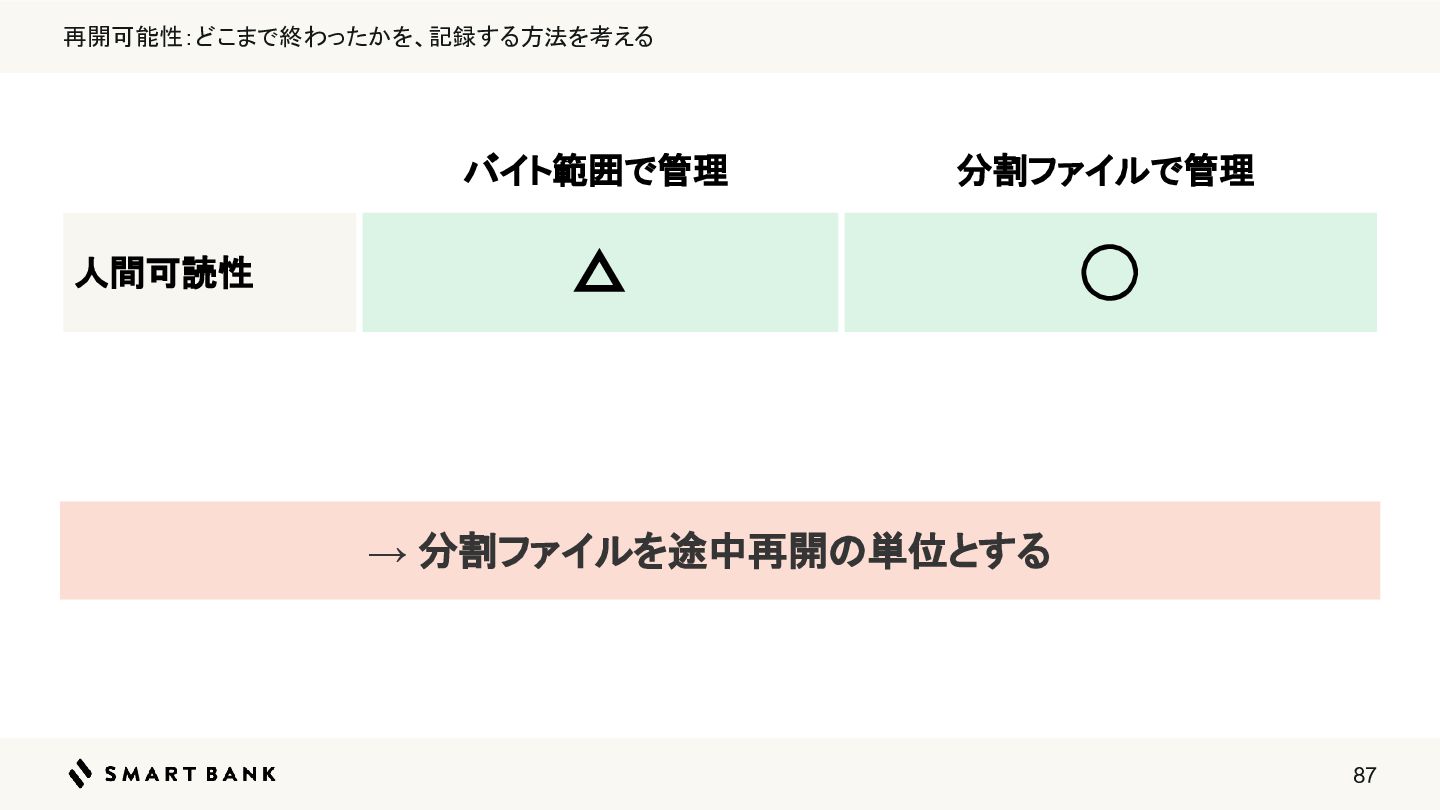
再開可能性:どこまで終わったかを、記録する方法を考える 人間可読性 バイト範囲で管理 分割ファイルで管理 △ ◯ → 分割ファイルを途中再開の単位とする 87
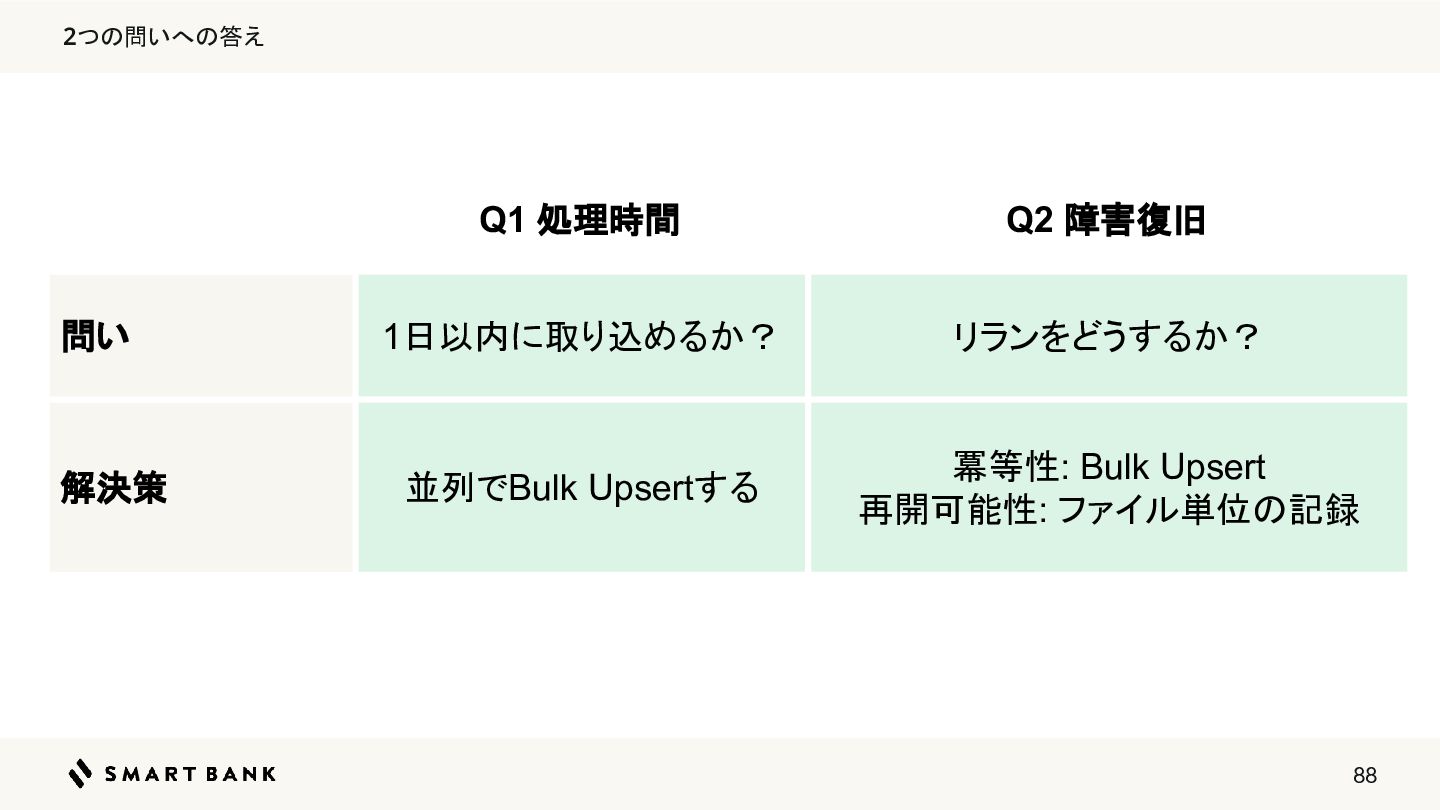
2つの問いへの答え Q1 処理時間 Q2 障害復旧 問い 1日以内に取り込めるか? リランをどうするか? 解決策 並列でBulk
Upsertする 冪等性: Bulk Upsert 再開可能性: ファイル単位の記録 88
全体アーキテクチャ 89
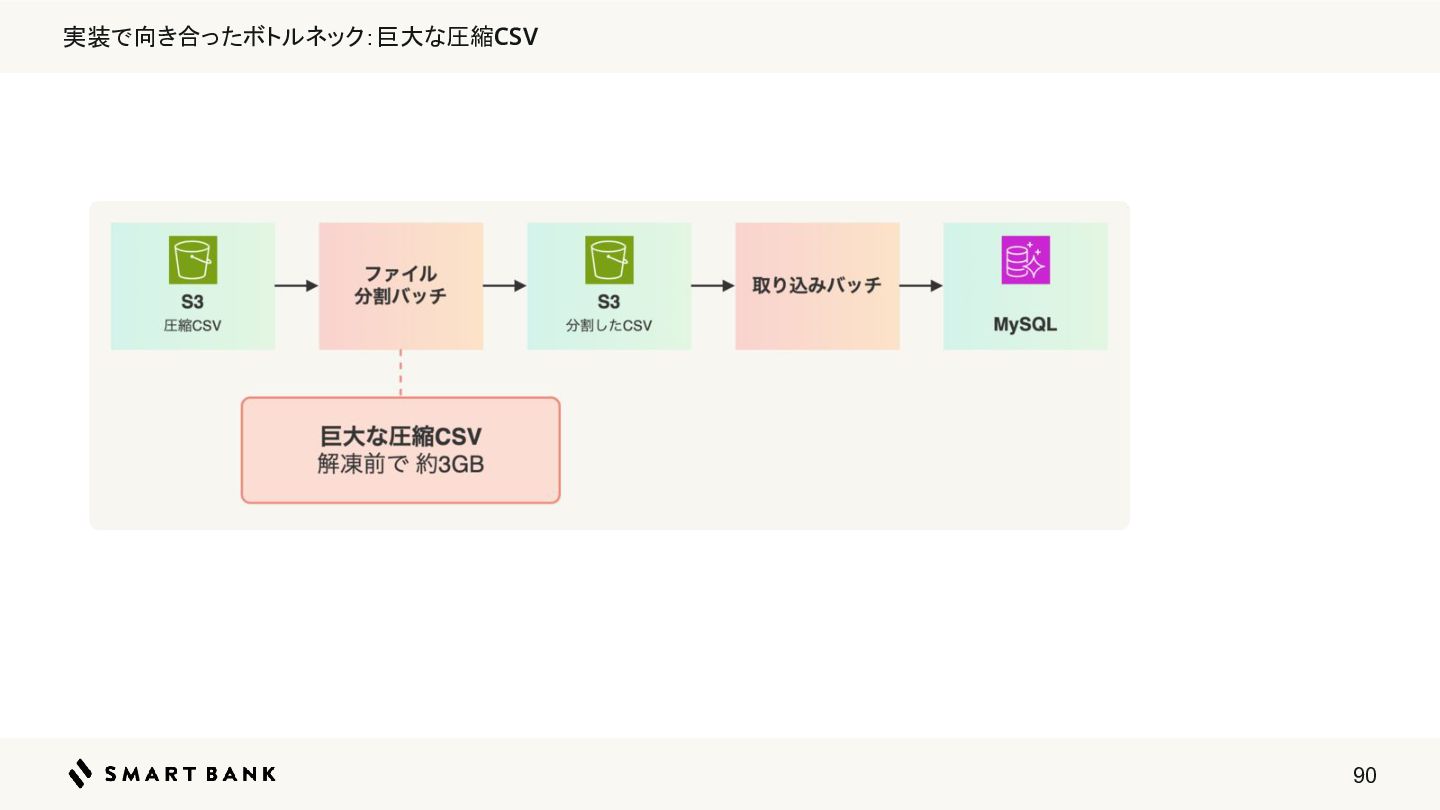
実装で向き合ったボトルネック:巨大な圧縮CSV 90
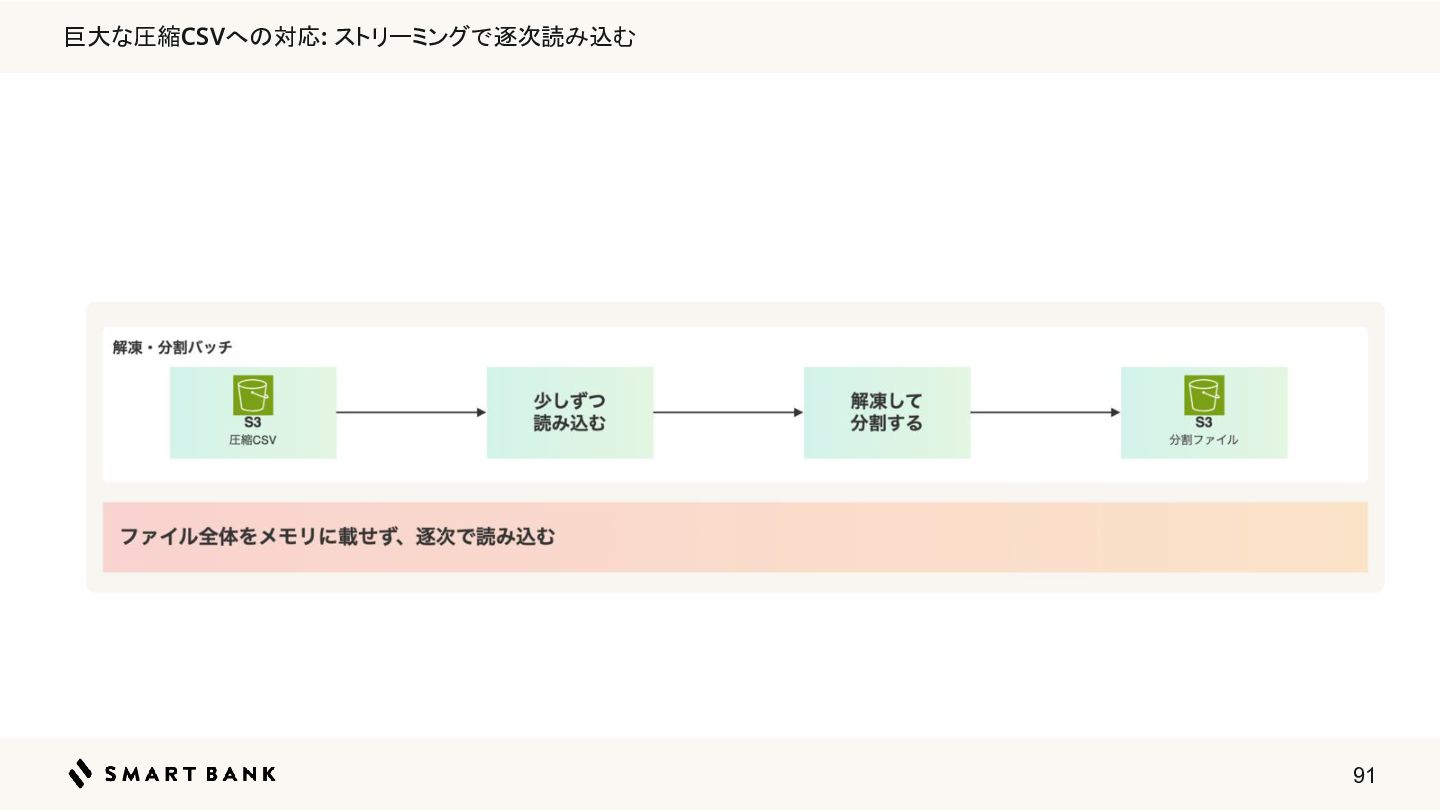
巨大な圧縮CSVへの対応: ストリーミングで逐次読み込む 91
アジェンダ 92
3. 運用時に発生したボトルネックとの戦い 93
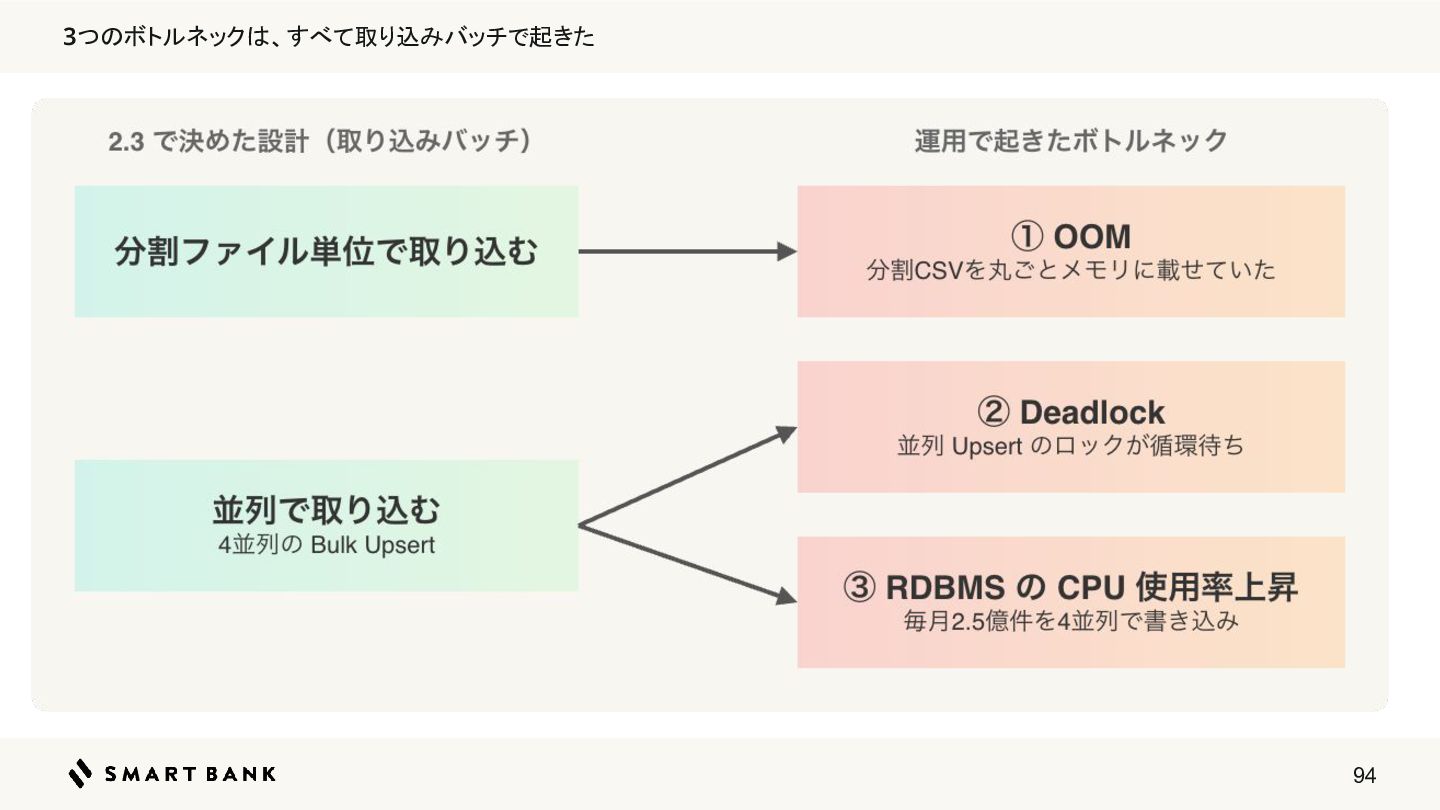
3つのボトルネックは、すべて取り込みバッチで起きた 94
OOMへの対応 95
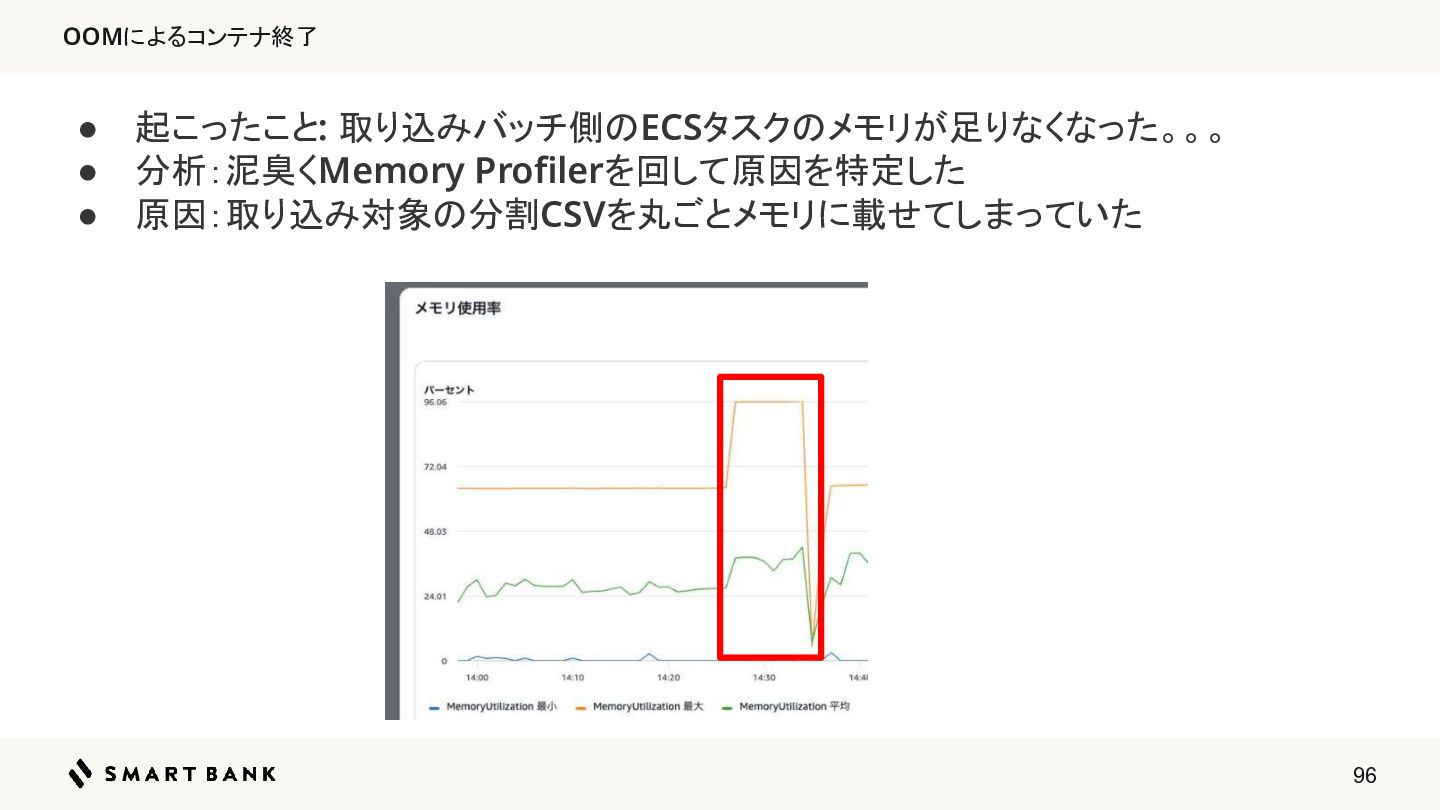
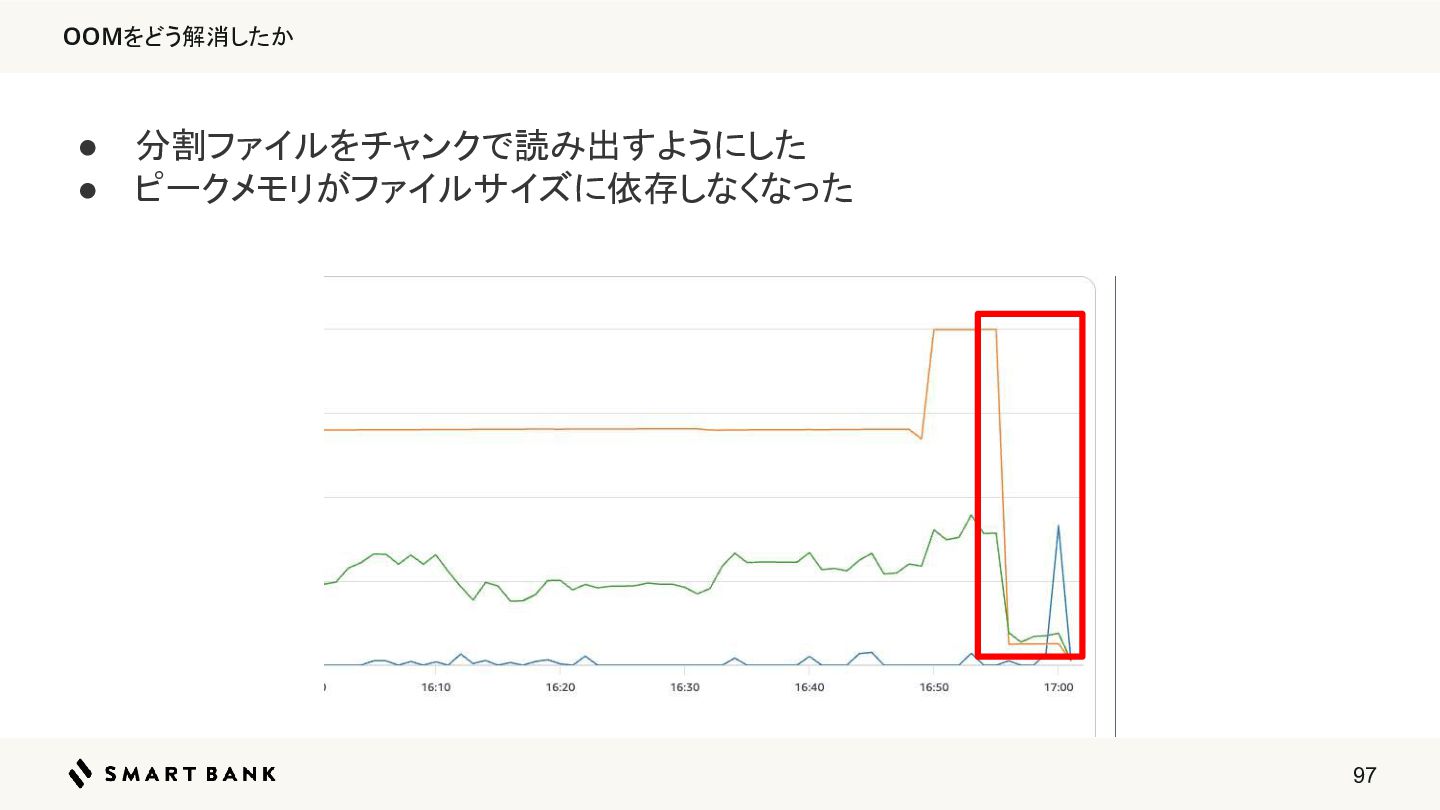
OOMによるコンテナ終了 • • • 起こったこと: 取り込みバッチ側のECSタスクのメモリが足りなくなった。。。 分析:泥臭くMemory Profilerを回して原因を特定した 原因:取り込み対象の分割CSVを丸ごとメモリに載せてしまっていた 96
OOMをどう解消したか • • 分割ファイルをチャンクで読み出すようにした ピークメモリがファイルサイズに依存しなくなった 97
Deadlockへの対応 98
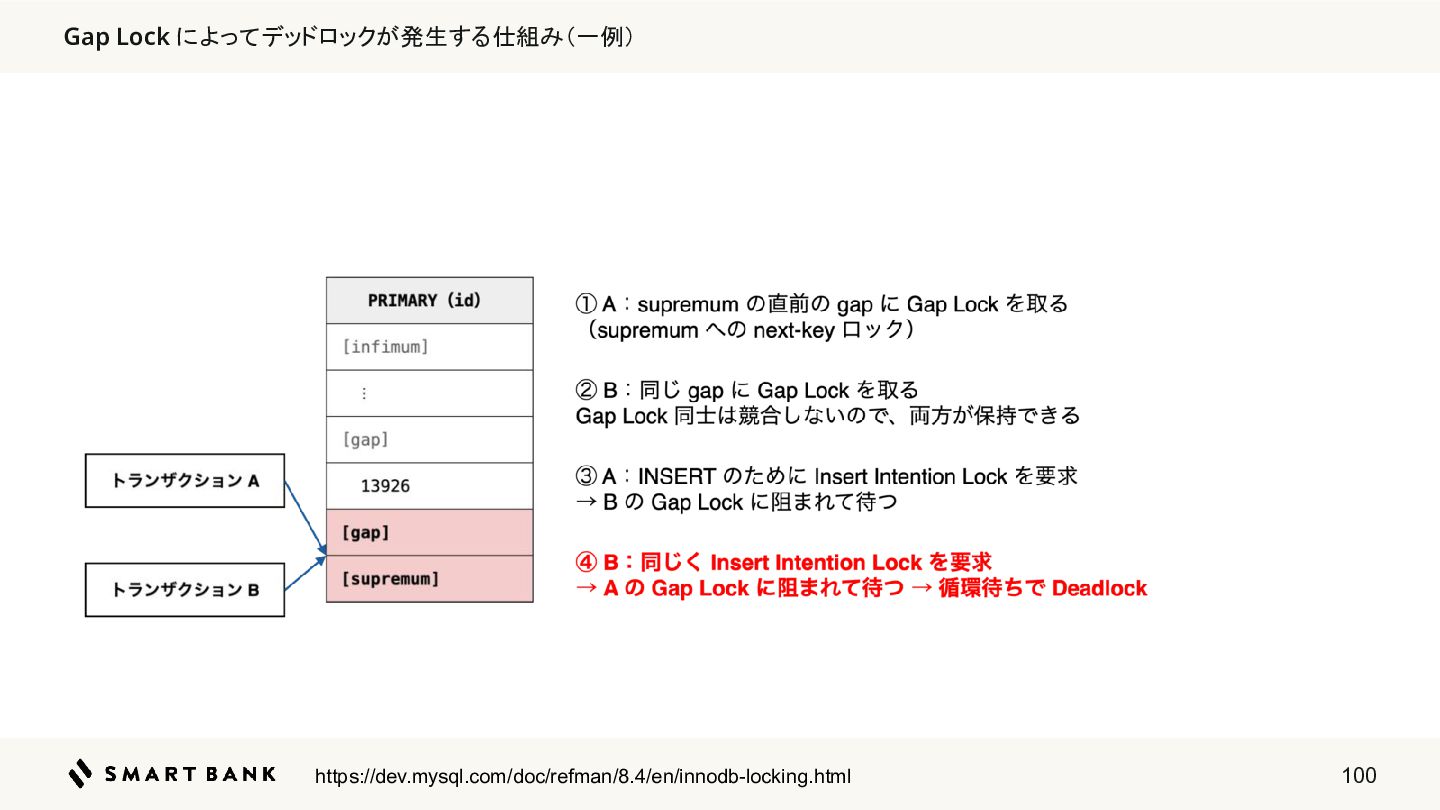
並列Bulk Upsertで大量のDeadlock • • • 起こったこと: ◦ 大量のDeadlockが発生した 分析: ◦
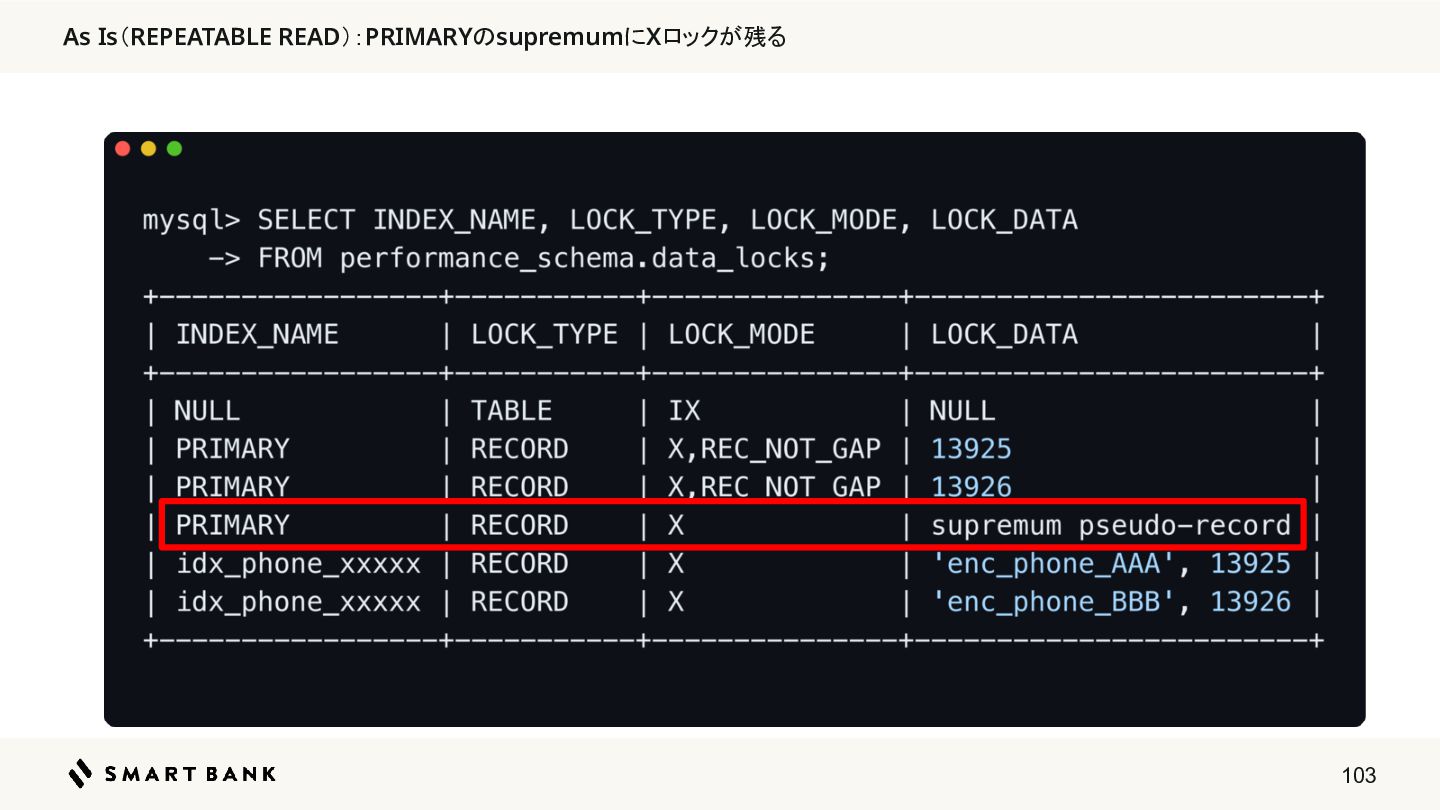
performance_schema.data_locksでロックの取得状況を調査した 原因: ◦ PRIMARYのsupremumに対するXロックと、後続INSERTのInsert Intention Lockが競合し、トランザクション間で循環待ちが発生した 再現用のスクリプトをpushしたgithubリポジトリはQRコードから! 99
Gap Lock によってデッドロックが発生する仕組み(一例) https://dev.mysql.com/doc/refman/8.4/en/innodb-locking.html 100
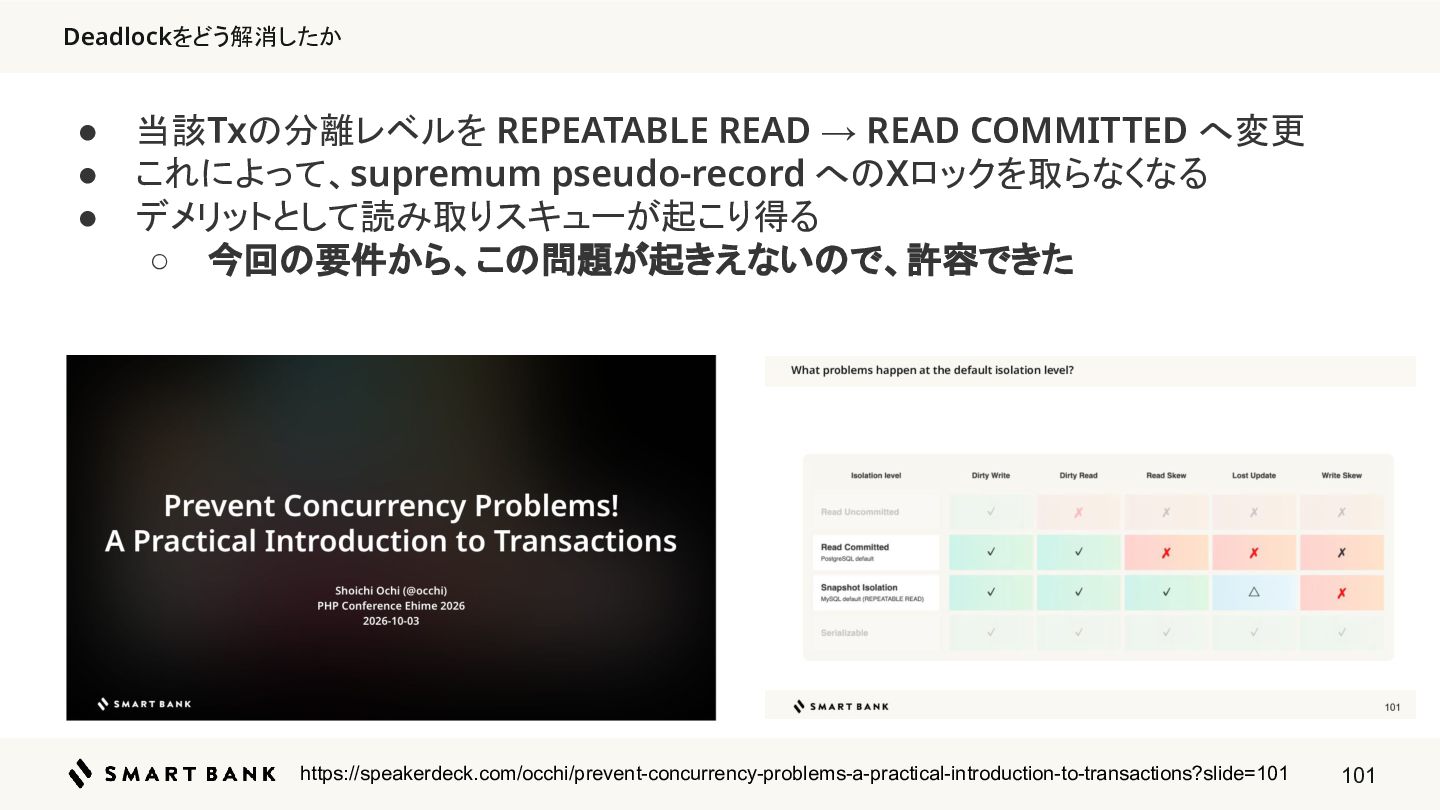
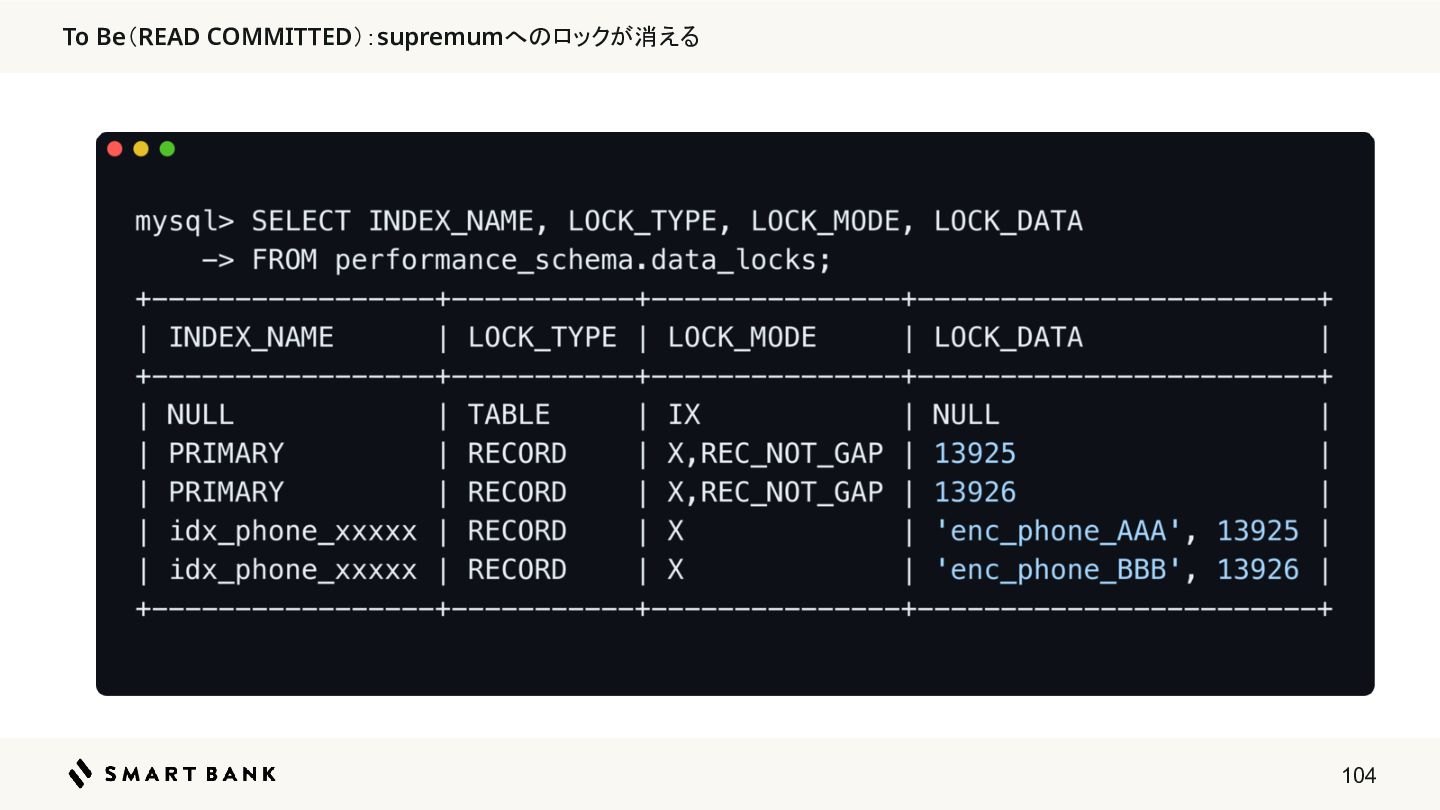
Deadlockをどう解消したか • • • 当該Txの分離レベルを REPEATABLE READ → READ COMMITTED
へ変更 これによって、supremum pseudo-record へのXロックを取らなくなる デメリットとして読み取りスキューが起こり得る ◦ 今回の要件から、この問題が起きえないので、許容できた https://speakerdeck.com/occhi/prevent-concurrency-problems-a-practical-introduction-to-transactions?slide=101 101
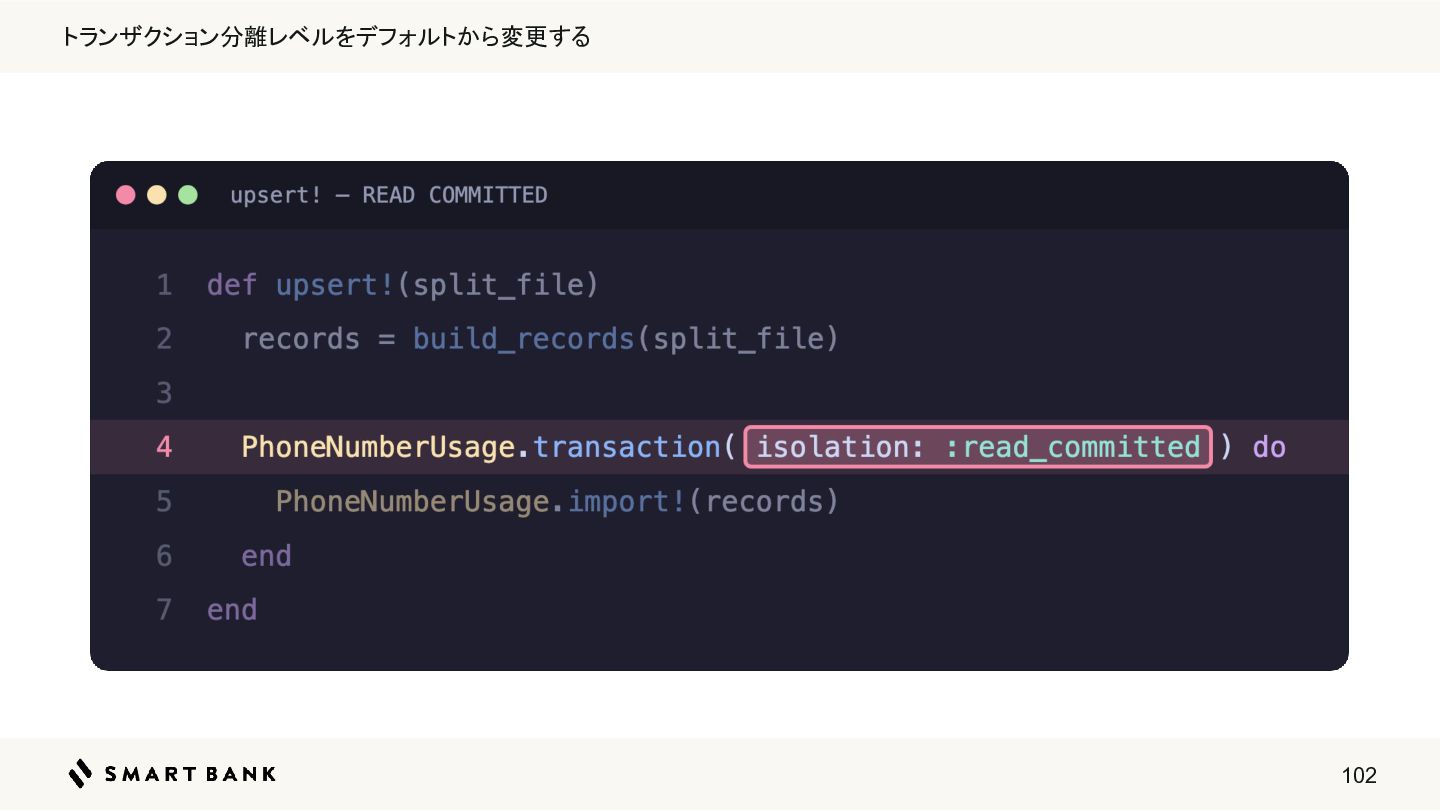
トランザクション分離レベルをデフォルトから変更する 102
As Is(REPEATABLE READ):PRIMARYのsupremumにXロックが残る 103
To Be(READ COMMITTED):supremumへのロックが消える 104
RDBMSのCPU使用率が上昇してしまう問題 105
RDBMSのCPU使用率上昇 • • 起こったこと: ◦ ユーザーからの書き込みトラフィックの増加に伴い、Writer DBのCPU使用率 への影響が深刻化 調査結果: ◦
2.5億件全件を毎月 Bulk Upsert していた。 ◦ 毎月の取り込みで、実際に更新したいのは500万件に達しない程度 106
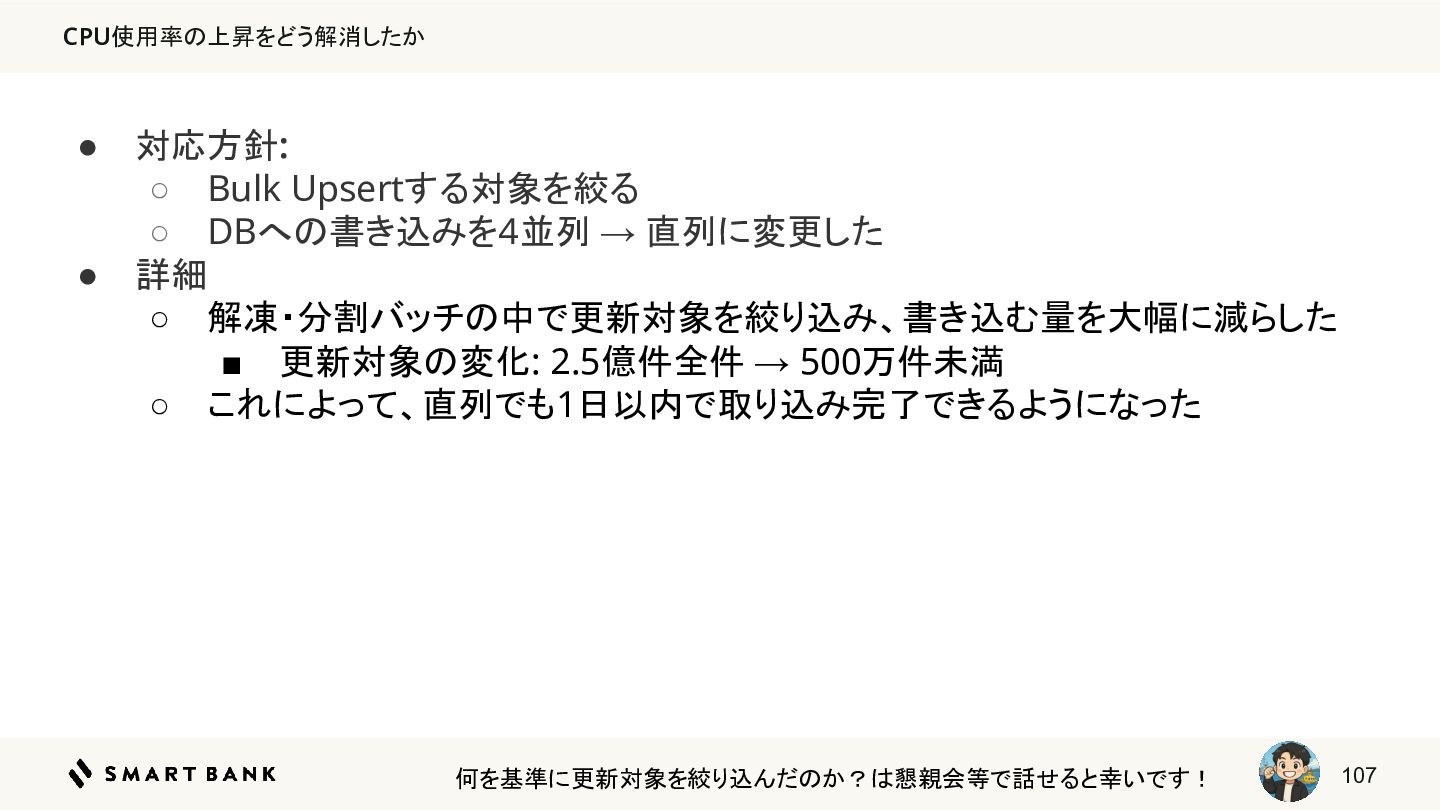
CPU使用率の上昇をどう解消したか • • 対応方針: ◦ Bulk Upsertする対象を絞る ◦ DBへの書き込みを4並列 →
直列に変更した 詳細 ◦ 解凍・分割バッチの中で更新対象を絞り込み、書き込む量を大幅に減らした ▪ 更新対象の変化: 2.5億件全件 → 500万件未満 ◦ これによって、直列でも1日以内で取り込み完了できるようになった 何を基準に更新対象を絞り込んだのか?は懇親会等で話せると幸いです! 107
まとめ 108
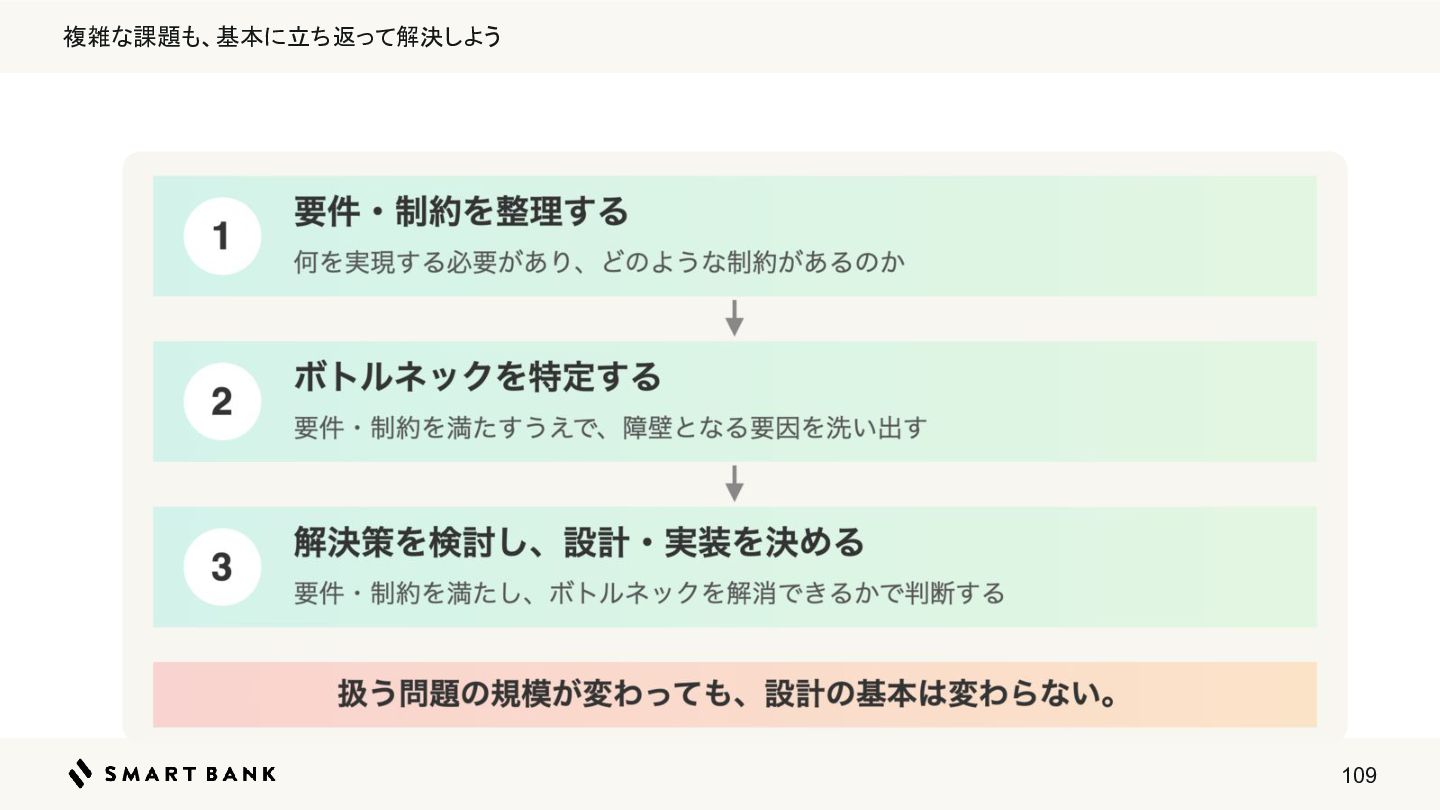
複雑な課題も、基本に立ち返って解決しよう 109
ご清聴ありがとうございました
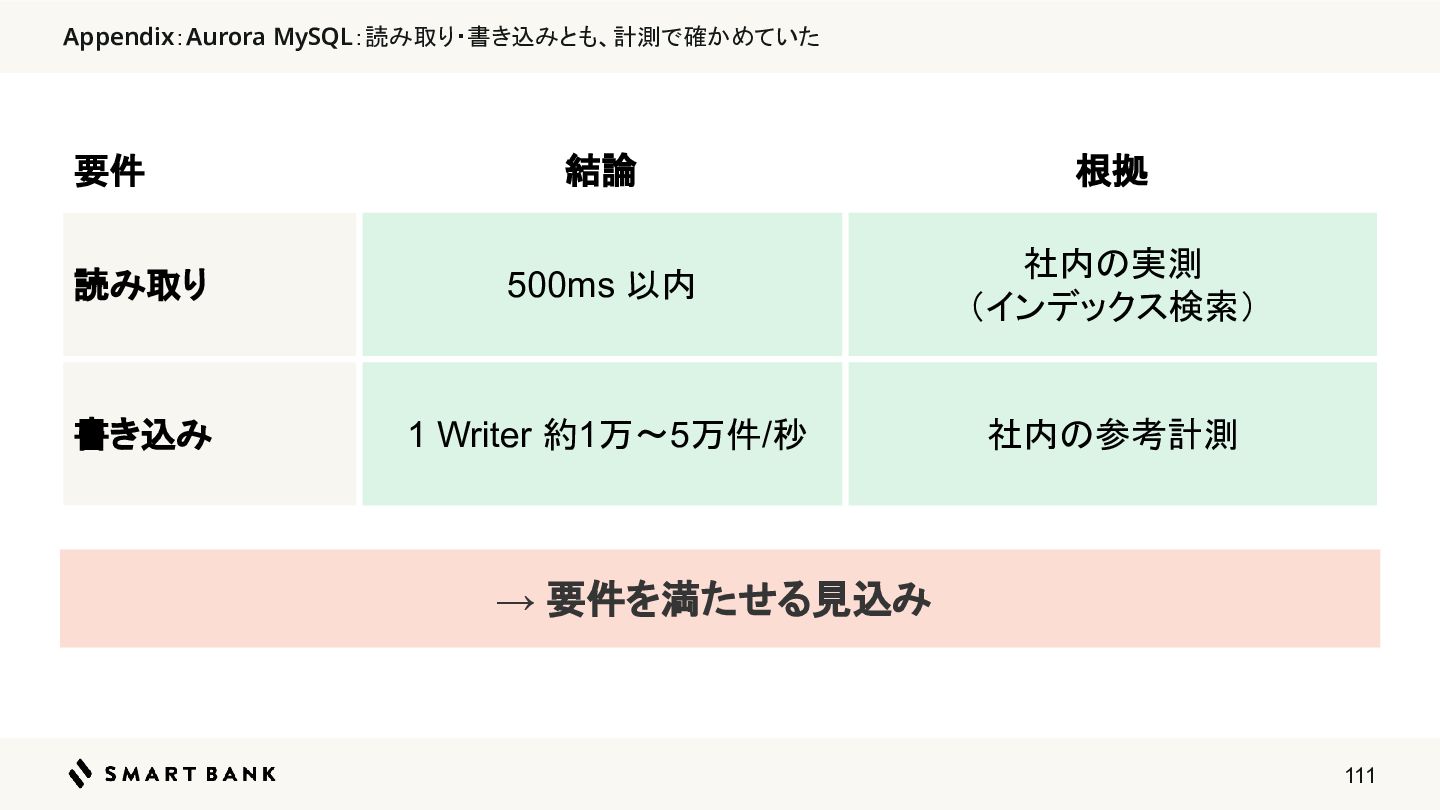
Appendix:Aurora MySQL:読み取り・書き込みとも、計測で確かめていた 要件 結論 根拠 読み取り 500ms 以内 社内の実測 (インデックス検索)
書き込み 1 Writer 約1万〜5万件/秒 社内の参考計測 → 要件を満たせる見込み 111
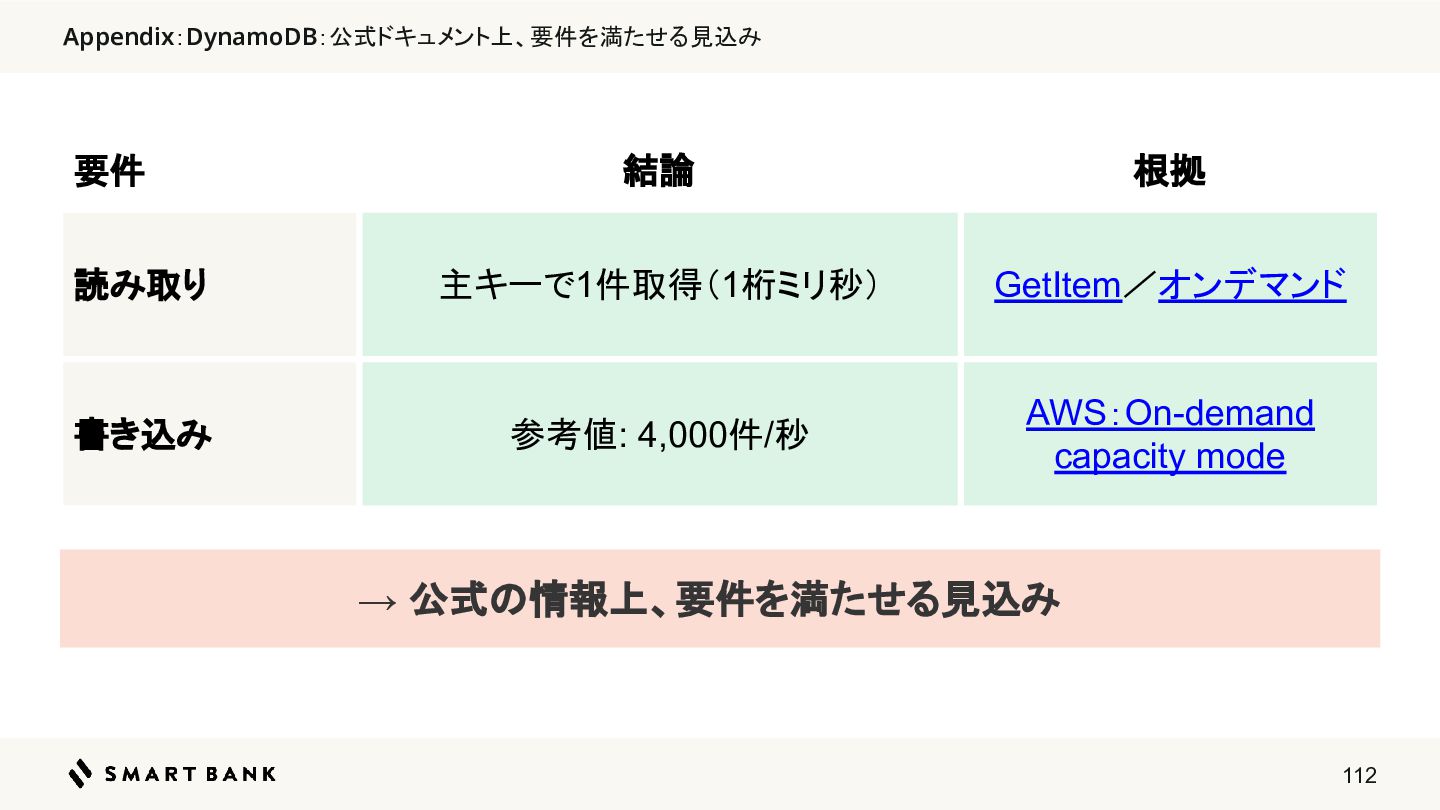
Appendix:DynamoDB:公式ドキュメント上、要件を満たせる見込み 要件 結論 根拠 読み取り 主キーで1件取得(1桁ミリ秒) GetItem/オンデマンド 書き込み 参考値: 4,000件/秒
AWS:On-demand capacity mode → 公式の情報上、要件を満たせる見込み 112
Appendix:Elasticsearch:公式ドキュメント・ベンチマーク上、要件を満たせる見込み 要件 読み取り 書き込み 結論 根拠 ID で1件取得。 複雑な検索でも P50
36ms・P99 316ms Get API/ストレステスト 参考値: 約51,700 docs/秒 Elastic Search Labs:Serverless のストレ ステスト → 公式の情報上、要件を満たせる見込み(条件は今回と異なる) 113
Appendix:選定時のコスト概算(前提条件つき) • • • • • いずれも選定時の概算。前提がそろっていないので、総額の横並び比較はしない Aurora MySQL:既存クラスタのストレージ・I/O の増分
◦ 月 $1,000 の予算内に収まる見込み。実測に基づく算出は未実施 DynamoDB(既存テーブルを更新):書き込み 約$186/月 + ストレージ ◦ 1件1KB以下・1 WRU/件・約2.6億件を仮定 DynamoDB(S3 Import):料金は非圧縮サイズが基準。約$1.37 は圧縮サイズ からの試算で未確定 Elasticsearch(Elastic Cloud Serverless):約$105/月 ◦ Search VCU 約$78・取り込み 約$10・ストレージ 約$17(VCU 使用量を仮定) 114
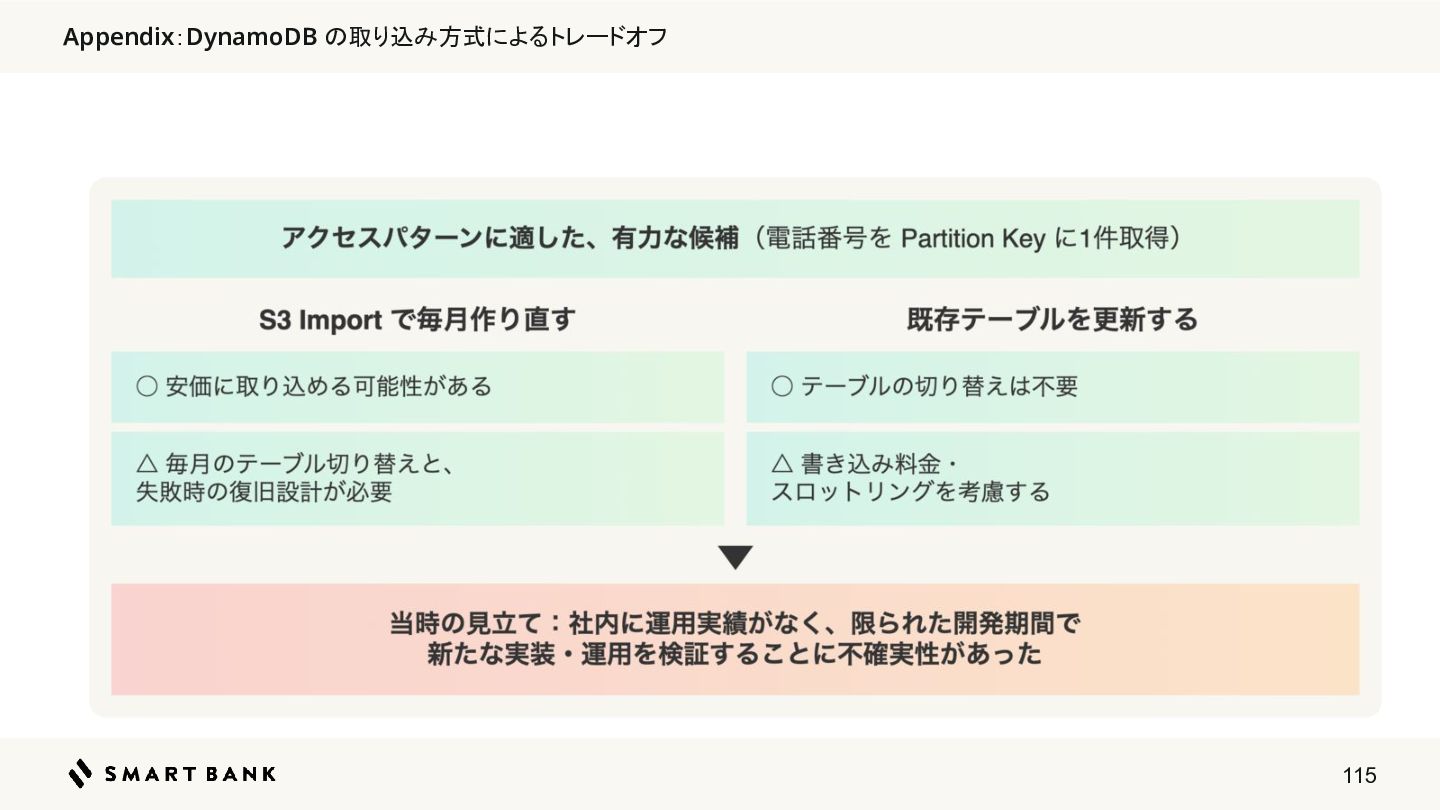
Appendix:DynamoDB の取り込み方式によるトレードオフ 115
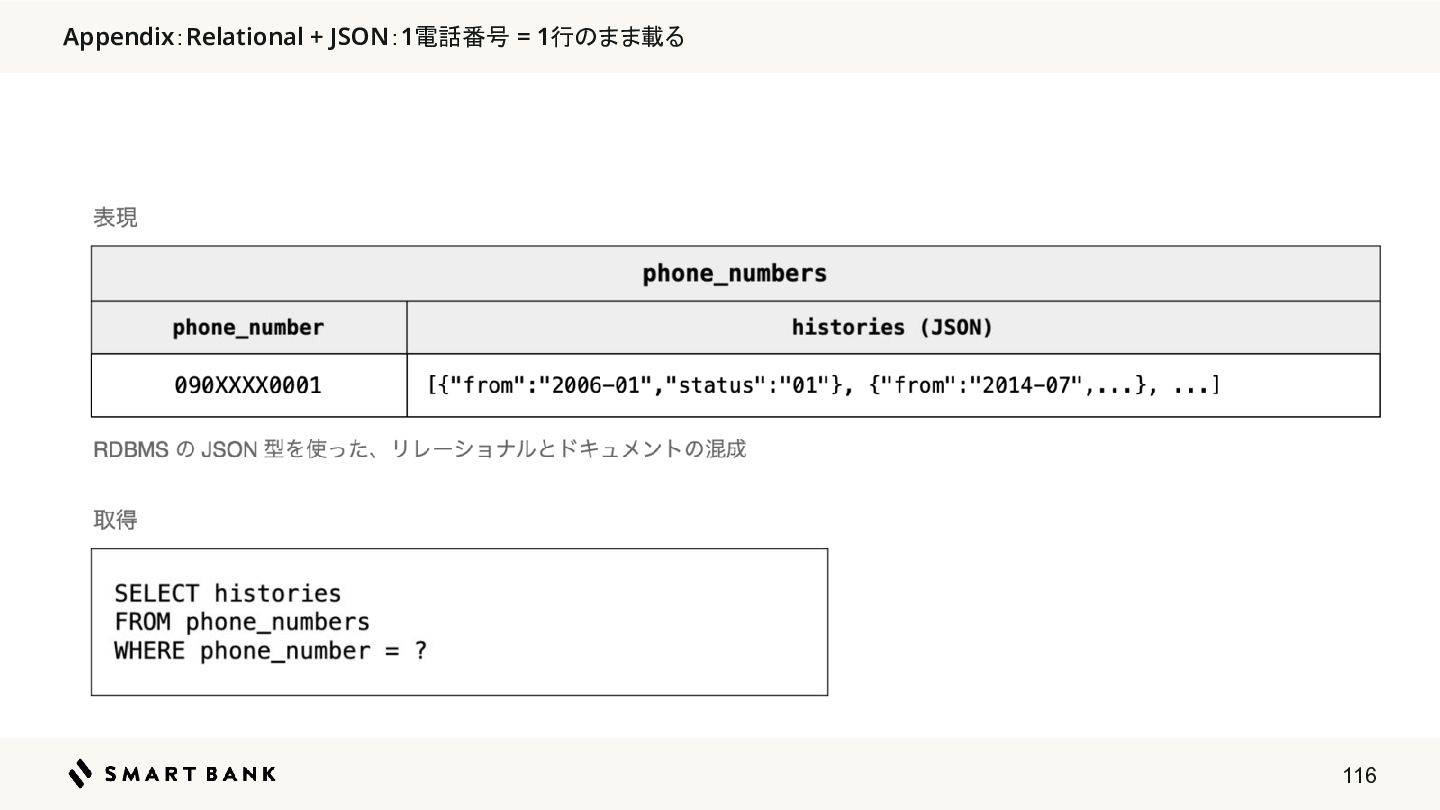
Appendix:Relational + JSON:1電話番号 = 1行のまま載る 116
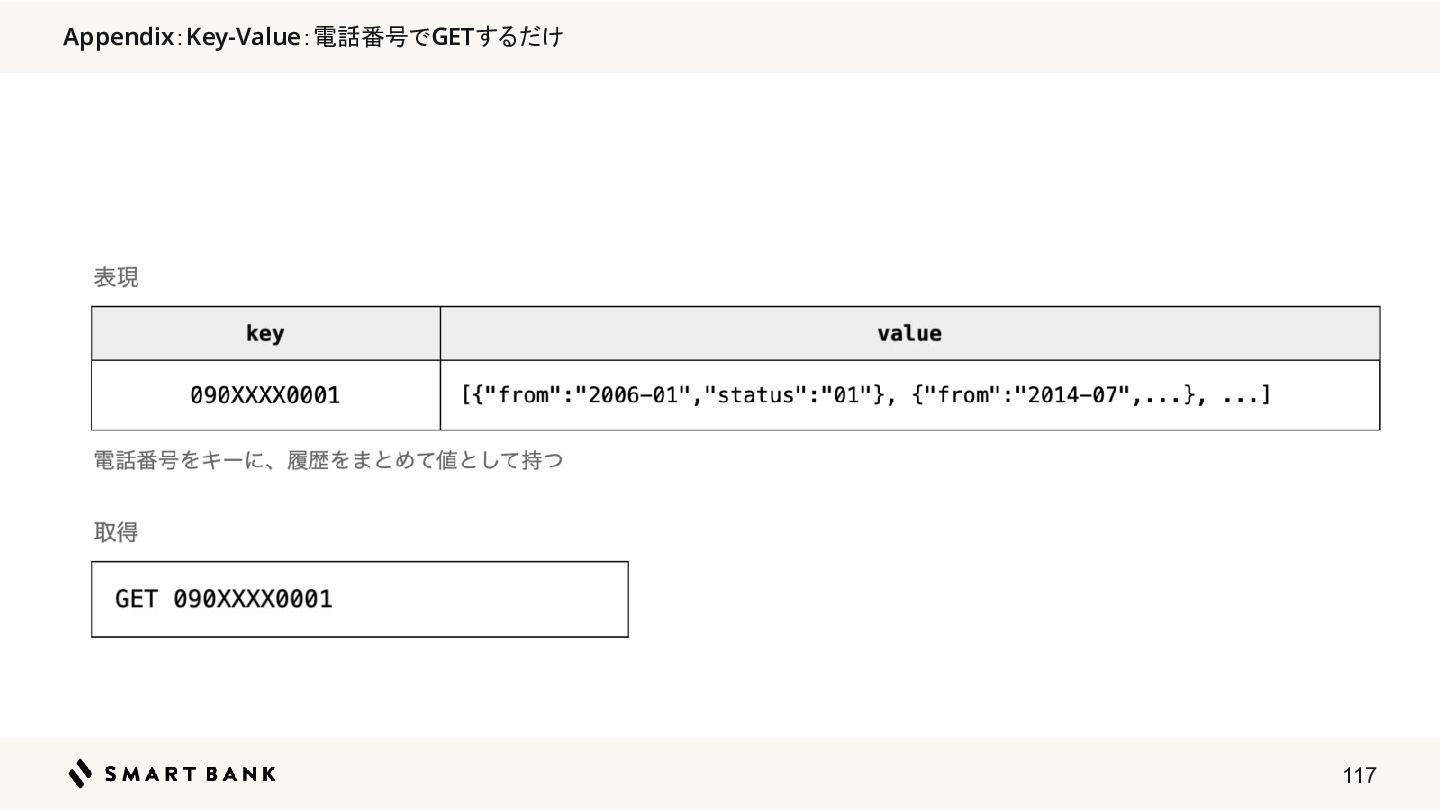
Appendix:Key-Value:電話番号でGETするだけ 117
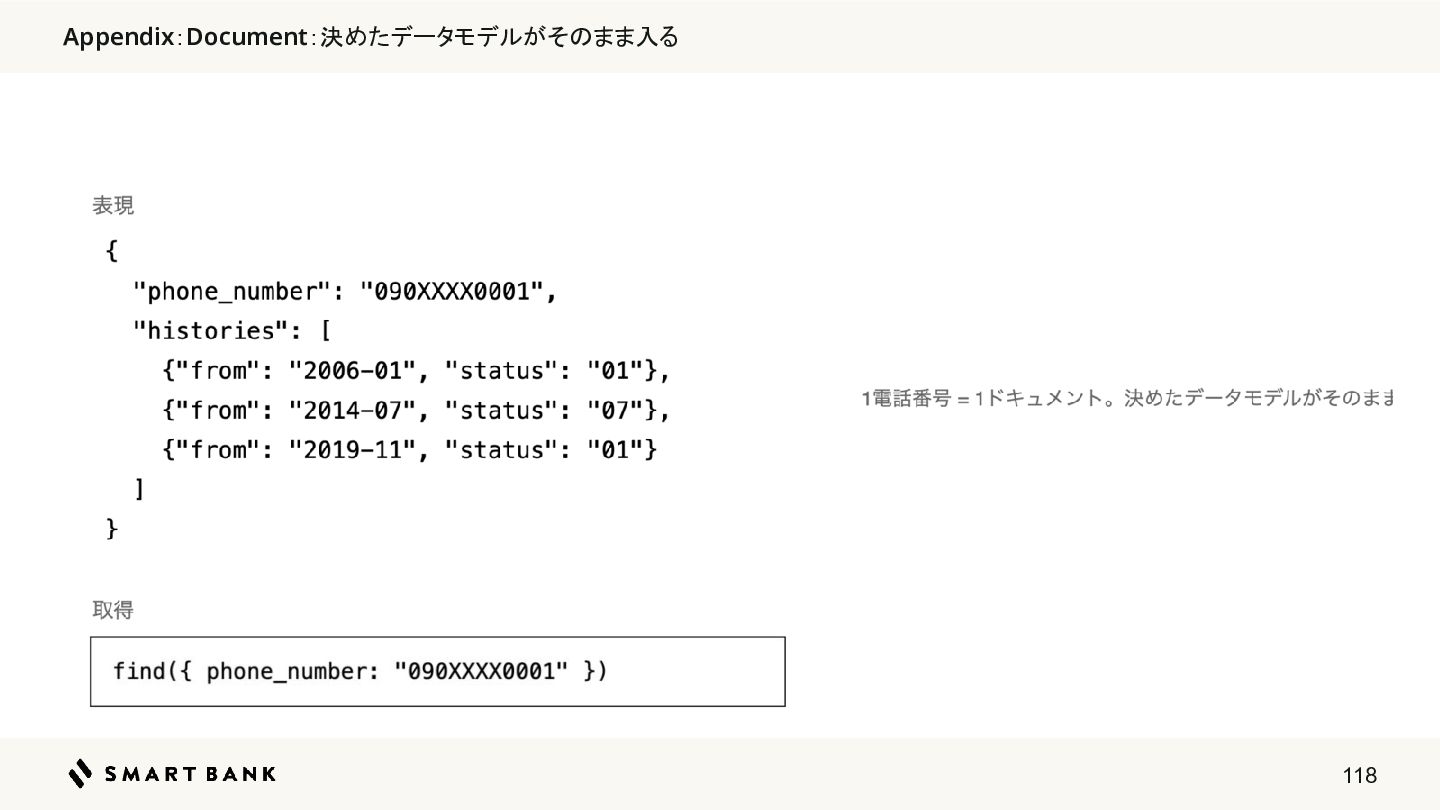
Appendix:Document:決めたデータモデルがそのまま入る 118
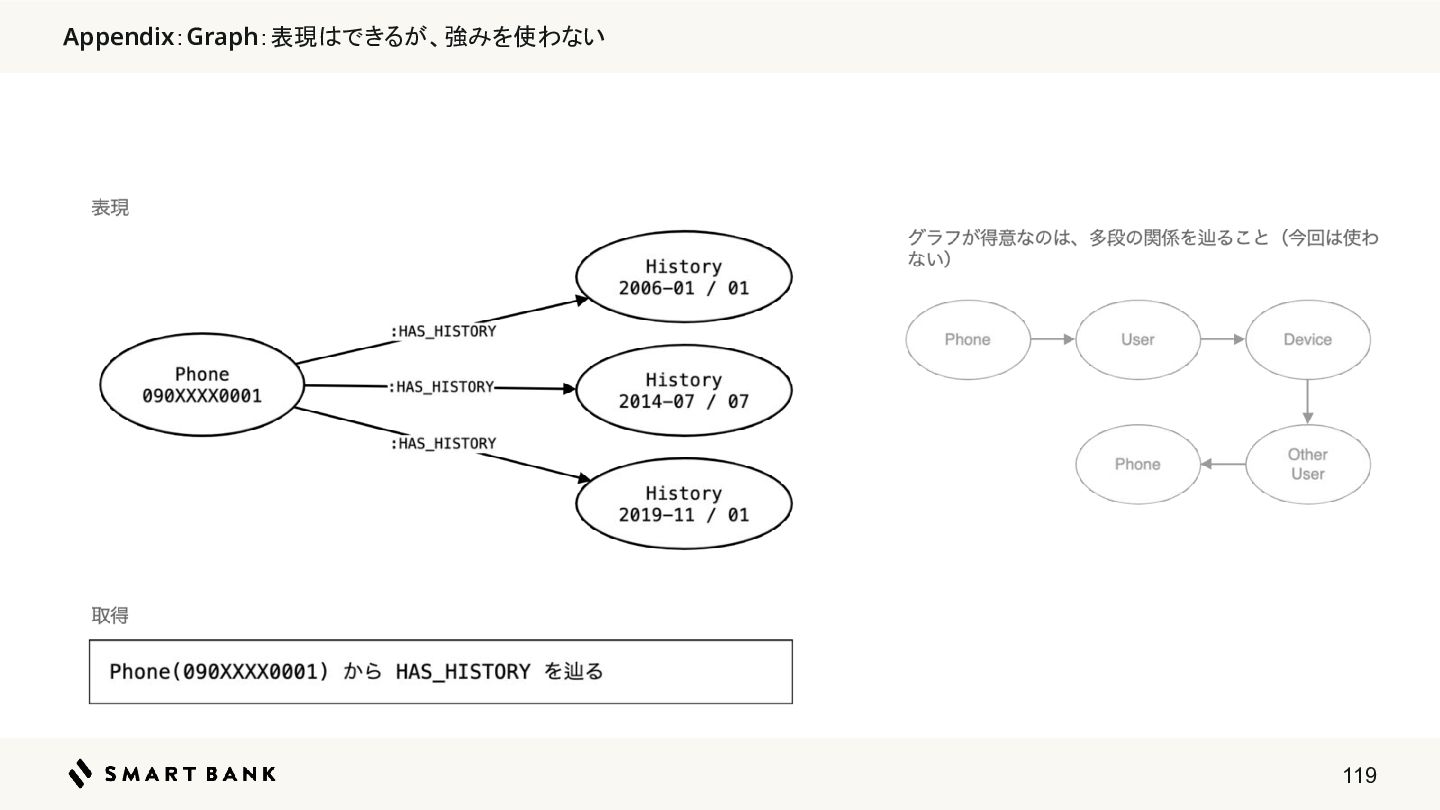
Appendix:Graph:表現はできるが、強みを使わない 119
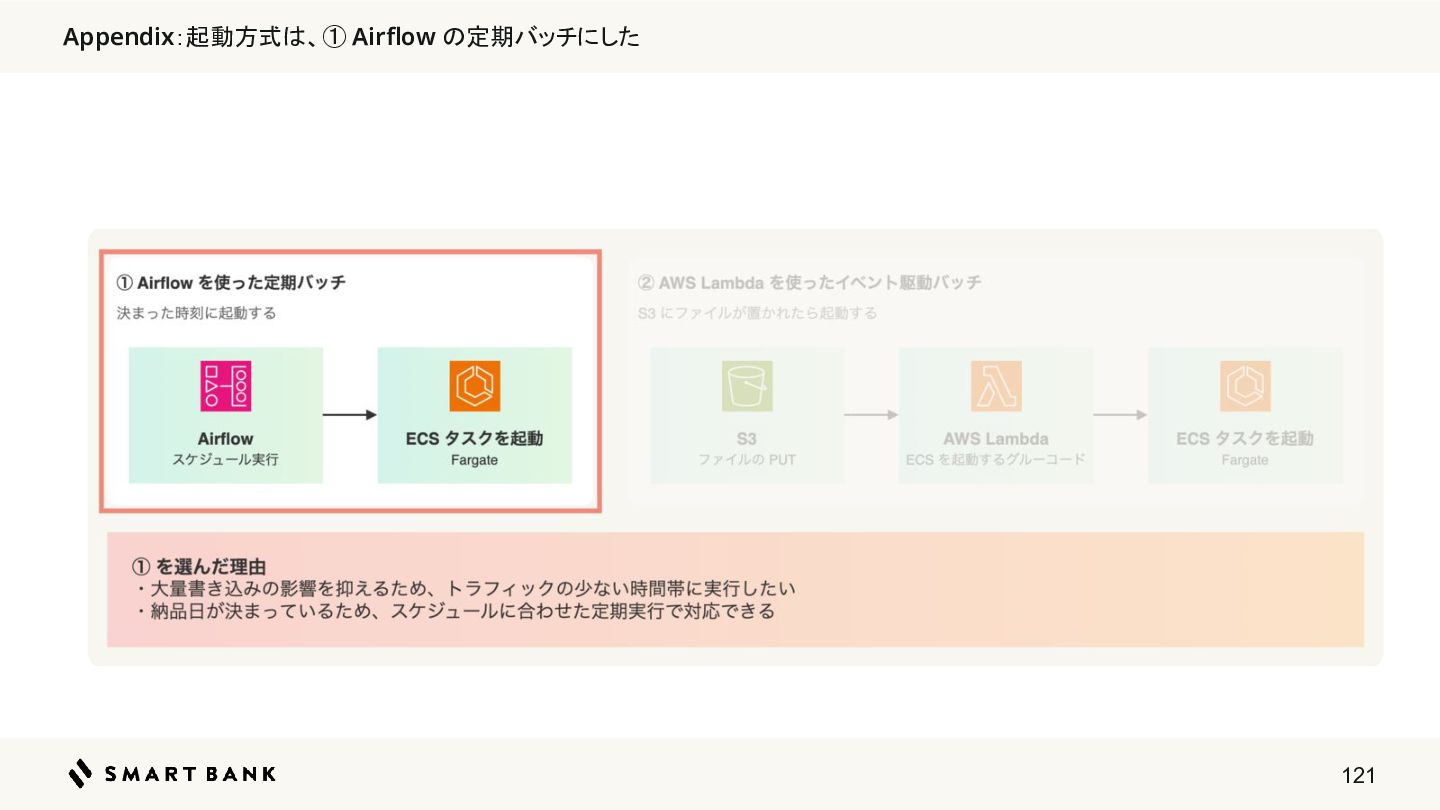
Appendix:前提: 弊社のバッチの起動方式は2種類あり、どちらもECSタスクを起動する 120
Appendix:起動方式は、① Airflow の定期バッチにした 121
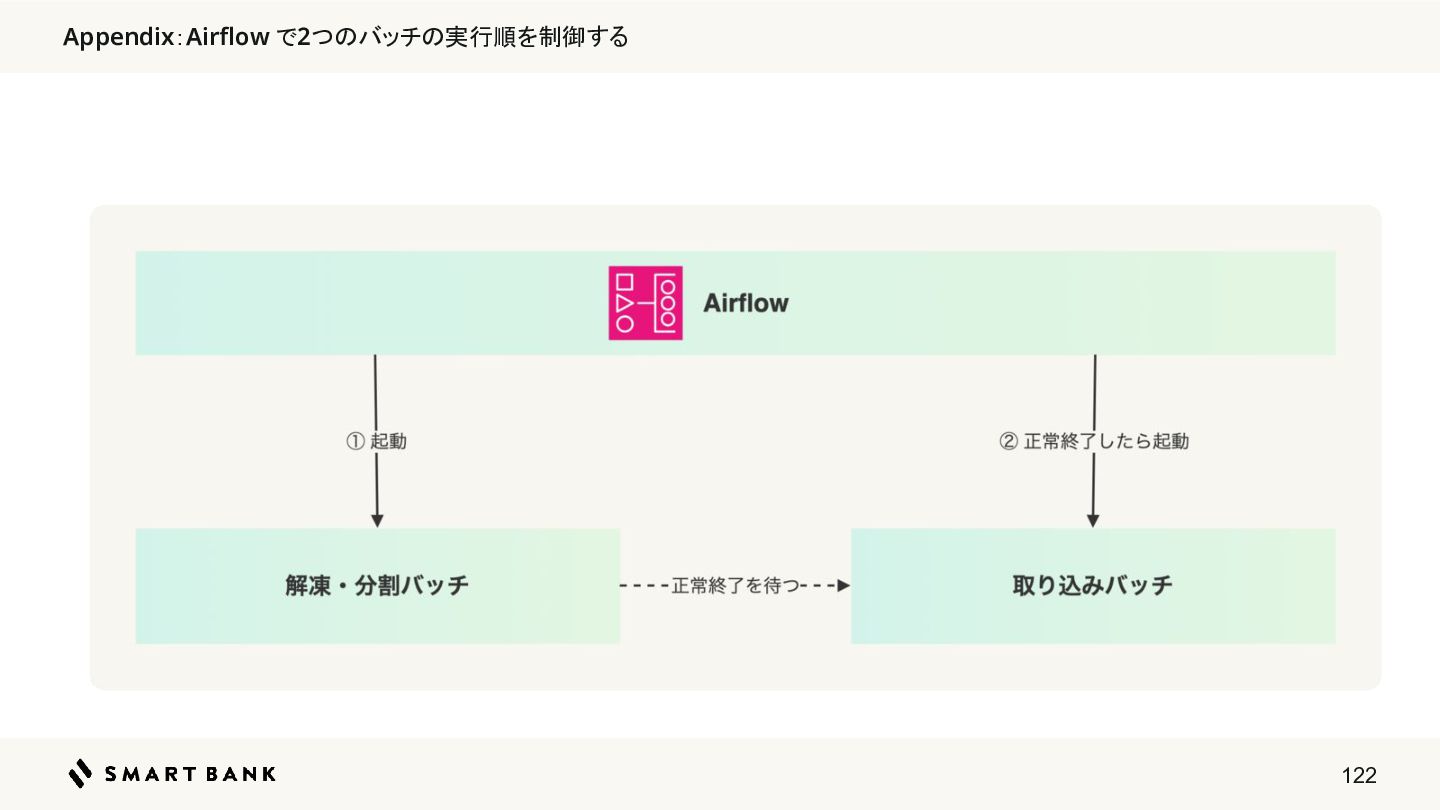
Appendix:Airflow で2つのバッチの実行順を制御する 122
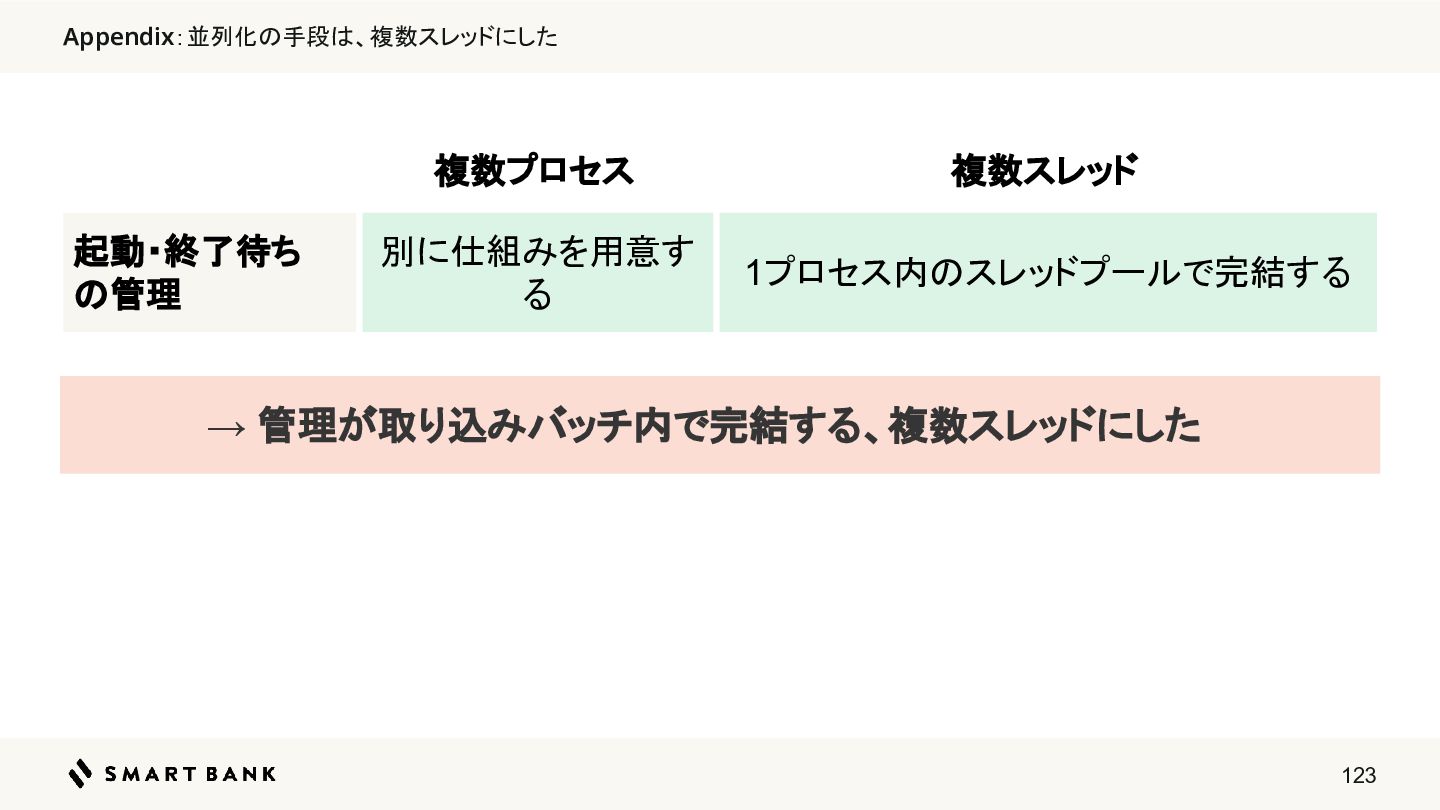
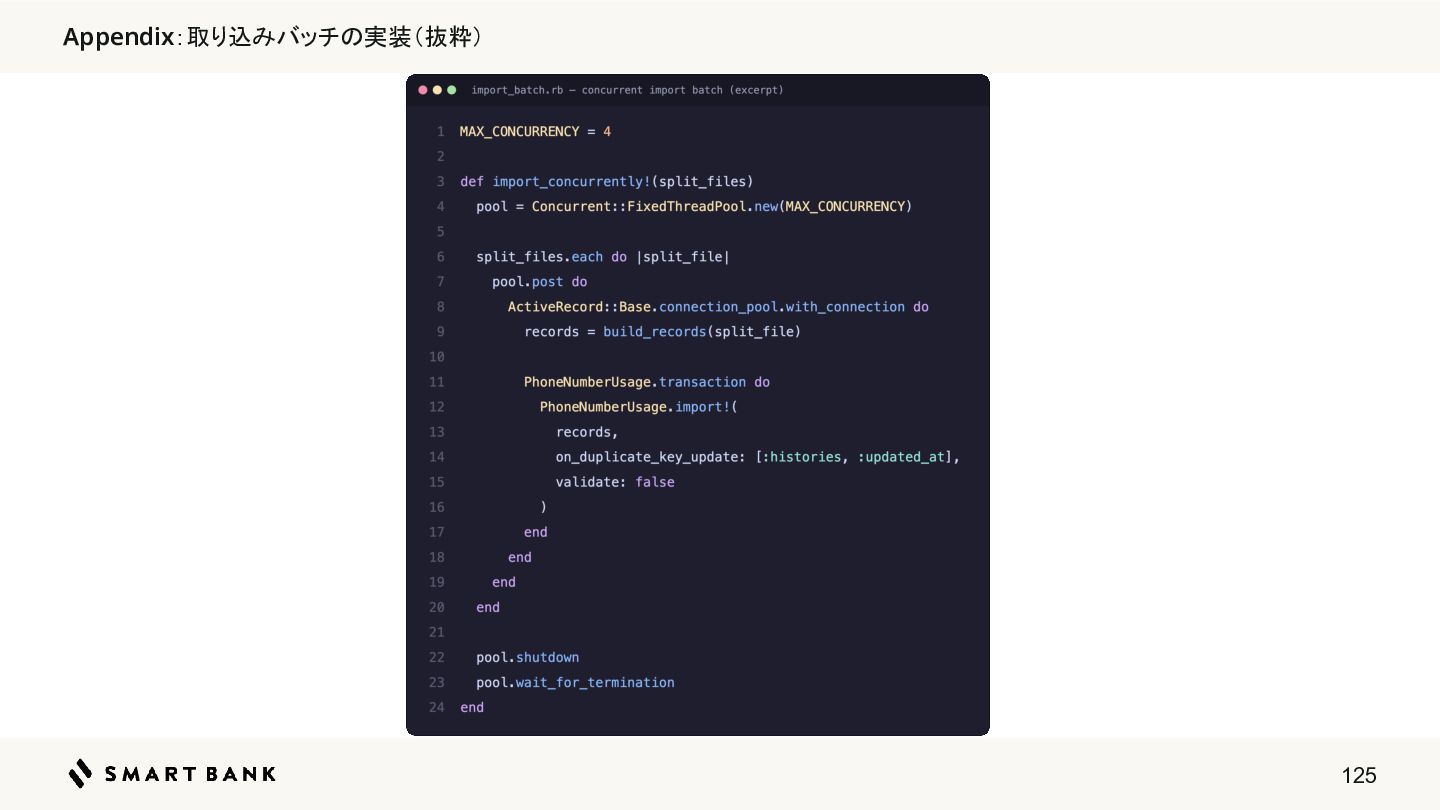
Appendix:並列化の手段は、複数スレッドにした 起動・終了待ち の管理 複数プロセス 複数スレッド 別に仕組みを用意す る 1プロセス内のスレッドプールで完結する → 管理が取り込みバッチ内で完結する、複数スレッドにした
123
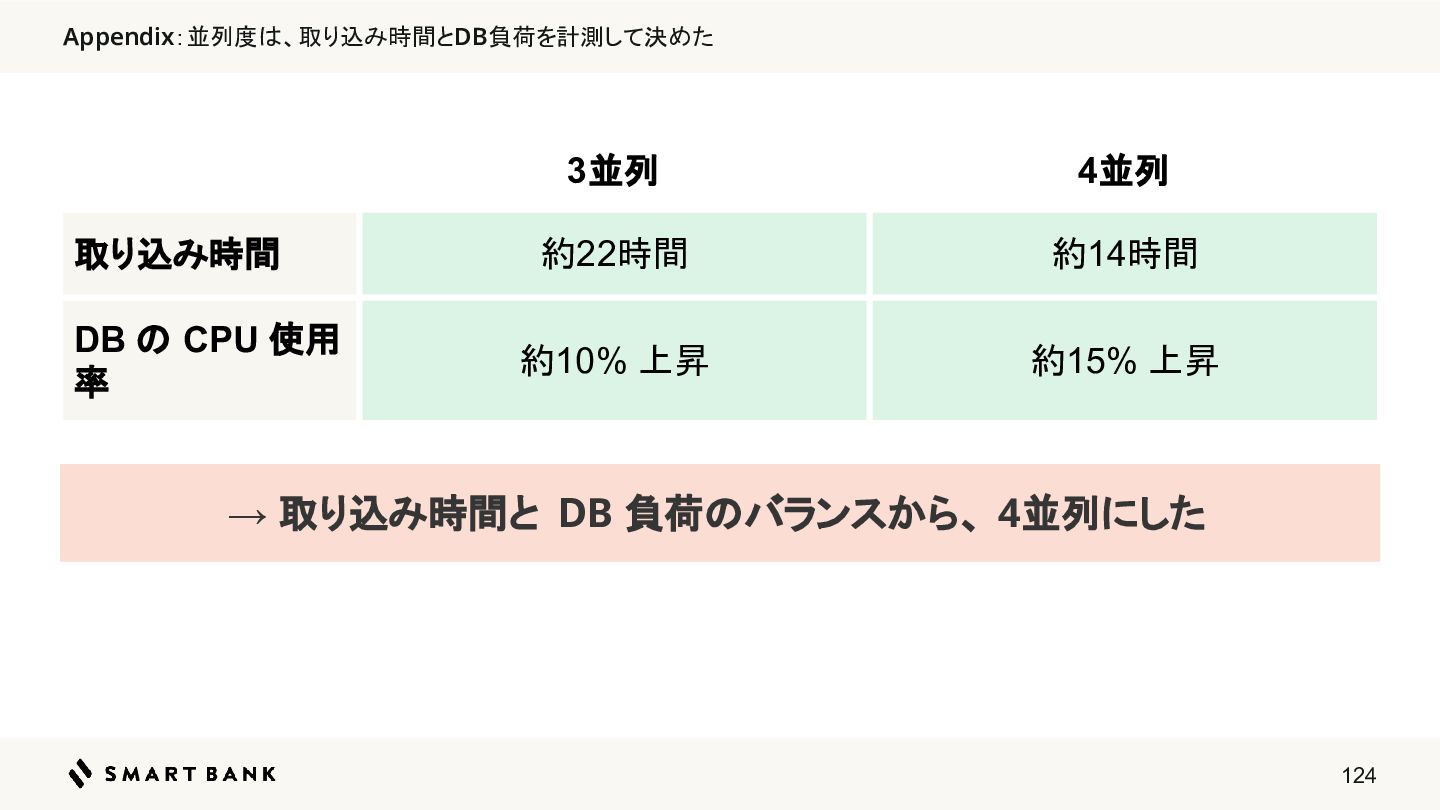
Appendix:並列度は、取り込み時間とDB負荷を計測して決めた 3並列 4並列 取り込み時間 約22時間 約14時間 DB の CPU 使用
率 約10% 上昇 約15% 上昇 → 取り込み時間と DB 負荷のバランスから、 4並列にした 124
Appendix:取り込みバッチの実装(抜粋) 125


 occhi
 kash1064
 philipz
 naruoga
 carta_engineering
 nayuts
 tsuchikazu
 kizawa2020
 yokawasa
 ufried
 satoshi7
 toshimaru
 mananyuki
 katiecoart
 aleyda
 cassininazir
 keithpitt
 techseoconnect
 aki_iinuma
 tammyeverts
 honnibal
 sugarenia
 danielanewman
 baasie
 davidcarrasco