Upgrade to Pro
— share decks privately, control downloads, hide ads and more …
Speaker Deck
Sign up for free
Menu
Search
Features
All features
Private URLs
Password Protection
Custom URLS
Scheduled publishing
Remove Branding
Restrict embedding
Deck Collections
Notes
Features
All features
Private URLs
Password Protection
Custom URLS
Scheduled publishing
Remove Branding
Restrict embedding
Deck Collections
Notes
Explore
Featured decks
Featured speakers
Programming
Technology
Storyboards
Explore
Featured decks
Featured speakers
Programming
Technology
Storyboards
Pricing
Search
Sign in
Sign up for free
日本語に強いオープンな大規模言語モデル「LLM-jp」
Search
Yusuke Oda
October 16, 2026
Technology
260
0
Share
Embed
Copy iframe code
Copy JS code
Copy link
Start on current slide
日本語に強いオープンな大規模言語モデル「LLM-jp」
2026年10月8日にインターネットプロバイダ協会で行った談話の資料です。
Yusuke Oda
October 16, 2026
More Decks by Yusuke Oda
See All by Yusuke Oda
オープンソースAIの開発事情 (2026-07-22 @NLPコロキウム)
odashi
9
1.9k
NIIにおける大規模言語モデル構築事業の現在地
odashi
8
3.6k
LLM-jp-3 and beyond: Training Large Language Models
odashi
1
970
Collaborative Development of Foundation Models at Japanese Academia
odashi
2
690
Other Decks in Technology
See All in Technology
ブラウザとサーバーから考えるAI時代のフロントエンド監視
shogo4131
3
860
Post AI時代のリファクタリング実践記 / Refactoring in the post AI era
kaminashi
1
170
AIカンパニーへの転換を支えた、エンジニアの仕事の再定義
kworkdev
PRO
0
300
脆弱性診断って、何をしているの? 〜弱点を見つけて、会社の改善につなげるまで〜
keeg
0
870
自作バイナリを動かす「入口」8選
puhitaku
2
1.3k
全人類(ほぼ)AWS Organizations の上でAWSを利用している、その世界を知る話
htan
1
140
会社説明資料
persolserverworks
0
9.7k
不可逆な意思決定を避けながら10億超の顧客データを AI Ready にするデータ基盤設計
baseballyama
1
310
「事実」を「計測」して、「解釈」する 〜AWS Lambdaのメモリ最適解の見つけ方〜
maimyyym
0
140
【Data Engineering Summit2026_登壇資料】医療ビッグデータ×AIエージェントを支えるデータ基盤とハーネスエンジニアリング
jmdc_presentation
0
130
AI時代に必要な脅威モデリング― 変化の速度に負けない理解とリスク判断
masakane55
5
1.3k
AIに攻撃される前に、AIに攻撃させる
tsuchikazu
0
170
Featured
See All Featured
Crafting Experiences
bethany
1
380
ラッコキーワード サービス紹介資料
rakko
1
5.3M
How to Get Subject Matter Experts Bought In and Actively Contributing to SEO & PR Initiatives.
livdayseo
0
210
A Tale of Four Properties
chriscoyier
163
24k
Heart Work Chapter 1 - Part 1
lfama
PRO
10
37k
Cheating the UX When There Is Nothing More to Optimize - PixelPioneers
stephaniewalter
287
14k
Neural Spatial Audio Processing for Sound Field Analysis and Control
skoyamalab
0
560
Dominate Local Search Results - an insider guide to GBP, reviews, and Local SEO
greggifford
PRO
0
360
Creating an realtime collaboration tool: Agile Flush - .NET Oxford
marcduiker
35
2.6k
SEO Brein meetup: CTRL+C is not how to scale international SEO
lindahogenes
2
2.9k
Navigating Weather and Climate Data
rabernat
0
550
The Illustrated Children's Guide to Kubernetes
chrisshort
51
53k
Transcript
【共有版資料】 日本語に強いオープンな大規模言語モデル 「LLM-jp」 これまでの歩み、ライセンス、LLM-jp-4 / 4.1 の技術、基盤運用 小田 悠介(国立情報学研究所 大規模言語モデル研究開発センター)
2026-10-08 | JAIPA
免責事項: 本スライドは、インターネットプロバイダ協会(JAIPA)の勉強会において 小田が雑談を交えた談話を行うための素材集として用意したものです。 LLM-jpの内部記録や過去の発表資料からClaude Codeで準備し、多少調整をしています。 自己完結していなかったり、生成文書特有の不自然さが残っていますが、何卒ご容赦下さい。 2026-10-08 | JAIPA 2
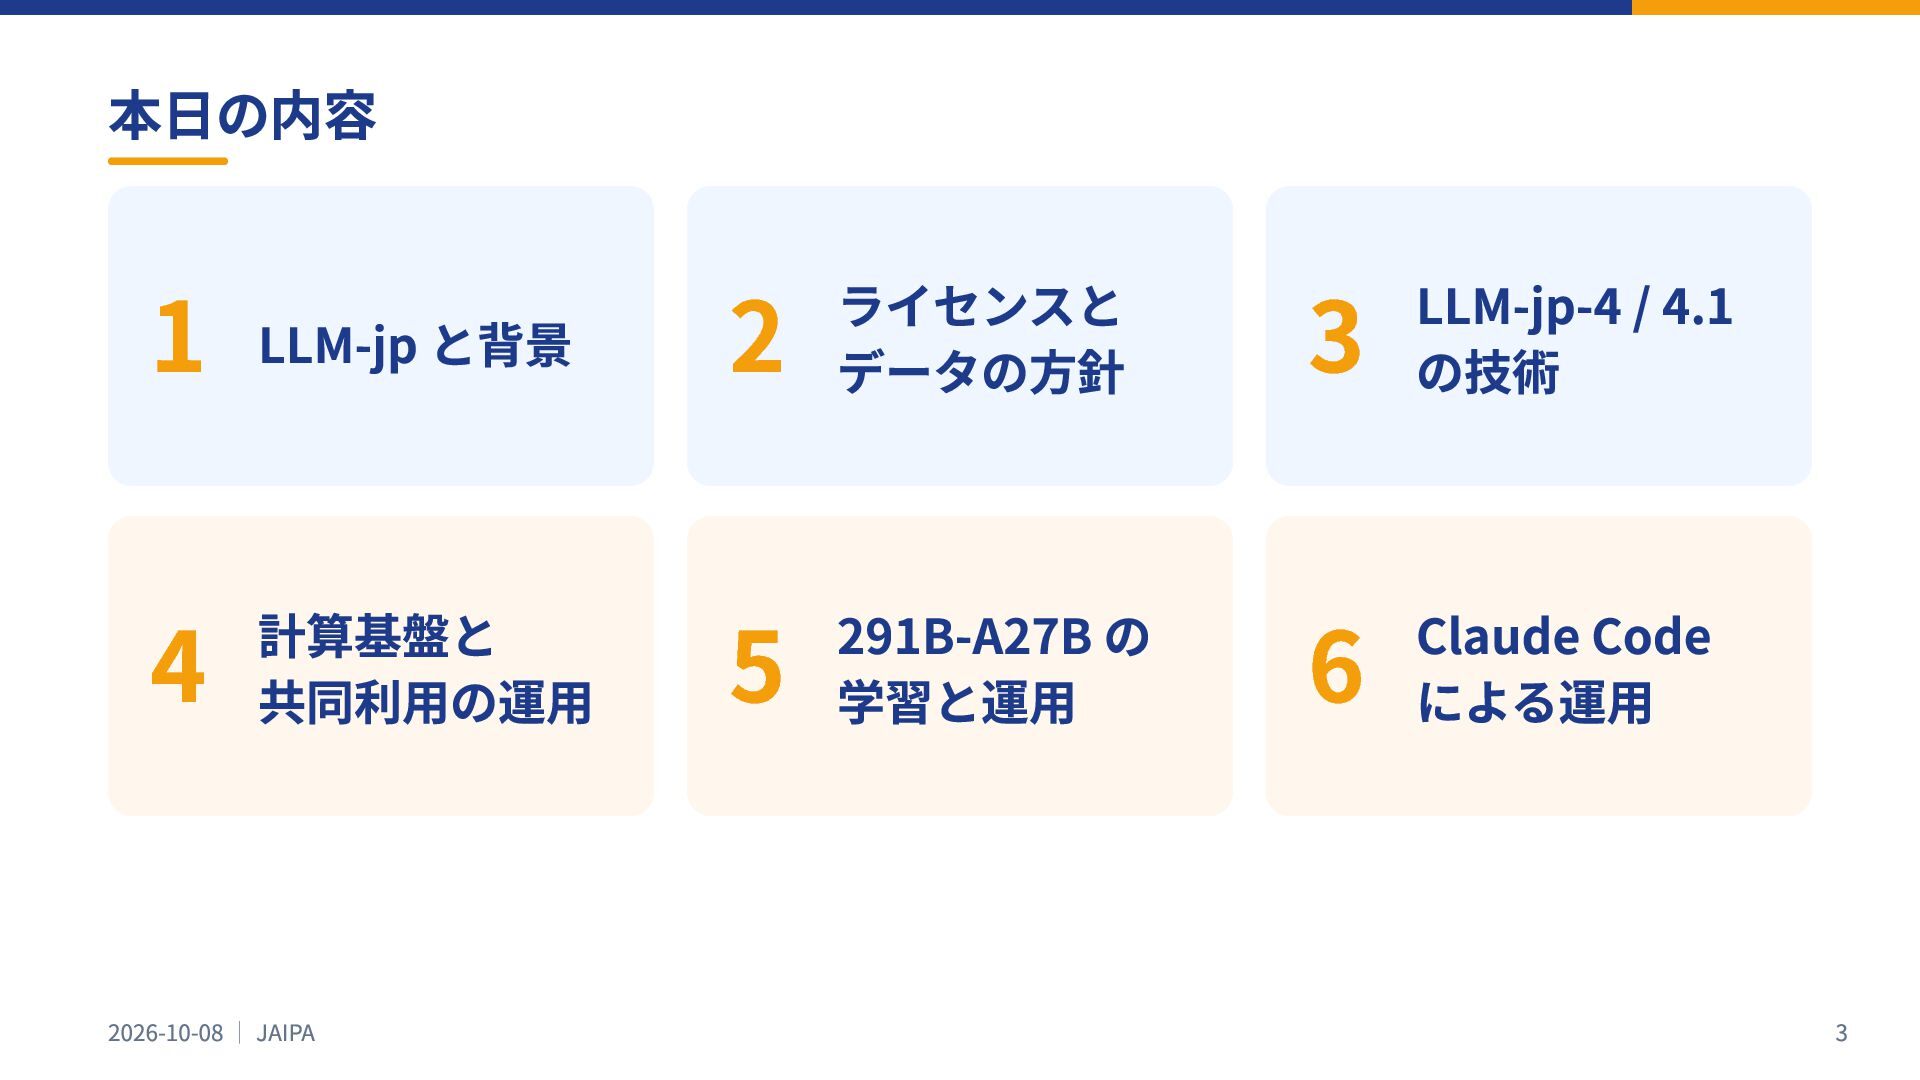
本日の内容 1 LLM-jp と背景 2 ライセンスと データの⽅針 3 LLM-jp-4 /
4.1 の技術 4 291B-A27B の 学習と運⽤ 6 Claude Code による運⽤ 計算基盤と 共同利⽤の運⽤ 2026-10-08 | JAIPA 5 3
第1部 LLM-jp と背景 国内でオープンに LLM を開発する理由 2026-10-08 | JAIPA 4
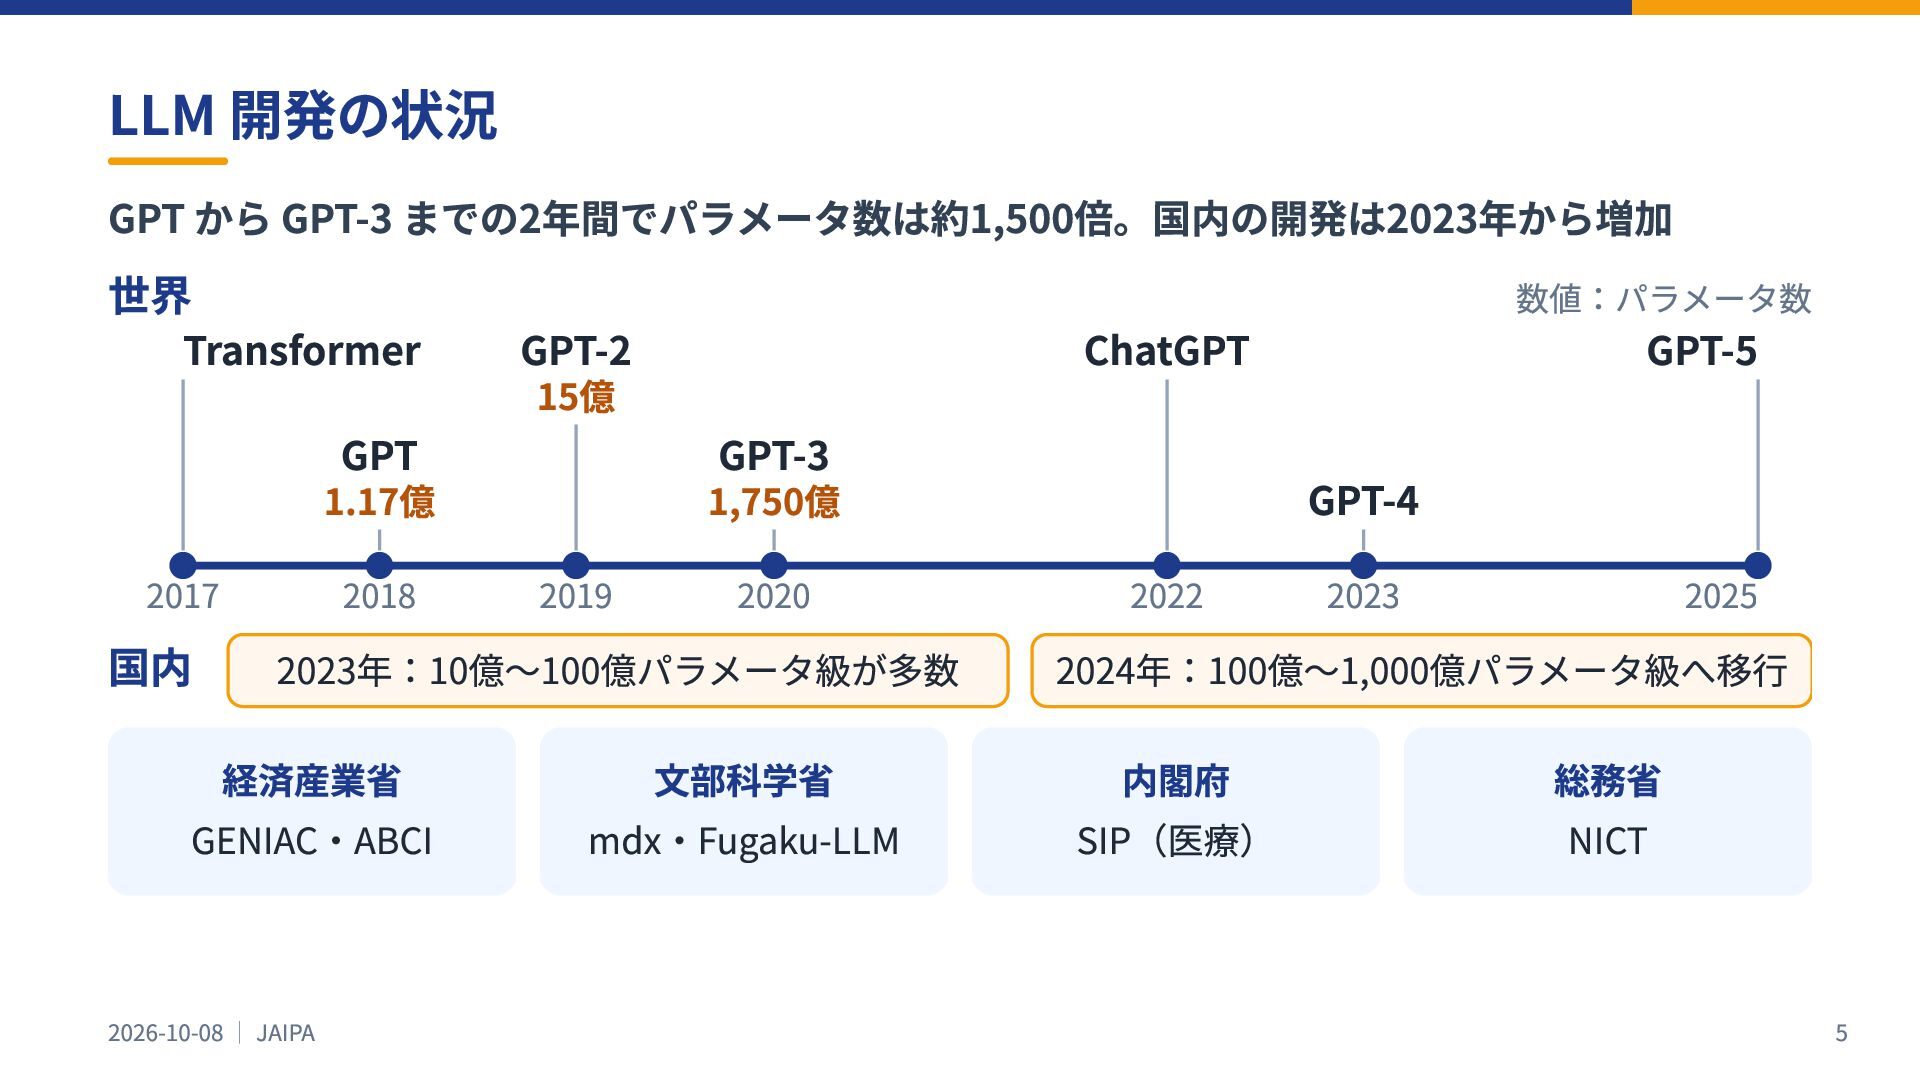
LLM 開発の状況 GPT から GPT-3 までの2年間でパラメータ数は約1,500倍。国内の開発は2023年から増加 世界 Transformer GPT GPT-2
2017 2019 15億 1.17億 国内 2018 ChatGPT GPT-3 2020 2026-10-08 | JAIPA ⽂部科学省 mdx‧Fugaku-LLM GPT-5 GPT-4 1,750億 2023年:10億〜100億パラメータ級が多数 経済産業省 GENIAC‧ABCI 数値:パラメータ数 2022 2023 2025 2024年:100億〜1,000億パラメータ級へ移⾏ 内閣府 SIP(医療) 総務省 NICT 5
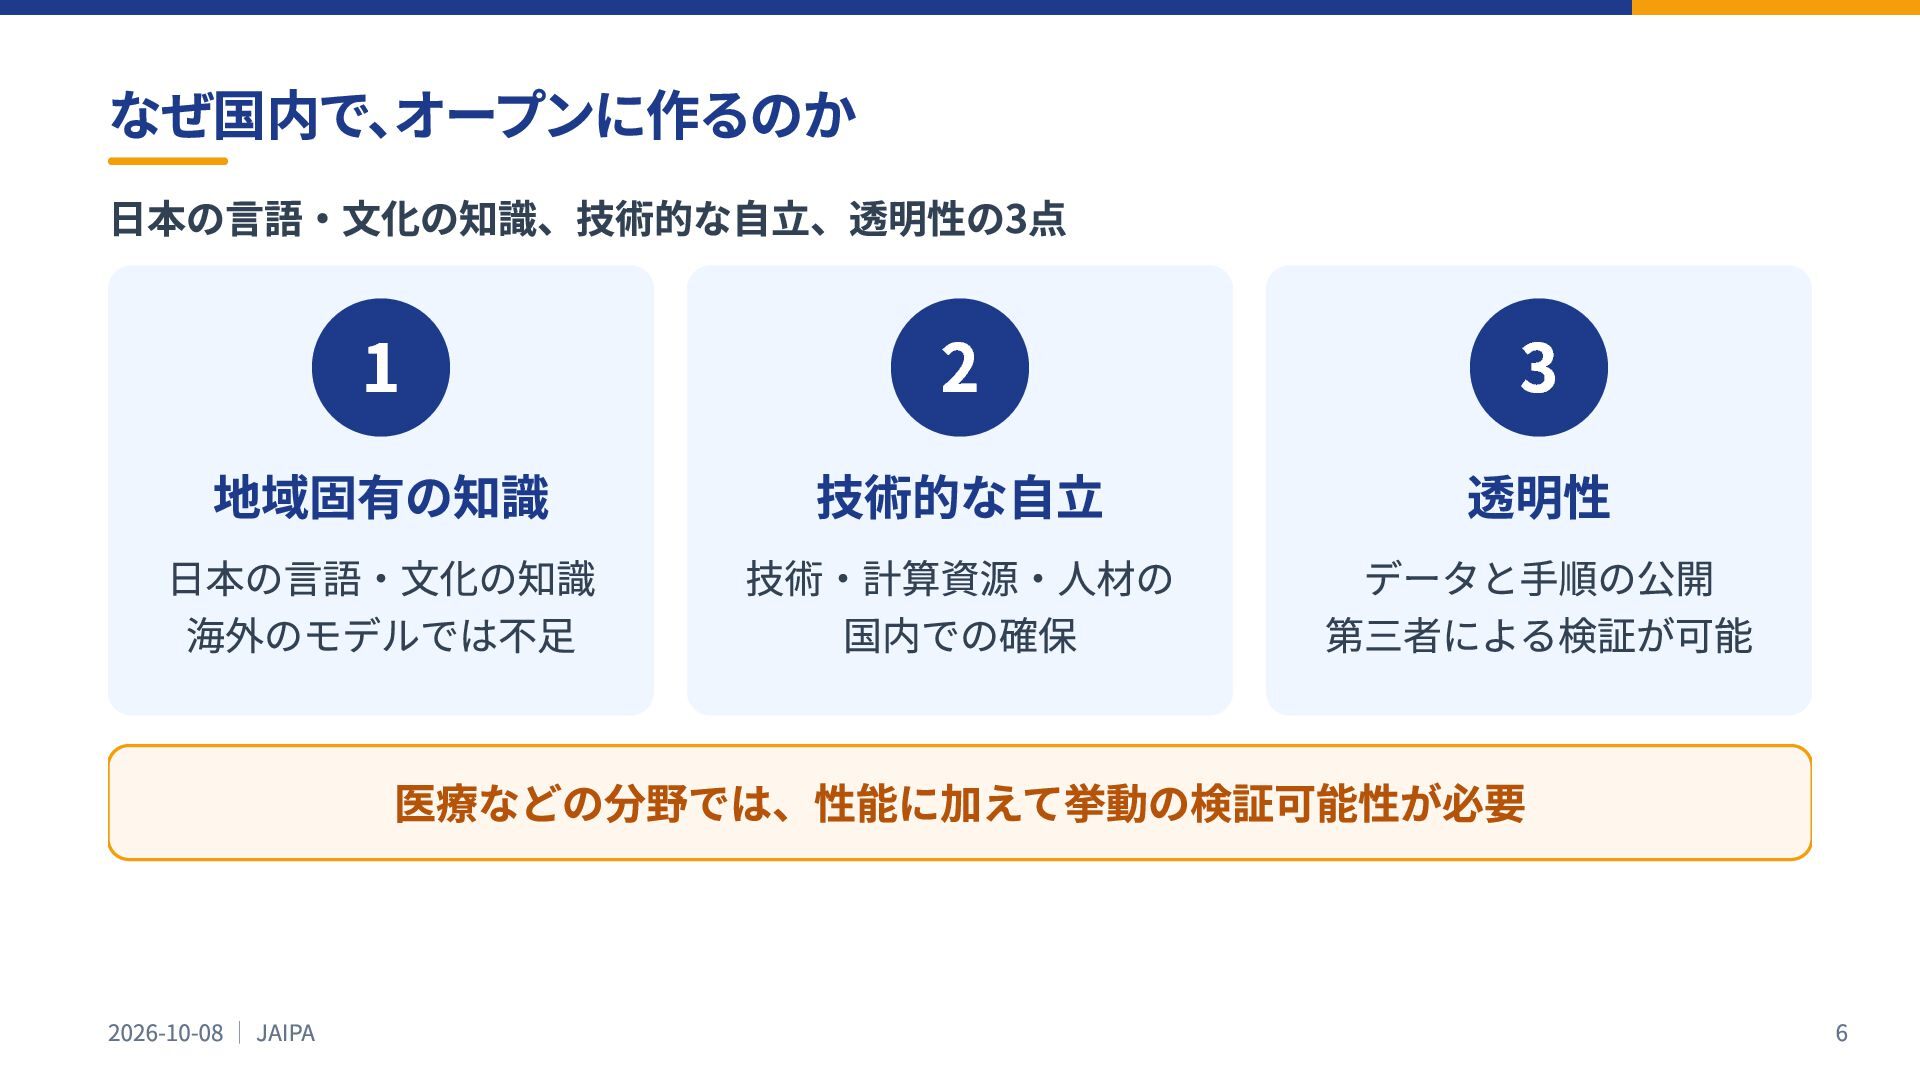
なぜ国内で、オープンに作るのか 日本の言語・文化の知識、技術的な自立、透明性の3点 1 地域固有の知識 ⽇本の⾔語‧⽂化の知識 海外のモデルでは不⾜ 2 技術的な⾃⽴ 技術‧計算資源‧⼈材の 国内での確保
3 透明性 データと⼿順の公開 第三者による検証が可能 医療などの分野では、性能に加えて挙動の検証可能性が必要 2026-10-08 | JAIPA 6
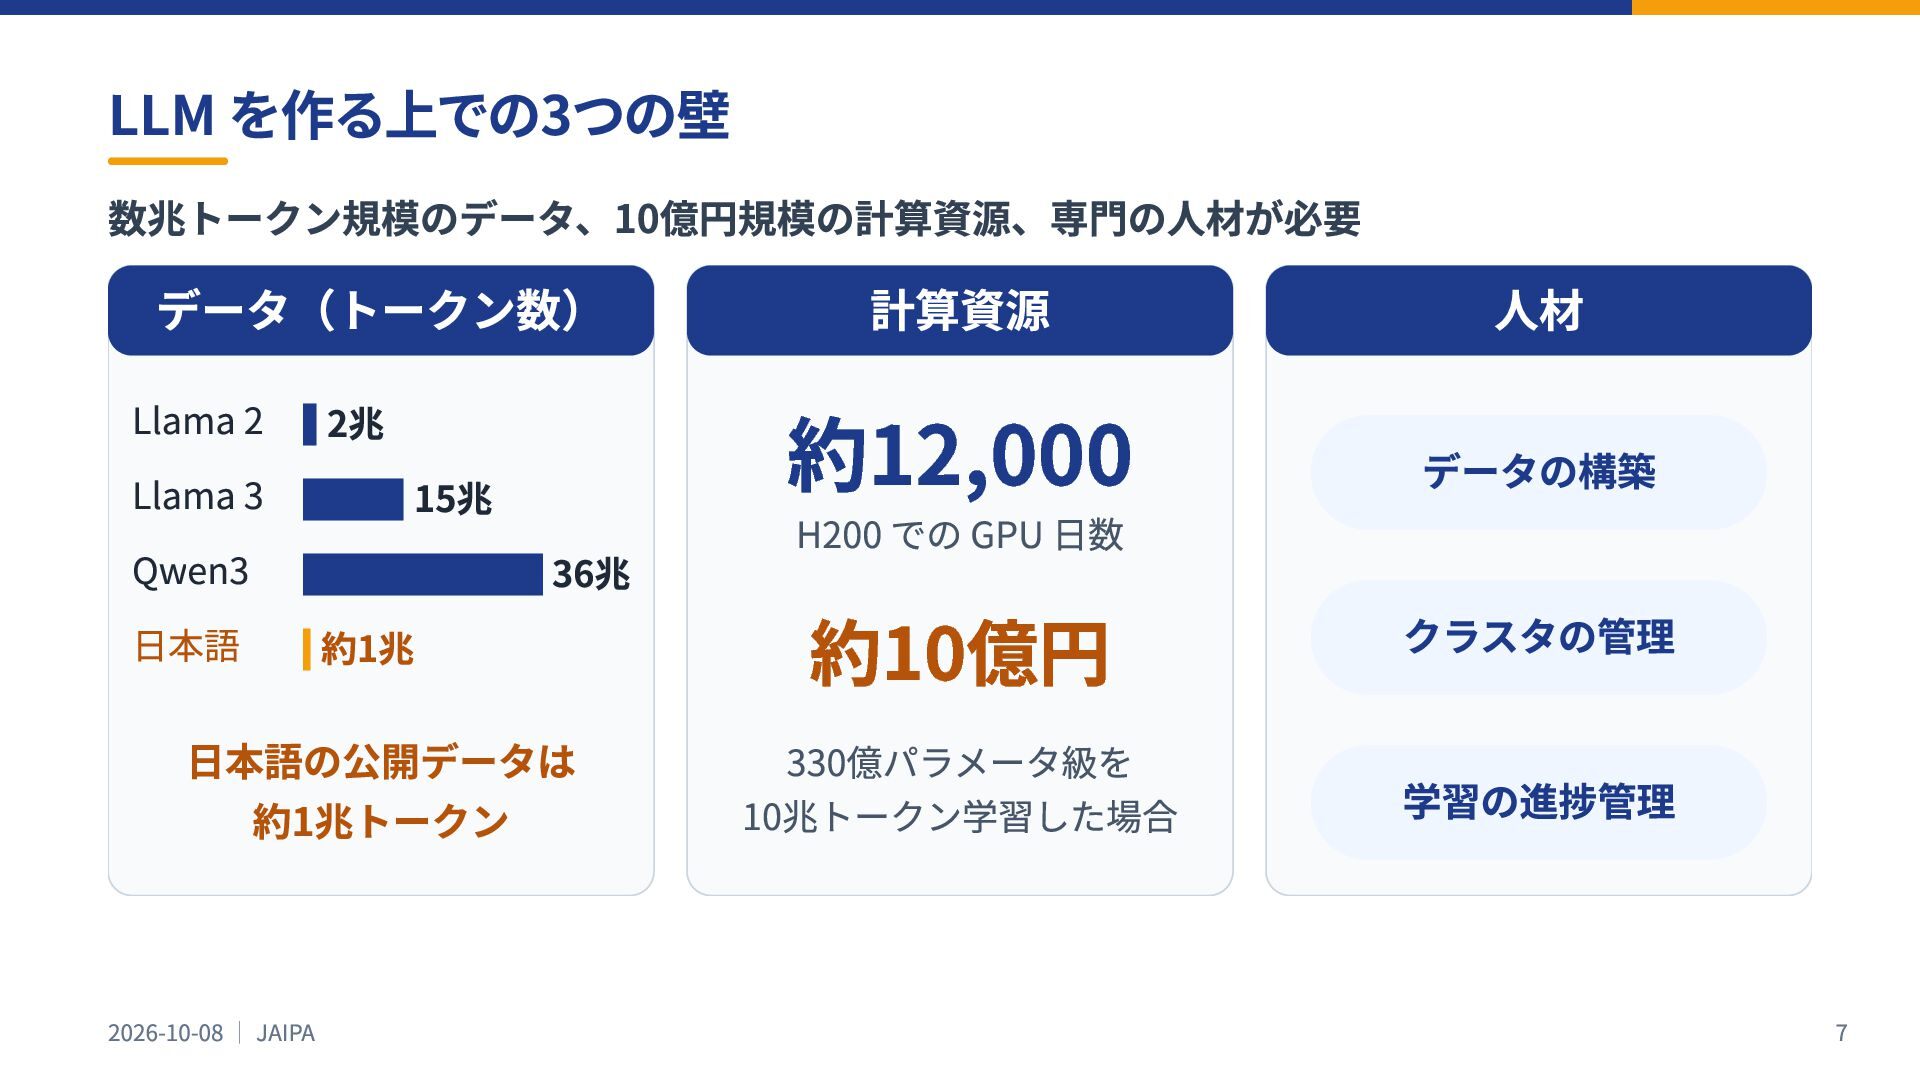
LLM を作る上での3つの壁 数兆トークン規模のデータ、10億円規模の計算資源、専門の人材が必要 データ(トークン数) 計算資源 Llama 2 2兆 Llama 3
15兆 Qwen3 36兆 ⽇本語 約1兆 約12,000 H200 での GPU ⽇数 ⽇本語の公開データは 約1兆トークン 330億パラメータ級を 10兆トークン学習した場合 2026-10-08 | JAIPA 約10億円 ⼈材 データの構築 クラスタの管理 学習の進捗管理 7
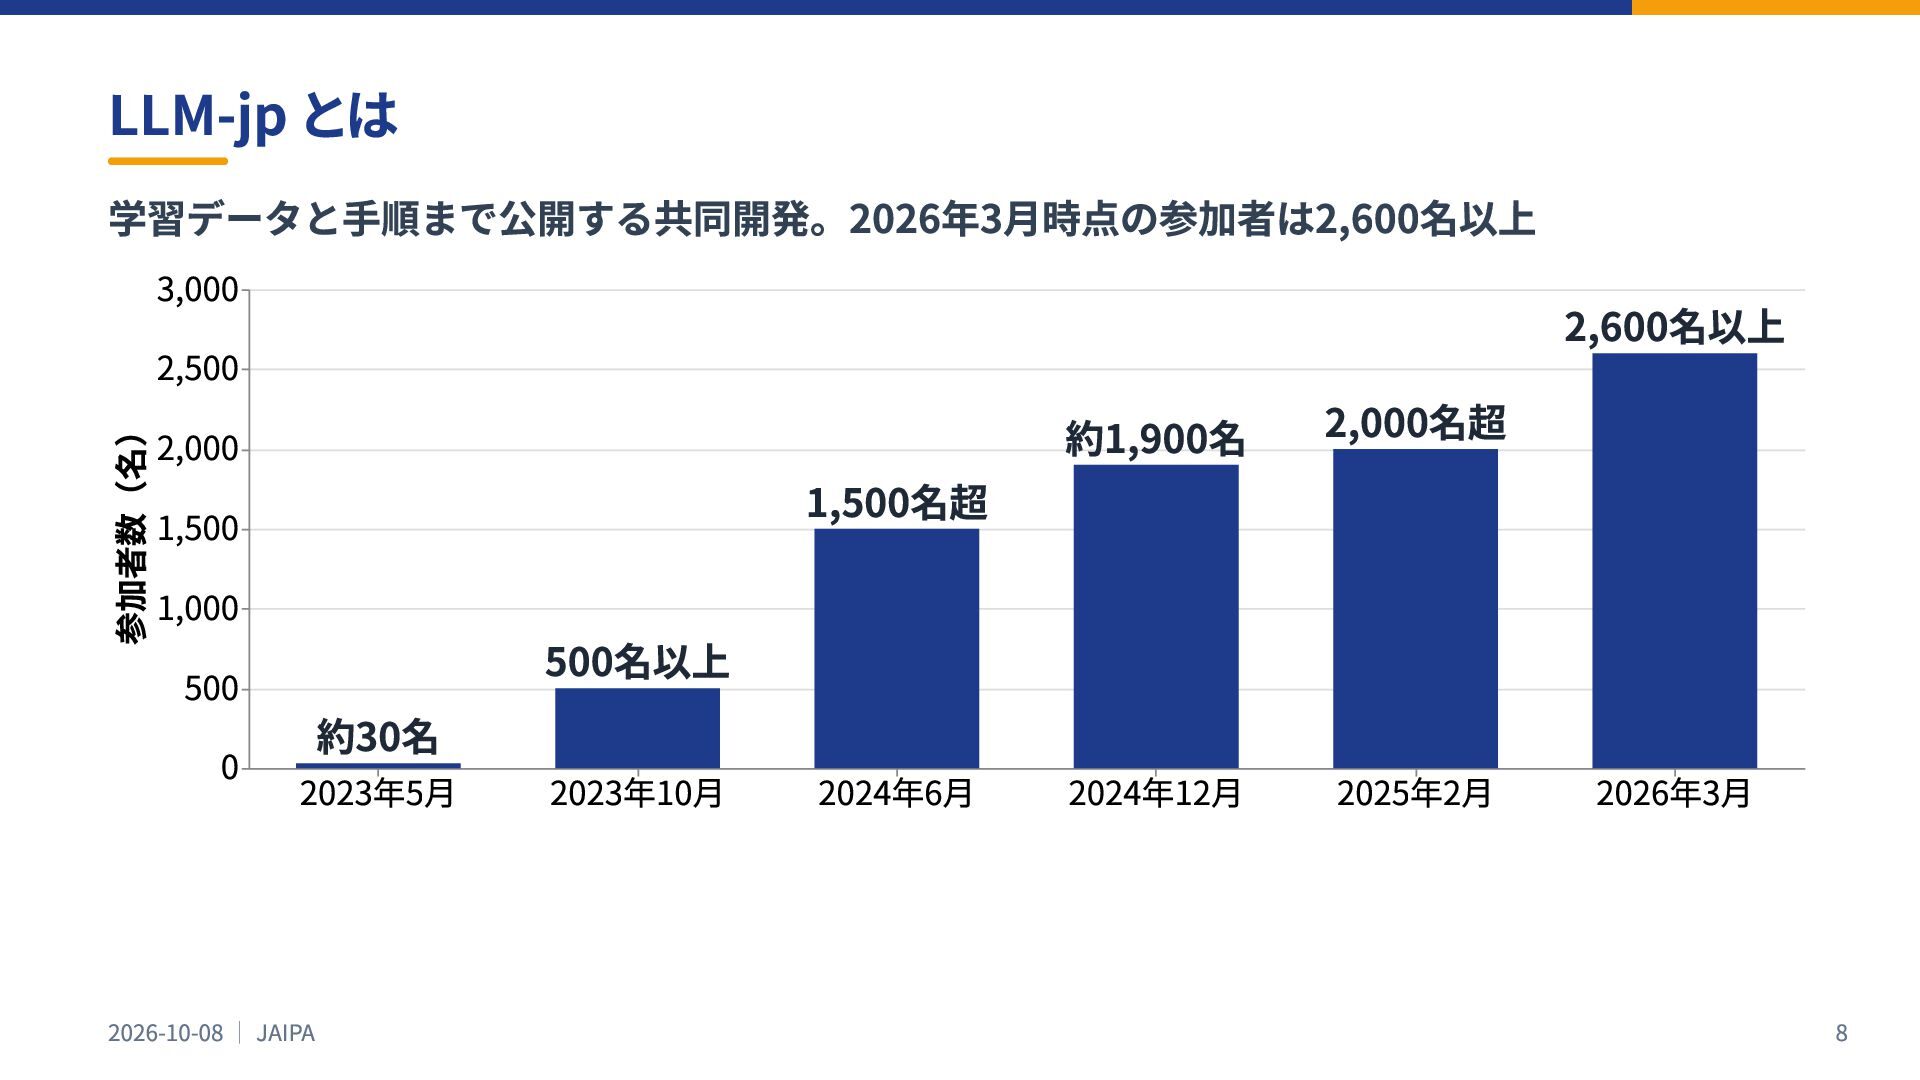
LLM-jp とは 学習データと手順まで公開する共同開発。2026年3月時点の参加者は2,600名以上 )名(数者加参 3,000 2,500 2,000 1,500 1,000 500
約30名 0 2023年5月 2026-10-08 | JAIPA 1,500名超 約1,900名 2,000名超 2,600名以上 500名以上 2023年10月 2024年6月 2024年12月 2025年2月 2026年3月 8
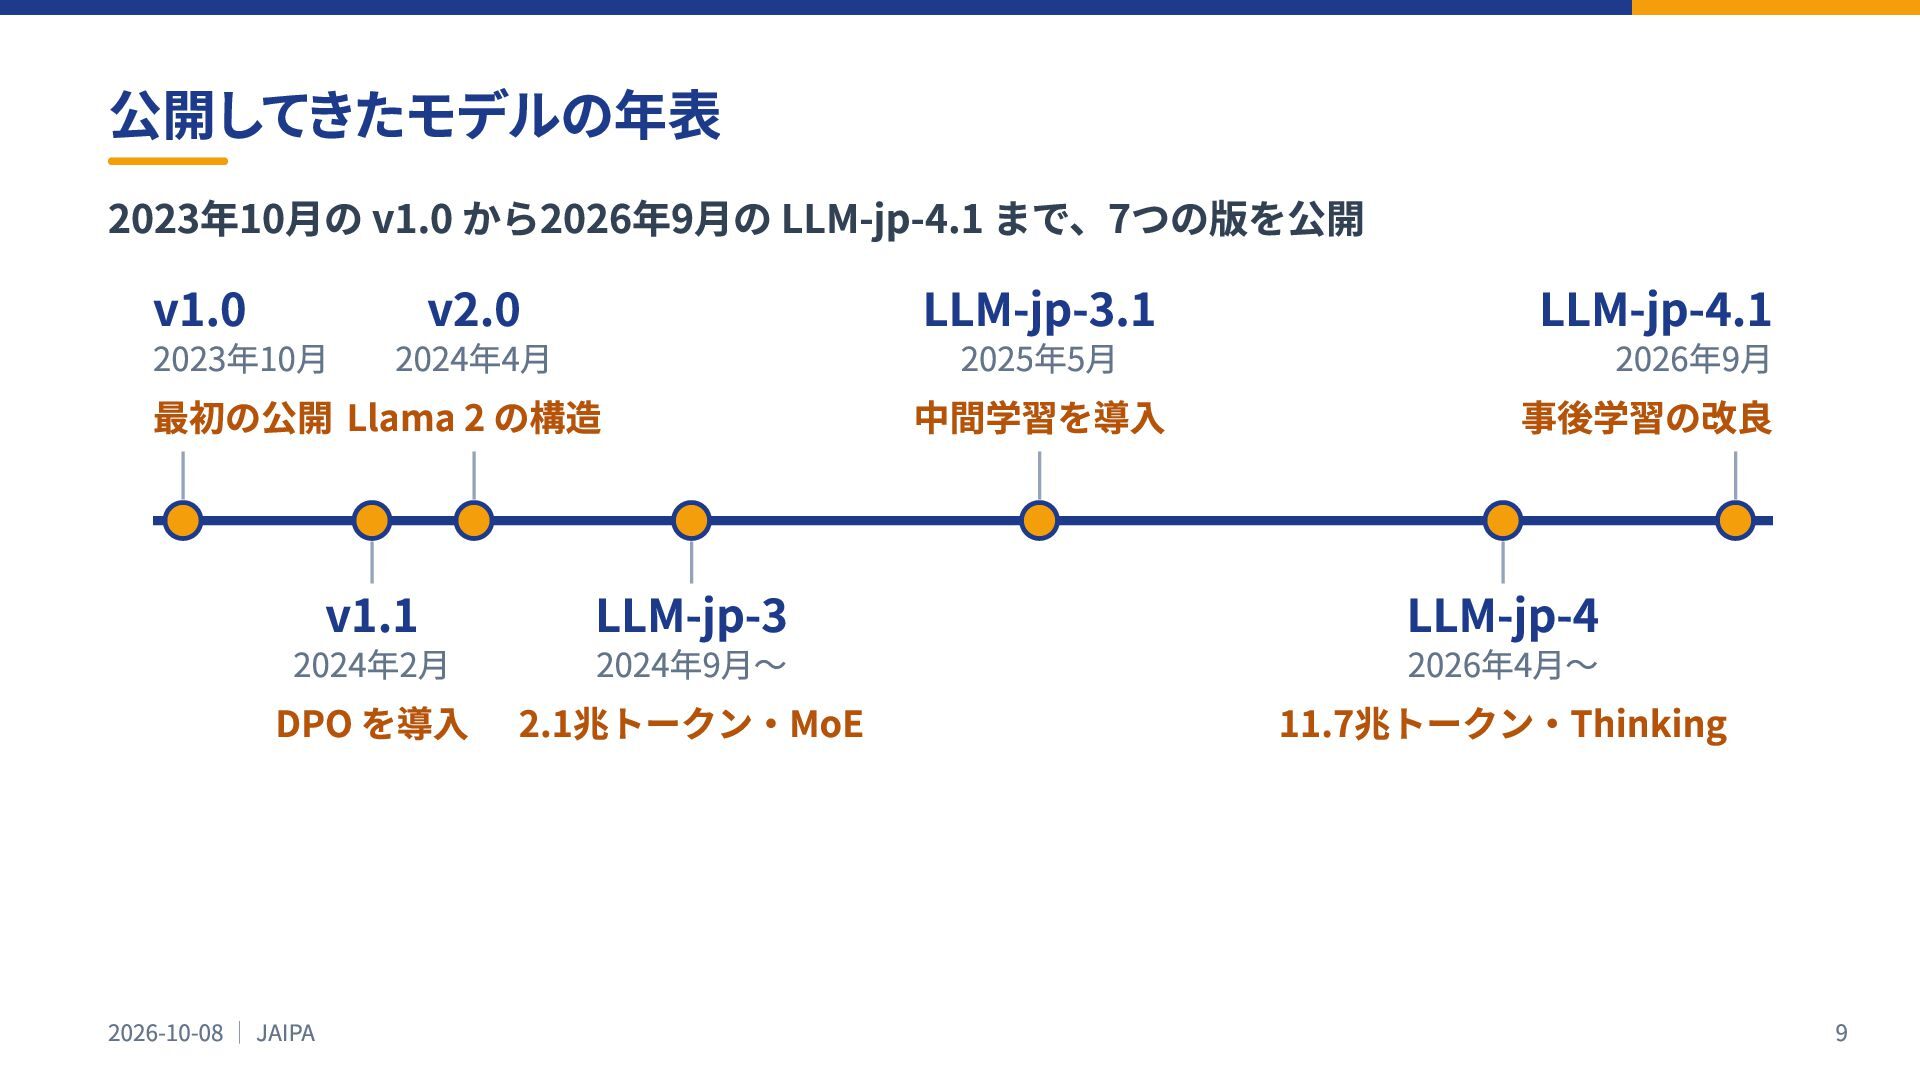
公開してきたモデルの年表 2023年10月の v1.0 から2026年9月の LLM-jp-4.1 まで、7つの版を公開 v1.0 2023年10⽉ v2.0 2024年4⽉
最初の公開 Llama 2 の構造 v1.1 2024年2⽉ LLM-jp-3 2024年9⽉〜 DPO を導⼊ 2.1兆トークン‧MoE 2026-10-08 | JAIPA LLM-jp-3.1 2025年5⽉ 中間学習を導⼊ LLM-jp-4.1 2026年9⽉ 事後学習の改良 LLM-jp-4 2026年4⽉〜 11.7兆トークン‧Thinking 9
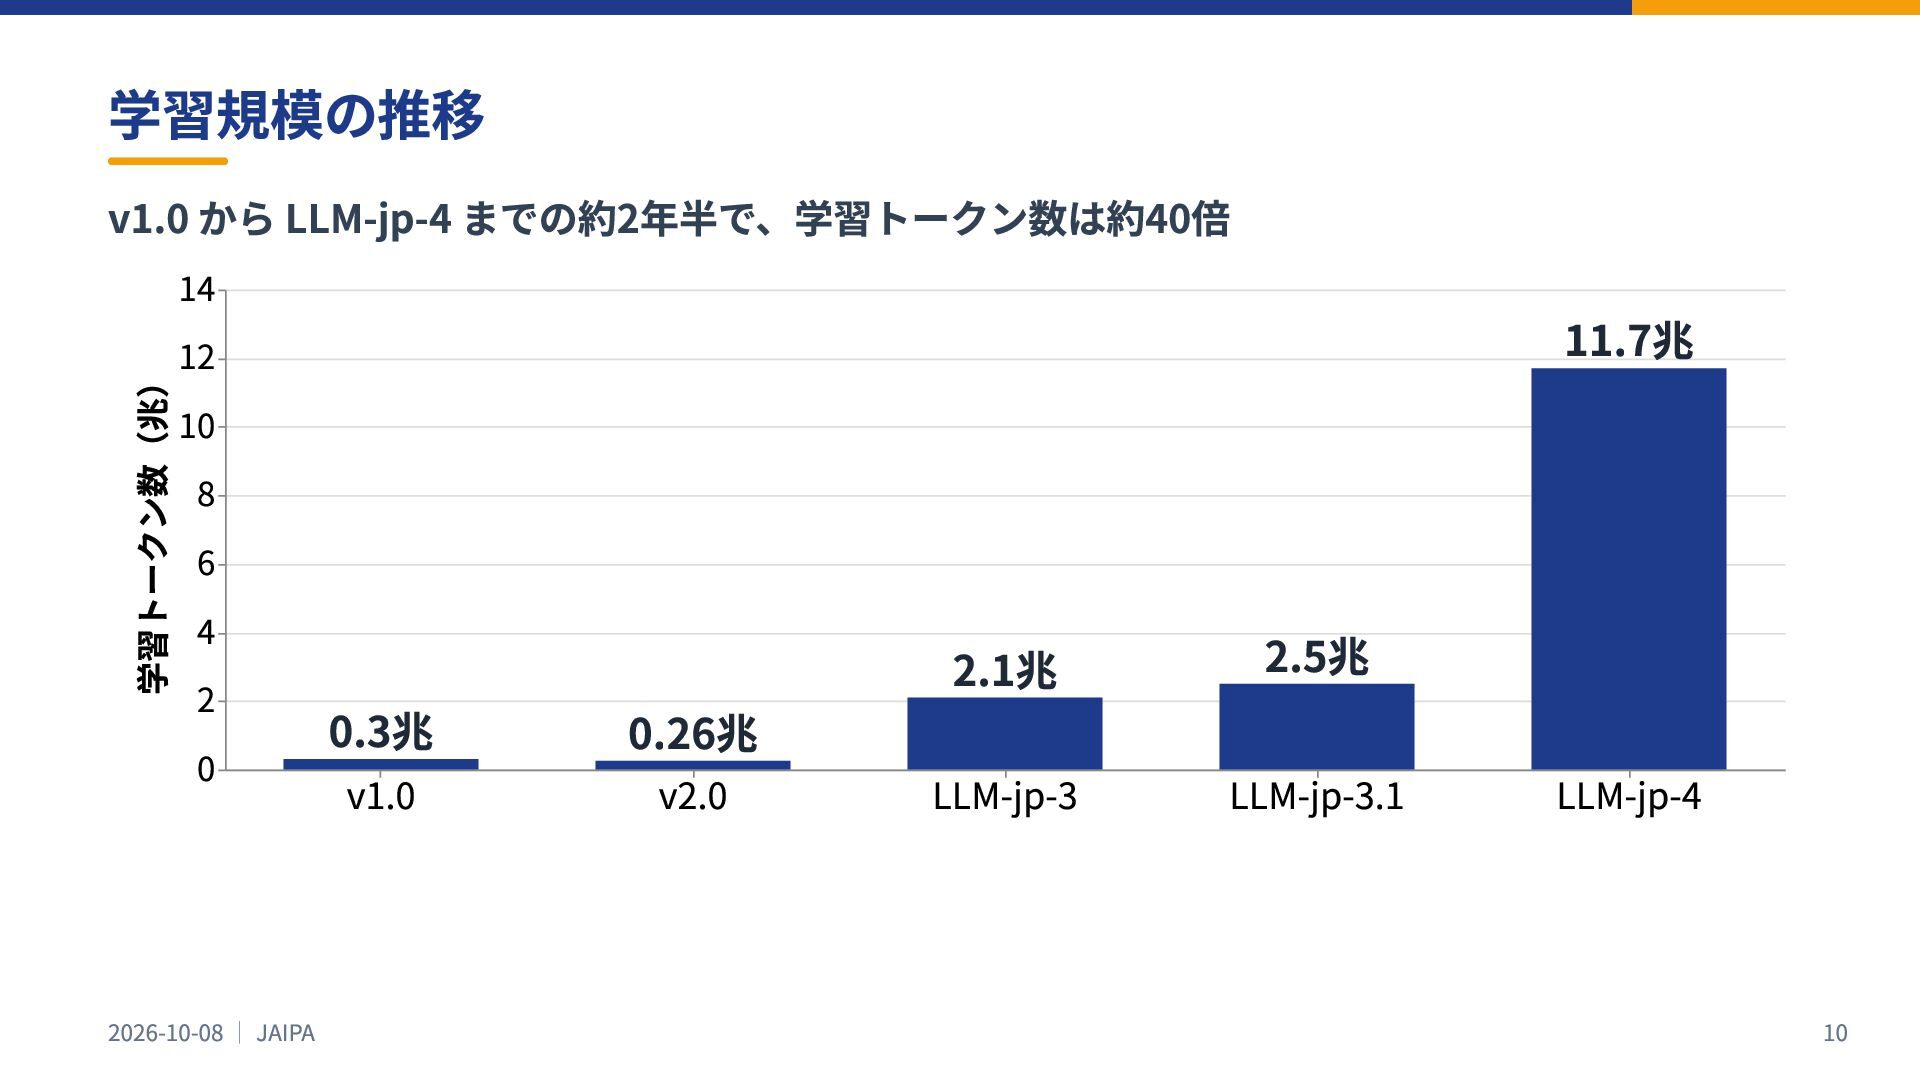
学習規模の推移 v1.0 から LLM-jp-4 までの約2年半で、学習トークン数は約40倍 )兆(数ンクート習学 14 12 10 8
6 4 2 0 2026-10-08 | JAIPA 11.7兆 0.3兆 v1.0 0.26兆 v2.0 2.1兆 2.5兆 LLM-jp-3 LLM-jp-3.1 LLM-jp-4 10
第2部 LLM-jp のライセンスとデータの方針 公開物と利用条件、学習データの選定基準 2026-10-08 | JAIPA 11
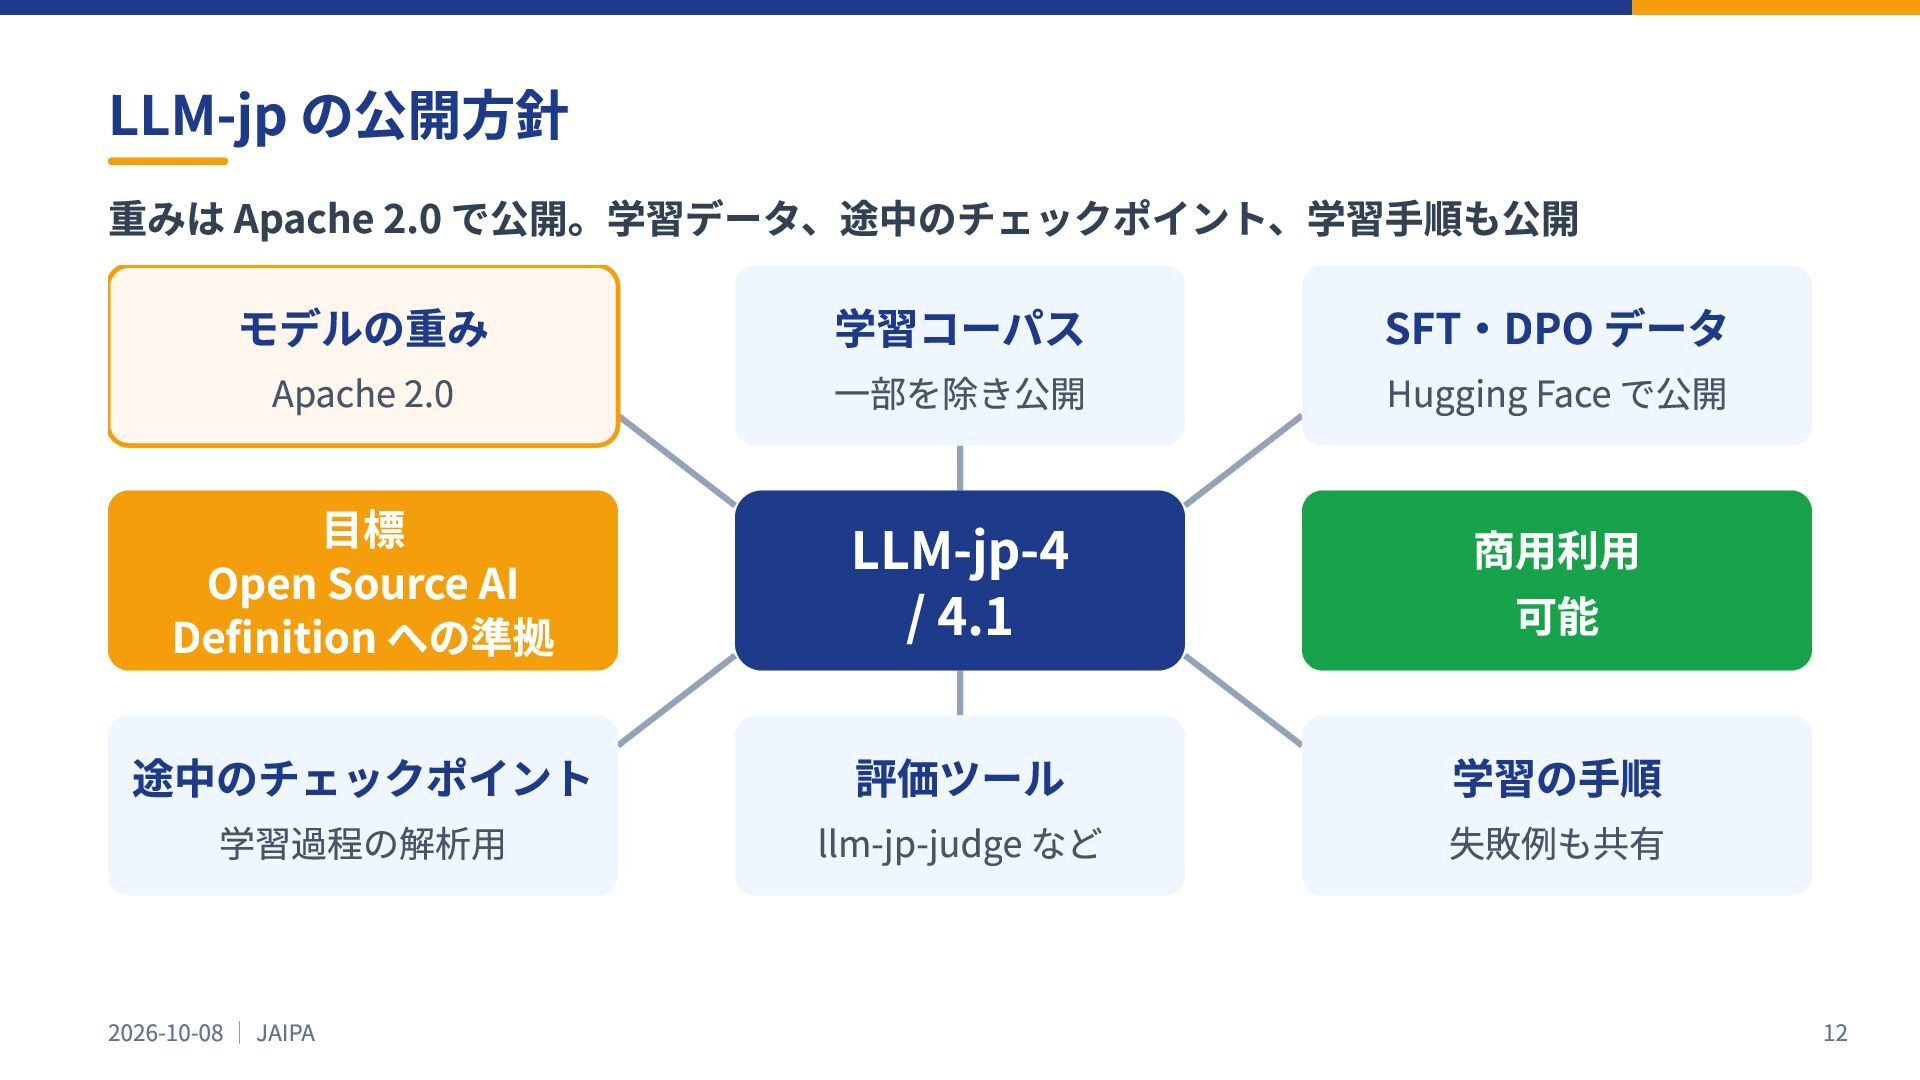
LLM-jp の公開方針 重みは Apache 2.0 で公開。学習データ、途中のチェックポイント、学習手順も公開 モデルの重み Apache 2.0 学習コーパス
⼀部を除き公開 SFT‧DPO データ ⽬標 Open Source AI Definition への準拠 LLM-jp-4 / 4.1 商⽤利⽤ 可能 途中のチェックポイント 評価ツール 学習の⼿順 学習過程の解析⽤ 2026-10-08 | JAIPA llm-jp-judge など Hugging Face で公開 失敗例も共有 12
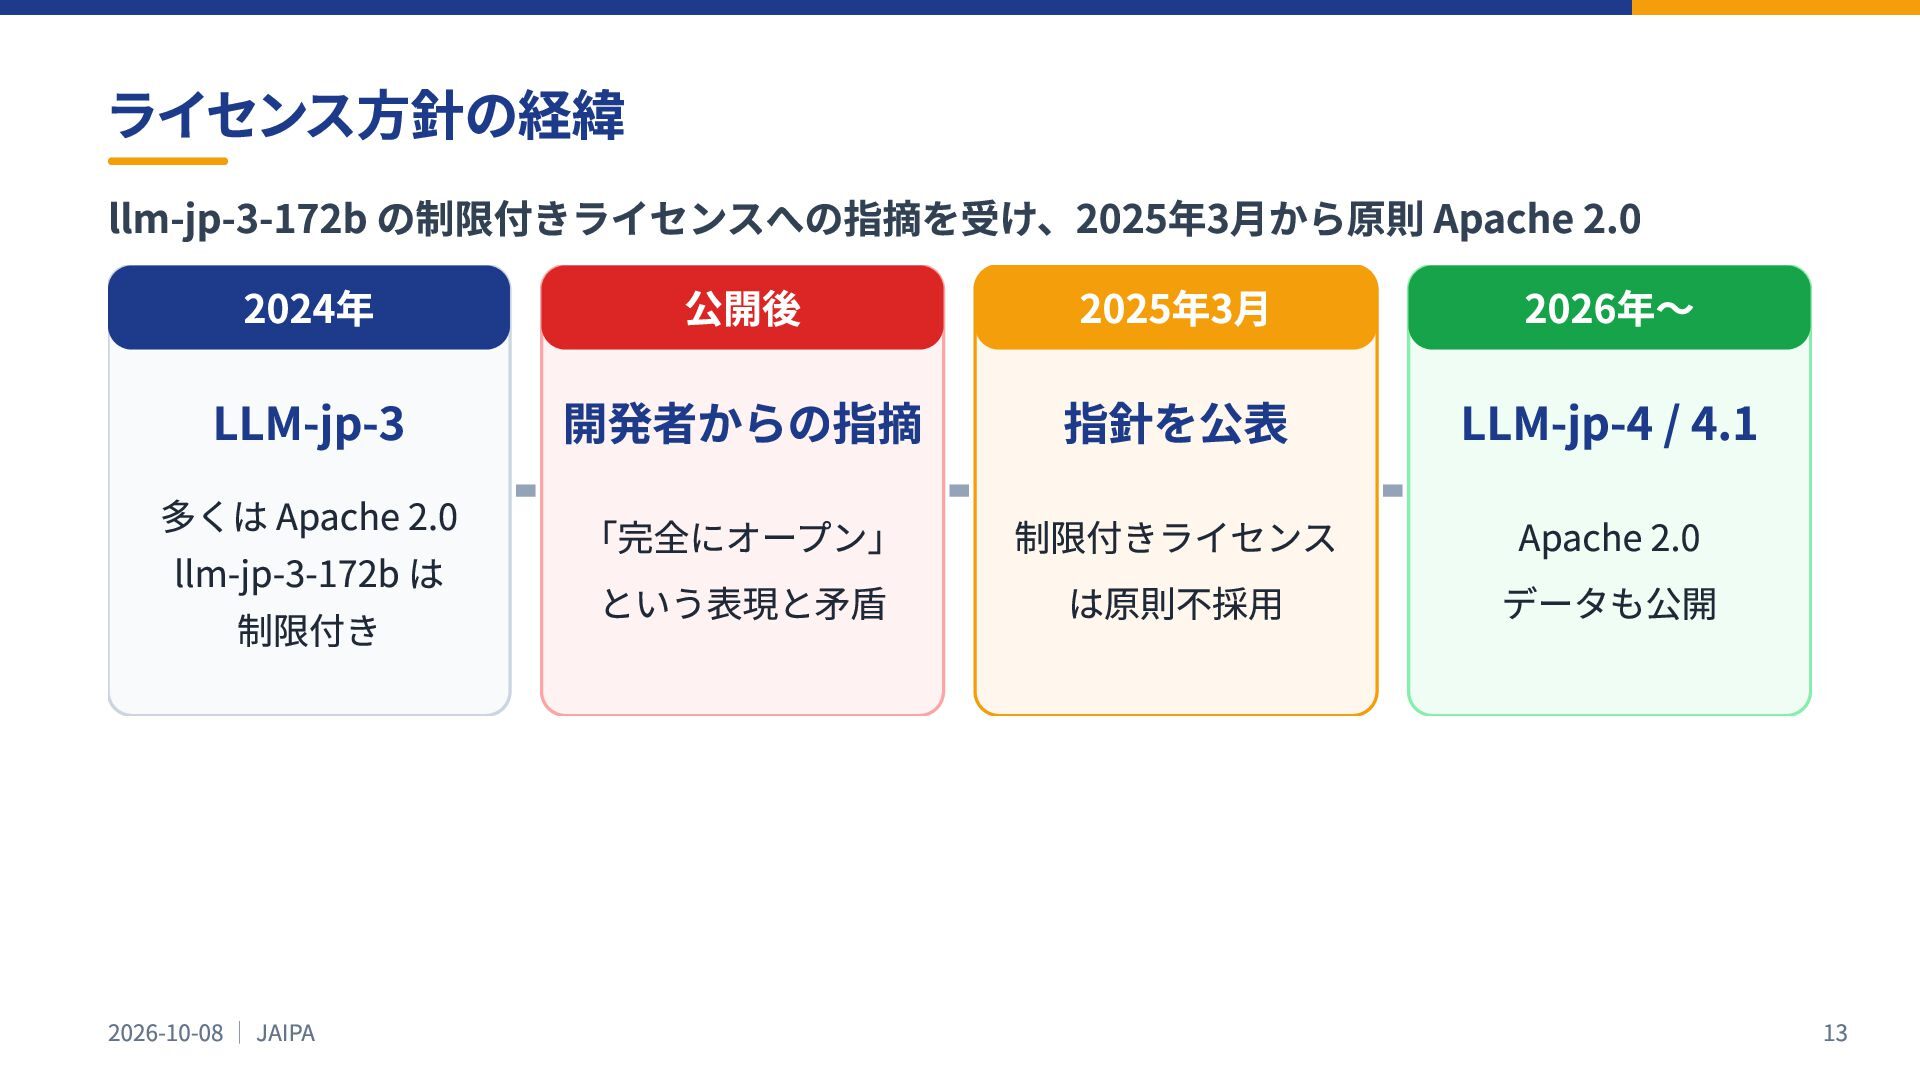
ライセンス方針の経緯 llm-jp-3-172b の制限付きライセンスへの指摘を受け、2025年3月から原則 Apache 2.0 2024年 公開後 2025年3⽉ 2026年〜 LLM-jp-3
多くは Apache 2.0 llm-jp-3-172b は 制限付き 2026-10-08 | JAIPA 開発者からの指摘 指針を公表 LLM-jp-4 / 4.1 「完全にオープン」 という表現と⽭盾 制限付きライセンス は原則不採⽤ Apache 2.0 データも公開 13
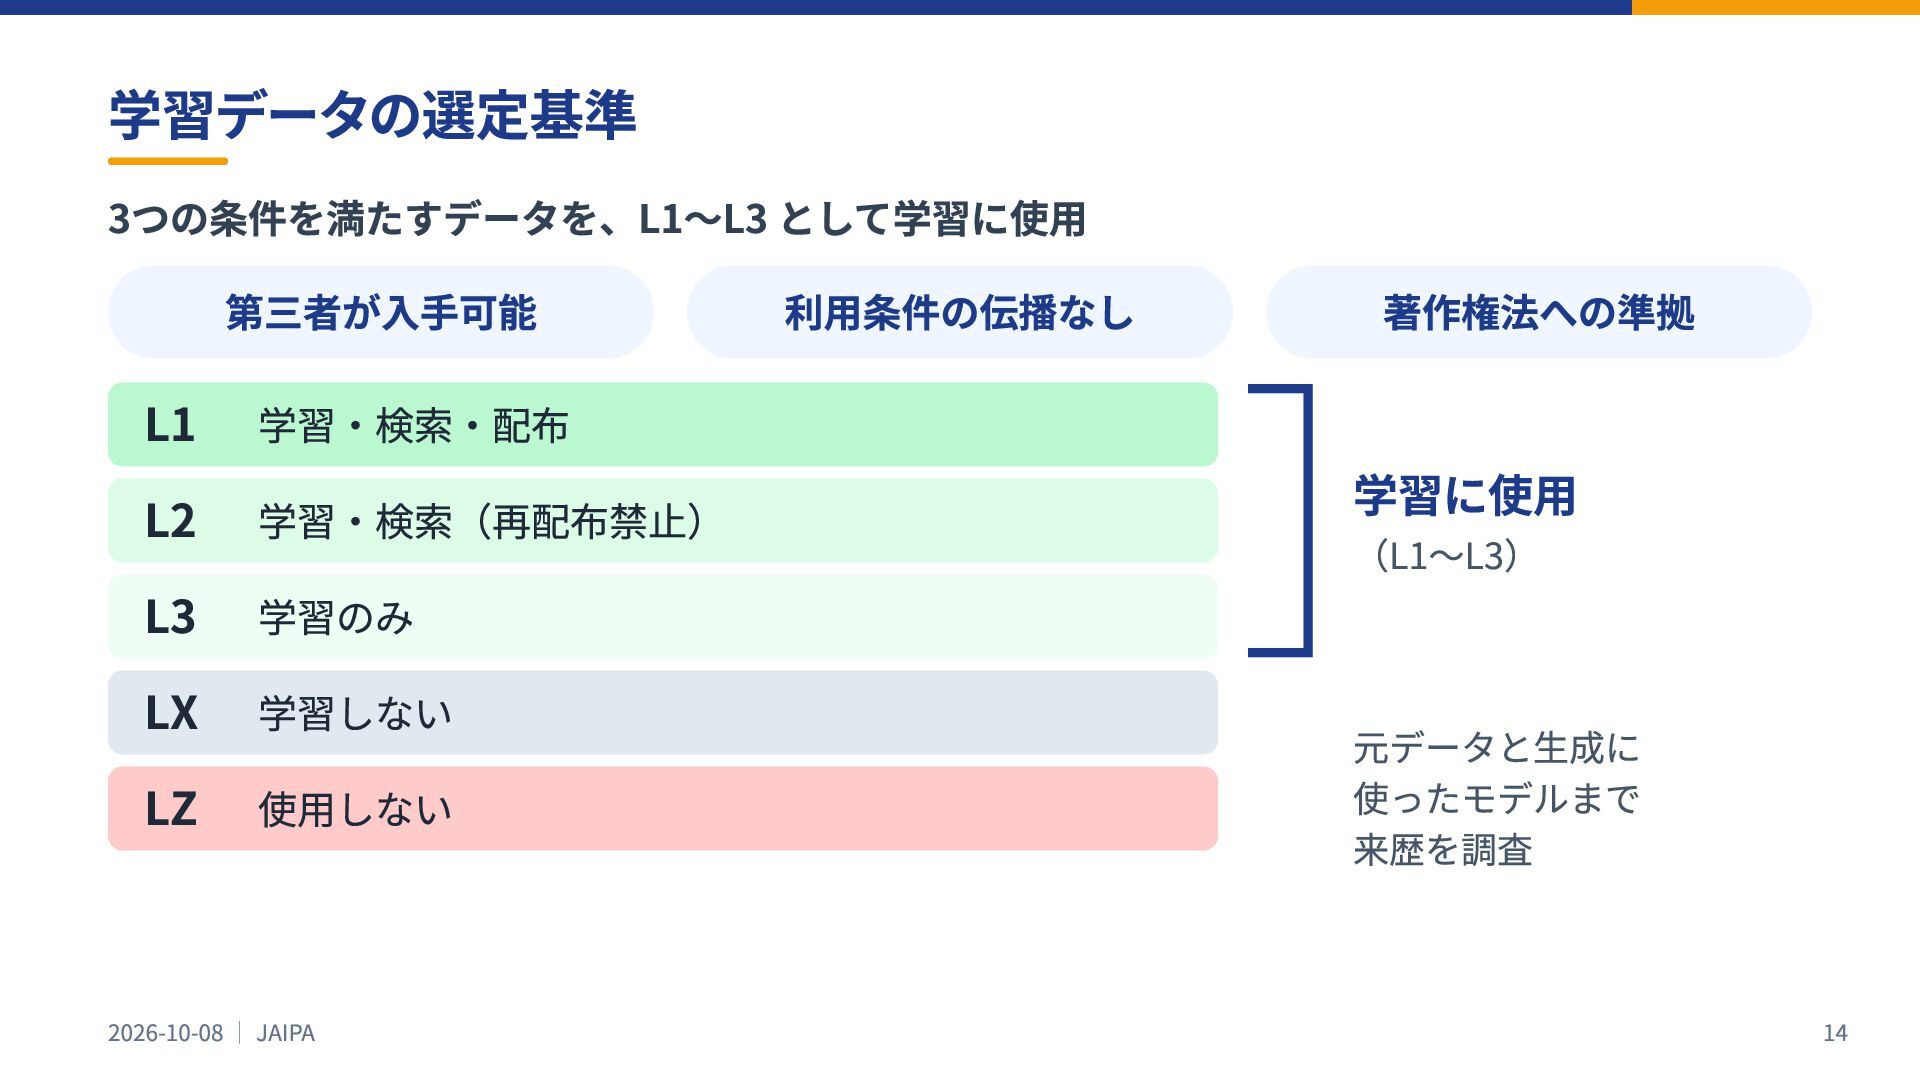
学習データの選定基準 3つの条件を満たすデータを、L1〜L3 として学習に使用 第三者が⼊⼿可能 利⽤条件の伝播なし L1 学習‧検索‧配布 L2 学習‧検索(再配布禁⽌) L3
学習のみ LX 学習しない LZ 使⽤しない 2026-10-08 | JAIPA 著作権法への準拠 学習に使⽤ (L1〜L3) 元データと⽣成に 使ったモデルまで 来歴を調査 14
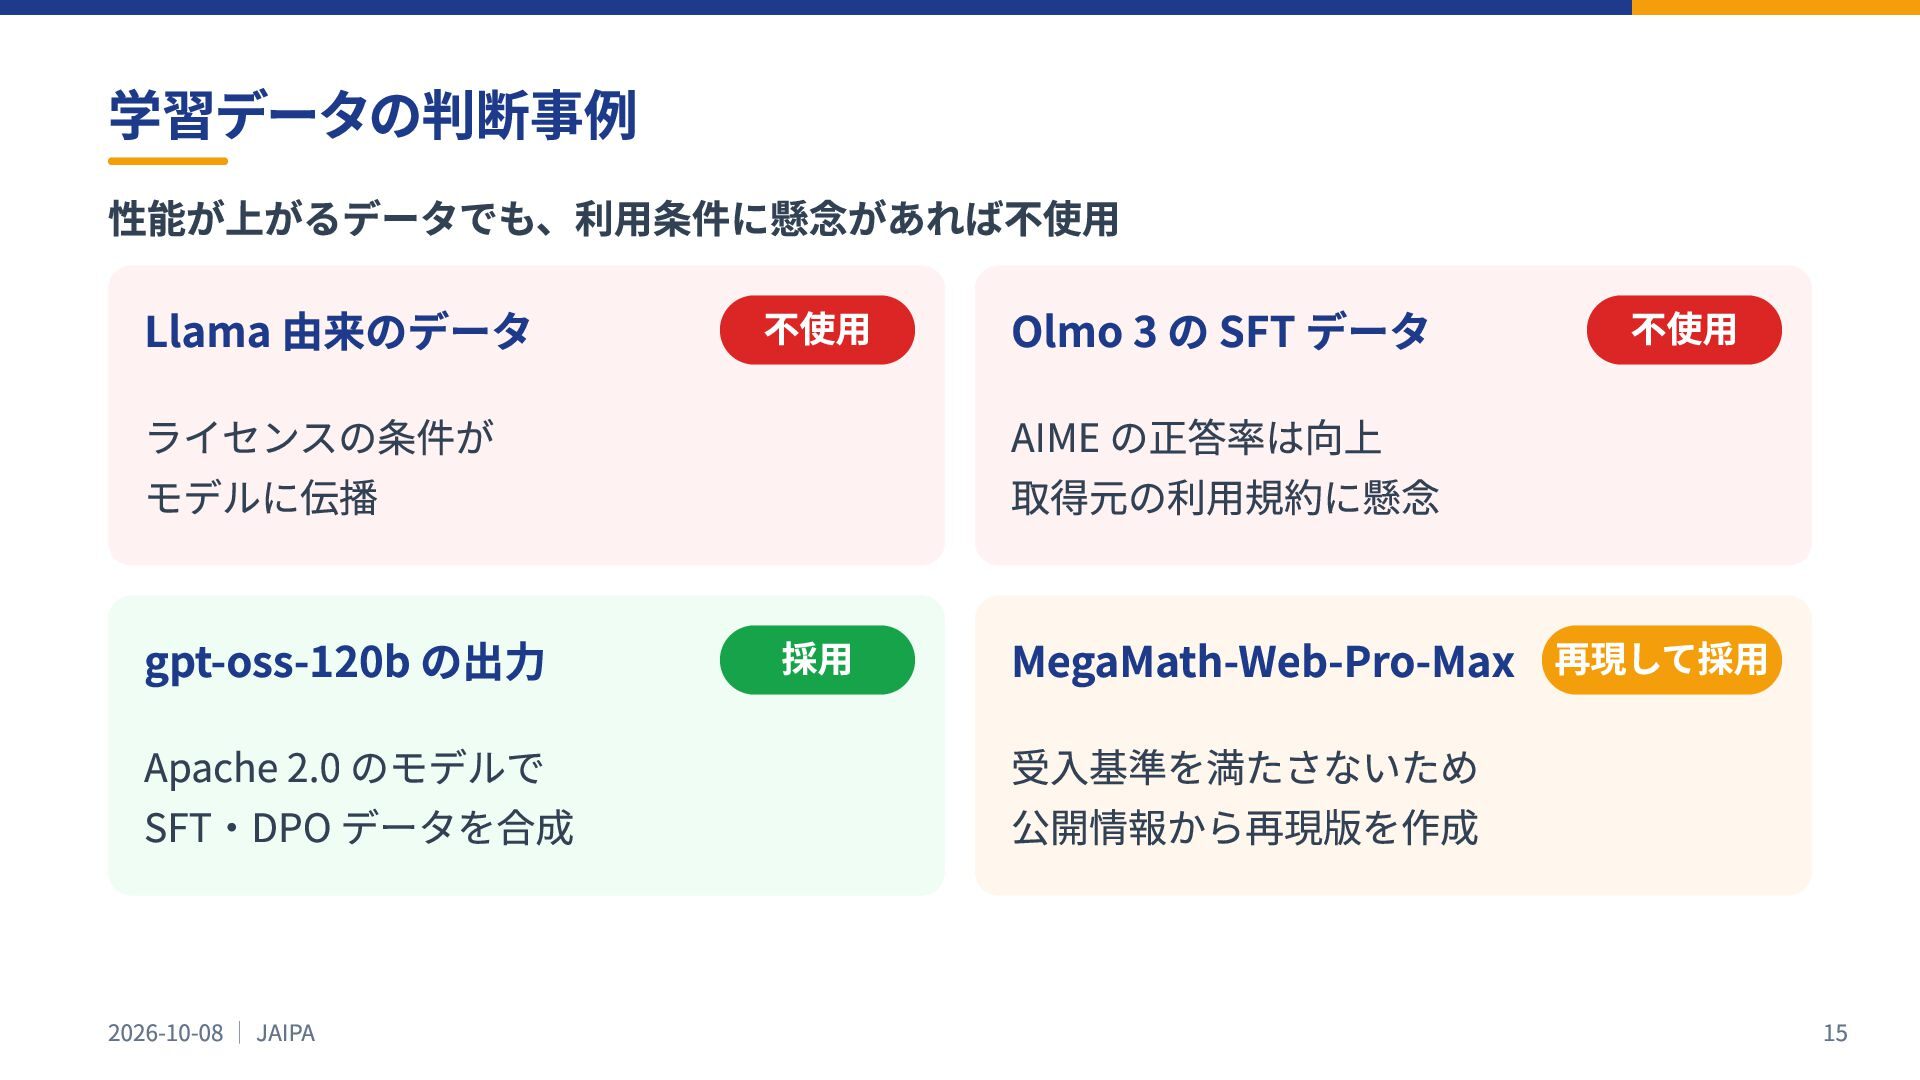
学習データの判断事例 性能が上がるデータでも、利用条件に懸念があれば不使用 Llama 由来のデータ 不使⽤ ライセンスの条件が モデルに伝播 gpt-oss-120b の出⼒ Apache
2.0 のモデルで SFT‧DPO データを合成 2026-10-08 | JAIPA Olmo 3 の SFT データ 不使⽤ AIME の正答率は向上 取得元の利⽤規約に懸念 採⽤ MegaMath-Web-Pro-Max 再現して採⽤ 受⼊基準を満たさないため 公開情報から再現版を作成 15
第3部 LLM-jp-4 / 4.1 の技術 コーパス、事前学習、事後学習、評価 2026-10-08 | JAIPA 16
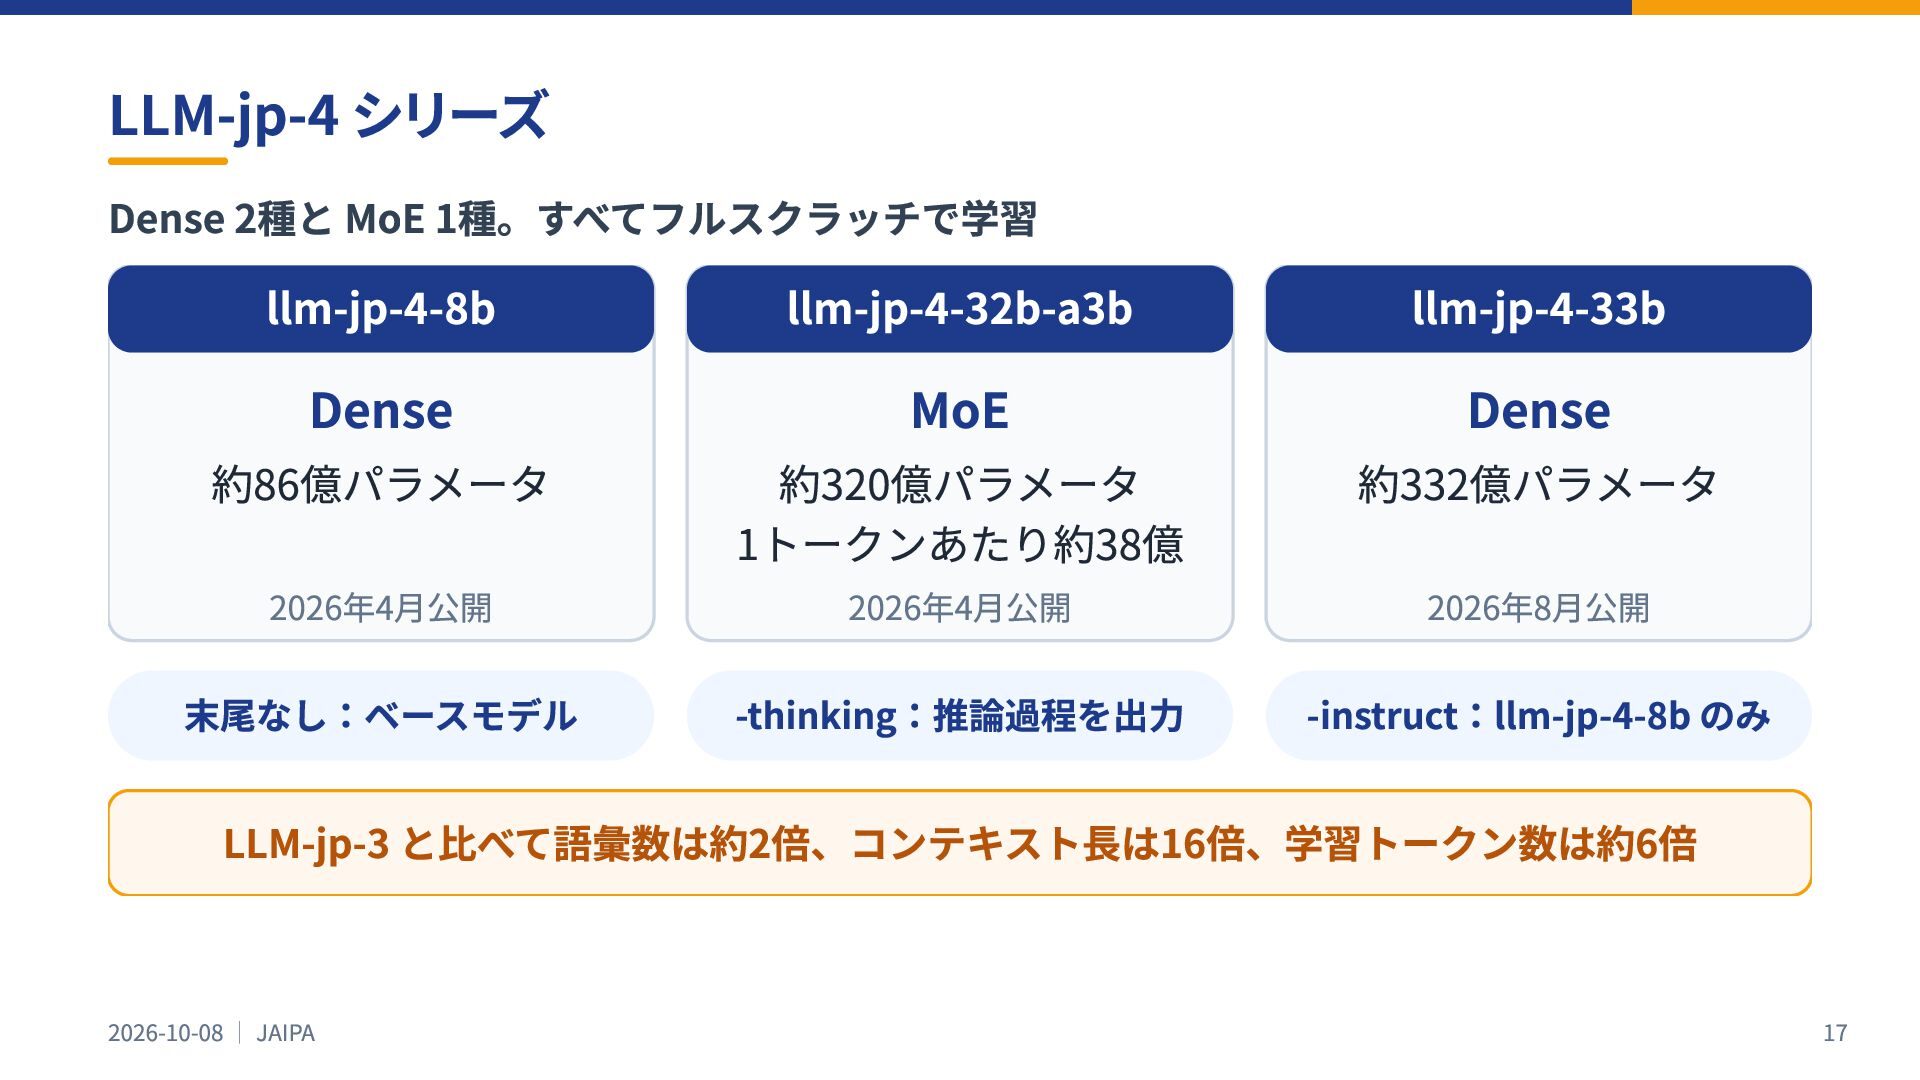
LLM-jp-4 シリーズ Dense 2種と MoE 1種。すべてフルスクラッチで学習 llm-jp-4-8b llm-jp-4-32b-a3b llm-jp-4-33b 約86億パラメータ
約320億パラメータ 1トークンあたり約38億 約332億パラメータ 2026年4⽉公開 2026年8⽉公開 -thinking:推論過程を出⼒ -instruct:llm-jp-4-8b のみ Dense 2026年4⽉公開 末尾なし:ベースモデル MoE Dense LLM-jp-3 と⽐べて語彙数は約2倍、コンテキスト⻑は16倍、学習トークン数は約6倍 2026-10-08 | JAIPA 17
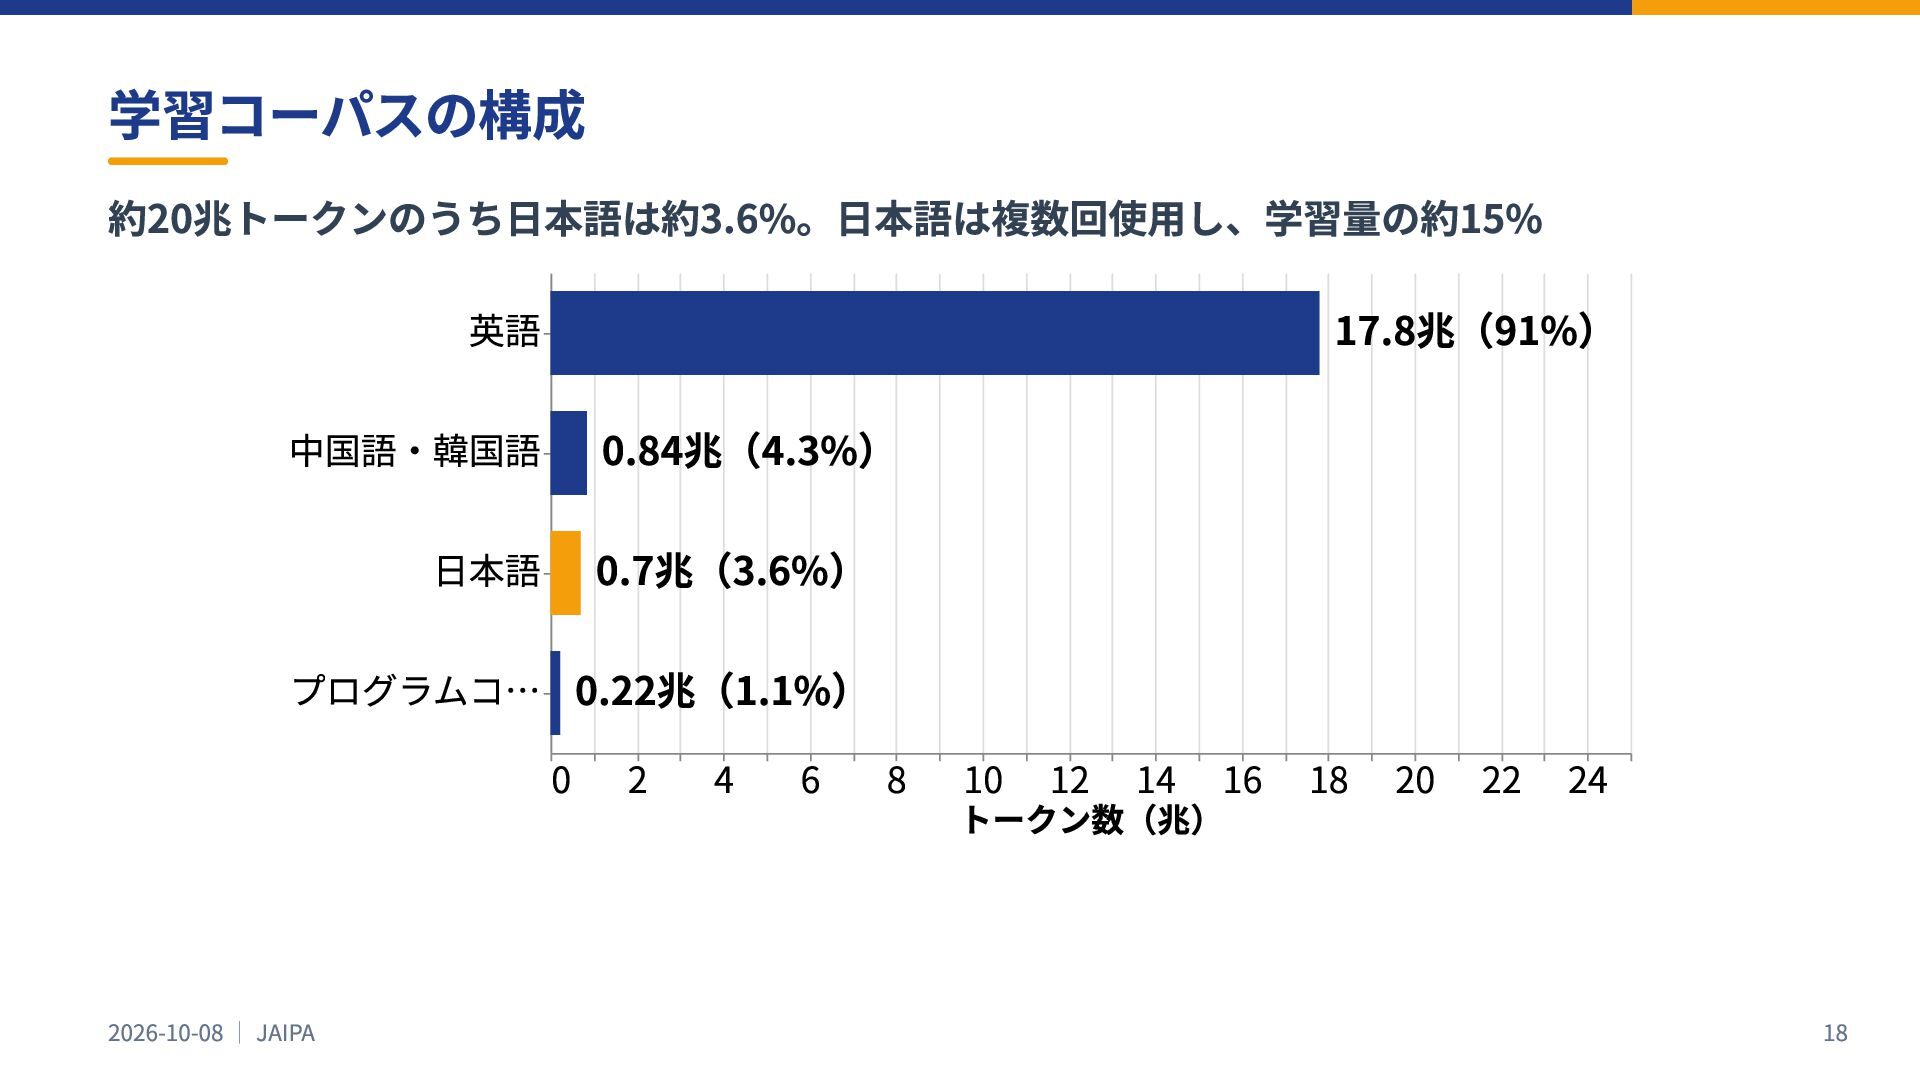
学習コーパスの構成 約20兆トークンのうち日本語は約3.6%。日本語は複数回使用し、学習量の約15% 英語 17.8兆(91%) 中国語・韓国語 0.84兆(4.3%) 日本語 0.7兆(3.6%) プログラムコ… 0.22兆(1.1%)
0 2 4 6 8 10 12 14 16 18 20 22 24 トークン数(兆) 2026-10-08 | JAIPA 18
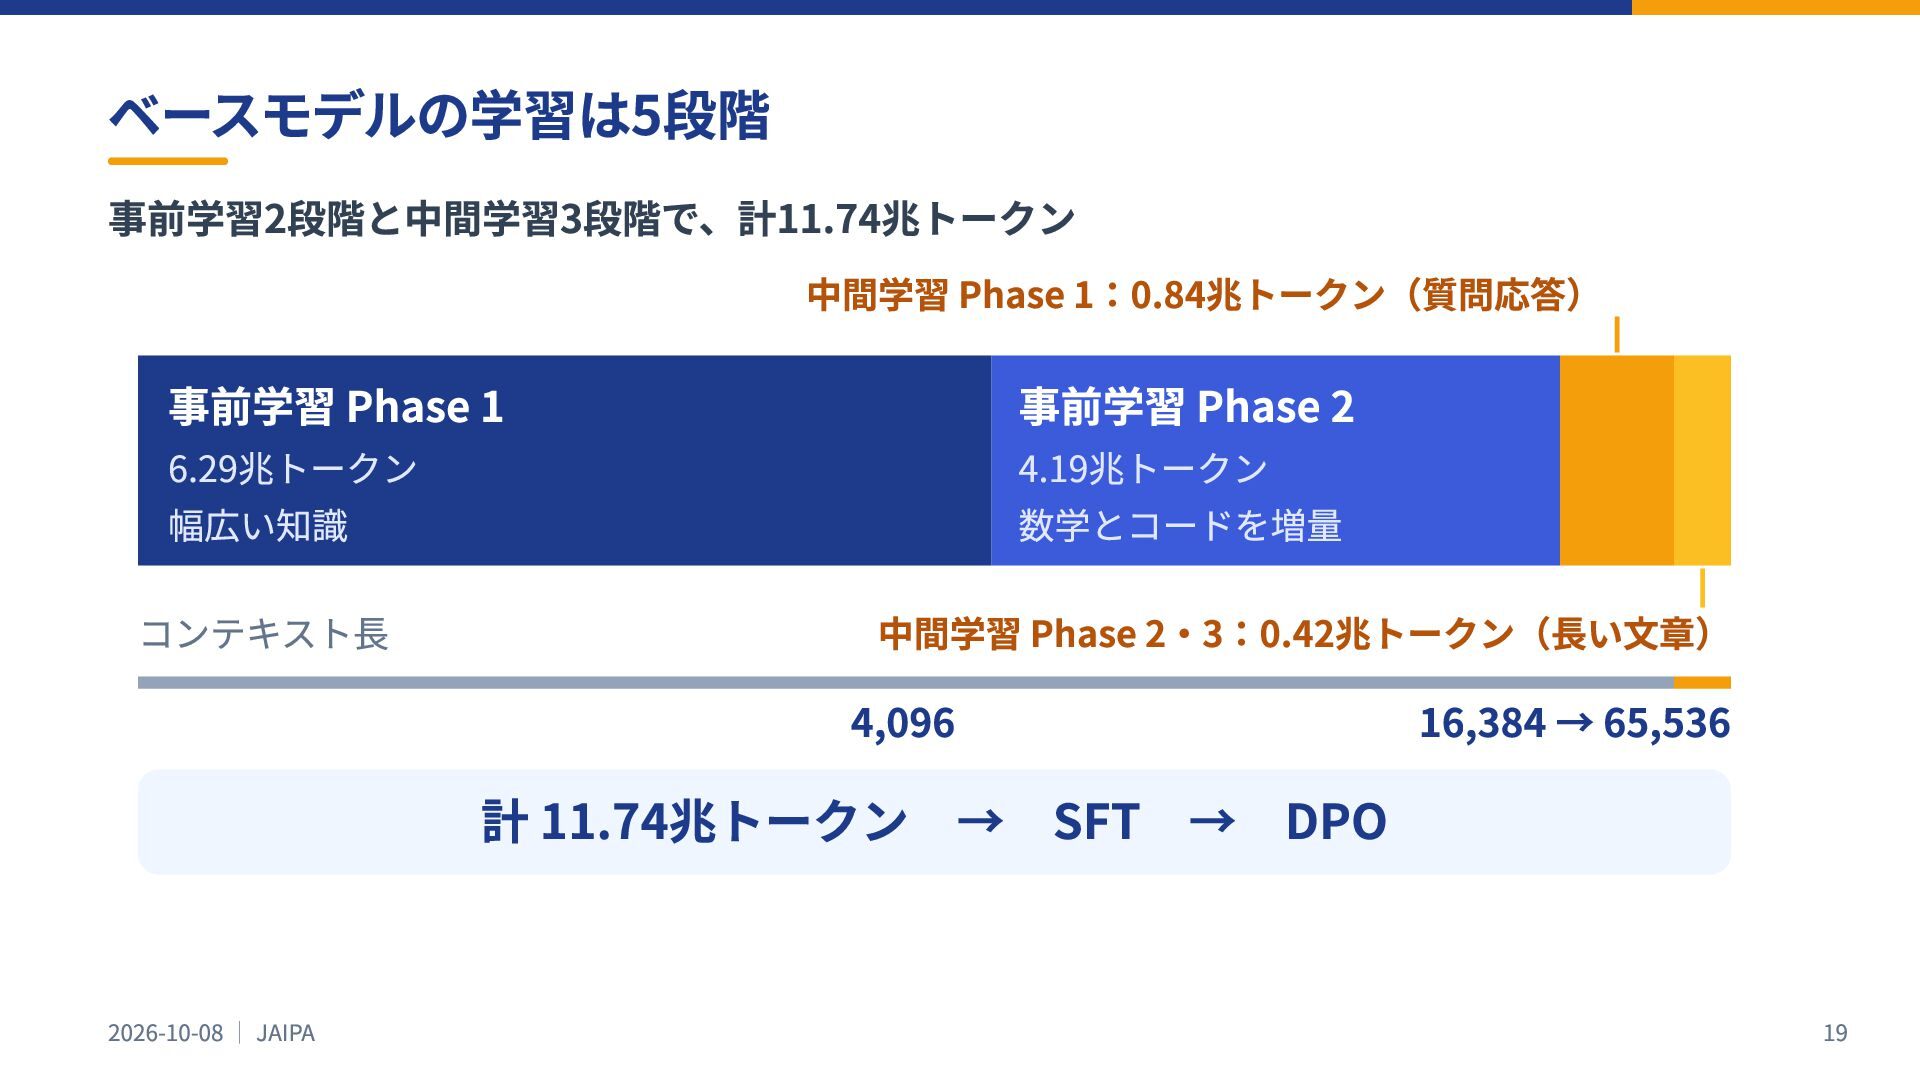
ベースモデルの学習は5段階 事前学習2段階と中間学習3段階で、計11.74兆トークン 中間学習 Phase 1:0.84兆トークン(質問応答) 事前学習 Phase 1 6.29兆トークン 幅広い知識
コンテキスト⻑ 事前学習 Phase 2 4.19兆トークン 数学とコードを増量 中間学習 Phase 2‧3:0.42兆トークン(⻑い⽂章) 4,096 計 11.74兆トークン → SFT → DPO 2026-10-08 | JAIPA 16,384 → 65,536 19
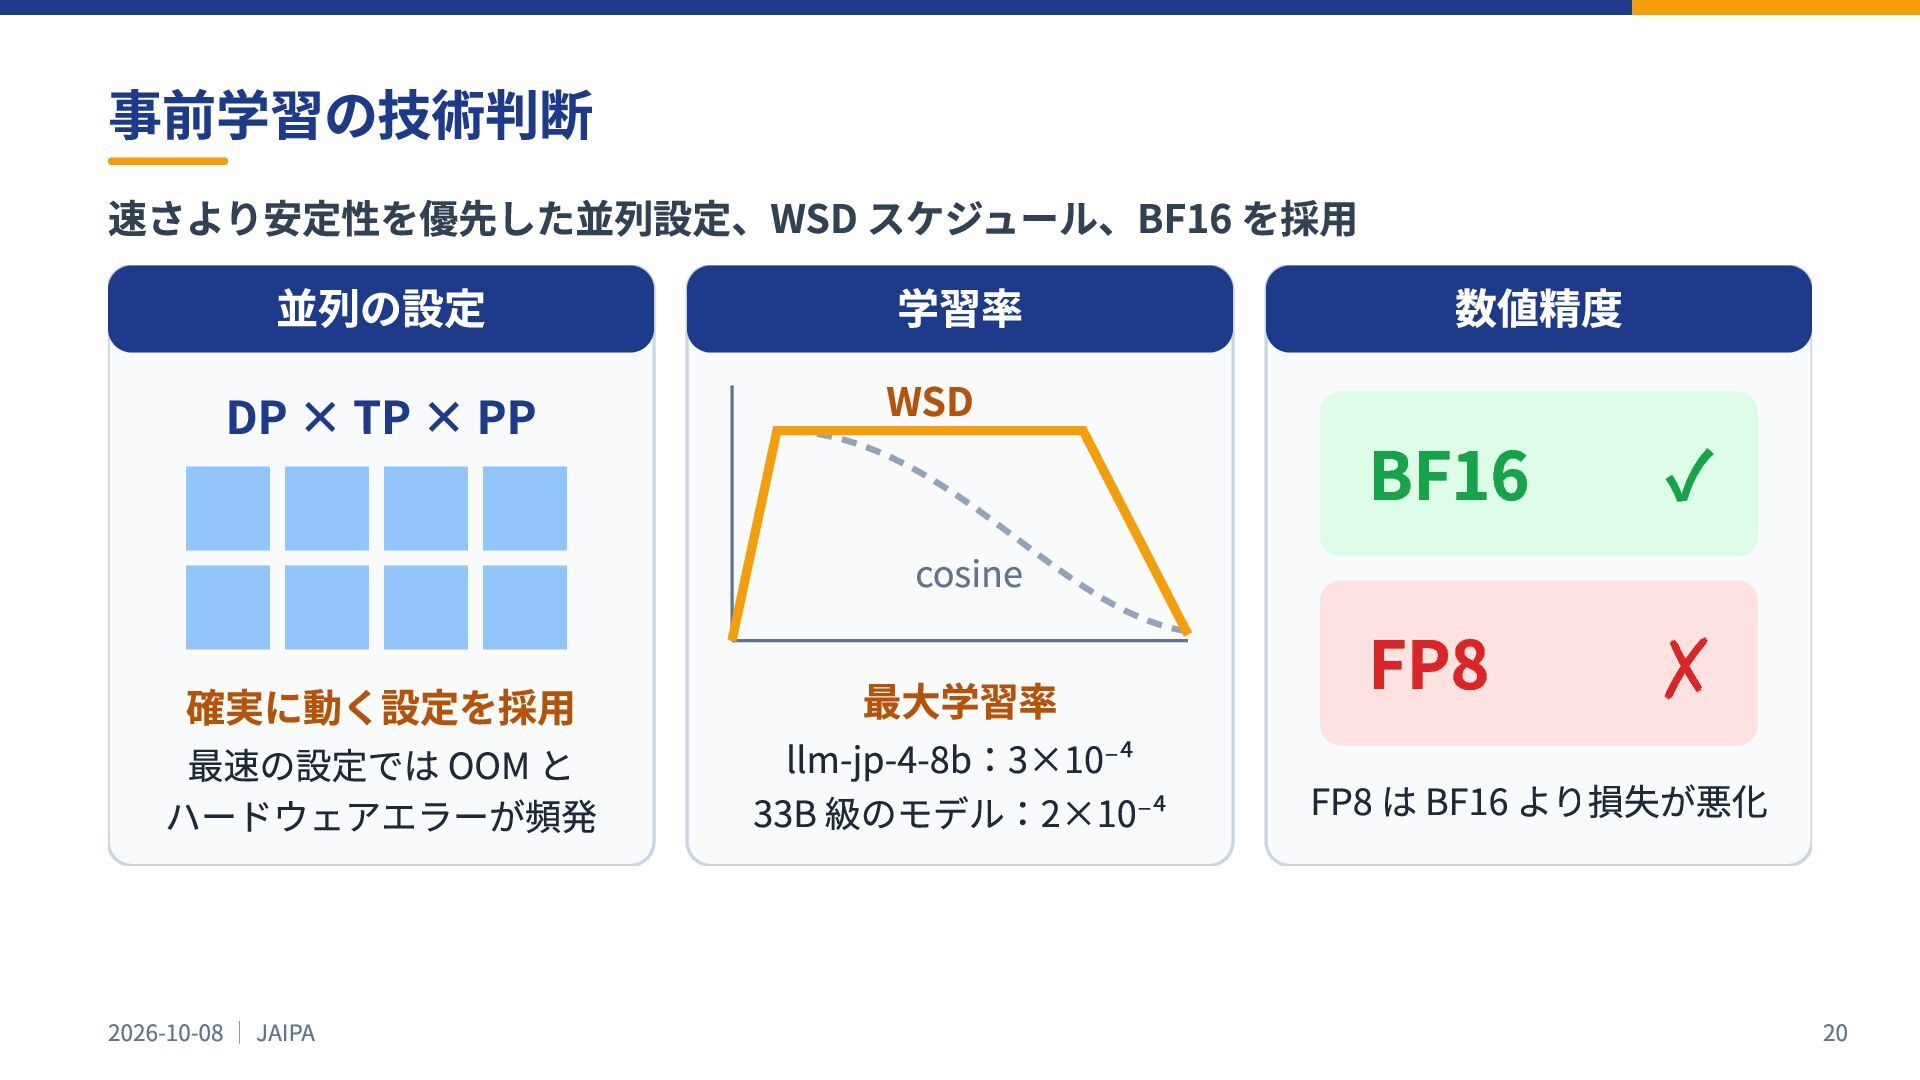
事前学習の技術判断 速さより安定性を優先した並列設定、WSD スケジュール、BF16 を採用 並列の設定 DP × TP × PP
学習率 WSD cosine 確実に動く設定を採⽤ 最速の設定では OOM と ハードウェアエラーが頻発 2026-10-08 | JAIPA 最⼤学習率 llm-jp-4-8b:3×10⁻⁴ 33B 級のモデル:2×10⁻⁴ 数値精度 BF16 FP8 ✓ ✗ FP8 は BF16 より損失が悪化 20
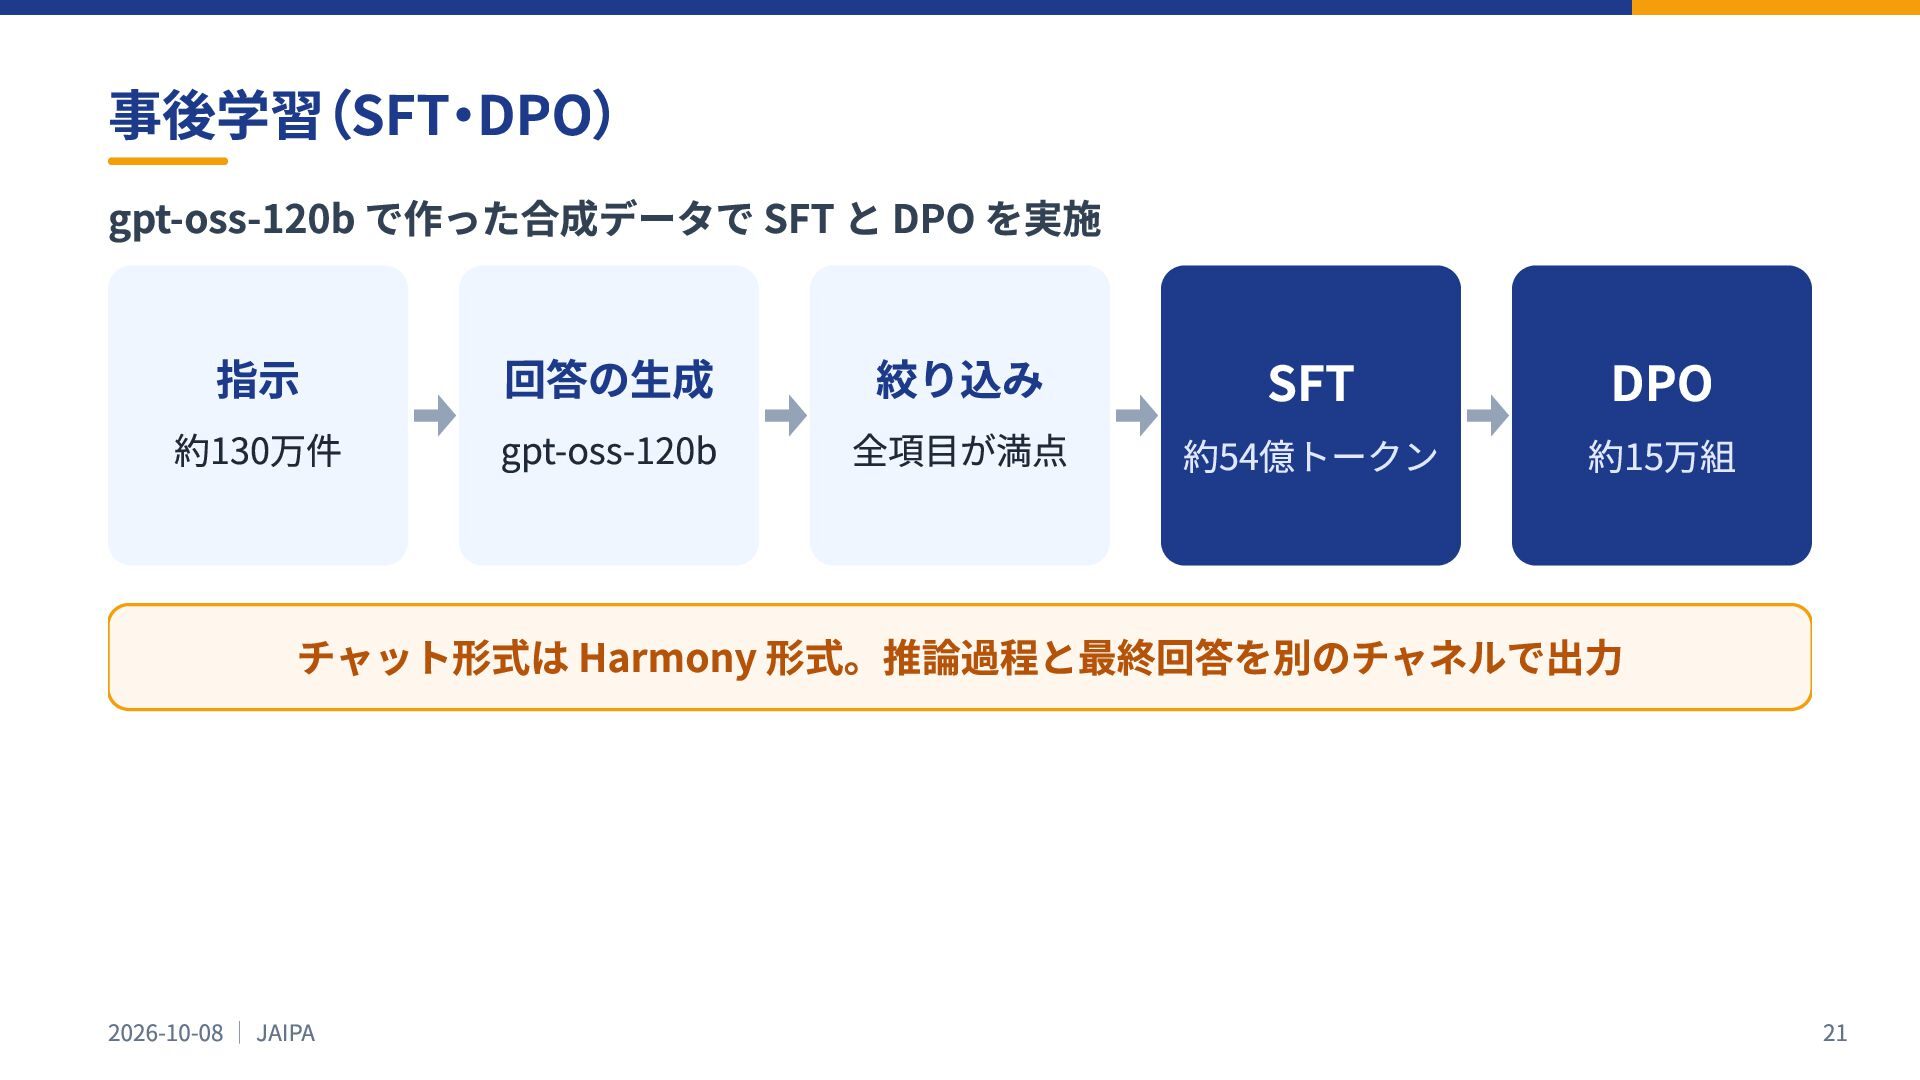
事後学習(SFT・DPO) gpt-oss-120b で作った合成データで SFT と DPO を実施 指⽰ 約130万件 回答の⽣成
gpt-oss-120b 絞り込み 全項⽬が満点 SFT 約54億トークン DPO 約15万組 チャット形式は Harmony 形式。推論過程と最終回答を別のチャネルで出⼒ 2026-10-08 | JAIPA 21
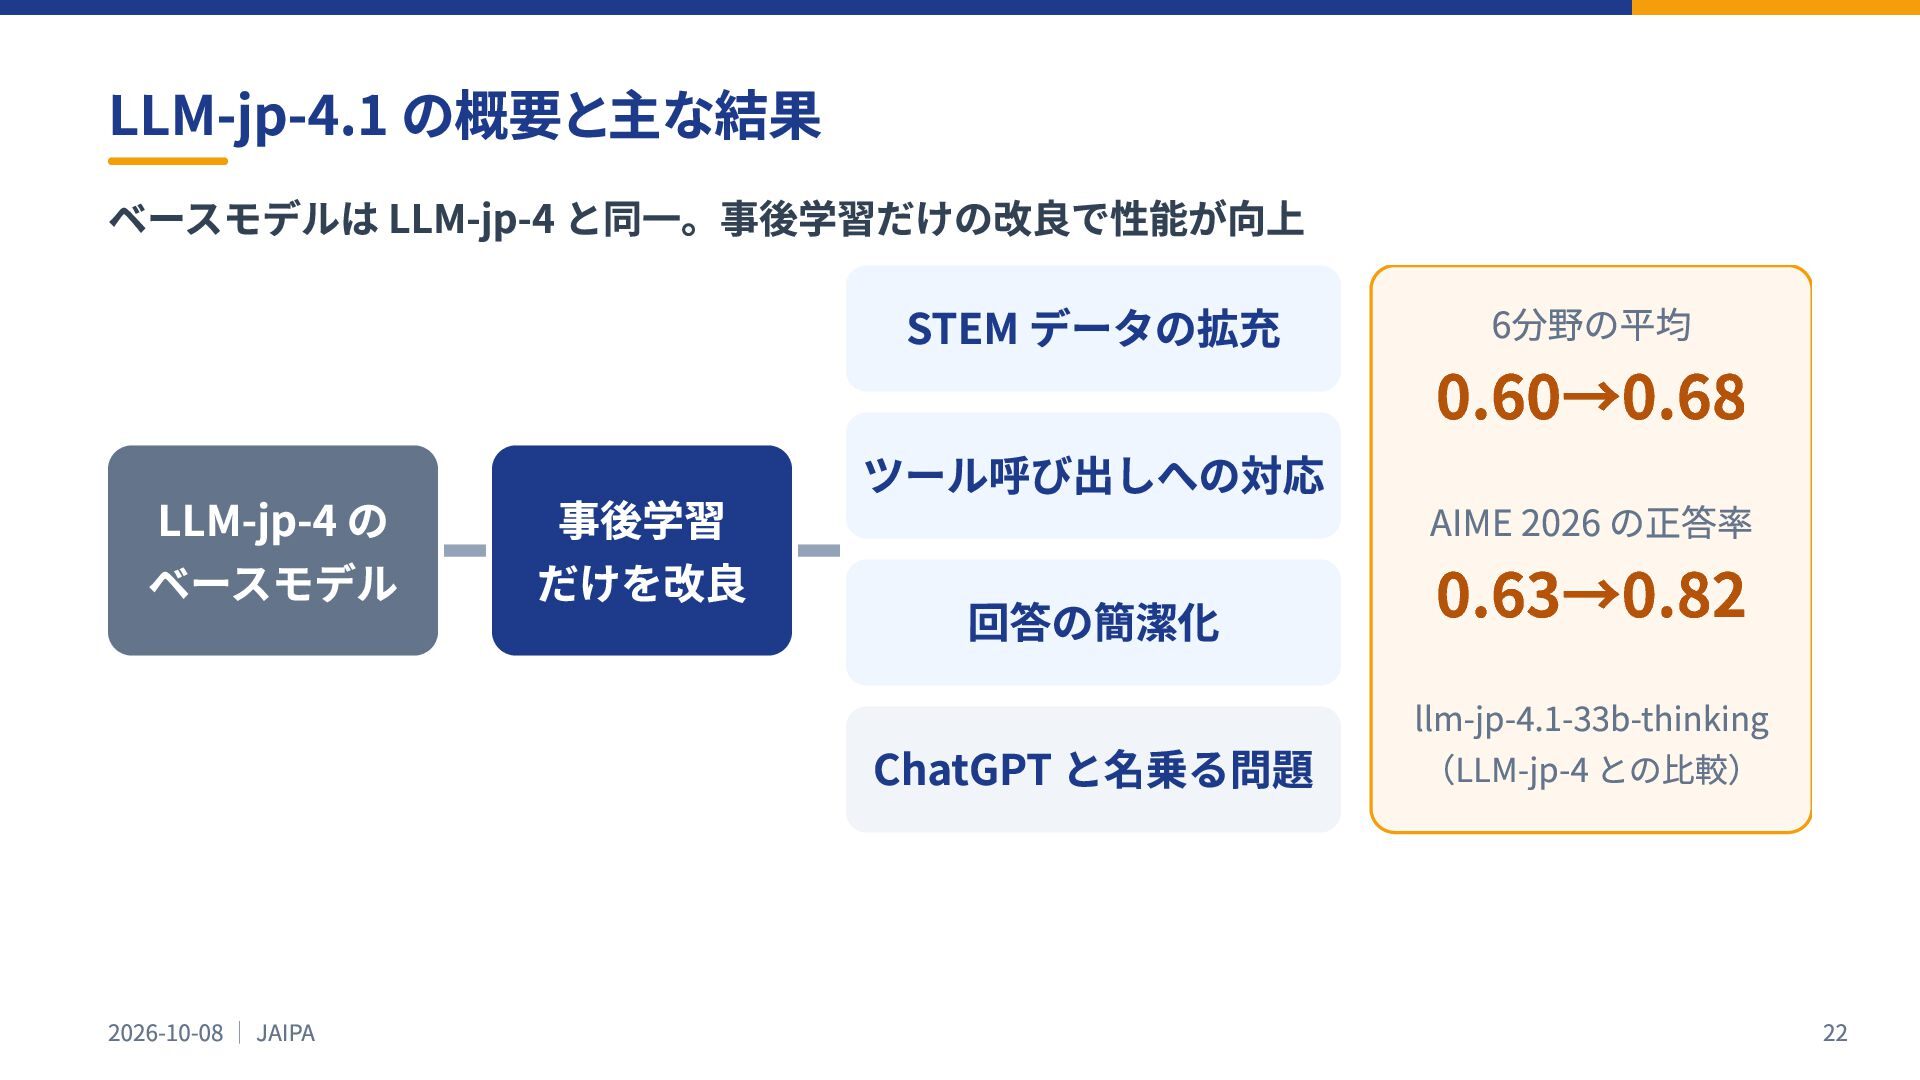
LLM-jp-4.1 の概要と主な結果 ベースモデルは LLM-jp-4 と同一。事後学習だけの改良で性能が向上 STEM データの拡充 LLM-jp-4 の ベースモデル
事後学習 だけを改良 ツール呼び出しへの対応 回答の簡潔化 ChatGPT と名乗る問題 2026-10-08 | JAIPA 6分野の平均 0.60→0.68 AIME 2026 の正答率 0.63→0.82 llm-jp-4.1-33b-thinking (LLM-jp-4 との⽐較) 22
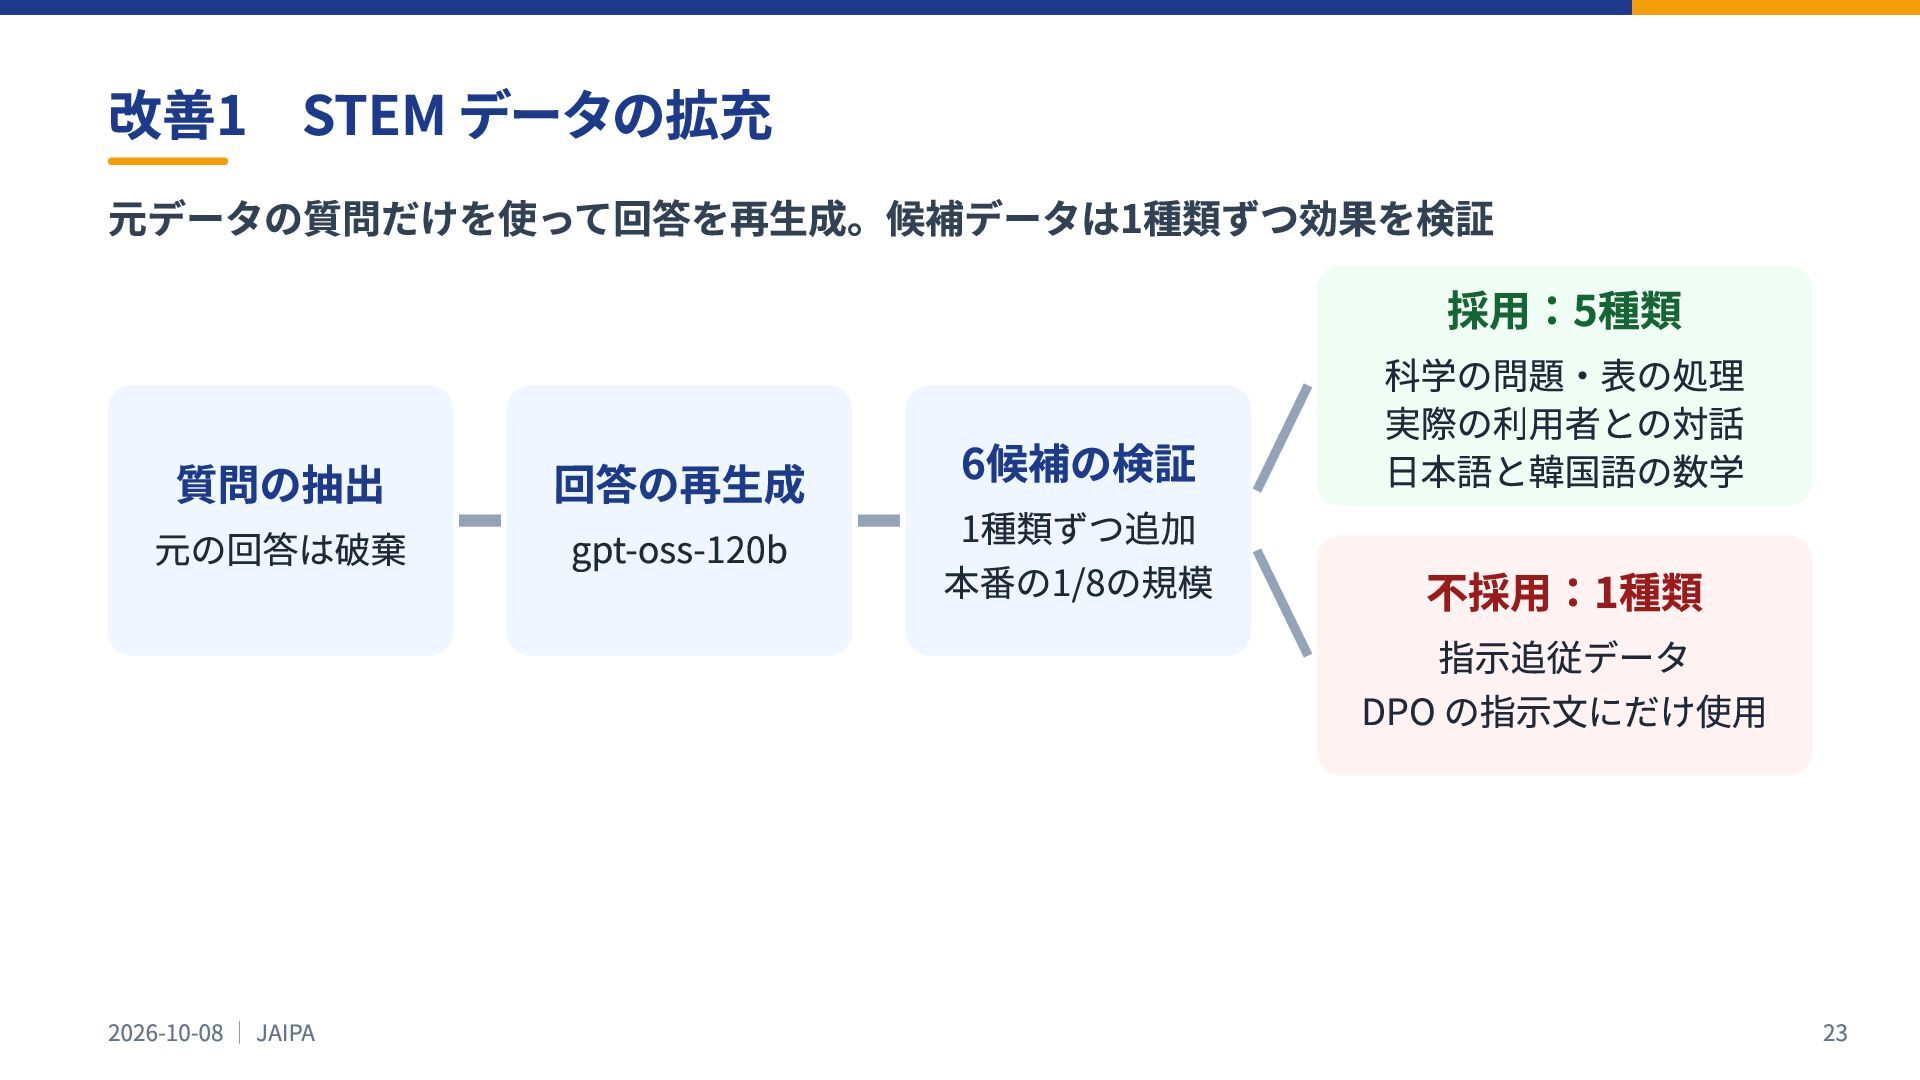
改善1 STEM データの拡充 元データの質問だけを使って回答を再生成。候補データは1種類ずつ効果を検証 採⽤:5種類 質問の抽出 元の回答は破棄 2026-10-08 | JAIPA
回答の再⽣成 gpt-oss-120b 6候補の検証 1種類ずつ追加 本番の1/8の規模 科学の問題‧表の処理 実際の利⽤者との対話 ⽇本語と韓国語の数学 不採⽤:1種類 指⽰追従データ DPO の指⽰⽂にだけ使⽤ 23
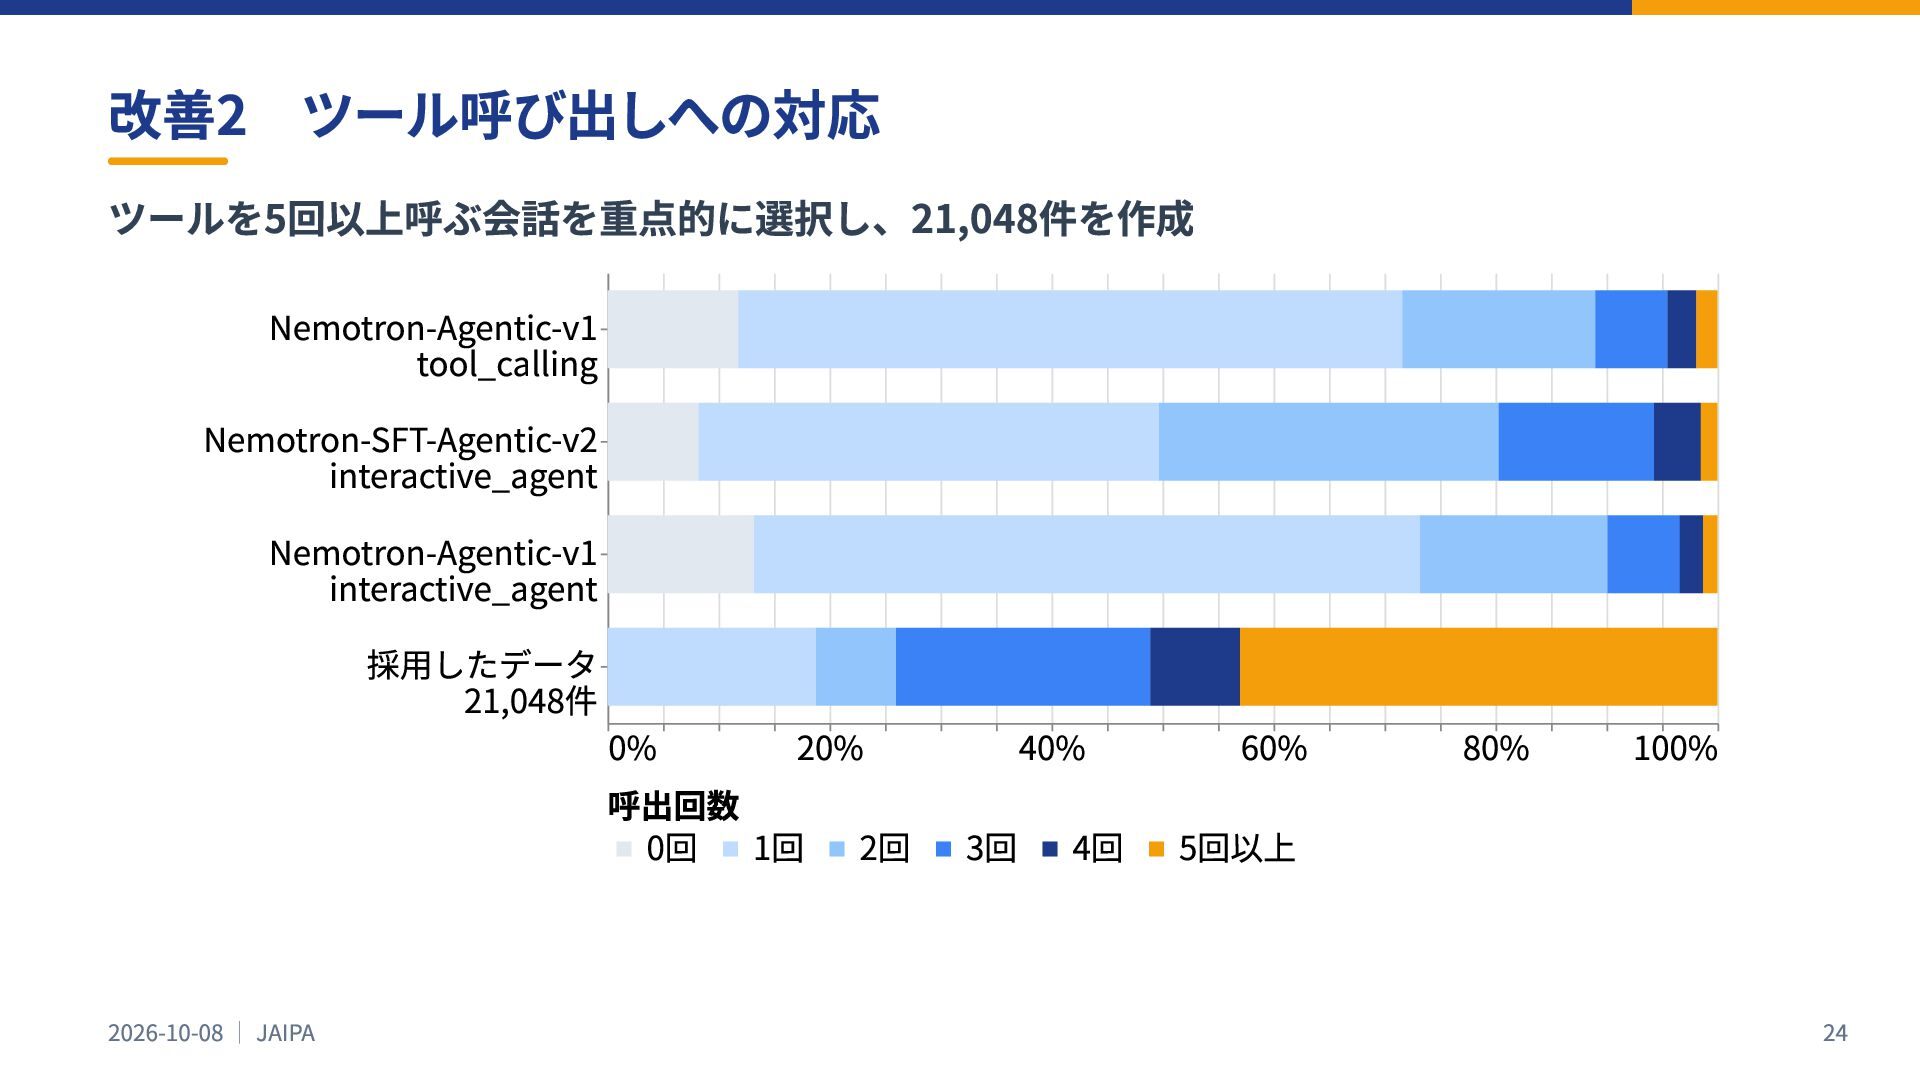
改善2 ツール呼び出しへの対応 ツールを5回以上呼ぶ会話を重点的に選択し、21,048件を作成 Nemotron-Agentic-v1 tool_calling Nemotron-SFT-Agentic-v2 interactive_agent Nemotron-Agentic-v1 interactive_agent 採用したデータ
21,048件 2026-10-08 | JAIPA 0% 20% 40% 60% 呼出回数 0回 1回 2回 3回 4回 5回以上 80% 100% 24
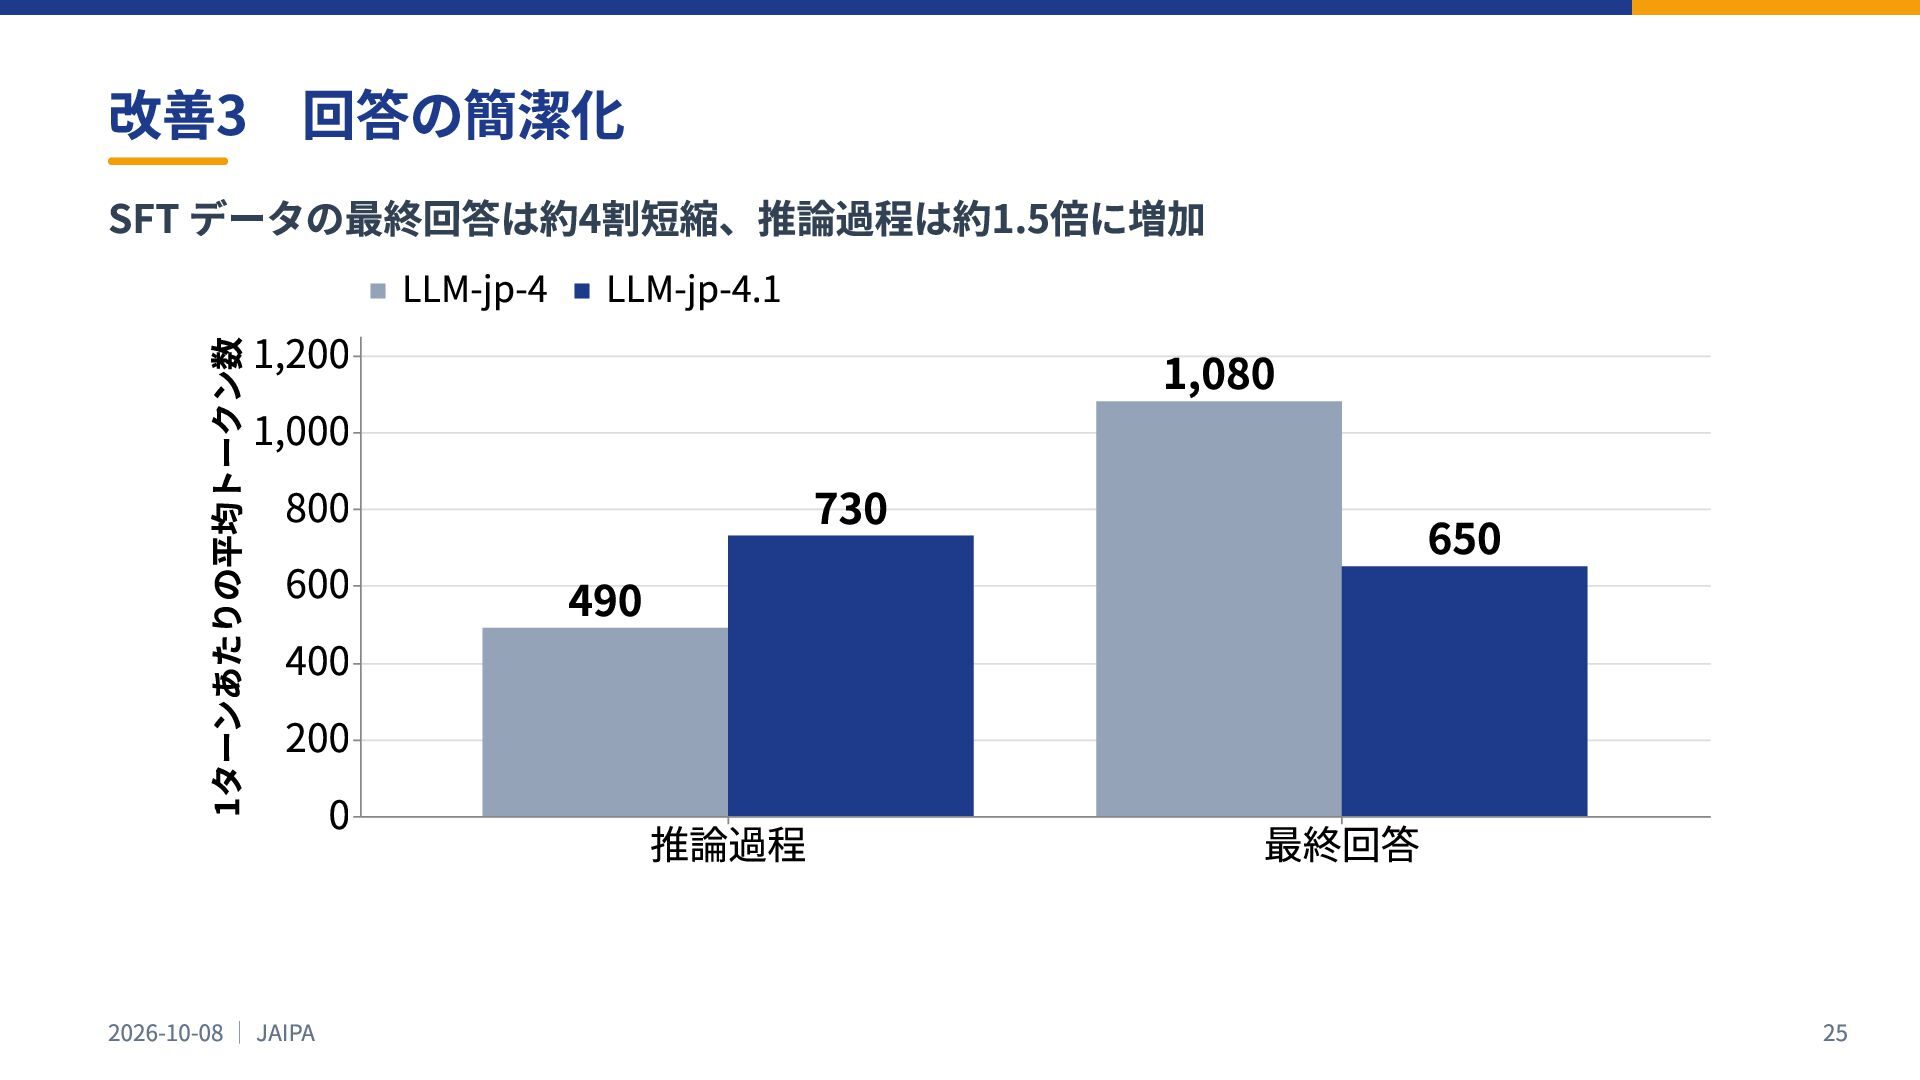
改善3 回答の簡潔化 SFT データの最終回答は約4割短縮、推論過程は約1.5倍に増加 数ンクート均平のりたあンータ1 1,200 1,000 800 600 400
200 0 2026-10-08 | JAIPA LLM-jp-4 LLM-jp-4.1 1,080 730 490 推論過程 650 最終回答 25
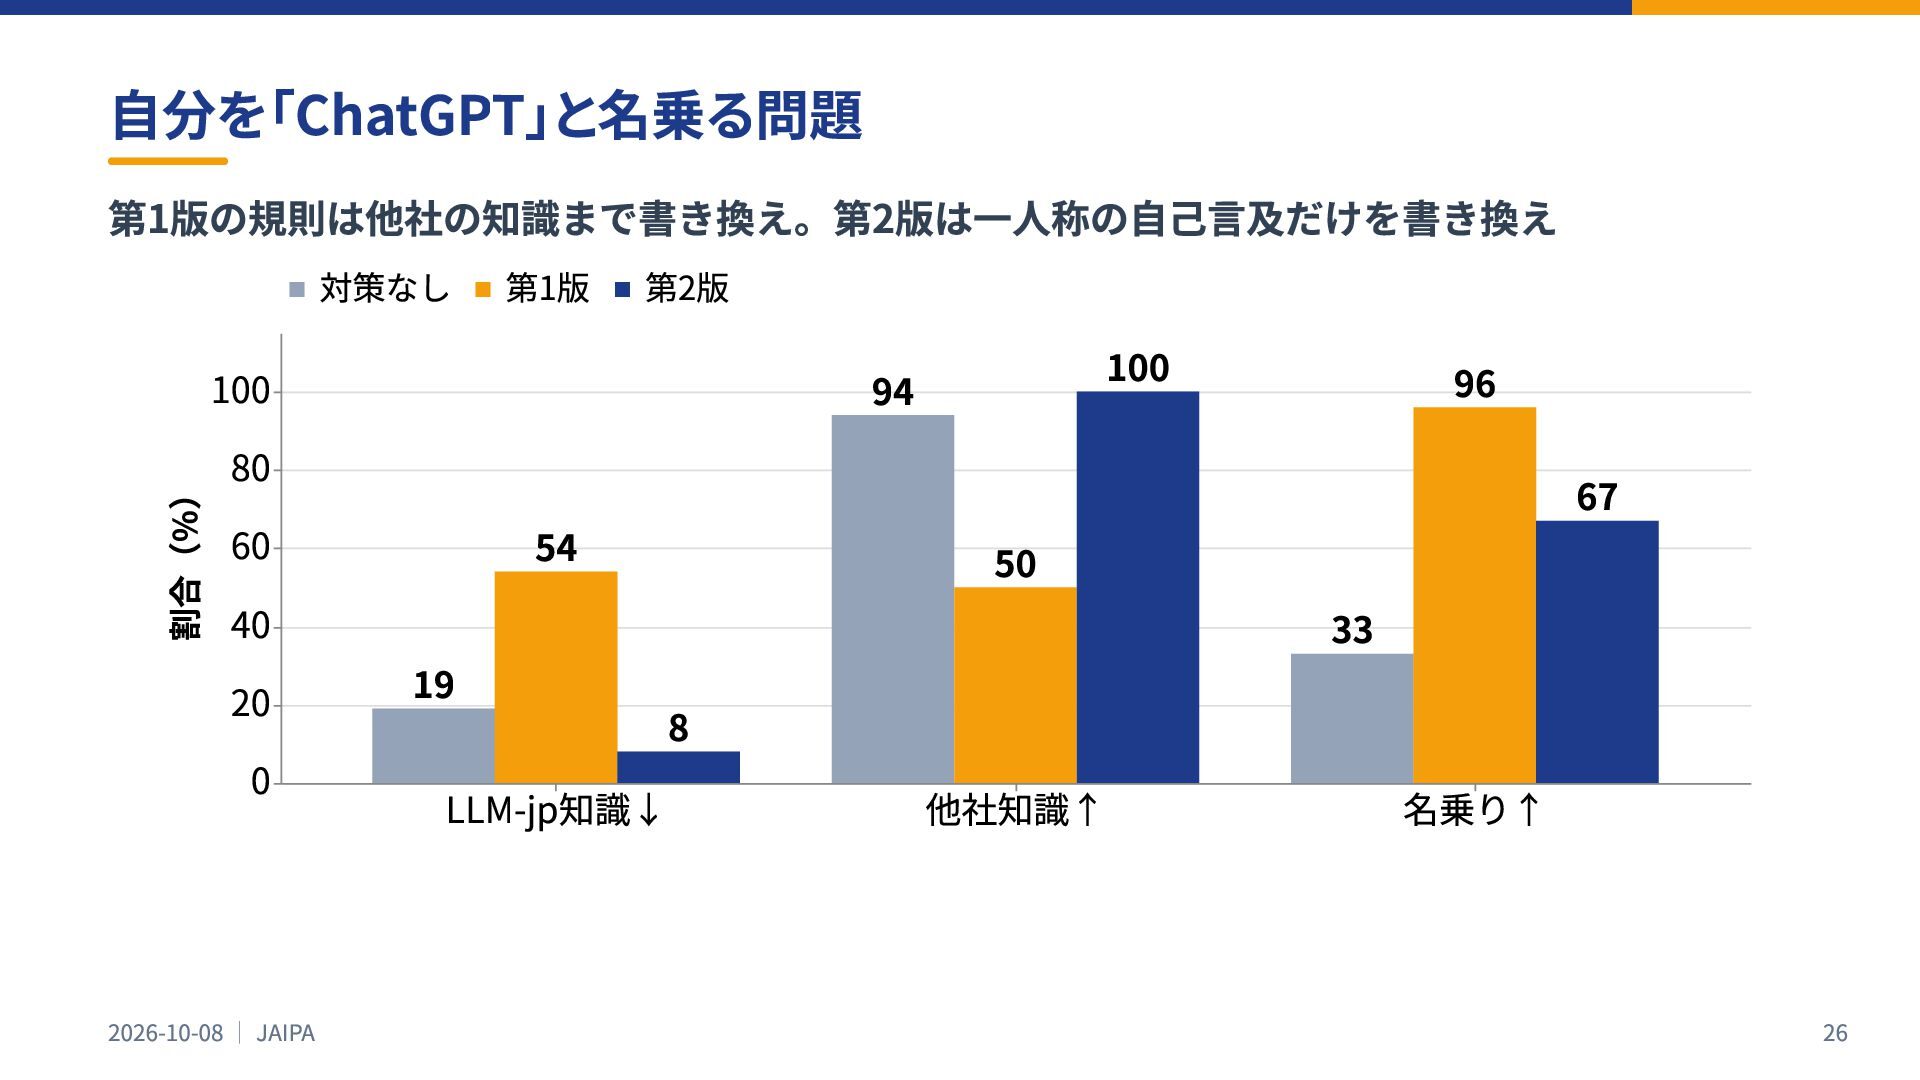
自分を「ChatGPT」と名乗る問題 第1版の規則は他社の知識まで書き換え。第2版は一人称の自己言及だけを書き換え 対策なし 第1版 第2版 )%(合割 100 80 60 40
20 0 2026-10-08 | JAIPA 100 94 54 19 LLM-jp知識↓ 50 8 他社知識↑ 96 67 33 名乗り↑ 26
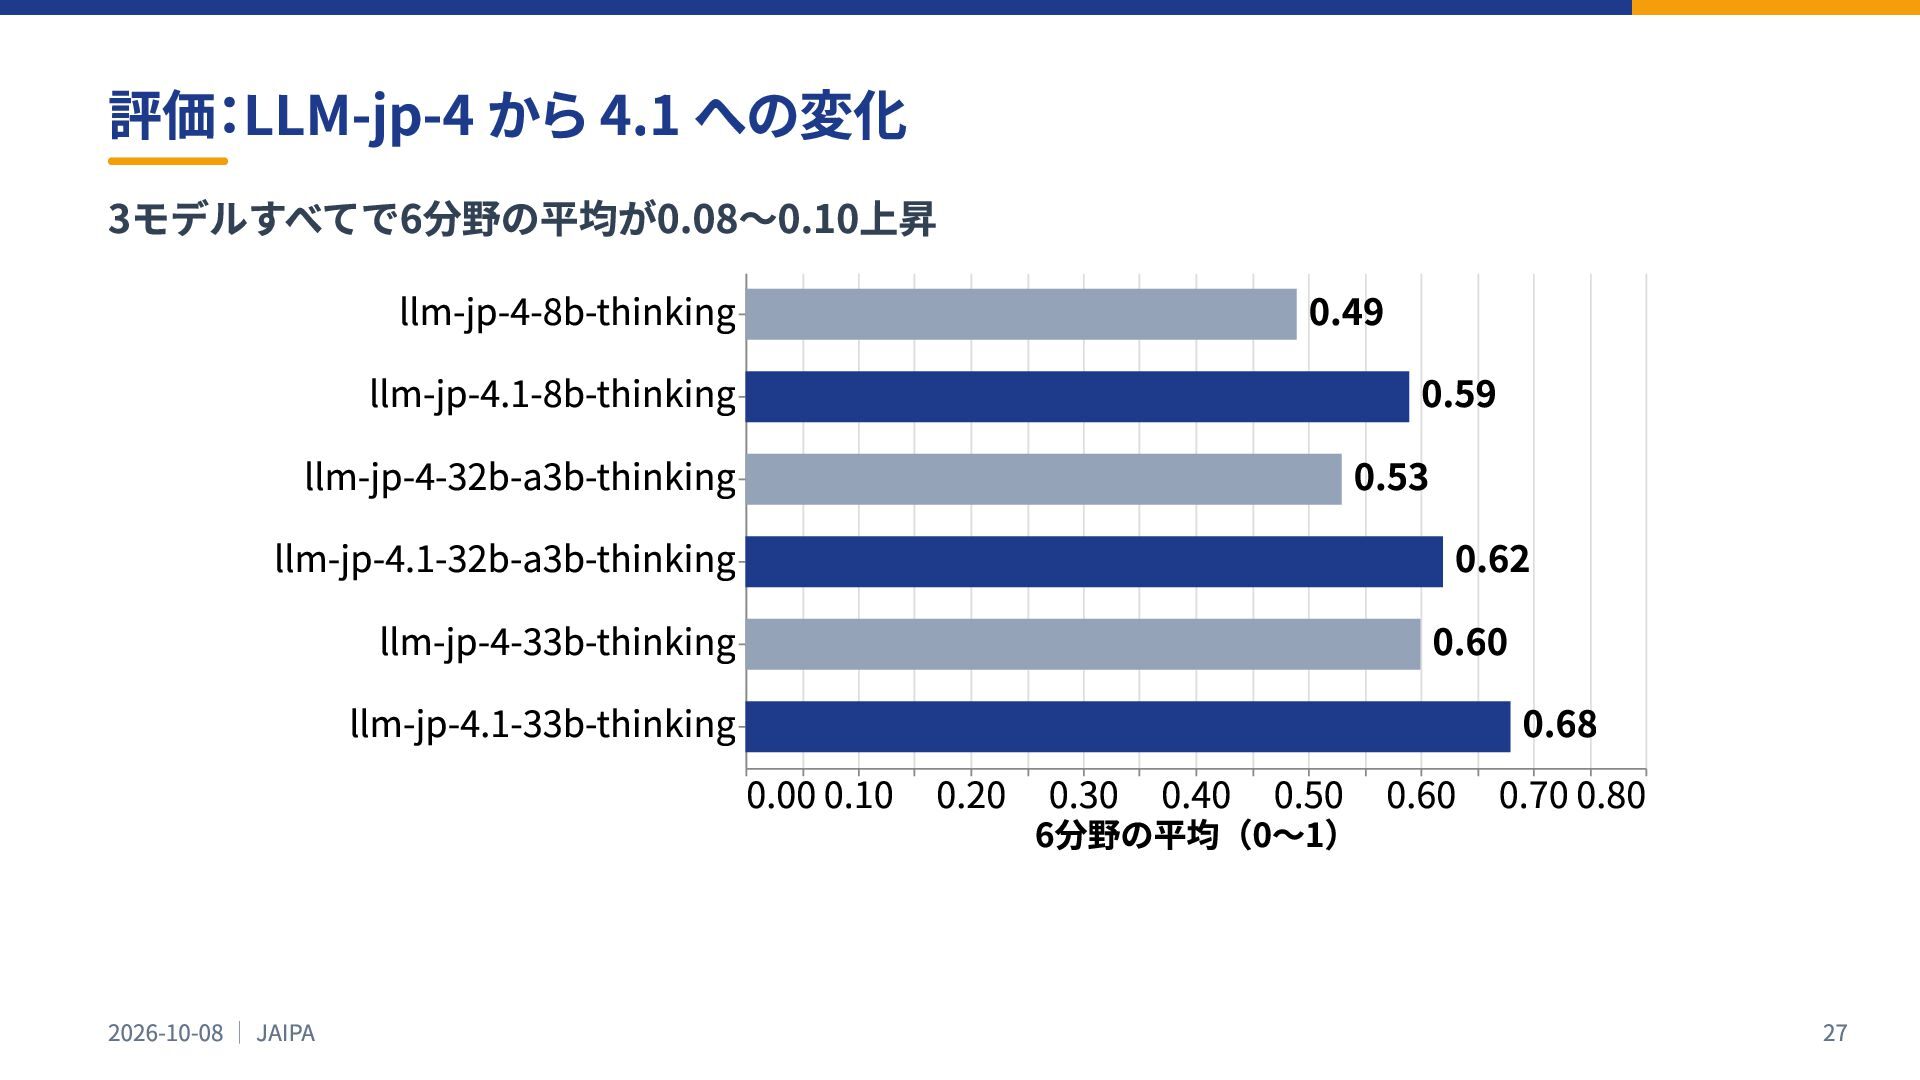
評価:LLM-jp-4 から 4.1 への変化 3モデルすべてで6分野の平均が0.08〜0.10上昇 llm-jp-4-8b-thinking llm-jp-4.1-8b-thinking llm-jp-4-32b-a3b-thinking llm-jp-4.1-32b-a3b-thinking llm-jp-4-33b-thinking
llm-jp-4.1-33b-thinking 0.49 0.59 0.53 0.62 0.60 0.68 0.00 0.10 0.20 0.30 0.40 0.50 0.60 0.70 0.80 6分野の平均(0〜1) 2026-10-08 | JAIPA 27
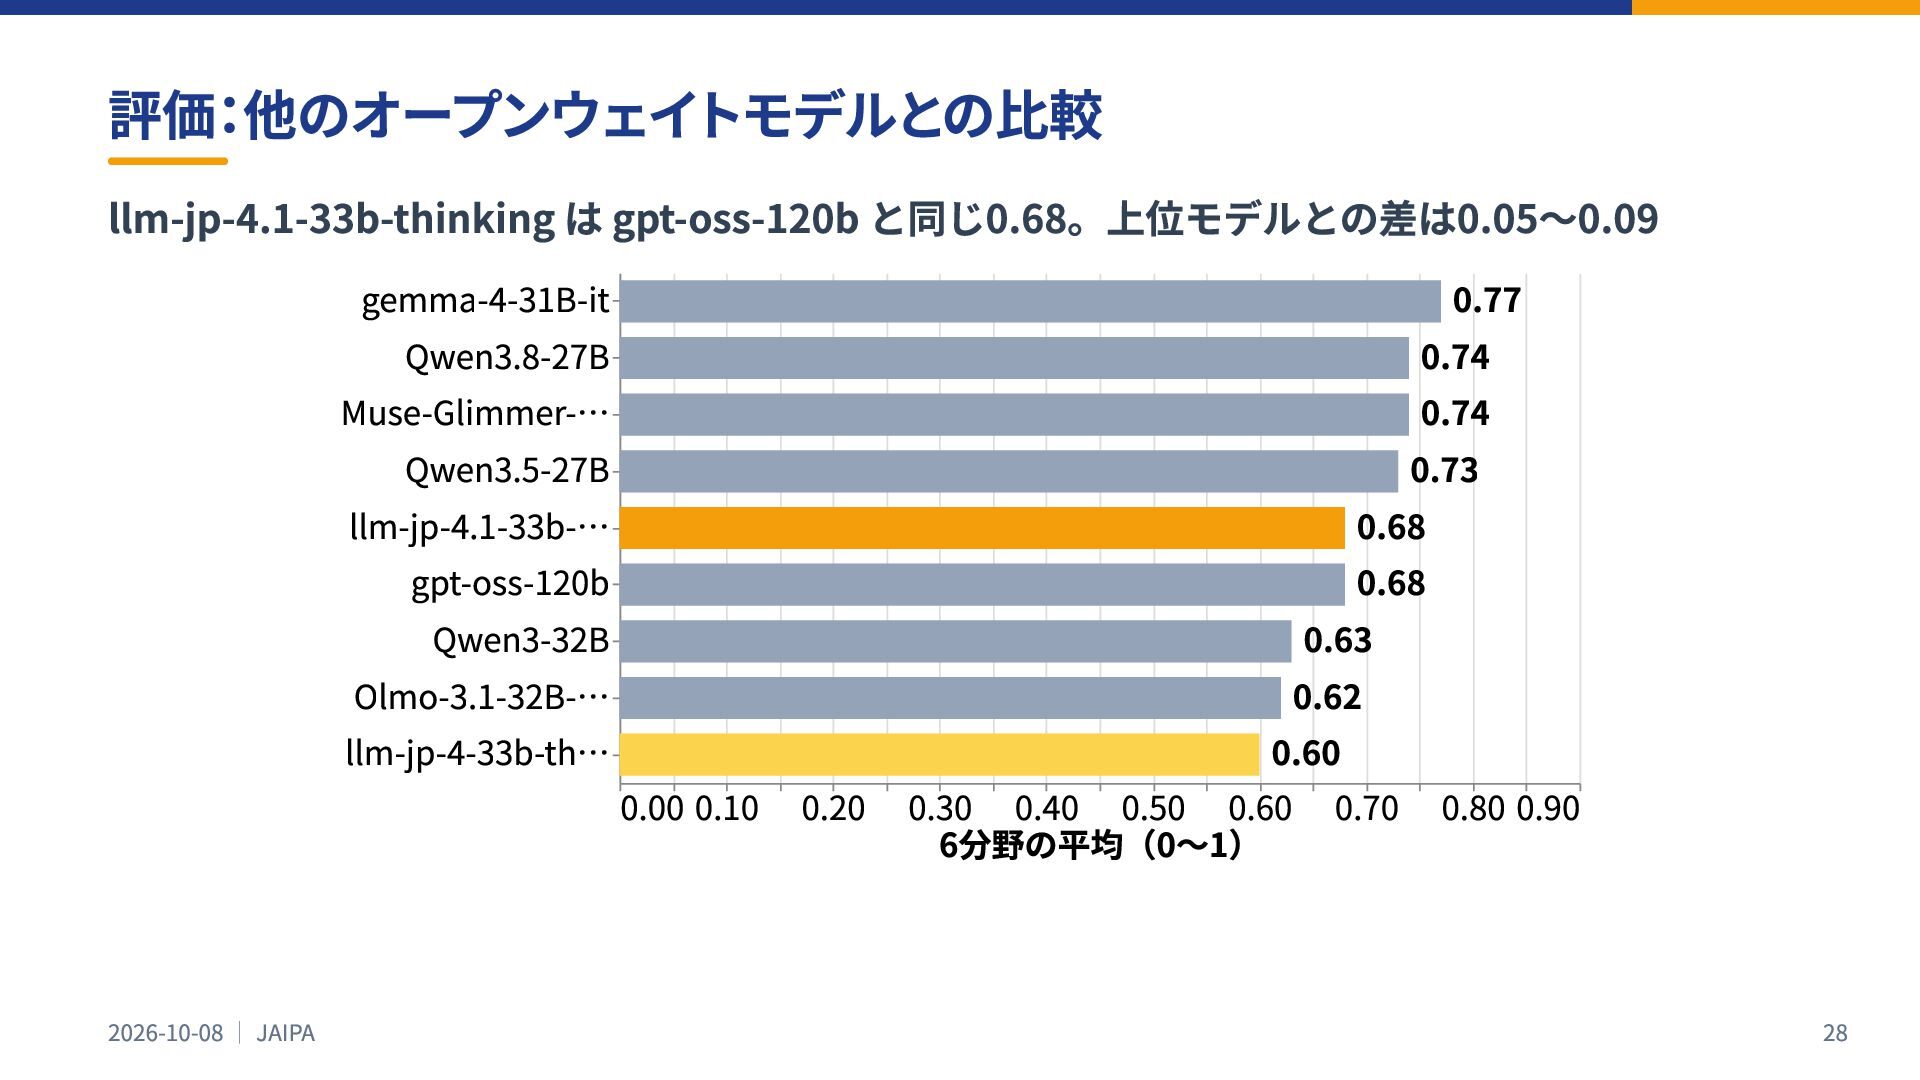
評価:他のオープンウェイトモデルとの比較 llm-jp-4.1-33b-thinking は gpt-oss-120b と同じ0.68。上位モデルとの差は0.05〜0.09 gemma-4-31B-it Qwen3.8-27B Muse-Glimmer-… Qwen3.5-27B llm-jp-4.1-33b-…
gpt-oss-120b Qwen3-32B Olmo-3.1-32B-… llm-jp-4-33b-th… 2026-10-08 | JAIPA 0.77 0.74 0.74 0.73 0.68 0.68 0.63 0.62 0.60 0.00 0.10 0.20 0.30 0.40 0.50 0.60 0.70 0.80 0.90 6分野の平均(0〜1) 28
第4部 計算基盤と共同利用の運用 2023年から2026年までの計算基盤の変遷と、ABCI の共同利用の仕組み 2026-10-08 | JAIPA 29
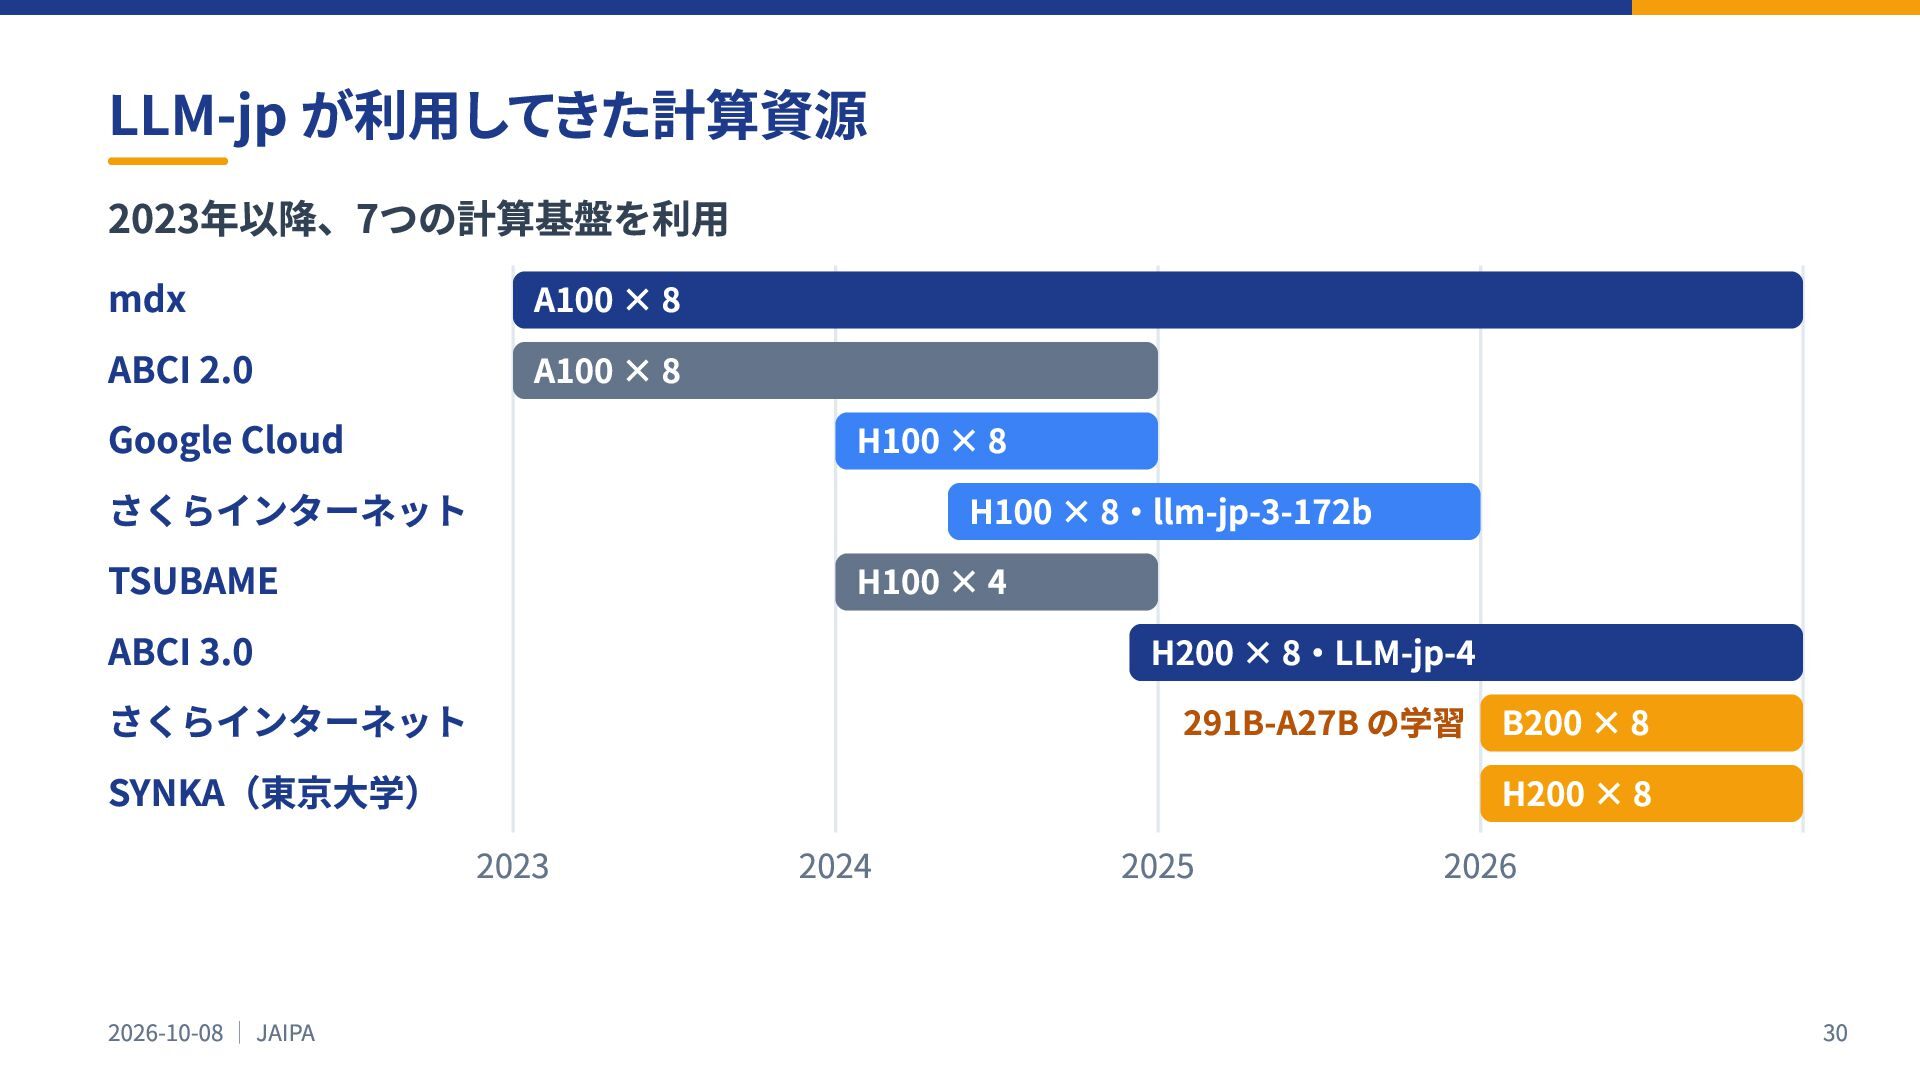
LLM-jp が利用してきた計算資源 2023年以降、7つの計算基盤を利用 mdx A100 × 8 ABCI 2.0 A100
× 8 Google Cloud さくらインターネット TSUBAME ABCI 3.0 さくらインターネット SYNKA(東京⼤学) 2023 2026-10-08 | JAIPA H100 × 8 H100 × 8‧llm-jp-3-172b H100 × 4 H200 × 8‧LLM-jp-4 291B-A27B の学習 B200 × 8 H200 × 8 2024 2025 2026 30
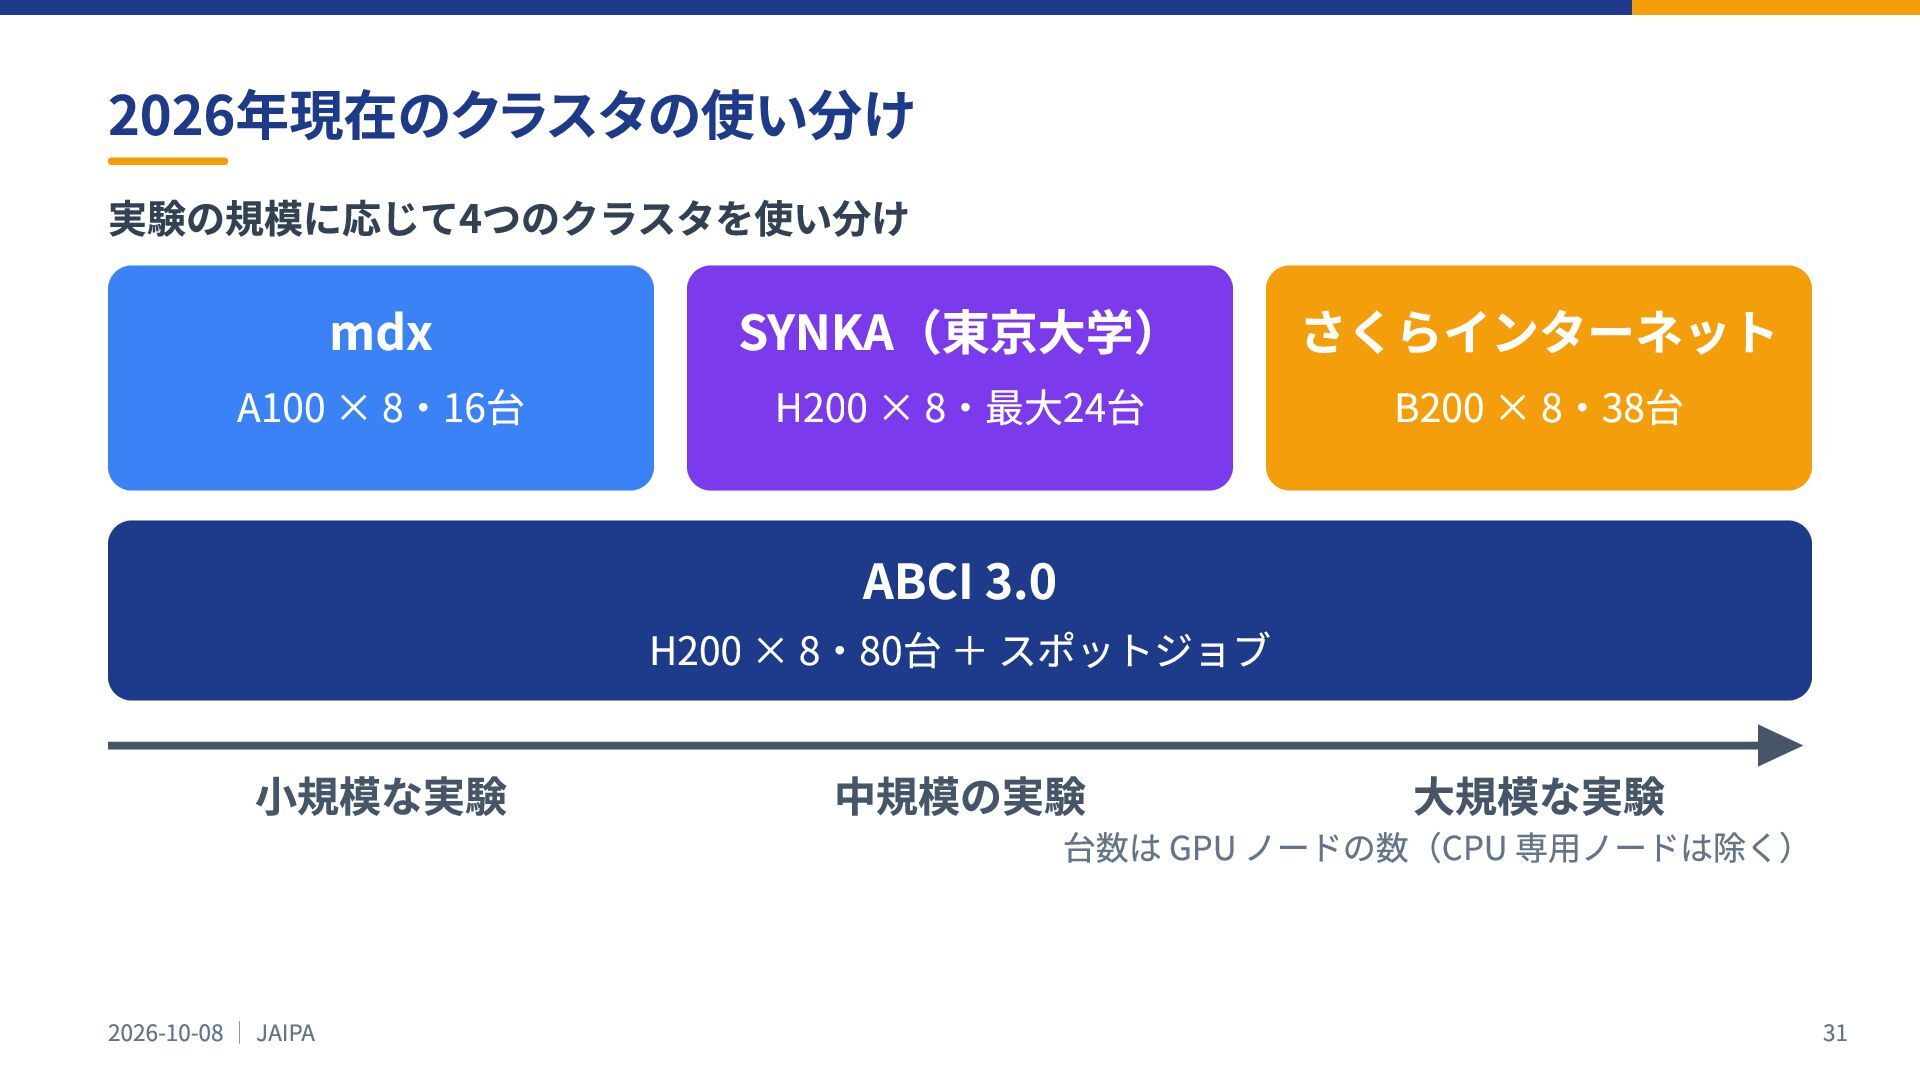
2026年現在のクラスタの使い分け 実験の規模に応じて4つのクラスタを使い分け mdx A100 × 8‧16台 SYNKA(東京⼤学) H200 × 8‧最⼤24台
さくらインターネット B200 × 8‧38台 ABCI 3.0 H200 × 8‧80台 + スポットジョブ ⼩規模な実験 2026-10-08 | JAIPA 中規模の実験 ⼤規模な実験 台数は GPU ノードの数(CPU 専⽤ノードは除く) 31
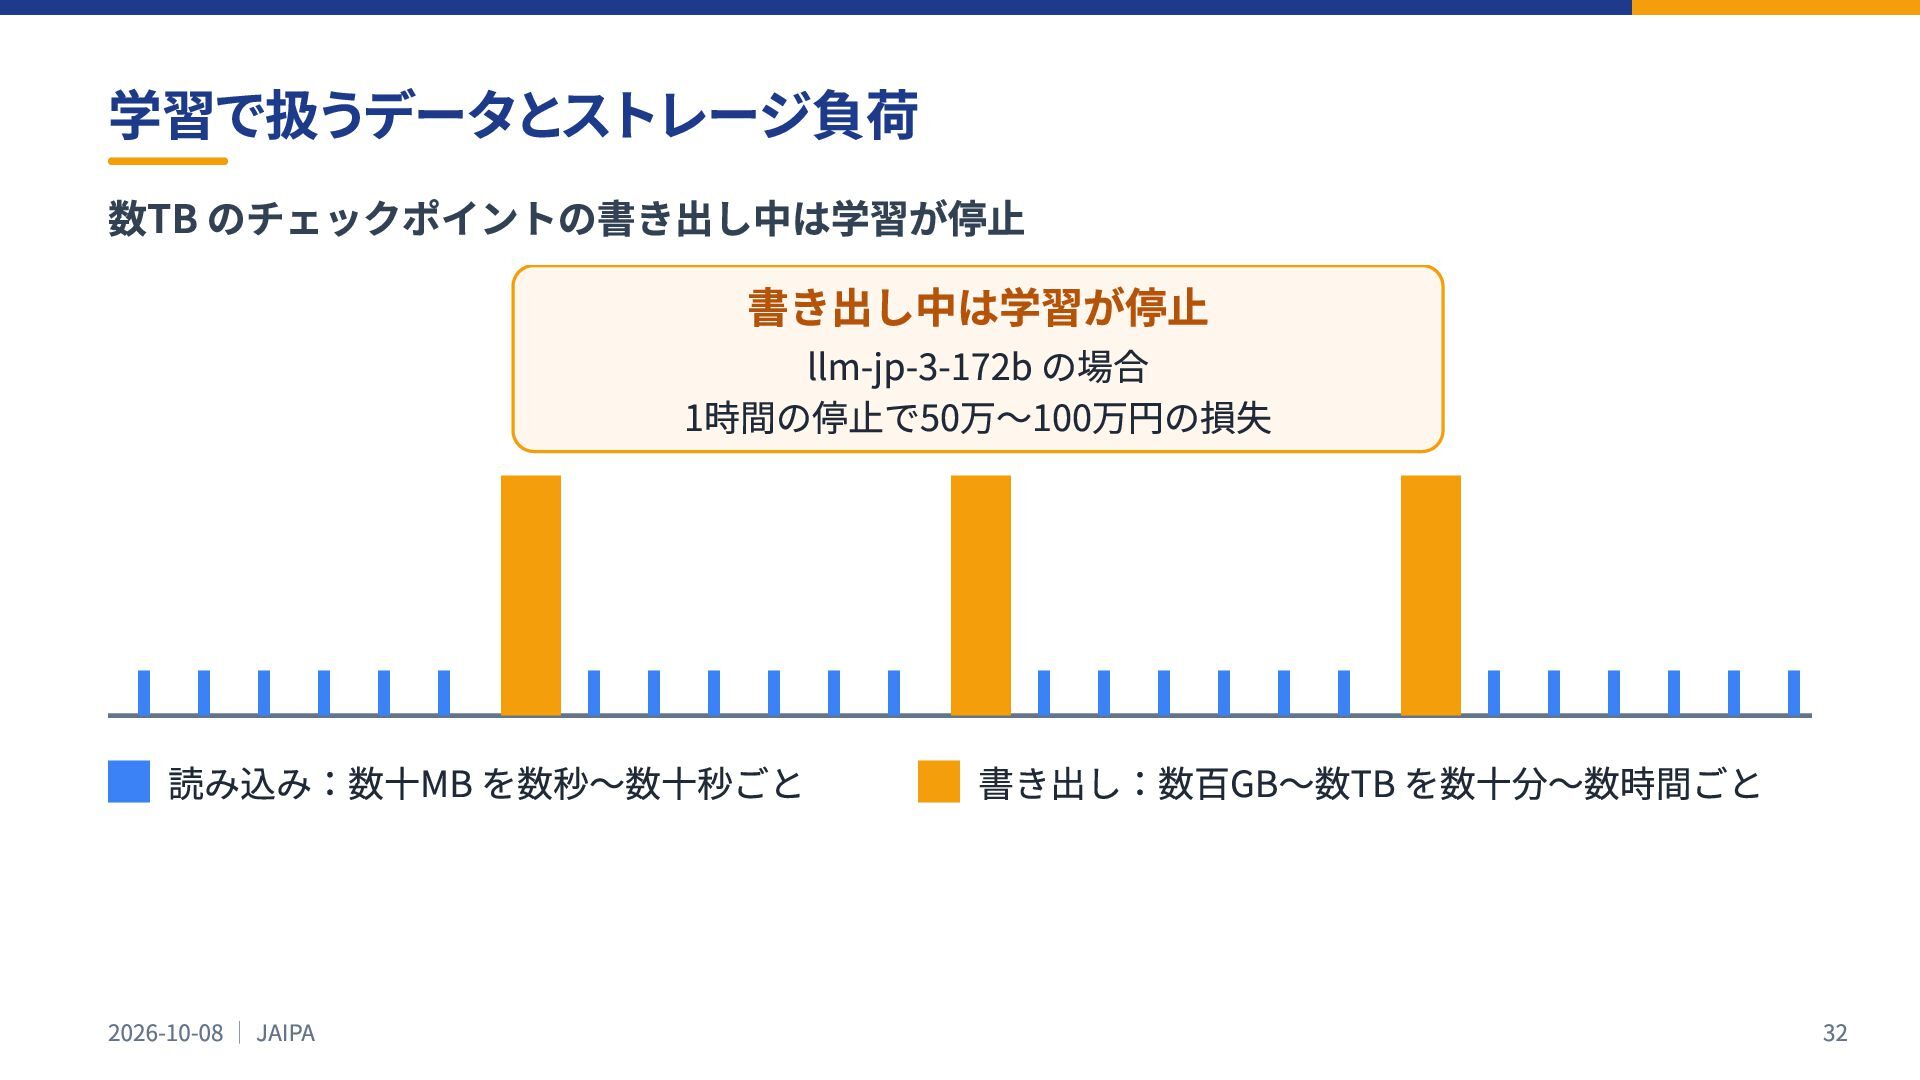
学習で扱うデータとストレージ負荷 数TB のチェックポイントの書き出し中は学習が停止 書き出し中は学習が停⽌ llm-jp-3-172b の場合 1時間の停⽌で50万〜100万円の損失 読み込み:数⼗MB を数秒〜数⼗秒ごと 2026-10-08
| JAIPA 書き出し:数百GB〜数TB を数⼗分〜数時間ごと 32
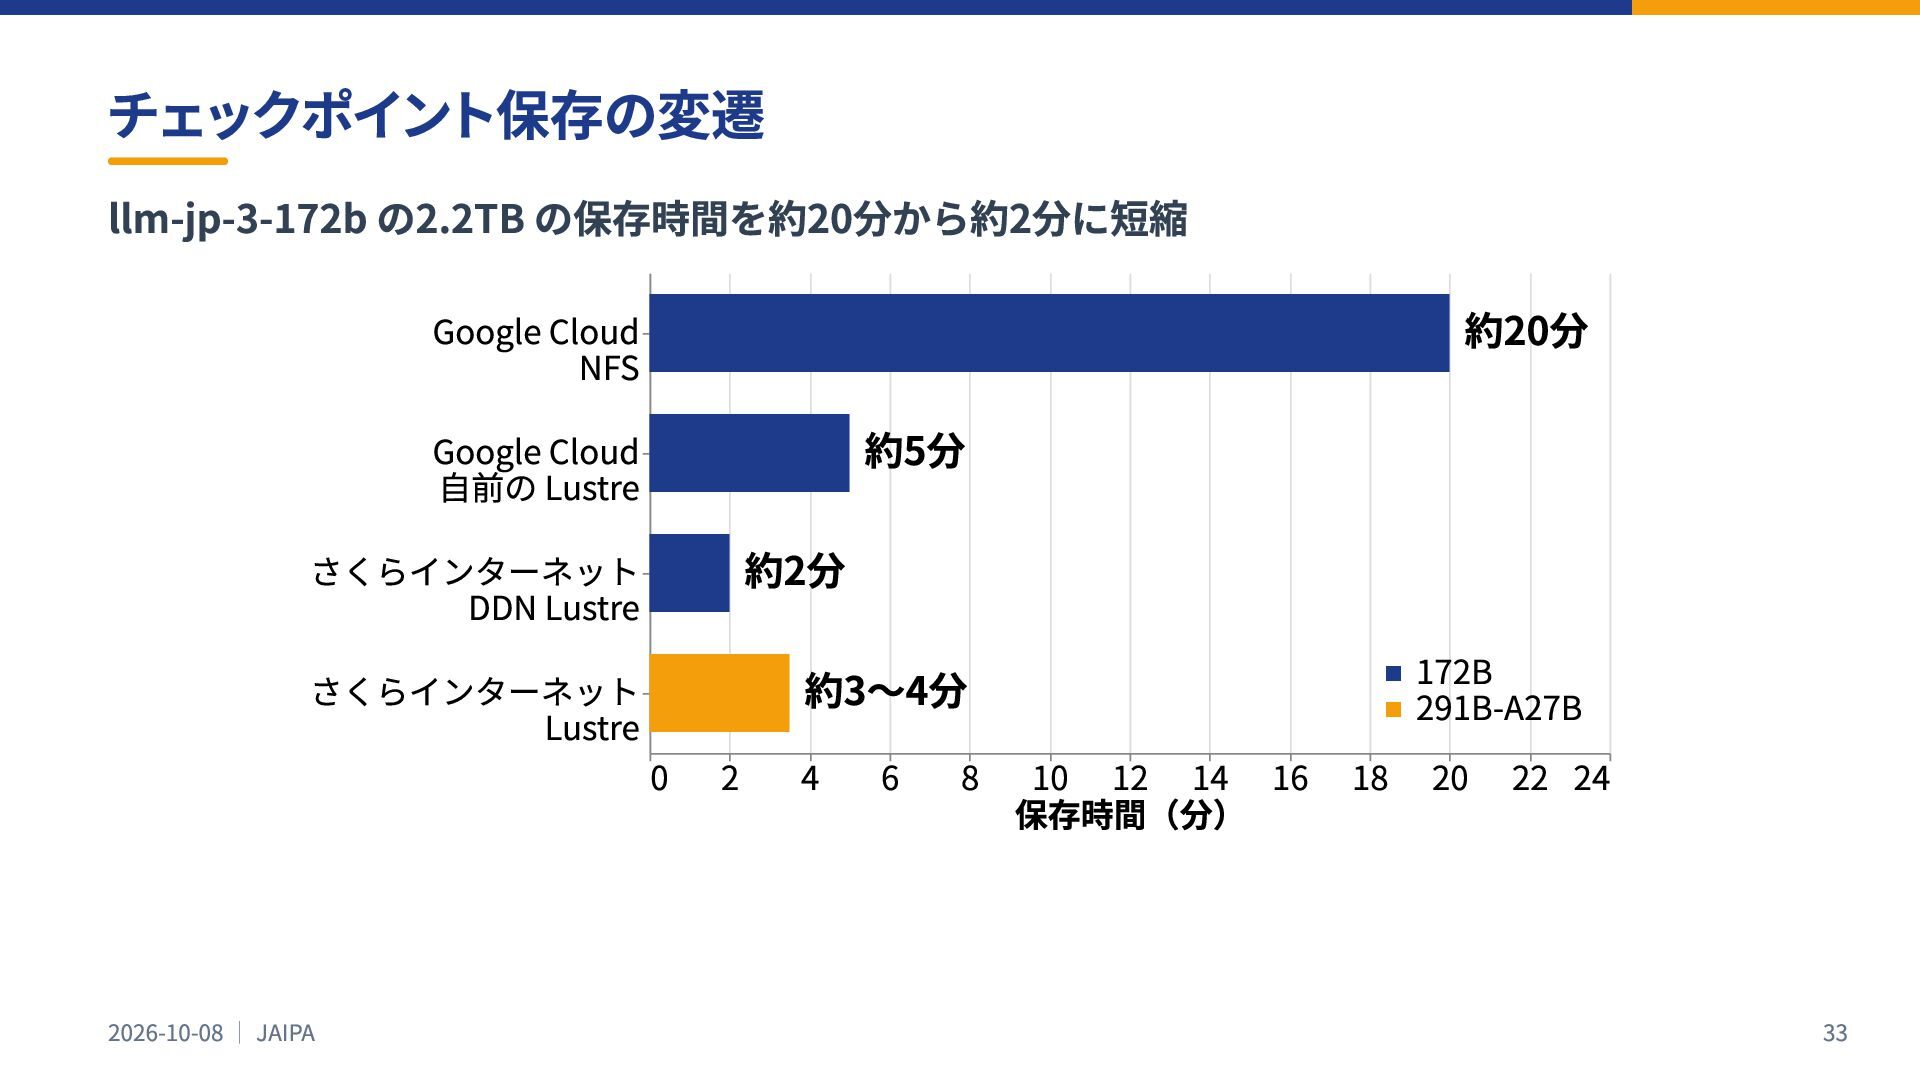
チェックポイント保存の変遷 llm-jp-3-172b の2.2TB の保存時間を約20分から約2分に短縮 Google Cloud NFS Google Cloud 自前の
Lustre さくらインターネット DDN Lustre さくらインターネット Lustre 2026-10-08 | JAIPA 約20分 約5分 約2分 172B 291B-A27B 0 2 4 6 8 10 12 14 16 18 20 22 24 保存時間(分) 約3〜4分 33
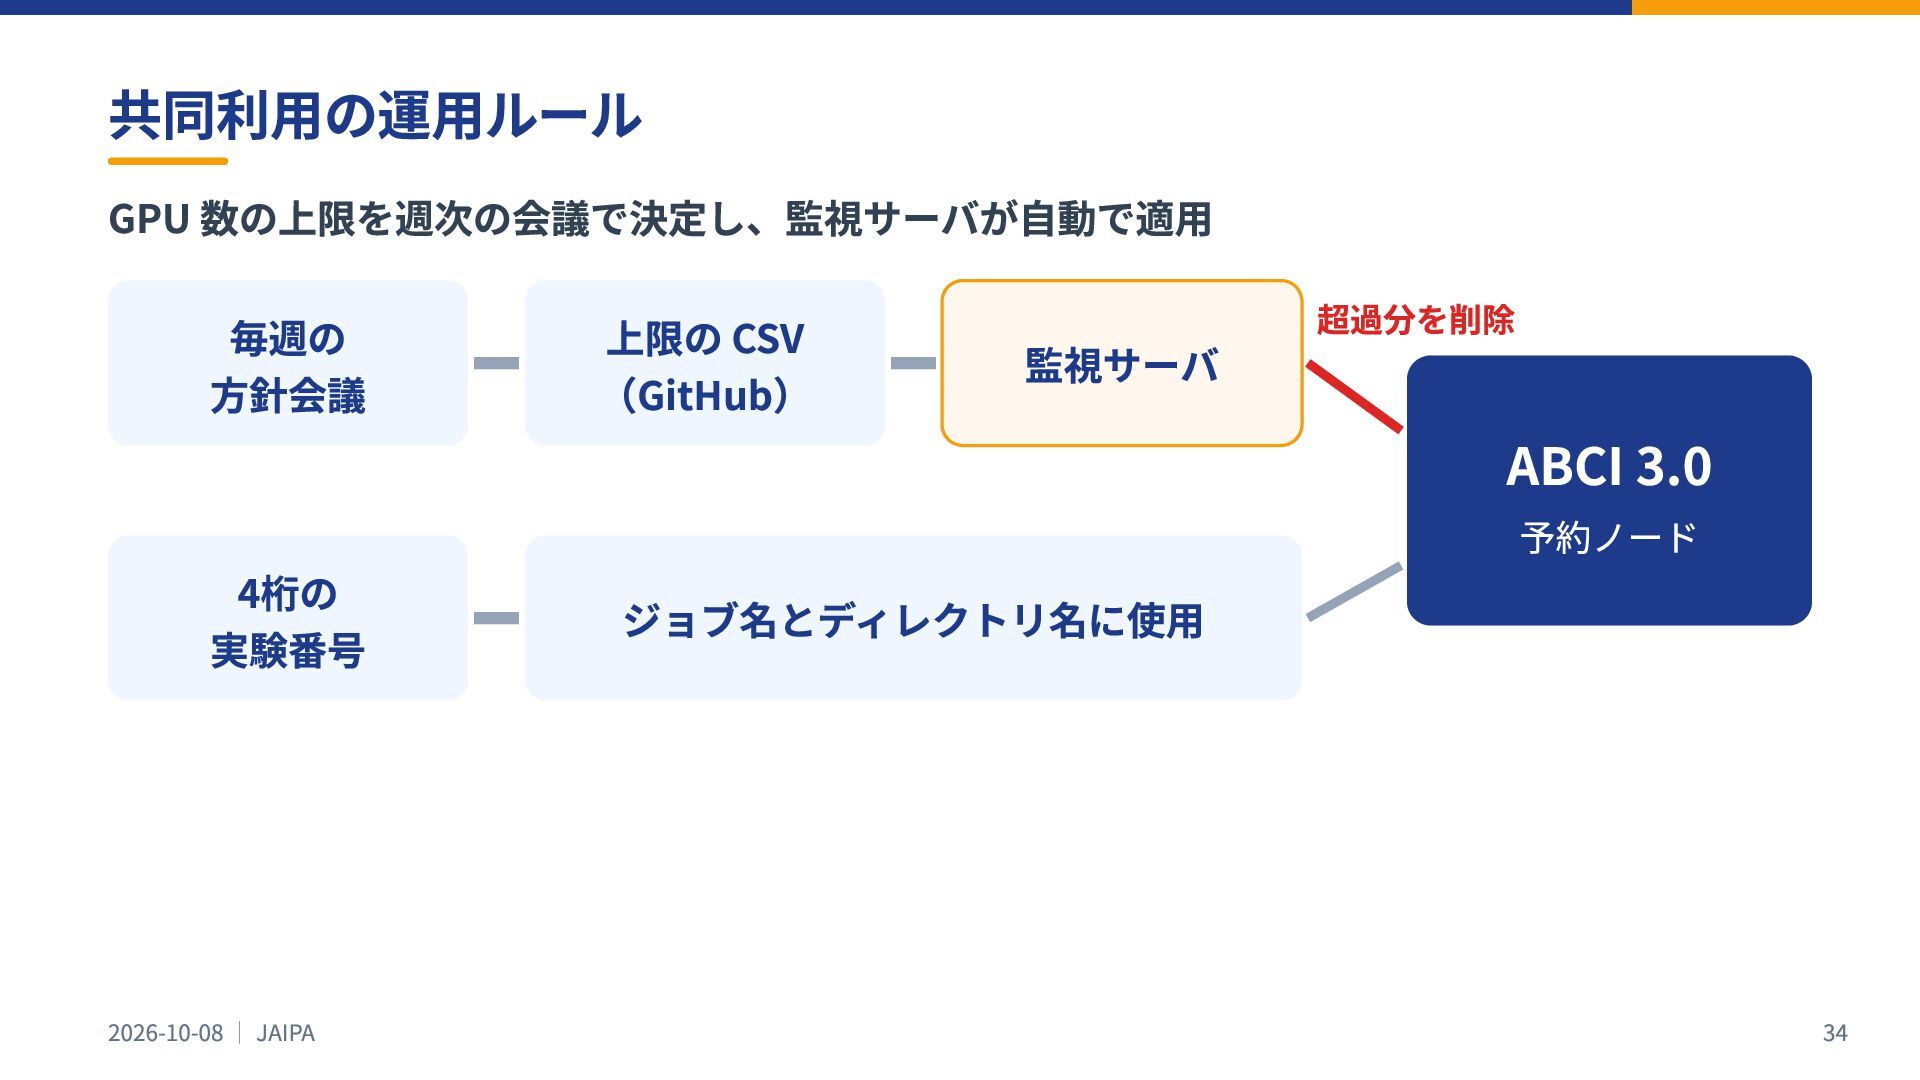
共同利用の運用ルール GPU 数の上限を週次の会議で決定し、監視サーバが自動で適用 毎週の ⽅針会議 4桁の 実験番号 2026-10-08 | JAIPA
上限の CSV (GitHub) 監視サーバ ジョブ名とディレクトリ名に使⽤ 超過分を削除 ABCI 3.0 予約ノード 34
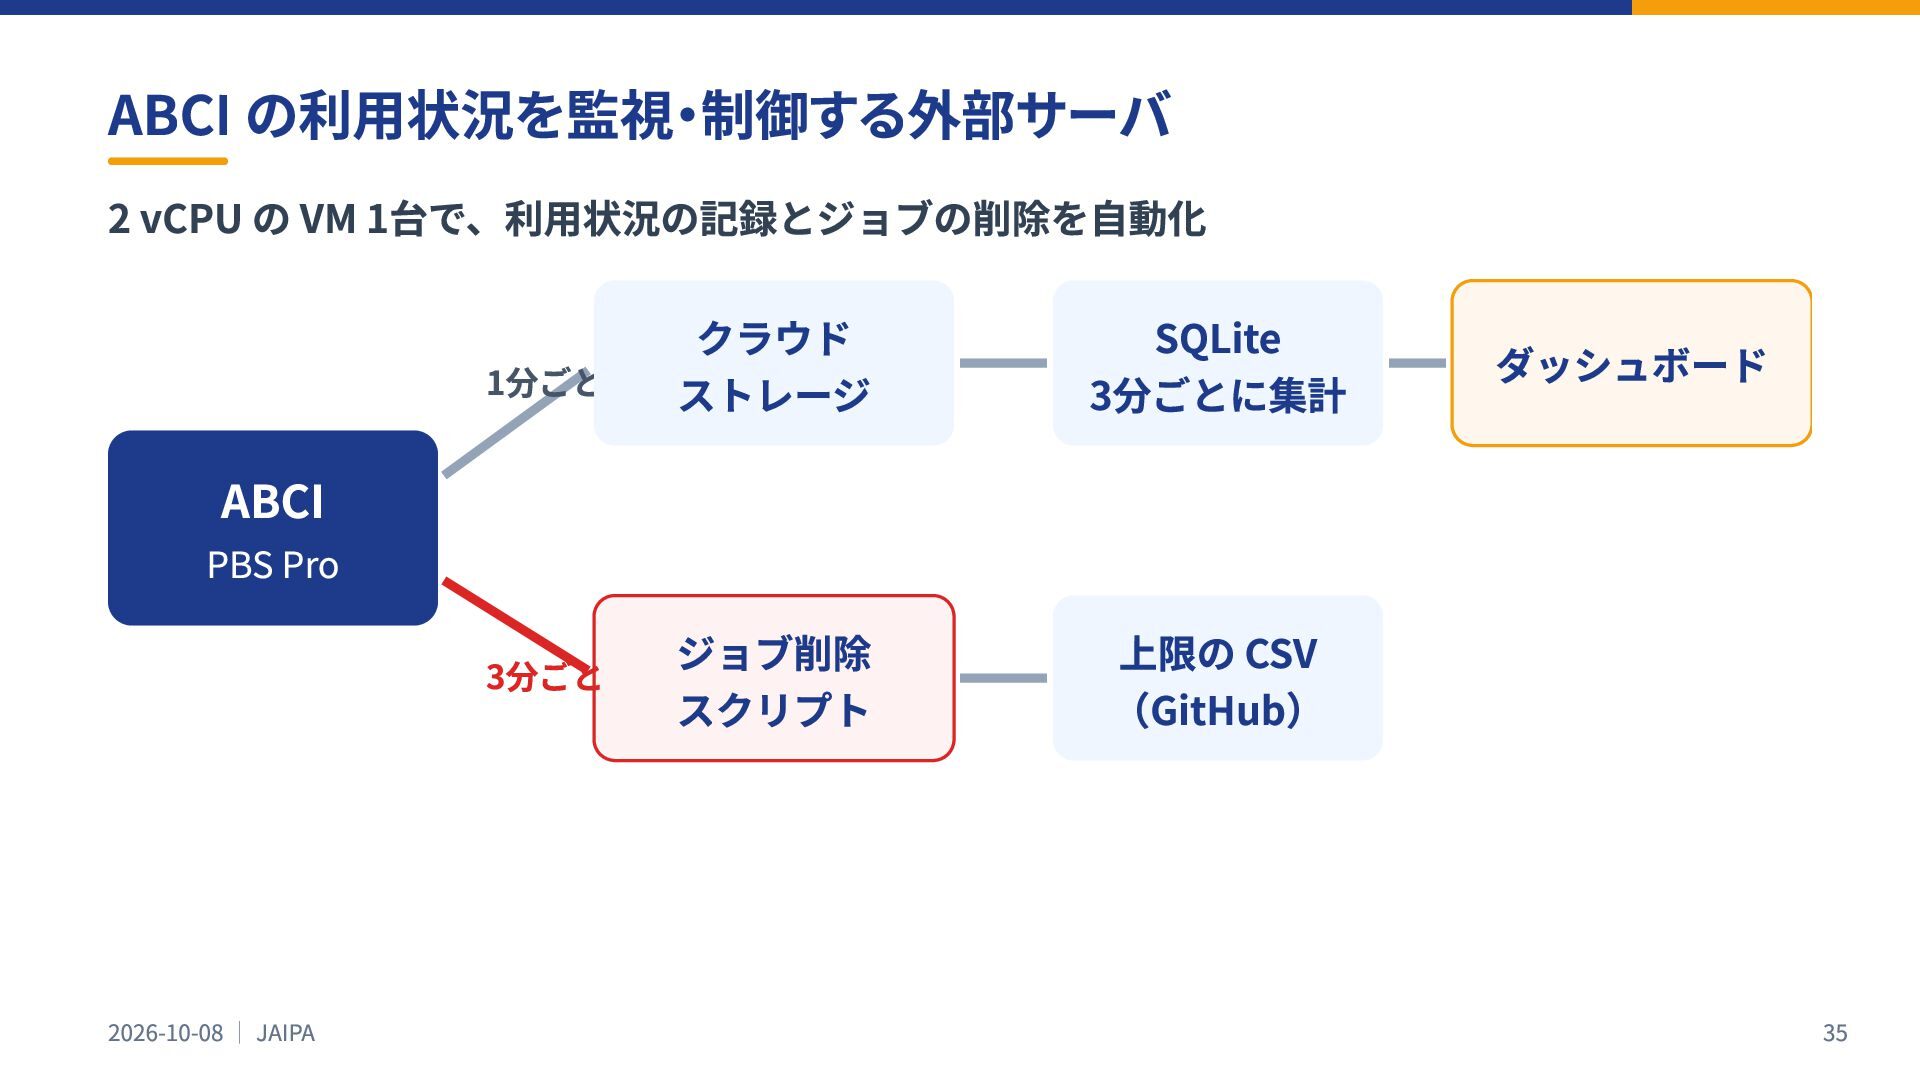
ABCI の利用状況を監視・制御する外部サーバ 2 vCPU の VM 1台で、利用状況の記録とジョブの削除を自動化 ABCI クラウド 1分ごと
ストレージ SQLite 3分ごとに集計 ジョブ削除 スクリプト 上限の CSV (GitHub) PBS Pro 3分ごと 2026-10-08 | JAIPA ダッシュボード 35
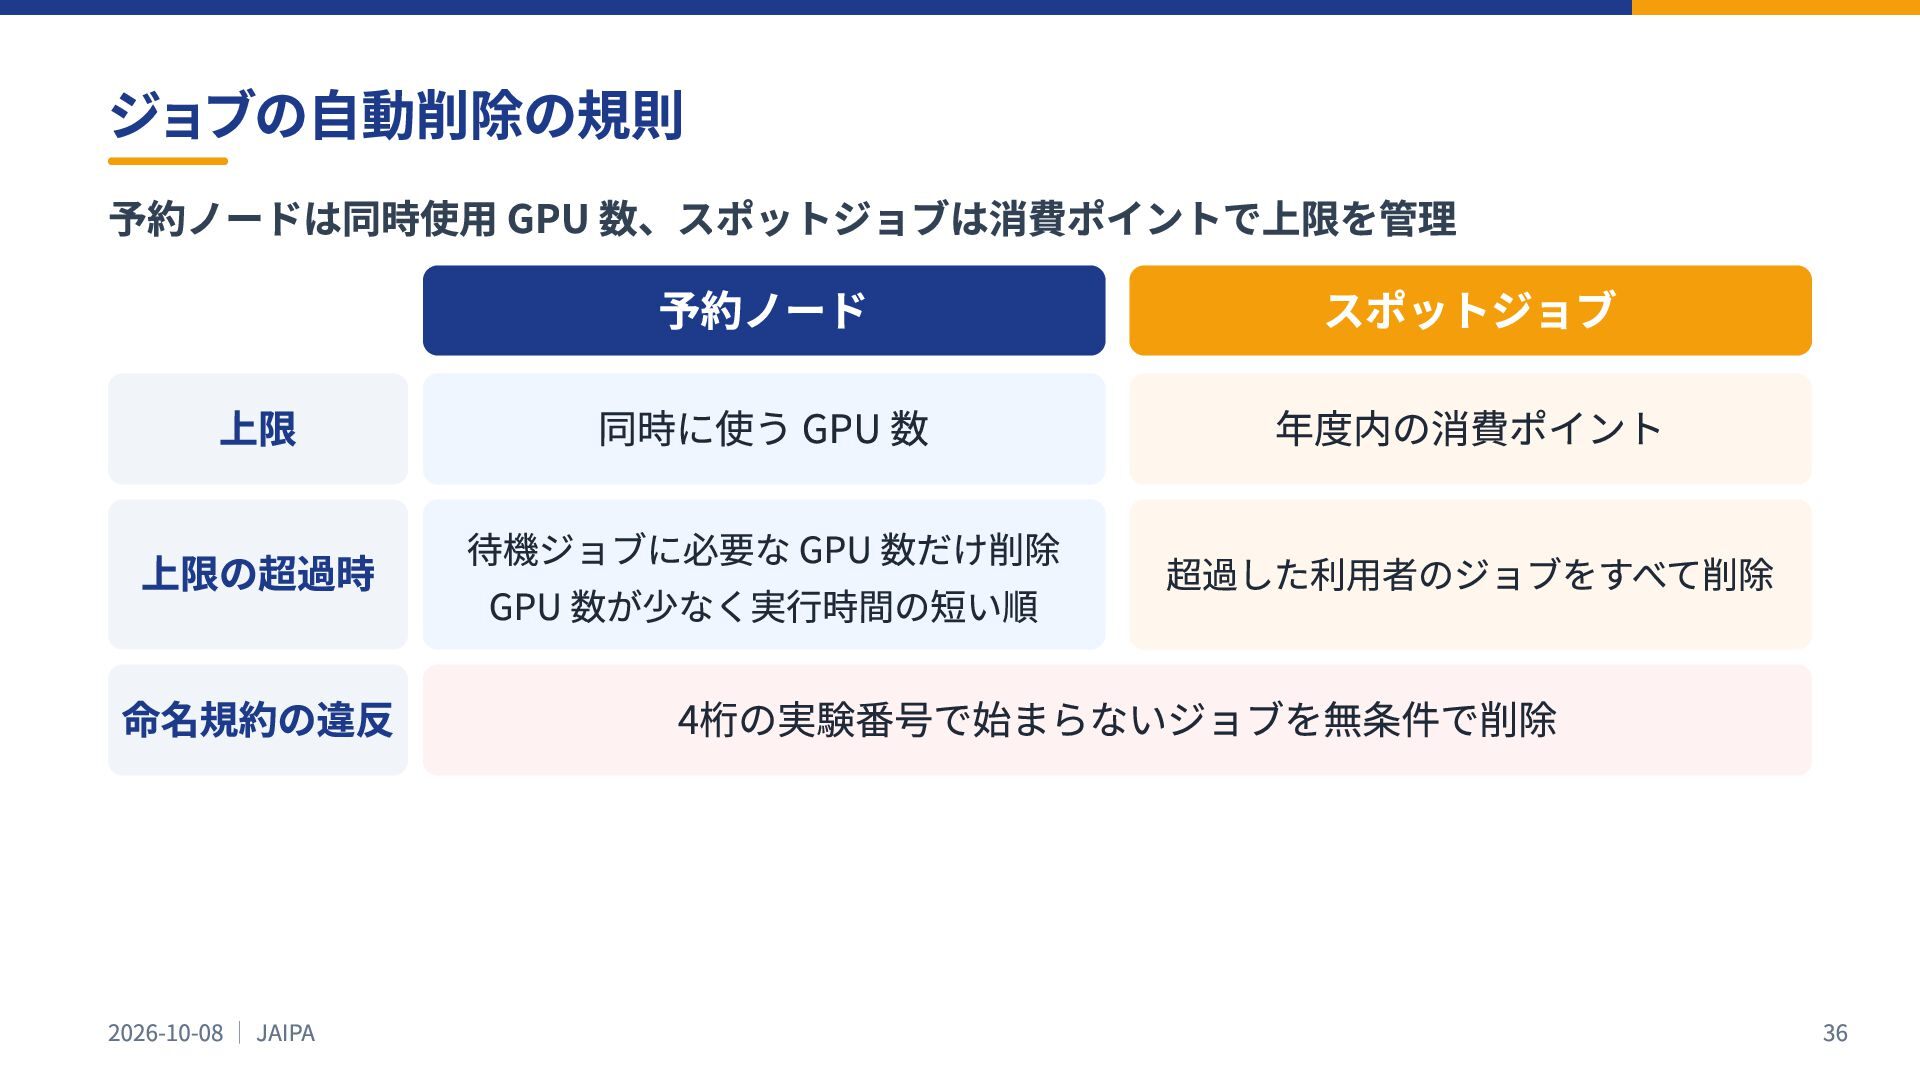
ジョブの自動削除の規則 予約ノードは同時使用 GPU 数、スポットジョブは消費ポイントで上限を管理 予約ノード スポットジョブ 上限 同時に使う GPU 数
年度内の消費ポイント 上限の超過時 待機ジョブに必要な GPU 数だけ削除 GPU 数が少なく実⾏時間の短い順 超過した利⽤者のジョブをすべて削除 命名規約の違反 2026-10-08 | JAIPA 4桁の実験番号で始まらないジョブを無条件で削除 36
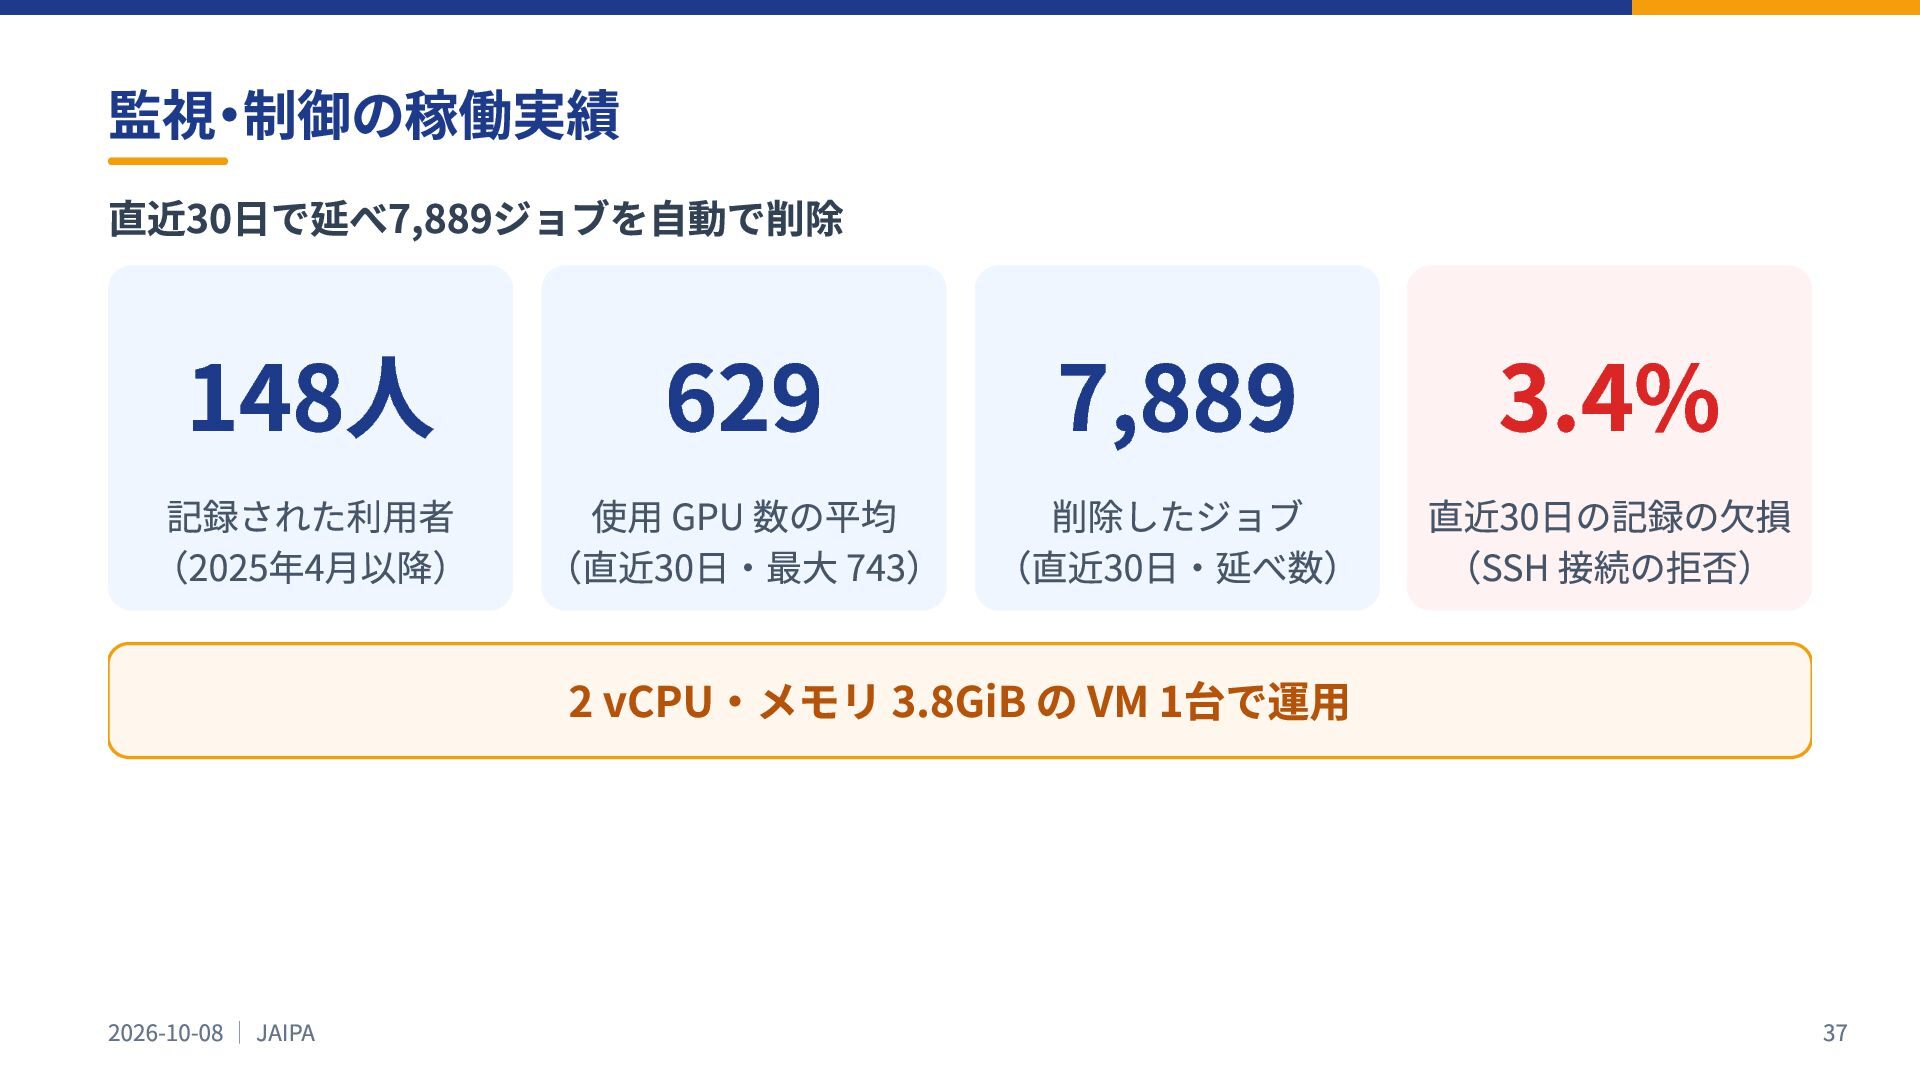
監視・制御の稼働実績 直近30日で延べ7,889ジョブを自動で削除 148⼈ 記録された利⽤者 (2025年4⽉以降) 629 7,889 3.4% 使⽤ GPU
数の平均 削除したジョブ 直近30⽇の記録の⽋損 (直近30⽇‧最⼤ 743) (直近30⽇‧延べ数) (SSH 接続の拒否) 2 vCPU‧メモリ 3.8GiB の VM 1台で運⽤ 2026-10-08 | JAIPA 37
第5部 291B-A27B の学習と運用 B200 × 288 による約170日の学習の計画と運用実績 2026-10-08 | JAIPA
38
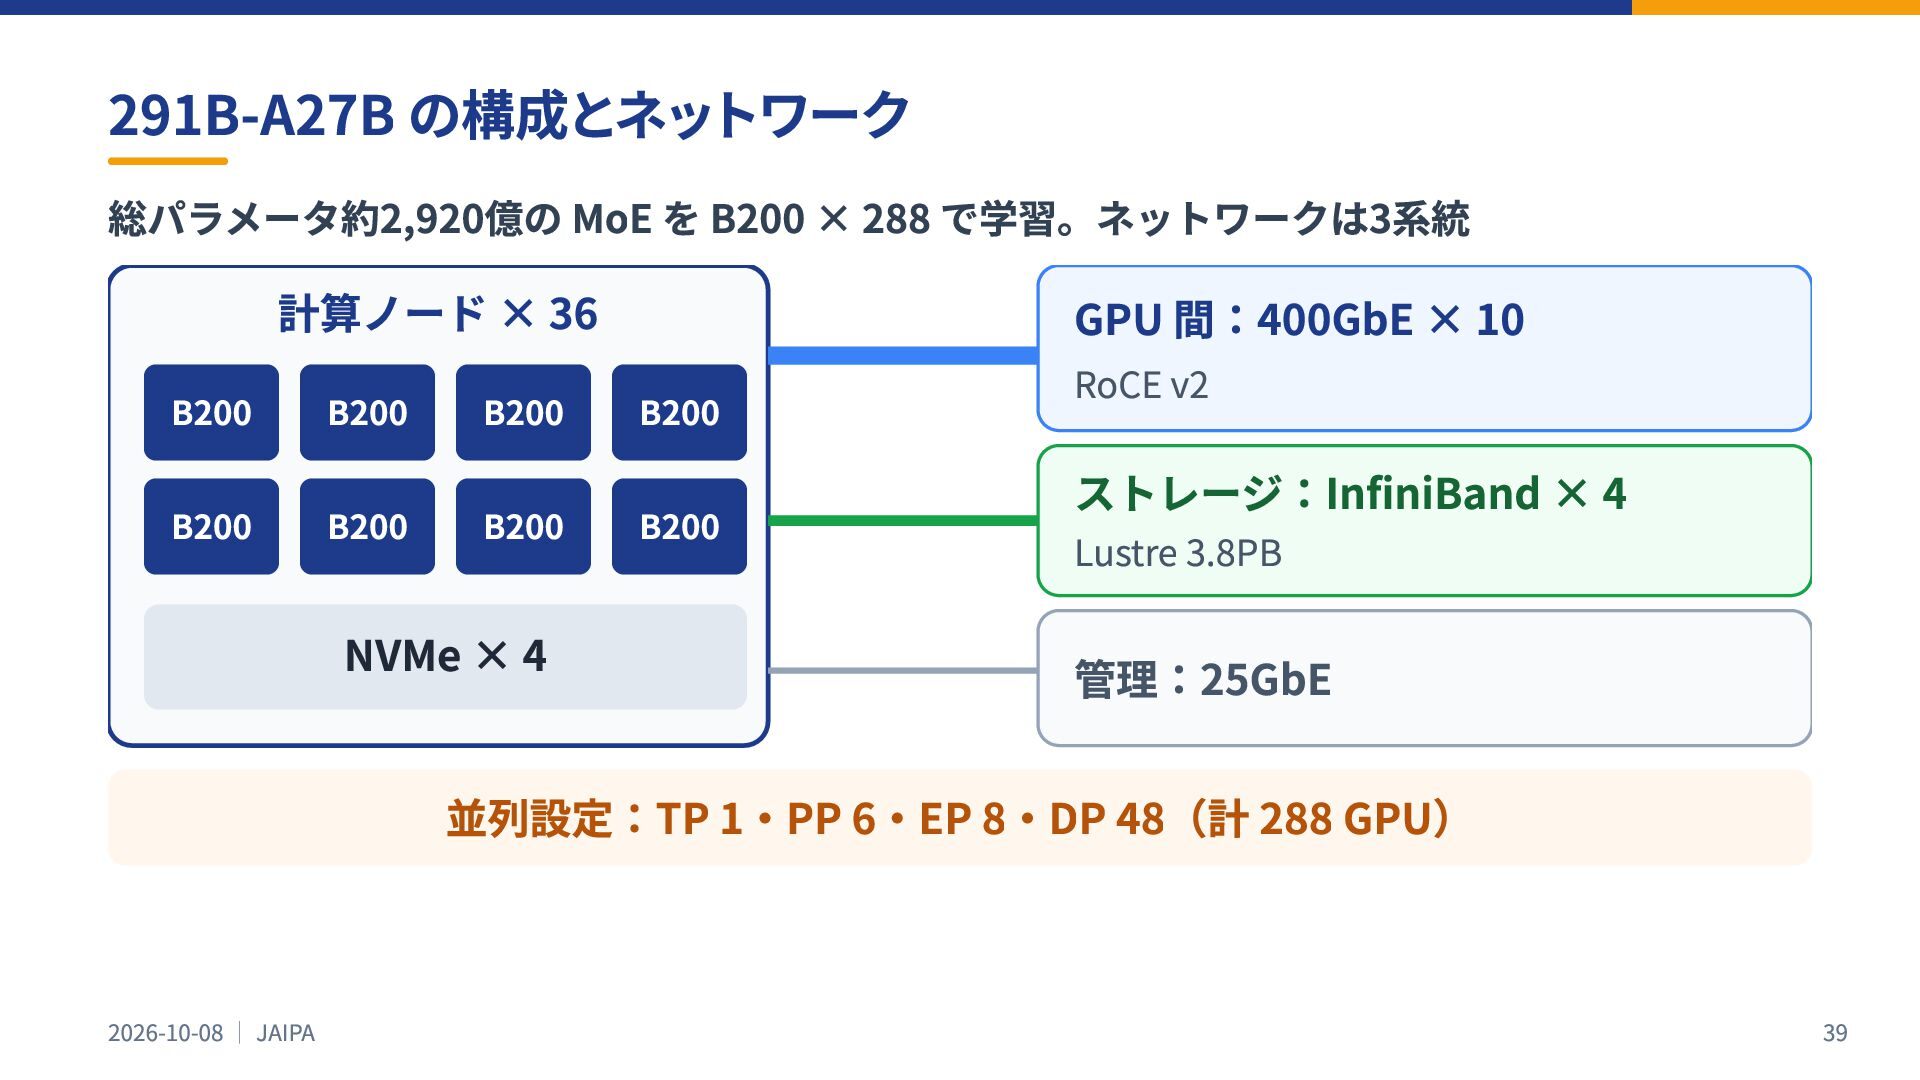
291B-A27B の構成とネットワーク 総パラメータ約2,920億の MoE を B200 × 288 で学習。ネットワークは3系統 計算ノード
× 36 B200 B200 B200 B200 B200 B200 B200 B200 NVMe × 4 GPU 間:400GbE × 10 RoCE v2 ストレージ:InfiniBand × 4 Lustre 3.8PB 管理:25GbE 並列設定:TP 1‧PP 6‧EP 8‧DP 48(計 288 GPU) 2026-10-08 | JAIPA 39
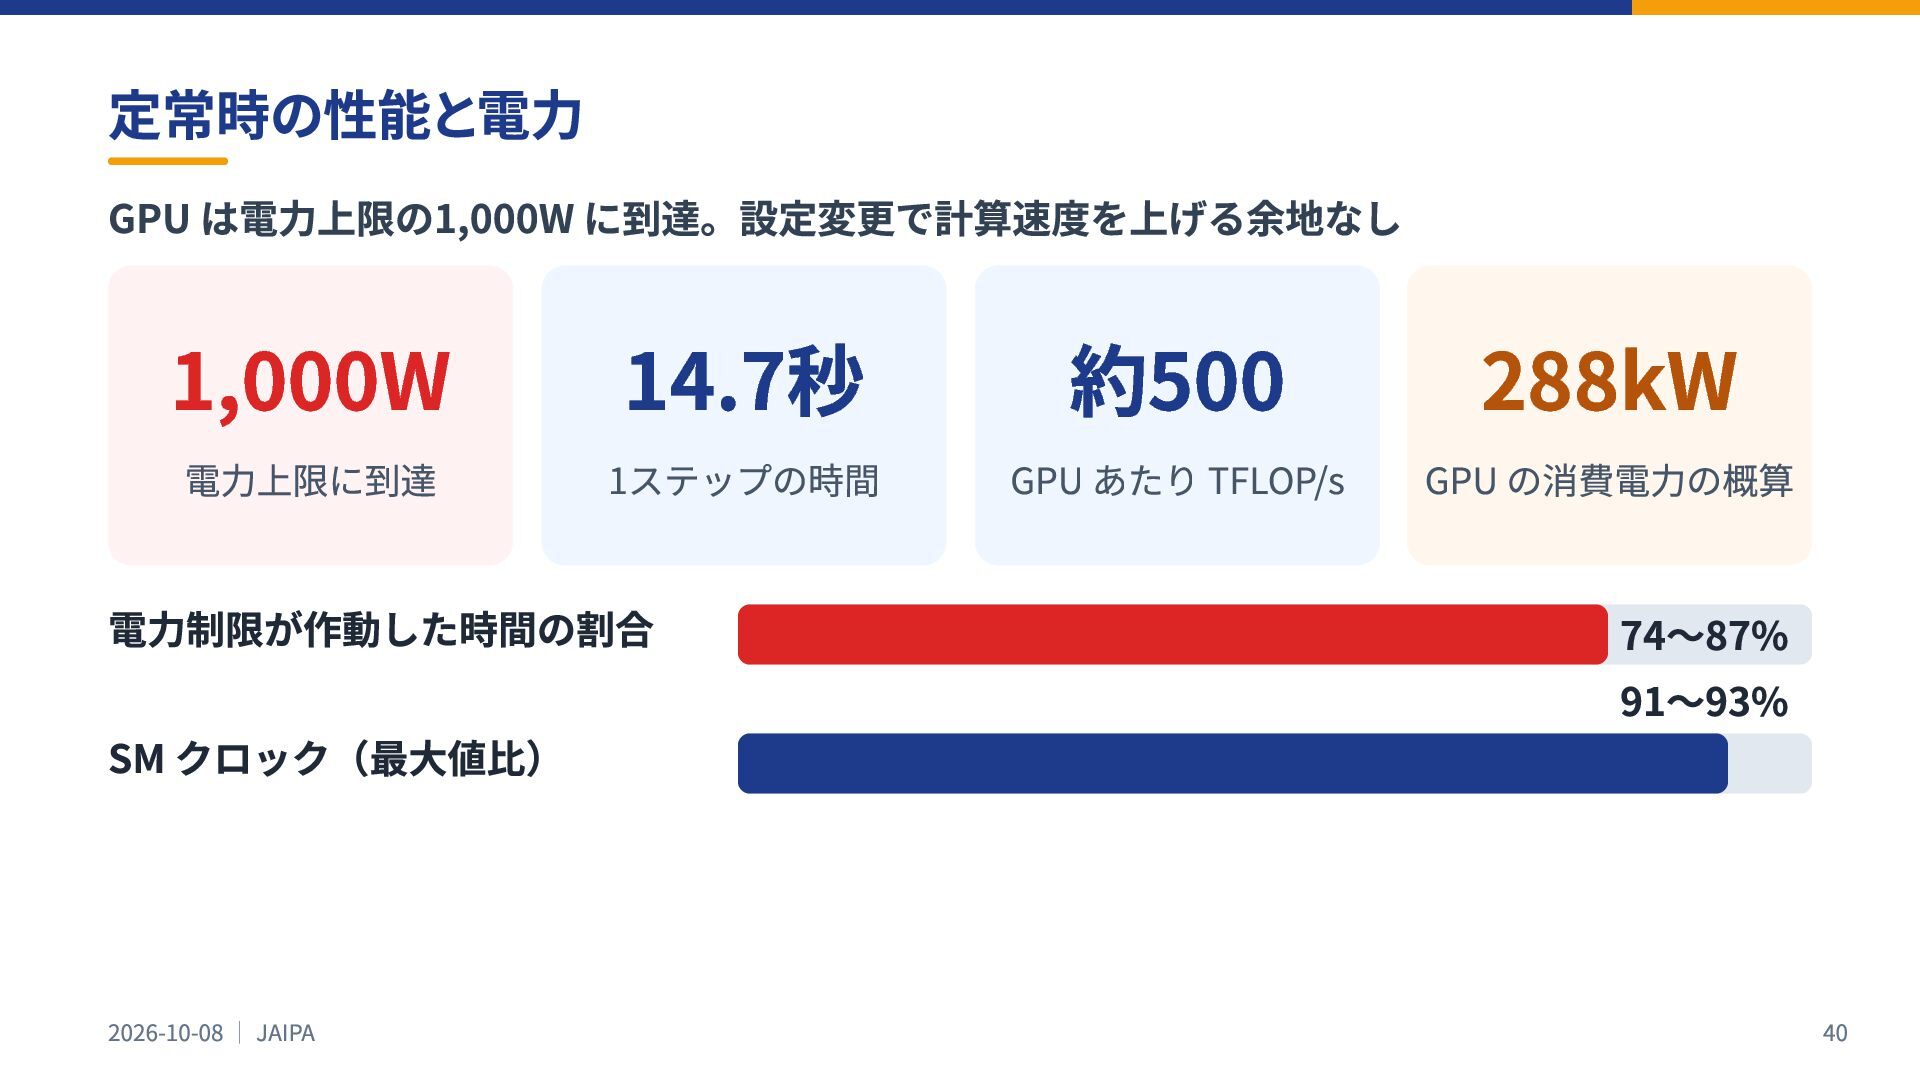
定常時の性能と電力 GPU は電力上限の1,000W に到達。設定変更で計算速度を上げる余地なし 1,000W 電⼒上限に到達 14.7秒 1ステップの時間 電⼒制限が作動した時間の割合 SM
クロック(最⼤値⽐) 2026-10-08 | JAIPA 約500 GPU あたり TFLOP/s 288kW GPU の消費電⼒の概算 74〜87% 91〜93% 40
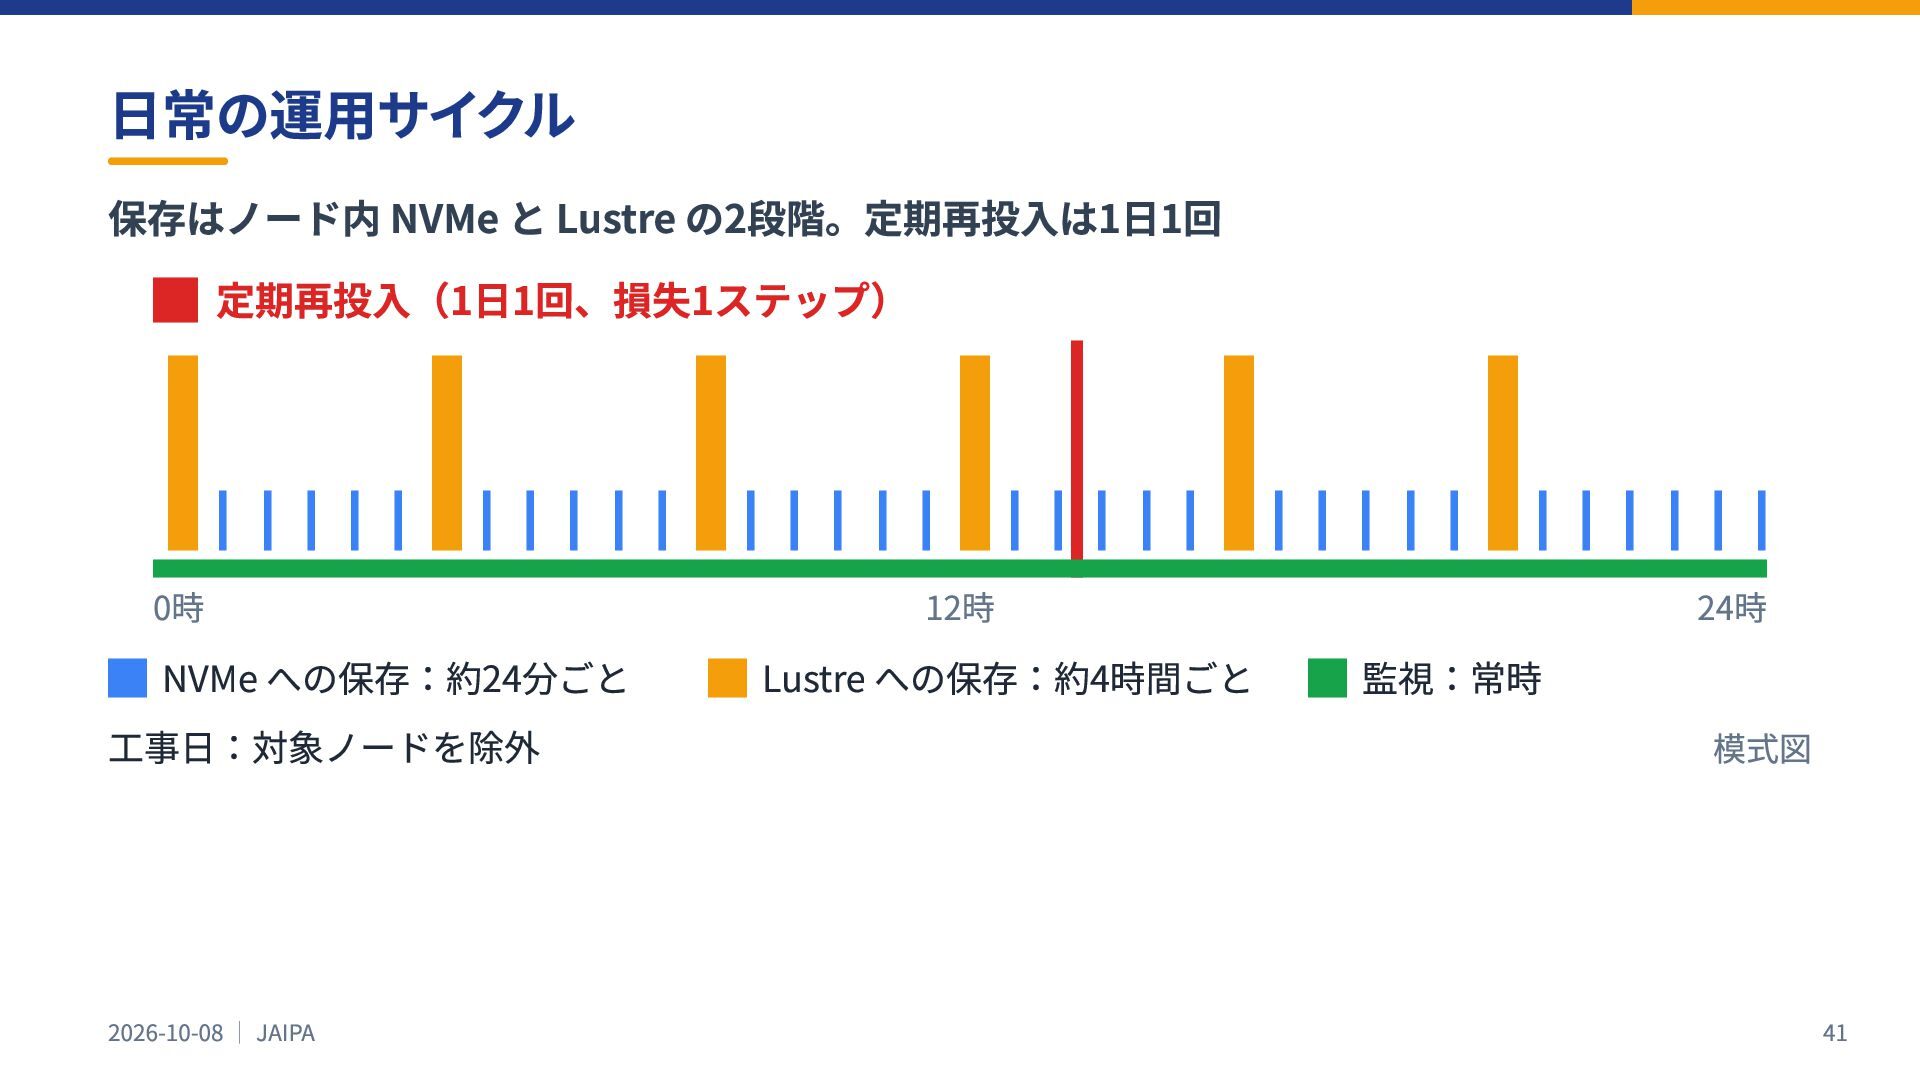
日常の運用サイクル 保存はノード内 NVMe と Lustre の2段階。定期再投入は1日1回 定期再投⼊(1⽇1回、損失1ステップ) 0時 NVMe への保存:約24分ごと
⼯事⽇:対象ノードを除外 2026-10-08 | JAIPA 12時 Lustre への保存:約4時間ごと 監視:常時 24時 模式図 41
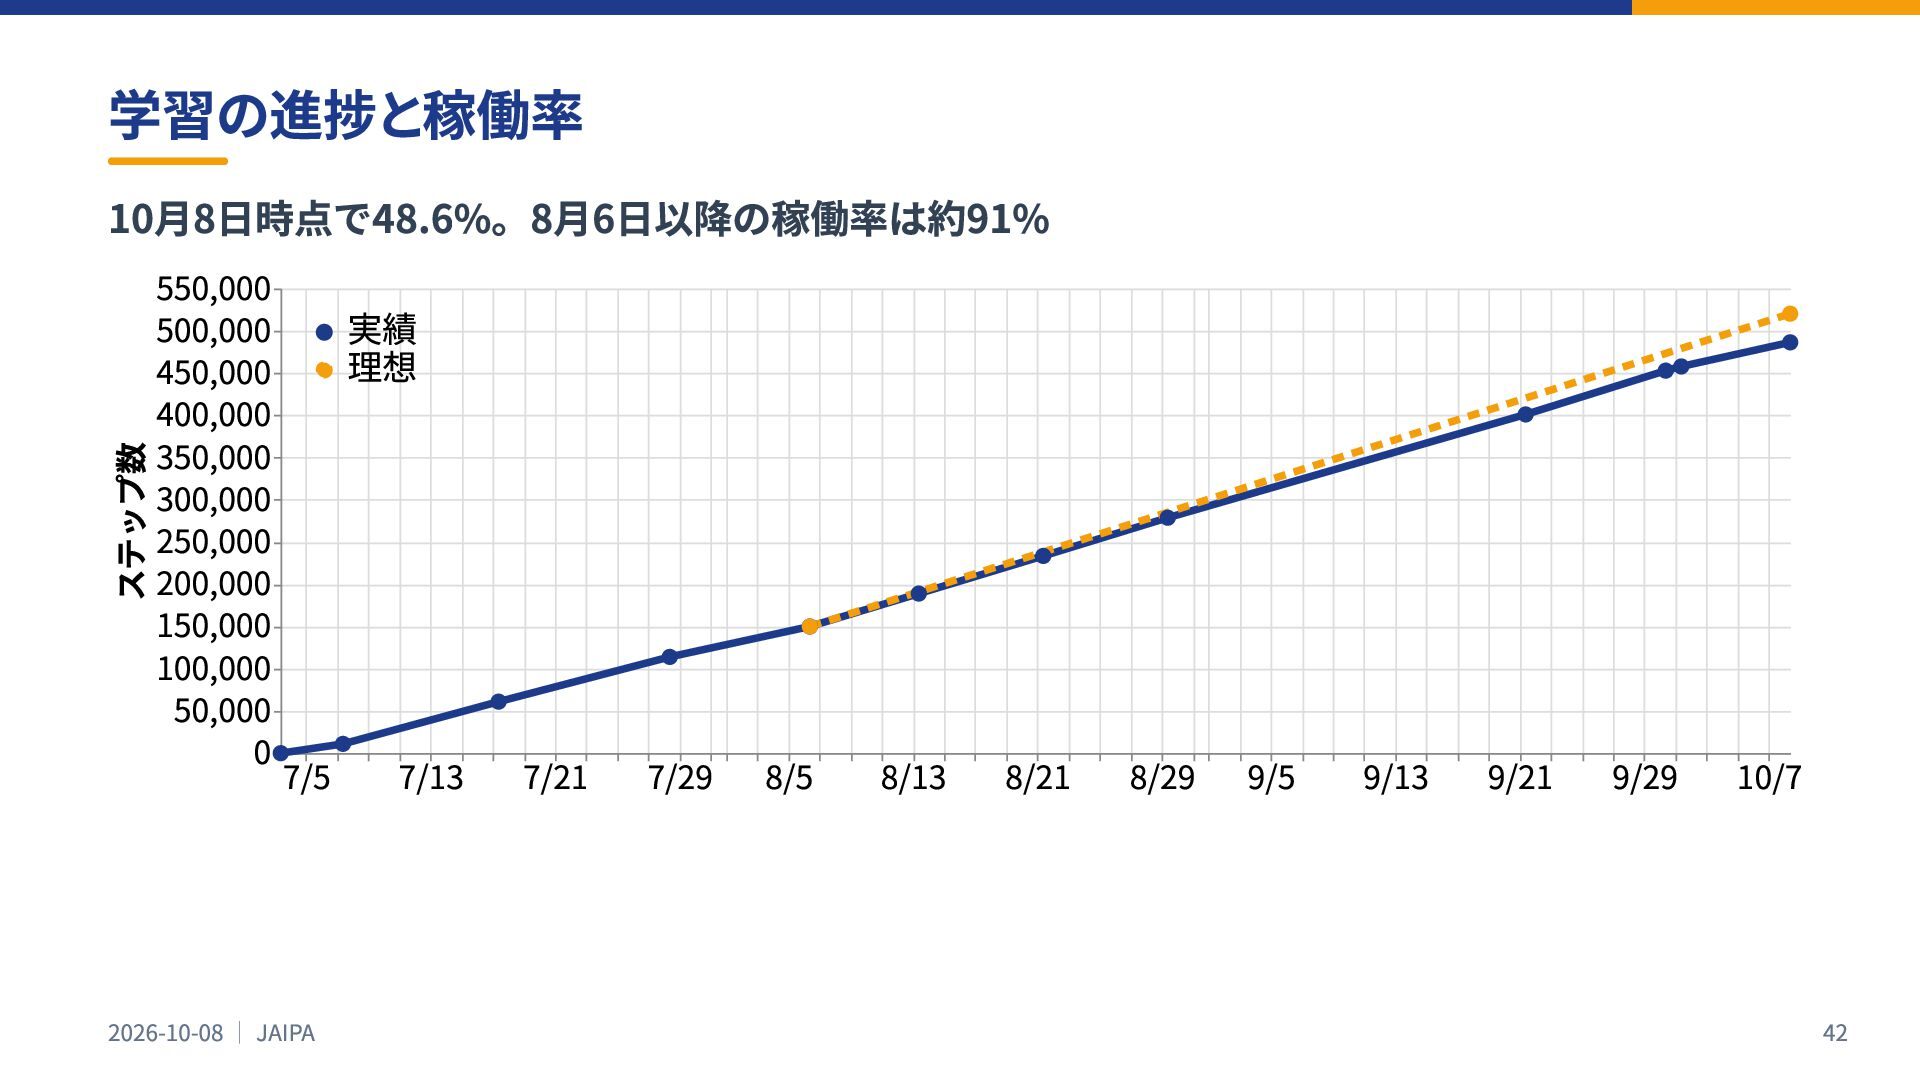
学習の進捗と稼働率 10月8日時点で48.6%。8月6日以降の稼働率は約91% 数プッテス 550,000 500,000 実績 450,000 理想 400,000 350,000
300,000 250,000 200,000 150,000 100,000 50,000 0 7/5 7/13 7/21 7/29 8/5 2026-10-08 | JAIPA 8/13 8/21 8/29 9/5 9/13 9/21 9/29 10/7 42
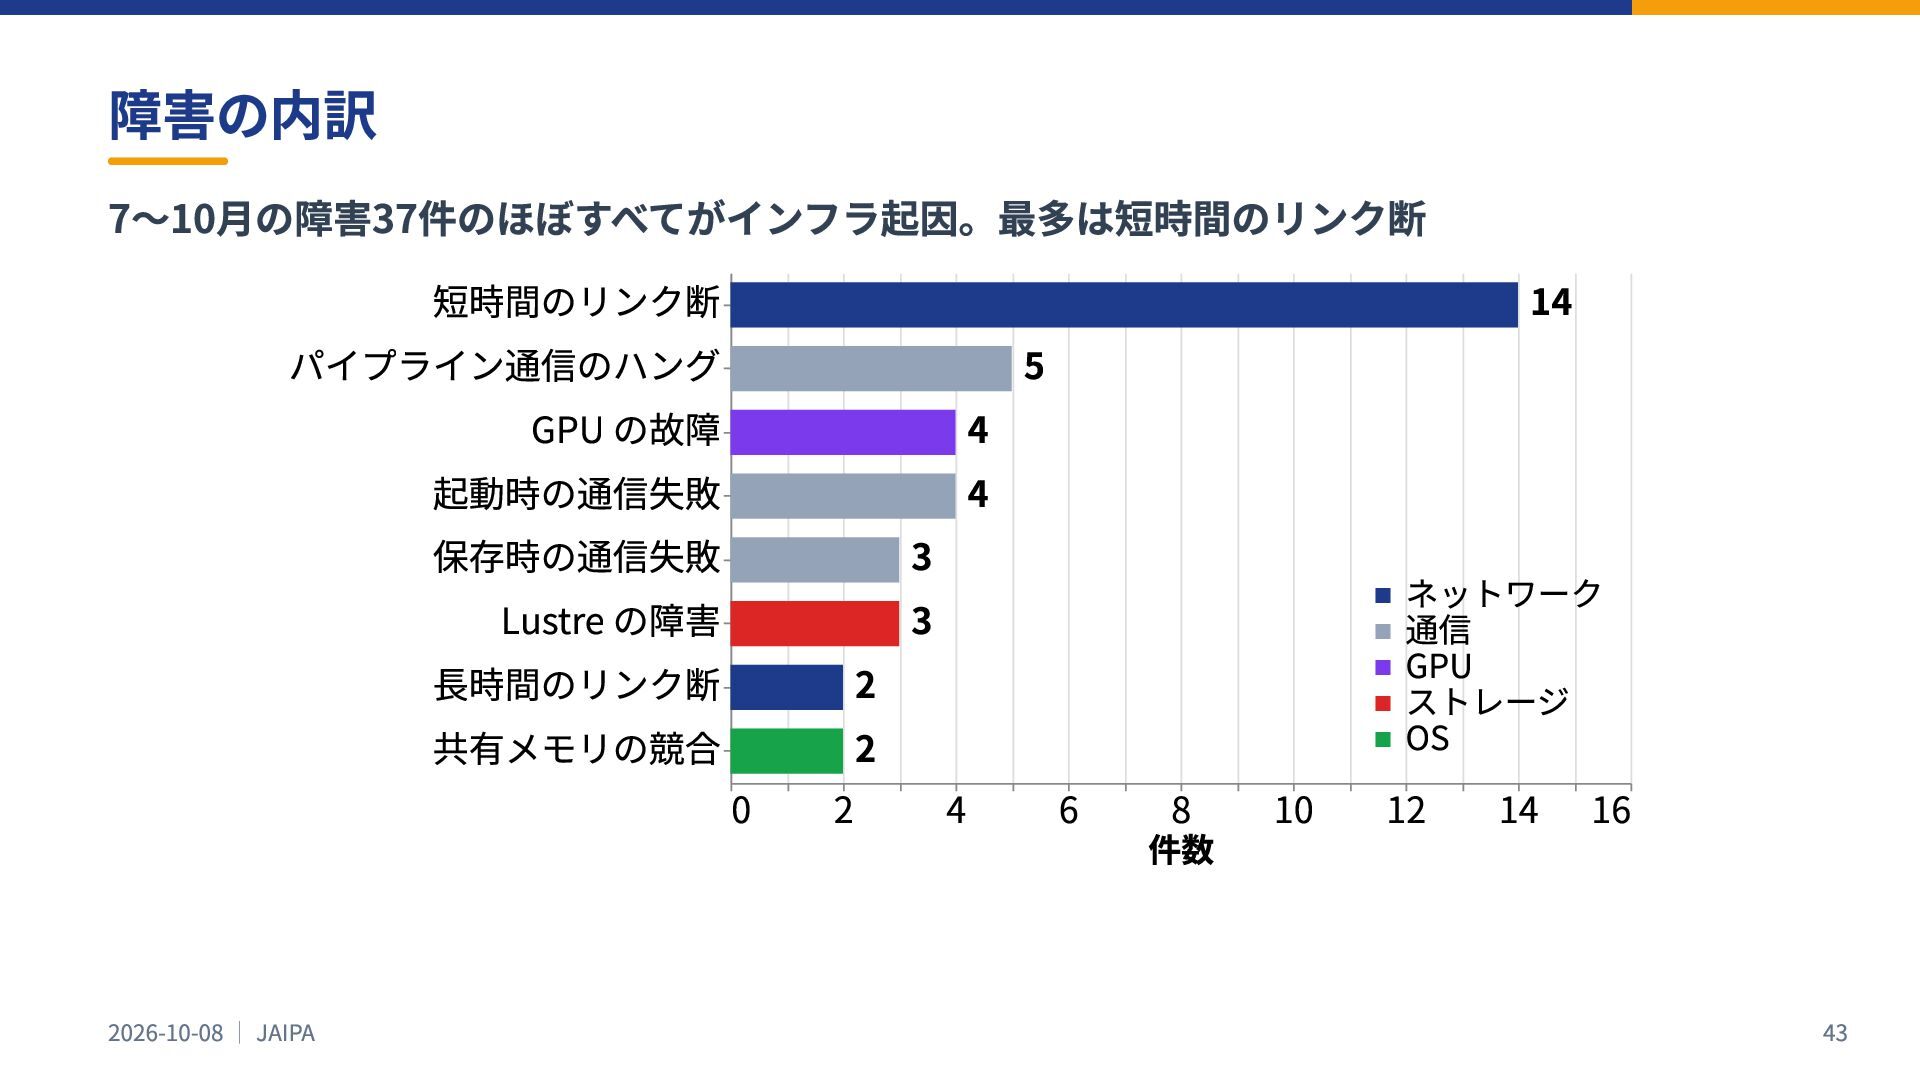
障害の内訳 7〜10月の障害37件のほぼすべてがインフラ起因。最多は短時間のリンク断 短時間のリンク断 パイプライン通信のハング GPU の故障 起動時の通信失敗 保存時の通信失敗 Lustre の障害
長時間のリンク断 共有メモリの競合 2026-10-08 | JAIPA 0 2 2 2 4 4 3 3 4 5 6 8 件数 10 14 ネットワーク 通信 GPU ストレージ OS 12 14 16 43
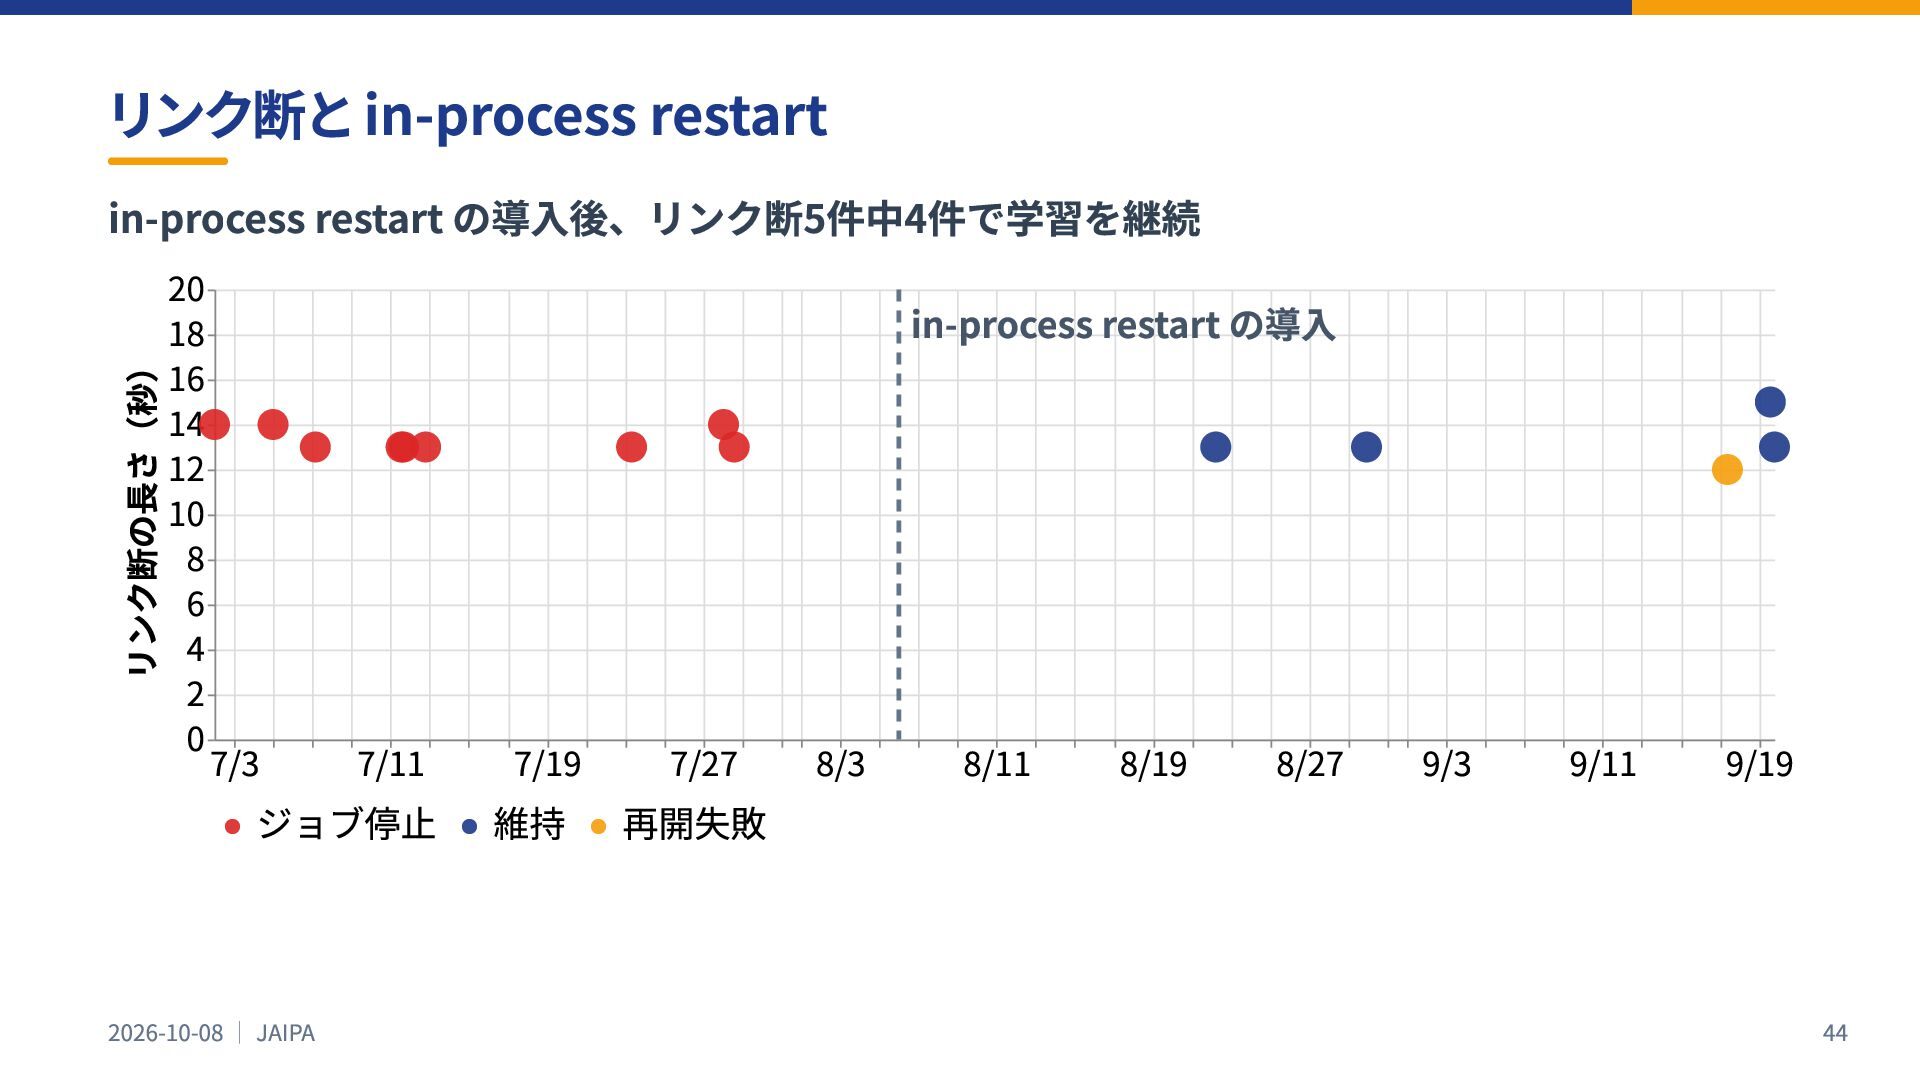
リンク断と in-process restart in-process restart の導入後、リンク断5件中4件で学習を継続 in-process restart の導入 )秒(さ長の断クンリ
20 18 16 14 12 10 8 6 4 2 0 7/3 7/11 7/19 7/27 ジョブ停止 維持 再開失敗 2026-10-08 | JAIPA 8/3 8/11 8/19 8/27 9/3 9/11 9/19 44
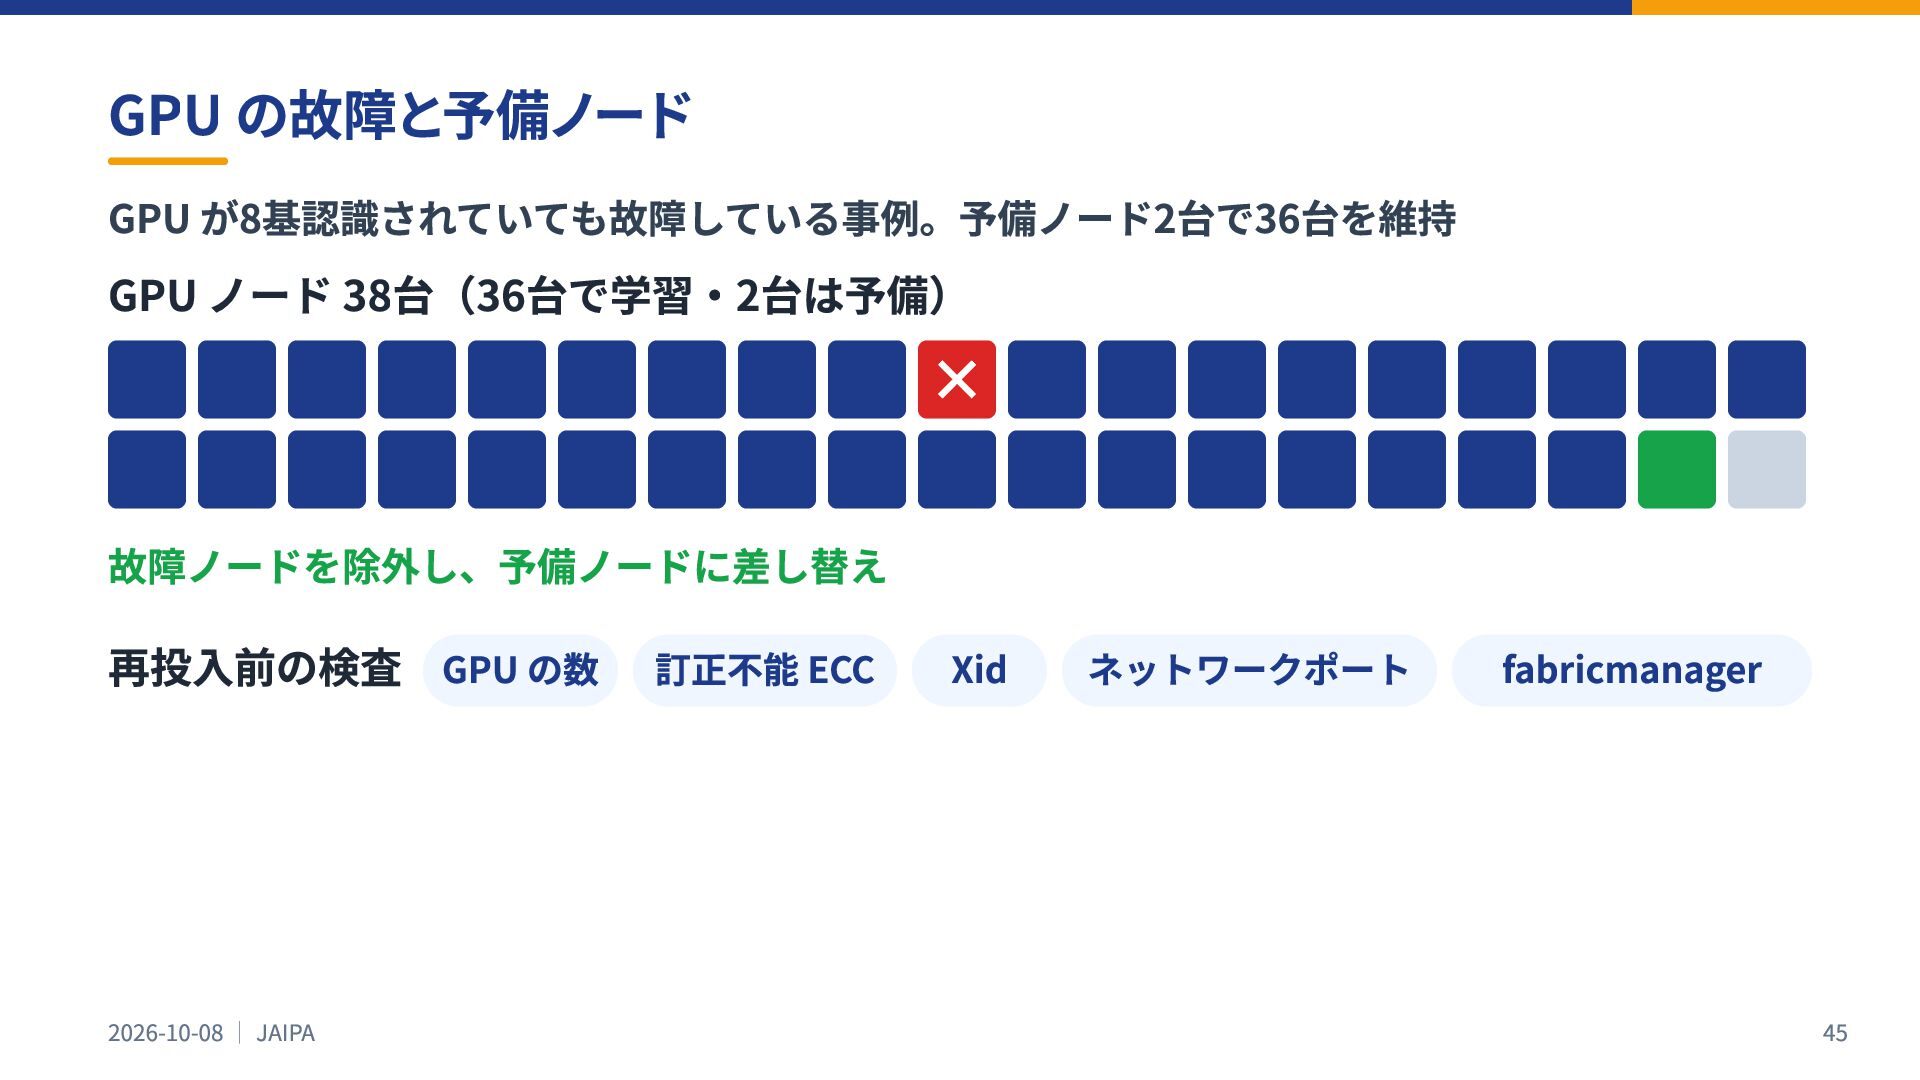
GPU の故障と予備ノード GPU が8基認識されていても故障している事例。予備ノード2台で36台を維持 GPU ノード 38台(36台で学習‧2台は予備) × 故障ノードを除外し、予備ノードに差し替え 再投⼊前の検査
GPU の数 訂正不能 ECC Xid ネットワークポート 2026-10-08 | JAIPA fabricmanager 45
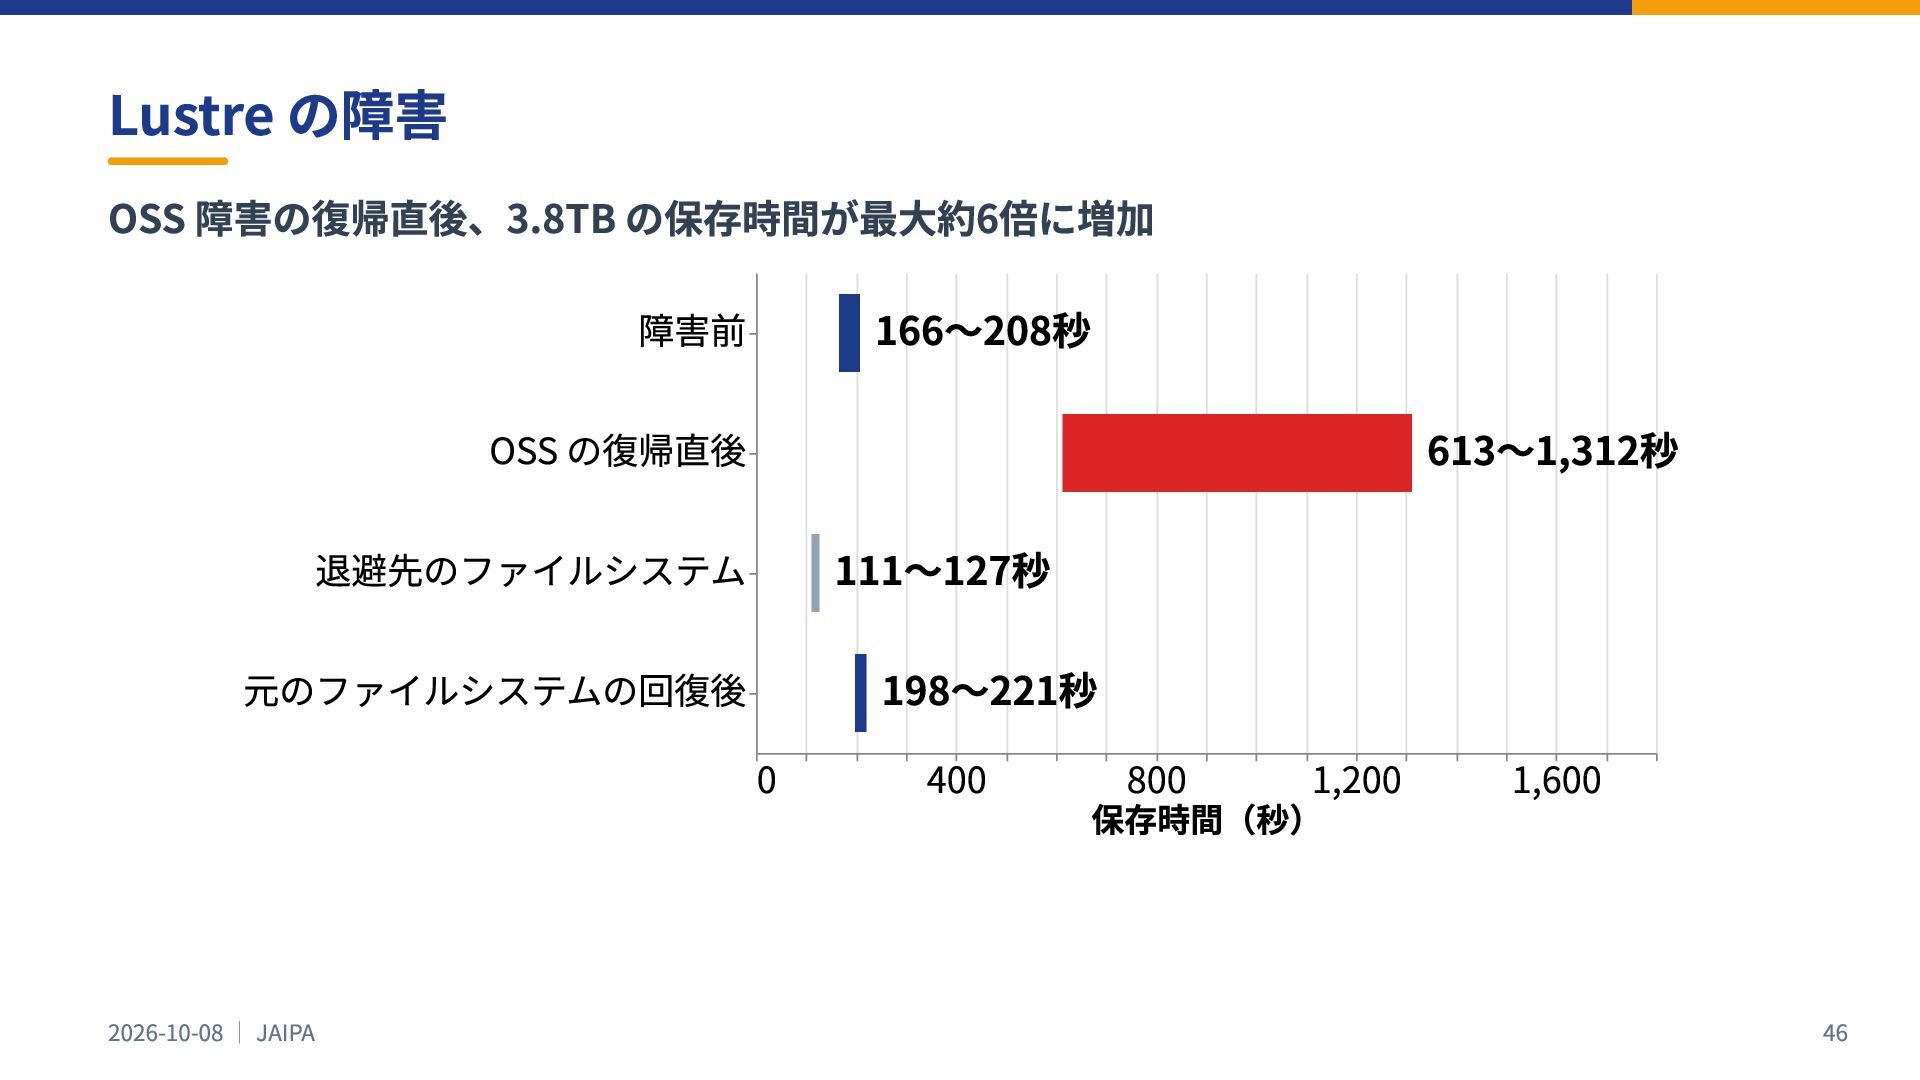
Lustre の障害 OSS 障害の復帰直後、3.8TB の保存時間が最大約6倍に増加 障害前 166〜208秒 613〜1,312秒 OSS の復帰直後
退避先のファイルシステム 111〜127秒 元のファイルシステムの回復後 198〜221秒 2026-10-08 | JAIPA 0 400 800 1,200 保存時間(秒) 1,600 46
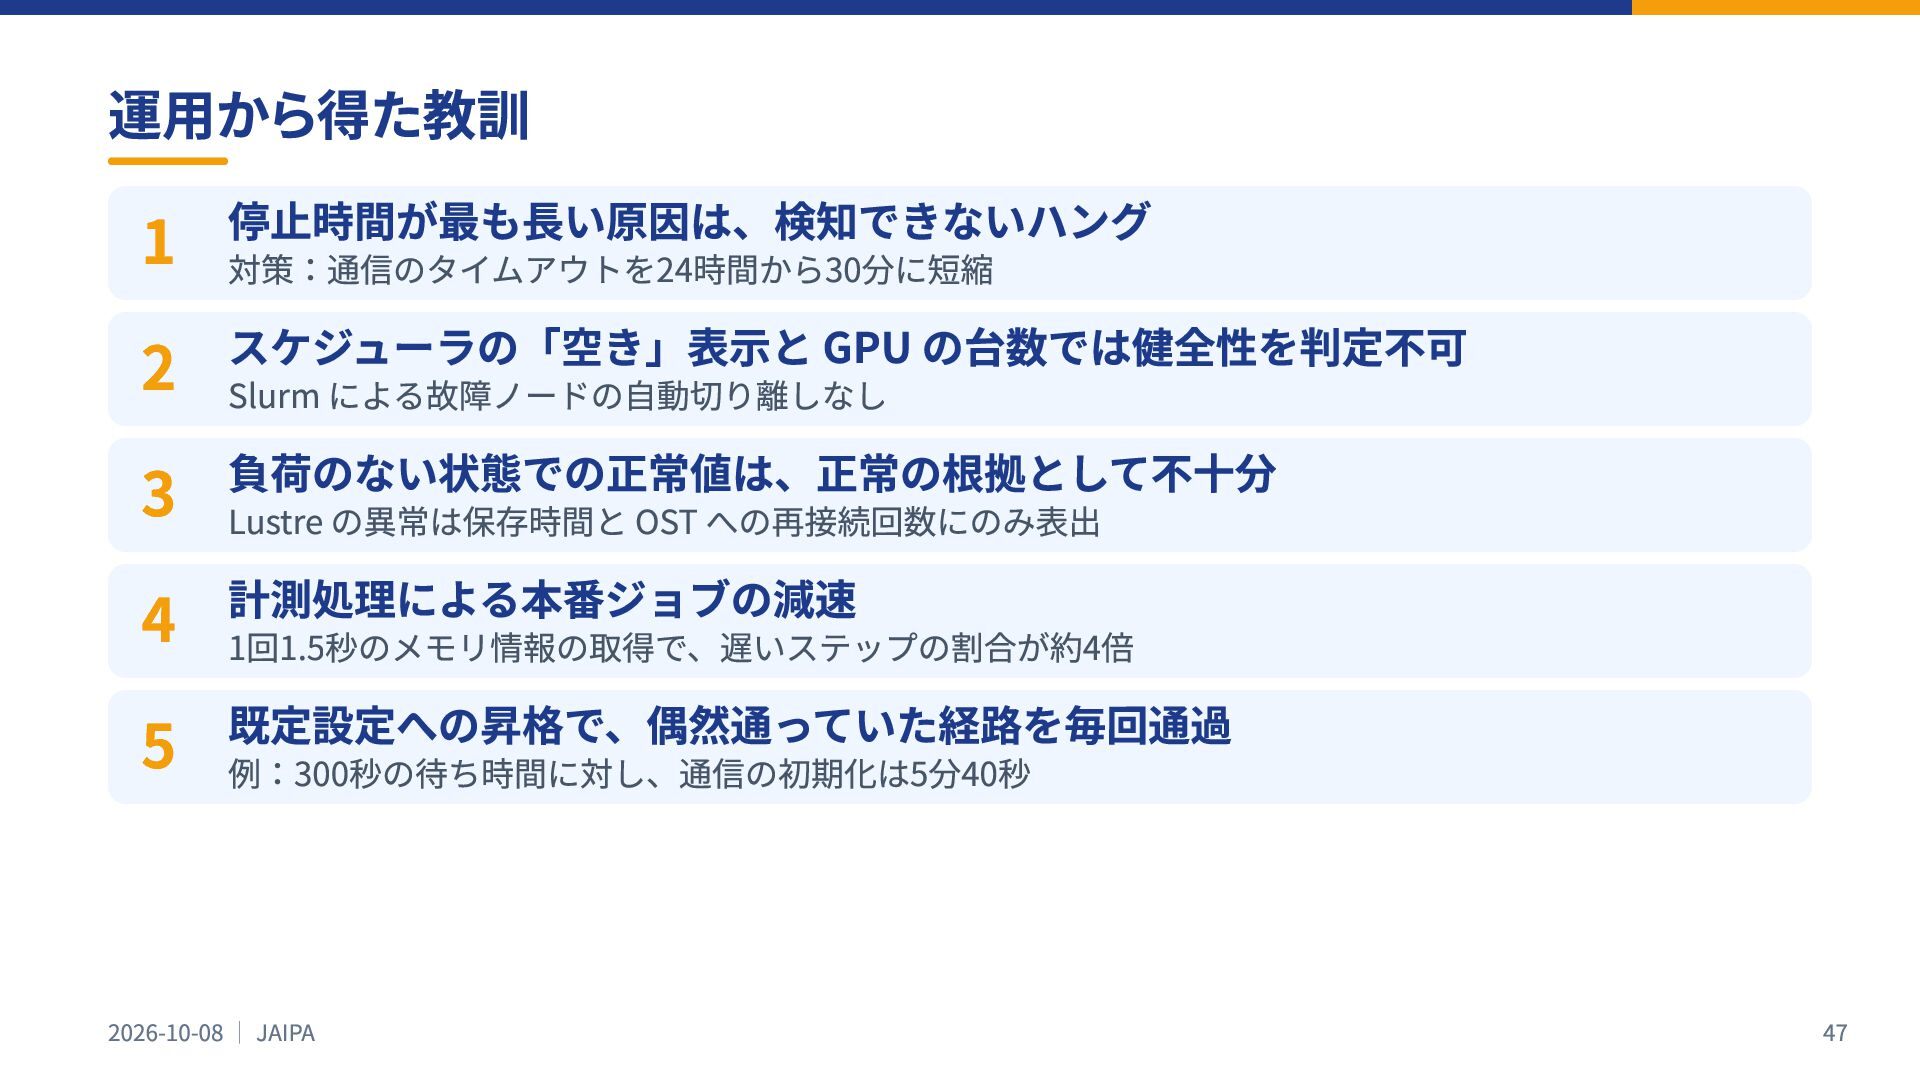
運用から得た教訓 1 停⽌時間が最も⻑い原因は、検知できないハング 対策:通信のタイムアウトを24時間から30分に短縮 GPU の台数では健全性を判定不可 2 スケジューラの「空き」表⽰と Slurm による故障ノードの⾃動切り離しなし
3 負荷のない状態での正常値は、正常の根拠として不⼗分 Lustre の異常は保存時間と OST への再接続回数にのみ表出 計測処理による本番ジョブの減速 4 1回1.5秒のメモリ情報の取得で、遅いステップの割合が約4倍 5 既定設定への昇格で、偶然通っていた経路を毎回通過 例:300秒の待ち時間に対し、通信の初期化は5分40秒 2026-10-08 | JAIPA 47
第6部 Claude Code による運用 291B-A27B の学習ジョブの監視と障害対応の自動化 2026-10-08 | JAIPA 48
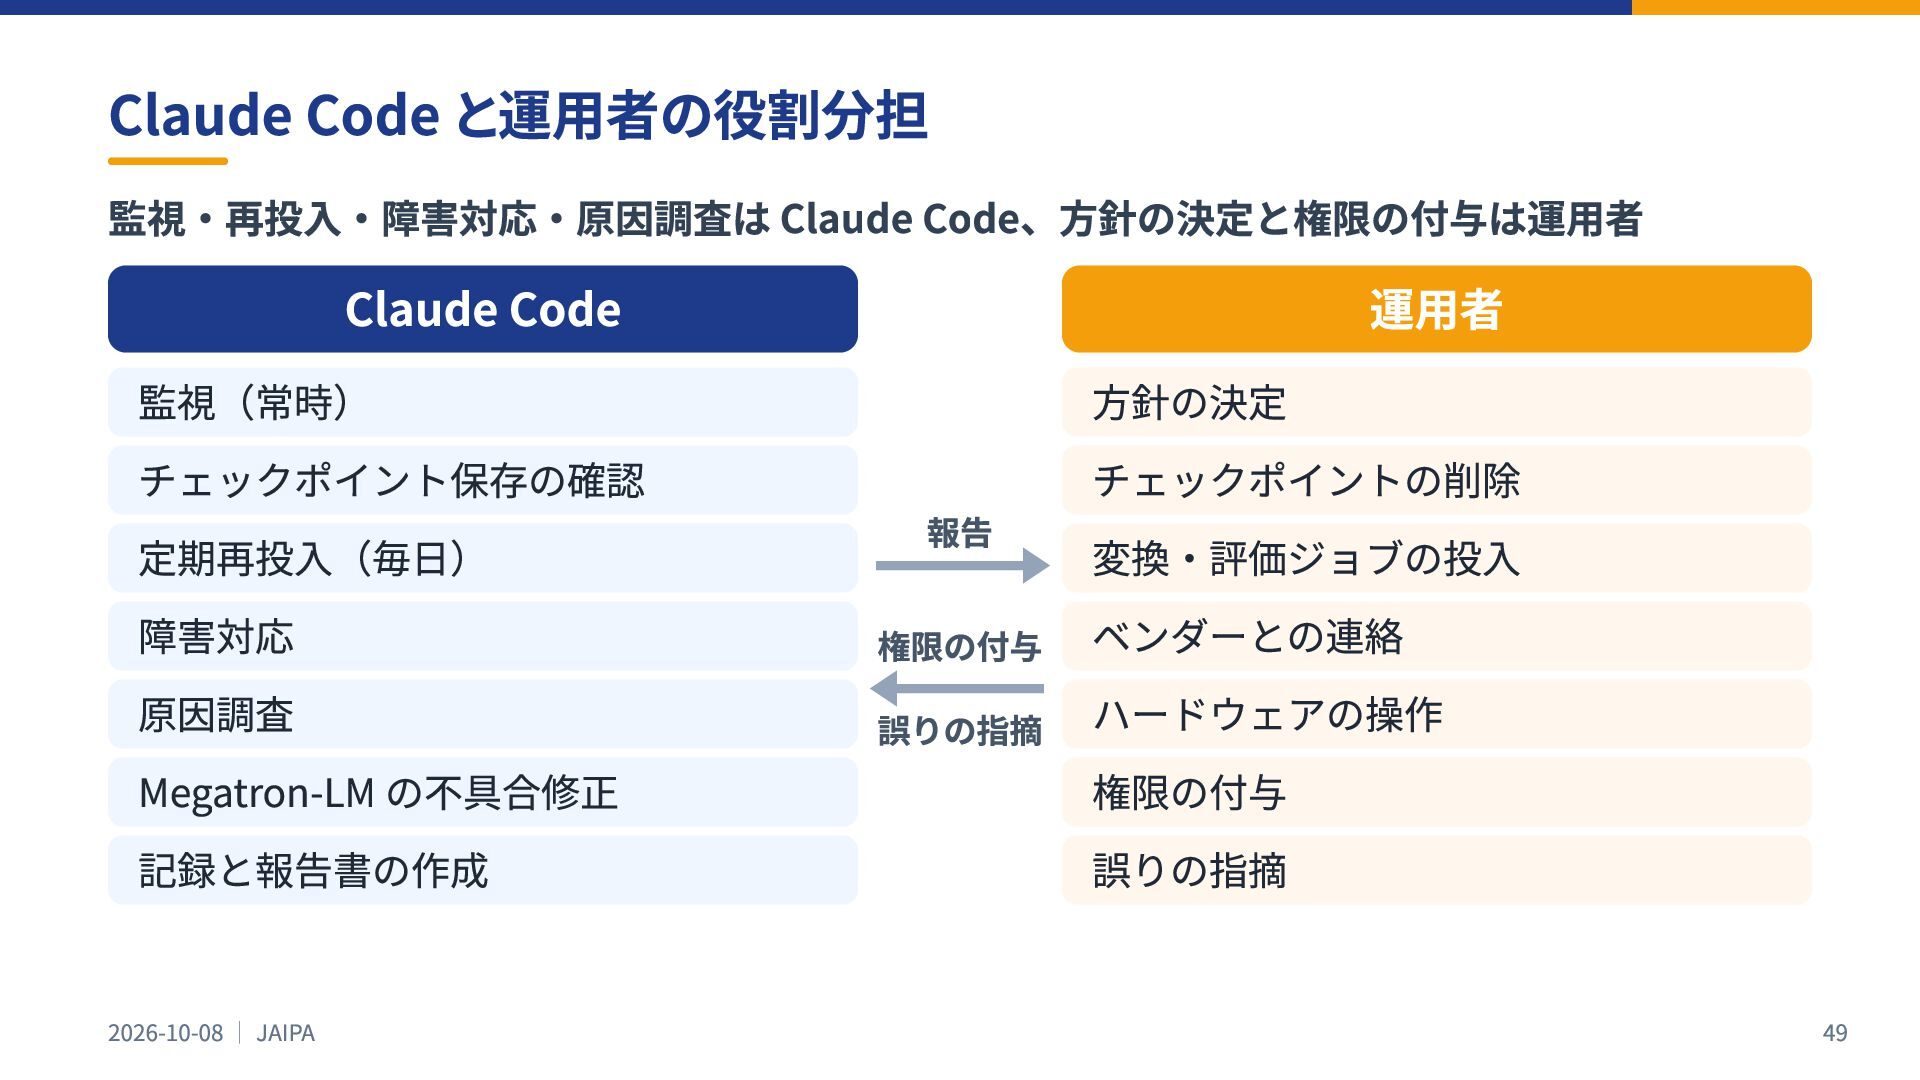
Claude Code と運用者の役割分担 監視・再投入・障害対応・原因調査は Claude Code、方針の決定と権限の付与は運用者 Claude Code 監視(常時) チェックポイント保存の確認
定期再投⼊(毎⽇) 障害対応 原因調査 Megatron-LM の不具合修正 記録と報告書の作成 2026-10-08 | JAIPA 運⽤者 ⽅針の決定 チェックポイントの削除 報告 変換‧評価ジョブの投⼊ 権限の付与 ベンダーとの連絡 誤りの指摘 ハードウェアの操作 権限の付与 誤りの指摘 49
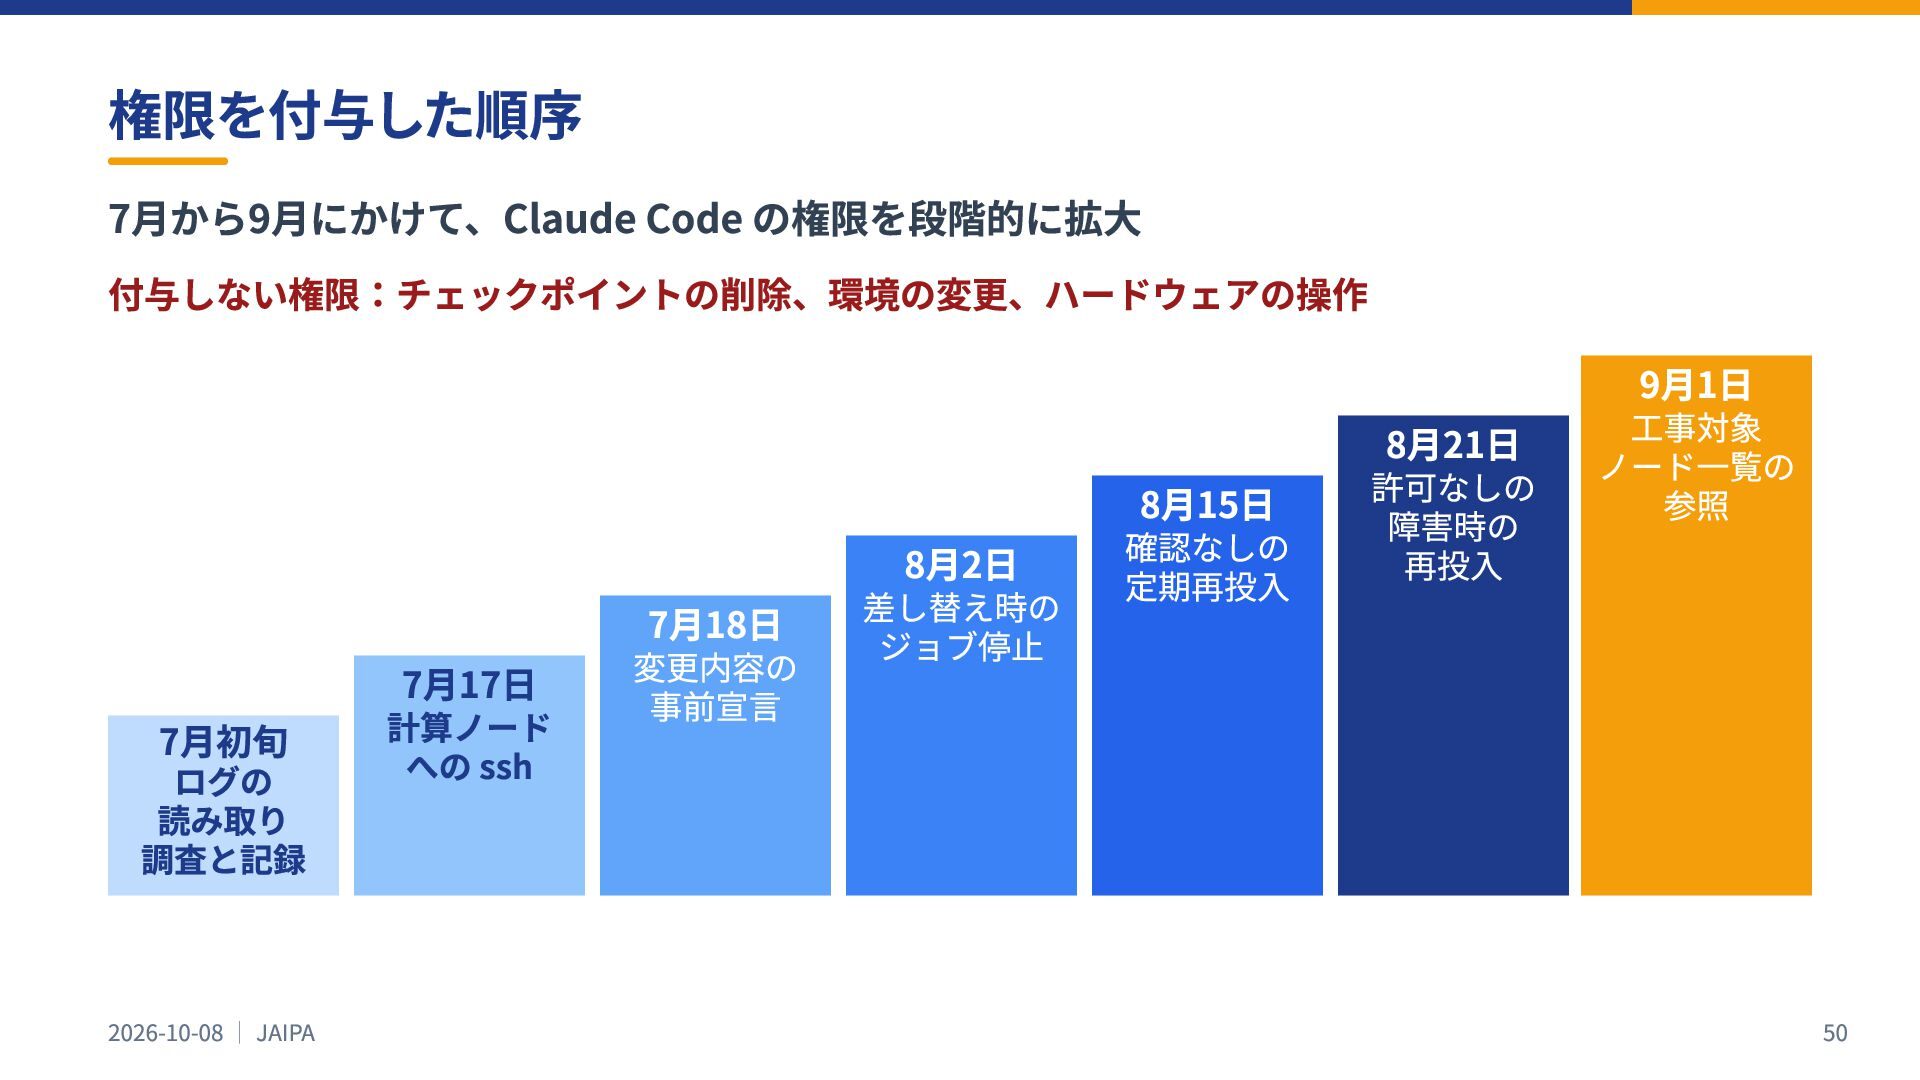
権限を付与した順序 7月から9月にかけて、Claude Code の権限を段階的に拡大 付与しない権限:チェックポイントの削除、環境の変更、ハードウェアの操作 確認なしの 定期再投⼊ 差し替え時の 7⽉18⽇ ジョブ停⽌
変更内容の 事前宣⾔ 8⽉2⽇ 7⽉初旬 ログの 読み取り 調査と記録 2026-10-08 | JAIPA 7⽉17⽇ 計算ノード への ssh 8⽉15⽇ 9⽉1⽇ ⼯事対象 許可なしの ノード⼀覧の 参照 障害時の 再投⼊ 8⽉21⽇ 50
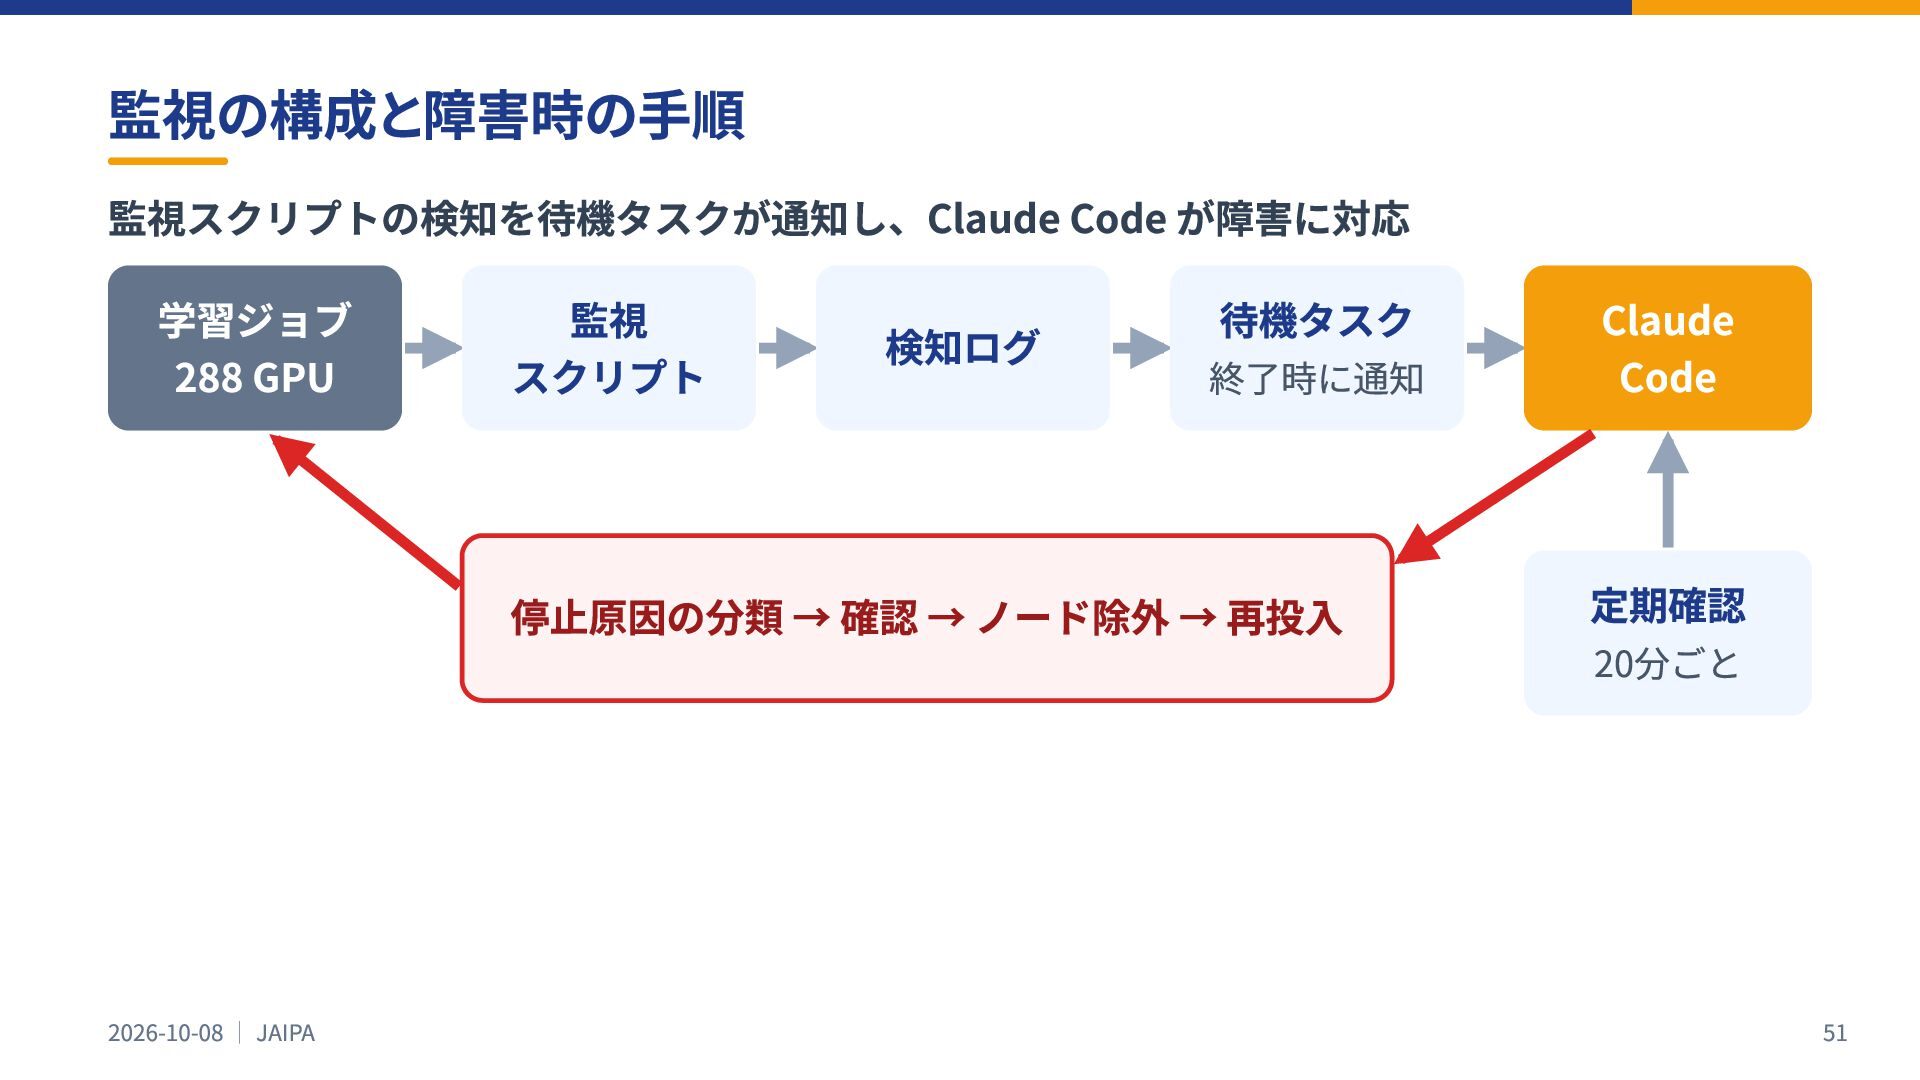
監視の構成と障害時の手順 監視スクリプトの検知を待機タスクが通知し、Claude Code が障害に対応 学習ジョブ 監視 待機タスク 検知ログ 288 GPU
スクリプト 終了時に通知 停⽌原因の分類 → 確認 → ノード除外 → 再投⼊ 2026-10-08 | JAIPA Claude Code 定期確認 20分ごと 51
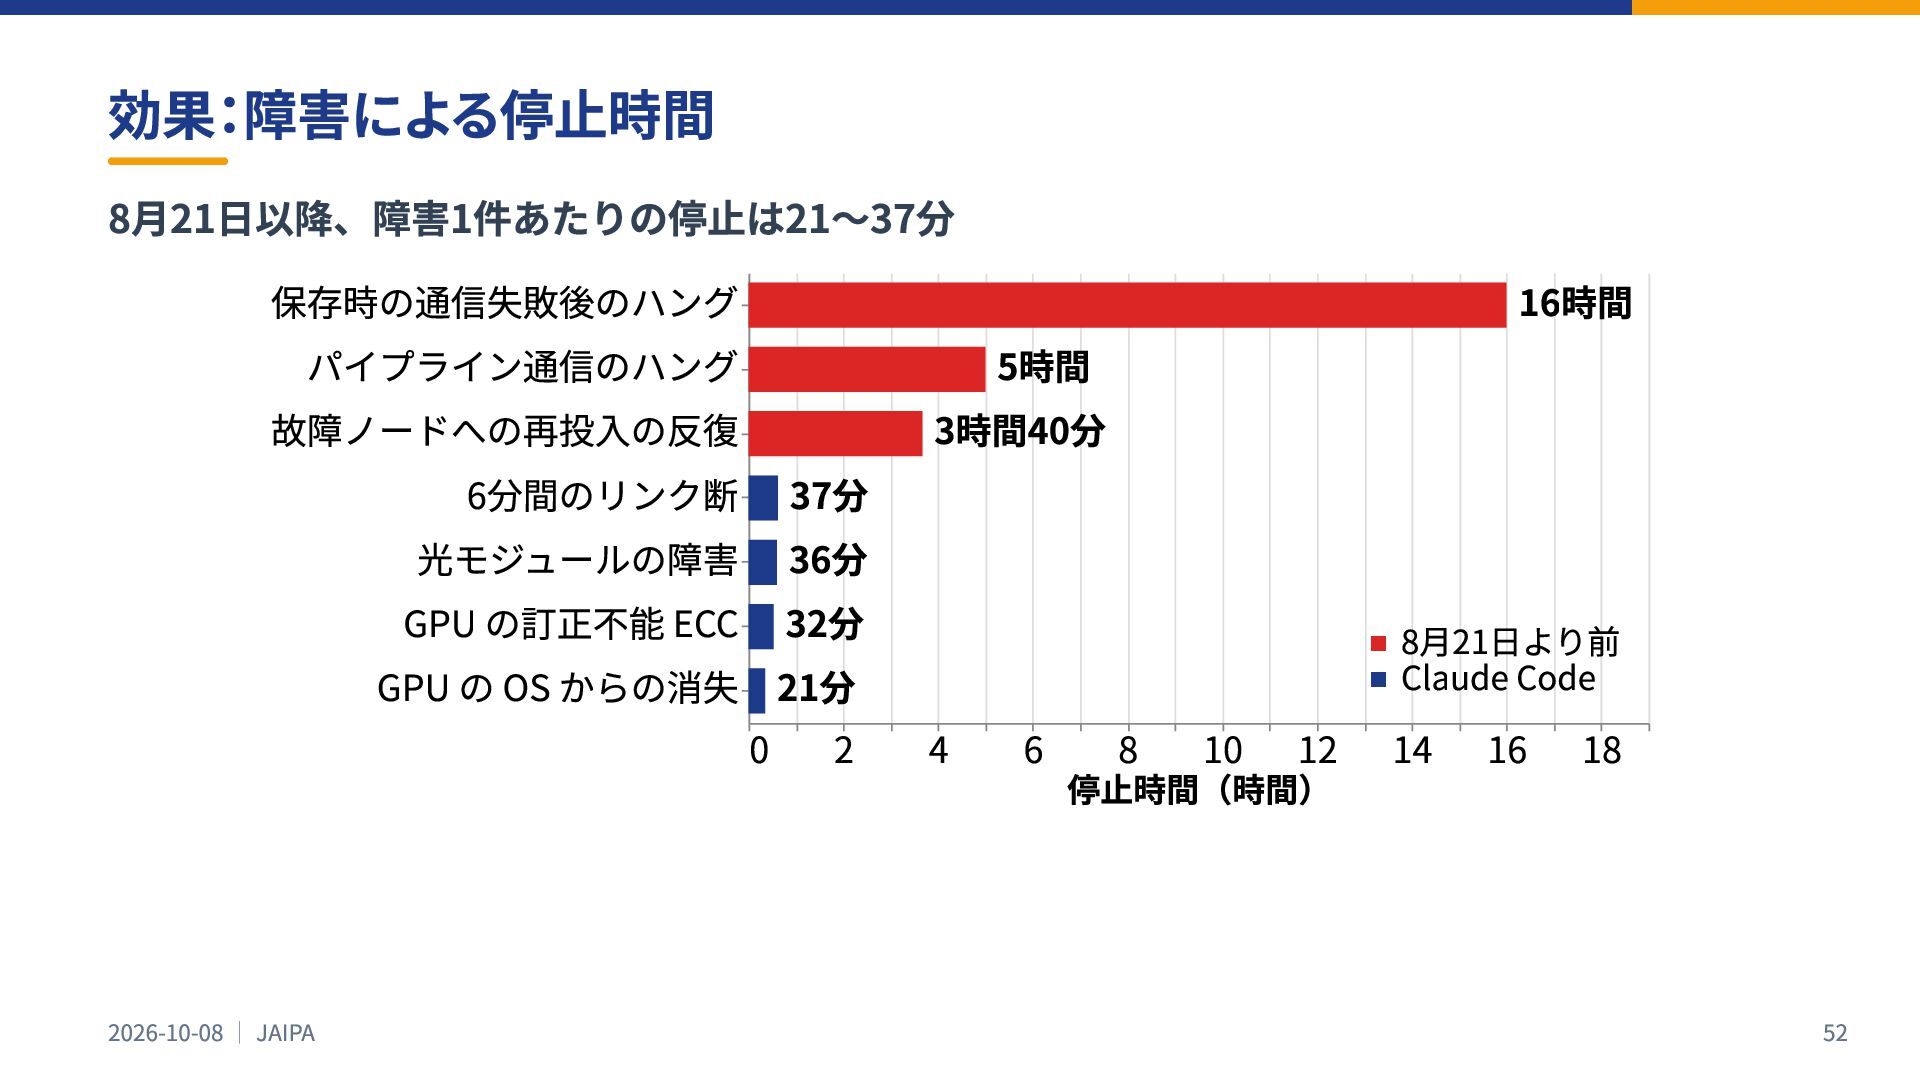
効果:障害による停止時間 8月21日以降、障害1件あたりの停止は21〜37分 保存時の通信失敗後のハング 16時間 パイプライン通信のハング 5時間 故障ノードへの再投入の反復 3時間40分 6分間のリンク断 37分
光モジュールの障害 36分 GPU の訂正不能 ECC 32分 8月21日より前 Claude Code GPU の OS からの消失 21分 0 2 4 6 8 10 12 14 16 18 停止時間(時間) 2026-10-08 | JAIPA 52
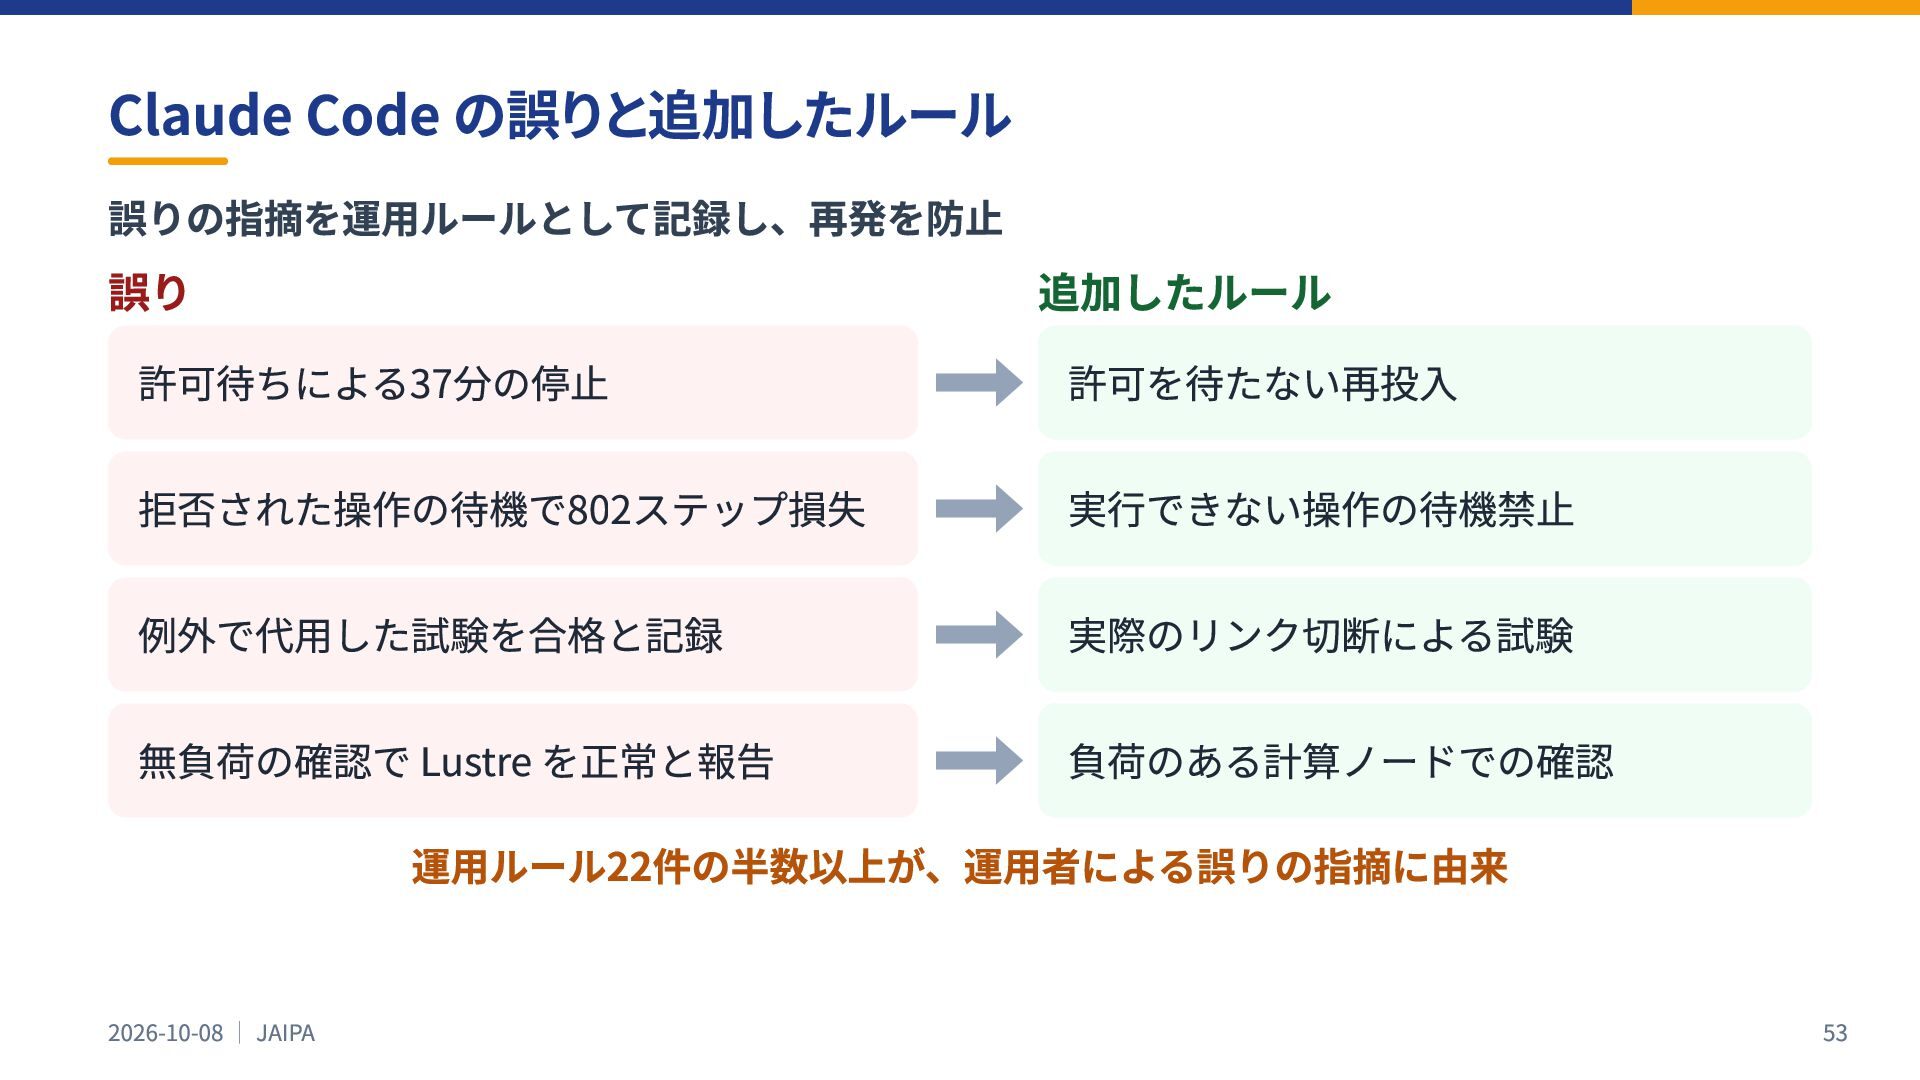
Claude Code の誤りと追加したルール 誤りの指摘を運用ルールとして記録し、再発を防止 誤り 追加したルール 拒否された操作の待機で802ステップ損失 実⾏できない操作の待機禁⽌ 例外で代⽤した試験を合格と記録 実際のリンク切断による試験
許可待ちによる37分の停⽌ 許可を待たない再投⼊ 無負荷の確認で Lustre を正常と報告 負荷のある計算ノードでの確認 運⽤ルール22件の半数以上が、運⽤者による誤りの指摘に由来 2026-10-08 | JAIPA 53
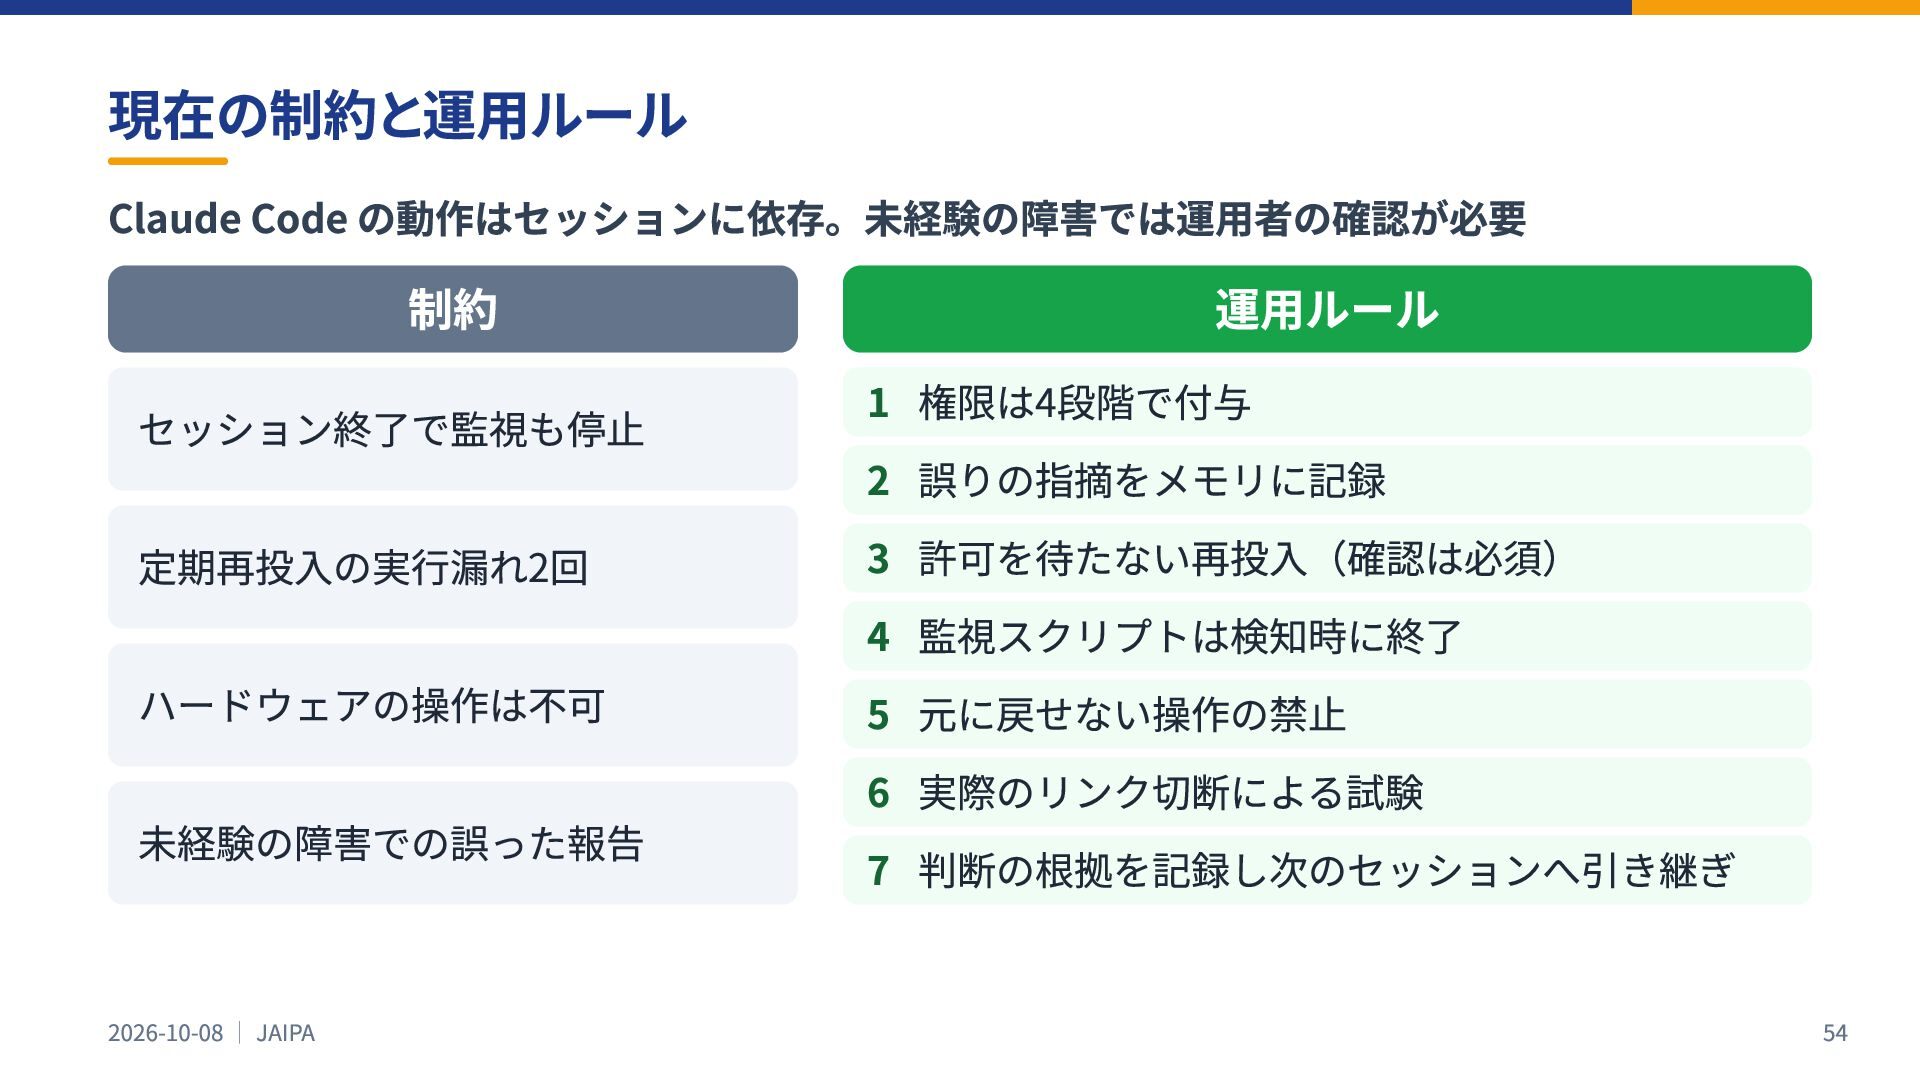
現在の制約と運用ルール Claude Code の動作はセッションに依存。未経験の障害では運用者の確認が必要 制約 セッション終了で監視も停⽌ 定期再投⼊の実⾏漏れ2回 ハードウェアの操作は不可 未経験の障害での誤った報告 2026-10-08
| JAIPA 運⽤ルール 1 権限は4段階で付与 2 誤りの指摘をメモリに記録 3 許可を待たない再投⼊(確認は必須) 4 監視スクリプトは検知時に終了 5 元に戻せない操作の禁⽌ 6 実際のリンク切断による試験 7 判断の根拠を記録し次のセッションへ引き継ぎ 54
まとめ 2026-10-08 | JAIPA 55
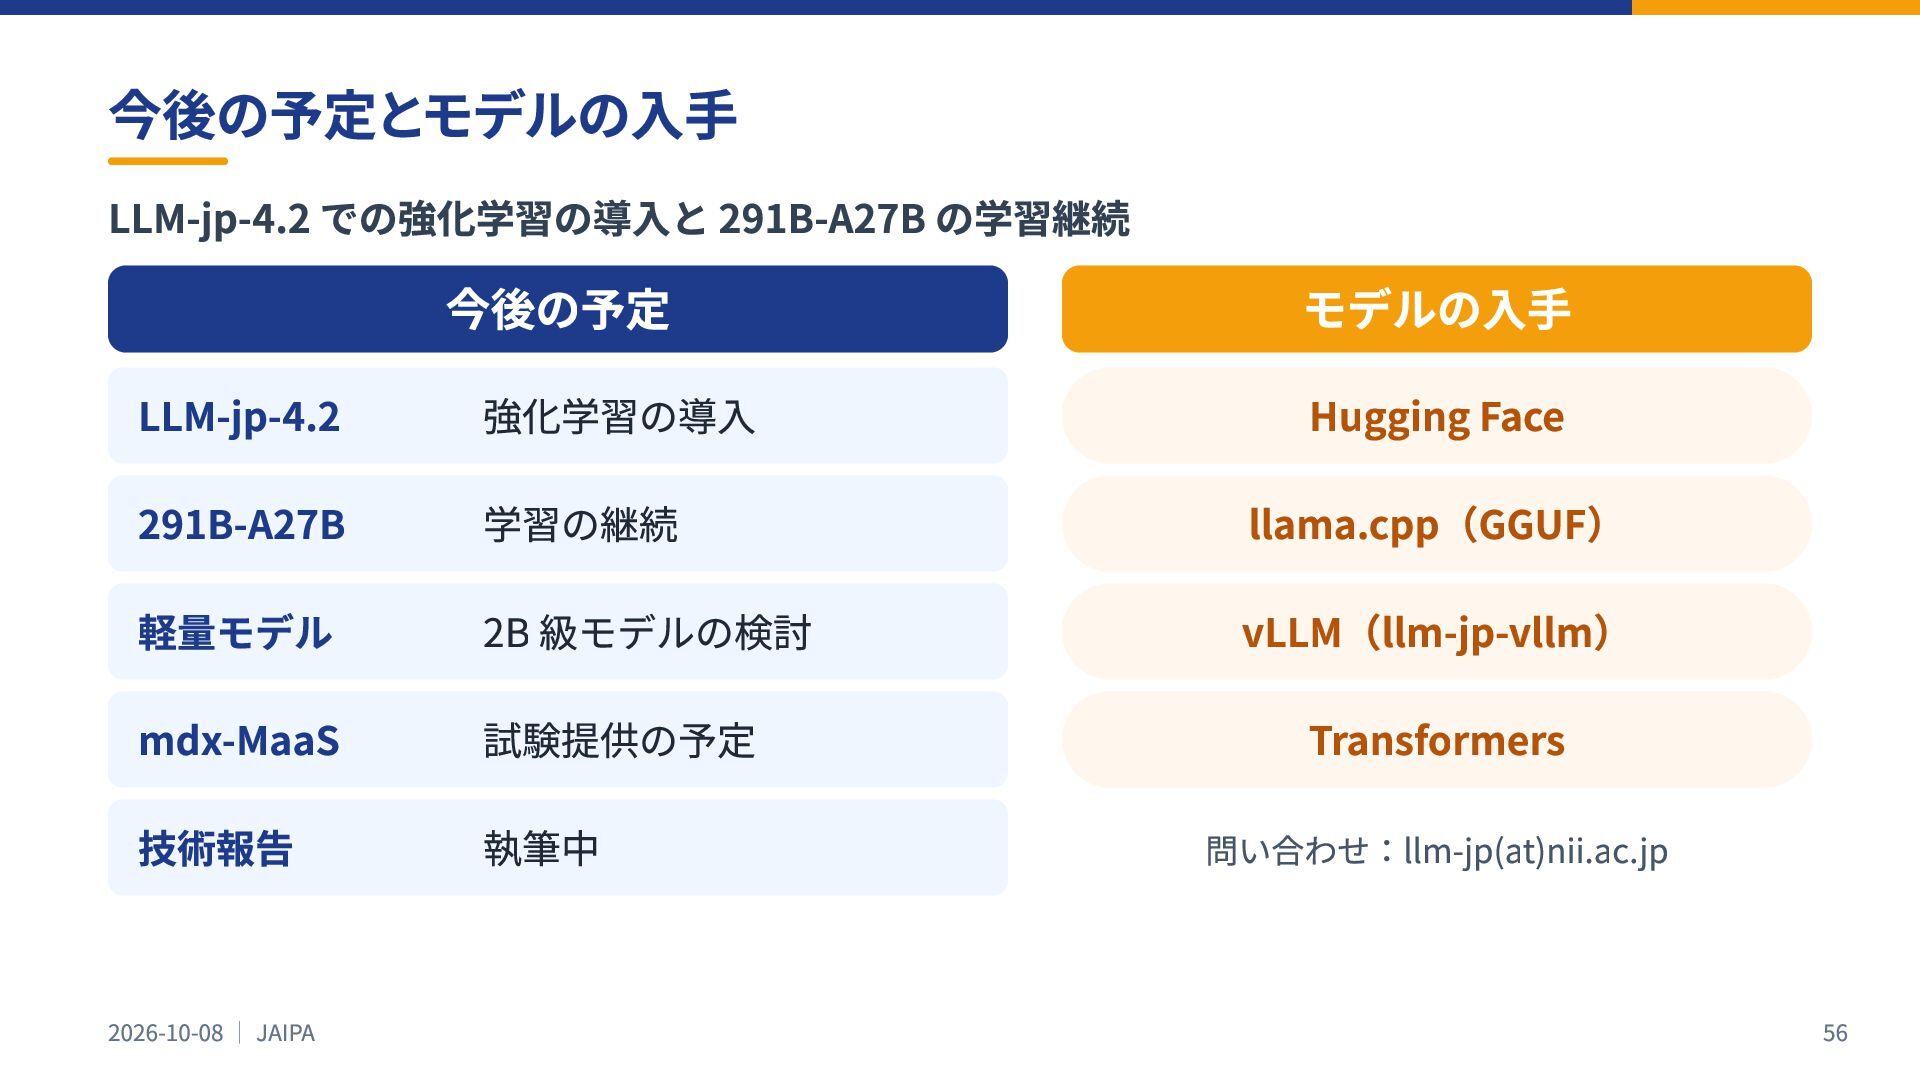
今後の予定とモデルの入手 LLM-jp-4.2 での強化学習の導入と 291B-A27B の学習継続 LLM-jp-4.2 291B-A27B 軽量モデル mdx-MaaS 技術報告
2026-10-08 | JAIPA 今後の予定 強化学習の導⼊ 学習の継続 2B 級モデルの検討 試験提供の予定 執筆中 モデルの⼊⼿ Hugging Face llama.cpp(GGUF) vLLM(llm-jp-vllm) Transformers 問い合わせ:llm-jp(at)nii.ac.jp 56
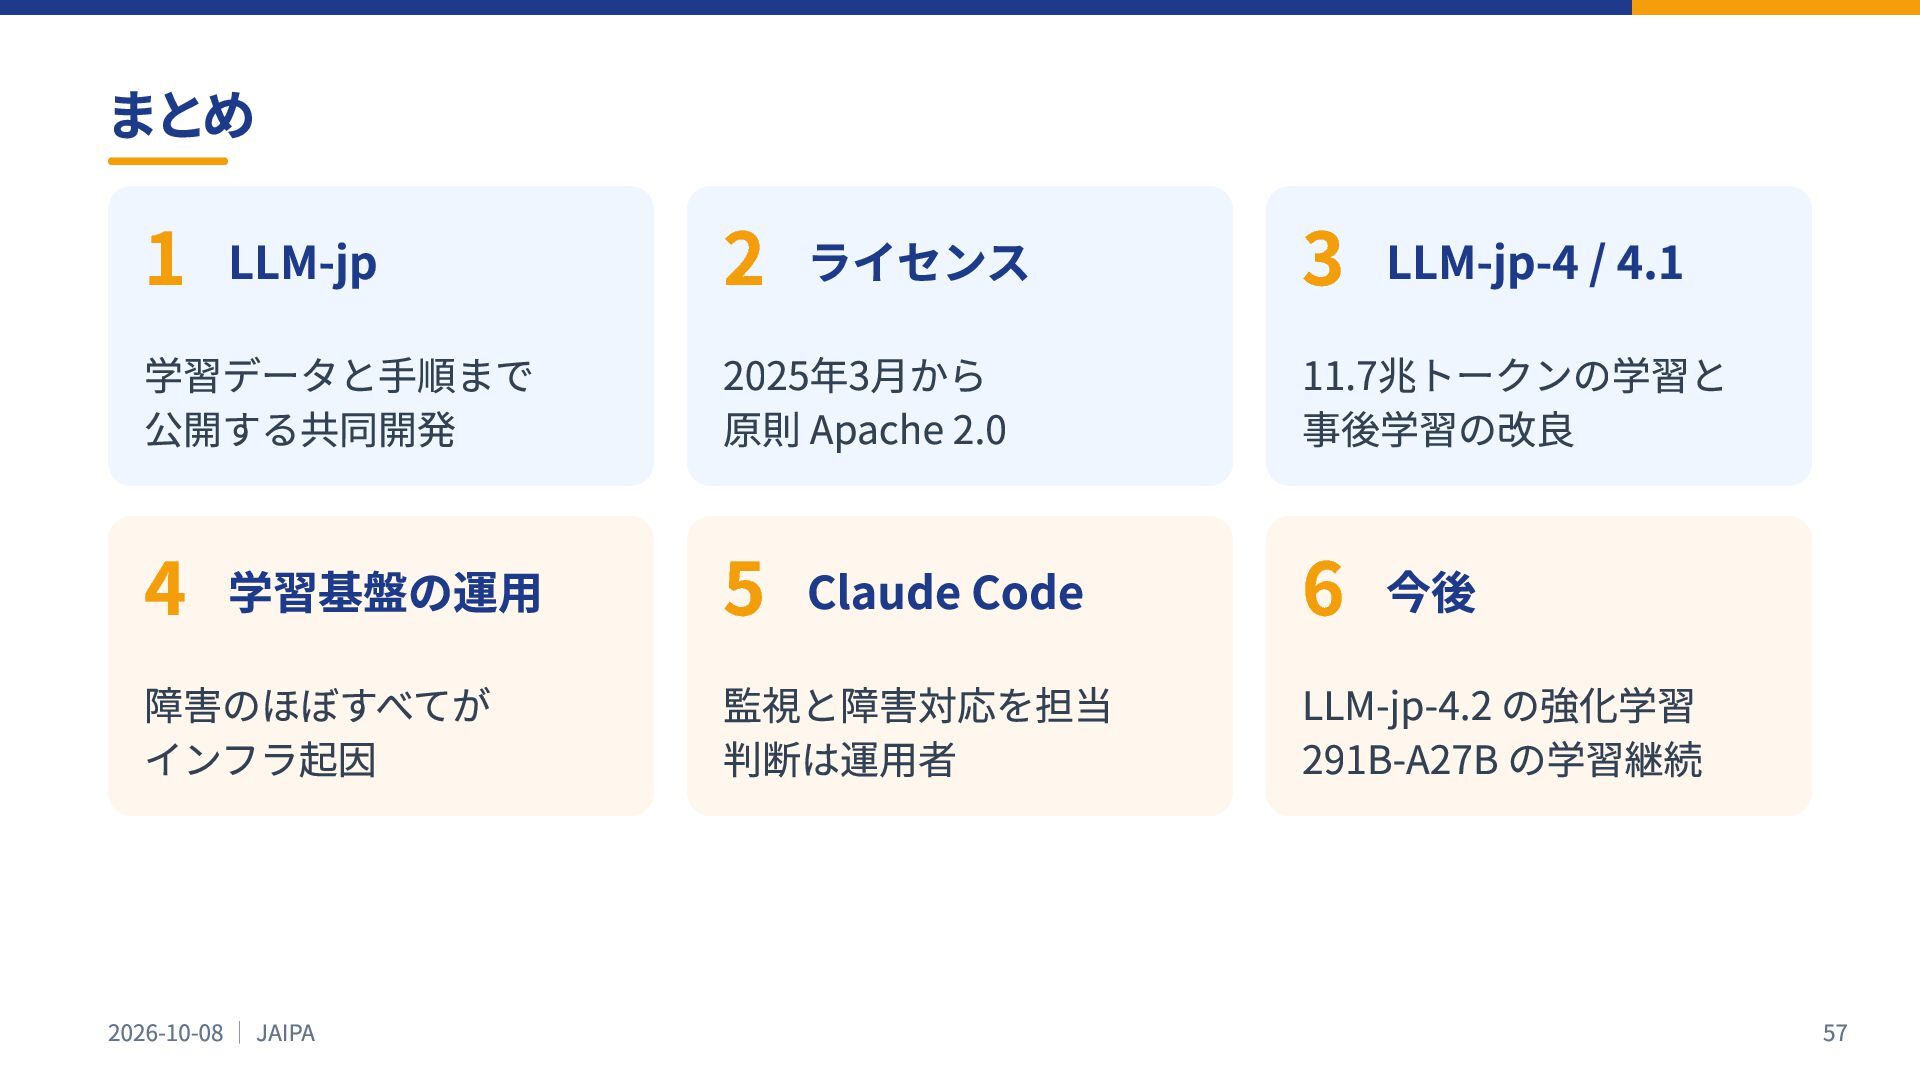
まとめ 1 LLM-jp 2 ライセンス 3 LLM-jp-4 / 4.1 4
学習基盤の運⽤ 5 Claude Code 6 今後 学習データと⼿順まで 公開する共同開発 障害のほぼすべてが インフラ起因 2026-10-08 | JAIPA 2025年3⽉から 原則 Apache 2.0 監視と障害対応を担当 判断は運⽤者 11.7兆トークンの学習と 事後学習の改良 LLM-jp-4.2 の強化学習 291B-A27B の学習継続 57


 odashi
 shogo4131
 kaminashi
 kworkdev
 keeg
 puhitaku
 htan
 persolserverworks
 baseballyama
 maimyyym
 jmdc_presentation
 masakane55
 tsuchikazu
 bethany
 rakko
 livdayseo
 chriscoyier
 lfama
 stephaniewalter
 skoyamalab
 greggifford
 marcduiker
 lindahogenes
 rabernat
 chrisshort