Upgrade to Pro — share decks privately, control downloads, hide ads and more …

AI_Agent_Coding_Agentの_コスト最適化手法キャッチアップ_Part1.pdf

Avatar for Keisuke Kamata Keisuke Kamata
September 30, 2026
3

 AI_Agent_Coding_Agentの_コスト最適化手法キャッチアップ_Part1.pdf

Avatar for Keisuke Kamata

Keisuke Kamata

September 30, 2026

More Decks by Keisuke Kamata

Transcript

  1. Part 1 - Agenda • • • APIの仕組みをまずは理解する ◦ Prompt

    Cashing ◦ Compaction ◦ Batch ◦ Differed Tool Calling コスト最適化のフロー (全体感) + Weaveで精度とコストのバランスを探る例 おまけ: Model Routing 2
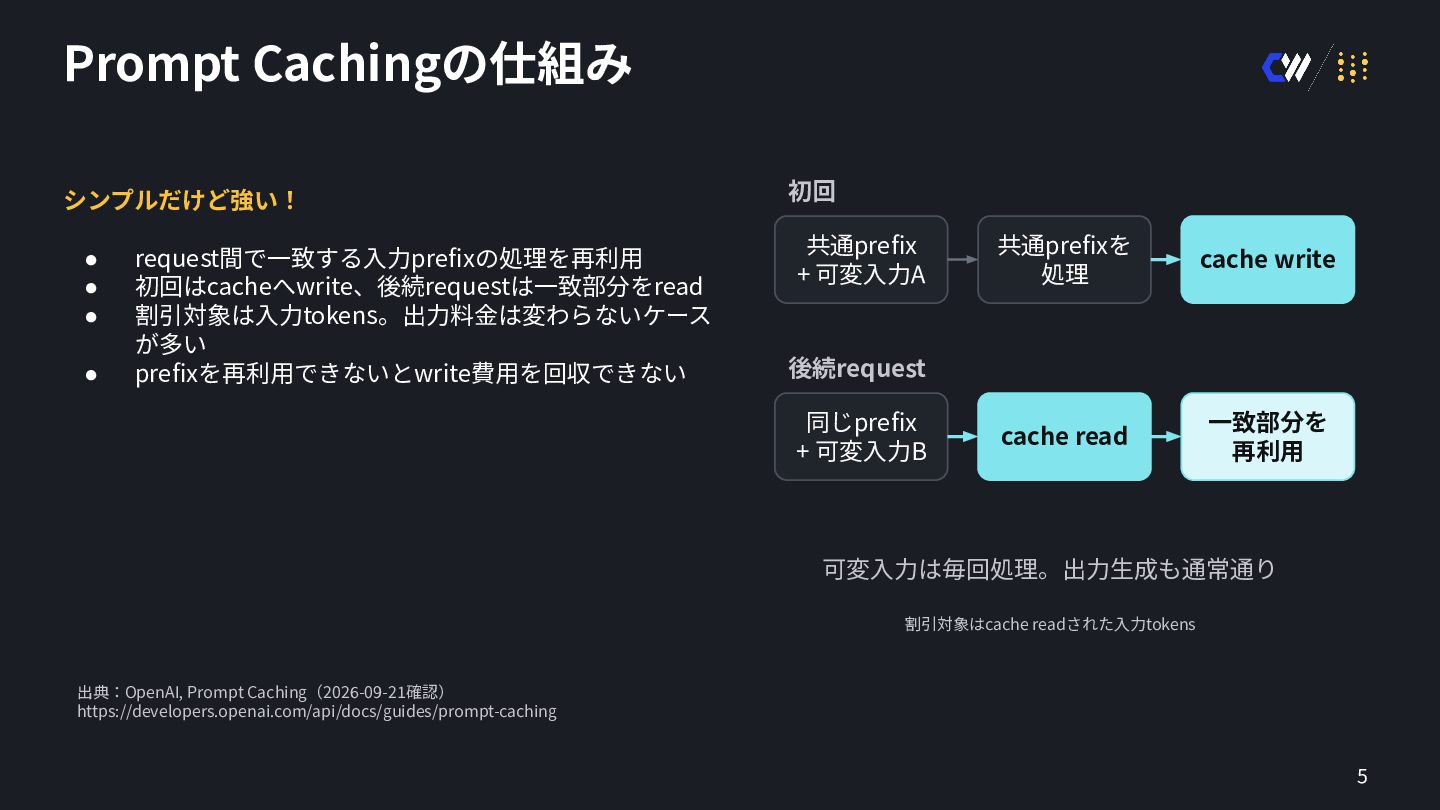
  2. Prompt Cachingの仕組み シンプルだけど強い! • • • • request間で⼀致する⼊⼒prefixの処理を再利⽤ 初回はcacheへwrite、後続requestは⼀致部分をread 割引対象は⼊⼒tokens。出⼒料⾦は変わらないケース

    が多い prefixを再利⽤できないとwrite費⽤を回収できない 初回 共通prefix + 可変⼊⼒A 共通prefixを 処理 cache write cache read ⼀致部分を 再利⽤ 後続request 同じprefix + 可変⼊⼒B 可変⼊⼒は毎回処理。出⼒⽣成も通常通り 割引対象はcache readされた⼊⼒tokens 出典:OpenAI, Prompt Caching(2026-09-21確認) https://developers.openai.com/api/docs/guides/prompt-caching 5
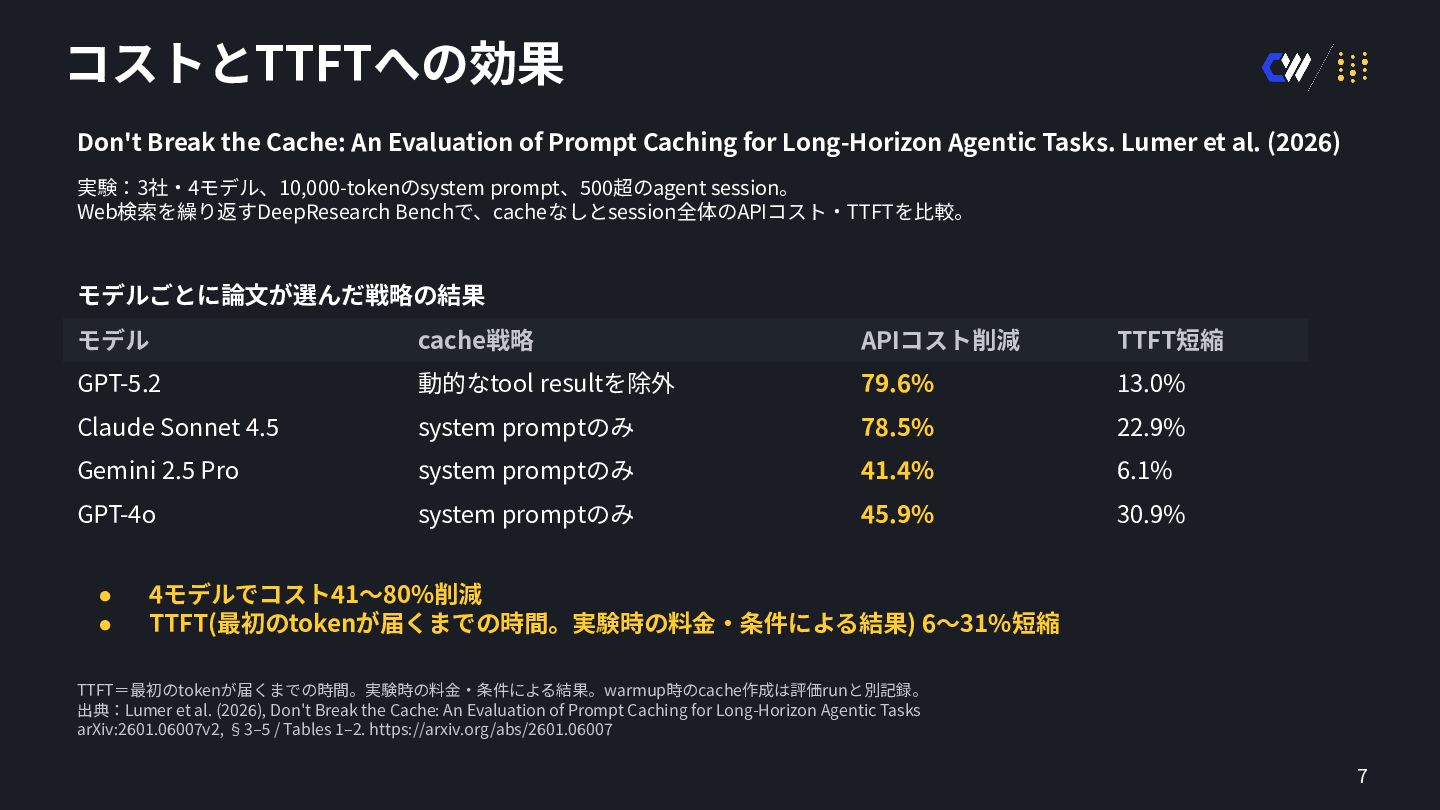
  3. コストとTTFTへの効果 Don't Break the Cache: An Evaluation of Prompt Caching

    for Long-Horizon Agentic Tasks. Lumer et al. (2026) 実験:3社‧4モデル、10,000-tokenのsystem prompt、500超のagent session。 Web検索を繰り返すDeepResearch Benchで、cacheなしとsession全体のAPIコスト‧TTFTを⽐較。 モデルごとに論⽂が選んだ戦略の結果 モデル cache戦略 APIコスト削減 TTFT短縮 GPT-5.2 動的なtool resultを除外 79.6% 13.0% Claude Sonnet 4.5 system promptのみ 78.5% 22.9% Gemini 2.5 Pro system promptのみ 41.4% 6.1% GPT-4o system promptのみ 45.9% 30.9% • • 4モデルでコスト41〜80%削減 TTFT(最初のtokenが届くまでの時間。実験時の料⾦‧条件による結果) 6〜31%短縮 TTFT=最初のtokenが届くまでの時間。実験時の料⾦‧条件による結果。warmup時のcache作成は評価runと別記録。 出典:Lumer et al. (2026), Don't Break the Cache: An Evaluation of Prompt Caching for Long-Horizon Agentic Tasks arXiv:2601.06007v2, §3‒5 / Tables 1‒2. https://arxiv.org/abs/2601.06007 7
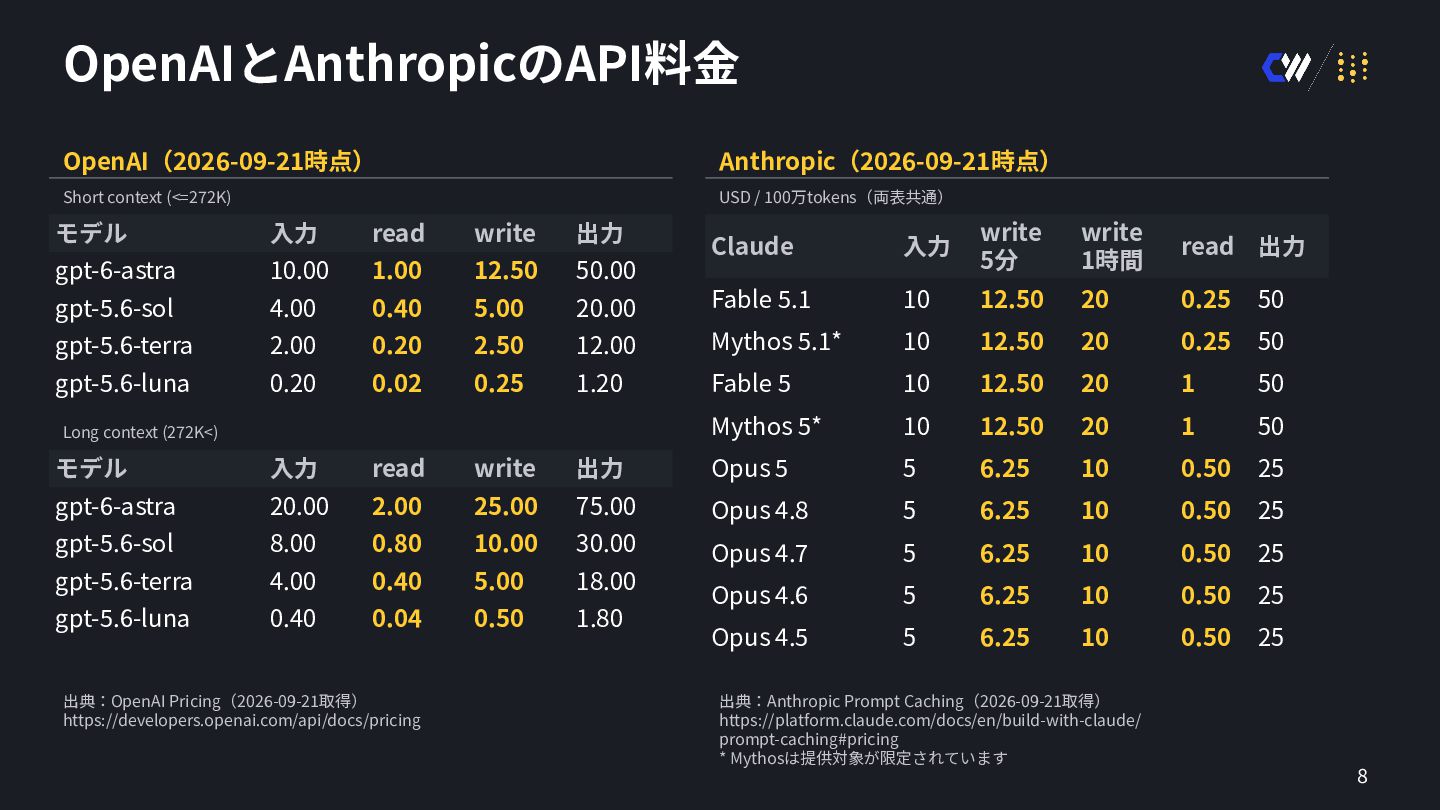
  4. OpenAIとAnthropicのAPI料⾦ OpenAI(2026-09-21時点) Anthropic(2026-09-21時点) Short context (<=272K) USD / 100万tokens(両表共通) Claude

    ⼊⼒ write 5分 write 1時間 read 出⼒ 20.00 Fable 5.1 10 12.50 20 0.25 50 2.50 12.00 Mythos 5.1* 10 12.50 20 0.25 50 0.25 1.20 Fable 5 10 12.50 20 1 50 Mythos 5* 10 12.50 20 1 50 モデル ⼊⼒ read write 出⼒ gpt-6-astra 10.00 1.00 12.50 50.00 gpt-5.6-sol 4.00 0.40 5.00 gpt-5.6-terra 2.00 0.20 gpt-5.6-luna 0.20 0.02 Long context (272K<) モデル ⼊⼒ read write 出⼒ Opus 5 5 6.25 10 0.50 25 gpt-6-astra 20.00 2.00 25.00 75.00 Opus 4.8 5 6.25 10 0.50 25 gpt-5.6-sol 8.00 0.80 10.00 30.00 Opus 4.7 5 6.25 10 0.50 25 gpt-5.6-terra 4.00 0.40 5.00 18.00 gpt-5.6-luna 0.40 0.04 0.50 1.80 Opus 4.6 5 6.25 10 0.50 25 Opus 4.5 5 6.25 10 0.50 25 出典:OpenAI Pricing(2026-09-21取得) https://developers.openai.com/api/docs/pricing 出典:Anthropic Prompt Caching(2026-09-21取得) https://platform.claude.com/docs/en/build-with-claude/ prompt-caching#pricing * Mythosは提供対象が限定されています 8
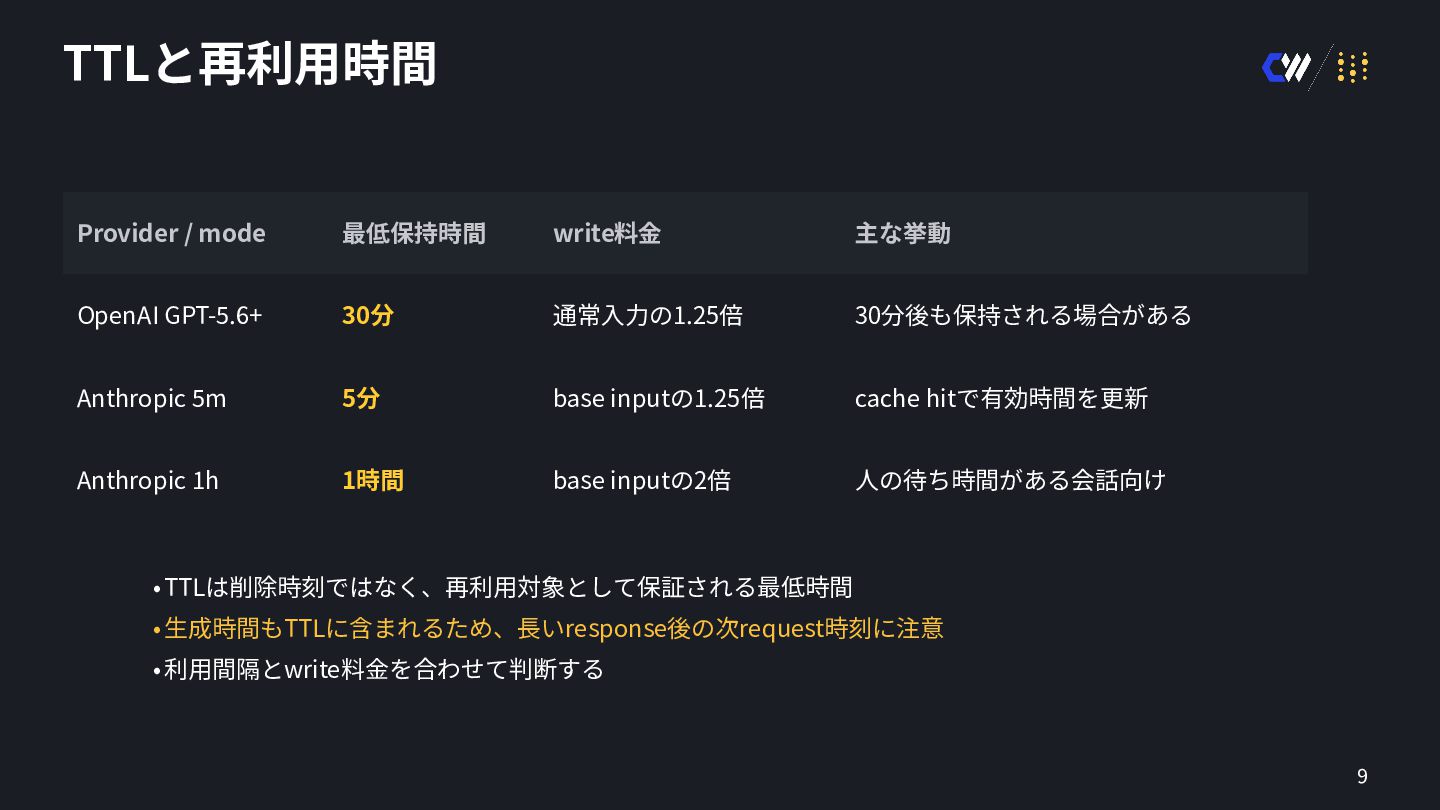
  5. TTLと再利⽤時間 Provider / mode 最低保持時間 write料⾦ 主な挙動 OpenAI GPT-5.6+ 30分

    通常⼊⼒の1.25倍 30分後も保持される場合がある Anthropic 5m 5分 base inputの1.25倍 cache hitで有効時間を更新 Anthropic 1h 1時間 base inputの2倍 ⼈の待ち時間がある会話向け •TTLは削除時刻ではなく、再利⽤対象として保証される最低時間 •⽣成時間もTTLに含まれるため、⻑いresponse後の次request時刻に注意 •利⽤間隔とwrite料⾦を合わせて判断する 9
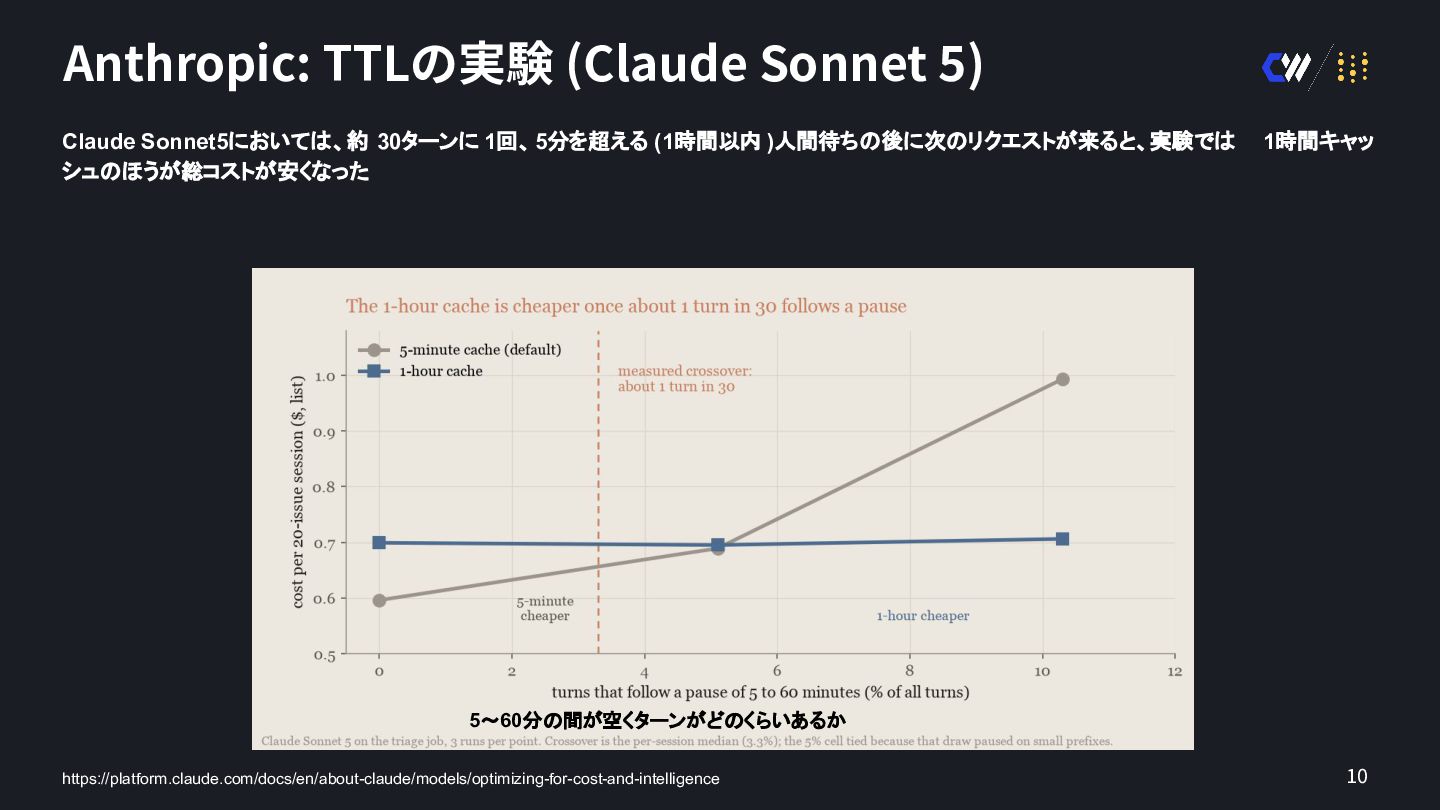
  6. Anthropic: TTLの実験 (Claude Sonnet 5) Claude Sonnet5においては、約 30ターンに 1回、 5分を超える

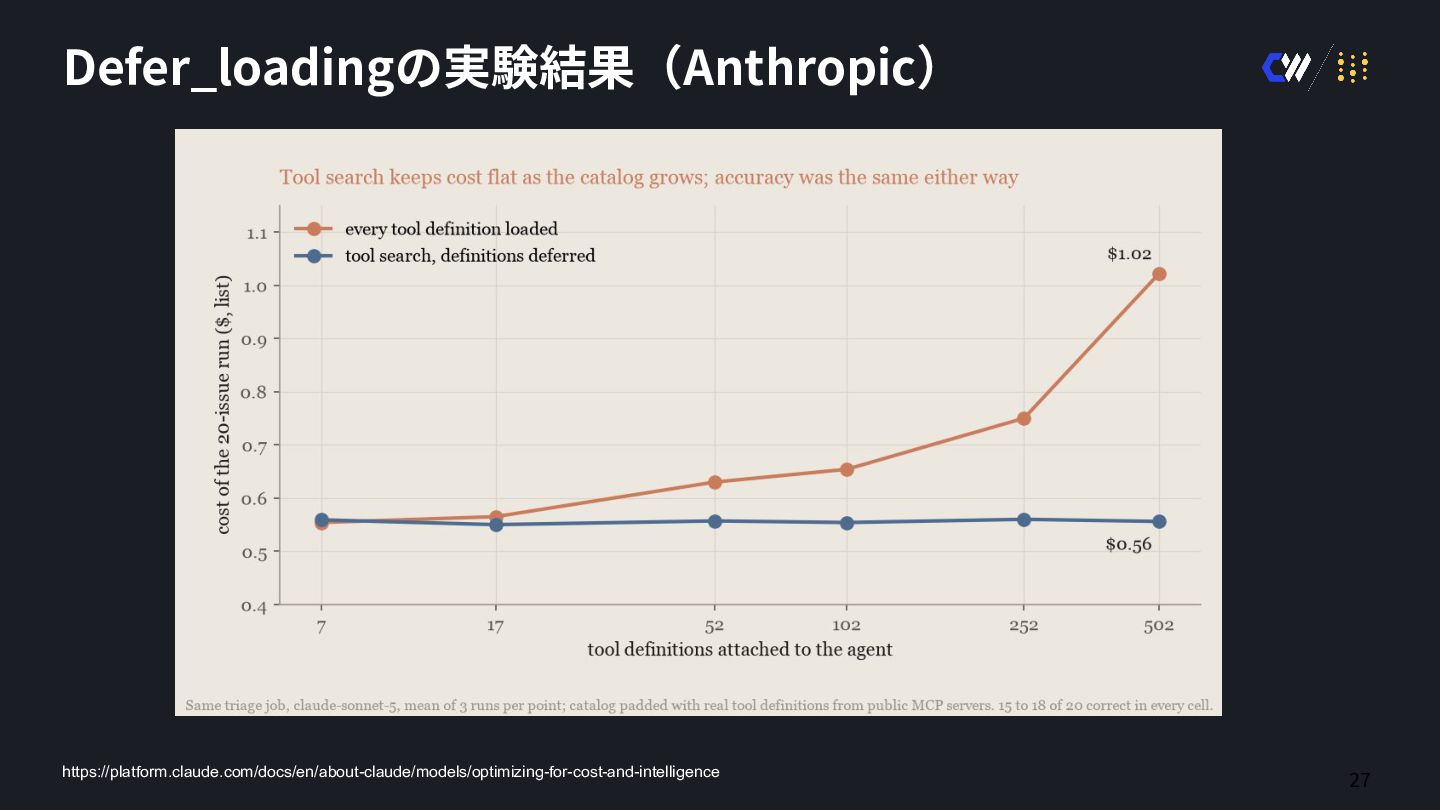
    (1時間以内 )人間待ちの後に次のリクエストが来ると、実験では シュのほうが総コストが安くなった 1時間キャッ 5〜60分の間が空くターンがどのくらいあるか https://platform.claude.com/docs/en/about-claude/models/optimizing-for-cost-and-intelligence 10
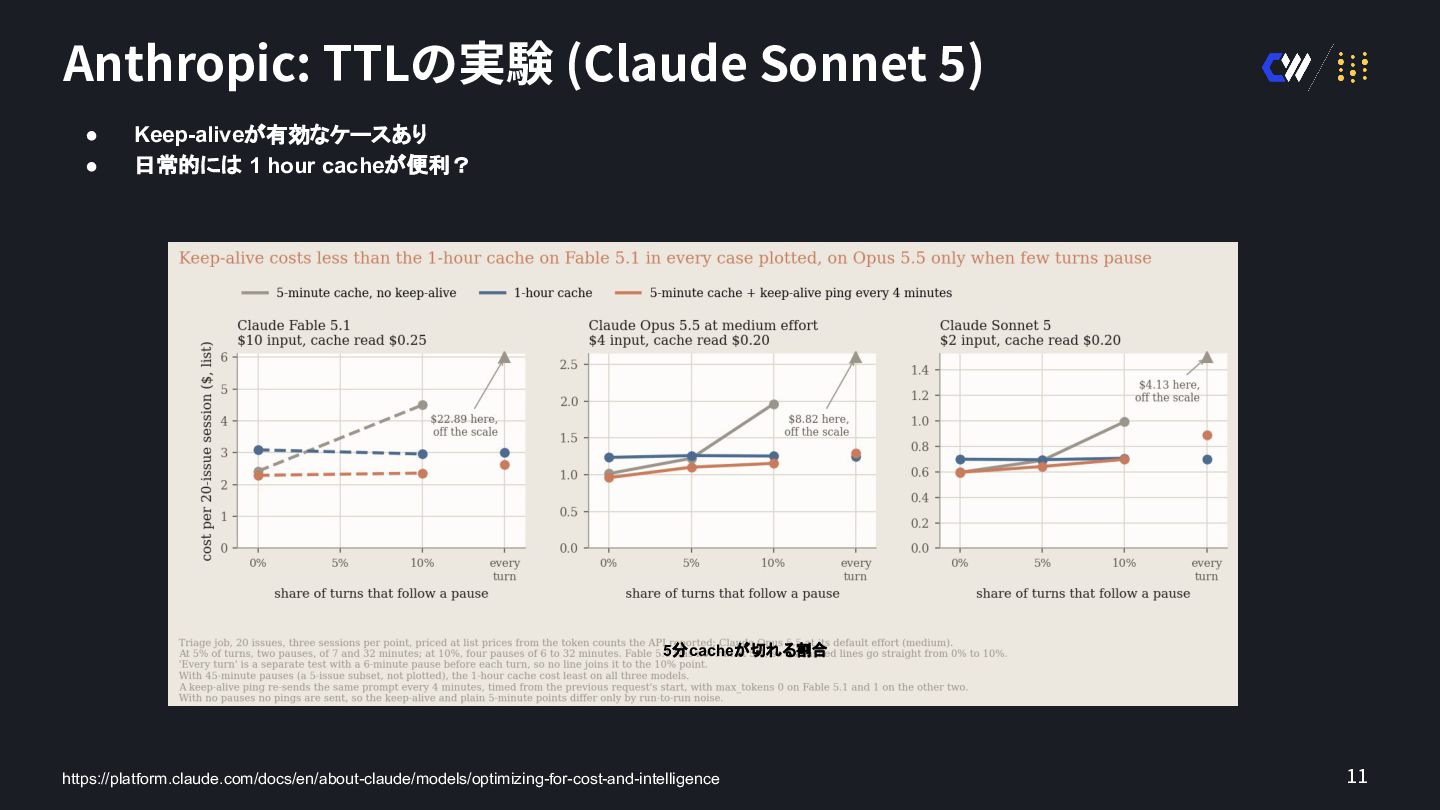
  7. Anthropic: TTLの実験 (Claude Sonnet 5) • • Keep-aliveが有効なケースあり 日常的には 1

    hour cacheが便利? 5分cacheが切れる割合 https://platform.claude.com/docs/en/about-claude/models/optimizing-for-cost-and-intelligence 11
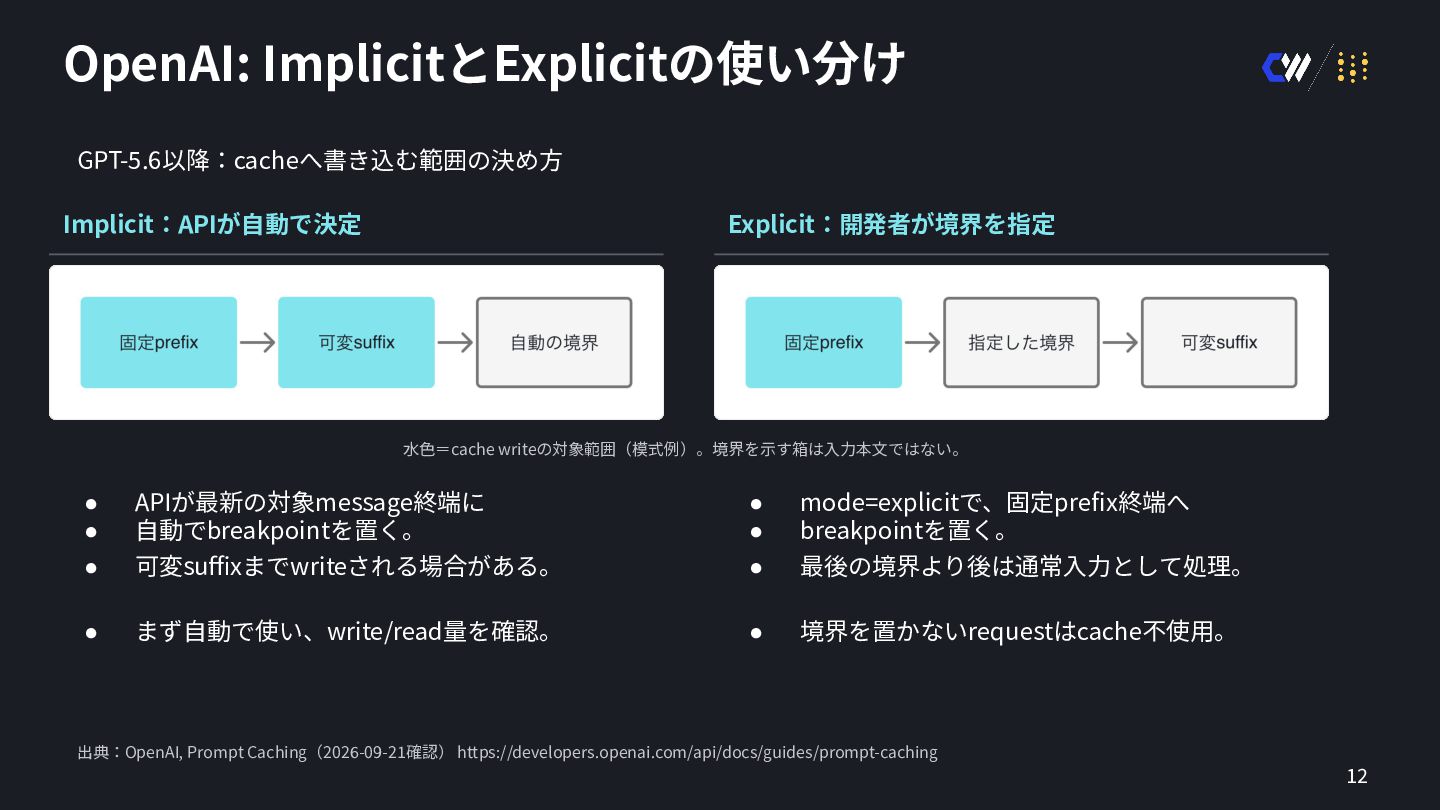
  8. OpenAI: ImplicitとExplicitの使い分け GPT-5.6以降:cacheへ書き込む範囲の決め⽅ Implicit:APIが⾃動で決定 Explicit:開発者が境界を指定 ⽔⾊=cache writeの対象範囲(模式例)。境界を⽰す箱は⼊⼒本⽂ではない。 • • •

    APIが最新の対象message終端に ⾃動でbreakpointを置く。 可変suffixまでwriteされる場合がある。 • • • mode=explicitで、固定prefix終端へ breakpointを置く。 最後の境界より後は通常⼊⼒として処理。 • まず⾃動で使い、write/read量を確認。 • 境界を置かないrequestはcache不使⽤。 出典:OpenAI, Prompt Caching(2026-09-21確認) https://developers.openai.com/api/docs/guides/prompt-caching 12
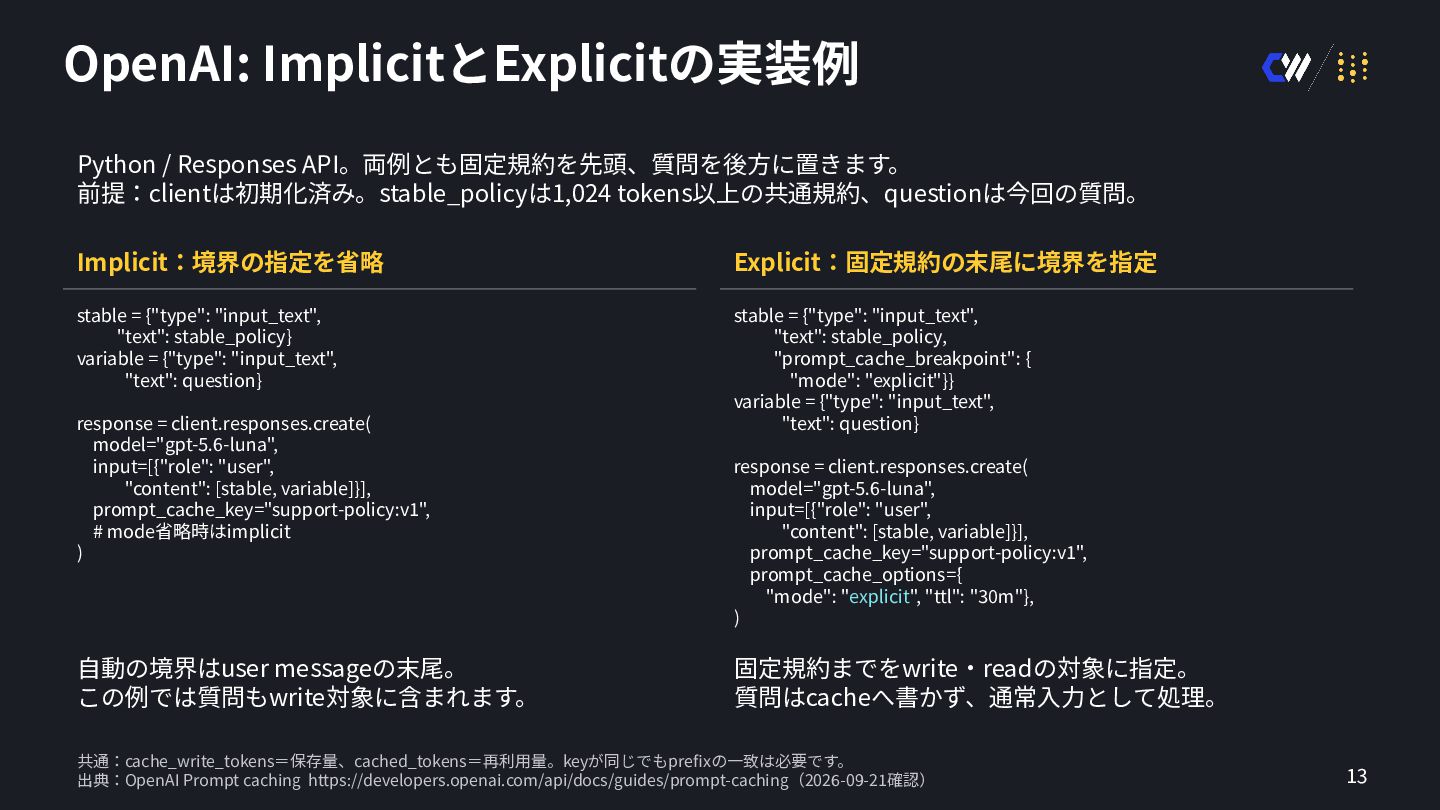
  9. OpenAI: ImplicitとExplicitの実装例 Python / Responses API。両例とも固定規約を先頭、質問を後⽅に置きます。 前提:clientは初期化済み。stable_policyは1,024 tokens以上の共通規約、questionは今回の質問。 Implicit:境界の指定を省略 Explicit:固定規約の末尾に境界を指定

    stable = {"type": "input_text", "text": stable_policy} variable = {"type": "input_text", "text": question} stable = {"type": "input_text", "text": stable_policy, "prompt_cache_breakpoint": { "mode": "explicit"}} variable = {"type": "input_text", "text": question} response = client.responses.create( model="gpt-5.6-luna", input=[{"role": "user", "content": [stable, variable]}], prompt_cache_key="support-policy:v1", # mode省略時はimplicit ) ⾃動の境界はuser messageの末尾。 この例では質問もwrite対象に含まれます。 response = client.responses.create( model="gpt-5.6-luna", input=[{"role": "user", "content": [stable, variable]}], prompt_cache_key="support-policy:v1", prompt_cache_options={ "mode": "explicit", "ttl": "30m"}, ) 固定規約までをwrite‧readの対象に指定。 質問はcacheへ書かず、通常⼊⼒として処理。 共通:cache_write_tokens=保存量、cached_tokens=再利⽤量。keyが同じでもprefixの⼀致は必要です。 出典:OpenAI Prompt caching https://developers.openai.com/api/docs/guides/prompt-caching(2026-09-21確認) 13
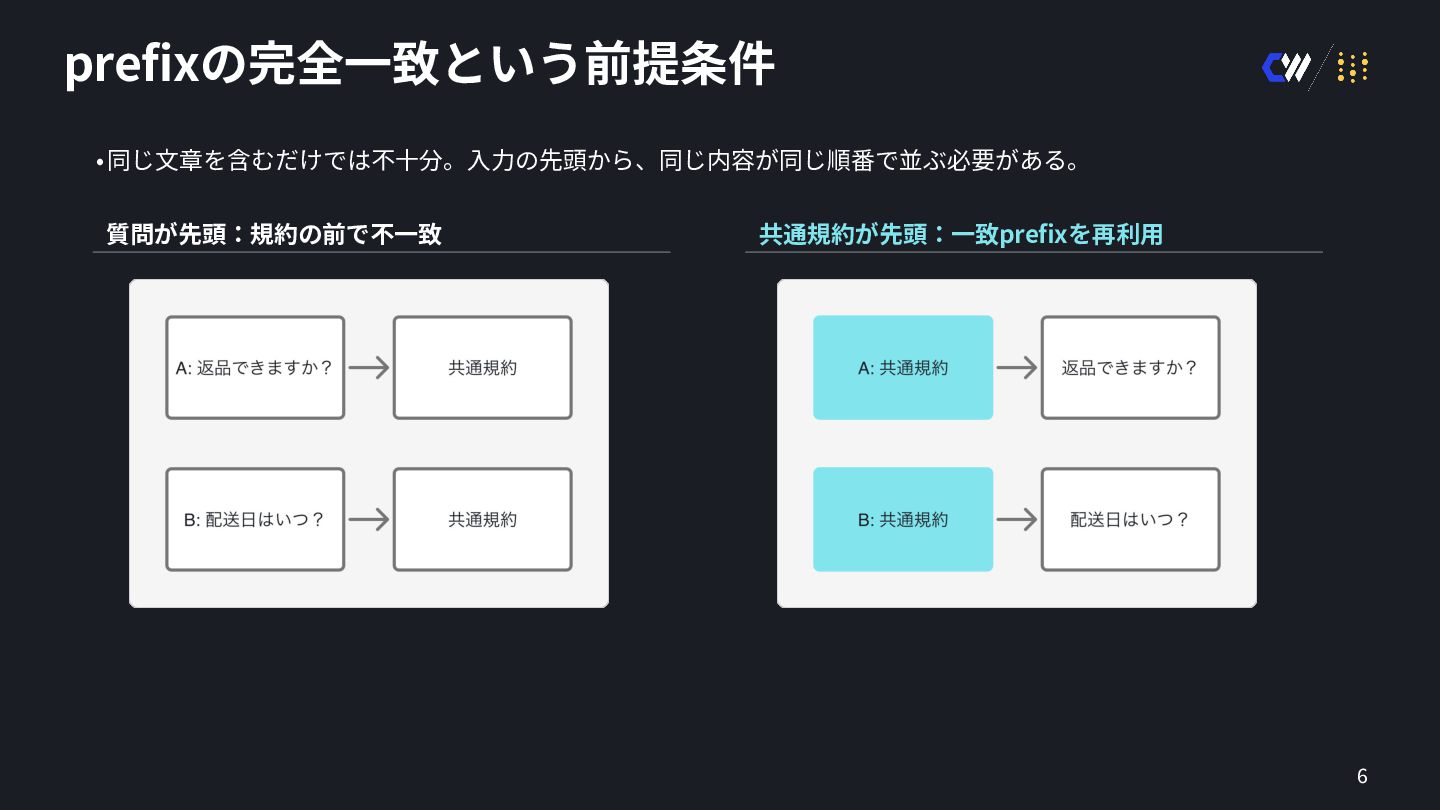
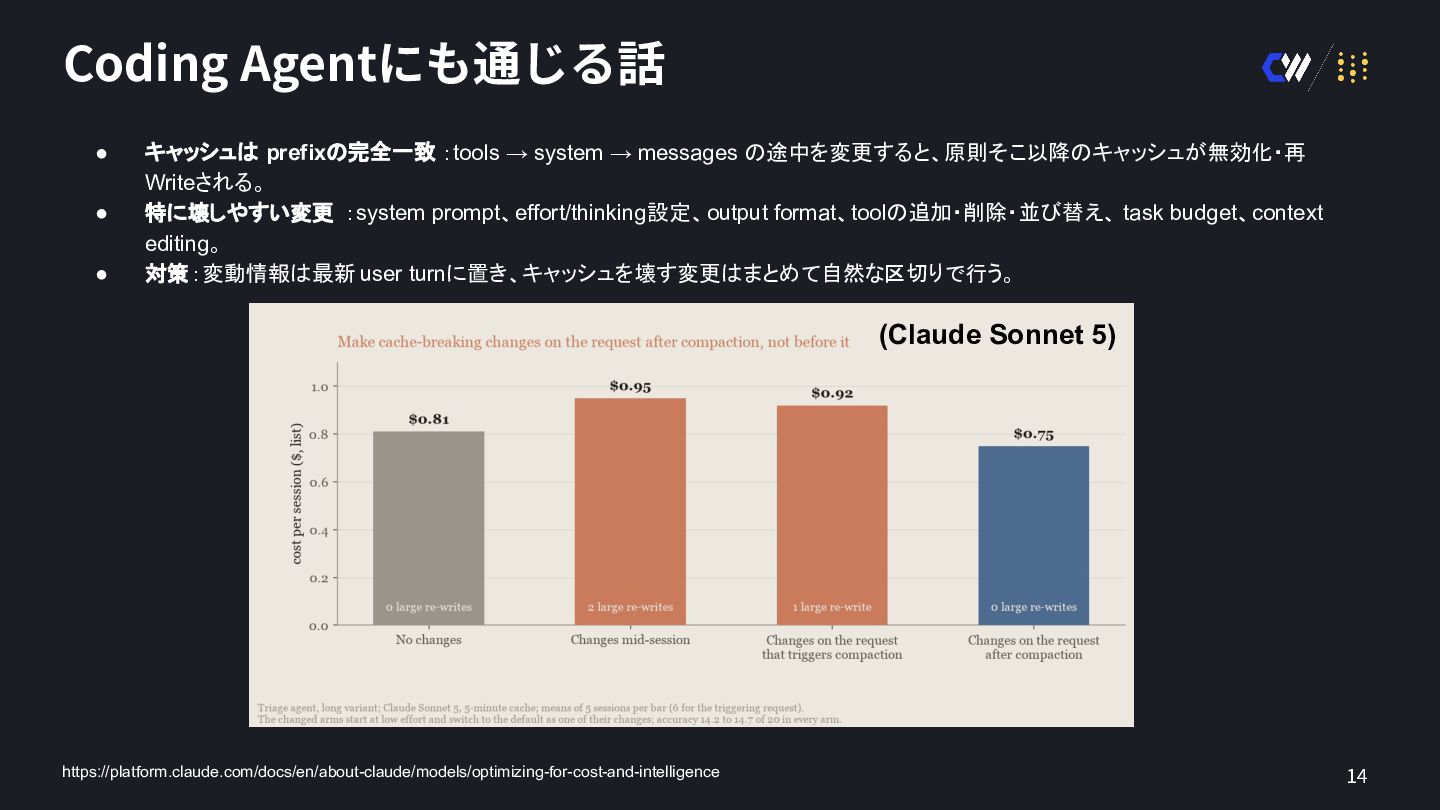
  10. Coding Agentにも通じる話 • • • キャッシュは prefixの完全一致 :tools → system

    → messages の途中を変更すると、原則そこ以降のキャッシュが無効化・再 Writeされる。 特に壊しやすい変更 :system prompt、effort/thinking設定、output format、toolの追加・削除・並び替え、 task budget、context editing。 対策 :変動情報は最新 user turnに置き、キャッシュを壊す変更はまとめて自然な区切りで行う。 (Claude Sonnet 5) https://platform.claude.com/docs/en/about-claude/models/optimizing-for-cost-and-intelligence 14
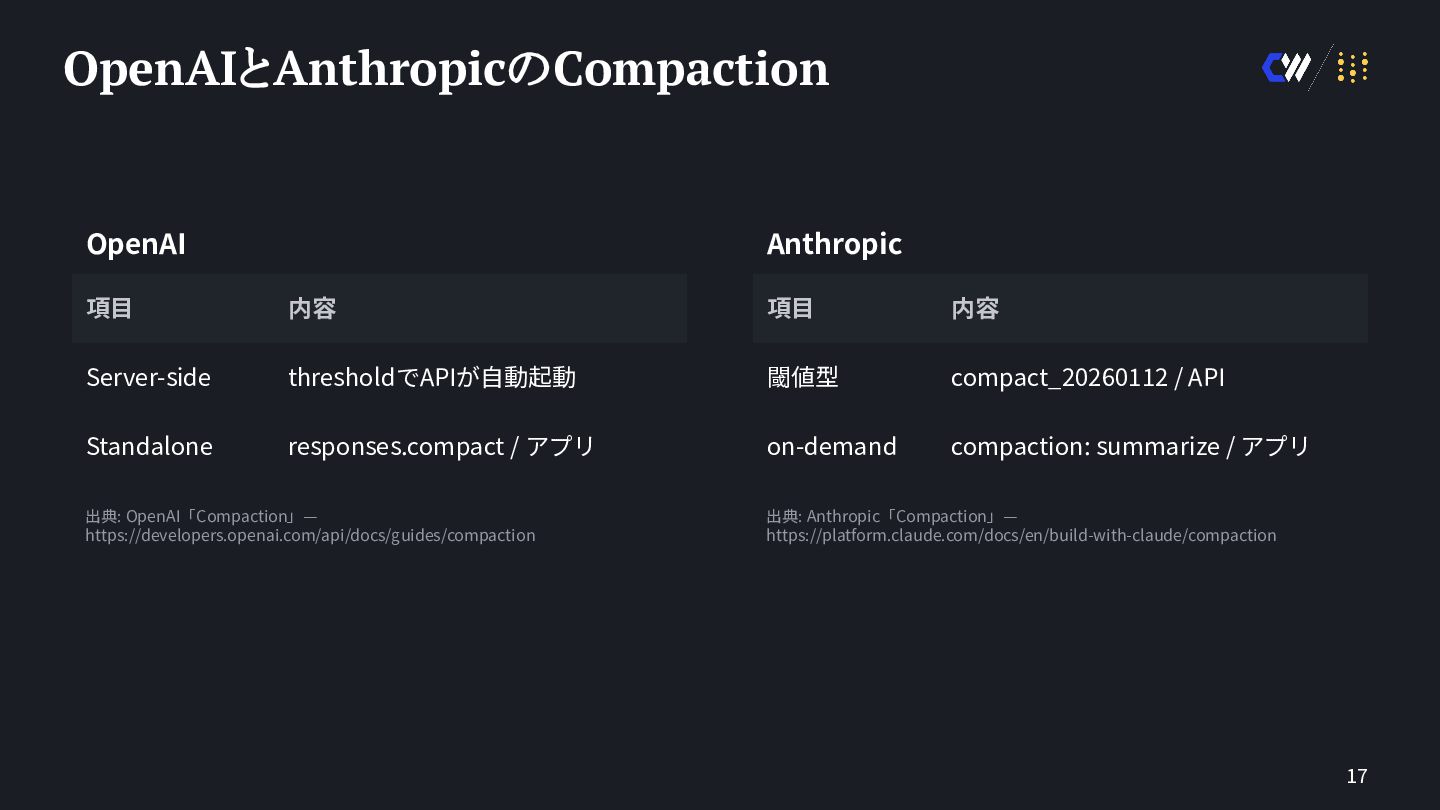
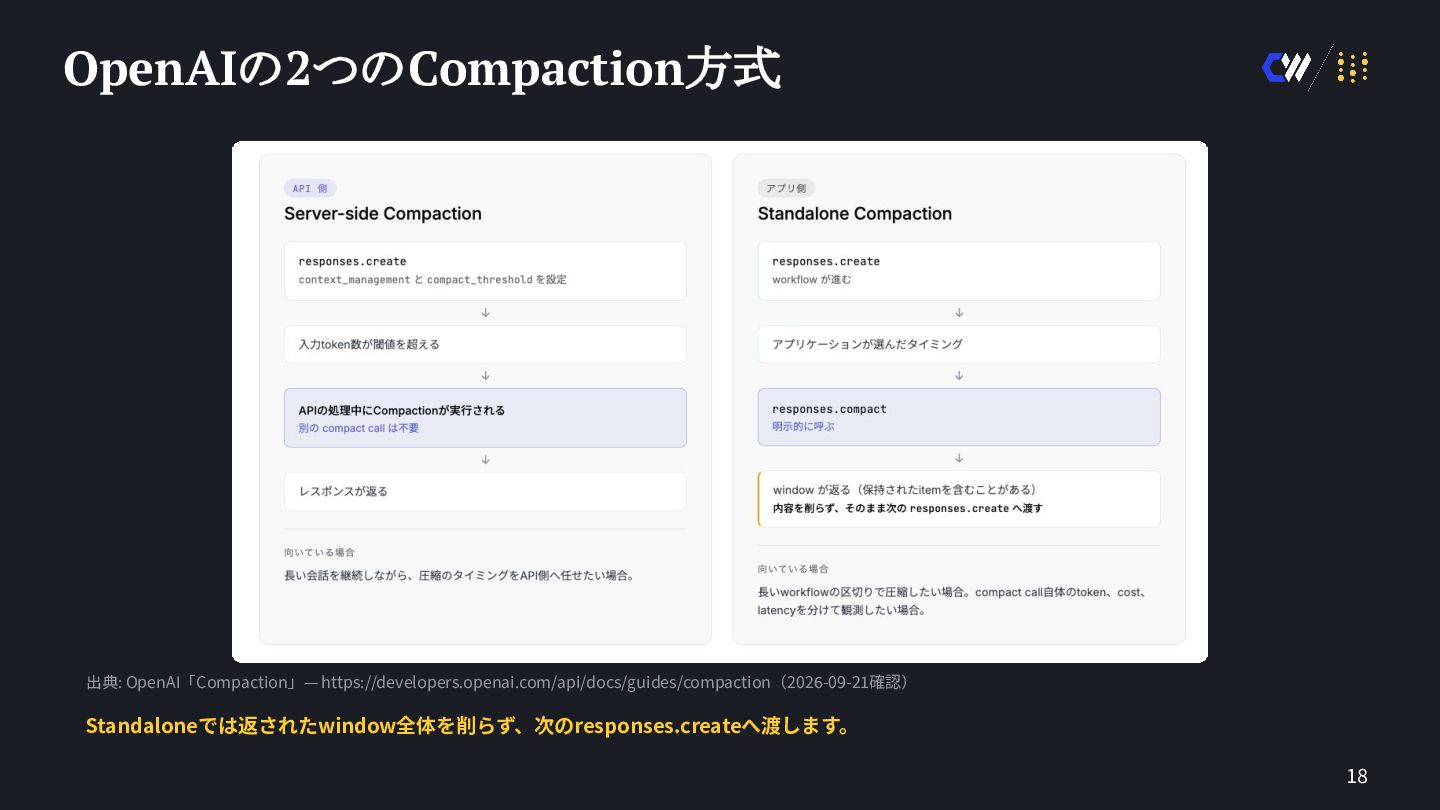
  11. OpenAIとAnthropicのCompaction OpenAI Anthropic 項⽬ 内容 項⽬ 内容 Server-side thresholdでAPIが⾃動起動 閾値型

    compact_20260112 / API Standalone responses.compact / アプリ on-demand compaction: summarize / アプリ 出典: OpenAI「Compaction」— https://developers.openai.com/api/docs/guides/compaction 出典: Anthropic「Compaction」— https://platform.claude.com/docs/en/build-with-claude/compaction 17
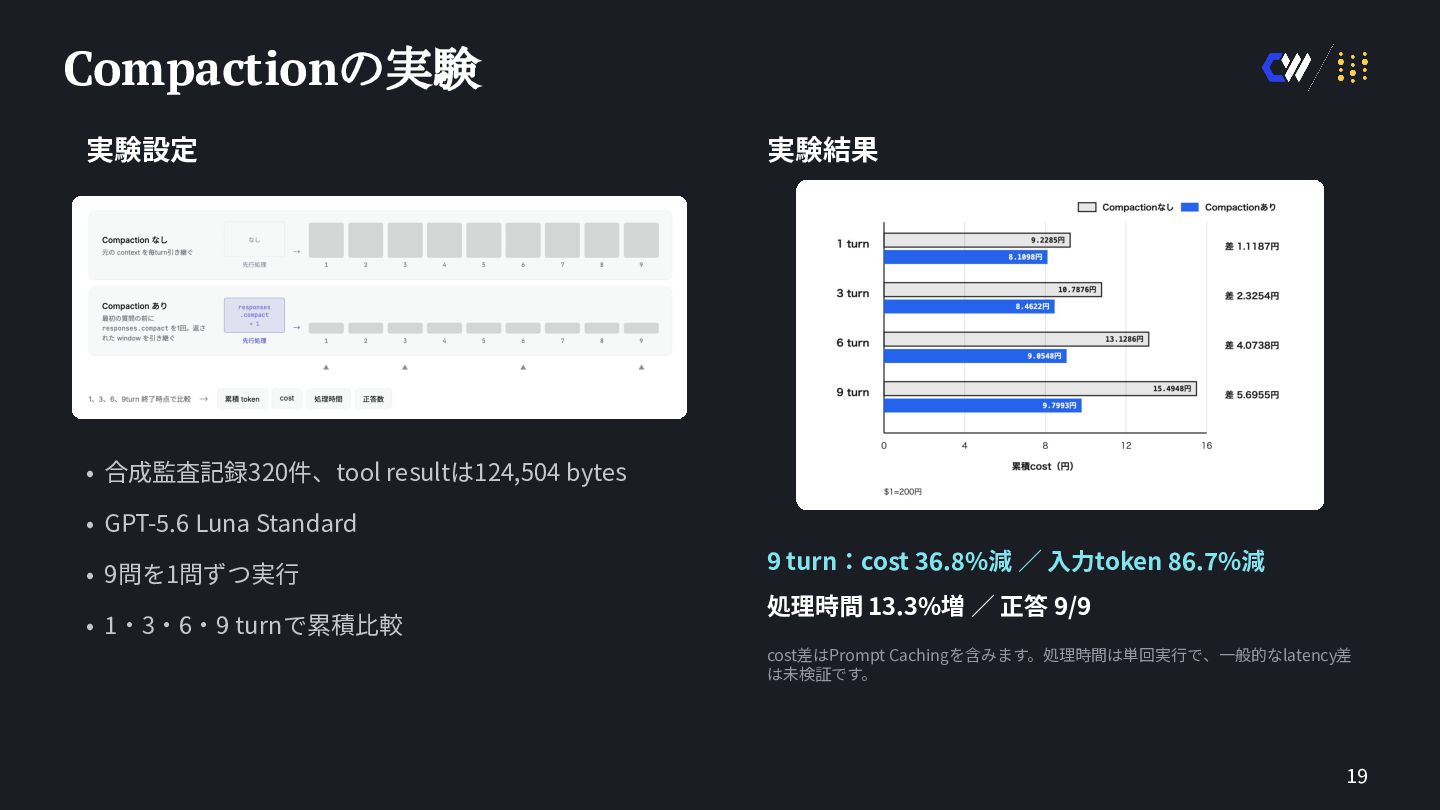
  12. Compactionの実験 実験設定 実験結果 • 合成監査記録320件、tool resultは124,504 bytes • GPT-5.6 Luna

    Standard • 9問を1問ずつ実⾏ • 1‧3‧6‧9 turnで累積⽐較 9 turn:cost 36.8%減 ∕ ⼊⼒token 86.7%減 処理時間 13.3%増 ∕ 正答 9/9 cost差はPrompt Cachingを含みます。処理時間は単回実⾏で、⼀般的なlatency差 は未検証です。 19
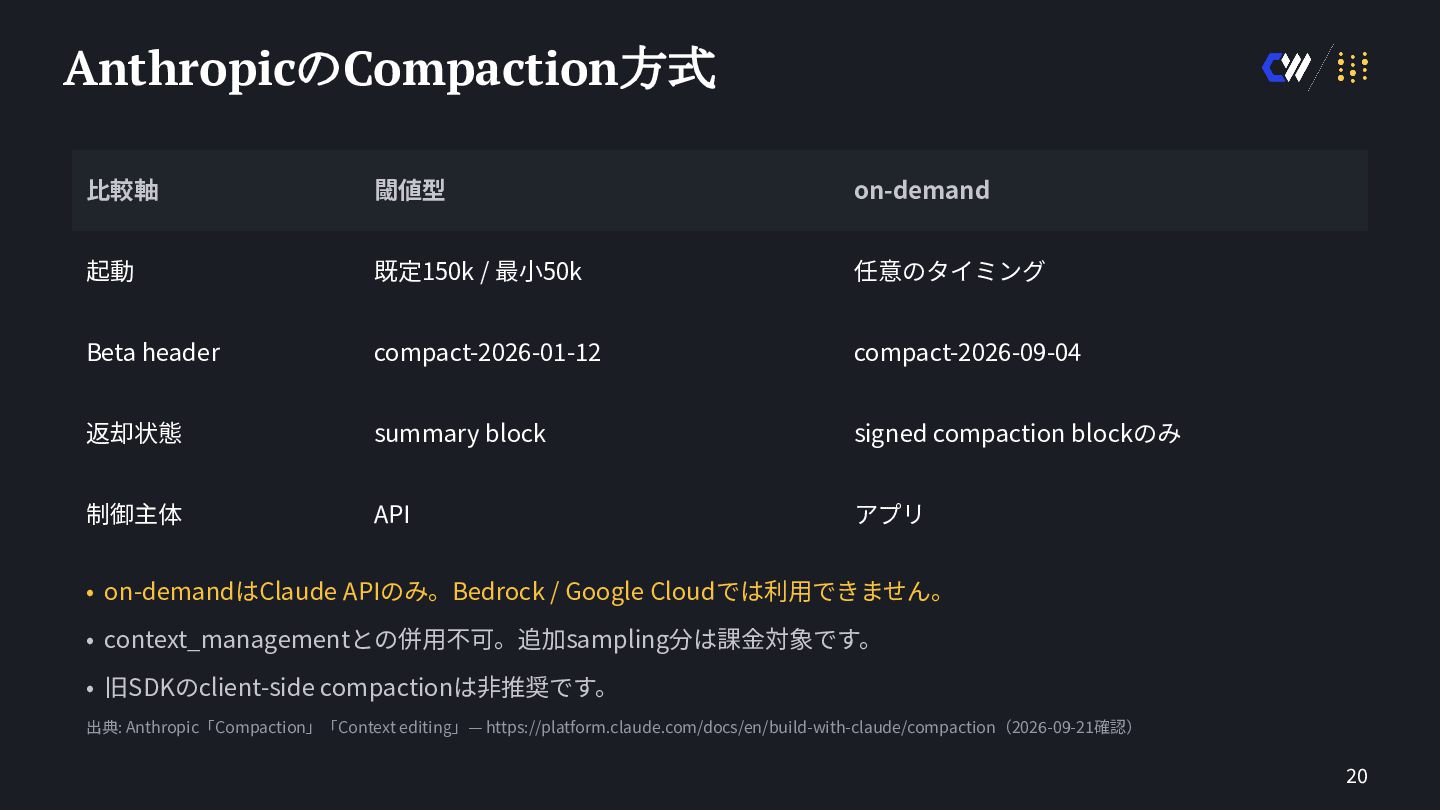
  13. AnthropicのCompaction方式 ⽐較軸 閾値型 on-demand 起動 既定150k / 最⼩50k 任意のタイミング Beta

    header compact-2026-01-12 compact-2026-09-04 返却状態 summary block signed compaction blockのみ 制御主体 API アプリ • on-demandはClaude APIのみ。Bedrock / Google Cloudでは利⽤できません。 • context_managementとの併⽤不可。追加sampling分は課⾦対象です。 • 旧SDKのclient-side compactionは⾮推奨です。 出典: Anthropic「Compaction」「Context editing」— https://platform.claude.com/docs/en/build-with-claude/compaction(2026-09-21確認) 20
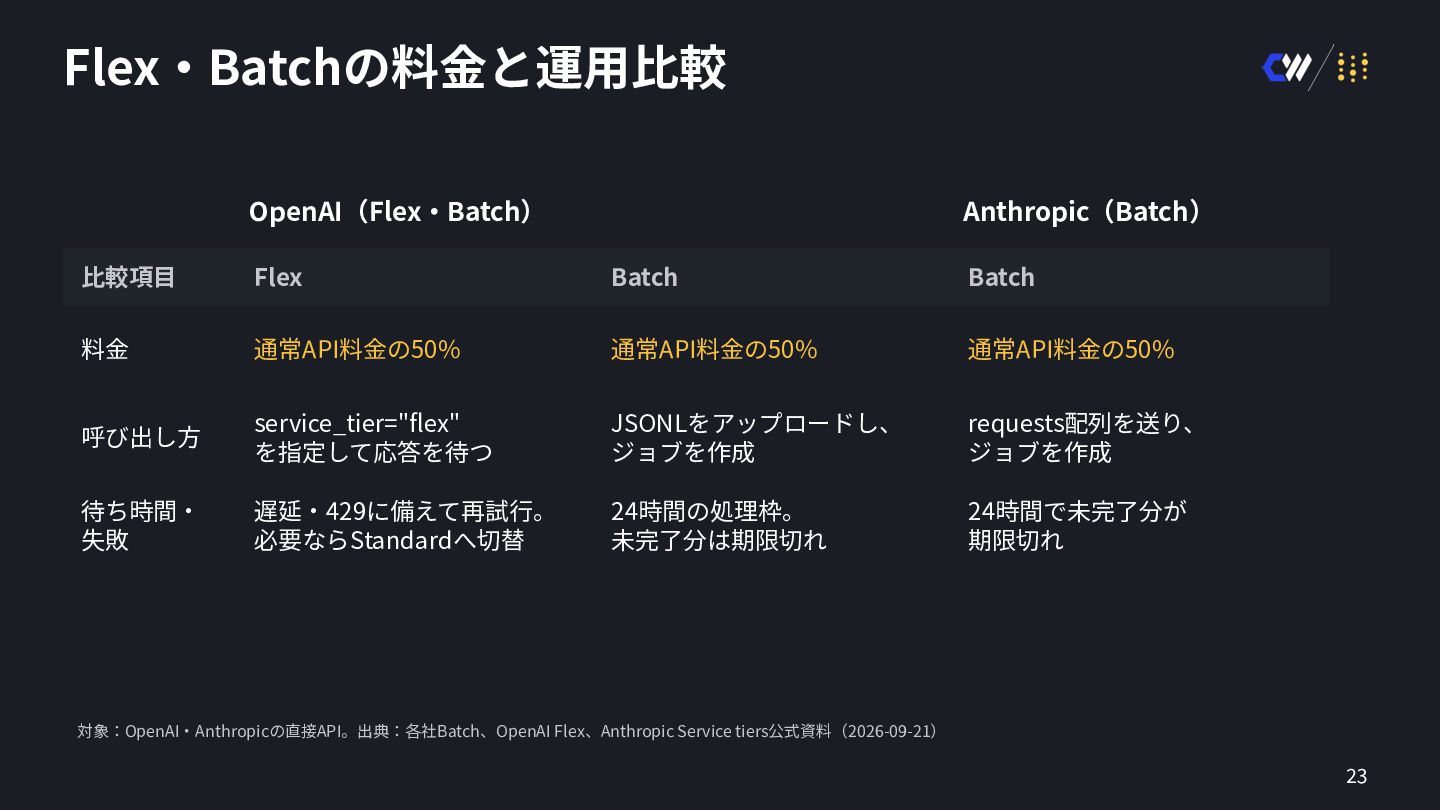
  14. Flex‧Batchの料⾦と運⽤⽐較 OpenAI(Flex‧Batch) Anthropic(Batch) ⽐較項⽬ Flex Batch Batch 料⾦ 通常API料⾦の50% 通常API料⾦の50%

    通常API料⾦の50% 呼び出し⽅ service_tier="flex" を指定して応答を待つ JSONLをアップロードし、 ジョブを作成 requests配列を送り、 ジョブを作成 待ち時間‧ 失敗 遅延‧429に備えて再試⾏。 必要ならStandardへ切替 24時間の処理枠。 未完了分は期限切れ 24時間で未完了分が 期限切れ 対象:OpenAI‧Anthropicの直接API。出典:各社Batch、OpenAI Flex、Anthropic Service tiers公式資料(2026-09-21) 23
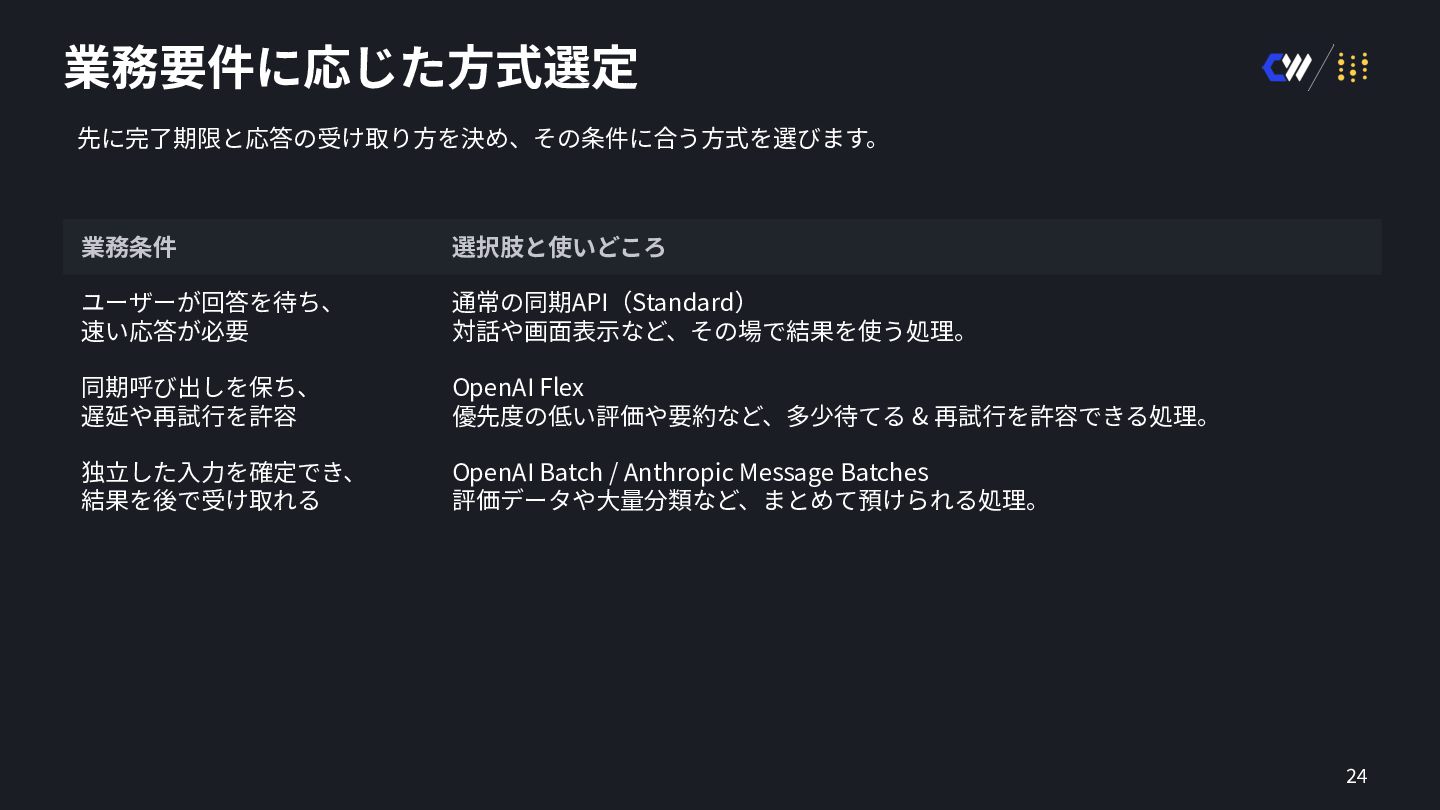
  15. 業務要件に応じた⽅式選定 先に完了期限と応答の受け取り⽅を決め、その条件に合う⽅式を選びます。 業務条件 選択肢と使いどころ ユーザーが回答を待ち、 速い応答が必要 通常の同期API(Standard) 対話や画⾯表⽰など、その場で結果を使う処理。 同期呼び出しを保ち、 遅延や再試⾏を許容

    OpenAI Flex 優先度の低い評価や要約など、多少待てる & 再試⾏を許容できる処理。 独⽴した⼊⼒を確定でき、 結果を後で受け取れる OpenAI Batch / Anthropic Message Batches 評価データや⼤量分類など、まとめて預けられる処理。 24
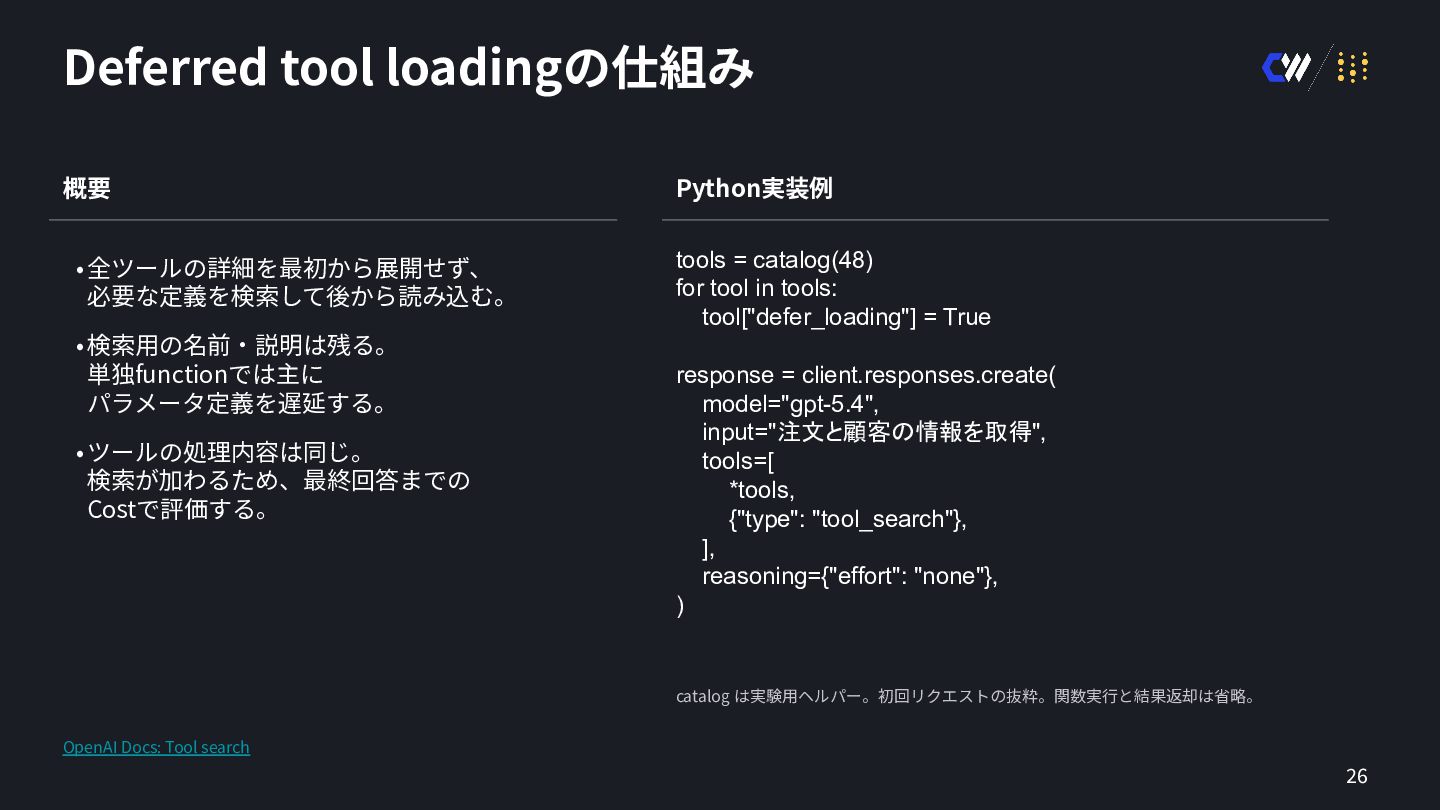
  16. Deferred tool loadingの仕組み 概要 Python実装例 •全ツールの詳細を最初から展開せず、 必要な定義を検索して後から読み込む。 tools = catalog(48)

    for tool in tools: tool["defer_loading"] = True •検索⽤の名前‧説明は残る。 単独functionでは主に パラメータ定義を遅延する。 •ツールの処理内容は同じ。 検索が加わるため、最終回答までの Costで評価する。 response = client.responses.create( model="gpt-5.4", input="注文と顧客の情報を取得", tools=[ *tools, {"type": "tool_search"}, ], reasoning={"effort": "none"}, ) catalog は実験⽤ヘルパー。初回リクエストの抜粋。関数実⾏と結果返却は省略。 OpenAI Docs: Tool search 26
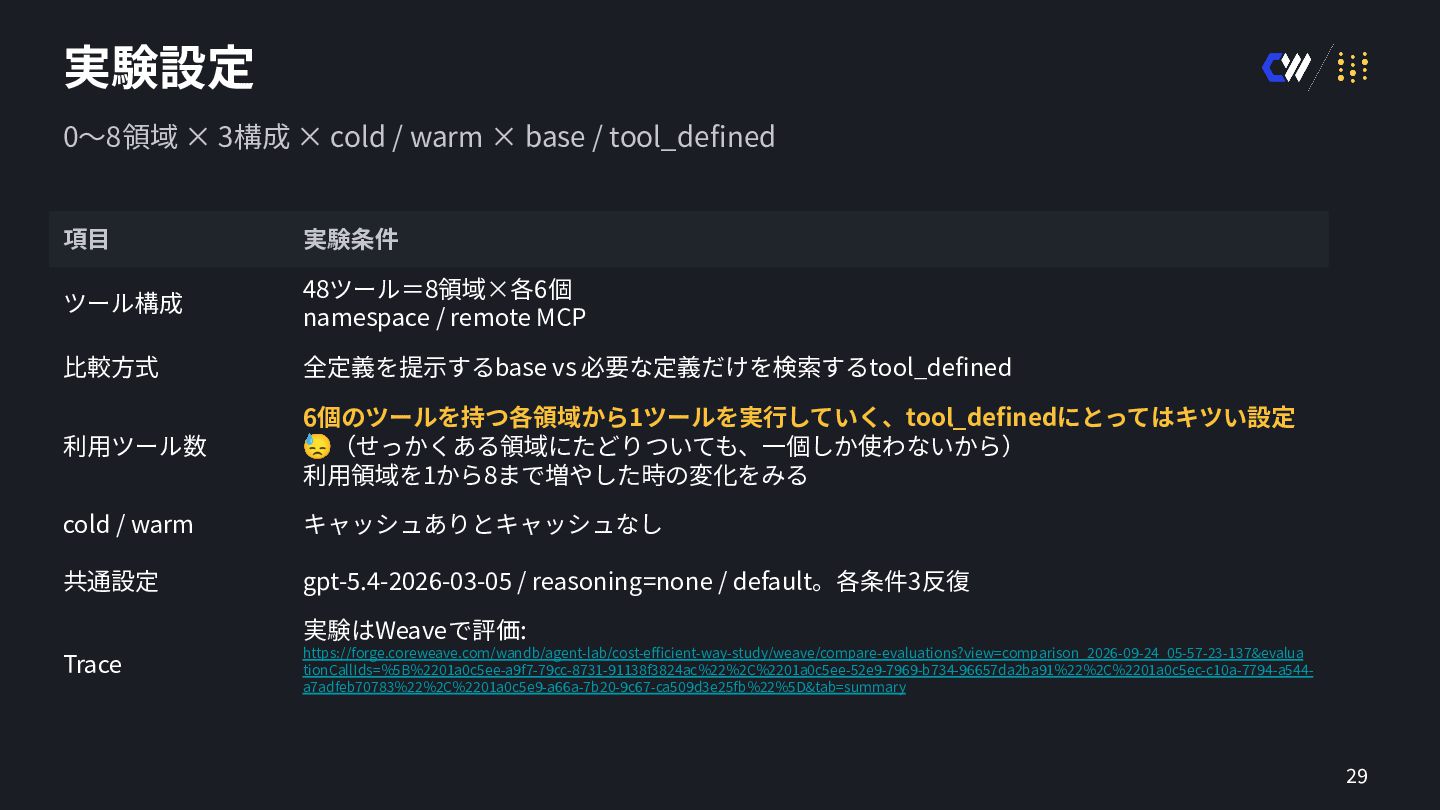
  17. 実験設定 0〜8領域 × 3構成 × cold / warm × base

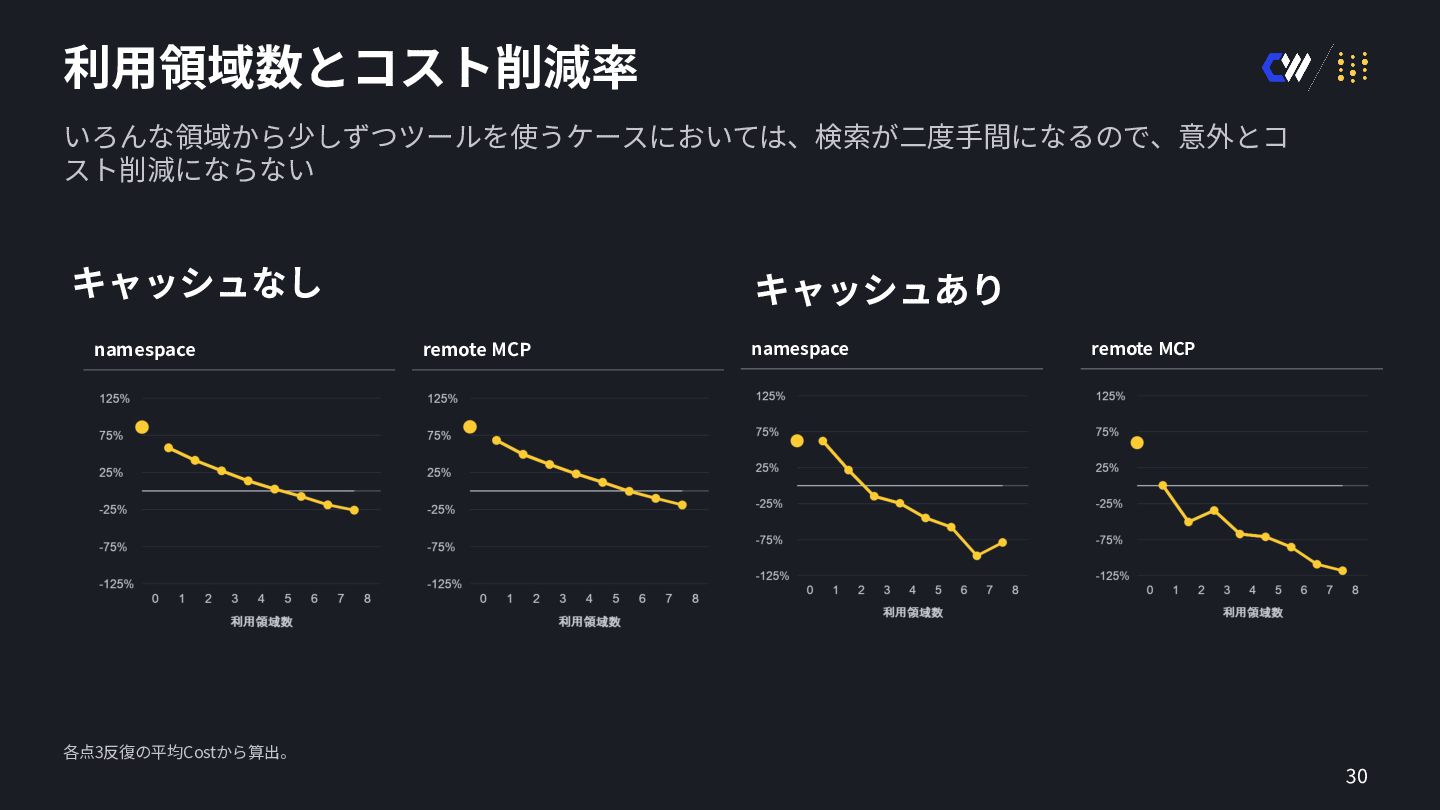
    / tool_defined 項⽬ 実験条件 ツール構成 48ツール=8領域×各6個 namespace / remote MCP ⽐較⽅式 全定義を提⽰するbase vs 必要な定義だけを検索するtool_defined 利⽤ツール数 6個のツールを持つ各領域から1ツールを実⾏していく、tool_definedにとってはキツい設定 😓(せっかくある領域にたどりついても、⼀個しか使わないから) 利⽤領域を1から8まで増やした時の変化をみる cold / warm キャッシュありとキャッシュなし 共通設定 gpt-5.4-2026-03-05 / reasoning=none / default。各条件3反復 実験はWeaveで評価: Trace https://forge.coreweave.com/wandb/agent-lab/cost-efficient-way-study/weave/compare-evaluations?view=comparison_2026-09-24_05-57-23-137&evalua tionCallIds=%5B%2201a0c5ee-a9f7-79cc-8731-91138f3824ac%22%2C%2201a0c5ee-52e9-7969-b734-96657da2ba91%22%2C%2201a0c5ec-c10a-7794-a544a7adfeb70783%22%2C%2201a0c5e9-a66a-7b20-9c67-ca509d3e25fb%22%5D&tab=summary 29
  18. Part 1 - Agenda • • • APIの仕組みをまずは理解する ◦ Prompt

    Cashing ◦ Compaction ◦ Batch ◦ Differed Tool Calling コスト最適化のフロー (全体感) + Weaveで精度とコストのバランスを探る例 おまけ: Jev 31
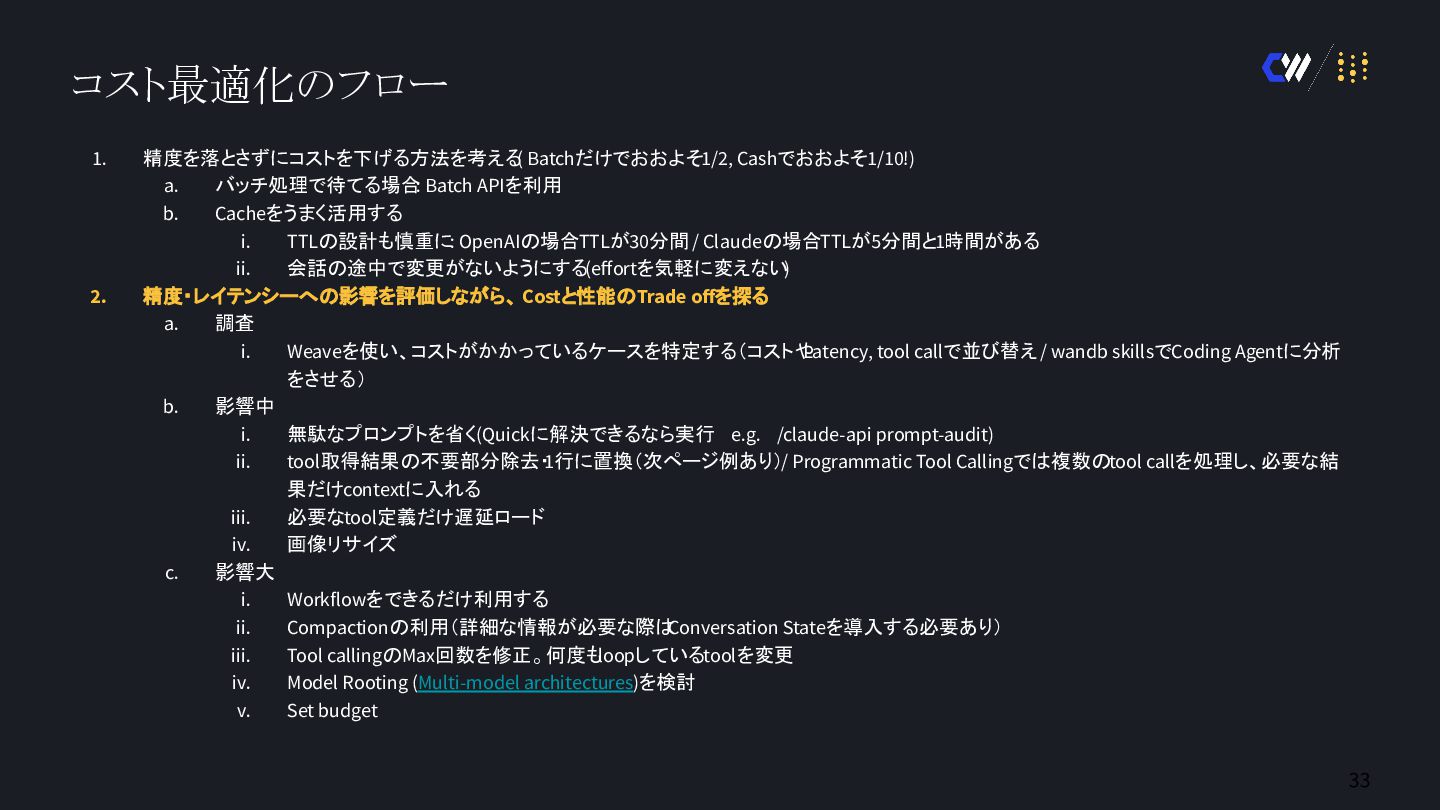
  19. コスト最適化のフロー 1. 2. 精度を落とさずにコストを下げる方法を考える( Batchだけでおおよそ1/2, Cashでおおよそ1/10!) a. バッチ処理で待てる場合: Batch APIを利用

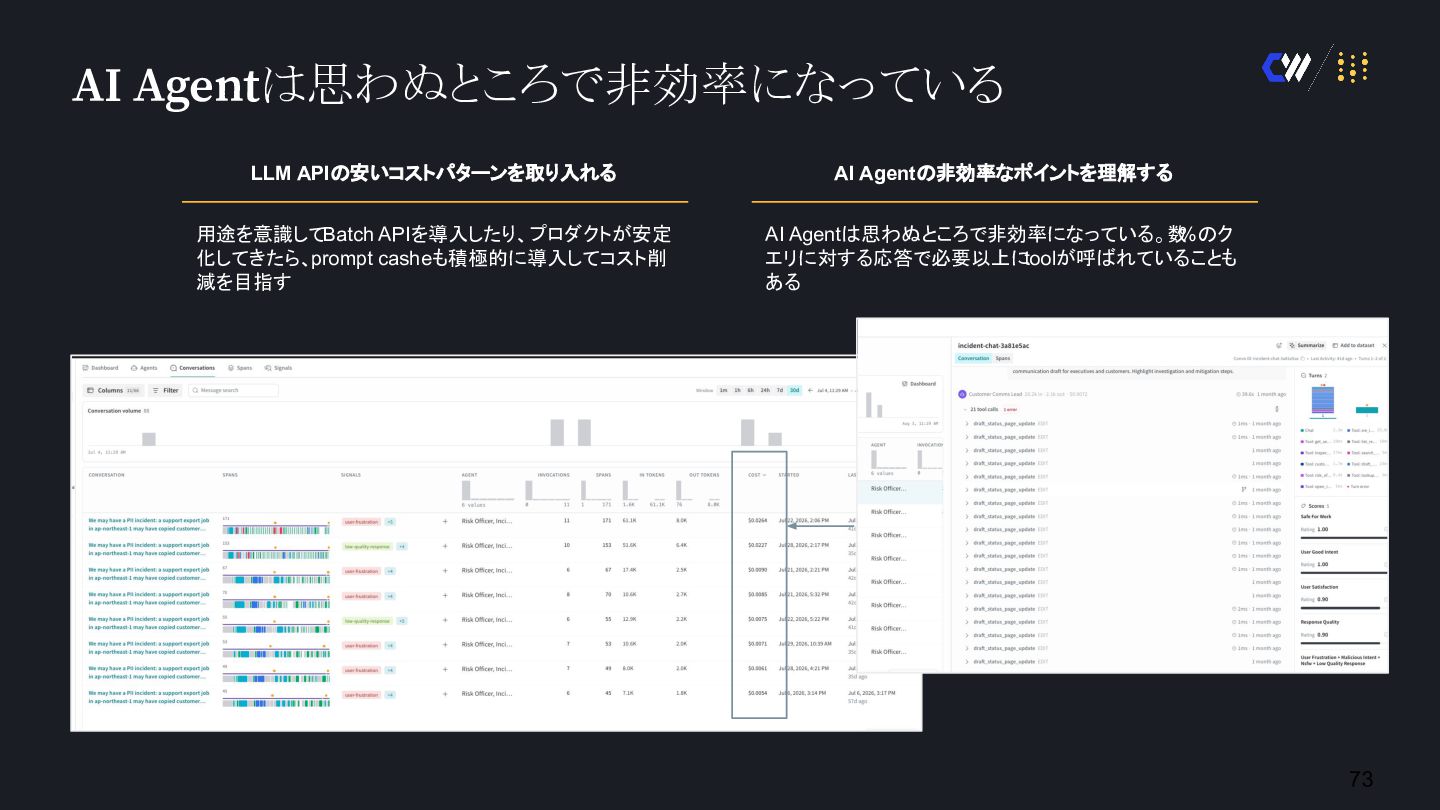
    b. Cacheをうまく活用する i. TTLの設計も慎重に: OpenAIの場合TTLが30分間 / Claudeの場合TTLが5分間と1時間がある ii. 会話の途中で変更がないようにする(effortを気軽に変えない) 精度・レイテンシーへの影響を評価しながら、 Costと性能のTrade offを探る a. 調査 i. Weaveを使い、コストがかかっているケースを特定する(コストや Latency, tool callで並び替え / wandb skillsでCoding Agentに分析 をさせる) b. 影響中 i. 無駄なプロンプトを省く(Quickに解決できるなら実行 e.g. /claude-api prompt-audit) ii. tool取得結果の不要部分除去・1行に置換(次ページ例あり)/ Programmatic Tool Callingでは複数のtool callを処理し、必要な結 果だけcontextに入れる iii. 必要なtool定義だけ遅延ロード iv. 画像リサイズ c. 影響大 i. Workflowをできるだけ利用する ii. Compactionの利用(詳細な情報が必要な際はConversation Stateを導入する必要あり) iii. Tool callingのMax回数を修正。何度もloopしているtoolを変更 iv. Model Rooting (Multi-model architectures)を検討 v. Set budget 33
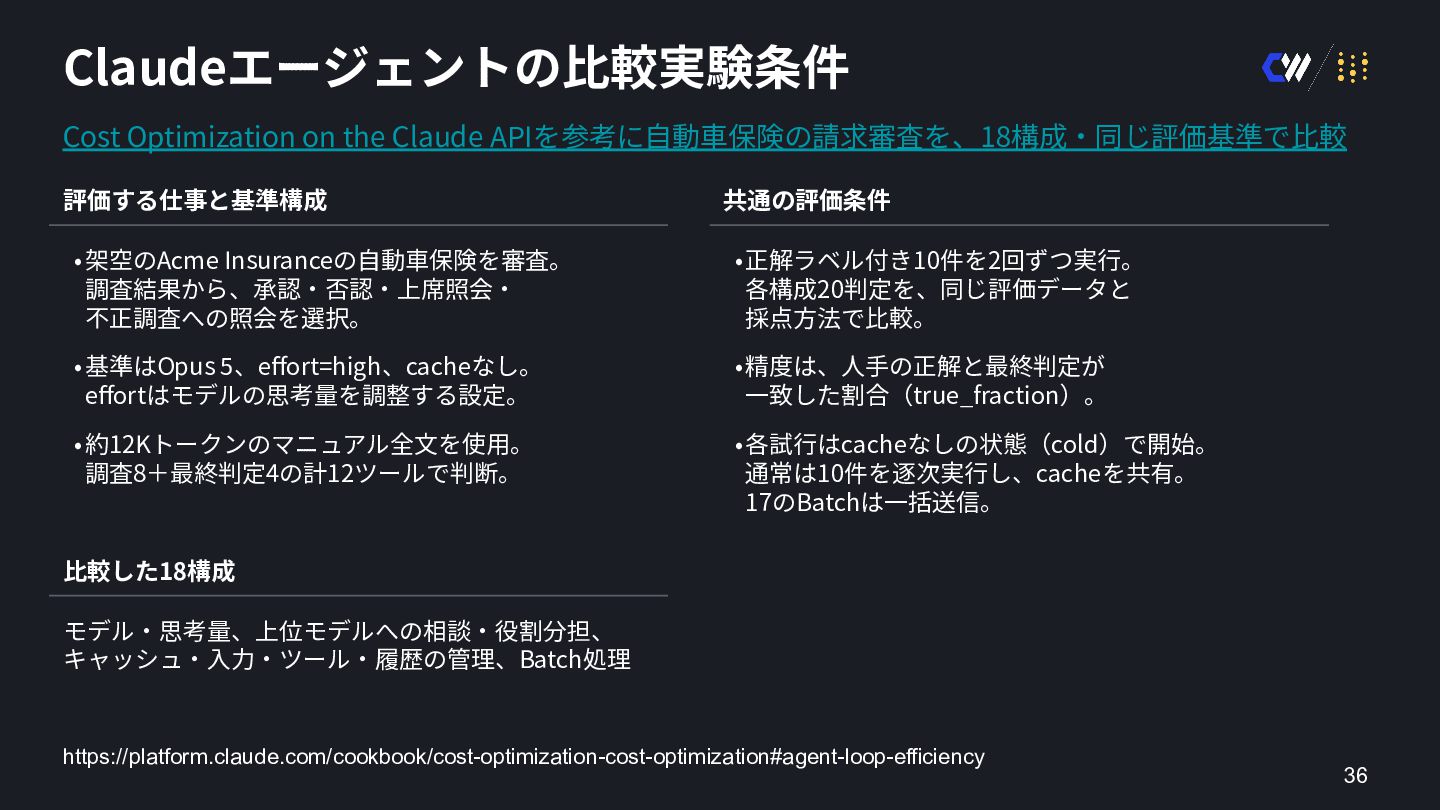
  20. Claudeエージェントの⽐較実験条件 Cost Optimization on the Claude APIを参考に⾃動⾞保険の請求審査を、18構成‧同じ評価基準で⽐較 評価する仕事と基準構成 共通の評価条件 •架空のAcme

    Insuranceの⾃動⾞保険を審査。 調査結果から、承認‧否認‧上席照会‧ 不正調査への照会を選択。 •正解ラベル付き10件を2回ずつ実⾏。 各構成20判定を、同じ評価データと 採点⽅法で⽐較。 •基準はOpus 5、effort=high、cacheなし。 effortはモデルの思考量を調整する設定。 •精度は、⼈⼿の正解と最終判定が ⼀致した割合(true_fraction)。 •約12Kトークンのマニュアル全⽂を使⽤。 調査8+最終判定4の計12ツールで判断。 •各試⾏はcacheなしの状態(cold)で開始。 通常は10件を逐次実⾏し、cacheを共有。 17のBatchは⼀括送信。 ⽐較した18構成 モデル‧思考量、上位モデルへの相談‧役割分担、 キャッシュ‧⼊⼒‧ツール‧履歴の管理、Batch処理 https://platform.claude.com/cookbook/cost-optimization-cost-optimization#agent-loop-efficiency 36
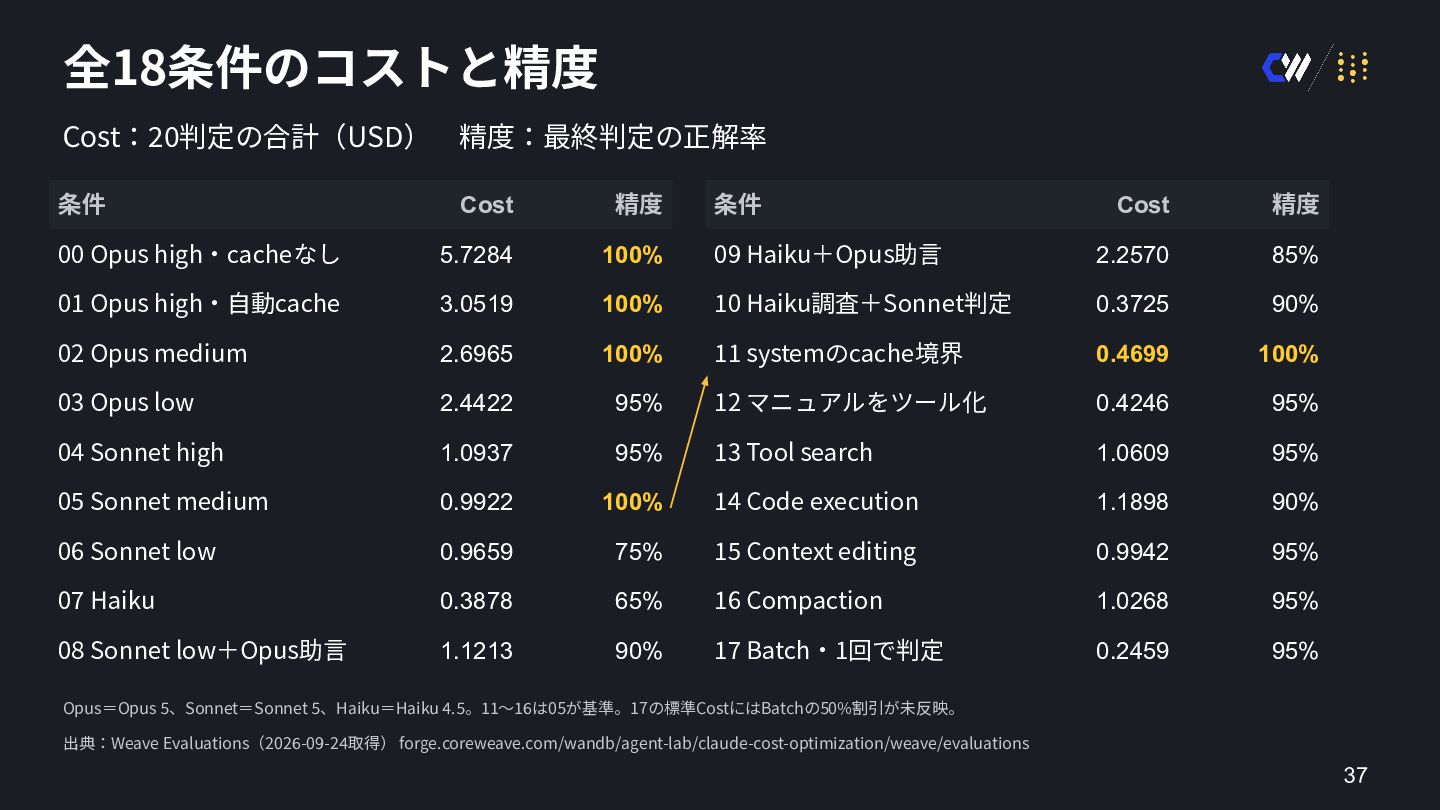
  21. 全18条件のコストと精度 Cost:20判定の合計(USD) 精度:最終判定の正解率 条件 Cost 精度 条件 00 Opus high‧cacheなし

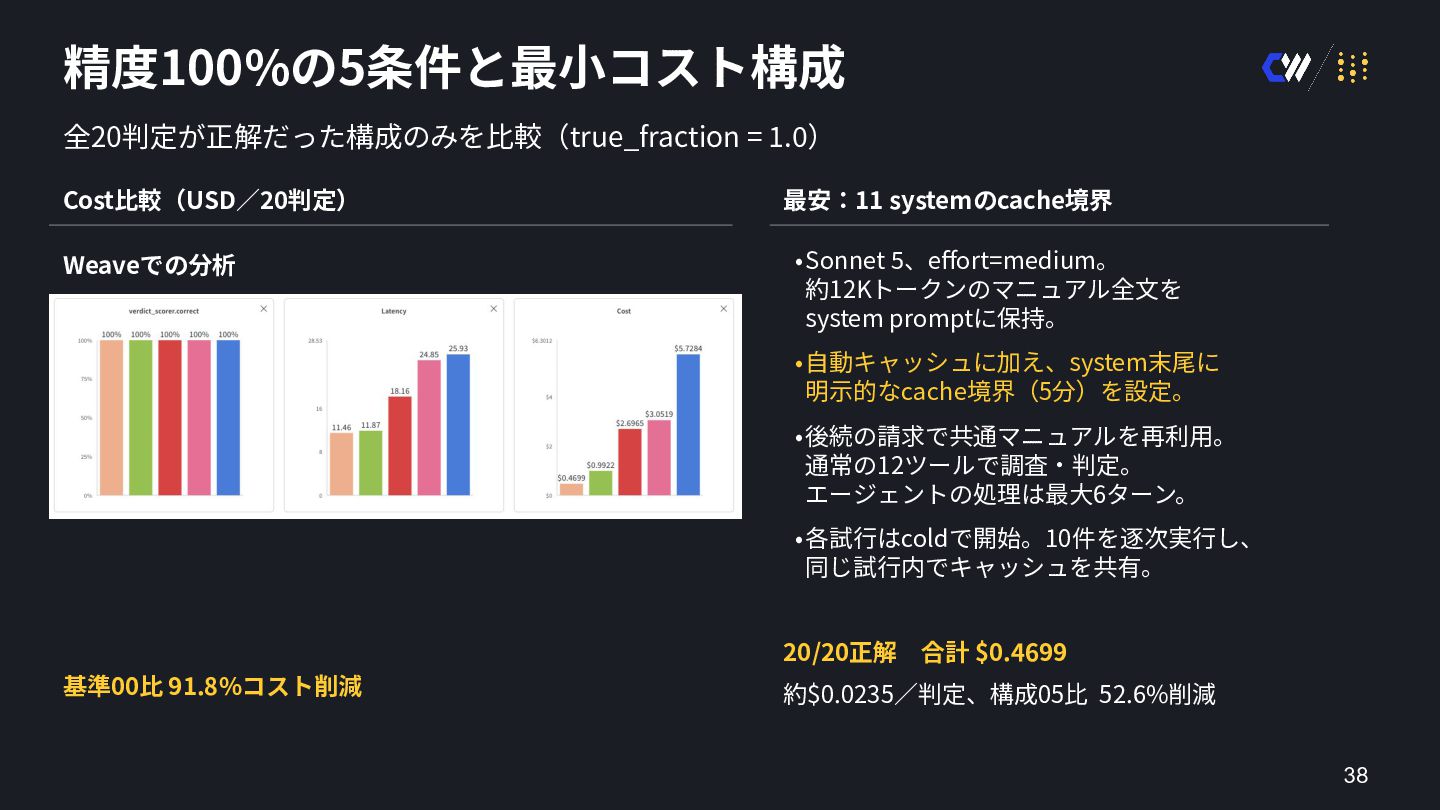
    5.7284 100% 01 Opus high‧⾃動cache 3.0519 02 Opus medium Cost 精度 09 Haiku+Opus助⾔ 2.2570 85% 100% 10 Haiku調査+Sonnet判定 0.3725 90% 2.6965 100% 11 systemのcache境界 0.4699 100% 03 Opus low 2.4422 95% 12 マニュアルをツール化 0.4246 95% 04 Sonnet high 1.0937 95% 13 Tool search 1.0609 95% 05 Sonnet medium 0.9922 100% 14 Code execution 1.1898 90% 06 Sonnet low 0.9659 75% 15 Context editing 0.9942 95% 07 Haiku 0.3878 65% 16 Compaction 1.0268 95% 08 Sonnet low+Opus助⾔ 1.1213 90% 17 Batch‧1回で判定 0.2459 95% Opus=Opus 5、Sonnet=Sonnet 5、Haiku=Haiku 4.5。11〜16は05が基準。17の標準CostにはBatchの50%割引が未反映。 出典:Weave Evaluations(2026-09-24取得) forge.coreweave.com/wandb/agent-lab/claude-cost-optimization/weave/evaluations 37
  22. 精度100%の5条件と最⼩コスト構成 全20判定が正解だった構成のみを⽐較(true_fraction = 1.0) Cost⽐較(USD∕20判定) 最安:11 systemのcache境界 Weaveでの分析 •Sonnet 5、effort=medium。

    約12Kトークンのマニュアル全⽂を system promptに保持。 •⾃動キャッシュに加え、system末尾に 明⽰的なcache境界(5分)を設定。 •後続の請求で共通マニュアルを再利⽤。 通常の12ツールで調査‧判定。 エージェントの処理は最⼤6ターン。 •各試⾏はcoldで開始。10件を逐次実⾏し、 同じ試⾏内でキャッシュを共有。 20/20正解 基準00⽐ 91.8%コスト削減 合計 $0.4699 約$0.0235∕判定、構成05⽐ 52.6%削減 38
  23. Part 1 - Agenda • • • APIの仕組みをまずは理解する ◦ Prompt

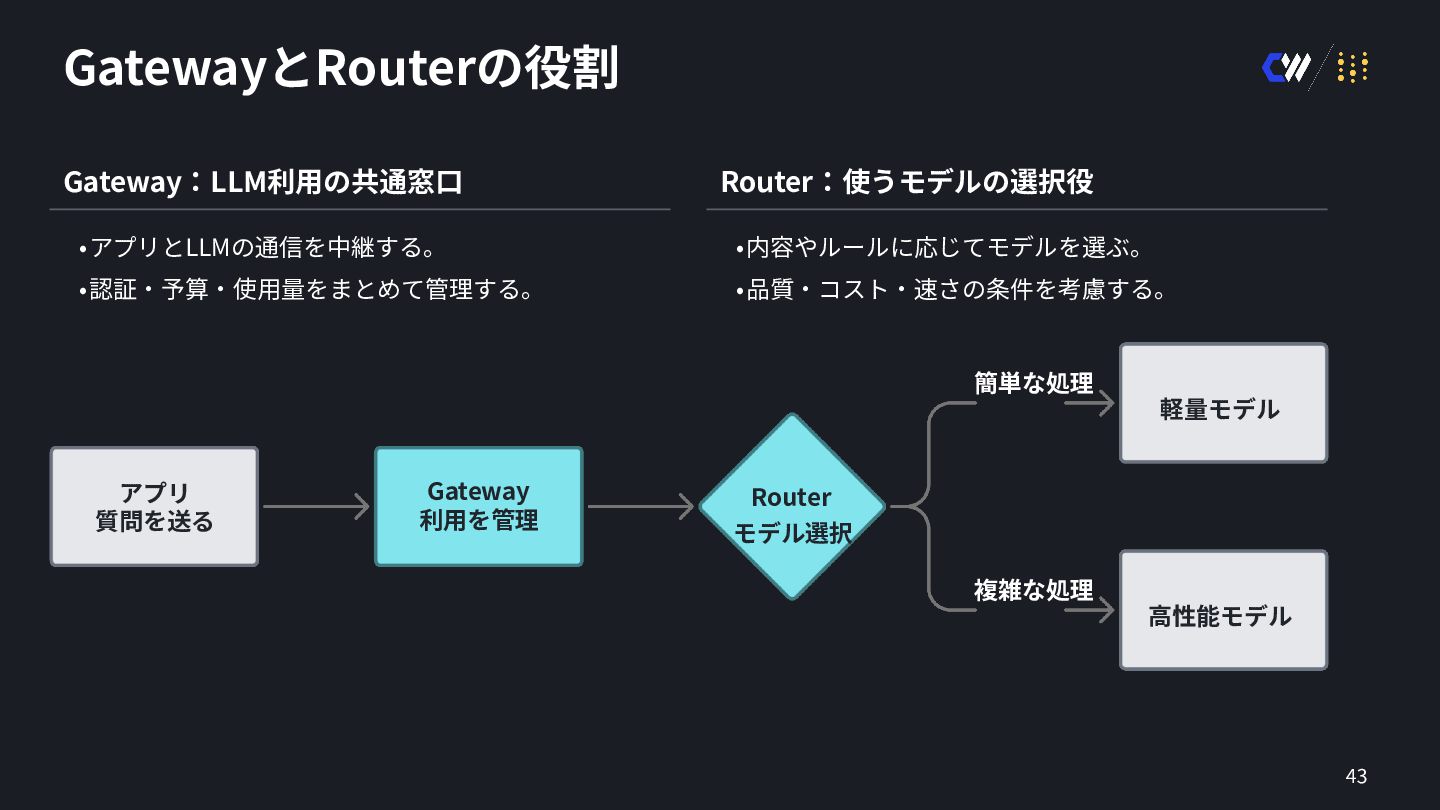
    Cashing ◦ Compaction ◦ Batch ◦ Differed Tool Calling コスト最適化のフロー (全体感) + Weaveで精度とコストのバランスを探る例 おまけ: Model Routing ◦ AI Agent呼び出しで Model routingする話は前述 (link) ◦ 組織で様々な用途で利用する LLMのRoutingの話(ここから) 40
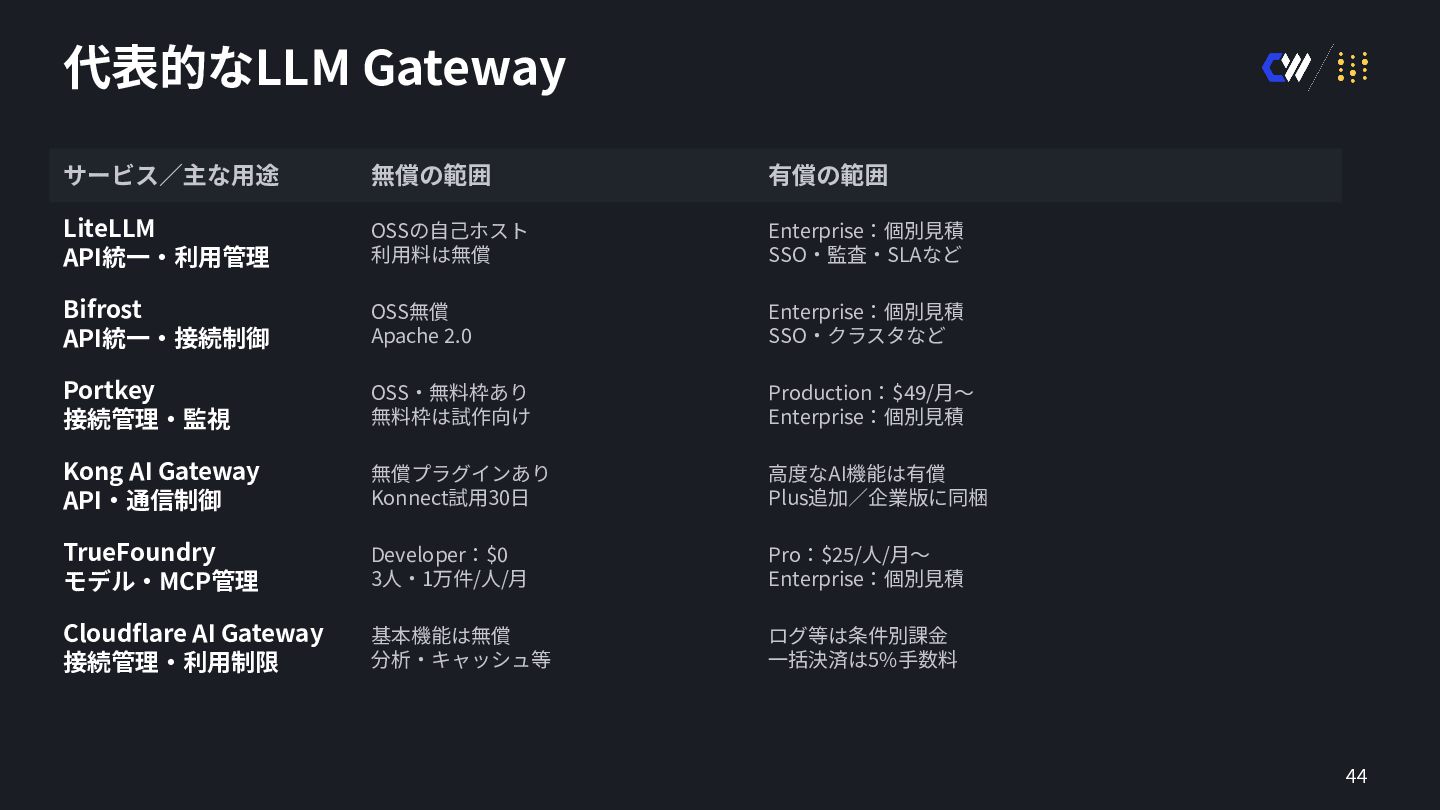
  24. 代表的なLLM Gateway サービス∕主な⽤途 無償の範囲 有償の範囲 LiteLLM API統⼀‧利⽤管理 OSSの⾃⼰ホスト 利⽤料は無償 Enterprise:個別⾒積

    SSO‧監査‧SLAなど Bifrost API統⼀‧接続制御 OSS無償 Apache 2.0 Enterprise:個別⾒積 SSO‧クラスタなど Portkey 接続管理‧監視 OSS‧無料枠あり 無料枠は試作向け Production:$49/⽉〜 Enterprise:個別⾒積 Kong AI Gateway API‧通信制御 無償プラグインあり Konnect試⽤30⽇ ⾼度なAI機能は有償 Plus追加∕企業版に同梱 TrueFoundry モデル‧MCP管理 Developer:$0 3⼈‧1万件/⼈/⽉ Pro:$25/⼈/⽉〜 Enterprise:個別⾒積 Cloudflare AI Gateway 接続管理‧利⽤制限 基本機能は無償 分析‧キャッシュ等 ログ等は条件別課⾦ ⼀括決済は5%⼿数料 44
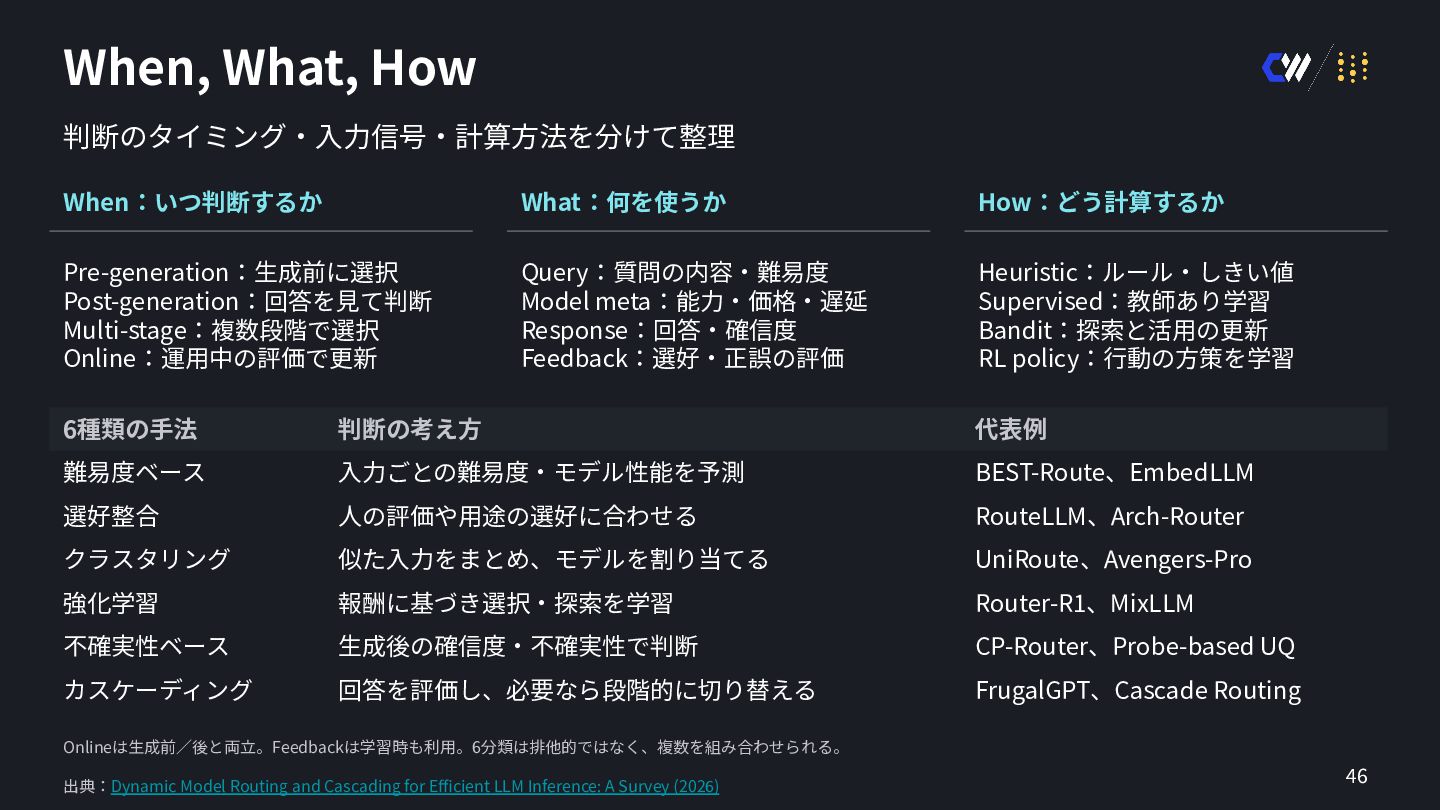
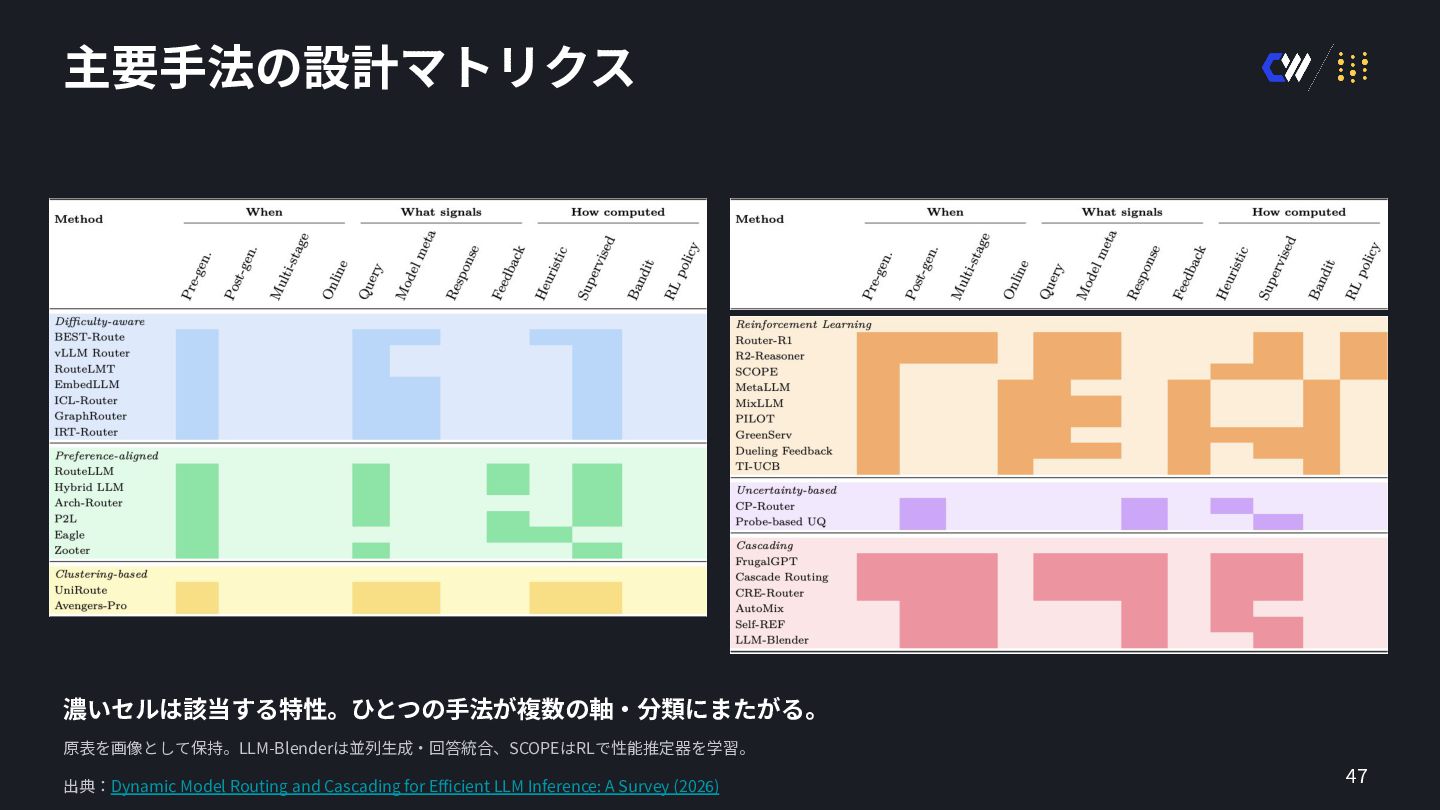
  25. When, What, How 判断のタイミング‧⼊⼒信号‧計算⽅法を分けて整理 When:いつ判断するか What:何を使うか How:どう計算するか Pre-generation:⽣成前に選択 Post-generation:回答を⾒て判断 Multi-stage:複数段階で選択

    Online:運⽤中の評価で更新 Query:質問の内容‧難易度 Model meta:能⼒‧価格‧遅延 Response:回答‧確信度 Feedback:選好‧正誤の評価 Heuristic:ルール‧しきい値 Supervised:教師あり学習 Bandit:探索と活⽤の更新 RL policy:⾏動の⽅策を学習 6種類の⼿法 判断の考え⽅ 代表例 難易度ベース ⼊⼒ごとの難易度‧モデル性能を予測 BEST-Route、EmbedLLM 選好整合 ⼈の評価や⽤途の選好に合わせる RouteLLM、Arch-Router クラスタリング 似た⼊⼒をまとめ、モデルを割り当てる UniRoute、Avengers-Pro 強化学習 報酬に基づき選択‧探索を学習 Router-R1、MixLLM 不確実性ベース ⽣成後の確信度‧不確実性で判断 CP-Router、Probe-based UQ カスケーディング 回答を評価し、必要なら段階的に切り替える FrugalGPT、Cascade Routing Onlineは⽣成前∕後と両⽴。Feedbackは学習時も利⽤。6分類は排他的ではなく、複数を組み合わせられる。 出典:Dynamic Model Routing and Cascading for Efficient LLM Inference: A Survey (2026) 46
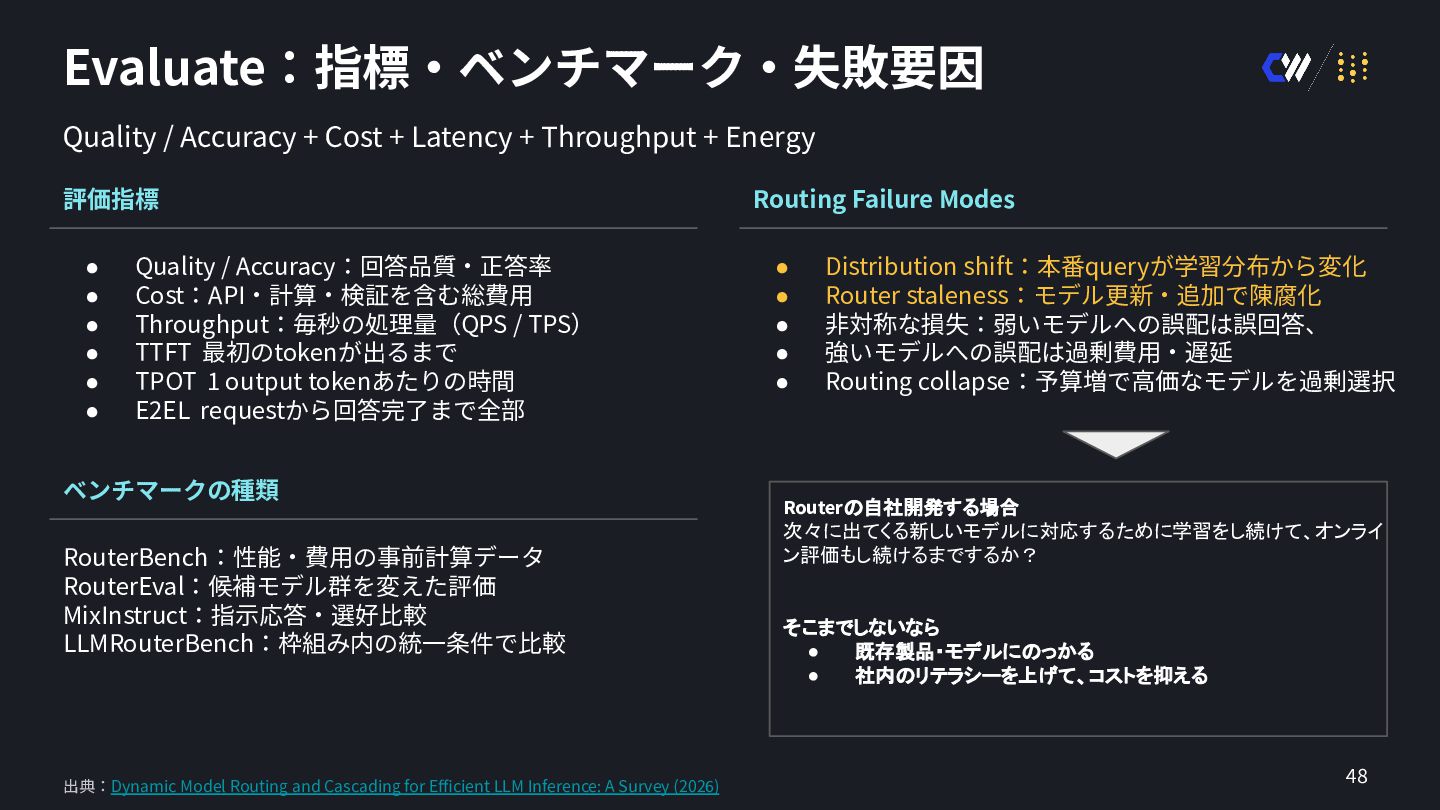
  26. Evaluate:指標‧ベンチマーク‧失敗要因 Quality / Accuracy + Cost + Latency + Throughput

    + Energy 評価指標 • • • • • • Quality / Accuracy:回答品質‧正答率 Cost:API‧計算‧検証を含む総費⽤ Throughput:毎秒の処理量(QPS / TPS) TTFT 最初のtokenが出るまで TPOT 1 output tokenあたりの時間 E2EL requestから回答完了まで全部 ベンチマークの種類 RouterBench:性能‧費⽤の事前計算データ RouterEval:候補モデル群を変えた評価 MixInstruct:指⽰応答‧選好⽐較 LLMRouterBench:枠組み内の統⼀条件で⽐較 出典:Dynamic Model Routing and Cascading for Efficient LLM Inference: A Survey (2026) Routing Failure Modes • • • • • Distribution shift:本番queryが学習分布から変化 Router staleness:モデル更新‧追加で陳腐化 ⾮対称な損失:弱いモデルへの誤配は誤回答、 強いモデルへの誤配は過剰費⽤‧遅延 Routing collapse:予算増で⾼価なモデルを過剰選択 Routerの自社開発する場合 次々に出てくる新しいモデルに対応するために学習をし続けて、オンライ ン評価もし続けるまでするか? そこまでしないなら • 既存製品・モデルにのっかる • 社内のリテラシーを上げて、コストを抑える 48
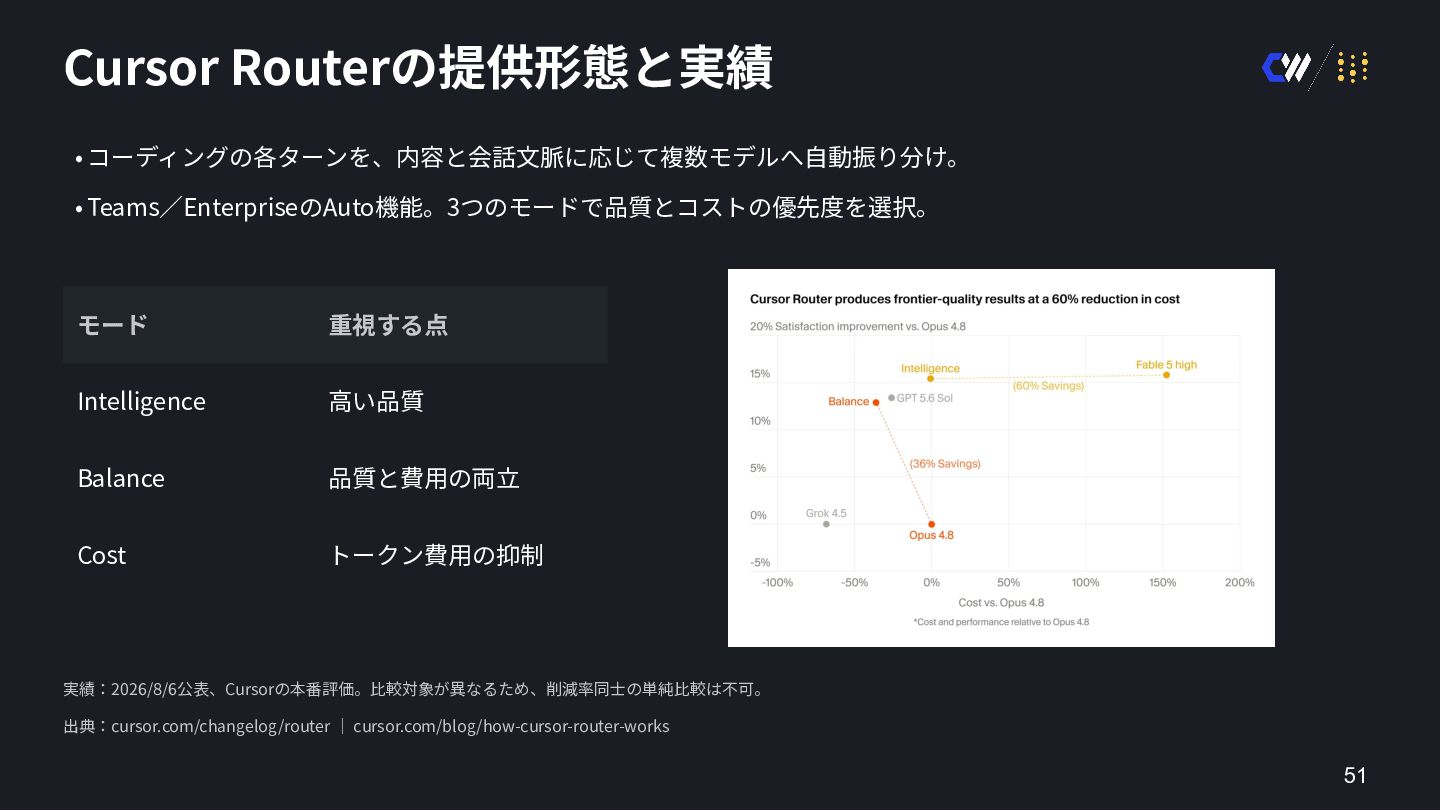
  27. Cursor Routerの提供形態と実績 • コーディングの各ターンを、内容と会話⽂脈に応じて複数モデルへ⾃動振り分け。 • Teams∕EnterpriseのAuto機能。3つのモードで品質とコストの優先度を選択。 モード 重視する点 Intelligence ⾼い品質

    Balance 品質と費⽤の両⽴ Cost トークン費⽤の抑制 実績:2026/8/6公表、Cursorの本番評価。⽐較対象が異なるため、削減率同⼠の単純⽐較は不可。 出典:cursor.com/changelog/router | cursor.com/blog/how-cursor-router-works 51
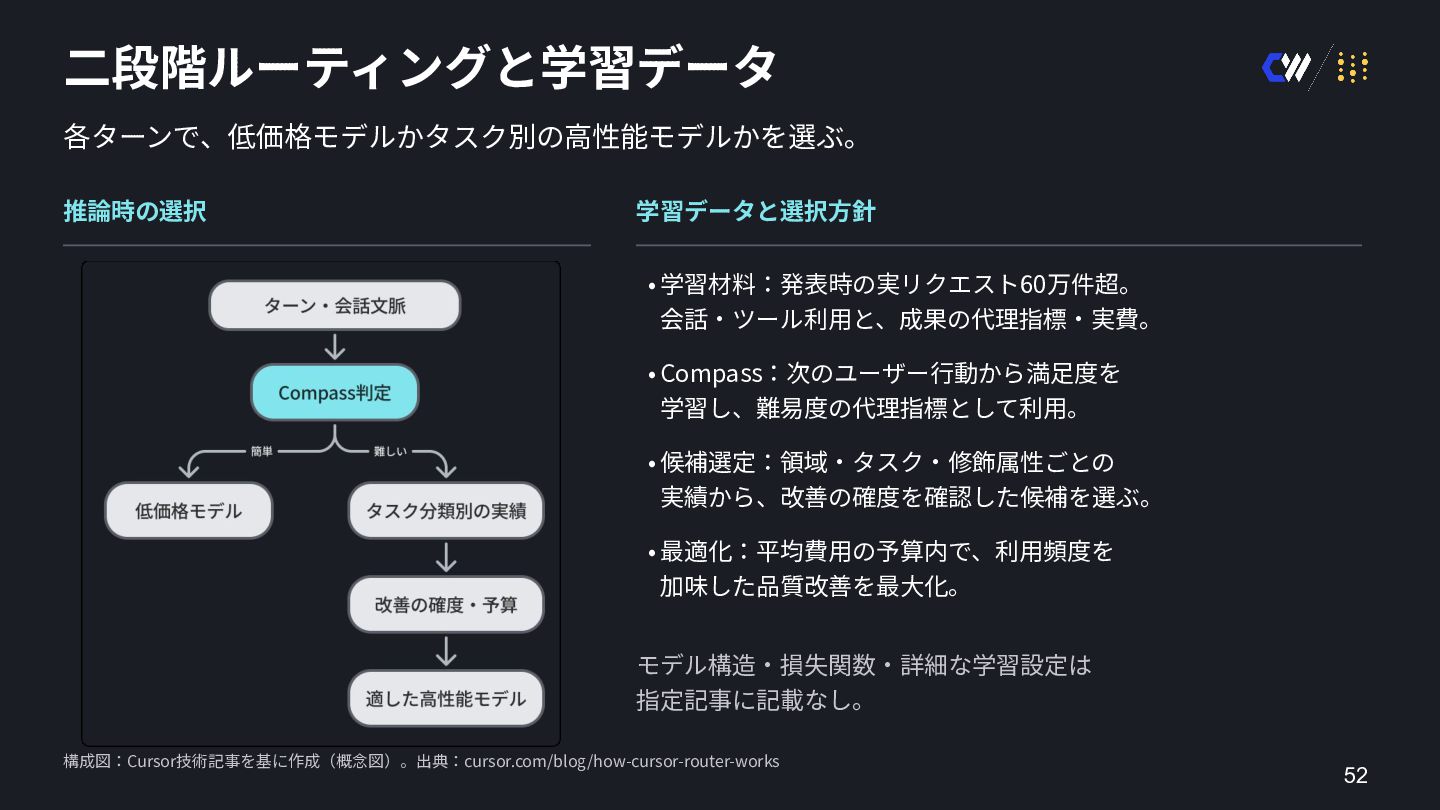
  28. ⼆段階ルーティングと学習データ 各ターンで、低価格モデルかタスク別の⾼性能モデルかを選ぶ。 推論時の選択 学習データと選択⽅針 • 学習材料:発表時の実リクエスト60万件超。 会話‧ツール利⽤と、成果の代理指標‧実費。 • Compass:次のユーザー⾏動から満⾜度を 学習し、難易度の代理指標として利⽤。

    • 候補選定:領域‧タスク‧修飾属性ごとの 実績から、改善の確度を確認した候補を選ぶ。 • 最適化:平均費⽤の予算内で、利⽤頻度を 加味した品質改善を最⼤化。 モデル構造‧損失関数‧詳細な学習設定は 指定記事に記載なし。 構成図:Cursor技術記事を基に作成(概念図)。出典:cursor.com/blog/how-cursor-router-works 52
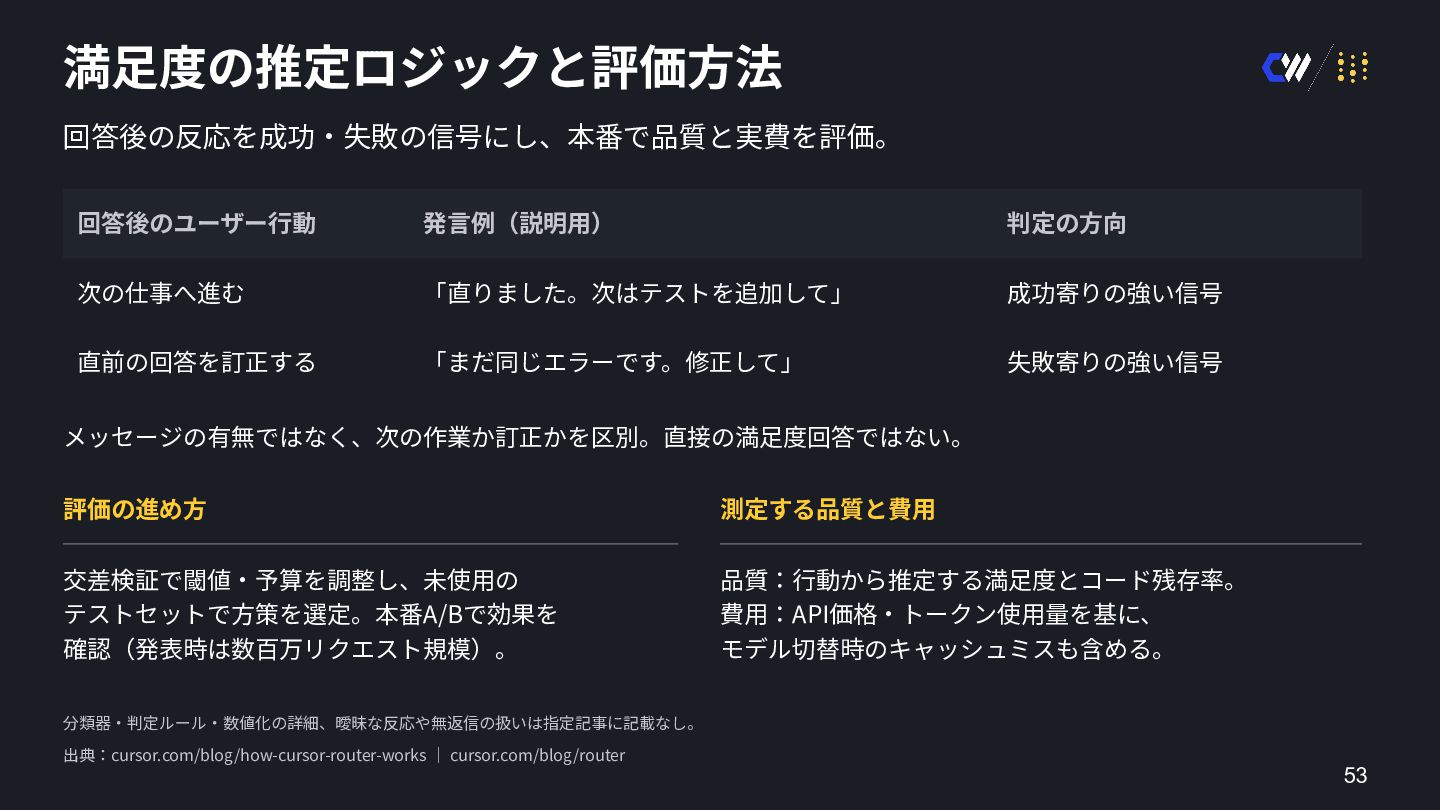
  29. 満⾜度の推定ロジックと評価⽅法 回答後の反応を成功‧失敗の信号にし、本番で品質と実費を評価。 回答後のユーザー⾏動 発⾔例(説明⽤) 判定の⽅向 次の仕事へ進む 「直りました。次はテストを追加して」 成功寄りの強い信号 直前の回答を訂正する 「まだ同じエラーです。修正して」

    失敗寄りの強い信号 メッセージの有無ではなく、次の作業か訂正かを区別。直接の満⾜度回答ではない。 評価の進め⽅ 測定する品質と費⽤ 交差検証で閾値‧予算を調整し、未使⽤の テストセットで⽅策を選定。本番A/Bで効果を 確認(発表時は数百万リクエスト規模)。 品質:⾏動から推定する満⾜度とコード残存率。 費⽤:API価格‧トークン使⽤量を基に、 モデル切替時のキャッシュミスも含める。 分類器‧判定ルール‧数値化の詳細、曖昧な反応や無返信の扱いは指定記事に記載なし。 出典:cursor.com/blog/how-cursor-router-works | cursor.com/blog/router 53
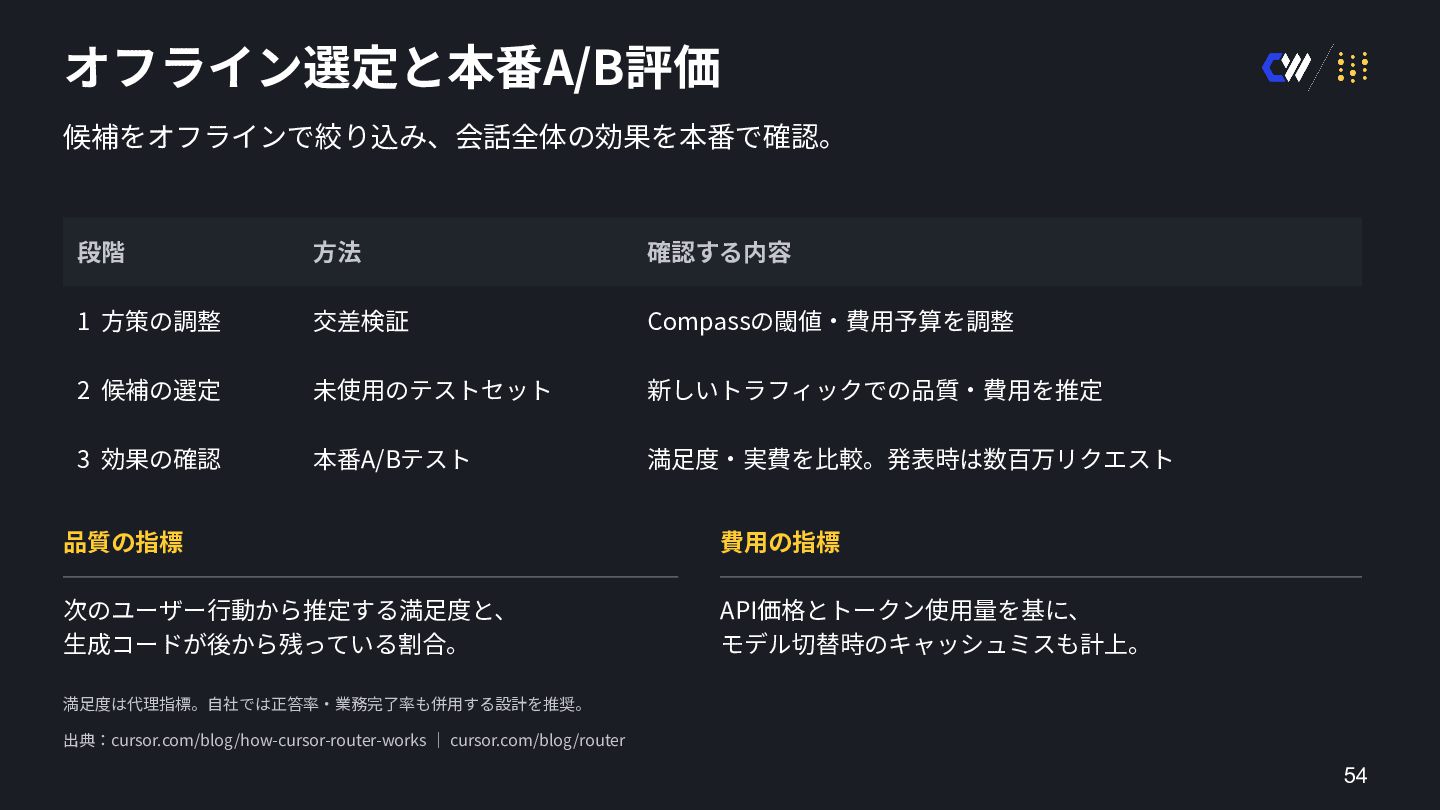
  30. オフライン選定と本番A/B評価 候補をオフラインで絞り込み、会話全体の効果を本番で確認。 段階 ⽅法 確認する内容 1 ⽅策の調整 交差検証 Compassの閾値‧費⽤予算を調整 2

    候補の選定 未使⽤のテストセット 新しいトラフィックでの品質‧費⽤を推定 3 効果の確認 本番A/Bテスト 満⾜度‧実費を⽐較。発表時は数百万リクエスト 品質の指標 費⽤の指標 次のユーザー⾏動から推定する満⾜度と、 ⽣成コードが後から残っている割合。 API価格とトークン使⽤量を基に、 モデル切替時のキャッシュミスも計上。 満⾜度は代理指標。⾃社では正答率‧業務完了率も併⽤する設計を推奨。 出典:cursor.com/blog/how-cursor-router-works | cursor.com/blog/router 54
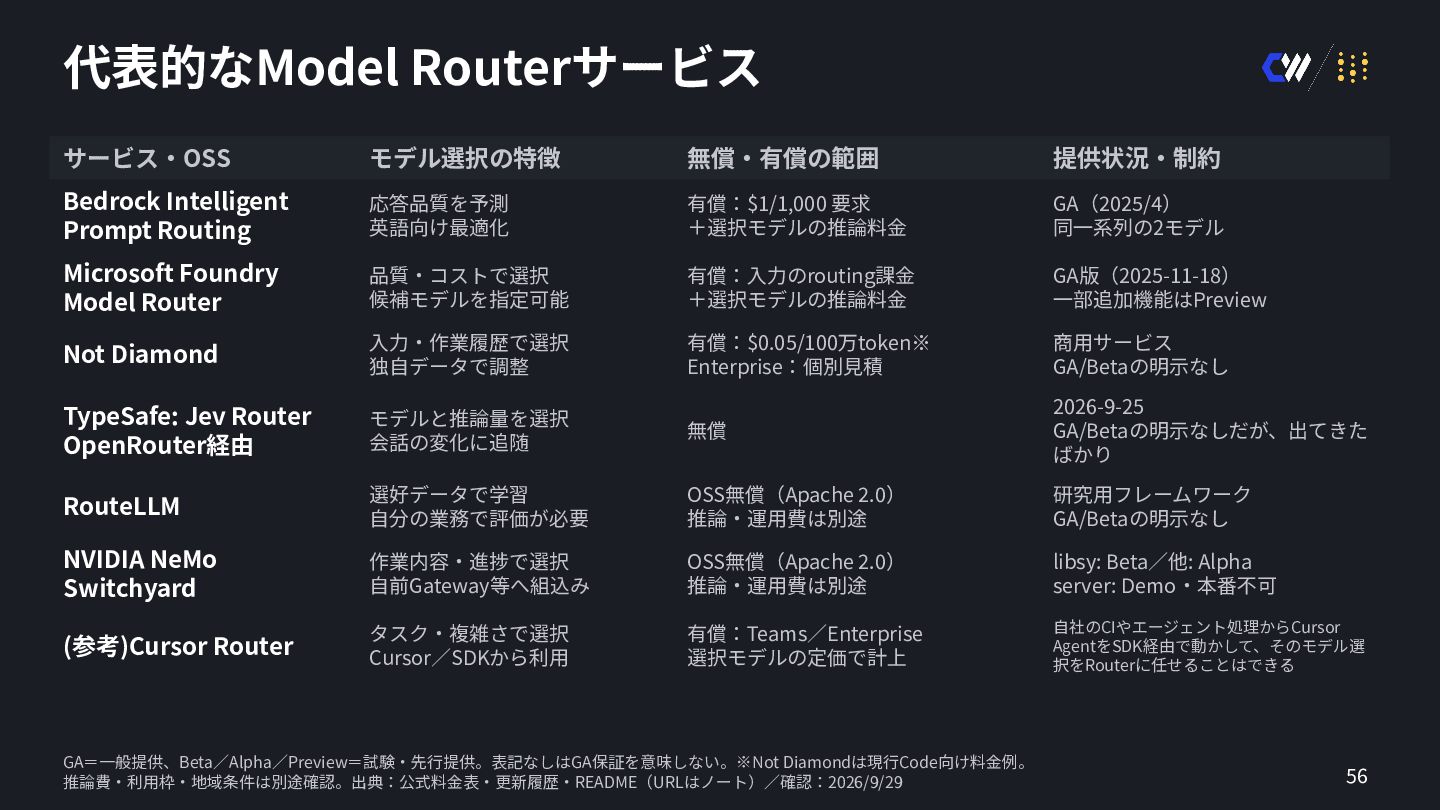
  31. 代表的なModel Routerサービス サービス‧OSS モデル選択の特徴 無償‧有償の範囲 提供状況‧制約 Bedrock Intelligent Prompt Routing

    応答品質を予測 英語向け最適化 有償:$1/1,000 要求 +選択モデルの推論料⾦ GA(2025/4) 同⼀系列の2モデル Microsoft Foundry Model Router 品質‧コストで選択 候補モデルを指定可能 有償:⼊⼒のrouting課⾦ +選択モデルの推論料⾦ GA版(2025-11-18) ⼀部追加機能はPreview Not Diamond ⼊⼒‧作業履歴で選択 独⾃データで調整 有償:$0.05/100万token※ Enterprise:個別⾒積 商⽤サービス GA/Betaの明⽰なし TypeSafe: Jev Router OpenRouter経由 モデルと推論量を選択 会話の変化に追随 無償 2026-9-25 GA/Betaの明⽰なしだが、出てきた ばかり RouteLLM 選好データで学習 ⾃分の業務で評価が必要 OSS無償(Apache 2.0) 推論‧運⽤費は別途 研究⽤フレームワーク GA/Betaの明⽰なし NVIDIA NeMo Switchyard 作業内容‧進捗で選択 ⾃前Gateway等へ組込み OSS無償(Apache 2.0) 推論‧運⽤費は別途 libsy: Beta∕他: Alpha server: Demo‧本番不可 (参考)Cursor Router タスク‧複雑さで選択 Cursor∕SDKから利⽤ 有償:Teams∕Enterprise 選択モデルの定価で計上 ⾃社のCIやエージェント処理からCursor AgentをSDK経由で動かして、そのモデル選 択をRouterに任せることはできる GA=⼀般提供、Beta∕Alpha∕Preview=試験‧先⾏提供。表記なしはGA保証を意味しない。※Not Diamondは現⾏Code向け料⾦例。 推論費‧利⽤枠‧地域条件は別途確認。出典:公式料⾦表‧更新履歴‧README(URLはノート)∕確認:2026/9/29 56
  32. AI Agent is easy to demo, hard to productionize Weaveは、

    1. チームで 2. 速く 3. 品質が高く 4. 安い AI Agentを作るためのAI Agent Opsツール 60
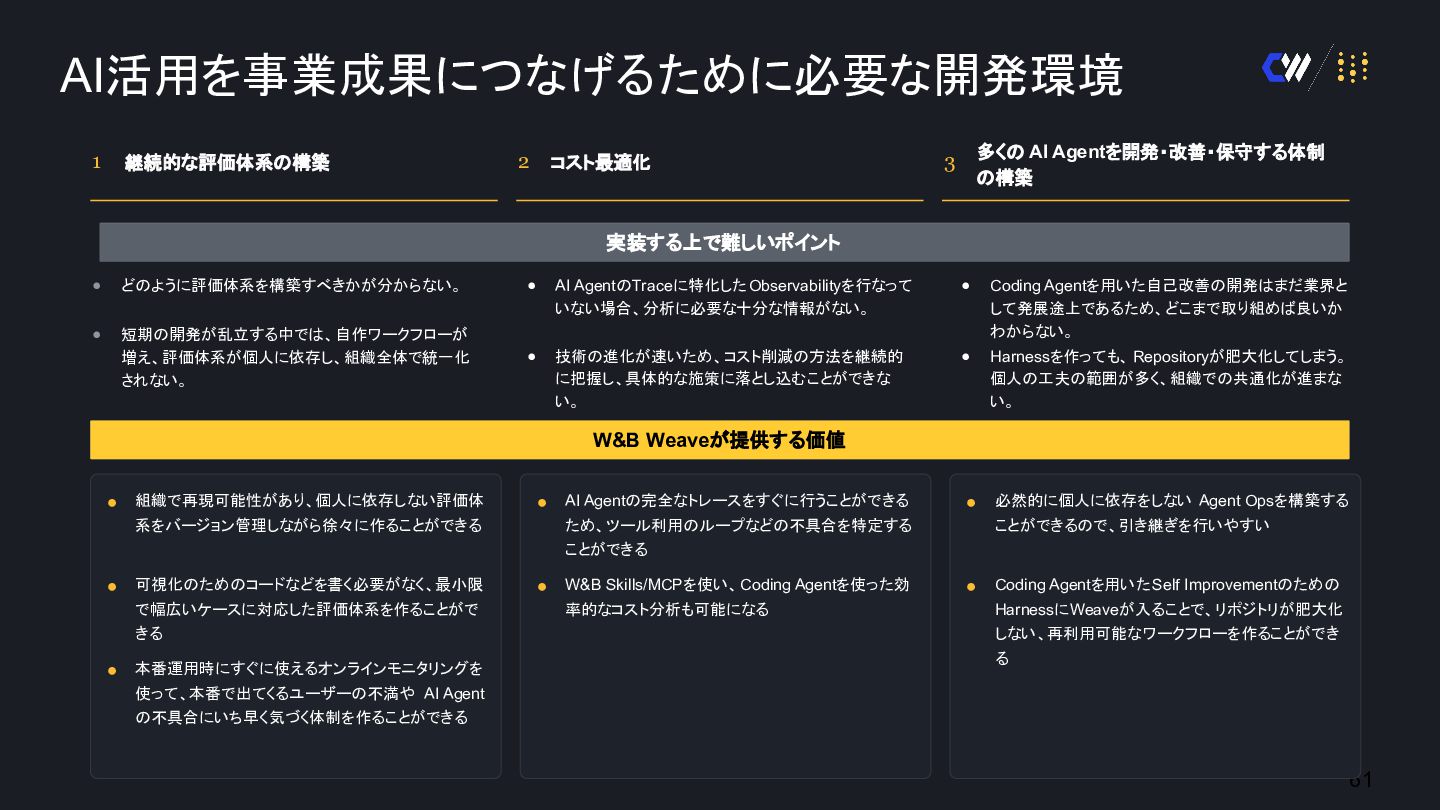
  33. AI活用を事業成果につなげるために必要な開発環境 1 継続的な評価体系の構築 2 コスト最適化 多くの AI Agentを開発・改善・保守する体制 の構築 3

    実装する上で難しいポイント • どのように評価体系を構築すべきかが分からない。 • AI AgentのTraceに特化した Observabilityを行なって いない場合、分析に必要な十分な情報がない。 • • 短期の開発が乱立する中では、自作ワークフローが 増え、評価体系が個人に依存し、組織全体で統一化 されない。 Coding Agentを用いた自己改善の開発はまだ業界と して発展途上であるため、どこまで取り組めば良いか わからない。 • 技術の進化が速いため、コスト削減の方法を継続的 に把握し、具体的な施策に落とし込むことができな い。 • Harnessを作っても、 Repositoryが肥大化してしまう。 個人の工夫の範囲が多く、組織での共通化が進まな い。 W&B Weaveが提供する価値 • 組織で再現可能性があり、個人に依存しない評価体 • AI Agentの完全なトレースをすぐに行うことができる 系をバージョン管理しながら徐々に作ることができる ため、ツール利用のループなどの不具合を特定する • 必然的に個人に依存をしない Agent Opsを構築する ことができるので、引き継ぎを行いやすい ことができる • 可視化のためのコードなどを書く必要がなく、最小限 で幅広いケースに対応した評価体系を作ることがで きる • 本番運用時にすぐに使えるオンラインモニタリングを • W&B Skills/MCPを使い、 Coding Agentを使った効 率的なコスト分析も可能になる • Coding Agentを用いた Self Improvementのための HarnessにWeaveが入ることで、リポジトリが肥大化 しない、再利用可能なワークフローを作ることができ る 使って、本番で出てくるユーザーの不満や AI Agent の不具合にいち早く気づく体制を作ることができる 61
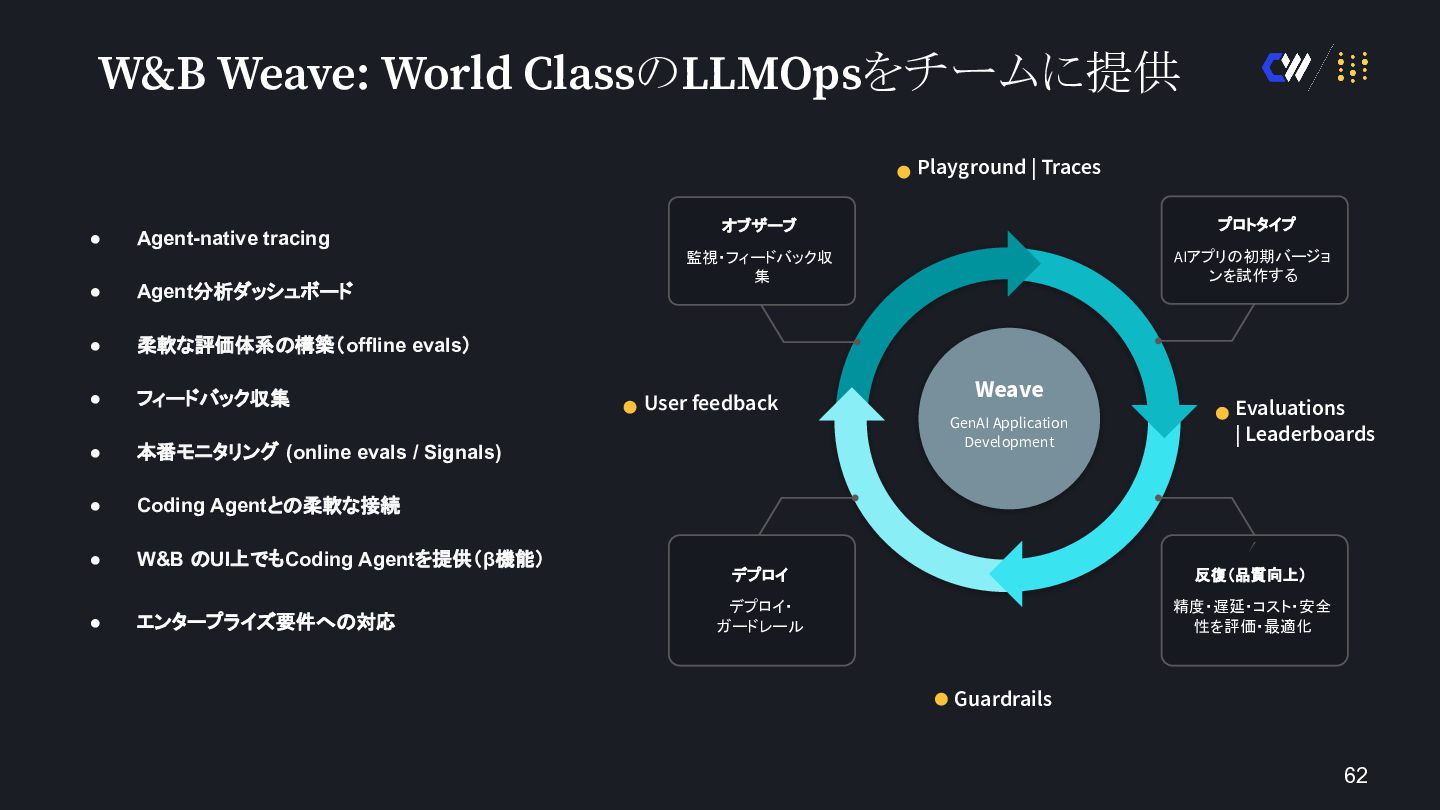
  34. W&B Weave: World ClassのLLMOpsをチームに提供 Playground | Traces • Agent-native tracing

    • Agent分析ダッシュボード • 柔軟な評価体系の構築(offline evals) • フィードバック収集 • 本番モニタリング (online evals / Signals) • Coding Agentとの柔軟な接続 • W&B のUI上でもCoding Agentを提供(β機能) • エンタープライズ要件への対応 オブザーブ プロトタイプ 監視・フィードバック収 集 AIアプリの初期バージョ ンを試作する User feedback Weave GenAI Application Development Evaluations | Leaderboards デプロイ 反復(品質向上) デプロイ・ ガードレール 精度・遅延・コスト・安全 性を評価・最適化 Guardrails 62
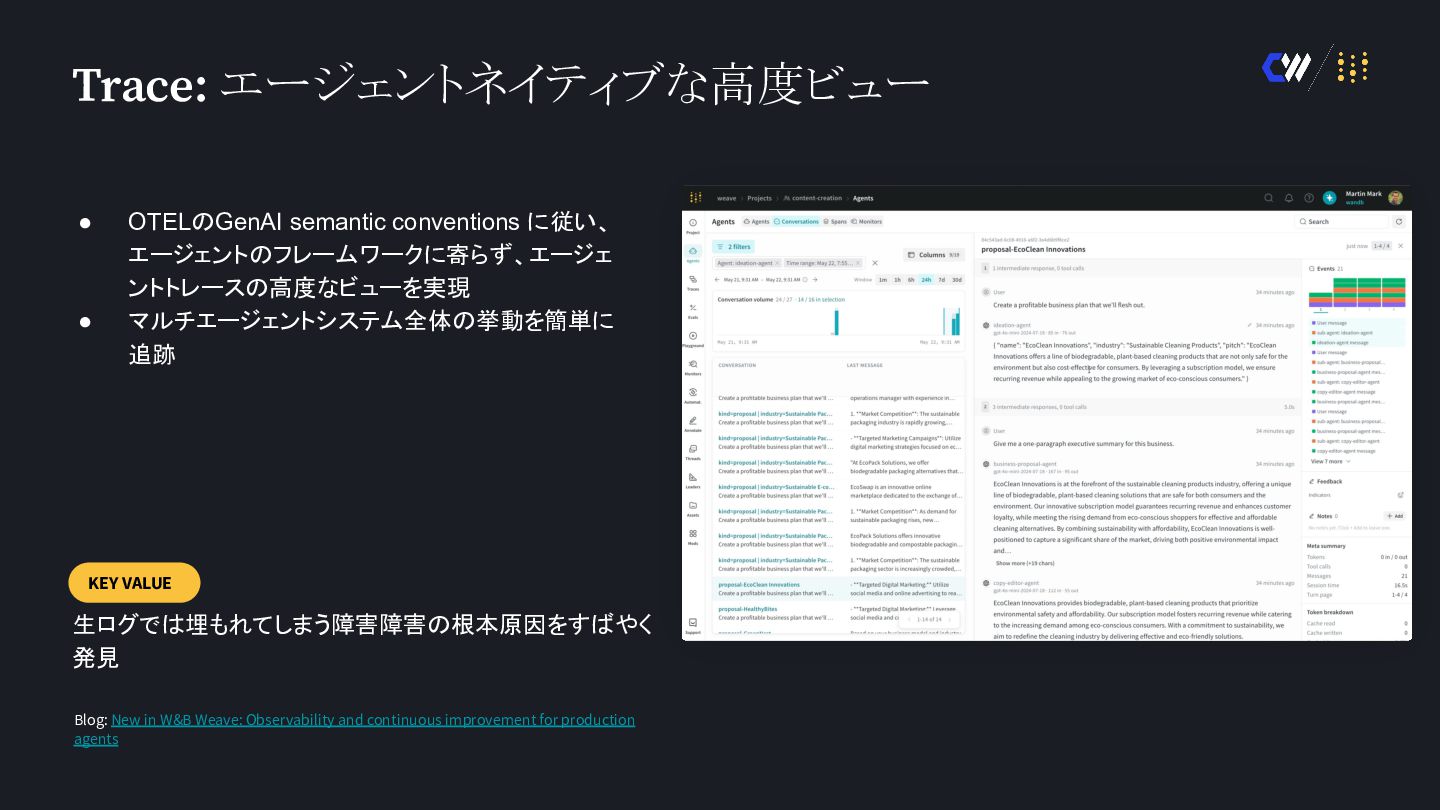
  35. Trace: エージェントネイティブな高度ビュー • • OTELのGenAI semantic conventions に従い、 エージェントのフレームワークに寄らず、エージェ ントトレースの高度なビューを実現

    マルチエージェントシステム全体の挙動を簡単に 追跡 KEY VALUE 生ログでは埋もれてしまう障害障害の根本原因をすばやく 発見 Blog: New in W&B Weave: Observability and continuous improvement for production agents
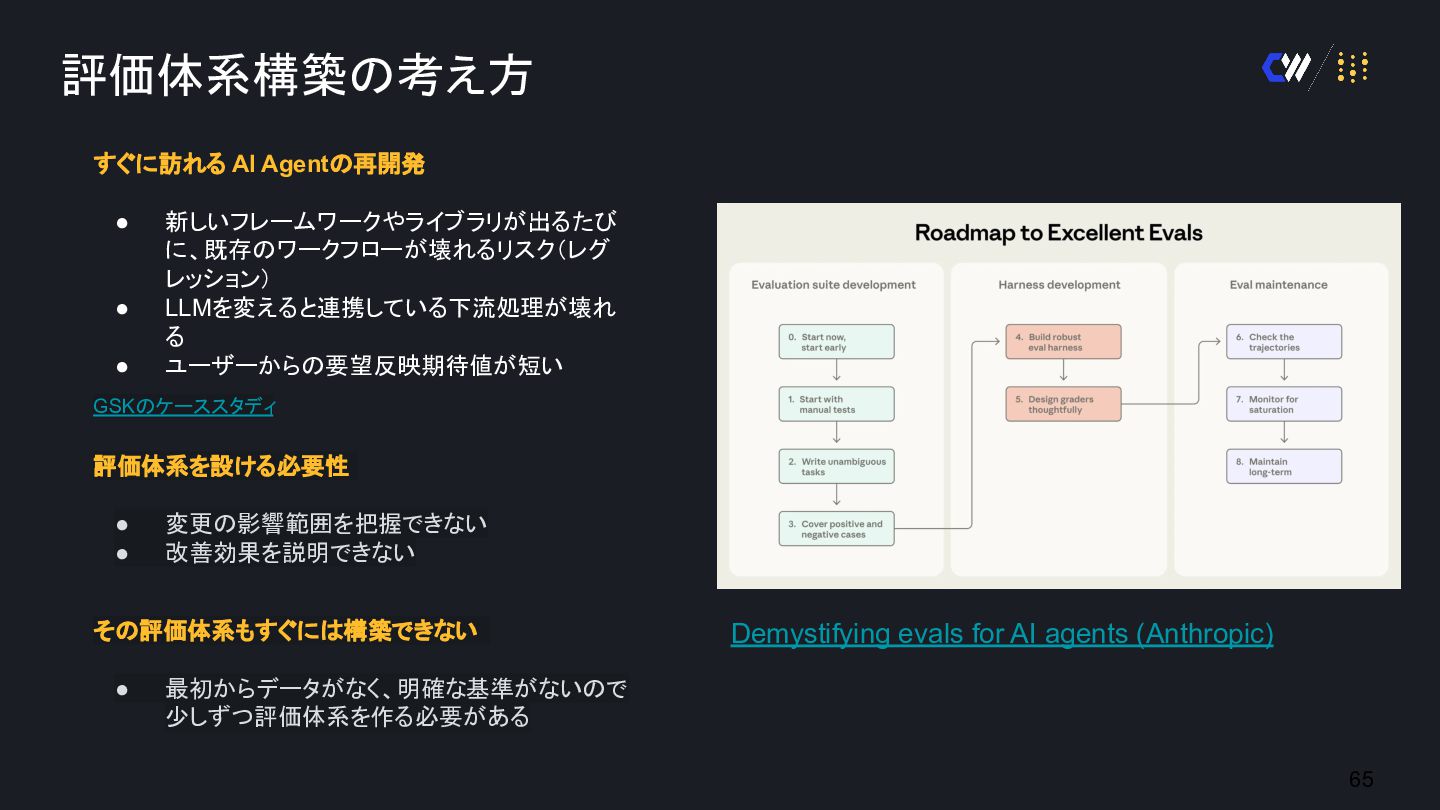
  36. 評価体系構築の考え方 すぐに訪れる AI Agentの再開発 • • • 新しいフレームワークやライブラリが出るたび に、既存のワークフローが壊れるリスク(レグ レッション)

    LLMを変えると連携している下流処理が壊れ る ユーザーからの要望反映期待値が短い GSKのケーススタディ 評価体系を設ける必要性 • • 変更の影響範囲を把握できない 改善効果を説明できない その評価体系もすぐには構築できない • Demystifying evals for AI agents (Anthropic) 最初からデータがなく、明確な基準がないので 少しずつ評価体系を作る必要がある 65
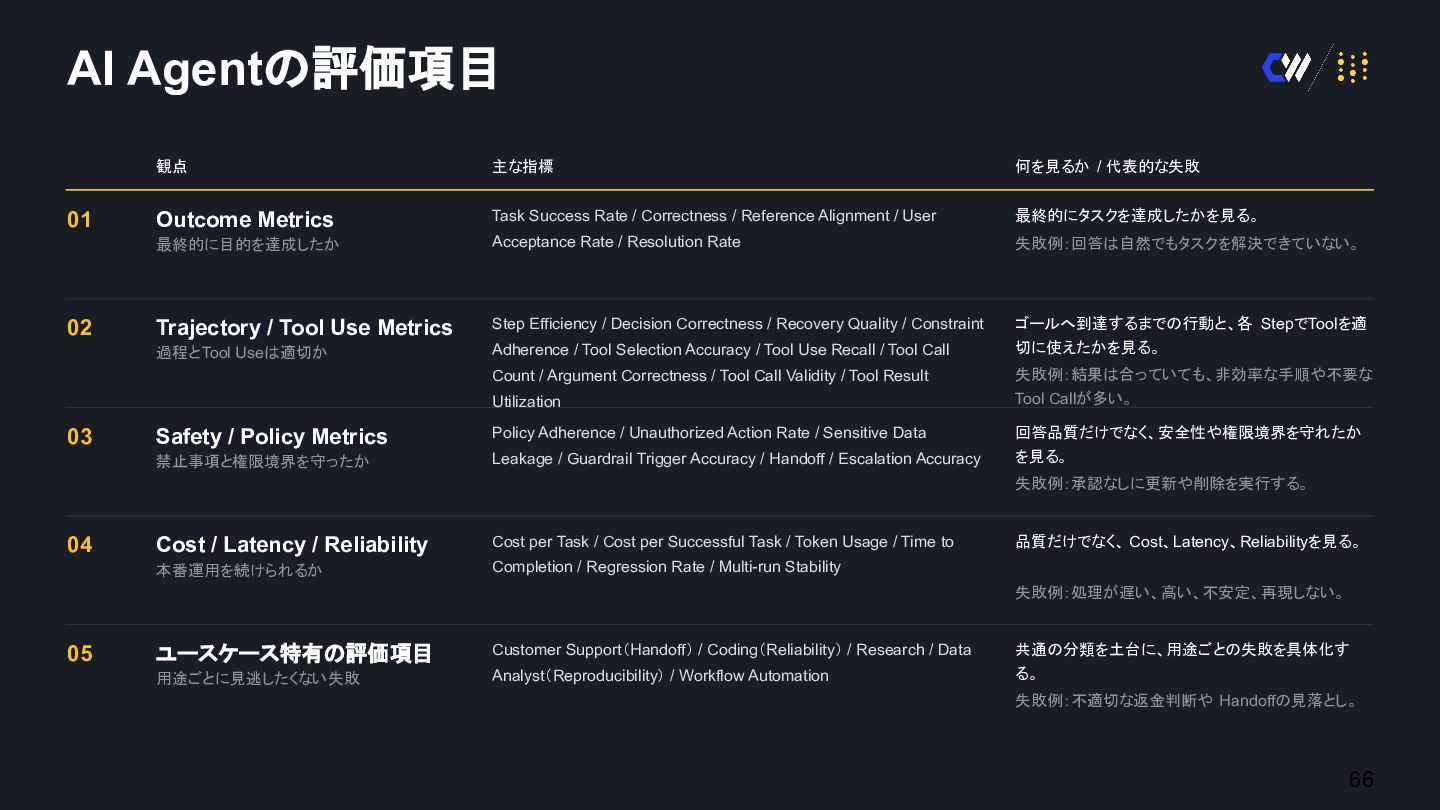
  37. AI Agentの評価項目 01 02 観点 主な指標 何を見るか / 代表的な失敗 Outcome

    Metrics Task Success Rate / Correctness / Reference Alignment / User 最終的にタスクを達成したかを見る。 最終的に目的を達成したか Acceptance Rate / Resolution Rate 失敗例:回答は自然でもタスクを解決できていない。 Trajectory / Tool Use Metrics Step Efficiency / Decision Correctness / Recovery Quality / Constraint 過程とTool Useは適切か Adherence / Tool Selection Accuracy / Tool Use Recall / Tool Call ゴールへ到達するまでの行動と、各 StepでToolを適 切に使えたかを見る。 Count / Argument Correctness / Tool Call Validity / Tool Result Utilization 03 Safety / Policy Metrics Policy Adherence / Unauthorized Action Rate / Sensitive Data 禁止事項と権限境界を守ったか Leakage / Guardrail Trigger Accuracy / Handoff / Escalation Accuracy 失敗例:結果は合っていても、非効率な手順や不要な Tool Callが多い。 回答品質だけでなく、安全性や権限境界を守れたか を見る。 失敗例:承認なしに更新や削除を実行する。 04 Cost / Latency / Reliability Cost per Task / Cost per Successful Task / Token Usage / Time to 本番運用を続けられるか Completion / Regression Rate / Multi-run Stability 品質だけでなく、 Cost、Latency、Reliabilityを見る。 失敗例:処理が遅い、高い、不安定、再現しない。 05 ユースケース特有の評価項目 Customer Support(Handoff) / Coding(Reliability) / Research / Data 用途ごとに見逃したくない失敗 Analyst(Reproducibility) / Workflow Automation 共通の分類を土台に、用途ごとの失敗を具体化す る。 失敗例:不適切な返金判断や Handoffの見落とし。 66
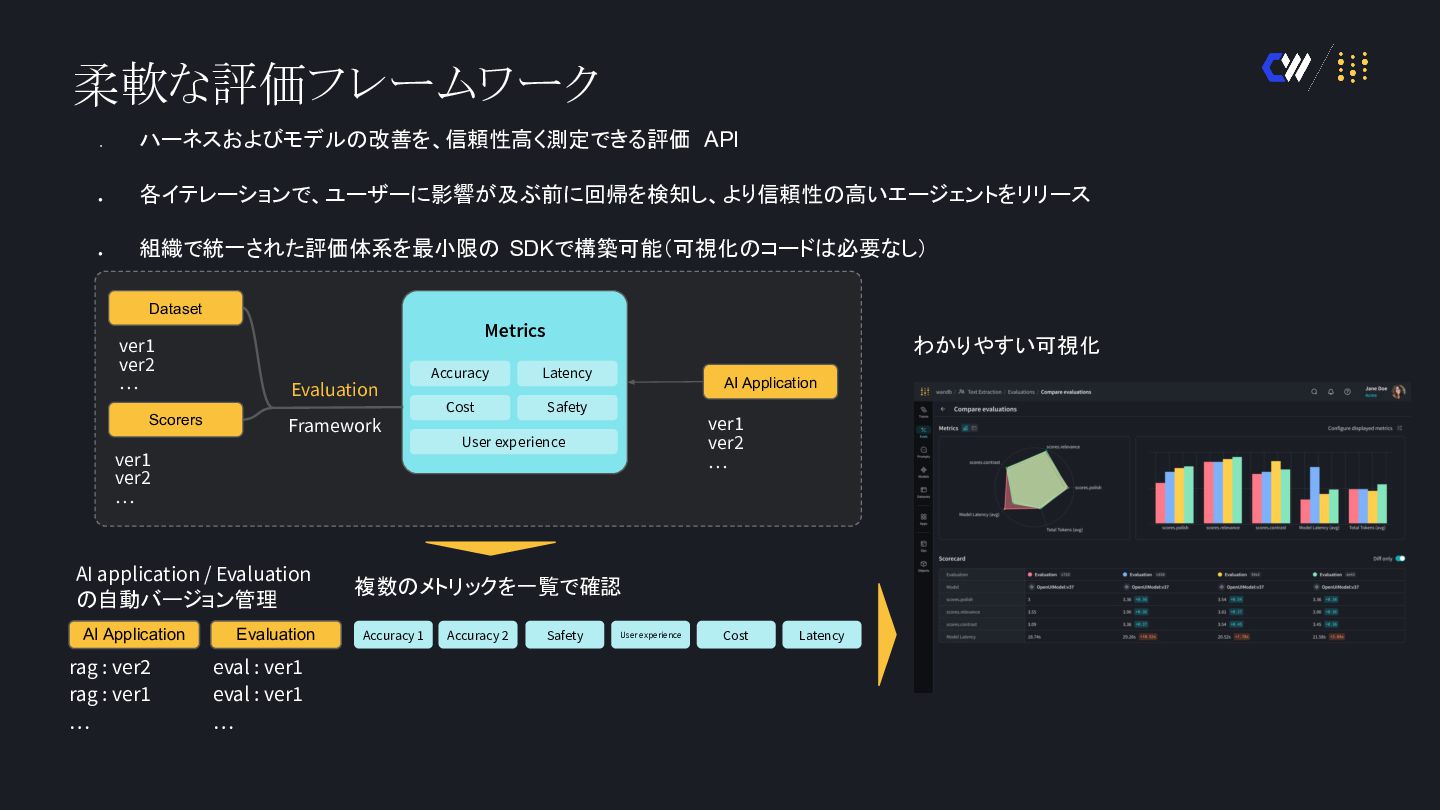
  38. 柔軟な評価フレームワーク • ハーネスおよびモデルの改善を、信頼性高く測定できる評価 API • 各イテレーションで、ユーザーに影響が及ぶ前に回帰を検知し、より信頼性の高いエージェントをリリース • 組織で統一された評価体系を最小限の SDKで構築可能(可視化のコードは必要なし) Dataset

    ver1 ver2 … Scorers Metrics Evaluation Framework わかりやすい可視化 Accuracy Latency Cost Safety AI Application ver1 ver2 … User experience ver1 ver2 … AI application / Evaluation の自動バージョン管理 複数のメトリックを一覧で確認 AI Application Accuracy 1 rag : ver2 rag : ver1 … Evaluation eval : ver1 eval : ver1 … Accuracy 2 Safety User experience Cost Latency
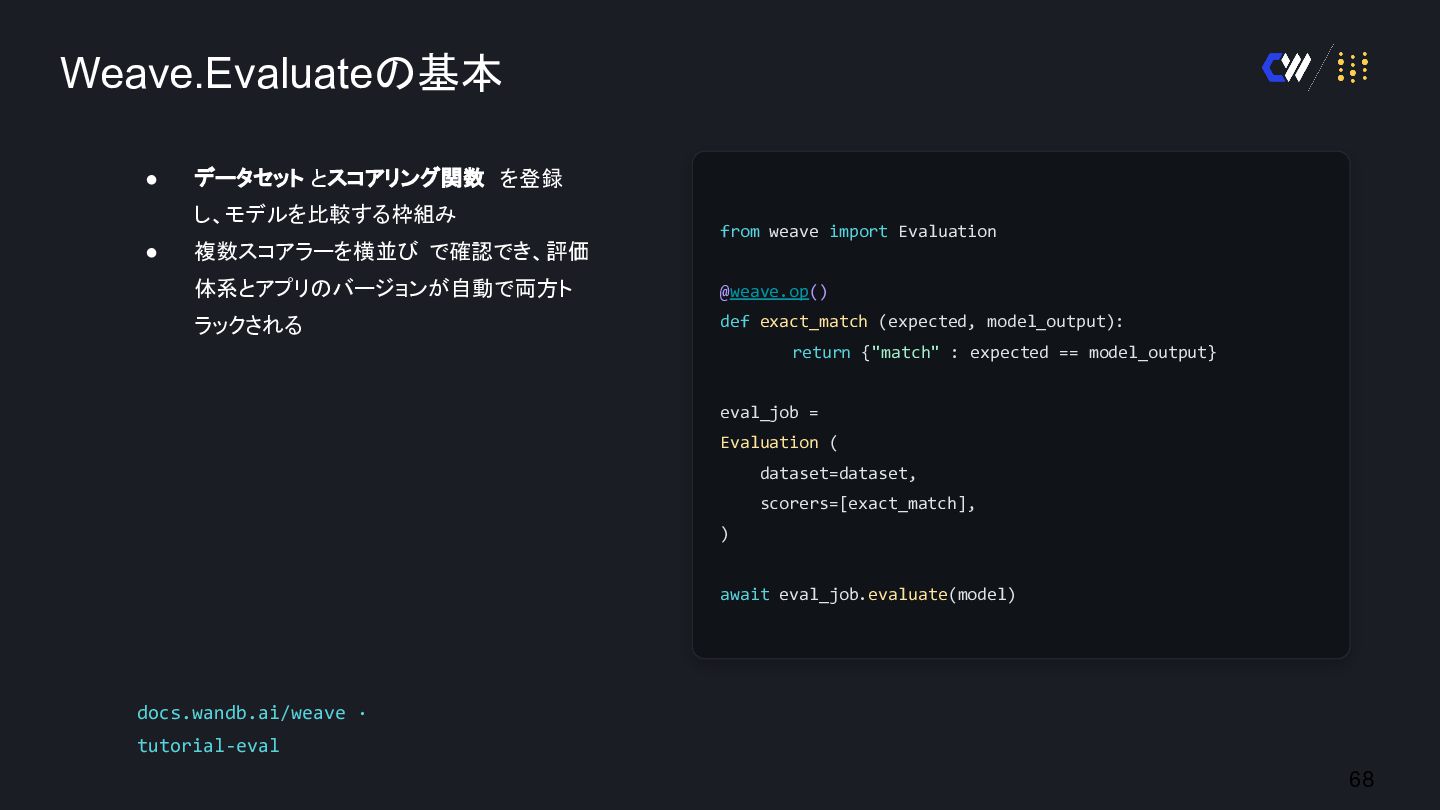
  39. Weave.Evaluateの基本 • データセット とスコアリング関数 を登録 し、モデルを比較する枠組み • 複数スコアラーを横並び で確認でき、評価 from

    weave import Evaluation 体系とアプリのバージョンが自動で両方ト @weave.op() ラックされる def exact_match (expected, model_output): return {"match" : expected == model_output} eval_job = Evaluation ( dataset=dataset, scorers=[exact_match], ) await eval_job.evaluate(model) docs.wandb.ai/weave · tutorial-eval 68
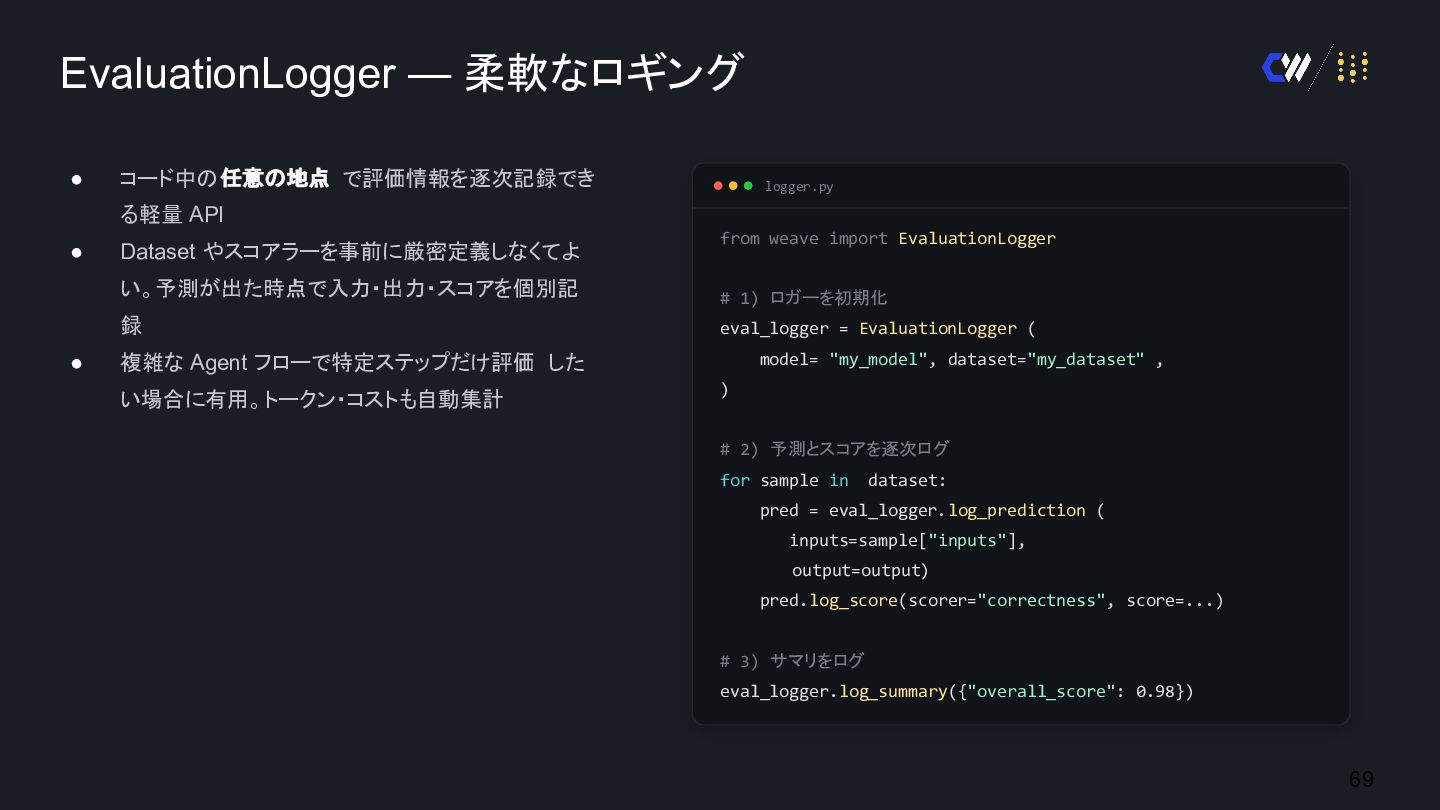
  40. EvaluationLogger — 柔軟なロギング • コード中の 任意の地点 で評価情報を逐次記録でき logger.py る軽量 API

    • Dataset やスコアラーを事前に厳密定義しなくてよ い。予測が出た時点で入力・出力・スコアを個別記 録 • from weave import EvaluationLogger # 1) ロガーを初期化 eval_logger = EvaluationLogger ( model= "my_model", dataset="my_dataset" , 複雑な Agent フローで特定ステップだけ評価 した い場合に有用。トークン・コストも自動集計 ) # 2) 予測とスコアを逐次ログ for sample in dataset: pred = eval_logger.log_prediction ( inputs=sample["inputs"], output=output) pred.log_score(scorer="correctness", score=...) # 3) サマリをログ eval_logger.log_summary({"overall_score": 0.98}) 69
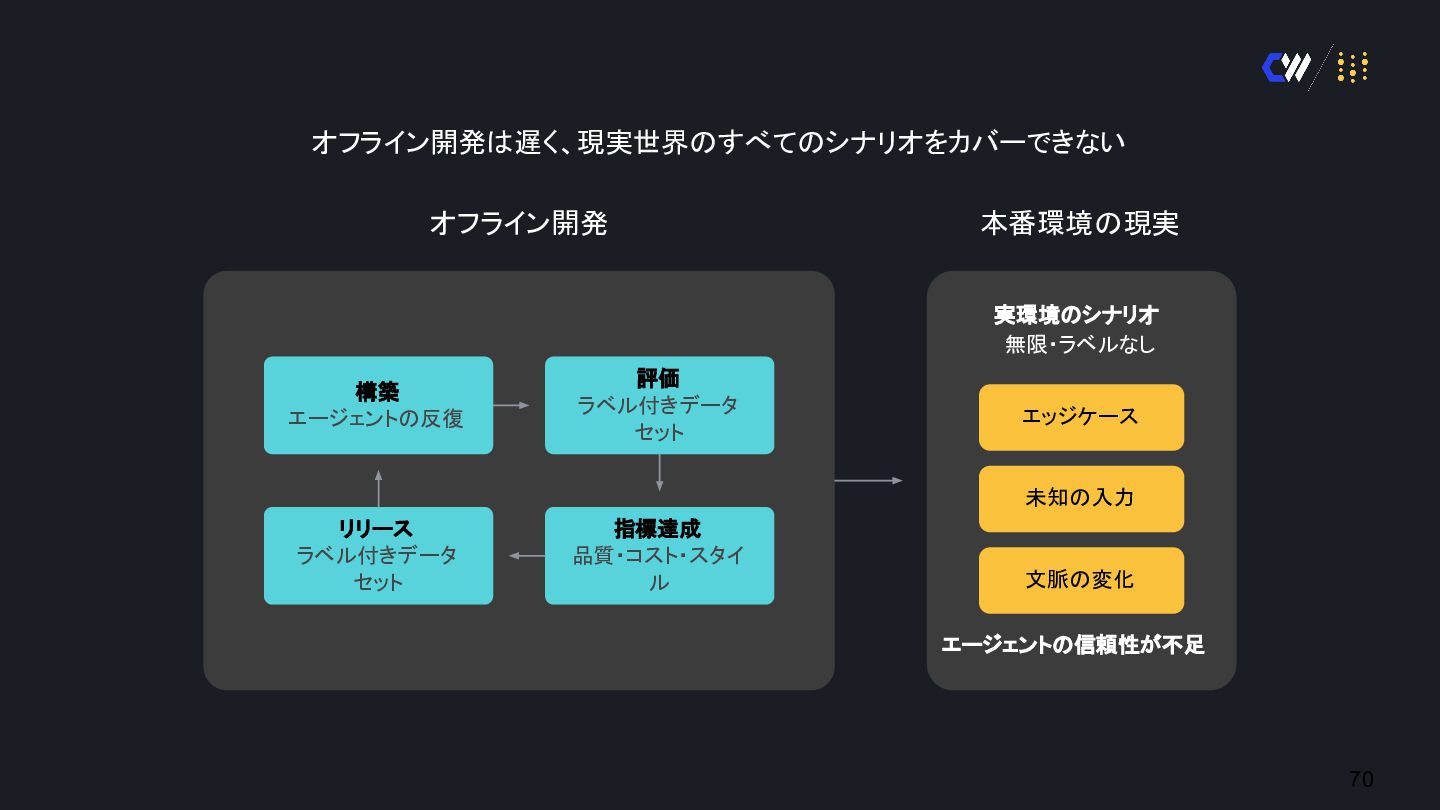
  41. オフライン開発は遅く、現実世界のすべてのシナリオをカバーできない オフライン開発 本番環境の現実 実環境のシナリオ 無限・ラベルなし 構築 エージェントの反復 評価 ラベル付きデータ セット

    エッジケース 未知の入力 リリース ラベル付きデータ セット 指標達成 品質・コスト・スタイ ル 文脈の変化 エージェントの信頼性が不足 70
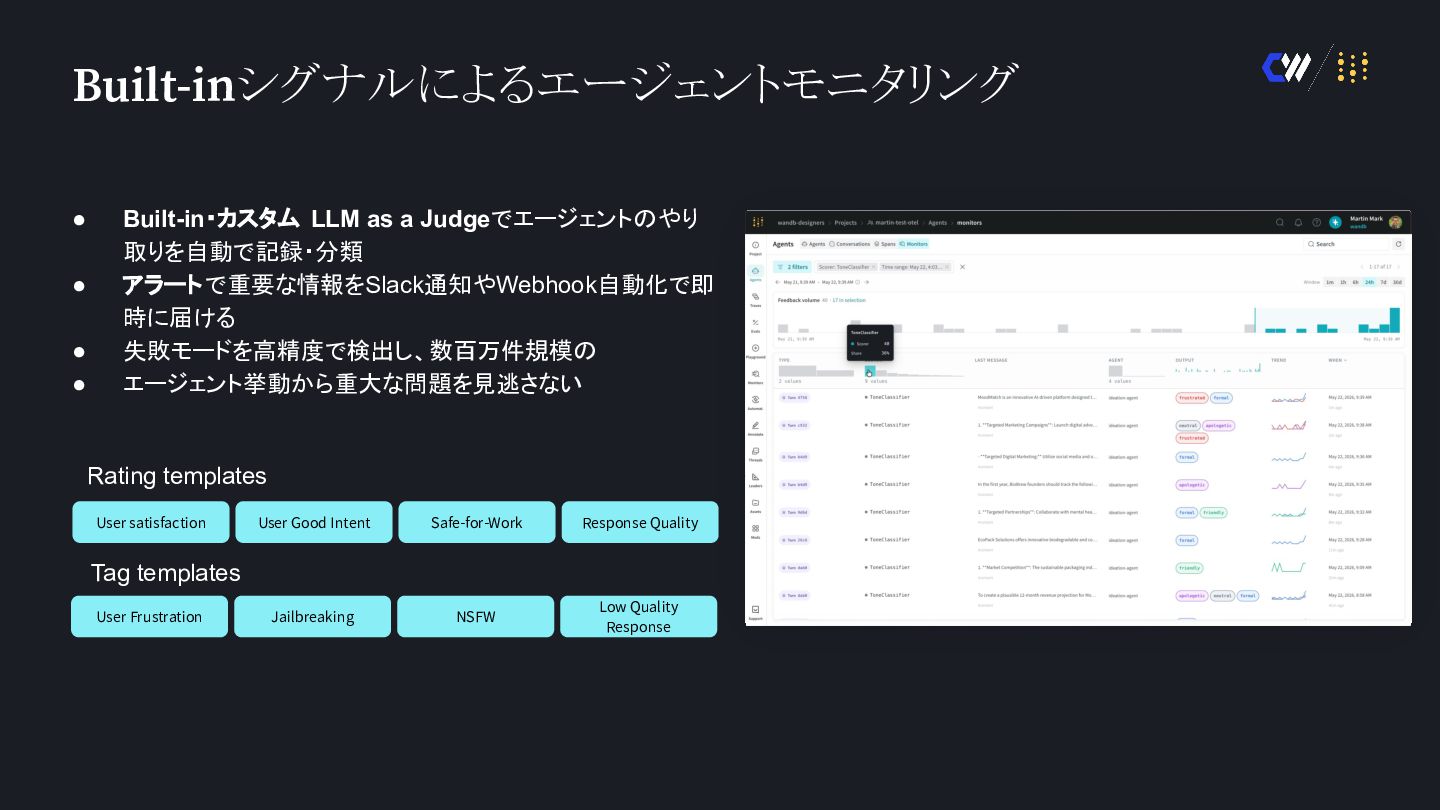
  42. Built-inシグナルによるエージェントモニタリング • • • • Built-in・カスタム LLM as a Judgeでエージェントのやり

    取りを自動で記録・分類 アラート で重要な情報をSlack通知やWebhook自動化で即 時に届ける 失敗モードを高精度で検出し、数百万件規模の エージェント挙動から重大な問題を見逃さない Rating templates User satisfaction User Good Intent Safe-for-Work Response Quality Jailbreaking NSFW Low Quality Response Tag templates User Frustration
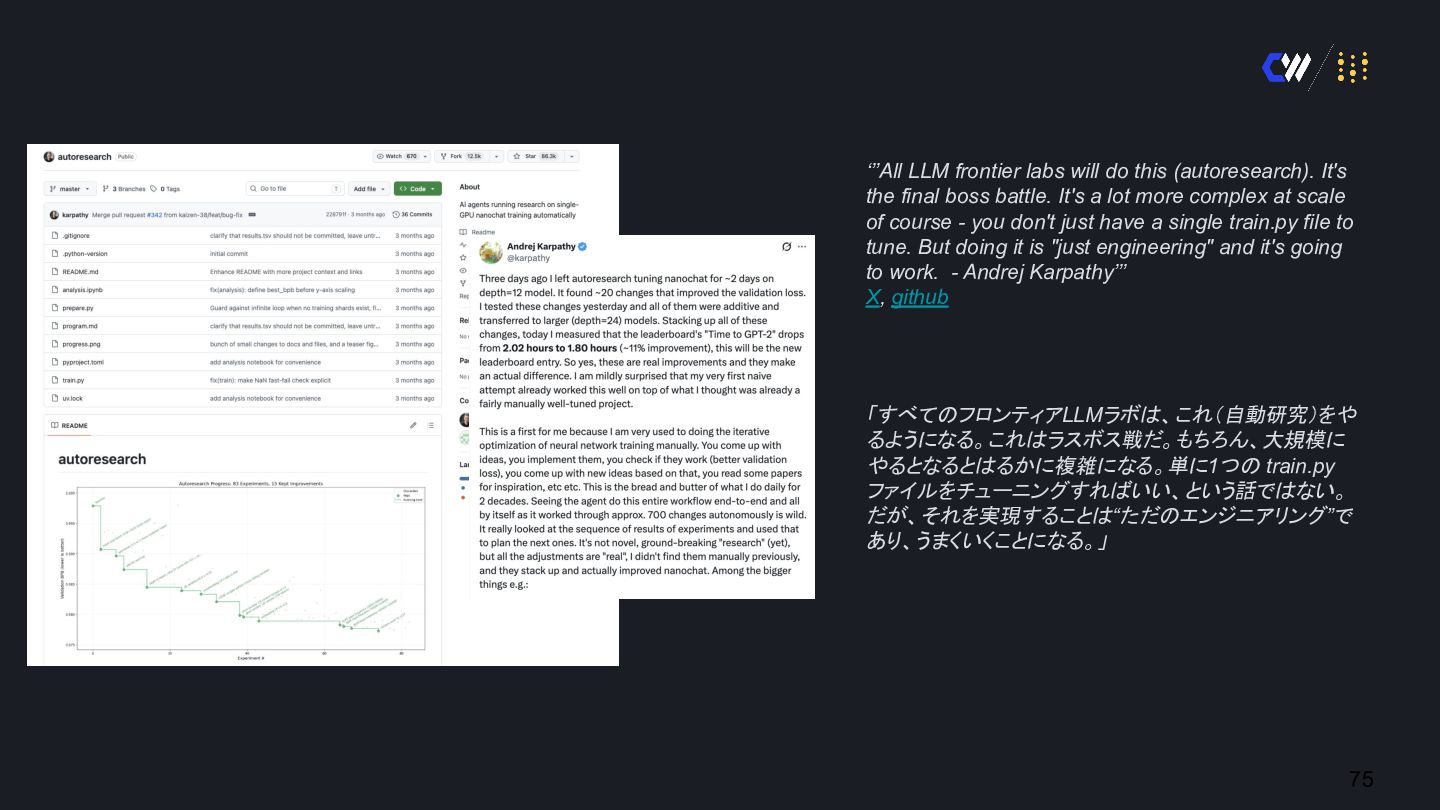
  43. ‘’’All LLM frontier labs will do this (autoresearch). It's the

    final boss battle. It's a lot more complex at scale of course - you don't just have a single train.py file to tune. But doing it is "just engineering" and it's going to work. - Andrej Karpathy’’’ X, github 「すべてのフロンティアLLMラボは、これ(自動研究)をや るようになる。これはラスボス戦だ。もちろん、大規模に やるとなるとはるかに複雑になる。単に1つの train.py ファイルをチューニングすればいい、という話ではない。 だが、それを実現することは“ただのエンジニアリング”で あり、うまくいくことになる。」 75
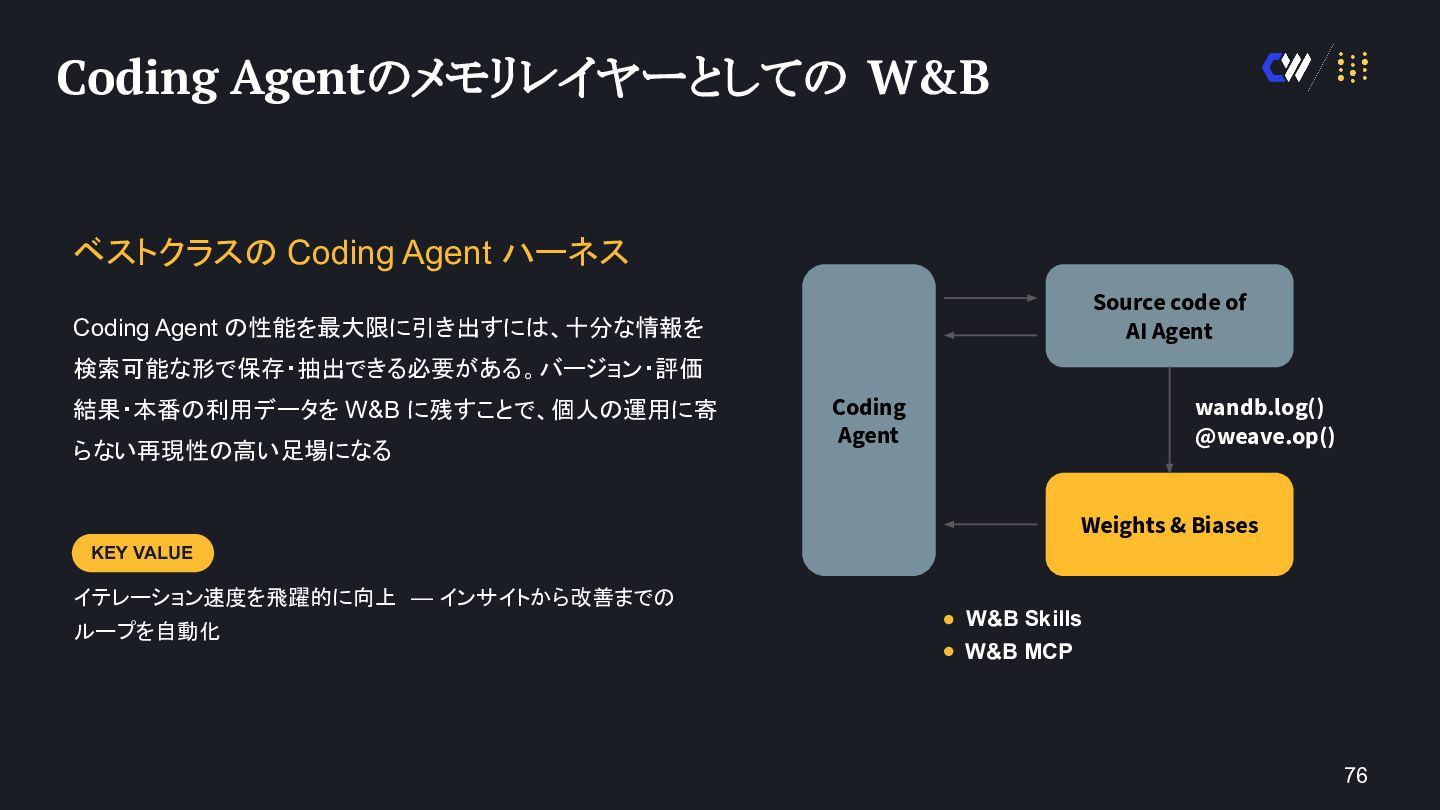
  44. Coding Agentのメモリレイヤーとしての W&B ベストクラスの Coding Agent ハーネス Source code of

    AI Agent Coding Agent の性能を最大限に引き出すには、十分な情報を 検索可能な形で保存・抽出できる必要がある。バージョン・評価 結果・本番の利用データを W&B に残すことで、個人の運用に寄 らない再現性の高い足場になる Coding Agent wandb.log() @weave.op() Weights & Biases KEY VALUE イテレーション速度を飛躍的に向上 — インサイトから改善までの ループを自動化 W&B Skills W&B MCP 76
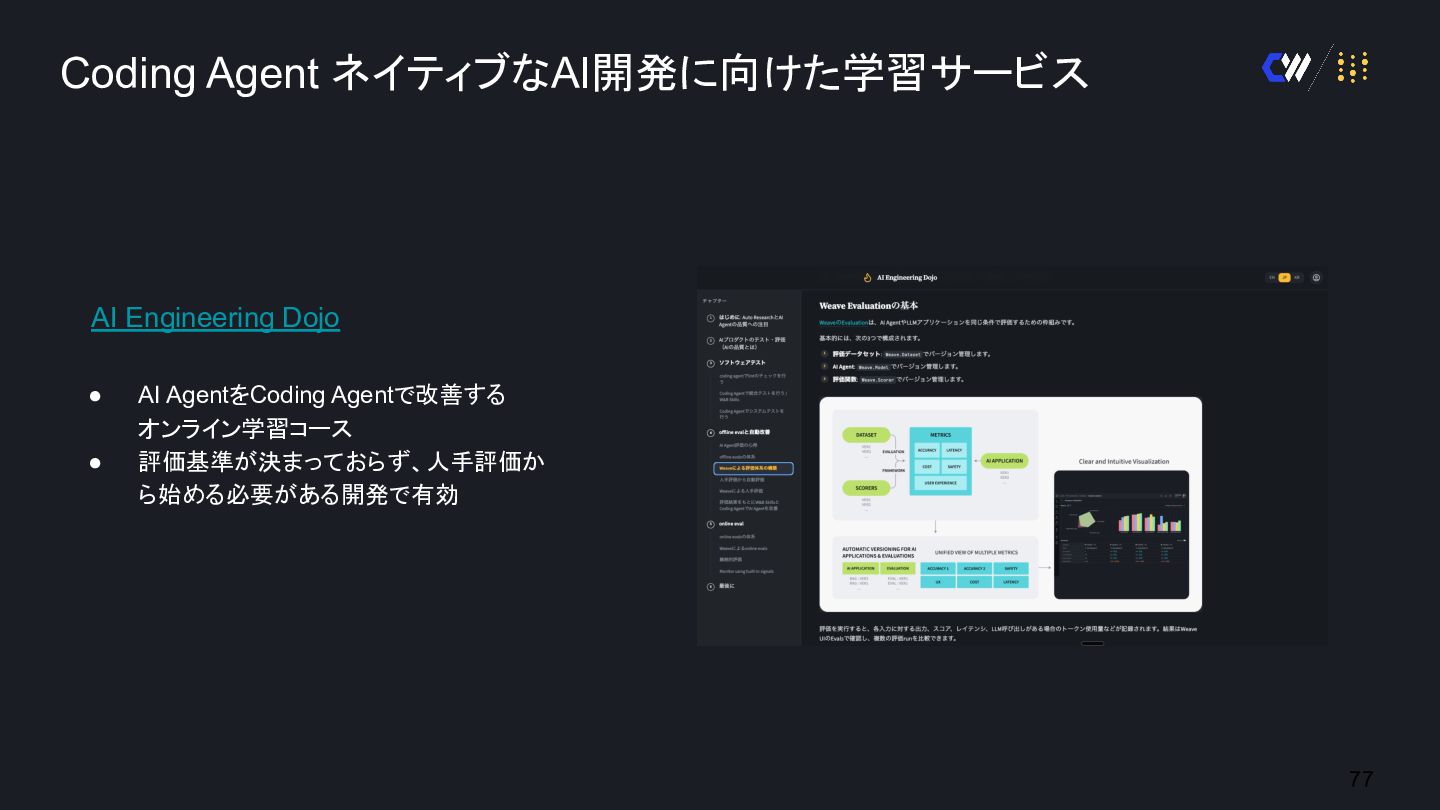
  45. Coding Agent ネイティブなAI開発に向けた学習サービス AI Engineering Dojo • • AI AgentをCoding

    Agentで改善する オンライン学習コース 評価基準が決まっておらず、人手評価か ら始める必要がある開発で有効 77
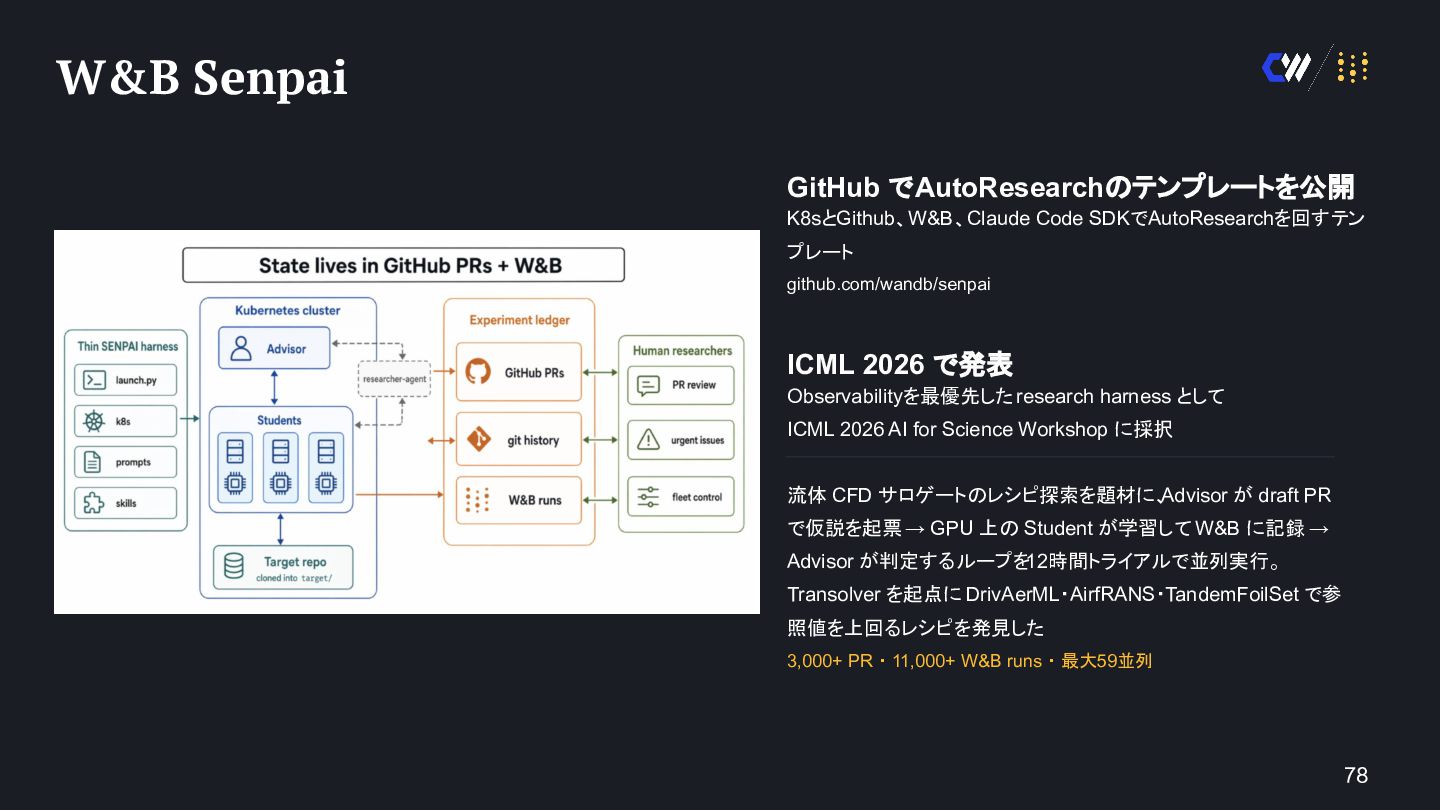
  46. W&B Senpai GitHub でAutoResearchのテンプレートを公開 K8sとGithub、W&B、Claude Code SDKでAutoResearchを回すテン プレート github.com/wandb/senpai ICML
    2026 で発表 Observabilityを最優先した research harness として ICML 2026 AI for Science Workshop に採択 流体 CFD サロゲートのレシピ探索を題材に、Advisor が draft PR で仮説を起票 → GPU 上の Student が学習して W&B に記録 → Advisor が判定するループを12時間トライアルで並列実行。 Transolver を起点に DrivAerML・AirfRANS・TandemFoilSet で参 照値を上回るレシピを発見した 3,000+ PR ・ 11,000+ W&B runs ・ 最大59並列 78
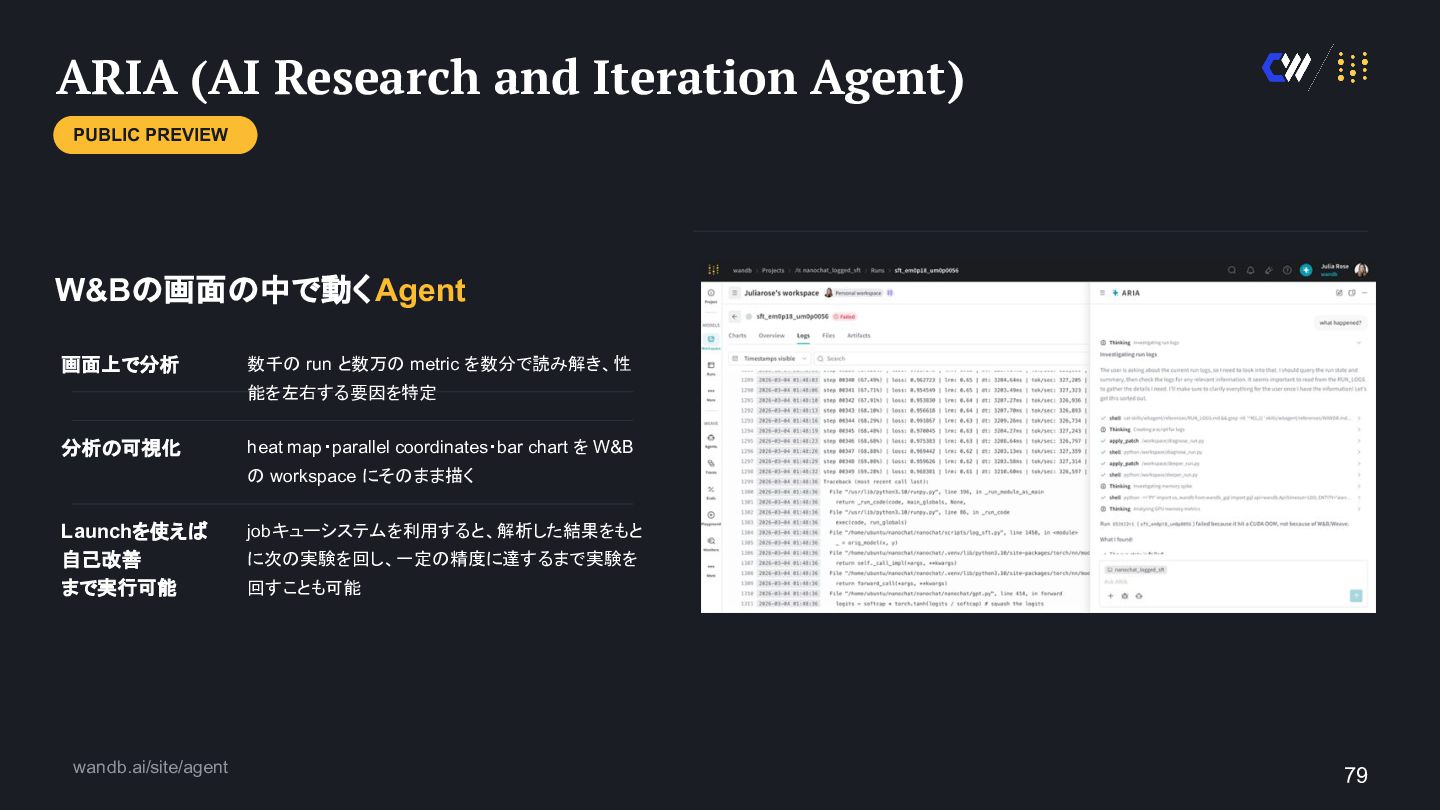
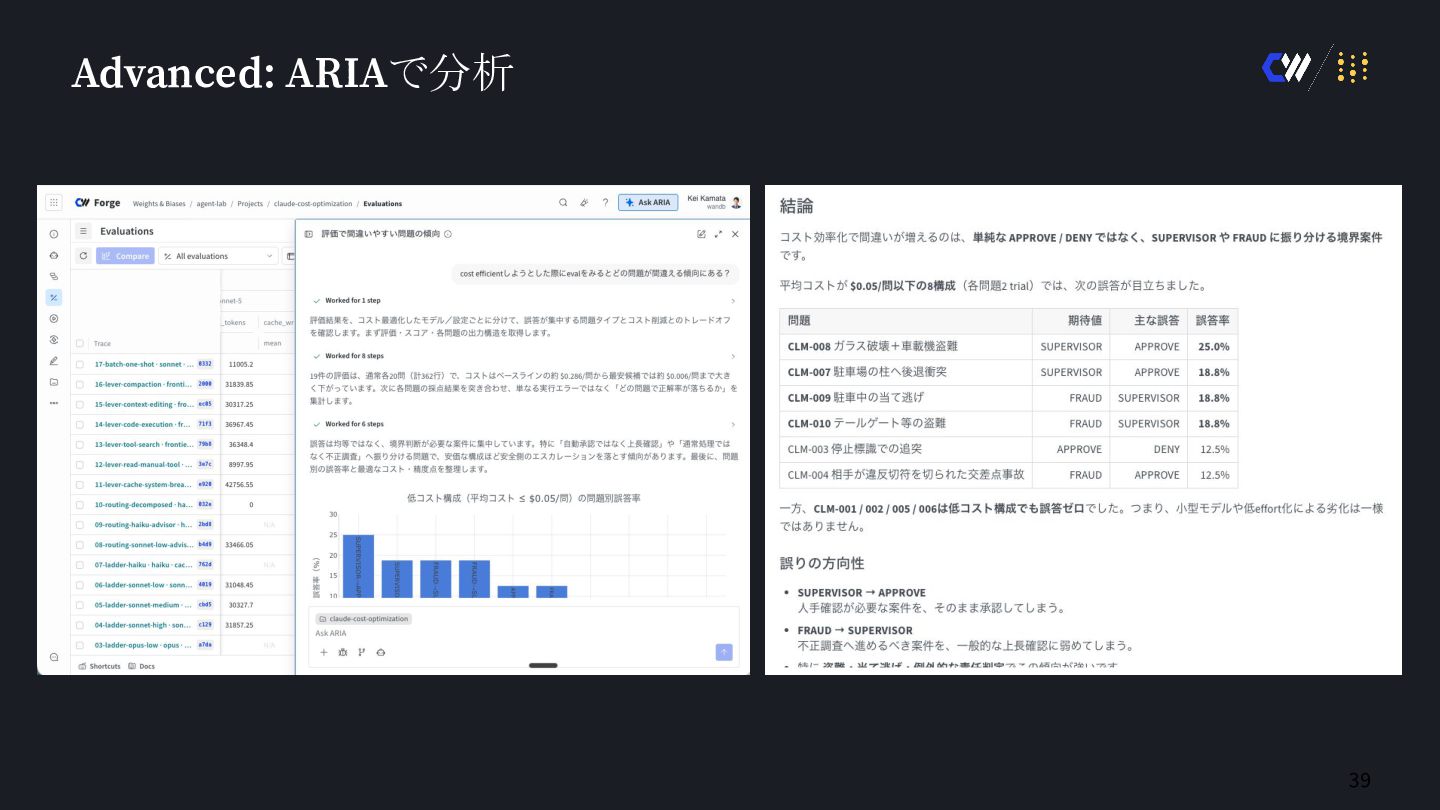
  47. ARIA (AI Research and Iteration Agent) PUBLIC PREVIEW W&Bの画面の中で動く Agent

    画面上で分析 数千の run と数万の metric を数分で読み解き、性 能を左右する要因を特定 分析の可視化 heat map・parallel coordinates・bar chart を W&B の workspace にそのまま描く Launchを使えば 自己改善 まで実行可能 wandb.ai/site/agent jobキューシステムを利用すると、解析した結果をもと に次の実験を回し、一定の精度に達するまで実験を 回すことも可能 79
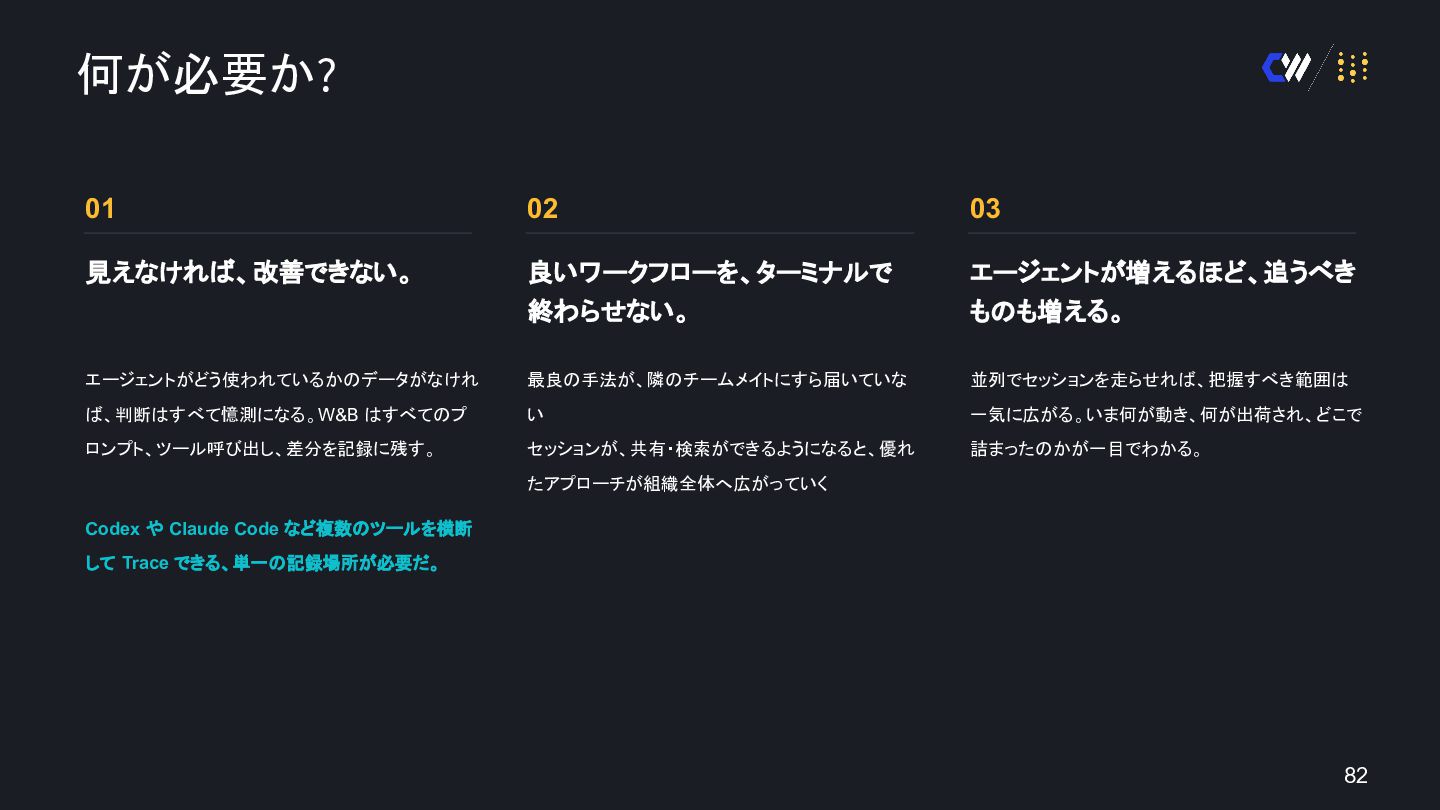
  48. 何が必要か? 01 02 03 見えなければ、改善できない。 良いワークフローを、ターミナルで 終わらせない。 エージェントが増えるほど、追うべき ものも増える。 エージェントがどう使われているかのデータがなけれ

    最良の手法が、隣のチームメイトにすら届いていな 並列でセッションを走らせれば、把握すべき範囲は ば、判断はすべて憶測になる。W&B はすべてのプ い 一気に広がる。いま何が動き、何が出荷され、どこで ロンプト、ツール呼び出し、差分を記録に残す。 セッションが、共有・検索ができるようになると、優れ 詰まったのかが一目でわかる。 たアプローチが組織全体へ広がっていく Codex や Claude Code など複数のツールを横断 して Trace できる、単一の記録場所が必要だ。 82
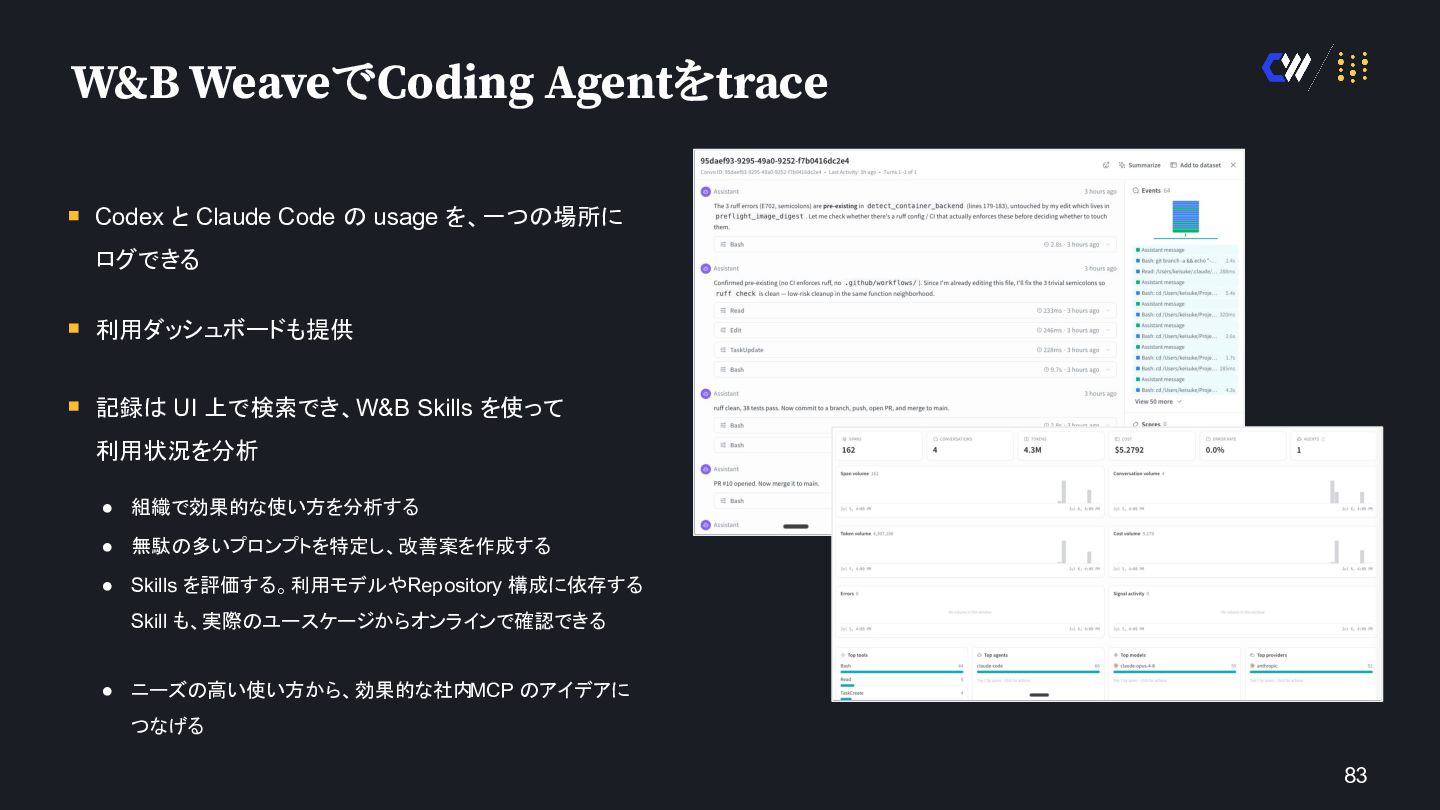
  49. W&B WeaveでCoding Agentをtrace Codex と Claude Code の usage を、一つの場所に

    ログできる 利用ダッシュボードも提供 記録は UI 上で検索でき、W&B Skills を使って 利用状況を分析 • 組織で効果的な使い方を分析する • 無駄の多いプロンプトを特定し、改善案を作成する • Skills を評価する。利用モデルやRepository 構成に依存する Skill も、実際のユースケージからオンラインで確認できる • ニーズの高い使い方から、効果的な社内MCP のアイデアに つなげる 83
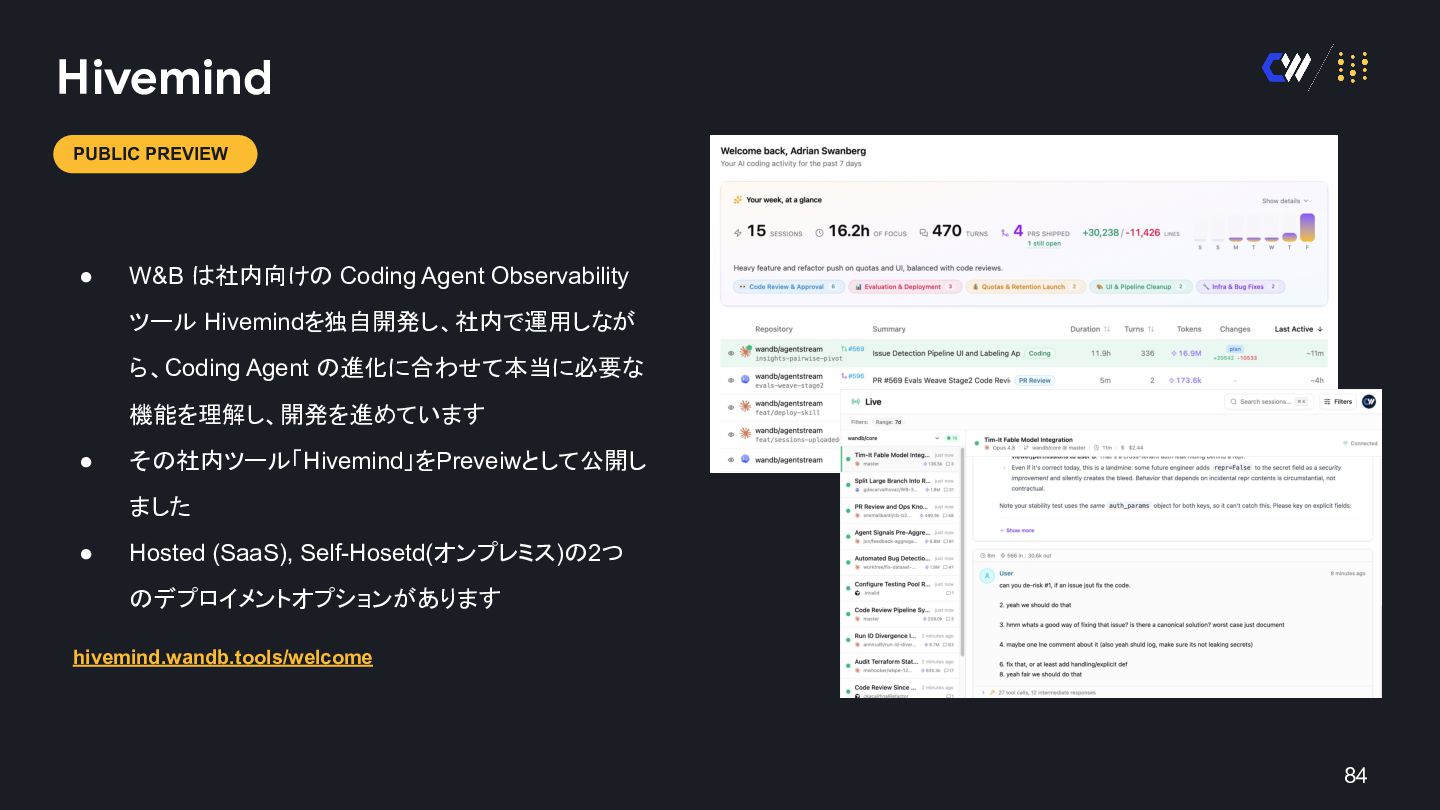
  50. Hivemind PUBLIC PREVIEW • W&B は社内向けの Coding Agent Observability ツール

    Hivemindを独自開発し、社内で運用しなが ら、Coding Agent の進化に合わせて本当に必要な 機能を理解し、開発を進めています • その社内ツール「Hivemind」をPreveiwとして公開し ました • Hosted (SaaS), Self-Hosetd(オンプレミス)の2つ のデプロイメントオプションがあります hivemind.wandb.tools/welcome 84