March 2024 ◦ Linux Foundation Launches Open Source Valkey Community • In Response to Redis's License Change ◦ 2024-03 Redis Adopts Dual Source-Available Licensing ◦ 2025-05 Redis is open source again - <antirez> Valkeyは2024-03に作られたRedisのfork。Redisがライセンス変更をしたのを受け て発足しました。Redisはその後AGPLv3になってまたOSSに戻っています。 5
to say this in the GitHub repo description ◦ A new project to resume development on the formerly open-source Redis project. We're calling it Valkey, since it's a twist on the key-value datastore. Valkeyの名前の由来はKey-Value Storeの「Key-Value」を逆に。昔はGitHubリポ ジトリのdescriptionに書いてあった。探すと痕跡があります 6
• Both continue to improve in performance ◦ Forked at version 7.2; now Redis 8.10/Valkey 9.1 RedisとValkeyのどっちを使うか。Elasticacheで明らかに安いのでValkeyを使って います。forkしたのがRedis 7.2で、その後それぞれ進化している。 7
late 2010s • Used as job queues for async processing ◦ Required by Resque and Sidekiq • Also used for session storage and caching ◦ Redis is already there, no need to add memcached ◦ redis-session-store, RedisCacheStore(Rails v5.2) 2010年代後半は特に親密で、非同期処理のResqueやSidekiqが要求するし、セッ ションストアやキャッシュにも使う。そこにもうRedisがあるので、memcachedは 追加しないって判断をしていた。Rails本体にも入りましたね。 8
have used it ◦ Sidekiq is the first choice for a job queue ◦ You may have used it for caching as well • But what about using it as part of the application itself? ◦ This is today's topic! なので、みんなRedisを使ったことはありそう?Sidekiqはジョブキューとして第一 選択肢だろうし、キャッシュにも利用したことはあるんじゃないか。でも「アプリ ケーションの一部として」だとどうだろう?これが今日の話! 9
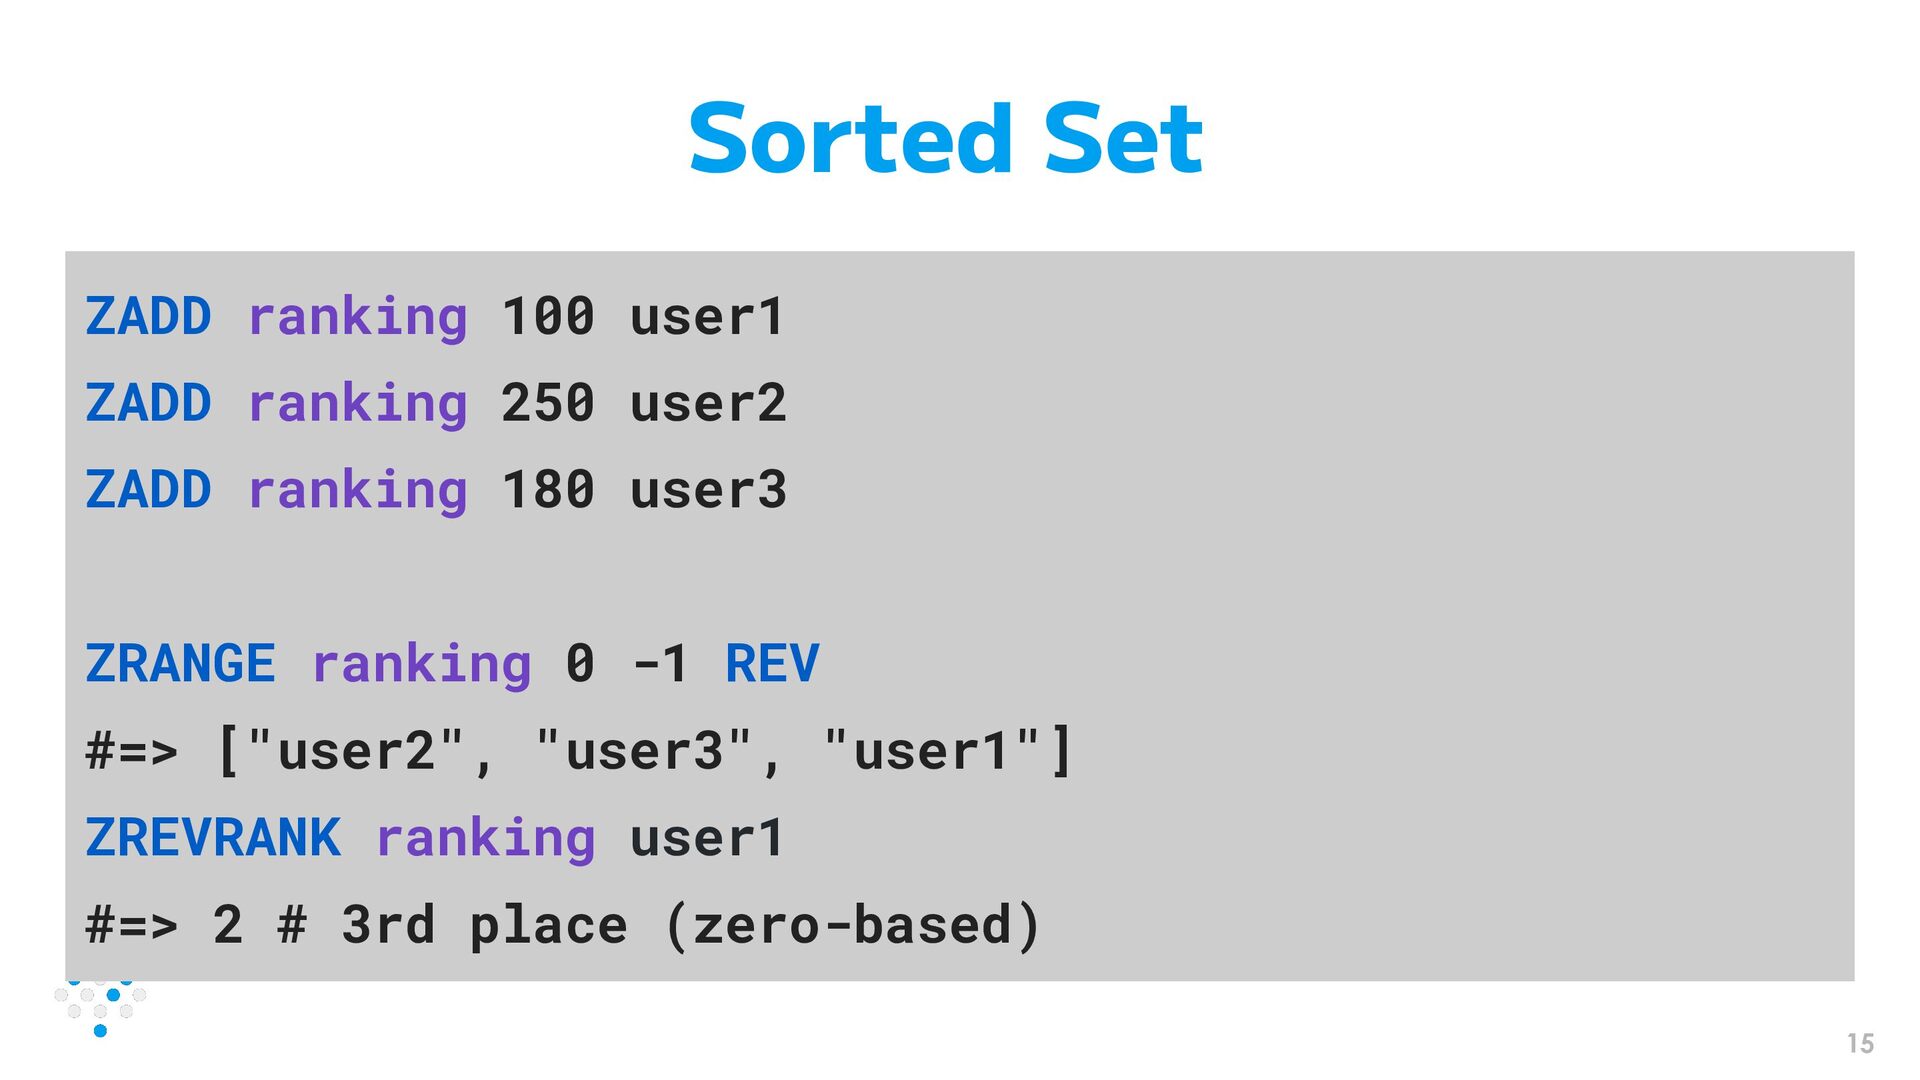
Set, Stream, Bitmap, etc. • Useful for caches, counters, queues, leaderboards, message delivery, and more • Provide commands for each data structure ◦ For Sorted Sets: ranking positions, score-range queries, etc. 多彩なデータ構造で、色々な使い道があります。各データ構造向けのコマンドもあ る。Sorted Setならランキング順位とかスコア範囲検索とか。 12
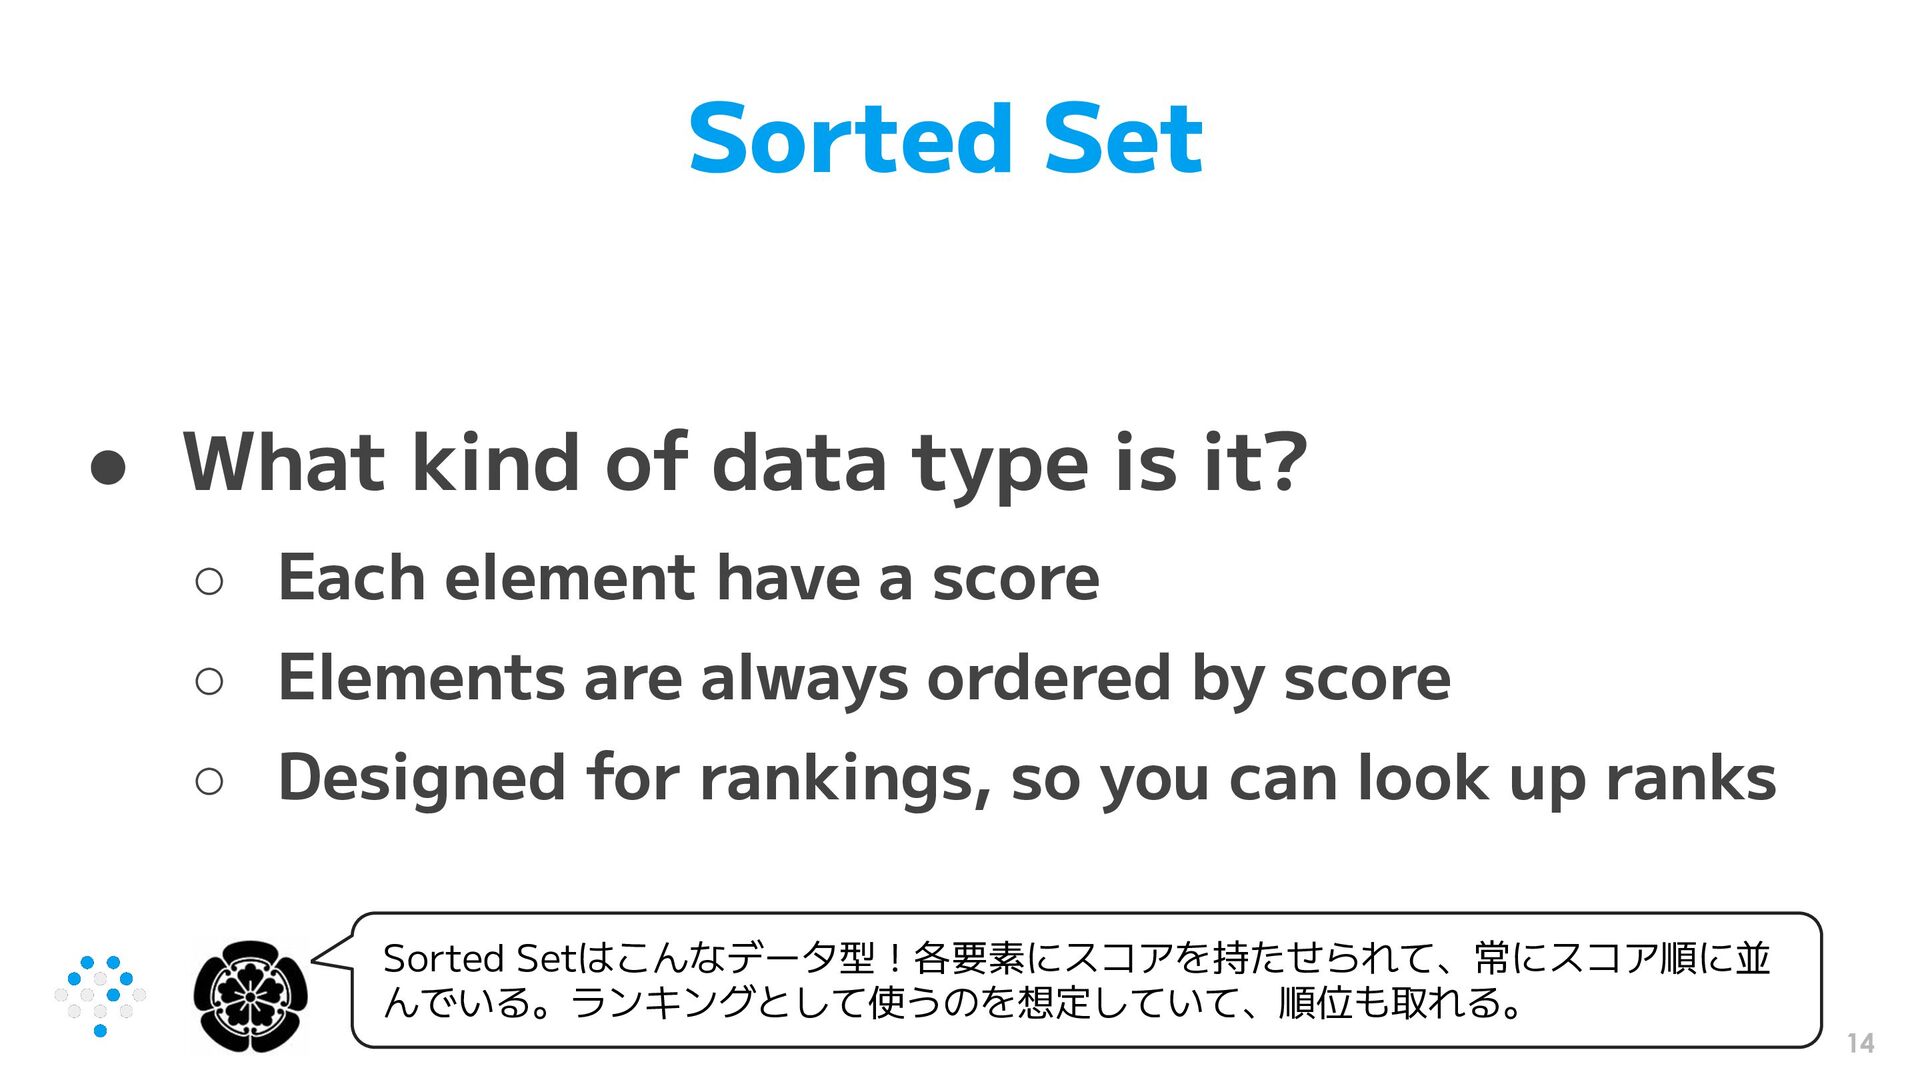
◦ Each element have a score ◦ Elements are always ordered by score ◦ Designed for rankings, so you can look up ranks Sorted Setはこんなデータ型!各要素にスコアを持たせられて、常にスコア順に並 んでいる。ランキングとして使うのを想定していて、順位も取れる。 14
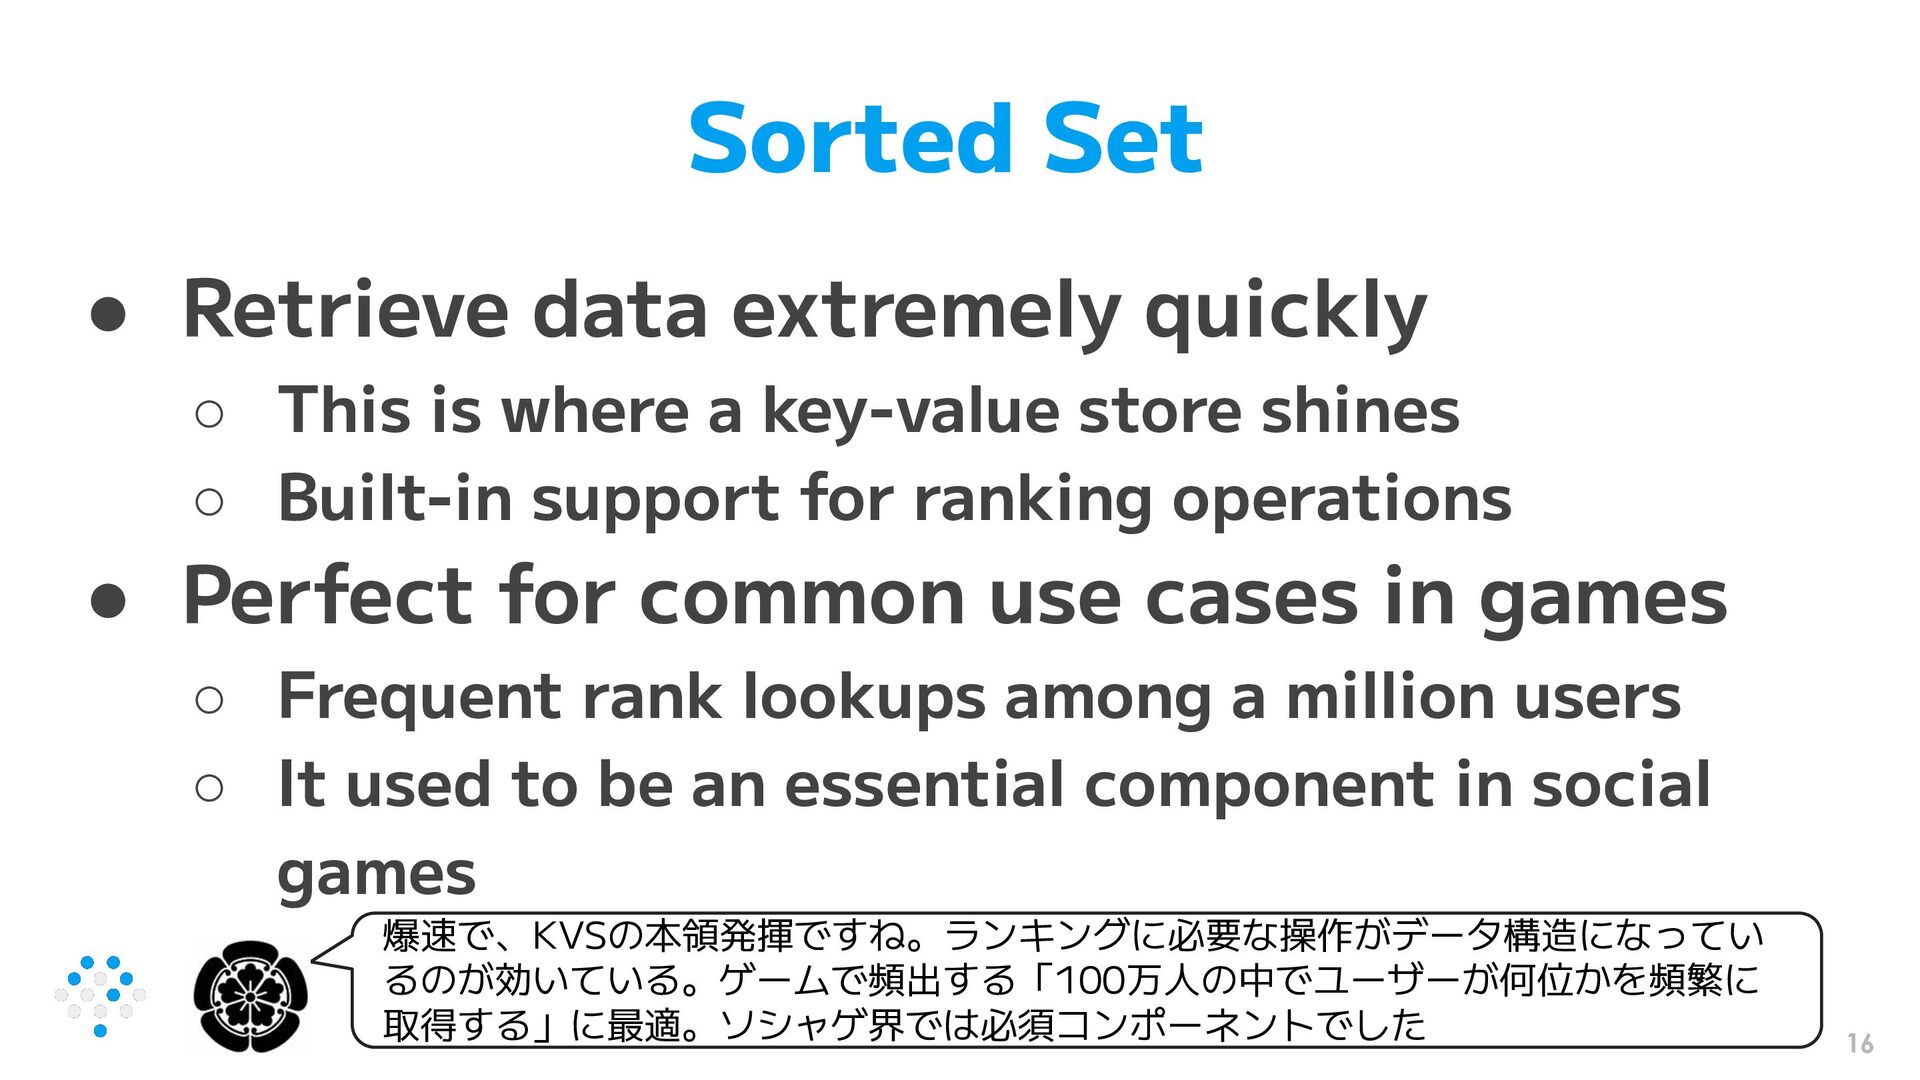
where a key-value store shines ◦ Built-in support for ranking operations • Perfect for common use cases in games ◦ Frequent rank lookups among a million users ◦ It used to be an essential component in social games 爆速で、KVSの本領発揮ですね。ランキングに必要な操作がデータ構造になってい るのが効いている。ゲームで頻出する「100万人の中でユーザーが何位かを頻繁に 取得する」に最適。ソシャゲ界では必須コンポーネントでした 16
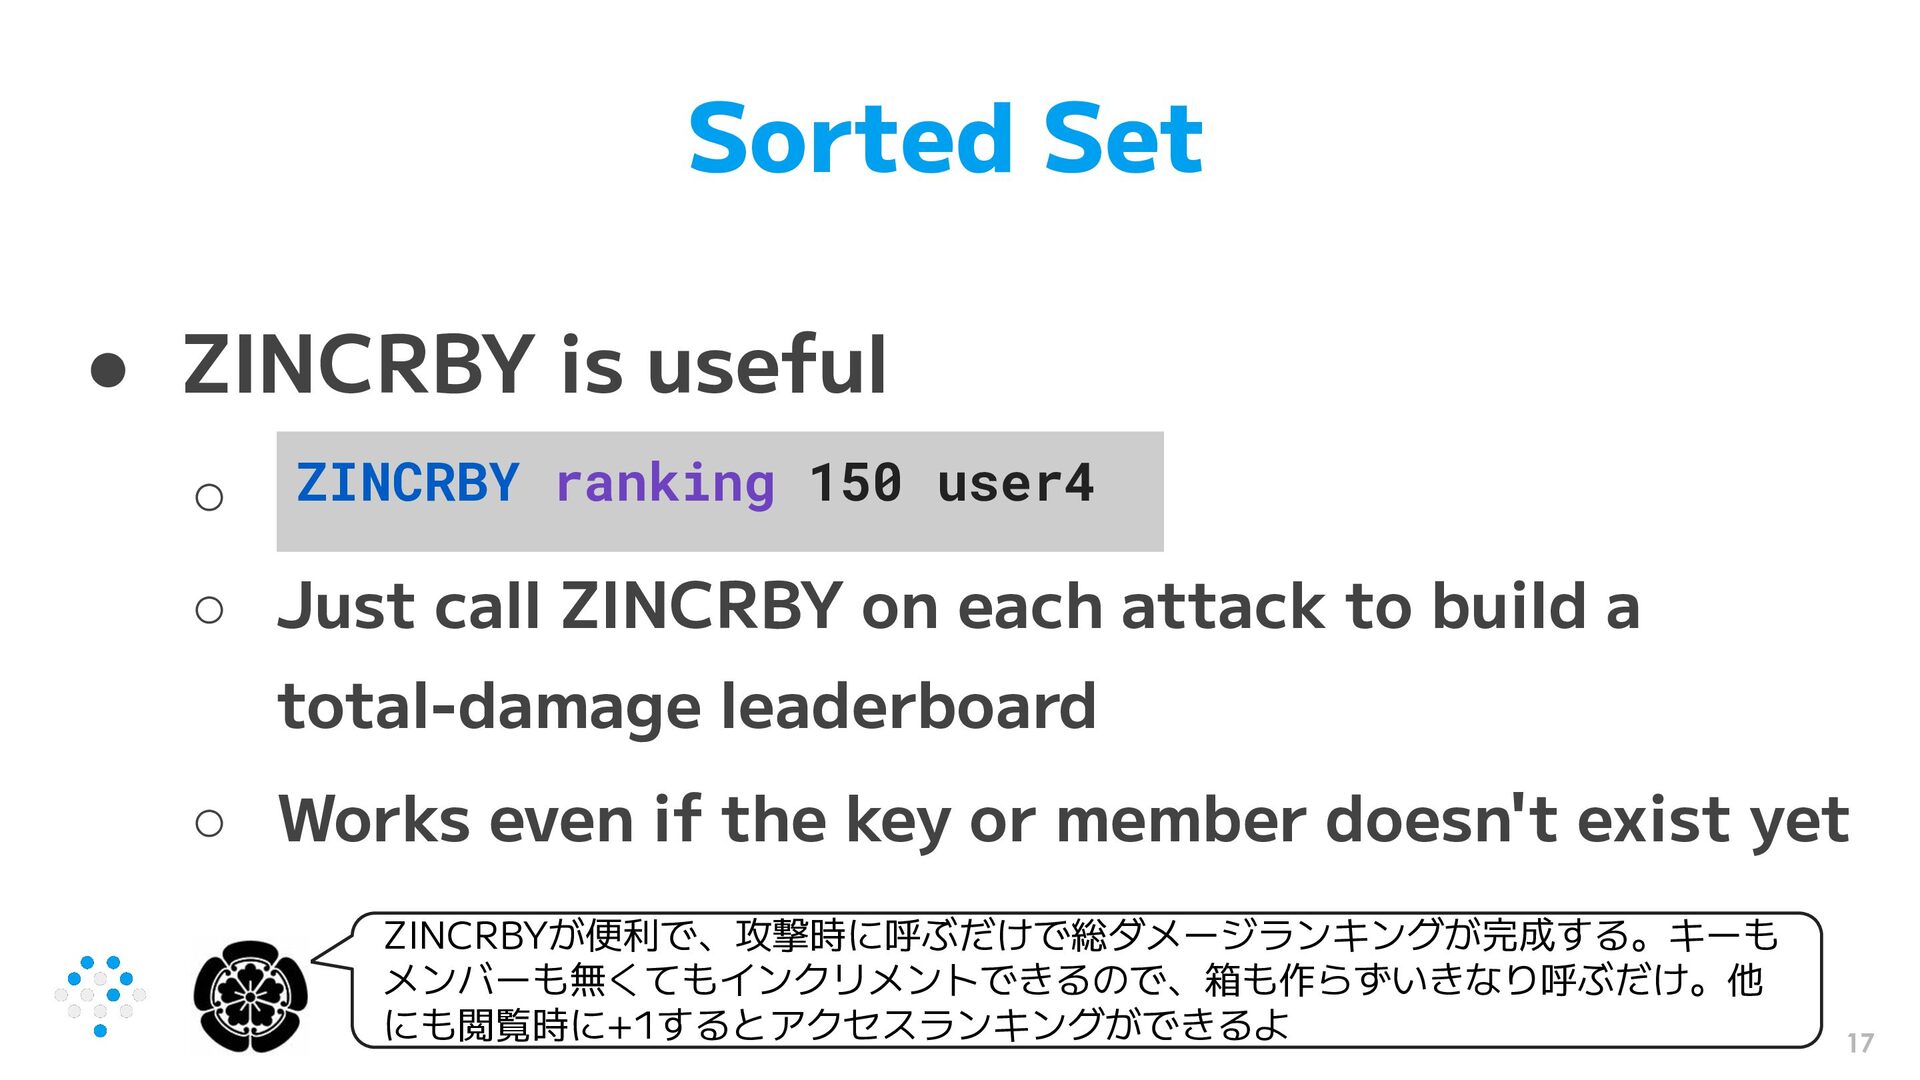
user4 ◦ Just call ZINCRBY on each attack to build a total-damage leaderboard ◦ Works even if the key or member doesn't exist yet ZINCRBYが便利で、攻撃時に呼ぶだけで総ダメージランキングが完成する。キーも メンバーも無くてもインクリメントできるので、箱も作らずいきなり呼ぶだけ。他 にも閲覧時に+1するとアクセスランキングができるよ 17
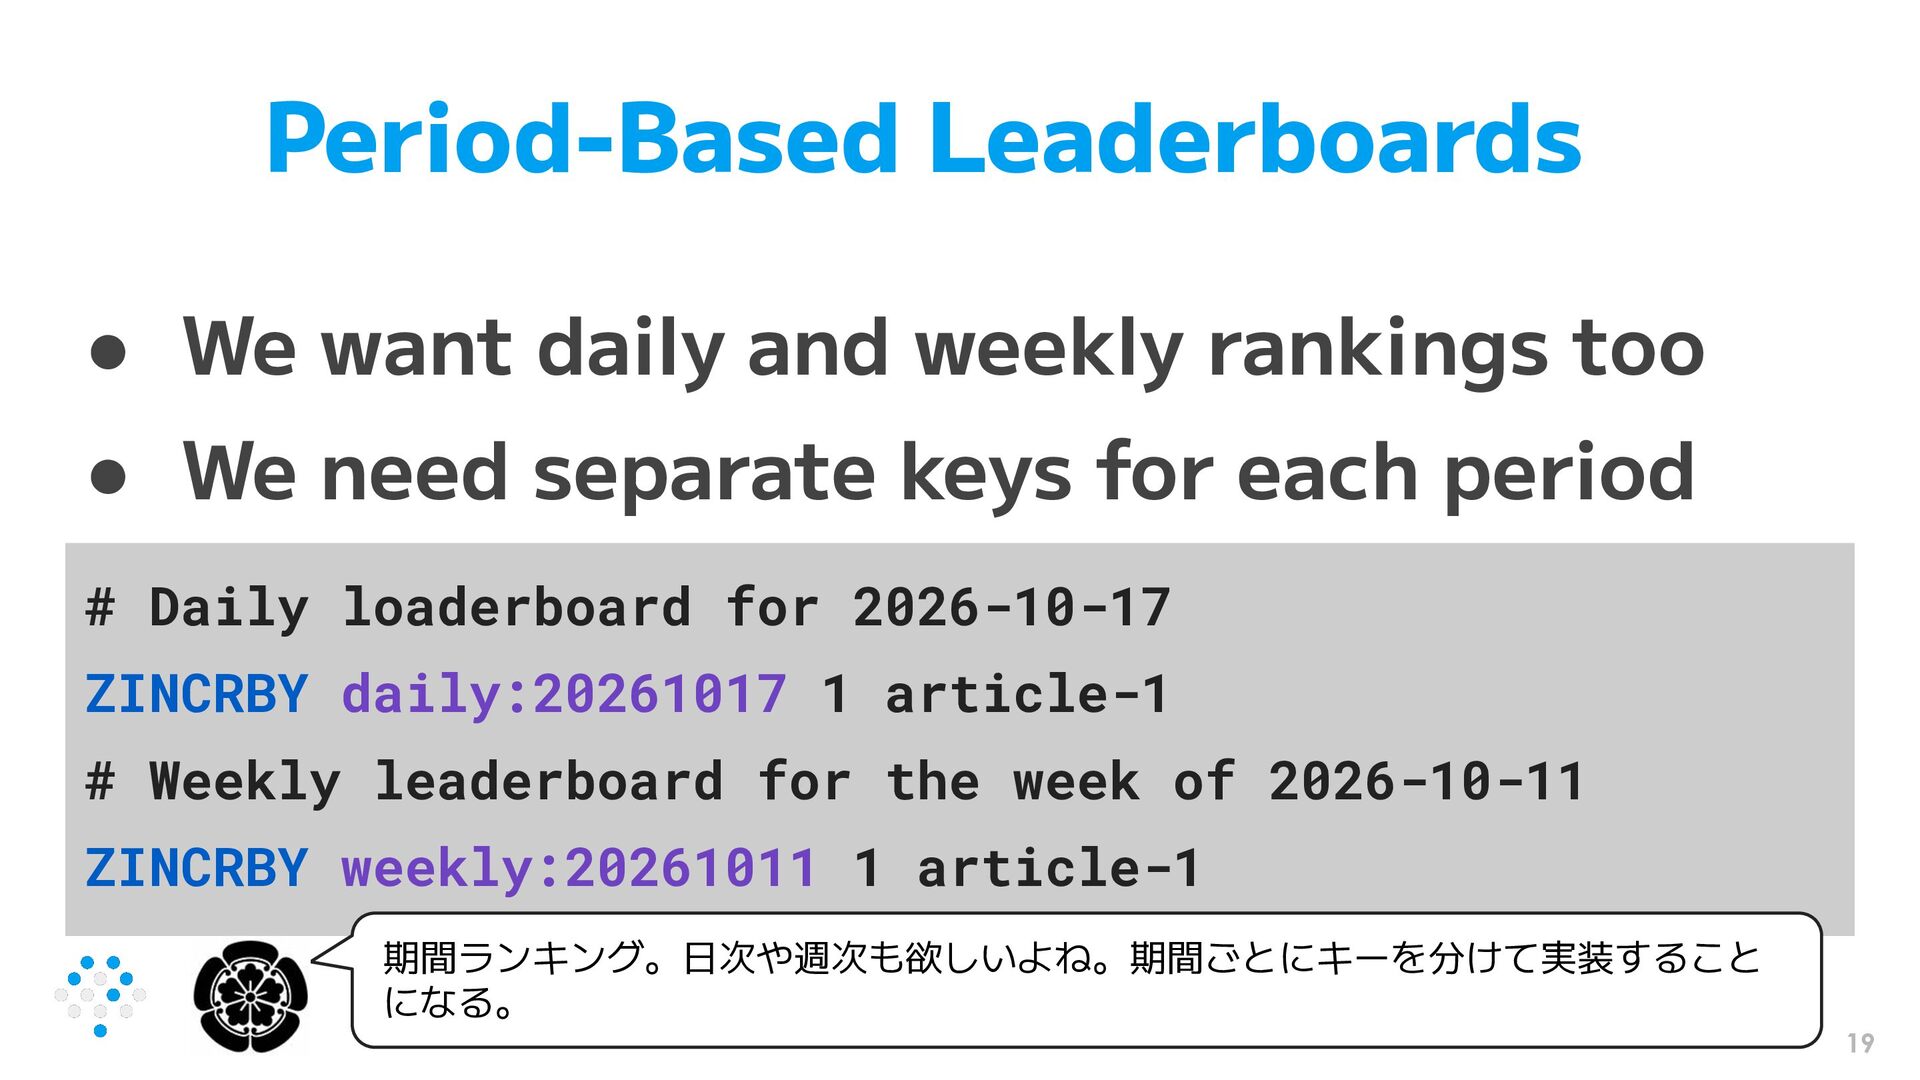
• We need separate keys for each period # Daily loaderboard for 2026-10-17 ZINCRBY daily:20261017 1 article-1 # Weekly leaderboard for the week of 2026-10-11 ZINCRBY weekly:20261011 1 article-1 期間ランキング。日次や週次も欲しいよね。期間ごとにキーを分けて実装すること になる。 19
leaderboard resets when the week changes • Weekly Leaderboard ≠ Last 7 Days • Fixed weekly keys cannot provide a leaderboard for the last seven days 週次ランキングなんだけど、月曜になった瞬間にリセットされる。週次ランキング は直近7日間ランキングではないのだよね。固定された週次キーでは「直近7日間」 ランキングが作れない。 20
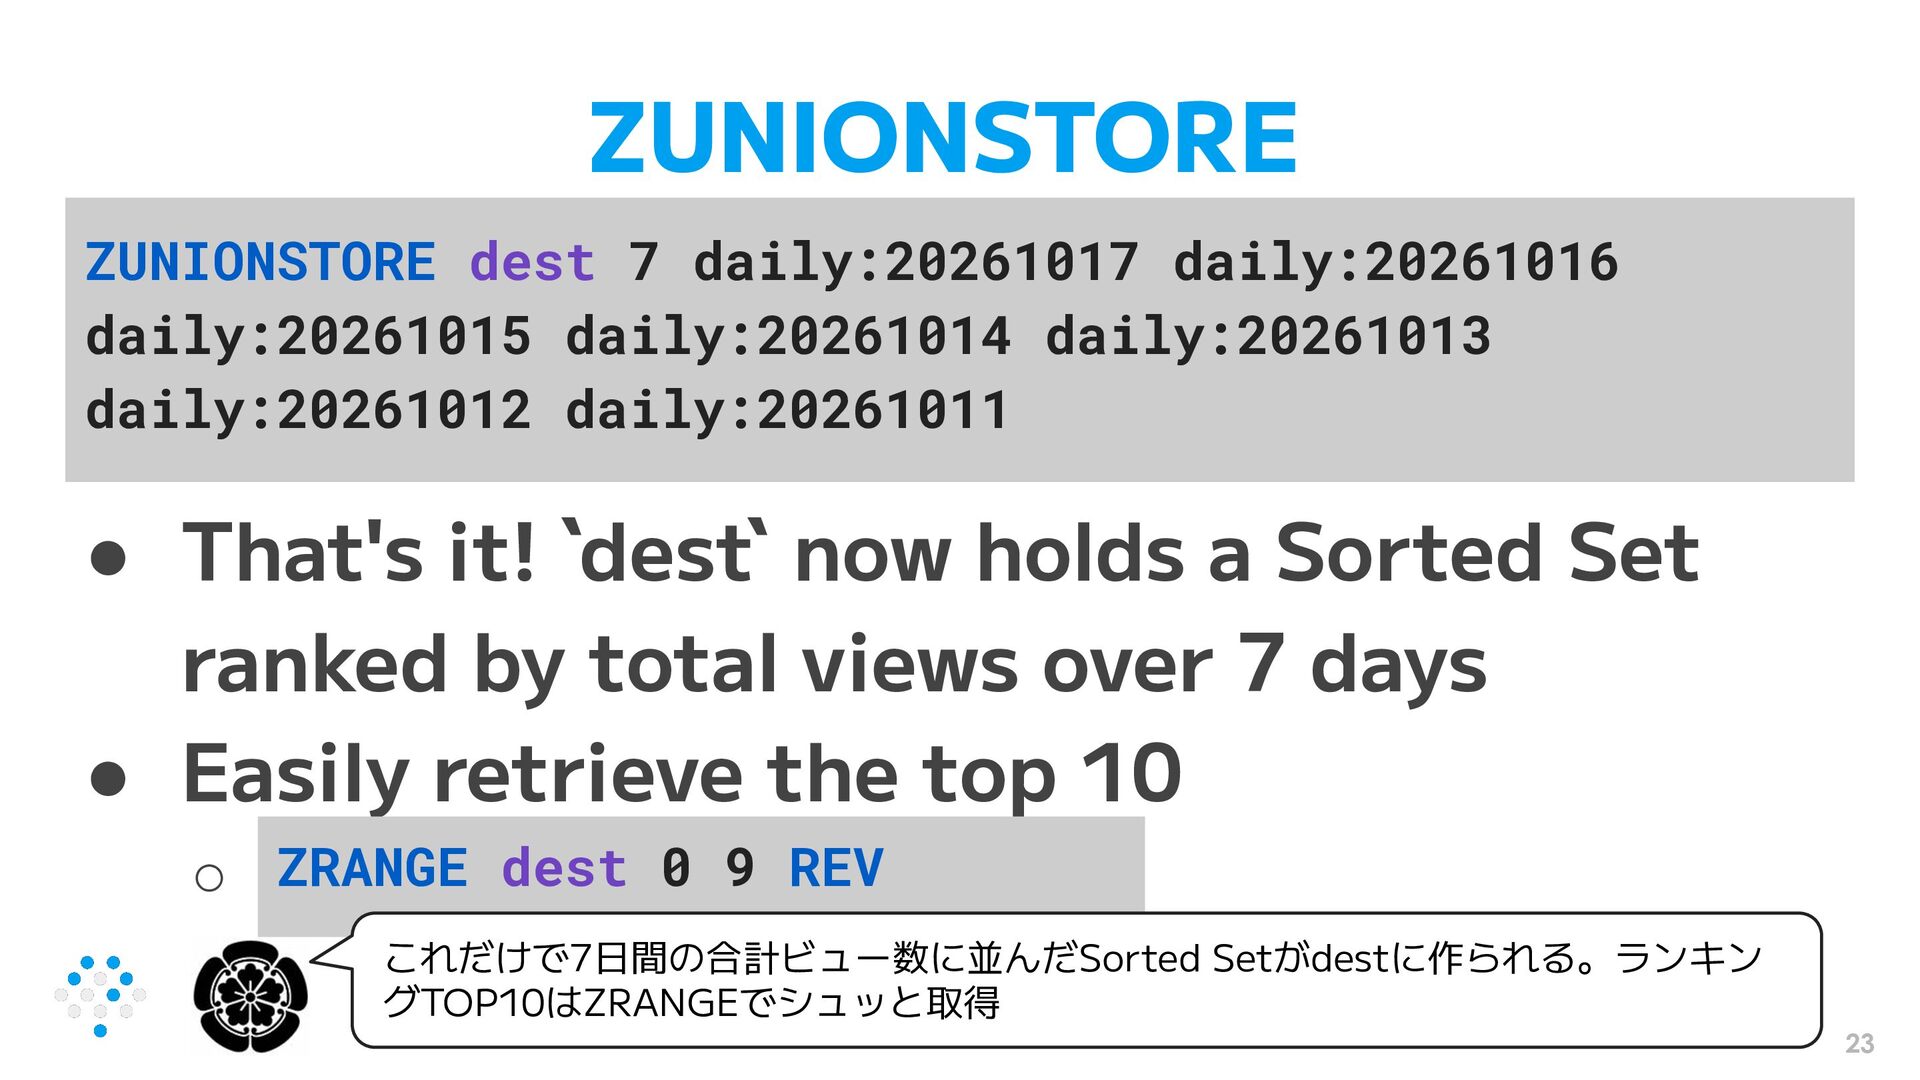
daily:20261011 • That's it! `dest` now holds a Sorted Set ranked by total views over 7 days • Easily retrieve the top 10 ◦ ZRANGE dest 0 9 REV これだけで7日間の合計ビュー数に並んだSorted Setがdestに作られる。ランキン グTOP10はZRANGEでシュッと取得 23
usually needed calendar-month rankings, so I've never used more than 30 keys 「30日間」って要件だったら30個並べます。私の用途だと月次は月次が欲しいって 言われることが多かったので、その辺りまでしか使ったことはない。 24
rankings • Easy to increment scores with ZINCRBY • Any time window when retrieving results • So cooool! ランキングのためのデータ型で、ZINCRBYで簡単に加算できて、取得時に必要なウ インドウをその場で指定しているの、カッコ良すぎるでしょ! 26
want an article that went viral 7 days ago to stay at the top • Apply exponential decay to view counts ◦ ZUNIONSTORE actually has a WEIGHTS option ランキングはなるべく鮮度を反映させたい。1週間前にバズった記事がずっと1位な のはちょっとね。指数関数的に減衰するといいはずで、なんとZUNIONSTOREには WEIGHTSオプションがある 29
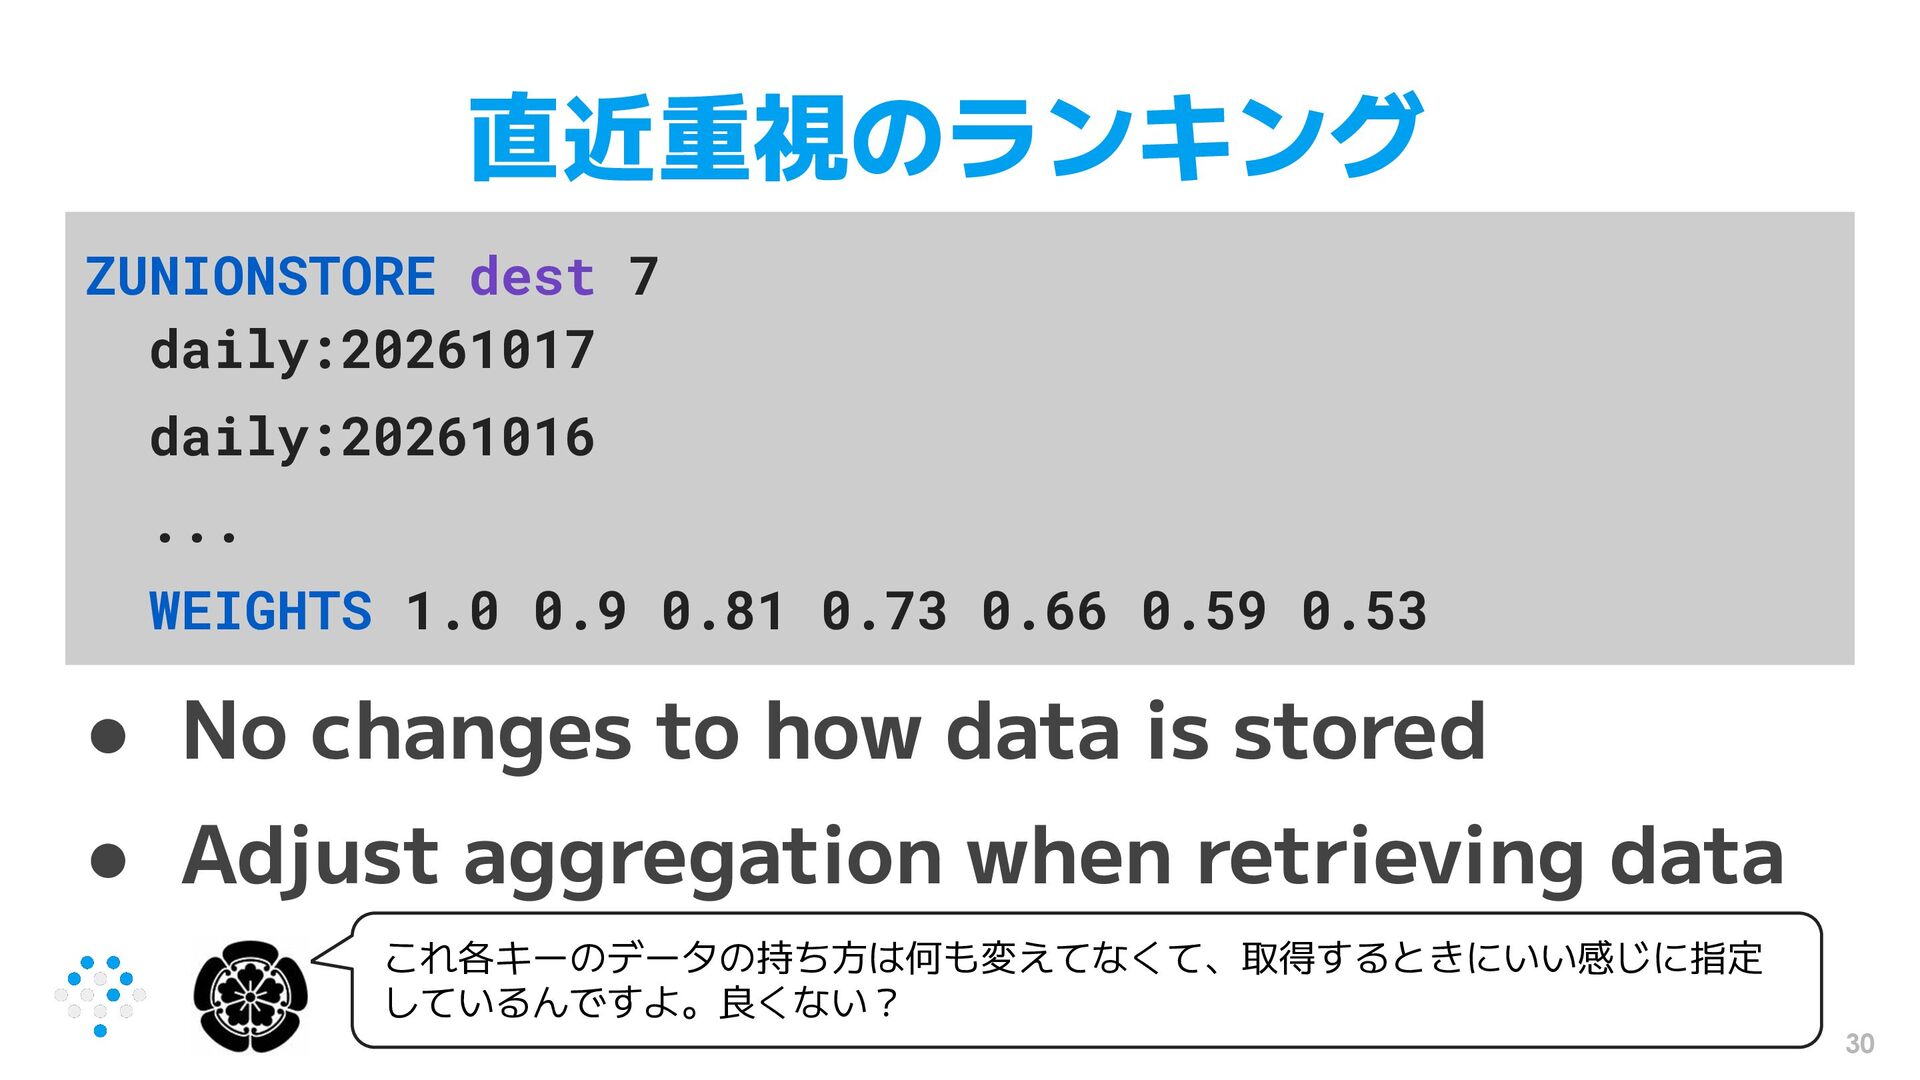
0.81 0.73 0.66 0.59 0.53 • No changes to how data is stored • Adjust aggregation when retrieving data これ各キーのデータの持ち方は何も変えてなくて、取得するときにいい感じに指定 しているんですよ。良くない? 30
◦ Increment scores with ZINCRBY • ZUNIONSTORE combines keys to create leaderboards for any time window ◦ Especially useful for windows like "last 7 days" • WEIGHTS lets you assign different weights ここまでのまとめ。Sorted Setはスコア順に並べるデータ型で、ZINCRBYで加算で きる。ZUNIONSTOREでキーを合算すると任意期間のランキングになり、「直近7 日間」みたいなウインドウ固定時に便利。WEIGHTSは重み付けもできる。 34
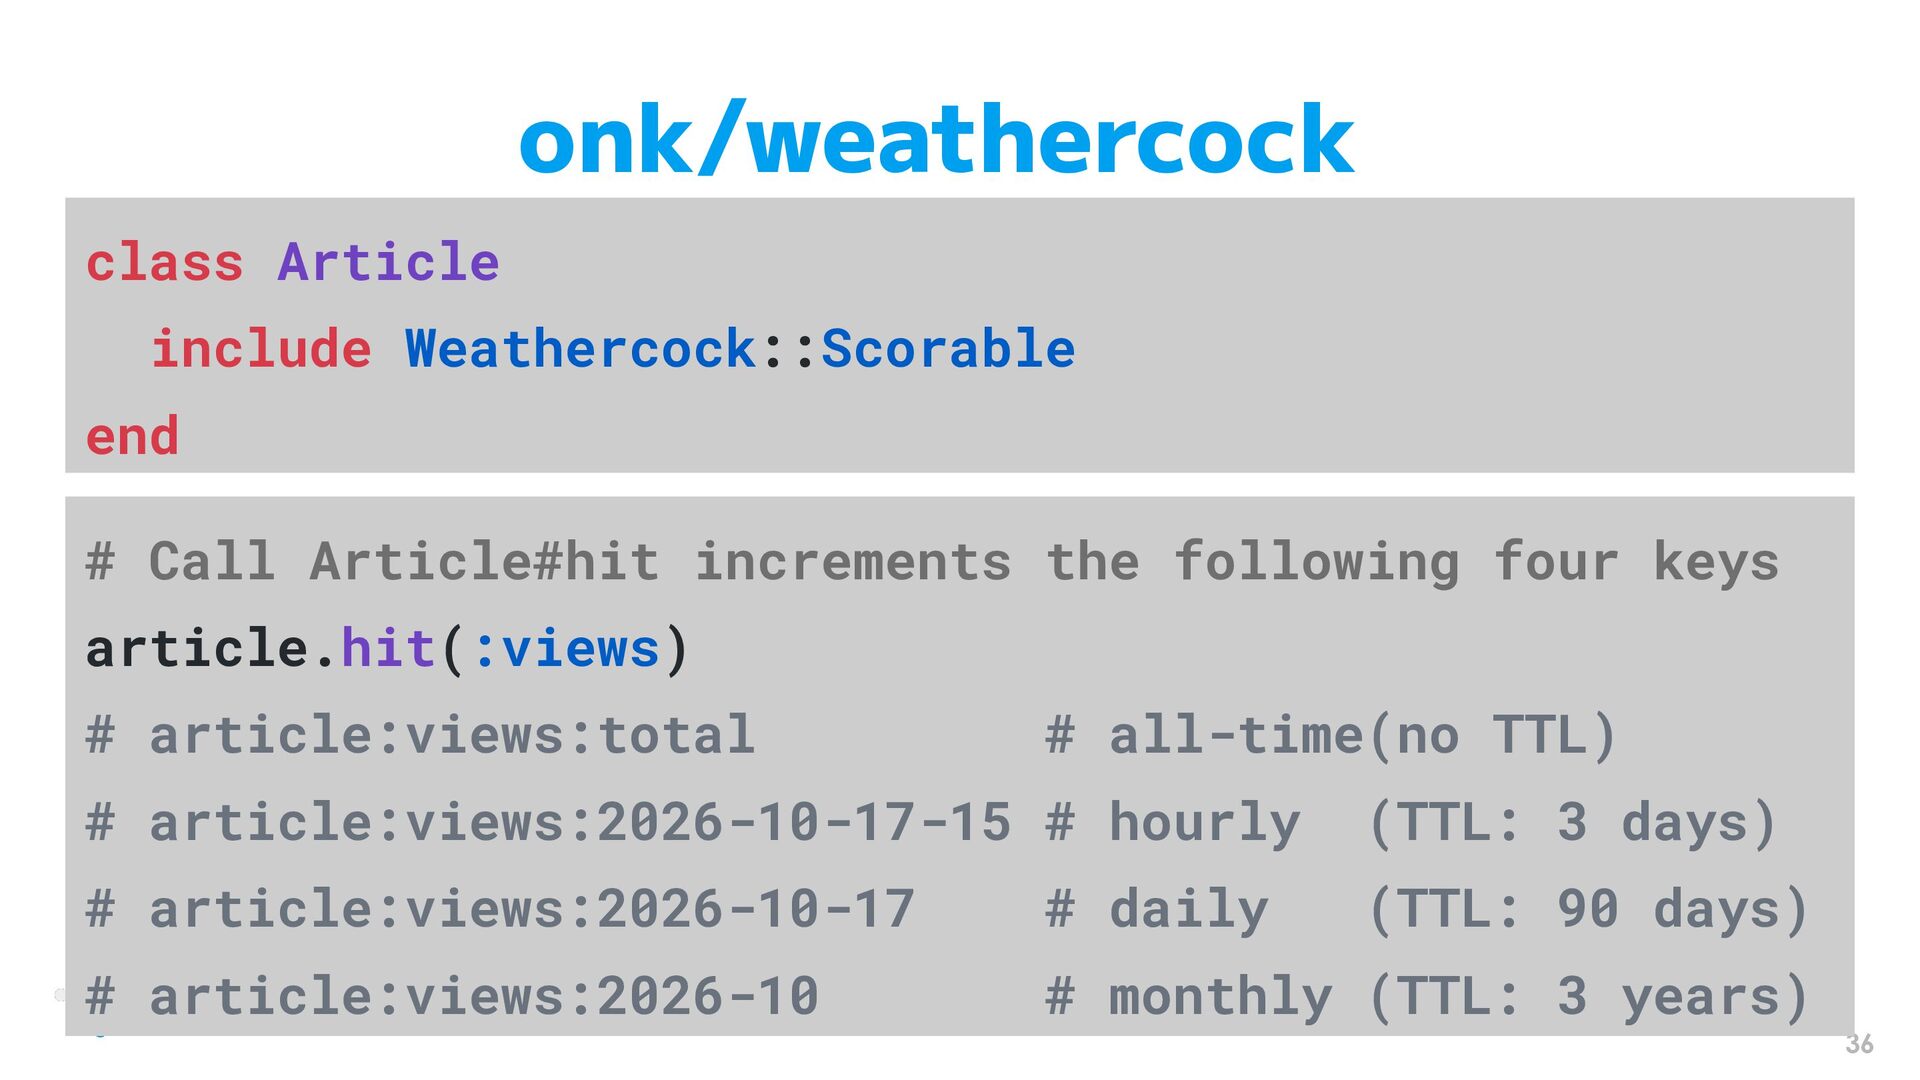
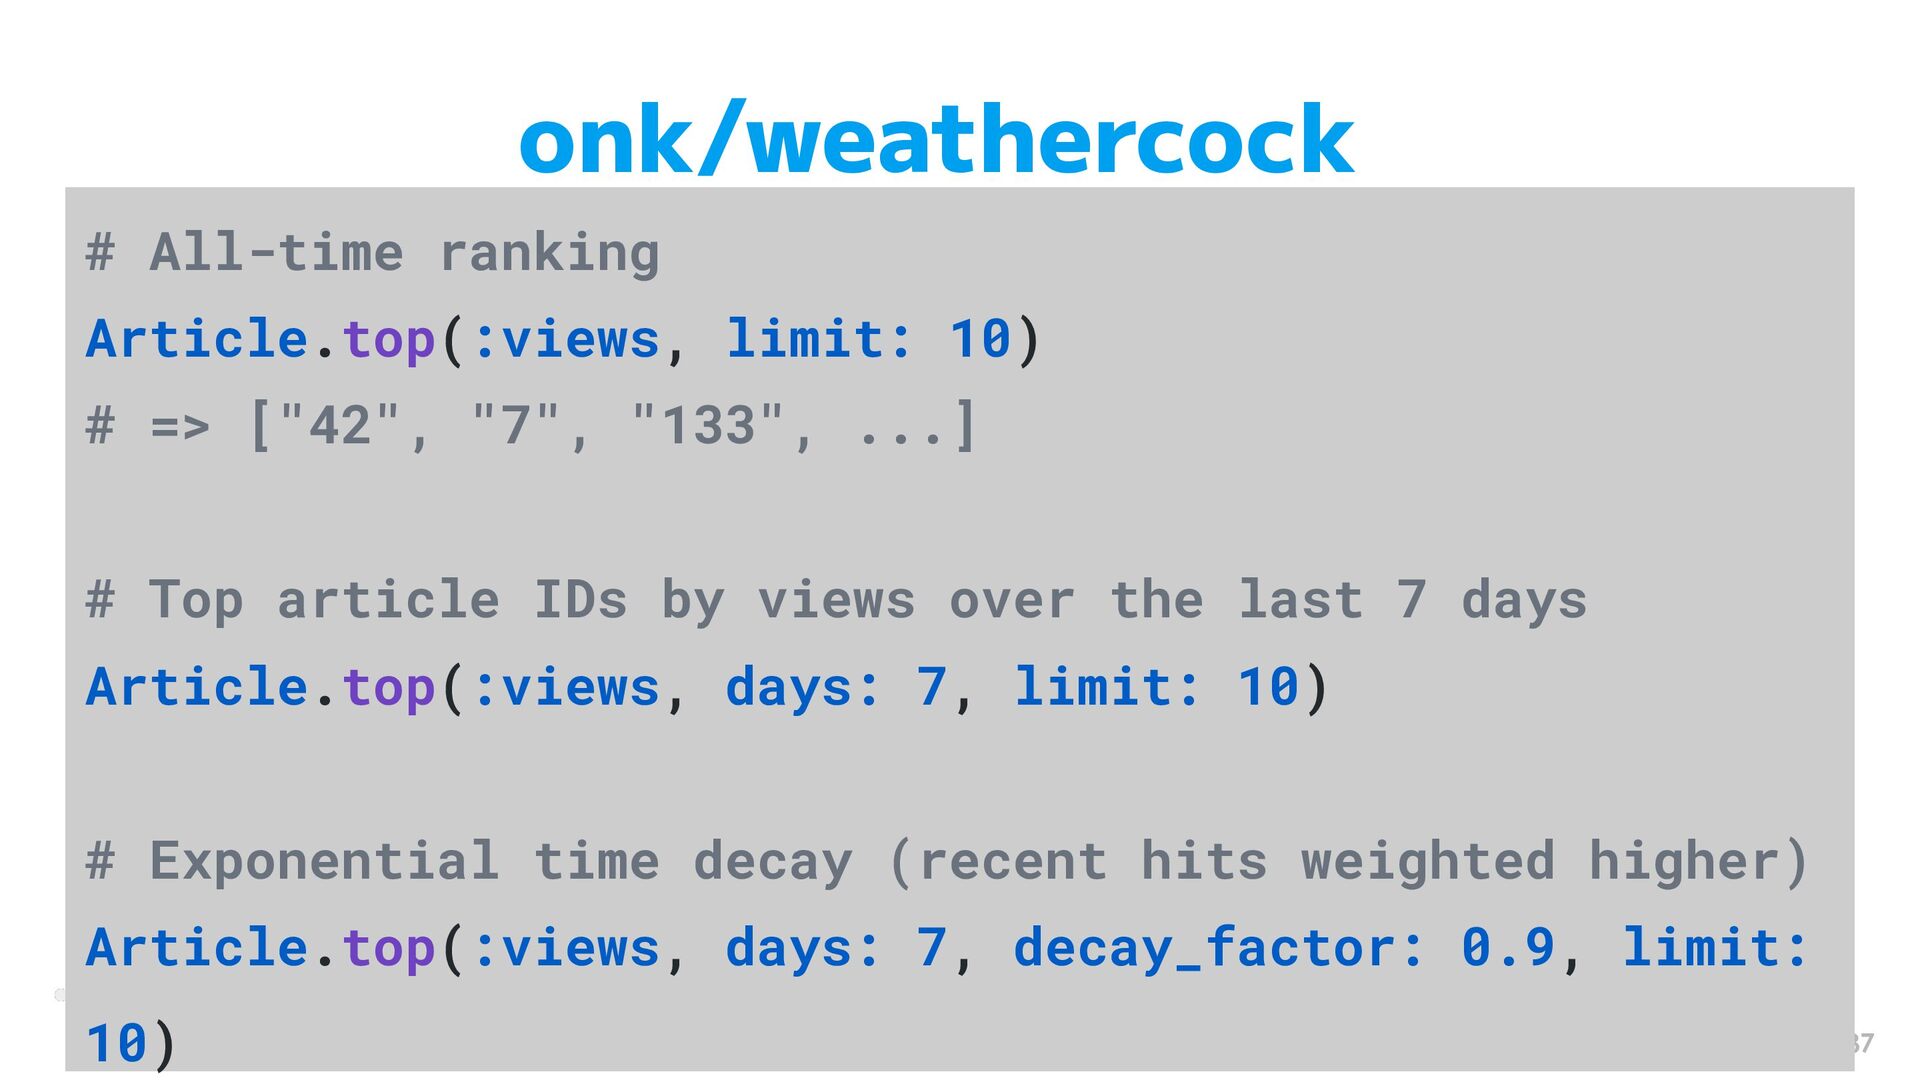
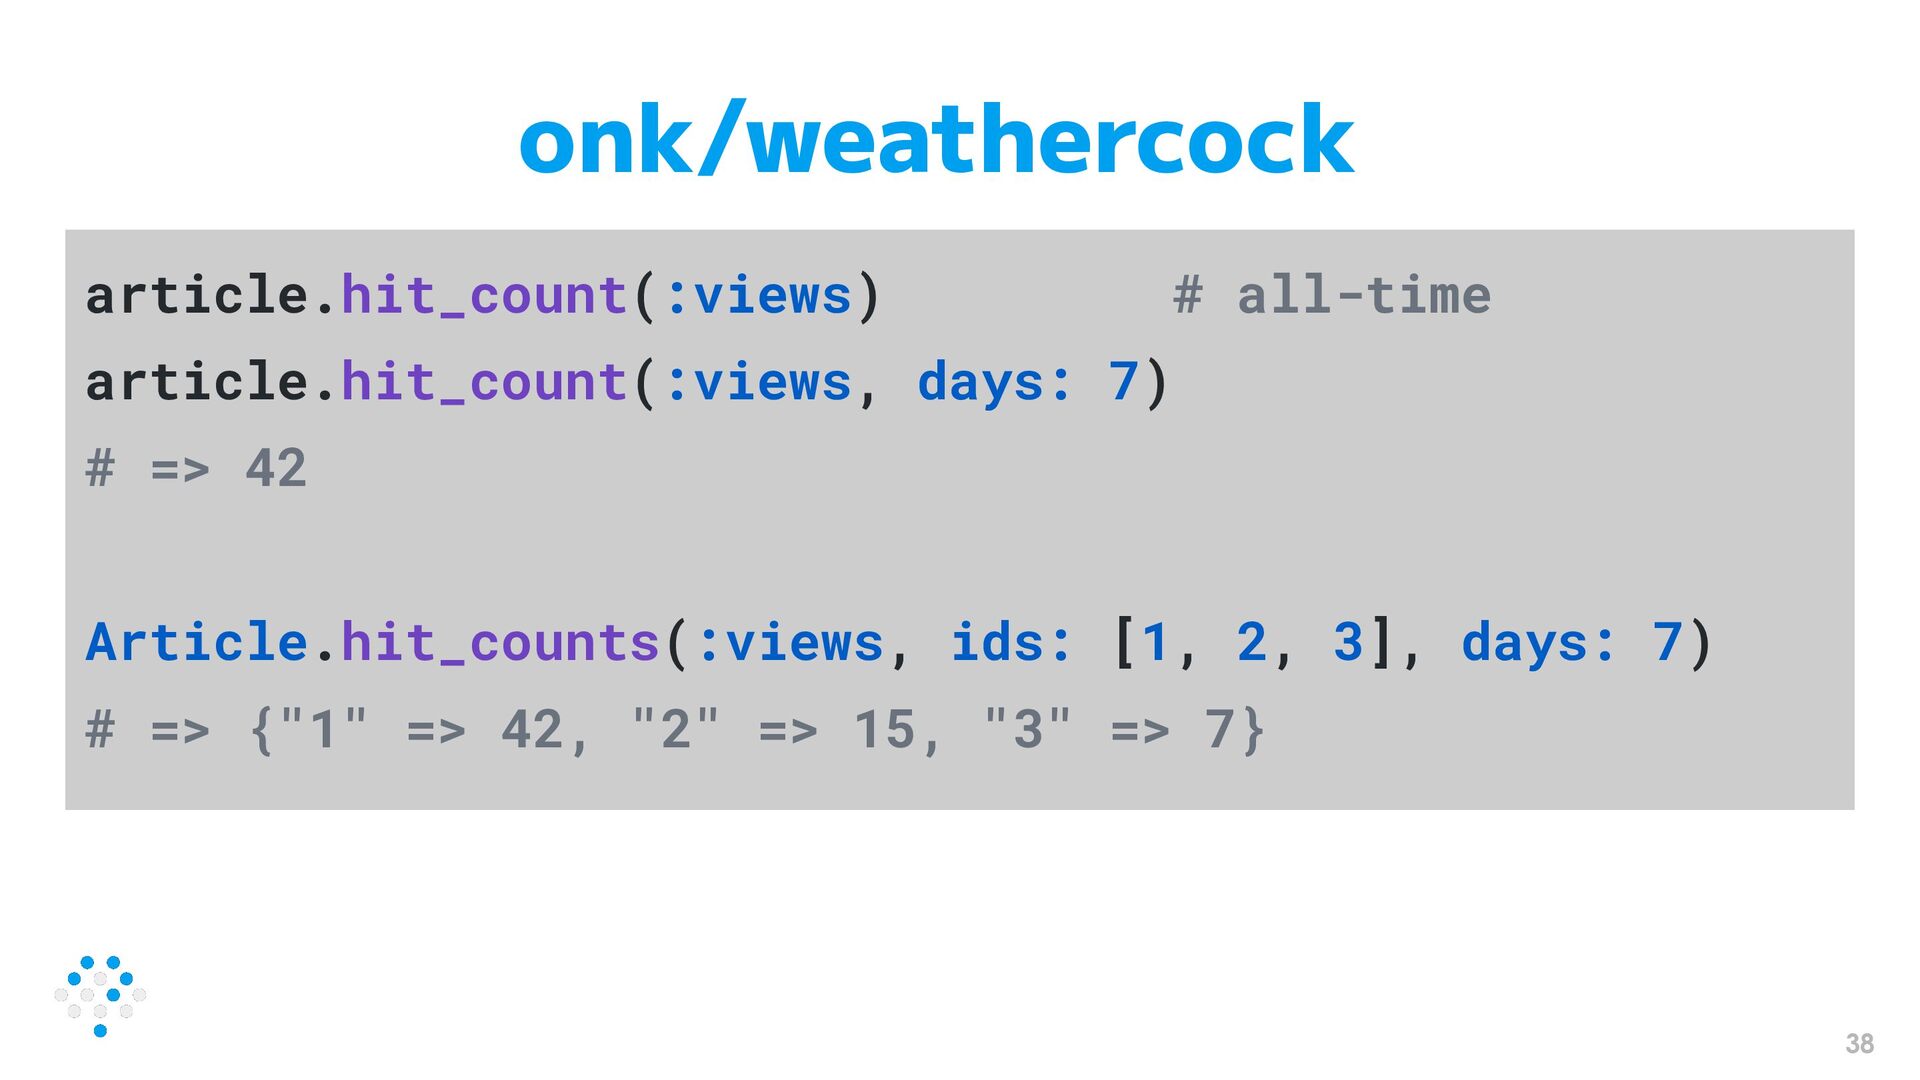
"7", "133", ...] # Top article IDs by views over the last 7 days Article.top(:views, days: 7, limit: 10) # Exponential time decay (recent hits weighted higher) Article.top(:views, days: 7, decay_factor: 0.9, limit: 10) 37
it used • I use it in production, and it works well for my use case ZUNIONSTOREはこんなにカッコイイのに、使われているところをほとんど見な い。weathercockはproductionで使っていて、自分のユースケースでは満足してい る。 39
https://valkey.io/topics/search/ ◦ Supports vector search • Find semantically similar data ◦ Generate vectors using an embedding model ◦ Search by vector distance or similarity 公式モジュールにValkey Searchがあり、ベクトル検索ができます。ベクトル検索 は、意味が近いデータを検索できるってことです。Embeddingモデルを使ってベク トルを得ておいて、ベクトル同士の距離や類似度で検索する。 41
by meaning, not just keywords • RAG ◦ Retrieve documents relevant to a question ◦ Pass the results to an LLM • Recommendations ◦ Recommend similar articles or articles users might like ベクトル検索のユースケースは、まずセマンティック検索。単語ではなく「意味」 が近いデータを検索する。RAGは質問に関連する文書を検索して結果をLLMに渡す ヤツ。レコメンドは類似記事や好きそうな記事を推薦する。 42
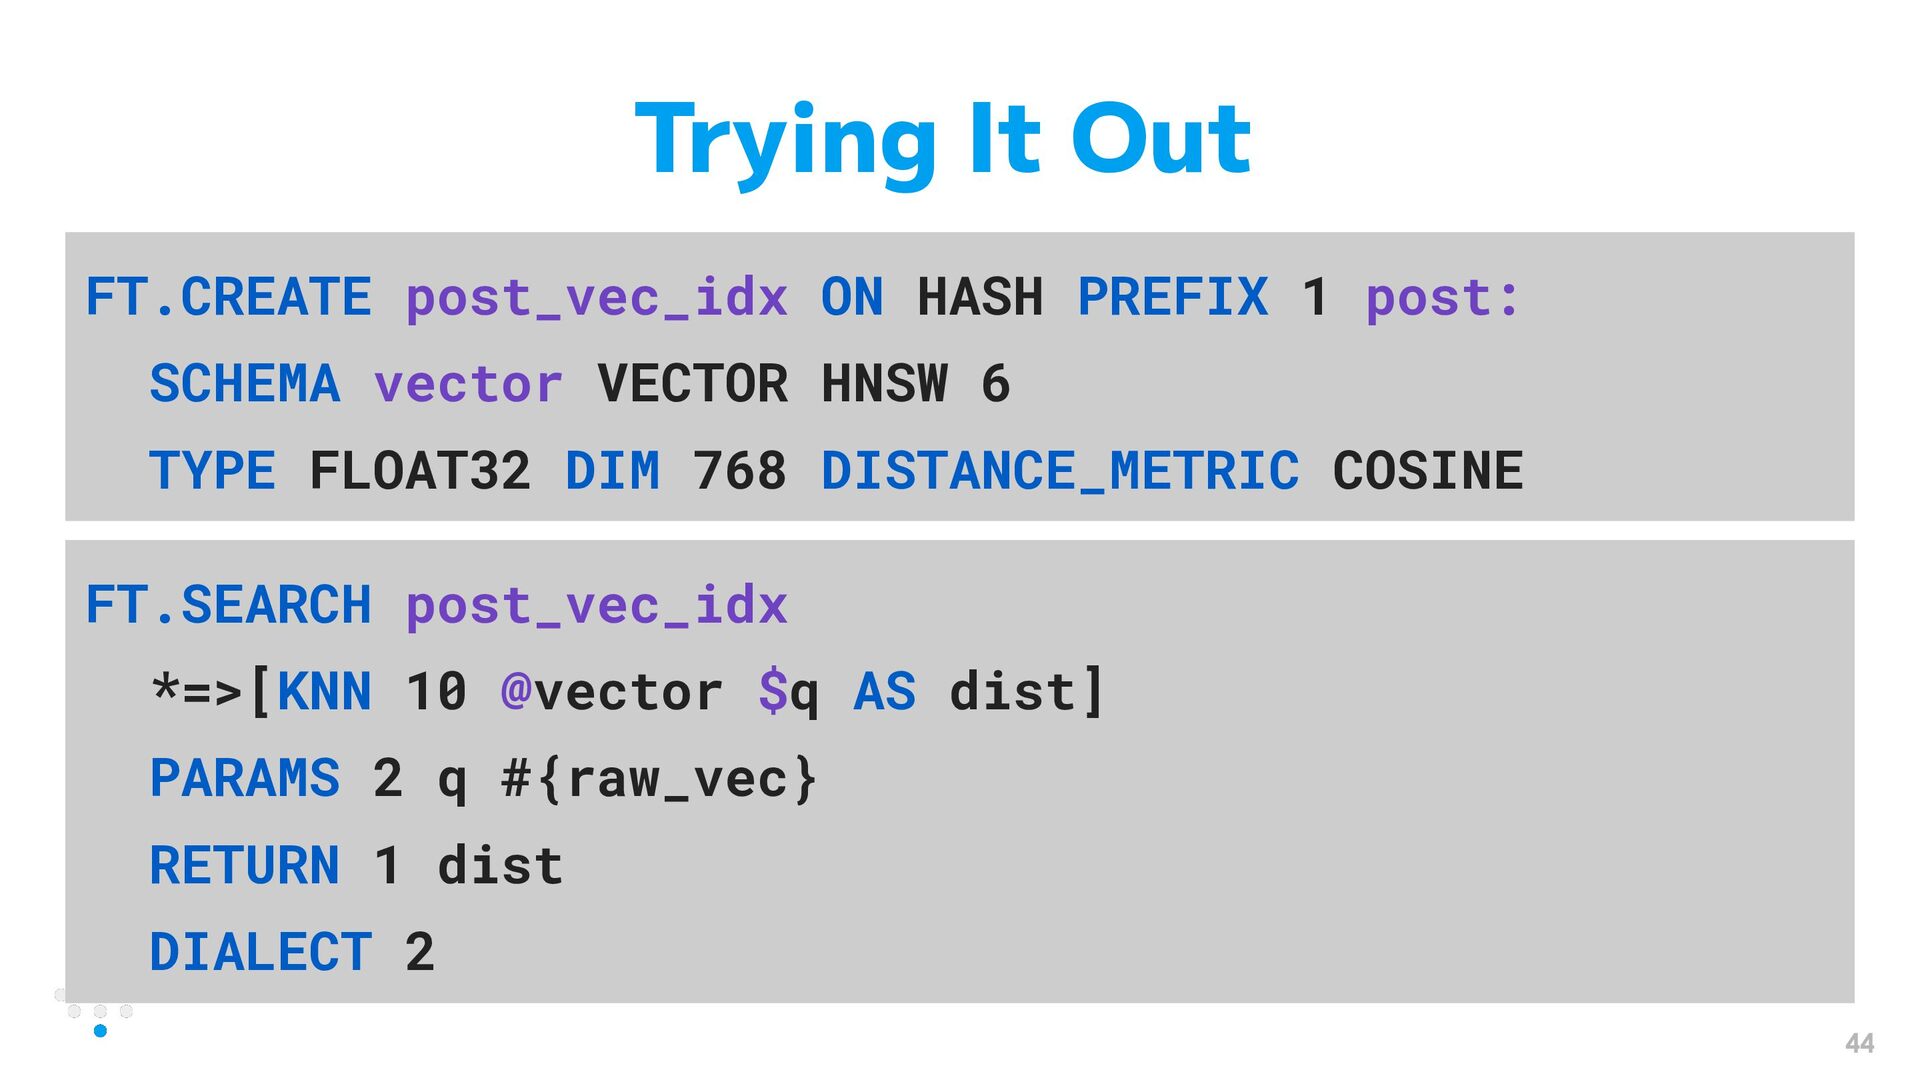
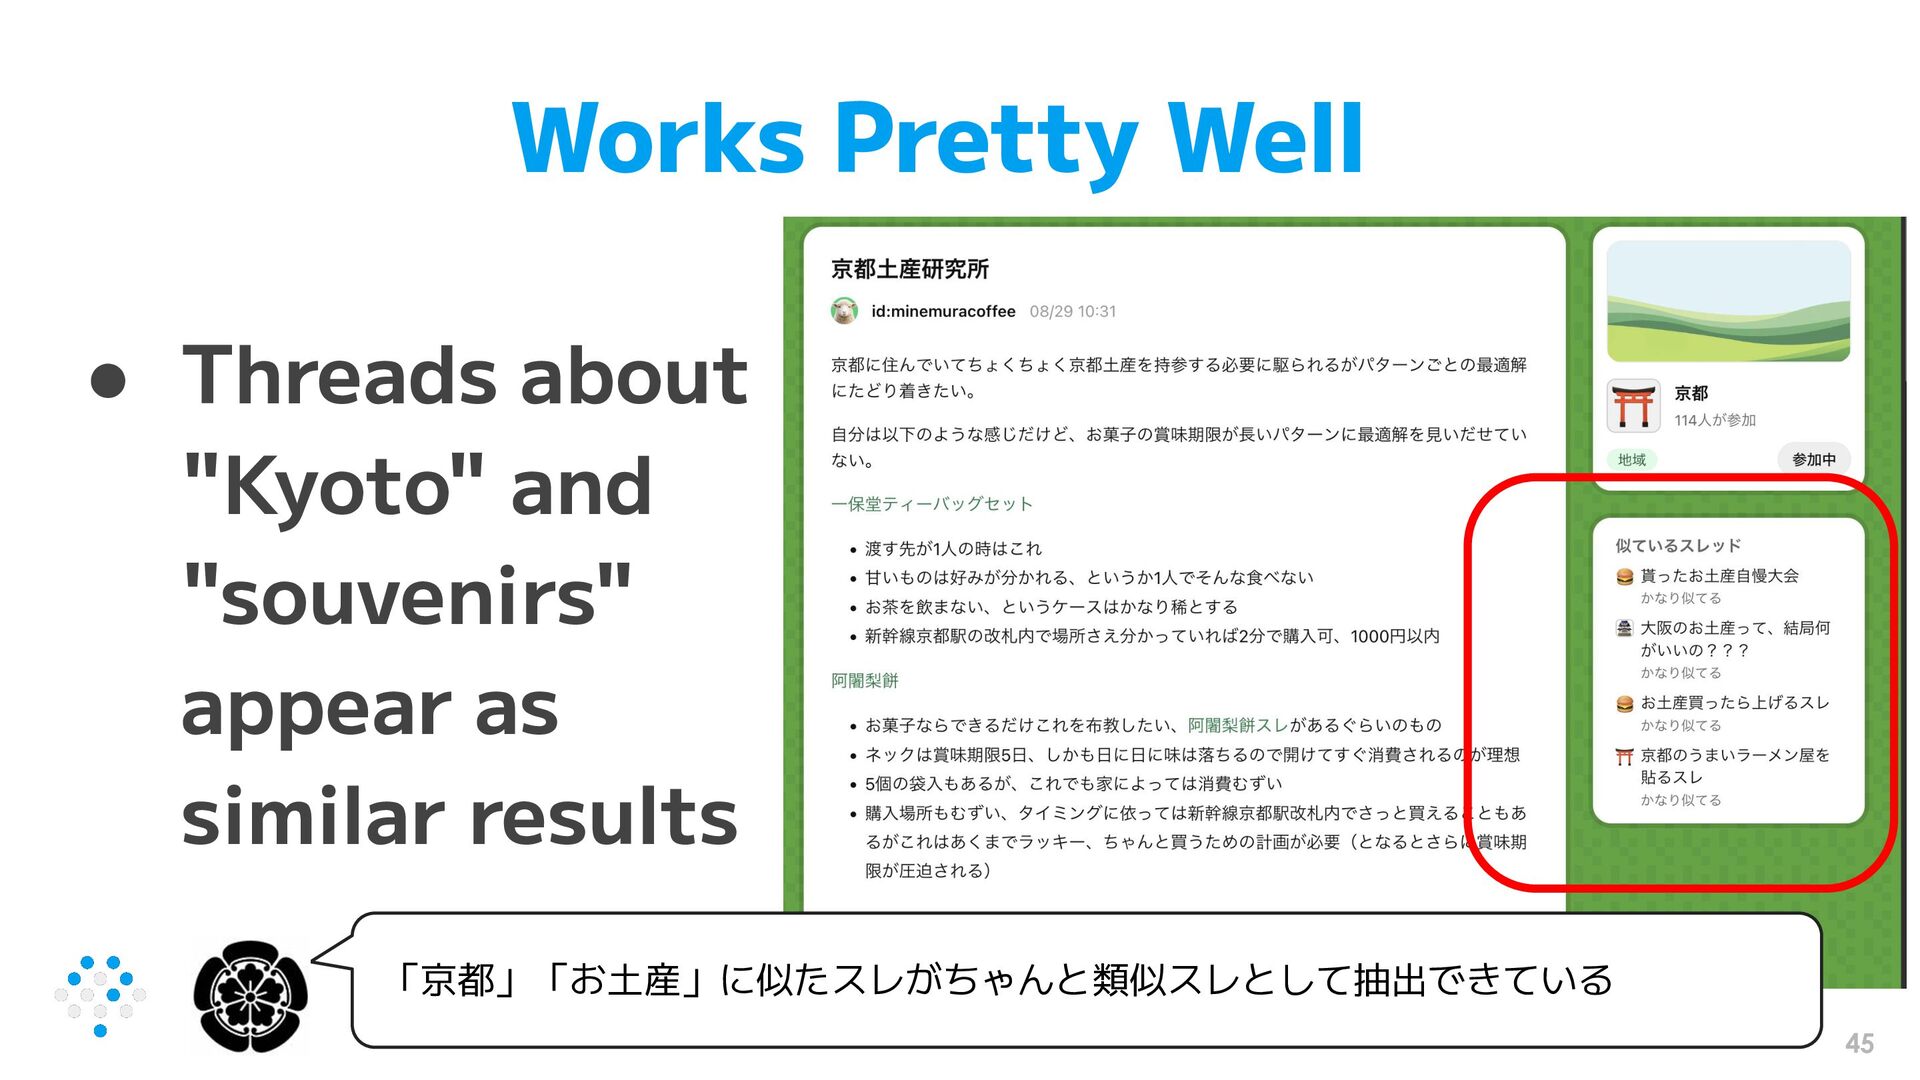
768-dimensional vectors • Stored vectors in Valkey Search ◦ Created an HNSW index for posts • KNN search with `FT.SEARCH` というわけでやってみたッス。text-multilingual-embedding-002にテキストを渡 すと768次元のベクトルを返すので、それをHNSWインデックスを作成して投稿ご とにValkey Searchに保存、FT.SEARCHでKNN検索 43
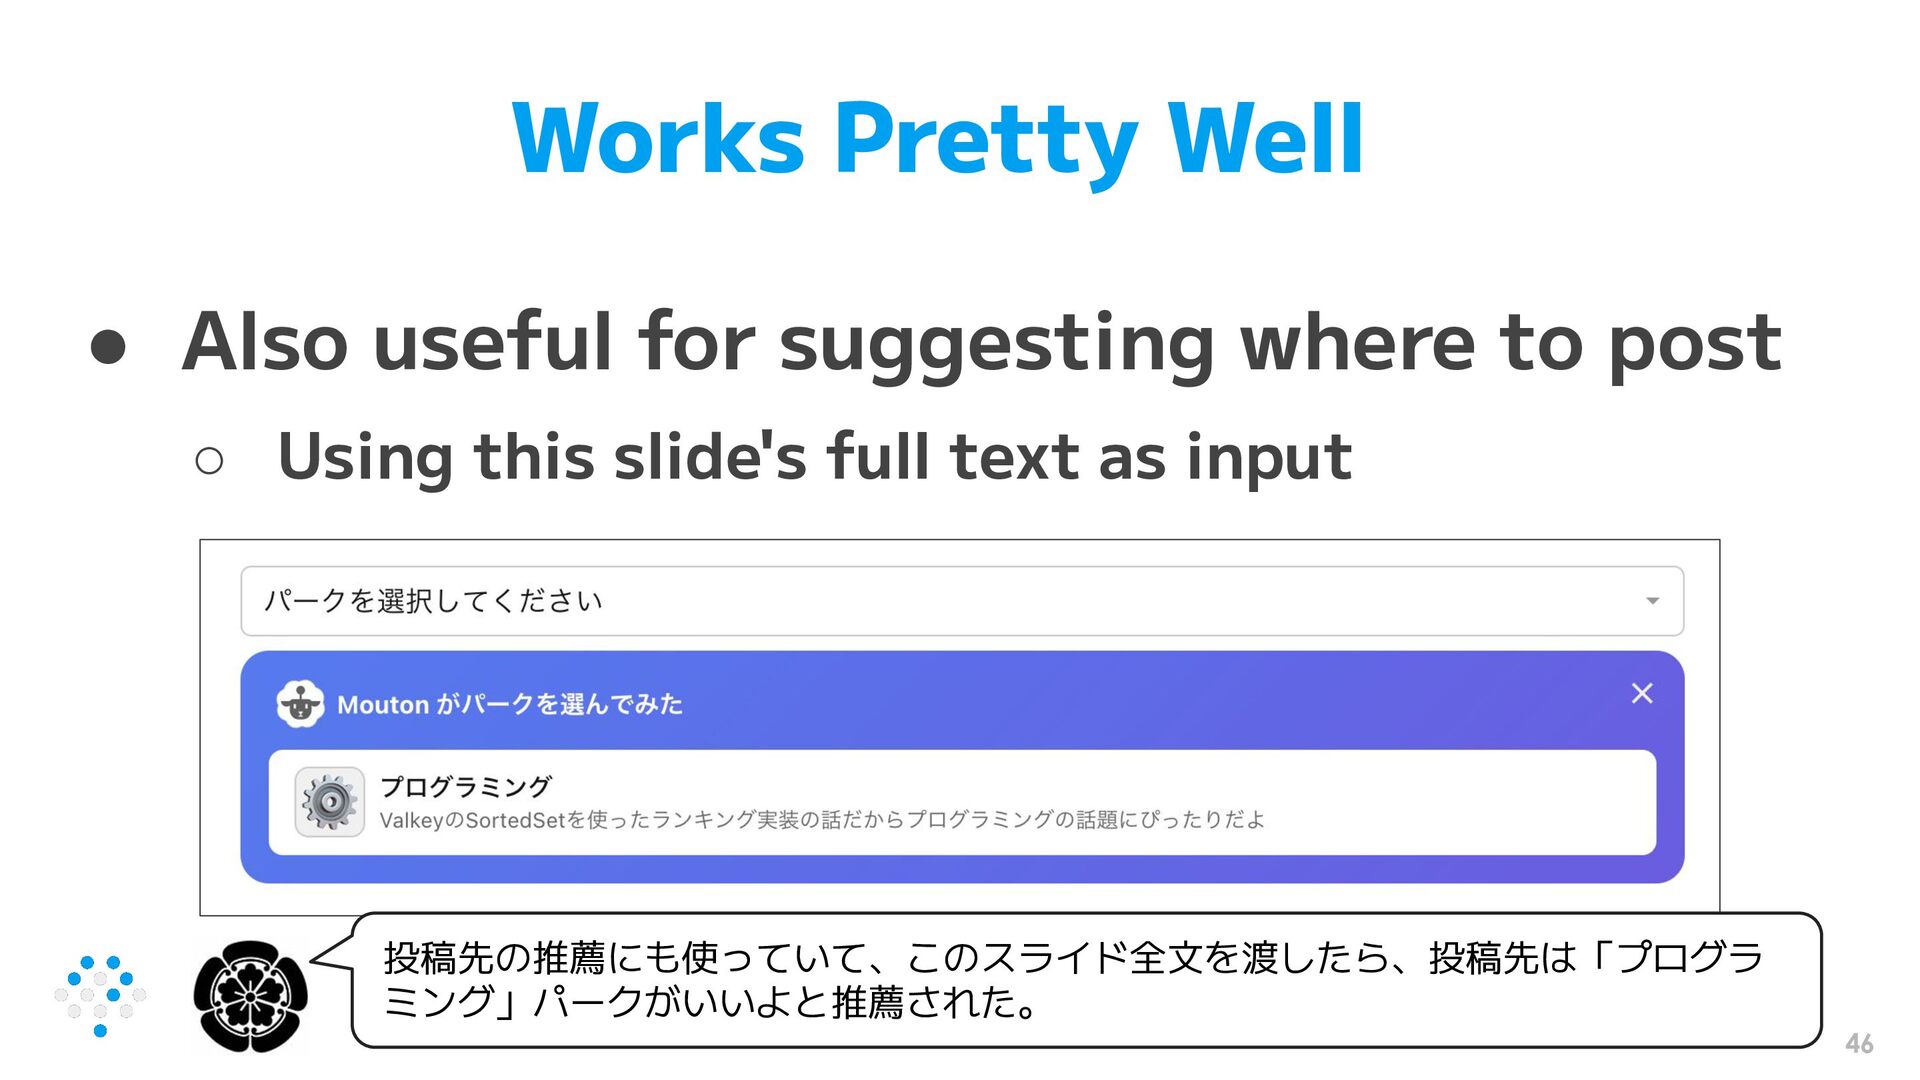
Split into chunks and embed each separately • Too many old posts get recommended ◦ Retrieve more candidates and rerank in the application 幾つか工夫するともっと良くて、長文をベクトル化すると特徴が薄れるので、チャ ンク分割してチャンクごとにベクトル化するといいとか、古い投稿が推薦されすぎ るので、検索時は多めにとってアプリケーション側でソートとか。 47
aims for compatibility, but is a separate implementation • Redis 8 also introduced Vector Sets ◦ A new data structure for vectors ◦ Add with VADD, search with VSIM Redisには以前からRedis Searchがあり、Valkey SearchはRedis Searchとの互換性 を目指して開発している(が、内部実装は別)。更にRedis 8ではVector Setが追加 された。これはベクトルを直接扱える新しいデータ構造。 48
timelines ◦ Push: Deliver posts to each user's feed ◦ Pull: Fetch and merge posts on demand • Hybrid approaches are also common ◦ Push is costly for users with millions of followers SNSを作るとタイムラインが必要になる。Push型Pull型があり、Push型は個人ごと の箱に配信、Pull型は閲覧時に投稿を集めてマージ。実際にはハイブリッド型も多 いのだけれど。極端にフォロワーが多い有名人の書き込みで破滅するので。 50
official Redis docs have an example ◦ https://redis.io/docs/latest/develop/clients/pa tterns/twitter-clone/ • I used Sorted Sets ◦ Use timestamps as scores in per-user keys ◦ Posts stay in order despite delays, without duplicates Redisの公式ドキュメントにもPush型タイムラインの実装例がある。私は今回は Sorted Setで実装した。投稿時刻をスコアにして、個人ごとのキーに保存する。配 信が遅延しても時系列に並ぶし、重複しない 51
These are often additional features, not core functionality ◦ Leaderboards, search, geospatial • Distribute the load ◦ Frequent reads have less impact on OLTP workloads ◦ Scale independently それでもValkeyに分離すると便利で、システム境界を切り離せる。ランキングや検 索、位置情報なんかは追加機能っぽいよね。また、高頻度参照がメイン機能に影響 しないように負荷分散したい。分けると独立してスケーリングできる 57
Diverse data structures ◦ Fast operations tailored to each data structure ◦ Atomic execution of complex data operations ▪ Not covered today, but you can also write Lua scripts! • Why use Valkey? ◦ Easier to separate load and responsibilities from the primary data store Valkeyを使いこなすって話をした。Valkeyは多彩なデータ構造と高速なコマンドを備 えていて、アトミックな操作にしやすい。今回説明してないけどLua Scriptを書け る。そしてValkeyを活用するとメインのデータストアから負荷や責務を分離できる 59


 onk
 ivry_presentationmaterials
 riyaamemiya
 mewuto
 camiha
 cogakira
 sudoakiy
 occhi
 shogo4131
 jmdc_presentation
 keeg
 baseballyama
 thoeni
 cassininazir
 trishagee
 techseoconnect
 kneath
 helenjbeal
 thekraken
 tammyeverts
 sarafernandez
 bryan
 khoart
 aleyda