Share
Embed
Cognitive Behaviors that Enable Self-Improving Reasoners, or, Four Habits of Highly Effective STaRs
論文紹介: Cognitive Behaviors that Enable Self-Improving Reasoners, or, Four Habits of Highly Effective STaRs
Kanishk Gandhi, Ayush Chakravarthy, Anikait Singh, Nathan Lile and Noah D. Goodman, 2025
arXiv preprint arXiv:2503.01307v1
https://arxiv.org/abs/2503.01307v1
太田 晋
2025-03-31
S. Ota
March 31, 2025
Transcript
30 slides
-
Cognitive Behaviors that Enable Self-Improving Reasoners, or, Four Habits of
Highly Effective STaRs Kanishk Gandhi, Ayush Chakravarthy, Anikait Singh, Nathan Lile and Noah D. Goodman, 2025 arXiv preprint arXiv:2503.01307v1 https://arxiv.org/abs/2503.01307v1 太田 晋 2025-03-31 -
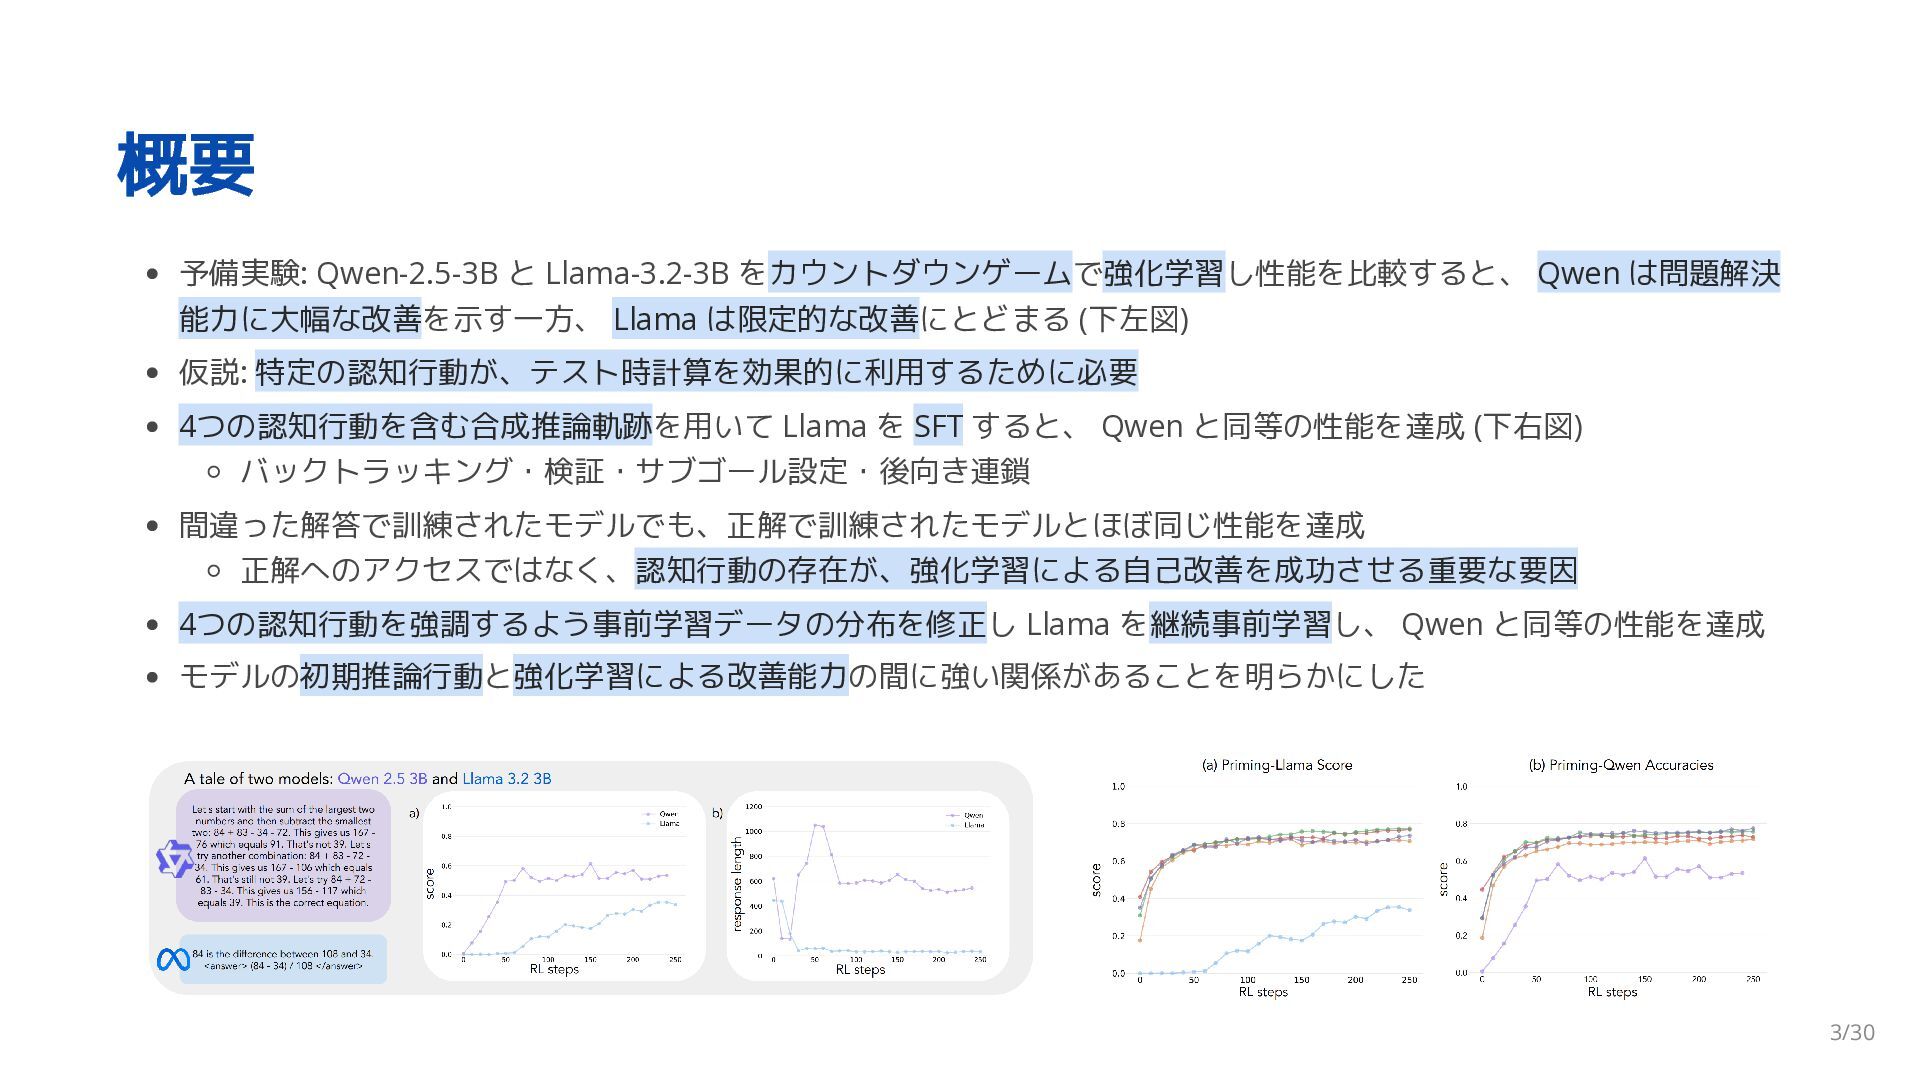
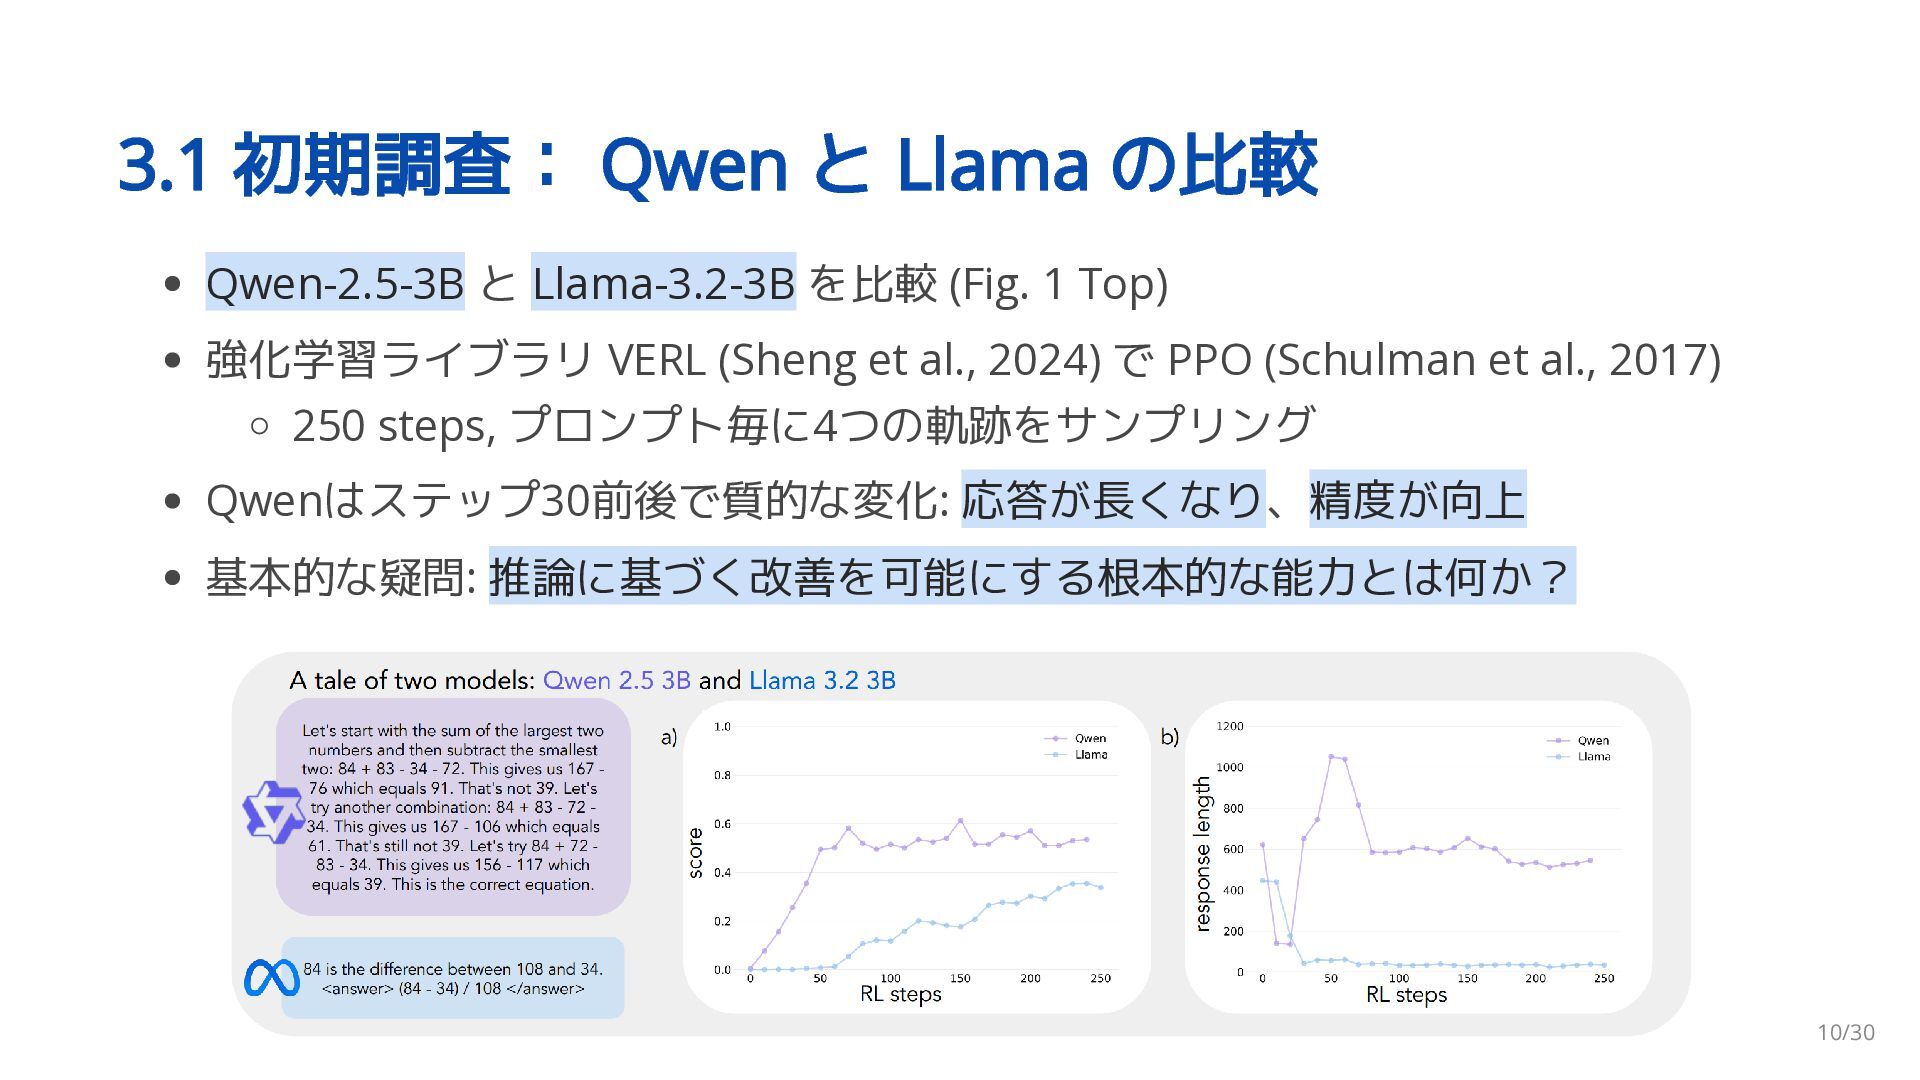
概要 予備実験: Qwen-2.5-3B と Llama-3.2-3B をカウントダウンゲームで強化学習し性能を比較すると、 Qwen は問題解決 能力に大幅な改善を示す一方、 Llama
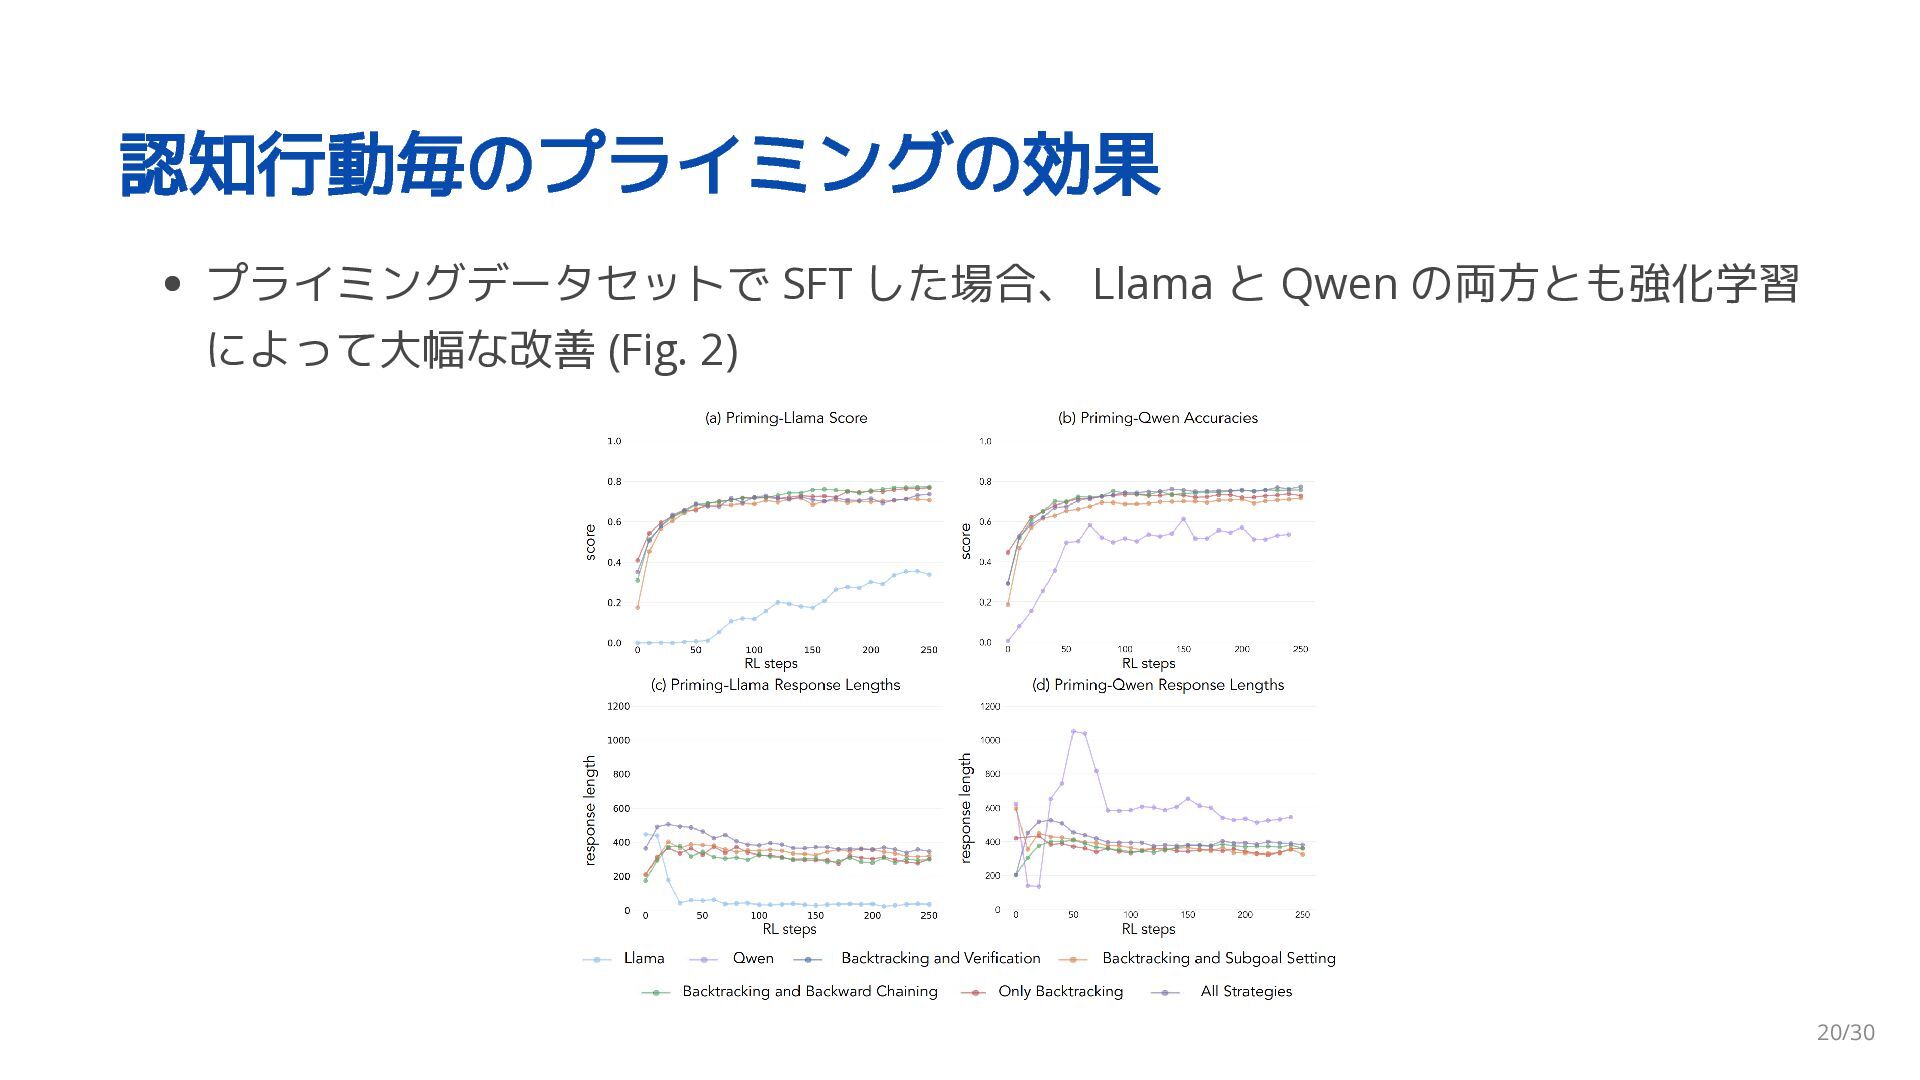
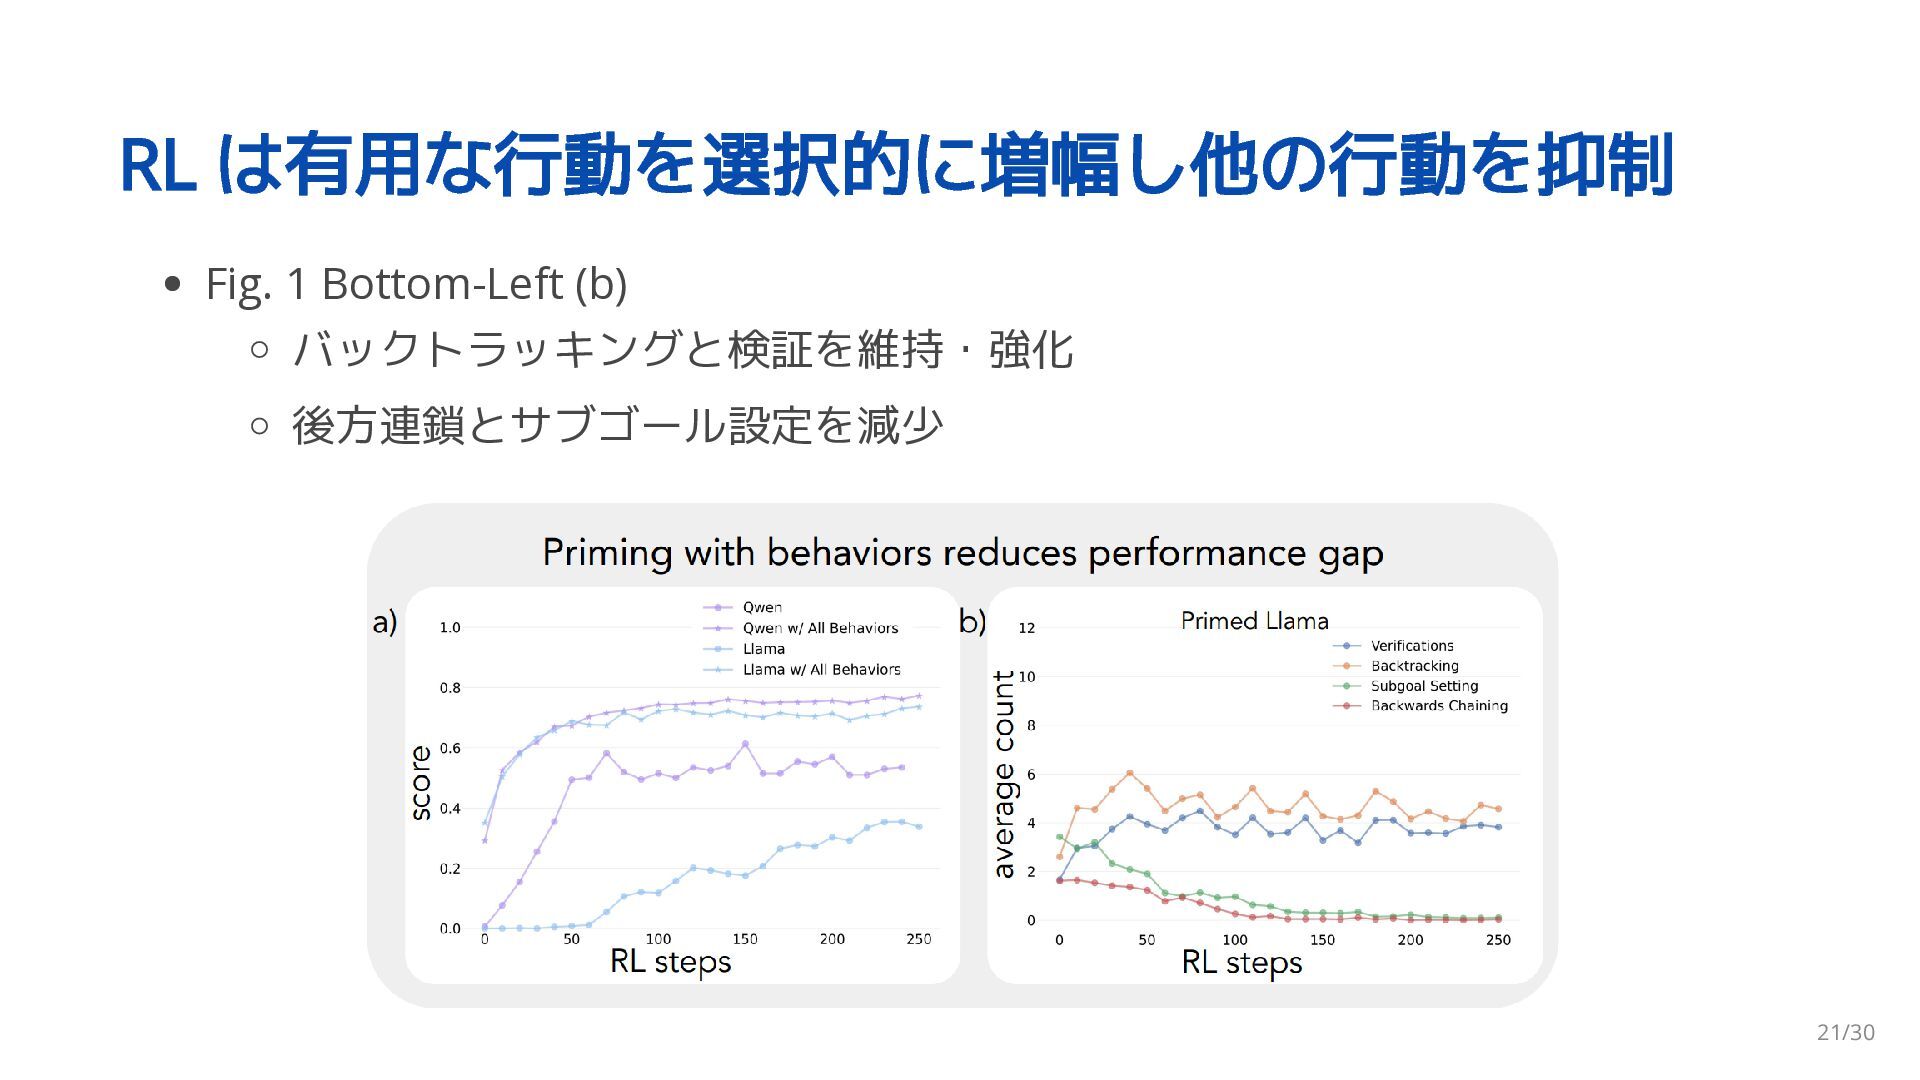
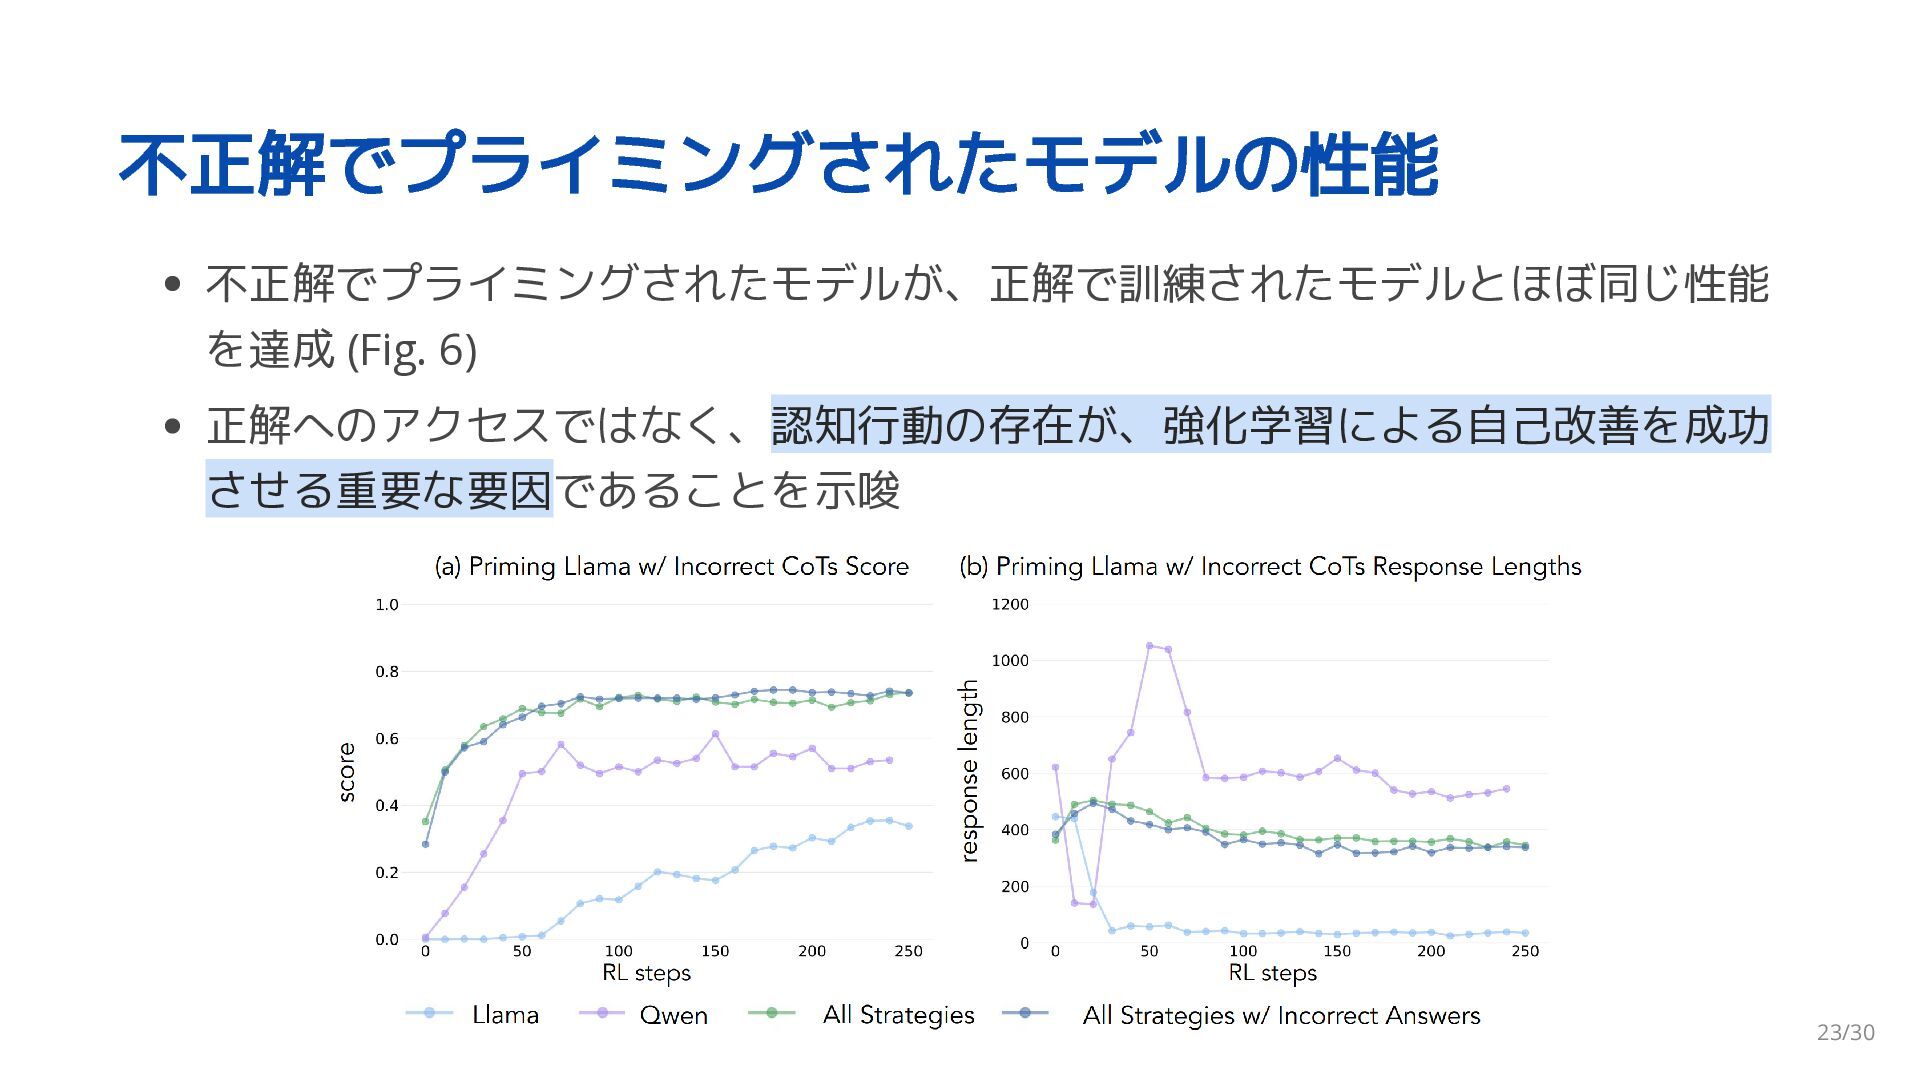
は限定的な改善にとどまる (下左図) 仮説: 特定の認知行動が、テスト時計算を効果的に利用するために必要 4つの認知行動を含む合成推論軌跡を用いて Llama を SFT すると、 Qwen と同等の性能を達成 (下右図) バックトラッキング・検証・サブゴール設定・後向き連鎖 間違った解答で訓練されたモデルでも、正解で訓練されたモデルとほぼ同じ性能を達成 正解へのアクセスではなく、認知行動の存在が、強化学習による自己改善を成功させる重要な要因 4つの認知行動を強調するよう事前学習データの分布を修正し Llama を継続事前学習し、 Qwen と同等の性能を達成 モデルの初期推論行動と強化学習による改善能力の間に強い関係があることを明らかにした 3/30 -
2 関連研究 言語モデルの推論能力を向上させるアプローチ 推論のための外部探索 (External Search for Reasoning) 文脈内探索と自己改善 (In-Context
Search and Self-Improvement) 推論のための強化学習 (Reinforcement Learning for Reasoning) 5/30 -
推論のための強化学習 強化学習により、モデルが自律的に効果的な推論戦略を発見する可能性 検証可能な結果(verifiable outcomes)を用いた言語モデルの推論学習: オンポリシ ー手法・オフポリシー手法・バッチ手法 DeepSeek-R1 PPO の簡略版の GRPO
文脈内探索行動の創発(emergence)による推論機能の大幅な向上 長く構造化された CoT での SFT は、短い CoT と比較して、強化学習の効率性と 性能を向上させる 未解決の問題: なぜ一部のモデルは強化学習で推論機能の学習に成功し、他のモデ ルは失敗するのか? 本研究: 推論行動の強化学習を可能にする初期モデルの重要な特性を調査 8/30 -
3 自己改善行動の特定とエンジニアリング カウントダウンゲーム プレイヤーが四則演算(+, -, ×, ÷)を使って入力された数字の集合を組み合わ せ、目標の数字に到達しなければならない数学的パズル 例: 25,
30, 3, 4 という数字と 32 という目標数字が与えられた場合、これらの 数字を一連の演算で組み合わせて、(30 - 25 + 3) × 4 = 32 数学的推論(reasoning)、計画(planning)、探索戦略(search strategies)が必要 推論を必要としながらも、扱いやすい分析を可能にする制限された探索空間 数学的知識よりも問題解決能力を評価 ドメイン知識が推論能力の評価を混乱させる可能性が低い 9/30 -
3.1 初期調査: Qwen と Llama の比較 Qwen-2.5-3B と Llama-3.2-3B を比較
(Fig. 1 Top) 強化学習ライブラリ VERL (Sheng et al., 2024) で PPO (Schulman et al., 2017) 250 steps, プロンプト毎に4つの軌跡をサンプリング Qwenはステップ30前後で質的な変化: 応答が長くなり、精度が向上 基本的な疑問: 推論に基づく改善を可能にする根本的な能力とは何か? 10/30 -
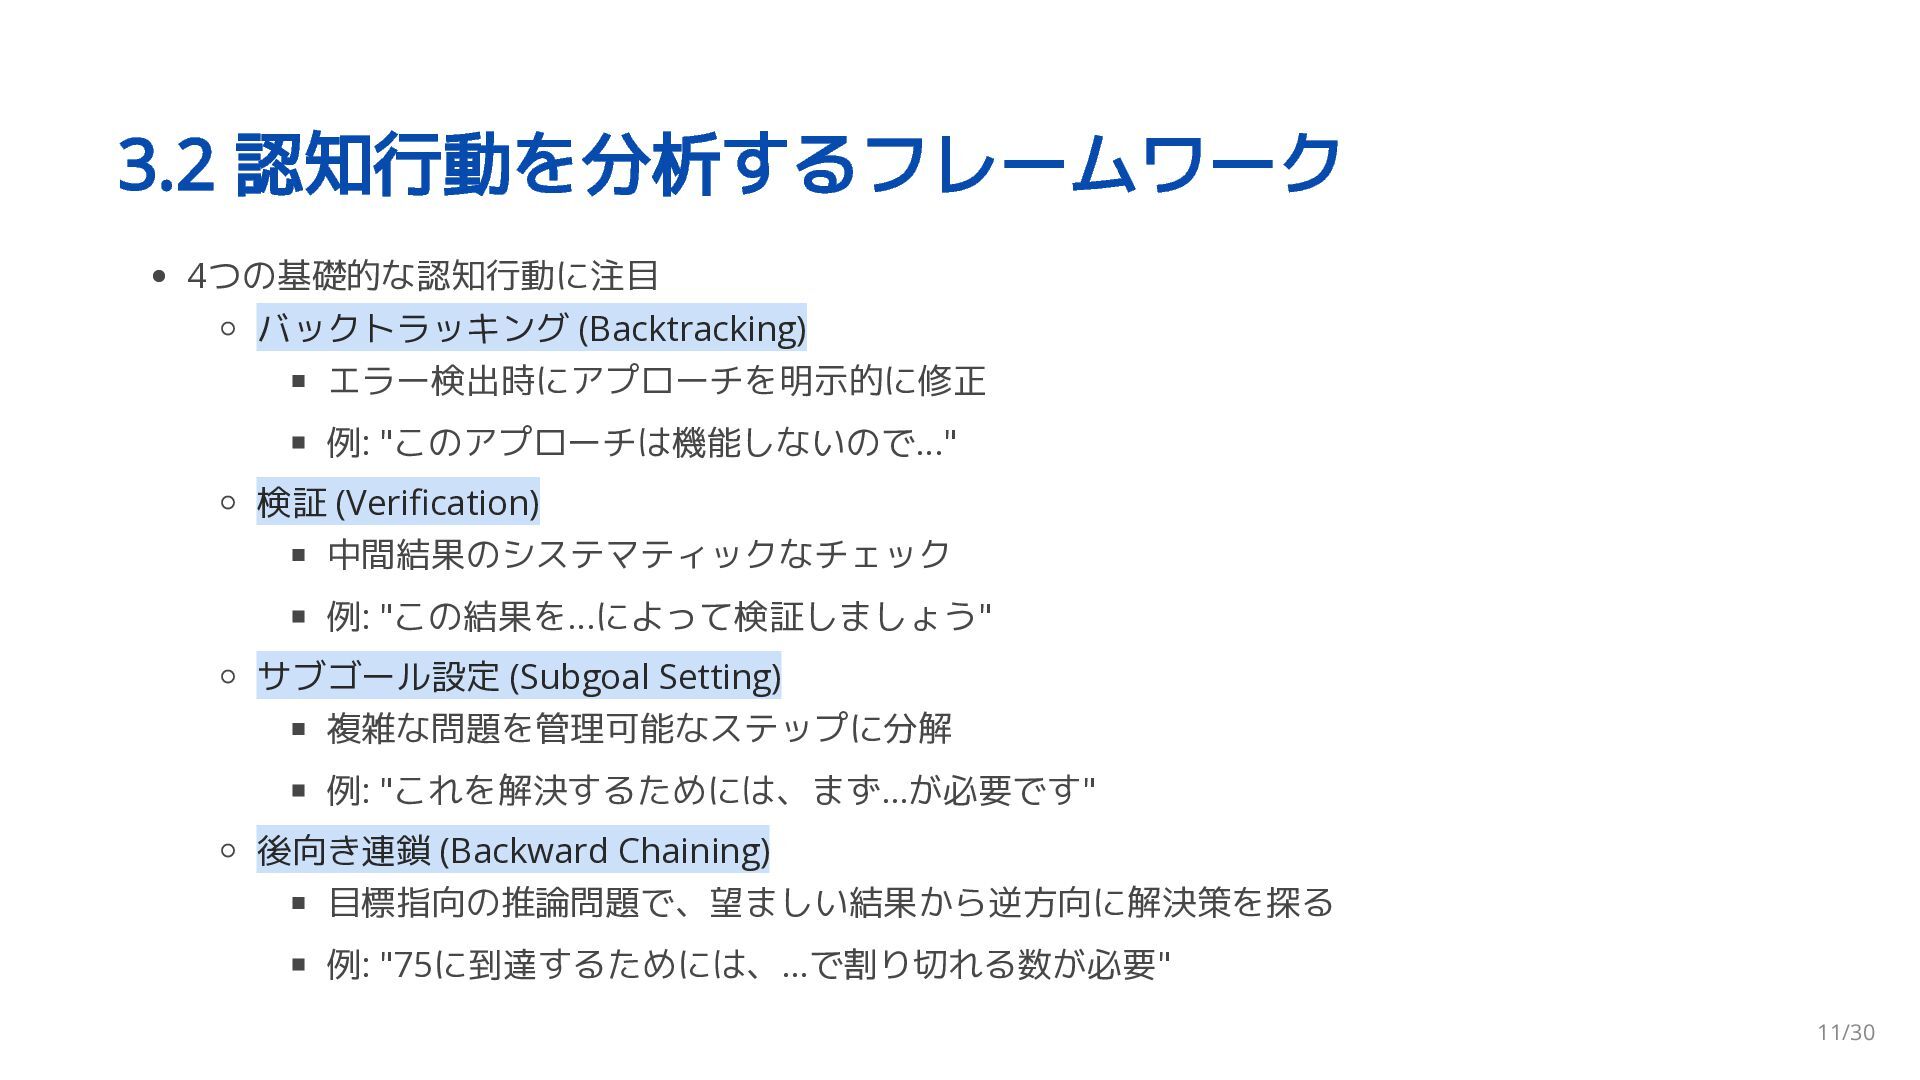
3.2 認知行動を分析するフレームワーク 4つの基礎的な認知行動に注目 バックトラッキング (Backtracking) エラー検出時にアプローチを明示的に修正 例: "このアプローチは機能しないので..." 検証 (Verification)
中間結果のシステマティックなチェック 例: "この結果を...によって検証しましょう" サブゴール設定 (Subgoal Setting) 複雑な問題を管理可能なステップに分解 例: "これを解決するためには、まず...が必要です" 後向き連鎖 (Backward Chaining) 目標指向の推論問題で、望ましい結果から逆方向に解決策を探る 例: "75に到達するためには、...で割り切れる数が必要" 11/30 -
フレームワークの妥当性 4つの認知行動は、直線的で単調な推論パターンではなく、より動的な探索のような推論の 軌跡を可能にする 4つの認知行動は完全ではないが、識別が容易 カウントダウンゲームと証明構築のような広範な数学的推論タスクの両方において、人間の 問題解決戦略と自然に一致 各認知行動は、推論トークン内のパターンによって識別可能 バックトラッキング: 前のステップを明確に否定して訂正するトークン列を生成 検証:
解の基準と結果を比較するトークンを生成 後向き連鎖: ゴールから初期状態への解のパスを構築するトークンを生成 サブゴール設定: 最終ゴールへのパスでターゲットとする中間ステップを明示的に提案 するトークンを生成 12/30 -
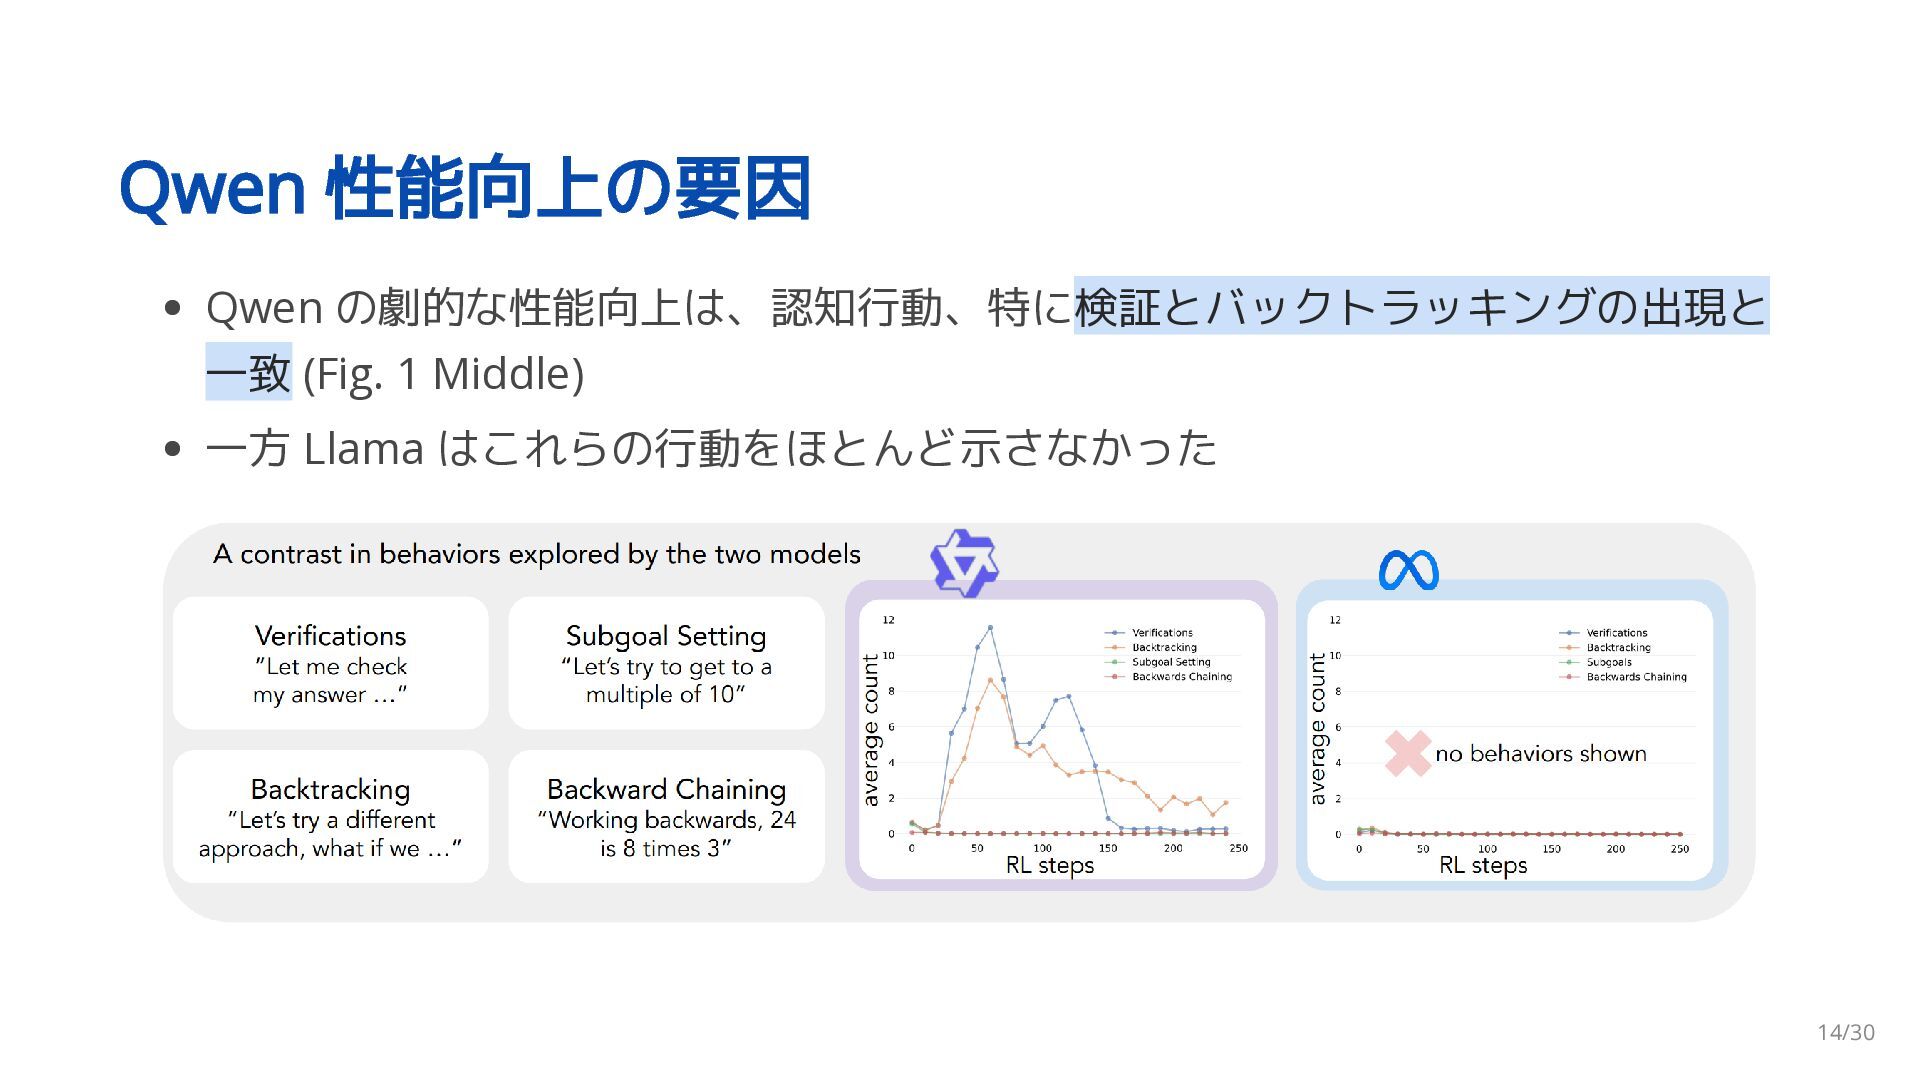
Qwen 性能向上の要因 Qwen の劇的な性能向上は、認知行動、特に検証とバックトラッキングの出現と 一致 (Fig. 1 Middle) 一方 Llama
はこれらの行動をほとんど示さなかった 14/30 -
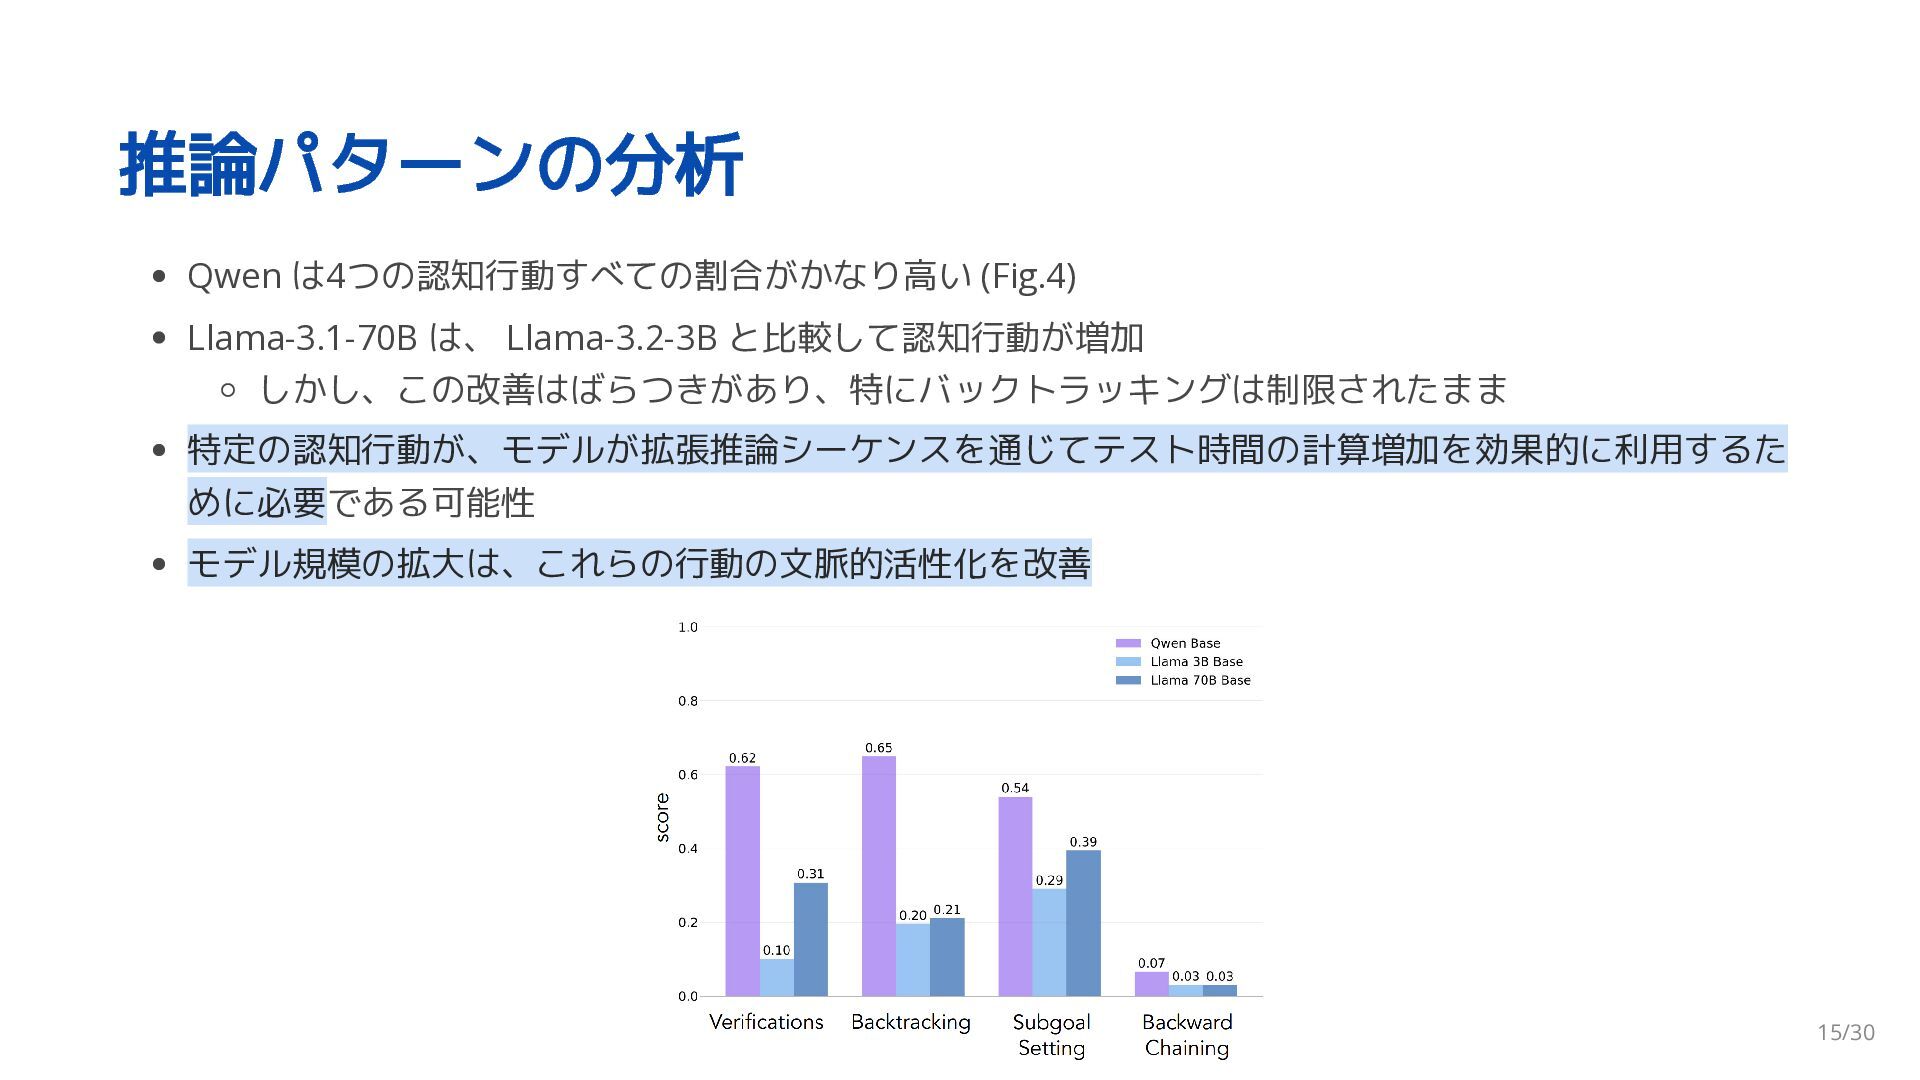
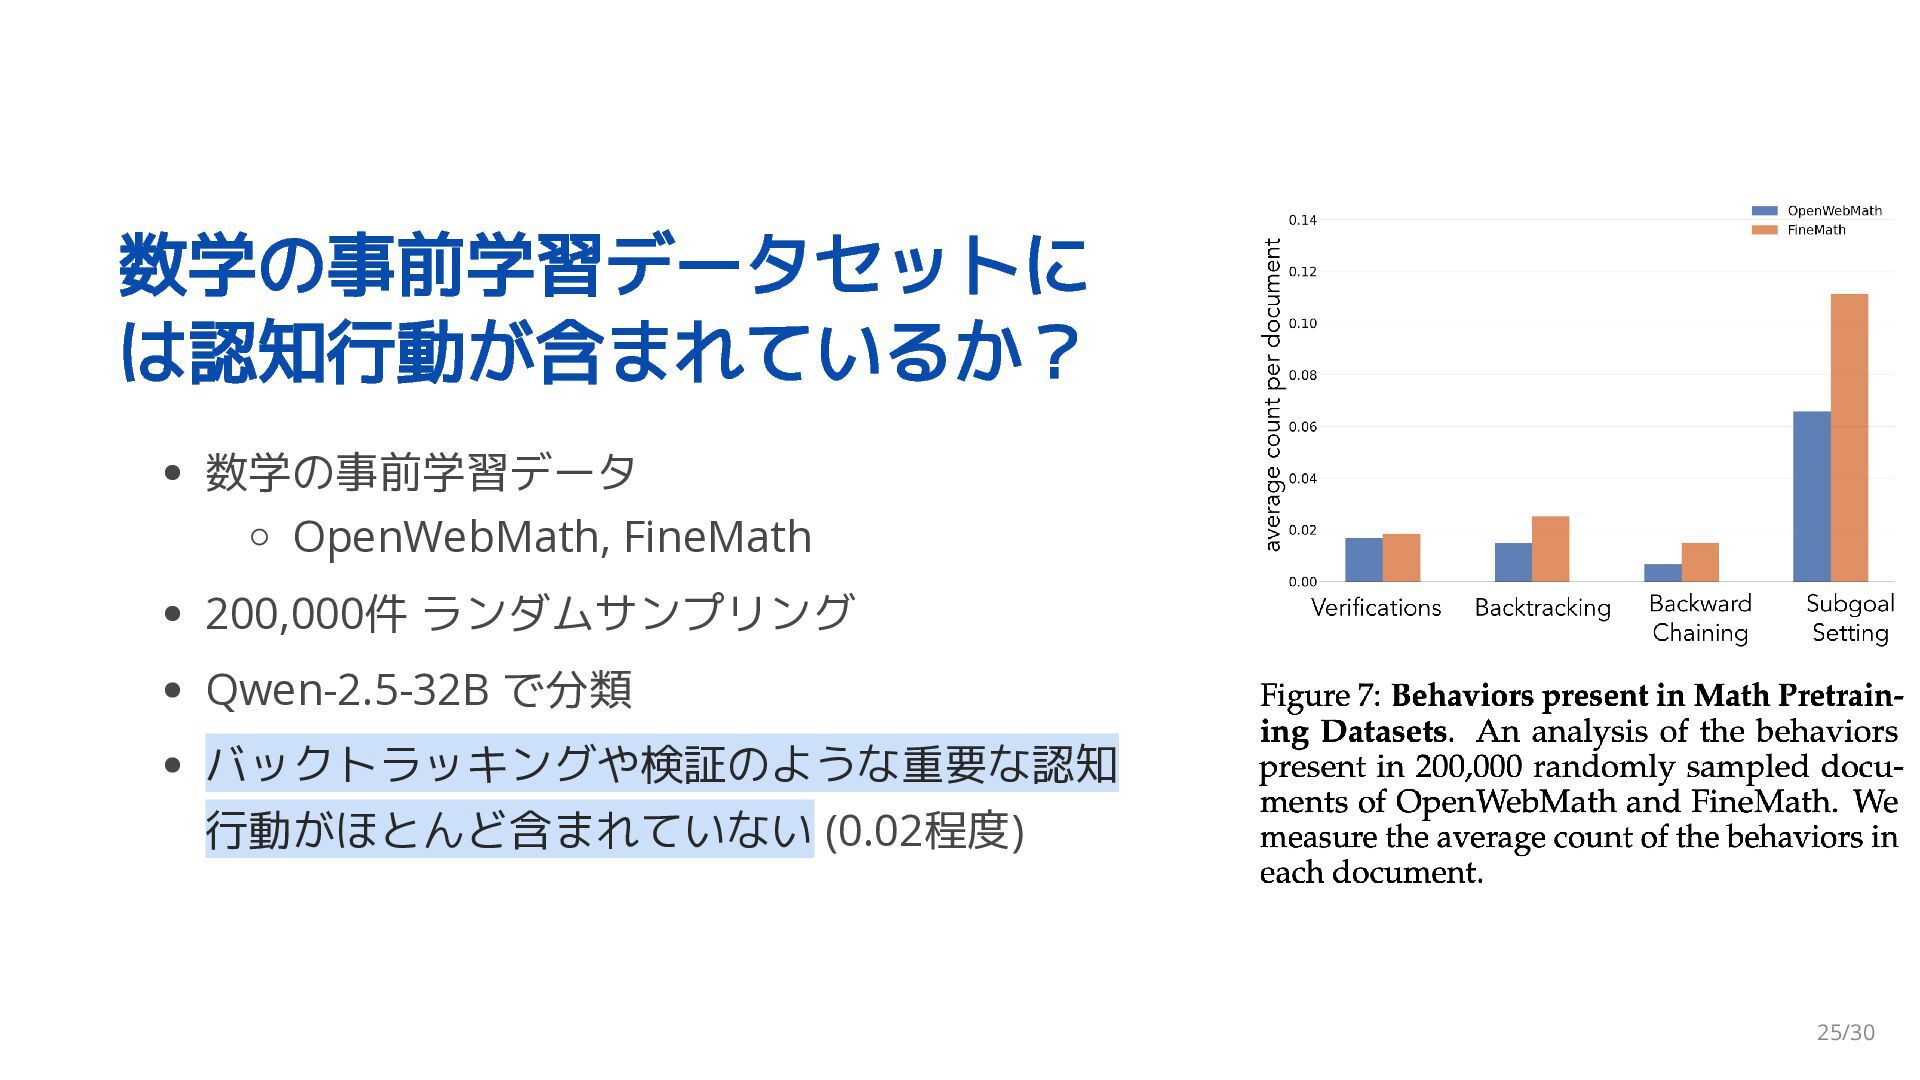
推論パターンの分析 Qwen は4つの認知行動すべての割合がかなり高い (Fig.4) Llama-3.1-70B は、 Llama-3.2-3B と比較して認知行動が増加 しかし、この改善はばらつきがあり、特にバックトラッキングは制限されたまま 特定の認知行動が、モデルが拡張推論シーケンスを通じてテスト時間の計算増加を効果的に利用するた
めに必要である可能性 モデル規模の拡大は、これらの行動の文脈的活性化を改善 15/30 -
プライミングデータセットの作成 Claude-3.5-Sonnet で以下5つの SFT 用の推論軌跡を生成 バックトラッキングのみ 解の経路を探索し、行き止まりに遭遇したら方針変更 バックトラッキングと検証 バックトラッキングに加え、計算途中の中間解をチェック バックトラッキングとサブゴール分解
バックトラッキングに加え、複雑な問題を扱いやすい中間ステップに分解 バックトラッキングと後向き連鎖 バックトラッキングに加え、ゴール状態から初期状態へ後ろ向きに推論 4個全ての推論戦略を包括 18/30 -
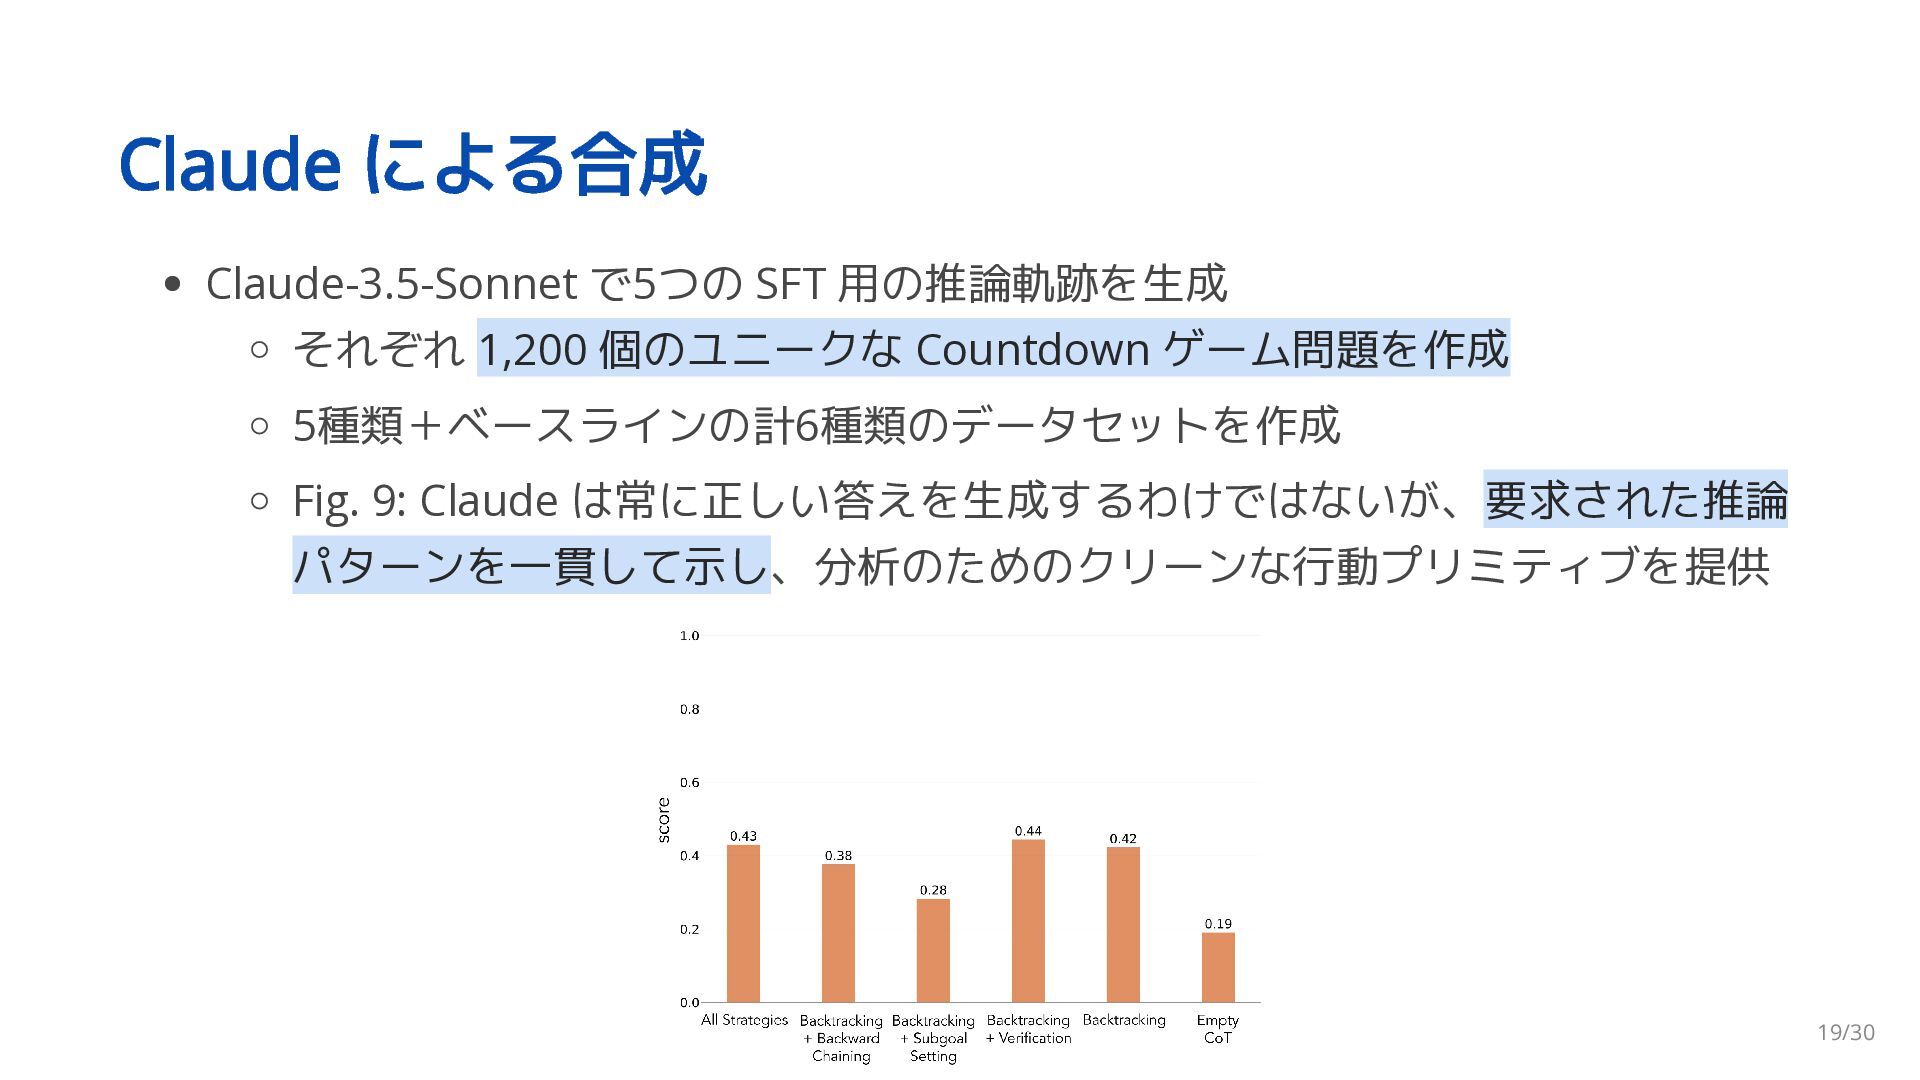
Claude による合成 Claude-3.5-Sonnet で5つの SFT 用の推論軌跡を生成 それぞれ 1,200 個のユニークな Countdown
ゲーム問題を作成 5種類+ベースラインの計6種類のデータセットを作成 Fig. 9: Claude は常に正しい答えを生成するわけではないが、要求された推論 パターンを一貫して示し、分析のためのクリーンな行動プリミティブを提供 19/30 -
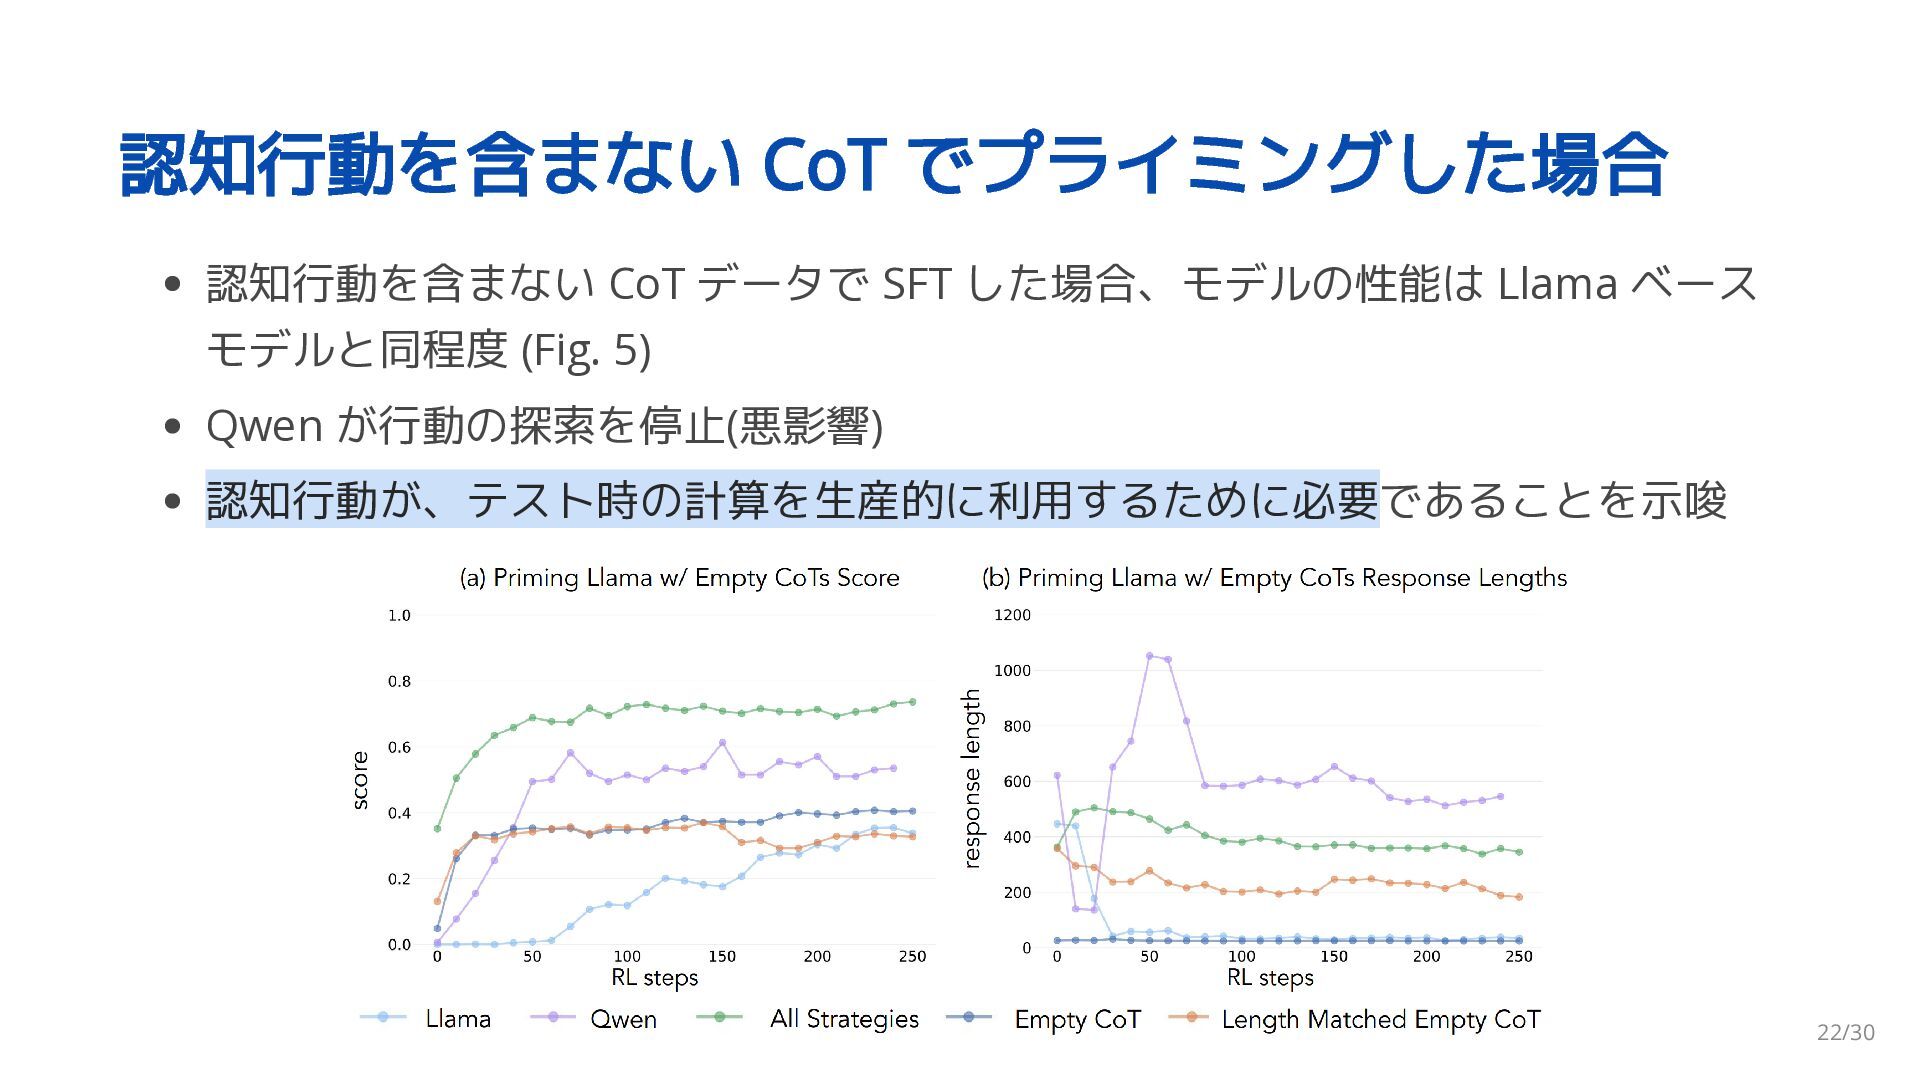
認知行動を含まない CoT でプライミングした場合 認知行動を含まない CoT データで SFT した場合、モデルの性能は Llama ベース
モデルと同程度 (Fig. 5) Qwen が行動の探索を停止(悪影響) 認知行動が、テスト時の計算を生産的に利用するために必要であることを示唆 22/30 -
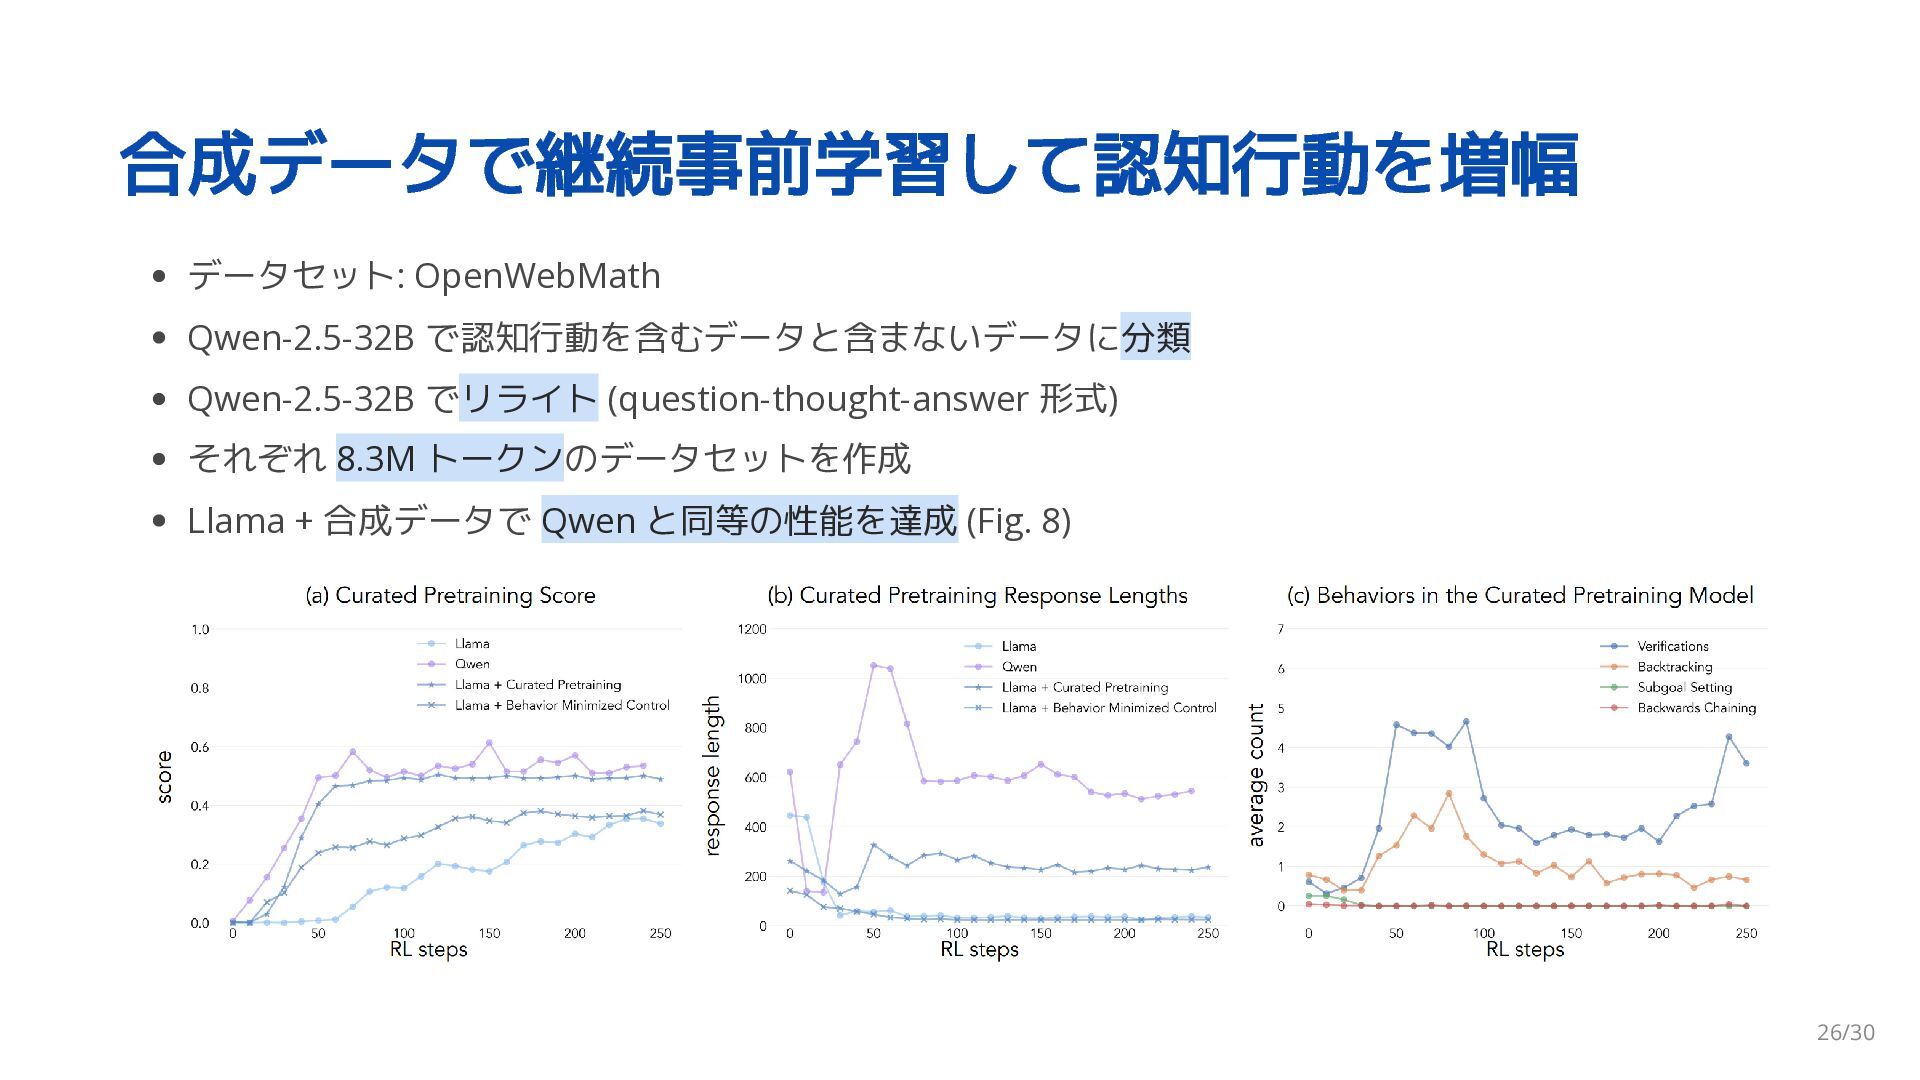
合成データで継続事前学習して認知行動を増幅 データセット: OpenWebMath Qwen-2.5-32B で認知行動を含むデータと含まないデータに分類 Qwen-2.5-32B でリライト (question-thought-answer 形式) それぞれ
8.3M トークンのデータセットを作成 Llama + 合成データで Qwen と同等の性能を達成 (Fig. 8) 26/30 -
4 議論 モデルの初期の認知行動探索が、自己改善を可能にする上で重要な役割を果たす バックトラッキング・検証・サブゴール設定・後向き連鎖 少量の SFT で認知行動をプライミングすることで、モデルの性能を大幅に向上 間違った解答でプライミングされたモデルでも、特定の認知行動パターンを含ん でいれば、正解でプライミングされたモデルとほぼ同じ性能を達成 これらの結果は、認知行動の存在が、強化学習を通じた自己改善を可能にするた
めの決定的な要因(causal factor)であることを示唆 OpenWebMath から派生した多様な認知行動を含む事前学習データセットを合成 し、 Llama で継続事前学習することで、 Qwen と同等の性能を達成 27/30 -
参考文献 Kanishk Gandhi et al., "Cognitive Behaviors that Enable Self-Improving
Reasoners, or, Four Habits of Highly Effective STaRs", arXiv preprint arXiv:2503.01307v1, 2025. https://arxiv.org/abs/2503.01307v1 Eric Zelikman et al., "STaR: Bootstrapping Reasoning With Reasoning", NeurIPS 2022, 2022, https://papers.nips.cc/paper_files/paper/2022/hash/639a9a172c044fbb64175b 5fad42e9a5-Abstract-Conference.html Noah D. Goodman, "Stanford CoCoLab", https://cocolab.stanford.edu/ndg, ア クセス日: 2025-03-31 30/30