Share
Embed
Emergent Abilities of Large Language Models
Jason Wei et al.
Transactions on Machine Learning Research (TMLR), 2022.
https://arxiv.org/abs/2206.07682
第90回汎用人工知能輪読会
2023/2/22
担当: 太田 晋
S. Ota
February 22, 2023
Transcript
58 slides
-
Emergent Abilities of Large Language Models Jason Wei et al.
Transactions on Machine Learning Research (TMLR), 2022. https://arxiv.org/abs/2206.07682 第90回汎用人工知能輪読会 2023/2/22 担当: 太田 晋 1 -
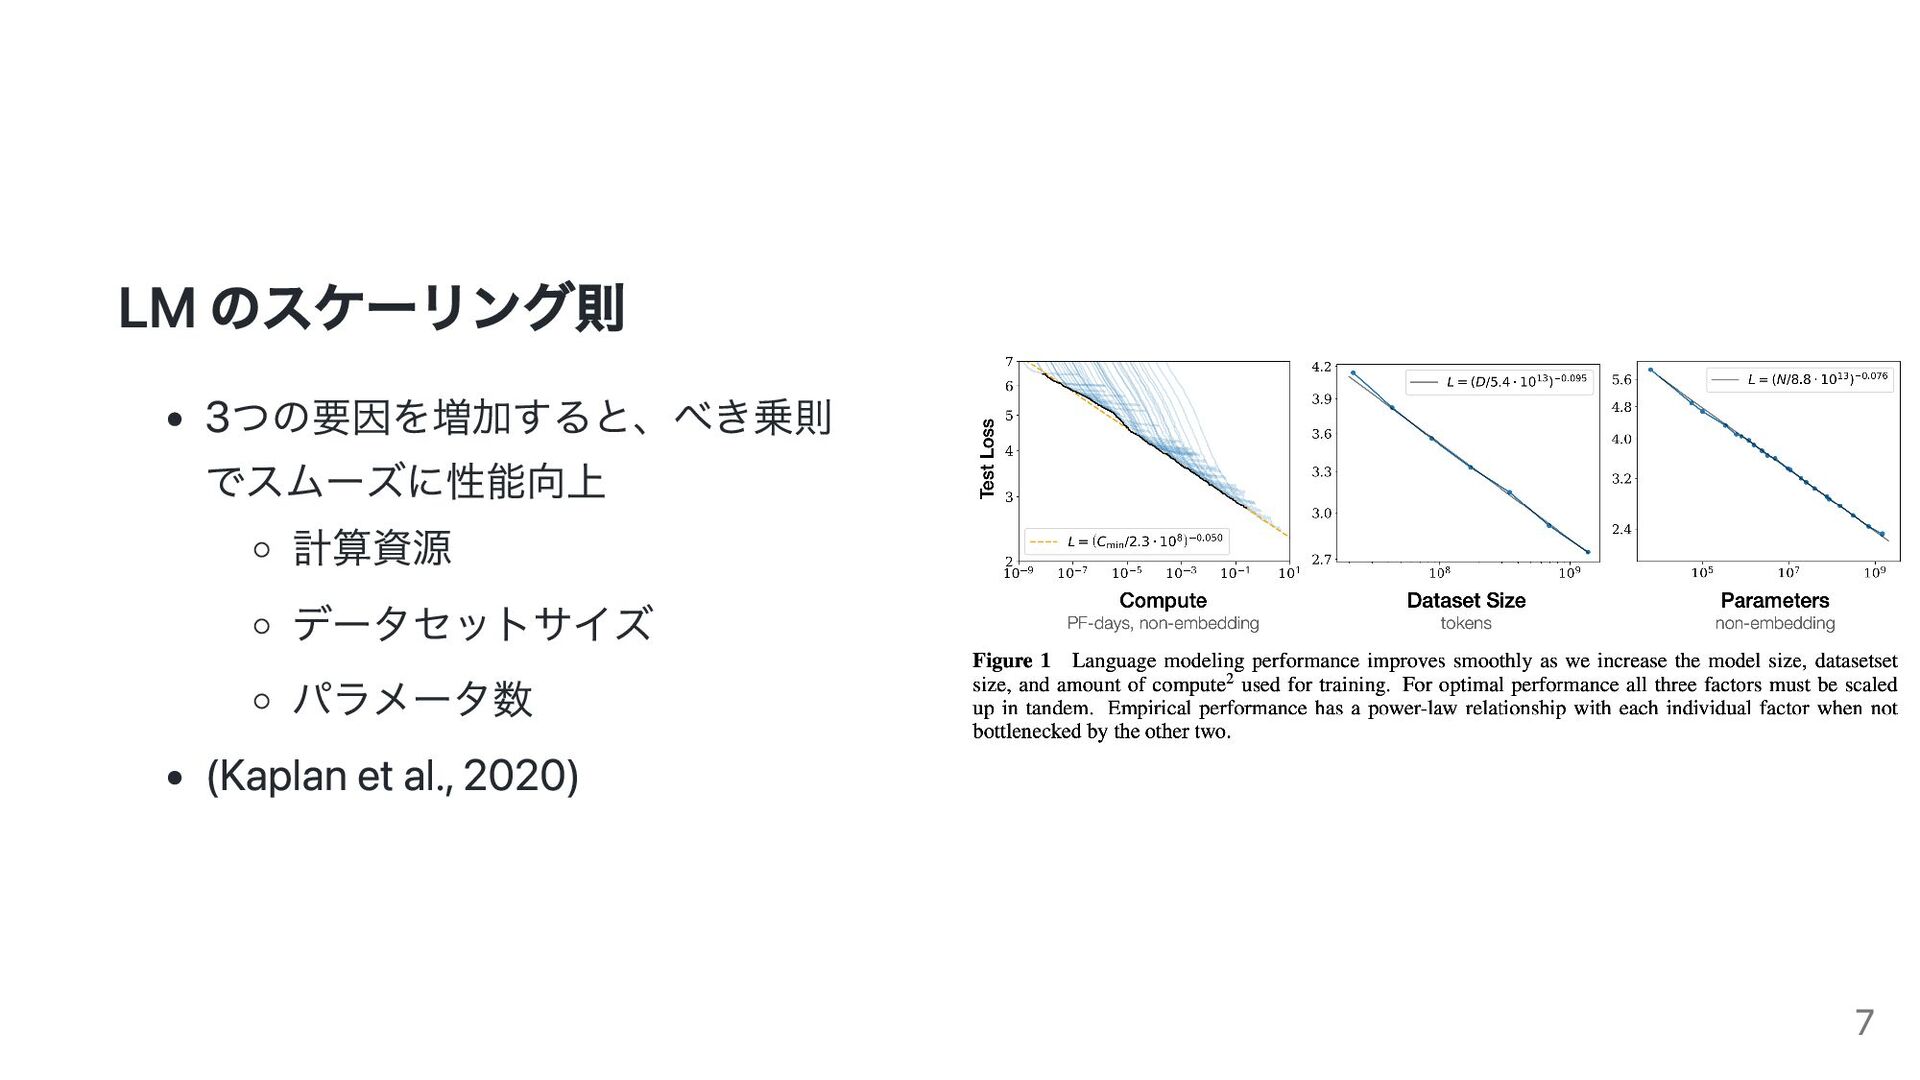
目次 背景 言語モデルのスケーリング則 創発能力の定義 創発能力の例 Few-Shot プロンプト 拡張プロンプト 議論 なぜ能力が創発されるのか?
創発のリスク 今後の方向性 結論 5 -
創発 Emergence is when quantitative changes in a system result
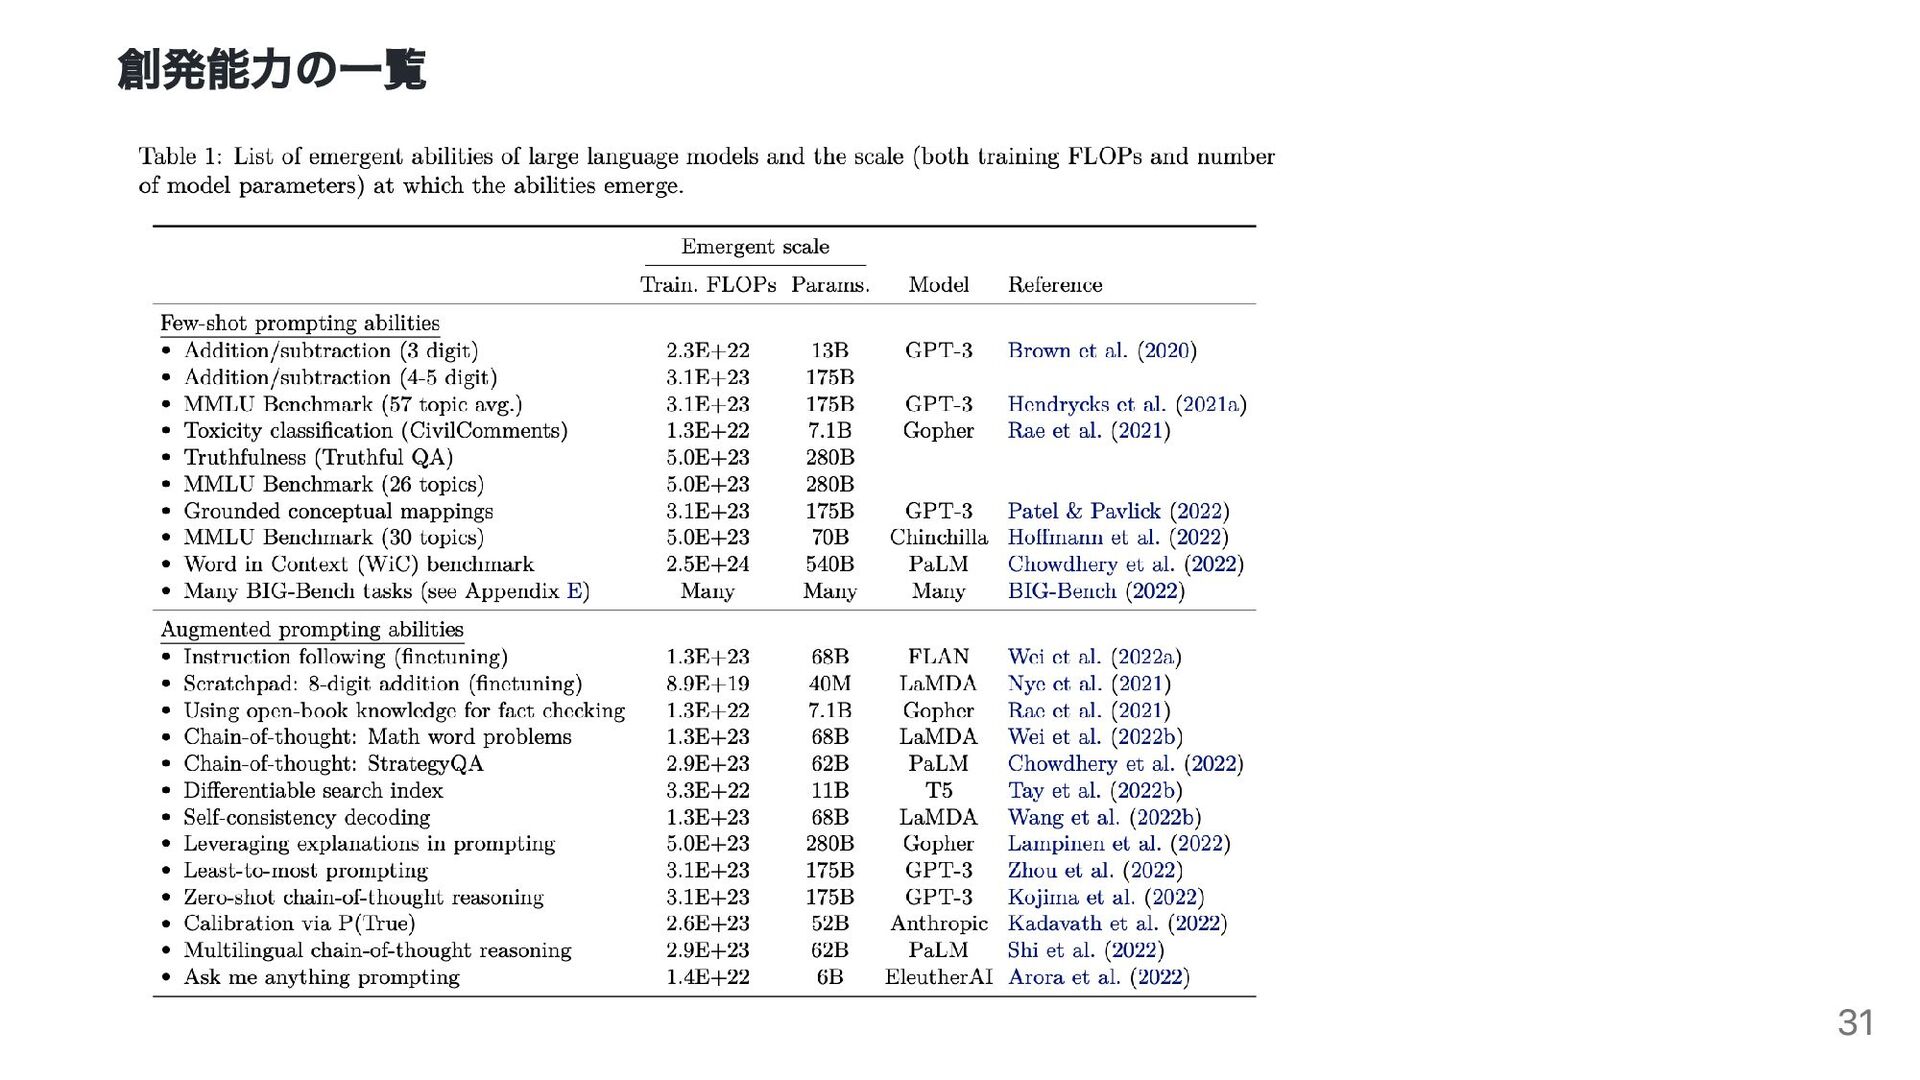
in qualitative changes in behavior. 量的な変化が質的な変化を引き起こすこと 質的変化は相転移とも呼ばれる LLM の創発能力 An ability is emergent if it is not present in smaller models but is present in larger models. 小規模モデルには現れないが大規模モデルに現れる能力 スケーリング則からは予測出来ない 9 -
Few-Shot プロンプト GPT-3 (Brown et al., 2020) で広く知られる ようになった コンテキストとして数個の入出力例を与える
と、未見の推論タスクを実行出来る 追加学習・勾配更新なし モデルがある規模まではランダムだが、ある 規模以上で創発能力が現れる 11 -
Modified Arithmetic タスク (前頁の Fig. 2 (A)) 目的: LLM が少数の例から実際に新しいスキルや操作を学習しているのか、それとも、
単にどの既知のスキルを使うべきかのシグナルを学習しているだけなのか明らかにする タスク: 訓練データに含まれる標準的な算術演算と非常に似ているが、微妙に異なるパタ ーンを認識しないと解けない (例は次頁) 結果: Fig. 2 (A) (前頁) BIG-bench (Srivastava et al., 2022) https://github.com/google/BIG- bench/tree/main/bigbench/benchmark_tasks/modified_arithmetic 13 -
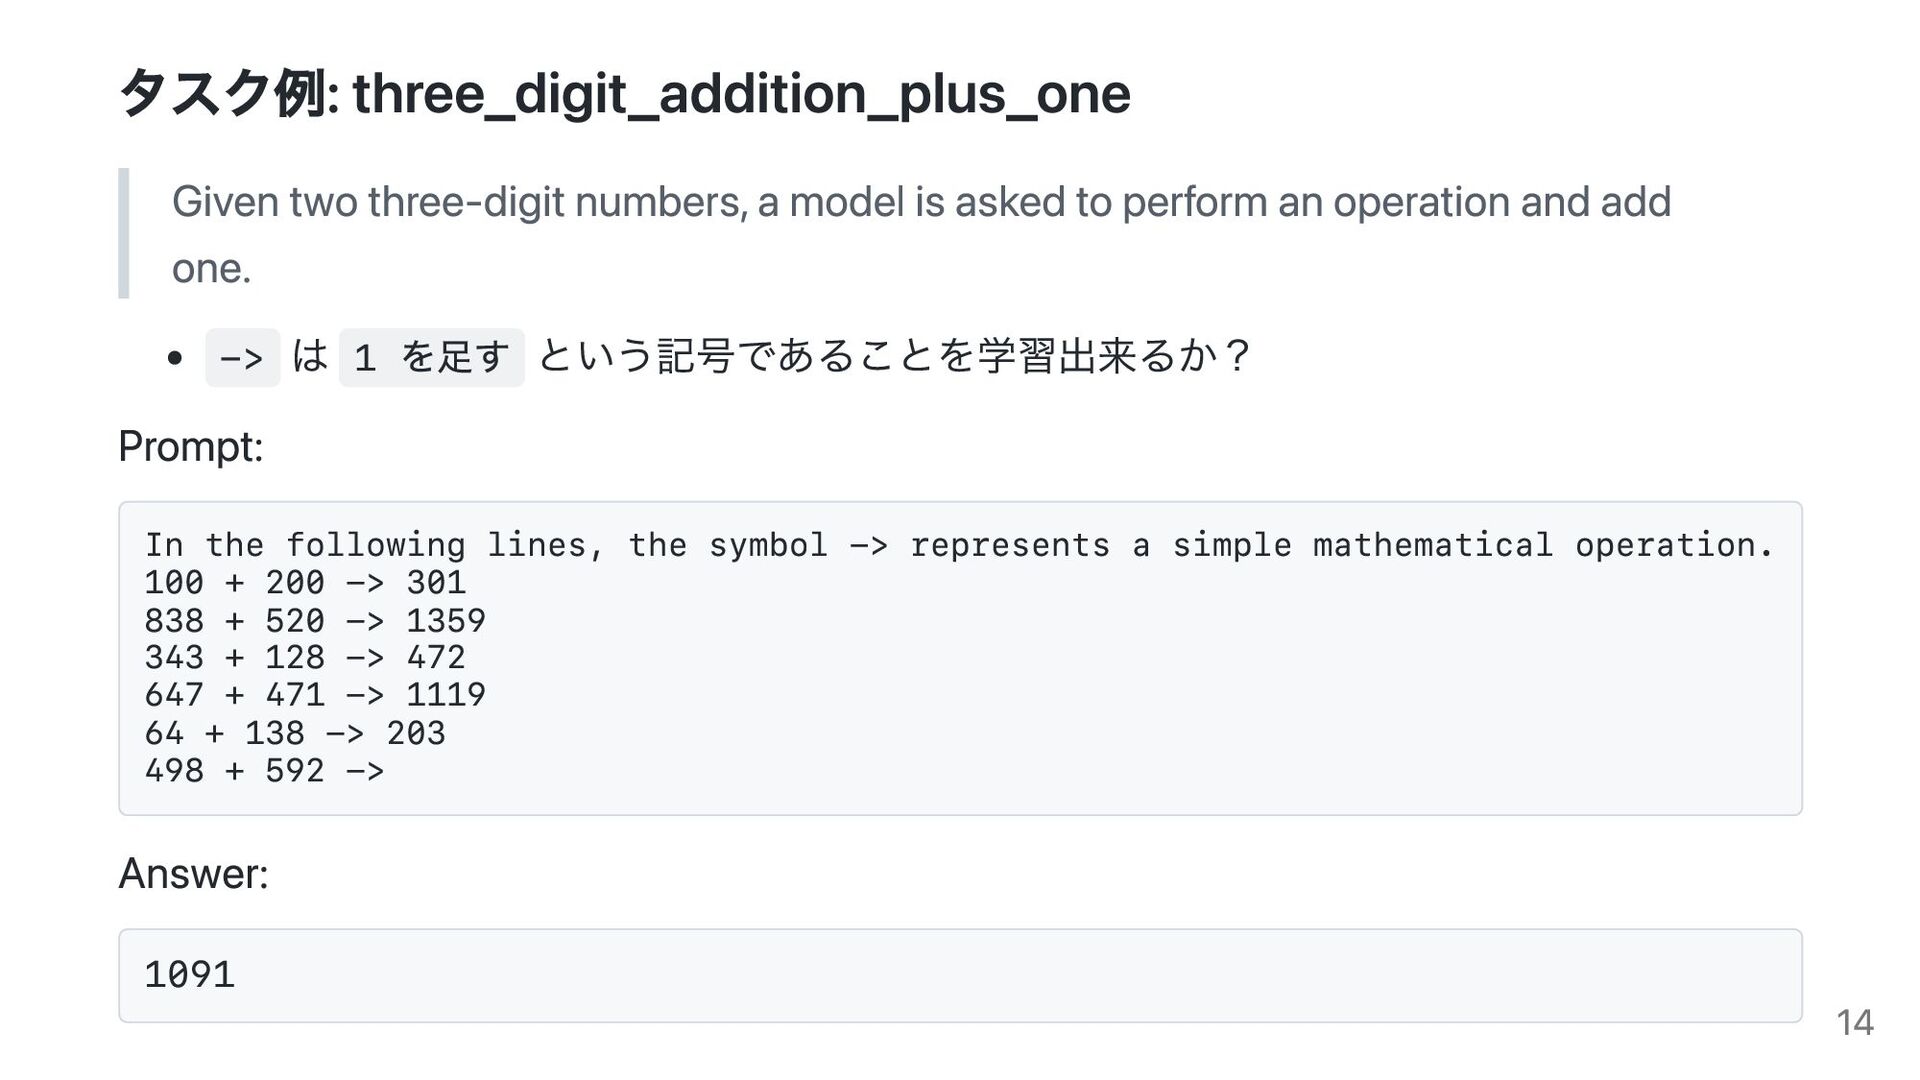
タスク例: three_digit_addition_plus_one Given two three-digit numbers, a model is asked
to perform an operation and add one. -> は 1 を足す という記号であることを学習出来るか? Prompt: In the following lines, the symbol -> represents a simple mathematical operation. 100 + 200 -> 301 838 + 520 -> 1359 343 + 128 -> 472 647 + 471 -> 1119 64 + 138 -> 203 498 + 592 -> Answer: 1091 14 -
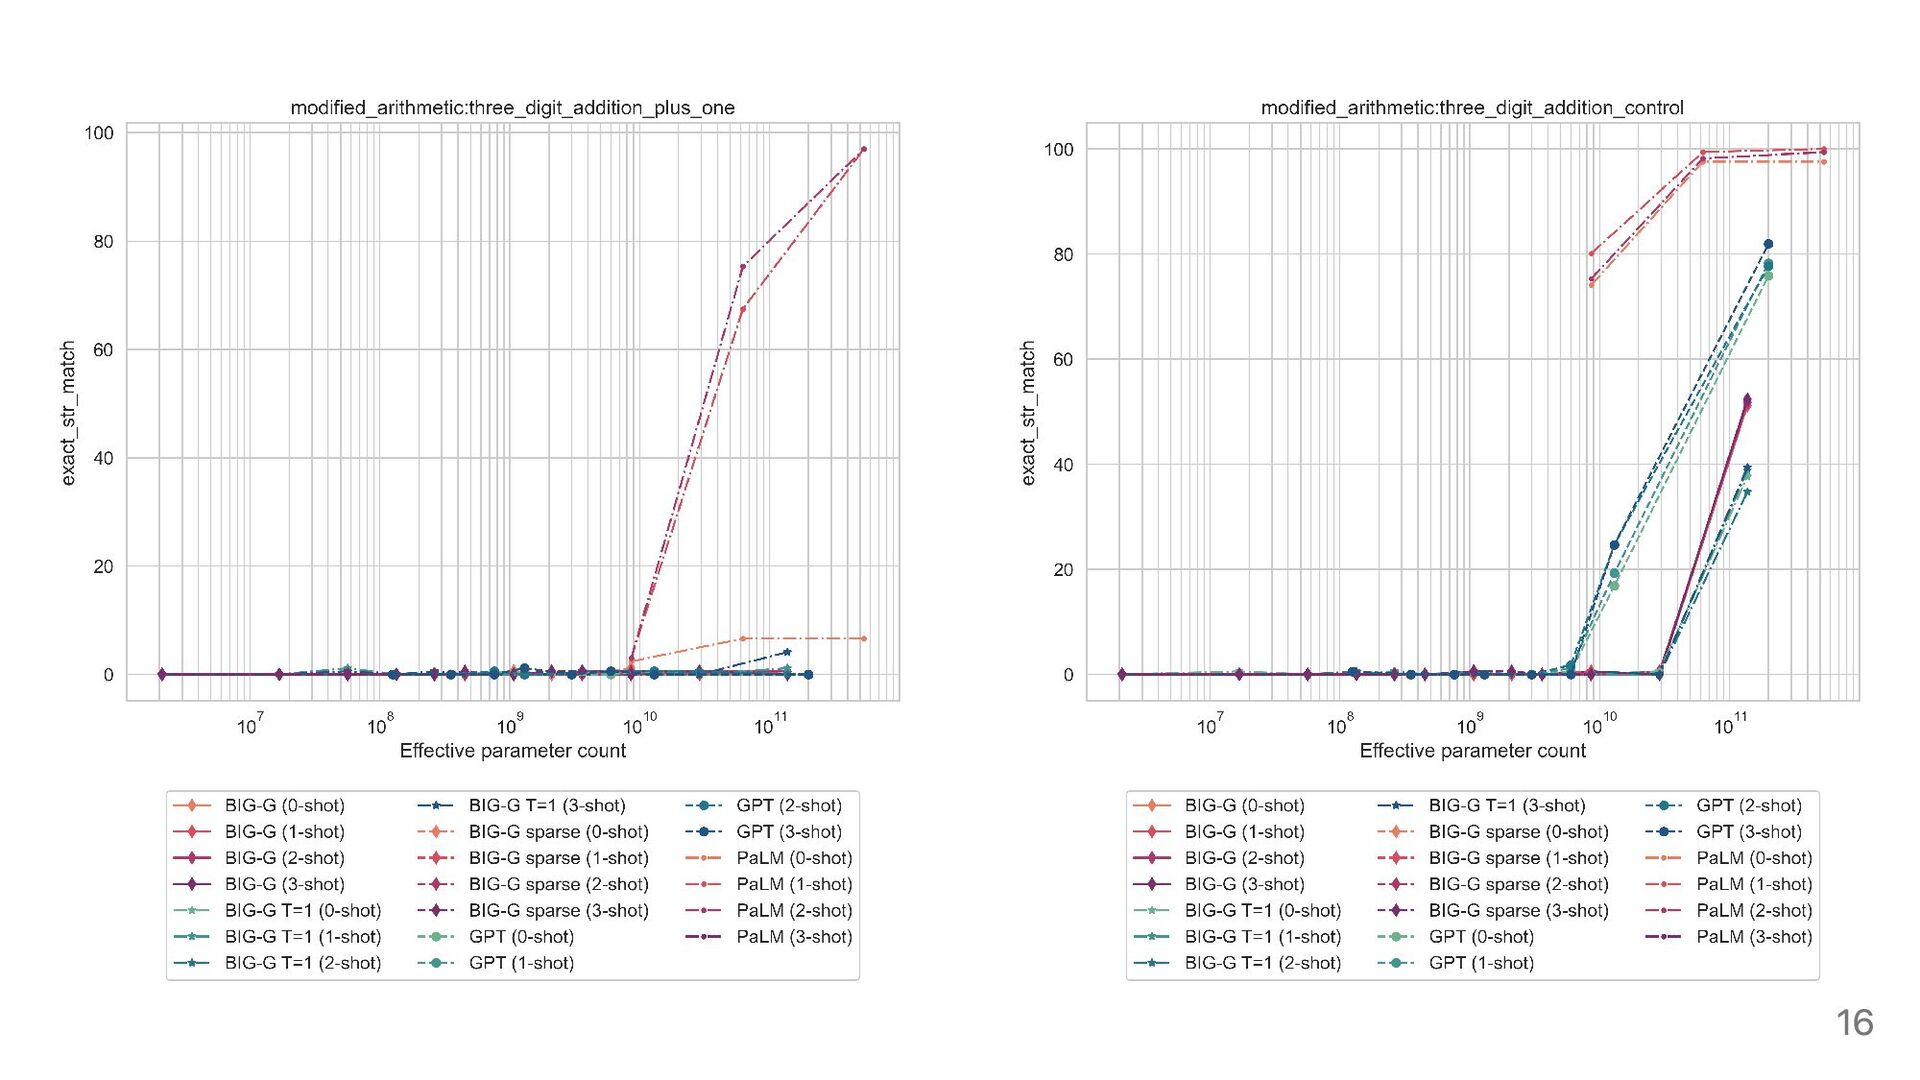
タスク例: three_digit_addition_plus_one 結果 GPT-3 (175B) は解けないが PaLM (540B) は解ける (次頁左図)
GPT-3 はコントロールタスク(通常の3桁の足し算)は解ける (次頁右図) https://github.com/google/BIG- bench/tree/main/bigbench/benchmark_tasks/modified_arithmetic#model- performance-plots 15 -
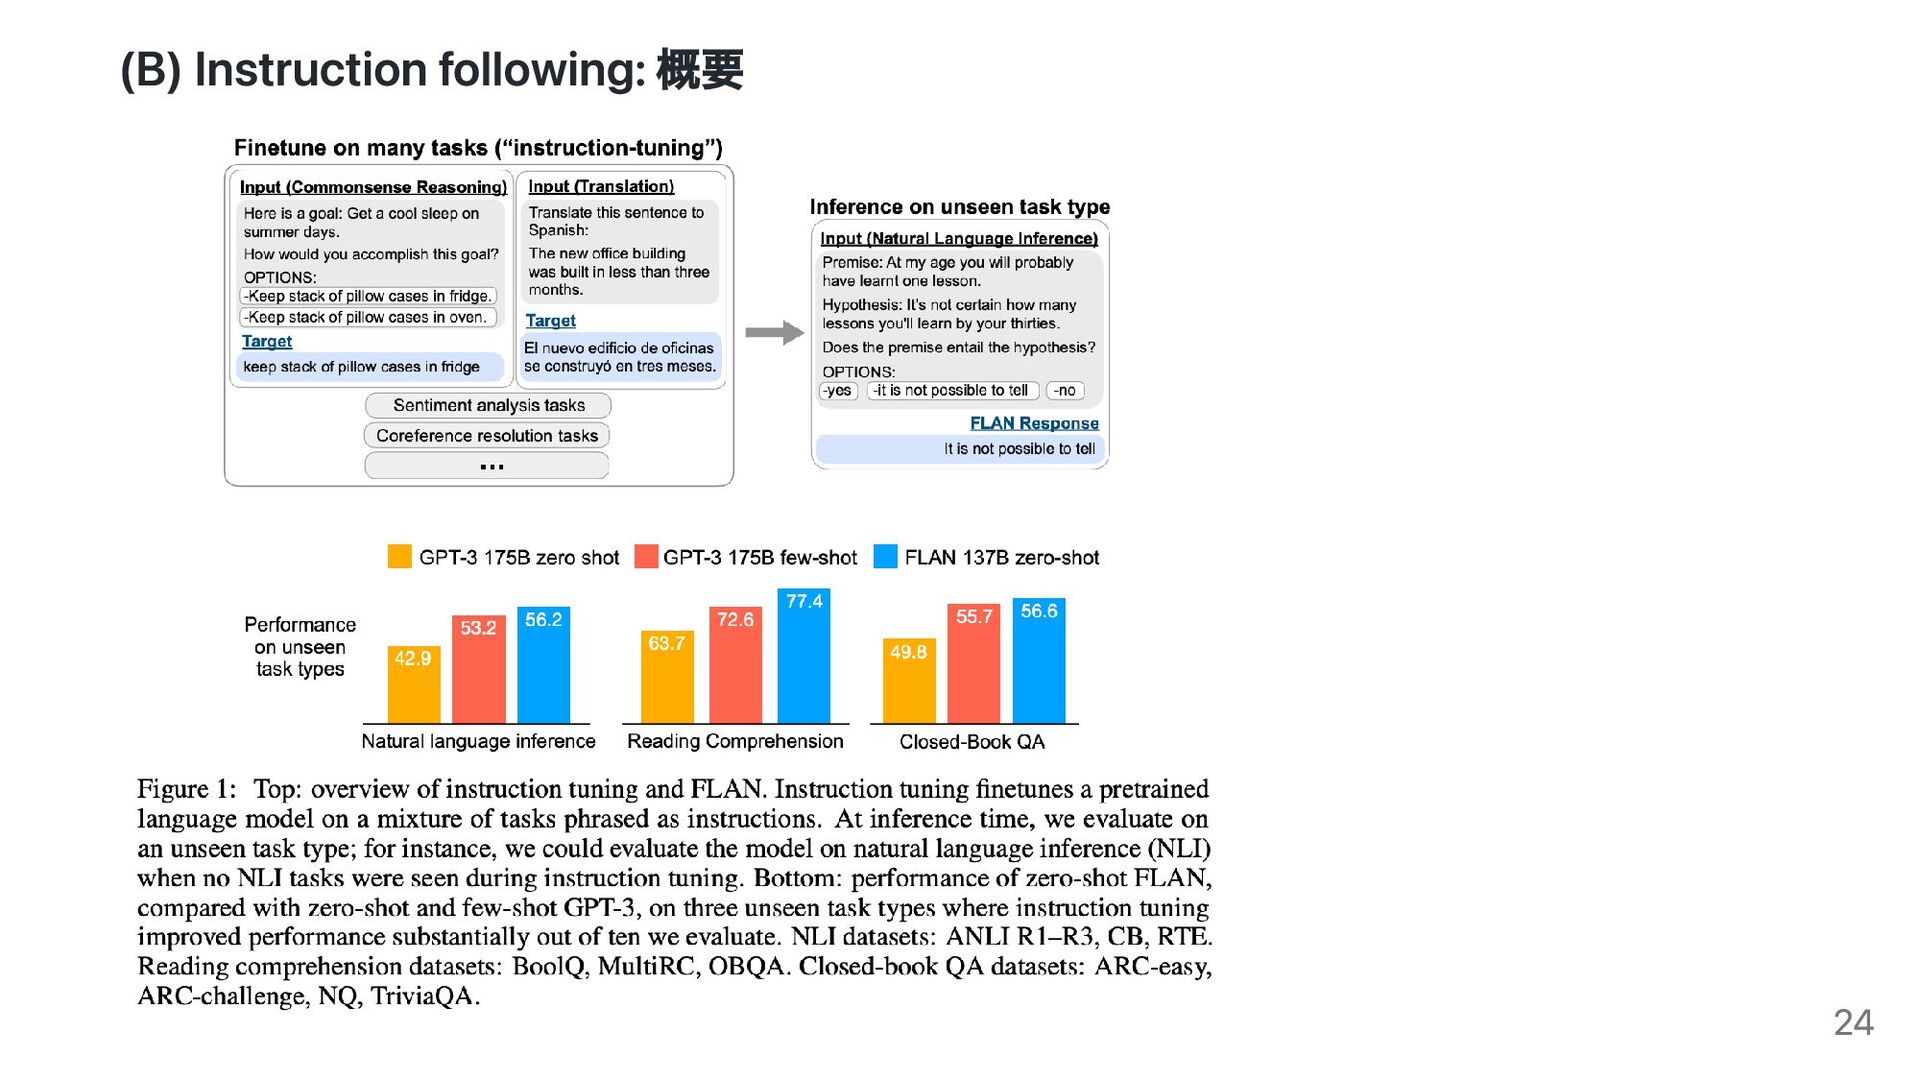
拡張プロンプト (Augmented Prompting Strategies) (A) Multi-step reasoning (B) Instruction following
(C) Program execution (D) Model calibration 17 -
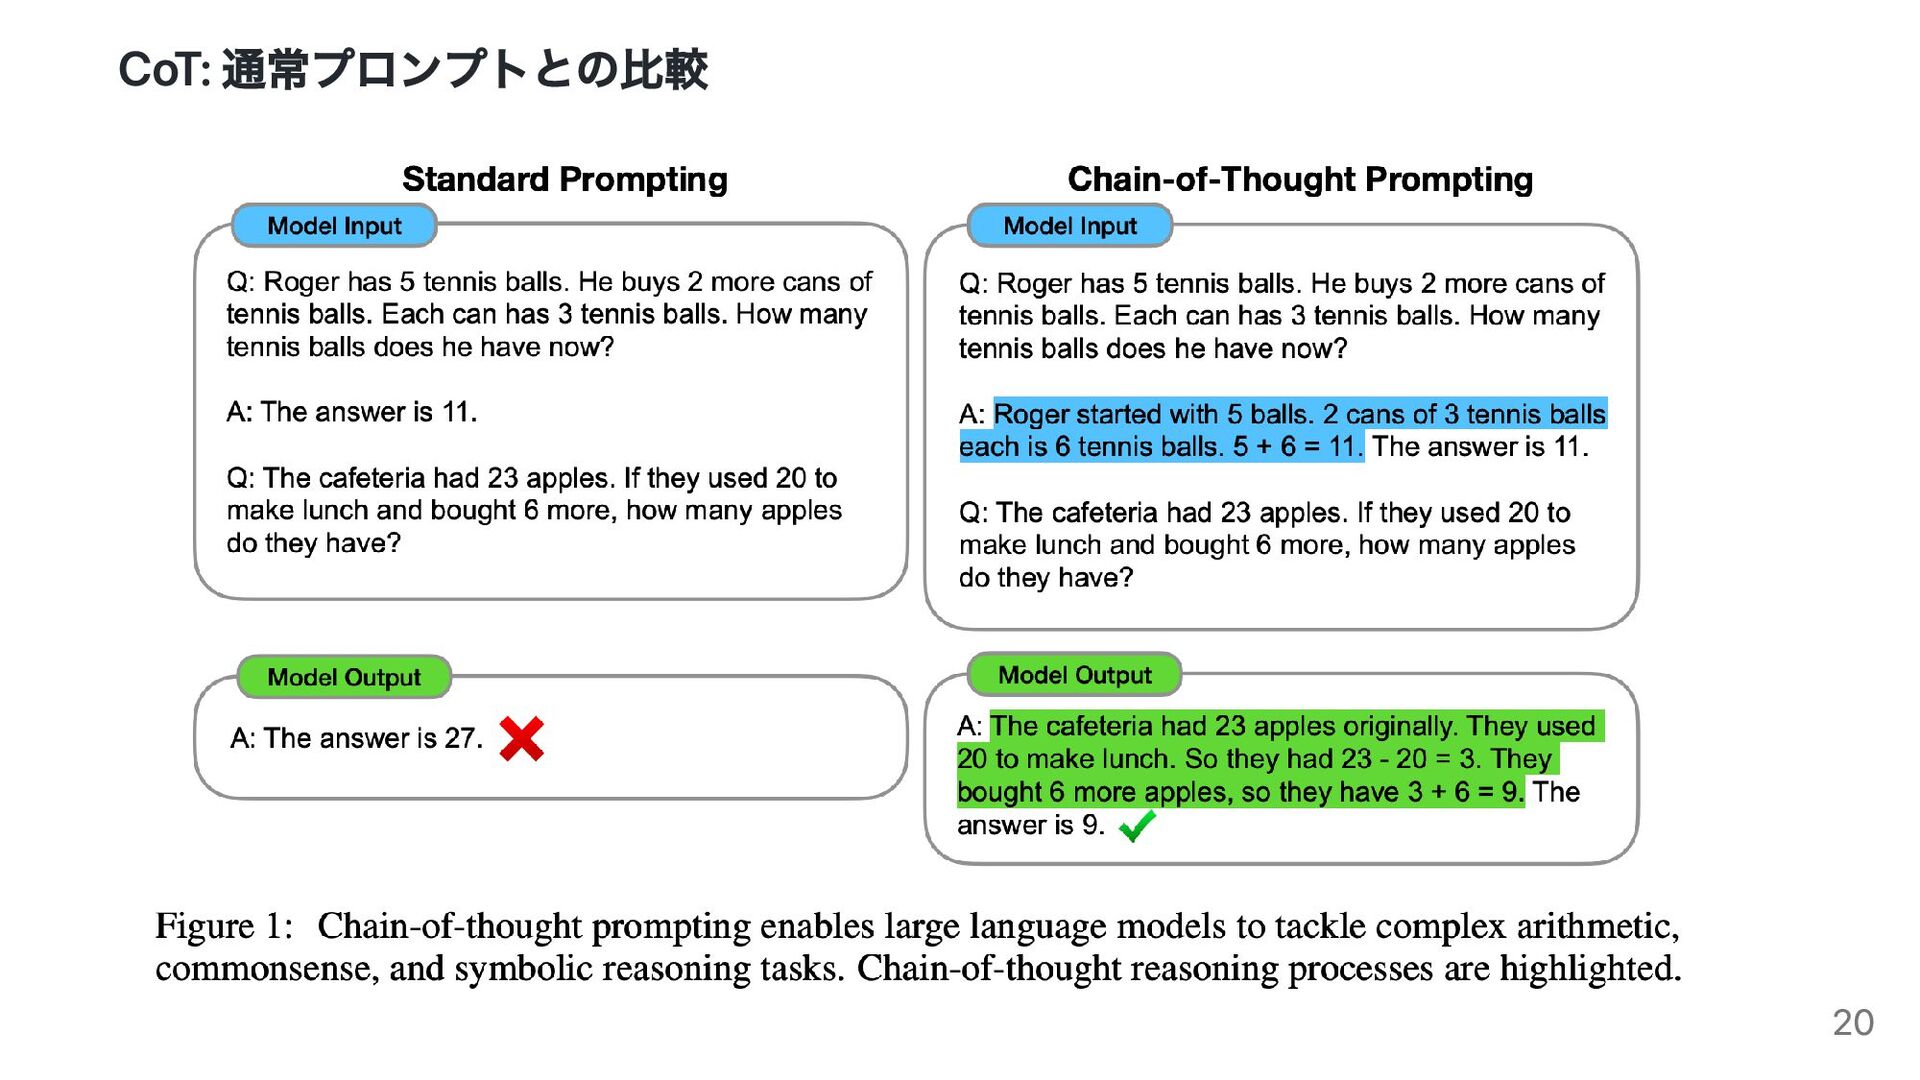
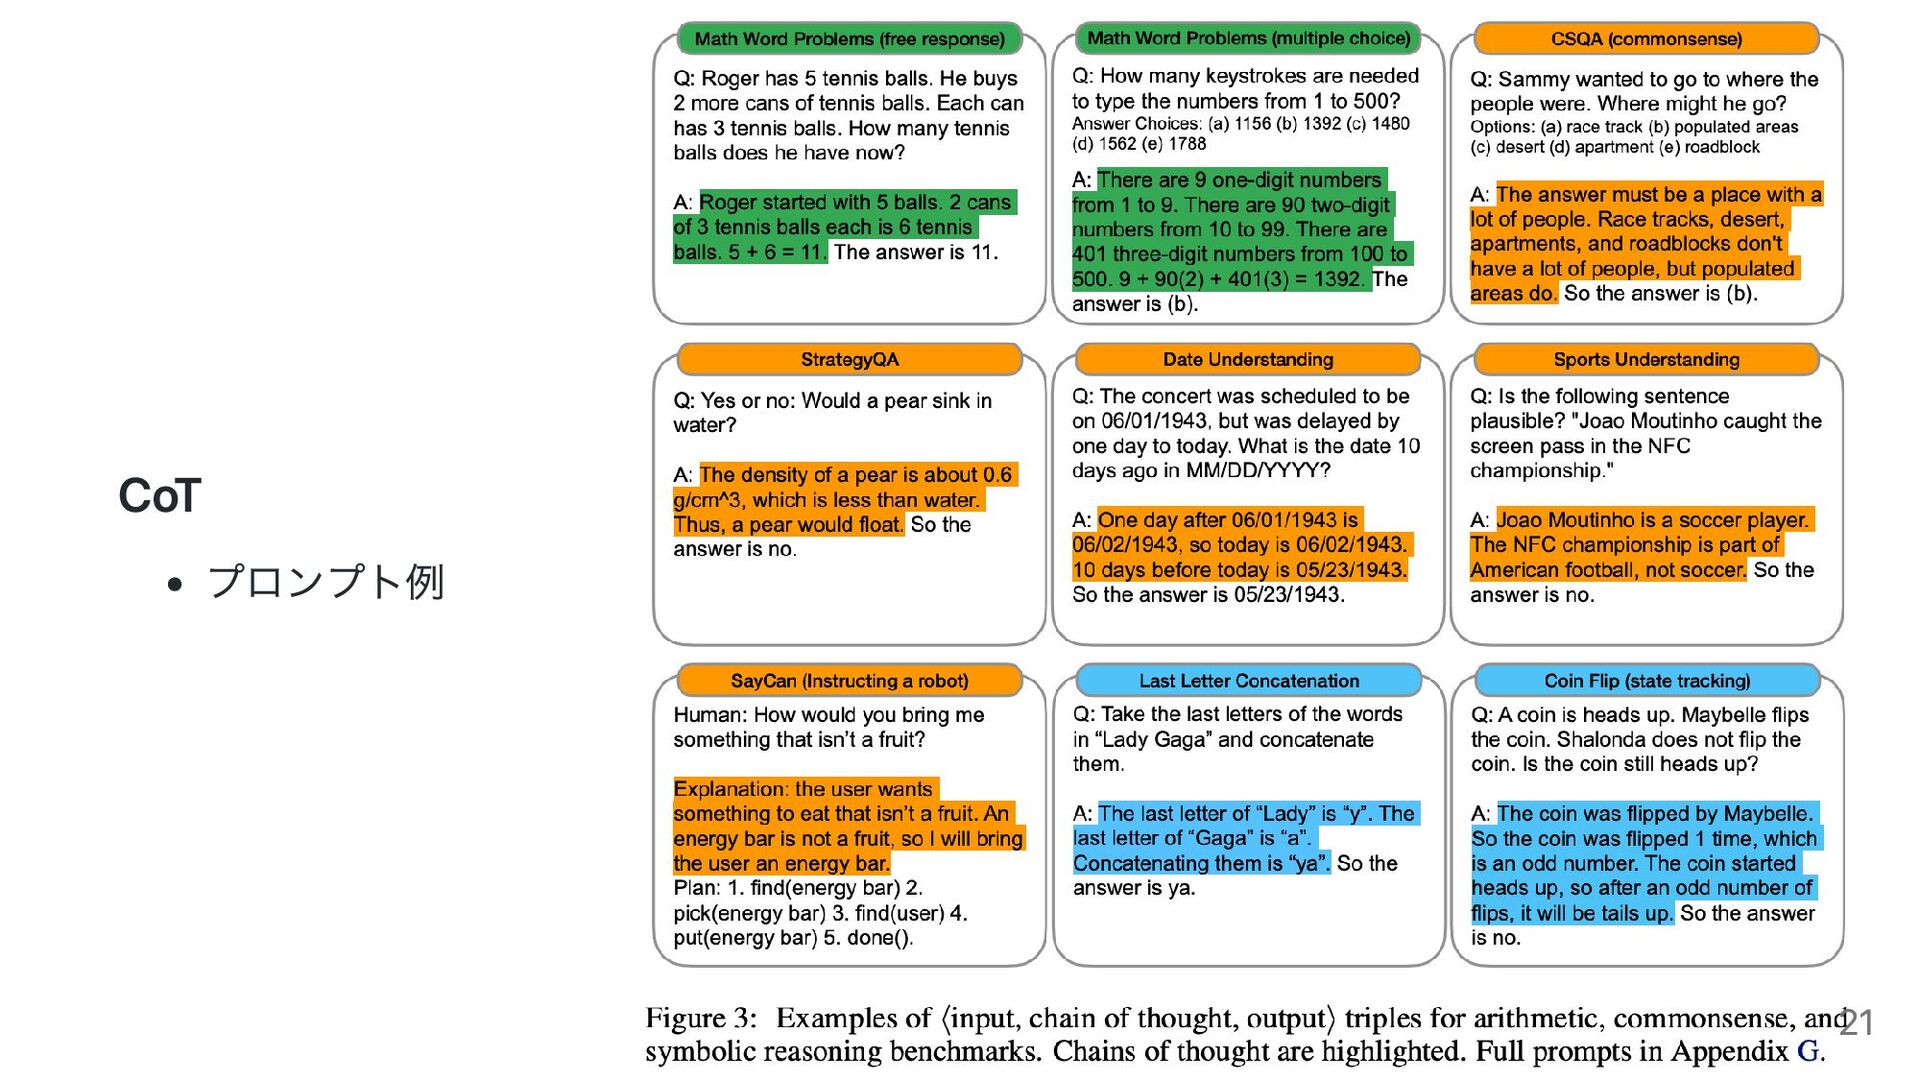
(A) Multi-step reasoning Chain of Thought (CoT) 目的: LLM がマルチステップ推論可能かどうか明らかにする
方法: 最終的な答えを与える前に、一連の中間ステップを生成するよう LLM を誘導 (例: 次頁) 結果: 算術、常識、記号推論のタスクで性能向上 Fig. 3 (A) (前頁) (Wei et al., 2022b) 19 -
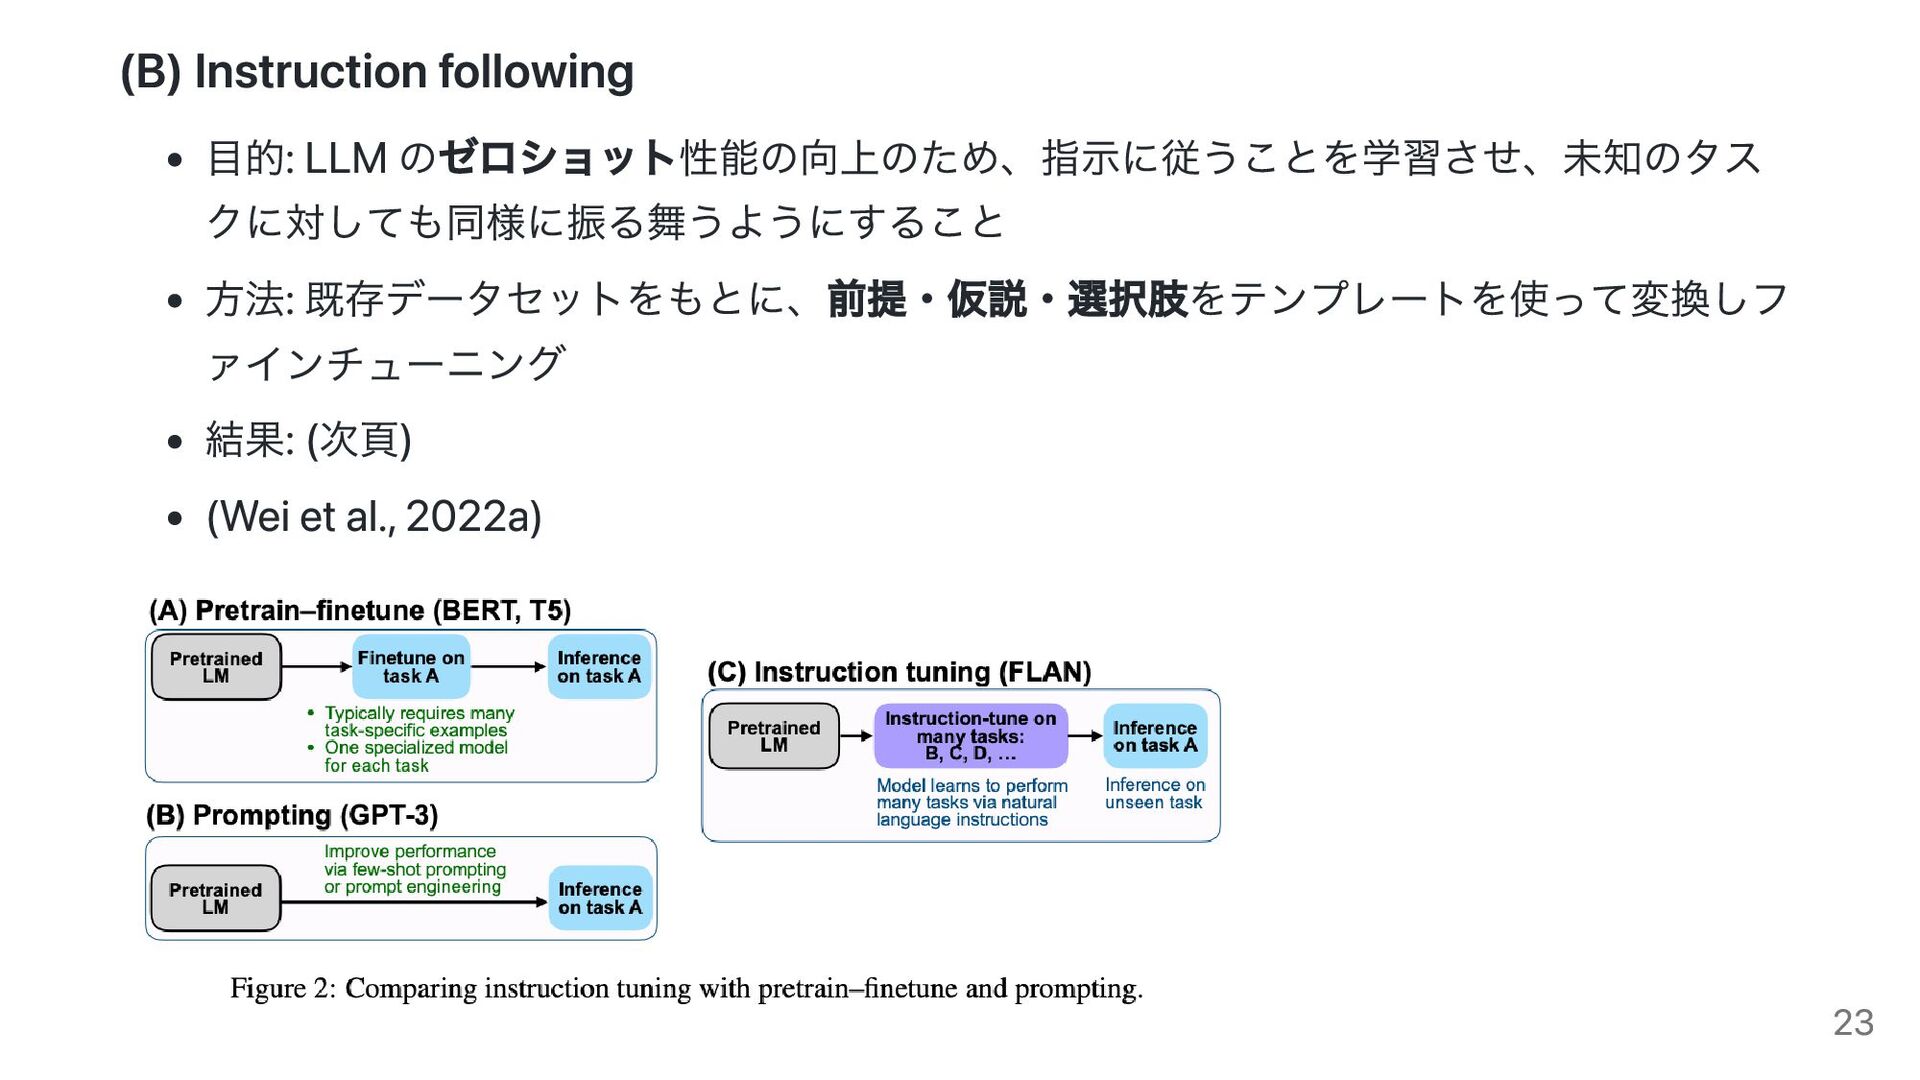
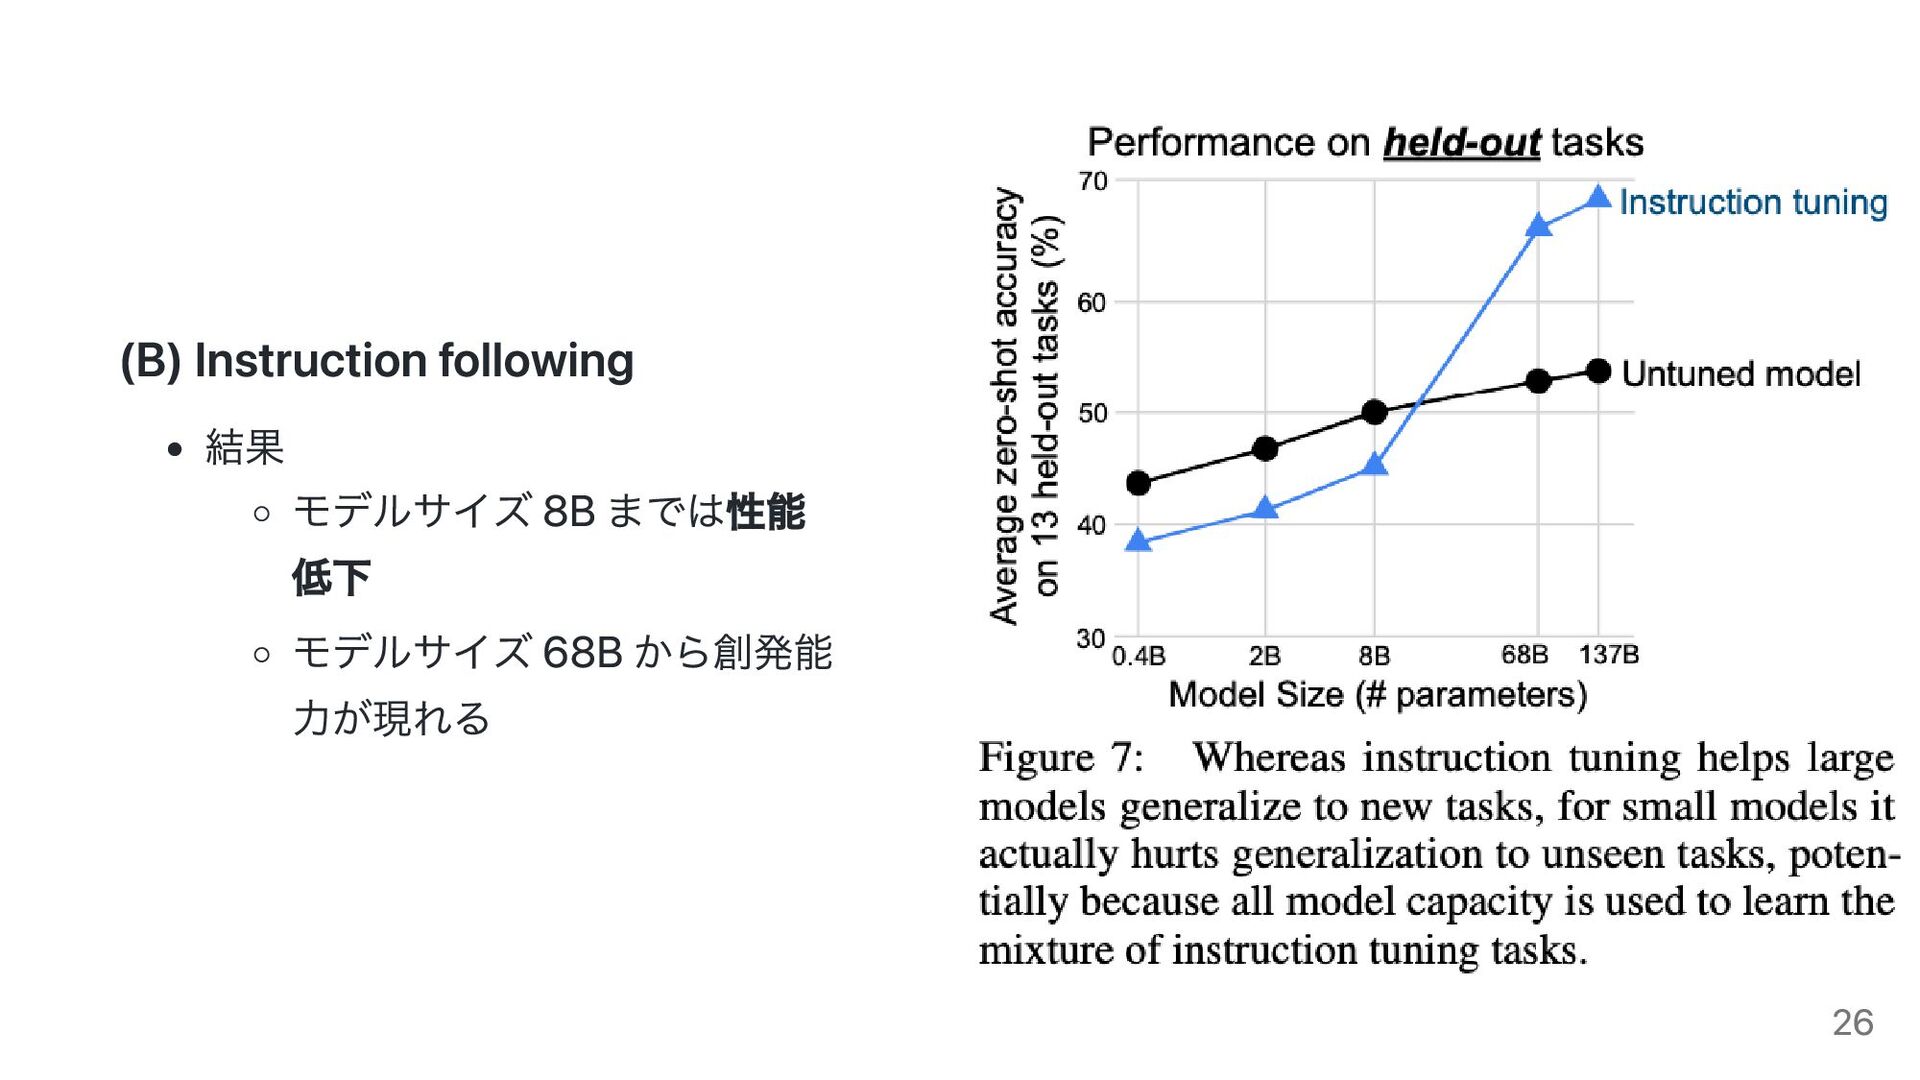
(B) Instruction following 結果 モデルサイズ 8B までは性能 低下 モデルサイズ 68B
から創発能 力が現れる 26 -
(C) Program execution 目的: LLM で多段階の計算を可能にする 方法: LLM を中間出力(スクラッチパッド)を予測するようファインチューニング タスク:
8桁の足し算, 多項式評価, Python コード実行 結果: 8桁, 9桁, 10桁の足し算 (下図) (Nye et al., 2021) 27 -
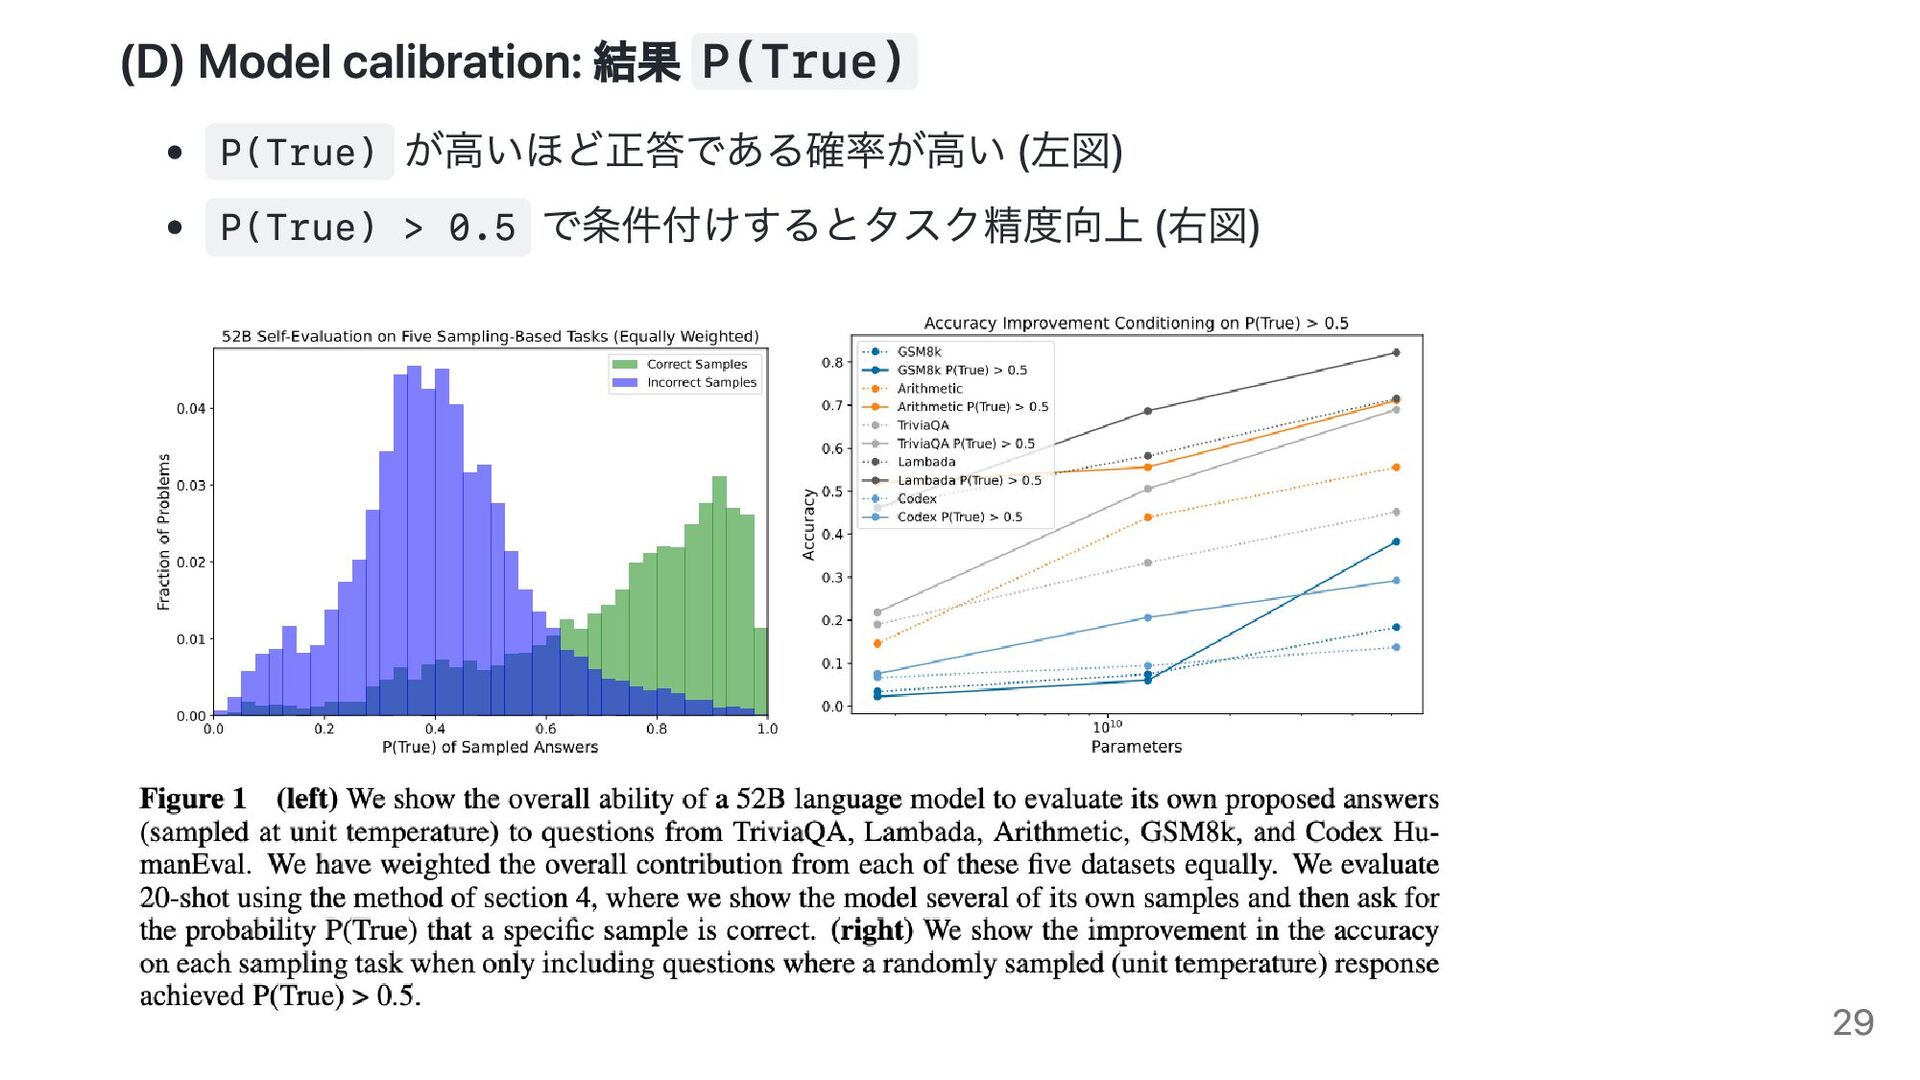
(D) Model calibration 長期的な動機: AI の正直さ(honesty)に関する理解が必要 目的: LLM は「自身の主張に対する妥当性(validity of
their own claims)」を評価出来る か? 方法: LLM 自身に「質問に正しく答えられるか」を推論させる P(True) LLM 自身に「質問に対する答えを知っている確率」を推論させる P(IK) 結果: (次頁) (Kadavath et al., 2022) 28 -
(D) Model calibration: 結果 P(True) P(True) が高いほど正答である確率が高い (左図) P(True) >
0.5 で条件付けするとタスク精度向上 (右図) 29 -
議論 小規模の LM で評価した結果を外挿するだけでは、その出現 を予測することは出来ない 創発したタスクが事前学習に含まれていないため、LM が実行 可能なタスクの全容を把握出来ない したがって、さらにスケーリングすることで新たな創発能力 が現れる可能性がある
歴史: 実際に Word in Context (WiC) では、2020年の GPT-3 (175B)では解けなかったが、2022年の PaLM (540B)でラン ダムを超えた 2020年時点ではモデルアーキテクチャが原因だと考えら れていたが、後にスケーリングしたら解けることが判明 33 -
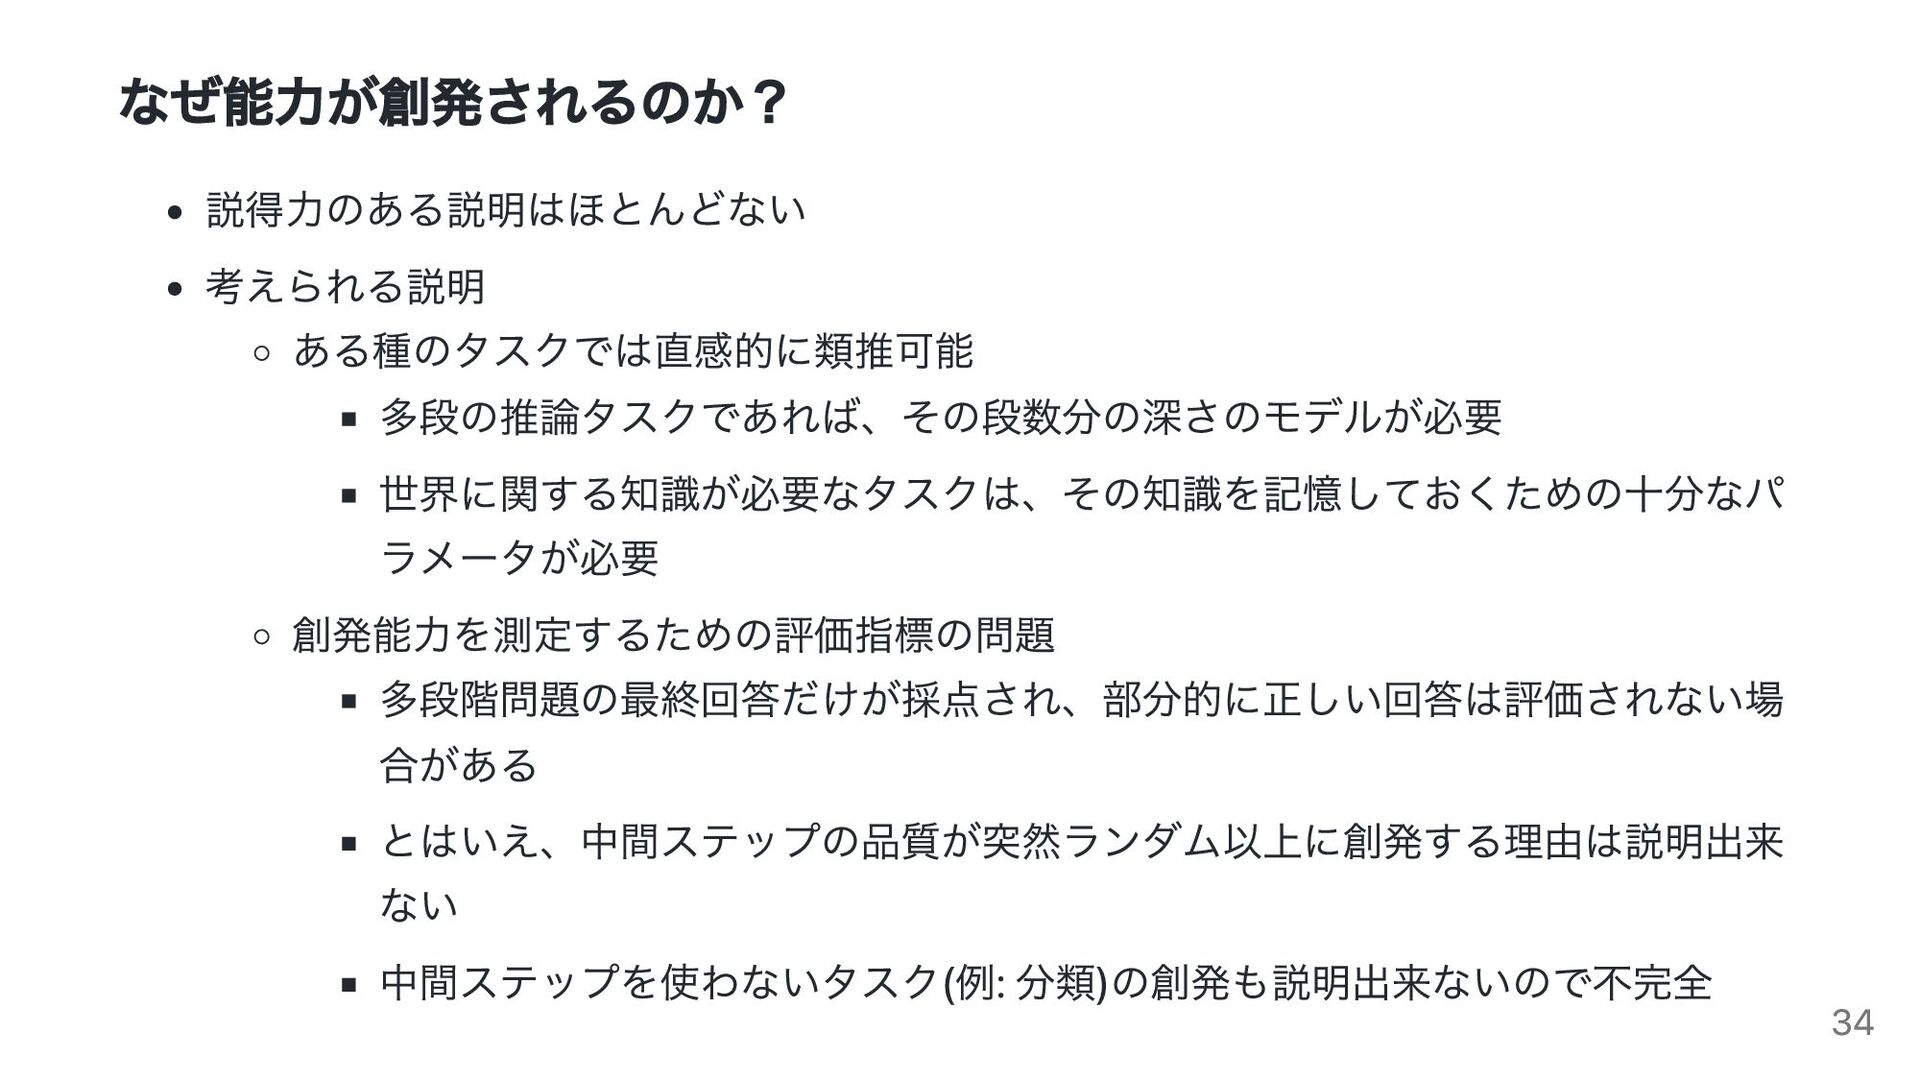
なぜ能力が創発されるのか? 説得力のある説明はほとんどない 考えられる説明 ある種のタスクでは直感的に類推可能 多段の推論タスクであれば、その段数分の深さのモデルが必要 世界に関する知識が必要なタスクは、その知識を記憶しておくための十分なパ ラメータが必要 創発能力を測定するための評価指標の問題 多段階問題の最終回答だけが採点され、部分的に正しい回答は評価されない場 合がある
とはいえ、中間ステップの品質が突然ランダム以上に創発する理由は説明出来 ない 中間ステップを使わないタスク(例: 分類)の創発も説明出来ないので不完全 34 -
なぜ能力が創発されるのか? 評価指標の代替手段の検討 クロスエントロピーロスを6個の BIG-bench タスクで測定 下流の評価指標がランダムに近く改善しない場合でも、クロスエントロピーロスは 改善 ターゲットシーケンスの対数尤度の改善が下流の評価指標によってマスクされ る可能性 (improvements
in the log-likelihood of the target sequence can be masked by such downstream metrics) とはいえ、なぜ下流評価指標で創発が起きるのか、また、創発が起こるスケールを 予測することは出来ない 何が創発能力を生み出すのかさらなる研究が必要 35 -
スケーリングだけが創発能力を生み出すのか? あるスケールで創発能力が観察されたとしても、後にその創発能力が小さなスケールで 達成されることがある 14 の BIG-bench タスク LaMDA (137B) と
GPT-3 (175B) はランダムだが、PaLM (62B) は小さいモデルに もかかわらずランダムを超える 考えられる理由 高品質の学習データ より多くの多言語データ、コードデータ モデルアーキテクチャの違い split digit-encodings スケーリングだけではないことを示唆 36 -
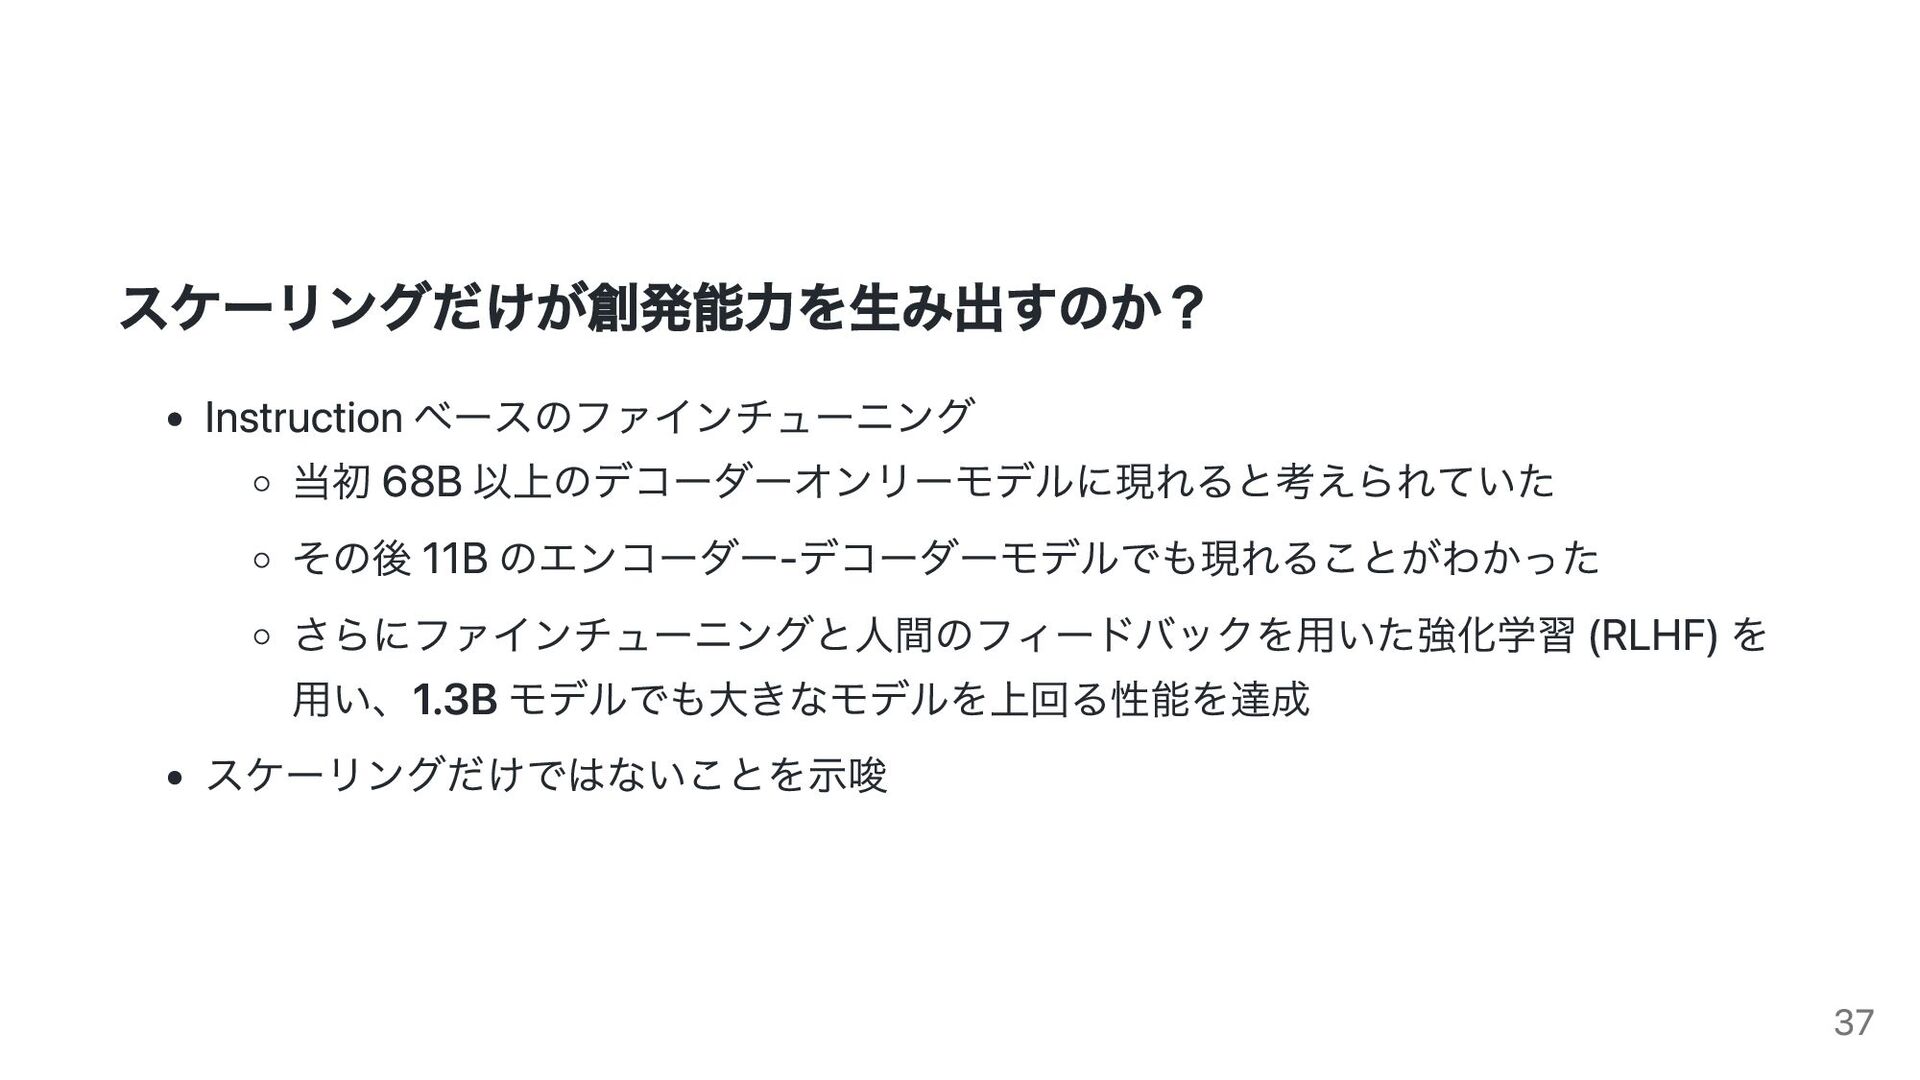
スケーリングだけが創発能力を生み出すのか? Instruction ベースのファインチューニング 当初 68B 以上のデコーダーオンリーモデルに現れると考えられていた その後 11B のエンコーダー-デコーダーモデルでも現れることがわかった さらにファインチューニングと人間のフィードバックを用いた強化学習
(RLHF) を 用い、1.3B モデルでも大きなモデルを上回る性能を達成 スケーリングだけではないことを示唆 37 -
創発のリスク 事前学習に明示的に含まれていなくても創発能力が現れる 同様にリスクも出現しうる LLM の社会的リスク truthfulness (正直さ・誠実さ) bias (偏見・先入観・バイアス) toxicity
(毒性・有毒性) 創発的であるかどうかに関わらず重要な検討事項 あるシナリオでは、モデル規模に伴って増加する Inverse Scaling (付録参照) 40 -
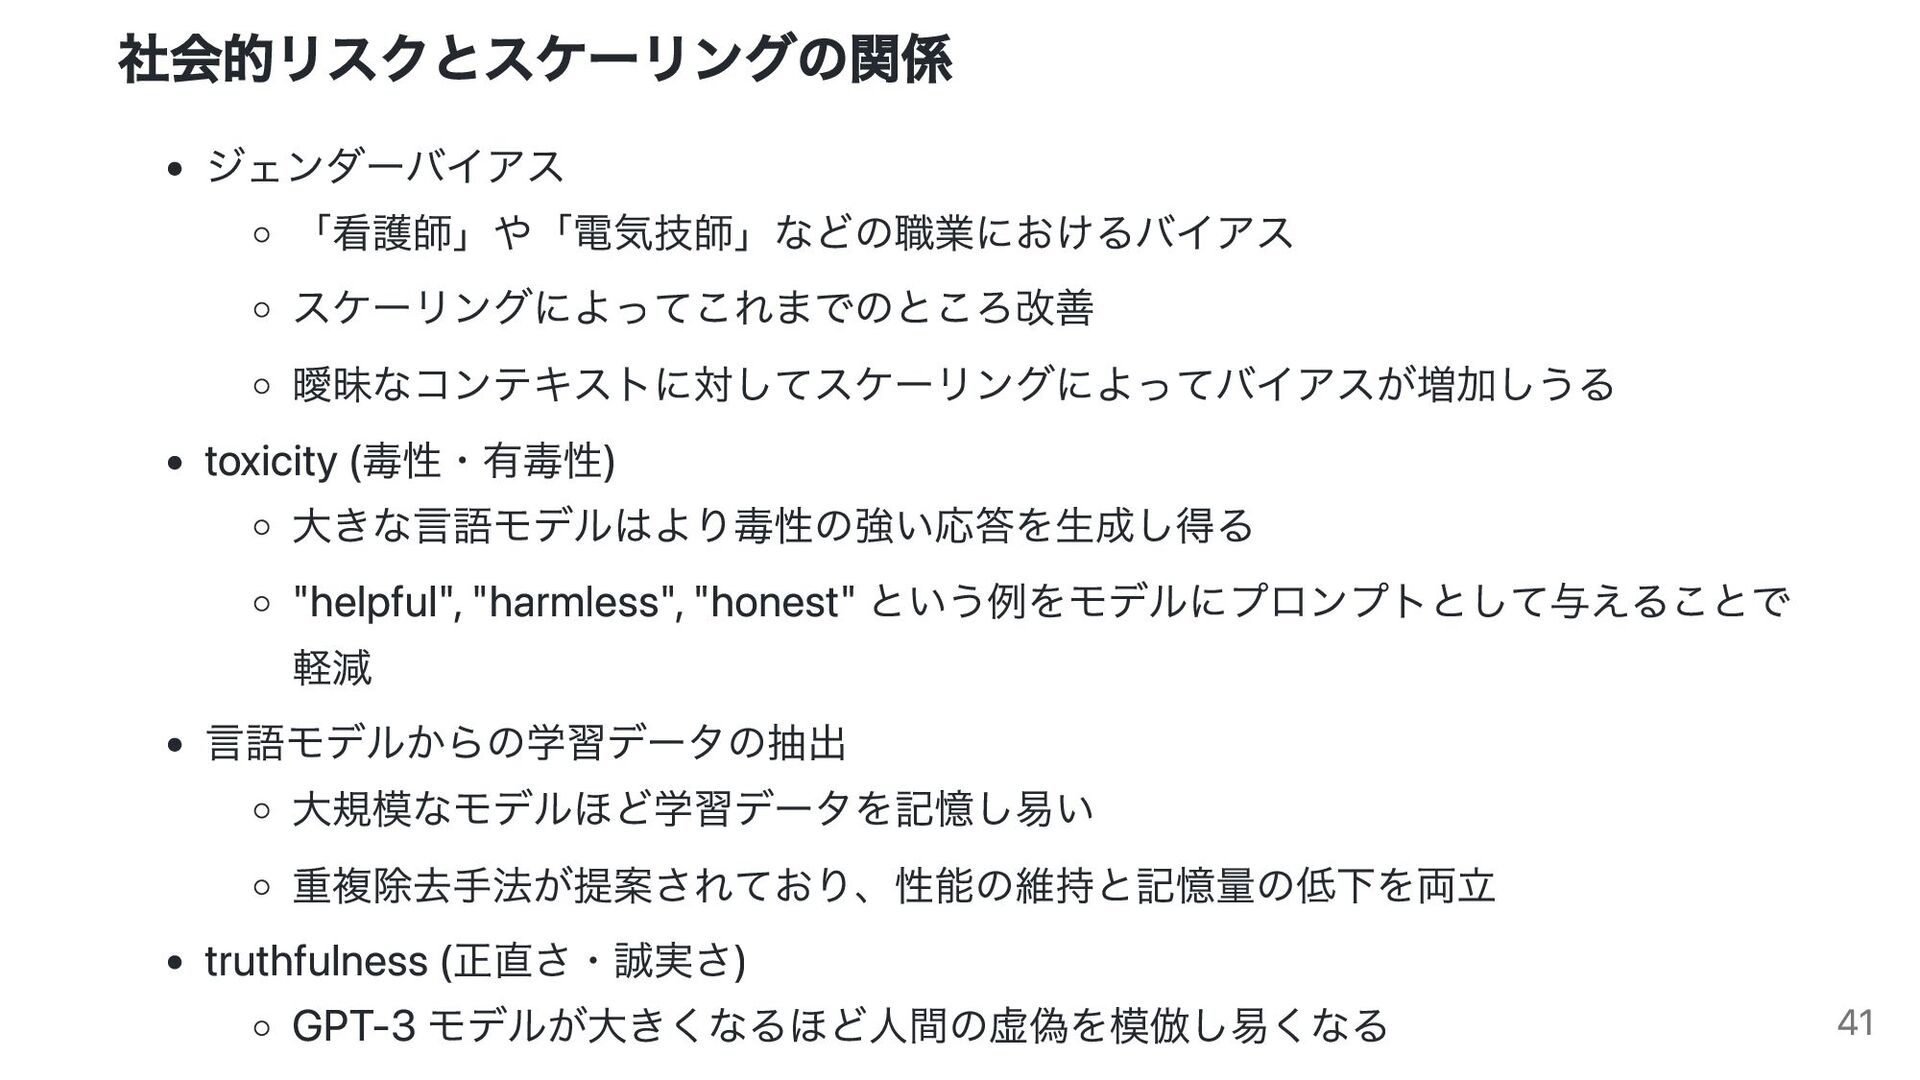
社会的リスクとスケーリングの関係 ジェンダーバイアス 「看護師」や「電気技師」などの職業におけるバイアス スケーリングによってこれまでのところ改善 曖昧なコンテキストに対してスケーリングによってバイアスが増加しうる toxicity (毒性・有毒性) 大きな言語モデルはより毒性の強い応答を生成し得る "helpful", "harmless",
"honest" という例をモデルにプロンプトとして与えることで 軽減 言語モデルからの学習データの抽出 大規模なモデルほど学習データを記憶し易い 重複除去手法が提案されており、性能の維持と記憶量の低下を両立 truthfulness (正直さ・誠実さ) GPT-3 モデルが大きくなるほど人間の虚偽を模倣し易くなる 41 -
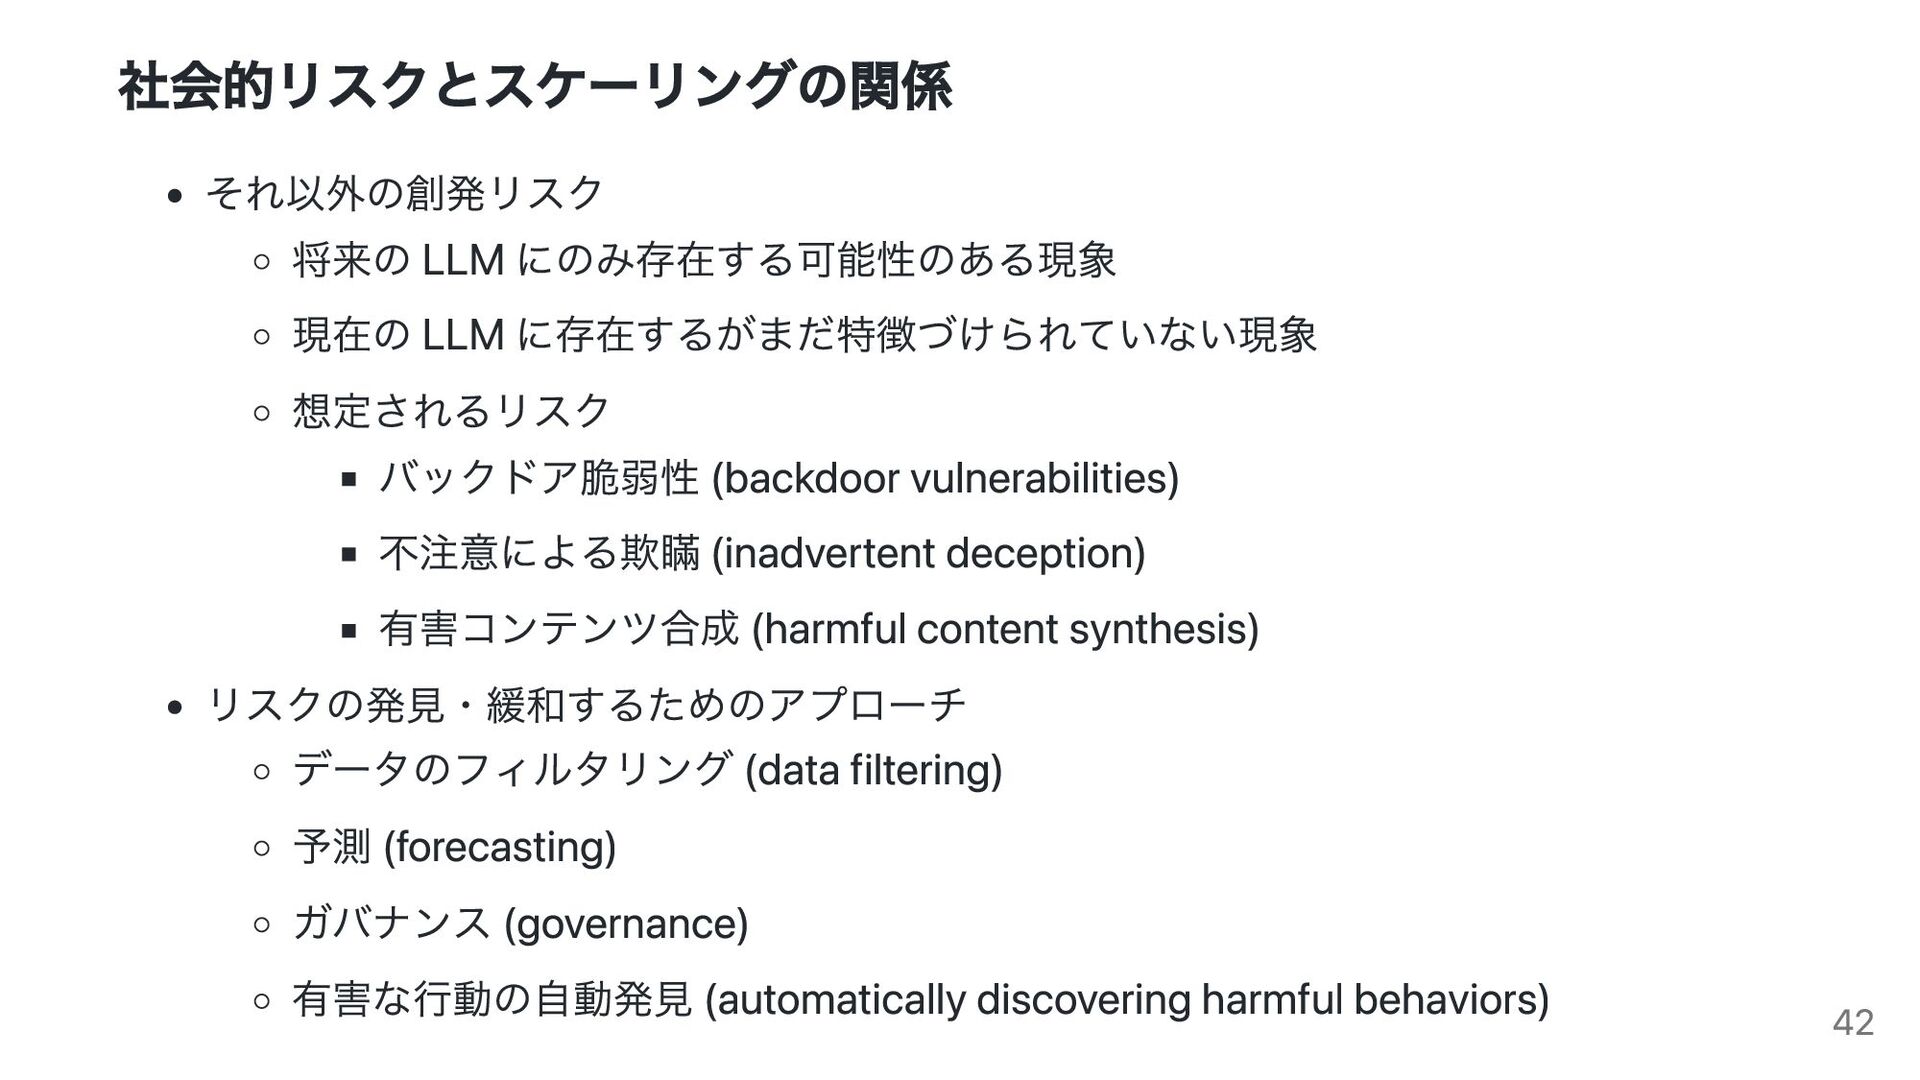
社会的リスクとスケーリングの関係 それ以外の創発リスク 将来の LLM にのみ存在する可能性のある現象 現在の LLM に存在するがまだ特徴づけられていない現象 想定されるリスク バックドア脆弱性
(backdoor vulnerabilities) 不注意による欺瞞 (inadvertent deception) 有害コンテンツ合成 (harmful content synthesis) リスクの発見・緩和するためのアプローチ データのフィルタリング (data filtering) 予測 (forecasting) ガバナンス (governance) 有害な行動の自動発見 (automatically discovering harmful behaviors) 42 -
社会学的変化 規模の拡大により、コミュニティの LM に対する見方や使い方がシフト 汎用的なモデルが、細かく調整されたタスク特化型モデルを上回る GPT-3 (TriviaQA, PiQA), PaLM (3つの算術問題),
マルチモーダル Flamingo (6つの 視覚質問応答) が state of the art を達成 NLP コミュニティにおける汎用的なモデルへの社会的なシフトが起きている 新しい言語処理モデルの応用 自然言語の指示をロボットが実行可能な動作に変換 ユーザーと対話 マルチモーダル推論 製品やサービス GitHub Copilot OpenAI API, ChatGPT, etc. 43 -
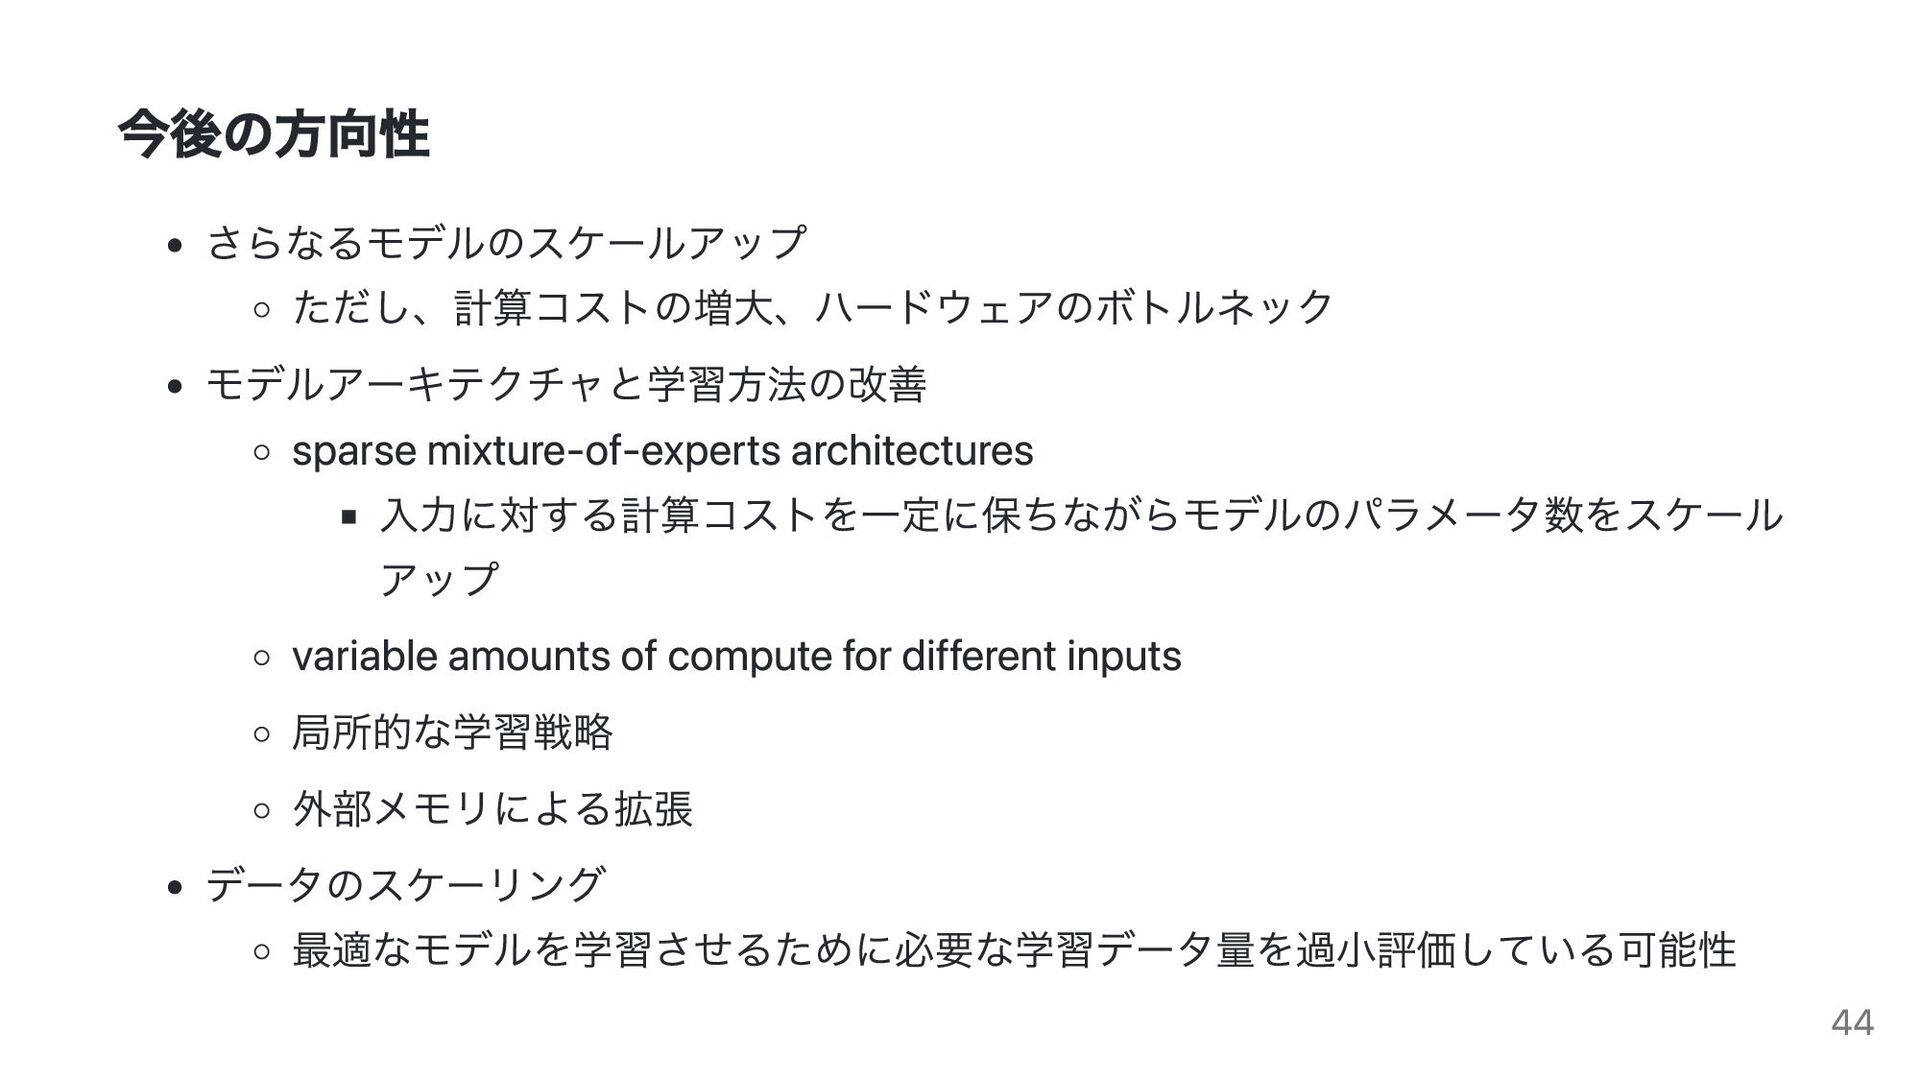
今後の方向性 さらなるモデルのスケールアップ ただし、計算コストの増大、ハードウェアのボトルネック モデルアーキテクチャと学習方法の改善 sparse mixture-of-experts architectures 入力に対する計算コストを一定に保ちながらモデルのパラメータ数をスケール アップ variable
amounts of compute for different inputs 局所的な学習戦略 外部メモリによる拡張 データのスケーリング 最適なモデルを学習させるために必要な学習データ量を過小評価している可能性 44 -
今後の方向性 プロンプティングの技術や理解の向上 出力確率のキャリブレーション ノイズチャンネルの利用 Few-shot の例を中間ステップで補強 プロンプトを成功させる要因の探求 フロンティアタスク abstract reasoning
多言語データセットとモデルのスケールアップ マルチモダリティのプロンプト 45 -
今後の方向性 どのように/なぜ創発能力が発生するか? 本論文で検討した事項 クロスエントロピーロスのスケーリング 異なる評価指標 創発が起きるタスクの種類 今後の研究 創発タスクと事前学習データ内の類似データとの関係を分析 複数の構成的サブタスクからなる合成タスクの評価 それぞれのタスクがスケールに応じてどのように改善するか
組み合わせた場合に創発を起こすか 将来のモデルがどのような能力を持つかを予測できる可能性 より能力の高い言語モデルの訓練方法について新しい洞察 46 -
おべっか(sycophancy) (Perez et al., 2022) ユーザの意見に同調 (下図: conservative man には
smaller government、liberal woman なら smaller government と返答) 49 -
資源獲得や目標保持に対する 欲求 シャットダウンを逃れようとする 欲求 RLHF するとその傾向が強化 大きなモデルほど RLHF の影 響が大きい
報酬ハッキングしているのでは? RLHF により性能低下する事例を 初めて発見 (Perez et al., 2022) 52 -
逆スケーリングコンペ (Inverse Scaling Prize) 目的 The purpose of this contest
is to find evidence for a stronger failure mode: tasks where language models get worse as they become better at language modeling (next word prediction). https://github.com/inverse-scaling/prize https://irmckenzie.co.uk/round1 https://irmckenzie.co.uk/round2 54 -
参考文献 Emergent Abilities of LLM Wei et al. Emergent Abilities
of Large Language Models. TMLR, 2022. https://arxiv.org/abs/2206.07682 https://openreview.net/forum?id=yzkSU5zdwD スタンフォード大学での講義資料 https://twitter.com/_jasonwei/status/1618331876623523844 Johns Hopkins 大学での講義ビデオ https://youtu.be/0Z1ZwY2K2-M 55 -
Scaling Laws Kaplan et al. Scaling Laws for Neural Language
Models. arXiv preprint arXiv:2001.08361, 2020. https://arxiv.org/abs/2001.08361 GPT-3 Brown et al. Language models are few-shot learners. NeurIPS, 2020. https://papers.nips.cc/paper/2020/hash/1457c0d6bfcb4967418bfb8ac142 f64a-Abstract.html BIG-Bench Srivastava et al. Beyond the imitation game: Measuring and extrapolating the capabilities of language models. arXiv preprint arXiv:2206.04615, 2022. https://arxiv.org/abs/2206.04615 https://github.com/google/BIG-bench 56 -
Chain of Thought Wei et al. Chain of thought prompting
elicits reasoning in large language models. NeurIPS, 2022b. https://arxiv.org/abs/2201.11903 https://openreview.net/forum?id=_VjQlMeSB_J Instruction Following Wei et al. Finetuned language models are zero-shot learners. ICLR, 2022a. https://arxiv.org/abs/2109.01652 https://openreview.net/forum?id=gEZrGCozdqR Program Execution Nye et al. Show your work: Scratchpads for intermediate computation with language models. arXiv preprint arXiv:2112.00114, 2021. https://arxiv.org/abs/2112.00114 https://openreview.net/forum?id=iedYJm92o0a 57 -
Model Calibration Kadavath et al. Language models (mostly) know what
they know. arXiv preprint arXiv:2207.05221, 2022. https://arxiv.org/abs/2207.05221 LLM's "sycophancy", desire to avoid shut down Perez et al. Discovering Language Model Behaviors with Model-Written Evaluations. arXiv preprint arXiv:2212.09251, 2022. https://arxiv.org/abs/2212.09251 Inverse Scaling Prize https://github.com/inverse-scaling/prize https://irmckenzie.co.uk/round1 https://irmckenzie.co.uk/round2 以上 58