Share
Embed
MLGym: A New Framework and Benchmark for Advancing AI Research Agents
MLGym: A New Framework and Benchmark for Advancing AI Research Agents
Deepak Nathani, et al., 2025.
arXiv preprint arXiv:2502.14499
https://arxiv.org/abs/2502.14499
第109回汎用人工知能輪読会
担当: 太田 晋
2025-02-28

S. Ota
February 28, 2025
Transcript
71 slides
-
MLGym: A New Framework and Benchmark for Advancing AI Research
Agents Deepak Nathani, et al., 2025. arXiv preprint arXiv:2502.14499 https://arxiv.org/abs/2502.14499 第109回汎用人工知能輪読会 担当: 太田 晋 2025-02-28 -
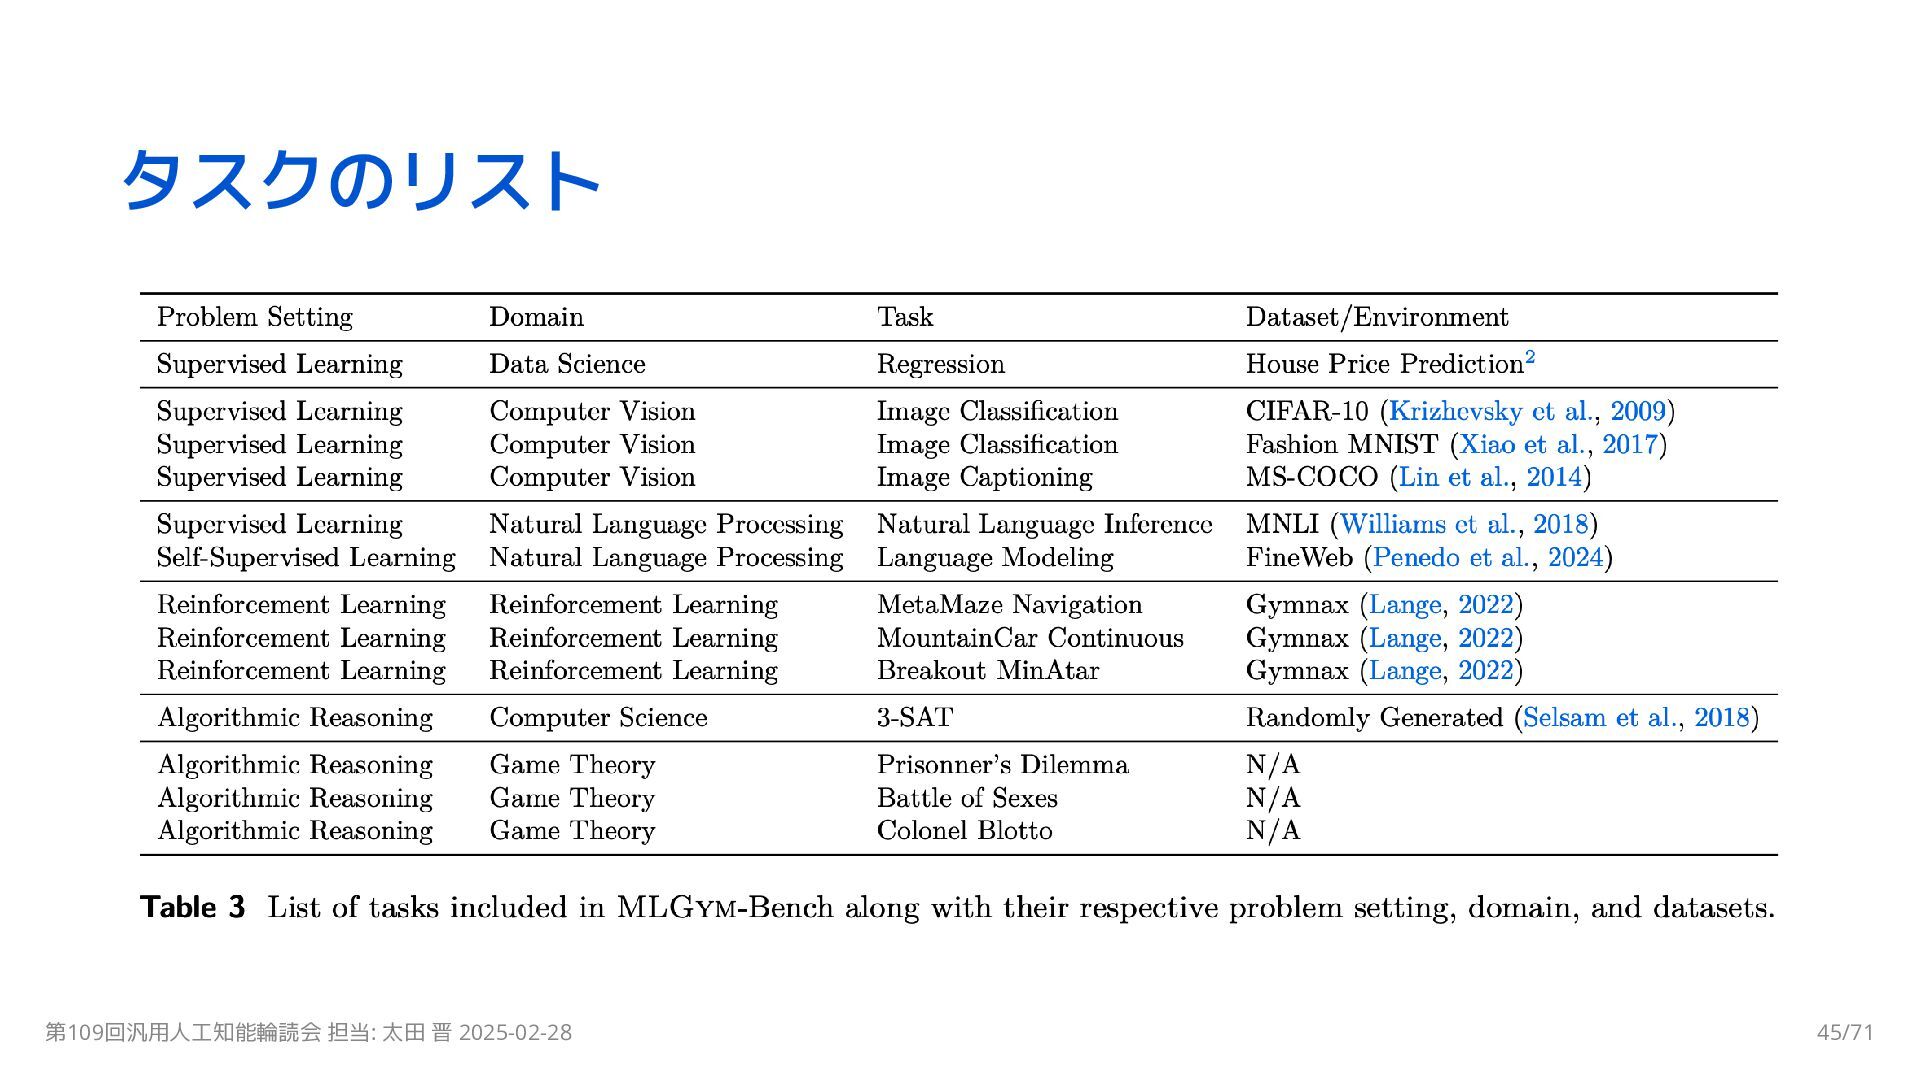
概要 MLGym, MLGym-Bench: LLMエージェントをAI研究タスクで評価・開発するため のフレームワーク・ベンチマーク Gym環境: 強化学習アルゴリズム等を用いてエージェントを訓練 AI研究タスク: コンピュータビジョン・自然言語処理・強化学習・ゲーム理論など 13のオープンエンドなタスク
AI研究スキル: 新しいアイデアや仮説の生成・データ作成と処理・ML手法の実 装・モデルのトレーニング・実験実施・結果分析・プロセス全体の改善と反復 最先端LLMの評価: Claude-3.5-Sonnet, Llama-3.1, GPT-4o, o1, Gemini-1.5 Pro フレームワーク: 新タスクの追加・モデルやエージェントの統合と評価・スケーラ ブルな合成データ生成・新たな学習アルゴリズムの開発・オープンソース 第109回汎用人工知能輪読会 担当: 太田 晋 2025-02-28 3/71 -
目次 1 Introduction 2 Related Work 3 MLGym 4 MLGym-Bench
5 Experimental Setup 6 Evaluation 7 Results 8 Discussion and Limitations 9 Ethical Considerations 10 Conclusions 第109回汎用人工知能輪読会 担当: 太田 晋 2025-02-28 5/71 -
背景 AI研究の長期目標: 科学的発見を加速すること 未来のビジョン AI研究エージェントが、文献検索・仮説生成・実験計画・新手法の実装・結 果の分析・論文執筆・製品への応用・研究プロセスの全ての部分を支援 完全自律 or 人間の監督下 これまでの成功例
新薬の発見 (Hessler and Baringhaus, 2018), (Schneider et al., 2020) マテリアルサイエンス (Guo et al., 2021) 膨大な知識グラフを分析することで、隠れた分野横断的関係性 (interdisciplinary relationships)を明らかにし、斬新な洞察と解決策を導く 第109回汎用人工知能輪読会 担当: 太田 晋 2025-02-28 6/71 -
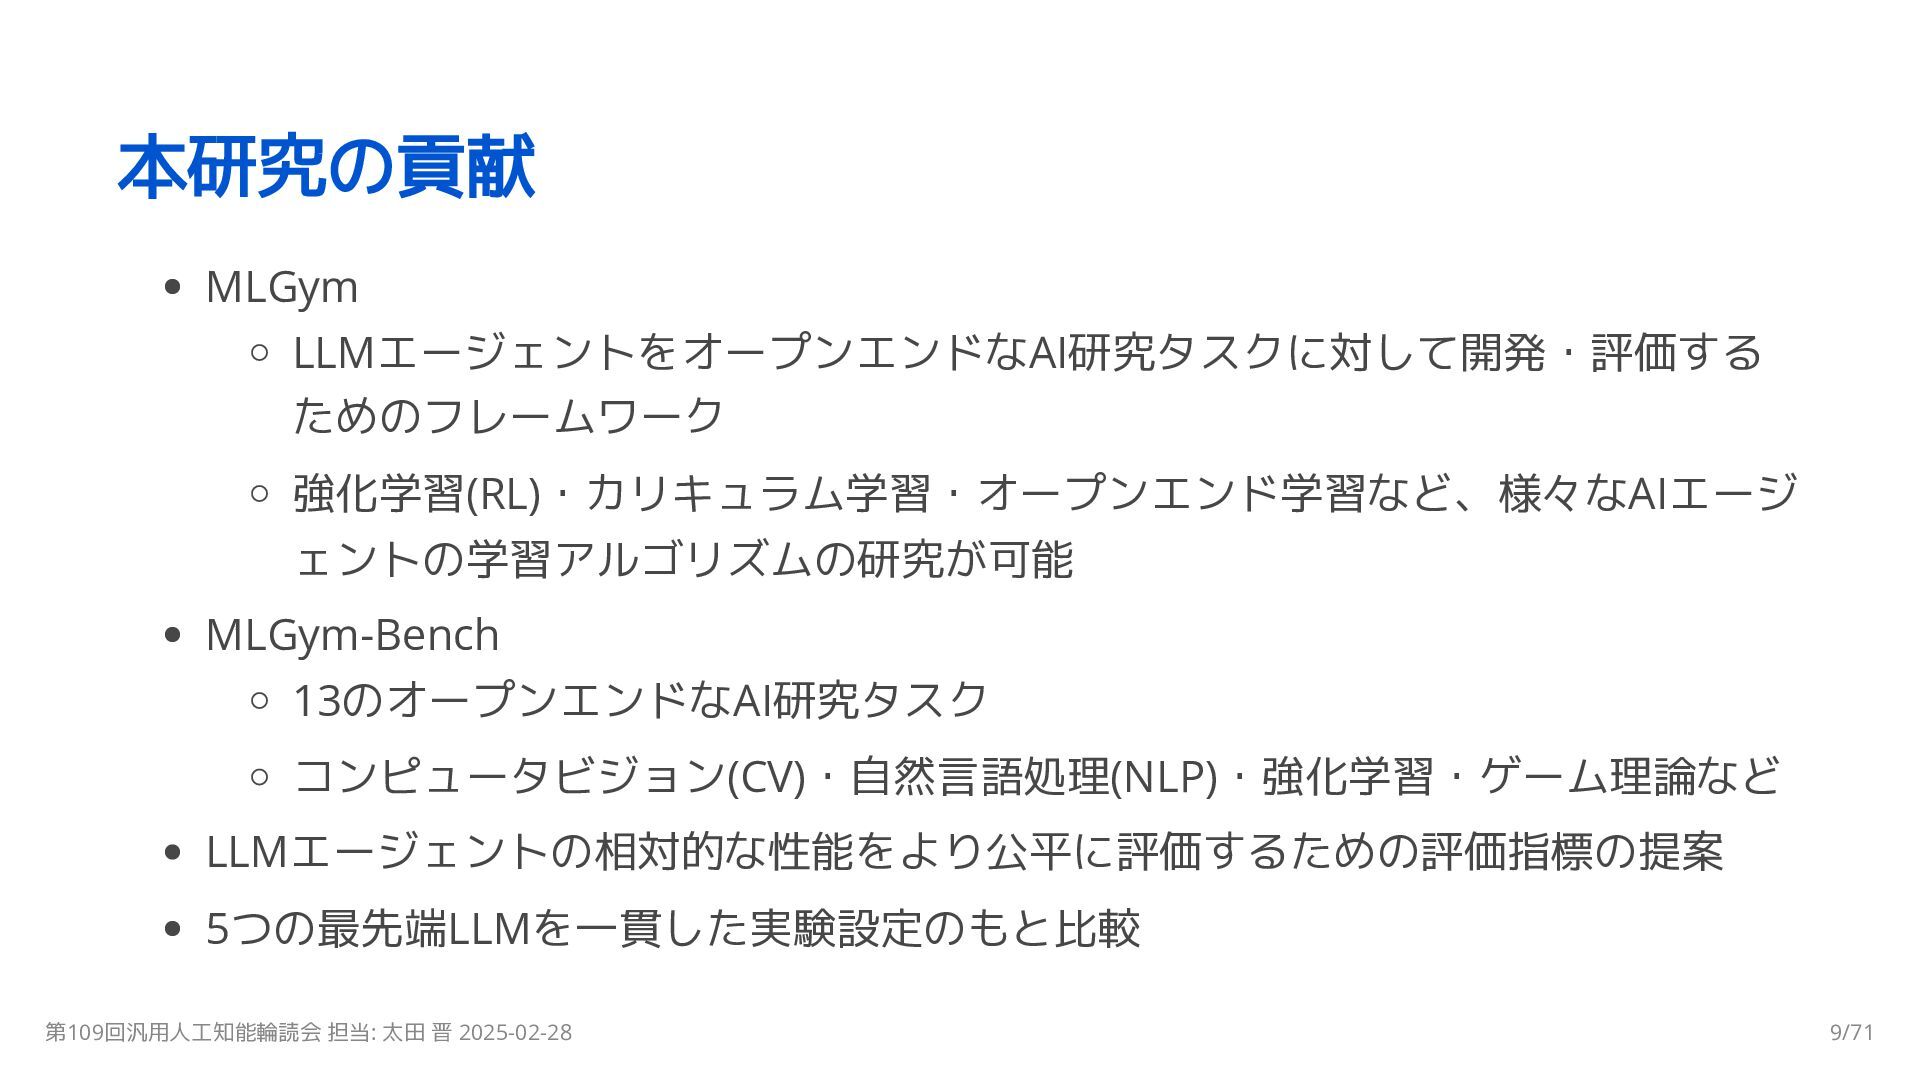
本研究の貢献 MLGym LLMエージェントをオープンエンドなAI研究タスクに対して開発・評価する ためのフレームワーク 強化学習(RL)・カリキュラム学習・オープンエンド学習など、様々なAIエージ ェントの学習アルゴリズムの研究が可能 MLGym-Bench 13のオープンエンドなAI研究タスク コンピュータビジョン(CV)・自然言語処理(NLP)・強化学習・ゲーム理論など LLMエージェントの相対的な性能をより公平に評価するための評価指標の提案
5つの最先端LLMを一貫した実験設定のもと比較 第109回汎用人工知能輪読会 担当: 太田 晋 2025-02-28 9/71 -
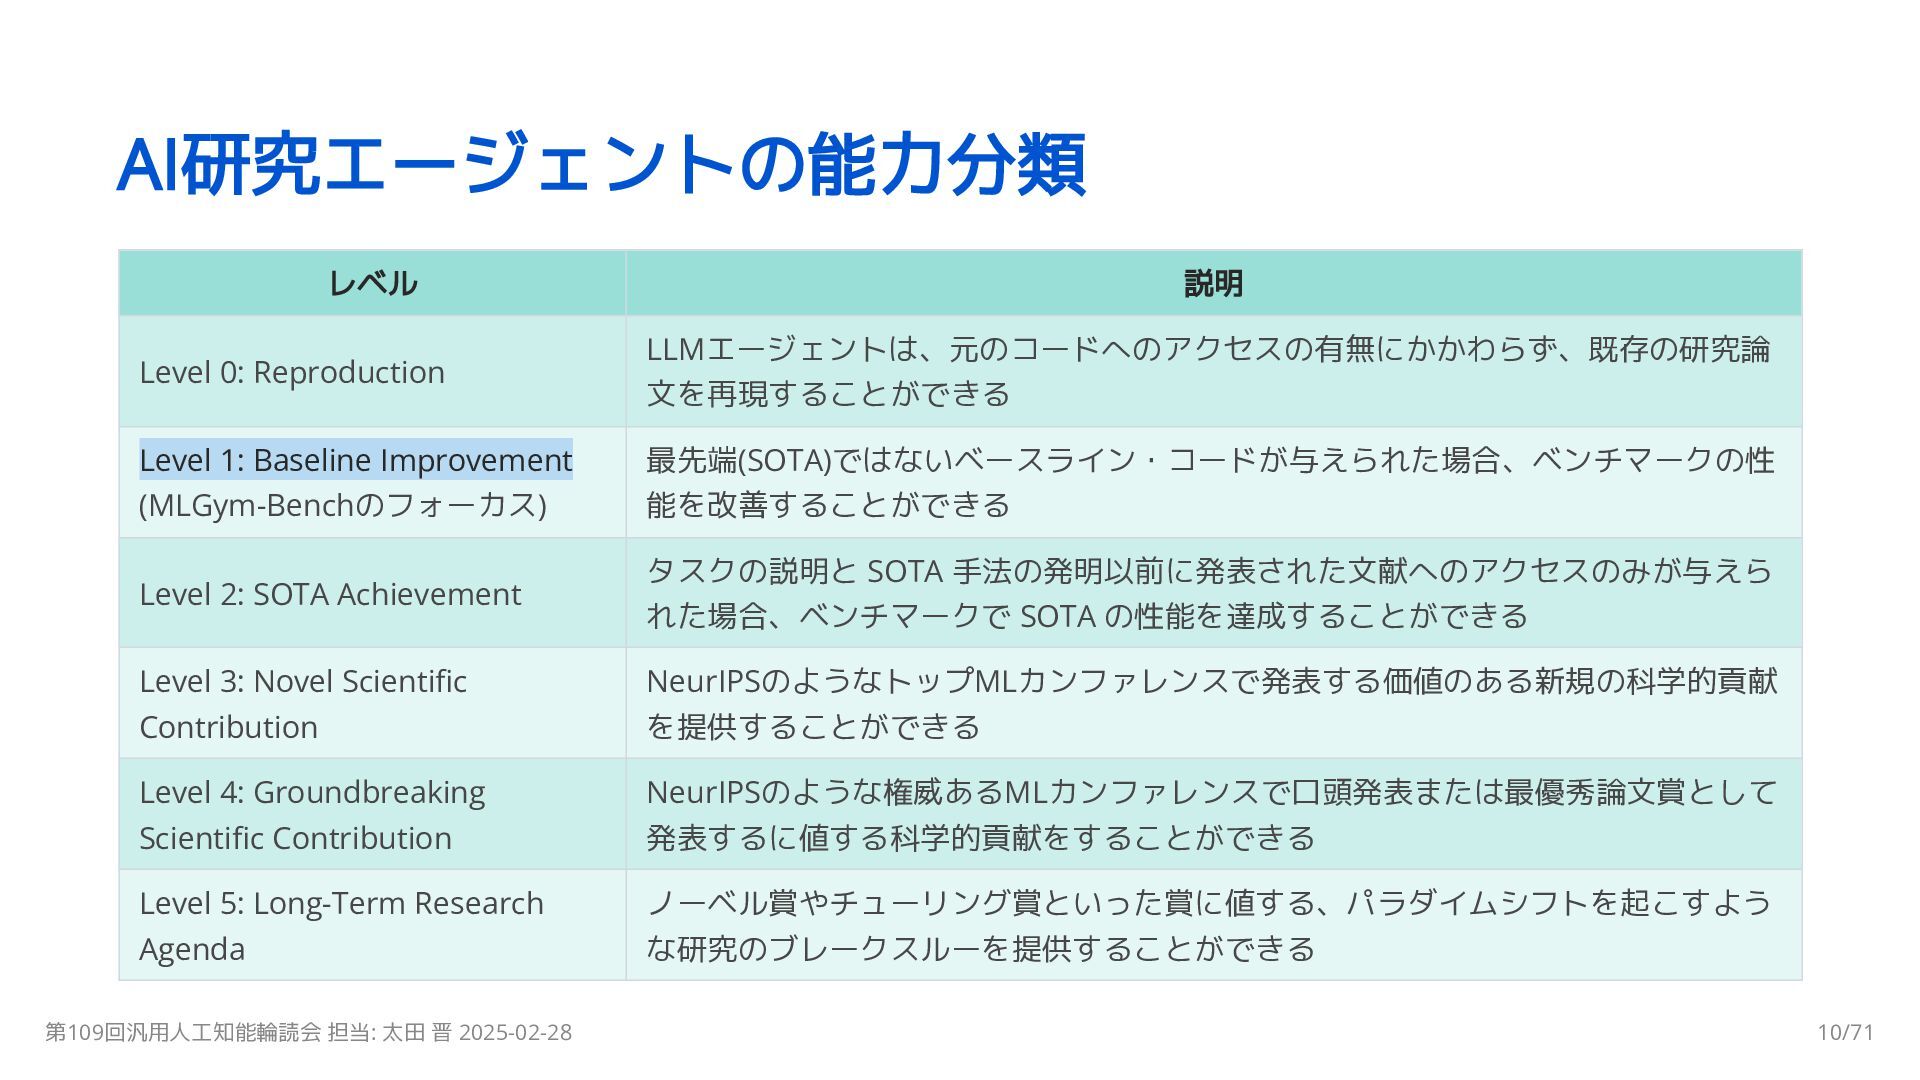
AI研究エージェントの能力分類 レベル 説明 Level 0: Reproduction LLMエージェントは、元のコードへのアクセスの有無にかかわらず、既存の研究論 文を再現することができる Level 1:
Baseline Improvement (MLGym-Benchのフォーカス) 最先端(SOTA)ではないベースライン・コードが与えられた場合、ベンチマークの性 能を改善することができる Level 2: SOTA Achievement タスクの説明と SOTA 手法の発明以前に発表された文献へのアクセスのみが与えら れた場合、ベンチマークで SOTA の性能を達成することができる Level 3: Novel Scientific Contribution NeurIPSのようなトップMLカンファレンスで発表する価値のある新規の科学的貢献 を提供することができる Level 4: Groundbreaking Scientific Contribution NeurIPSのような権威あるMLカンファレンスで口頭発表または最優秀論文賞として 発表するに値する科学的貢献をすることができる Level 5: Long-Term Research Agenda ノーベル賞やチューリング賞といった賞に値する、パラダイムシフトを起こすよう な研究のブレークスルーを提供することができる 第109回汎用人工知能輪読会 担当: 太田 晋 2025-02-28 10/71 -
目次 1 Introduction 2 Related Work 3 MLGym 4 MLGym-Bench
5 Experimental Setup 6 Evaluation 7 Results 8 Discussion and Limitations 9 Ethical Considerations 10 Conclusions 第109回汎用人工知能輪読会 担当: 太田 晋 2025-02-28 11/71 -
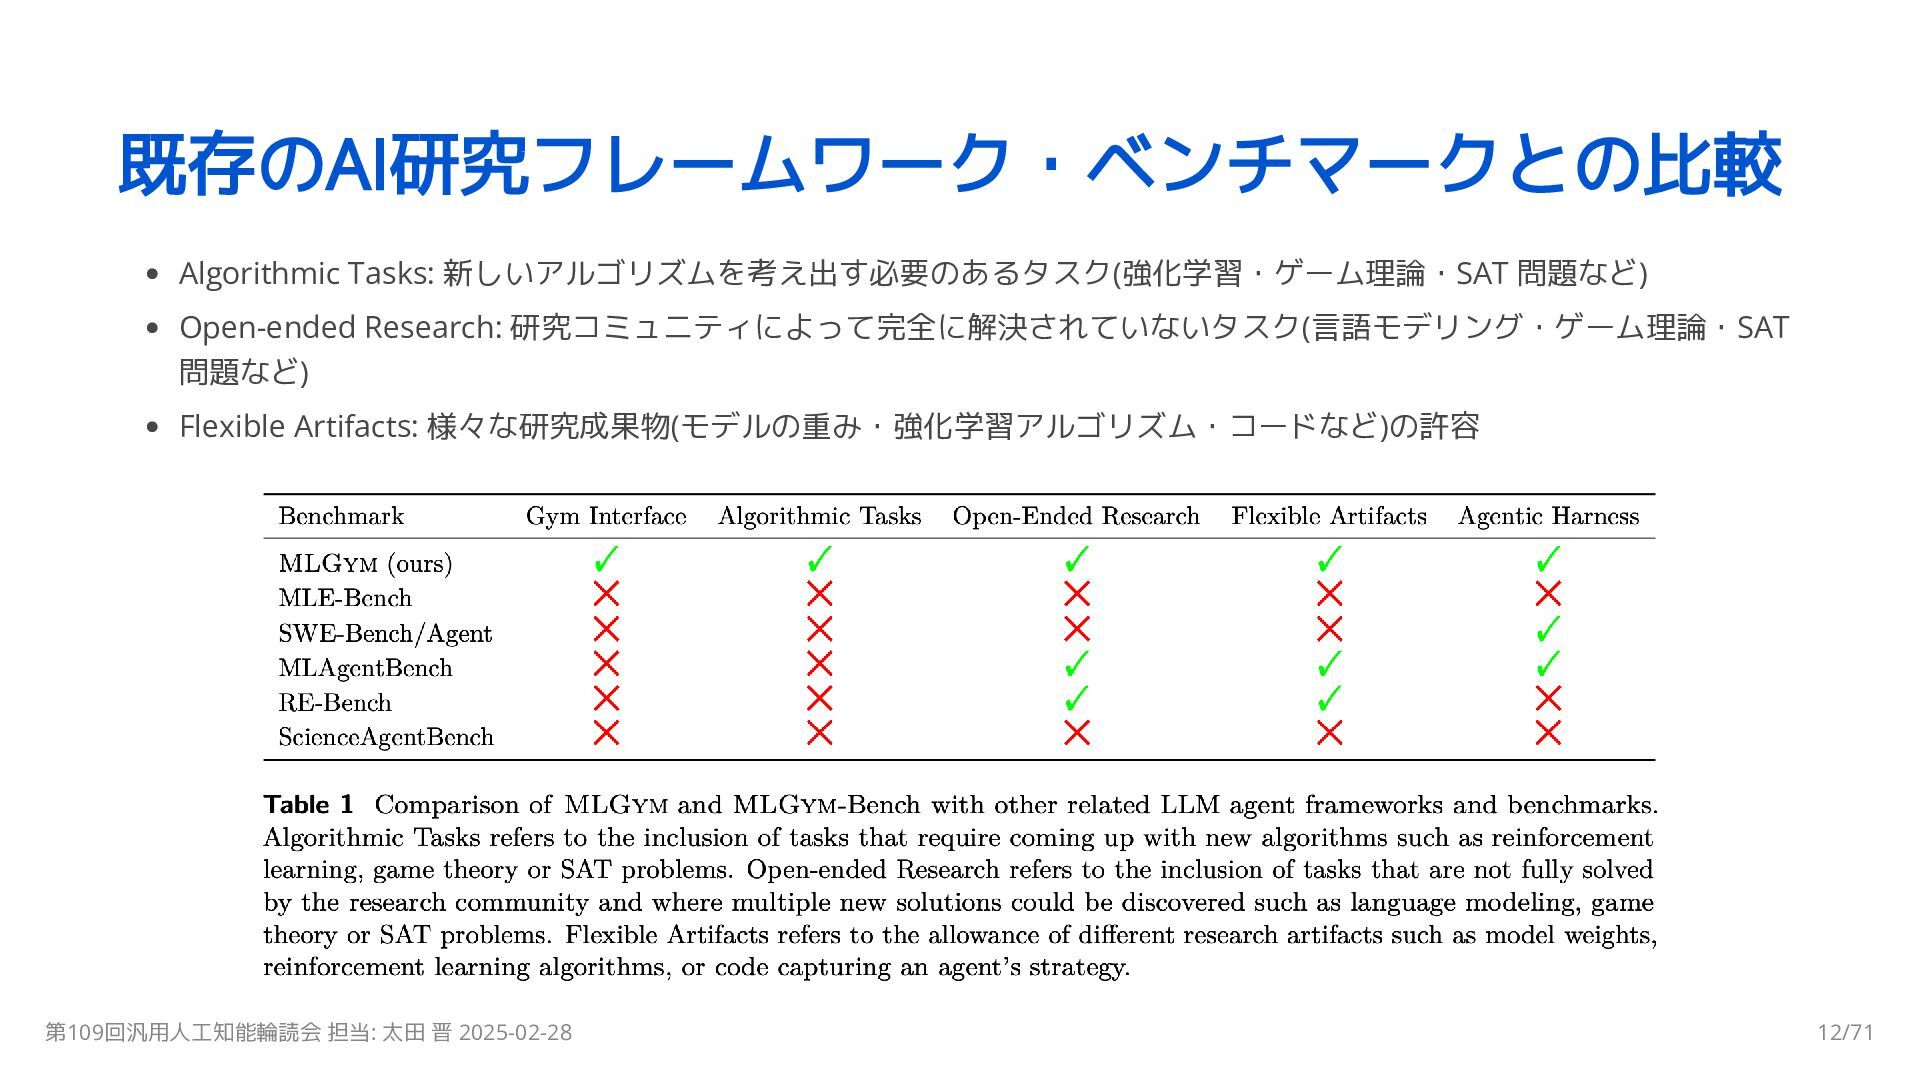
既存のAI研究フレームワーク・ベンチマークとの比較 Algorithmic Tasks: 新しいアルゴリズムを考え出す必要のあるタスク(強化学習・ゲーム理論・SAT 問題など) Open-ended Research: 研究コミュニティによって完全に解決されていないタスク(言語モデリング・ゲーム理論・SAT 問題など) Flexible
Artifacts: 様々な研究成果物(モデルの重み・強化学習アルゴリズム・コードなど)の許容 第109回汎用人工知能輪読会 担当: 太田 晋 2025-02-28 12/71 -
既存のAI研究ベンチマーク MLE-Bench (Chan et al., 2024) Kaggleコンペティションの狭い範囲の機械学習タスク SWE-Bench / SWE-Agent
(Yang et al., 2024) Githubのissuesを解決することに焦点 MLAgentBench (Huang et al., 2024) ML専門のタスク(回帰・分類・コードの高速化)と最近の研究課題に焦点 RE-bench (METR, 2024) 広範なMLエンジニアリングタスク ScienceAgentBench (Chen et al., 2024) 査読付き論文から抽出されたデータ駆動型の科学的発見タスク 第109回汎用人工知能輪読会 担当: 太田 晋 2025-02-28 13/71 -
評価方法の比較 MLGym Pythonコードを提供するだけでよく、エージェントが現在の解決策の品質を 調べることができる 簡単にモデルとエージェントの両方を評価することができる MLE-Bench 各質問の採点にCSVファイルを提出 SWE-Bench / SWE-Agent
ユニットテストのコレクションを通じてコードを評価 MLAgentBench, RE-Bench, ScienceAgentBench 評価スコアを計算するためのPythonスクリプトを提供 第109回汎用人工知能輪読会 担当: 太田 晋 2025-02-28 14/71 -
エージェント型LLM ツール拡張型LLMの研究に触発され、エージェント型LLM("agentic" LLMs)という 研究課題が提案されている 既存研究 LLMにツールやAPIを使わせる・Webをナビゲートさせる・OSとの接続・ゲ ームをプレイ・シミュレーション世界 or 物理的世界との相互作用 エージェント型LLMの評価
環境の設計・ツールの提供・タスクと目標の定義・システムの性能を測定す るための定量的指標の設定が必要 エージェント型LLMのベンチマーク 複雑なタスクに対する、体系的で多面的な評価、結果の検証可能性・再現性 を担保するベンチマークが求められている 第109回汎用人工知能輪読会 担当: 太田 晋 2025-02-28 15/71 -
既存のLLMエージェント研究 ソフトウェアエンジニアリング(SWE)エージェント 体系的な評価が可能な管理された環境において、エージェントがコードレベ ルの課題を解決する能力を評価 データサイエンスエージェント データサイエンス作業の自動化・テキスト to SQL・自律型マルチモーダルエ ージェントなど 探索指向エージェント
モンテカルロツリーサーチ(MCTS)・最良優先探索(best-first search)・テスト タイム探索(test-time search)・エージェントレスシステムなど 第109回汎用人工知能輪読会 担当: 太田 晋 2025-02-28 16/71 -
ソフトウェアエンジニアリングエージェント SWE-Agent (Yang et al., 2024) ファイル作成・リポジトリナビゲーション・コードテスト OpenHands (Wang et
al., 2024c) 安全なコマンド実行・検証可能なWebブラウジング Magentic-One (Fourney et al., 2024) Webナビゲーション機能 AutoCodeRover (Zhang et al., 2024b) LLMベースのプログラミングと、抽象構文木としてのプログラム表現を組み 合わせて、Githubのissuesを解決 第109回汎用人工知能輪読会 担当: 太田 晋 2025-02-28 17/71 -
データサイエンスエージェント AutoKaggle (Li et al., 2024) マルチエージェントの人間支援システム AgentK v1.0 (Grosnit
et al., 2024) エンドツーエンドの自律型データサイエンスエージェント Spider 2.0 (Lei et al., 2024) テキストからSQLへのワークフローの自動化 Spider 2-V (Cao et al., 2024) 自律的なマルチモーダルエージェント 企業データサイエンス・エンジニアリングワークフローの自動化 第109回汎用人工知能輪読会 担当: 太田 晋 2025-02-28 18/71 -
探索指向エージェント SWE-Search (Antoniades et al., 2024) MCTSと反復改良を組み合わせたマルチエージェントフレームワーク (Koh et al.,
2024b) LLMエージェントに最良優先探索(best-first search)を組み込む (Yu et al., 2025) MCTSベースのテストタイム探索(test-time search)と自己学習技術 (Xia et al., 2024) 3ステッププロセスに従う比較的単純なエージェントレスシステム SWE-bench Liteで複雑なエージェントベースの方法を上回る 第109回汎用人工知能輪読会 担当: 太田 晋 2025-02-28 19/71 -
科学研究エージェント 制御されたソフトウェア工学タスク研究は、より複雑な自動化の基盤を築く一方 で、再現可能で検証可能なアプローチも維持 しかし、ソフトウェア基盤だけでは、科学研究の加速という目標には不十分 限定された環境と評価指標のある明確に定義された課題から、オープンエンド課 題というあまり定義されていない領域に向かうには、研究エージェントの能力を 高めるために多大な努力が必要 例 科学的な新規性を測定する自動化可能な基準の提案 異分野からの自動化された発見を継承した理論の構築(constructing
theories inheriting the automated findings from heterogeneous disciplines) 第109回汎用人工知能輪読会 担当: 太田 晋 2025-02-28 20/71 -
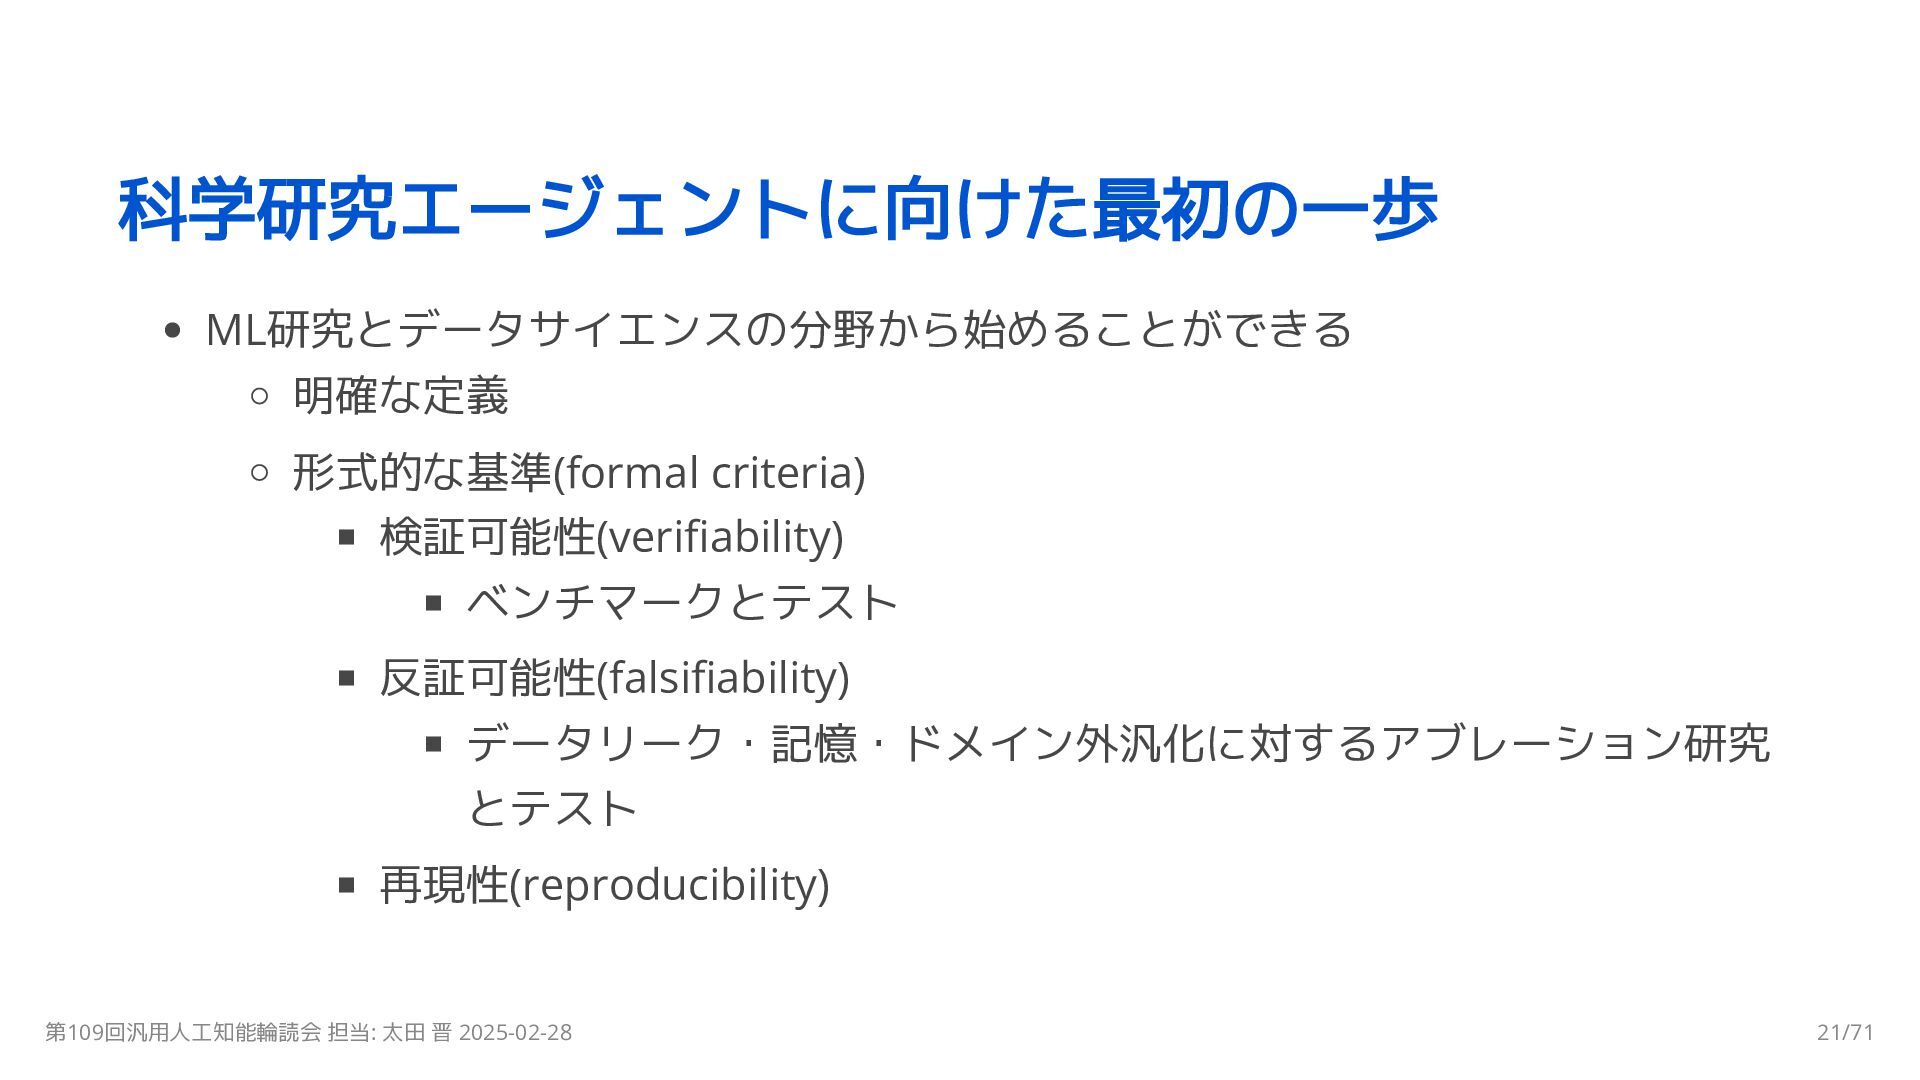
科学研究エージェントに向けた最初の一歩 ML研究とデータサイエンスの分野から始めることができる 明確な定義 形式的な基準(formal criteria) 検証可能性(verifiability) ベンチマークとテスト 反証可能性(falsifiability) データリーク・記憶・ドメイン外汎化に対するアブレーション研究 とテスト
再現性(reproducibility) 第109回汎用人工知能輪読会 担当: 太田 晋 2025-02-28 21/71 -
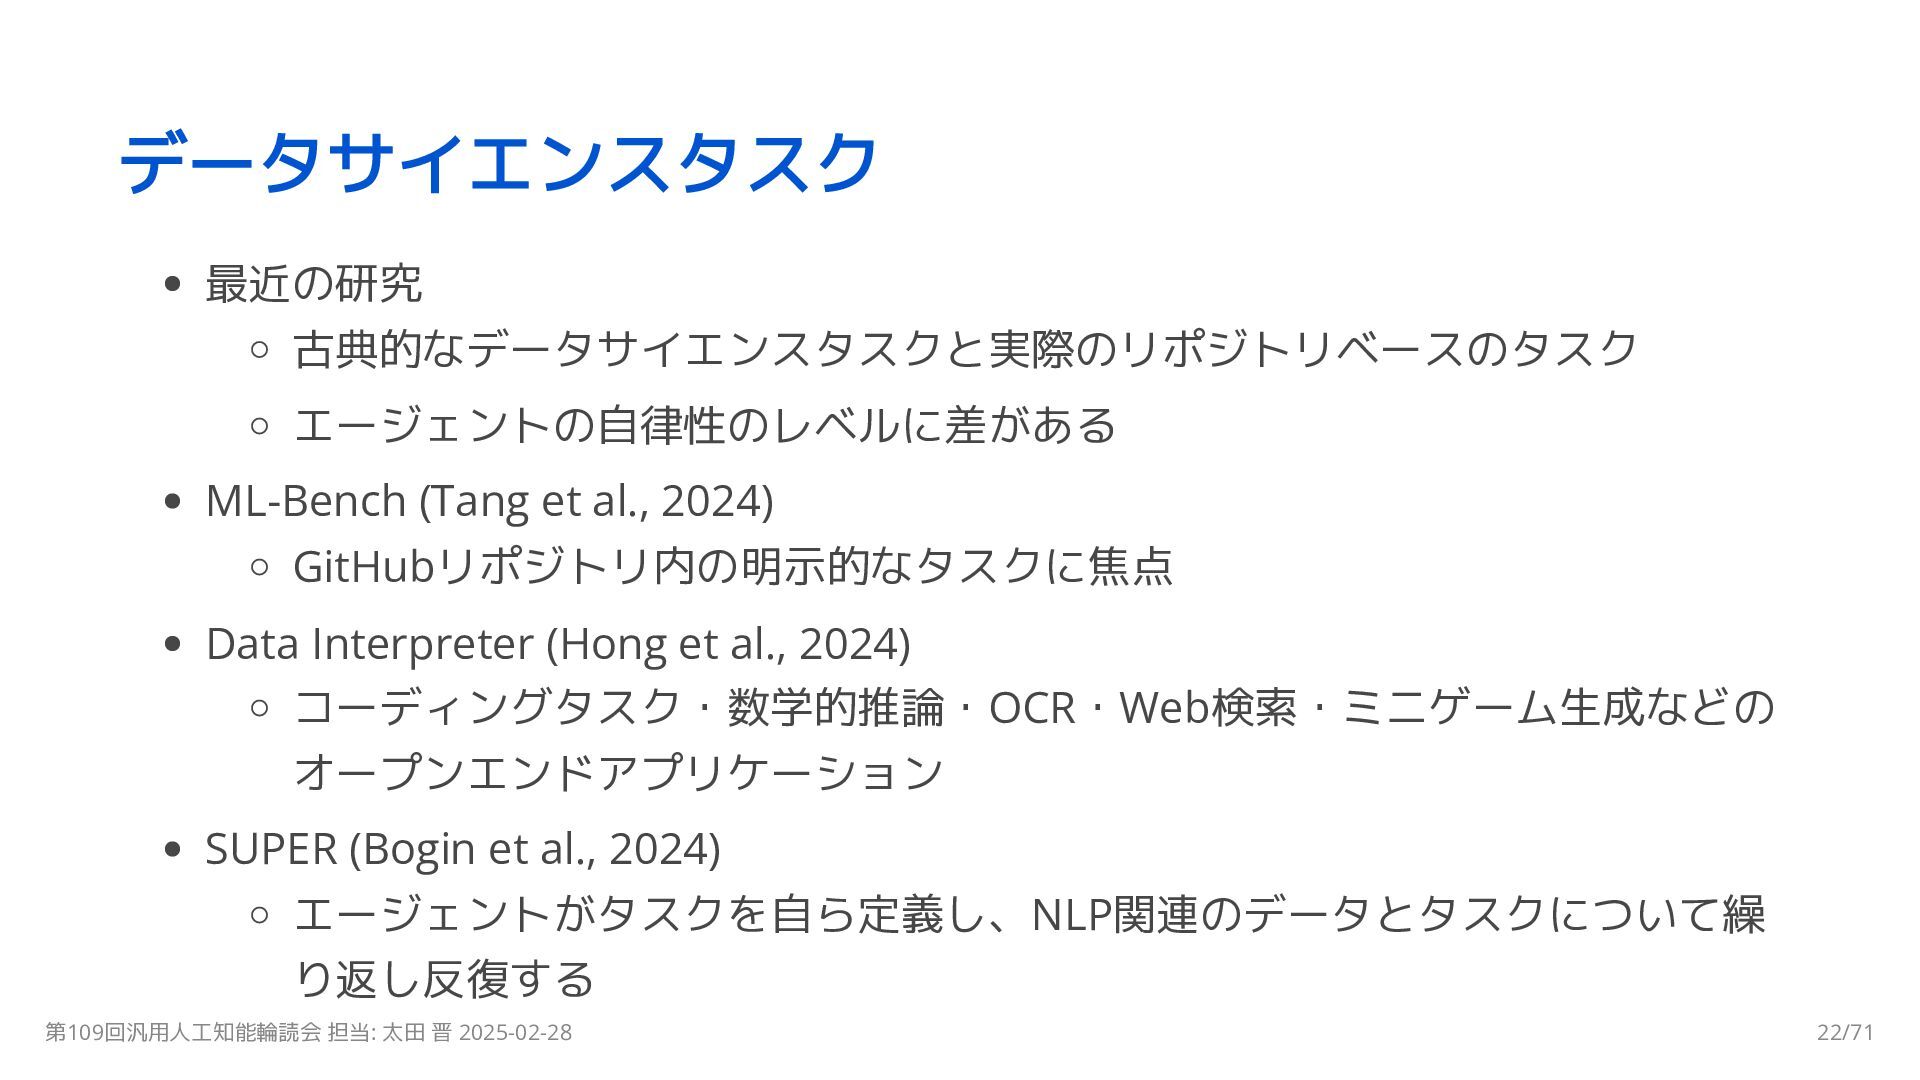
データサイエンスタスク 最近の研究 古典的なデータサイエンスタスクと実際のリポジトリベースのタスク エージェントの自律性のレベルに差がある ML-Bench (Tang et al., 2024) GitHubリポジトリ内の明示的なタスクに焦点
Data Interpreter (Hong et al., 2024) コーディングタスク・数学的推論・OCR・Web検索・ミニゲーム生成などの オープンエンドアプリケーション SUPER (Bogin et al., 2024) エージェントがタスクを自ら定義し、NLP関連のデータとタスクについて繰 り返し反復する 第109回汎用人工知能輪読会 担当: 太田 晋 2025-02-28 22/71 -
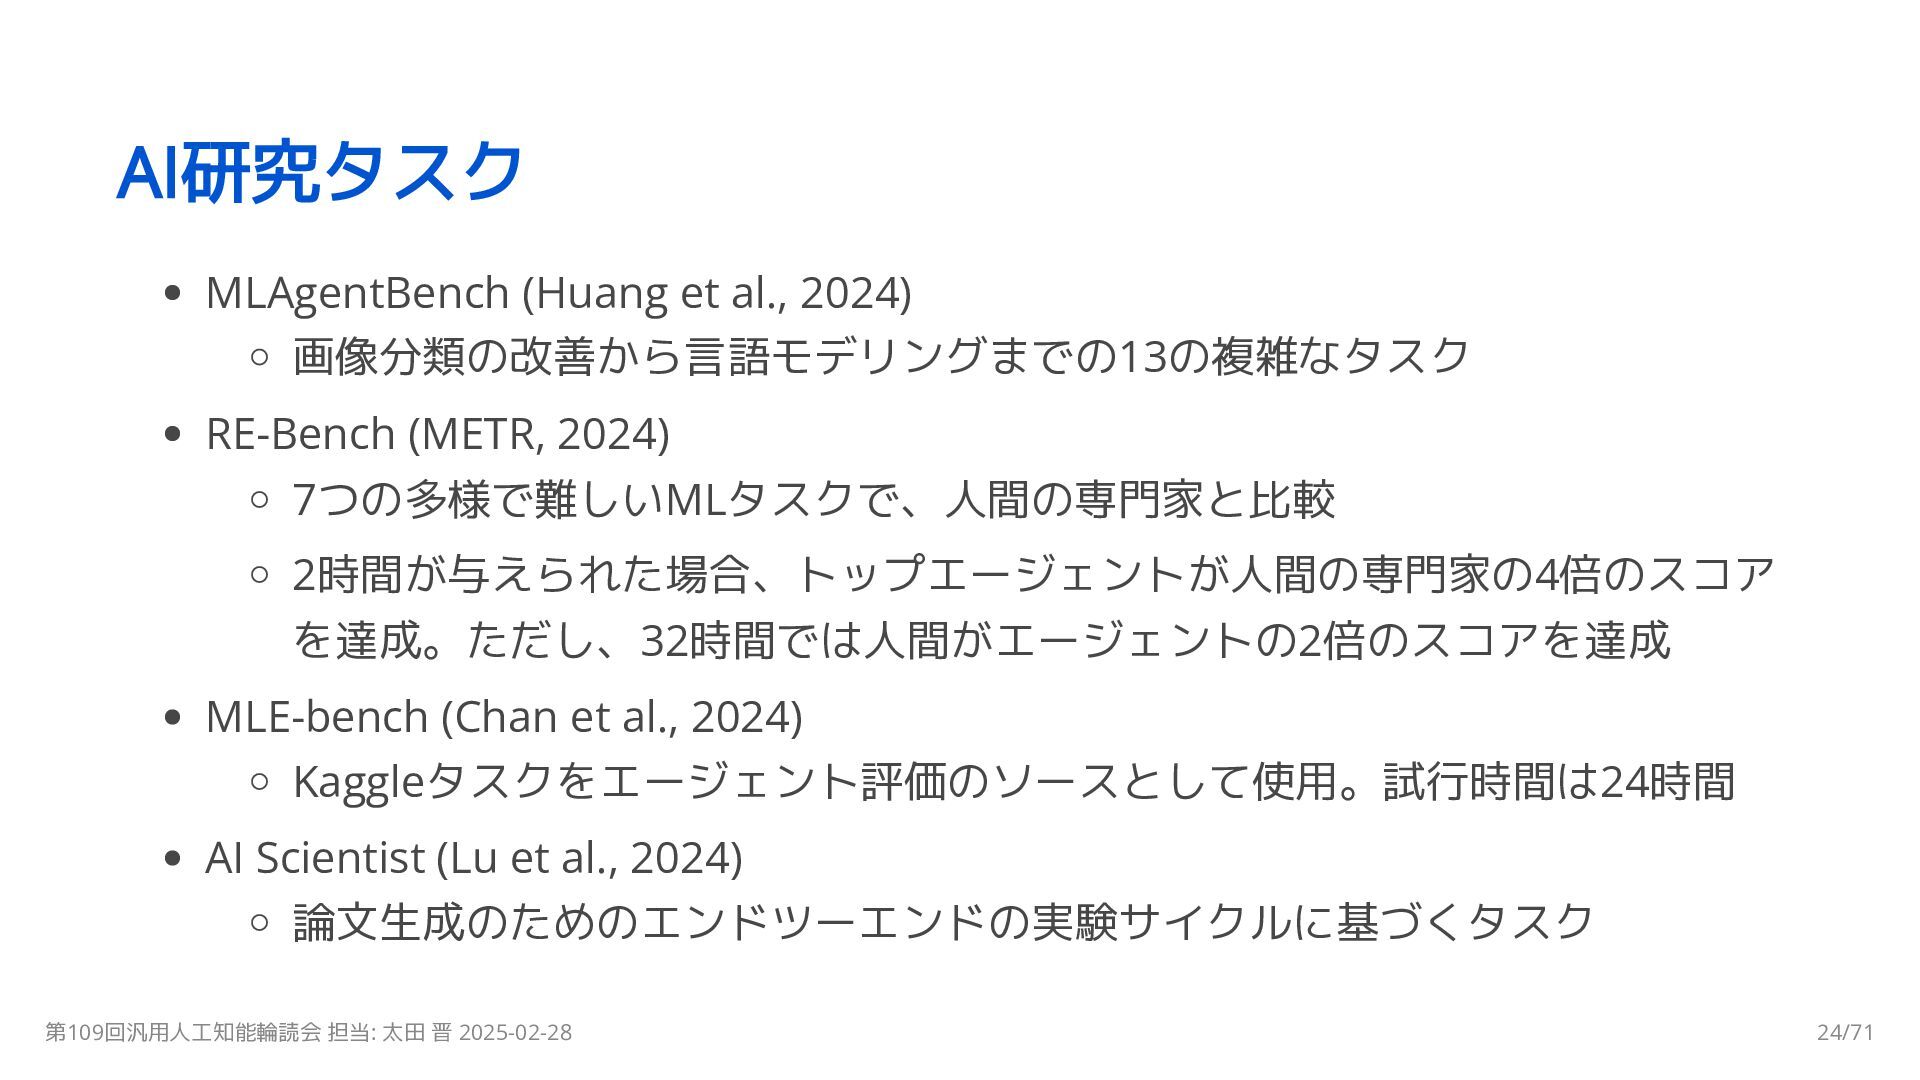
AI研究タスク MLAgentBench (Huang et al., 2024) 画像分類の改善から言語モデリングまでの13の複雑なタスク RE-Bench (METR, 2024)
7つの多様で難しいMLタスクで、人間の専門家と比較 2時間が与えられた場合、トップエージェントが人間の専門家の4倍のスコア を達成。ただし、32時間では人間がエージェントの2倍のスコアを達成 MLE-bench (Chan et al., 2024) Kaggleタスクをエージェント評価のソースとして使用。試行時間は24時間 AI Scientist (Lu et al., 2024) 論文生成のためのエンドツーエンドの実験サイクルに基づくタスク 第109回汎用人工知能輪読会 担当: 太田 晋 2025-02-28 24/71 -
科学的発見タスク (DiscoveryWorld) DiscoveryWorld (Jansen et al., 2024) ゲームのような仮想発見環境で評価される科学エージェントのベンチマーク エージェントに、仮説の生成・実験計画と実行・結果の分析・結論に基づい た行動を求める
120のタスク: プロテオミクス・化学・考古学・物理学・農学・ロケット科 学・言語学・疫学などの分野 カスタムシミュレーションエンジンは、限られた対象と14の行動のみ タスクに特化した解決策ではなく、一般的な発見スキルに焦点 評価・対象空間・行動空間がすべての科学的ドメインに共通している 第109回汎用人工知能輪読会 担当: 太田 晋 2025-02-28 25/71 -
科学的発見タスク (ScienceAgentBench) ScienceAgentBench (Chen et al., 2024) 44の厳選された査読付き論文に基づくデータ駆動型の発見タスク 分野: バイオインフォマティクス・計算化学・地理情報科学・神経科学
102のタスク: データ処理・モデリング・可視化など 各タスクはPythonベースの評価環境、最終結果の評価、中間評価基準で定義 データ汚染とエージェントのショートカット問題を制御する特別な評価基準 プロンプトを用いた純粋なLLMを含む異なるベースラインを比較 エージェントが有用な解を生成するためには、実行フィードバックが必要 第109回汎用人工知能輪読会 担当: 太田 晋 2025-02-28 26/71 -
科学的発見タスク (ResearchAgent) ResearchAgent (Baek et al., 2024) 実行フィードバックと反復的改善のアイデア 文献ベースの発見に基づくエージェント的な概念ベースのアプローチが、エ ンドツーエンドの反復的な解決策生成を大幅に改善
エージェントは、主観的な人間の好みのアノテーションと、自動的な人間の 好みだけで評価 エンドツーエンドの実験パイプラインの構造化された側面をカバー 問題の明確さ・実現可能性・重要性・関連性・独創性・方法の汎用性・ 革新性・実験の再現性・妥当性など 客観的な評価基準で補完された人間の判断だけに依存することは不十分 第109回汎用人工知能輪読会 担当: 太田 晋 2025-02-28 27/71 -
目次 1 Introduction 2 Related Work 3 MLGym 4 MLGym-Bench
5 Experimental Setup 6 Evaluation 7 Results 8 Discussion and Limitations 9 Ethical Considerations 10 Conclusions 第109回汎用人工知能輪読会 担当: 太田 晋 2025-02-28 28/71 -
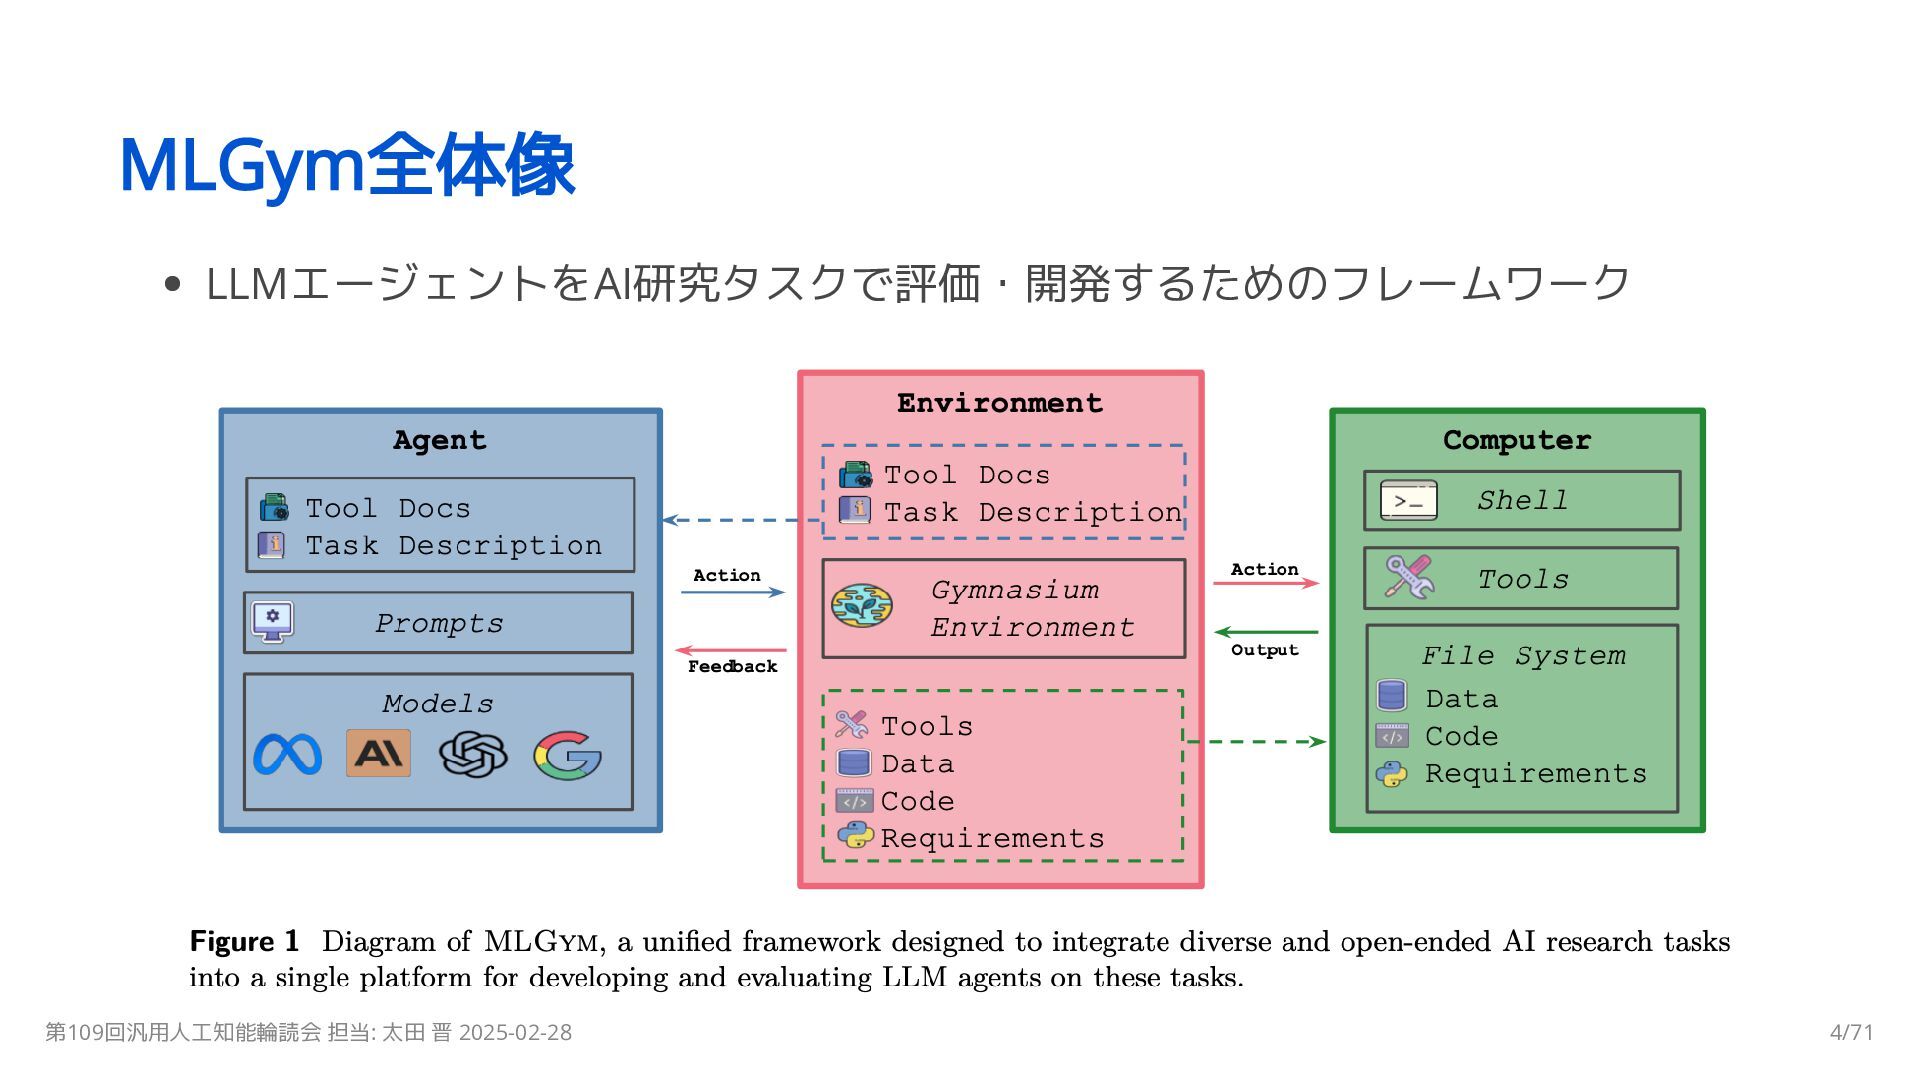
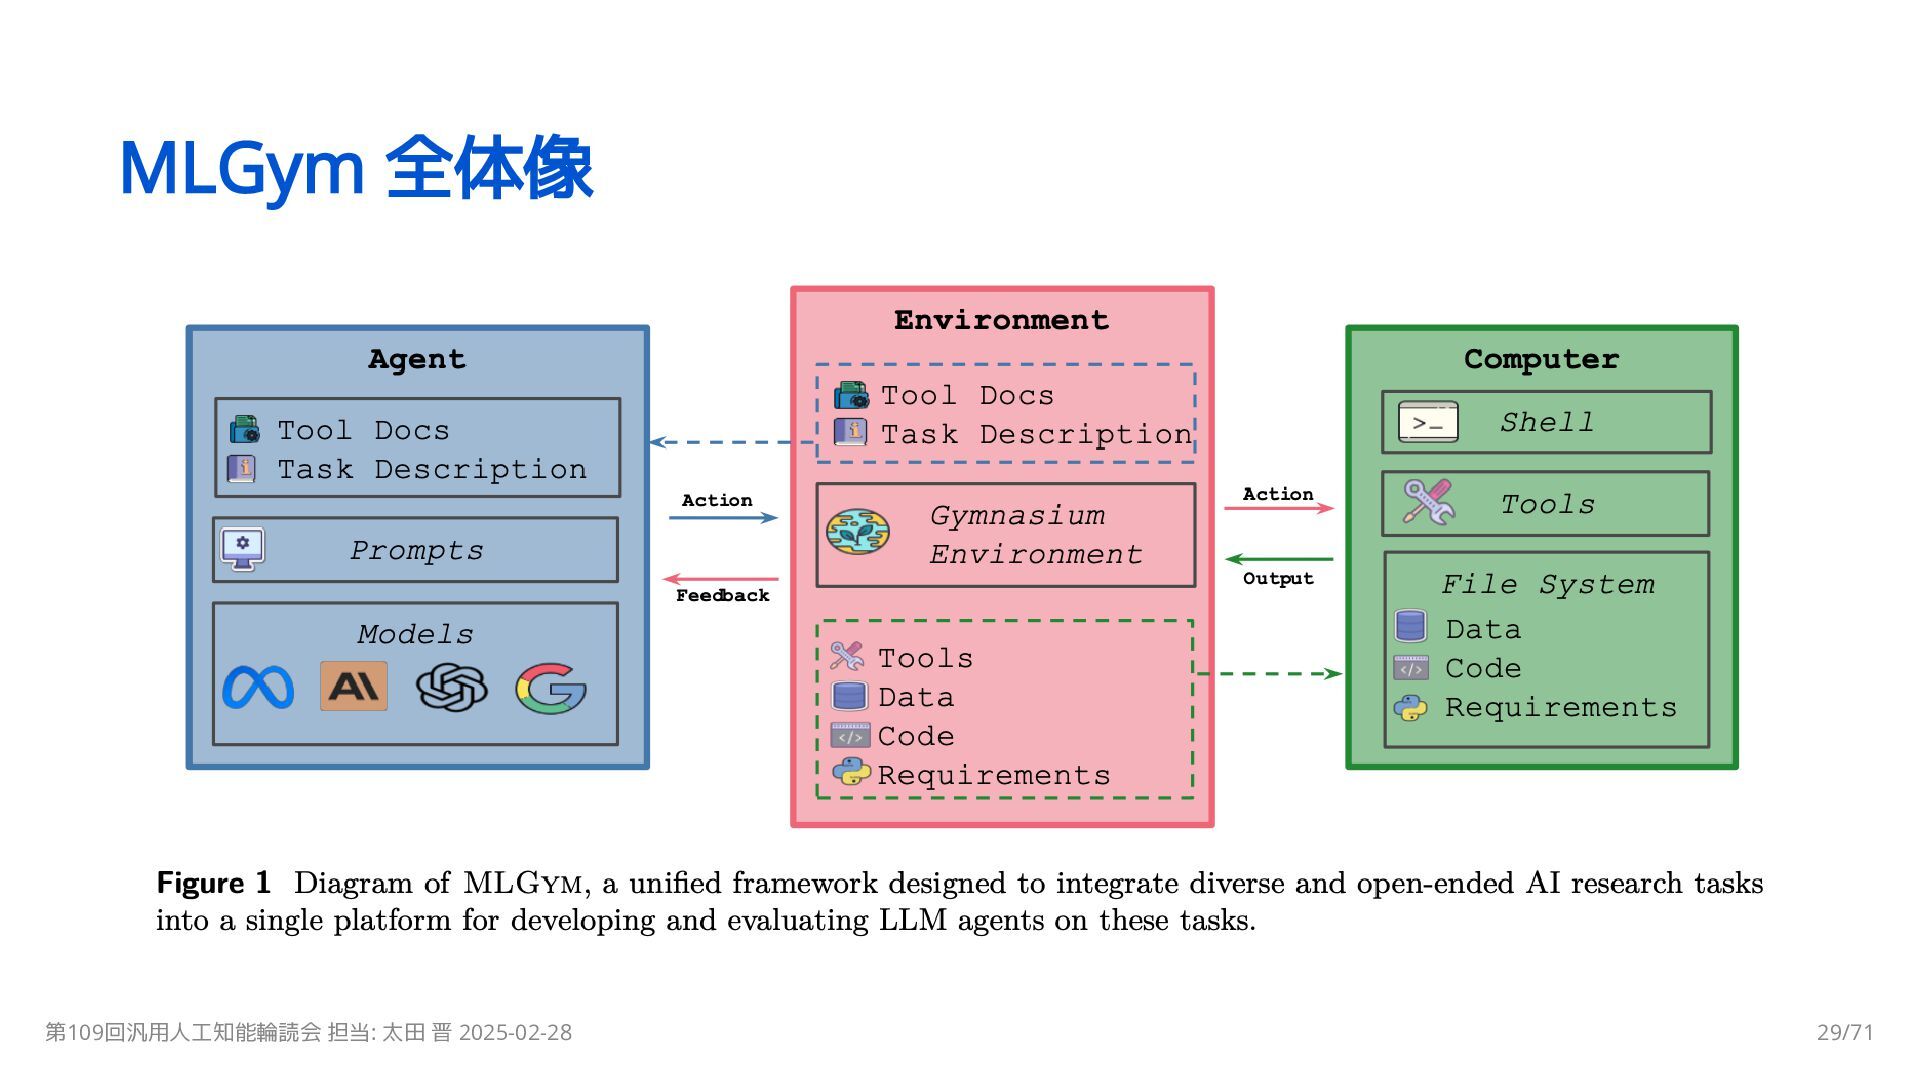
MLGymフレームワーク 既存の強化学習分野から着想を得て、AI研究エージェント向け Gym (Brockman et al., 2016) 環境を構築 ローカルのdockerコンテナのシェルでコマンドを実行できる エージェント・環境・データセット・タスクの4つのコアコンポーネント
MLGymのモジュラー設計により、ライブラリを簡単に利用・拡張可能 他のエージェントハーネスを実装して性能向上 ツールを追加して環境を拡張 タスクに対するデータセットを追加 例: CIFAR-10の画像分類タスクにImageNetを追加 ベンチマークにタスクを追加 第109回汎用人工知能輪読会 担当: 太田 晋 2025-02-28 31/71 -
エージェント エージェントクラスは、ベースLLMをラップし、さまざまなモデル・履歴プロセ ッサ・コスト管理を統合 エージェントと環境を分離しているため、外部エージェントを簡単に統合できる 過去の全ての観測と行動の履歴を入力として受け取り、次の行動を返す 行動は環境に渡され、コマンドが実行され、コマンドの出力に基づいて次の観測 が返される 環境で任意のbashコマンドを実行できる ファイルの編集などのbashスクリプトのセットにアクセスでき、他のbashコマン ドと同様に使用できる
デフォルトのエージェントとしてSWE-Agentを適応したエージェントを提供 第109回汎用人工知能輪読会 担当: 太田 晋 2025-02-28 32/71 -
環境 MLGym環境は、Gymnasium (gym) 環境として設計 シェル環境をローカルのdockerマシンで初期化 ツールのインストール・Python依存関係のインストール・全ての必要なデー タとコードを別々のエージェントワークスペースにコピー・LLMエージェン トとシステムの間のやり取りを管理 ファイルとディレクトリの権限を管理 ツールとACI
(Agent-Computer Interface)をエージェントから分離して、エージェ ントと環境が緊密に結合されることを防ぐ 環境が初期化されると、作業環境のツールも初期化され、ツールのドキュメント が作成され、LLMエージェントのプロンプトに追加できる 第109回汎用人工知能輪読会 担当: 太田 晋 2025-02-28 33/71 -
データセット データセットの定義を簡単な構成ファイルを使用して抽象化 ローカルのデータセットとHugging Faceデータセットの両方をサポート データセットの定義をタスクの定義から分離 単一のデータセットを複数のタスクで使用可能 単一のタスクに複数のデータセットを持たせることができ、エージェントの コードをすべてのデータセットで評価することで、実装された手法の汎用性 を実証 ローカルのデータセットの場合、環境は関連ファイルを読み取り専用でコピー
エージェントがデータセットファイルを変更できないようにし、再現性と不 正行為を防止 第109回汎用人工知能輪読会 担当: 太田 晋 2025-02-28 34/71 -
タスク 設定ファイルを使って、任意のML研究タスクを簡単に定義 各タスクには、1つ以上のデータセット・評価スクリプト(読み取り専用)・conda 環境・オプションのスターターコードなどを組み込むことができる 評価: すべてのMLタスクにとって重要なコンポーネント タスクごとに異なる評価プロトコルが必要 KaggleのようなCSVファイルの提出させる評価方法は、すべての問題に適し ているわけではない タスク定義で、評価スクリプトと提出成果物の指示を提供
LLMエージェントは、提出指示に従い適切なコードを書くよう促される 第109回汎用人工知能輪読会 担当: 太田 晋 2025-02-28 35/71 -
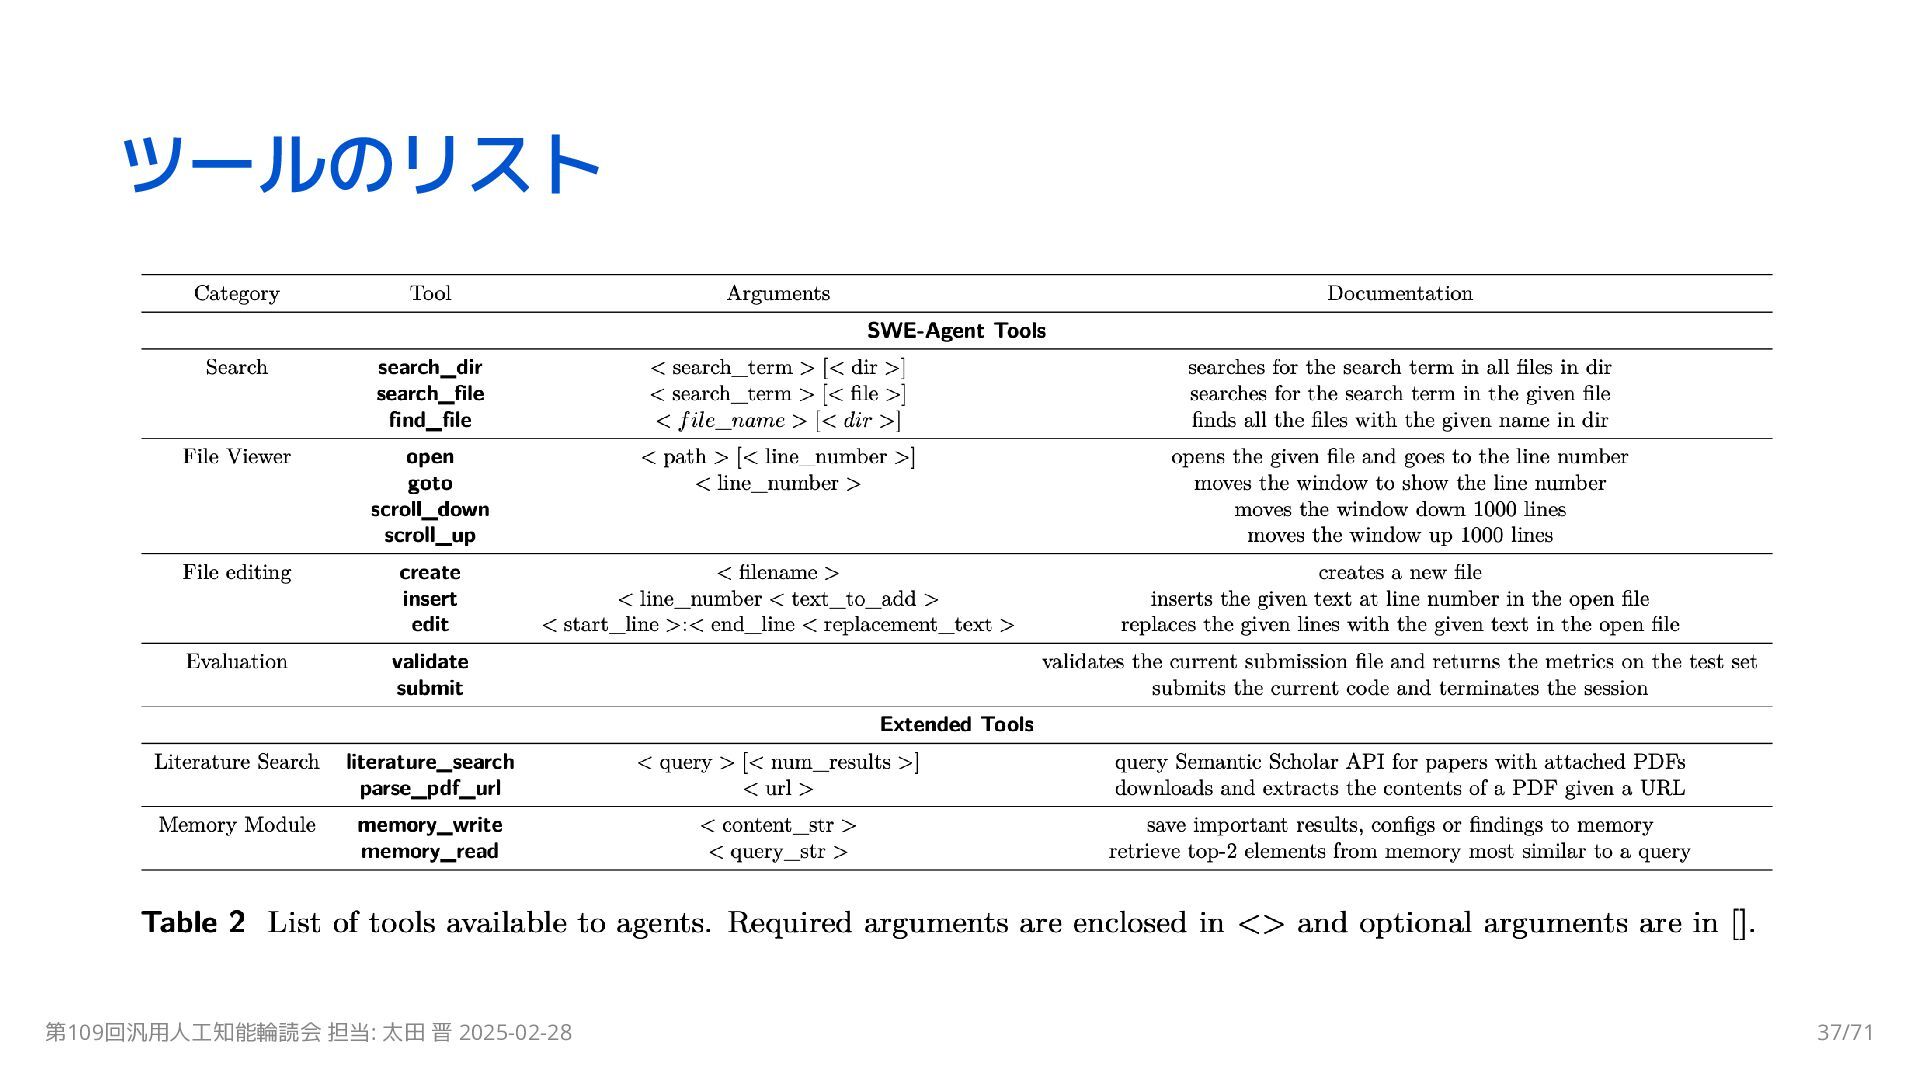
ツールとACI 外部ツールを使用できるようにすることは、知識集約的なタスクを進める上で重 要なコンポーネント SWE-Agentで導入されたACI (agent-computer interface) を拡張 検索・ナビゲーション・ファイルビューア・ファイルエディタ・コンテキス ト管理を、権限管理システム付きで拡張 新しいコマンドとして、文献検索とメモリモジュールを導入
文献検索と実験ログをメモリに保持する機能は、エージェントがオープンエ ンドの研究タスクでSOTA解を超えるために重要 ツールは、BashまたはPythonスクリプトとして定義 システムプロンプトですべてのツールのドキュメントを提供 第109回汎用人工知能輪読会 担当: 太田 晋 2025-02-28 36/71 -
文献検索とPDFパーサー 外部ソースから知識を検索・抽出するための2つのツールを提供 文献検索ツール: Semantic Scholar APIに問い合わせ、指定されたクエリに関 する研究論文を検索し、オープンアクセスのPDFをダウンロード PDFパーサーツール: PDFをダウンロードして、テキストベースの表現に変換 論文の内容は、コンテキストウィンドウとメモリモジュールに保存可能
2つのツールを組み合わせることで、研究論文の検索・分析をワークフローの一部 として組み込むことができる 第109回汎用人工知能輪読会 担当: 太田 晋 2025-02-28 38/71 -
メモリモジュール エージェントの長期的なAI研究タスクのパフォーマンスを向上させるための重要 なツール 構造化されたメモリシステムを使用して、重要な発見と成功した訓練構成を永続 的に保存し、長いタスクにおけるコンテキスト保持という課題を克服 メモリモジュールがある場合、エージェントはメモリから最適な訓練構成を取得 し、それに続いて反復し続けることができることが観察された メモリモジュールがない場合、エージェントの軌跡がモデルのコンテキスト長よ りも長くなり、最適な設定を取り出すことが出来ず、古い実験を忘れ、最近の構 成に対してのみ局所的に反復してしまう
第109回汎用人工知能輪読会 担当: 太田 晋 2025-02-28 39/71 -
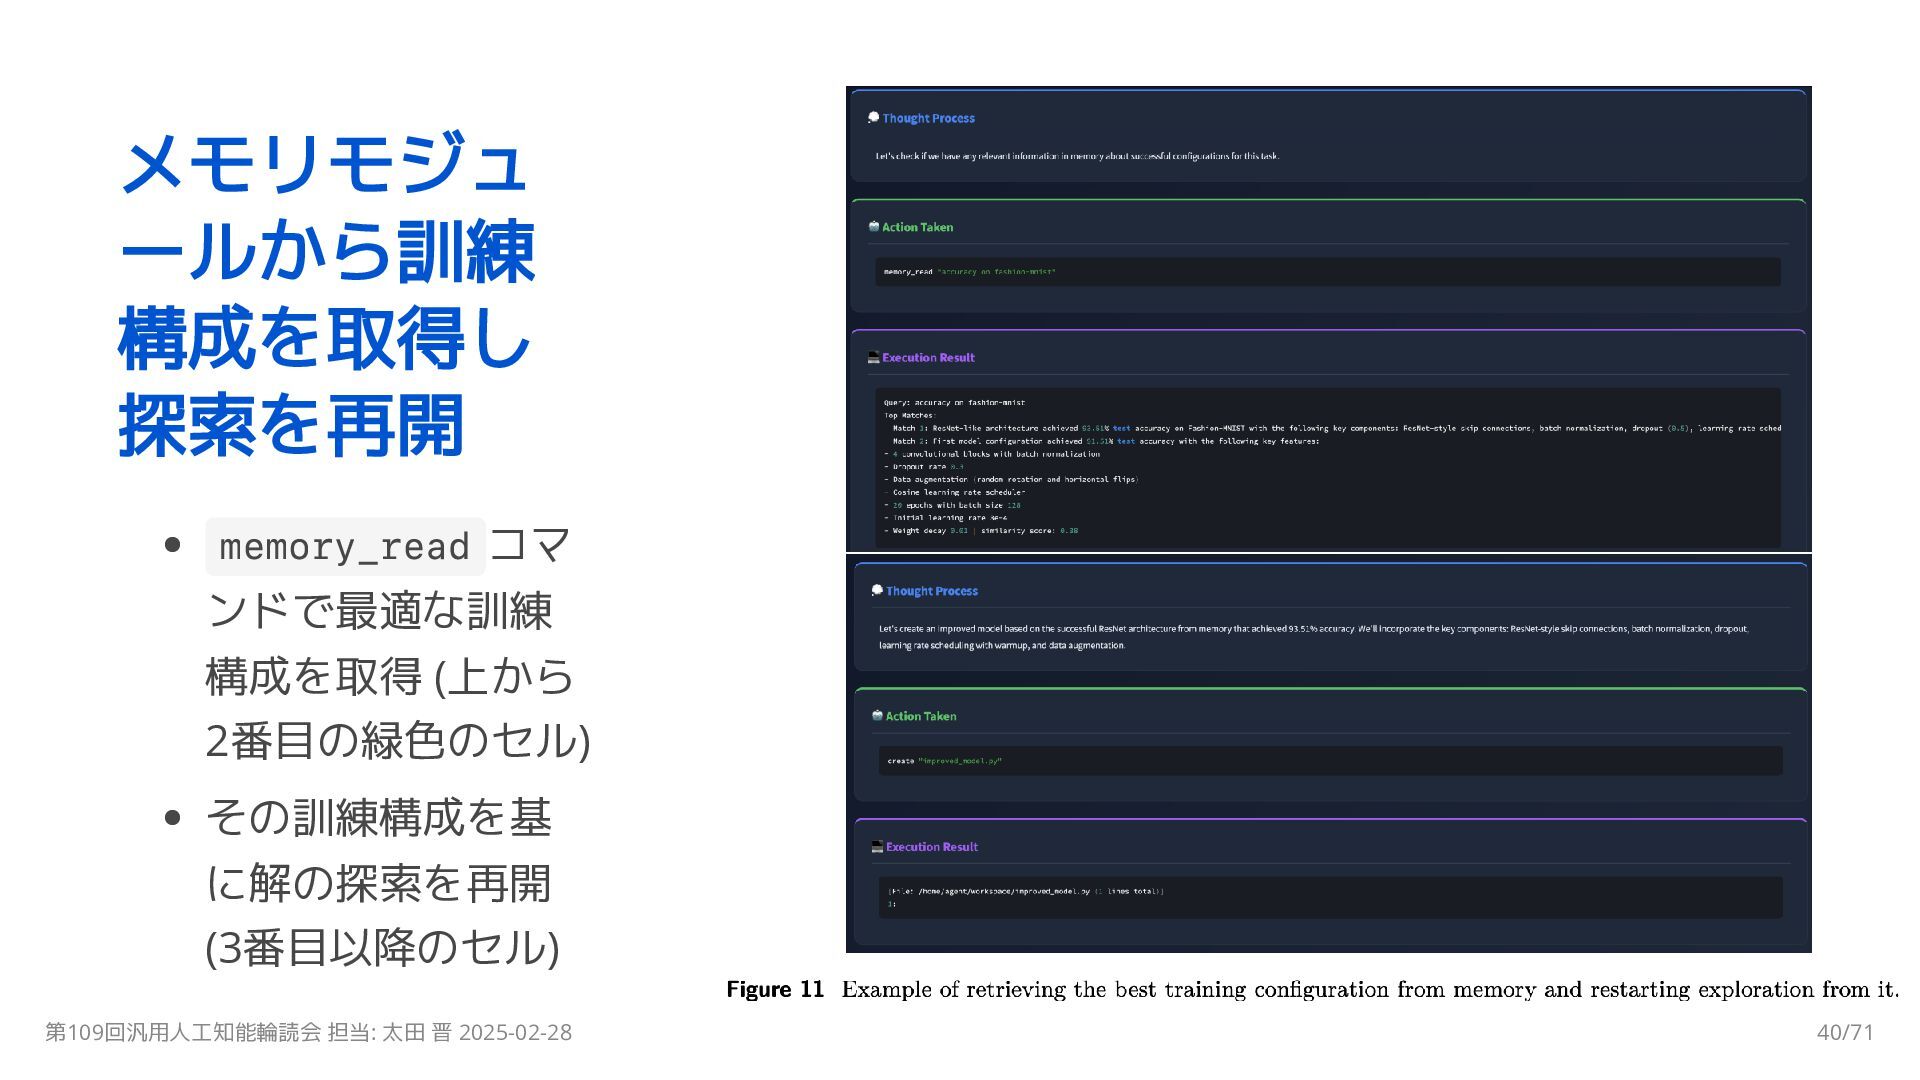
メモリモジュ ールから訓練 構成を取得し 探索を再開 memory_read コマ ンドで最適な訓練 構成を取得 (上から 2番目の緑色のセル)
その訓練構成を基 に解の探索を再開 (3番目以降のセル) 第109回汎用人工知能輪読会 担当: 太田 晋 2025-02-28 40/71 -
メモリモジュールの機能 memory_writeとmemory_readという2つのコア機能 memory_write: テキストデータをJSON形式で保存し、それに対応する埋め込 みとタグを保存して、主要な洞察と効果的な構成を保存 memory_read: 与えられたクエリとのコサイン類似度に基づいて、最も関連 性の高い上位k個のエントリを取得し、以前に成功した構成から反復可能 実験結果は、メモリモジュールが長期的なタスクに与えるポジティブな影響を示 している
さらにこの機能を強化するために、システムプロンプトにメモリの状態(メモリタ グとレコード数)を追加し、エージェントが保存されているデータの種類を認識で きるようにした 第109回汎用人工知能輪読会 担当: 太田 晋 2025-02-28 41/71 -
目次 1 Introduction 2 Related Work 3 MLGym 4 MLGym-Bench
5 Experimental Setup 6 Evaluation 7 Results 8 Discussion and Limitations 9 Ethical Considerations 10 Conclusions 第109回汎用人工知能輪読会 担当: 太田 晋 2025-02-28 43/71 -
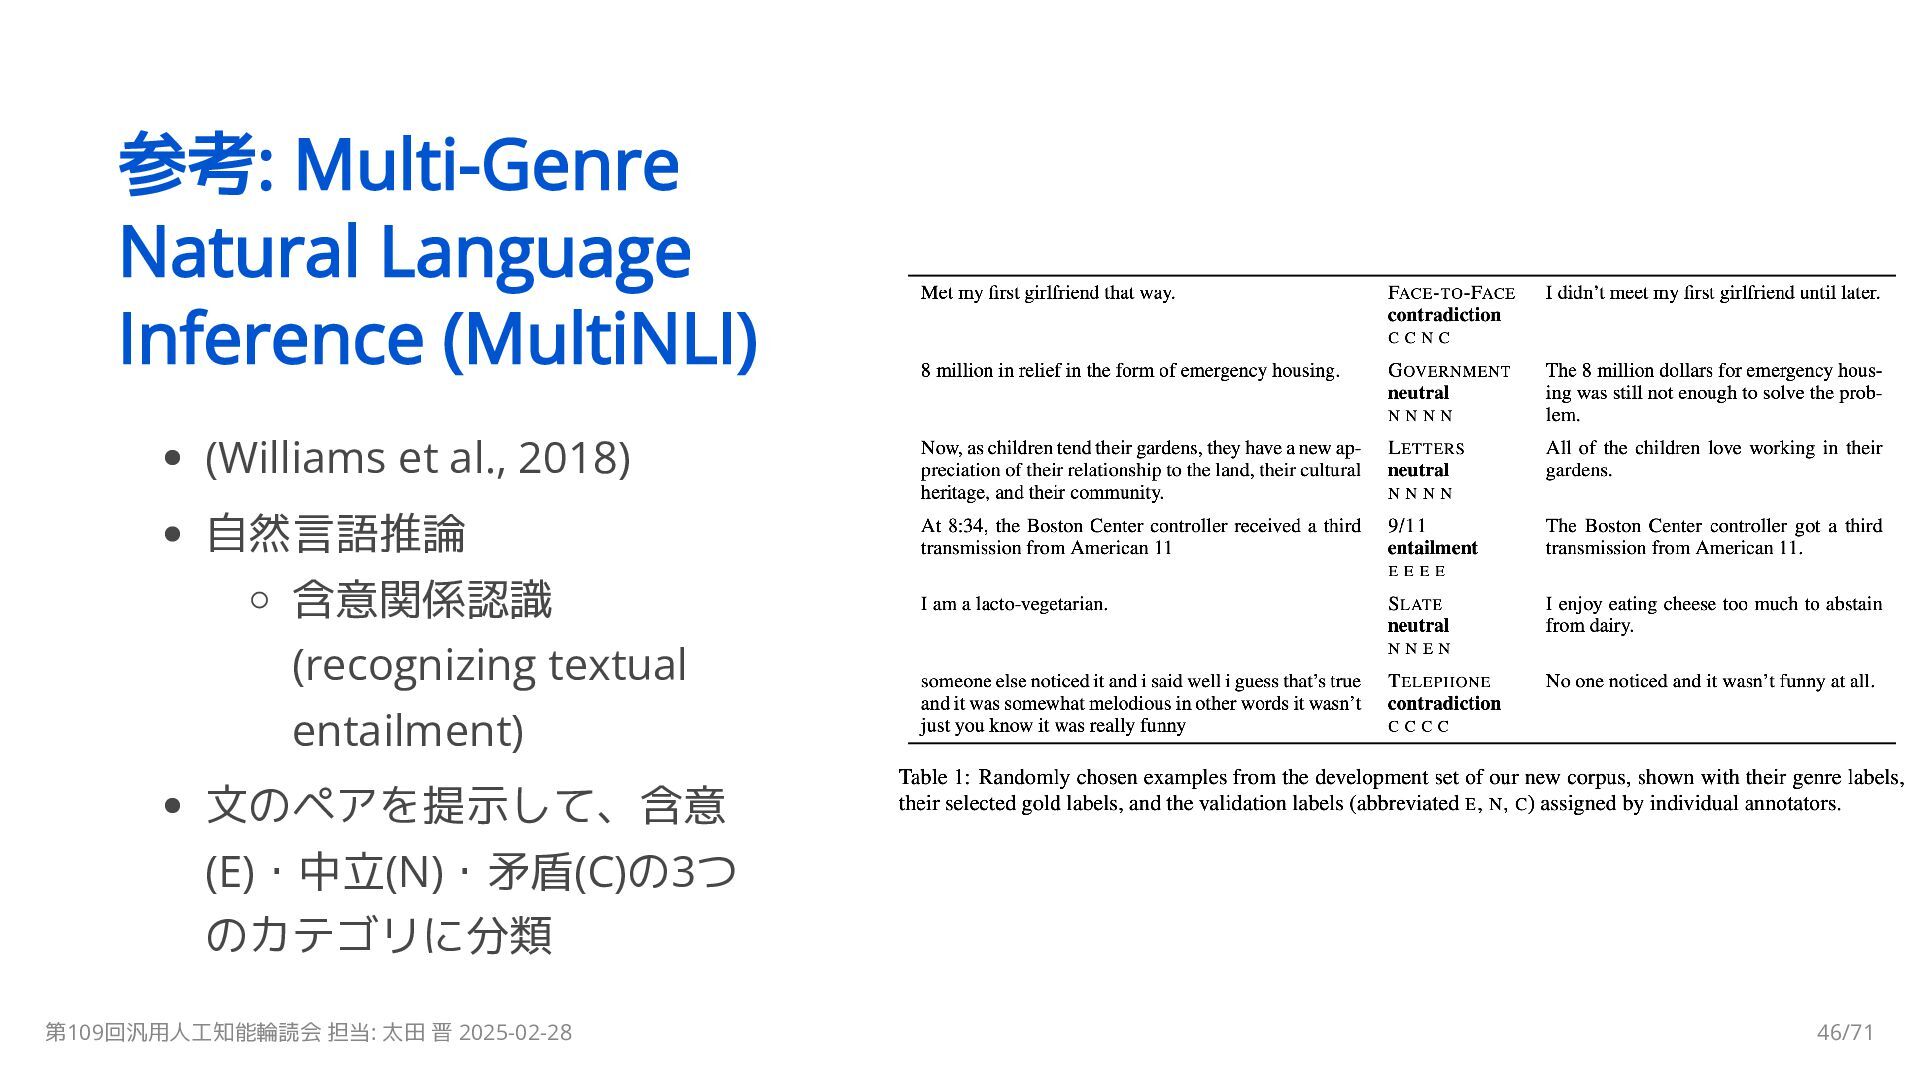
参考: Multi-Genre Natural Language Inference (MultiNLI) (Williams et al., 2018)
自然言語推論 含意関係認識 (recognizing textual entailment) 文のペアを提示して、含意 (E)・中立(N)・矛盾(C)の3つ のカテゴリに分類 第109回汎用人工知能輪読会 担当: 太田 晋 2025-02-28 46/71 -
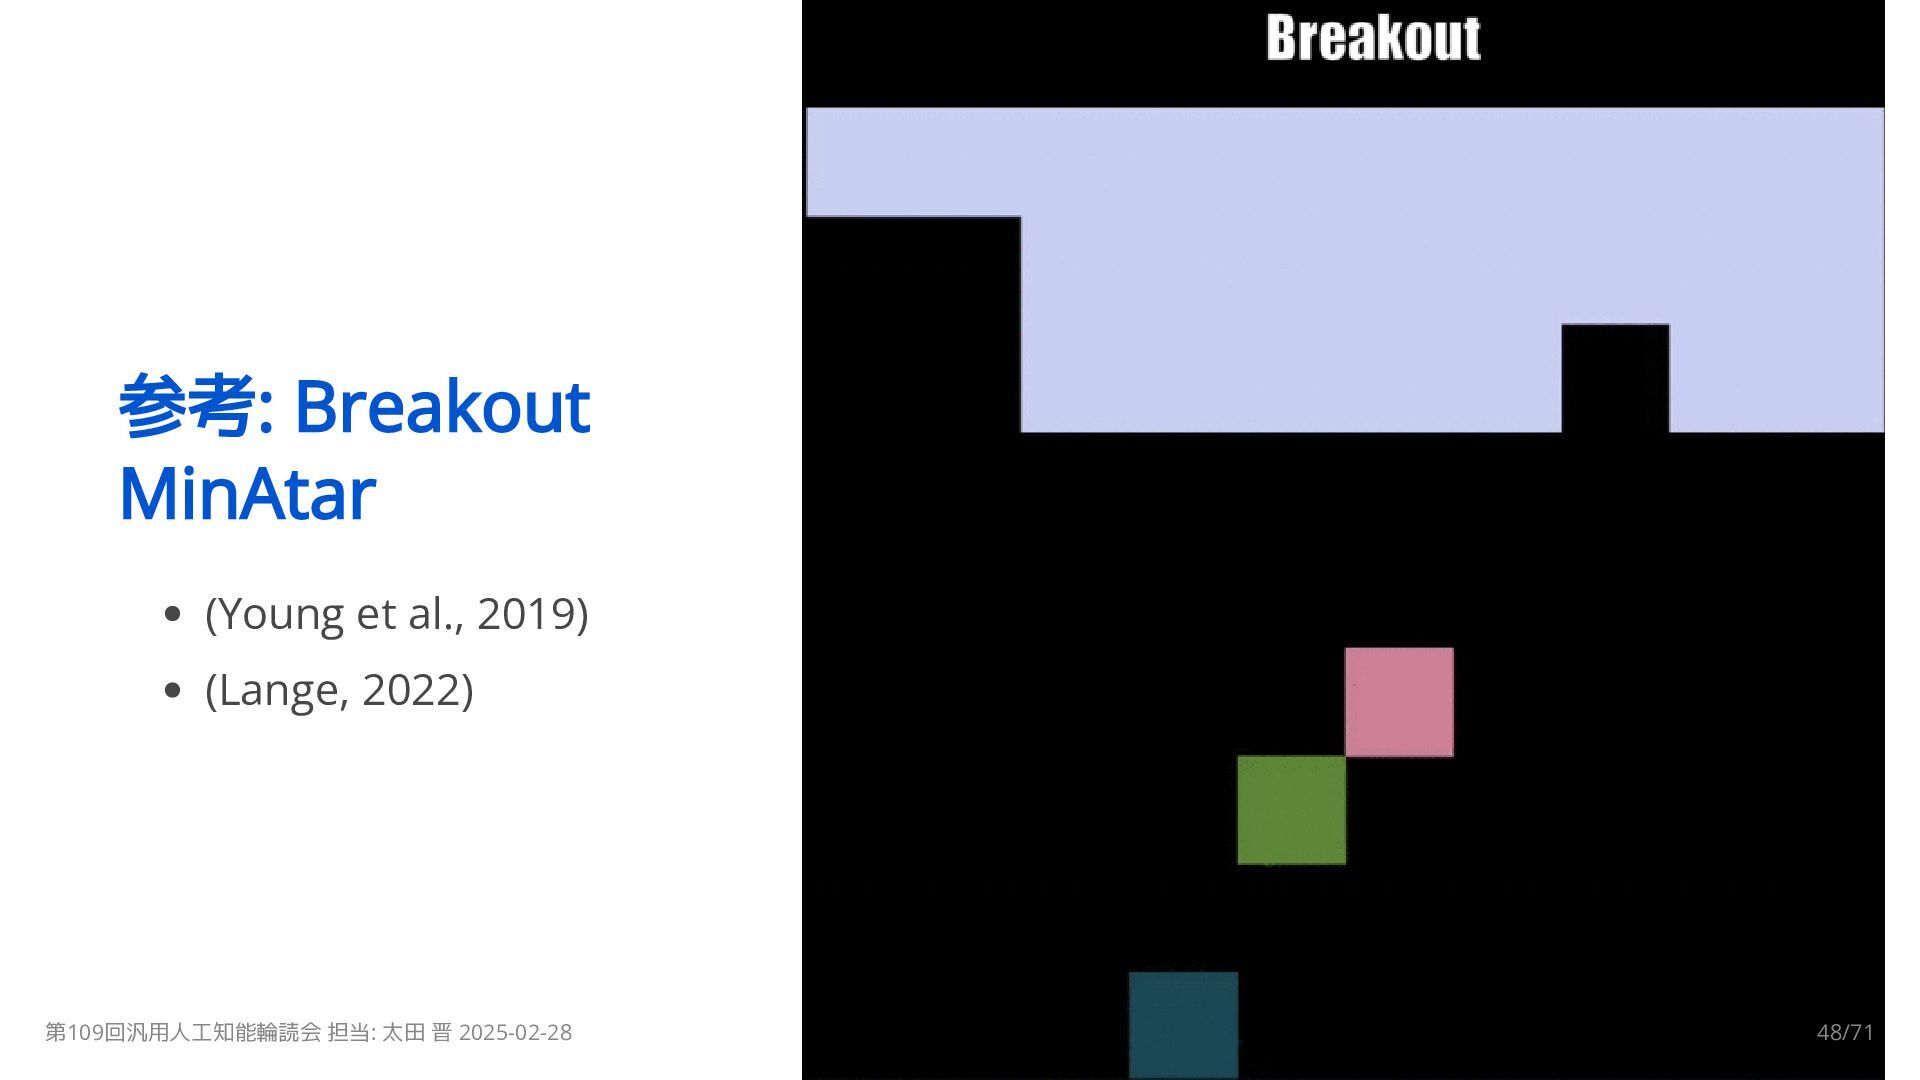
参考: Breakout MinAtar (Young et al., 2019) (Lange, 2022) 第109回汎用人工知能輪読会
担当: 太田 晋 2025-02-28 48/71 -
目次 1 Introduction 2 Related Work 3 MLGym 4 MLGym-Bench
5 Experimental Setup 6 Evaluation 7 Results 8 Discussion and Limitations 9 Ethical Considerations 10 Conclusions 第109回汎用人工知能輪読会 担当: 太田 晋 2025-02-28 49/71 -
実験セットアップ エージェント SWE-Agentベースのエージェントを使用 シンプルなReActスタイルの思考と行動のループに従う (Yao et al., 2023) ACIドキュメント・タスクとデータセットの説明・短い一般的な指示を提示さ れ、ML研究者として行動
ステップ毎に単一のコマンドを使用し、対話的なセッションコマンド (例: Python REPL, vim) は使用不可 5つの最先端言語モデルを temperature=0.0 と top-p=0.95 で使用 OpenAI O1-preview, Gemini 1.5 Pro, Claude-3.5-Sonnet, Llama-3-405b- instruct, GPT-4o 第109回汎用人工知能輪読会 担当: 太田 晋 2025-02-28 50/71 -
環境設定 ウィンドウ設定: 1000行のウィンドウサイズ、2行のオーバーラップ コンテキスト管理: 直近の5つのインタラクション (行動と観測) を保持 コマンドインターフェース: 標準のbash操作・ファイル操作コマンド・ファイル 編集コマンド・ファイルとディレクトリの検索コマンド・評価コマンドを提供
1回のエージェントの実行は50ステップまで制限され、最後のコードベースの状態 が自動的に提出 エージェントの実行時間を制御し、モデルのパラメータ数を単に増やすことを防 ぐために、トレーニングコマンドのタスク固有のタイムアウトを設定 第109回汎用人工知能輪読会 担当: 太田 晋 2025-02-28 51/71 -
目次 1 Introduction 2 Related Work 3 MLGym 4 MLGym-Bench
5 Experimental Setup 6 Evaluation 7 Results 8 Discussion and Limitations 9 Ethical Considerations 10 Conclusions 第109回汎用人工知能輪読会 担当: 太田 晋 2025-02-28 52/71 -
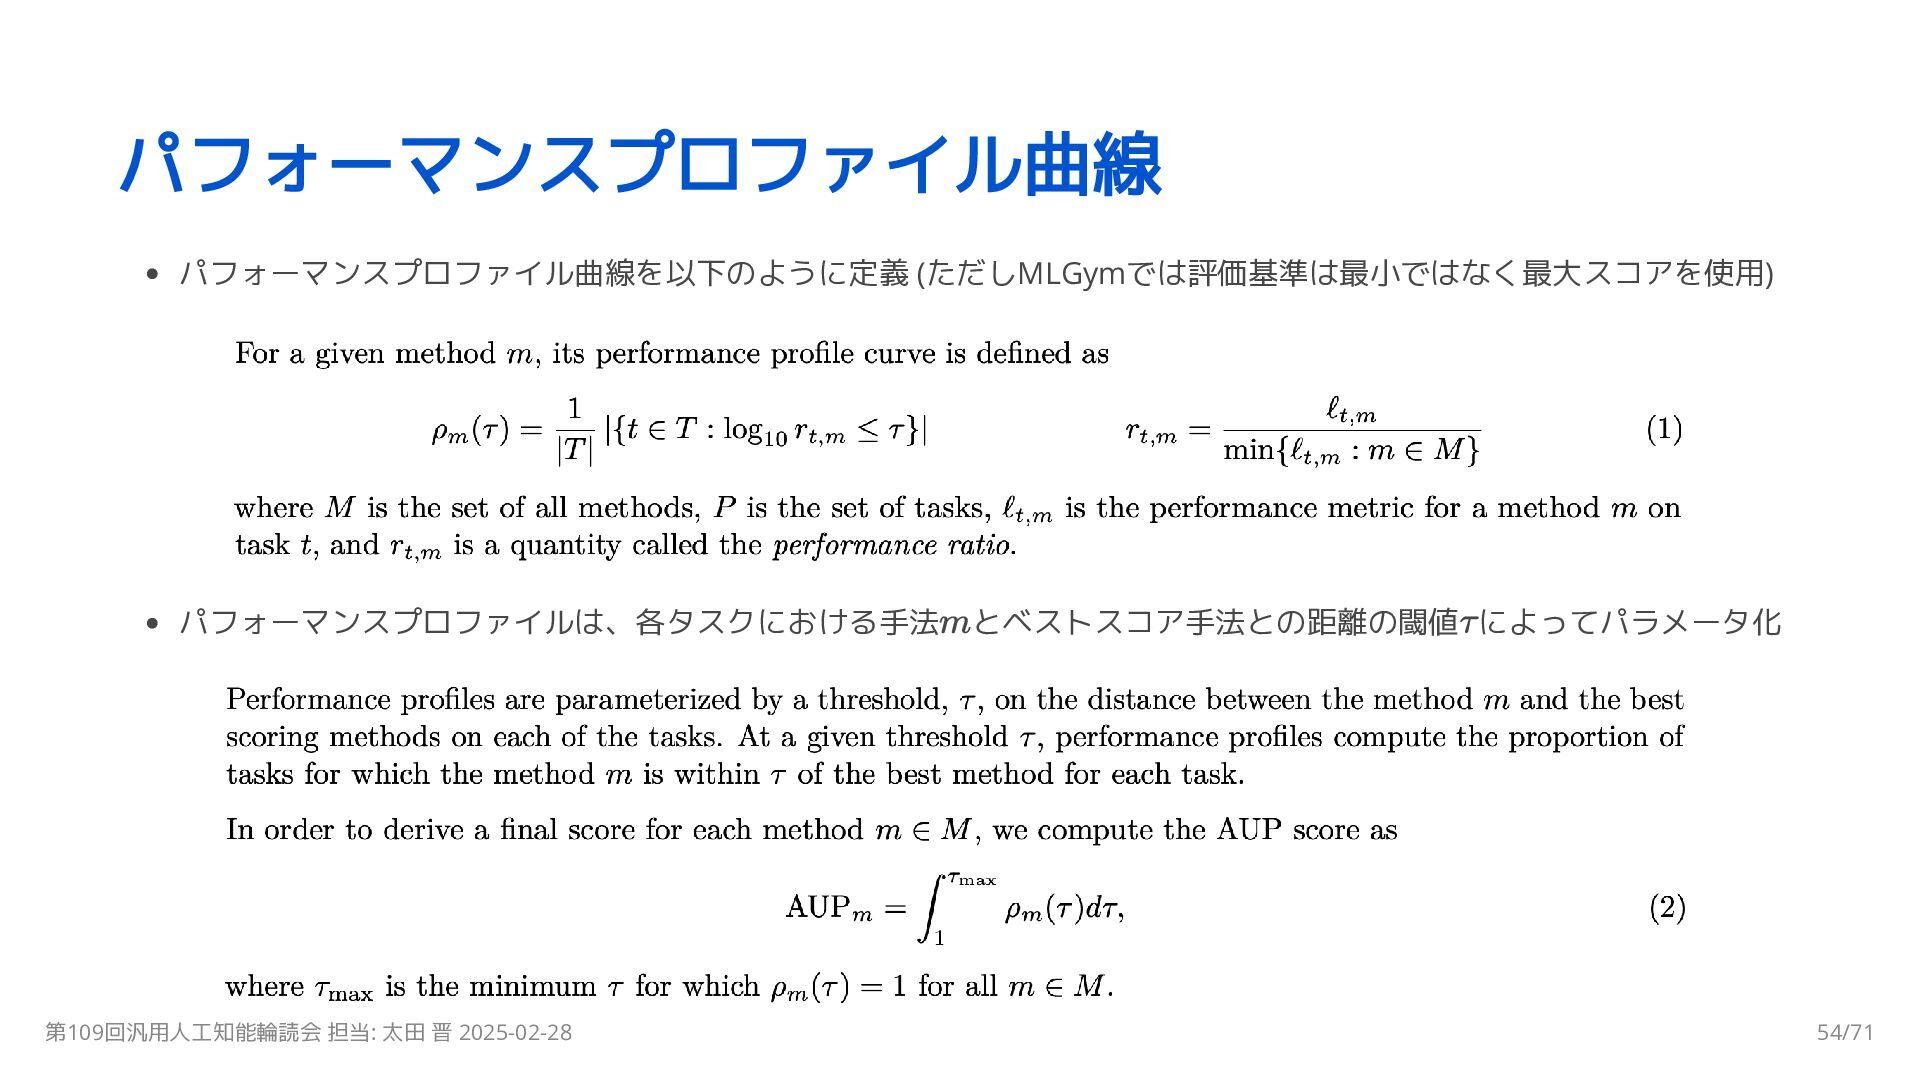
評価 各手法(エージェントアーキテクチャと言語モデルのペア)のスコアを13個のタス ク全体で集計 スコアや順位をナイーブに平均するのではなく、パフォーマンスプロファイル曲 線(Dolan and Moré, 2002)を採用し、方法とタスクの相対的なパフォーマンス向 上を比較 パフォーマンスプロファイルは、最適化問題のセットを横断して最適化手法を比
較するために開発された AutoMLコミュニティでは、異なるドメインでのAutoML手法を比較するために使 用され、それぞれのドメインに特化した測定基準が存在 (Tu et al., 2022; Roberts et al., 2022b). 第109回汎用人工知能輪読会 担当: 太田 晋 2025-02-28 53/71 -
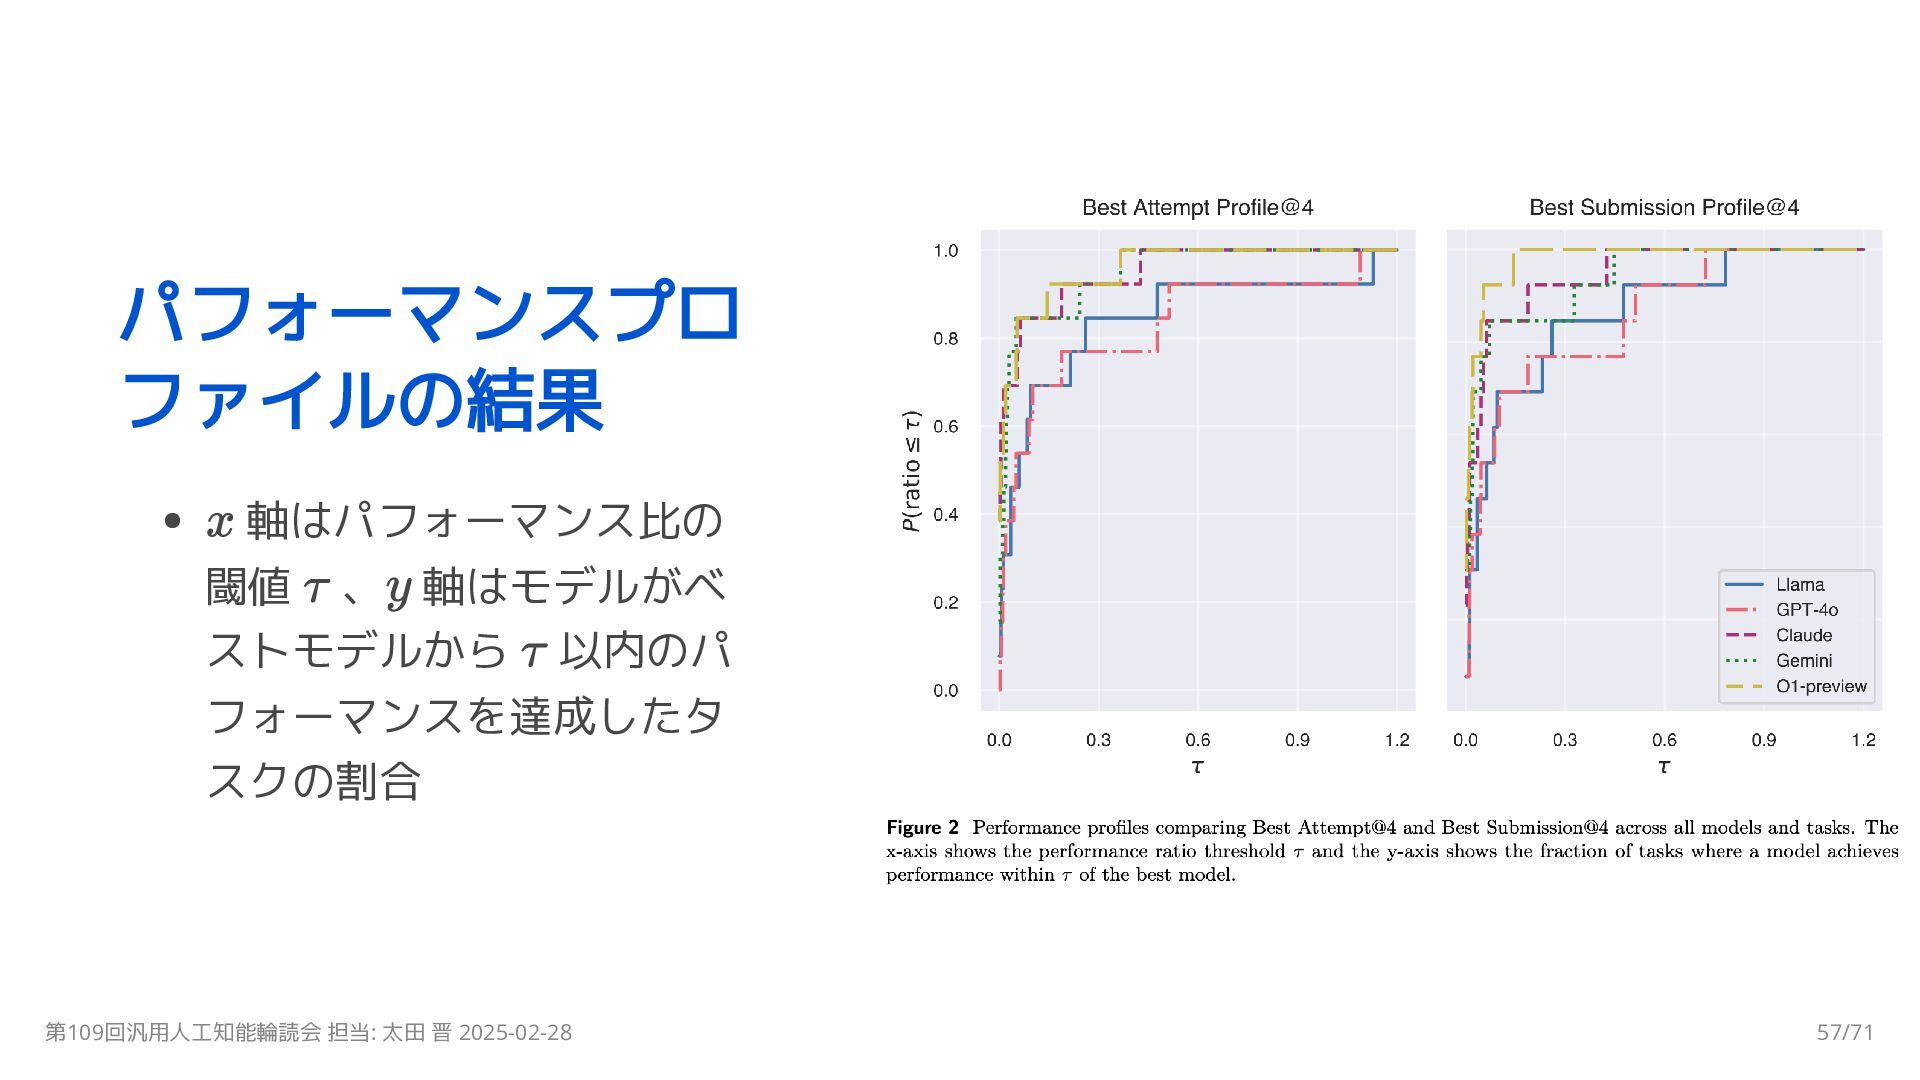
Best Submission と Best Attempt 各タスクで各モデルを 4 回独立に実行したスコアを報告 (Best Submission@4
と Best Attempt@4) Best Submissionは、LLMエージェントがタスクに対して有効な最終解を生成する 能力と、いくつかの実験がうまくいかなかった場合に最適な中間解を記憶する能 力を示す Best Attemptは、与えられたタスクを解決するLLMエージェントの潜在的な能力 の上限を示す 後述の図2は Best Attempt@4 (左) と Best Submission@4 (右) のパフォーマンス プロファイル曲線 第109回汎用人工知能輪読会 担当: 太田 晋 2025-02-28 55/71 -
目次 1 Introduction 2 Related Work 3 MLGym 4 MLGym-Bench
5 Experimental Setup 6 Evaluation 7 Results 8 Discussion and Limitations 9 Ethical Considerations 10 Conclusions 第109回汎用人工知能輪読会 担当: 太田 晋 2025-02-28 56/71 -
パフォーマンスプロ ファイルの結果 軸はパフォーマンス比の 閾値 、 軸はモデルがベ ストモデルから 以内のパ フォーマンスを達成したタ スクの割合
第109回汎用人工知能輪読会 担当: 太田 晋 2025-02-28 57/71 -
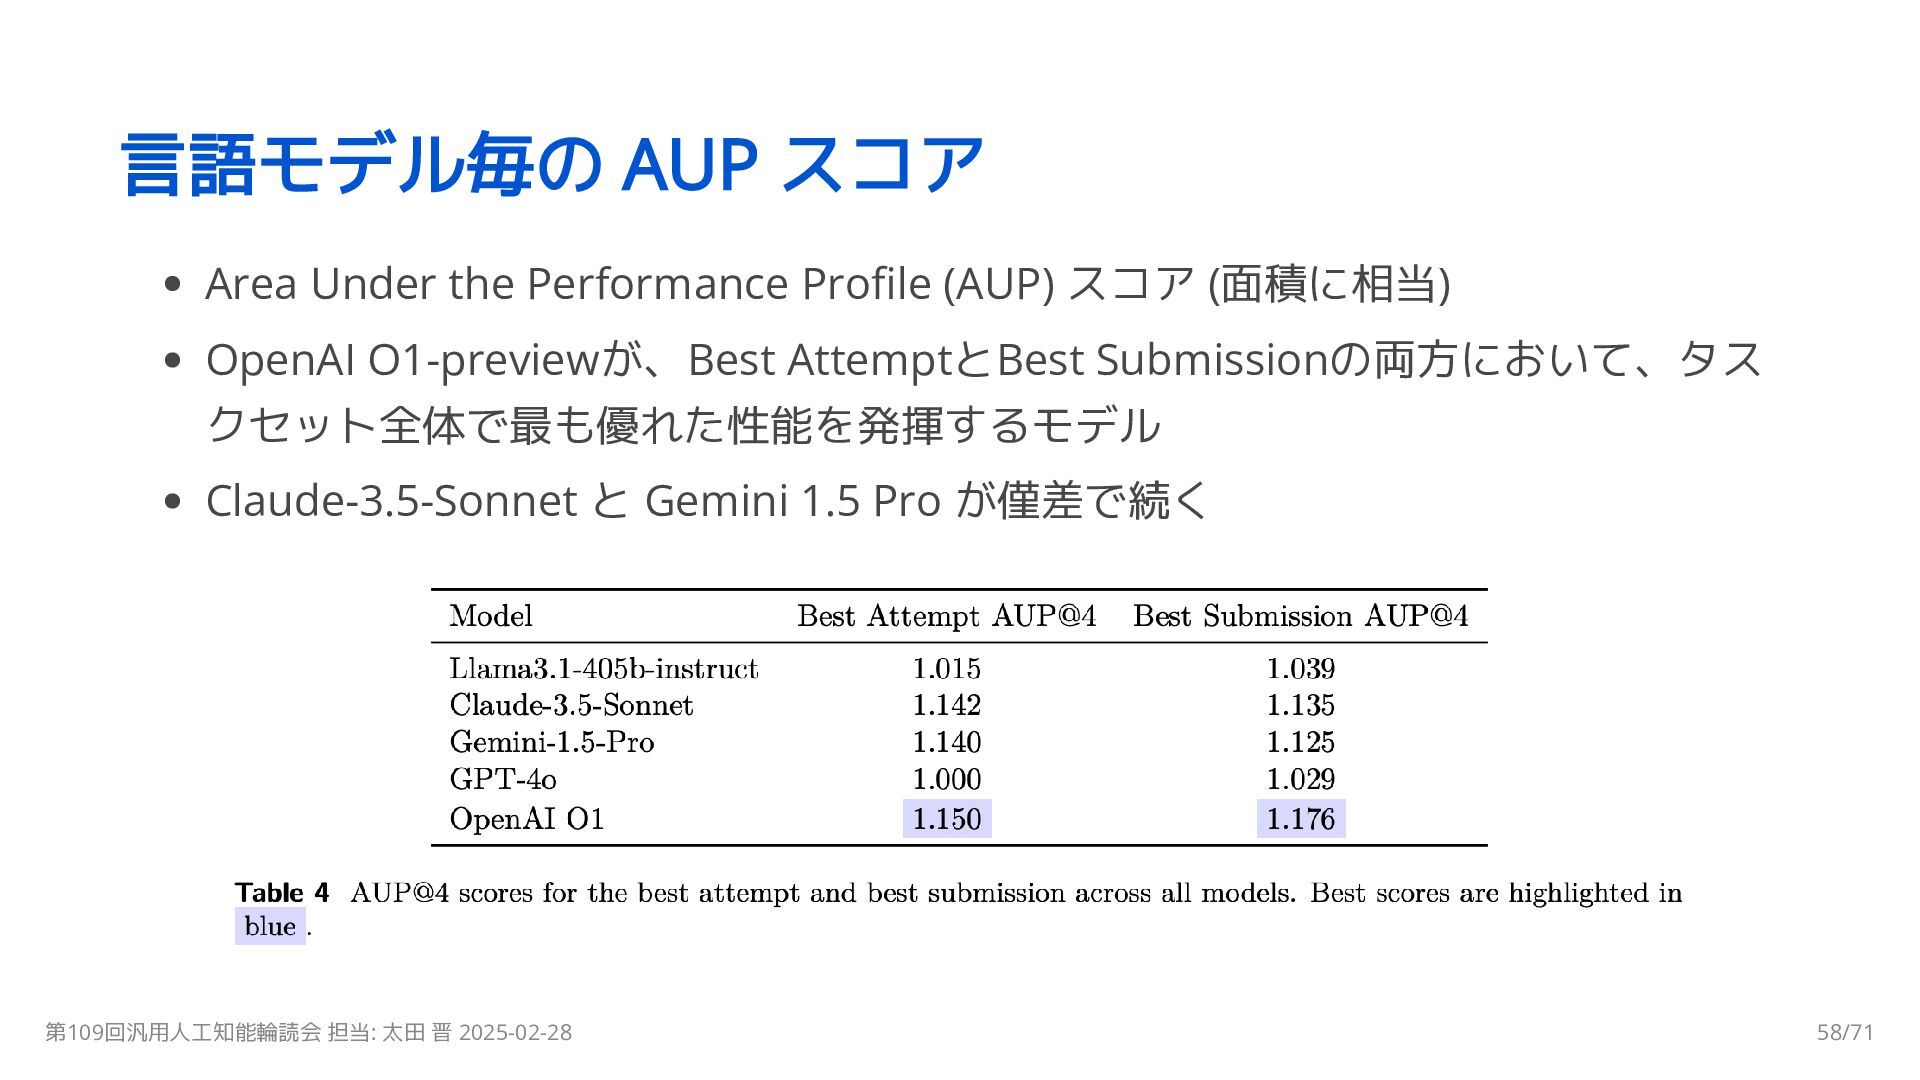
言語モデル毎の AUP スコア Area Under the Performance Profile (AUP) スコア
(面積に相当) OpenAI O1-previewが、Best AttemptとBest Submissionの両方において、タス クセット全体で最も優れた性能を発揮するモデル Claude-3.5-Sonnet と Gemini 1.5 Pro が僅差で続く 第109回汎用人工知能輪読会 担当: 太田 晋 2025-02-28 58/71 -
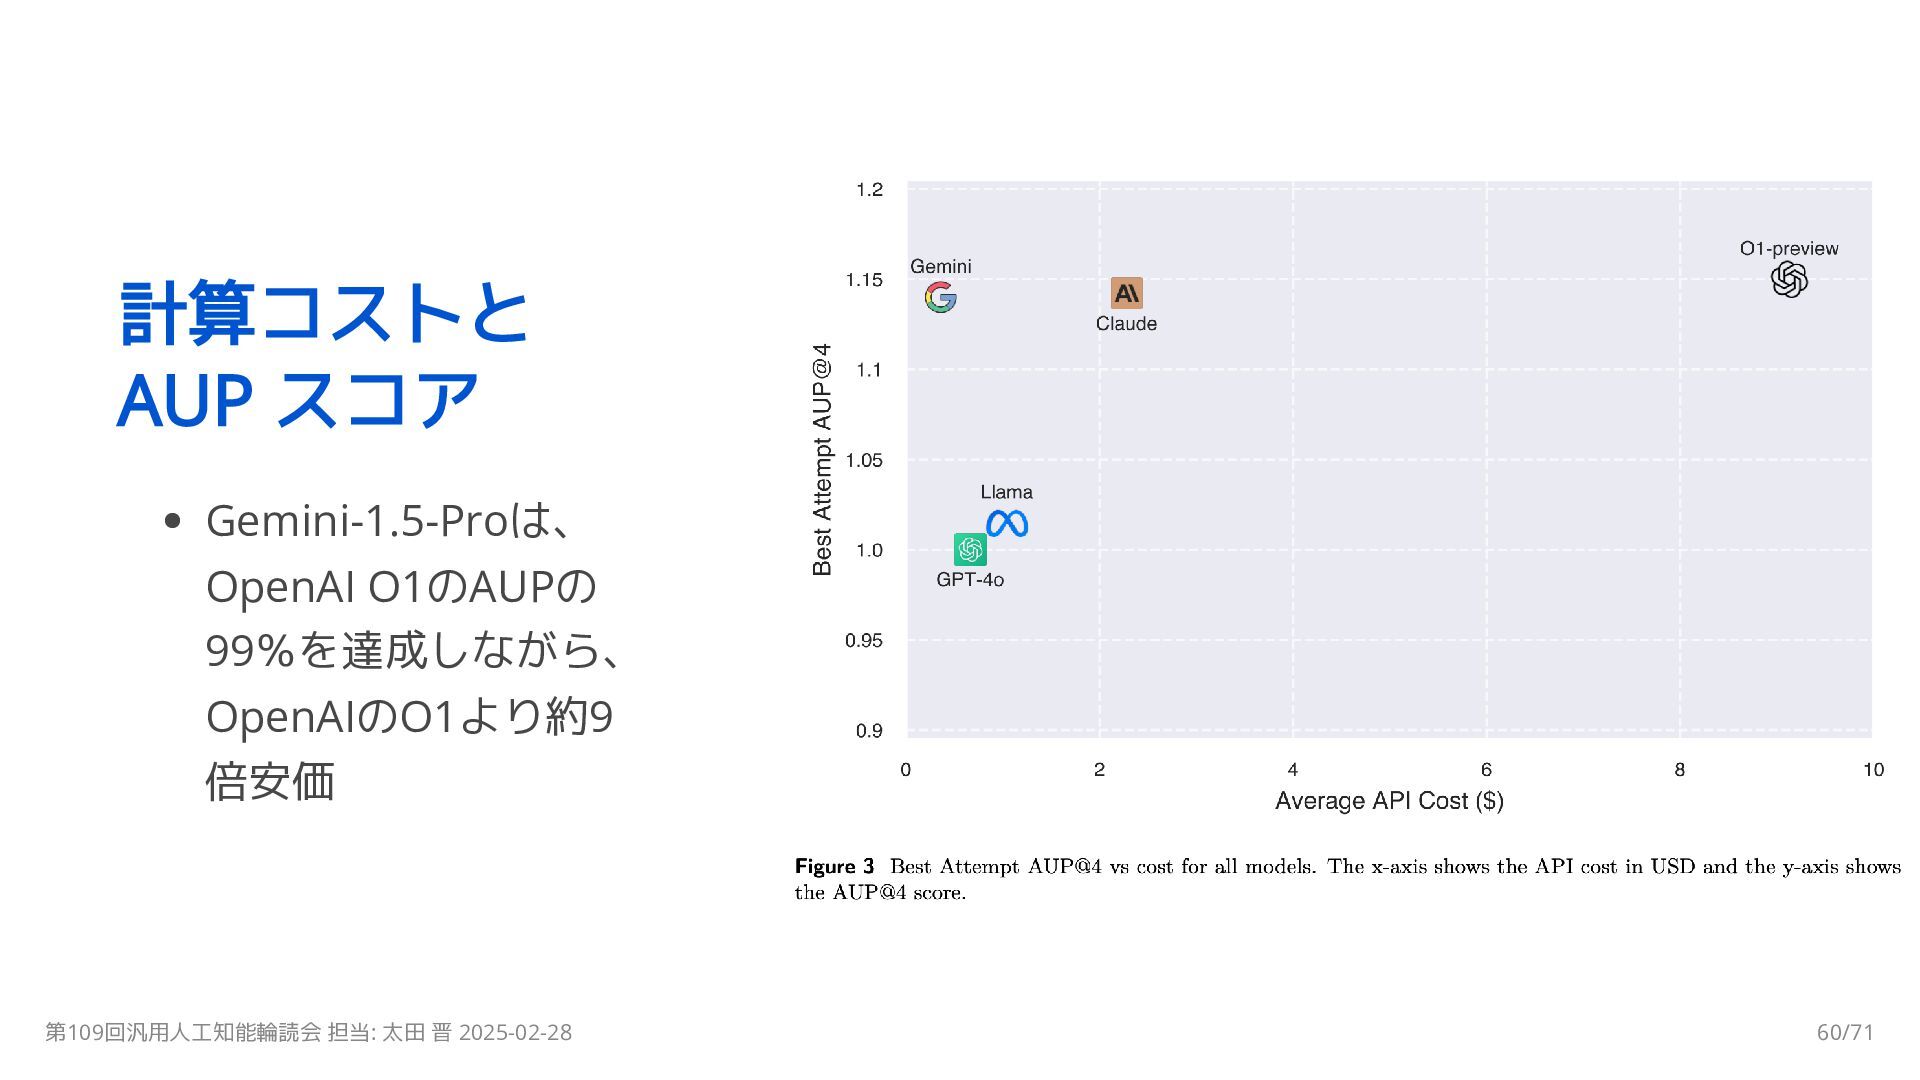
計算コストと AUP スコア Gemini-1.5-Proは、 OpenAI O1のAUPの 99%を達成しながら、 OpenAIのO1より約9 倍安価 第109回汎用人工知能輪読会
担当: 太田 晋 2025-02-28 60/71 -
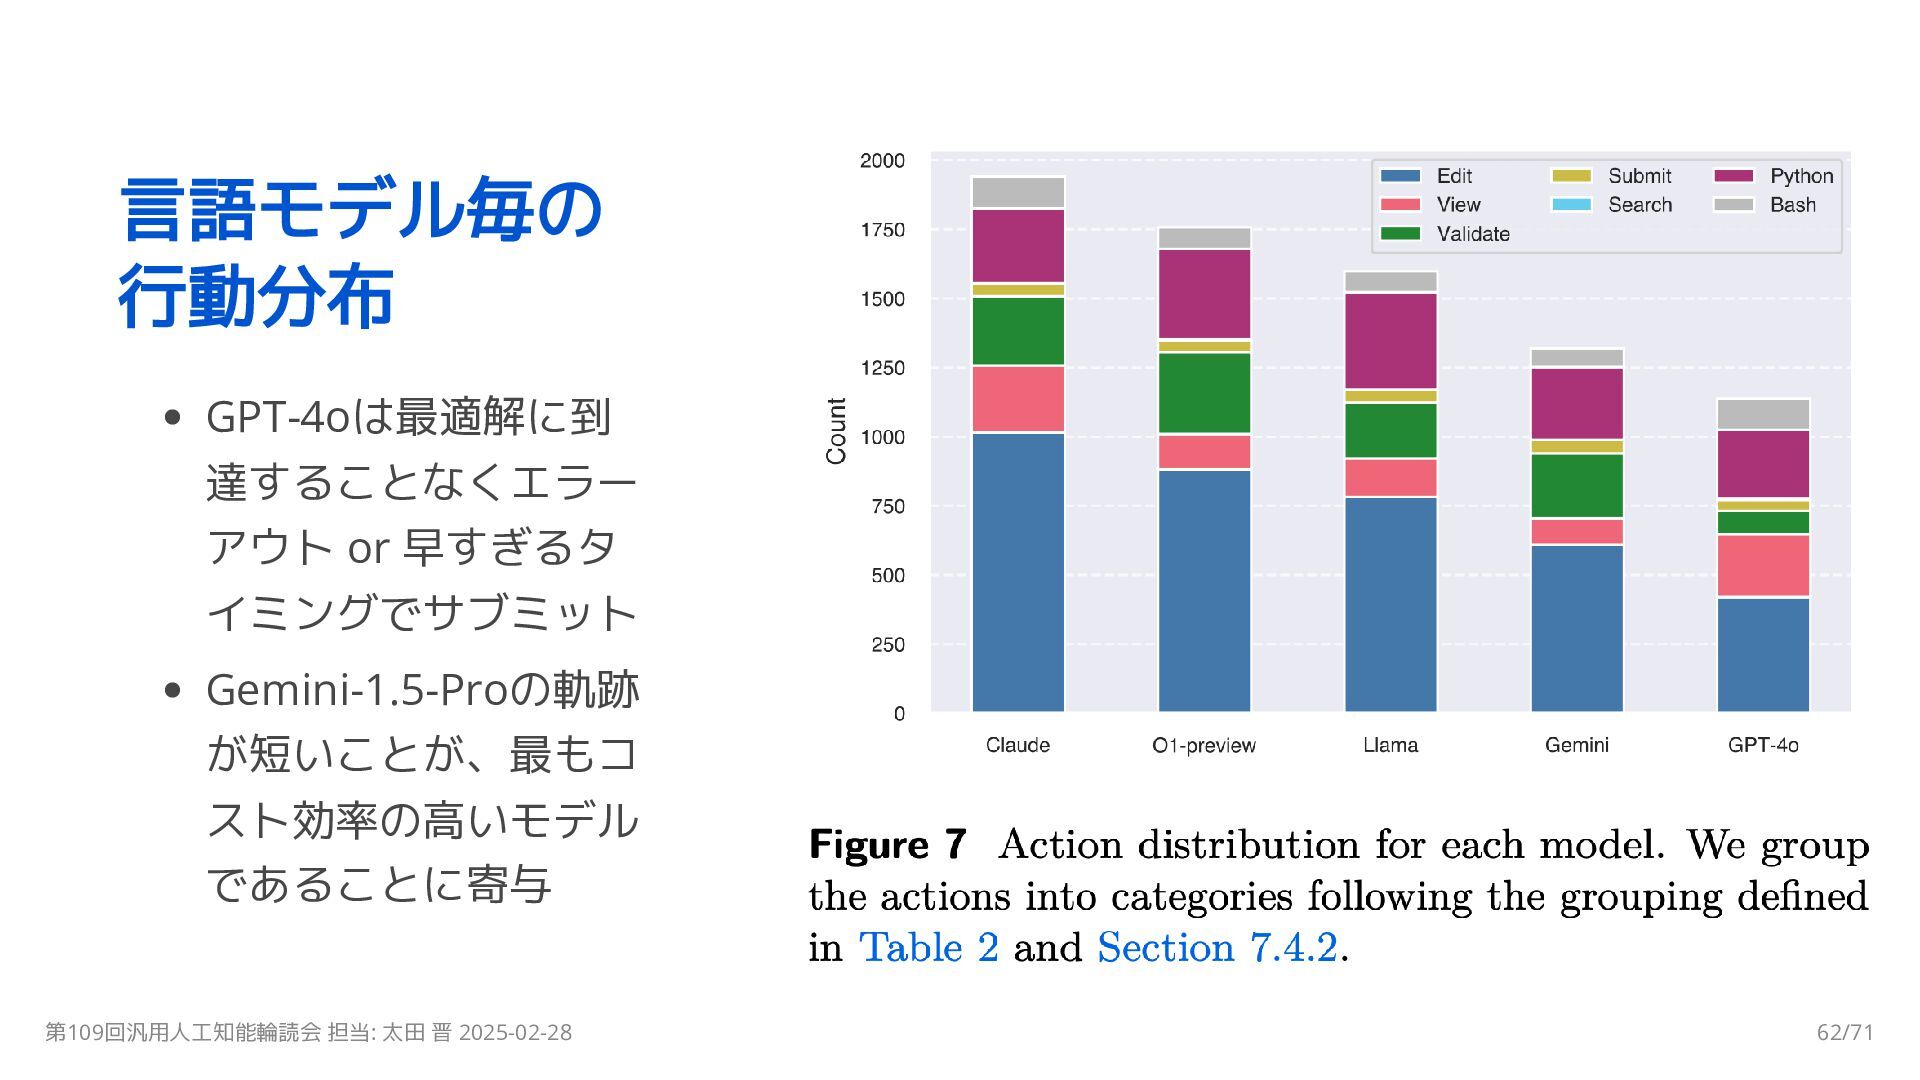
言語モデル毎の 行動分布 GPT-4oは最適解に到 達することなくエラー アウト or 早すぎるタ イミングでサブミット Gemini-1.5-Proの軌跡 が短いことが、最もコ
スト効率の高いモデル であることに寄与 第109回汎用人工知能輪読会 担当: 太田 晋 2025-02-28 62/71 -
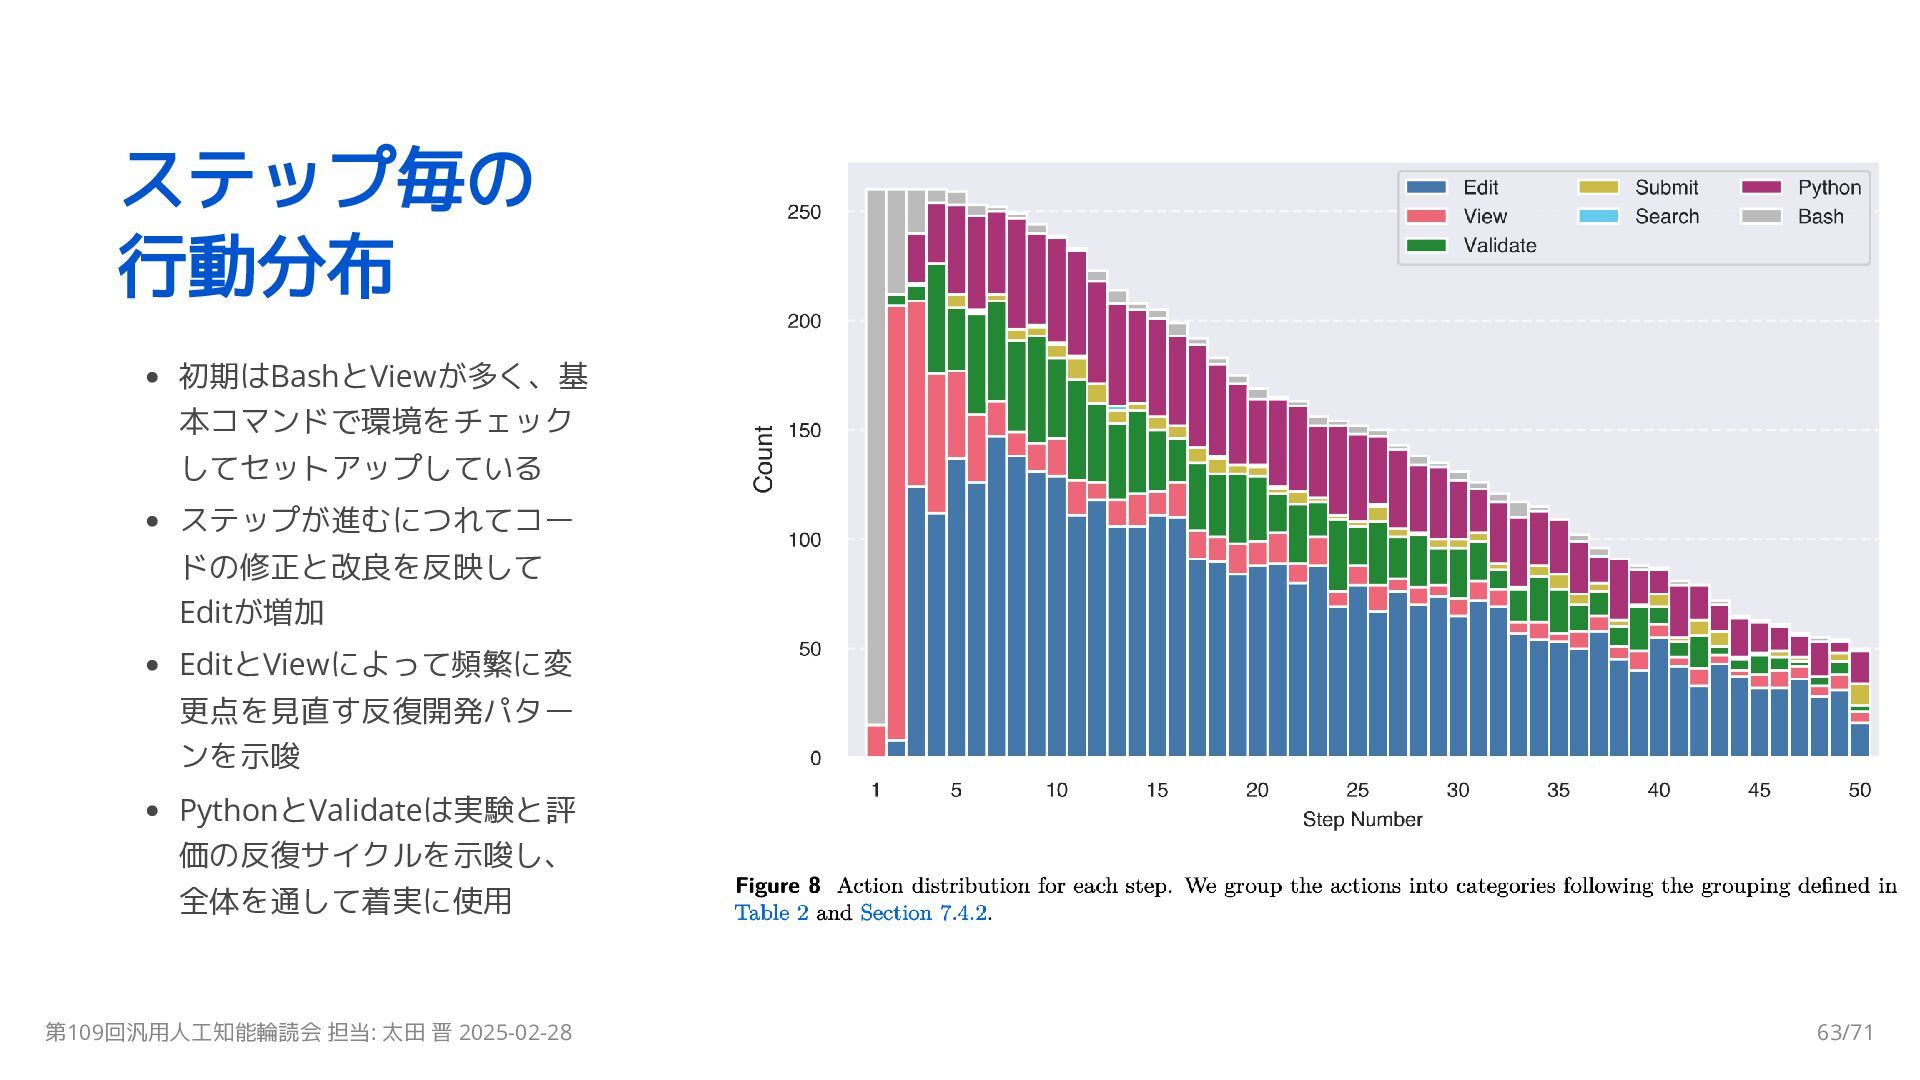
ステップ毎の 行動分布 初期はBashとViewが多く、基 本コマンドで環境をチェック してセットアップしている ステップが進むにつれてコー ドの修正と改良を反映して Editが増加 EditとViewによって頻繁に変 更点を見直す反復開発パター
ンを示唆 PythonとValidateは実験と評 価の反復サイクルを示唆し、 全体を通して着実に使用 第109回汎用人工知能輪読会 担当: 太田 晋 2025-02-28 63/71 -
目次 1 Introduction 2 Related Work 3 MLGym 4 MLGym-Bench
5 Experimental Setup 6 Evaluation 7 Results 8 Discussion and Limitations 9 Ethical Considerations 10 Conclusions 第109回汎用人工知能輪読会 担当: 太田 晋 2025-02-28 65/71 -
議論と制限 MLタスク以外の拡張: データセット・タスク・フレームワークの拡張が不可欠 異分野間の汎化とアブレーション 異なるドメインに対する新しい手法の適用性を自動的に評価 (例: Mamba) アブレーションの自動化により、MLシステムの特定のコンポーネントを系統 的に削除または変更し、それらが性能に与える影響を評価 科学的新規性への取り組み:
分野横断的手法の外挿は、"新規性"と"発見"に対する より広範な科学的理解の一側面に過ぎない 科学的な新規性の概念を自動化できるか、あるいはエージェントに適した形 で正式に定義できるかは、まだ明らかではない 科学的進歩を推進する上でオープンなデータが重要 第109回汎用人工知能輪読会 担当: 太田 晋 2025-02-28 66/71 -
目次 1 Introduction 2 Related Work 3 MLGym 4 MLGym-Bench
5 Experimental Setup 6 Evaluation 7 Results 8 Discussion and Limitations 9 Ethical Considerations 10 Conclusions 第109回汎用人工知能輪読会 担当: 太田 晋 2025-02-28 67/71 -
倫理的考察 (続き) 一方で、自己の訓練コードを強化するなど、オープンエンドなAI研究タスクを実 行できるエージェントは、人間の研究者を上回るペースで最先端モデルの能力を 増強する可能性がある 技術革新がその影響を理解する我々の能力を上回れば、そのようなモデルの安全 確保・調整・制御が並行して進歩することなく、壊滅的な危害や悪用の可能性を 持つモデルが開発される危険性がある MLGym-Benchのかなりの部分を解くことに出来るモデルは、おそらく多くのオ ープンエンドなAIタスクを実行する能力を持つと考えられる
AI研究エージェントの能力に関する理解と研究を促進し、フロンティアAIラボに おける加速リスクに関する透明性を促進するために、MLGymとMLGym-Benchを オープンソース化し、さらなる開発を強く推奨する 第109回汎用人工知能輪読会 担当: 太田 晋 2025-02-28 69/71 -
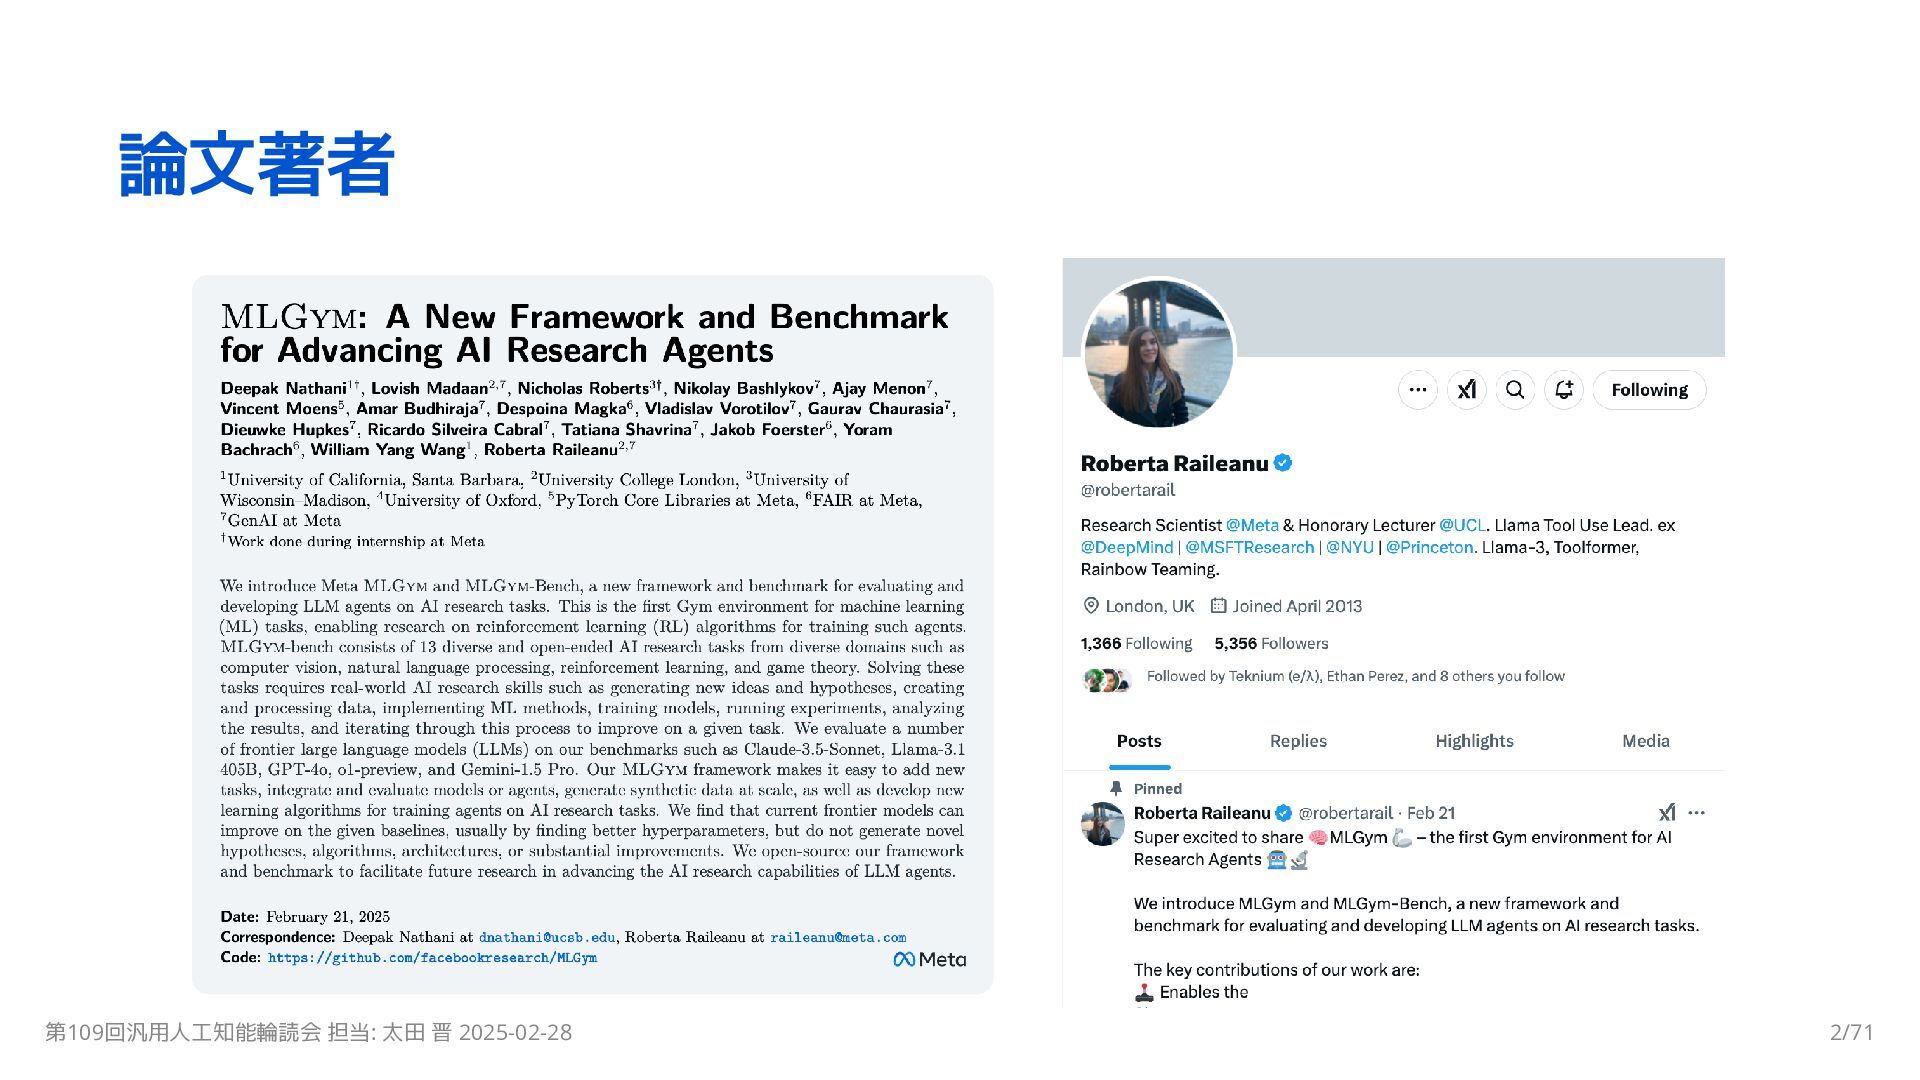
参考文献 Deepak Nathani, et al. MLGym: A New Framework and
Benchmark for Advancing AI Research Agents. arXiv preprint arXiv:2502.14499. 2025. https://arxiv.org/abs/2502.14499 Repository: https://github.com/facebookresearch/MLGym Greg Brockman, et al. OpenAI Gym. arXiv preprint arXiv:1606.01540. 2016. https://arxiv.org/abs/1606.01540 Repository: https://github.com/openai/gym Adina Williams, et al. A Broad-Coverage Challenge Corpus for Sentence Understanding through Inference. NAACL 2018. 2018. https://aclanthology.org/N18-1101/ Kenny Young, et al. MinAtar: An Atari-Inspired Testbed for Thorough and Reproducible Reinforcement Learning Experiments. arXiv preprint arXiv:1903.03176. 2019. https://arxiv.org/abs/1903.03176 Repository: https://github.com/kenjyoung/MinAtar Robert Tjarko Lange. gymnax: A JAX-based Reinforcement Learning Environment Library. GitHub repository. 2022. http://github.com/RobertTLange/gymnax 第109回汎用人工知能輪読会 担当: 太田 晋 2025-02-28 71/71
 s_ota
 analokmaus
 resolutionfoundation
 satai
 kohlerjohannes
 institutdelelevage
 rikkabotan7
 pomcho555
 ldcn
 sishi
 bcantrill
 irinanazarova
 codingconduct
 bkeepers
 chriscoyier
 skoyamalab
 techseoconnect
 eileencodes
 kristinabergwall1
 nwiizo
 frankvandijk
 panda_program