Upgrade to Pro
— share decks privately, control downloads, hide ads and more …
Speaker Deck
Sign up for free
Menu
Search
Features
All features
Private URLs
Password Protection
Custom URLS
Scheduled publishing
Remove Branding
Restrict embedding
Deck Collections
Notes
Features
All features
Private URLs
Password Protection
Custom URLS
Scheduled publishing
Remove Branding
Restrict embedding
Deck Collections
Notes
Explore
Featured decks
Featured speakers
Programming
Technology
Storyboards
Explore
Featured decks
Featured speakers
Programming
Technology
Storyboards
Pricing
Search
Sign in
Sign up for free
LLMでAI-OCR、実際どうなの? / llm_ai_ocr_layerx_bet_ai_d...
Search
Sponsored
·
SiteGround - Reliable hosting with speed, security, and support you can count on.
→
sbrf248
July 30, 2025
Technology
10k
1
Share
Embed
Copy iframe code
Copy JS code
Copy link
Start on current slide
LLMでAI-OCR、実際どうなの? / llm_ai_ocr_layerx_bet_ai_day_lt
sbrf248
July 30, 2025
More Decks by sbrf248
See All by sbrf248
自社開発SaaSバクラクのAI技術とそれに向き合うエンジニアのやりがい / layerx-ai-engineer-dataconference20240601
sbrf248
0
490
バクラクのアノテーション基盤の伸びしろを考えてみた
sbrf248
1
250
Other Decks in Technology
See All in Technology
Vue で書く 空間コンピューティング、TresJS と WebXR を使ったXR デバイスのフロントエンド開発
hiranuma
0
140
AIがGISを代替する日:〜すべてをAIが創る時代に、私たちがFOSS4Gに関わる意味〜
lehupa
0
130
AI時代のエンジニアの情報発信〜個人の発信を組織の力に変える〜
ryo_kawamata
0
4.7k
Technical Project Manager の役割とやりがい、少しだけ AI
yoshiiryo1
0
390
SLOを阻む不安
sraku2159
0
160
"AWSはちょっと苦手"でも大丈夫。AWS Blocks で手軽に作る Flutter のバックエンド #FlutterKaigi
tacck
PRO
0
110
契約で守るコンパウンドプロダクトのデザインシステム
yug1224
1
1.6k
re:Invent の去年のスケジュールを公開します!
miu_crescent
PRO
0
130
Lint の層を組み直した話
bengo4com
2
250
ビジネス部門からPOを迎えての半年間の進歩と課題
zozotech
PRO
0
170
[re:Invent2026事前勉強会(有志開催)]続きは、ラスベガスの廊下で / continue-in-the-vegas-hallway
sh_fk2
0
430
「作れる」と「リリースできる」の間にあったもの── PdMを外して見えた、PdMがやるべき仕事/Buildable ≠ Shippable: What Removing the PM Taught Me About the PM’s Job
yappli_developers
0
390
Featured
See All Featured
Odyssey Design
rkendrick25
PRO
2
900
Why Our Code Smells
bkeepers
PRO
340
58k
Agile Leadership in an Agile Organization
kimpetersen
PRO
0
300
So, you think you're a good person
axbom
PRO
2
2.2k
HTML-Aware ERB: The Path to Reactive Rendering @ RubyCon 2026, Rimini, Italy
marcoroth
5
870
Lightning Talk: Beautiful Slides for Beginners
inesmontani
PRO
2
750
Fantastic passwords and where to find them - at NoRuKo
philnash
53
4k
Un-Boring Meetings
codingconduct
0
470
The innovator’s Mindset - Leading Through an Era of Exponential Change - McGill University 2025
jdejongh
PRO
1
380
Build your cross-platform service in a week with App Engine
jlugia
234
19k
VelocityConf: Rendering Performance Case Studies
addyosmani
331
25k
Fashionably flexible responsive web design (full day workshop)
malarkey
409
67k
Transcript
© LayerX Inc. LLMでAI-OCR、実際どうなの? バクラク事業部 AI・機械学習部 AI-OCRグループ 伊藤 駿 ITO,
Shun DAY06 topic Deep into AI Speaker
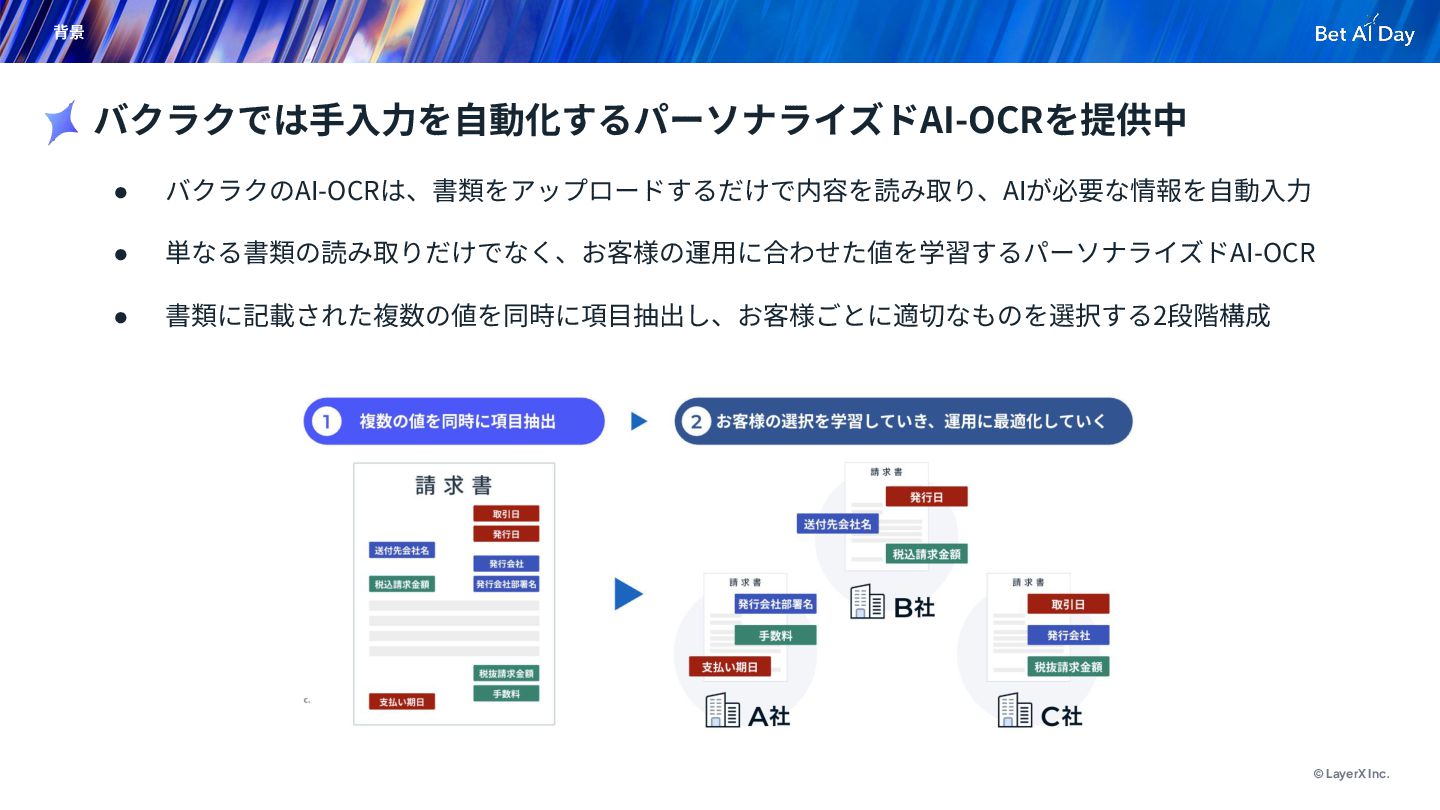
© LayerX Inc. 背景 • バクラクのAI-OCRは、書類をアップロードするだけで内容を読み取り、AIが必要な情報を⾃動⼊⼒ • 単なる書類の読み取りだけでなく、お客様の運⽤に合わせた値を学習するパーソナライズドAI-OCR • 書類に記載された複数の値を同時に項⽬抽出し、お客様ごとに適切なものを選択する2段階構成
バクラクでは⼿⼊⼒を⾃動化するパーソナライズドAI-OCRを提供中
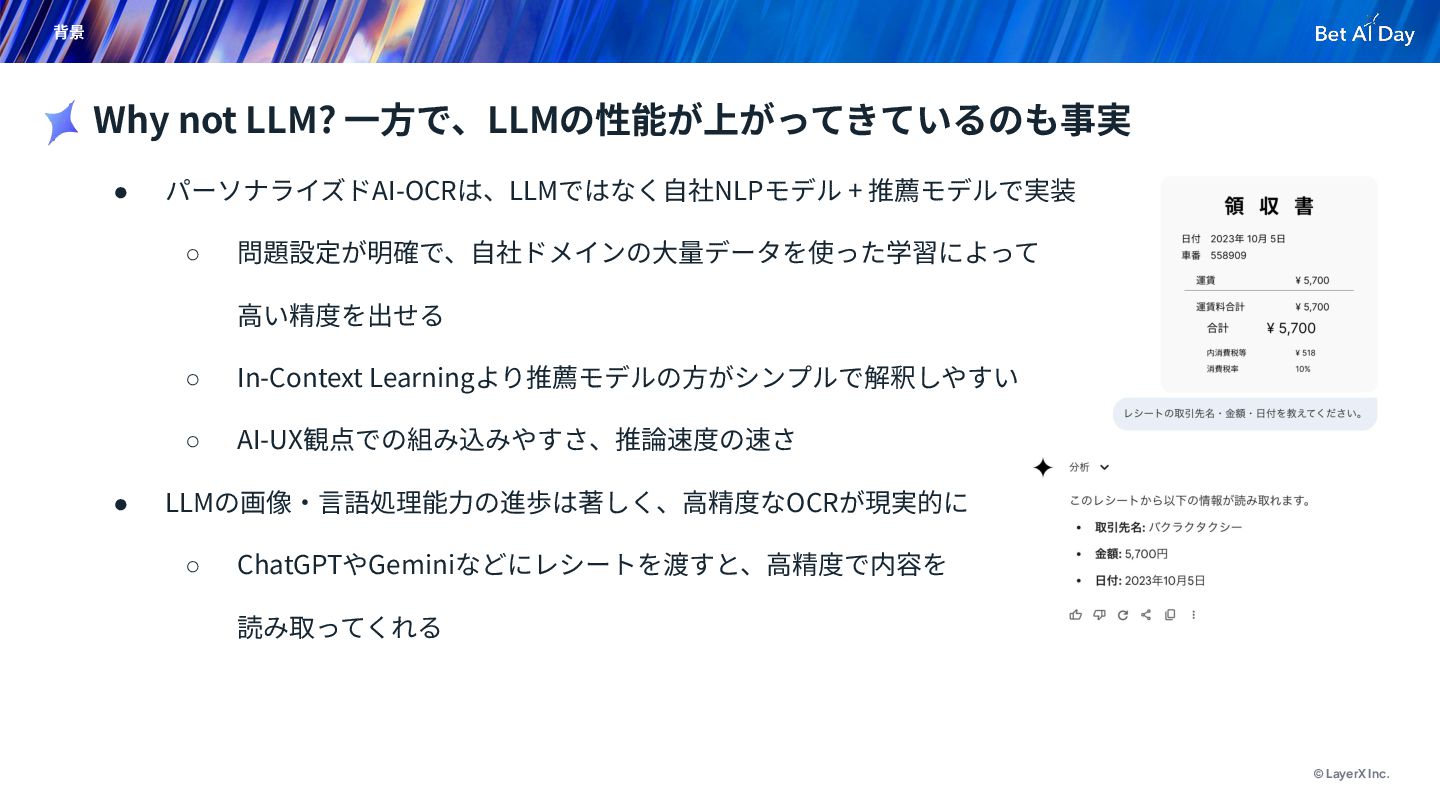
© LayerX Inc. 背景 • パーソナライズドAI-OCRは、LLMではなく⾃社NLPモデル + 推薦モデルで実装 ◦ 問題設定が明確で、⾃社ドメインの⼤量データを使った学習によって
⾼い精度を出せる ◦ In-Context Learningより推薦モデルの⽅がシンプルで解釈しやすい ◦ AI-UX観点での組み込みやすさ、推論速度の速さ • LLMの画像‧⾔語処理能⼒の進歩は著しく、⾼精度なOCRが現実的に ◦ ChatGPTやGeminiなどにレシートを渡すと、⾼精度で内容を 読み取ってくれる Why not LLM? ⼀⽅で、LLMの性能が上がってきているのも事実
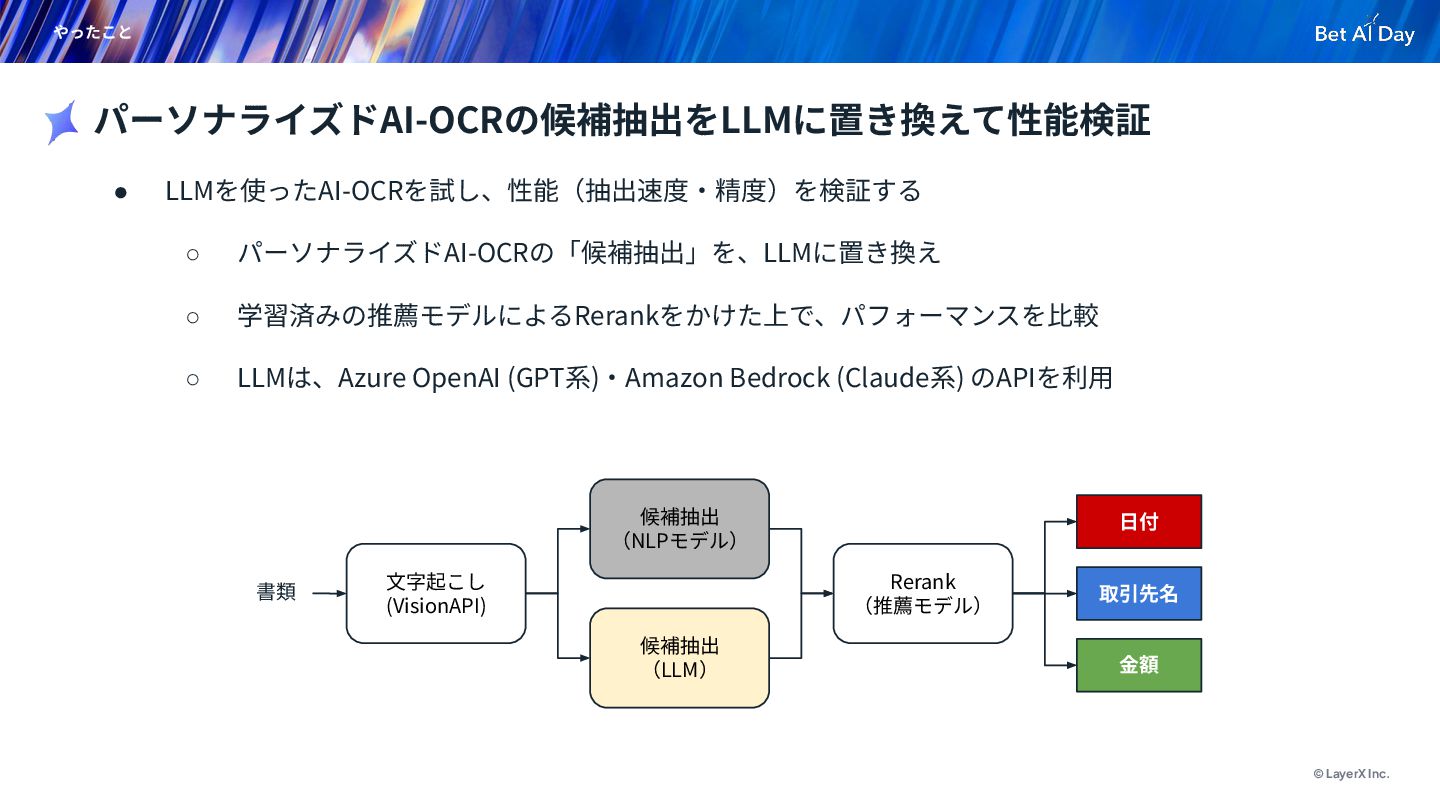
© LayerX Inc. やったこと • LLMを使ったAI-OCRを試し、性能(抽出速度‧精度)を検証する ◦ パーソナライズドAI-OCRの「候補抽出」を、LLMに置き換え ◦ 学習済みの推薦モデルによるRerankをかけた上で、パフォーマンスを⽐較
◦ LLMは、Azure OpenAI (GPT系)‧Amazon Bedrock (Claude系) のAPIを利⽤ パーソナライズドAI-OCRの候補抽出をLLMに置き換えて性能検証 候補抽出 (NLPモデル) 候補抽出 (LLM) Rerank (推薦モデル) ⽇付 取引先名 ⾦額 ⽂字起こし (VisionAPI) 書類
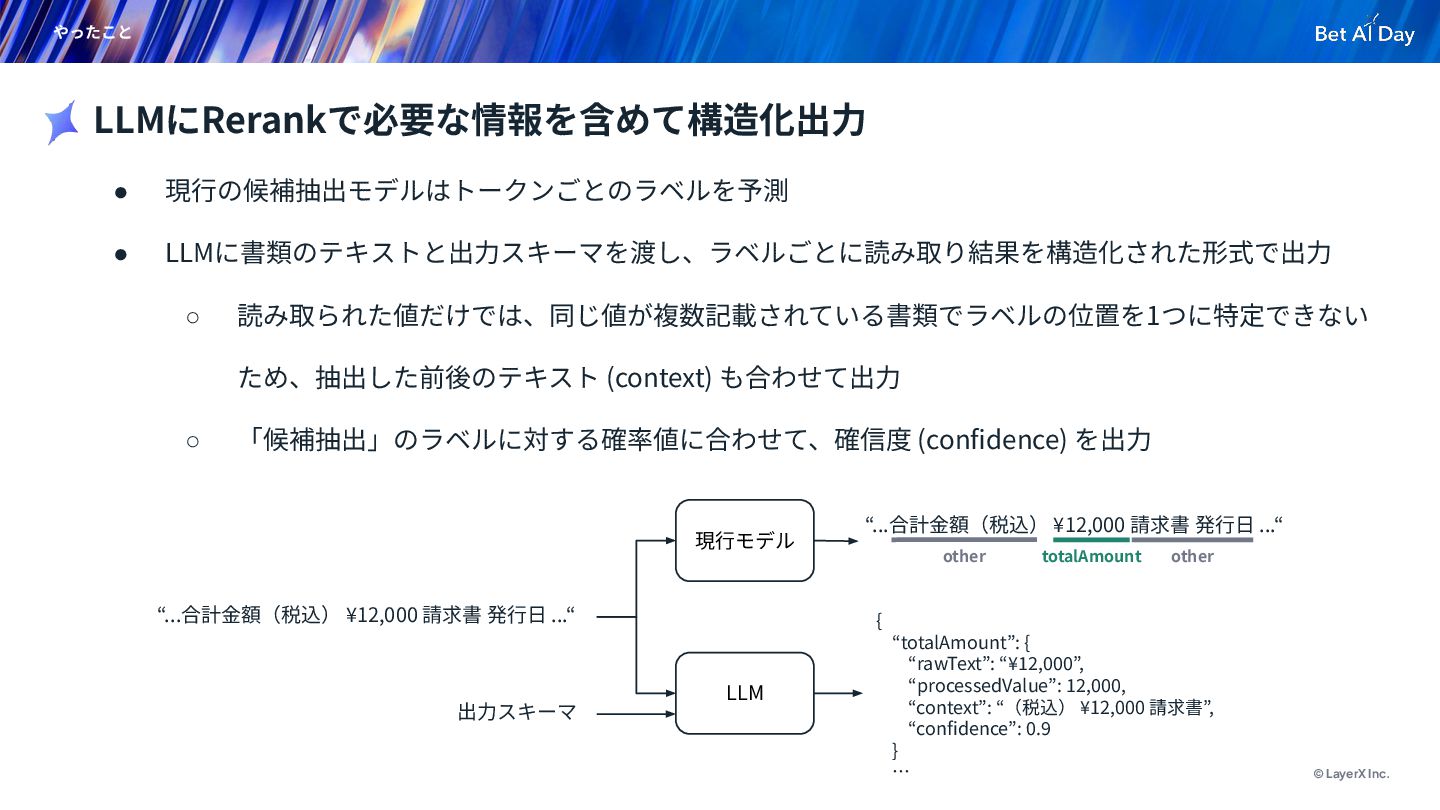
© LayerX Inc. やったこと • 現⾏の候補抽出モデルはトークンごとのラベルを予測 • LLMに書類のテキストと出⼒スキーマを渡し、ラベルごとに読み取り結果を構造化された形式で出⼒ ◦ 読み取られた値だけでは、同じ値が複数記載されている書類でラベルの位置を1つに特定できない
ため、抽出した前後のテキスト (context) も合わせて出⼒ ◦ 「候補抽出」のラベルに対する確率値に合わせて、確信度 (confidence) を出⼒ LLMにRerankで必要な情報を含めて構造化出⼒ “...合計⾦額(税込) ¥12,000 請求書 発⾏⽇ ...“ 現⾏モデル LLM 出⼒スキーマ { “totalAmount”: { “rawText”: “¥12,000”, “processedValue”: 12,000, “context”: “(税込) ¥12,000 請求書”, “confidence”: 0.9 } … totalAmount “...合計⾦額(税込) ¥12,000 請求書 発⾏⽇ ...“ other other
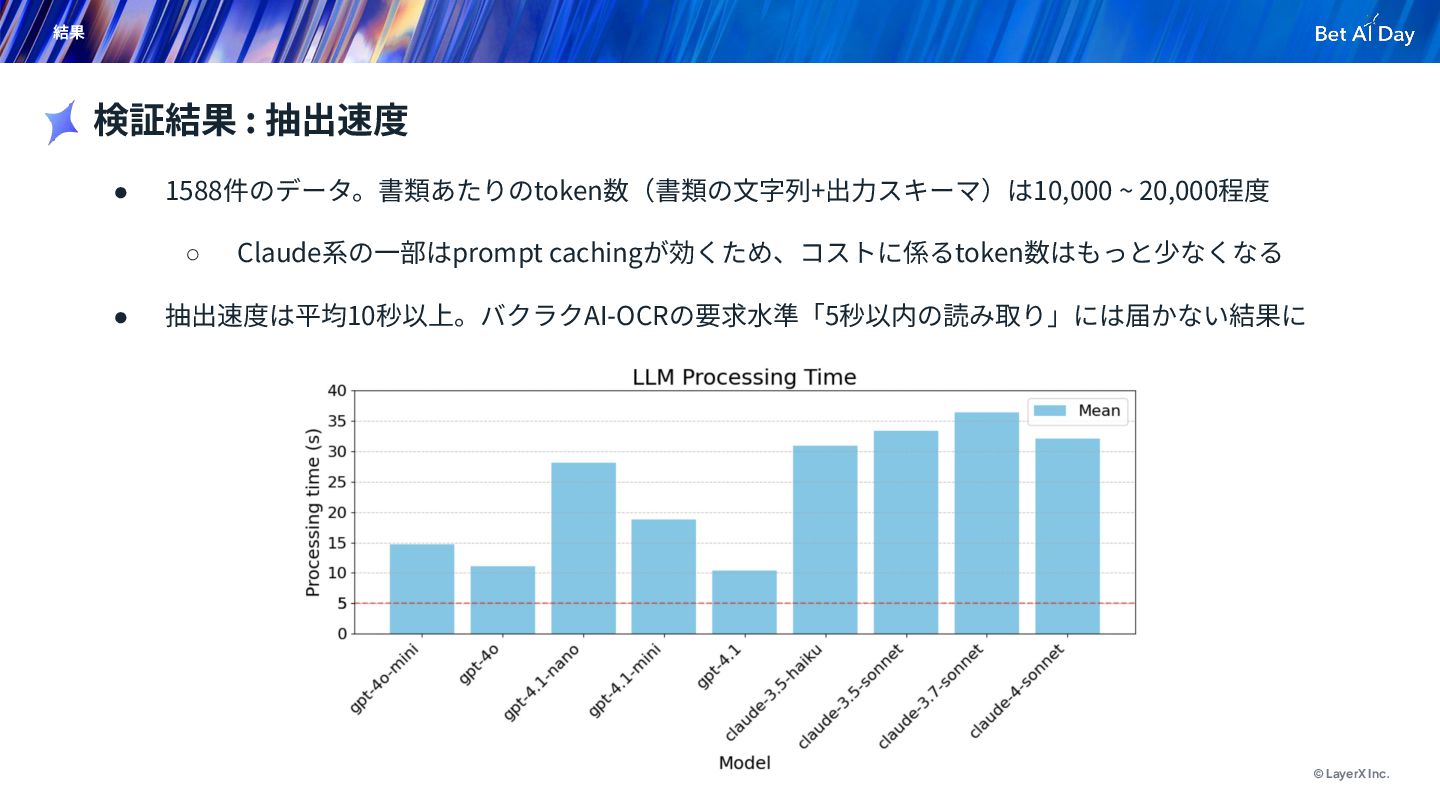
© LayerX Inc. 結果 • 1588件のデータ。書類あたりのtoken数(書類の⽂字列+出⼒スキーマ)は10,000 ~ 20,000程度 ◦ Claude系の⼀部はprompt
cachingが効くため、コストに係るtoken数はもっと少なくなる • 抽出速度は平均10秒以上。バクラクAI-OCRの要求⽔準「5秒以内の読み取り」には届かない結果に 検証結果 : 抽出速度
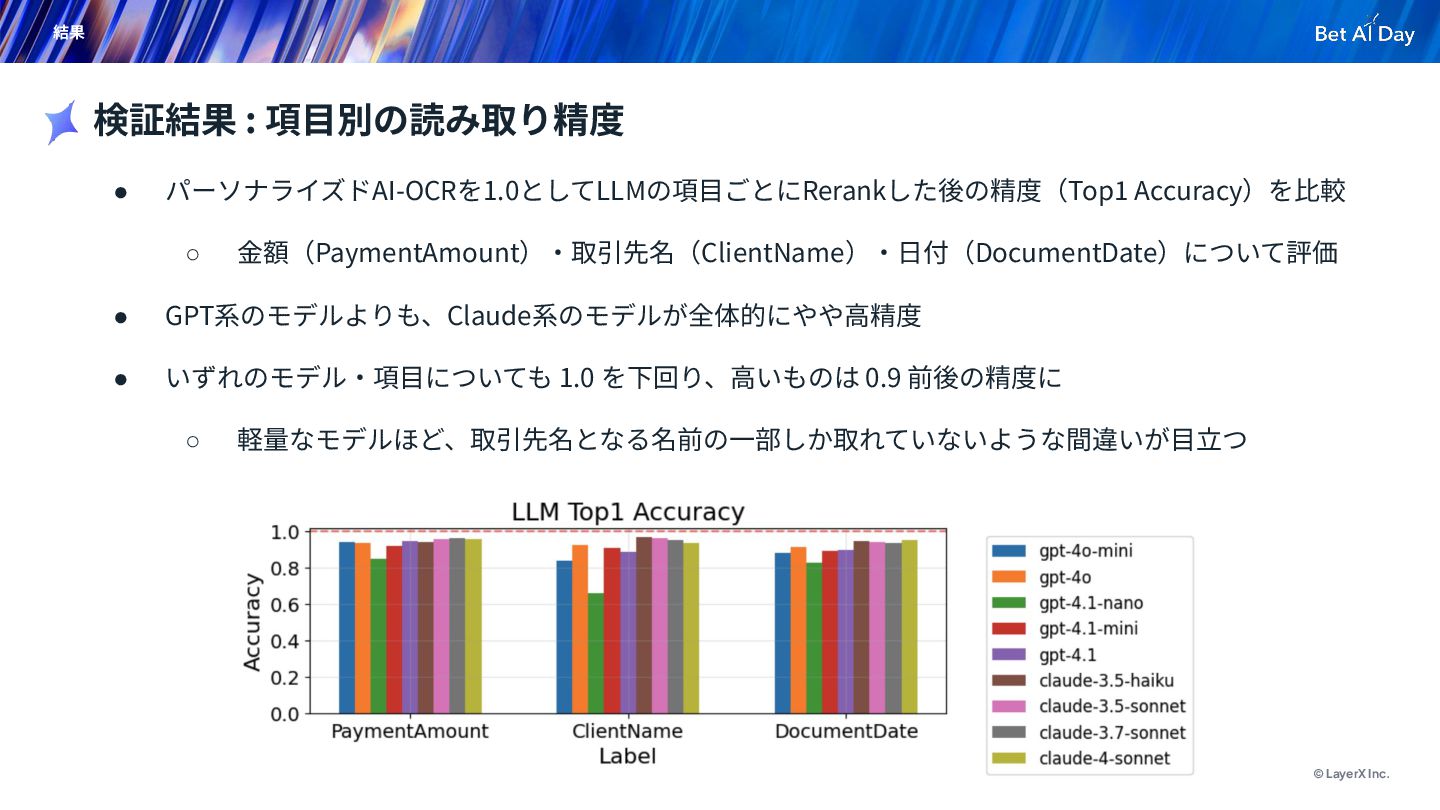
© LayerX Inc. 結果 • パーソナライズドAI-OCRを1.0としてLLMの項⽬ごとにRerankした後の精度(Top1 Accuracy)を⽐較 ◦ ⾦額(PaymentAmount)‧取引先名(ClientName)‧⽇付(DocumentDate)について評価 •
GPT系のモデルよりも、Claude系のモデルが全体的にやや⾼精度 • いずれのモデル‧項⽬についても 1.0 を下回り、⾼いものは 0.9 前後の精度に ◦ 軽量なモデルほど、取引先名となる名前の⼀部しか取れていないような間違いが⽬⽴つ 検証結果 : 項⽬別の読み取り精度
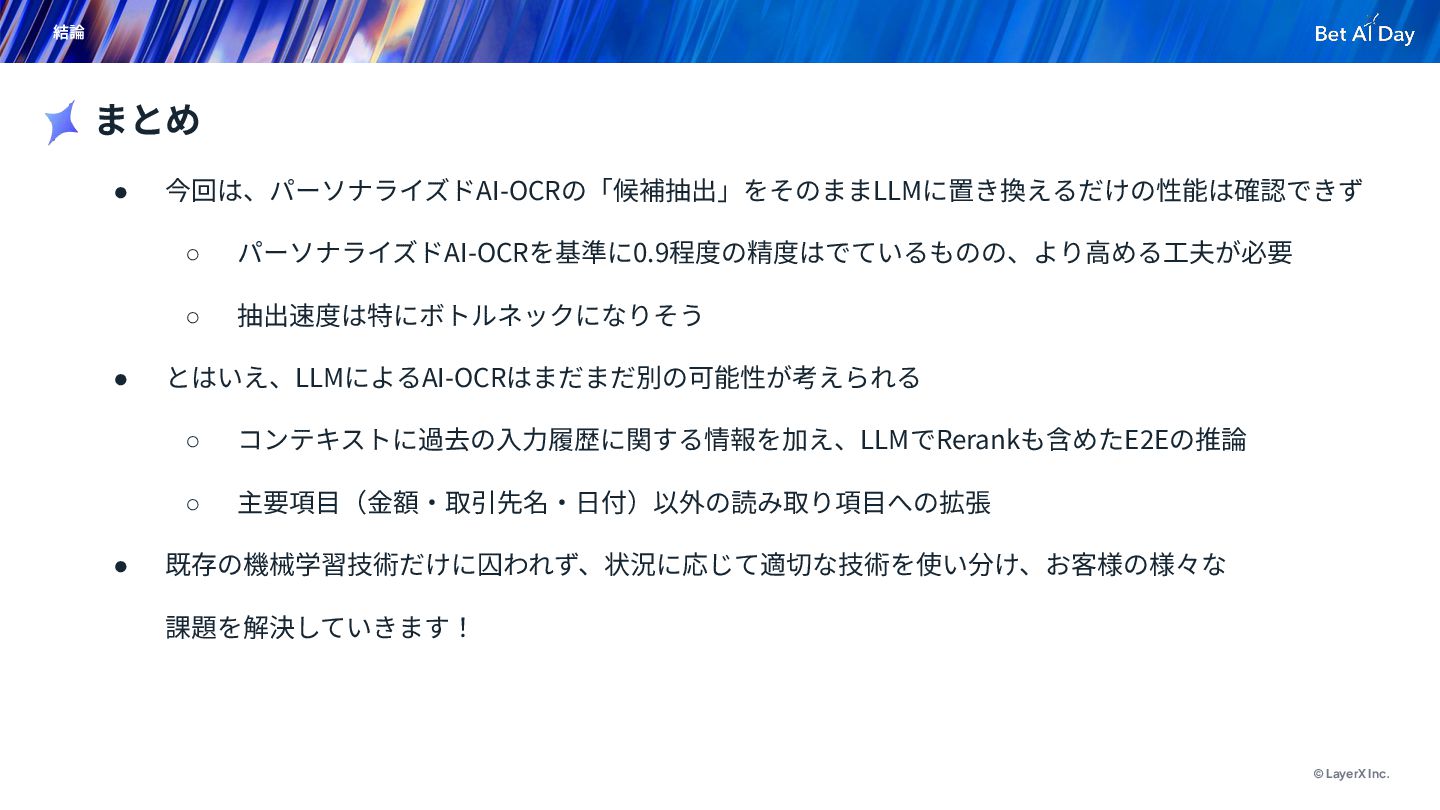
© LayerX Inc. 結論 • 今回は、パーソナライズドAI-OCRの「候補抽出」をそのままLLMに置き換えるだけの性能は確認できず ◦ パーソナライズドAI-OCRを基準に0.9程度の精度はでているものの、より⾼める⼯夫が必要 ◦ 抽出速度は特にボトルネックになりそう
• とはいえ、LLMによるAI-OCRはまだまだ別の可能性が考えられる ◦ コンテキストに過去の⼊⼒履歴に関する情報を加え、LLMでRerankも含めたE2Eの推論 ◦ 主要項⽬(⾦額‧取引先名‧⽇付)以外の読み取り項⽬への拡張 • 既存の機械学習技術だけに囚われず、状況に応じて適切な技術を使い分け、お客様の様々な 課題を解決していきます! まとめ

 SiteGround - Reliable hosting with speed, security, and support you can count on.


 sbrf248
 hiranuma
 lehupa
 ryo_kawamata
 yoshiiryo1
 sraku2159
 tacck
 yug1224
 miu_crescent
 bengo4com
 zozotech
 sh_fk2
 yappli_developers
 rkendrick25
 bkeepers
 kimpetersen
 axbom
 marcoroth
 inesmontani
 philnash
 codingconduct
 jdejongh
 jlugia
 addyosmani
 malarkey