Upgrade to Pro — share decks privately, control downloads, hide ads and more …

LLMの安全なモデル乗り換え戦略!Shadow TestingとA/B検証 - Google ...

Avatar for Shu Kobuchi Shu Kobuchi PRO
September 30, 2026

LLMの安全なモデル乗り換え戦略!Shadow TestingとA/B検証 - Google Cloud × Google ADK で実践するモデル評価・検証基盤と実証知見

新モデルへの即時切り替えによる「プロンプト挙動の変化」「JSON出力の崩れ」「429レート制限」「コスト・レイテンシ悪化」を防ぐため、本番影響ゼロで検証・移行を行う「3段階の防壁アーキテクチャ」と実証知見をまとめた登壇資料です。

Google Cloud と Google Agent Development Kit (ADK) を用いたチャット基盤をベースに、生トラフィックによるモデル比較(Gemini 3.8 Flash / 3.7 Flash / 3.5 Flash Lite)を行った検証結果や、動的ルーティングへの展望を解説しています。

📌 本資料のポイント・アジェンダ
新モデル移行に潜む4つの落とし穴
プロンプト互換性の破壊、出力フォーマット崩れ、プレビュー版の429エラー、予期せぬコスト・遅延増
モデル移行を守る「3段階の防壁」
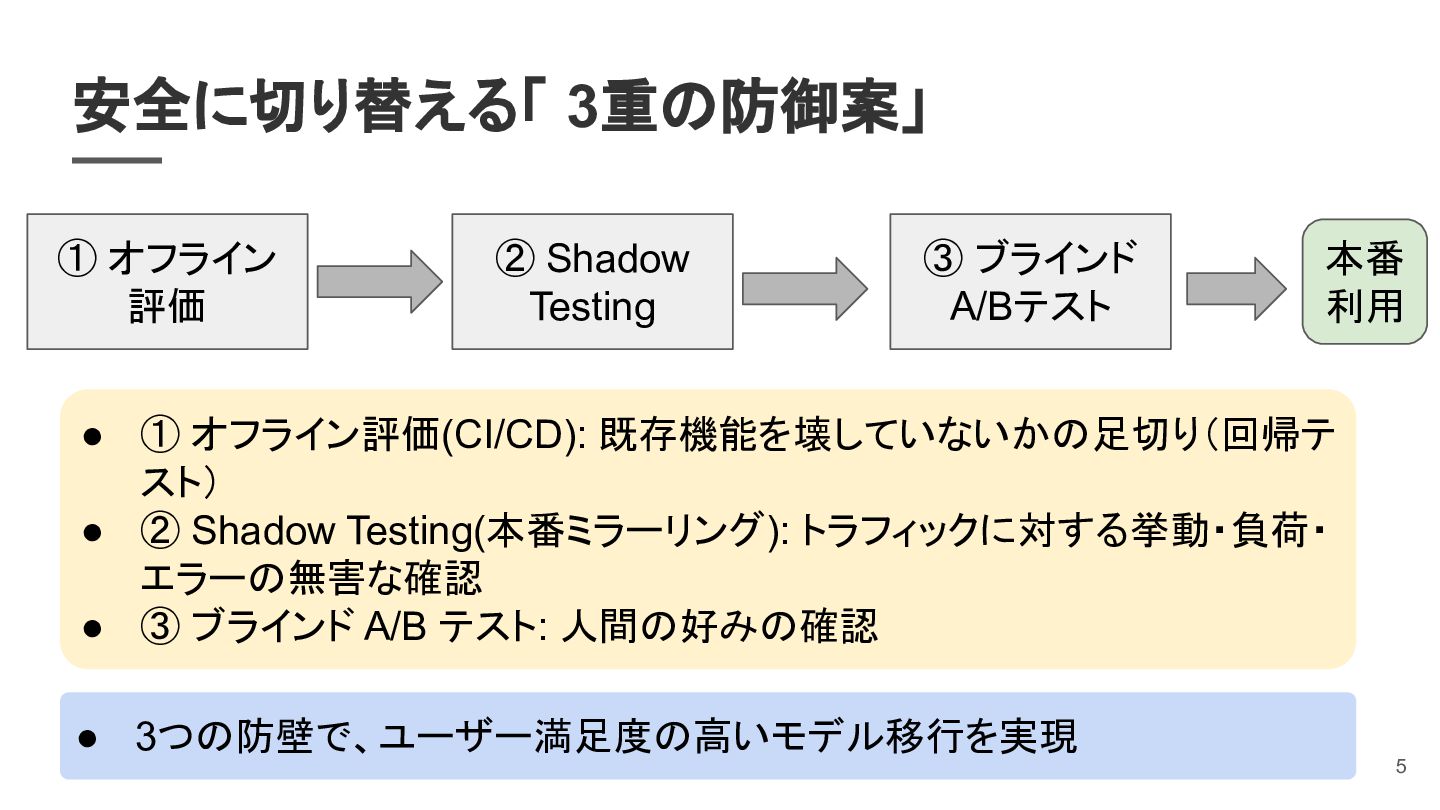
第1の防壁:オフライン評価(ゴールデンデータセットを用いた回帰テスト、ルールベース採点)
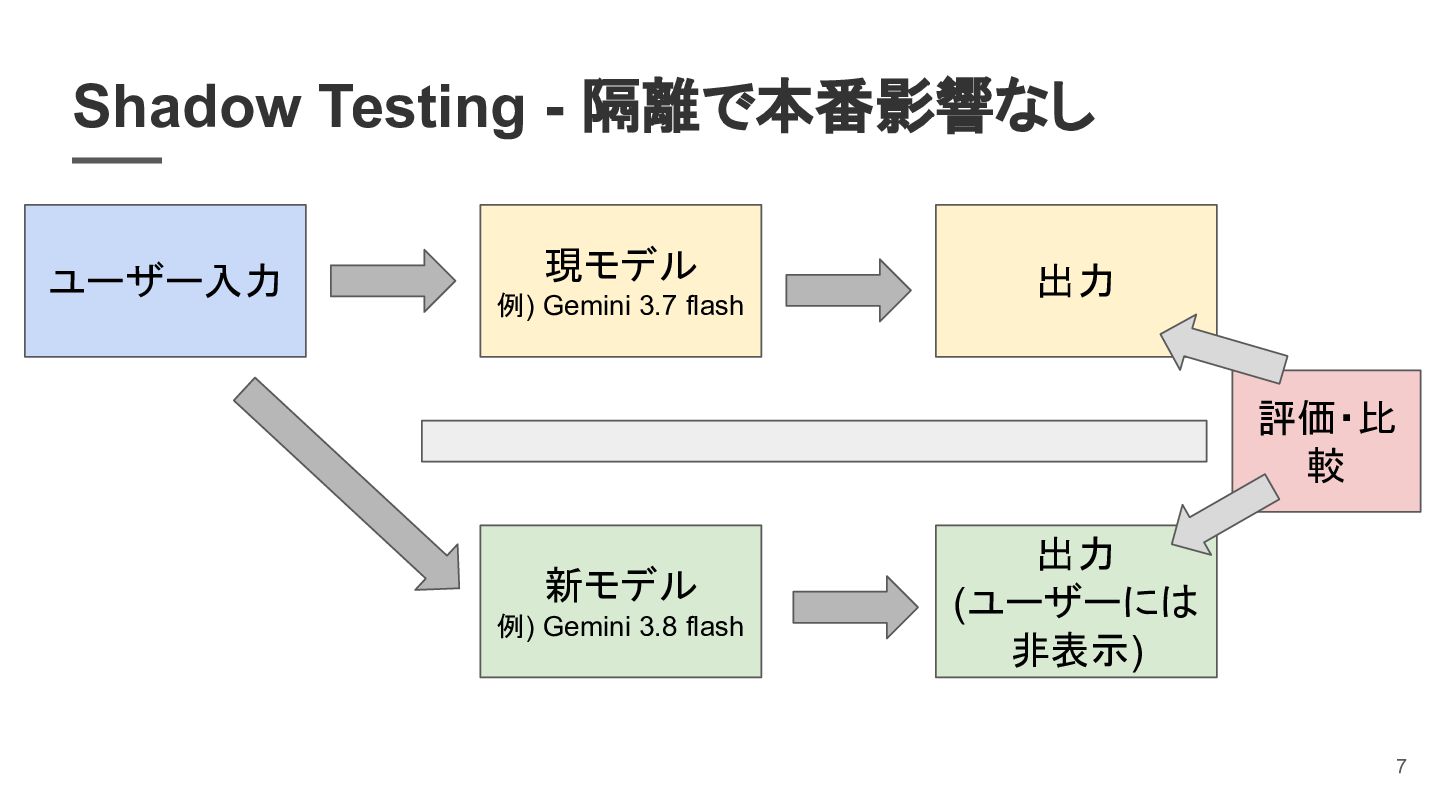
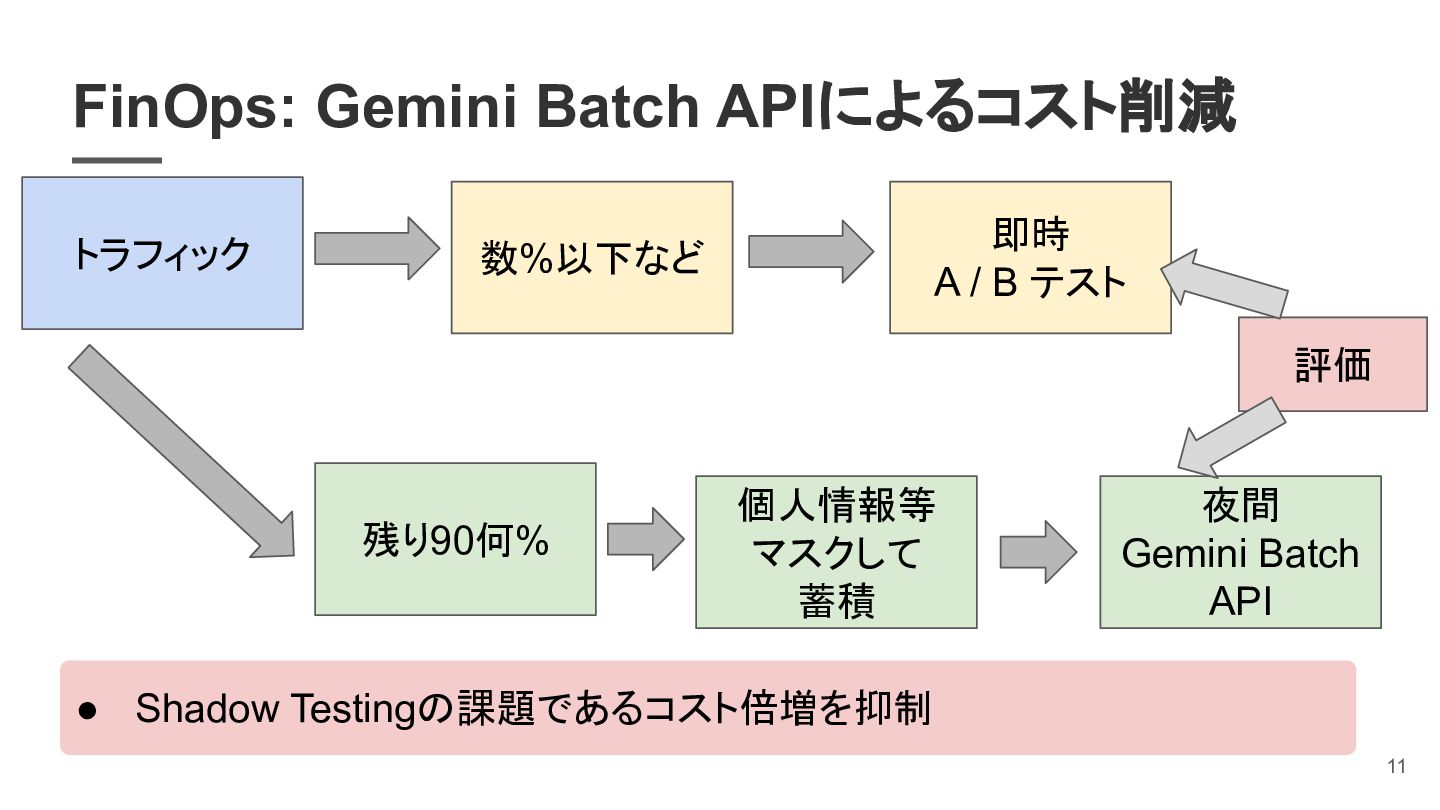
第2の防壁:遅延0msの Shadow Testing(本番ユーザー影響ゼロの非同期ミラーリング、429自動フェイルオーバー、PIIマスキング、Gemini Batch APIによる50%コスト削減)
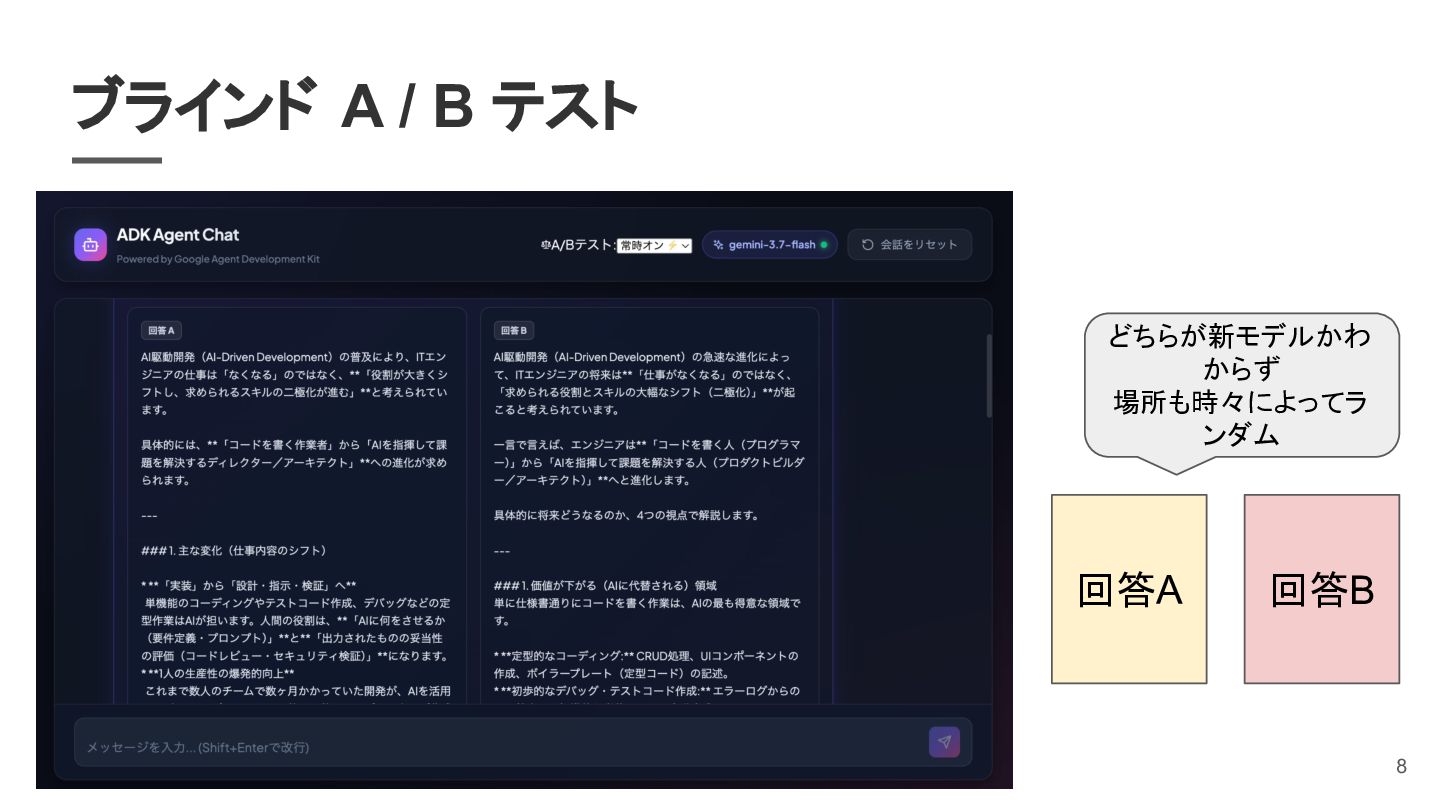
第3の防壁:ブラインド A/B テスト(Chatbot Arena方式による位置バイアス排除、回答後のモデル開示演出)
生トラフィック検証から得られた知見
「最高性能・高コストなモデルが常に勝つとは限らない」実態(相槌・即答性における軽量モデルの優位性と複雑推論での上位モデルの使い分け)
今後の展望:動的モデルルーティング(Contextual Bandit)
意図分類やコンテキストに応じたモデルの自動最適化
開発基盤
Googleの次世代AIコーディング環境「Antigravity」によるバイブコーディング実装

🔗 関連リンク
GitHub リポジトリ(ソースコード・実装):
https://github.com/shu-kob/adk-agent-chat
YouTube 発表アーカイブ(動画):
https://youtube.com/live/T1GN27CgNak
イベント詳細(connpass):
https://genai-users.connpass.com/event/407986/
発表者 X (Twitter):
https://x.com/shu_kob

Avatar for Shu Kobuchi

Shu Kobuchi PRO

September 30, 2026

More Decks by Shu Kobuchi

Other Decks in Technology

Transcript

  1. 自己紹介 小渕 周 (Shu Kobuchi) こぶシュー X: @shu_kob 株式会社スリーシェイク Sreake

    事業部 アプリケーション開発支援チーム マネージャー • Google Cloud, Geminiを用いた生成 AI アプリケーション開発 • 生成AIアプリ開発とSREの真ん中にいる人間 • Google Cloud 認定試験全冠 / Jagu'e'r AI/ML分科会運営メンバー 2
  2. 本日のアジェンダ 1. 2. 3. 4. 5. なぜ「新モデルへの即時切り替え」は危険なのか? 第1の防壁:決定論的アサーションとオフライン評価 第2の防壁:遅延0msの Shadow

    Testing 基盤 第3の防壁:ブラインド A/B テストで起きた「大逆転劇」 最適解:動的ルーティングと FinOps ポイント:新モデルを安全に検証・運用するための設計パターン 3
  3. 現場の悩み: LLMの進化スピード • LLM進化の速さ ◦ Gemini 3.5 → 3.6 →

    3.7 → 3.8 と新モデル連発 ◦ 公開ベンチマークでSoTA(State-of-the-Art:世界最高記録) ▪ → 今すぐ使用モデルを差し替えたい、という誘惑 • 即時切り替えで本番に起きるトラブル ◦ プロンプトの利き方が変わり、JSON出力構造などの崩れ ◦ 期待する回答とのズレ ◦ レート制限(429 Quota Exhaunted)や推論増によるレイテンシ増 4
  4. 安全に切り替える「 3重の防御案」 ① オフライン 評価 ② Shadow Testing ③ ブラインド

    A/Bテスト 本番 利用 • ① オフライン評価(CI/CD): 既存機能を壊していないかの足切り(回帰テ スト) • ② Shadow Testing(本番ミラーリング): トラフィックに対する挙動・負荷・ エラーの無害な確認 • ③ ブラインド A/B テスト: 人間の好みの確認 • 3つの防壁で、ユーザー満足度の高いモデル移行を実現 5
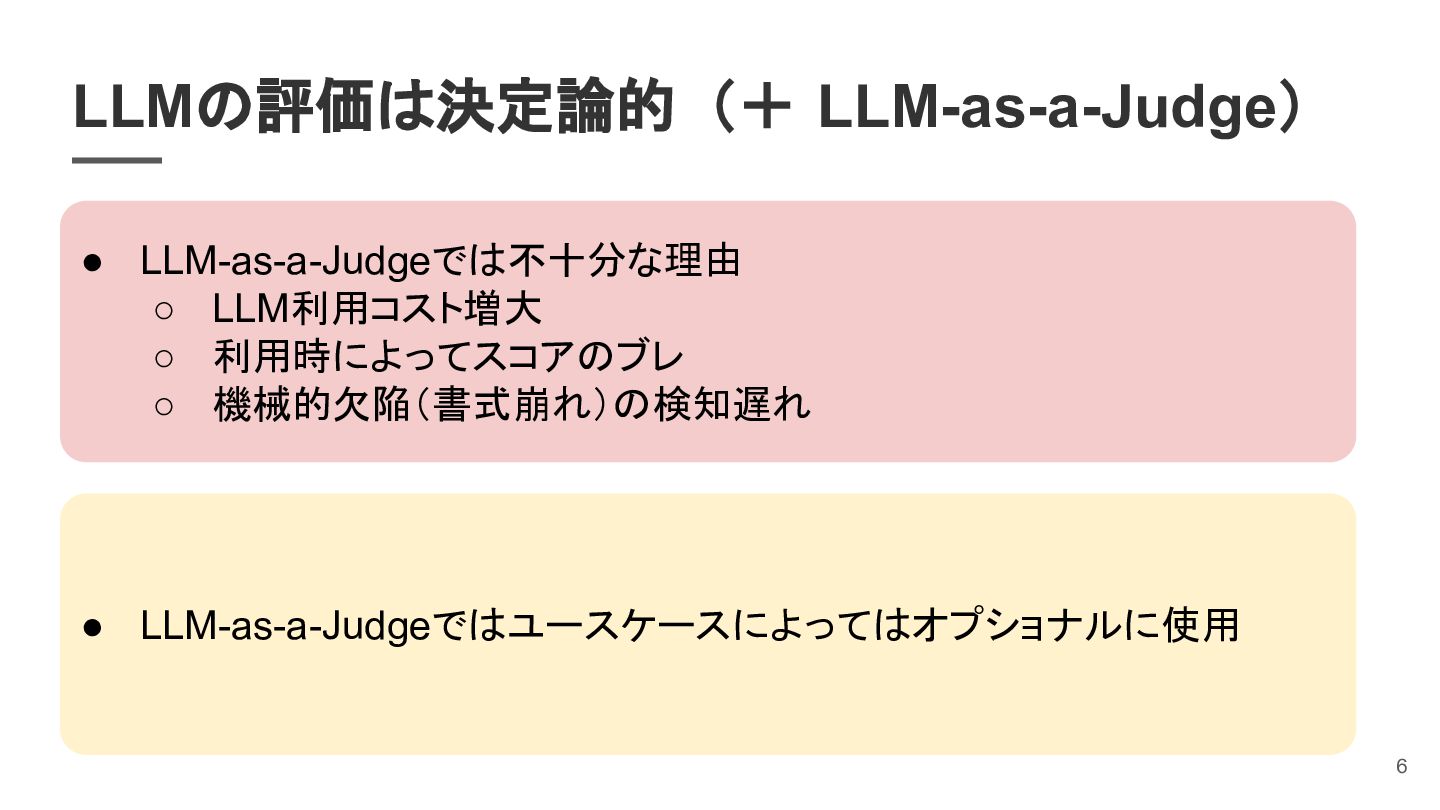
  5. LLMの評価は決定論的 (+ LLM-as-a-Judge) • LLM-as-a-Judgeでは不十分な理由 ◦ LLM利用コスト増大 ◦ 利用時によってスコアのブレ ◦

    機械的欠陥(書式崩れ)の検知遅れ • LLM-as-a-Judgeではユースケースによってはオプショナルに使用 6
  6. Shadow Testing - 隔離で本番影響なし ユーザー入力 現モデル 例) Gemini 3.7 flash

    出力 評価・比 較 新モデル 例) Gemini 3.8 flash 出力 (ユーザーには 非表示) 7
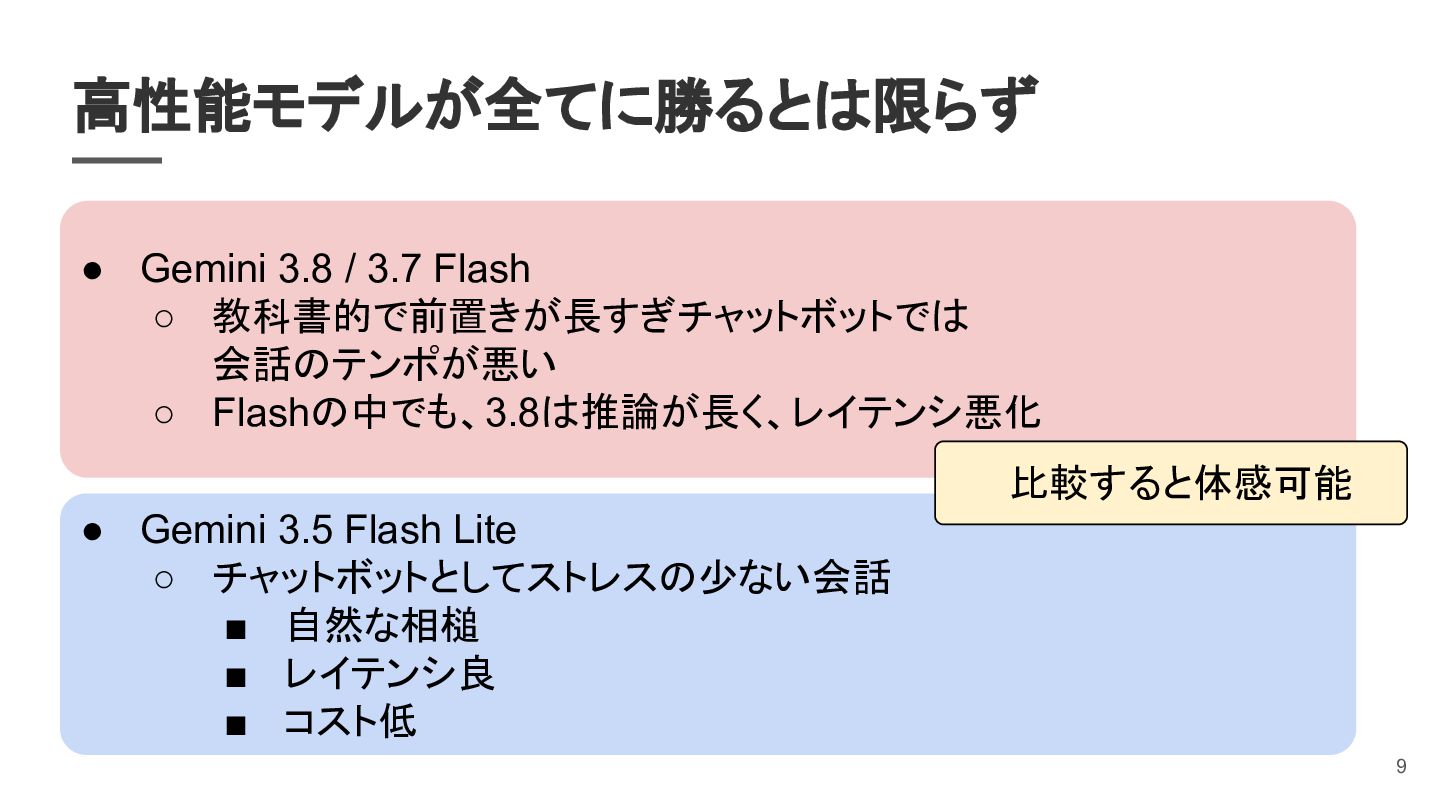
  7. 高性能モデルが全てに勝るとは限らず • Gemini 3.8 / 3.7 Flash ◦ 教科書的で前置きが長すぎチャットボットでは 会話のテンポが悪い

    ◦ Flashの中でも、3.8は推論が長く、レイテンシ悪化 比較すると体感可能 • Gemini 3.5 Flash Lite ◦ チャットボットとしてストレスの少ない会話 ▪ 自然な相槌 ▪ レイテンシ良 ▪ コスト低 9
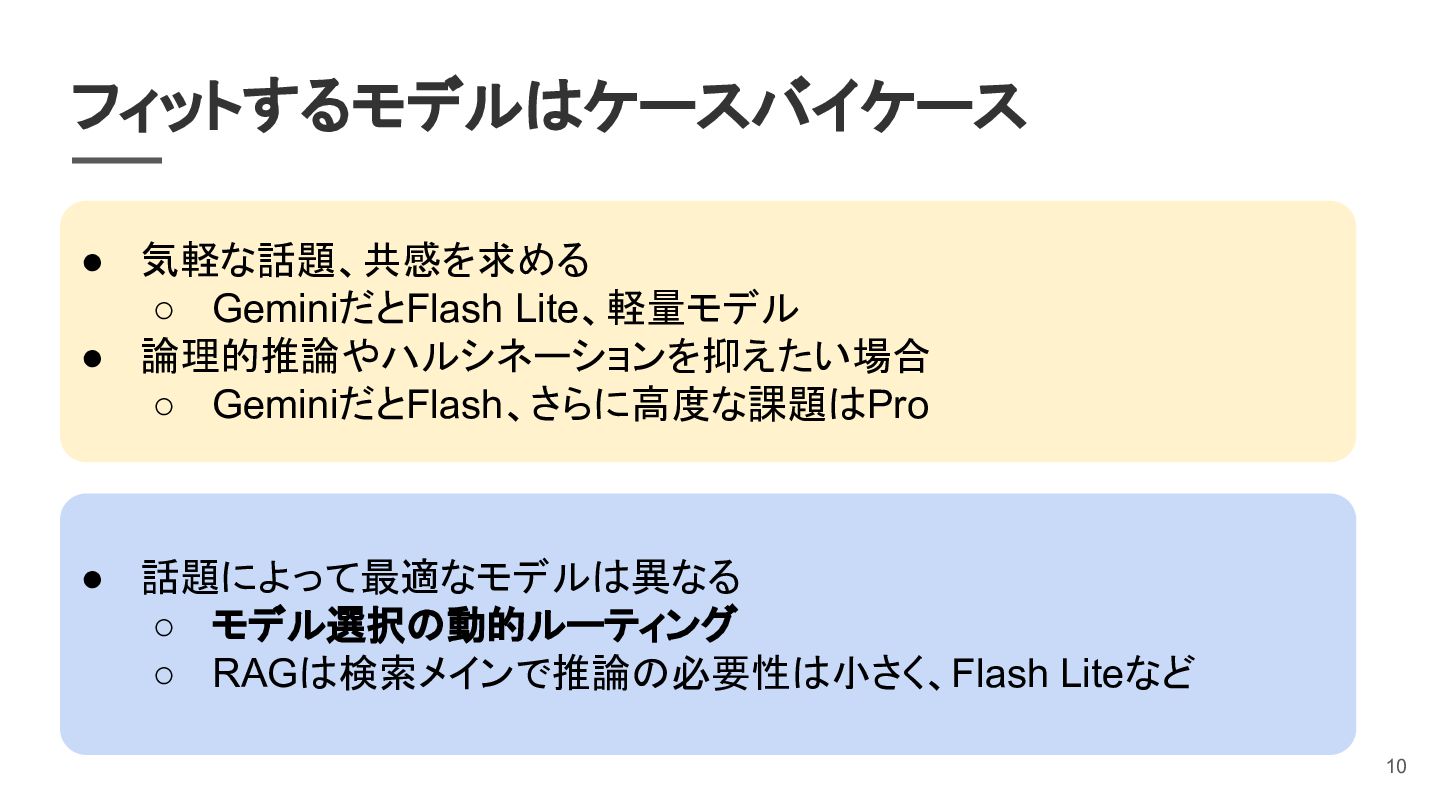
  8. フィットするモデルはケースバイケース • 気軽な話題、共感を求める ◦ GeminiだとFlash Lite、軽量モデル • 論理的推論やハルシネーションを抑えたい場合 ◦ GeminiだとFlash、さらに高度な課題はPro

    • 話題によって最適なモデルは異なる ◦ モデル選択の動的ルーティング ◦ RAGは検索メインで推論の必要性は小さく、Flash Liteなど 10
  9. FinOps: Gemini Batch APIによるコスト削減 トラフィック 即時 A / B テスト

    数%以下など 評価 残り90何% 個人情報等 マスクして 蓄積 夜間 Gemini Batch API • Shadow Testingの課題であるコスト倍増を抑制 11