Upgrade to Pro
— share decks privately, control downloads, hide ads and more …
Speaker Deck
Sign up for free
Menu
Search
Features
All features
Private URLs
Password Protection
Custom URLS
Scheduled publishing
Remove Branding
Restrict embedding
Deck Collections
Notes
Features
All features
Private URLs
Password Protection
Custom URLS
Scheduled publishing
Remove Branding
Restrict embedding
Deck Collections
Notes
Explore
Featured decks
Featured speakers
Programming
Technology
Storyboards
Explore
Featured decks
Featured speakers
Programming
Technology
Storyboards
Pricing
Search
Sign in
Sign up for free
LLMチャットボットの評価モデル
Search
Sponsored
·
Your Podcast. Everywhere. Effortlessly.
Share. Educate. Inspire. Entertain. You do you. We'll handle the rest.
→
Shinsuke Matsuki(snsk)
January 20, 2025
Technology
40
0
Share
Embed
Copy iframe code
Copy JS code
Copy link
Start on current slide
LLMチャットボットの評価モデル
Shinsuke Matsuki(snsk)
January 20, 2025
More Decks by Shinsuke Matsuki(snsk)
See All by Shinsuke Matsuki(snsk)
品質定義の組織レベル
snsk
0
71
メタモルフィックテスティングでMBT気分
snsk
0
29
ゲームのテスト設計のチャレンジ
snsk
0
65
JSTQB Conference2023 基調講演2
snsk
0
28
Other Decks in Technology
See All in Technology
高負荷プロダクション環境におけるAWS Lambdaのリアル 〜スケールとコストを左右する実行ライフサイクルの技術仕様〜
maimyyym
2
600
Claude Codeを「使うほど育つ」AI秘書にするノウハウ
minorun365
PRO
33
32k
「今盗んで、後で解く」に備える ― AWSのポスト量子暗号入門
yama3133
2
240
AgentCore Runtime上にAgentic Coding基盤を構築・展開する際の設計ポイントと限界点 / Design considerations and limitations when building an agentic coding platform on AgentCore Runtime
har1101
6
760
What the customer really needed
kawaguti
PRO
3
230
ボードゲームの遊び相手をFoundation Modelsで作る / iOSDC Japan 2026
genda
0
180
spanner-autoscalerに学ぶ CRD設計パターン 〜自動化と緊急時対応を両立する Kubernetesコントローラーの作り方〜
tkuchiki
0
100
品質と信頼性を地続きにする
grimoh
2
1k
AI coding 整合正規方法
philipz
0
550
顧客に向き合う開発組織へ。リアーキテクチャとフィーチャーチーム化で挑む組織改革
safie
0
2.5k
バイブコーディング時代のWebアプリ開発入門~Cloud Runで学ぶセキュアなビルドとデプロイ
waiwai2111
1
150
Kiro Meetup #8 Kiro アップデート (2026/3/21〜2026/9/24)
katzueno
1
220
Featured
See All Featured
Writing Fast Ruby
sferik
630
63k
Producing Creativity
orderedlist
PRO
348
41k
The innovator’s Mindset - Leading Through an Era of Exponential Change - McGill University 2025
jdejongh
PRO
1
340
Impact Scores and Hybrid Strategies: The future of link building
tamaranovitovic
0
440
A better future with KSS
kneath
240
18k
VelocityConf: Rendering Performance Case Studies
addyosmani
331
25k
The AI Revolution Will Not Be Monopolized: How open-source beats economies of scale, even for LLMs
inesmontani
PRO
3
3.7k
16th Malabo Montpellier Forum Presentation
akademiya2063
PRO
0
390
How to Get Subject Matter Experts Bought In and Actively Contributing to SEO & PR Initiatives.
livdayseo
0
200
[Rails World 2026] Durable orchestration on Rails: from continuation to workflow
palkan
1
320
Everyday Curiosity
cassininazir
0
330
AI: The stuff that nobody shows you
jnunemaker
PRO
10
1.1k
Transcript
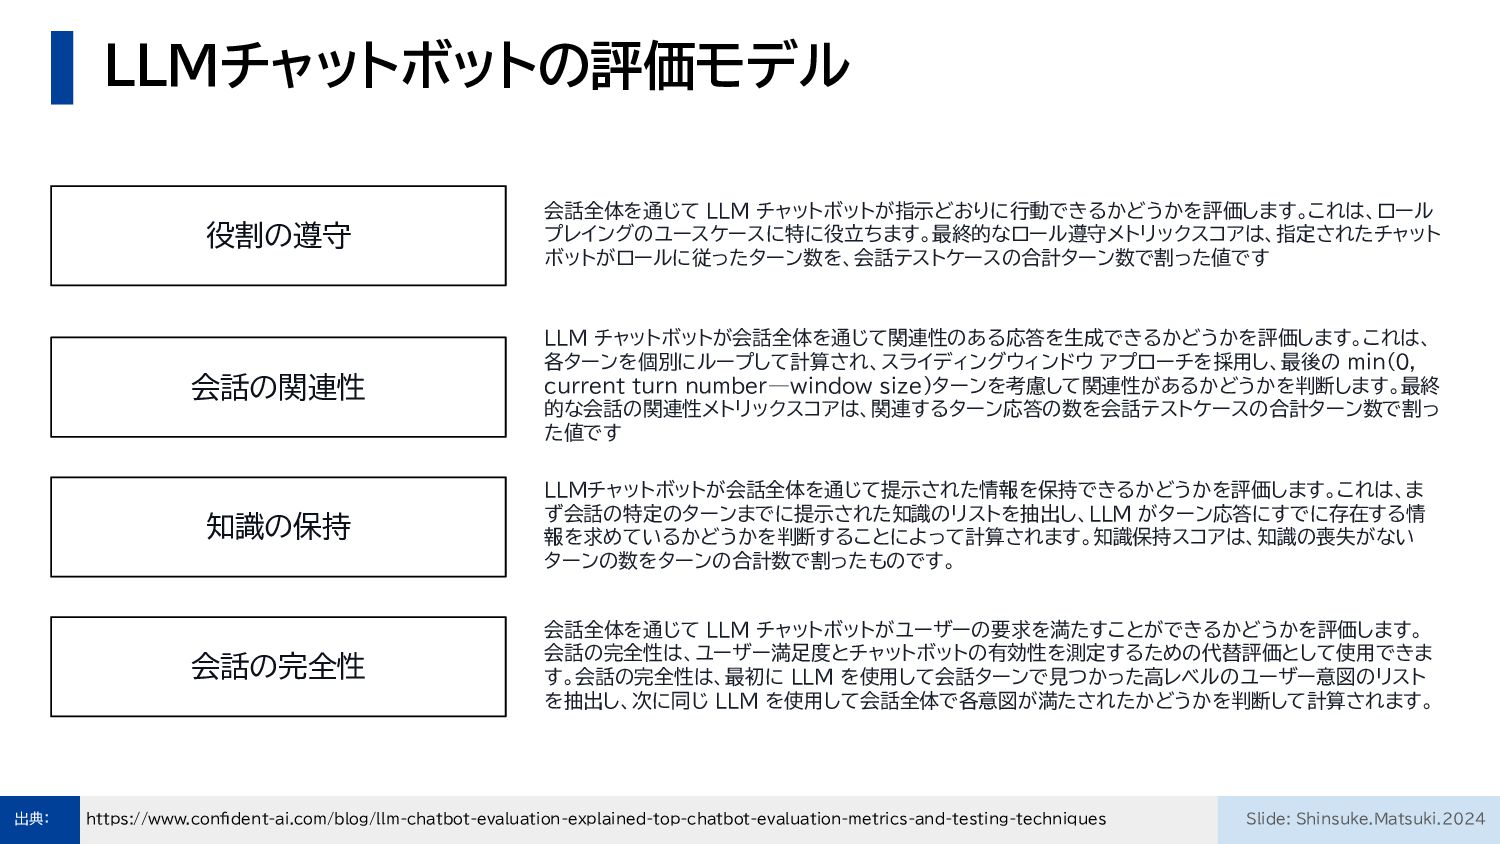
LLMチャットボットの評価モデル https://www.confident-ai.com/blog/llm-chatbot-evaluation-explained-top-chatbot-evaluation-metrics-and-testing-techniques 出典: 役割の遵守 会話の関連性 知識の保持 会話の完全性 会話全体を通じて LLM チャットボットが指示どおりに行動できるかどうかを評価します。これは、ロール
プレイングのユースケースに特に役立ちます。最終的なロール遵守メトリックスコアは、指定されたチャット ボットがロールに従ったターン数を、会話テストケースの合計ターン数で割った値です LLM チャットボットが会話全体を通じて関連性のある応答を生成できるかどうかを評価します。これは、 各ターンを個別にループして計算され、スライディングウィンドウ アプローチを採用し、最後の min(0, current turn number — window size)ターンを考慮して関連性があるかどうかを判断します。最終 的な会話の関連性メトリックスコアは、関連するターン応答の数を会話テストケースの合計ターン数で割っ た値です LLMチャットボットが会話全体を通じて提示された情報を保持できるかどうかを評価します。これは、ま ず会話の特定のターンまでに提示された知識のリストを抽出し、LLM がターン応答にすでに存在する情 報を求めているかどうかを判断することによって計算されます。知識保持スコアは、知識の喪失がない ターンの数をターンの合計数で割ったものです。 会話全体を通じて LLM チャットボットがユーザーの要求を満たすことができるかどうかを評価します。 会話の完全性は、ユーザー満足度とチャットボットの有効性を測定するための代替評価として使用できま す。会話の完全性は、最初に LLM を使用して会話ターンで見つかった高レベルのユーザー意図のリスト を抽出し、次に同じ LLM を使用して会話全体で各意図が満たされたかどうかを判断して計算されます。 Slide: Shinsuke.Matsuki.2024
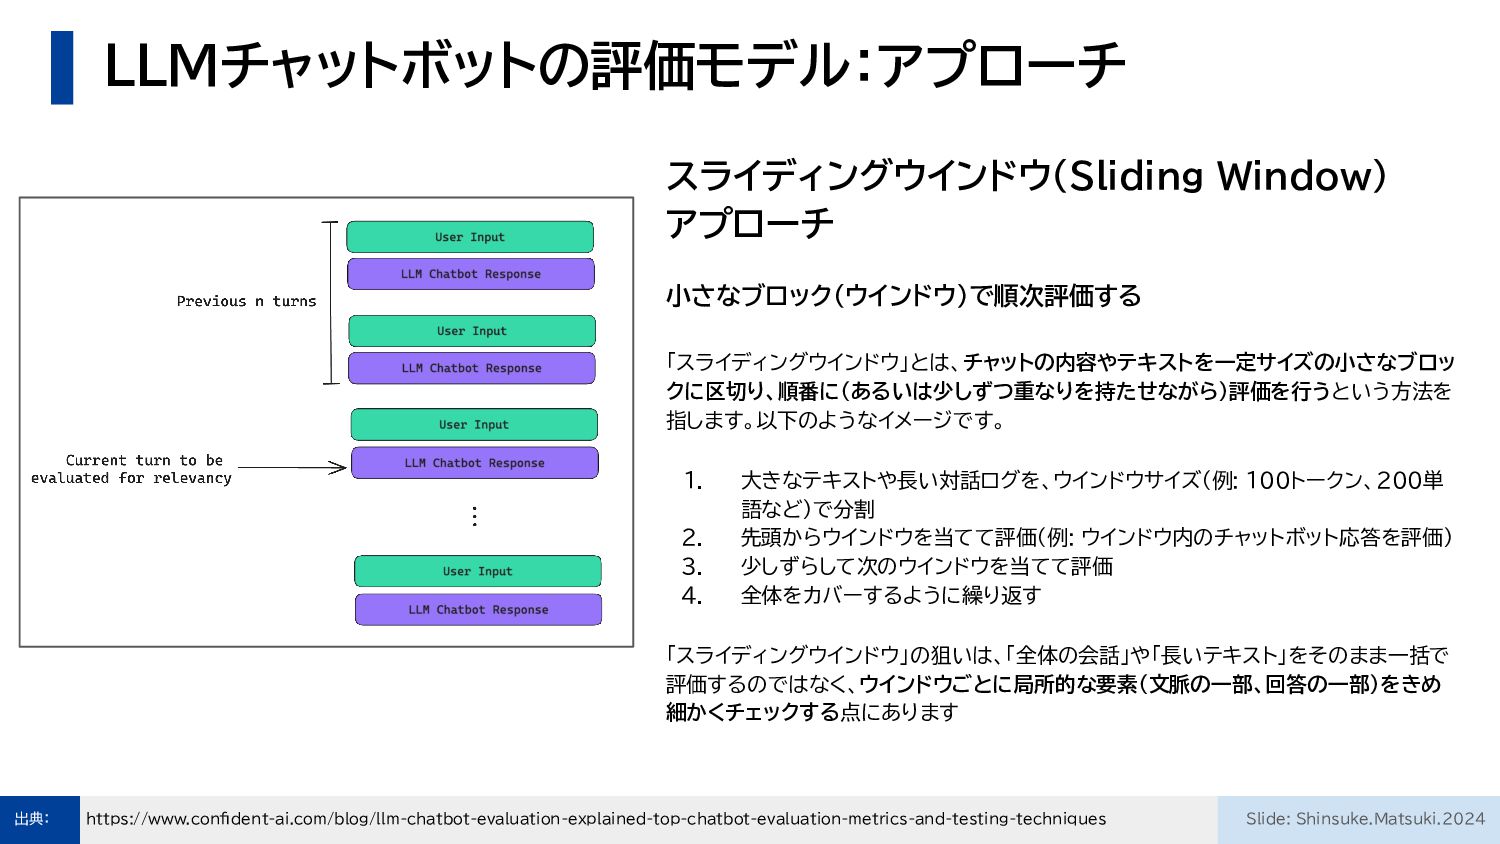
LLMチャットボットの評価モデル:アプローチ https://www.confident-ai.com/blog/llm-chatbot-evaluation-explained-top-chatbot-evaluation-metrics-and-testing-techniques 出典: Slide: Shinsuke.Matsuki.2024 スライディングウインドウ(Sliding Window) アプローチ 小さなブロック(ウインドウ)で順次評価する 「スライディングウインドウ」とは、チャットの内容やテキストを一定サイズの小さなブロッ
クに区切り、順番に(あるいは少しずつ重なりを持たせながら)評価を行うという方法を 指します。以下のようなイメージです。 1. 大きなテキストや長い対話ログを、ウインドウサイズ(例: 100トークン、200単 語など)で分割 2. 先頭からウインドウを当てて評価(例: ウインドウ内のチャットボット応答を評価) 3. 少しずらして次のウインドウを当てて評価 4. 全体をカバーするように繰り返す 「スライディングウインドウ」の狙いは、「全体の会話」や「長いテキスト」をそのまま一括で 評価するのではなく、ウインドウごとに局所的な要素(文脈の一部、回答の一部)をきめ 細かくチェックする点にあります
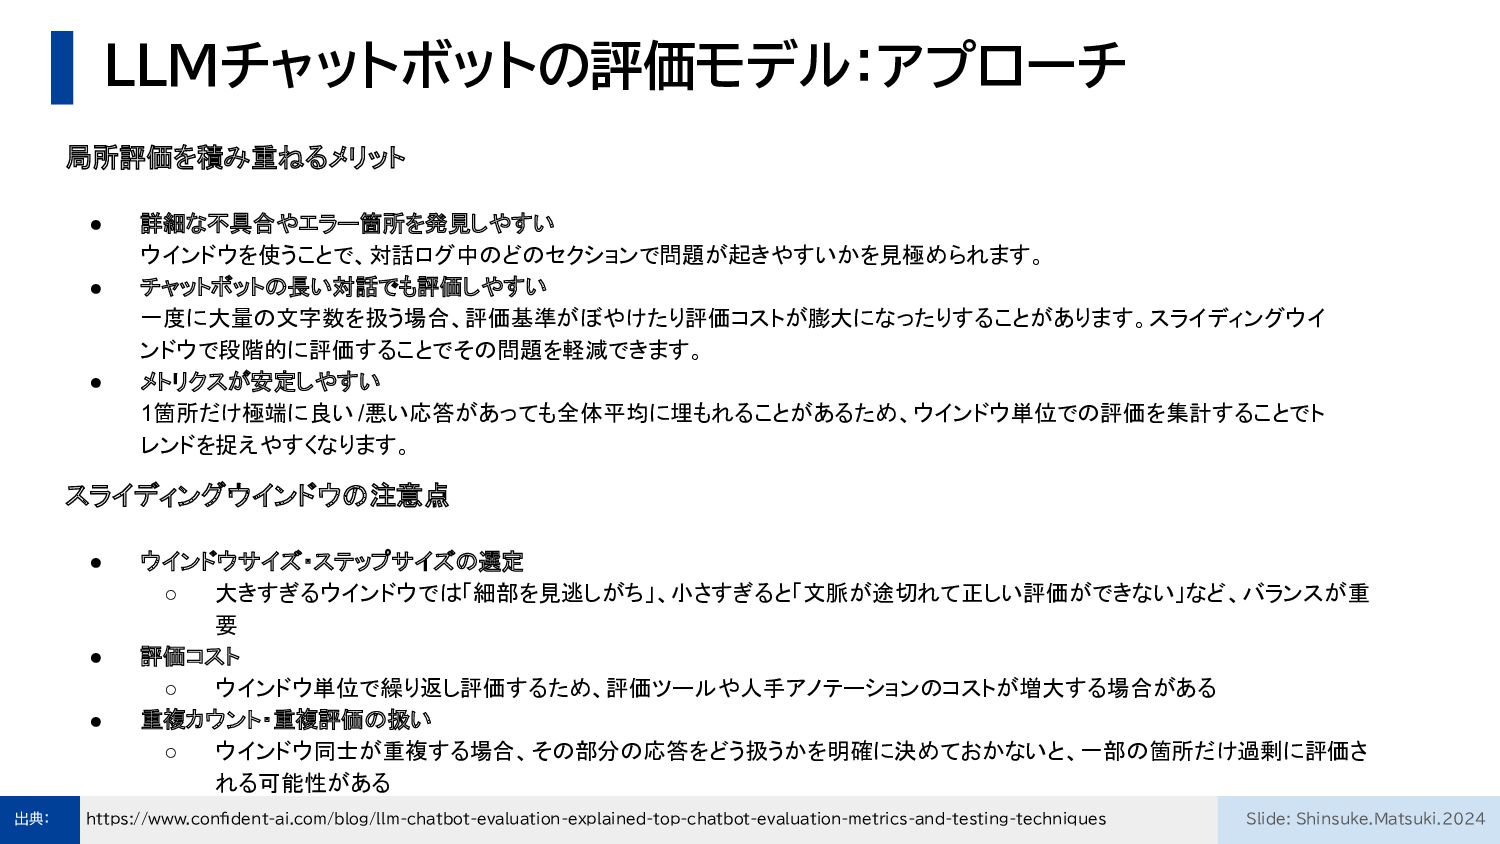
LLMチャットボットの評価モデル:アプローチ https://www.confident-ai.com/blog/llm-chatbot-evaluation-explained-top-chatbot-evaluation-metrics-and-testing-techniques 出典: Slide: Shinsuke.Matsuki.2024 局所評価を積み重ねるメリット • 詳細な不具合やエラー箇所を発見しやすい ウインドウを使うことで、対話ログ中のどのセクションで問題が起きやすいかを見極められます。 •
チャットボットの長い対話でも評価しやすい 一度に大量の文字数を扱う場合、評価基準がぼやけたり評価コストが膨大になったりすることがあります。スライディングウイ ンドウで段階的に評価することでその問題を軽減できます。 • メトリクスが安定しやすい 1箇所だけ極端に良い /悪い応答があっても全体平均に埋もれることがあるため、ウインドウ単位での評価を集計することでト レンドを捉えやすくなります。 スライディングウインドウの注意点 • ウインドウサイズ・ステップサイズの選定 ◦ 大きすぎるウインドウでは「細部を見逃しがち」、小さすぎると「文脈が途切れて正しい評価ができない」など、バランスが重 要 • 評価コスト ◦ ウインドウ単位で繰り返し評価するため、評価ツールや人手アノテーションのコストが増大する場合がある • 重複カウント・重複評価の扱い ◦ ウインドウ同士が重複する場合、その部分の応答をどう扱うかを明確に決めておかないと、一部の箇所だけ過剰に評価さ れる可能性がある


 snsk
 maimyyym
 minorun365
 yama3133
 har1101
 kawaguti
 genda
 tkuchiki
 grimoh
 philipz
 safie
 waiwai2111
 katzueno
 sferik
 orderedlist
 jdejongh
 tamaranovitovic
 kneath
 addyosmani
 inesmontani
 akademiya2063
 livdayseo
 palkan
 cassininazir
 jnunemaker