[Kotlin Fest 2026] eBPF Tracing for Kotlin
Sponsored
·
 Your Podcast. Everywhere. Effortlessly.
Share. Educate. Inspire. Entertain. You do you. We'll handle the rest.
→
Your Podcast. Everywhere. Effortlessly.
Share. Educate. Inspire. Entertain. You do you. We'll handle the rest.
→

Share
Embed
[Kotlin Fest 2026] eBPF Tracing for Kotlin
Kotlin Fest 2026で話したeBPFを利用した自動計装に関する話の資料です
https://2026.kotlinfest.dev/sessions/session-06
https://github.com/takehaya/obi-kotlin-coroutine-poc

Takeru Hayasaka
November 13, 2026
Transcript
55 slides
-
$whoami 早坂 彪流 (Hayasaka Takeru) • 社会人6年目 • Senior Software
Engineer at SAKURA internet Inc. • さくらインターネット研究所所属 • https://research.sakura.ad.jp/members/takemio • NWとSystemSoftware領域の研究などをしている • さくらONEというGPUスパコンの運用もやっている • 趣味: eBPF、自宅インフラ • Co-Organizer of the eBPF Japan Meetup • https://speakerdeck.com/takehaya X: @takemioIO | @gtpv2 github: takehaya 2 -
今回の目的 • Kotlin のアプリケーションの振る舞いを観測したい! • だがソースコードには手を入れたくない! • このプレゼンでは、eBPF を使って Kotlin
アプリケーションの 内部を覗くことにより、これを実現します • つまり…eBPFで 「Kotlinを愛でて 」しまおう!ということかも しれません • ジー < … 3 -
目次 1. なぜ計測をするのか? 2. eBPFとは? 3. Kotlinをどう計測するか? 4. 現代のスレッドモデルで計測する難しさ 5.
トレースの繋ぎ直し 6. 手法の限界とまとめ 4 -
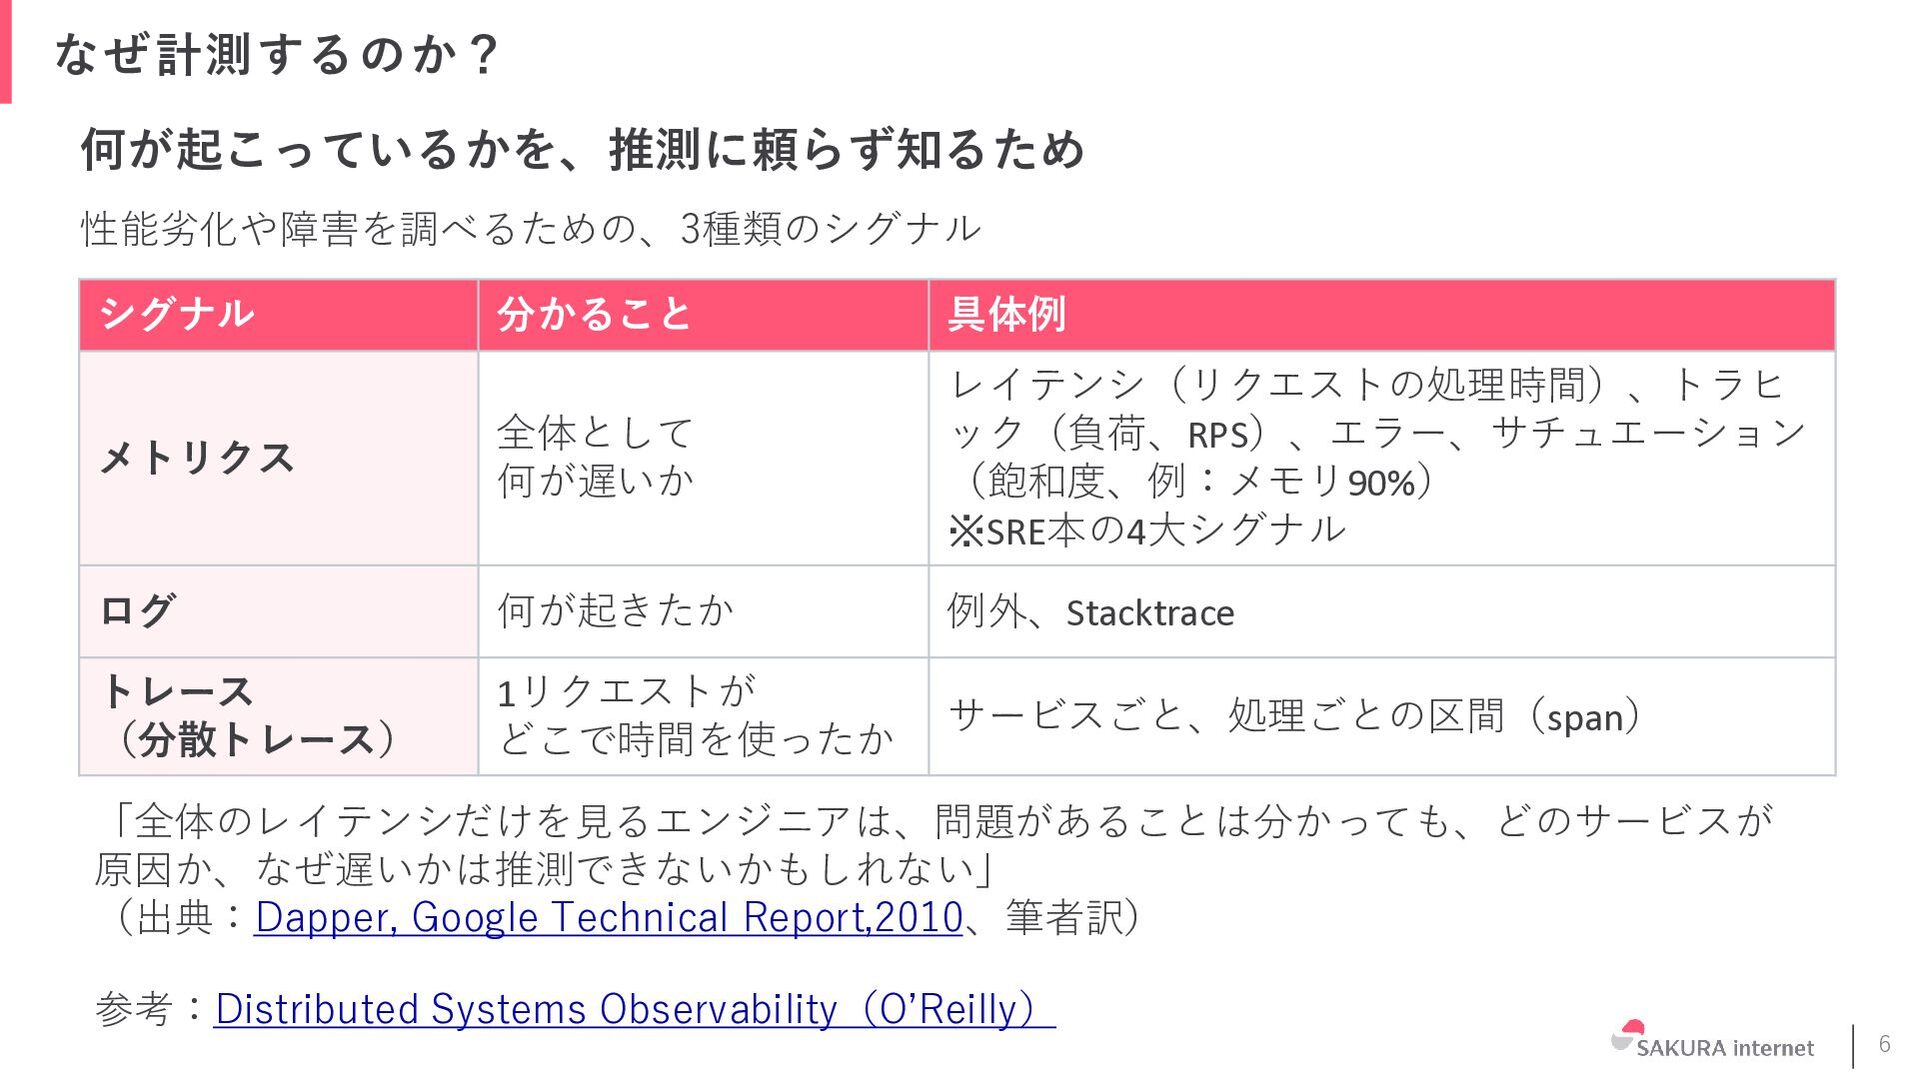
なぜ計測するのか? 例えば複数サービスをまたがるシステムで障害が起こったとき、どこで何が 起こっているか知りたい! シグナル 分かること 具体例 メトリクス 全体として 何が遅いか レイテンシ(リクエストの処理時間)、トラヒ
ック(負荷、RPS)、エラー、サチュエーション (飽和度、例:メモリ90%) ログ 何が起きたか 例外、Stacktrace トレース (分散トレース) 1リクエストが どこで時間を使ったか サービスごと、処理ごとの区間(span) 「全体のレイテンシだけを見るエンジニアは、問題があることは分かっても、どのサービスが 原因か、なぜ遅いかは推測できないかもしれない」 (出典:Dapper, Google Technical Report,2010、筆者訳) 参考:Distributed Systems Observability(O’Reilly) 6 -
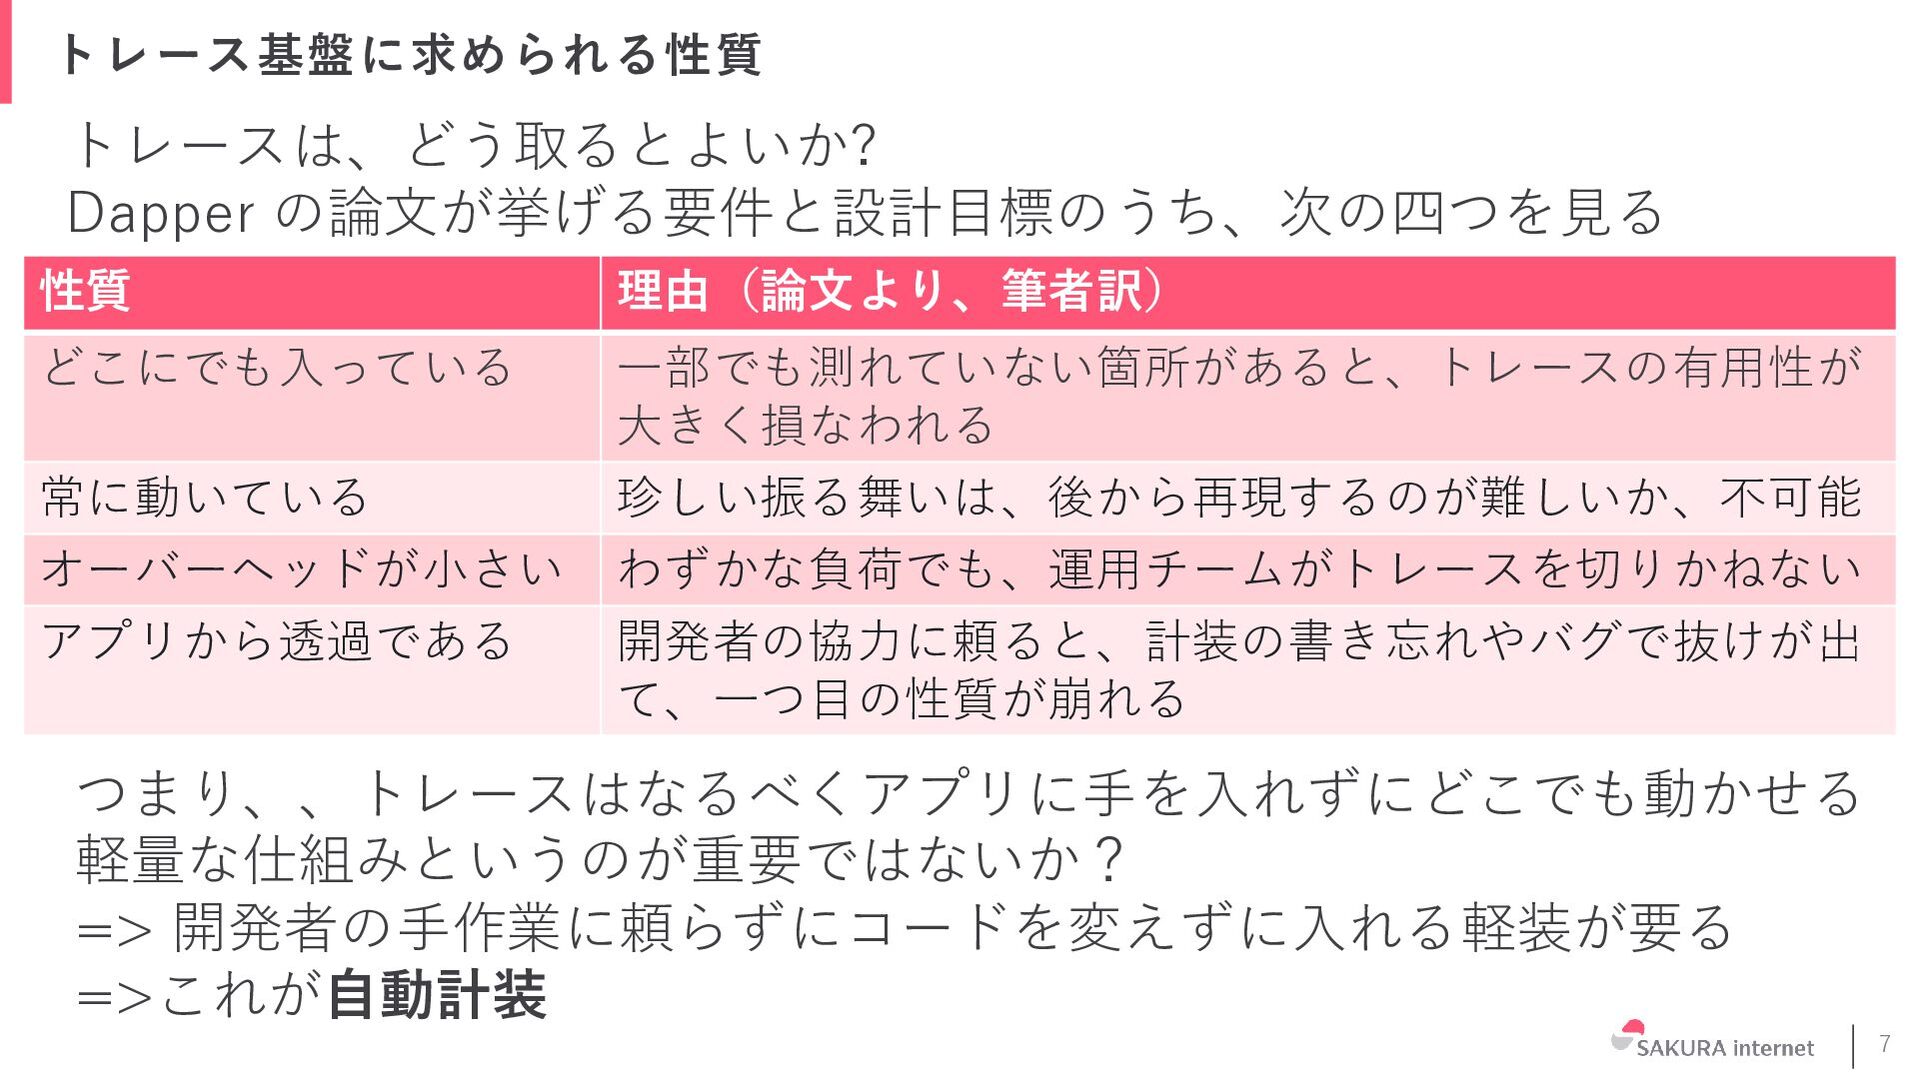
トレース基盤に求められる性質 Dapper の論文が挙げる要件と設計目標のうち、次の四つを見る 性質 理由(論文より、筆者訳) どこにでも⼊っている ⼀部でも測れていない箇所があると、トレースの有⽤性が ⼤きく損なわれる 常に動いている 珍しい振る舞いは、後から再現するのが難しいか、不可能
オーバーヘッドが⼩さい 大きいとトレースを OFF にしたくなってしまうため アプリから透過である 開発者の協⼒に頼ると、計装の書き忘れやバグで抜けが出 て、⼀つ⽬の性質が崩れる => 開発者の手作業に頼らずにコードを変えずに入れる計装が要る =>これが自動計装 7 -
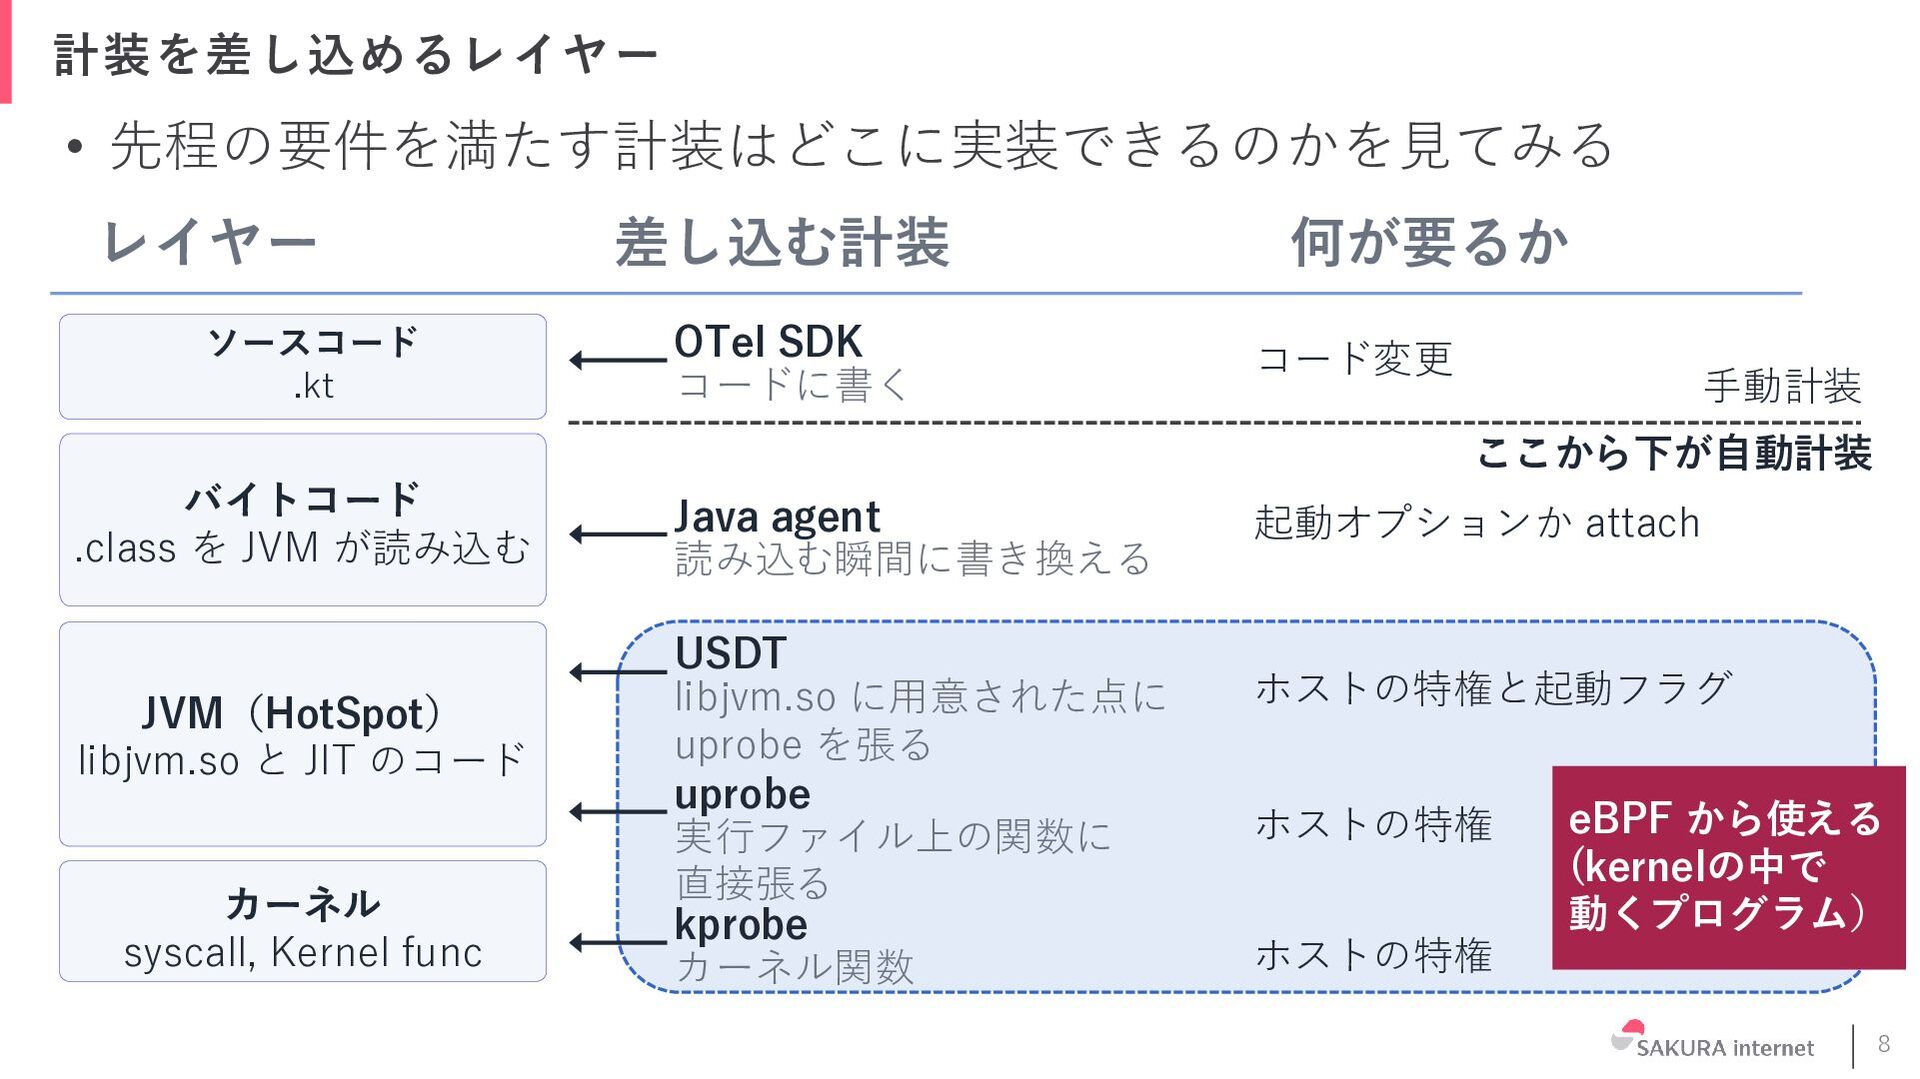
計装を差し込めるレイヤー • 先程の要件を満たす計装はどこに実装できるのかを見てみる レイヤー ソースコード .kt 差し込む計装 OTel SDK コードに書く
何が要るか コード変更 手動計装 ここから下が自動計装 バイトコード .class を JVM が読み込む JVM(HotSpot) libjvm.so と JIT のコード カーネル syscall, Kernel func Java agent 読み込む瞬間に書き換える USDT libjvm.so に⽤意された点に uprobe を張る uprobe 実行ファイル上の関数に 直接張る kprobe カーネル関数 起動オプションか attach ホストの特権と起動フラグ ホストの特権 eBPF から使える (kernelの中で 動くプログラム) ホストの特権 8 -
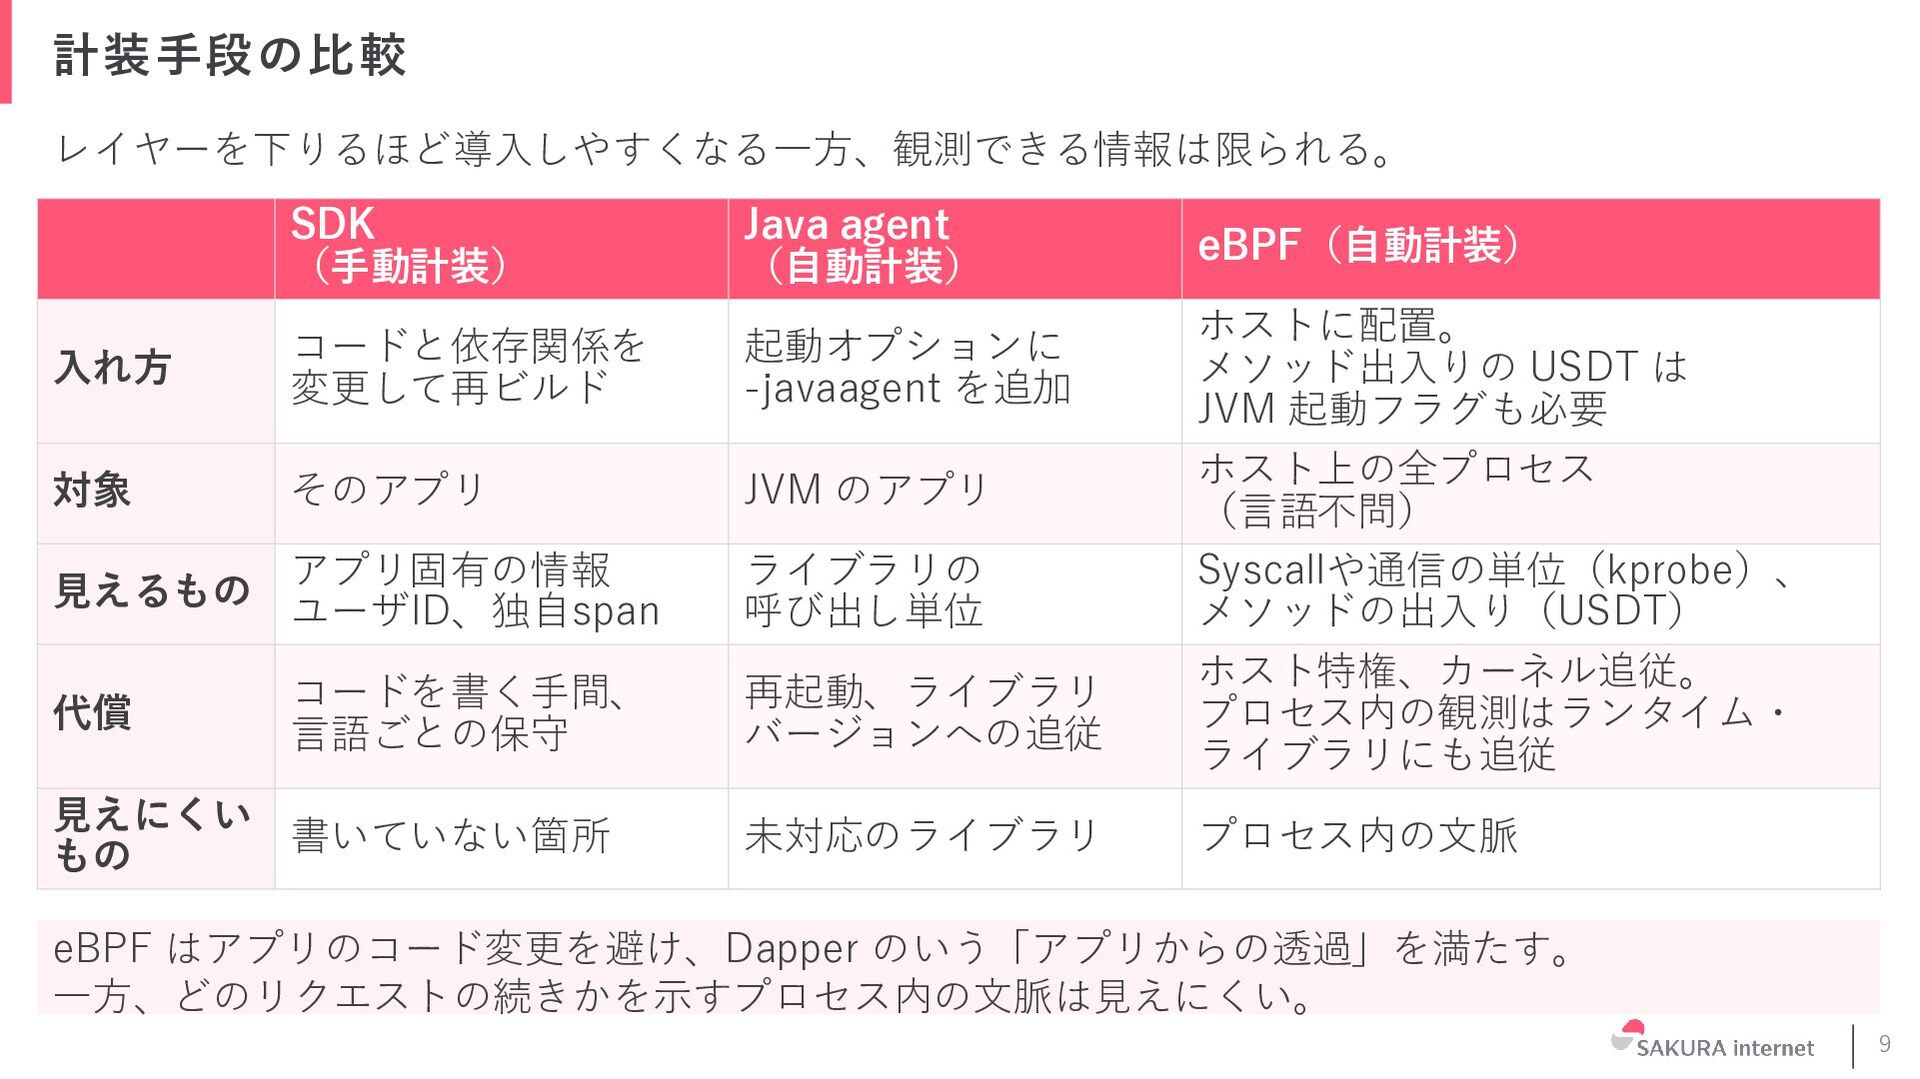
計装手段の比較 下のレイヤのものほど、導入の手間は少ないが得られる情報は限定されていく SDK (手動計装) Java agent (自動計装) eBPF(自動計装) 導入方法 コードと依存関係を変更して
再ビルド 起動オプション追加 ホストに配置 (コードを書く手間、 言語ごとの保守が必要) 対象 そのアプリ JVM のアプリ ホスト上の全プロセス (言語不問) 取れるもの アプリ固有の情報 (ユーザID、独自span) が取 れる ライブラリの 呼び出し単位 syscallや通信(kprobe)、 メソッドの出入り(USDT) 取れないもの 手を入れていない箇所の情報 未対応のライブラリ アプリ固有の情報は取れない 9 -
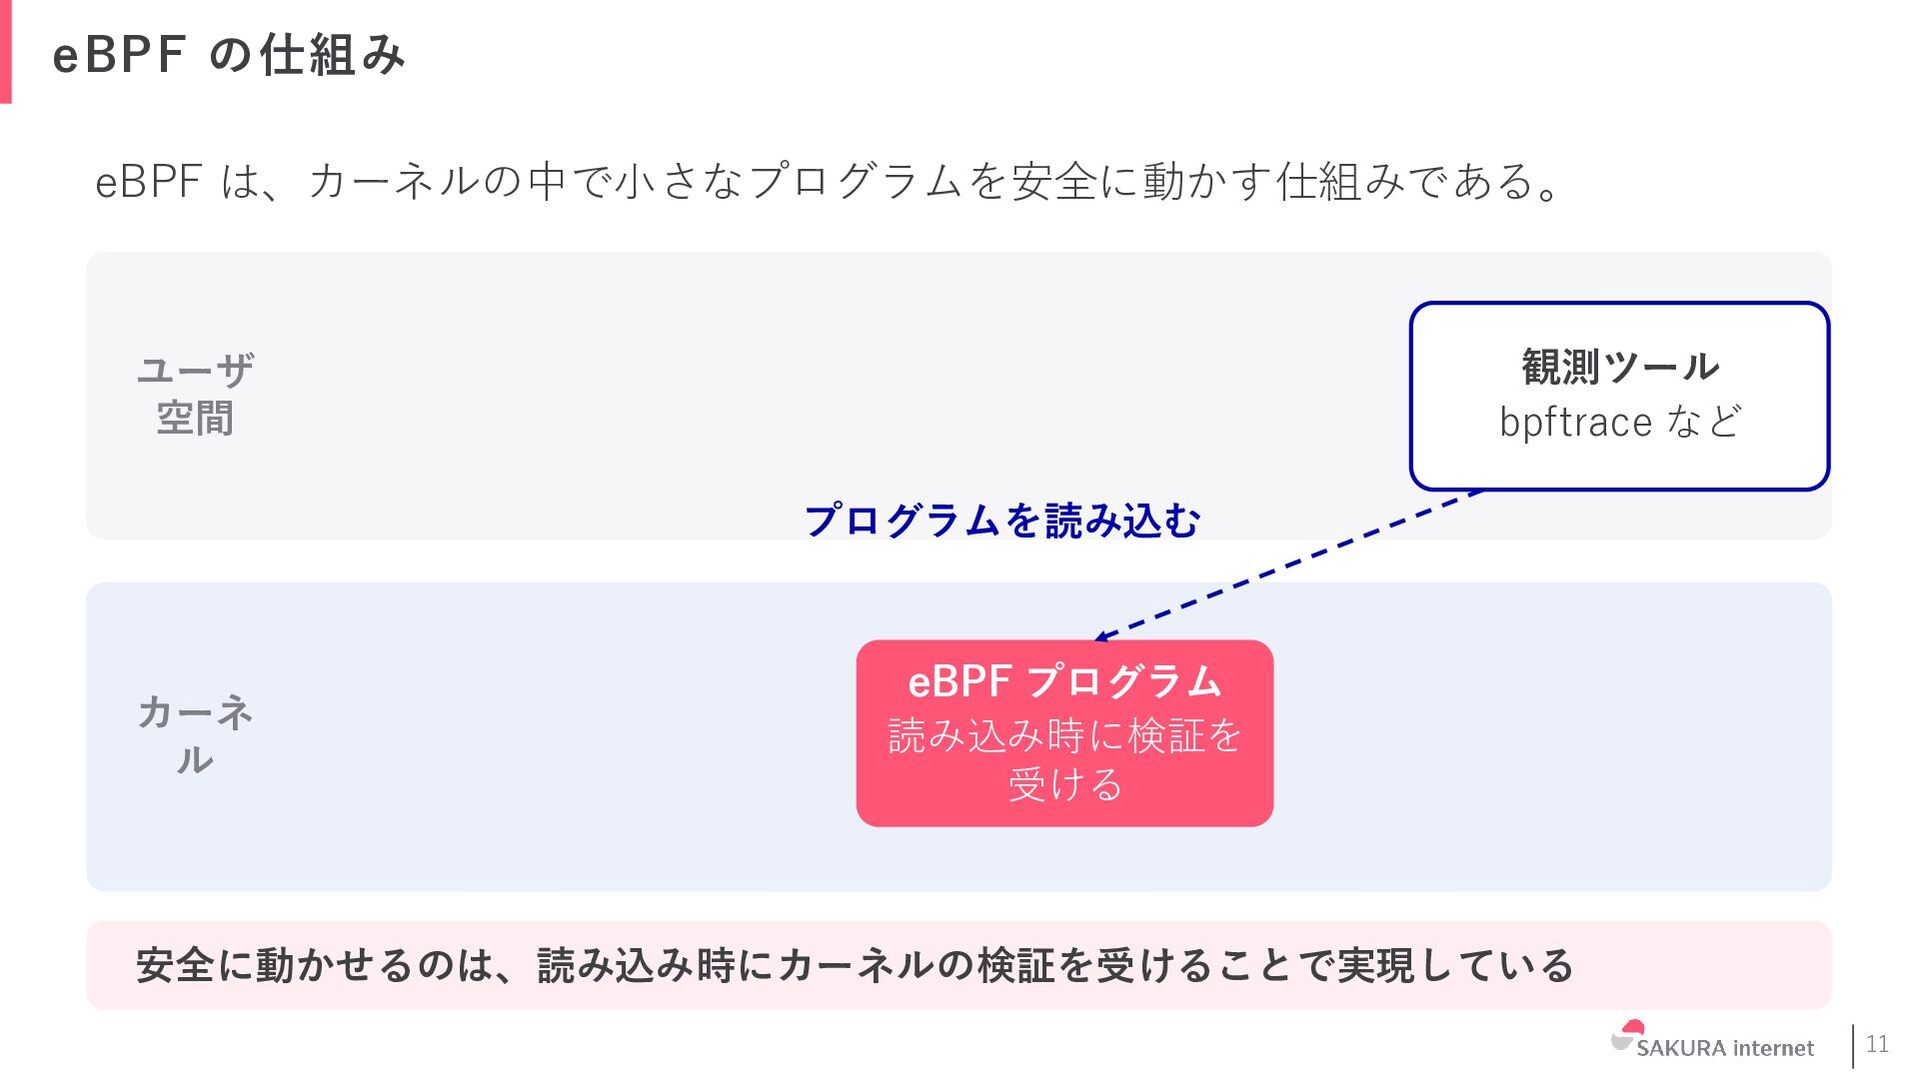
eBPF の仕組み eBPF は、カーネルの中で⼩さなプログラムを安全に動かす仕組みである。 観測ツール bpftrace など ユーザ 空間 プログラムを読み込む
カーネ ル eBPF プログラム 読み込み時に検証を 受ける 安全に動かせるのは、読み込み時にカーネルの検証を受けることで実現している 11 -
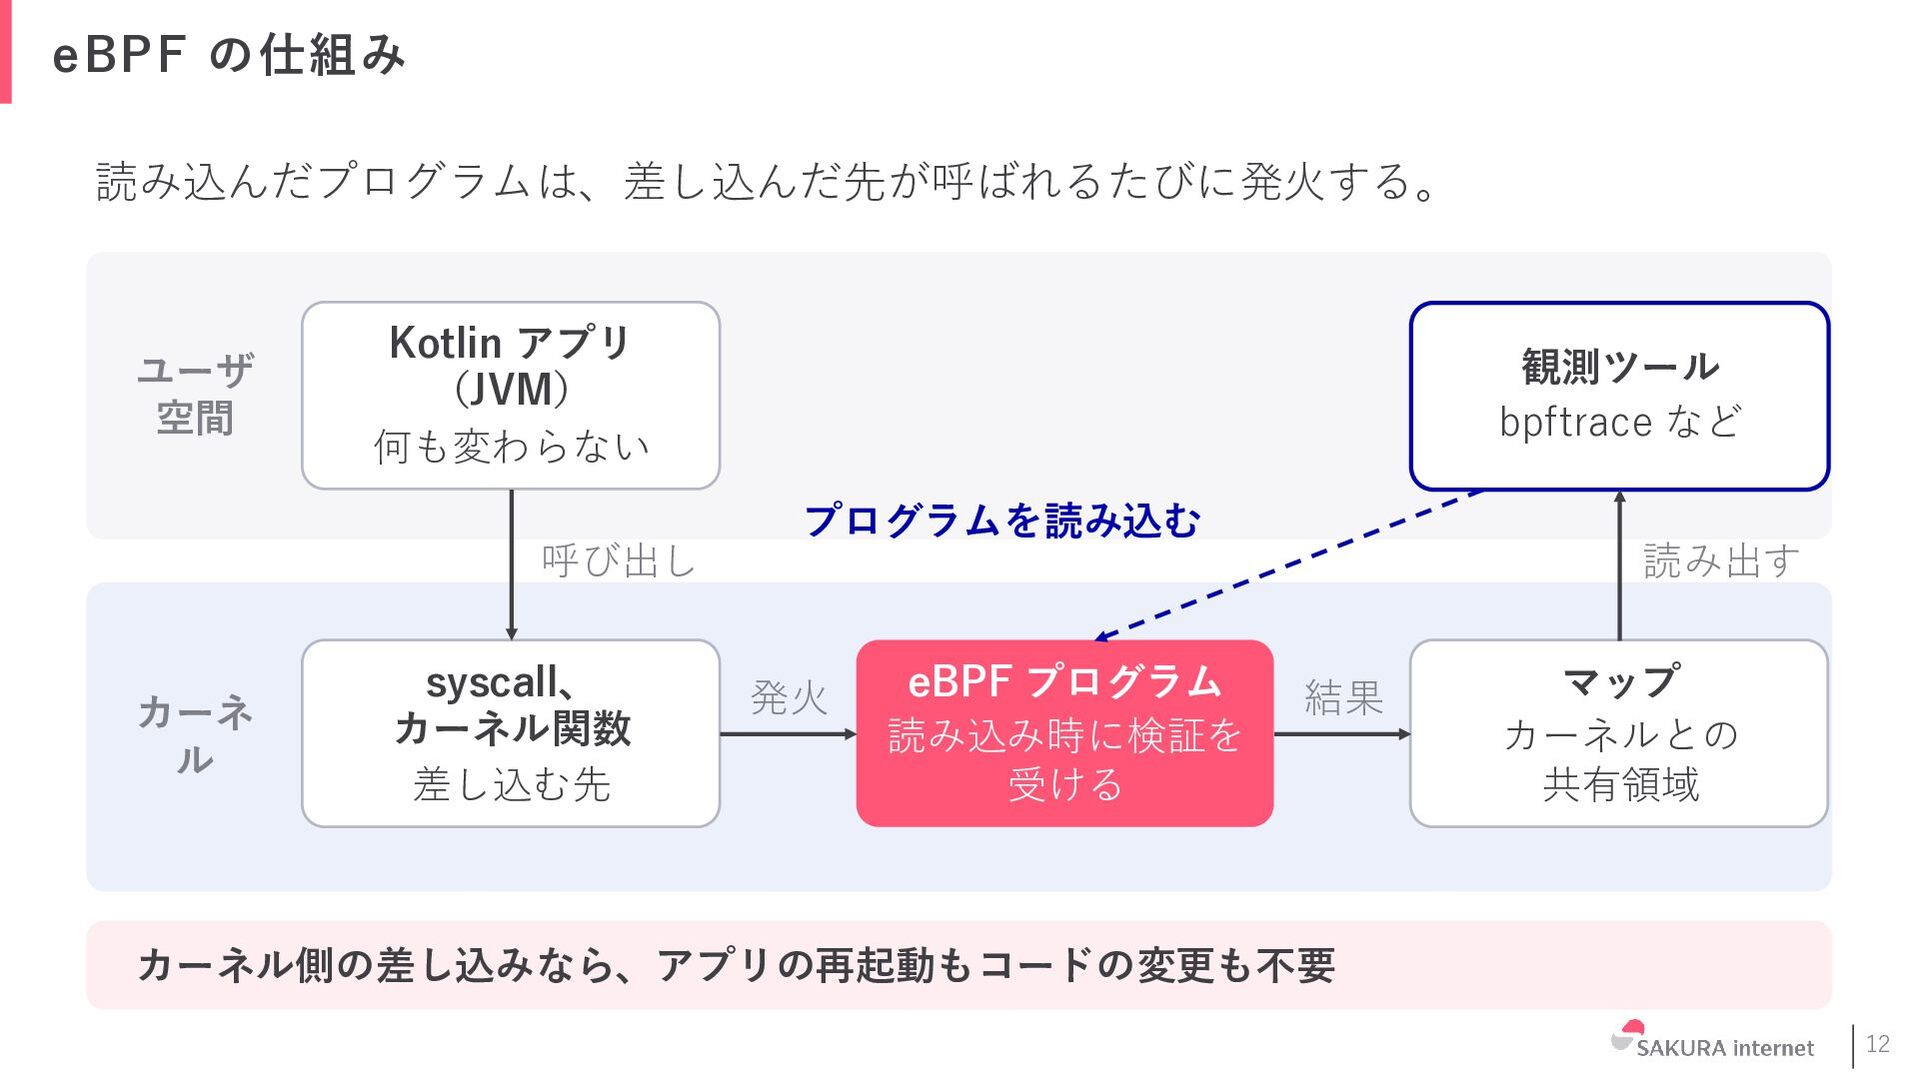
eBPF の仕組み 読み込んだプログラムは、差し込んだ先が呼ばれるたびに発火する。 ユーザ 空間 Kotlin アプリ (JVM) 何も変わらない 呼び出し
カーネ ル syscall、 カーネル関数 差し込む先 観測ツール bpftrace など プログラムを読み込む 発火 eBPF プログラム 読み込み時に検証を 受ける 読み出す 結果 マップ カーネルとの 共有領域 カーネル側の差し込みなら、アプリの再起動もコードの変更も不要 12 -
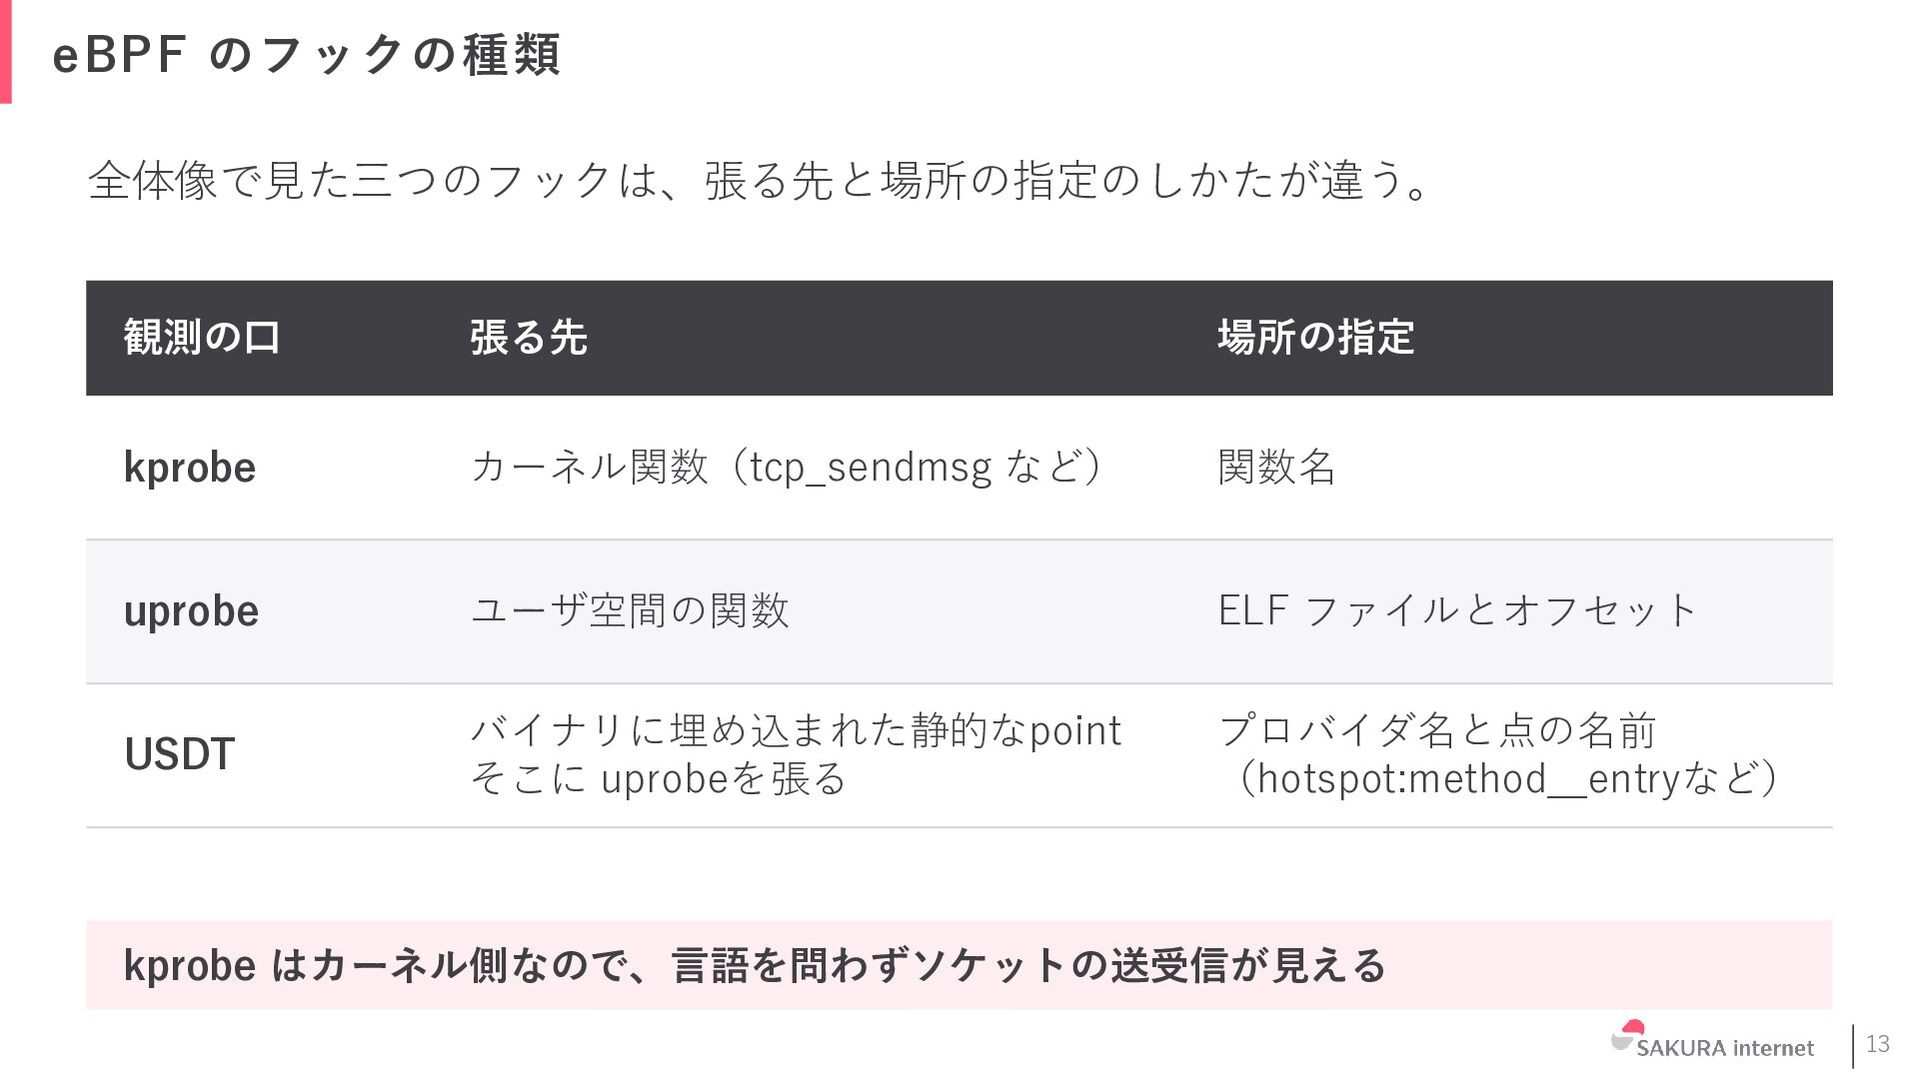
eBPF のフックの種類 観測の口 張る先 場所の指定 kprobe カーネル関数(tcp_sendmsg など) 関数名 uprobe
ユーザ空間の関数 (glibc等のCの関数など) ELF ファイルとオフセット USDT uprobeが貼れないところを補完する ためにフックポイントを静的に バイナリに埋め込んで実現します プロバイダ名と点の名前 (hotspot:method__entryなど) kprobe はカーネル側なので、言語を問わずソケットの送受信が見える 13 -
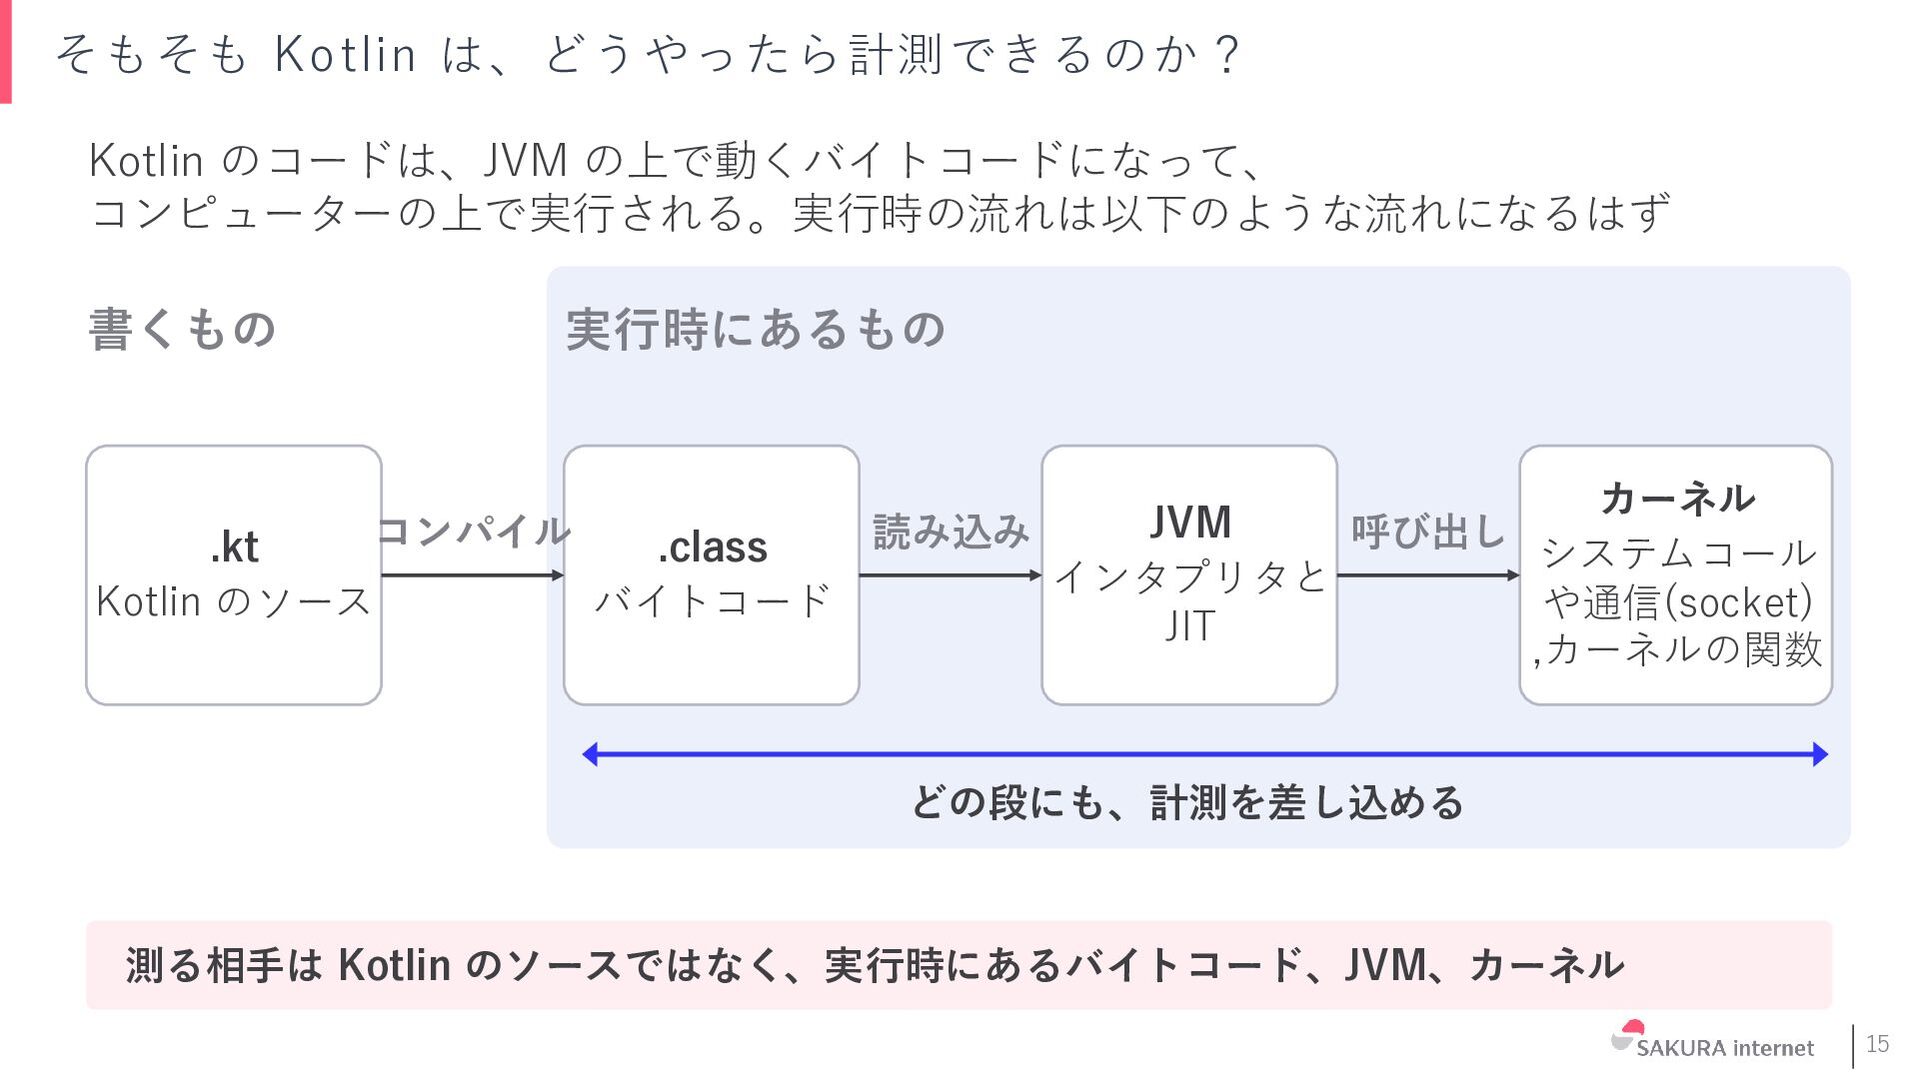
そもそも Kotlin は、どうやったら計測できるのか? Kotlin のコードは、JVM の上で動くバイトコードになって、 コンピューターの上で実行される。実行時の流れは以下のような流れになるはず 書くもの 実行時にあるもの カーネル
JVM コンパイル 読み込み 呼び出し .kt .class システムコール インタプリタと Kotlin のソース バイトコード や通信(socket) JIT ,カーネルの関数 どの段にも、計測を差し込める 測る相⼿は Kotlin のソースではなく、実⾏時にあるバイトコード、JVM、カーネル 15 -
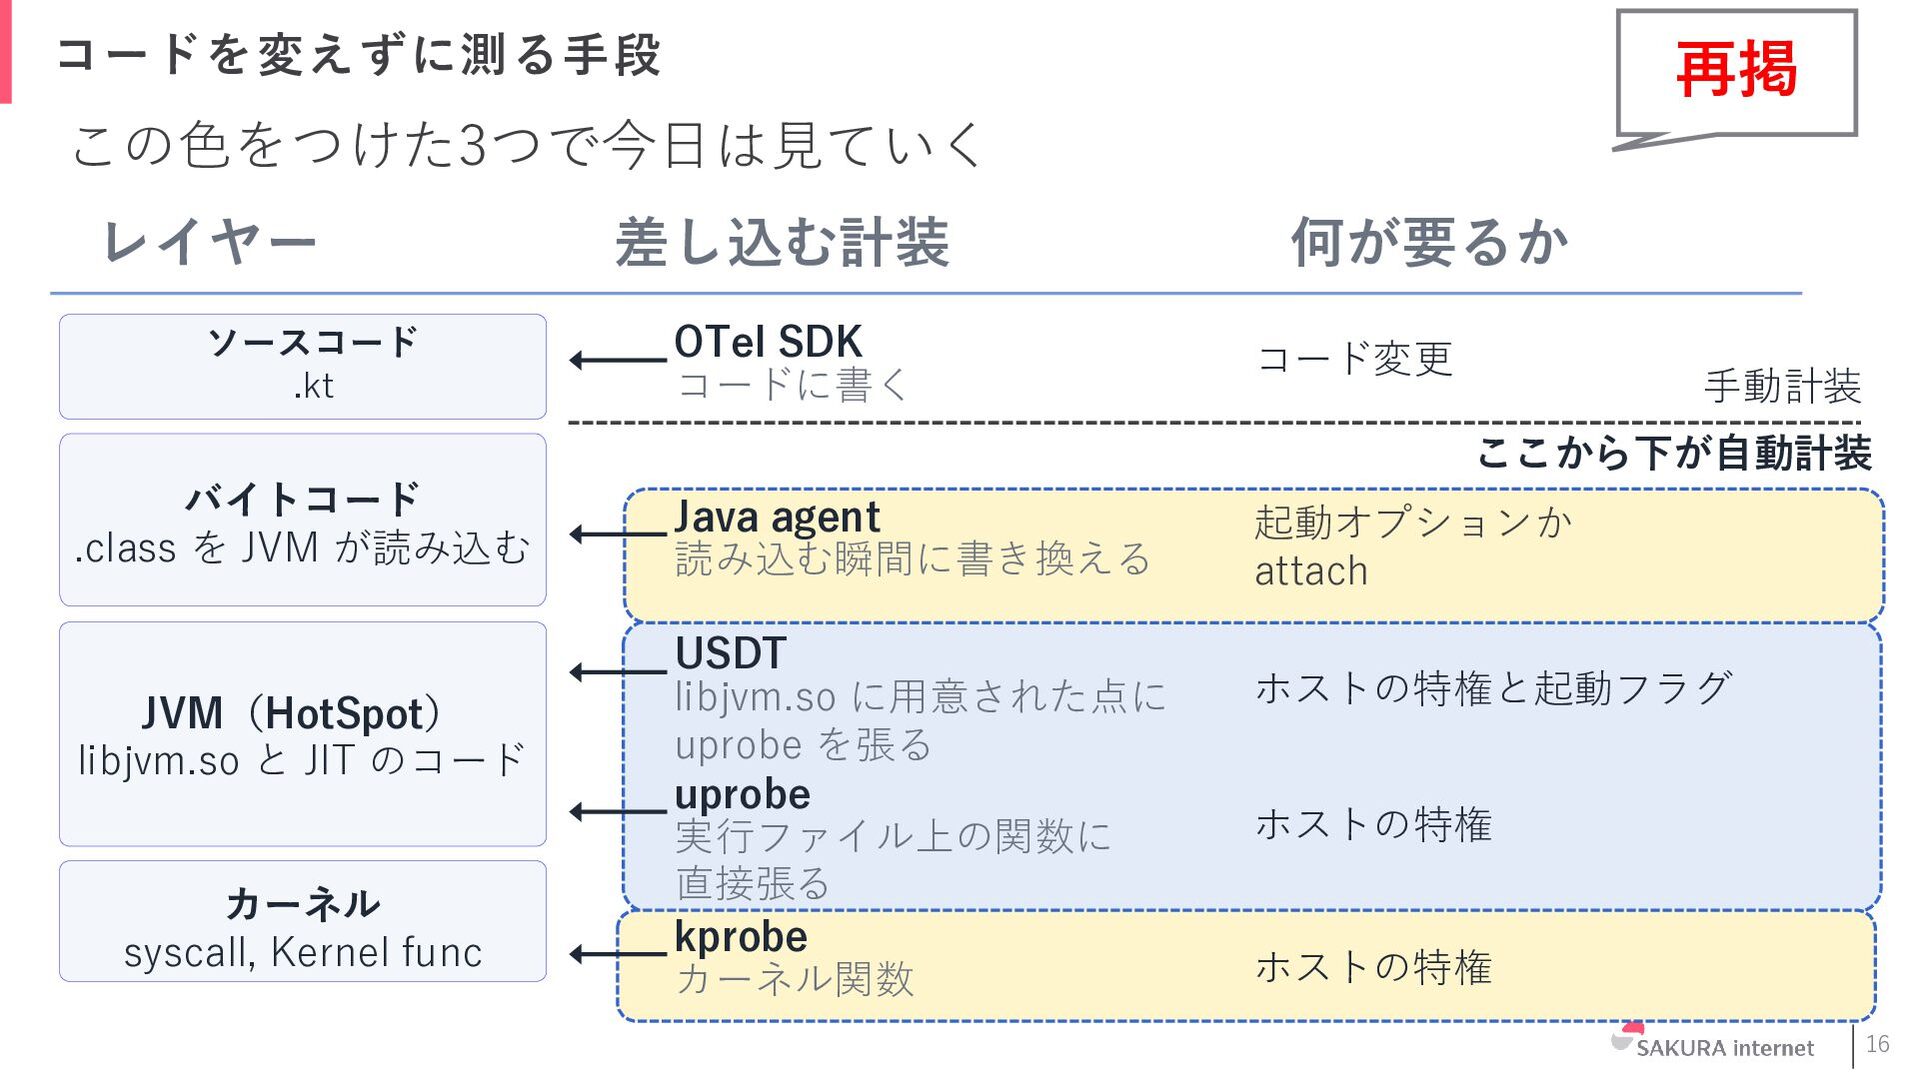
コードを変えずに測る⼿段 再掲 この色をつけた3つで今日は見ていく レイヤー ソースコード .kt 差し込む計装 OTel SDK コードに書く
何が要るか コード変更 手動計装 ここから下が自動計装 バイトコード .class を JVM が読み込む JVM(HotSpot) libjvm.so と JIT のコード カーネル syscall, Kernel func Java agent 読み込む瞬間に書き換える USDT libjvm.so に⽤意された点に uprobe を張る uprobe 実行ファイル上の関数に 直接張る kprobe カーネル関数 起動オプションか attach ホストの特権と起動フラグ ホストの特権 ホストの特権 16 -
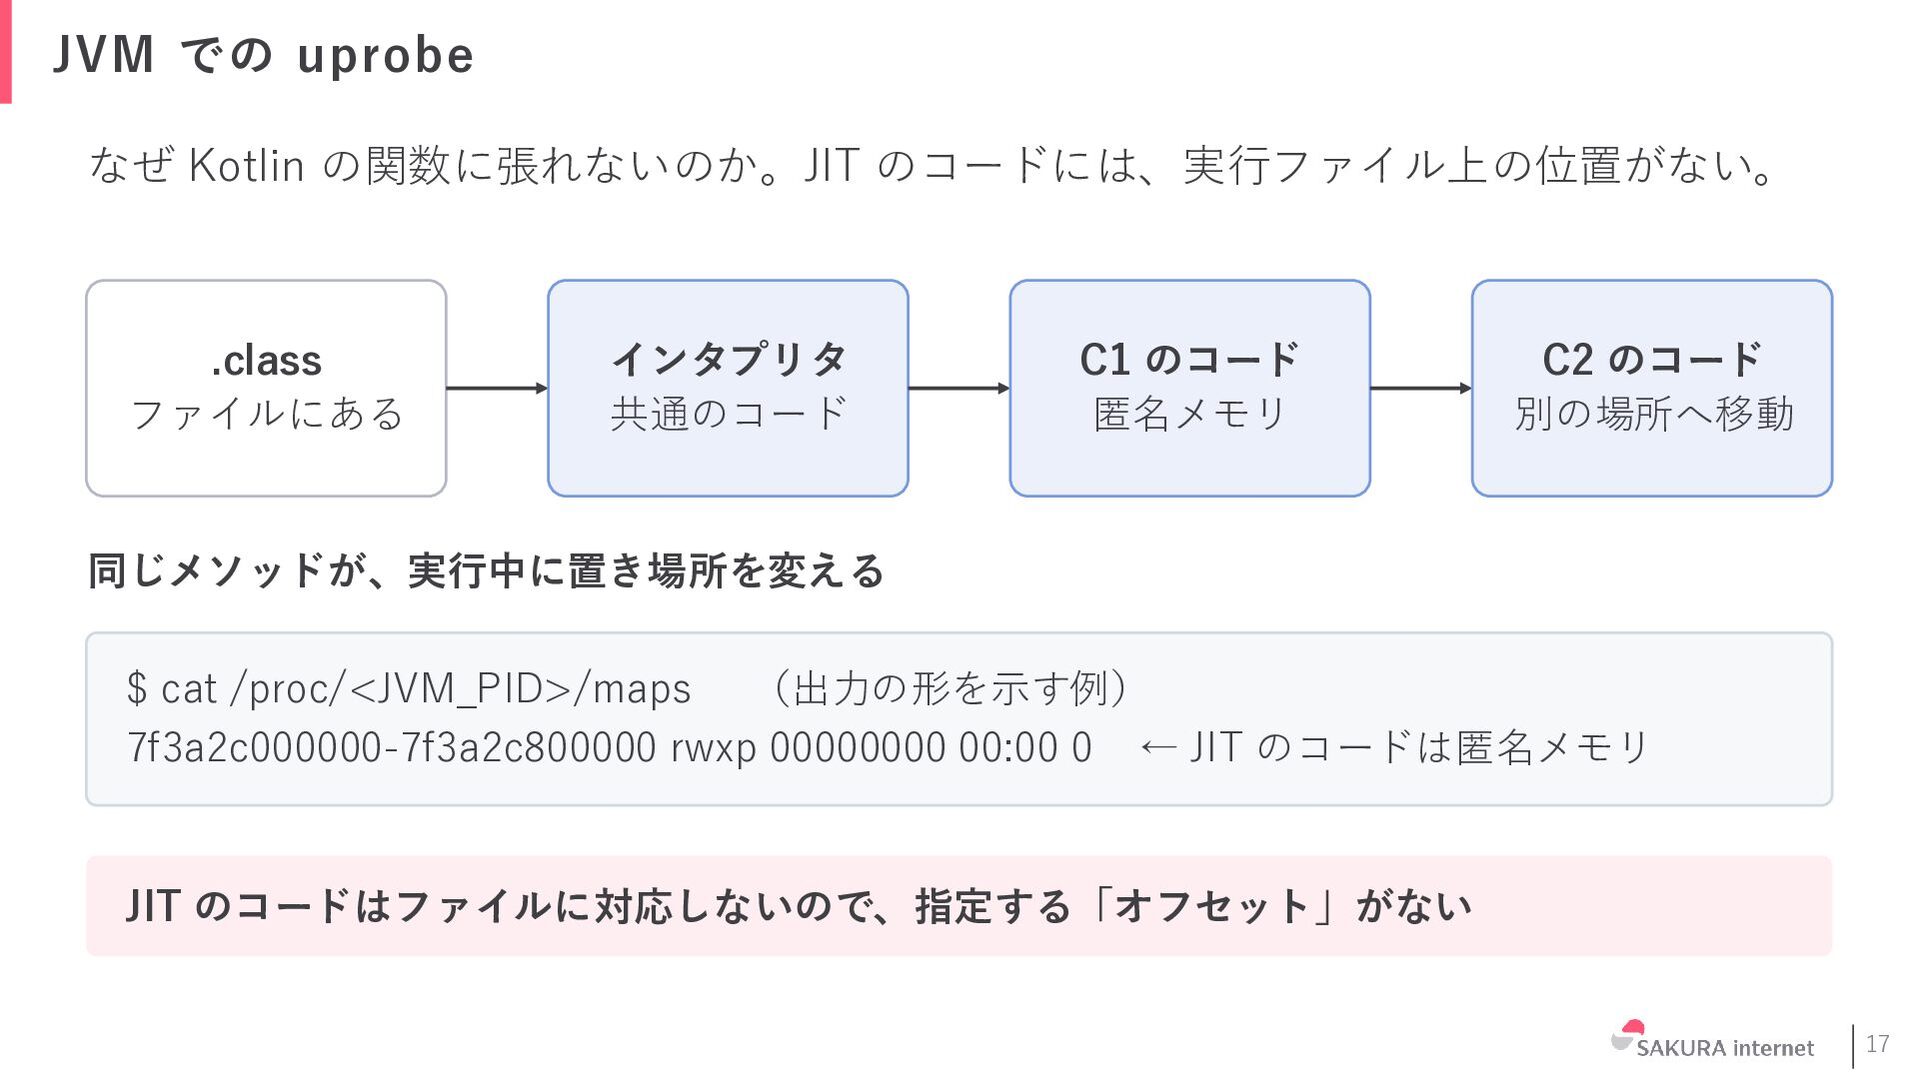
JVM(HotSpot)に手をいれる仕組みだけでの解決は困難! • uprobe でなんとかならないか? • JIT コンパイルを挟むため匿名化されてしまい厳しい…… $ cat /proc/<JVM_PID>/maps
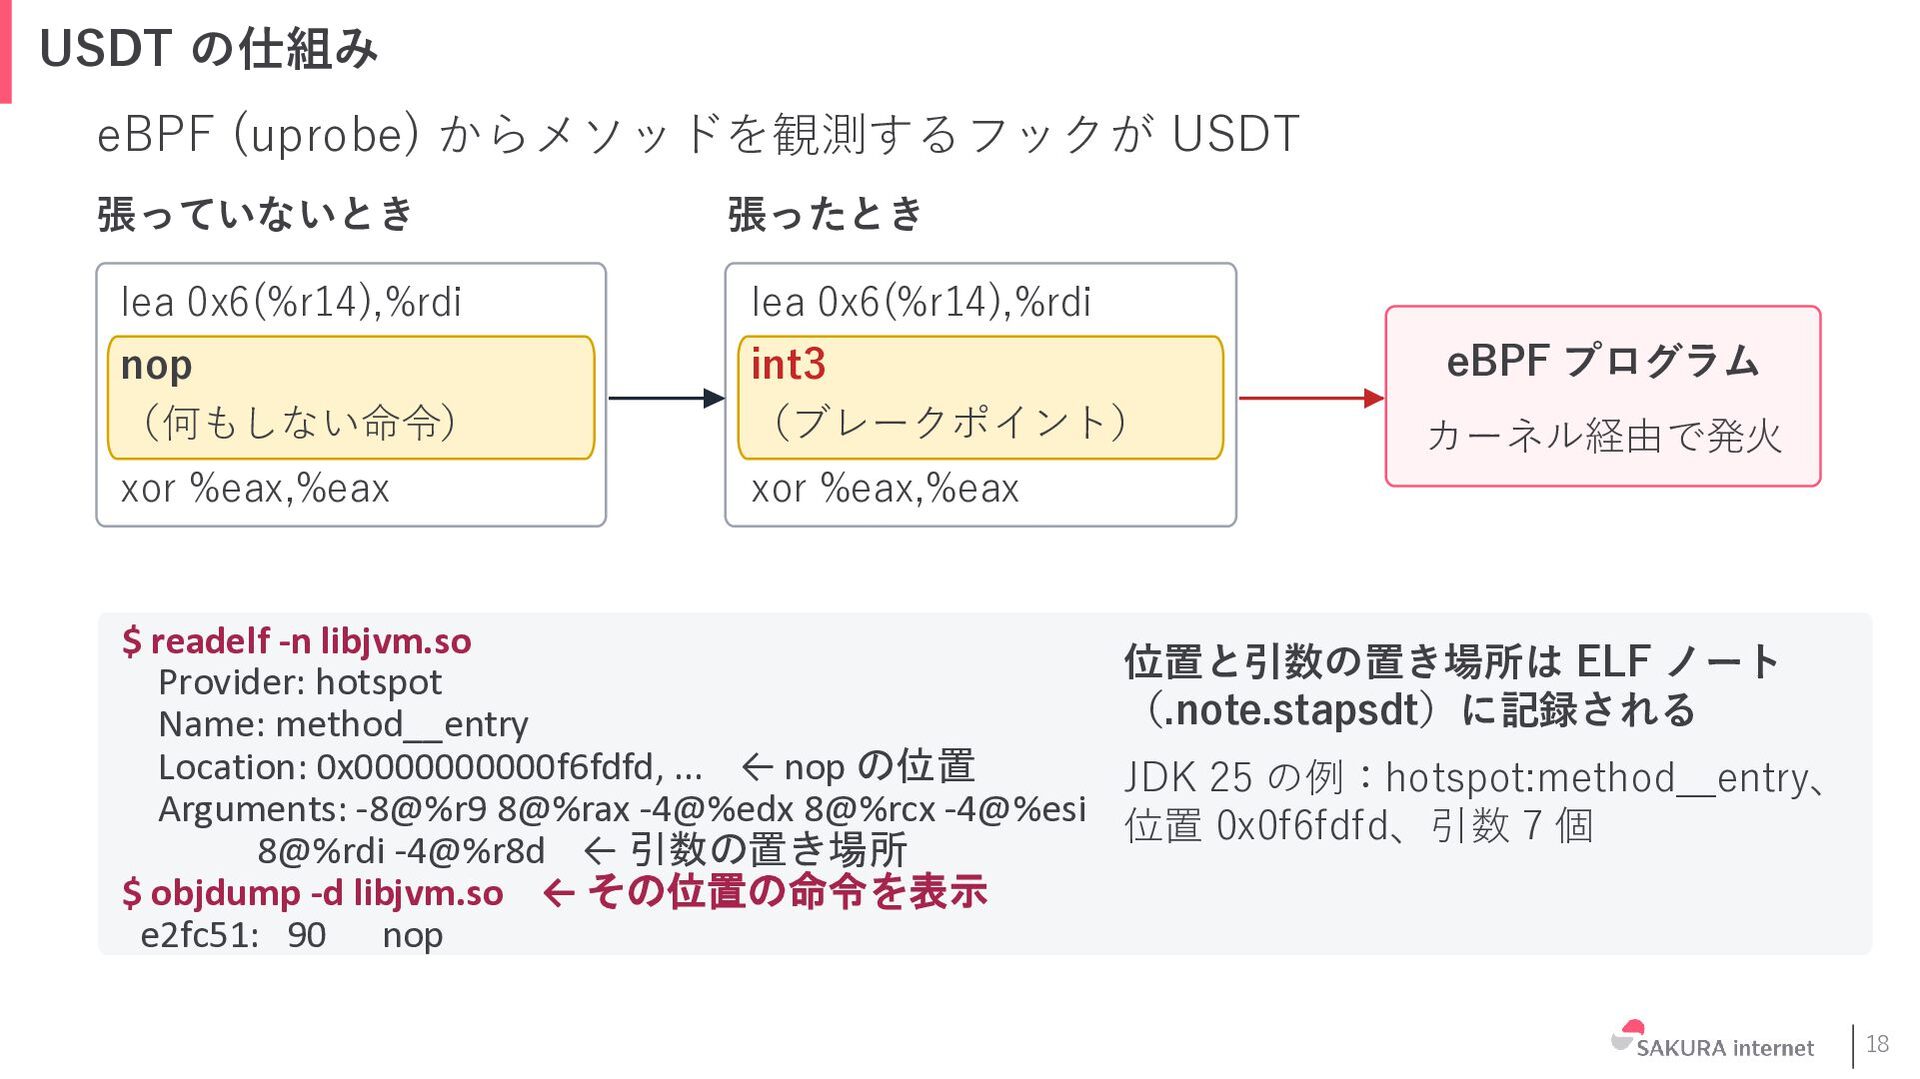
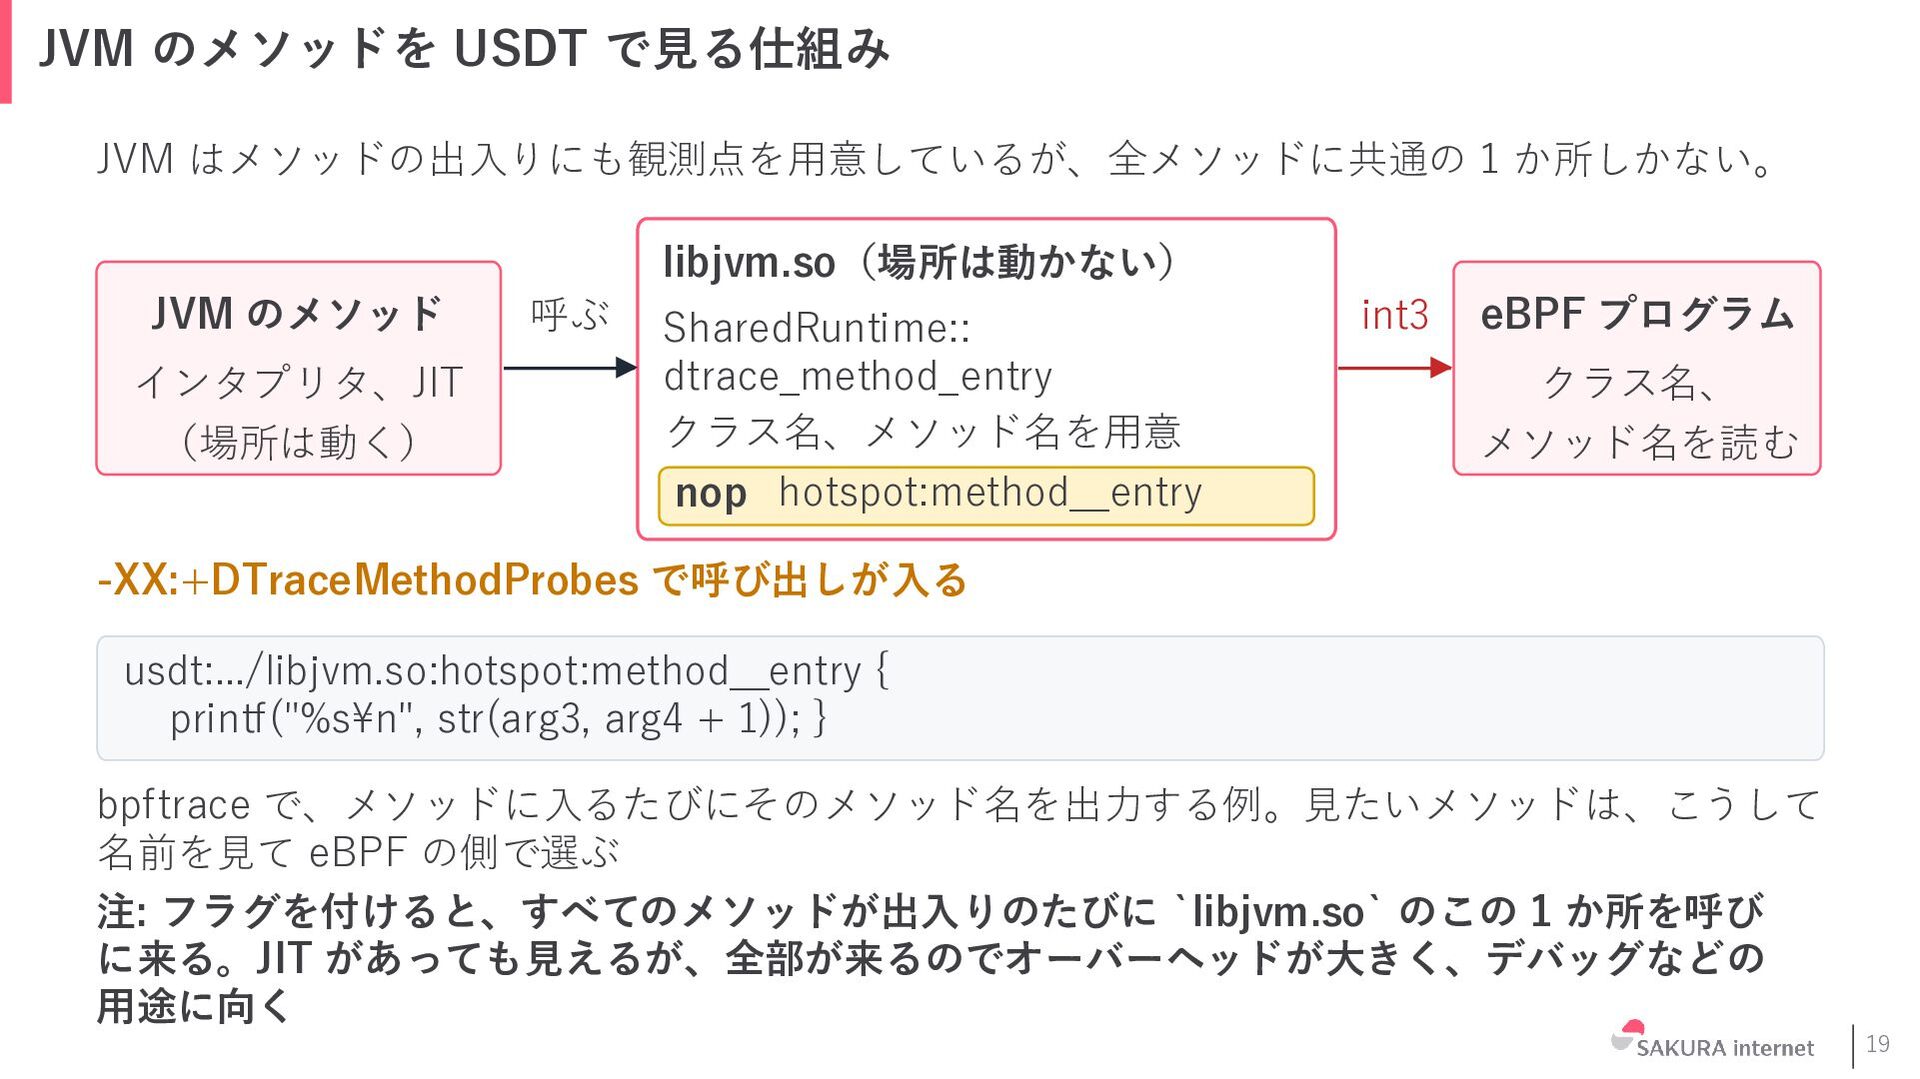
(出力の形を示す例) 7f3a2c000000-7f3a2c800000 rwxp 00000000 00:00 0 ← JIT のコードは匿名メモリ • USDT (User Statically-Defined Tracing) という仕組みが使えないか? • ユーザー空間プログラム内のトレースポイントを定義する技術 • JVM でも使えるが、提供されてるUSDTでは使い勝手が悪い • あらゆる関数のあらゆる呼び出しが hook されてしまったりする • ※コード変更を許容するなら特定のメソッドだけに適用することもできますが、 自動計装ではないので対象外… 17 -
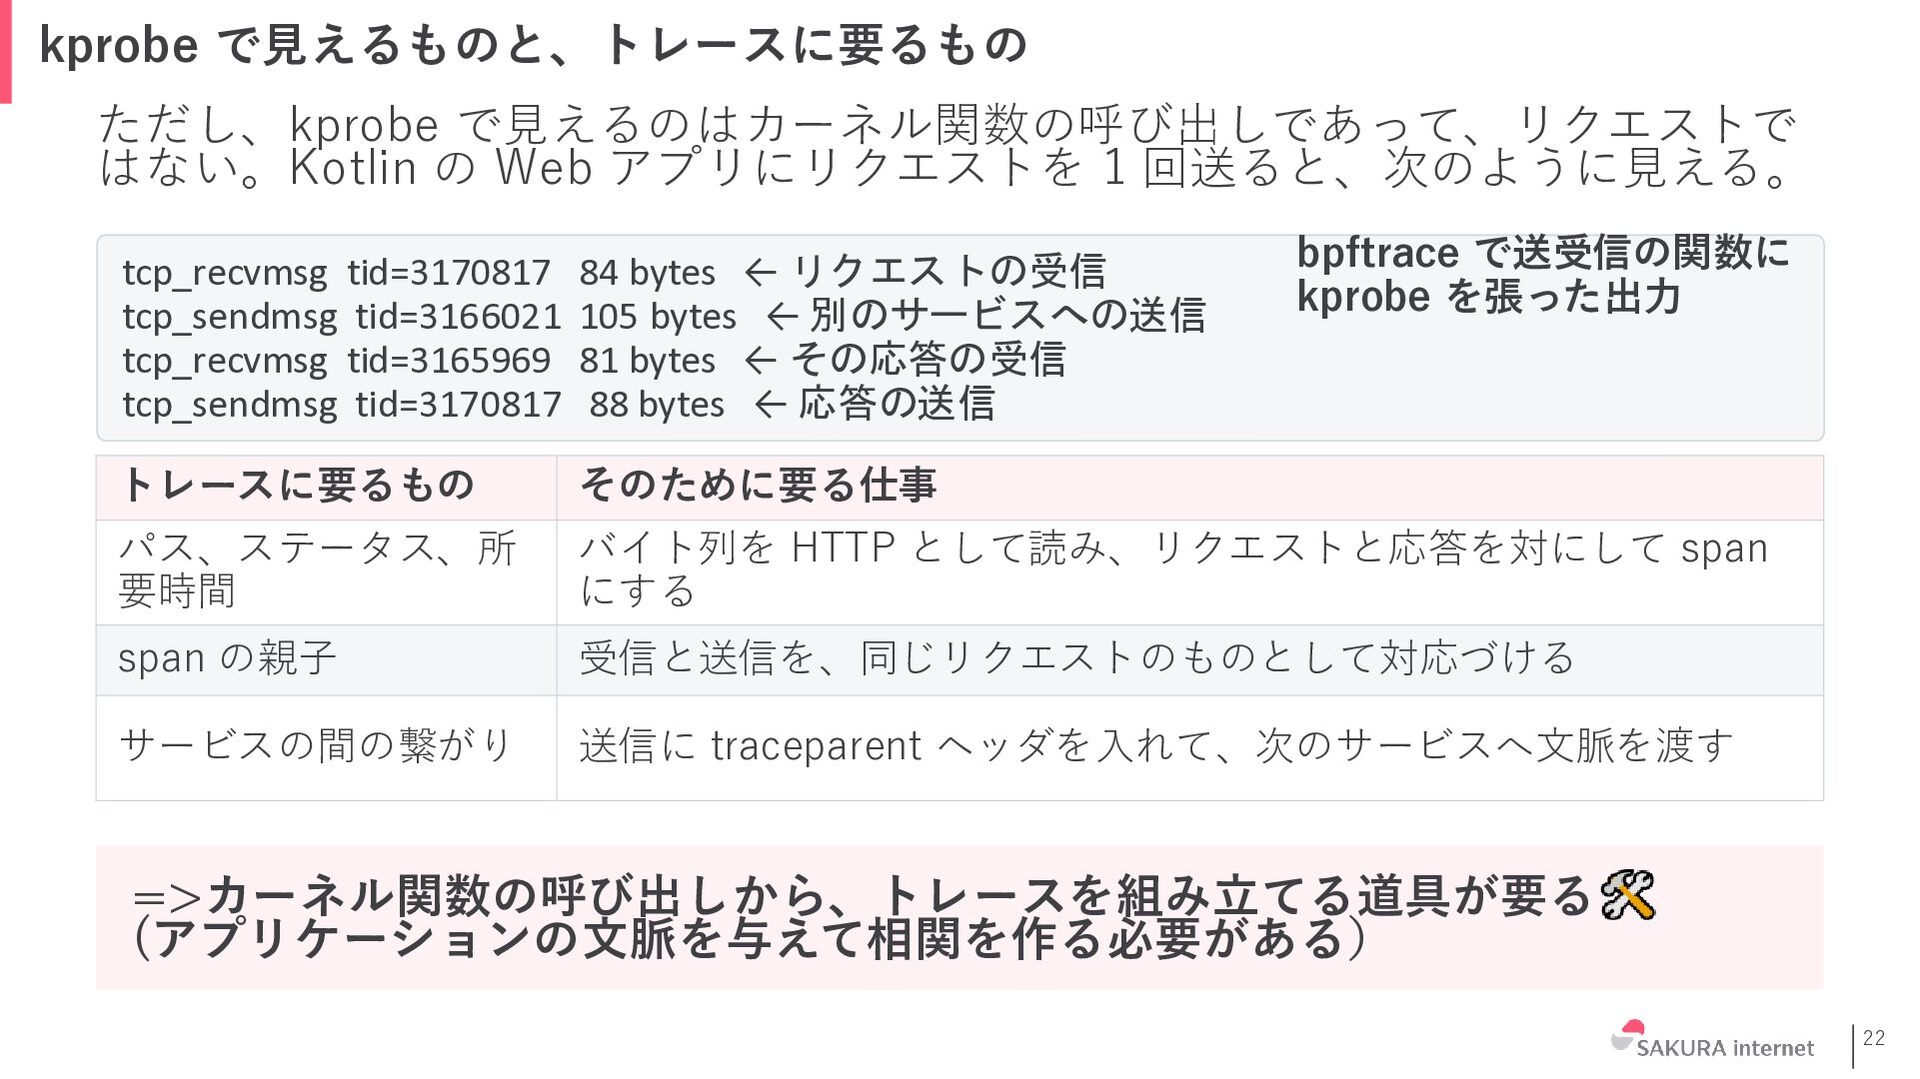
ではもっと下のレイヤの kprobe でやってみよう! kprobe で⾒えるのはカーネル関数の呼び出しだけであって、 リクエストの内容は見えない tcp_recvmsg tid=3170817 84 bytes
← リクエストの受信 tcp_sendmsg tid=3166021 105 bytes ← 別のサービスへの送信 tcp_recvmsg tid=3165969 81 bytes ← その応答の受信 tcp_sendmsg tid=3170817 88 bytes ← 応答の送信 bpftrace で送受信の関数に kprobe を張った出⼒ トレースに要るもの そのために要る仕事 パス、ステータス、 所要時間 バイト列を HTTP として読み、リクエストと応答を対にして span にする span の親⼦ 受信と送信を、同じリクエストのものとして対応づける サービスの間の繋がり 送信に traceparent ヘッダを⼊れて、次のサービスへ⽂脈を渡す =>カーネル関数の呼び出しから、トレースを組み⽴てる道具が要る (アプリケーションの文脈を与えて相関を作る必要がある) 22 -
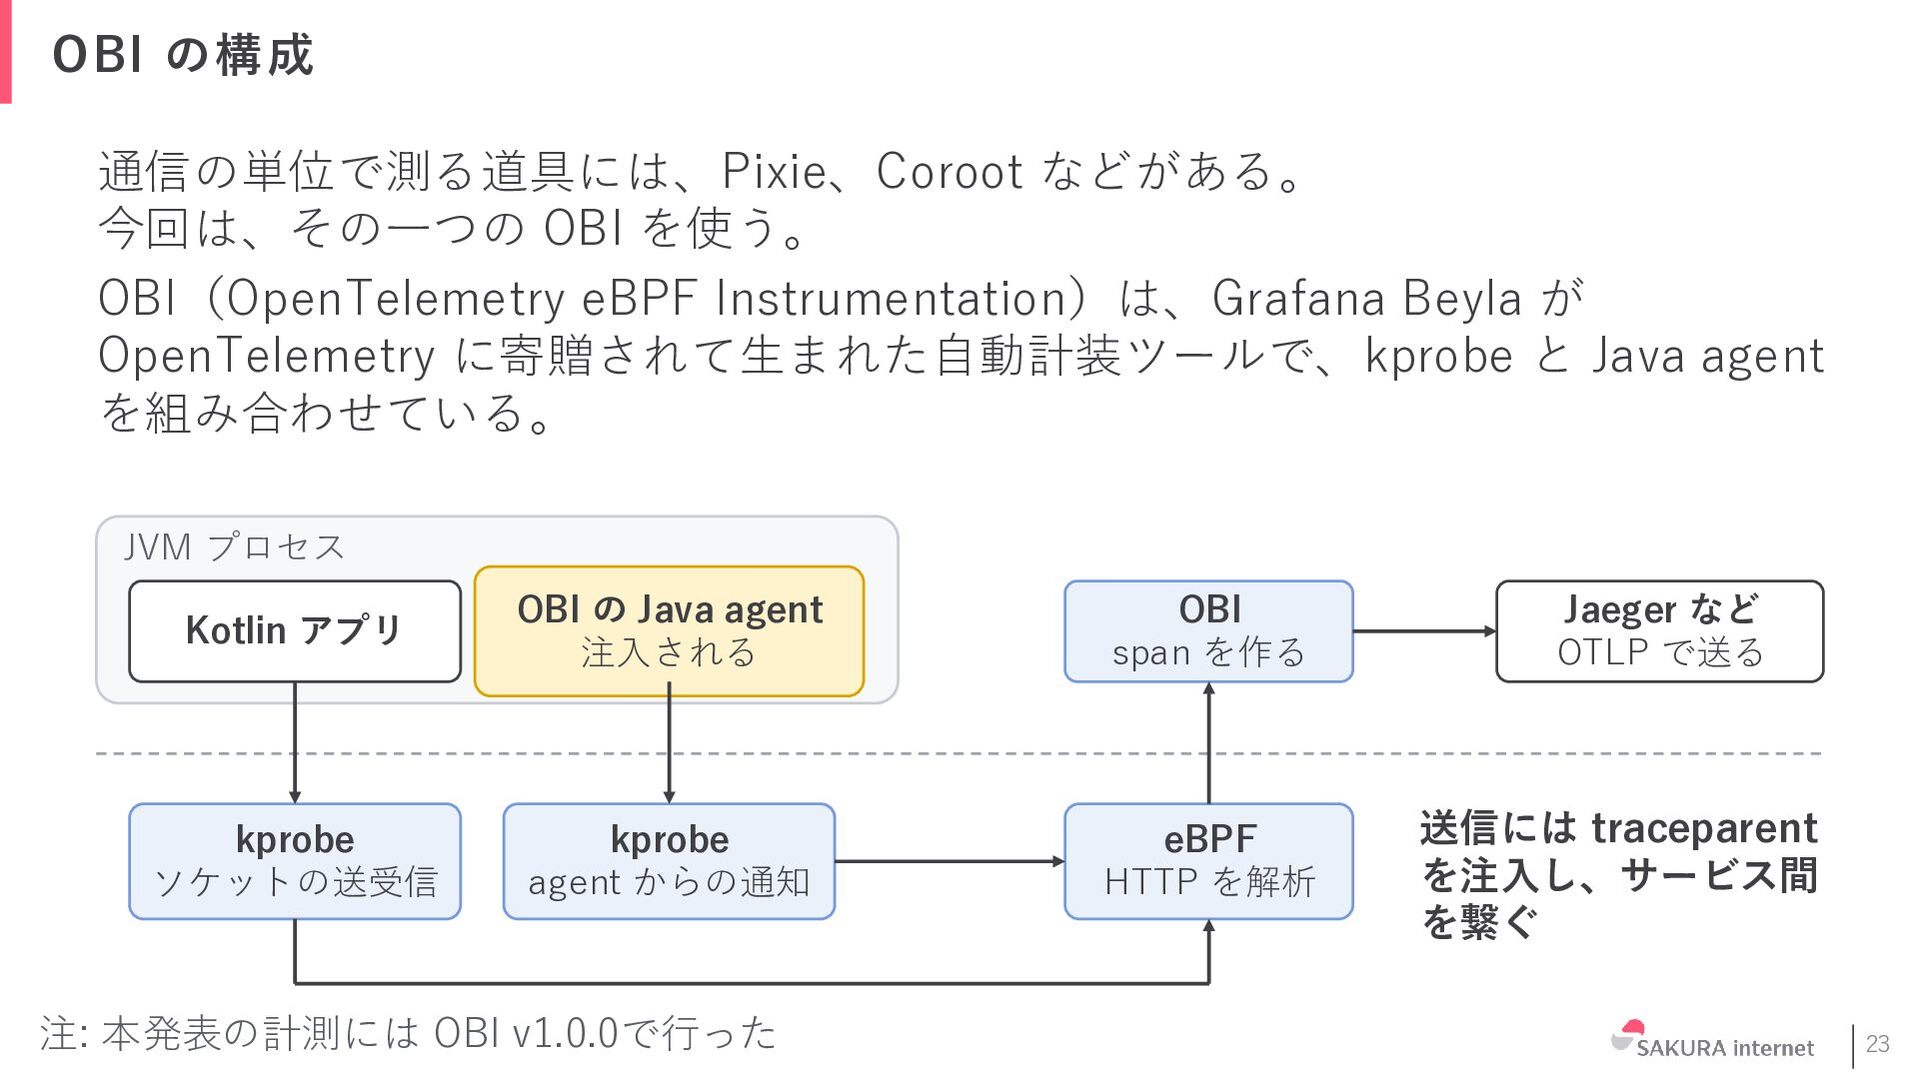
OBI の構成 この組み立てをする道具には、Pixie、Coroot などがあるが、今回は、このうち OBI を使う。OBI(OpenTelemetry eBPF Instrumentation)は、Grafana Beyla が
OpenTelemetry に寄贈されて生まれた自動計装ツールで、JVM のアプリには kprobe と Java agent を組み合わせて使う JVM プロセス Kotlin アプリ OBI の Java agent 注入される OBI span を作る Jaeger など OTel の形式で送る ユーザ空間 送受信 kprobe 送受信の関数 発火 通知(ioctl を呼ぶ) 読み出す kprobe ioctl のシステムコール 発火 OBI の eBPF プログラム 送受信を HTTP として読み、見えない分は通知で補う 注: 本発表の計測には OBI v1.0.0 と JDK 25 を利用 結果 マップ カーネルとの共有領域 カーネル 送信には traceparent ヘッダ も入れて、サービス の間を繋ぐ 19 -
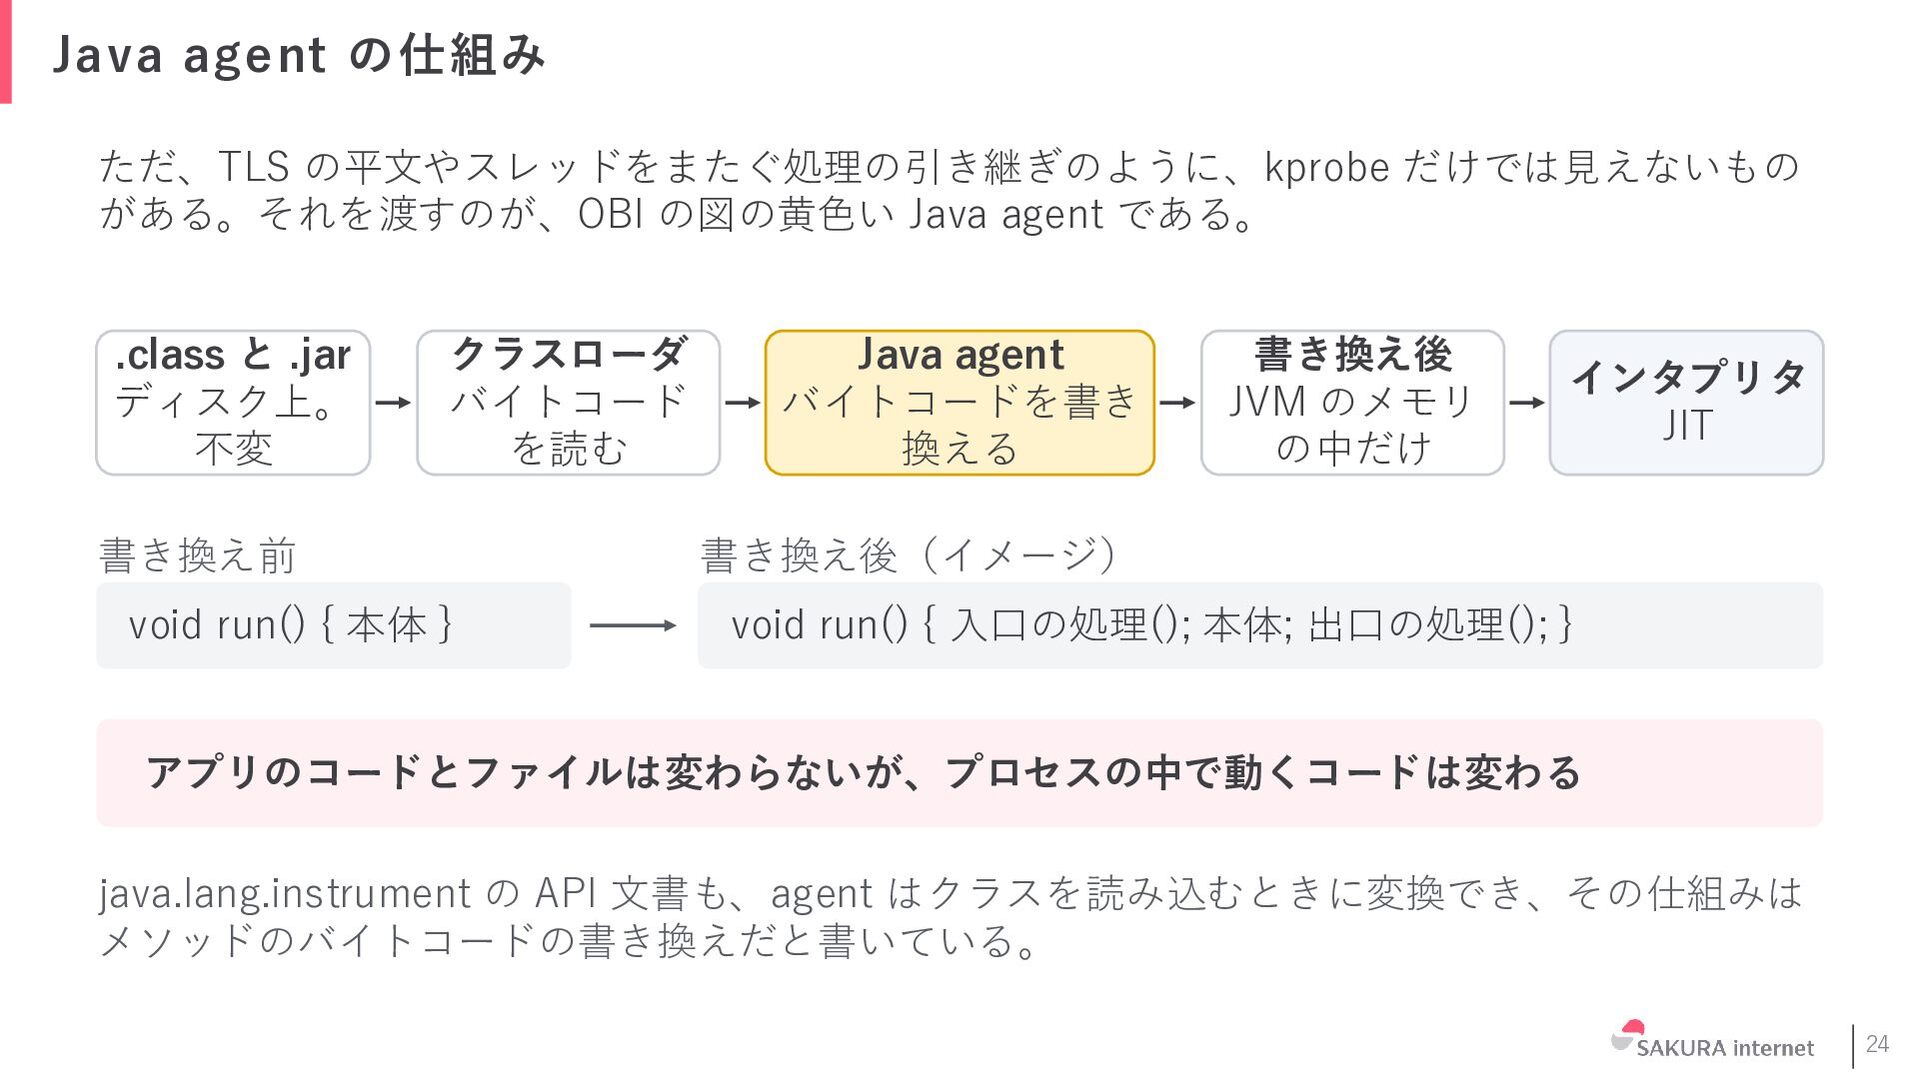
Java agent の仕組み ただ、TLS の平文やスレッドをまたぐ処理の引き継ぎのように、kprobe だけでは見えないもの がある。それを渡すのが、OBI の図の黄色い Java agent
である。 .class と .jar ディスク上。 不変 クラスローダ バイトコード を読む 書き換え前 void run() { 本体 } Java agent バイトコードを書き 換える 書き換え後 JVM のメモリ の中だけ インタプリタ JIT 書き換え後(イメージ) void run() { 入口の処理(); 本体; 出口の処理(); } アプリのコードとファイルは変わらないが、プロセスの中で動くコードは変わる java.lang.instrument の API 文書も、agent はクラスを読み込むときに変換でき、その仕組みは メソッドのバイトコードの書き換えだと書いている。 20 -
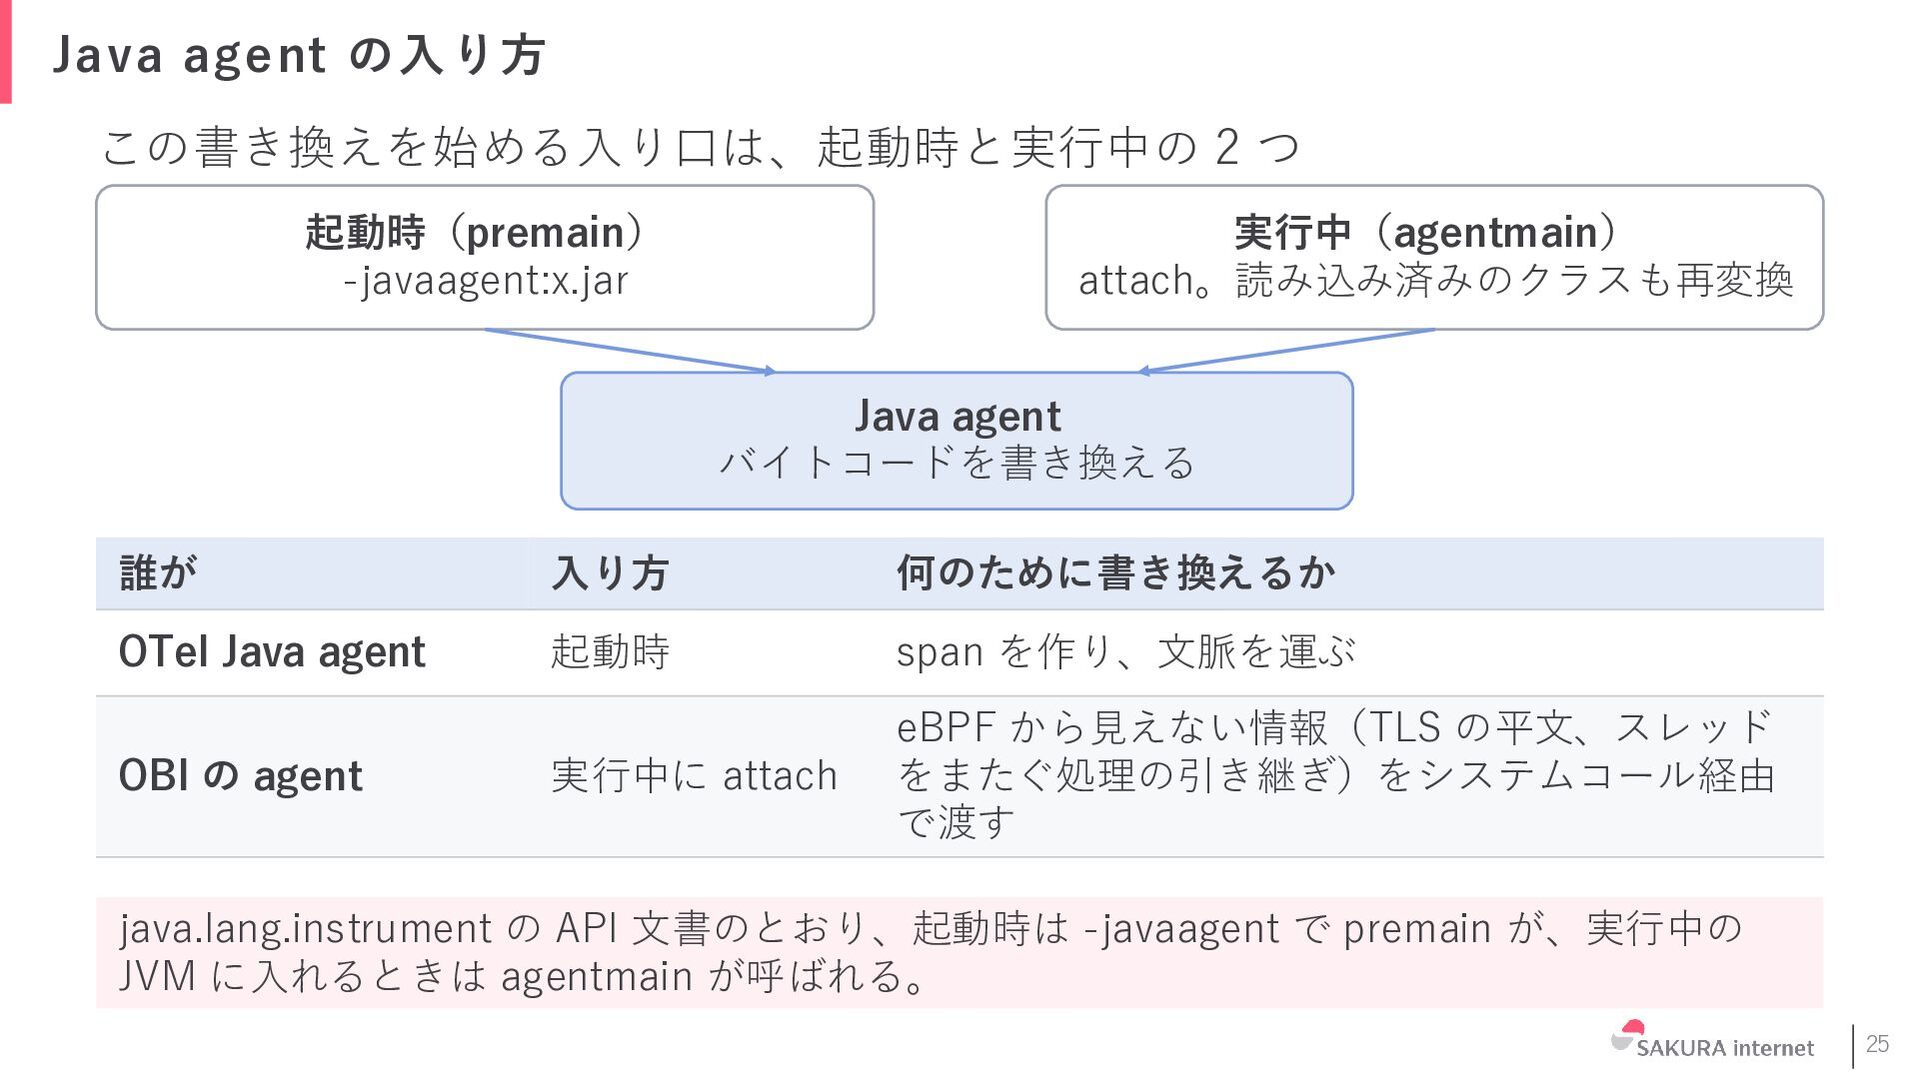
Java agent の⼊り⽅ この書き換えを始める入り口は、起動時と実行中の 2 つ 起動時(premain) -javaagent:x.jar 実行中(agentmain) attach。読み込み済みのクラスも再変換
Java agent バイトコードを書き換える 誰が 入り方 何のために書き換えるか OTel Java agent (※OBIとは別) 起動時 対応するライブラリの呼び出しごとに span を作 り、⽂脈を運ぶ 実行中に attach eBPF から見えない情報(TLS の平文、スレッド をまたぐ処理の引き継ぎ)をシステムコール経由 で渡す OBI の agent java.lang.instrument の API 文書のとおり、起動時は -javaagent で premain が、 実行中の JVM に入れるときは agentmain が呼ばれる。 21 -
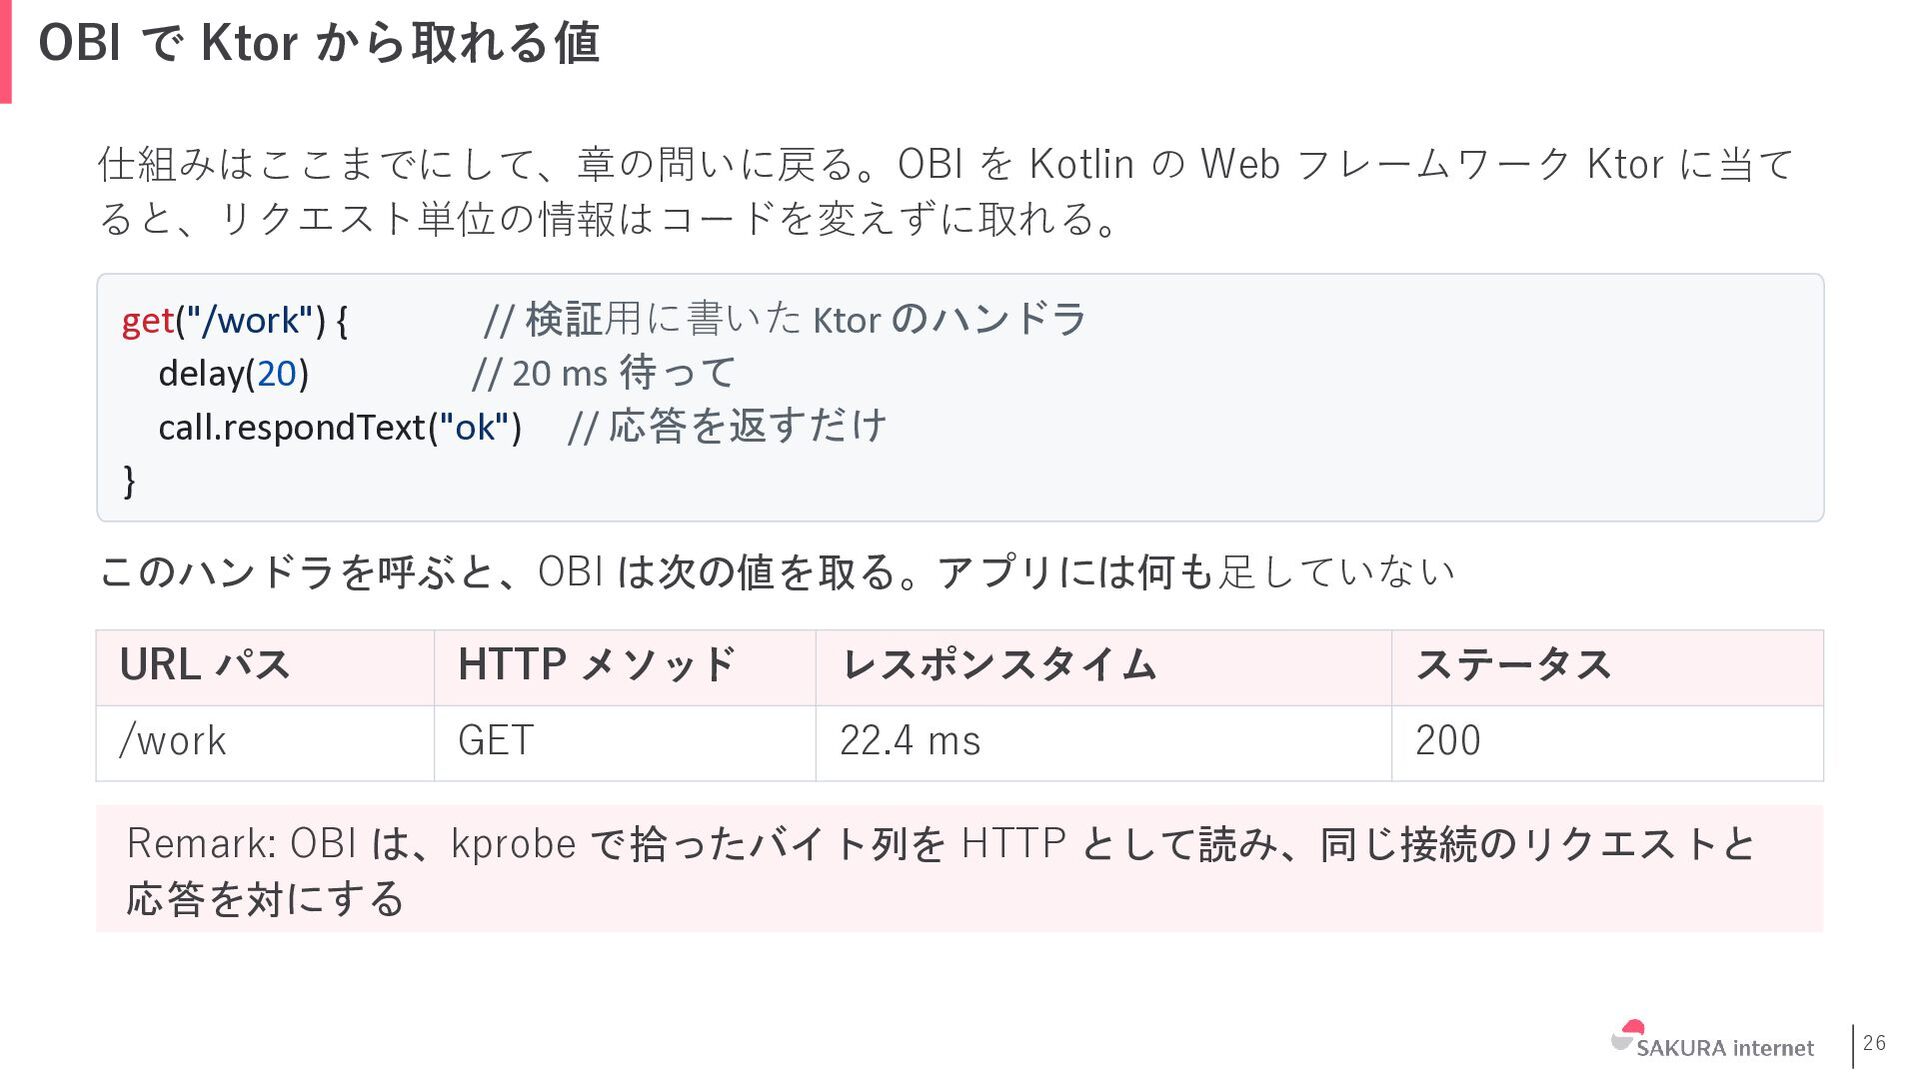
OBI で Ktor から取れる値 仕組みはここまでにして、実際にトレースできるかを見る。 OBI を Kotlin の Web
フレームワーク Ktor に当てると、リクエスト単位の情報はコードを 変えずに取れる。 get("/work") { // 検証⽤に書いた Ktor のハンドラ delay(20) // 20 ms 待って call.respondText("ok") // 応答を返すだけ } このハンドラを呼ぶと、OBI は次の値を取る。アプリには何も⾜していない URL パス HTTP メソッド レスポンスタイム ステータス /work GET 22.4 ms 200 Remark: kprobe で拾うのは受信した GET /work HTTP/1.1 と、送信した `HTTP/1.1 200 OK` というバイト列である。OBI は、1 つ目からメソッドとパスを、2 つ目からステータス を読み、二つの時刻の差をレスポンスタイムにすることで取り出している 26 -
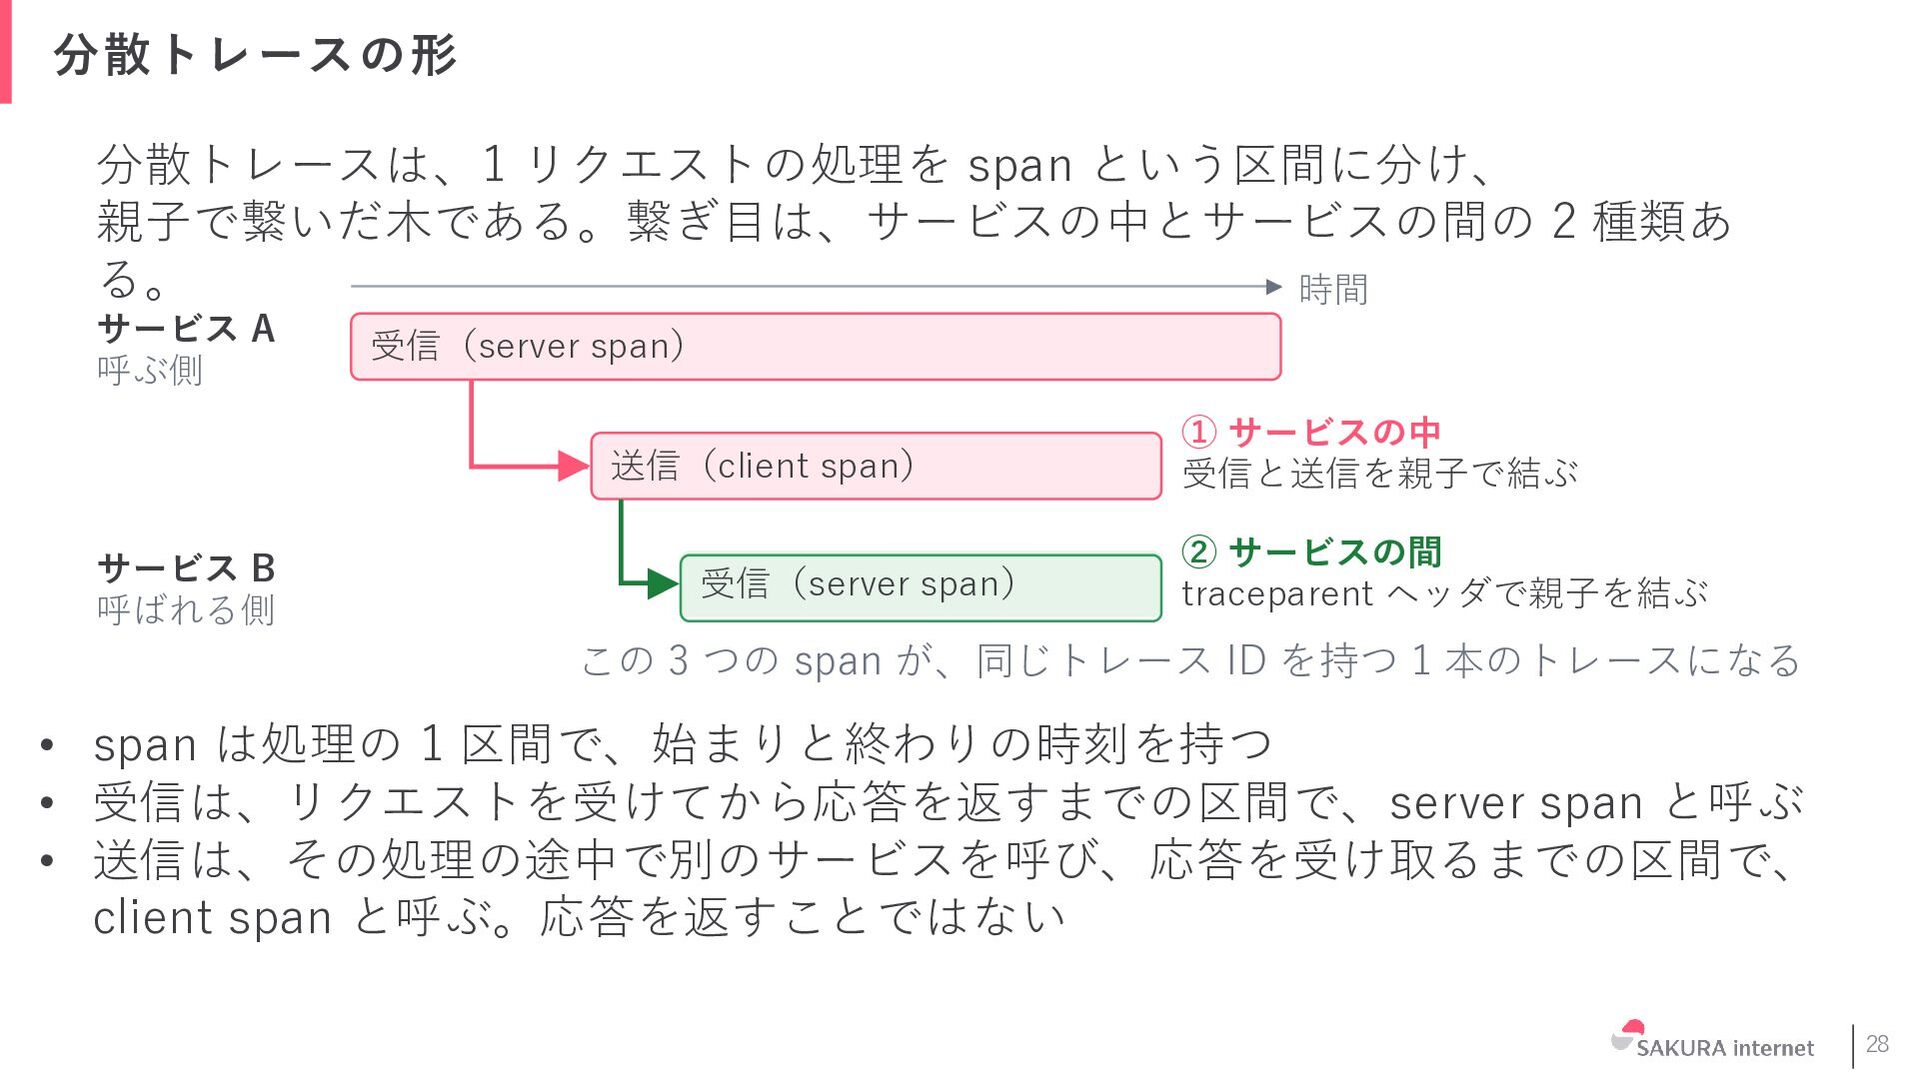
分散トレースの形 分散トレースは、1 リクエストの処理を span という区間に分け、 親⼦で繋いだ⽊である。繋ぎ⽬は、サービスの中とサービスの間の 2 種類ある。 時間 サービス
A 呼ぶ側 受信(server span) 送信(client span) サービス B 呼ばれる側 受信(server span) ① サービスの中 受信と送信を親⼦で結ぶ ② サービスの間 traceparent ヘッダで親⼦を結ぶ この 3 つの span が、同じトレース ID を持つ 1 本のトレースになる • span は処理の 1 区間で、始まりと終わりの時刻を持つ • 受信は、リクエストを受けてから応答を返すまでの区間で、server span と呼ぶ • 送信は、その処理の途中で別のサービスを呼び、応答を受け取るまでの区間で、 client span と呼ぶ。応答を返すことではない 24 -
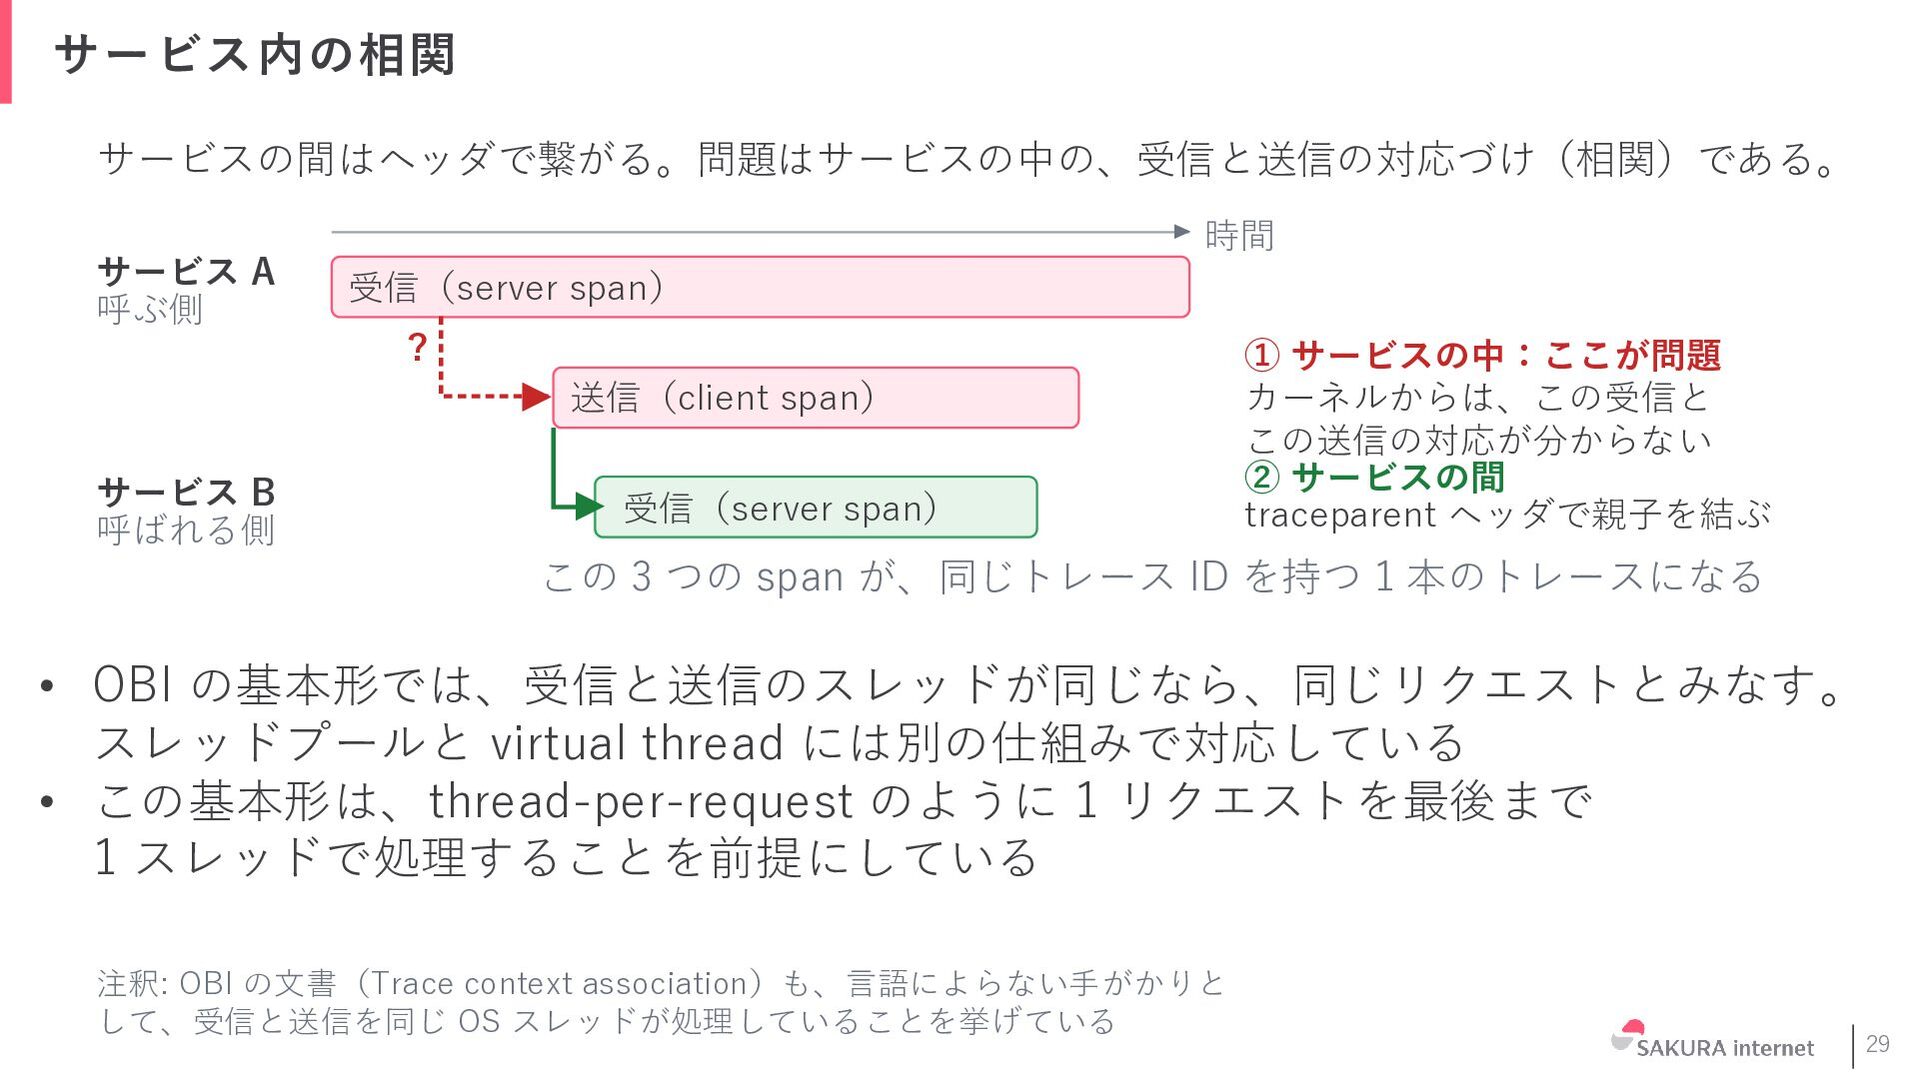
サービス内の相関 サービスの間はヘッダで繋がる。問題はサービスの中の、受信と送信の対応づけ(相関)である。 時間 サービス A 呼ぶ側 受信(server span) ? 送信(client
span) サービス B 呼ばれる側 受信(server span) ① サービスの中:ここが問題 カーネルからは、この受信と この送信の対応が分からない ② サービスの間 traceparent ヘッダで親⼦を結ぶ この 3 つの span が、同じトレース ID を持つ 1 本のトレースになる • OBI の基本形では、受信と送信のスレッドが同じなら、同じリクエストとみなす。 スレッドプールと virtual thread には別の仕組みで対応している • この基本形は、thread-per-request のように 1 リクエストを最後まで 1 スレッドで処理することを前提にしている 注釈: OBI の⽂書(Trace context association)も、⾔語によらない⼿がかりと して、受信と送信を同じ OS スレッドが処理していることを挙げている 25 -
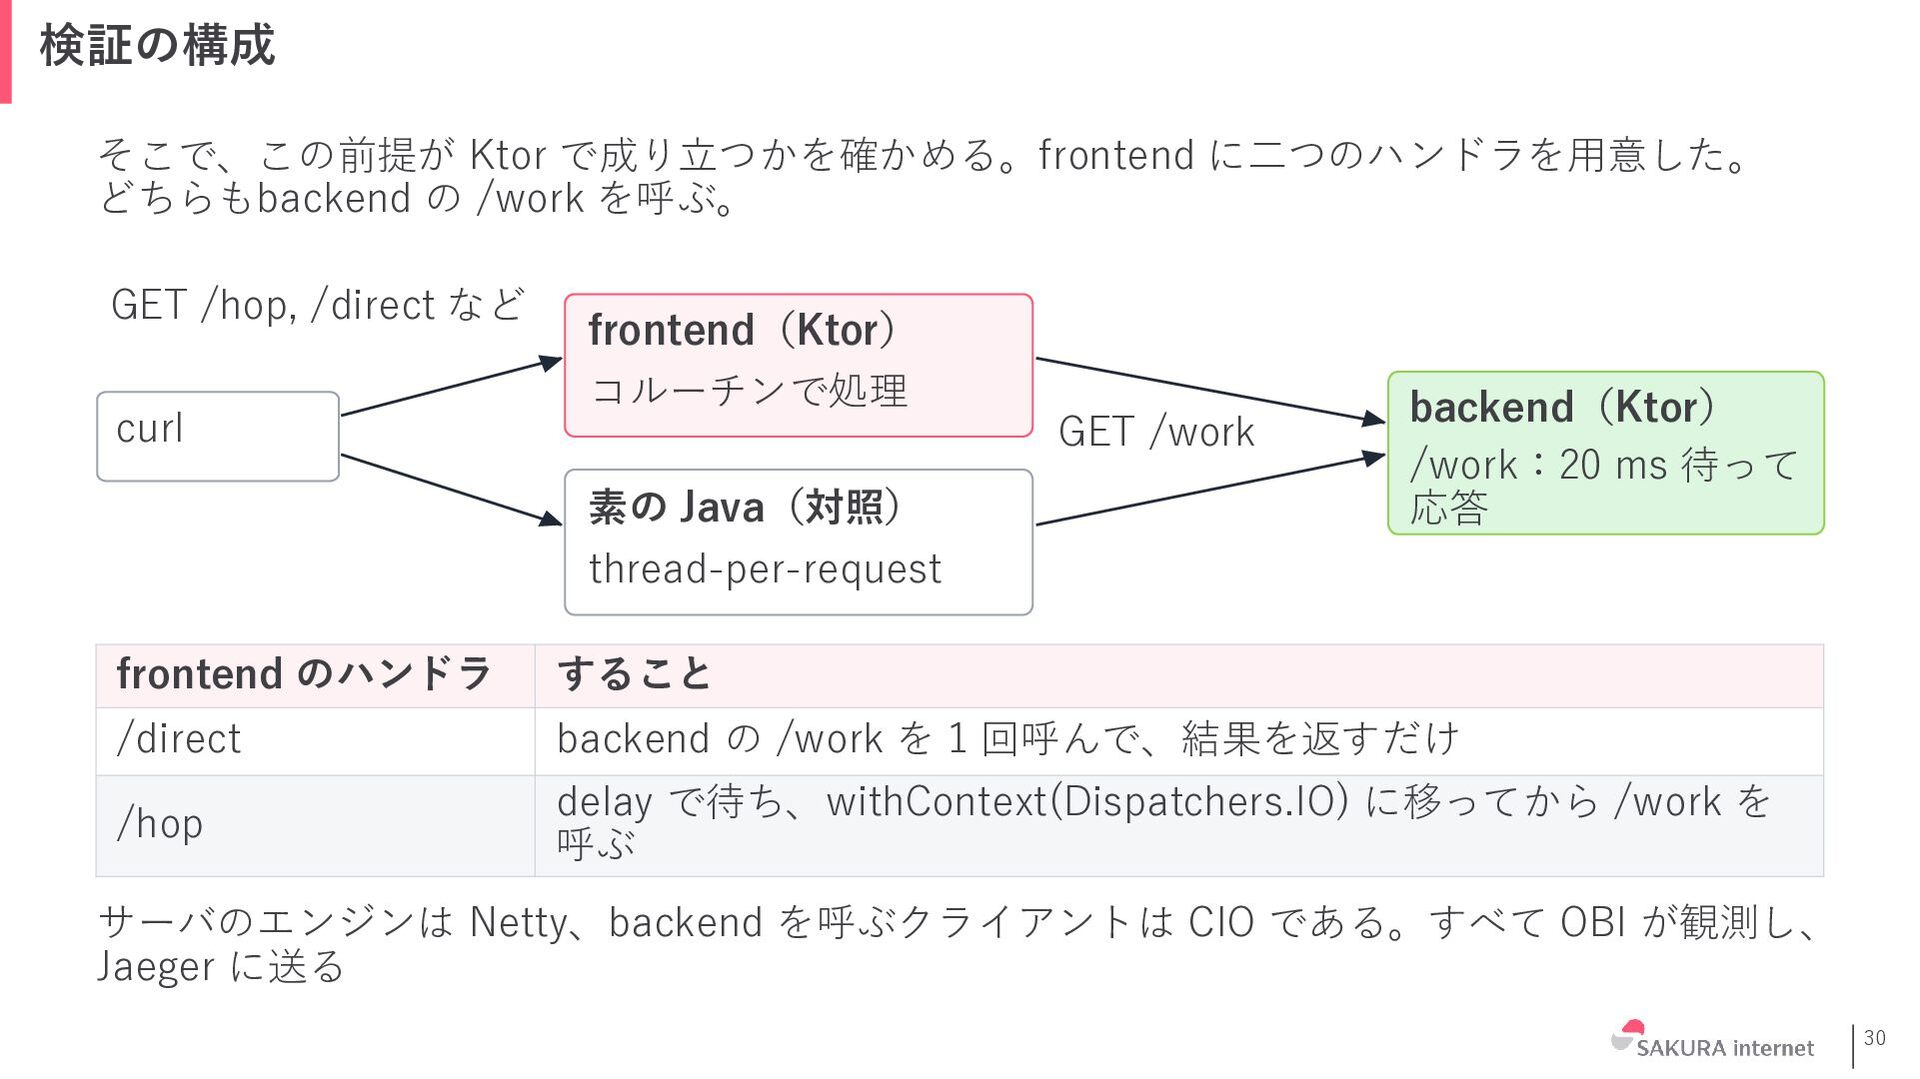
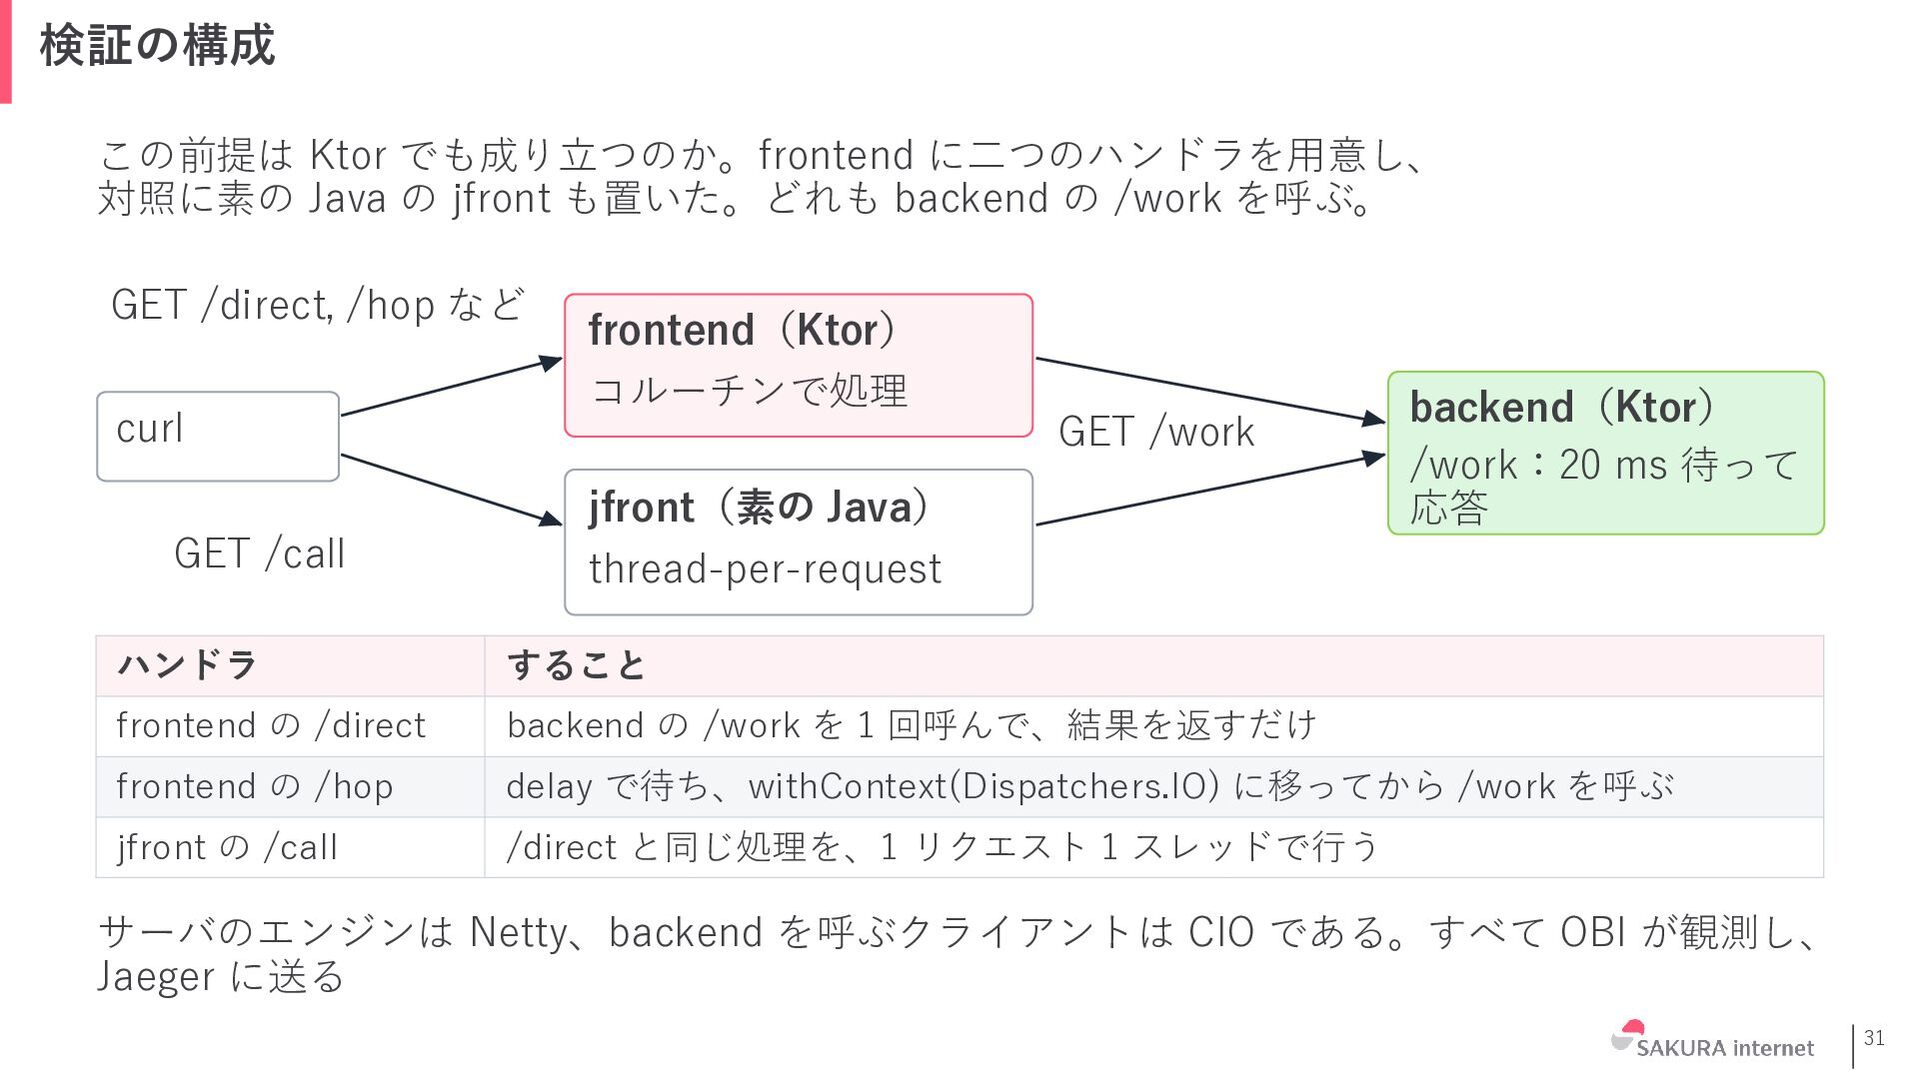
検証の構成 この前提は Ktor でも成り⽴つのか。確かめるために、Ktor の frontend から backend の /work
を呼ぶ構成を用意した。対照として、同じことをする素の Java のサービスも置いた。 GET /direct など curl frontend(Ktor) コルーチンで処理 GET /work 対照(素の Java) GET /call backend(Ktor) /work:20 ms 待って 応答 thread-per-request ハンドラ 作り方 すること frontend の /direct Ktor(コルーチン) backend の /work を 1 回呼んで、 結果を返すだけ 対照 の /call 素の Java(JDK 標準の HTTP サーバ、 1 リクエストを 1スレッドで処理) 同じ サーバのエンジンは Netty、backend を呼ぶクライアントは CIO である。すべて OBI が観測し、 Jaeger に送る 31 -
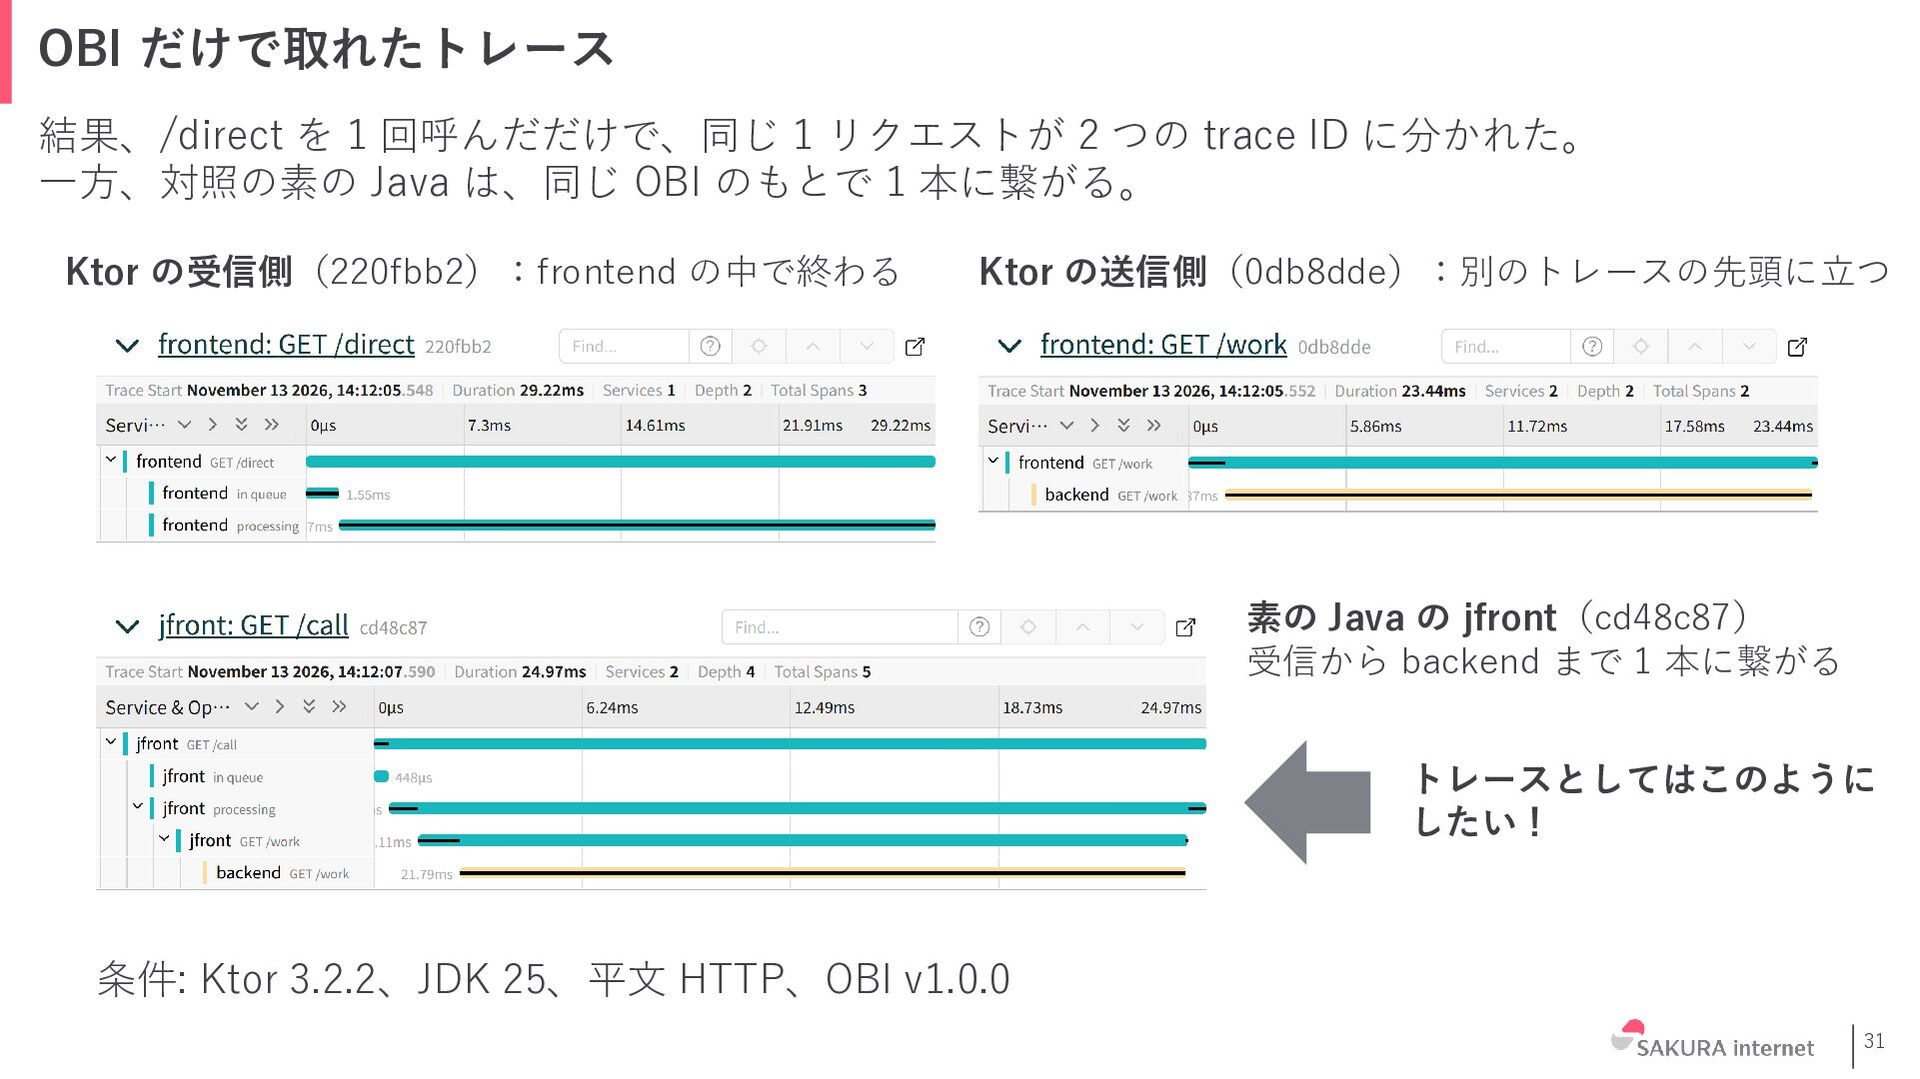
OBI だけで取れたトレース 結果、/direct を 1 回呼んだだけで、同じ 1 リクエストが 2 つの
trace ID に分かれた。 ⼀⽅、対照の素の Java は、同じ OBI のもとで 1 本に繋がる。 Ktor の受信側(220fbb2):frontend の中で終わる Ktor の送信側(0db8dde):別のトレースの先頭に⽴つ 対照の素の Java (cd48c87) 受信から backend まで 1 本に繋がる トレースとしては このようにしたい! 条件: Ktor 3.2.2、JDK 25、平⽂ HTTP、OBI v1.0.0 31 -
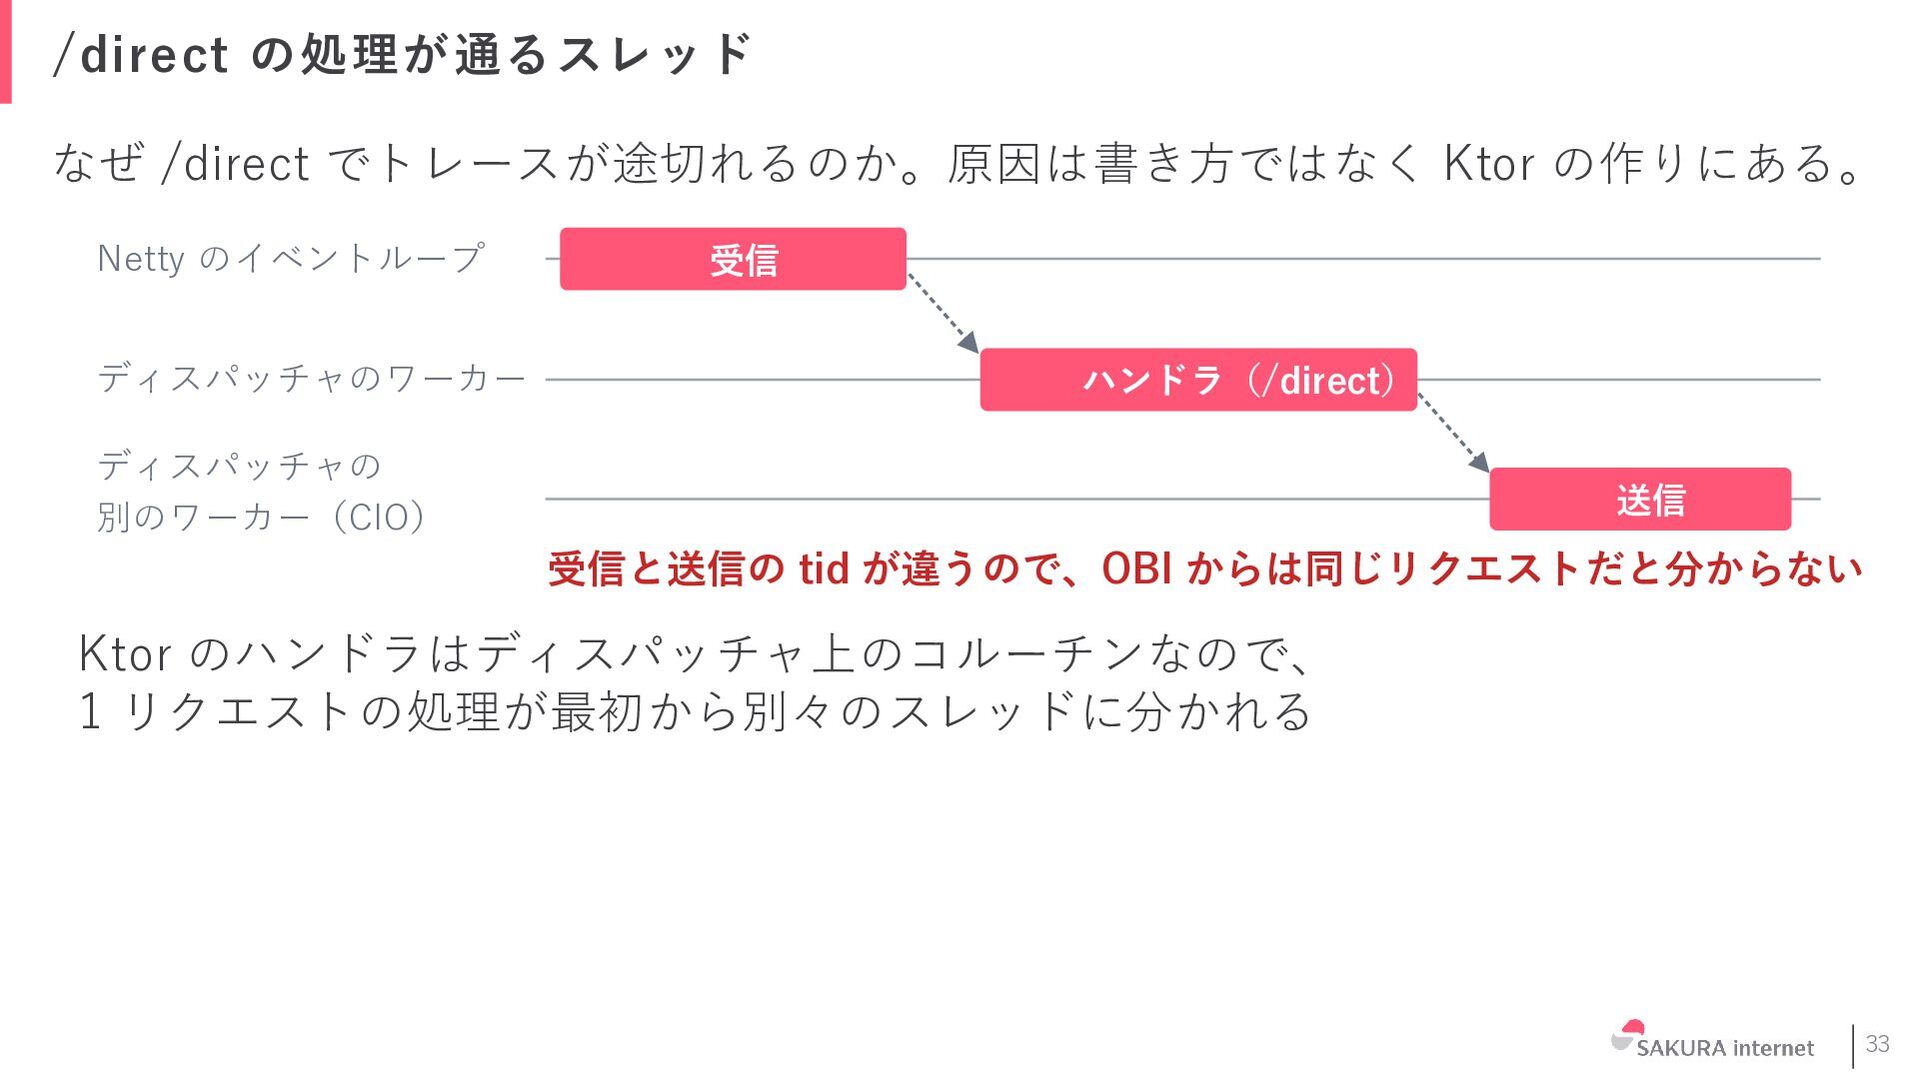
/direct の処理が通るスレッド なぜ /direct でトレースが途切れるのか。原因は書き⽅ではなく Ktor の作りにある。 Netty のイベントループ ディスパッチャのワーカー
ディスパッチャの 別のワーカー(CIO) 受信 ハンドラ(/direct) 送信 受信と送信の tid が違うので、OBI からは同じリクエストだと分からない OBI が⽐べるのは、受信のスレッドと送信のスレッドである。 Ktor では、ハンドラもクライアントもそれぞれのディスパッチャの上で動くので、 この⼆つが最初から違う 28 -
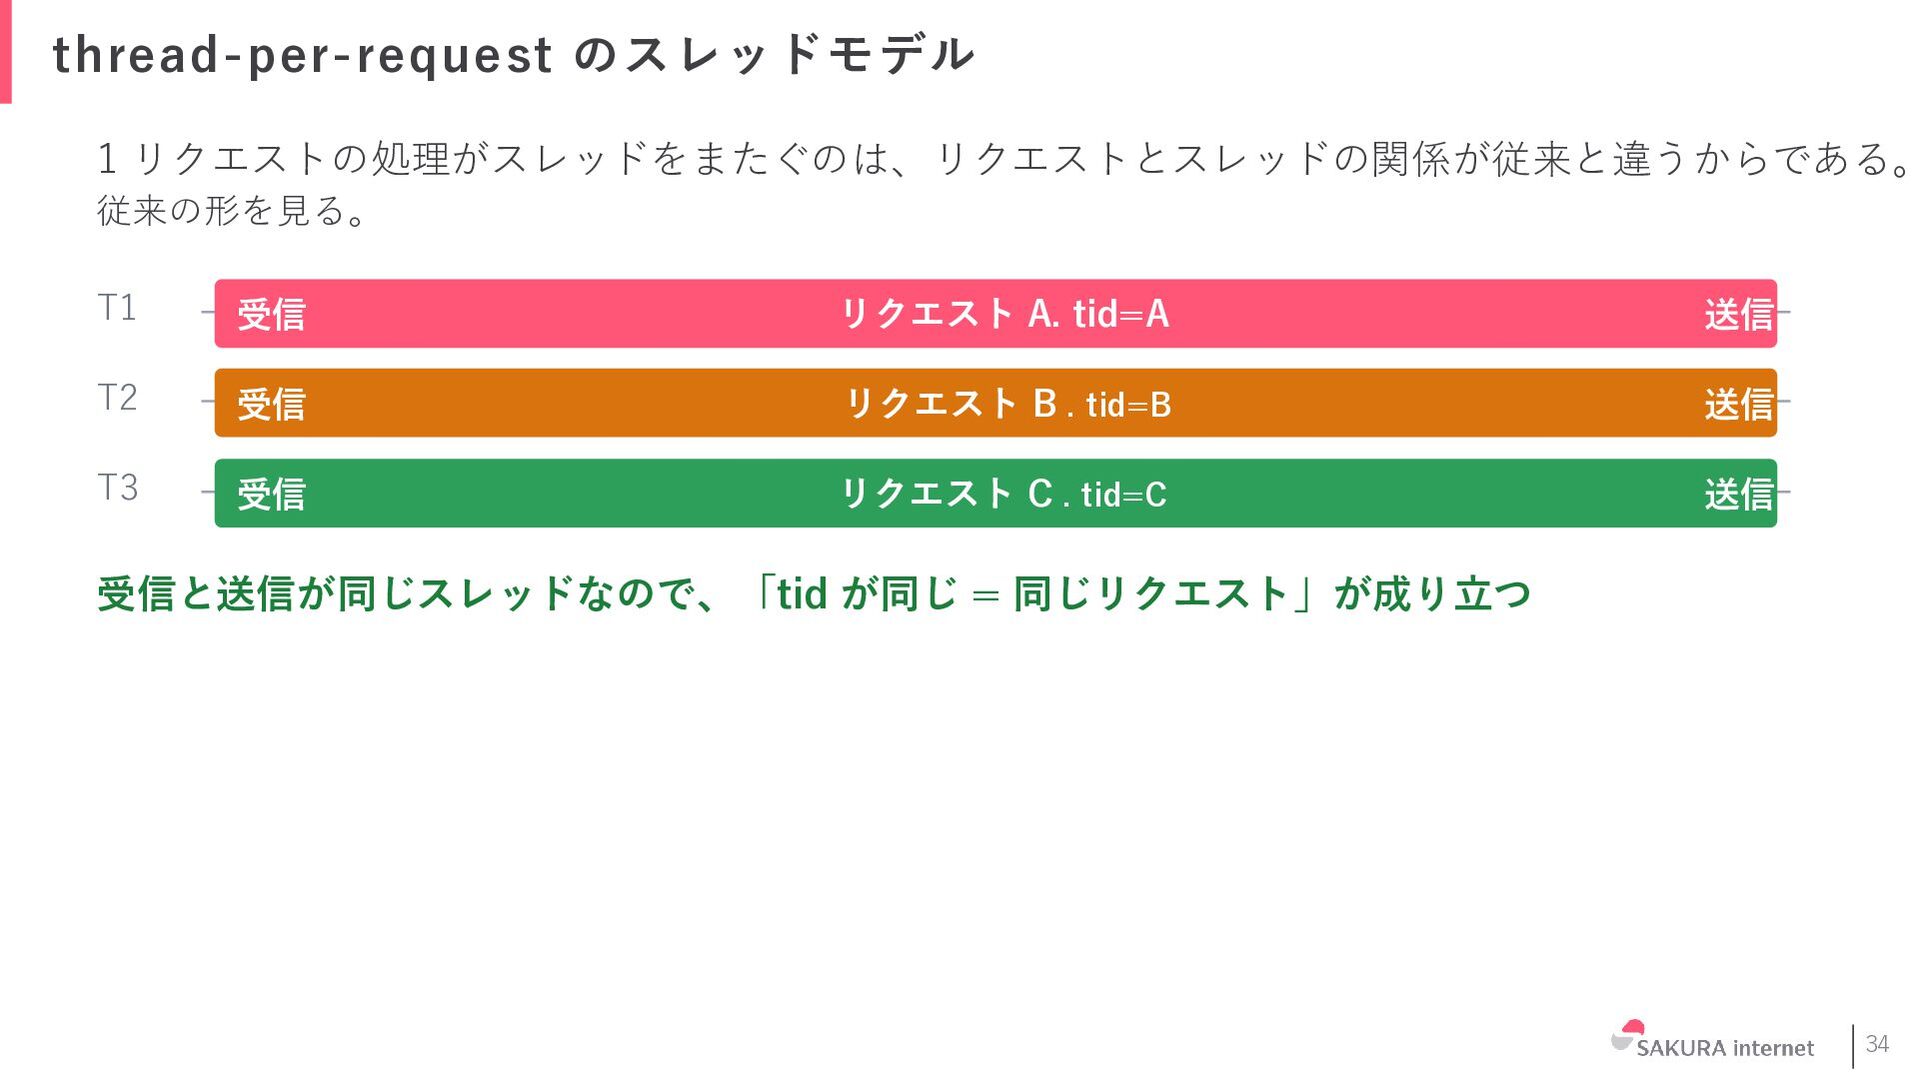
thread-per-request のスレッドモデル コルーチンでは、リクエストとスレッドの関係そのものが従来と違う。 まず従来の形を⾒る。 T1 受信 リクエスト A. tid=A 送信
T2 受信 リクエスト B . tid=B 送信 T3 受信 リクエスト C . tid=C 送信 受信と送信が同じスレッドなので、「tid が同じ = 同じリクエスト」が成り⽴つ 29 -
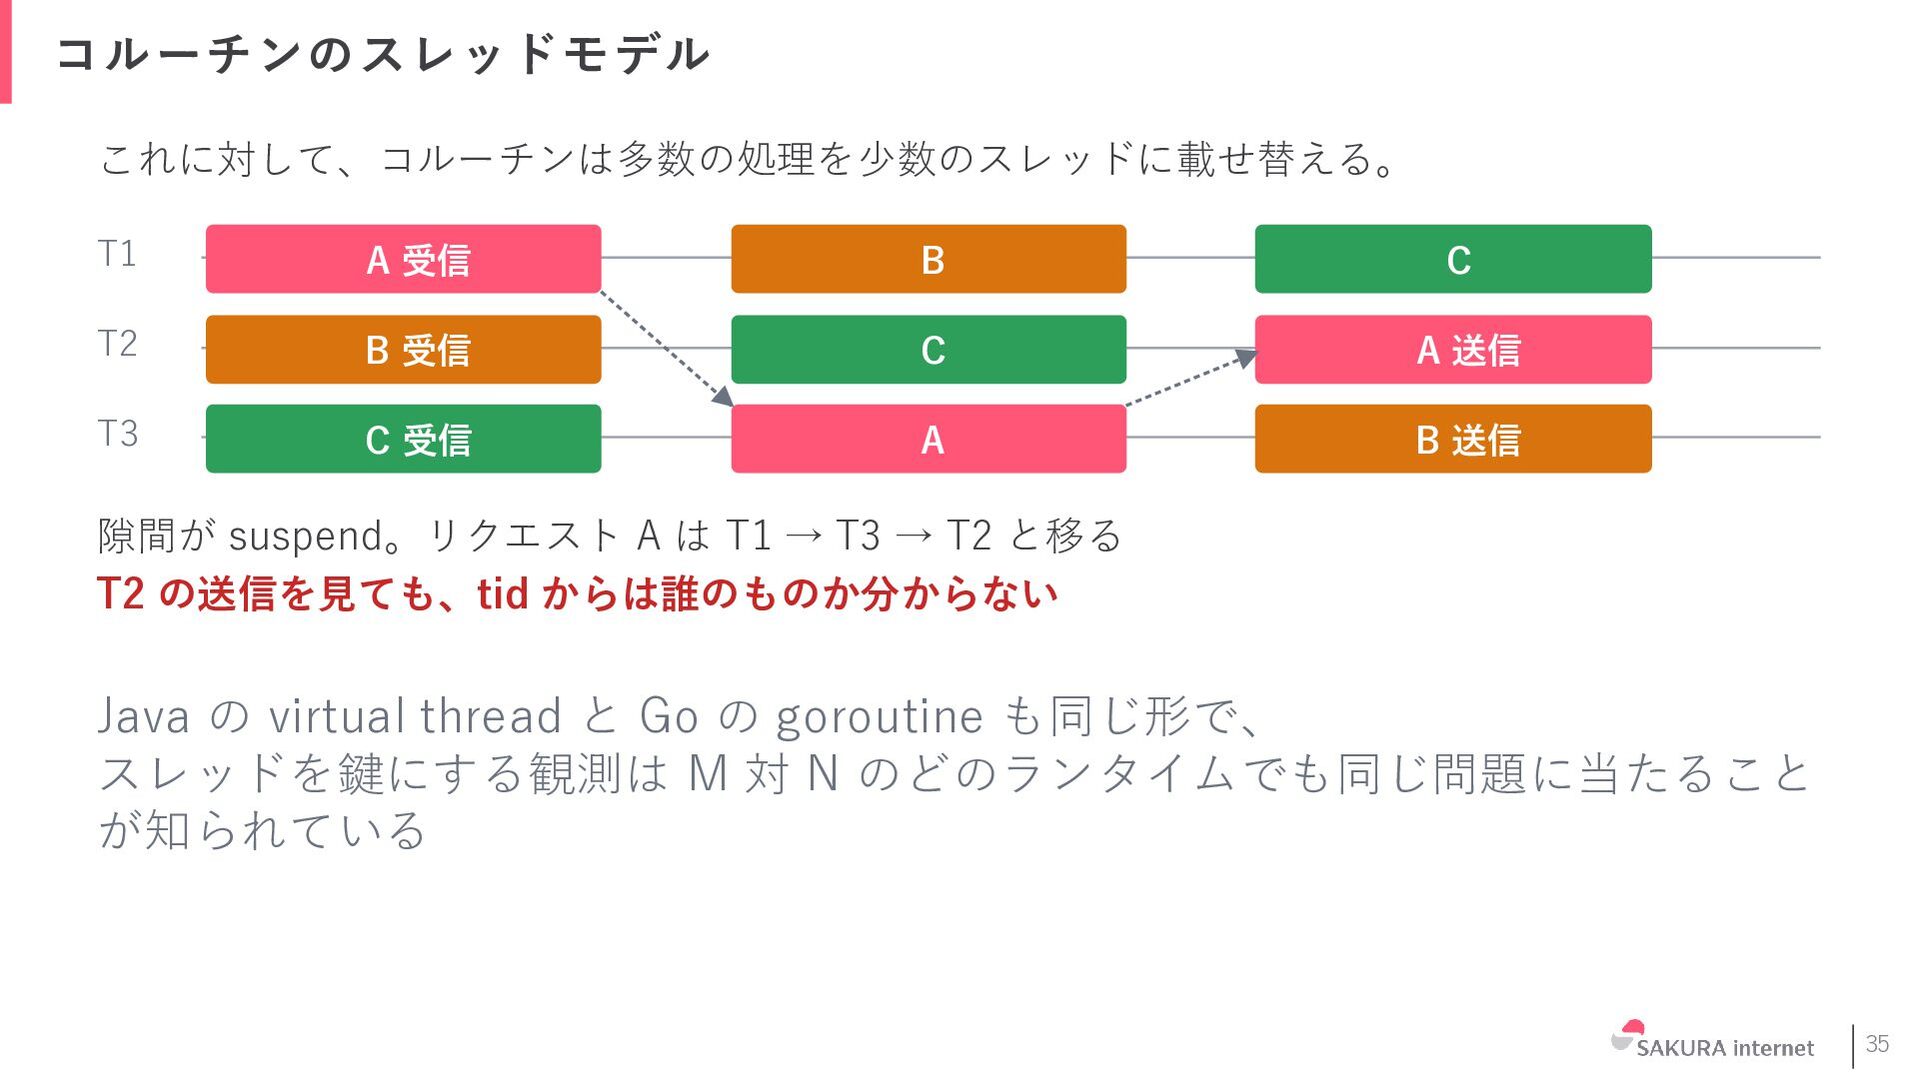
コルーチンのスレッドモデル これに対して、コルーチンは多数の処理を少数のスレッドに載せ替える。 どのスレッドに載るかは、毎回変わる。 T1 A 受信 B C T2 B
受信 C A 送信 T3 C 受信 A B 送信 隙間が suspend。リクエスト A は T1 → T3 → T2 と移る T2 の送信を⾒ても、tid からは誰のものか分からない suspend(中断)とは、コルーチンが delayや通信の応答待ちで処理を止めて、 スレッドを手放すこと。再開時はディスパッチャが選んだスレッドに載るので 元のスレッドとは限らない 多数の処理を少数のスレッドに載せ替える形を、M 対 N と呼ぶ。Java の virtual thread と Go の goroutine も同じ形で、スレッド自体をkeyにする観測は、 どのランタイムでも同じ問題に当たる 30 -
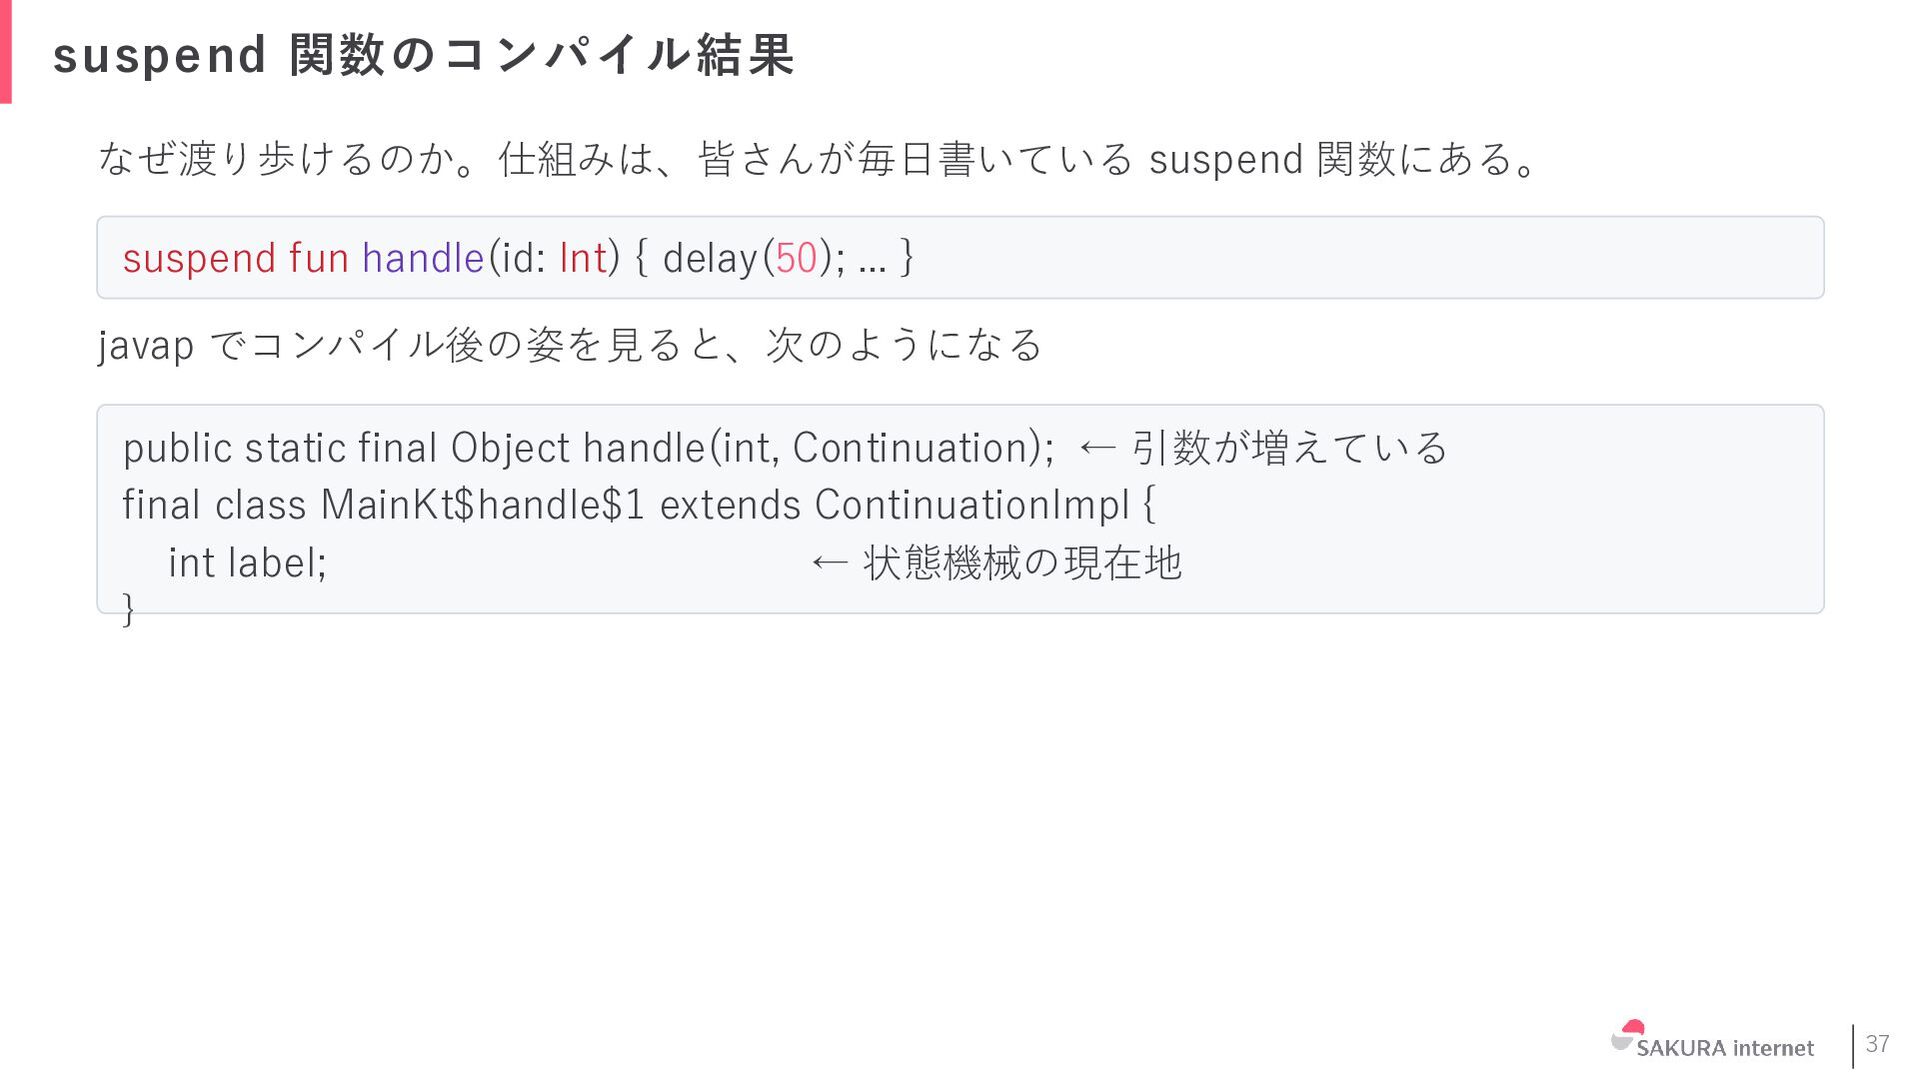
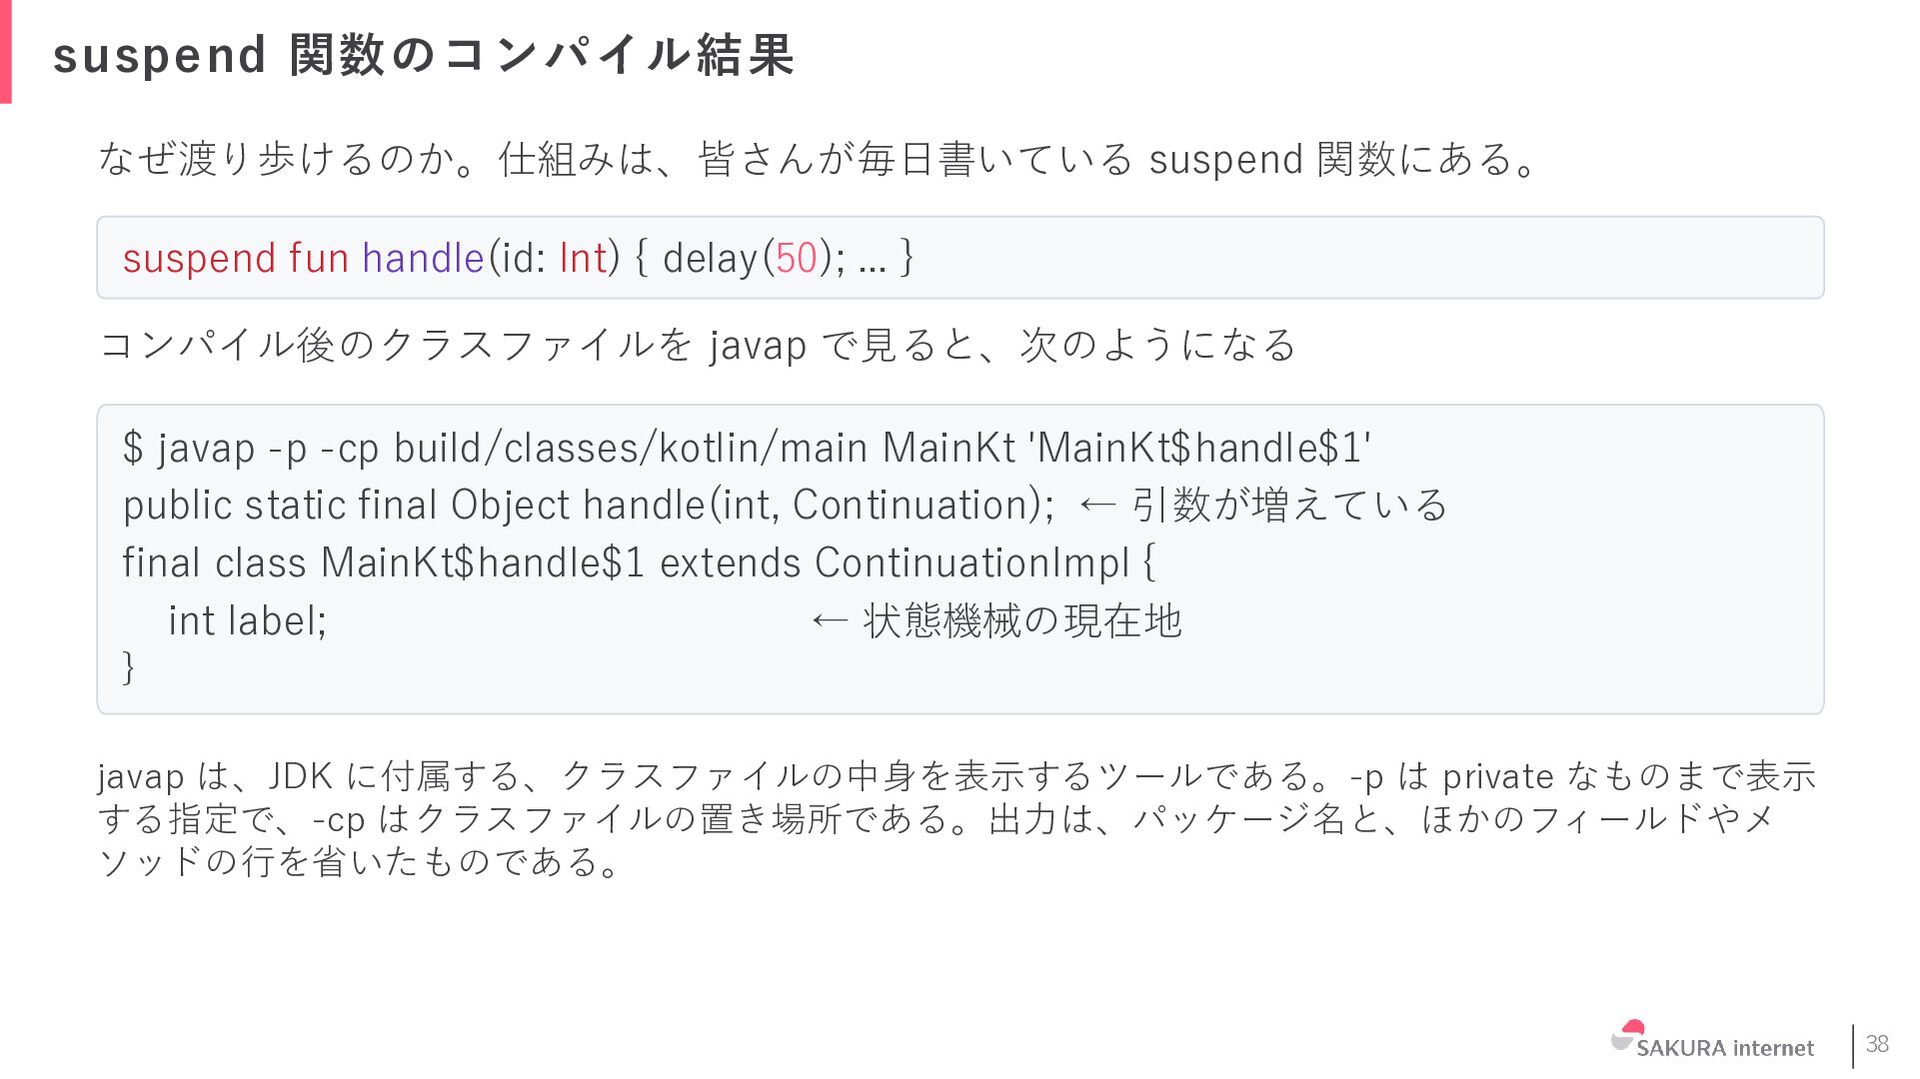
suspend 関数のコンパイル結果 では、スレッドの代わりに、何がリクエストを見分けるのか。 =>答えはsuspend 関数にある! suspend fun handle(id: Int) {
delay(50); ... } コンパイル後のクラスファイルを javap で⾒ると、次のようになる $ javap -p -cp build/classes/kotlin/main MainKt 'MainKt$handle$1' public static final Object handle(int, Continuation); ← 引数が増えている final class MainKt$handle$1 extends ContinuationImpl { int label; ← 状態機械の現在地 } javap は、JDK に付属する、クラスファイルの中⾝を表⽰するツールである。-p は private なものまで表⽰ する指定で、-cp はクラスファイルの置き場所である。出⼒は、パッケージ名と、ほかのフィールドやメ ソッドの⾏を省いたものである。 =>つまりContinuationに処理の続きを持つ領域がある 31 -
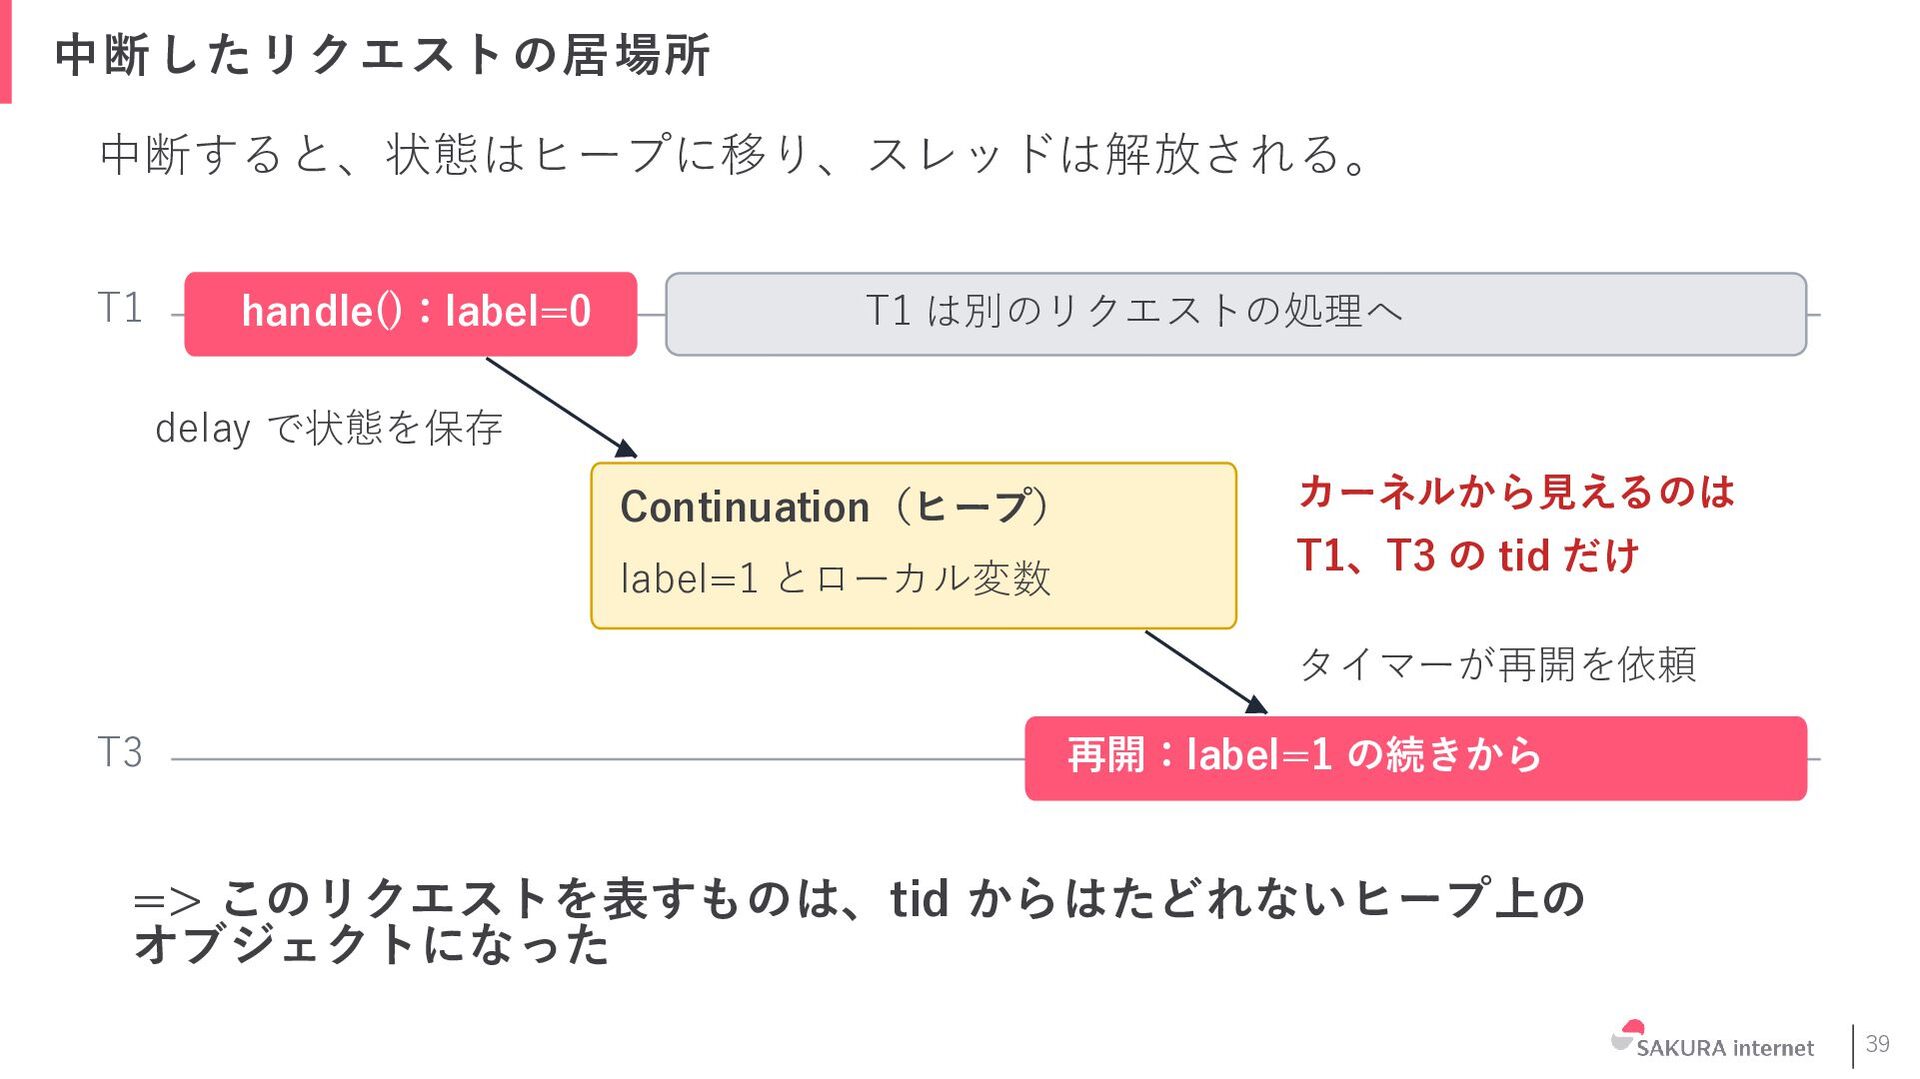
中断したリクエストの居場所 しかし、、、Continuation は JVM のヒープにあり、カーネルからは見れない T1 handle():label=0 T1 は別のリクエストの処理へ delay
で状態を保存 Continuation(ヒープ) label=1 とローカル変数 カーネルから⾒えるのは T1、T3 の tid だけ タイマーが再開を依頼 T3 再開:label=1 の続きから => このリクエストを表すものは、tid からはたどれないヒープ上の オブジェクトになった 32 -
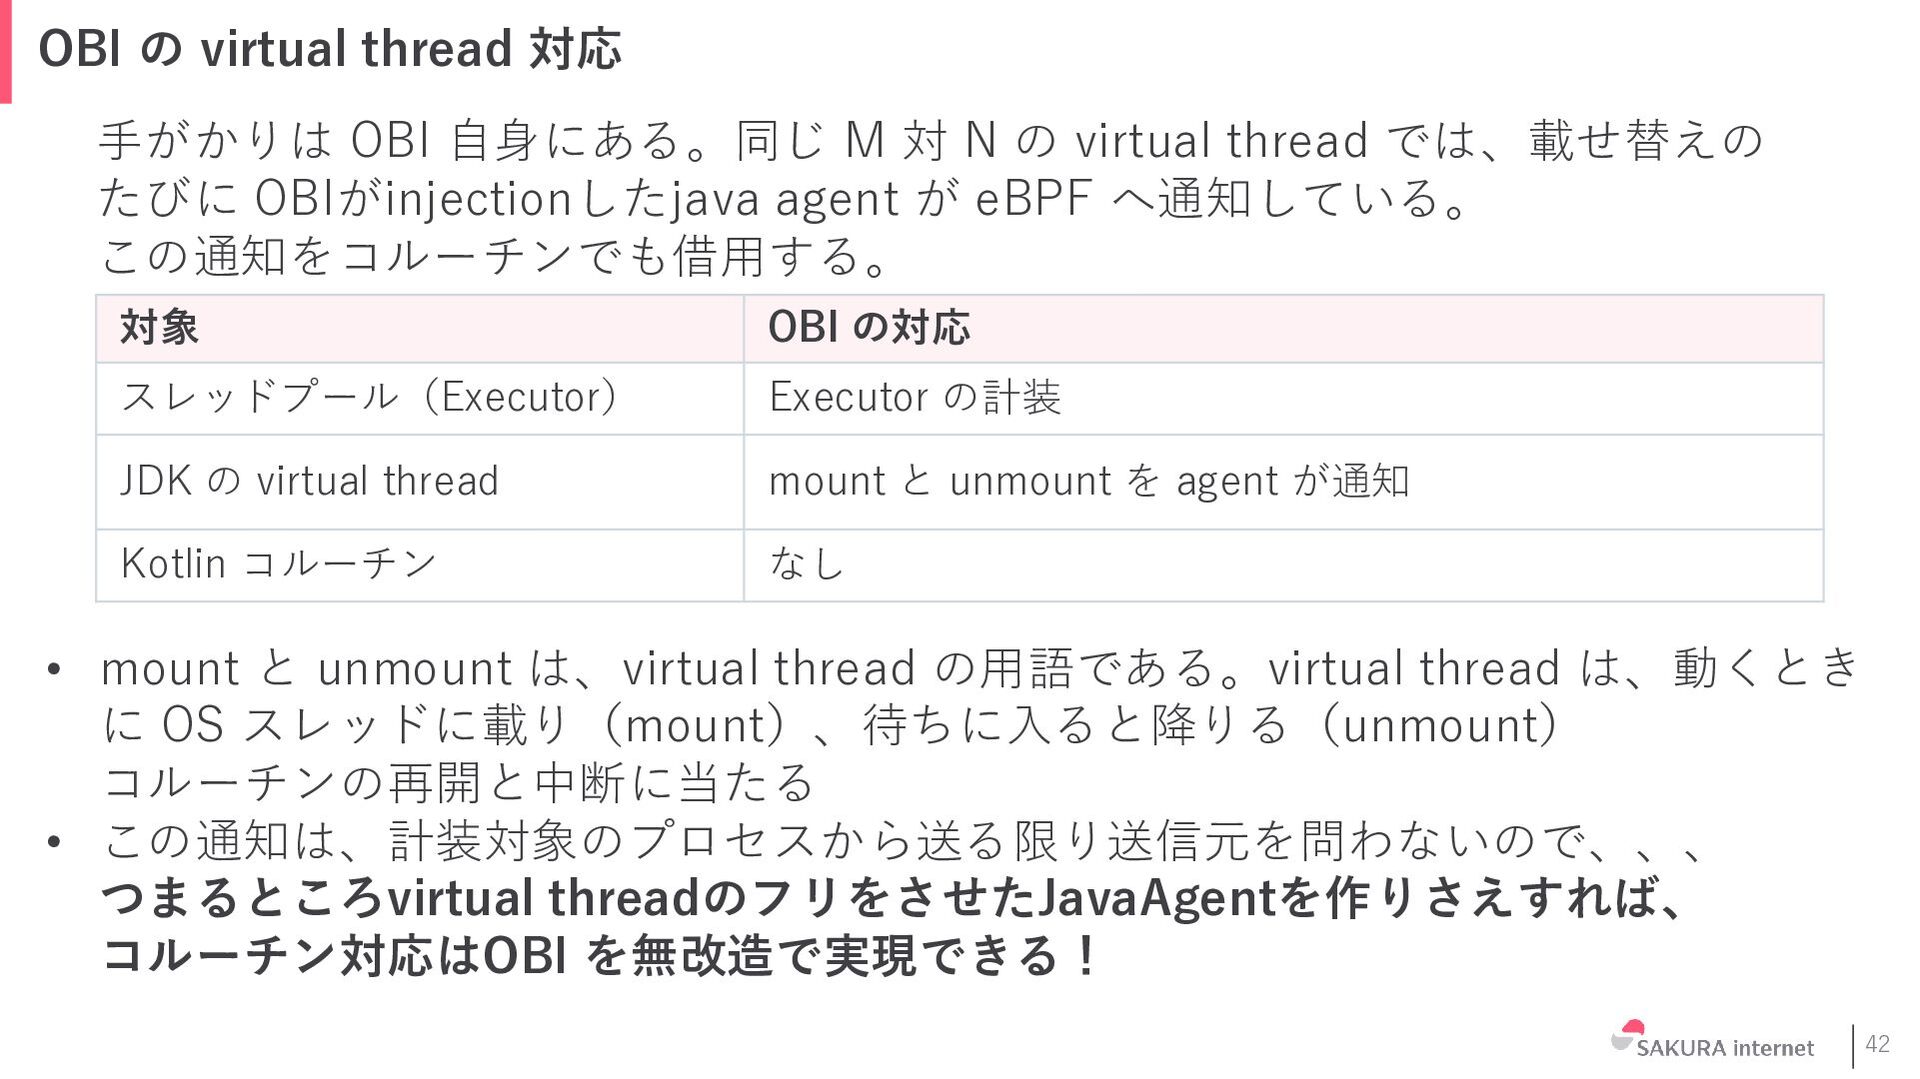
OBI の virtual thread 対応 手がかりは OBI 自身にある。同じ M 対
N の virtual thread では、載せ替えの たびに OBIがinjectionしたjava agent が eBPF へ通知している。 この通知をコルーチンでも借用する。 対象 OBI の対応 スレッドプール(Executor) Executor の計装 JDK の virtual thread mount と unmount を agent が通知 Kotlin コルーチン なし • mount と unmount は、virtual thread の⽤語である。virtual thread は、動くとき に OS スレッドに載り(mount)、待ちに⼊ると降りる(unmount) コルーチンの再開と中断に当たる • この通知は、計装対象のプロセスから送る限り送信元を問わないので、、、 つまるところvirtual threadのフリをさせたJavaAgentを作りさえすれば、 コルーチン対応はOBI を無改造で実現できる! ちなみに、今回の成果物はこちら https://github.com/takehaya/obi-kotlin-coroutine-poc/tree/master/agent 34 -
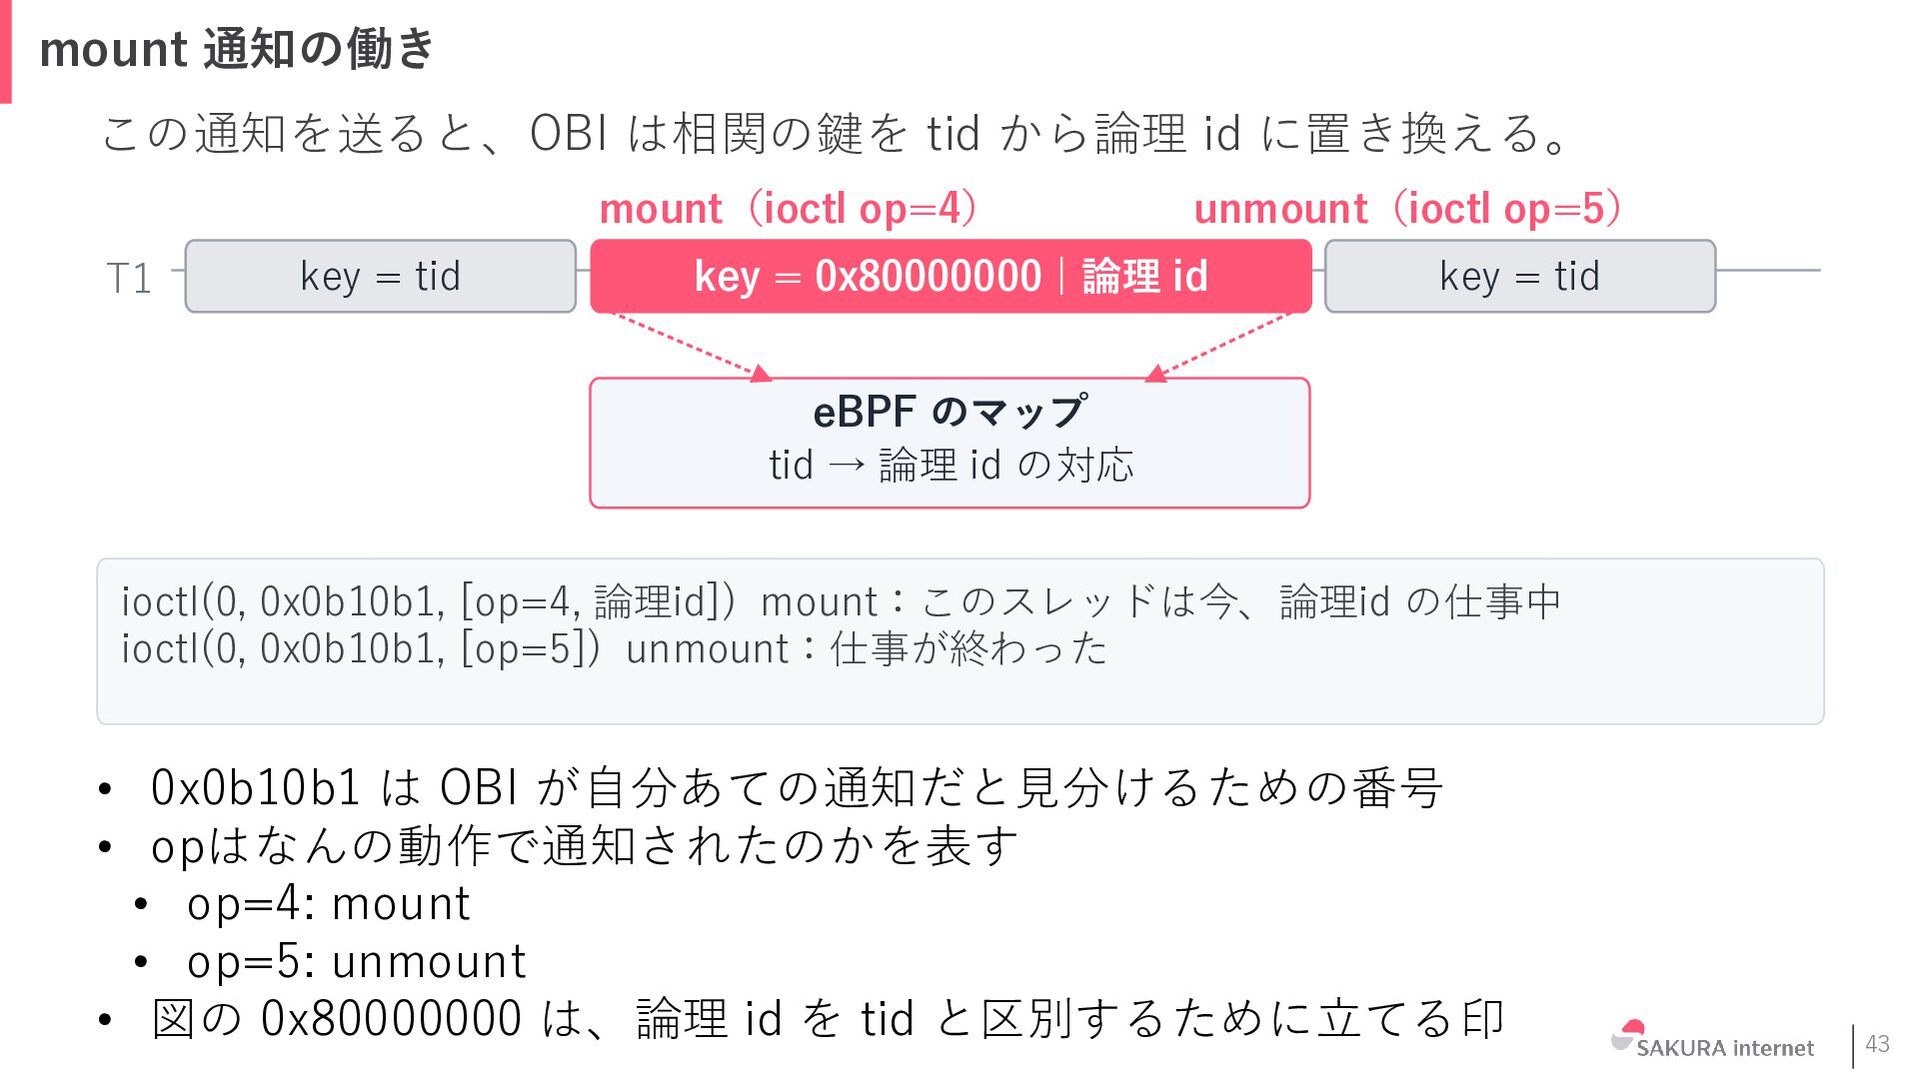
mount 通知の働き この通知を送ると、OBI は相関の鍵を tid から論理 id に置き換える。 mount(ioctl op=4)
T1 key = tid unmount(ioctl op=5) key = 0x80000000 | 論理 id key = tid eBPF のマップ tid → 論理 id の対応 ioctl(0, 0x0b10b1, [op=4, 論理id]) mount:このスレッドは今、論理id の仕事中 ioctl(0, 0x0b10b1, [op=5]) unmount:仕事が終わった • 0x0b10b1 は OBI が自分あての通知だと見分けるための番号 • opはなんの動作で通知されたのかを表す • op=4: mount • op=5: unmount • 図の 0x80000000 は、論理 id を tid と区別するために立てる印 35 -
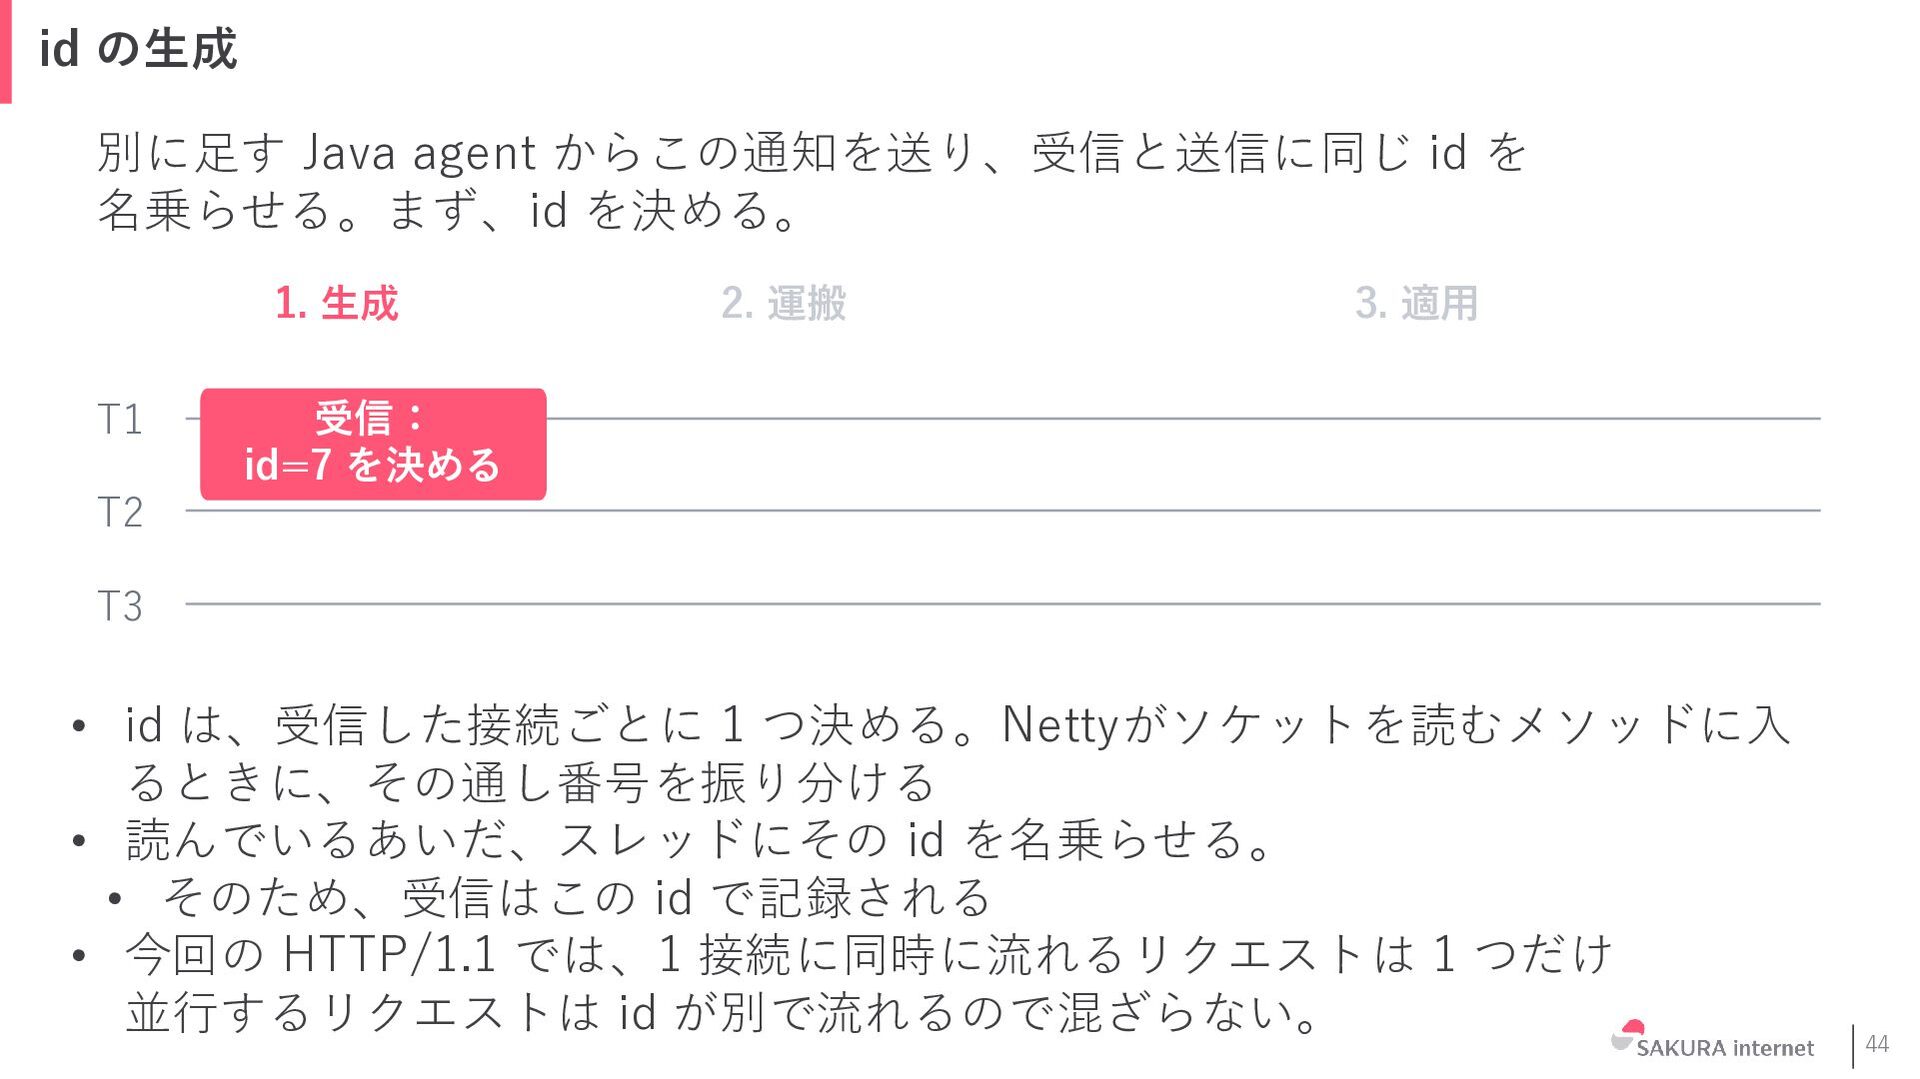
id の⽣成 別に⾜す Java agent からこの通知を送り、受信と送信に同じ id を 名乗らせる。まず、id を決める。
1. ⽣成 T1 2. 運搬 3. 適⽤ 受信: id=7 を決める T2 T3 • id は、受信した接続ごとに 1 つ決める。Nettyがソケットを読むメソッドに入 るときに、その通し番号を振り分ける • 読んでいるあいだ、スレッドにその id を名乗らせる。 • そのため、受信はこの id で記録される • 今回の HTTP/1.1 では、1 接続に同時に流れるリクエストは 1 つだけ 並行するリクエストは id が別で流れるので混ざらない。 36 -
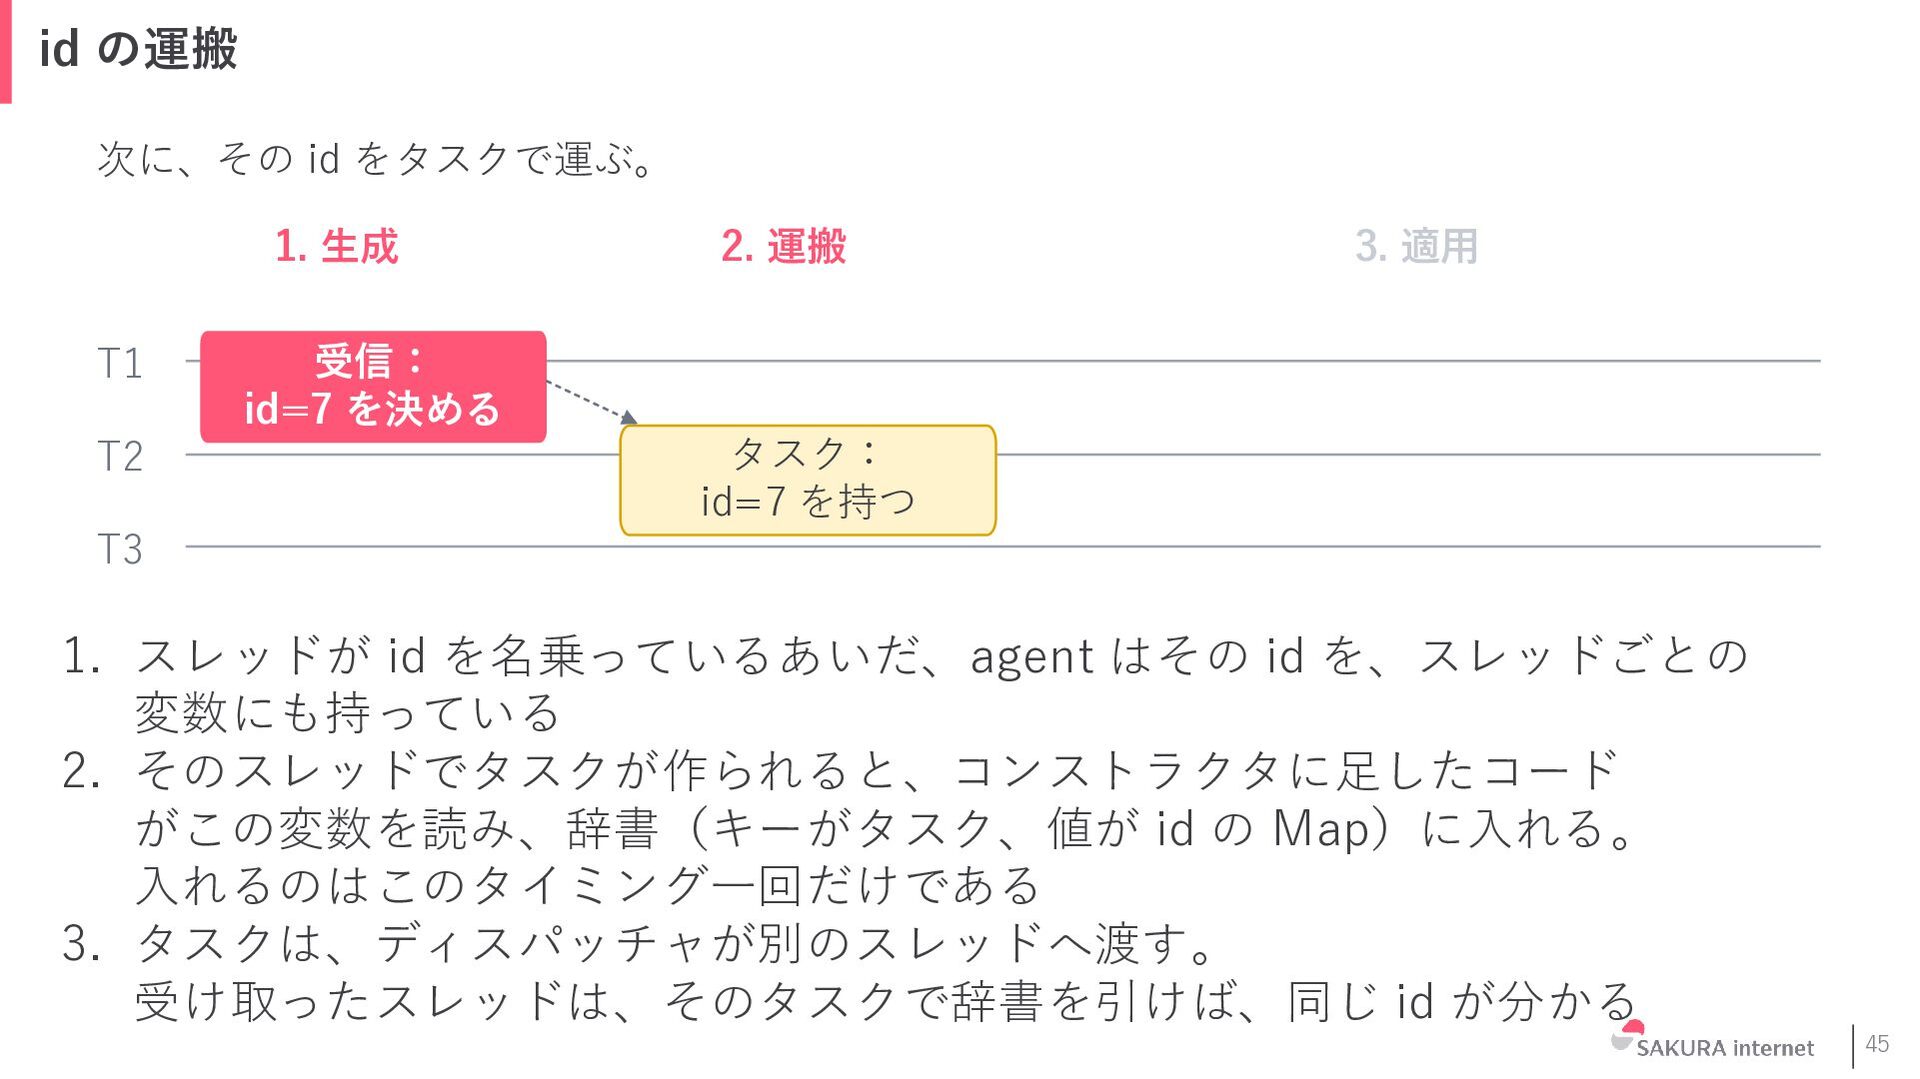
id の運搬 次に、その id をタスクで運ぶ。 1. ⽣成 T1 T2 2.
運搬 3. 適⽤ 受信: id=7 を決める タスク: id=7 を持つ T3 1. スレッドが id を名乗っているあいだ、agent は JVM の中に、 その id をスレッドごとの変数として持っている 2. そのスレッドでタスクが作られると、コンストラクタに足したコード がこの変数を読み、辞書(キーがタスク、値が id の Map)に入れる。 入れるのはこのタイミング一回だけである(他のスレッドでも読める様にする) 3. タスクは、ディスパッチャが別のスレッドへ渡す。 受け取ったスレッドは、そのタスクで辞書を引けば、受信で決めた id が分かる 37 -
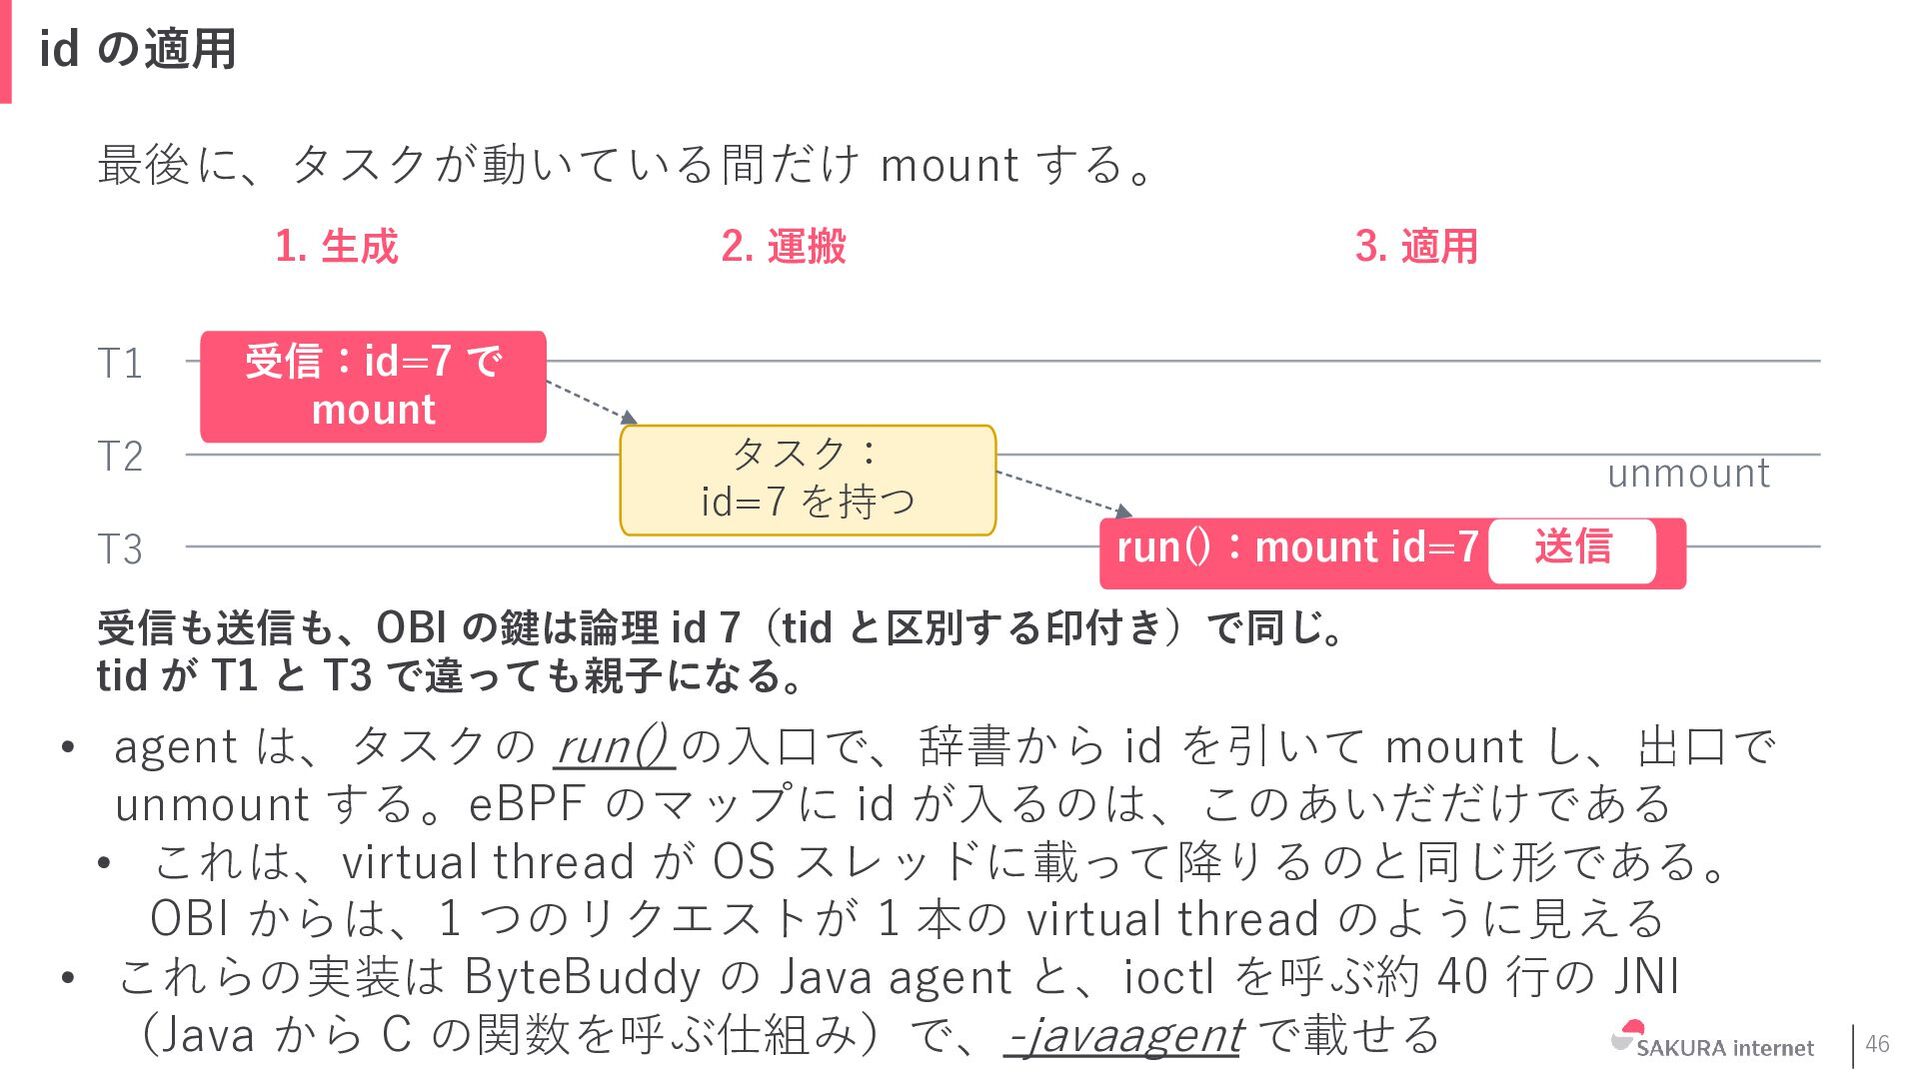
id の適⽤ 最後に、タスクが動いている間だけ mount する。 1. ⽣成 T1 T2 T3
2. 運搬 3. 適⽤ 受信:id=7 で mount タスク: id=7 を持つ unmount run():mount id=7 送信 受信も送信も、OBI の鍵は論理 id 7(tid と区別する印付き)で同じ。 tid が T1 と T3 で違っても親子になる。 • run() の入口は、コルーチンがスレッドに載る瞬間 • ここで、辞書から id を引いて mount する。出口は、中断か完了でスレッドを 手放す瞬間で、ここで unmount する • これは、virtual thread が OS スレッドに載って降りるのと同じ形 • OBI からは、1 つのリクエストが 1 本の virtual thread のように見える • これらの実装は ByteBuddy の Java agent と、ioctl を呼ぶ約 40 行の JNI (Java から C の関数を呼ぶ仕組み)で、-javaagent で載せる 38 -
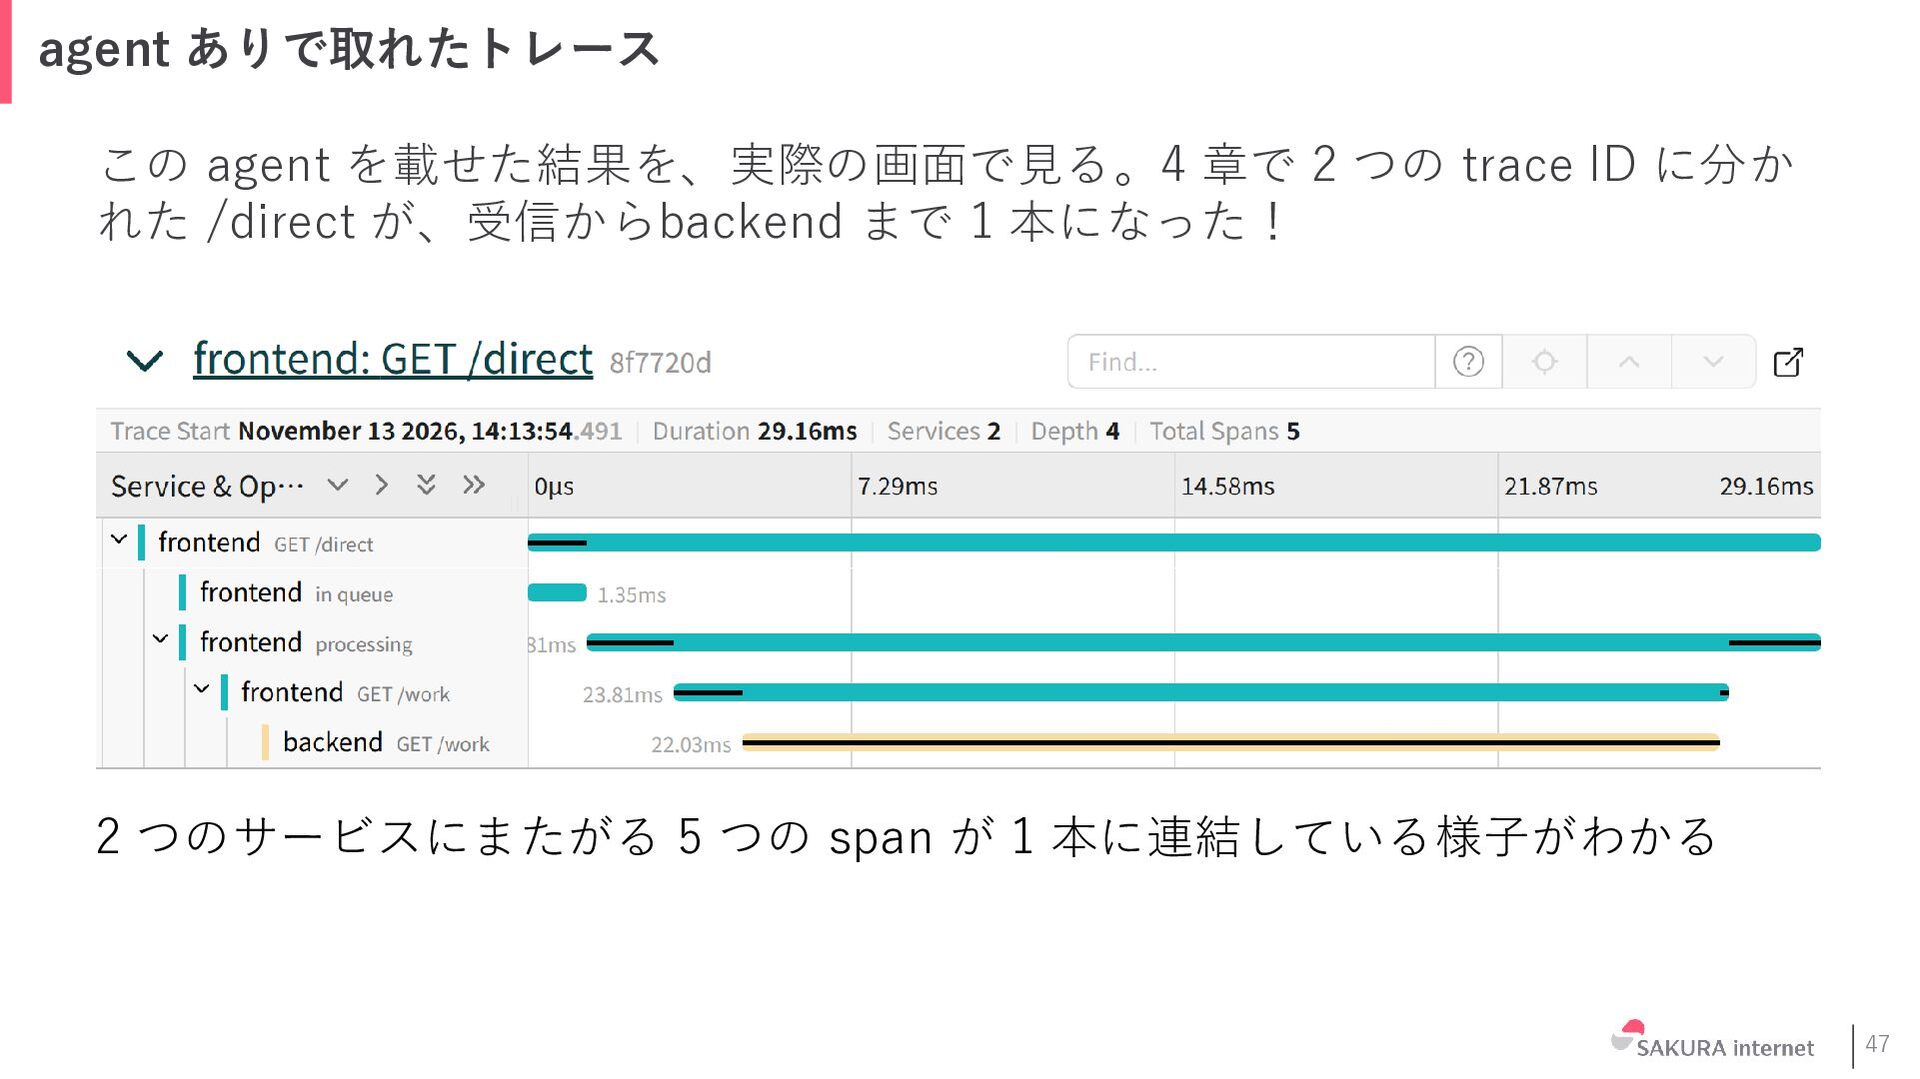
agent ありで取れたトレース この agent を載せた結果を、実際の画⾯で⾒る。4 章で 2 つの trace ID
に分か れた /direct が、受信からbackend まで 1 本になった! 2 つのサービスにまたがる 5 つの span が 1 本に連結している様子がわかる 39 -
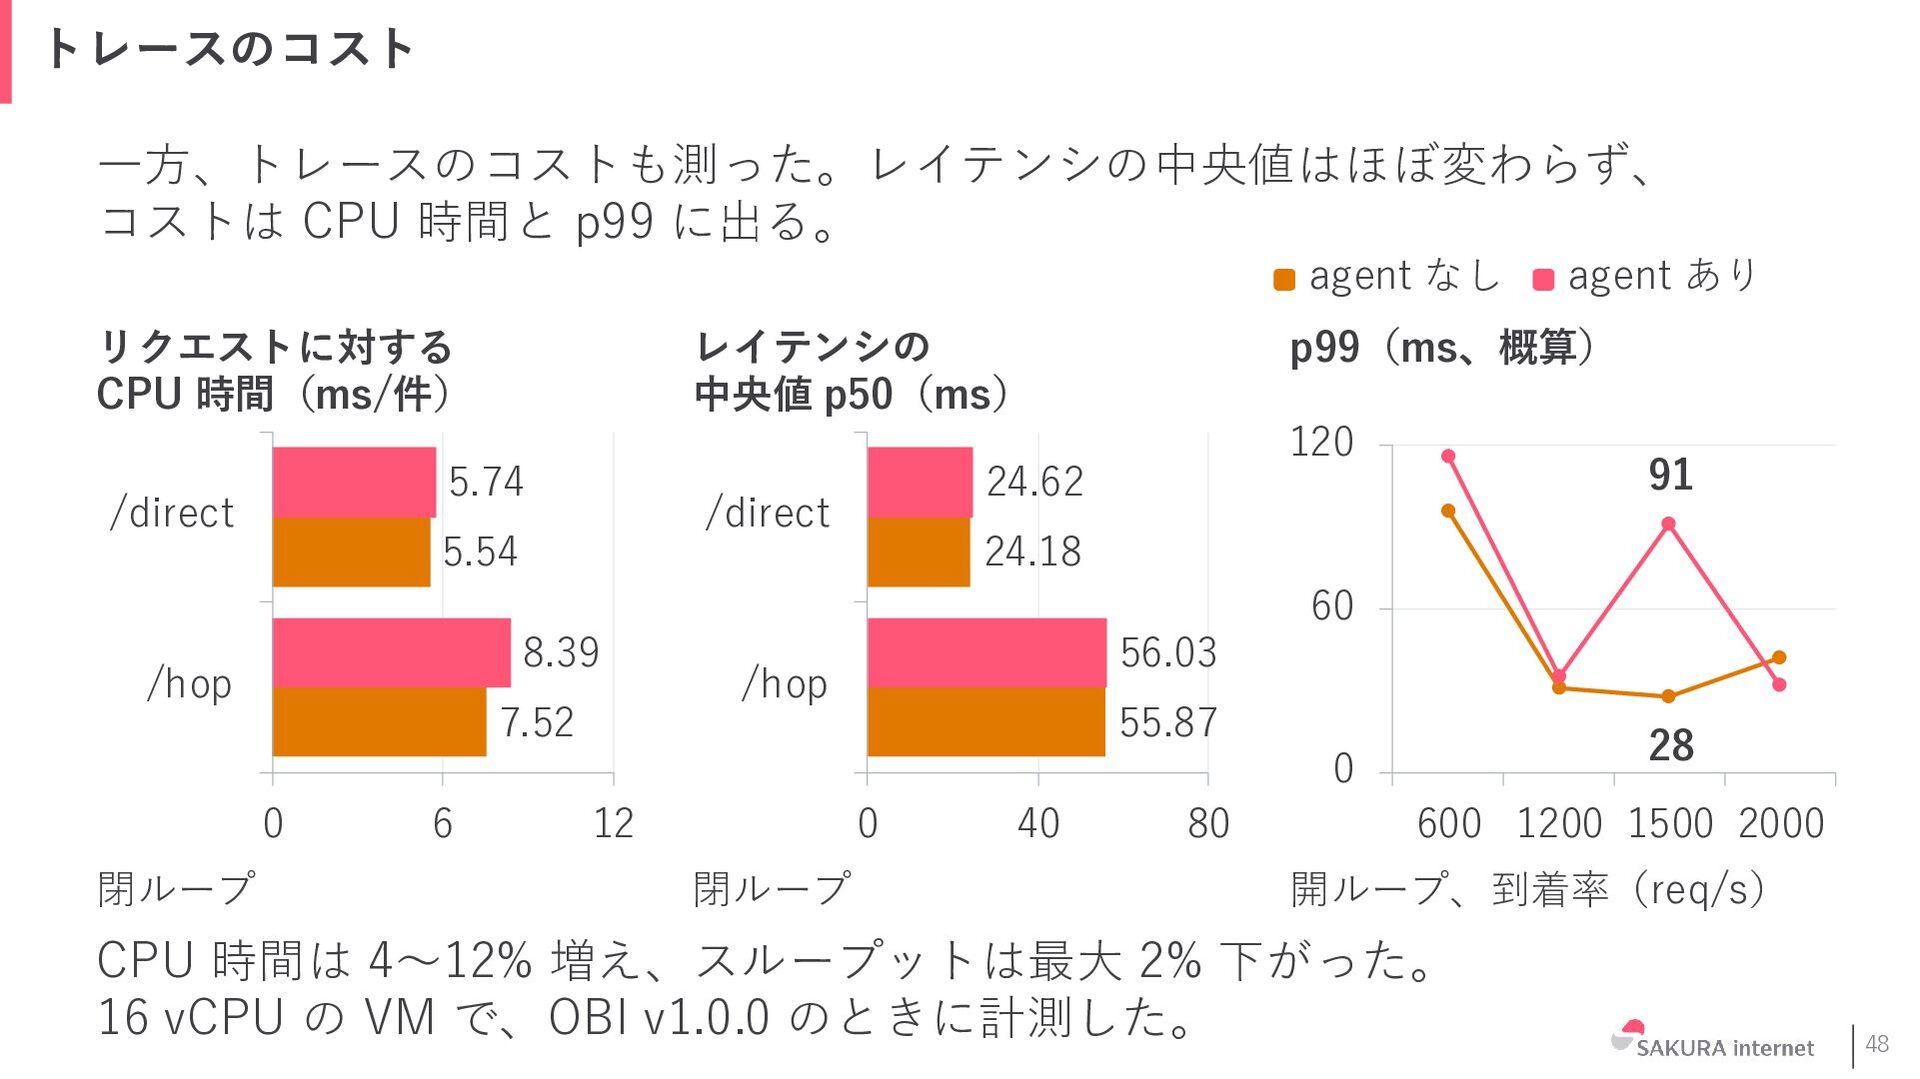
トレースのコスト ⼀⽅、トレースのコストも測った。レイテンシの中央値はほぼ変わらず、 コストは CPU 時間と p99 に出る。 agent なし リクエストに対する
CPU 時間(ms/件) レイテンシの 中央値 p50(ms) p99(ms、概算) 120 5.74 /direct 5.54 91 24.62 /direct agent あり 24.18 60 8.39 /hop 7.52 56.03 /hop 55.87 28 0 0 閉ループ 6 12 0 閉ループ 40 80 600 1200 1500 2000 開ループ、到着率(req/s) CPU 時間は 4〜12% 増え、スループットは最大 2% 下がった。 16 vCPU の VM で、OBI v1.0.0 のときに計測した。 40 -
ランタイムごとの相関の鍵 ちなみにほかのランタイムでは、OBI はKeyをどこから得ているのか? ランタイム 実行の単位 eBPF 側のKey Keyの入手先 Java(thread-perrequest) OS
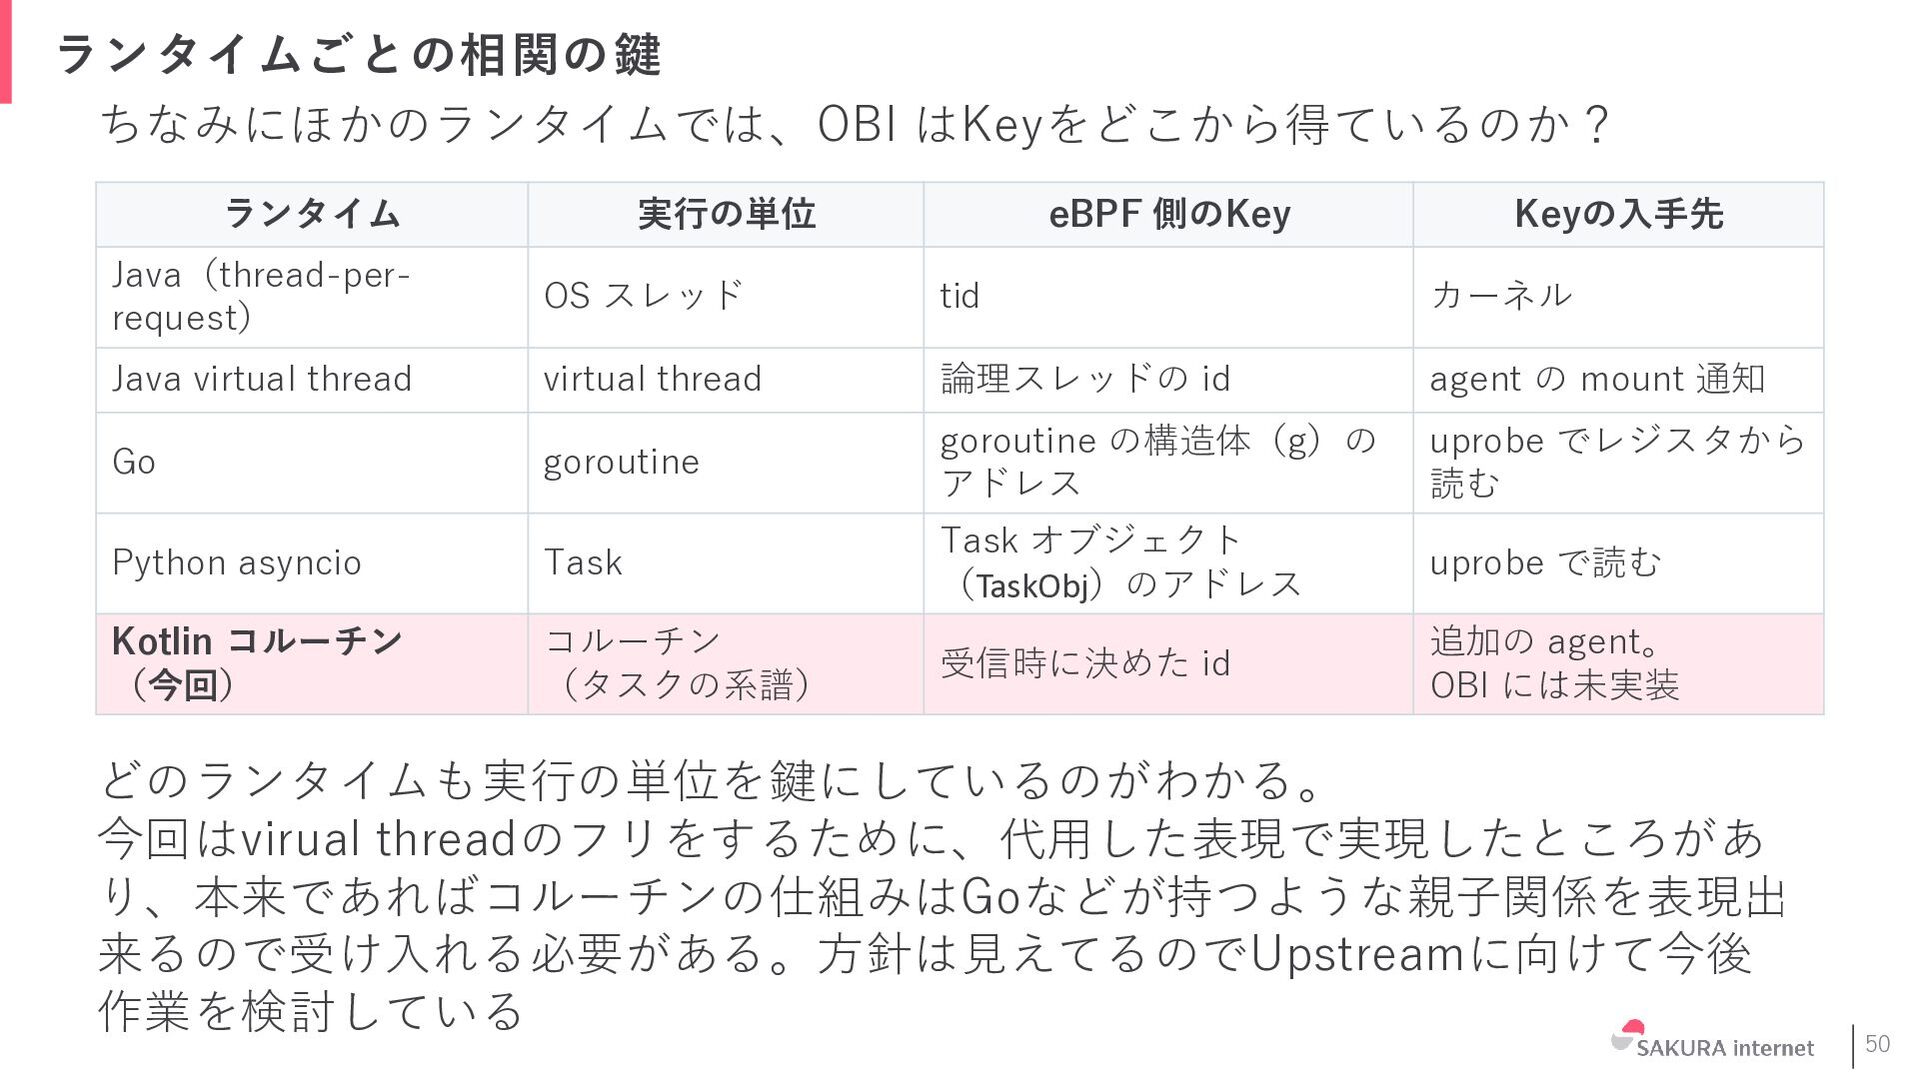
スレッド tid カーネル Java virtual thread virtual thread 論理スレッドの id agent の mount 通知 Go goroutine goroutine の構造体(g)の アドレス uprobe でレジスタから 読む Python asyncio Task Task オブジェクト (TaskObj)のアドレス uprobe で読む Kotlin コルーチン (今回) コルーチン (タスクの系譜) 受信時に決めた id 追加の agent。 OBI には未実装 どのランタイムも実行の単位を鍵にしているのがわかる。 今回はvirual threadのフリをするために、代用した表現で実現したところがあ り、本来であればコルーチンの仕組みはGoなどが持つような親子関係を表現出 来るので受け入れる必要がある。方針は見えてるのでUpstreamに向けて今後 作業を検討している 42 -
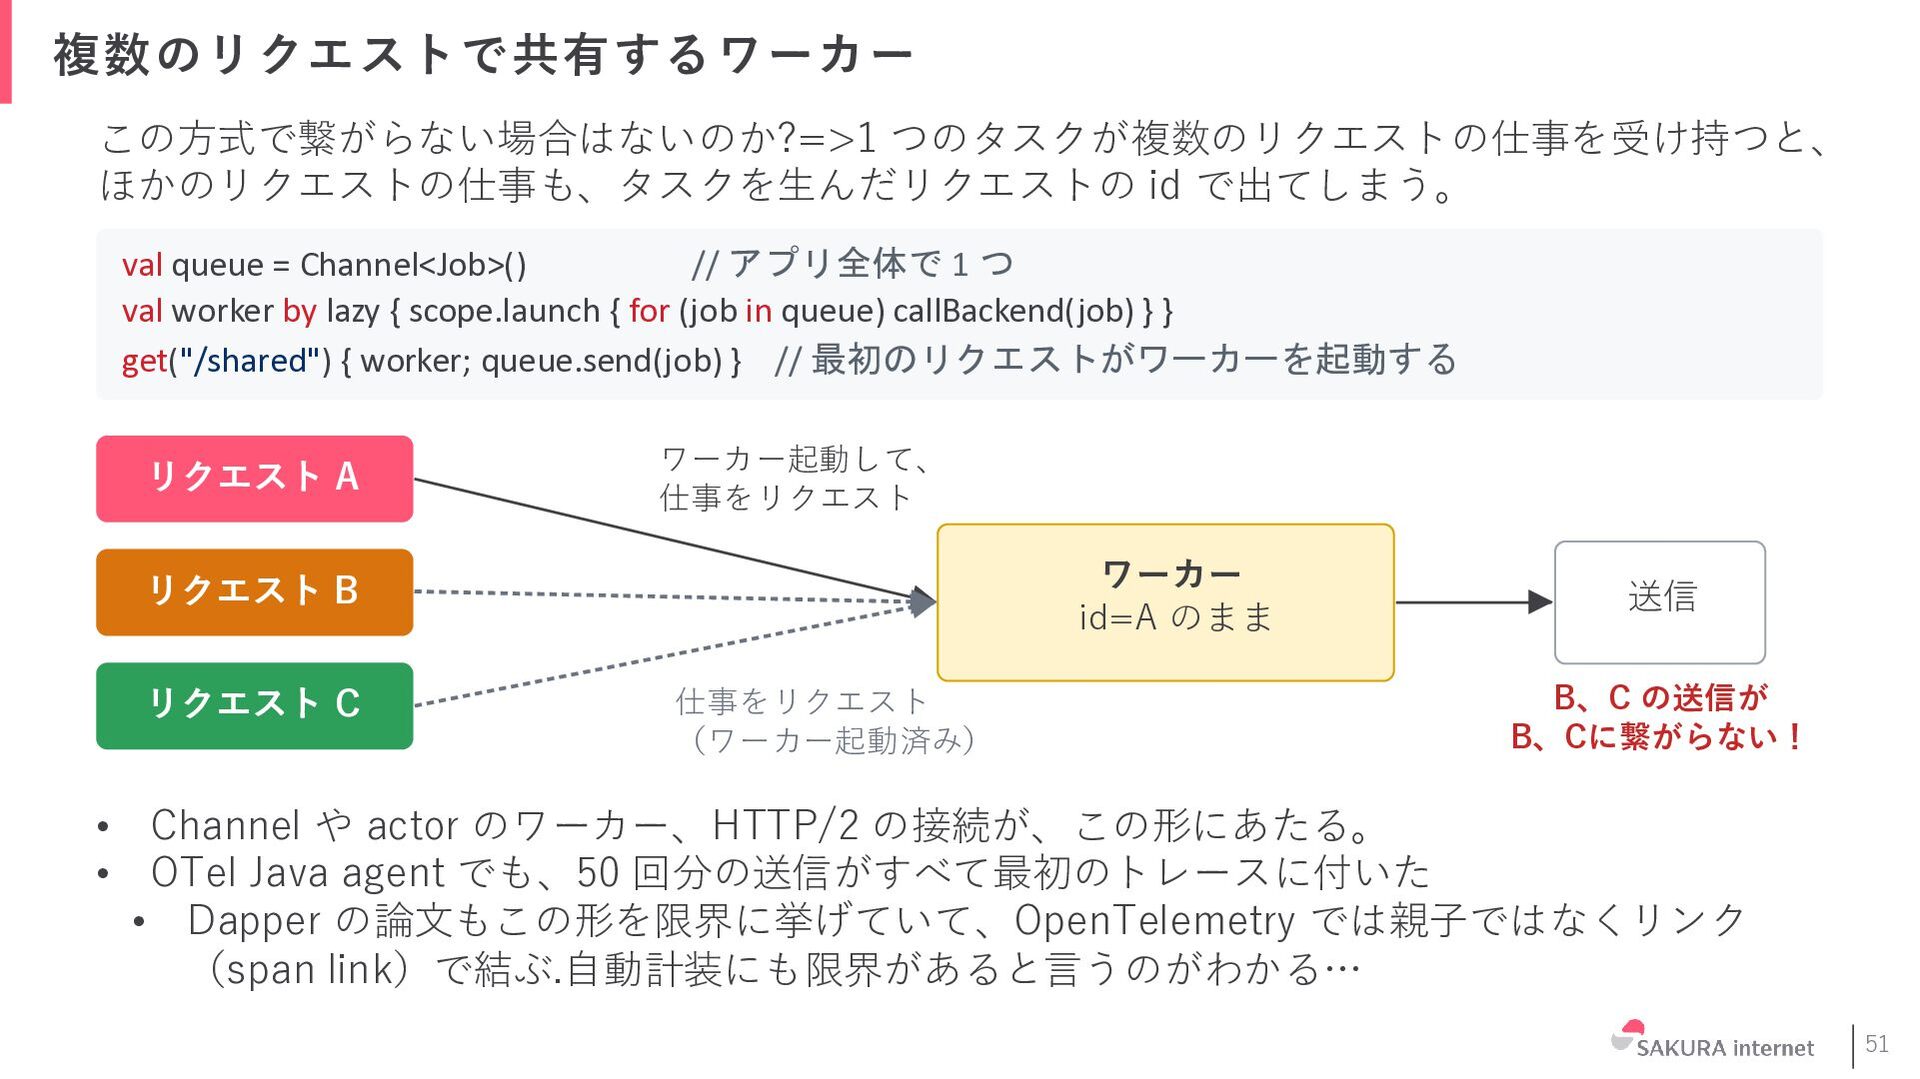
複数のリクエストで共有するワーカー この方式で繋がらない場合はないのか?=>1 つのタスクが複数のリクエストの仕事を受け持つと、 ほかのリクエストの仕事も、タスクを生んだリクエストの id で出てしまう。 val queue = Channel<Job>()
// アプリ全体で 1 つ val worker by lazy { scope.launch { for (job in queue) callBackend(job) } } get("/shared") { worker; queue.send(job) } // 最初のリクエストがワーカーを起動する リクエスト A ワーカー起動して、 仕事をリクエスト ワーカー id=A のまま リクエスト B リクエスト C 仕事をリクエスト (ワーカー起動済み) 送信 B、C の送信が B、Cに繋がらない! • Channel や actor のワーカー、HTTP/2 の接続が、この形にあたる。 • OTel Java agent でも、50 回分の送信がすべて最初のトレースに付いた • Dapper の論文もこの形を限界に挙げていて、OpenTelemetry では親子ではなくリンク (span link)で結ぶ.自動計装にも限界があると言うのがわかる… 43 -
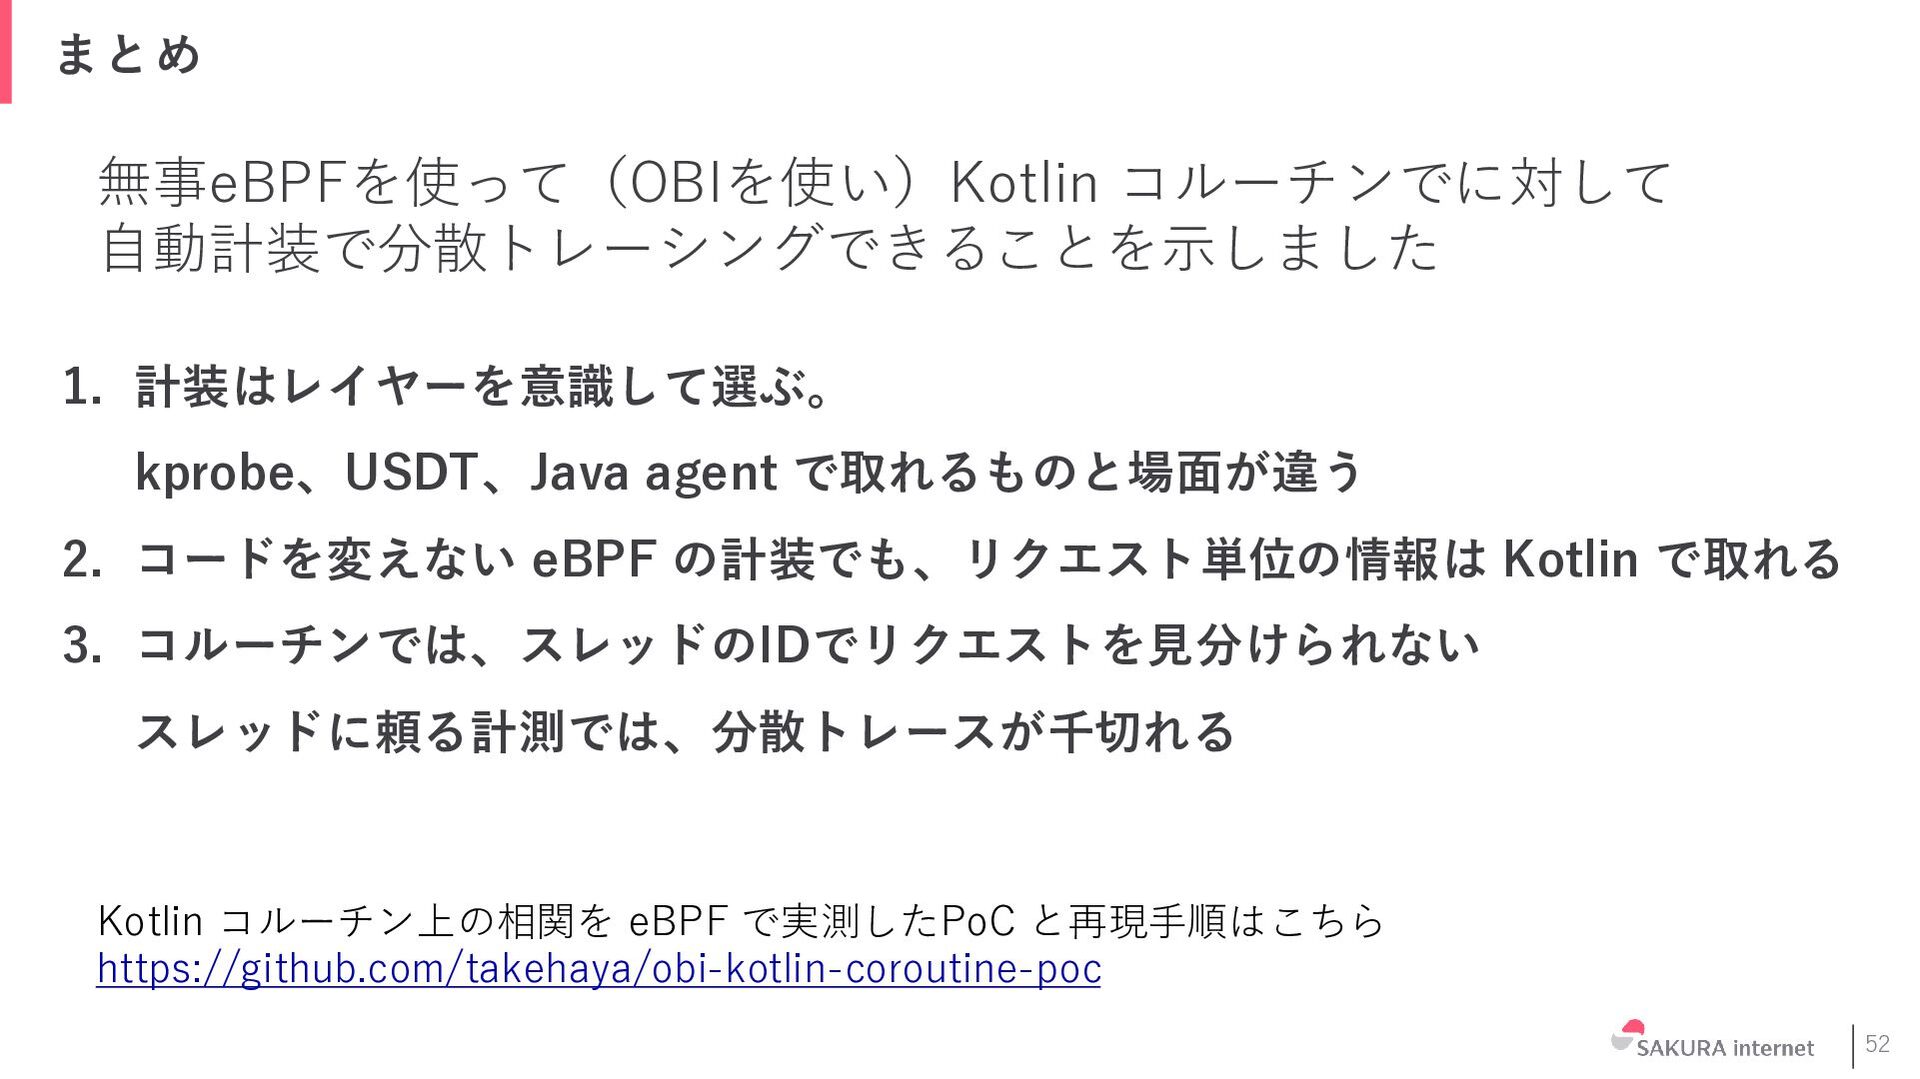
まとめ 無事eBPFを使って(OBIを使い)Kotlin コルーチンでに対して 自動計装で分散トレーシングできることを示しました 1. 計装はレイヤーを意識して選ぶ。 kprobe、USDT、Java agent で取れるものと場面が違う 2.
コードを変えない eBPF の計装でも、1 つのサービスの中で分かる値はKotlin で取れる ※一つのサービスであればOBI(eBPF)で取れると言うこと 3. コルーチンでは、スレッドのIDでリクエストを見分けられない スレッドに頼る計測では、分散トレースが千切れる Kotlin コルーチン上の相関を eBPF で実測したPoC と再現手順はこちら https://github.com/takehaya/obi-kotlin-coroutine-poc 44 -
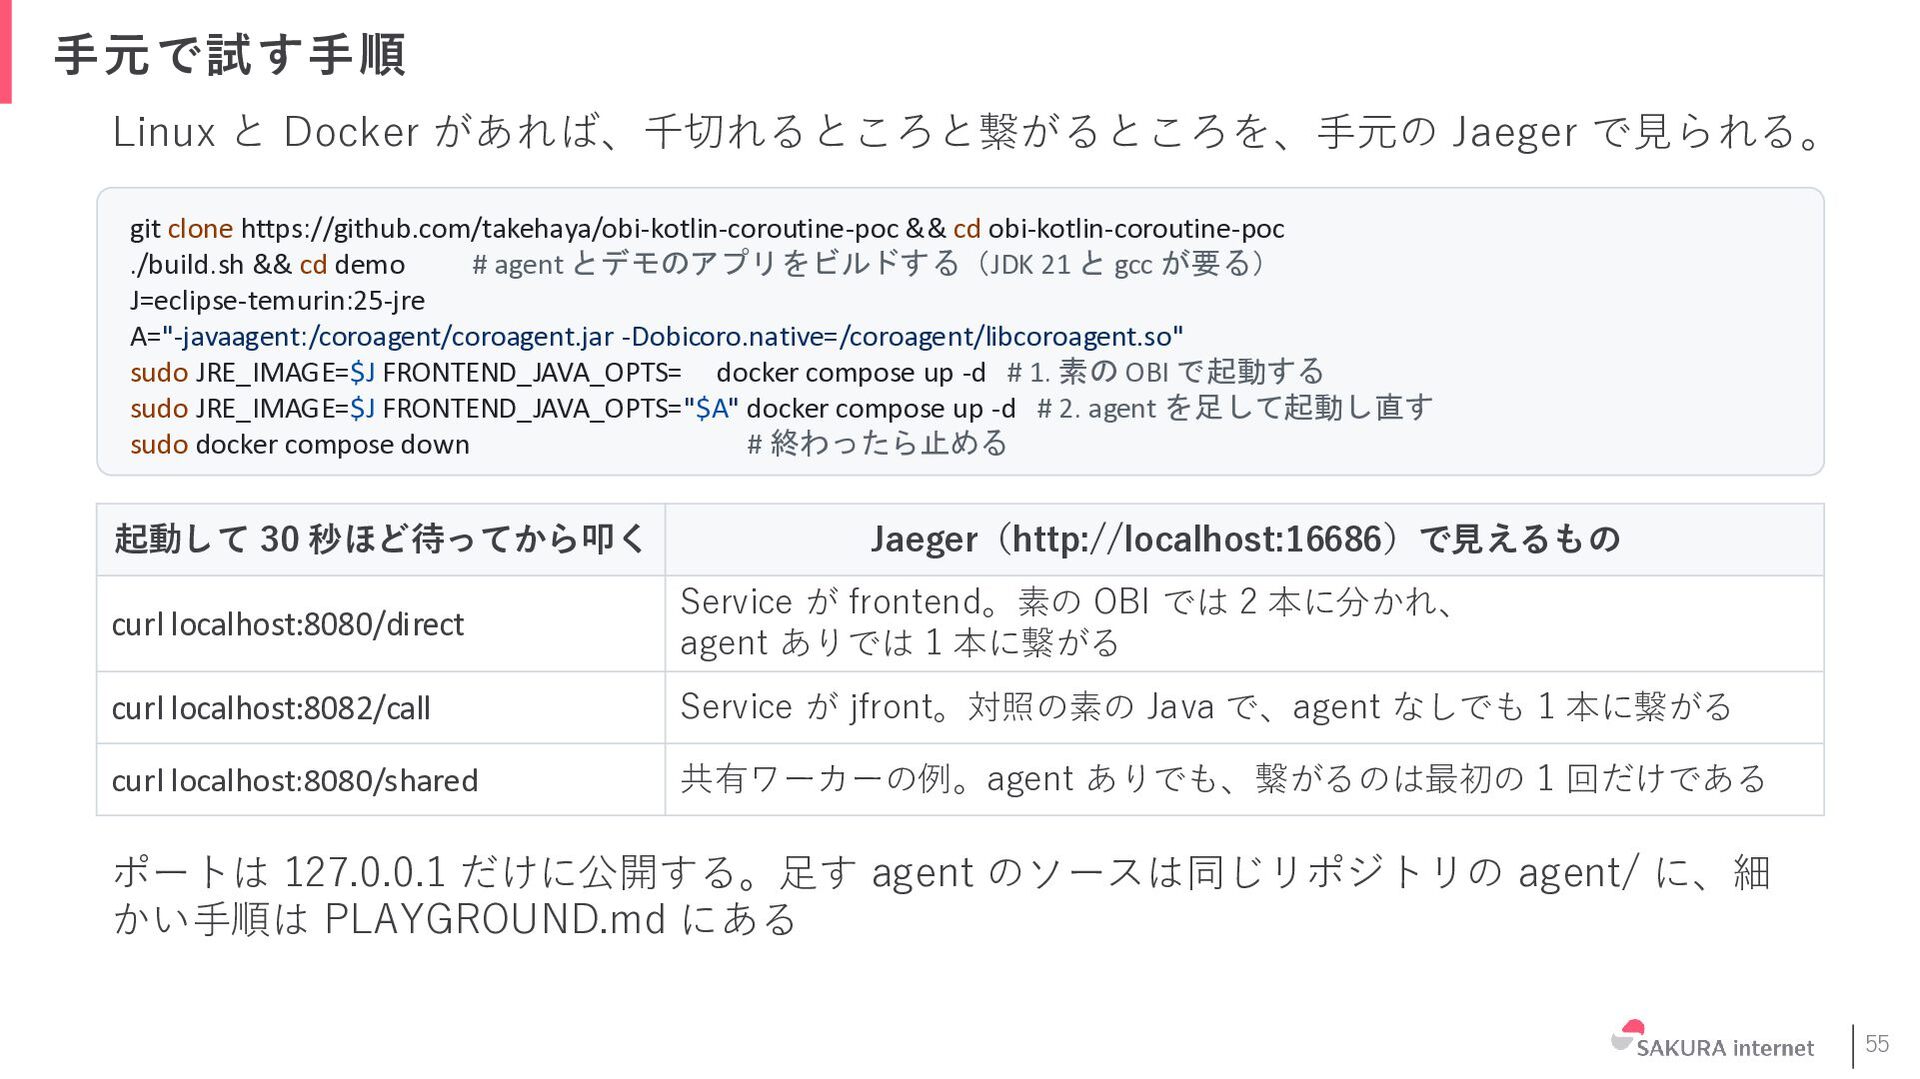
手元で試す手順 Linux と Docker があれば、千切れるところと繋がるところを、手元の Jaeger で見られ る。 git clone
https://github.com/takehaya/obi-kotlin-coroutine-poc && cd obi-kotlin-coroutine-poc ./build.sh && cd demo # agent とデモのアプリをビルドする(JDK 21 と gcc が要る) J=eclipse-temurin:25-jre A="-javaagent:/coroagent/coroagent.jar -Dobicoro.native=/coroagent/libcoroagent.so" sudo JRE_IMAGE=$J FRONTEND_JAVA_OPTS= docker compose up -d # 1. 素の OBI で起動する sudo JRE_IMAGE=$J FRONTEND_JAVA_OPTS="$A" docker compose up -d # 2. agent を足して起動し直す sudo docker compose down # 終わったら止める 起動して 30 秒ほど待ってから叩く Jaeger(http://localhost:16686)で見えるもの curl localhost:8080/direct Service が frontend。素の OBI では 2 本に分かれ、 agent ありでは 1 本に繋がる curl localhost:8082/call Service が jfront。対照の素の Java で、agent なしでも 1 本に繋がる curl localhost:8080/shared 共有ワーカーの例。agent ありでも、繋がるのは最初の 1 回だけである ポートは 127.0.0.1 だけに公開する。足す agent のソースは同じリポジトリの agent/ に、細 かい手順は PLAYGROUND.md にある 46 -
JVM での uprobe なぜ Kotlin の関数に張れないのか。JIT のコードには、実行ファイル上の位置がない。 .class ファイルにある インタプリタ
共通のコード JIT のコード 匿名メモリ 再JIT のコード 別の場所へ移動 同じメソッドが、実行中に置き場所を変える $ cat /proc/<JVM_PID>/maps (出力の形を示す例) 7f3a2c000000-7f3a2c800000 rwxp 00000000 00:00 0 ← JIT のコードは匿名メモリ JIT のコードはファイルに対応しないので、指定する「オフセット」がない 47 -
USDT(User Statically-Defined Tracing) の仕組み eBPF (uprobe) からメソッドを観測するフックが USDT(User StaticallyDefined Tracing)
張っていないとき 張ったとき lea 0x6(%r14),%rdi lea 0x6(%r14),%rdi nop (何もしない命令) int3 (ブレークポイント) xor %eax,%eax xor %eax,%eax $ readelf -n libjvm.so Provider: hotspot Name: method__entry Location: 0x0000000000f6fdfd, ... ← nop の位置 Arguments: -8@%r9 8@%rax -4@%edx 8@%rcx -4@%esi 8@%rdi -4@%r8d ← 引数の置き場所 $ objdump -d libjvm.so ← その位置の命令を表示 e2fc51: 90 nop eBPF プログラム カーネル経由で発⽕ 位置と引数の置き場所は ELF ノート (.note.stapsdt)に記録される JDK 25 の例:hotspot:method__entry、 位置 0x0f6fdfd、引数 7 個 48 -
JVM のメソッドを USDT で⾒る仕組み JVM はメソッドの出⼊りにも観測点を⽤意しているが、全メソッドに共通の 1 か所しかない。 libjvm.so(場所は動かない) JVM
のメソッド インタプリタ、JIT (場所は動く) 呼ぶ SharedRuntime:: dtrace_method_entry クラス名、メソッド名を⽤意 nop hotspot:method__entry int3 eBPF プログラム クラス名、 メソッド名を読む -XX:+DTraceMethodProbes で呼び出しが⼊る usdt:.../libjvm.so:hotspot:method__entry { printf("%s\n", str(arg3, arg4 + 1)); } bpftrace で、メソッドに⼊るたびにそのメソッド名を出⼒する例。⾒たいメソッドは、こうして 名前を⾒て eBPF の側で選ぶ 注: フラグを付けると、すべてのメソッドが出入りのたびに `libjvm.so` のこの 1 か所を呼び に来る。JIT があっても見えるが、全部が来るのでオーバーヘッドが大きく、デバッグなどの 用途に向く 49 -
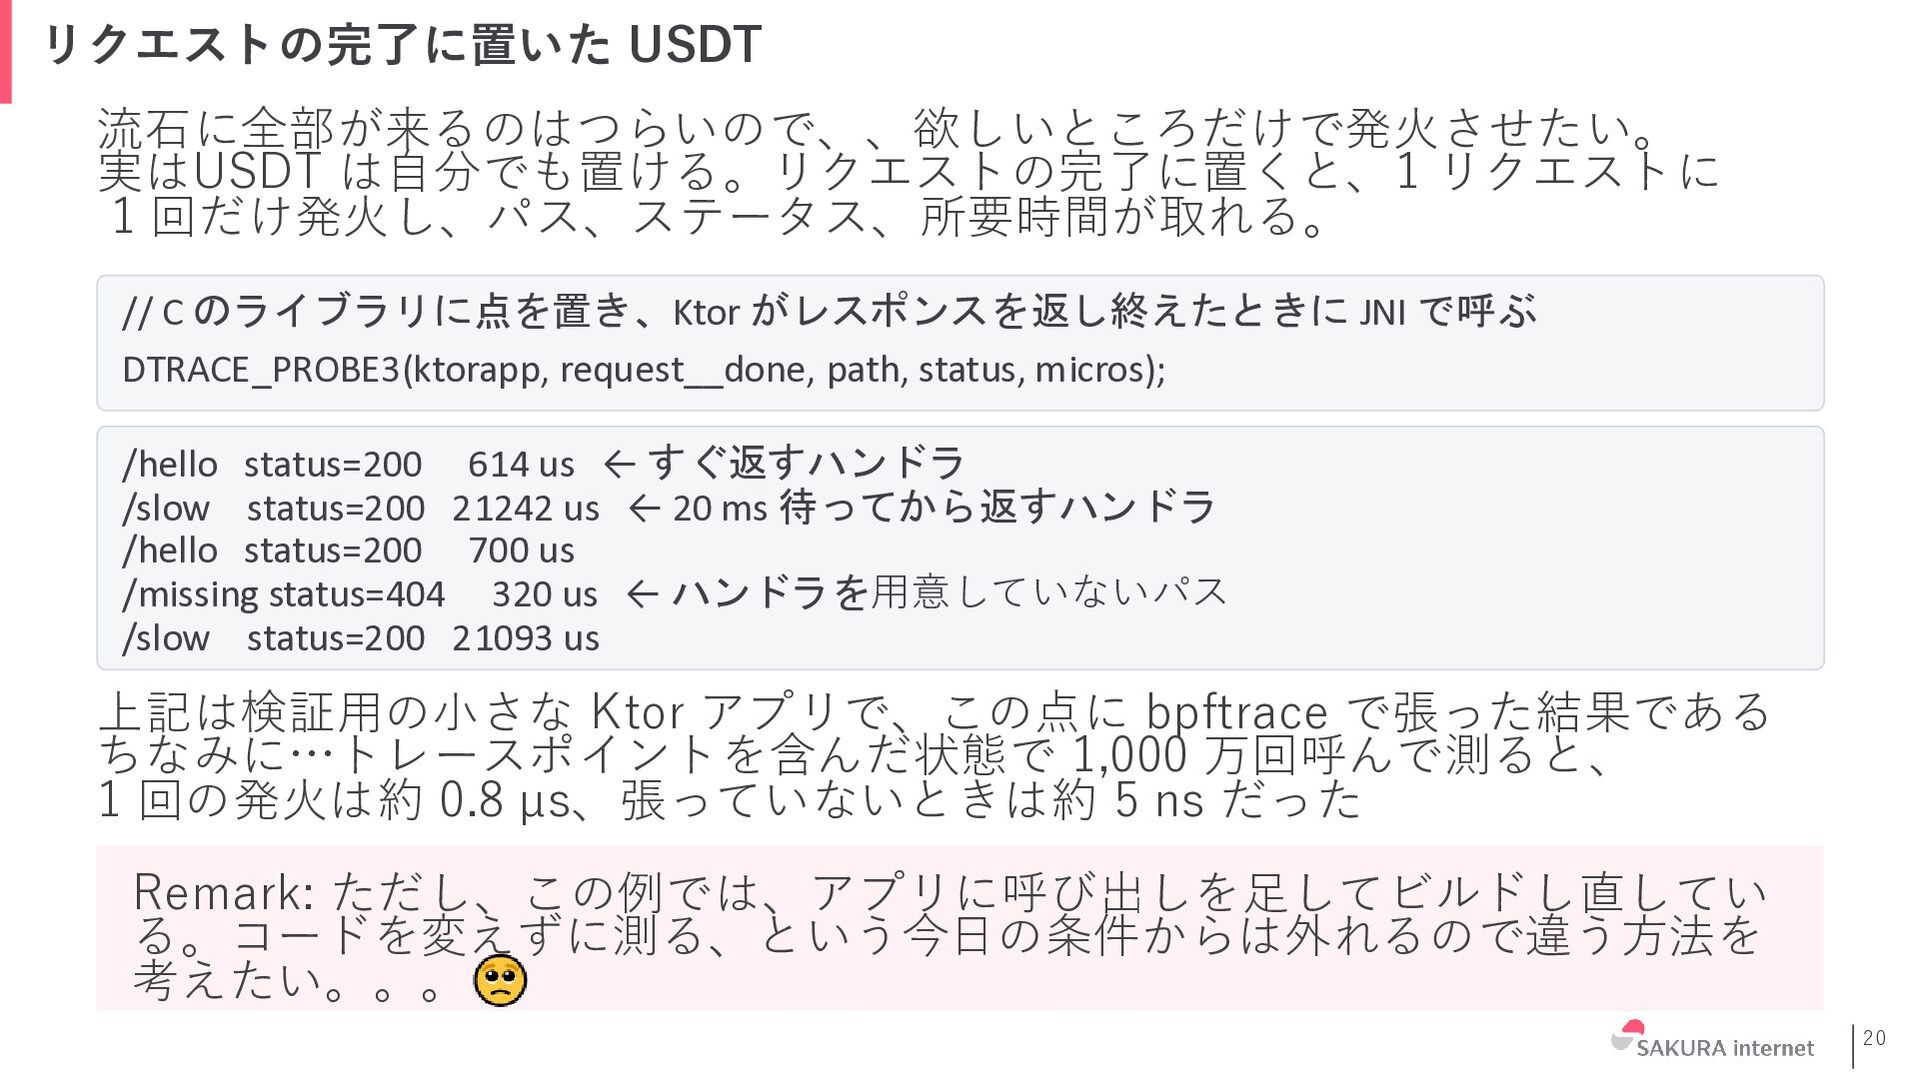
リクエストの完了に置いた USDT 流石に全部が来るのはつらいので、、欲しいところだけで発⽕させたい。 実はUSDT は⾃分でも置ける。リクエストの完了に置くと、1 リクエストに 1 回だけ発⽕し、パス、ステータス、所要時間が取れる。 // C
のライブラリに点を置き、Ktor がレスポンスを返し終えたときに JNI で呼ぶ DTRACE_PROBE3(ktorapp, request__done, path, status, micros); /hello status=200 614 us ← すぐ返すハンドラ /slow status=200 21242 us ← 20 ms 待ってから返すハンドラ /missing status=404 320 us ← ハンドラを⽤意していないパス 上記は検証⽤の⼩さな Ktor アプリで、この点に bpftrace で張った結果である Remark: ただし、この例では、アプリに呼び出しを⾜してビルドし直してい る。コードを変えずに測る、という今⽇の条件からは外れるので違う方法を 考えたい。。。 20 -
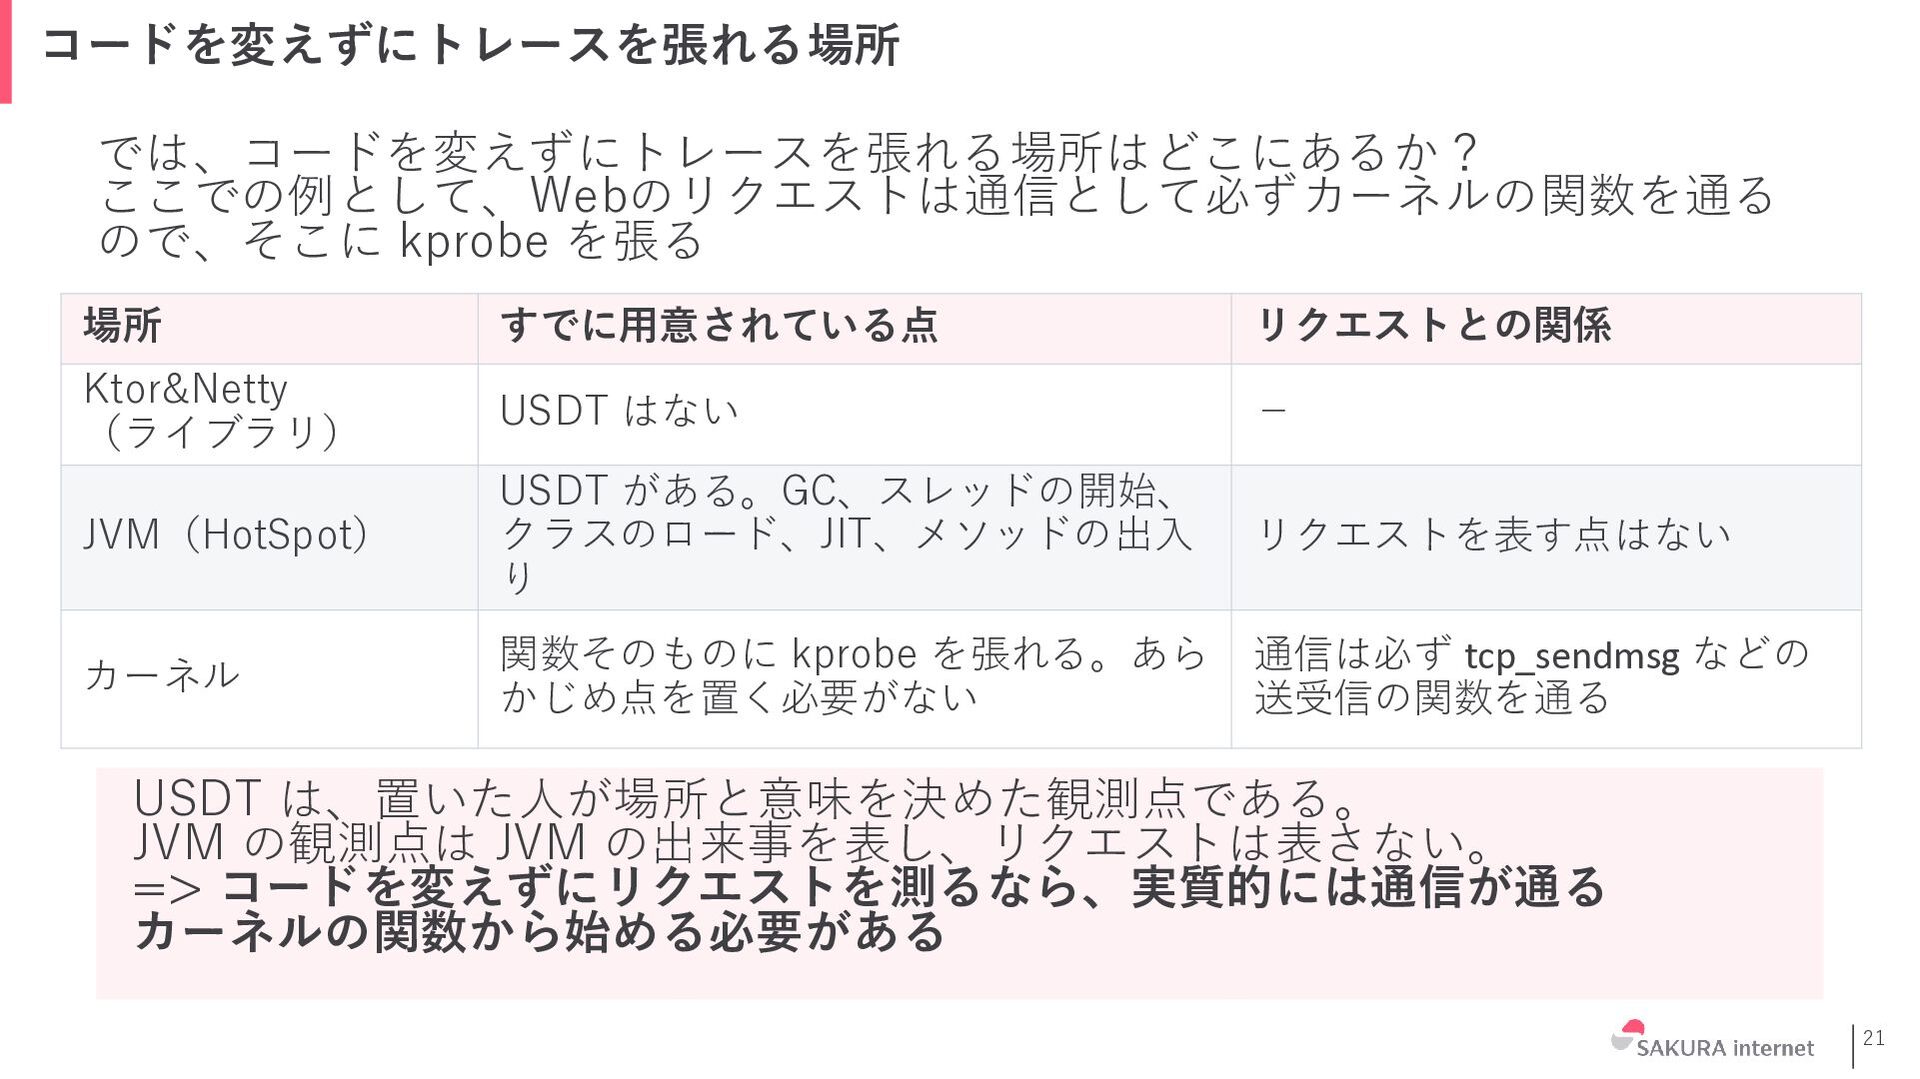
コードを変えずにトレースを張れる場所 では、コードを変えずにトレースを張れる場所はどこにあるか? ここでの例として、Webのリクエストは通信として必ずカーネルの関数を通る ので、そこに kprobe を張る 場所 すでに⽤意されている点 リクエストとの関係 Ktor&Netty
(ライブラリ) USDT はない - JVM(HotSpot) USDT がある。GC、スレッドの開始、 クラスのロード、JIT、メソッドの出⼊ り リクエストを表す点はない カーネル 関数そのものに kprobe を張れる。あら かじめ点を置く必要がない 通信は必ず tcp_sendmsg などの 送受信の関数を通る USDT は、置いた⼈が場所と意味を決めた観測点である。 JVM の観測点は JVM の出来事を表し、リクエストは表さない。 => コードを変えずにリクエストを測るなら、実質的には通信が通る カーネルの関数から始める必要がある 21 -
kprobe で⾒えるものと、トレースに要るもの ただし、kprobe で⾒えるのはカーネル関数の呼び出しであって、リクエストで はない。Kotlin の Web アプリにリクエストを 1 回送ると、次のように⾒える。
tcp_recvmsg tid=3170817 84 bytes ← リクエストの受信 tcp_sendmsg tid=3166021 105 bytes ← 別のサービスへの送信 tcp_recvmsg tid=3165969 81 bytes ← その応答の受信 tcp_sendmsg tid=3170817 88 bytes ← 応答の送信 bpftrace で送受信の関数に kprobe を張った出⼒ トレースに要るもの そのために要る仕事 パス、ステータス、所 要時間 バイト列を HTTP として読み、リクエストと応答を対にして span にする span の親⼦ 受信と送信を、同じリクエストのものとして対応づける サービスの間の繋がり 送信に traceparent ヘッダを⼊れて、次のサービスへ⽂脈を渡す =>カーネル関数の呼び出しから、トレースを組み⽴てる道具が要る (アプリケーションの文脈を与えて相関を作る必要がある) 22 -
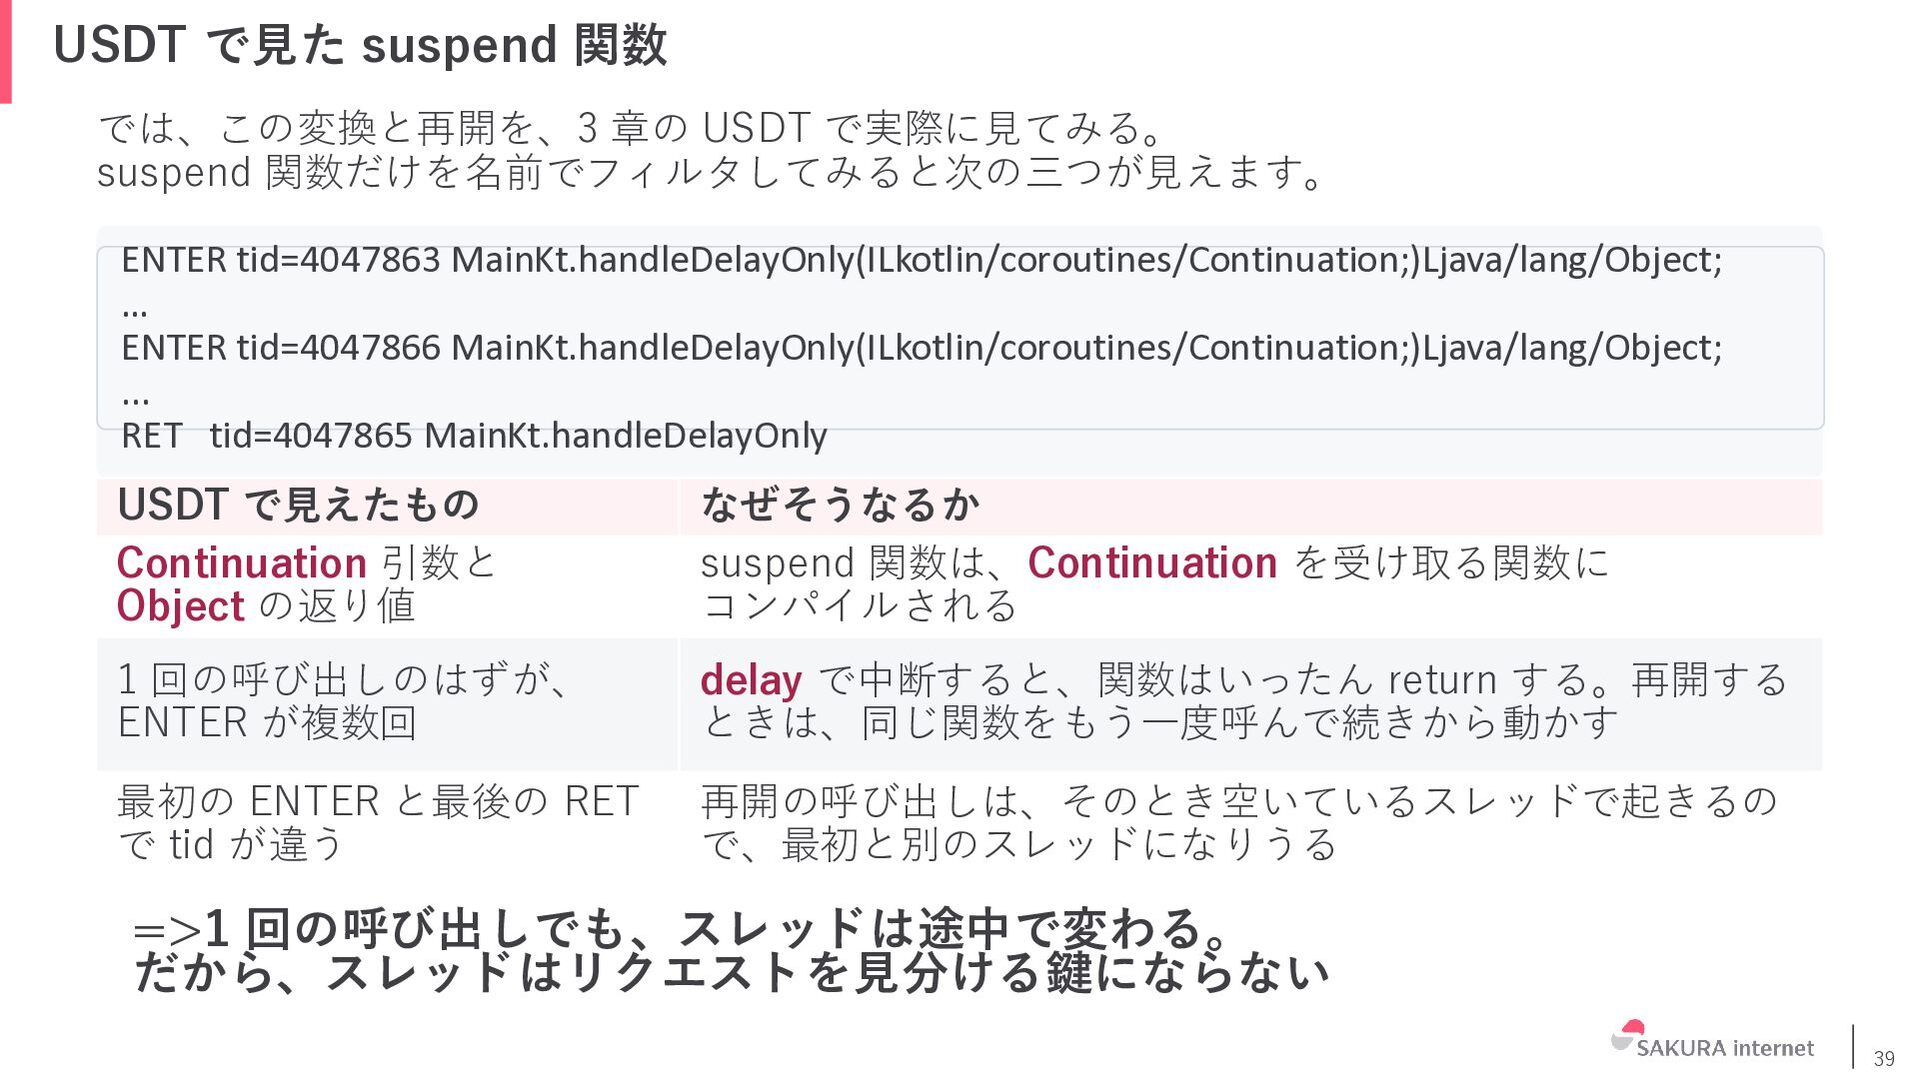
USDT で⾒た suspend 関数 では、この変換と再開を、3 章の USDT で実際に⾒てみる。 suspend 関数だけを名前でフィルタしてみると次の三つが見えます。
ENTER tid=4047863 MainKt.handleDelayOnly(ILkotlin/coroutines/Continuation;)Ljava/lang/Object; … ENTER tid=4047866 MainKt.handleDelayOnly(ILkotlin/coroutines/Continuation;)Ljava/lang/Object; ... RET tid=4047865 MainKt.handleDelayOnly USDT で⾒えたもの Continuation 引数と Object の返り値 なぜそうなるか suspend 関数は、Continuation を受け取る関数に コンパイルされる 1 回の呼び出しのはずが、 ENTER が複数回 delay で中断すると、関数はいったん return する。再開する ときは、同じ関数をもう⼀度呼んで続きから動かす 最初の ENTER と最後の RET で tid が違う 再開の呼び出しは、そのとき空いているスレッドで起きるの で、最初と別のスレッドになりうる =>1 回の呼び出しでも、スレッドは途中で変わる。 だから、スレッドはリクエストを⾒分ける鍵にならない 39 -
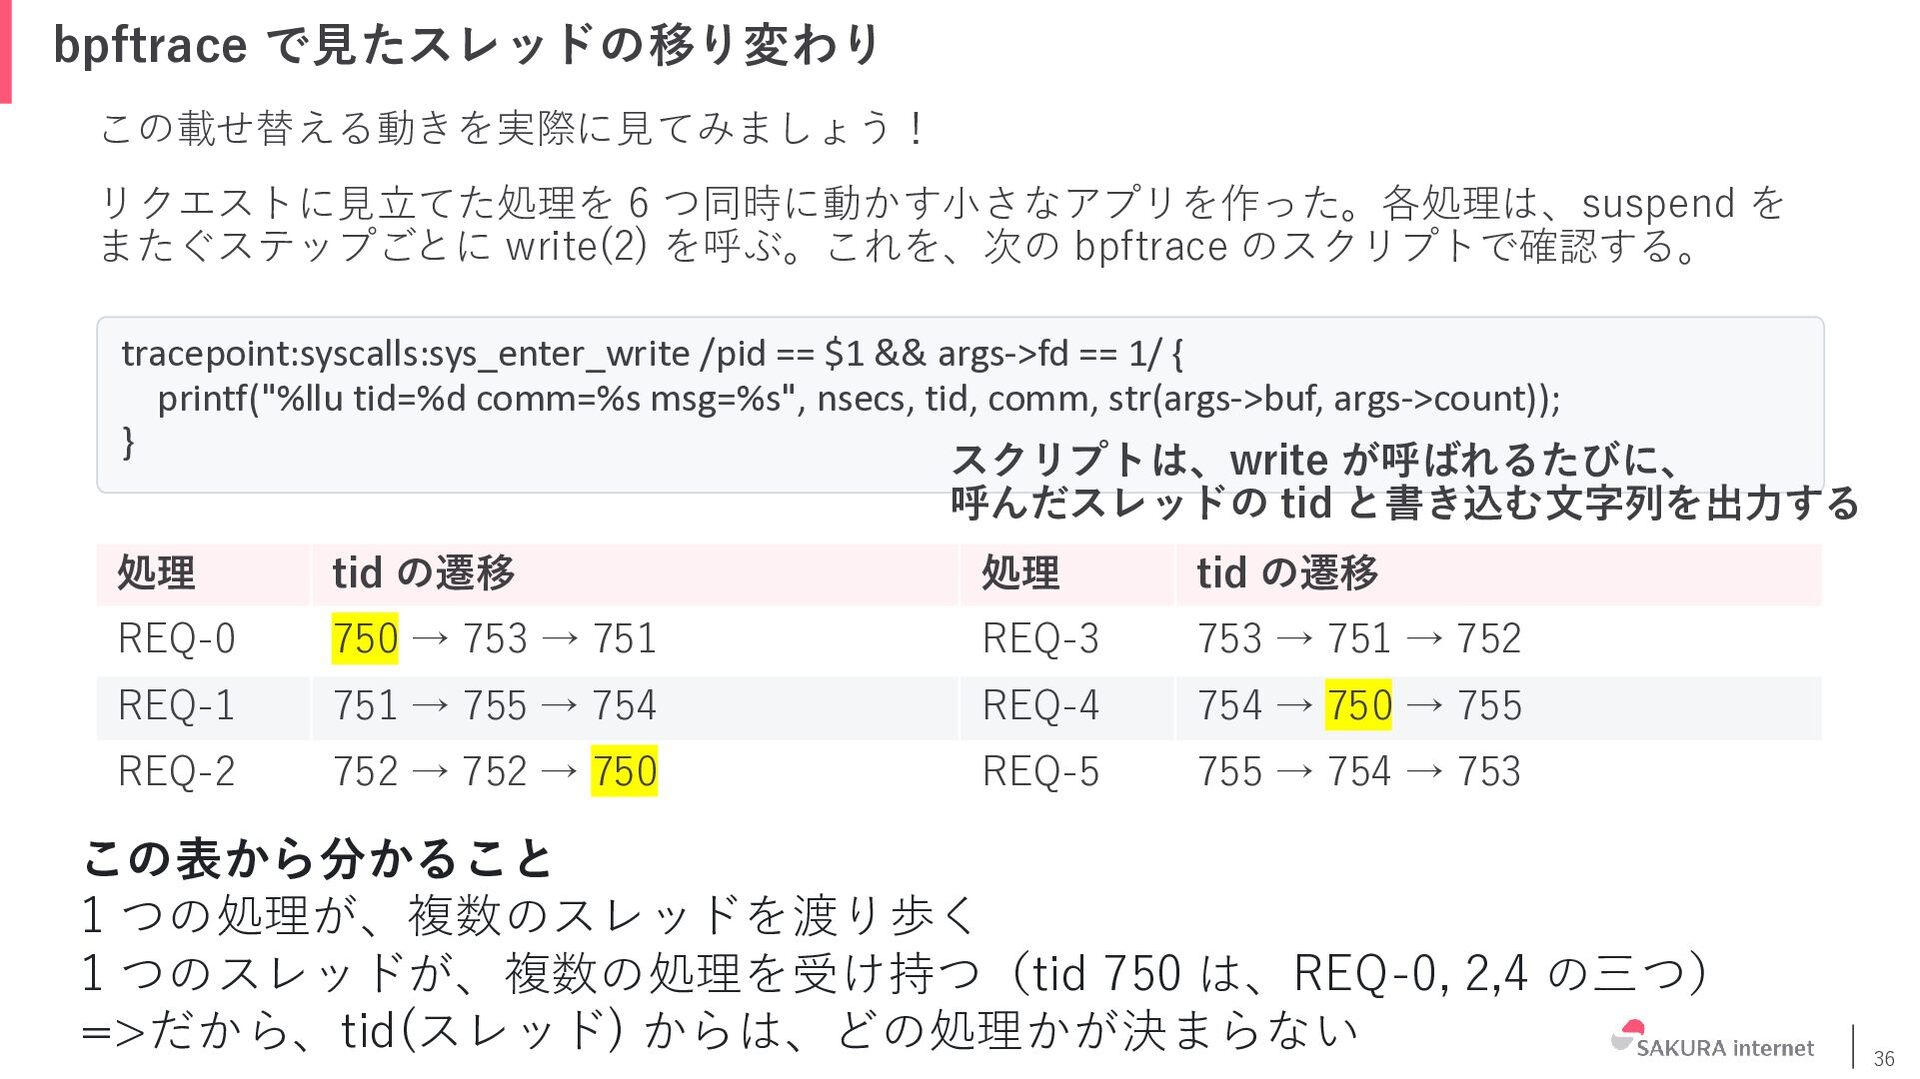
bpftrace で⾒たスレッドの移り変わり この載せ替える動きを実際に見て、コルーチンの動きを観察してみましょう! リクエストに⾒⽴てた処理を 6 つ同時に動かす⼩さなアプリを作った。各処理は、suspend を またぐステップごとに write(2) を呼ぶ。これを、次の
bpftrace のスクリプトで確認する。 tracepoint:syscalls:sys_enter_write /pid == $1 && args->fd == 1/ { printf("%llu tid=%d comm=%s msg=%s", nsecs, tid, comm, str(args->buf, args->count)); } スクリプトは、write が呼ばれるたびに、 呼んだスレッドの tid と書き込む⽂字列を出⼒する 処理 tid の遷移 処理 tid の遷移 REQ-0 750 → 753 → 751 REQ-3 753 → 751 → 752 REQ-1 751 → 755 → 754 REQ-4 754 → 750 → 755 REQ-2 752 → 752 → 750 REQ-5 755 → 754 → 753 この表から分かること 1 つの処理が、複数のスレッドを渡り歩く 1 つのスレッドが、複数の処理を受け持つ(tid 750 は、REQ-0, 2,4 の三つ) =>だから、tid(スレッド) からは、どの処理かが決まらない 36 -
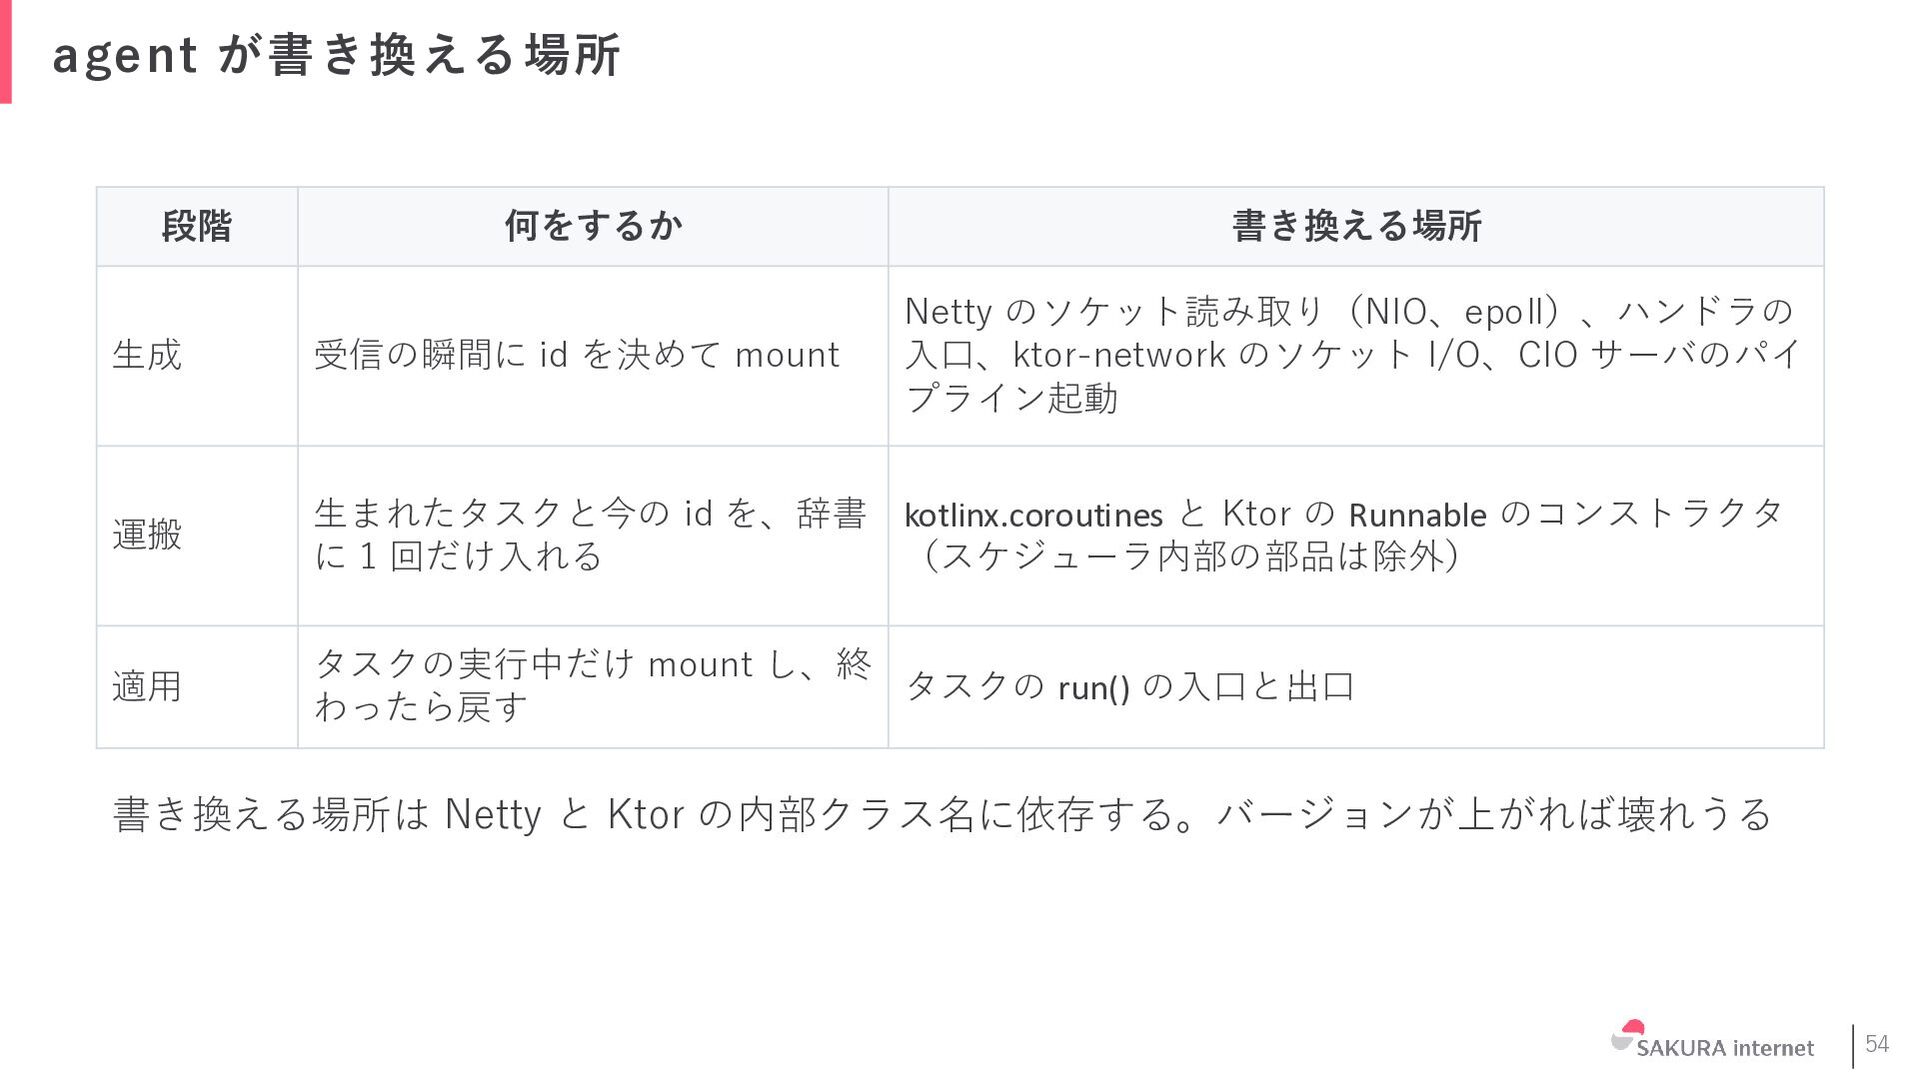
agent が書き換える場所 段階 何をするか 書き換える場所 生成 受信の瞬間に id を決めて mount
Netty のソケット読み取り(NIO、epoll)、ハンドラの 入口、ktor-network のソケット I/O、CIO サーバのパイ プライン起動 運搬 生まれたタスクと今の id を、辞書 kotlinx.coroutines と Ktor の Runnable のコンストラクタ に 1 回だけ入れる (スケジューラ内部の部品は除外) 適用 タスクの実行中だけ mount し、終 タスクの run() の入口と出口 わったら戻す 書き換える場所は Netty と Ktor の内部クラス名に依存する。バージョンが上がれば壊れうる 55
 takehaya
 yasunori0418
 vivion
 seosoft
 siroemk
 tarao
 akihisaikeda
 simas
 kasacchiful
 rkaga
 cclai999
 sakawe_ee
 fuqda
 aki_iinuma
 codingconduct
 427marketing
 aleyda
 khoart
 keithpitt
 inesmontani
 wjessup
 keavy
 tanoku