Upgrade to Pro — share decks privately, control downloads, hide ads and more …

DATA × AIをスケールさせるデータ基盤へ ― セルフサービスで実現するデータ品質管理 /...

Sponsored · Ship Features Fearlessly Turn features on and off without deploys. Used by thousands of Ruby developers. →

DATA × AIをスケールさせるデータ基盤へ ― セルフサービスで実現するデータ品質管理 / Shibuya_AI_6

2026年10月16日開催の「渋谷 Biz × AI: ビジネスにおける AI 利活用 事例勉強会 第6回」の登壇資料です。
https://cyberagent.connpass.com/event/406165/

▼関連資料
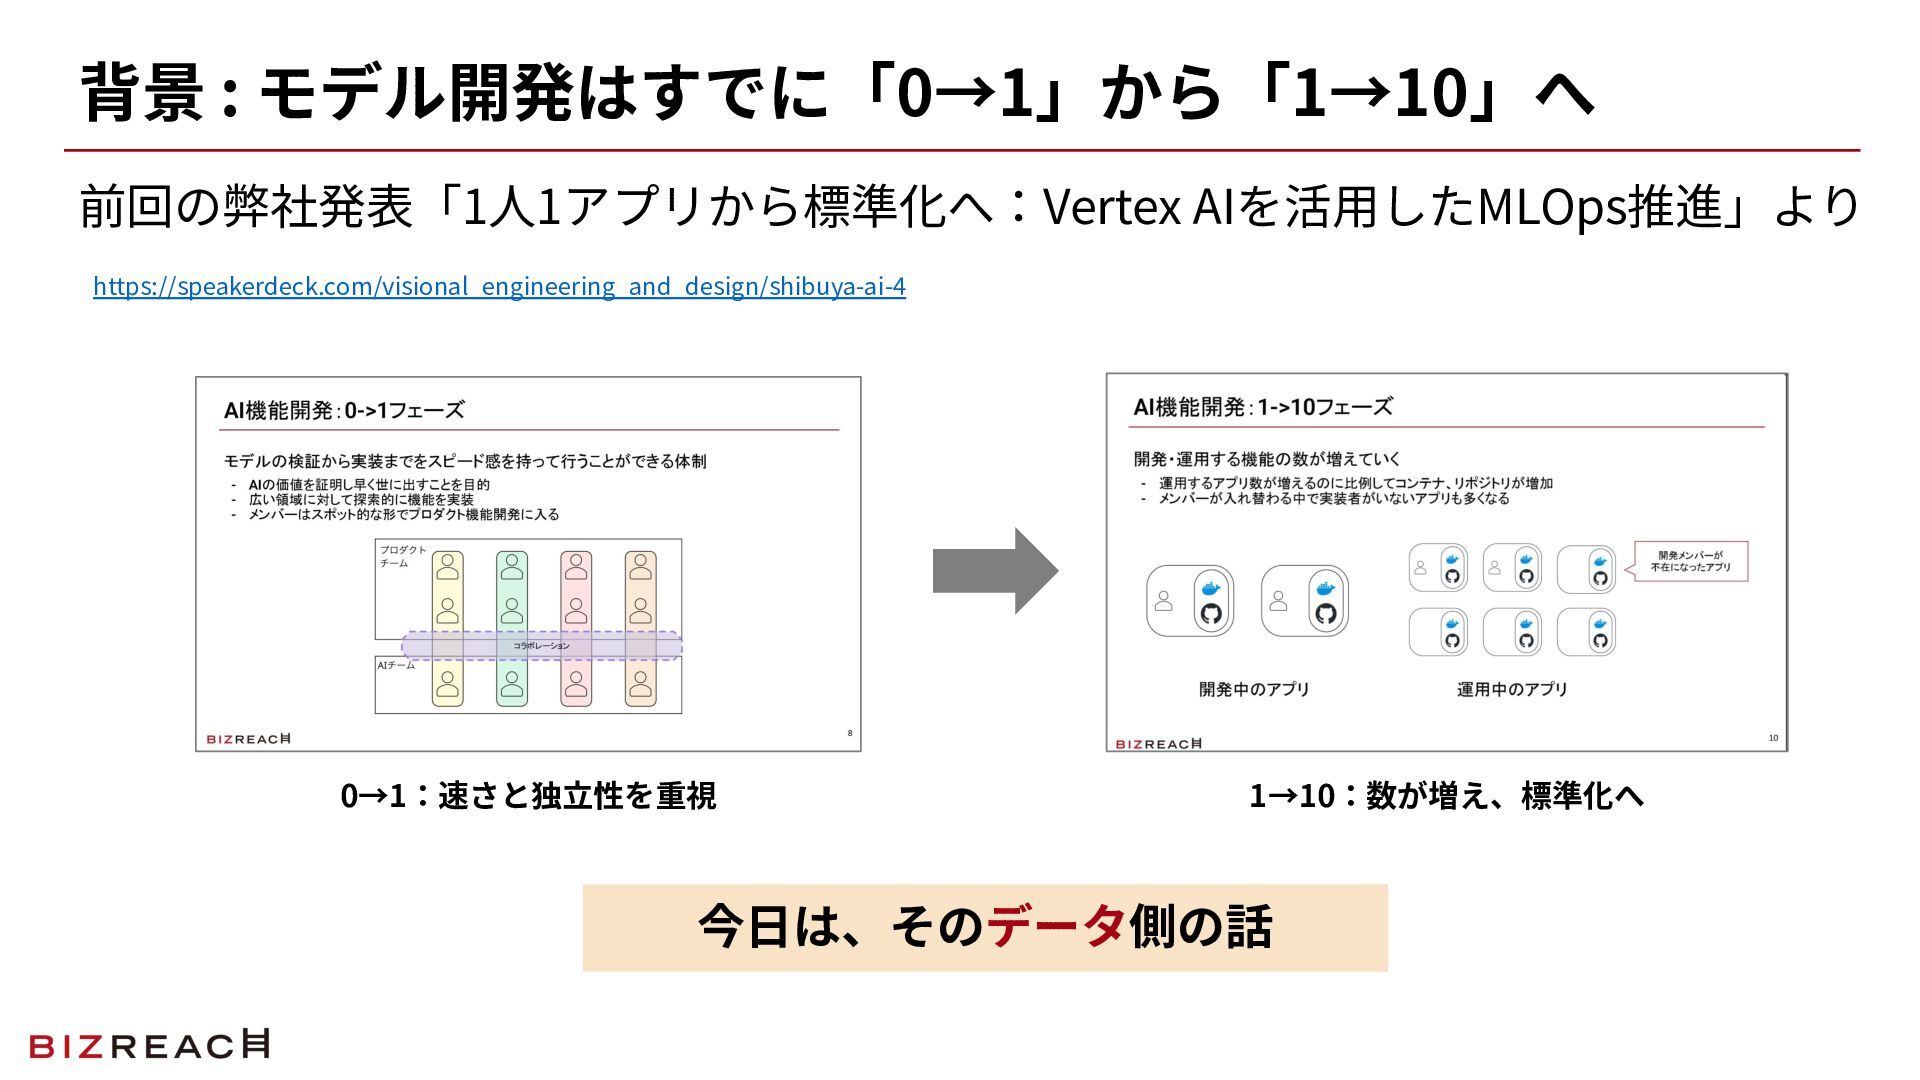
1人1アプリから標準化へ:Vertex AIを活用したMLOps推進
https://speakerdeck.com/visional_engineering_and_design/shibuya-ai-4

技術的負債から考える、AI時代のエンジニアリング投資 — ビズリーチの技術的負債と向き合った経験から、変更し続けられるソフトウェアを考える
https://speakerdeck.com/visional_engineering_and_design/technical-debt-con2026

AI駆動開発が変える、大規模開発の前提 ーHuman in the Loop から Human on the Loop へ
https://speakerdeck.com/visional_engineering_and_design/aie2026

Percolatorを廃止し、マルチ検索サービスへ刷新した話
https://speakerdeck.com/visional_engineering_and_design/search-engineering-tech-talk-2026-spring

ブラックボックス化したMLシステムのVertex AI移行
https://speakerdeck.com/visional_engineering_and_design/mlops-community-62

ビズリーチにおける検索・推薦の取り組み
https://speakerdeck.com/visional_engineering_and_design/deim2026

-----
Visionalのエンジニアリングに関する最新情報はX、ブログで発信しています!📣

▼Visional Engineering Blog
https://engineering.visional.inc/blog/

▼VISIONAL ENGINEERING / X
https://twitter.com/VISIONAL_ENG

More Decks by Visional Engineering & Design

Other Decks in Technology

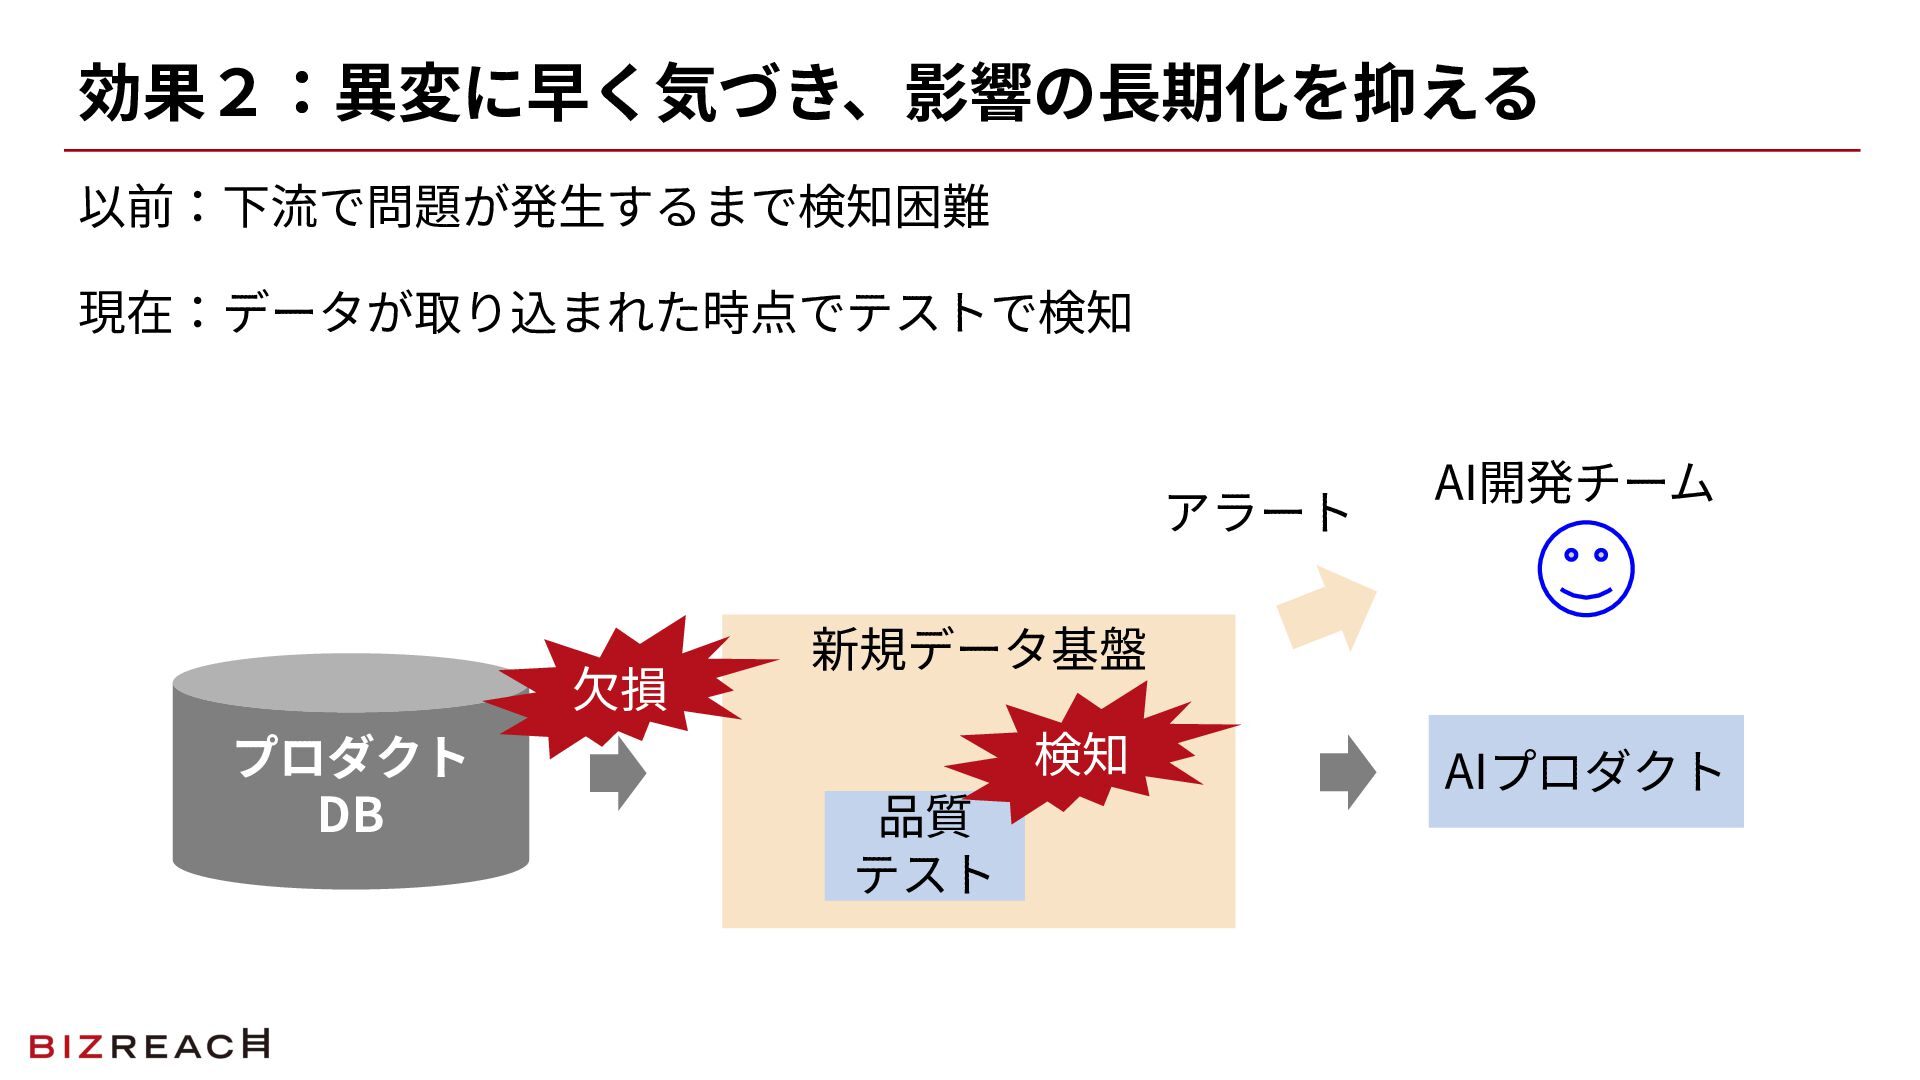
Transcript

  1. ⾃⼰紹介 ⽯⼭ 和樹 (いしやま かずき) 株式会社ビズリーチ プロダクト本部 データプロダクト部 データエンジニアリンググループ 経歴

    ‧2026年 ⼤阪⼤学⼤学院 情報科学研究科 修了 (コンピュータビジョンの研究) ‧同年 新卒としてビズリーチに⼊社、データエンジニアリンググループに配属 ‧現在は BigQuery / dbt を⽤いた新規データ基盤の開発‧運⽤に従事 趣味 ‧漫画、アニメ、旅⾏、五⽬並べ
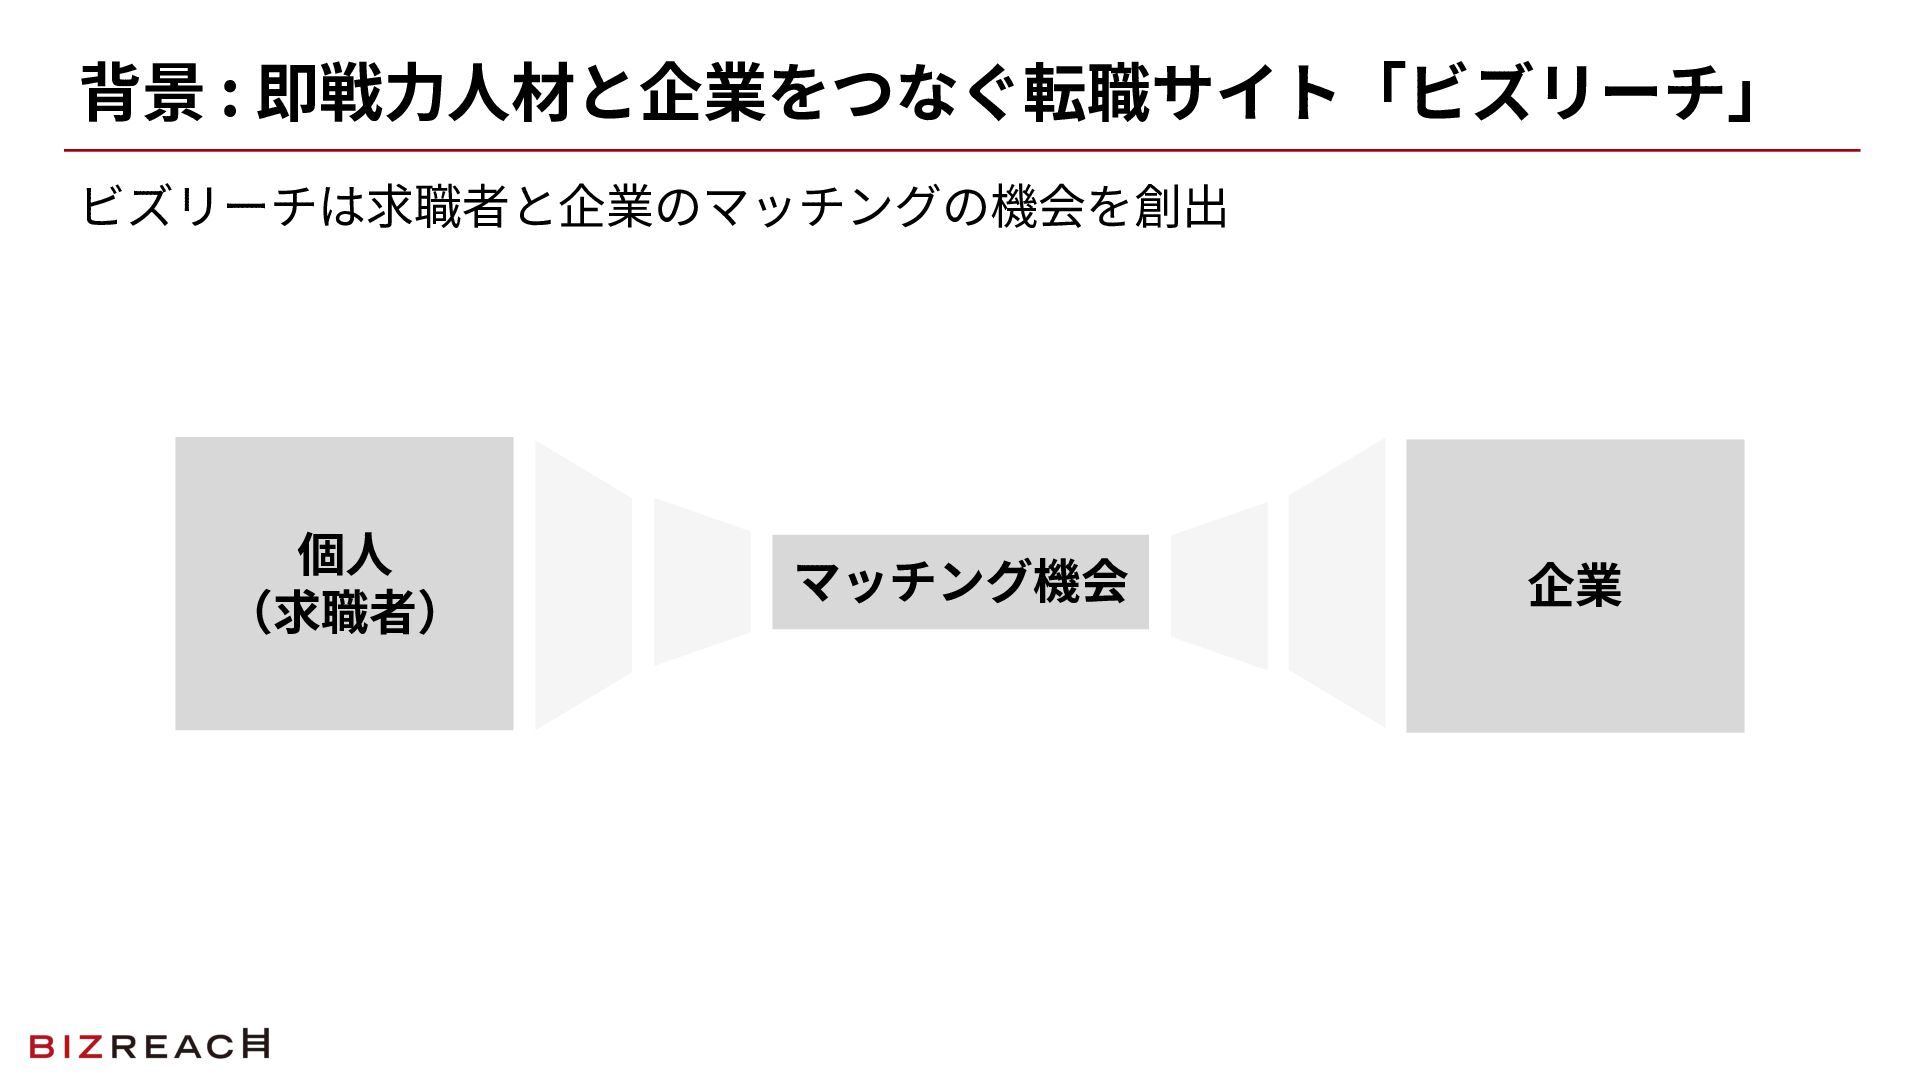
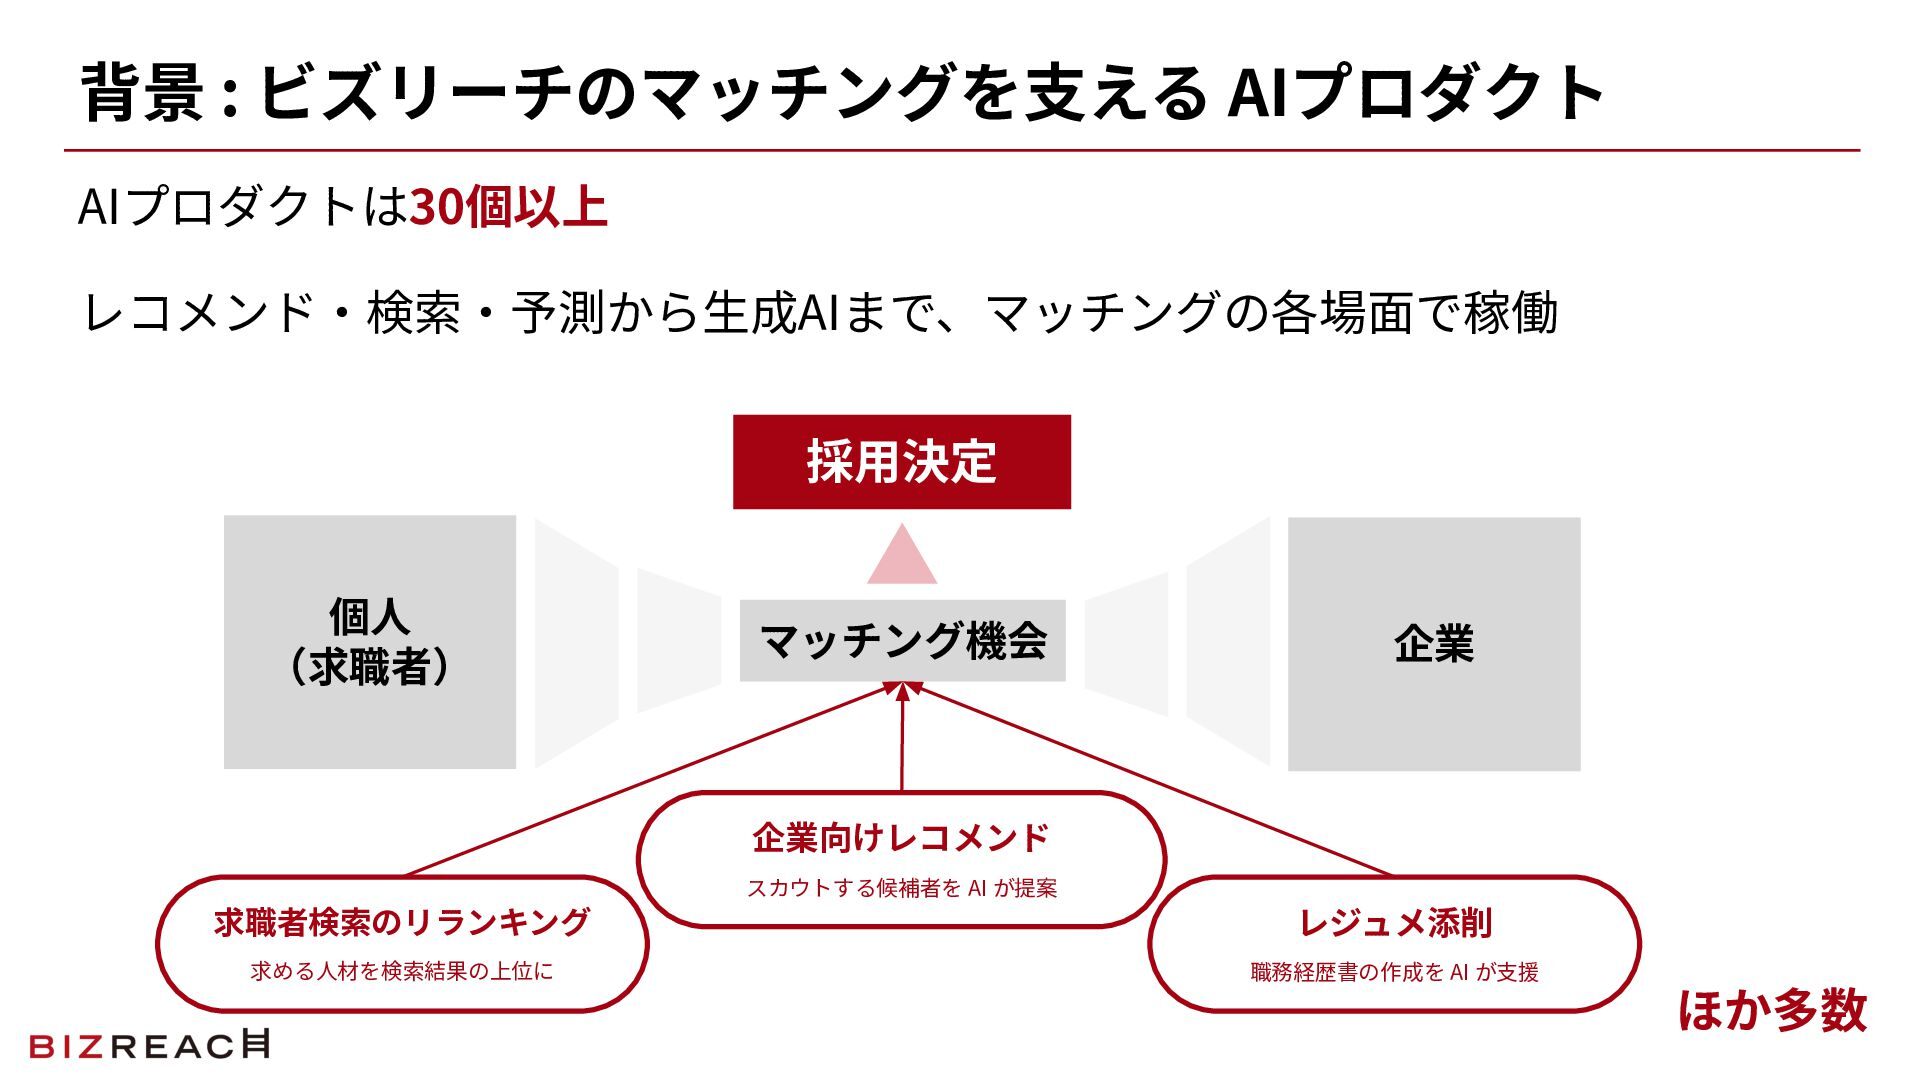
  2. 背景 : ビズリーチのマッチングを⽀える AIプロダクト AIプロダクトは30個以上 レコメンド‧検索‧予測から⽣成AIまで、マッチングの各場⾯で稼働 採⽤決定 個⼈ (求職者) マッチング機会

    企業 企業向けレコメンド スカウトする候補者を AI が提案 求職者検索のリランキング レジュメ添削 求める⼈材を検索結果の上位に 職務経歴書の作成を AI が⽀援 ほか多数
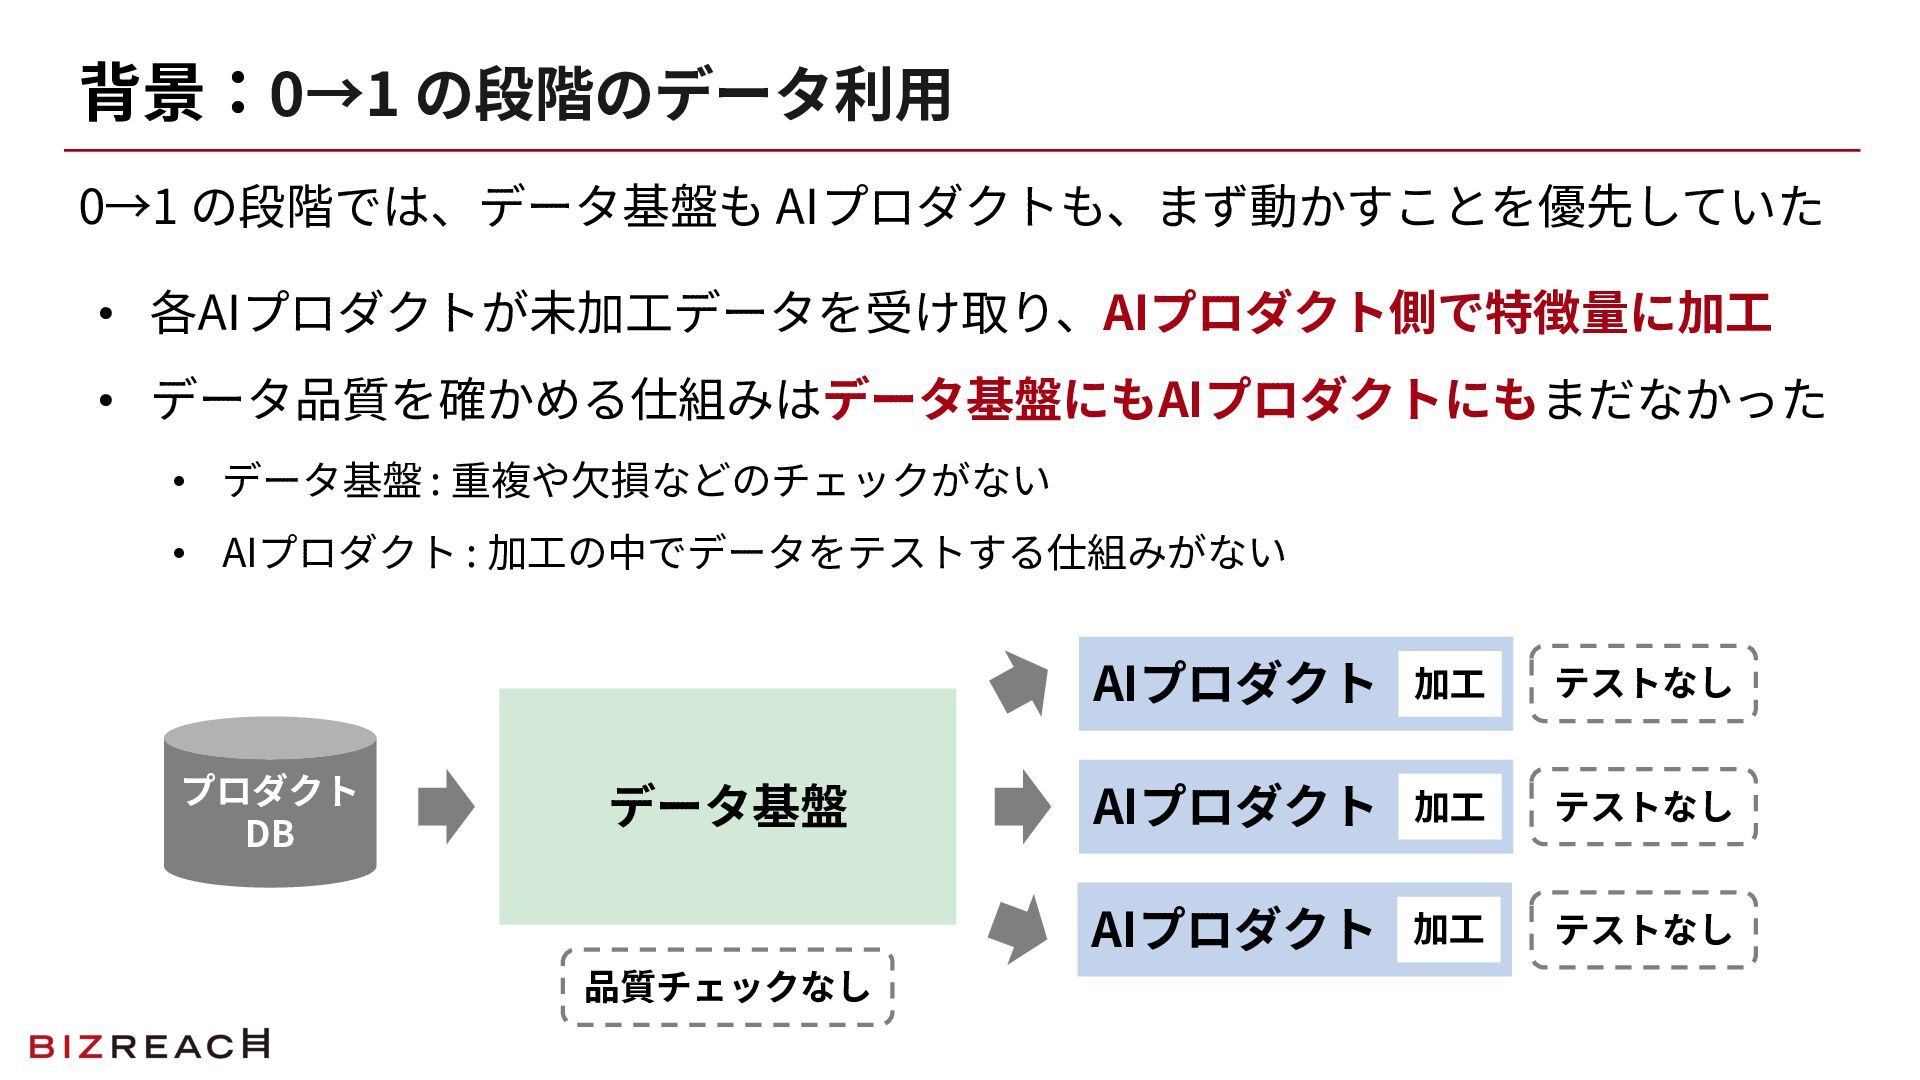
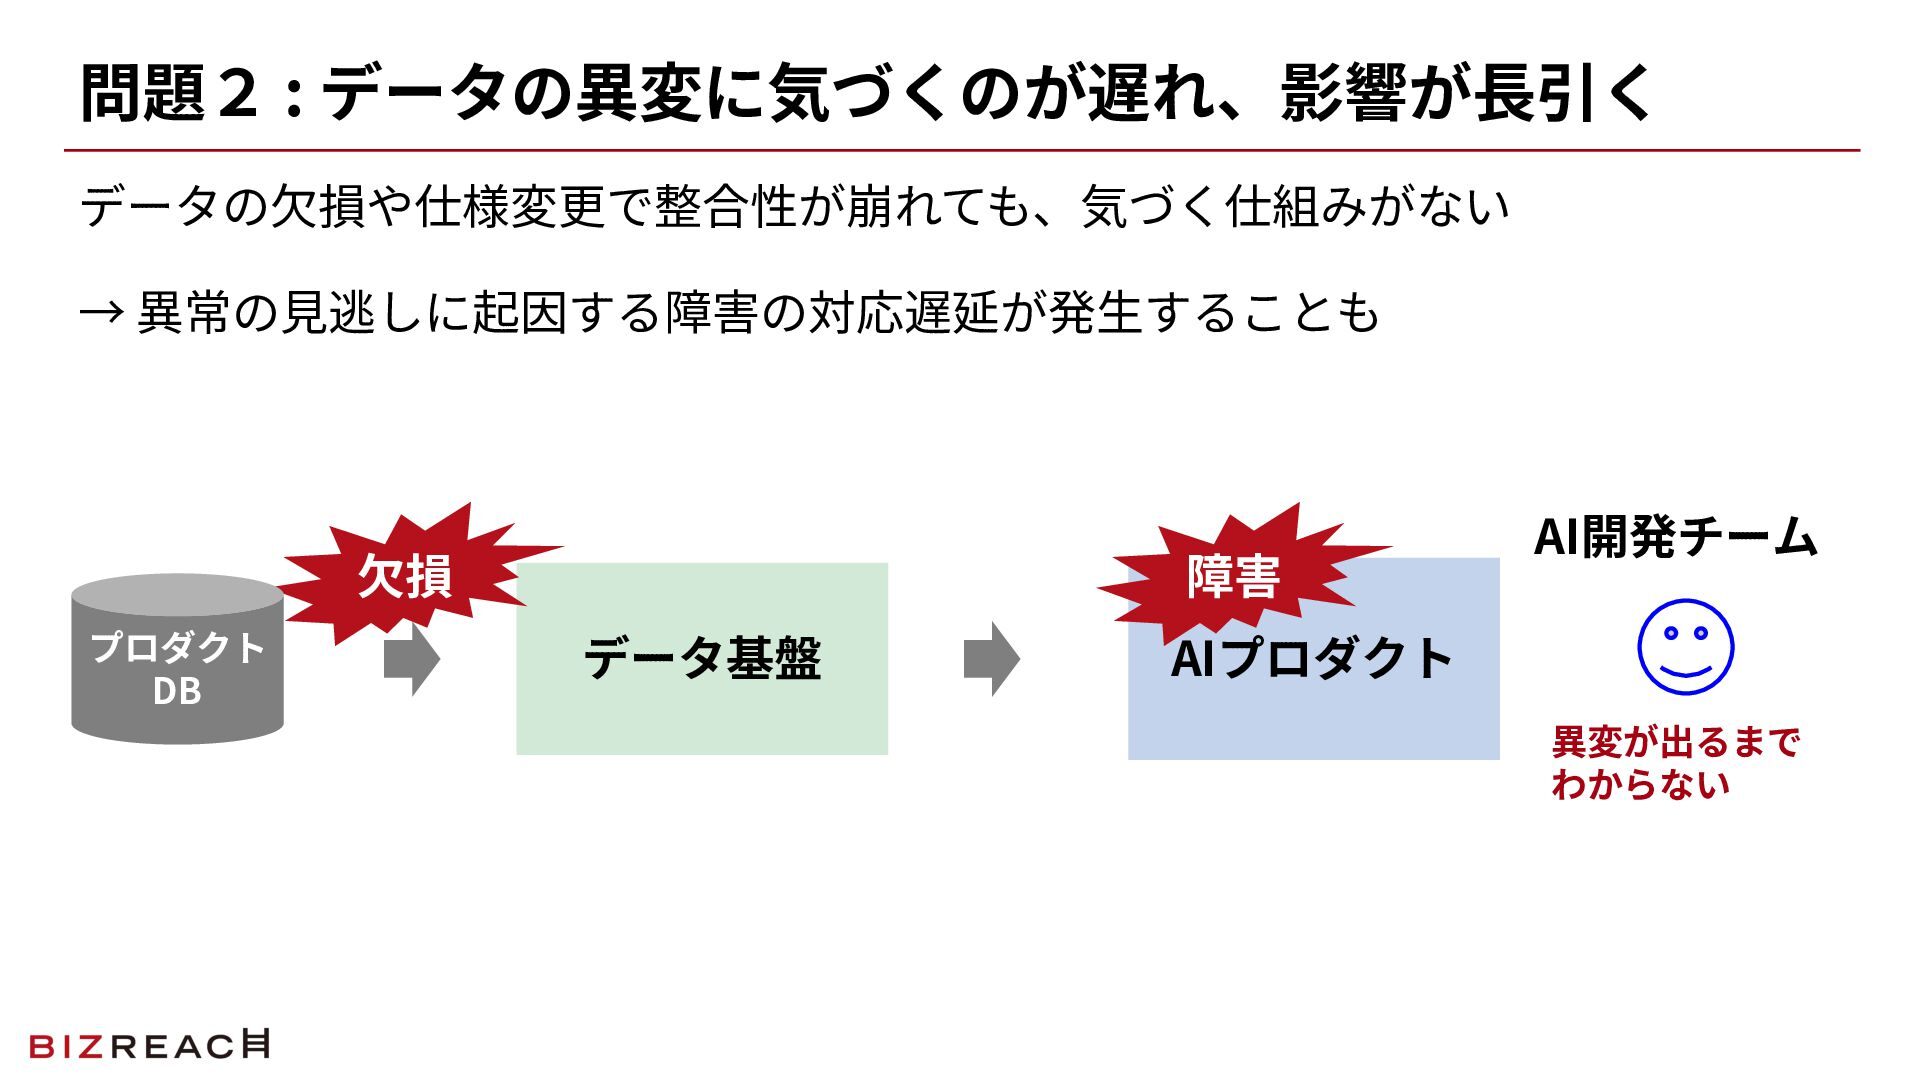
  3. 背景:0→1 の段階のデータ利⽤ 0→1 の段階では、データ基盤も AIプロダクトも、まず動かすことを優先していた • 各AIプロダクトが未加⼯データを受け取り、AIプロダクト側で特徴量に加⼯ • データ品質を確かめる仕組みはデータ基盤にもAIプロダクトにもまだなかった •

    データ基盤 : 重複や⽋損などのチェックがない • AIプロダクト : 加⼯の中でデータをテストする仕組みがない プロダクト DB データ基盤 品質チェックなし AIプロダクト 加⼯ テストなし AIプロダクト 加⼯ テストなし AIプロダクト 加⼯ テストなし
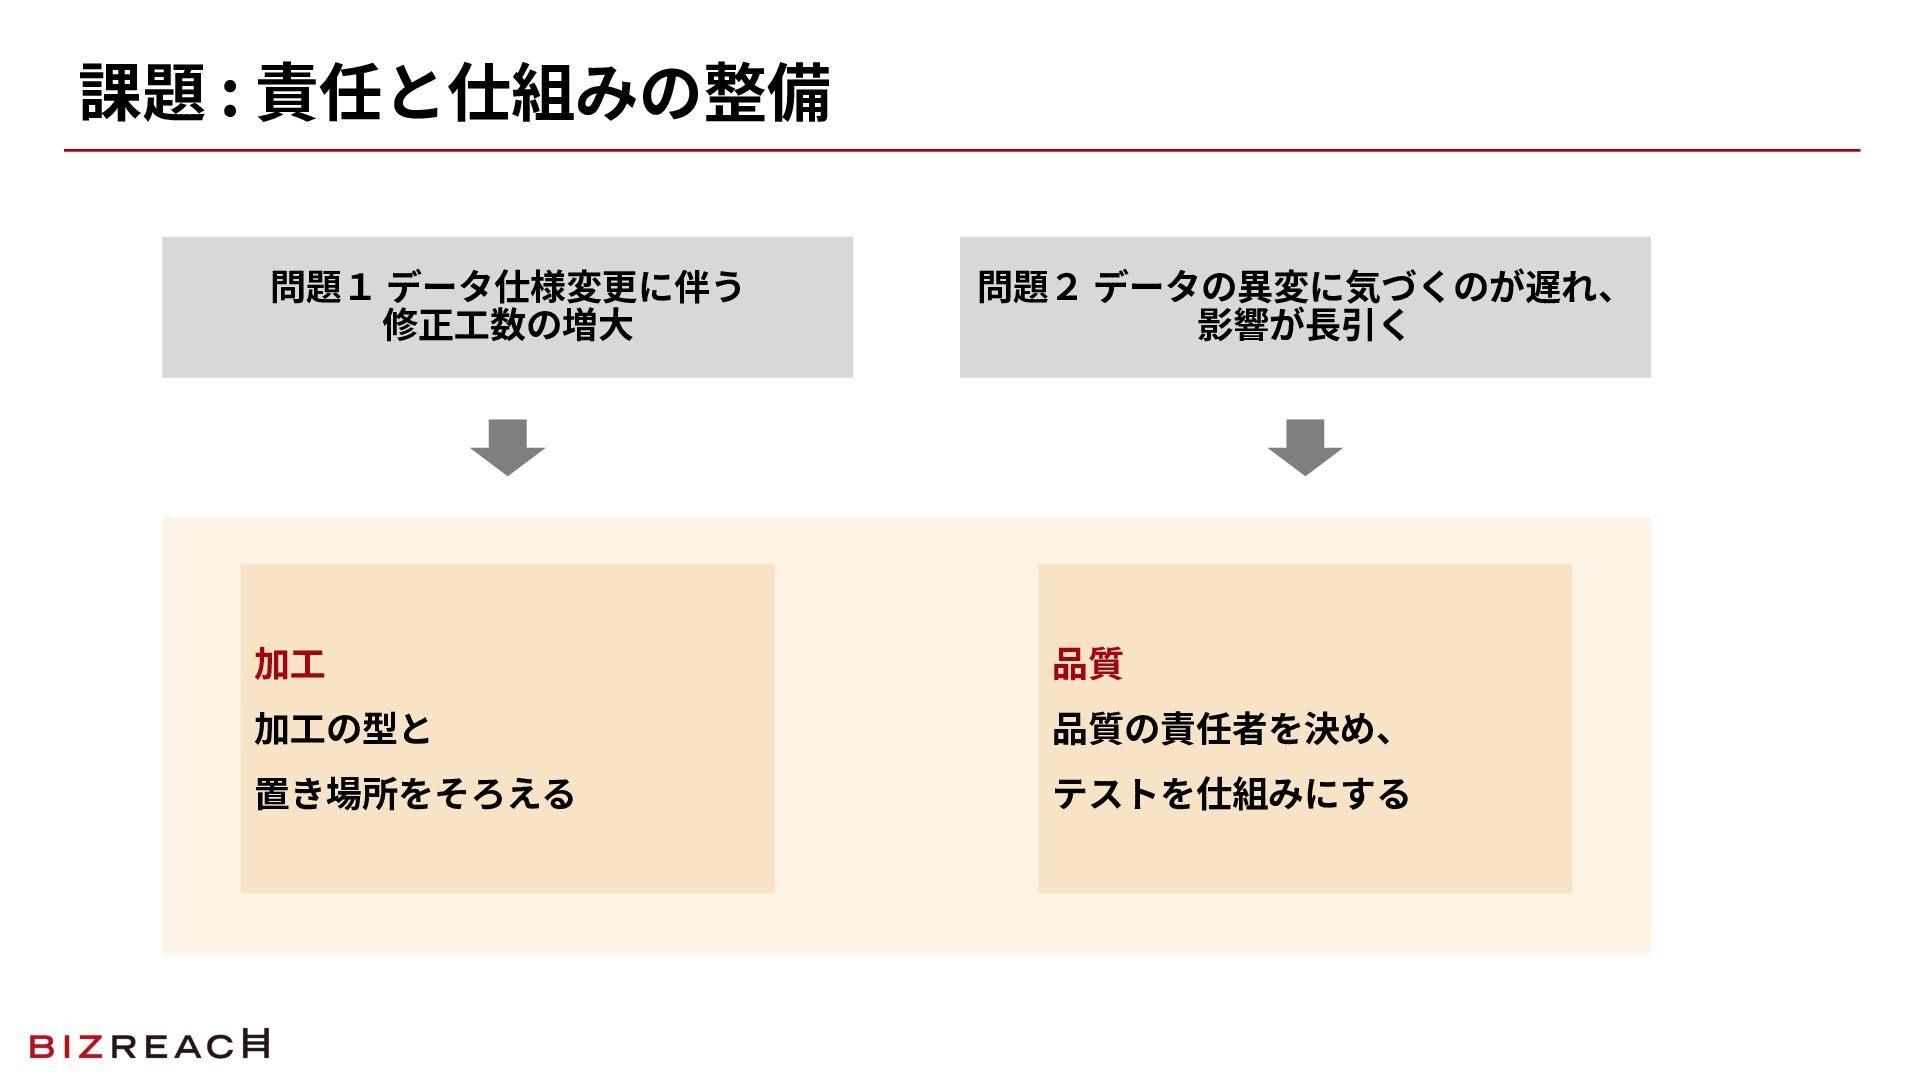
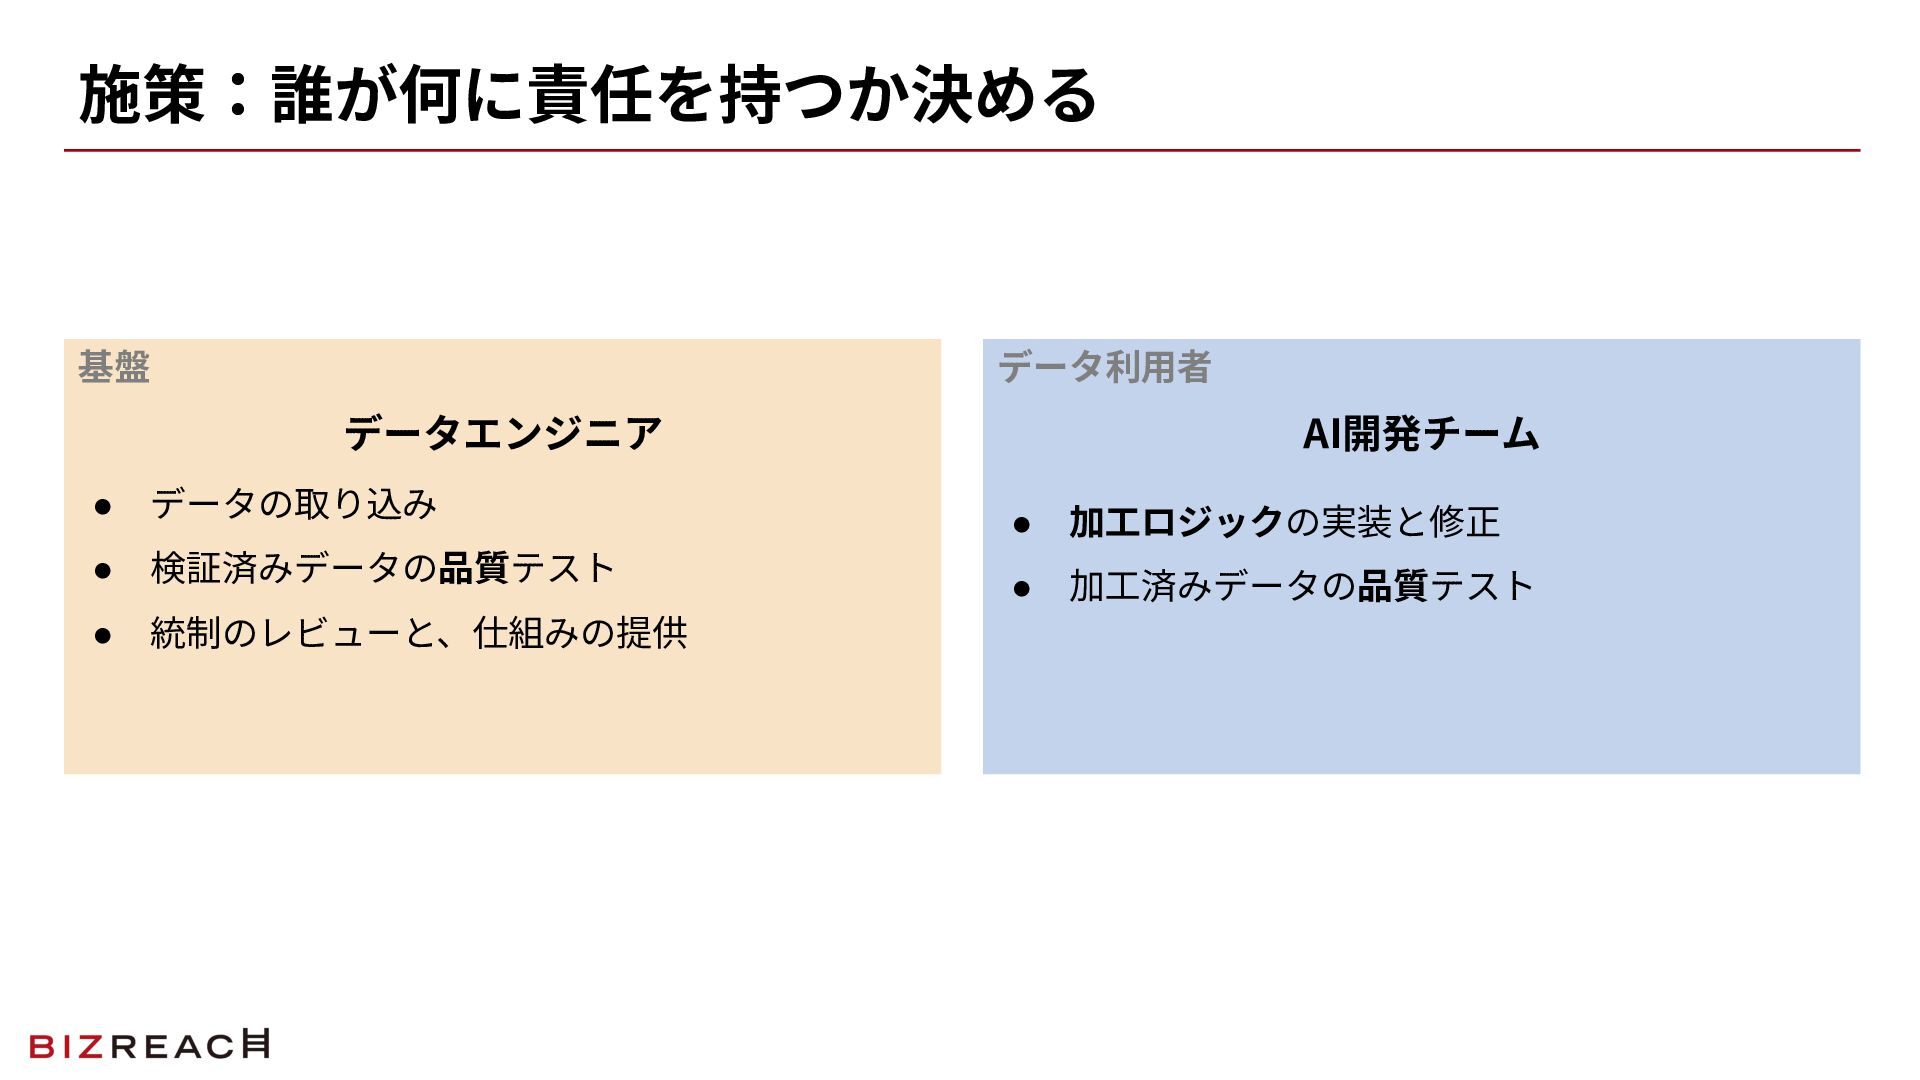
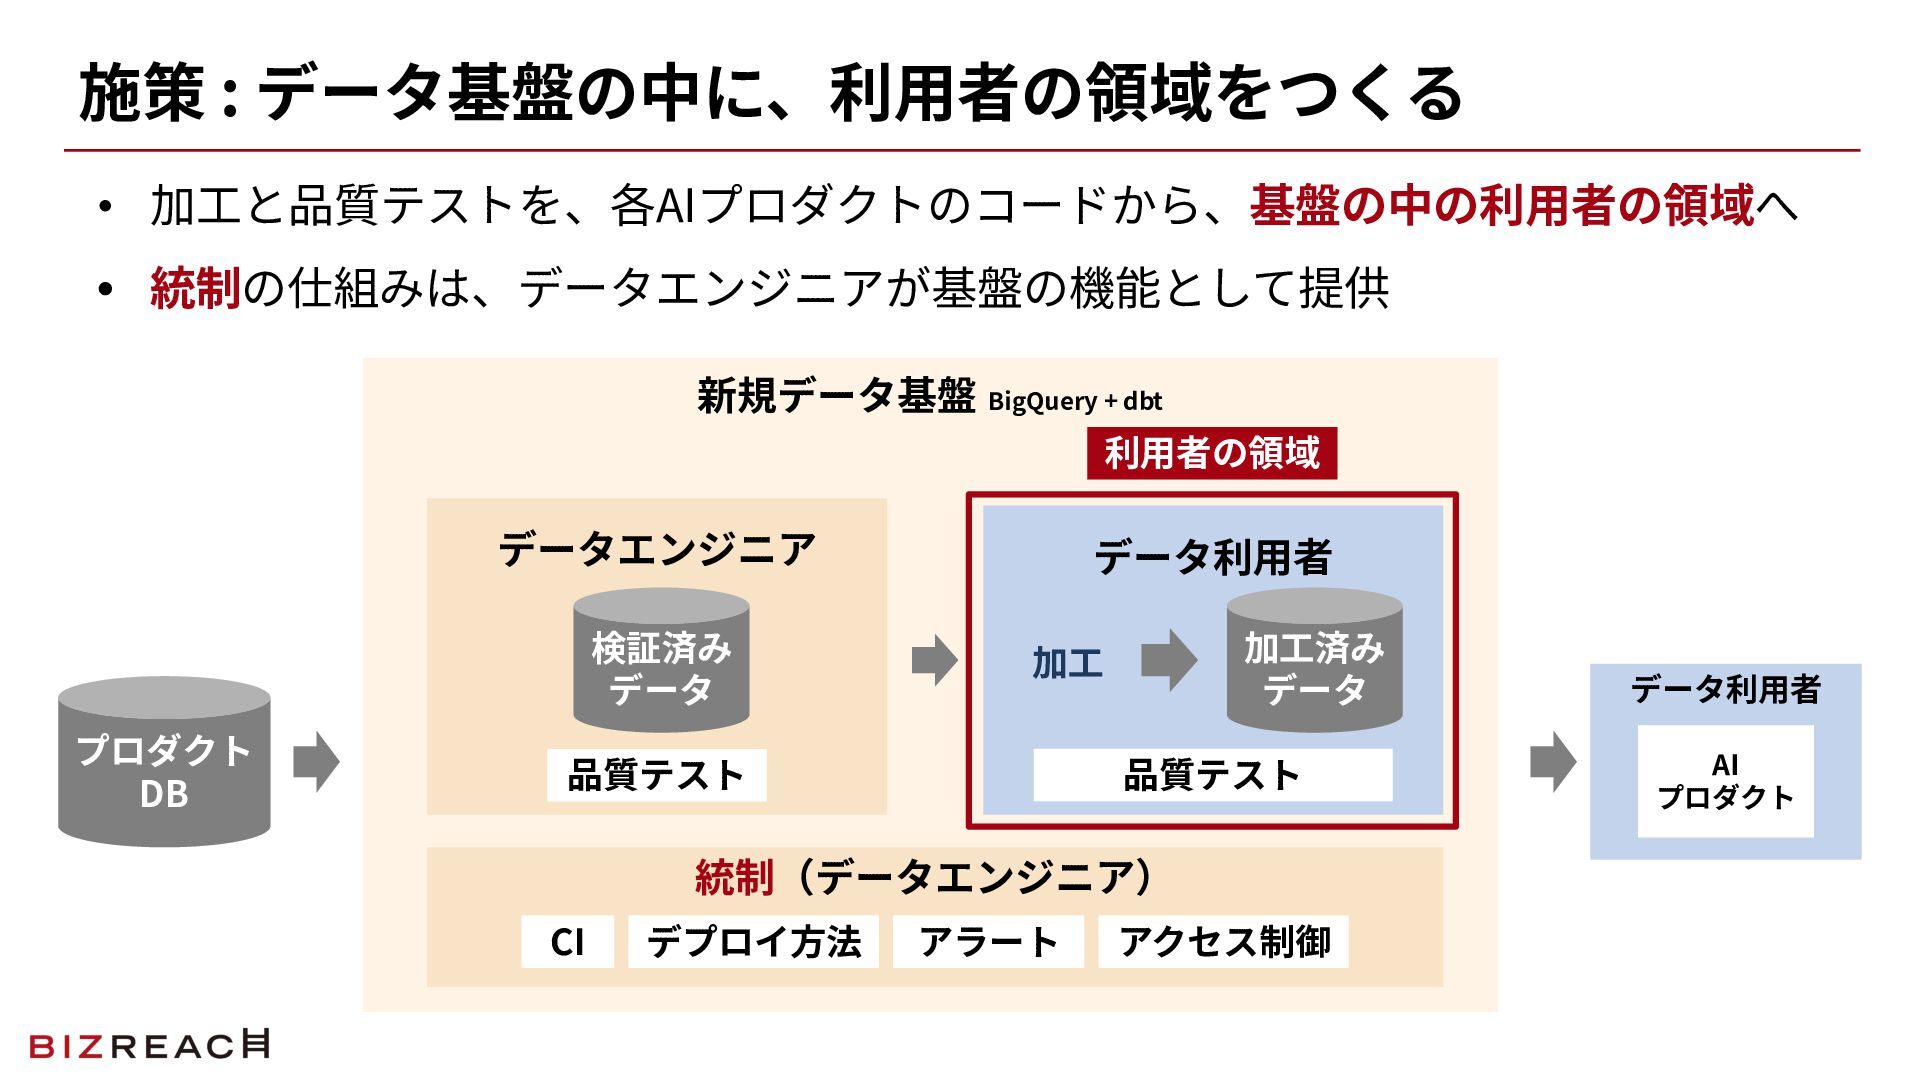
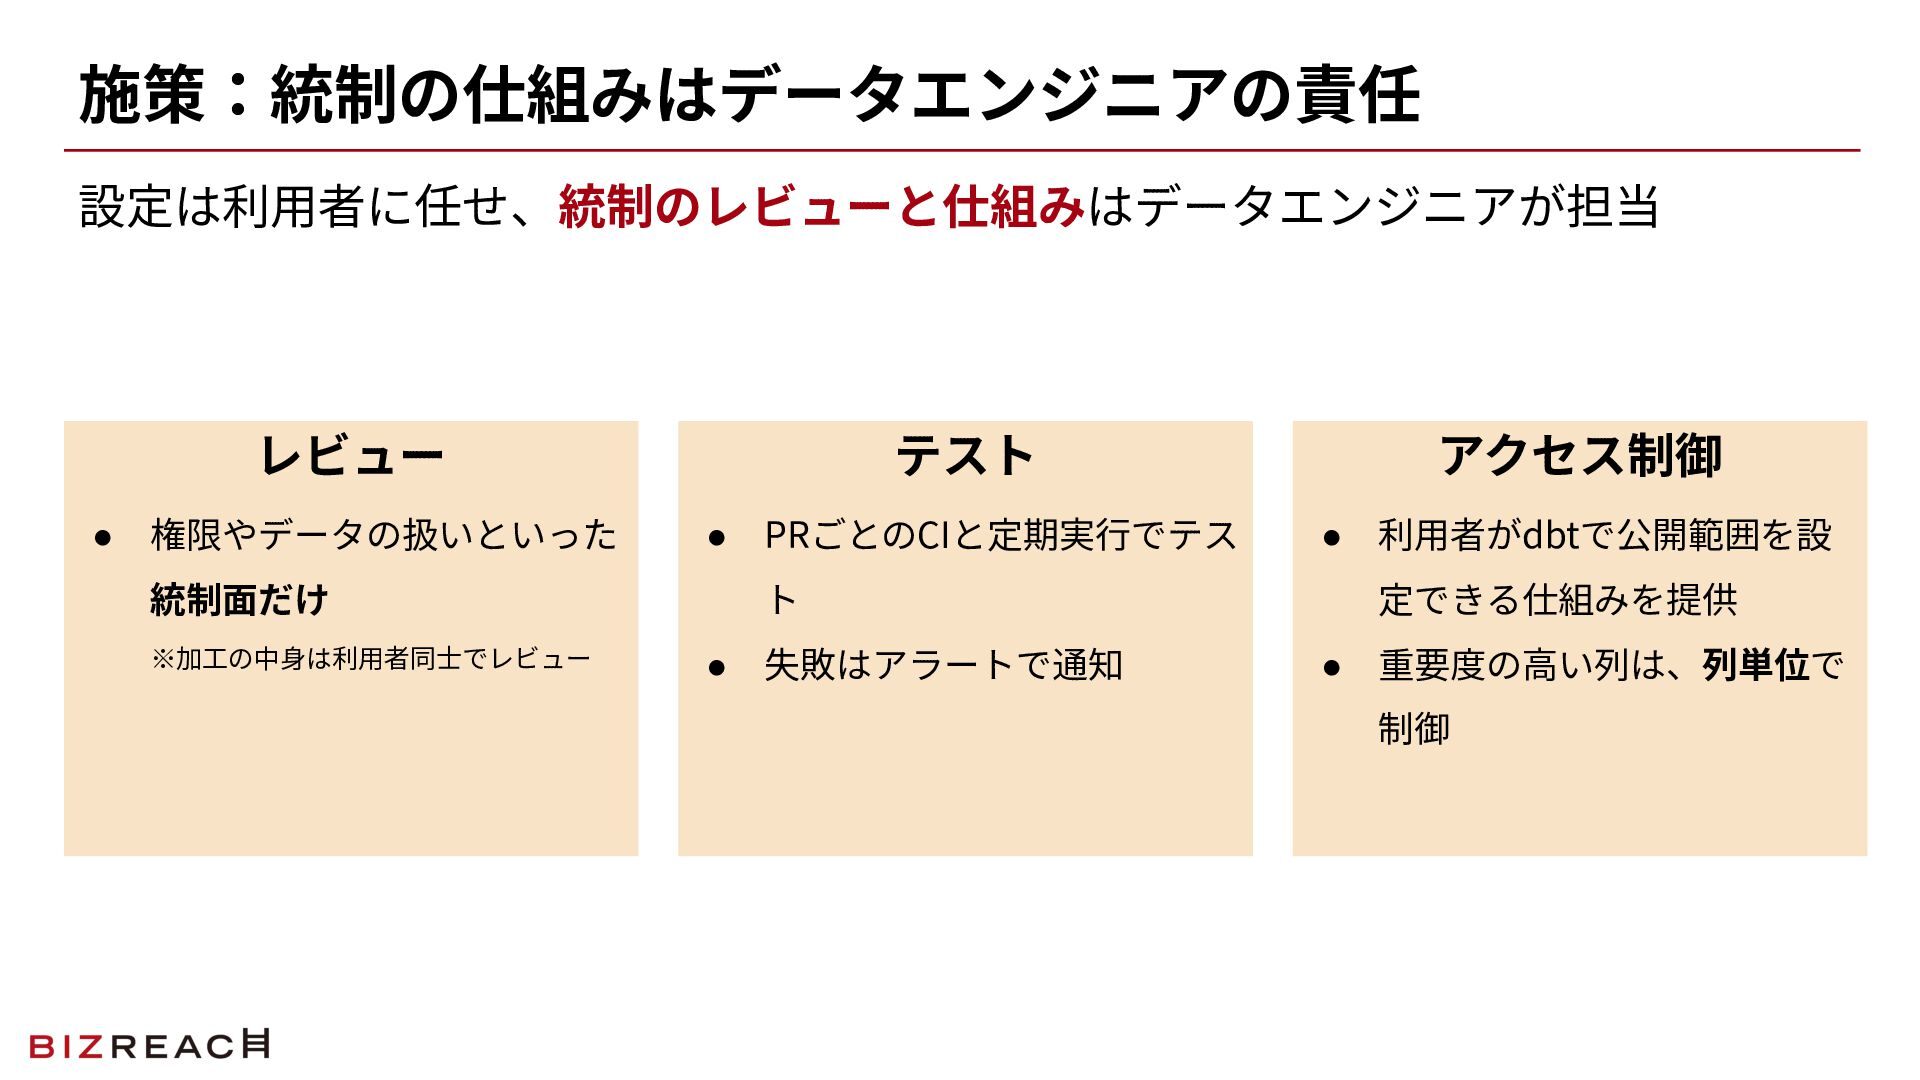
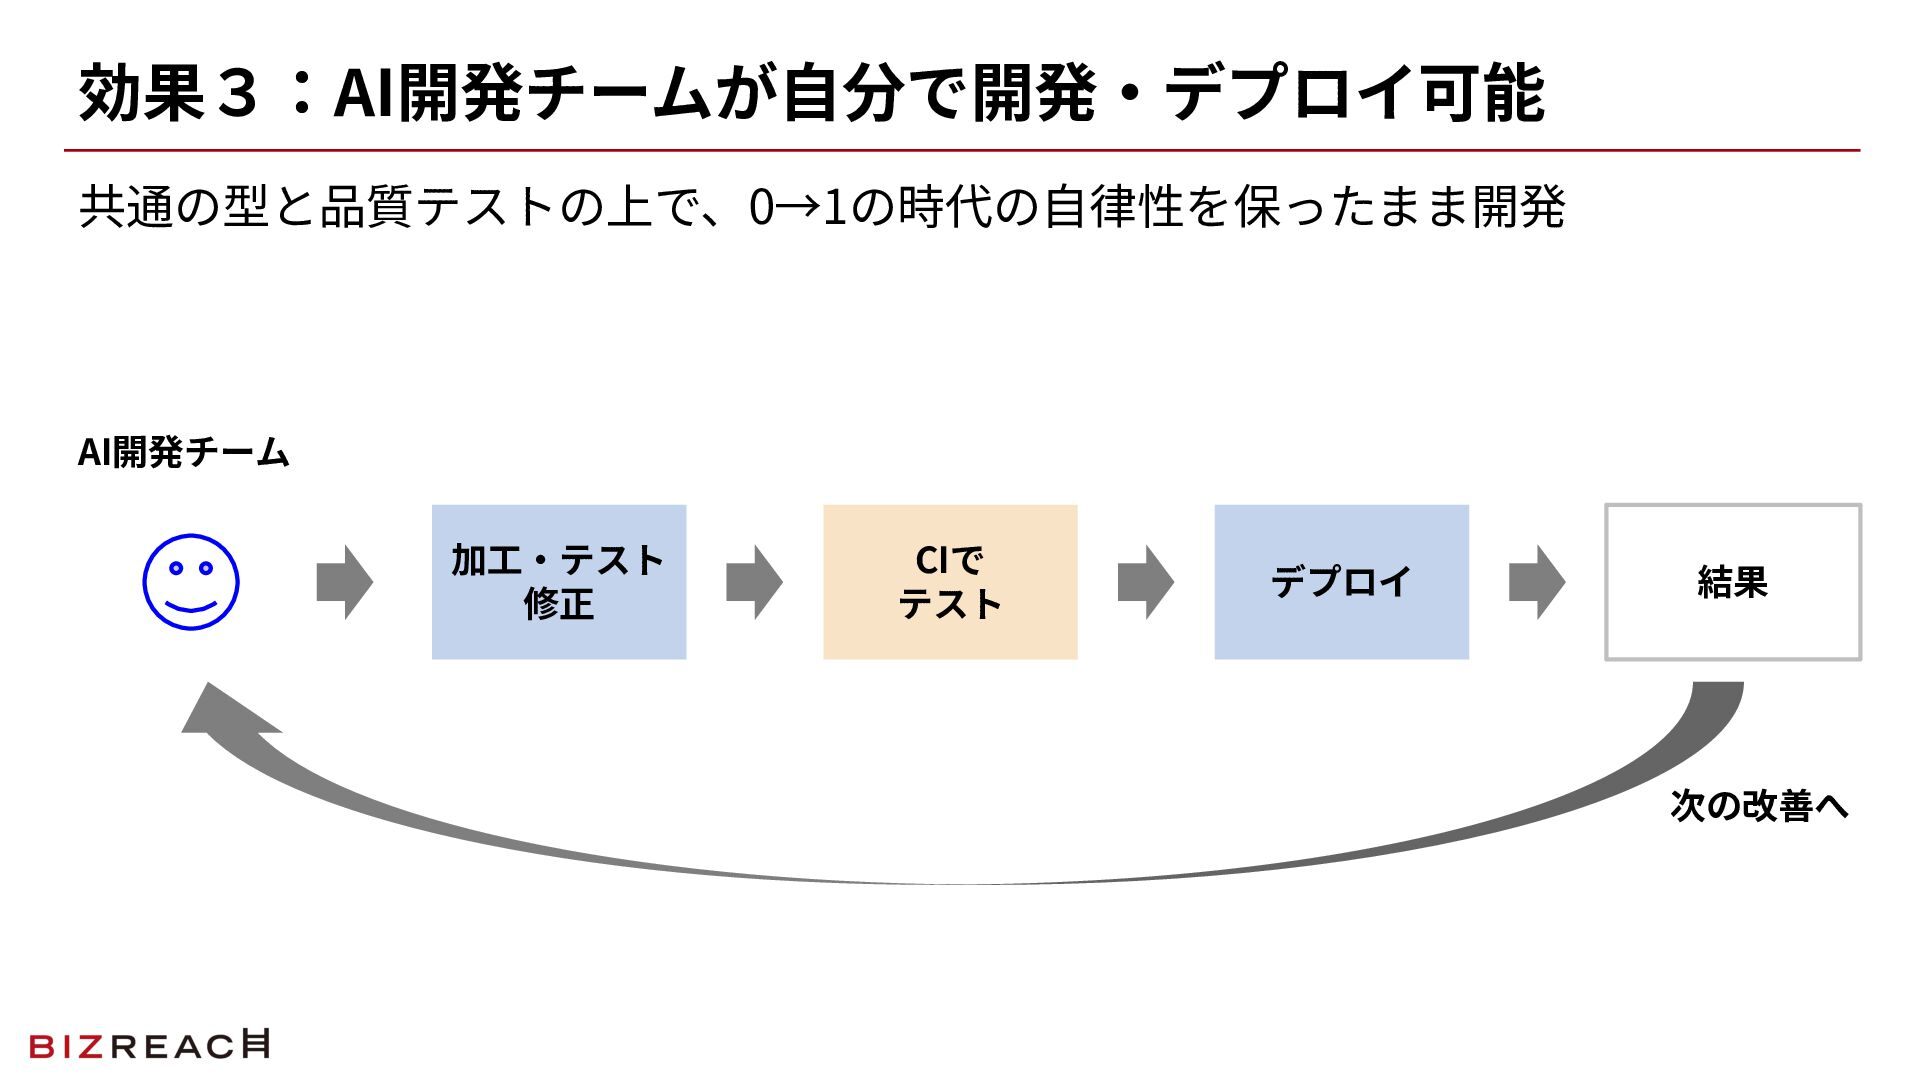
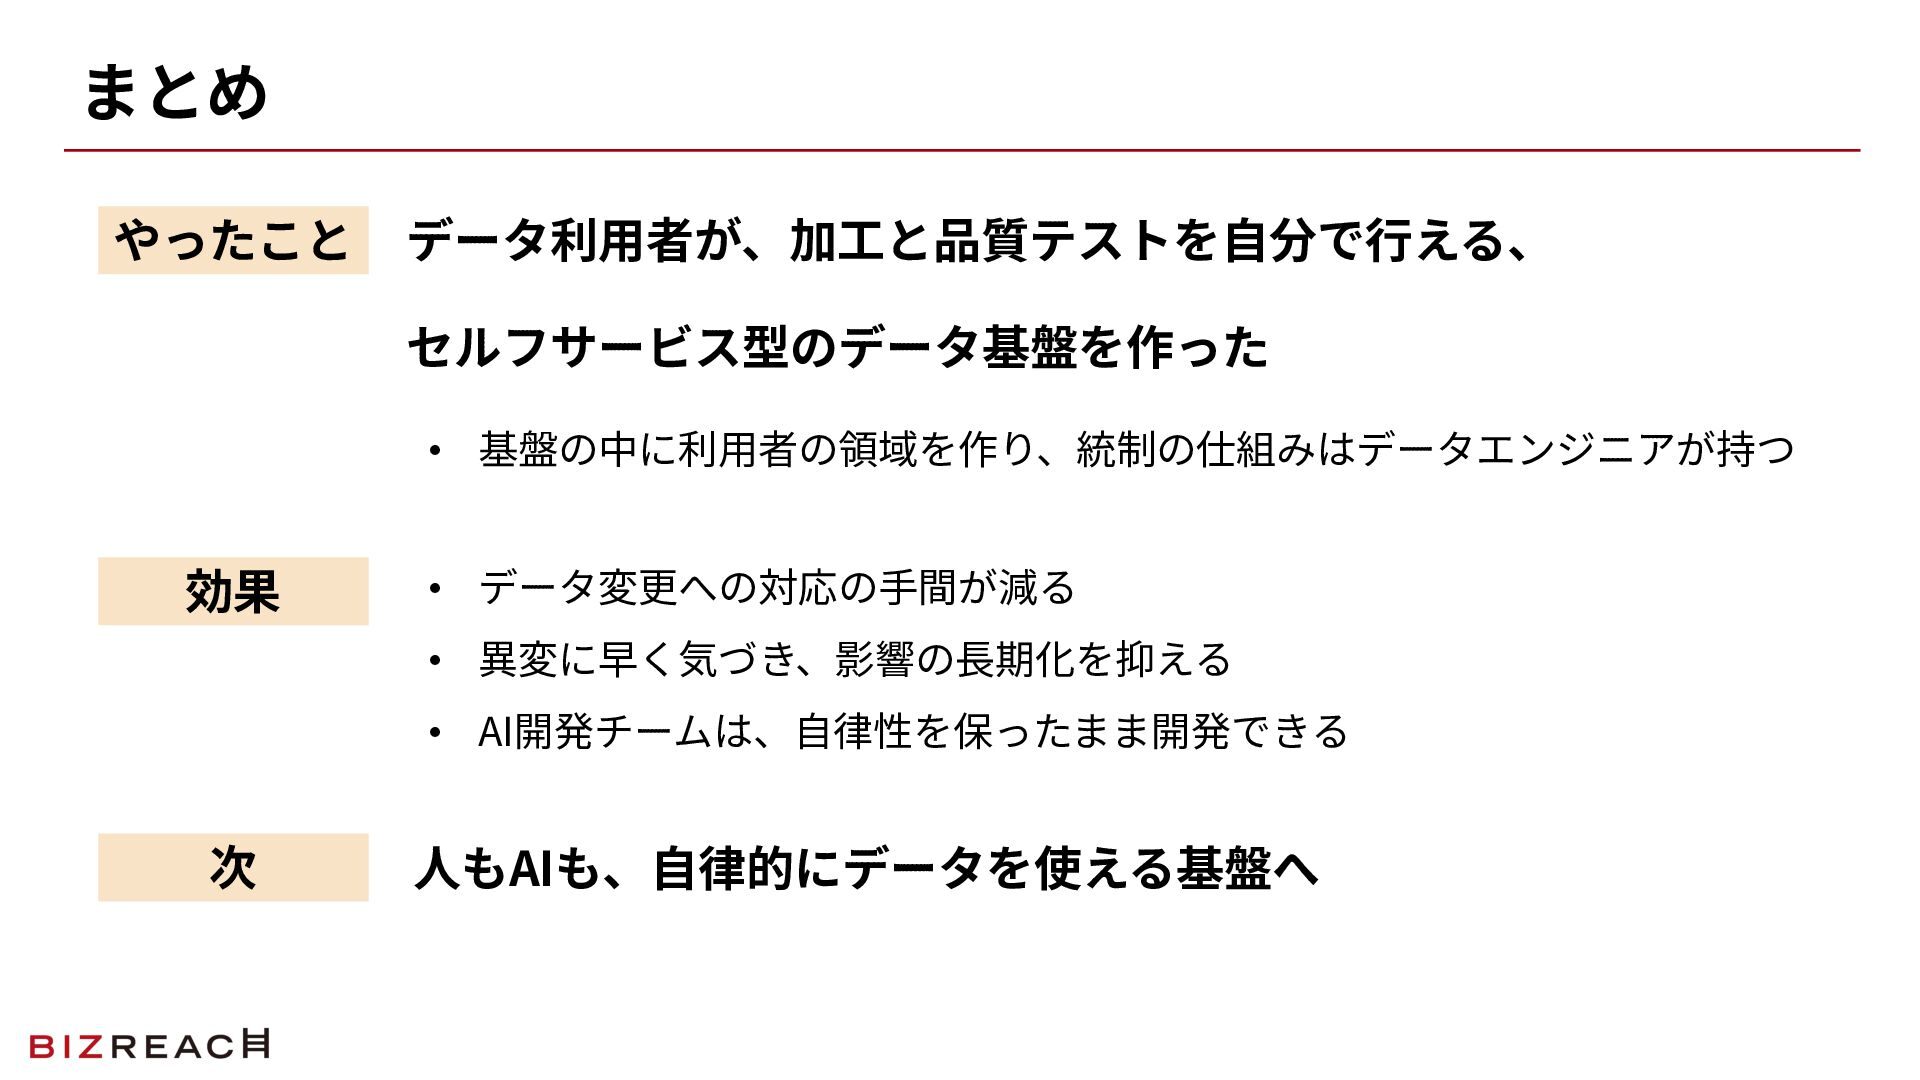
  4. 施策 : データ基盤の中に、利⽤者の領域をつくる • 加⼯と品質テストを、各AIプロダクトのコードから、基盤の中の利⽤者の領域へ • 統制の仕組みは、データエンジニアが基盤の機能として提供 新規データ基盤 BigQuery +

    dbt 利⽤者の領域 データエンジニア 検証済み データ プロダクト DB データ利⽤者 加⼯済み データ 加⼯ 品質テスト 品質テスト 統制(データエンジニア) CI デプロイ⽅法 アラート アクセス制御 データ利⽤者 AI プロダクト
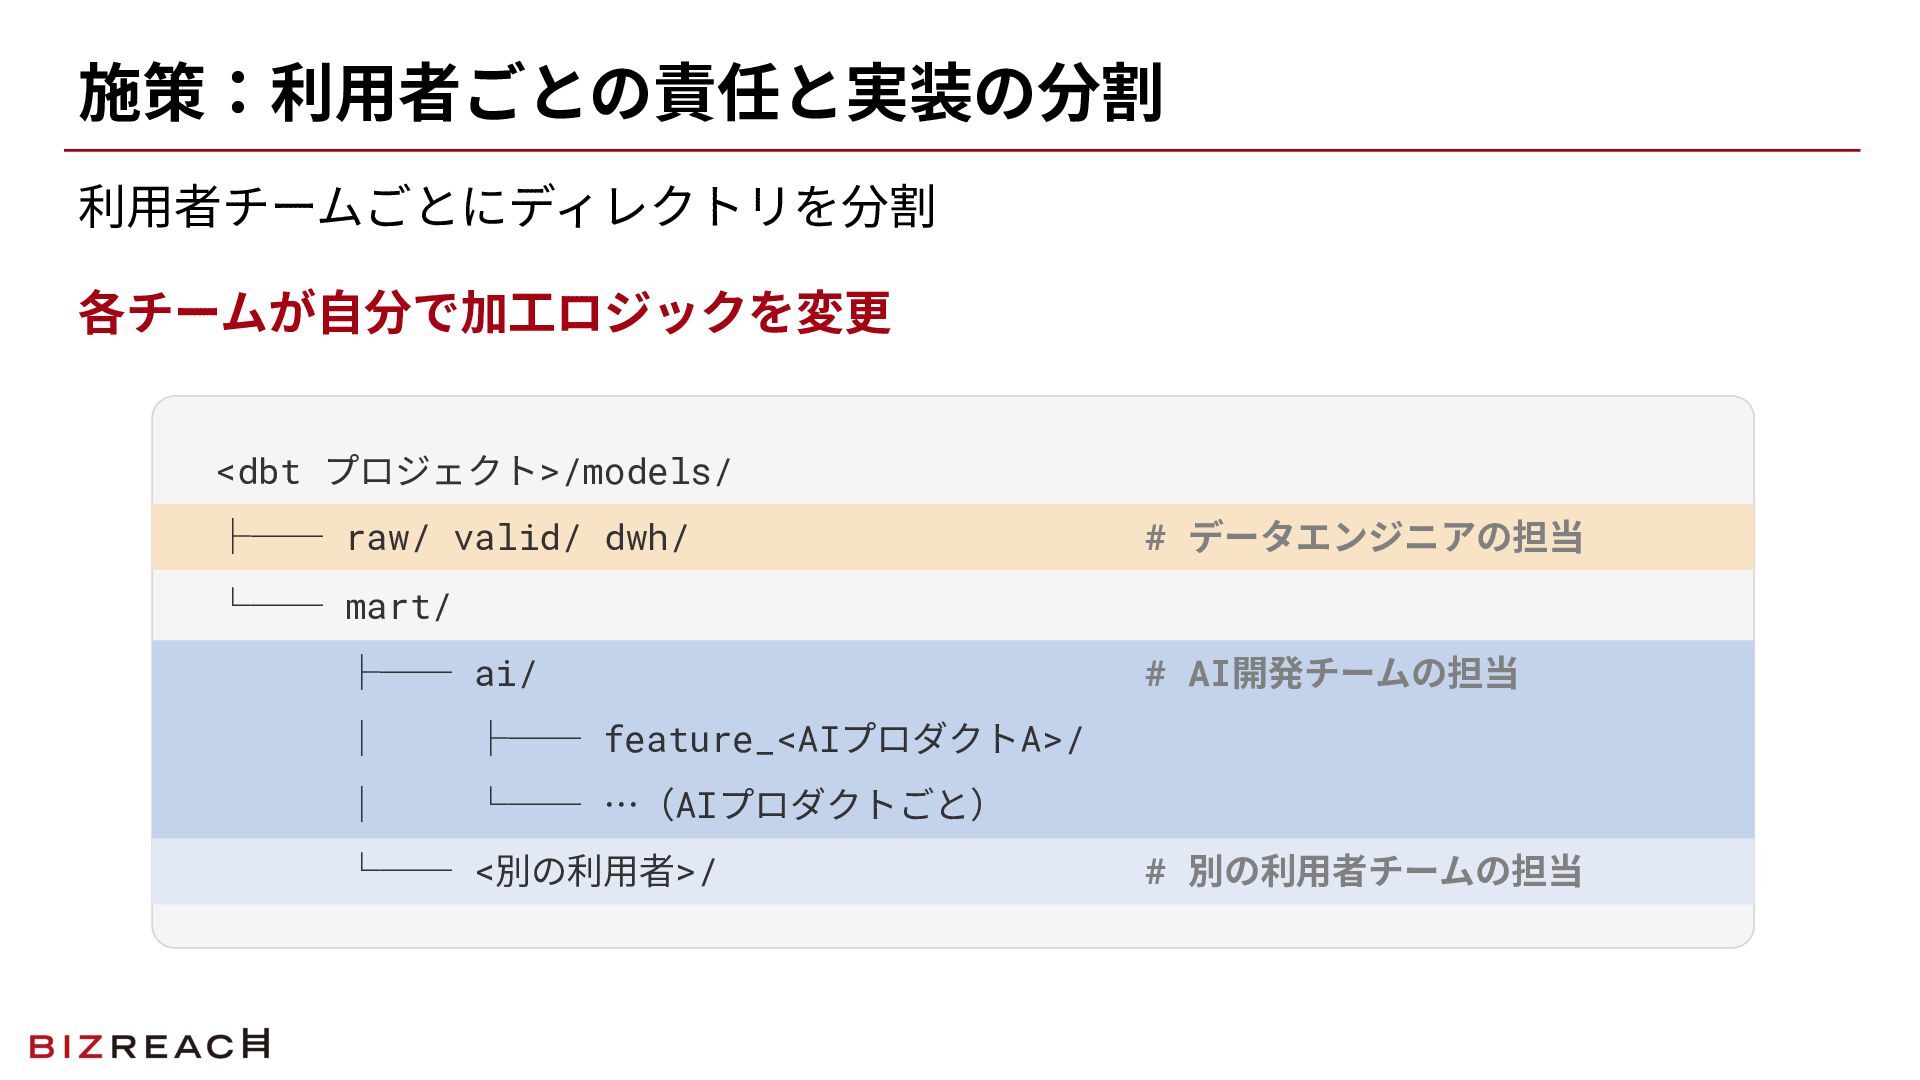
  5. 施策:利⽤者ごとの責任と実装の分割 利⽤者チームごとにディレクトリを分割 各チームが⾃分で加⼯ロジックを変更 <dbt プロジェクト>/models/ ├── raw/ valid/ dwh/ #

    データエンジニアの担当 └── mart/ ├── ai/ │ ├── feature_<AIプロダクトA>/ │ └── …(AIプロダクトごと) └── <別の利⽤者>/ # AI開発チームの担当 # 別の利⽤者チームの担当
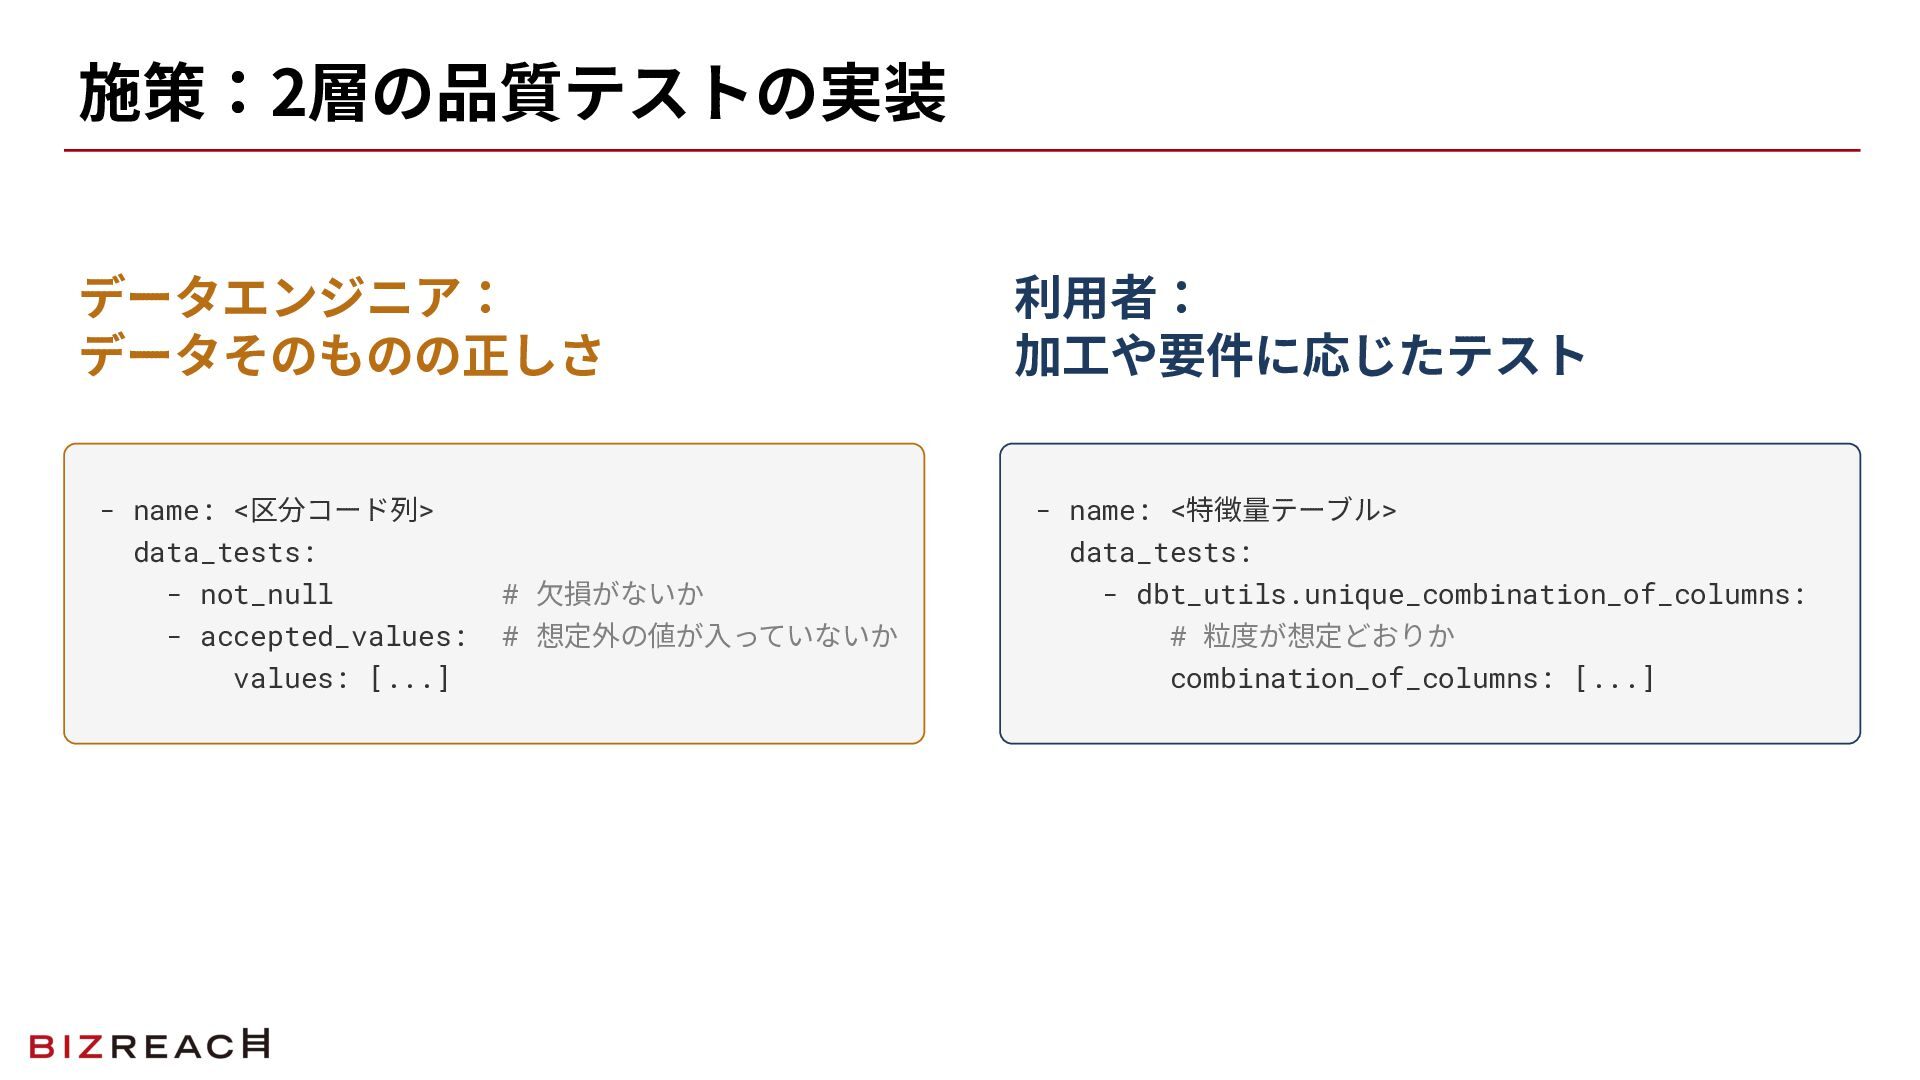
  6. 施策:2層の品質テストの実装 データエンジニア: データそのものの正しさ - name: <区分コード列> data_tests: - name: <特徴量テーブル>

    data_tests: - not_null # ⽋損がないか - accepted_values: # 想定外の値が⼊っていないか values: [...] 利⽤者: 加⼯や要件に応じたテスト - dbt_utils.unique_combination_of_columns: # 粒度が想定どおりか combination_of_columns: [...]
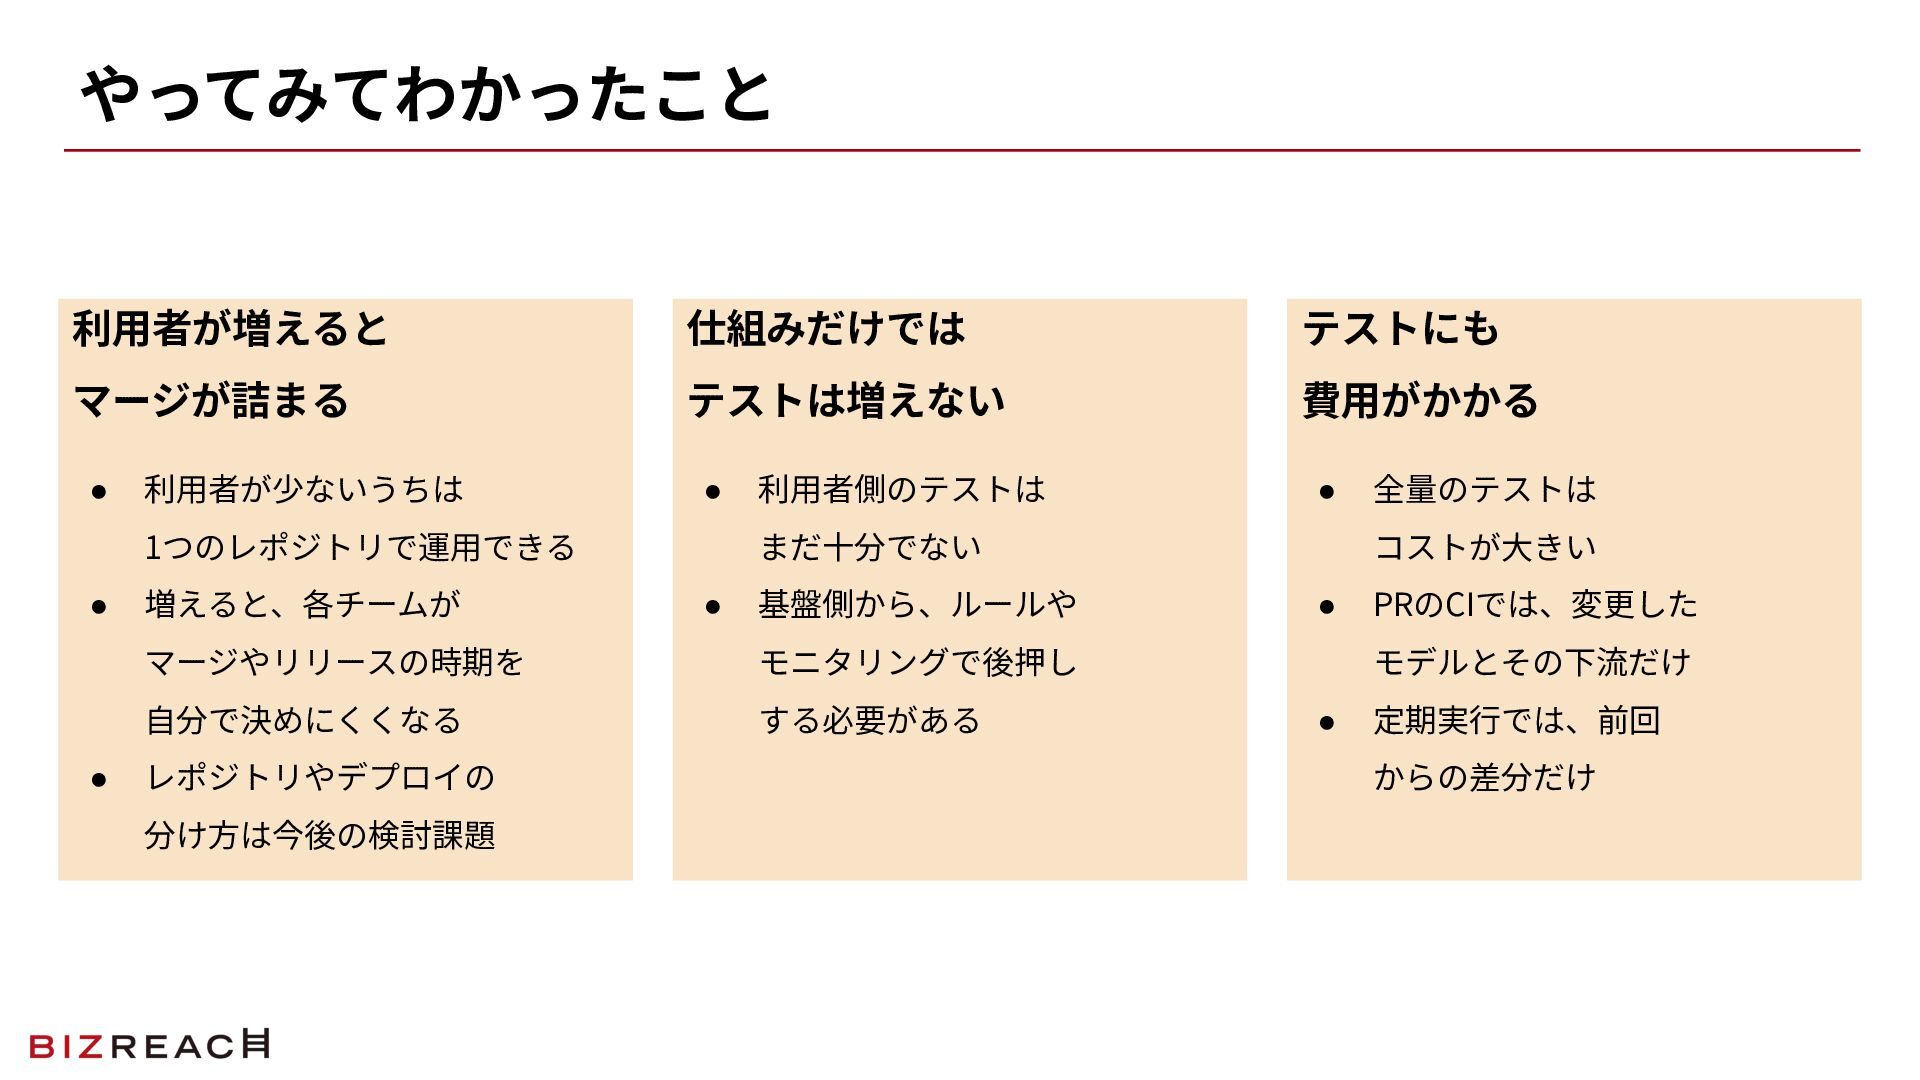
  7. やってみてわかったこと 利⽤者が増えると 仕組みだけでは テストにも マージが詰まる テストは増えない 費⽤がかかる • 利⽤者が少ないうちは •

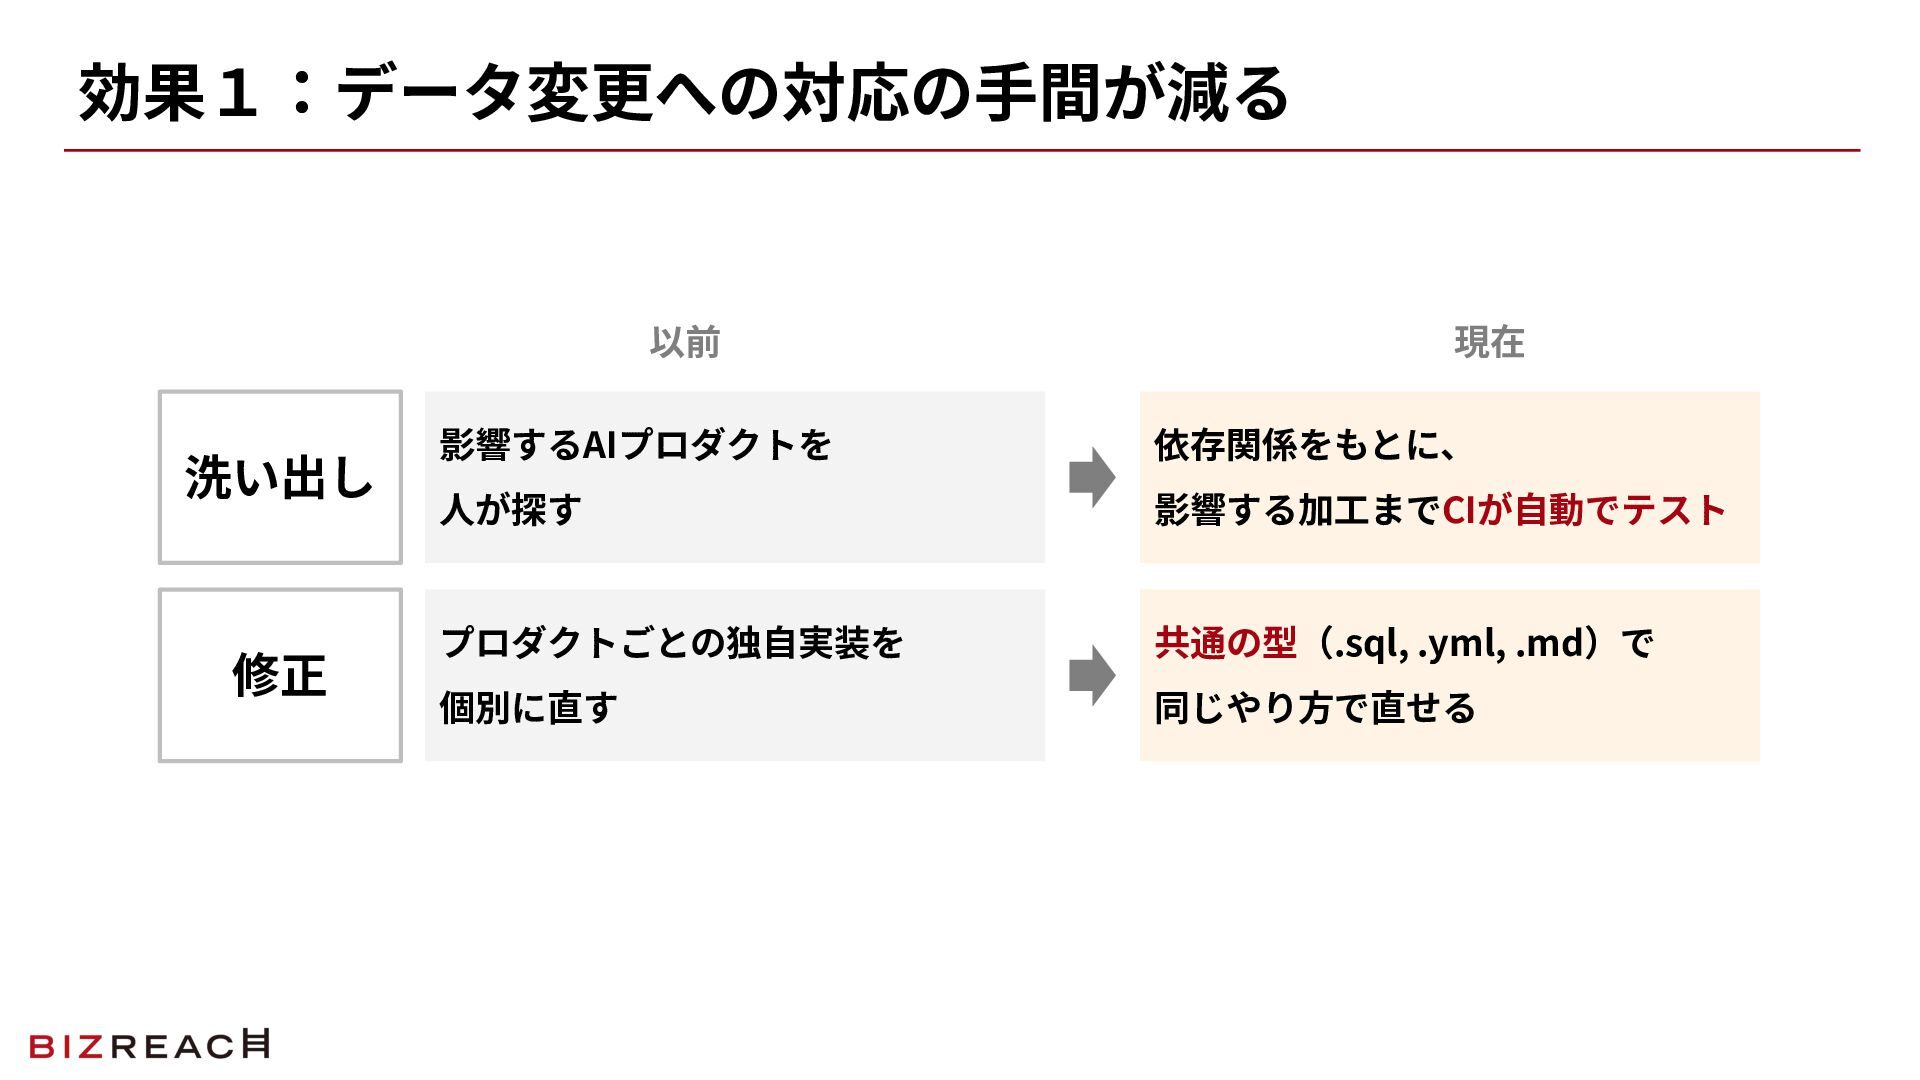
    1つのレポジトリで運⽤できる • • 増えると、各チームが 利⽤者側のテストは まだ⼗分でない • 基盤側から、ルールや マージやリリースの時期を モニタリングで後押し ⾃分で決めにくくなる する必要がある レポジトリやデプロイの 分け⽅は今後の検討課題 • 全量のテストは コストが⼤きい • PRのCIでは、変更した モデルとその下流だけ • 定期実⾏では、前回 からの差分だけ
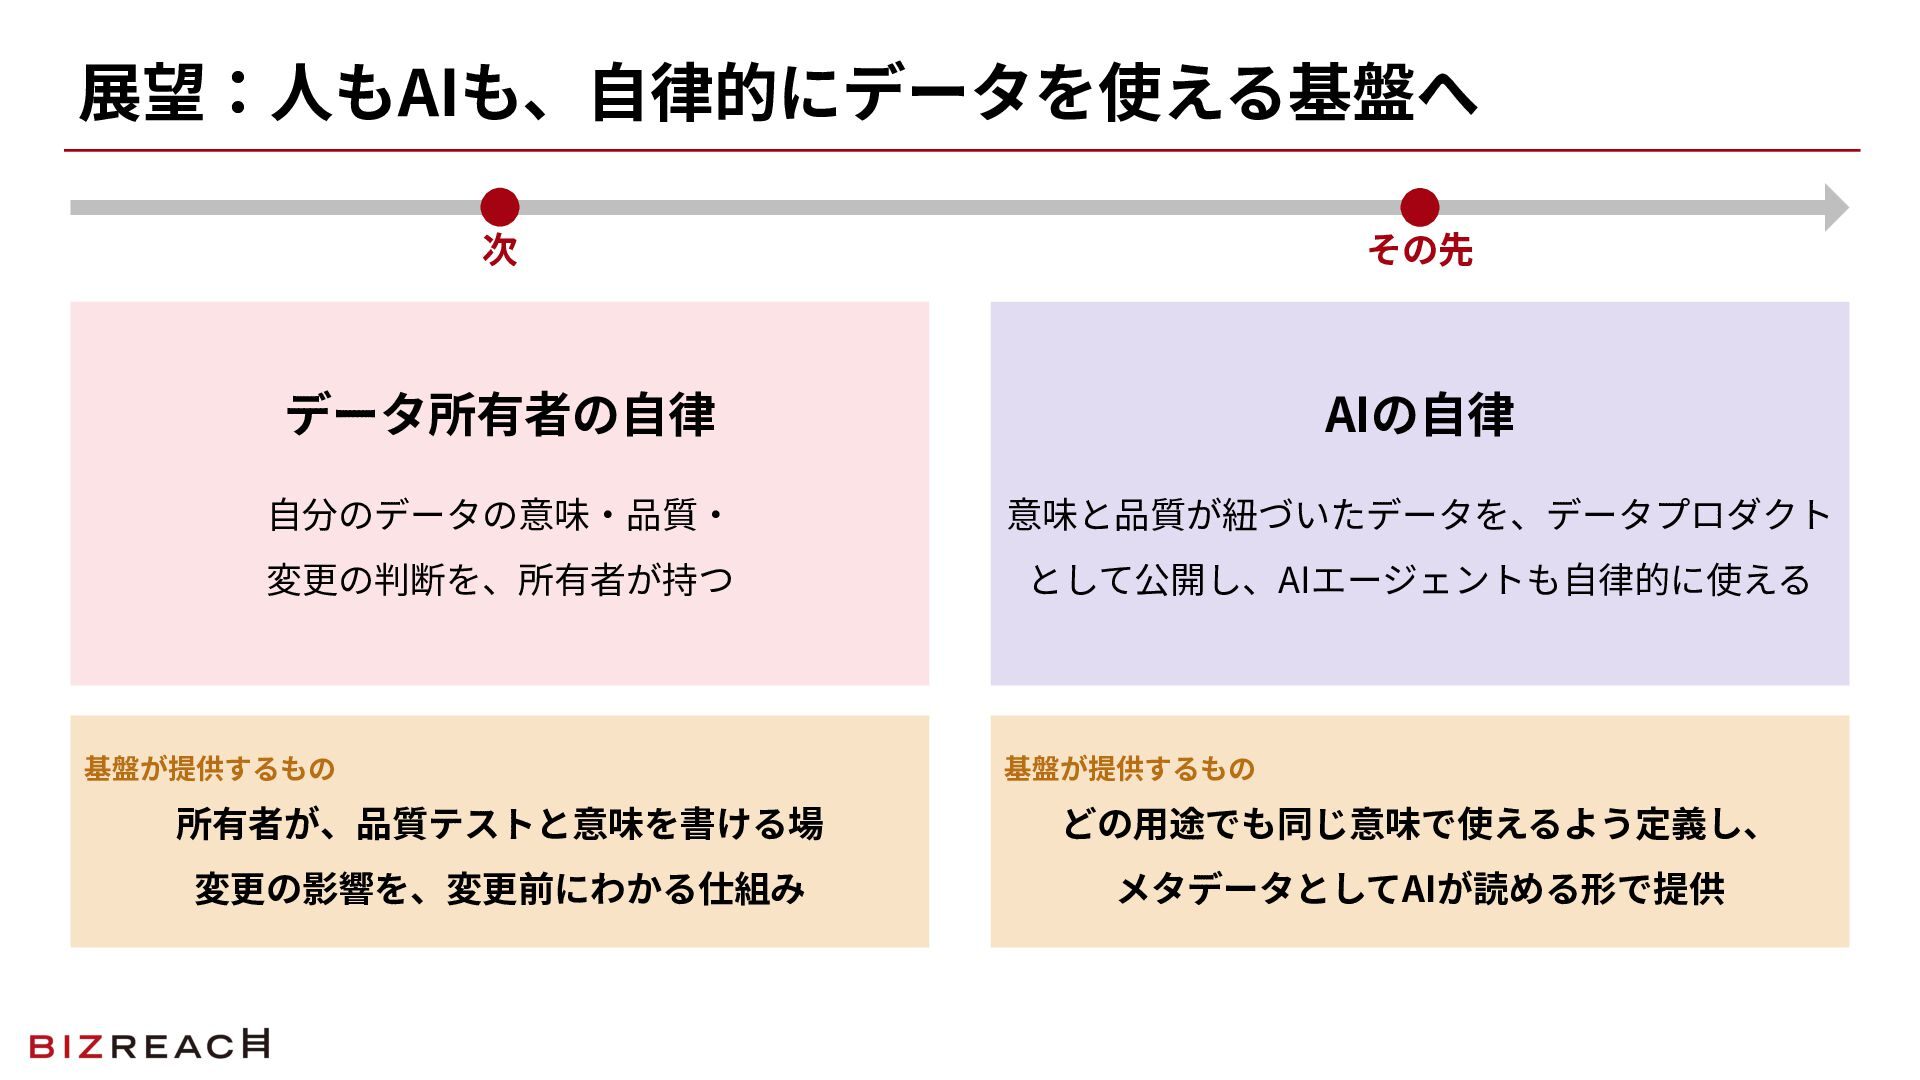
  8. 展望:⼈もAIも、⾃律的にデータを使える基盤へ 次 その先 データ所有者の⾃律 AIの⾃律 ⾃分のデータの意味‧品質‧ 意味と品質が紐づいたデータを、データプロダクト 変更の判断を、所有者が持つ として公開し、AIエージェントも⾃律的に使える 基盤が提供するもの

    基盤が提供するもの 所有者が、品質テストと意味を書ける場 どの⽤途でも同じ意味で使えるよう定義し、 変更の影響を、変更前にわかる仕組み メタデータとしてAIが読める形で提供