Upgrade to Pro — share decks privately, control downloads, hide ads and more …

「表象」を再定義するー潜在表現解析の落とし穴

Sponsored · Your Podcast. Everywhere. Effortlessly. Share. Educate. Inspire. Entertain. You do you. We'll handle the rest. →
Avatar for Yuki Kamitani Yuki Kamitani
September 30, 2026

 「表象」を再定義するー潜在表現解析の落とし穴

脳の活動も、AI のユニットの活動も、内容を表現する「潜在表現」とみなすことができます。本トークで考えたいのは、その潜在表現において何かを測ることには、どういう意味があるのかという問題です。対象は脳とことばで違っても、共通に立てられる問いだと思っています。

潜在表現で測るというのは、突き詰めれば、特定の座標を恣意的に選んで、その上で数値を出しているにすぎません。座標を取り替えてよいのか、相関を測るときにどの変換まで大きさの違いを許すのか ― こうした仮定は、指標を選んだ時点で暗黙に置かれています。そのため、内容を何も変えないちょっとした変換で、類似度や予測精度の値が動き、モデルの優劣まで入れ替わってしまいます。

手がかりは、その表現を誰が読むのか ― 消費者を宣言することだと考えています。消費者の側も、受け取った情報をどう使うのかを言わなければ、何を表現しているかは決まりません。言い換えれば、どういう違いを「同じ」とみなすかを決めることです。読み出しを一つ決めると、そのヤコビアンによって表現空間は像(下流に届く方向)と核(届かない方向)に割れます。

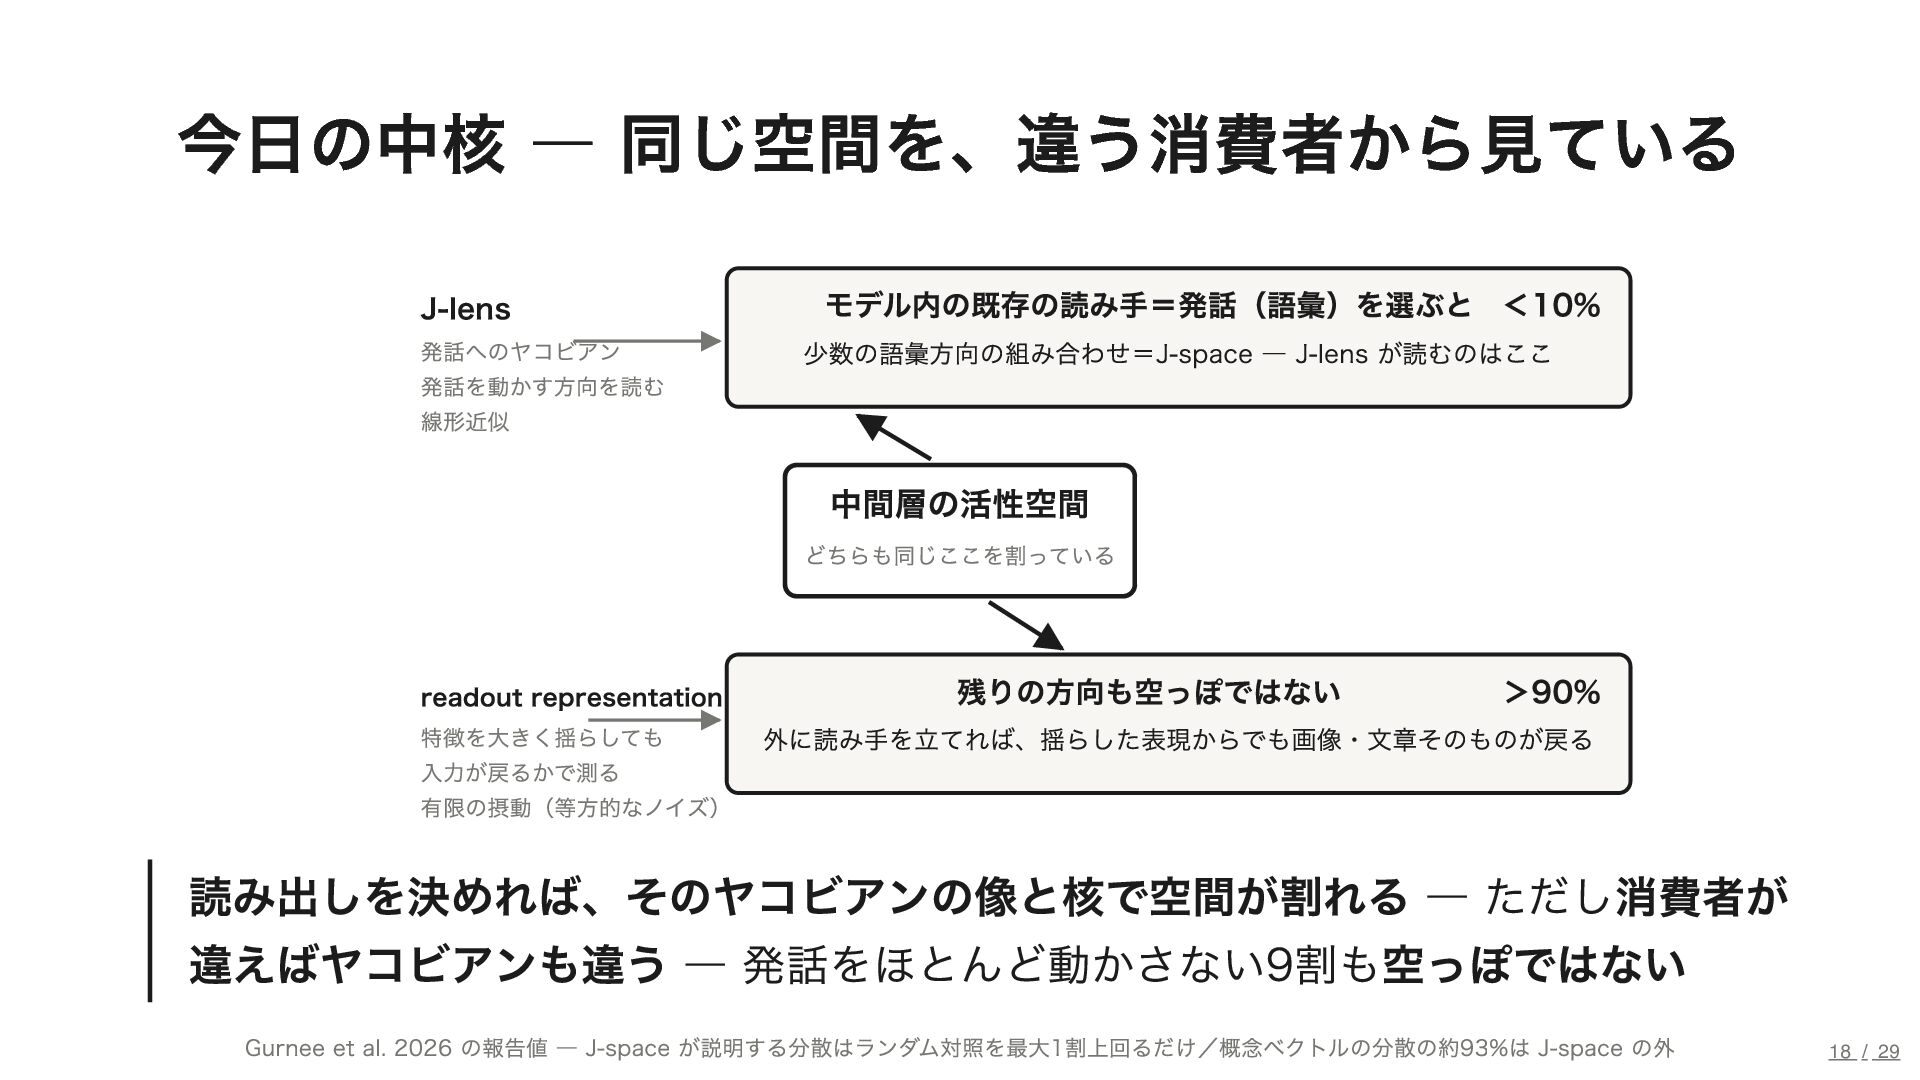
この見方で、二つの試みを並べてみます。Anthropic の J-lens は、発話(語彙)という既存の読み手に向かって何が届くかを見る、いわば像の側の仕事です(彼らの報告では、その像は活性の分散の1割にも満たないとされています)。一方、私たちの readout representation は、表現に何が書き込まれているかを問い、それを取り出せる読み手を別に立てられるか ― 読み出しの可能性そのものを探ります。前者はモデルの中にすでにある読み出しを扱い、後者はその外に新しい読み出しの系を作る、という違いです。

ただし、消費者を宣言するのは入口にすぎないとも考えています。その先には、どの変換で答えが変わらないのか ― 表現がもつ群(代数構造としての群)を同定するという道があります。色の測定が、感覚そのものを覗き込むのではなく、等色を与える変換の構造を押さえることで学問になったように、潜在表現も「何を同じとみなすか」の構造から捉え直せるはずです。当日は、この共通の問題を一緒に考える時間にできればと思っています。

Avatar for Yuki Kamitani

Yuki Kamitani

September 30, 2026

More Decks by Yuki Kamitani

Other Decks in Science

Transcript

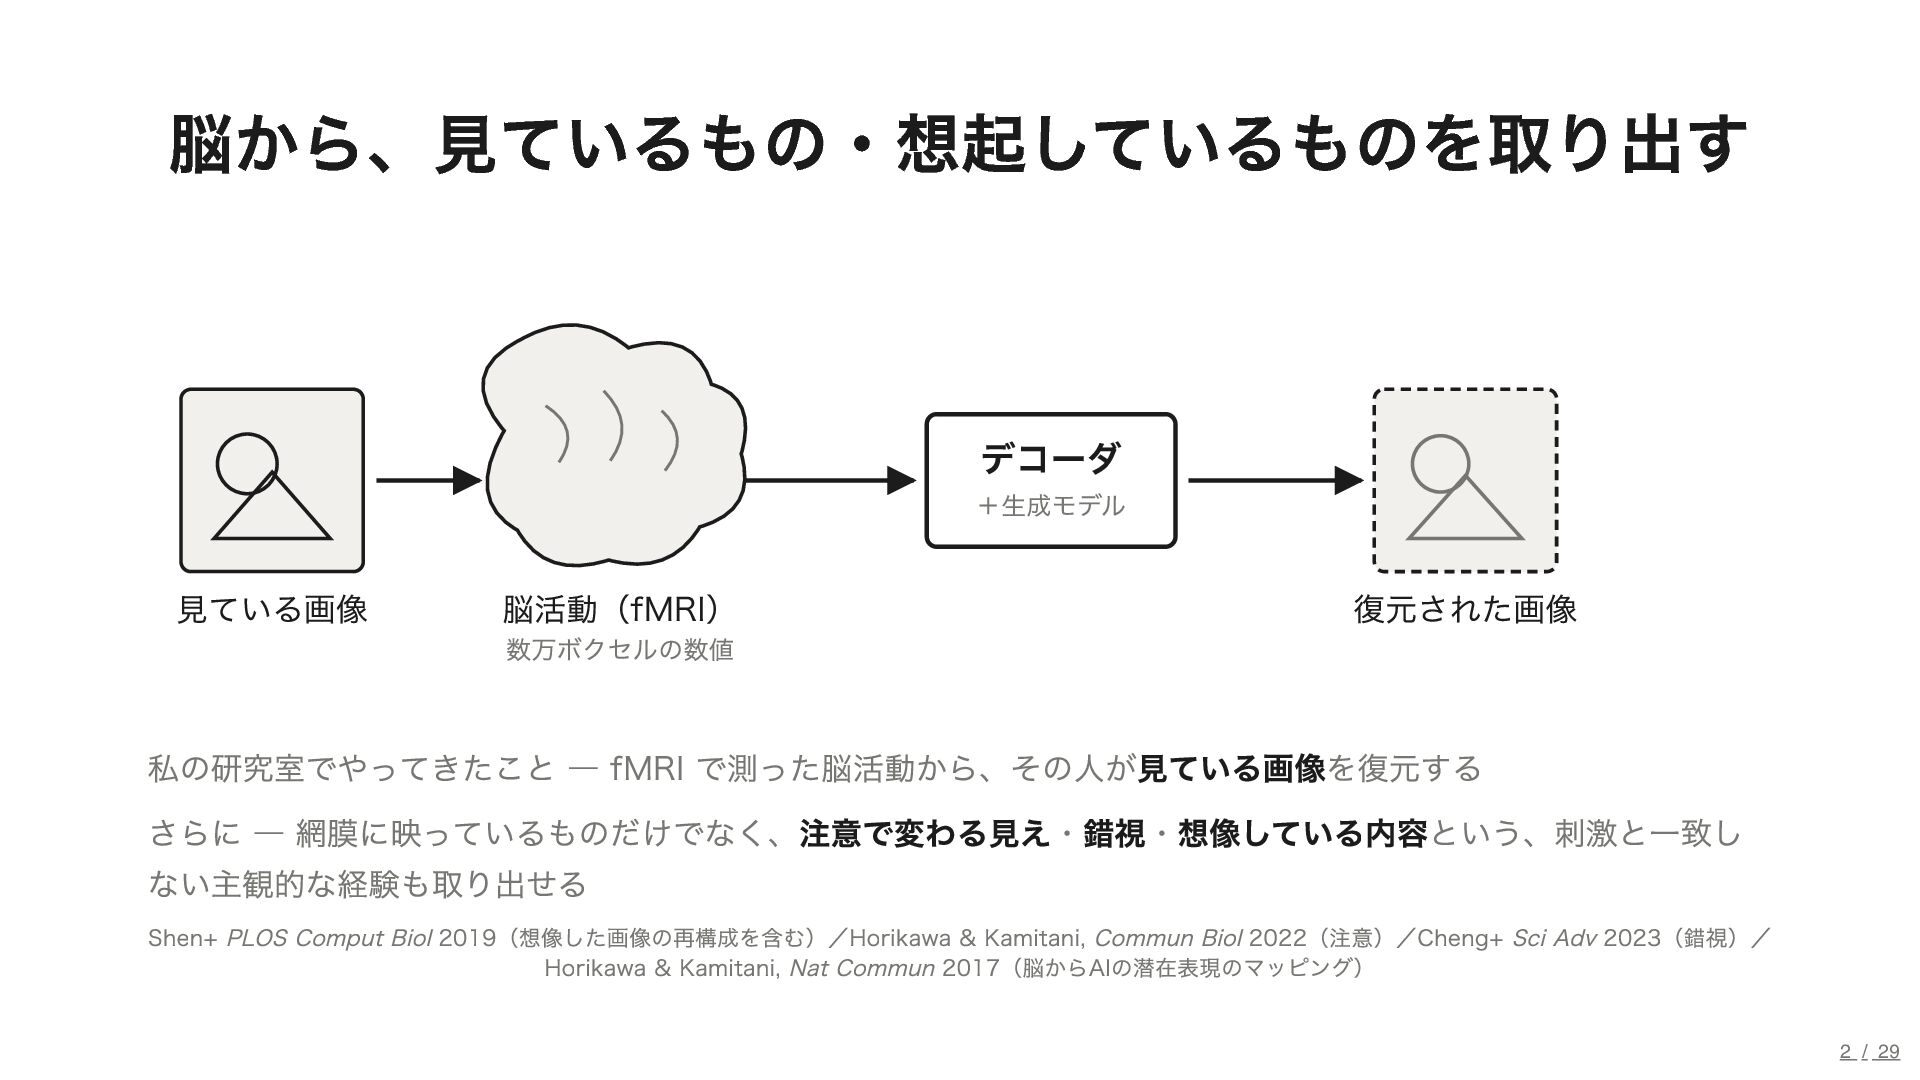
  1. 脳から、見ているもの・想起しているものを取り出す デコーダ +生成モデル 見ている画像 脳活動(fMRI) 数万ボクセルの数値 復元された画像 私の研究室でやってきたこと ― fMRI

    で測った脳活動から、その人が見ている画像を復元する さらに ― 網膜に映っているものだけでなく、注意で変わる見え・錯視・想像している内容という、刺激と一致し ない主観的な経験も取り出せる Shen+ PLOS Comput Biol 2019(想像した画像の再構成を含む)/Horikawa & Kamitani, Commun Biol 2022(注意)/Cheng+ Sci Adv 2023(錯視)/ Horikawa & Kamitani, Nat Commun 2017(脳からAIの潜在表現のマッピング) 2 / 29
  2. だが主流は ―「脳活動を予測することがゴール」 多くの脳研究者は「そこまでやらなくてよい」と考える ― こちらが主流=事実上のゴ ールドスタンダード 刺激や刺激の特徴から脳活動を予測できればよい この形で脳と AI のアライメントの度合いを採点する

    ― Brain-Score など 予測精度をゴールに置くこと自体は問題ではない ― 問題なのは脳活動を予測の対 象にすること ボクセルの座標は装置の都合、潜在空間の座標は設計・学習の都合 4 / 29
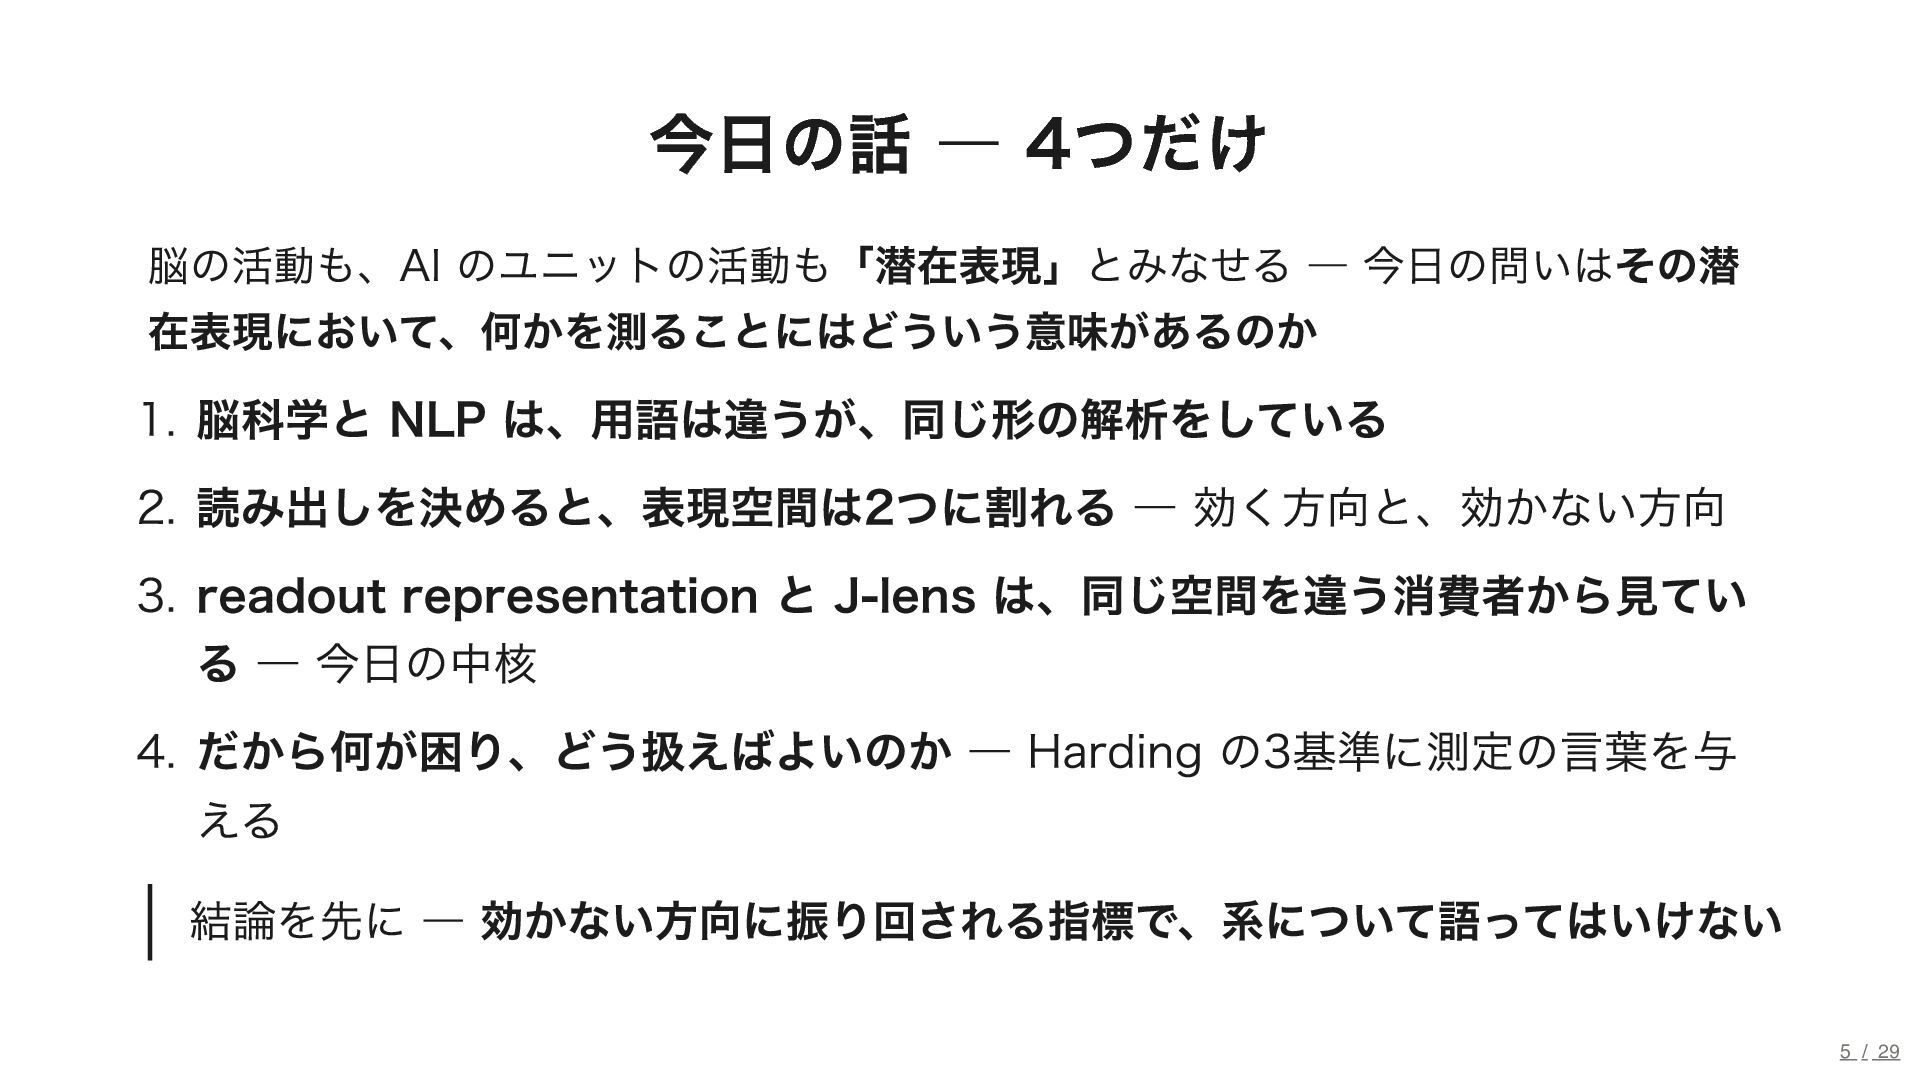
  3. 今日の話 ― 4つだけ 脳の活動も、AI のユニットの活動も「潜在表現」とみなせる ― 今日の問いはその潜 在表現において、何かを測ることにはどういう意味があるのか 1. 脳科学と

    NLP は、用語は違うが、同じ形の解析をしている 2. 読み出しを決めると、表現空間は2つに割れる ― 効く方向と、効かない方向 3. readout representation と J-lens は、同じ空間を違う消費者から見てい る ― 今日の中核 4. だから何が困り、どう扱えばよいのか ― Harding の3基準に測定の言葉を与 える 結論を先に ― 効かない方向に振り回される指標で、系について語ってはいけない 5 / 29
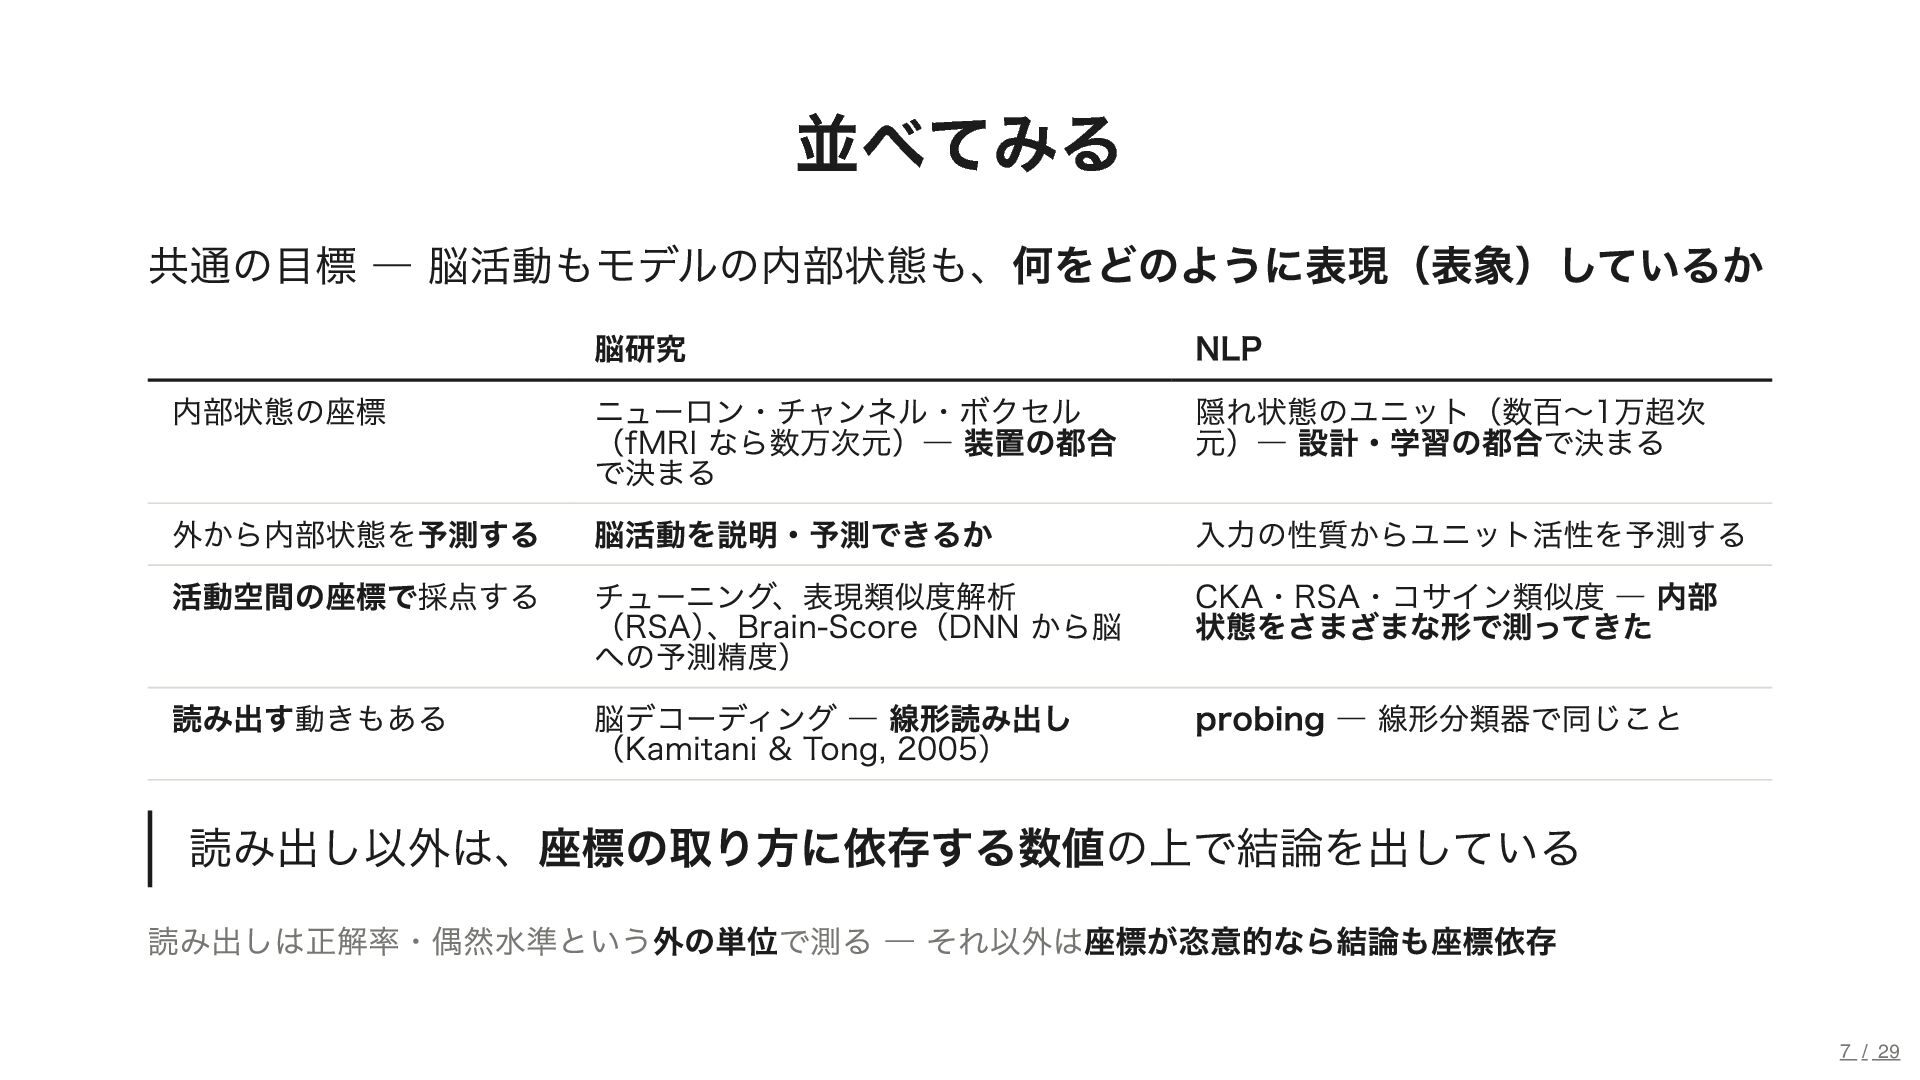
  4. 並べてみる 共通の目標 ― 脳活動もモデルの内部状態も、何をどのように表現(表象)しているか 脳研究 内部状態の座標 ニューロン・チャンネル・ボクセル (fMRI なら数万次元)― 装置の都合

    で決まる 外から内部状態を予測する 脳活動を説明・予測できるか 活動空間の座標で採点する チューニング、表現類似度解析 (RSA) 、Brain-Score(DNN から脳 への予測精度) 読み出す動きもある 脳デコーディング ― 線形読み出し (Kamitani & Tong, 2005) NLP 隠れ状態のユニット(数百〜1万超次 元)― 設計・学習の都合で決まる 入力の性質からユニット活性を予測する CKA・RSA・コサイン類似度 ― 内部 状態をさまざまな形で測ってきた probing ― 線形分類器で同じこと 読み出し以外は、座標の取り方に依存する数値の上で結論を出している 読み出しは正解率・偶然水準という外の単位で測る ― それ以外は座標が恣意的なら結論も座標依存 7 / 29
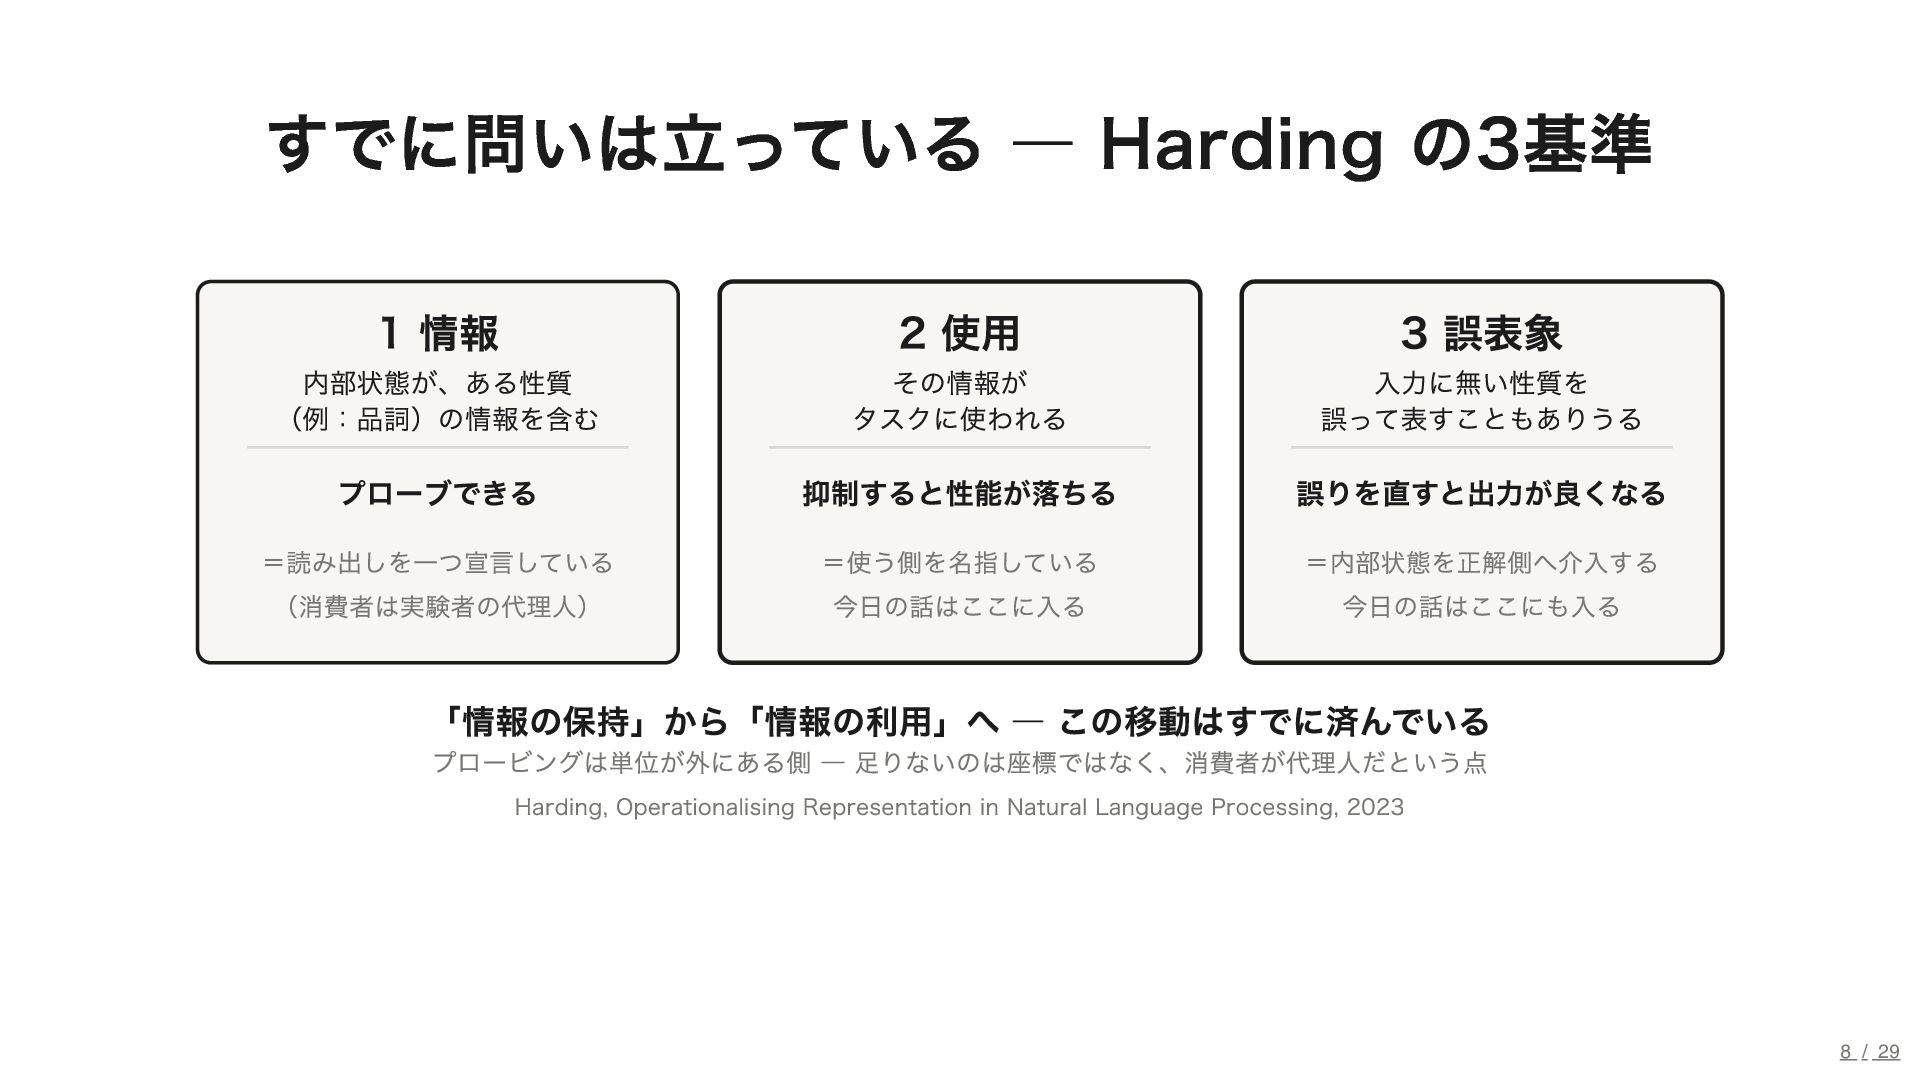
  5. すでに問いは立っている ― Harding の3基準 1 情報 2 使用 3 誤表象

    内部状態が、ある性質 (例:品詞)の情報を含む その情報が タスクに使われる 入力に無い性質を 誤って表すこともありうる プローブできる 抑制すると性能が落ちる 誤りを直すと出力が良くなる =読み出しを一つ宣言している (消費者は実験者の代理人) =使う側を名指している 今日の話はここに入る =内部状態を正解側へ介入する 今日の話はここにも入る 「情報の保持」から「情報の利用」へ ― この移動はすでに済んでいる プロービングは単位が外にある側 ― 足りないのは座標ではなく、消費者が代理人だという点 Harding, Operationalising Representation in Natural Language Processing, 2023 8 / 29
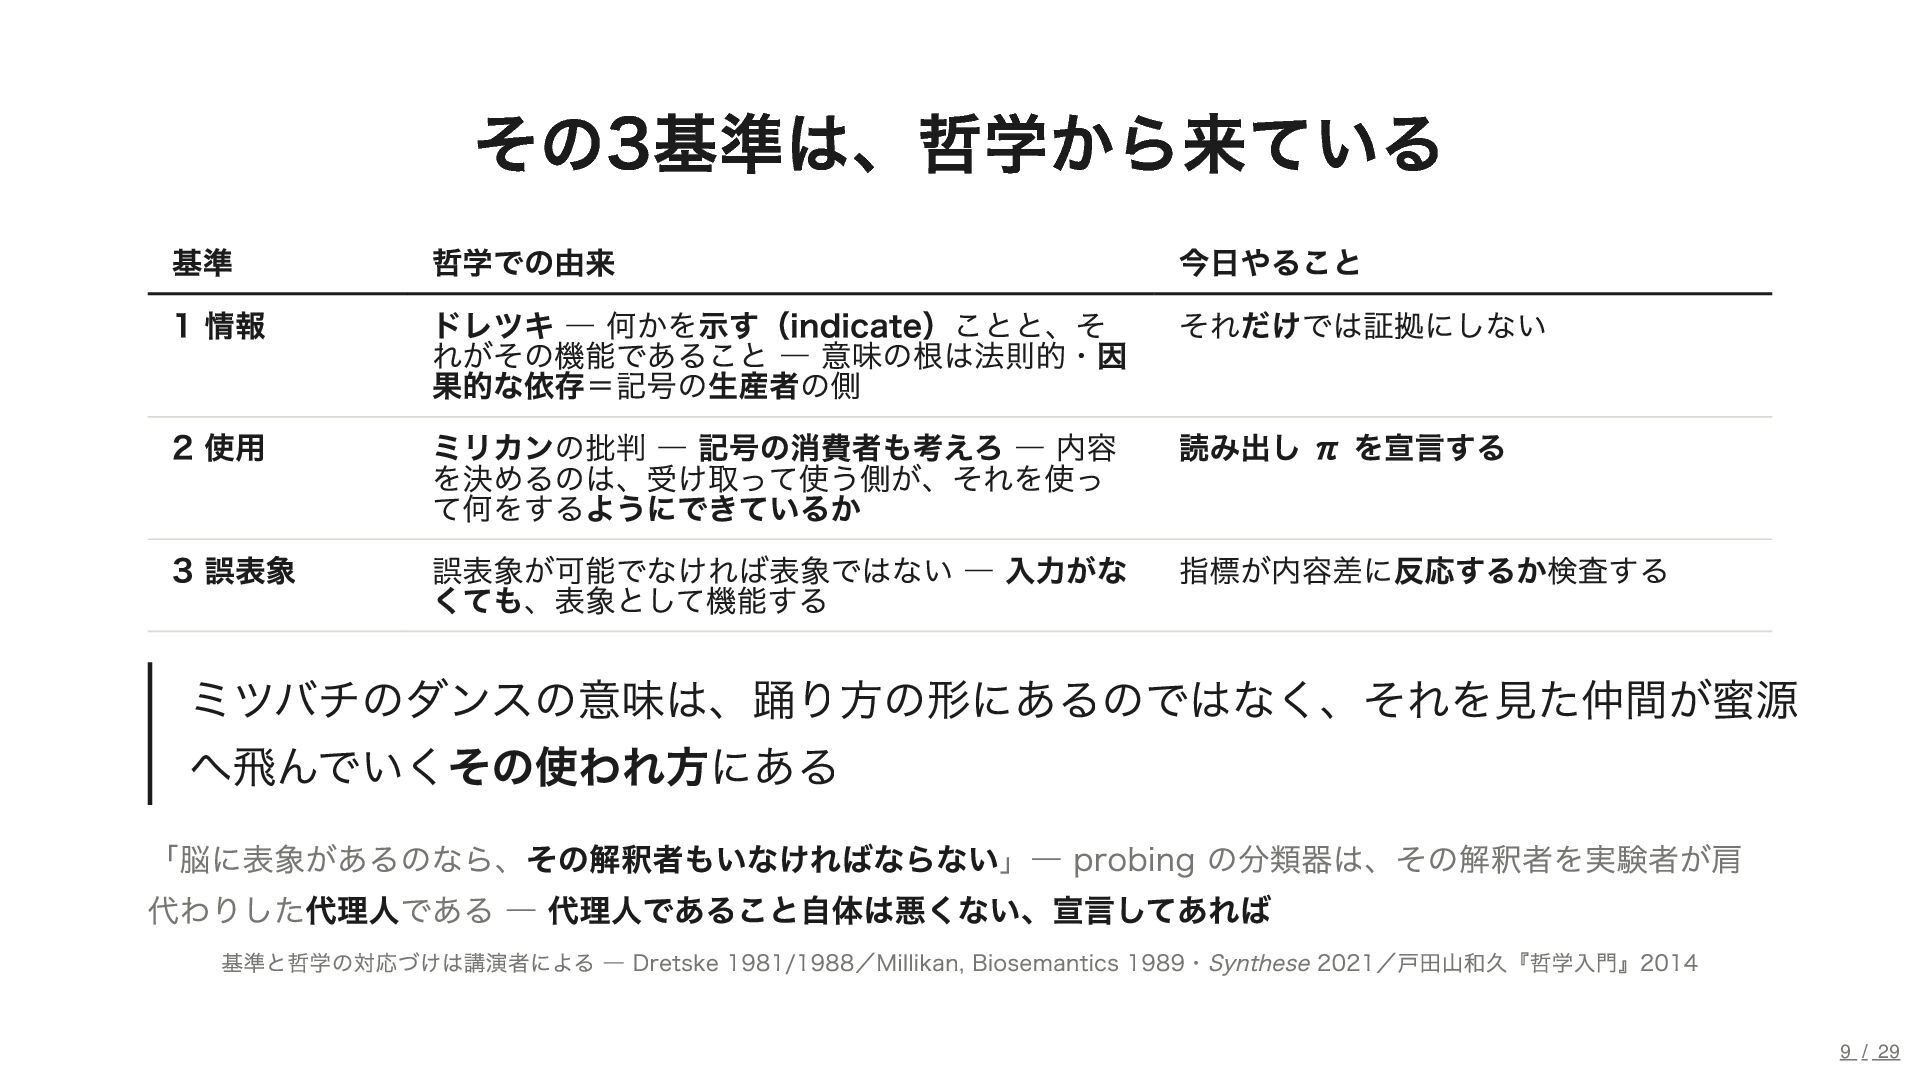
  6. その3基準は、哲学から来ている 基準 1 情報 2 使用 3 誤表象 哲学での由来 ドレツキ

    ― 何かを示す(indicate)ことと、そ れがその機能であること ― 意味の根は法則的・因 果的な依存=記号の生産者の側 ミリカンの批判 ― 記号の消費者も考えろ ― 内容 を決めるのは、受け取って使う側が、それを使っ て何をするようにできているか 誤表象が可能でなければ表象ではない ― 入力がな くても、表象として機能する 今日やること それだけでは証拠にしない 読み出し π を宣言する 指標が内容差に反応するか検査する ミツバチのダンスの意味は、踊り方の形にあるのではなく、それを見た仲間が蜜源 へ飛んでいくその使われ方にある 「脳に表象があるのなら、その解釈者もいなければならない」― probing の分類器は、その解釈者を実験者が肩 代わりした代理人である ― 代理人であること自体は悪くない、宣言してあれば 基準と哲学の対応づけは講演者による ― Dretske 1981/1988/Millikan, Biosemantics 1989・Synthese 2021/戸田山和久『哲学入門』2014 9 / 29
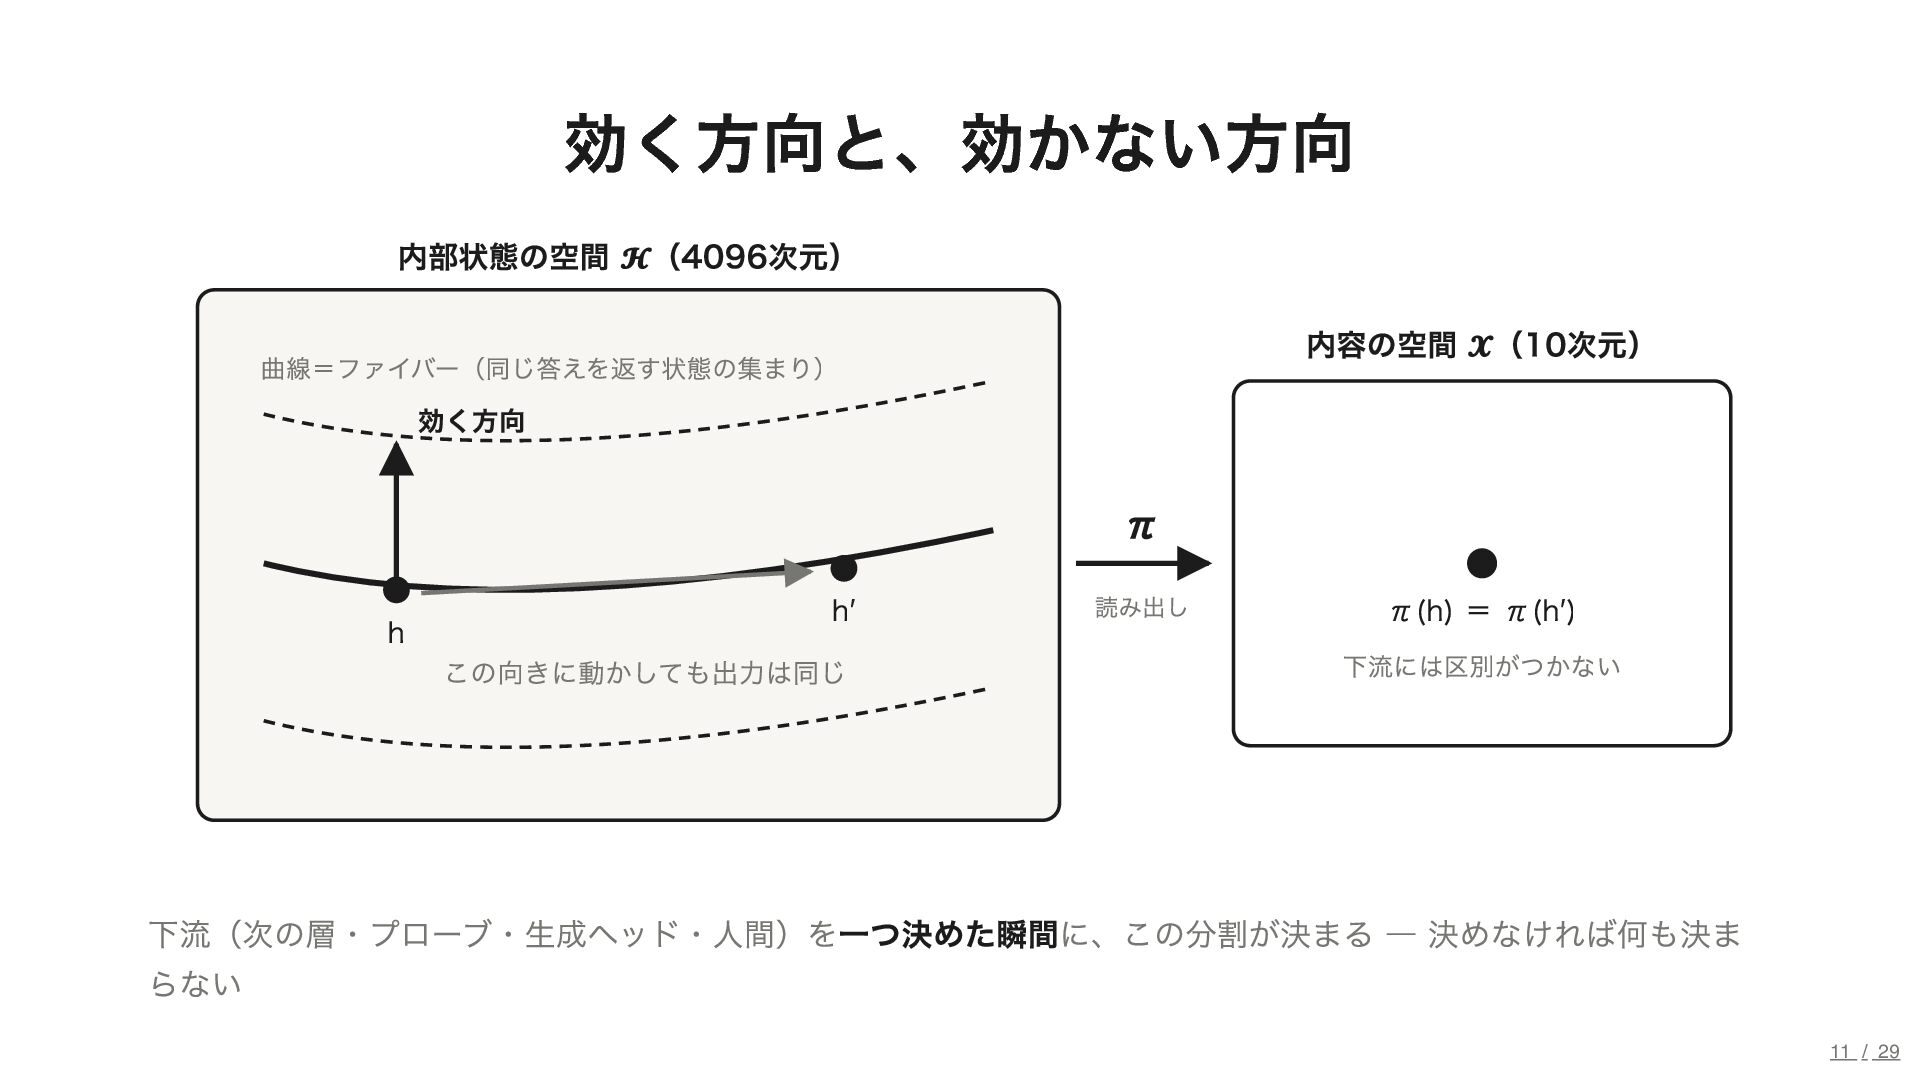
  7. 効く方向と、効かない方向 内部状態の空間 𝓗(4096次元) 内容の空間 𝓧(10次元) 曲線=ファイバー(同じ答えを返す状態の集まり) 効く方向 π h h′

    この向きに動かしても出力は同じ 読み出し π(h) = π(h′) 下流には区別がつかない 下流(次の層・プローブ・生成ヘッド・人間)を一つ決めた瞬間に、この分割が決まる ― 決めなければ何も決ま らない 11 / 29
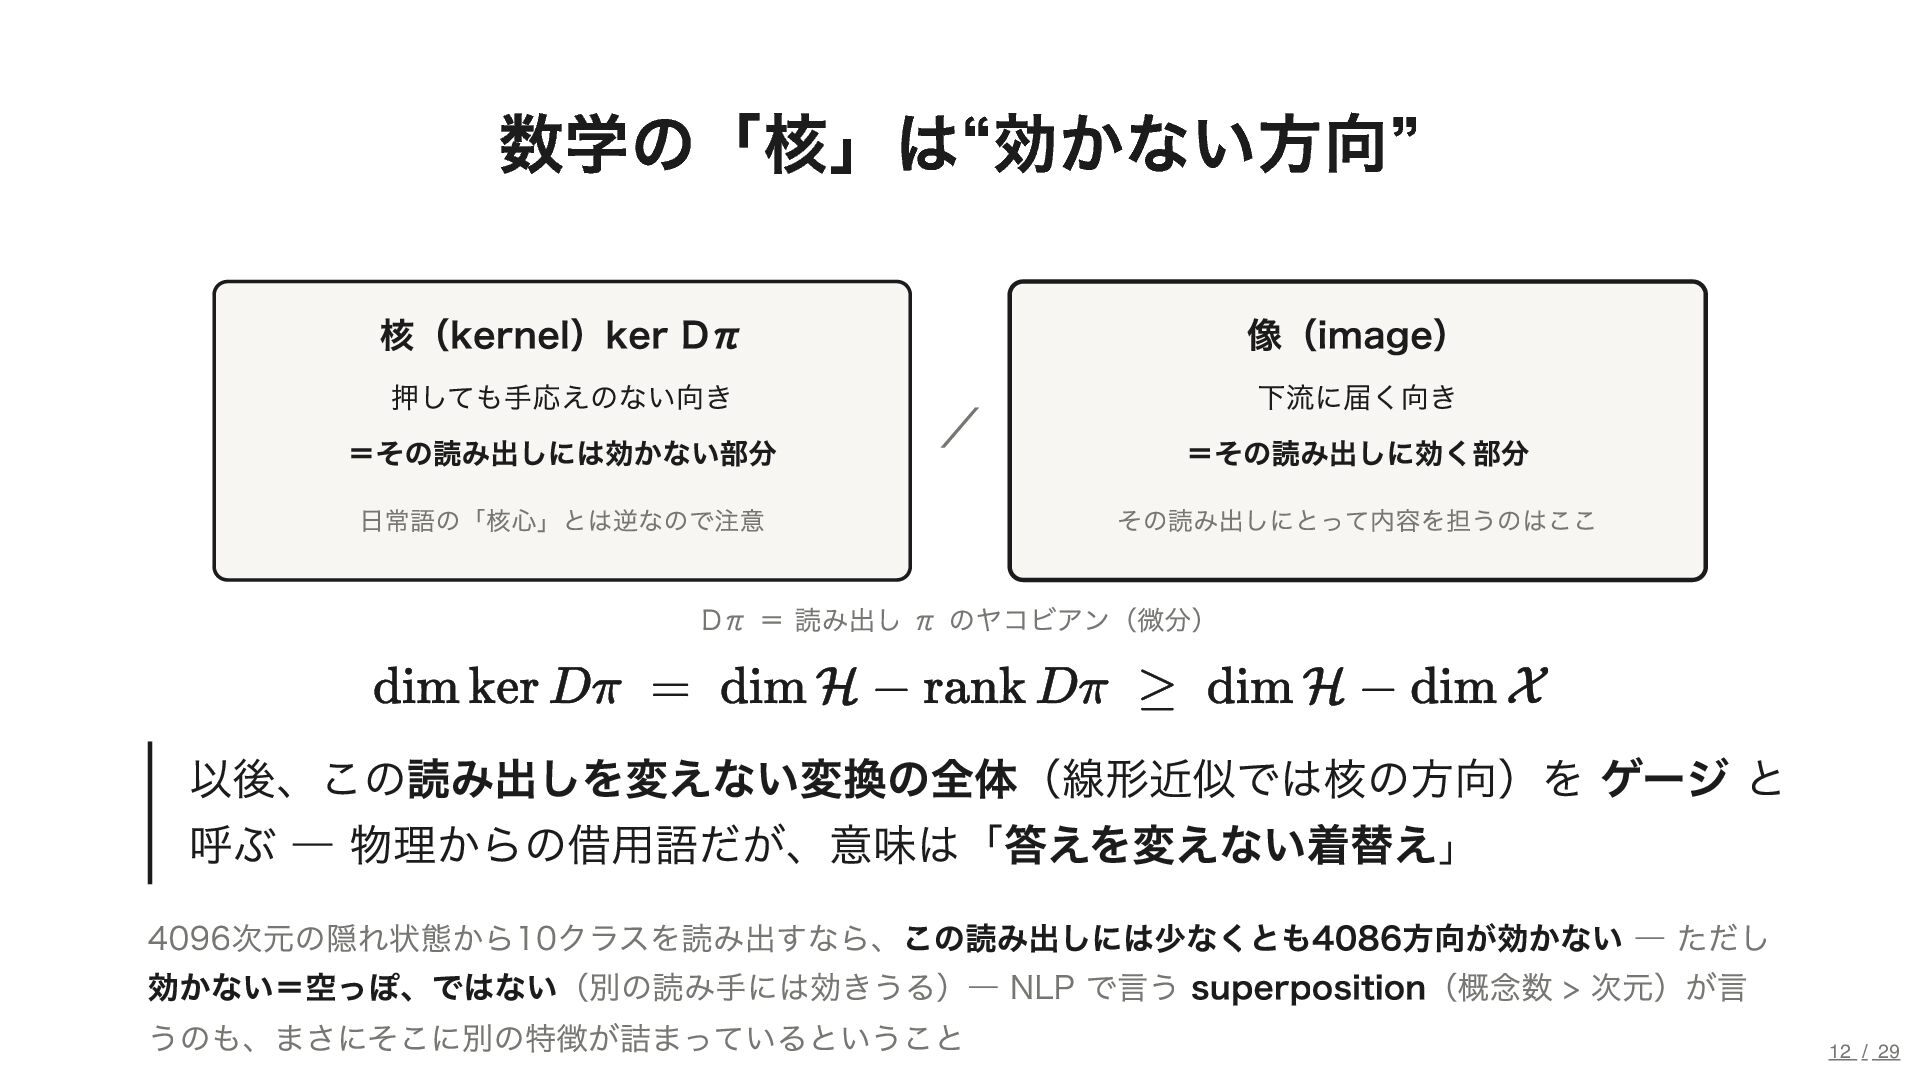
  8. 数学の「核」は“効かない方向” 核(kernel)ker Dπ 押しても手応えのない向き =その読み出しには効かない部分 日常語の「核心」とは逆なので注意 / 像(image) 下流に届く向き =その読み出しに効く部分

    その読み出しにとって内容を担うのはここ Dπ = 読み出し π のヤコビアン(微分) 以後、この読み出しを変えない変換の全体(線形近似では核の方向)を ゲージ と 呼ぶ ― 物理からの借用語だが、意味は「答えを変えない着替え」 4096次元の隠れ状態から10クラスを読み出すなら、この読み出しには少なくとも4086方向が効かない ― ただし 効かない=空っぽ、ではない(別の読み手には効きうる)― NLP で言う superposition(概念数 > 次元)が言 うのも、まさにそこに別の特徴が詰まっているということ 12 / 29
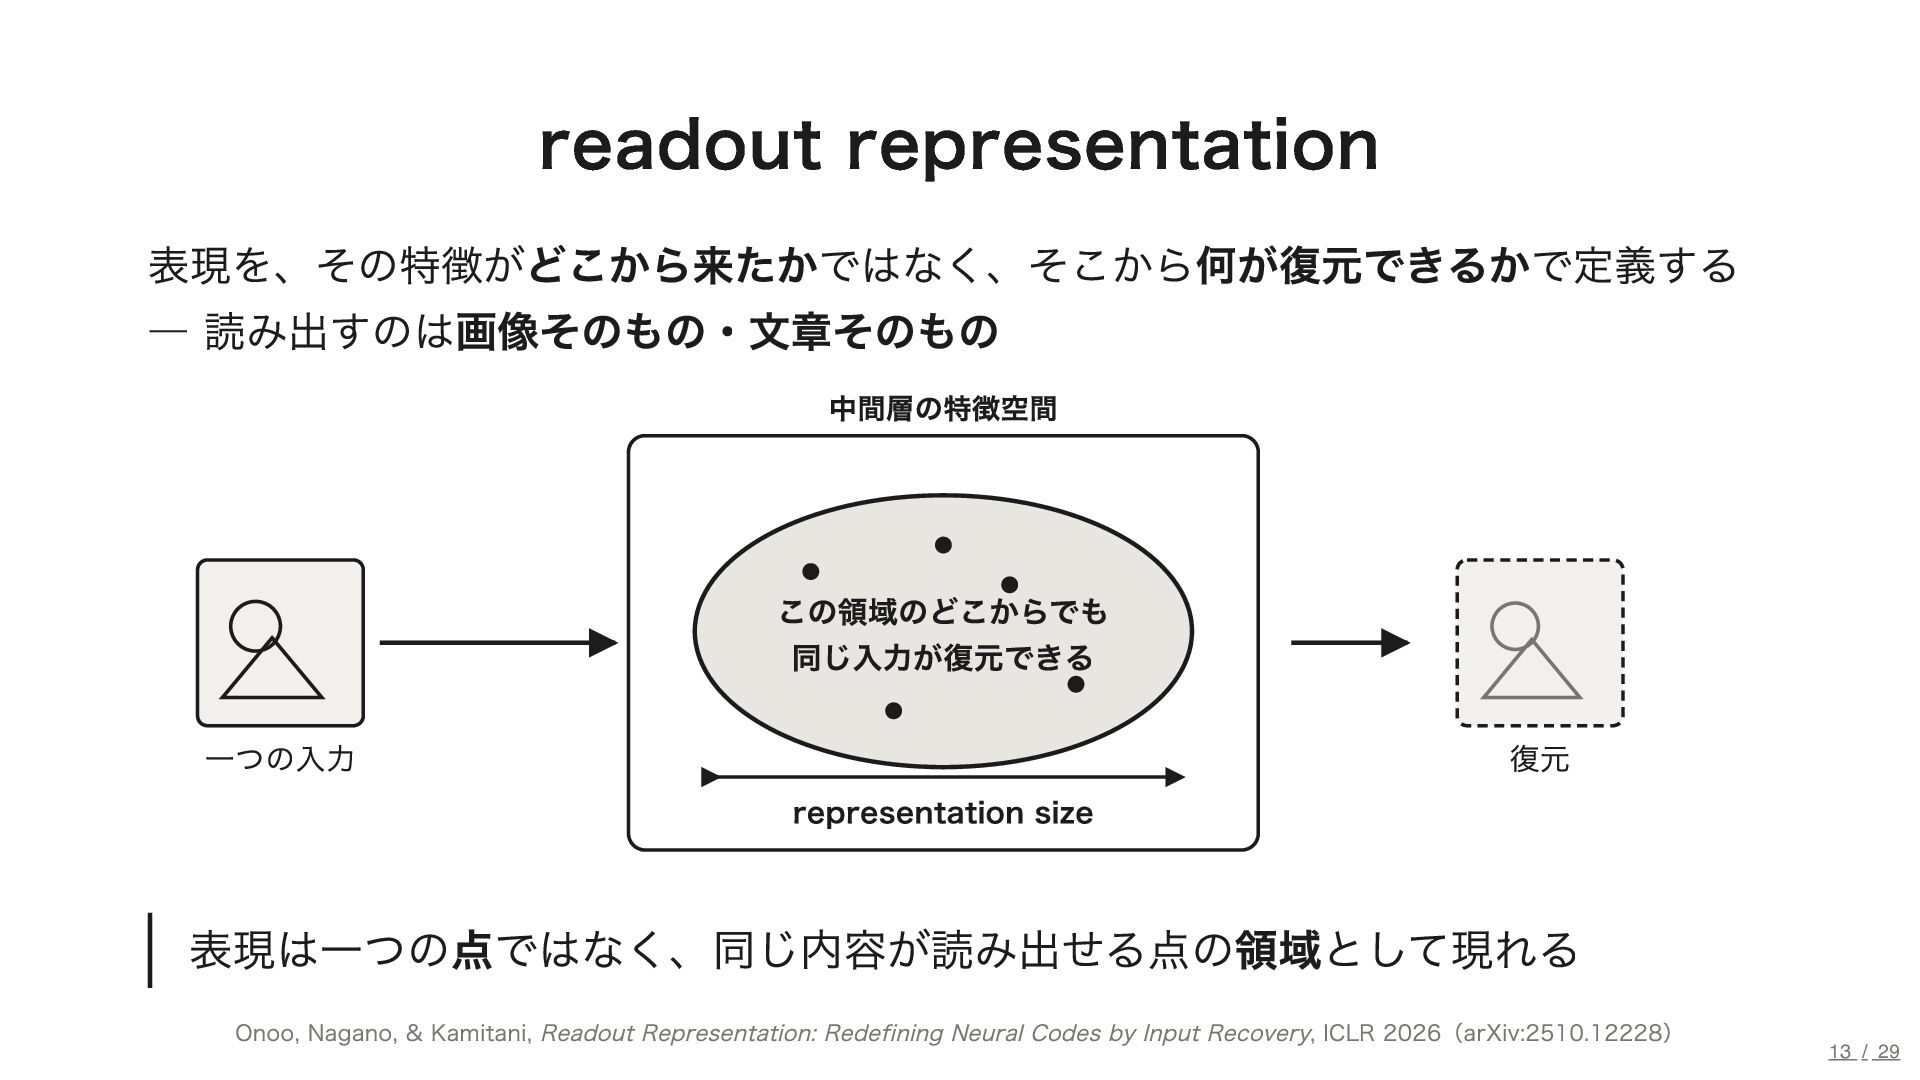
  9. readout representation 表現を、その特徴がどこから来たかではなく、そこから何が復元できるかで定義する ― 読み出すのは画像そのもの・文章そのもの 中間層の特徴空間 この領域のどこからでも 同じ入力が復元できる 一つの入力 representation

    size 復元 表現は一つの点ではなく、同じ内容が読み出せる点の領域として現れる Onoo, Nagano, & Kamitani, Readout Representation: Redefining Neural Codes by Input Recovery, ICLR 2026(arXiv:2510.12228) 13 / 29
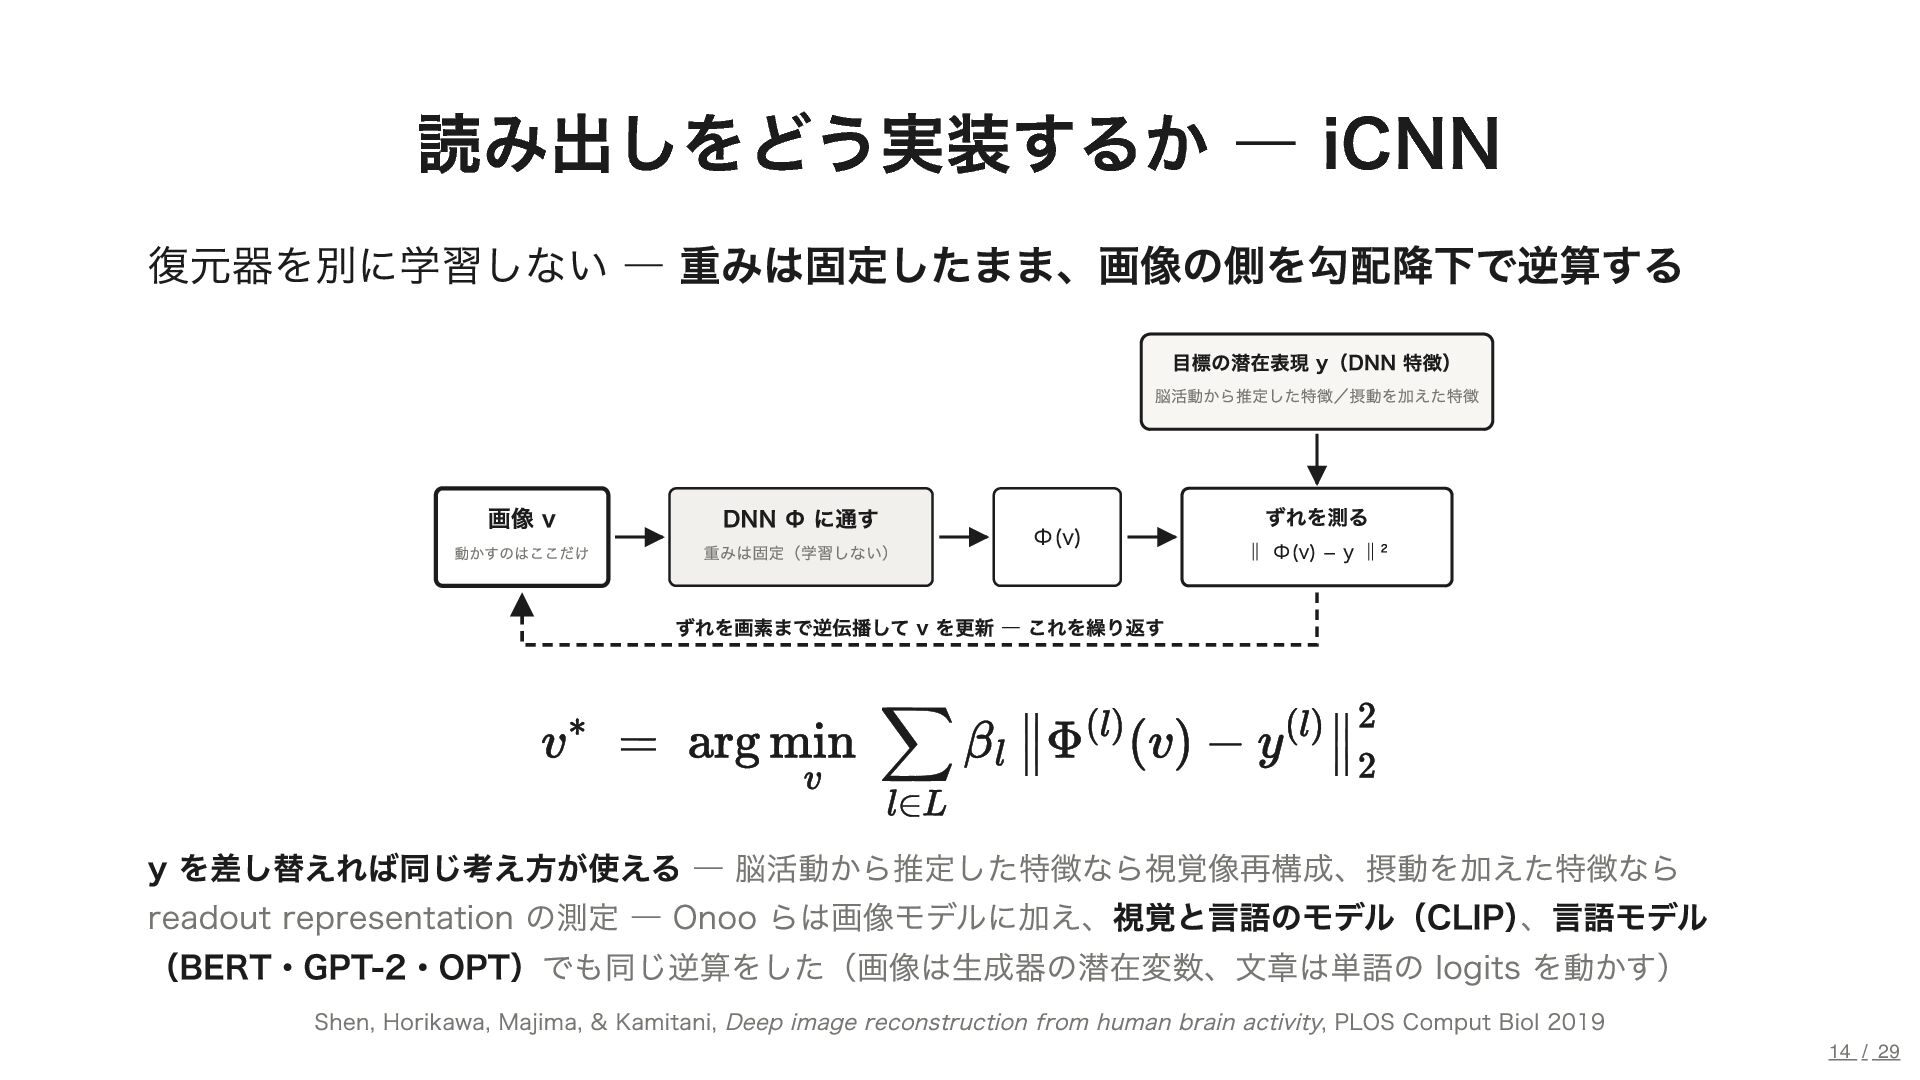
  10. 読み出しをどう実装するか ― iCNN 復元器を別に学習しない ― 重みは固定したまま、画像の側を勾配降下で逆算する 目標の潜在表現 y(DNN 特徴) 脳活動から推定した特徴/摂動を加えた特徴

    画像 v 動かすのはここだけ DNN Φ に通す 重みは固定(学習しない) Φ(v) ずれを測る ‖ Φ(v) − y ‖² ずれを画素まで逆伝播して v を更新 ― これを繰り返す y を差し替えれば同じ考え方が使える ― 脳活動から推定した特徴なら視覚像再構成、摂動を加えた特徴なら readout representation の測定 ― Onoo らは画像モデルに加え、視覚と言語のモデル(CLIP)、言語モデル (BERT・GPT-2・OPT)でも同じ逆算をした(画像は生成器の潜在変数、文章は単語の logits を動かす) Shen, Horikawa, Majima, & Kamitani, Deep image reconstruction from human brain activity, PLOS Comput Biol 2019 14 / 29
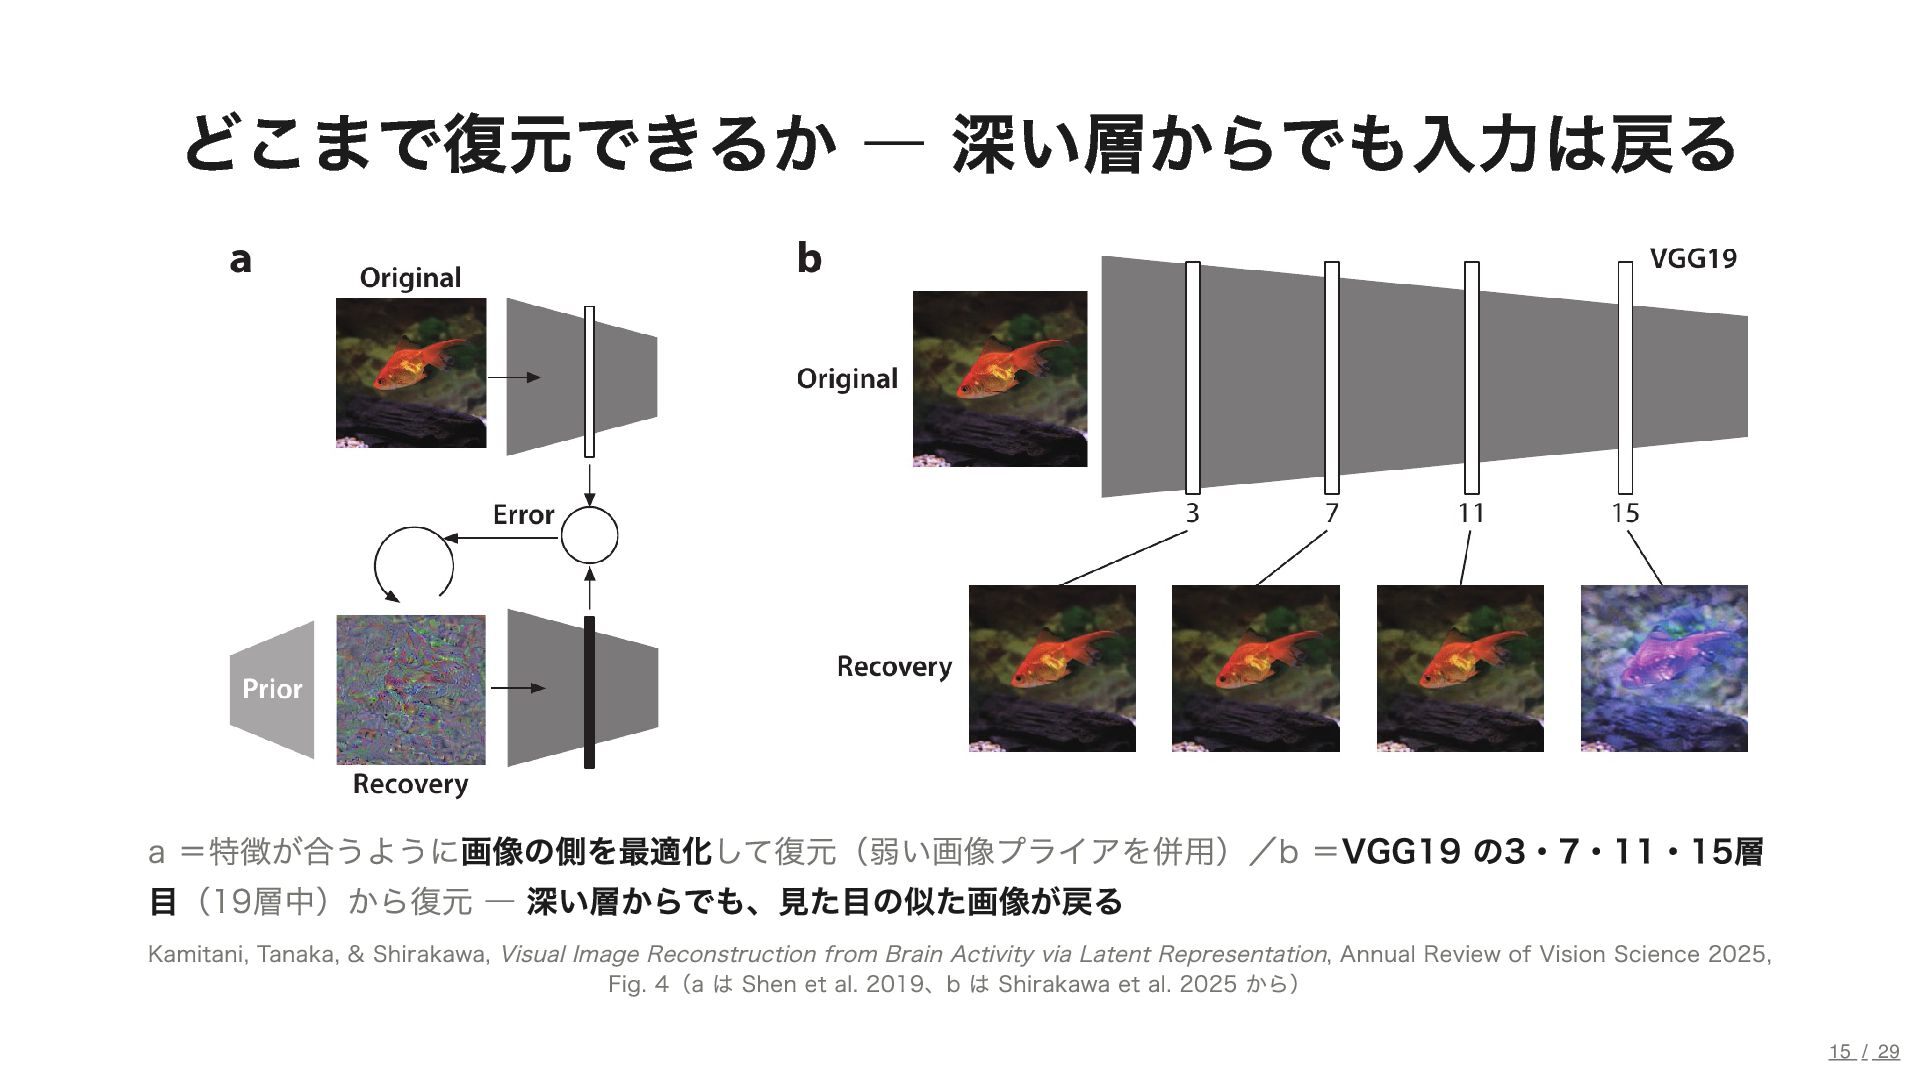
  11. どこまで復元できるか ― 深い層からでも入力は戻る a =特徴が合うように画像の側を最適化して復元(弱い画像プライアを併用)/b =VGG19 の3・7・11・15層 目(19層中)から復元 ― 深い層からでも、見た目の似た画像が戻る

    Kamitani, Tanaka, & Shirakawa, Visual Image Reconstruction from Brain Activity via Latent Representation, Annual Review of Vision Science 2025, Fig. 4(a は Shen et al. 2019、b は Shirakawa et al. 2025 から) 15 / 29
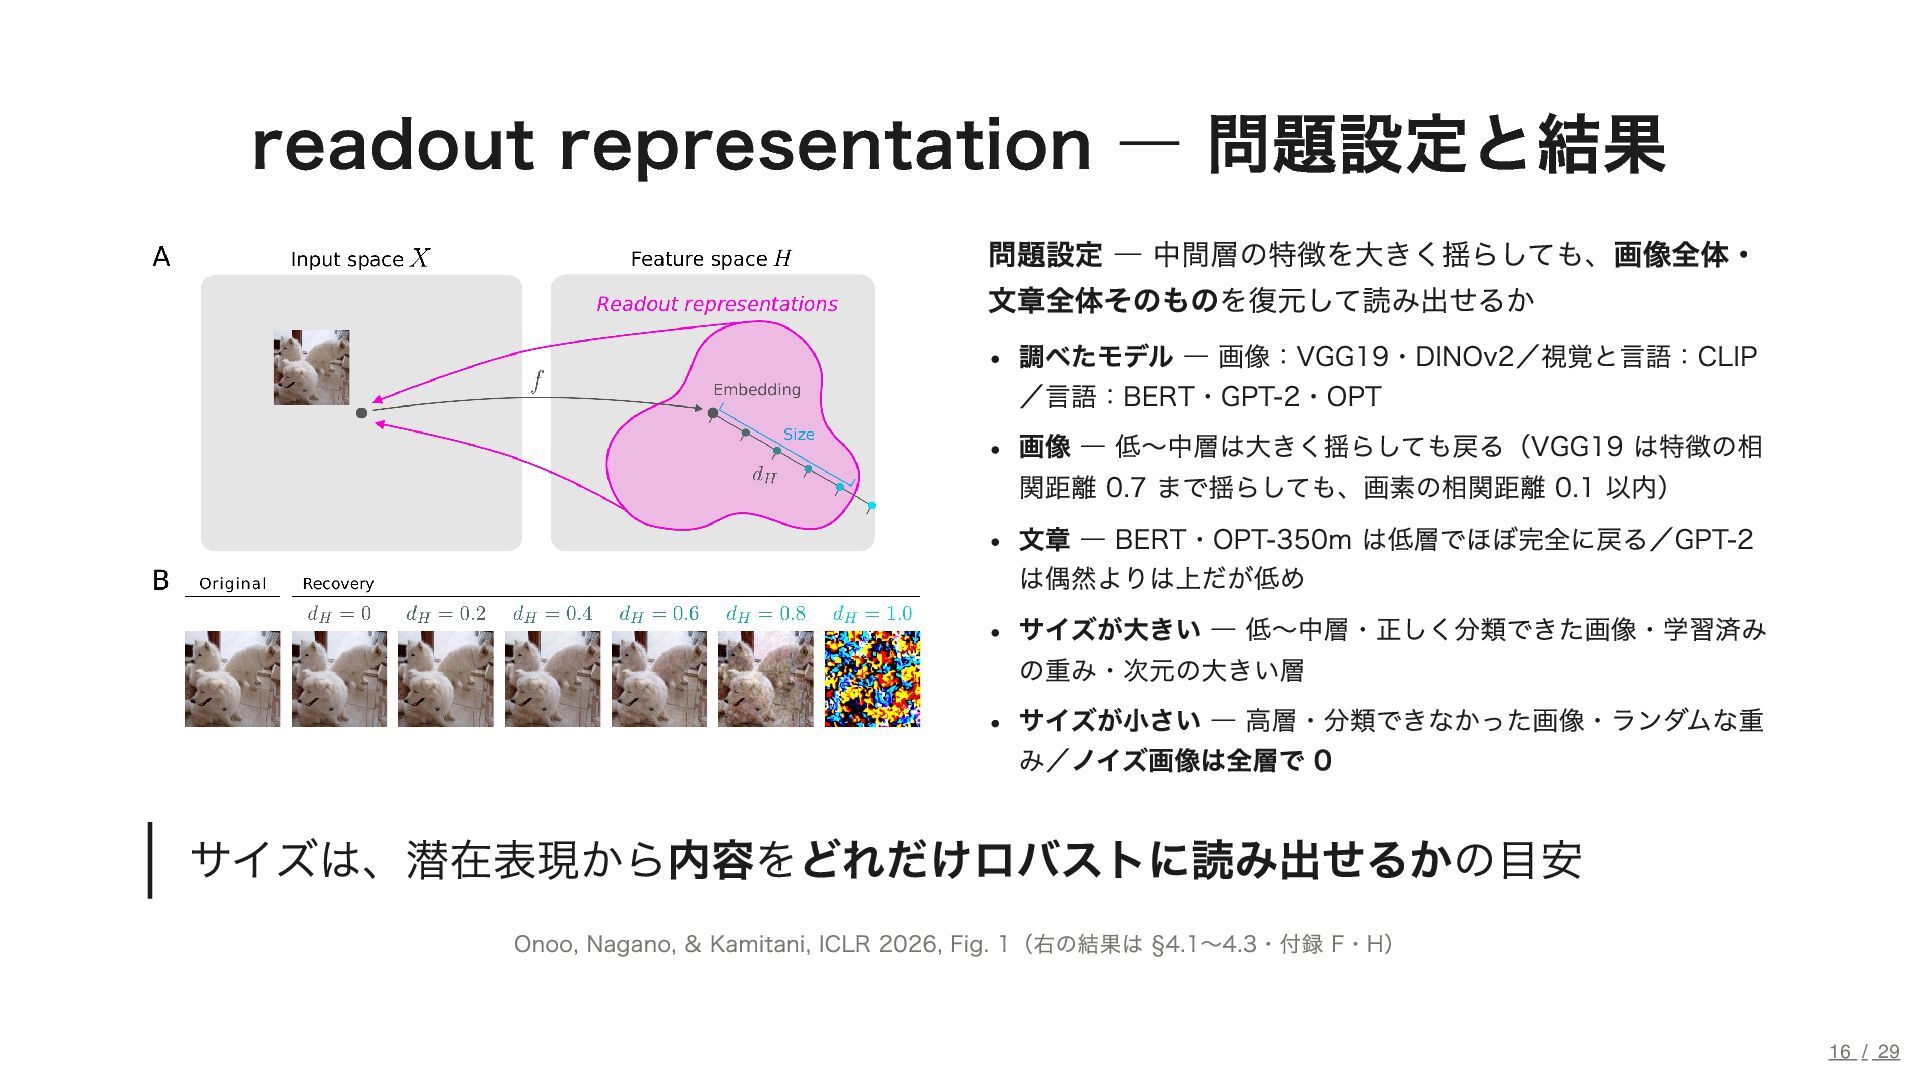
  12. readout representation ― 問題設定と結果 問題設定 ― 中間層の特徴を大きく揺らしても、画像全体・ 文章全体そのものを復元して読み出せるか 調べたモデル ―

    画像:VGG19・DINOv2/視覚と言語:CLIP /言語:BERT・GPT-2・OPT 画像 ― 低〜中層は大きく揺らしても戻る(VGG19 は特徴の相 関距離 0.7 まで揺らしても、画素の相関距離 0.1 以内) 文章 ― BERT・OPT-350m は低層でほぼ完全に戻る/GPT-2 は偶然よりは上だが低め サイズが大きい ― 低〜中層・正しく分類できた画像・学習済み の重み・次元の大きい層 サイズが小さい ― 高層・分類できなかった画像・ランダムな重 み/ノイズ画像は全層で 0 サイズは、潜在表現から内容をどれだけロバストに読み出せるかの目安 Onoo, Nagano, & Kamitani, ICLR 2026, Fig. 1(右の結果は §4.1〜4.3・付録 F・H) 16 / 29
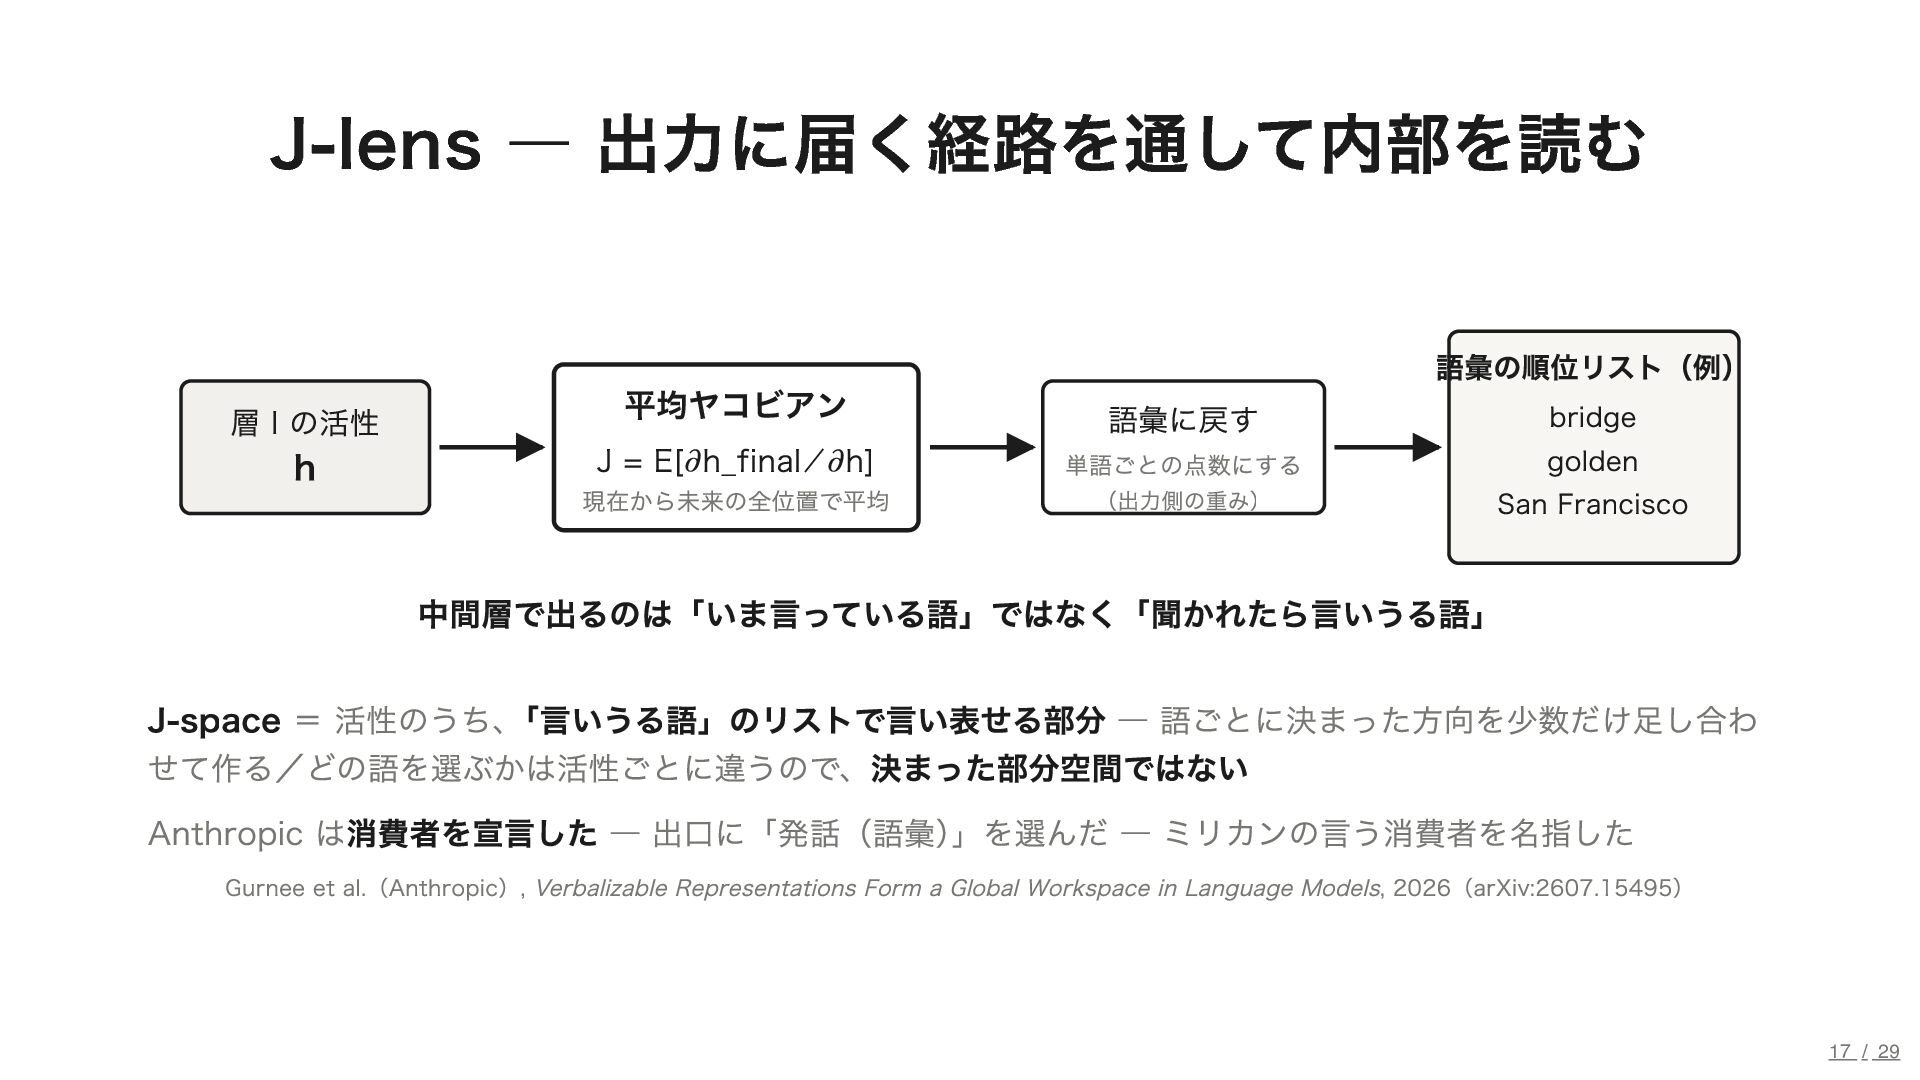
  13. J-lens ― 出力に届く経路を通して内部を読む 層 l の活性 h 平均ヤコビアン J =

    E[∂h_final ⁄ ∂h] 現在から未来の全位置で平均 語彙に戻す 単語ごとの点数にする (出力側の重み) 語彙の順位リスト(例) bridge golden San Francisco 中間層で出るのは「いま言っている語」ではなく「聞かれたら言いうる語」 J-space = 活性のうち、「言いうる語」のリストで言い表せる部分 ― 語ごとに決まった方向を少数だけ足し合わ せて作る/どの語を選ぶかは活性ごとに違うので、決まった部分空間ではない Anthropic は消費者を宣言した ― 出口に「発話(語彙)」を選んだ ― ミリカンの言う消費者を名指した Gurnee et al.(Anthropic), Verbalizable Representations Form a Global Workspace in Language Models, 2026(arXiv:2607.15495) 17 / 29
  14. 今日の中核 ― 同じ空間を、違う消費者から見ている J-lens 発話へのヤコビアン 発話を動かす方向を読む 線形近似 モデル内の既存の読み手=発話(語彙)を選ぶと <10% 少数の語彙方向の組み合わせ=J-space

    ― J-lens が読むのはここ 中間層の活性空間 どちらも同じここを割っている readout representation 残りの方向も空っぽではない >90% 特徴を大きく揺らしても 外に読み手を立てれば、揺らした表現からでも画像・文章そのものが戻る 入力が戻るかで測る 有限の摂動(等方的なノイズ) 読み出しを決めれば、そのヤコビアンの像と核で空間が割れる ― ただし消費者が 違えばヤコビアンも違う ― 発話をほとんど動かさない9割も空っぽではない Gurnee et al. 2026 の報告値 ― J-space が説明する分散はランダム対照を最大1割上回るだけ/概念ベクトルの分散の約93%は J-space の外 18 / 29
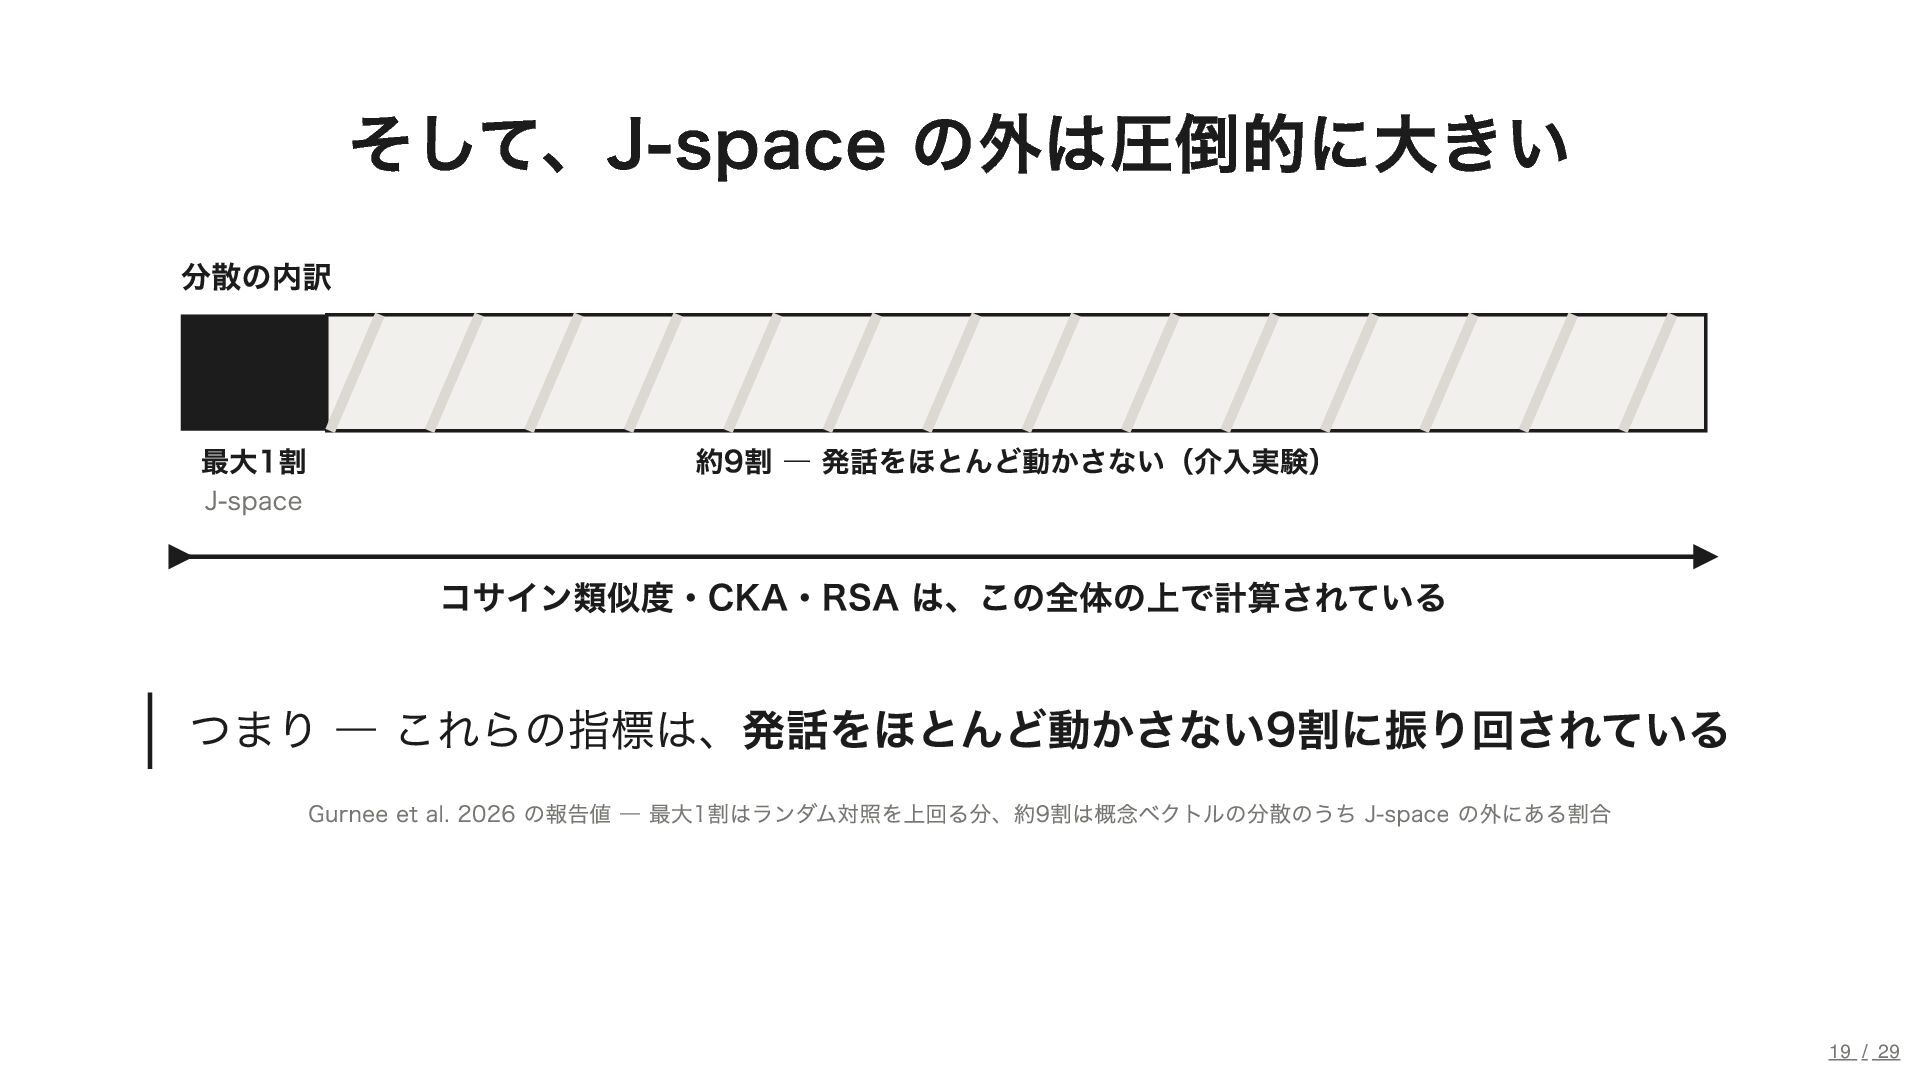
  15. そして、J-space の外は圧倒的に大きい 分散の内訳 最大1割 J-space 約9割 ― 発話をほとんど動かさない(介入実験) コサイン類似度・CKA・RSA は、この全体の上で計算されている

    つまり ― これらの指標は、発話をほとんど動かさない9割に振り回されている Gurnee et al. 2026 の報告値 ― 最大1割はランダム対照を上回る分、約9割は概念ベクトルの分散のうち J-space の外にある割合 19 / 29
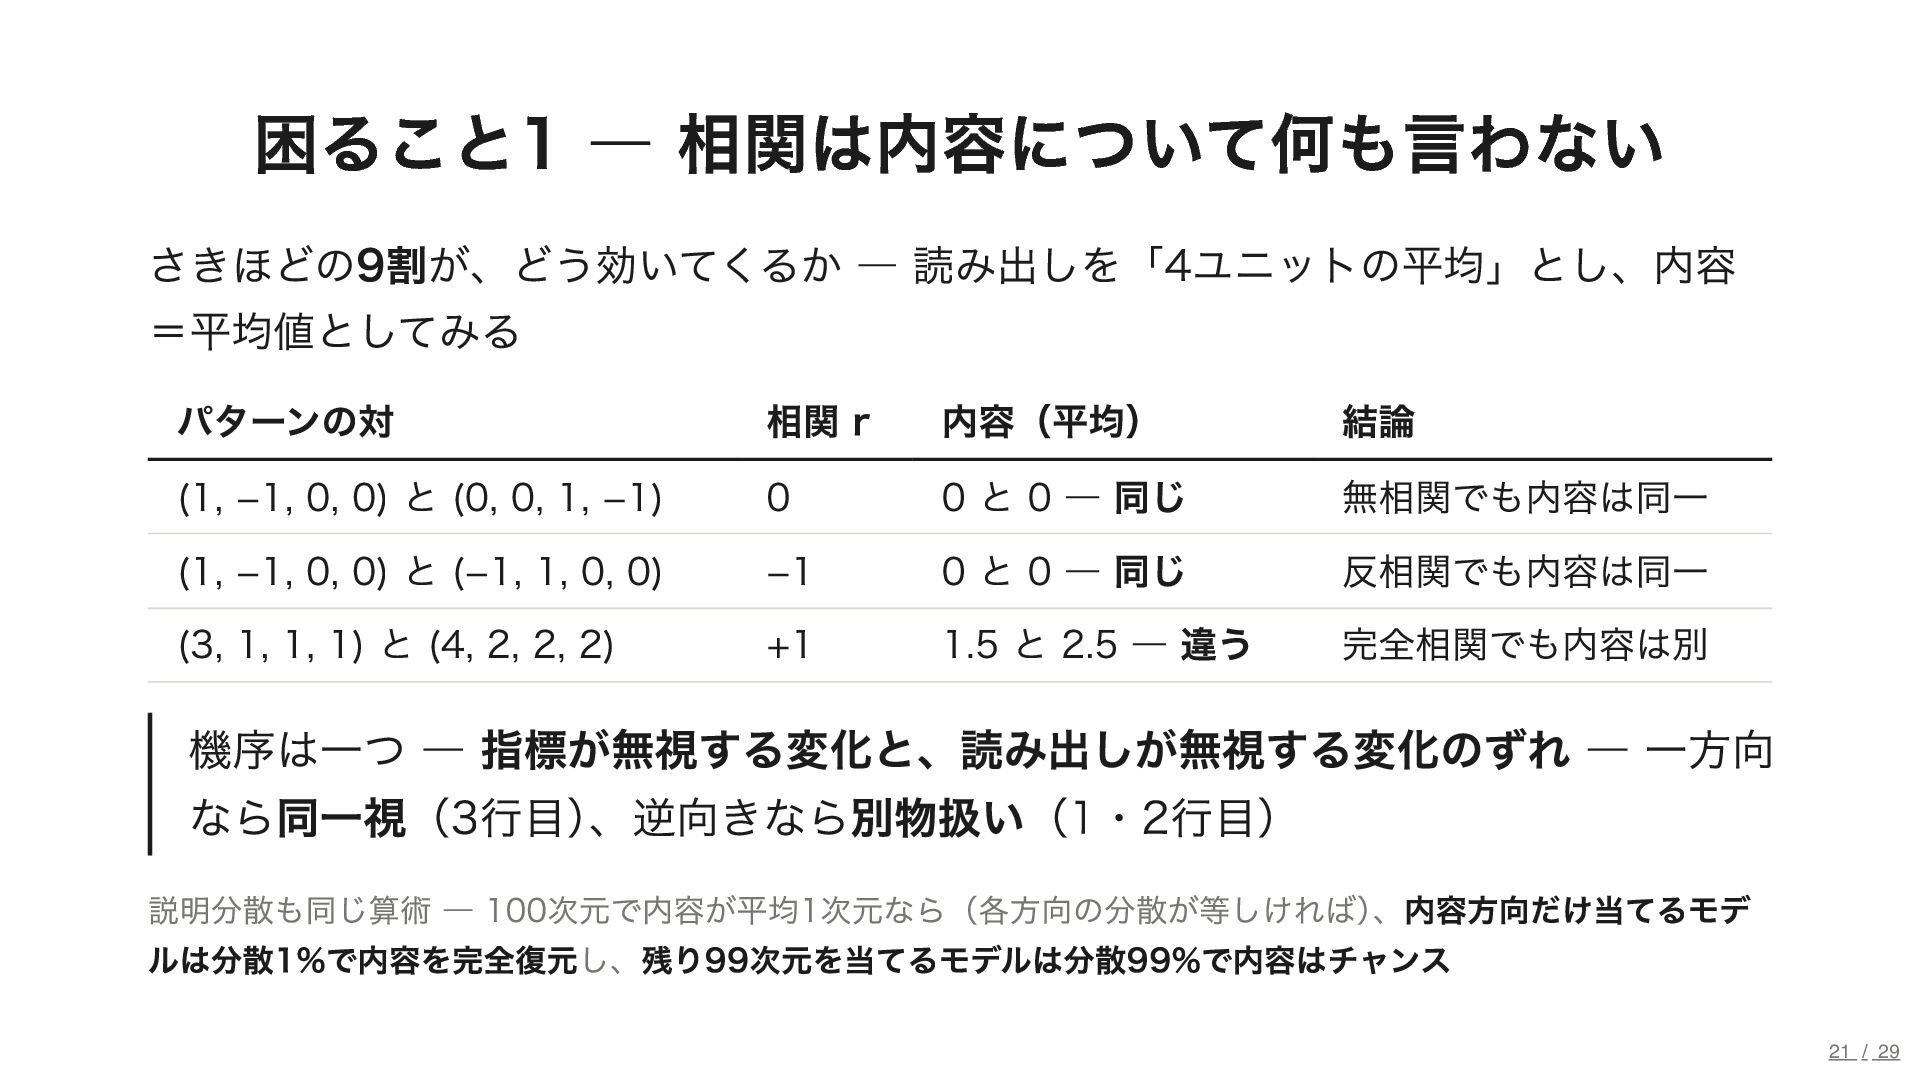
  16. 困ること1 ― 相関は内容について何も言わない さきほどの9割が、どう効いてくるか ― 読み出しを「4ユニットの平均」とし、内容 =平均値としてみる パターンの対 (1, −1,

    0, 0) と (0, 0, 1, −1) (1, −1, 0, 0) と (−1, 1, 0, 0) (3, 1, 1, 1) と (4, 2, 2, 2) 相関 r 0 −1 +1 内容(平均) 0 と 0 ― 同じ 0 と 0 ― 同じ 1.5 と 2.5 ― 違う 結論 無相関でも内容は同一 反相関でも内容は同一 完全相関でも内容は別 機序は一つ ― 指標が無視する変化と、読み出しが無視する変化のずれ ― 一方向 なら同一視(3行目)、逆向きなら別物扱い(1・2行目) 説明分散も同じ算術 ― 100次元で内容が平均1次元なら(各方向の分散が等しければ)、内容方向だけ当てるモデ ルは分散1%で内容を完全復元し、残り99次元を当てるモデルは分散99%で内容はチャンス 21 / 29
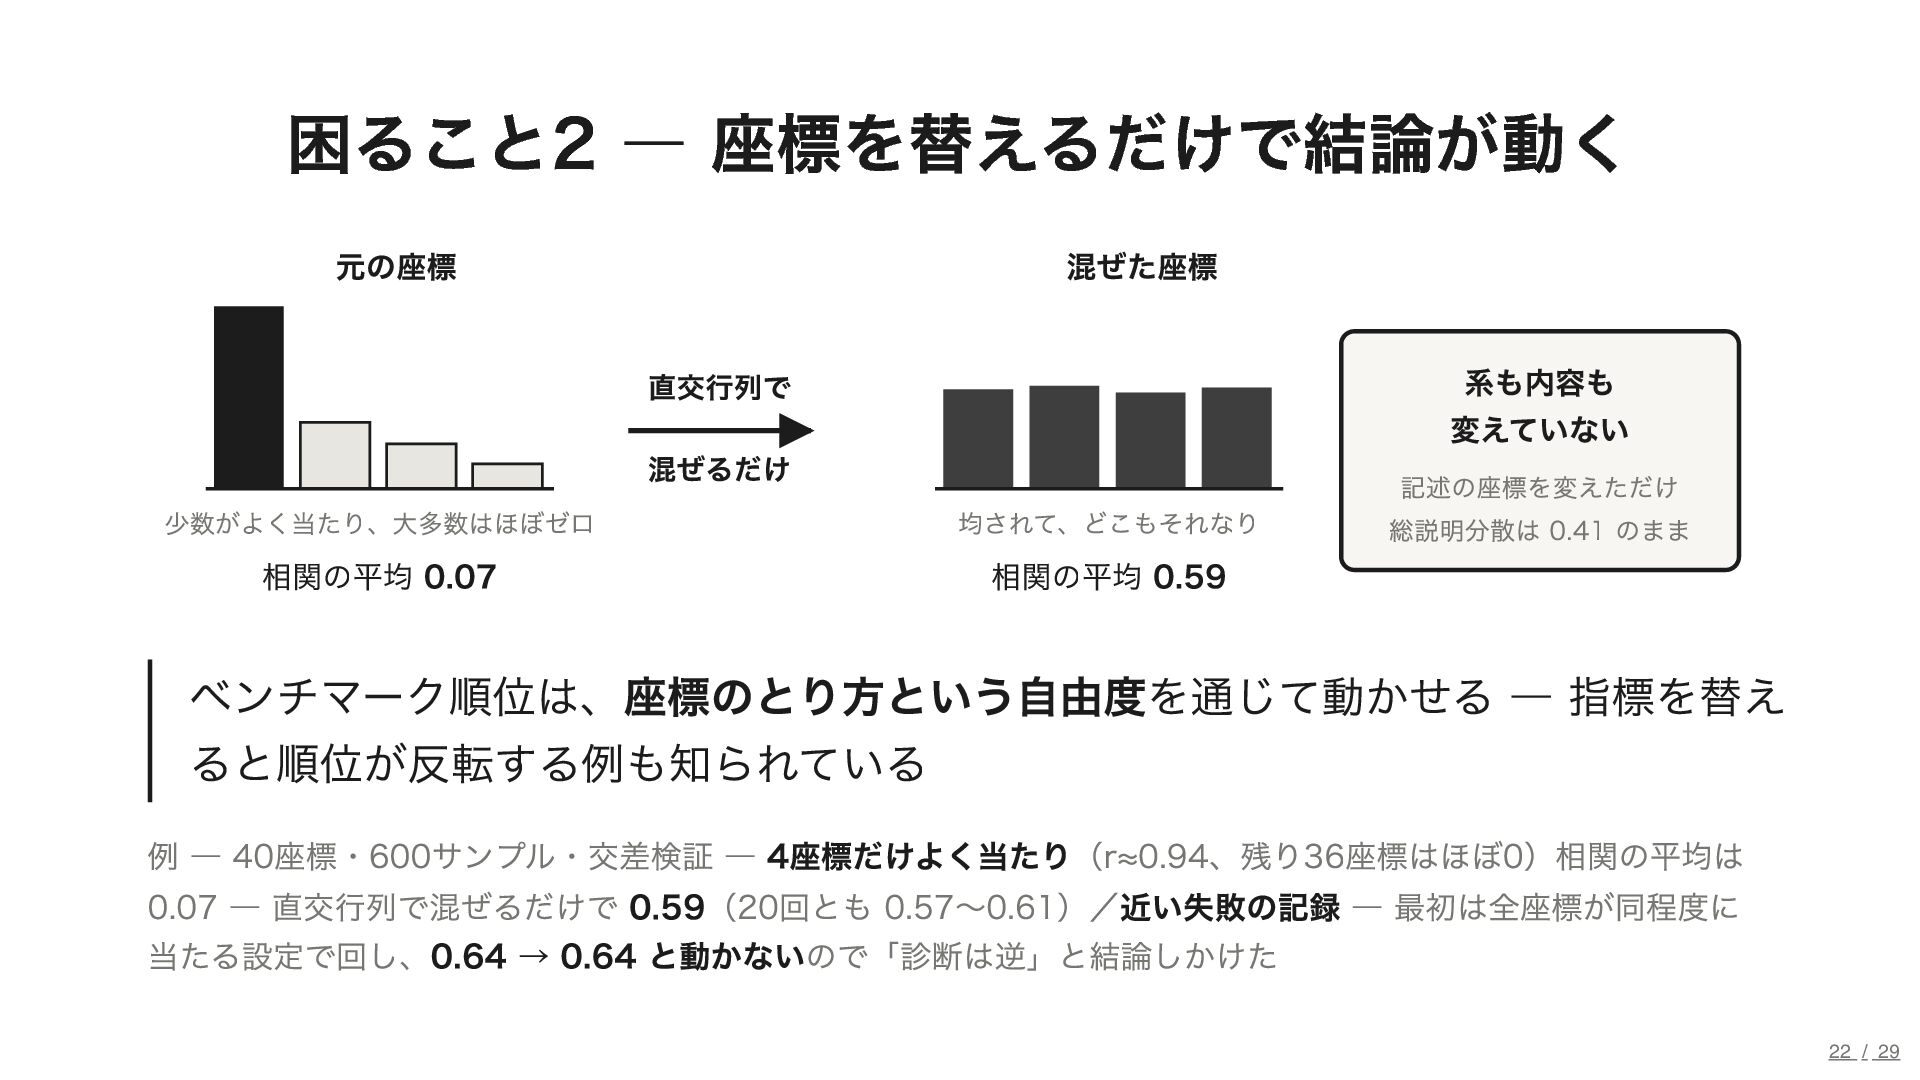
  17. 困ること2 ― 座標を替えるだけで結論が動く 元の座標 少数がよく当たり、大多数はほぼゼロ 相関の平均 0.07 混ぜた座標 直交行列で 混ぜるだけ

    系も内容も 変えていない 均されて、どこもそれなり 相関の平均 0.59 記述の座標を変えただけ 総説明分散は 0.41 のまま ベンチマーク順位は、座標のとり方という自由度を通じて動かせる ― 指標を替え ると順位が反転する例も知られている 例 ― 40座標・600サンプル・交差検証 ― 4座標だけよく当たり(r≈0.94、残り36座標はほぼ0)相関の平均は 0.07 ― 直交行列で混ぜるだけで 0.59(20回とも 0.57〜0.61)/近い失敗の記録 ― 最初は全座標が同程度に 当たる設定で回し、0.64 → 0.64 と動かないので「診断は逆」と結論しかけた 22 / 29
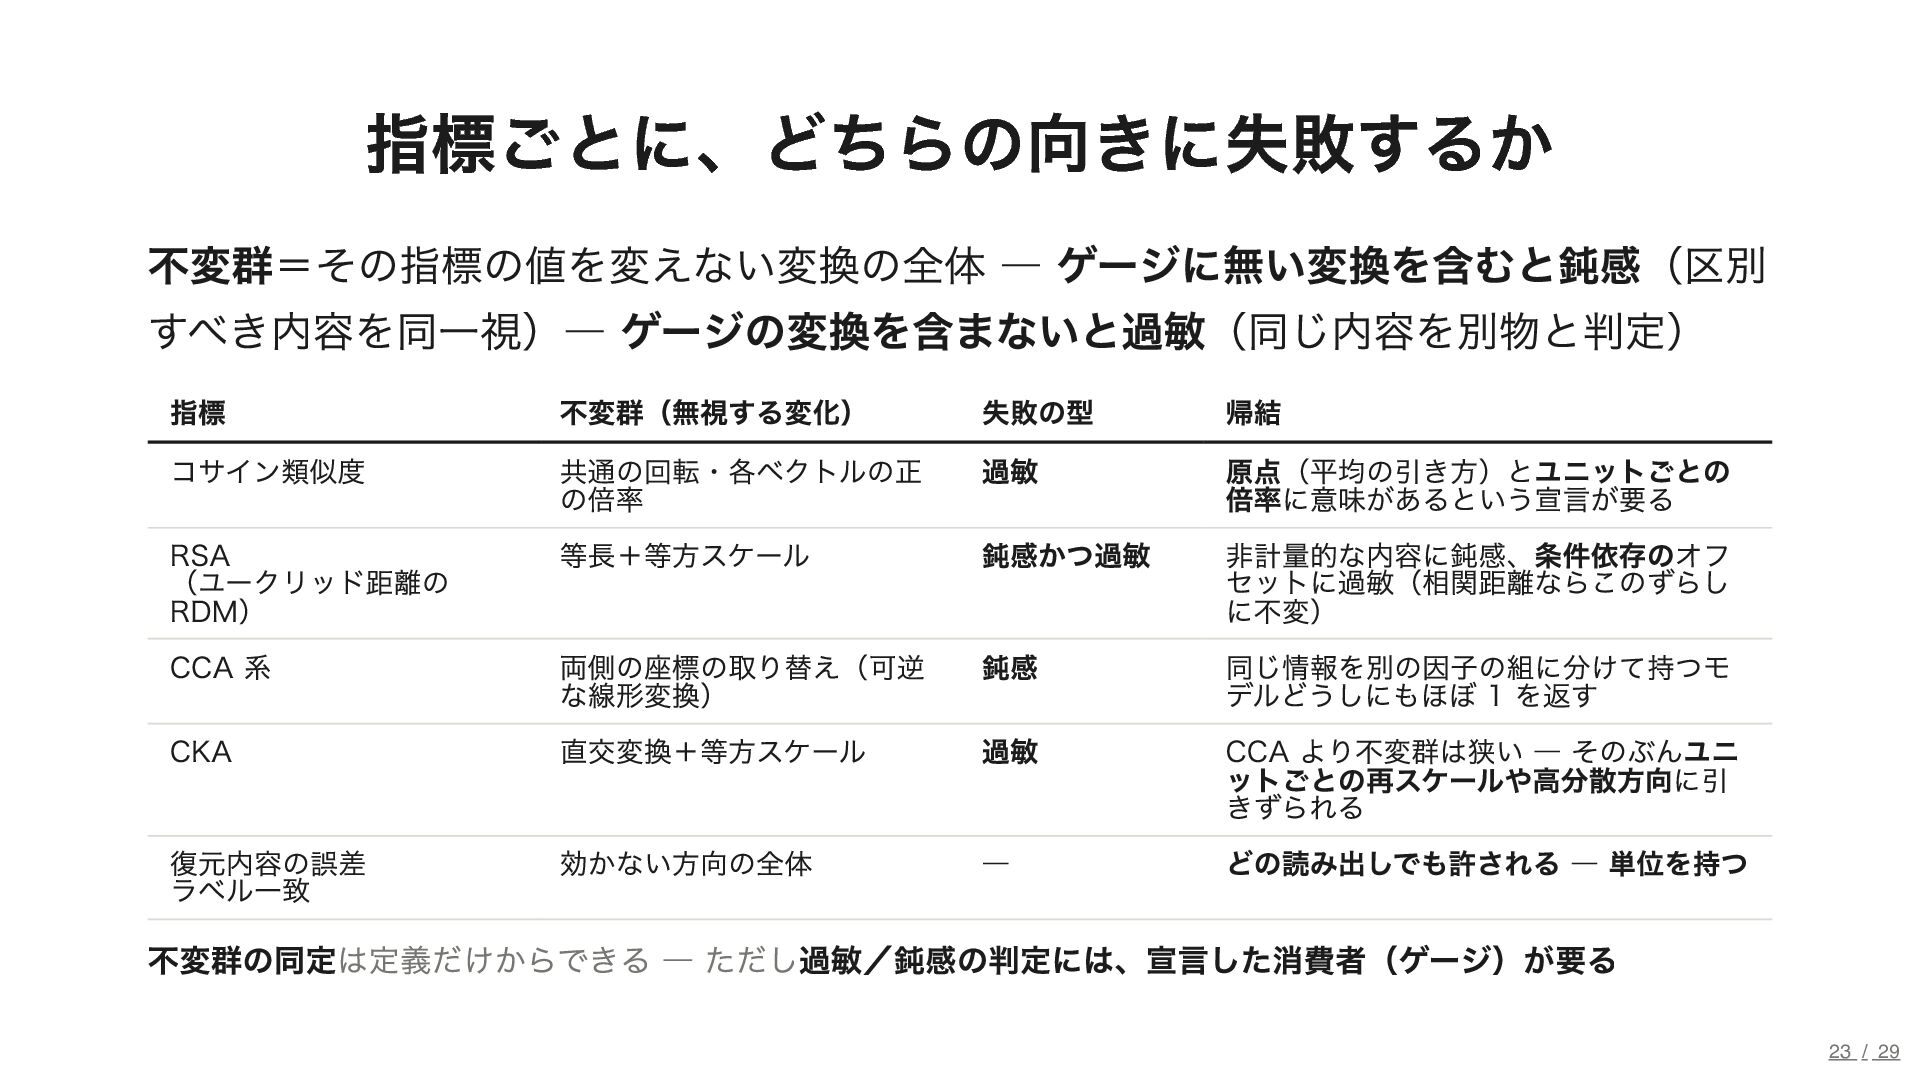
  18. 指標ごとに、どちらの向きに失敗するか 不変群=その指標の値を変えない変換の全体 ― ゲージに無い変換を含むと鈍感(区別 すべき内容を同一視)― ゲージの変換を含まないと過敏(同じ内容を別物と判定) 指標 コサイン類似度 不変群(無視する変化) 共通の回転・各ベクトルの正

    の倍率 失敗の型 過敏 等長+等方スケール 鈍感かつ過敏 鈍感 CKA 両側の座標の取り替え(可逆 な線形変換) 直交変換+等方スケール 復元内容の誤差 ラベル一致 効かない方向の全体 ― RSA (ユークリッド距離の RDM) CCA 系 過敏 帰結 原点(平均の引き方)とユニットごとの 倍率に意味があるという宣言が要る 非計量的な内容に鈍感、条件依存のオフ セットに過敏(相関距離ならこのずらし に不変) 同じ情報を別の因子の組に分けて持つモ デルどうしにもほぼ 1 を返す CCA より不変群は狭い ― そのぶんユニ ットごとの再スケールや高分散方向に引 きずられる どの読み出しでも許される ― 単位を持つ 不変群の同定は定義だけからできる ― ただし過敏/鈍感の判定には、宣言した消費者(ゲージ)が要る 23 / 29
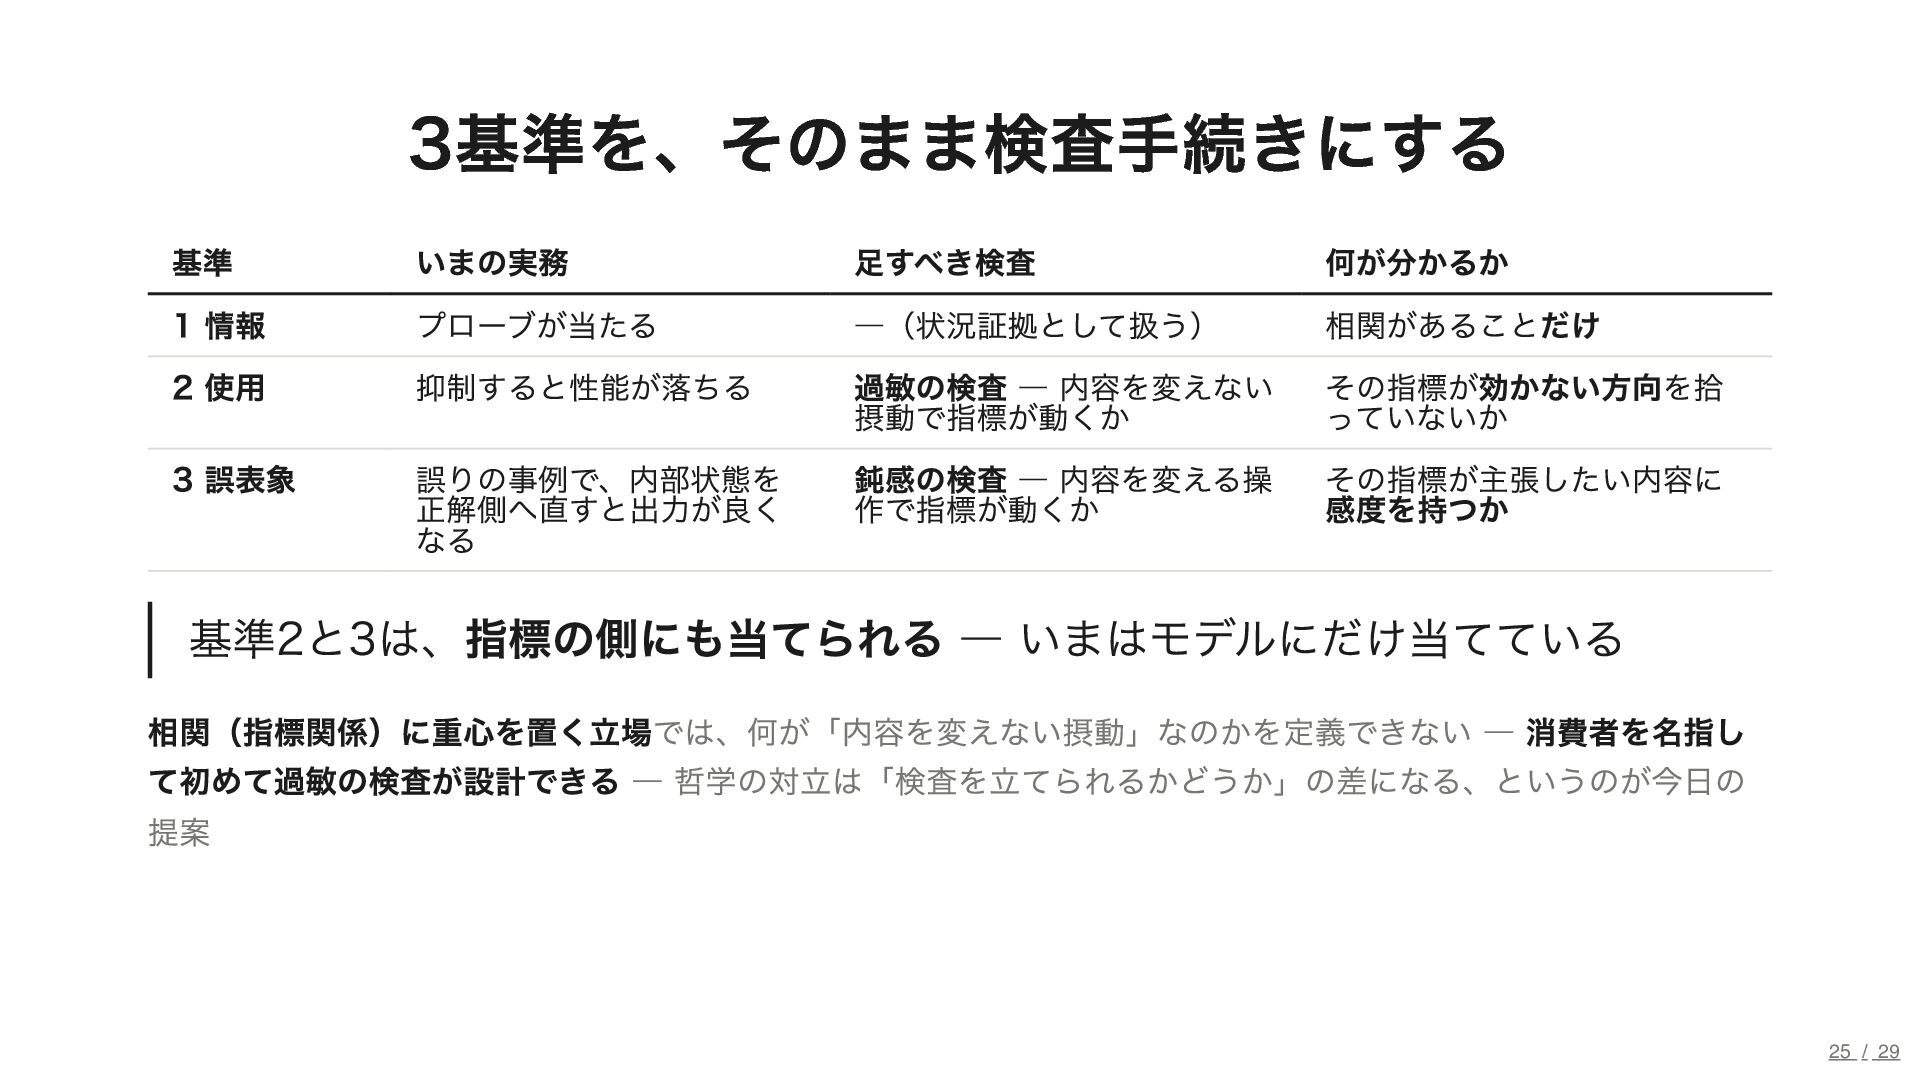
  19. 3基準を、そのまま検査手続きにする 基準 1 情報 2 使用 いまの実務 プローブが当たる 抑制すると性能が落ちる 3

    誤表象 誤りの事例で、内部状態を 正解側へ直すと出力が良く なる 足すべき検査 ―(状況証拠として扱う) 過敏の検査 ― 内容を変えない 摂動で指標が動くか 何が分かるか 相関があることだけ その指標が効かない方向を拾 っていないか 鈍感の検査 ― 内容を変える操 その指標が主張したい内容に 作で指標が動くか 感度を持つか 基準2と3は、指標の側にも当てられる ― いまはモデルにだけ当てている 相関(指標関係)に重心を置く立場では、何が「内容を変えない摂動」なのかを定義できない ― 消費者を名指し て初めて過敏の検査が設計できる ― 哲学の対立は「検査を立てられるかどうか」の差になる、というのが今日の 提案 25 / 29
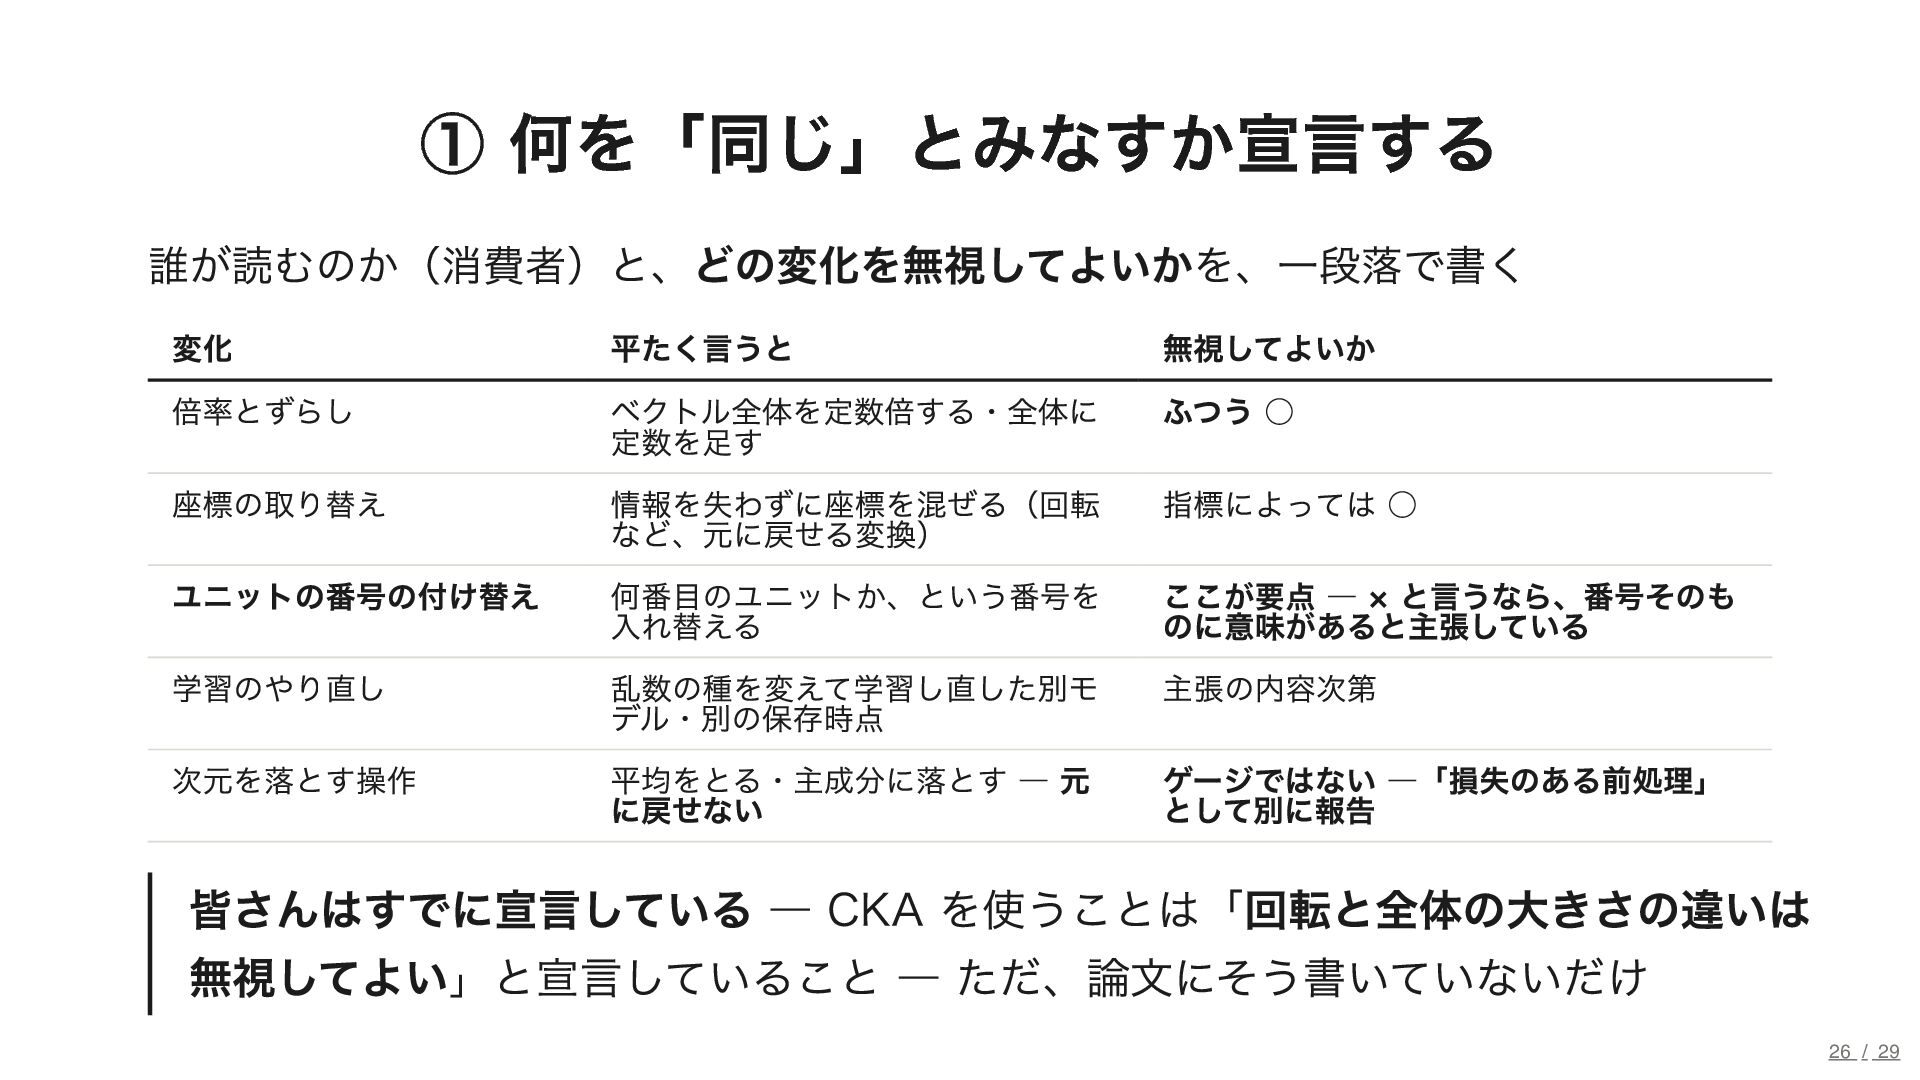
  20. ① 何を「同じ」とみなすか宣言する 誰が読むのか(消費者)と、どの変化を無視してよいかを、一段落で書く 変化 倍率とずらし 座標の取り替え ユニットの番号の付け替え 学習のやり直し 次元を落とす操作 平たく言うと

    ベクトル全体を定数倍する・全体に 定数を足す 情報を失わずに座標を混ぜる(回転 など、元に戻せる変換) 何番目のユニットか、という番号を 入れ替える 乱数の種を変えて学習し直した別モ デル・別の保存時点 平均をとる・主成分に落とす ― 元 に戻せない 無視してよいか ふつう ◦ 指標によっては ◦ ここが要点 ― × と言うなら、番号そのも のに意味があると主張している 主張の内容次第 ゲージではない ―「損失のある前処理」 として別に報告 皆さんはすでに宣言している ― CKA を使うことは「回転と全体の大きさの違いは 無視してよい」と宣言していること ― ただ、論文にそう書いていないだけ 26 / 29
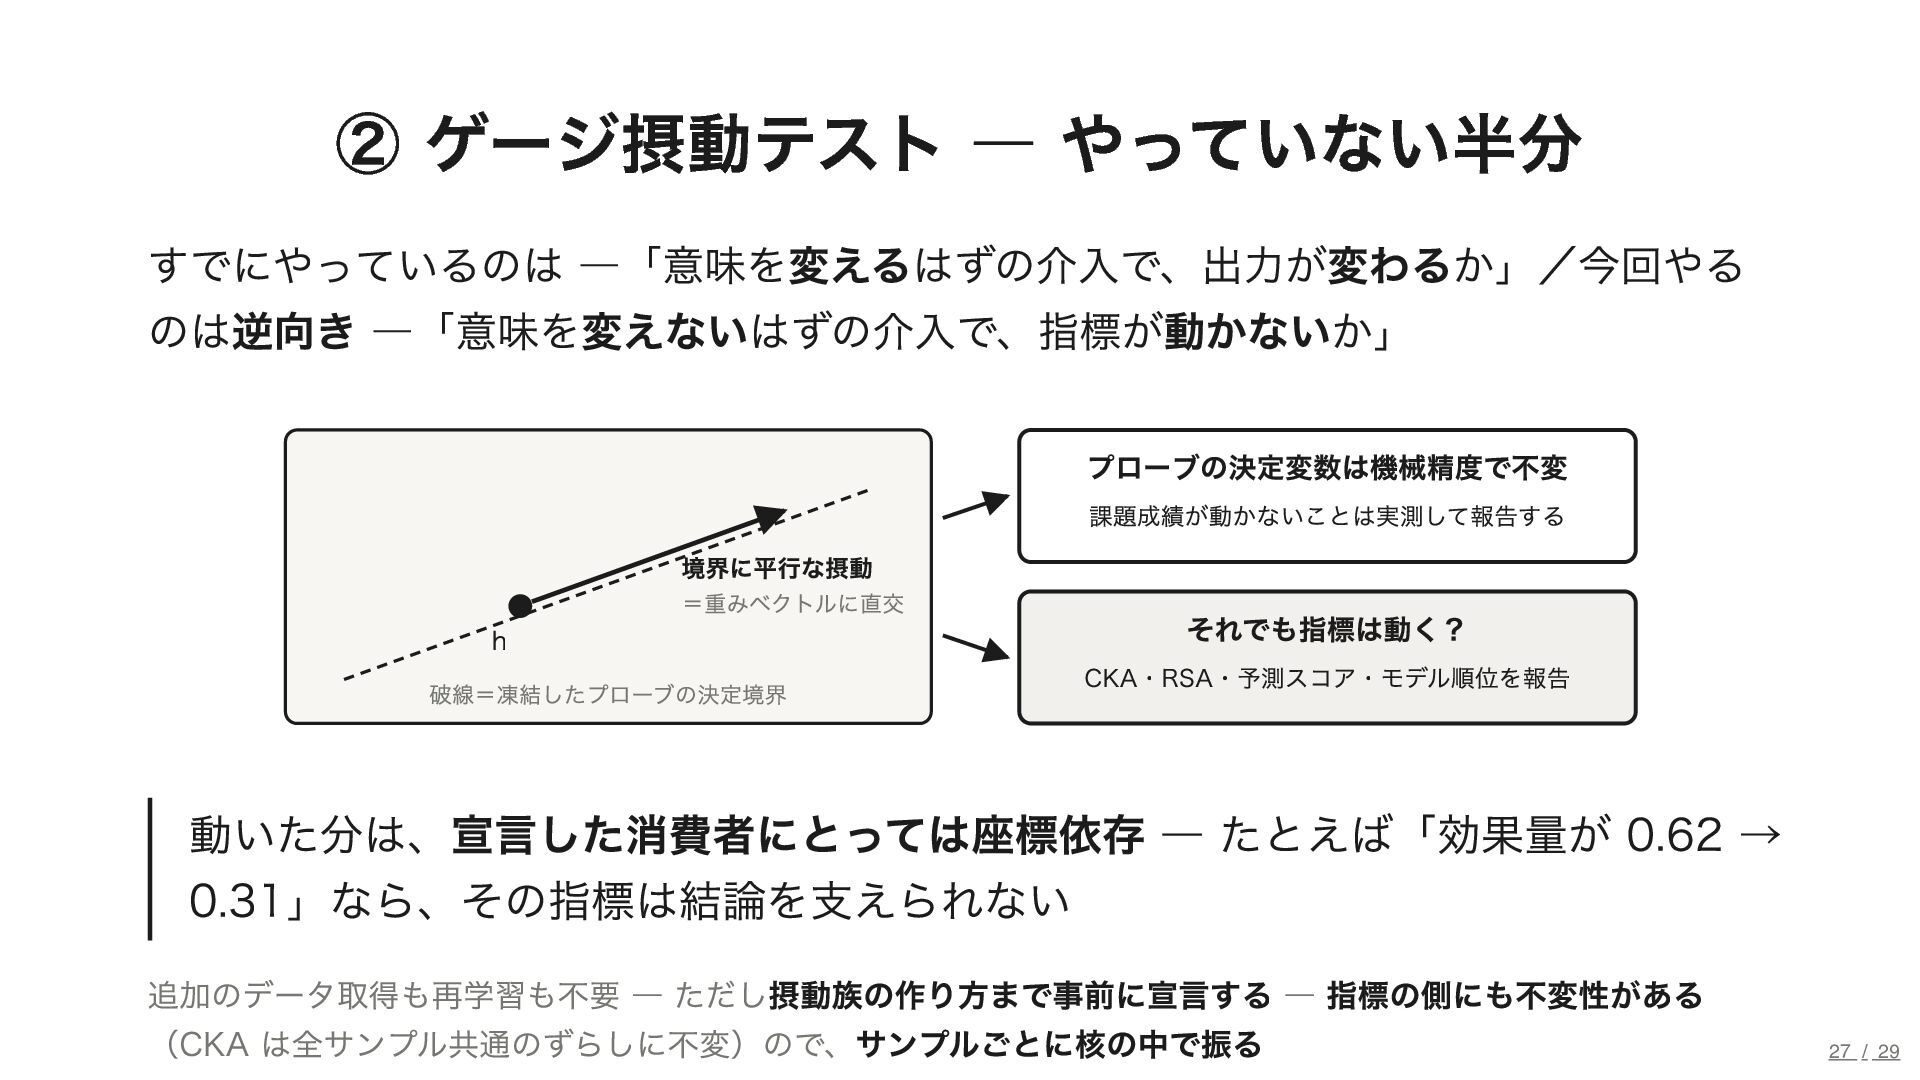
  21. ② ゲージ摂動テスト ― やっていない半分 すでにやっているのは ―「意味を変えるはずの介入で、出力が変わるか」/今回やる のは逆向き ―「意味を変えないはずの介入で、指標が動かないか」 プローブの決定変数は機械精度で不変 境界に平行な摂動

    h =重みベクトルに直交 破線=凍結したプローブの決定境界 課題成績が動かないことは実測して報告する それでも指標は動く? CKA・RSA・予測スコア・モデル順位を報告 動いた分は、宣言した消費者にとっては座標依存 ― たとえば「効果量が 0.62 → 0.31」なら、その指標は結論を支えられない 追加のデータ取得も再学習も不要 ― ただし摂動族の作り方まで事前に宣言する ― 指標の側にも不変性がある (CKA は全サンプル共通のずらしに不変)ので、サンプルごとに核の中で振る 27 / 29
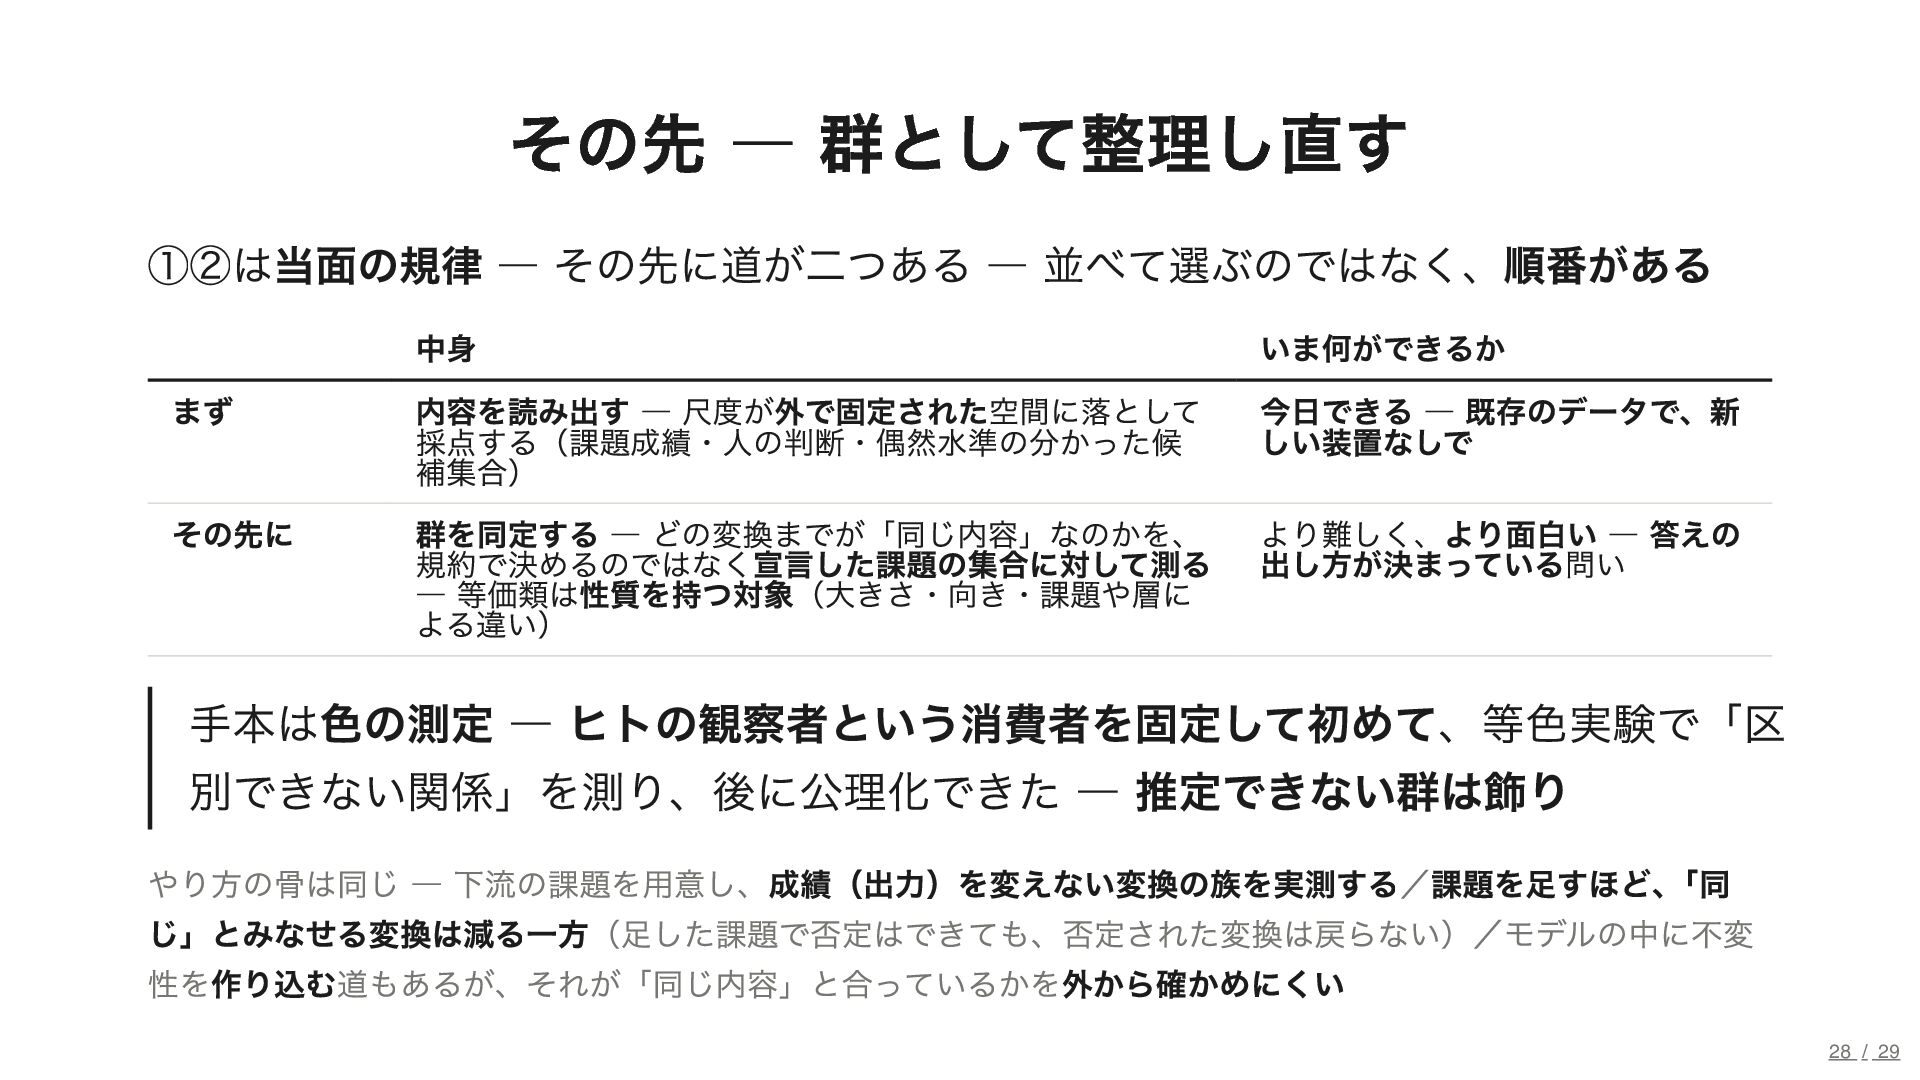
  22. その先 ― 群として整理し直す ①②は当面の規律 ― その先に道が二つある ― 並べて選ぶのではなく、順番がある まず その先に

    中身 内容を読み出す ― 尺度が外で固定された空間に落として 採点する(課題成績・人の判断・偶然水準の分かった候 補集合) 群を同定する ― どの変換までが「同じ内容」なのかを、 規約で決めるのではなく宣言した課題の集合に対して測る ― 等価類は性質を持つ対象(大きさ・向き・課題や層に よる違い) いま何ができるか 今日できる ― 既存のデータで、新 しい装置なしで より難しく、より面白い 出し方が決まっている問い― 答えの 手本は色の測定 ― ヒトの観察者という消費者を固定して初めて、等色実験で「区 別できない関係」を測り、後に公理化できた ― 推定できない群は飾り やり方の骨は同じ ― 下流の課題を用意し、成績(出力)を変えない変換の族を実測する/課題を足すほど、「同 じ」とみなせる変換は減る一方(足した課題で否定はできても、否定された変換は戻らない)/モデルの中に不変 性を作り込む道もあるが、それが「同じ内容」と合っているかを外から確かめにくい 28 / 29
  23. まとめ 内容(画像、文章)まで読み出して人が判定するなら、単位は外にある ― 危ないのは座 標の中で採点すること ― 予測精度でも CKA・RSA でも同じ 消費者を一つ決めると空間が2つに割れる

    ― その消費者にとって無視してよい方向(核) と、内容を担う方向(像) 核か像かは、宣言した消費者ごとに決まる ― J-lens は発話を動かす方向を、readout representation は入力に戻れる範囲を測る ― 発話をほとんど動かさない9割も空っぽで はない だから ― 宣言する・摂動で検査する・外の単位に載せる ― その先に群を同定するとい う道がある スコアは、高くても低くても教えない ― 誰が読むのかを宣言していない限り 気軽に内部表現を覗いて、モデルについて/脳について知ったつもりになるのは避けたい ― という話 29 / 29