Upgrade to Pro
— share decks privately, control downloads, hide ads and more …
Speaker Deck
Sign up for free
Menu
Search
Features
All features
Private URLs
Password Protection
Custom URLS
Scheduled publishing
Remove Branding
Restrict embedding
Deck Collections
Notes
Features
All features
Private URLs
Password Protection
Custom URLS
Scheduled publishing
Remove Branding
Restrict embedding
Deck Collections
Notes
Explore
Featured decks
Featured speakers
Programming
Technology
Storyboards
Explore
Featured decks
Featured speakers
Programming
Technology
Storyboards
Pricing
Search
Sign in
Sign up for free
データ基盤統合への歩み - ハッカーズチャンプルー2025前夜祭
Search
Yuji Takaesu
August 01, 2025
Programming
46
2
Share
Embed
Copy iframe code
Copy JS code
Copy link
Start on current slide
データ基盤統合への歩み - ハッカーズチャンプルー2025前夜祭
Yuji Takaesu
August 01, 2025
More Decks by Yuji Takaesu
See All by Yuji Takaesu
サーバーレスのテストを取り巻く環境
yusabana
0
950
IT筋トレを続けるための技術
yusabana
0
290
テスト導入支援
yusabana
0
120
社内向けgyazo
yusabana
0
200
社内開発環境/テスト環境
yusabana
0
130
hubotを使ったチャット環境
yusabana
0
89
Other Decks in Programming
See All in Programming
新卒PdEのリアル
ryu1013
1
500
大喜利で理解するLLM as a Judge / Understanding LLM-as-a-Judge through Ogiri
rockname
0
100
Heart of Swift Concurrency
koher
0
740
AI に Inclusive UI を書かせよう — Design Rules Skill で Compose UI を作り直す
theoriatec2024
1
490
自分的「カンファレンスの楽しみ方」
syumai
0
200
AWS DevOps Agentで インシデント対応をAIに任せたい
honmarkhunt
7
2.9k
Building an Out-of-Order CPU
latte72
1
780
What We Talk About When We Talk About XP
m_seki
2
620
技術的負債を組織課題として解く-増えすぎたマイクロサービスとの戦い-
reimaru
1
1.8k
iOSDC Japan 2026 - Swiftで作って学ぼう!データベース自作入門
kaseken
2
160
Omarchy Tokyo やると聞いて UMPC 買ってセットアップしてきた
mtsmfm
0
140
アクセシビリティから考える情報設計
high_g_engineer
0
380
Featured
See All Featured
The Hidden Cost of Media on the Web [PixelPalooza 2025]
tammyeverts
2
500
Build The Right Thing And Hit Your Dates
maggiecrowley
39
3.4k
Documentation Writing (for coders)
carmenintech
77
5.5k
The Language of Interfaces
destraynor
162
27k
A Modern Web Designer's Workflow
chriscoyier
699
190k
Beyond borders and beyond the search box: How to win the global "messy middle" with AI-driven SEO
davidcarrasco
3
240
Building an army of robots
kneath
307
46k
B2B Lead Gen: Tactics, Traps & Triumph
marketingsoph
0
240
Introduction to Domain-Driven Design and Collaborative software design
baasie
1
990
Mozcon NYC 2025: Stop Losing SEO Traffic
samtorres
1
540
ピンチをチャンスに:未来をつくるプロダクトロードマップ #pmconf2020
aki_iinuma
128
56k
WCS-LA-2024
lcolladotor
0
830
Transcript
Hackers Champloo 2025 前夜祭 データ基盤統合への歩み RedshiftからBigQueryへ
⾼江洲 祐治 (たかえす ゆうじ) X: https://x.com/takaesu_ug 沖縄在住 リモートワーク歴 8年 ランニング(NAHAマラソン)
クラフトビール 【経歴】 - 2020年に⼊社してからトクバイ(チラシ‧買物情報 プラットフォーム)の開発 - https://tokubai.co.jp/ - 主にRailsやReactを⽤いた開発 - 今年からプラットフォーム開発部 - データ基盤などの開発を主軸 - ID統合や開発標準化 - データエンジニアリングとしては初⼼者
なぜデータ基盤統合するのか?!
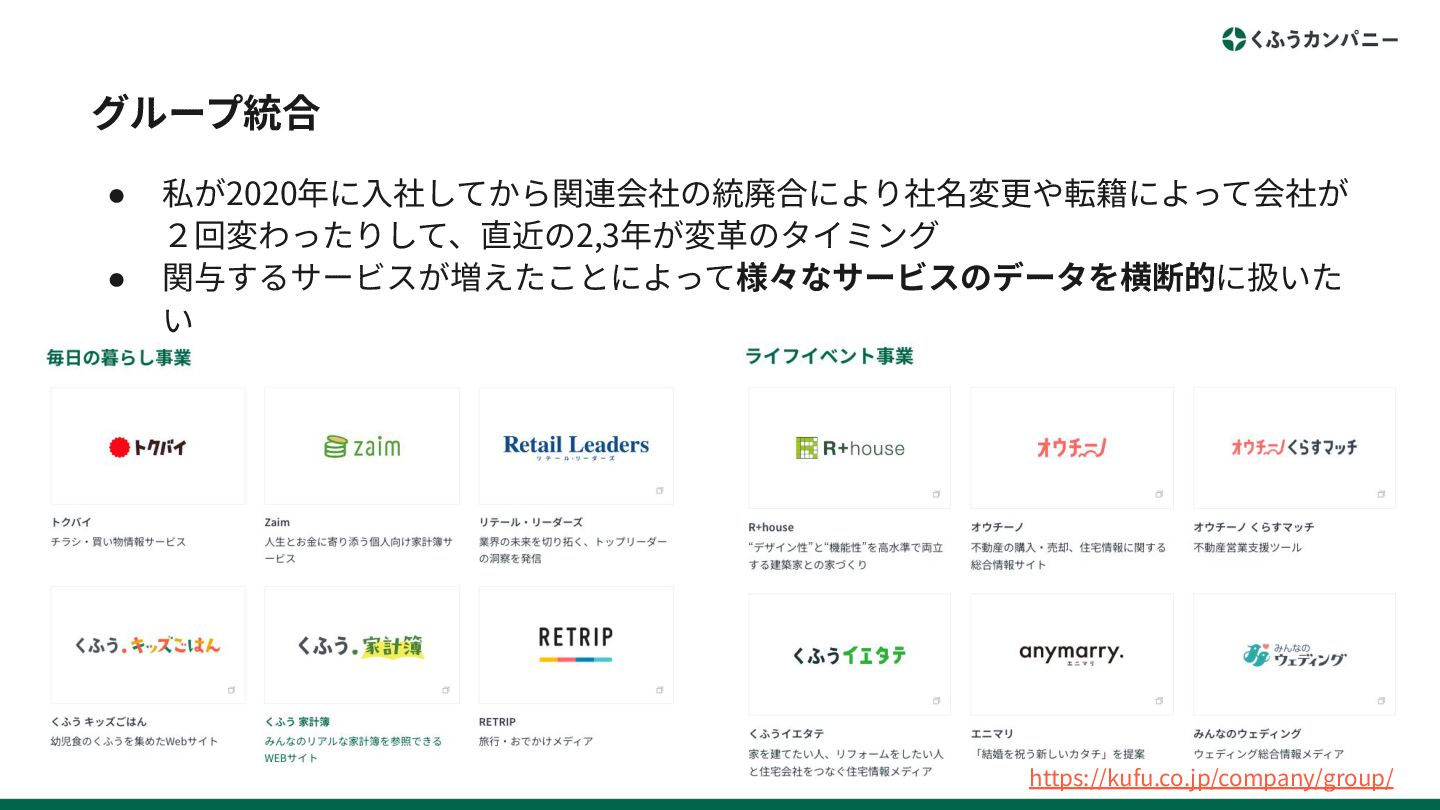
グループ統合 • 私が2020年に⼊社してから関連会社の統廃合により社名変更や転籍によって会社が 2回変わったりして、直近の2,3年が変⾰のタイミング • 関与するサービスが増えたことによって様々なサービスのデータを横断的に扱いた い https://kufu.co.jp/company/group/
データ基盤がサービス毎に最適化されて横展開が難しい • グループ内の各種サービス毎にデータ基盤を活⽤している ◦ 主にRedshift とBigQuery、またサービス内のDBが⼊り混じっている • データの取り込み、変換、活⽤などそれぞれが最適な⼿段を適⽤しているため、 サービス毎にバラバラな状態 ◦
独⾃実装のデータ取り込み⽤のツール ◦ Embulkによる定期的な取り込み ◦ Railsのアプリケーション側のバッチ処理
データ品質に関して⼀貫性や担保が難しい • 共通化可能な条件が集計クエリ毎に定義されている ◦ クエリごとに条件が統⼀されておらず結果の担保や⼀貫性が難しい ◦ (例) 不要なBotのログを除外する条件など • 集計処理の状況把握や追跡がやりづらい
◦ どこで、どの分析基盤のテーブルを利⽤しているの分かりづらい ◦ 集計処理などをコード管理して、⼀貫性のある状態で追跡可能にしたい
⽬指す理想像
None
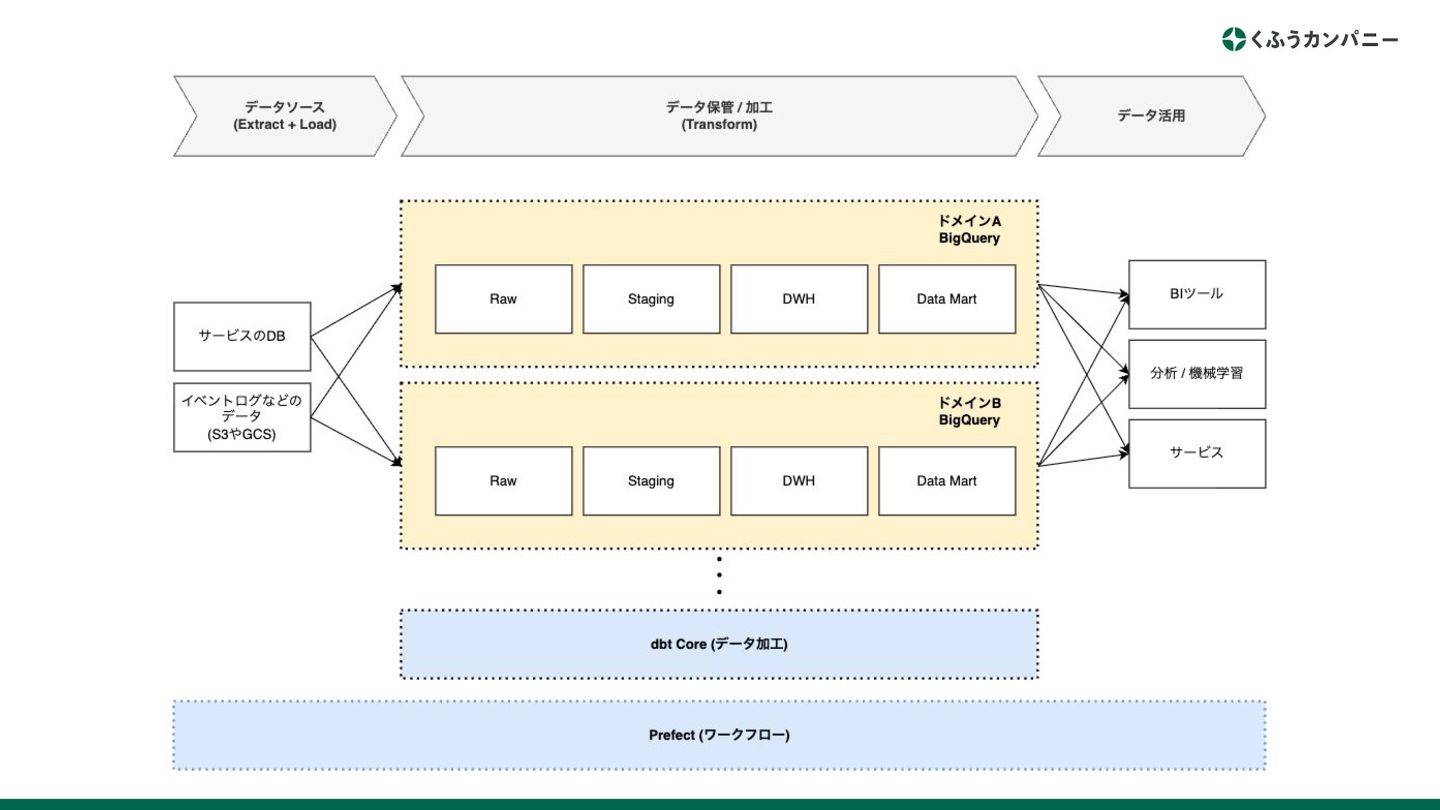
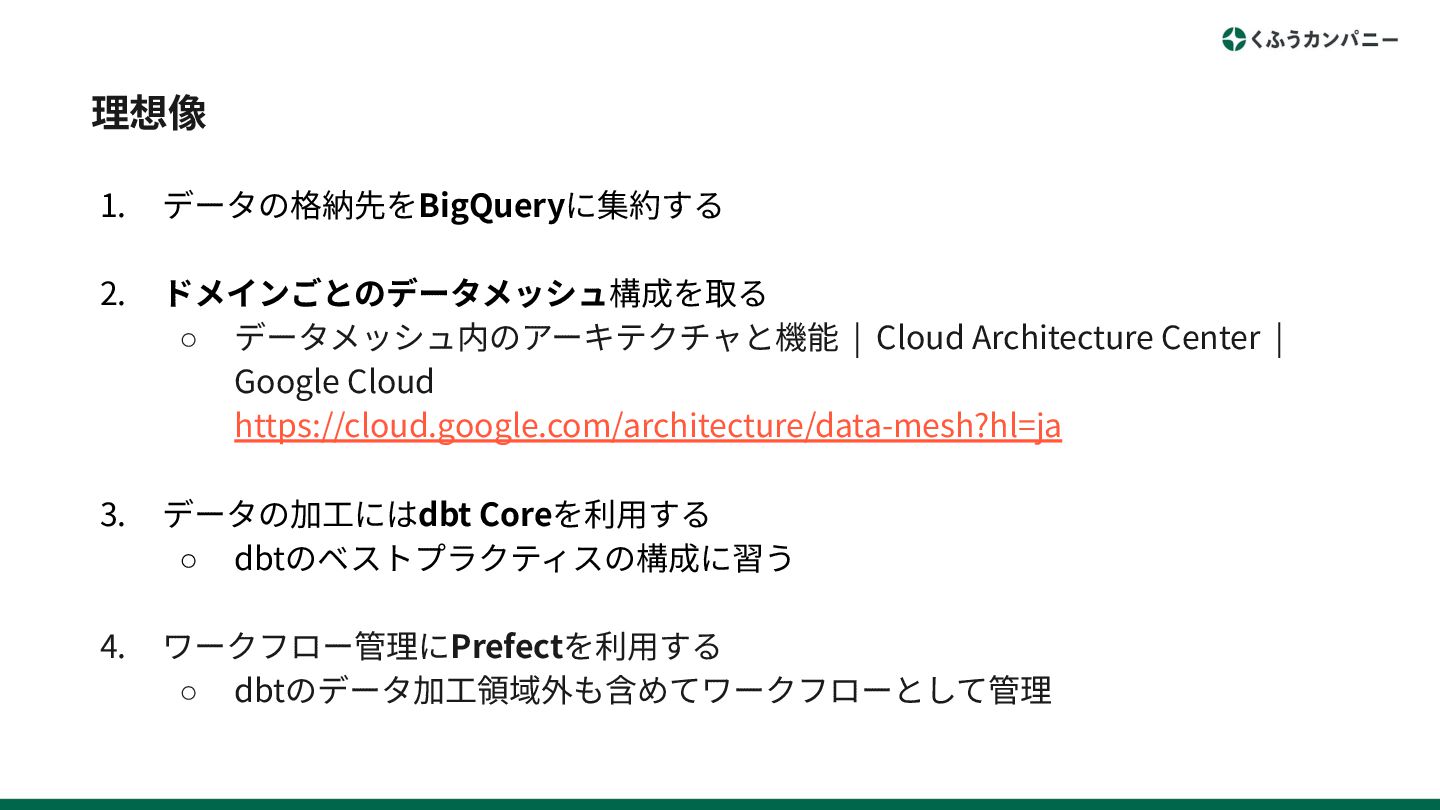
理想像 1. データの格納先をBigQueryに集約する 2. ドメインごとのデータメッシュ構成を取る ◦ データメッシュ内のアーキテクチャと機能 | Cloud Architecture
Center | Google Cloud https://cloud.google.com/architecture/data-mesh?hl=ja 3. データの加⼯にはdbt Coreを利⽤する ◦ dbtのベストプラクティスの構成に習う 4. ワークフロー管理にPrefectを利⽤する ◦ dbtのデータ加⼯領域外も含めてワークフローとして管理
現状やっていることの ⼀部を紹介します
データの格納先をBigQueryに集約する (Redshift廃⽌)
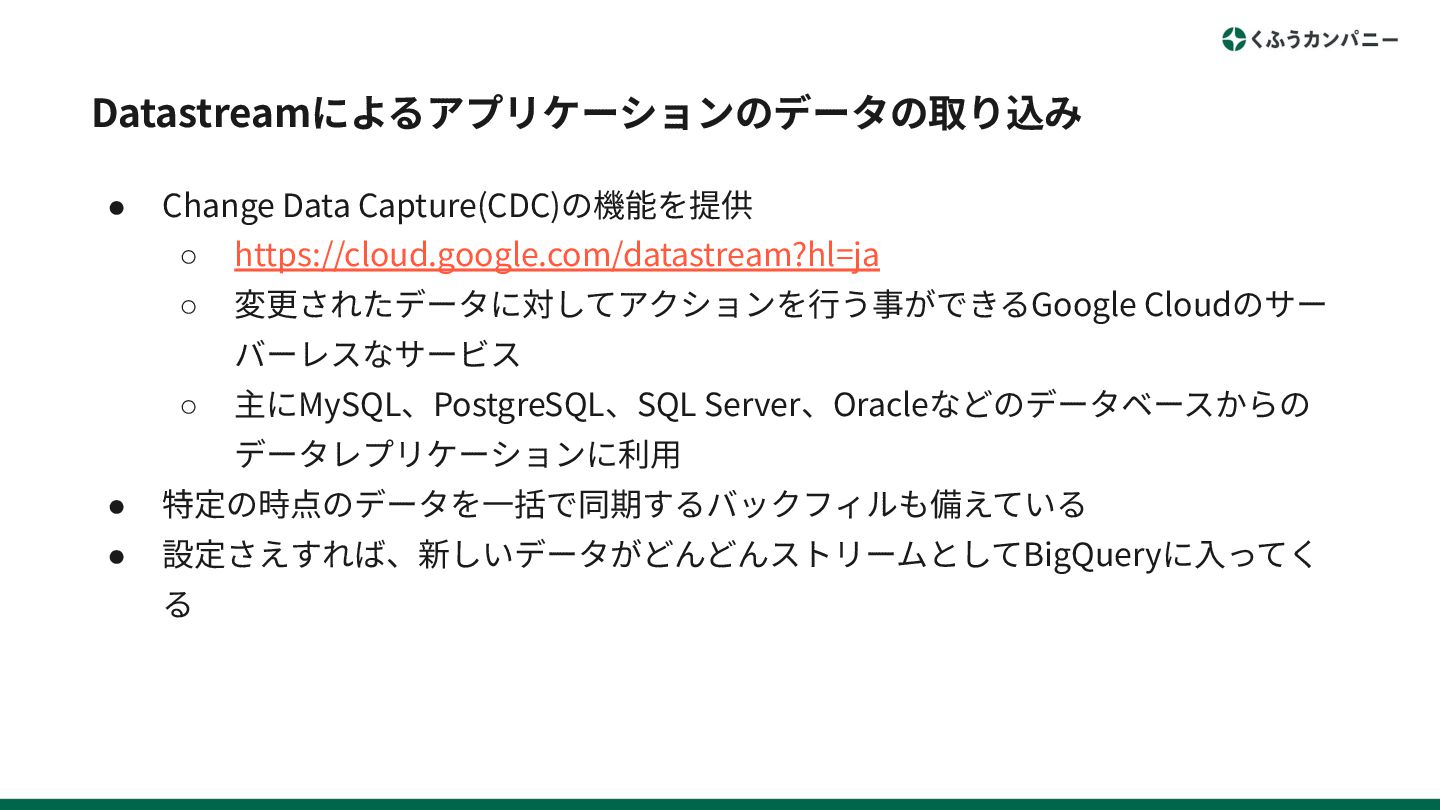
Datastreamによるアプリケーションのデータの取り込み • Change Data Capture(CDC)の機能を提供 ◦ https://cloud.google.com/datastream?hl=ja ◦ 変更されたデータに対してアクションを⾏う事ができるGoogle Cloudのサー
バーレスなサービス ◦ 主にMySQL、PostgreSQL、SQL Server、Oracleなどのデータベースからの データレプリケーションに利⽤ • 特定の時点のデータを⼀括で同期するバックフィルも備えている • 設定さえすれば、新しいデータがどんどんストリームとしてBigQueryに⼊ってく る
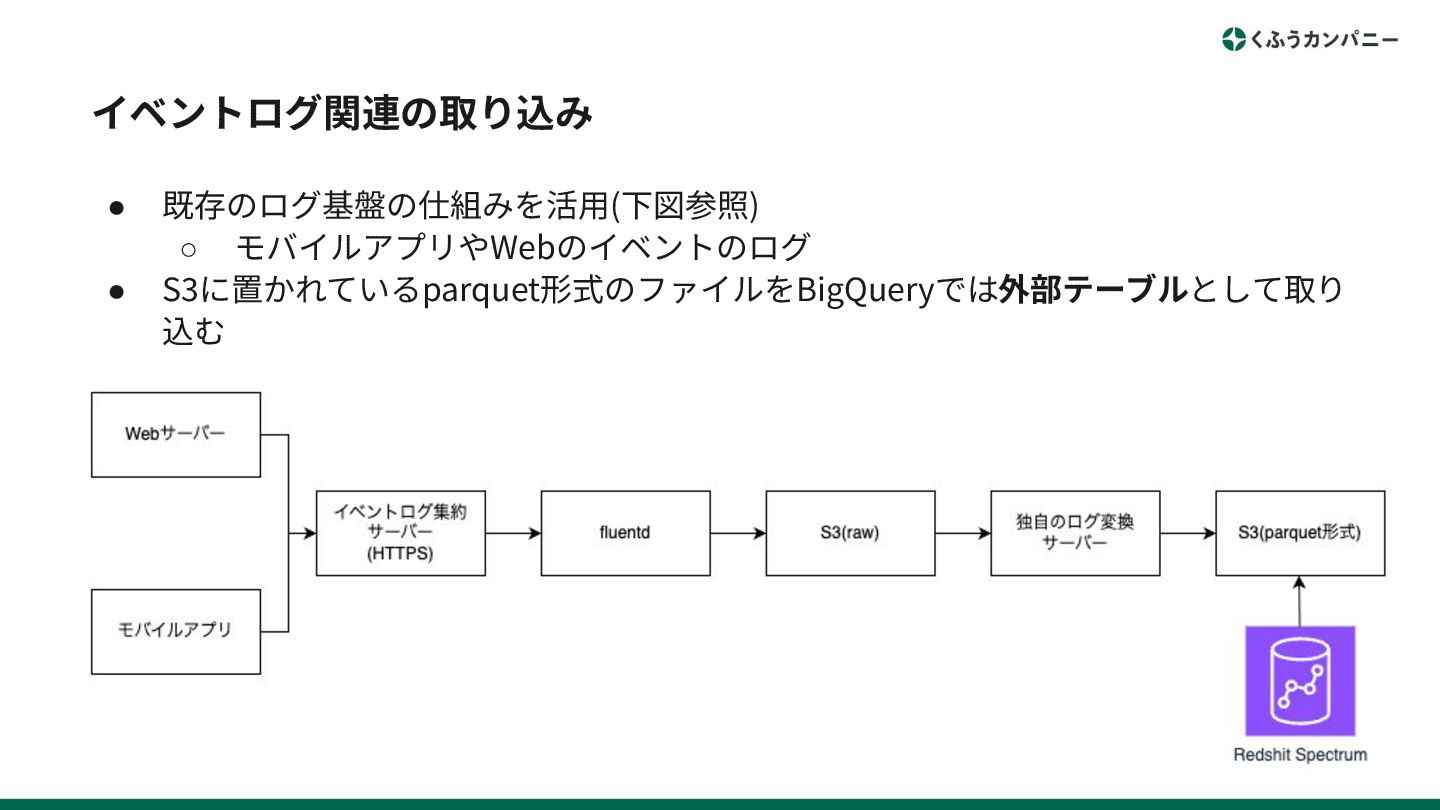
イベントログ関連の取り込み • 既存のログ基盤の仕組みを活⽤(下図参照) ◦ モバイルアプリやWebのイベントのログ • S3に置かれているparquet形式のファイルをBigQueryでは外部テーブルとして取り 込む
アプリケーション側に実装されたアドホックなバッチ処理 • ⽇次や週次の様々な集計バッチをRedshiftからBigQueryに向けるように変更 ◦ PV集計やUU集計など • ここにいくつかつらみがある ◦ TimeStamp型のTimeZone ◦
RailsのActiveRecordの依存を除く
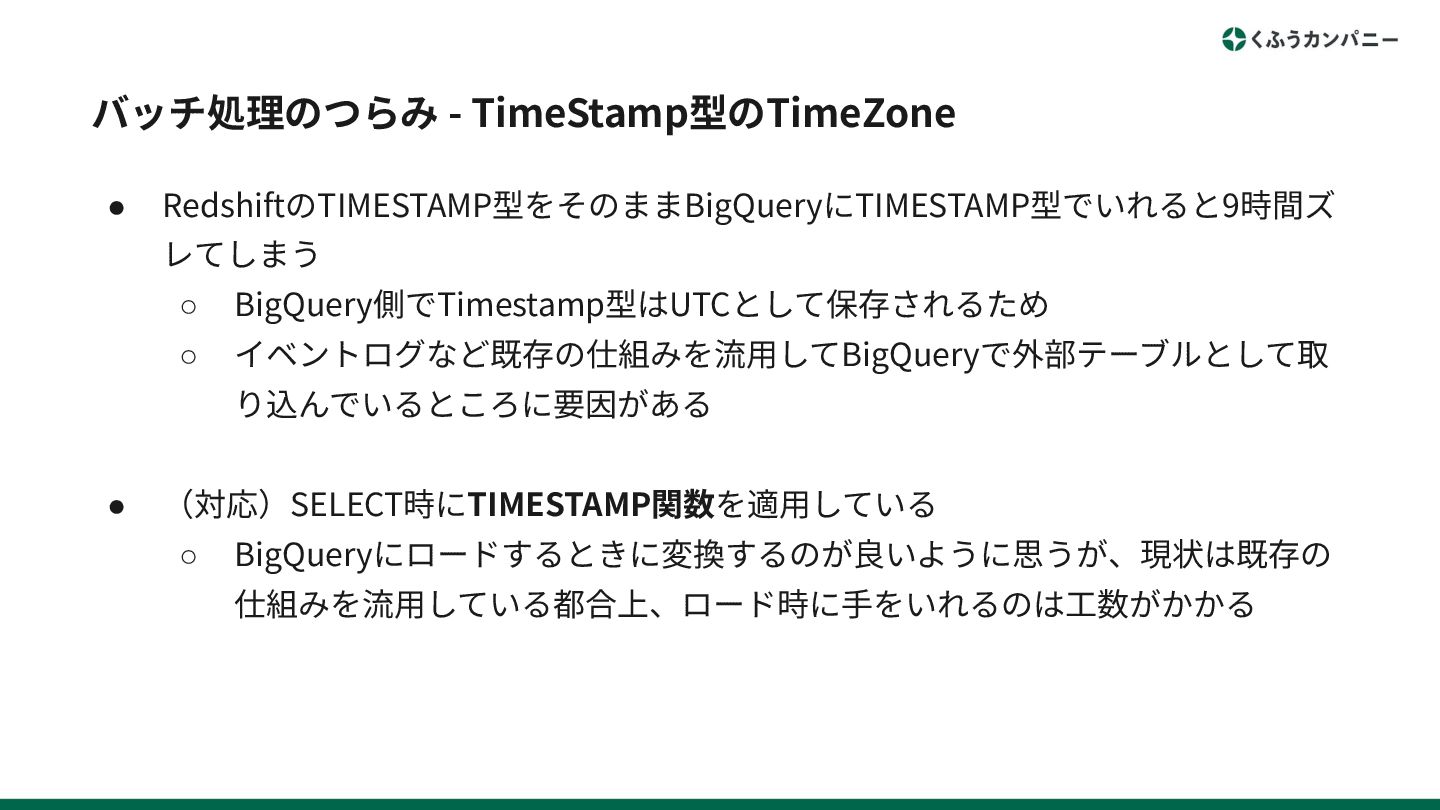
バッチ処理のつらみ - TimeStamp型のTimeZone • RedshiftのTIMESTAMP型をそのままBigQueryにTIMESTAMP型でいれると9時間ズ レてしまう ◦ BigQuery側でTimestamp型はUTCとして保存されるため ◦ イベントログなど既存の仕組みを流⽤してBigQueryで外部テーブルとして取
り込んでいるところに要因がある • (対応)SELECT時にTIMESTAMP関数を適⽤している ◦ BigQueryにロードするときに変換するのが良いように思うが、現状は既存の 仕組みを流⽤している都合上、ロード時に⼿をいれるのは⼯数がかかる
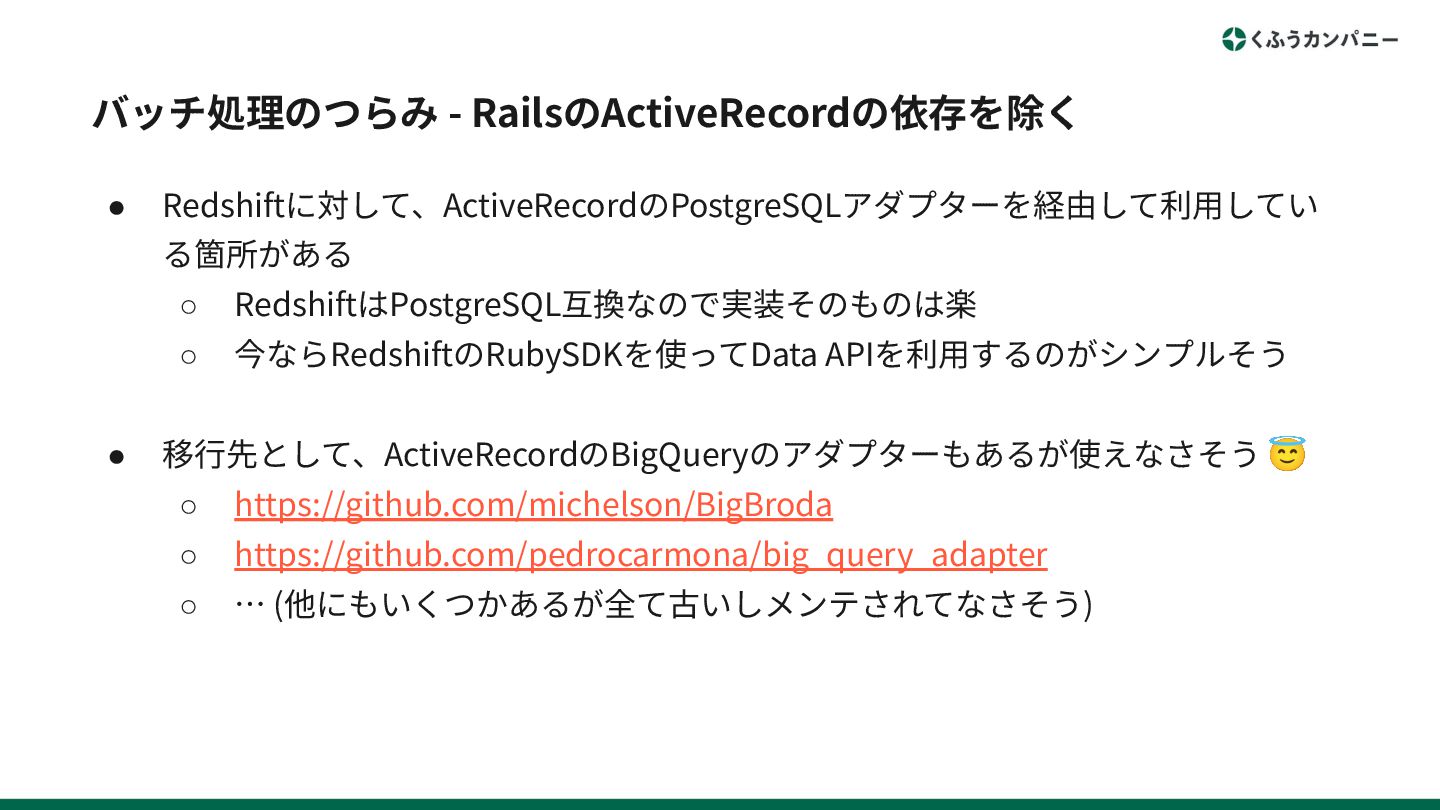
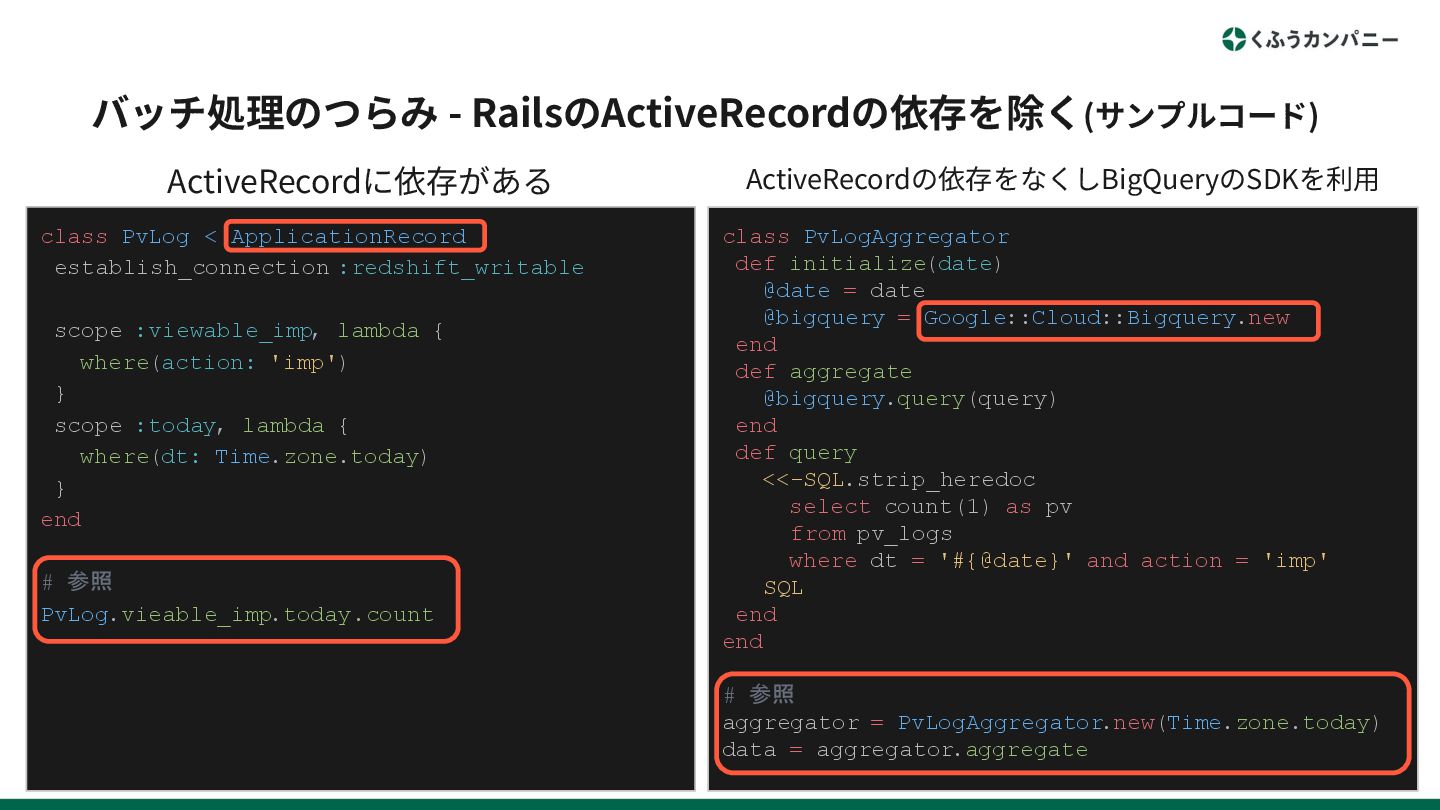
バッチ処理のつらみ - RailsのActiveRecordの依存を除く • Redshiftに対して、ActiveRecordのPostgreSQLアダプターを経由して利⽤してい る箇所がある ◦ RedshiftはPostgreSQL互換なので実装そのものは楽 ◦ 今ならRedshiftのRubySDKを使ってData
APIを利⽤するのがシンプルそう • 移⾏先として、ActiveRecordのBigQueryのアダプターもあるが使えなさそう 😇 ◦ https://github.com/michelson/BigBroda ◦ https://github.com/pedrocarmona/big_query_adapter ◦ … (他にもいくつかあるが全て古いしメンテされてなさそう)
バッチ処理のつらみ - RailsのActiveRecordの依存を除く(サンプルコード) class PvLog < ApplicationRecord establish_connection :redshift_writable scope
:viewable_imp, lambda { where(action: 'imp') } scope :today, lambda { where(dt: Time.zone.today) } end # 参照 PvLog.vieable_imp.today.count class PvLogAggregator def initialize(date) @date = date @bigquery = Google::Cloud::Bigquery.new end def aggregate @bigquery.query(query) end def query <<-SQL.strip_heredoc select count(1) as pv from pv_logs where dt = '#{@date}' and action = 'imp' SQL end end # 参照 aggregator = PvLogAggregator.new(Time.zone.today) data = aggregator.aggregate ActiveRecordに依存がある ActiveRecordの依存をなくしBigQueryのSDKを利⽤
まとめ • RedshiftからBigQueryへ基盤統合しているとい う話をしました • 理想を掲げ、少しずつ進めていってる • データ基盤の統合のようにグループ全社横断する プラットフォーム開発はサービス開発とはまた 違った⾯⽩さと難しさやつらみがある
◦ 新しい学びがあること(Prefectやdbtなど)
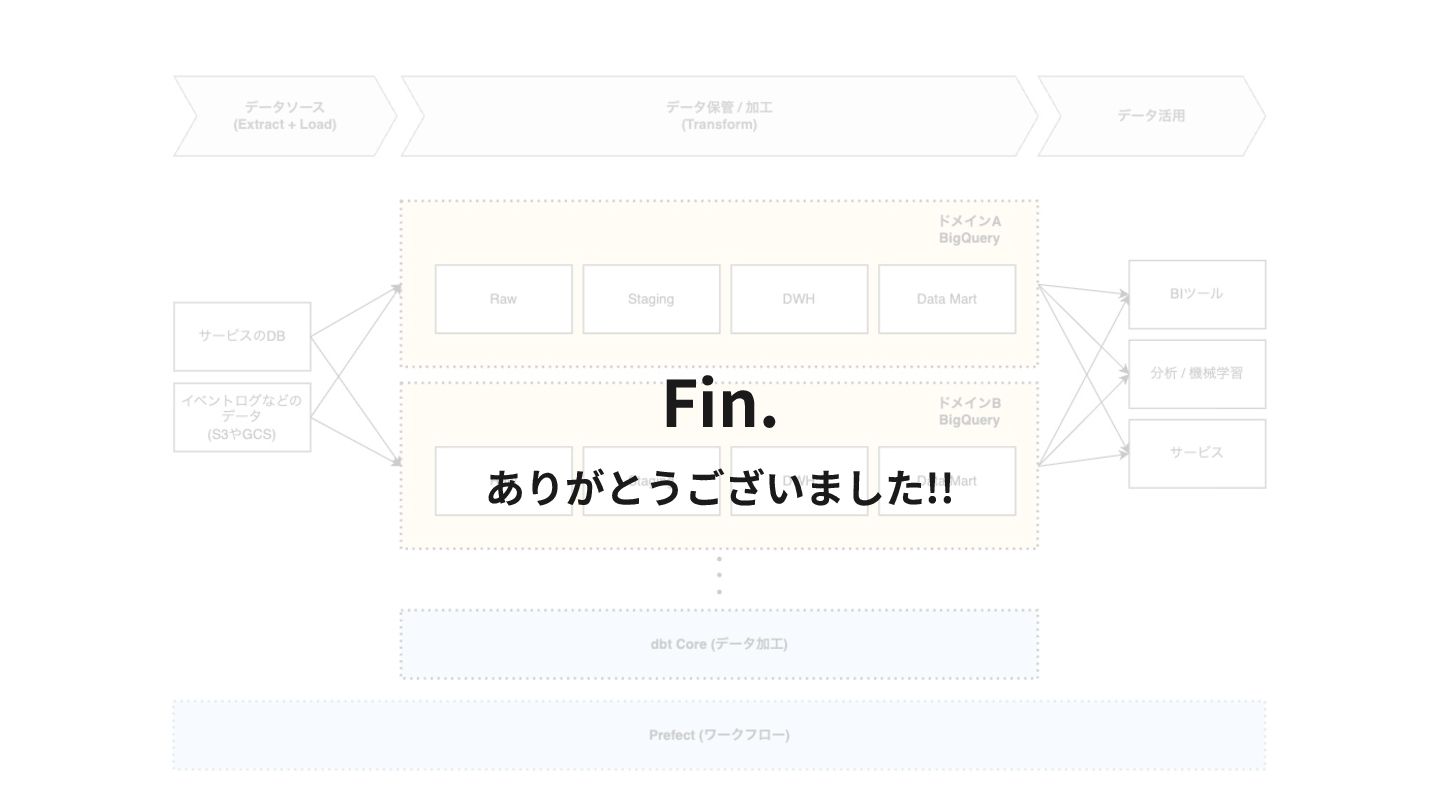
Fin. ありがとうございました!!


 yusabana
 ryu1013
 rockname
 koher
 theoriatec2024
 syumai
 honmarkhunt
 latte72
 m_seki
 reimaru
 kaseken
 mtsmfm
 high_g_engineer
 tammyeverts
 maggiecrowley
 carmenintech
 destraynor
 chriscoyier
 davidcarrasco
 kneath
 marketingsoph
 baasie
 samtorres
 aki_iinuma
 lcolladotor