Upgrade to Pro
— share decks privately, control downloads, hide ads and more …
Speaker Deck
Sign up for free
Menu
Search
Features
All features
Private URLs
Password Protection
Custom URLS
Scheduled publishing
Remove Branding
Restrict embedding
Deck Collections
Notes
Features
All features
Private URLs
Password Protection
Custom URLS
Scheduled publishing
Remove Branding
Restrict embedding
Deck Collections
Notes
Explore
Featured decks
Featured speakers
Programming
Technology
Storyboards
Explore
Featured decks
Featured speakers
Programming
Technology
Storyboards
Pricing
Search
Sign in
Sign up for free
会社でMLモデルを作るとは @電気通信大学 データアントレプレナーフェロープログラム
Search
Sponsored
·
Your Podcast. Everywhere. Effortlessly.
Share. Educate. Inspire. Entertain. You do you. We'll handle the rest.
→
yuto16
September 21, 2025
Science
820
1
Share
Embed
Copy iframe code
Copy JS code
Copy link
Start on current slide
会社でMLモデルを作るとは @電気通信大学 データアントレプレナーフェロープログラム
下記登壇時の発表資料です。
https://www.de.uec.ac.jp/
yuto16
September 21, 2025
More Decks by yuto16
See All by yuto16
Snowflakeで実現する全社横断の顧客の声(VOC)分析・活用基盤@Snowflake World Tour Tokyo 2026
yuto16
0
210
Streamlit in Snowflakeで加速する 不動産テック企業のデータ活用@Tech業界ネットワーキングイベント
yuto16
0
200
Snowflakeで実現する広告画像評価の自動化と属人化解消 @Snowflake MEATup
yuto16
0
410
GA technologiesでのAI-Readyの取り組み@DataOps Night
yuto16
0
760
Cortexで加速する AI不動産投資 RENOSYのデータ活用 @Snowflake ACCELERATE
yuto16
0
580
Streamlit in Snowflakeで加速する不動産テック企業のデータ活用 @Snowflake WESTユーザー会
yuto16
1
820
Other Decks in Science
See All in Science
YouTubeにおける撤回論文の参照実態 / metascience-meetup2026
corgies
3
360
presen_司法書士学員会.pdf
tagtag
PRO
1
110
AIを用いた PID制御で部屋 の温度制御をしてみた
nearme_tech
PRO
0
250
HOLO: Homography-Guided Pose Estimator Network for Fine-Grained Visual Localization on SD Maps
tomoaki0705
0
150
From Prediction to Understanding: Causal Discovery for Data Science and AI Applications
sshimizu2006
0
300
「遂行理論の未来」(松島斉教授最終講義記念セッションの発表資料)
shunyanoda
0
1k
データベース09: 実体関連モデル上の一貫性制約
trycycle
PRO
0
1.9k
AI bij literatuuronderzoek in de wetenschap
voginip
0
250
サンプル対応のない複数遺伝子発現プロファイルに対するテンソル分解型統合解析の要約
tagtag
PRO
0
250
(SIGBIO84) Inverse MSMD法による化合物部分構造プロファイリングと結合親和性推定
keisukeyanagisawa
PRO
0
120
Tensor Factorization Meets Deformed Information Geometry: Convex Relaxation under Deformed Algebra
gkazunii
0
150
Visual Linear Algebra - Lecture at Shosen Grande
hiranabe
0
500
Featured
See All Featured
Raft: Consensus for Rubyists
vanstee
142
7.7k
Build The Right Thing And Hit Your Dates
maggiecrowley
39
3.4k
Put a Button on it: Removing Barriers to Going Fast.
kastner
60
4.6k
How Fast Is Fast Enough? [PerfNow 2025]
tammyeverts
3
880
The AI Search Optimization Roadmap by Aleyda Solis
aleyda
1
6.2k
Abbi's Birthday
coloredviolet
4
10k
Google's AI Overviews - The New Search
badams
0
1.6k
The SEO Collaboration Effect
kristinabergwall1
1
560
The Art of Delivering Value - GDevCon NA Keynote
reverentgeek
16
2.2k
Leadership Guide Workshop - DevTernity 2021
reverentgeek
1
370
AI Search: Implications for SEO and How to Move Forward - #ShenzhenSEOConference
aleyda
1
1.4k
Getting science done with accelerated Python computing platforms
jacobtomlinson
2
480
Transcript
会社でMLモデルを作るとは? ~入社1ヶ月目でMLモデルを作成した話 ~ @電気通信大学 データアントレプレナーフェロープログラム GA technologies Data本部
Applied ML部 酒井悠斗 Data Scientist 2025/09/13
1. 登壇者紹介 / 会社紹介 2. 会社でMLモデルを作るとは? ~具体例ともに ~ 3. まとめ
アジェンダ
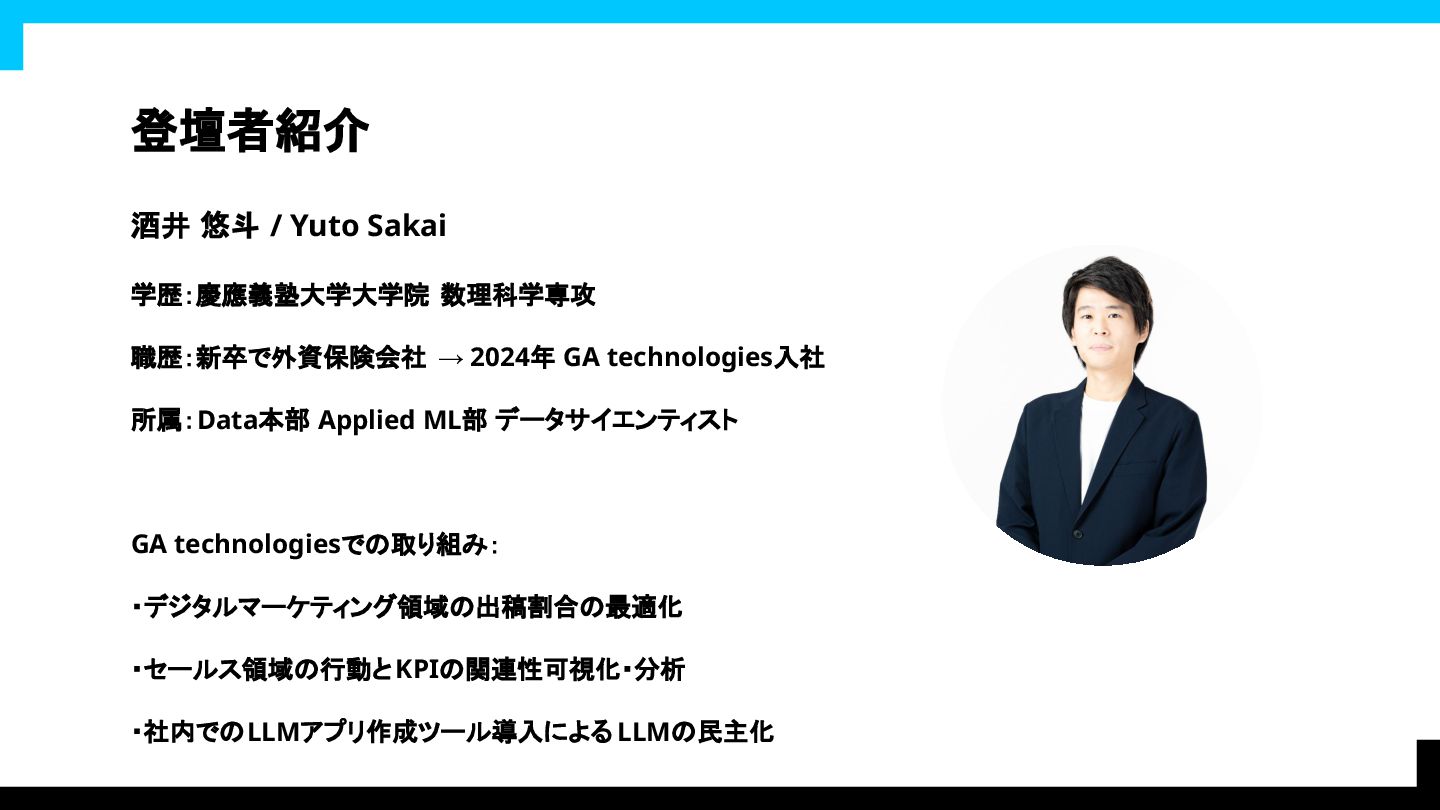
登壇者紹介 酒井 悠斗 / Yuto Sakai 学歴:慶應義塾大学大学院 数理科学専攻 職歴:新卒で外資保険会社
→ 2024年 GA technologies入社 所属:Data本部 Applied ML部 データサイエンティスト GA technologiesでの取り組み: ・デジタルマーケティング領域の出稿割合の最適化 ・セールス領域の行動とKPIの関連性可視化・分析 ・社内でのLLMアプリ作成ツール導入による LLMの民主化
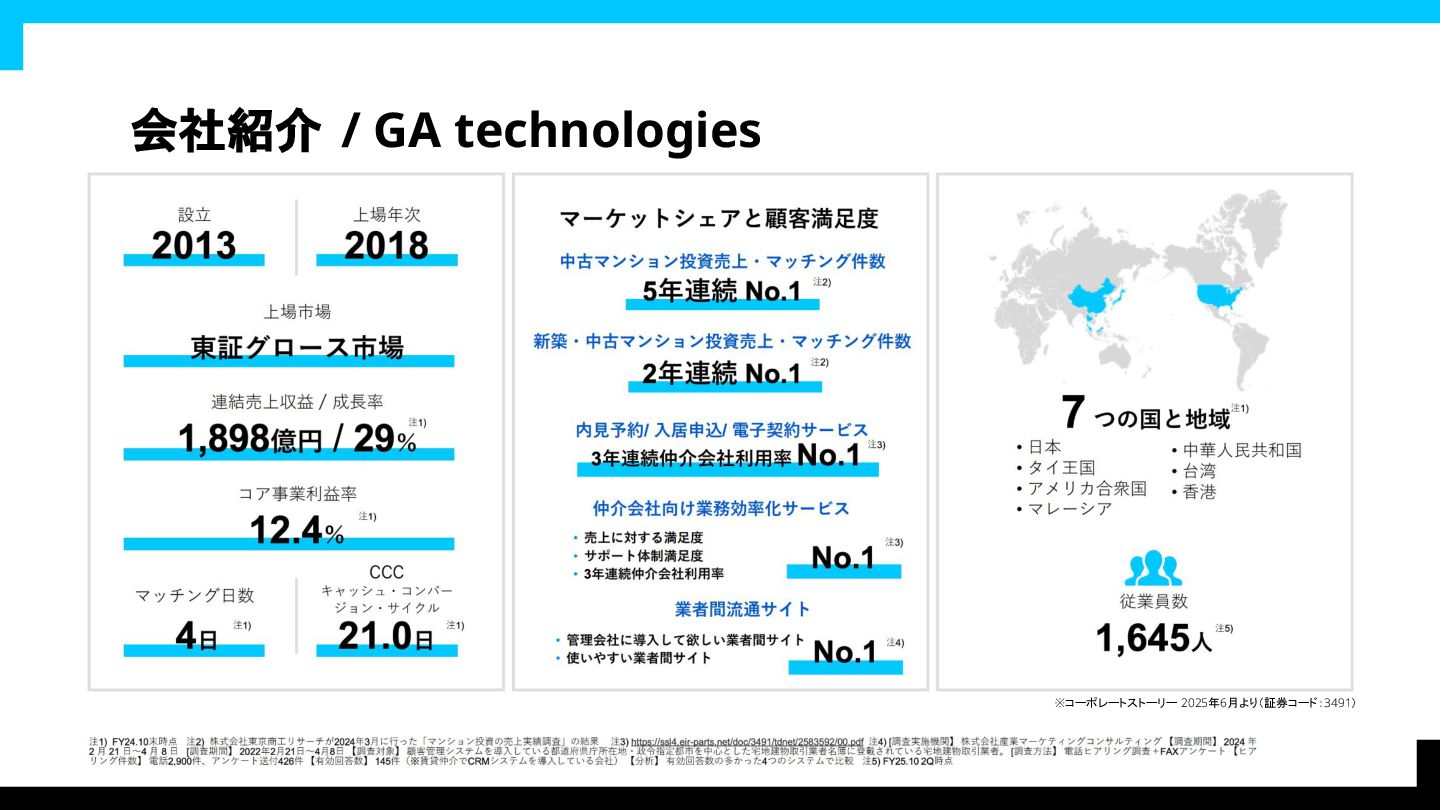
会社紹介 / GA technologies ※コーポレートストーリー 2025年6月より(証券コード:3491)
事業紹介 / RENOSY ※1 東京商工リサーチによる投資用不動産の売上実績(2025年3月調べ) ※2 東京商工リサーチによる投資用不動産会社の売上原価調査(2024年10月調べ)
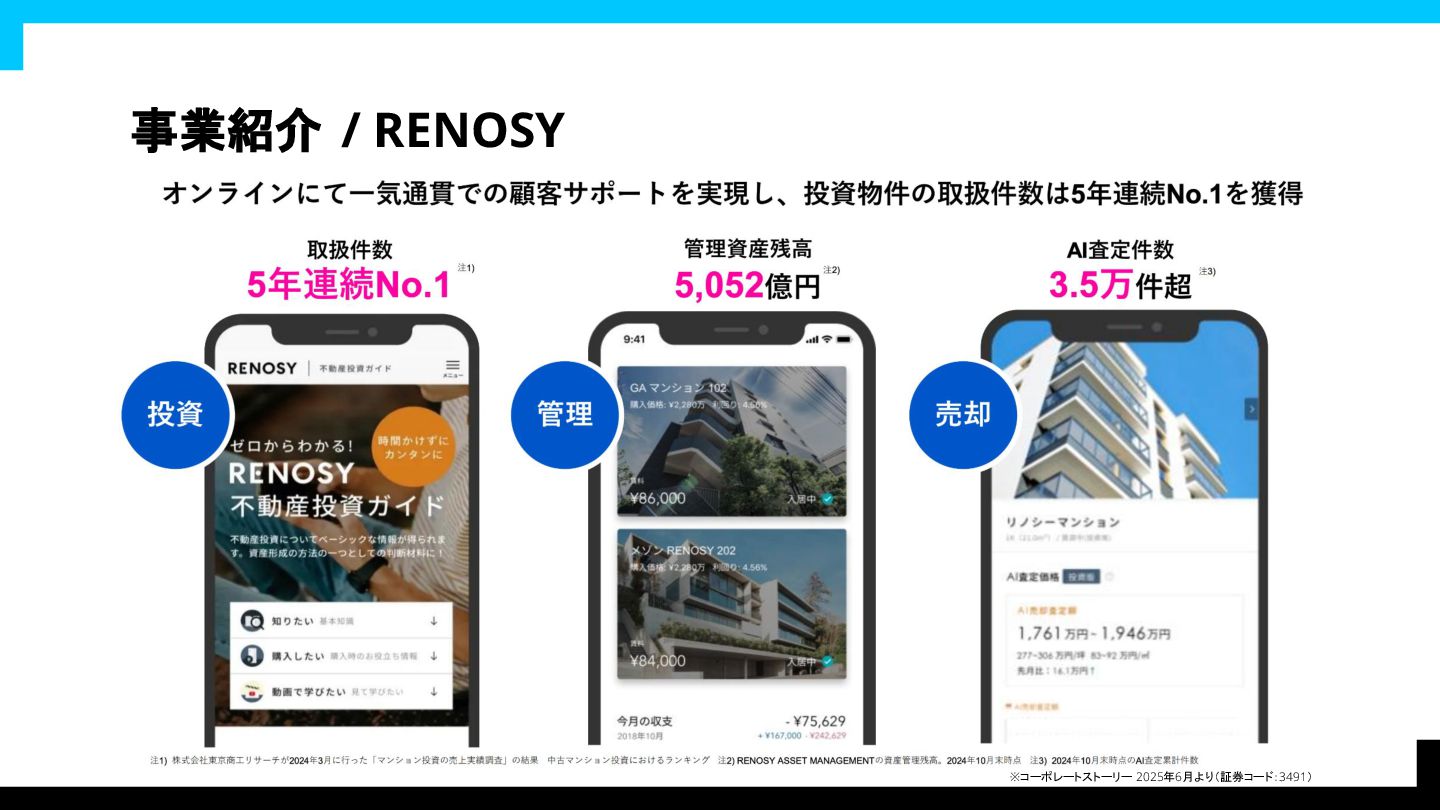
事業紹介 / RENOSY ※コーポレートストーリー 2025年6月より(証券コード:3491)
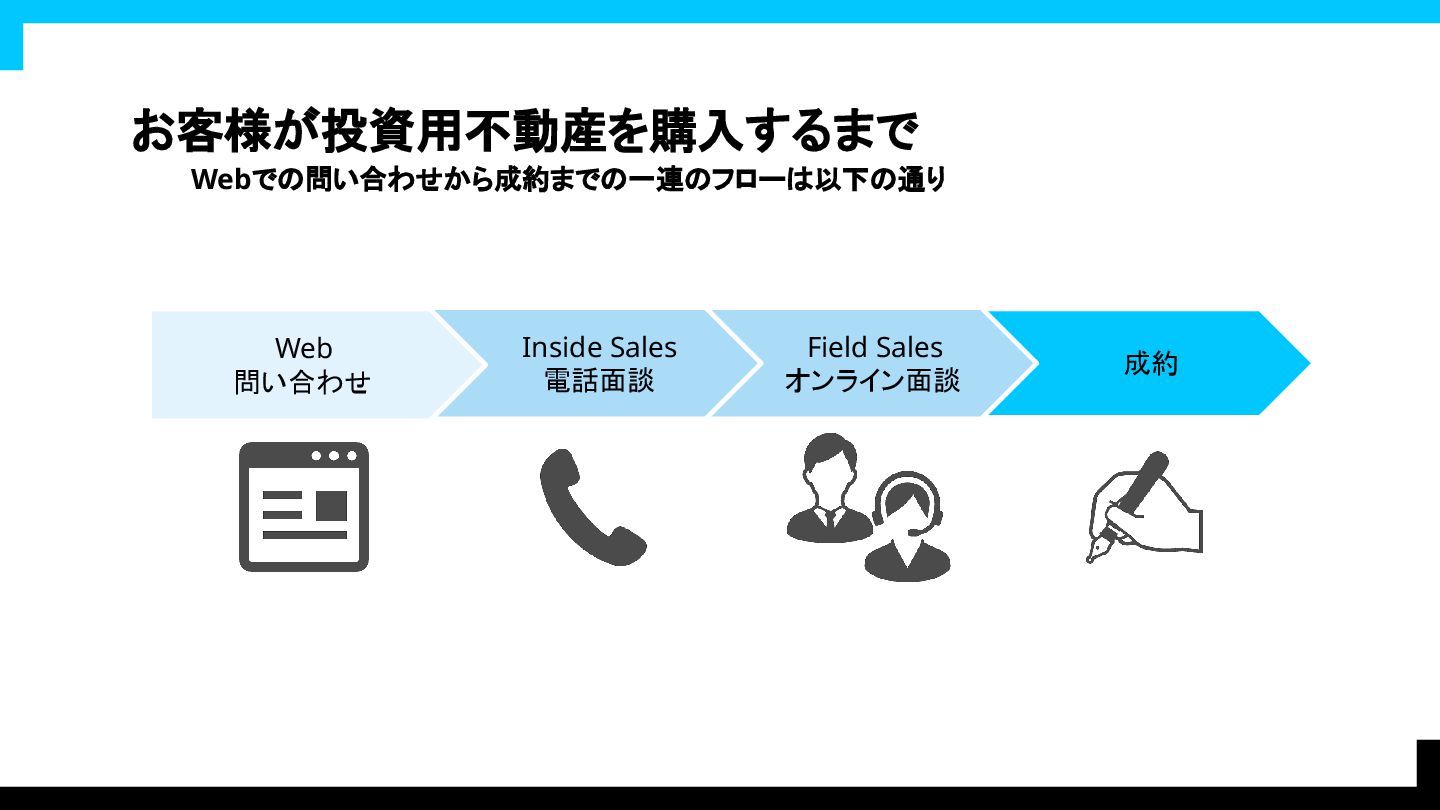
お客様が投資用不動産を購入するまで Webでの問い合わせから成約までの一連のフローは以下の通り 成約 Field Sales オンライン面談 Inside Sales
電話面談 Web 問い合わせ
入社直後のある日 MLモデル作成してね 承知しました! MLモデルを作成して欲しい。 広告コストの最適化 (CAPI*) で使いたいんだ。 *CAPI:
Conversion API
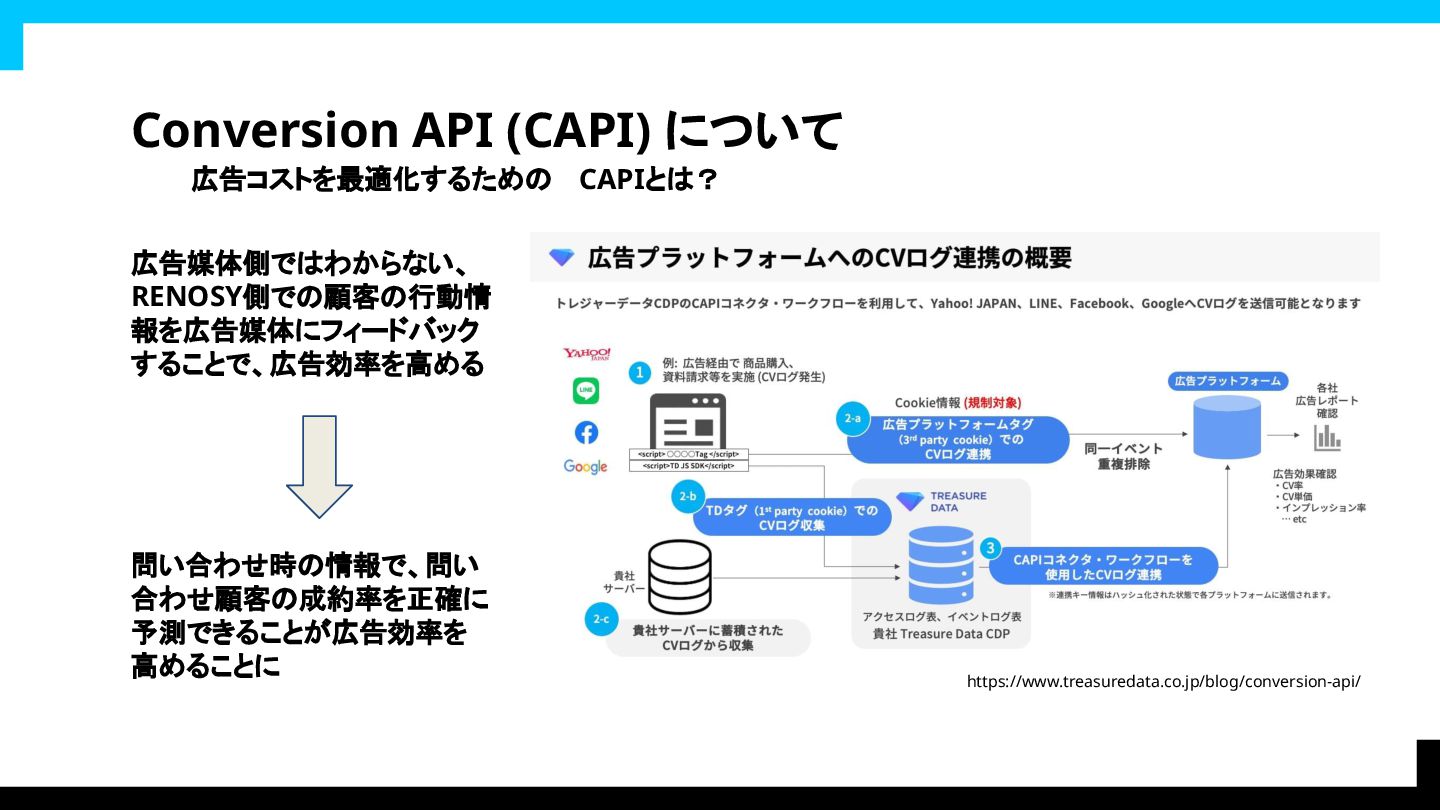
Conversion API (CAPI) について 広告コストを最適化するための CAPIとは? https://www.treasuredata.co.jp/blog/conversion-api/ 広告媒体側ではわからない、 RENOSY側での顧客の行動情 報を広告媒体にフィードバック
することで、広告効率を高める 問い合わせ時の情報で、問い 合わせ顧客の成約率を正確に 予測できることが広告効率を 高めることに
入社直後のある日 いざMLモデル作り よし!がんばるぞ!あれ・・・?
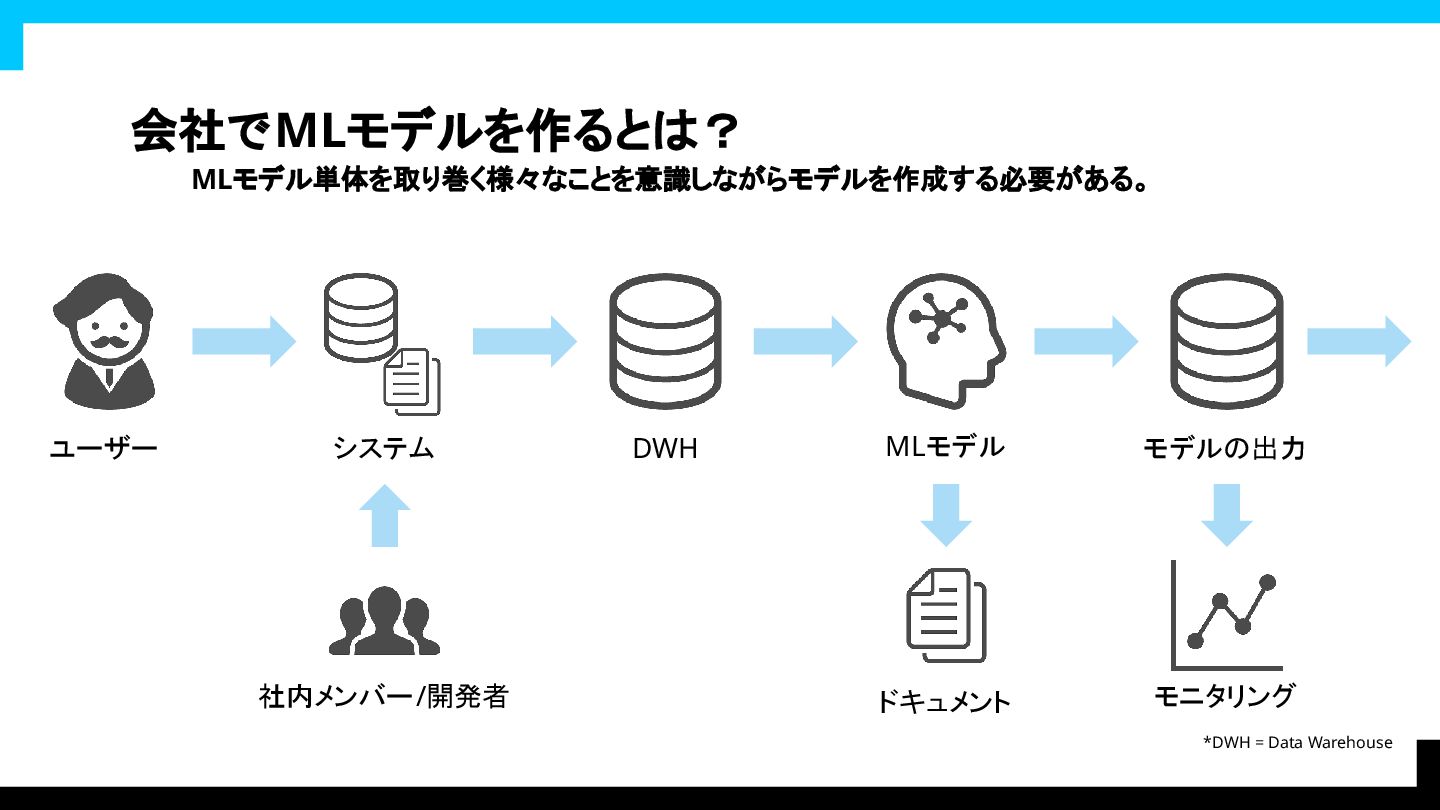
会社でMLモデルを作るとは? MLモデル単体を取り巻く様々なことを意識しながらモデルを作成する必要がある。 ユーザー 社内メンバー/開発者 システム DWH *DWH =
Data Warehouse MLモデル ドキュメント モデルの出力 モニタリング
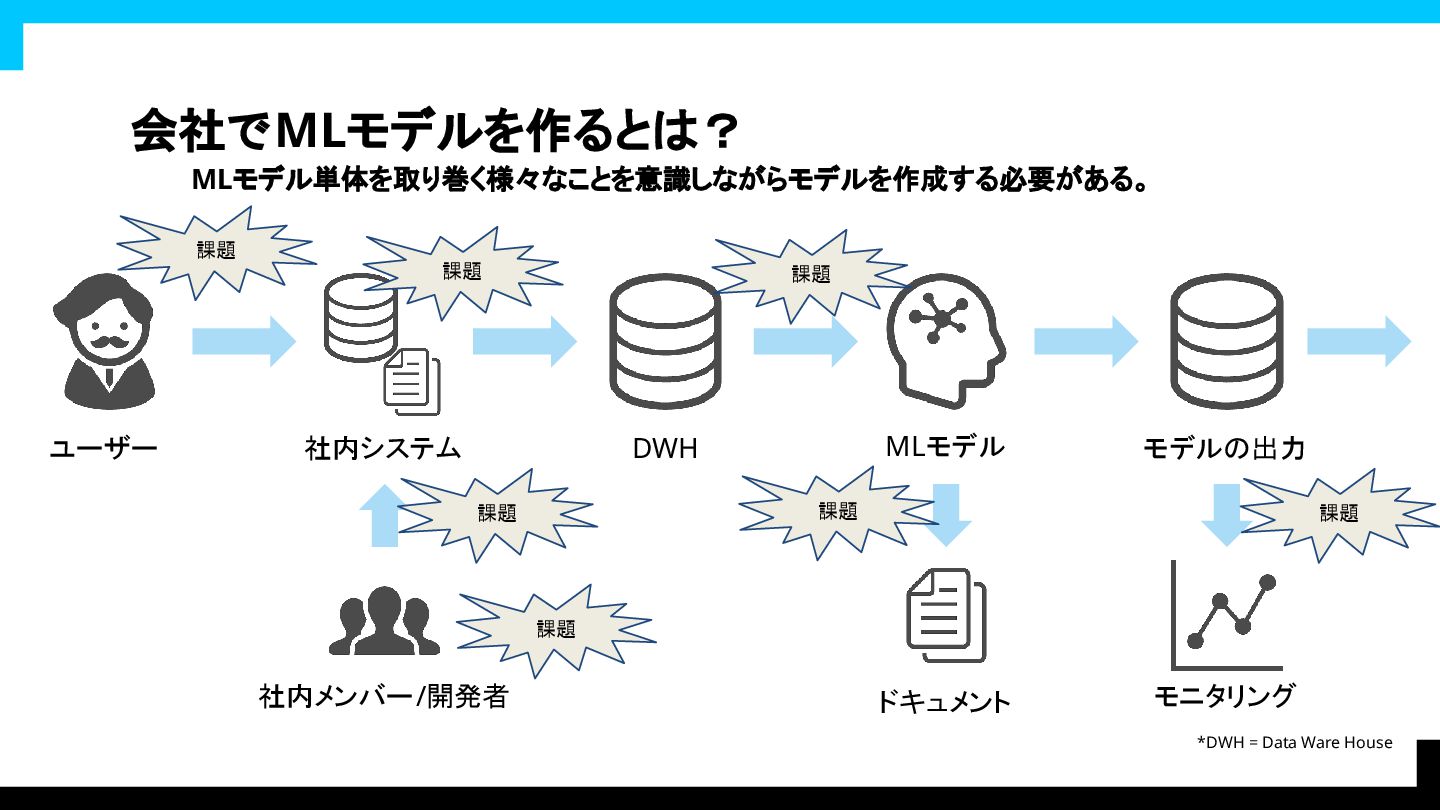
会社でMLモデルを作るとは? MLモデル単体を取り巻く様々なことを意識しながらモデルを作成する必要がある。 ユーザー 社内メンバー/開発者 社内システム DWH *DWH =
Data Ware House MLモデル ドキュメント モデルの出力 モニタリング 課題 課題 課題 課題 課題 課題 課題
どんな変数使えそうかな? 変数の意味調べてみよう! モデル作成段階
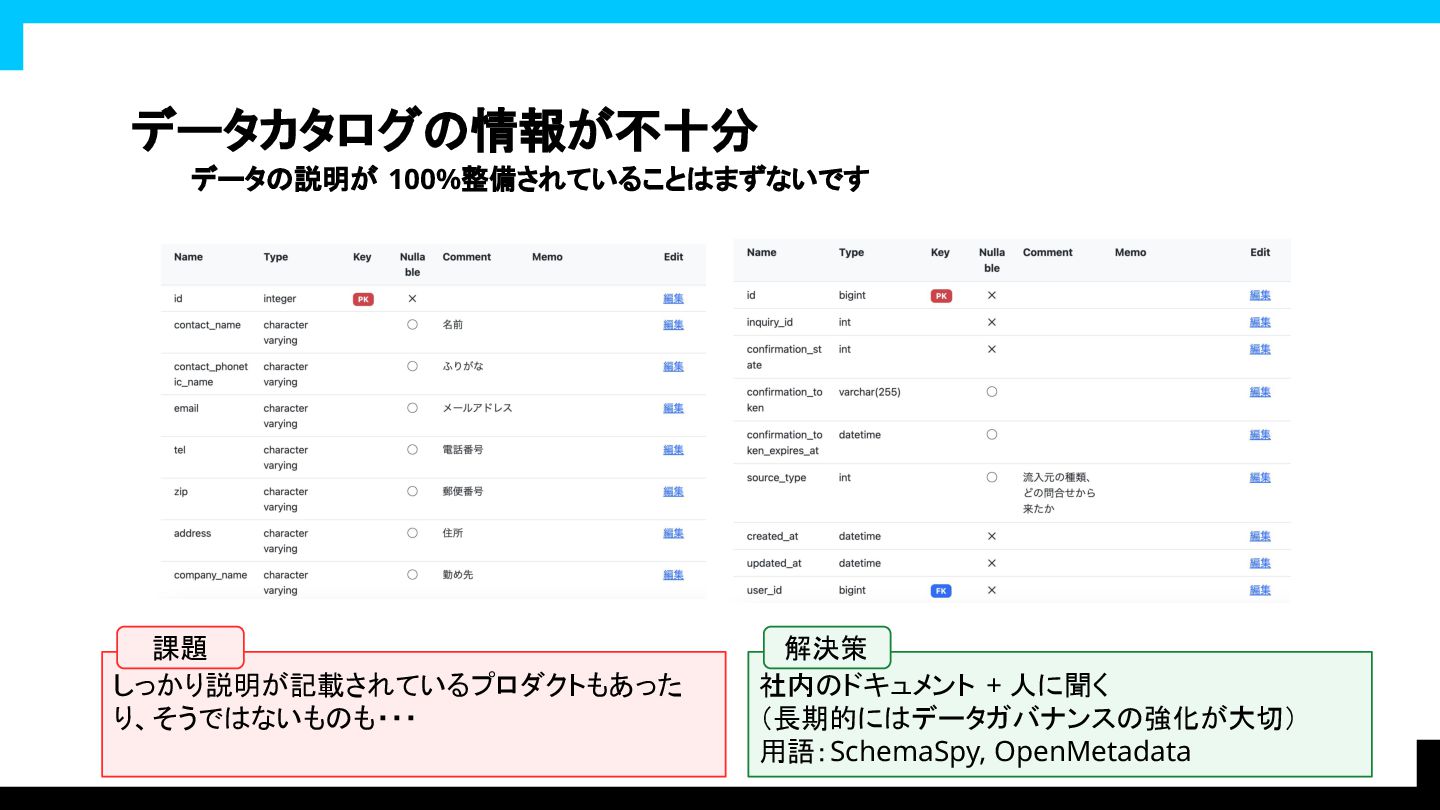
データカタログの情報が不十分 データの説明が 100%整備されていることはまずないです しっかり説明が記載されているプロダクトもあった り、そうではないものも・・・ 社内のドキュメント +
人に聞く (長期的にはデータガバナンスの強化が大切) 用語:SchemaSpy, OpenMetadata 課題 解決策
変数の時系列での分布がおかしいぞ? モデル作成段階
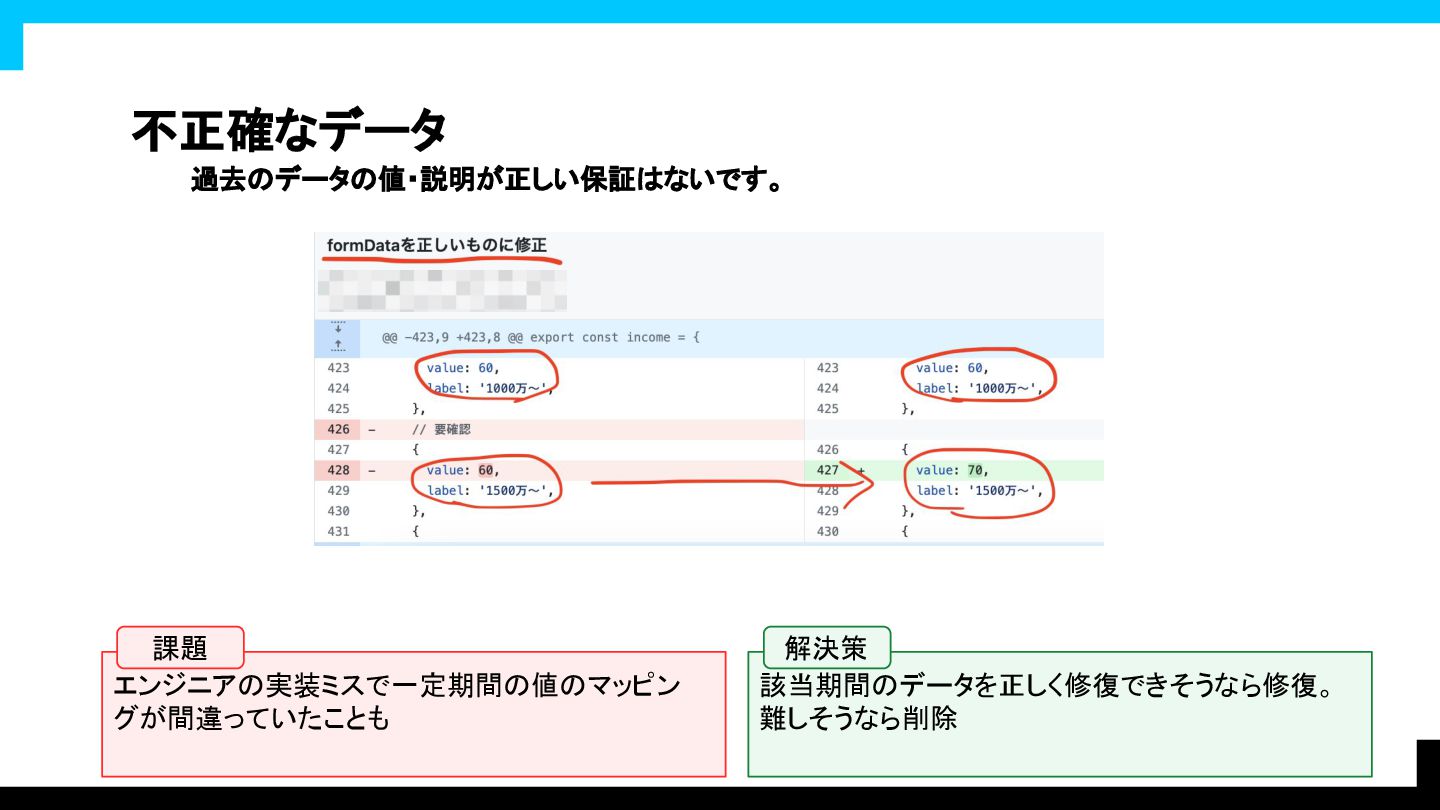
不正確なデータ 過去のデータの値・説明が正しい保証はないです。 エンジニアの実装ミスで一定期間の値のマッピン グが間違っていたことも 該当期間のデータを正しく修復できそうなら修復。 難しそうなら削除
課題 解決策
あれ、ありえないデータが? モデル作成段階
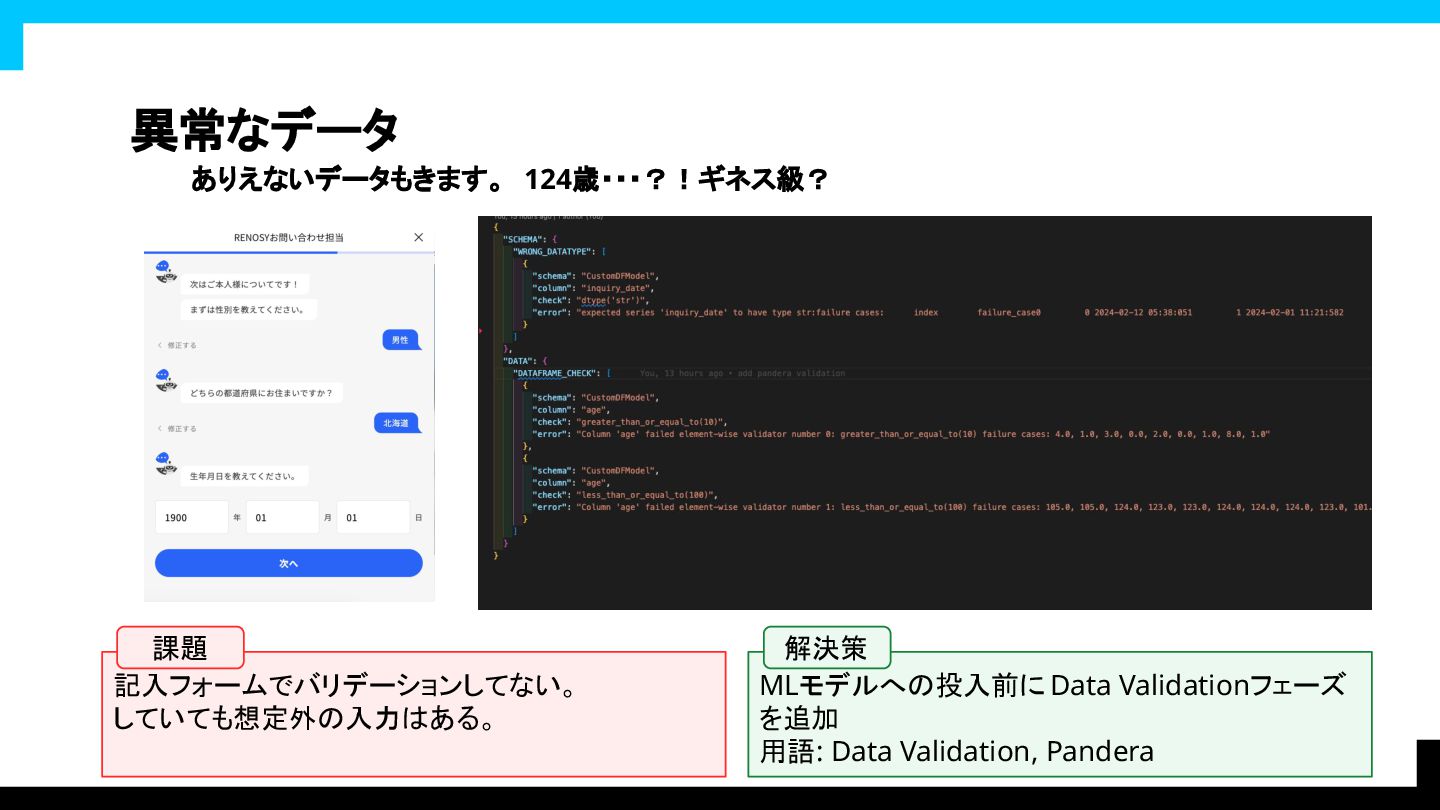
異常なデータ ありえないデータもきます。 124歳・・・?!ギネス級? 記入フォームでバリデーションしてない。 していても想定外の入力はある。 MLモデルへの投入前に
Data Validationフェーズ を追加 用語: Data Validation, Pandera 課題 解決策
リリース直後: モデルうまく動いているかな・・・ ドキドキ・・・ モデルリリース
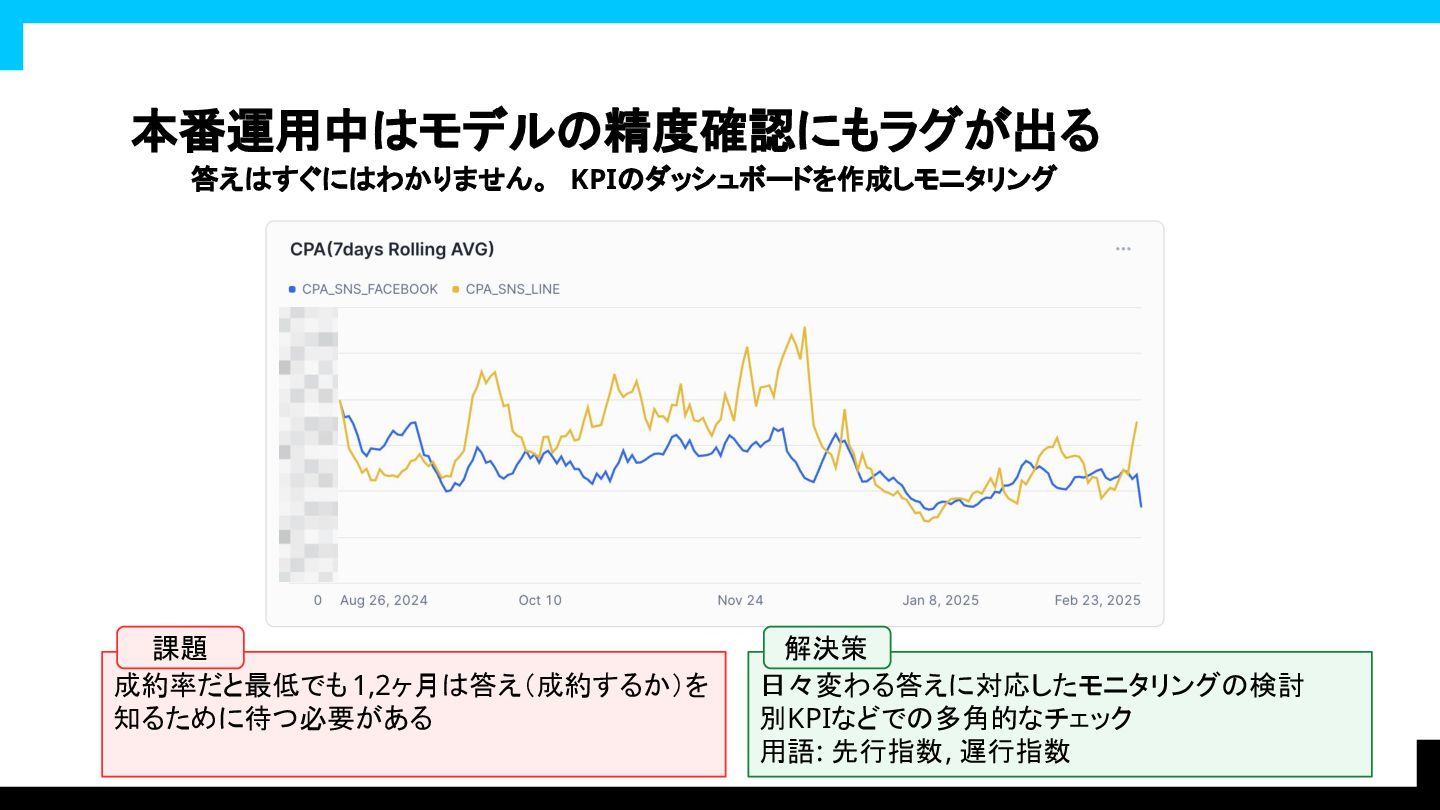
本番運用中はモデルの精度確認にもラグが出る 答えはすぐにはわかりません。 KPIのダッシュボードを作成しモニタリング 成約率だと最低でも 1,2ヶ月は答え(成約するか)を 知るために待つ必要がある 日々変わる答えに対応したモニタリングの検討
別KPIなどでの多角的なチェック 用語: 先行指数, 遅行指数 課題 解決策
リリース後のある日: あれ、今日の分のMLモデルの出力が 無い?! リリース後
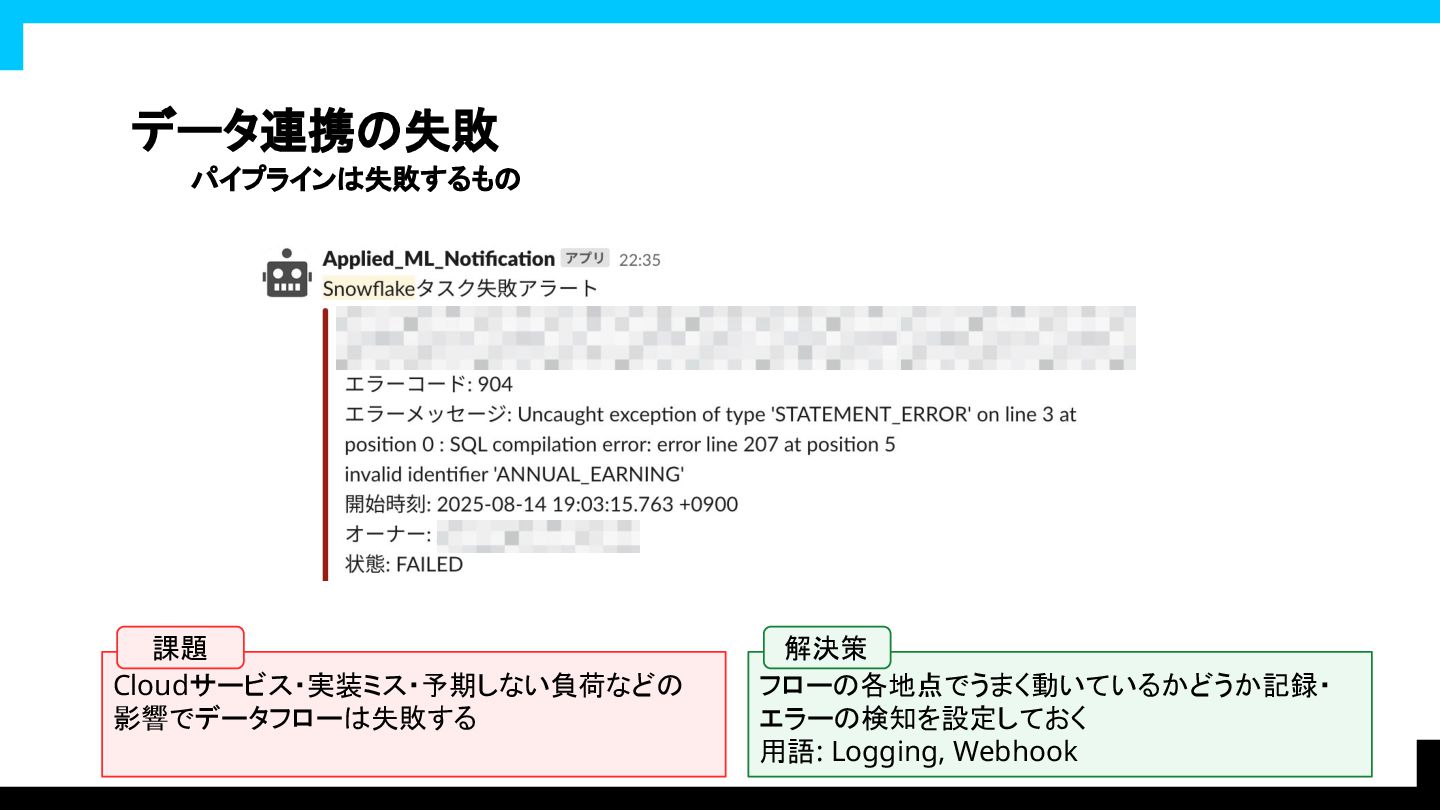
データ連携の失敗 パイプラインは失敗するもの Cloudサービス・実装ミス・予期しない負荷などの 影響でデータフローは失敗する フローの各地点でうまく動いているかどうか記録・ エラーの検知を設定しておく
用語: Logging, Webhook 課題 解決策
リリース後のある日: あれ、MLモデルの出力おかしいぞ * *フィクションです。実際この時は事前に 社内で情報共有がありました。 リリース後
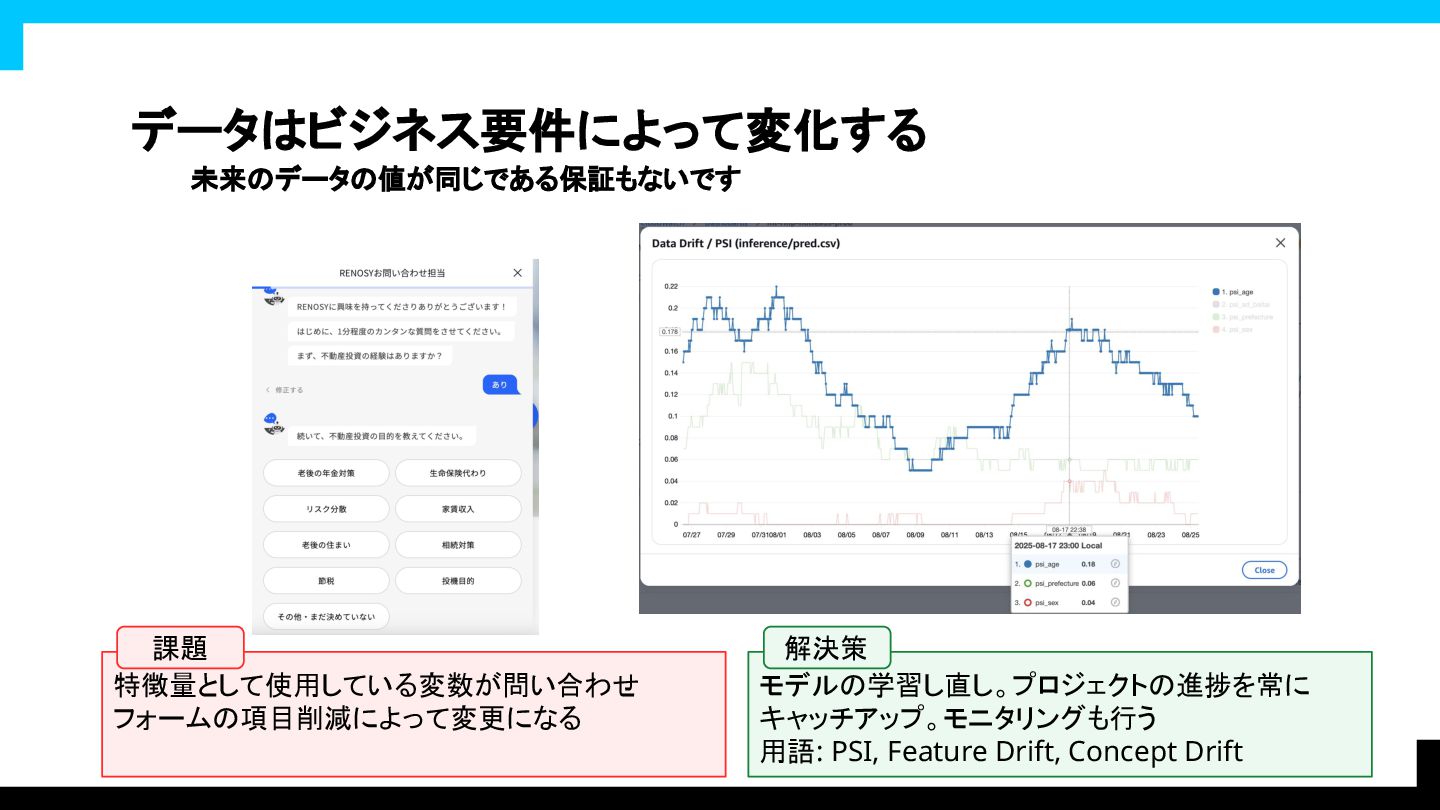
データはビジネス要件によって変化する 未来のデータの値が同じである保証もないです 特徴量として使用している変数が問い合わせ フォームの項目削減によって変更になる モデルの学習し直し。プロジェクトの進捗を常に キャッチアップ。モニタリングも行う
用語: PSI, Feature Drift, Concept Drift 課題 解決策
他にも気にする点あります
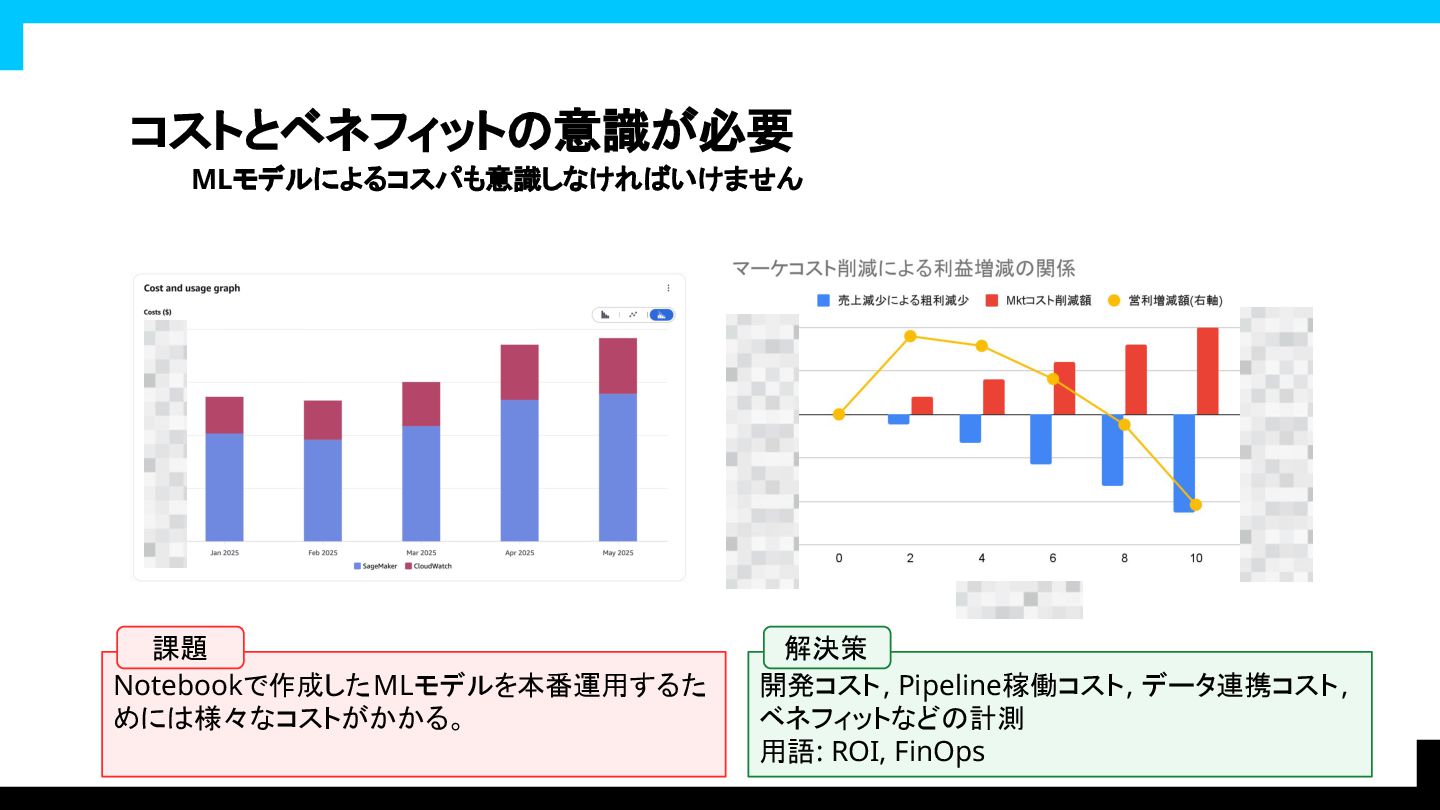
コストとベネフィットの意識が必要 MLモデルによるコスパも意識しなければいけません Notebookで作成したMLモデルを本番運用するた めには様々なコストがかかる。 開発コスト, Pipeline稼働コスト, データ連携コスト,
ベネフィットなどの計測 用語: ROI, FinOps 課題 解決策
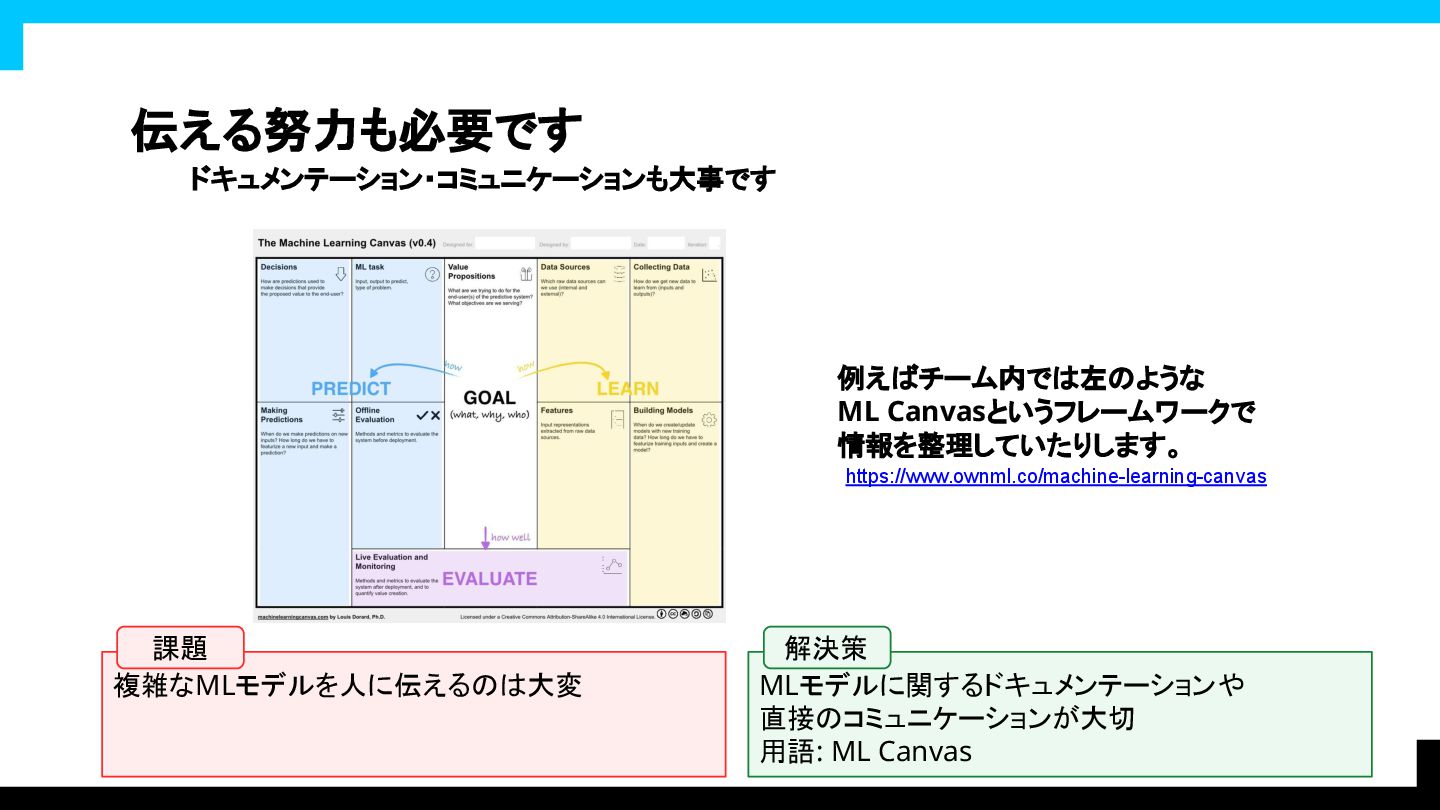
伝える努力も必要です ドキュメンテーション・コミュニケーションも大事です https://www.ownml.co/machine-learning-canvas 例えばチーム内では左のような ML Canvasというフレームワークで 情報を整理していたりします。
複雑なMLモデルを人に伝えるのは大変 MLモデルに関するドキュメンテーションや 直接のコミュニケーションが大切 用語: ML Canvas 課題 解決策
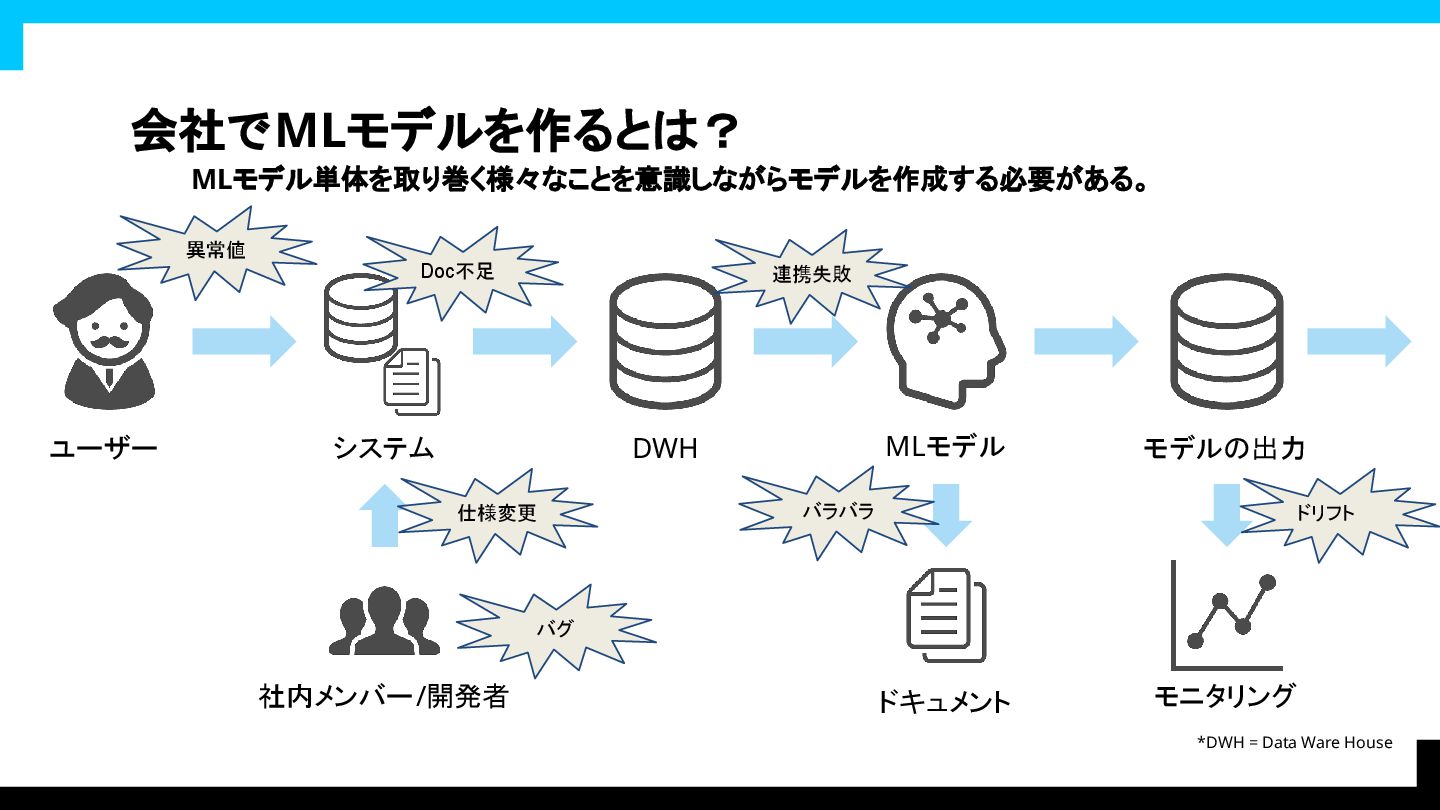
会社でMLモデルを作るとは? MLモデル単体を取り巻く様々なことを意識しながらモデルを作成する必要がある。 ユーザー 社内メンバー/開発者 システム DWH *DWH =
Data Ware House MLモデル ドキュメント モデルの出力 モニタリング 仕様変更 異常値 バグ 連携失敗 Doc不足 ドリフト バラバラ
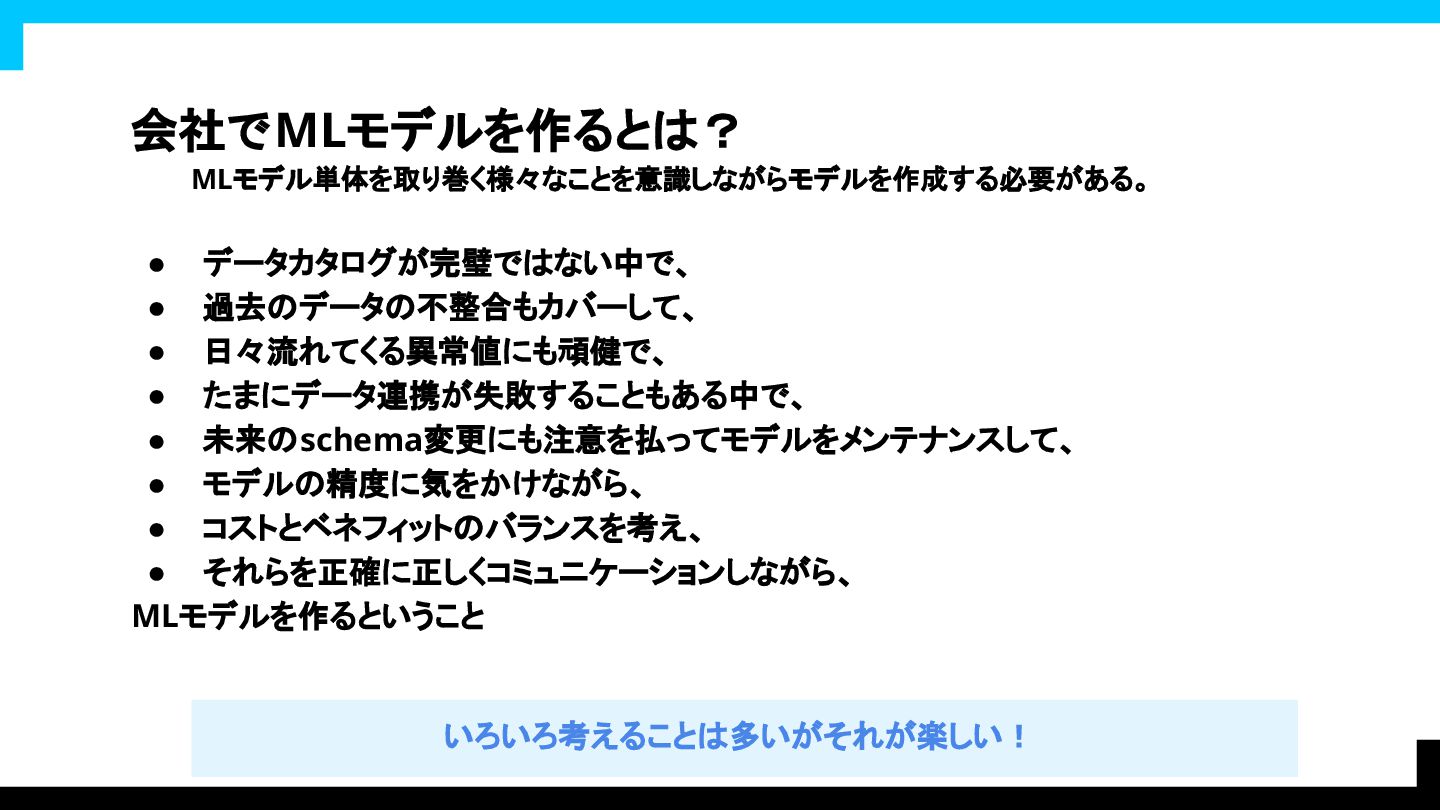
会社でMLモデルを作るとは? MLモデル単体を取り巻く様々なことを意識しながらモデルを作成する必要がある。 • データカタログが完璧ではない中で、 • 過去のデータの不整合もカバーして、
• 日々流れてくる異常値にも頑健で、 • たまにデータ連携が失敗することもある中で、 • 未来のschema変更にも注意を払ってモデルをメンテナンスして、 • モデルの精度に気をかけながら、 • コストとベネフィットのバランスを考え、 • それらを正確に正しくコミュニケーションしながら、 MLモデルを作るということ いろいろ考えることは多いがそれが楽しい!
MLモデルを作成するだけでも ... 前述のような前後のこと、 • データがどのように集められてくるか • MLモデルの出力をどのように活用するか
にも思いをめぐらせることで、より良い分析・モデリングができ ると思います!
最近のはなし LLMアプリ作成してね 承知しました! LLMでアプリケーションを 作って欲しい。営業社員 の効率化のために使いた いんだ。
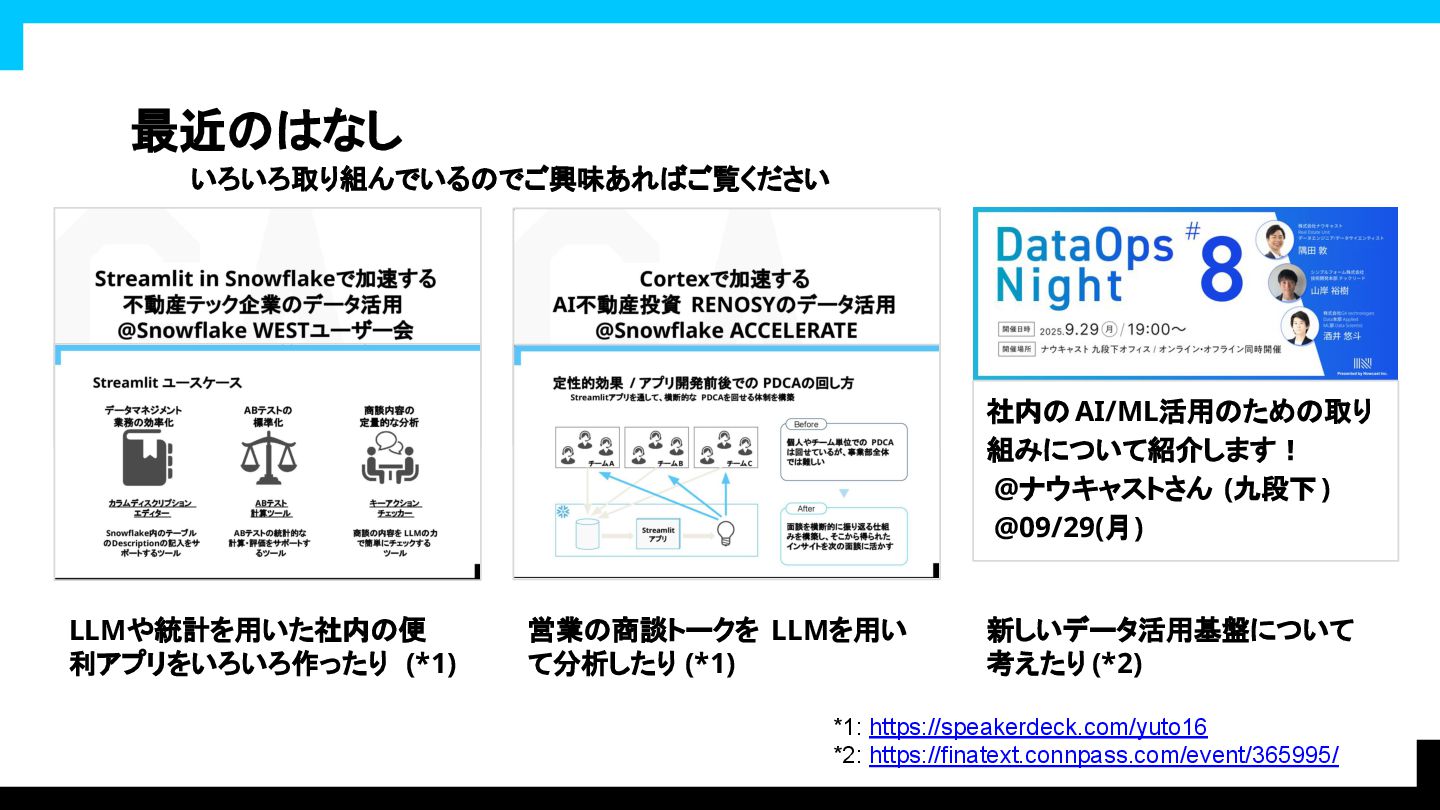
最近のはなし いろいろ取り組んでいるのでご興味あればご覧ください 社内のAI/ML活用のための取り 組みについて紹介します! @ナウキャストさん (九段下) @09/29(月)
LLMや統計を用いた社内の便 利アプリをいろいろ作ったり (*1) 営業の商談トークを LLMを用い て分析したり (*1) 新しいデータ活用基盤について 考えたり (*2) *1: https://speakerdeck.com/yuto16 *2: https://finatext.connpass.com/event/365995/
ご清聴ありがとうございました!

 Your Podcast. Everywhere. Effortlessly.


 yuto16
 corgies
 tagtag
 nearme_tech
 tomoaki0705
 sshimizu2006
 shunyanoda
 trycycle
 voginip
 keisukeyanagisawa
 gkazunii
 hiranabe
 vanstee
 maggiecrowley
 kastner
 tammyeverts
 aleyda
 coloredviolet
 badams
 kristinabergwall1
 reverentgeek
 jacobtomlinson