Upgrade to Pro — share decks privately, control downloads, hide ads and more …

Algorithm behind Gemini Enterprise Agent Designer

Asei Sugiyama
February 26, 2026

Algorithm behind Gemini Enterprise Agent Designer

Asei Sugiyama

February 26, 2026

Transcript

55 slides
  1. 自己紹介 杉山 阿聖 (@K_Ryuichirou) Software Engineer @ Citadel AI Google

    Developer Expert @ Cloud AI MLSE GenAIOps WG 機械学習図鑑 共著 事例でわかる MLOps 共著
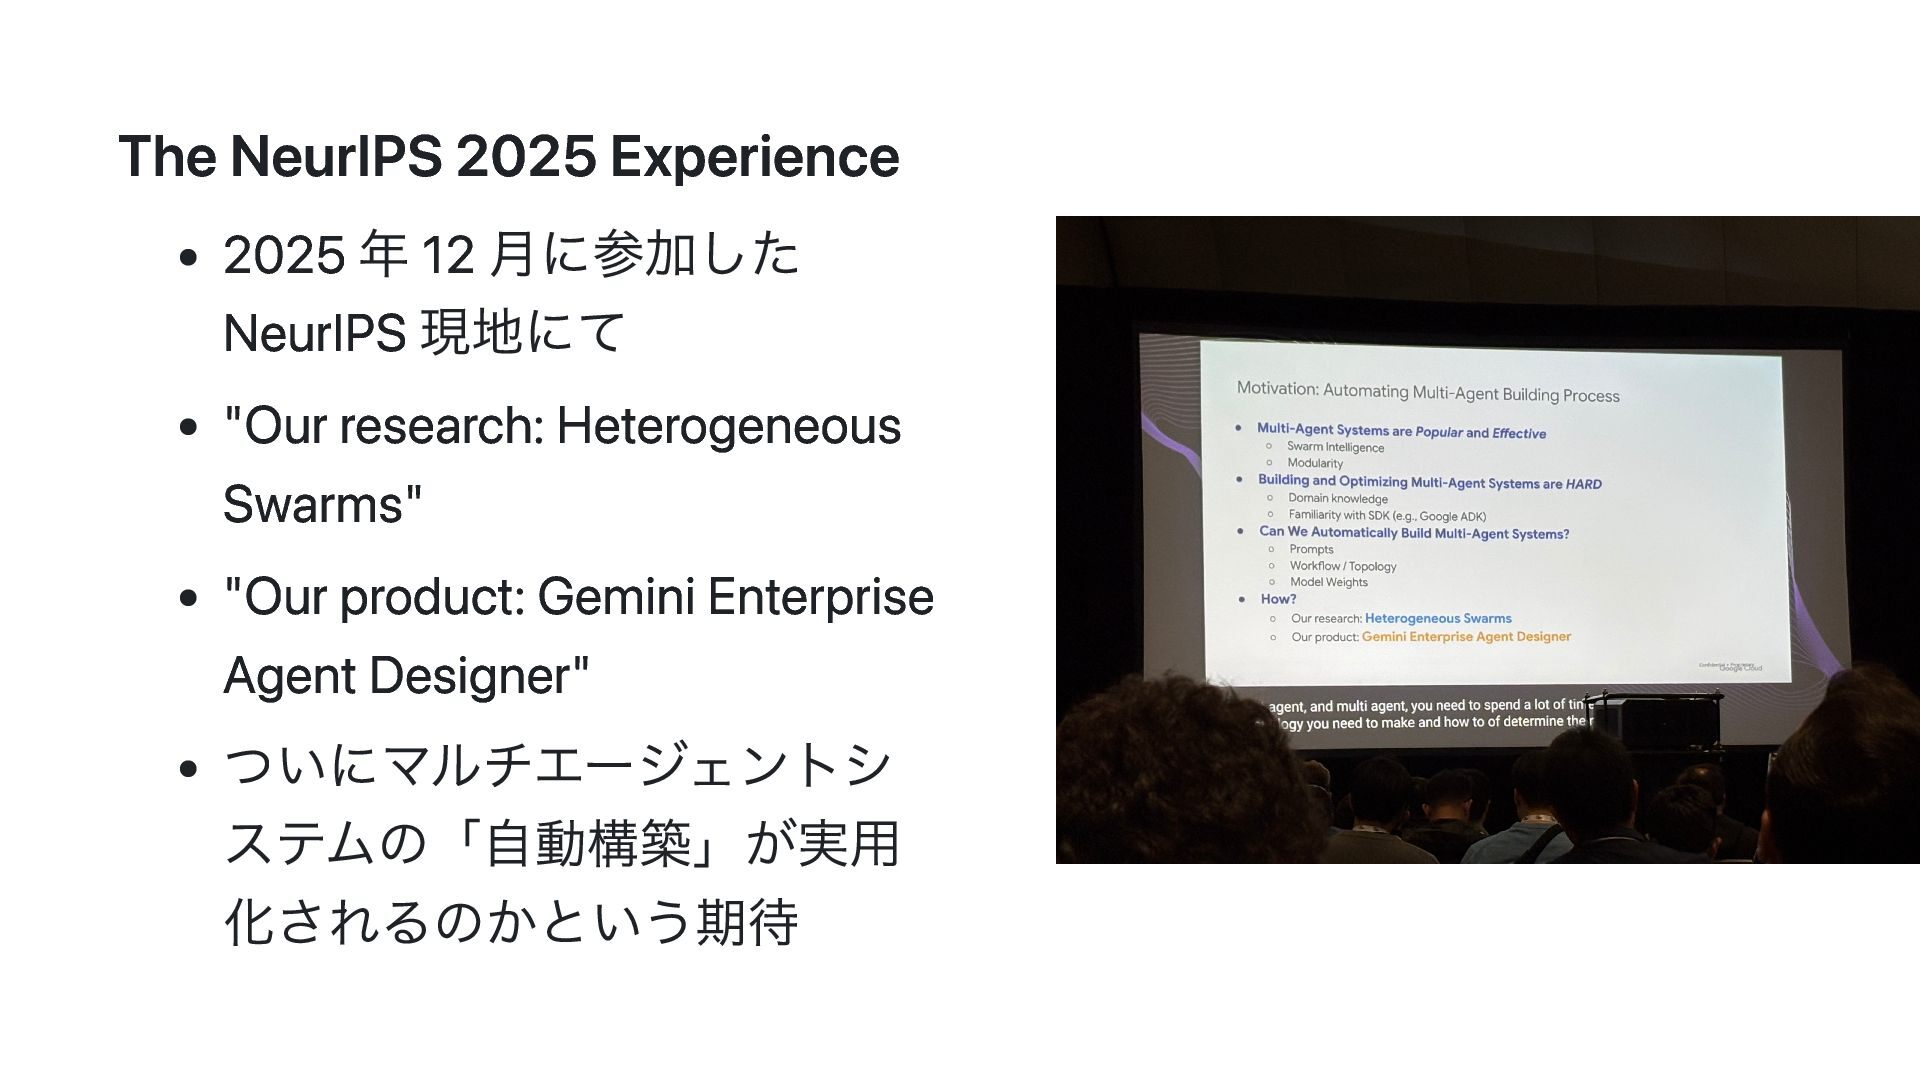
  2. The NeurIPS 2025 Experience 2025 年 12 月に参加した NeurIPS 現地にて

    "Our research: Heterogeneous Swarms" "Our product: Gemini Enterprise Agent Designer" ついにマルチエージェントシ ステムの「自動構築」が実用 化されるのかという期待
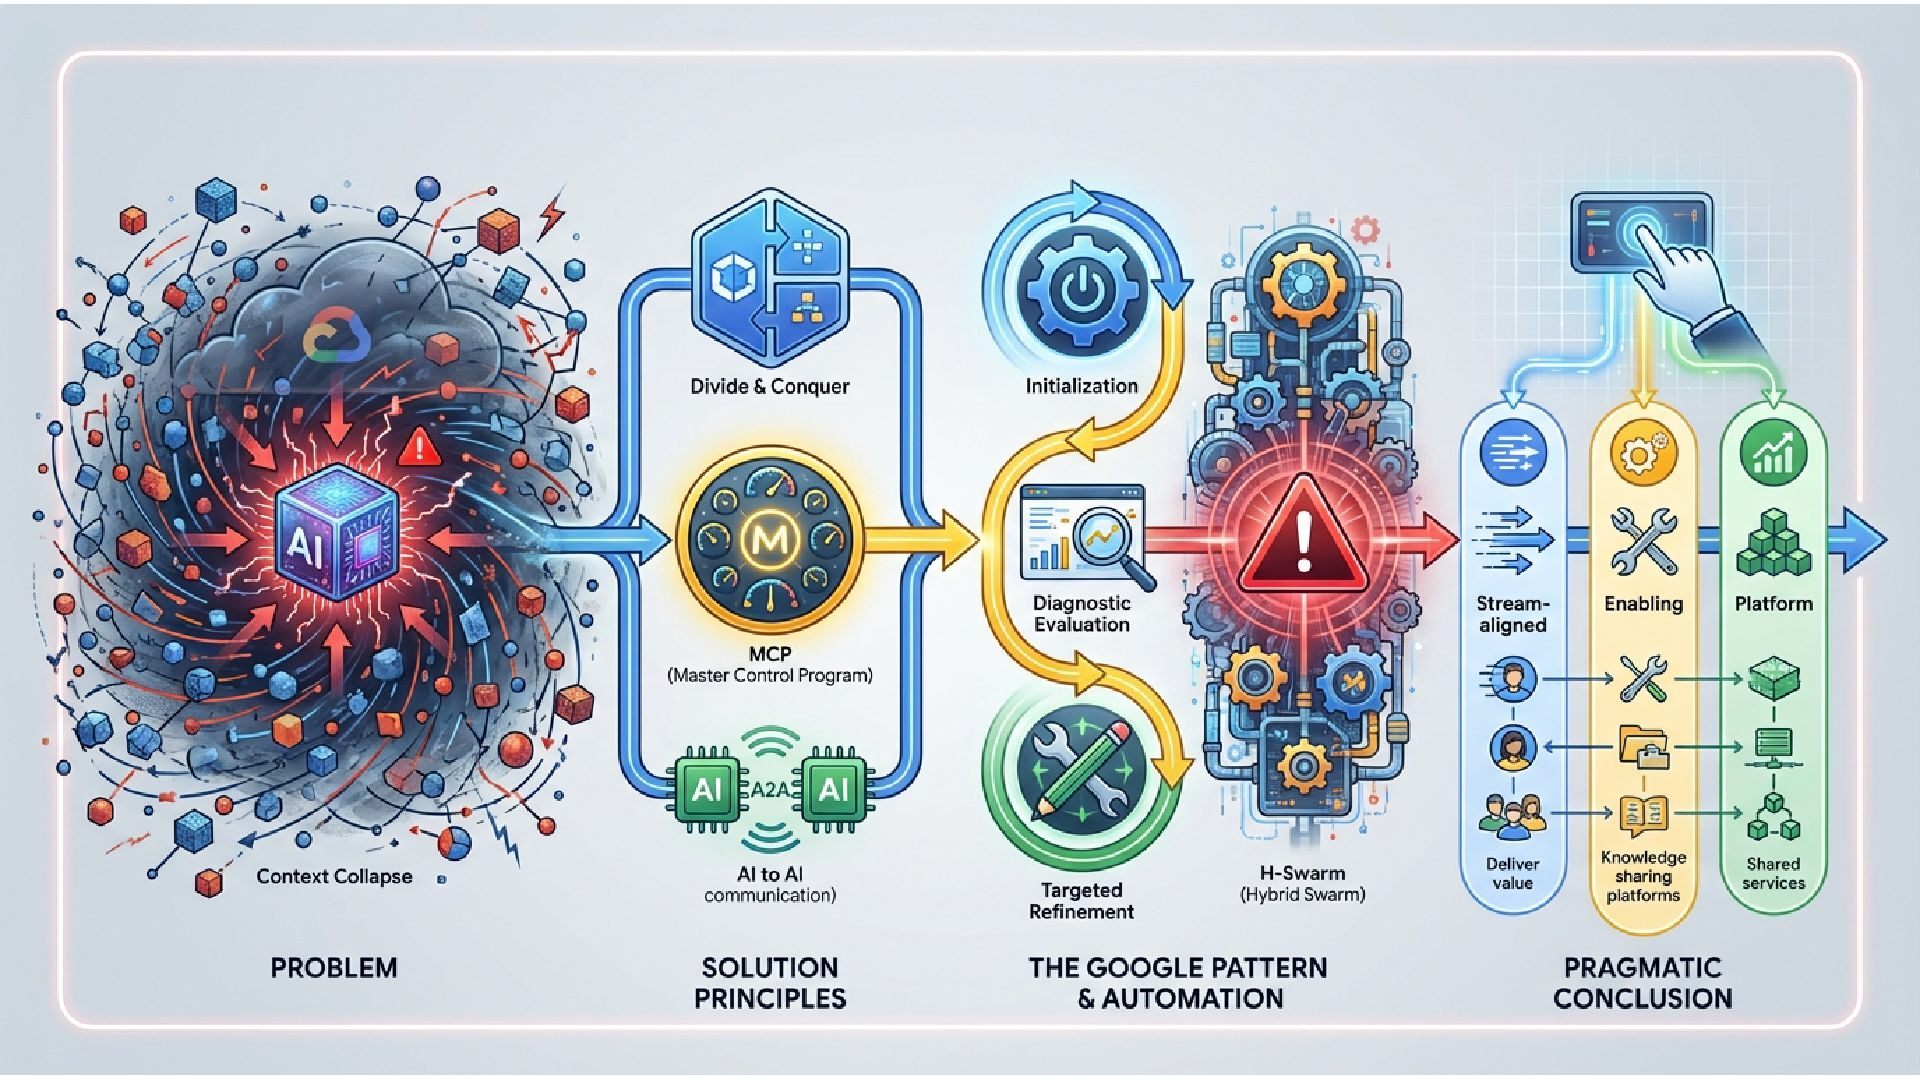
  3. 本セッションの概要 Gemini Enterprise Agent Designer に搭載予定の自動構築アルゴリズ ム H-Swarm の背景にある研究の紹介 マルチエージェントシステムが必要となる背景:

    コンテキスト崩壊 複数の論文 (MLE-STAR, DS-STAR) に共通する設計パターンの抽出 H-Swarm の重厚長大さと、現実に直面するコストや制約の分析 スケーリング則から学ぶ「盲目的なエージェント追加」の弊害と、 真にスケールするための条件 組織論 (Team Topologies) を応用し、AI エージェントを「新たな同 僚」と捉える設計原則の提言
  4. LLM から AI エージェントへの進化 LLM のプランニング能力の向上 (Gemini 2.0 / 3.0

    等) ツール利用 (Tool Use / Function Calling) の標準化 単なるチャットボットから自律的に行動するエージェントへの変容
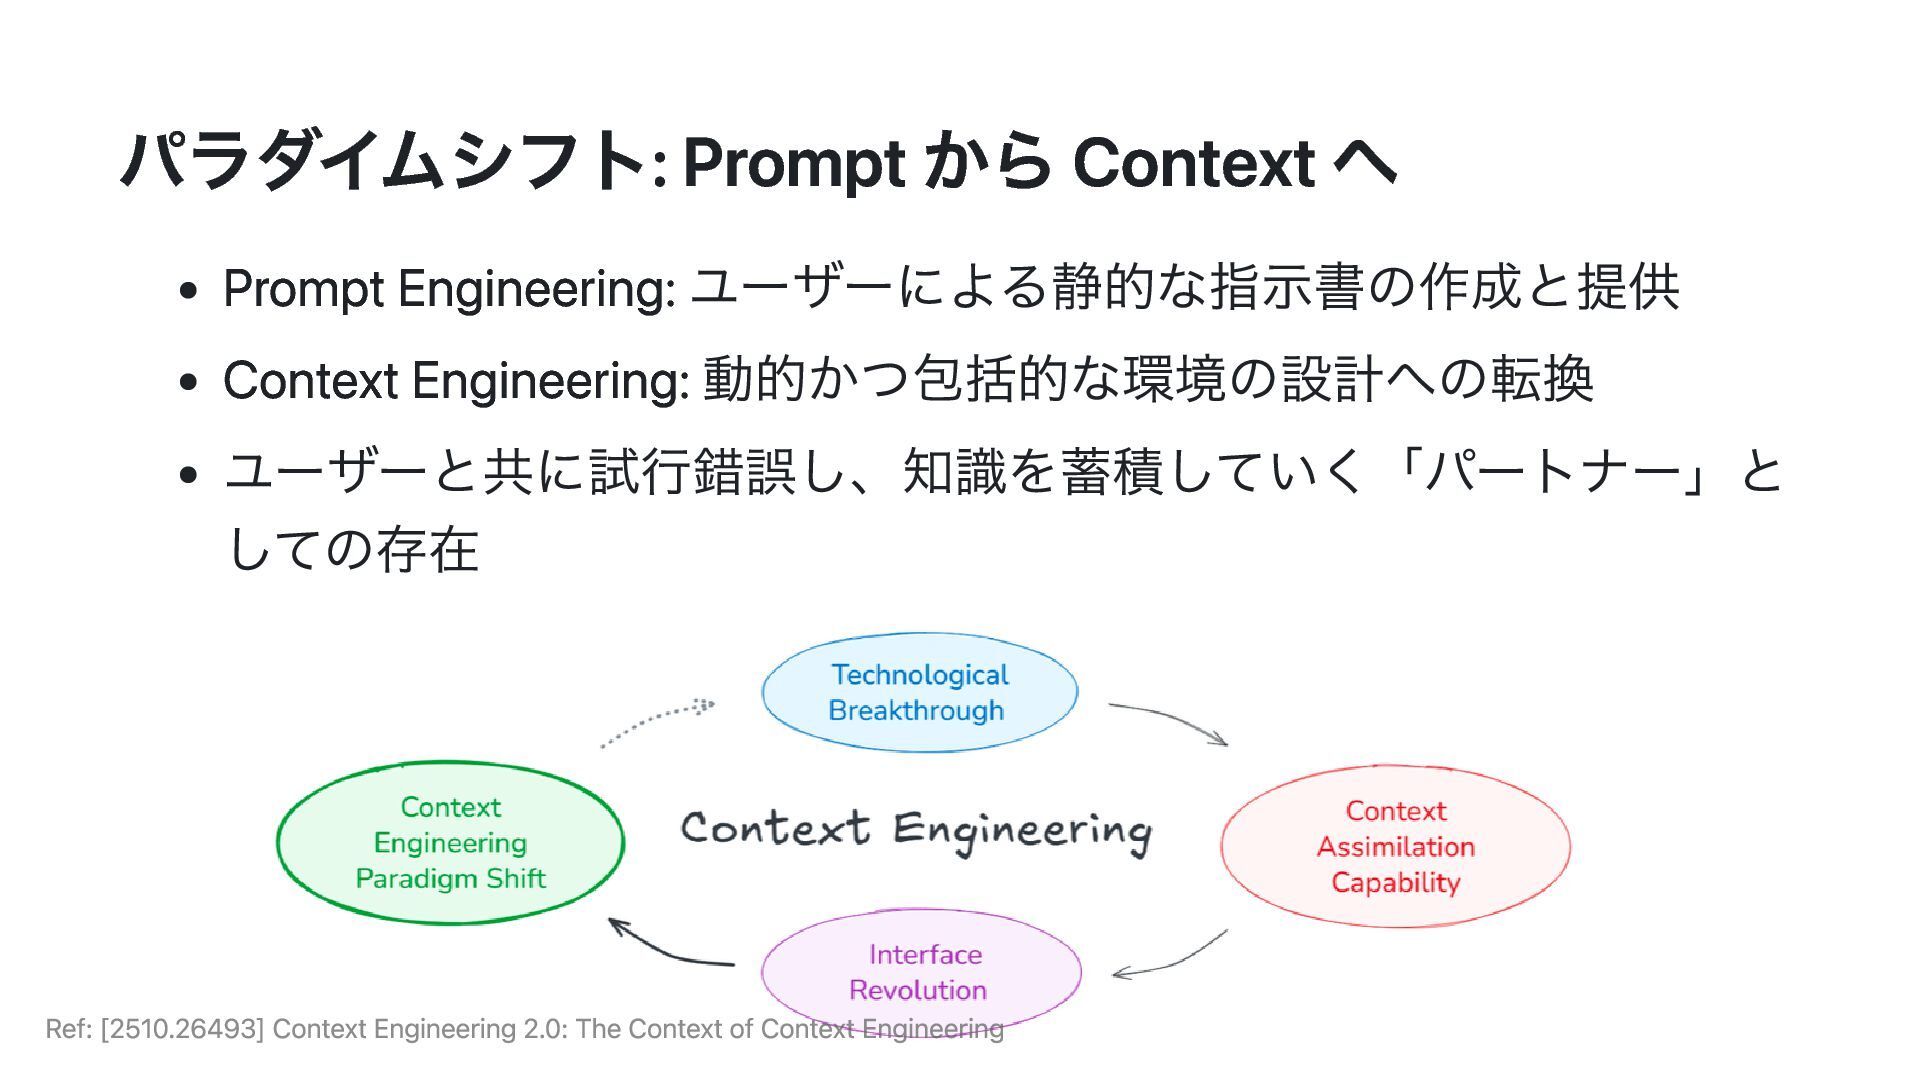
  5. パラダイムシフト: Prompt から Context へ Prompt Engineering: ユーザーによる静的な指示書の作成と提供 Context Engineering:

    動的かつ包括的な環境の設計への転換 ユーザーと共に試行錯誤し、知識を蓄積していく「パートナー」と しての存在 Ref: [2510.26493] Context Engineering 2.0: The Context of Context Engineering
  6. Context Collapse (コンテキスト崩壊) 2/2 具体例: 開発者の失敗談 (Reddit "I was wrong

    about Agent Skills" より) 自分の知識をすべてコンテキストファイルに書き出 すことによる機能不全 コンテキストの構造化・分割と、必要な知識を必 要なタイミングで読み込む設計
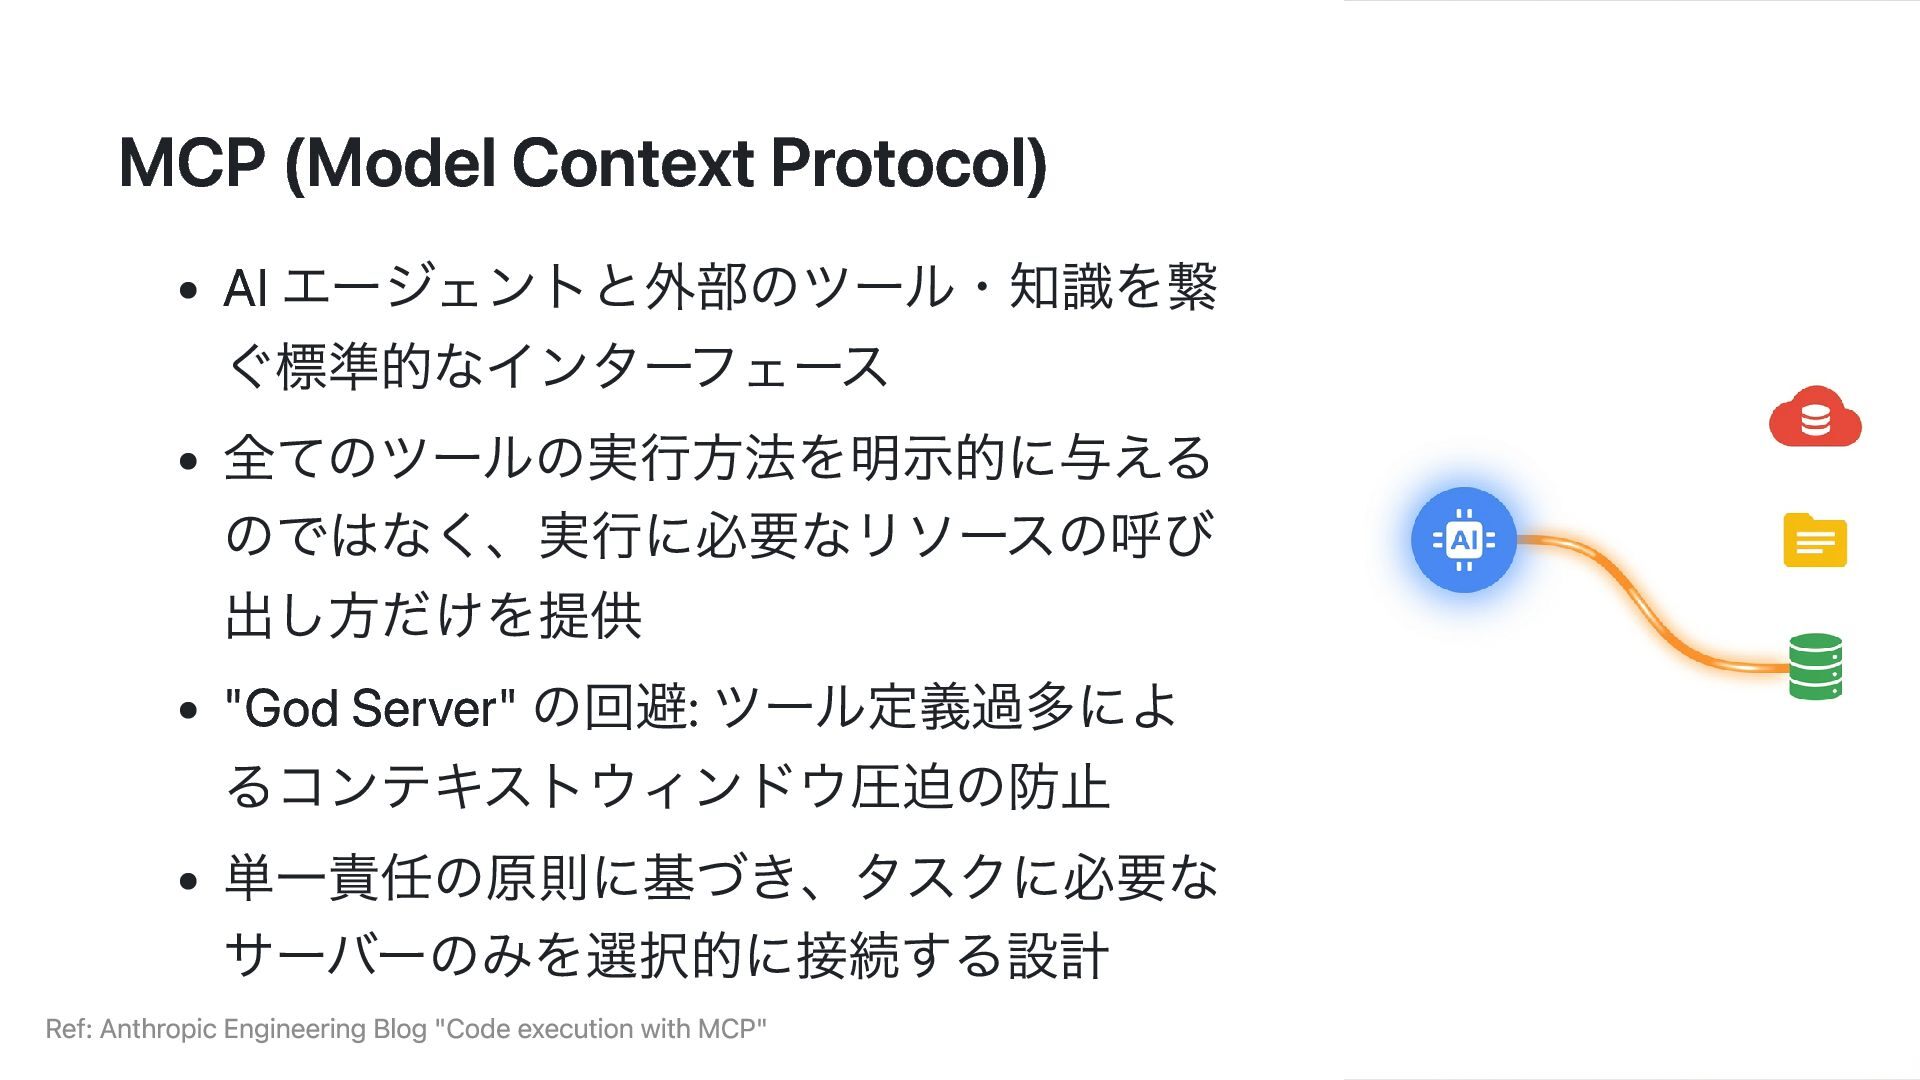
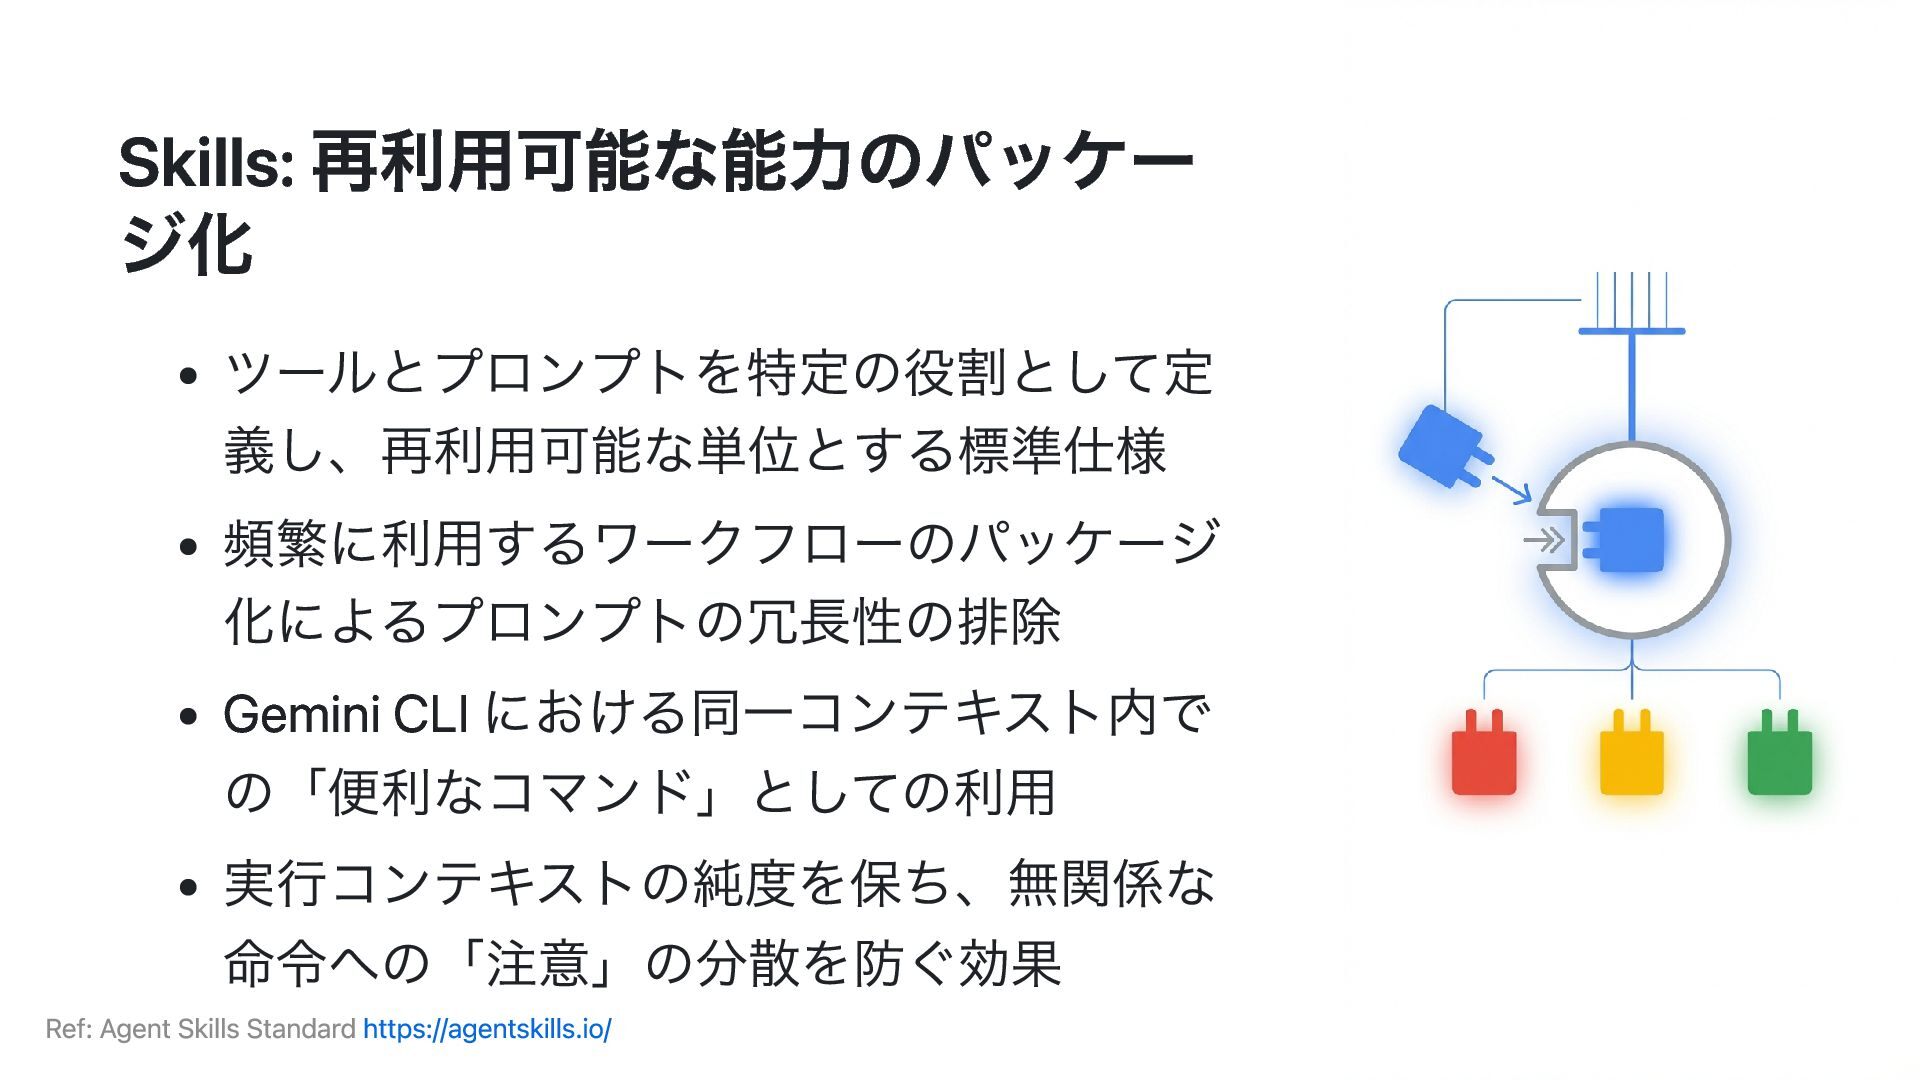
  7. MCP (Model Context Protocol) AI エージェントと外部のツール・知識を繋 ぐ標準的なインターフェース 全てのツールの実行方法を明示的に与える のではなく、実行に必要なリソースの呼び 出し方だけを提供

    "God Server" の回避: ツール定義過多によ るコンテキストウィンドウ圧迫の防止 単一責任の原則に基づき、タスクに必要な サーバーのみを選択的に接続する設計 Ref: Anthropic Engineering Blog "Code execution with MCP"
  8. TOC イントロダクション : AI エージェントの時代 コンテキスト設計の原則 : 責務の分離と疎結合 Google のマルチエージェント事例に学ぶ「成功パターン」

    <- マルチエージェントシステムの「設計」を自動化する試み 現実的な設計指針 : 組織論としてのアプローチ
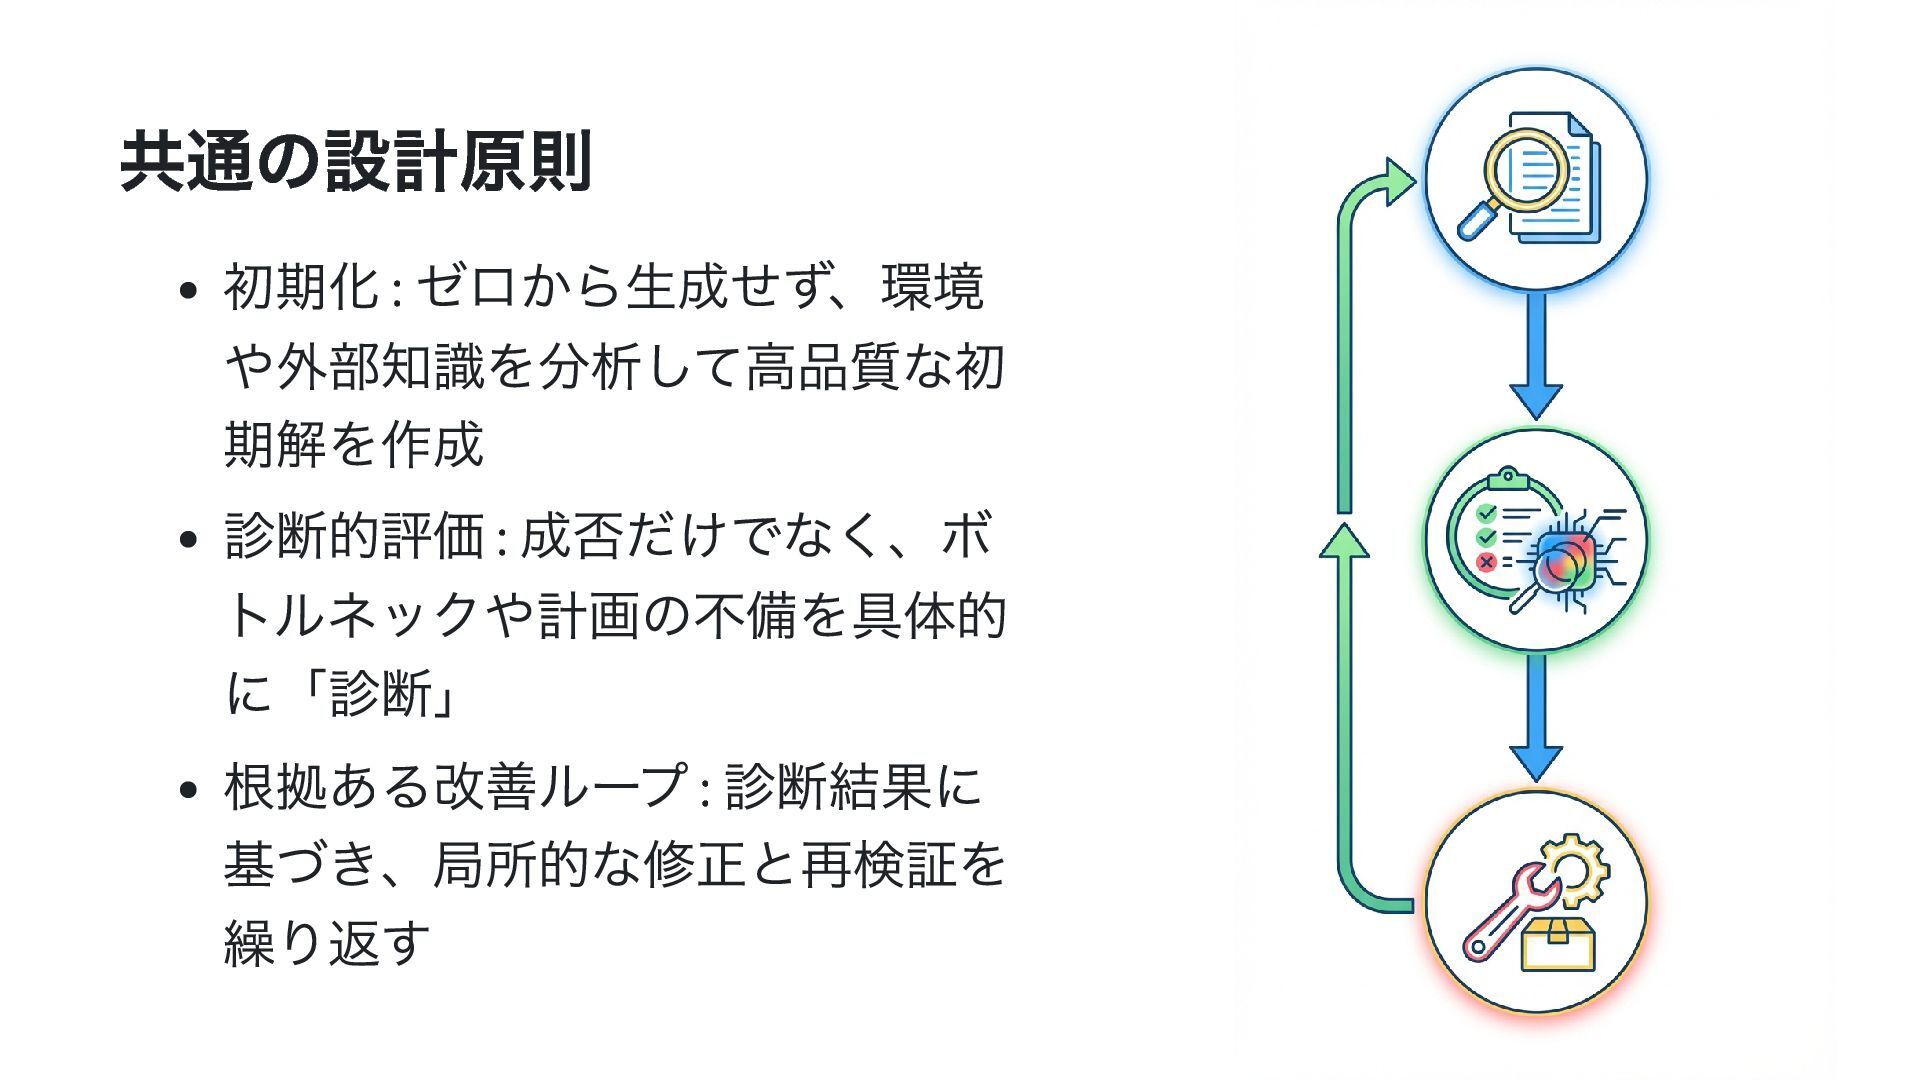
  9. 本セクションの概要 先行事例 (MLE-STAR, DS-STAR) を通じたマルチエージェントの適 用パターンの理解 Google の研究に共通する設計原則「The Google Pattern」の抽出

    モデル非依存のフレームワーク「PlanGen」による一般化 エージェントが機能するための絶対条件「評価可能性 (Evaluatability)」の重要性
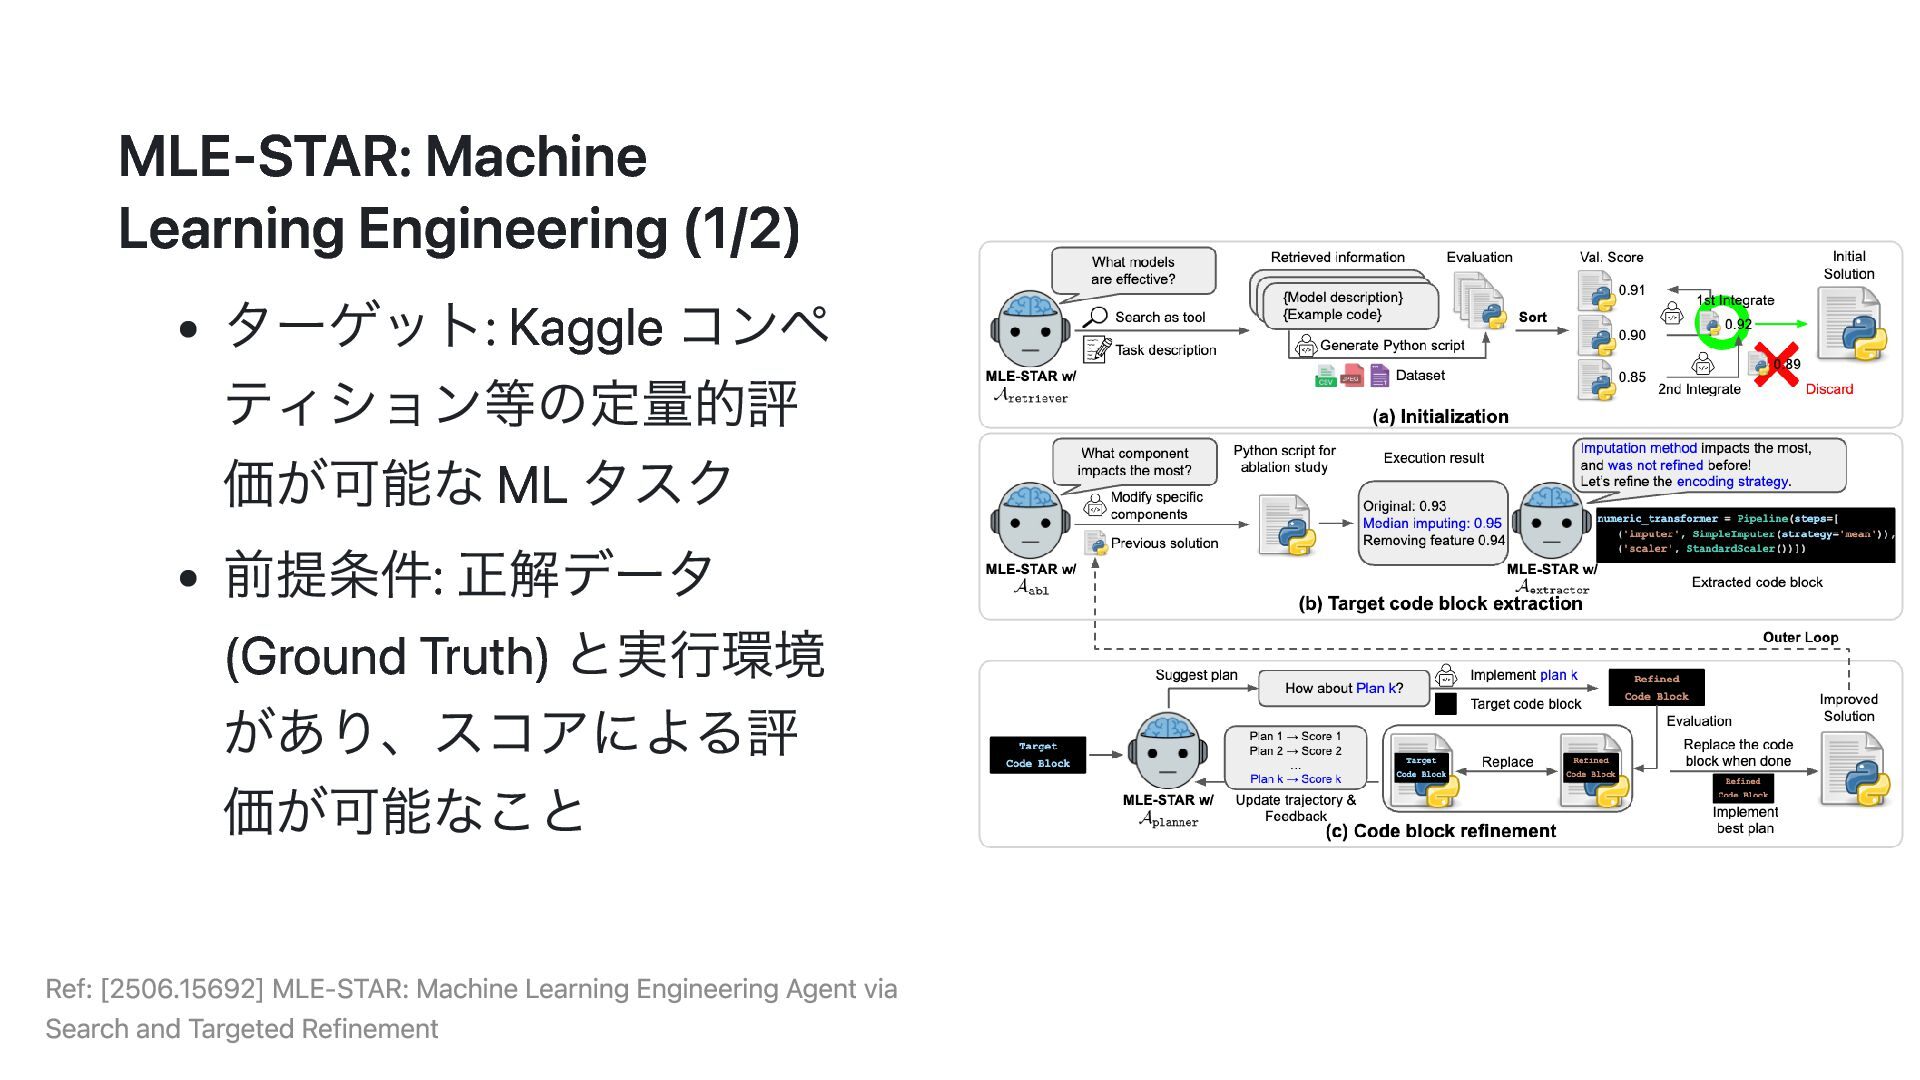
  10. MLE-STAR: Machine Learning Engineering (1/2) ターゲット: Kaggle コンペ ティション等の定量的評 価が可能な

    ML タスク 前提条件: 正解データ (Ground Truth) と実行環境 があり、スコアによる評 価が可能なこと Ref: [2506.15692] MLE-STAR: Machine Learning Engineering Agent via Search and Targeted Refinement
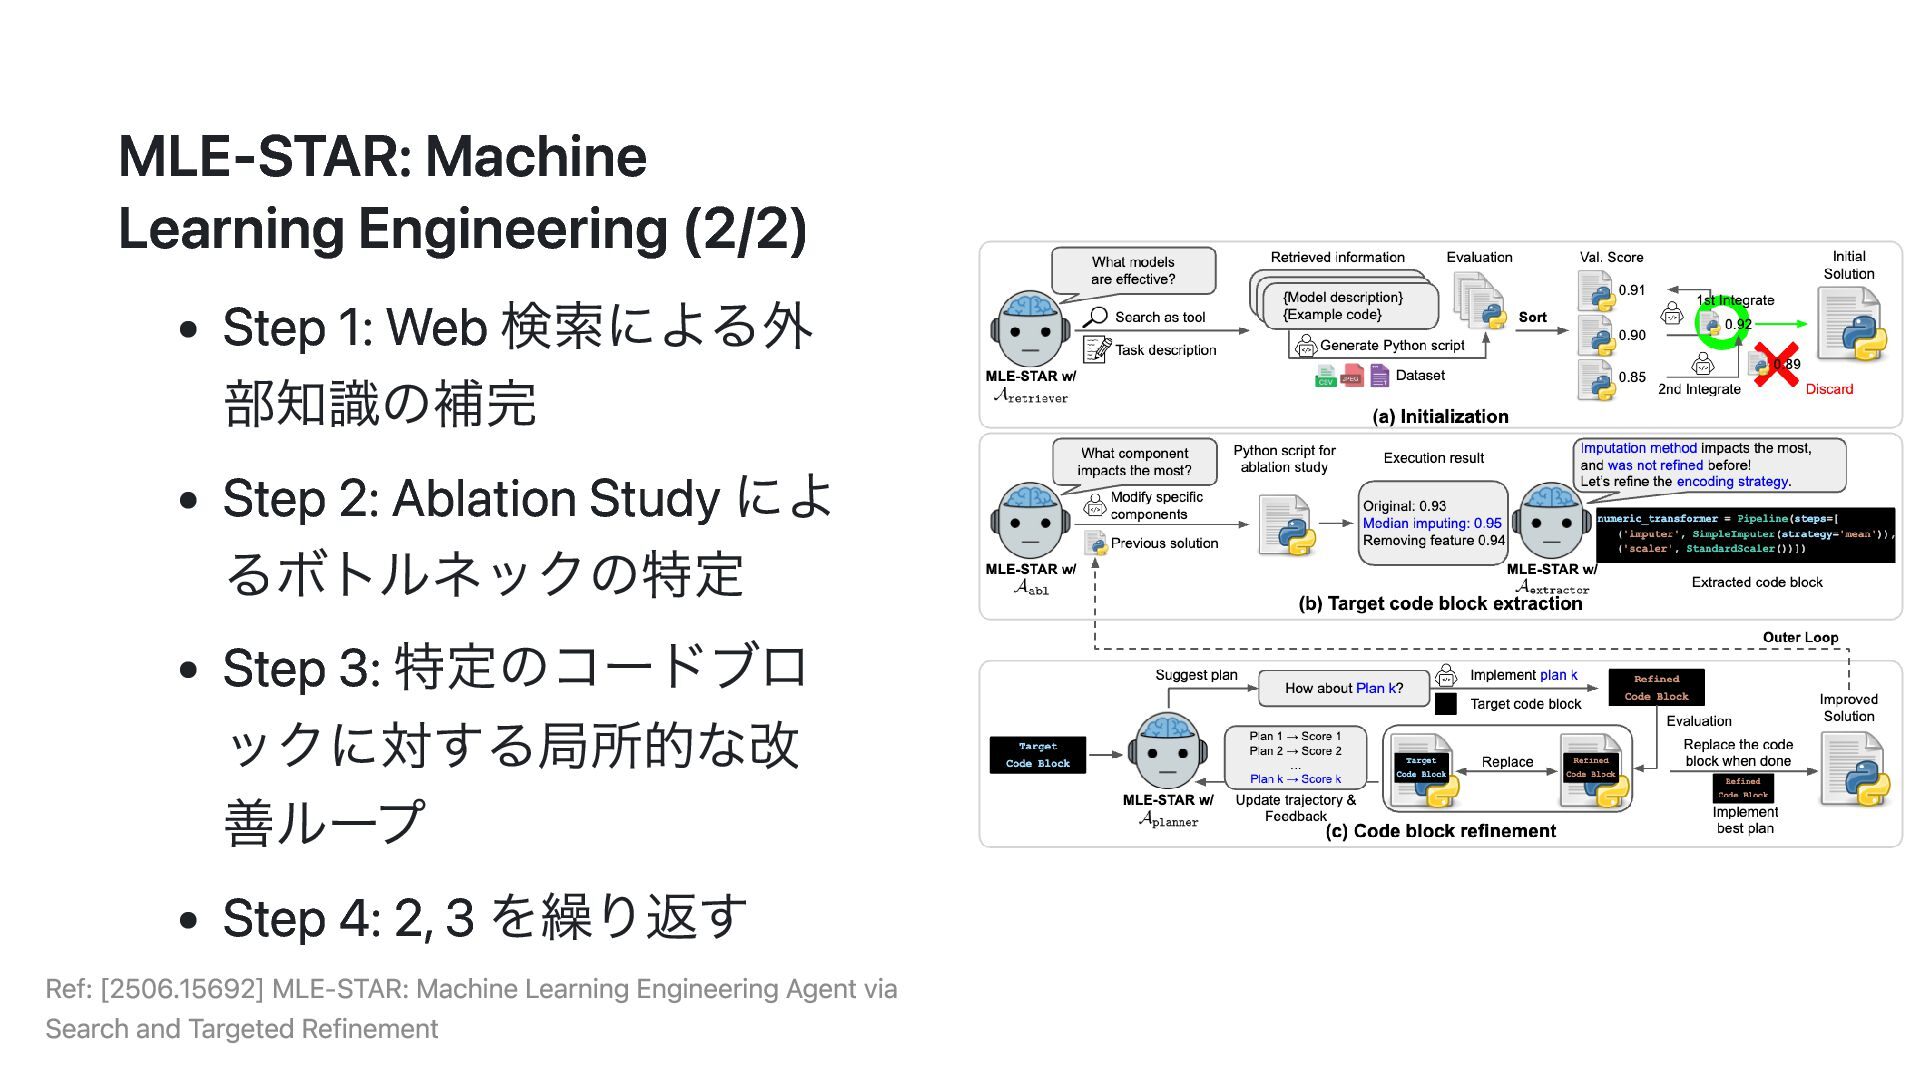
  11. MLE-STAR: Machine Learning Engineering (2/2) Step 1: Web 検索による外 部知識の補完

    Step 2: Ablation Study によ るボトルネックの特定 Step 3: 特定のコードブロ ックに対する局所的な改 善ループ Step 4: 2, 3 を繰り返す Ref: [2506.15692] MLE-STAR: Machine Learning Engineering Agent via Search and Targeted Refinement
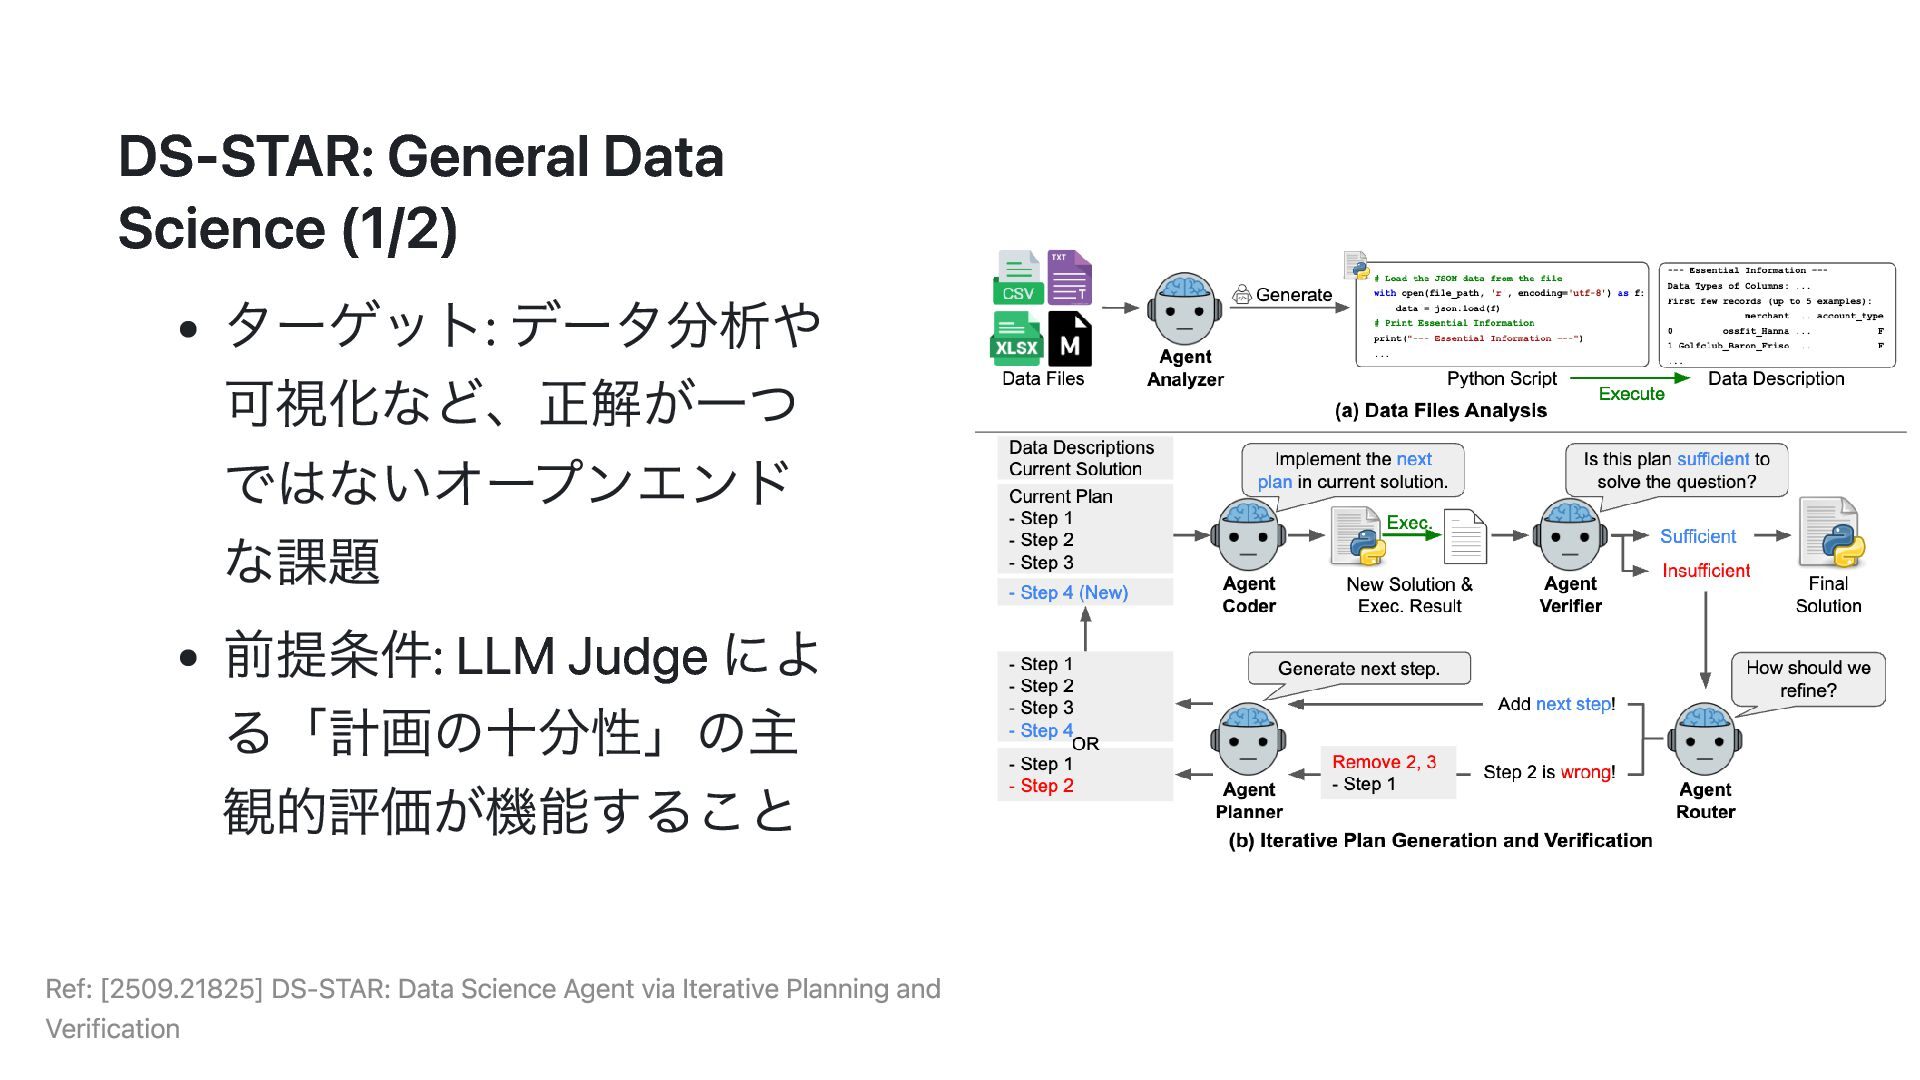
  12. DS-STAR: General Data Science (1/2) ターゲット: データ分析や 可視化など、正解が一つ ではないオープンエンド な課題

    前提条件: LLM Judge によ る「計画の十分性」の主 観的評価が機能すること Ref: [2509.21825] DS-STAR: Data Science Agent via Iterative Planning and Verification
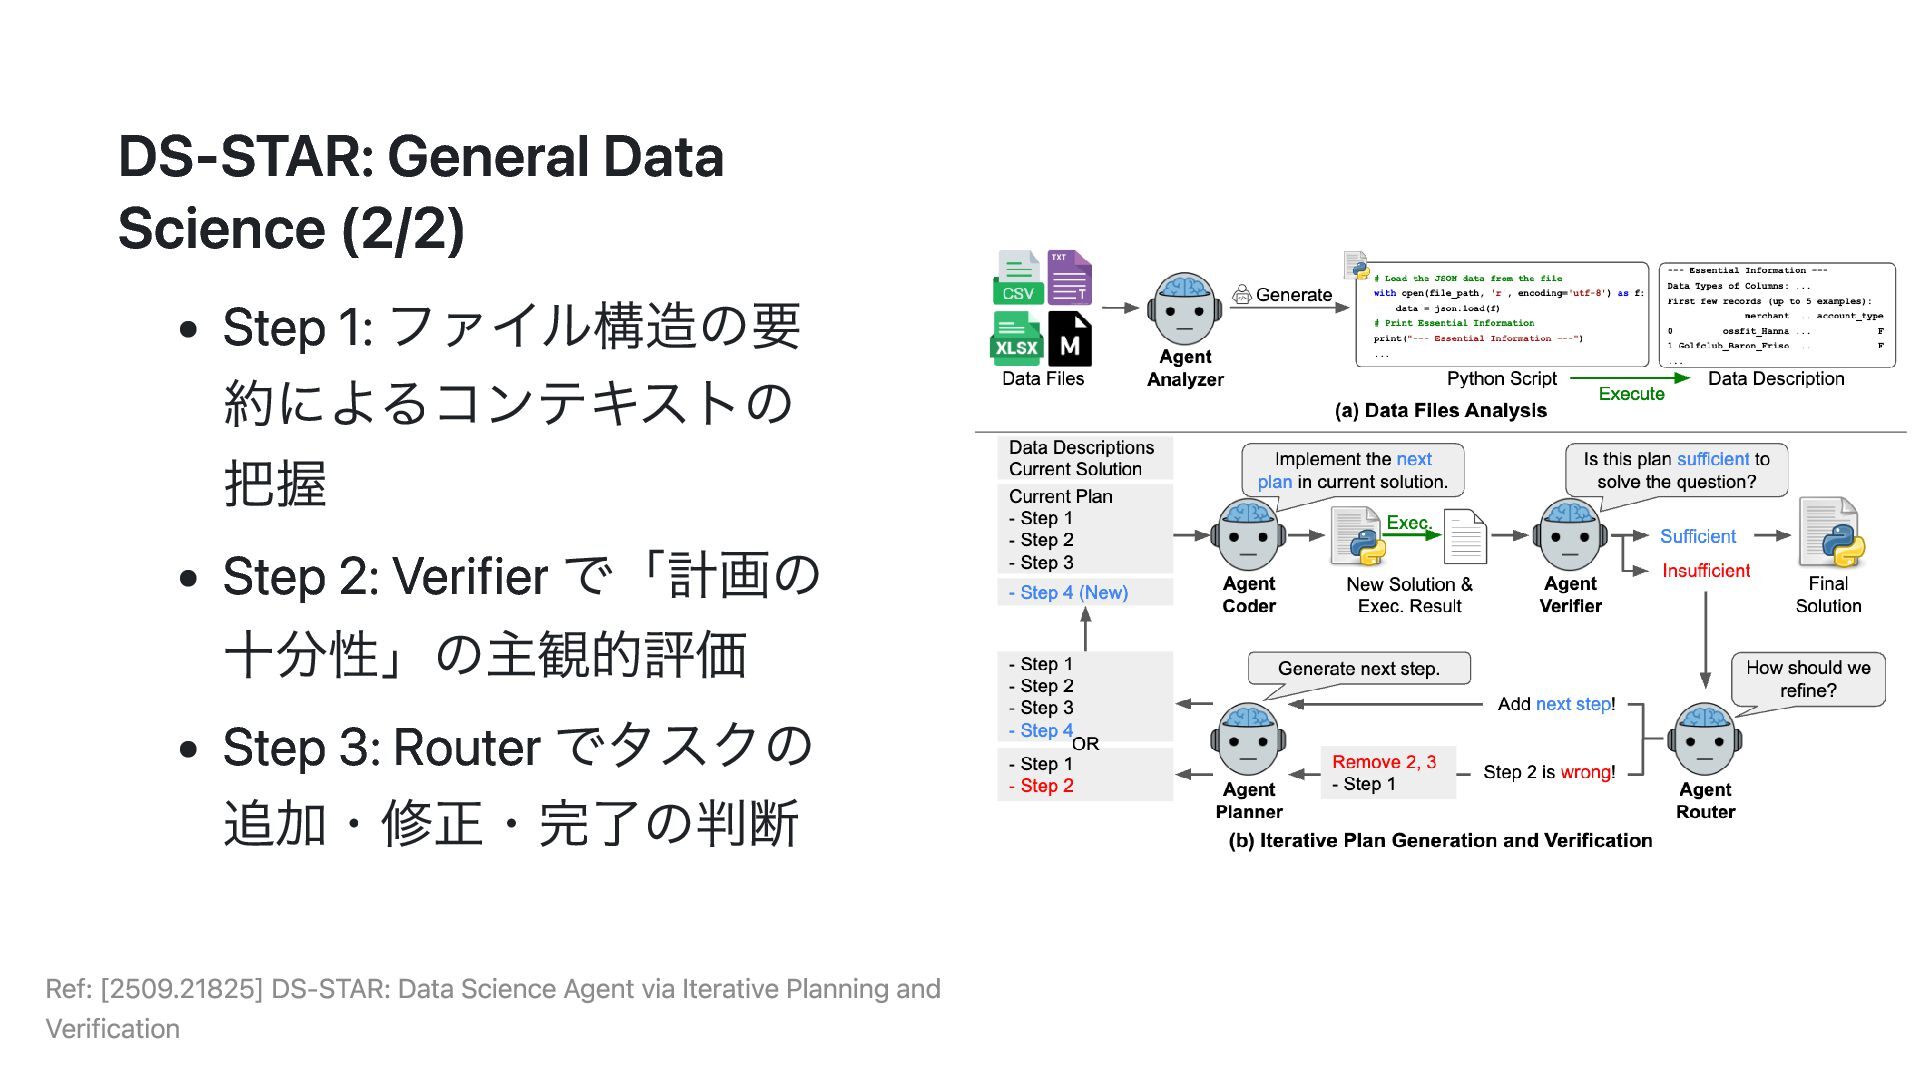
  13. DS-STAR: General Data Science (2/2) Step 1: ファイル構造の要 約によるコンテキストの 把握

    Step 2: Verifier で「計画の 十分性」の主観的評価 Step 3: Router でタスクの 追加・修正・完了の判断 Ref: [2509.21825] DS-STAR: Data Science Agent via Iterative Planning and Verification
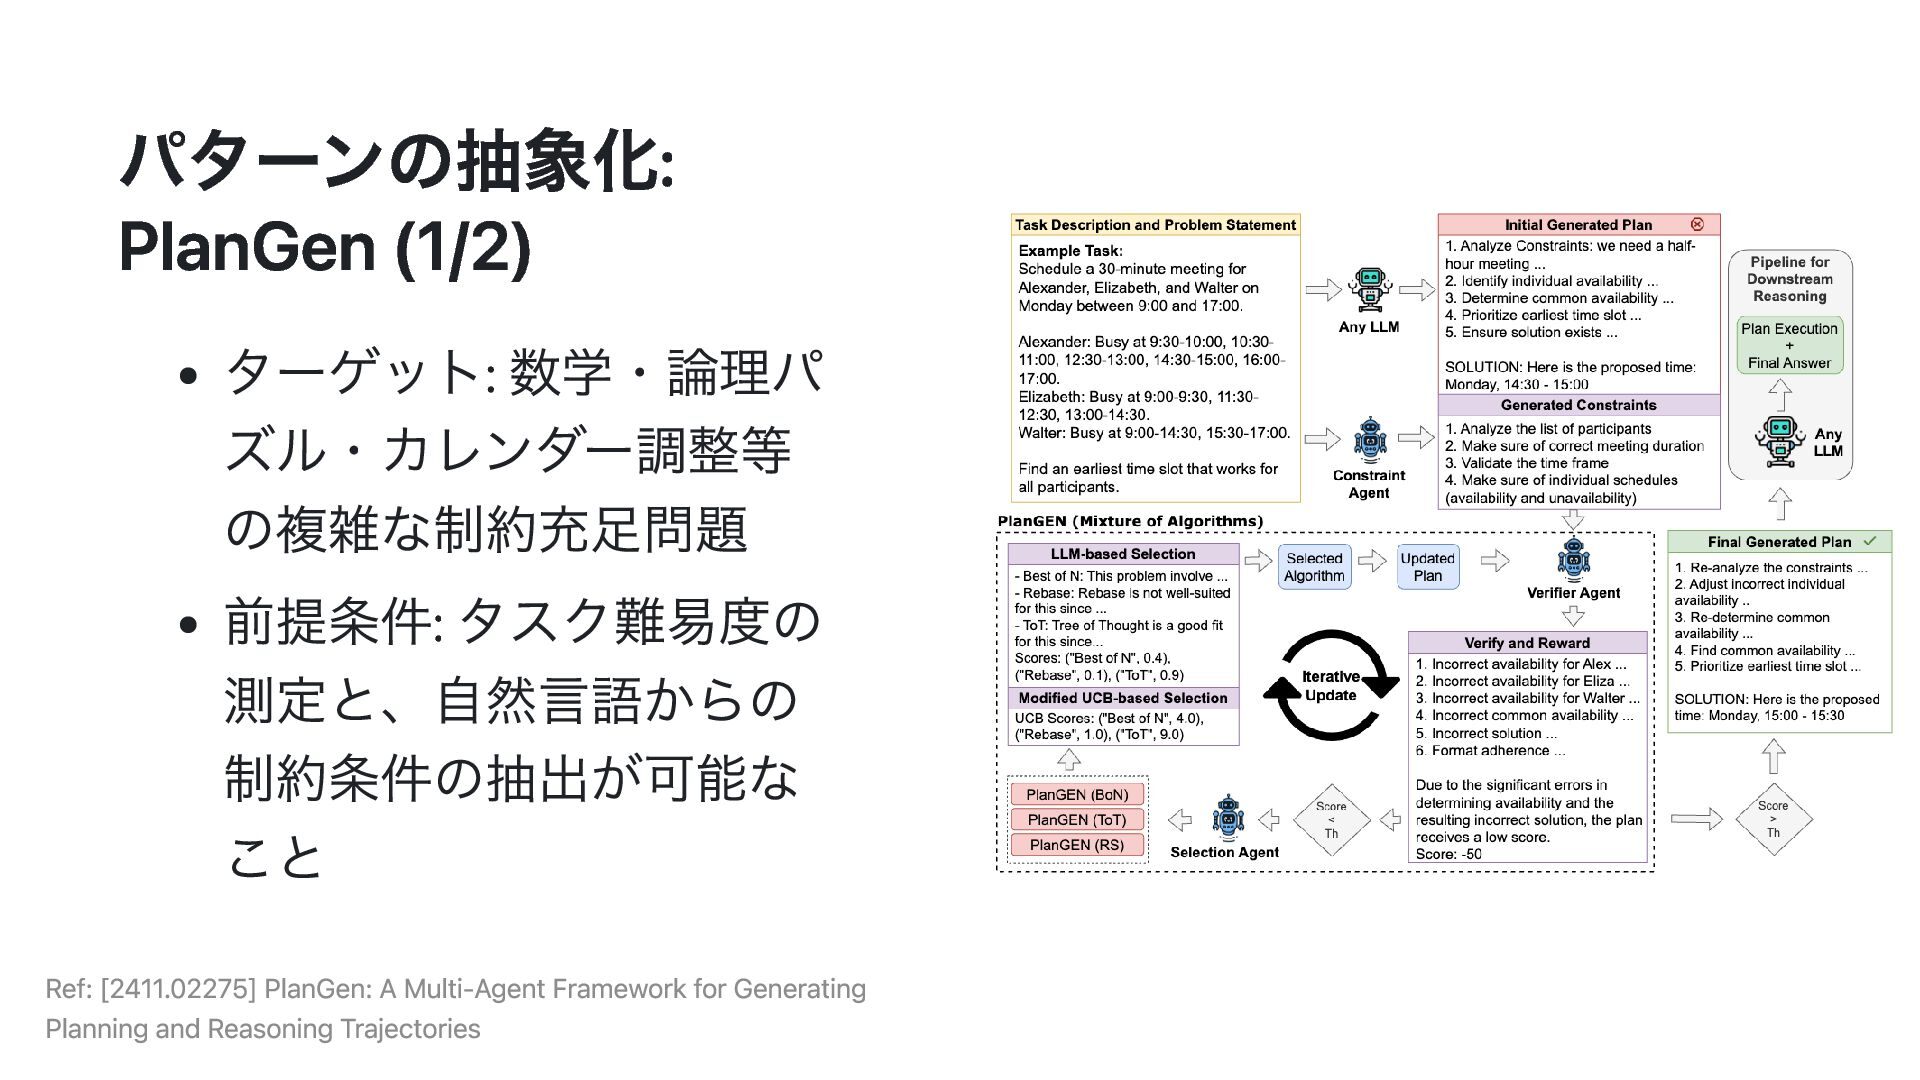
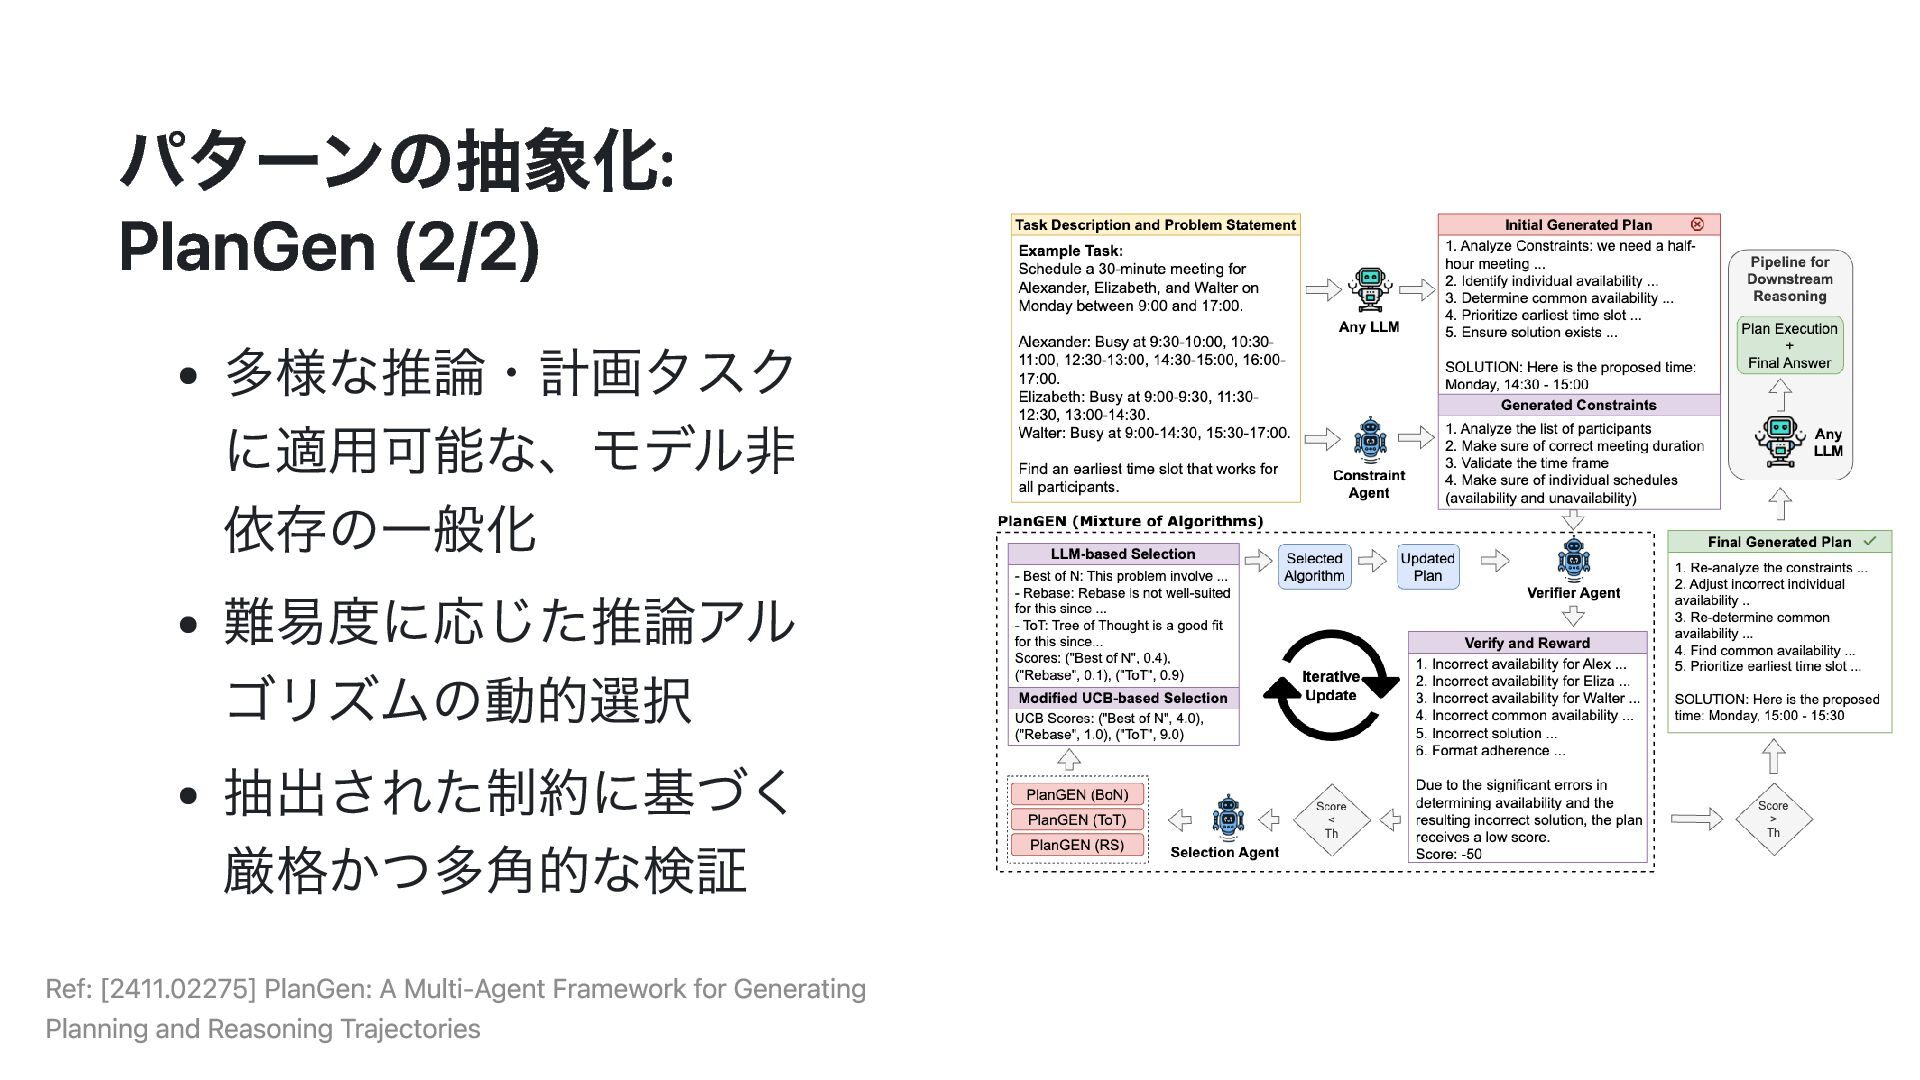
  14. パターンの抽象化: PlanGen (1/2) ターゲット: 数学・論理パ ズル・カレンダー調整等 の複雑な制約充足問題 前提条件: タスク難易度の 測定と、自然言語からの

    制約条件の抽出が可能な こと Ref: [2411.02275] PlanGen: A Multi-Agent Framework for Generating Planning and Reasoning Trajectories
  15. ループを回すための大前提: 評価可能性 改善ループを回すには、エージェント自身が出力の「良し悪し」を 判定できる必要がある 客観的評価 (MLE-STAR): 実行エラーや精度スコアといった明確な指 標による検証 主観的評価 (DS-STAR):

    スコアがない課題では、LLM 自身を「裁判 官」として妥当性を検証 適応的計算量 (PlanGen): 課題の難易度に応じて、ループの回数や探 索手法を動的に変える
  16. 実践的な自動設計: MASS (1/2) 概要 : 重み更新を伴わない、プロンプトとトポロジーの自動最適化 ターゲットタスク : 複雑な推論、多段 QA、コード生成

    前提条件 : 検証用データセットを用いた探索が可能なこと (重みは 固定) 知見 : 複雑なトポロジーを組む前に「プロンプトを磨く」ことが最 も効果的 Ref: [2502.02533] Multi-Agent Design: Optimizing Agents with Better Prompts and Topologies
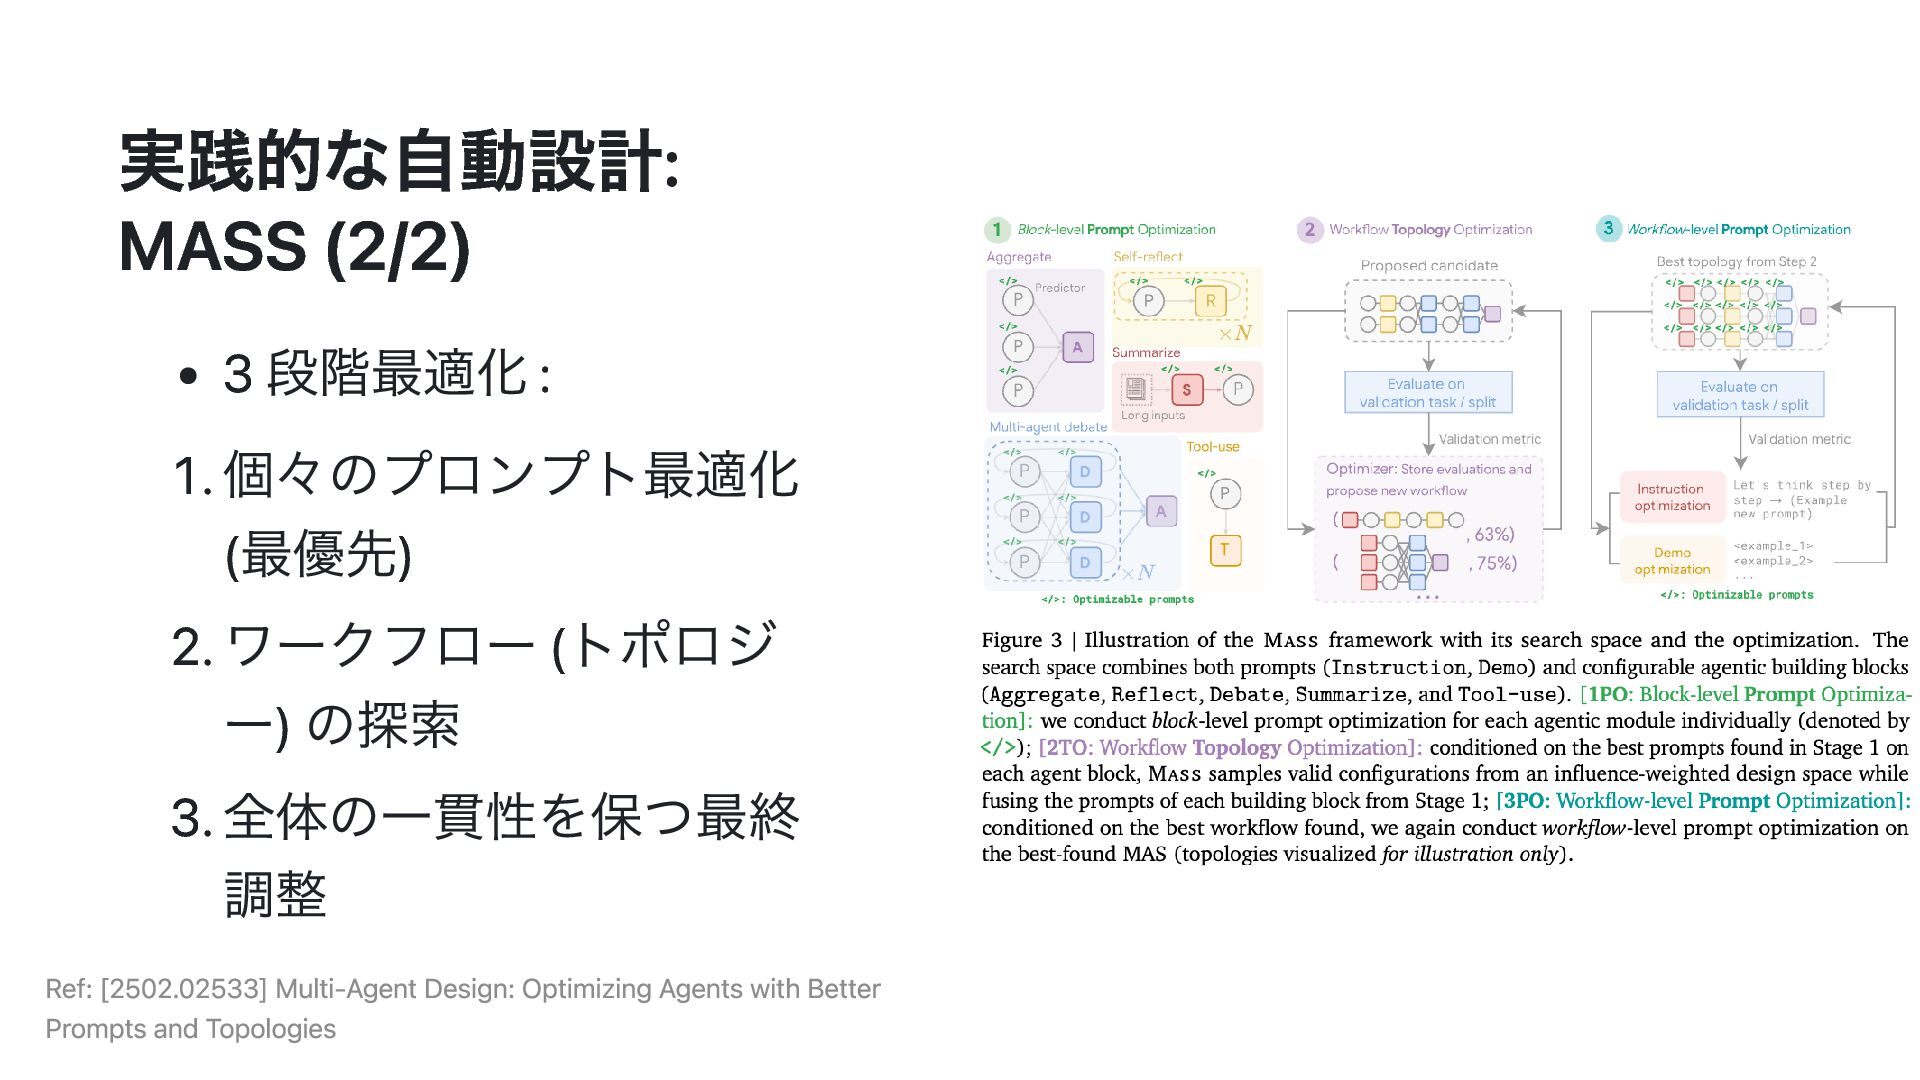
  17. 実践的な自動設計: MASS (2/2) 3 段階最適化 : 1. 個々のプロンプト最適化 (最優先) 2.

    ワークフロー (トポロジ ー) の探索 3. 全体の一貫性を保つ最終 調整 Ref: [2502.02533] Multi-Agent Design: Optimizing Agents with Better Prompts and Topologies
  18. 理想の極北: H-Swarm (1/2) 概要 : トポロジー (役割) とモデルの重みを同時に最適化する野心的 な試み ターゲット

    : 知識探索、複雑な推論、エージェントタスク全般 前提条件 : モデルの重みが更新可能であり、膨大な計算資源がある こと 特徴 : 各タスクに特化した「専用の脳と神経系」をゼロから構築す る Ref: [2502.13840] Heterogeneous Swarms: Jointly Optimizing Model Roles and Weights
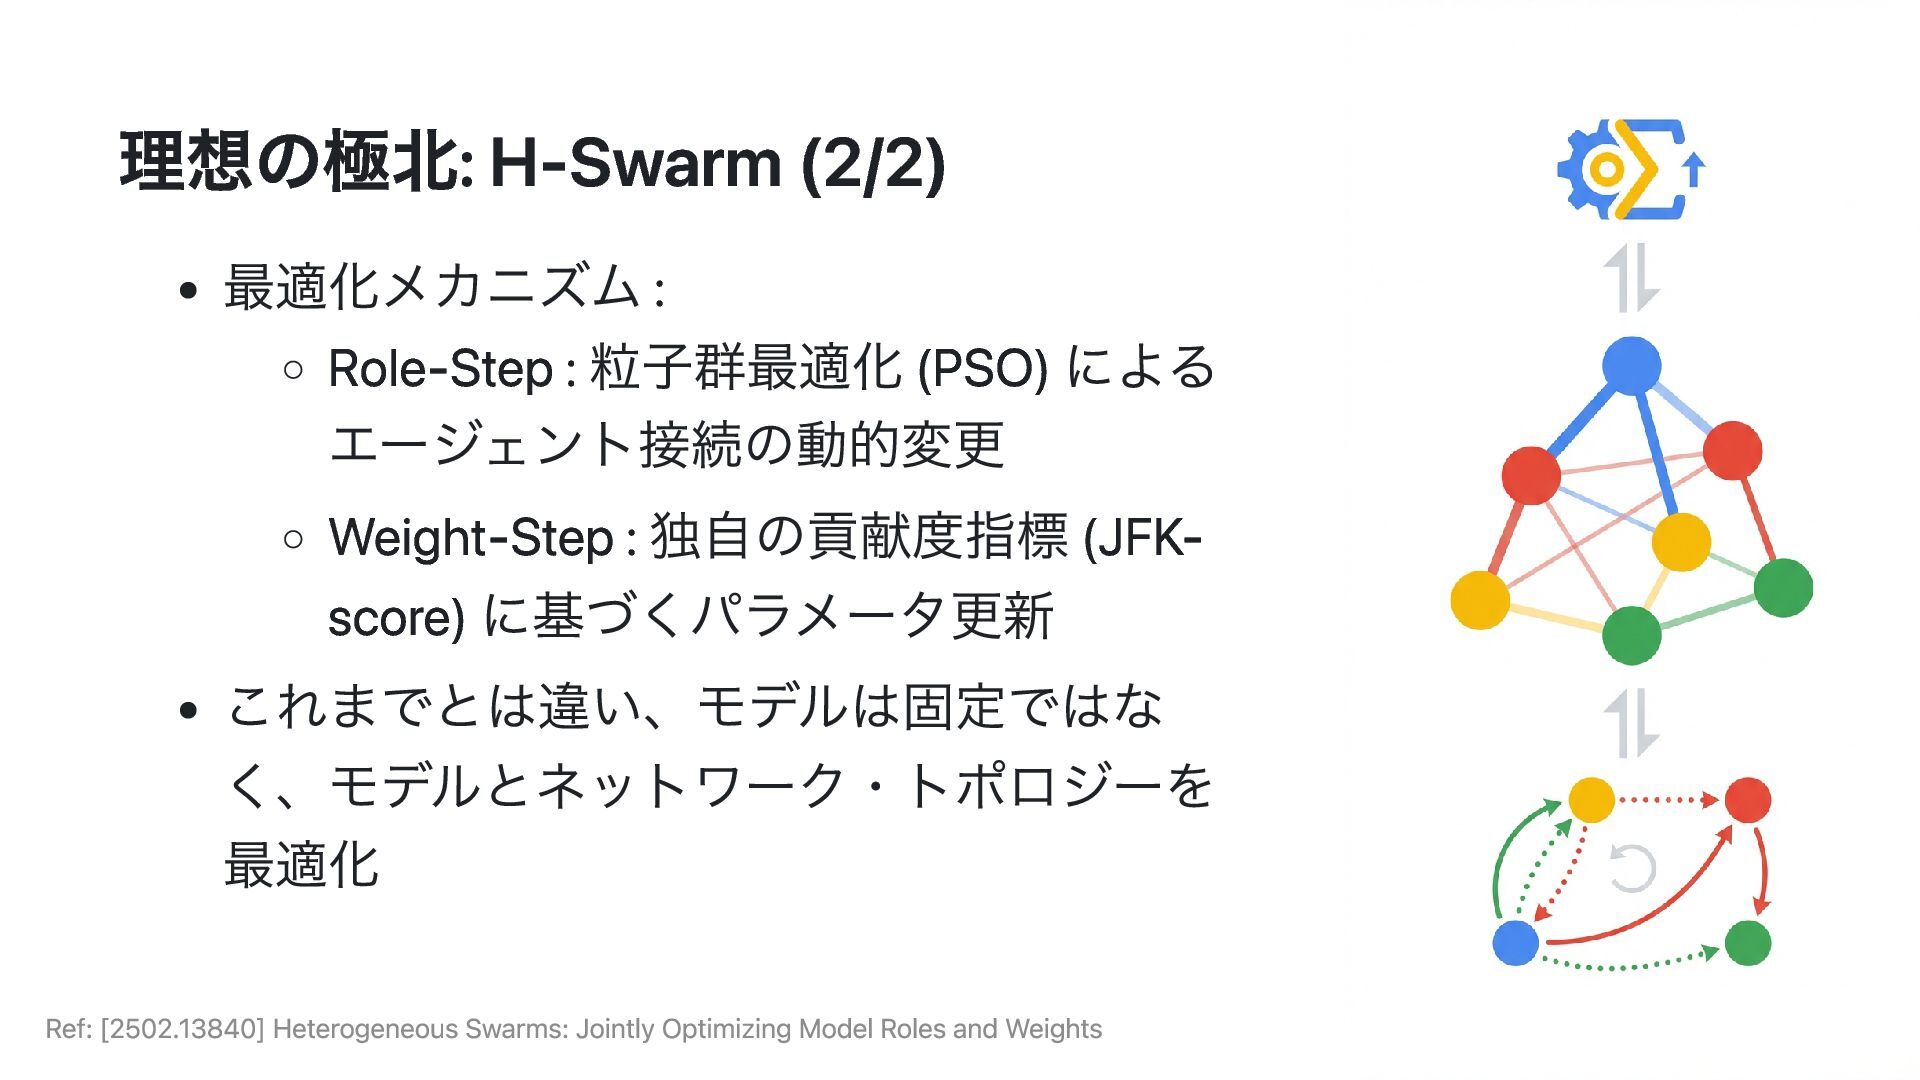
  19. 理想の極北: H-Swarm (2/2) 最適化メカニズム : Role-Step : 粒子群最適化 (PSO) による

    エージェント接続の動的変更 Weight-Step : 独自の貢献度指標 (JFK- score) に基づくパラメータ更新 これまでとは違い、モデルは固定ではな く、モデルとネットワーク・トポロジーを 最適化 Ref: [2502.13840] Heterogeneous Swarms: Jointly Optimizing Model Roles and Weights
  20. H-Swarm 実用化における壁 評価可能性の前提 : 全てのタスクで定量・定性的な「評価」ができ るとは限らない 複雑性の増大 : モデルの管理が必要で、システムが複雑化する 環境構築のハードル

    : 「モデルを学習できる環境」の用意が必要 で、手軽さが失われる 費用対効果の疑問 : 1 タスクの最適化に A100 GPU 数時間の投資が 必要で割に合わない 結論 : Agent Designer に期待される「手軽さ」と、H-Swarm の要件 は現状乖離している
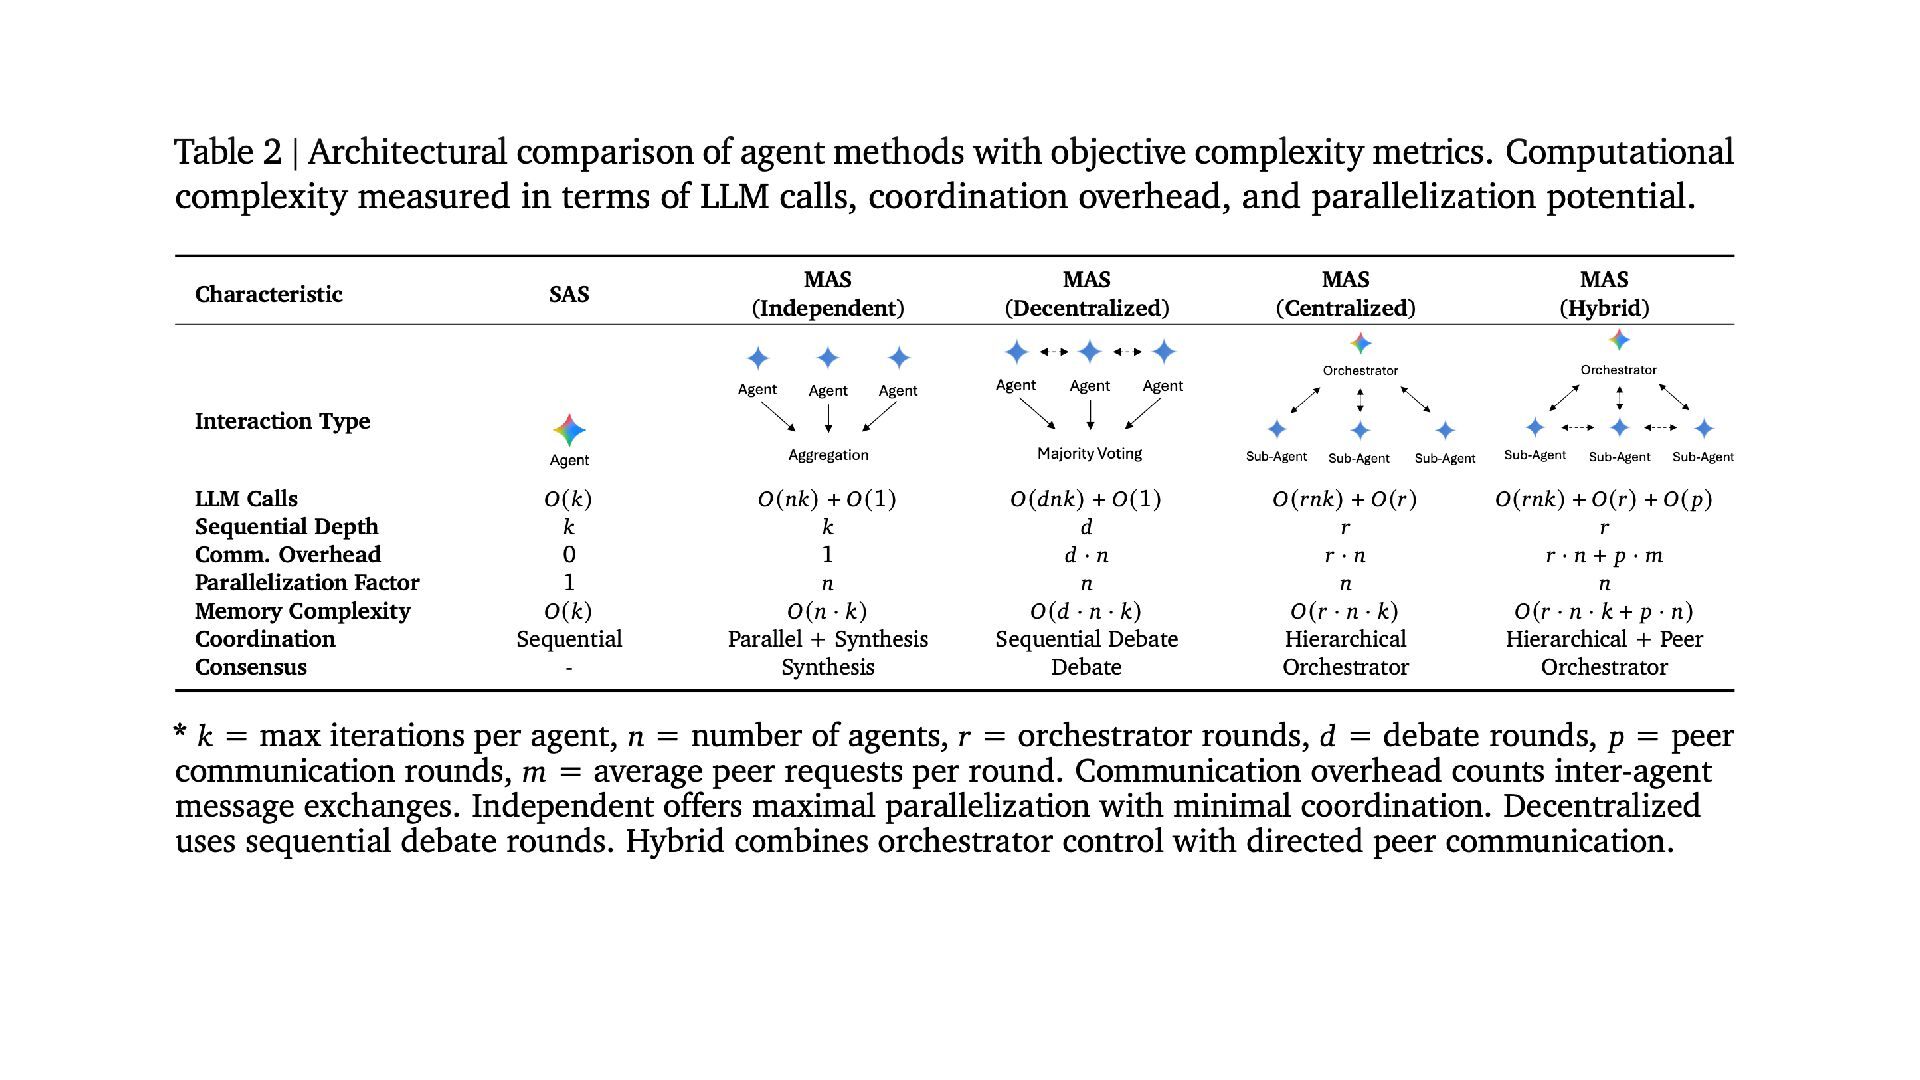
  21. Towards a Science of Scaling Agent Systems (1/4) 概要 :

    マルチエージェントの性能を左右する「スケーリング則」を 定量化した研究 目的 : 「エージェントを増やせば賢くなる」という期待の妥当性を 検証 規模 : 5 つのアーキテクチャ、180 の設定、4 つのベンチマークでの 大規模比較 Ref: [2501.12948] Towards a Science of Scaling Agent Systems
  22. Towards a Science of Scaling Agent Systems (2/4) ターゲット :

    Web ナビゲーション、金融分析、複雑な計画、ワーク フロー 前提条件 (Agentic Evaluation) : i. 継続的な環境との対話 ii. 部分観測下での反復的な情報収集 iii. フィードバックに基づく適応的な戦略修正 Ref: [2501.12948] Towards a Science of Scaling Agent Systems
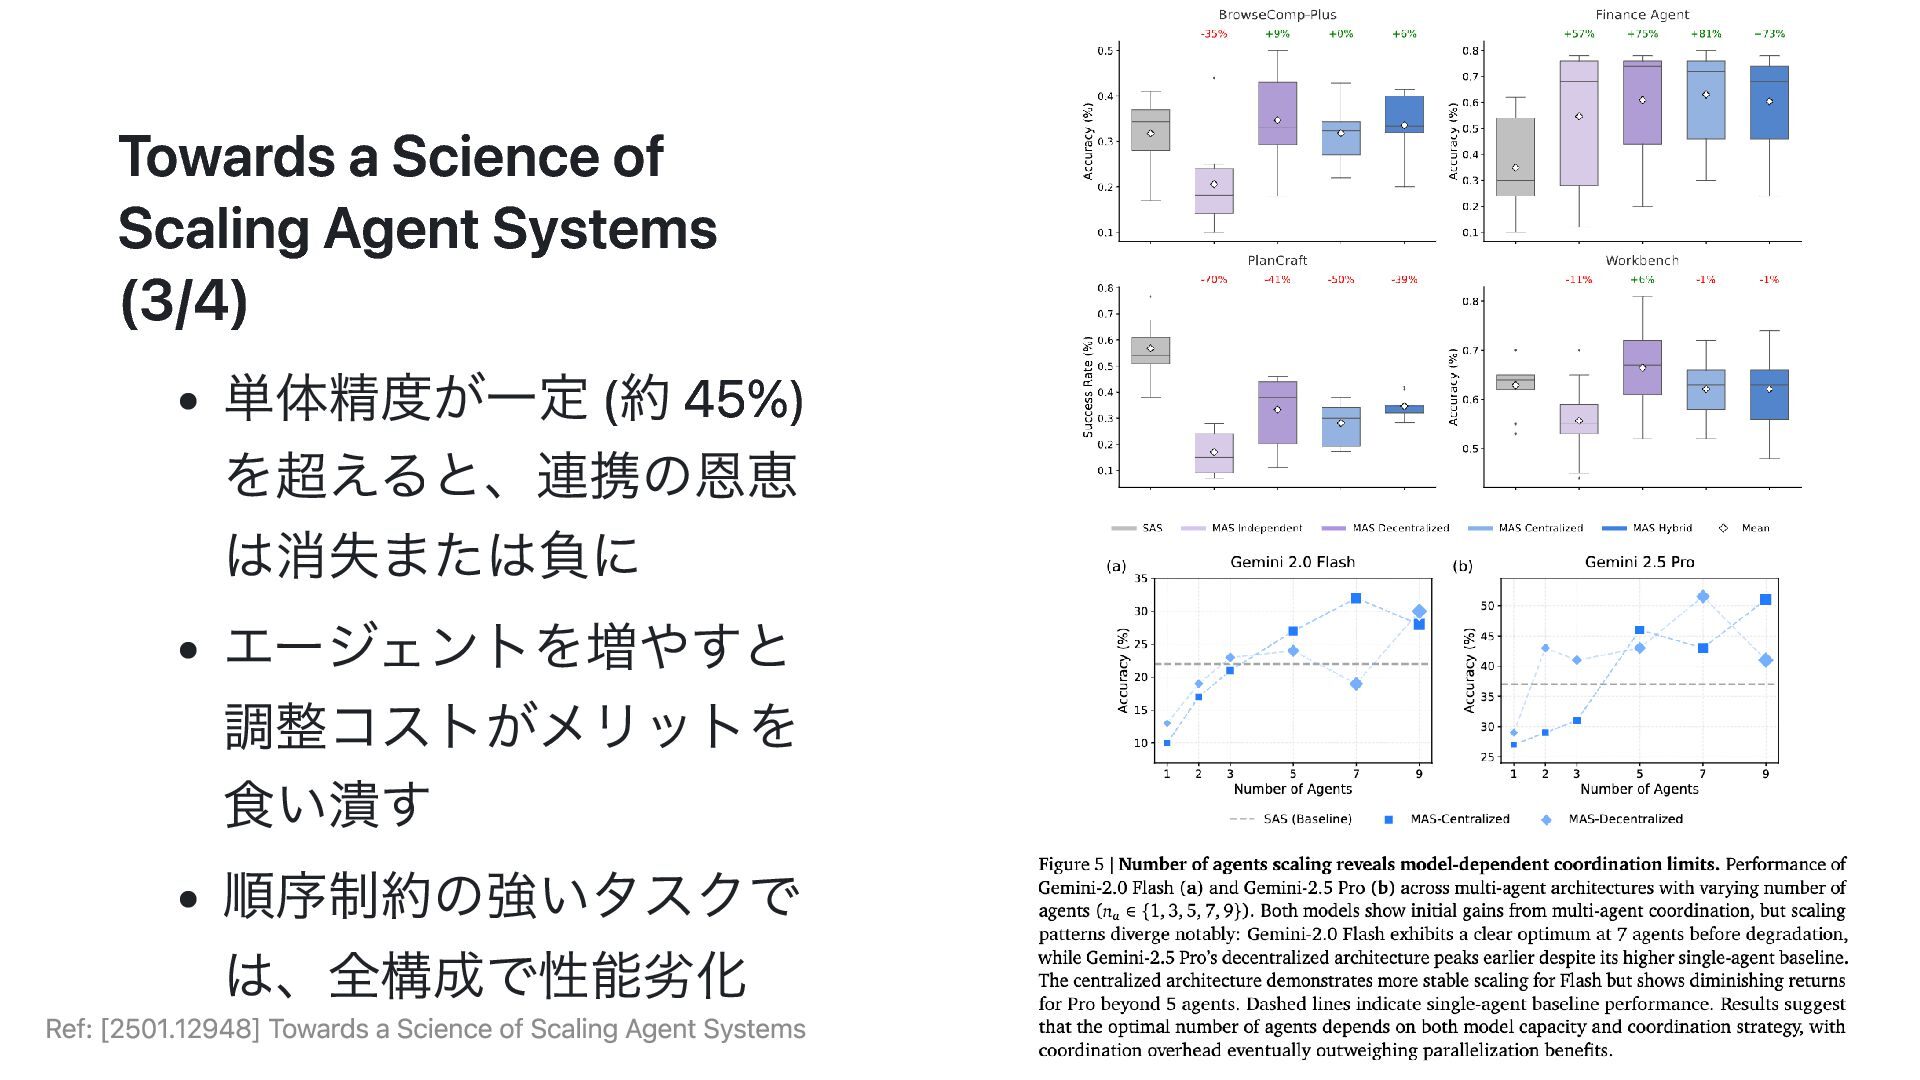
  23. Towards a Science of Scaling Agent Systems (3/4) 単体精度が一定 (約

    45%) を超えると、連携の恩恵 は消失または負に エージェントを増やすと 調整コストがメリットを 食い潰す 順序制約の強いタスクで は、全構成で性能劣化 Ref: [2501.12948] Towards a Science of Scaling Agent Systems
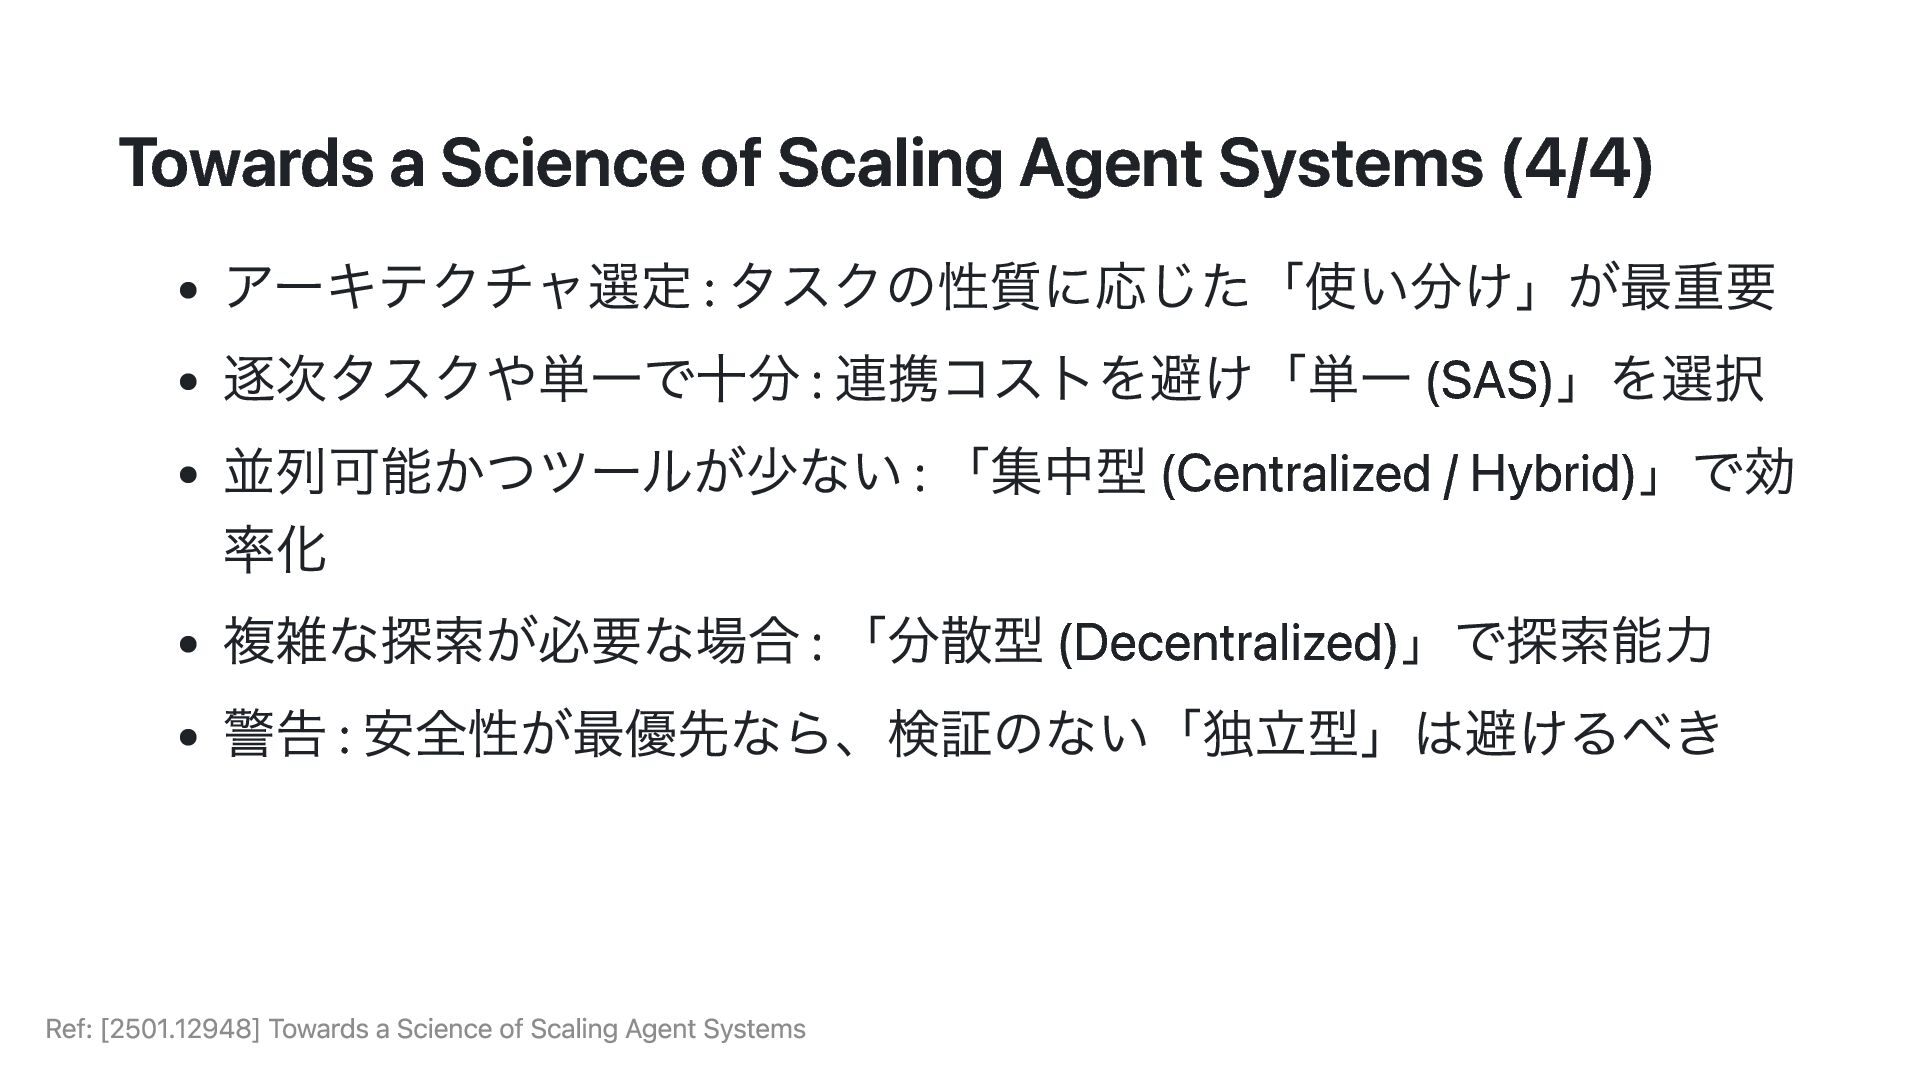
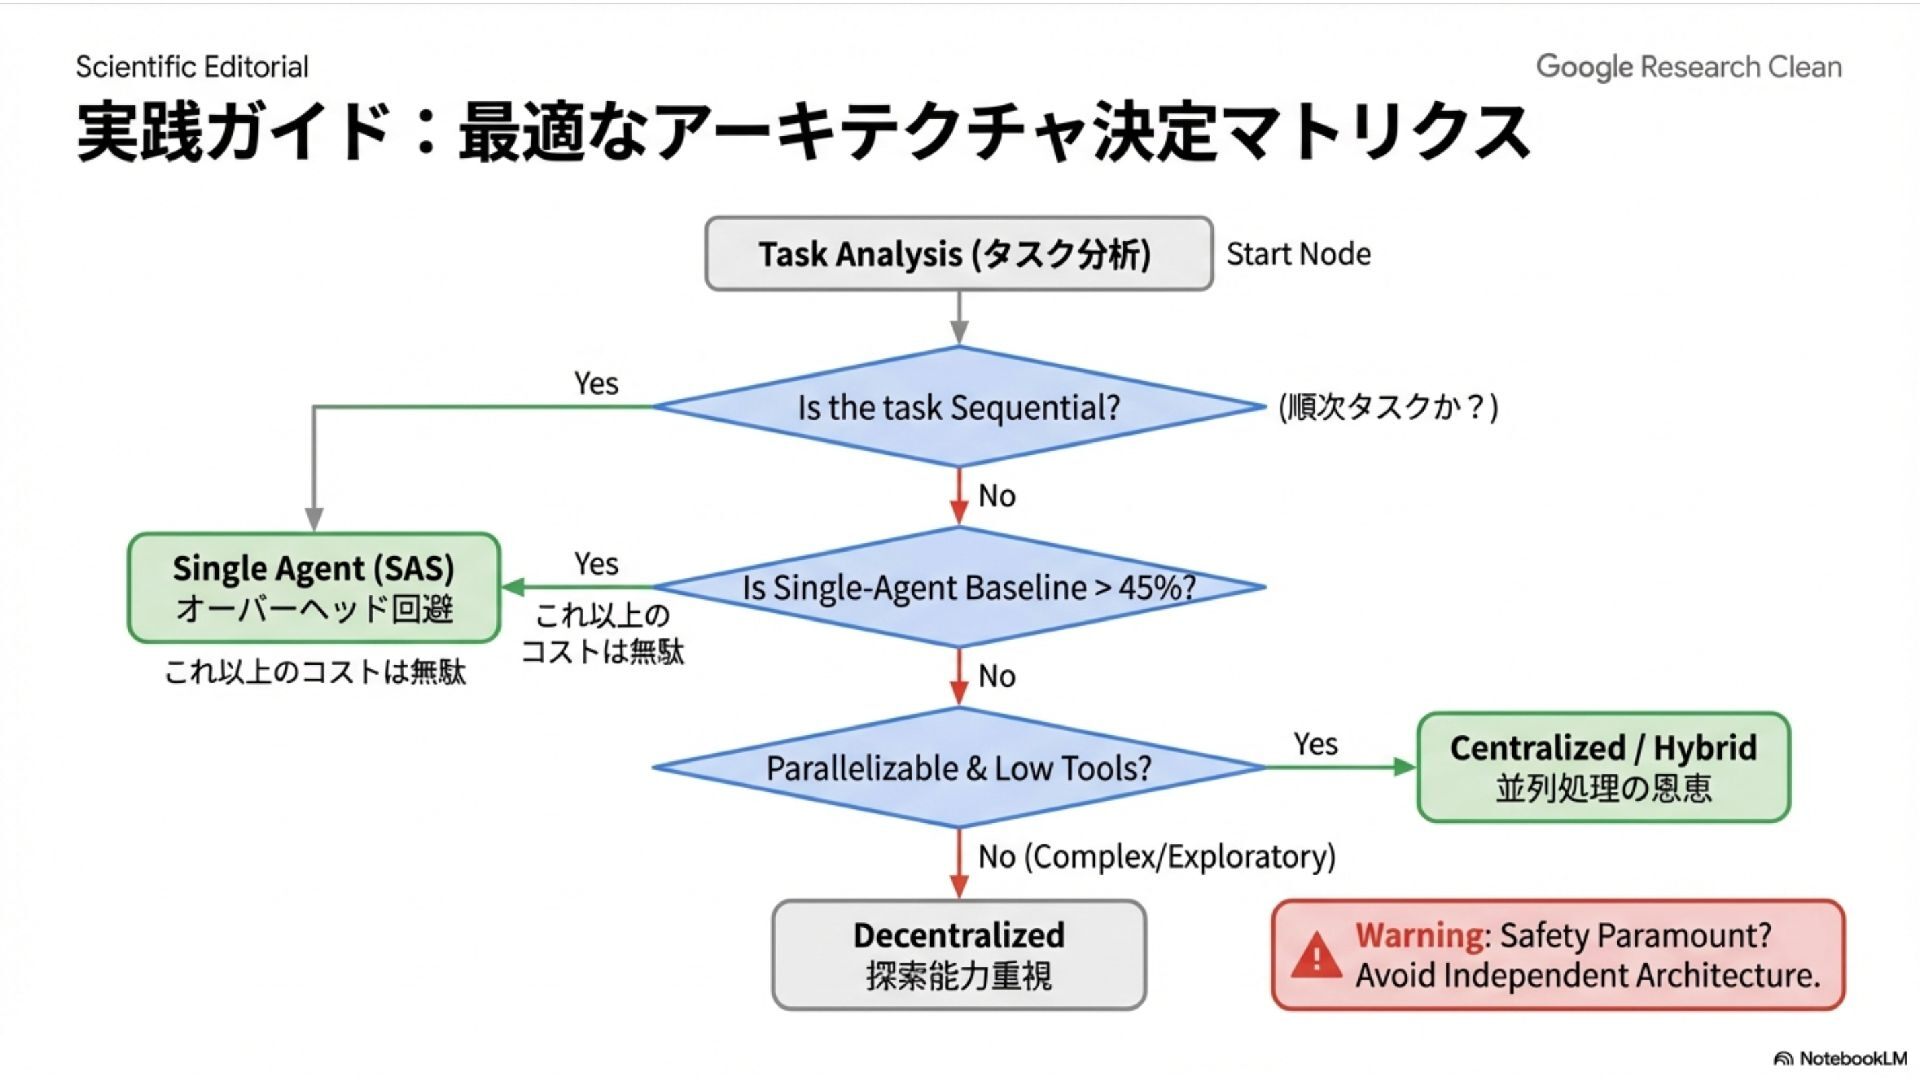
  24. Towards a Science of Scaling Agent Systems (4/4) アーキテクチャ選定 :

    タスクの性質に応じた「使い分け」が最重要 逐次タスクや単一で十分 : 連携コストを避け「単一 (SAS)」を選択 並列可能かつツールが少ない : 「集中型 (Centralized / Hybrid)」で効 率化 複雑な探索が必要な場合 : 「分散型 (Decentralized)」で探索能力 警告 : 安全性が最優先なら、検証のない「独立型」は避けるべき Ref: [2501.12948] Towards a Science of Scaling Agent Systems
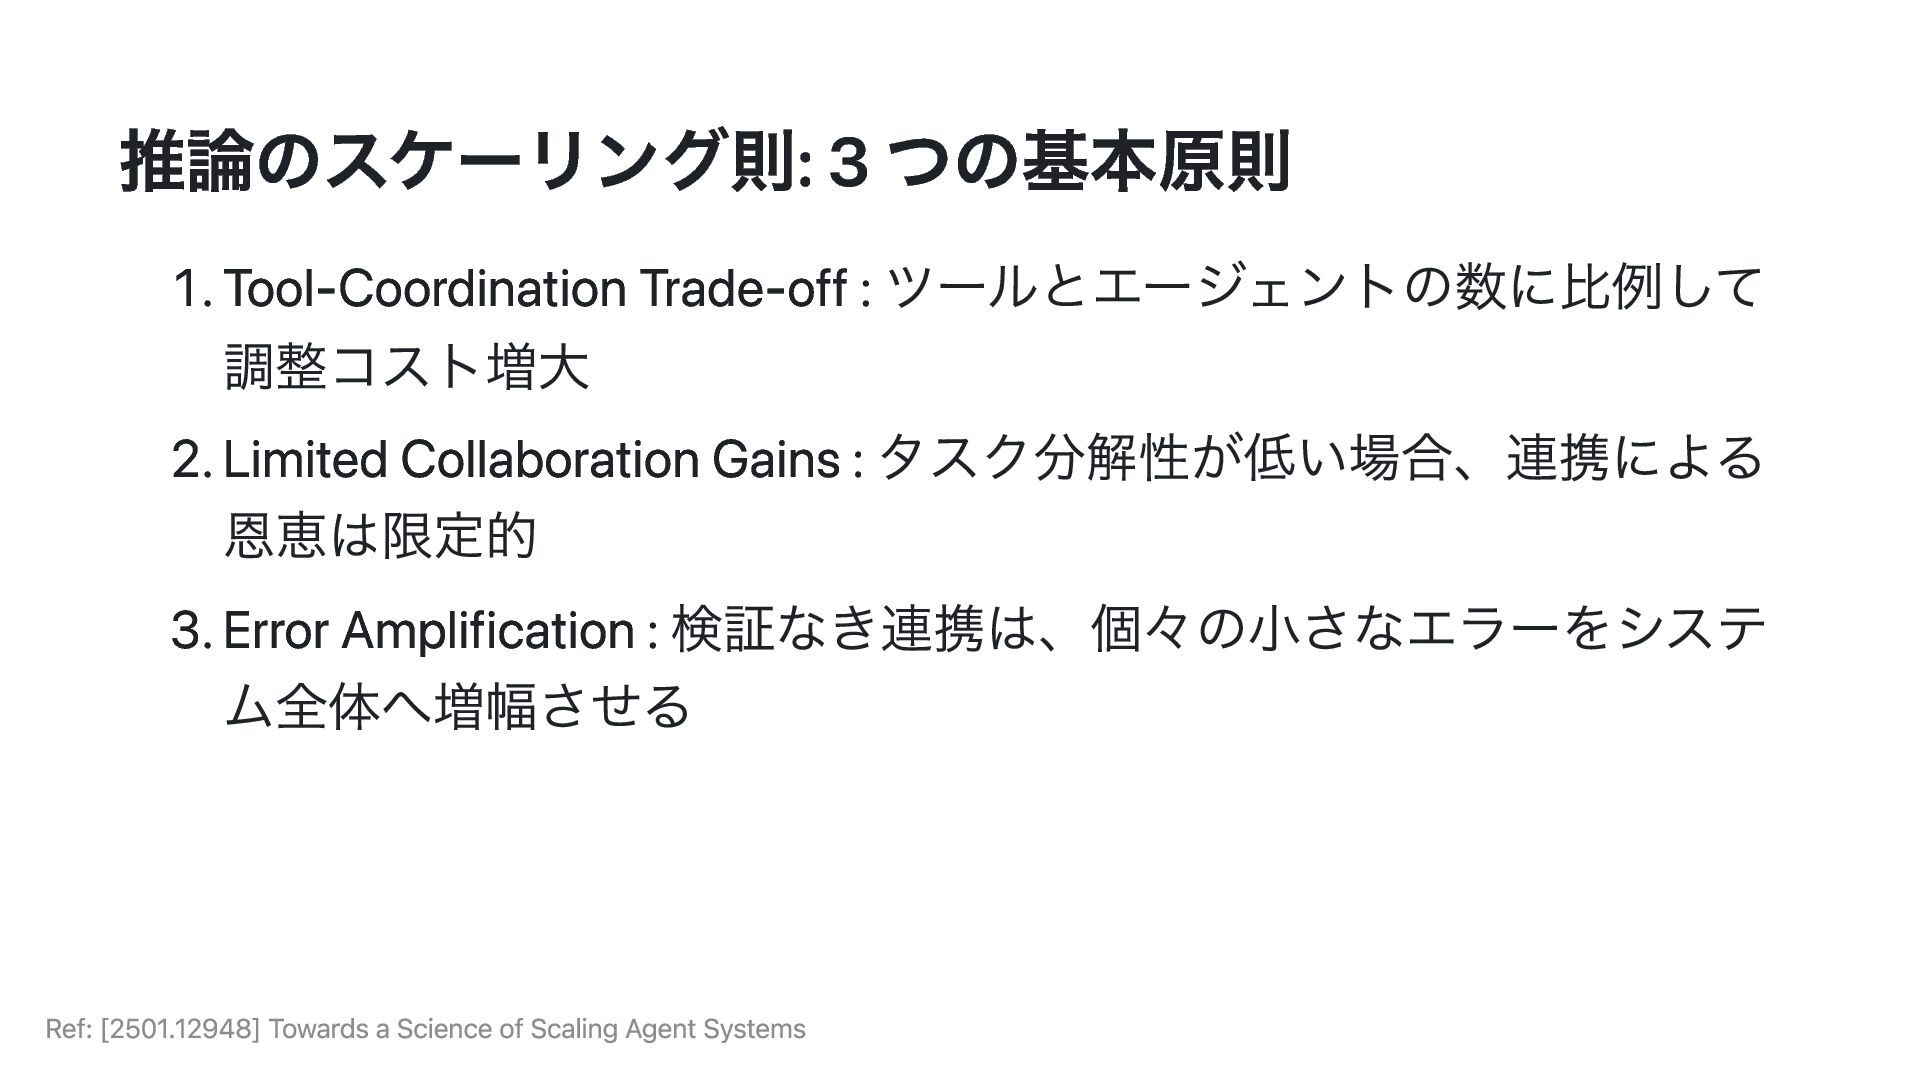
  25. 推論のスケーリング則: 3 つの基本原則 1. Tool-Coordination Trade-off : ツールとエージェントの数に比例して 調整コスト増大 2.

    Limited Collaboration Gains : タスク分解性が低い場合、連携による 恩恵は限定的 3. Error Amplification : 検証なき連携は、個々の小さなエラーをシステ ム全体へ増幅させる Ref: [2501.12948] Towards a Science of Scaling Agent Systems
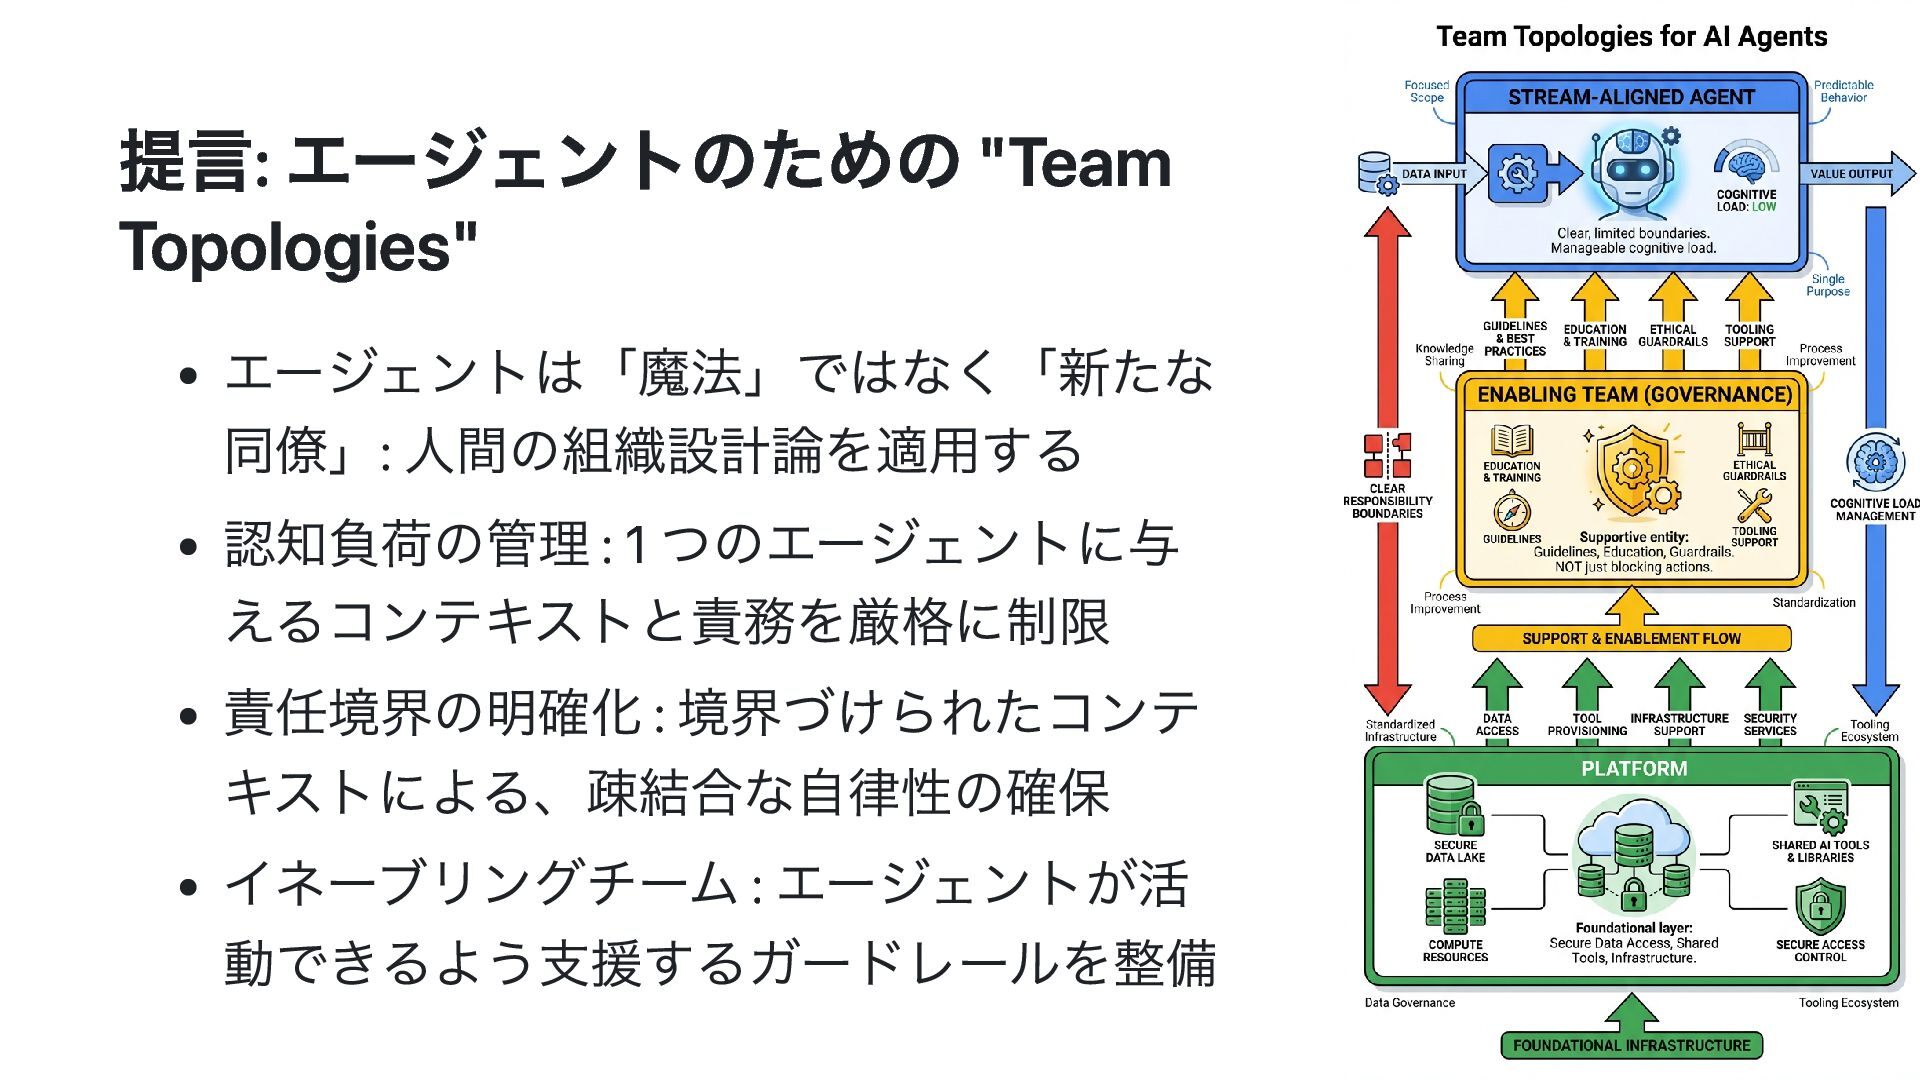
  26. 提言: エージェントのための "Team Topologies" エージェントは「魔法」ではなく「新たな 同僚」: 人間の組織設計論を適用する 認知負荷の管理 : 1

    つのエージェントに与 えるコンテキストと責務を厳格に制限 責任境界の明確化 : 境界づけられたコンテ キストによる、疎結合な自律性の確保 イネーブリングチーム : エージェントが活 動できるよう支援するガードレールを整備
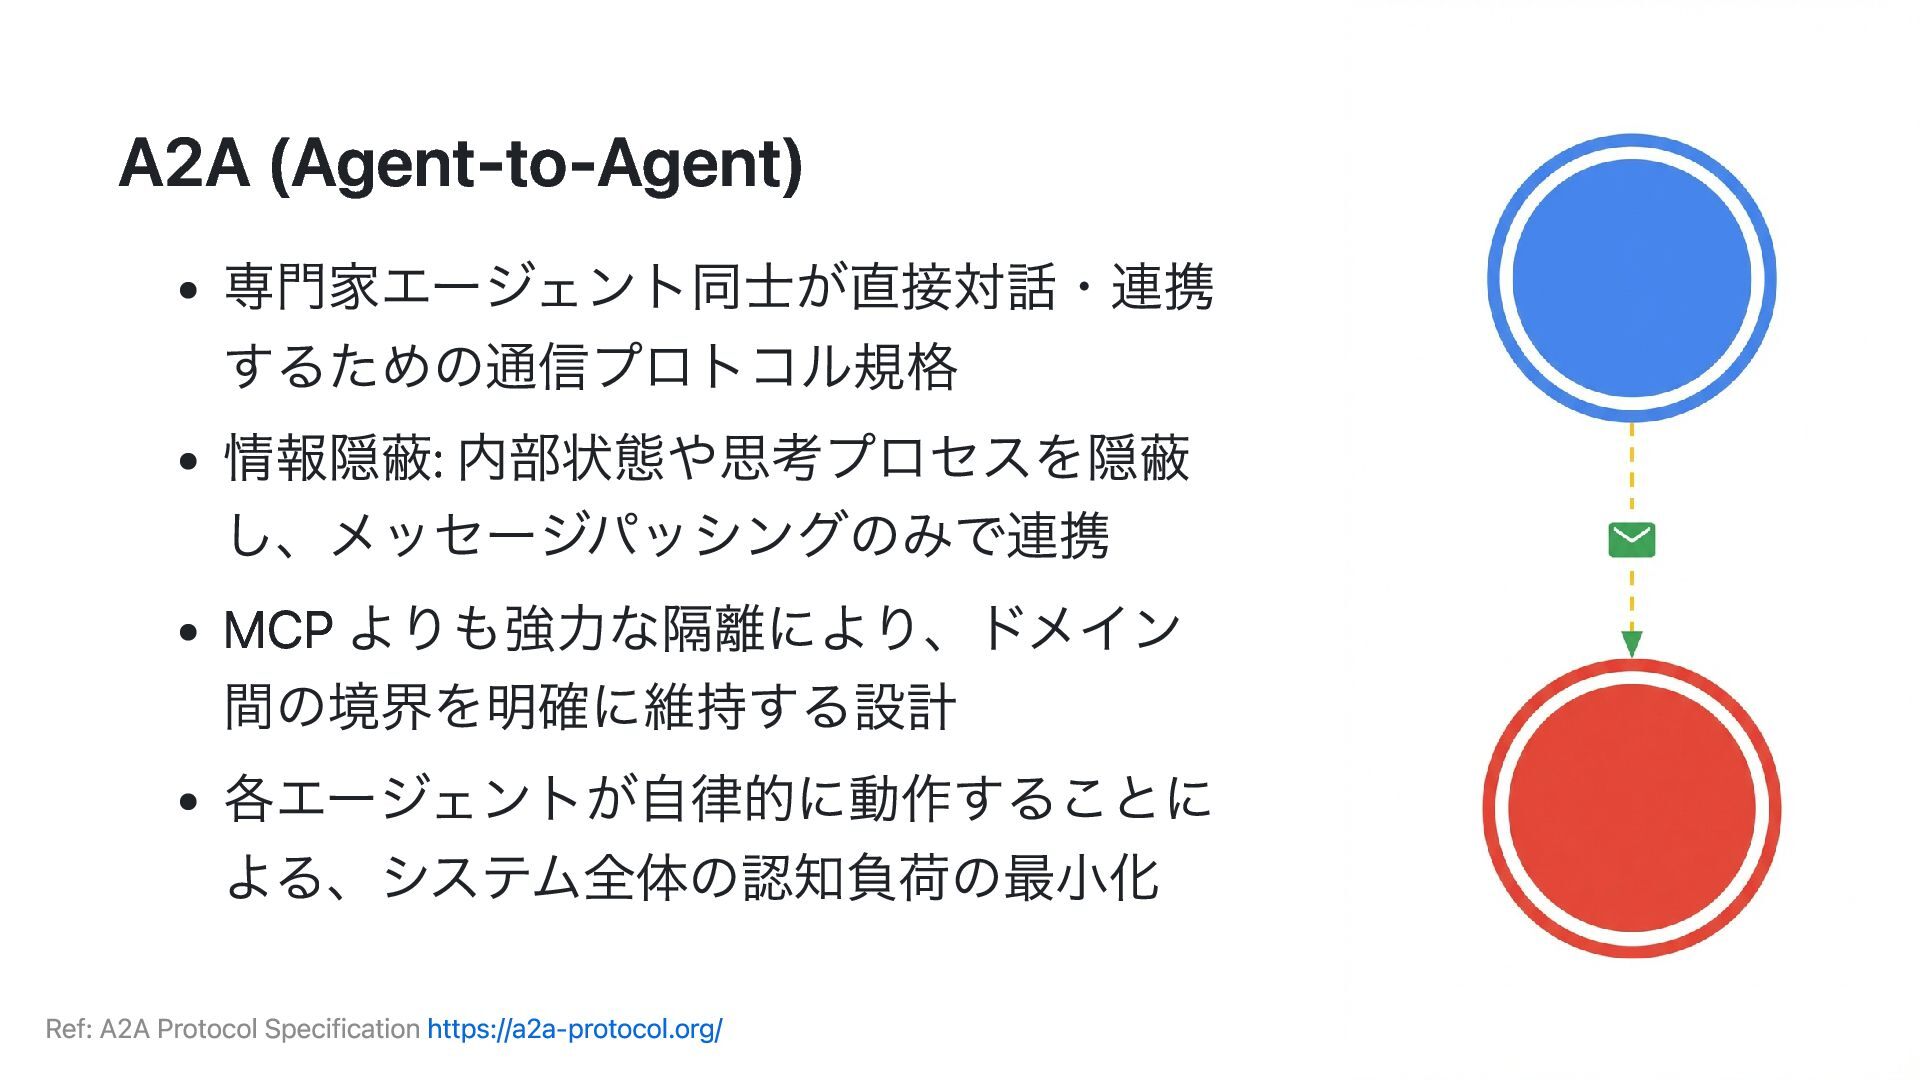
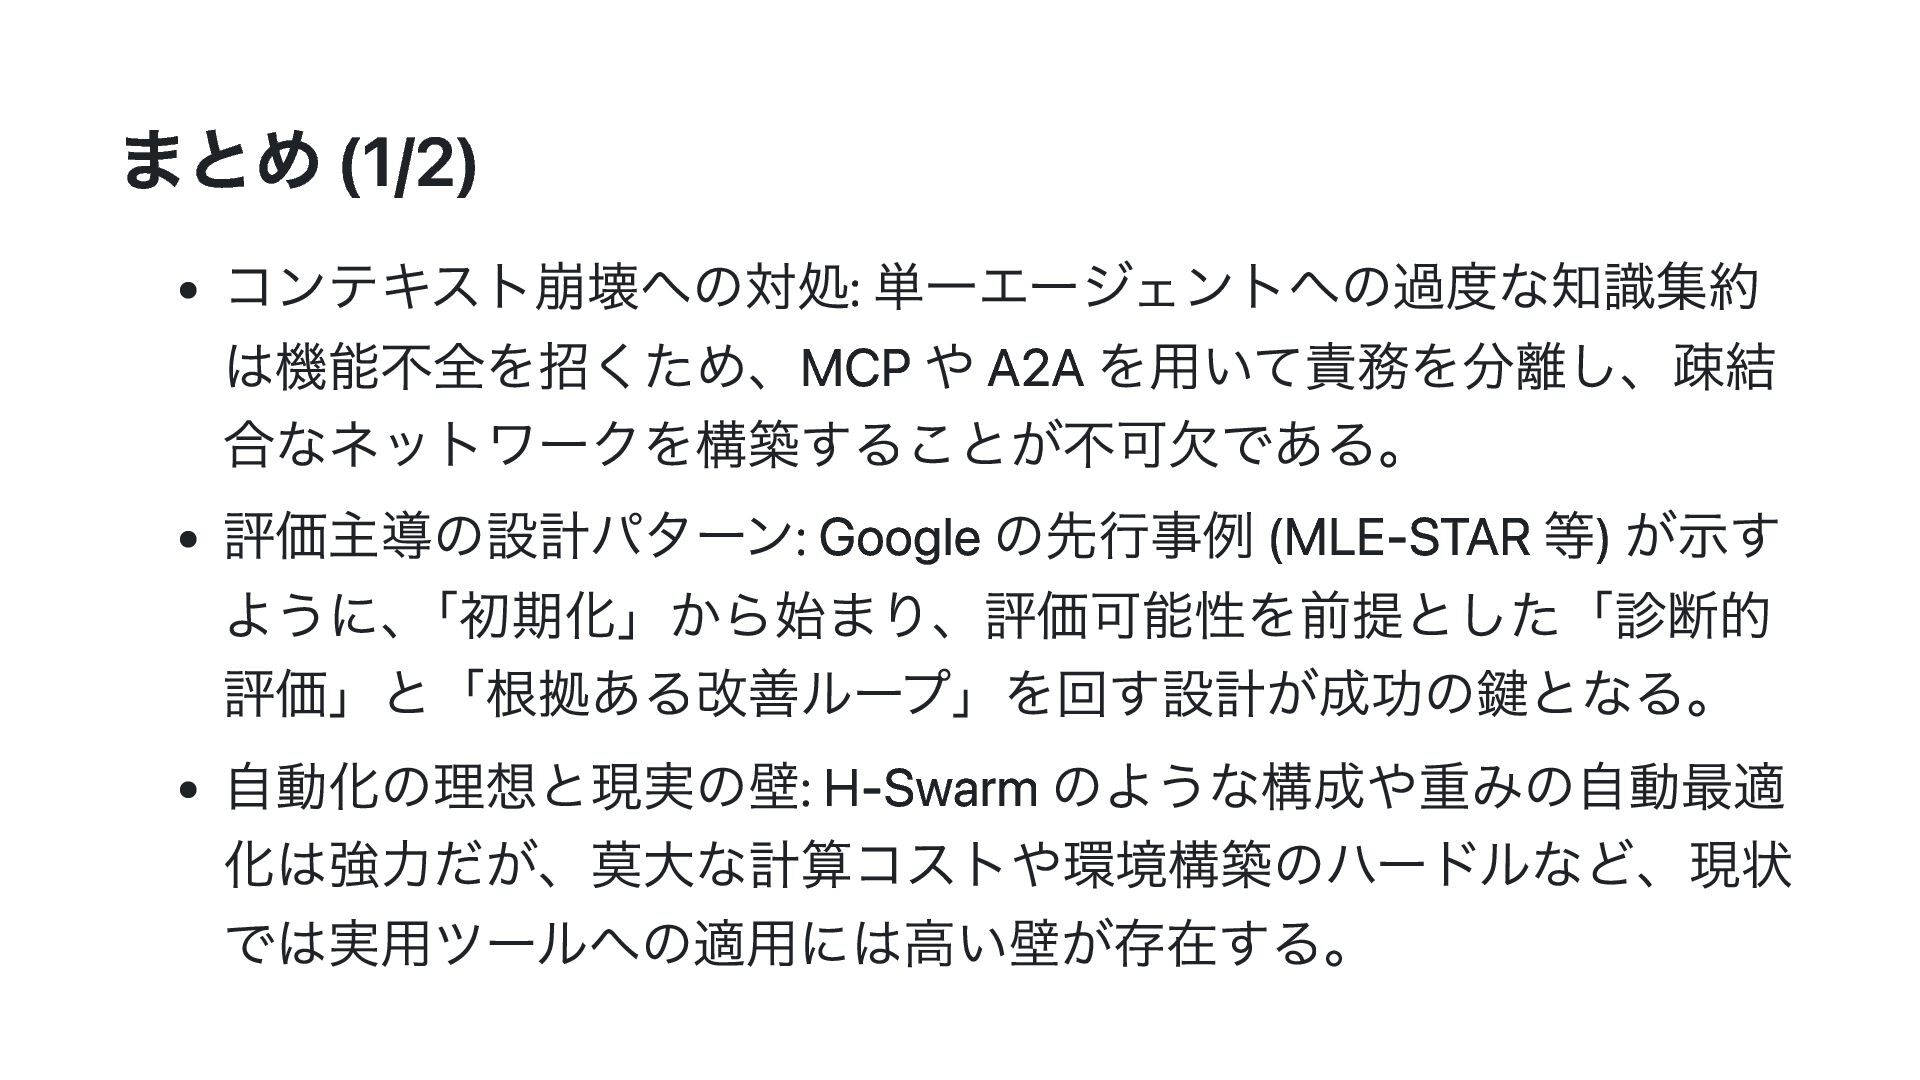
  27. まとめ (1/2) コンテキスト崩壊への対処: 単一エージェントへの過度な知識集約 は機能不全を招くため、MCP や A2A を用いて責務を分離し、疎結 合なネットワークを構築することが不可欠である。 評価主導の設計パターン:

    Google の先行事例 (MLE-STAR 等) が示す ように、 「初期化」から始まり、評価可能性を前提とした「診断的 評価」と「根拠ある改善ループ」を回す設計が成功の鍵となる。 自動化の理想と現実の壁: H-Swarm のような構成や重みの自動最適 化は強力だが、莫大な計算コストや環境構築のハードルなど、現状 では実用ツールへの適用には高い壁が存在する。
  28. 参考文献 (References) Context Engineering 2.0: [2510.26493] Context Engineering 2.0: The

    Context of Context Engineering MLE-STAR: [2506.15692] MLE-STAR: Machine Learning Engineering Agent via Search and Targeted Refinement DS-STAR: [2509.21825] DS-STAR: Data Science Agent via Iterative Planning and Verification PlanGen: [2411.02275] PlanGen: A Multi-Agent Framework for Generating Planning and Reasoning Trajectories MASS: [2502.02533] Multi-Agent Design: Optimizing Agents with Better Prompts and Topologies
  29. 参考文献 (References) H-Swarm: [2502.13840] Heterogeneous Swarms: Jointly Optimizing Model Roles

    and Weights Scaling Agent Systems: [2501.12948] Towards a Science of Scaling Agent Systems MCP: Model Context Protocol Specification (Anthropic / community- led) Skills: Agent Skills Standard (https://agentskills.io/) A2A: Agent-to-Agent Protocol (https://a2a-protocol.org/)

More Decks by Asei Sugiyama

Other Decks in Technology