Upgrade to Pro
— share decks privately, control downloads, hide ads and more …
Speaker Deck
Sign up for free
Menu
Search
Features
All features
Private URLs
Password Protection
Custom URLS
Scheduled publishing
Remove Branding
Restrict embedding
Deck Collections
Notes
Features
All features
Private URLs
Password Protection
Custom URLS
Scheduled publishing
Remove Branding
Restrict embedding
Deck Collections
Notes
Explore
Featured decks
Featured speakers
Programming
Technology
Storyboards
Explore
Featured decks
Featured speakers
Programming
Technology
Storyboards
Pricing
Search
Sign in
Sign up for free
RAGの改善を速く回すための評価基盤
Search
Sponsored
·
SiteGround - Reliable hosting with speed, security, and support you can count on.
→
yosukeyoshida
November 15, 2026
Technology
1.8k
4
Share
Embed
Copy iframe code
Copy JS code
Copy link
Start on current slide
RAGの改善を速く回すための評価基盤
AI本気で社会実装Night 2026/11/16
yosukeyoshida
November 15, 2026
Transcript
10 slides
AI本気で社会実装Night · 2026.11.16 RAGの改善を速く回すための評価基盤 株式会社LayerX バクラク事業部 機械学習エンジニア 吉田 陽祐
目次 01 背景 ヘルプデスク エージェントと RAG 改善の難しさ 02 評価基盤 評価セットの作成と採点
03 事例 回答を簡潔にする改善 04 まとめと今後の課題 © LayerX Inc. 2
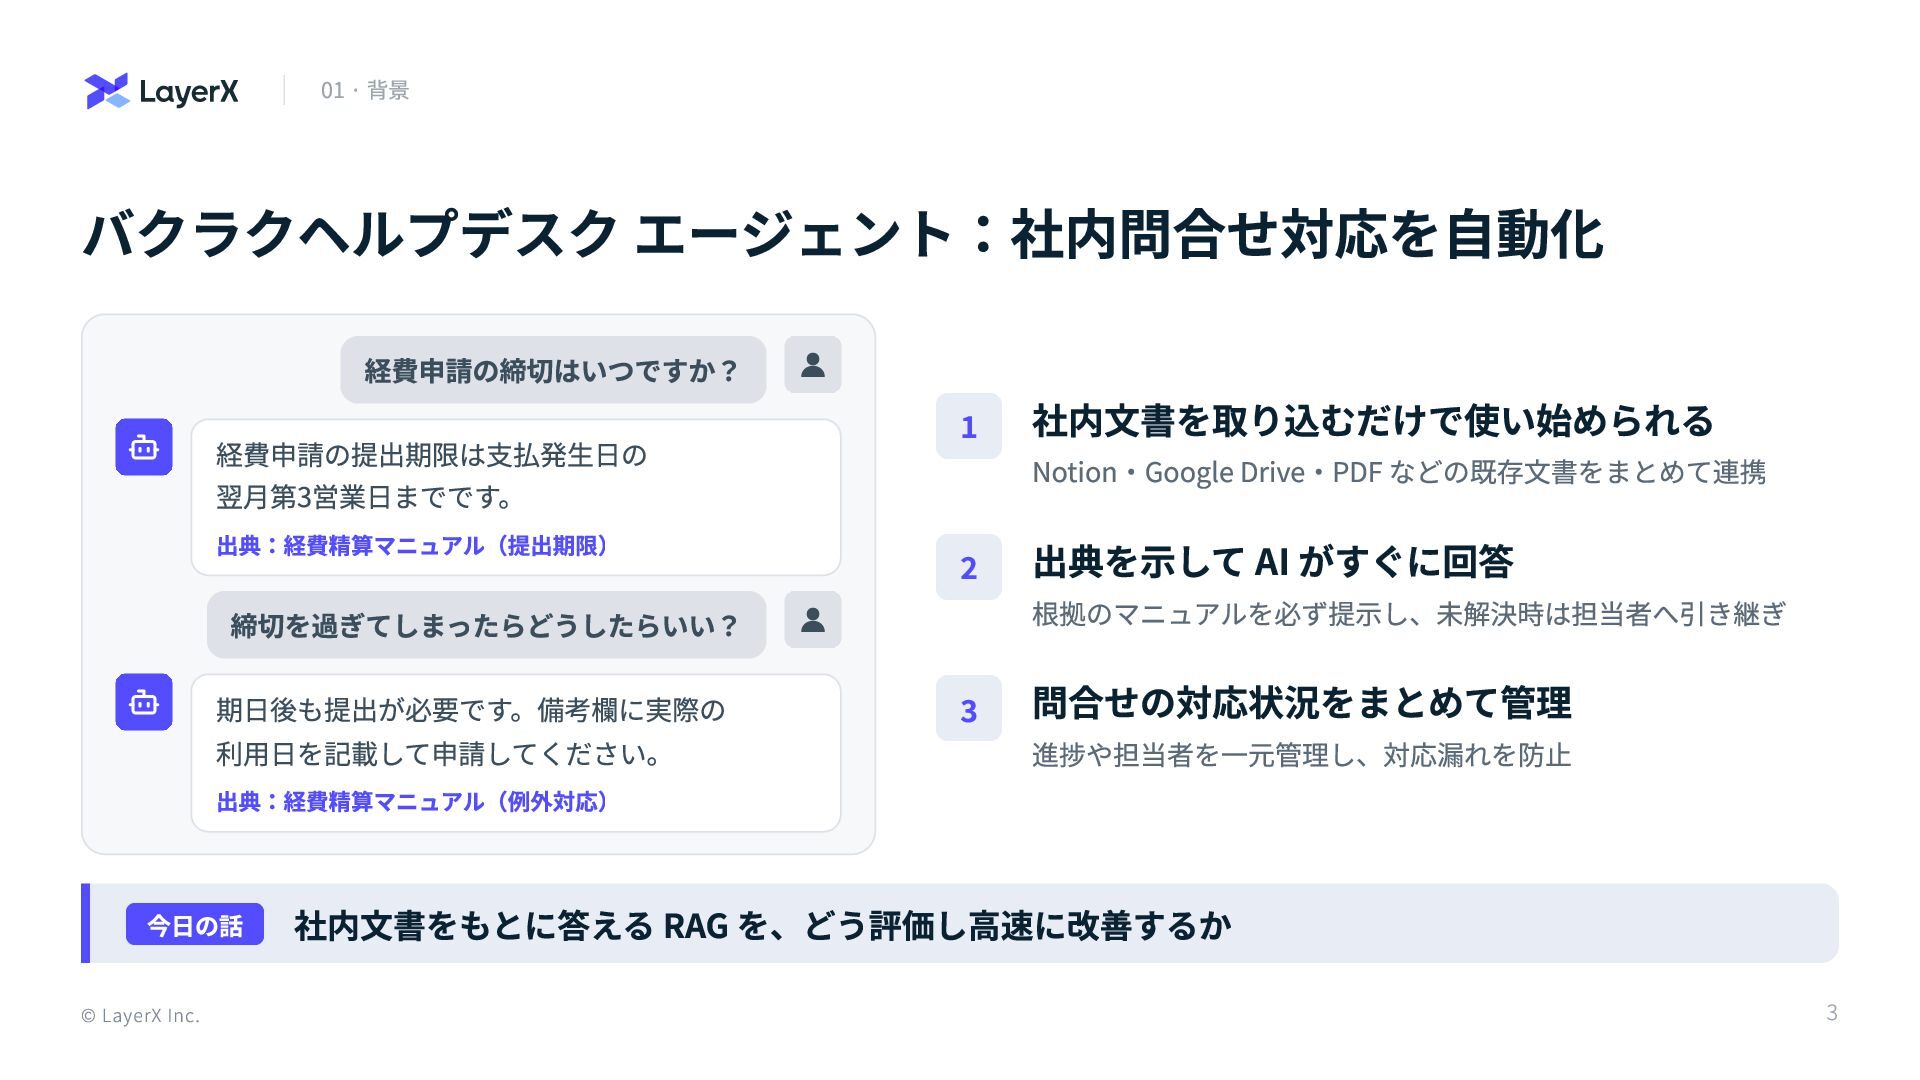
01 · 背景 バクラクヘルプデスク エージェント:社内問合せ対応を自動化 経費申請の締切はいつですか? 経費申請の提出期限は支払発生日の 翌月第3営業日までです。 出典:経費精算マニュアル(提出期限) 締切を過ぎてしまったらどうしたらいい?
期日後も提出が必要です。備考欄に実際の 利用日を記載して申請してください。 出典:経費精算マニュアル(例外対応) 今日の話 © LayerX Inc. 1 社内文書を取り込むだけで使い始められる Notion・Google Drive・PDF などの既存文書をまとめて連携 2 出典を示して AI がすぐに回答 根拠のマニュアルを必ず提示し、未解決時は担当者へ引き継ぎ 3 問合せの対応状況をまとめて管理 進捗や担当者を一元管理し、対応漏れを防止 社内文書をもとに答える RAG を、どう評価し高速に改善するか 3
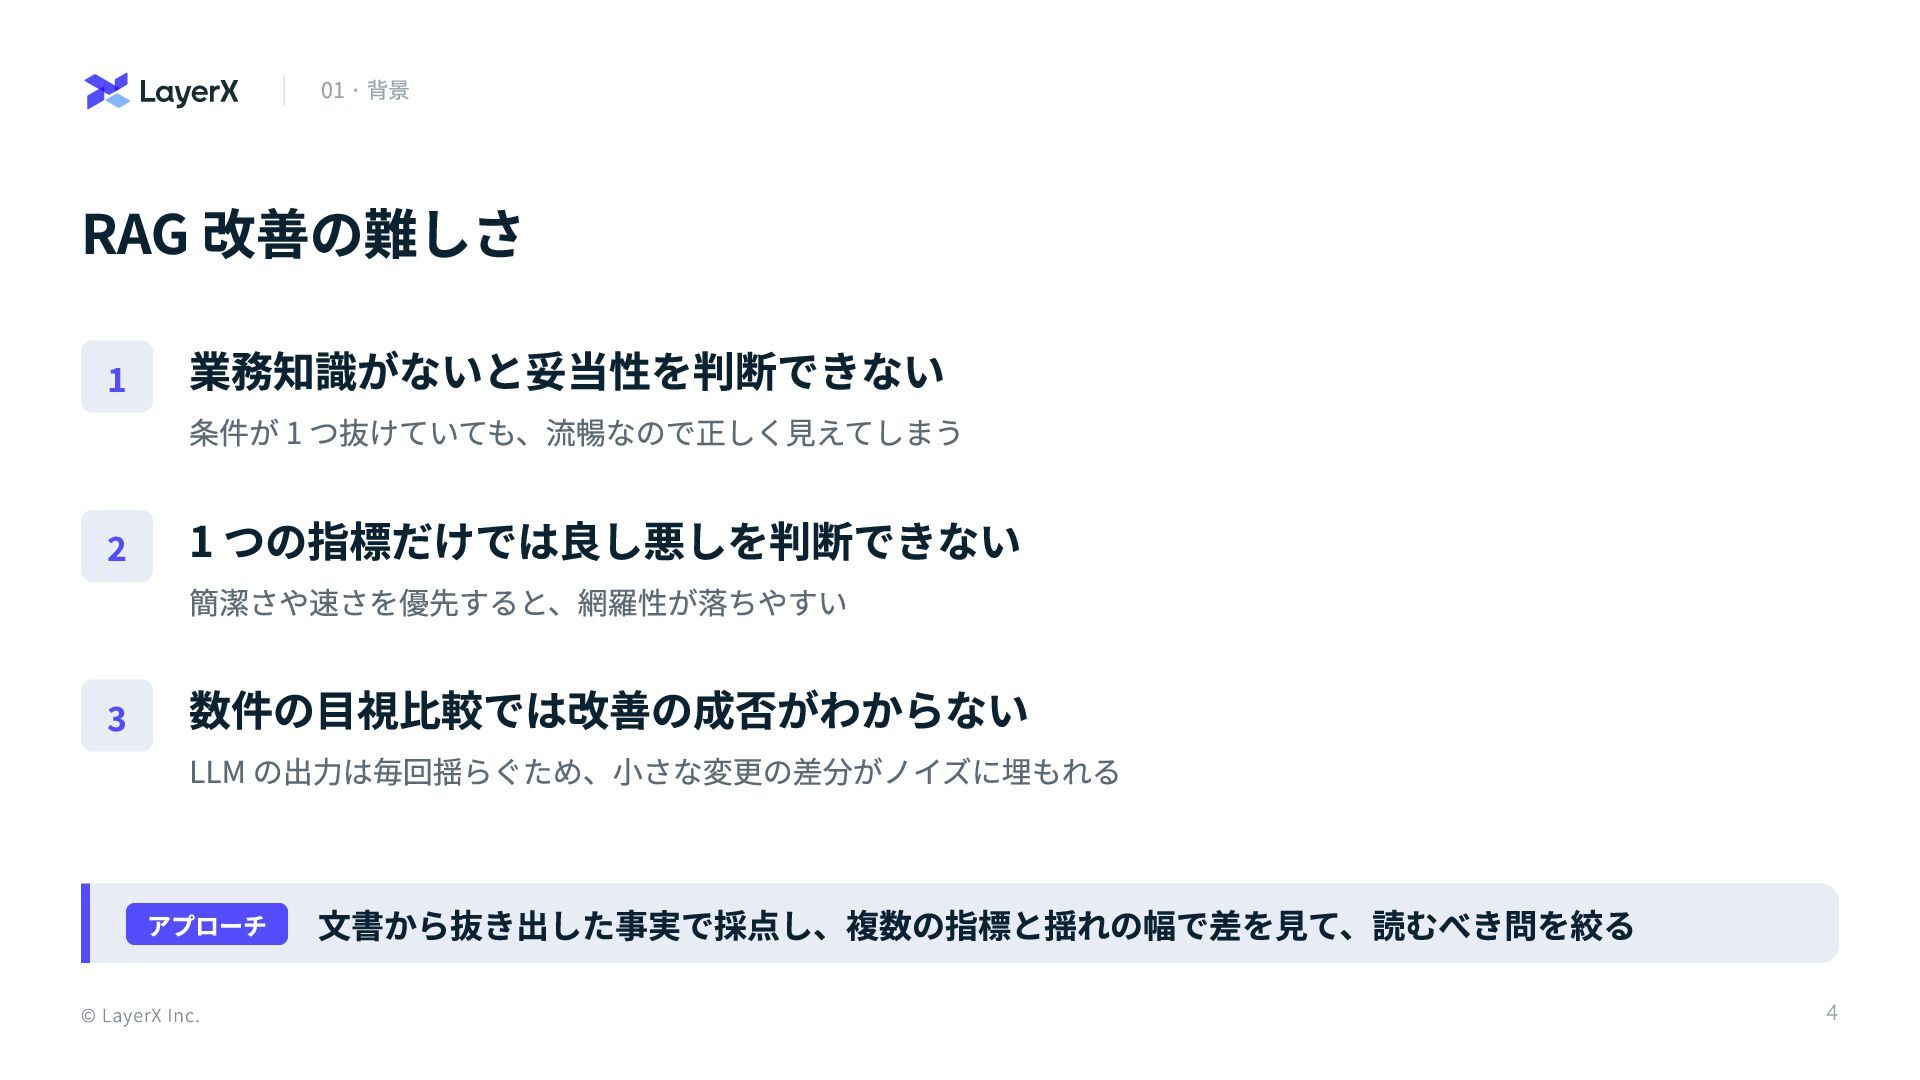
01 · 背景 RAG 改善の難しさ 1 業務知識がないと妥当性を判断できない 2 1 つの指標だけでは良し悪しを判断できない
3 数件の目視比較では改善の成否がわからない 条件が 1 つ抜けていても、流暢なので正しく見えてしまう 簡潔さや速さを優先すると、網羅性が落ちやすい LLM の出力は毎回揺らぐため、小さな変更の差分がノイズに埋もれる アプローチ © LayerX Inc. 文書から抜き出した事実で採点し、複数の指標と揺れの幅で差を見て、読むべき問を絞る 4
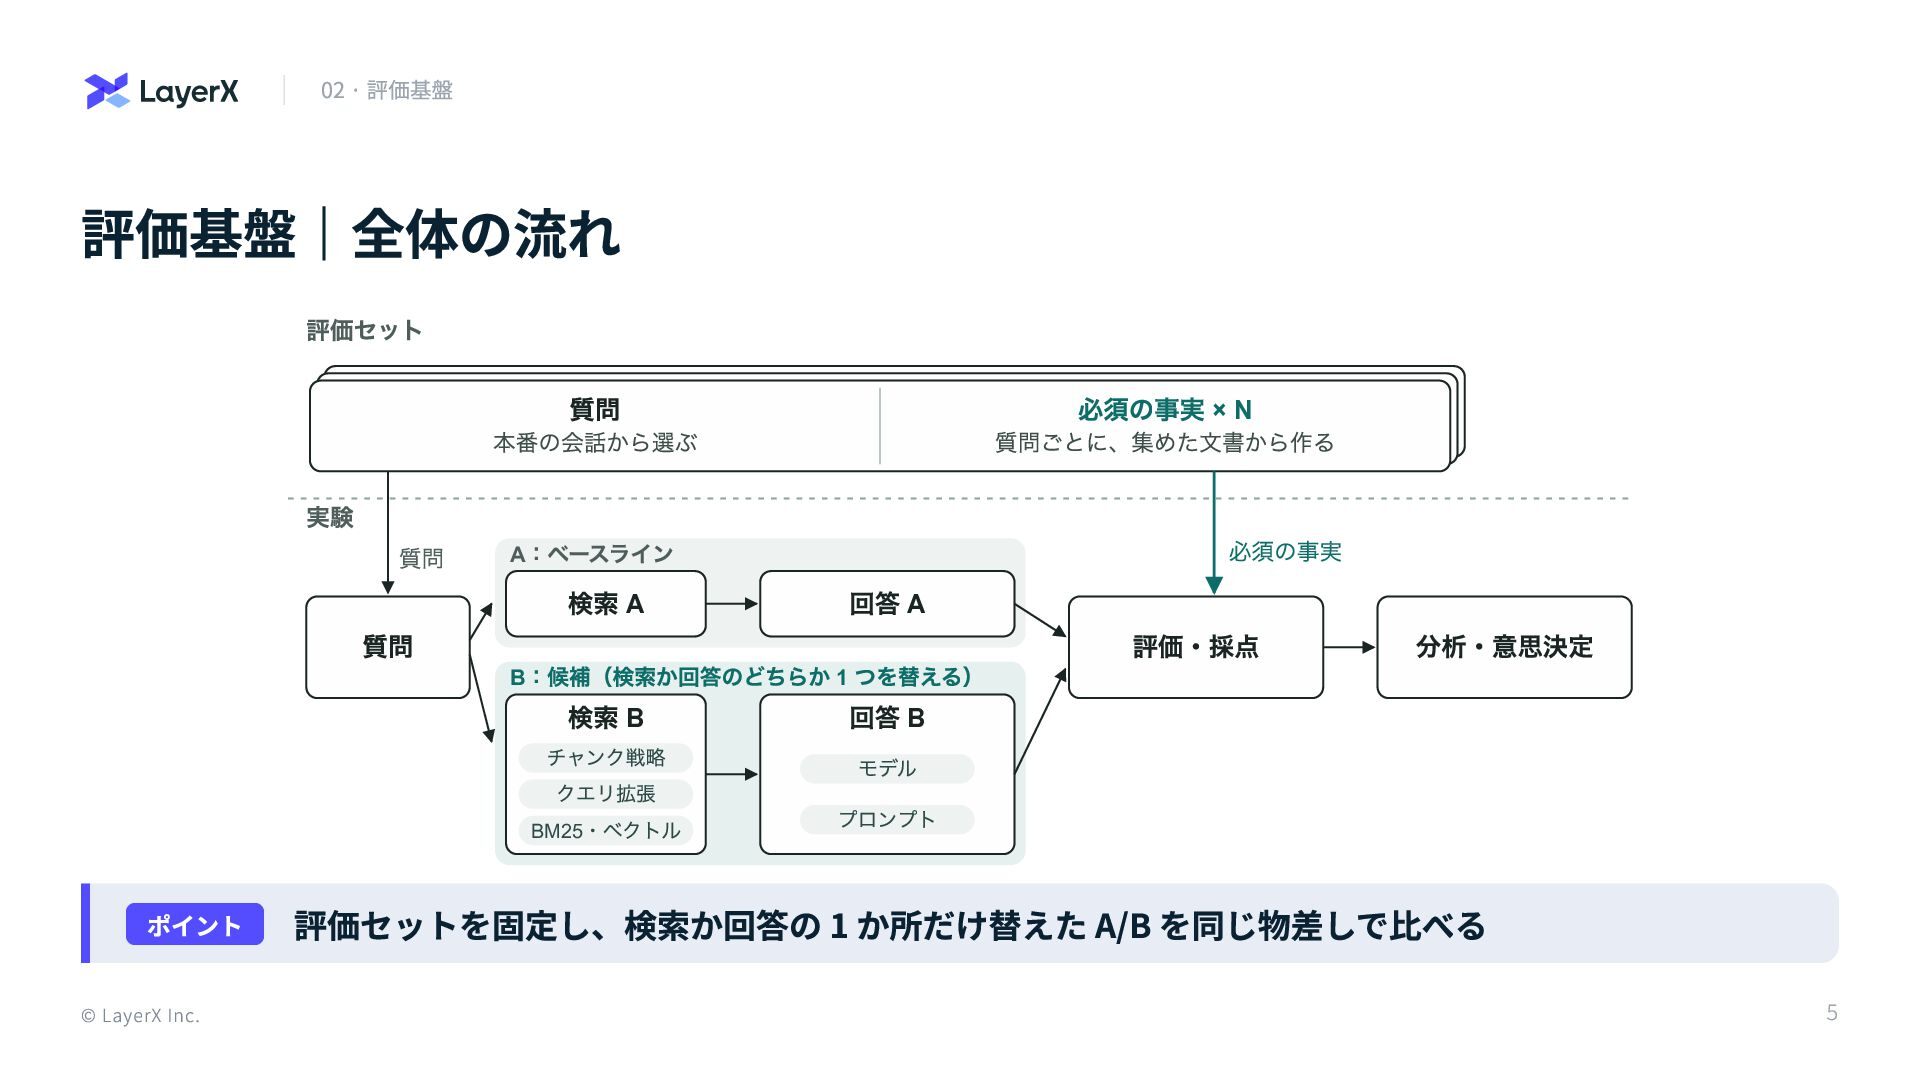
02 · 評価基盤 評価基盤|全体の流れ 評価セット 質問 実験 質問 質問 本番の会話から選ぶ
質問ごとに、集めた⽂書から作る :ベースライン 必須の事実 A 検索 A © LayerX Inc. 回答 A :候補(検索か回答のどちらか 1 つを替える) B 検索 B チャンク戦略 クエリ拡張 BM25・ベクトル ポイント 必須の事実 × N 評価・採点 分析・意思決定 回答 B モデル プロンプト 評価セットを固定し、検索か回答の 1 か所だけ替えた A/B を同じ物差しで比べる 5
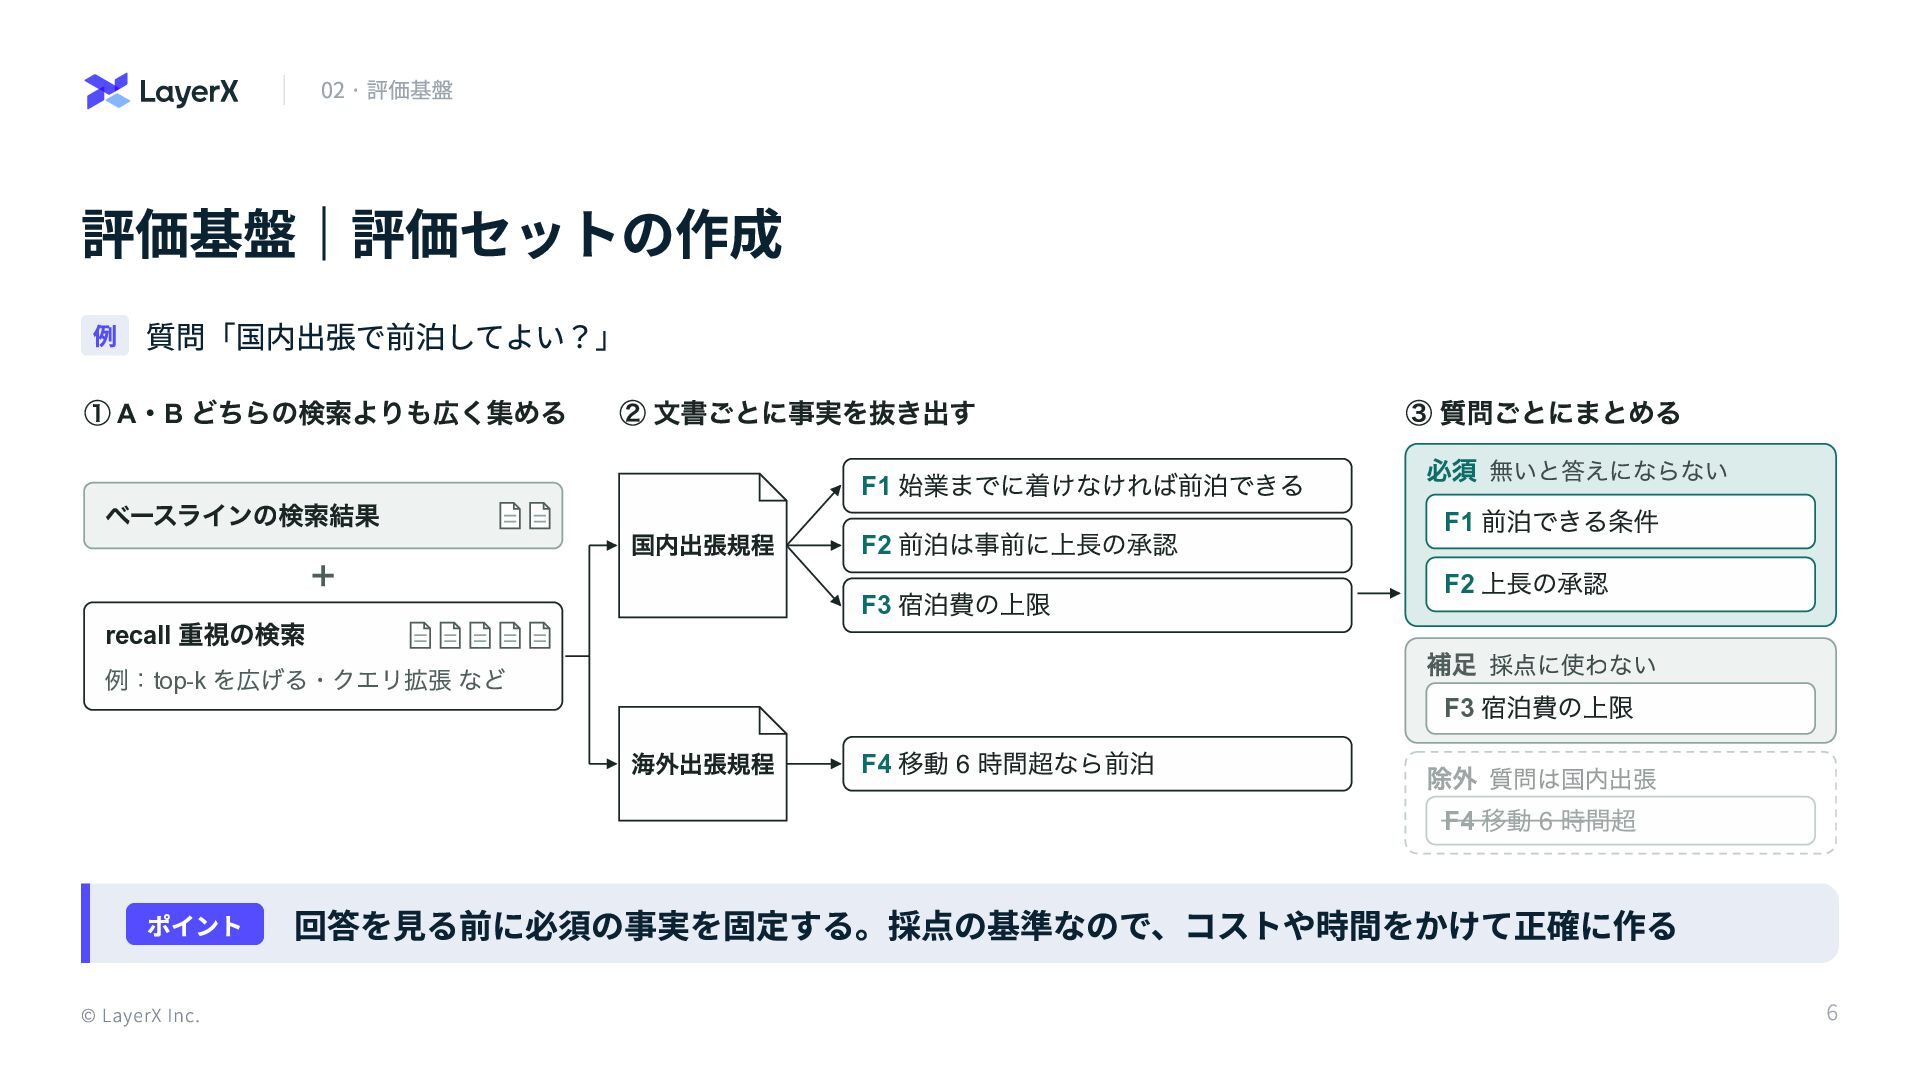
02 · 評価基盤 評価基盤|評価セットの作成 例 質問「国内出張で前泊してよい?」 ① A・B どちらの検索よりも広く集める ②
⽂書ごとに事実を抜き出す ベースラインの検索結果 recall 重視の検索 + 始業までに着けなければ前泊できる F2 前泊は事前に上⻑の承認 F3 宿泊費の上限 F1 国内出張規程 例:top-k を広げる・クエリ拡張 など 海外出張規程 ポイント © LayerX Inc. F4 移動 6 時間超なら前泊 ③ 質問ごとにまとめる 必須 無いと答えにならない F1 前泊できる条件 F2 上⻑の承認 補⾜ 採点に使わない F3 宿泊費の上限 除外 質問は国内出張 F4 移動 6 時間超 回答を見る前に必須の事実を固定する。採点の基準なので、コストや時間をかけて正確に作る 6
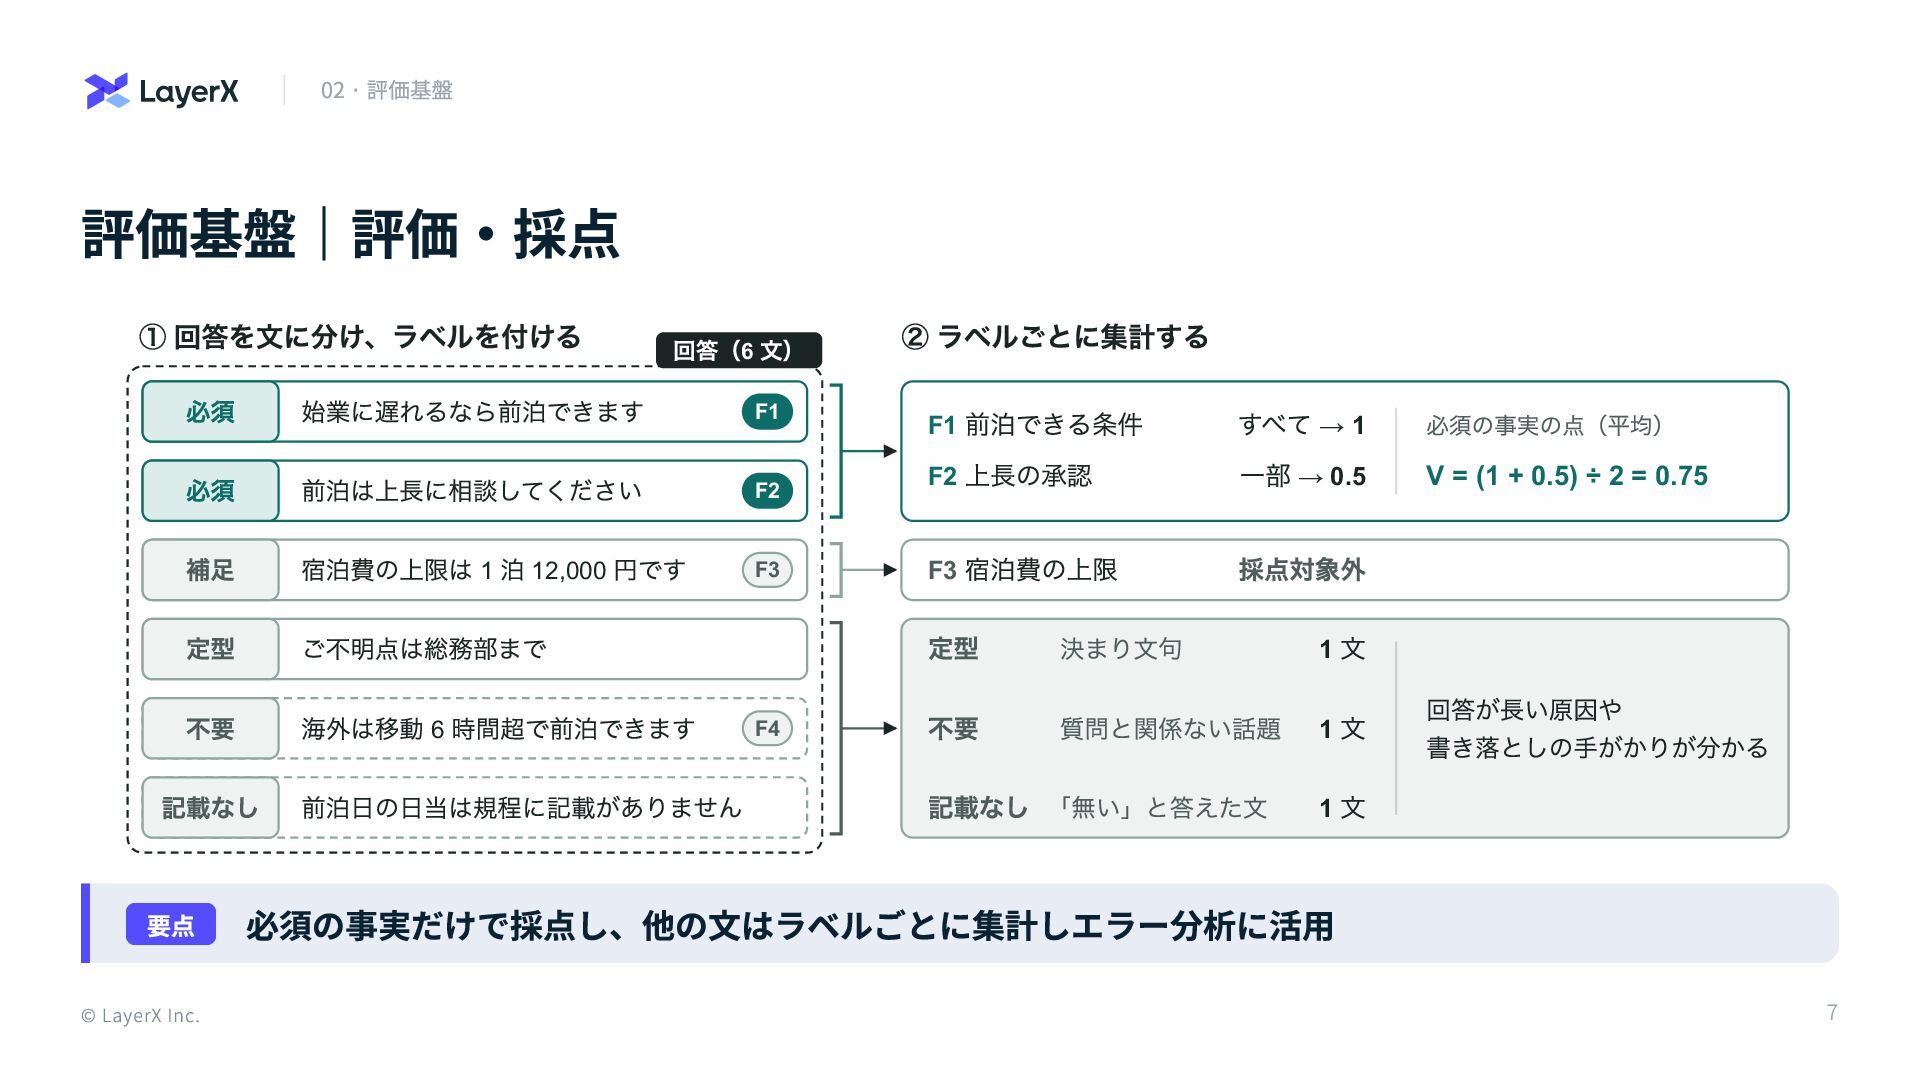
02 · 評価基盤 評価基盤|評価・採点 ① 回答を⽂に分け、ラベルを付ける 回答(6 ⽂) 必須 始業に遅れるなら前泊できます
必須 前泊は上⻑に相談してください 補⾜ 宿泊費の上限は 1 泊 12,000 円です 定型 ご不明点は総務部まで 不要 海外は移動 6 時間超で前泊できます 記載なし 前泊⽇の⽇当は規程に記載がありません 要点 © LayerX Inc. ② ラベルごとに集計する F2 前泊できる条件 F2 上⻑の承認 すべて → 1 ⼀部 → 0.5 F3 F3 宿泊費の上限 採点対象外 F1 F4 F1 定型 決まり⽂句 1 ⽂ 不要 質問と関係ない話題 1 ⽂ 記載なし 「無い」と答えた⽂ 1 ⽂ 必須の事実の点(平均) V = (1 + 0.5) ÷ 2 = 0.75 回答が⻑い原因や 書き落としの⼿がかりが分かる 必須の事実だけで採点し、他の文はラベルごとに集計しエラー分析に活用 7
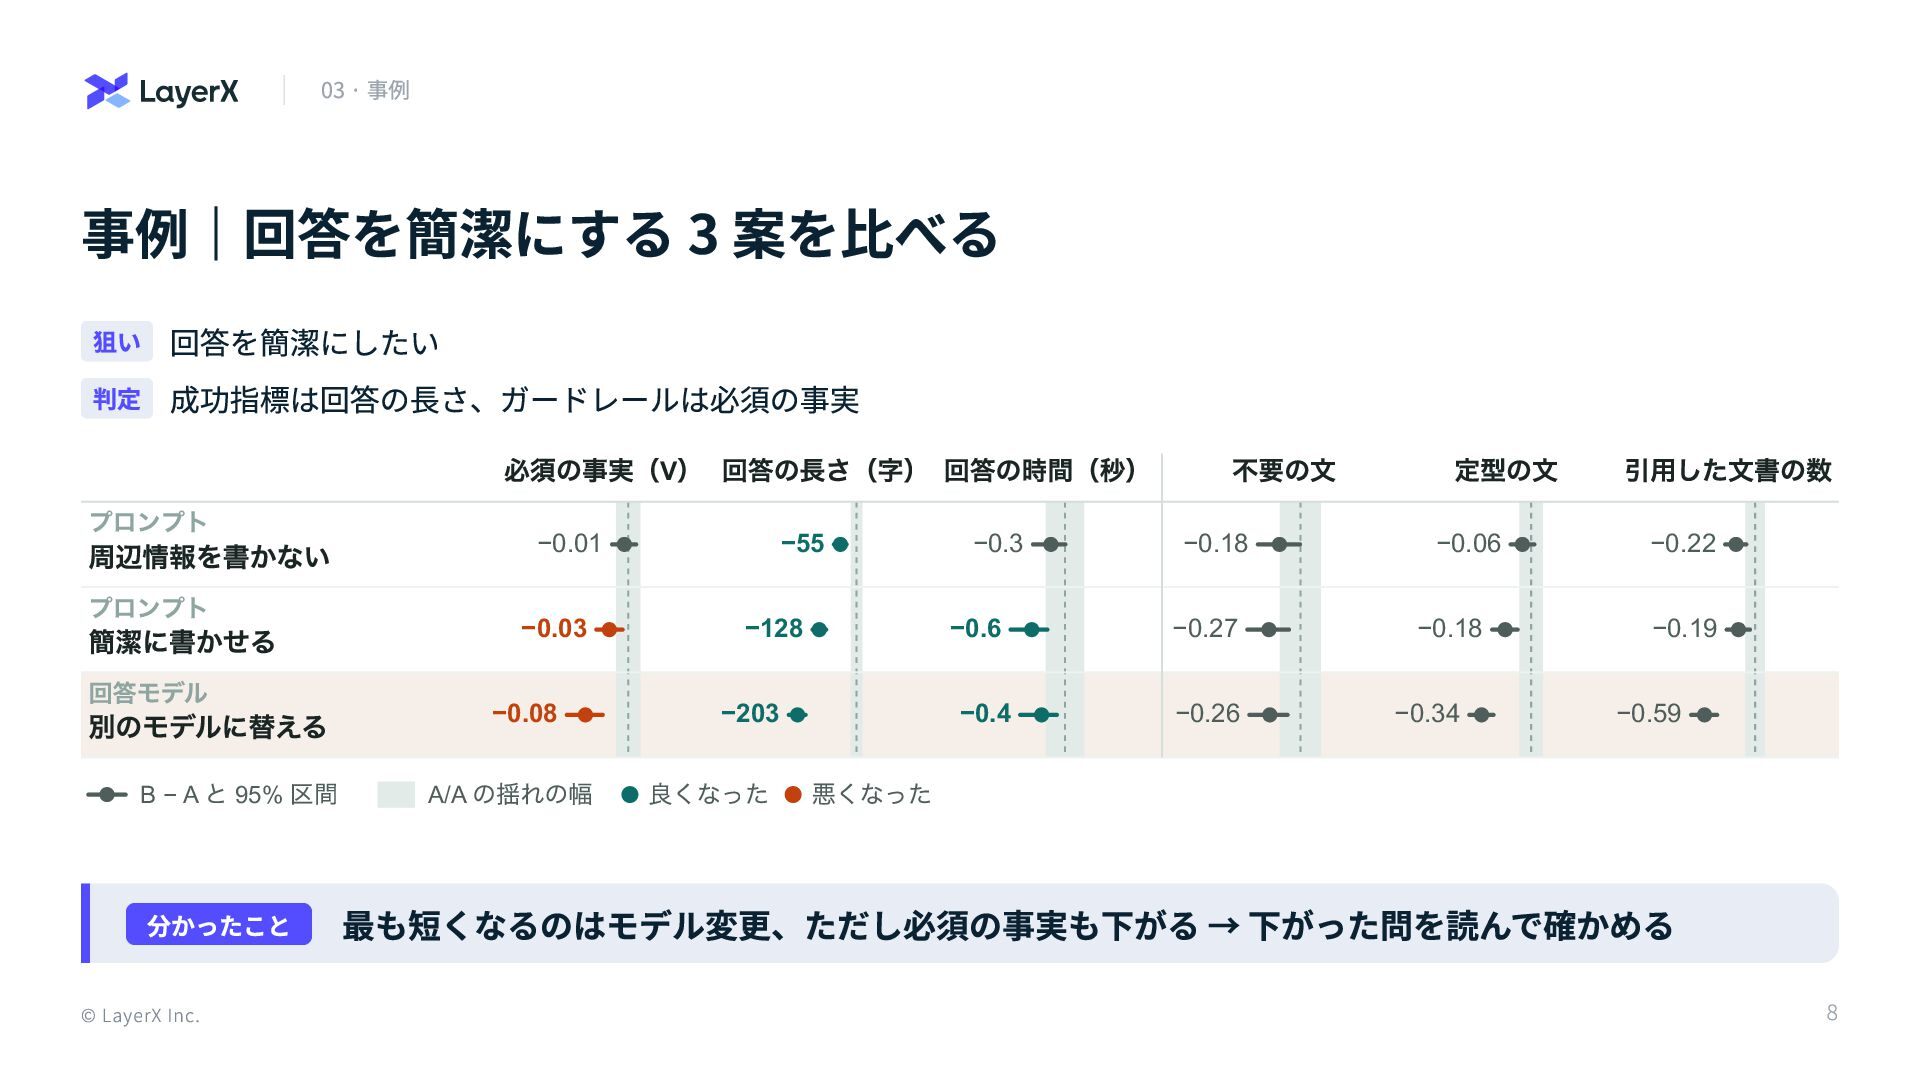
03 · 事例 事例|回答を簡潔にする 3 案を比べる 狙い 回答を簡潔にしたい 判定 成功指標は回答の長さ、ガードレールは必須の事実
必須の事実(V) 回答の⻑さ(字) 回答の時間(秒) プロンプト 周辺情報を書かない −0.01 簡潔に書かせる −0.03 プロンプト 回答モデル 別のモデルに替える B−A と 95% 区間 分かったこと © LayerX Inc. −0.08 A/A の揺れの幅 −55 −128 −203 −0.3 不要の⽂ −0.18 −0.6 −0.27 −0.4 −0.26 定型の⽂ −0.06 −0.18 −0.34 引⽤した⽂書の数 −0.22 −0.19 −0.59 良くなった 悪くなった 最も短くなるのはモデル変更、ただし必須の事実も下がる → 下がった問を読んで確かめる 8
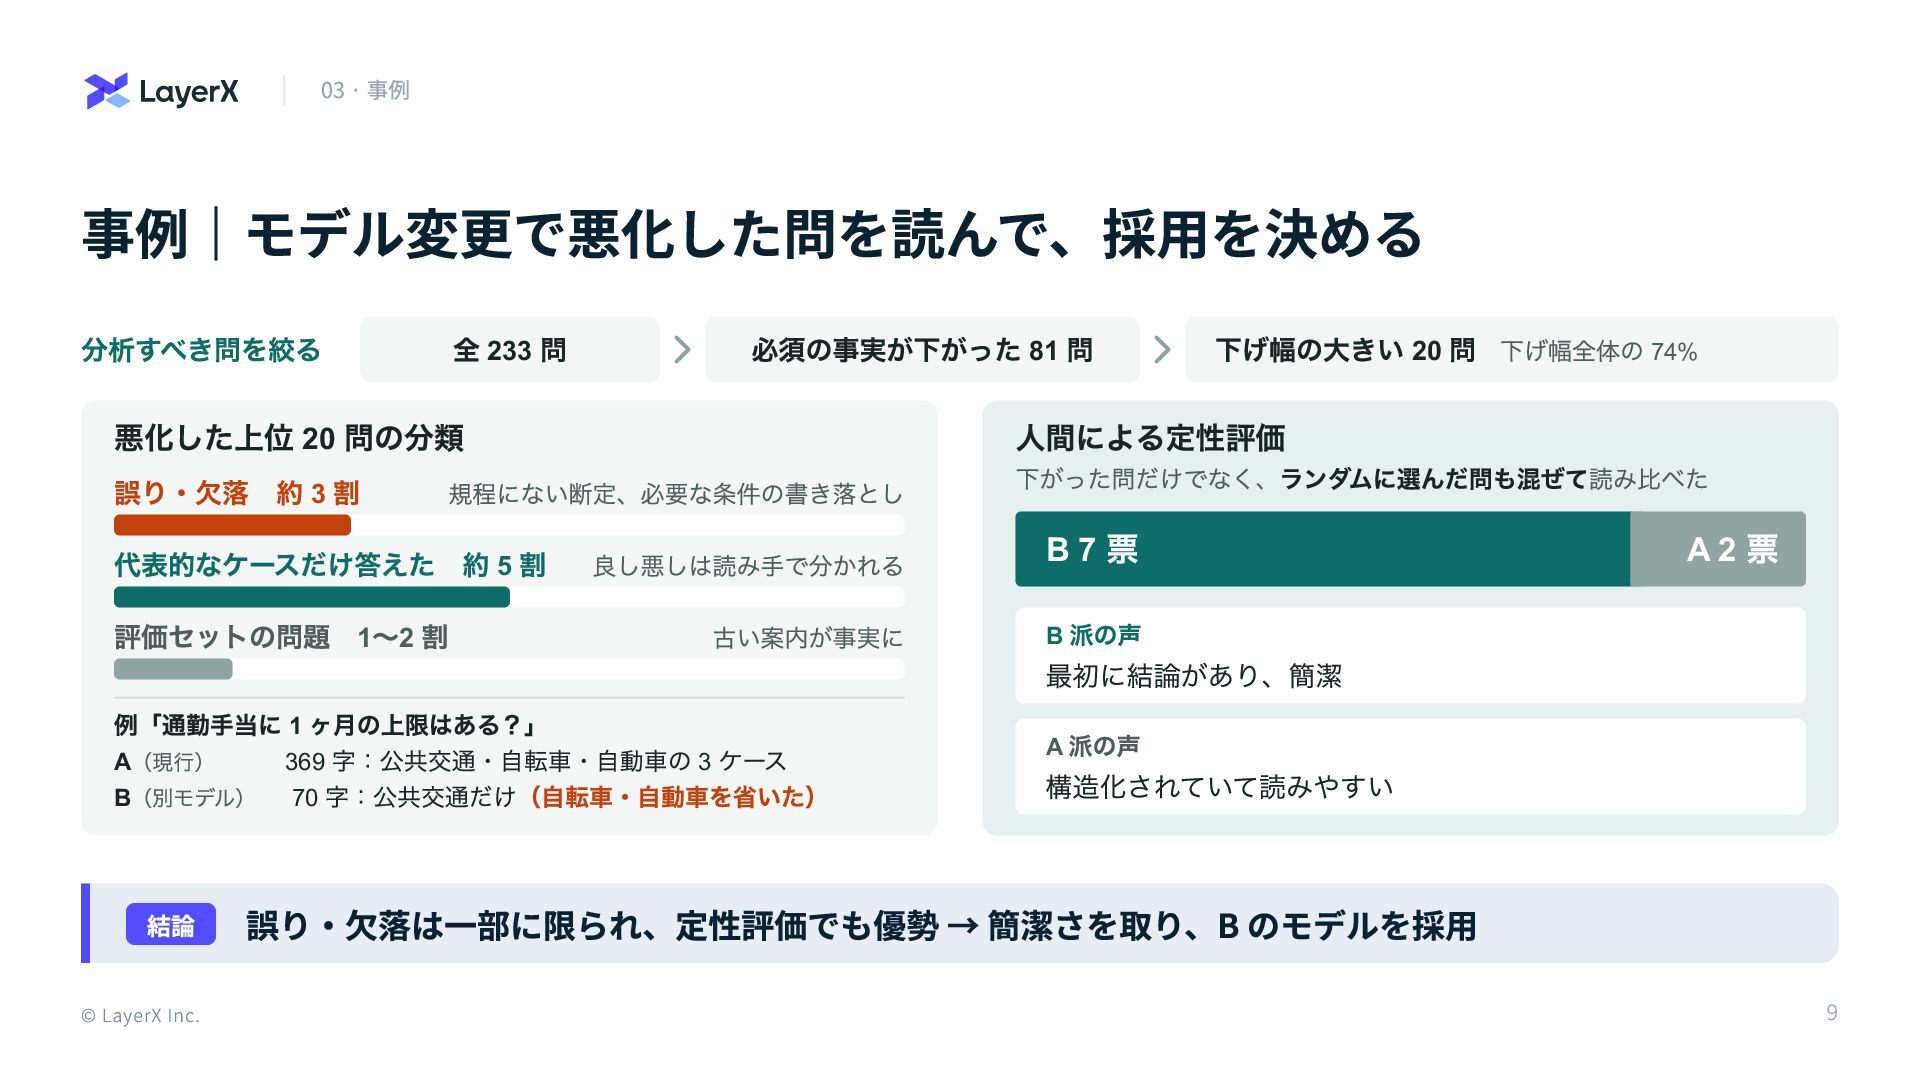
03 · 事例 事例|モデル変更で悪化した問を読んで、採用を決める 分析すべき問を絞る 全 233 問 必須の事実が下がった 81
問 悪化した上位 20 問の分類 誤り・⽋落 約 3 割 規程にない断定、必要な条件の書き落とし 代表的なケースだけ答えた 約 5 割 良し悪しは読み⼿で分かれる 評価セットの問題 1〜2 割 古い案内が事実に 例「通勤⼿当に 1 ヶ⽉の上限はある?」 A(現⾏) 369 字:公共交通・⾃転⾞・⾃動⾞の 3 ケース B(別モデル) 70 字:公共交通だけ(⾃転⾞・⾃動⾞を省いた) 結論 © LayerX Inc. 下げ幅の⼤きい 20 問 下げ幅全体の 74% ⼈間による定性評価 下がった問だけでなく、ランダムに選んだ問も混ぜて読み⽐べた B7 票 B 派の声 A 派の声 A2 票 最初に結論があり、簡潔 構造化されていて読みやすい 誤り・欠落は一部に限られ、定性評価でも優勢 → 簡潔さを取り、B のモデルを採用 9
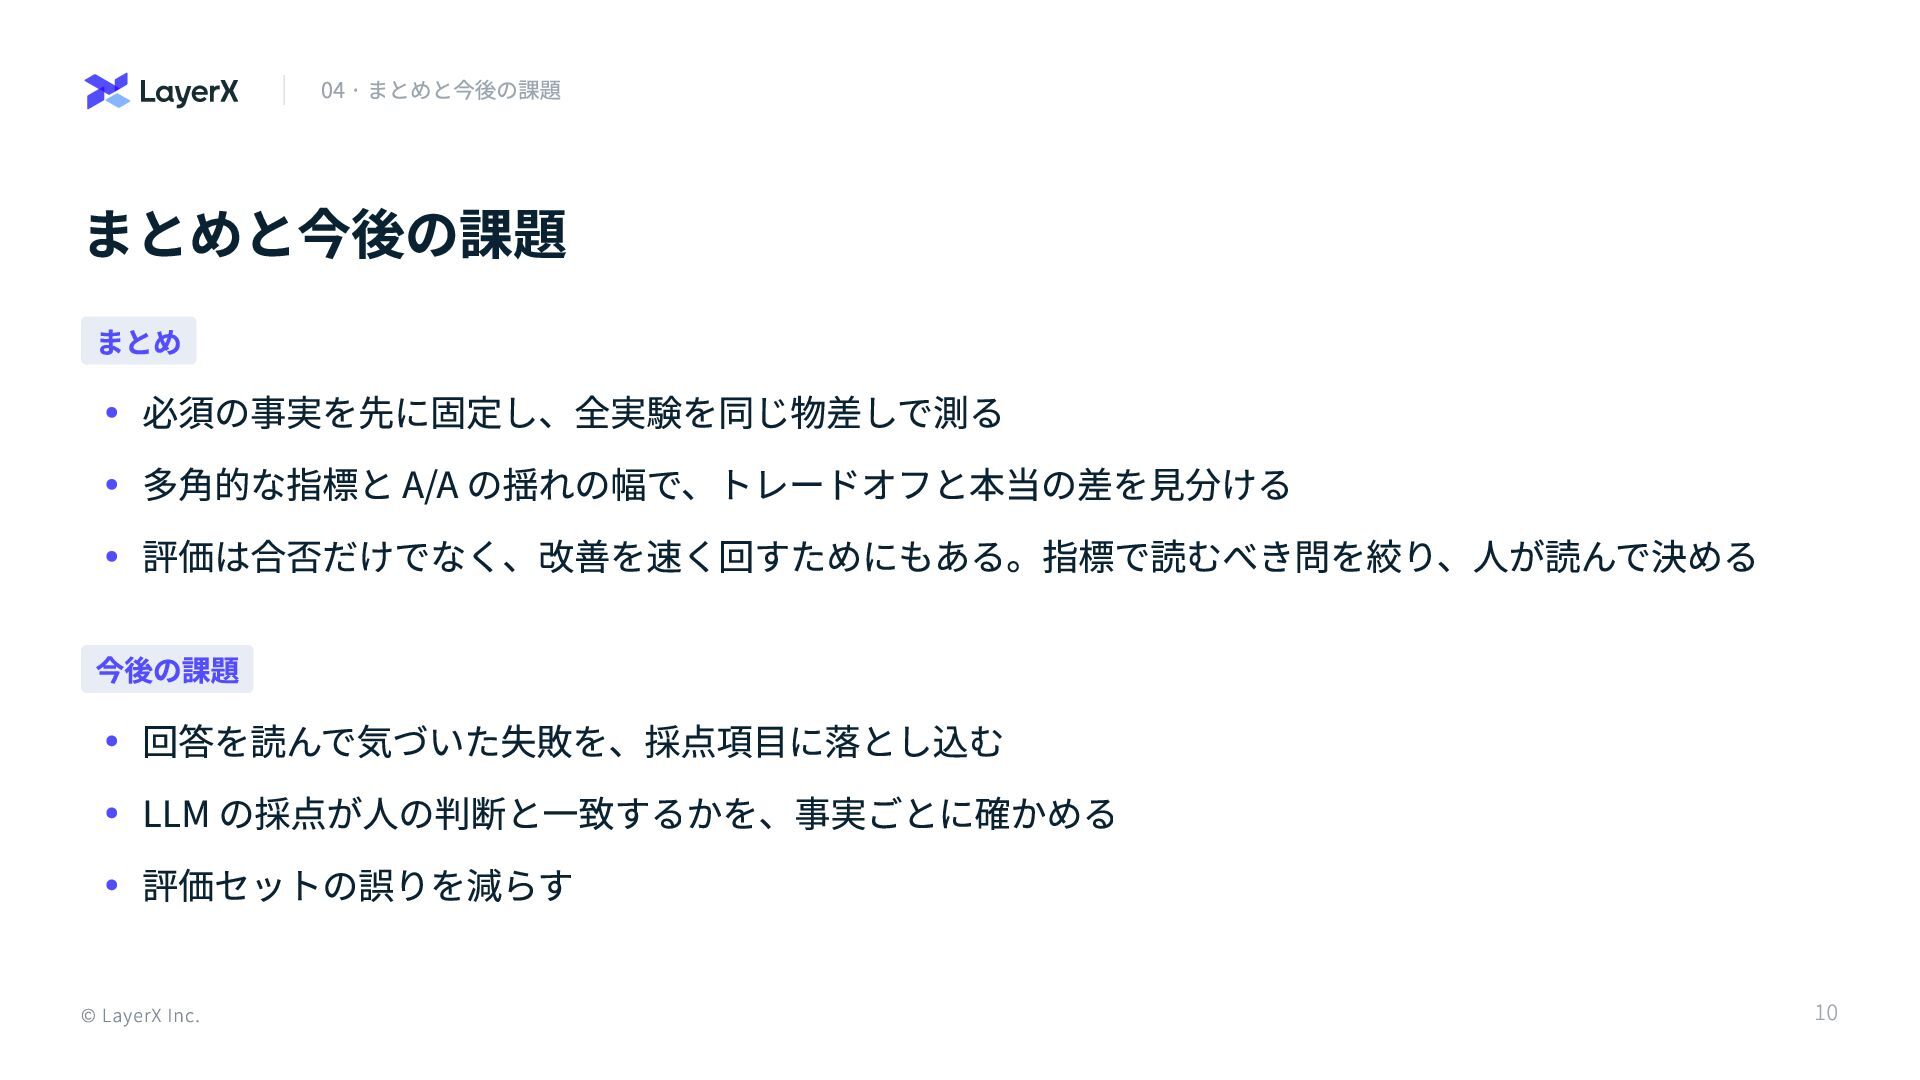
04 · まとめと今後の課題 まとめと今後の課題 まとめ 必須の事実を先に固定し、全実験を同じ物差しで測る 多角的な指標と A/A の揺れの幅で、トレードオフと本当の差を見分ける 評価は合否だけでなく、改善を速く回すためにもある。指標で読むべき問を絞り、人が読んで決める
今後の課題 回答を読んで気づいた失敗を、採点項目に落とし込む LLM の採点が人の判断と一致するかを、事実ごとに確かめる 評価セットの誤りを減らす © LayerX Inc. 10
More Decks by yosukeyoshida
See All by yosukeyoshida
帳票構造化タスクにおけるLLMファインチューニングの性能評価
yosukeyoshida
1
510
Other Decks in Technology
See All in Technology
「AIチャットからもできないの?」と言われたら ~業務アプリをMCP対応するときの認証・認可の勘所
oidfj
0
360
Oracle Base Database Service 技術詳細
oracle4engineer
PRO
17
120k
マネジメントされる側の仕事は「文句」を言うこと
riyaamemiya
7
5.7k
パスワードのない鍵で、 データを手元に置く
ginjihayashi
0
260
こんなに変わった! AWSネットワークの常識
shotashiratori
15
9.4k
SORACOM × AWS IoT Core でSREする
butadora
0
110
会社説明資料_最新版
demaecan
0
32k
AWS基盤改善を支える 私たちの理念と行動指針
kentosuzuki
0
240
MCPでネットワーク障害調査を自動化する前に直すべき3つのこと
yama3133
1
520
HTTP通信に使おうとすると実はめんどくさいfile_get_contents
maguroalternative
0
170
文書画像からの情報抽出を行うエージェントを、軌跡の正解データ無しで作れるか
sansantech
PRO
2
170
AIネイティブ組織の作り方。1人のPOとAIから始める、自社での実験
ama_ch
2
1.1k
Featured
See All Featured
How Software Deployment tools have changed in the past 20 years
geshan
3
35k
Being A Developer After 40
akosma
PRO
92
590k
AI Search: Where Are We & What Can We Do About It?
aleyda
0
8.2k
Ecommerce SEO: The Keys for Success Now & Beyond - #SERPConf2024
aleyda
1
2.3k
Digital Ethics as a Driver of Design Innovation
axbom
PRO
2
530
XXLCSS - How to scale CSS and keep your sanity
sugarenia
250
1.3M
Impact Scores and Hybrid Strategies: The future of link building
tamaranovitovic
0
490
Introduction to Domain-Driven Design and Collaborative software design
baasie
1
1.1k
Navigating Algorithm Shifts & AI Overviews - #SMXNext
aleyda
1
1.7k
Designing Powerful Visuals for Engaging Learning
tmiket
1
660
The Pragmatic Product Professional
lauravandoore
37
7.5k
We Analyzed 250 Million AI Search Results: Here's What I Found
joshbly
2
2.1k


 SiteGround - Reliable hosting with speed, security, and support you can count on.


 yosukeyoshida
 oidfj
 oracle4engineer
 riyaamemiya
 ginjihayashi
 shotashiratori
 butadora
 demaecan
 kentosuzuki
 yama3133
 maguroalternative
 sansantech
 ama_ch
 geshan
 akosma
 aleyda
 axbom
 sugarenia
 tamaranovitovic
 baasie
 tmiket
 lauravandoore
 joshbly