Upgrade to Pro — share decks privately, control downloads, hide ads and more …

不可逆な意思決定を避けながら10億超の顧客データを AI Ready にするデータ基盤設計

Sponsored · Your Podcast. Everywhere. Effortlessly. Share. Educate. Inspire. Entertain. You do you. We'll handle the rest. →

不可逆な意思決定を避けながら10億超の顧客データを AI Ready にするデータ基盤設計

Data Engineering Summit 2026(2026/10/9)での発表資料です。

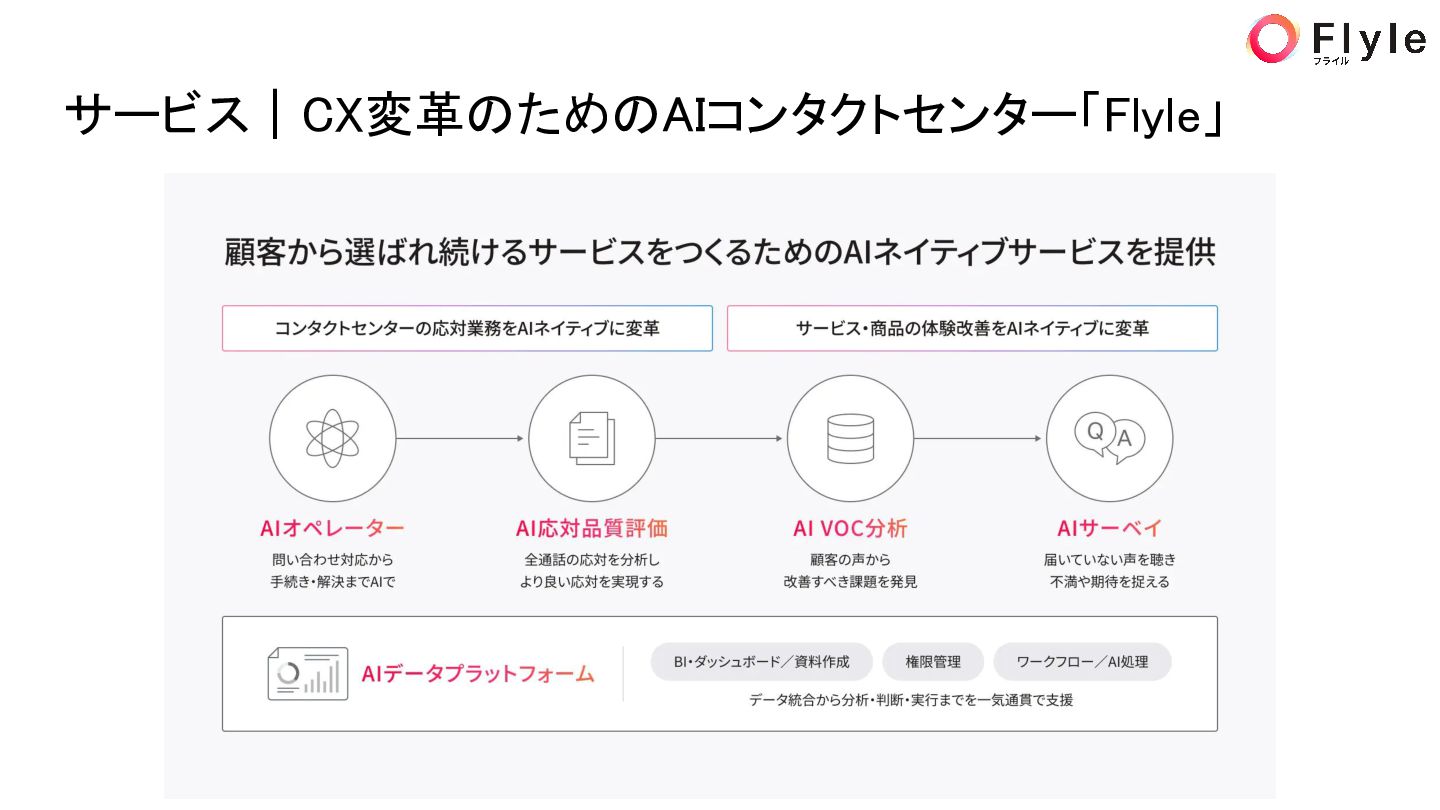
Flyle は、顧客ごとにスキーマが異なる雑多なデータをワークフローで整え、AI で分析できる状態(AI Ready)にするプロダクトです。本発表では、DB 上の物理行で約 15 億行に達したデータ基盤を、不可逆な意思決定を避けながらどう設計・運用してきたかをお話しします。

■ 話すこと
・データ:PostgreSQL の制約・RLS を使い倒し、データの破損を DB で止める
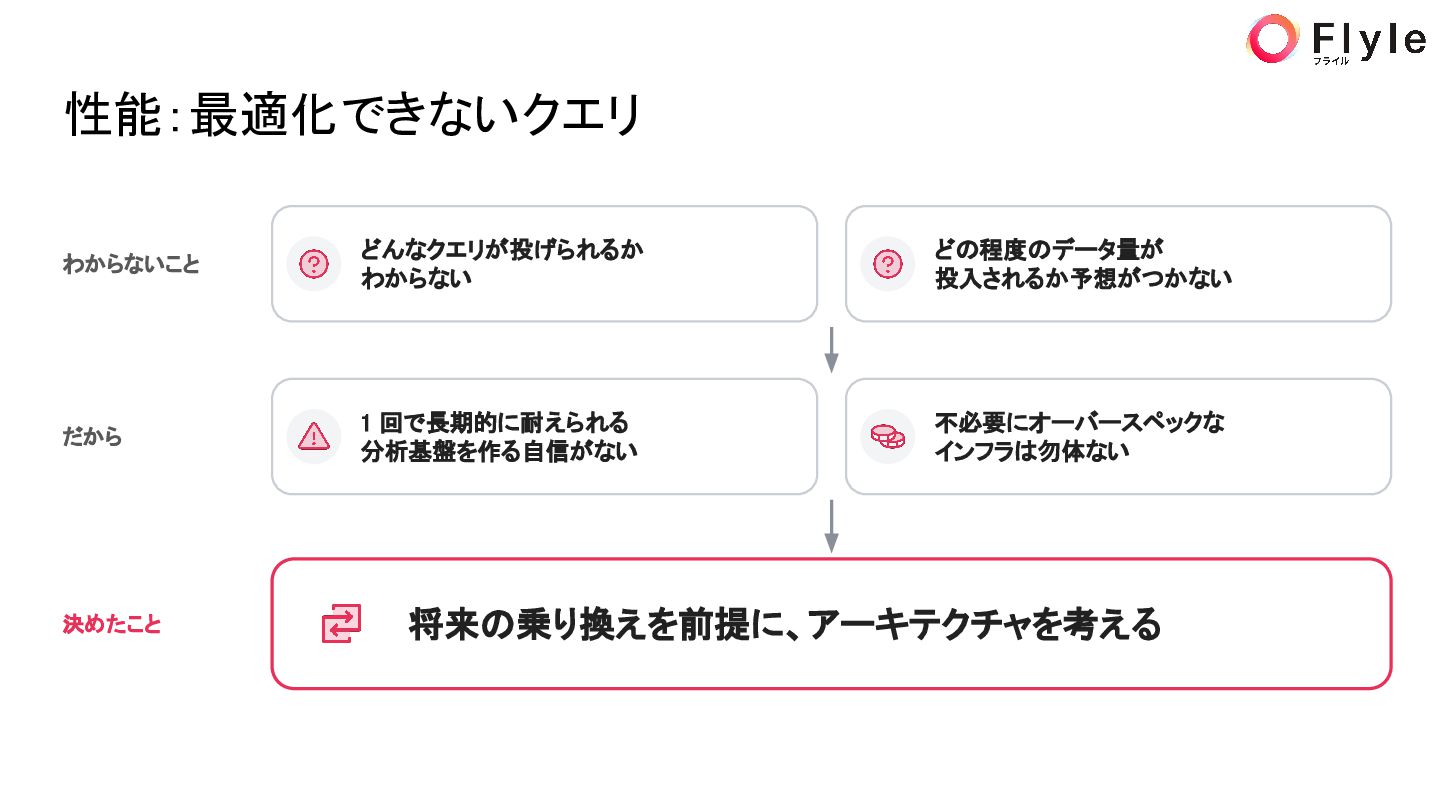
・性能:クエリもデータ量も読めない前提で、検索・集計基盤(ClickHouse)を「作り直せる OLAP」として設計。履歴(temporal)を手放し、ETL を約 3,300 行から約 700 行に単純化した移行の振り返り
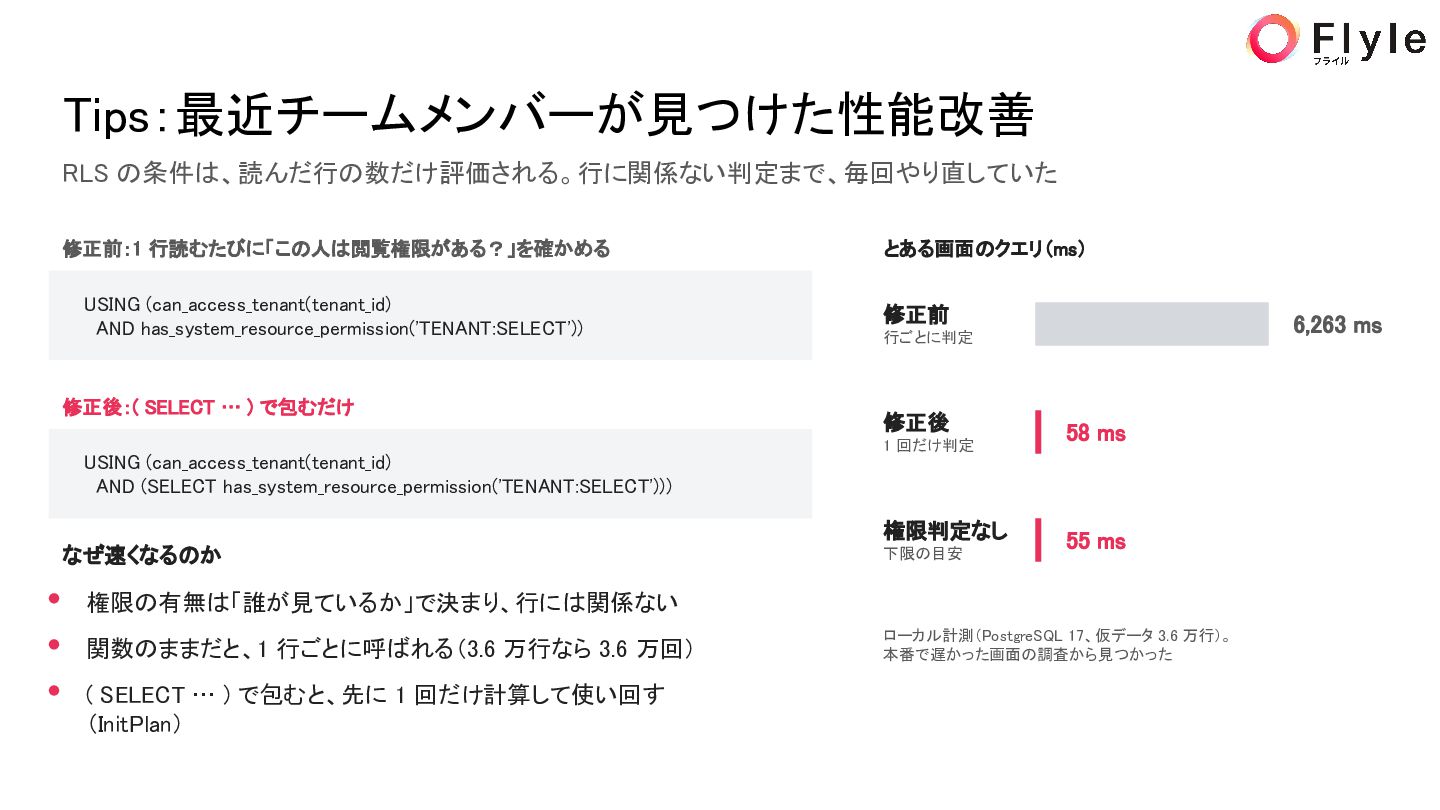
・権限:テナント/ロール/レコードの 3 層の RLS と、ClickHouse との役割分担。RLS を ( SELECT … ) で包むだけで 6,263ms → 58ms になった性能改善の Tips

技術の一般論よりも、自社の個別の状況に対して何を判断し、どう取り組んだかという経験の部分にフォーカスしています。

■ 採用情報
フライルでは、ここで紹介した課題を一緒に解いてくれるエンジニアを募集しています。
https://herp.careers/v1/flyle

Avatar for Yuichiro Yamashita
Yuichiro Yamashita

October 08, 2026

More Decks by Yuichiro Yamashita

Other Decks in Technology

Transcript

  1. 自己紹介 (山下裕一朗) 株式会社フライル 執行役員 / VPoT(Vice President of Technology) OSS

    • Svelte コアチーム ◦ ◦ ◦ ◦ ◦ • Svelte コンパイラ (https://github.com/sveltejs/svelte) ESLint パーサー (https://github.com/sveltejs/svelte-eslint-parser) ESLint プラグイン (https://github.com/sveltejs/eslint-plugin-svelte) エコシステムの Rust 化 (https://github.com/baseballyama/rsvelte) vite-devtools-svelte (https://github.com/baseballyama/vite-devtools-svelte) その他 (一部) ◦ ◦ ◦ ◦ office-kit PostgreSQL ESLint パーサー (https://github.com/baseballyama/postgresql-eslint-parser) PostgreSQL ESLint ライブラリ (https://github.com/baseballyama/eslint-plugin-postgresql) office-kit (https://office-kit.github.io/) ▪ pptx / xlsx / docx を TypeScript / AIエージェントで扱えるライブラリ。エディター有り
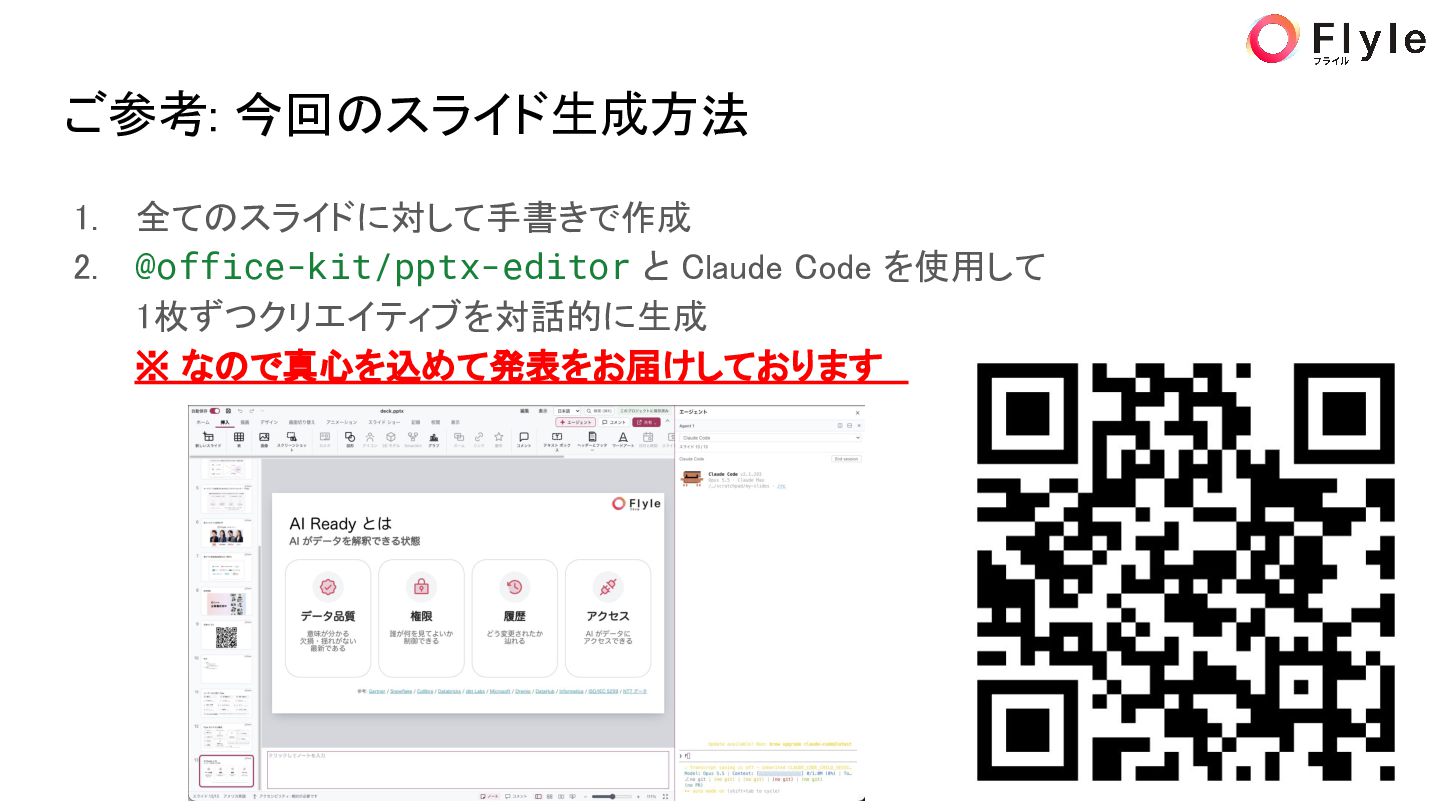
  2. ご参考: 今回のスライド生成方法 1. 2. 全てのスライドに対して手書きで作成 @office-kit/pptx-editor と Claude Code を使用して

    1枚ずつクリエイティブを対話的に生成 ※ なので真心を込めて発表をお届けしております
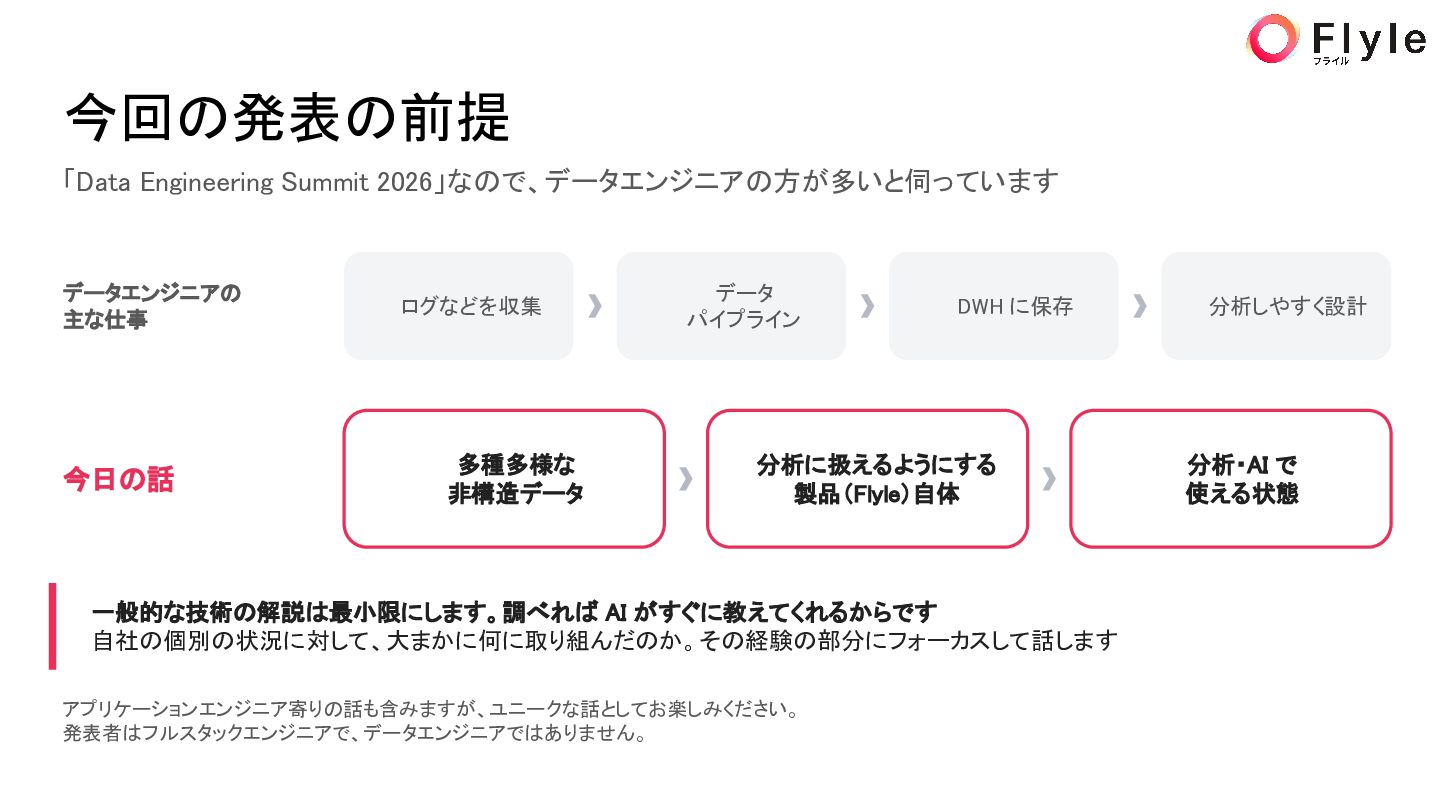
  3. 今回の発表の前提 「Data Engineering Summit 2026」なので、データエンジニアの方が多いと伺っています データエンジニアの 主な仕事 今日の話 ログなどを収集 多種多様な

    非構造データ データ パイプライン DWH に保存 分析に扱えるようにする 製品(Flyle)自体 一般的な技術の解説は最小限にします。調べれば AI がすぐに教えてくれるからです 自社の個別の状況に対して、大まかに何に取り組んだのか。その経験の部分にフォーカスして話します アプリケーションエンジニア寄りの話も含みますが、ユニークな話としてお楽しみください。 発表者はフルスタックエンジニアで、データエンジニアではありません。 分析しやすく設計 分析・AI で 使える状態
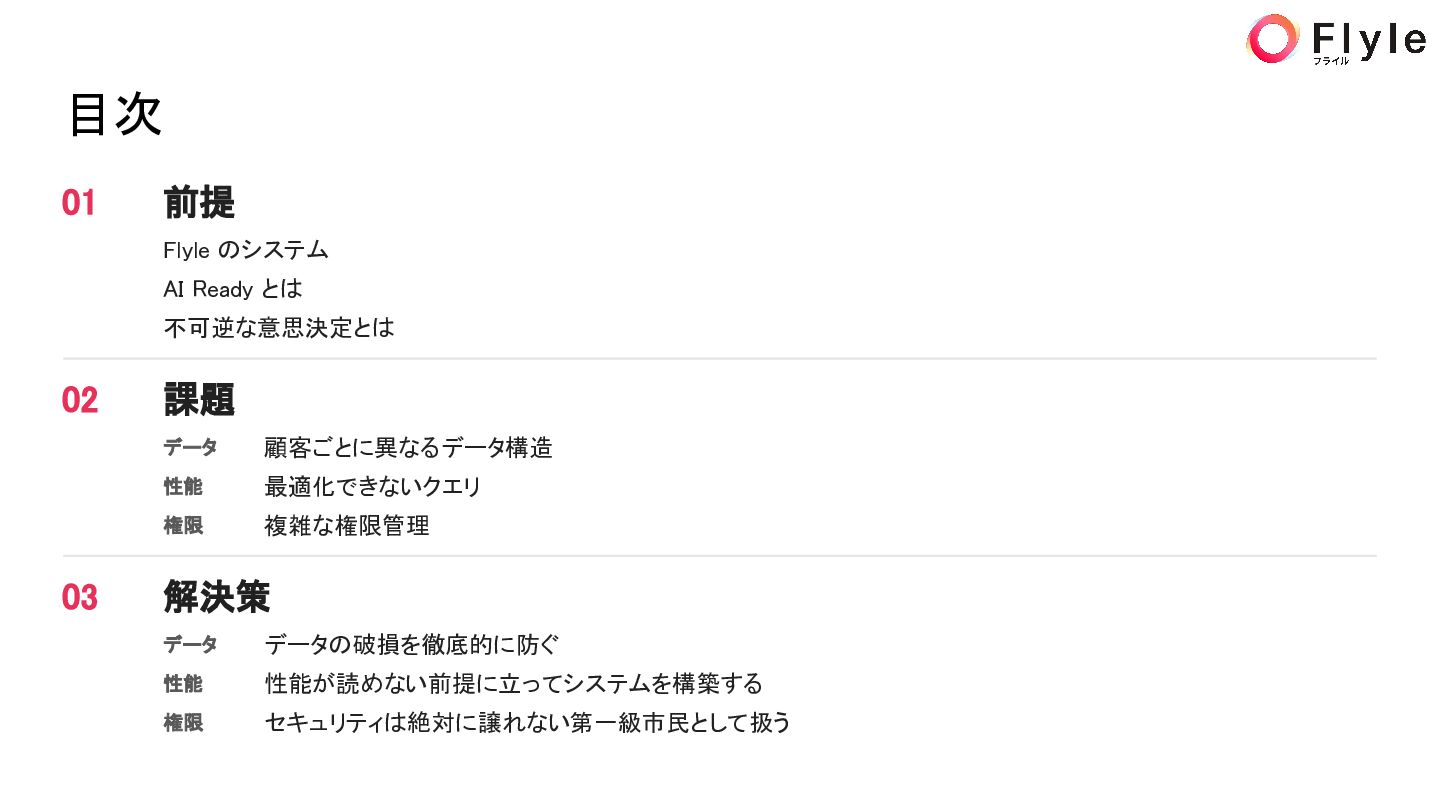
  4. 目次 01 前提 Flyle のシステム AI Ready とは 不可逆な意思決定とは 02

    03 課題 データ 顧客ごとに異なるデータ構造 性能 最適化できないクエリ 権限 複雑な権限管理 解決策 データ データの破損を徹底的に防ぐ 性能 性能が読めない前提に立ってシステムを構築する 権限 セキュリティは絶対に譲れない第一級市民として扱う
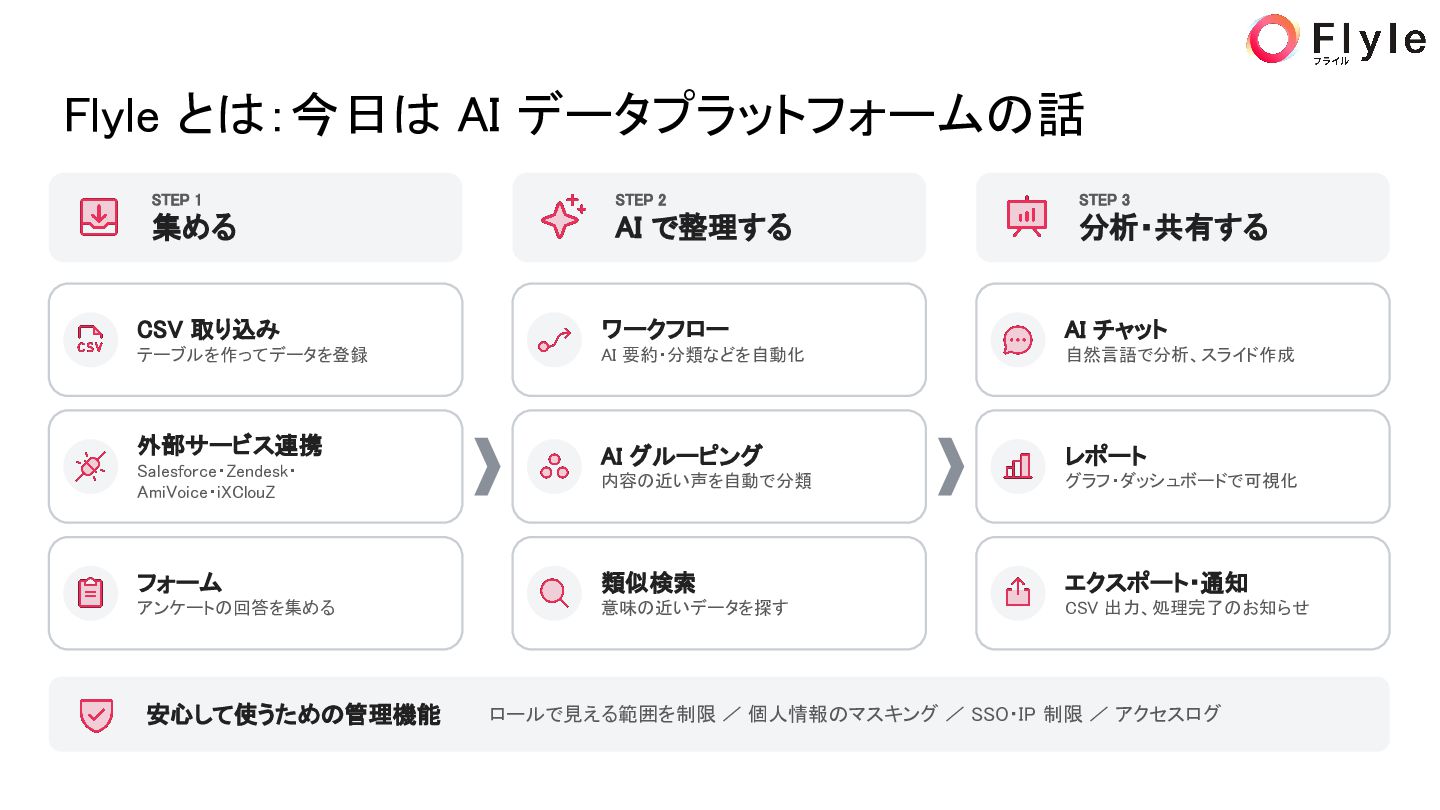
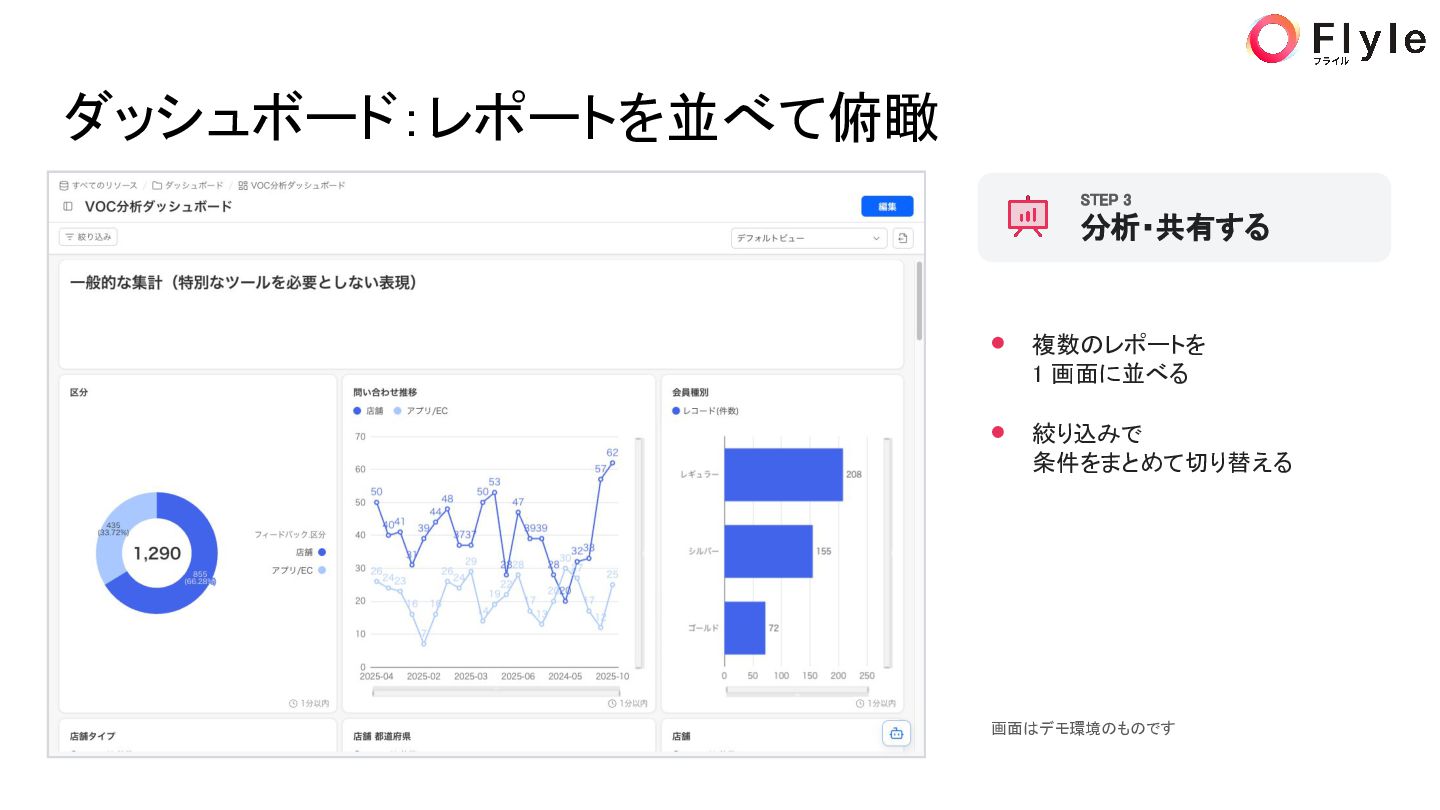
  5. Flyle とは:今日は AI データプラットフォームの話 STEP 1 STEP 2 STEP 3

    集める AI で整理する 分析・共有する CSV 取り込み ワークフロー AI チャット テーブルを作ってデータを登録 AI 要約・分類などを自動化 自然言語で分析、スライド作成 AI グルーピング レポート 内容の近い声を自動で分類 グラフ・ダッシュボードで可視化 フォーム 類似検索 エクスポート・通知 アンケートの回答を集める 意味の近いデータを探す CSV 出力、処理完了のお知らせ 外部サービス連携 Salesforce・Zendesk・ AmiVoice・iXClouZ 安心して使うための管理機能 ロールで見える範囲を制限 / 個人情報のマスキング / SSO・IP 制限 / アクセスログ
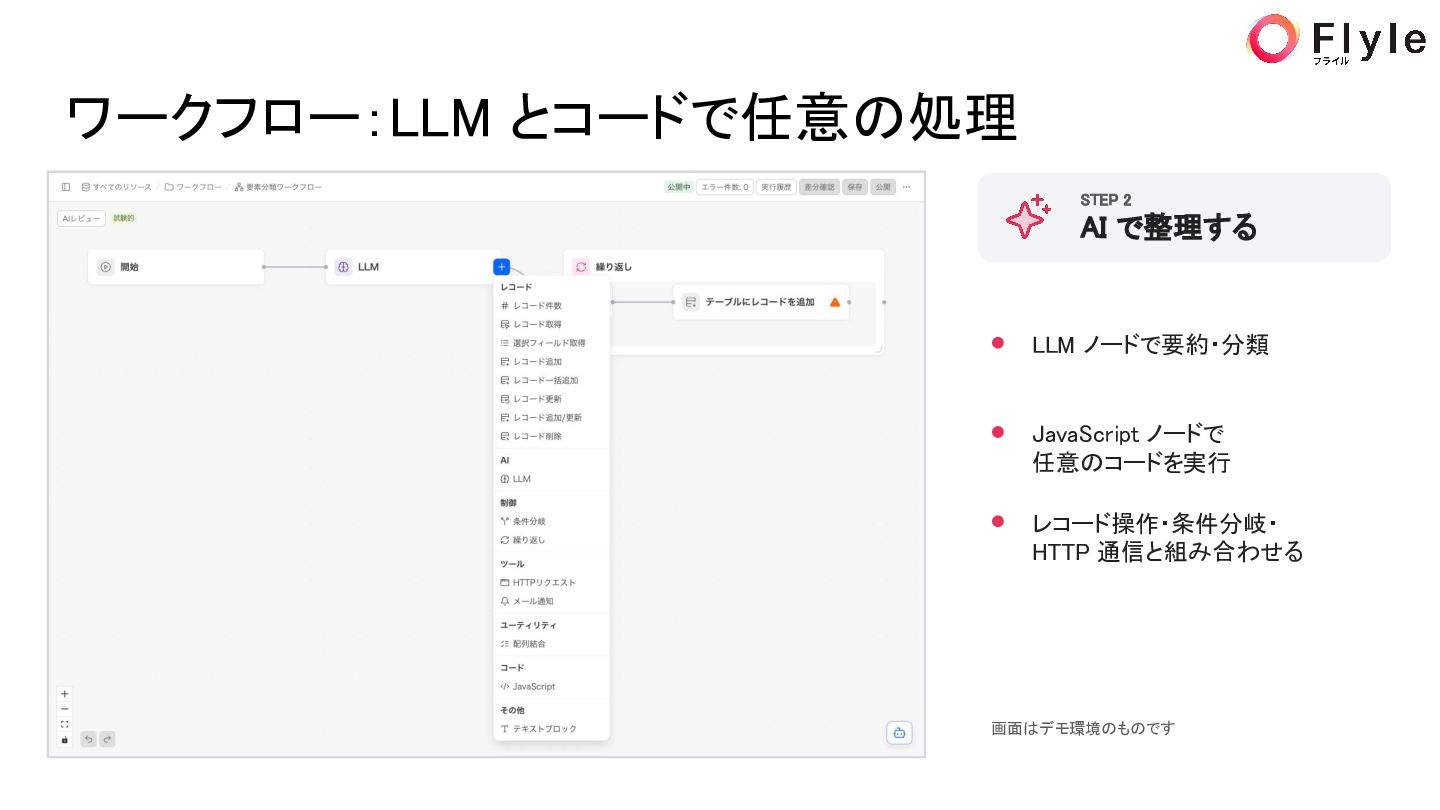
  6. ワークフロー:LLM とコードで任意の処理 STEP 2 AI で整理する LLM ノードで要約・分類 JavaScript ノードで

    任意のコードを実行 レコード操作・条件分岐・ HTTP 通信と組み合わせる 画面はデモ環境のものです
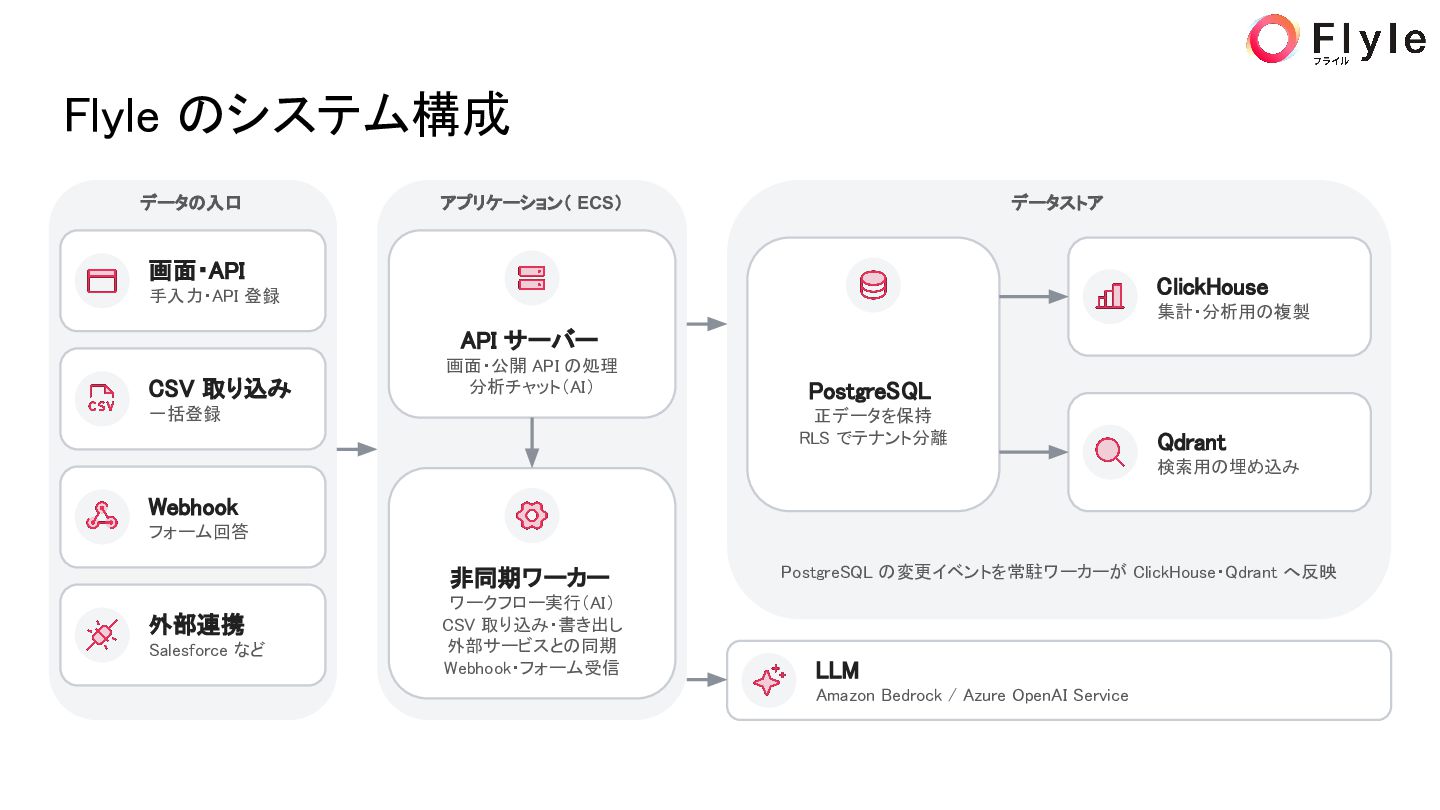
  7. Flyle のシステム構成 データの入口 アプリケーション( ECS) データストア 画面・API ClickHouse 手入力・API 登録

    集計・分析用の複製 API サーバー CSV 取り込み 画面・公開 API の処理 分析チャット(AI) 一括登録 PostgreSQL 正データを保持 RLS でテナント分離 Qdrant 検索用の埋め込み Webhook フォーム回答 非同期ワーカー 外部連携 Salesforce など ワークフロー実行(AI) CSV 取り込み・書き出し 外部サービスとの同期 Webhook・フォーム受信 PostgreSQL の変更イベントを常駐ワーカーが ClickHouse・Qdrant へ反映 LLM Amazon Bedrock / Azure OpenAI Service
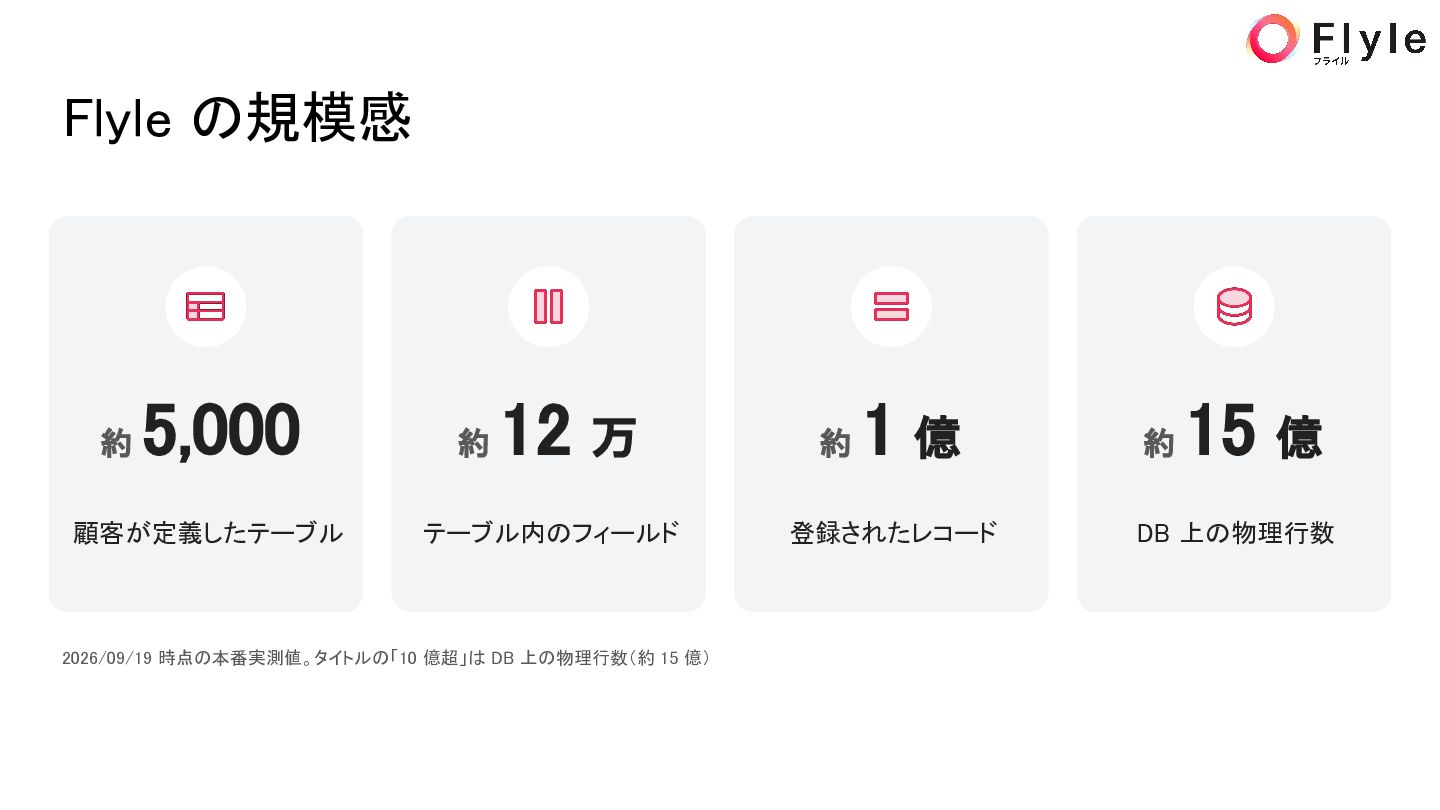
  8. Flyle の規模感 約 5,000 顧客が定義したテーブル 約 12 万 テーブル内のフィールド 2026/09/19

    時点の本番実測値。タイトルの「10 億超」は DB 上の物理行数(約 15 億) 約 1億 登録されたレコード 約 15 億 DB 上の物理行数
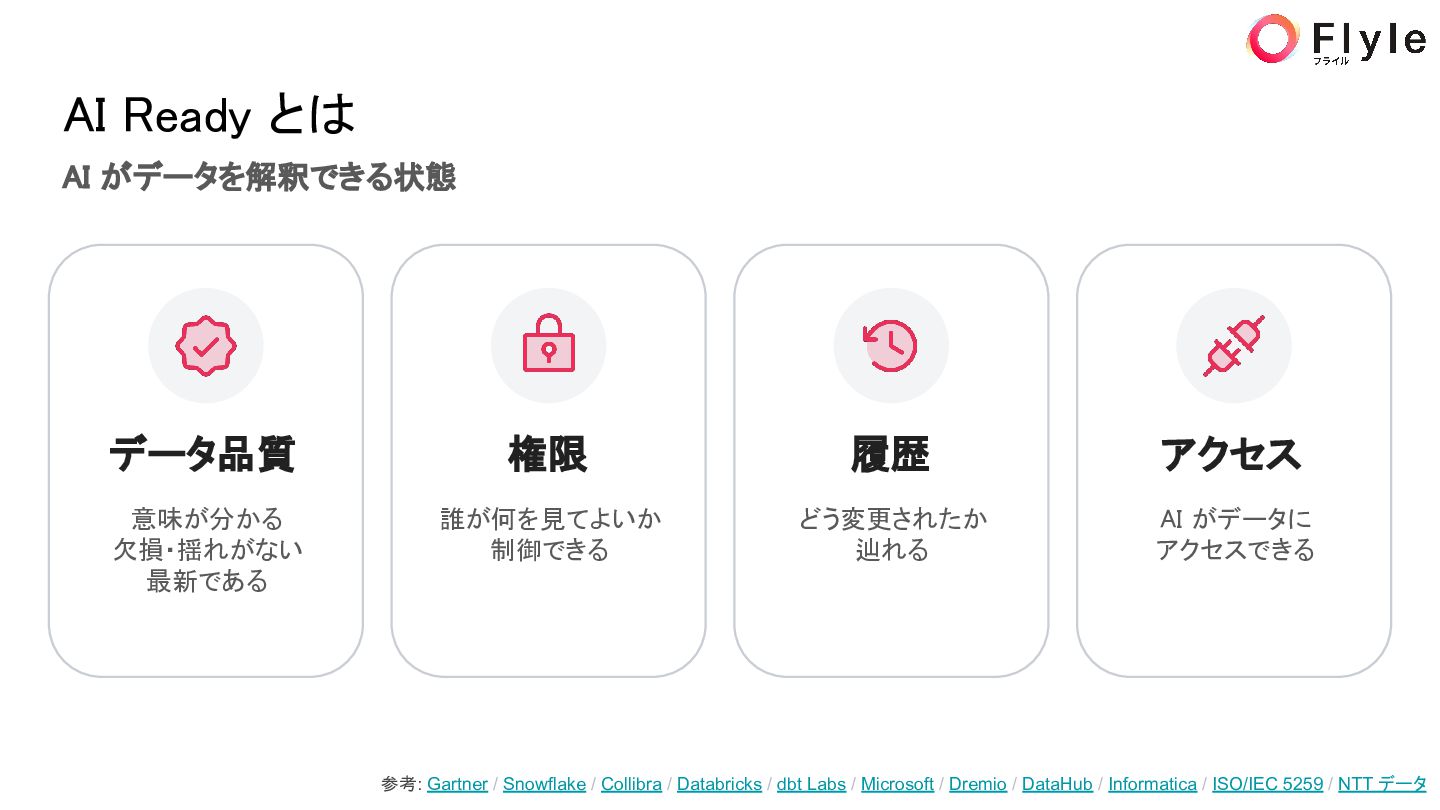
  9. AI Ready とは AI がデータを解釈できる状態 データ品質 権限 履歴 アクセス 意味が分かる

    欠損・揺れがない 最新である 誰が何を見てよいか 制御できる どう変更されたか 辿れる AI がデータに アクセスできる 参考: Gartner / Snowflake / Collibra / Databricks / dbt Labs / Microsoft / Dremio / DataHub / Informatica / ISO/IEC 5259 / NTT データ
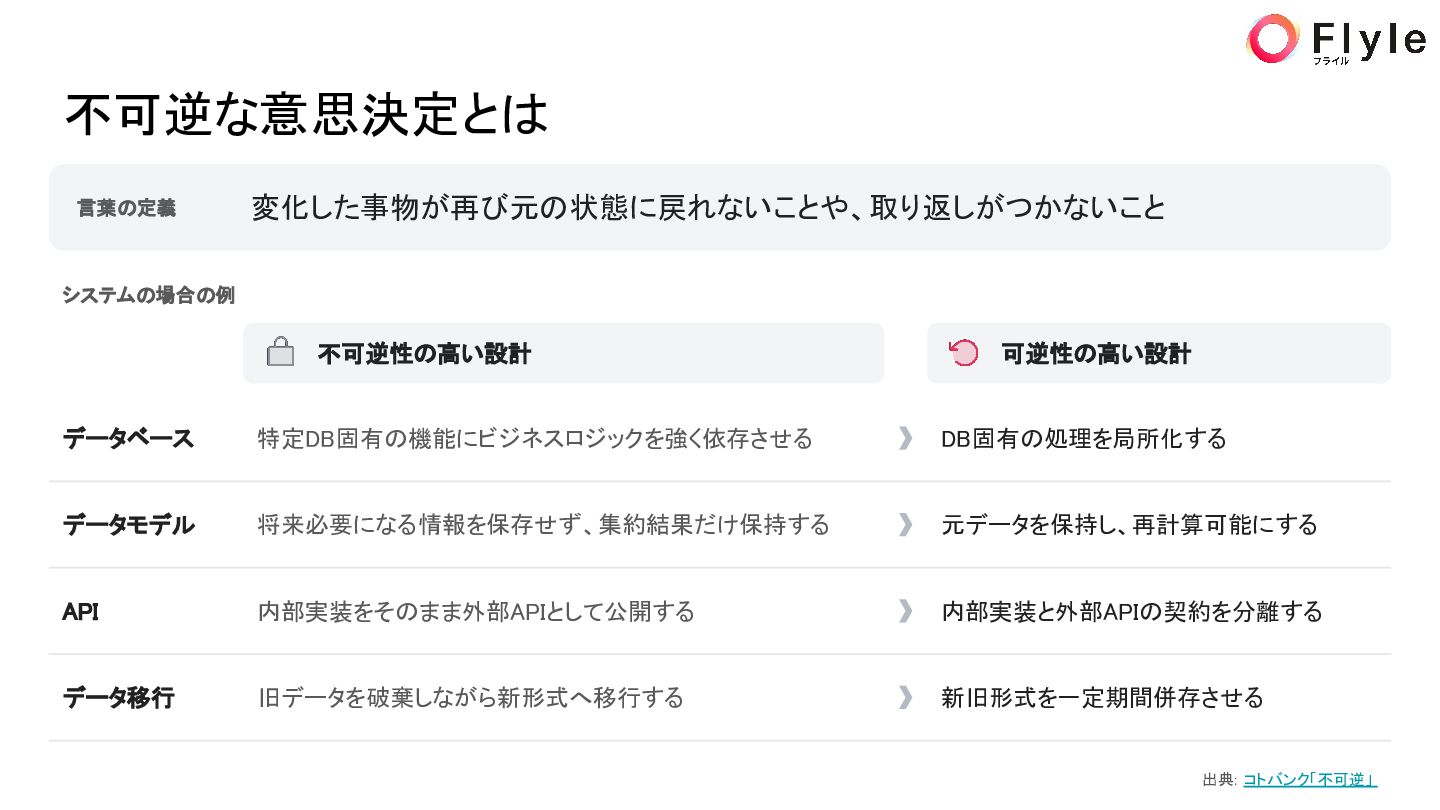
  10. 不可逆な意思決定とは 言葉の定義 変化した事物が再び元の状態に戻れないことや、取り返しがつかないこと システムの場合の例 不可逆性の高い設計 可逆性の高い設計 データベース 特定DB固有の機能にビジネスロジックを強く依存させる DB固有の処理を局所化する データモデル

    将来必要になる情報を保存せず、集約結果だけ保持する 元データを保持し、再計算可能にする API 内部実装をそのまま外部APIとして公開する 内部実装と外部APIの契約を分離する データ移行 旧データを破棄しながら新形式へ移行する 新旧形式を一定期間併存させる 出典: コトバンク「不可逆」
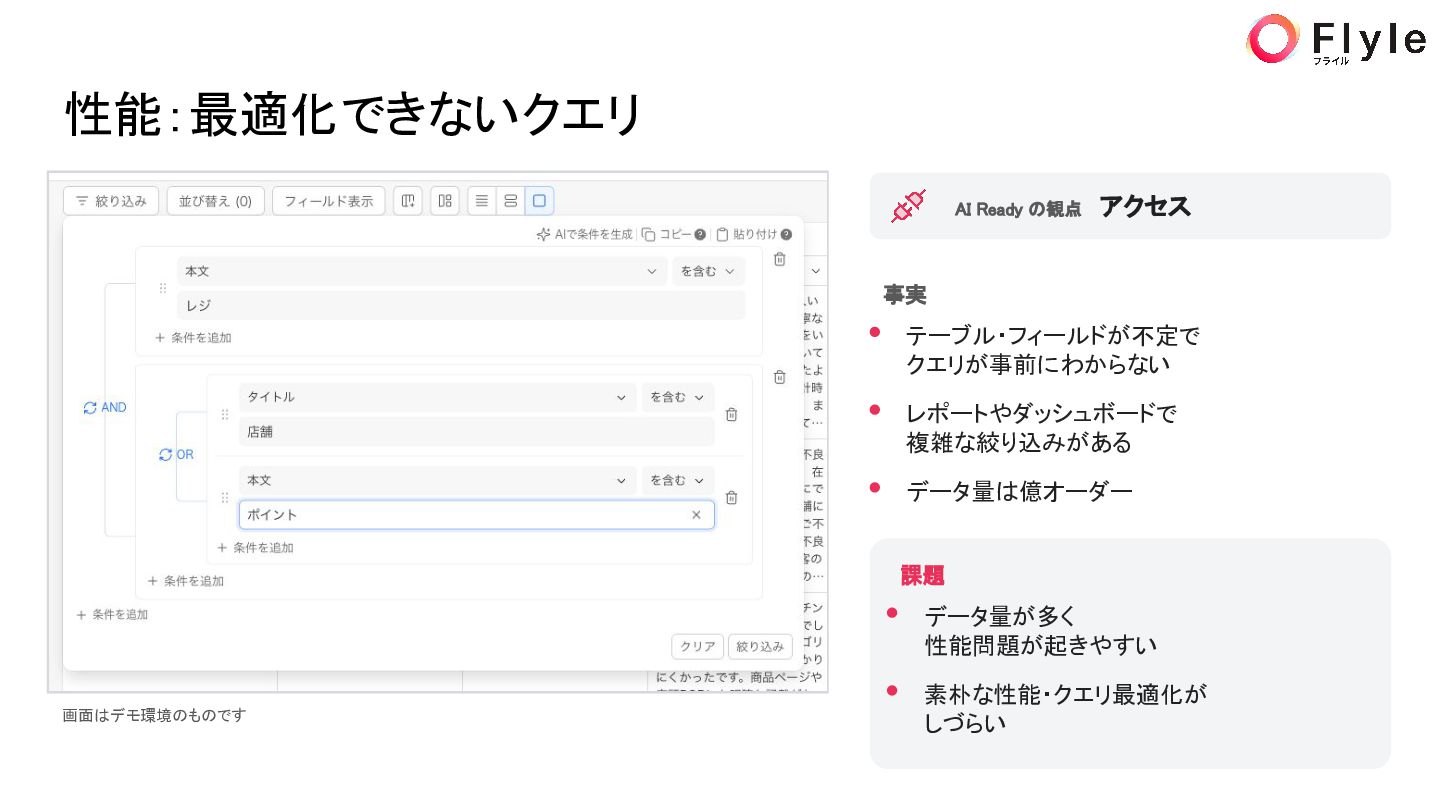
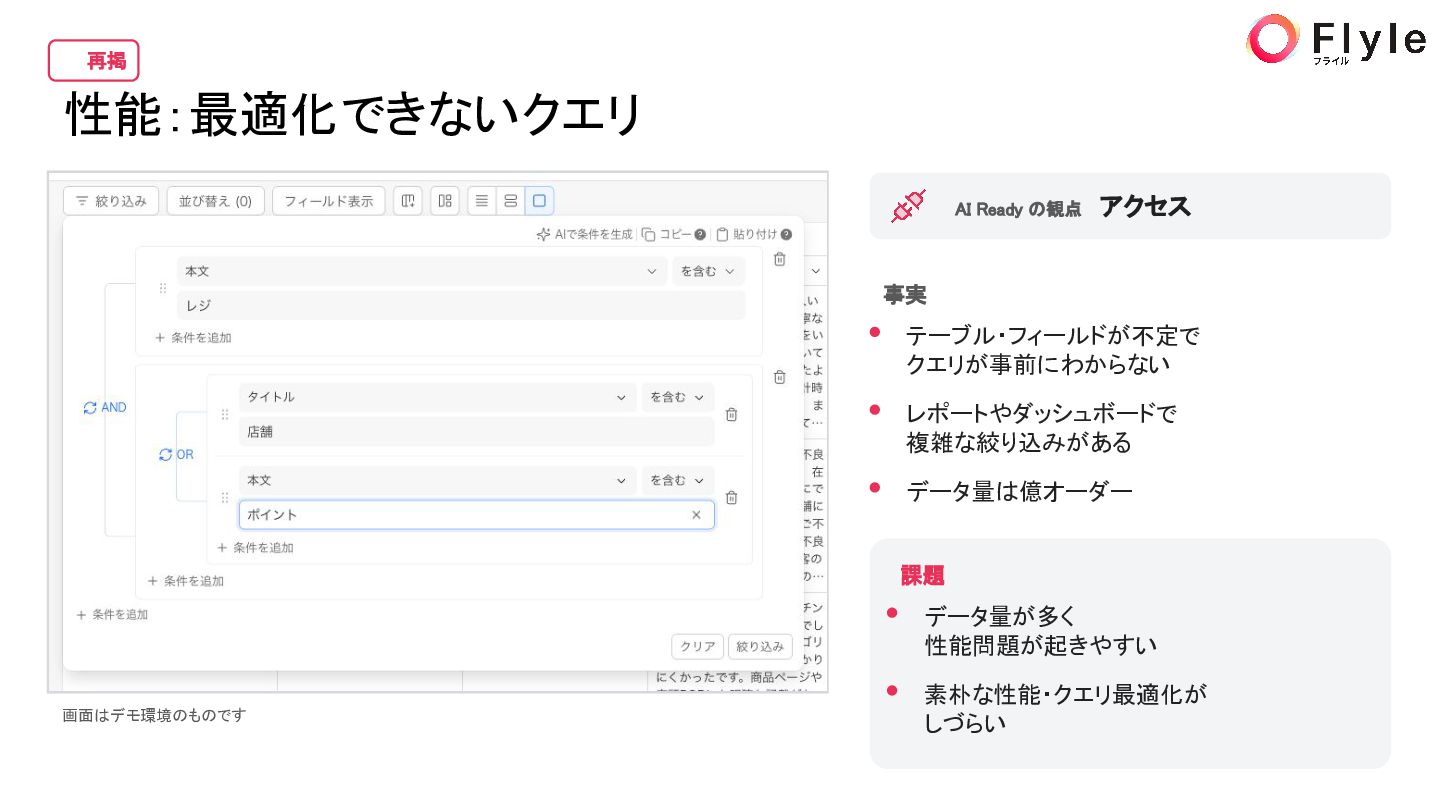
  11. 性能:最適化できないクエリ AI Ready の観点 アクセス 事実 テーブル・フィールドが不定で クエリが事前にわからない レポートやダッシュボードで 複雑な絞り込みがある

    データ量は億オーダー 課題 データ量が多く 性能問題が起きやすい 画面はデモ環境のものです 素朴な性能・クエリ最適化が しづらい
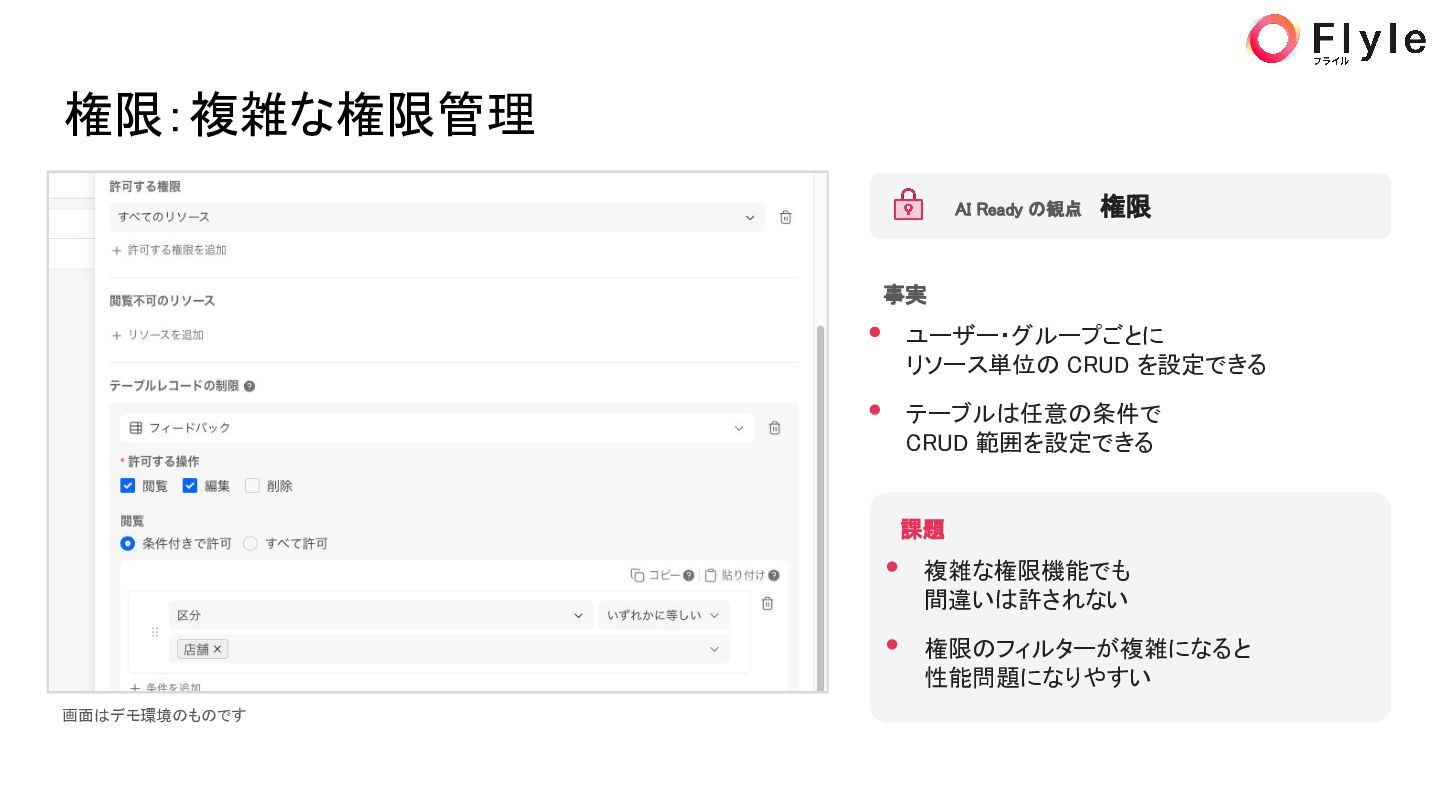
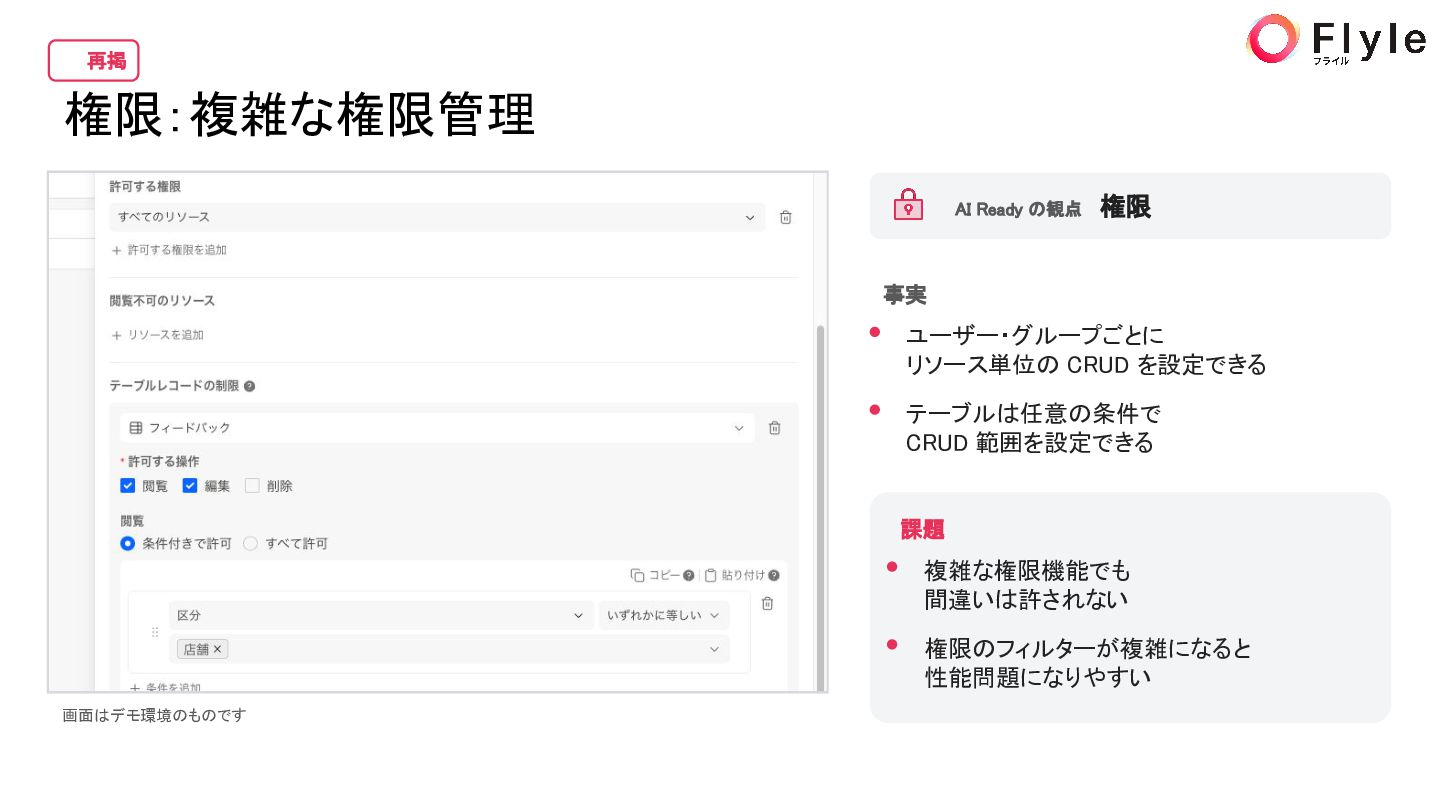
  12. 権限:複雑な権限管理 AI Ready の観点 権限 事実 ユーザー・グループごとに リソース単位の CRUD を設定できる

    テーブルは任意の条件で CRUD 範囲を設定できる 課題 複雑な権限機能でも 間違いは許されない 権限のフィルターが複雑になると 性能問題になりやすい 画面はデモ環境のものです
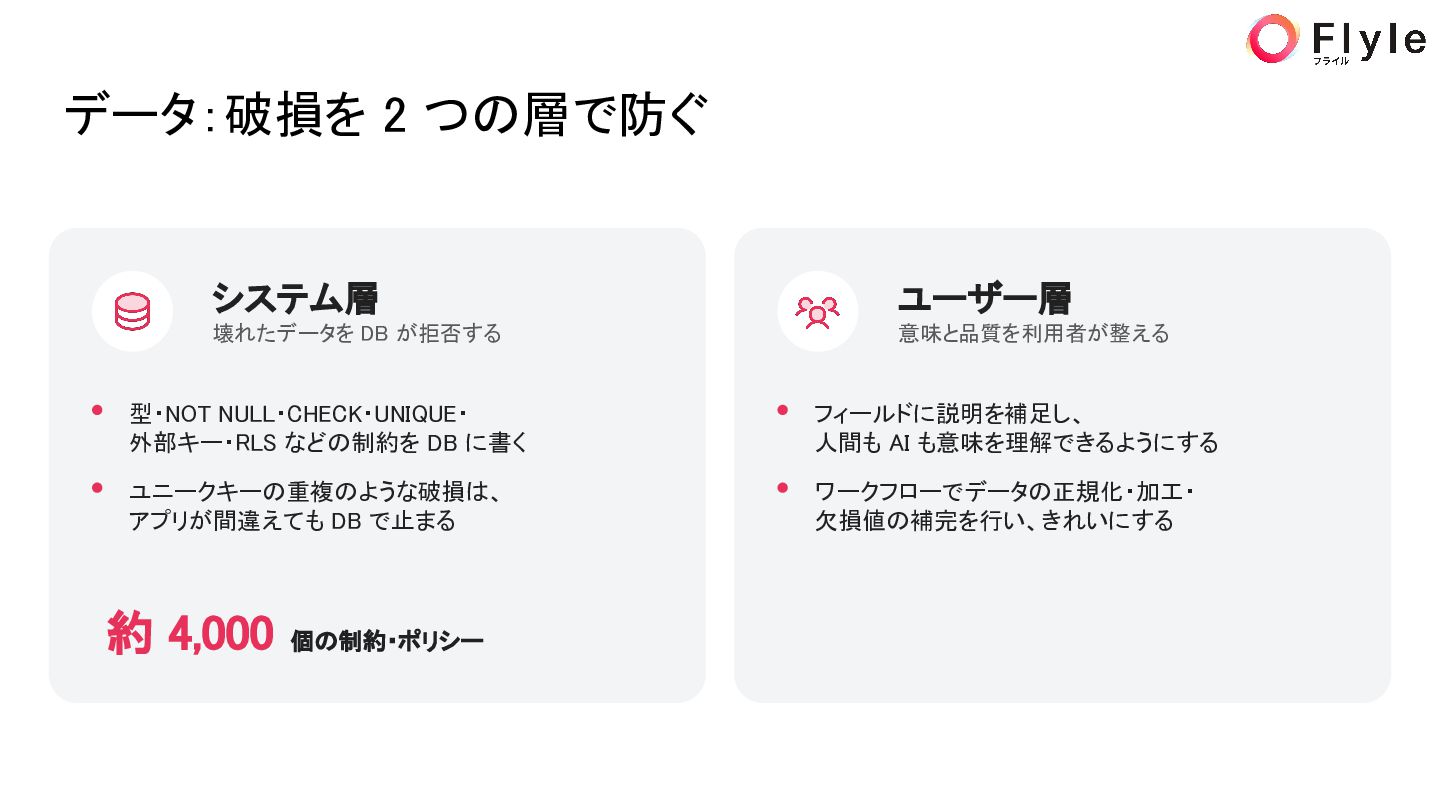
  13. データ:破損を 2 つの層で防ぐ システム層 ユーザー層 壊れたデータを DB が拒否する 意味と品質を利用者が整える 型・NOT

    NULL・CHECK・UNIQUE・ 外部キー・RLS などの制約を DB に書く フィールドに説明を補足し、 人間も AI も意味を理解できるようにする ユニークキーの重複のような破損は、 アプリが間違えても DB で止まる ワークフローでデータの正規化・加工・ 欠損値の補完を行い、きれいにする 約 4,000 個の制約・ポリシー
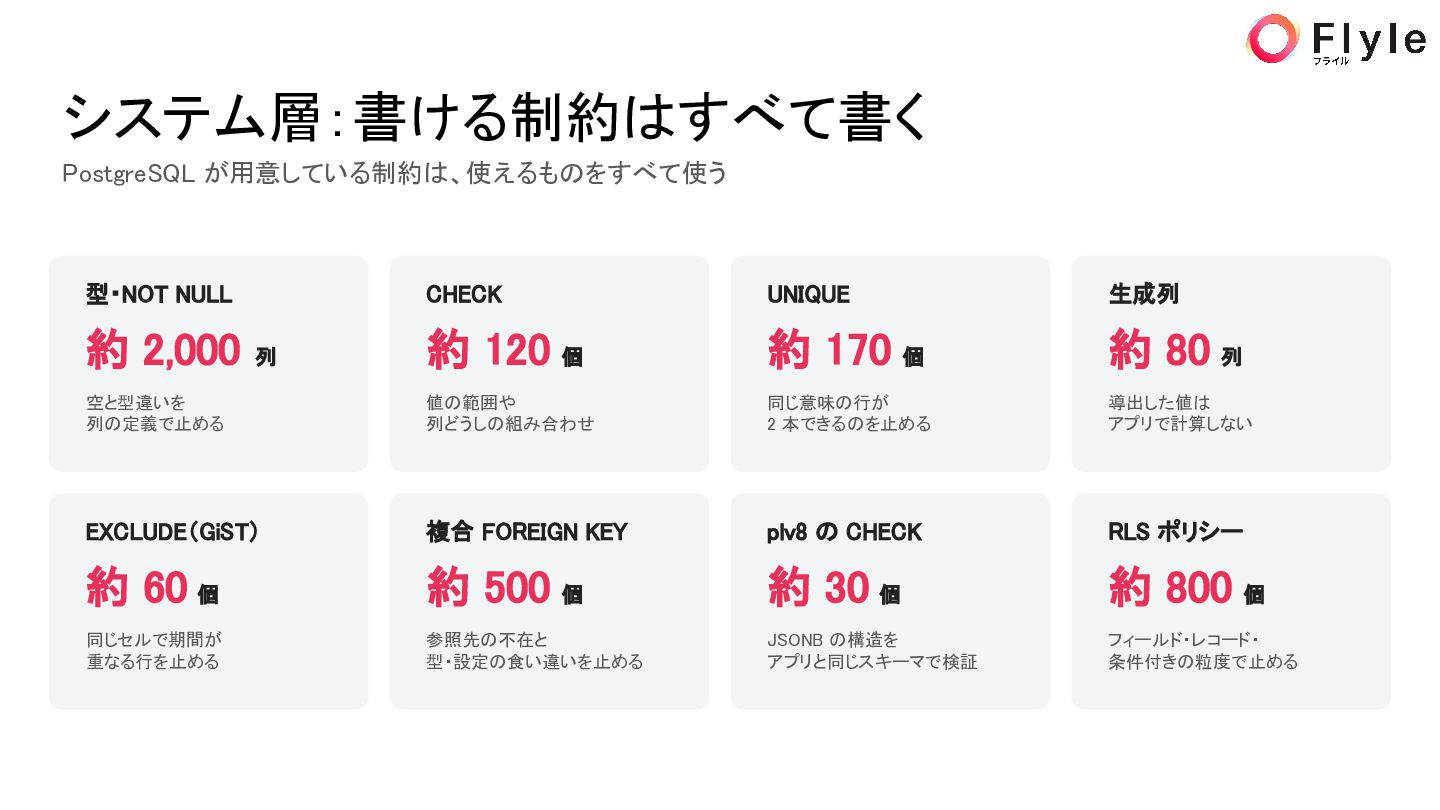
  14. システム層:書ける制約はすべて書く PostgreSQL が用意している制約は、使えるものをすべて使う 型・NOT NULL CHECK UNIQUE 生成列 約 2,000

    列 約 120 個 約 170 個 約 80 列 空と型違いを 列の定義で止める 値の範囲や 列どうしの組み合わせ 同じ意味の行が 2 本できるのを止める 導出した値は アプリで計算しない EXCLUDE(GiST) 複合 FOREIGN KEY plv8 の CHECK RLS ポリシー 約 60 個 約 500 個 約 30 個 約 800 個 同じセルで期間が 重なる行を止める 参照先の不在と 型・設定の食い違いを止める JSONB の構造を アプリと同じスキーマで検証 フィールド・レコード・ 条件付きの粒度で止める
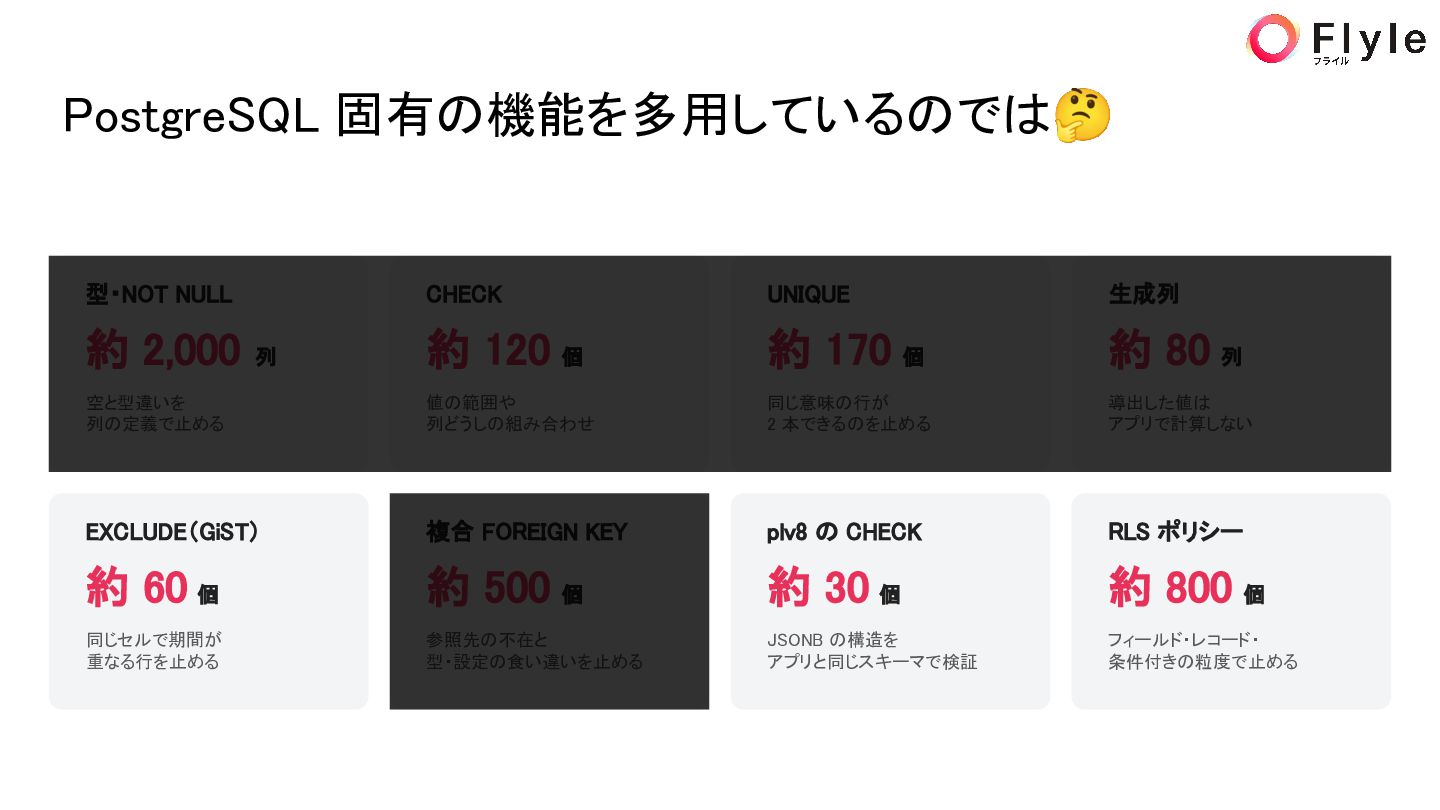
  15. PostgreSQL 固有の機能を多用しているのでは🤔 型・NOT NULL CHECK UNIQUE 生成列 約 2,000 列

    約 120 個 約 170 個 約 80 列 空と型違いを 列の定義で止める 値の範囲や 列どうしの組み合わせ 同じ意味の行が 2 本できるのを止める 導出した値は アプリで計算しない EXCLUDE(GiST) 複合 FOREIGN KEY plv8 の CHECK RLS ポリシー 約 60 個 約 500 個 約 30 個 約 800 個 同じセルで期間が 重なる行を止める 参照先の不在と 型・設定の食い違いを止める JSONB の構造を アプリと同じスキーマで検証 フィールド・レコード・ 条件付きの粒度で止める
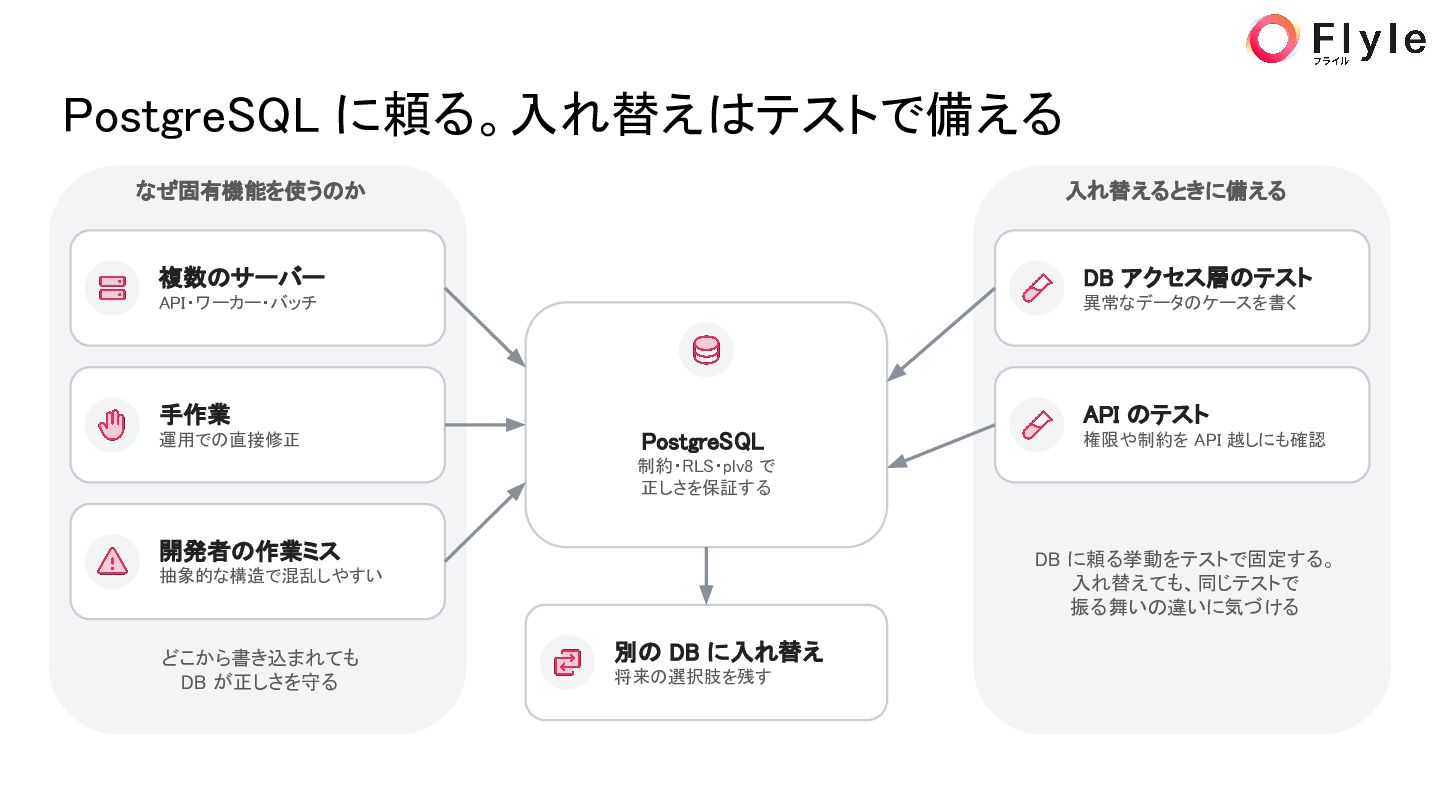
  16. PostgreSQL に頼る。入れ替えはテストで備える なぜ固有機能を使うのか 入れ替えるときに備える 複数のサーバー DB アクセス層のテスト API・ワーカー・バッチ 異常なデータのケースを書く 手作業

    API のテスト 運用での直接修正 PostgreSQL 権限や制約を API 越しにも確認 制約・RLS・plv8 で 正しさを保証する 開発者の作業ミス DB に頼る挙動をテストで固定する。 入れ替えても、同じテストで 振る舞いの違いに気づける 抽象的な構造で混乱しやすい どこから書き込まれても DB が正しさを守る 別の DB に入れ替え 将来の選択肢を残す
  17. 再掲 性能:最適化できないクエリ AI Ready の観点 アクセス 事実 テーブル・フィールドが不定で クエリが事前にわからない レポートやダッシュボードで

    複雑な絞り込みがある データ量は億オーダー 課題 データ量が多く 性能問題が起きやすい 画面はデモ環境のものです 素朴な性能・クエリ最適化が しづらい
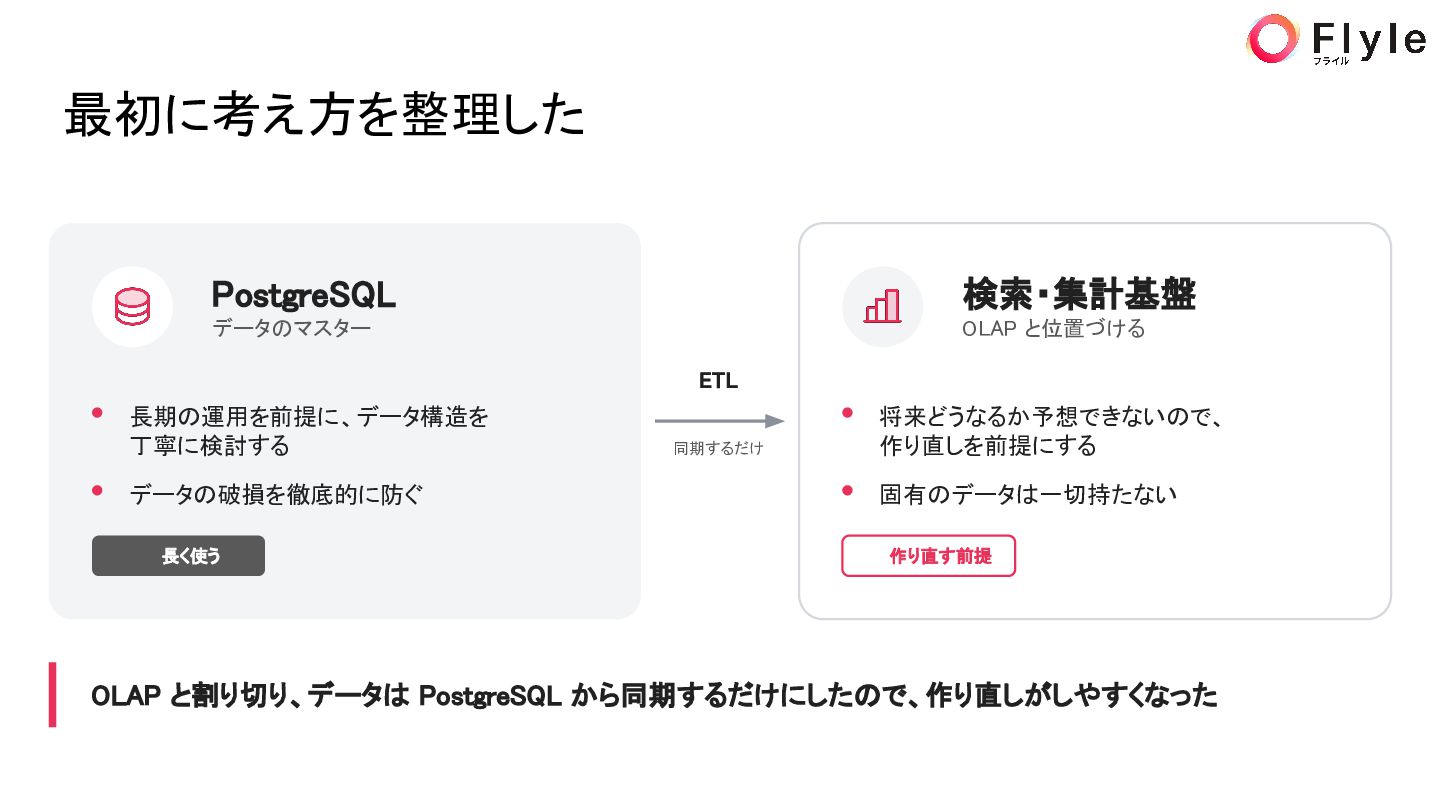
  18. 最初に考え方を整理した PostgreSQL 検索・集計基盤 データのマスター OLAP と位置づける ETL 長期の運用を前提に、データ構造を 丁寧に検討する データの破損を徹底的に防ぐ

    長く使う 同期するだけ 将来どうなるか予想できないので、 作り直しを前提にする 固有のデータは一切持たない 作り直す前提 OLAP と割り切り、データは PostgreSQL から同期するだけにしたので、作り直しがしやすくなった
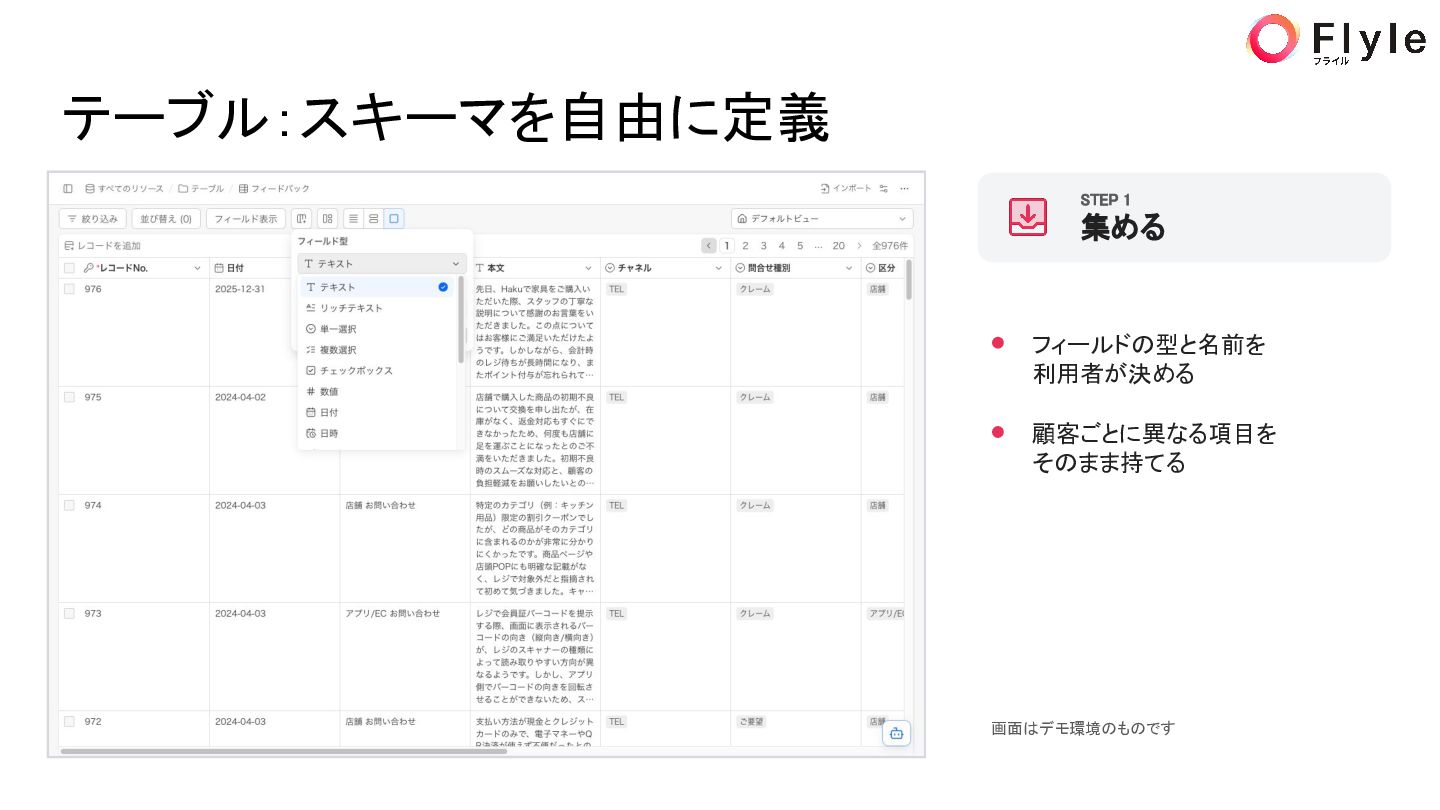
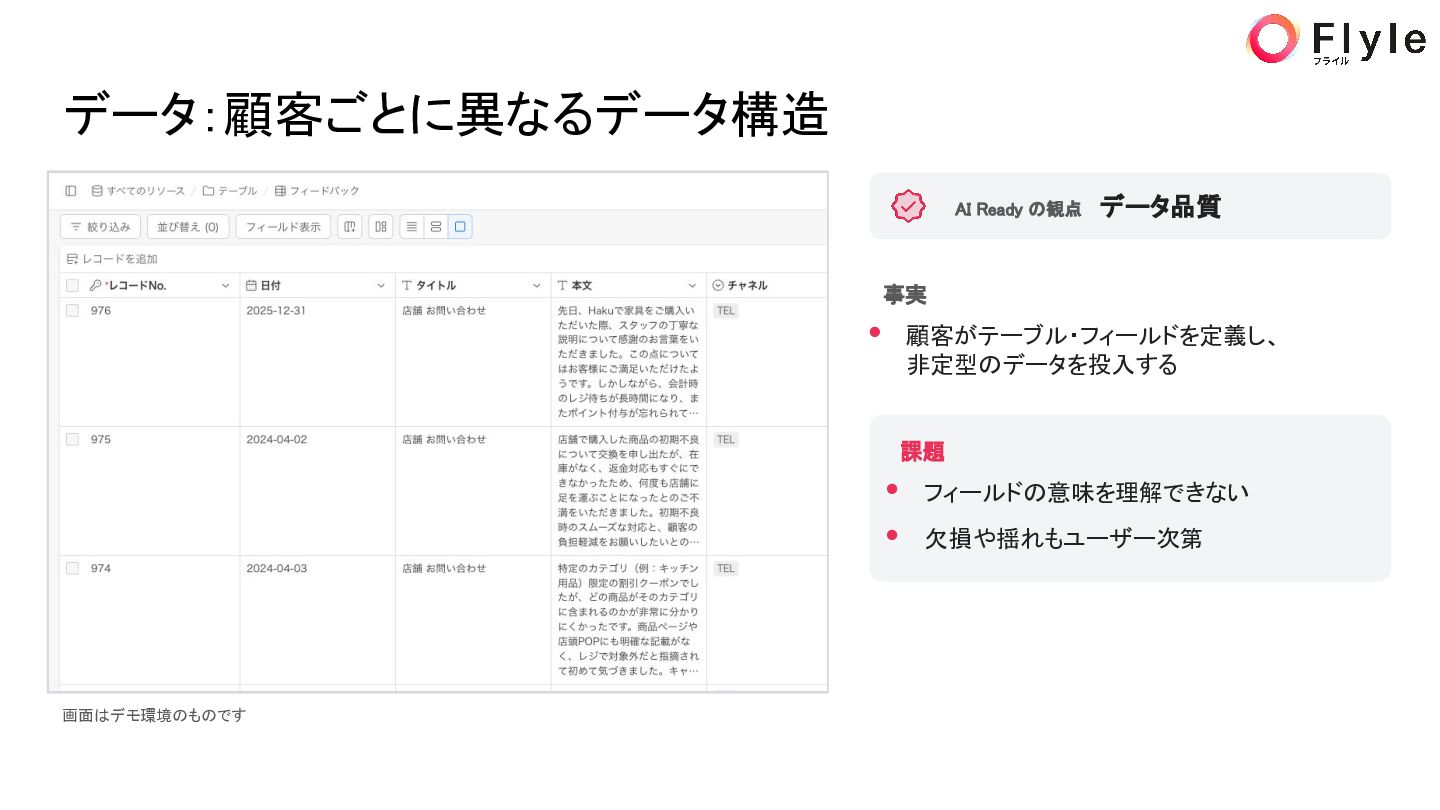
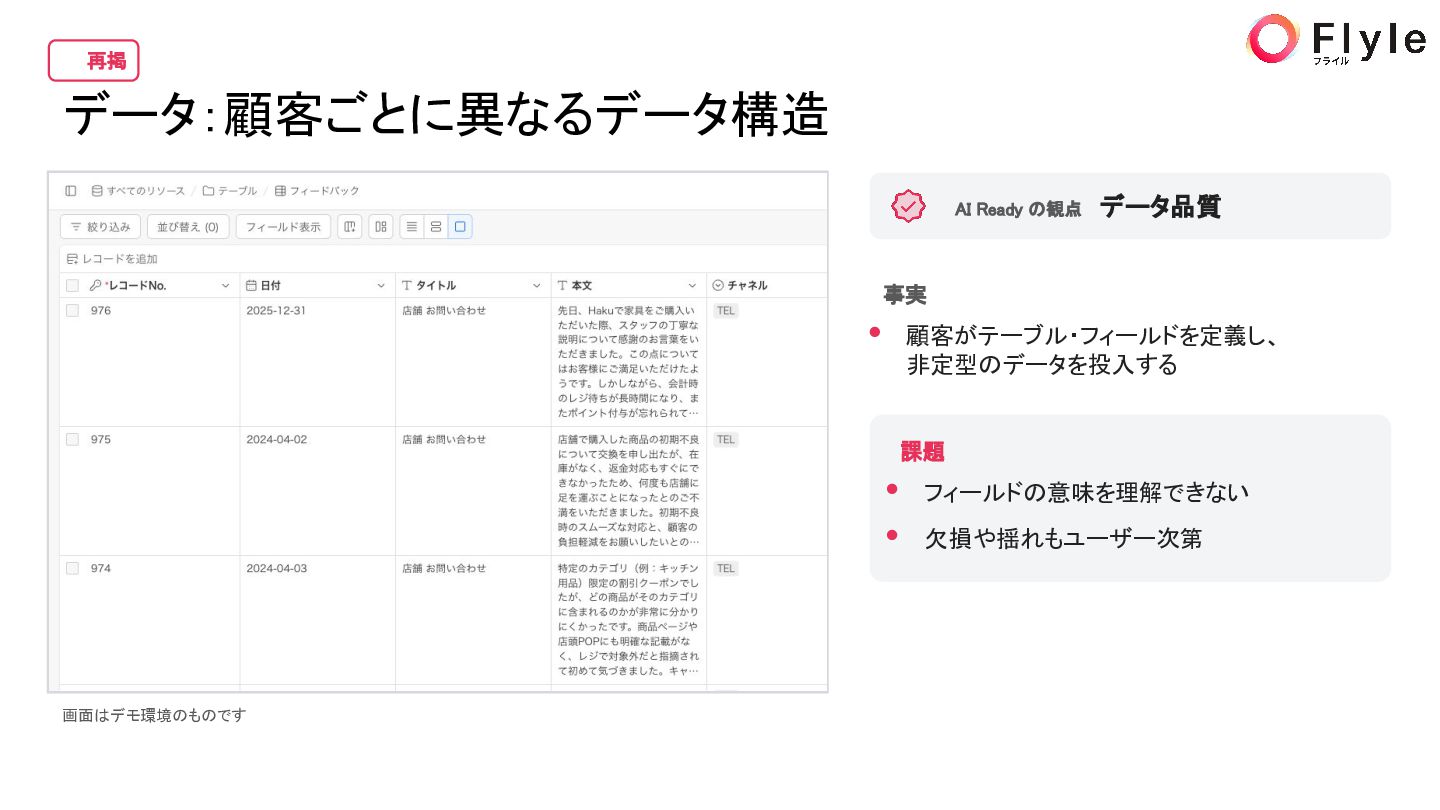
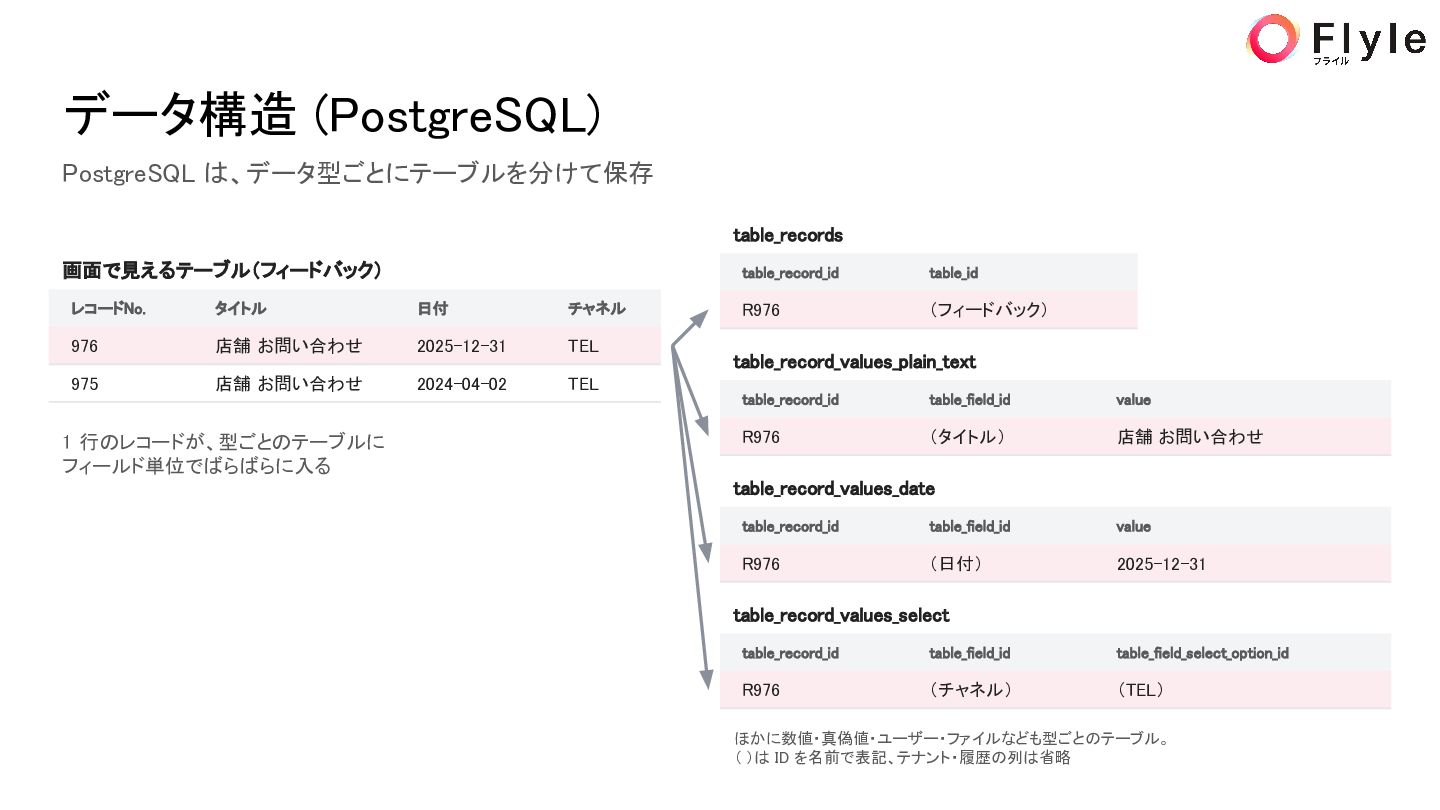
  19. データ構造 (PostgreSQL) PostgreSQL は、データ型ごとにテーブルを分けて保存 table_records 画面で見えるテーブル(フィードバック) レコードNo. タイトル 日付 チャネル

    976 店舗 お問い合わせ 2025-12-31 TEL 975 店舗 お問い合わせ 2024-04-02 TEL 1 行のレコードが、型ごとのテーブルに フィールド単位でばらばらに入る table_record_id table_id R976 (フィードバック) table_record_values_plain_text table_record_id table_field_id value R976 (タイトル) 店舗 お問い合わせ table_record_values_date table_record_id table_field_id value R976 (日付) 2025-12-31 table_record_values_select table_record_id table_field_id table_field_select_option_id R976 (チャネル) (TEL) ほかに数値・真偽値・ユーザー・ファイルなども型ごとのテーブル。 ( )は ID を名前で表記、テナント・履歴の列は省略
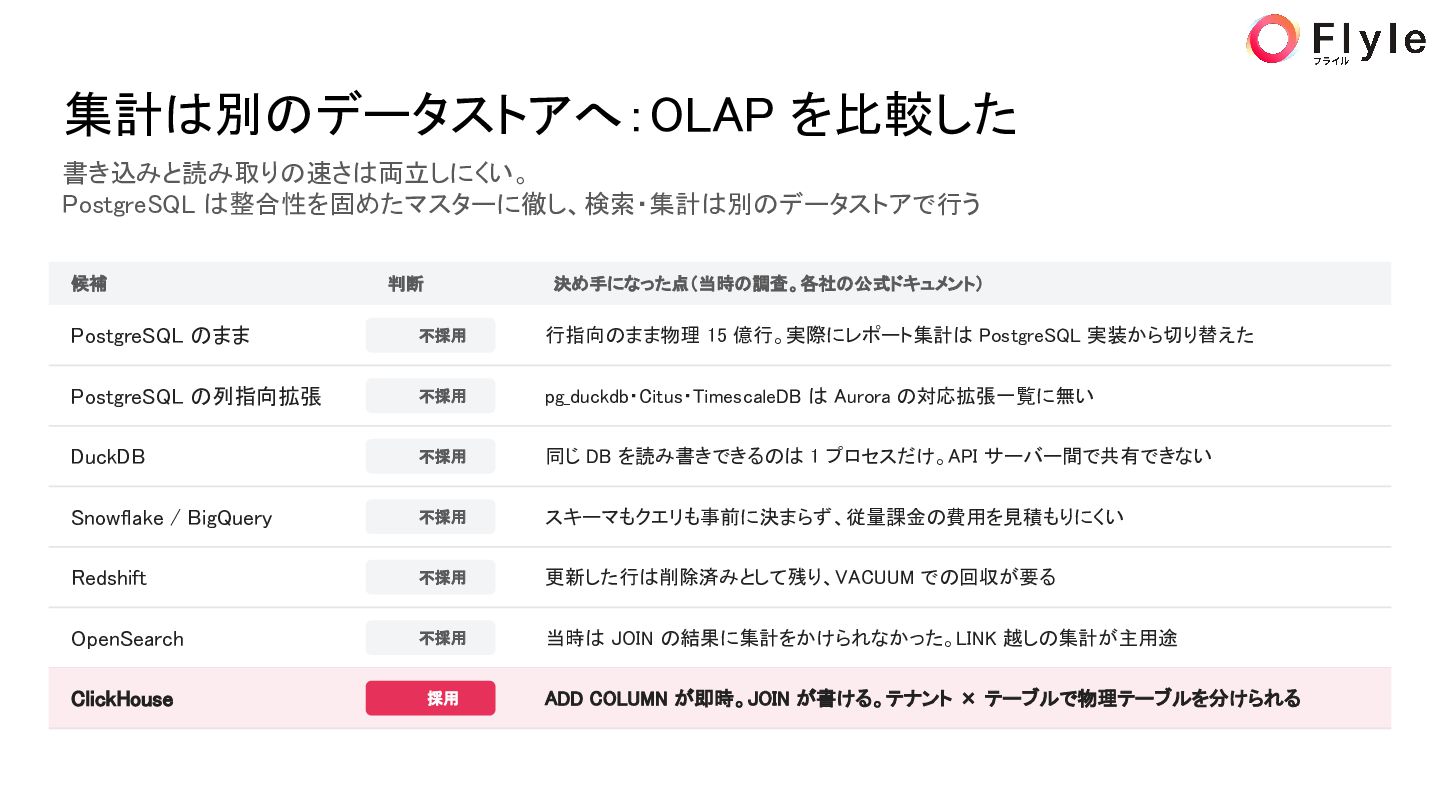
  20. 集計は別のデータストアへ:OLAP を比較した 書き込みと読み取りの速さは両立しにくい。 PostgreSQL は整合性を固めたマスターに徹し、検索・集計は別のデータストアで行う 候補 判断 決め手になった点(当時の調査。各社の公式ドキュメント) PostgreSQL のまま

    不採用 行指向のまま物理 15 億行。実際にレポート集計は PostgreSQL 実装から切り替えた PostgreSQL の列指向拡張 不採用 pg_duckdb・Citus・TimescaleDB は Aurora の対応拡張一覧に無い DuckDB 不採用 同じ DB を読み書きできるのは 1 プロセスだけ。API サーバー間で共有できない Snowflake / BigQuery 不採用 スキーマもクエリも事前に決まらず、従量課金の費用を見積もりにくい Redshift 不採用 更新した行は削除済みとして残り、VACUUM での回収が要る OpenSearch 不採用 当時は JOIN の結果に集計をかけられなかった。LINK 越しの集計が主用途 ClickHouse 採用 ADD COLUMN が即時。JOIN が書ける。テナント × テーブルで物理テーブルを分けられる
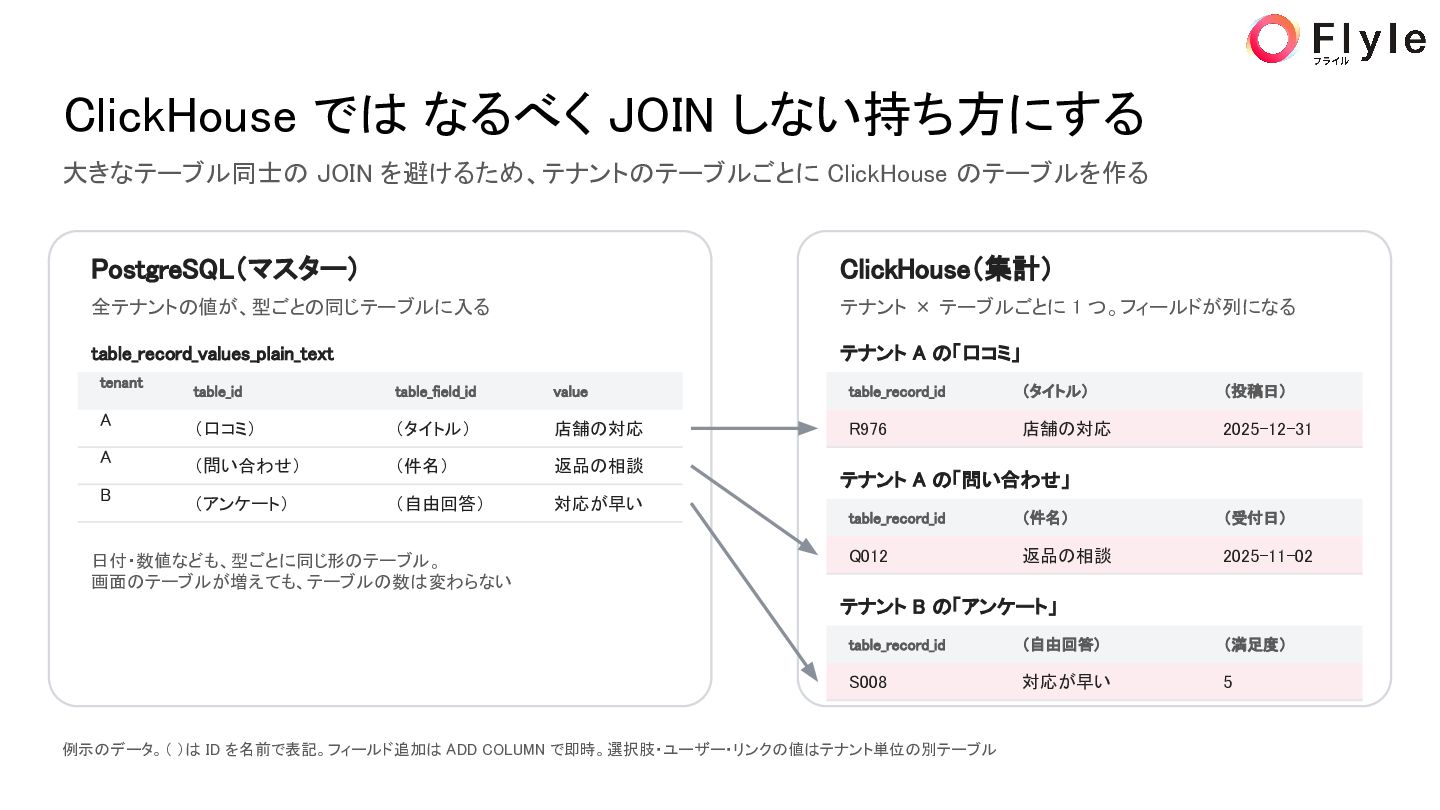
  21. ClickHouse では なるべく JOIN しない持ち方にする 大きなテーブル同士の JOIN を避けるため、テナントのテーブルごとに ClickHouse のテーブルを作る

    PostgreSQL(マスター) ClickHouse(集計) 全テナントの値が、型ごとの同じテーブルに入る テナント × テーブルごとに 1 つ。フィールドが列になる table_record_values_plain_text テナント A の「口コミ」 tenant A A B table_id table_field_id value table_record_id (タイトル) (投稿日) (口コミ) (タイトル) 店舗の対応 R976 店舗の対応 2025-12-31 (問い合わせ) (件名) 返品の相談 (アンケート) (自由回答) 対応が早い 日付・数値なども、型ごとに同じ形のテーブル。 画面のテーブルが増えても、テーブルの数は変わらない テナント A の「問い合わせ」 table_record_id (件名) (受付日) Q012 返品の相談 2025-11-02 テナント B の「アンケート」 table_record_id (自由回答) (満足度) S008 対応が早い 5 例示のデータ。( )は ID を名前で表記。フィールド追加は ADD COLUMN で即時。選択肢・ユーザー・リンクの値はテナント単位の別テーブル
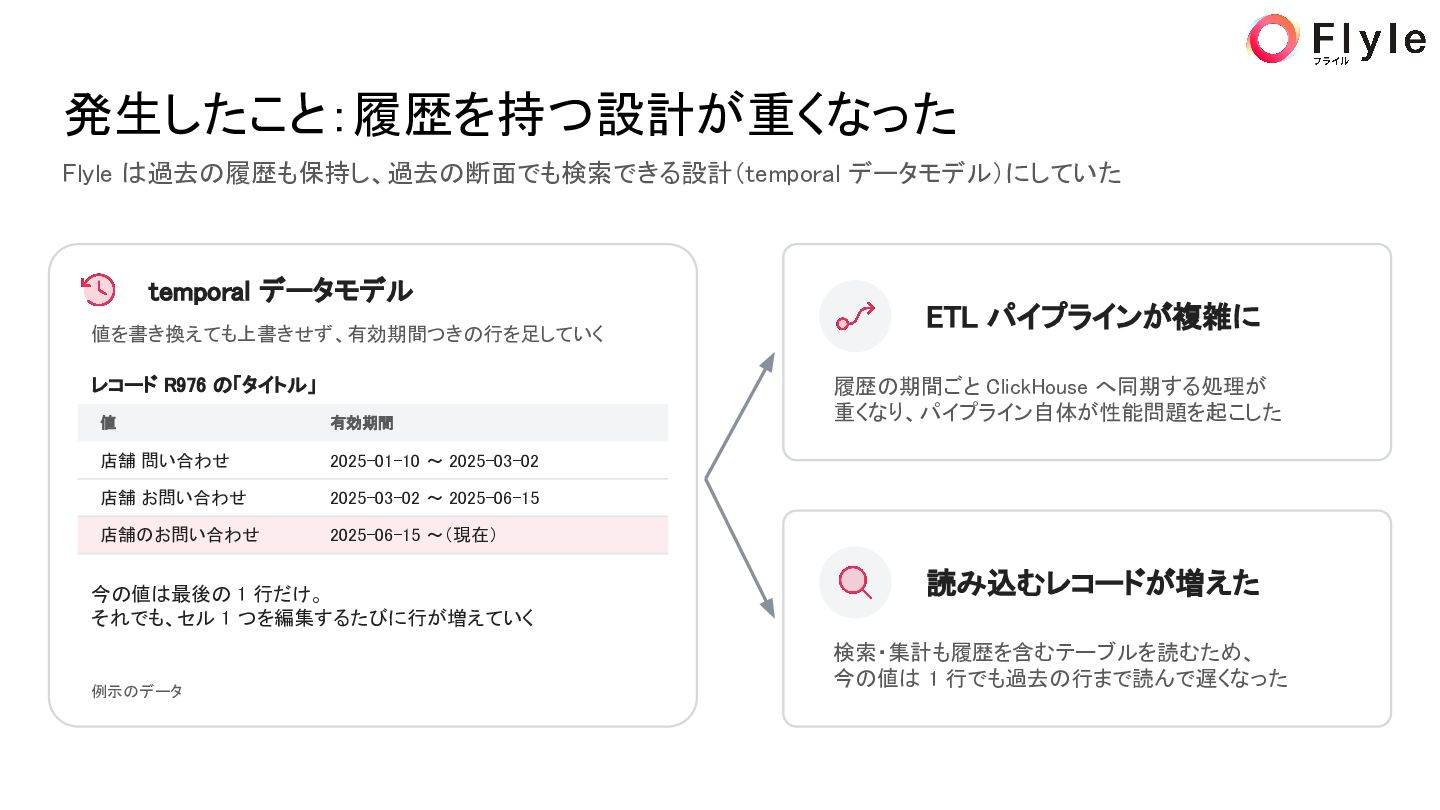
  22. 発生したこと:履歴を持つ設計が重くなった Flyle は過去の履歴も保持し、過去の断面でも検索できる設計(temporal データモデル)にしていた temporal データモデル 値を書き換えても上書きせず、有効期間つきの行を足していく レコード R976 の「タイトル」

    値 有効期間 店舗 問い合わせ 2025-01-10 〜 2025-03-02 店舗 お問い合わせ 2025-03-02 〜 2025-06-15 店舗のお問い合わせ 2025-06-15 〜(現在) 今の値は最後の 1 行だけ。 それでも、セル 1 つを編集するたびに行が増えていく 例示のデータ ETL パイプラインが複雑に 履歴の期間ごと ClickHouse へ同期する処理が 重くなり、パイプライン自体が性能問題を起こした 読み込むレコードが増えた 検索・集計も履歴を含むテーブルを読むため、 今の値は 1 行でも過去の行まで読んで遅くなった
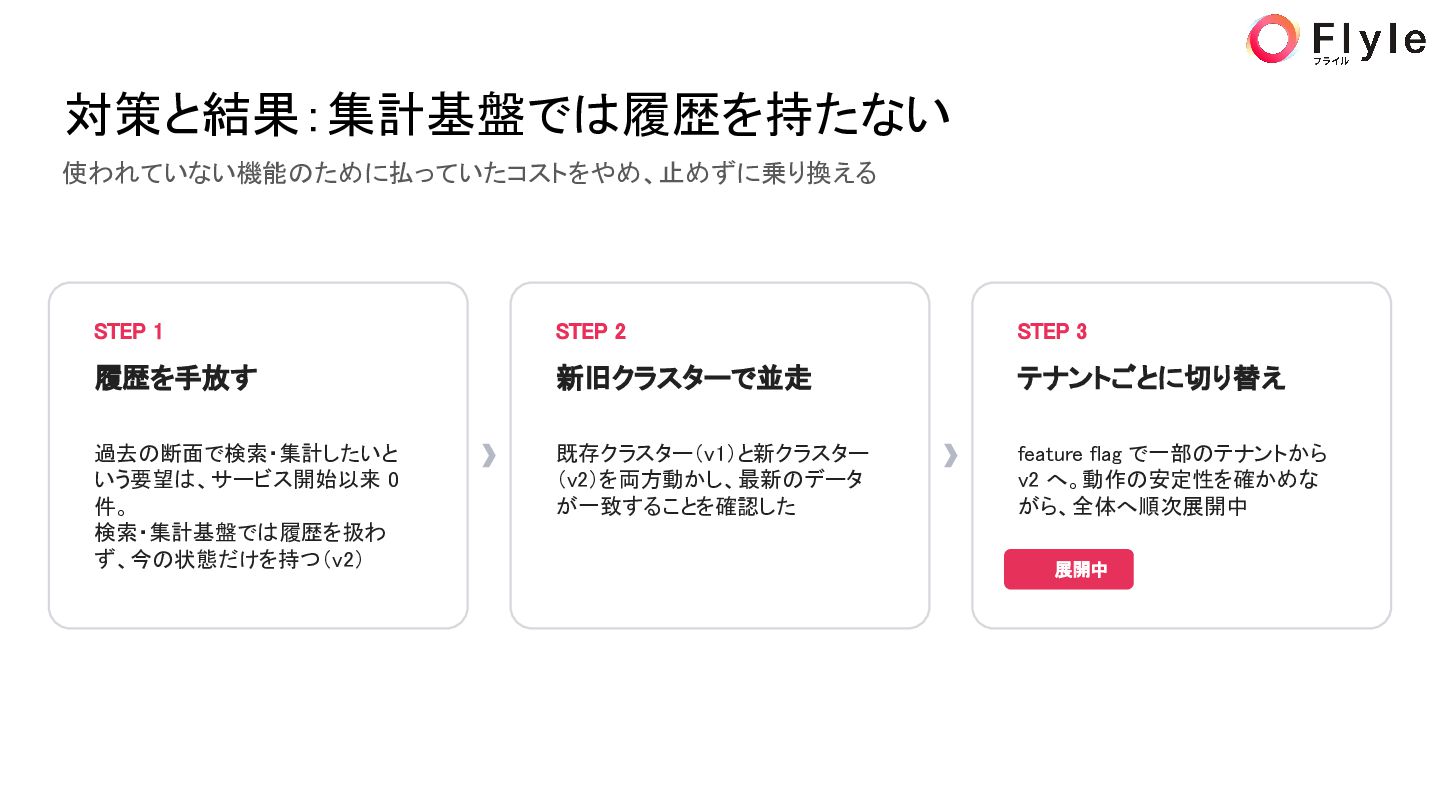
  23. 対策と結果:集計基盤では履歴を持たない 使われていない機能のために払っていたコストをやめ、止めずに乗り換える STEP 1 STEP 2 STEP 3 履歴を手放す 新旧クラスターで並走

    テナントごとに切り替え 過去の断面で検索・集計したいと いう要望は、サービス開始以来 0 件。 検索・集計基盤では履歴を扱わ ず、今の状態だけを持つ(v2) 既存クラスター(v1)と新クラスター (v2)を両方動かし、最新のデータ が一致することを確認した feature flag で一部のテナントから v2 へ。動作の安定性を確かめな がら、全体へ順次展開中 展開中
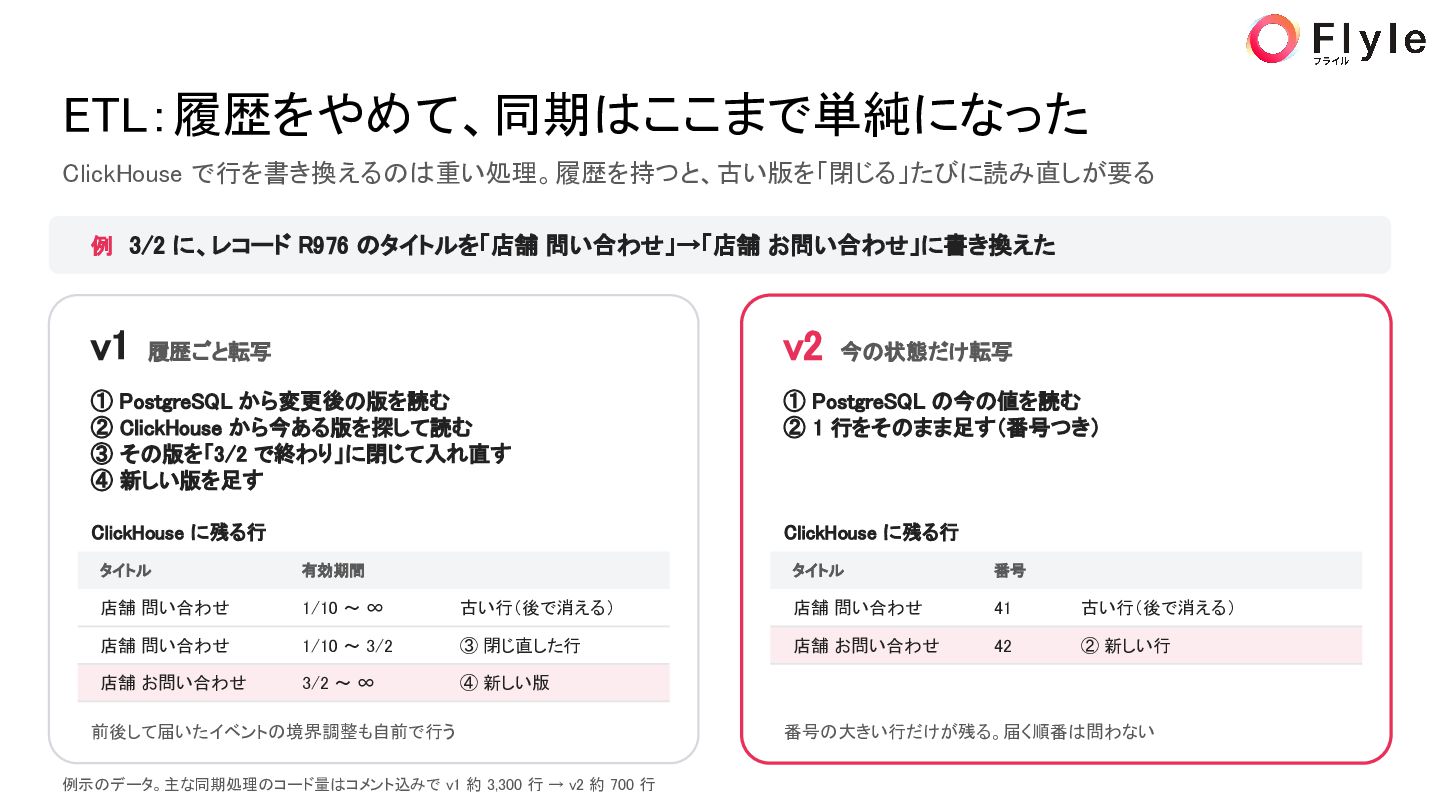
  24. ETL:履歴をやめて、同期はここまで単純になった ClickHouse で行を書き換えるのは重い処理。履歴を持つと、古い版を「閉じる」たびに読み直しが要る 例 3/2 に、レコード R976 のタイトルを「店舗 問い合わせ」→「店舗 お問い合わせ」に書き換えた

    v1 履歴ごと転写 v2 今の状態だけ転写 ① PostgreSQL から変更後の版を読む ② ClickHouse から今ある版を探して読む ③ その版を「3/2 で終わり」に閉じて入れ直す ④ 新しい版を足す ① PostgreSQL の今の値を読む ② 1 行をそのまま足す(番号つき) ClickHouse に残る行 ClickHouse に残る行 タイトル 有効期間 タイトル 番号 店舗 問い合わせ 1/10 〜 ∞ 古い行(後で消える) 店舗 問い合わせ 41 古い行(後で消える) 店舗 問い合わせ 1/10 〜 3/2 ③ 閉じ直した行 店舗 お問い合わせ 42 ② 新しい行 店舗 お問い合わせ 3/2 〜 ∞ ④ 新しい版 前後して届いたイベントの境界調整も自前で行う 例示のデータ。主な同期処理のコード量はコメント込みで v1 約 3,300 行 → v2 約 700 行 番号の大きい行だけが残る。届く順番は問わない
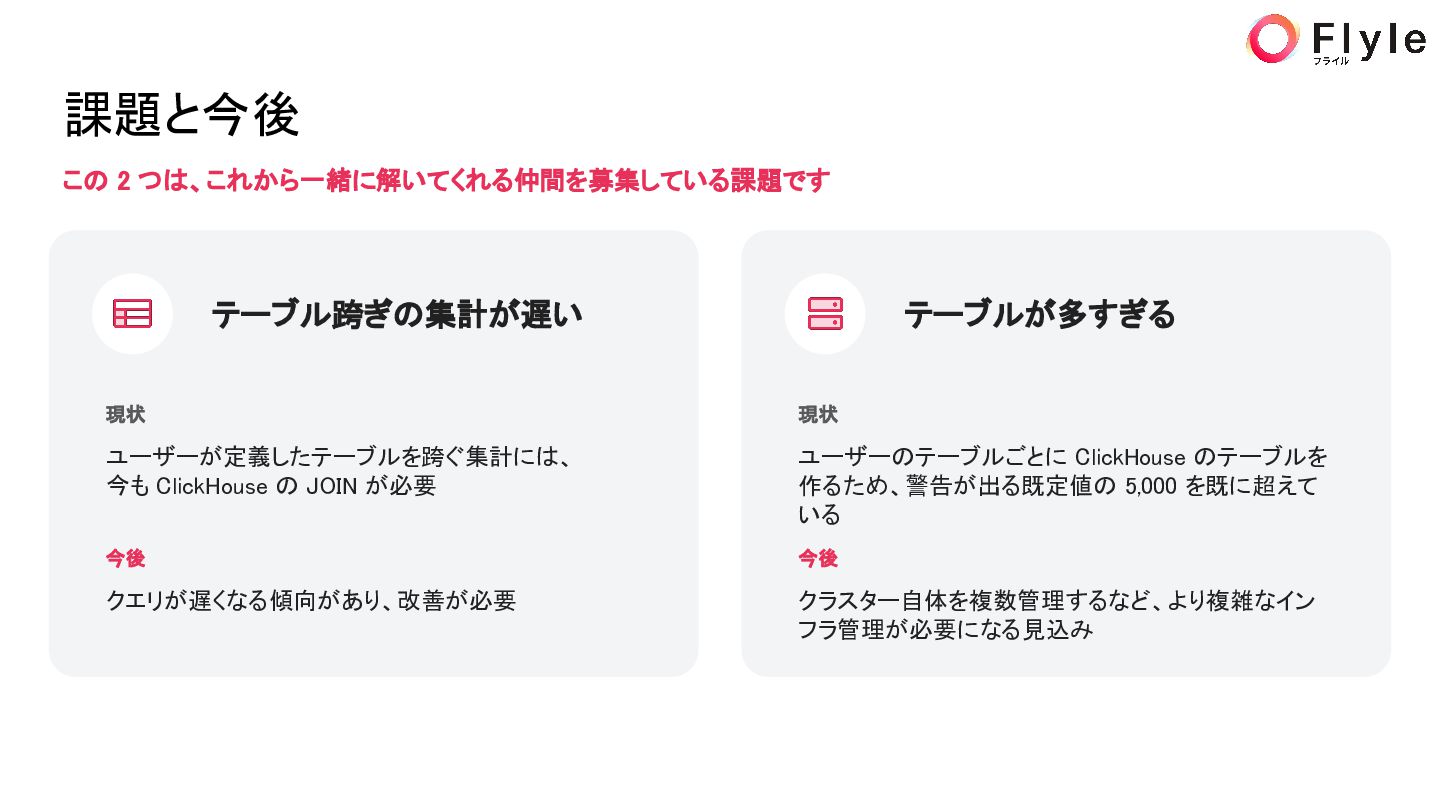
  25. 課題と今後 この 2 つは、これから一緒に解いてくれる仲間を募集している課題です テーブル跨ぎの集計が遅い テーブルが多すぎる 現状 現状 ユーザーが定義したテーブルを跨ぐ集計には、 今も

    ClickHouse の JOIN が必要 ユーザーのテーブルごとに ClickHouse のテーブルを 作るため、警告が出る既定値の 5,000 を既に超えて いる 今後 今後 クエリが遅くなる傾向があり、改善が必要 クラスター自体を複数管理するなど、より複雑なイン フラ管理が必要になる見込み
  26. 再掲 権限:複雑な権限管理 AI Ready の観点 権限 事実 ユーザー・グループごとに リソース単位の CRUD

    を設定できる テーブルは任意の条件で CRUD 範囲を設定できる 課題 複雑な権限機能でも 間違いは許されない 権限のフィルターが複雑になると 性能問題になりやすい 画面はデモ環境のものです
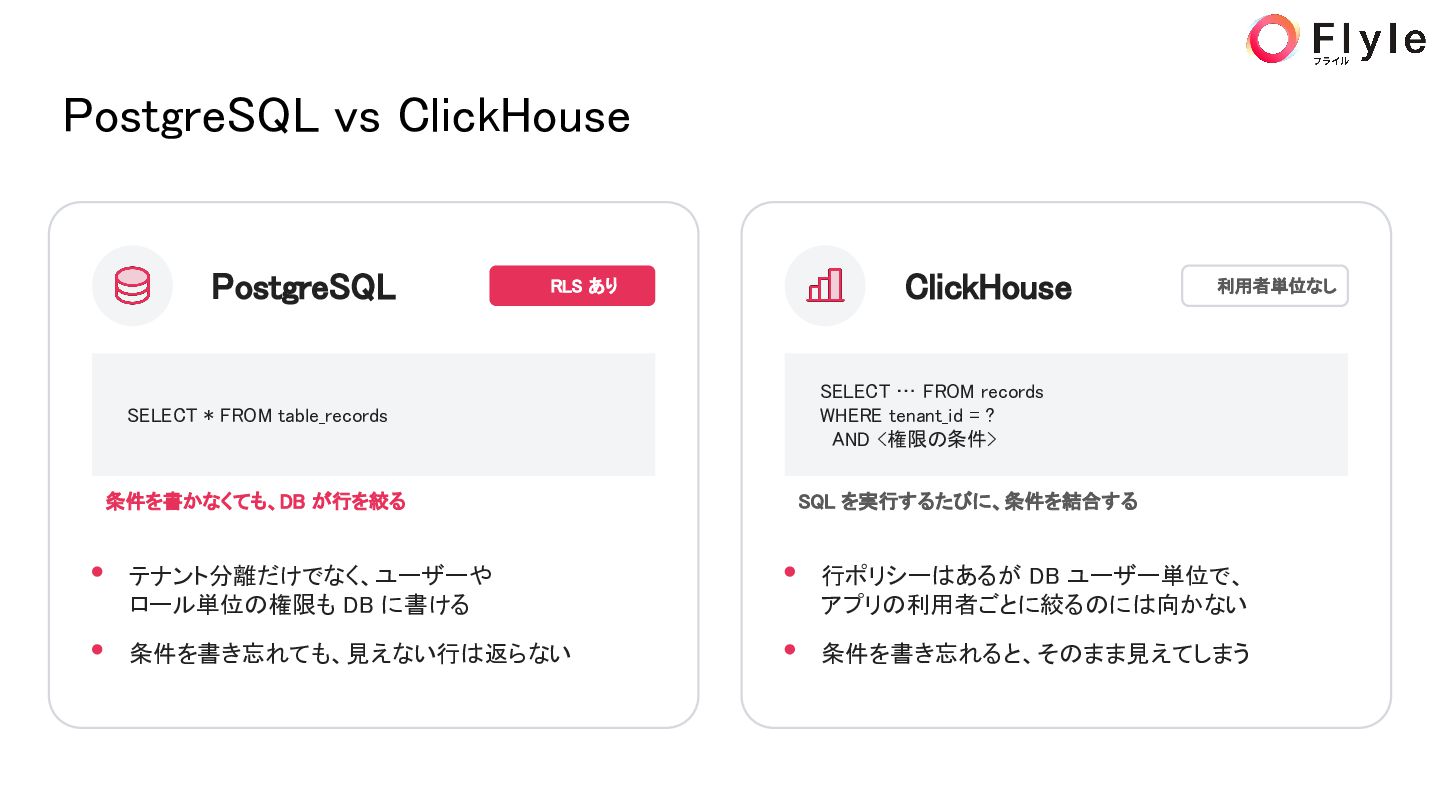
  27. PostgreSQL vs ClickHouse PostgreSQL RLS あり SELECT * FROM table_records

    条件を書かなくても、DB が行を絞る ClickHouse 利用者単位なし SELECT … FROM records WHERE tenant_id = ? AND <権限の条件> SQL を実行するたびに、条件を結合する テナント分離だけでなく、ユーザーや ロール単位の権限も DB に書ける 行ポリシーはあるが DB ユーザー単位で、 アプリの利用者ごとに絞るのには向かない 条件を書き忘れても、見えない行は返らない 条件を書き忘れると、そのまま見えてしまう
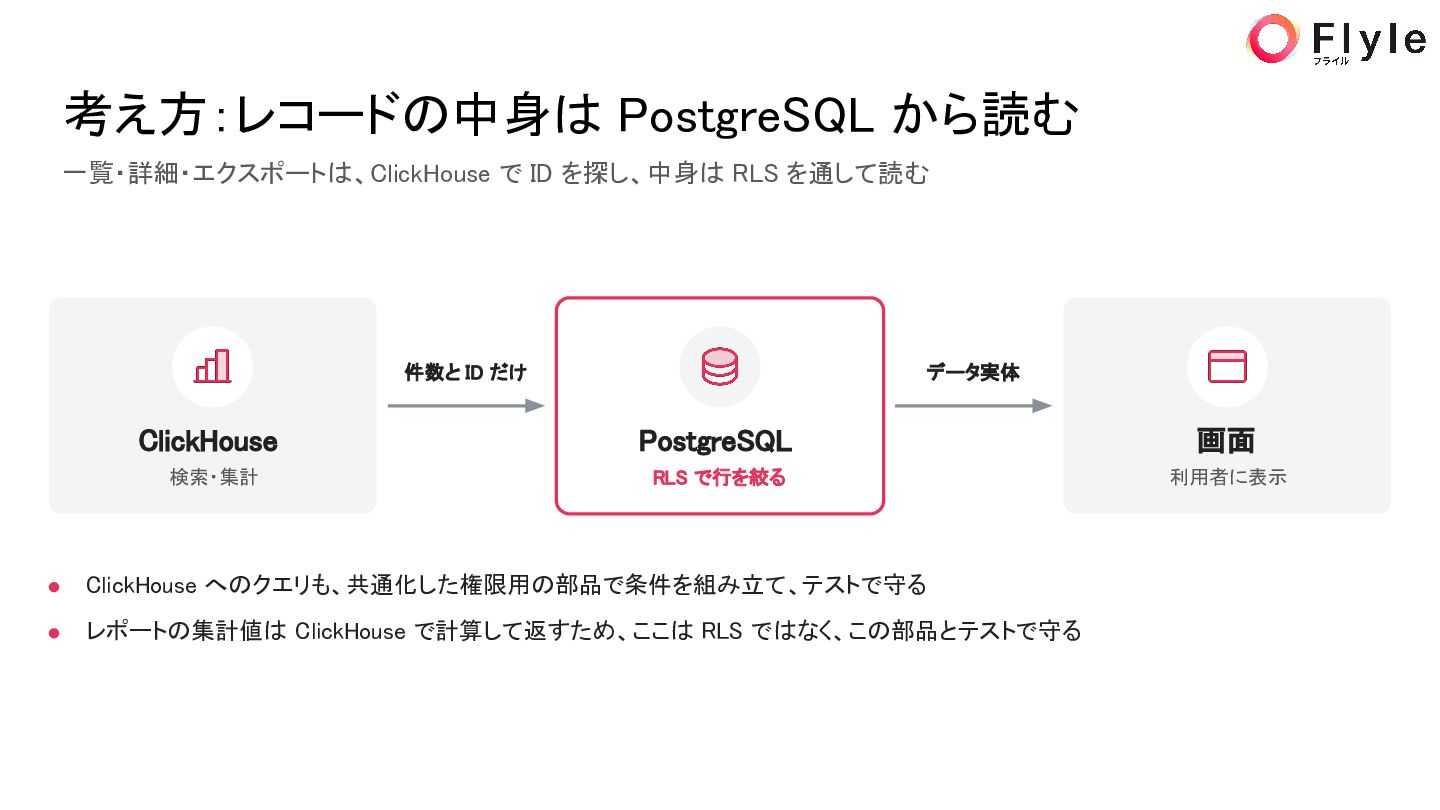
  28. 考え方:レコードの中身は PostgreSQL から読む 一覧・詳細・エクスポートは、ClickHouse で ID を探し、中身は RLS を通して読む 件数と

    ID だけ データ実体 ClickHouse PostgreSQL 画面 検索・集計 RLS で行を絞る 利用者に表示 ClickHouse へのクエリも、共通化した権限用の部品で条件を組み立て、テストで守る レポートの集計値は ClickHouse で計算して返すため、ここは RLS ではなく、この部品とテストで守る
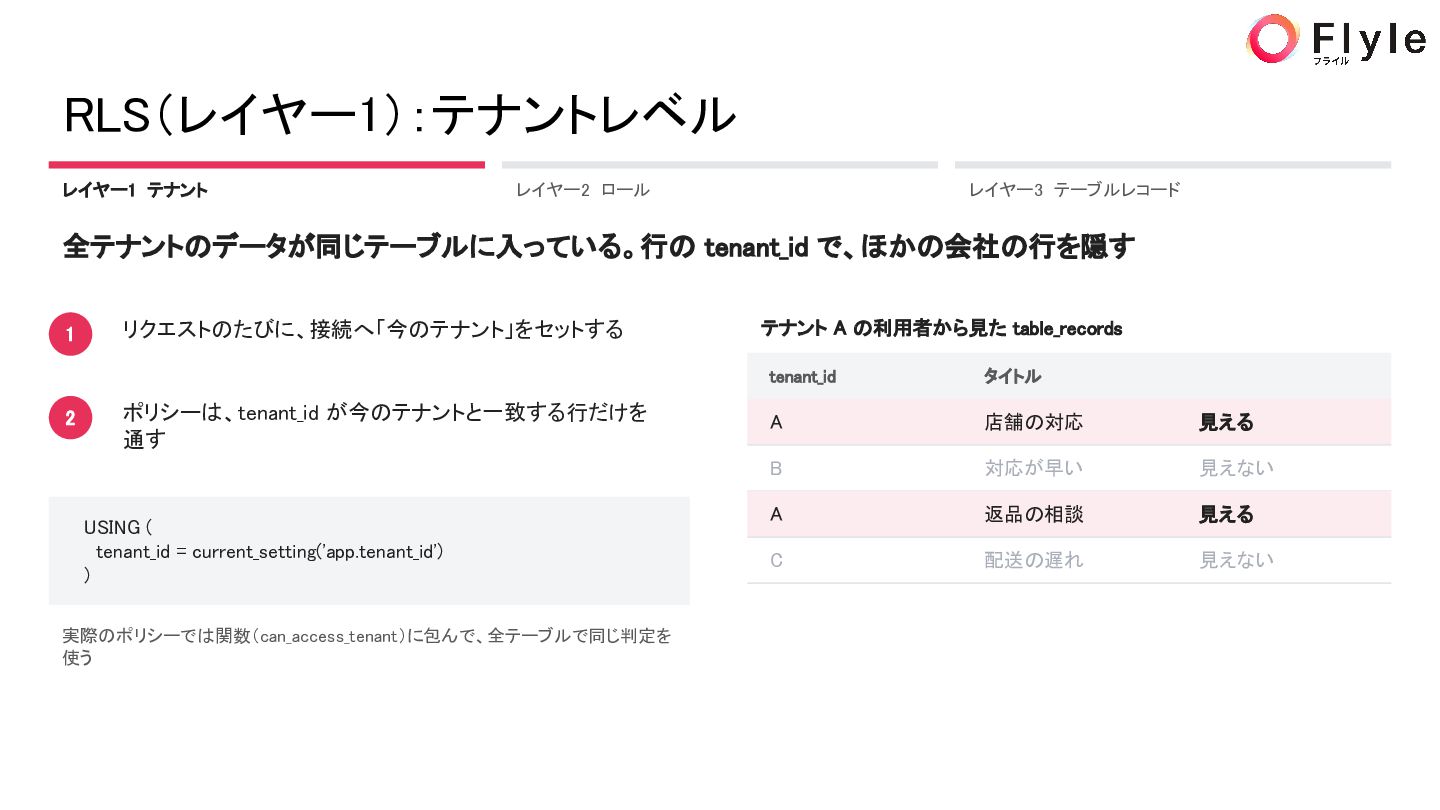
  29. RLS(レイヤー1):テナントレベル レイヤー1 テナント レイヤー2 ロール レイヤー3 テーブルレコード 全テナントのデータが同じテーブルに入っている。行の tenant_id で、ほかの会社の行を隠す

    1 2 リクエストのたびに、接続へ「今のテナント」をセットする ポリシーは、tenant_id が今のテナントと一致する行だけを 通す USING ( tenant_id = current_setting('app.tenant_id') ) 実際のポリシーでは関数(can_access_tenant)に包んで、全テーブルで同じ判定を 使う テナント A の利用者から見た table_records tenant_id タイトル A 店舗の対応 見える B 対応が早い 見えない A 返品の相談 見える C 配送の遅れ 見えない
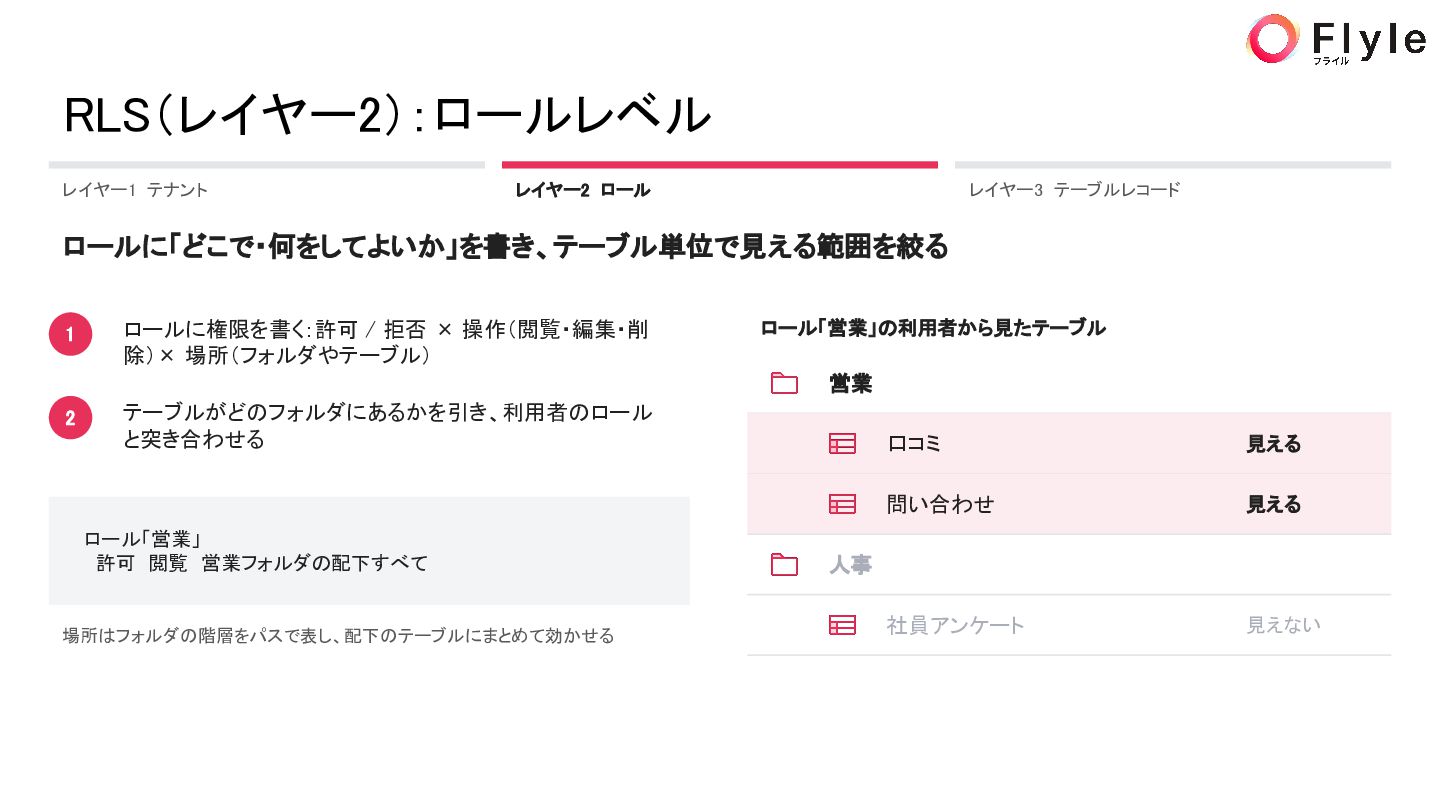
  30. RLS(レイヤー2):ロールレベル レイヤー1 テナント レイヤー2 ロール レイヤー3 テーブルレコード ロールに「どこで・何をしてよいか」を書き、テーブル単位で見える範囲を絞る 1 ロールに権限を書く:許可

    / 拒否 × 操作(閲覧・編集・削 除)× 場所(フォルダやテーブル) ロール「営業」の利用者から見たテーブル 営業 2 テーブルがどのフォルダにあるかを引き、利用者のロール と突き合わせる ロール「営業」 許可 閲覧 営業フォルダの配下すべて 場所はフォルダの階層をパスで表し、配下のテーブルにまとめて効かせる 口コミ 見える 問い合わせ 見える 社員アンケート 見えない 人事
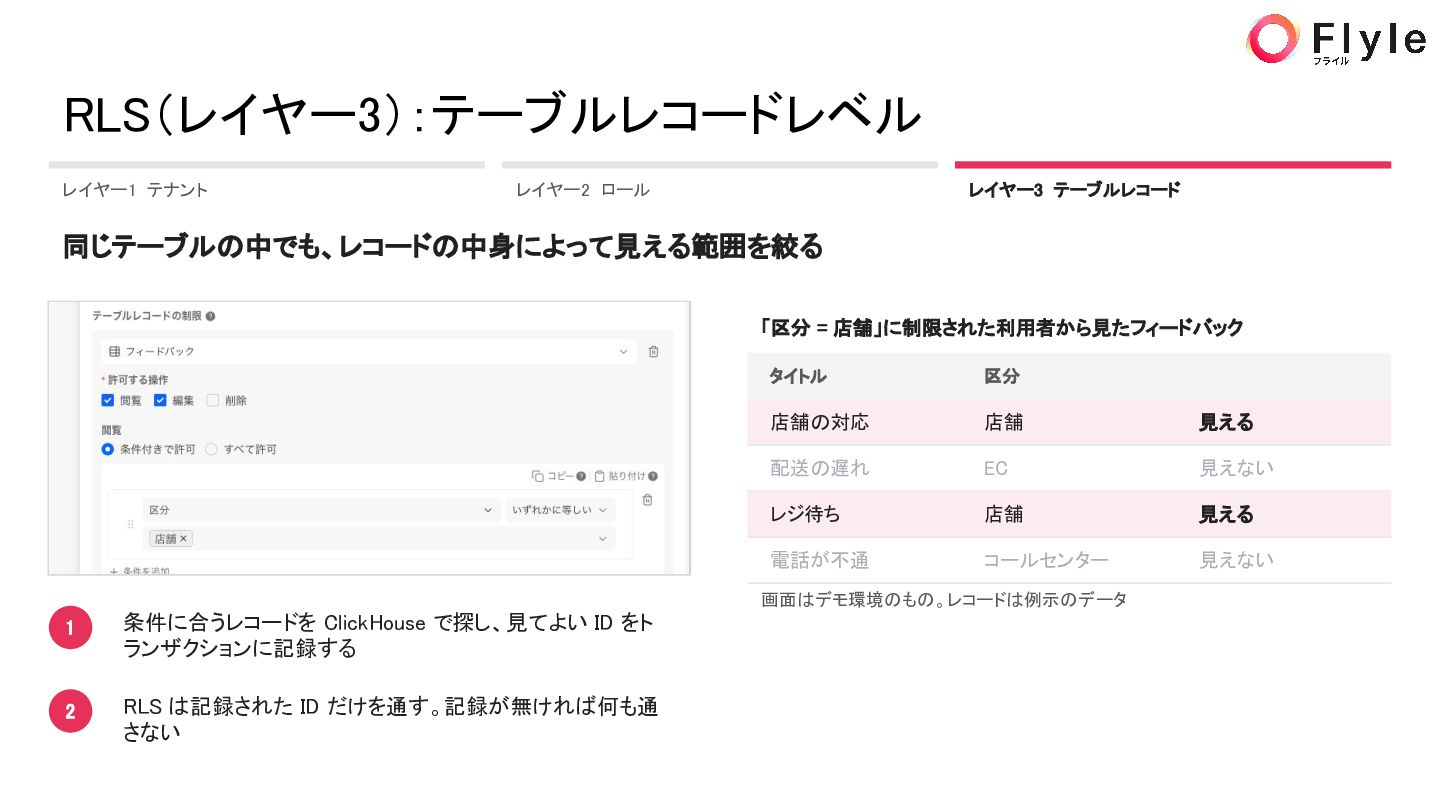
  31. RLS(レイヤー3):テーブルレコードレベル レイヤー1 テナント レイヤー2 ロール レイヤー3 テーブルレコード 同じテーブルの中でも、レコードの中身によって見える範囲を絞る 「区分 =

    店舗」に制限された利用者から見たフィードバック タイトル 区分 店舗の対応 店舗 見える 配送の遅れ EC 見えない レジ待ち 店舗 見える 電話が不通 コールセンター 見えない 画面はデモ環境のもの。レコードは例示のデータ 1 条件に合うレコードを ClickHouse で探し、見てよい ID をト ランザクションに記録する 2 RLS は記録された ID だけを通す。記録が無ければ何も通 さない
  32. Tips:最近チームメンバーが見つけた性能改善 RLS の条件は、読んだ行の数だけ評価される。行に関係ない判定まで、毎回やり直していた 修正前:1 行読むたびに「この人は閲覧権限がある?」を確かめる USING (can_access_tenant(tenant_id) AND has_system_resource_permission('TENANT:SELECT')) 修正後:(

    SELECT … ) で包むだけ USING (can_access_tenant(tenant_id) AND (SELECT has_system_resource_permission('TENANT:SELECT'))) とある画面のクエリ(ms) 修正前 修正後 1 回だけ判定 権限判定なし なぜ速くなるのか 6,263 ms 行ごとに判定 下限の目安 58 ms 55 ms 権限の有無は「誰が見ているか」で決まり、行には関係ない 関数のままだと、1 行ごとに呼ばれる(3.6 万行なら 3.6 万回) ( SELECT … ) で包むと、先に 1 回だけ計算して使い回す (InitPlan) ローカル計測(PostgreSQL 17、仮データ 3.6 万行)。 本番で遅かった画面の調査から見つかった
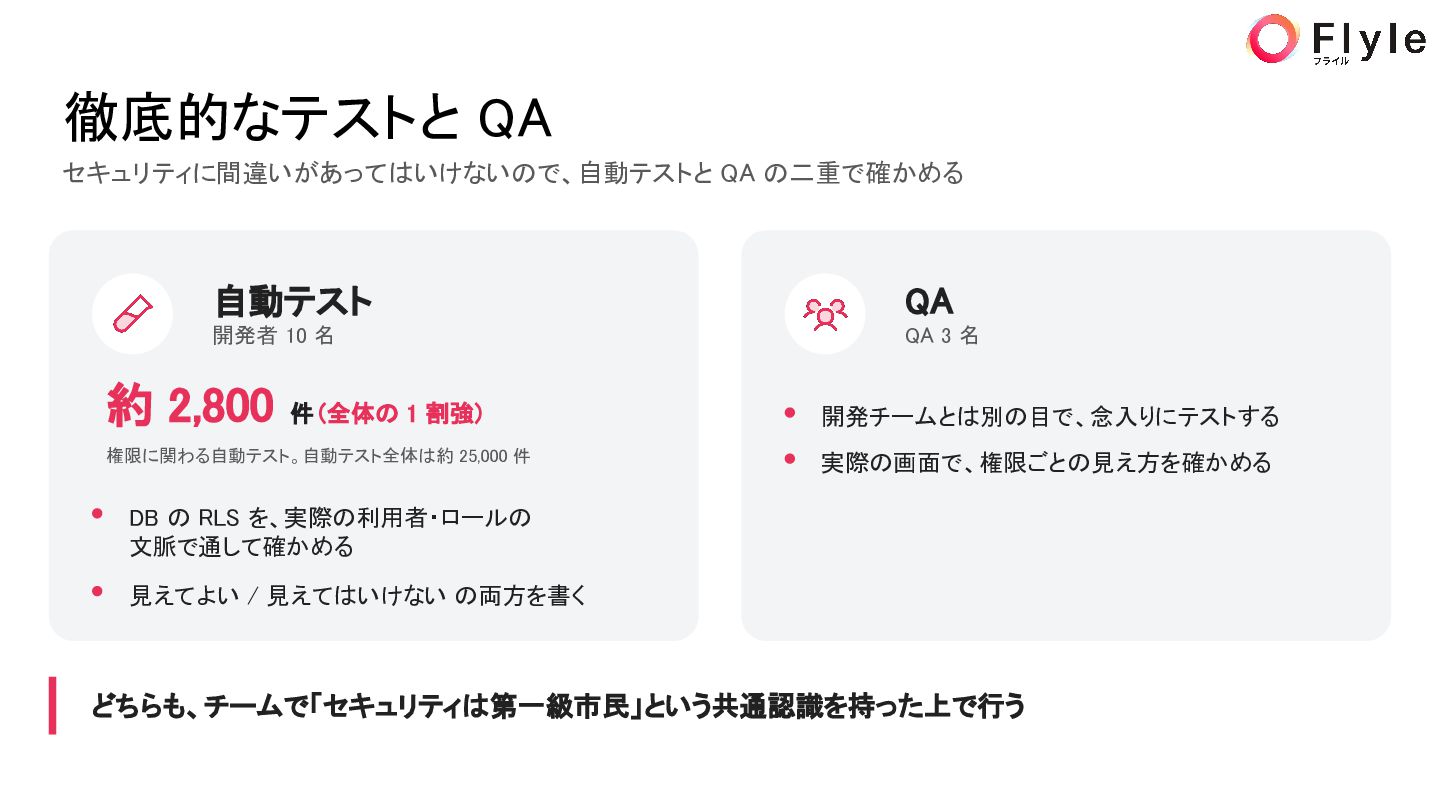
  33. 徹底的なテストと QA セキュリティに間違いがあってはいけないので、自動テストと QA の二重で確かめる 自動テスト QA 開発者 10 名

    QA 3 名 約 2,800 件(全体の 1 割強) 権限に関わる自動テスト。自動テスト全体は約 25,000 件 開発チームとは別の目で、念入りにテストする 実際の画面で、権限ごとの見え方を確かめる DB の RLS を、実際の利用者・ロールの 文脈で通して確かめる 見えてよい / 見えてはいけない の両方を書く どちらも、チームで「セキュリティは第一級市民」という共通認識を持った上で行う
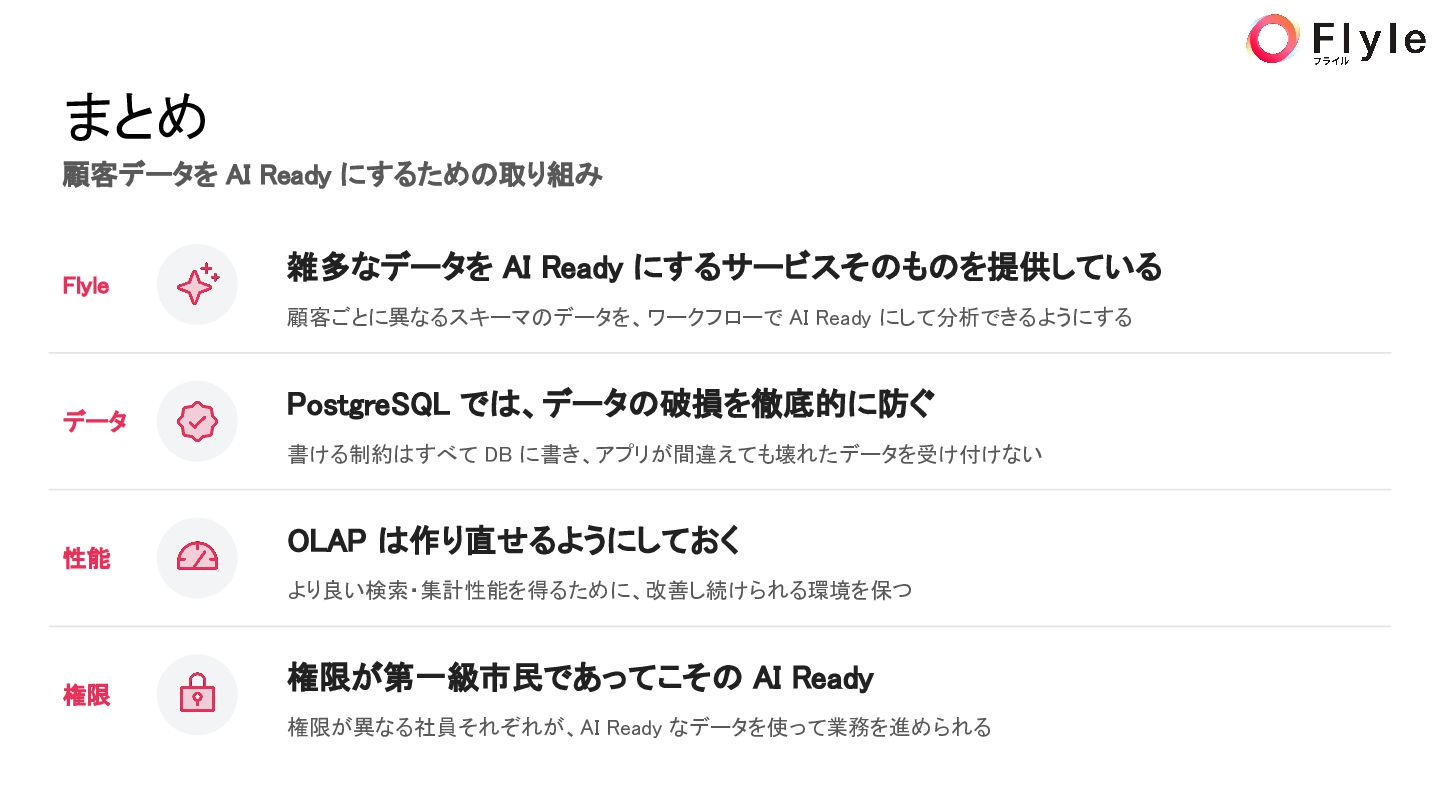
  34. まとめ 顧客データを AI Ready にするための取り組み Flyle 雑多なデータを AI Ready にするサービスそのものを提供している

    顧客ごとに異なるスキーマのデータを、ワークフローで AI Ready にして分析できるようにする データ PostgreSQL では、データの破損を徹底的に防ぐ 書ける制約はすべて DB に書き、アプリが間違えても壊れたデータを受け付けない 性能 OLAP は作り直せるようにしておく より良い検索・集計性能を得るために、改善し続けられる環境を保つ 権限 権限が第一級市民であってこその AI Ready 権限が異なる社員それぞれが、AI Ready なデータを使って業務を進められる