Share
Embed
atmaCup#9 1st place solution
atma株式会社が主催するデータサイエンスコンペティション「atmaCup」の第9回において優勝したので、そのソリューションの紹介です。
ソリューションそのものというよりは、考え方について説明したスライドです。
※コンペティションの内容を知らないとよく分からないかもしれません。
https://atma.connpass.com/event/199979/
pao
February 25, 2021
Transcript
41 slides
-
自己紹介 • pao • データサイエンティスト@ABEJA • Kaggle Master • 息子がかわいい
pao (@pppaaaooo) -
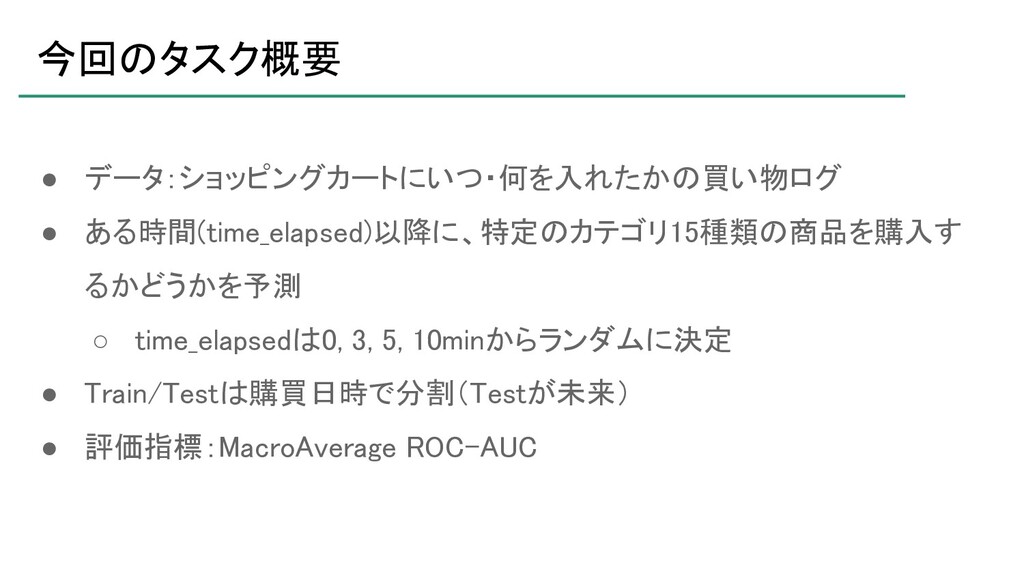
今回のタスク概要 • データ:ショッピングカートにいつ・何を入れたかの買い物ログ • ある時間(time_elapsed)以降に、特定のカテゴリ15種類の商品を購入す るかどうかを予測 ◦ time_elapsedは0, 3, 5,
10minからランダムに決定 • Train/Testは購買日時で分割(Testが未来) • 評価指標:MacroAverage ROC-AUC -
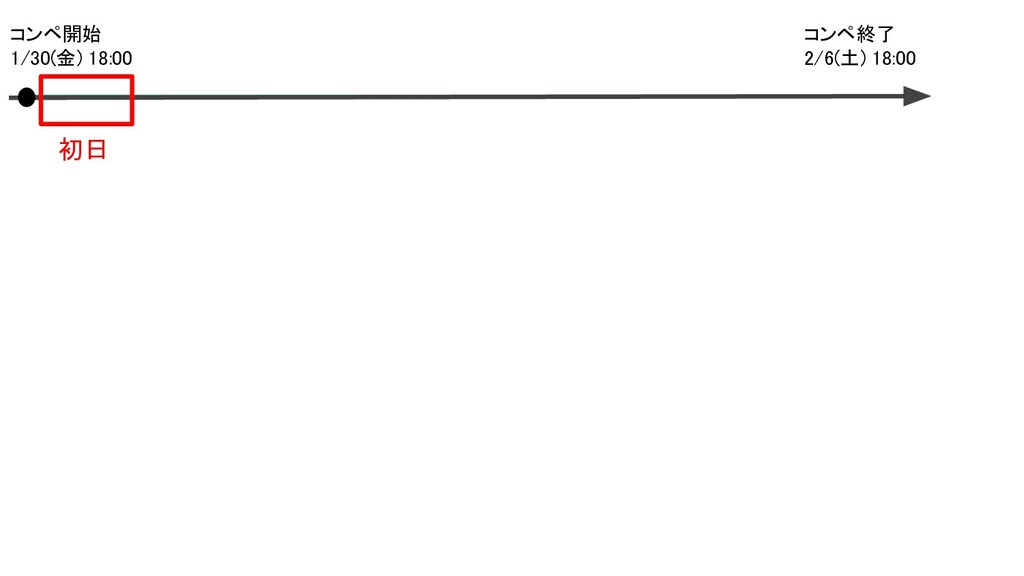
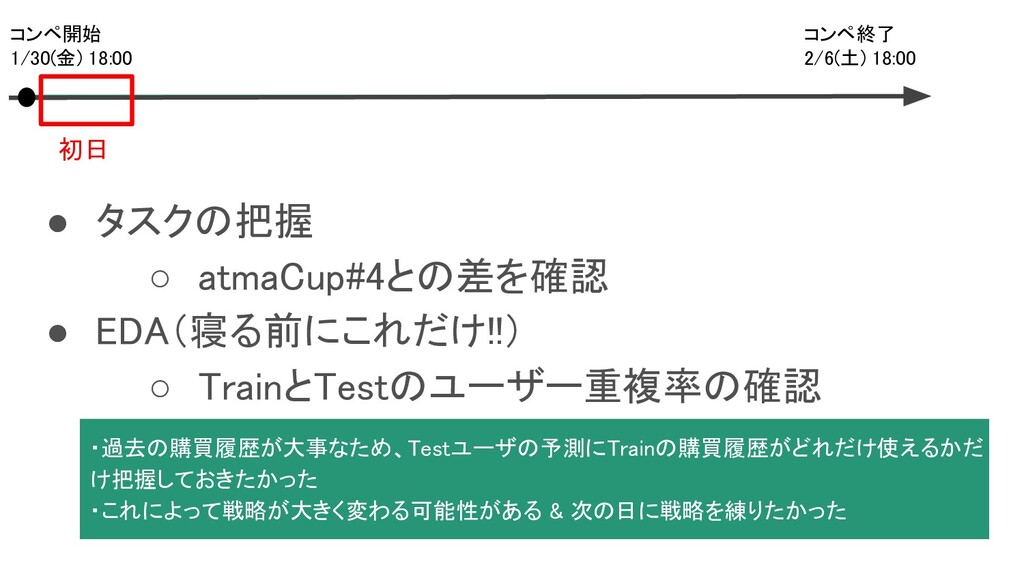
• タスクの把握 ◦ atmaCup#4との差を確認 • EDA(寝る前にこれだけ!!) ◦ TrainとTestのユーザー重複率の確認 コンペ開始 1/30(金)
18:00 コンペ終了 2/6(土) 18:00 初日 ・過去の購買履歴が大事なため、Testユーザの予測にTrainの購買履歴がどれだけ使えるかだ け把握しておきたかった ・これによって戦略が大きく変わる可能性がある & 次の日に戦略を練りたかった -
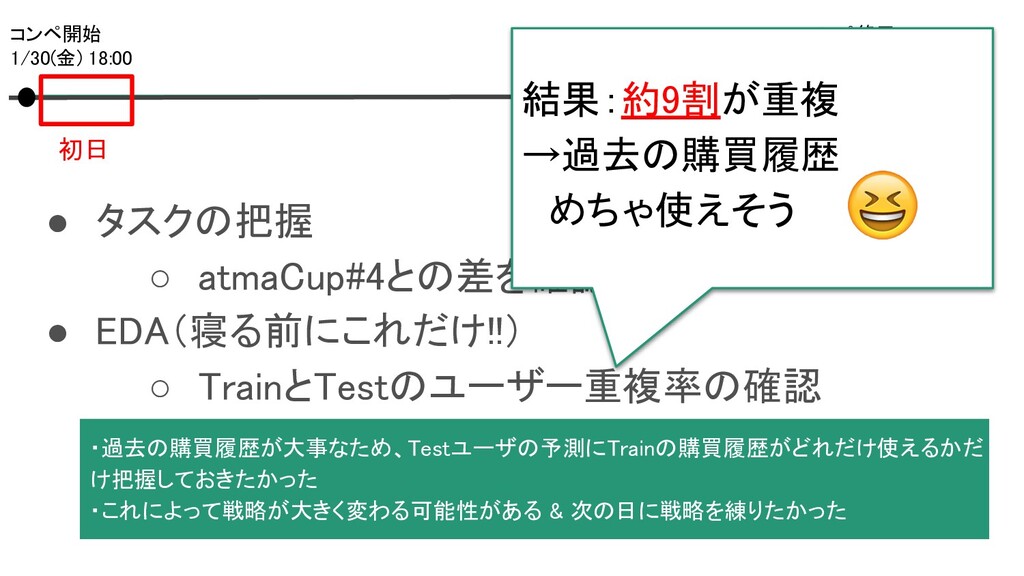
• タスクの把握 ◦ atmaCup#4との差を確認 • EDA(寝る前にこれだけ!!) ◦ TrainとTestのユーザー重複率の確認 コンペ開始 1/30(金)
18:00 コンペ終了 2/6(土) 18:00 初日 ・過去の購買履歴が大事なため、Testユーザの予測にTrainの購買履歴がどれだけ使えるかだ け把握しておきたかった ・これによって戦略が大きく変わる可能性がある & 次の日に戦略を練りたかった 結果:約9割が重複 →過去の購買履歴 めちゃ使えそう -
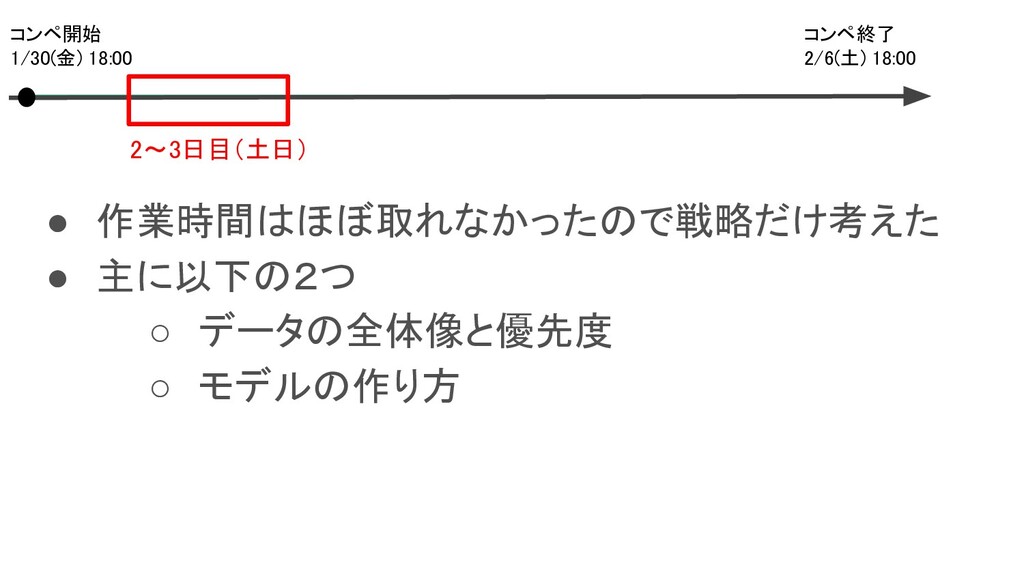
• 作業時間はほぼ取れなかったので戦略だけ考えた • 主に以下の2つ ◦ データの全体像と優先度 ◦ モデルの作り方 コンペ開始 1/30(金)
18:00 コンペ終了 2/6(土) 18:00 2〜3日目(土日) -
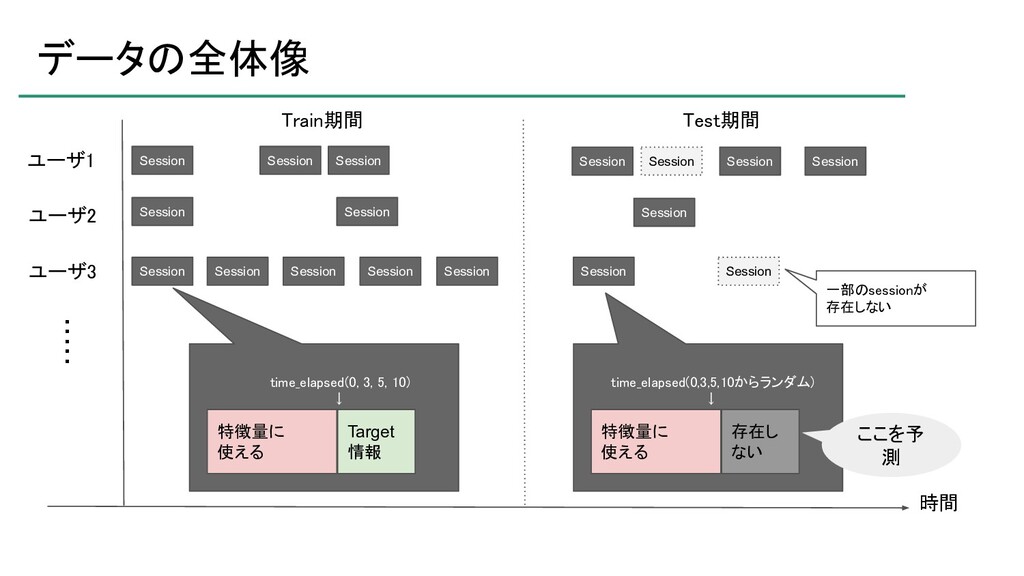
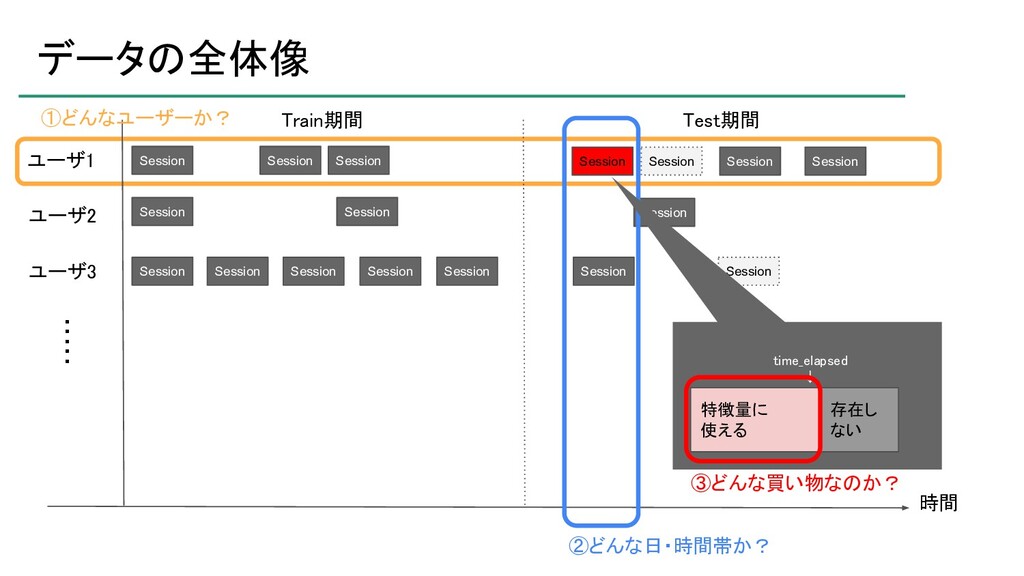
データの全体像 Session ユーザ1 ユーザ2 ユーザ3 ・・・・・ 時間 Train期間 Test期間 Session
Session Session Session Session Session Session Session Session Session Session Session Session Session Session Session time_elapsed(0, 3, 5, 10) ↓ 特徴量に 使える Target 情報 time_elapsed(0,3,5,10からランダム) ↓ 特徴量に 使える 存在し ない 一部のsessionが 存在しない ここを予 測 -
Session データの全体像 Session ユーザ1 ユーザ2 ユーザ3 ・・・・・ 時間 Train期間 Test期間
Session Session Session Session Session Session Session Session Session Session Session Session Session Session time_elapsed ↓ 特徴量に 使える 存在し ない ①どんなユーザーか? ②どんな日・時間帯か? ③どんな買い物なのか? Session -
Session データの全体像 Session ユーザ1 ユーザ2 ユーザ3 ・・・・・ 時間 Train期間 Test期間
Session Session Session Session Session Session Session Session Session Session Session Session Session Session time_elapsed ↓ 特徴量に 使える 存在し ない ①どんなユーザーか? ②どんな日・時間帯か? ③どんな買い物なのか? ①どんなユーザーか? →最重要。 ②どんな日・時間帯か? →そこそこ重要そう。 ③どんな買い物なのか? →今回のデータの新規ポイントの一つ ここで勝敗を分ける可能性も大いにある データの優先度:① >> ③ >> ② Session -
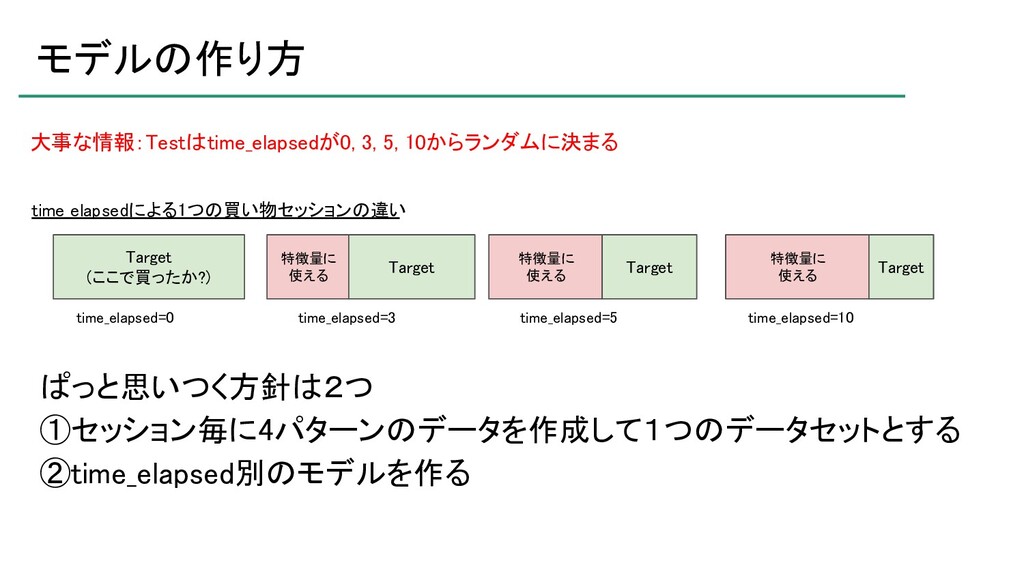
モデルの作り方 ぱっと思いつく方針は2つ ①セッション毎に4パターンのデータを作成して1つのデータセットとする ②time_elapsed別のモデルを作る 大事な情報:Testはtime_elapsedが0, 3, 5, 10からランダムに決まる Target (ここで買ったか?)
time_elapsed=0 特徴量に 使える Target time_elapsed=3 特徴量に 使える Target time_elapsed=5 特徴量に 使える Target time_elapsed=10 time_elapsedによる1つの買い物セッションの違い -
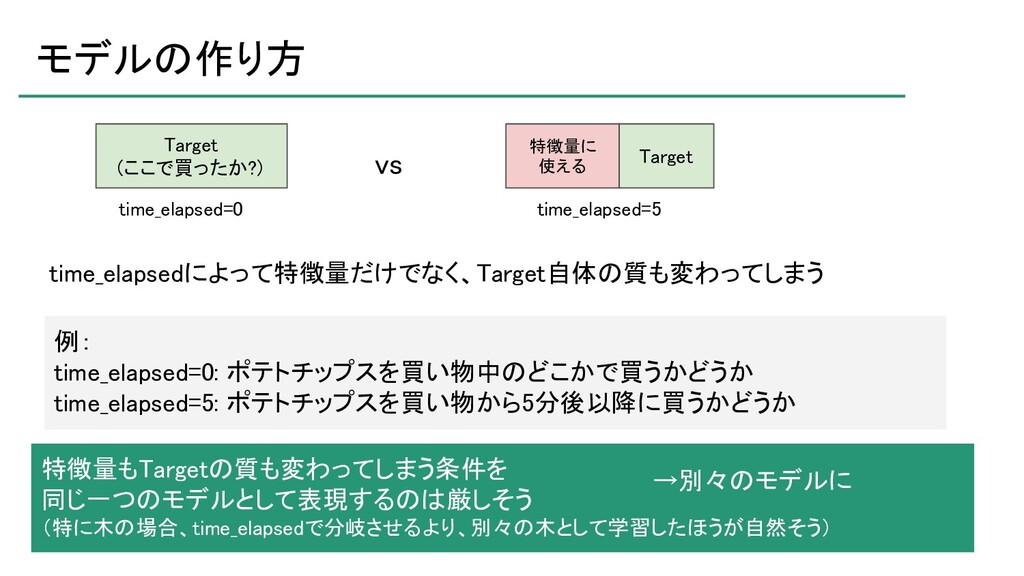
モデルの作り方 Target (ここで買ったか?) time_elapsed=0 特徴量に 使える Target time_elapsed=5 vs time_elapsedによって特徴量だけでなく、Target自体の質も変わってしまう
例: time_elapsed=0: ポテトチップスを買い物中のどこかで買うかどうか time_elapsed=5: ポテトチップスを買い物から5分後以降に買うかどうか 特徴量もTargetの質も変わってしまう条件を 同じ一つのモデルとして表現するのは厳しそう (特に木の場合、time_elapsedで分岐させるより、別々の木として学習したほうが自然そう) →別々のモデルに -
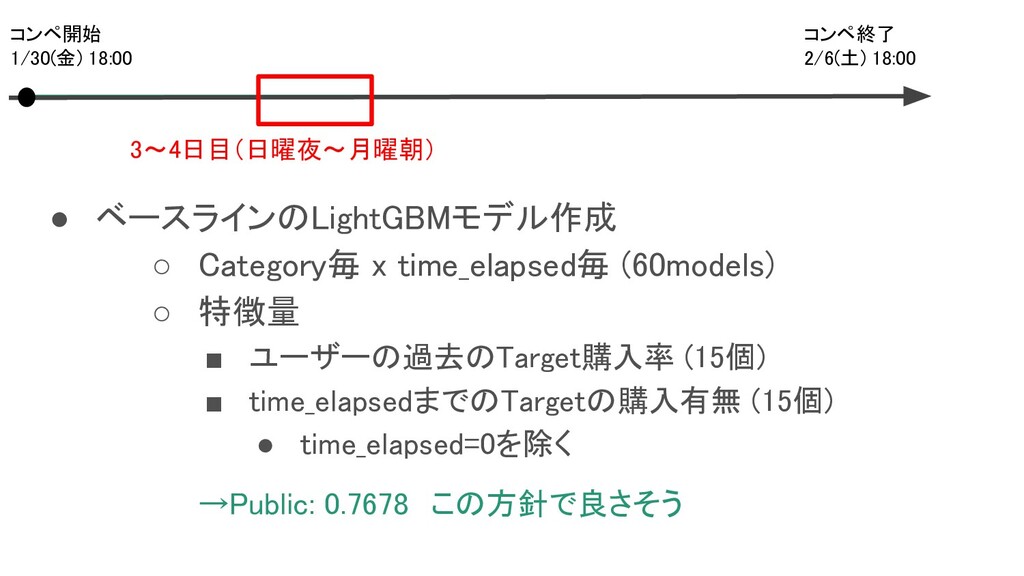
• ベースラインのLightGBMモデル作成 ◦ Category毎 x time_elapsed毎 (60models) ◦ 特徴量 ▪
ユーザーの過去のTarget購入率 (15個) ▪ time_elapsedまでのTargetの購入有無 (15個) • time_elapsed=0を除く →Public: 0.7678 この方針で良さそう コンペ開始 1/30(金) 18:00 コンペ終了 2/6(土) 18:00 3〜4日目(日曜夜〜月曜朝) -
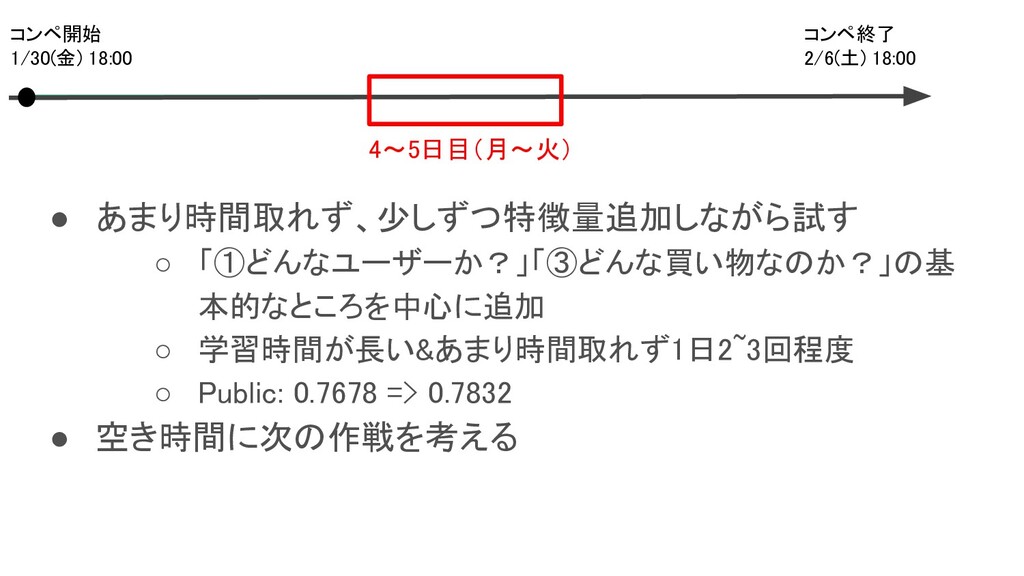
• あまり時間取れず、少しずつ特徴量追加しながら試す ◦ 「①どんなユーザーか?」「③どんな買い物なのか?」の基 本的なところを中心に追加 ◦ 学習時間が長い&あまり時間取れず1日2~3回程度 ◦ Public: 0.7678
=> 0.7832 • 空き時間に次の作戦を考える コンペ開始 1/30(金) 18:00 コンペ終了 2/6(土) 18:00 4〜5日目(月〜火) -
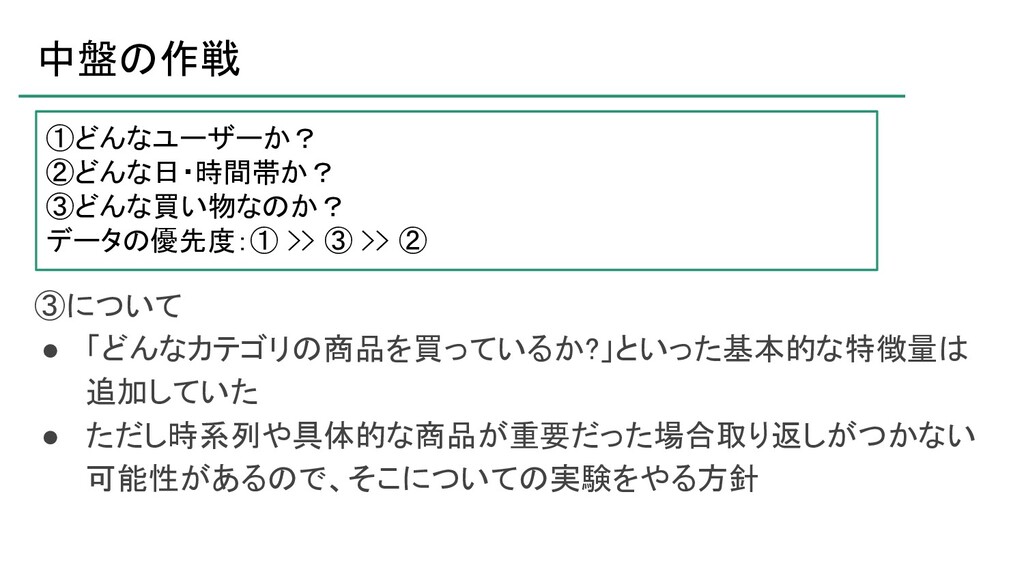
中盤の作戦 ①どんなユーザーか? ②どんな日・時間帯か? ③どんな買い物なのか? データの優先度:① >> ③ >> ② ③について
• 「どんなカテゴリの商品を買っているか?」といった基本的な特徴量は 追加していた • ただし時系列や具体的な商品が重要だった場合取り返しがつかない 可能性があるので、そこについての実験をやる方針 -
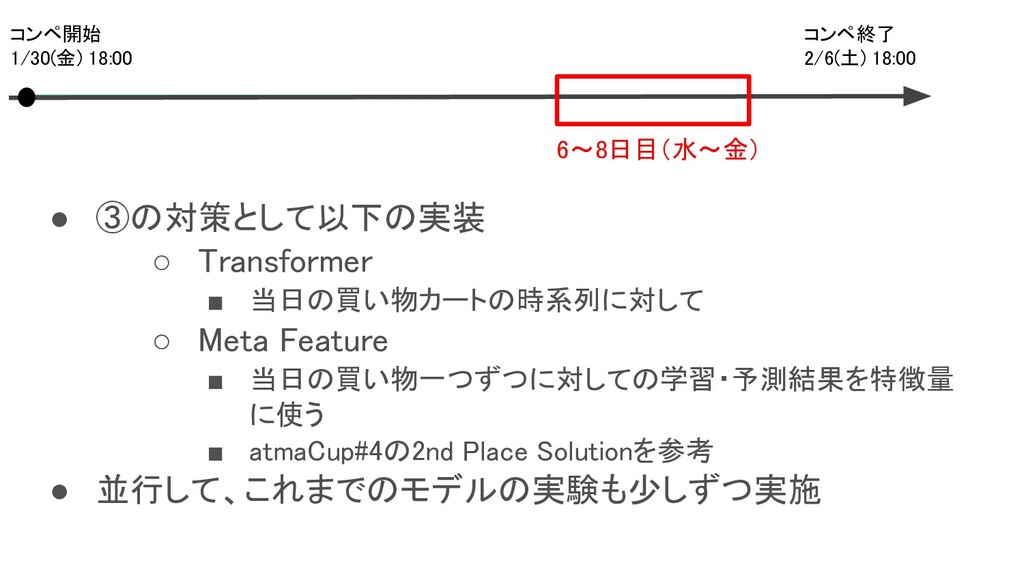
• ③の対策として以下の実装 ◦ Transformer ▪ 当日の買い物カートの時系列に対して ◦ Meta Feature ▪
当日の買い物一つずつに対しての学習・予測結果を特徴量 に使う ▪ atmaCup#4の2nd Place Solutionを参考 • 並行して、これまでのモデルの実験も少しずつ実施 コンペ開始 1/30(金) 18:00 コンペ終了 2/6(土) 18:00 6〜8日目(水〜金) -
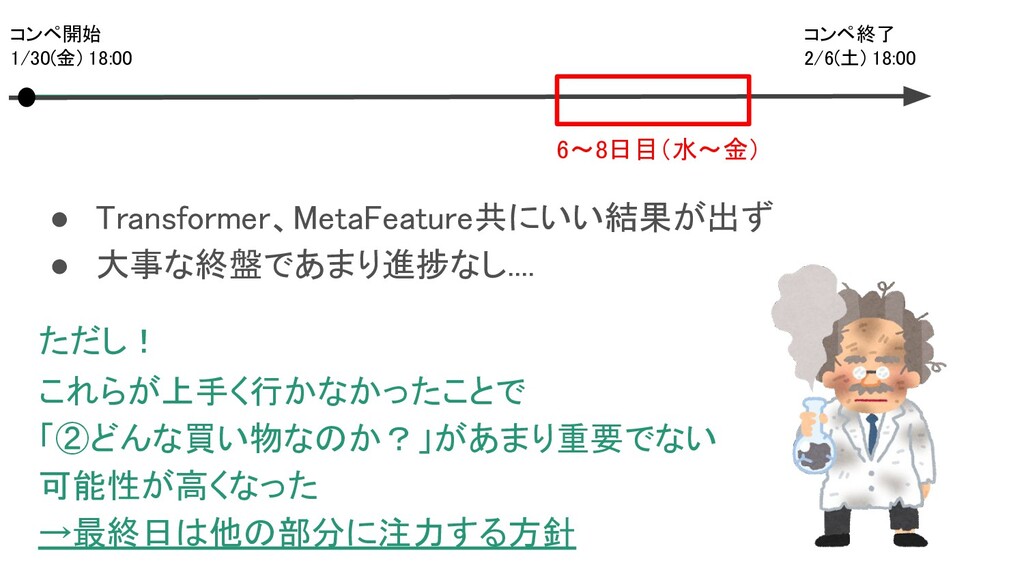
• Transformer、MetaFeature共にいい結果が出ず • 大事な終盤であまり進捗なし.... コンペ開始 1/30(金) 18:00 コンペ終了 2/6(土) 18:00
ただし! これらが上手く行かなかったことで 「②どんな買い物なのか?」があまり重要でない 可能性が高くなった →最終日は他の部分に注力する方針 6〜8日目(水〜金) -
• 妻の協力のもと、1日フルで時間を使えるように • 以下を複数サーバで並列に実施 ◦ 特徴量追加 ◦ ハイパーパラメータ調整 ◦ TestOnlyユーザ用モデルの作成
◦ アンサンブル・後処理 コンペ開始 1/30(金) 18:00 コンペ終了 2/6(土) 18:00 金曜日夜〜コンペ終了 -
• 最終日主に伸びたところ ◦ ハイパーパラメータ調整 ▪ 浅めの木(max_depth小さめ)を使っていたが、深めにしたら大 きくアップ ◦ 「①どんなユーザか?」についての特徴量追加 コンペ開始
1/30(金) 18:00 コンペ終了 2/6(土) 18:00 金曜日夜〜コンペ終了 -
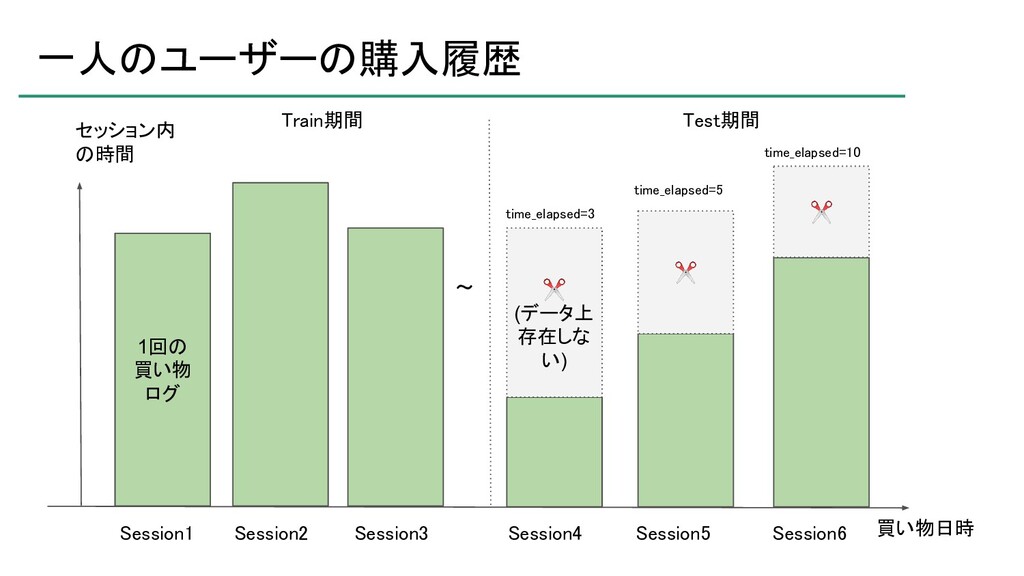
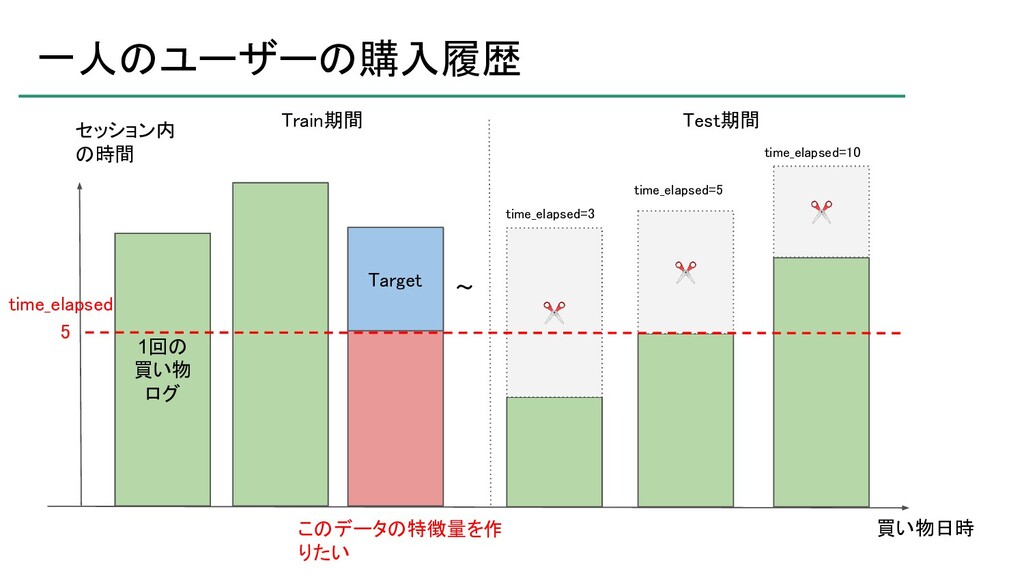
一人のユーザーの購入履歴 1回の 買い物 ログ セッション内 の時間 買い物日時 Train期間 Test期間 〜
✂ ✂ (データ上 存在しな い) ✂ time_elapsed=3 time_elapsed=5 time_elapsed=10 Session1 Session2 Session3 Session4 Session5 Session6 -
一人のユーザーの購入履歴 1回の 買い物 ログ セッション内 の時間 買い物日時 Train期間 Test期間 〜
✂ ✂ ✂ time_elapsed=3 time_elapsed=5 time_elapsed=10 time_elapsed このデータの特徴量を作 りたい Target 5 -
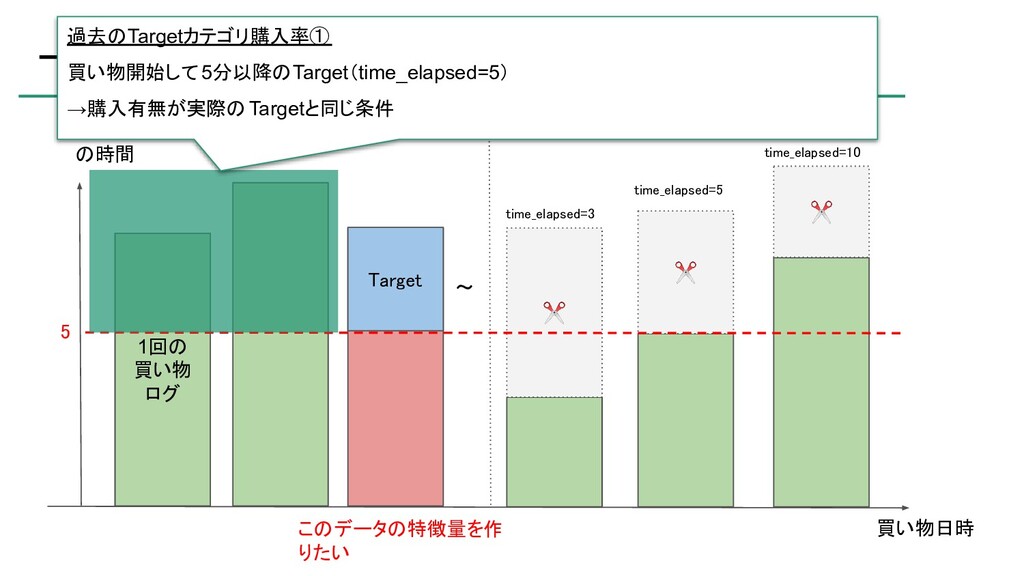
一人のユーザーの購入履歴 1回の 買い物 ログ セッション内 の時間 買い物日時 Train期間 Test期間 〜
✂ ✂ ✂ time_elapsed=3 time_elapsed=5 time_elapsed=10 このデータの特徴量を作 りたい Target 5 過去のTargetカテゴリ購入率① 買い物開始して5分以降のTarget(time_elapsed=5) →購入有無が実際のTargetと同じ条件 -
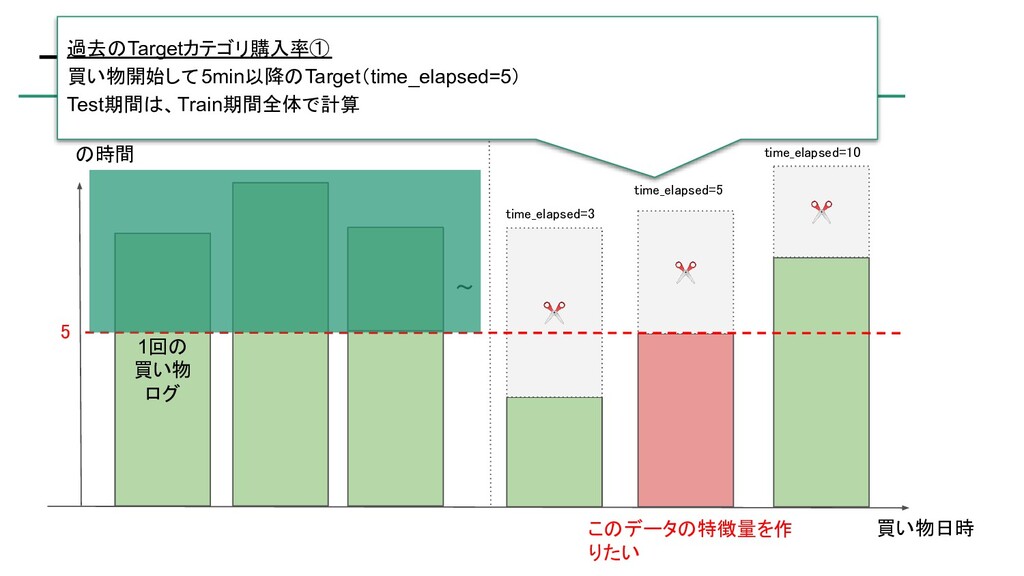
一人のユーザーの購入履歴 1回の 買い物 ログ セッション内 の時間 買い物日時 Train期間 Test期間 〜
✂ ✂ ✂ time_elapsed=3 time_elapsed=5 time_elapsed=10 このデータの特徴量を作 りたい 5 過去のTargetカテゴリ購入率① 買い物開始して5min以降のTarget(time_elapsed=5) Test期間は、Train期間全体で計算 -
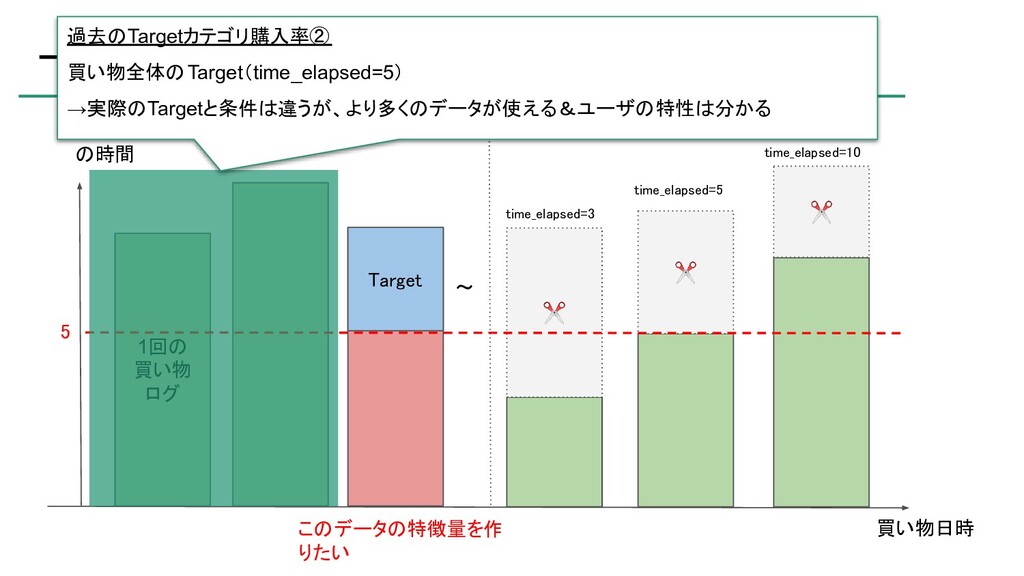
一人のユーザーの購入履歴 1回の 買い物 ログ セッション内 の時間 買い物日時 Train期間 Test期間 〜
✂ ✂ ✂ time_elapsed=3 time_elapsed=5 time_elapsed=10 このデータの特徴量を作 りたい Target 5 過去のTargetカテゴリ購入率② 買い物全体のTarget(time_elapsed=5) →実際のTargetと条件は違うが、より多くのデータが使える&ユーザの特性は分かる -
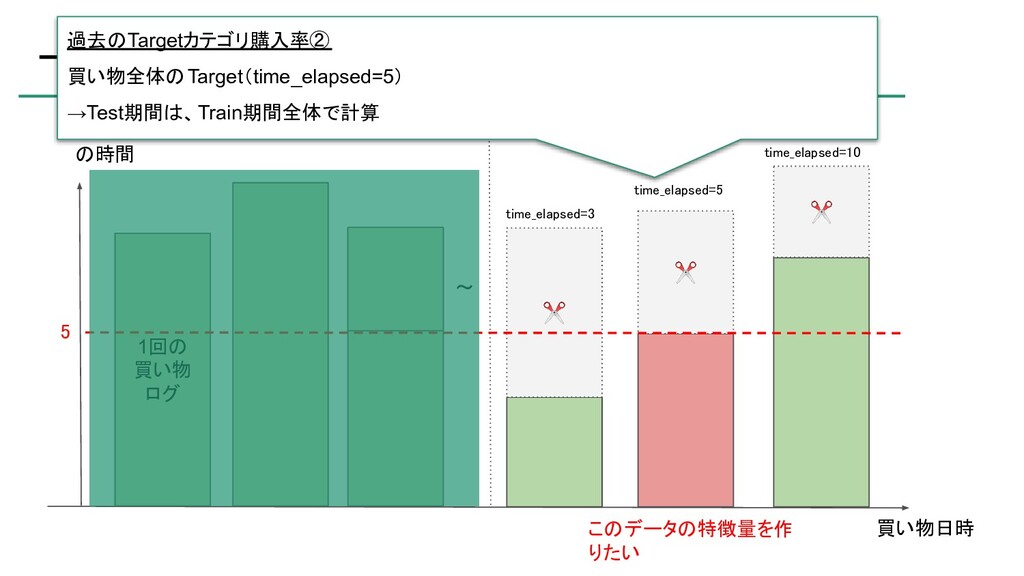
一人のユーザーの購入履歴 1回の 買い物 ログ セッション内 の時間 買い物日時 Train期間 Test期間 〜
✂ ✂ ✂ time_elapsed=3 time_elapsed=5 time_elapsed=10 このデータの特徴量を作 りたい 5 過去のTargetカテゴリ購入率② 買い物全体のTarget(time_elapsed=5) →Test期間は、Train期間全体で計算 -
一人のユーザーの購入履歴 1回の 買い物 ログ セッション内 の時間 買い物日時 Train期間 Test期間 〜
✂ ✂ ✂ time_elapsed=3 time_elapsed=5 time_elapsed=10 このデータの特徴量を作 りたい 5 ここの情報は 特徴量として利用済み -
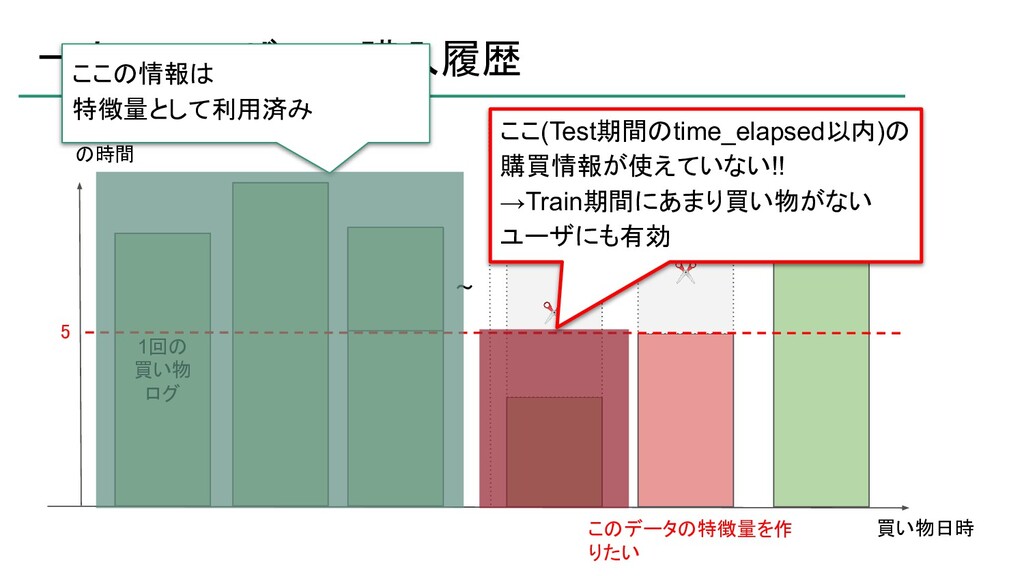
一人のユーザーの購入履歴 1回の 買い物 ログ セッション内 の時間 買い物日時 Train期間 Test期間 〜
✂ ✂ ✂ time_elapsed=3 time_elapsed=5 time_elapsed=10 このデータの特徴量を作 りたい 5 ここの情報は 特徴量として利用済み ここ(Test期間のtime_elapsed以内)の 購買情報が使えていない!! →Train期間にあまり買い物がない ユーザにも有効 -
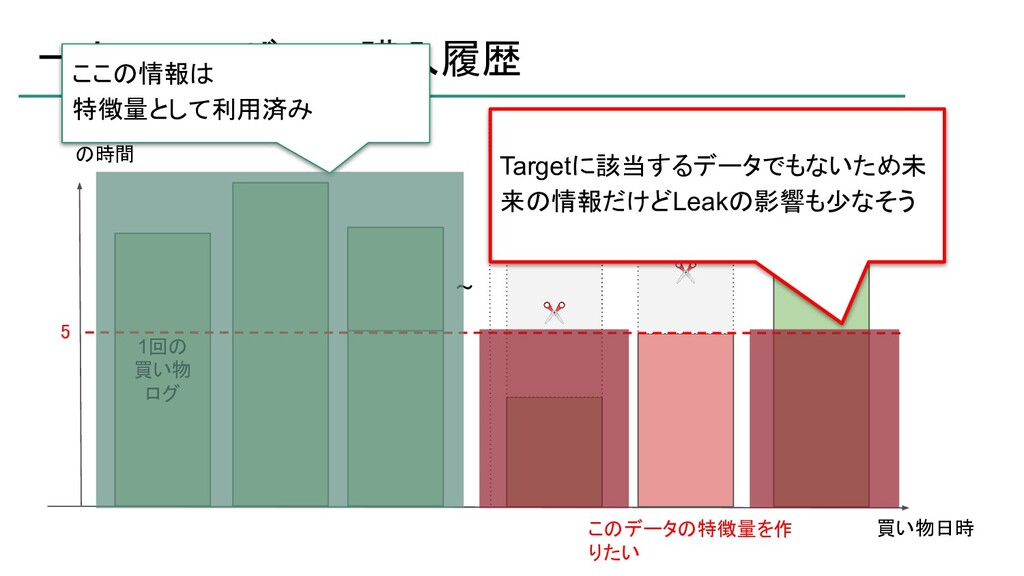
一人のユーザーの購入履歴 1回の 買い物 ログ セッション内 の時間 買い物日時 Train期間 Test期間 〜
✂ ✂ ✂ time_elapsed=3 time_elapsed=5 time_elapsed=10 このデータの特徴量を作 りたい 5 ここの情報は 特徴量として利用済み Targetに該当するデータでもないため未 来の情報だけどLeakの影響も少なそう -
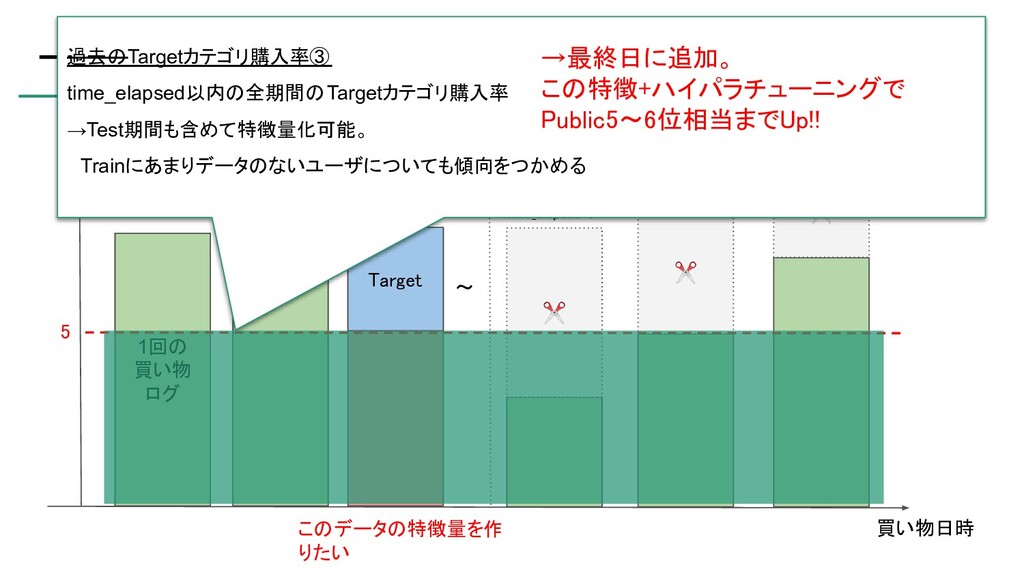
一人のユーザーの購入履歴 1回の 買い物 ログ セッション内 の時間 買い物日時 Train期間 Test期間 〜
✂ ✂ ✂ time_elapsed=3 time_elapsed=5 time_elapsed=10 このデータの特徴量を作 りたい Target 5 過去のTargetカテゴリ購入率③ time_elapsed以内の全期間のTargetカテゴリ購入率 →Test期間も含めて特徴量化可能。 Trainにあまりデータのないユーザについても傾向をつかめる →最終日に追加。 この特徴+ハイパラチューニングで Public5〜6位相当までUp!! -
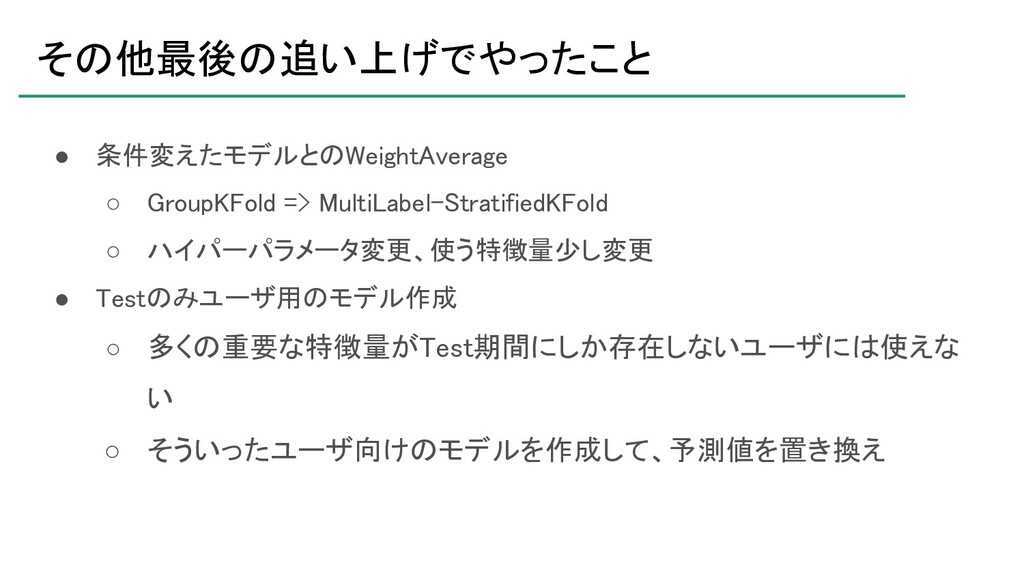
その他最後の追い上げでやったこと • 条件変えたモデルとのWeightAverage ◦ GroupKFold => MultiLabel-StratifiedKFold ◦ ハイパーパラメータ変更、使う特徴量少し変更 •
Testのみユーザ用のモデル作成 ◦ 多くの重要な特徴量がTest期間にしか存在しないユーザには使えな い ◦ そういったユーザ向けのモデルを作成して、予測値を置き換え -
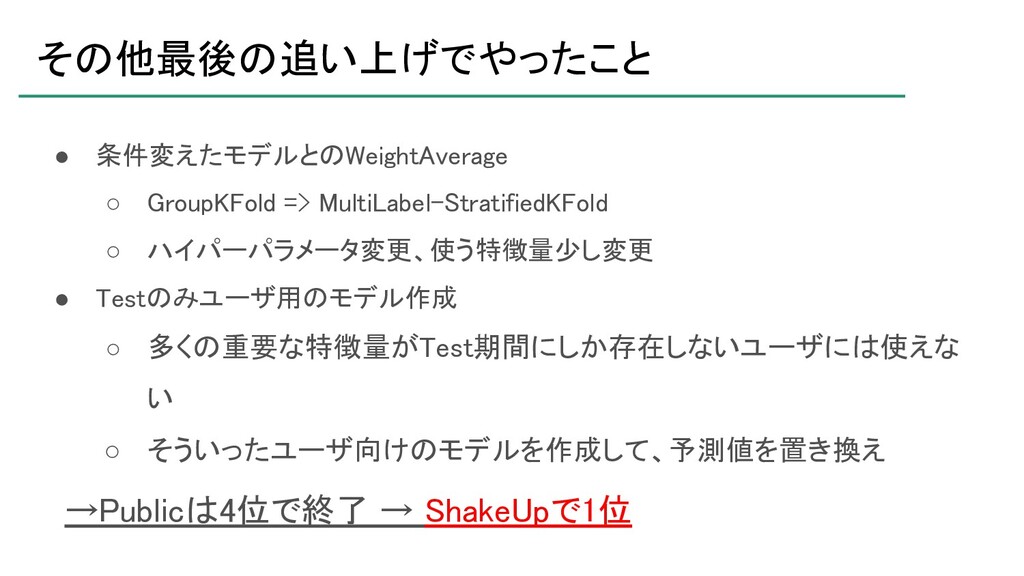
その他最後の追い上げでやったこと • 条件変えたモデルとのWeightAverage ◦ GroupKFold => MultiLabel-StratifiedKFold ◦ ハイパーパラメータ変更、使う特徴量少し変更 •
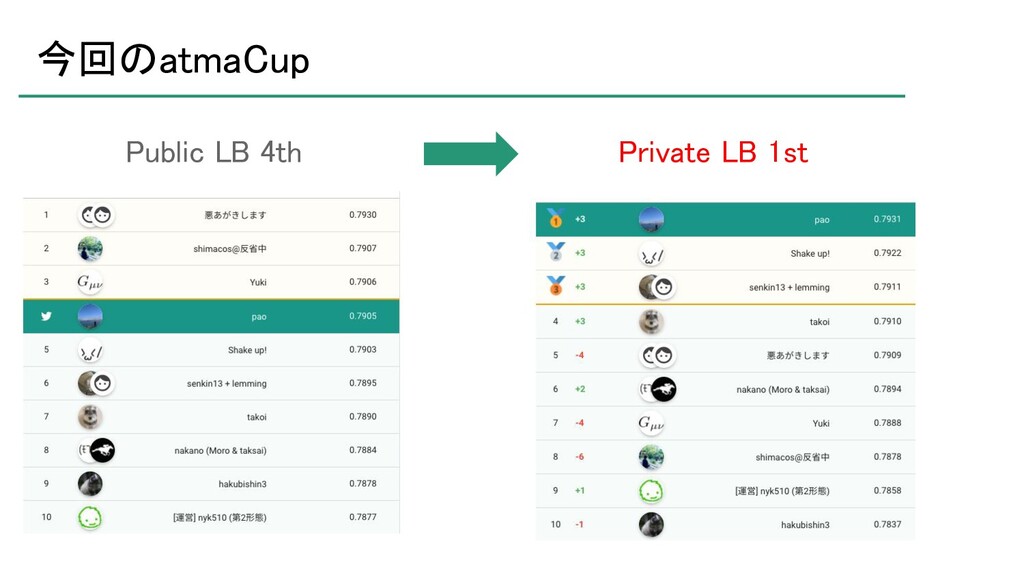
Testのみユーザ用のモデル作成 ◦ 多くの重要な特徴量がTest期間にしか存在しないユーザには使えな い ◦ そういったユーザ向けのモデルを作成して、予測値を置き換え →Publicは4位で終了 → ShakeUpで1位 -
振り返り • 良かったこと ◦ 実験のロス(MetaFeature, Transformer)はあったものの、仮説ベース で戦略を立てることで、限られた時間の中で効率的に良いモデルを作 れた • 改善すべきとこ
◦ time_elapsed毎モデルは時間がかかりすぎた。中盤の実験は簡易 Validation用モデルを作るなどして高速化すべきだった