Upgrade to Pro
— share decks privately, control downloads, hide ads and more …
Speaker Deck
Sign up for free
Menu
Search
Features
All features
Private URLs
Password Protection
Custom URLS
Scheduled publishing
Remove Branding
Restrict embedding
Deck Collections
Notes
Features
All features
Private URLs
Password Protection
Custom URLS
Scheduled publishing
Remove Branding
Restrict embedding
Deck Collections
Notes
Explore
Featured decks
Featured speakers
Programming
Technology
Storyboards
Explore
Featured decks
Featured speakers
Programming
Technology
Storyboards
Pricing
Search
Sign in
Sign up for free
DSB2019 10th Solutionの一部とShakeについて
Search
pao
February 29, 2020
Technology
830
2
Share
Embed
Copy iframe code
Copy JS code
Copy link
Start on current slide
DSB2019 10th Solutionの一部とShakeについて
pao
February 29, 2020
More Decks by pao
See All by pao
JOAI2026 講評
go5paopao
0
500
いろんなものと両立する Kaggleの向き合い方
go5paopao
3
2.7k
データサイエンティストとは何か論争にAI(gpt-2)で終止符を打とうとした話
go5paopao
0
260
短期間コンペの戦い方
go5paopao
13
14k
atmaCup#9 1st place solution
go5paopao
6
3.9k
Kaggle Malware competition 2th→1485th solution
go5paopao
2
9.8k
Other Decks in Technology
See All in Technology
AI Native Platform Engineering 〜PlatformとAgileで“作る速さ”を“価値”へ〜
uya116
0
440
なぜAI任せのゲームは面白くならないのか?
hirohasuyoutube
0
290
Apache Iceberg が拓く AI 時代のオープンレイクハウス
tomtanaka
0
190
DORA_Metrics.pdf
wagnerfusca
1
130
なぜ「決定性」が 決定的に重要なのか? Durable Execution 基盤の数理的理解 #serverlessjp / ServerlessDays Tokyo 2026
ytaka23
4
1.4k
【Findyテック文化祭ワークショップ】新卒エンジニア&採用担当と作る、 なりたい姿と今やるべき一歩
dip_tech
PRO
0
150
2026-09-26 Platform Engineering Kaigi 2026 インフラとアプリの境界線と委譲の設計 / Drawing the Infra and App Line
masasuzu
0
450
1人アドミンな私は AWSアカウント申請をSlackで完結したい!
ysuzuki
0
100
AI駆動開発で仕様はどこまで書くべきか? ― 人とAIの責務境界から考える開発プロセスの実践
takahiromatsui
1
220
AI coding 整合正規方法
philipz
0
570
Antigravity SDK for the Java Developer
glaforge
0
230
雪かき部 #7 もう怖くない!SELECT文!
foursue
0
160
Featured
See All Featured
[RailsConf 2023 Opening Keynote] The Magic of Rails
eileencodes
31
10k
Have SEOs Ruined the Internet? - User Awareness of SEO in 2025
akashhashmi
0
510
Amusing Abliteration
ianozsvald
1
320
実際に使うSQLの書き方 徹底解説 / pgcon21j-tutorial
soudai
PRO
203
76k
Fantastic passwords and where to find them - at NoRuKo
philnash
52
3.9k
Believing is Seeing
oripsolob
1
230
Neural Spatial Audio Processing for Sound Field Analysis and Control
skoyamalab
0
530
Marketing Yourself as an Engineer | Alaka | Gurzu
gurzu
0
320
The AI Revolution Will Not Be Monopolized: How open-source beats economies of scale, even for LLMs
inesmontani
PRO
3
3.7k
Building Experiences: Design Systems, User Experience, and Full Site Editing
marktimemedia
1
610
Designing for humans not robots
tammielis
254
26k
Google's AI Overviews - The New Search
badams
0
1.6k
Transcript
Shake と 10th Place Solutionの一部 pao DataScienceBowl2019 振り返り
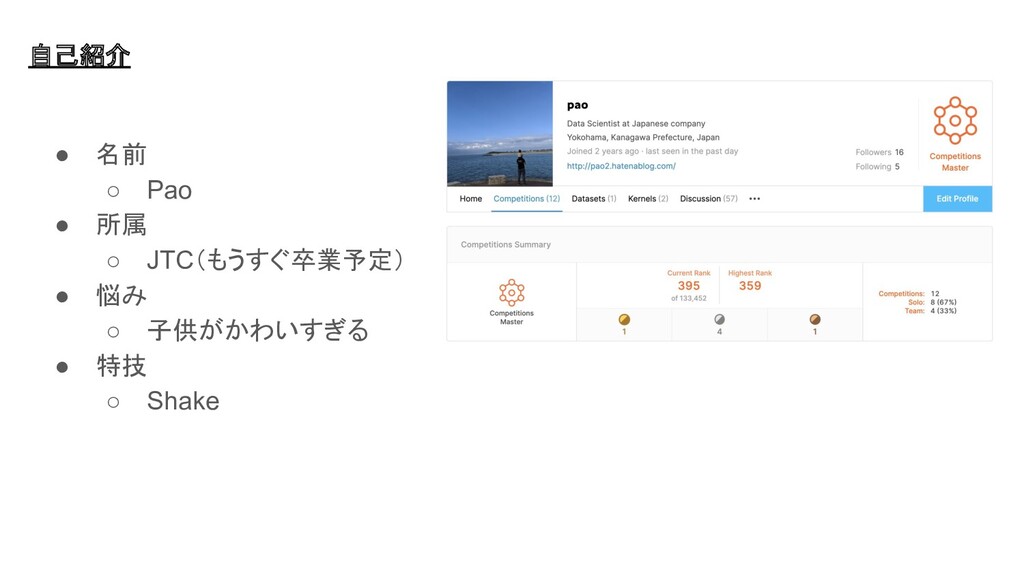
• 名前 ◦ Pao • 所属 ◦ JTC(もうすぐ卒業予定) • 悩み
◦ 子供がかわいすぎる • 特技 ◦ Shake 自己紹介
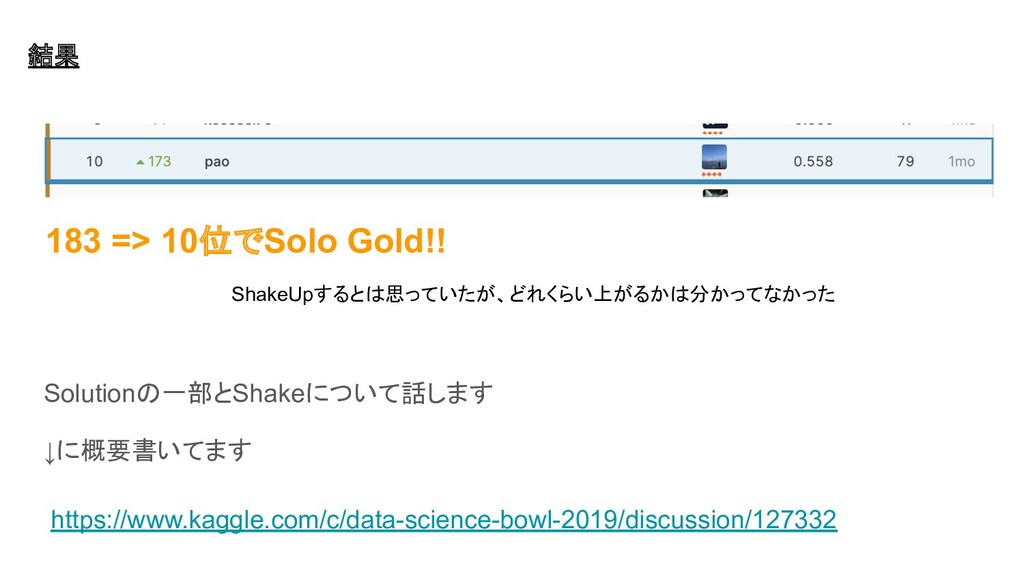
Solutionの一部とShakeについて話します ↓に概要書いてます https://www.kaggle.com/c/data-science-bowl-2019/discussion/127332 183 => 10位でSolo Gold!! ShakeUpするとは思っていたが、どれくらい上がるかは分かってなかった 結果
• 10th Place Solutionの一部 • Shakeについて
• 10th Place Solutionの一部 • Shakeについて
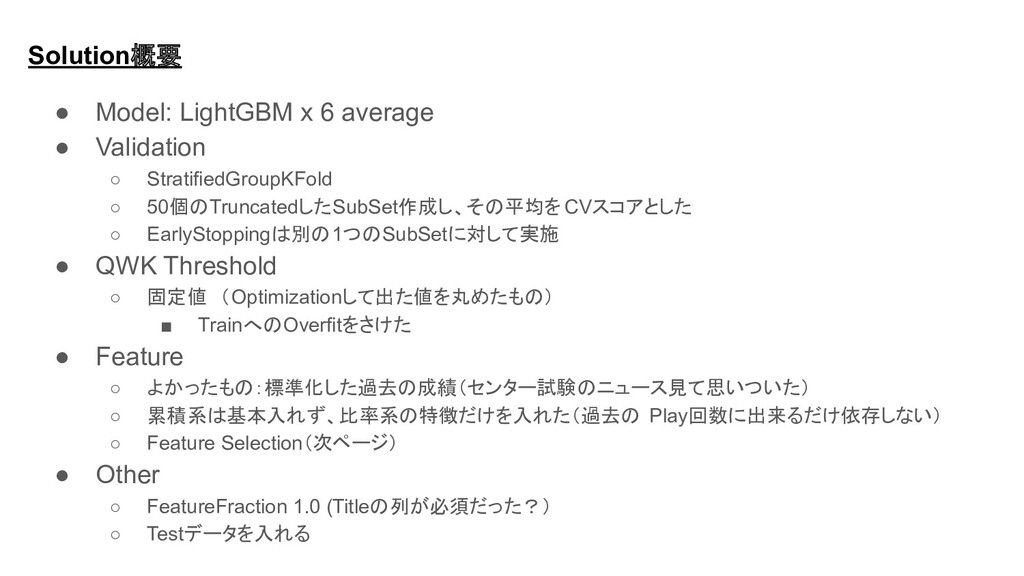
• Model: LightGBM x 6 average • Validation ◦ StratifiedGroupKFold
◦ 50個のTruncatedしたSubSet作成し、その平均をCVスコアとした ◦ EarlyStoppingは別の1つのSubSetに対して実施 • QWK Threshold ◦ 固定値 (Optimizationして出た値を丸めたもの) ▪ TrainへのOverfitをさけた • Feature ◦ よかったもの:標準化した過去の成績(センター試験のニュース見て思いついた) ◦ 累積系は基本入れず、比率系の特徴だけを入れた(過去の Play回数に出来るだけ依存しない) ◦ Feature Selection(次ページ) • Other ◦ FeatureFraction 1.0 (Titleの列が必須だった?) ◦ Testデータを入れる Solution概要
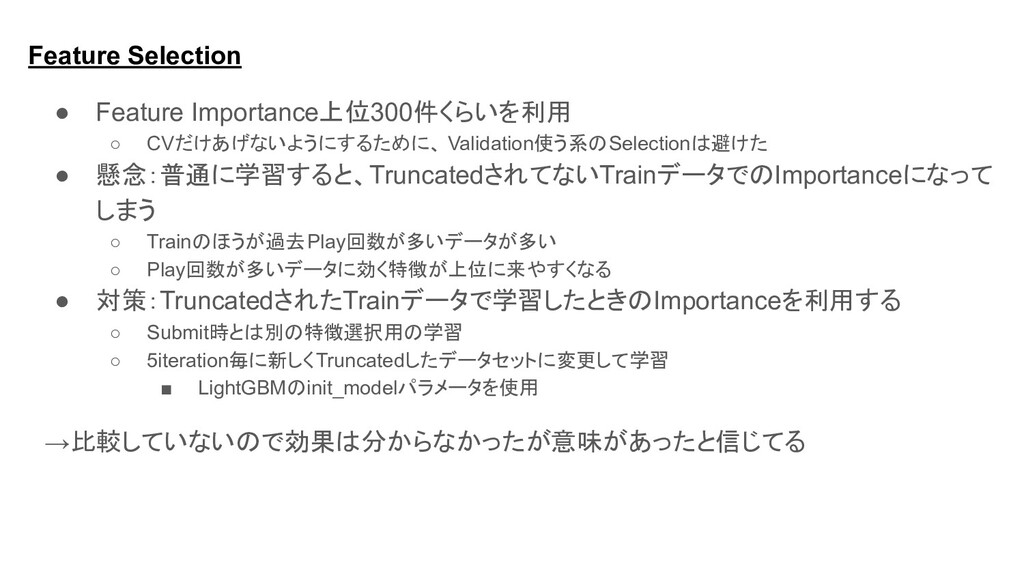
• Feature Importance上位300件くらいを利用 ◦ CVだけあげないようにするために、 Validation使う系のSelectionは避けた • 懸念:普通に学習すると、TruncatedされてないTrainデータでのImportanceになって しまう ◦
Trainのほうが過去Play回数が多いデータが多い ◦ Play回数が多いデータに効く特徴が上位に来やすくなる • 対策:TruncatedされたTrainデータで学習したときのImportanceを利用する ◦ Submit時とは別の特徴選択用の学習 ◦ 5iteration毎に新しくTruncatedしたデータセットに変更して学習 ▪ LightGBMのinit_modelパラメータを使用 →比較していないので効果は分からなかったが意味があったと信じてる Feature Selection
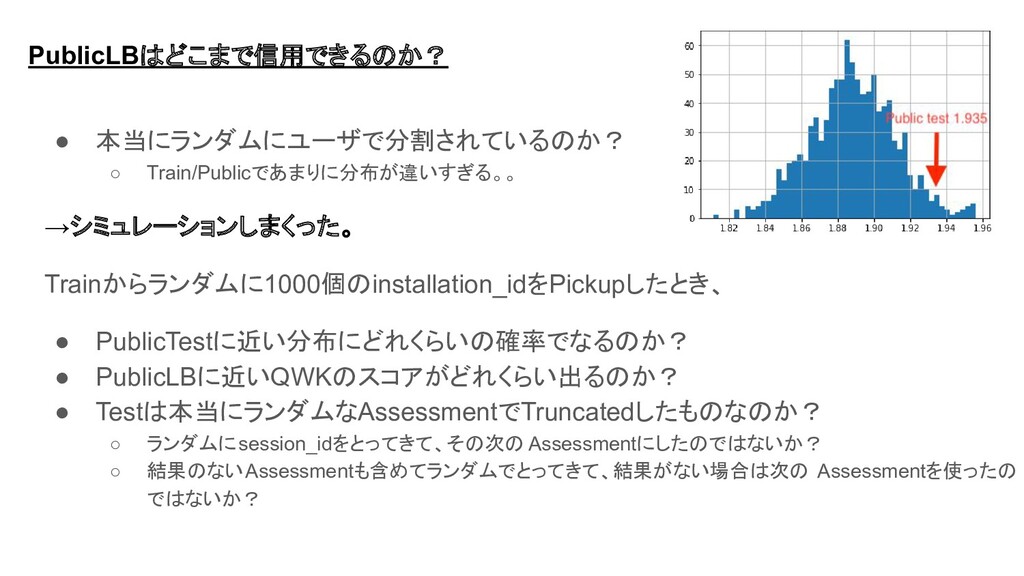
• 本当にランダムにユーザで分割されているのか? ◦ Train/Publicであまりに分布が違いすぎる。。 →シミュレーションしまくった。 Trainからランダムに1000個のinstallation_idをPickupしたとき、 • PublicTestに近い分布にどれくらいの確率でなるのか? • PublicLBに近いQWKのスコアがどれくらい出るのか?
• Testは本当にランダムなAssessmentでTruncatedしたものなのか? ◦ ランダムにsession_idをとってきて、その次の Assessmentにしたのではないか? ◦ 結果のないAssessmentも含めてランダムでとってきて、結果がない場合は次の Assessmentを使ったの ではないか? PublicLBはどこまで信用できるのか?
• 10th Place Solutionの一部 • Shakeについて
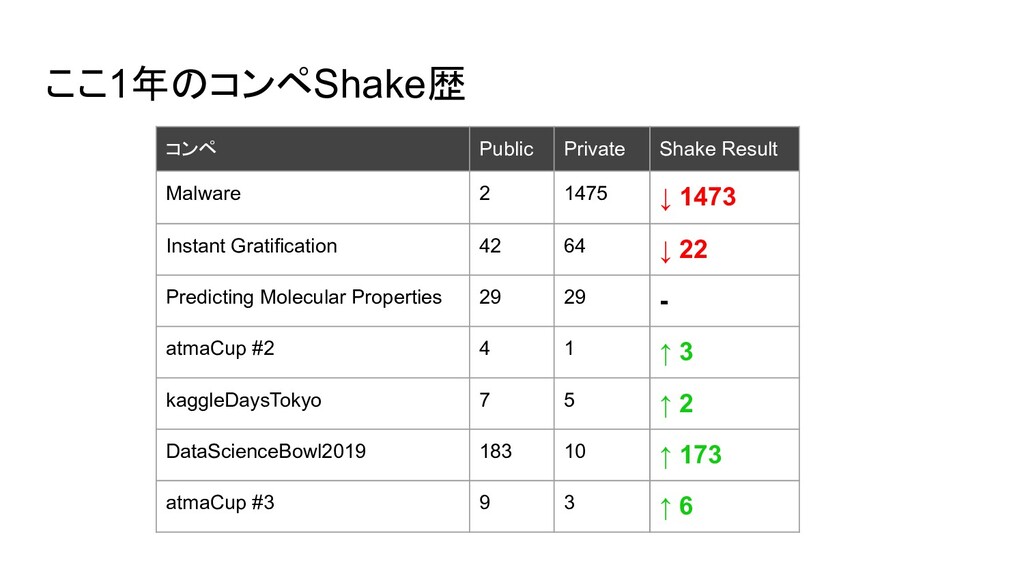
ここ1年のコンペShake歴 コンペ Public Private Shake Result Malware 2 1475 ↓
1473 Instant Gratification 42 64 ↓ 22 Predicting Molecular Properties 29 29 - atmaCup #2 4 1 ↑ 3 kaggleDaysTokyo 7 5 ↑ 2 DataScienceBowl2019 183 10 ↑ 173 atmaCup #3 9 3 ↑ 6
調子乗って書いていますが、 Shakeは運ゲーなところも、かなりあると思います。 (これを書いた翌週にはatmaCupでShakeDownしてるかも)
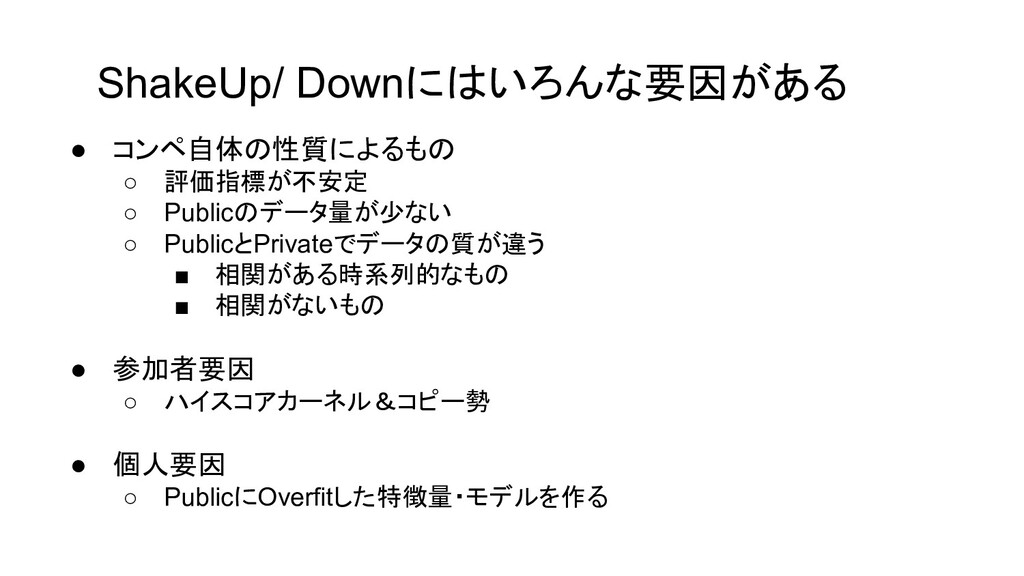
ShakeUp/ Downにはいろんな要因がある • コンペ自体の性質によるもの ◦ 評価指標が不安定 ◦ Publicのデータ量が少ない ◦ PublicとPrivateでデータの質が違う
▪ 相関がある時系列的なもの ▪ 相関がないもの • 参加者要因 ◦ ハイスコアカーネル&コピー勢 • 個人要因 ◦ PublicにOverfitした特徴量・モデルを作る
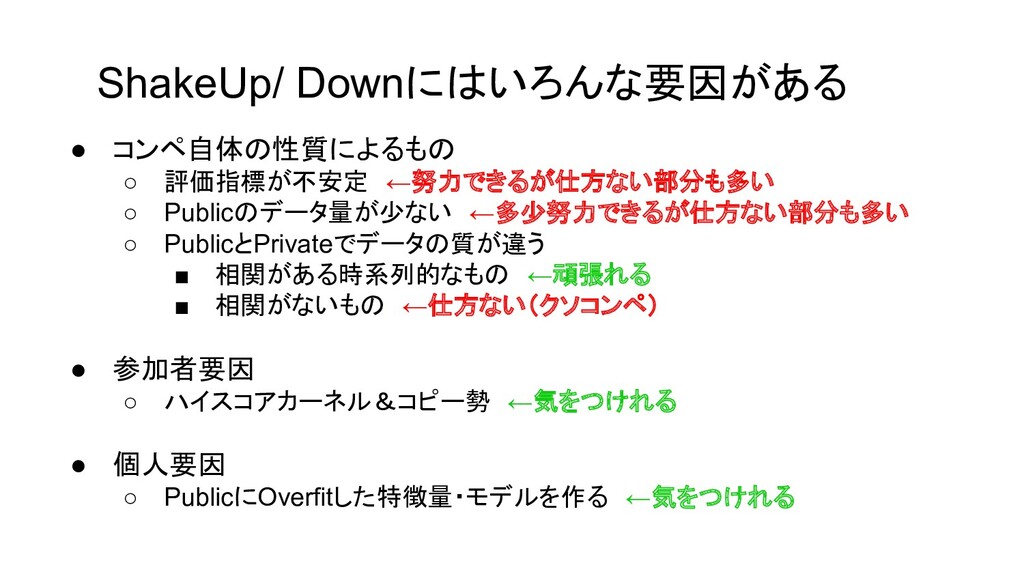
ShakeUp/ Downにはいろんな要因がある • コンペ自体の性質によるもの ◦ 評価指標が不安定 ←努力できるが仕方ない部分も多い ◦ Publicのデータ量が少ない ←多少努力できるが仕方ない部分も多い ◦ PublicとPrivateでデータの質が違う
▪ 相関がある時系列的なもの ←頑張れる ▪ 相関がないもの ←仕方ない(クソコンペ) • 参加者要因 ◦ ハイスコアカーネル&コピー勢 ←気をつけれる • 個人要因 ◦ PublicにOverfitした特徴量・モデルを作る ←気をつけれる
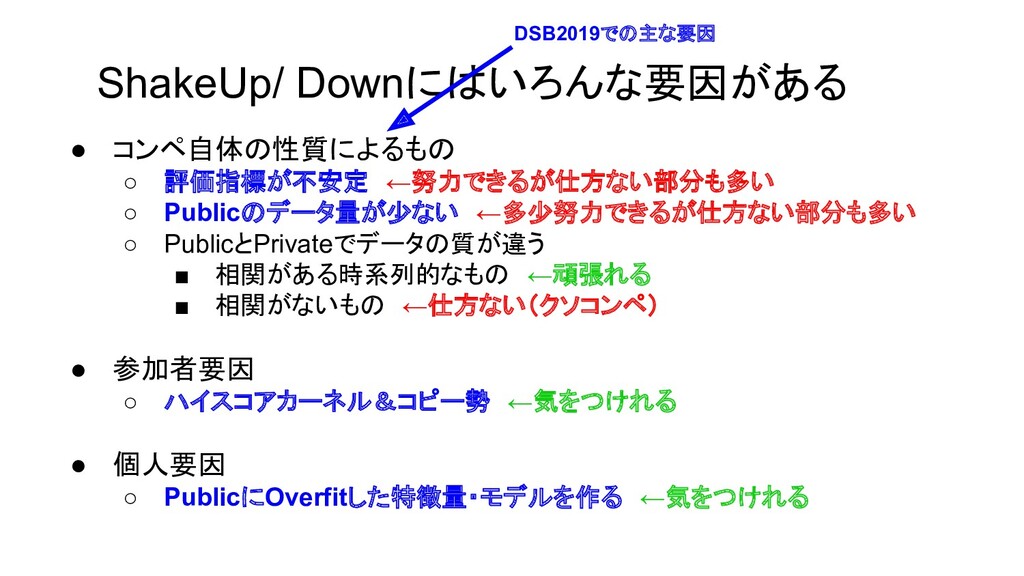
ShakeUp/ Downにはいろんな要因がある • コンペ自体の性質によるもの ◦ 評価指標が不安定 ←努力できるが仕方ない部分も多い ◦ Publicのデータ量が少ない ←多少努力できるが仕方ない部分も多い ◦ PublicとPrivateでデータの質が違う
▪ 相関がある時系列的なもの ←頑張れる ▪ 相関がないもの ←仕方ない(クソコンペ) • 参加者要因 ◦ ハイスコアカーネル&コピー勢 ←気をつけれる • 個人要因 ◦ PublicにOverfitした特徴量・モデルを作る ←気をつけれる DSB2019での主な要因
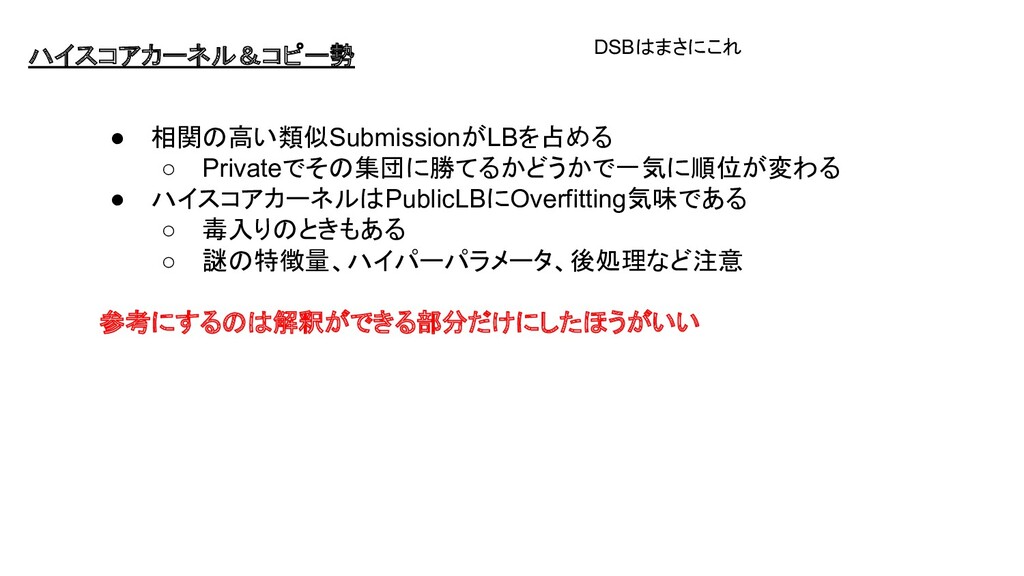
ハイスコアカーネル&コピー勢 • 相関の高い類似SubmissionがLBを占める ◦ Privateでその集団に勝てるかどうかで一気に順位が変わる • ハイスコアカーネルはPublicLBにOverfitting気味である ◦ 毒入りのときもある ◦
謎の特徴量、ハイパーパラメータ、後処理など注意 参考にするのは解釈ができる部分だけにしたほうがいい DSBはまさにこれ
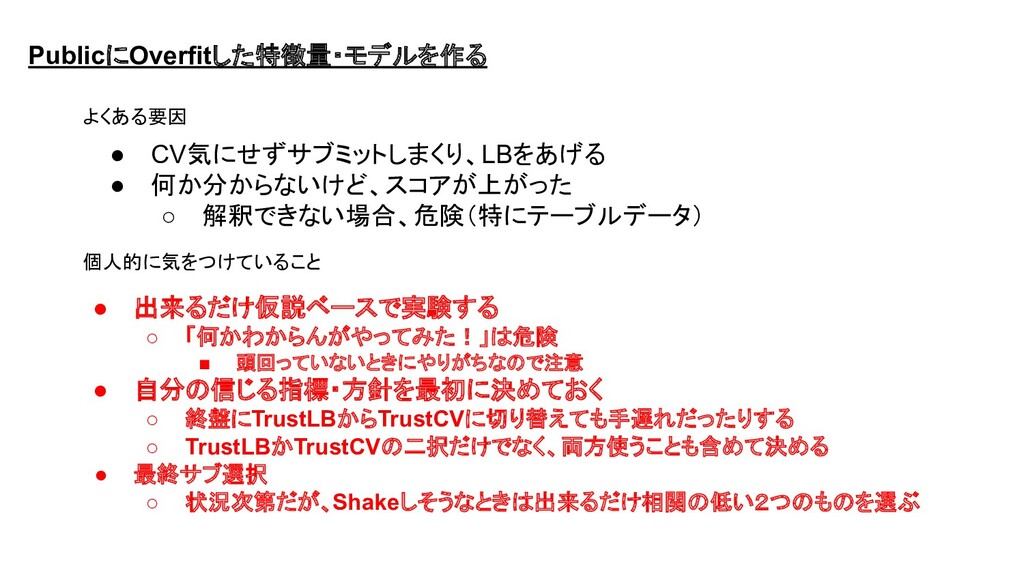
PublicにOverfitした特徴量・モデルを作る • CV気にせずサブミットしまくり、LBをあげる • 何か分からないけど、スコアが上がった ◦ 解釈できない場合、危険(特にテーブルデータ) よくある要因 個人的に気をつけていること •
出来るだけ仮説ベースで実験する ◦ 「何かわからんがやってみた!」は危険 ▪ 頭回っていないときにやりがちなので注意 • 自分の信じる指標・方針を最初に決めておく ◦ 終盤にTrustLBからTrustCVに切り替えても手遅れだったりする ◦ TrustLBかTrustCVの二択だけでなく、両方使うことも含めて決める • 最終サブ選択 ◦ 状況次第だが、Shakeしそうなときは出来るだけ相関の低い2つのものを選ぶ
その他 • ShakeDownして自ら辛い経験をすることで次から気を つけられるようになる ◦ Malware以降、異常に考えるようになった ShakeDownの数だけ強くなれる
End


 go5paopao
 uya116
 hirohasuyoutube
 tomtanaka
 wagnerfusca
 ytaka23
 dip_tech
 masasuzu
 ysuzuki
 takahiromatsui
 philipz
 glaforge
 foursue
 eileencodes
 akashhashmi
 ianozsvald
 soudai
 philnash
 oripsolob
 skoyamalab
 gurzu
 inesmontani
 marktimemedia
 tammielis
 badams