Share
Embed
Transcript
20 slides
-
今⽇お話しすること モチベーション ModelNet10データセットを⽤いた3次元データのクラスタリング Voxel化したデータのk-means++/t-SNEによるクラスタリング 10クラスの識別器として学習させた3D-CNNモデルの特徴ベクトルを使ったクラスタリング
Autoencoderの隠れベクトルを使ったクラスタリング k-means++による疑似ラベル⽣成と3D-CNN訓練によるクラスタリング AugmentationとTriplet Lossによる距離学習から得た特徴ベクトルのクラスタリング 上記の実験結果 まとめ コード(Jupyter Notebook)は下記で公開している https://github.com/masa-ita/3d_clustering_experiments 2 -
モチベーション 新潟国際情報⼤学藤⽥教授と、新潟県歴史博物館、東京国⽴博物館、九州国⽴博物館の研究者の ⽅々、BSNアイネットと私で、考古学へのディープラーニング適⽤を研究している中で、縄⽂⼟器 の3Dスキャニングデータをもとにしたクラスタリングが題材に上った。 縄⽂⼟器のスキャンはまだ始まったばかりであったため、ModelNetを使って分析モデルの調査を ⾏うことになった。 深層学習によるクラスタリングの⼿法を調べているうち、Autoencoderの隠れベクトルに距離学
習を組み込んでいる例を知り、距離学習⾃体がクラスタリングに使えないかと考えた。 3 https://arxiv.org/abs/2009.04091v1 -
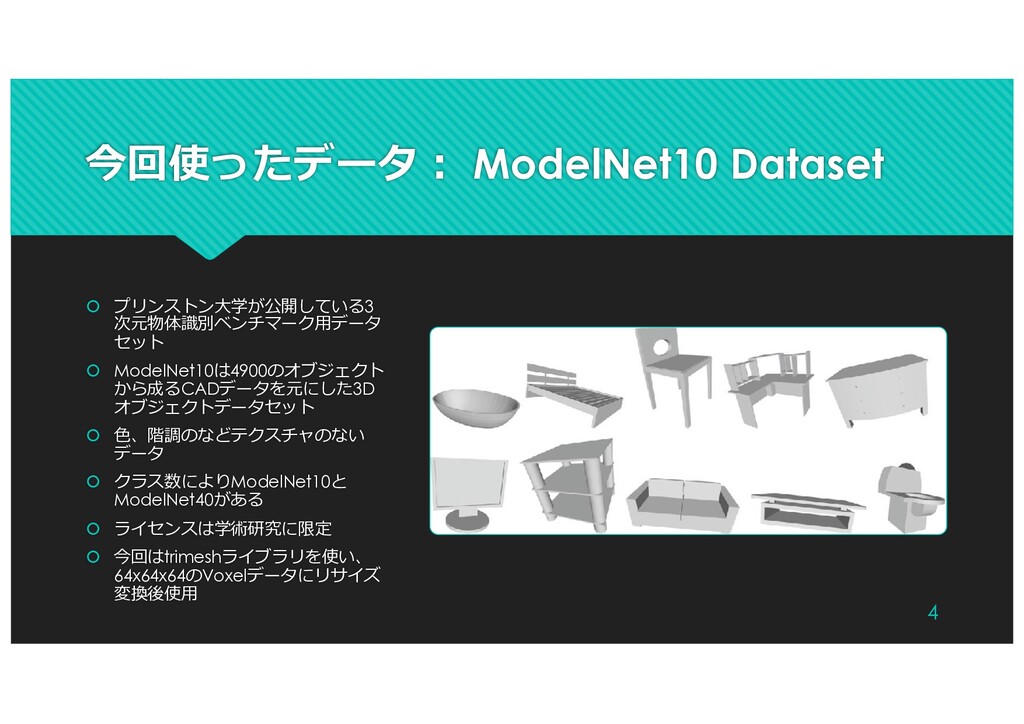
今回使ったデータ︓ ModelNet10 Dataset プリンストン⼤学が公開している3 次元物体識別ベンチマーク⽤データ セット ModelNet10は4900のオブジェクト から成るCADデータを元にした3D
オブジェクトデータセット ⾊、階調のなどテクスチャのない データ クラス数によりModelNet10と ModelNet40がある ライセンスは学術研究に限定 今回はtrimeshライブラリを使い、 64x64x64のVoxelデータにリサイズ 変換後使⽤ 4 -
クラスタリングと可視化のための⼿法 k-means クラスタリングの代表的⼿法 ランダムに選んだ中⼼(セントロイド)からの距離をもとに初期クラスターを形成、クラスターの中⼼の 再計算とクラスターの⽣成を繰り返す⽅法。 PCA(主成分分析)
分散共分散⾏列の固有ベクトルを⽤いて、相関のある特徴量から互いに相関のない特徴量空間へのマッピ ングを⾏う⽅法。 次元削減にも⽤いられる。 t-SNE 次元削減とクラスター顕著化の⼿法。 ⾼次元空間の中のサンプル(点)を中⼼とする t分布を仮定し、距離から類似度を計算。Kullback–Leibler 情報量を指標として⽬的とする低次元空間に類似分布を反復再現し、低次元へのマッピングを⾏う⽅法。 5 -
特徴量抽出︓4種類の⽅法 Raw Features 64x64x64のVoxelの3Dデータ(3階のテンソル)を226224次元のフラットなベクトルに変換 3D-CNN Classifier
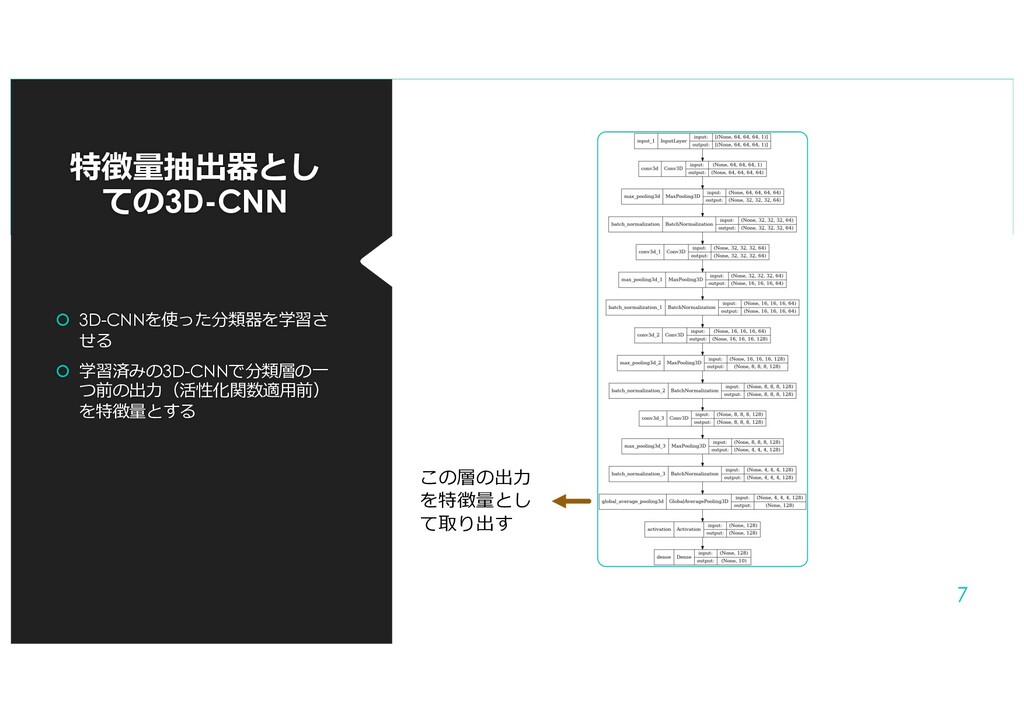
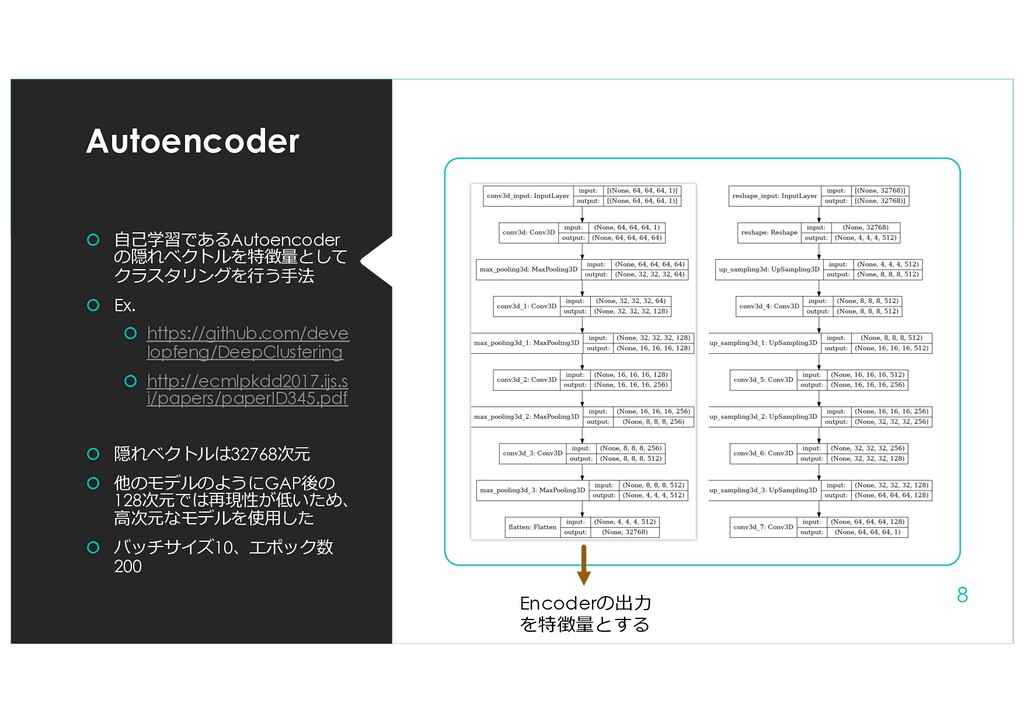
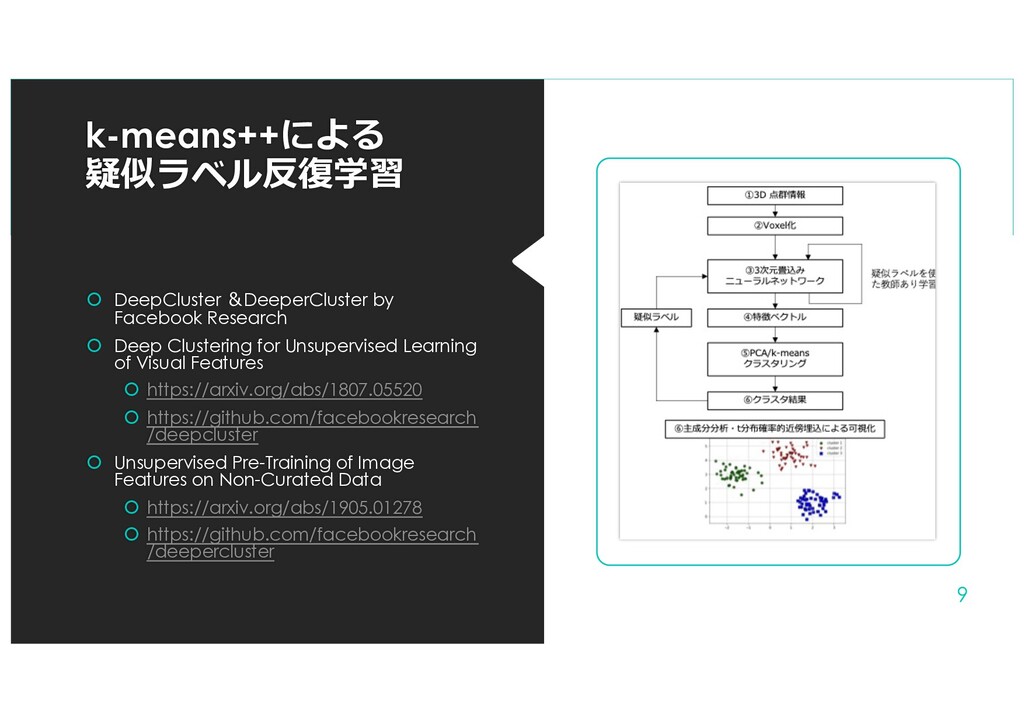
分類器として訓練した3D-CNNから得たベクトルを特徴量とする Autoencoder ⼊⼒を再現するように学習させたAutoencoderの隠れベクトルを特徴量とする k-means Pseudo Label 3D-CNN k−means法での疑似ラベル⽣成と3D-CNNの学習を繰り返す Triplet Loss with Augmented Data サンプルをデータ拡張により⽔増して1つのクラスとし、Triplet Lossで距離学習させ特徴量とする 6 -
Autoencoder ⾃⼰学習であるAutoencoder の隠れベクトルを特徴量として クラスタリングを⾏う⼿法 Ex. https://github.com/deve lopfeng/DeepClustering
http://ecmlpkdd2017.ijs.s i/papers/paperID345.pdf 隠れベクトルは32768次元 他のモデルのようにGAP後の 128次元では再現性が低いため、 ⾼次元なモデルを使⽤した バッチサイズ10、エポック数 200 8 Encoderの出⼒ を特徴量とする -
k-means++による 疑似ラベル反復学習 DeepCluster &DeeperCluster by Facebook Research Deep
Clustering for Unsupervised Learning of Visual Features https://arxiv.org/abs/1807.05520 https://github.com/facebookresearch /deepcluster Unsupervised Pre-Training of Image Features on Non-Curated Data https://arxiv.org/abs/1905.01278 https://github.com/facebookresearch /deepercluster 9 -
距離学習とは 多次元の特徴量(⾔い換えれば埋め込み ベクトル)を⽣成する上で、下記のよう に学習させる 似た対象の埋め込みベクトル同⼠は近く 似ていない対象の埋め込みベクトル同⼠は 遠く
検索や顔認証、異常検知などの分野で提 案されてきた⼿法 深層学習以前 マハラノビス距離学習 深層学習以後 Siamese Network Triplet Network L2 Softmax Network 10 -
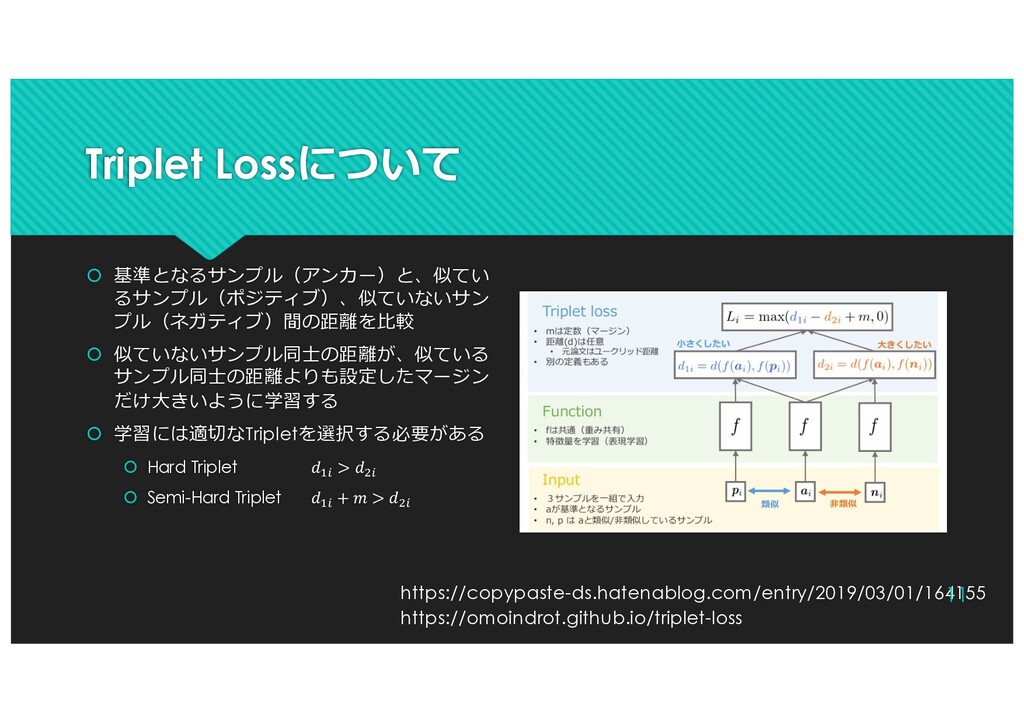
Triplet Lossについて 基準となるサンプル(アンカー)と、似てい るサンプル(ポジティブ)、似ていないサン プル(ネガティブ)間の距離を⽐較 似ていないサンプル同⼠の距離が、似ている サンプル同⼠の距離よりも設定したマージン だけ⼤きいように学習する
学習には適切なTripletを選択する必要がある Hard Triplet 𝑑!" > 𝑑#" Semi-Hard Triplet 𝑑!" + 𝑚 > 𝑑#" https://copypaste-ds.hatenablog.com/entry/2019/03/01/164155 11 https://omoindrot.github.io/triplet-loss -
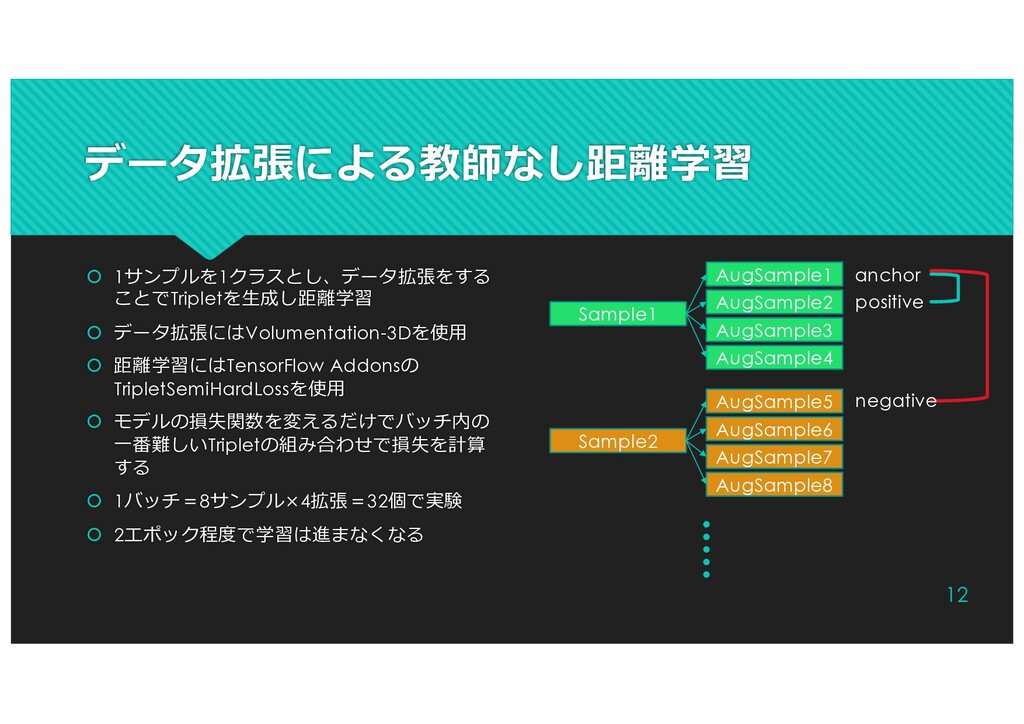
データ拡張による教師なし距離学習 1サンプルを1クラスとし、データ拡張をする ことでTripletを⽣成し距離学習 データ拡張にはVolumentation-3Dを使⽤ 距離学習にはTensorFlow Addonsの TripletSemiHardLossを使⽤
モデルの損失関数を変えるだけでバッチ内の ⼀番難しいTripletの組み合わせで損失を計算 する 1バッチ=8サンプル×4拡張=32個で実験 2エポック程度で学習は進まなくなる Sample1 AugSample1 AugSample2 AugSample3 AugSample4 Sample2 AugSample5 AugSample6 AugSample7 AugSample8 anchor positive negative 12 -
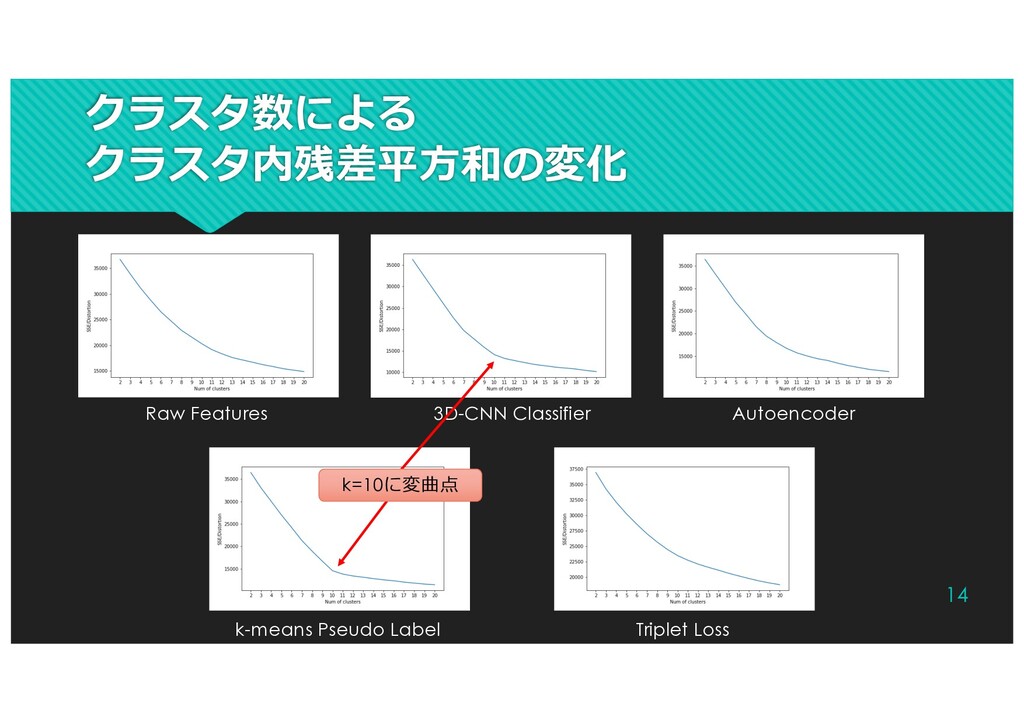
クラスタ数による クラスタ内残差平⽅和の変化 14 Raw Features Autoencoder k-means Pseudo Label Triplet
Loss 3D-CNN Classifier k=10に変曲点 -
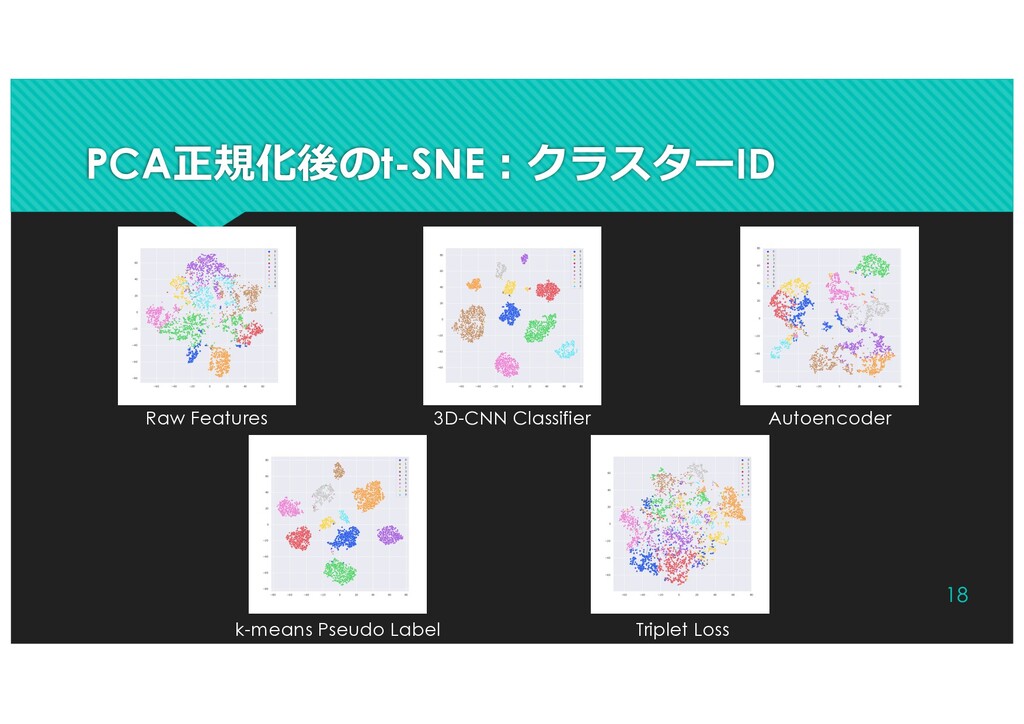
クラスタとラベルの対応関係 15 Raw Features Autoencoder k-means Pseudo Label Triplet Loss
3D-CNN Classifier クラスター とラベルが 1対1対応 クラスター とラベルの 関係は はっきりし ない -
PCAによる可視化︓クラスラベル 16 Raw Features Autoencoder k-means Pseudo Label Triplet Loss
3D-CNN Classifier クラスター が最もはっ きりしてい る -
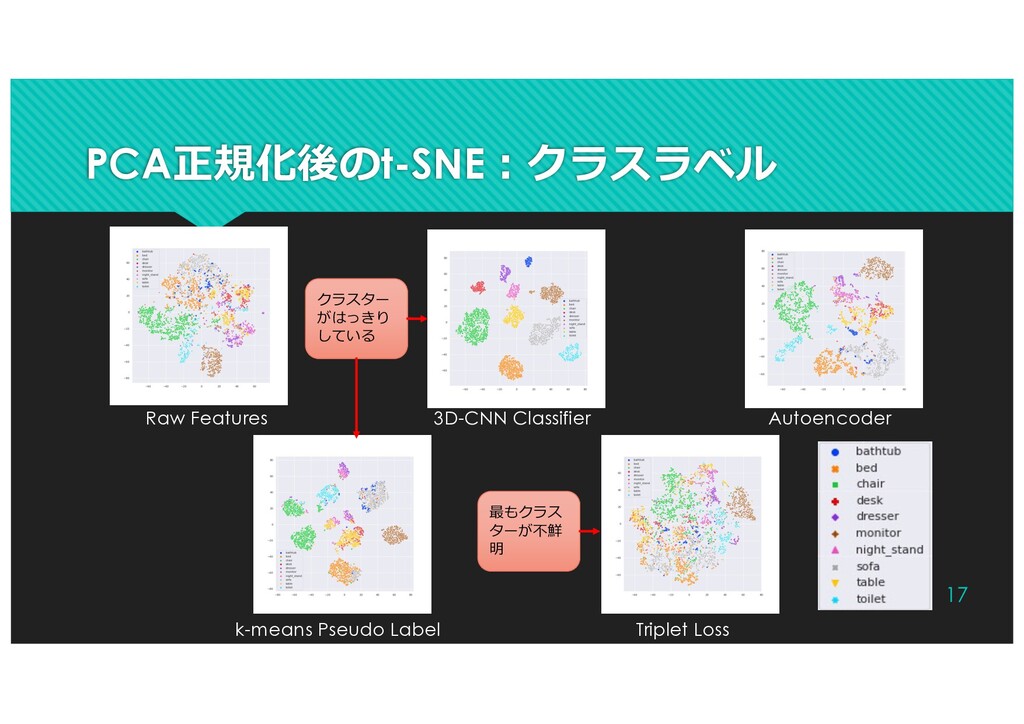
PCA正規化後のt-SNE︓クラスラベル 17 Raw Features Autoencoder k-means Pseudo Label Triplet Loss
3D-CNN Classifier クラスター がはっきり している 最もクラス ターが不鮮 明 -
まとめ Voxelデータによる3次元オブジェクトのクラスタリングを試⾏した 特徴抽出を⾏う3D-CNNの事前学習データによるバイアスを避けるため、教師なし学習によるク ラスタリングを前提とし、下記の3つを⽐較した Autoencoder クラスタリングによる疑似ラベル⽣成と3D-CNNの学習の⼆重ループ
データ拡張とTriplet Lossによる距離学習 疑似ラベル⽣成を⽤いた3D-CNNの学習では、分離性能の良いクラスタが得られたが、特徴量⾃ 体が初期設定のクラスタ数に影響を受けていることが確認された データ拡張とTriplet Lossによる距離学習では、学習が早い段階で収束してしまうため、抽象度の ⾼い特徴抽出ができなかった Autoencoderはバイアス無しに特徴量を学習できる⼿法である 19 -
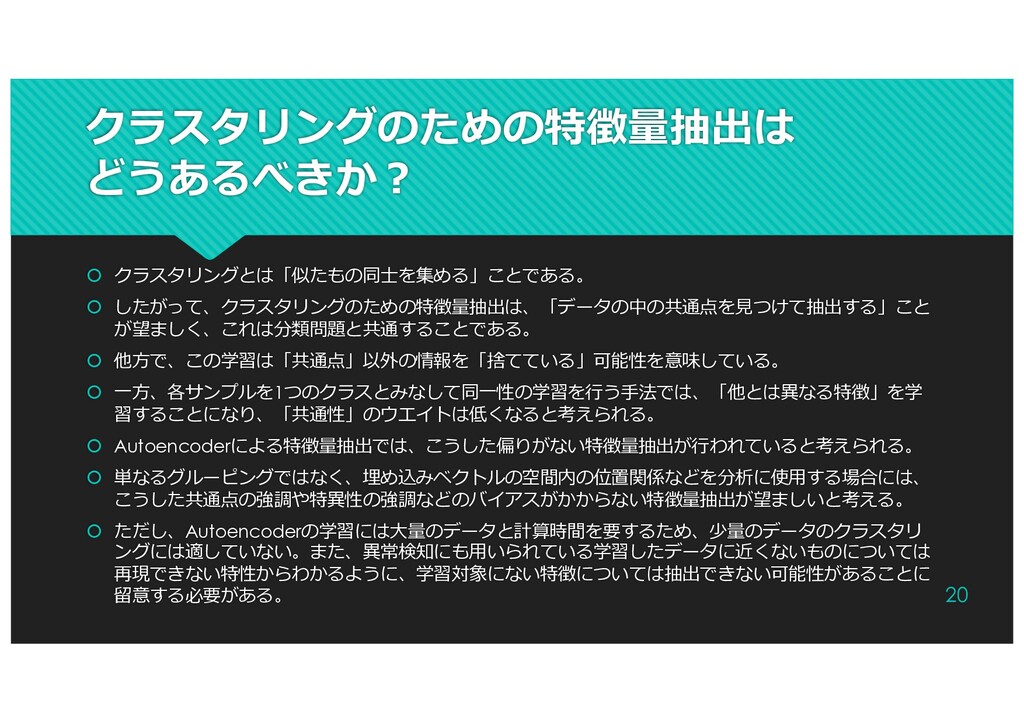
クラスタリングのための特徴量抽出は どうあるべきか︖ クラスタリングとは「似たもの同⼠を集める」ことである。 したがって、クラスタリングのための特徴量抽出は、「データの中の共通点を⾒つけて抽出する」こと が望ましく、これは分類問題と共通することである。 他⽅で、この学習は「共通点」以外の情報を「捨てている」可能性を意味している。
⼀⽅、各サンプルを1つのクラスとみなして同⼀性の学習を⾏う⼿法では、「他とは異なる特徴」を学 習することになり、「共通性」のウエイトは低くなると考えられる。 Autoencoderによる特徴量抽出では、こうした偏りがない特徴量抽出が⾏われていると考えられる。 単なるグルーピングではなく、埋め込みベクトルの空間内の位置関係などを分析に使⽤する場合には、 こうした共通点の強調や特異性の強調などのバイアスがかからない特徴量抽出が望ましいと考える。 ただし、Autoencoderの学習には⼤量のデータと計算時間を要するため、少量のデータのクラスタリ ングには適していない。また、異常検知にも⽤いられている学習したデータに近くないものについては 再現できない特性からわかるように、学習対象にない特徴については抽出できない可能性があることに 留意する必要がある。 20