Share
Embed
Transcript
38 slides
-
GitLab Copyright @jyoshise 吉瀬 淳一 Senior Solutions Architect, GitLab •
19992014 Hewlett Packard Enterprise Japan ◦ プロジェクトマネージャーとかやるふりをしながらインフラエ ンジニアをやっていた • 20142023 Hewlett Packard Enterprise Global ◦ グローバルのビジネスマネージャー(プロフェッショナルサー ビス)をやるふりをしながらクラウドネイティブインフラエンジ ニアをやっていた • 20232025 Nutanix Japan ◦ APJのSA(プリセールス)をやるふりをしながらクラウドネイ ティブおじさんをやっていた • 2025 GitLab ◦ なんもわからん • 2022 GAFA社長 ◦ ほんとにGAFA社長 -
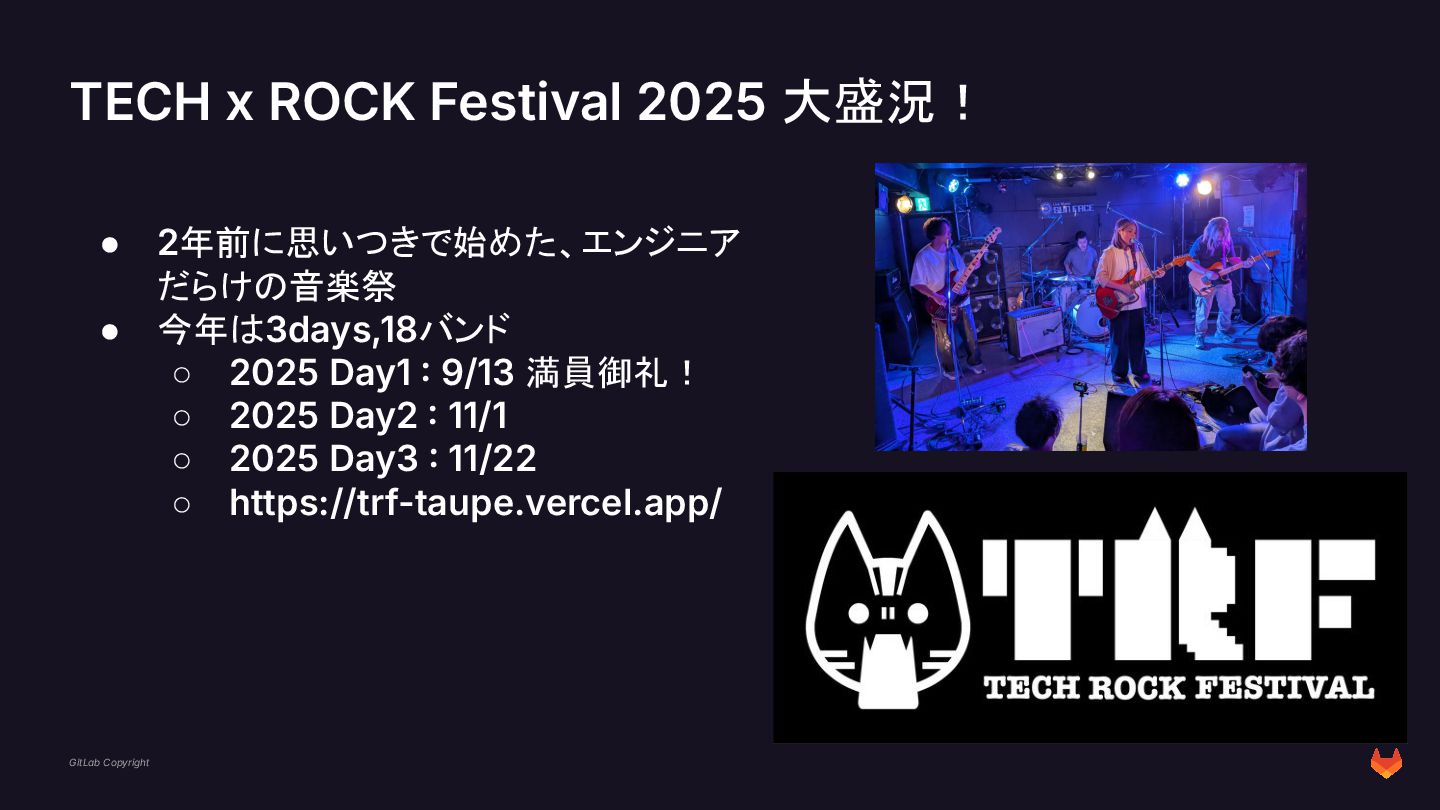
GitLab Copyright TECH x ROCK Festival 2025 大盛況! • 2年前に思いつきで始めた、エンジニア
だらけの音楽祭 • 今年は3days,18バンド ◦ 2025 Day1 9/13 満員御礼! ◦ 2025 Day2 11/1 ◦ 2025 Day3 11/22 ◦ https://trf-taupe.vercel.app/ -
GitLab Copyright Agenda 1. AIがコード書きすぎ問題 2. AIが量産したコードにどう立ち向かうか 3. コンテキストが全てを決める 4.
プラットフォームエンジニアにできること(やらなきゃいけないこと) 5. まとめ -
GitLab Copyright Disclaimer • 今日はやせいのエンジニア枠で登壇していますが、私の職務はGitLab(有償 版)を売ることです • アプリケーション開発におけるAIの利用を推進することも職務に含まれます • この資料作成にはAIは使ってません
◦ 嘘です。ちょっと使いました • このセッションでGitLabに言及する時、2つの意味合いが含まれます ◦ GitLabというプロダクト(統合DevSecOpsプラットフォーム) ◦ そのプロダクトを開発するためにGitLab社が実践しているプラットフォー ムエンジニアリング -
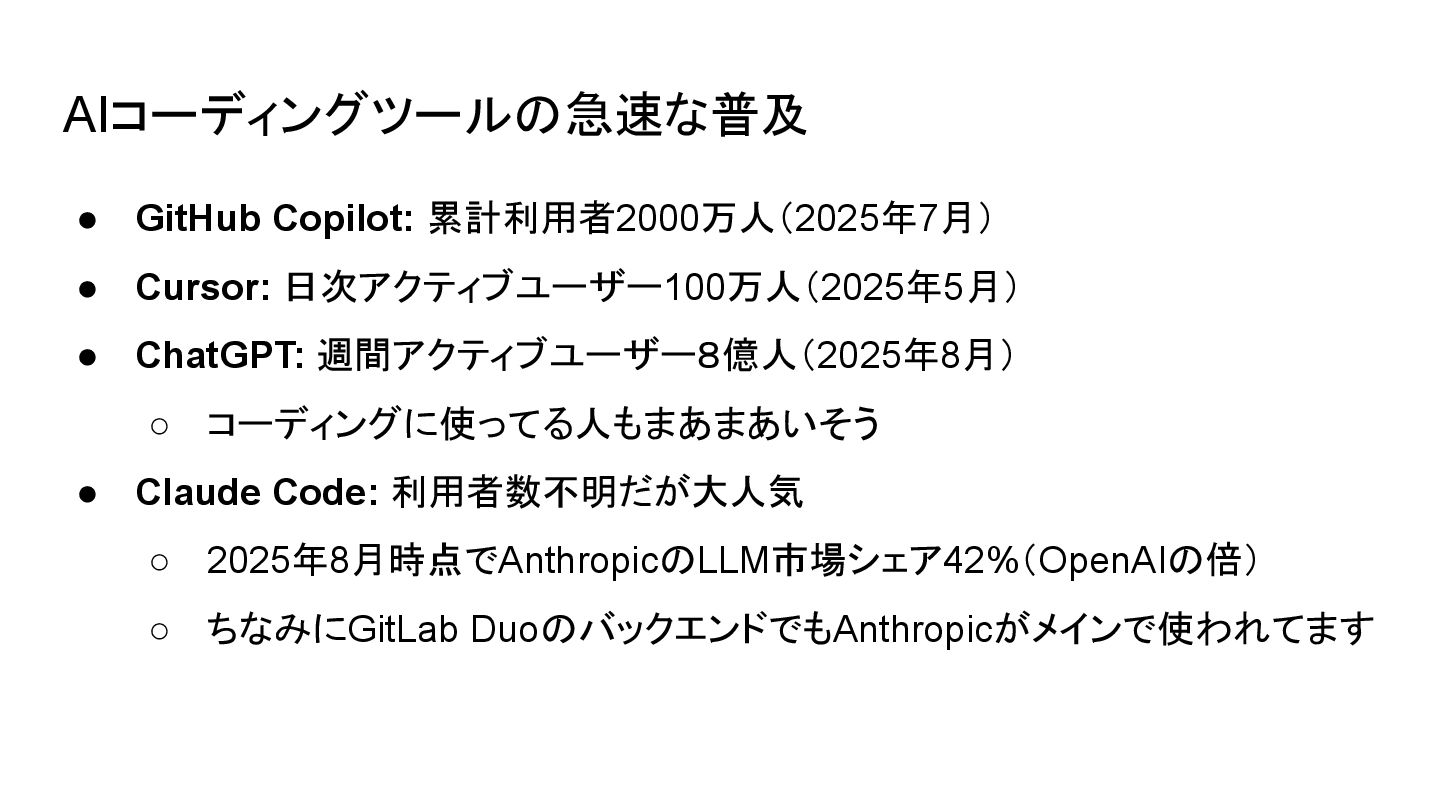
AIコーディングツールの急速な普及 • GitHub Copilot: 累計利用者2000万人(2025年7月) • Cursor: 日次アクティブユーザー100万人(2025年5月) • ChatGPT:
週間アクティブユーザー8億人(2025年8月) ◦ コーディングに使ってる人もまあまあいそう • Claude Code: 利用者数不明だが大人気 ◦ 2025年8月時点でAnthropicのLLM市場シェア42%(OpenAIの倍) ◦ ちなみにGitLab DuoのバックエンドでもAnthropicがメインで使われてます -
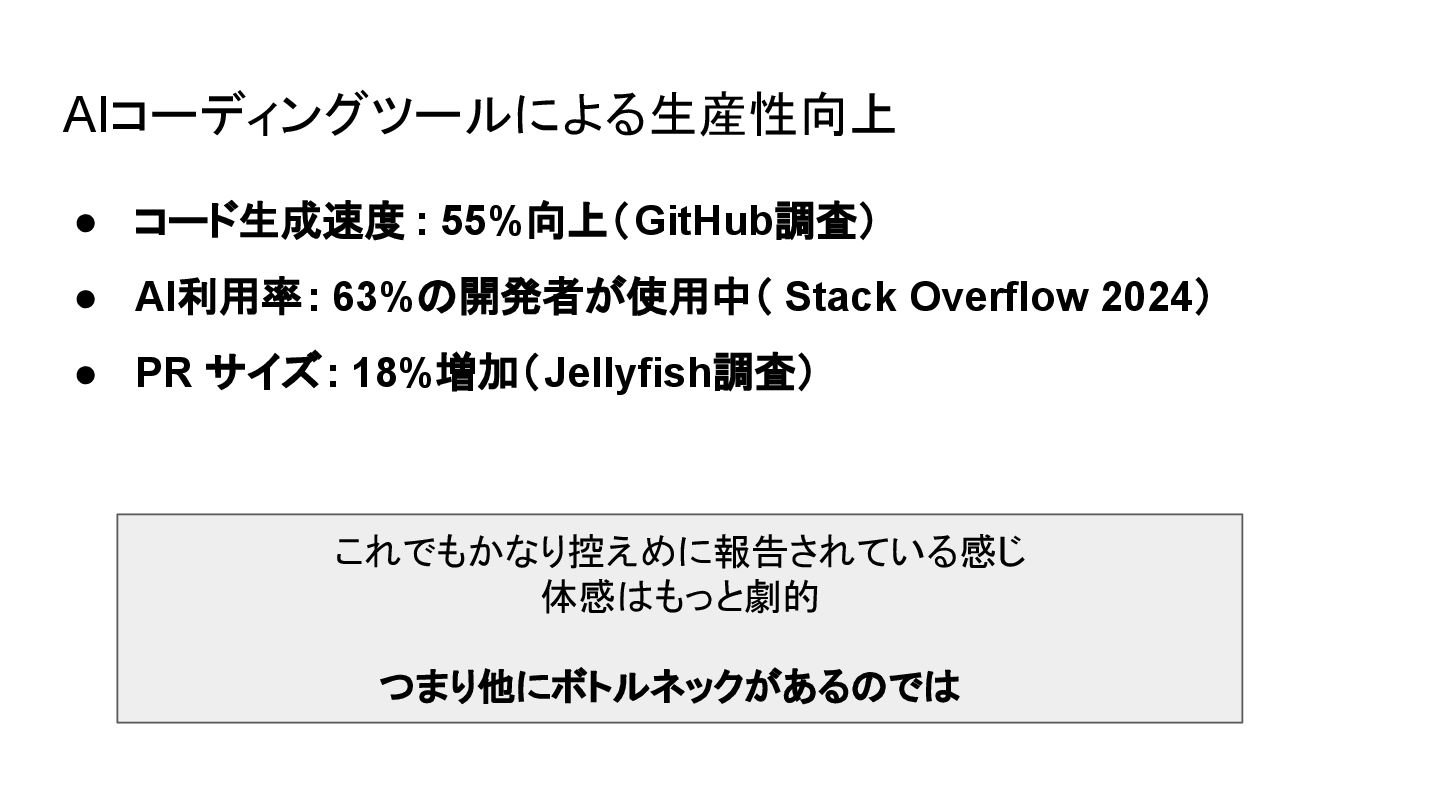
AIコーディングツールによる生産性向上 • コード生成速度 : 55%向上(GitHub調査) • AI利用率: 63%の開発者が使用中( Stack Overflow
2024) • PR サイズ: 18%増加(Jellyfish調査) これでもかなり控えめに報告されている感じ 体感はもっと劇的 つまり他にボトルネックがあるのでは -
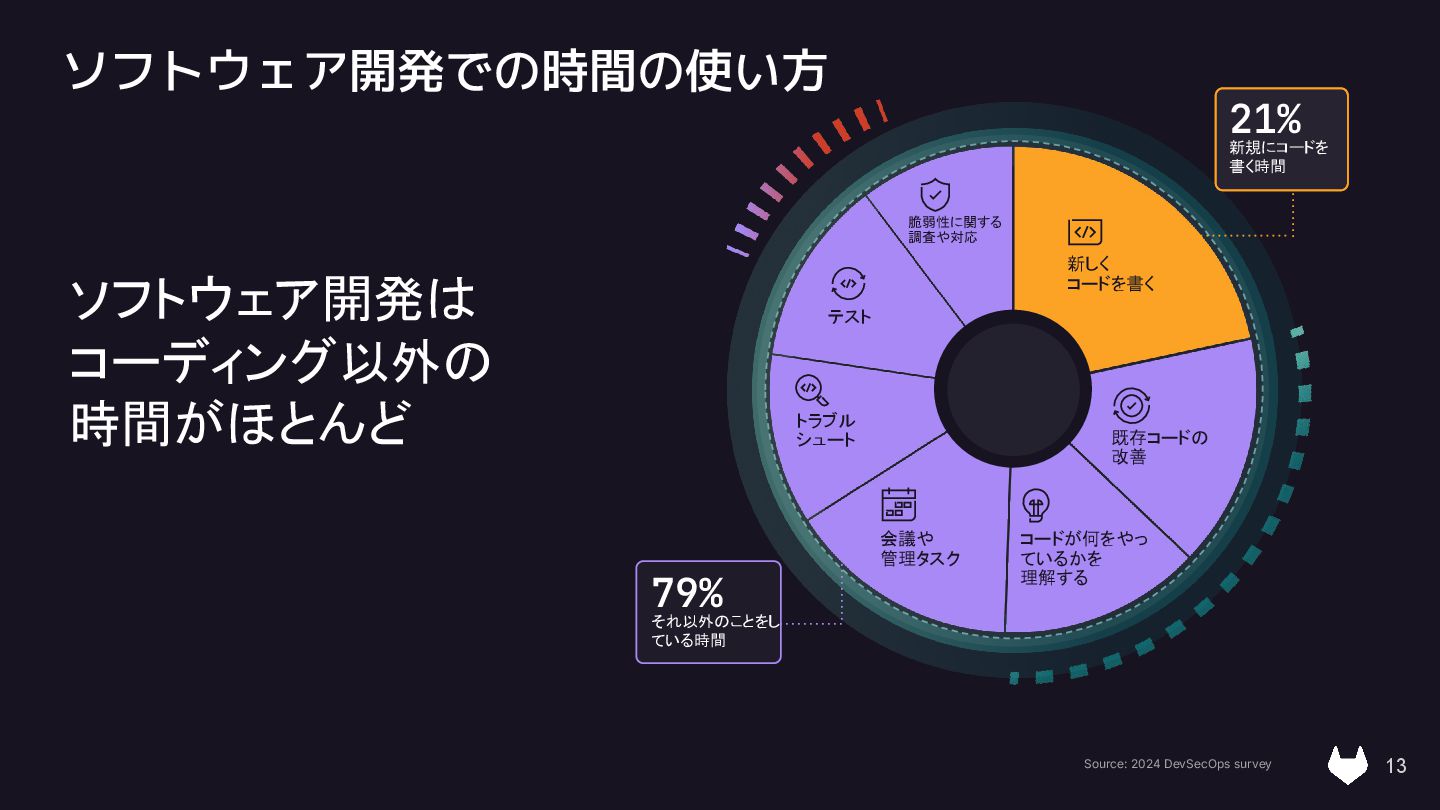
ソフトウェア開発での時間の使い方 新しく コードを書く 既存コードの 改善 コードが何をやっ ているかを 理解する 会議や 管理タスク
トラブル シュート テスト 脆弱性に関する 調査や対応 21% 新規にコードを 書く時間 それ以外のことをし ている時間 79% Source: 2024 DevSecOps survey 13 ソフトウェア開発は コーディング以外の 時間がほとんど -
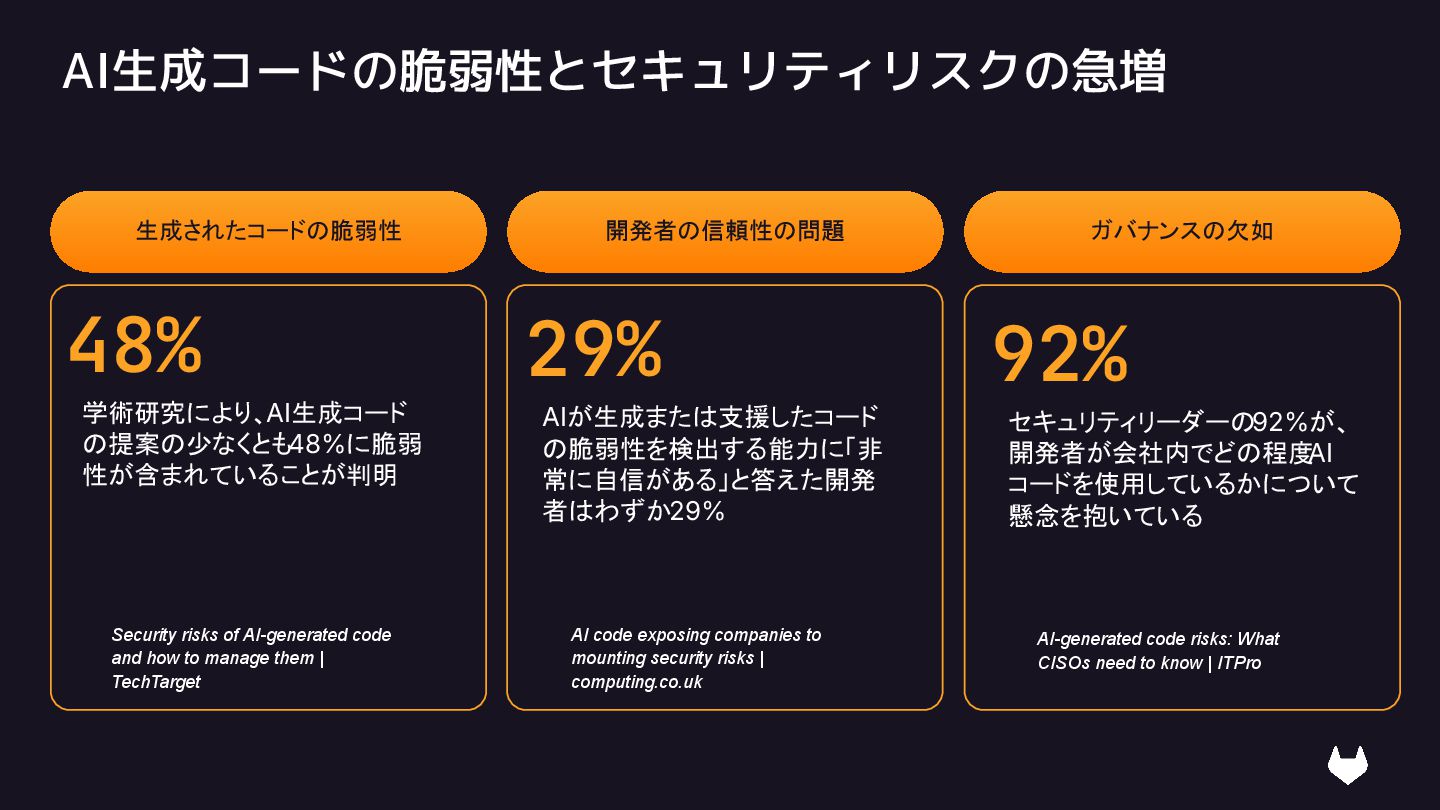
AI生成コードの脆弱性とセキュリティリスクの急増 生成されたコードの脆弱性 開発者の信頼性の問題 ガバナンスの欠如 学術研究により、AI生成コード の提案の少なくとも48%に脆弱 性が含まれていることが判明 48% Security risks
of AI-generated code and how to manage them | TechTarget AIが生成または支援したコード の脆弱性を検出する能力に「非 常に自信がある」と答えた開発 者はわずか29% 29% AI code exposing companies to mounting security risks | computing.co.uk セキュリティリーダーの92%が、 開発者が会社内でどの程度 AI コードを使用しているかについて 懸念を抱いている 92% AI-generated code risks: What CISOs need to know | ITPro -
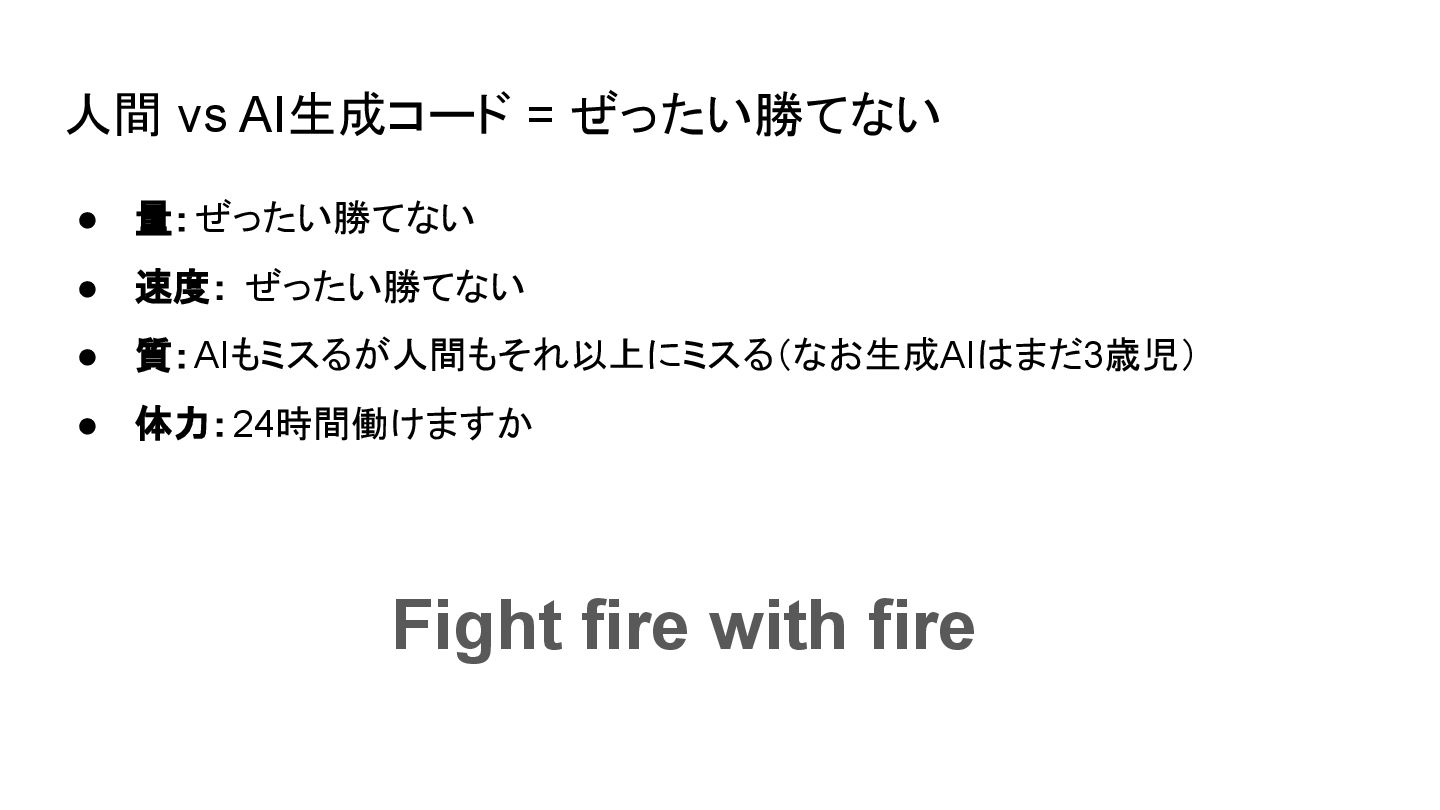
人間 vs AI生成コード = ぜったい勝てない • 量:ぜったい勝てない • 速度: ぜったい勝てない
• 質:AIもミスるが人間もそれ以上にミスる(なお生成AIはまだ3歳児) • 体力:24時間働けますか Fight fire with fire -
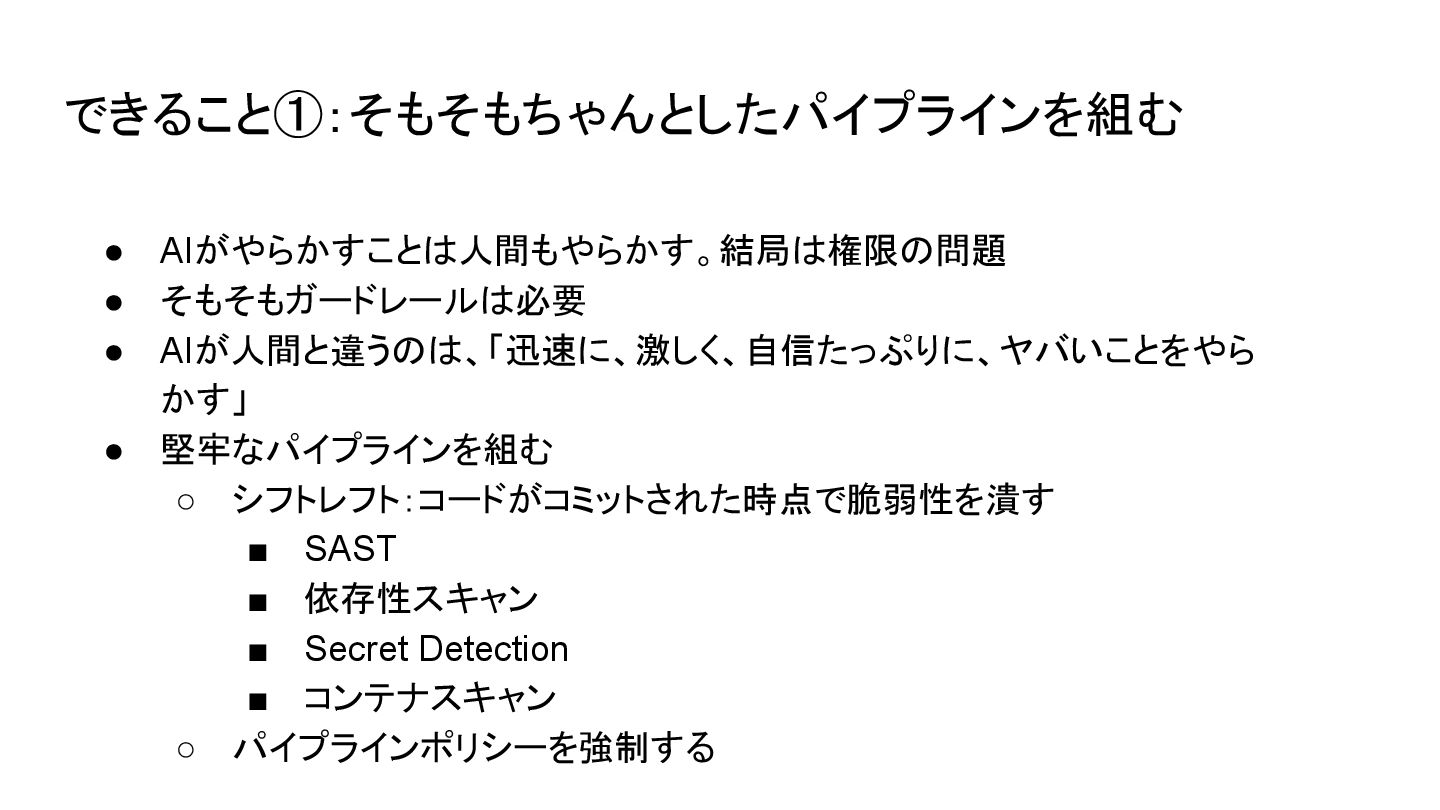
できること①:そもそもちゃんとしたパイプラインを組む • AIがやらかすことは人間もやらかす。結局は権限の問題 • そもそもガードレールは必要 • AIが人間と違うのは、「迅速に、激しく、自信たっぷりに、ヤバいことをやら かす」 • 堅牢なパイプラインを組む
◦ シフトレフト:コードがコミットされた時点で脆弱性を潰す ▪ SAST ▪ 依存性スキャン ▪ Secret Detection ▪ コンテナスキャン ◦ パイプラインポリシーを強制する -
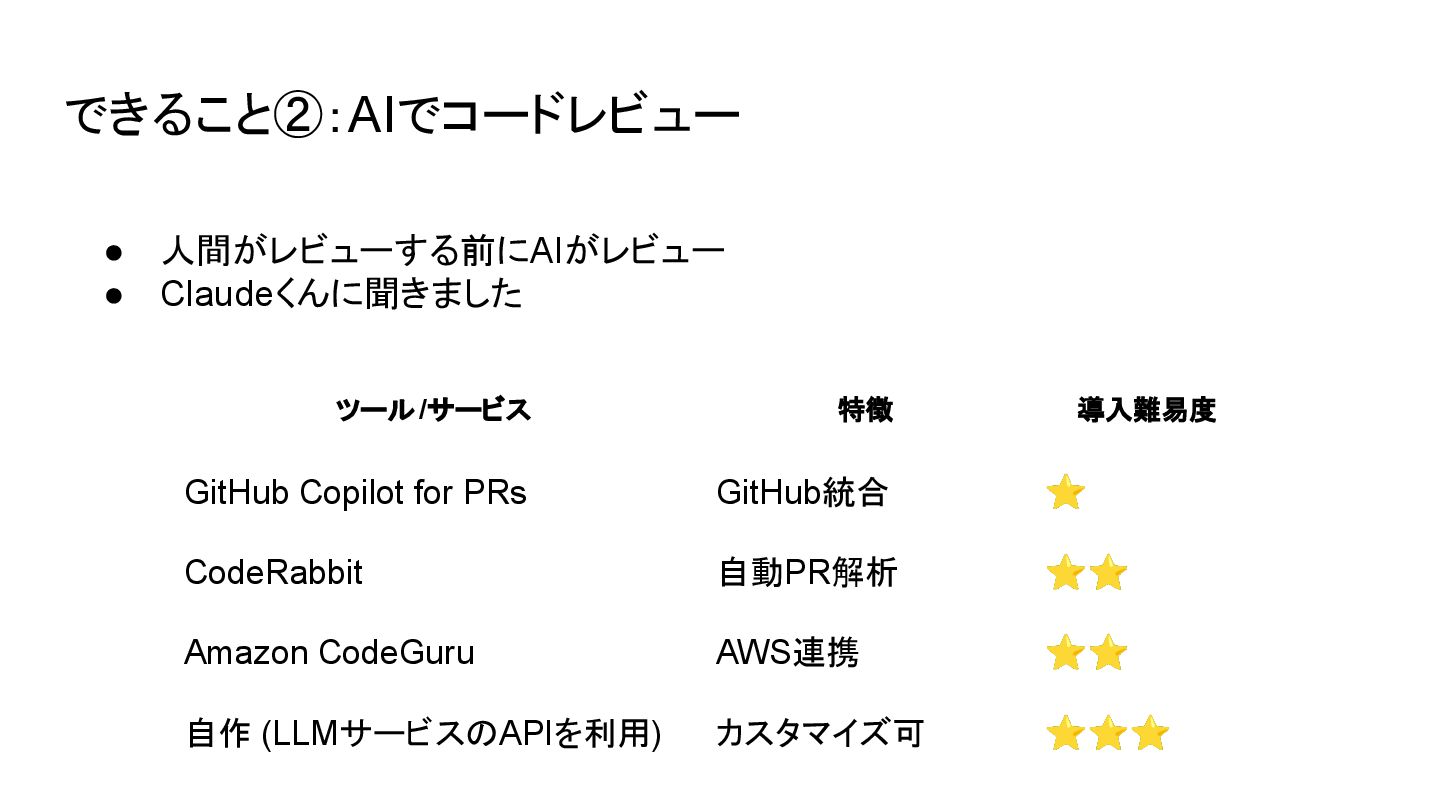
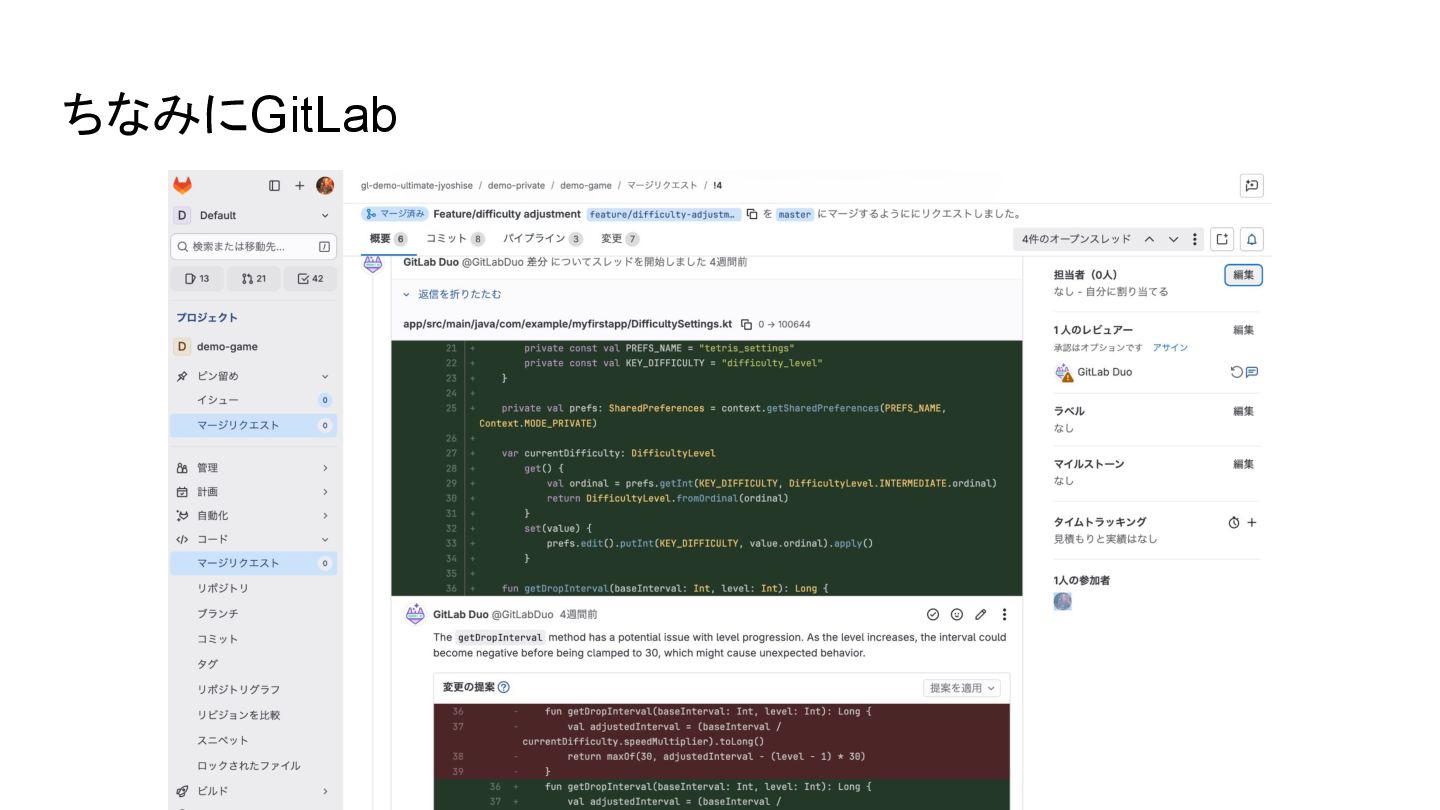
できること②:AIでコードレビュー ツール/サービス 特徴 導入難易度 GitHub Copilot for PRs GitHub統合 ⭐
CodeRabbit 自動PR解析 ⭐⭐ Amazon CodeGuru AWS連携 ⭐⭐ 自作 (LLMサービスのAPIを利用) カスタマイズ可 ⭐⭐⭐ • 人間がレビューする前にAIがレビュー • Claudeくんに聞きました -
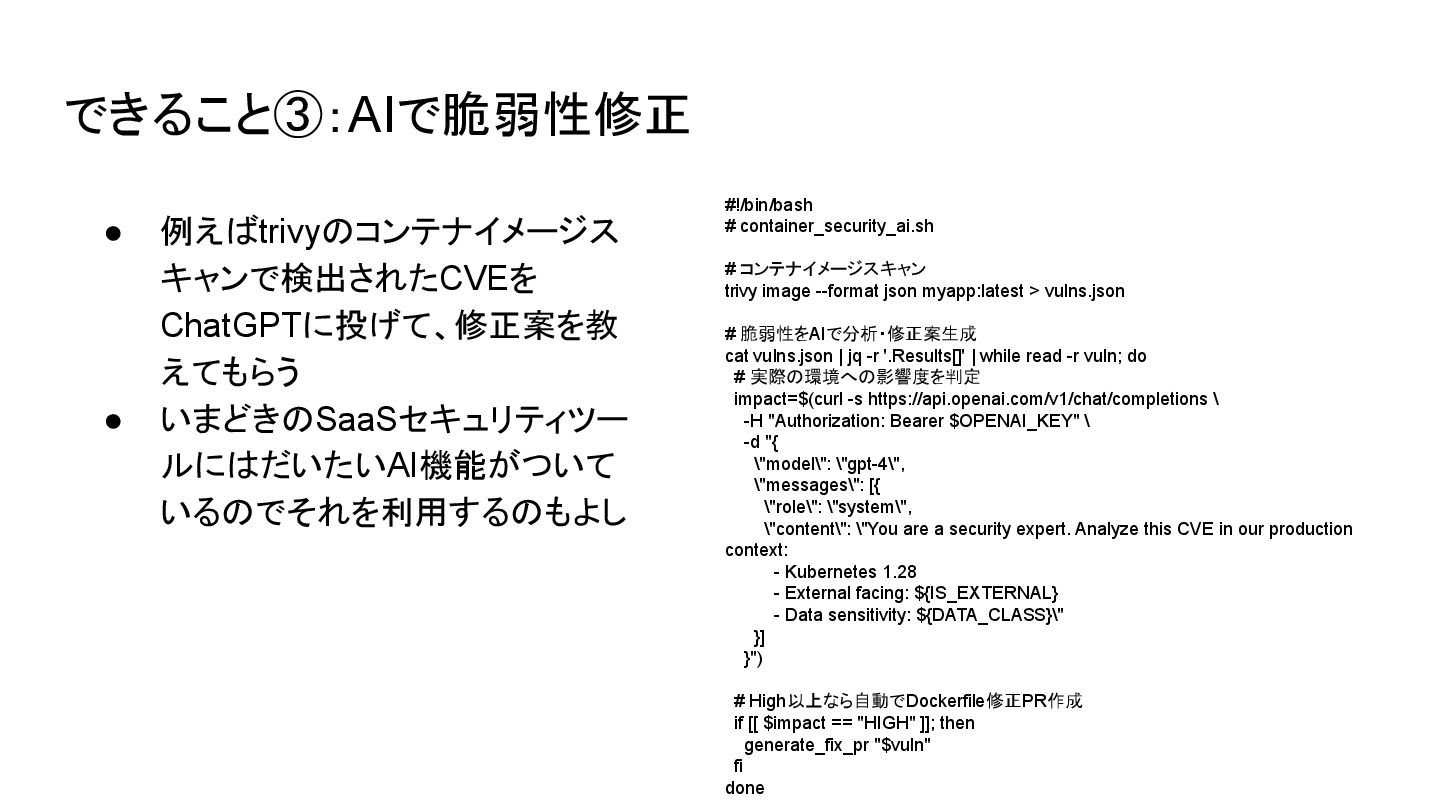
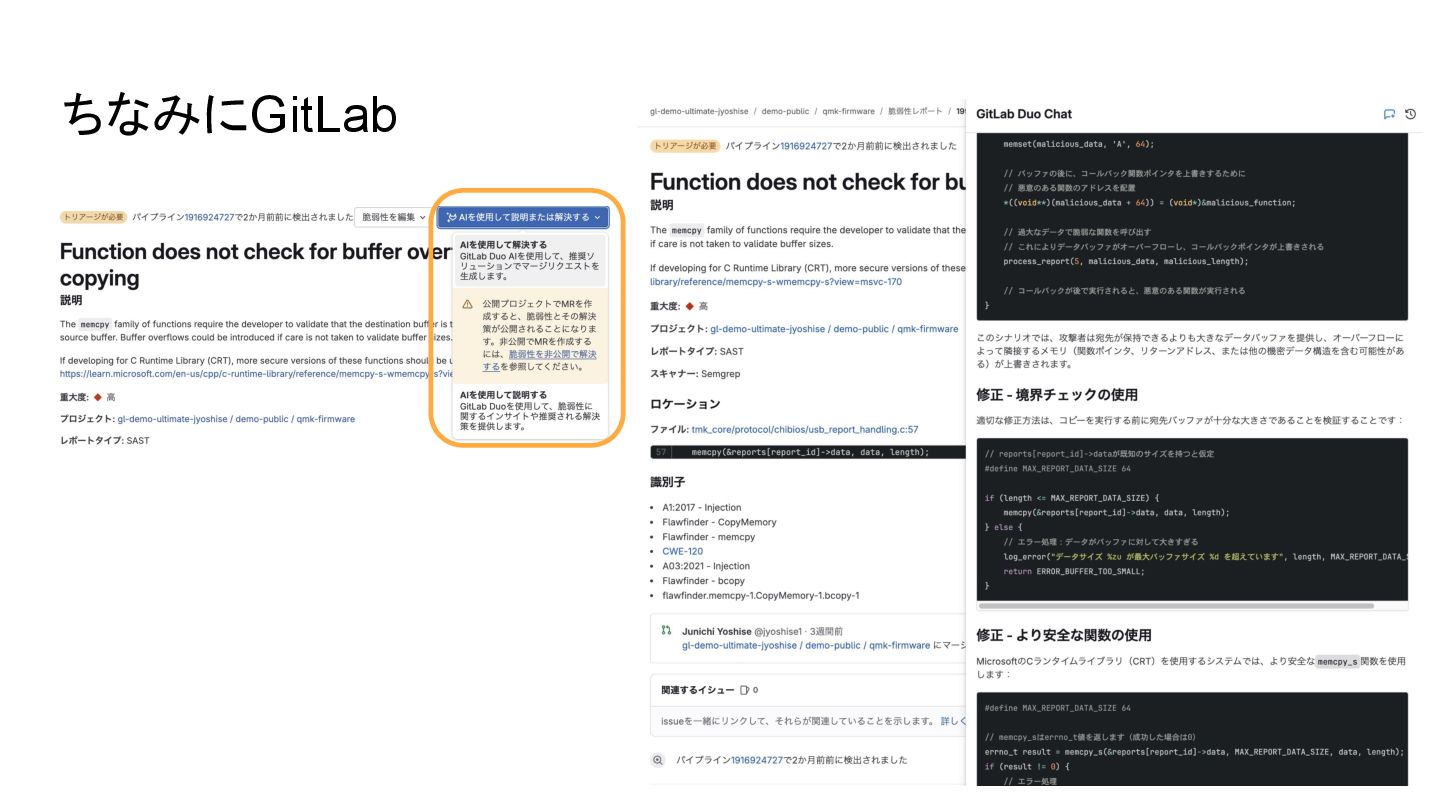
できること③:AIで脆弱性修正 #!/bin/bash # container_security_ai.sh # コンテナイメージスキャン trivy image --format json
myapp:latest > vulns.json # 脆弱性をAIで分析・修正案生成 cat vulns.json | jq -r '.Results[]' | while read -r vuln; do # 実際の環境への影響度を判定 impact=$(curl -s https://api.openai.com/v1/chat/completions \ -H "Authorization: Bearer $OPENAI_KEY" \ -d "{ \"model\": \"gpt-4\", \"messages\": [{ \"role\": \"system\", \"content\": \"You are a security expert. Analyze this CVE in our production context: - Kubernetes 1.28 - External facing: ${IS_EXTERNAL} - Data sensitivity: ${DATA_CLASS}\" }] }") # High以上なら自動でDockerfile修正PR作成 if [[ $impact == "HIGH" ]]; then generate_fix_pr "$vuln" fi done • 例えばtrivyのコンテナイメージス キャンで検出されたCVEを ChatGPTに投げて、修正案を教 えてもらう • いまどきのSaaSセキュリティツー ルにはだいたいAI機能がついて いるのでそれを利用するのもよし -
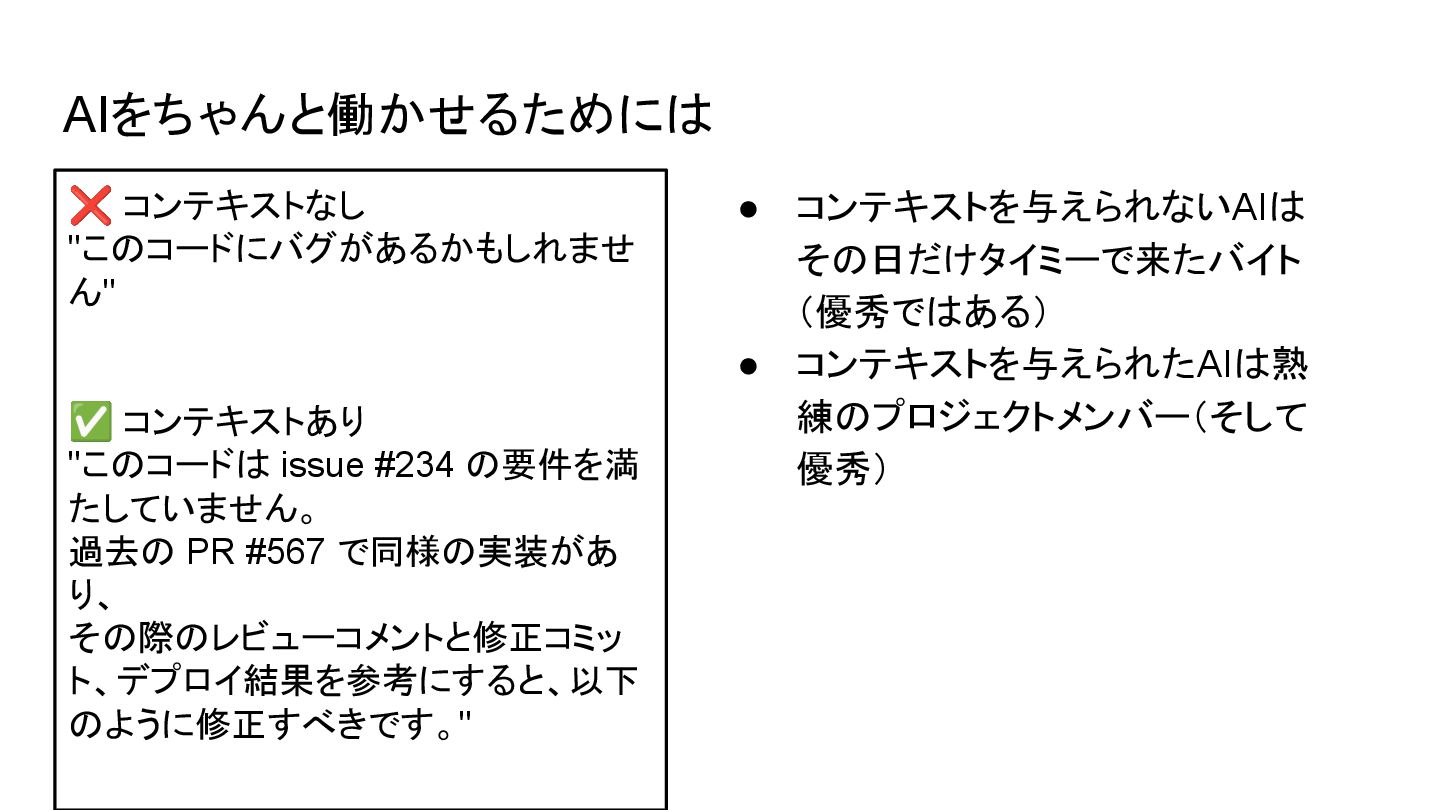
AIをちゃんと働かせるためには ❌ コンテキストなし "このコードにバグがあるかもしれませ ん" ✅ コンテキストあり "このコードは issue #234
の要件を満 たしていません。 過去の PR #567 で同様の実装があ り、 その際のレビューコメントと修正コミッ ト、デプロイ結果を参考にすると、以下 のように修正すべきです。" • コンテキストを与えられないAIは その日だけタイミーで来たバイト (優秀ではある) • コンテキストを与えられたAIは熟 練のプロジェクトメンバー(そして 優秀) -
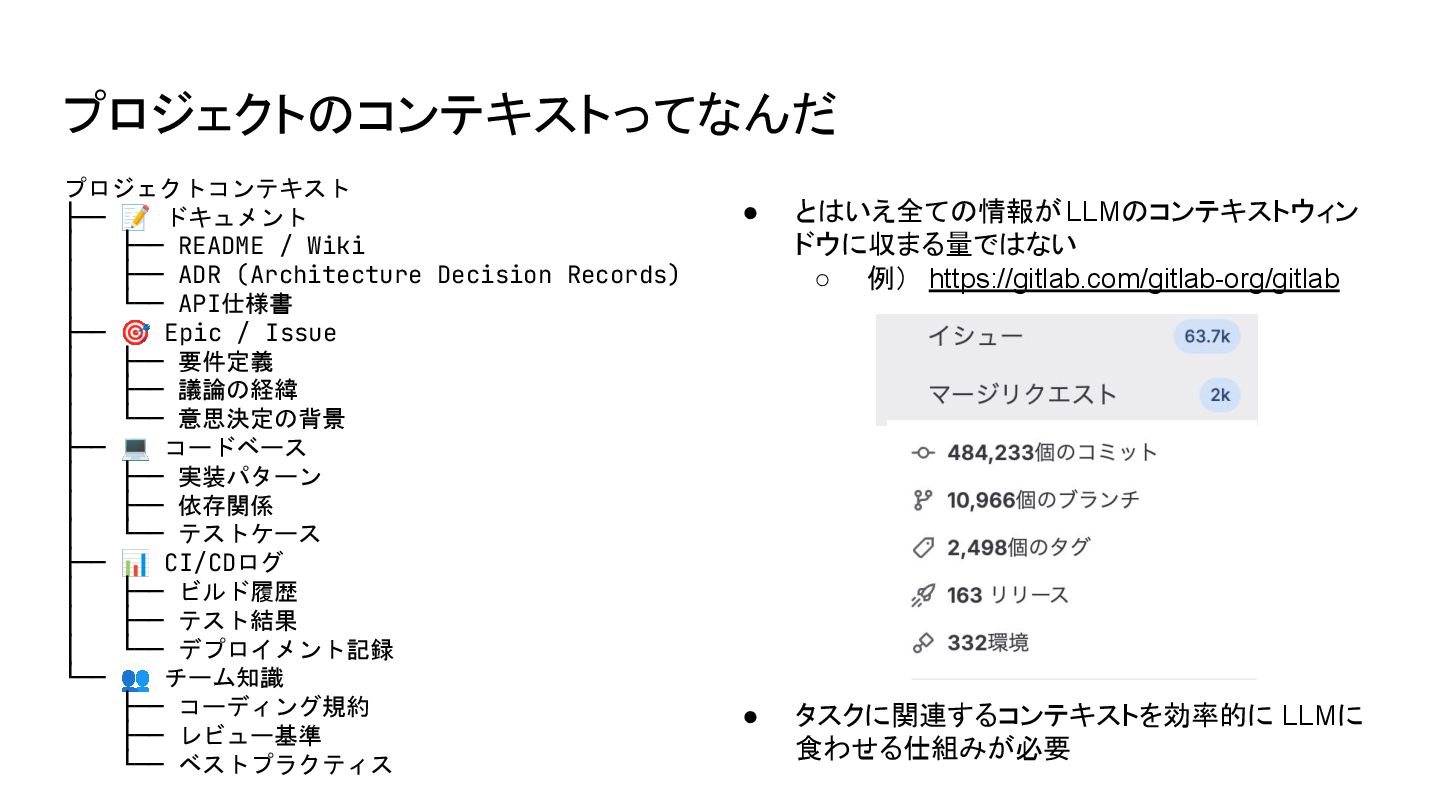
プロジェクトのコンテキストってなんだ プロジェクトコンテキスト ├── 📝 ドキュメント │ ├── README / Wiki
│ ├── ADR (Architecture Decision Records) │ └── API仕様書 ├── 🎯 Epic / Issue │ ├── 要件定義 │ ├── 議論の経緯 │ └── 意思決定の背景 ├── 💻 コードベース │ ├── 実装パターン │ ├── 依存関係 │ └── テストケース ├── 📊 CI/CDログ │ ├── ビルド履歴 │ ├── テスト結果 │ └── デプロイメント記録 └── 👥 チーム知識 ├── コーディング規約 ├── レビュー基準 └── ベストプラクティス • とはいえ全ての情報が LLMのコンテキストウィン ドウに収まる量ではない ◦ 例) https://gitlab.com/gitlab-org/gitlab • タスクに関連するコンテキストを効率的に LLMに 食わせる仕組みが必要 -
① プロジェクト情報をコンテキストとして扱うための人間のルー ルを整備する • ドキュメントをRepositoryに収める ◦ 設計書、仕様書、開発標準etc ◦ 人間にもAIにも読めるフォーマット(.mdなど) ◦
仕様書のないコードはAIに仕様書を吐き出させる仕組みを用意する • Issueをちゃんと書く ◦ Issueとは仕様決定の経緯=重要なコンテキスト ◦ 結果だけでなく、議論をIssueの履歴に残す ◦ Issueテンプレートを整備する • Issueがアサインされたらマージリクエストから始める ※ GitLab流 ◦ コミット→CI→修正の履歴がマージリクエストに残る -
② プロジェクトのコンテキストをLLMのコンテキストとして利用 するための仕組みを整備する • 情報をできるだけ1箇所にまとめる • 情報の関連性/類似性を検索して必要なコンテキストを拾うための仕組み ◦ MCP+RAG ▪
情報がバラバラに存在していると高コスト ◦ Knowledge Graph ▪ 常時インデックスを更新したいので軽量なものが望ましい -
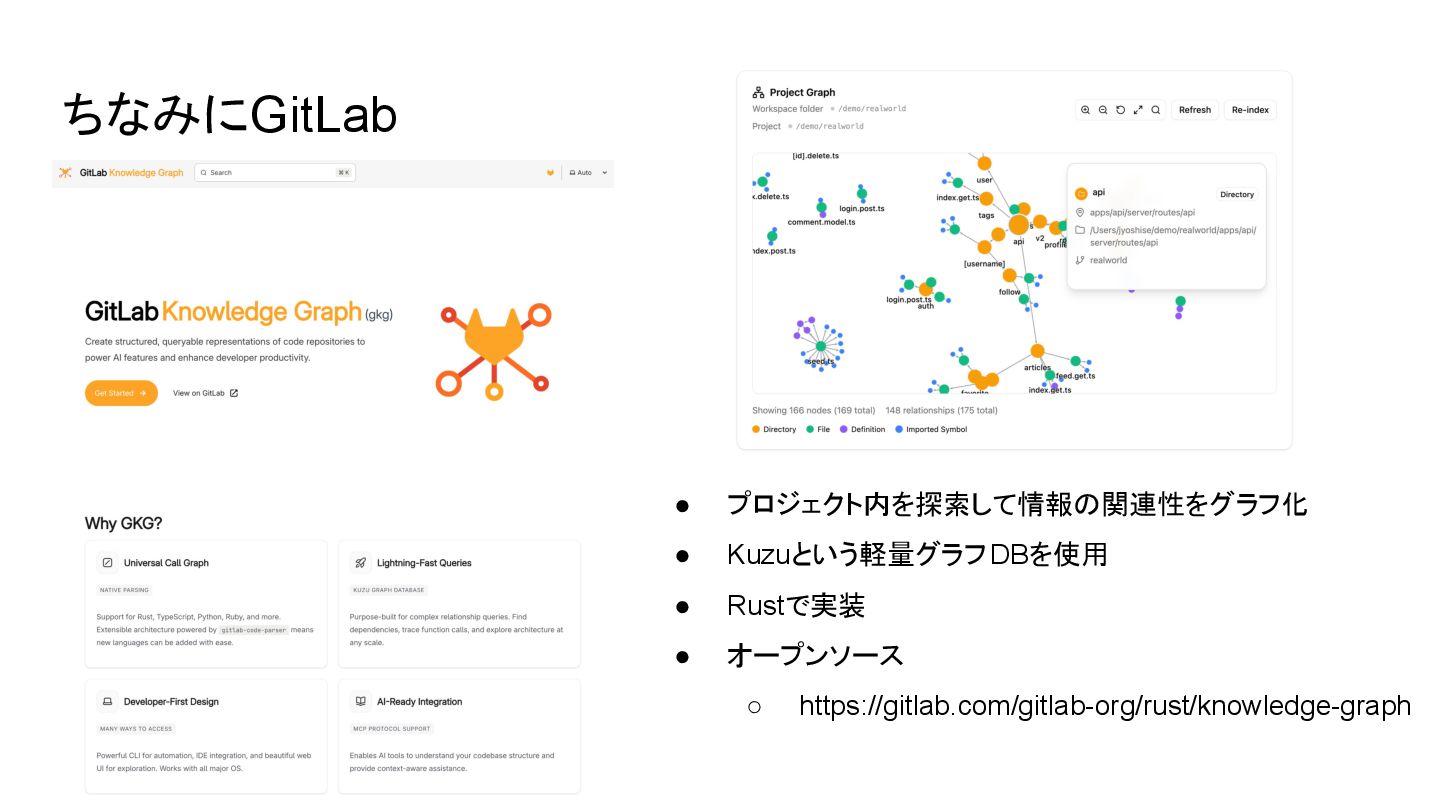
ちなみにGitLab • プロジェクト内を探索して情報の関連性をグラフ化 • Kuzuという軽量グラフDBを使用 • Rustで実装 • オープンソース ◦
https://gitlab.com/gitlab-org/rust/knowledge-graph -
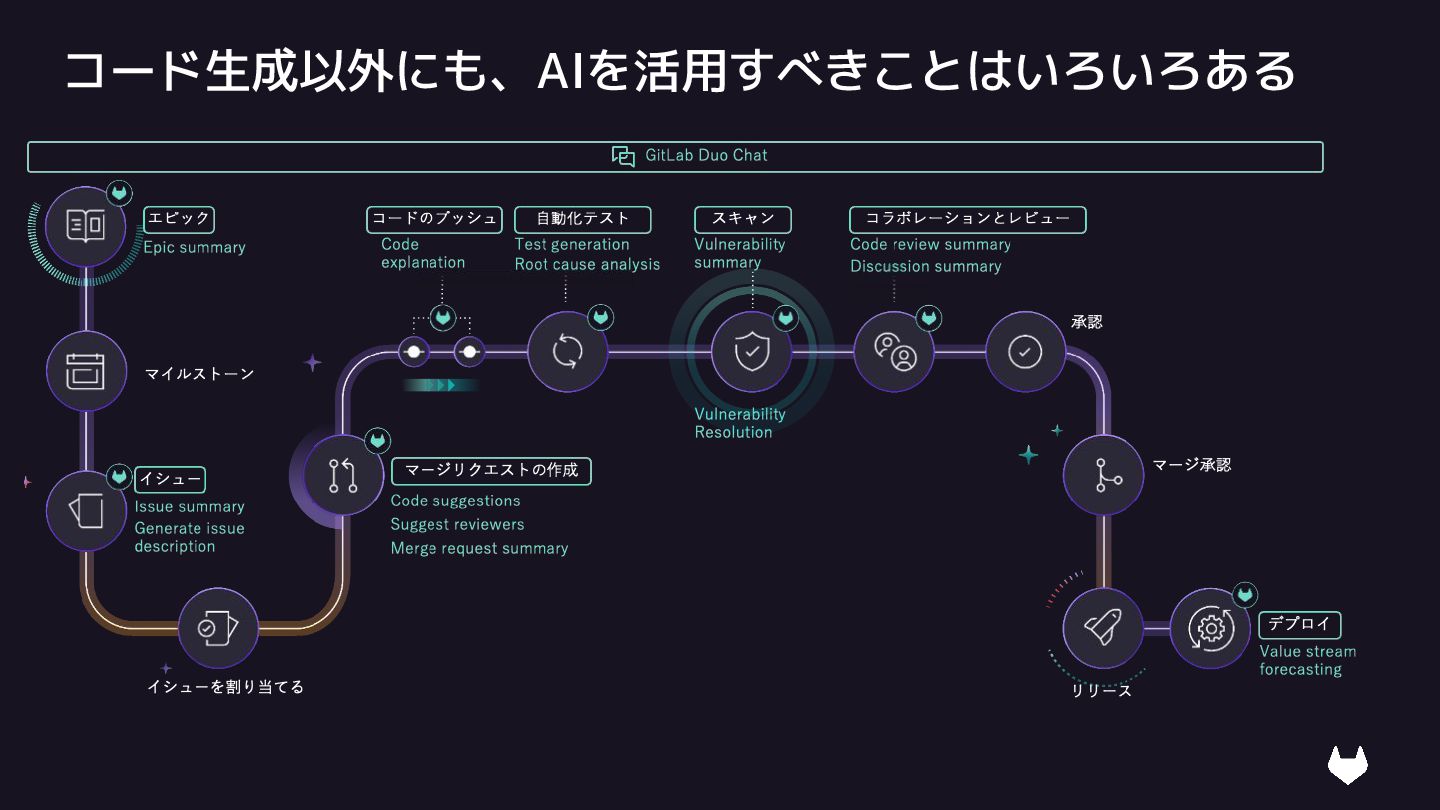
③ パイプラインタスクを実行するAIエージェントを導入する • 開発チームにとって負担となっているタスクを AIエージェントで補完する • エージェントの例 ◦ Issueをサマライズしてコードへの影響と作業量を見積もるエージェント ◦
Issueからマージリクエストを作成するエージェント ◦ コードをレビューするエージェント ◦ テストの失敗原因を分析するエージェント ◦ などなど • 性能はバックエンドのLLMと与えられるコンテキストに依存する • 組織としてどのLLMを使っていいのか問題 ◦ コスト、セキュリティ、ガバナンス -
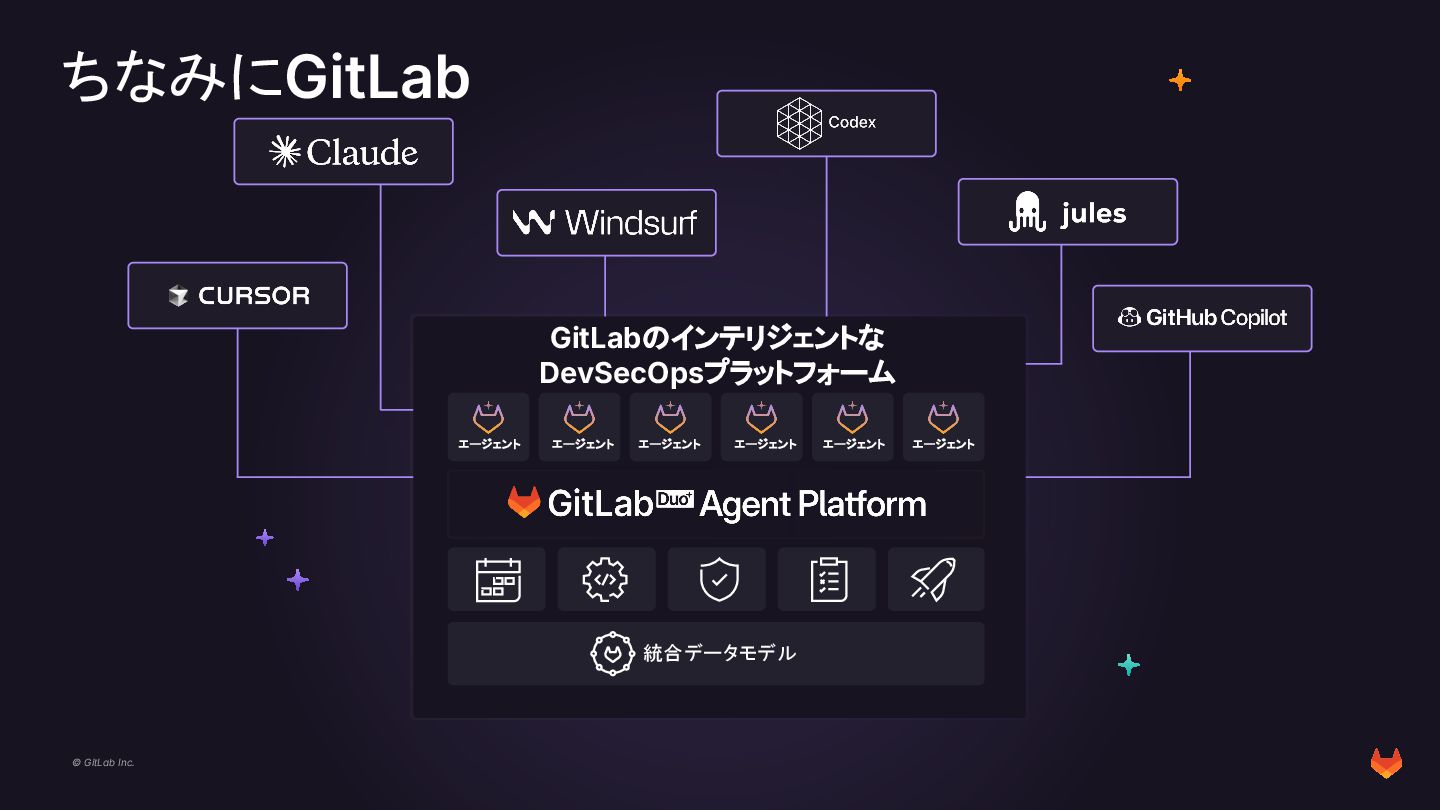
© GitLab Inc. GitLabのインテリジェントな DevSecOpsプラットフォーム エージェント 統合データモデル エージェント エージェント エージェント
エージェント エージェント ちなみにGitLab -
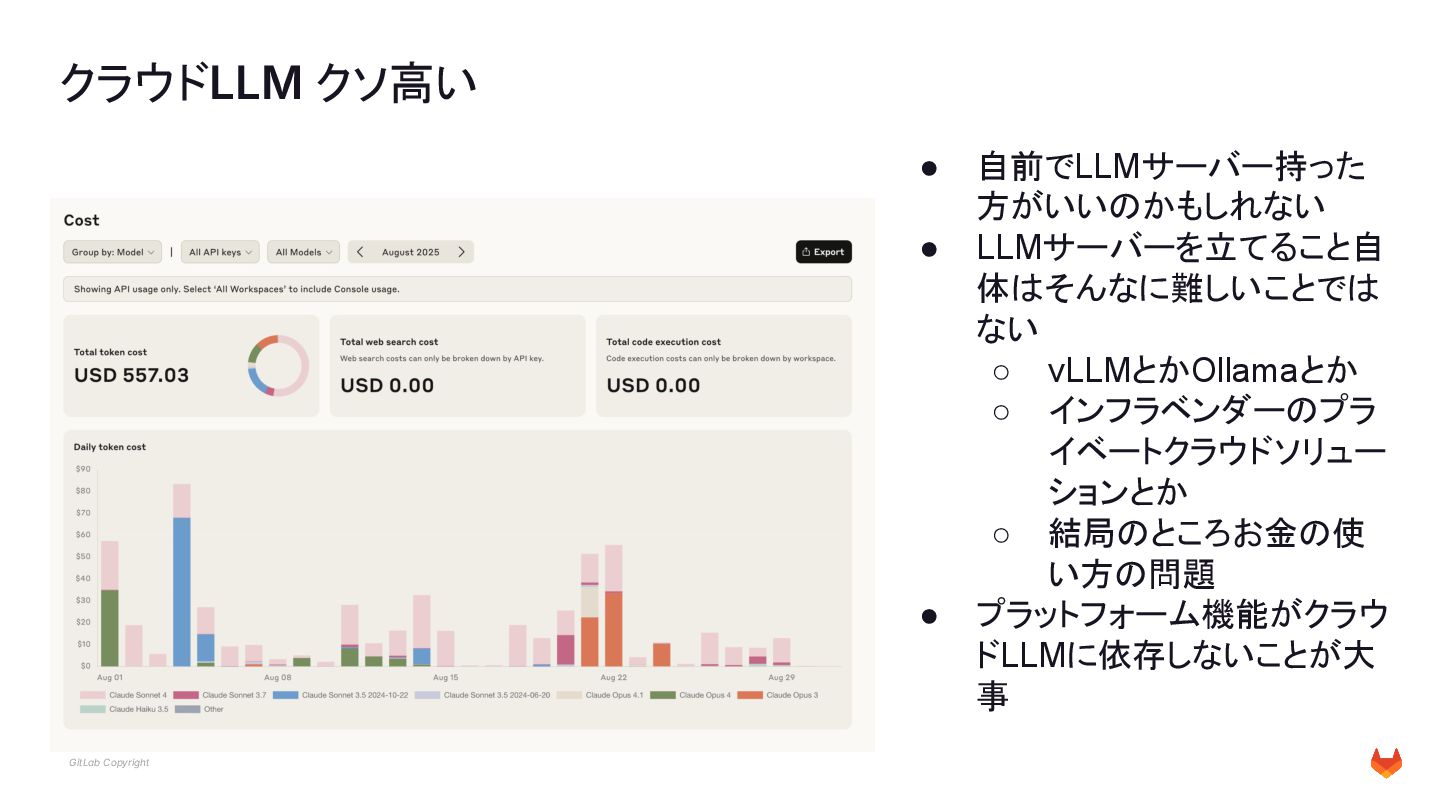
GitLab Copyright クラウドLLM クソ高い • 自前でLLMサーバー持った 方がいいのかもしれない • LLMサーバーを立てること自 体はそんなに難しいことでは
ない ◦ vLLMとかOllamaとか ◦ インフラベンダーのプラ イベートクラウドソリュー ションとか ◦ 結局のところお金の使 い方の問題 • プラットフォーム機能がクラウ ドLLMに依存しないことが大 事 -
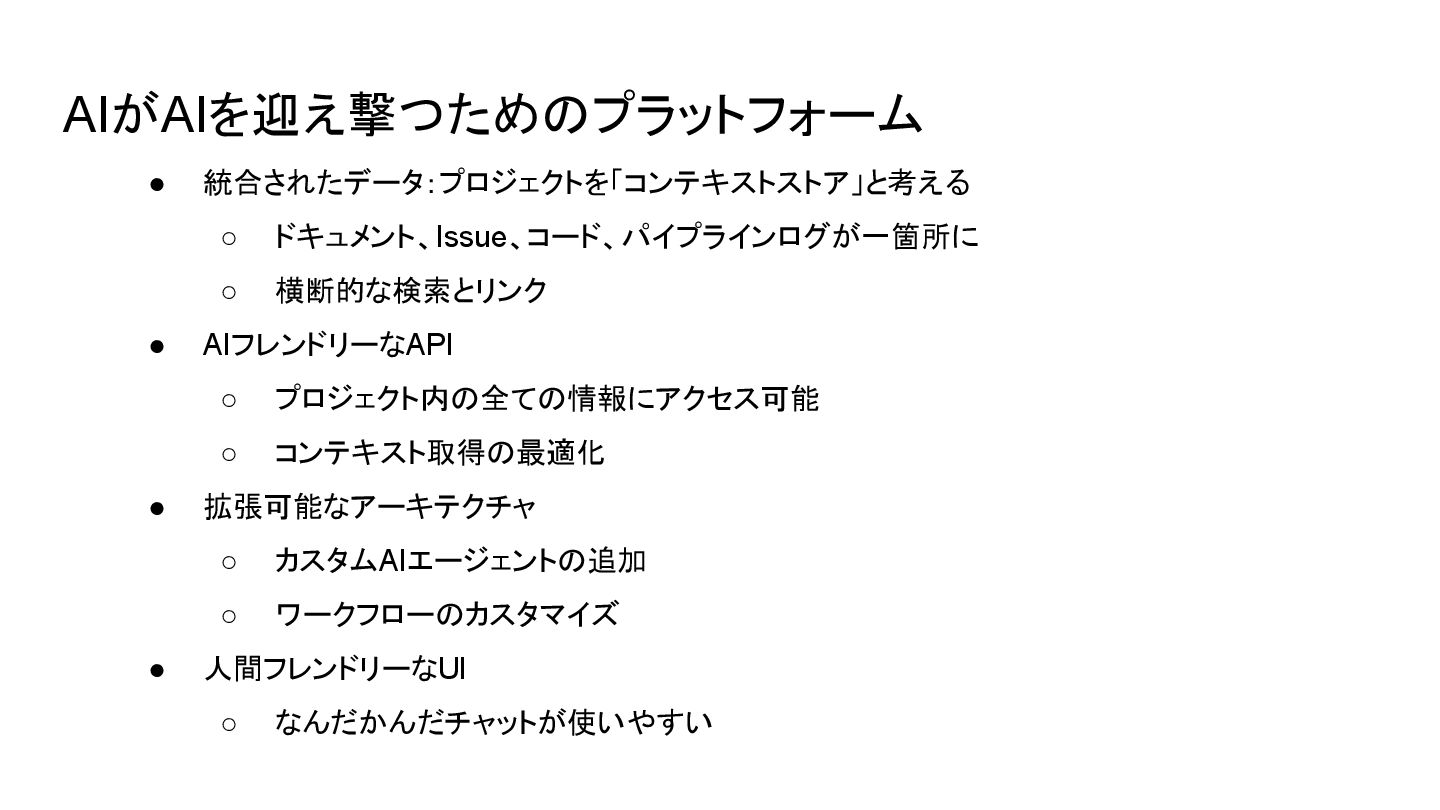
AIがAIを迎え撃つためのプラットフォーム • 統合されたデータ:プロジェクトを「コンテキストストア」と考える ◦ ドキュメント、Issue、コード、パイプラインログが一箇所に ◦ 横断的な検索とリンク • AIフレンドリーなAPI ◦
プロジェクト内の全ての情報にアクセス可能 ◦ コンテキスト取得の最適化 • 拡張可能なアーキテクチャ ◦ カスタムAIエージェントの追加 ◦ ワークフローのカスタマイズ • 人間フレンドリーなUI ◦ なんだかんだチャットが使いやすい -
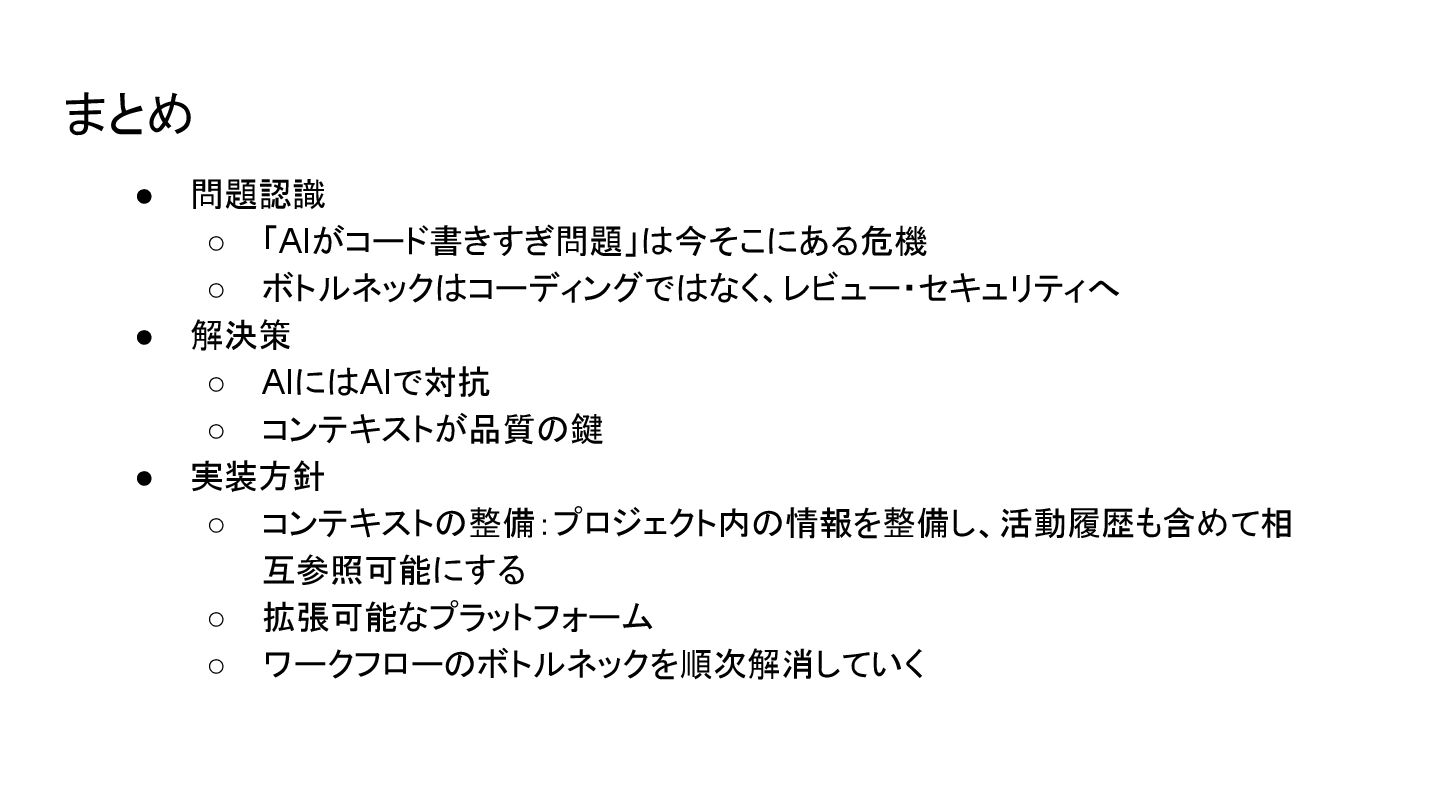
まとめ • 問題認識 ◦ 「AIがコード書きすぎ問題」は今そこにある危機 ◦ ボトルネックはコーディングではなく、レビュー・セキュリティへ • 解決策 ◦
AIにはAIで対抗 ◦ コンテキストが品質の鍵 • 実装方針 ◦ コンテキストの整備:プロジェクト内の情報を整備し、活動履歴も含めて相 互参照可能にする ◦ 拡張可能なプラットフォーム ◦ ワークフローのボトルネックを順次解消していく