Upgrade to Pro
— share decks privately, control downloads, hide ads and more …
Speaker Deck
Sign up for free
Menu
Search
Features
All features
Private URLs
Password Protection
Custom URLS
Scheduled publishing
Remove Branding
Restrict embedding
Deck Collections
Notes
Features
All features
Private URLs
Password Protection
Custom URLS
Scheduled publishing
Remove Branding
Restrict embedding
Deck Collections
Notes
Explore
Featured decks
Featured speakers
Programming
Technology
Storyboards
Explore
Featured decks
Featured speakers
Programming
Technology
Storyboards
Pricing
Search
Sign in
Sign up for free
SREでアラート疲れを 解決しよう!
Search
Sponsored
·
Ship Features Fearlessly
Turn features on and off without deploys. Used by thousands of Ruby developers.
→
KairiM
October 05, 2026
Technology
110
1
Share
Embed
Copy iframe code
Copy JS code
Copy link
Start on current slide
SREでアラート疲れを 解決しよう!
KairiM
October 05, 2026
More Decks by KairiM
See All by KairiM
1万名の社員が使う認証基盤で どう信頼性を担保するか?
kairim0
0
180
エラーバジェットのアラートのタイミングを考える.pdf
kairim0
0
240
はじめてのDatadog
kairim0
0
590
Other Decks in Technology
See All in Technology
ビジネスを止めない技術的負債の返済のための戦略とその手法 - 技術的負債と向き合う / Complexity and Simplicity
soudai
PRO
3
500
IR Today: Theory, Practice, and Agents
dtunkelang
0
330
Lambda MicroVMsが分からなすぎたので使い所を1から考えてみた
tsukuboshi
2
310
Apache Iceberg が拓く AI 時代のオープンレイクハウス
tomtanaka
0
210
AI臭い文章とは何なのか
nasuvitz
38
78k
Lambda MicroVMsは常駐サーバーの代わりに なるか? Kiro Crew を動かして検証してみた / Kiro Crew on Lambda MicroVMs
k_adachi_01
2
350
「とりあえず動く」の先へ。 AI時代のチーム開発と内部設計/2026-slsdays
slsops
0
120
検証フェーズはAIの回答を判断するための学習機会
toru_kubota
2
430
Snowflake Horizon Catalog と Apache Iceberg で作る オープンなデータ基盤
kitagawaz
0
390
カンファレンスに参加した後の浮遊感とセルフケア
pauli
0
300
サーバーフルコンピューティング?AWS Lambda
iwatatomoya
0
140
Codex概要
ymiya55
0
250
Featured
See All Featured
Easily Structure & Communicate Ideas using Wireframe
afnizarnur
194
17k
Distributed Sagas: A Protocol for Coordinating Microservices
caitiem20
333
23k
Building Better People: How to give real-time feedback that sticks.
wjessup
370
20k
Self-Hosted WebAssembly Runtime for Runtime-Neutral Checkpoint/Restore in Edge–Cloud Continuum
chikuwait
0
850
We Analyzed 250 Million AI Search Results: Here's What I Found
joshbly
1
2k
The State of eCommerce SEO: How to Win in Today's Products SERPs - #SEOweek
aleyda
2
12k
Skip the Path - Find Your Career Trail
mkilby
1
240
SEO in 2025: How to Prepare for the Future of Search
ipullrank
3
3.9k
GraphQLの誤解/rethinking-graphql
sonatard
75
12k
Rails Girls Zürich Keynote
gr2m
96
14k
HU Berlin: Industrial-Strength Natural Language Processing with spaCy and Prodigy
inesmontani
PRO
0
730
Are puppies a ranking factor?
jonoalderson
2
4k
Transcript
DevelopersIO 2026 Okinawa @Gwave Cafe 2026/10/02 #devio2026 SREでアラート疲れを 解決しよう! 1
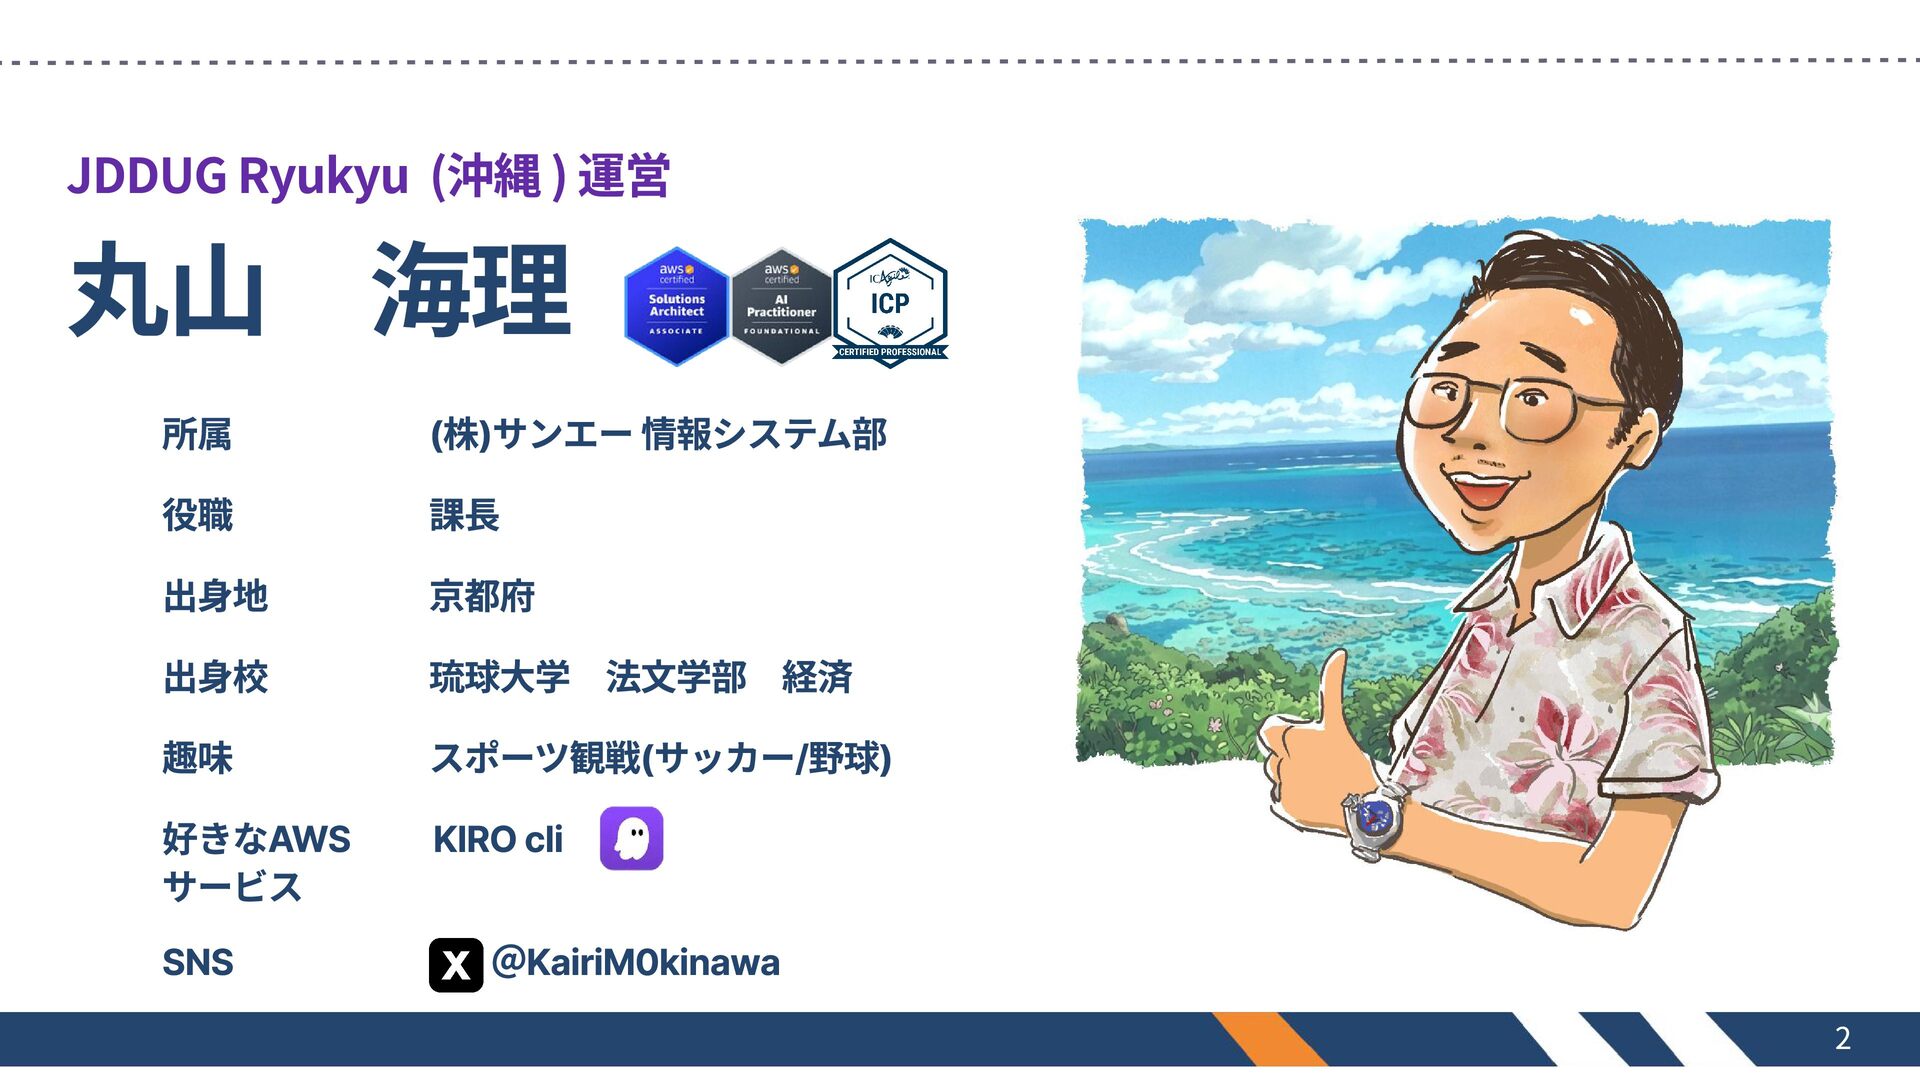
JDDUG Ryukyu (沖縄 ) 運営 丸山 海理 所属 (株)サンエー 情報システム部
役職 課長 出身地 京都府 出身校 琉球大学 法文学部 経済 趣味 スポーツ観戦(サッカー/野球) 好きなAWS サービス KIRO cli SNS @KairiM0kinawa 2
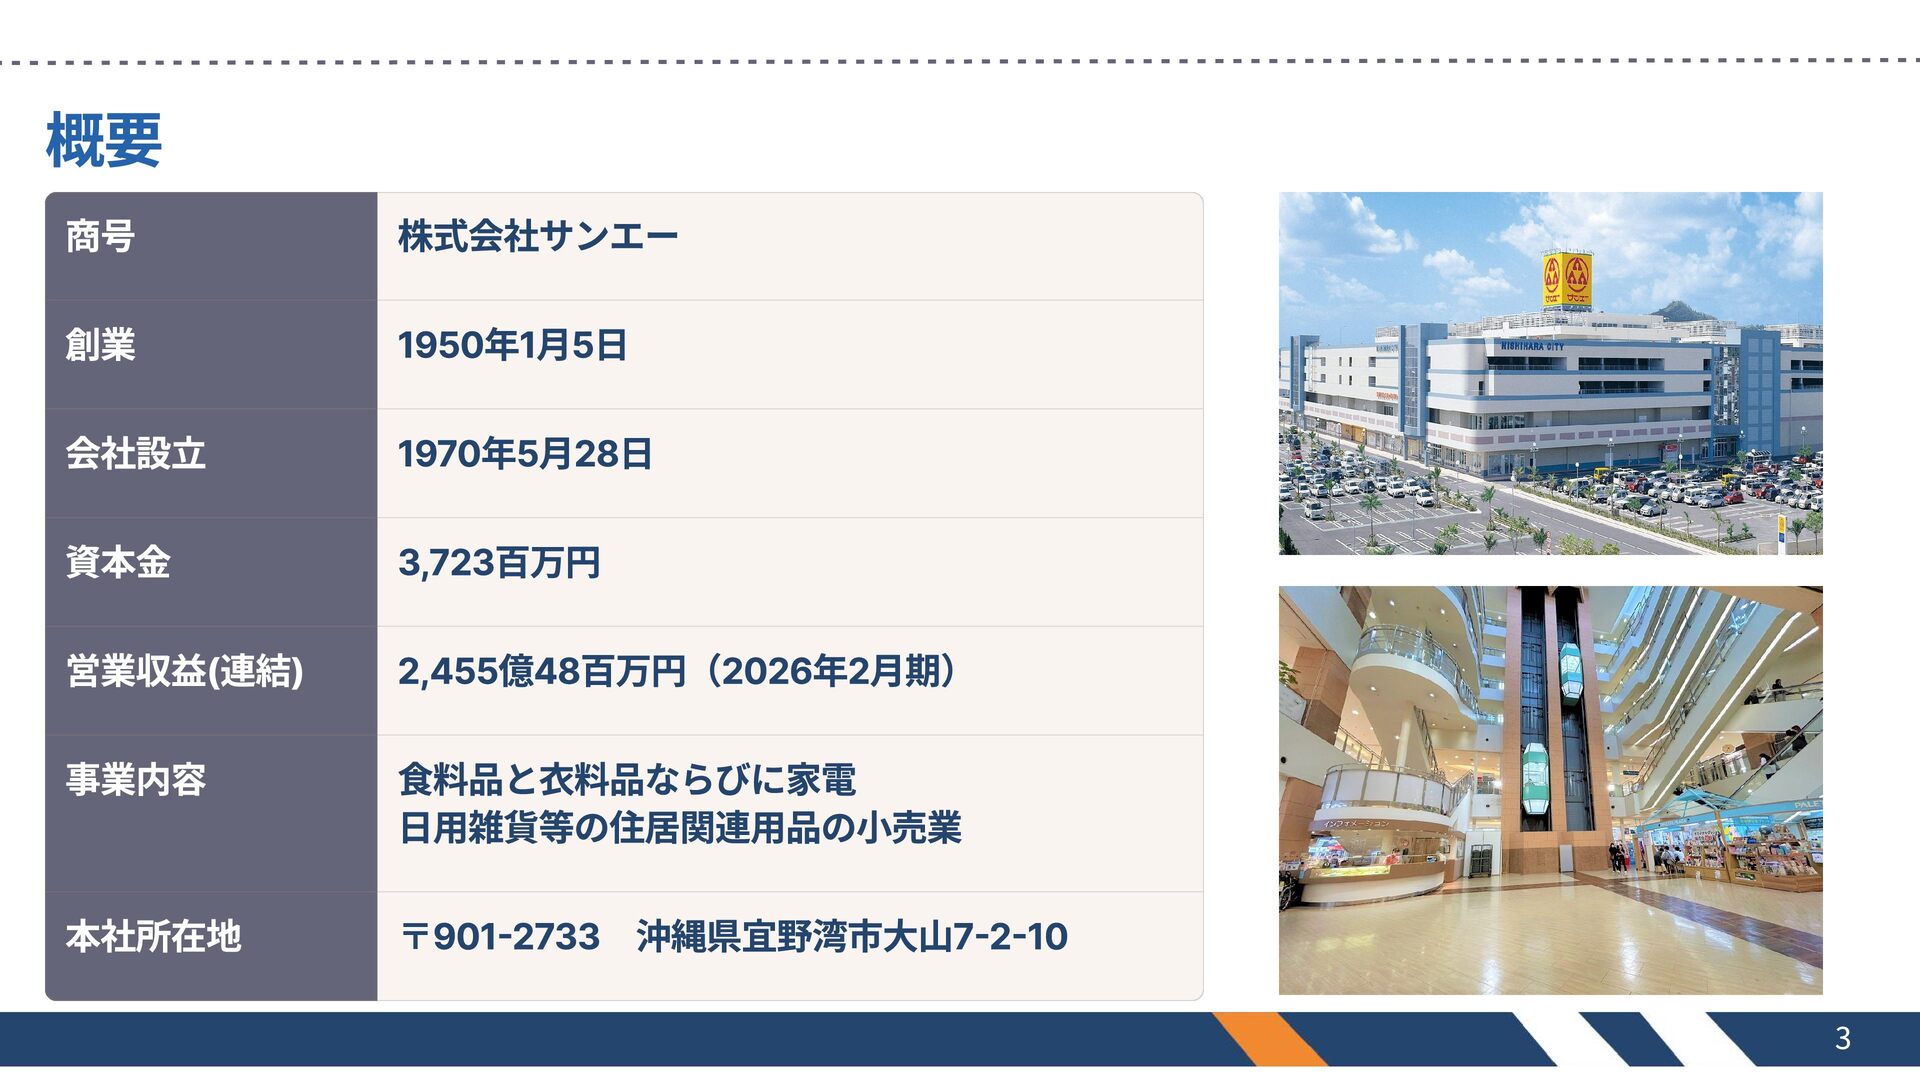
概要 商号 株式会社サンエー 創業 1950年1月5日 会社設立 1970年5月28日 資本金 3,723百万円 営業収益(連結)
2,455億48百万円(2026年2月期) 事業内容 食料品と衣料品ならびに家電 日用雑貨等の住居関連用品の小売業 本社所在地 〒901-2733 沖縄県宜野湾市大山7-2-10 3
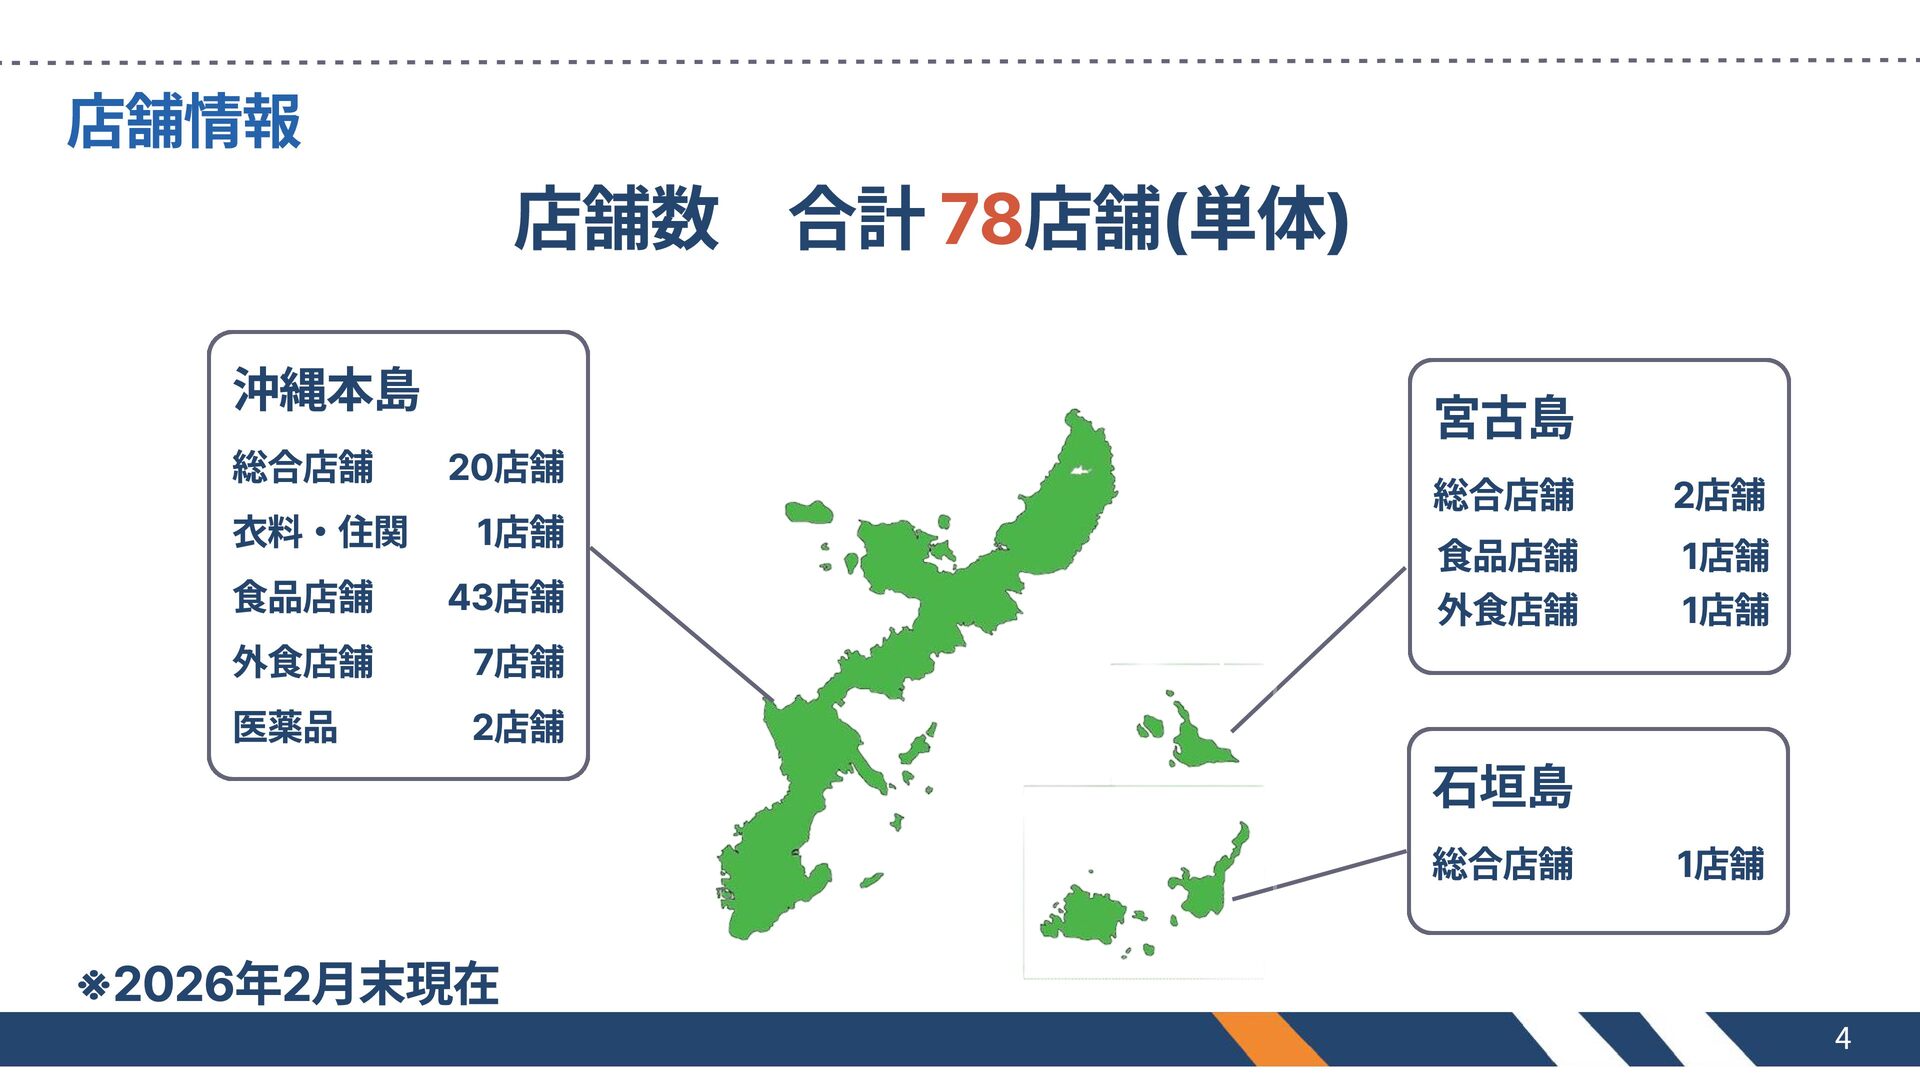
店舗情報 店舗数 合計 78店舗(単体) 沖縄本島 総合店舗 20店舗 衣料・住関 1店舗 食品店舗
43店舗 外食店舗 7店舗 医薬品 2店舗 宮古島 総合店舗 2店舗 食品店舗 外食店舗 1店舗 1店舗 石垣島 総合店舗 ※2026年2月末現在 1店舗 4
5
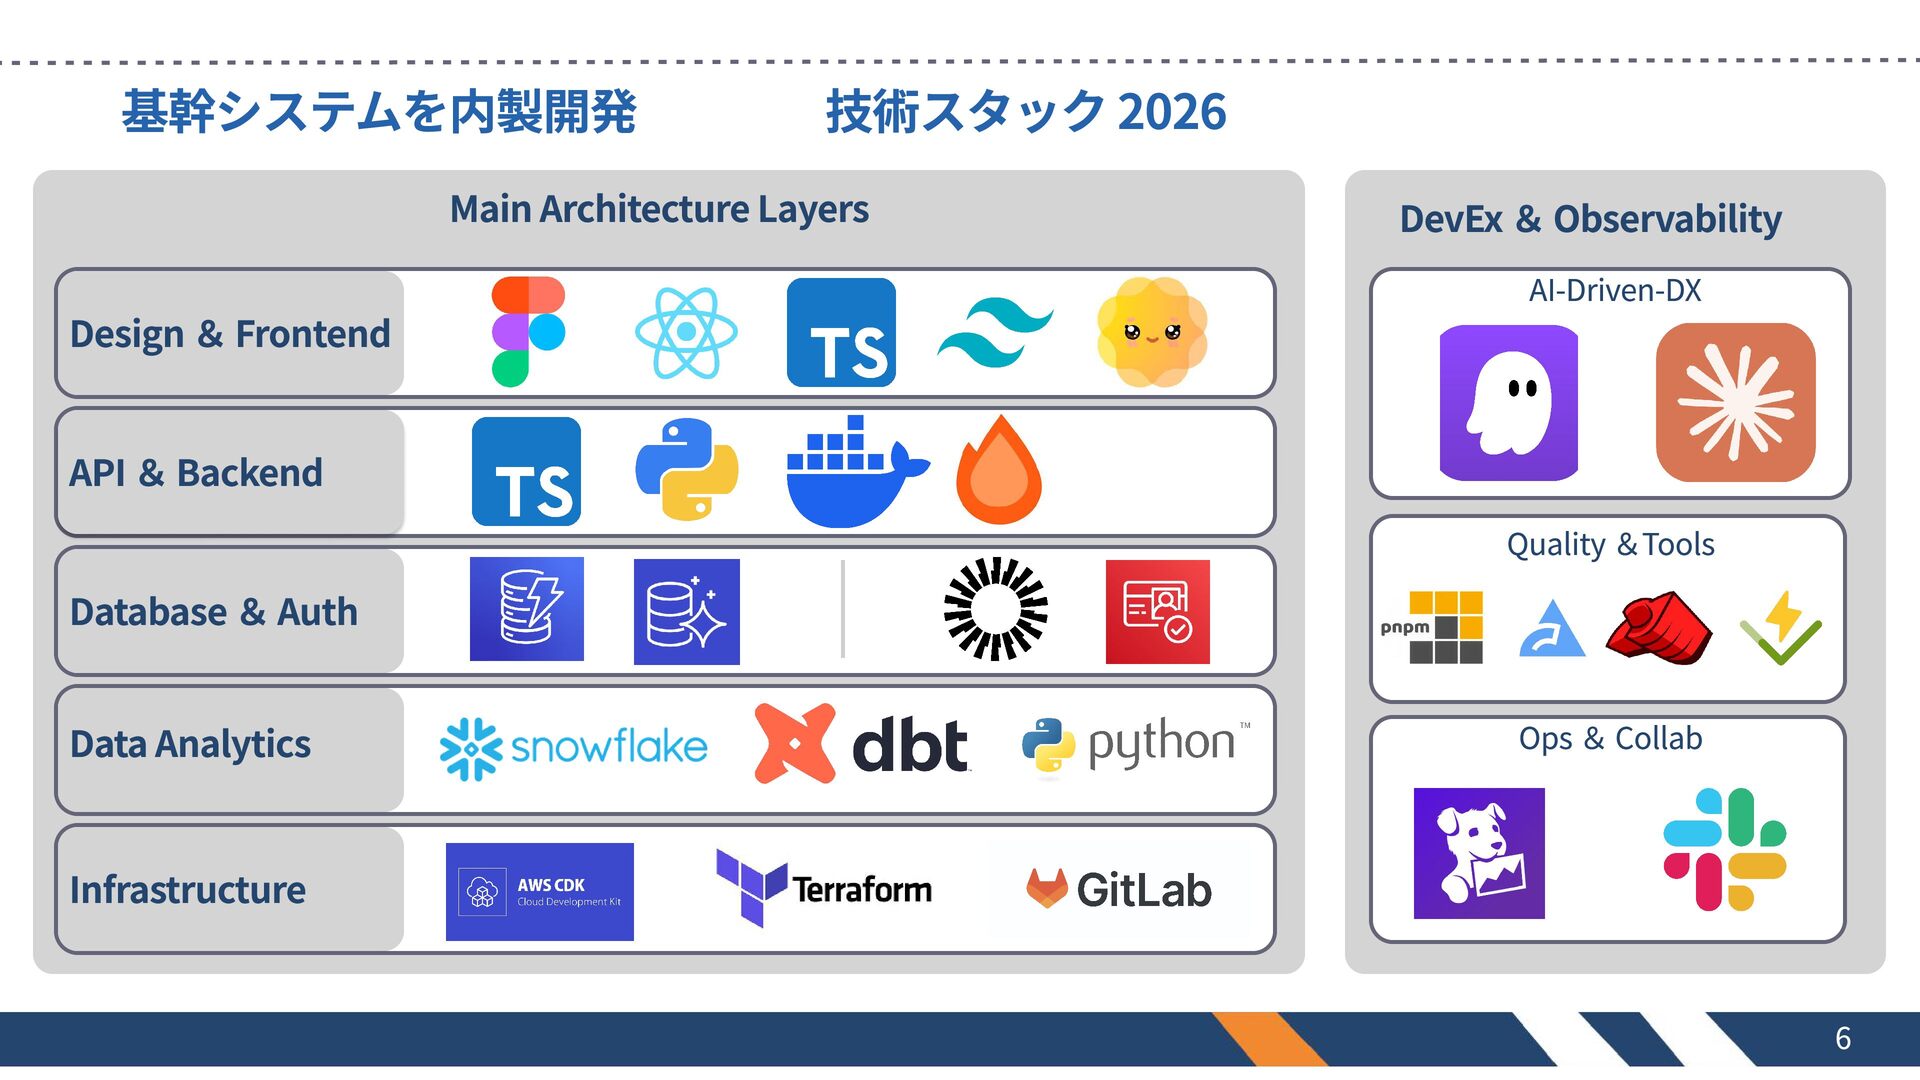
基幹システムを内製開発 技術スタック 2026 Main Architecture Layers Design & Frontend DevEx
& Observability AI-Driven-DX API & Backend Quality &Tools Database & Auth Data Analytics Ops & Collab Infrastructure 6
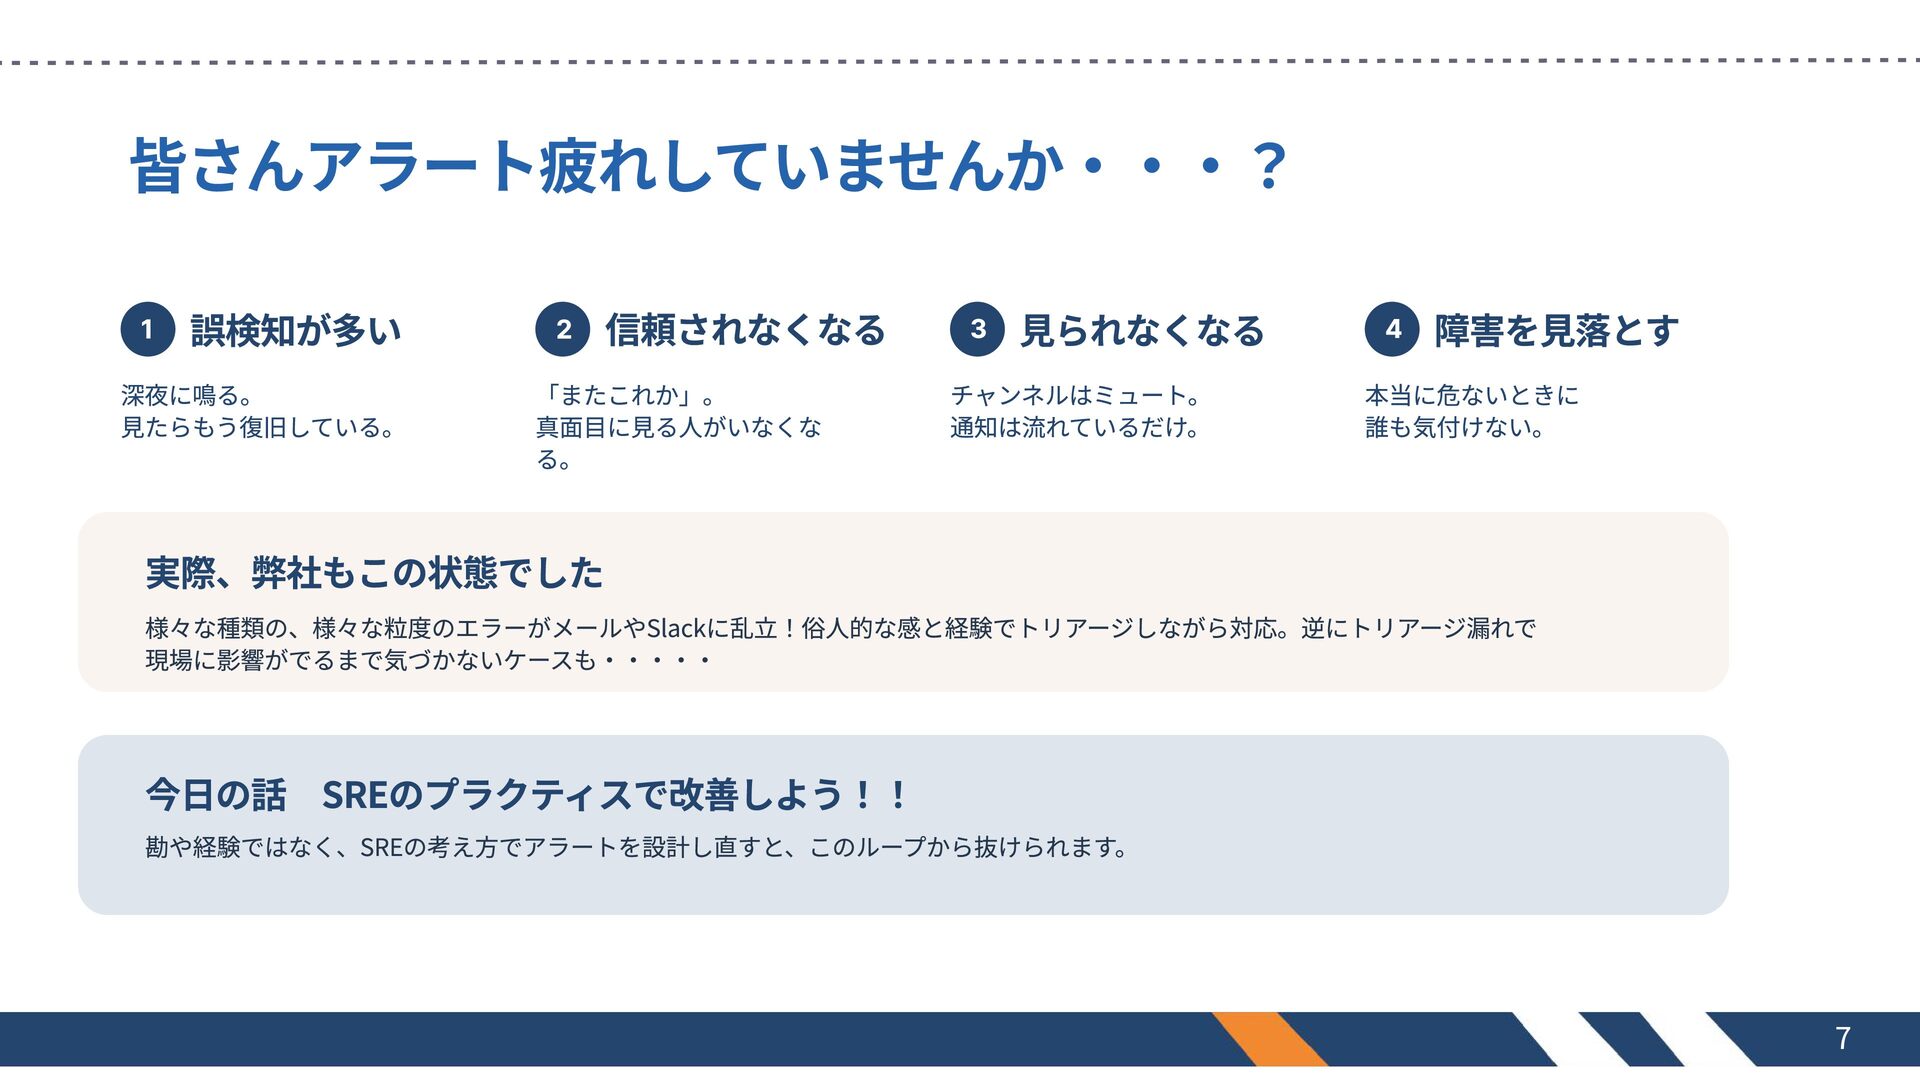
皆さんアラート疲れしていませんか・・・? 1 誤検知が多い 深夜に鳴る。 見たらもう復旧している。 2 信頼されなくなる 「またこれか」。 真面目に見る人がいなくな る。
3 見られなくなる チャンネルはミュート。 通知は流れているだけ。 4 障害を見落とす 本当に危ないときに 誰も気付けない。 実際、弊社もこの状態でした 様々な種類の、様々な粒度のエラーがメールやSlackに乱立!俗人的な感と経験でトリアージしながら対応。逆にトリアージ漏れで 現場に影響がでるまで気づかないケースも・・・・・ 今日の話 SREのプラクティスで改善しよう!! 勘や経験ではなく、SREの考え方でアラートを設計し直すと、このループから抜けられます。 7
google sre workbook にベストプラクティス書いて るよ! 今日の話は Chaptaer 5 の個人解釈の話です https://sre.google/workbook/table-of-contents/
8
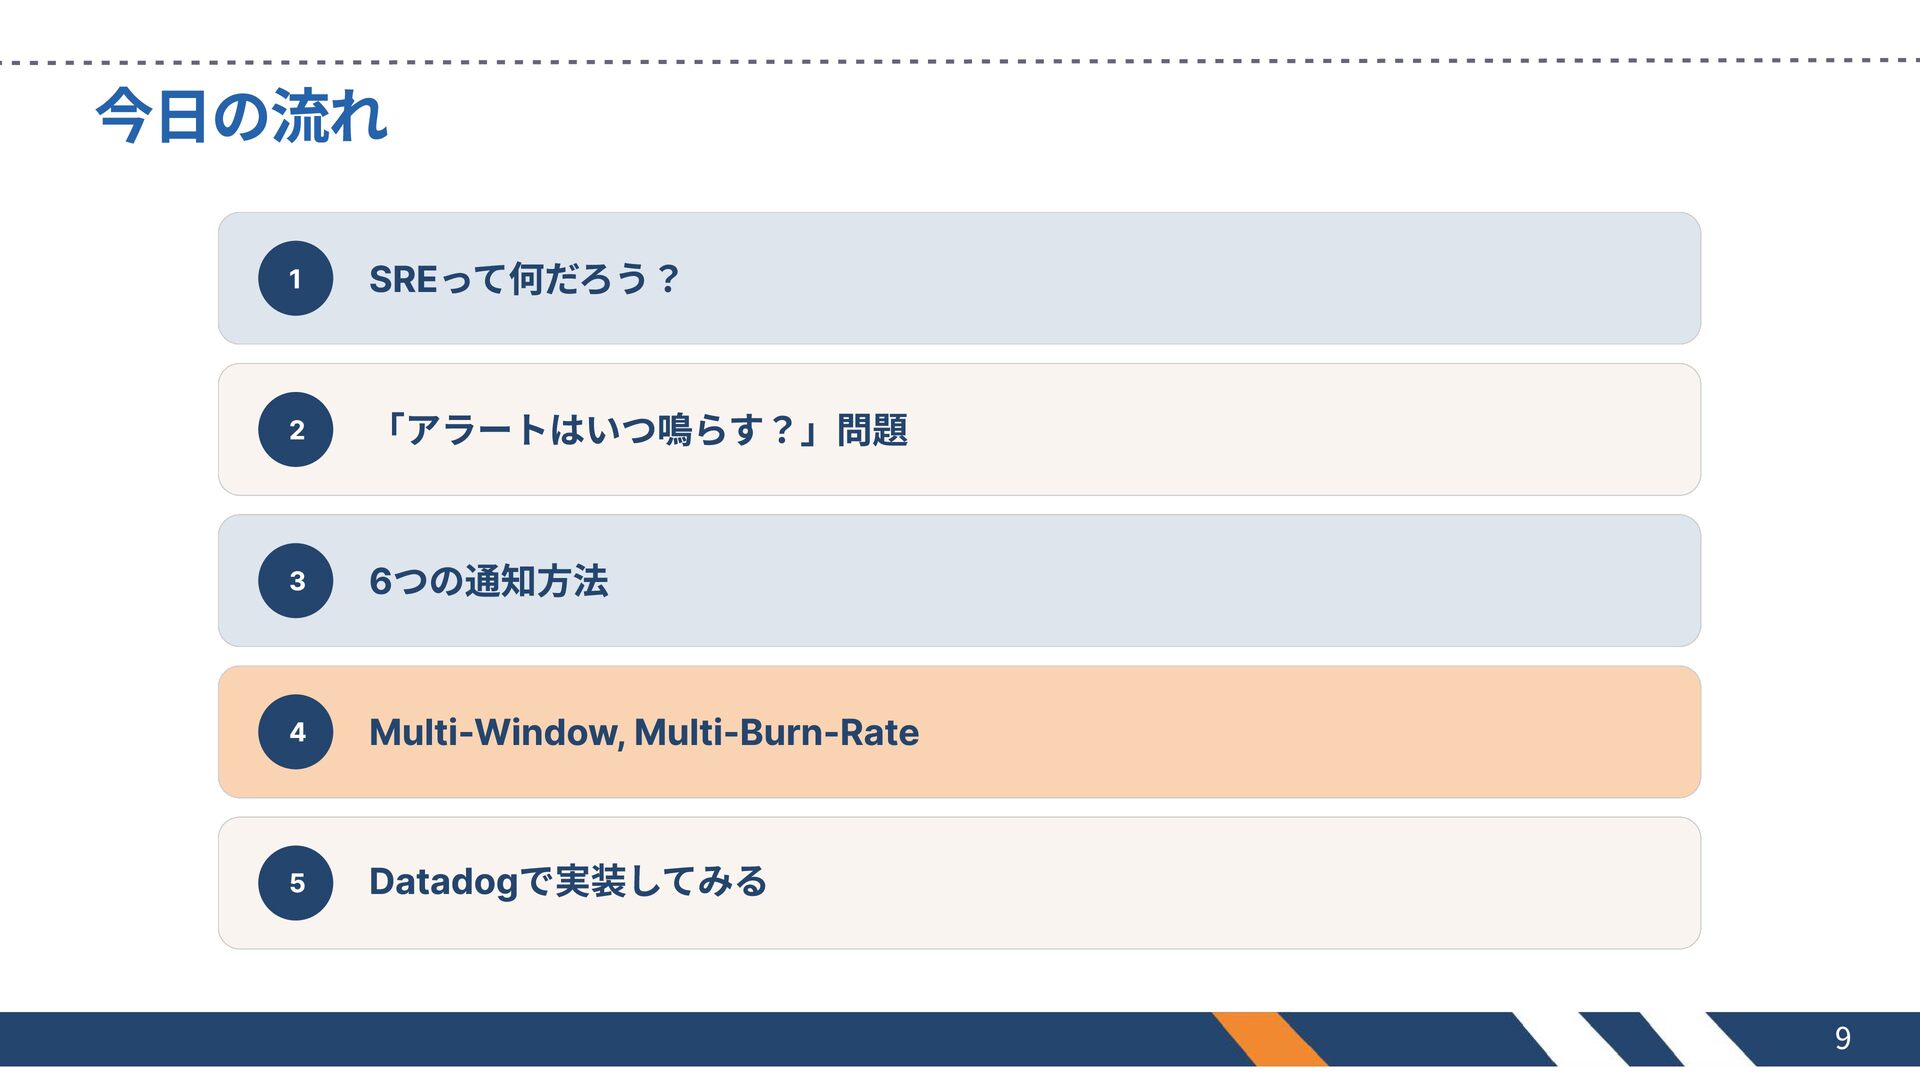
今日の流れ 1 SREって何だろう? 2 「アラートはいつ鳴らす?」問題 3 6つの通知方法 4 Multi-Window, Multi-Burn-Rate
5 Datadogで実装してみる 9
section 1 SREって何だろう? 10
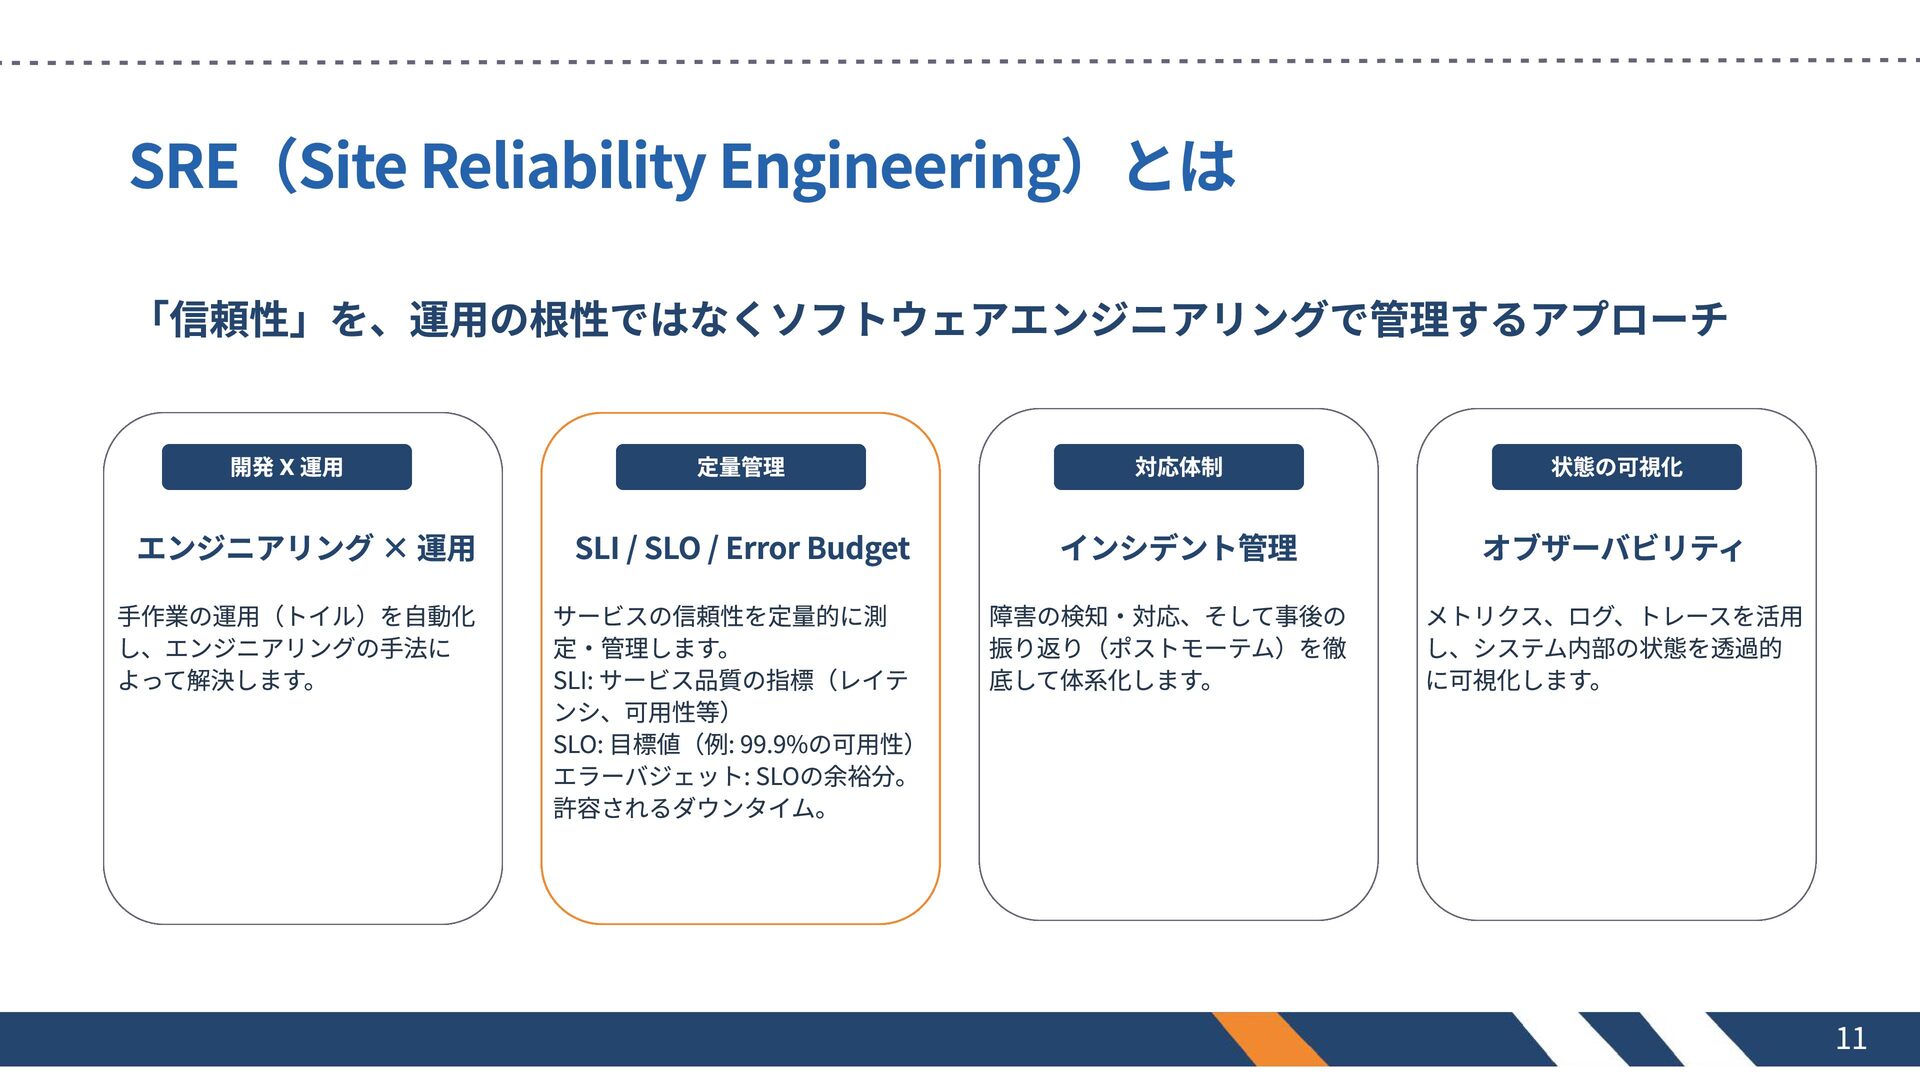
SRE(Site Reliability Engineering)とは 「信頼性」を、運用の根性ではなくソフトウェアエンジニアリングで管理するアプローチ 開発 X 運用 開発 定量管理 X
運用 対応体制 状態の可視化 エンジニアリング × 運用 SLI / SLO / Error Budget インシデント管理 オブザーバビリティ 手作業の運用(トイル)を自動化 し、エンジニアリングの手法に よって解決します。 サービスの信頼性を定量的に測 定・管理します。 SLI: サービス品質の指標(レイテ ンシ、可用性等) SLO: 目標値(例: 99.9%の可用性) エラーバジェット: SLOの余裕分。 許容されるダウンタイム。 障害の検知・対応、そして事後の 振り返り(ポストモーテム)を徹 底して体系化します。 メトリクス、ログ、トレースを活用 し、システム内部の状態を透過的 に可視化します。 11
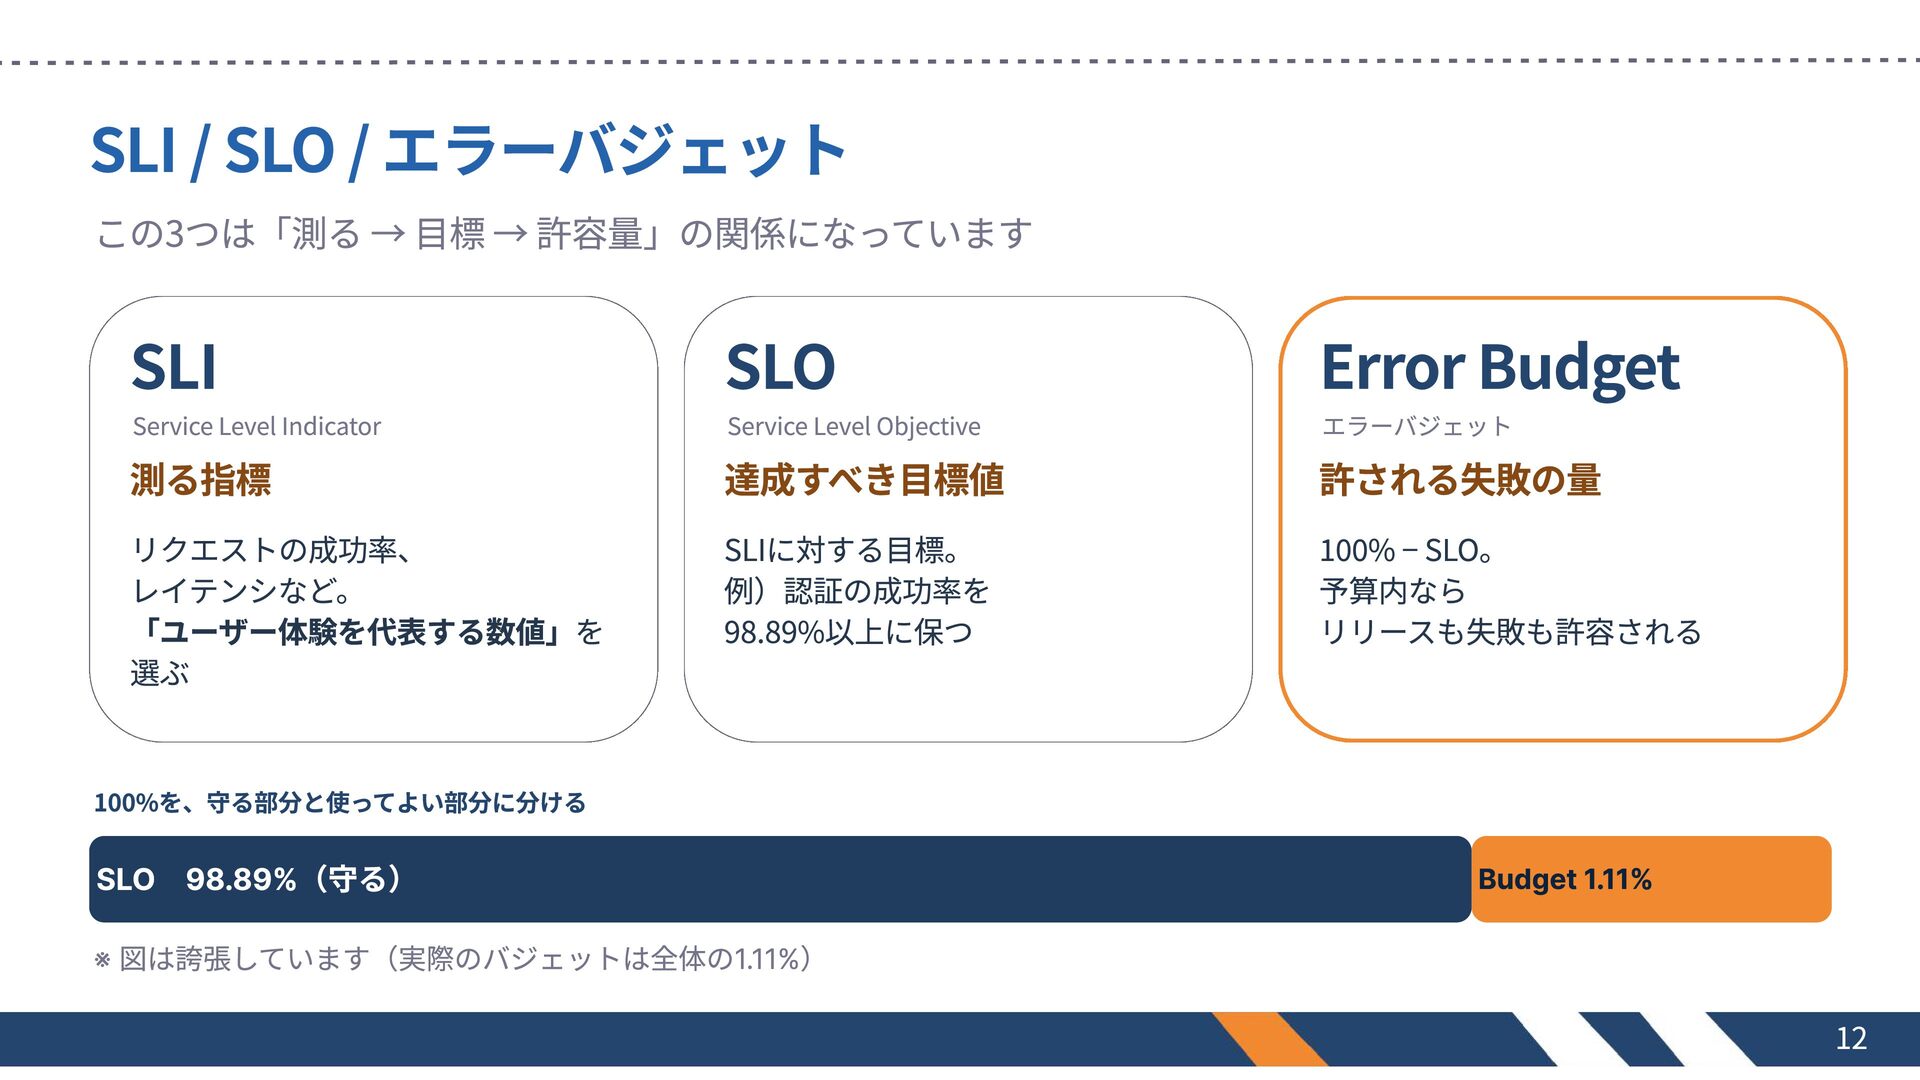
/ / エラーバジェット SLI SLO Error Budget 測る指標 達成すべき目標値 許される失敗の量
リクエストの成功率、 レイテンシなど。 「ユーザー体験を代表する数値」を 選ぶ SLIに対する目標。 例)認証の成功率を 98.89%以上に保つ 100% − SLO。 予算内なら リリースも失敗も許容される SLI SLO この3つは「測る → 目標 → 許容量」の関係になっています Service Level Indicator Service Level Objective エラーバジェット 100%を、守る部分と使ってよい部分に分ける SLO 98.89%(守る) Budget 1.11% ※ 図は誇張しています(実際のバジェットは全体の1.11%) 12
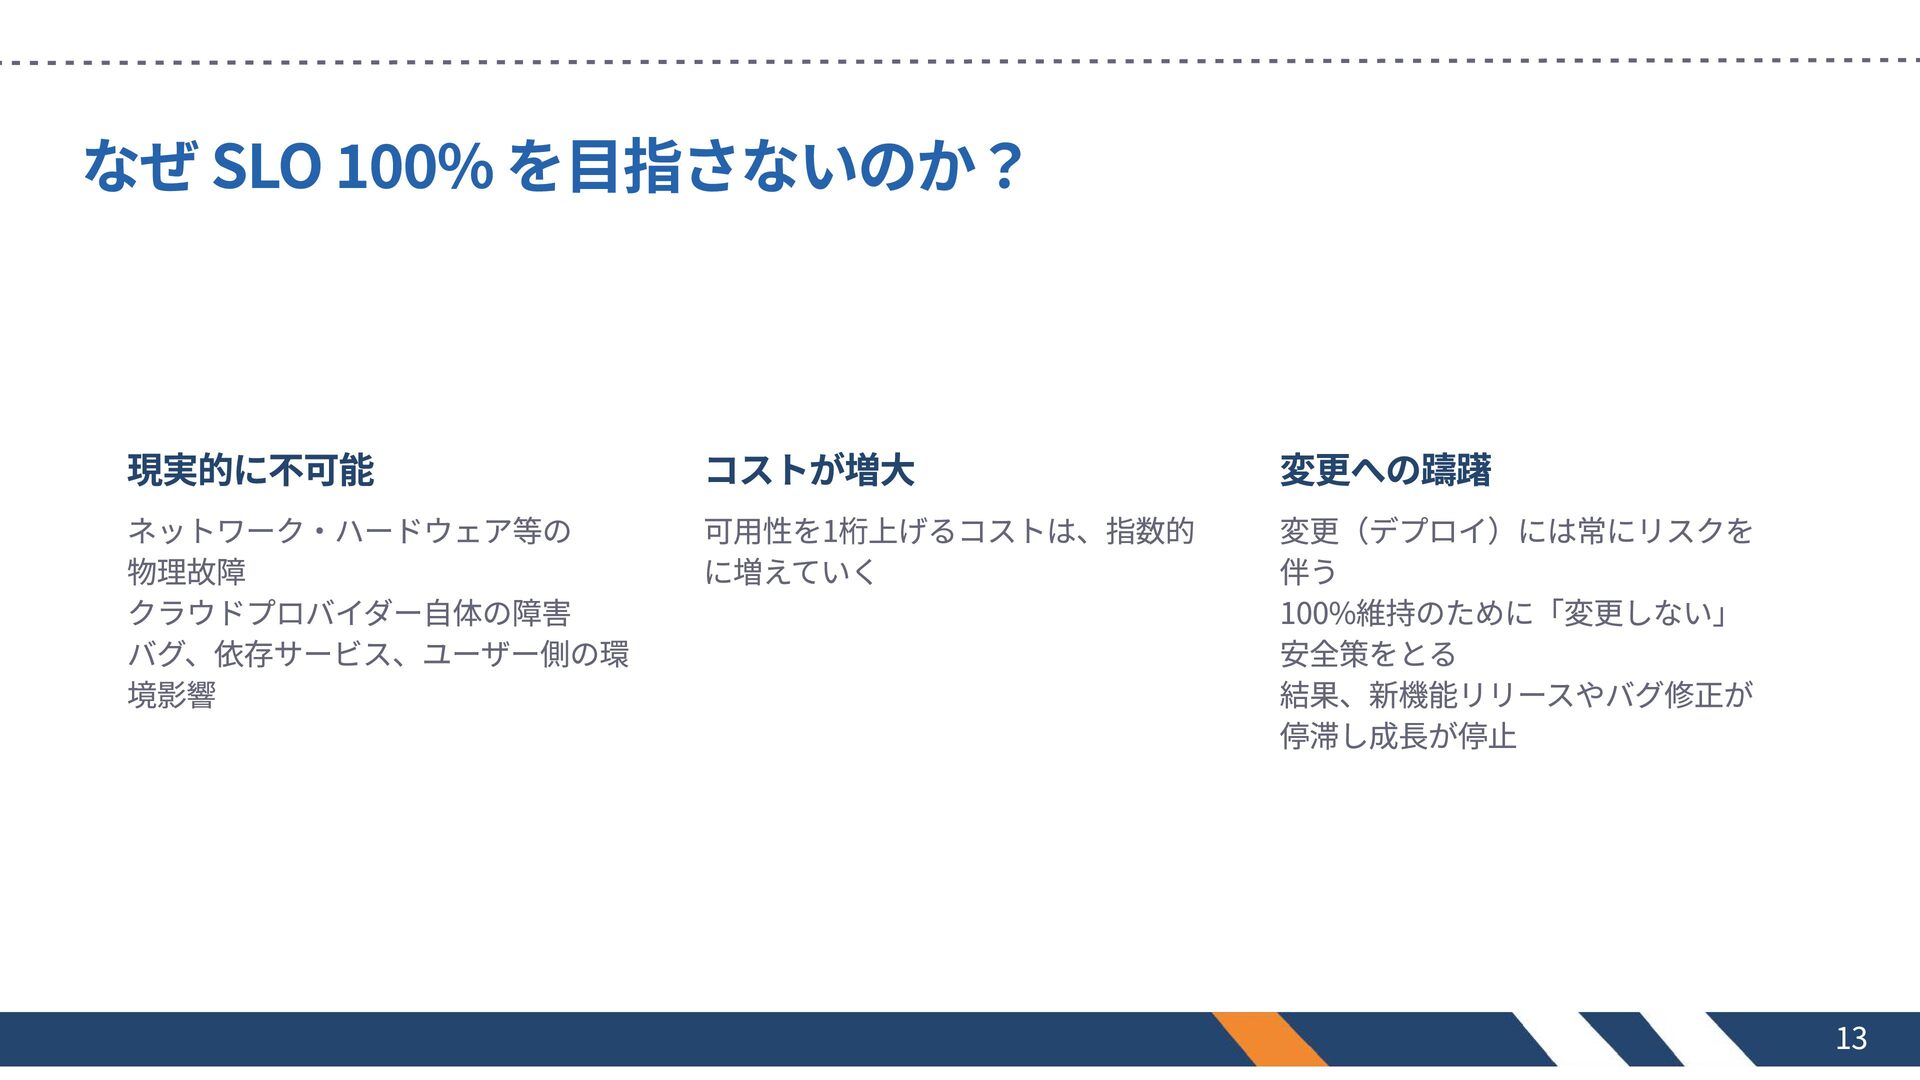
なぜ SLO 100% を目指さないのか? 現実的に不可能 ネットワーク・ハードウェア等の 物理故障 クラウドプロバイダー自体の障害 バグ、依存サービス、ユーザー側の環 境影響
コストが増大 可用性を1桁上げるコストは、指数的 に増えていく 変更への躊躇 変更(デプロイ)には常にリスクを 伴う 100%維持のために「変更しない」 安全策をとる 結果、新機能リリースやバグ修正が 停滞し成長が停止 13
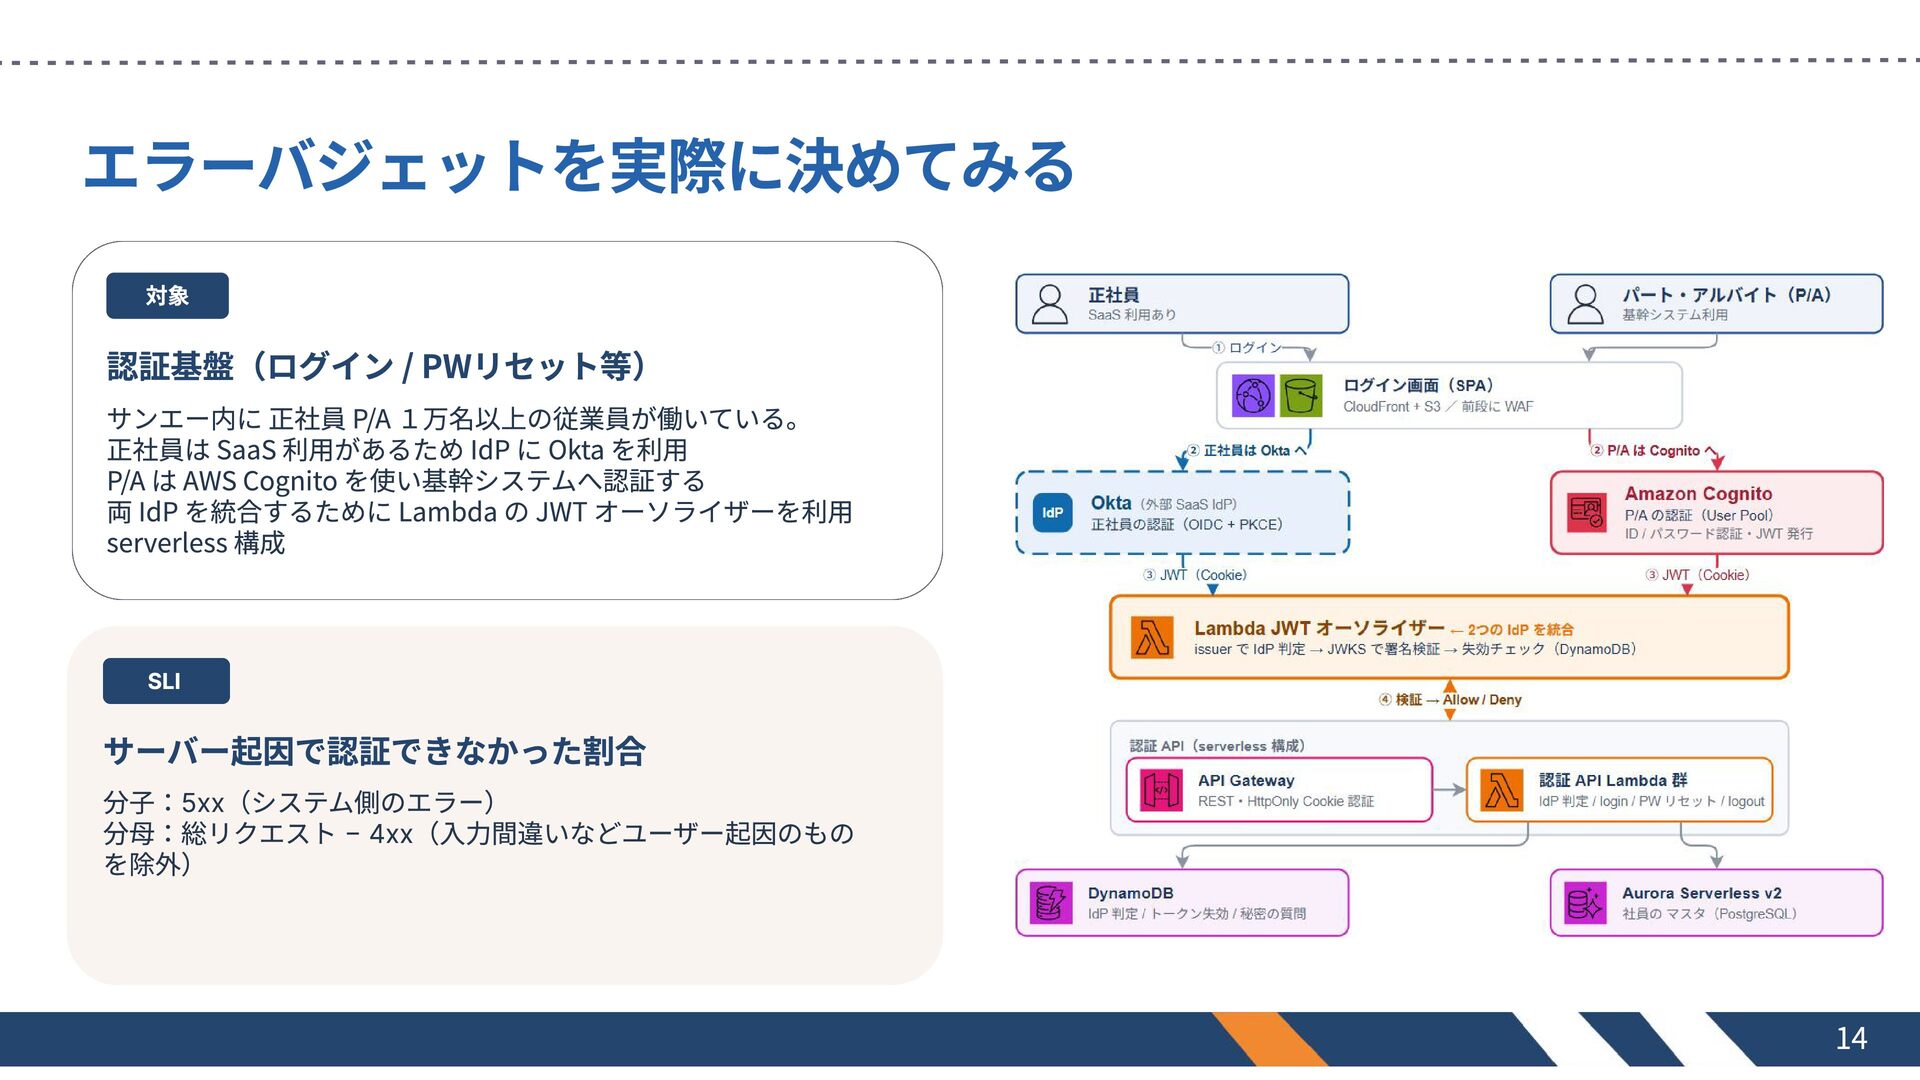
エラーバジェットを実際に決めてみる 対象 認証基盤(ログイン / PWリセット等) サンエー内に 正社員 P/A 1万名以上の従業員が働いている。 正社員は
SaaS 利用があるため IdP に Okta を利用 P/A は AWS Cognito を使い基幹システムへ認証する 両 IdP を統合するために Lambda の JWT オーソライザーを利用 serverless 構成 SLI サーバー起因で認証できなかった割合 分子:5xx(システム側のエラー) 分母:総リクエスト − 4xx(入力間違いなどユーザー起因のもの を除外) 14
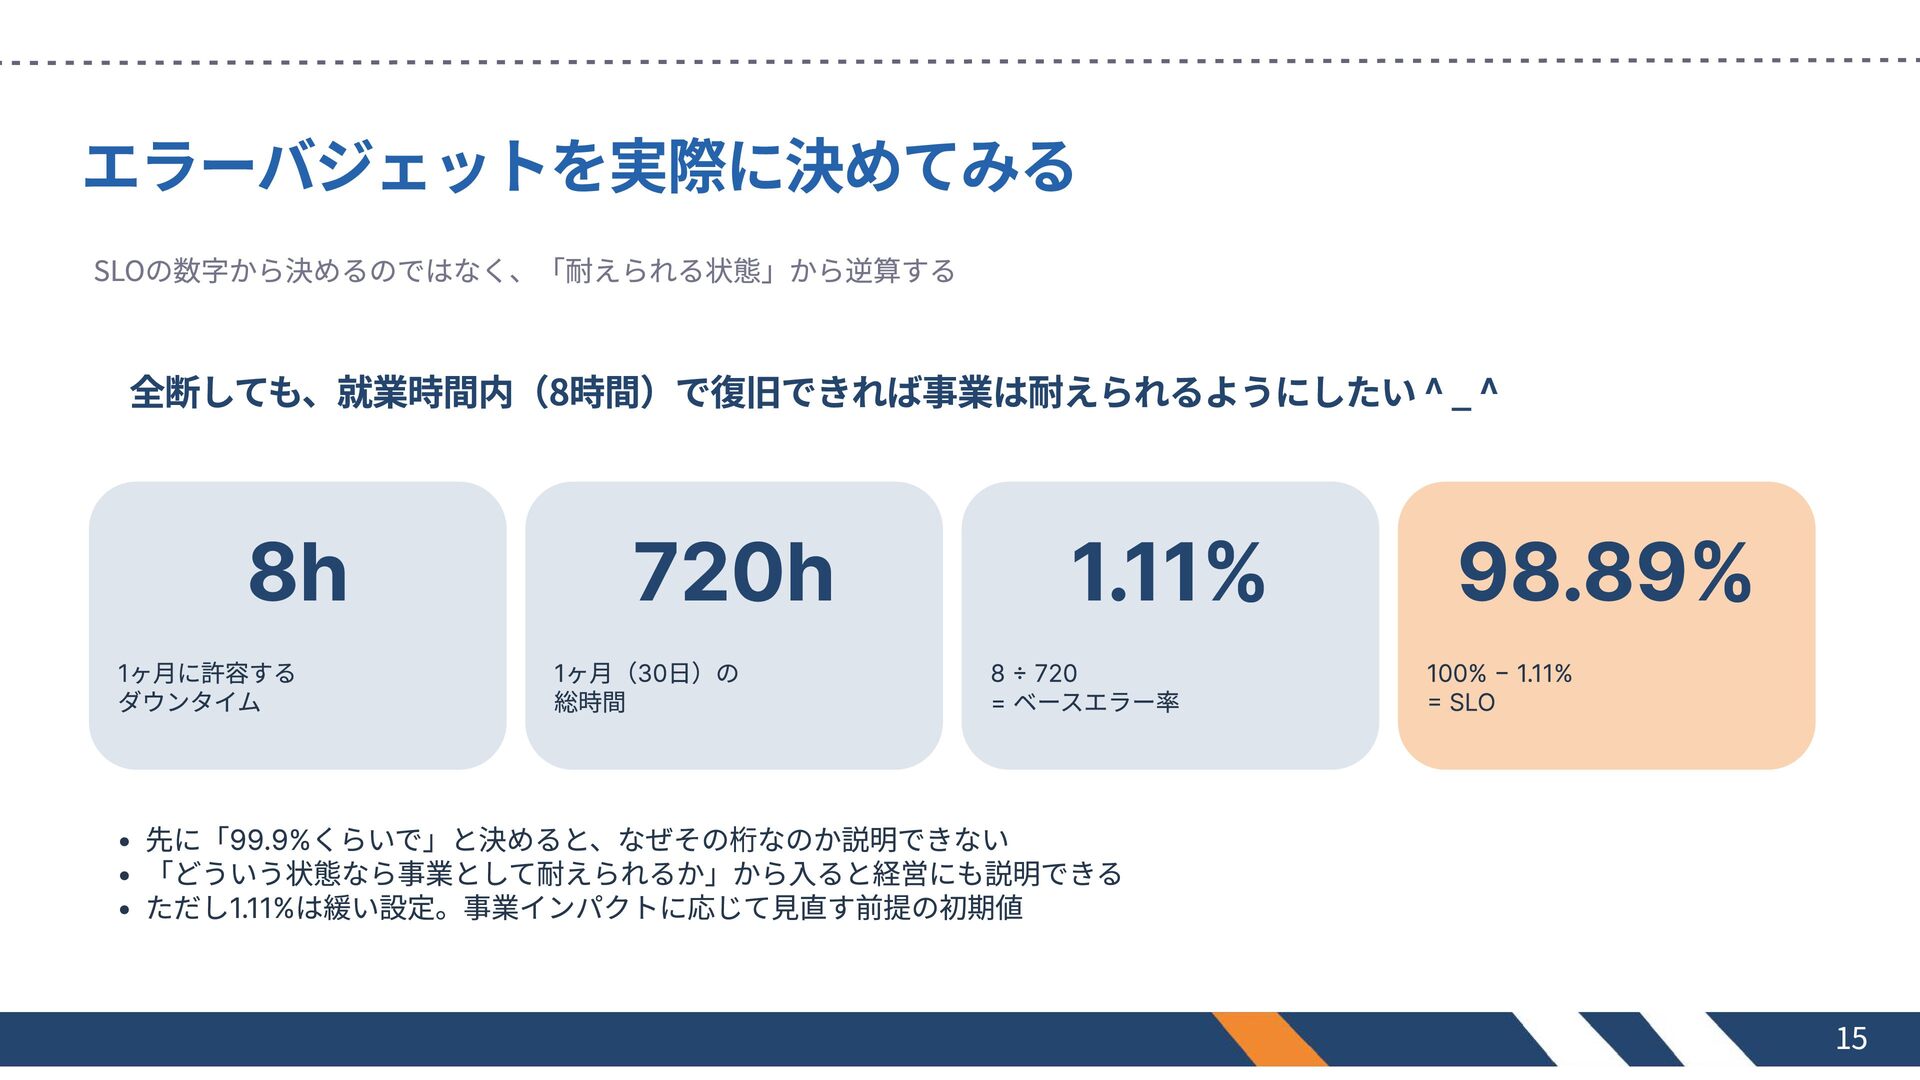
エラーバジェットを実際に決めてみる SLOの数字から決めるのではなく、「耐えられる状態」から逆算する 全断しても、就業時間内(8時間)で復旧できれば事業は耐えられるようにしたい ^ _ ^ 8h 1ヶ月に許容する ダウンタイム 720h
1ヶ月(30日)の 総時間 1.11% 8 ÷ 720 = ベースエラー率 98.89% 100% − 1.11% = SLO 先に「99.9%くらいで」と決めると、なぜその桁なのか説明できない 「どういう状態なら事業として耐えられるか」から入ると経営にも説明できる ただし1.11%は緩い設定。事業インパクトに応じて見直す前提の初期値 15
section 2 「アラートはいつ鳴らす?」問題 16
やりたいこと SLI、SLO、エラーバジェットを定義した。 次のアクションとして 対応すべきインシデントにできるだけ早く気付き、 かつ対応時間にゆとりがあり、ユーザー体験に 影響が出る前に解決できるようにしたい。 適切なアラートタイミングを決めたい。 17
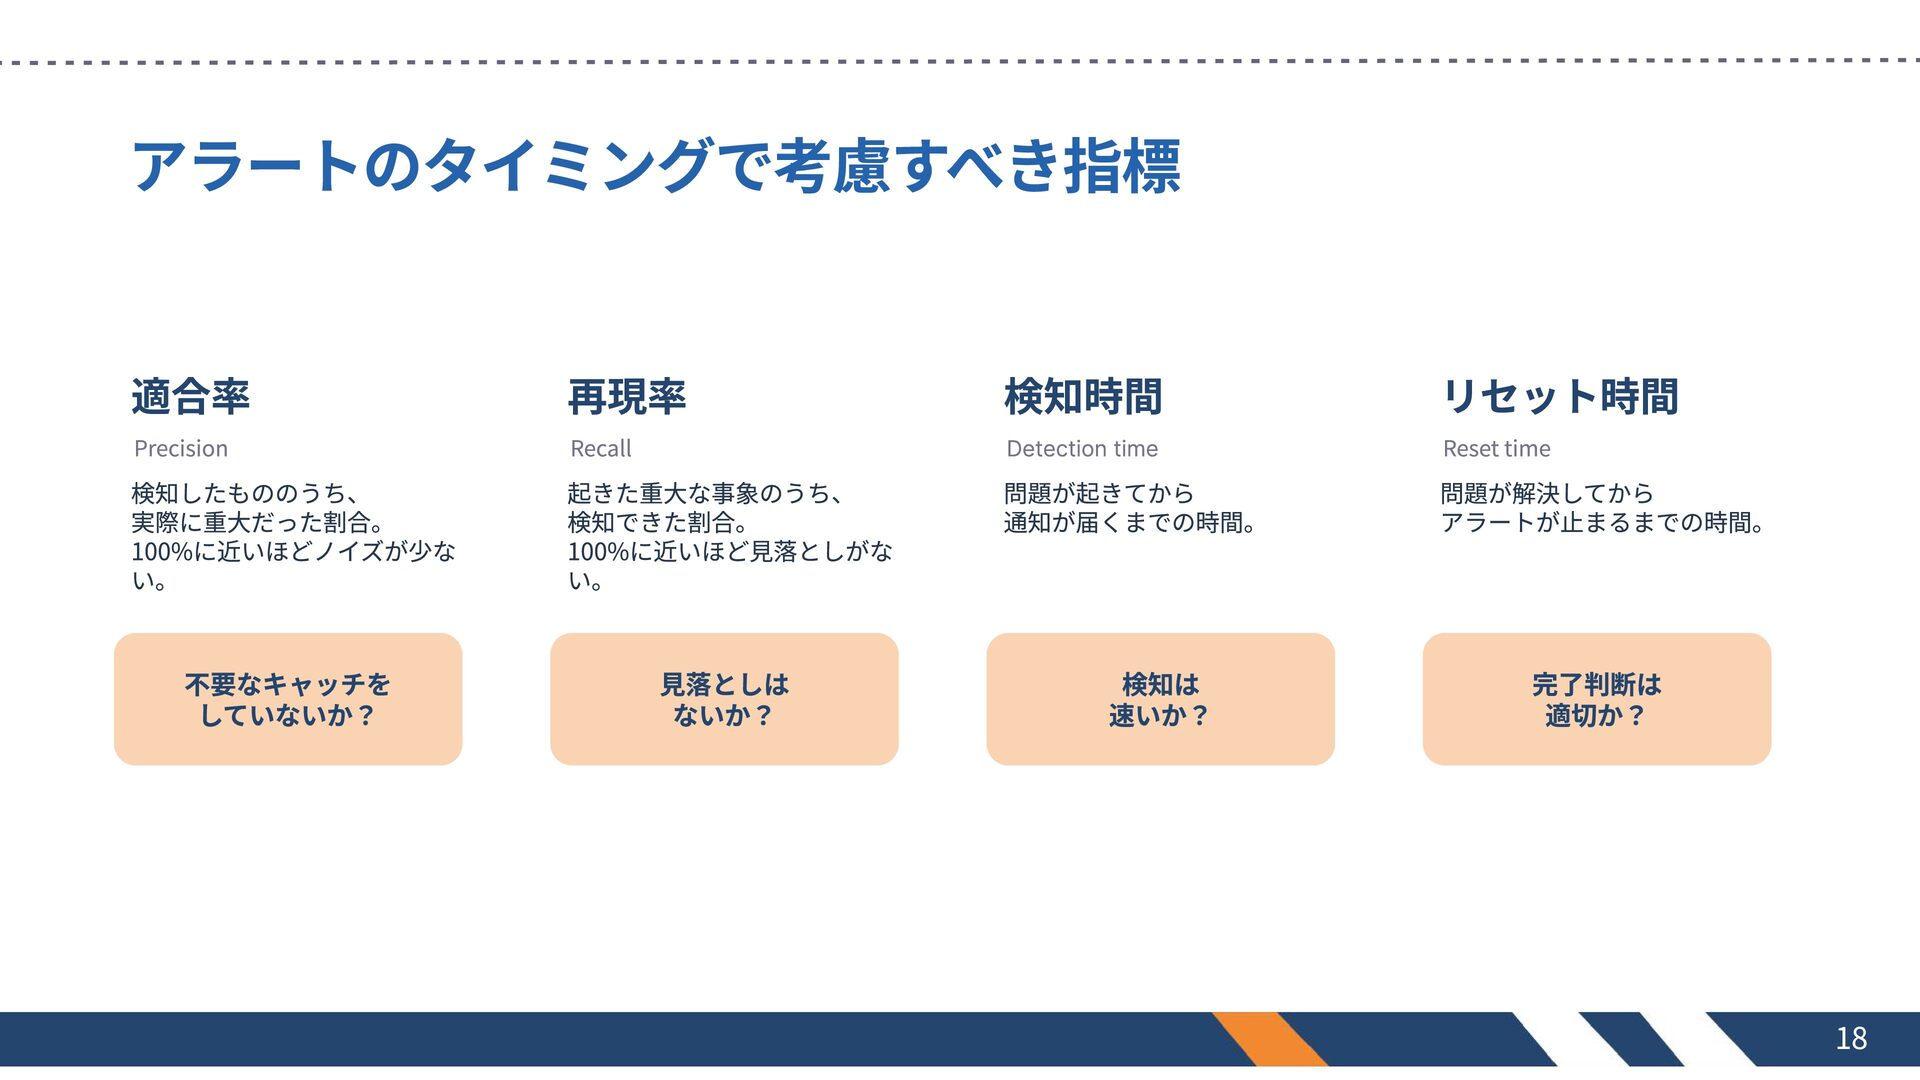
アラートのタイミングで考慮すべき指標 適合率 再現率 検知時間 リセット時間 Precision Recall Detection time Reset
time 検知したもののうち、 実際に重大だった割合。 100%に近いほどノイズが少な い。 起きた重大な事象のうち、 検知できた割合。 100%に近いほど見落としがな い。 問題が起きてから 通知が届くまでの時間。 問題が解決してから アラートが止まるまでの時間。 不要なキャッチを していないか? 見落としは ないか? 検知は 速いか? 完了判断は 適切か? 18
section 3 6つの通知方法 19
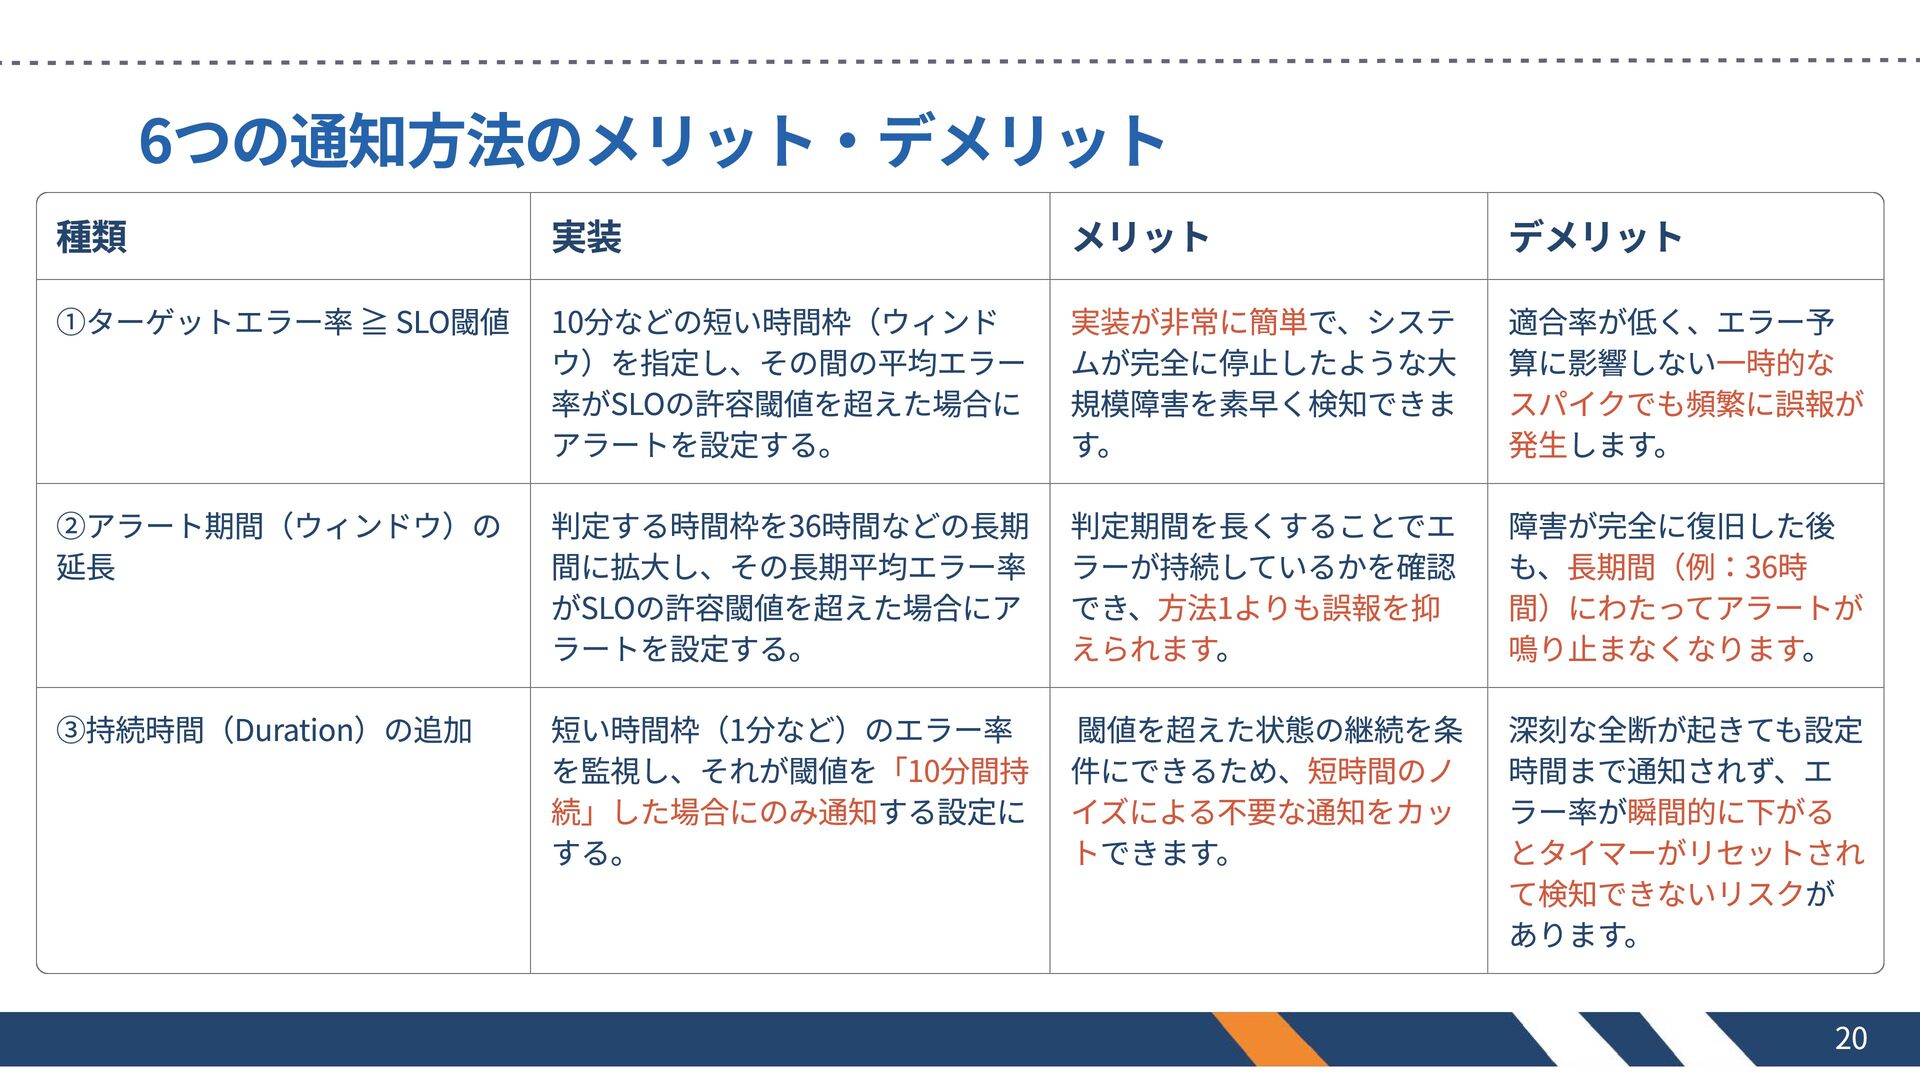
6つの通知方法のメリット・デメリット 種類 実装 メリット デメリット ①ターゲットエラー率 ≧ SLO閾値 10分などの短い時間枠(ウィンド ウ)を指定し、その間の平均エラー
率がSLOの許容閾値を超えた場合に アラートを設定する。 実装が非常に簡単で、システ ムが完全に停止したような大 規模障害を素早く検知できま す。 適合率が低く、エラー予 算に影響しない一時的な スパイクでも頻繁に誤報が 発生します。 ②アラート期間(ウィンドウ)の 延長 判定する時間枠を36時間などの長期 間に拡大し、その長期平均エラー率 がSLOの許容閾値を超えた場合にア ラートを設定する。 ③持続時間(Duration)の追加 復旧 後 も 長期間(例:36 方法1より を抑 間) わたってアラート えられます 鳴り止ま く ります 短い時間枠(1分など)のエラー率 閾値を超えた状態の継続を条 深刻な全断が起きても設定 を監視し、それが閾値を「10分間持 件にできるため、短時間のノ 時間まで通知されず、エ 続」した場合にのみ通知する設定に イズによる不要な通知をカッ ラー率が瞬間的に下がる する。 トできます。 とタイマーがリセットされ て検知できないリスクが あります。 判定期間を長くすることでエ ラーが持続しているかを確認 でき、 も誤報 。 障害が完全に した 、 時 に が な な 。 20
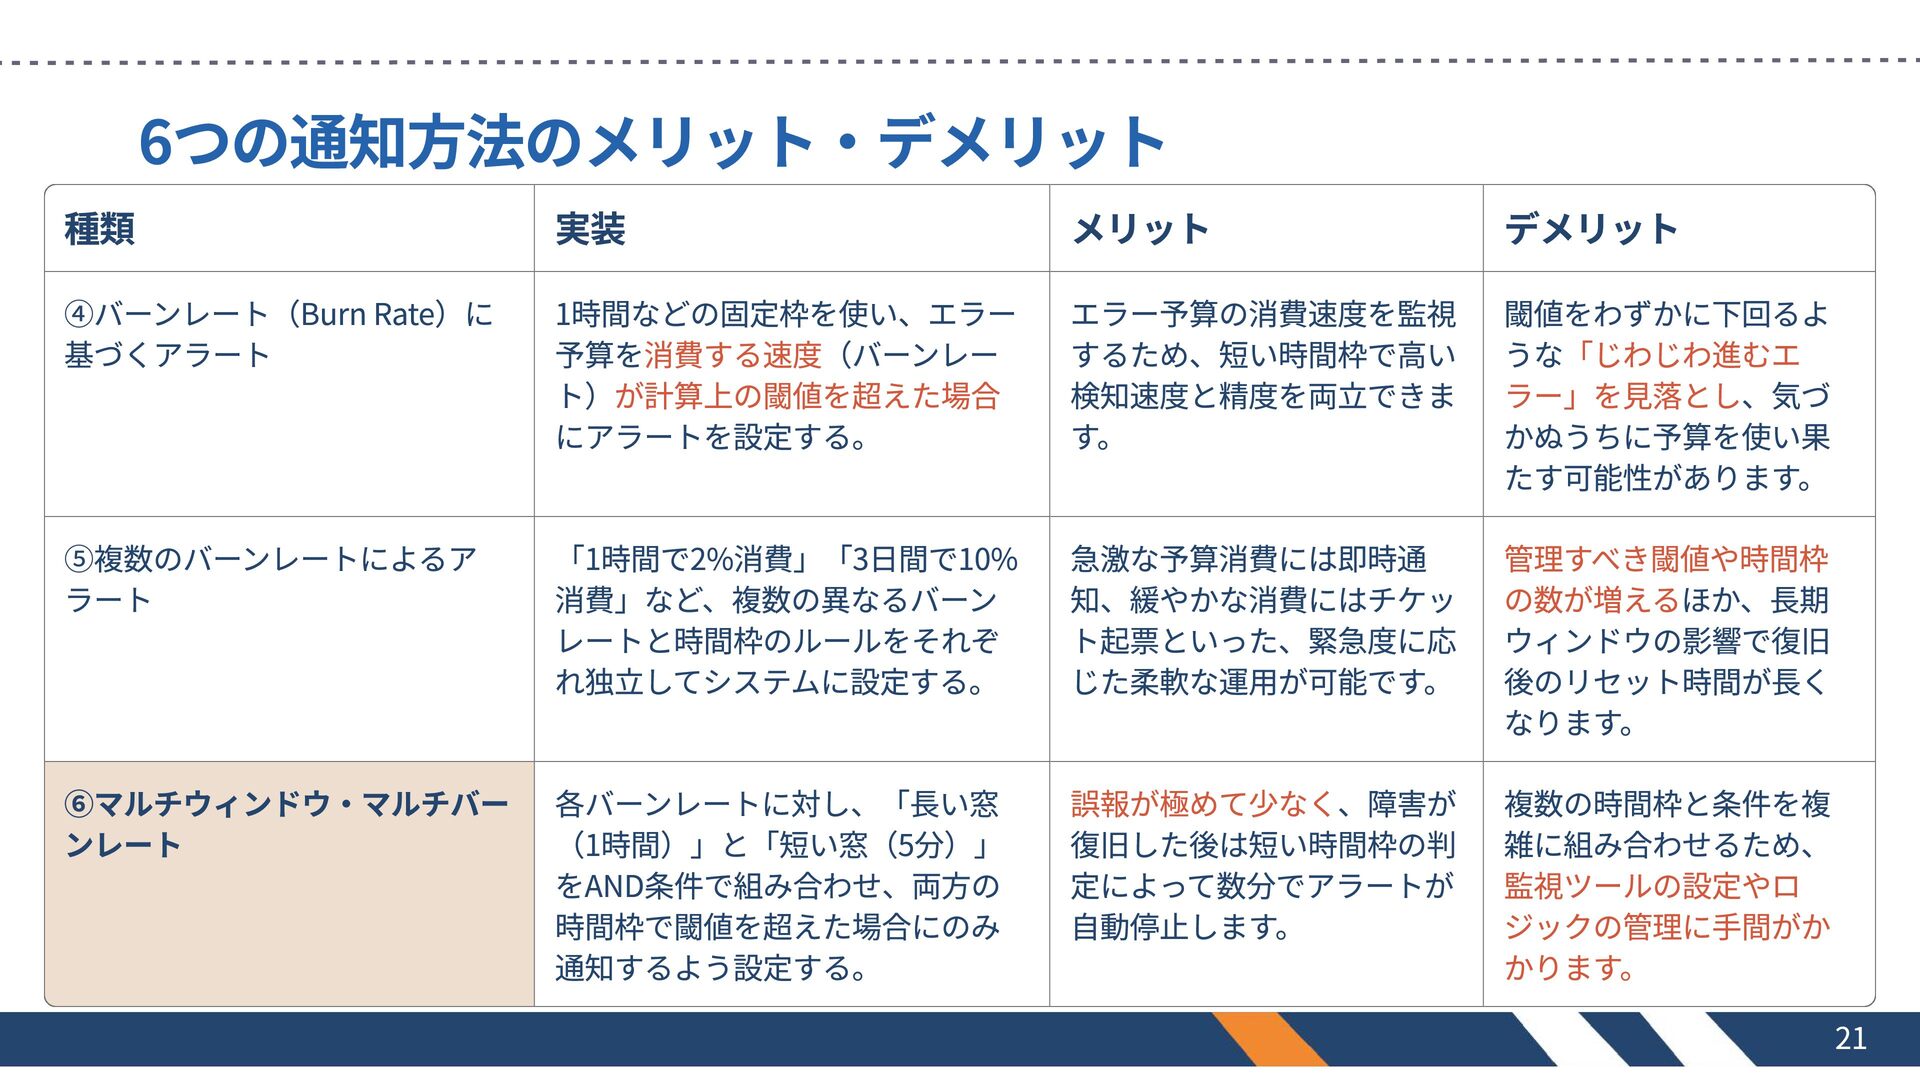
6つの通知方法のメリット・デメリット 種類 実装 メリット デメリット ④バーンレート(Burn Rate)に 基づくアラート 1時間などの固定枠を使い、エラー 予算を消費する速度(バーンレー
ト)が計算上の閾値を超えた場合 にアラートを設定する。 エラー予算の消費速度を監視 するため、短い時間枠で高い 検知速度と精度を両立できま す。 閾値をわずかに下回るよ うな「じわじわ進むエ ラー」を見落とし、気づ かぬうちに予算を使い果 たす可能性があります。 ⑤複数のバーンレートによるア ラート 「1時間で2%消費」「3日間で10% 消費」など、複数の異なるバーン レートと時間枠のルールをそれぞ れ独立してシステムに設定する。 急激な予算消費には即時通 管理すべき閾値や時間枠 知、緩やかな消費にはチケッ の数が増えるほか、長期 ト起票といった、緊急度に応 ウィンドウの影響で復旧 じた柔軟な運用が可能です。 後のリセット時間が長く ⑥マルチウィンドウ・マルチバー 各バーンレートに対し、「長い窓 ンレート (1時間)」と「短い窓(5分)」 をAND条件で組み合わせ、両方の 時間枠で閾値を超えた場合にのみ 通知するよう設定する。 誤報が極めて少なく、障害が 複数の時間枠と条件を複 復旧した後は短い時間枠の判 雑に組み合わせるため、 定によって数分でアラートが 監視ツールの設定やロ 自動停止します。 ジックの管理に手間がか かります。 なります。 21
section 4 Multi-Window, Multi-Burn-Rate 22
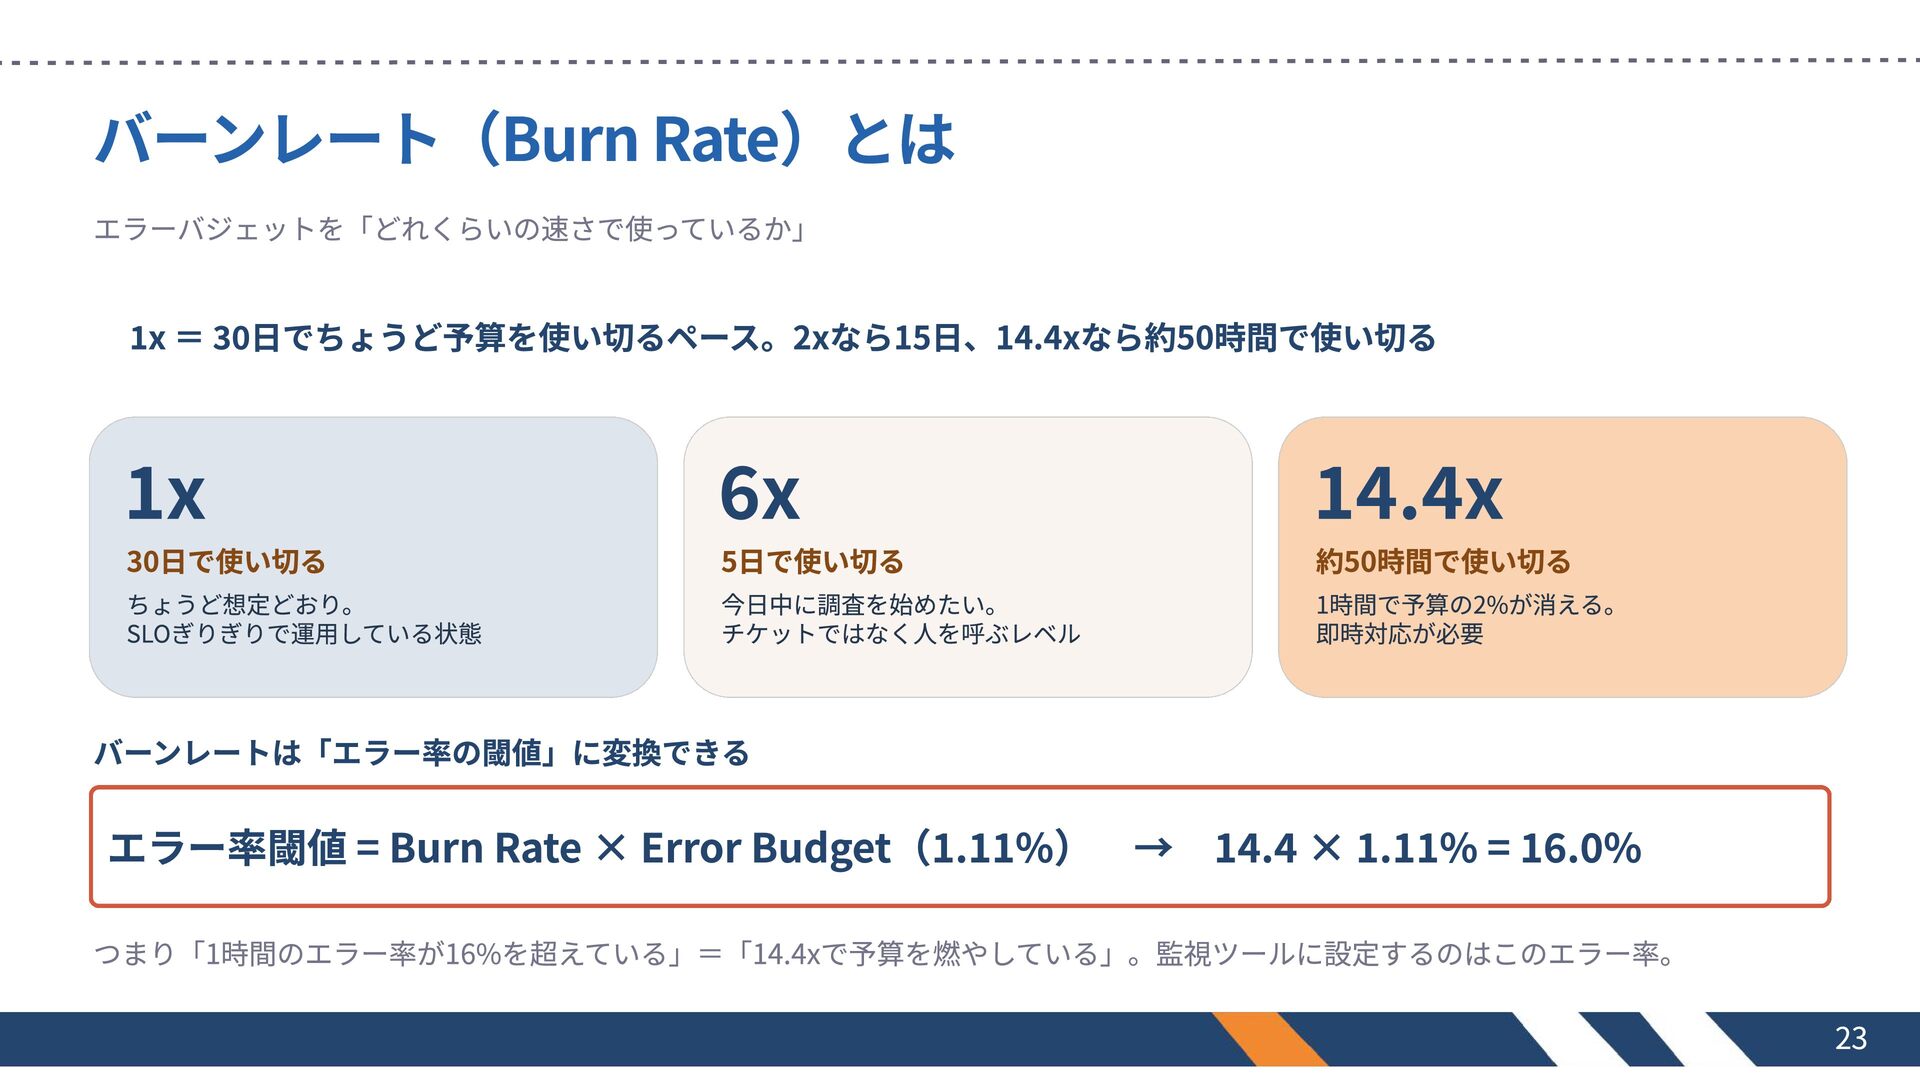
バーンレート(Burn Rate)とは エラーバジェットを「どれくらいの速さで使っているか」 1x = 30日でちょうど予算を使い切るペース。2xなら15日、14.4xなら約50時間で使い切る 1x 6x 14.4x ちょうど想定どおり。
SLOぎりぎりで運用している状態 今日中に調査を始めたい。 チケットではなく人を呼ぶレベル 1時間で予算の2%が消える。 即時対応が必要 30日で使い切る 5日で使い切る 約50時間で使い切る バーンレートは「エラー率の閾値」に変換できる エラー率閾値 = Burn Rate × Error Budget(1.11%) → 14.4 × 1.11% = 16.0% つまり「1時間のエラー率が16%を超えている」=「14.4xで予算を燃やしている」。監視ツールに設定するのはこのエラー率。 23
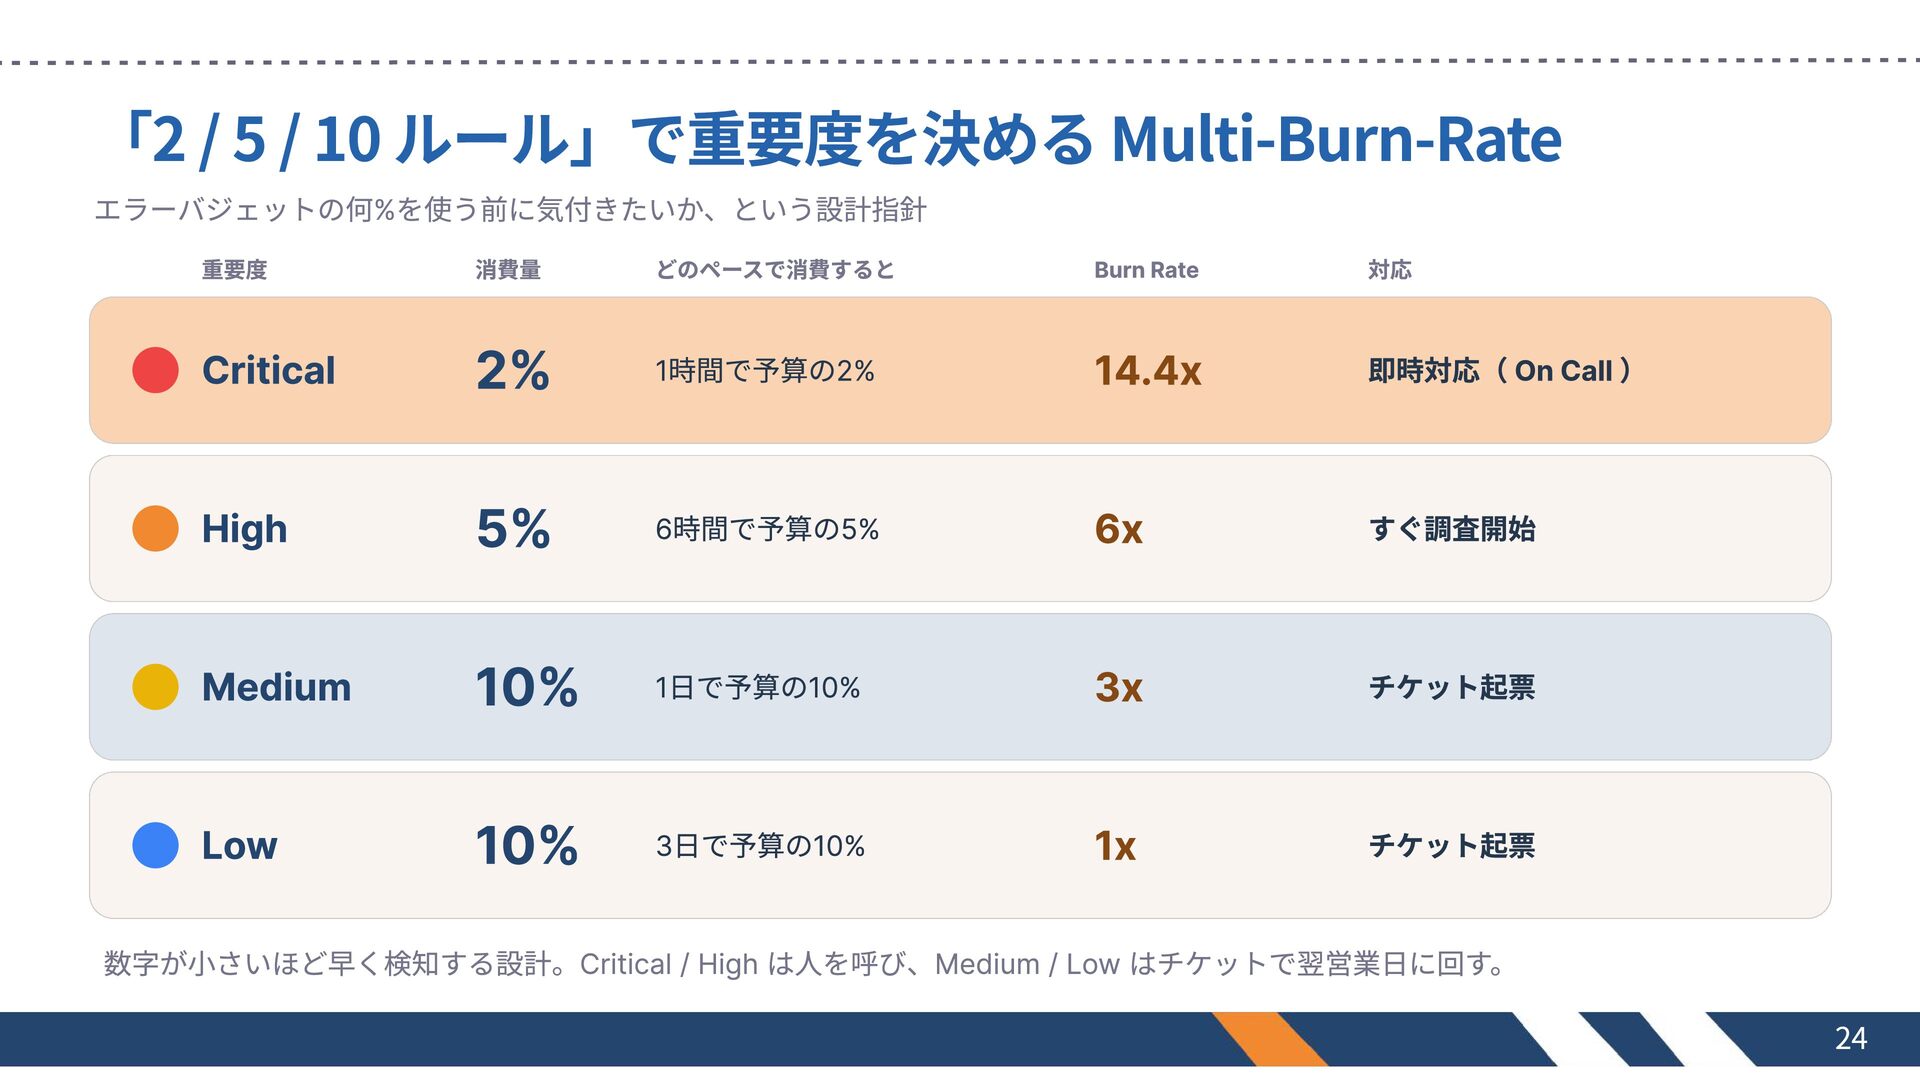
「2 / 5 / 10 ルール」で重要度を決める Multi-Burn-Rate エラーバジェットの何%を使う前に気付きたいか、という設計指針 重要度 消費量
どのペースで消費すると Burn Rate 対応 Critical 2% 1時間で予算の2% 14.4x 即時対応( On Call ) High 5% 6時間で予算の5% 6x すぐ調査開始 Medium 10% 1日で予算の10% 3x チケット起票 Low 10% 3日で予算の10% 1x チケット起票 数字が小さいほど早く検知する設計。Critical / High は人を呼び、Medium / Low はチケットで翌営業日に回す。 24
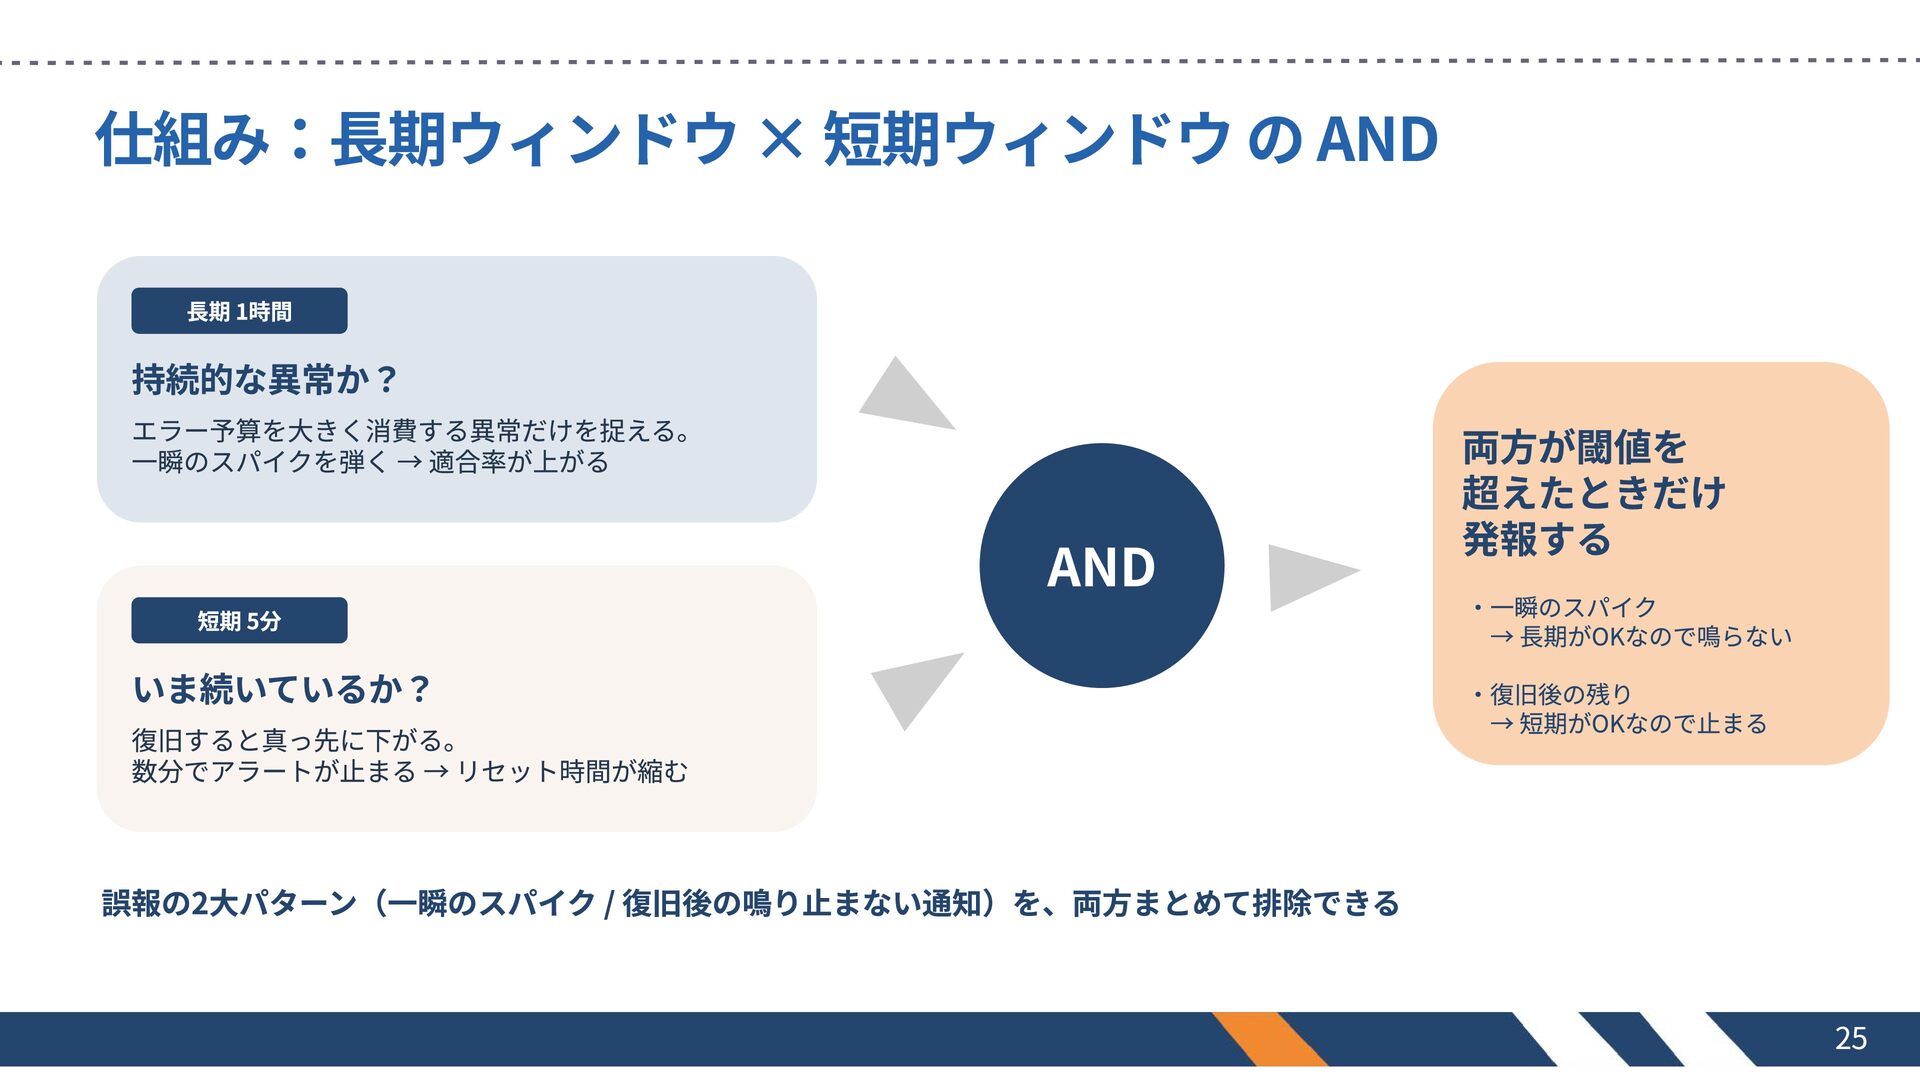
仕組み:長期ウィンドウ × 短期ウィンドウ の AND 長期 1時間 持続的な異常か? エラー予算を大きく消費する異常だけを捉える。 一瞬のスパイクを弾く
→ 適合率が上がる 短期 5分 AND いま続いているか? 復旧すると真っ先に下がる。 数分でアラートが止まる → リセット時間が縮む 両方が閾値を 超えたときだけ 発報する ・一瞬のスパイク → 長期がOKなので鳴らない ・復旧後の残り → 短期がOKなので止まる 誤報の2大パターン(一瞬のスパイク / 復旧後の鳴り止まない通知)を、両方まとめて排除できる 25
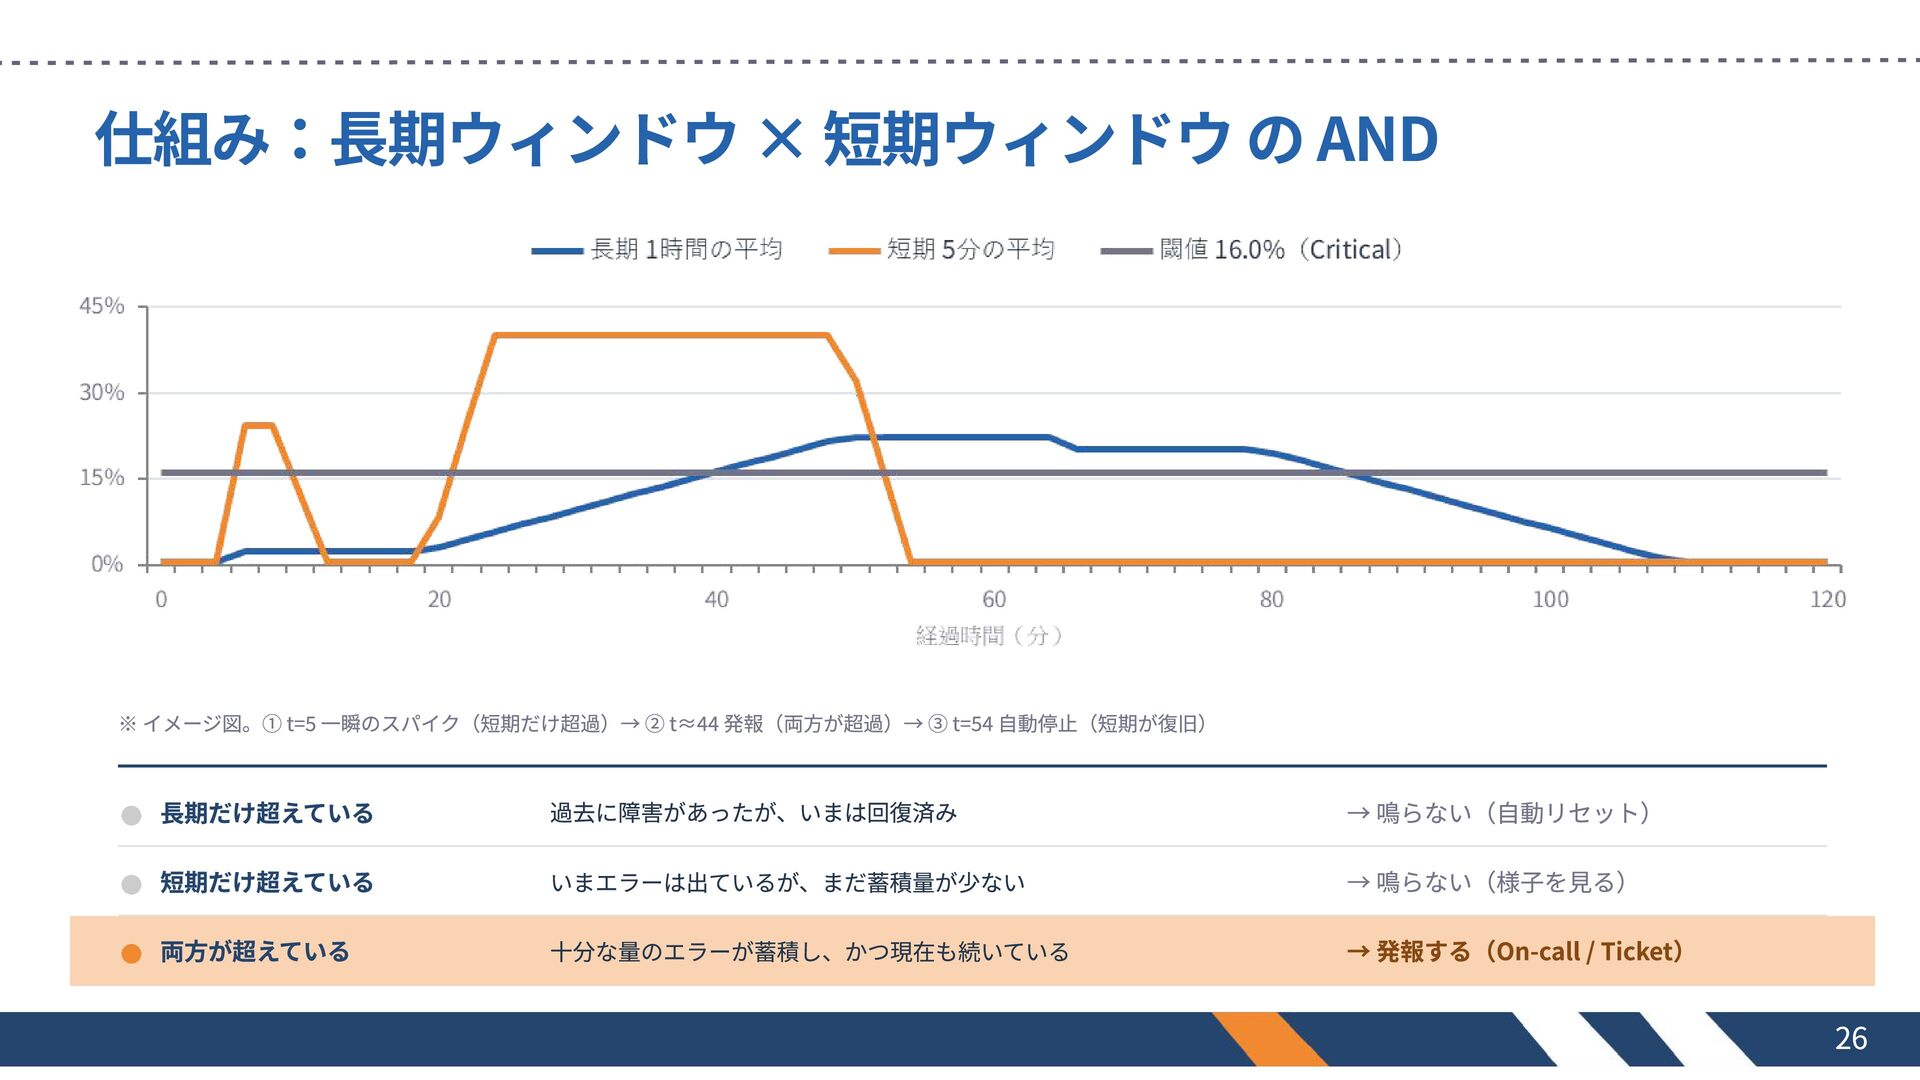
仕組み:長期ウィンドウ × 短期ウィンドウ の AND ※ イメージ図。① t=5 一瞬のスパイク(短期だけ超過)→ ②
t≈44 発報(両方が超過)→ ③ t=54 自動停止(短期が復旧) 長期だけ超えている 過去に障害があったが、いまは回復済み → 鳴らない(自動リセット) 短期だけ超えている いまエラーは出ているが、まだ蓄積量が少ない → 鳴らない(様子を見る) 両方が超えている 十分な量のエラーが蓄積し、かつ現在も続いている → 発報する(On-call / Ticket) 26
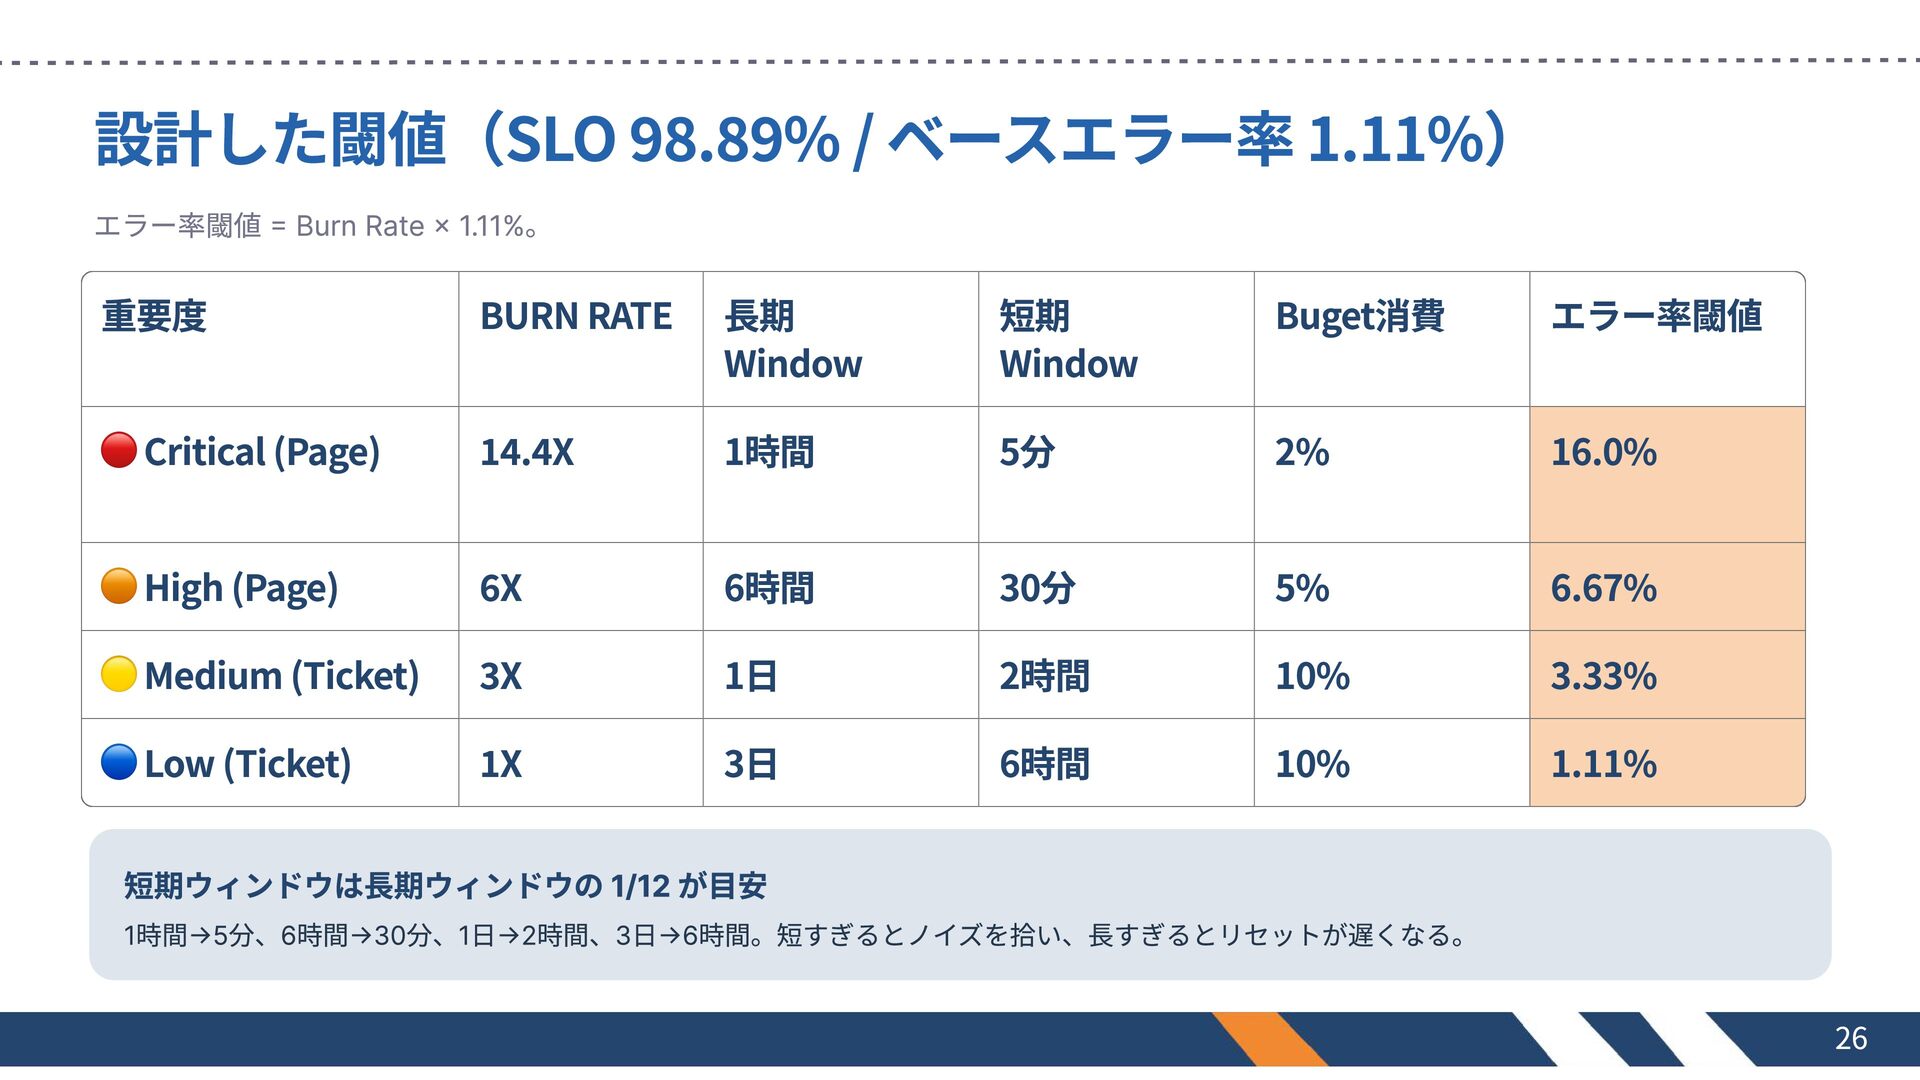
設計した閾値(SLO 98.89% / ベースエラー率 1.11%) エラー率閾値 = Burn Rate ×
1.11%。 重要度 BURN RATE 長期 Window 短期 Window Buget消費 エラー率閾値 🔴 Critical (Page) 14.4X 1時間 5分 2% 16.0% 🟠 High (Page) 6X 6時間 30分 5% 6.67% 🟡 Medium (Ticket) 3X 1日 2時間 10% 3.33% 🔵 Low (Ticket) 1X 3日 6時間 10% 1.11% 短期ウィンドウは長期ウィンドウの 1/12 が目安 1時間→5分、6時間→30分、1日→2時間、3日→6時間。短すぎるとノイズを拾い、長すぎるとリセットが遅くなる。 26
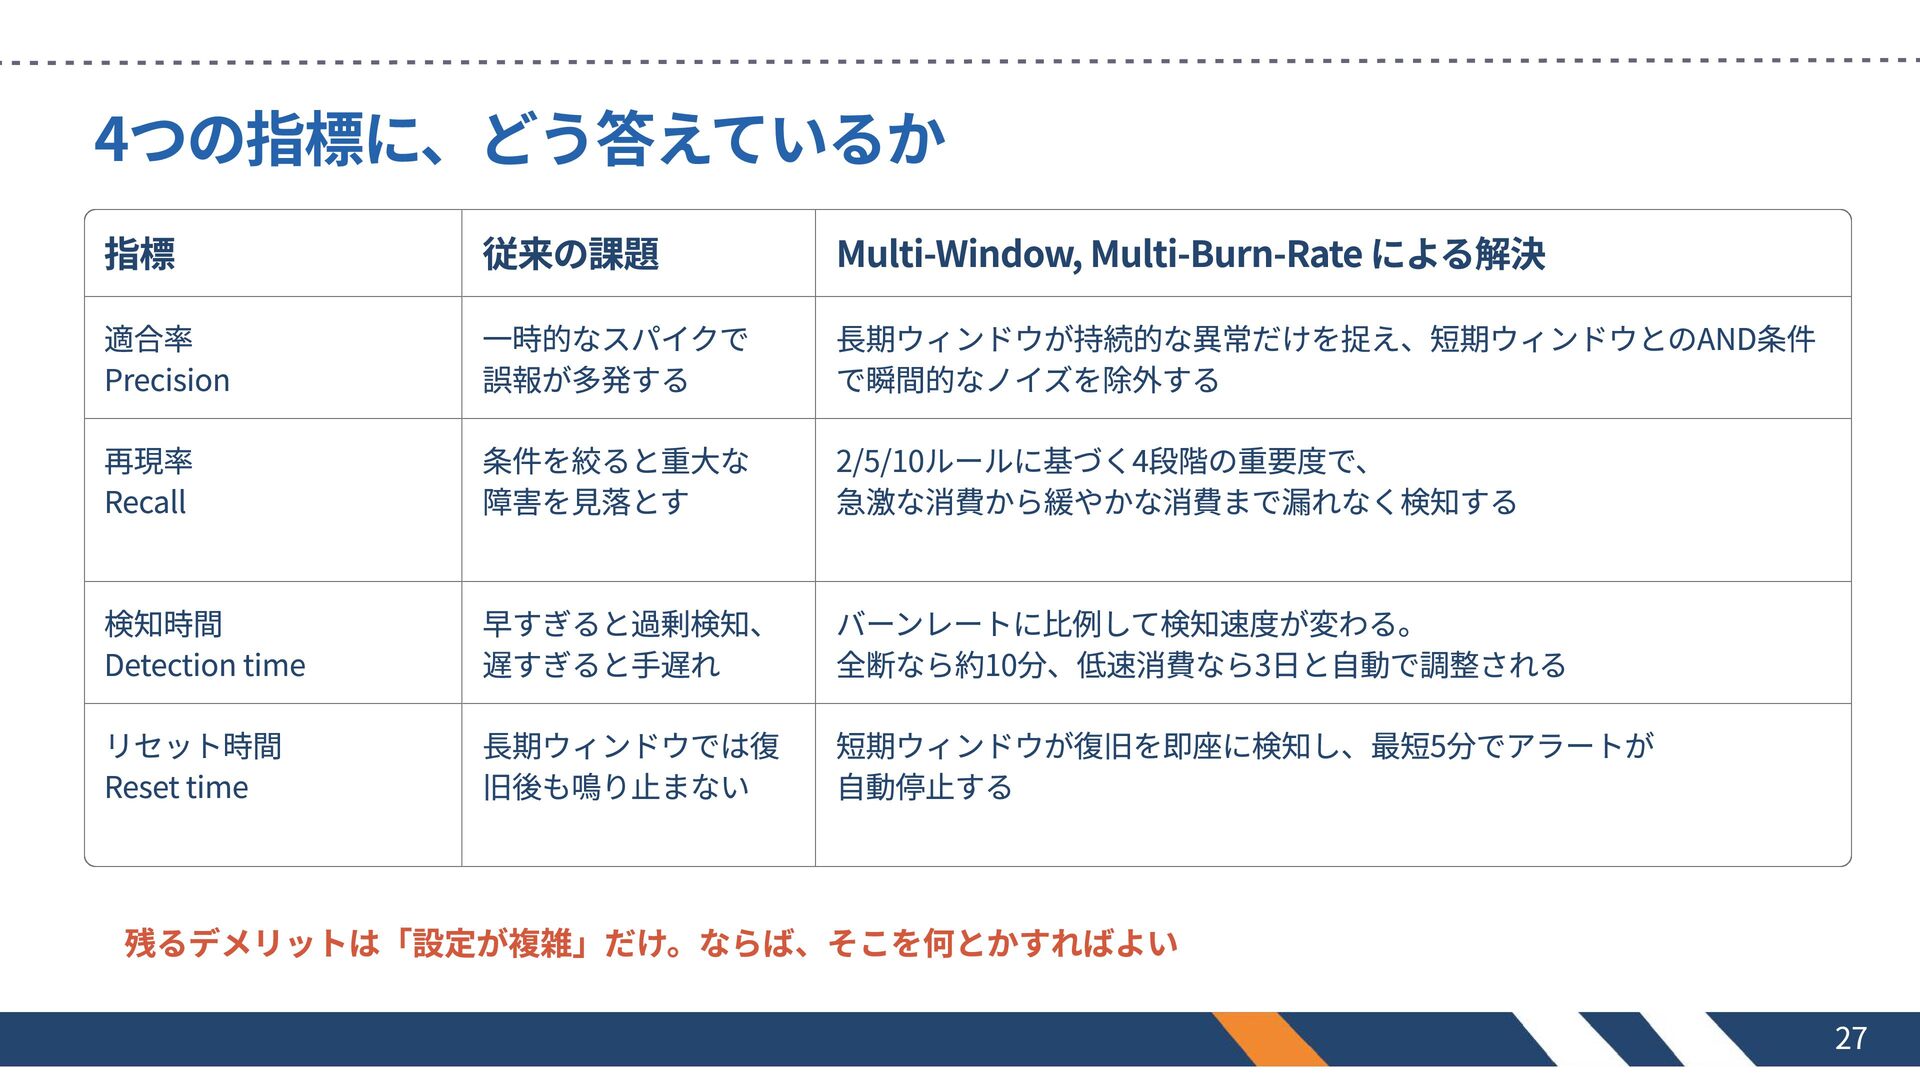
4つの指標に、どう答えているか 指標 従来の課題 Multi-Window, Multi-Burn-Rate による解決 適合率 Precision 一時的なスパイクで 誤報が多発する
長期ウィンドウが持続的な異常だけを捉え、短期ウィンドウとのAND条件 で瞬間的なノイズを除外する 再現率 Recall 条件を絞ると重大な 障害を見落とす 2/5/10ルールに基づく4段階の重要度で、 急激な消費から緩やかな消費まで漏れなく検知する 検知時間 Detection time 早すぎると過剰検知、 遅すぎると手遅れ リセット時間 Reset time バーンレートに比例して検知速度が変わる。 全断なら約10分、低速消費なら3日と自動で調整される 長期ウィンドウでは復 短期ウィンドウが復旧を即座に検知し、最短5分でアラートが 旧後も鳴り止まない 自動停止する 残るデメリットは「設定が複雑」だけ。ならば、そこを何とかすればよい 27
section 5 Datadogで実装してみる 28
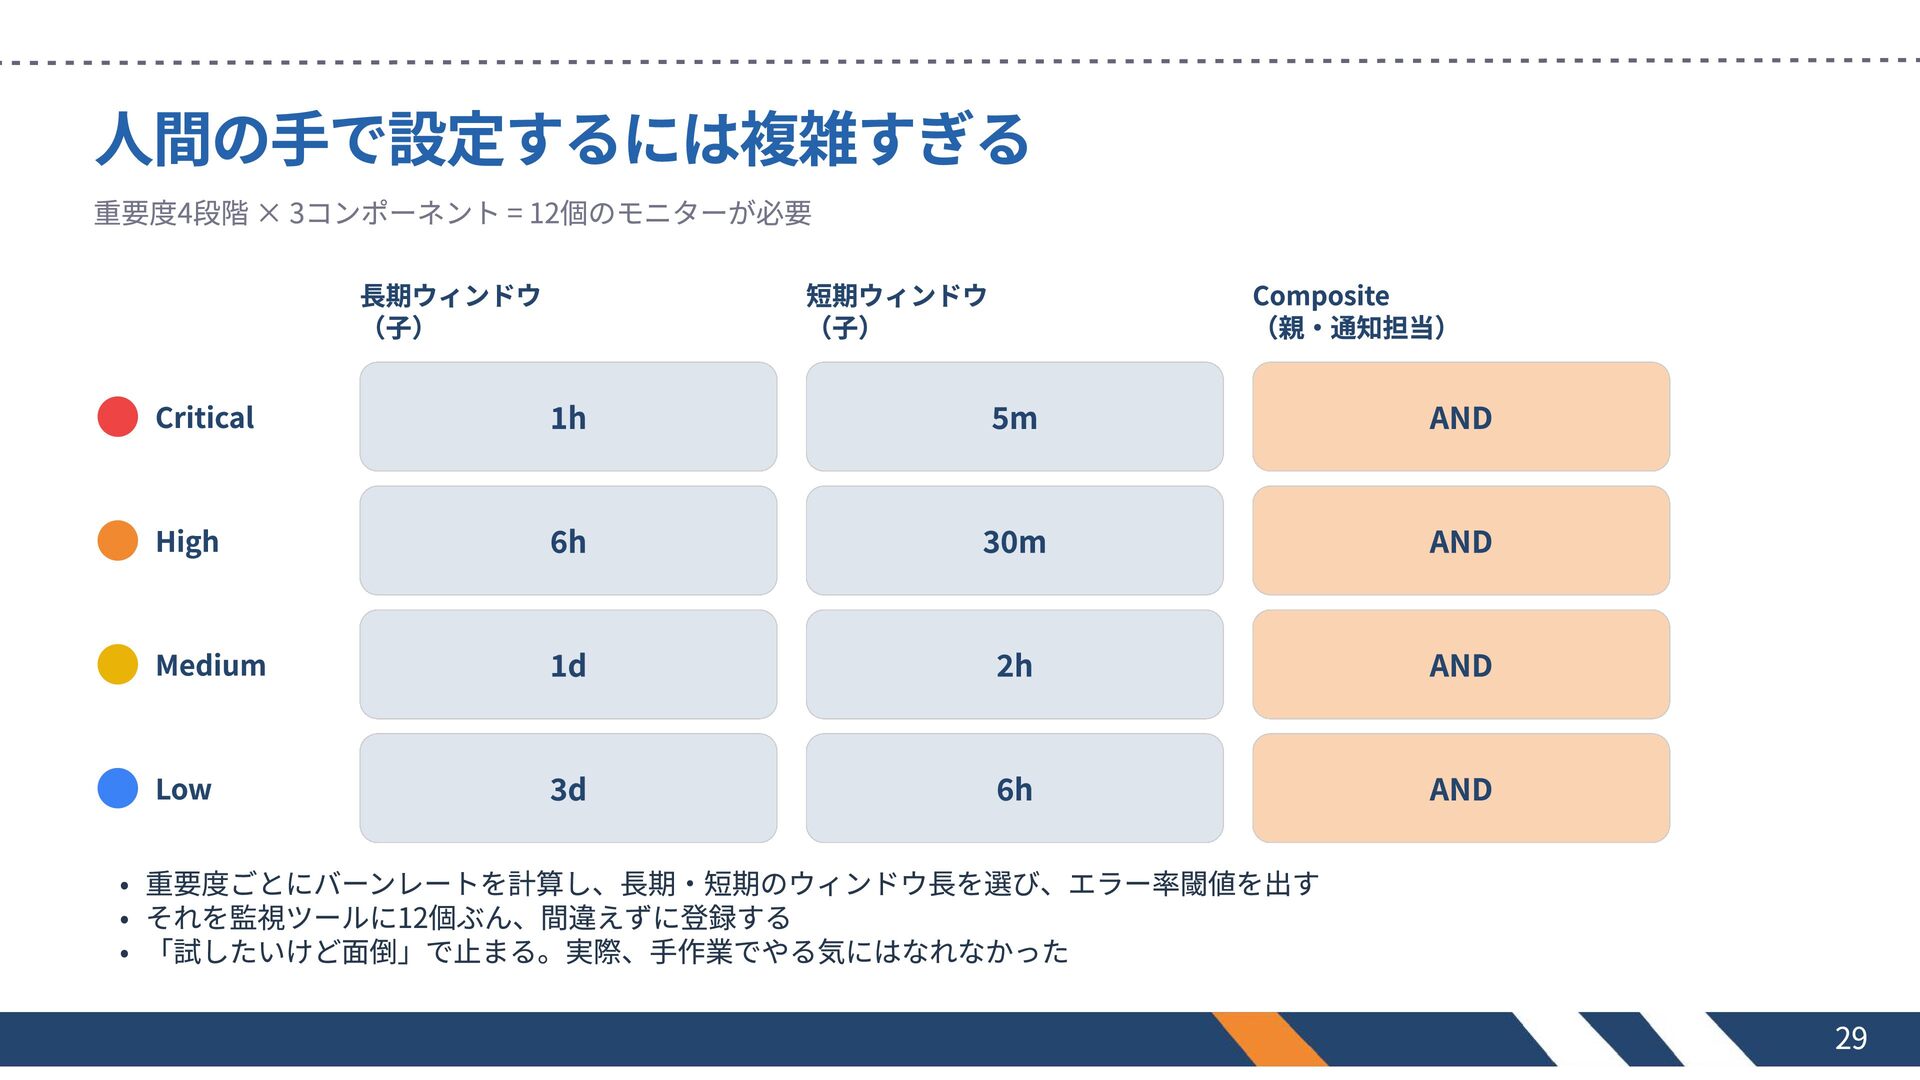
人間の手で設定するには複雑すぎる 重要度4段階 × 3コンポーネント = 12個のモニターが必要 長期ウィンドウ (子) 短期ウィンドウ (子)
Composite (親・通知担当) Critical 1h 5m AND High 6h 30m AND Medium 1d 2h AND Low 3d 6h AND 重要度ごとにバーンレートを計算し、長期・短期のウィンドウ長を選び、エラー率閾値を出す それを監視ツールに12個ぶん、間違えずに登録する 「試したいけど面倒」で止まる。実際、手作業でやる気にはなれなかった 29
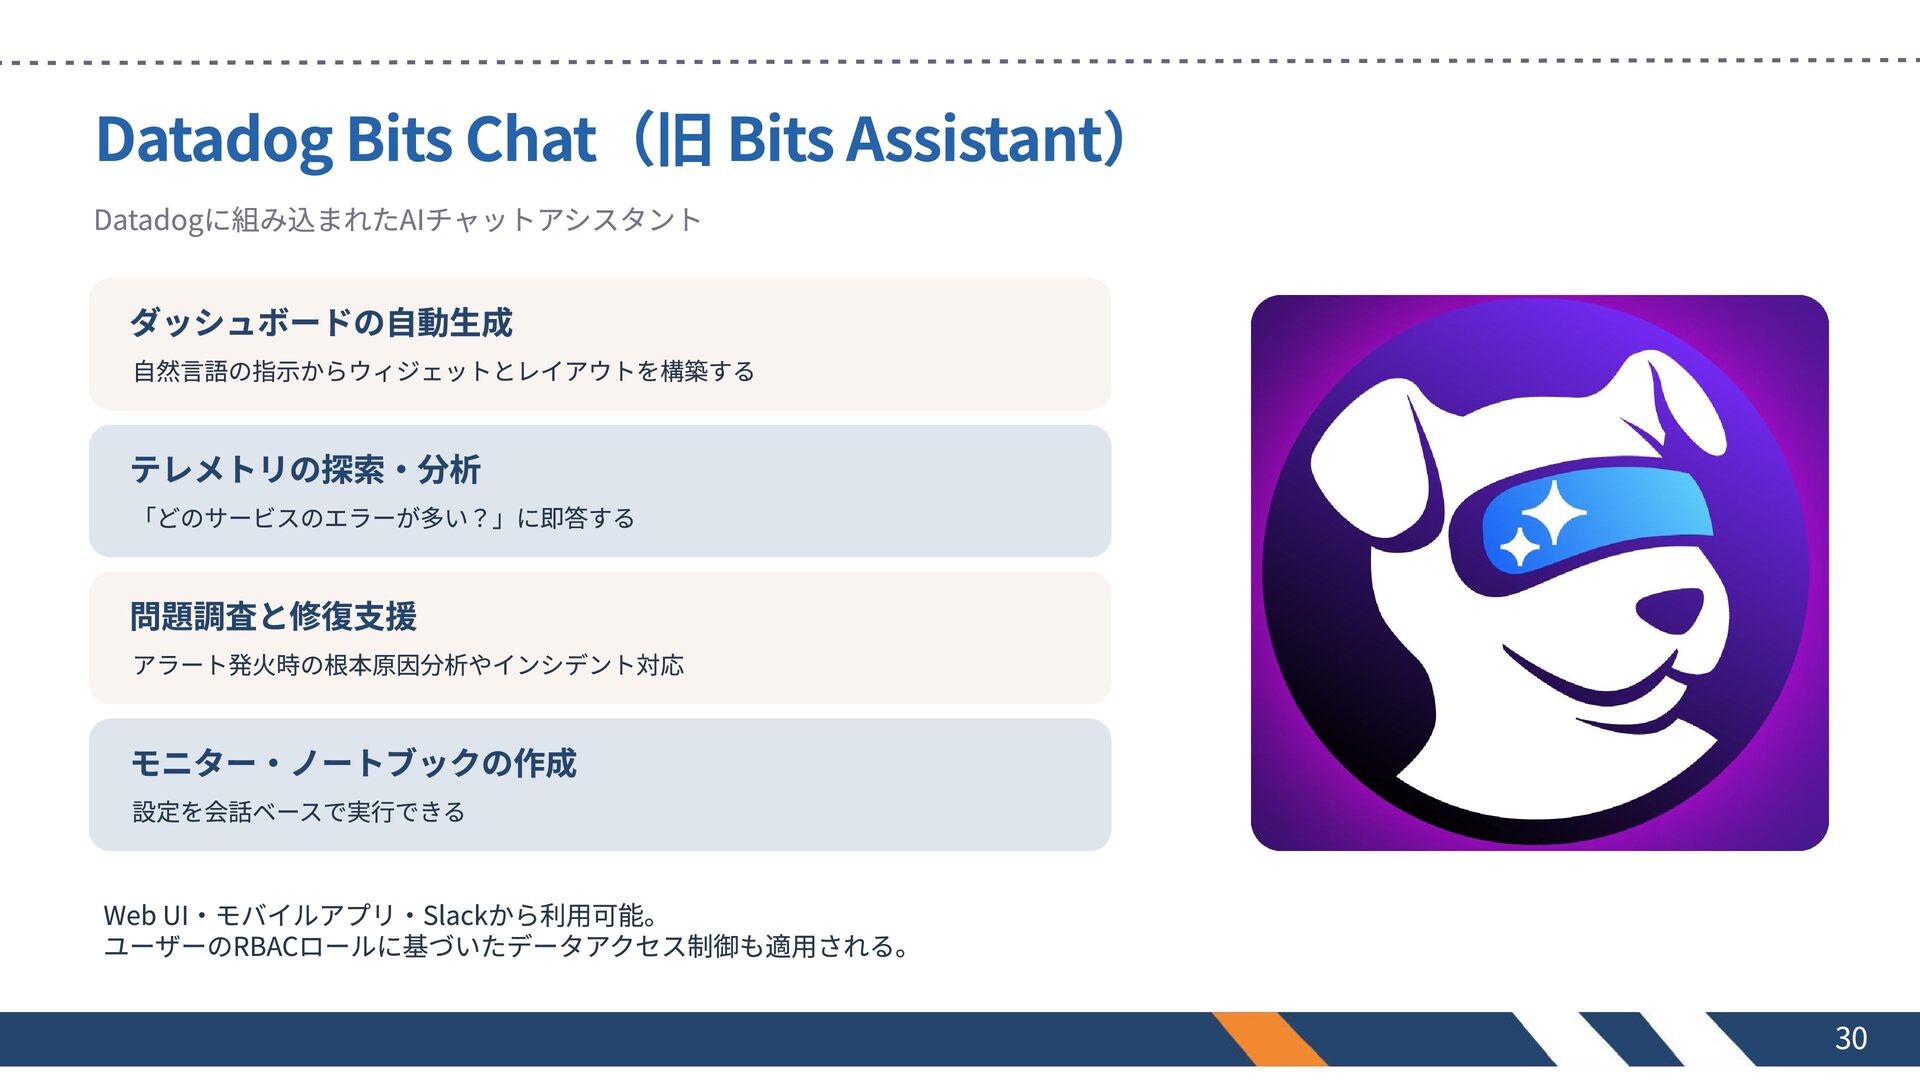
Datadog Bits Chat(旧 Bits Assistant) Datadogに組み込まれたAIチャットアシスタント ダッシュボードの自動生成 自然言語の指示からウィジェットとレイアウトを構築する テレメトリの探索・分析 「どのサービスのエラーが多い?」に即答する
問題調査と修復支援 アラート発火時の根本原因分析やインシデント対応 モニター・ノートブックの作成 設定を会話ベースで実行できる Web UI・モバイルアプリ・Slackから利用可能。 ユーザーのRBACロールに基づいたデータアクセス制御も適用される。 30
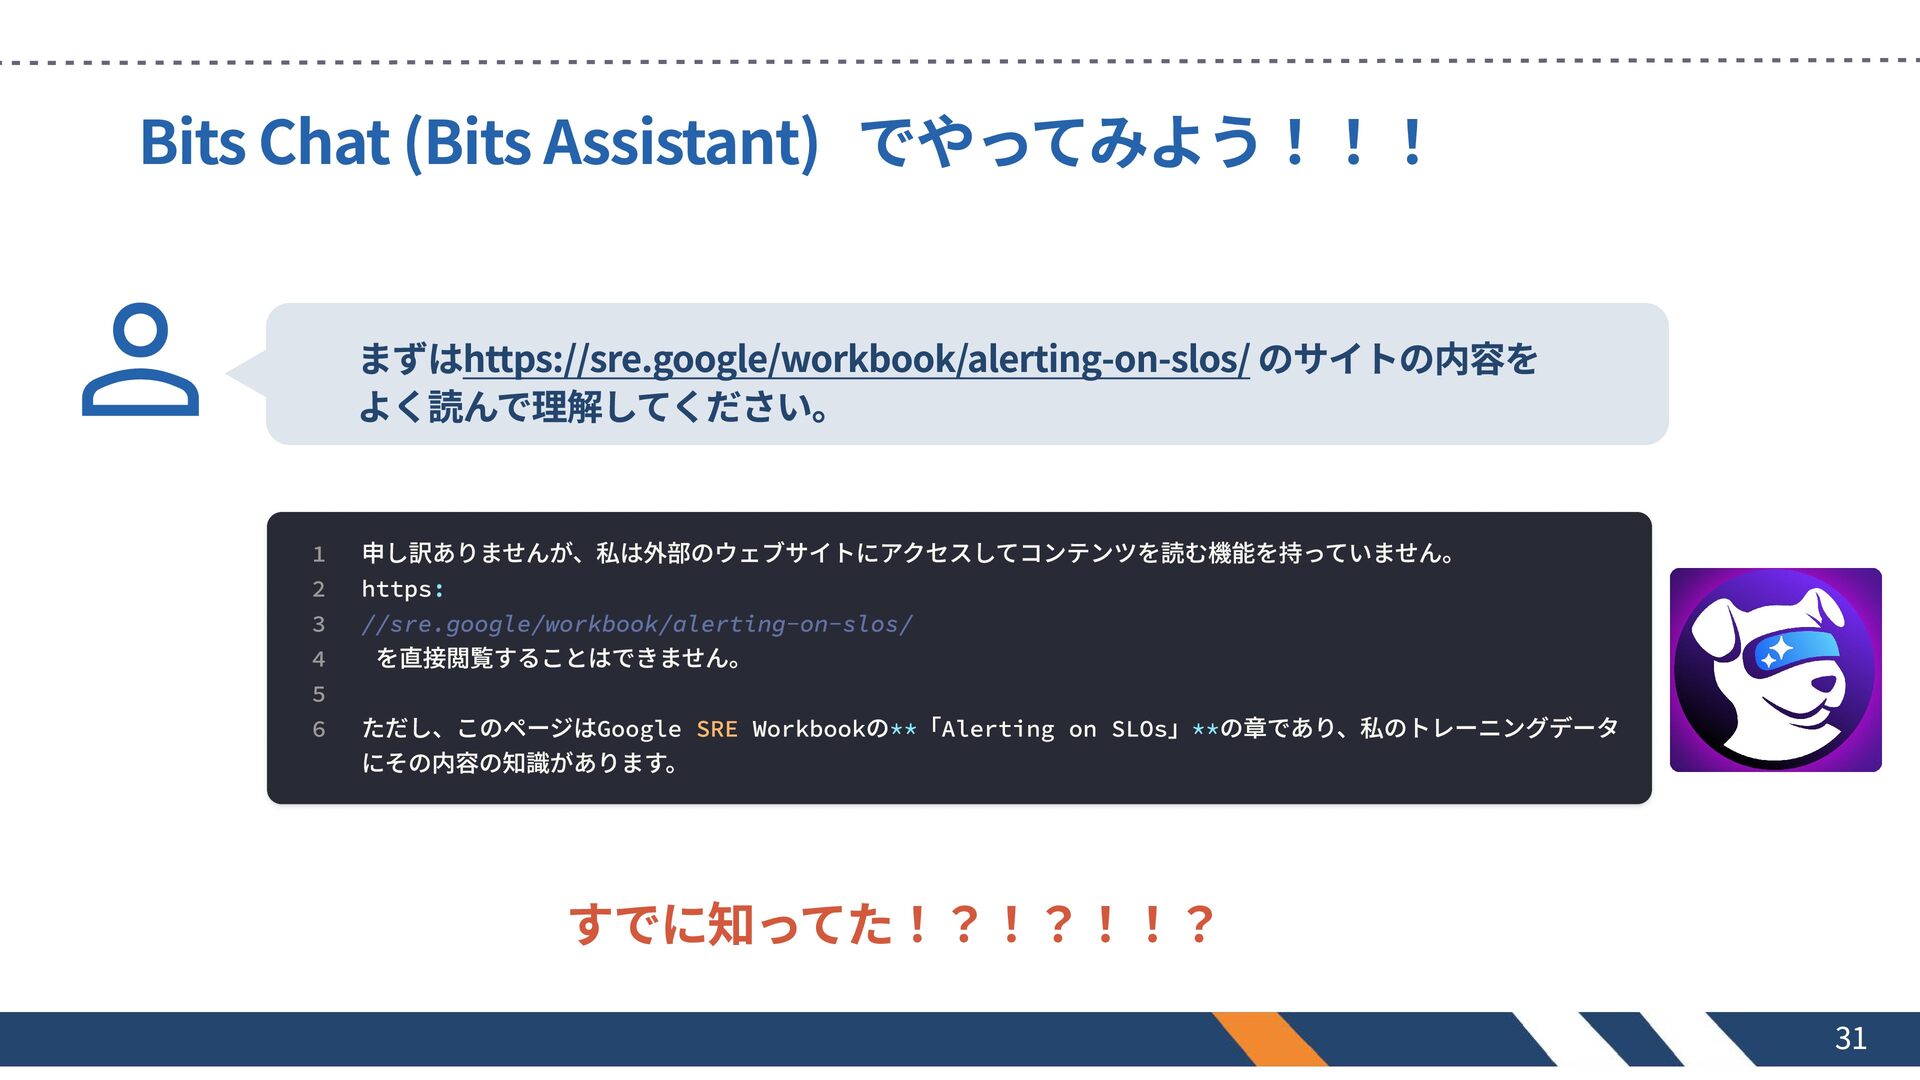
Bits Chat (Bits Assistant) でやってみよう!!! まずはhttps://sre.google/workbook/alerting-on-slos/ のサイトの内容を よく読んで理解してください。 1 2
3 4 5 6 申し訳ありませんが、私は外部のウェブサイトにアクセスしてコンテンツを読む機能を持っていません。 https: //sre.google/workbook/alerting-on-slos/ を直接閲覧することはできません。 ただし、このページはGoogle SRE Workbookの**「Alerting on SLOs」**の章であり、私のトレーニングデータ にその内容の知識があります。 すでに知ってた!?!?!!? 31
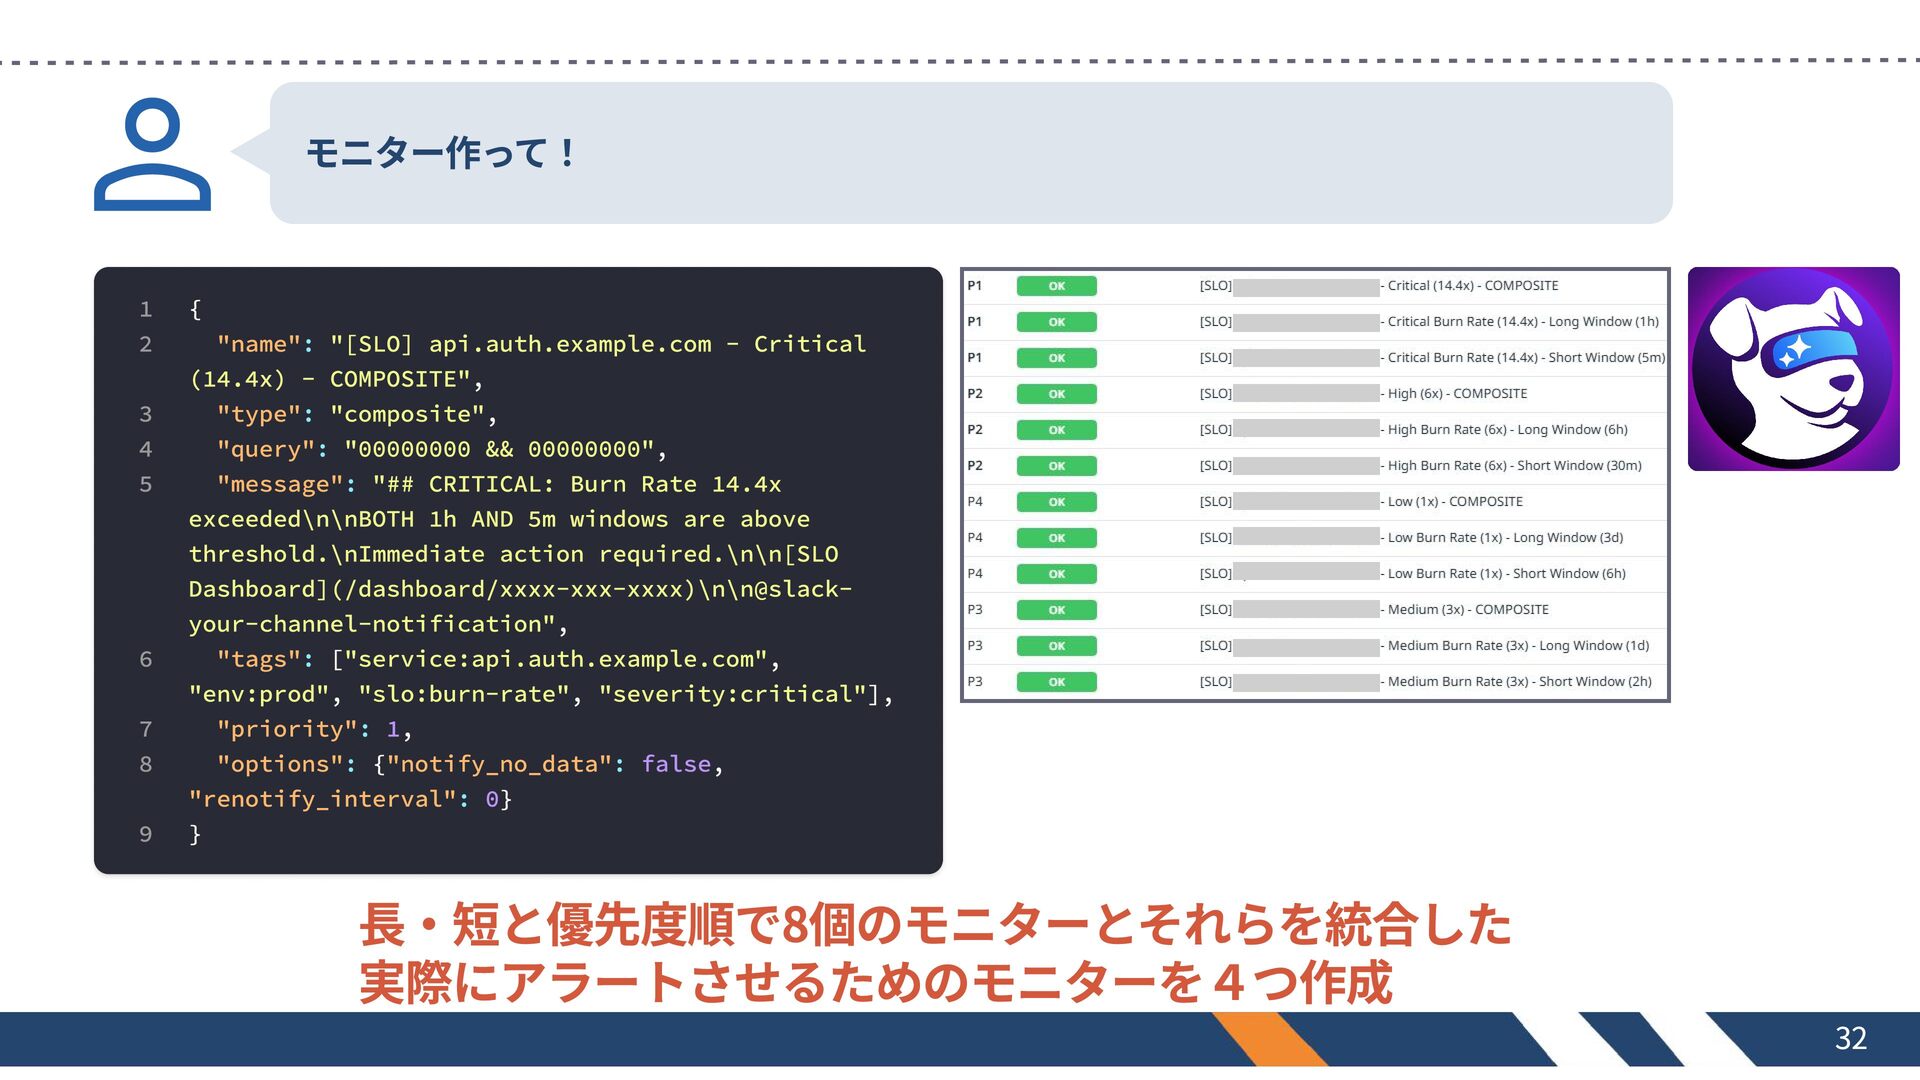
モニター作って! 1 2 3 4 5 6 7 8 9
{ "name": "[SLO] api.auth.example.com - Critical (14.4x) - COMPOSITE", "type": "composite", "query": "00000000 && 00000000", "message": "## CRITICAL: Burn Rate 14.4x exceeded\n\nBOTH 1h AND 5m windows are above threshold.\nImmediate action required.\n\n[SLO Dashboard](/dashboard/xxxx-xxx-xxxx)\n\n@slackyour-channel-notification", "tags": ["service:api.auth.example.com", "env:prod", "slo:burn-rate", "severity:critical"], "priority": 1, "options": {"notify_no_data": false, "renotify_interval": 0} } 長・短と優先度順で8個のモニターとそれらを統合した 実際にアラートさせるためのモニターを4つ作成 32
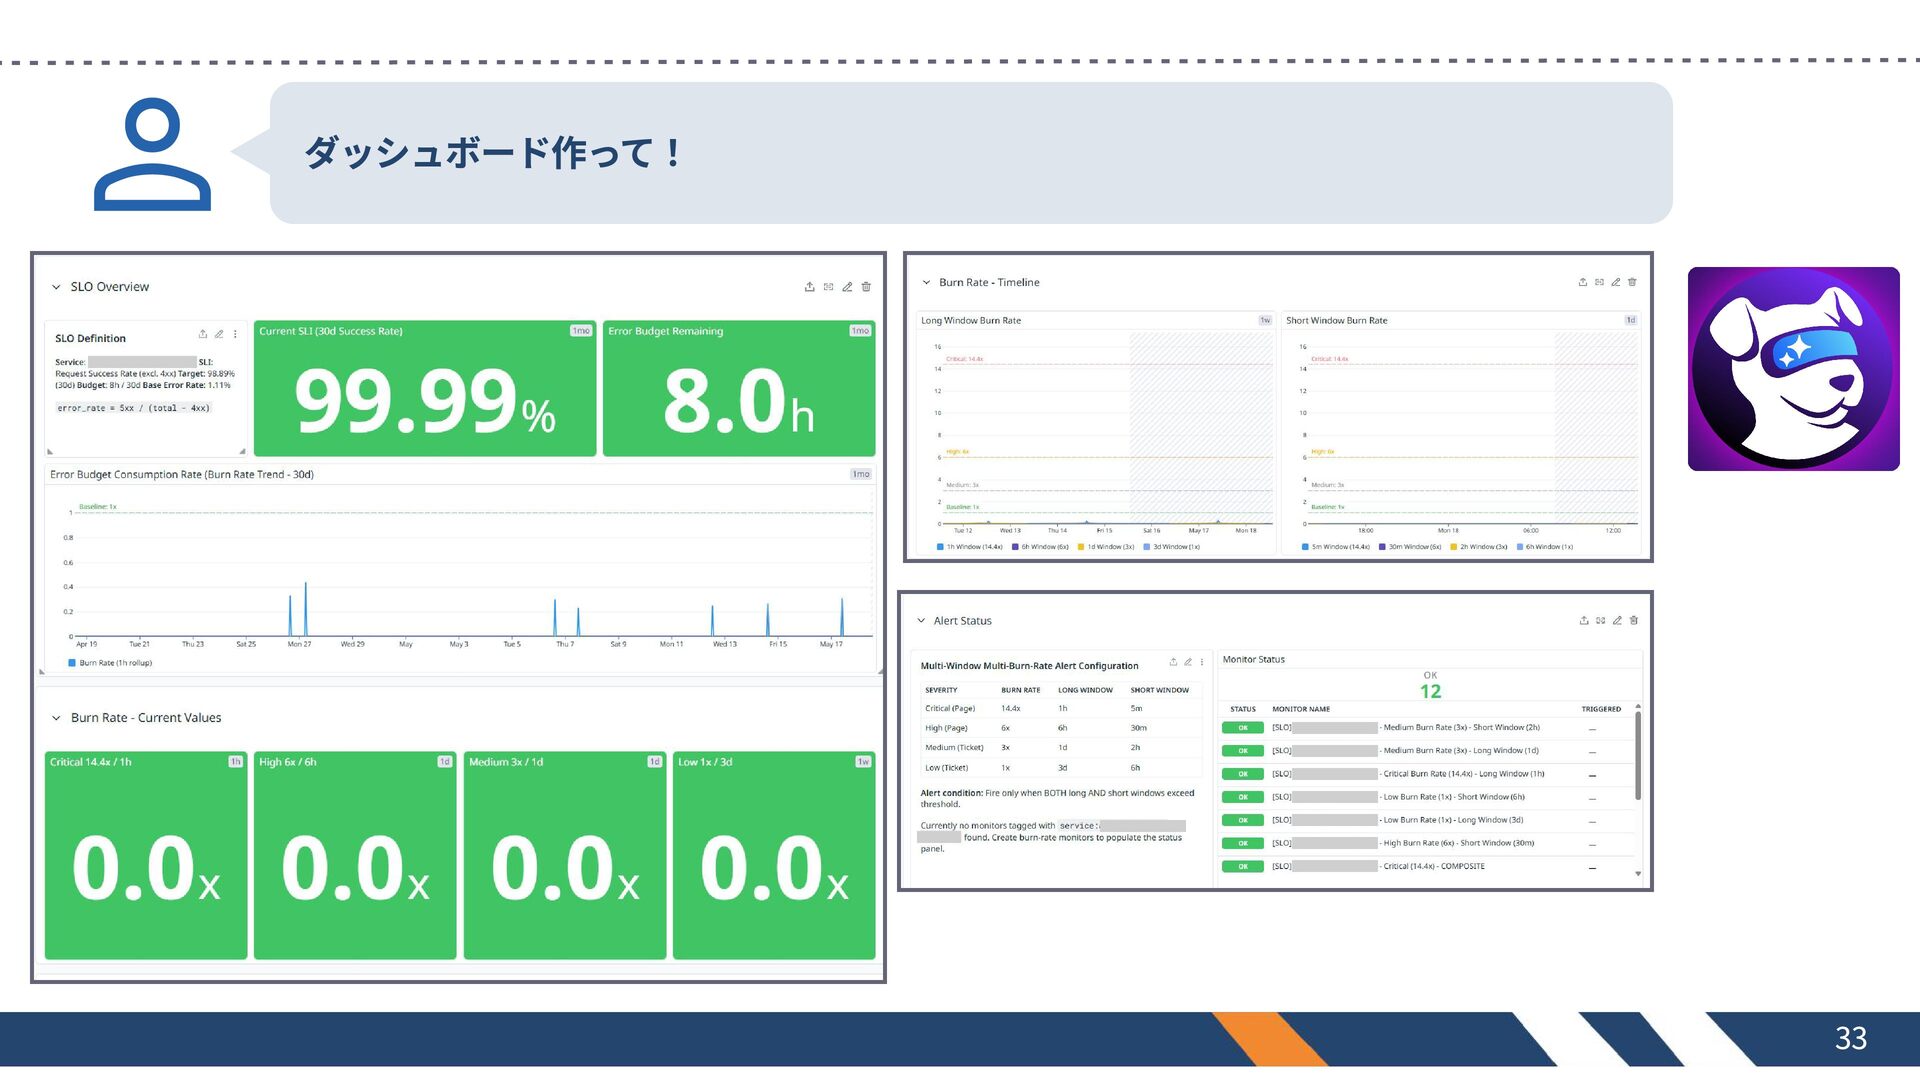
ダッシュボード作って! 33
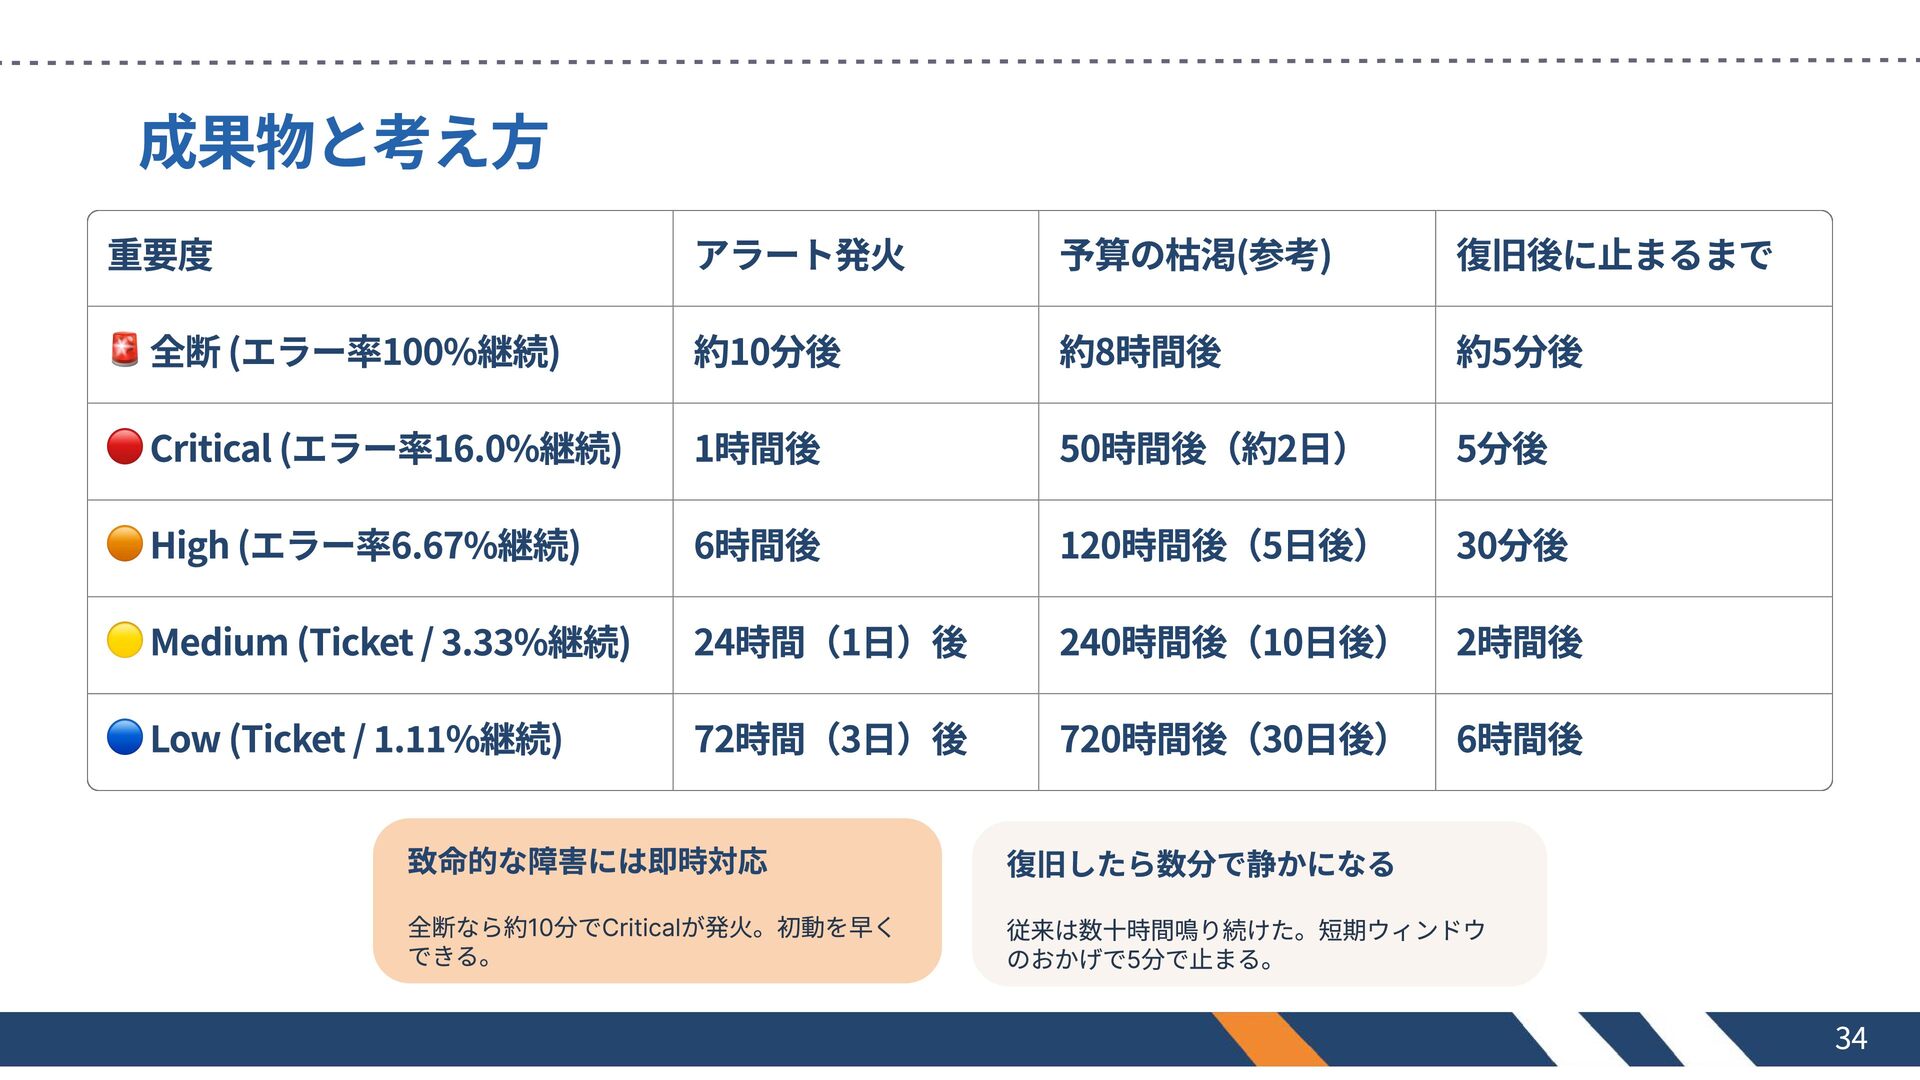
成果物と考え方 重要度 アラート発火 予算の枯渇(参考) 復旧後に止まるまで 🚨 全断 (エラー率100%継続) 約10分後 約8時間後
約5分後 🔴 Critical (エラー率16.0%継続) 1時間後 50時間後(約2日) 5分後 🟠 High (エラー率6.67%継続) 6時間後 120時間後(5日後) 30分後 🟡 Medium (Ticket / 3.33%継続) 24時間(1日)後 240時間後(10日後) 2時間後 🔵 Low (Ticket / 1.11%継続) 72時間(3日)後 720時間後(30日後) 6時間後 致命的な障害には即時対応 復旧したら数分で静かになる 全断なら約10分でCriticalが発火。初動を早く できる。 従来は数十時間鳴り続けた。短期ウィンドウ のおかげで5分で止まる。 34
WE ARE HIRING‼ 株式会社サンエー 情報システム部 OUR MISSION 会社の進化を 支える仕事! もっと働きやすく、もっと笑顔になる
詳細・エントリーはこちら
今回は初心者向け!! SREとかO11Yとかも含めて話したい! 38
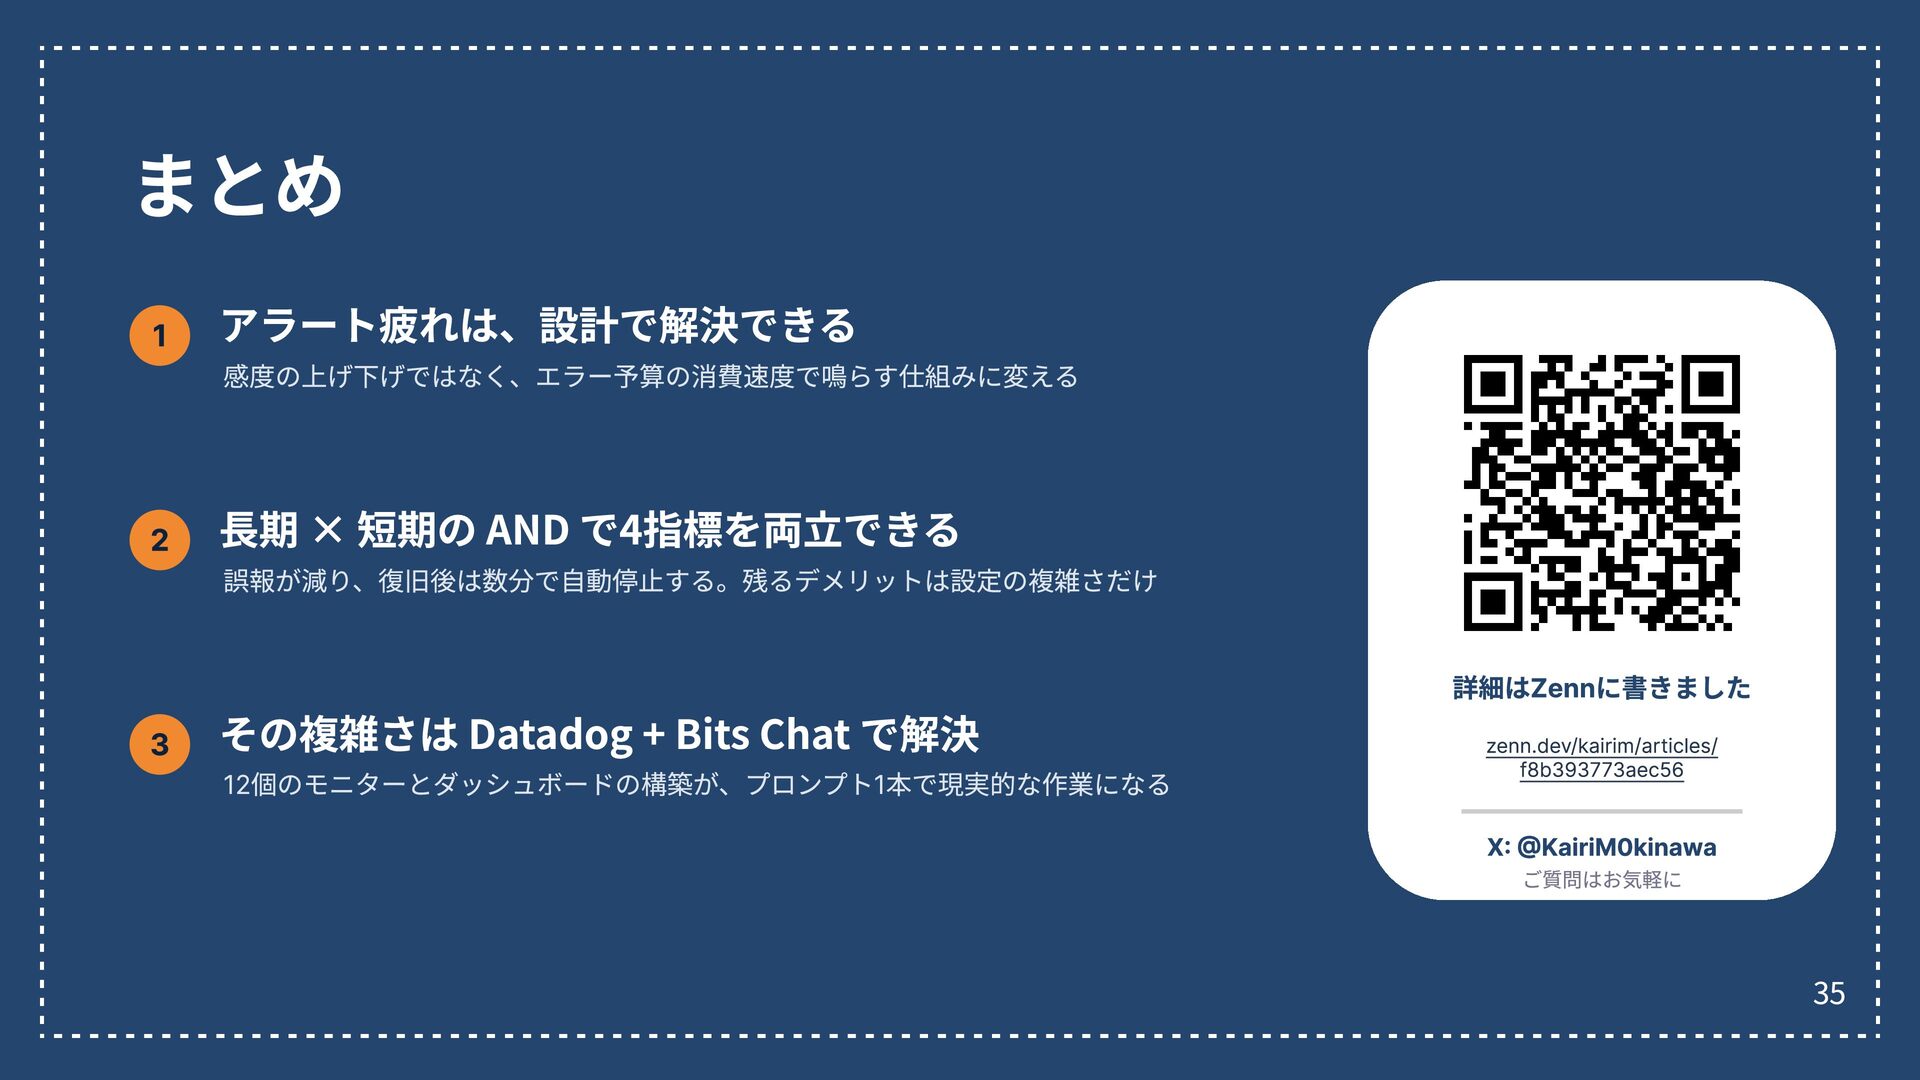
まとめ 1 アラート疲れは、設計で解決できる 感度の上げ下げではなく、エラー予算の消費速度で鳴らす仕組みに変える 2 長期 × 短期の AND で4指標を両立できる
誤報が減り、復旧後は数分で自動停止する。残るデメリットは設定の複雑さだけ 3 その複雑さは Datadog + Bits Chat で解決 12個のモニターとダッシュボードの構築が、プロンプト1本で現実的な作業になる 詳細はZennに書きました zenn.dev/kairim/articles/ f8b393773aec56 X: @KairiM0kinawa ご質問はお気軽に 35


 kairim0
 soudai
 dtunkelang
 tsukuboshi
 tomtanaka
 nasuvitz
 k_adachi_01
 slsops
 toru_kubota
 kitagawaz
 pauli
 iwatatomoya
 ymiya55
 afnizarnur
 caitiem20
 wjessup
 chikuwait
 joshbly
 aleyda
 mkilby
 ipullrank
 sonatard
 gr2m
 inesmontani
 jonoalderson