Upgrade to Pro
— share decks privately, control downloads, hide ads and more …
Speaker Deck
Sign up for free
Menu
Search
Features
All features
Private URLs
Password Protection
Custom URLS
Scheduled publishing
Remove Branding
Restrict embedding
Deck Collections
Notes
Features
All features
Private URLs
Password Protection
Custom URLS
Scheduled publishing
Remove Branding
Restrict embedding
Deck Collections
Notes
Explore
Featured decks
Featured speakers
Programming
Technology
Storyboards
Explore
Featured decks
Featured speakers
Programming
Technology
Storyboards
Pricing
Search
Sign in
Sign up for free
1万名の社員が使う認証基盤で どう信頼性を担保するか?
Search
KairiM
October 01, 2026
Technology
110
0
Share
Embed
Copy iframe code
Copy JS code
Copy link
Start on current slide
1万名の社員が使う認証基盤で どう信頼性を担保するか?
KairiM
October 01, 2026
More Decks by KairiM
See All by KairiM
エラーバジェットのアラートのタイミングを考える.pdf
kairim0
0
240
はじめてのDatadog
kairim0
0
580
Other Decks in Technology
See All in Technology
Snowflake Horizon Catalog と Apache Iceberg で作る オープンなデータ基盤
kitagawaz
0
360
React Nativeでの OTA Updateって、 どう説明する?
ichiki1023
0
130
AIに書かせて、プラットフォームで縛る ― EKSプラットフォームで実践した責任境界と権限設計
elmodev09
1
1.1k
Confitura 2026
logico_jp
0
120
いちAWSエンジニアのAI活用を振り返る #devio2026 / devio osaka 2026 kawahara
masahirokawahara
1
290
Amazon Bedrock Agents ClassicからAmazon Bedrock AgentCoreへ移行した際、ガードレール設定が2箇所に割れた話
matsunobu
0
160
AI Native Platform Engineering 〜PlatformとAgileで“作る速さ”を“価値”へ〜
uya116
0
570
Oracle Base Database Service 技術詳細
oracle4engineer
PRO
16
120k
20260929_AmazonGuardDutyの検出通知メールにAWS DevOpsAgentの調査結果を追加する
yhana
1
390
覗いてみよう 関数型ビジュアル言語×2Dグラフィックスの世界
yohyamasaki
0
160
Oracle Cloud Infrastructure(OCI):Onboarding Session(はじめてのOCI/Oracle Supportご利⽤ガイド)
oracle4engineer
PRO
3
21k
SQL Server 2025 最適化されたロック
odashinsuke
0
110
Featured
See All Featured
Art, The Web, and Tiny UX
lynnandtonic
304
22k
Unsuck your backbone
ammeep
672
58k
Fantastic passwords and where to find them - at NoRuKo
philnash
52
3.9k
How Fast Is Fast Enough? [PerfNow 2025]
tammyeverts
3
910
Jamie Indigo - Trashchat’s Guide to Black Boxes: Technical SEO Tactics for LLMs
techseoconnect
PRO
0
690
Building Flexible Design Systems
yeseniaperezcruz
330
41k
How to build an LLM SEO readiness audit: a practical framework
nmsamuel
2
930
The #1 spot is gone: here's how to win anyway
tamaranovitovic
4
1.2k
Fight the Zombie Pattern Library - RWD Summit 2016
marcelosomers
234
18k
30 Presentation Tips
portentint
PRO
1
410
Building Applications with DynamoDB
mza
96
7.2k
Unlocking the hidden potential of vector embeddings in international SEO
frankvandijk
0
960
Transcript
小売Night @マネーフォワード 新福岡拠点 2026/09/30 1万名の社員が使う認証基盤で どう信頼性を担保するか? 1
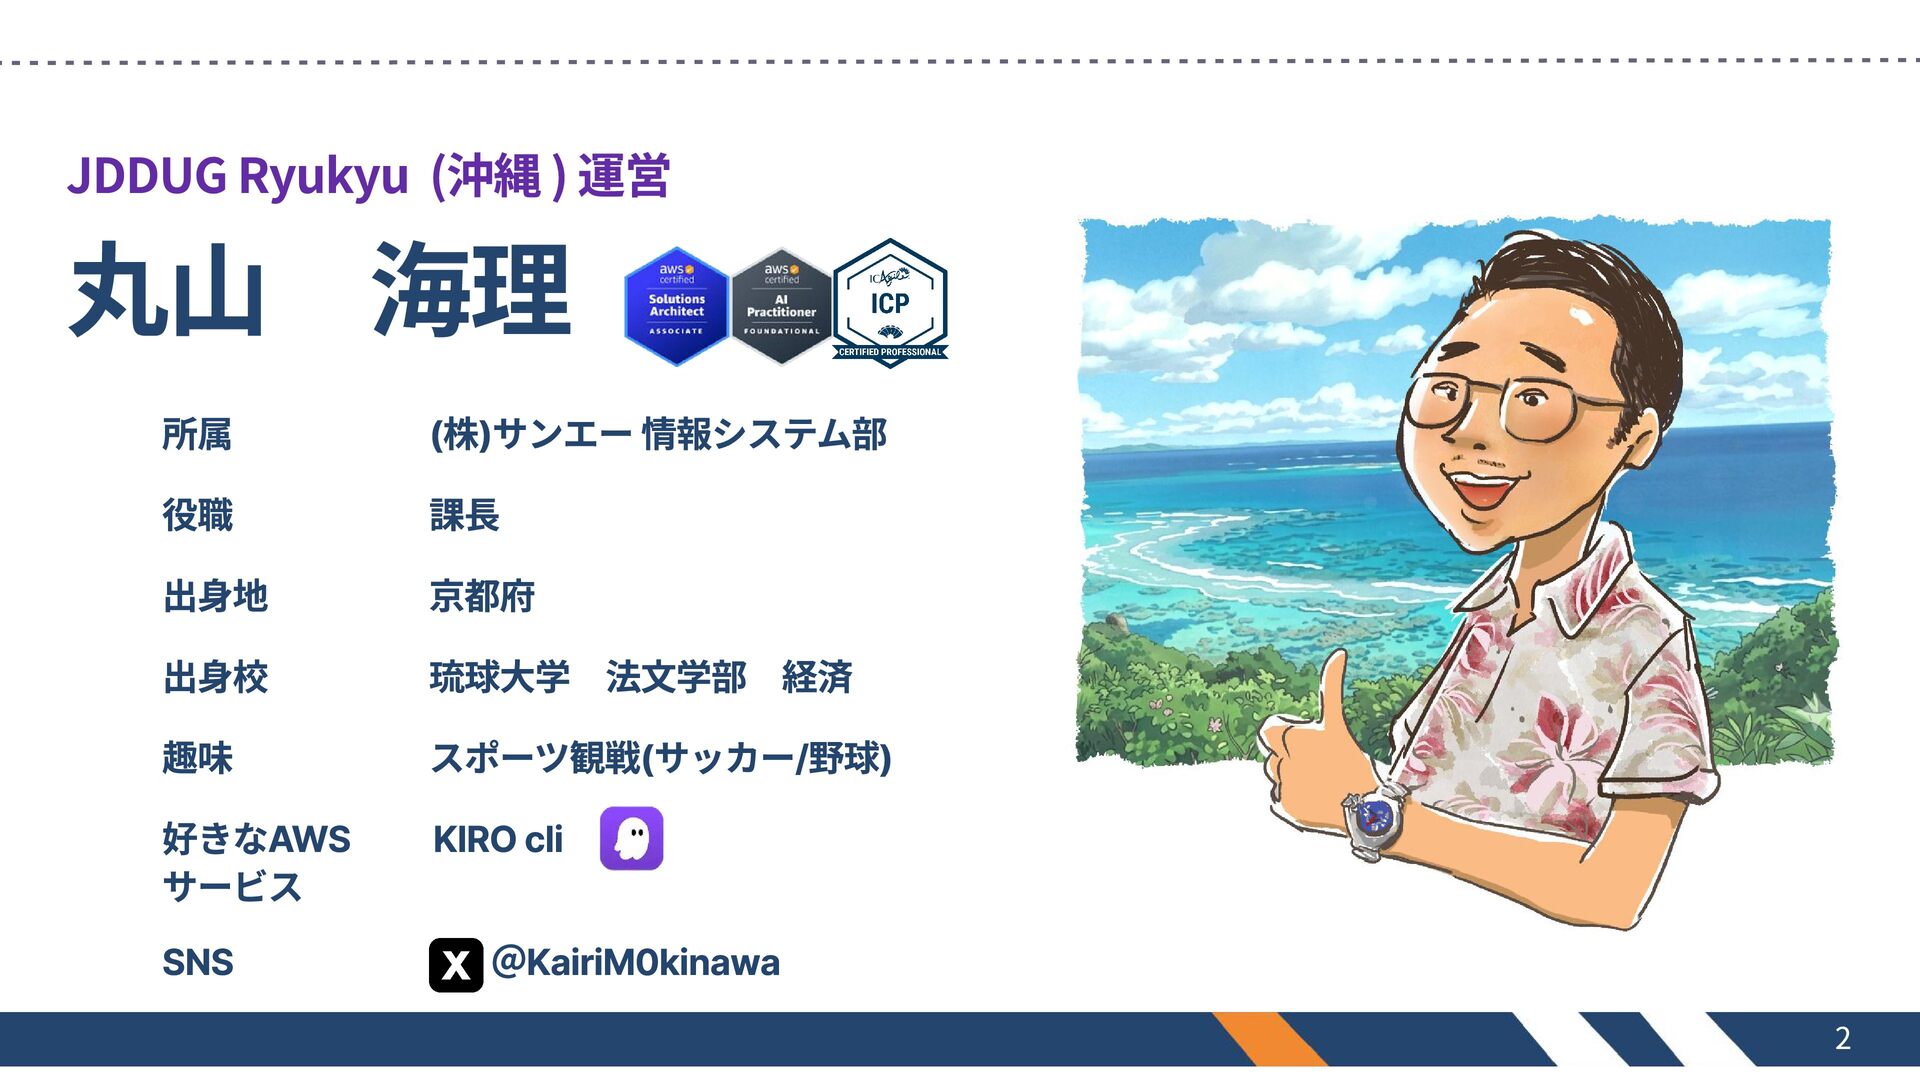
JDDUG Ryukyu (沖縄 ) 運営 丸山 海理 所属 (株)サンエー 情報システム部
役職 課長 出身地 京都府 出身校 琉球大学 法文学部 経済 趣味 スポーツ観戦(サッカー/野球) 好きなAWS サービス KIRO cli SNS @KairiM0kinawa 2
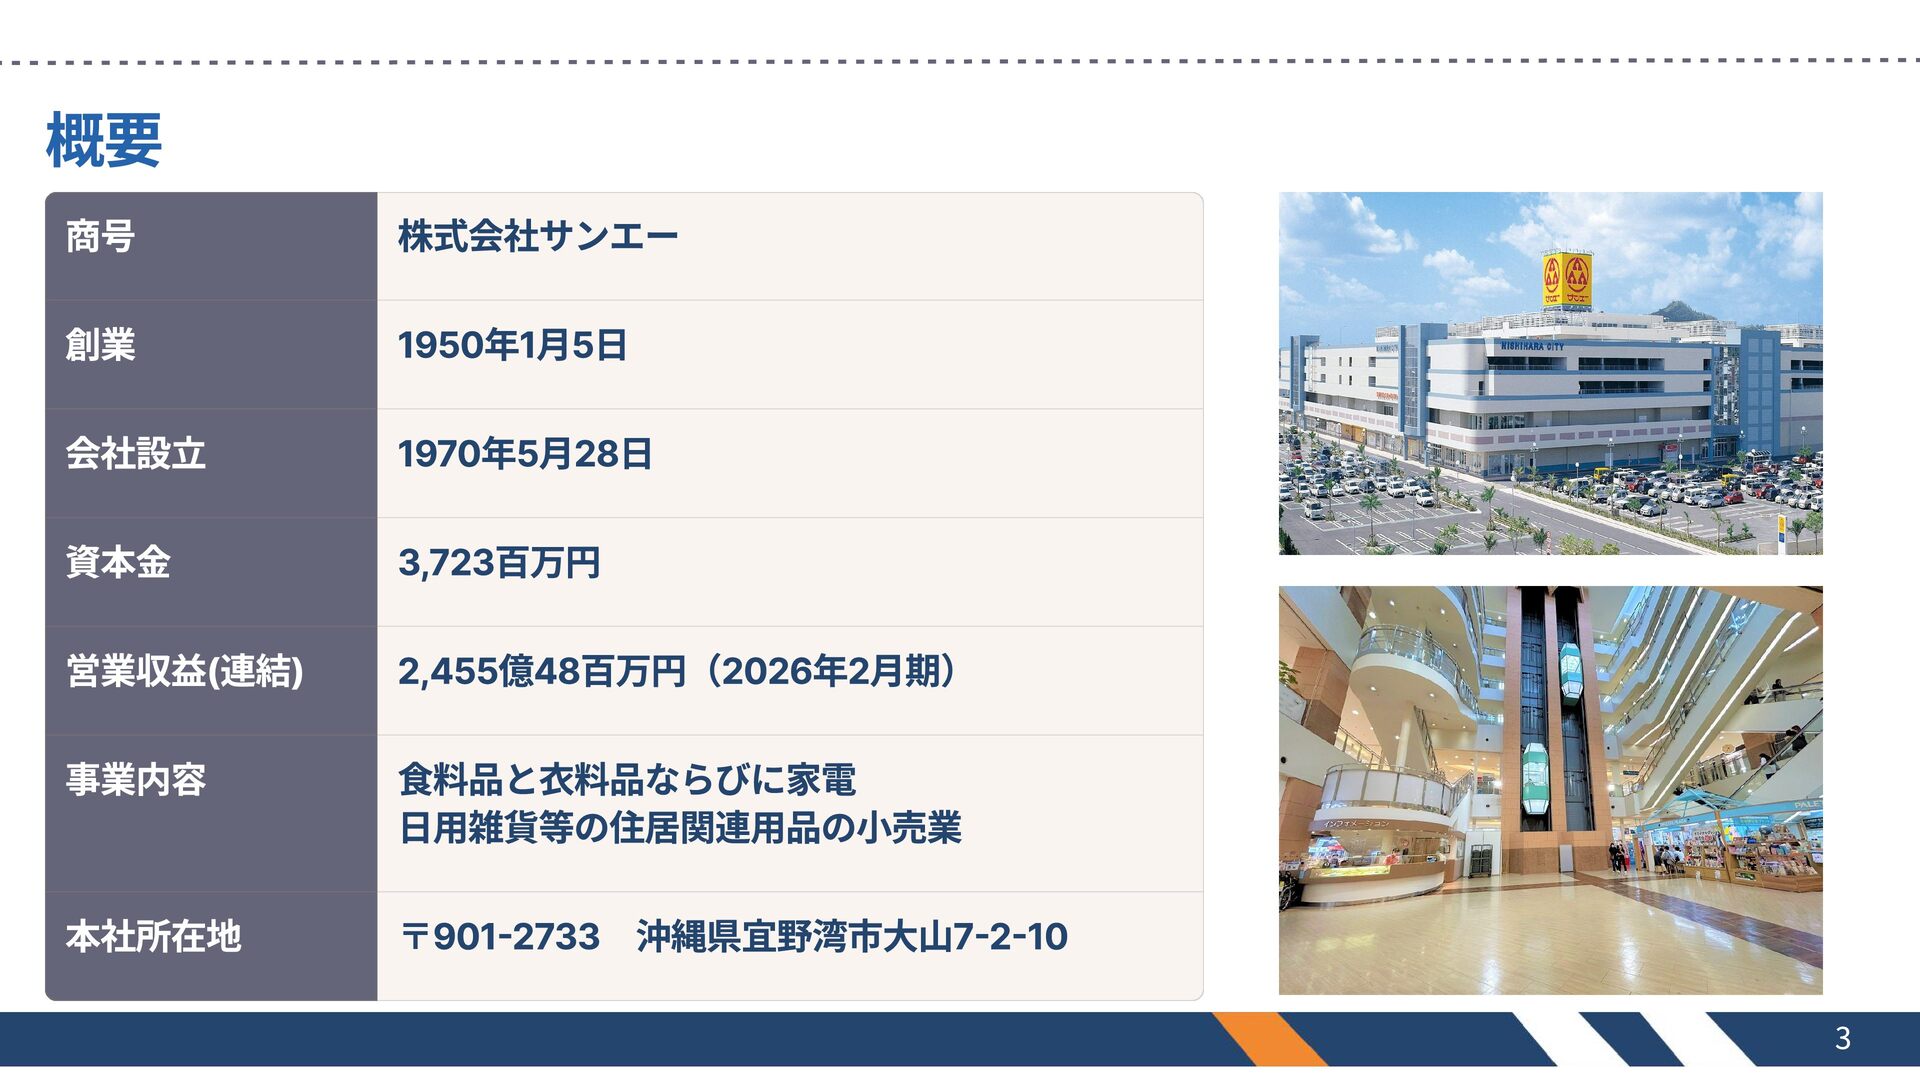
概要 商号 株式会社サンエー 創業 1950年1月5日 会社設立 1970年5月28日 資本金 3,723百万円 営業収益(連結)
2,455億48百万円(2026年2月期) 事業内容 食料品と衣料品ならびに家電 日用雑貨等の住居関連用品の小売業 本社所在地 〒901-2733 沖縄県宜野湾市大山7-2-10 3
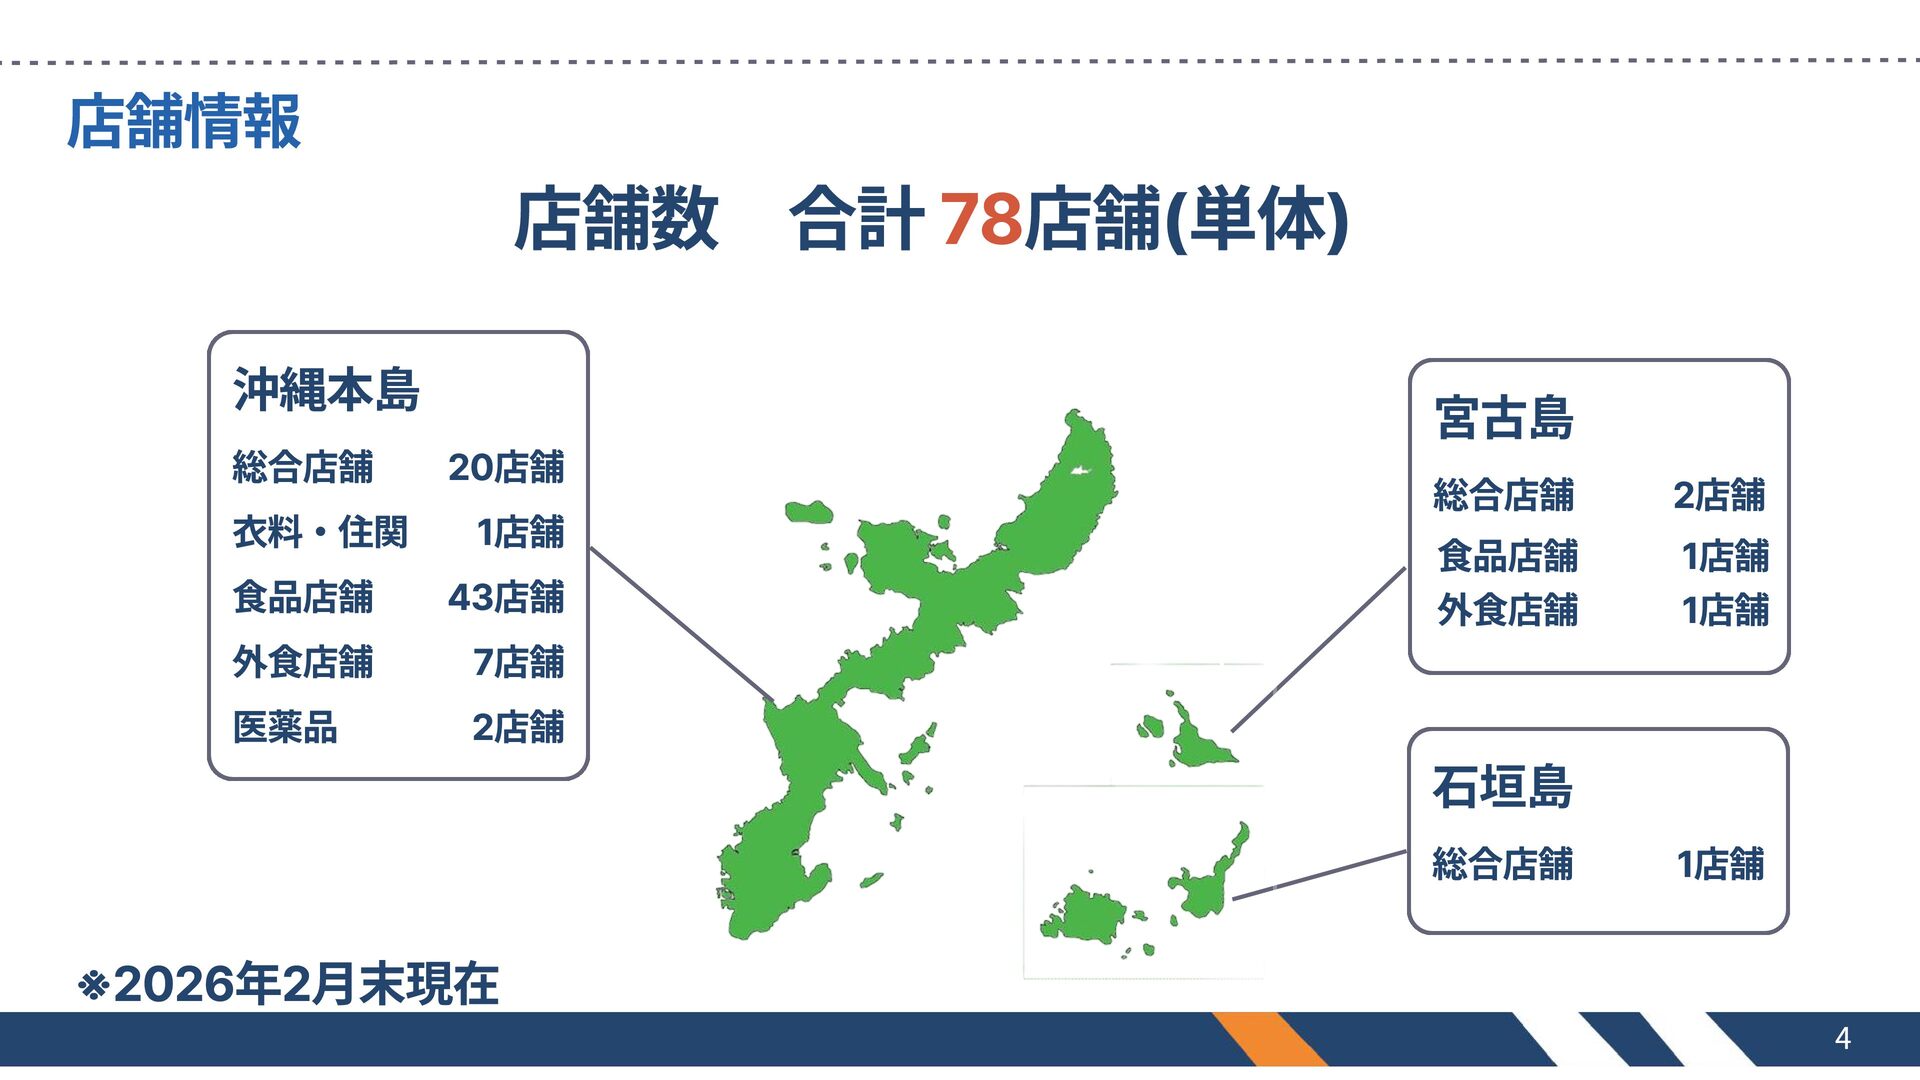
店舗情報 店舗数 合計 78店舗(単体) 沖縄本島 総合店舗 20店舗 衣料・住関 1店舗 食品店舗
43店舗 外食店舗 7店舗 医薬品 2店舗 宮古島 総合店舗 2店舗 食品店舗 外食店舗 1店舗 1店舗 石垣島 総合店舗 ※2026年2月末現在 1店舗 4
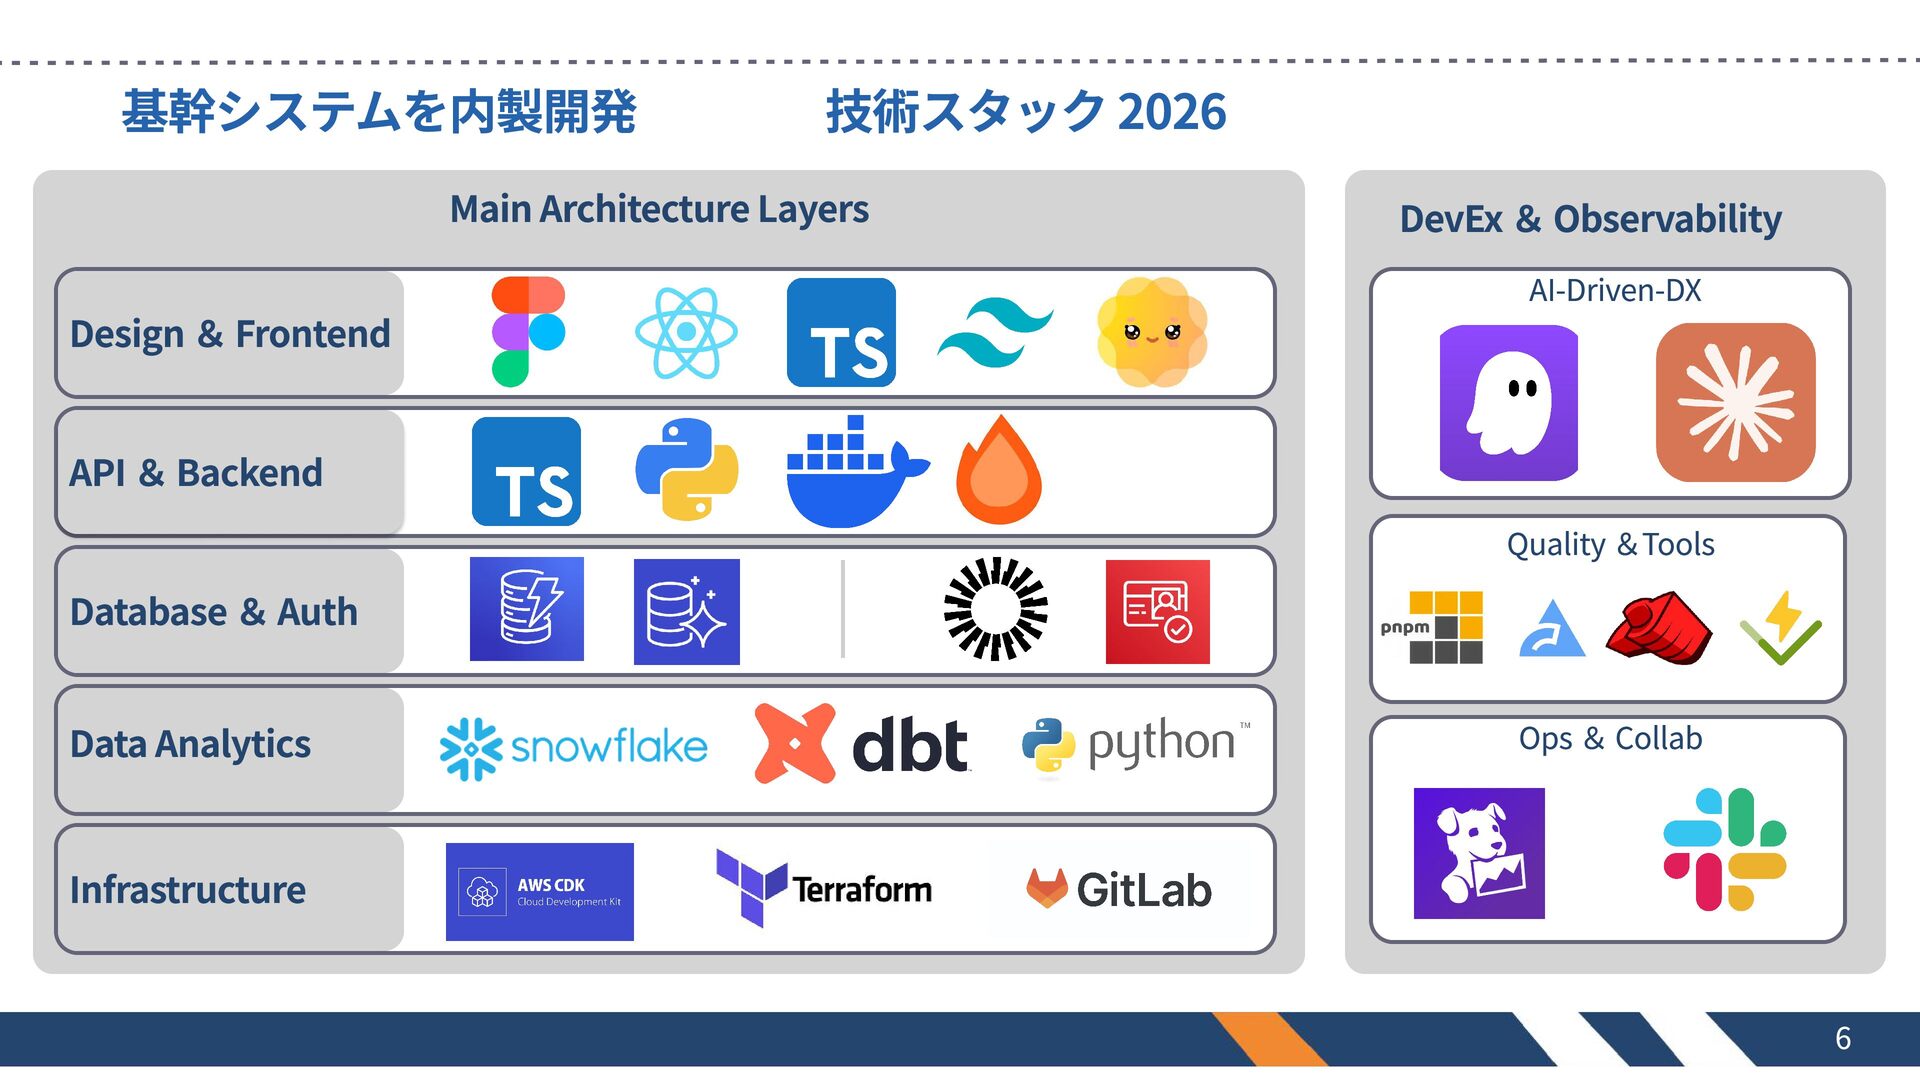
基幹システムを内製開発 技術スタック 2026 Main Architecture Layers Design & Frontend DevEx
& Observability AI-Driven-DX API & Backend Quality &Tools Database & Auth Data Analytics Ops & Collab Infrastructure 6
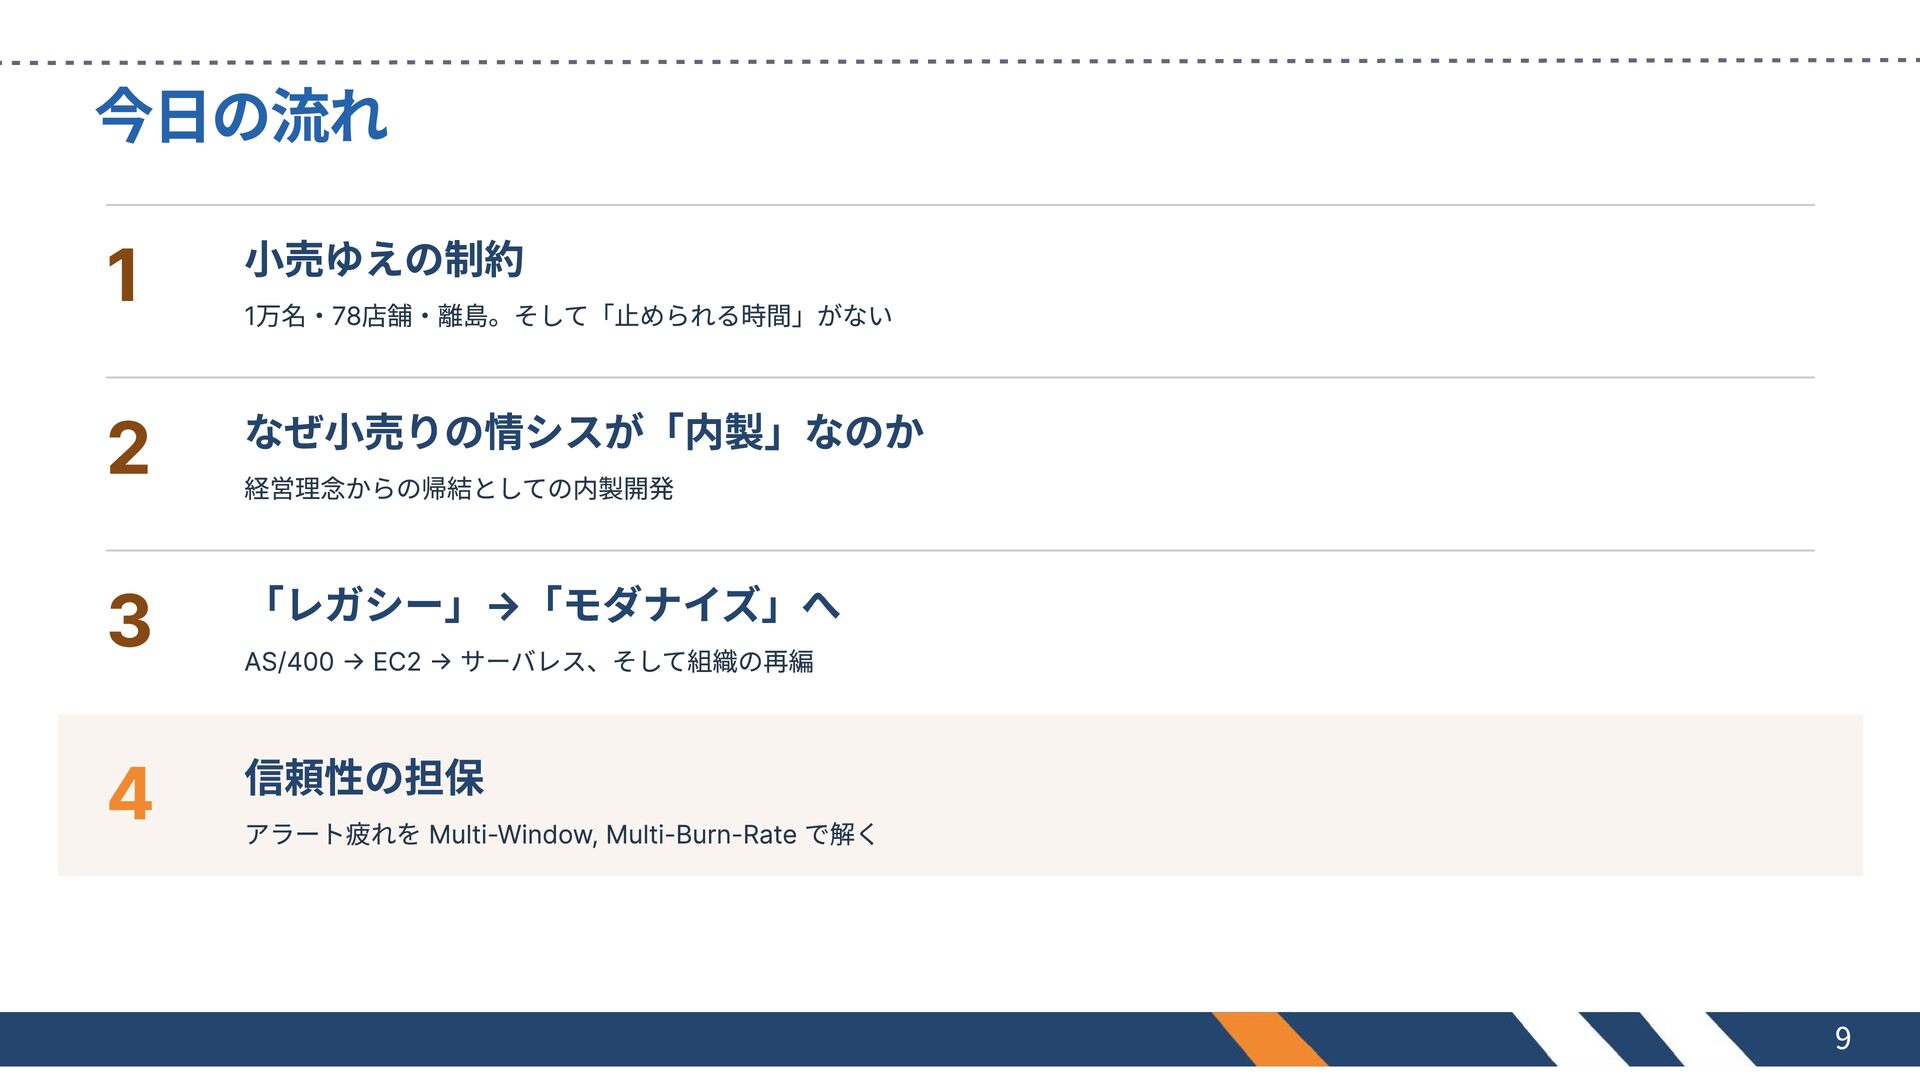
今日の流れ 1 小売ゆえの制約 2 なぜ小売りの情シスが「内製」なのか 3 「レガシー」→「モダナイズ」へ 4 信頼性の担保 1万名・78店舗・離島。そして「止められる時間」がない
経営理念からの帰結としての内製開発 AS/400 → EC2 → サーバレス、そして組織の再編 アラート疲れを Multi-Window, Multi-Burn-Rate で解く 9
SECTION 1 小売ゆえの制約 7
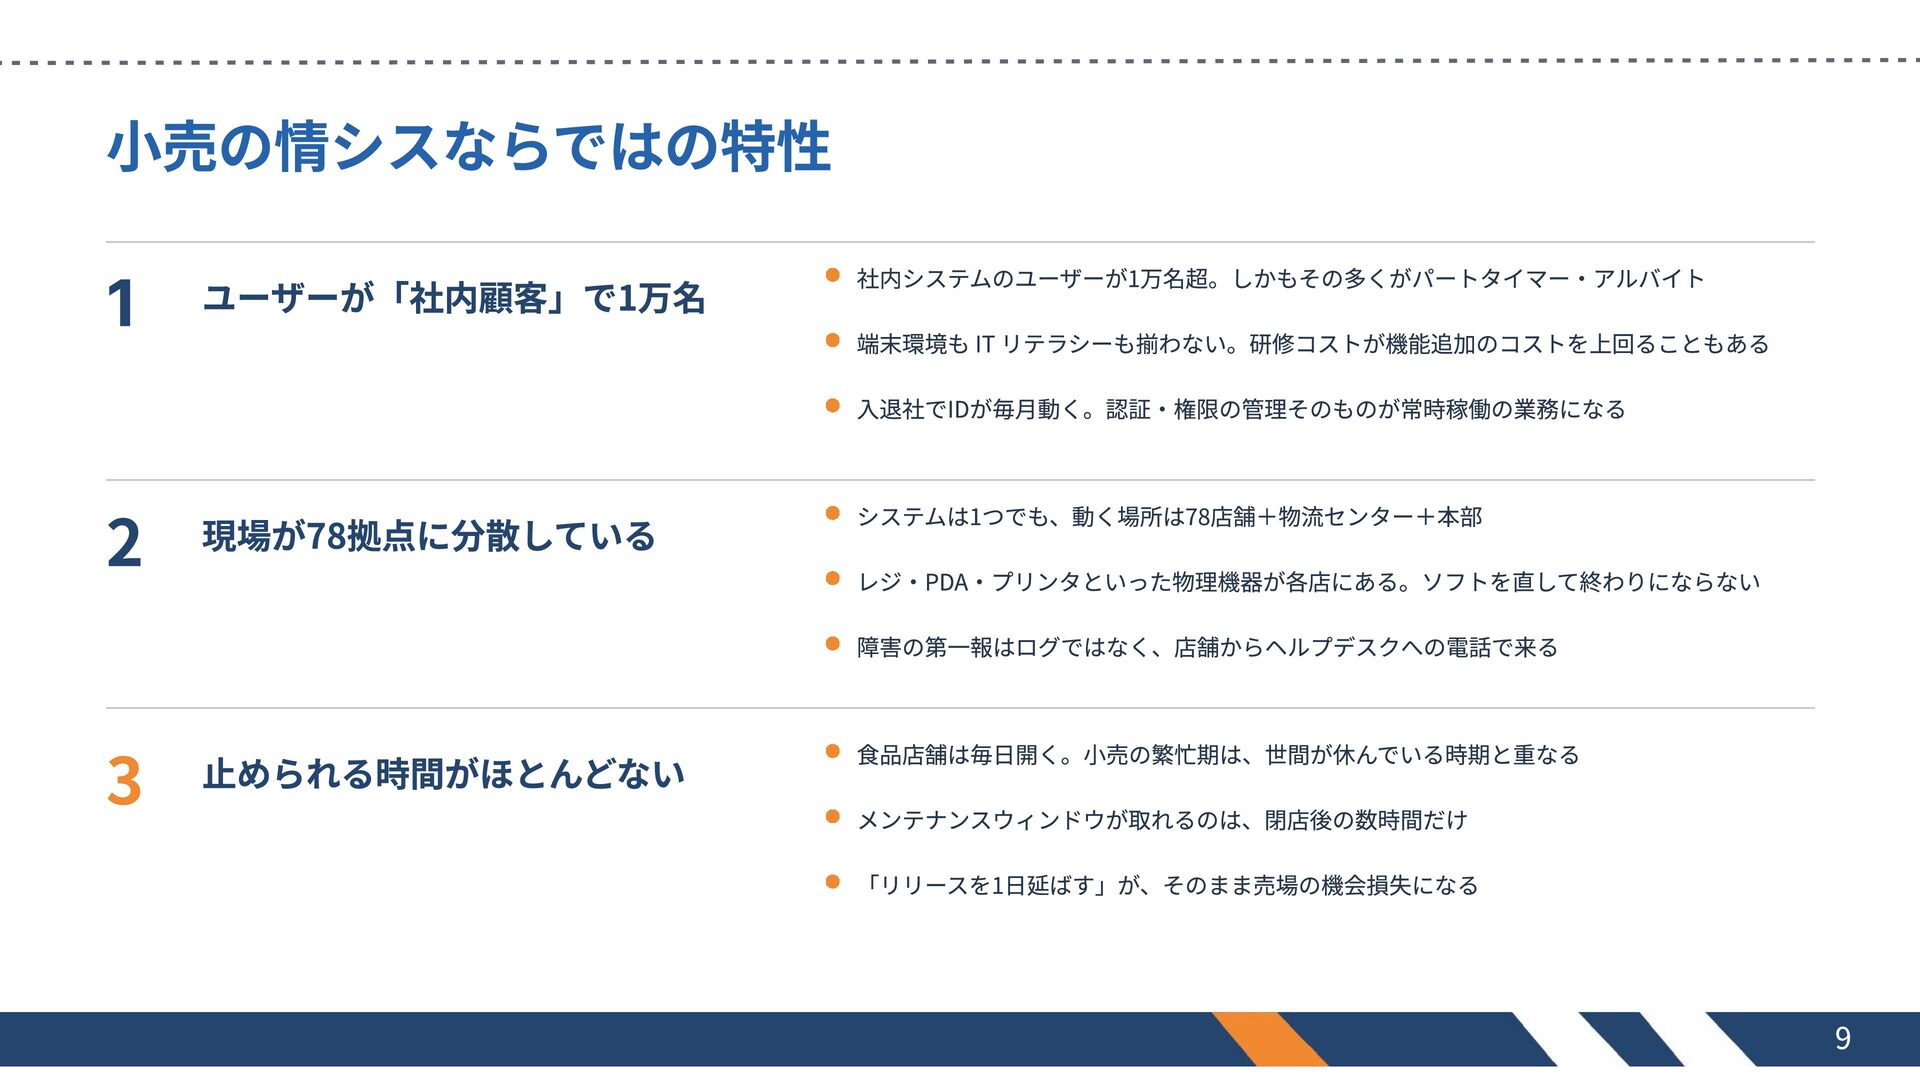
小売の情シスならではの特性 1 ユーザーが「社内顧客」で1万名 社内システムのユーザーが1万名超。しかもその多くがパートタイマー・アルバイト 端末環境も IT リテラシーも揃わない。研修コストが機能追加のコストを上回ることもある 入退社でIDが毎月動く。認証・権限の管理そのものが常時稼働の業務になる 2 現場が78拠点に分散している
システムは1つでも、動く場所は78店舗+物流センター+本部 レジ・PDA・プリンタといった物理機器が各店にある。ソフトを直して終わりにならない 障害の第一報はログではなく、店舗からヘルプデスクへの電話で来る 3 止められる時間がほとんどない 食品店舗は毎日開く。小売の繁忙期は、世間が休んでいる時期と重なる メンテナンスウィンドウが取れるのは、閉店後の数時間だけ 「リリースを1日延ばす」が、そのまま売場の機会損失になる 9
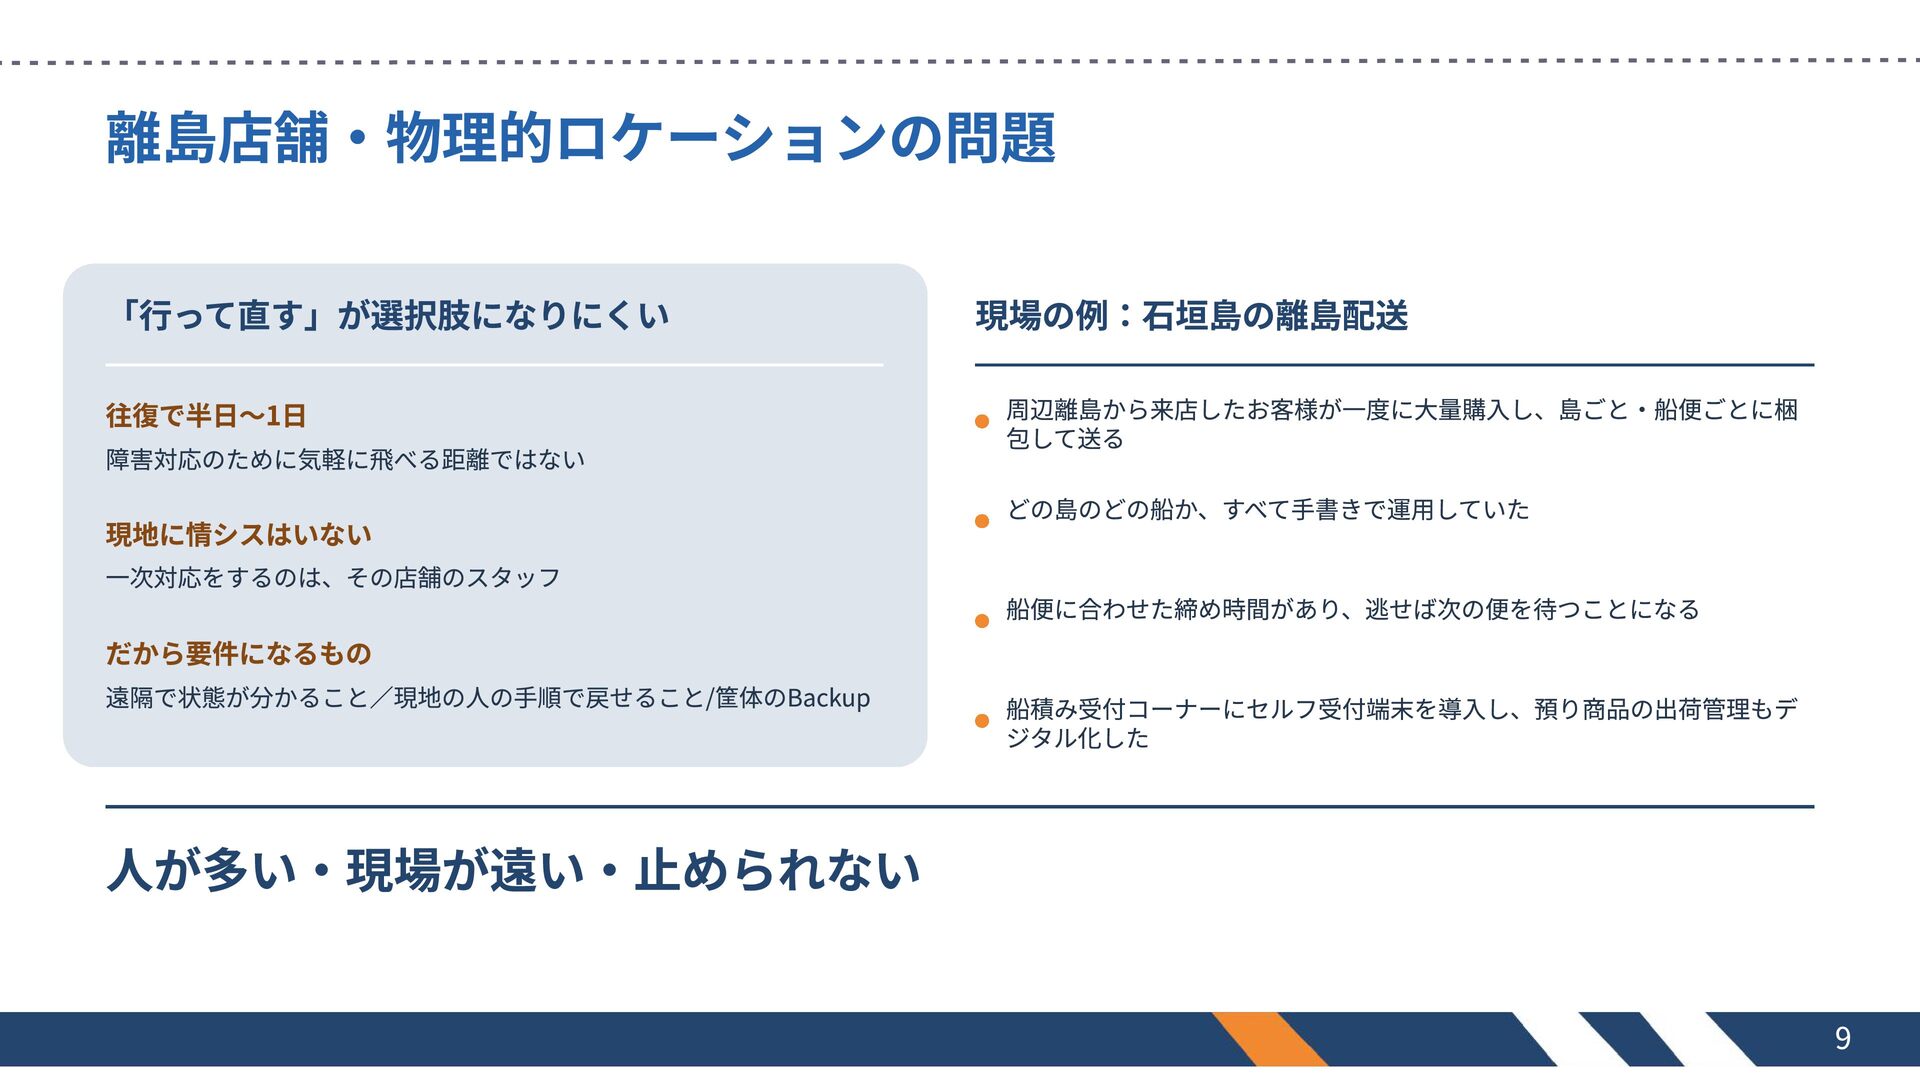
離島店舗・物理的ロケーションの問題 「行って直す」が選択肢になりにくい 往復で半日〜1日 障害対応のために気軽に飛べる距離ではない 現地に情シスはいない 一次対応をするのは、その店舗のスタッフ 現場の例:石垣島の離島配送 周辺離島から来店したお客様が一度に大量購入し、島ごと・船便ごとに梱 包して送る どの島のどの船か、すべて手書きで運用していた
船便に合わせた締め時間があり、逃せば次の便を待つことになる だから要件になるもの 遠隔で状態が分かること/現地の人の手順で戻せること/筐体のBackup 船積み受付コーナーにセルフ受付端末を導入し、預り商品の出荷管理もデ ジタル化した 人が多い・現場が遠い・止められない 9
SECTION 2 なぜ小売の情シスが「内製」なのか 8
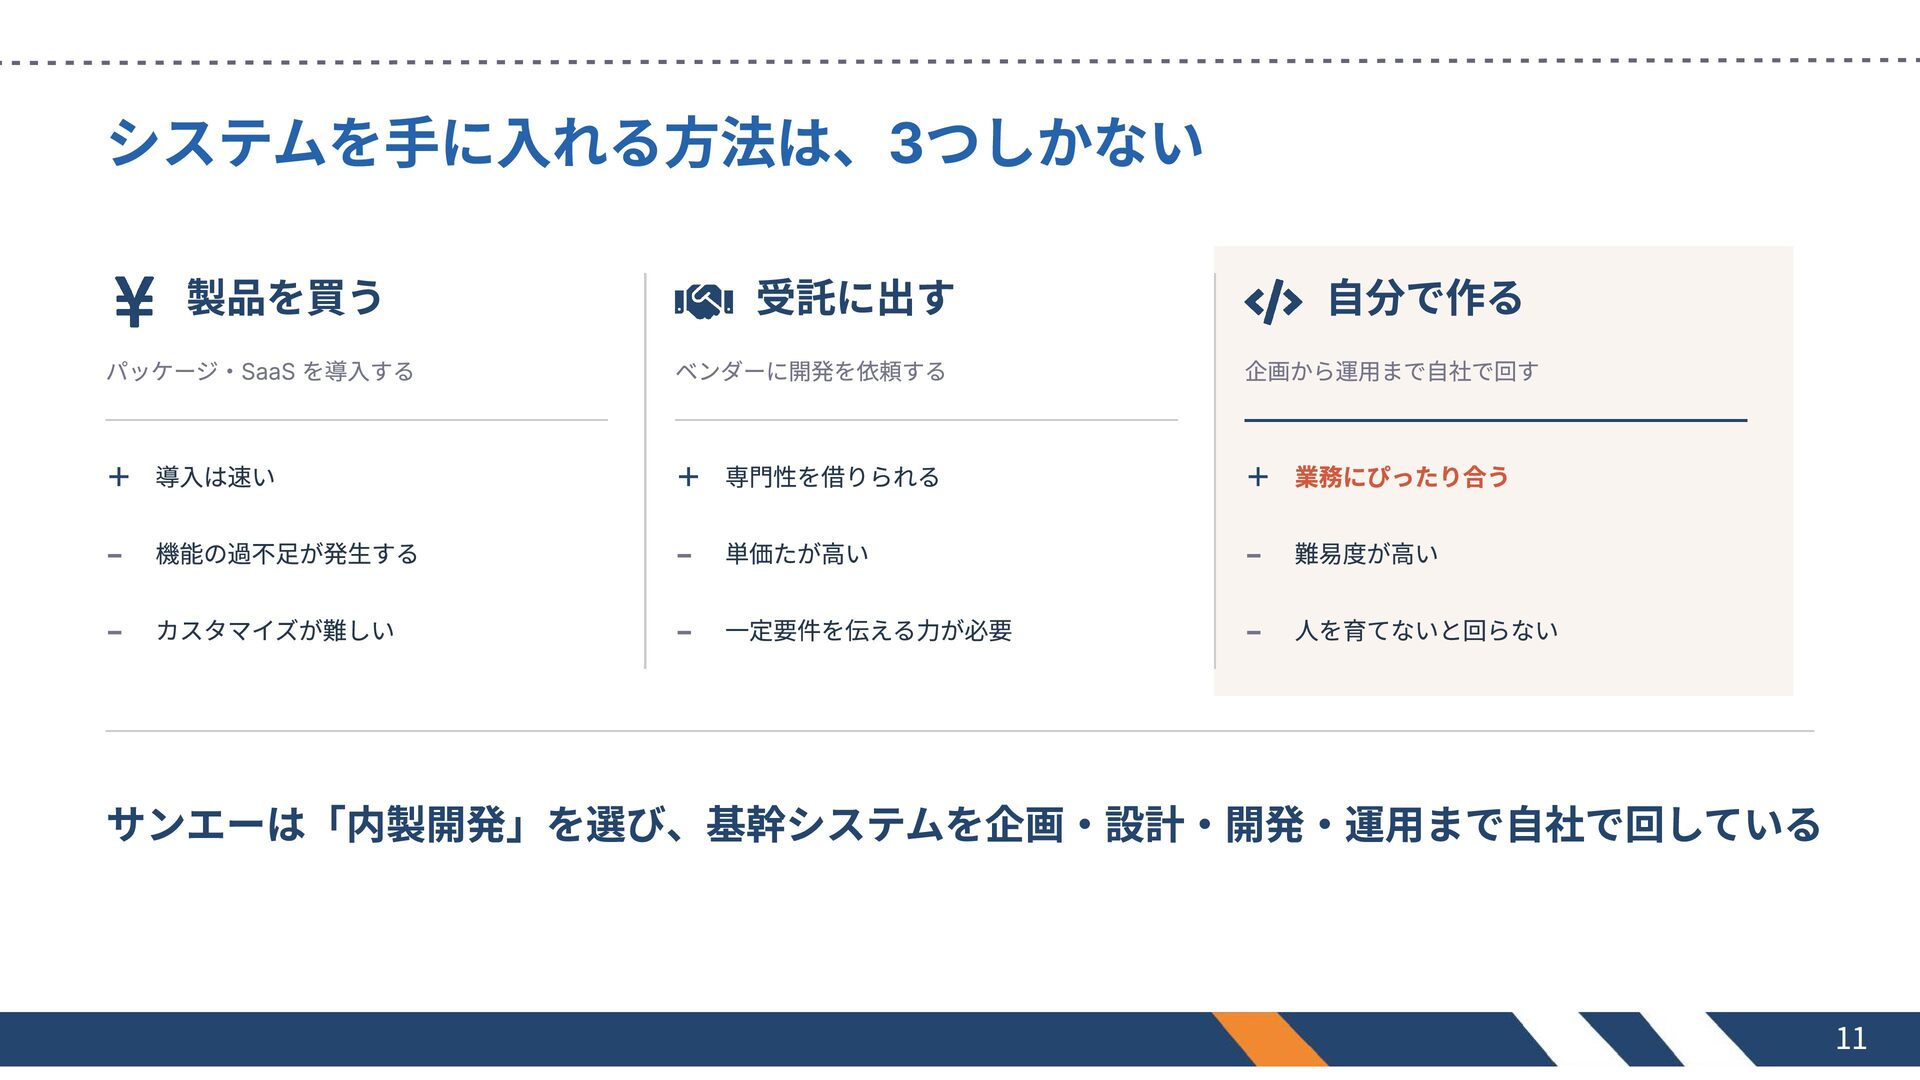
システムを手に入れる方法は、3つしかない 製品を買う 受託に出す 自分で作る パッケージ・SaaS を導入する ベンダーに開発を依頼する 企画から運用まで自社で回す + 導入は速い
+ 専門性を借りられる + 業務にぴったり合う − 機能の過不足が発生する − 単価たが高い − 難易度が高い − カスタマイズが難しい − 一定要件を伝える力が必要 − 人を育てないと回らない サンエーは「内製開発」を選び、基幹システムを企画・設計・開発・運用まで自社で回している 11
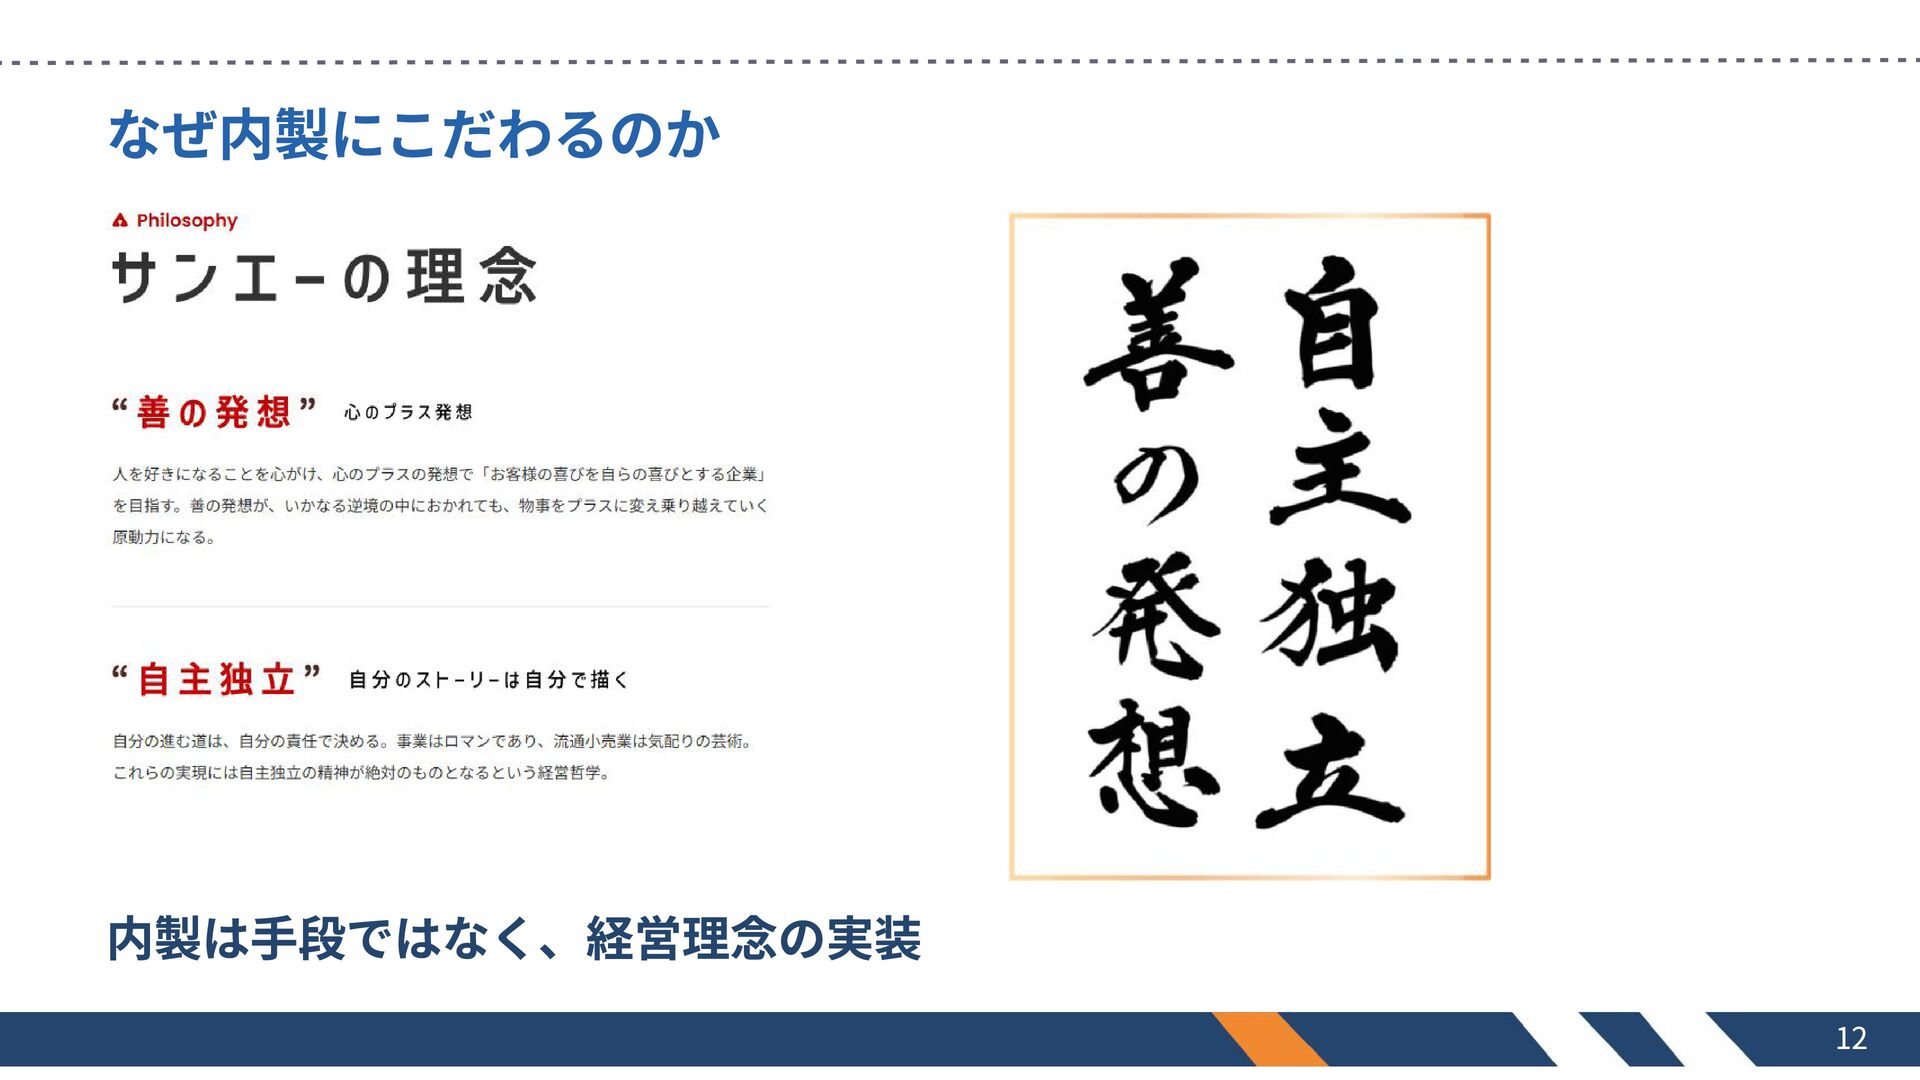
なぜ内製にこだわるのか 内製は手段ではなく、経営理念の実装 12
SECTION 3 「レガシー」から「モダナイズ」へ 11
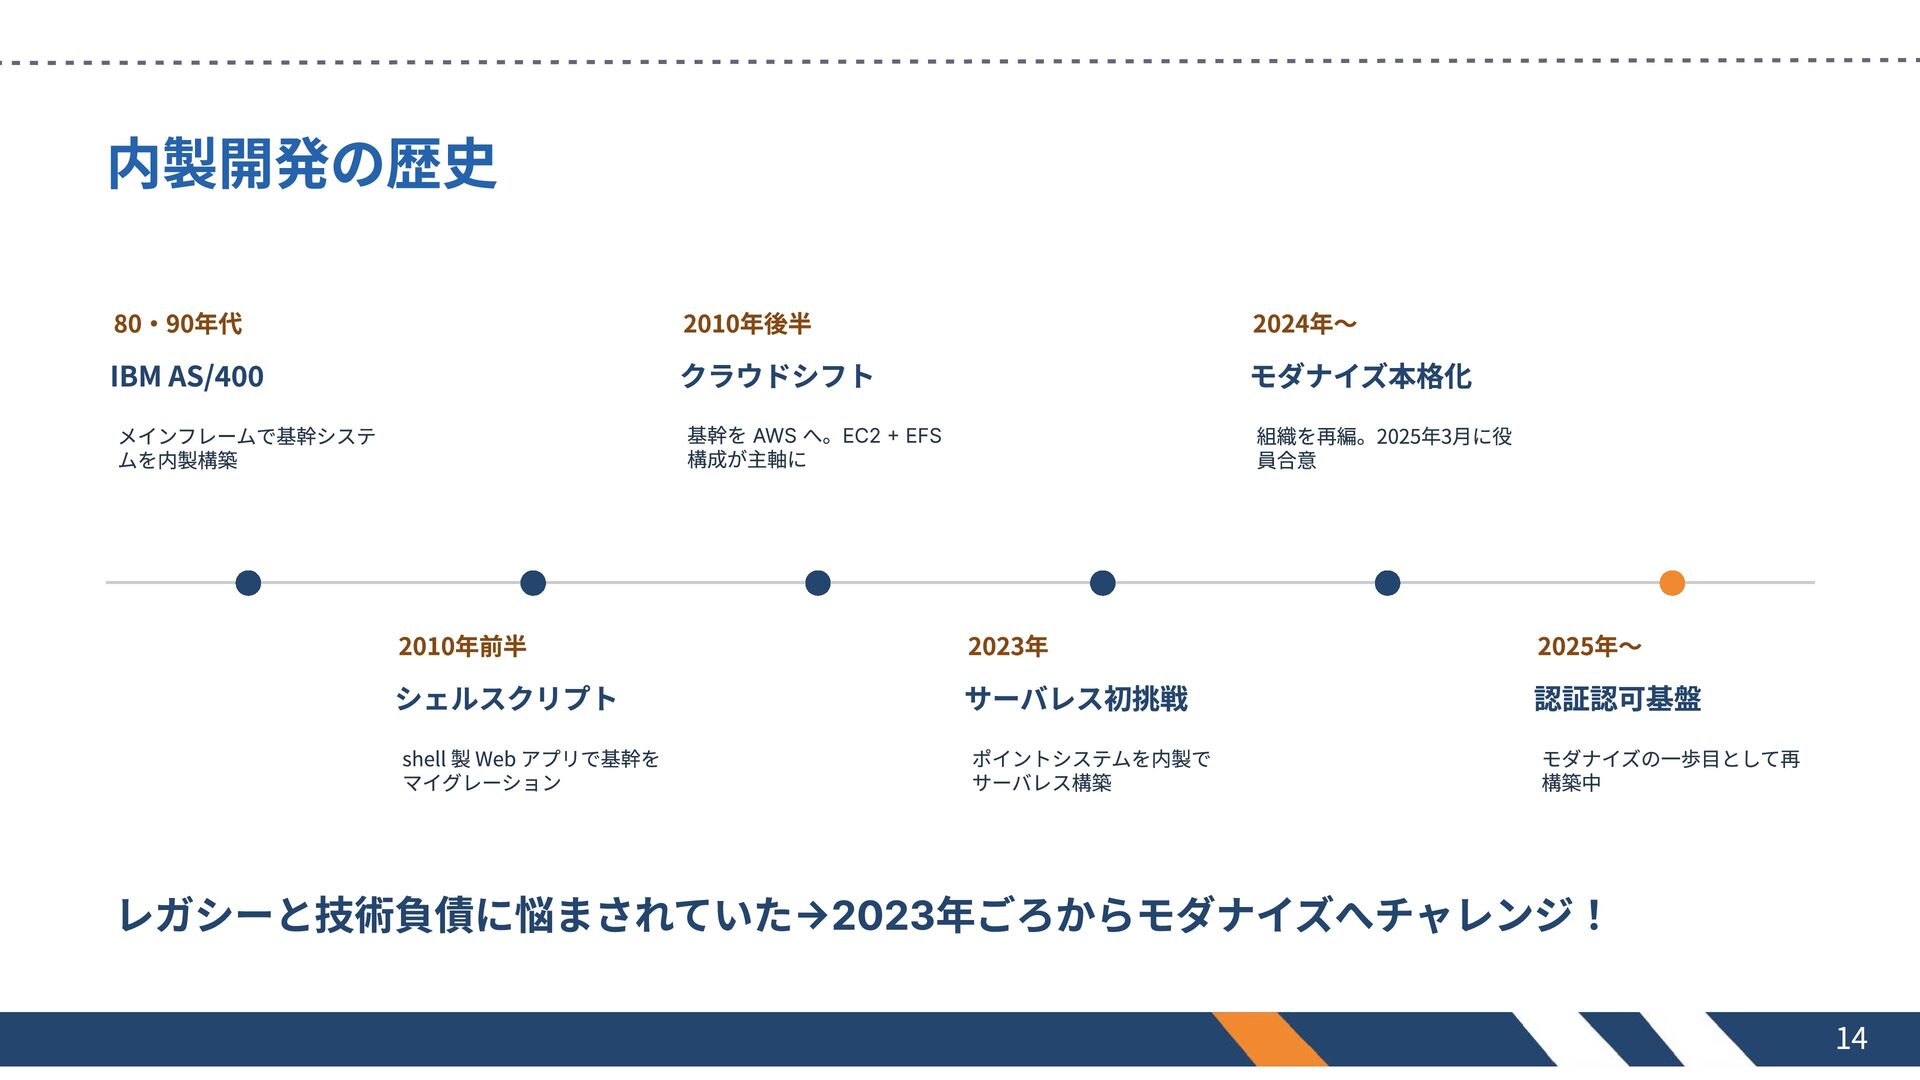
内製開発の歴史 80・90年代 2010年後半 2024年〜 IBM AS/400 クラウドシフト モダナイズ本格化 メインフレームで基幹システ ムを内製構築
基幹を AWS へ。EC2 + EFS 構成が主軸に 組織を再編。2025年3月に役 員合意 2010年前半 2023年 2025年〜 シェルスクリプト サーバレス初挑戦 認証認可基盤 shell 製 Web アプリで基幹を マイグレーション ポイントシステムを内製で サーバレス構築 モダナイズの一歩目として再 構築中 レガシーと技術負債に悩まされていた→2023年ごろからモダナイズへチャレンジ! 14
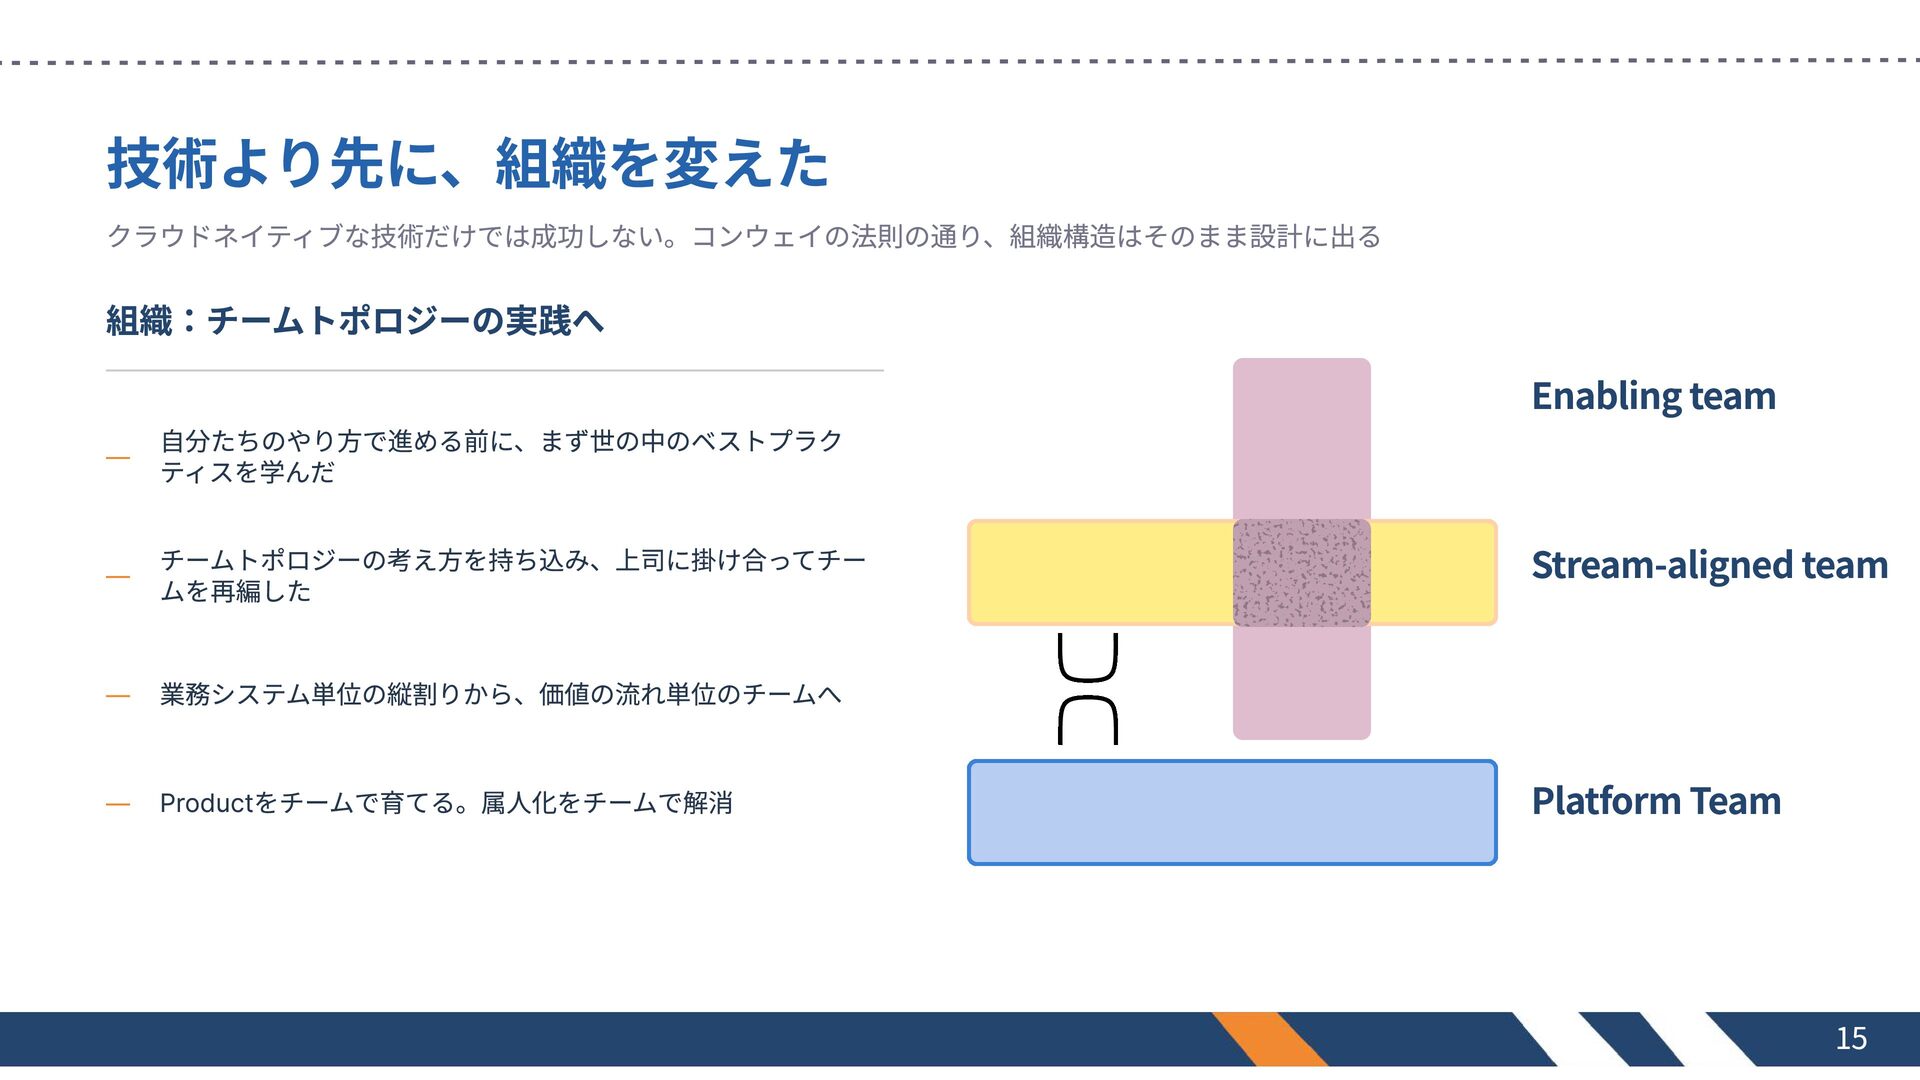
技術より先に、組織を変えた クラウドネイティブな技術だけでは成功しない。コンウェイの法則の通り、組織構造はそのまま設計に出る 組織:チームトポロジーの実践へ Enabling team — 自分たちのやり方で進める前に、まず世の中のベストプラク ティスを学んだ — チームトポロジーの考え方を持ち込み、上司に掛け合ってチー
ムを再編した — 業務システム単位の縦割りから、価値の流れ単位のチームへ — Productをチームで育てる。属人化をチームで解消 Stream-aligned team Platform Team 15
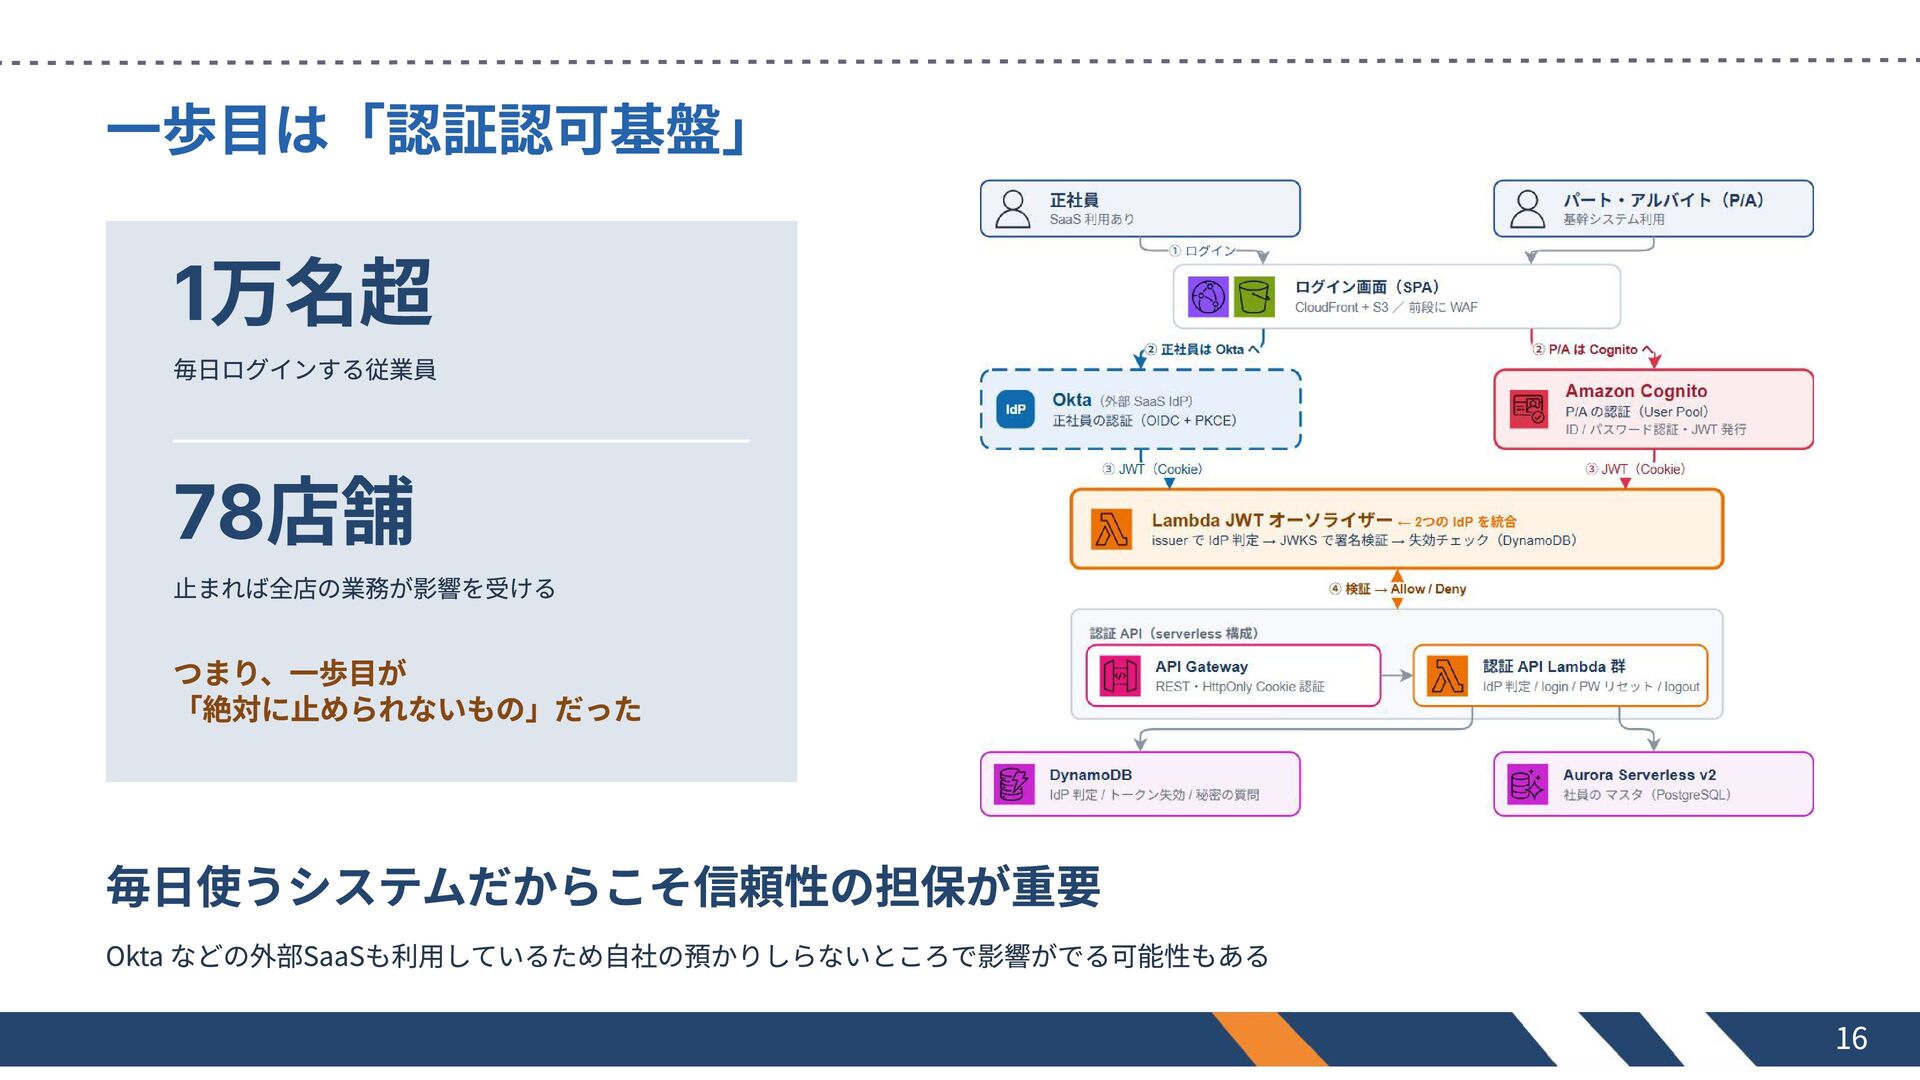
一歩目は「認証認可基盤」 1万名超 毎日ログインする従業員 78店舗 止まれば全店の業務が影響を受ける つまり、一歩目が 「絶対に止められないもの」だった 毎日使うシステムだからこそ信頼性の担保が重要 Okta などの外部SaaSも利用しているため自社の預かりしらないところで影響がでる可能性もある
16
SECTION 4 信頼性の担保 16
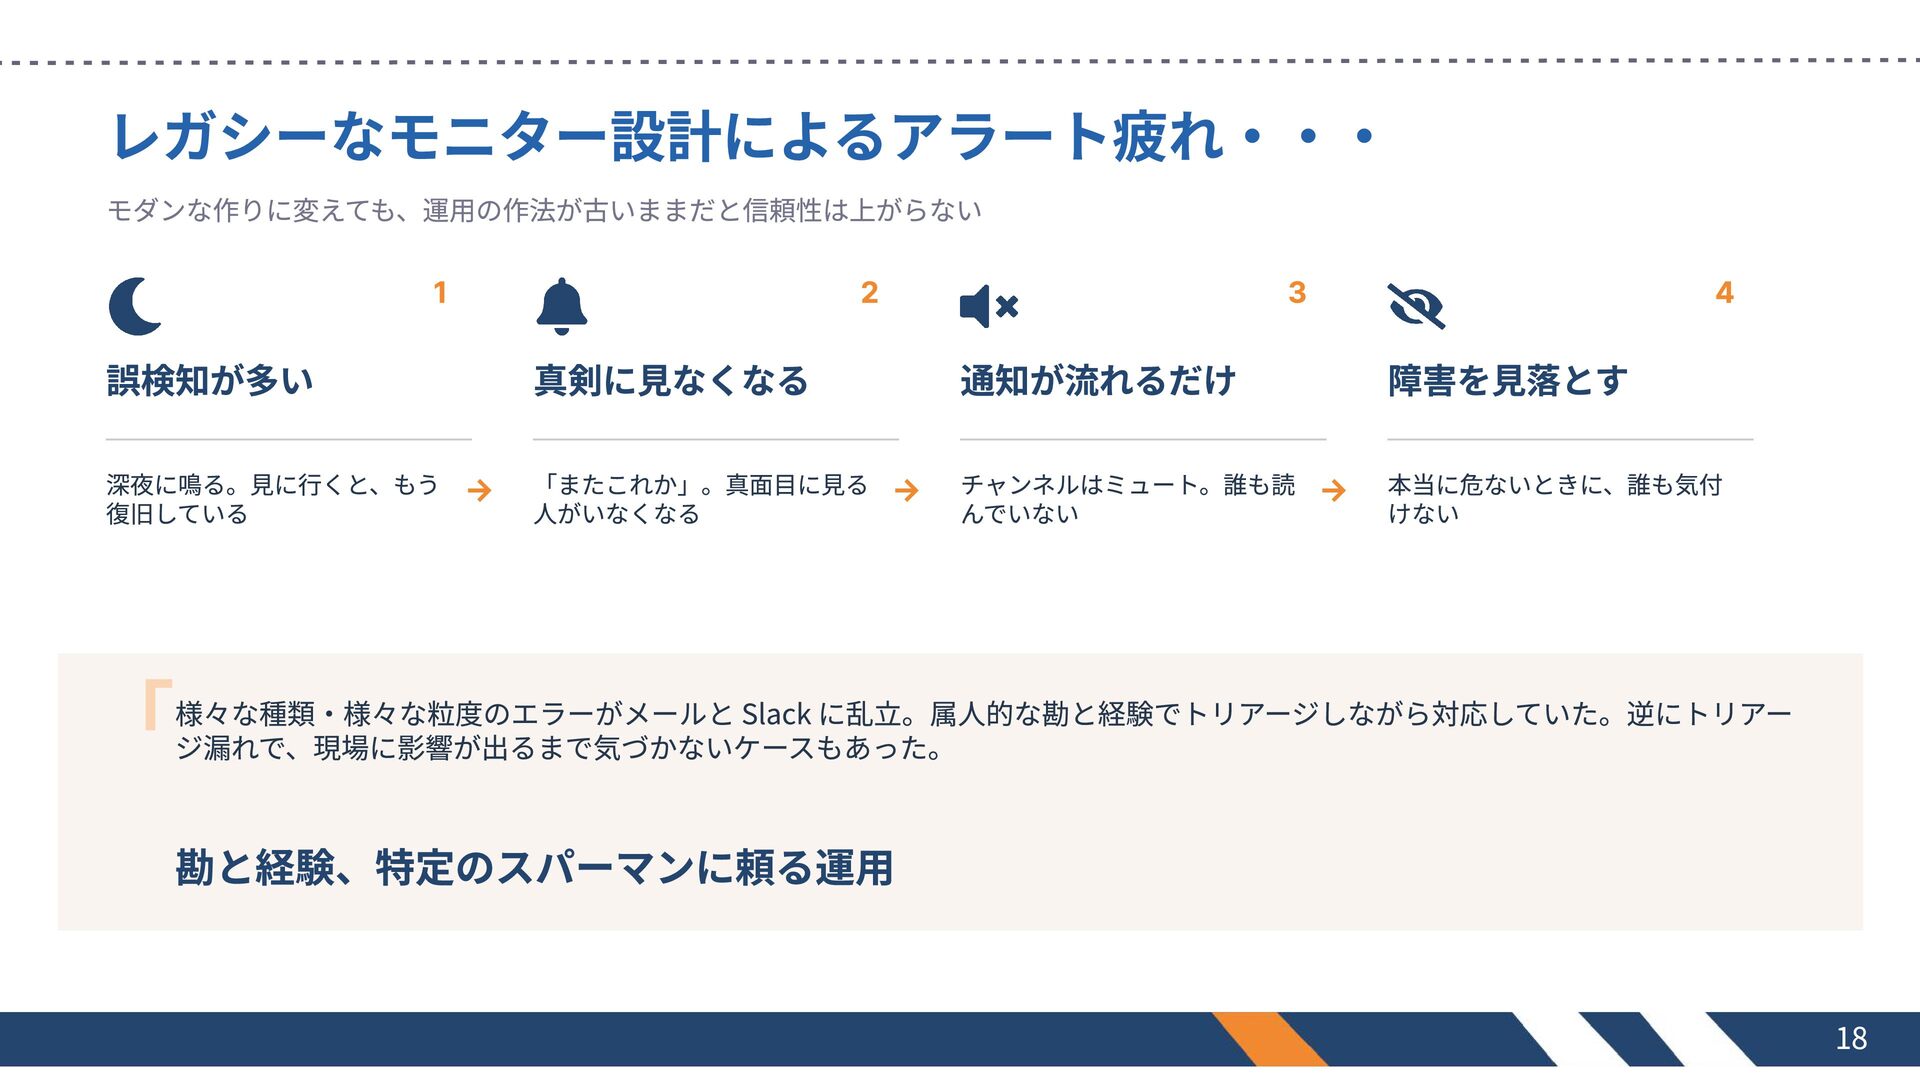
レガシーなモニター設計によるアラート疲れ・・・ モダンな作りに変えても、運用の作法が古いままだと信頼性は上がらない 1 2 誤検知が多い 深夜に鳴る。見に行くと、もう 復旧している 「 3 真剣に見なくなる
→ 「またこれか」。真面目に見る 人がいなくなる 4 通知が流れるだけ → チャンネルはミュート。誰も読 んでいない 障害を見落とす → 本当に危ないときに、誰も気付 けない 様々な種類・様々な粒度のエラーがメールと Slack に乱立。属人的な勘と経験でトリアージしながら対応していた。逆にトリアー ジ漏れで、現場に影響が出るまで気づかないケースもあった。 勘と経験、特定のスパーマンに頼る運用 18
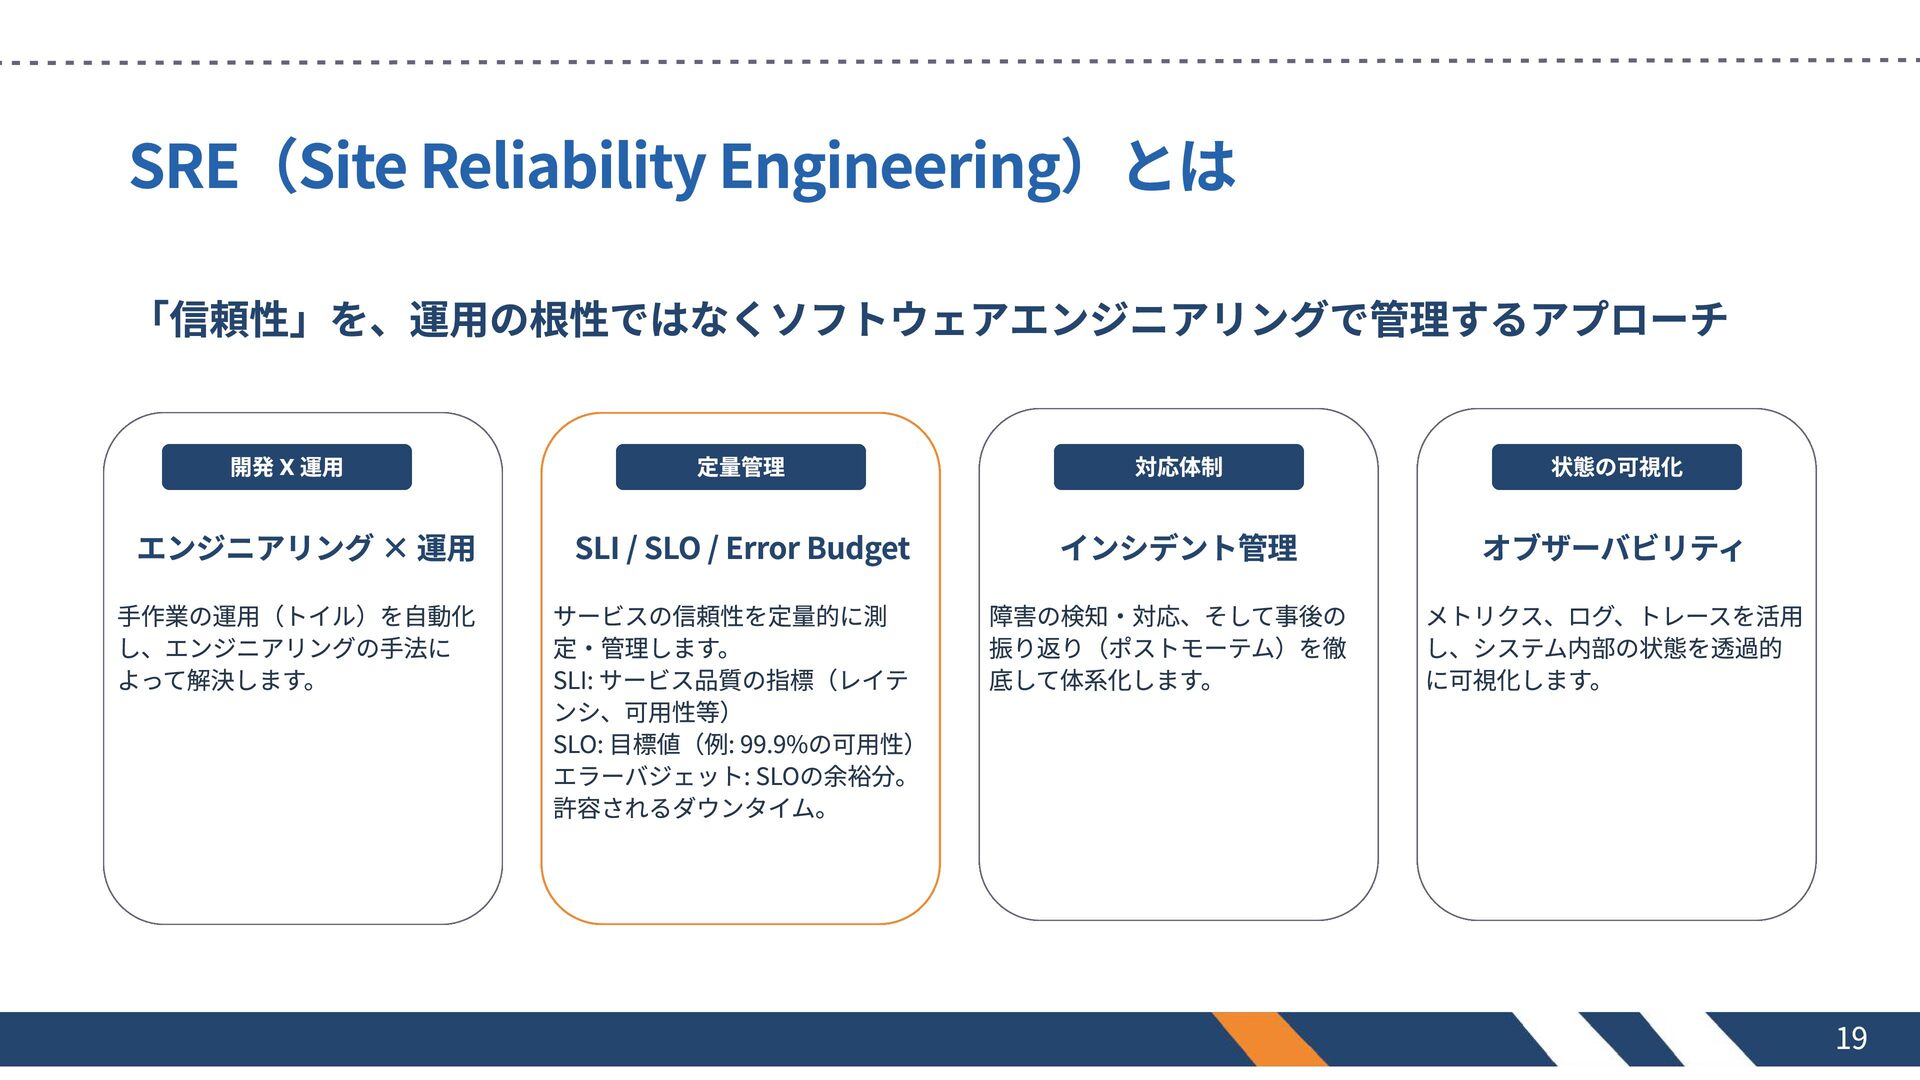
SRE(Site Reliability Engineering)とは 「信頼性」を、運用の根性ではなくソフトウェアエンジニアリングで管理するアプローチ 開発 X 運用 開発 定量管理 X
運用 対応体制 状態の可視化 エンジニアリング × 運用 SLI / SLO / Error Budget インシデント管理 オブザーバビリティ 手作業の運用(トイル)を自動化 し、エンジニアリングの手法に よって解決します。 サービスの信頼性を定量的に測 定・管理します。 SLI: サービス品質の指標(レイテ ンシ、可用性等) SLO: 目標値(例: 99.9%の可用性) エラーバジェット: SLOの余裕分。 許容されるダウンタイム。 障害の検知・対応、そして事後の 振り返り(ポストモーテム)を徹 底して体系化します。 メトリクス、ログ、トレースを活用 し、システム内部の状態を透過的 に可視化します。 19
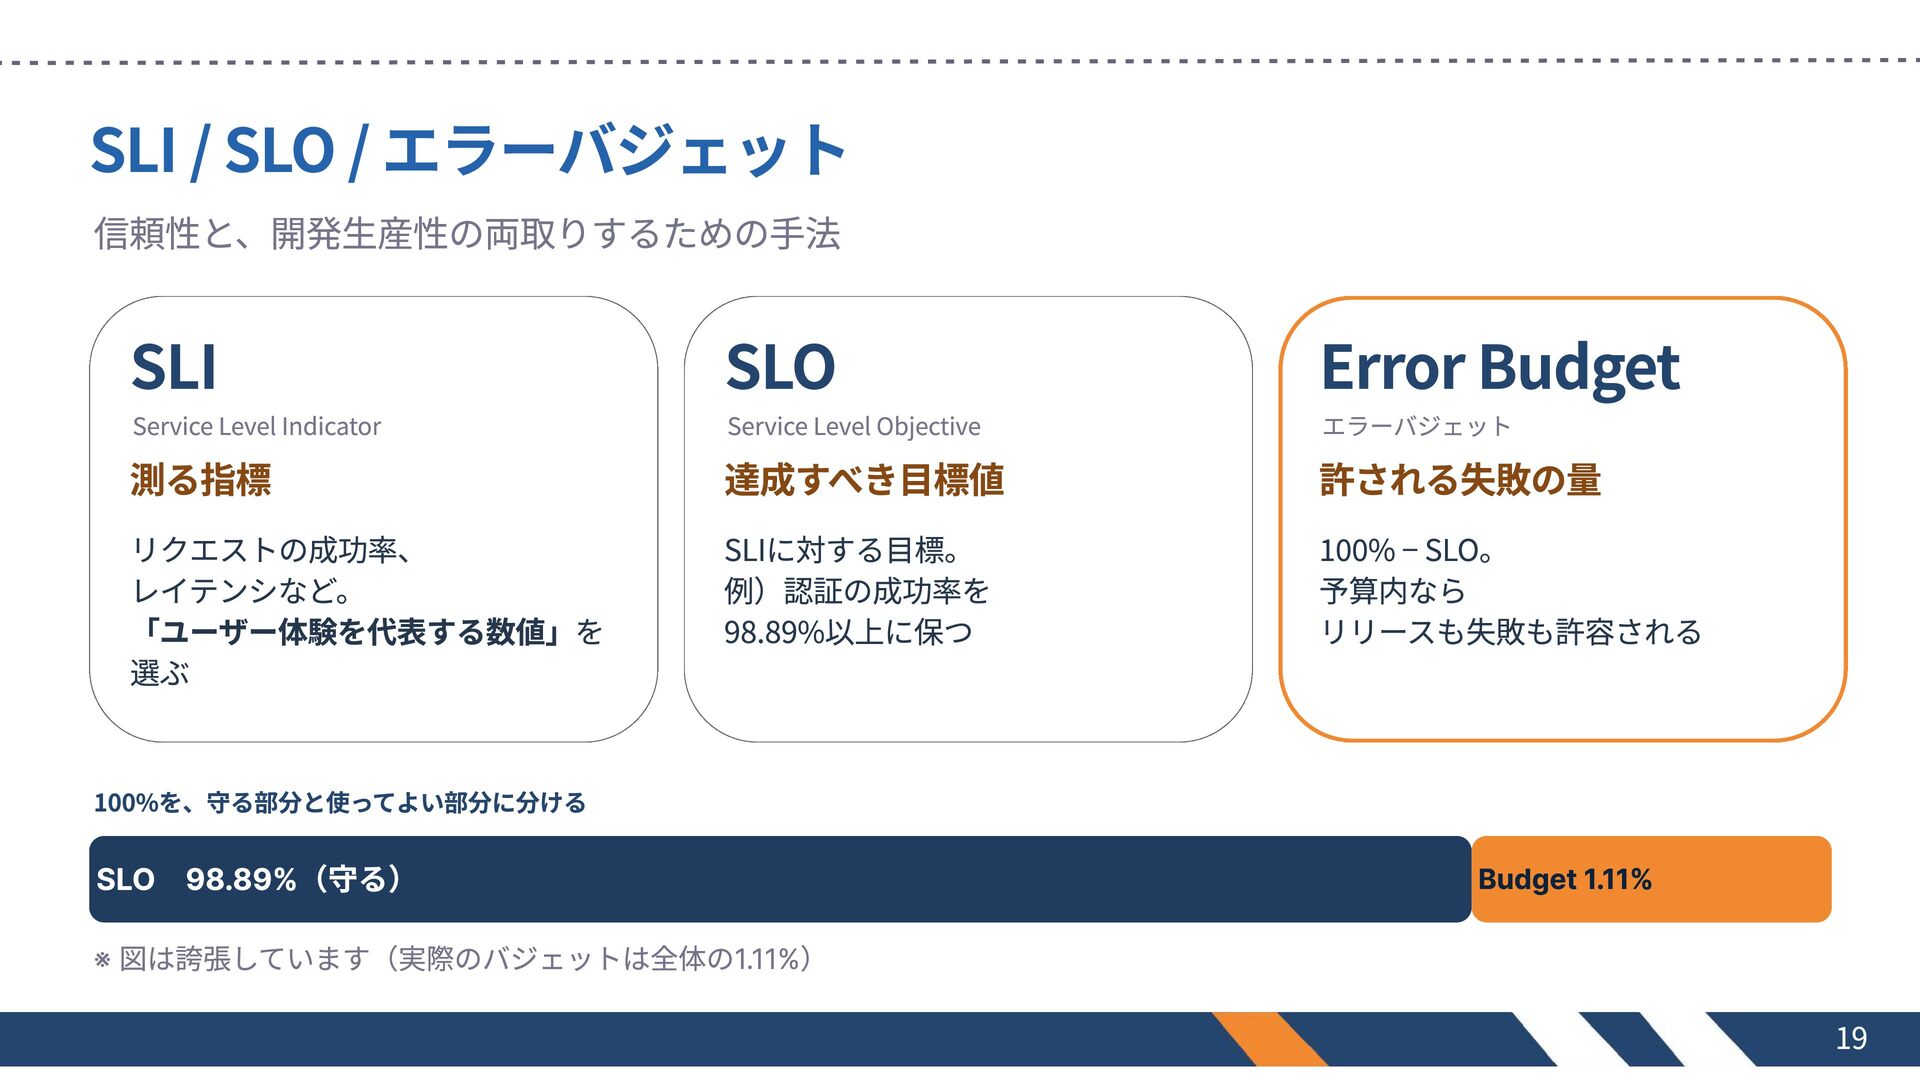
/ / エラーバジェット SLI SLO Error Budget 測る指標 達成すべき目標値 許される失敗の量
リクエストの成功率、 レイテンシなど。 「ユーザー体験を代表する数値」を 選ぶ SLIに対する目標。 例)認証の成功率を 98.89%以上に保つ 100% − SLO。 予算内なら リリースも失敗も許容される SLI SLO 信頼性と、開発生産性の両取りするための手法 Service Level Indicator Service Level Objective エラーバジェット 100%を、守る部分と使ってよい部分に分ける SLO 98.89%(守る) Budget 1.11% ※ 図は誇張しています(実際のバジェットは全体の1.11%) 19
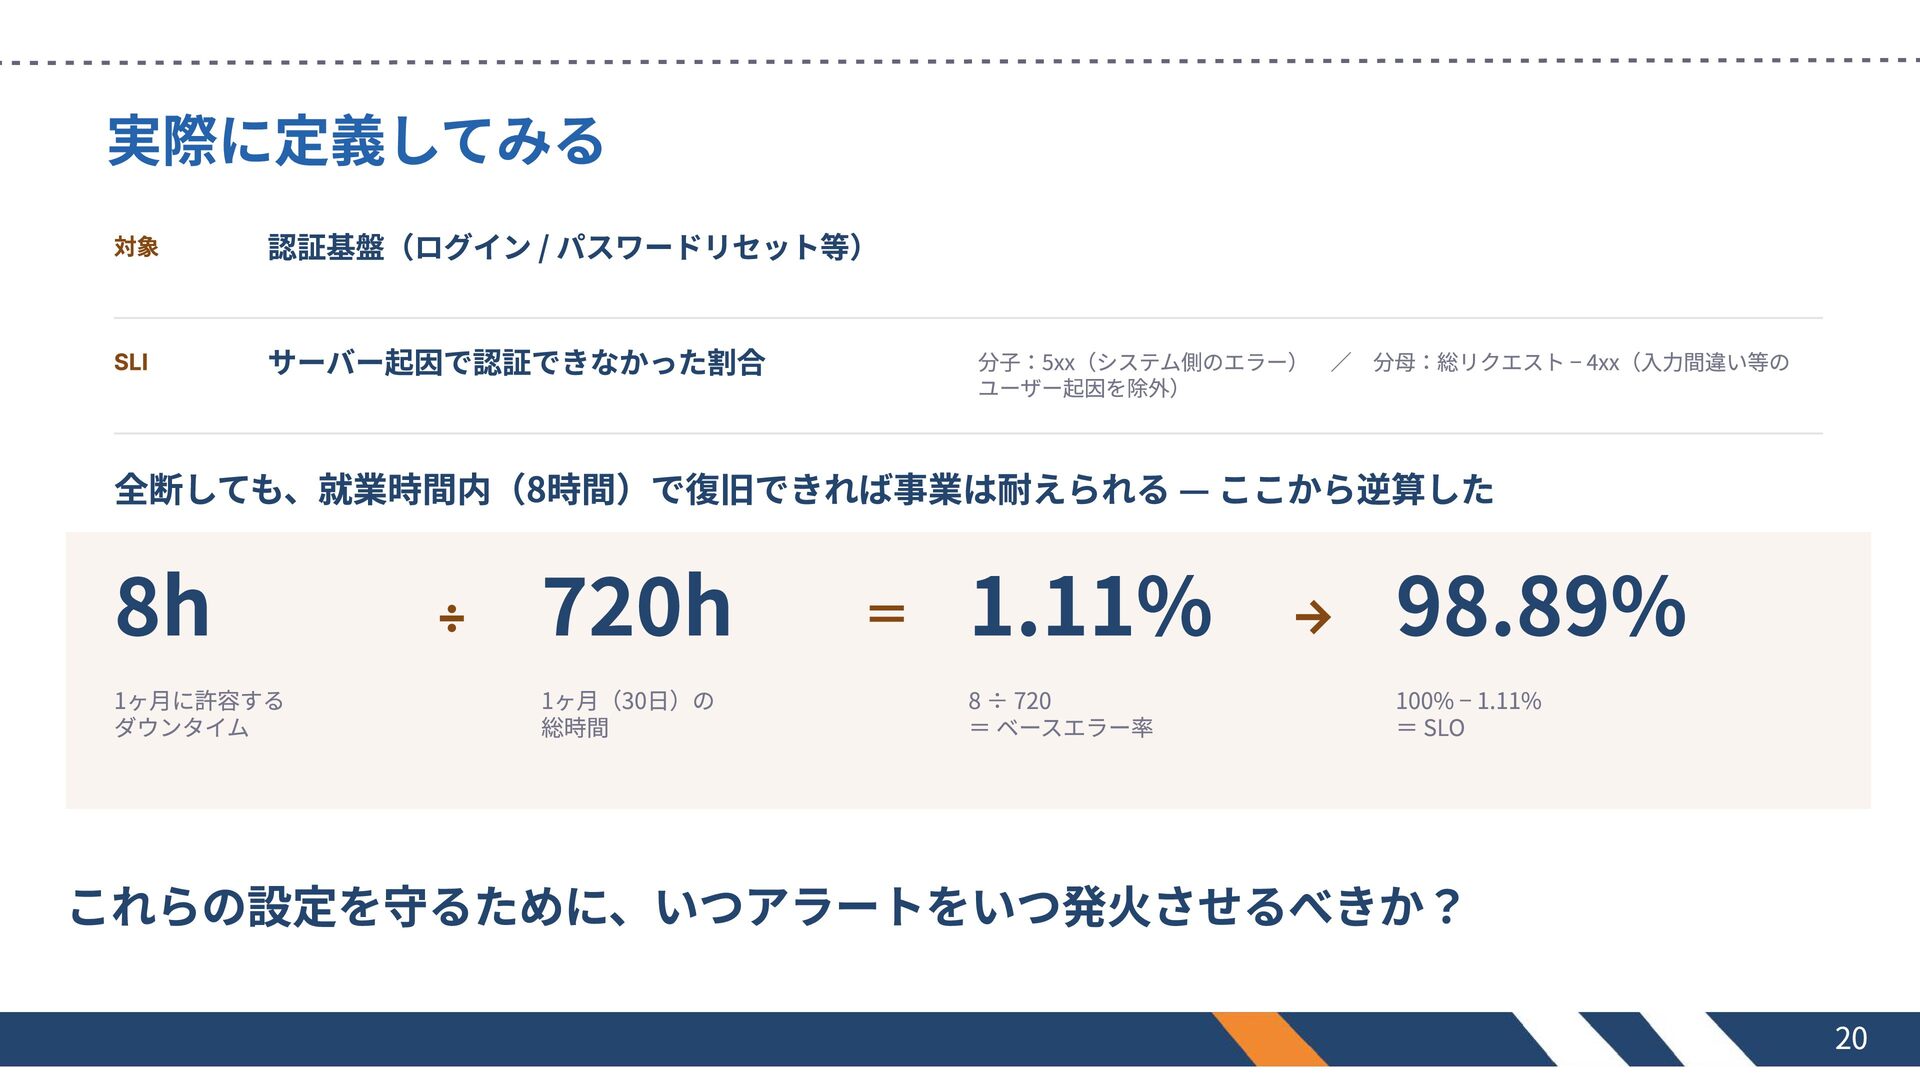
実際に定義してみる 対象 認証基盤(ログイン / パスワードリセット等) SLI サーバー起因で認証できなかった割合 分子:5xx(システム側のエラー) / 分母:総リクエスト
− 4xx(入力間違い等の ユーザー起因を除外) 全断しても、就業時間内(8時間)で復旧できれば事業は耐えられる — ここから逆算した 8h 1ヶ月に許容する ダウンタイム ÷ 720h 1ヶ月(30日)の 総時間 = 1.11% 8 ÷ 720 = ベースエラー率 → 98.89% 100% − 1.11% = SLO これらの設定を守るために、いつアラートをいつ発火させるべきか? 20
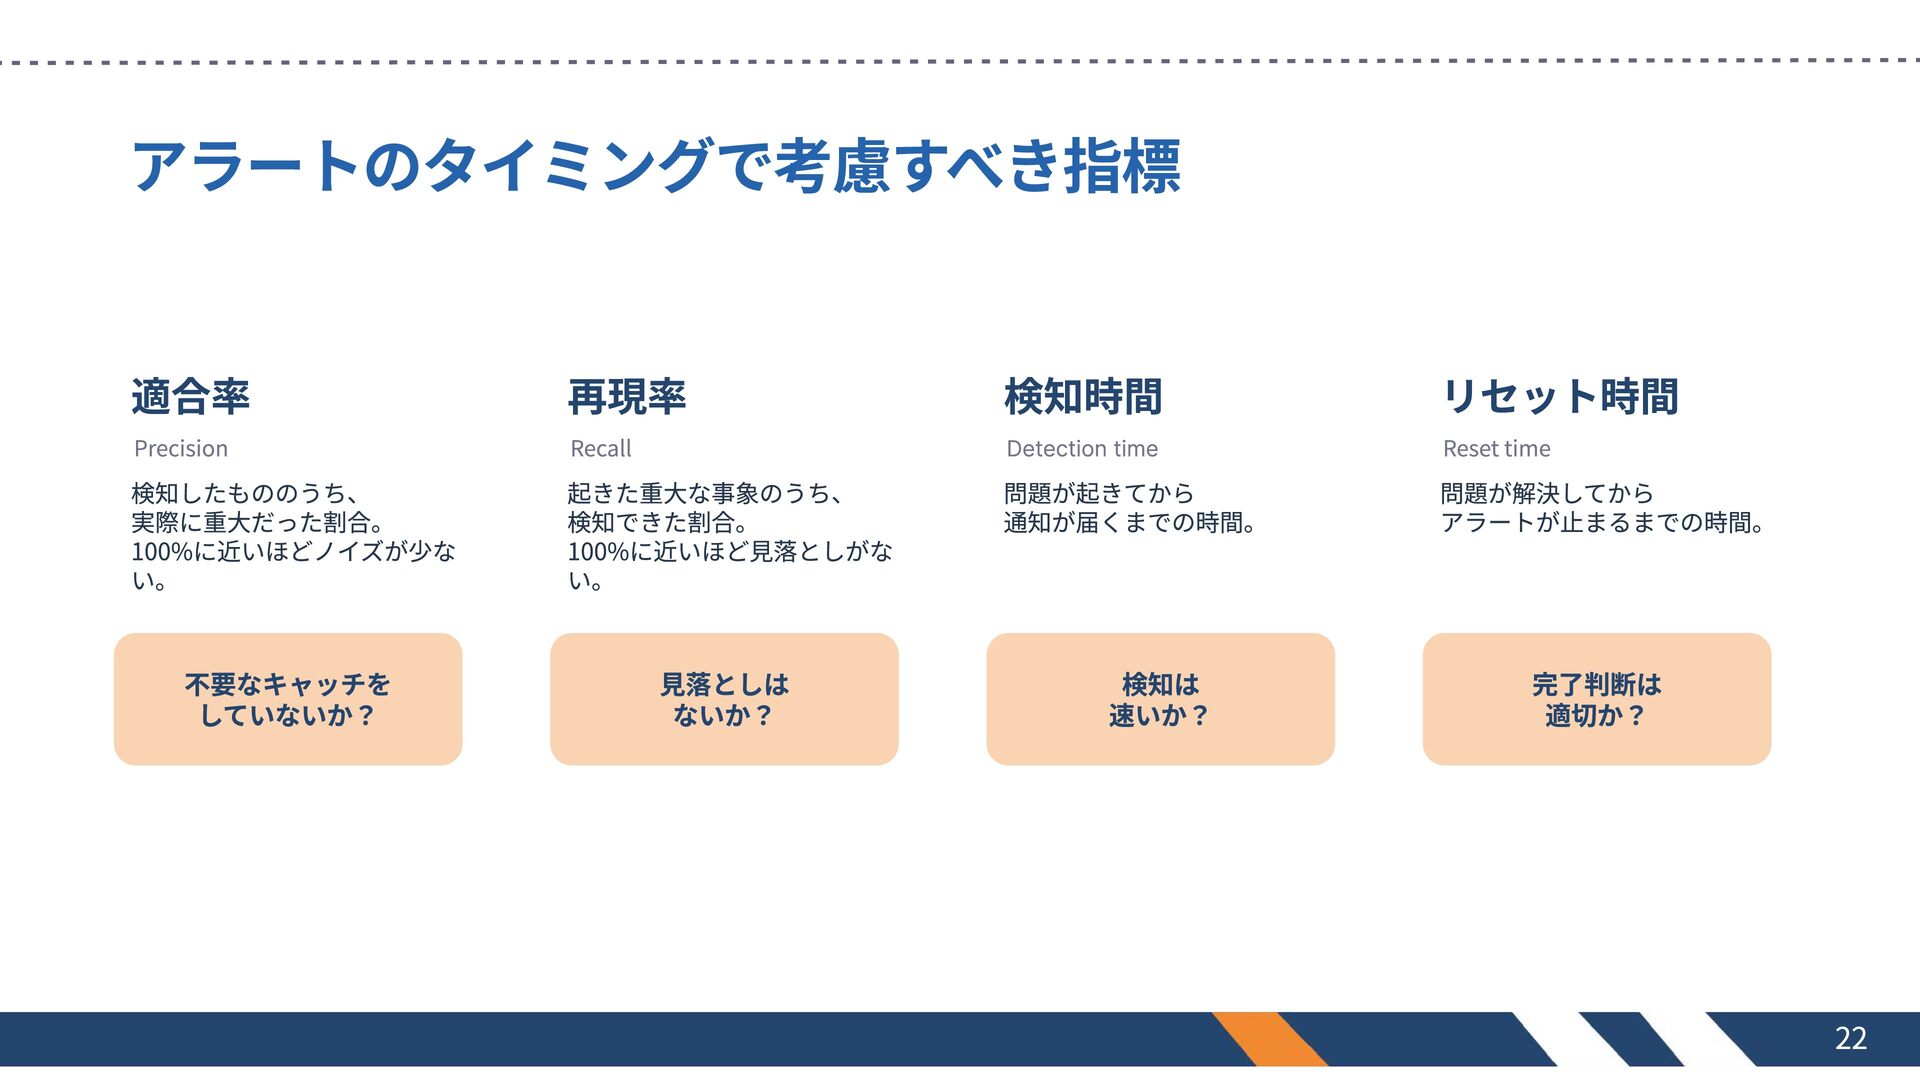
アラートのタイミングで考慮すべき指標 適合率 再現率 検知時間 リセット時間 Precision Recall Detection time Reset
time 検知したもののうち、 実際に重大だった割合。 100%に近いほどノイズが少な い。 起きた重大な事象のうち、 検知できた割合。 100%に近いほど見落としがな い。 問題が起きてから 通知が届くまでの時間。 問題が解決してから アラートが止まるまでの時間。 不要なキャッチを していないか? 見落としは ないか? 検知は 速いか? 完了判断は 適切か? 22
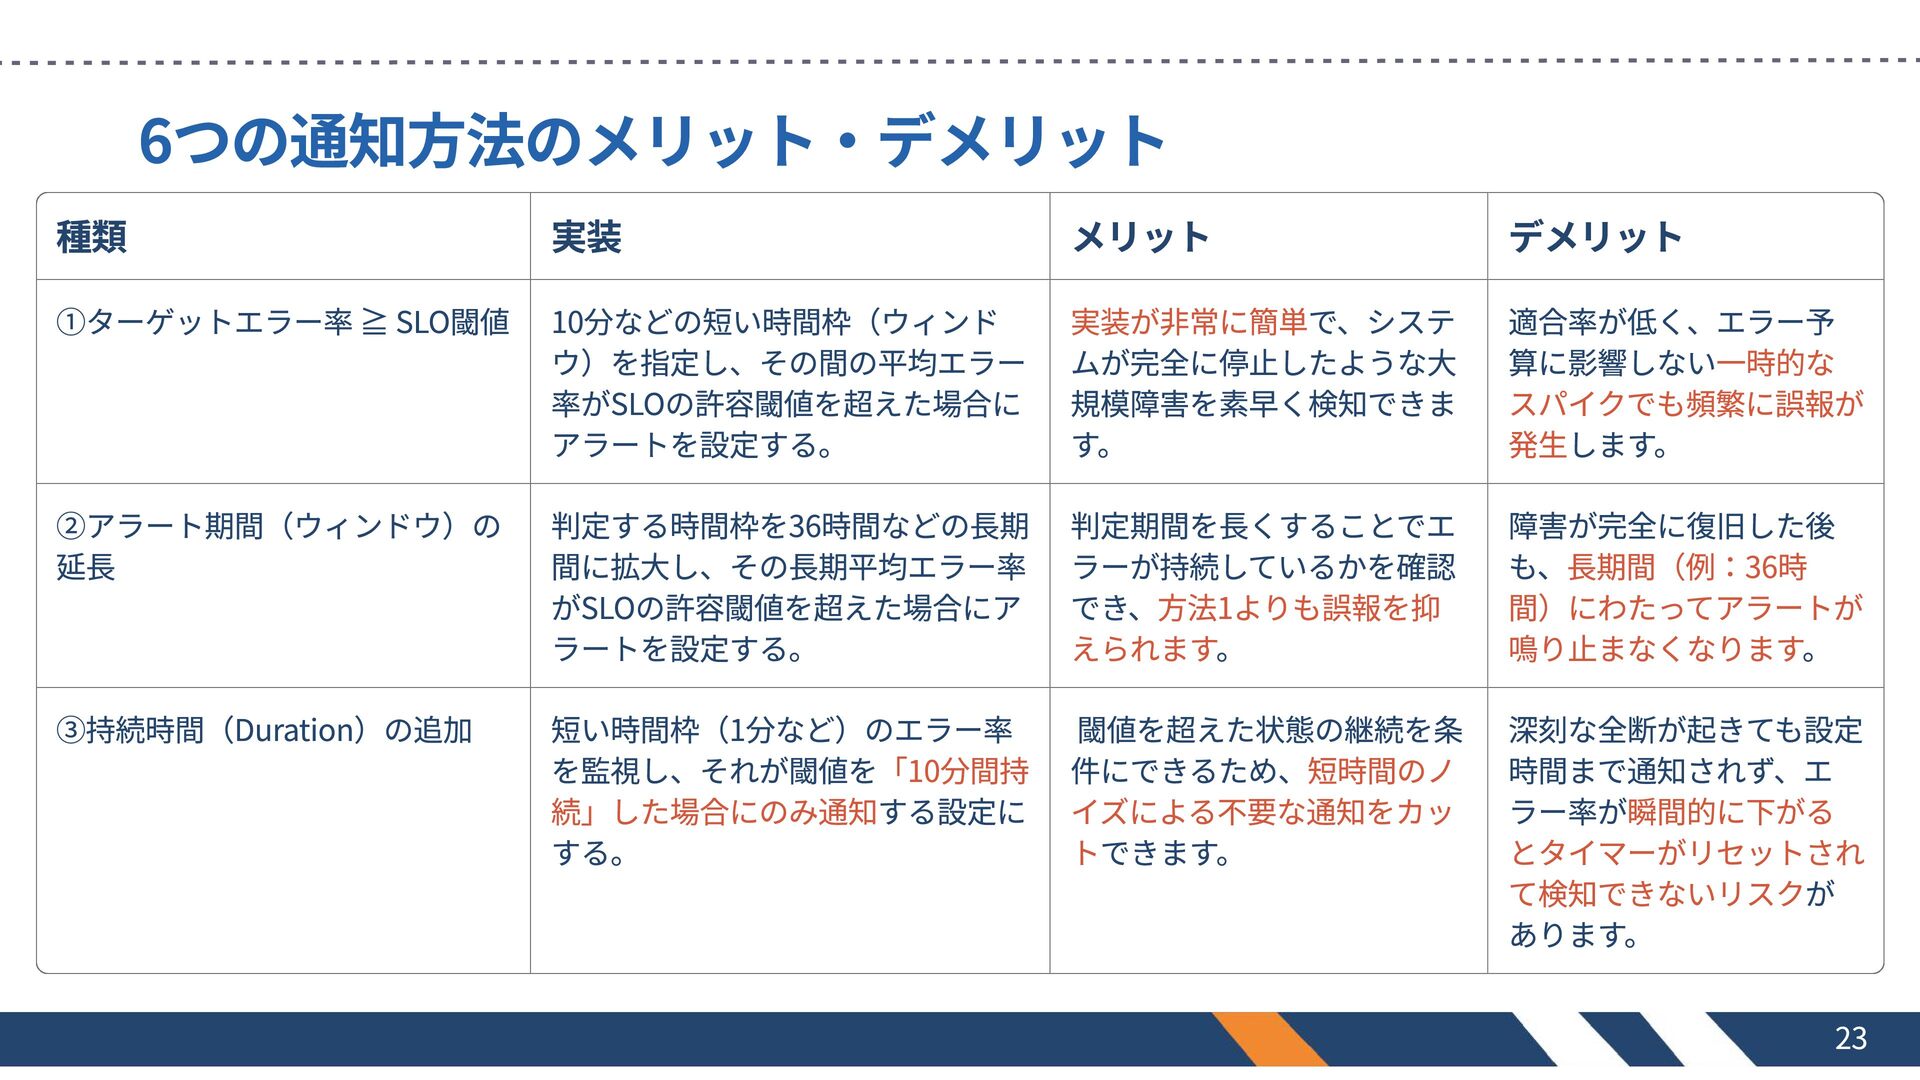
6つの通知方法のメリット・デメリット 種類 実装 メリット デメリット ①ターゲットエラー率 ≧ SLO閾値 10分などの短い時間枠(ウィンド ウ)を指定し、その間の平均エラー
率がSLOの許容閾値を超えた場合に アラートを設定する。 実装が非常に簡単で、システ ムが完全に停止したような大 規模障害を素早く検知できま す。 適合率が低く、エラー予 算に影響しない一時的な スパイクでも頻繁に誤報が 発生します。 ②アラート期間(ウィンドウ)の 延長 判定する時間枠を36時間などの長期 間に拡大し、その長期平均エラー率 がSLOの許容閾値を超えた場合にア ラートを設定する。 ③持続時間(Duration)の追加 復旧 後 も 長期間(例:36 方法1より を抑 間) わたってアラート えられます 鳴り止ま く ります 短い時間枠(1分など)のエラー率 閾値を超えた状態の継続を条 深刻な全断が起きても設定 を監視し、それが閾値を「10分間持 件にできるため、短時間のノ 時間まで通知されず、エ 続」した場合にのみ通知する設定に イズによる不要な通知をカッ ラー率が瞬間的に下がる する。 トできます。 とタイマーがリセットされ て検知できないリスクが あります。 判定期間を長くすることでエ ラーが持続しているかを確認 でき、 も誤報 。 障害が完全に した 、 時 に が な な 。 23
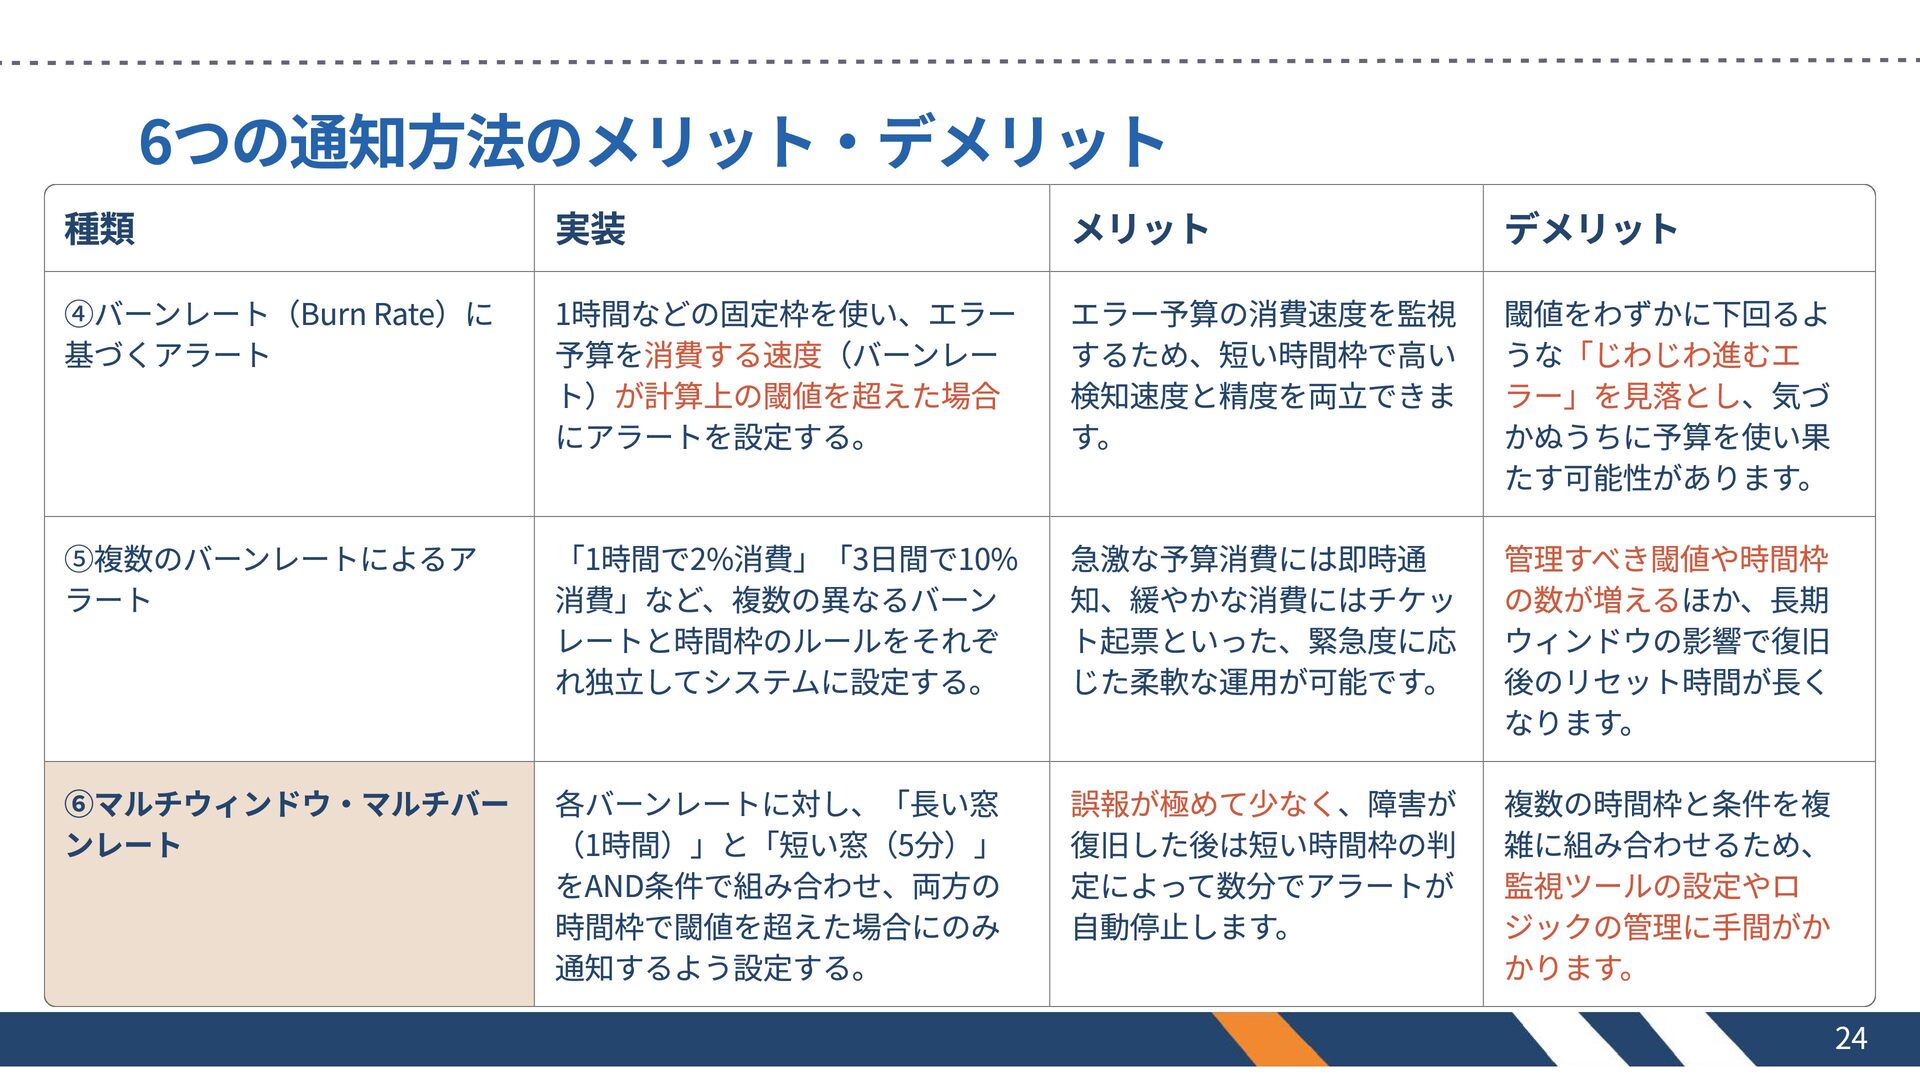
6つの通知方法のメリット・デメリット 種類 実装 メリット デメリット ④バーンレート(Burn Rate)に 基づくアラート 1時間などの固定枠を使い、エラー 予算を消費する速度(バーンレー
ト)が計算上の閾値を超えた場合 にアラートを設定する。 エラー予算の消費速度を監視 するため、短い時間枠で高い 検知速度と精度を両立できま す。 閾値をわずかに下回るよ うな「じわじわ進むエ ラー」を見落とし、気づ かぬうちに予算を使い果 たす可能性があります。 ⑤複数のバーンレートによるア ラート 「1時間で2%消費」「3日間で10% 消費」など、複数の異なるバーン レートと時間枠のルールをそれぞ れ独立してシステムに設定する。 急激な予算消費には即時通 管理すべき閾値や時間枠 知、緩やかな消費にはチケッ の数が増えるほか、長期 ト起票といった、緊急度に応 ウィンドウの影響で復旧 じた柔軟な運用が可能です。 後のリセット時間が長く ⑥マルチウィンドウ・マルチバー 各バーンレートに対し、「長い窓 ンレート (1時間)」と「短い窓(5分)」 をAND条件で組み合わせ、両方の 時間枠で閾値を超えた場合にのみ 通知するよう設定する。 誤報が極めて少なく、障害が 複数の時間枠と条件を複 復旧した後は短い時間枠の判 雑に組み合わせるため、 定によって数分でアラートが 監視ツールの設定やロ 自動停止します。 ジックの管理に手間がか かります。 なります。 24
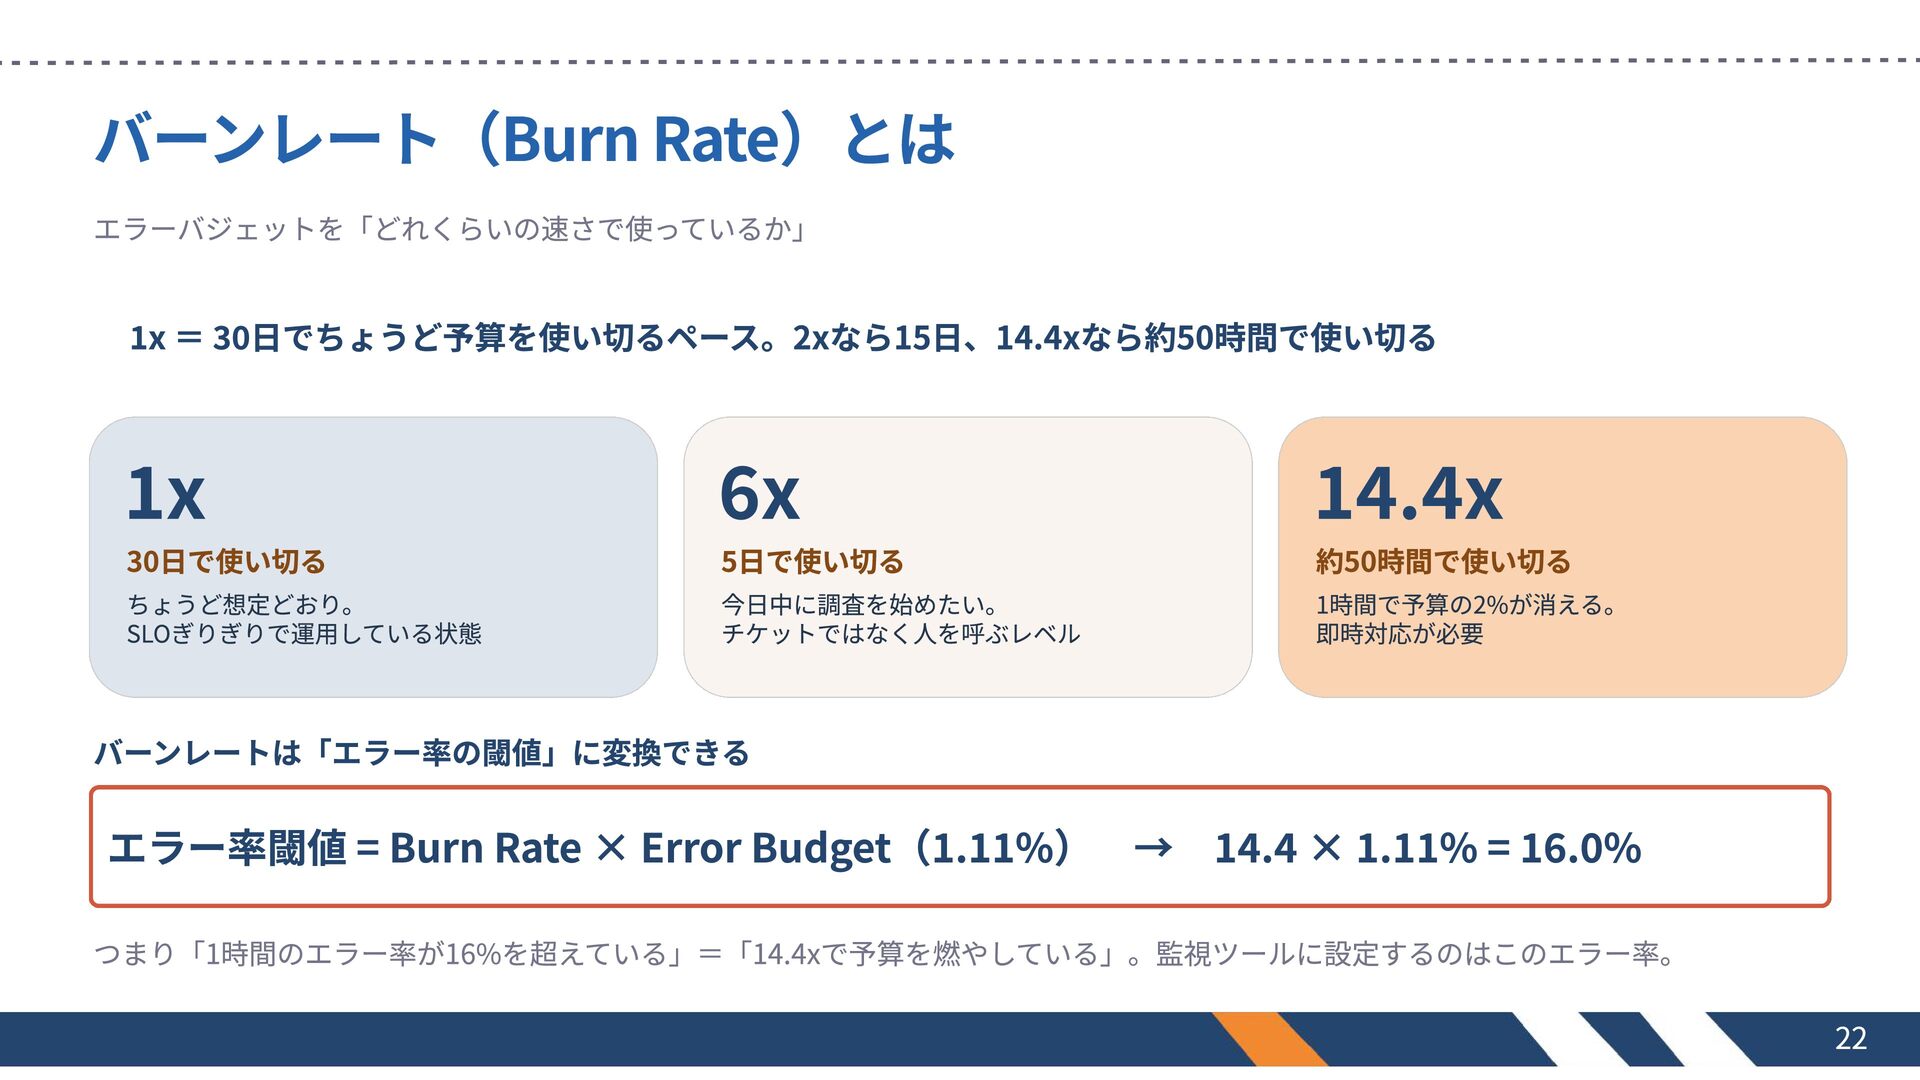
バーンレート(Burn Rate)とは エラーバジェットを「どれくらいの速さで使っているか」 1x = 30日でちょうど予算を使い切るペース。2xなら15日、14.4xなら約50時間で使い切る 1x 6x 14.4x ちょうど想定どおり。
SLOぎりぎりで運用している状態 今日中に調査を始めたい。 チケットではなく人を呼ぶレベル 1時間で予算の2%が消える。 即時対応が必要 30日で使い切る 5日で使い切る 約50時間で使い切る バーンレートは「エラー率の閾値」に変換できる エラー率閾値 = Burn Rate × Error Budget(1.11%) → 14.4 × 1.11% = 16.0% つまり「1時間のエラー率が16%を超えている」=「14.4xで予算を燃やしている」。監視ツールに設定するのはこのエラー率。 22
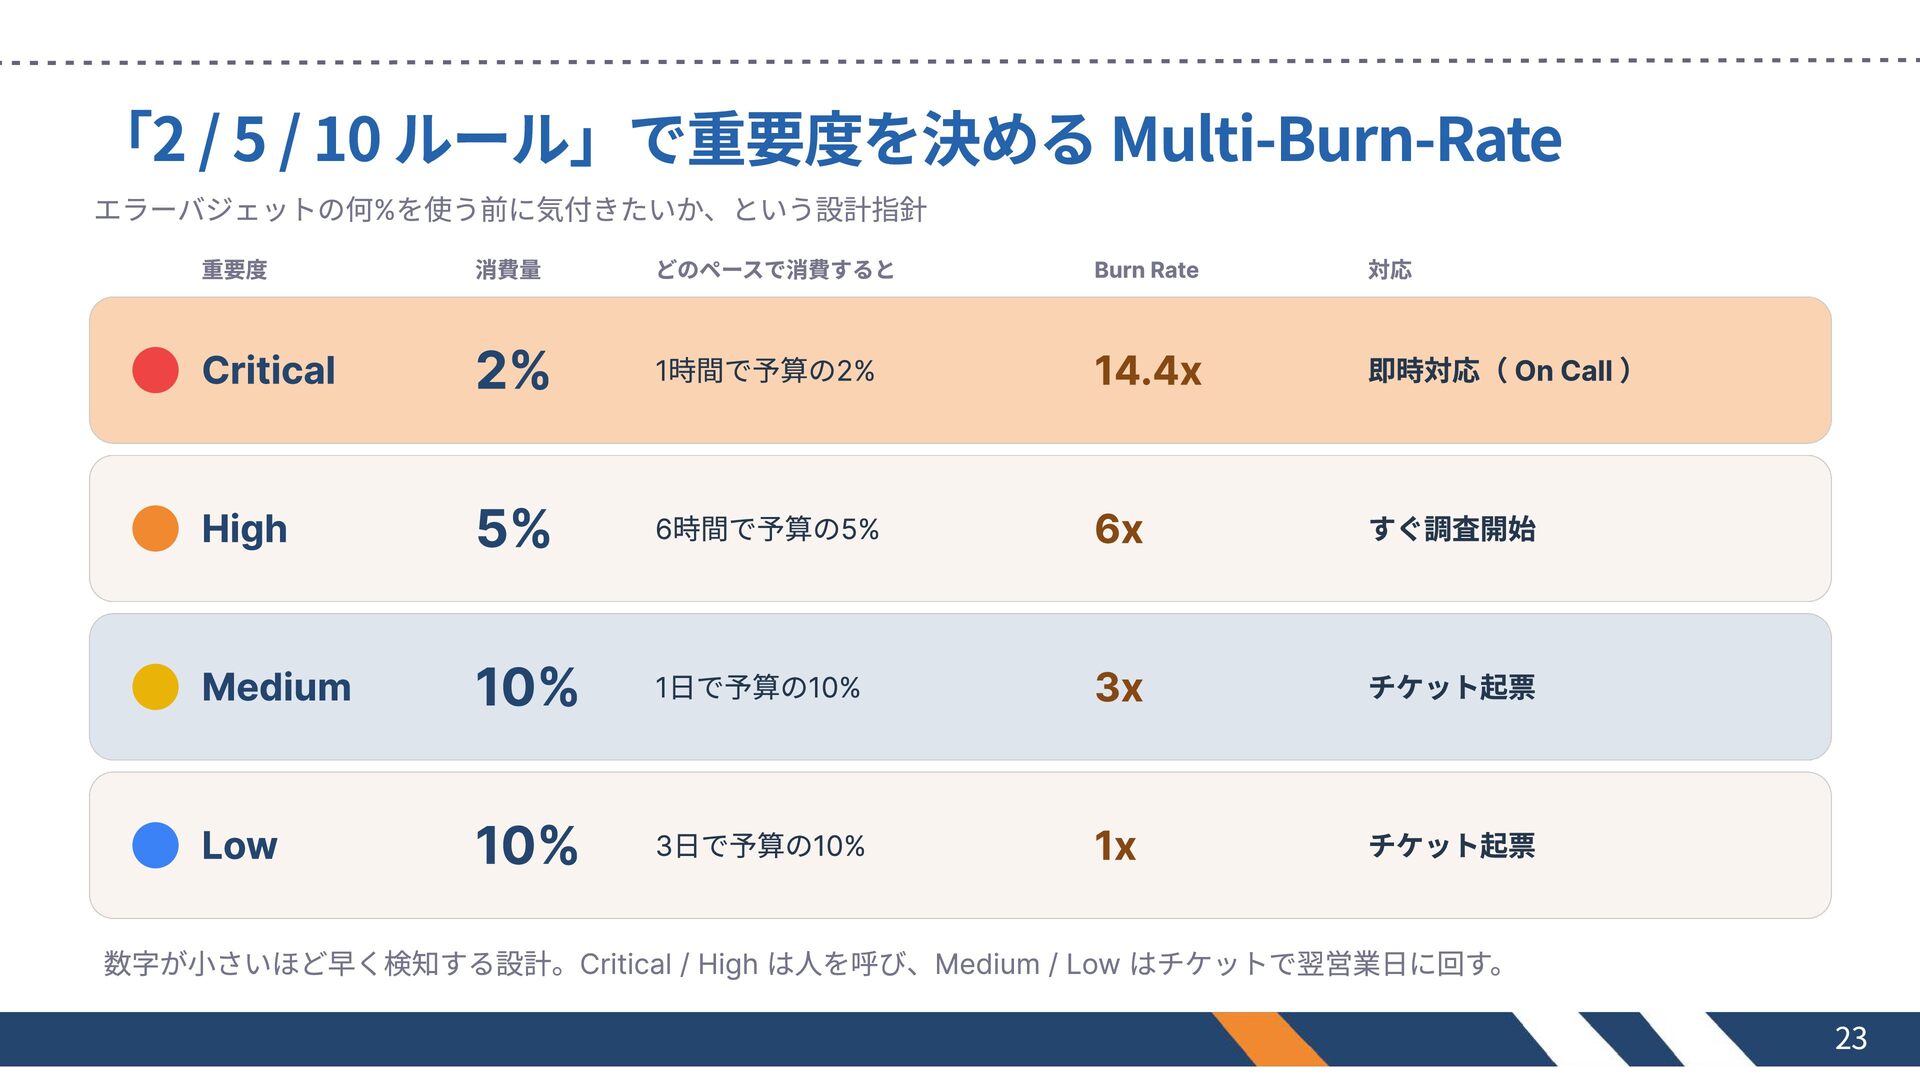
「2 / 5 / 10 ルール」で重要度を決める Multi-Burn-Rate エラーバジェットの何%を使う前に気付きたいか、という設計指針 重要度 消費量
どのペースで消費すると Burn Rate 対応 Critical 2% 1時間で予算の2% 14.4x 即時対応( On Call ) High 5% 6時間で予算の5% 6x すぐ調査開始 Medium 10% 1日で予算の10% 3x チケット起票 Low 10% 3日で予算の10% 1x チケット起票 数字が小さいほど早く検知する設計。Critical / High は人を呼び、Medium / Low はチケットで翌営業日に回す。 23
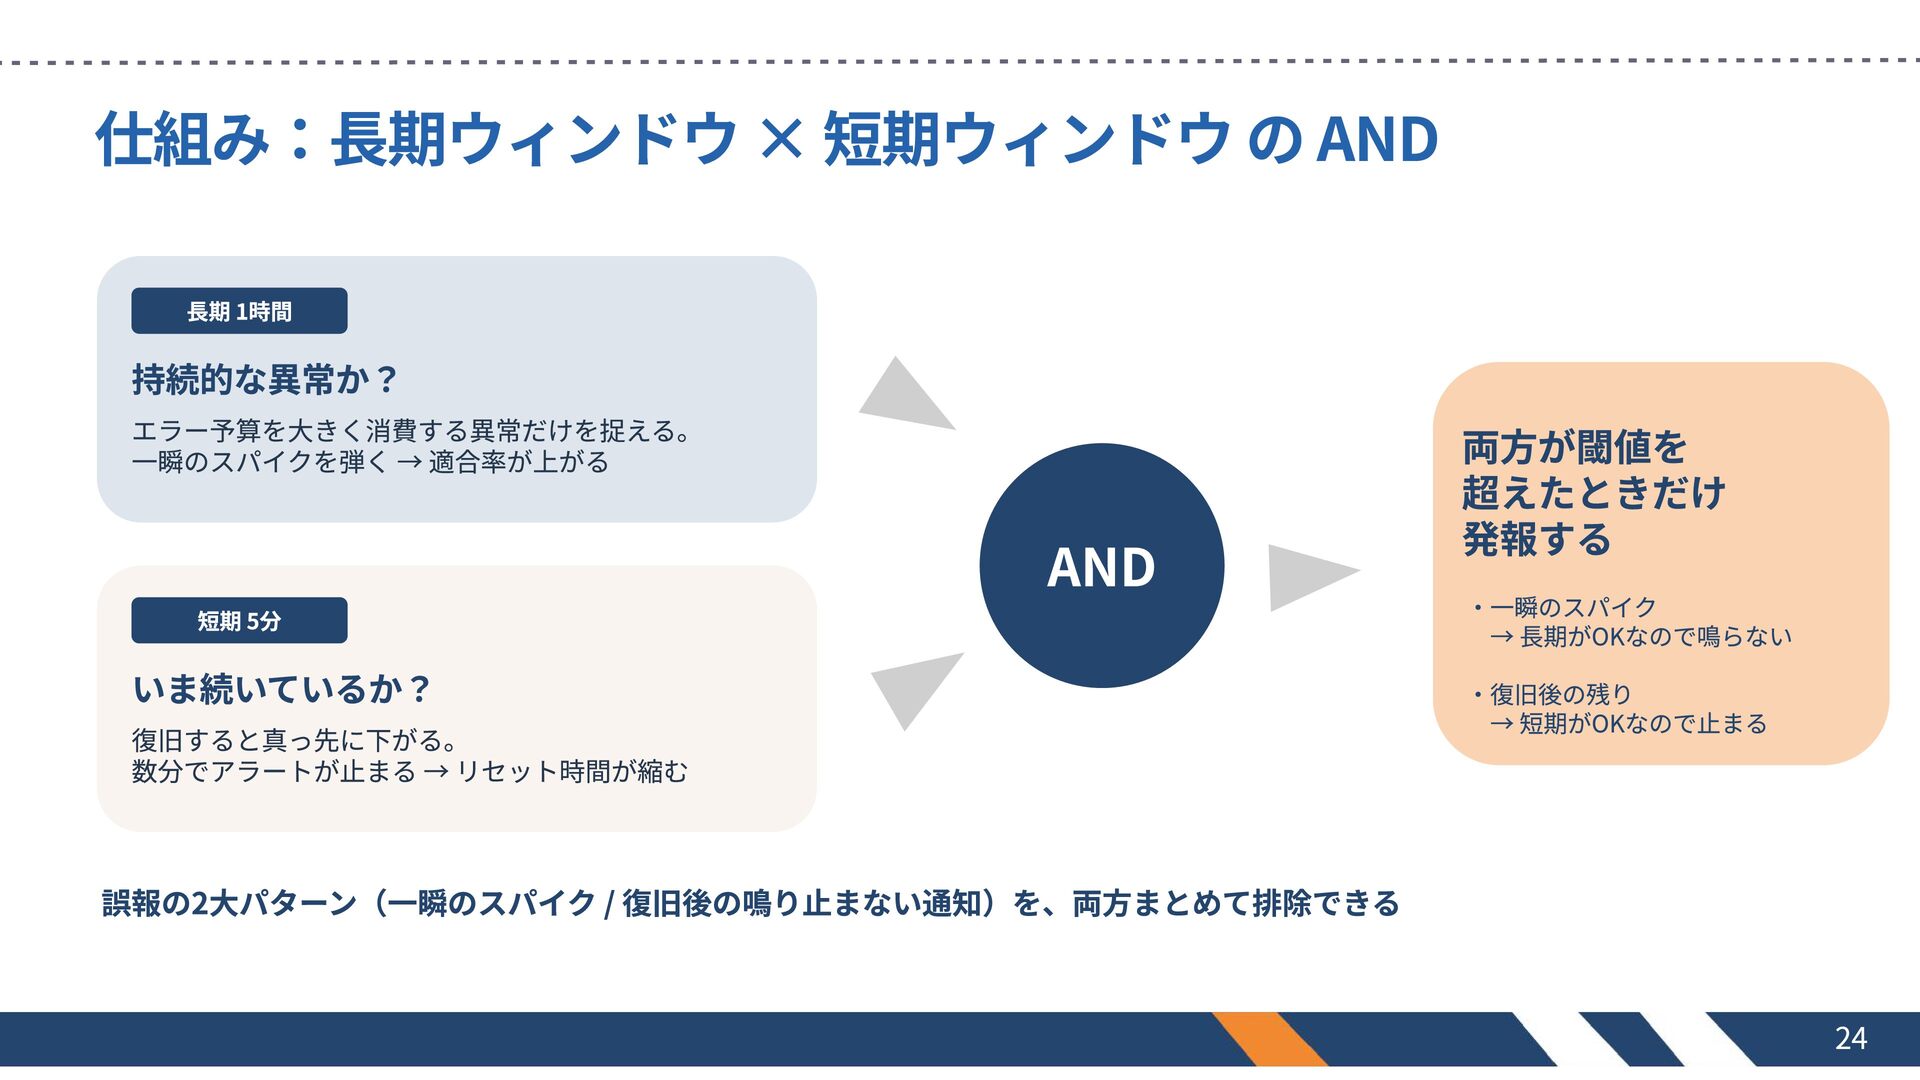
仕組み:長期ウィンドウ × 短期ウィンドウ の AND 長期 1時間 持続的な異常か? エラー予算を大きく消費する異常だけを捉える。 一瞬のスパイクを弾く
→ 適合率が上がる 短期 5分 AND いま続いているか? 復旧すると真っ先に下がる。 数分でアラートが止まる → リセット時間が縮む 両方が閾値を 超えたときだけ 発報する ・一瞬のスパイク → 長期がOKなので鳴らない ・復旧後の残り → 短期がOKなので止まる 誤報の2大パターン(一瞬のスパイク / 復旧後の鳴り止まない通知)を、両方まとめて排除できる 24
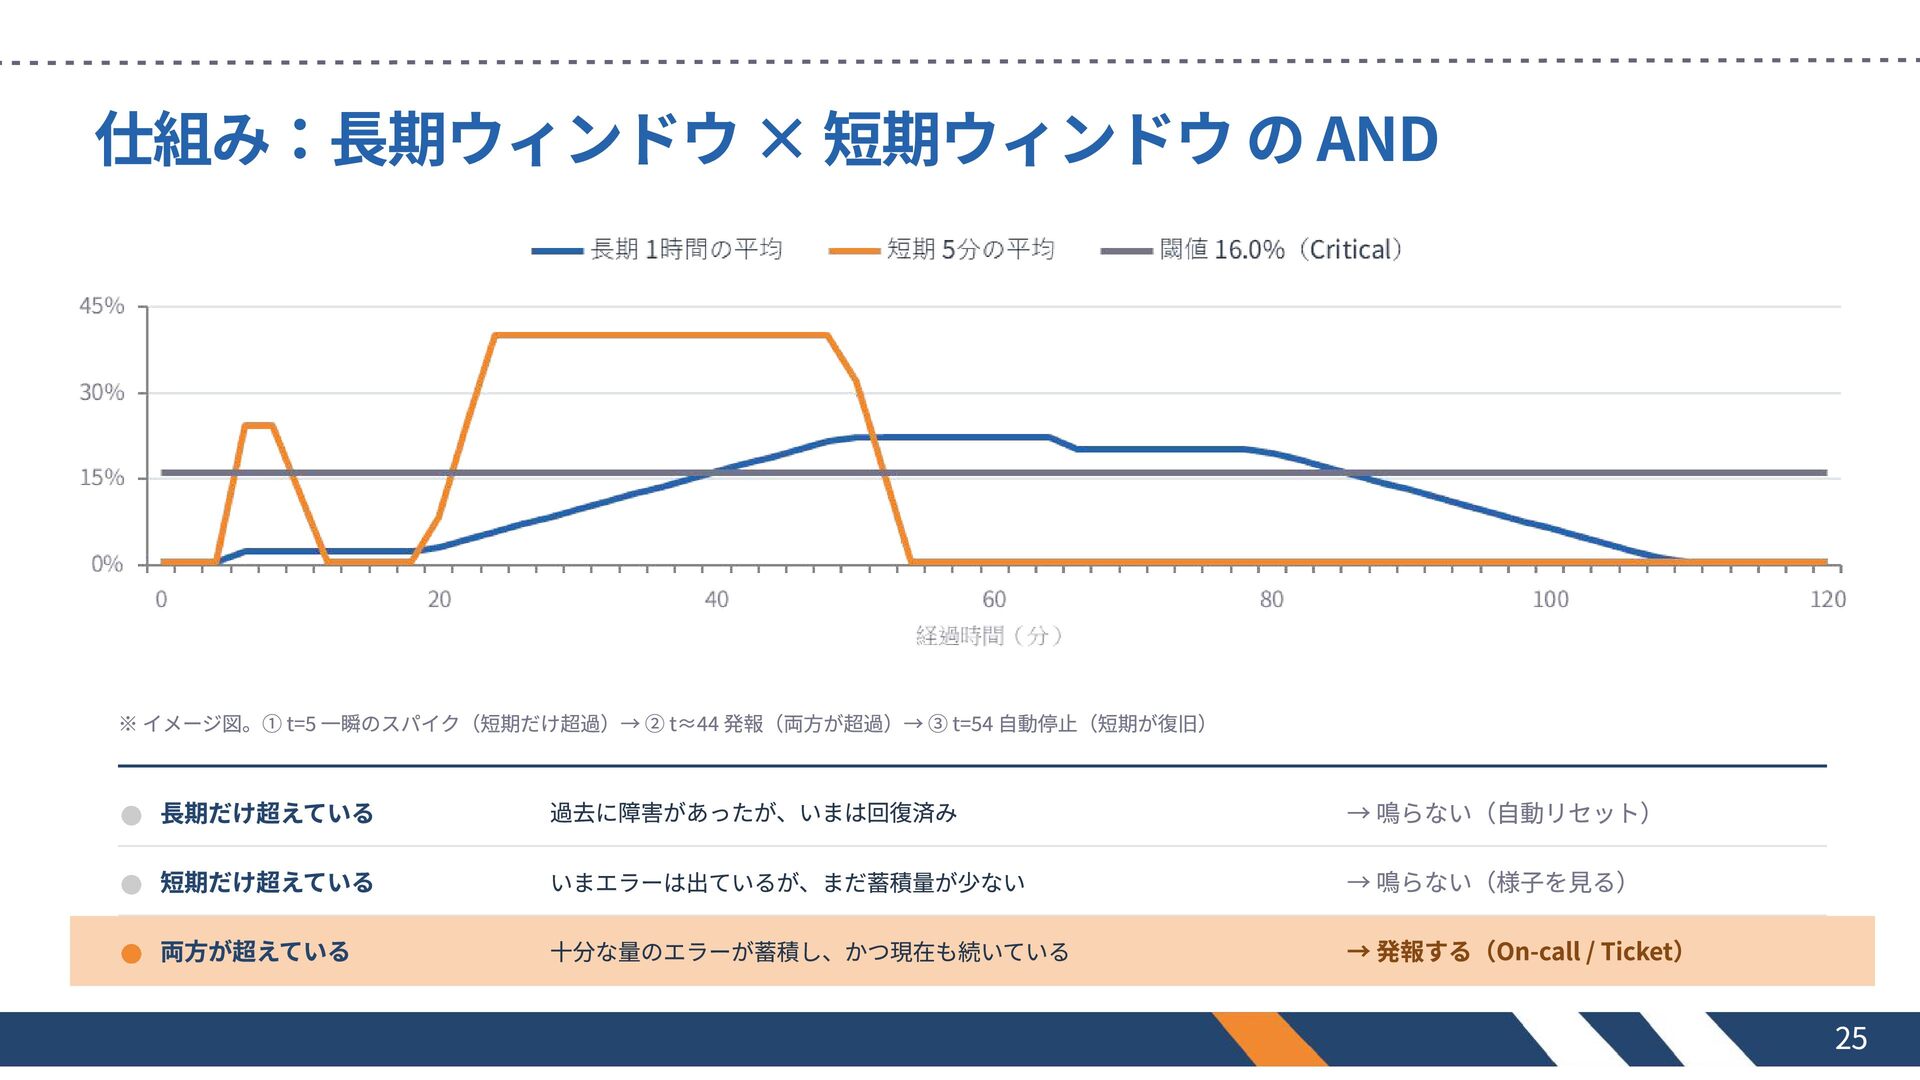
仕組み:長期ウィンドウ × 短期ウィンドウ の AND ※ イメージ図。① t=5 一瞬のスパイク(短期だけ超過)→ ②
t≈44 発報(両方が超過)→ ③ t=54 自動停止(短期が復旧) 長期だけ超えている 過去に障害があったが、いまは回復済み → 鳴らない(自動リセット) 短期だけ超えている いまエラーは出ているが、まだ蓄積量が少ない → 鳴らない(様子を見る) 両方が超えている 十分な量のエラーが蓄積し、かつ現在も続いている → 発報する(On-call / Ticket) 25
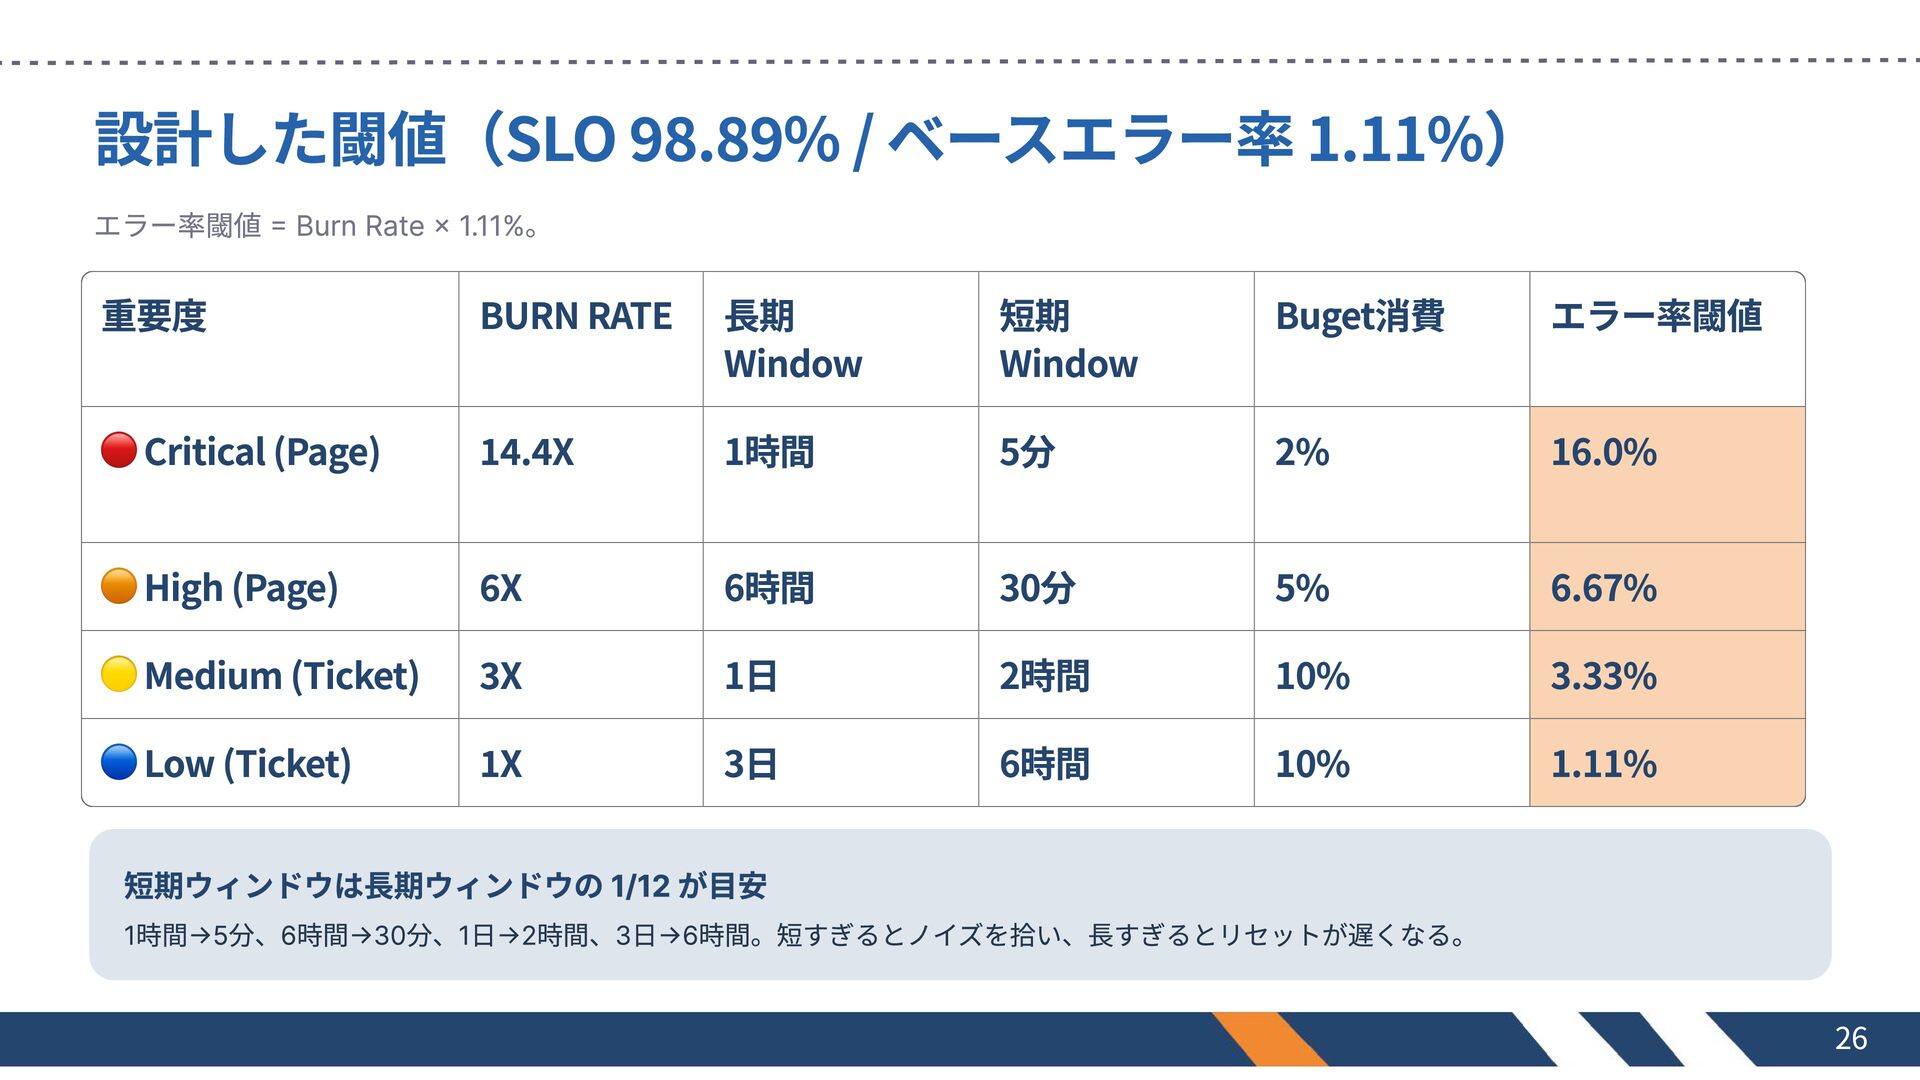
設計した閾値(SLO 98.89% / ベースエラー率 1.11%) エラー率閾値 = Burn Rate ×
1.11%。 重要度 BURN RATE 長期 Window 短期 Window Buget消費 エラー率閾値 🔴 Critical (Page) 14.4X 1時間 5分 2% 16.0% 🟠 High (Page) 6X 6時間 30分 5% 6.67% 🟡 Medium (Ticket) 3X 1日 2時間 10% 3.33% 🔵 Low (Ticket) 1X 3日 6時間 10% 1.11% 短期ウィンドウは長期ウィンドウの 1/12 が目安 1時間→5分、6時間→30分、1日→2時間、3日→6時間。短すぎるとノイズを拾い、長すぎるとリセットが遅くなる。 26
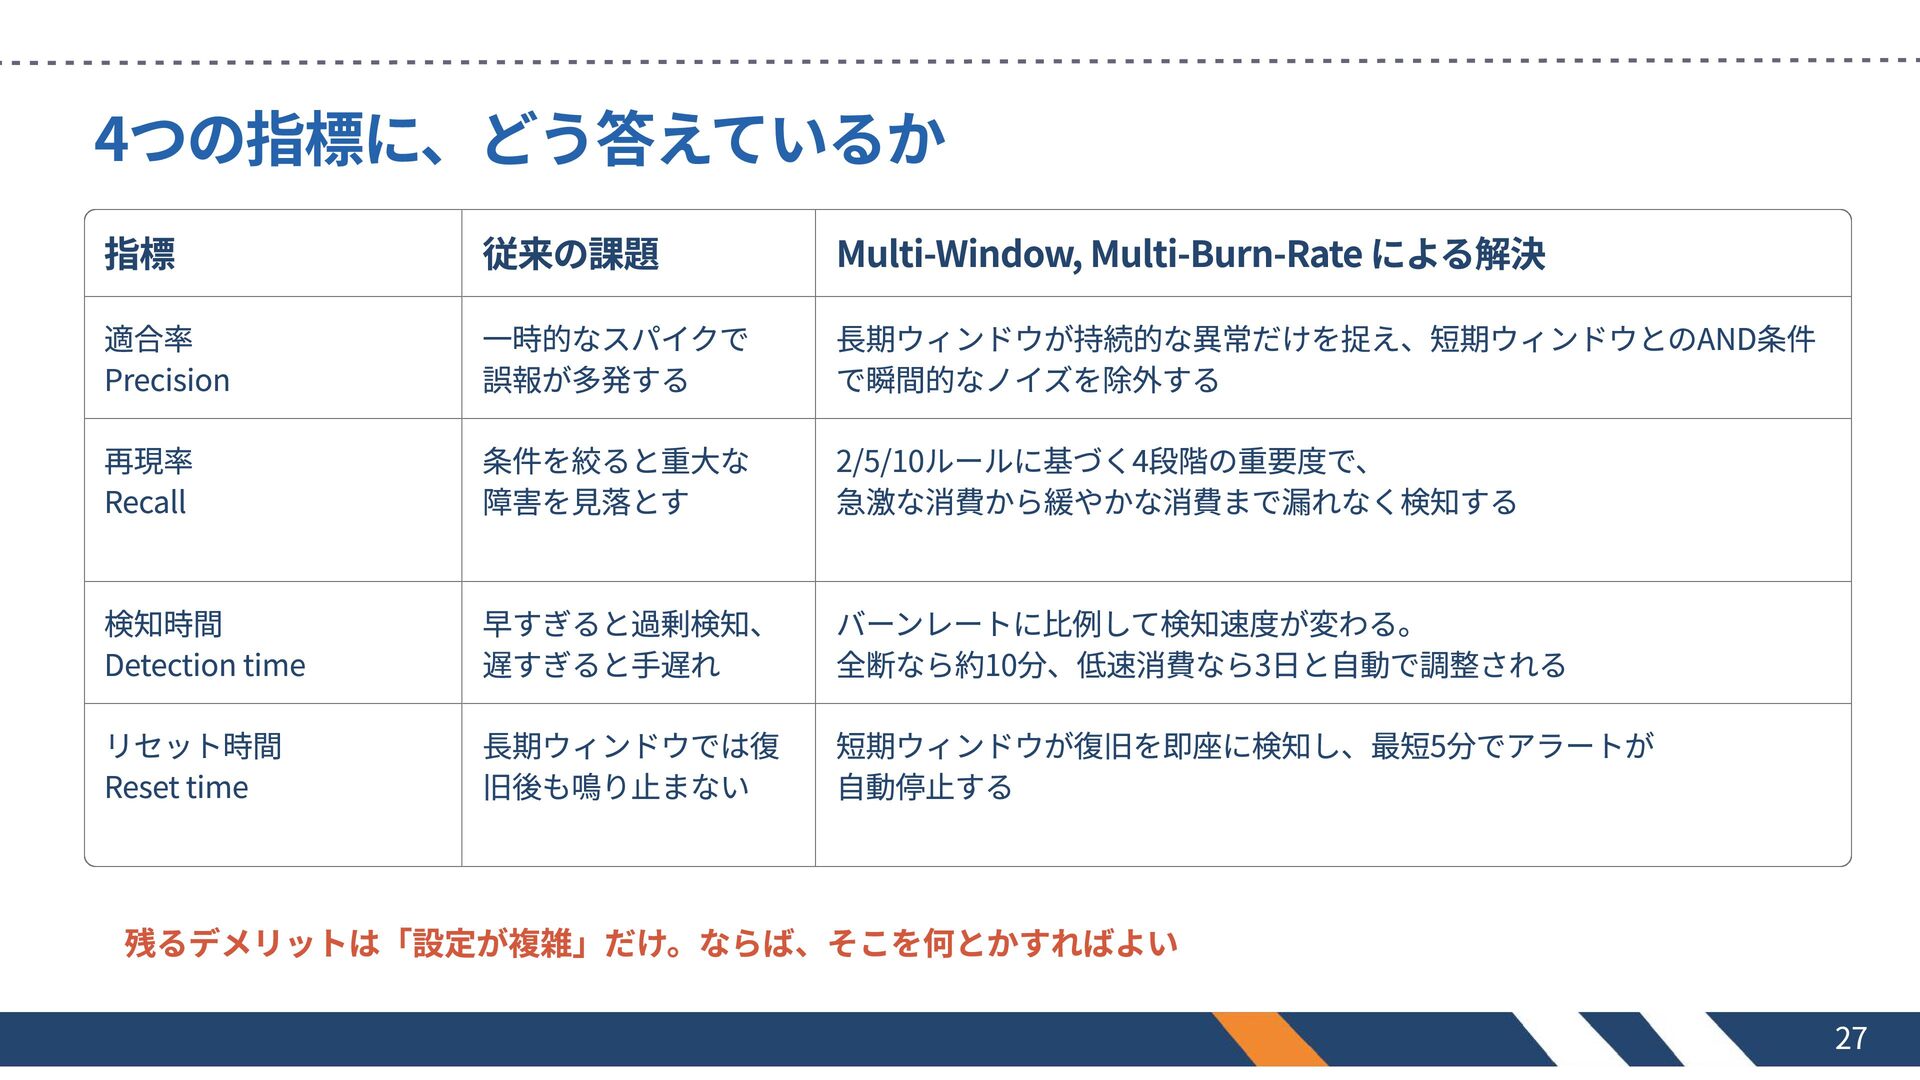
4つの指標に、どう答えているか 指標 従来の課題 Multi-Window, Multi-Burn-Rate による解決 適合率 Precision 一時的なスパイクで 誤報が多発する
長期ウィンドウが持続的な異常だけを捉え、短期ウィンドウとのAND条件 で瞬間的なノイズを除外する 再現率 Recall 条件を絞ると重大な 障害を見落とす 2/5/10ルールに基づく4段階の重要度で、 急激な消費から緩やかな消費まで漏れなく検知する 検知時間 Detection time 早すぎると過剰検知、 遅すぎると手遅れ リセット時間 Reset time バーンレートに比例して検知速度が変わる。 全断なら約10分、低速消費なら3日と自動で調整される 長期ウィンドウでは復 短期ウィンドウが復旧を即座に検知し、最短5分でアラートが 旧後も鳴り止まない 自動停止する 残るデメリットは「設定が複雑」だけ。ならば、そこを何とかすればよい 27
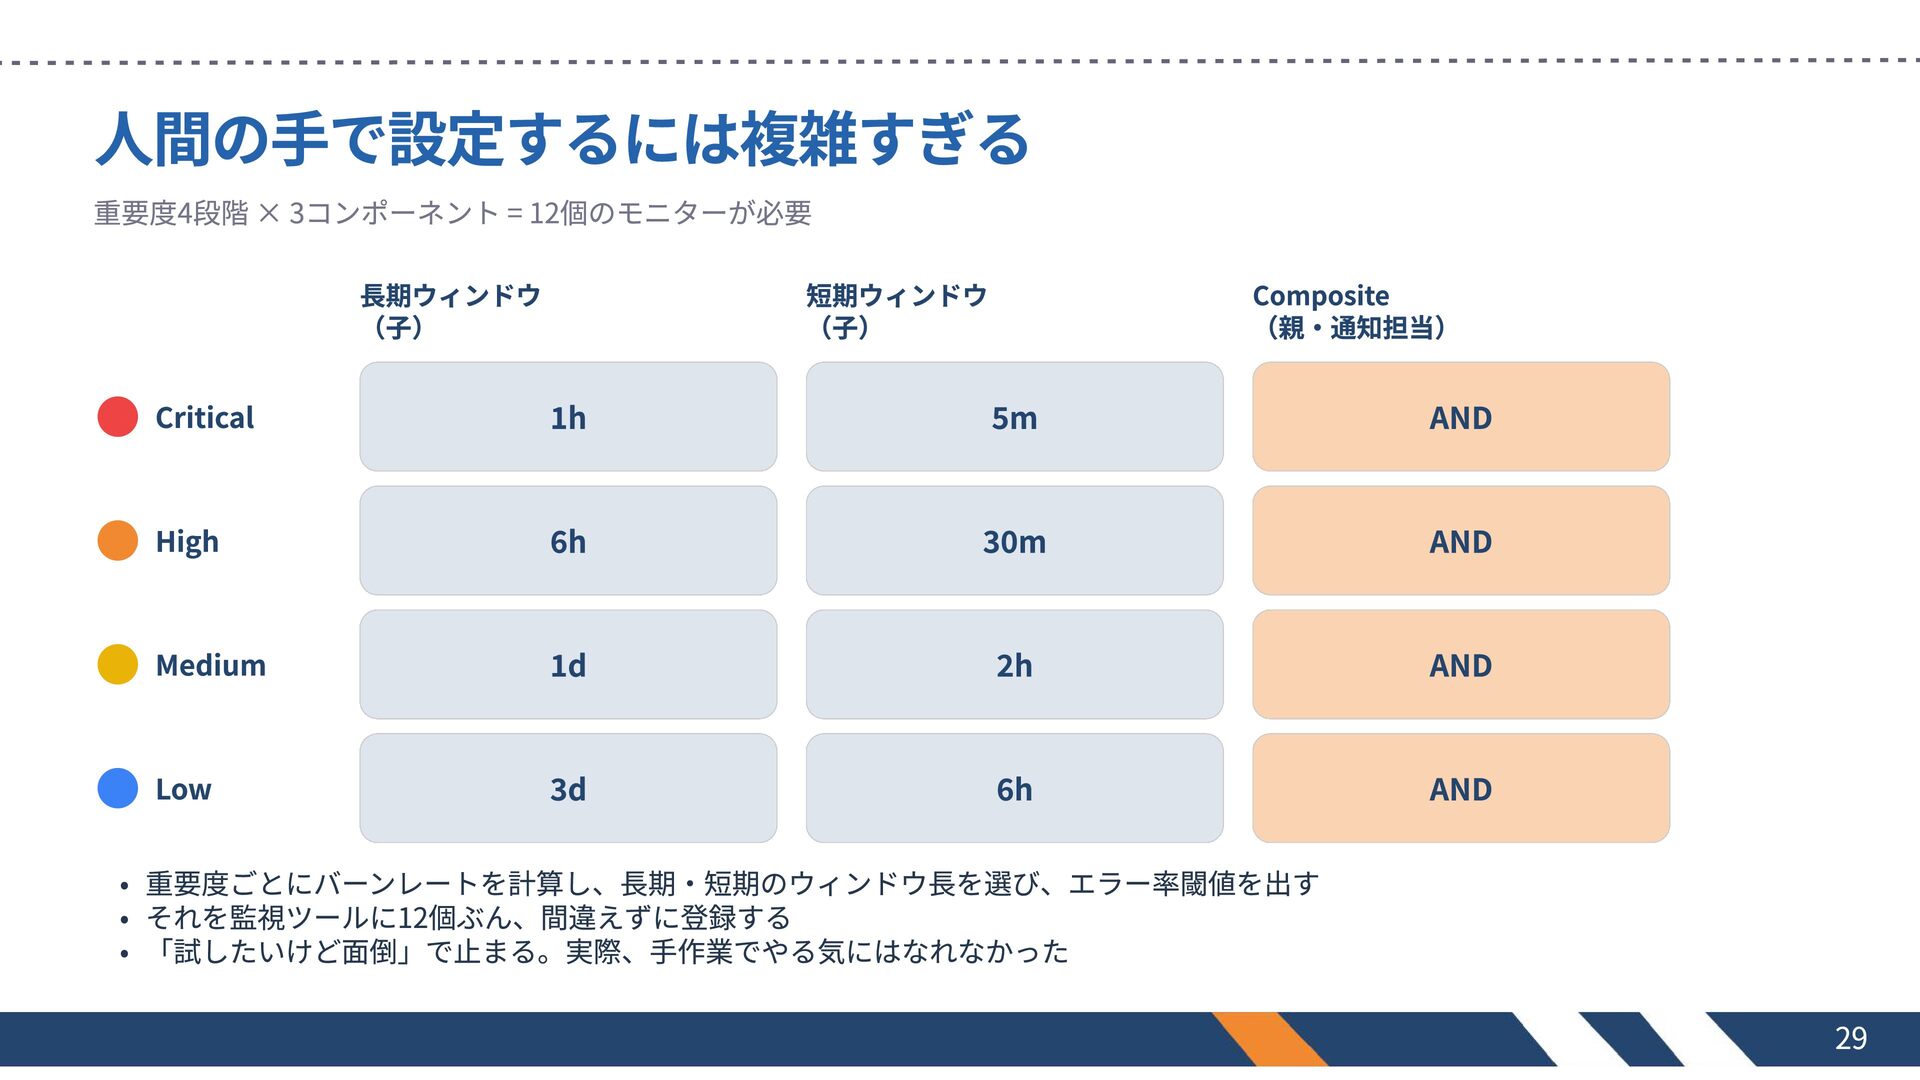
人間の手で設定するには複雑すぎる 重要度4段階 × 3コンポーネント = 12個のモニターが必要 長期ウィンドウ (子) 短期ウィンドウ (子)
Composite (親・通知担当) Critical 1h 5m AND High 6h 30m AND Medium 1d 2h AND Low 3d 6h AND 重要度ごとにバーンレートを計算し、長期・短期のウィンドウ長を選び、エラー率閾値を出す それを監視ツールに12個ぶん、間違えずに登録する 「試したいけど面倒」で止まる。実際、手作業でやる気にはなれなかった 29
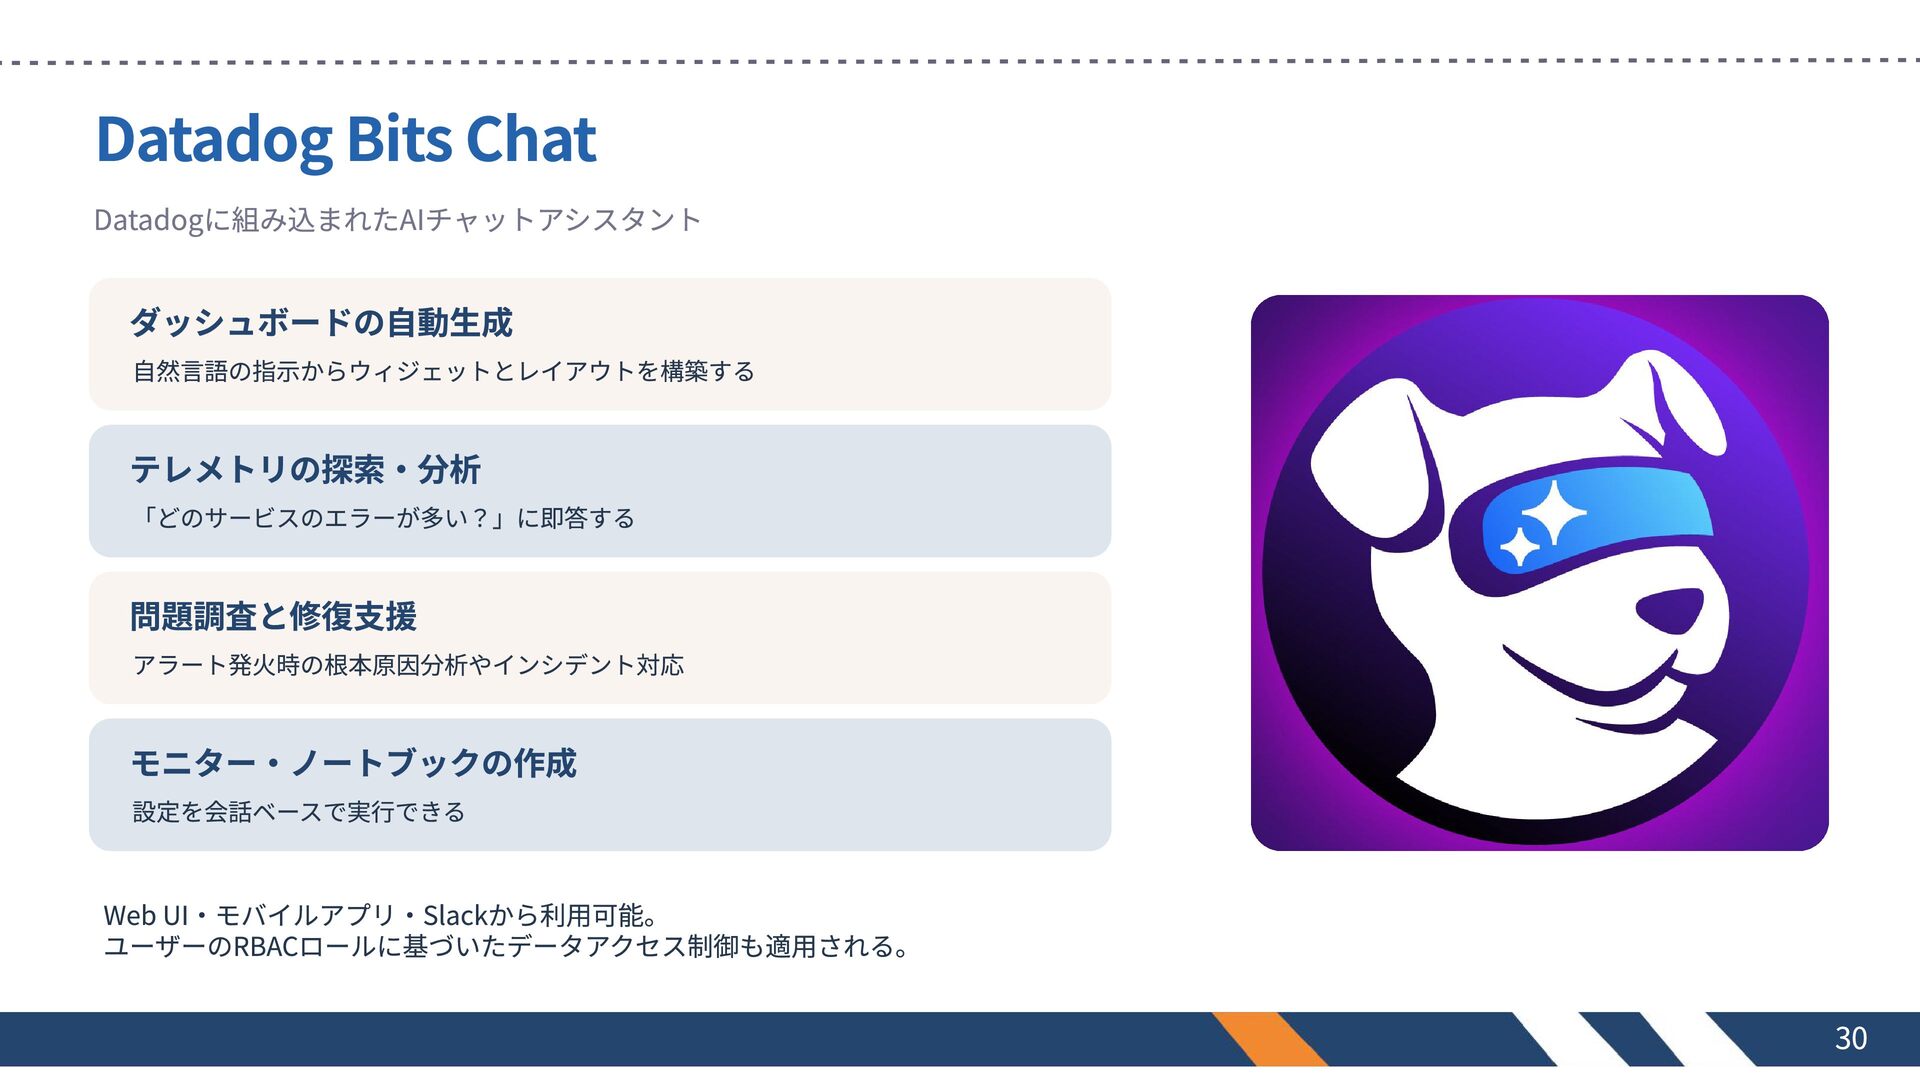
Datadog Bits Chat Datadogに組み込まれたAIチャットアシスタント ダッシュボードの自動生成 自然言語の指示からウィジェットとレイアウトを構築する テレメトリの探索・分析 「どのサービスのエラーが多い?」に即答する 問題調査と修復支援 アラート発火時の根本原因分析やインシデント対応
モニター・ノートブックの作成 設定を会話ベースで実行できる Web UI・モバイルアプリ・Slackから利用可能。 ユーザーのRBACロールに基づいたデータアクセス制御も適用される。 30
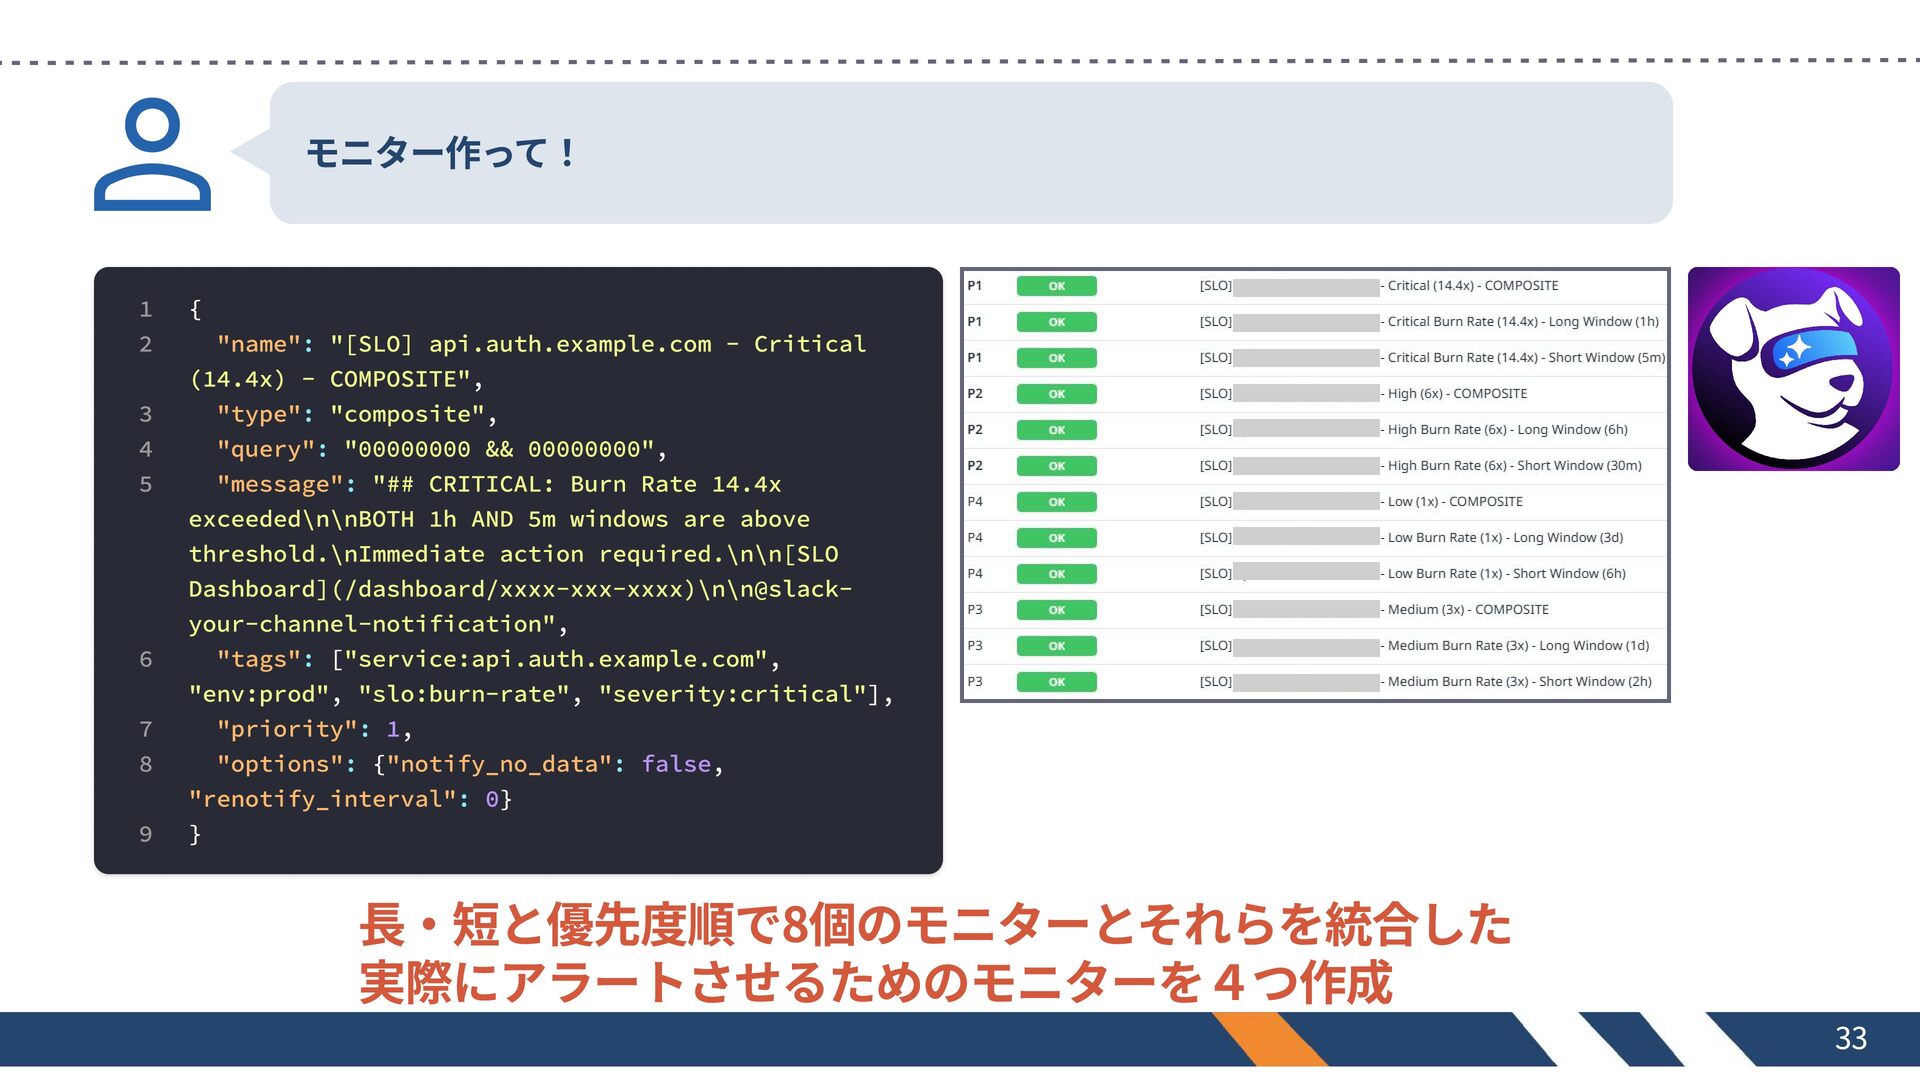
モニター作って! 1 2 3 4 5 6 7 8 9
{ "name": "[SLO] api.auth.example.com - Critical (14.4x) - COMPOSITE", "type": "composite", "query": "00000000 && 00000000", "message": "## CRITICAL: Burn Rate 14.4x exceeded\n\nBOTH 1h AND 5m windows are above threshold.\nImmediate action required.\n\n[SLO Dashboard](/dashboard/xxxx-xxx-xxxx)\n\n@slackyour-channel-notification", "tags": ["service:api.auth.example.com", "env:prod", "slo:burn-rate", "severity:critical"], "priority": 1, "options": {"notify_no_data": false, "renotify_interval": 0} } 長・短と優先度順で8個のモニターとそれらを統合した 実際にアラートさせるためのモニターを4つ作成 33
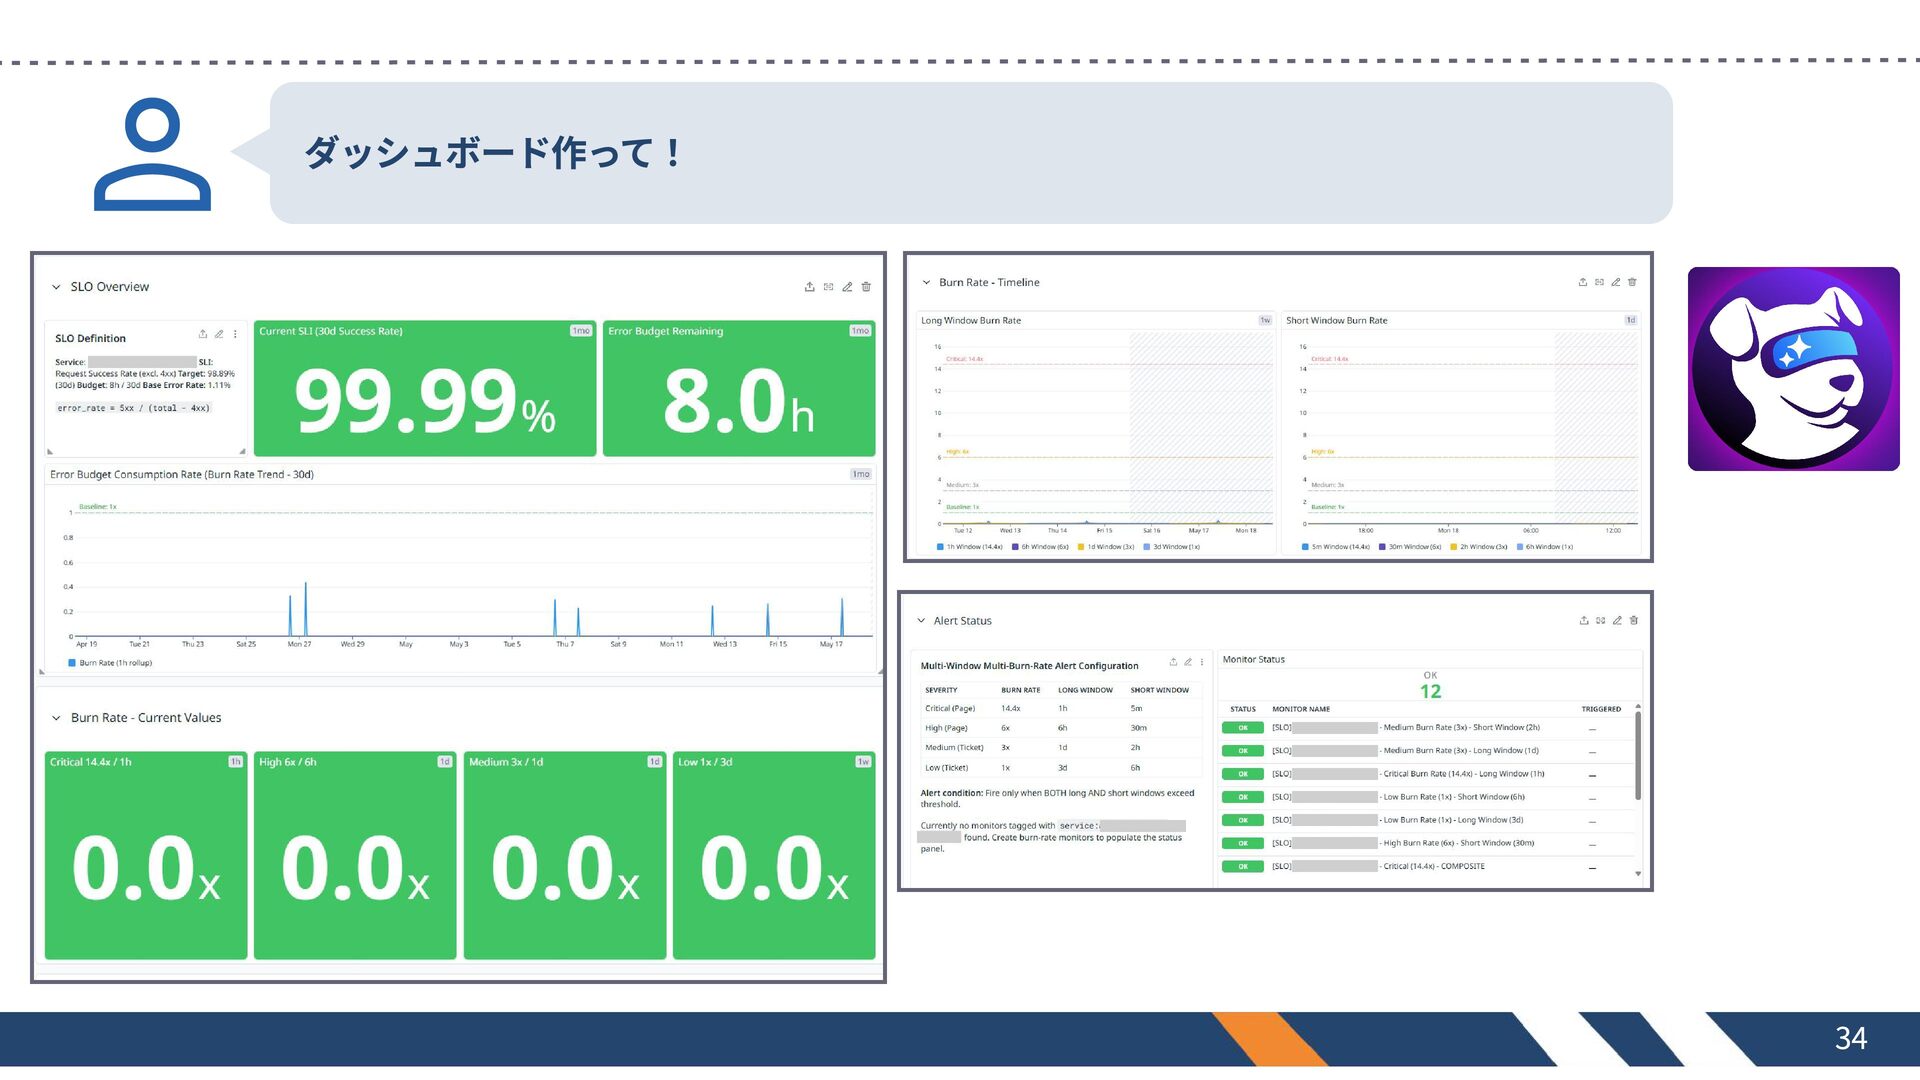
ダッシュボード作って! 34
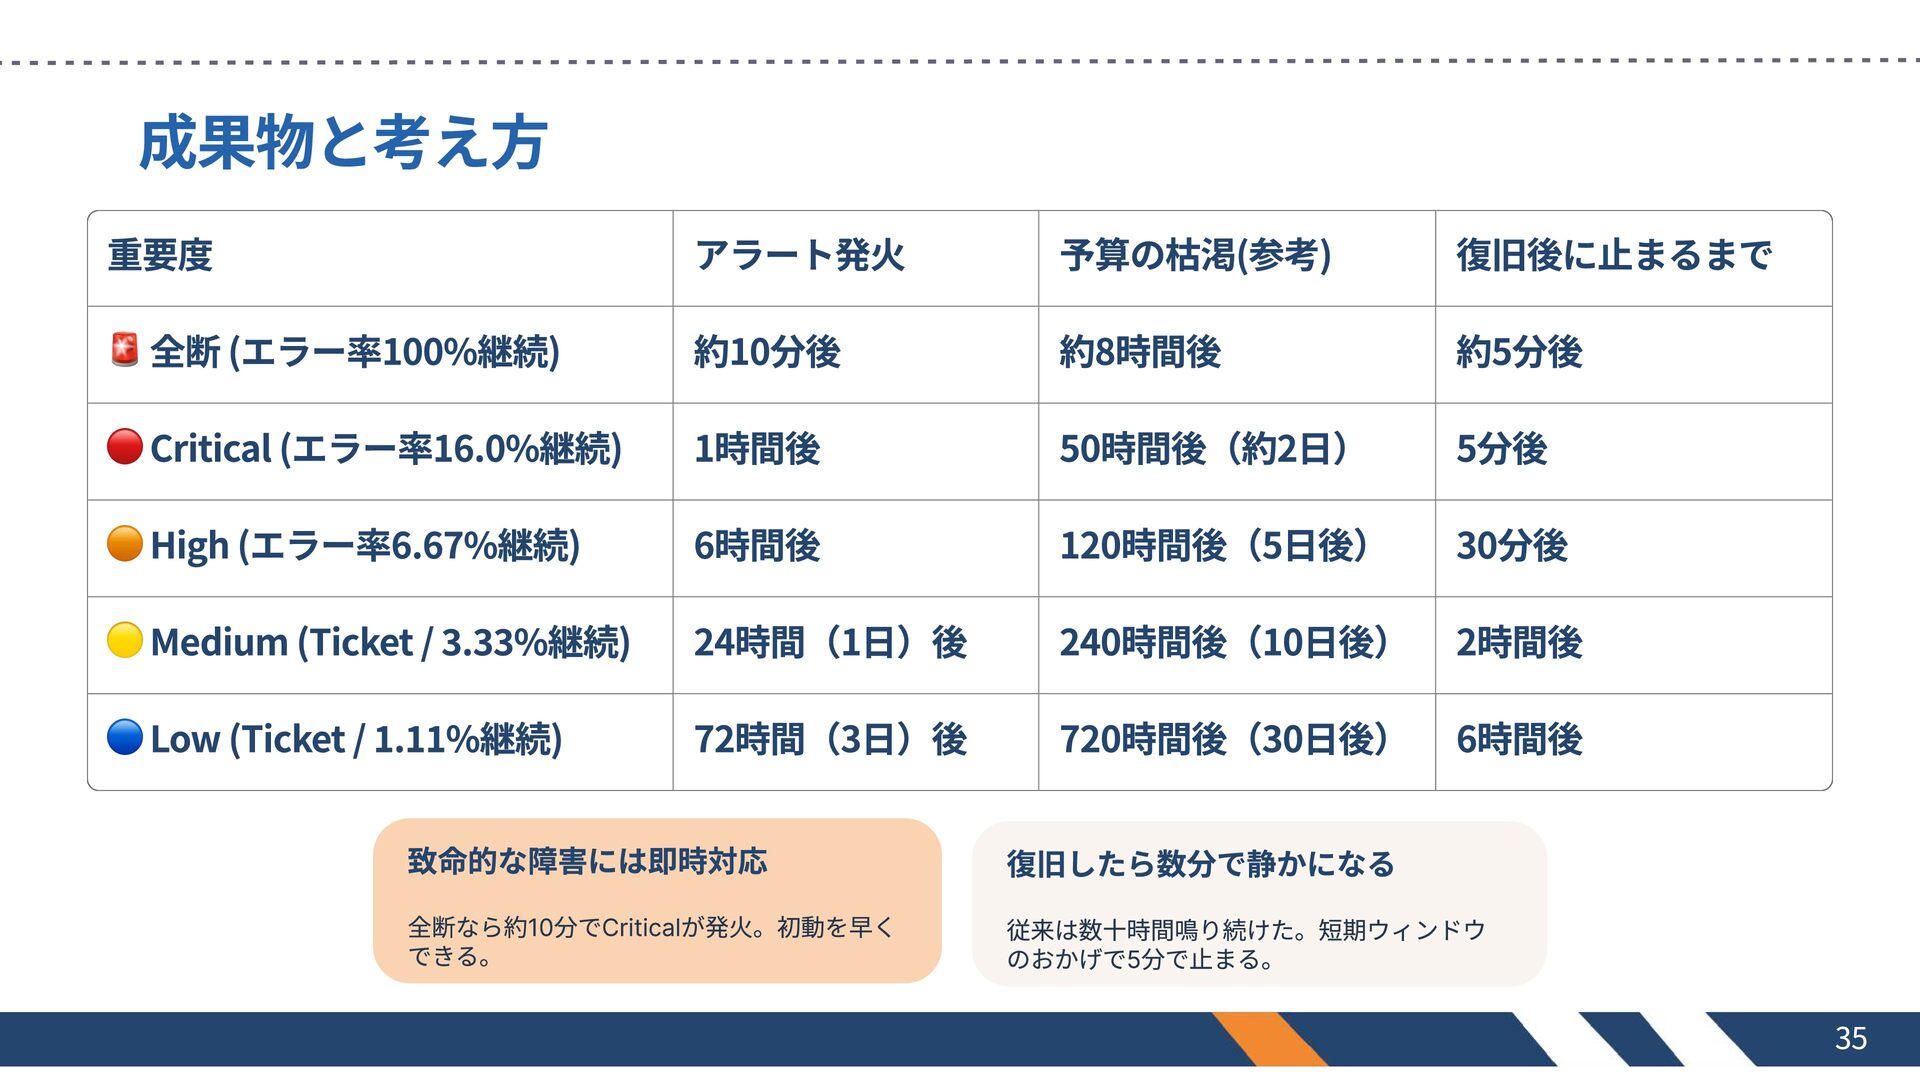
成果物と考え方 重要度 アラート発火 予算の枯渇(参考) 復旧後に止まるまで 🚨 全断 (エラー率100%継続) 約10分後 約8時間後
約5分後 🔴 Critical (エラー率16.0%継続) 1時間後 50時間後(約2日) 5分後 🟠 High (エラー率6.67%継続) 6時間後 120時間後(5日後) 30分後 🟡 Medium (Ticket / 3.33%継続) 24時間(1日)後 240時間後(10日後) 2時間後 🔵 Low (Ticket / 1.11%継続) 72時間(3日)後 720時間後(30日後) 6時間後 致命的な障害には即時対応 復旧したら数分で静かになる 全断なら約10分でCriticalが発火。初動を早く できる。 従来は数十時間鳴り続けた。短期ウィンドウ のおかげで5分で止まる。 35
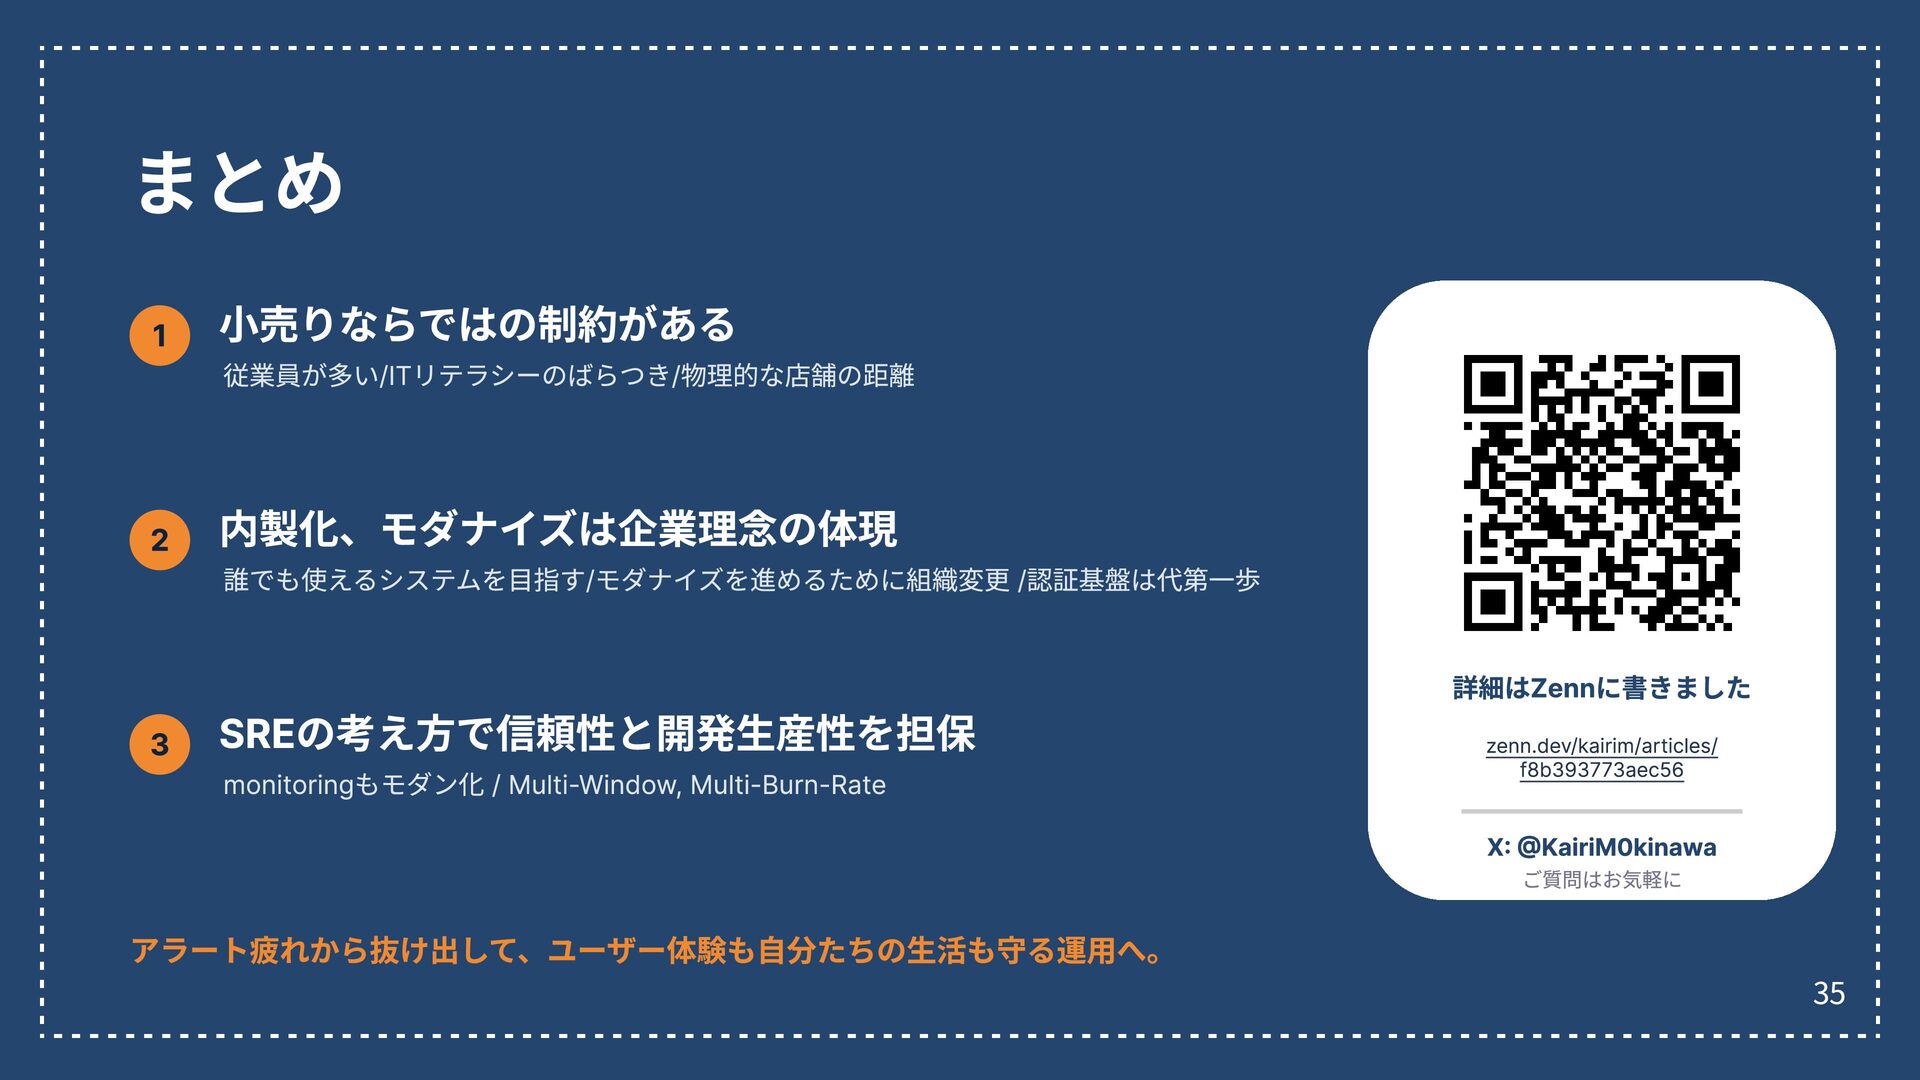
まとめ 1 小売りならではの制約がある 2 内製化、モダナイズは企業理念の体現 3 従業員が多い/ITリテラシーのばらつき/物理的な店舗の距離 誰でも使えるシステムを目指す/モダナイズを進めるために組織変更 /認証基盤は代第一歩 SREの考え方で信頼性と開発生産性を担保
monitoringもモダン化 / Multi-Window, Multi-Burn-Rate 詳細はZennに書きました zenn.dev/kairim/articles/ f8b393773aec56 X: @KairiM0kinawa ご質問はお気軽に アラート疲れから抜け出して、ユーザー体験も自分たちの生活も守る運用へ。 35


 kairim0
 kitagawaz
 ichiki1023
 elmodev09
 logico_jp
 masahirokawahara
 matsunobu
 uya116
 oracle4engineer
 yhana
 yohyamasaki
 odashinsuke
 lynnandtonic
 ammeep
 philnash
 tammyeverts
 techseoconnect
 yeseniaperezcruz
 nmsamuel
 tamaranovitovic
 marcelosomers
 portentint
 mza
 frankvandijk