Upgrade to Pro
— share decks privately, control downloads, hide ads and more …
Speaker Deck
Sign up for free
Menu
Search
Features
All features
Private URLs
Password Protection
Custom URLS
Scheduled publishing
Remove Branding
Restrict embedding
Deck Collections
Notes
Features
All features
Private URLs
Password Protection
Custom URLS
Scheduled publishing
Remove Branding
Restrict embedding
Deck Collections
Notes
Explore
Featured decks
Featured speakers
Programming
Technology
Storyboards
Explore
Featured decks
Featured speakers
Programming
Technology
Storyboards
Pricing
Search
Sign in
Sign up for free
慶應義塾大学 機械学習基礎04 順伝播型ニューラルネット
Search
Semantic Machine Intelligence Lab., Keio Univ.
PRO
October 08, 2021
Technology
2k
3
Share
Embed
Copy iframe code
Copy JS code
Copy link
Start on current slide
慶應義塾大学 機械学習基礎04 順伝播型ニューラルネット
Semantic Machine Intelligence Lab., Keio Univ.
PRO
October 08, 2021
More Decks by Semantic Machine Intelligence Lab., Keio Univ.
See All by Semantic Machine Intelligence Lab., Keio Univ.
[EMNLP26] RIGEL: Self-Distilled Score Adaptation for Image and Video Captioning Evaluation
keio_smilab
PRO
0
76
[RSJ26] Building a VLA Model Based on Self-Distilled Classification
keio_smilab
PRO
0
210
[RSJ26] AnoleVLA: Lightweight Vision-Language-Action Model with Deep State Space Models for Mobile Manipulation
keio_smilab
PRO
0
180
[RSJ26] NarrativeFlow: Flow-Based Vision-Language-Action Model Using Robot Velocity Fields
keio_smilab
PRO
0
250
[RSJ26] Flow as Flow: Modeling Robot Velocity Fields as Probability Velocity Fields
keio_smilab
PRO
1
240
[RSJ26] Hierarchy-Aware Multimodal Retrieval-Augmented Generation for Embodied Question Answering
keio_smilab
PRO
1
200
[MIRU26] Open-Vocabulary Intention-Guided Object Detection in Diverse Scenes
keio_smilab
PRO
0
250
[Journal club] Evo-1: Lightweight Vision-Language-Action Model with Preserved Semantic Alignment
keio_smilab
PRO
0
74
[MIRU26] To What Extent Does MLLM-as-a-Judge Exhibit Cross-Model Preference Bias?
keio_smilab
PRO
0
330
Other Decks in Technology
See All in Technology
sue445's proposals 2026
sue445
0
120
What Is JetBrains Air
x5gtrn
PRO
0
110
フィンテック養成勉強会#68
finengine
0
160
How to Design Configuration for Rails Applications
willnet
1
860
Persisting Massive Data with Rails ~Designing for 60 billion rows, and fighting the bottlenecks~ Railsで挑む大量データ永続化 〜600億件を永続化するための設計とボトルネックとの戦い〜
occhi
0
740
スプシの手作業からの解脱 ~更新はClaude Codeに、見せ方と使い方はGASアプリに任せる~
kentarofujii
0
160
Refining Active Record
shugo
0
170
Rust で関数型ドメインモデリング
takonda
0
170
エンタメ企業のM&Aを支えるデータ基盤 ― 統合から店舗のリアルタイム分析まで / Data Engineering Summit 2026
genda
0
210
Metadata - Section 1: HTML Basics
mohab1
0
130
20261017福岡devIO 「AIは"良いダッシュボード"を作れるか?
jtakeda
0
200
LambdaWebFunctionsを試してみた / exploring-lambda-web-functions
koukihosaka
1
360
Featured
See All Featured
Ten Tips & Tricks for a 🌱 transition
stuffmc
1
270
ラッコキーワード サービス紹介資料
rakko
1
5.4M
Design of three-dimensional binary manipulators for pick-and-place task avoiding obstacles (IECON2024)
konakalab
0
630
Agile Leadership in an Agile Organization
kimpetersen
PRO
0
290
The SEO Collaboration Effect
kristinabergwall1
1
590
How GitHub (no longer) Works
holman
316
150k
Writing Fast Ruby
sferik
630
63k
The browser strikes back
jonoalderson
0
1.8k
Design in an AI World
tapps
1
360
Scaling GitHub
holman
464
140k
Bash Introduction
62gerente
615
220k
Abbi's Birthday
coloredviolet
4
10k
Transcript
慶應義塾大学理工学部 機械学習基礎 第4回 順伝播型ニューラルネット 情報工学科 教授 杉浦孔明
[email protected]
本講義の到達目標と今回の授業の狙い 本講義の到達目標 ▪ DNNの基礎理論と実装の関係を理解する ▪ 種々のDNNをコーディングできる 今回の授業の狙い ▪ 順伝播型ニューラルネットの基礎を習得する ▪
出席確認: K-LMS上の機械学習基礎のMainページへアクセス -2-
順伝播型ニューラルネット -3-
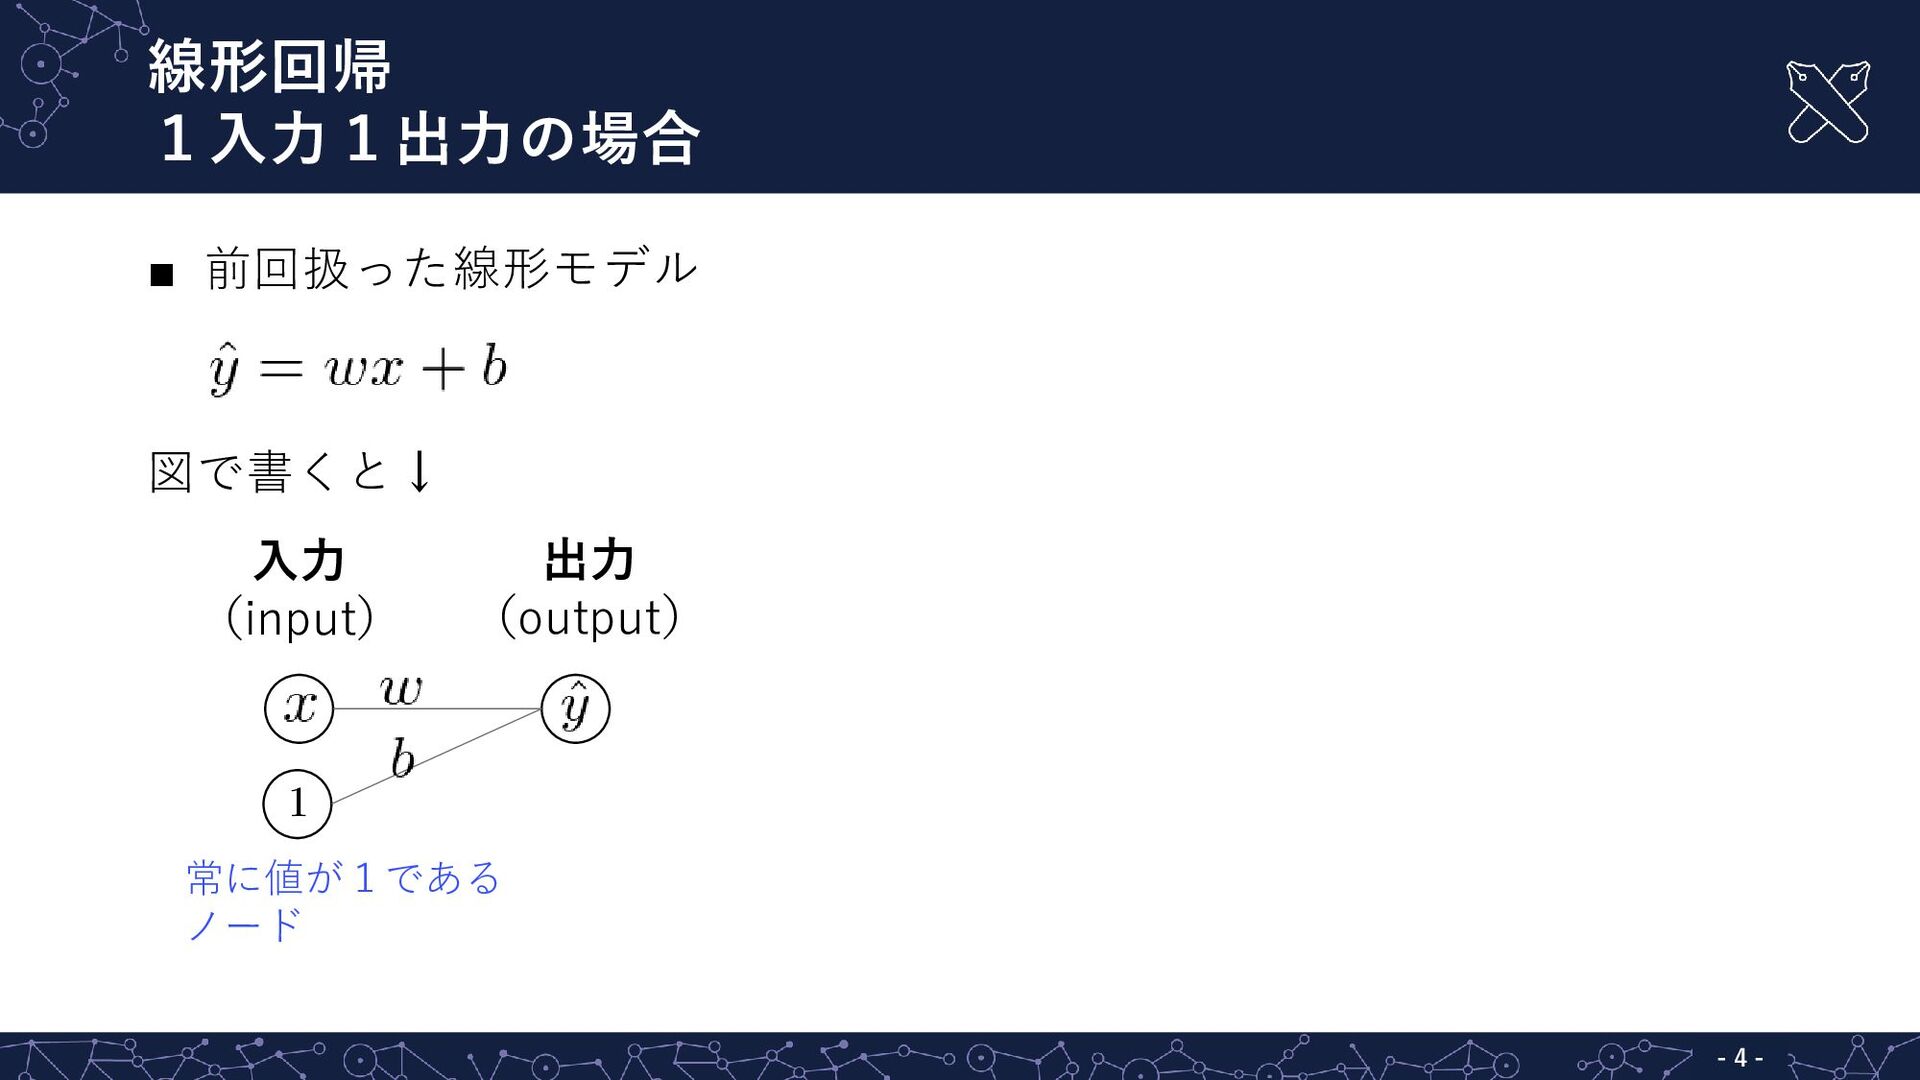
線形回帰 1入力1出力の場合 ▪ 前回扱った線形モデル 図で書くと↓ 入力 (input) 出力 (output) 常に値が1である
ノード -4-
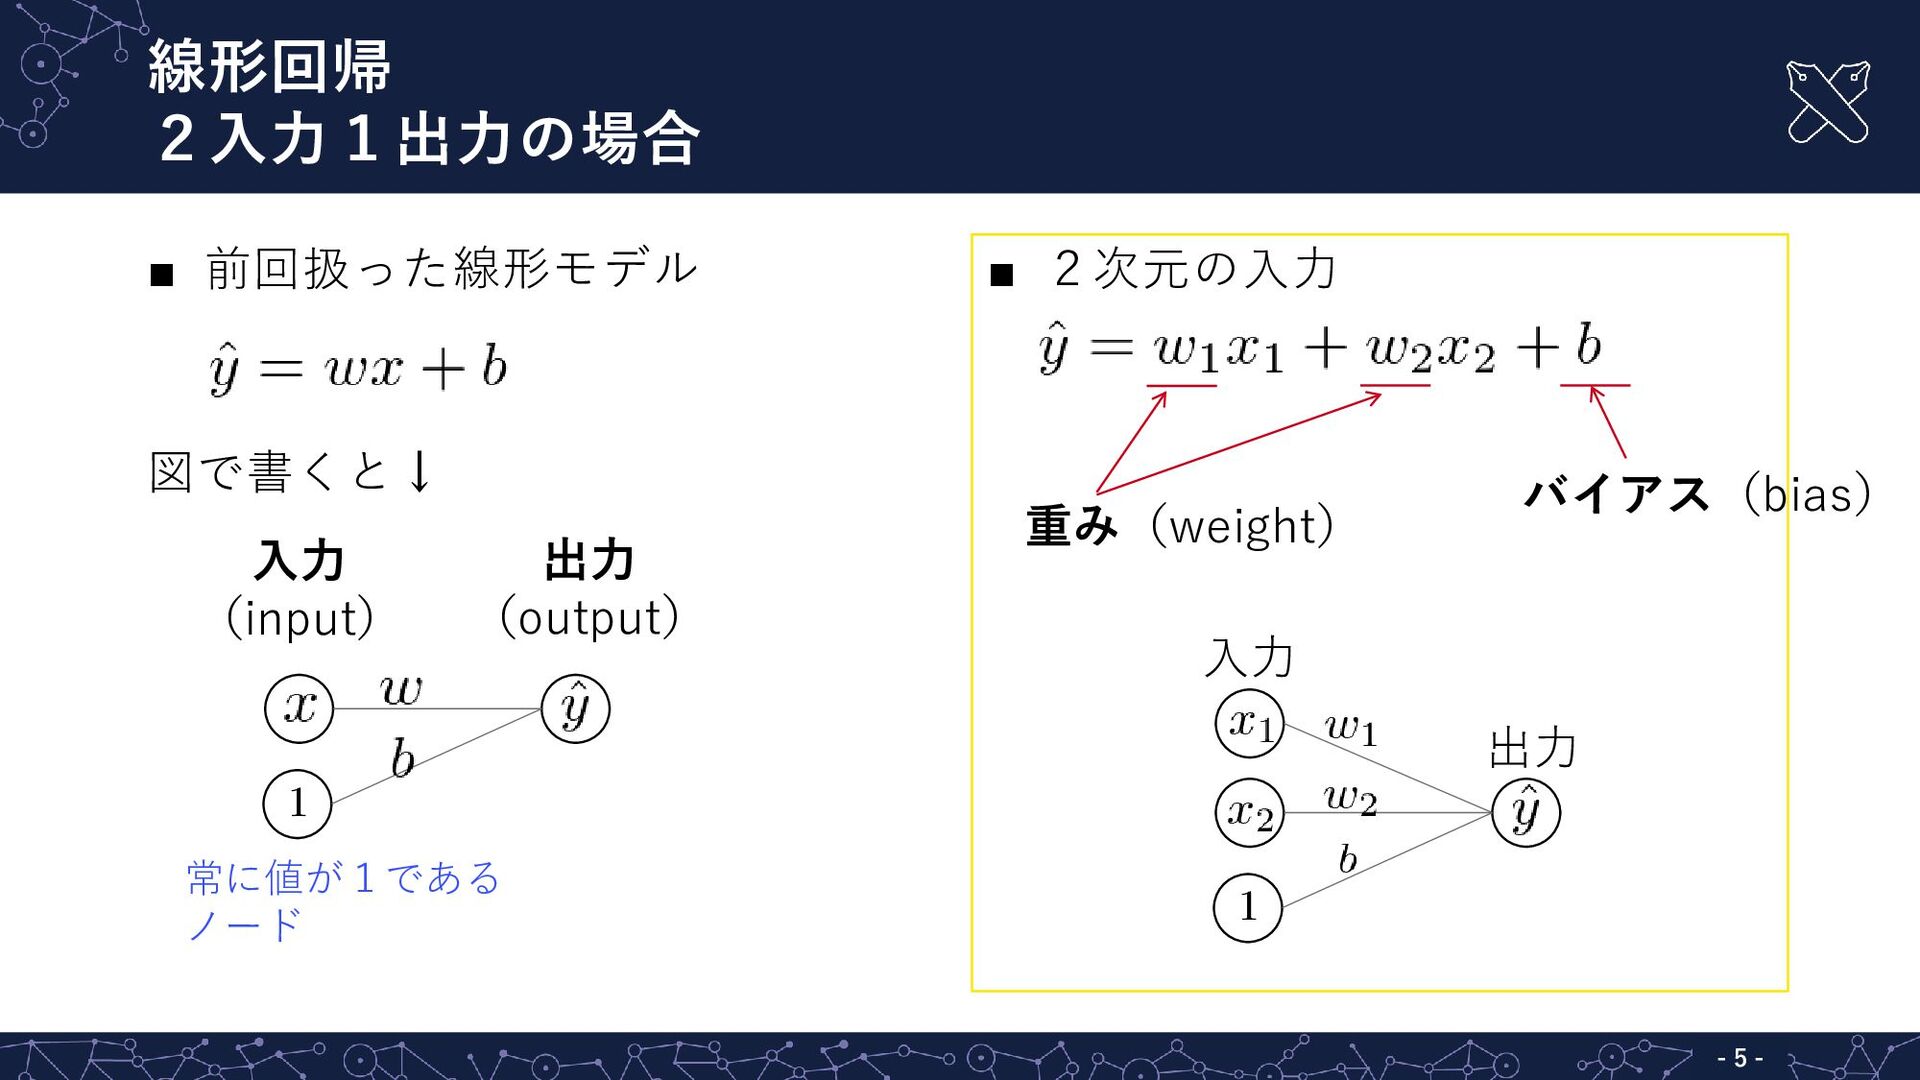
線形回帰 2入力1出力の場合 ▪ 前回扱った線形モデル 図で書くと↓ 入力 (input) 出力 (output) ▪
2次元の入力 重み(weight) バイアス(bias) 入力 出力 常に値が1である ノード -5-
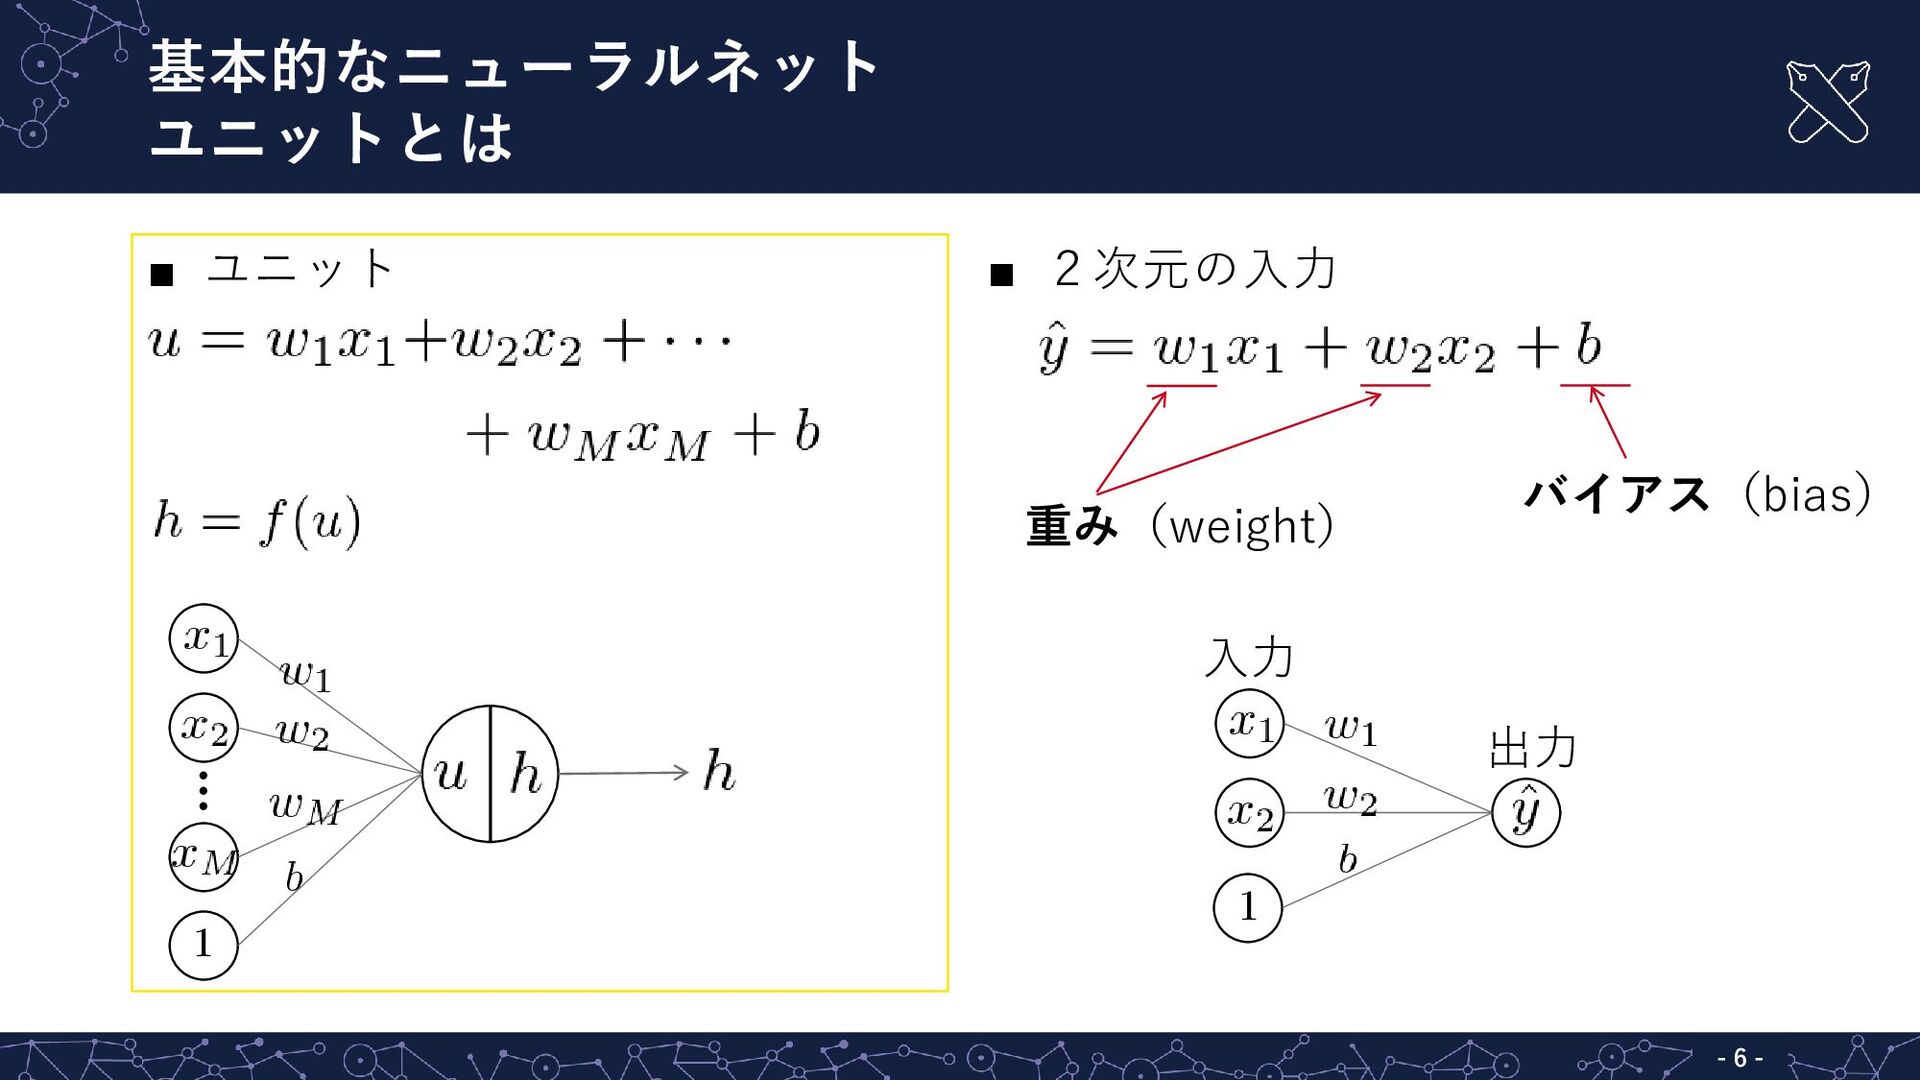
基本的なニューラルネット ユニットとは ▪ ユニット ▪ 2次元の入力 重み(weight) バイアス(bias) 入力 出力
-6-
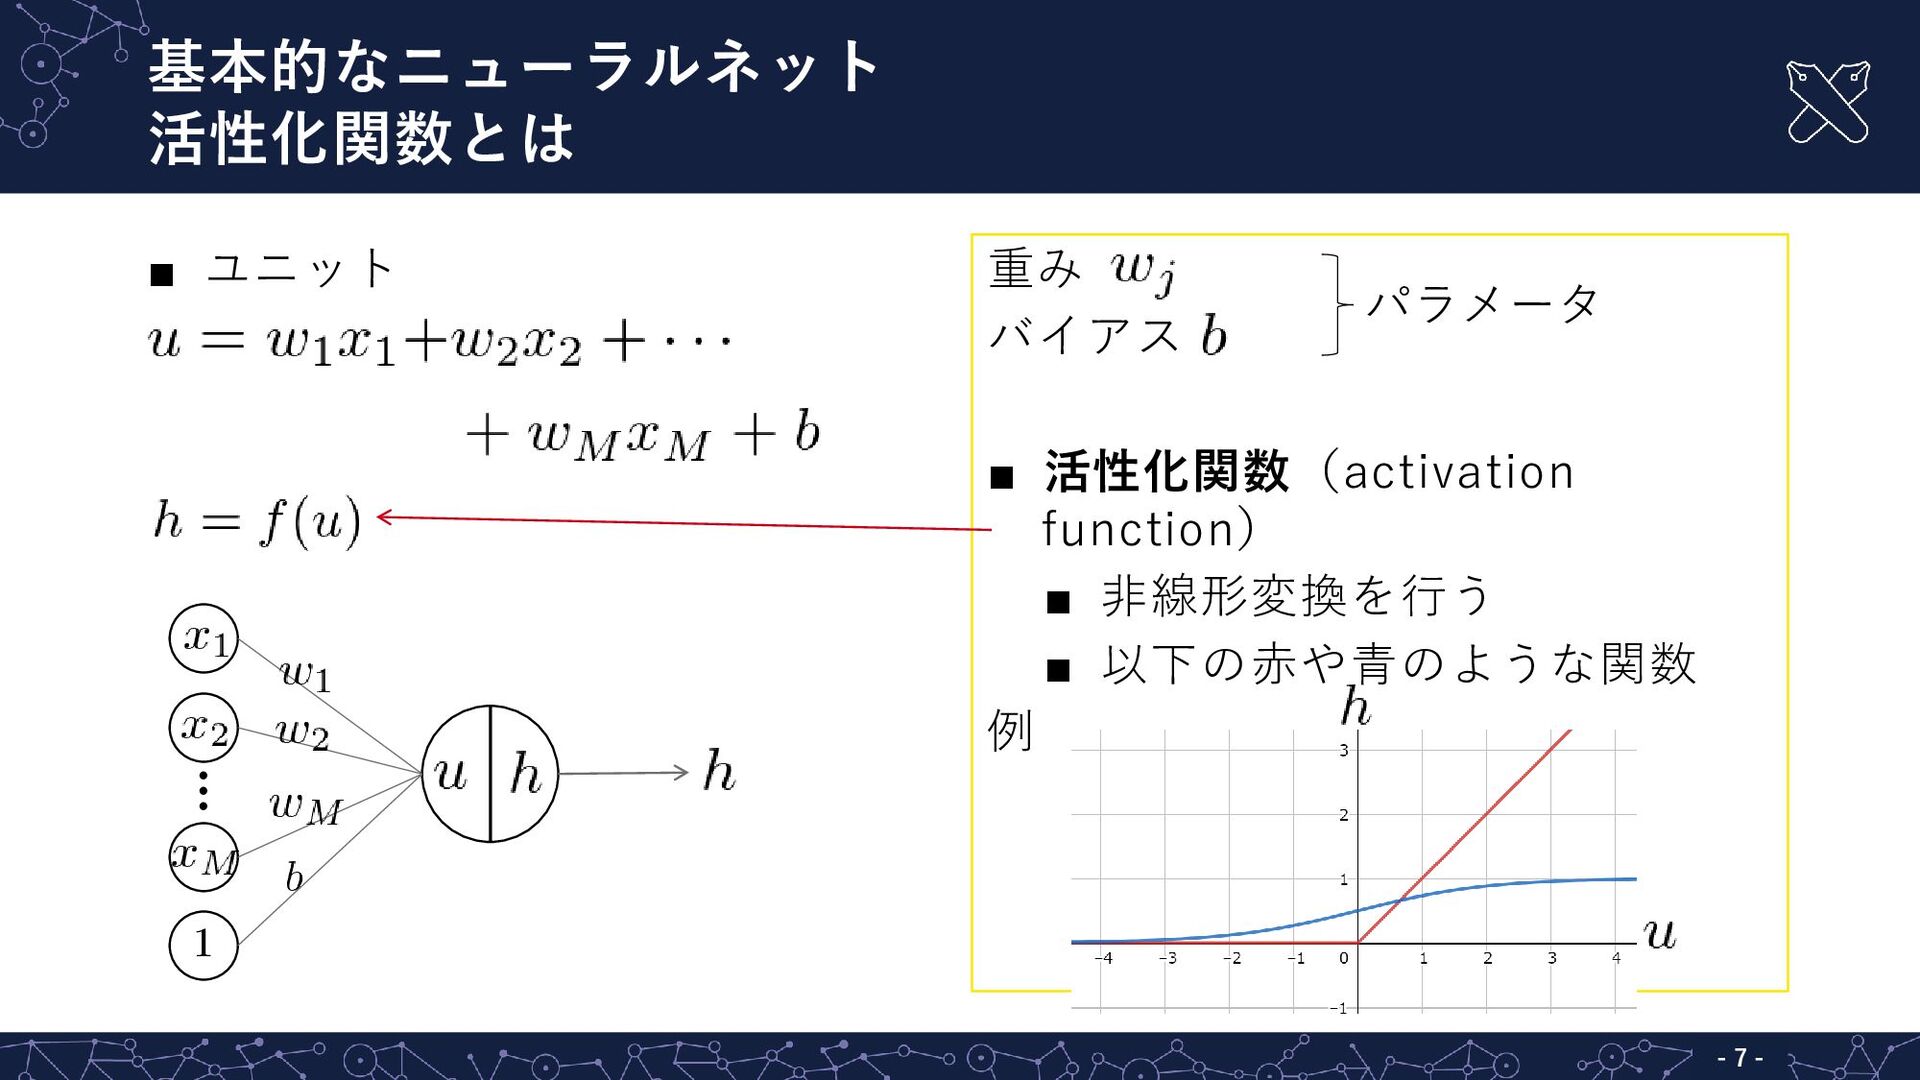
基本的なニューラルネット 活性化関数とは ▪ ユニット 重み バイアス パラメータ ▪ 活性化関数(activation function)
▪ 非線形変換を行う ▪ 以下の赤や青のような関数 例 -7-
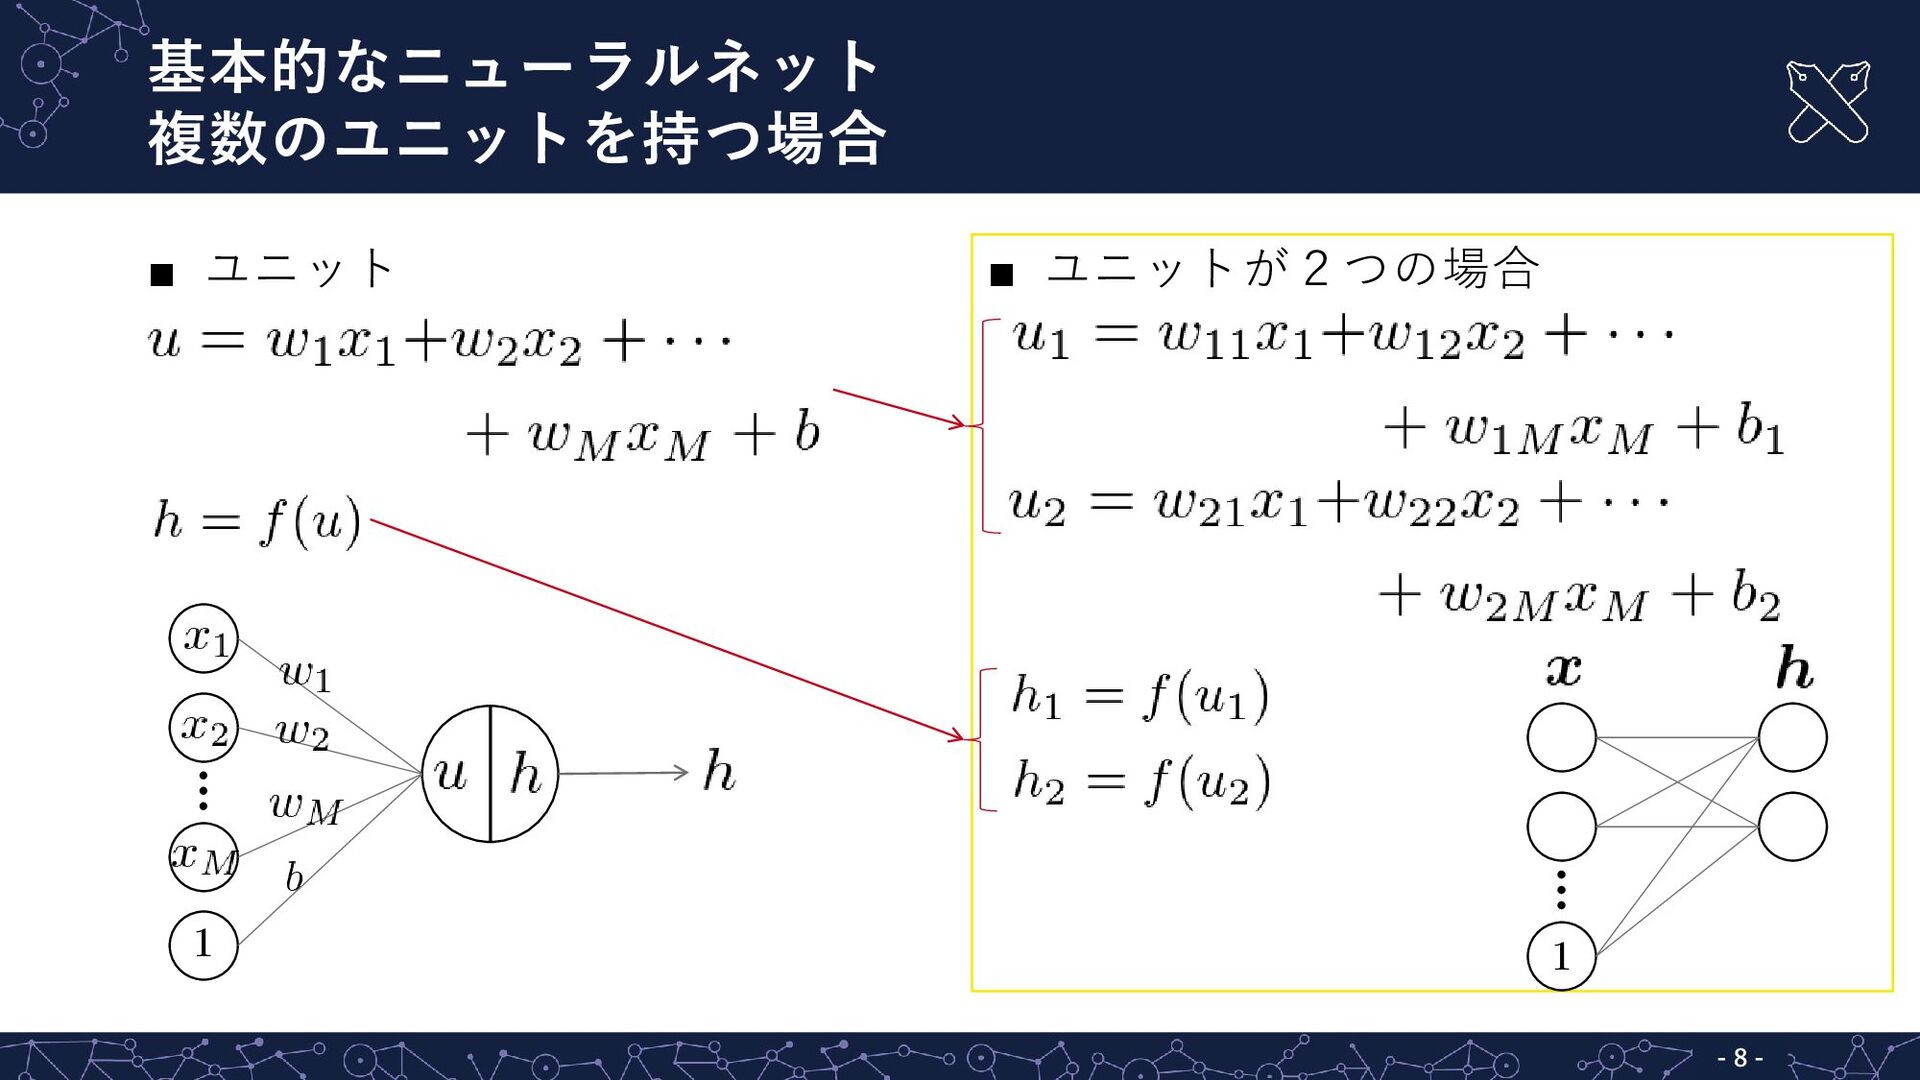
基本的なニューラルネット 複数のユニットを持つ場合 ▪ ユニット ▪ ユニットが2つの場合 -8-
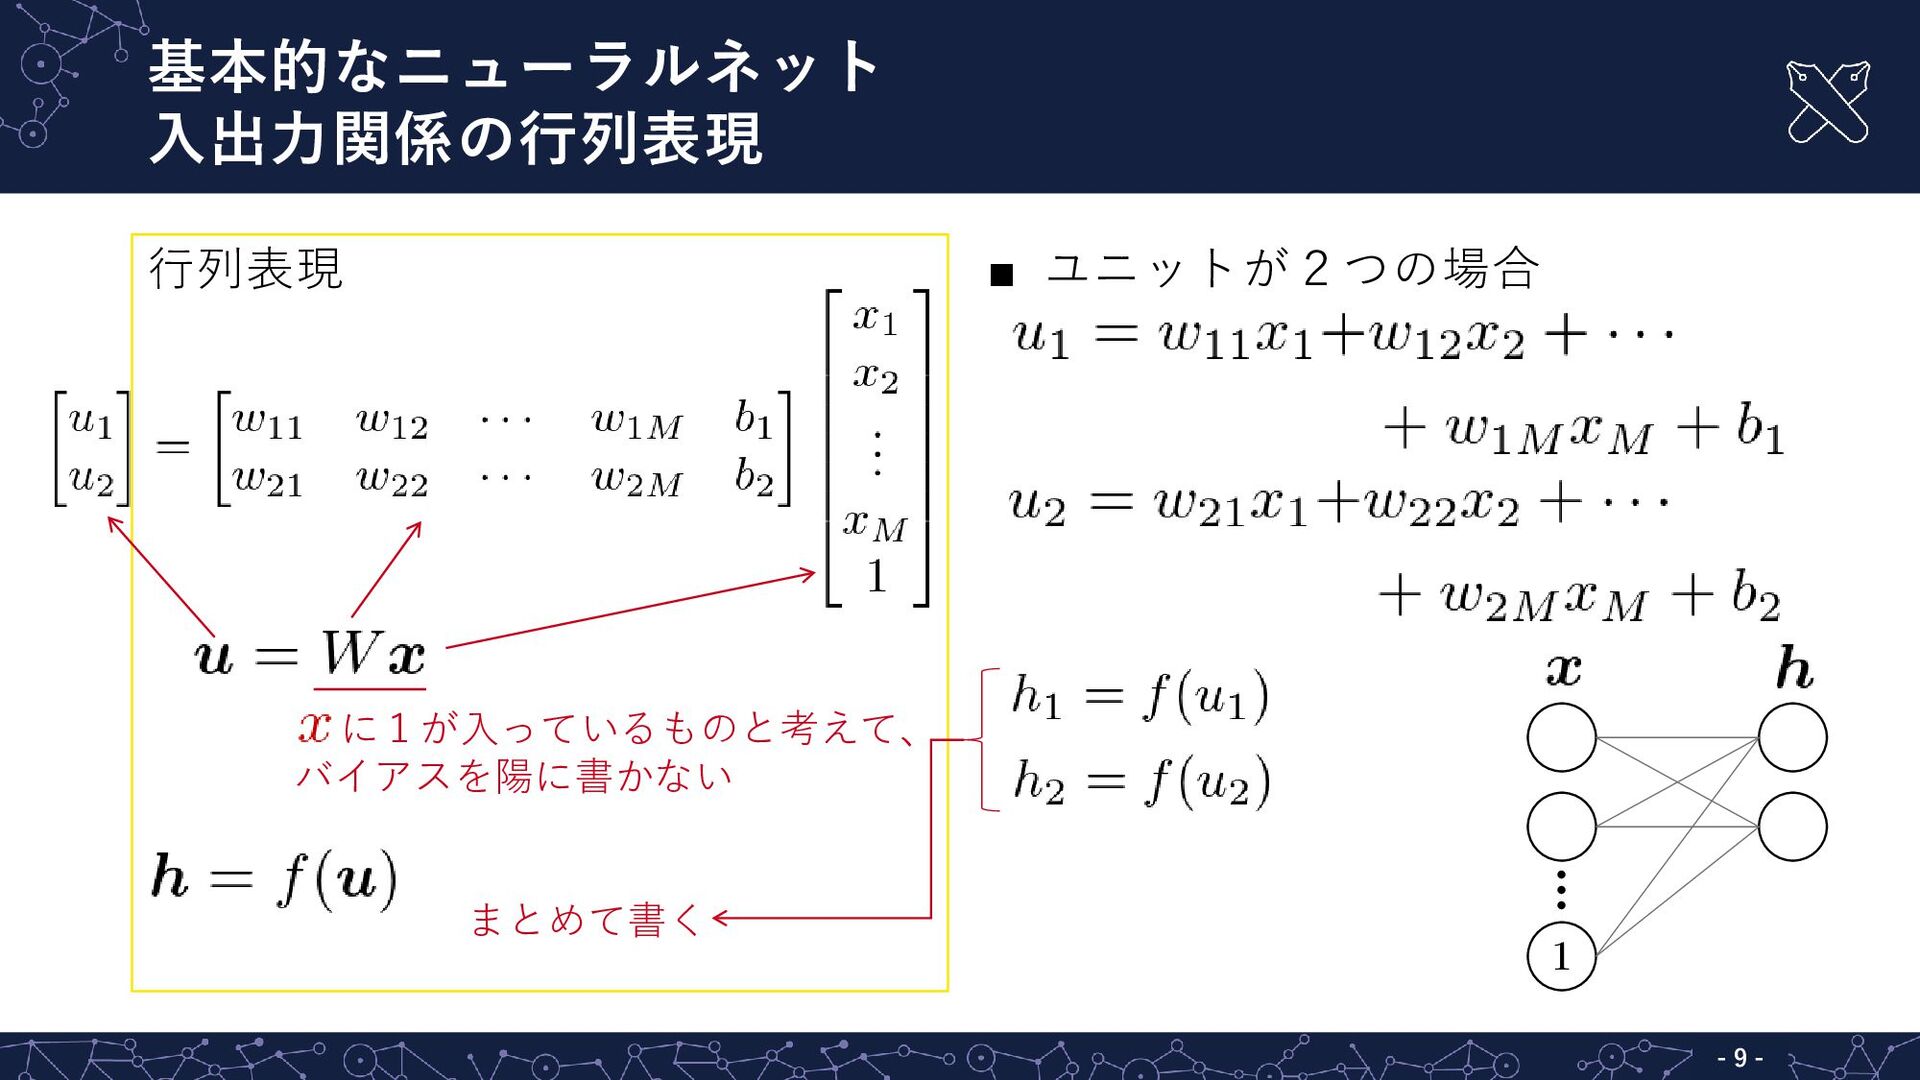
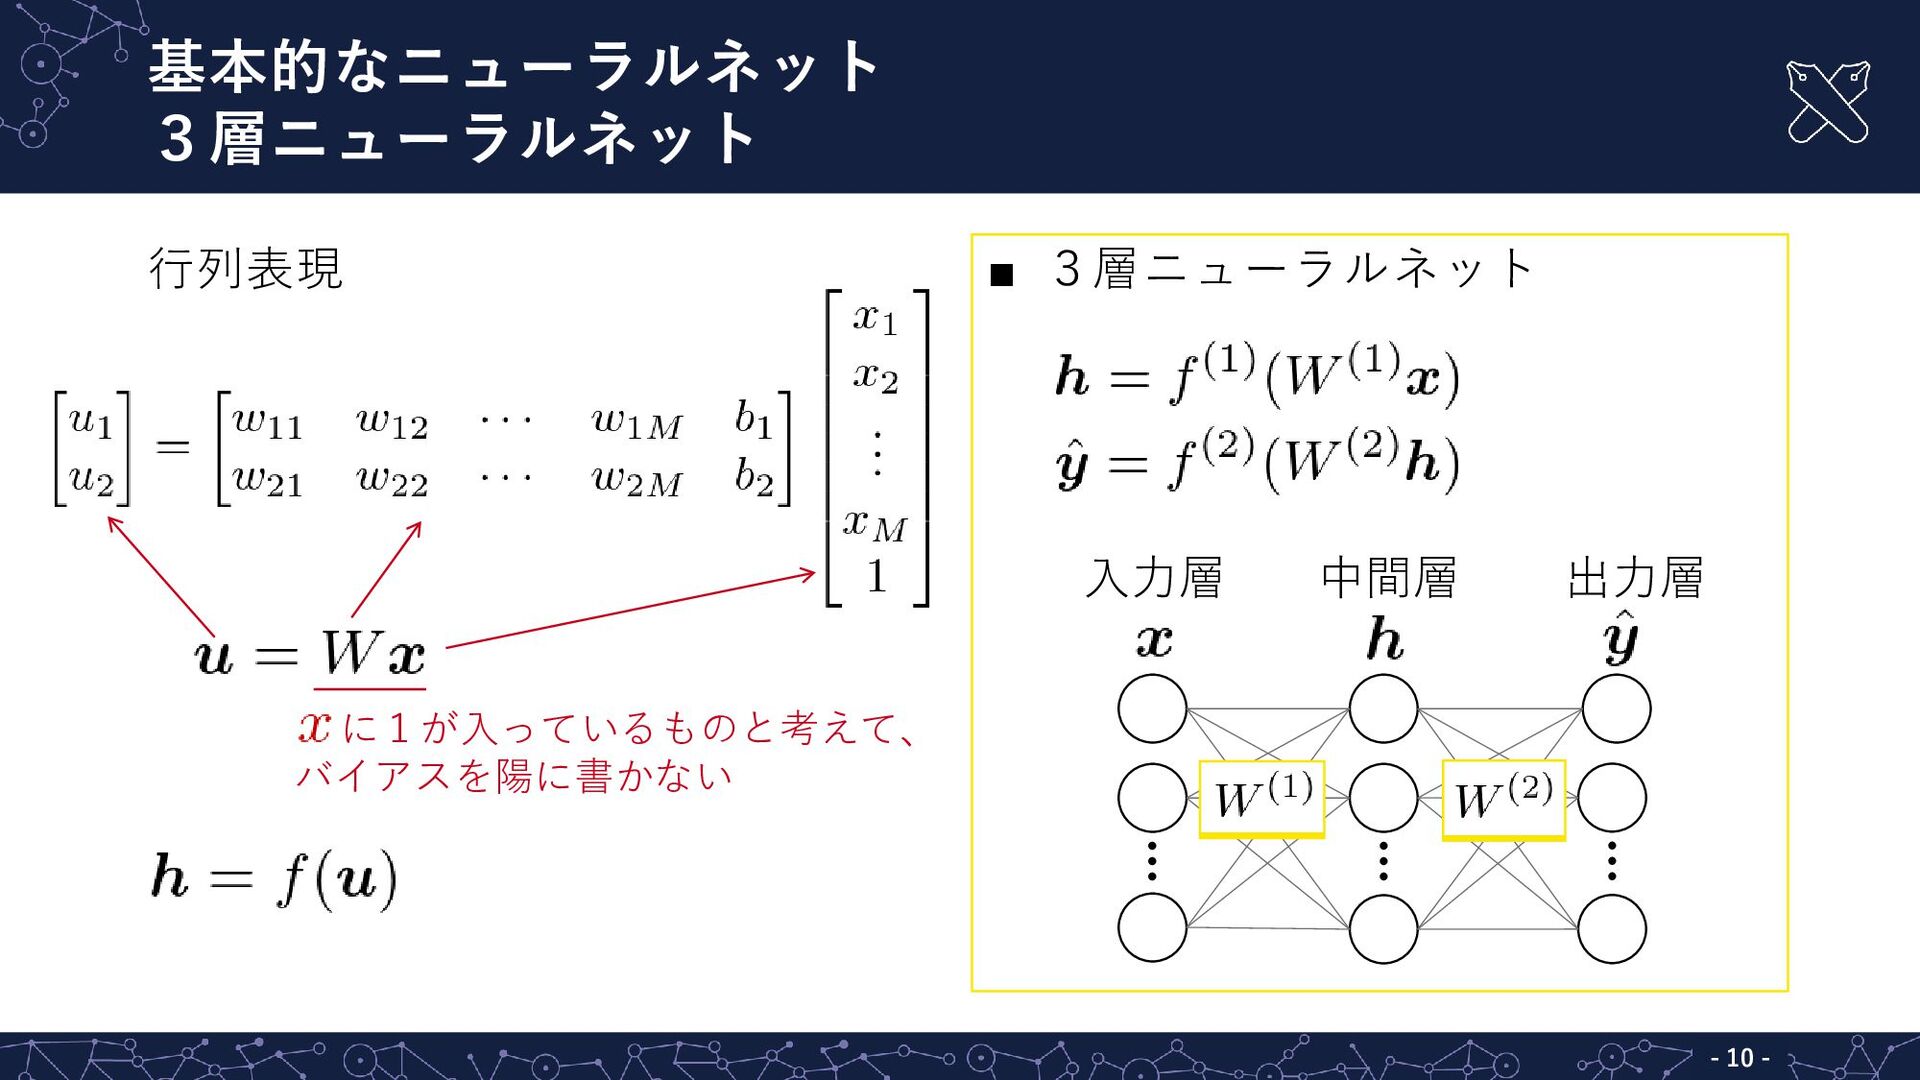
基本的なニューラルネット 入出力関係の行列表現 行列表現 ▪ ユニットが2つの場合 に1が入っているものと考えて、 バイアスを陽に書かない まとめて書く -9-
基本的なニューラルネット 3層ニューラルネット 行列表現 ▪ 3層ニューラルネット 入力層 中間層 出力層 に1が入っているものと考えて、 バイアスを陽に書かない
- 10 -
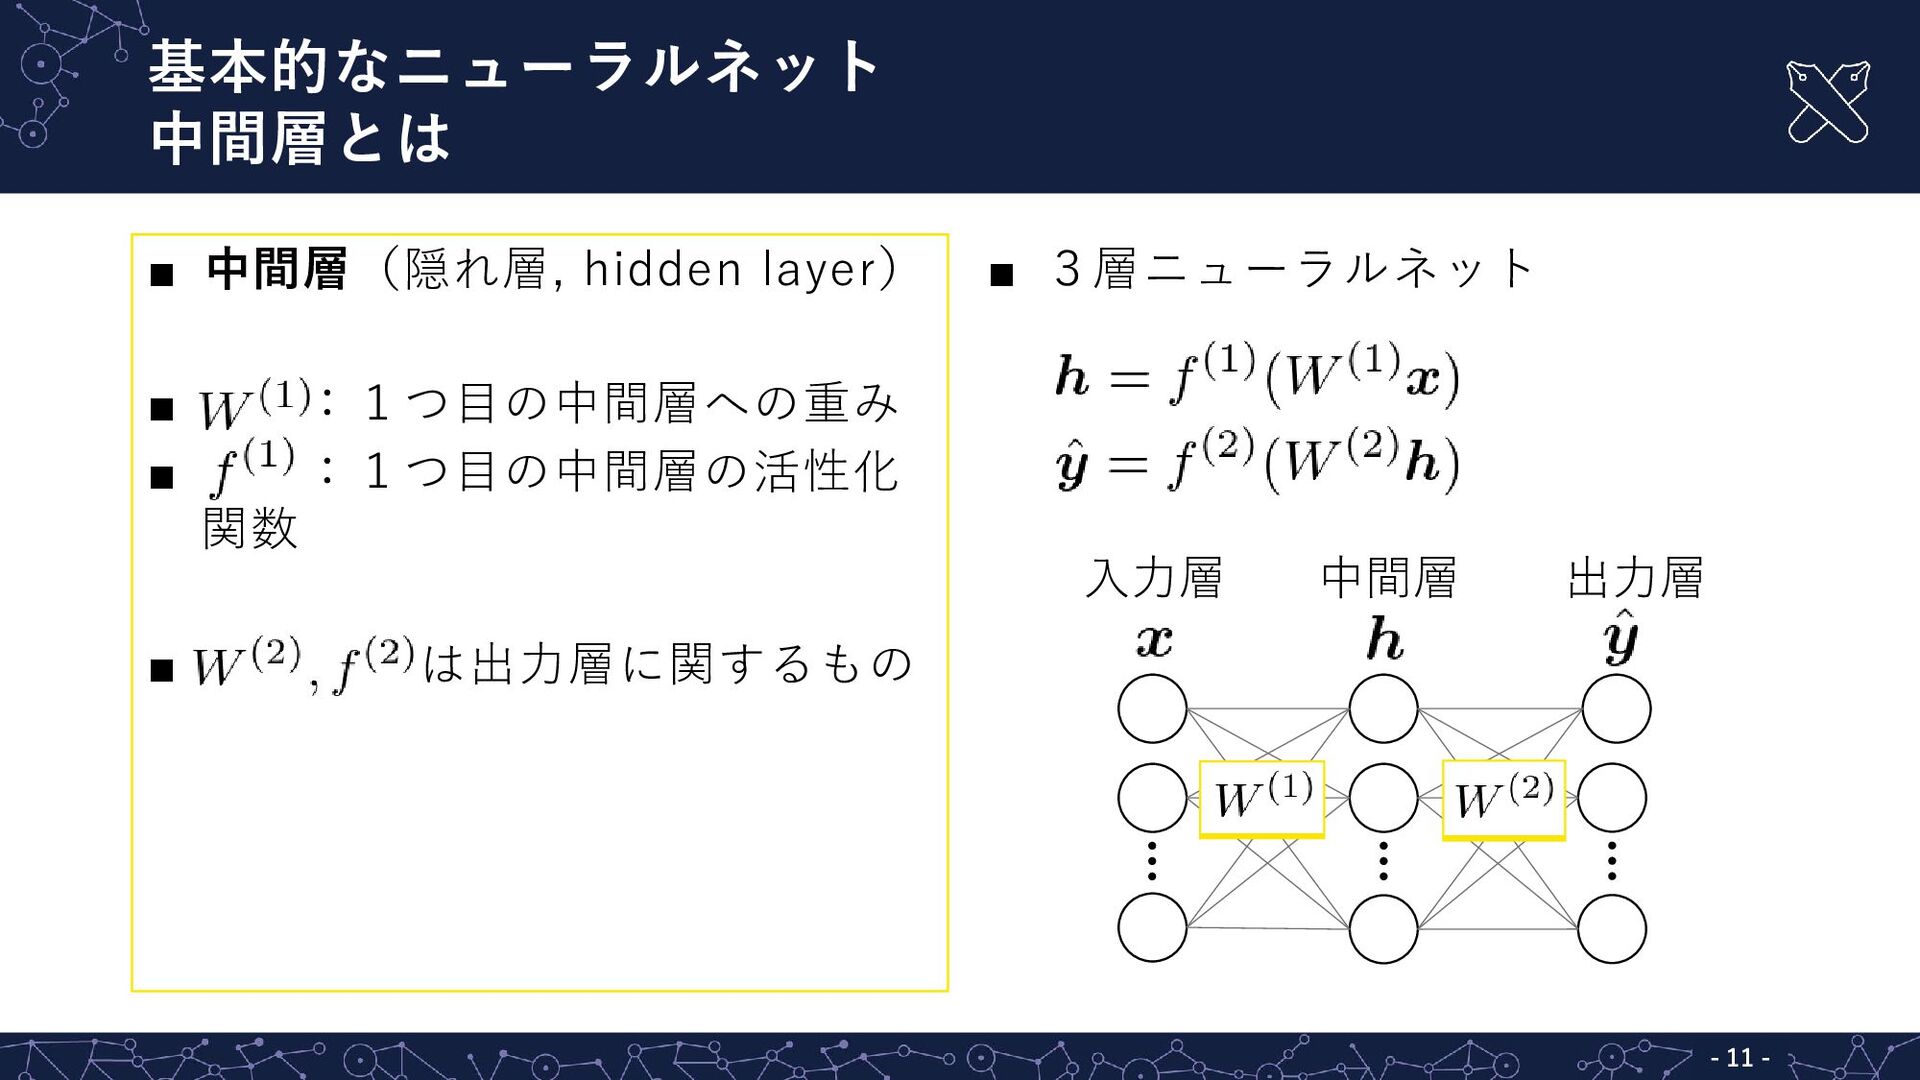
基本的なニューラルネット 中間層とは ▪ 中間層(隠れ層, hidden layer) ▪ ▪ ▪ 関数
▪ 3層ニューラルネット :1つ目の中間層への重み :1つ目の中間層の活性化 入力層 中間層 出力層 は出力層に関するもの - 11 -
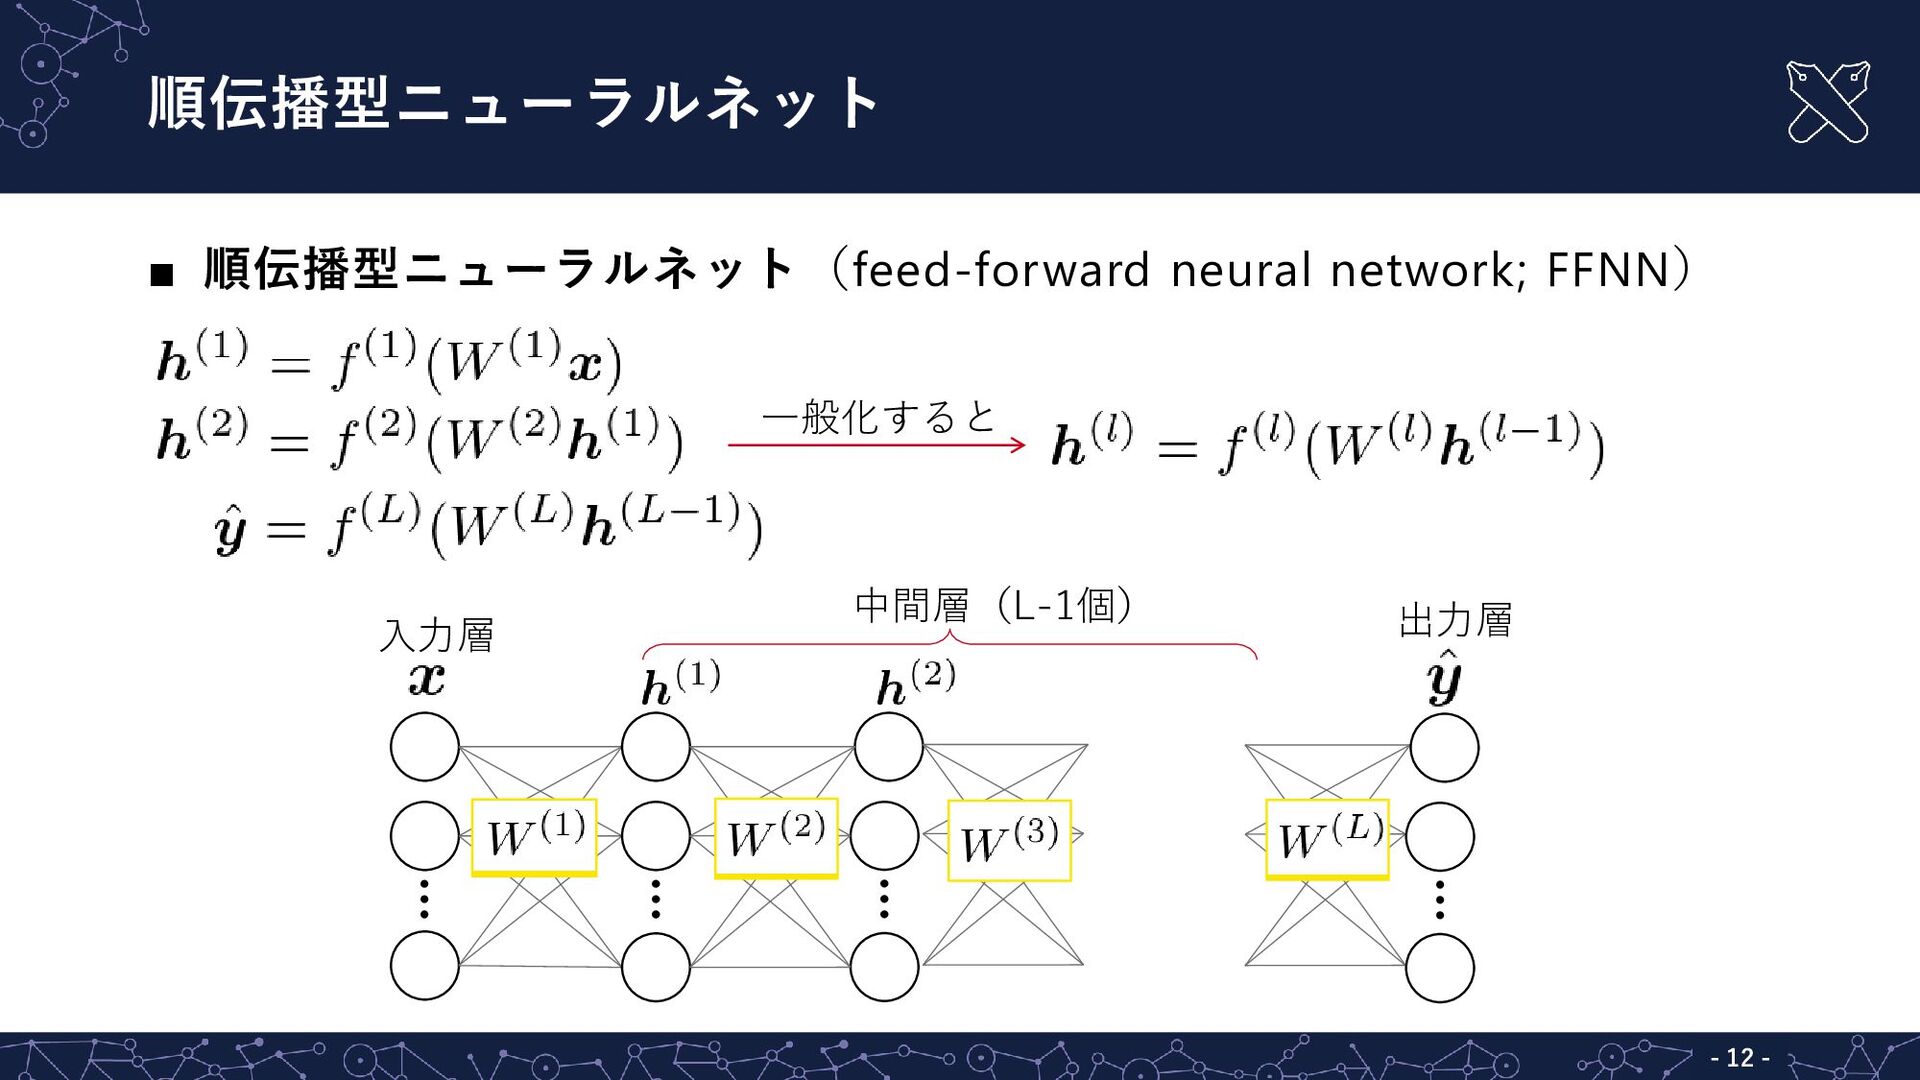
順伝播型ニューラルネット ▪ 順伝播型ニューラルネット(feed-forward neural network; FFNN) 一般化すると 入力層 中間層(L-1個) 出力層
- 12 -
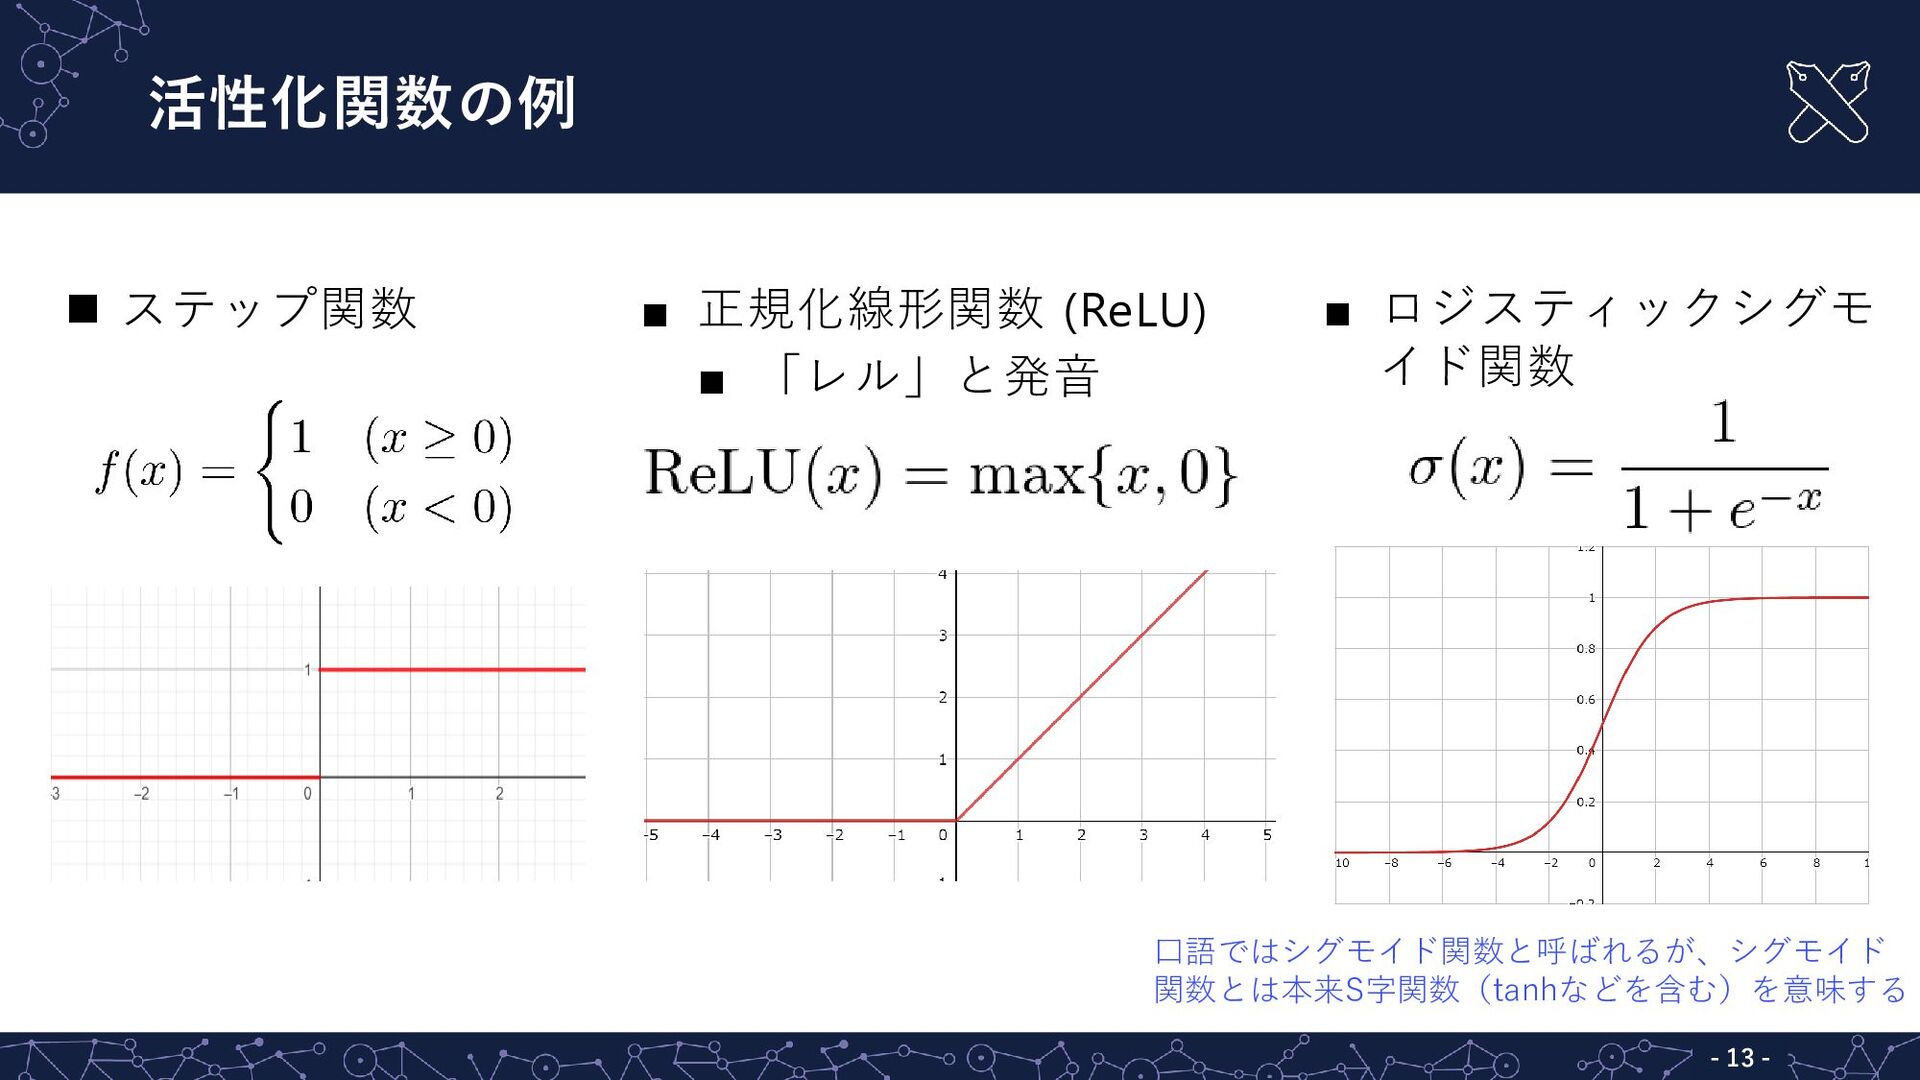
活性化関数の例 ステップ関数 ▪ 正規化線形関数 (ReLU) ▪ 「レル」と発音 ▪ ロジスティックシグモ
イド関数 口語ではシグモイド関数と呼ばれるが、シグモイド 関数とは本来S字関数(tanhなどを含む)を意味する - 13 -
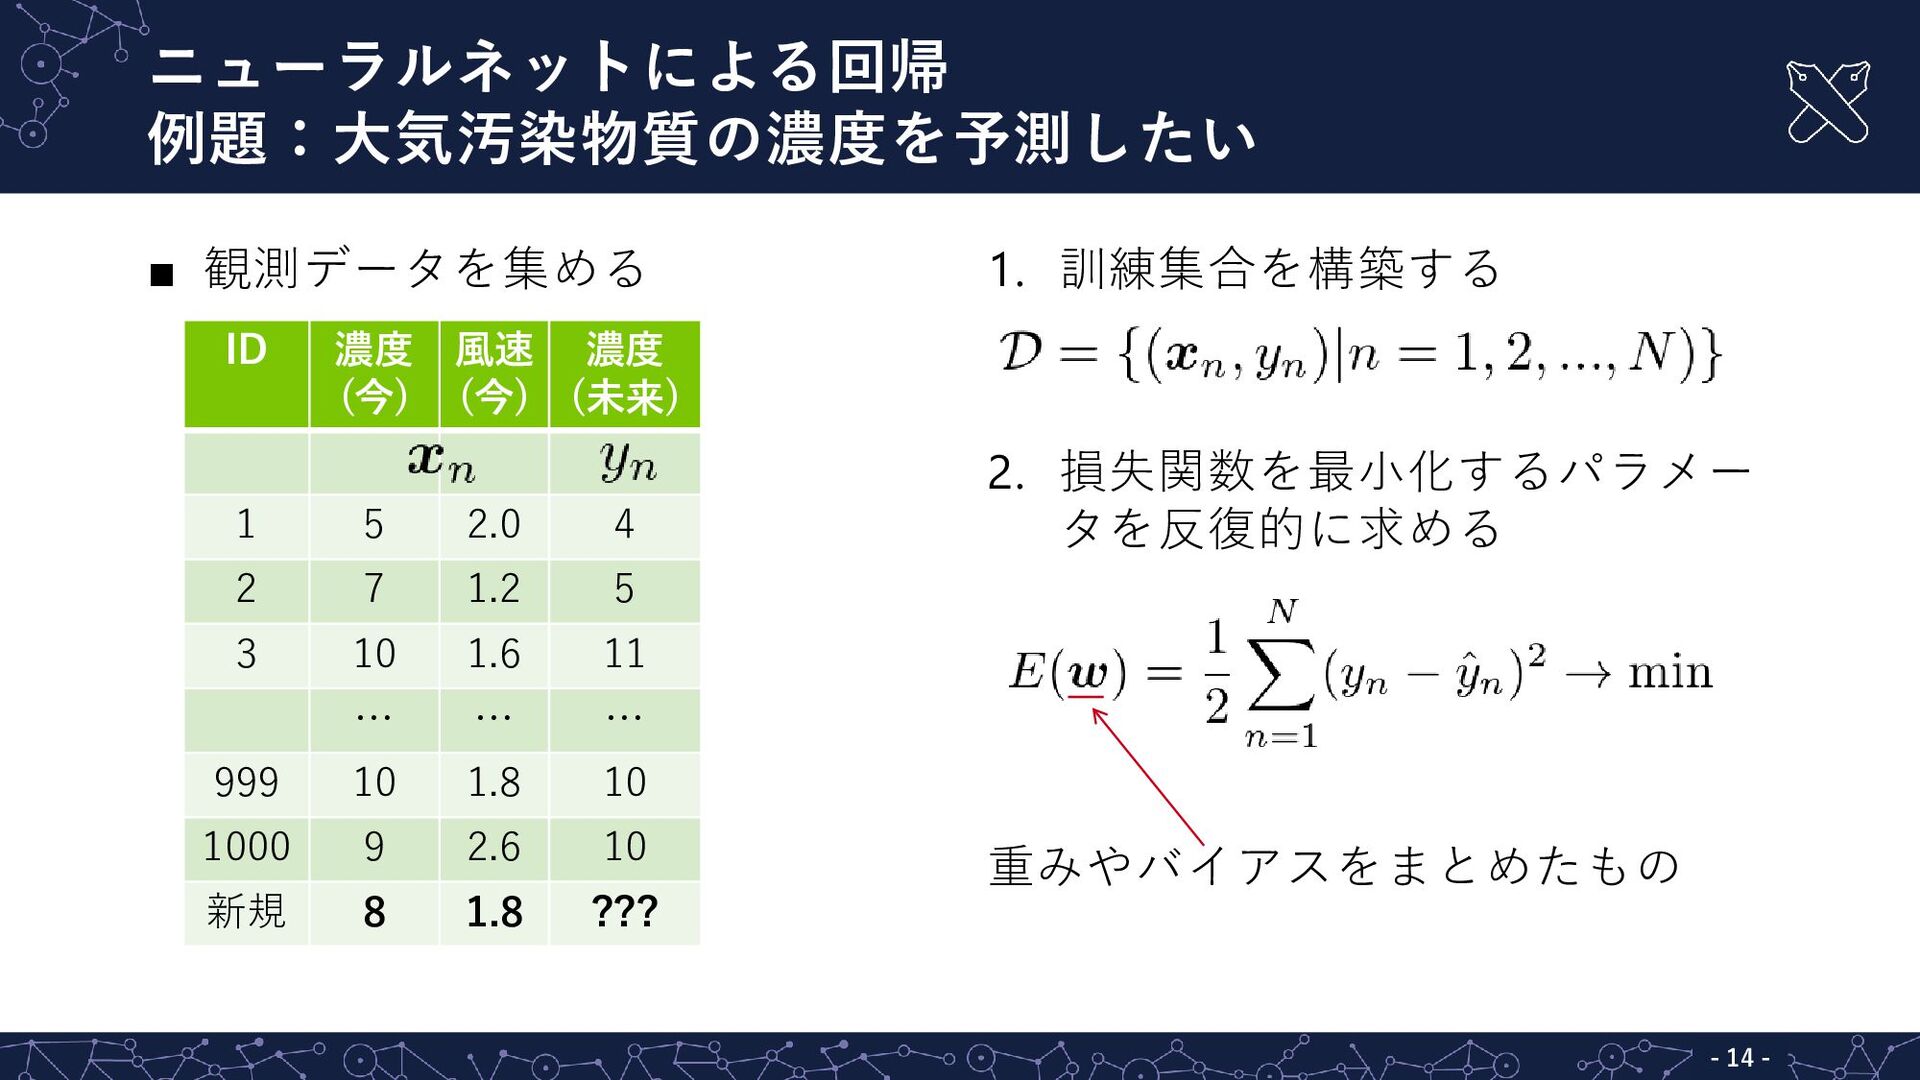
ニューラルネットによる回帰 例題:大気汚染物質の濃度を予測したい ▪ 観測データを集める ID 濃度 風速 濃度 (今) (今)
(未来) 1 5 2.0 4 2 7 1.2 5 3 10 1.6 11 … … … 999 10 1.8 10 1000 9 2.6 10 新規 8 1.8 ??? 1. 訓練集合を構築する 2. 損失関数を最小化するパラメー タを反復的に求める 重みやバイアスをまとめたもの - 14 -
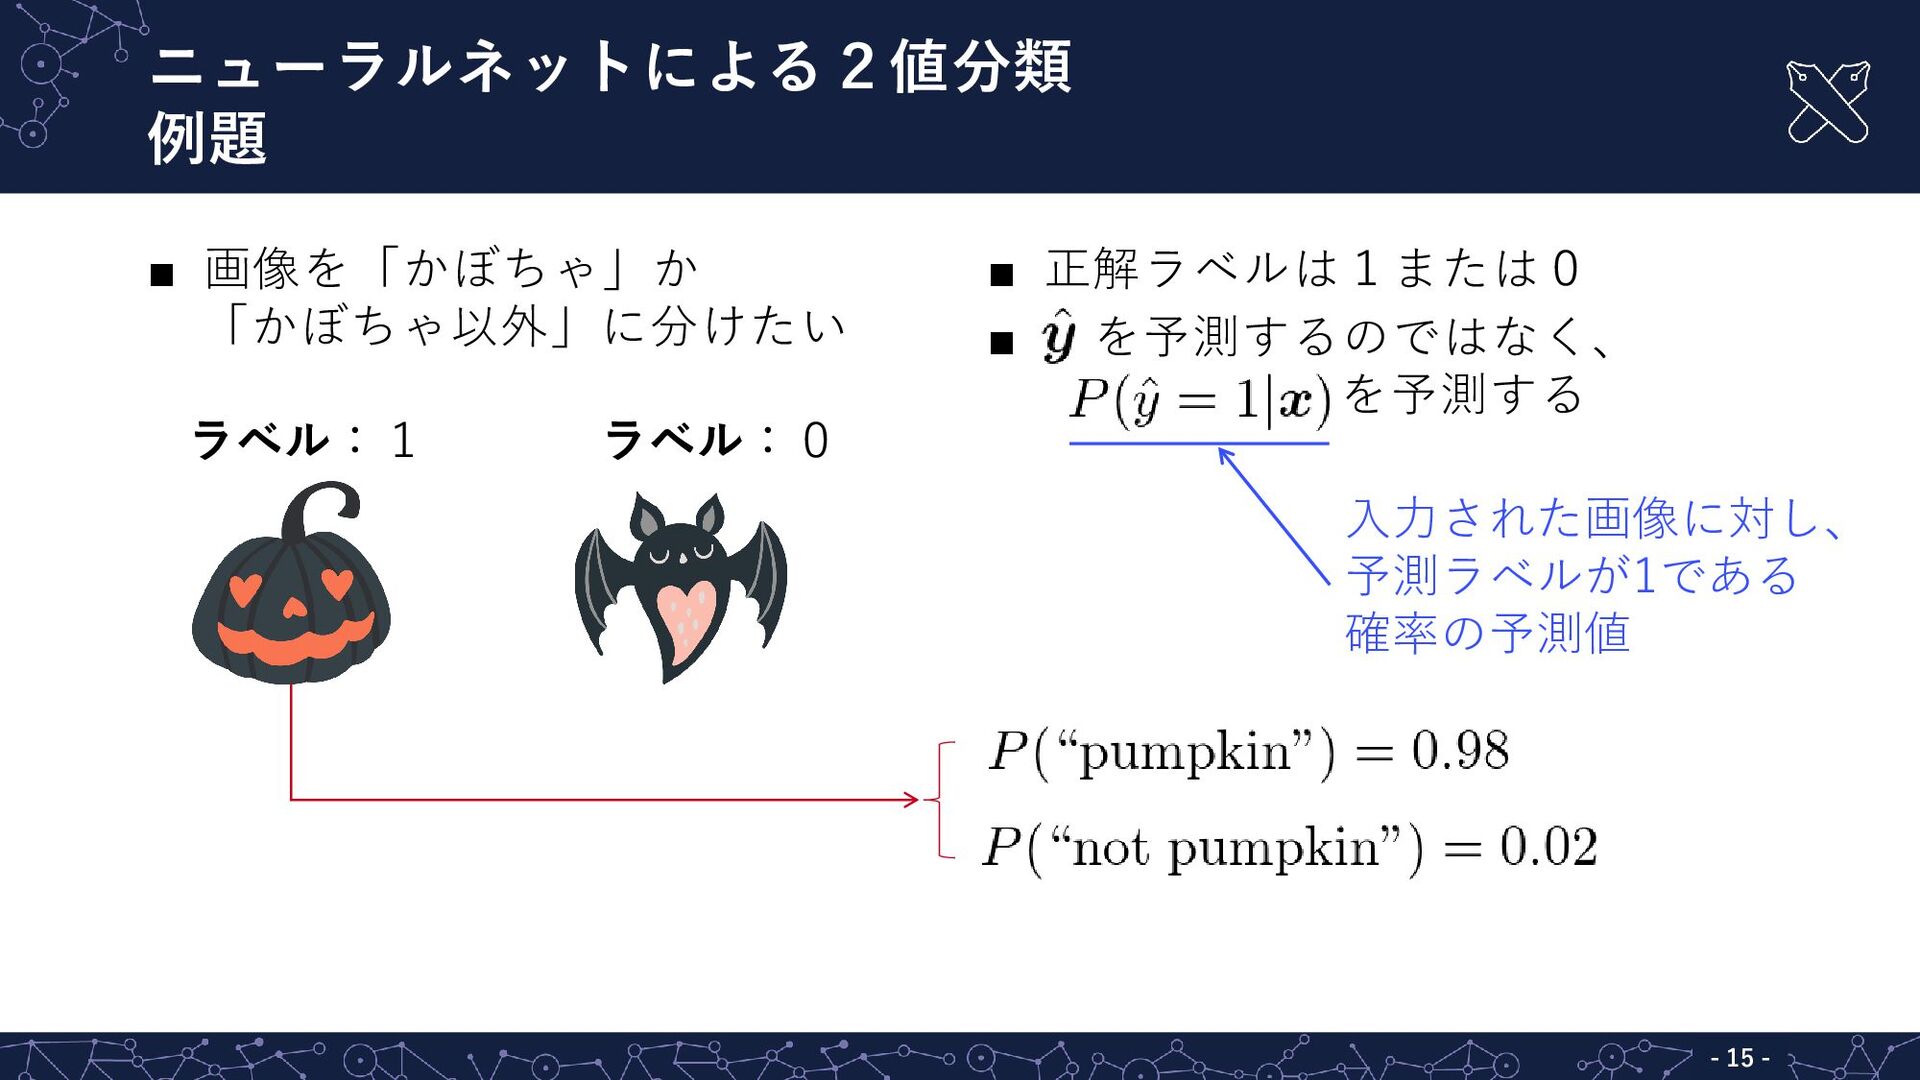
ニューラルネットによる2値分類 例題 ▪ 画像を「かぼちゃ」か 「かぼちゃ以外」に分けたい ラベル:1 ラベル:0 ▪ 正解ラベルは1または0 ▪
を予測するのではなく、 を予測する 入力された画像に対し、 予測ラベルが1である 確率の予測値 - 15 -
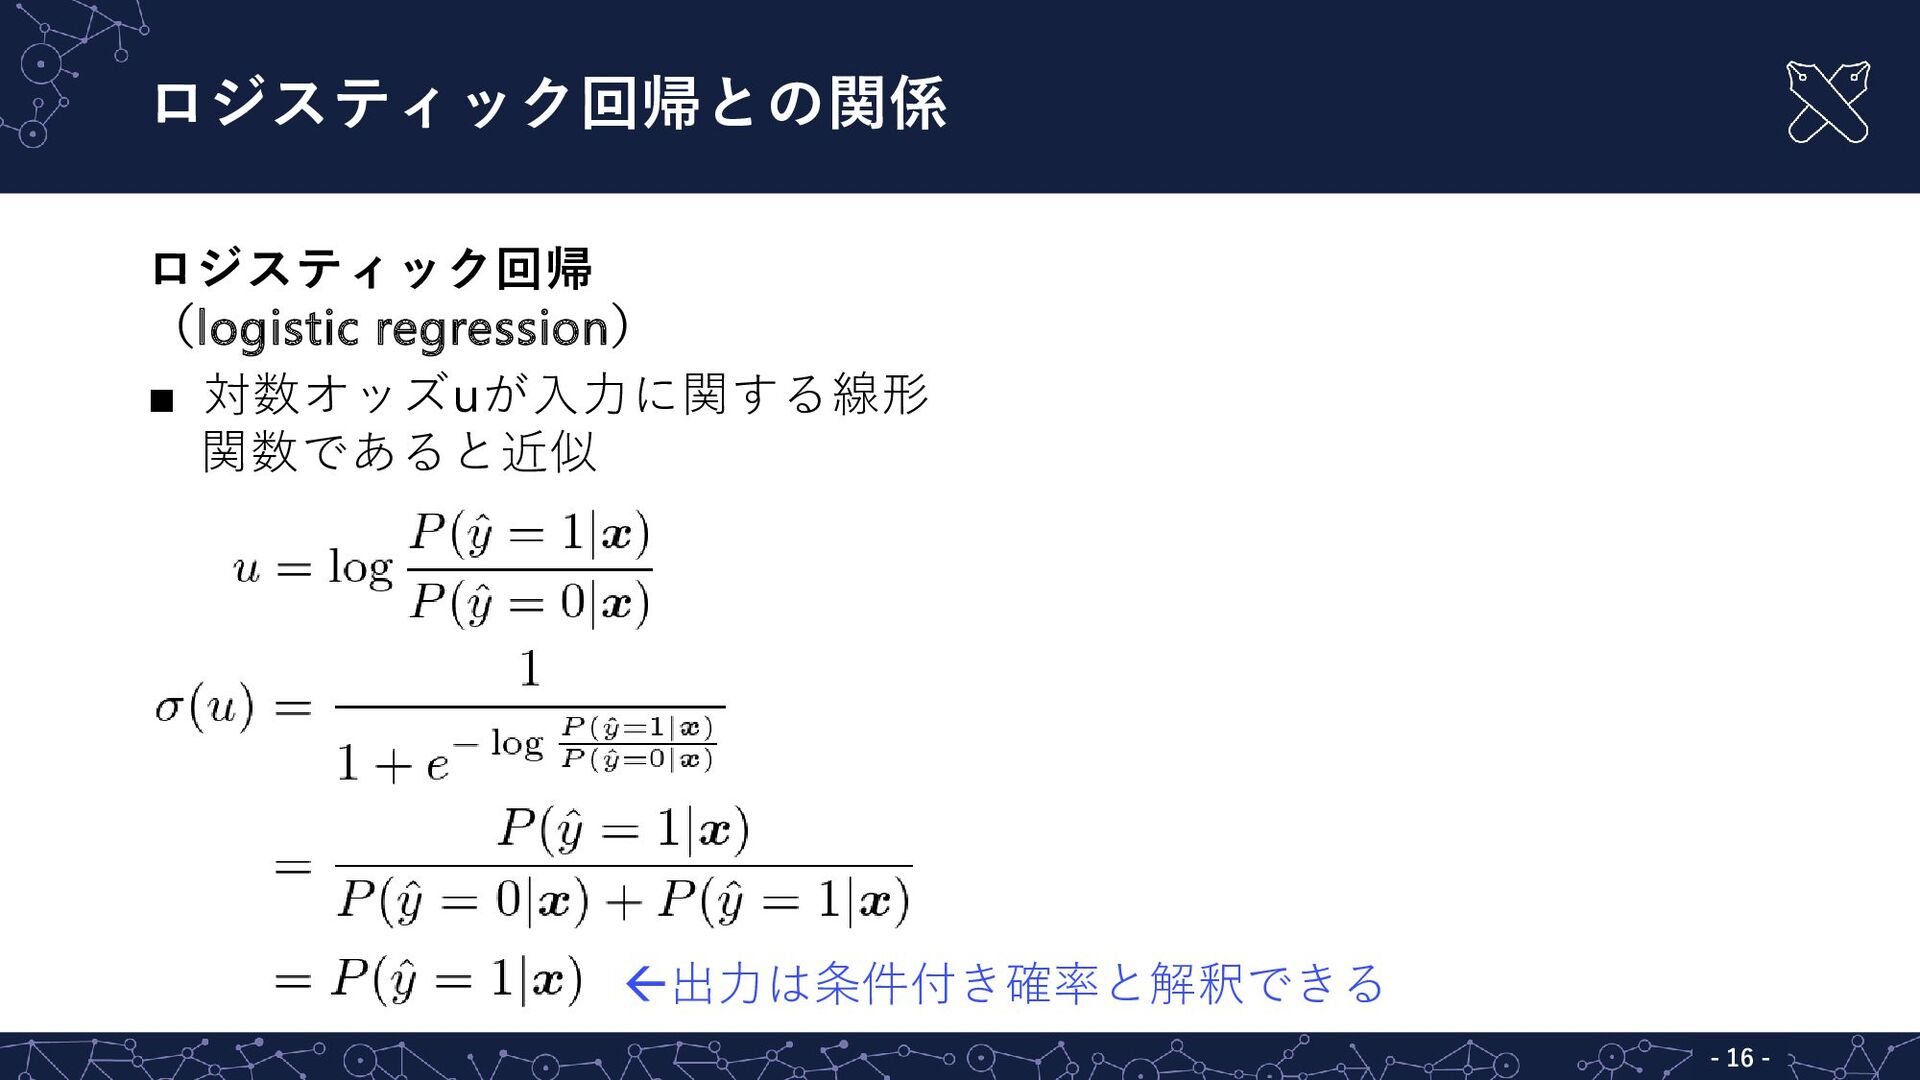
ロジスティック回帰との関係 ロジスティック回帰 (logistic regression): ロジット(logit)uをxの線形関数と してモデル化 - 16 -
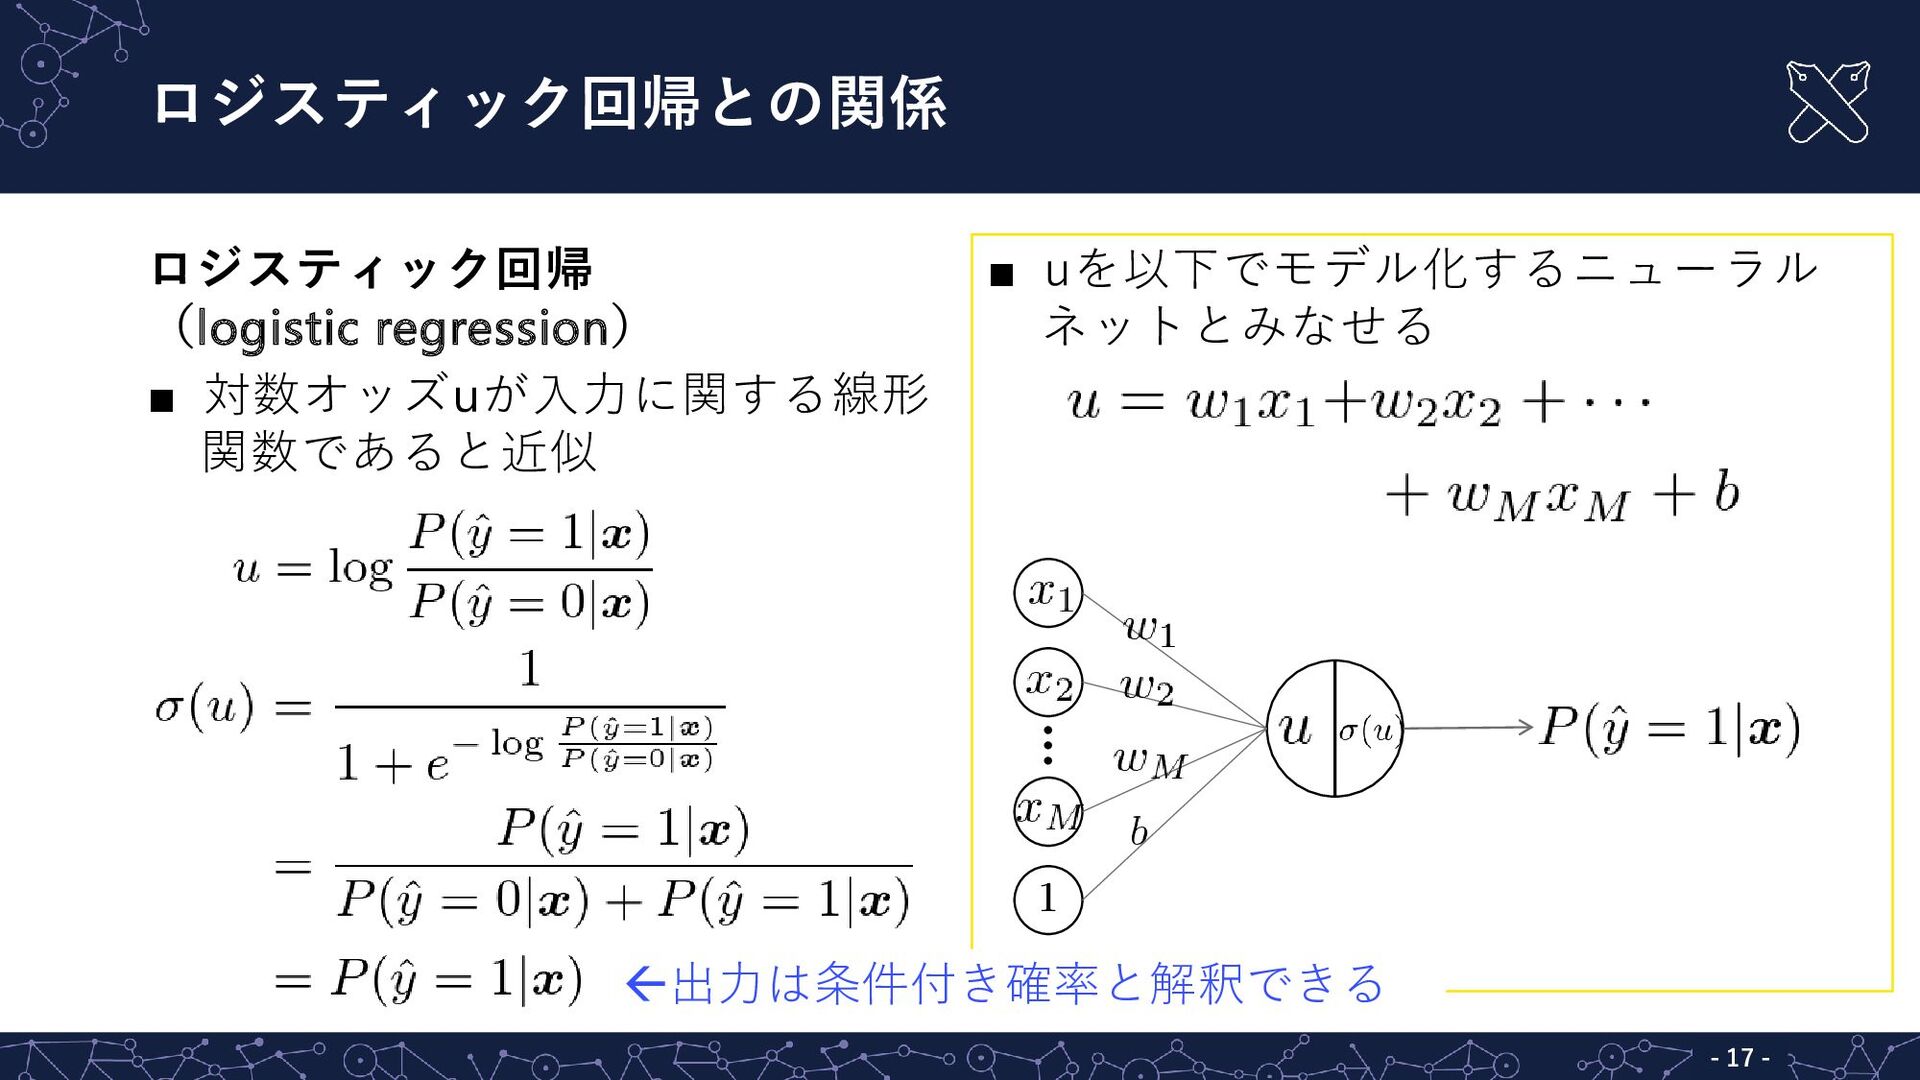
ロジスティック回帰との関係 用語 ロジスティック回帰 (logistic regression): ▪ pの例:画像xが「かぼちゃ」である ロジット(logit)uをxの線形関数と 確率の予測値 してモデル化
▪ オッズ ▪ pのロジット 対数オッズとも呼ばれる - 17 -
ロジスティック回帰との関係 ロジスティックシグモイド関数に よるuの変換を考える 用語 ▪ pの例:画像xが「かぼちゃ」である 確率の予測値 ▪ オッズ ▪
pのロジット xが「かぼちゃ」である確率を予測する 簡単なニューラルネットと等価 - 18 -
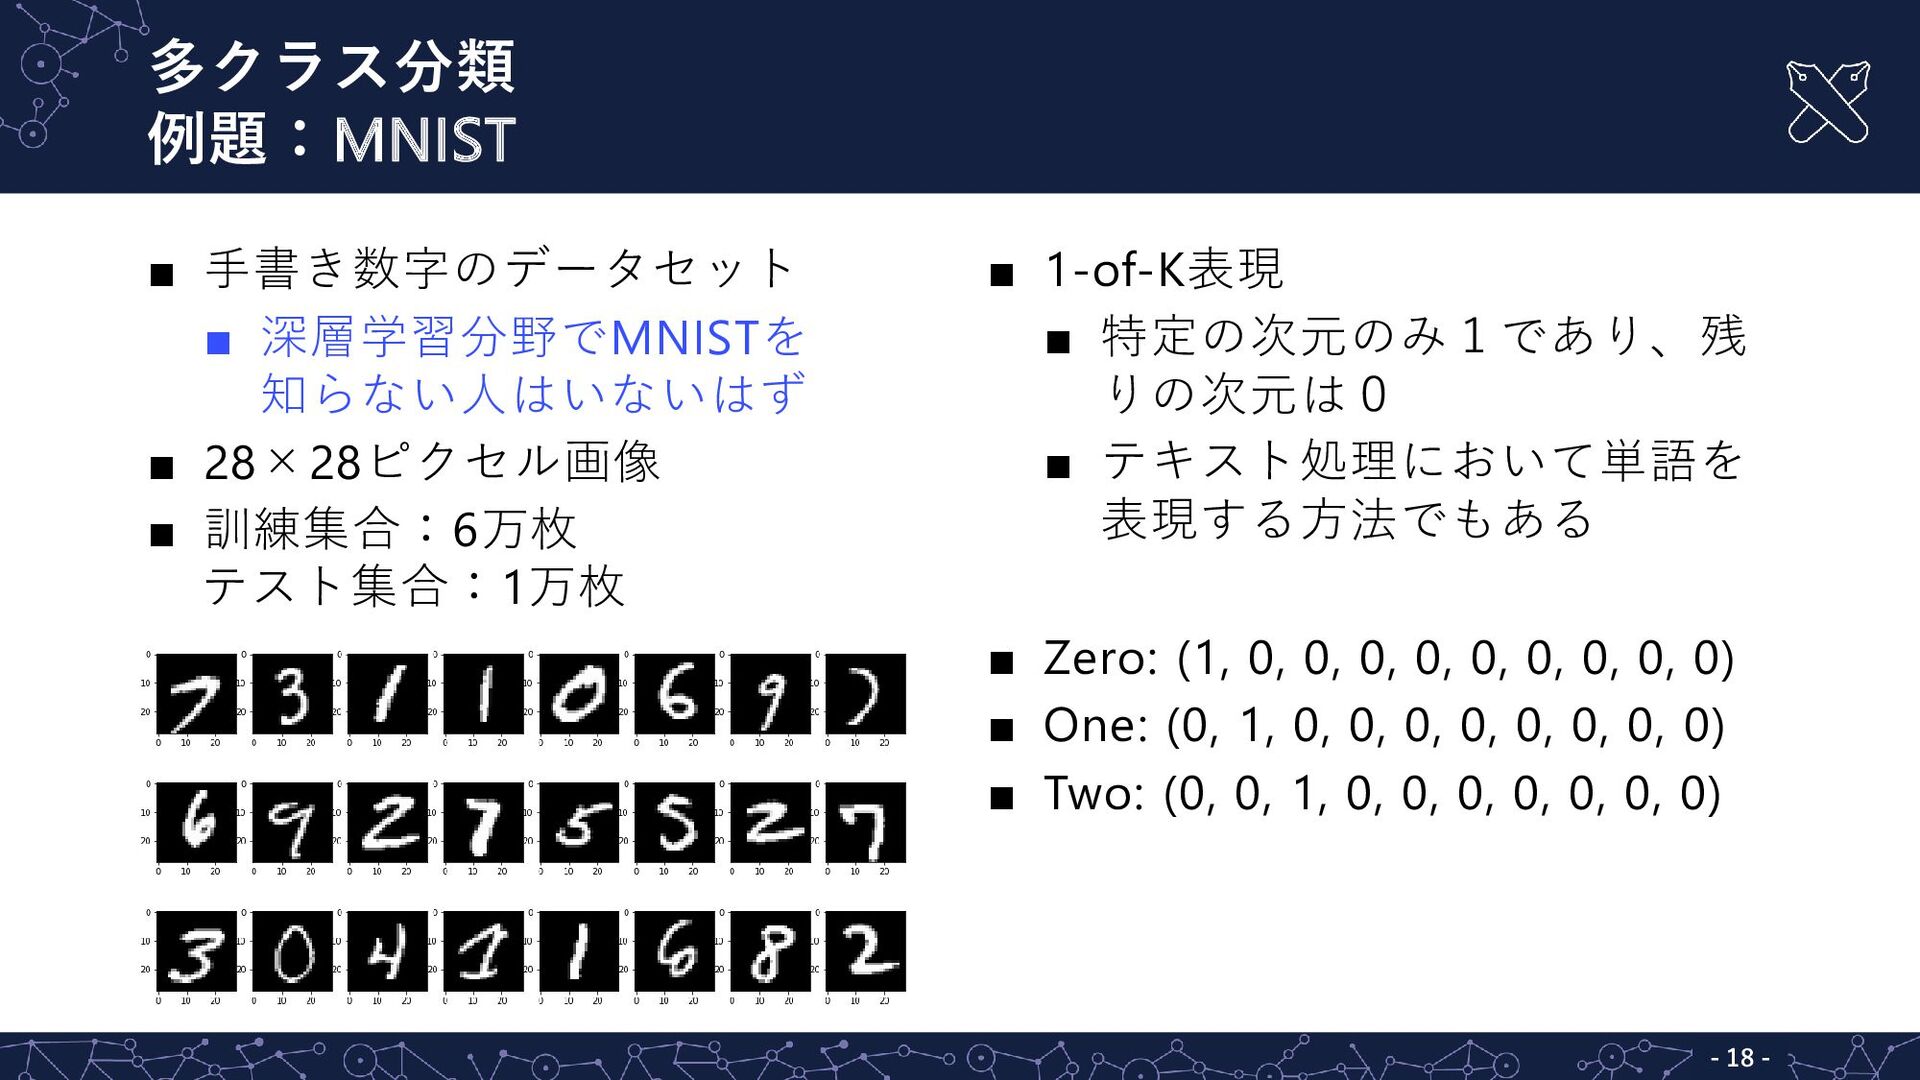
多クラス分類 例題:MNIST ▪ 手書き数字のデータセット ▪ 深層学習分野でMNISTを 知らない人はいないはず ▪ 28×28ピクセル画像 ▪
訓練集合:6万枚 テスト集合:1万枚 ▪ 1-of-K表現 ▪ 特定の次元のみ1であり、残 りの次元は0 ▪ テキスト処理において単語を 表現する方法でもある ▪ Zero: (1, 0, 0, 0, 0, 0, 0, 0, 0, 0) ▪ One: (0, 1, 0, 0, 0, 0, 0, 0, 0, 0) ▪ Two: (0, 0, 1, 0, 0, 0, 0, 0, 0, 0) - 19 -
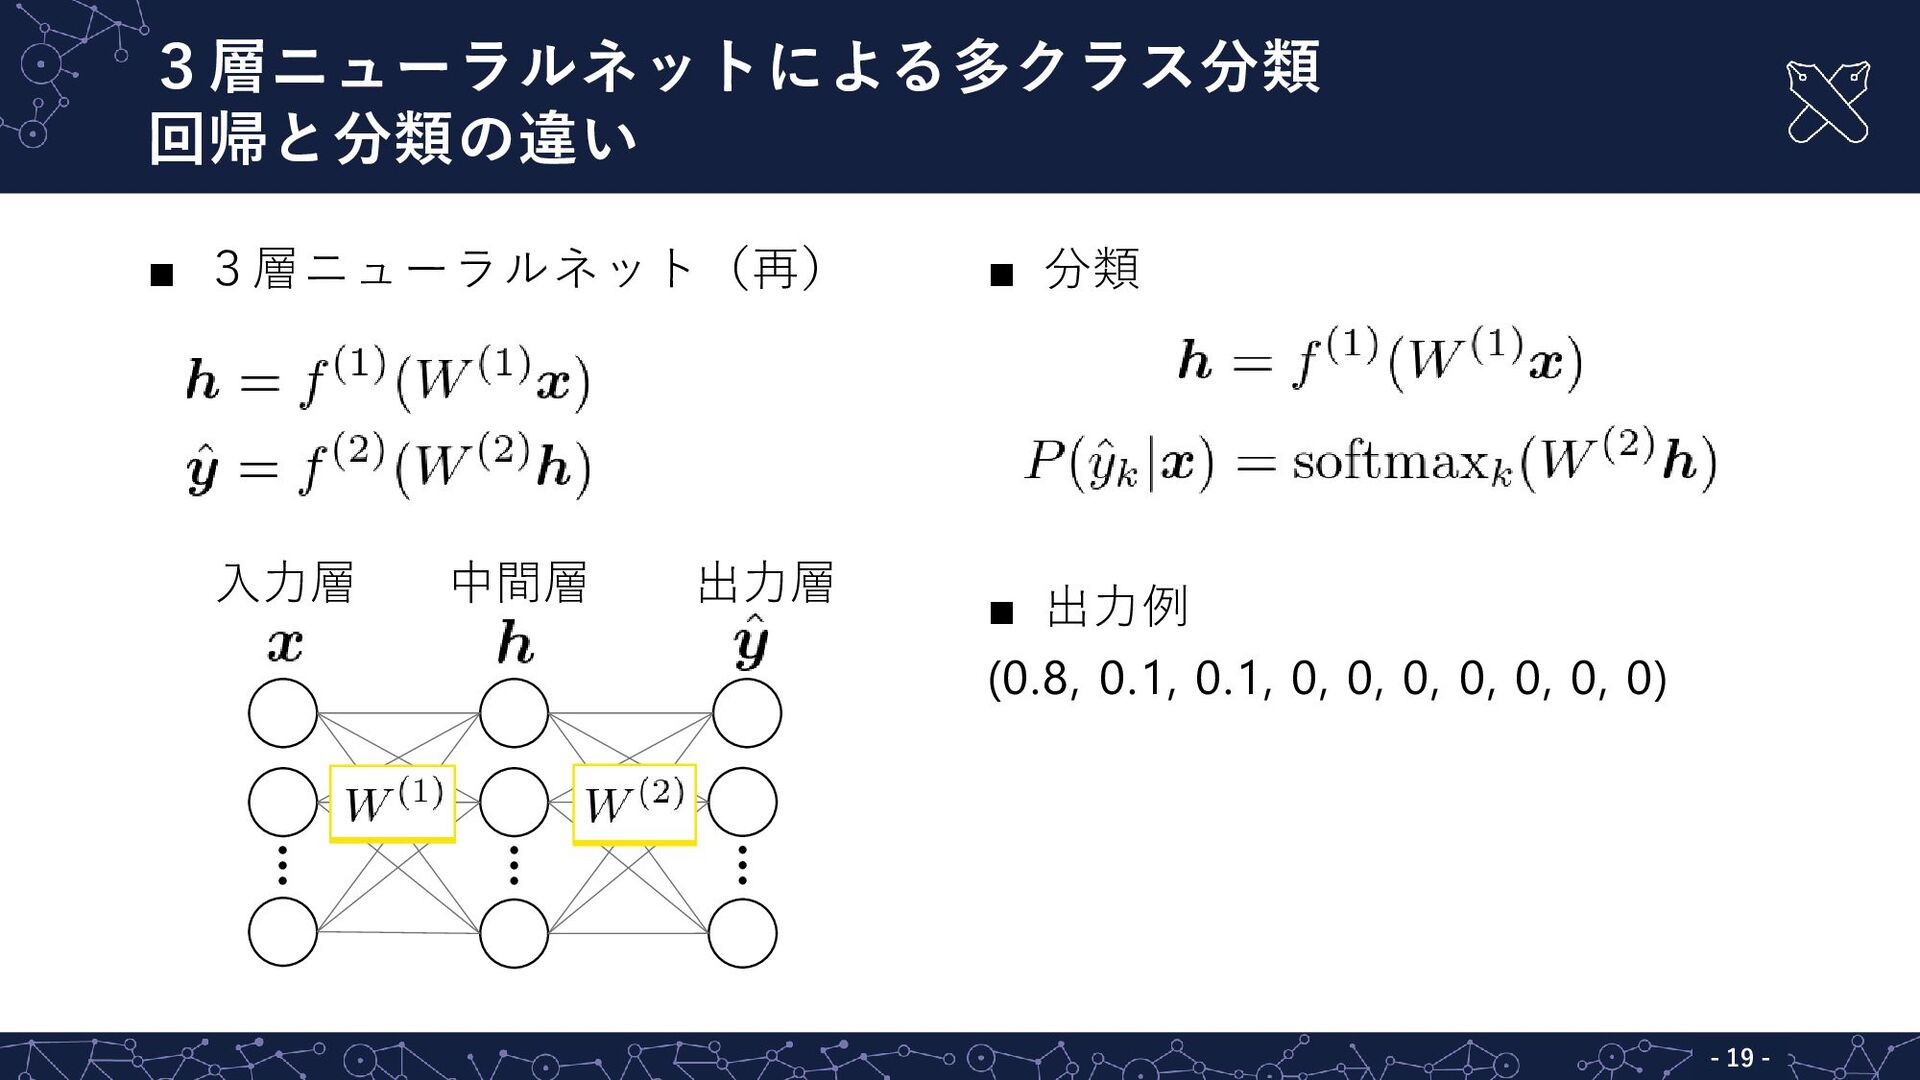
3層ニューラルネットによる多クラス分類 回帰と分類の違い ▪ 3層ニューラルネット(再) 入力層 中間層 出力層 ▪ 分類 ▪
出力例 (0.8, 0.1, 0.1, 0, 0, 0, 0, 0, 0, 0) - 20 -
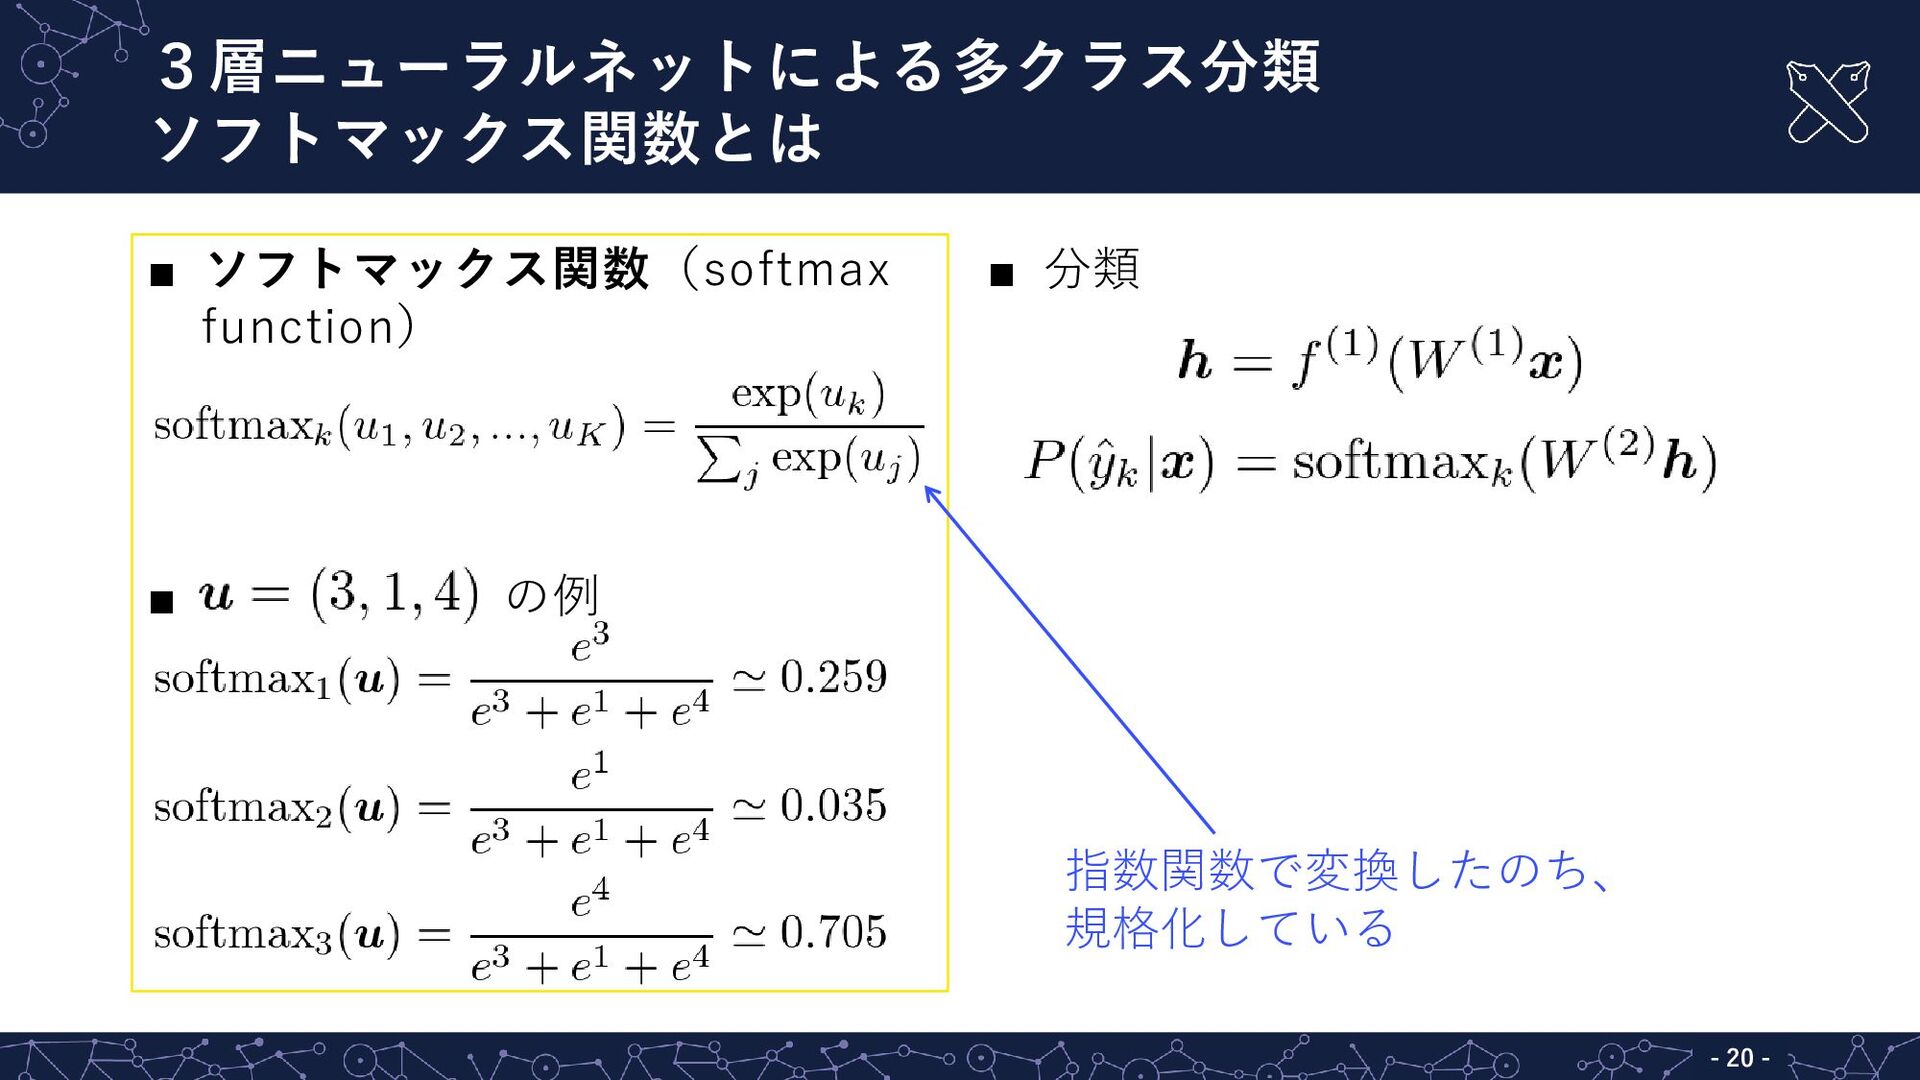
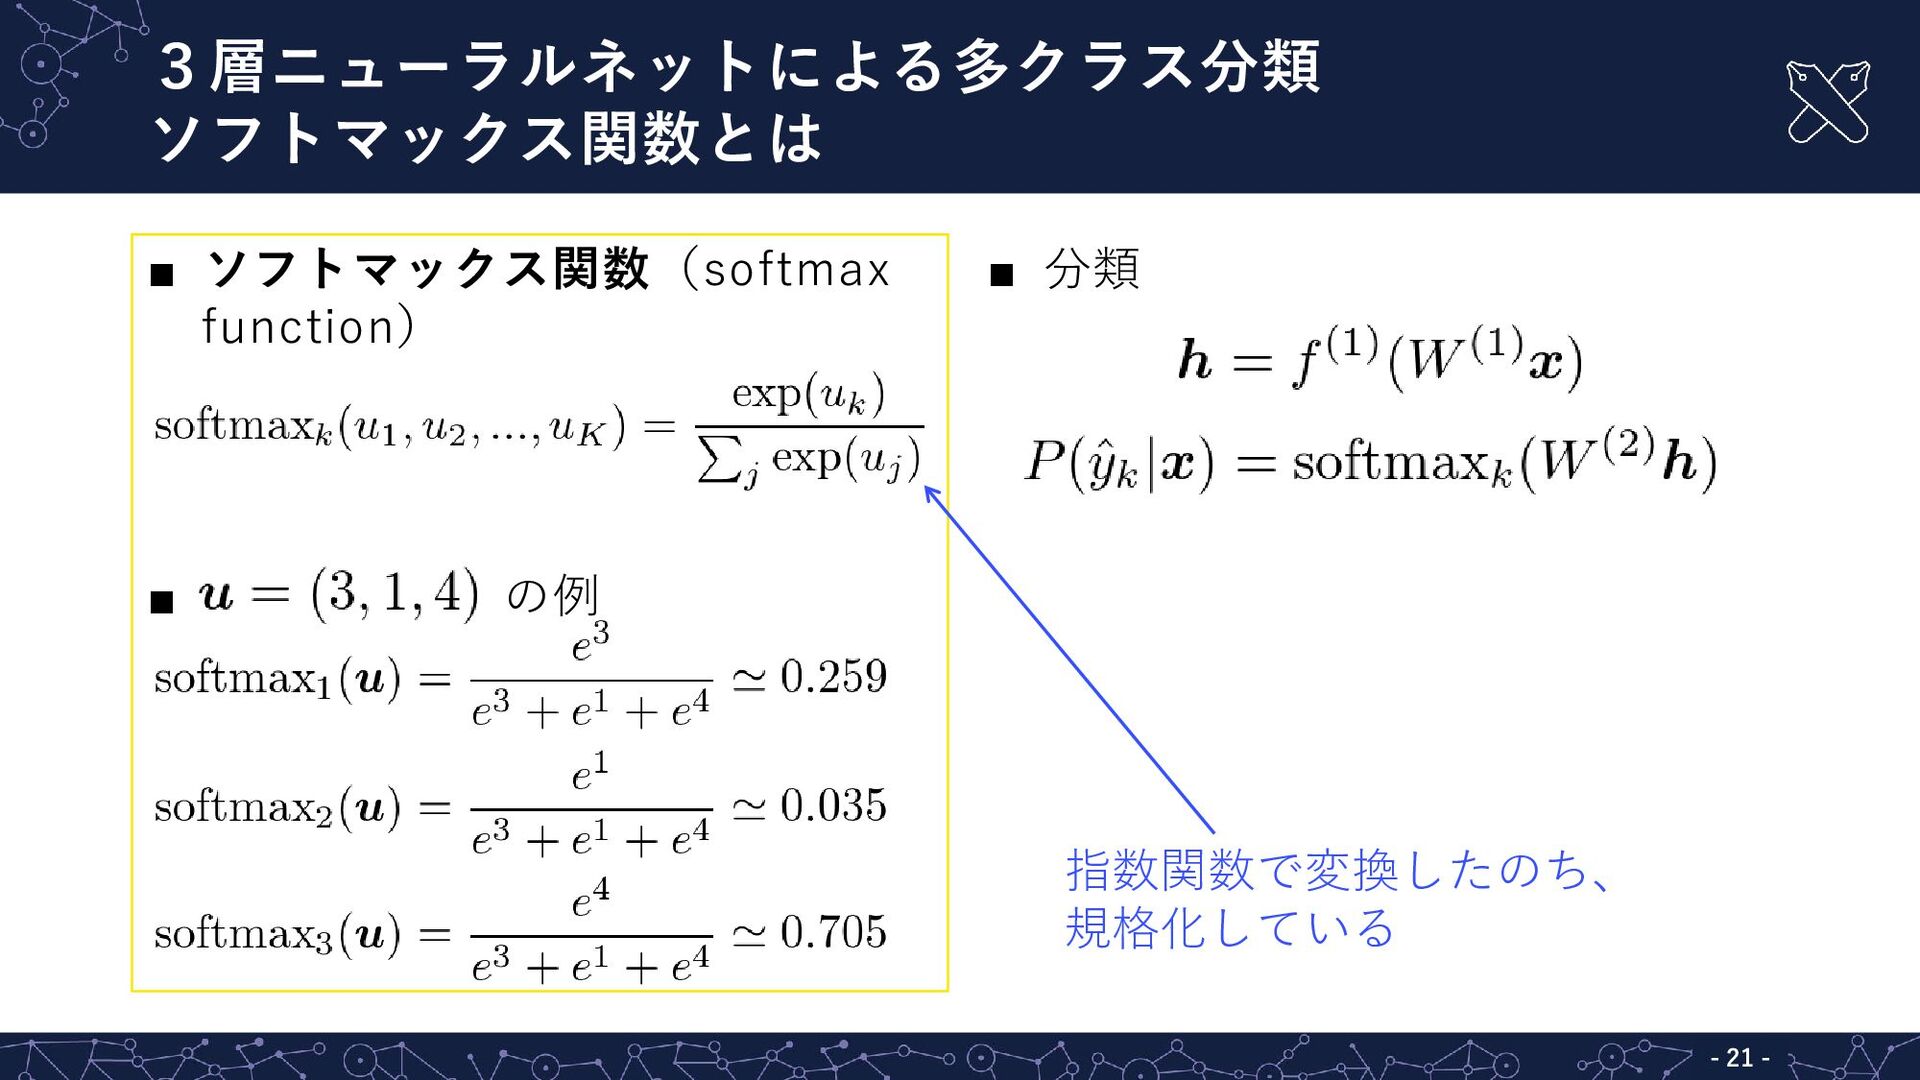
3層ニューラルネットによる多クラス分類 ソフトマックス関数とは ▪ ソフトマックス関数(softmax function) ▪ ▪ 分類 の例 指数関数で変換したのち、
規格化している - 21 -
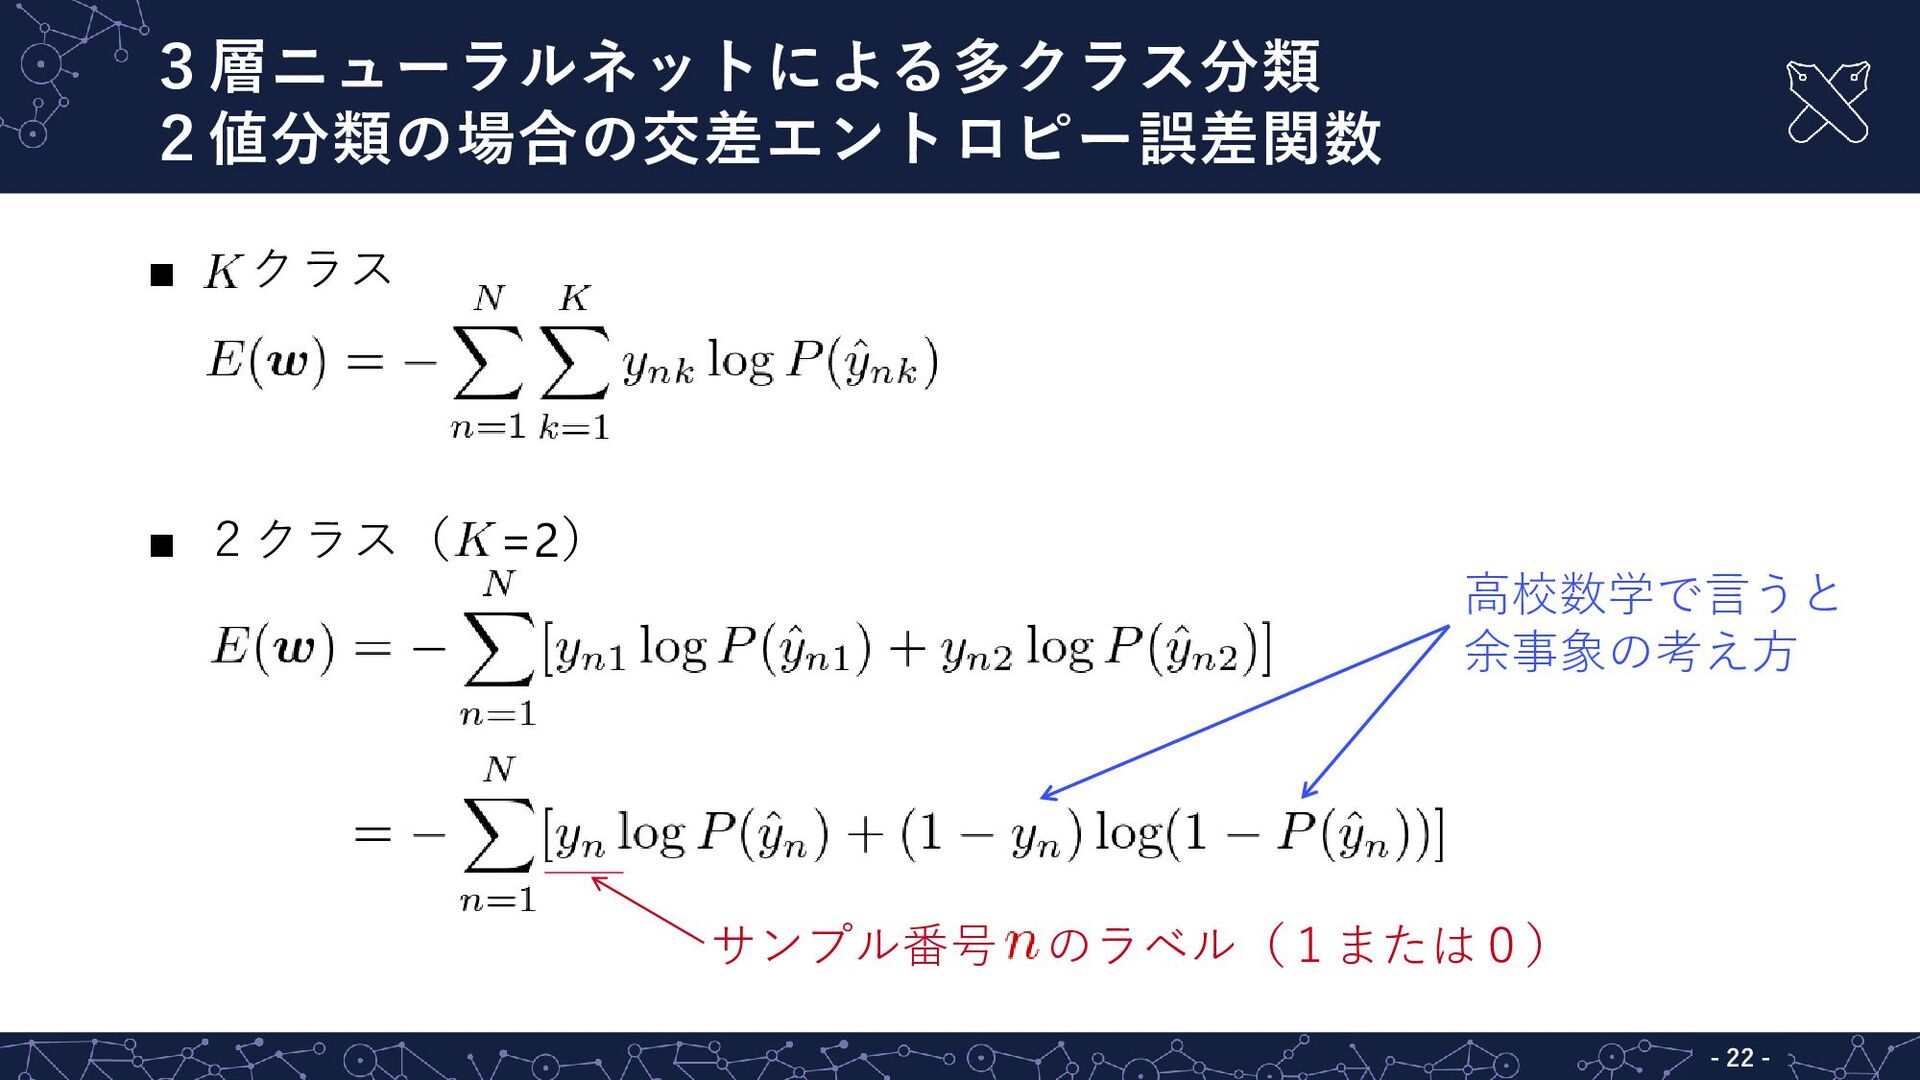
3層ニューラルネットによる多クラス分類 交差エントロピー誤差関数とは ▪ 情報理論における離散分布 間の交差エントロピー ▪ 交差エントロピー誤差関数 (cross-entropy error function)
(普通の)エントロピー 正解ラベル は固定値なので 確率で表す必要がない サンプル番号 のラベルの 次元目の値 (クラスkであれば1であり、そうでなければ0) - 22 -
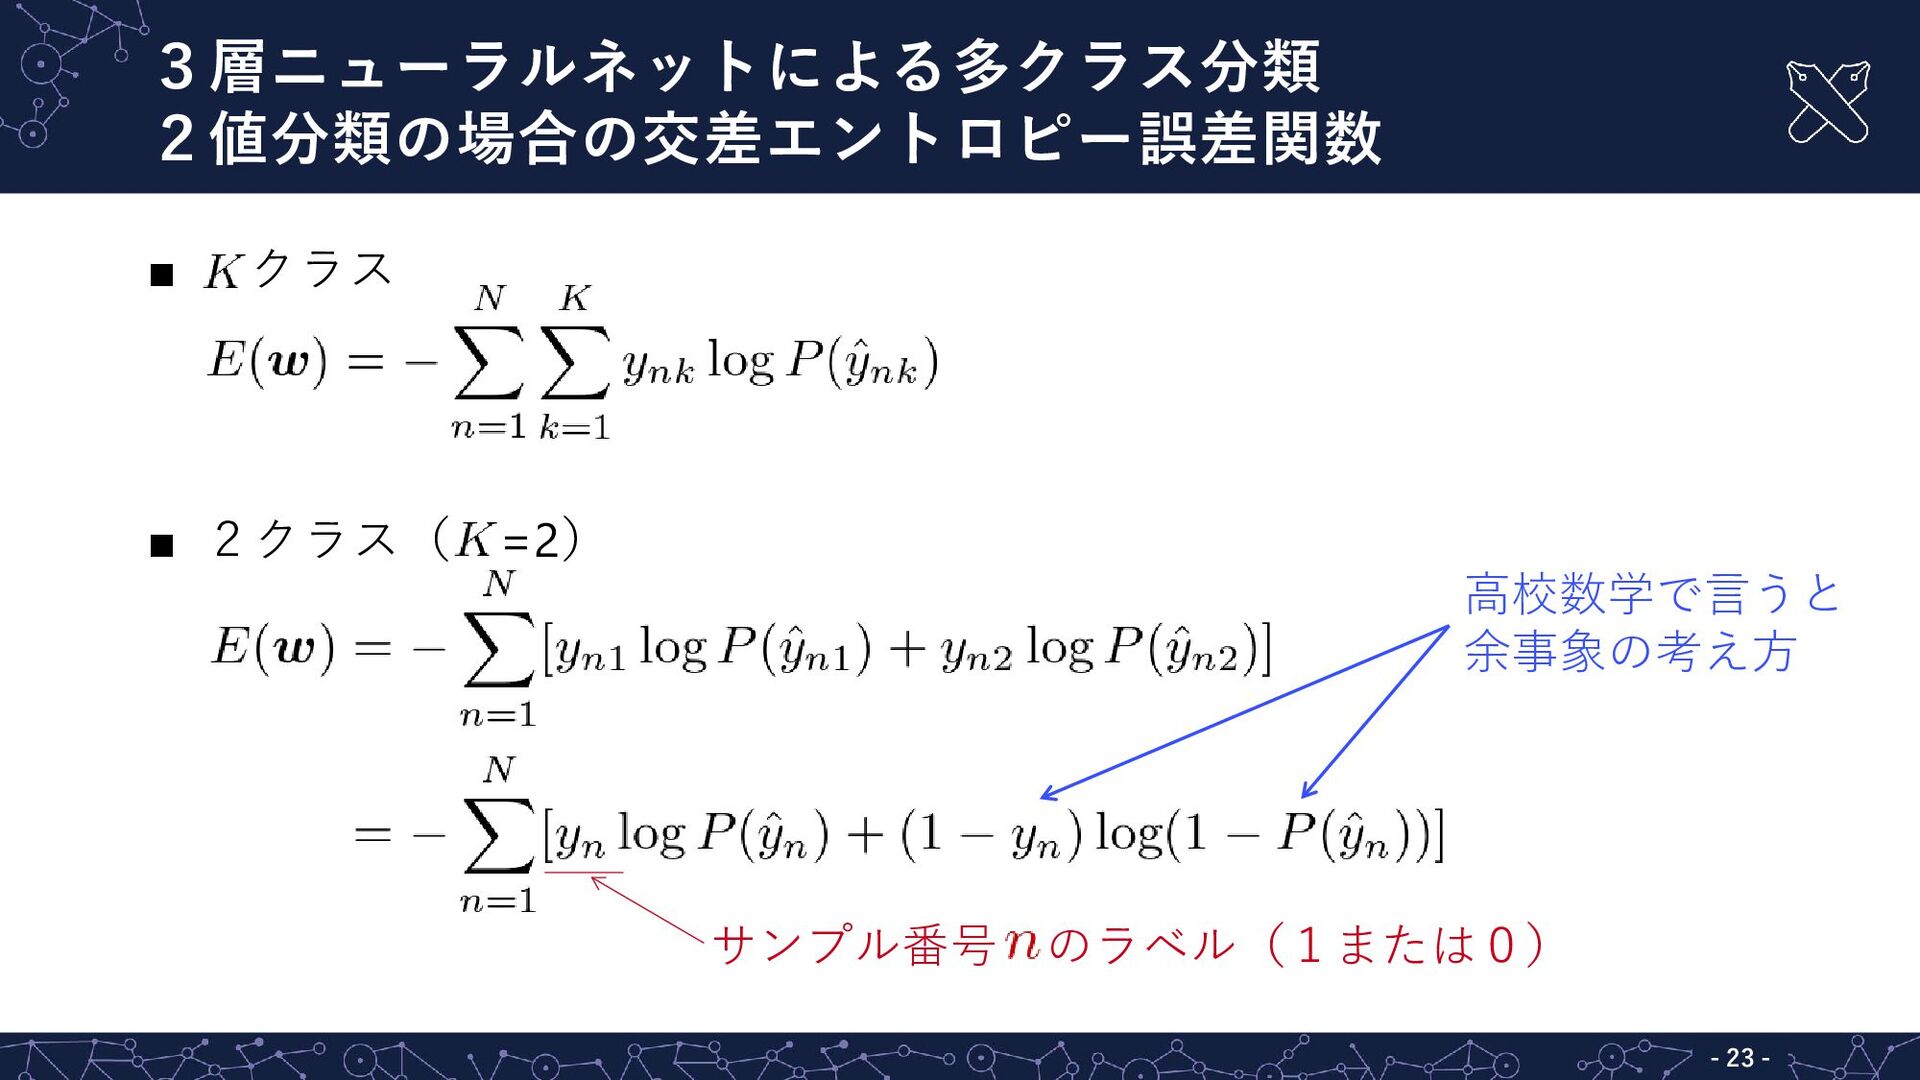
3層ニューラルネットによる多クラス分類 2値分類の場合の交差エントロピー誤差関数 ▪ クラス ▪ 2クラス( =2) 高校数学で言うと 余事象の考え方 サンプル番号
のラベル(1または0) - 23 -
理解度確認 - 24 -
理解度確認 以下について周りと相談して1分以内に答えよ 1. 訓練集合とテスト集合の違いは何か? 2. 訓練集合と訓練サンプルの違いは何か? 3. ミニバッチ確率的勾配降下法の英語名は何か? 4. 損失関数の例を挙げよ。
※LLMに聞いても良いが、ハルシネーションの場合に「LLMが誤った (のであって自分は悪くない)」という回答は不適切 =検証が必要 - 25 -
交差エントロピー誤差関数 と最尤推定 - 26 -
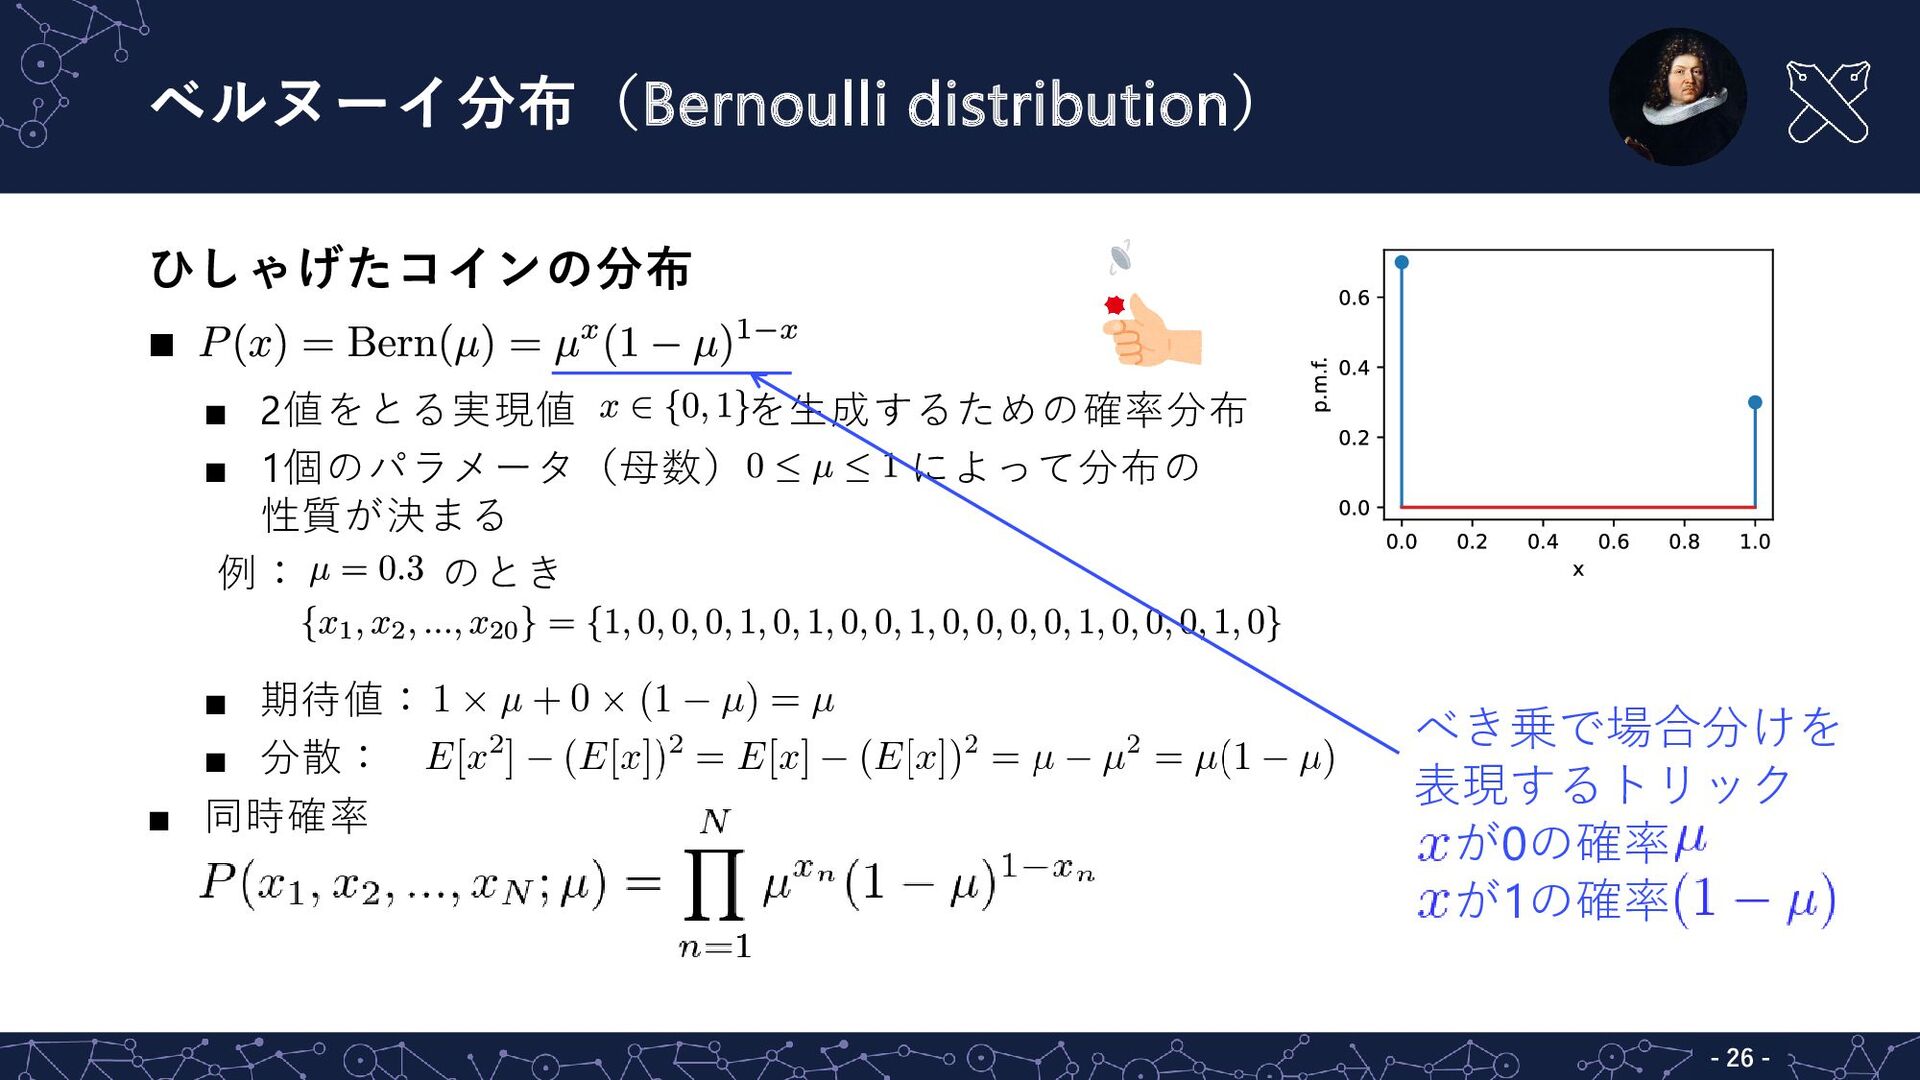
ベルヌーイ分布(Bernoulli distribution) ひしゃげたコインの分布 ▪ ▪ 2値をとる実現値 を生成するための確率分布 ▪ 1個のパラメータ(母数) によって分布の
性質が決まる 例: のとき ▪ 期待値: ▪ 分散: ▪ 同時確率 べき乗で場合分けを 表現するトリック が1の確率 が0の確率 - 27 -
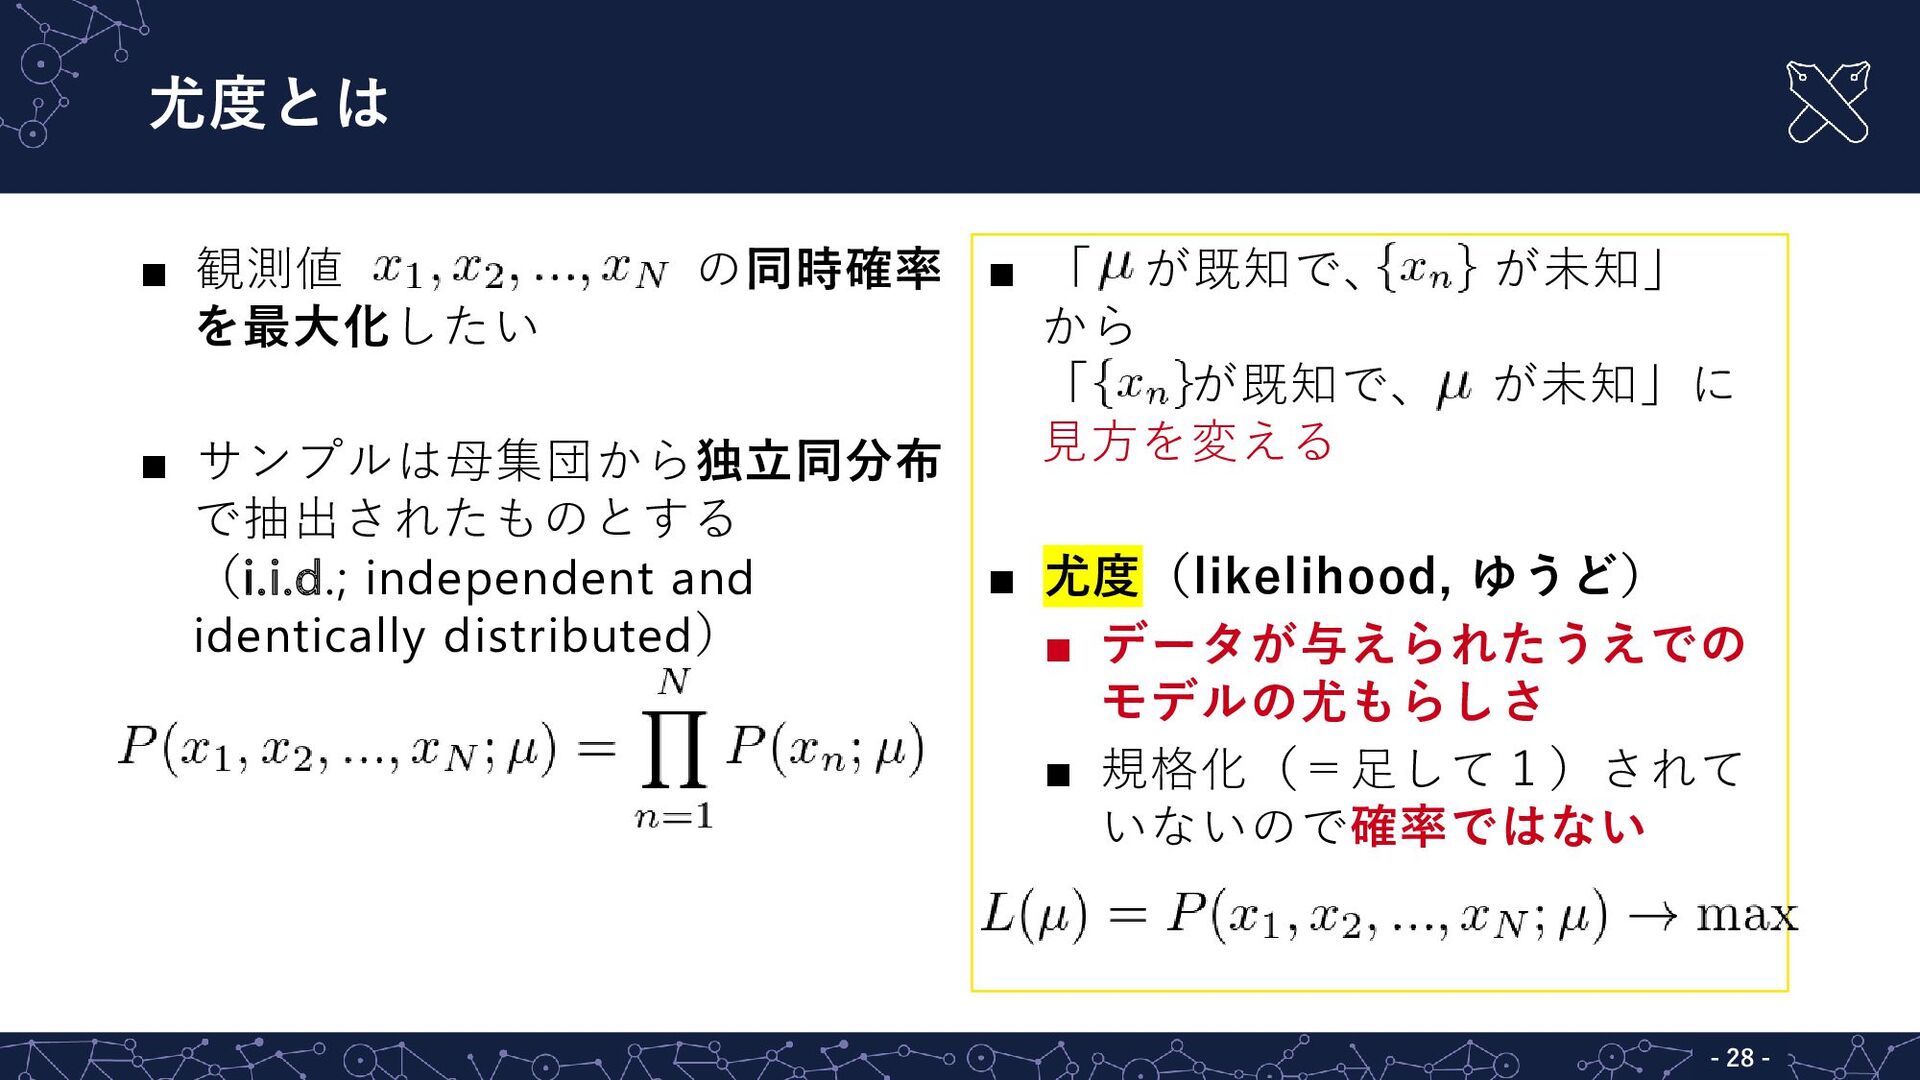
最尤推定 ▪ 観測値 を最大化したい の同時確率 ▪ サンプルは母集団から独立同分布 で抽出されたものとする (i.i.d.; independent
and identically distributed) - 28 -
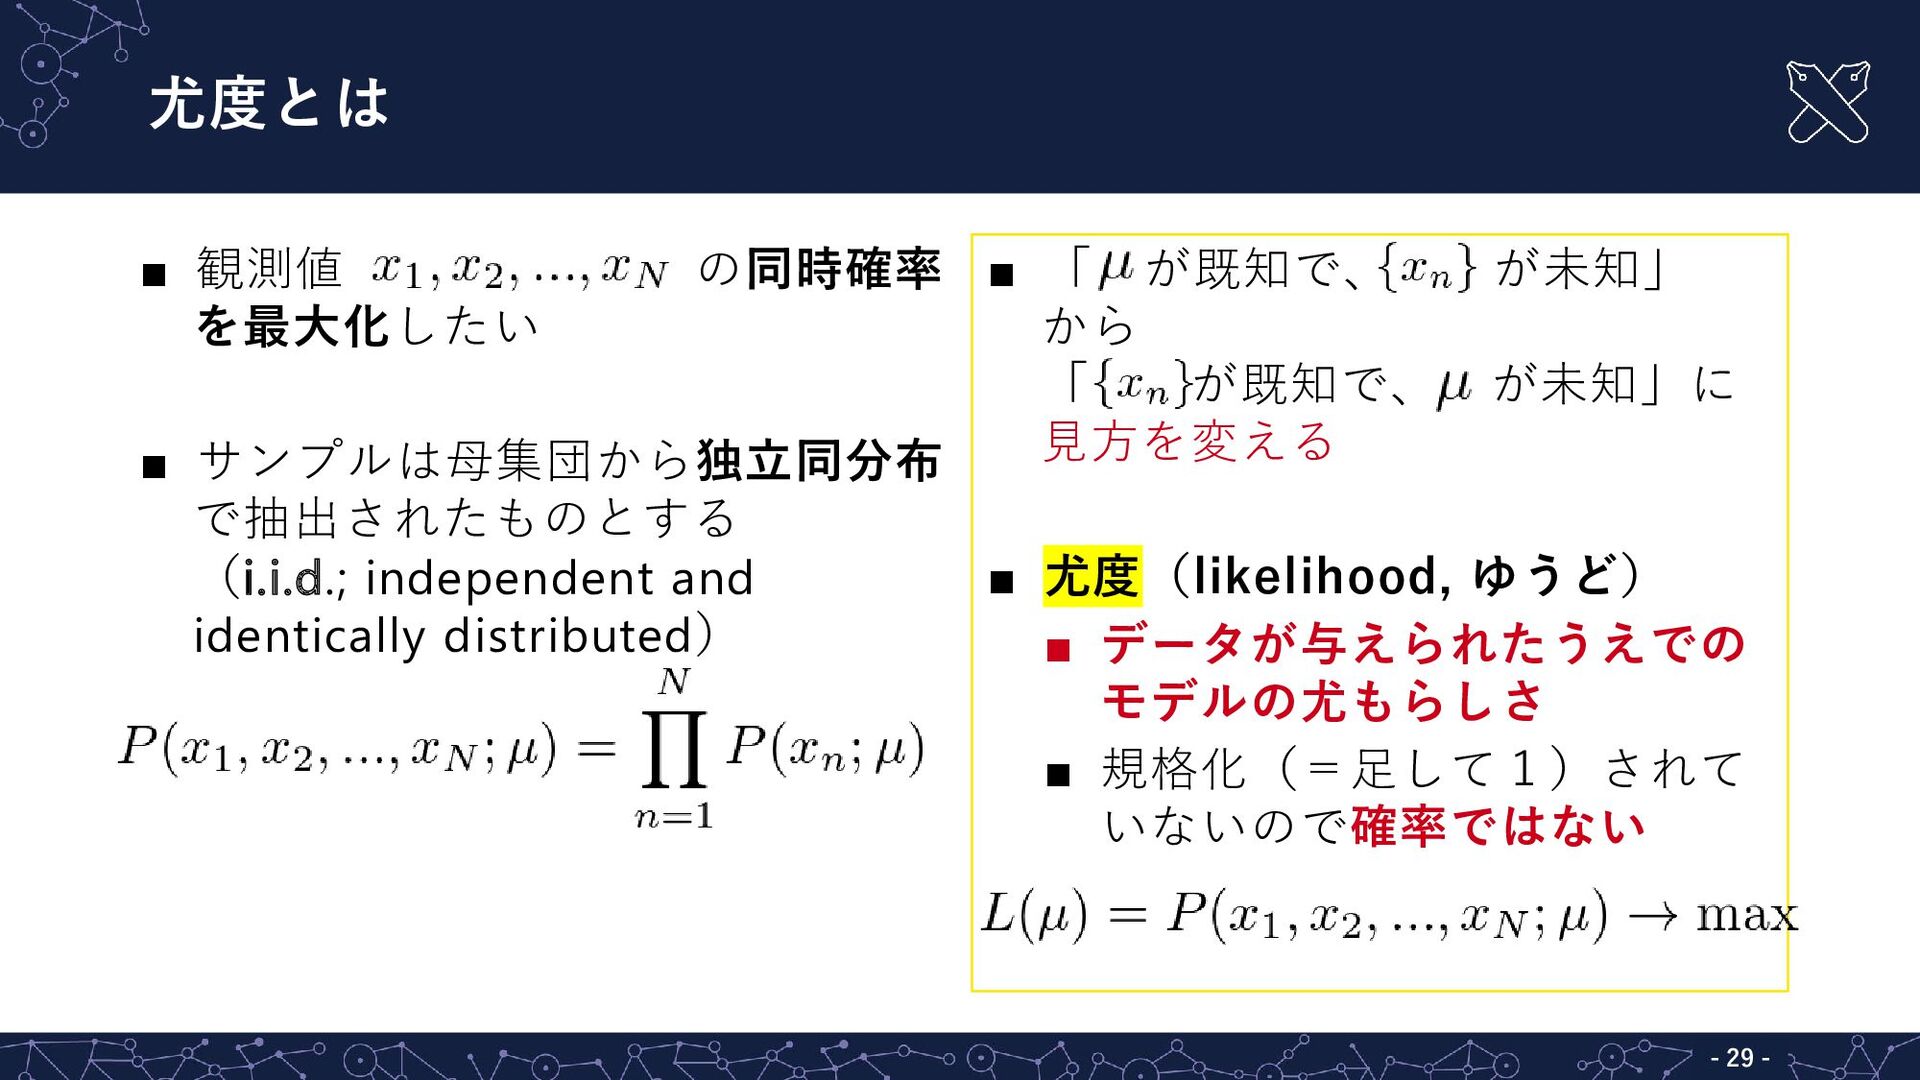
尤度とは ▪ 観測値 を最大化したい の同時確率 ▪ 「 が既知で、 から 「
が既知で、 見方を変える ▪ サンプルは母集団から独立同分布 で抽出されたものとする (i.i.d.; independent and identically distributed) が未知」 が未知」に ▪ 尤度(likelihood, ゆうど) ▪ データが与えられたうえでの モデルの尤もらしさ ▪ 規格化(=足して1)されて いないので確率ではない - 29 -
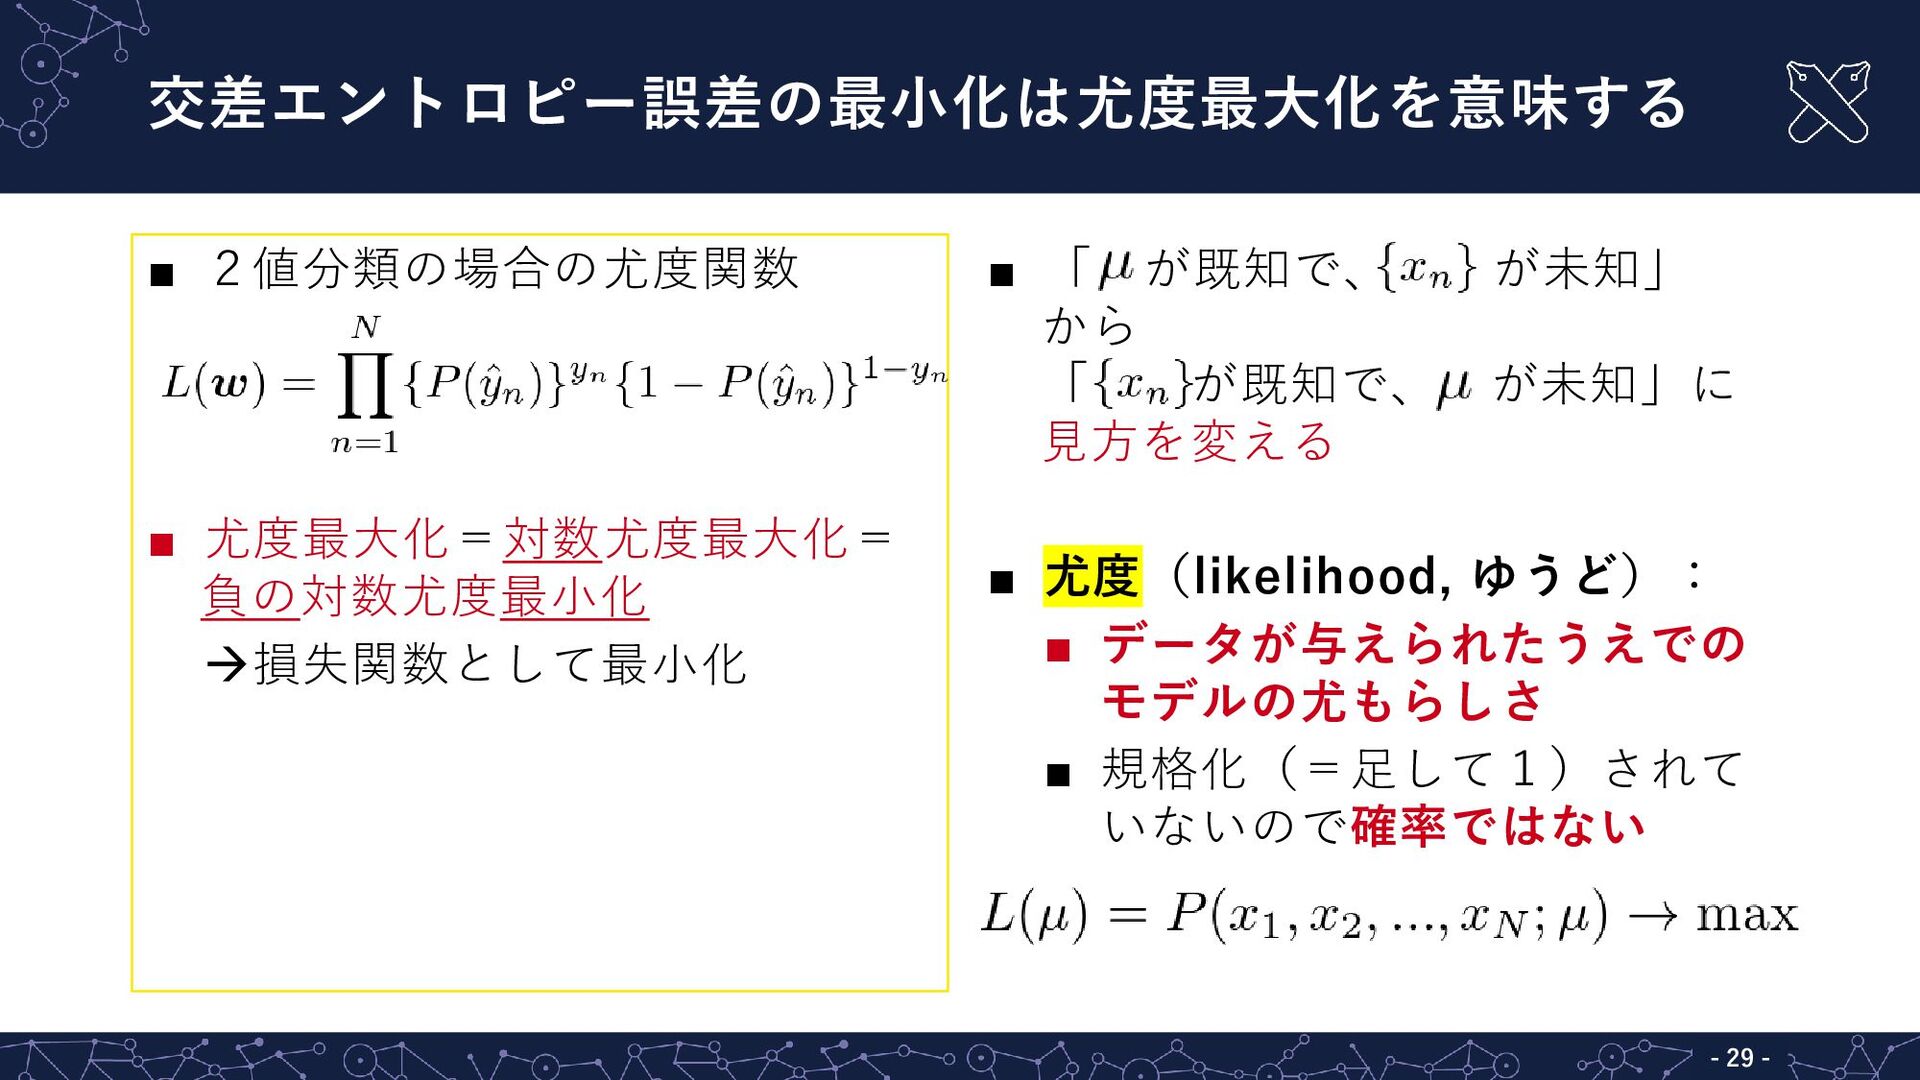
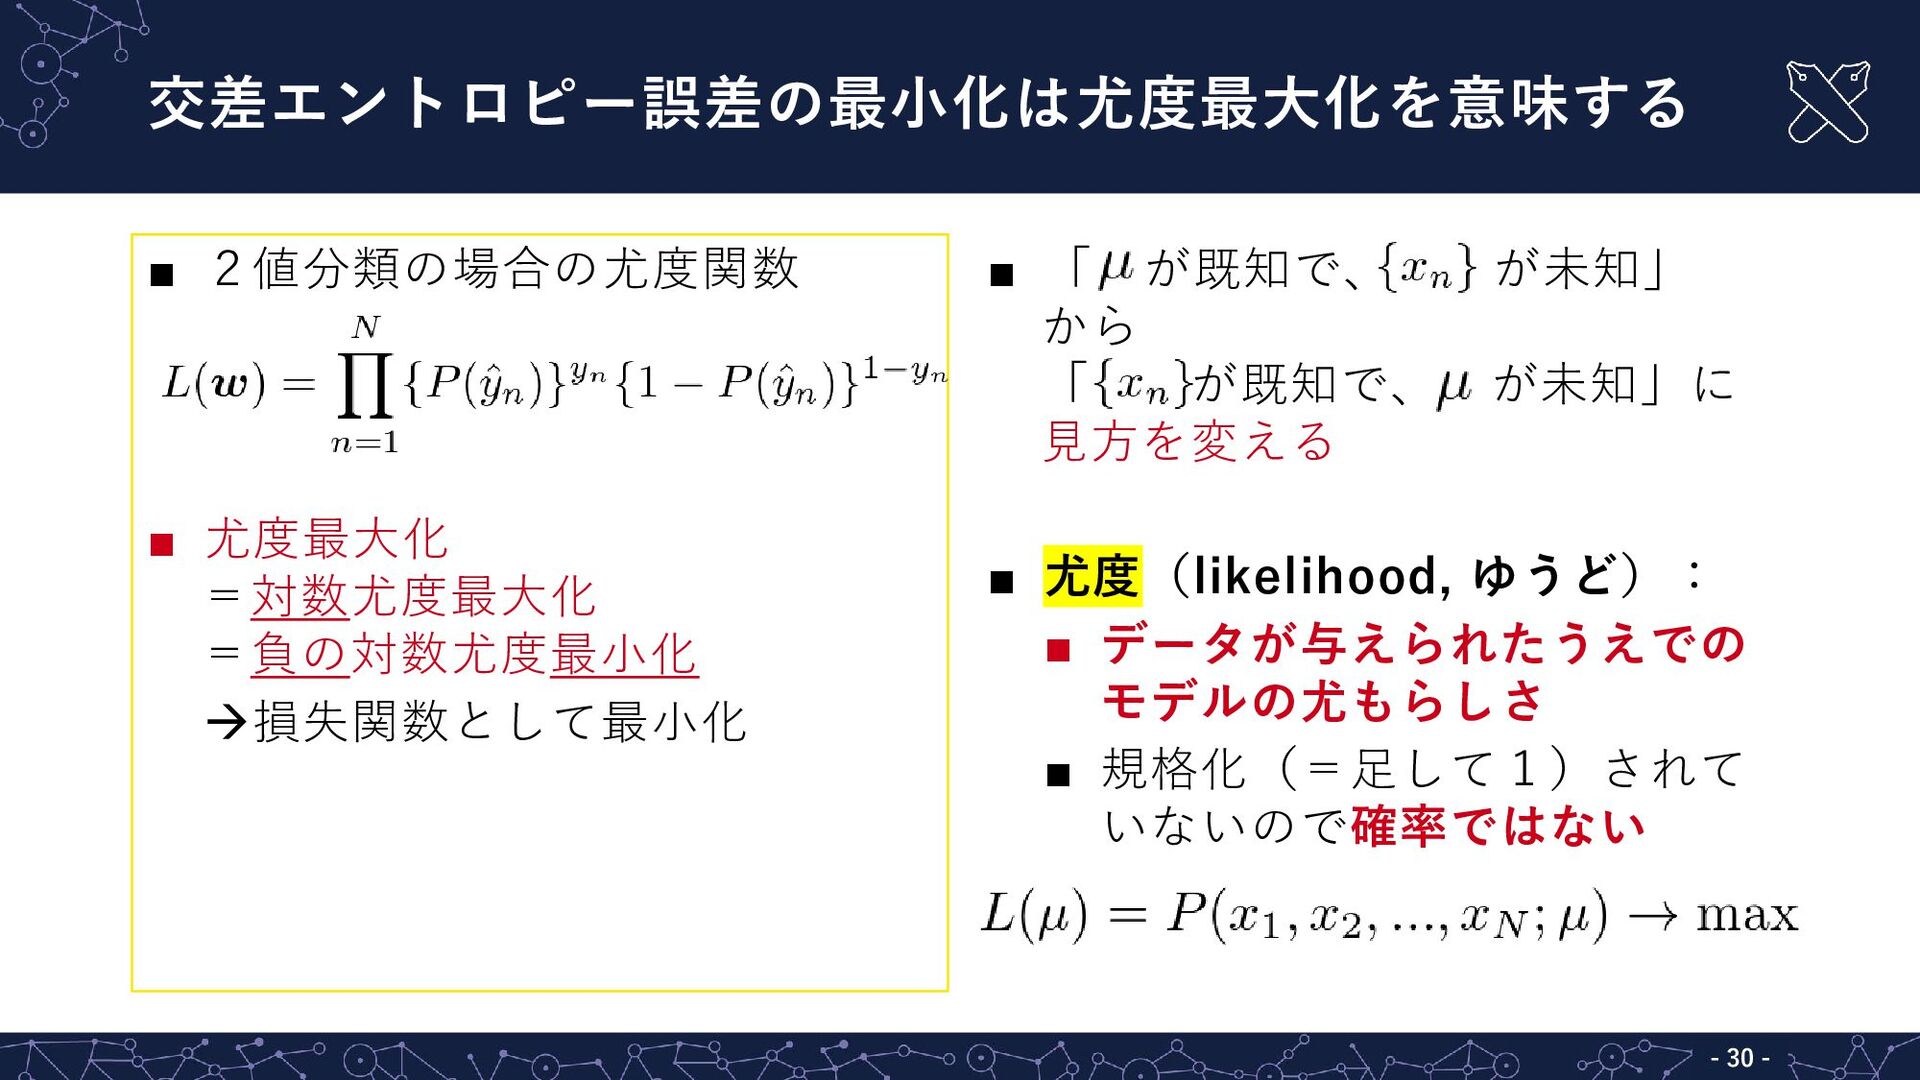
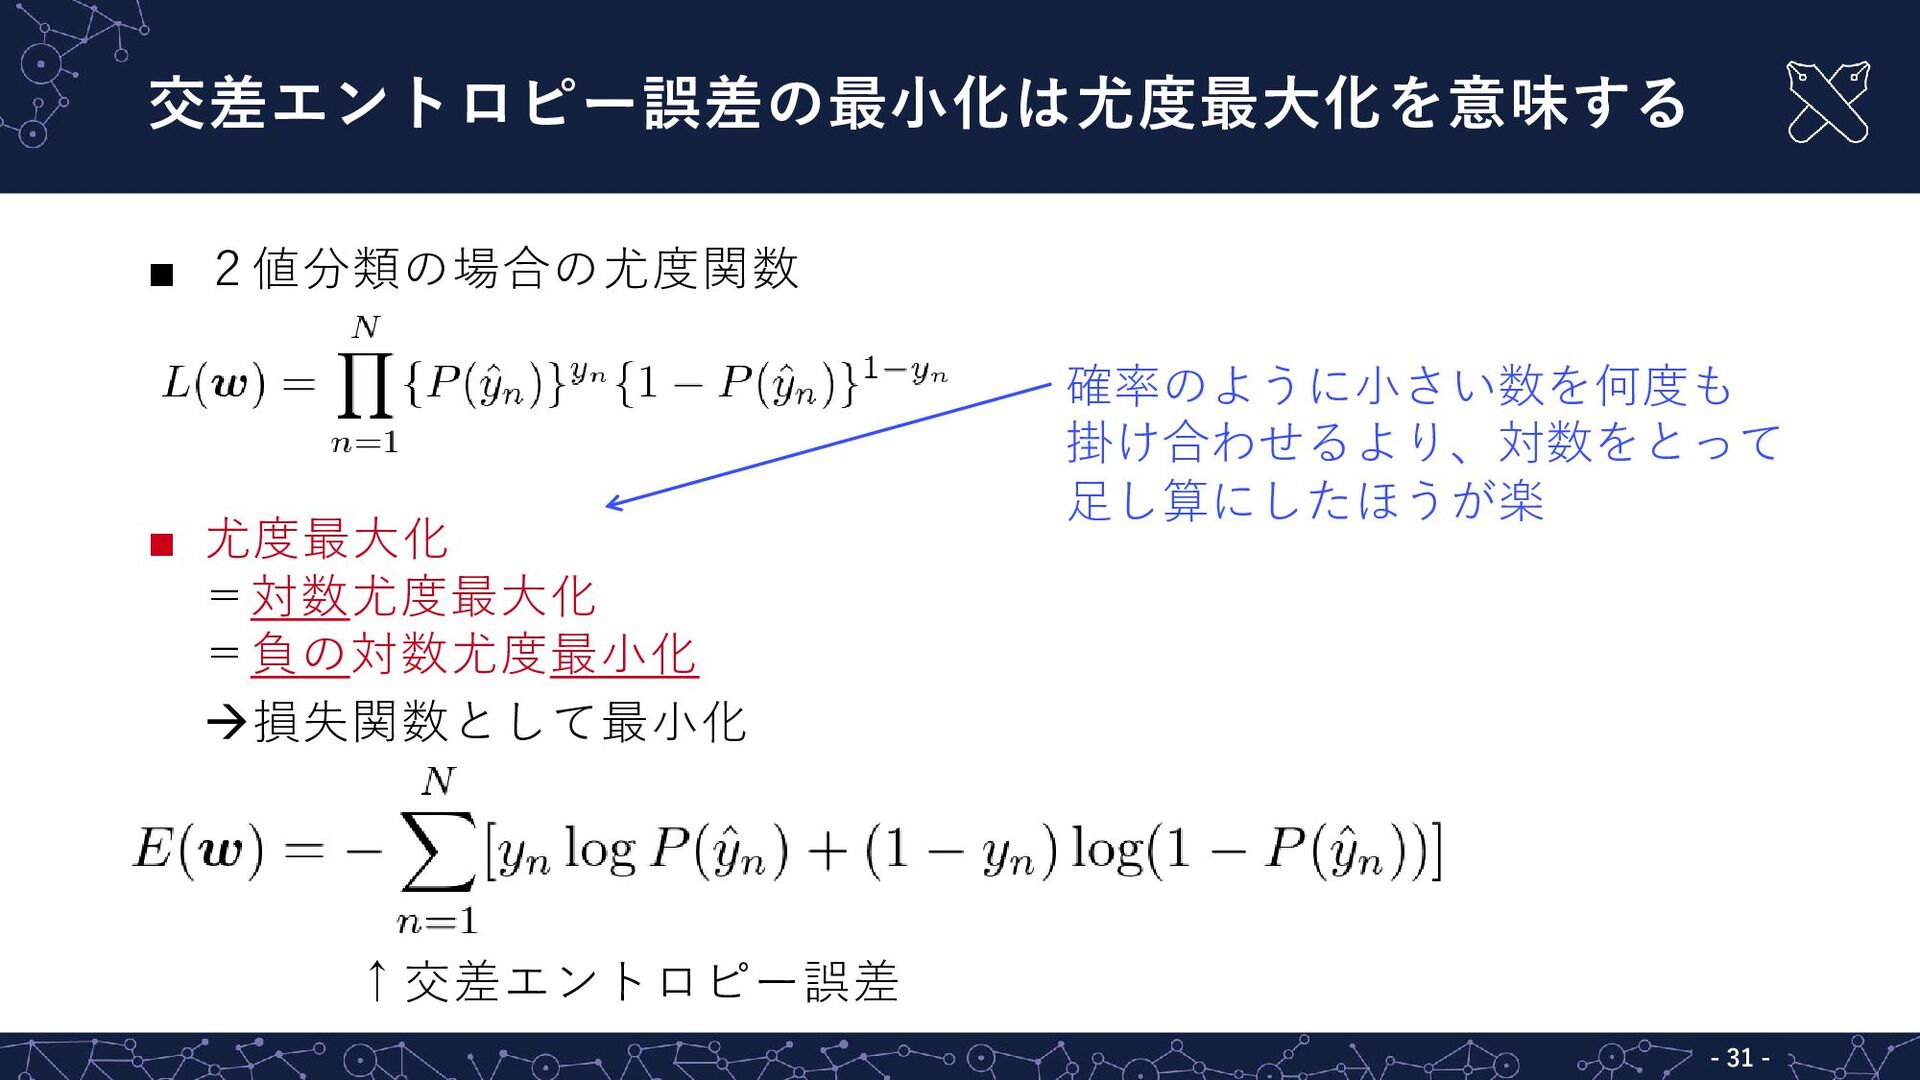
交差エントロピー誤差の最小化は尤度最大化を意味する ▪ 2値分類の場合の尤度関数 ▪ 尤度最大化 =対数尤度最大化 =負の対数尤度最小化 損失関数として最小化 ▪ 「
が既知で、 から 「 が既知で、 見方を変える が未知」 が未知」に ▪ 尤度(likelihood, ゆうど): ▪ データが与えられたうえでの モデルの尤もらしさ ▪ 規格化(=足して1)されて いないので確率ではない - 30 -
交差エントロピー誤差の最小化は尤度最大化を意味する ▪ 2値分類の場合の尤度関数 ▪ 尤度最大化 =対数尤度最大化 =負の対数尤度最小化 損失関数として最小化 確率のように小さい数を何度も 掛け合わせるより、対数をとって
足し算にしたほうが楽 ↑交差エントロピー誤差 - 31 -
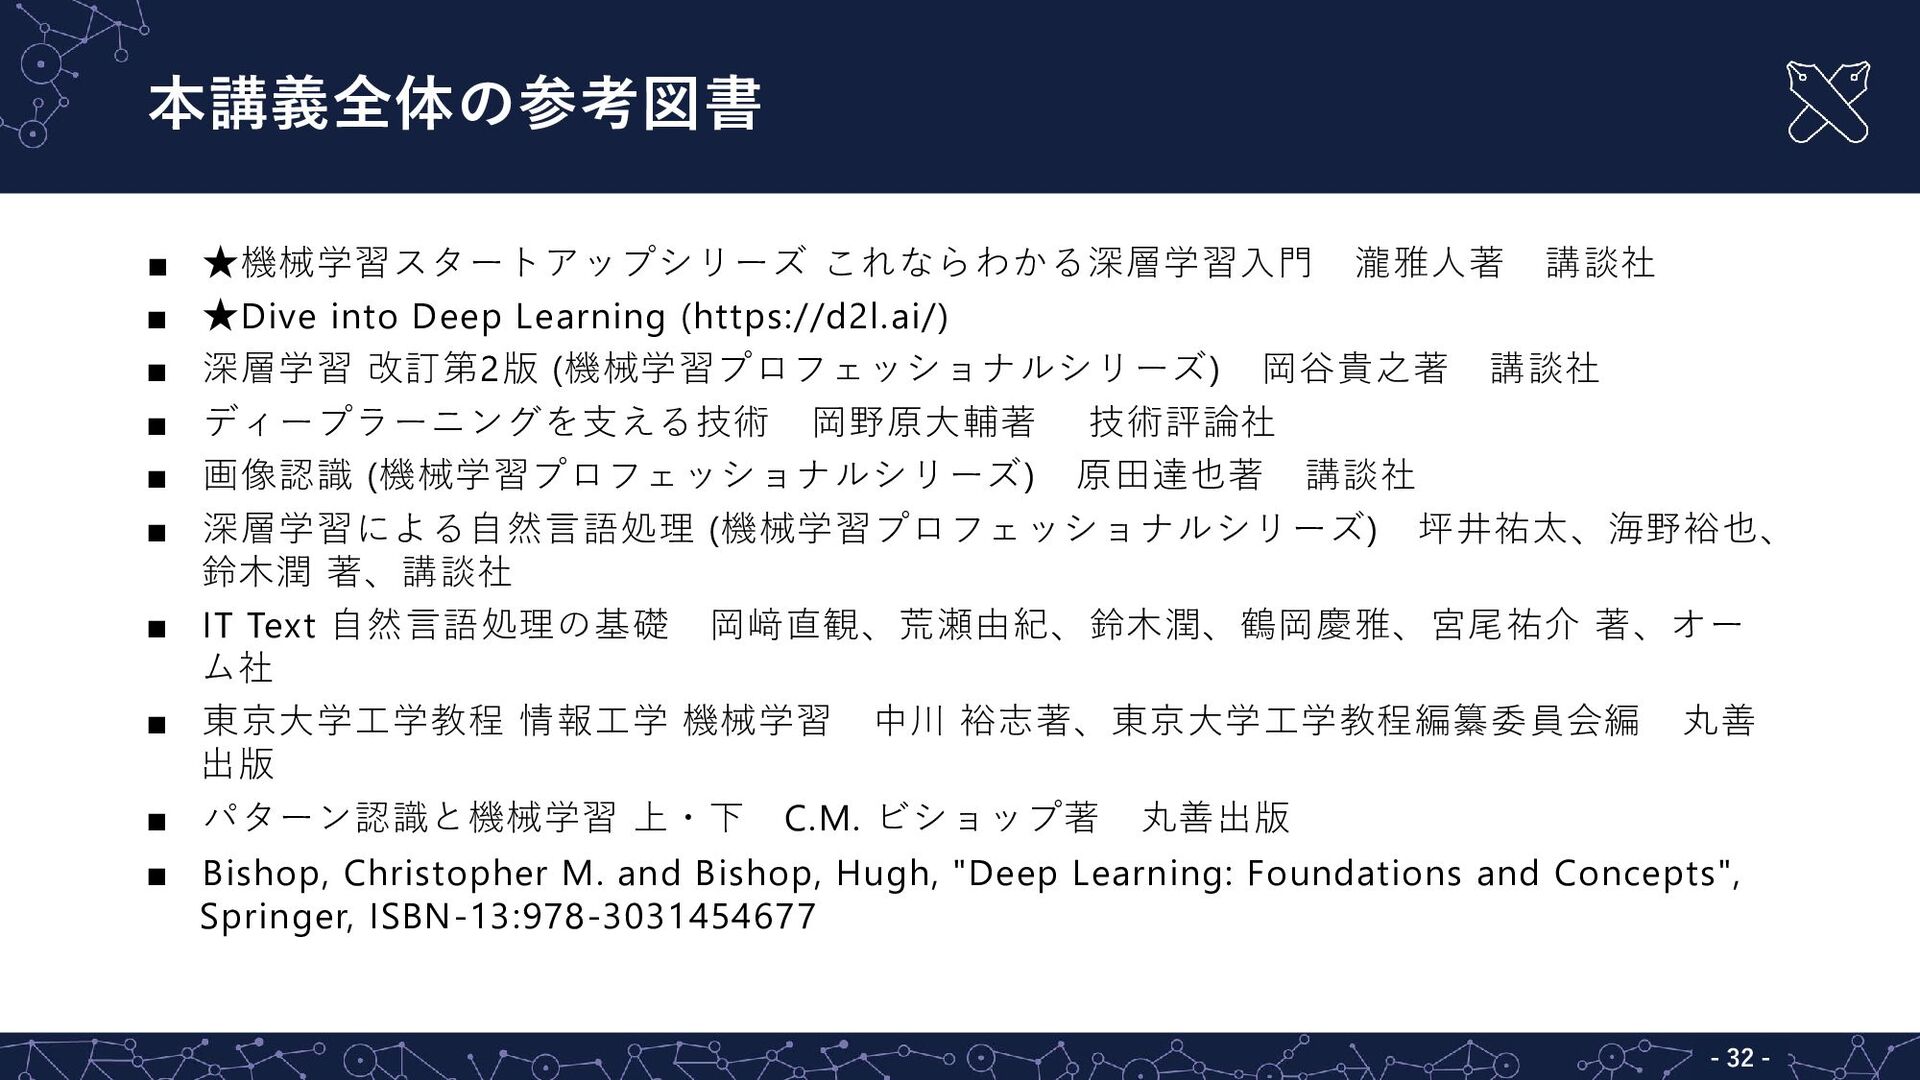
本講義全体の参考図書 ★機械学習スタートアップシリーズ これならわかる深層学習入門 瀧雅人著 講談社 ★Dive into Deep Learning (https://d2l.ai/)
深層学習 改訂第2版 (機械学習プロフェッショナルシリーズ) 岡谷貴之著 講談社 ディープラーニングを支える技術 岡野原大輔著 技術評論社 画像認識 (機械学習プロフェッショナルシリーズ) 原田達也著 講談社 深層学習による自然言語処理 (機械学習プロフェッショナルシリーズ) 坪井祐太、海野裕也、 鈴木潤 著、講談社 ▪ IT Text 自然言語処理の基礎 岡﨑直観、荒瀬由紀、鈴木潤、鶴岡慶雅、宮尾祐介 著、オー ム社 ▪ 東京大学工学教程 情報工学 機械学習 中川 裕志著、東京大学工学教程編纂委員会編 丸善 出版 ▪ パターン認識と機械学習 上・下 C.M. ビショップ著 丸善出版 ▪ ▪ ▪ ▪ ▪ ▪ ▪ Bishop, Christopher M. and Bishop, Hugh, "Deep Learning: Foundations and Concepts", Springer, ISBN-13:978-3031454677 - 32 -
実装課題①の準備 - 33 -
実装課題①の準備 ▪ Kaggleとは ▪ 機械学習コンペを開催するプラットフォーム ▪ 次回講義までの宿題 ▪ 「Kaggleへのユーザ登録」を行ってください ▪
次回講義で行うこと ▪ 実装課題①の内容・締切の説明 - 34 -
ユーザ登録(1/4) ① 以下へアクセス https://www.kaggle.com/ ② Googleアカウント等でログイン
[email protected]
- 35 -
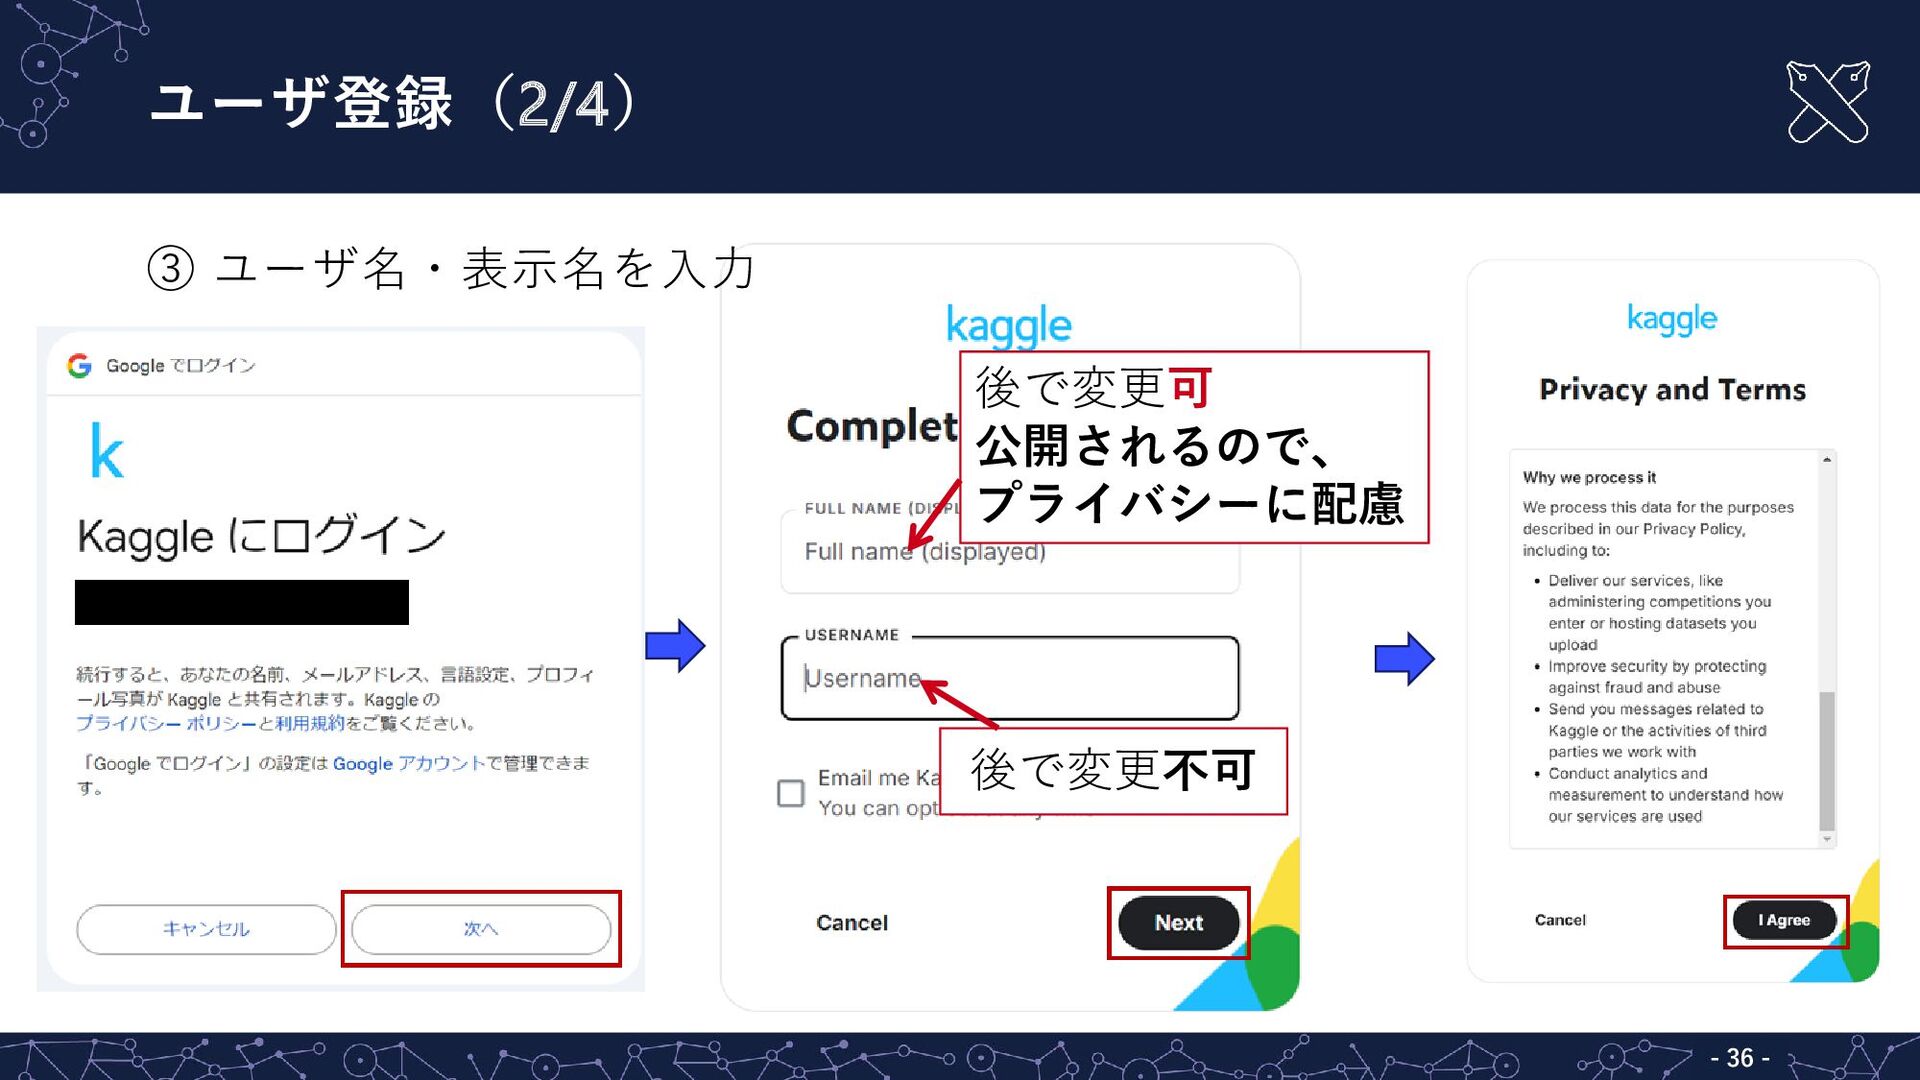
ユーザ登録(2/4) ③ ユーザ名・表示名を入力 後で変更可 公開されるので、 プライバシーに配慮 後で変更不可 - 36 -
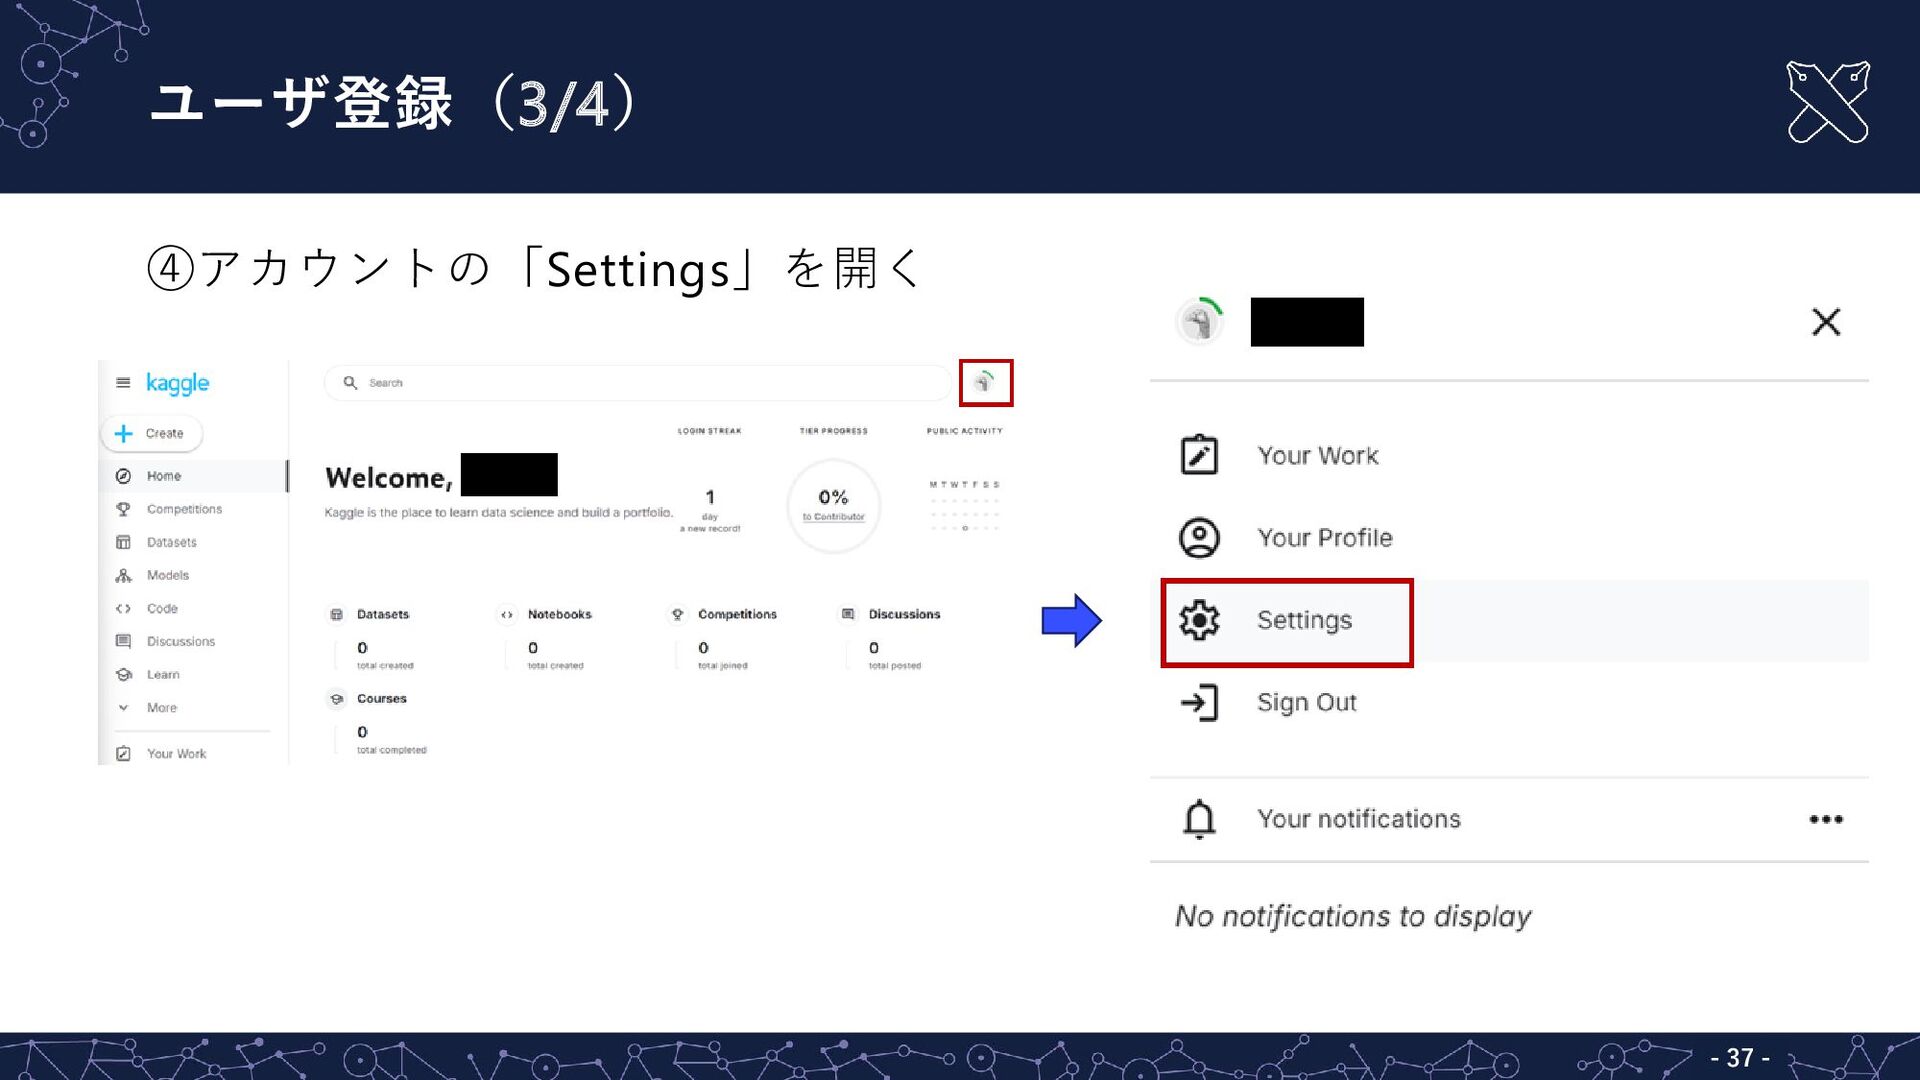
ユーザ登録(3/4) ④アカウントの「Settings」を開く - 37 -
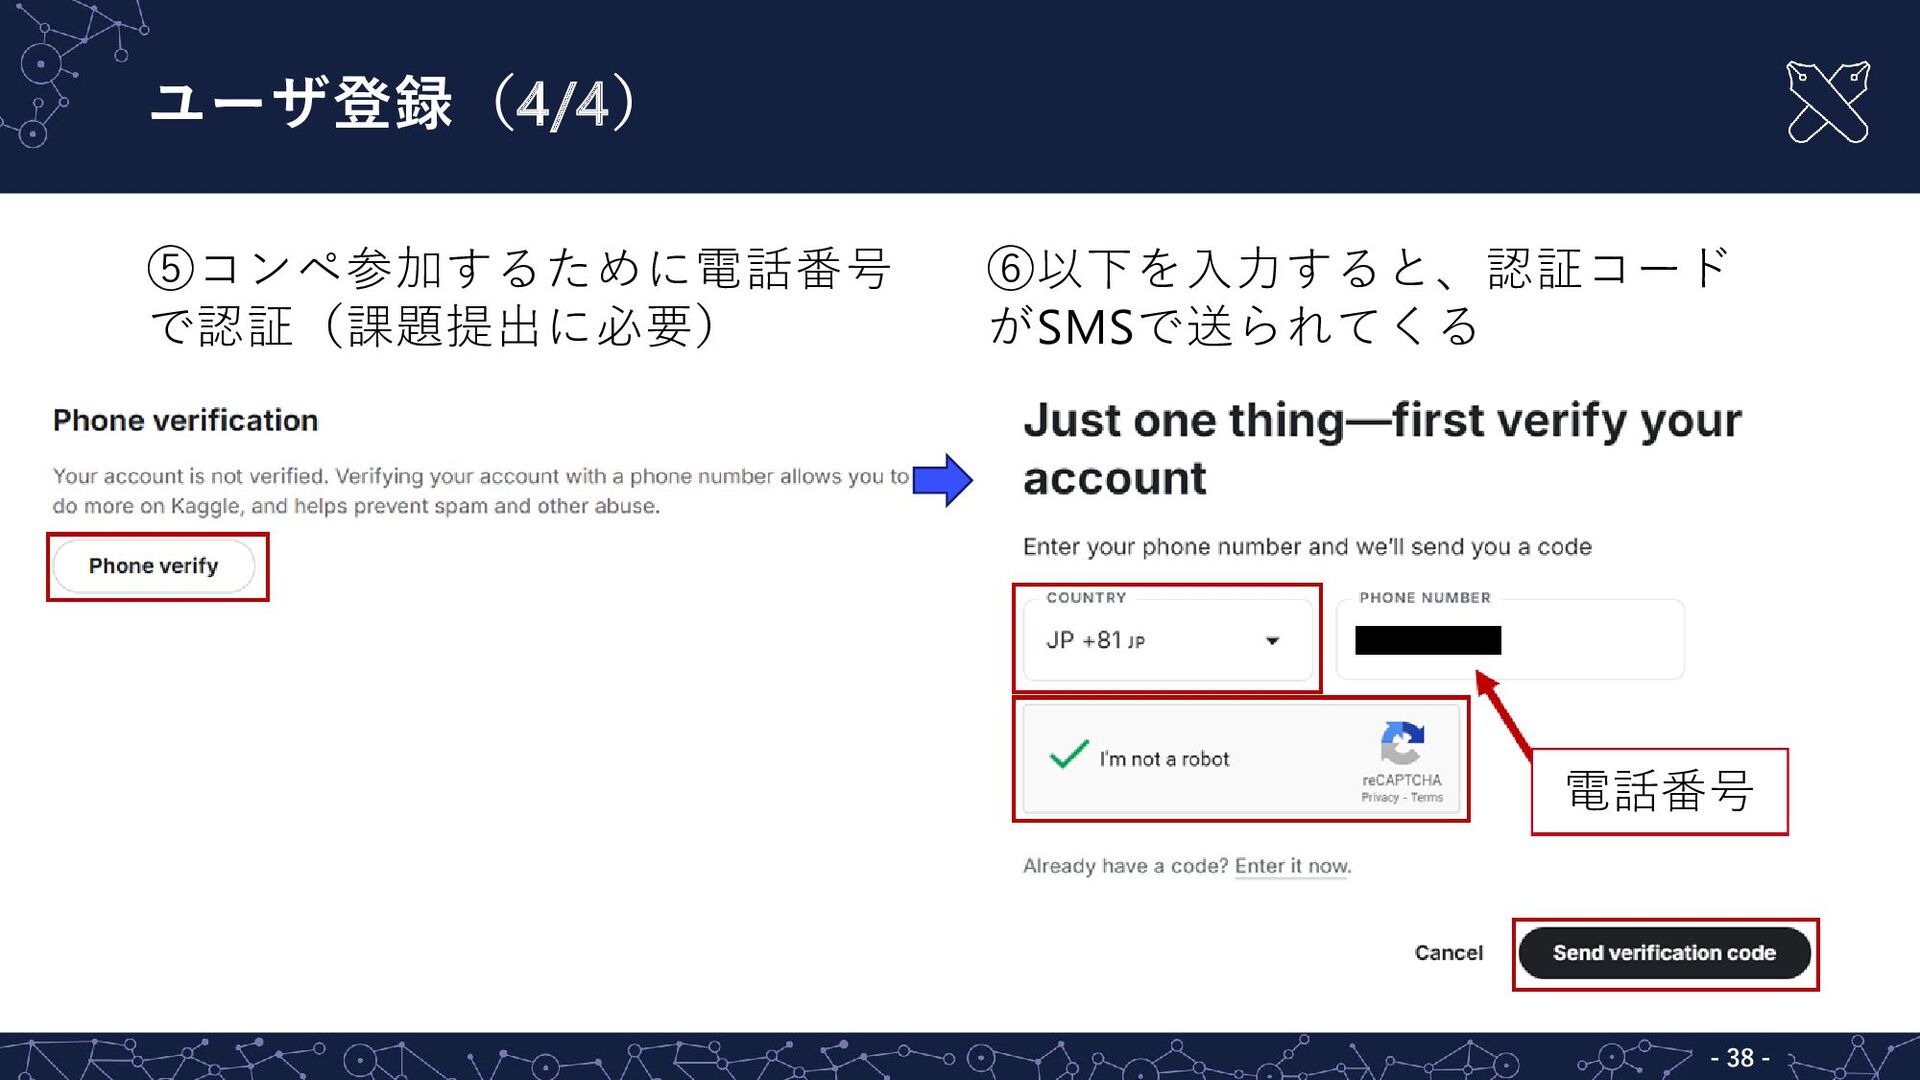
ユーザ登録(4/4) ⑤コンペ参加するために電話番号 で認証(課題提出に必要) ⑥以下を入力すると、認証コード がSMSで送られてくる 電話番号 - 38 -
実習 - 39 -
実習 MNISTへの3層ニューラルネットの適用 ▪ ニューラルネットの出力:10次元 ▪ 10次元のうち最大値を取る成分の添字を予測ラベルとする ▪ 損失関数:交差エントロピー誤差関数 ▪ ミニバッチSGDで反復的に損失を最小化
▪ 理工学基礎実験との違いは、コーディングが多いJ科向けか否か ▪ 理工学基礎実験: 視覚的にわかりやすいが自由度は低いコード ▪ 機械学習基礎: 各自が改変しやすいように不要な関数を削除 - 40 -
実習 実習の目的 ▪ コーディングと基礎理論の関係を学ぶ 実習課題の場所 ▪ K-LMSから辿る 実習に関する質問 ▪ LLMに説明させる
▪ 教科書で調べる・検索・周囲と相談(私語禁止ではありません) ▪ 上記で解消しなければ挙手 - 41 -


 keio_smilab
 sue445
 x5gtrn
 finengine
 willnet
 occhi
 kentarofujii
 shugo
 takonda
 genda
 mohab1
 jtakeda
 koukihosaka
 stuffmc
 rakko
 konakalab
 kimpetersen
 kristinabergwall1
 holman
 sferik
 jonoalderson
 tapps
 62gerente
 coloredviolet